Débilmente discriminativo, no reparado por inyección de perfil y manipulable: autoconfianza en la evaluación de LLM
Esta es una traducción. La versión de referencia es el original en inglés; cite esa.
Vadym Chernets, Investigador Independiente · ORCID 0009-0007-4845-3163
Zenodo DOI 10.5281/zenodo.23197651 · GitHub
Aceptado como póster en el taller NeurIPS 2026 "TAE (Trust-AI-Eval): ¿Podemos confiar en la evaluación de IA?" (no archivado). Copia archivada: 10.5281/zenodo.23197651. PDF: self-confidence-evaluation.pdf. Los gráficos y tablas a continuación se convierten de la fuente LaTeX; el PDF es autoridad.
Resumen
Los conductos de evaluación consumen cada vez más la confianza enunciada por el propio modelo como señal de confianza—como un peso de confiabilidad de juez, un desencadenante de abstención, o un perfil de competencia autorreportado. Probamos si esa señal merece el peso, utilizando una colección preregistrada y congelada en protocolo (16 modelos—un modelo de API de presupuesto/medio nivel de cada uno de nueve proveedores, más siete modelos locales de pesos abiertos; 22,248 respuestas calificadas a temperatura cero con confianza enunciada de 0–100). Cuatro hallazgos. (1) El exceso de confianza es consistente en los dieciséis modelos evaluados: la confianza enunciada típica se sitúa en 85–95 para siete de nueve modelos de API mientras que la precisión abarca 16,5–66,5%, y el 60,1% de las respuestas de frontera enunciadas con confianza 80 son incorrectas. (2) La autoconfianza es débilmente discriminativa: su AUROC para predecir la corrección propia del modelo abarca 0,532–0,788 y está por debajo de 0,62 para seis de nueve modelos. (3) Un panel de modelos independientes alcanza AUROC 0,832 donde la autoevaluación da 0,545 ( , IC 95% ); bajo una recodificación más estricta libre de etiquetas del acuerdo del panel, el panel sigue liderando (0,775 vs. 0,545). (4) La inyección del perfil de precisión medido por dominio del propio modelo no mejoró demostrablemente la discriminación en el único peldaño confirmatorio de una escalera de proveedor único controlada por placebo (AUROC , Holm-adjusted ), mientras que el mismo canal de inyección es causalmente manipulable: un perfil falso llevó el AUROC de autoevaluación de un peldaño exploratorio al nivel del azar (0,474) y, una vez que los elementos están etiquetados por tema, degradó la calibración en cuatro de cinco modelos locales. Concluimos que la confianza autoevaluada, tal como se obtiene y mide actualmente aquí en la confianza entera verbalizada en el recuerdo fáctico de forma abierta, es un objetivo para la medición, no una entrada para confiar: los arneses que ingieren competencia autorreportada heredan un canal de entrada no autenticado. Las tres cláusulas del título descansan en evidencia diferente y las etiquetamos como tales en todo momento: débilmente discriminativa es confirmatoria en dieciséis modelos; no reparada por inyección de perfil es un peldaño confirmatorio en una familia de proveedor, insuficientemente potente para el efecto observado; manipulable es exploratoria, con la dirección causal mostrada en elementos coincidentes pero sin ataque probado en un arnés implementado. La autoevaluación de estilo juez, donde un modelo califica la respuesta de otro modelo, es una tarea diferente y no se prueba aquí.
Introducción
La práctica moderna de evaluación trata silenciosamente la confianza expresada de un modelo como un instrumento de medición: los jueces de LLM reportan puntuaciones de certeza, los marcos de agentes se basan en competencia autoevaluada, las políticas de abstención se activan ante la incertidumbre verbalizada, y los puntos de referencia de calibración asumen que el canal de autorreporte es al menos honesto. El supuesto es conveniente—los autorreportes son gratuitos, siempre disponibles y se producen en el mismo paso que la respuesta—y casi nunca se auditan en el punto de consumo. Nos planteamos la pregunta previa: ¿cuán discriminativa es la señal de autoevaluación, se puede reparar con el perfil medido del propio modelo, y se puede manipular?
Respondemos con una colección preregistrada, de protocolo congelado y ciega: dieciséis modelos (un modelo de API presupuestario/de nivel medio de cada uno de nueve proveedores, más siete de pesos abiertos locales), 1.500 preguntas factuales posteriores a 2023 cada una, temperatura cero, cada respuesta acompañada de una confianza expresada de 0–100—22.248 respuestas calificadas, todo análisis determinista a partir de datos crudos. Frente a este estándar de medición, el canal de autorreporte falla en tres pruebas sucesivamente más caritativas.
C1 (débilmente discriminativa). La confianza expresada está saturada y desacoplada de la competencia: las medianas por modelo se sitúan en 85–95 para siete de nueve modelos de API mientras que la precisión abarca 16,5–66,5%, y el 60,1% de respuestas de frontera expresadas con confianza 80 son incorrectas. Como predictor de la corrección por elemento del propio modelo, la autoconfianza alcanza AUROC solo 0,532–0,788 dependiendo del modelo—cada IC de bootstrap excluye el azar, pero seis de nueve modelos se sitúan por debajo de 0,62, y la predicción selectiva incluso en el mejor de ellos deja un error residual sustancial (Sección 4). Un panel de modelos independientes alcanza 0,832 donde la autoevaluación da 0,545—una ventaja que sobrevive una recodificación más estricta sin etiquetas de acuerdo del panel—mientras que el aparente contraejemplo en el otro panel refleja en gran medida la identidad entre modelos en lugar de conocimiento de sí mismo por elemento (descomposición en Sección 4); identificar el único modelo cuyo autorreporte discrimina bien aún requiere la medición independiente que el autorreporte estaba destinado a reemplazar.
C2 (sin reparación confirmatoria de inyección de perfil). La reparación más directa—proporcionar al modelo su propio perfil de precisión medido por dominio en el momento de la respuesta—no superó significativamente un perfil placebo en el peldaño confirmatorio de un experimento de escalera congelado y controlado con placebo (AUROC , p bruto , ajustado por Holm ; ningún punto de correlación confirmatorio se cumplió). Informamos esto como un nulo, no como una tendencia (Sección 5).
C3 (manipulable). El canal de inyección que usaría una reparación acepta falsificaciones: un perfil barajado (falso) llevó el AUROC de autoevaluación del peldaño exploratorio de frontera al nivel del azar (0,474 frente a 0,710; caída ), una única afirmación de precisión fabricada del «95%» movió la confianza expresada de un modelo local de 50 a 95 en un elemento que obtiene mal, y una vez que los elementos están etiquetados por tema, cuatro de cinco modelos locales consumen un perfil falso en su propio detrimento (Brier a ; Sección 6).
En conjunto, estos resultados argumentan a favor de un cambio de rol: la confianza autoevaluada debe ser un objetivo medido de evaluación, no una entrada no auditada a ella. La Sección 7 explica las consecuencias para tuberías de jueces, enrutamiento de agentes y diseño de arnés; el artículo complementario (Chernets, 2026) examina los modos de fallo de la alternativa basada en panel y se cita, no se reformula, aquí.
Trabajos relacionados
Confianza verbalizada y calibración. La descalibración de las redes modernas es un hallazgo de larga data (Guo et al., 2017), y para los modelos de lenguaje sintonizados con QA, se encontró que la calibración era deficiente mucho antes de la generación actual de modelos (Jiang et al., 2021). Los modelos pueden aprender a expresar incertidumbre en palabras (Lin et al., 2022b) y los modelos más grandes parcialmente «saben lo que saben» en sondeos de autoevaluación (Kadavath et al., 2022), pero en gran medida no logran reconocer lo que no saben (Yin et al., 2023); las auditorías empíricas de la confianza elicitada encuentran una confianza excesiva persistente entre los formatos de elicitación (Xiong et al., 2024), con puntuaciones verbalizadas a veces mejor calibradas que las probabilidades de tokens pero aún infladas (Tian et al., 2023). El sondeo de estado interno refina el marco: los clasificadores simples sobre las activaciones de capas ocultas logran un 71–83% de veracidad (Azaria and Mitchell, 2023)—el fallo reside en el canal de salida verbalizado, no necesariamente en las representaciones internas. Nuestra contribución es de escala y diseño: una colección ciega preregistrada congelada de 16 modelos que puntúa la misma elicitación contra la verdad fundamental y contra el acuerdo de panel independiente en elementos idénticos—más dos preguntas que esta literatura rara vez se plantea: ¿puede la señal ser reparada con el perfil medido propio del modelo, y puede el canal de reparación ser atacado?
Consumo de autoinformes aguas abajo. Las tuberías de LLM-como-juez heredan sesgos del juez y límites de confiabilidad (Zheng et al., 2023), y las señales de confianza basadas en acuerdo se encuentran bajo auditoría (Ding, 2026); los detectores de entropía semántica (Farquhar et al., 2024) evitan los autoinformes midiendo distribuciones de respuestas en su lugar. Los marcos de evaluación de terceros establecen el caso de gobernanza para la medición independiente (Raji et al., 2022); proporcionamos un piso cuantitativo: para seis de los nueve modelos de API, el autoinforme que una tubería consumiría tiene un AUROC inferior a 0,62.
Entradas no fiables. La inyección indirecta de indicación muestra que cualquier canal de texto que un LLM ingiere es una superficie de ataque (Greshake et al., 2023). La sección 6 identifica una instancia específica, hasta ahora sin nombre: la ranura del perfil de autocompetencia que las reparaciones de calibración utilizarían es un canal de entrada no autenticado, y falsificarlo degrada la discriminación al nivel del azar.
Paneles y sus propios fallos. Los paneles de modelos diversos son un instrumento de evaluación cada vez más estándar (Verga et al., 2024). La señal de panel que utilizamos como comparador no es un almuerzo gratis: sus regímenes de fallo (inversión de dificultad, espacios de respuesta limitados, supuestos de independencia basados en etiquetas, conformidad) se miden en un documento complementario (Chernets, 2026) en la misma colección sin procesar; este trabajo se ocupa de la autoevaluación, el complementario se ocupa del panel, y ninguna tabla se duplica entre ambos.
Puntos de referencia. Realizamos elicitación en un subconjunto de SimpleQA posterior a 2023 (Wei et al., 2024) precisamente debido a la brecha de antigüedad de los puntos de referencia que medimos contra TruthfulQA de 2021 (Lin et al., 2022a) (Sección 3).
Experimento preregistrado: diseño y datos
Una recopilación preregistrada, ciega, protocolo congelado públicamente antes de datos confirmatorios: dieciséis modelos (un modelo de API de presupuesto/nivel medio por proveedor en nueve proveedores, más siete modelos locales de pesos abiertos) respondieron las mismas 1,500 preguntas fácticas posteriores a 2023 (subconjunto SimpleQA) a temperatura cero, cada respuesta acompañada de una confianza declarada de 0–100; 22,248 respuestas calificadas en total (13,446 frontera, 8,802 local).
Preregistro y congelación.
El protocolo de recopilación fue congelado en un registro público antes de que existieran datos confirmatorios (ruta de acceso en el apéndice de reproducibilidad). El registro especifica previamente el punto de referencia y la submuestra (n aleatorio , semilla fija, SHA-256 del archivo de submuestra registrado), el registro de modelos, el formato de elicitación, el procedimiento de calificación, el plan de análisis —incluyendo la comparación AUROC del acuerdo del panel frente a la confianza propia utilizada en la Sección 4, una métrica secundaria prespecificada (el punto final primario del registro, la tasa de marcador de error de confianza del desacuerdo del panel, es una cantidad del lado del panel informada en la presentación complementaria)— y una regla de decisión contra la selección de métricas post-hoc. Un pequeño piloto exploratorio (95 elementos de TruthfulQA, tres modelos locales) se ejecutó antes de la congelación para validar la canalización; sus números nunca se mezclan con datos confirmatorios.
Modelos y elicitación.
Nueve proveedores fronterizos a través de sus API —un modelo de presupuesto/nivel medio por proveedor, así que los nombres de proveedores a continuación etiquetan modelos individuales, no líneas de productos (IDs de modelo exactos y fechas de recopilación en el apéndice de reproducibilidad)— y siete modelos locales de pesos abiertos. Cada modelo responde cada elemento de forma independiente a temperatura 0 y establece una confianza entera de 0–100 en la misma respuesta; los paneles son combinaciones analíticas de esta recopilación ciega única —ningún modelo ve la salida de otro modelo.
Calificación.
Equivalencia normalizada de cadena a oro y detección de rechazo primero; los casos de forma abierta no resueltos van a un calificador LLM de pesos abiertos local restringido solo a equivalencia-a-oro (qwen3:8b, local). Una verificación puntual humana de 50 elementos encontró un 98% de acuerdo (un error conservador); una auditoría multifamiliar de los 342 veredictos de consenso más difíciles acordaron 342/342 (Limitaciones). Sin exclusiones excepto fallos de análisis (informados); se concentran en un modelo de razonamiento local, que retiene solo 98 respuestas calificables de 1,500 —todos los reclamos de nivel local llevan n por modelo . Todo análisis confirmatorio es determinista desde el JSONL sin procesar.
Elección de punto de referencia, medida.
El punto de referencia principal posterior a 2023 es una decisión de diseño justificada por medición, no por suposición: en una comparación exploratoria de antigüedad de punto de referencia, los mismos modelos obtuvieron a puntos porcentuales más altos en TruthfulQA MC de 2021 que en SimpleQA posterior a 2023 (deepseek pp, IC 95% ; mistral ; zhipu ; por ej., 89.2% vs. 28.4%) —una brecha consistente con efectos de antigüedad de punto de referencia y exposición, aunque este diseño no puede separar la contaminación de las diferencias de dificultad y construcción. Ningún número de titular descansa en el punto de referencia más antiguo; el brazo TruthfulQA MC1 de 750 elementos en el nivel local se utiliza solo donde esté etiquetado como tal.
Preregistrado vs. exploratorio.
Preregistrado y confirmatorio: la recopilación anterior y la comparación AUROC del panel versus propio (Sección 4). Exploratorio, y etiquetado como tal donde sea que se use: el brazo de comparación de antigüedad de punto de referencia, el peldaño de inyección de perfil fronterizo y la microsonda local de la Sección 6. La escala de inyección de perfil de la Sección 5 es un protocolo separado congelado, controlado con placebo (brazos, puntos finales y familia Holm fijos antes de su fase confirmatoria).
Resultado 1: la autoconfianza está mal calibrada y tiene un débil poder discriminativo
Separamos dos propiedades que el término «calibración» a menudo confunde: calibración general (¿el nivel de confianza coincide con el nivel de precisión?) y discriminación (¿la confianza clasifica las respuestas correctas propias del modelo por encima de las incorrectas?).
Calibración. La confianza declarada está saturada y desacoplada de la competencia: en los nueve modelos de API, la confianza declarada se sitúa en 85–95 (mediana por modelo) para siete de nueve mientras que la precisión oscila entre 16,5–66,5 %; dos se desvían—el modelo con alta tasa de rechazo (mediana 42 con precisión del 10,3 %) y un modelo de confianza dispersa (mediana 60). Todos los modelos son excesivamente confiados en general: la brecha confianza menos precisión (CITL, Tabla 1) oscila entre y puntos porcentuales. La columna ECE es casi igual a CITL: la brecha confianza–precisión es positiva en todos los contenedores ocupados para siete de nueve modelos (todos excepto uno para los otros dos), por lo que la falta de calibración en contenedores y la global coinciden. Incluso el modelo con alta tasa de rechazo retiene pp (ECE 0.310)—su banda baja refleja el comportamiento de rechazo, no el autoconocimiento calibrado. Parte de su ventaja de discriminación puede ser igualmente mecánica—los rechazos calificados como incorrectos con baja confianza declarada aumentan AUROC (excluyendo filas de rechazo es 0.660, )—por lo que interpretamos su 0.788 como un límite superior del autoconocimiento elicitado, no como un ranking de calibración. Agrupados en los nueve modelos de API, el 60,1 % de las respuestas declaradas con confianza 80 son incorrectas (5,598 de 9,310); la tasa por modelo oscila entre 29,0–83,2 % (media macro 57,6 %). Un consumidor que confía en una confianza declarada alta acepta la mayoría de los errores. Discriminación. Como predictor de la corrección propia del modelo, la autoconfianza logra AUROC 0.532–0.788 dependiendo del modelo. Los intervalos de confianza del bootstrap del 95 % (Tabla 1) excluyen 0.5 para todos los modelos, por lo que la señal no es literalmente aleatoria—pero para seis de nueve modelos se sitúa por debajo de 0.62. La consecuencia es operacional: con una cobertura del 20 % (respondiendo solo el quinto de los elementos con mayor confianza), las tasas de error de los tres modelos con mayor self-AUROC son aún del 75,3 %, 33,3 % y 15,1 % (Tabla 2)—una reducción significativa solo para el tercero, y lejos de ser una barrera de confianza para los otros dos.
Una alternativa arquitectónica—contando modelos independientes que coinciden—alcanza AUROC 0.832 (IC 95% ) en el panel donde la autoevaluación produce 0.545 (); la diferencia agrupada a nivel de elemento, , excluye cero por un amplio margen. Los tres paneles prespecificados: US (Anthropic, OpenAI, Google), CN (DeepSeek, Alibaba, Moonshot), entre bloques (Anthropic, DeepSeek, Mistral); la comparación principal es el panel CN. En el otro panel prespecificado la comparación agrupada parece invertirse: autoevaluación 0.842 agrupada sobre la población del panel frente a panel 0.697; . Un análisis de descomposición muestra que esta aparente inversión refleja en gran medida la identidad entre modelos más que el autoconocimiento por elemento: el valor agrupado 0.842 mezcla tres modelos cuyos AUROC de autoevaluación dentro de modelos son solo 0.596–0.784 (promedio macro 0.709; valores de población del panel—la Tabla 1 reporta el conjunto completamente calificado), y después de la normalización de rango dentro de modelos (que elimina diferencias de nivel entre modelos mientras preserva la clasificación propia de cada modelo) el valor agrupado cae a 0.672—una contribución de identidad entre modelos de . El panel 0.545 pasa la misma verificación (0.545 agrupado vs. 0.582 con normalización de rango): su fracaso de autoevaluación es genuinamente por elemento. Lo que sobrevive de la inversión es una afirmación más estrecha: el modelo con predominancia de rechazos y la mayor discriminación de autoconfianza (0.788 en el conjunto completamente calificado) sí supera la señal de acuerdo de este panel—e identificar cuál es ese modelo requiere exactamente la medición independiente que los autoreportes estaban destinados a reemplazar. El tercer panel prespecificado (entre bloques) cae entre los dos: panel 0.722 frente a propio 0.659 , .
Sensibilidad a la recodificación sin etiquetas de la señal del panel.
La codificación de equivalencia canónica detrás de la señal del panel se basa en la etiqueta de corrección del modelo primario (dos respuestas ambas calificadas como correctas cuentan como coincidentes), de modo que el acuerdo del panel es parcialmente una función determinística de la etiqueta objetivo—una dependencia mediada por etiquetas, aunque sin fuga de autovoto: por construcción, el registro de un modelo nunca entra en su propia señal de panel. Una recodificación sin etiquetas (solo concordancia de cadena; sin consultar banderas de corrección de primario ni panelista) reduce el AUROC del panel de 0.832 a 0.775 en el panel donde la autoevaluación produce 0.545, y de 0.697 a 0.628 en el otro; la ventaja principal del panel se mantiene con la codificación más estricta (0.775 frente a 0.545).
La Tabla 1 proporciona la imagen por modelo; la Figura 1 muestra el mismo desacoplamiento en los dieciséis modelos: todos los modelos se encuentran por encima de la diagonal de calibración, y el nivel local se comprime en una banda de confianza declarada del 85–100 en exactitud 9.2%.
| Modelo | Exactitud (%) | Conf. media | CITL (pp) | Brier | ECE | AUROC propio | IC 95% | |
|---|---|---|---|---|---|---|---|---|
| 1,461 | 66.5 | 92.8 | 0.271 | 0.263 | 0.746 | [0.722, 0.770] | ||
| moonshot | 1,500 | 51.6 | 75.8 | 0.292 | 0.242 | 0.619 | [0.590, 0.648] | |
| alibaba | 1,497 | 47.4 | 92.3 | 0.446 | 0.448 | 0.532 | [0.510, 0.556] | |
| xai | 1,500 | 37.9 | 48.9 | 0.197 | 0.111 | 0.777 | [0.755, 0.798] | |
| deepseek | 1,500 | 35.7 | 89.2 | 0.513 | 0.535 | 0.570 | [0.549, 0.592] | |
| zhipu | 1,493 | 28.4 | 92.6 | 0.612 | 0.642 | 0.611 | [0.582, 0.639] | |
| openai | 1,500 | 16.7 | 77.6 | 0.531 | 0.610 | 0.598 | [0.559, 0.636] | |
| mistral | 1,495 | 16.5 | 90.6 | 0.686 | 0.742 | 0.584 | [0.550, 0.616] | |
| anthropic | 1,500 | 10.3 | 41.3 | 0.206 | 0.310 | 0.788 | [0.758, 0.817] |
Calibración por modelo en la colección confirmadora de SimpleQA (nivel frontera, conjunto completamente calificado; los nombres de proveedores identifican el único modelo de presupuesto/nivel medio recopilado de cada proveedor). CITL: calibración en general, confianza declarada media menos exactitud, en puntos porcentuales. ECE: error de calibración esperado de 10 intervalos. Auto-AUROC: confianza declarada como predictor de la exactitud de cada elemento del modelo (Mann–Whitney corregido por empates), con 95% IC de arranque (remuestreo a nivel de fila dentro del modelo, 2000 extracciones, semilla fija). Todos los valores son recomputaciones deterministas de JSONL sin procesar calificado; cada IC excluye 0.5. CITL usa medias sin redondear; los valores mostrados se redondean a un decimal. {#tab:vendor}
| Tasa de error en cobertura | |||||
|---|---|---|---|---|---|
| 2-6 Modelo | 100% | 80% | 60% | 40% | 20% |
| anthropic (auto-AUROC 0.788) | 89.7% | 87.1% | 82.9% | 80.3% | 75.3% |
| xai (0.777) | 62.1% | 52.8% | 45.1% | 39.5% | 33.3% |
| google (0.746) | 33.5% | 24.5% | 20.0% | 18.7% | 15.1% |
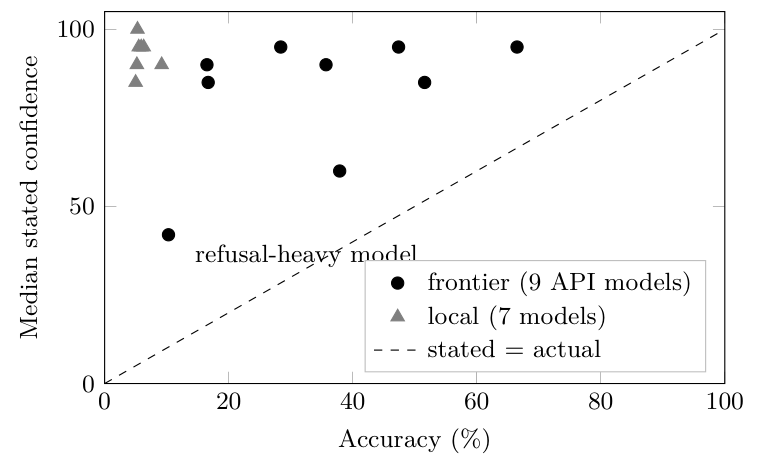 Exceso de confianza consistente en todos los dieciséis modelos evaluados: confianza mediana declarada por modelo (las medias aparecen en Table 1) vs. precisión real de todos los 16 modelos en los mismos 1,500 elementos ciegos de SimpleQA. Todos los modelos están por encima de la diagonal de calibración; el modelo cargado de rechazos (confianza mediana declarada 42 con 10.3% de precisión, CITL +31.0 pp) tiene el mejor auto-AUROC, 0.788, pero sigue siendo excesivamente confiado; la brecha de calibración más pequeña corresponde al modelo de confianza dispersa (+11.1 pp). Medianas frontera por modelo: 95/85/95/60/90/95/85/90/42 en el orden de fila de Table 1; el nivel local de siete modelos abarca precisión 5.0–9.2% a confianza mediana 85–100 (n de 98–1,498 por modelo local después de la exclusión de error de análisis; el nivel local sirve para las sondas de manipulación y esta imagen, no para reclamos de discriminación).
Resultado 2: sin mejora confirmatoria en discriminación por inyección de perfil medido
Una solución natural es proporcionar al modelo su propio perfil de competencia medido—precisión por dominio a partir de datos retenidos—al momento de responder. En un experimento de escalera controlado con placebo (brazos: sin perfil, perfil placebo coincidente en nivel general, perfil medido propio, perfil barajado), el brazo de perfil propio no superó significativamente el placebo en el punto final confirmatorio: AUROC , IC del 95% , sin ajustar , ajustado por Holm ; ningún punto final confirmatorio se cumplió. Reportamos esto como un nulo con alcance explícitamente estrecho: en un escalón confirmatorio, la discriminación no fue corregida por inyección de perfil medido. La estimación puntual es positiva, pero bajo corrección preregistrada la reparación no se demuestra; el diseño tenía potencia solo para efectos moderados (SE del IC: potencia del 80% solo para AUROC , mayor que el observado —por lo que los datos son compatibles tanto con un nulo verdadero como con un efecto verdadero pequeño). El techo del diseño no es el factor limitante. Tomando la precisión de contenedor propia de cada elemento—calculada dejando uno fuera, para que un elemento nunca contribuya a su propio predictor—como el único predictor de la corrección de ese elemento produce un AUROC oráculo de 0.758 para el sujeto confirmatorio (0.716–0.789 en los cuatro sujetos de escalera), con variabilidad de precisión por contenedor SD 0.195 y rango 0.15–1.00 sobre los 21 contenedores. Los contenedores difieren lo suficiente para que un perfil veraz lleve información sustancial: el nulo concierne al canal de inyección, no a una batería demasiado insensible para detectar un efecto.1 Los patrones exploratorios (mayores ganancias donde la calibración basal es más débil) son solo generadores de hipótesis.
Diseño de escalera y validación de placebo.
Cuatro escalones congelados (sujetos: Claude Haiku 4.5, Sonnet 5, Opus 4.8 y Fable 5; IDs exactos claude-haiku-4-5-20251001, claude-sonnet-5, claude-opus-4-8, claude-fable-5), cada uno con cuatro brazos cegados ocupando el mismo espacio de calibración en una indicación por lo demás idéntica: off (vacío estructural con forma de perfil), placebo (perfil irrelevante para calibración coincidente en nivel general; validado por escalón contra el perfil verdadero en —medido , , , ), core (el perfil por dominio medido propio del modelo), y shuffled (perfil falso con contenedores permutados; exploratorio después de que una verificación de manipulación fallida lo degradó del estado confirmatorio). La batería de 315 elementos abarca 21 contenedores de dominio con elementos trampa y un token de abstención explícito; las asignaciones elemento–brazo se congelaron antes de la fase confirmatoria, con orden de brazo aleatorizado por elemento y sin nombres de brazo en texto visible para el sujeto. Un límite de degeneración preregistrado (off precisión ) degradó tres de cuatro escalones de todo cálculo confirmatorio; la tabla 3 reporta el único escalón elegible. La precisión del brazo off del escalón sobreviviente es 0.847 contra el umbral 0.85, mientras que los escalones degradados están en 0.855, 0.888 y 0.900—con AUROCs del brazo off solo de respuestas de 0.575, 0.628 y 0.500 (descriptivamente, la precisión próxima al techo deja poca señal de calibración disponible para la corrección). Los cuatro sujetos se extraen de una sola familia de proveedores; ver Limitaciones.
| Brazo | Precisión (todos los elementos) | AUROC | Brier | ECE | Apareado AUROC (núcleobrazo) |
|---|---|---|---|---|---|
| desactivado (sin perfil) | 0.847 | 0.564 | 0.138 | 0.110 | [] |
| placebo | 0.857 | 0.578 | 0.127 | 0.090 | [] |
| núcleo (perfil propio) | 0.857 | 0.625 | 0.127 | 0.099 | — |
| barajado (falso) | 0.842 | 0.589 | 0.140 | 0.113 | no calculado (exploratorio) |
Escalera de inyección de perfil, peldaño confirmatorio-elegible (sujeto: Claude Sonnet 5; : 294 elementos sin trampa 2 replicaciones de proceso nuevo preregistradas—el arnés no expone ni temperatura ni semilla; AUROC de respuesta únicamente). Contrastes confirmatorios (bootstrap con agrupamiento por elementos): coreplacebo AUROC , IC 95% , sin corregir ; coreoff , IC , sin corregir ; ambos fallan la corrección de Holm () y la compuerta de dos vías para elementode lote (un requisito de robustez preregistrado que agrupa por elemento y por lote de colección). La columna de apareado repite los contrastes apareados con agrupamiento por elementos del análisis congelado contra core; no son la diferencia aritmética de la columna AUROC por brazo, y no se calculó ningún contraste apareado confirmatorio para shuffled (degradado a exploratorio antes de la fase confirmatoria). Señalamos en contra de nuestra propia hipótesis que core no domina en calibración: su ECE (0.099) es peor que la de placebo (0.090), que es una razón más para interpretar el nulo confirmatorio como un nulo. {#tab:ladder}
Resultado 3: el canal de autoimagen es manipulable
Si un arnés de evaluación consume un perfil de autocompetencia, esa ranura es un canal de entrada, y las entradas pueden ser falsificadas. Distinguimos tres afirmaciones de fortaleza probatoria decreciente y declaramos cuál apoya cada resultado. (i) Manipulabilidad causal—demostrada a continuación: sustituir un perfil falso cambia causalmente la confianza declarada y degrada la calibración en ejecuciones controladas. (ii) Vulnerabilidad de integridad—condicional: solo importa para arneses que efectivamente inyectan perfiles de competencia desde una fuente que un adversario puede influir. (iii) Superficie de ataque práctica en canalizaciones de evaluación implementadas—una hipótesis que este artículo motiva pero no prueba. Reemplazar el perfil verdadero con uno barajado (falso) llevó el AUROC de autoevaluación del escalón fronterizo exploratorio al nivel de azar: 0.474 versus 0.710 con el perfil verdadero (escalón exploratorio con techo rebajado; arranque agrupado por elementos: 0.710 [0.586, 0.820] vs. 0.474 [0.349, 0.599], diferencia [, ]). Para contrastar, en el escalón apto para confirmación shuffled se situó entre placebo y core (0.589 vs. 0.578 y 0.625; contraste pareado agrupado por elementos, exploratorio: ). Ese escalón es una evidencia débil de manipulación por construcción: el perfil falso falló dos veces la verificación preregistrada (juez externo 0.99/0.94 vs. un límite ); la regla congelada degradó el brazo antes de que existieran datos confirmatorios, un sujeto puede descartar un perfil detectablemente implausible, y no existe una verificación consumida. Hallazgo independiente: un juez fronterizo detecta la falsificación solo por plausibilidad. En una prueba local de costo cero, una única afirmación fabricada ("95% de precisión en este dominio") elevó la confianza declarada del modelo en el mismo elemento de 50 a 95; el efecto se concentra en modelos que tienen calibración declarativa que perder; en esta prueba el cambio más grande ( puntos) ocurrió en el modelo que tenía más para perder (glm4:9b). Dos condiciones límite acotan el efecto: el modelo debe ser capaz de asociar el elemento actual con un contenedor de perfil (en elementos sin etiquetar, los modelos locales pequeños ignoran el perfil; deltas , consistente con el nulo congelado del Resultado 2), y los modelos fijados por techo (confianza independientemente) no tienen nada que atacar.
La evidencia de manipulación—un escalón fronterizo exploratorio, una microsonda local y una prueba local etiquetada por tema—establece la manipulabilidad causal, afirmación (i). La tabla 4 muestra la microsonda: el mismo elemento, el mismo modelo, y un cambio de una línea en el perfil propio inyectado desplazan la confianza declarada hasta puntos.
Prueba exploratoria etiquetada por tema: ambos lados del límite, activos.
La primera condición límite anterior (el modelo debe ser capaz de asociar el elemento con un contenedor de perfil) es en sí misma comprobable: etiquetar cada sonda con su tema—una desviación revelada del protocolo congelado—elimina el obstáculo de asociación. En una prueba local completa (cinco modelos, 16 sondas retenidas por brazo, temperatura 0, semilla fija), el perfil falso que era inerte en elementos sin etiquetar es consumido por cuatro de cinco modelos una vez que los elementos están etiquetados: Brier se degrada por (glm4:9b), (llama3.2:3b, con precisión cayendo 37.5%25.0%), (mistral:7b), y (phi4-mini); CIs de arranque por sonda en incluyen cero para cada modelo, por lo que la microsonda establece la dirección y mecanismo en lugar de tamaños de efecto por modelo;
el quinto (qwen3:8b) responde a la batería en techo (precisión del 100%, confianza 100 en ambos brazos, ), reproduciendo el límite "nada que atacar". El mecanismo es direccional y simétrico: una afirmación falsa alta infla la confianza exactamente en el grupo más débil (física de llama3.2: confianza declarada 0100 en un grupo con precisión retenida del 25%; lógica de phi4-mini 1365), y una afirmación falsa baja desinfla la confianza en respuestas correctas (historia de llama3.2 1000 con precisión retenida del 75%), hasta el punto de inducir la abstención en elementos que el modelo respondería de otro modo. Ambos lados del límite se muestran así mediante ejecuciones en directo: elementos sin etiquetar, perfil inerte (el nulo congelado); elementos etiquetados, la auto-imagen forjada se propaga directamente en la confianza declarada y degrada la calibración de extremo a extremo.
| Modelo | Conf. @ "0%" | Conf. @ "95%" | |
|---|---|---|---|
| glm4:9b | 50 | 95 | |
| llama3.2:3b | 80 | 95 | |
| mistral:7b | 90 | 100 | |
| phi4-mini | 90 | 95 | |
| qwen3:8b | 100 | 100 |
Microsonda local (exploratoria): confianza declarada en el mismo elemento (respondido incorrectamente) cuando la ranura de perfil inyectado declara "precisión del 0%" frente a "precisión del 95%" en el dominio del elemento; cinco modelos de código abierto locales, temperatura 0. El modelo anclado en techo (fila inferior) no tiene calibración declarativa que atacar. {#tab:microprobe}
Implicaciones para la práctica de evaluación
Nuestros resultados se miden en una familia de tareas (preguntas abiertas factales posteriores a 2023) con un formato de elicitación; las implicaciones que se presentan a continuación se extrapolan de esas mediciones.
(1) Invertir el papel de la confianza manifestada. La confianza autoinformada debe ser un objetivo medido de la evaluación, no una entrada a ella bajo la elicitación actual. Números de apoyo: el 60,1 % de las respuestas de frontera de alta confianza son incorrectas, y el mejor AUROC autoinformado (0,788) pertenece al modelo que un ranking de precisión clasificaría en último lugar, ningún ranking predice cuyos autoinformes discriminan.
(2) Los pipelines de jueces heredan pesos débilmente discriminativos. Cualquier esquema de LLM-como-juez o ensemble que pondere votos por autocerteza importa, para seis de nueve modelos aquí, una señal con AUROC por debajo de 0,62, silenciosamente, porque la banda saturada 85–95 se ve reconfortante en los registros. Si se utiliza ponderación de certeza en absoluto, los pesos deben provenir de la calibración medida por modelo, no del informe en sí.
(3) Autenticar la ranura de perfil. El modelo de amenaza de tres niveles de la Sección 6 ordena la preocupación: la manipulabilidad causal está demostrada, la vulnerabilidad de integridad es condicional a un arnés que realmente inyecte perfiles de una fuente influenciable, y una superficie de ataque práctica en pipelines desplegados sigue siendo una hipótesis. Para arneses en la clase condicional, el canal de reparación es la exposición: el mismo perfil inyectado que se suponía que debía arreglar la calibración acepta falsificaciones que empujan la discriminación al nivel del azar (0,474) y degradan las puntuaciones de Brier de un extremo a otro una vez que los elementos son asociables. Tal arnés necesita una puerta de integridad, perfiles firmados, comprobaciones de procedencia, o como mínimo separar quién mide el perfil de quién lo proporciona en tiempo de inferencia. Una ranura de autoimagen no autenticada es un puerto abierto de inyección de indicaciones con una carga útil de calibración.
(4) La medición externa es la alternativa, con su propia auditoría. El acuerdo de panel independiente domina la autoevaluación donde la autoevaluación falla peor (AUROC ), pero los paneles tienen sus propios regímenes de fallo medidos, examinados en el documento complementario (Chernets, 2026); adoptar la señal del panel sin esa auditoría repetiría el mismo error un nivel más arriba. Una extensión preregistrada como exploratoria añade un tercer ángulo: en 12 pares de intercambio de perfil dirigido (3.780 llamadas), sustituyendo el perfil medido de otro modelo, cambió AUROC como máximo —y ocasionalmente ayudó—mientras que la predicción de rango de similitud de la pérdida de transferencia falló (Spearman ): los perfiles medidos son instrumentos portátiles, no acceso privilegiado a uno mismo. Una batería de diagnóstico de autoevaluación práctica se describe en el apéndice.
Limitaciones
Familia única de referencia para la línea principal (QA de formulario abierto post-2023); cada proveedor está representado por un modelo de presupuesto/nivel intermedio, por lo que no se afirma generalización a nivel de proveedor; la elicitación de confianza declarada es un formato de consulta para los números principales—aunque un brazo exploratorio de dos etapas (150 elementos cinco modelos locales) sugiere que el formato no es responsable: una consulta de confianza post-hoc sin estado redujo la confianza declarada y las tasas de errores confiados pero no la discriminación (AUROC independiente 0.43–0.61 en ambos formatos; AUROC de bootstrap emparejado agrupado en pares, etiquetas deterministas sin LLM en 142–150 filas por modelo—una desviación etiquetada del calificador solo de texto, bajo la cual 90% de los casos son irresolubles); la inyección nula es un peldaño confirmatorio de una escalera (315 elementos, 21 categorías), todos los cuatro sujetos de una familia de proveedores única, y no descarta diseños de reparación mejores; la evidencia de manipulación combina un peldaño fronterizo exploratorio, una microsonda local, y un paso local etiquetado por tema (una desviación divulgada)—no un estudio de ataque confirmatorio; la calificación es parcialmente basada en LLM y su validación humana es una verificación puntual de 50 elementos (98% de acuerdo, un error conservador). La familia de proveedores del calificador también cuenta con un miembro del panel CN, por lo que la independencia del calificador se mide en sí misma: un segundo calificador de una familia fuera de todos los paneles y del propio calificador recalificó todos los 342 veredictos de consenso del quintil más difícil y coincidió 342/342. El calificador es en sí mismo un sujeto de nivel local; una recalificación entre familias de todas las 1.441 filas autocalificadas coincidió en el 98.3%, con desacuerdo inclinándose hacia la autopermisividad (24 cambios descendentes vs. 1 ascendente; precisión 5.94.4%)—fortaleciendo la imagen del exceso de confianza; una re-auditoría estratificada más completa sigue siendo trabajo futuro. Las comparaciones Panel-vs-self comparten datos con el envío complementario; ninguna tabla está duplicada, el límite se indica en las Secciones 1–2, y el alcance de este artículo permanece como solo autoevaluación.
Conclusión
La autoevaluación, tal como se obtiene actualmente, no supera tres pruebas que debe pasar una señal de evaluación: rastrea la precisión demasiado débilmente como para regular decisiones pero se mantiene severamente sobreconfiada; la intervención de autoconocimiento más directa no produjo reparación demostrable bajo control placebo; y su canal de entrada acepta falsificaciones que empujan la discriminación al nivel del azar. Hasta que los modelos logren calibración sobre evidencia medida, la confianza declarada es un fenómeno a estudiar, no una señal para consumir.
References
Vadym Chernets. Verification theater: Measured failure modes of AI verifier panels. NeurIPS 2026 Workshop Who Verifies the Agents?, 2026. https://doi.org/10.5281/zenodo.23197641 (cited for panel-side regimes only).
Kaihua Ding. When LLMs agree, are they right? Auditing self-consistency and cross-model agreement as confidence signals. arXiv preprint arXiv:2607.08065, 2026.
S. Farquhar, J. Kossen, L. Kuhn, and Y. Gal. Detecting hallucinations in large language models using semantic entropy. Nature, 630(8017):625–630, 2024.
K. Greshake, S. Abdelnabi, S. Mishra, C. Endres, T. Holz, and M. Fritz. Not what you’ve signed up for: Compromising real-world LLM-integrated applications with indirect prompt injection. In Proceedings of the 16th ACM Workshop on Artificial Intelligence and Security (AISec), 2023. arXiv:2302.12173.
C. Guo, G. Pleiss, Y. Sun, and K. Q. Weinberger. On calibration of modern neural networks. In ICML, 2017. arXiv:1706.04599.
Z. Jiang, J. Araki, H. Ding, and G. Neubig. How can we know when language models know? On the calibration of language models for question answering. Transactions of the Association for Computational Linguistics, 9:962–977, 2021. arXiv:2012.00955.
S. Kadavath, T. Conerly, A. Askell, et al. Language models (mostly) know what they know. arXiv:2207.05221, 2022.
A. Azaria and T. Mitchell. The internal state of an LLM knows when it’s lying. In Findings of EMNLP, 2023. arXiv:2304.13734.
S. Lin, J. Hilton, and O. Evans. TruthfulQA: Measuring how models mimic human falsehoods. In ACL, 2022. arXiv:2109.07958.
S. Lin, J. Hilton, and O. Evans. Teaching models to express their uncertainty in words. Transactions on Machine Learning Research, 2022. arXiv:2205.14334.
I. D. Raji, P. Xu, C. Honigsberg, and D. Ho. Outsider oversight: Designing a third party audit ecosystem for AI governance. In AIES, pages 557–571, 2022.
K. Tian, E. Mitchell, A. Zhou, A. Sharma, R. Rafailov, H. Yao, C. Finn, and C. D. Manning. Just ask for calibration: Strategies for eliciting calibrated confidence scores from language models fine-tuned with human feedback. In EMNLP, 2023. arXiv:2305.14975.
P. Verga, S. Hofstätter, S. Althammer, Y. Su, A. Piktus, A. Arkhangorodsky, M. Xu, N. White, and P. Lewis. Replacing judges with juries: Evaluating LLM generations with a panel of diverse models. arXiv:2404.18796, 2024.
J. Wei et al. Measuring short-form factuality in large language models (SimpleQA). arXiv:2411.04368, 2024.
M. Xiong, Z. Hu, X. Lu, Y. Li, J. Fu, J. He, and B. Hooi. Can LLMs express their uncertainty? An empirical evaluation of confidence elicitation in LLMs. In ICLR, 2024. arXiv:2306.13063.
Z. Yin, Q. Sun, Q. Guo, J. Wu, X. Qiu, and X. Huang. Do large language models know what they don’t know? In Findings of ACL, 2023. arXiv:2305.18153.
L. Zheng, W.-L. Chiang, Y. Sheng, et al. Judging LLM-as-a-judge with MT-Bench and Chatbot Arena. In NeurIPS Datasets and Benchmarks, 2023. arXiv:2306.05685.
Herramienta práctica: un diagnóstico de autoevaluación
Un subproducto de este estudio es un diagnóstico de autoevaluación compacto: una batería fija de sondeos cortos, calificables de manera determinista, que abarcan los dominios del estudio (numérico, lógica, física, historia, código, probabilidad y otros), más elementos trampa con un token de abstención explícito. Cada respuesta conlleva una confianza declarada de 0–100, y la herramienta calcula un compuesto de puntuación de Brier, brecha de sobreconfianza (confianza media menos precisión), discriminación de confianza (confianza media en respuestas correctas menos en respuestas incorrectas) y tasa de abstención de trampa, mapeando el resultado a niveles desde bien calibrado a ciegamente confiado. Operacionaliza la tesis de este artículo—la calibración es algo que se debe medir en un modelo, no algo que pueda extraerse de sus autoinformes—y se distribuye con el paquete de replicación como una herramienta, no como un resultado: utiliza sondeos parafraseados en lugar de la batería congelada, y su puntuación de discriminación es un proxy, no el AUROC final de la escala.
Apéndice de reproducibilidad
Todos los números principales en este artículo son funciones deterministas del JSONL sin procesar liberado; ningún paso implica aleatoriedad, acceso a la red, computación de GPU o re-consulta de ningún modelo.
Disponibilidad de datos.
El pre-registro congelado y el paquete de replicación (registro OSF público): https://osf.io/4y9dv. El script oracle-ceiling oracle_auroc.py se deposita con este artículo en https://doi.org/10.5281/zenodo.23197651.
Indicación de elicitación (textual).
Sistema: You answer short factual questions. Respond with ONLY a JSON object like {"answer": "<short answer>", "confidence": 85}. confidence is an integer 0-100 for how sure you are the answer is correct. No other text. El turno del usuario contiene la pregunta simple; los rechazos se detectan a partir del campo de respuesta por el léxico de rechazo congelado en el script de calificación.
Identificadores de modelo y fechas de ejecución.
Un modelo API de presupuesto/nivel medio por proveedor, verificado en vivo el 2026-07-24 y recopilado a finales de julio de 2026 (marcas de tiempo por llamada en el manifiesto de ejecución, liberadas con el paquete de replicación): anthropic claude-haiku-4-5-20251001; openai gpt-5-mini; google gemini-3.6-flash; xai grok-4-fast; deepseek deepseek-chat; alibaba qwen-plus; moonshot kimi-k3 (una desviación de recopilación divulgada: 670 de 1,500 elementos en la cuenta de primera parte, el resto a través de una ruta agregadora servida por la misma infraestructura de primera parte con razonamiento deshabilitado, served_by registrado por llamada; una división de sensibilidad de solo primera parte fue pre-registrada); zhipu glm-4.5; mistral mistral-small-latest. Nivel local (Ollama, temperatura 0): gemma4:e4b, llama3.2:3b, phi4-mini, qwen3:8b, deepseek-r1:8b, glm4:9b, mistral:7b.
El artículo complementario (Chernets, 2026) comparte el mismo registro congelado y la recopilación sin procesar. El paquete de replicación contiene: el texto de registro congelado y el protocolo, el manifiesto de ejecución con identificadores de modelo exactos, las colecciones calificadas sin procesar (niveles frontera y local, más el brazo exploratorio de comparación de edad de referencia), y tres scripts de CPU sin dependencias. El primero (compute_panel_vs_own_auroc.py) es la definición canónica de la comparación AUROC de acuerdo de panel versus confianza propia (Sección 4) e imprime, junto con los valores canónicos, todas las lecturas alternativas no canónicas (señal de panel binaria, codificación indeterminada, manejo de empates, variantes de agrupación) para que la elección de lectura sea auditable. El segundo (analysis_tae_week1.py) re-imprime la Tabla 1, las coordenadas de la Figura 1, las brechas de edad de referencia de la Sección 3, y realiza una verificación de solo lectura de los valores de escalera congelada informados en la Tabla 3 contra el archivo de análisis congelado de la escalera. El tercero (analysis_tae_decomposition.py) re-imprime la descomposición AUROC agrupada y la normalización de rango de la Sección 4, la recodificación sin etiqueta de la señal del panel, las tasas de error de confianza alta por modelo, las columnas CITL/Brier/ECE de la Tabla 1, los valores de riesgo–cobertura de la Tabla 2, y los descriptivos de escalón degradado de la Sección 5. Cada script se ejecuta en segundos en una CPU portátil solo con la biblioteca estándar de Python. La escalera de inyección de perfil se envía como su propio paquete congelado (protocolo, batería, filas puntuadas por brazo, y JSON de análisis), señalado desde el paquete.
Calculado a partir de las puntuaciones de brazo por elemento congeladas (
scored-arms-*.jsonl; no trampa, estadook; para el sujeto confirmatorio) pororacle_auroc.py, liberado con este artículo; todos los brazos y réplicas de un elemento se dejan fuera juntos.↩︎
Cómo citar
Chernets, V. (2026). Weakly Discriminative, Not Repaired by Profile Injection, and Manipulable: Self-Confidence in LLM Evaluation [Presentación de artículo]. NeurIPS 2026 Workshop: TAE. Zenodo. https://doi.org/10.5281/zenodo.23197651
@misc{chernets2026selfconfidenceevaluation,
  author       = {Chernets, Vadym},
  title        = {{Weakly Discriminative, Not Repaired by Profile Injection, and Manipulable: Self-Confidence in LLM Evaluation}},
  year         = {2026},
  howpublished = {Zenodo; NeurIPS 2026 Workshop: TAE},
  doi          = {10.5281/zenodo.23197651},
  url          = {https://doi.org/10.5281/zenodo.23197651}
}