Teatro de Verificación: Modos de Fallo Medidos de Paneles Verificadores de IA
Esta es una traducción. La versión de referencia es el original en inglés; cite esa.
Vadym Chernets, Investigador Independiente · ORCID 0009-0007-4845-3163
Zenodo DOI 10.5281/zenodo.23197641 · GitHub
Aceptado como póster en el taller NeurIPS 2026 "Who Verifies the Agents? Toward Reliable Agent Development" (no archivado). Copia archivada: 10.5281/zenodo.23197641. PDF: verification-theater.pdf. Las figuras y tablas a continuación se han convertido del código fuente LaTeX; el PDF es la versión autorizada.
Resumen
La verificación multiagente se está convirtiendo en un mecanismo de confianza predeterminado: una respuesta es confiable porque modelos independientes acordaron en ella. Utilizando una colección preregistrada, ciega, con temperatura cero en la que dieciséis modelos (nueve proveedores de frontera, siete de pesos abiertos locales) respondieron las mismas 1,500 preguntas fácticas (más un brazo de opción múltiple de 750 preguntas y un brazo de diálogo exploratorio), medimos cuándo la verificación del panel deja de funcionar mientras continúa pareciendo que funciona—una condición que llamamos teatro de verificación. Informamos de cuatro regímenes de falla. Primero, una inversión de dificultad: el levantamiento de certificación del acuerdo independiente—2.7–4.6 en los tres quintiles más fáciles de preguntas—cae a 0.82 en el segundo quintil más difícil y a cero en el más difícil, donde las respuestas replicadas fueron correctas en 0 de 342 casos (13 esperado bajo independencia). Una re-estratificación sin incluir el panel (dificultad ordenada por los 13 modelos fuera del panel) elimina la inversión agrupada (78/354 correcto, levantamiento 2.36) mientras que el cero persiste para el panel entre bloques (0/116); informamos ambas codificaciones juntas a lo largo de todo: en las preguntas que la población desplegada encuentra más difíciles, el acuerdo funciona como certificación de error. Segundo, espacios de respuesta restringidos: bajo opción múltiple (nivel local), los paneles certificaron unánimemente una respuesta incorrecta en el 4.0–7.9% de las preguntas, versus 1.5–4.6% en las respuestas de formato abierto del mismo nivel y 0.3–4.9% de formato abierto fronterizo. Tercero, las etiquetas utilizadas como indicadores de independencia fallan empíricamente: el bloque geopolítico no predice la correlación de errores (media intra-bloque 0.285 vs. entre bloques 0.274, diferencia ), y un modelo de razonamiento destilado de la misma base que su compañero del panel estuvo entre los pares menos correlacionados medidos (; 14.º de los 15 pares locales del bloque US/CN, 20.º de todos los 21 pares locales). Cuarto, conformidad: un verificador que había estado en desacuerdo con una respuesta la endosó a ciegas en el 38.5% de los casos cuando se le mostró como la de un colega; un control de indicación inversa muestra que estos cambios rastrean la presencia de una propuesta confiada, no su verdad (38.9% hacia lo incorrecto vs. 34.7% hacia lo correcto; McNemar exacto ). Argumentamos que estos regímenes comparten una raíz económica y derivamos una disciplina de medición que separa la verificación de su teatro.
Introducción: el problema del teatro
Paneles de modelos de IA que se verifican mutuamente se están implementando como infraestructura de confianza, y el acuerdo entre ellos es cada vez más valorado como evidencia. La investigación en seguridad ha identificado de hace tiempo un término para los mecanismos que producen la estética de la protección sin su sustancia (Schneier, 2003); preguntamos, con mediciones en lugar de metáforas, cuándo la verificación de paneles merece ese término. El hallazgo central es una inversión: el valor de certificación del acuerdo se concentra en preguntas fáciles y desaparece—o se invierte—exactamente donde es más importante la verificación. Tratamos esto no como una anomalía aislada sino como uno de cuatro regímenes distintos en los cuales un panel verificador mantiene la apariencia de verificación mientras pierde su sustancia, y vinculamos los cuatro a una causa económica común y un remedio común.
Concretamente, este artículo contribuye: (C1) una medición de ganancia de certificación estratificada por dificultad que muestra que el valor de certificación del acuerdo independiente se concentra en preguntas fáciles y, bajo la medida de dificultad poblacional, se invierte en el quintil más difícil (0 de 342 respuestas replicadas correctas; bajo la dificultad independiente del panel la inversión agrupada desaparece y el cero persiste para el panel entre bloques, 0/116)—los dos códigos se reportan juntos en todo; (C2) evidencia de que espacios de respuesta restringidos (opción múltiple) llevan el error certificado unánime a 4.0–7.9%, bien por encima del rango de forma abierta de 0.3–4.9%; (C3) dos resultados nulos pre-registrados que muestran que las etiquetas rutinariamente usadas como proxies de independencia—bloque geopolítico y linaje de modelo—no predicen la correlación de errores, por lo que la independencia debe medirse por pares como una -matriz en lugar de asumirse a partir de marca o árbol genealógico; y (C4) una medición de conformidad con un control de solicitud invertida que demuestra que los verificadores en modo diálogo rastrean la presencia de una propuesta confiada más que su verdad. El protocolo de recolección ciega y la construcción de confianza se enuncian completamente en el artículo complementario y se resumen aquí solo hasta donde lo requieren las mediciones; todo lo reportado como resultado en este artículo (C1–C4) se mide aquí y no se reitera desde él. De estos derivamos (C5) una disciplina de medición—-matrices publicadas por clase de tarea, afirmaciones de certificación estratificadas por dificultad, elicitación ciega-primero, y escalación de régimen duro—que operacionalmente separa la verificación de su teatro.
Arte previo y encuadre
Consenso tolerante a fallos (BFT) asume fallos independientes—la suposición que probamos y encontramos injustificada. La literatura sobre paradoja de consenso ya nombra errores estabilizados por acuerdo en enjambres homogéneos (Shehata and Li, 2026). zkML verifica que un cálculo se ejecutó, no que su respuesta sea verdadera—complementario, no compitiendo. El Dilema del Verificador proporciona el análisis de incentivos; (Raji et al., 2022) proporcionan el problema de selección de auditor; (Du et al., 2024), (Farquhar et al., 2024), y (Ding, 2026) proporcionan la literatura de señales de acuerdo que este documento pone a prueba. El propio constructo de confianza se introdujo en un documento complementario (Chernets, 2026); este documento mapea dónde el motor de verificación del constructo falla mientras parece estar funcionando. El trabajo de cálculo en tiempo de prueba llega a la conclusión complementaria desde el lado constructivo: conjuntos de verificadores de aspectos diversos superan a cualquier verificador individual (Lifshitz et al., 2025), un panel de jueces pequeños extraídos de familias disjuntas supera a un juez grande único a una fracción del costo (Verga et al., 2024), y una reevaluación sistemática del debate multiagente identifica la heterogeneidad del modelo como el único mejorador confiable (Zhang et al., 2025); la línea del debate muestra argumentación adversarial estructurada ayudando a jueces más débiles a alcanzar respuestas más verdaderas (Khan et al., 2024). La evidencia revisada por pares ya documenta una correlación de error sustancial entre proveedores—mayor precisamente entre los modelos más precisos, incluso entre distintas arquitecturas y proveedores (Kim et al., 2025)—que motiva independientemente medir la dependencia en lugar de inferirla de las etiquetas. Esa literatura selecciona paneles por diversidad; este documento mide cuánto vale la propiedad seleccionada—y cuánto cuesta silenciosamente su ausencia—en la verificación.
Datos y medición
Una colección pre-registrada, ciega (protocolo congelado públicamente antes de la recopilación de datos confirmatorios; registro público en https://osf.io/4y9dv): dieciséis modelos una submuestra aleatoria pre-registrada de 1,500 de los 4,326 elementos de SimpleQA (semilla fija, extraída antes de cualquier recopilación; CSV de submuestra con su SHA-256 adjunto al registro congelado) a temperatura cero con confianza establecida de 0–100 (13,446 respuestas fronterizas limpias; 8,802 respuestas de nivel local); un brazo MC1 de TruthfulQA de 750 elementos en el nivel local, derivado de una copia congelada del archivo del repositorio oficial (790 elementos, idénticos en bytes al CSV canónico) por un constructor pre-registrado que requiere al menos dos opciones incorrectas distintas por elemento (semilla de barajado fija; 695 elementos completamente respondidos por los siete modelos); un brazo de diálogo exploratorio activo-vs-ciego. SimpleQA se recopila adversarialmente contra un modelo de frontera, con una única respuesta indisputable por pregunta (Wei et al., 2024): el estrato difícil, por lo tanto, sondea los límites genuinos del conocimiento paramétrico, y la calificación se reduce a equivalencia-con-oro. TruthfulQA proporciona el brazo del espacio de respuestas restringido (Lin et al., 2022). Los paneles son combinaciones analíticas de la única colección ciega; todo re-análisis es determinístico (codificación de equivalencia de cadena con rechazos y no superposición contados como desacuerdo; pares indeterminados reportados como corchetes). La dificultad se operacionaliza observacionalmente como la precisión media de 16 modelos por pregunta, dividida en quintiles de rango de 300 preguntas. La misma colección bruta fundamenta el artículo complementario (Chernets, 2026), que reporta los ratios de certificación agrupados y breves resúmenes de los análisis detallados aquí; la escalera de elevación estratificada por dificultad, suite de robustez, -matrix, y descomposiciones de conformidad aparecen solo en este artículo, y cada superposición restante se marca cruzadamente en el texto.
La calificación de respuesta abierta es de dos etapas: una pasada determinística de equivalencia de cadena (26.8% de calificaciones fronterizas) más detección de rechazo (6.6%), con el 66.5% restante calificado por un calificador de LLM; una verificación puntual humana estuvo de acuerdo con el calificador en el 98% de una muestra aleatoria (). Porque dos tercios de las calificaciones son producidas por modelos, todos los resultados principales van acompañados de un remuestreo de sensibilidad al error del calificador (10% de veredictos calificados por modelo invertidos, 200 remuestras sembradas; Sección 4 y Apéndice A).
Régimen de fallo I: la inversión de dificultad
Los tres paneles fronterizos preestablecidos son combinaciones analíticas de 3 modelos de la recolección única a ciegas: bloque estadounidense (Anthropic, OpenAI, Google), bloque chino (DeepSeek, Alibaba, Moonshot), y bloque cruzado (Anthropic, DeepSeek, Mistral); una respuesta se cuenta como replicada cuando al menos uno de los dos compañeros de panel del primario produjo de forma independiente una respuesta equivalente bajo la codificación determinista congelada de la Sección 3, y la ganancia es . Agrupados entre los tres paneles, la probabilidad de que una respuesta replicada sea correcta aumenta de 0.0% (0/342, IC 0.0–1.1) en el quintil más difícil a través de 12.8%, 57.5% y 81.0% hasta 95.1% en el más fácil; la ganancia correspondiente sobre respuestas no replicadas es 0.00 / 0.82 / 2.68 / 3.09 / 4.56. En el 20% más difícil de las preguntas, cada acuerdo observado certificó una respuesta incorrecta, y en el siguiente quintil la estimación puntual coloca el acuerdo por debajo de la paridad con el desacuerdo (0.82, IC [0.51, 1.21]); el cero del quintil más difícil se replica en cada panel por separado (bloque estadounidense 0.00–4.25, bloque chino 0.00–9.76, bloque cruzado 0.00–4.04); la sub-paridad Q2 se mantiene en los paneles chino y de bloque cruzado, mientras que la ganancia Q2 del panel estadounidense es 1.20. Gran parte de la ganancia de certificación agrupada es llevada por preguntas fáciles, así que una afirmación de ganancia no estratificada exagera lo que la verificación proporciona donde más se necesita. El cero Q1 se mide contra una tasa base activa, no un piso: las respuestas Q1 no replicadas son correctas el 3.9% del tiempo (89/2286), así que la independencia predice respuestas replicadas correctas—las 0 observadas (límite superior 1.1%) se sitúan significativamente por debajo de la tasa base del propio estrato. El punto de referencia de independencia es conservador aquí, no liberal: un nulo que preserve la estructura de correlación entre modelos medida completa—una permutación común de etiquetas de corrección en las preguntas del estrato, estructura de replicación congelada (2,000 permutaciones)—espera 11.7–12.4 respuestas replicadas correctas y nunca produjo el 0 observado (; mínimo 3); incorporando la por pares medida en un nulo bivariado analítico eleva aún más la expectativa, porque los errores correlacionados positivamente implican respuestas correctas correlacionadas positivamente. Lo que puebla el estrato es en sí mismo informativo: las 342 celdas abarcan 106 preguntas—factoides ordinarios estrechos (mediana 17 palabras), no frases ambiguas, y los modelos raramente se abstienen en ellas (0.5 de 9 respuestas por pregunta). Sus respuestas incorrectas se agrupan: en el 70.8% de estas preguntas al menos tres de los nueve modelos fronterizos produjeron la misma respuesta incorrecta, y en el 67.4% de las preguntas replicadas por más de un panel, los paneles compuestos independientemente certificaron el idéntico consenso incorrecto—típicamente una respuesta de vecino famoso desplazando la entidad correcta pero menos prominente. Una adjudicación manual por especialista de todas las 106 etiquetas de oro encontró 2 cuestionables y 0 claramente incorrectas; reconociendo la respuesta de panel claramente defendible y dos parcialmente defendibles mueve el recuento del quintil más difícil de 0/342 a como máximo 13/342 (3.8%), así que la conclusión casi cero se mantiene mientras se suaviza desde un cero literal (una etiqueta señalada: una elección de la Academia Real de 2010 puntuada contra un título de honores que la academia no confiere). La afirmación es directamente comprobable: predice ganancia Q1 en cualquier replicación estratificada por la precisión de la población desplegada (bajo estratificación independiente de paneles la predicción es el cero de bloque cruzado, no la ganancia agrupada). Tampoco el cero es un artefacto del calificador: un calificador segundo independiente de una familia de proveedores fuera de cada panel y el calificador original (temperatura cero, la idéntica solicitud congelada de equivalencia-a-oro) volvió a calificar todos los 342 veredictos Q1 replicados y estuvo de acuerdo en 342/342 (cambios a correcta 0/342, límite superior 1.1%); el cambio sintético del 10% de las etiquetas calificadas por modelo igualmente deja la participación de errores certificados en o por encima del 86.5% en cada remuestreo (apéndice).
Re-estratificación omitiendo el panel.
Dado que los miembros del panel contribuyen al índice de dificultad de la población, el quintil más difícil está parcialmente condicionado por el propio fracaso del panel. Al re-estratificar únicamente por los 13 modelos no del panel, las respuestas replicadas en el quintil más difícil son correctas en 78/354 casos (22.0%, elevación conjunta 2.36, por encima del 33/354 esperado bajo independencia), y el cero persiste solo para el panel entre bloques (0/116; 0/88 en el estrato donde todos los 13 modelos no del panel fracasan). El cero persistente se caracteriza por sí mismo: la tasa base del estrato es 31/778 = 3.98% (Wilson 2.8–5.6%), dando una expectativa de independencia de 4.6 respuestas correctas entre las 116; una permutación nula que preserva correlación (2,000 permutaciones) da , rango del 95% , y —significativamente por debajo de la nula, aunque no inaccesible bajo ella. La inversión anterior es por lo tanto una afirmación sobre dónde falla la verificación en relación con lo que la población implementada encuentra difícil, no en relación con la dificultad independiente del panel. Como segunda verificación de sensibilidad, re-derivamos la escala bajo una codificación de replicación completamente libre de etiquetas (comparación de cadenas determinística de solo respuestas ciegas, nunca consultando la etiqueta de corrección): el resultado de Q1 es esencialmente sin cambios (2/344 respuestas replicadas correctas, 0.6% [0.2–2.1]; elevación 0.15) y las elevaciones por debajo de 1 en los dos quintiles más difíciles persisten, mientras que la elevación del quintil superior se atenúa (4.56 a 2.33) porque la coincidencia de cadenas pura pierde variantes superficiales de la misma respuesta correcta; los resultados de opción múltiple no se ven afectados, ya que el acuerdo allí se codifica por letra de respuesta y es libre de etiquetas por construcción.
Tres verificaciones de robustez apoyan la inversión. (i) El bootstrap a nivel de pregunta (2,000 remuestreos sembrados dentro del quintil) da ICs del 95% para las cinco elevaciones de [0.00, 0.00], [0.51, 1.21], [2.32, 3.09], [2.84, 3.35], y [4.16, 5.03]: los intervalos del régimen duro excluyen completamente los del régimen fácil. (ii) Sensibilidad del error del calificador: invertir el 10% de los veredictos calificados por modelo (200 remuestreos sembrados; 97.1% de las 342 respuestas replicadas del quintil más difícil se califican por modelo y por lo tanto se pueden invertir) mantiene la proporción del error certificado del quintil más difícil en o por encima del 86.5% en cada remuestreo, mantiene la elevación de Q1 por debajo de 1 en el 92% de los remuestreos (mediana 0.82), y nunca acerca las elevaciones de Q1–Q2 a las de Q3–Q5, que se mantienen por encima de 2 en los 200 remuestreos. (iii) El nivel local de siete modelos replica el contraste difícil–fácil con modelos y paneles independientes, no monótonamente (Q3 ): elevaciones 0.00 / 0.94 / 0.00 / 1.89 / 4.37 en los mismos quintiles, con 0 de 166 respuestas replicadas correctas en el quintil más difícil; este nivel es 94.8% calificado por LLM y está cubierto por el mismo remuestreo de sensibilidad del calificador que (ii).
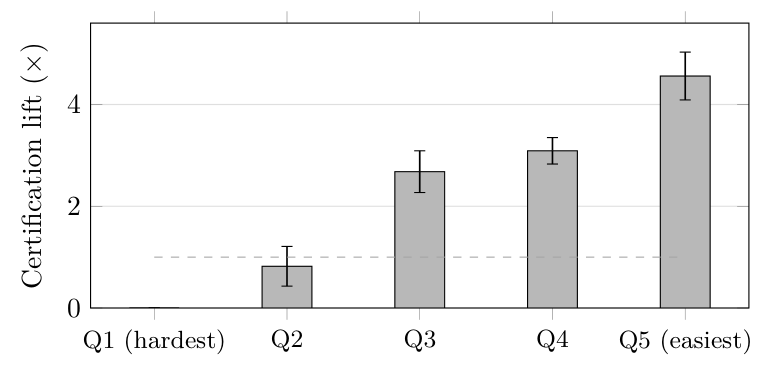 Elevación de certificación por quintil de dificultad, agrupada en tres paneles de frontera, con intervalos de bootstrap del 95% a nivel de pregunta (2,000 remuestreos sembrados; Apéndice A.1). La línea discontinua marca elevación = 1, paridad con respuestas no replicadas: los dos quintiles más difíciles se encuentran en o por debajo de ella por estimación puntual (Q1 0.00×—un cero medido, no datos faltantes; Q2 0.82×, su IC cruzando paridad), los tres más fáciles muy por encima de ella.
Régimen de fallo II: espacios de respuesta restringidos
En opción múltiple, cuatro paneles de nivel local preestablecidos convergieron unánimemente en una opción incorrecta en el 4.0–7.9% de las 695 preguntas completamente respondidas (por panel: 4.0, 5.9, 6.6, 7.9), versus un intervalo determinista de 0.3–4.9% para respuestas unánimes incorrectas confiadas de forma abierta en el nivel frontera. Recomputing the same certification metric on the local tier's own open-form answers (8,802 graded SimpleQA responses) removes the tier–format confound: los mismos paneles del nivel local certifican errores unánimes confiados solo en el 1.5–4.6% de los elementos de forma abierta bajo codificación determinista estricta (hasta 9.8% incluyendo el intervalo indeterminado), consistente con el intervalo de forma abierta del nivel frontera—un patrón consistente con el espacio de respuesta restringido, en lugar del nivel del modelo, impulsando la certificación de errores; sin embargo, queda una confusión: el brazo de opción múltiple y los brazos de forma abierta son conjuntos de preguntas diferentes (TruthfulQA MC1 contra SimpleQA), por lo que el formato y el conjunto de preguntas no se separan aquí, y la forma causal de la afirmación se resuelve solo mediante un intercambio de formato de la misma pregunta, que no ejecutamos.1 El bootstrap por panel proporciona intervalos en la brecha donde tiene potencia: MC menos error de consenso certificado de forma abierta es pp [2.9, 6.8] (piloto), pp [3.9, 8.1] (local-EE.UU.), y pp [2.6, 6.3] (entre bloques), cada uno excluyendo cero; el panel CN-local, cuya celda de forma abierta se basa en el conjunto de 87 elementos de la nota al pie, no lo resuelve. Un menú convierte errores dispersos en compartidos: cuando el espacio de respuesta es pequeño, los modelos similares caen en el mismo distractor y la unanimidad del panel se convierte en un amplificador de errores. Las tasas no se pueden explicar por errores independientes: con cada miembro independientemente incorrecto en su tasa marginal y los errores distribuidos sobre las opciones incorrectas (), la tasa esperada de unanimidad-misma-opción-incorrecta es 0.49–0.92% en los cuatro paneles—el 4.0–7.9% observado es un exceso de 4.9–13.5 sobre la línea base de independencia. Consecuencia de diseño, establecida como una regla comprobable: cualquier interfaz que proporciona a los agentes un conjunto de opciones fijo debe esperar un error de consenso certificado materialmente más alto que la elicitación de forma abierta sobre el mismo contenido.
Requerir confianza declarada de los tres panelistas apenas reduce el efecto: el rango de error de consenso certificado se desplaza de 4.0–7.9% a 4.0–7.2% (por panel 4.0, 5.2, 6.0, 7.2), es decir, casi todas las respuestas unánimes incorrectas también son confiadas. El fracaso tampoco se limita a un nicho temático: en las diez categorías de TruthfulQA con al menos 20 elementos, el error de consenso certificado agrupado abarca 1.0% (Conspiraciones) a 8.6% (Economía), con Derecho, Salud y Sociología en medio (Apéndice A).
Régimen de fallo III: las etiquetas de independencia no predicen la independencia
A través de 36 pares de proveedores fronterizos (1.448 preguntas compartidas), la correlación de error por pares abarca 0.123–0.395, y el intervalo no se organiza por las etiquetas que la gente busca: los pares más y menos correlacionados son ambos intra-bloque (googlexai 0.395 frente a googleopenai 0.123), la media intra- frente a entre-bloque difieren en , y el par de linaje de la misma base ocupa el lugar 14 de los 15 pares formados por los seis modelos locales del bloque US/CN en los 695 elementos de opción múltiple completamente respondidos (; el séptimo modelo local es del bloque UE y está fuera del diseño de bloque/linaje pre-registrado—su inclusión arroja 21 pares, de los cuales el par de linaje ocupa el lugar 20). Ambas hipótesis nulas pre-registradas (bloque, linaje) sobreviven al re-análisis; lo que sigue siendo predictivo es la correlación medida en sí. La regla práctica: la independencia es una cantidad por-par, por-clase-de-tarea a medir (una -matrix), no inferida de marca, bandera o árbol genealógico—montar un panel por etiquetas es especulación, no verificación. El por pares mide la dependencia de error empírica, no la independencia estadística completa: un bajo no excluye la dependencia de orden superior en paneles de tres o más, una razón adicional para tratar la independencia como una cantidad medida, condicionada por la tarea, en lugar de una propiedad asumida.
Una prueba de permutación exacta sobre las 630 asignaciones de las etiquetas de bloque a los nueve proveedores no encuentra evidencia de un efecto de bloque: la diferencia intra-menos-entre observada de es excedida o igualada por 132 de las 630 reetiquetaciones (unilateral ; IC del 95% de bootstrap agrupado para la diferencia ). La prueba acota la afirmación—no se excluyen los efectos de bloque pequeños—y la conclusión operativa se mantiene: la etiqueta no lleva ninguna señal utilizable en lugar de la medición por pares. Debido a que está limitado por arriba cuando las tasas de error base del par difieren, volvimos a ejecutar el análisis en la razón marginal-normalizada : ambas hipótesis nulas pre-registradas sobreviven (diferencia de bloque , permutación ; el par de linaje se mantiene como el 14 de 15), la dispersión persiste (0.278–0.821 en pares fronterizos), y los extremos se desplazan a dos pares entre-bloque (anthropicmoonshot 0.821, mistralopenai 0.278)—bajo cualquier métrica, ninguna etiqueta organiza la dispersión. Extendiendo la matriz a los dieciséis modelos: en las 81 preguntas respondidas por cada modelo, el por pares abarca a (120 pares; medias de bloque: frontera–frontera 0.320, local–local 0.350, frontera–local 0.210)—una dispersión de orden de magnitud que ninguna taxonomía de etiqueta en nuestros datos predice (Figura 2). Con 81 elementos comunes, las estimaciones de celdas individuales llevan intervalos amplios; el resultado es la dispersión en sí, no ninguna celda individual.
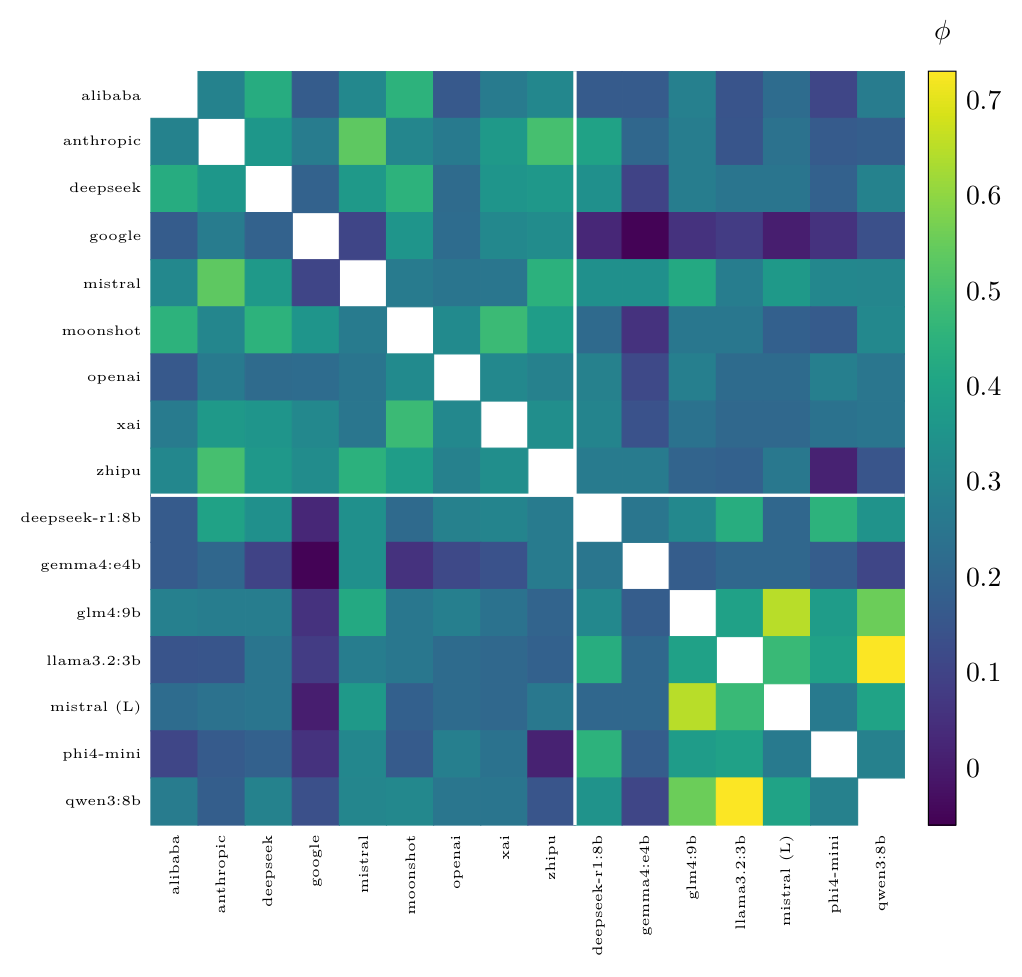 Correlación de errores por pares (ϕ) entre todos los dieciséis modelos en las 81 preguntas respondidas por cada modelo (nueve proveedores punteros, luego siete pesos abiertos locales; la partición puntero/local está marcada por las líneas blancas). Cada celda fuera de la diagonal es uno de los 120 pares únicos; la diagonal (autocorrelación = 1,0) se deja en blanco por diseño para que no comprima la escala de colores. ϕ abarca de −0,05 a 0,73 (media 0,27): una dispersión de orden de magnitud en cuán correlacionados están los errores de dos verificadores cualesquiera, lo que ningún bloc o etiqueta de linaje en nuestros datos predice. Los valores se emiten de forma determinística por emit_phi_matrix.py (reutilizando analysis_week1.py sec. W5); ninguno se introduce manualmente.
Régimen de fallo IV: verificación que cede (exploratorio)
Cuando a un verificador que había estado en desacuerdo de forma ciega se le mostró la misma respuesta que la propuesta de un colega, cedió en el 38.5% de los casos (168/436); cuando había producido la respuesta correcta de forma ciega, la abandonó por la incorrecta en el 30.9% (46/149), con tasas de abandono por proveedor del 13.1% al 51.6% (la capitulación por proveedor en el subconjunto completo de desacuerdo-ciego abarca 20.4–58.1%).
¿Podrían estos cambios ser una actualización racional de creencias en lugar de conformidad? Un control de indicación inversa argumenta en contra. En un panel local de seis modelos, re-ejecutamos el procedimiento emparejado con la dirección de exposición invertida: a un verificador que había estado en desacuerdo de forma ciega se le mostró, para el mismo conjunto de preguntas, ya sea la respuesta incorrecta presentada con confianza (brazo directo) o la respuesta correcta (brazo inverso). Los dos brazos tienen indicaciones idénticas—una plantilla compartida («Respuesta propuesta: …»), la respuesta mostrada diferenciándose solo en contenido, sin valores de confianza o atribución de fuente mostrados—de modo que el contraste aísla el valor de verdad de la respuesta mostrada. Si los verificadores estuvieran actualizando en base a evidencia, la exposición a la respuesta correcta debería motivarlos más; en su lugar, los dos brazos produjeron tasas de cambio casi idénticas—38.9% hacia la respuesta incorrecta, 34.7% hacia la correcta—y la comparación intra-pareja va en el sentido equivocado para la narrativa de actualización: de 174 pares discordantes, el verificador desertó su posición ciega hacia la respuesta incorrecta en 104 casos y hacia la correcta en 70 (McNemar exacto ). A nivel de modelo, los dos brazos eran indistinguibles (propensión al cambio 89.9% frente a 89.9% para el verificador más dócil, 1.5% frente a 1.5% para el menos): lo que desencadena el acuerdo es que una propuesta presentada con confianza esté presente, no que sea verdadera—el aspecto de verificación-panel de la adulación entrenada por preferencia (Sharma et al., 2024). Tampoco la asimetría depende del verificador más dócil: excluyéndolo quedan 835 elementos emparejados con conteos discordantes 94 frente a 60 (exacto ). Dos descomposiciones adicionales refuerzan esta interpretación (Apéndice A): cada cambio registrado en cualquiera de los brazos vino acompañado de confianza declarada después de la exposición (0 cambios por debajo de ese umbral, ), y en el brazo directo los verificadores que habían sido correctos de forma ciega abandonaron la respuesta correcta en el 40.8% de los casos (20/49), reflejando el hallazgo de frontera. El control se ejecutó en el nivel local (Limitaciones). Un resumen en prosa de este control también aparece en el artículo complementario (Chernets, 2026); la descomposición por modelo, la división de puerta de confianza, y el análisis de abandono correcto-ciego se reportan solo aquí.
Esto establece los límites de una afirmación de diseño: cuando el objetivo es medir el desacuerdo independiente, la elicitación debe ser ciega-primero—un panel que delibera antes de comprometer posiciones no mide su desacuerdo, lo borra.
Discusión: la economía del teatro (conjetura, no evidencia)
Esta sección es una discusión más que una evidencia: no reporta ninguna medición nueva, y nada en ella debe ser leído como equivalente a los cuatro regímenes medidos anteriormente. Con eso establecido, los cuatro regímenes pueden persistir porque ninguna parte es pagada para notarlos: los consumidores no pueden asignar precio a la calidad de la verificación, las plataformas son pagadas por confianza en lugar de por duda, y la estrategia más económica de cada verificador es estar de acuerdo. Agregue a esto el problema de la selección del auditor (la independencia es una propiedad de quien selecciona los verificadores) y el precedente de la granja de enlaces (cualquier señal de acuerdo que lleva peso comercial invita al cultivo), y el teatro es un equilibrio, no un accidente—una conjetura que las mediciones motivan pero no prueban. La cuenta de incentivos complementa, en lugar de excluir, la inercia de ingeniería y la ausencia de estándares de medición; se destaca porque es el componente falsable. Esta sección formula predicciones de mercado falsables en lugar de afirmaciones normativas—por ejemplo, los paneles no auditados deben converger hacia composiciones de diversidad mínima a lo largo del tiempo porque los paneles correlacionados son más económicos y concuerdan más.
Del teatro a la medición
El remedio es una disciplina, no un componente: (1) publicar la matriz medida del panel por clase de tarea, no su lista de marcas (una recopilación ciega por clase de tarea es suficiente—la matriz de 16 modelos de este artículo provino de un único paso de 1.500 elementos); (2) estratificar cada afirmación de certificación por dificultad e informar el aumento del régimen difícil por separado (la dificultad se operacionaliza por clase de tarea a partir de una colección de calibración, no por elemento en la inferencia); (3) obtener respuestas ciegas primero, siempre—el esquema de compromiso-revelación de la verificación del panel, que reordena la obtención de respuestas en lugar de añadir computación, ya que las respuestas ciegas son paralelizables; (4) tratar el régimen más difícil como un desencadenante de escalada—en preguntas donde el aumento medido del panel es , el acuerdo debe dirigirse a un humano o a la abstención, nunca a la certificación. Cada regla se enuncia para que un sistema desplegado pueda auditarse contra ella.
Como ejemplo práctico, aplique la receta al panel de frontera del propio artículo. Regla (1): su independencia se informa como la matriz medida de la Sección 6 (intervalo 0.123–0.395), no como un catálogo de proveedores—que habría ocultado que el par más correlacionado es intra-bloque (googlexai). Regla (2): su aumento de certificación se informa estratificado (Tabla 1), con el aumento del régimen difícil ( en Q1, en Q2) que se enuncia por separado en lugar de incluirse en un titular agrupado único. Regla (3): cada respuesta aquí fue solicitada a ciegas antes de que se ensamblara ningún panel, que es precisamente lo que hace que el brazo de conformidad (Sección 7) sea medible en lugar de estar confundido. Regla (4): porque el aumento medido del panel es en los dos quintiles más difíciles, un despliegue auditado de este mismo panel dirigiría esas preguntas a la abstención o revisión humana, nunca a la certificación por consenso. La disciplina no es, por lo tanto, hipotética: es el protocolo bajo el cual se produjeron los propios números del artículo.
Limitaciones
Una única familia de benchmark por nivel (SimpleQA frontera de forma abierta; TruthfulQA MC local), por lo que los límites del régimen son relativos al benchmark; cada proveedor de frontera está representado por un modelo de nivel presupuestario/medio, por lo que no se hacen afirmaciones sobre las capacidades del proveedor. La estratificación de la dificultad es observacional (post-hoc sobre una colección preregistrada) y la asignación de quintiles comparte datos con los modelos evaluados. El brazo de conformidad es exploratorio y modesto en ; su control de prompt inverso utilizó modelos locales, por lo que la transferencia a paneles de frontera es por analogía, no por medición. Aproximadamente dos tercios de las calificaciones de forma abierta provienen de un calificador LLM (verificación manual con 98% de acuerdo; una recalificación entre familias de los 342 veredictos replicados del quintil más difícil coincidieron en 342/342; remuestreo de sensibilidad en el apéndice). Ambos benchmarks son públicos, por lo que no se puede descartar la fuga del conjunto de entrenamiento; en SimpleQA su dirección favorece respuestas memorizadas-correctas, lo que reduce el estrato difícil y hace que los resultados del régimen difícil sean conservadores; en TruthfulQA el corpus público contiene los conceptos erróneos en sí, por lo que la dirección allí no es clara: una lectura alternativa ya limitada por la limitación formato-contenido de la Sección 5. No se hace ninguna afirmación causal sobre por qué el acuerdo falla en preguntas difíciles—los mecanismos candidatos (suposiciones compartidas, puntos ciegos compartidos, datos de entrenamiento compartidos) se nombran pero no se separan.
Conclusión
El acuerdo es evidencia solo después de que se midan la independencia y la competencia, y la medición es barata—el re-análisis completo aquí se ejecuta en segundos en hardware comercial a partir de archivos de datos públicos brutos. Hasta que los paneles se distribuyan con sus -matrices y elevaciones estratificadas, «verificado por consenso» debe leerse de la manera en que los ingenieros de seguridad aprendieron a leer un registro de bolsa.
References
B. Schneier. Beyond Fear: Thinking Sensibly About Security in an Uncertain World. Copernicus Books, 2003.
D. Shehata and M. Li. The inverse-wisdom law: Architectural tribalism and the consensus paradox in agentic swarms. arXiv:2604.27274, 2026.
I. D. Raji, P. Xu, C. Honigsberg, and D. Ho. Outsider oversight: Designing a third party audit ecosystem for AI governance. In AIES, pages 557–571, 2022.
Y. Du, S. Li, A. Torralba, J. B. Tenenbaum, and I. Mordatch. Improving factuality and reasoning in language models through multiagent debate. In ICML, 2024. arXiv:2305.14325.
S. Farquhar, J. Kossen, L. Kuhn, and Y. Gal. Detecting hallucinations in large language models using semantic entropy. Nature, 630(8017):625–630, 2024.
Kaihua Ding. When LLMs agree, are they right? Auditing self-consistency and cross-model agreement as confidence signals. arXiv preprint arXiv:2607.08065, 2026.
E. Kim, A. Garg, K. Peng, and N. Garg. Correlated errors in large language models. In ICML, 2025. arXiv:2506.07962.
M. Sharma, M. Tong, T. Korbak, D. Duvenaud, et al. Towards understanding sycophancy in language models. In ICLR, 2024. arXiv:2310.13548.
A. Khan, J. Hughes, D. Valentine, L. Ruis, et al. Debating with more persuasive LLMs leads to more truthful answers. In ICML, 2024. arXiv:2402.06782.
J. Wei, K. Nguyen, H. W. Chung, Y. J. Jiao, S. Papay, A. Glaese, J. Schulman, and W. Fedus. Measuring short-form factuality in large language models. arXiv:2411.04368, 2024.
S. Lin, J. Hilton, and O. Evans. TruthfulQA: Measuring how models mimic human falsehoods. In ACL, 2022. arXiv:2109.07958.
S. Lifshitz, S. A. McIlraith, and Y. Du. Multi-agent verification: Scaling test-time compute with multiple verifiers. arXiv:2502.20379, 2025.
P. Verga, S. Hofstätter, S. Althammer, Y. Su, A. Piktus, A. Arkhangorodsky, M. Xu, N. White, and P. Lewis. Replacing judges with juries: Evaluating LLM generations with a panel of diverse models. arXiv:2404.18796, 2024.
H. Zhang, Z. Cui, J. Chen, et al. Stop overvaluing multi-agent debate—we must rethink evaluation and embrace model heterogeneity. arXiv:2502.08788, 2025.
Vadym Chernets. Architectural trust: Verifiable decision architecture for agentic commerce. SSRN working paper 7191261, 2026. https://doi.org/10.2139/ssrn.7191261 (cited for the trust construct and for its summary treatment of the shared blind collection; overlapping analyses are cross-flagged where they occur).
Apéndice de reproducibilidad
Todo reanálisis es determinista dados los archivos JSONL calificados sin procesar y dos scripts de semilla fija (un script de línea de base que reproduce cada número titular y un complemento de semana 1 que produce las tablas de bootstrap, sensibilidad y descomposición que se muestran a continuación); el recálculo completo toma menos de 15 segundos en hardware común sin GPU, red o llamadas de modelo. El paquete pre-registrado congelado y de replicación (registro OSF público): https://osf.io/4y9dv.
Intervalos de confianza de bootstrap para la escala de elevación
Remuestreo a nivel de pregunta dentro del quintil, 2,000 sorteos con semilla, agrupados en los tres paneles fronterizos.
| Quintil | Wilson 95% | Bootstrap 95% | Elevación | Elevación bootstrap 95% | |
|---|---|---|---|---|---|
| Q1 (el más difícil) | 0/342 = 0.0% | [0.0, 1.1] | [0.0, 0.0] | 0.00 | [0.00, 0.00] |
| Q2 | 46/359 = 12.8% | [9.7, 16.7] | [8.2, 18.2] | 0.82 | [0.51, 1.21] |
| Q3 | 272/473 = 57.5% | [53.0, 61.9] | [50.7, 64.6] | 2.68 | [2.32, 3.09] |
| Q4 | 732/904 = 81.0% | [78.3, 83.4] | [76.6, 85.1] | 3.09 | [2.84, 3.35] |
| Q5 (el más fácil) | 1700/1788 = 95.1% | [94.0, 96.0] | [93.4, 96.6] | 4.56 | [4.16, 5.03] |
Elevación de certificación por quintil de dificultad con intervalos de Wilson y bootstrap del 95% (porcentajes para , razones para elevación). Bajo dificultad de exclusión de panel (clasificado por los 13 modelos sin panel) la celda Q1 agrupada es 78/354 (22.0%, elevación 2.36), el cero persiste en el panel entre bloques (0/116); Sección 4. Tasas base por quintil: 3.9 / 15.6 / 21.5 / 26.2 / 20.8% ( = 2286 / 2308 / 2209 / 1778 / 912).
Sensibilidad del error del calificador
Invertir el 10% de los 8,948 veredictos fronterizos calificados por modelo (200 remuestreos con semilla; codificación de acuerdo y asignación de quintil congeladas en la codificación del protocolo determinista original para que solo las etiquetas de corrección se muevan): la celda del quintil más difícil "certificada correcta" se eleva de 0/342 a una mediana de 33/342 (9.6%; rango del 95% 23–46), por lo que la participación de error certificado del acuerdo Q1 se mantiene en o por encima del 86.5% en cada remuestreo; la elevación Q1 se mantiene por debajo de 1 en el 92% de los remuestreos (mediana 0.82, rango del 95% 0.56–1.08) mientras que las elevaciones Q3–Q5 nunca caen por debajo de 2 (medianas 2.17 / 2.51 / 3.42). De las 342 respuestas Q1 replicadas, 332 (97.1%) se califican por modelo y por lo tanto son invertibles en este ejercicio. Más allá de los cambios sintéticos, una auditoría entre familias revaloró todos los 342 veredictos Q1 replicados con un segundo calificador independiente (una familia de proveedor externa a todos los paneles y a la familia del calificador original; temperatura 0; prompt congelado idéntico en bytes): acuerdo 342/342 (cambios a correcto 0/342, límite superior de Wilson 1.1%), uniforme en todas las celdas calificadas por modelo (332) y celdas codificadas como cadena/rechazo (10). Porque las 342 celdas abarcan 106 preguntas únicas, una lectura conservadora de clústeres trata las preguntas como la unidad: 0/106 da un límite superior de Wilson del 3.4%; la hipótesis nula de permutación a nivel de pregunta de la Sección 4 ya opera a nivel de clúster.
Control de indicación inversa: descomposición por modelo
Seis modelos locales, 2.399 observaciones pareadas válidas; flip = el verificador abandona su respuesta ciega por la mostrada.
| Verificador | Directo (hacia incorrecto) | Inverso (hacia correcto) | Dif |
|---|---|---|---|
| qwen3:8b | 204/227 = 89.9% | 196/218 = 89.9% | pp |
| mistral | 132/213 = 62.0% | 113/203 = 55.7% | pp |
| glm4:9b | 66/213 = 31.0% | 39/200 = 19.5% | pp |
| llama3.2:3b | 40/234 = 17.1% | 38/227 = 16.7% | pp |
| gemma4:e4b | 33/202 = 16.3% | 19/195 = 9.7% | pp |
| phi4-mini | 2/137 = 1.5% | 2/130 = 1.5% | pp |
| Agrupado | 477/1226 = 38.9% | 407/1173 = 34.7% | pp |
Tasas de cambio por verificador y rama. Ningún modelo cambia más fácilmente hacia la respuesta correcta que hacia la incorrecta segura. Reconteo pareado: 1.028 elementos presentes en ambas ramas (296 cambiados en ambas, 558 en ninguna); pares discordantes 104 (solo incorrecto) vs. 70 (solo correcto), McNemar binomial exacto (asintótico ). Los 884 cambios registrados tienen confianza post-exposición declarada ; la tasa de cambio por debajo de ese umbral es 0/547.
Error de consenso certificado de MC por categoría de TruthfulQA
Agrupado entre los cuatro paneles locales pre-especificados (eventos por panel de elemento; categorías con al menos 20 elementos): Economics 8.6%, Fiction 6.2%, Paranormal 6.0%, Law 5.9%, Superstitions 5.7%, Stereotypes 5.4%, Sociology 4.9%, Health 4.9%, Misconceptions 2.6%, Conspiracies 1.0%. Tasas por panel con todos los tres miembros en confianza : 4.0% (CN-local), 5.2% (cross-bloc), 6.0% (pilot), 7.2% (US-local).
El extremo superior del 4.6% se basa en el único panel local que comparte solo 87 elementos con las 98 respuestas calificables del modelo de razonamiento; excluyéndolo, el rango estricto de formato abierto local es 1.5–1.8%.↩︎
Cómo citar
Chernets, V. (2026). Verification Theater: Measured Failure Modes of AI Verifier Panels [Presentación de artículo]. NeurIPS 2026 Workshop: Who Verifies the Agents?. Zenodo. https://doi.org/10.5281/zenodo.23197641
@misc{chernets2026verificationtheater,
  author       = {Chernets, Vadym},
  title        = {{Verification Theater: Measured Failure Modes of AI Verifier Panels}},
  year         = {2026},
  howpublished = {Zenodo; NeurIPS 2026 Workshop: Who Verifies the Agents?},
  doi          = {10.5281/zenodo.23197641},
  url          = {https://doi.org/10.5281/zenodo.23197641}
}