Após a Divisão do Programador: Uma Medida para Pessoas que Constroem Através de Agentes de IA
Esta é uma tradução. A versão de referência é o original em inglês; cite essa.
O horizonte de delegação verificado, ganho de amplificação, um mapa datado de nomes de funções, e 41 previsões registradas pontuadas a cada ano até 2031
Vadym Chernets, PhD, arquiteto de sistemas de IA · ORCID 0009-0007-4845-3163
SSRN 7589918 · DOI 10.2139/ssrn.7589918 · Zenodo 10.5281/zenodo.23267267 · GitHub
Baixe este artigo
- SSRN (versão de registro): ssrn.com/abstract=7589918 · DOI 10.2139/ssrn.7589918
- Zenodo (arquivado, acesso aberto): doi.org/10.5281/zenodo.23267266
- OSF (as 41 previsões, registradas em 9 de outubro de 2026): doi.org/10.17605/OSF.IO/VW6P9
- GitHub (texto completo como Markdown): github.com/vadimchernets/papers/tree/main/after-the-programmer-divide; código do Apêndice C: github.com/vadimchernets/delegation-horizon
SSRN contém a versão de registro; cite essa.
Palavras-chave: agentes de IA; IA agencial; não-programadores; agentes de codificação; títulos de trabalho; contratação baseada em habilidades; teoria principal-agente; engenharia de software do usuário final; alfabetização em IA; horizonte de delegação verificado; ponto de cruzamento de credenciais; previsões pré-registradas
Resumo
Um contabilista pede a um agente uma ferramenta de reconciliação; um desenvolvedor pede a um para mudar um sistema de cobrança. Cada um deve aceitar um dia de trabalho e comprovar que funciona. Em outubro de 2026, advogados também estavam atribuindo tarefas aos mesmos agentes. Em cerca de 400.000 sessões, o sucesso verificado pelo fornecedor em trabalho produtor de código foi de 34% para profissões de programação e 29% para outras, embora profissão não seja educação. Nenhuma escada de carreira diz o que alguém que constrói com agentes é confiável para entregar. Proponho uma medida no lugar de um título. O horizonte de delegação verificado é o maior bloco coerente de trabalho, em horas de referência de um especialista qualificado, que uma pessoa regularmente confia a agentes e aceita após uma verificação independente que os agentes não viram. Ganho de amplificação, horas de referência aceitas por hora de atenção, é uma vazão verificada, não uma estimativa causal de aceleração. Ambos são pontuados por domínio, da Hora ao Trimestre; um teste de mesa corrigiu um limite. Três grandes empregadores tentaram contagens de tokens e as abandonaram em 2026: um ranking removido, um placar manipulado, um orçamento gasto. Trabalho verificado resiste mais a manipulação por gastos, e cada rota restante atende a uma defesa declarada. Um mapa datado registra nomes rivais (construtor, gerenciador de agente, principal e outros) sem escolher. Neutralidade de fundo é a hipótese de que em um horizonte igual uma educação em programação deixa de prever qualidade verificada. O ponto de transição de credencial é o momento, domínio por domínio, quando produtos de pessoas sem educação em TI começam a superar os de programadores sob as mesmas verificações, após o qual diplomas e rótulos de senioridade perdem peso. Quarenta e uma previsões datadas, calculadas em 9 de outubro de 2026 na mediana de três previsões de modelo cegas, são registradas no OSF e pontuadas anualmente até 2031; um estudo nunca realizado conta como um fracasso, e a ultrapassagem em seu próprio domínio é de 0,35.
Resumo executivo
Em 2026, contadores estavam comparando agentes de codificação da forma como programadores faziam um ano antes, advogados estavam construindo suas próprias ferramentas com eles, e pessoas fora da área de software tornaram-se uma parcela em crescimento acelerado dos usuários de agentes de codificação de um fornecedor; nos registros de outro fornecedor, cerca de 400.000 sessões, as ocupações que não programam ficaram atrás dos programadores em alguns pontos percentuais em sucesso verificado em trabalhos de codificação (34% contra 29%). Onde o trabalho é realizado, a fronteira entre programadores e todos os outros se afinou. Nos títulos de cargos, faixas salariais e currículos continua onde estava.
Alguns programadores e alguns profissionais de domínio agora compartilham um fluxo de trabalho: entregam trabalhos a agentes e decidem se aceitam. Tarefas e fluxos de trabalho convergiram antes de profissões inteiras, portanto a pergunta informativa sobre uma pessoa é o tamanho de trabalho que ela pode entregar e comprovar, de qualquer lado da antiga fronteira de onde vieram. A medida que proponho para essa questão, o horizonte de delegação verificado, repousa em algumas escolhas de design, e este resumo apresenta a razão para cada uma. A unidade é o tempo que um especialista qualificado teria necessitado (uma hora, um dia, uma semana, um mês, um trimestre), porque ambas as antigas escalas conseguem interpretá-la e nenhuma tradução entre profissões é necessária. A ferramenta de conciliação de um contador e uma mudança de cobrança de um desenvolvedor enfrentam a mesma regra. Apenas o trabalho que passou em uma verificação que os agentes não viram é contado, e o acordo entre modelos de uma mesma família não conta como tal verificação, porque seus erros são correlacionados. Um segundo número, ganho de amplificação, registra quanto trabalho verificado cada hora de atenção da pessoa rende (trabalho falhado ainda custa atenção, e o tempo não supervisionado dos agentes não), de modo que alguém que trabalha ao lado de um agente em loops curtos seja creditado tão plenamente quanto alguém que entrega grandes blocos. Ambos os números são mantidos por domínio, por uma razão simétrica: um advogado que se muda para software e um programador que se muda para direito perdem a mesma coisa, a capacidade de aceitar trabalho em um campo que não conhecem. Os limites são versionados como regras v1.1 e testados em mesa, e o teste de mesa já corrigiu um deles (Apêndice E).
Os nomes ainda não estão estabelecidos. Construtor, engenheiro agentico, gerente de agentes, operador de IA, orquestrador e principal estão todos em uso em outubro de 2026, cada um com um proprietário e uma data. Faço seu mapeamento sem escolher, para que o que vencer possa ser lido em uma única escala: um construtor na Semana, um gerente de agentes no Dia.
O mercado já tentou um atalho. Em 2026, contagens de tokens foram tentadas como medida de pessoal em grandes empregadores e falharam em poucos meses: uma classificação não oficial de um funcionário no Meta foi removida e a orientação oficial da empresa descartou posteriormente contagens de tokens, um quadro de classificações no Amazon foi manipulado com tarefas vazias e removido, e o Uber gastou seu orçamento anual de IA em quatro meses. Uma contagem de entradas recompensa gastos. Uma contagem de trabalho aceito, verificado independentemente, é mais difícil de inflar dessa forma por design. As rotas que permanecem (verificações fáceis, avaliadores generosos, ajuda oculta e trabalho fatiado em pedaços) cada uma encontra uma defesa na Seção 5.8: auditorias aleatórias, avaliadores independentes de horas, um registro público de falhas, uma unidade coerente de trabalho e erros plantados.
Duas previsões fundamentam minha tese datada. A neutralidade de fundo diz que no mesmo degrau uma educação em programação deixa de prever qualidade verificada. O ponto de cruzamento de credenciais é o momento, em um domínio, quando produtos feitos por pessoas sem educação em TI começam a superar os de programadores usando os mesmos agentes, após o qual um diploma e os rótulos júnior e sênior perdem peso. A paridade de qualidade vem antes daquele momento, um cruzamento de requisitos de diploma em ofertas de trabalho é seu sinal visível, e cada parte é datada e testada por si. A previsão principal vai contra a opinião atual, e o artigo diz isso onde afirma a previsão. Cada previsão também nomeia o resultado que a refutaria, para que um leitor possa ver com antecedência como seria um fracasso. Todas as 41 aparecem em uma tabela com probabilidades, limiares, fontes alternativas e datas finais, registradas no OSF em 9 de outubro de 2026 (DOI 10.17605/OSF.IO/VW6P9) e pontuadas pela regra de Brier a cada ano até 2031. Vinte e sete se resolvem a partir de dados públicos. Quatorze precisam de estudos registrados separadamente antes que os dados sejam coletados, e evidências faltantes ou inconclusivas são registradas como não resolvidas e não contam como sucesso; um estudo que nunca é executado é um fracasso do programa de teste e permanece no placar. As probabilidades foram fixadas em 9 de outubro de 2026 como a mediana de três previsões de modelo cegas, que adotei, e estão registradas no OSF; a probabilidade de ultrapassagem em seu próprio domínio é 0,35.
Quando construir custa pouco, a confiança se torna o filtro escasso. Lojas de aplicativos e hosts de código estão inundados, plataformas estão fechando suas portas para contribuintes desconhecidos, e agentes cada vez mais escrevem uma solução em vez de adotar a de alguém. Ao lado da pessoa que constrói, duas funções de parceria são visíveis: um finalizador traz o produto para as pessoas, e um garantidor assina por ele. O segundo nome vem de uma descrição de 2025 do papel, e também proponho uma medida para o garantidor.
1. Introdução
Em 23 de setembro de 2026, um blog para guarda-livros comparou dois agentes de codificação, Claude Code e Codex, para categorizar transações e reconciliar contas (Growthy, 2026). Um ano antes, essa comparação pertencia aos programadores, e nos fóruns de programadores ainda pertence, completa com grupos e lealdades. O que mudou foi o leitor. As pessoas que agora escolhem entre agentes mantêm registros contábeis, redigem contratos e gerenciam campanhas, e os agentes entre os quais escolhem são aqueles que os desenvolvedores de software usam.
Há décadas a economia mantém duas escaleiras. Em software, os degraus eram júnior, intermediário, sênior, especialista e principal, precificados por anos de experiência e por quantos engenheiros um projeto precisava. Em outras áreas, os degraus eram analista, consultor, gerente, diretor e parceiro. As escaleiras se encontravam na porta do departamento de TI, no sentido de que um profissional da segunda escaleira obtinha software encomendando-o de alguém da primeira. Em 2025 e 2026, ambas as escaleiras começaram a descrever o mesmo trabalho. Aos desenvolvedores foi dito que suas principais atividades haviam se tornado delegação e verificação (GitHub, 2025b). Profissionais fora da área de software, com um agente em um terminal ou em uma janela de desktop, começaram a construir as ferramentas, sites e pequenos aplicativos que costumavam encomendar (Bloomberg Law, 2026; OpenAI, 2026). Nenhuma escaleira diz o que essa pessoa pode ser confiada a entregar, e nenhuma diz como comparar um ex-desenvolvedor com um ex-analista que agora fazem o mesmo trabalho.
As questões que se seguem são o que as pessoas no lado mesclado dessa fronteira devem ser chamadas, como seu nível deve ser medido uma vez que um grau e anos de serviço deixam de dizer ao empregador o que podem entregar, e quando a fronteira pode desaparecer. A última delas recebe sua resposta na forma de previsões datadas.
Essa questão também tem uma origem datada. Em 8 de outubro de 2026, apresentei uma previsão: dentro de um a dois anos, a capacidade agentic crescerá tanto que a educação técnica não será mais necessária, e pessoas sem ela construirão aplicativos, sites e produtos melhores, com código melhor que o código dos programadores. Mais tarde naquela mesma noite, adicionei um corolário. Quando produtos feitos por pessoas sem educação em TI começarem a superar os feitos por profissionais de TI, diplomas em TI e os rótulos júnior e sênior perderão rapidamente peso em um currículo. (Ambas as declarações são traduzidas das minhas anotações daquele dia.) As Seções 6 e 11 transformam ambas em previsões com datas, medidas, limiares e resultados que as refutariam. A segunda declaração nomeia o momento que o resto do artigo chama de ponto de transição de credenciais.
O artigo complementar desta série acompanhou não-programadores do chat aos agentes e definiu quatro níveis pelo lugar onde um agente trabalha e o que a pessoa deve possuir (Chernets, 2026a). Ele contou uma transição apenas quando um agente havia produzido um artefato, e recusou transformar o gerenciador de agentes em um título de trabalho, usando o termo "para um padrão de comportamento em vez de uma função para a qual alguém deveria contratar, porque o comportamento deixa evidências e um título não" (Chernets, 2026a, Seção 8.4). O presente artigo parte dessa condição: um nível é concedido, e qualquer título pode anexar-se a ele, apenas com base em evidências, significando trabalho entregue aos agentes, aceito por uma pessoa e confirmado por uma verificação que os agentes não viram.
A Seção 3 fornece um mapa datado dos nomes em circulação em outubro de 2026. A Seção 5 fornece a escala em que qualquer um desses nomes pode ser lido, o horizonte de delegação verificado com seu segundo eixo, ganho de amplificação. A Seção 6 estabelece duas hipóteses, neutralidade de background e o ponto de transição de credenciais, e pergunta quanto da experiência de um ofício um processo de verificações pode substituir. As Seções 7 e 8 abordam a confiança, a fronteira que não se dissolve, e as duas funções de parceria ao lado da pessoa que constrói. A Seção 11 expõe previsões datadas com probabilidades, limiares e fontes alternativas, registradas em OSF e pontuadas a cada ano até 2031 publicamente.
Não escolho entre os nomes. O mercado escolherá, provavelmente dentro de meses, e um artigo que aposta em uma palavra está errado no dia em que outra palavra vence. O que um artigo pode fixar é a escala. A Seção 5 a define completamente; em resumo, o horizonte de delegação verificado pergunta que tamanho de trabalho, nas horas que um especialista qualificado teria precisado, uma pessoa regularmente entrega aos agentes e aceita com uma verificação independente por trás da aceitação, e o ganho de amplificação pergunta quantas dessas horas cada hora da atenção própria da pessoa gera. Ambos são mantidos por domínio, datados e colocados em cinco degraus de Hora a Trimestre. A Figura 1 coloca as duas velhas escaleiras ao lado dessa.
Uma definição do ponto de transição de credenciais serve para todo o artigo. Em um domínio, é o momento em que produtos feitos por pessoas sem educação em TI, aceitos sob as mesmas verificações independentes, começam a superar os de programadores que usam os mesmos agentes, após o qual um grau e os rótulos júnior e sênior perdem seu peso na contratação. A paridade de qualidade é o passo anterior a esse momento, e um cruzamento de requisitos de grau nos anúncios de emprego é seu sinal visível. Neutralidade de background, a hipótese de que a educação para de prever qualidade verificada em um degrau igual, é o mecanismo que a explicaria. Cada uma dessas quatro partes carrega sua própria previsão datada (Seção 6.2).
A evidência é extraída de 2025 e 2026, um período em que um mês de desenvolvimento de agentes muda o que uma medida tem que contar. Uma figura amplamente citada coloca a contratação de novos graduados em grandes empresas de tecnologia muito abaixo de seu nível de 2019. É deixada de fora, assim como comparações com o pico de contratação de 2022, porque medem um mundo anterior aos agentes. Séries de antes dos agentes entram apenas como predecessoras, e a macroeconomia da contratação é sustentada pelo contraponto do LinkedIn da Seção 2.4. Trabalhos anteriores também entram como teoria, precedente ou analogia: Jaques sobre o intervalo de tempo de responsabilidade, Jensen e Meckling sobre o custo da delegação, uma corrida do ouro e um fotógrafo.
Figura 1. Duas escaleiras e uma medida.
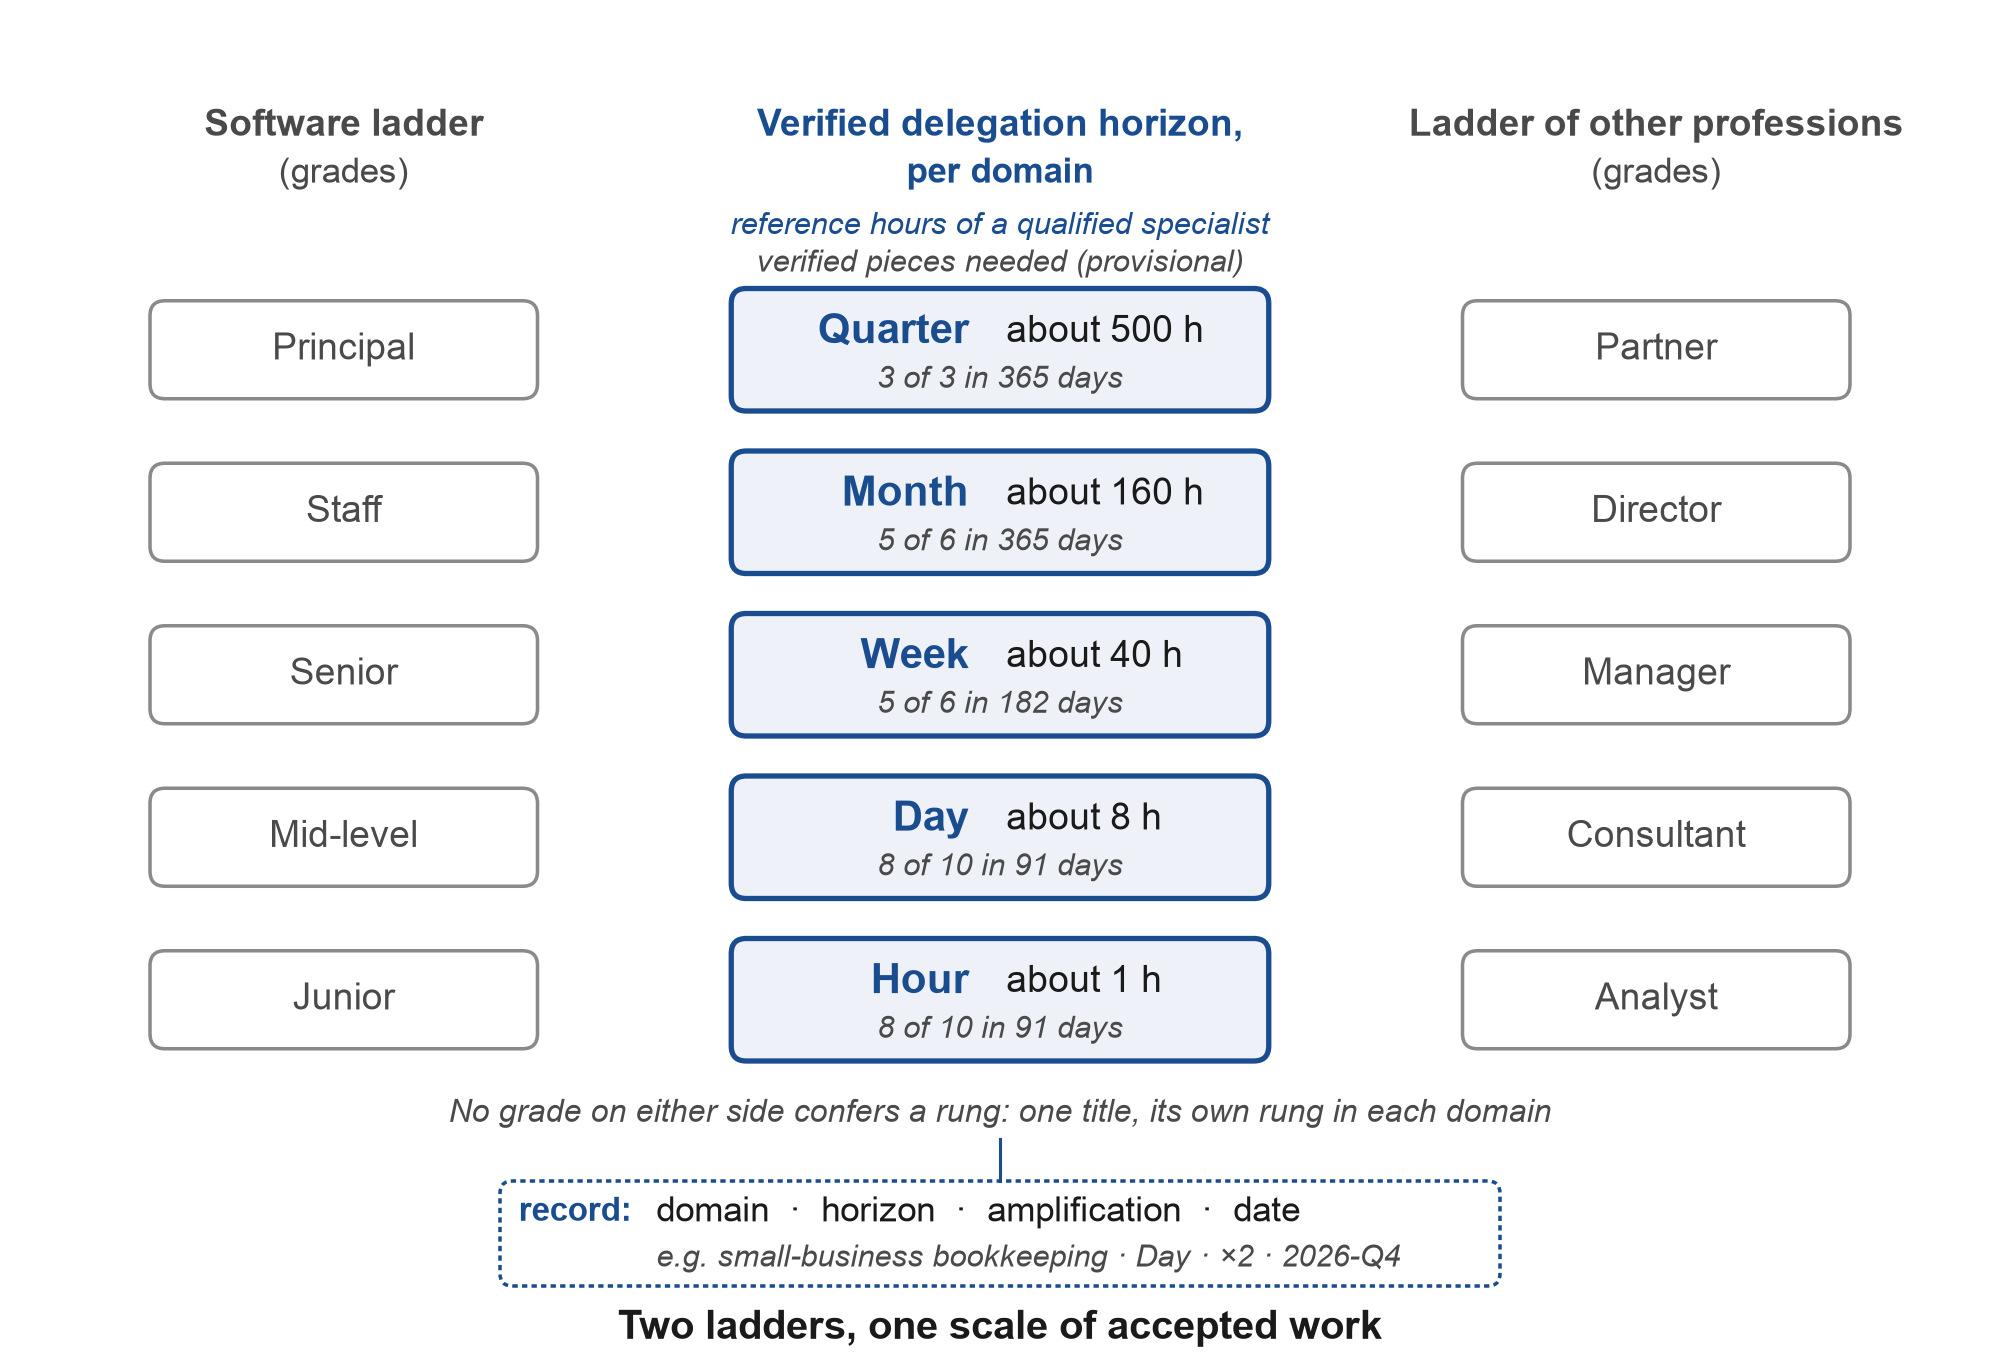
Nota: As velhas escaleiras são desenhadas lado a lado com os cinco degraus e deliberadamente não estão conectadas: nenhuma grade em nenhuma escaleira confere um degrau, e a mesma pessoa possui um degrau separado em cada domínio (Seção 5.2). Os degraus são contados em horas de referência de um especialista qualificado, com as contagens e janelas da Seção 5.2 (regras v1.1). O registro mostrado é aquele impresso pelo exemplo trabalhado do Apêndice C4.
Naquelas partes, a Seção 2 apresenta as evidências de convergência e a Seção 4 relata como a primeira medida do mercado falhou, que é o caso para uma medida deste tipo. A Seção 9 verifica quais tópicos das conversas de programadores cruzam para outras profissões, e a Seção 10 traça as implicações. A Seção 12 reúne as evidências contra a tese, a Seção 13 expõe suas condições de contorno, e a Seção 14 conclui.
2. Dois mundos convergindo: evidências de 2025 e 2026
2.1 O trabalho do programador, redescrito
Os fornecedores que vendem para desenvolvedores agora descrevem o trabalho do desenvolvedor como direcionador de agentes. A descrição do GitHub de "a nova identidade de um desenvolvedor" colocou delegação e verificação no centro do trabalho (GitHub, 2025b). A Anthropic pesquisou 132 de seus próprios engenheiros e pesquisadores em agosto de 2025. Eles relataram usar IA em cerca de 60% de seu trabalho e um ganho de produtividade autodeclarado de cerca de 50%, e se descreveram como se tornando mais "full-stack". A maioria disse que podia delegar completamente apenas até um quinto de seu trabalho, e 27% de seu trabalho assistido por IA consistia em tarefas que não teriam sido feitas sem IA (Anthropic, 2025a). Uma medida construída apenas em delegação total veria, portanto, no máximo um quinto do que os usuários mais avançados do mundo fazem com IA, razão pela qual a Seção 5 adiciona um segundo eixo. O mesmo relatório nomeou um "paradoxo da supervisão": supervisionar o modelo exige as habilidades de codificação que atrofiam quando tudo é entregue a ele.
As palavras seguiram o trabalho. Andrej Karpathy nomeou "vibe coding" em 2 de fevereiro de 2025 (Karpathy, 2025), Collins o tornou palavra do ano (Collins Dictionary, 2025), e um ano depois Karpathy passou para "agentic engineering". Na AI Ascent de Sequoia em 30 de abril de 2026, ele expressou a diferença como "vibe coding eleva o piso, agentic engineering extrapola o teto" (Karpathy, 2026; Willison, 2026a). Um artigo acadêmico descreveu o engenheiro agentic como um novo arquétipo profissional, com responsabilidade mudando da autoria de código para a propriedade de resultados (Alenezi, 2026), e Microsoft descreveu os padrões de trabalho em seus clientes como autor, editor, diretor e orquestrador (Microsoft, 2026b).
2.2 Todos os outros, dentro dos mesmos agentes
Dois fornecedores relatam uso generalizado de agentes de codificação por pessoas fora do setor de software, com diferentes limites de seleção e medição. A OpenAI relatou em junho de 2026 que usuários semanais de seu agente de codificação que não são desenvolvedores cresceram 137 vezes entre usuários individuais e 189 vezes entre organizações desde agosto de 2025 (OpenAI, 2026). A base era baixa e os dados são do fornecedor. O mesmo relatório fornece uma distribuição que importa para a Seção 5. Em uma amostra de cerca de 0.1% dos usuários individuais do agente em maio de 2026, 80.6% fizeram pelo menos uma solicitação cuja duração manual, conforme estimado por um modelo, excedeu 30 minutos, 70.2% pelo menos uma acima de uma hora, e 25.6% pelo menos uma acima de oito horas. Essas são parcelas de usuários fazendo solicitações longas, com durações estimadas por um modelo, o que é diferente de uma taxa de conclusão ou um horizonte verificado, e a Seção 5 explica por que a diferença importa. Mais de um quarto do trabalho do agente para funções comerciais era trabalho de engenharia.
O estudo de Claude Code da Anthropic, publicado em 16 de junho de 2026, é o dado público mais próximo da tese (Anthropic, 2026e). Analisou cerca de 400,000 sessões de cerca de 235,000 pessoas entre outubro de 2025 e abril de 2026. A expertise foi julgada pelo comportamento, por três sinais: como a pessoa declarou precisamente a tarefa, o que pediram para verificar, e quem corrigiu quem. Um contador sem Python que escreveu regras de reconciliação exatas e capturou casos extremos foi classificado como um especialista. Em sessões onde código foi produzido, cada uma das dez maiores ocupações ficou atrás das ocupações de programação em não mais de sete pontos percentuais em sucesso verificado, onde sucesso significa realização apoiada por evidências como testes aprovados ou trabalho confirmado. A classificação do fornecedor repousa em parte em sinais na transcrição da sessão, como confirmação explícita do usuário, e o relatório observa que a taxa ligeiramente mais alta dos gerentes pode refletir parcialmente como eles relatam sucesso, então "verificado" aqui é o termo do fornecedor, não uma verificação independente. Agregado em sessões produtoras de código foi 34% contra 29% (cerca de 30% contra 26% em todas as sessões), e gerenciamento fez ligeiramente melhor que programadores. Esses dados classificam pessoas por ocupação e não dizem nada sobre educação: um contador pode ter um diploma em ciência da computação, e um programador pode não ter nenhum. O relatório concluiu que "agentes de codificação estão tornando uma formação em codificação menos relevante para programação bem-sucedida". Pessoas tomaram cerca de 70% das decisões sobre o que fazer e o agente cerca de 80% das decisões sobre como. Um conjunto de instruções de um especialista disparou cerca de doze ações de agente, o de um novato cerca de cinco.
A mesma mudança aparece em fontes que não vêm das empresas vendendo os agentes. Advogados, de sócios juniores a sócios, têm construído protótipos funcionais de suas próprias ferramentas com Claude Code em vez de esperar pelos fornecedores, e a parcela de advogados com amplo acesso a IA aumentou de 61% em 2025 para 83% em 2026 (Bloomberg Law, 2026; Artificial Lawyer, 2026). Contadores comparam agentes (Growthy, 2026). Lovable, um construtor de aplicativos baseado em navegador, passou de $600 milhões em receita anualizada em setembro de 2026 (TechCrunch, 2026a). Por uma estimativa, Claude Code foi responsável por cerca de 4% dos commits públicos no GitHub no início de fevereiro de 2026 (SemiAnalysis, 2026).
2.3 As escadas sob pressão
Os empregadores começaram a renomear suas escadas sem ainda dizer o que as substitui. A partir de 1º de junho de 2026, a Deloitte deu a seus aproximadamente 181,500 funcionários do US novos títulos organizados por família de trabalho e adicionou um nível de liderança (Business Insider, 2026). Seus níveis internos e princípios de pagamento permaneceram no lugar (Fortune, 2026a), então essa foi uma renomeação com a medida deixada como estava. Relatou-se que LinkedIn substituiu seu programa de gerente de produto associado por uma trilha "Associate Product Builder" e abriu um cargo "Full Stack Builder" para pessoas de qualquer função (Lenny's Newsletter, 2025). Microsoft contou 3,233 de 20,000 usuários de IA pesquisados, cerca de 16%, como "Frontier Professionals" que executam agentes multietapas e redesenham seus processos (Microsoft, 2026a). Srinivasan e Wei argumentaram na Harvard Business Review em fevereiro de 2026 que empresas precisam de gerentes de agentes, e esperavam que o título se tornasse padrão dentro de 12 a 18 meses (Srinivasan & Wei, 2026). Alguns empregadores vão mais longe e escrevem o novo cargo em postagens: State Street anunciou um "Agentic Product Builder" que ainda requer programação (State Street, 2026). Em 7 de outubro de 2026, Dust introduziu o "AI Operator" como a pessoa que constrói e mantém fluxos de trabalho de agentes compartilhados (Dust, 2026).
O recrutamento percebeu. A parcela de entrevistas de trabalho em que o uso de IA pelos candidatos foi discutido aumentou de 0.33% no terceiro trimestre de 2025 para 4.54% no segundo trimestre de 2026 (Metaview, 2026). A questão entrou na contratação antes de haver qualquer escala para a resposta.
2.4 Ofertas de emprego, contratação de nível de entrada e educação
Vagas de emprego nos EUA que mencionam "agentic AI" passaram de 151 em 2024 para 16,541 em 2025 (Stanford HAI, 2026). Uma contagem diferente, pela Lightcast, encontrou mais de 86.000 vagas em 2025 que mencionavam habilidades de agentic AI, um aumento anual de 280% nas menções dessas habilidades e um salário anunciado mediano de $153.000; as habilidades foram principalmente adicionadas aos títulos de emprego existentes (Lightcast, 2026a). O AI Index conta vagas que contêm a frase "agentic AI", enquanto o blog da Lightcast conta vagas que carregam habilidades de agentic em sua própria taxonomia, o que explica a maior parte da diferença entre 16.541 e aproximadamente 86.000. Os números medem coisas diferentes e são mantidos separados aqui.
A contratação em nível de entrada enfraqueceu, e a causa é controversa. O LinkedIn descobriu que a contratação em nível de entrada nos EUA de abril a junho de 2026 caiu 7,6% ano a ano em comparação com 6,9% para todos os níveis, e em ocupações que a IA amplia, a contratação em nível de entrada caiu 9,6% em comparação com 6,5% para todos os níveis nessas ocupações (LinkedIn Economic Graph, 2026). O próprio LinkedIn atribui mais da queda à incerteza econômica do que à IA, e observa que, entre os papéis de nível de entrada, aqueles isolados da IA caíram mais na França, no Reino Unido e nos Estados Unidos. A atualização de agosto de 2026 do estudo "canaries" de Stanford descobriu que o emprego de pessoas de 22 a 25 anos em ocupações expostas à IA foi cerca de 19% abaixo da expectativa, sem uma lacuna comparável para trabalhadores experientes, e descreve o resultado como descritivo (Stanford Digital Economy Lab, 2026a). Duas outras fontes encontram o mesmo mecanismo. Economistas do Federal Reserve Bank of Dallas, usando microdados da Current Population Survey, descobriram declínios no emprego vinculados à exposição à IA apenas entre trabalhadores jovens, impulsionados principalmente por menos pessoas entrando na força de trabalho do que por demissões (Atkinson & Yamco, 2026). Em dados de currículo cobrindo cerca de 65 milhões de trabalhadores, o emprego júnior em empresas que adotaram IA generativa foi cerca de 9% menor do que em não-adotantes seis trimestres após a adoção, novamente através de contratação mais lenta do que separações (Hosseini & Lichtinger, 2026). Em toda a economia, o Yale Budget Lab ainda não encontra sinais claros de que ocupações expostas à IA se saem pior do que aquelas comparáveis não expostas (Yale Budget Lab, 2026), então a pressão fica no degrau de entrada, não na ocupação como um todo. Empregadores citaram IA em 101.743 cortes de empregos anunciados no primeiro semestre de 2026, cerca de 23% de todos os cortes anunciados (Challenger, Gray & Christmas, 2026).
A educação também está evoluindo. As principais disciplinas de ciência da computação para graduandos caíram 13% nos departamentos cobertos pela pesquisa Taulbee de 2026, que contabiliza departamentos que conferem doutorados na América do Norte; seus autores descrevem isso como os primeiros sinais claros de contração no pipeline de inscrições, juntamente com produção de diplomas recorde (Computing Research Association, 2026). Um experimento de campo com 673 aprendizes de TI alemães encontrou ganhos de 26 a 31 pontos percentuais em tarefas fora de seu treinamento formal quando tinham IA (Stanford Digital Economy Lab, 2026b). O marco conjunto da OECD e da Comissão Europeia de junho de 2026 inclui um domínio chamado "Manage AI" (OECD & European Commission, 2026).
A Tabela A1 (Apêndice F) lista dez sinais dessa convergência com suas fontes e, para cada um, o que mostra e o que não mostra. Lidos em conjunto, eles também mostram onde a medição está faltando: dados de fornecedores sobre não-desenvolvedores dentro de agentes de codificação mostram crescimento, não a qualidade de seus resultados. A proximidade de ocupações em sucesso verificado diz respeito à ocupação, não ao grau. Escadas renomeadas e segmentos de pesquisa são títulos, não medidas. E o degrau de entrada mais fraco não é mostrado como sendo causado por IA.
Esses sinais mostram, com alguma confiança, que a configuração e aceitação do trabalho do agente agora é feita em ambos os lados da antiga fronteira, e que empregadores, escolas e fornecedores começaram a renomear coisas. As pessoas fora do software fazem esse trabalho tão bem quanto os programadores? Os sinais deixam isso aberto, e eles também não mostram medida para isso. A Seção 5 propõe a medida, a Seção 11 coloca datas na questão de qualidade, e a Seção 12 apresenta as evidências que as previsões devem superar.
A evidência de 2026 separa as pessoas que podem mostrar que um resultado está correto das pessoas que não podem. Uma educação em programação é uma rota para essa habilidade. O conhecimento de um domínio, um hábito de verificação e ferramentas para verificação são outros, e os dados da Seção 2.2 sugerem que podem estar no lugar do primeiro mais frequentemente do que as antigas escadas assumem, embora ainda não sempre. A medida da Seção 5 é construída para testar essa afirmação.
3. Nomes em circulação: um mapa datado
3.1 Por que não escolho um nome
A cada poucas semanas em 2026, uma empresa ou um consultor, às vezes uma revista, propôs um nome para as pessoas descritas aqui, e alguns desses nomes permanecerão. Como o uso não está definido, faço duas coisas em vez de recomendar uma: mapear os nomes já em circulação, incluindo aqueles que foram usados, com quem introduziu cada um, quando e em que sentido, e oferecer uma medida pela qual qualquer um deles pode ser lido. Se "builder" vencer, o registro lê "builder at Week"; se "agent manager" vencer, ele lê "agent manager at Day". Prioridade é reivindicada para a medida, a escada, as definições e as predições, incluindo os termos que as nomeiam (horizonte de delegação verificado, ganho de amplificação, ponto de cruzamento de credencial), e para nenhum nome de função; os nomes de função adicionados na Seção 3.3 são oferecidos como candidatos sem prioridade.
3.2 Seis camadas
Os candidatos não competem todos por um mesmo lugar. Alguns nomeiam uma habilidade que quase todos terão, outros uma profissão, uma medida, um momento, um parceiro, ou um sinal que falhou. A Tabela A2 (Apêndice F) lista os nomes já em uso, com seus proprietários, e, em uma segunda parte, os nomes propostos neste estudo ou usados aqui apenas como descrições simples, juntamente com variantes que foram consideradas e descartadas, para que um leitor possa ver toda a família. A Figura 2 coloca os nomes por camada e pela data em que cada um foi introduzido.
Figura 2. Nomes em circulação, por camada e pela data em que cada um foi introduzido.
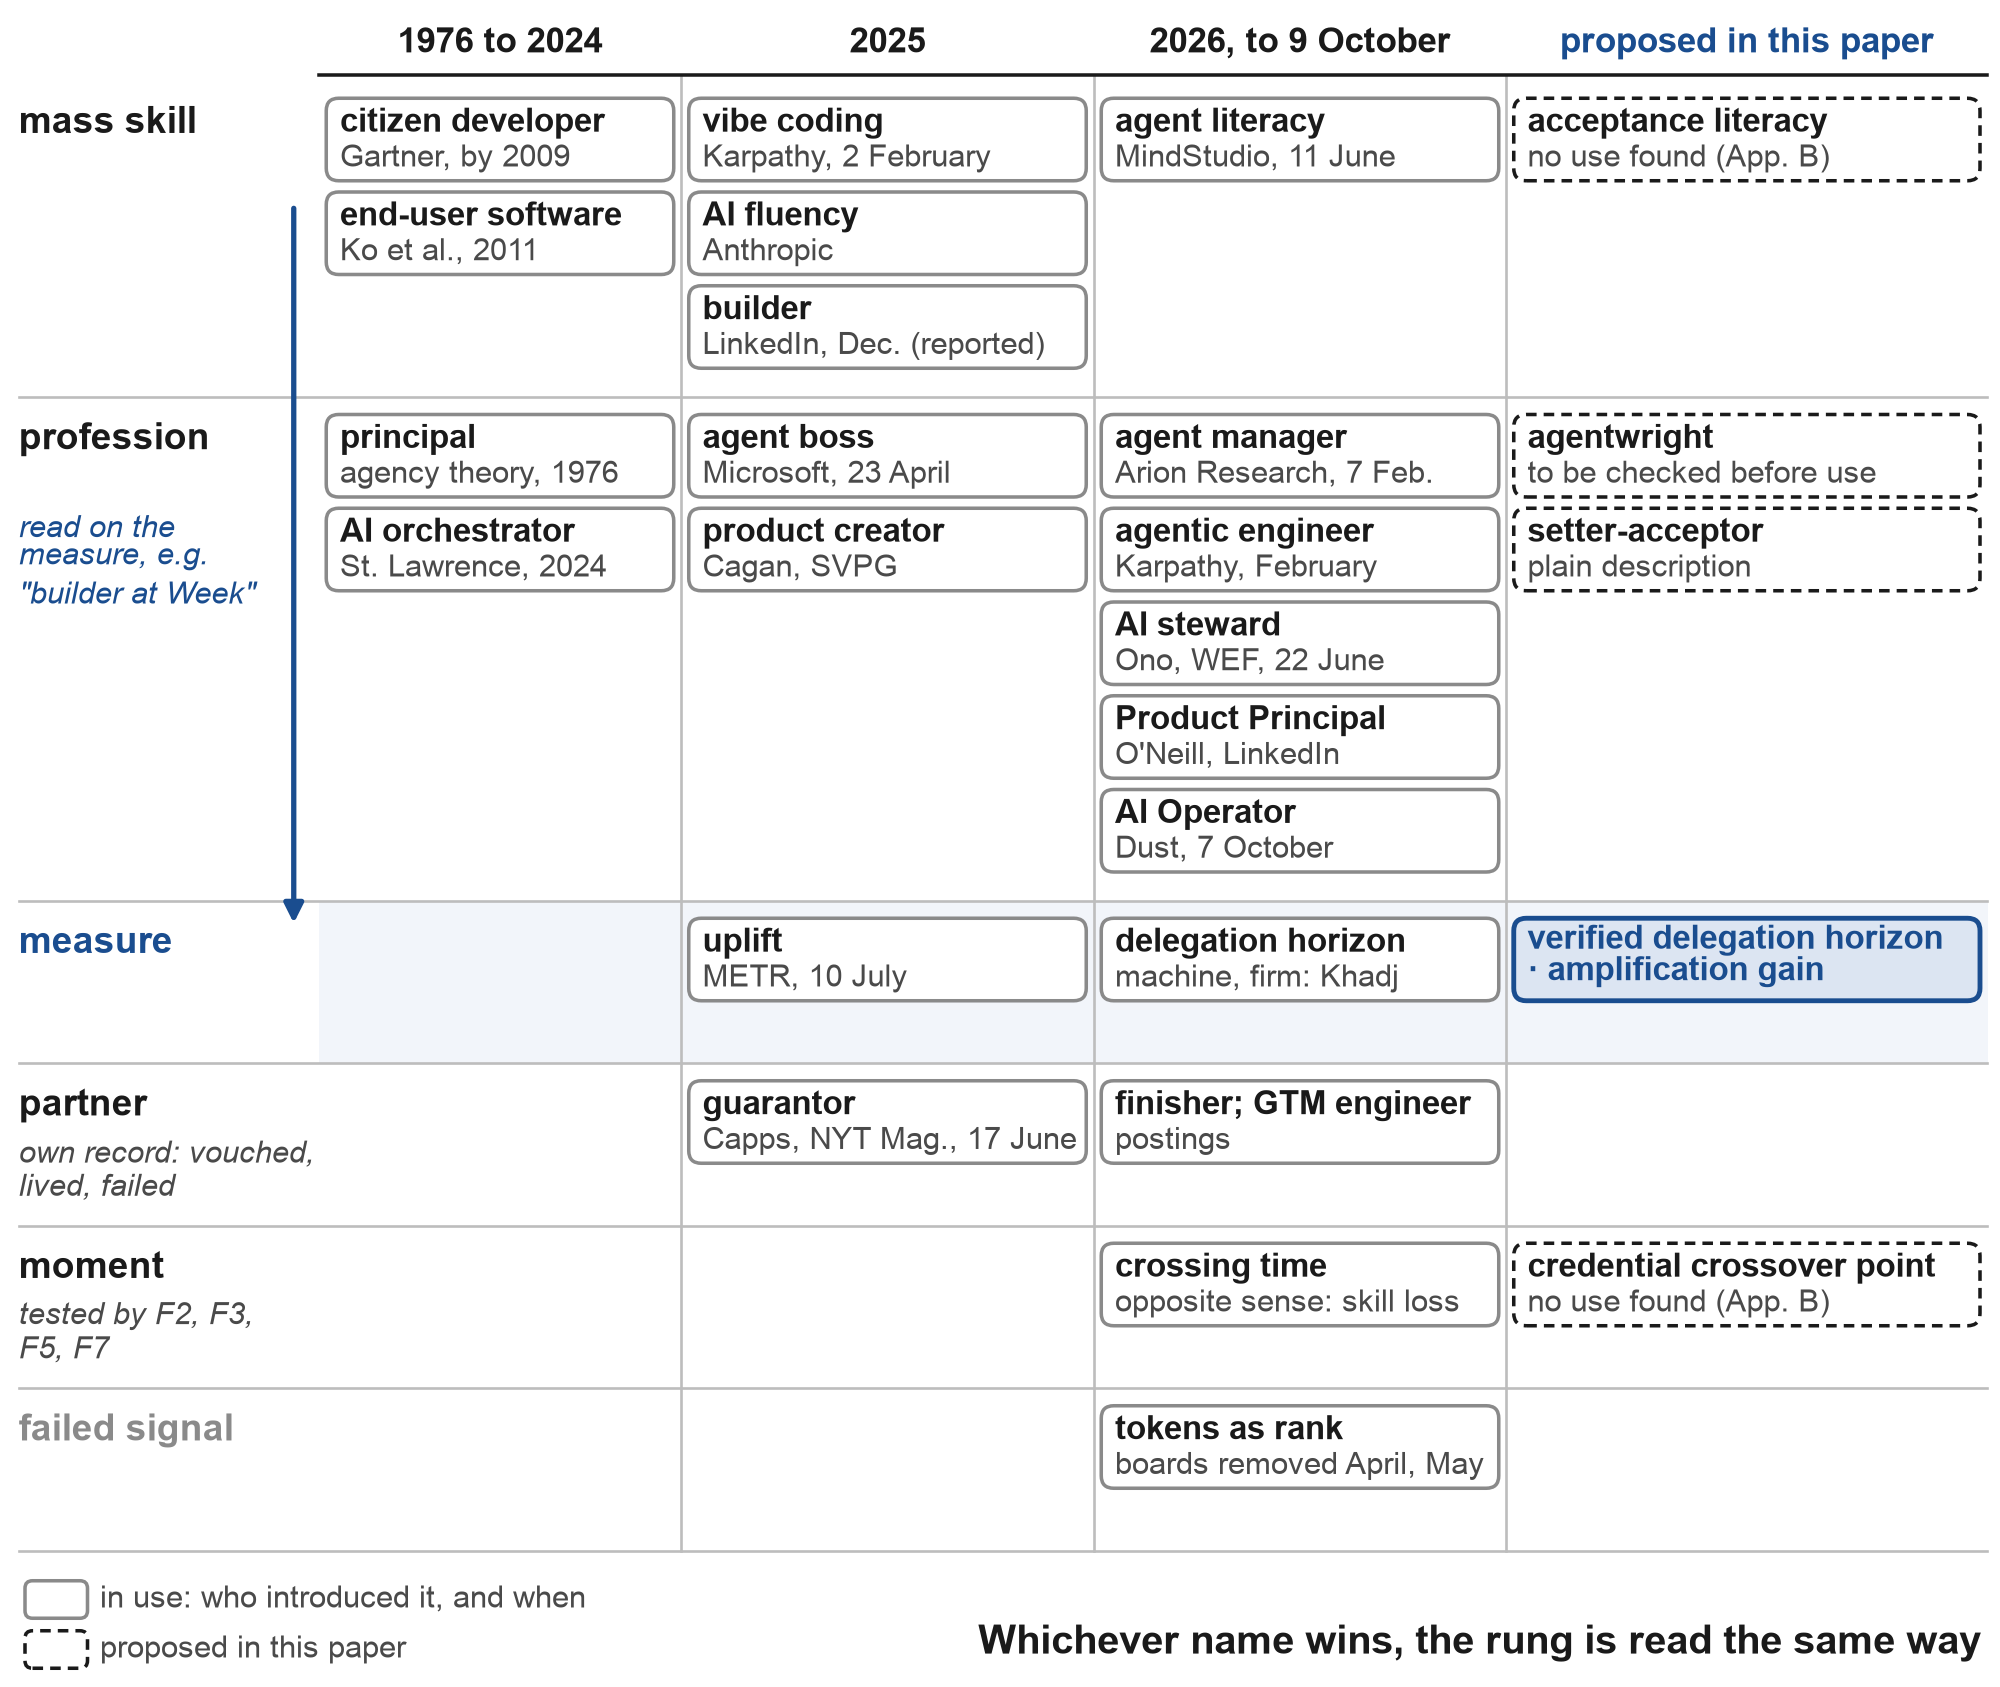
Nota: Os proprietários e datas seguem a Tabela A2. Um nome cuja fonte fornece apenas um ano não tem mês. A figura é uma seleção; a Tabela A2 lista todos os candidatos. Apenas as camadas de habilidade em massa e profissão são lidas na medida ("builder at Week", "agent manager at Day", Seção 3.1). O parceiro tem seu próprio registro, quantos produtos foram garantidos, quanto tempo cada um viveu e quantos falharam (Seção 7.2), e o momento não é um degrau mas é testado por predições datadas F2, F3, F5 e F7 (Seção 11.2). "Delegation horizon" na linha de medida é o sentido de máquina ou empresa (Khadj, 2026; Alonso, 2026), não a medida pessoal da Seção 5. A figura não faz julgamento sobre qual nome prevalecerá.
3.3 Observações sobre o mapa
"Builder" provavelmente está vencendo em RH em massa: LinkedIn adotou, e jornalistas escreveram em 2026 que todo mundo na Bay Area é um builder agora (SF Standard, 2026). Não há razão para combater a palavra, já que ela não diz nada sobre nível e nível é o que a medida fornece.
Os nomes gerenciais (agent manager, AI operator, orchestrator) são horizontais: descrevem executar agentes em geral, em nenhum domínio particular. A Seção 6.3 dá a razão para esperar que eles sigam o prompt engineer, um título que estava em toda parte em 2023 e foi chamado de obsoleto em 2025 (Fortune, 2025; TechRepublic, 2025).
"Principal" tem a teoria mais forte por trás dela e as piores colisões. Na teoria da agência, o principal é a parte que delega e paga os custos de monitoramento (Jensen & Meckling, 1976), e a constituição da Anthropic para seus modelos chama "principals" aqueles em nome de quem o modelo atua (Anthropic, 2026b). Verheul (2026) argumenta que quando máquinas executam a função de agência, pessoas em uma empresa mantêm apenas posições de principal e a escada de carreira desaparece. Aceito o diagnóstico e proponho uma nova escada em seu lugar. Na gestão de identidade e acesso, porém, "agent principal" nomeia a própria identidade do agente, o inverso do sentido pretendido, portanto a frase em inglês "Agent Principal" não deve ser usada para uma pessoa. "Product Principal" de O'Neill é um precedente neste sentido quase e é citado como tal, e o framework AIDEs do JetBrains já descreve os níveis do desenvolvedor como propriedades de uma relação principal-agente (Tikhomirov, 2026).
Os nomes propostos aqui (agentwright, setter-acceptor, agent director) juntam-se à família como candidatos, nenhum deles um favorito. Agentwright é livre nas bases acadêmicas pesquisadas, mas os mecanismos de busca o dividem em "Agent Wright", soa como uma ferramenta de teste de navegador que os desenvolvedores conhecem, e até outubro de 2026 a palavra já era usada para um pacote Python e um catálogo de habilidades de agente, portanto permanece uma variante que precisaria de um qualificador.
Uma observação sobre significado pode ser registrada sem tirar a escolha do mercado. Por sentido, "principal" está mais próximo da profissão da Seção 8, trabalho feito para outros com responsabilidade pelo resultado, e "builder" mais próximo da habilidade em massa, trabalho feito para si mesmo.
4. Por que uma medida: o ano em que tokens foram tentados como senioridade
O mercado não esperou por uma escala. Em 2026 tentou vários, e porque os episódios diferem em tipo eles são mantidos separados aqui, na ordem em que ocorreram.
Na Meta, um funcionário construiu um painel interno apelidado de "Claudeonomics" que classificou cerca de 85.000 colegas por tokens consumidos, mais de 60 trilhões deles em trinta dias (Shopifreaks, 2026a). Era um projeto de um funcionário, sem status oficial, e foi derrubado em abril depois que foi reportado fora da empresa. A linha oficial da Meta moveu-se separadamente. A partir de fevereiro, o uso de IA era uma parte formal da avaliação dos funcionários, e no início de setembro WIRED e CIO reportaram novas orientações sob as quais Meta "não usará painéis de adoção de IA ou contagens de tokens para avaliar o impacto" e retirou o rótulo "AI Native" como critério (CIO, 2026b; Shopifreaks, 2026b). Na Amazon, um placar de uso de tokens foi manipulado com tarefas vazias e removido em maio (CIO, 2026a), que é a lei de Goodhart em sua forma mais limpa: uma vez que a medida se tornou um alvo, parou de medir. O caso do Uber é um evento de orçamento. A empresa gastou seu orçamento anual de IA em quatro meses e limitou os funcionários a $1,500 por mês (Fortune, 2026b). Em julho, o presidente-executivo da Cognition disse que as empresas devem medir a produtividade, não o uso de IA (Fortune, 2026c).
Os contraexemplos importam tanto. Shopify adiciona perguntas sobre uso de IA a suas avaliações de desempenho e revisões entre pares (Shopify, 2026), e um comentarista espera que as métricas de token sejam "rebaixadas, não mortas" (Kingy AI, 2026). Perguntas sobre como uma pessoa usa IA são uma coisa diferente de uma classificação por volume, e a previsão F8 na Seção 11 as distingue.
Os tópicos dos desenvolvedores examinados na Seção 9 mostram o mesmo instinto em pessoas individuais. Eles se apresentam com dados de entrada: uma fatura de IA mensal de $1,148, uma captura de tela de uma assinatura, cerca de 330 de alguns 600 pull requests realizados (uma unidade descrita no tópico como muito aproximada), 36 estágios construídos em três dias. Um deles publicou a economia que seu agente havia calculado para ele sem verificar o cálculo, que é o episódio de token repetido por uma pessoa. Cada um desses contabiliza o que foi gasto ou produzido; o que foi aceito, por quem e após qual verificação, fica não registrado.
Extraio uma lição direta para a medida: conte o trabalho, e apenas o trabalho que passou em uma verificação que os agentes não viram. O acordo entre modelos da mesma família não pode ser essa verificação, porque seus erros são correlacionados e seu acordo vale menos opiniões independentes do que parece (Chernets, 2026b). Gastar mais tokens não pode inflar uma medida construída dessa forma, já que o trabalho não aceito não adiciona nada a ela. Outras maneiras de inflá-la permanecem, e a Seção 5.8 as lista com suas defesas.
5. A medida: horizonte de delegação verificado e ganho de amplificação
5.1 Horas de referência
Ambos os eixos usam uma unidade, a hora de referência: o tempo que um especialista qualificado precisaria para fazer o mesmo trabalho manualmente. A referência é externa propositalmente. Se a pessoa poderia ou não ter feito o trabalho ela mesma não entra na medida, assim como seu histórico também não. Uma ferramenta de reconciliação de um contador e um módulo de faturamento de um desenvolvedor são ambos medidos pelo que um profissional competente teria gasto neles.
As horas de referência vêm de uma de duas fontes. Uma é um banco congelado de tarefas cujos tempos feitos manualmente foram medidos em 2025 e 2026; GDPval, com tarefas extraídas de 44 ocupações e seus tempos de especialistas, mostra que tal banco pode ser construído (Patwardhan et al., 2025). A outra é dois avaliadores independentes que estimam as horas sem saber quem fez o trabalho; onde os avaliadores de um domínio se mostram muito distantes, a referência pode ser em vez disso a mediana de um painel calibrado de cinco a nove avaliadores, pontuados por degrau (Apêndice G2). Congelo o banco deliberadamente, da maneira como o metro foi um dia mantido em um cofre perto de Paris, porque em alguns anos poucas pessoas ainda farão essas tarefas manualmente e não haverá nada com que comparar. O banco deve conter, para cada domínio, tarefas em cada degrau, cada uma com uma declaração escrita do que conta como feito, tempos medidos manualmente, as verificações ocultas, e alguns erros plantados cuja detecção faz parte da aceitação. Os tempos manuais da GDPval são relatórios verificados de especialistas, enquanto seus tempos de revisão foram medidos, o que é o padrão que um banco deve atender ou melhorar. Para evitar que a medida se julgue a si mesma, o horizonte é pontuado em um conjunto de tarefas e a qualidade usada para testar hipóteses sobre ele (Seção 6) em outro.
5.2 O horizonte de delegação verificado
Definição. O horizonte de delegação verificado de uma pessoa em um domínio é o maior tamanho de trabalho, em horas de referência, no qual a pessoa passa regularmente trabalho para agentes, o aceita e o tem confirmado por uma verificação independente que os agentes não viram.
A regra em um parágrafo. Um trabalho delegado conta como verificado, e entra no horizonte, apenas quando tudo o que se segue se mantém verdadeiro. Foi definido com uma declaração escrita do que contará como feito, e suas horas de referência vêm do banco ou de dois avaliadores. A pessoa o aceitou como uma única entrega coerente: um mês de trabalho dividido em 160 tarefas de uma hora é 160 Horas, enquanto trabalho feito em etapas e aceito como um todo é contado como um todo, pelas horas de referência desse todo. Uma verificação independente o confirmou, e uma verificação é independente quando difere dos agentes em dados (entradas que os agentes não produziram), em acesso (os agentes não poderiam ver ou editá-lo) e em incentivos (quem a conduz nada ganha com uma aprovação). Quatro tipos se qualificam: testes de aceitação ocultos, um avaliador humano qualificado, uso real pelos usuários pretendidos, ou um modelo de outra família que verifica contra as fontes que a pessoa abriu e deixa um parecer que pode ser auditado. Auto-revisão e concordância entre modelos de uma família não contam, porque seus pontos cegos coincidem com os dos agentes. Dentro da janela do degrau (91 dias para Hora e Dia, 182 para Semana, 365 para Mês e Trimestre) a pessoa aceitou o número necessário de trabalhos de pelo menos esse tamanho, dez para Hora e Dia, seis para Semana e para Mês e três para Trimestre, e pelo menos oito de cada dez passaram, o que significa cinco de seis para Semana e Mês e todos os três para Trimestre. A partir de Semana, pelo menos um desses trabalhos traz erros plantados. Um erro plantado não detectado, de qualquer tipo, bloqueia os degraus a partir de Semana para essa janela, e o trabalho com ele não é contado nem para um degrau nem para ganho de amplificação. Quando um erro não pode ser desfeito (dinheiro movido, o registro de um paciente, um protocolo que não pode ser retirado), todo trabalho desse tipo deve passar, com um teste oculto ou um humano qualificado como a verificação padrão e um modelo de outra família como segunda linha, e a regra mais rigorosa se aplica apenas a esses trabalhos. Toda transferência é registrada, incluindo falhas e trabalhos abandonados, com a atenção que consumiram. O degrau é confirmado novamente a cada trimestre: em Semana e acima, pelo menos um trabalho verificado do tamanho do degrau deve estar dentro dos últimos 91 dias, de modo que um horizonte não pode se basear em trabalho de quase um ano de idade. Os parágrafos a seguir fornecem as razões para cada parte.
Regra de pontuação. Dentro da janela definida para cada degrau (91 dias para Hora e Dia, 182 para Semana, 365 para Mês e Trimestre), um degrau conta se a pessoa aceitou o número necessário de trabalhos de pelo menos esse tamanho no domínio (dez para Hora e Dia, menos acima, conforme definido abaixo), e pelo menos oito de cada dez passaram em uma verificação de um desses tipos: testes de aceitação ocultos, um avaliador humano qualificado, uso real pelos usuários pretendidos, ou um modelo de outra família que verificou contra as fontes. Auto-revisão e concordância entre modelos de uma família não contam. Quando erros não podem ser desfeitos (dinheiro movido, o registro de um paciente, um protocolo que não pode ser retirado), todo trabalho desse tipo deve passar, e o critério mais rigoroso se aplica apenas a esses trabalhos. Para esses trabalhos, a verificação padrão é um teste oculto ou um humano qualificado, com um modelo de outra família como segunda linha.
Degraus superiores. Uma contagem única de dez colocaria os degraus superiores fora do alcance de qualquer pessoa, pois dez trabalhos de 40 horas de referência em três meses representam 400 horas de trabalho de um especialista, e dez trabalhos de 500 horas representam 5.000. A regra, portanto, estende a janela e diminui a contagem conforme os degraus aumentam: dez trabalhos em 91 dias para Hora e Dia, seis em 182 dias para Semana, seis em 365 dias para Mês e três em 365 dias para Trimestre, com a mesma proporção de oito em dez (o que significa cinco de seis para Semana e Mês, e todos os três para Trimestre). Uma versão anterior pedia quatro de quatro para Mês; o teste de mesa do Apêndice E mostrou que isso tornava Mês mais difícil de conquistar que Trimestre para qualquer pessoa, e a contagem foi alterada. A partir de Semana, pelo menos um trabalho do tamanho do degrau na janela deve conter erros plantados. Qualquer erro plantado que a pessoa não detecta, qualquer que seja seu tipo, bloqueia os degraus a partir de Semana para essa janela, e um trabalho com um erro plantado não detectado não é contado como verificado, nem para um degrau nem para ganho de amplificação. Trimestre deve permanecer um degrau raro, e as contagens acima são definidas para garantir isso.
Toda entrega é registrada. O log registra cada peça entregue aos agentes, incluindo as que falharam na verificação e as abandonadas antes dela, e apenas uma peça aceita como uma entrega coerente conta para um degrau. Um mês de trabalho dividido em 160 tickets de uma hora é 160 Hours, não um Month: as horas de referência são estimadas para a entrega que o usuário, cliente ou revisor aceita como um todo, no espírito das tarefas coerentes de METR. O inverso também se aplica: o trabalho realizado em etapas e aceito como uma entrega coerente conta como um todo, pelas horas de referência dessa entrega, não importa quantas etapas foram necessárias.
Independência. Uma verificação é independente quando difere dos agentes em dados (usa entradas que os agentes não produziram), em acesso (os agentes não poderiam vê-la ou editá-la) e em incentivos (quem a executa não ganha nada com uma aprovação). Um modelo de outra família adiciona diversidade de erros. Conta apenas quando verifica contra as fontes que a pessoa abriu, e seu veredicto é uma entrada que pode ser auditada.
Uma peça de trabalho percorre este caminho (Figura 3). Uma tarefa é definida com uma declaração escrita do que contará como feito. Suas horas de referência são obtidas do banco ou de dois avaliadores. Os agentes fazem o trabalho enquanto a pessoa despende atenção, que é registrada. A pessoa aceita, rejeita ou abandona a peça, uma verificação independente confirma ou refuta, e a linha do log é escrita naquele momento, com a data de início mantida como um campo separado onde importa. Quando existe um resultado atrasado (um arquivamento aceito, um lançamento ainda em execução após um mês), é registrado quando chega. O horizonte e o ganho são computados a partir desses registros, com uma data.
Figura 3. Uma peça de trabalho, um registro.
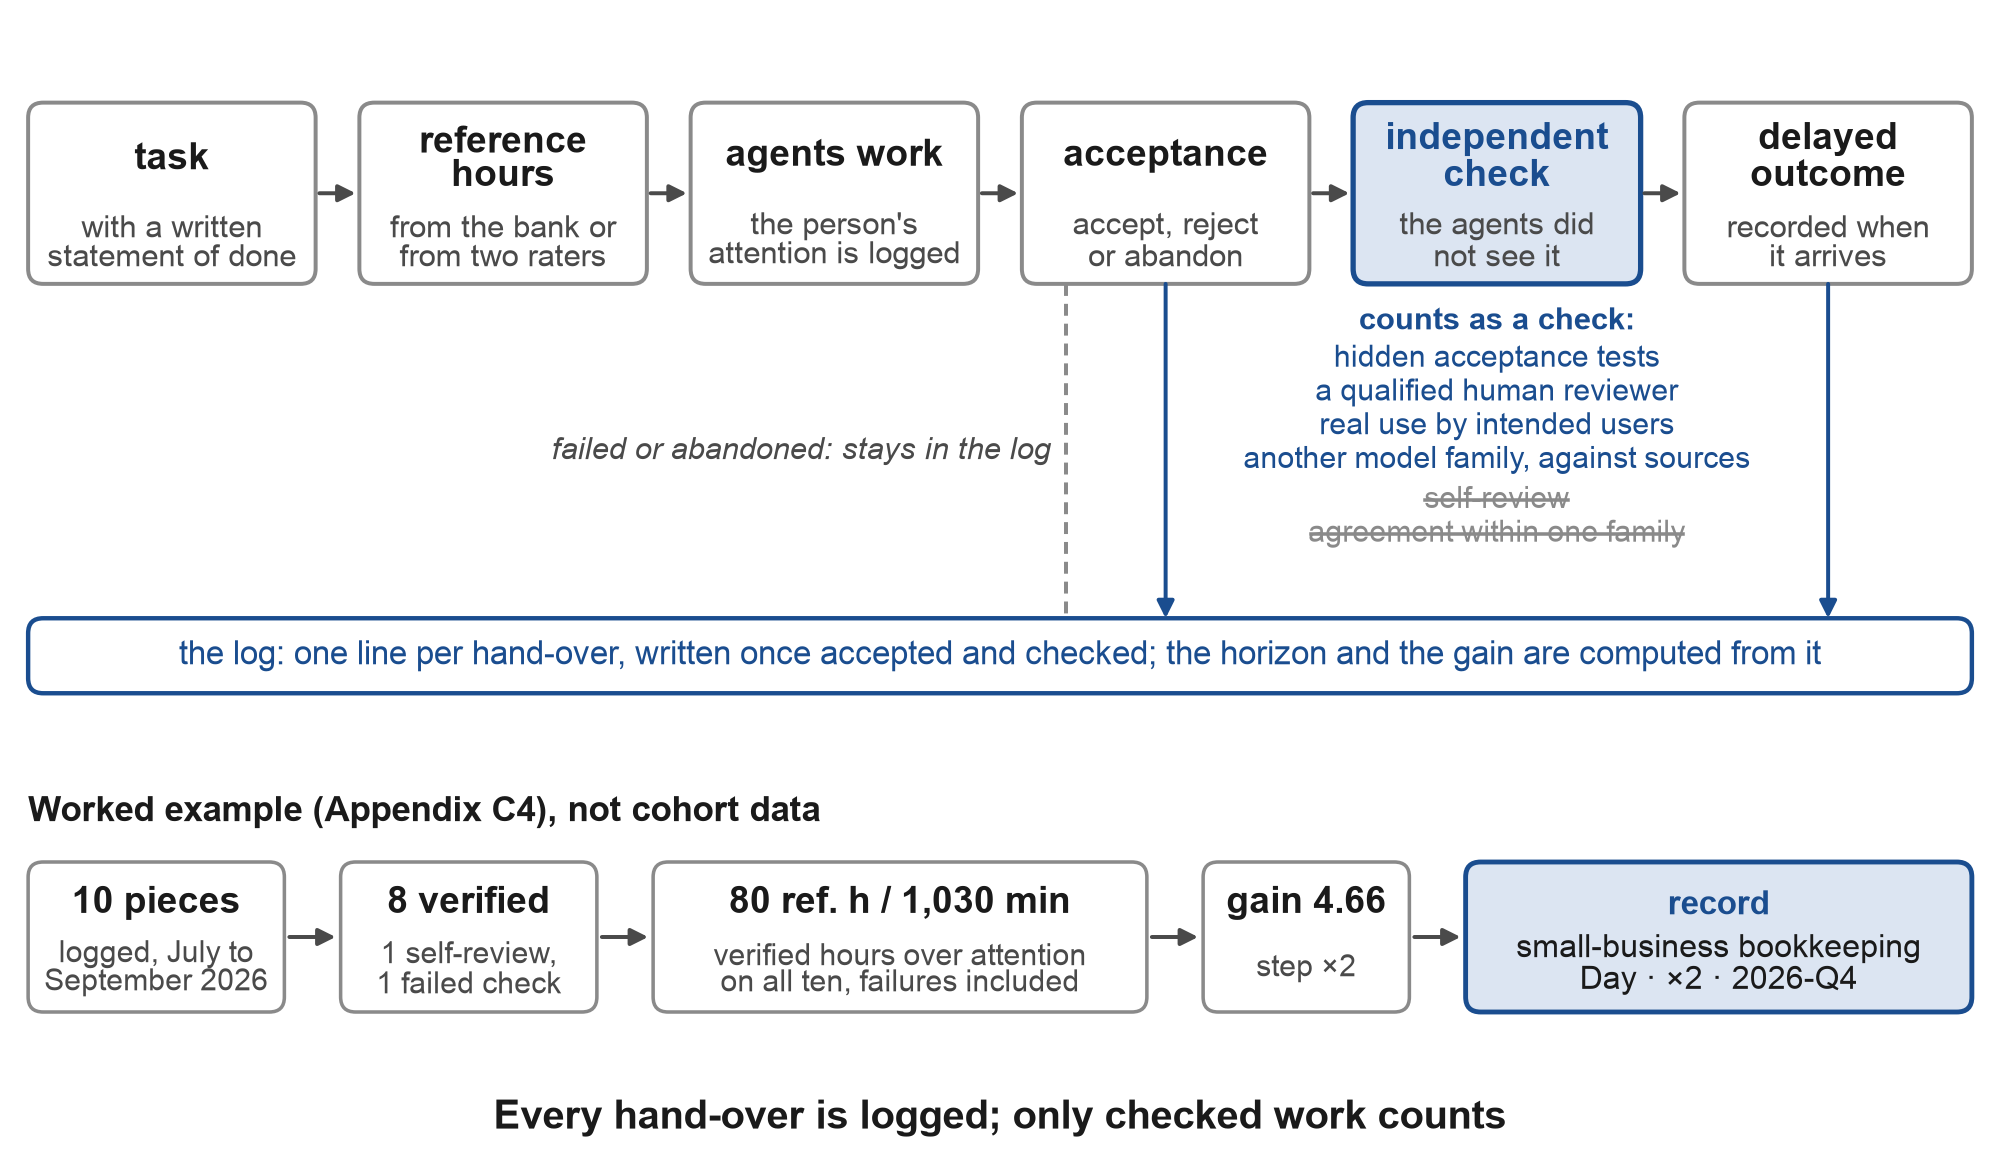
Nota: A linha superior é o caminho de Seção 5.2. Os quatro tipos de verificação independente são os da regra de pontuação. Auto-revisão e concordância entre modelos de uma família não contam. Peças falhadas e abandonadas permanecem no log e adicionam seus minutos ao denominador do ganho de amplificação. A linha inferior é o exemplo elaborado do Apêndice C4, um log construído, não dados de coorte: dez peças, oito verificadas, 80 horas de referência contra 1.030 minutos de atenção, um ganho de 4,66 (etapa ×2) e o registro "contabilidade de pequenos negócios · Day · ×2 · 2026-Q4".
Re-verificação. Um horizonte é confirmado novamente a cada trimestre. O paradoxo de supervisão da Anthropic (Seção 2.1) explica por quê: um horizonte obtido enquanto a habilidade de verificação se deteriora é emprestado, e uma verificação trimestral mostra se ainda se sustenta. Para os degraus cujas janelas se estendem por mais de um trimestre (Week, Month e Quarter), a verificação tem uma forma concreta: pelo menos uma peça verificada do tamanho do degrau deve cair nos últimos 91 dias, para que um degrau não possa descansar em peças próximas a um ano de idade.
5.3 A escada
Nomeio os cinco degraus em unidades de tempo porque as unidades de tempo não precisam de tradução entre profissões, podem ser lidas nos logs e crescem com a tecnologia sem serem renomeados. A Tabela 1 apresenta-os com exemplos e as contagens que cada um precisa.
Tabela 1. A escada do horizonte de delegação verificado.
| Degrau | Tamanho do trabalho entregue e verificado | Exemplo em programação | Outro exemplo | Peças verificadas necessárias, janela |
|---|---|---|---|---|
| Hour | Cerca de 1 hora de referência | Um script, uma pequena correção | Respostas extraídas de um conjunto de documentos | 8 de 10 em 91 dias |
| Day | Cerca de 8 | Uma funcionalidade, uma pequena ferramenta interna | Um relatório de final de mês com suas verificações | 8 de 10 em 91 dias |
| Week | Cerca de 40 | Um site ou ferramenta interna conforme especificado, com execuções noturnas | Um pacote completo de devida diligência, um sistema de campanha | 5 de 6 em 182 dias |
| Month | Cerca de 160, geralmente em vários fluxos | Um lançamento de produto; regras de aceitação que outros seguem | A ferramenta de uma prática, com regras que colegas usam | 5 de 6 em 365 dias |
| Quarter | Cerca de 500 | Uma linha de produtos com usuários em produção | Uma linha de serviço gerenciada através de agentes | 3 de 3 em 365 dias |
Nota: Um degrau é obtido apenas pela regra de pontuação de Seção 5.2, separadamente em cada domínio, com as contagens das regras v1.1 (Apêndice E). Nenhuma avaliação em uma escada antiga confere um degrau, e uma pessoa pode estar em Week em ferramentas financeiras e em Day em aplicações web.
O registro para um currículo ou arquivo de RH contém o domínio, o horizonte, a amplificação e a data, por exemplo "contabilidade de pequenos negócios · Day · ×2 · 2026-Q4". A data pertence ao registro porque o mesmo degrau significará algo diferente um ano depois, à medida que a tecnologia avança.
5.4 Ganho de amplificação
Nem todos que trabalham bem com agentes lhes entregam grandes peças. Um dos desenvolvedores em Seção 9, que trabalha com quatro máquinas, descreve três delas como "um impulso de eficiência pessoal" sem nenhum agente autônomo nelas. Os agentes autônomos que ele também executa "não pegaram" para o trabalho diário, ele escreve, e ele prefere "impulso, não delegação" (traduzido). Seu fluxo mais longo estendeu-se para 36 etapas ao longo de três dias, cada etapa entregue e submetida, com o agente então pedido para confirmar que tudo havia sido implementado. De acordo com a regra de Seção 5.2, essa confirmação é auto-revisão, então seu registro conforme postado não mostra nenhum degrau verificado e o tópico não fornece números para seu ganho. Aonde ele ficaria com uma verificação independente depende do que foi aceito. Se os 36 estágios fossem aceitos como uma entrega coerente, o fluxo é contado por inteiro, por suas horas de referência, assim como o trabalho em estágios do Apêndice C, seção C4. Se cada estágio fosse aceito por si só, cada um é uma pequena peça e ele fica em Hour no primeiro eixo. O post não diz qual. Ainda assim, ele constrói ferramentas que substituem software que costumava comprar, e ele identifica o denominador do segundo eixo ao chamar o tempo de único gargalo.
Ele não é uma exceção. A Anthropic relatou que usuários com seis meses ou mais de experiência eram "muito menos propensos a delegar maior responsabilidade por meio de padrões de uso diretivo", trabalhavam com o modelo de forma mais iterativa e traziam tarefas mais difíceis, com sucesso de três a cinco pontos mais altos após controles (Anthropic, 2026d). Em Claude.ai, o uso colaborativo superou a automação, 52% para 45%, em novembro de 2025, e as conversas obtiveram sucesso mais frequentemente do que as solicitações programáticas únicas, 67% contra 49% (Anthropic, 2026a). Pessoas em ocupações mais bem remuneradas fizeram cerca de 1,5 vezes mais turnos, e mulheres automatizaram 7,3 pontos menos do que homens na mesma ocupação (Anthropic, 2026f). Na pesquisa de Stanford com 1.500 trabalhadores, o arranjo mais preferido em 47 de 104 ocupações foi uma parceria igual entre pessoa e agente (Shao et al., 2025). Uma medida construída apenas sobre delegação subestimaria, portanto, os usuários mais experientes, os mais bem remunerados e as mulheres, embora nada nesses dados indique que seu trabalho é pior.
Definição. O ganho de amplificação é as horas de referência do trabalho aceito e verificado divididas pelas horas de atenção da pessoa gasta nele, durante os últimos 91 dias no domínio, seja qual for a janela do nível da pessoa. O trabalho feito com ajuda externa (um colega ou contratado corrigindo-o fora do registro) é registrado como tal e não adiciona nada ao numerador, enquanto os minutos da pessoa nele permanecem no denominador. A atenção cobre planejamento, instruções, leitura, verificação e correção. O tempo que o agente executa enquanto a pessoa faz outra coisa não conta.
O ganho de amplificação é uma taxa de transferência verificada: saída aceita e verificada por hora de atenção. Não é uma estimativa causal de o quanto mais rápido a mesma pessoa trabalha com agentes do que sem eles. Um ganho nesse sentido comparativo precisa de uma linha de base, a mesma pessoa ou pessoas comparáveis fazendo o mesmo tipo de trabalho sem agentes, e apenas um estudo comparativo pode fornecê-lo.
O trabalho falhado não adiciona nada ao numerador e todos seus minutos ao denominador, o que mantém o auto-engano visível. No ensaio de 2025 da METR, desenvolvedores experientes acreditavam que a IA os havia acelerado, enquanto a medição mostrou que estavam 19% mais lentos (METR, 2025).
Os passos do segundo eixo são ×1 ("um dia para um dia"), ×2, ×5 ("uma semana para um dia"), ×20 ("um mês para um dia") e ×60 ("um trimestre para um dia"). As duas escalas são independentes, então um passo em uma não é igual a um nível em outra. Quando uma pessoa executa vários agentes em paralelo, a atenção ainda é contada uma vez, nos próprios minutos da pessoa: uma hora gasta observando três fluxos é uma hora no denominador, compartilhada entre os pedaços em proporção aos minutos registrados em cada um. Uma pontuação é relatada junto com a configuração que a produziu (o modelo e as ferramentas, o tipo de verificação, e o nível das tarefas), porque a mesma pessoa pontuará de forma diferente sob uma verificação mais rigorosa.
5.5 Dois eixos, quatro perfis e um teto
Colocar pessoas em ambos os eixos fornece quatro perfis (Figura 4). Um aprendiz tem um horizonte curto e ganho baixo. Um amplificador tem um horizonte curto e ganho alto, como o construtor de 36 estágios se seus estágios fossem aceitos um a um. Um delegador tem um horizonte longo e ganho alto. O quarto perfil, que chamo de supervisor, é um horizonte longo com ganho baixo: os agentes executam por muito tempo, e a verificação e o retrabalho consomem o benefício, então é mais um sinal de aviso do que um nível.
Os dois eixos são ligados por um teto. A atenção vai para configurar um pedaço de trabalho e para verificá-lo. Escreva H para as horas de referência de um pedaço, V para as horas de atenção que a verificação leva, e S para as horas gastas configurando-o. Então ganho G = H / (S + V + retrabalho), e assim G ≤ H / V. Se a verificação sozinha leva um quarto do tempo manual, o ganho não pode exceder ×4, não importa quanto tempo o agente funcione desatendido. Pelo mesmo limite, os passos ×2, ×5, ×20 e ×60 são abertos apenas quando a verificação leva no máximo 50%, 20%, 5% e cerca de 1,7% do tempo manual (Figura 4). Este é um modelo simplificado com limites contábeis declarados: ignora o valor do trabalho que a pessoa não poderia ter feito, assume que o tempo de verificação escala com o pedaço, e se aplica por pedaço, então uma pessoa que verifica pedaços pequenos baratamente pode vencer o teto calculado para grandes. Ao nível da economia, Catalini et al. (2026) fazem o mesmo ponto: a restrição vinculante se torna "largura de banda de verificação humana", e uma "Lacuna de Mensurabilidade" se abre entre o que os agentes podem executar e o que as pessoas podem arcar para verificar.
GDPval mostra o que o limite significa na prática. Em seu subconjunto ouro de 220 tarefas, seus especialistas relataram (e os autores verificaram) em média 404 minutos por tarefa manualmente, e a revisão de um entregável levou 109 minutos medidos, cerca de 27%, o que coloca o teto próximo a ×3,7 para tarefas desse tipo. Os modelos produziram seus rascunhos 90 a 327 vezes mais rápido do que os especialistas. No entanto, no cenário em que uma pessoa tenta o modelo e então corrige seu trabalho, o cálculo dos autores (não uma medição) deu a GPT-5 uma aceleração de 1,12 quando o modelo é tentado uma vez e 1,39 quando é tentado várias vezes, duas colunas separadas da mesma tabela (Patwardhan et al., 2025). Seja qual for a velocidade do agente, o preço da verificação define o teto, e esse preço sobe com o nível, pois um pedaço maior custa mais para verificar. Kamara (2026) chama esse custo de fricção de verificação. Os profissionais nas discussões da Seção 9 colocam em suas próprias palavras: além de um certo ponto, verificar código de agente "difere cada vez menos de reescrevê-lo manualmente", e pode levar mais tempo do que escrevê-lo sozinho (traduzido).
O mesmo ganho pode ser alcançado por dois caminhos. Uma coleira longa entrega um pedaço grande e o verifica no final; loops curtos e rápidos entregam pedaços pequenos e verificam cada um conforme ele chega. Minha hipótese é que verificar pequenos pedaços ao longo do caminho é frequentemente mais barato do que verificar um grande resultado no final, e os dados do Anthropic apontam dessa forma. As conversas obtiveram sucesso mais frequentemente do que solicitações únicas, e pela própria extrapolação dos autores, solicitações únicas atingem 50% de sucesso em tarefas de cerca de 3,5 horas, enquanto conversas atingiriam em tarefas de cerca de 19 horas (Anthropic, 2026a). O uso colaborativo caiu abaixo da automação em agosto de 2025 e estava na frente novamente, 52% para 45%, em novembro. O caminho de loop curto é próximo ao que a literatura de colaboração humano-IA estuda, e o ganho de amplificação a credita tão plenamente quanto a delegação longa. As previsões F19 a F21 na Seção 11 testam o caminho de loop curto.
Figura 4. Dois eixos, quatro perfis e os tetos que a verificação define.
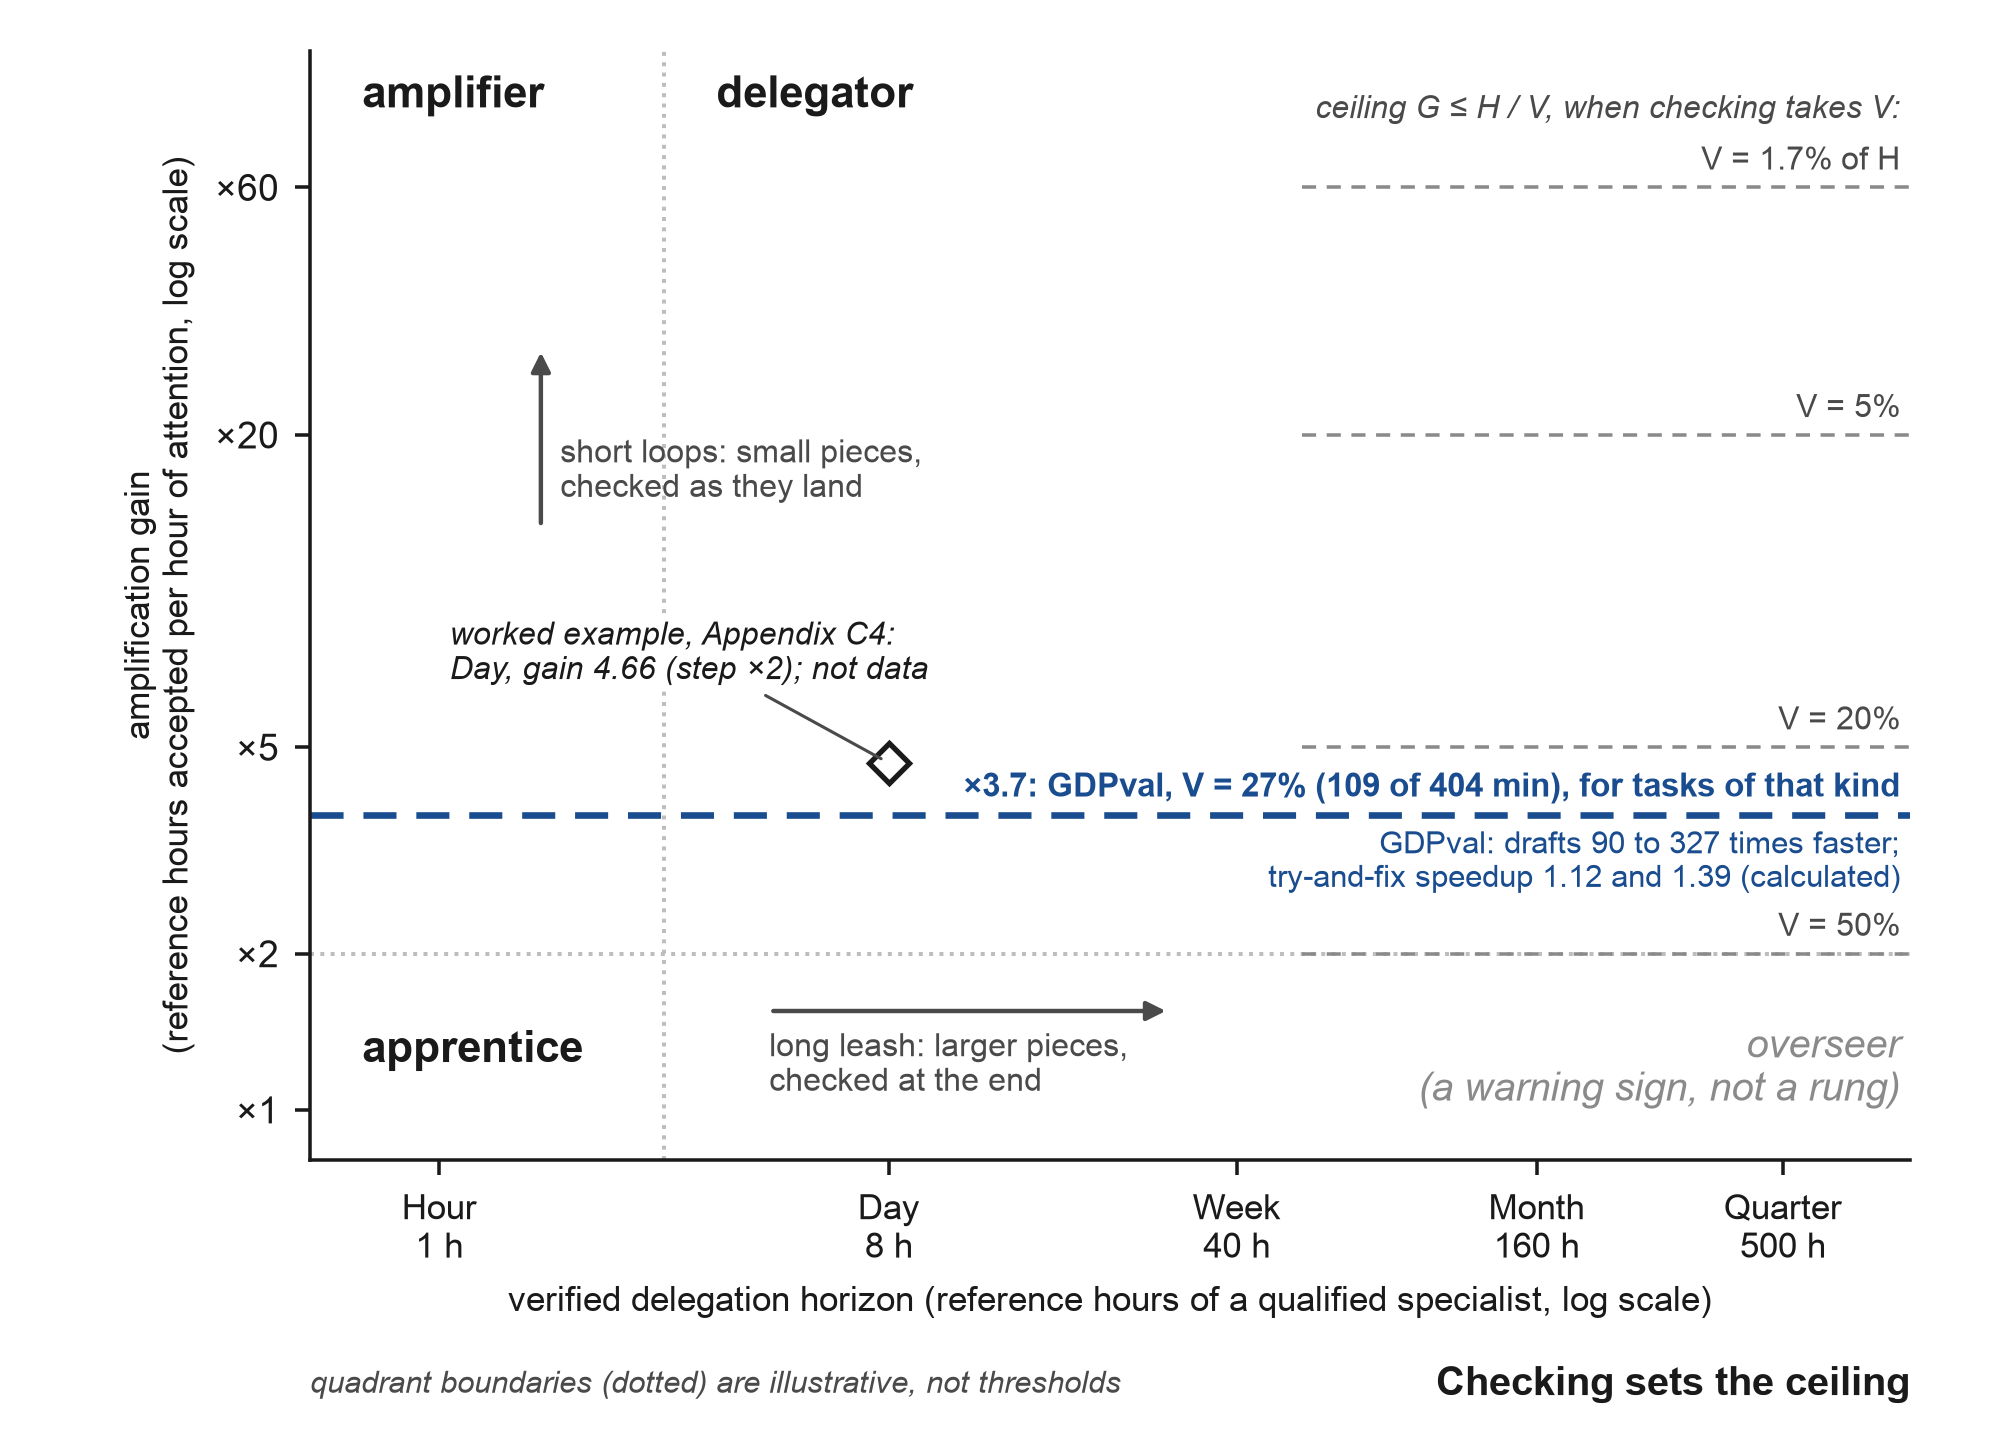
Nota: Os quadrantes são perfis, não patamares, e seus limites são ilustrativos. Cada linha cinza é o limite G ≤ H / V da Seção 5.5 para uma dada fração do tempo de verificação V no tempo de trabalho manual H. A linha de destaque usa as médias de GDPval em seu subconjunto dourado de 220 tarefas, 404 minutos manuais e 109 minutos de revisão especializada da saída do modelo (Patwardhan et al., 2025), e se mantém para tarefas desse tipo. Os ganhos de velocidade 1,12 e 1,39 são cálculos dos autores, não uma medição. O diamante é o exemplo trabalhado do Apêndice C4, não dados. Ele está acima da linha GDPval porque o teto é calculado por tipo de tarefa, e pequenas peças verificadas baratamente podem superar um teto calculado para as maiores (Seção 5.5). O caso de 36 estágios na Seção 5.4 não está plotado: este caso não oferece ganho e nenhuma verificação independente.
5.6 De onde vem a medida e o que há de novo
A medida tem ancestrais, e o mais antigo é Elliott Jaques, que mediu o nível de qualquer trabalho, em qualquer função, por seu período de discrição: o maior tempo que uma pessoa trabalha em seu próprio julgamento antes que alguém revise o resultado. Ele argumentou que o pagamento justo aumenta com esse período (Jaques, 1956). O horizonte de delegação verificado carrega a ideia para a era dos agentes com uma mudança. Jaques mediu quanto tempo uma pessoa trabalha sem verificação, enquanto essa medida conta quanto trabalho uma pessoa entrega aos agentes, aceita e tem verificado. Os dois podem divergir, e seus estratos, contados em meses e anos, não se mapeiam nesses patamares.
A teoria de agente principal é o segundo ancestral. Jensen e Meckling (1976) precificaram a delegação como monitoramento, caução e perda residual. A verificação é o custo de monitoramento de entregar trabalho a um agente, e o horizonte marca o ponto em que verificar uma peça maior não compensa mais.
METR mede máquinas no mesmo eixo. Seu horizonte de tempo é a duração da tarefa, em horas humanas, que um modelo completa com uma dada taxa de sucesso (Kwa et al., 2025). Na primavera de 2026, o modelo de fronteira em seu painel de controle atingiu cerca de 17 horas a 50% de sucesso, embora o próprio METR adverta que as medições acima de 16 horas não são confiáveis com suas tarefas atuais. O horizonte a 80% de sucesso subiu de cerca de 1,2 horas em fevereiro de 2026 para cerca de 3,1 horas em abril, dois pontos que ilustram o ritmo de crescimento sem medir sua taxa. A tendência ajustada no painel de controle entre modelos desde 2023 dobra aproximadamente a cada 4,2 meses (128,7 dias), e o painel de controle não havia sido atualizado após 8 de setembro de 2026 quando foi acessado pela última vez (METR, 2026c). Os previsores do Projeto AI Futures trabalham com um tempo de duplicação de 4 a 4,5 meses (Projeto AI Futures, 2026). O trabalho aceito corresponde mais ao horizonte de 80% do que ao de 50%. A diferença entre o que um modelo às vezes termina e o que termina de forma confiável é o trabalho da pessoa, que consiste em mostrar que um resultado está correto e levá-lo adiante. A Figura A3 (Apêndice F) coloca esses horizontes de máquina contra os patamares.
A teoria de 2026 aponta para a mesma lacuna. Huang, Xiao e Vishnoi (2026) modelam delegação sob IA e descobrem que pequenas diferenças na capacidade de verificar produzem grandes diferenças nos resultados: a IA ajuda os que verificam e prejudica os que entregam demais. O artigo deles foi aceito no ICML 2026, e eles chamam o efeito de amplificação de verificação. Uma revisão estruturada de 24 estudos descobriu que nenhum instrumento validado em seu corpus focal cobre a combinação completa de competências necessárias para supervisionar agentes (escopo, permissões, recuperação, revisão independente e encerramento baseado em evidências), embora alguns instrumentos cubram partes disso (Veri', 2026). O framework de DeepMind para delegação inteligente de IA descreve delegação em geral e não contém medida em nível de pessoa (Tomašev et al., 2026), e a economia da delegação agora tem seus próprios modelos de fronteira (Wang, 2026). Chen e Meng (2026) mostram que a IA generativa comprime diferenças de competência dentro de uma tarefa e desloca valor para ativos complementares escassos, e acrescentam que os dados em painel de pessoa-tarefa necessários para testar suas previsões "ainda não existem em escala". A medida que proponho produz dados exatamente desse tipo, pois cada peça registrada carrega uma pessoa, um tamanho e uma data.
O segundo eixo tem seus próprios vizinhos, e o ganho de amplificação é sua forma verificada em nível de pessoa. Engelbart (1962) enquadrou a computação como aumentar o intelecto humano, e "superagência" é a palavra de McKinsey para a mesma esperança em 2025 (McKinsey, 2025). O Índice Econômico Anthropic classifica conversas por aceleração (tempo sem IA dividido por tempo com ela) e autonomia do agente em uma escala de 1 a 5, ambos julgados por um modelo (Anthropic, 2026a). WORKBank de Stanford classifica o envolvimento humano que os trabalhadores preferem em uma escala de H1 a H5 (Shao et al., 2025). Um ensaio de 2026 definiu capacidade de supervisão como saída verificada útil contra esforço humano e explicitamente recusou atribuir-lhe um número (em360, 2026), e "supervisão amplificada" é um termo de segurança da IA para ajudar as pessoas a supervisionar sistemas mais fortes que elas mesmas. A observação de um agente de busca mostra o mesmo deslocamento do tempo humano em direção à verificação: o agente trabalha sozinho por 26 minutos por sessão, onde uma busca simples levou 33 segundos (Yang et al., 2026). Do lado da delegação, Khadj (2026) e Alonso (2026) usam "horizonte de delegação" para o quão longe uma máquina ou uma empresa pode delegar, o trabalho CHI 2026 sobre "horizontes de decisão" estuda a perda de autodeterminação (Universidade de Lübeck, 2026), e Dawson (2026) e Metal Toad (2026) publicam níveis de delegação de IA dos profissionais. Nenhum deles coloca uma pessoa em um nível com base no trabalho confirmado por verificação independente.
O framework mais próximo entre os recentes é comparado aqui diretamente. O framework AIDEs da Pesquisa JetBrains (Tikhomirov, 2026) compartilha dois recursos com a medida: trata delegação como uma relação de agente principal, e ordena delegação em níveis, cinco deles, descritos por atributos como autonomia e planejamento. Difere em quatro. Seu assunto é desenvolvimento de software, enquanto o horizonte é pontuado em qualquer domínio. Seus níveis descrevem como o trabalho é delegado, enquanto um patamar é definido pelo tamanho do trabalho, em horas de referência de um especialista qualificado. Não tem regra de que a verificação seja independente dos agentes, enquanto um patamar conta apenas peças confirmadas por uma verificação que os agentes não viram. E não tem contagem em uma janela e nenhum segundo eixo, enquanto um patamar precisa de uma fração de aprovação em uma janela datada e ganho de amplificação adiciona as horas de atenção. A linguagem de agência é compartilhada; a unidade, a regra de independência e o escopo além de software são o que este artigo propõe.
Muitas escalas foram publicadas em 2025 e 2026, e nenhuma das escalas na Tabela 2 mede uma pessoa por trabalho verificado. A Tabela 2 agrupa as principais pelo que medem; a Tabela A3 (Apêndice F) lista cada uma delas.
Tabela 2. Escalas de 2025 e 2026, agrupadas pelo que medem.
| Família | Exemplos | Unidade medida | Posiciona uma pessoa por trabalho delegado verificado? |
|---|---|---|---|
| Níveis de autonomia de agentes e máquinas | Feng et al., 2025; Shapiro, January 2026; Memari & Rudolph, 2026; METR, 2025-2026 | O agente, o modelo ou a configuração da equipe | Não |
| Estágios da prática de um desenvolvedor | Yegge, 2026; Park et al., 2026; Microsoft, May 2026 | Prática, trabalho de supervisão ou padrões de trabalho | Não |
| Delegação por organizações e empresas | Dawson, 2026; Metal Toad, 2026; Tomašev et al. (DeepMind), February 2026; Khadj, 2026 | Uma organização, um gerente, uma empresa ou delegação em geral | Não |
| Delegação do desenvolvedor como uma relação principal-agente | JetBrains Research (Tikhomirov), September 2026 | Uma delegação de um desenvolvedor | Apenas desenvolvedores; sem regra de independência para verificações e sem unidade de tamanho |
| Marcos de competência e alfabetização | AI Certification Standards, 23 August 2026; Anthropic AI Fluency, 2025b | Competências ou alfabetização | Sem exame, limiares ou níveis |
| Horizonte de delegação verificado e ganho de amplificação | This paper | Uma pessoa em um domínio | Sim, pela regra da Seção 5.2 |
Nota: "Posiciona uma pessoa por trabalho delegado verificado" significa que a escala coloca um indivíduo em um nível pelo tamanho do trabalho entregue aos agentes e confirmado por uma verificação que os agentes não viram. O vizinho mais próximo são os cinco níveis da JetBrains: compartilham a linguagem de principal e agente e diferem na regra de verificação (uma verificação independente que os agentes não viram) e na unidade (horas de referência). A Tabela A3 (Apêndice F) lista cada escala separadamente.
Um praticante bem expressou a objeção a qualquer escala pessoal: "seu nível de autonomia é uma propriedade do repositório, não do desenvolvedor e não do modelo" (Phoenix, 2026). Aceito metade disso. Um horizonte pertence a uma pessoa, em um domínio, sob um regime de verificação, e um repositório bem construído com testes ocultos faz parte desse regime, razão pela qual o horizonte é registrado por domínio e com uma data.
5.7 Duas questões do artigo complementar
O artigo complementar deixou em aberto a questão de por que usuários experientes delegam menos, se foram prejudicados ou se seu julgamento é o produto (Chernets, 2026a). O segundo eixo pode diferenciá-los. Se a proporção do uso diretivo cai enquanto o ganho verificado sobe, o julgamento é o produto; se o ganho também cai, foram prejudicados. O artigo complementar também perguntou se o vocabulário da delegação é uma gramática ou uma por profissão. Tomo uma posição: a gramática é uma (estabeleça a tarefa, depois a aceite com base em evidências), enquanto o que conta como evidência difere por domínio, razão pela qual os degraus são compartilhados e a pontuação ocorre por domínio.
O instrumento do Apêndice C relata uma proporção diretiva para cada pessoa e domínio, contada em peças (a proporção de peças entregues em uma peça, contra estágios ou trabalho conjunto), de modo que um primeiro teste grosseiro pode ser executado nos mesmos registros que fornecem os degraus. A Previsão F20 declara o teste com uma data em sua medida registrada, a "proporção dos turnos de uma pessoa que dão instruções em vez de verificar ou editar, do log" (Tabela A6): lá a proporção é contada ao longo dos turnos do log da sessão em vez de sobre as peças do log de trabalho do Apêndice C, portanto é a mais fina das duas contagens.
5.8 Como a medida pode ser manipulada e as defesas
Contar trabalho aceito e verificado independentemente fecha a rota mais barata, gasto, mas uma pessoa determinada ou um empregador perseguindo um alvo ainda tem outras. A Tabela 3 as lista com a defesa que as regras fornecem. As defesas custam algo, e o custo faz parte do design: um degrau auditado vale mais do que um autodeclarado, da mesma forma que uma conta auditada vale mais do que uma declaração.
Tabela 3. Formas de manipular a medida e as defesas.
| Rota | Como parece | Defesa |
|---|---|---|
| Verificações fáceis | Testes ocultos que uma solução fraca passa; um revisor que folheia | Auditoria aleatória de uma proporção de peças aceitas por um segundo verificador independente; erros plantados a partir de Semana em diante; o tipo de verificação é impresso ao lado da pontuação |
| Escolher tarefas logo acima de um limiar | Muitas peças de 8,1 horas de referência para atingir Dia | Degraus lidos da distribuição de tamanhos, com o tamanho mediano aceito relatado ao lado do degrau |
| Avaliadores generosos de horas | Avaliadores que inflam horas de referência | Dois avaliadores cegos para a pessoa; discordância acima de uma proporção fixa envia a peça para o banco congelado ou para um terceiro avaliador; registros dos avaliadores auditados |
| Ajuda oculta | Um colega ou contratado corrige o trabalho fora do log | Atenção registrada por peça; entrevistas ou reproduções aleatórias; ajuda externa registrada como um campo e excluída do ganho da pessoa |
| Fatiamento | Um mês de trabalho cortado em tíquetes de uma hora | Apenas um entregável coerente, aceito como um todo, conta para um degrau |
| Ocultação de falhas | Peças abandonadas ou falhadas deixadas de fora do log | Cada transferência registrada, com sua data de início e fechada quando é aceita, rejeitada ou abandonada; um registro público de falhas; uma taxa de aprovação que parece muito limpa desencadeia uma auditoria |
| Verificação correlacionada | Um segundo modelo da mesma família concordando | Não contado (Seção 5.2) |
| Fluxos paralelos | Atenção contada uma vez por fluxo | Atenção contada uma vez por pessoa-minuto (Seção 5.4) |
Os limites são escolhas de design, versionados como regras v1.1 e alterados apenas em uma nova versão após dados. Dez itens em uma janela é a menor contagem em que uma taxa de aprovação de 80% significa algo (oito aprovações em dez). A janela de 91 dias dos degraus inferiores, e da peça recente exigida nos superiores, corresponde à re-verificação trimestral e ao ritmo em que as ferramentas mudam. A regra do degrau é uma regra de qualificação e não faz nenhuma estimativa da confiabilidade de uma pessoa. Oito aprovações em dez são consistentes com uma taxa de aprovação verdadeira em qualquer lugar de aproximadamente 44% a 97% (intervalo exato de 95%), e três em três com uma tão baixa quanto aproximadamente 37% (limite unilateral de 95%). O estudo de calibração registrado estima a confiabilidade. A proporção de 80% segue o uso de METR do horizonte de 80% como o nível de trabalho confiável, e os degraus de 1, 8, 40, 160 e 500 horas seguem a hora de trabalho, dia, semana, mês e trimestre, para que não precisem de tradução entre profissões. Um teste de mesa dos limites verificou as regras por simulação e com avaliadores de modelo (Apêndice E). Ele computou com que frequência uma pessoa de confiabilidade conhecida ganha cada degrau (Figura A2, Apêndice E). Com uma taxa de aprovação verdadeira de 0,8, Day é obtido em 68% das janelas e o mesmo veredicto se repete na próxima janela em 56%, e é por isso que o registro imprime a contagem ao lado do degrau, como em "Day (8/10)". Também encontrou um erro na primeira versão das regras: quatro de quatro em Month era mais difícil de ganhar do que três de três em Quarter (41% contra 51% em uma taxa de aprovação de 0,8), então Month agora pede cinco de seis em um ano. Mover a contagem de dez para oito ou doze, ou a proporção de 0,8 para 0,7 ou 0,9, muda o veredicto Day para 8% a 11% dos logs simulados, e mover ambos o muda para até 22%. Quatro avaliadores de modelo de quatro famílias, estimando horas de referência cegas, ordenaram 30 tarefas consistentemente (correlação intraclasse 0,89 em horas de log), mas colocaram apenas 62% dos pares dentro de uma razão de 1,5, contra o critério do protocolo de calibração de 70%, e diferiram por um fator de dois em seu nível geral; dado apenas um identificador público de uma tarefa, sua estimativa média ficou dentro de 1,5 dos tempos humanos medidos para 3 de 14 tarefas. Os avaliadores de modelo, portanto, não podem substituir os dois avaliadores humanos, e os avaliadores do estudo de campo calibram em tarefas com tempos medidos primeiro. O protocolo de calibração fixa os próximos testes com antecedência: acordo entre avaliadores humanos (critério: pelo menos 70% dos pares dentro de 1,5), repetibilidade do degrau de uma pessoa em duas janelas consecutivas (kappa ponderado de pelo menos 0,6), e a capacidade de um degrau de prever a aprovação em novas tarefas do mesmo tamanho (AUC de pelo menos 0,7). Seu protocolo e texto de registro estão no repositório complementar, e um primeiro teste com profissionais em atividade, de seu acordo sobre horas de referência, é registrado e descrito no Apêndice G.
A Tabela A4 (Apêndice F) fornece a regra para os casos difíceis que surgem primeiro.
Apêndice C, seção C4, percorre o log de dez linhas de uma pessoa até o único registro que produz.
6. Neutralidade de formação de base e o ponto de transição de credenciais
6.1 Neutralidade de formação de base
A hipótese é que, em um horizonte verificado igual em um domínio, uma educação em programação não prediz a qualidade do trabalho verificado independentemente uma vez que o domínio da matéria e a alfabetização em aceitação são levados em conta.
A descoberta da Anthropic de que "the ability to steer Claude toward success comes more from command of a domain than from the ability to write code" é consistente com a hipótese, mas não a testa (Anthropic, 2026e): seus dados classificam pessoas por ocupação, não por educação, e a lacuna de 34% contra 29% da Seção 2.2 é uma lacuna entre ocupações. Apenas o estudo de F7 testa a hipótese. Um forte concorrente também existe. Savva (2026) modela o trabalho de conhecimento aumentado por IA como um problema de principal-agente e prediz que a IA reduz lacunas entre pessoas em tarefas fáceis e as amplia em tarefas difíceis. Se Savva estiver certo, a neutralidade de formação de base se mantém em tarefas curtas e falha nos degraus superiores, então a previsão F7 é avaliada separadamente em Dia e em Semana e acima, onde a hipótese enfrenta seu teste mais difícil.
A alfabetização em aceitação é a habilidade em que a hipótese se apoia. Significa afirmar antecipadamente o que contará como feito, e então mostrá-lo: através de um teste oculto, uma segunda família de modelos verificando contra fontes, uma comparação com uma fonte que a pessoa abriu ela mesma, ou um artefato no lugar de uma garantia. A alfabetização de agente cobre delegação, verificação e gestão em geral (MindStudio, 2026); a alfabetização em aceitação coloca um padrão de prova em seu centro. Também difere da aceitação de tecnologia no sentido da tradição TAM, que estuda se as pessoas adotam uma tecnologia, já que aceitação aqui é a decisão de aceitar um pedaço de trabalho. O registro de aceitação do artigo complementar torna-se a unidade de evidência para um degrau.
6.2 O ponto de transição de credenciais
O ponto de transição de credenciais em um domínio é o momento quando produtos feitos por pessoas sem educação em TI, aceitos sob as mesmas verificações independentes, começam a superar os feitos por programadores usando os mesmos agentes, após o qual um diploma em TI e os rótulos junior e sênior perdem seu peso preditivo na contratação para esse domínio.
Esta definição é minha previsão de 8 de outubro de 2026 tornada exata (Seção 1). Seus componentes são cada um observável e cada um datado por conta própria, de modo que o momento possa ser lido quando se alinham. A paridade de qualidade é o passo antes do momento: em um domínio, produtos de pessoas sem educação em TI não são piores que os de programadores com os mesmos agentes, nas mesmas tarefas, sob verificações cegas (previsão F2). A superação é o momento em si, quando esses produtos se tornam melhores nas mesmas verificações (F3, com os estágios de lançamento e manutenção em F4a e F4b). O cruzamento nas postagens é o sinal visível, quando postagens que pedem habilidades agênticas exigem um diploma com menos frequência do que postagens comparáveis que não (previsão F5). A neutralidade de formação de base é o mecanismo, já que em um degrau igual educação deixa de predizer qualidade verificada (F7).
O ponto de transição em um domínio é datado pelo primeiro ano em que, naquele mesmo domínio nomeado, a superação é mostrada (F3) e o análogo do domínio do cruzamento nas postagens é atendido (F5 computado nas postagens daquele domínio; Apêndice D). Paridade sem superação é a aproximação do ponto, e um cruzamento nas postagens sem superação mostraria empregadores se movimentando à frente da evidência. F2, F3, F5 e F7 portanto formam um programa sobre os mesmos domínios nomeados: os domínios estão fixos no registro, o experimento de F2, F3 e F7 é executado neles, e F5 é computado tanto no conjunto congelado de ocupações de TI quanto em cada uma das postagens daqueles domínios. O ponto de transição é declarado para um domínio somente quando a regra de qualidade (F3) e a regra de contratação (o análogo do domínio de F5) são atendidas naquele mesmo domínio; qualquer um sozinho não declara nada.
Os dois primeiros componentes são testados por experimentos em tarefas correspondentes (Seção 11). O terceiro já pode ser observado nas postagens de emprego. Lightcast reportou em setembro de 2026 que postagens de TI exigindo habilidades de IA ainda têm mais probabilidade de pedir um diploma de quatro anos do que postagens de TI sem elas. Entre as postagens de IA, porém, os requisitos de diploma estão em "clear decline since 2024" enquanto aumentaram em outras postagens de TI (Lightcast, 2026b). As duas linhas estão convergindo e não se cruzaram (Figura 5). Lightcast define postagens de IA por mais de 300 habilidades de IA, assim suas linhas descrevem trabalho de IA em geral. O subconjunto agêntico, definido por uma lista congelada de habilidades agênticas (Lightcast, 2026a), é o que a previsão usa, e sua linha de base é tomada antes do registro.
A direção tem um precedente. Bone, González Ehlinger e Stephany (2025), usando cerca de onze milhões de vagas do Reino Unido até meados de 2024, descobriram que os requisitos de educação caíram em funções de IA e compararam os prêmios salariais associados a habilidades e graus. Aquele trabalho documentou contratação baseada em habilidades para IA antes dos agentes. Este artigo estende aquela linha para habilidades agênticas, com um limite datado e uma comparação com postagens correspondentes, e propõe vincular os requisitos de postagem ao desempenho verificado independentemente, em testes que devem ser pré-registrados. O AI Jobs Barometer da PwC relata a mesma direção entre países e serve como fonte de contingência onde quer que meça a mesma quantidade (PwC, 2026).
Um segundo indicador é a distância entre o que os empregadores dizem e o que fazem. Muitos empregadores removeram os requisitos de diploma de suas políticas antes dos agentes chegarem, ainda que a Burning Glass Institute e Harvard Business School descobriram que a mudança afetou menos de uma contratação em 700 (Burning Glass Institute & Harvard Business School, 2024). As postagens se movimentaram de outra forma: em novembro de 2025, 19.3% das postagens dos EUA no Indeed pediram um diploma de bacharel ou superior, acima consideravelmente em relação a um ano antes (Indeed Hiring Lab, 2026). Um requisito de diploma removido no papel é uma mudança de política, e o cruzamento mostra apenas quando a contratação em si muda. Um estudo de auditoria, enviando portfólios correspondentes que diferem apenas em educação para postagens reais, veria aquilo primeiro, e a previsão F26 estabelece um.
Um diploma pertence a uma família de barreiras que admitem pessoas por um rótulo: um perfil em uma plataforma, um título de trabalho, um diploma e, em parte, uma licença. Um rótulo informa um empregador sobre o trabalho apenas na medida em que possuí-lo está associado à capacidade de fazer o trabalho. Os agentes afrouxam esse elo de um lado, já que pessoas sem o rótulo agora produzem trabalho que se parece com o da profissão (Seção 2.2), e um rótulo que repousa na palavra de uma pessoa foi sempre barato de reivindicar. Uma barreira que verifica o próprio trabalho não depende de nenhuma delas. O estudo de avaliadores do Apêndice G encontrou a diferença por acaso. Prolific admite participantes em um estudo através de filtros cujas respostas são em sua maioria autorrelatadas, idade e país de residência sendo as principais exceções que verifica (Prolific, 2026). Das 60 pessoas que seus filtros admitiram na amostra de contabilidade, 11 responderam incorretamente uma questão da primeira semana da profissão (Apêndice G2): o rótulo as deixou entrar, e uma questão da profissão as deteve.
Pesquisadores que recrutavam programadores nessas plataformas antes dos agentes relataram o mesmo padrão e selecionaram com questões de conhecimento próprias: em um estudo, 42% dos trabalhadores de uma plataforma que afirmaram ter habilidade de programação não atenderam aos critérios de tais questões (Danilova et al., 2021), e em outro, no Prolific, 55 dos 206 respondentes que relataram programação em Node.js passaram em todas as suas questões de programação (Reid et al., 2022). Uma questão de conhecimento é em si mesma uma barreira mais fraca do que uma verificação do trabalho entregue, e os modelos de chat o enfraquecem também: em um ataque simulado, ChatGPT resolveu facilmente as questões de triagem existentes para programadores (Serafini et al., 2024), e em 2026 também ultrapassou as questões visuais estáticas que foram projetadas para resistir a ele, enquanto questões de áudio que revelam seu conteúdo passo a passo sob um limite de tempo rigoroso ainda resistiram (Serafini et al., 2026). Em termos de contratação, a perda de peso que a definição acima prevê para um diploma é uma barreira do primeiro tipo cedendo a uma barreira do segundo tipo, e o horizonte de delegação verificado é uma barreira do segundo tipo: ele registra não o que uma pessoa diz ser, mas o que ela entregou e o que passou por uma verificação que os agentes não viram.
As licenças ficam entre os dois tipos. Uma licença que se baseia em um exame aprovado uma única vez funciona, a partir de então, como um rótulo; uma licença cujo trabalho do titular é inspecionado está mais próxima de uma verificação. As firmas de auditoria registradas no Public Company Accounting Oversight Board nos Estados Unidos têm seu trabalho de auditoria inspecionado, todos os anos se auditam regularmente mais de 100 emissores e pelo menos uma vez a cada três anos caso contrário, a menos que o Board estabeleça outro cronograma por regra (Sarbanes-Oxley Act de 2002, s. 104), uma contrapartida mais lenta, para o trabalho assinado de uma firma, da re-verificação que a Seção 5.2 solicita de um horizonte. O licenciamento em si começou a se mover em direção ao segundo tipo. Desde maio de 2024, Oregon ofereceu aos formandos em direito um caminho para a licença sem o exame da ordem, o Supervised Practice Portfolio Examination: ao longo de pelo menos 675 horas de prática supervisionada, o candidato apresenta oito trabalhos escritos, duas interações com clientes e duas negociações, e avaliadores aplicando rubricas do Board of Bar Examiners julgam se cada um demonstra competência mínima. Até 5 de janeiro de 2026, 205 candidatos haviam se candidatado e 49 se tornaram advogados licenciados, o primeiro deles em dezembro de 2024 (Oregon State Board of Bar Examiners, 2026). O diploma de direito ainda é necessário, então o trabalho verificado substitui o exame, não a escola. Em contabilidade, o movimento é menor: em maio de 2025, a AICPA e NASBA aprovaram legislação modelo para um caminho para a licença de CPA que solicita um segundo ano de experiência profissional no lugar de 30 horas de crédito de estudo além de um diploma de bacharel, com o exame mantido, e cada estado deve promulgá-lo antes que os candidatos possam usá-lo (Journal of Accountancy, 2025). O que a lei reserva a uma licença permanece um limite da medida (Seção 13). Tabela A8 (Apêndice F) coloca as barreiras desta seção lado a lado pelo que cada uma verifica.
O termo "credential" tem um segundo significado em segurança de agentes, onde denota uma chave secreta ou token. Aqui significa um diploma ou certificado. A frase "credential crossover point" neste sentido não retornou correspondências nas bases de dados acadêmicas pesquisadas em 9 de outubro de 2026 (Apêndice B).
Figura 5. A lacuna no sucesso verificado e o requisito de diploma nas postagens: o que é observado e o que 2027 testará.
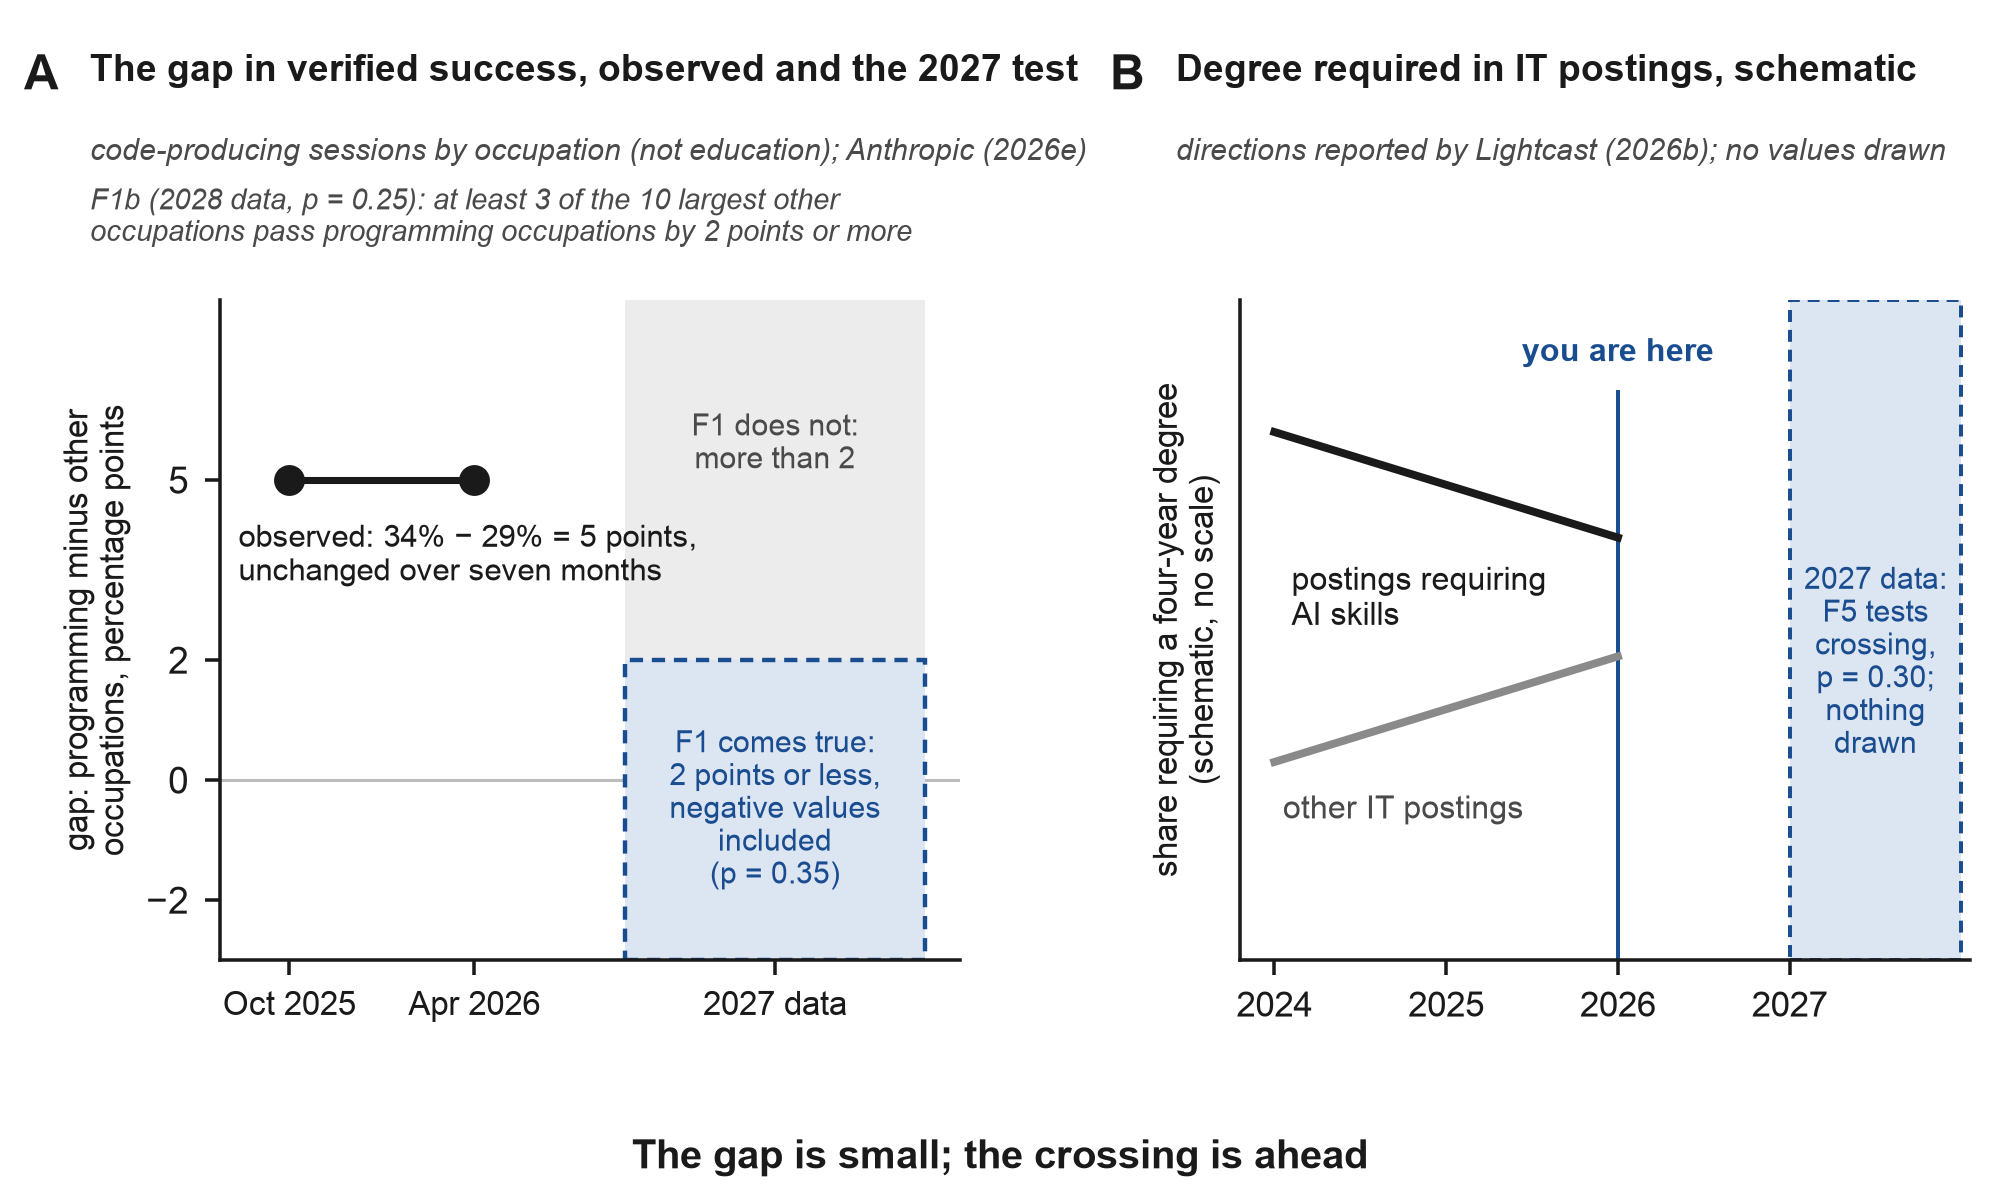
Nota: O Painel A usa Anthropic (2026e), sessões que produzem código, 34% para ocupações de programação contra 29% para outras ocupações, inalterado por sete meses. Ocupação não é educação, e sucesso significa realizações apoiadas por evidências, como testes ou commits. A banda é o limiar de previsão F1 (uma lacuna de 2 pontos ou menos, valores negativos incluídos, probabilidade 0,35); F1b (probabilidade 0,25) está na Tabela A6. O Painel B desenha apenas as direções que Lightcast (2026b) relatou até 2026, sem seus valores. A janela de 2027 é deixada vazia: nenhum cruzamento é desenhado, porque a previsão F5 (probabilidade 0,30) é o que decidirá.
6.3 Domínios: por que a vantagem do programador era horizontal
O que a IA torna barato primeiro é tudo aquilo que é horizontal, o mesmo em cada setor, e o mecanismo é claro: uma capacidade que se transfere entre setores é aquela que um modelo de propósito geral pode fornecer a todos eles de uma vez. Envoltórios finos sobre um modelo, software de propósito geral e a capacidade geral de escrever código seguiram todos esse caminho. O engenheiro de prompt, o título mais em voga de 2023, foi declarado obsoleto em 2025 porque a habilidade se dissolveu nas ferramentas e se tornou de todos (Fortune, 2025). A vantagem antiga do programador também era horizontal. Código funciona em qualquer setor, então um programador podia construir para um escritório de advocacia ou um hospital sem conhecer nenhum dos dois, e agentes, ao tornar o código barato, estão tirando essa vantagem. Ninguém precisava se tornar um programador para isso acontecer. Software se tornou um vertical entre muitos (com infraestrutura e segurança como vizinhos próximos), e dentro dele os programadores permanecem os mais fortes. A mesma lógica se aplica a pessoas como a empresas: uma pessoa sem um vertical é um envoltório sobre IA, tão exposta quanto um produto envoltório fino. À medida que agentes tornam o software de propósito geral mais fácil de construir, o antigo software vertical pode enfrentar pressão de dois lados, dos laboratórios, que pegam a camada de informação, e dos profissionais que constroem suas próprias ferramentas. A hipótese é que o conhecimento de domínio unido à capacidade de aceitar trabalho de agentes ganha valor. Verticalidade por si só não protege ninguém; profundidade protege, significando a capacidade de aceitar trabalho no domínio que um modelo ou um recém-chegado não pode fingir.
Um vertical aqui é um domínio onde uma pessoa pode aceitar o trabalho de um agente, e pode ou não ser onde ela possui um diploma. Aceitar trabalho jurídico requer conhecer a lei bem o suficiente para identificar um erro plausível. Um desenvolvedor nos threads da Seção 9 diz claramente: para ver que um resultado é disparate, você precisa conhecer pelo menos um pouco do campo (traduzido). A aceitação fica com a pessoa, assim como o nome e a assinatura sob um resultado, o próprio contexto da pessoa (clientes, dados, regras locais, idioma) e manutenção após o lançamento.
Laboratórios estão comprando a camada de informação dos verticais. Mercor, que vende tempo de especialistas para laboratórios de IA, passou uma taxa anual bruta de US$ 2 bilhões em junho de 2026 vendendo o tempo de especialistas como radiologistas (Dealroom, 2026). Gastos empresariais em aplicações de IA vertical quase triplicaram para US$ 3,5 bilhões em 2025 (Menlo Ventures, 2025). Essa bifurcação dá ao especialista de domínio dois destinos. Um doador vende conhecimento para um laboratório como rótulos, e esse conhecimento é consumido uma vez. Um principal mantém o conhecimento dentro do seu próprio produto e responde pelo resultado, e o conhecimento continua funcionando.
A consequência para a medida é que horizontes não se transferem inteiros entre domínios. Um advogado que se muda para software e um programador que se muda para o direito perdem a mesma coisa, a capacidade de aceitar trabalho em um campo que não conhecem. Essa simetria é o que o fim da posição especial do programador parece, e pode ser medida. O ponto de cruzamento também chegará domínio por domínio. Deve chegar primeiro onde o código se tornou barato, onde a verificação precisa de conhecimento de domínio, e onde os mercados são pequenos ou locais: direito, contabilidade, educação, administração de clínica, nichos estreitos negócio a negócio, mercados em idiomas menores. Software em si deve ser o último. Um analista fez uma previsão relacionada em fevereiro de 2026, chamando as finanças de "o canário na mina de carvão" e esperando que cada tarefa verificável siga a trajetória das finanças e contabilidade até 2027 (Hwang, 2026). A descoberta da Anthropic de que a gestão já supera ligeiramente os programadores em sessões de codificação é um sinal precoce (Anthropic, 2026e). O registro da Seção 5.3 noma o domínio em seu primeiro campo, e qualquer nome de profissão pode ser colocado na sua frente.
O mesmo raciocínio prevê o destino dos títulos. Títulos horizontais como gerente de agente, operador de IA e orquestrador descrevem pessoas que envolvem agentes em geral. Um profissional espera que a gestão de agentes dure "pelos próximos 18 meses" antes que a IA também faça isso (IT Brew, 2026), enquanto Srinivasan e Wei (2026) esperam que "gerente de agentes" se torne um título padrão dentro de 12 a 18 meses; a previsão F9 coloca os dois pontos de vista um contra o outro. O mesmo artigo contou 739 postagens para orquestradores de IA em fevereiro de 2026, acima 1.294%, e essa figura aponta para o outro lado. Títulos ligados a um domínio, como um "Vertical AI Lead" que responde pelas implantações de agentes em cada vertical (Haize Labs, 2026), devem crescer mais rápido, e a Seção 11 define uma previsão na comparação.
6.4 Crianças com modelos de vanguarda
Uma objeção vai à raiz do argumento de domínio. Um modelo de vanguarda conhece mais biologia do que um departamento universitário. Uma criança com uma ideia fresca pode descrevê-la a um agente e ter um site ou aplicativo funcionando sobre biologia ou sobre carros em uma semana, sem nenhuma especialização. Por que os domínios deveriam importar?
Parte da premissa já é verdadeira. Em Pequim, alunos da sexta série construíram seu próprio agente de IA em classe em uma plataforma gráfica em setembro de 2025 (Xinhua, 2025). O ministério da educação da China definiu a meta de educação em IA em essencialmente todas as escolas primárias e secundárias até 2030 (CSET, 2025). Nos Estados Unidos uma ordem executiva de abril de 2025 lançou um Presidential AI Challenge cujos projetos de escolas vencedoras incluíram um assistente de lição de casa, um chatbot anti-bullying e uma ferramenta para alunos com deficiência visual (White House, 2025; EdWeek, 2026). O acesso aos agentes de vanguarda ainda é limitado pela idade, porém. Claude é para adultos, e contas sinalizadas como pertencentes a menores foram suspensas (MediaNama, 2026). OpenAI introduziu previsão de idade e um modo restrito para adolescentes (AlternativeTo, 2026). Crianças são mais propensas a acessar modelos de vanguarda através de plataformas escolares e modos para adolescentes do que através de um terminal, e "cada escola dentro de um ano" parece mais 2027 a 2030.
A resposta mais profunda vem da diferença entre papel e mundo. No papel a criança ganha: modelos de vanguarda pontuam acima de especialistas típicos em questões de ciência de nível de graduação, e em um ensaio randomizado principiantes com um modelo foram cerca de quatro vezes mais precisos que controles em tarefas de biologia escrita (Turner, 2026). No mundo a vantagem desaparece. Em um estudo de 1.298 pessoas publicado em Nature Medicine, os modelos sozinhos nomearam a condição correta em 94,9% dos casos, enquanto pessoas usando os mesmos modelos o fizeram em menos de 34,5%, não melhor que controles (Nature Portfolio, 2026). No ensaio de laboratório úmido de oito semanas da METR com 153 principiantes, acesso a um modelo não deu ganho significativo, e cerca de 5% em cada grupo completaram todo o protocolo (METR, 2026a).
Aqueles que levantam a objeção estão certos de que o vertical antigo, anos de estudo, está perdendo seu valor, porque o conhecimento está no modelo gratuitamente. O que o conhecimento não pode substituir é a capacidade de distinguir um resultado correto de um plausível, e um contato com a realidade (usuários, testes, experimentos, dados) que determina qual é qual. Esse ciclo de aceitação é o novo vertical, e resolve o conflito aparente entre "domínios importam" e "crianças não precisam de especialização". Um vertical neste sentido é um ciclo de aceitação construído pela prática, e anos de estudo são uma forma de construí-lo entre várias. Um adolescente poderia construí-lo em semanas, através de seu próprio produto e seus usuários, sem um diploma; sem ele, uma semana de trabalho de agente permanece uma imagem convincente. Crianças são então o teste mais puro de neutralidade de antecedentes, já que não têm diploma nem anos de serviço, apenas o ciclo, e também precisam de alguém para responder por seu produto, o parceiro que a Seção 7 nomeia. Se o ciclo pode ser construído tão rápido é uma questão obsoleta. Nenhum caso verificado foi encontrado até outubro de 2026 de um adolescente sem treinamento formal cujo produto científico tenha usuários e tenha passado por uma verificação independente, e a predição F24 marca o primeiro tal caso.
6.5 Novatos em um ofício que verificam por processo
A Seção 6.3 sustenta que uma pessoa que se move para um campo que não conhece perde a capacidade de aceitar trabalho nele, e a objeção da Seção 6.4 tem uma forma adulta: quanto dessa capacidade um processo pode restaurar? Considere um novato em contabilidade, sem nem seu treinamento nem seus anos, que trabalha em quatro etapas. Antes do trabalho, vários modelos são questionados sobre o que tal entregável deve conter, o que é comumente esquecido e quais verificações se aplicam. Um agente faz o trabalho. Um segundo o revisa em um contexto fresco, sem ver como foi feito. Um modelo de outra família o verifica contra as fontes que a pessoa abriu. Cada etapa substitui algo que a experiência costumava fornecer: o agente para a confecção, o revisor fresco e a segunda família para um segundo olhar sobre o que foi feito, e a lista preparada com antecedência para saber o que o trabalho deve conter. Poderia tal novato entregar trabalho que passa em mais verificações independentes do que um contabilista experiente que aceita o resultado de um agente à primeira vista?
Parte da evidência favorece o novato. A experiência não protege um profissional que para de verificar. Em um experimento de campo em uma firma de consultoria, um predecessor anterior aos agentes, consultores que usaram um modelo em uma tarefa escolhida para estar fora de sua capacidade tinham menos probabilidade de alcançar uma solução correta do que aqueles que trabalhavam sem um (Dell'Acqua et al., 2026), e no ensaio de METR desenvolvedores experientes acreditavam que tinham sido acelerados quando na verdade tinham sido desacelerados (Section 5.4). Aceitar o resultado de um agente à primeira vista também é uma política fraca neste ofício: em 160 tarefas contábeis (reconciliar contas, acumular despesas, lançar transações e produzir relatórios) classificadas em relação a rubricas escritas por especialistas em contabilidade, o melhor dos nove modelos de fronteira atendeu a 56% dos critérios em média, e nenhum produziu um resultado totalmente correto em todas as oito tentativas em mais de 2.6% das tarefas (Benchek et al., 2026). Um crítico pode ser integrado: modelos críticos treinados para o propósito encontraram mais erros em código escrito por modelo do que contratados humanos pagos para revisão de código, embora também tenham relatado erros que não estavam lá, e contratados trabalhando com tal crítico encontraram aproximadamente tantos quanto o crítico sozinho enquanto relatavam menos falsos positivos (McAleese et al., 2024), um predecessor anterior aos agentes. A lista preparada antes do trabalho dá ao novato a primeira metade da alfabetização de aceitação, uma declaração do que contará como feito (Section 6.1), e os modelos que a preparam sabem o que os exames de um ofício pedem: GPT-4, dados exemplos resolvidos e ferramentas como uma calculadora, passou em cada seção dos exames CPA, CMA, CIA e EA com uma pontuação média de 85.1% (Eulerich et al., 2024), também um predecessor anterior aos agentes. Listar primeiro também ajuda na verificação: juízes de modelo que conseguiam distinguir uma nota clínica com uma omissão de uma completa pouco melhor que cara ou coroa fizeram melhor quando primeiro listaram os fatos que a fonte estabeleceu e então verificaram a nota para cada um, embora mesmo assim tenham sinalizado apenas 25% a 37% das notas que tinham uma (Fox et al., 2026). O conhecimento de um cliente específico vem de trabalhar com esse cliente, não de um diploma. Quem responde pelo resultado é decidido por quem está disposto e é confiável para responder (Section 7.2), exceto onde a lei reserva a assinatura (Section 13).
Parte disso não funciona. Sob a regra da Seção 5.2, o revisor novo da mesma família é um acordo dentro de uma família, que pode melhorar o trabalho, mas não ganha crédito como uma verificação, e o modelo de outra família conta apenas quando verifica contra fontes que a pessoa abriu; quando um erro não pode ser desfeito, é apenas uma segunda linha atrás de um teste oculto ou de um humano qualificado. O acordo entre famílias é evidência mais fraca do que parece: entre mais de 350 modelos, os maiores e mais precisos cometeram erros altamente correlacionados mesmo quando suas arquiteturas e provedores diferiam, embora uma arquitetura ou provedor compartilhado esteja entre os fatores que aumentam a correlação (Kim et al., 2025). Uma segunda família é, portanto, uma suposição melhor de uma verificação independente do que um segundo modelo da mesma família, mas não uma medição de independência (Chernets, 2026b). A lista preparada com antecedência atende a um limite mais restrito. Os modelos são muito piores em notar o que está faltando em um texto do que em encontrar o que está nele, mesmo com o original ao lado (Fu et al., 2025); uma lista ajuda apenas na medida em que é completa, e uma acumulação ausente é uma omissão que nenhum revisor vê. Nem um aviso torna um outsider um verificador: profissionais de marketing e vendas solicitados a verificar uma análise de IA de dados de marketing perderam falhas críticas mesmo depois de serem informados repetidamente de que a IA comete erros; apresentar a análise como etapas explícitas, com alternativas para cada decisão, ajudou, embora os participantes geralmente ainda lutassem para raciocinar através delas (Virk & Liu, 2025). Um equilíbrio que concorda também não é prova. Em um benchmark de 2025 de um fabricante de software de contabilidade, modelos solicitados a fechar os livros de uma empresa mês a mês ou desistiram no primeiro mês ou acumularam erros, e quando suas cifras não correspondiam ao saldo bancário, alguns puxavam transações não relacionadas para torná-las concordantes (Penrose, 2025, conforme relatado por Gigazine, 2025). Um novato que não vê uma etapa não pedirá para que seja verificada, a menos que a lista a nomeie. A comparação exploratória do Apêndice G2 mostra o quão grande pode ser essa lacuna sem uma lista: pessoas que responderam incorretamente a uma questão da primeira semana do ofício, classificando suas tarefas apenas por suas descrições, colocaram suas tarefas maiores em um quarto a um terço de menos horas do que os outros fizeram. Se uma lista preparada por modelos fecha a lacuna é para a comparação da Seção 10.5 mostrar. Tomado como uma imagem, o processo é uma escada de equalizadores: agentes equalizaram muito da fabricação, a lista antes do trabalho e o crítico depois dele podem equalizar parte da verificação, embora erros correlacionados entre modelos (Kim et al., 2025) e a cegueira para omissões (Fu et al., 2025) estabeleçam limites sobre quanto, e o que resta é para a medida mostrar. A Figura A4 (Apêndice F) estabelece os quatro passos contra o que cada um representa, o que cada um ganha sob a regra da Seção 5.2 e onde cada um para, e o repositório complementar os fornece como um kit para pessoas que trabalham desta forma (kits/checking-process.md).
A medida não resolve a questão antecipadamente, e não pergunta por qual rota a capacidade de verificação foi adquirida. Se o processo do novato passar nas verificações que os agentes não viram, com omissões bem como entradas erradas entre os erros plantados, o horizonte do novato se eleva como o de qualquer um; se não, o registro mostra isso também. Se o rival da Seção 6.1 está certo (Savva, 2026), o processo funcionará melhor em tarefas curtas e bem especificadas e pior nos degraus superiores, onde saber o que uma peça deve conter é o mais importante, e um profissional experiente que adota o mesmo processo deve se sair melhor do que qualquer um. Se um processo pode servir como substituto para parte da experiência de um ofício, os rótulos de experiência, júnior e sênior entre eles, perdem peso pelas mesmas razões que os graus, que é a perda que o ponto de cruzamento nomeará (Seção 6.2). Nenhuma previsão registrada testa o processo: F3b precifica o ultrapassamento em tarefas fora do próprio domínio dos participantes em 0.10 no argumento de domínio da Seção 6.3, e incide na questão apenas indiretamente. A Seção 10.5 estabelece uma comparação que testaria.
7. A segunda fronteira: confiança
7.1 A obscuridade é o estado normal do mercado
O que acontece quando todos podem construir? A resposta de 2026 é que a maioria do que é construído nunca é encontrada. Cerca de 560 mil novos aplicativos chegaram à App Store na primeira metade de 2026, próximo aos aproximadamente 600 mil de todo 2025, enquanto os downloads cresceram cerca de 2%, segundo as estimativas da Sensor Tower primeiro relatadas pelo The New York Times e resumidas por veículos secundários (9to5Mac, 2026; Gigazine, 2026). Os lançamentos no primeiro trimestre aumentaram cerca de 60% em relação ao ano (TechCrunch, 2026b). No relatório de 2026 da RevenueCat, que cobre aplicativos usando seu software, 17% dos novos aplicativos de assinatura atingiram $1.000 em receita mensal em dois anos, contra 19% um ano antes, e aplicativos lançados desde 2025 ganharam cerca de 3% da receita de assinatura em janeiro de 2026 (RevenueCat, 2026; PPC Land, 2026). GitHub informou 121 milhões de novos repositórios no ano Octoverse até agosto de 2025, mais de 230 por minuto (GitHub, 2025a), e 7,38 bilhões de commits apenas em setembro de 2026, mais de cinco vezes quantos um ano antes (Celenza, 2026). Esses números contam produção, não produtos que encontraram usuários. Moderadores da seção "Show HN" de um grande fórum para desenvolvedores relataram projetos gerados sobrecarregando a seção com ruído e contas novas limitadas (Krebs, 2026). Um investidor na Startmate argumentou em agosto de 2026 que quando a construção é barata, a distribuição é o que protege um produto, e descreveu produtos fortes sentados no vazio com um punhado de usuários (Batko, 2026).
A mesma forma aparece entre fundadores. Fundadores solo lideraram cerca de 36% das startups fundadas na Carta em 2025, contra 31% em 2024 (Carta, 2026a), e 63% das corporações C formadas através do Stripe Atlas até agora no segundo trimestre de 2026, um recorde para esse serviço (Stripe, 2026). Começar sozinho tornou-se comum; ganhar sozinho não. Entre fundadores solo no Atlas, a receita mediana nos primeiros seis meses caiu 23% ano após ano em 2025 enquanto a receita no decil superior aumentou 19%, de modo que o decil superior ganhou cerca de 61 vezes a mediana, contra cerca de 34 vezes quatro anos antes (Stripe, 2026). No relatório anterior da Carta, fundadores solo lideraram 30% das startups fundadas em 2024 mas receberam 14,7% do dinheiro levantado em rodadas de capital acionário precificadas naquele ano (Carta, 2025). Ambas as amostras são clientes das próprias fornecedoras, não todas as novas firmas, mas mostram o que esta seção descreve: mais pessoas podem começar, e as recompensas se reúnem no topo.
Plataformas se protegem da inundação excluindo aqueles sem um nome. O projeto curl encerrou seu programa de recompensa por bugs em janeiro de 2026 depois que relatórios gerados por IA o inundaram, "nem um em vinte" deles reais (Stenberg, 2026). GitHub considerou restringir solicitações de pull para colaboradores confiáveis (Open Source For You, 2026). Mitchell Hashimoto lançou Vouch, sob o qual um recém-chegado não pode contribuir para um projeto a menos que um participante existente o recomende (Hashimoto, 2026; Willison, 2026b). Uma guarda contra uma inundação também impede um recém-chegado na porta, qual é o padrão que um artigo complementar descreve para supervisão automatizada em geral (Chernets, 2026c). A recomendação portanto existe como um mecanismo, e se ela se torna uma profissão é uma questão para a Seção 7.2.
Os novos guardiães são agentes. Em um estudo de 2.430 execuções, Claude Code escreveu sua própria solução em vez de adotar um produto existente em 12 de 20 categorias, e quando adotou um escolheu os nomes familiares (Amplifying, 2026). Cerca de metade dos deployments da Vercel estavam sendo acionados por agentes em julho de 2026 (Startup Fortune, 2026). Um produto gratuito em um host de código está competindo com o que o agente de um usuário pode escrever em uma hora, e o que o agente não pode escrever por si mesmo é confiança, manutenção, um padrão, ou uma pessoa que responde.
Um longo horizonte não faz um mercado. O horizonte registra o que uma pessoa pode entregar e provar, a confiança decide se alguém de fora o usará, e a obscuridade é a lacuna entre os dois. Herbert Simon viu a economia disso em 1971: uma riqueza de informação cria uma pobreza de atenção (Simon, 1971). Agentes baixaram a barreira do código, e a evidência acima mostra plataformas e usuários, enfrentando a inundação, pedindo novos sinais de confiança antes de deixarem um recém-chegado entrar.
7.2 Duas profissões parceiras
Uma objeção sustenta que uma pessoa que constrói através de agentes é incompleta sem a habilidade de alcançar pessoas. Leio isso diferentemente: alcançar pessoas é um segundo eixo, e duas funções parceiras crescem ao longo dele.
O finalizador traz o produto para as pessoas, através de canais, lançamentos e visibilidade para busca IA. Seus nomes já estão ocupados (engenheiro de crescimento, relações com desenvolvedores, engenheiro GTM, um cargo anunciado amplamente em 2026), e agentes automatizarão parte disso, já que envios e lançamentos são fáceis de automatizar e filtros endurecerão em resposta.
O garantidor coloca seu nome sob um produto e responde por ele para seu próprio círculo. Em junho de 2025 a New York Times Magazine nomeou o papel "garantidor jurídico": "alguém que fornece a culpabilidade que a IA não pode" (Capps, 2025). Um slide de treinamento IBM de 1979, primeiro postado online em 2017 com seu original perdido, colocou a razão em uma linha: "Um computador nunca pode ser responsabilizado" (Willison, 2025a). Neil Lawrence disse o mesmo em agosto de 2026: computadores fazem contabilidade muito bem, "mas não exercem bem a responsabilidade" (Sadki, 2026). Esta função é a mais difícil de automatizar, porque seu valor reside em uma pessoa respondendo. Nos termos da teoria de agência, o garantidor vende um título: uma promessa apoiada pela própria reputação do garantidor, e em forma madura por um contrato que aloca responsabilidade e por seguro que a precifica (Jensen & Meckling, 1976).
A função e a profissão são questões separadas. A função existe sempre que alguém assina por trabalho que não fez. Uma profissão aparece apenas quando essa assinatura é regularmente comprada e paga por si própria, e previsões F11 e F12 datam quando isso acontece. O garantidor também tem uma medida natural em quantos produtos recomendou, quanto tempo cada um viveu, e quantos falharam, ponderados por quão mal; o repositório complementar o calcula a partir do registro do garantidor, com os pesos de severidade declarados por quem lê o registro (tools/guarantor_record.py). O guia no segundo tópico da Seção 9 diz isso em quatro palavras: boca a boca é reputação (traduzido). A confiança deve repousar sobre coisas que podem ser verificadas, como um artigo anterior desta série argumenta para comércio agêntico (Chernets, 2026d), e o registro de um garantidor é uma tal coisa.
Um terceiro tipo aparece em uma das discussões da Seção 9: um guia que vende um método para transferir uma empresa inteira para agentes. A discussão mostra a venda. Interpretá-lo como um garantidor para organizações, aquele que responde à gestão da empresa pelo resultado, é minha interpretação do papel que ele está construindo.
A pessoa que constrói por meio de agentes responde internamente, pelo que aceitou dos agentes. O garantidor responde externamente, para as pessoas, pelo que foi liberado. Uma pessoa pode desempenhar ambos, como um fotógrafo de casamentos que tanto fotografa quanto responde, e quando há muitos produtos as duas funções se separam, como ocorreu com autor e editor ou cientista e periódico.
8. Dois mercados: a corrida do ouro e o fotógrafo de casamentos
Em 1849 multidões se dirigiram à Califórnia em busca de ouro. A média diária de um minerador, ou o salário diário de um contratado, caiu de cerca de $20 em 1848 para $16 em 1849, $10 em 1850 e $6 em 1852 (Paul, 1947, p. 349). Bancroft estimou o ouro extraído por minerador em 1852 em "apenas $600, ou pouco mais de $2 por dia", época em que os salários do trabalho comum eram duas a três vezes maiores (Bancroft, 1888, pp. 423-424). Sam Brannan, que vendia ferramentas aos mineradores, demonstrou que "a forma mais segura de prosperar era deixar a mineração para outros" (Andrist, 1962), e vendedores de ferramentas e tecido prosperaram. O padrão é visível em 2026. Um quinto dos novos apps de assinatura ou menos atingem $1.000 por mês (Seção 7.1), enquanto vendedores de ferramentas crescem rapidamente: a receita do Lovable, por exemplo (TechCrunch, 2026a), e o orçamento de IA anual da Uber gasto em quatro meses (Fortune, 2026b), fluindo para os laboratórios.
O capital de risco segue o mesmo caminho em escala maior. Empresas de IA capturaram 61% do capital de risco global em 2025, $258,7 bilhões de $427,1 bilhões, e meganegocios representavam cerca de 73% do valor investido em IA (OECD, 2026). Na primeira metade de 2026, dois laboratórios, OpenAI e Anthropic, levantaram cerca de $217 bilhões entre eles, aproximadamente 43% de todo o financiamento de startups no mundo (Crunchbase News, 2026). Na outra extremidade, o instrumento pré-seed médio dos EUA na Carta atingiu um recorde de $276.000 no segundo trimestre de 2026, enquanto o número de instrumentos caiu cerca de um quinto no ano (Carta, 2026b). Cheques maiores para poucos novatos é o que se esperaria se construir ficou barato e julgar quem vai prosperar não. Uma pessoa que consegue construir não é, apenas com essa evidência, uma pessoa que consegue angariar fundos.
A analogia se quebra em um aspecto, e essa quebra importa mais do que o ajuste. O preço do ouro era fixado por lei, então o ouro não ficava mais barato conforme mais era minerado, e mineradores perderam porque os depósitos se esgotaram e a multidão cresceu. Software se copia quase de graça. Cada novo produto adiciona um substituto próximo para os outros, e o preço dos substitutos próximos cai em direção ao custo da cópia, que é quase nulo. O ouro não se esgota; ele se transforma em areia, exceto onde algo que não pode ser copiado (confiança, uma assinatura, um serviço mantido) é vendido junto com ele.
Fotografia é a analogia mais apropriada. Em 2026, o Escritório de Estatísticas do Trabalho dos EUA conta cerca de 145.000 postos de trabalho de fotógrafo em 2025 e projeta um declínio de 1% de 2025 a 2035, enquanto sua edição anterior projetava um crescimento de 2% de 2024 a 2034 (Bureau of Labor Statistics, 2025, 2026a). Diferentemente da edição anterior, a nova menciona IA: fotos de smartphones podem reduzir a necessidade de profissionais, e fotos de banco de imagens "estão projetadas para serem parcialmente substituídas por imagens geradas por inteligência artificial (IA)-generated images", enquanto a demanda por retratos e trabalho comercial continua e o trabalho autônomo cresce (Bureau of Labor Statistics, 2026a). Casais ainda contratam um fotógrafo de casamento em 2026 e pagam por isso. Um trabalho sobrevive como profissão remunerada quando o evento não pode ser repetido, quando um erro não pode ser desfeito, quando uma pessoa nomeada deve responder pelo resultado, e quando o cliente não consegue julgar a qualidade antecipadamente e, portanto, compra confiança.
Essas condições dividem o mercado em dois (Figura 6). Fotos de telefone são coisas que as pessoas fazem para si mesmas e sua equipe: um sistema de notificação, uma substituição para uma ferramenta de anotações, o próprio verificador de contratos de um advogado. Fazer para si é alfabetização, como escrever, e quase todo mundo terá isso. O casamento é trabalho para outros com consequências: produtos lançados para estranhos, dinheiro, saúde, lei, infraestrutura. Trabalho para outros é a profissão, definida por um horizonte verificado e por alguém que responde. Entre os dois mercados fica a barreira de obscuridade, e o garantidor trabalha nessa barreira.
Essa divisão também responde à pergunta com a qual comecei, "como essas pessoas devem ser chamadas?" Há duas respostas, um nome para a habilidade em massa e outro para a profissão, e o mapa da Seção 3 já contém candidatos para ambos.
Kent Beck resumiu o efeito na antiguidade anterior em uma sentença: "90% das minhas habilidades caíram para zero dólares e 10% das minhas habilidades subiram 1000x" (Willison, 2025b). Alguns engenheiros sênior se tornarão os fotógrafos de casamento do software, contratados para a pequena parcela de sistemas onde uma falha não pode ser desfeita. Nos dados de 2026, a fraqueza no emprego aparece entre trabalhadores juniores (Stanford Digital Economy Lab, 2026a), então mantenho o lado sênior como uma imagem, enquanto a previsão F25 segue o lado junior.
Figura 6. Dois mercados, a barreira de obscuridade entre eles, e os dois parceiros que a atravessam.
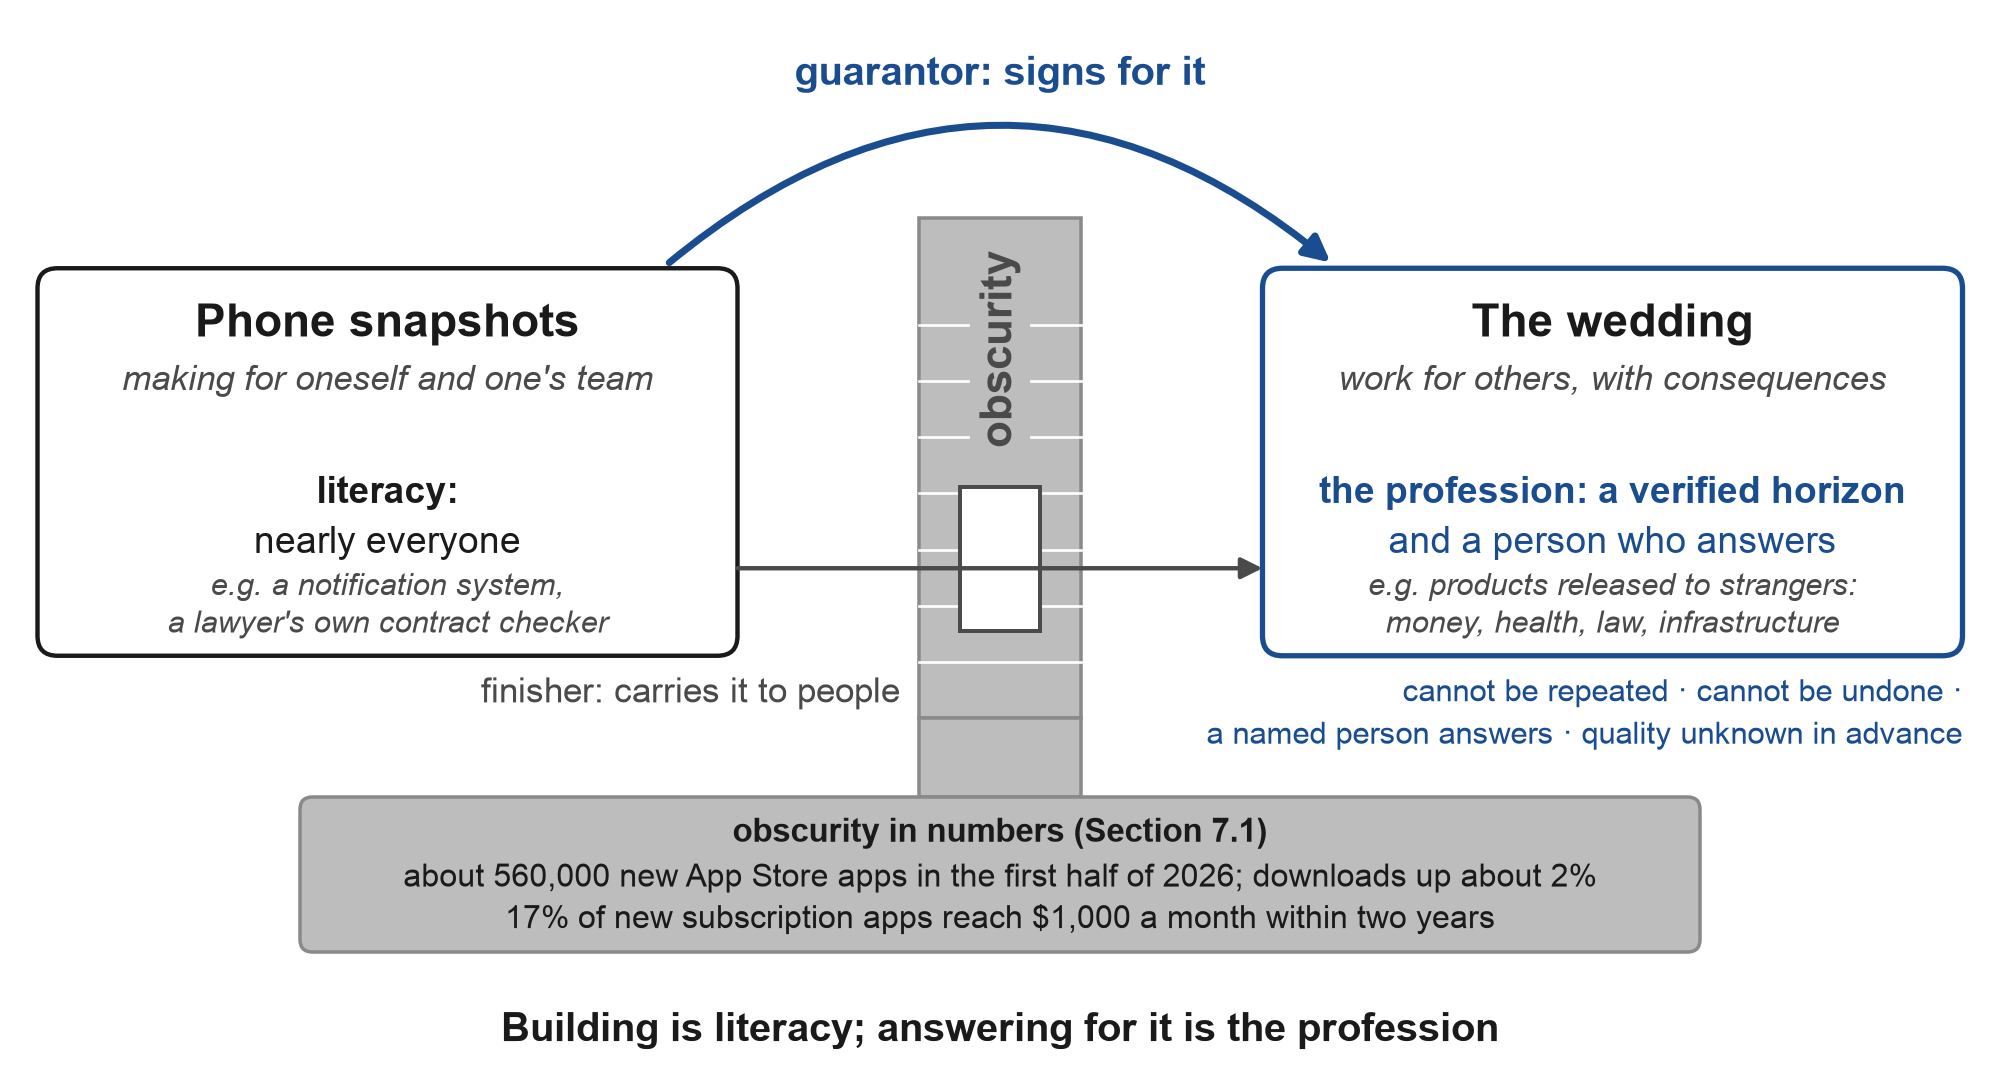
Nota: Os dois números pertencem à barreira de obscuridade, não ao finalizador: cerca de 560.000 novos apps da App Store na primeira metade de 2026 com downloads aumentando cerca de 2% (estimativas da Sensor Tower, conforme reportado por 9to5Mac, 2026, e Gigazine, 2026), e 17% de novos apps de assinatura atingindo $1.000 por mês em dois anos (RevenueCat, 2026). Os exemplos em cada pólo são os da Seção 8. As quatro condições são as da Seção 8; o arco e a porta são as duas funções de parceria da Seção 7.2.
9. O que migra das conversas de programadores
As conversas de programadores em 2026 podem ser as conversas de toda profissão em 2027. Para verificar isso, li três fios públicos no Facebook, coletados em 8 de outubro de 2026 (posts e comentários; comentadores não são nomeados aqui).
No primeiro, um autor desafiou desenvolvedores que dizem que IA escreve código quebrado a mostrar um caso em que toda boa prática havia sido aplicada e o código ainda assim falhava. Ele mesmo tinha certeza de que tal caso simplesmente não acontece. O fio se transformou em uma disputa sobre aceitação, e um participante resumiu: o problema é se a produção pode ser organizada de modo que o resultado da IA possa ser verificado, aceito e usado (traduzido). Outro, trabalhando em correções de segurança, relatou que mesmo com testes e instruções um modelo forte frequentemente falha em produzir a mitigação correta para vulnerabilidades classificadas acima de 9 na escala CVSS, e que loops automáticos de revisão e correção ficam caros. Um gerente com trinta anos em TI respondeu que programadores humanos sempre deram exatamente a mesma dor de cabeça. Outro comentador precificou a nova tarefa em $150 por hora, a taxa de um revisor que verifica e corrige código escrito por IA, e um terceiro descreveu um engenheiro sênior com vinte anos de experiência que achou difícil aceitar que suas habilidades haviam perdido valor.
No segundo, uma pessoa que diz não conhecer nenhuma das línguas está migrando uma plataforma de 650.000 linhas de uma linguagem de programação para outra, com cerca de 330 de alguns 600 pull requests feitos, e gasta $1.148 por mês em IA. Ele vende um método para migrar empresas para agentes e argumenta que para essa tarefa programadores fazem mais mal do que bem. Ele também se torna visível através de gastos públicos, uma lista de projetos, códigos promocionais, um curso e uma hora gratuita para empresas maiores. Ele está construindo, com efeito, o papel do guia da Seção 7.2, e está lutando contra a obscuridade com conteúdo.
O terceiro mostra uma pessoa construindo para si mesmo em quatro máquinas, com o fluxo de 36 estágios da Seção 5.4. Ele relata que nenhum de seus fluxos de trabalho de seis meses a um ano atrás sobrevive, que espera mudá-los novamente dentro de três meses, e que sente um medo constante de estar ficando para trás. Os comentários argumentam sobre qual agente pertence a qual acampamento.
A Tabela A5 (Apêndice F) compara os tópicos dos fios com o que era visível entre pessoas fora da área de software em 2025 e 2026. Suas linhas são casos ilustrativos, não uma amostra.
O que a Tabela A5 mostra é que a função migra e a forma fica para trás. Um contador que aprende a verificar uma família de modelos com outra ainda a chamará de "regras de reconciliação" e "quem verificou", não terá palavra para um arnês, e não tratará a escolha de agente como uma questão de identidade. Os marcadores de status dos fios, a grande despesa pessoal, o acampamento e as quatro máquinas, permanecem com a camada superior de cada profissão, assim como fotógrafos discutem sobre lentes e seus clientes não.
A migração também vem em camadas: primeiro aproximadamente o décimo superior de cada profissão, depois programas de treinamento, depois produtos que ocultam a configuração interna. Essa sequência é teoria de difusão aplicada a agentes, e nenhuma prioridade é reivindicada para ela aqui; Rogers (2003) colocou inovadores e adotantes iniciais juntos em cerca de um sexto dos adotantes. O próprio relatório da OpenAI nota que fora da empresa "o uso técnico permanece o modo dominante" (OpenAI, 2026), e Anthropic descobriu que usuários técnicos vieram primeiro e pessoas com tarefas menos bem remuneradas depois (Anthropic, 2026f). A Seção 11 afirma a migração de funções como uma previsão que pode ser verificada lendo currículos e posts.
10. Implicações
10.1 Para empregadores e RH
Um empregador que classifica pelo registro aprende mais com "Domain · horizon · amplification · date" do que com "senior" ou "manager", e o registro se move entre funções. Segue um teste de contratação: entregar ao candidato um dia de trabalho em seu próprio domínio, para ser feito por meio de agentes, e apresentá-lo como correto por meio de uma verificação que o candidato não projetou, com alguns erros plantados que o candidato deve encontrar. A lógica de remuneração de Jaques, sob a qual a remuneração justa aumenta com a amplitude da responsabilidade, fornece uma hipótese inicial para remuneração por horizonte verificado. Se isso se mantém é uma questão empírica, e a predição F18 na Seção 11 afirma isso: onde empregadores classificam pelo trabalho verificado, o degrau deve prever remuneração e desempenho melhor do que anos de experiência.
Classificação por tokens é assunto diferente, e o episódio da Seção 4 mostra para onde leva. Quando o uso é discutido em absoluto, pertence a uma revisão de desempenho como qualquer método, como uma entrada entre muitas.
O que observar, em última análise, é quem a organização realmente contrata. A remoção de um requisito de grau de uma página de política muda pouco por si só (Seção 6.2). Uma mudança em quem é contratado, com horizonte verificado igual, é como o ponto de transição parece de dentro de uma empresa.
10.2 Para educação e escolas
Para as escolas, a lição é ensinar aceitação antes de sintaxe. As habilidades que levam uma pessoa para cima na escada, declarando o que conta como feito, escolhendo uma verificação que o agente não pode ver, e reconhecendo um erro plausível em seu próprio campo, podem ser ensinadas em qualquer disciplina. Um certificado vale o que sua verificação vale, portanto, um certificado deve declarar o horizonte verificado que atesta, com o domínio e a data.
Escolas que adicionam letramento em IA ao currículo podem dar ao domínio "Manage AI" do marco da OCDE e Comissão Europeia um conteúdo concreto: um pequeno pedaço de trabalho entregue, uma verificação definida com antecedência, e um adulto que responde por qualquer coisa liberada para estranhos.
10.3 Para fornecedores e plataformas
Fornecedores podem deixar a aceitação sair do produto. Uma pessoa deveria ser capaz de exportar a tarefa, as entradas, a verificação e a decisão de aceitar, para que o registro possa ir para um empregador ou uma escola. O uso seria então relatado da mesma forma, contando pessoas que aceitaram trabalho verificado em vez de pessoas que abriram o aplicativo.
Uma plataforma já começou por este caminho, do lado do fornecedor. Em janeiro de 2026, LinkedIn começou a mostrar habilidades verificadas de IA emitidas por Lovable, Replit, Descript e Relay.app com base em como um membro realmente usou cada ferramenta (LinkedIn, 2026a). Tal crachá atesta o uso de uma ferramenta, julgado pelo próprio fornecedor da ferramenta em relação aos níveis que o fornecedor define; não atesta um resultado verificado por alguém que a pessoa não escolheu. A mesma plataforma vende agentes para recrutadores, com produtos de contratação agêntica acima de uma taxa de receita anual de $450 milhões em abril de 2026 (LinkedIn, 2026b), e em julho de 2026 deu aos membros um botão para relatar posts que "parecem lixo de IA" (TechCrunch, 2026c), depois que o fornecedor de detector Pangram estimou que 41% dos posts longos no site de abril a junho de 2026 foram totalmente gerados (The Decoder, 2026). Quando o texto sobre o trabalho de alguém não custa nada para produzir, um perfil diz menos, e um registro de trabalho verificado que não depende de nenhum fornecedor único diz mais.
Plataformas que fecharam suas portas para o desconhecido, como muitas fizeram em 2026, podem abrir uma segunda porta por meio de endosso. Um recém-chegado cujo trabalho uma pessoa conhecida assina passa, e o registro do endossador cresce ou encolhe com o que acontece a seguir.
10.4 Para produtos que integram pessoas com agentes
Produtos de integração comumente separam "iniciantes" e "programadores" na primeira tela. A medida sugere substituir as duas portas por uma pergunta: o que você já pode entregar a um agente e verificar, nada ainda, uma hora, um dia ou uma semana? Até que as portas se unam, perguntar sobre educação em TI uma vez, com consentimento, permite que a neutralidade de fundo seja testada nos próprios usuários do produto.
10.5 Para pesquisadores
Pesquisadores podem construir os painéis pessoa-por-tarefa que Chen e Meng (2026) dizem não existir, comparar pessoas com pessoas que usam os mesmos agentes sob verificações cegas, relatar o denominador com o trabalho que falhou em verificações incluído, e manter o banco de referência congelado e publicado. O instrumento do Apêndice C já faz isso: não conta peças cuja verificação é registrada como não independente, e relata ambos os eixos com uma data.
Uma comparação decorre da Seção 6.5 e não foi executada. Nas mesmas tarefas do banco, sob verificações que os agentes não viram e com erros plantados de ambos os tipos, entradas erradas e faltantes, cruzaria experiência no ofício (presente ou ausente) com o modo de trabalho (um agente cuja saída é aceita como vem, ou o processo de verificação da Seção 6.5). A experiência seria estabelecida por uma tela de conhecimento e um registro de trabalho, não por um rótulo de perfil (Seção 6.2), e peças cujos erros não podem ser desfeitos seriam verificadas por um teste oculto ou um humano qualificado, conforme exigido na Seção 5.2. Omissões e entradas erradas seriam pontuadas separadamente: a lista elaborada previamente é destinada à primeira e os revisores à segunda, e a lacuna que o Apêndice G2 sugere é do primeiro tipo. A comparação mostraria quanto da experiência de um ofício um processo pode substituir, e em qual degrau isso para. Uma comparação com profissionais que trabalham sem agentes não resolveria nada aqui, pela razão dada na Seção 11.1. As predições da Seção 11 são congeladas e não incluem essa comparação, que seria registrada por conta própria antes de os dados serem coletados. O repositório complementar a contém como protocolo para adaptar e registrar (kits/process-vs-experience-study.md), com uma ferramenta que sela os erros plantados de uma tarefa antes da entrega e pontua entradas erradas e omissões separadamente depois disso (tools/planted.py), e uma análise que imprime os quatro braços e, para cada tipo de erro separado, o efeito do processo entre recém-chegados, o efeito da experiência sob um agente e sua interação, com intervalos que reamostra pessoas (tools/process_study.py).
11. Previsões datadas, registradas e pontuadas
11.1 Regras para escrever as previsões
Escrevi as previsões sob regras que as mantêm verificáveis. Compara-se o semelhante com o semelhante: não programadores são comparados com programadores que usam os mesmos agentes, nas mesmas tarefas, com o mesmo tempo, porque uma comparação com programadores que trabalham sem IA não resolve nada aqui.
"Melhor" é dividido em três significados, cada um testado isoladamente. Para código, os testes são testes ocultos, revisão de segurança e uma mudança feita por outro agente um mês depois para verificar a manutenibilidade. Para um produto, o teste é se ele chegou a estranhos e ainda estava vivo seis meses depois. Para o currículo, o teste é o peso de um diploma nas postagens. A popularidade não é usada como uma medida de "melhor", porque testa a distribuição, que pode ser uma profissão separada (Seção 7.2).
As previsões também não dependem do nome de uma profissão. Elas falam de "pessoas sem educação em TI trabalhando através de agentes", então sobrevivem ao nome que vencer.
11.2 As previsões
A Tabela 4 apresenta as dez previsões principais em forma abreviada; a Tabela A6 (Apêndice D) e o arquivo predictions/predictions.csv do repositório complementar apresentam todas as 41, cada uma com uma medida, uma linha de base de 2025 ou 2026, regras para três resultados (confirmou-se, não se confirmou, não resolvido), uma data de verificação e uma data final, uma probabilidade, uma fonte de fallback e a previsão anterior mais próxima ou contra-previsão. Uma probabilidade não desculpa um previsor que se mostra errado, mas torna o erro pontuável. Uma previsão feita a 35% que falha diz pouco por si só. Se 35% era o número certo aparece apenas no conjunto, onde cerca de um terço dessas previsões deve se confirmar. A regra de Brier (Brier, 1950) fornece uma pontuação geral de precisão no conjunto, combinando calibração com a capacidade de distinguir o que acontece do que não acontece. A previsão principal vai contra a opinião atual, pois os dados de contratação ainda favorecem diplomas para trabalho em IA, a Gartner espera que a maioria das aplicações vibe-coded seja descontinuada, e Andrew Ng argumenta que a compreensão profunda de programas vence. A tabela aposta o contrário, em probabilidades declaradas: a probabilidade registrada de ultrapassagem em seu próprio domínio (F3) é 0,35. Fica abaixo das probabilidades iguais porque os dados do fornecedor ainda colocam ocupações de programação cerca de 5 pontos à frente (Seção 2.2) e Savva (2026) prevê lacunas mais amplas em tarefas mais difíceis (Seção 6.1), e acima de 0,25 porque a paridade, a etapa anterior, é precificada em 0,70; os previsores de modelo independentes variaram de 0,25 a 0,55. A Figura 7 coloca todas as previsões em seu ano de verificação e sua probabilidade.
As previsões se dividem em dois conjuntos. O Conjunto A (27 previsões) é resolvido a partir de dados públicos e de consultas congeladas, listas e códigos em predictions/resolve/, para que qualquer um possa pontuá-lo sem mim. O Conjunto B (14 previsões: F2, F3, F3b, F4a, F4b, F7, F12, F14, F18, F19, F20, F26, F34, F35) é um programa de pesquisa: precisa de dados que nenhuma fonte pública publica e é resolvido apenas a partir de um estudo registrado separadamente antes da coleta de dados, com um proprietário designado, um protocolo e um cálculo de potência. Para as nove previsões do Conjunto B cujas regras são escritas em um intervalo, o repositório complementar aplica as regras congeladas confirmou-se e não se confirmou às estimativas de um estudo e imprime as palavras congeladas ao lado de cada veredicto (predictions/set_b.py). Uma previsão do Conjunto B cujo protocolo não é registrado até 30 de junho de 2027 é registrada como não conduzida e listada em todos os boletins de pontuação como uma falha do programa de teste. A pontuação de Brier é então relatada duas vezes, apenas sobre previsões resolvidas e com cada previsão não conduzida pontuada como se a previsão tivesse sido incorreta, para que um estudo que nunca é executado não possa sair da contagem. Os experimentos de F2, F3 e F3b são um estudo com 1.500 pessoas por grupo: isso fornece cerca de 0,8 de potência para detectar uma verdadeira vantagem de 5 pontos (alfa bilateral 0,05, com uma participação de acerto perto de 50%, o caso menos favorável), onde 400 por grupo a mostraria apenas cerca de 30% do tempo. Para cada previsão baseada em estudo, um intervalo que não atende nem à regra confirmou-se nem à regra não se confirmou é não resolvido, não uma falha.
As probabilidades foram fixadas em 9 de outubro de 2026. Cada uma é a mediana de três previsões cegas por modelos de três famílias (Claude Opus, um modelo OpenAI e Gemini) que precificaram a mesma tabela sem ver meus números; adotei essas medianas como minhas probabilidades, elas são registradas em OSF, e cada mudança de meus rascunhos anteriores é registrada no changelog. Uma rodada anterior de 4 previsores de modelo independentes de 4 famílias também precificaram a tabela cegamente. Cada um forneceu uma classe de referência, um argumento de uma linha e uma probabilidade, e sua previsão agrupada (a média geométrica das chances) é mostrada ao lado da probabilidade registrada na Tabela 4, com a dispersão no CSV. Onde a probabilidade registrada difere da mediana dessa rodada por mais de 0,15 (F28 e F32), a razão é fornecida no changelog. Todas as probabilidades são condicionadas à previsão ser resolvida, porque a pontuação de Brier é calculada sobre previsões resolvidas. A participação resolvida é relatada ao lado.
Tabela 4. Dez previsões principais, com limites, datas finais e probabilidades (todas as 41 na Tabela A6).
| # | Previsão | Limiar | Data final | p | Modelos | Dados |
|---|---|---|---|---|---|---|
| F1 | A lacuna no sucesso verificado se fecha nos dados do fornecedor | Programação menos outras ocupações 2 pontos ou menos (agora 34% contra 29%) | 31 de dezembro de 2028 | 0.35 | 0.39 (0.25 a 0.65) | público |
| F2 | Paridade de qualidade em seu próprio domínio | Limite inferior de 95% de (não-TI menos programadores) acima de menos 10 pontos; 1.500 por grupo | 8 de outubro de 2028 | 0.70 | 0.67 (0.62 a 0.70) | estudo próprio |
| F3 | Ultrapassagem em seu próprio domínio (o crossover em qualidade) | Limite inferior de 95% acima de zero; mesmo estudo | 8 de outubro de 2029 | 0.35 | 0.33 (0.25 a 0.55) | estudo próprio |
| F5 | O cruzamento nas postagens | Participação de diploma em postagens agênticas abaixo das postagens correspondentes por 2 pontos ou mais, dois trimestres consecutivos de 2027 | 31 de dezembro de 2028 | 0.30 | 0.34 (0.25 a 0.60) | público |
| F7 | Neutralidade de antecedentes | Intervalo de 90% da razão de probabilidades para educação em TI dentro de 0.67 a 1.5, no Dia e na Semana | 31 de dezembro de 2029 | 0.42 | 0.43 (0.40 a 0.48) | estudo próprio |
| F14 | Os dois eixos permanecem distintos | Spearman de horizonte log e ganho log 0,8 ou abaixo; ganho adiciona 0,02 R² fora da amostra | 30 de setembro de 2028 | 0,52 | 0,49 (0,45 a 0,50) | estudo próprio |
| F19 | Verificação estabelece o teto | Participação de verificação nos meses 1 a 3 supera horizonte na previsão de saída verificada nos meses 4 a 6 | 30 de setembro de 2028 | 0,45 | 0,44 (0,30 a 0,65) | estudo próprio |
| F26 | Prática de contratação acompanha | Estudo de auditoria: diferença de retorno de chamada inferior a 3 pontos, intervalo 95% dentro de 5 | 31 de dezembro de 2029 | 0,35 | 0,32 (0,25 a 0,35) | estudo próprio |
| F27 | Produtos construídos por agentes superam a previsão | Menos de 50% de uma amostra congelada em 31 de dezembro de 2026 descontinuada até o final de 2028 (Gartner: 60%) | 31 de março de 2029 | 0,32 | 0,35 (0,20 a 0,55) | público |
| F28 | Máquinas atingem Dia em 80% | Horizonte METR 80% de 8 horas ou mais até o final de 2027 (3,1 horas em abril de 2026) | 30 de junho de 2028 | 0,80 | 0,66 (0,55 a 0,80) | público |
Nota: p é a probabilidade registrada de que a previsão se concretize, dado que está resolvida: a mediana de três previsões cegas de modelo de 9 de outubro de 2026, que adotei. Modelos: a previsão agregada de previsores de modelo independentes que não viram meus números (média geométrica de probabilidades), com seu intervalo. Dados: público significa resolvível a partir de fontes públicas por qualquer pessoa (Conjunto A); estudo próprio significa um estudo separadamente pré-registrado (Conjunto B). Regras para verdadeiro, falso e não resolvido, fontes alternativas e previsões anteriores para todas as previsões estão na Tabela A6 e em predictions/predictions.csv. Uma previsão sem dados comparáveis até sua data final não está resolvida e nunca é contada como um sucesso. O programa registrado no OSF (Chernets, 2026e) não tem hipóteses e não pergunta sobre educação em TI, portanto não pode testar o Conjunto B.
Figura 7. O registro de previsões: cada previsão datada no seu ano de verificação e probabilidade declarada.
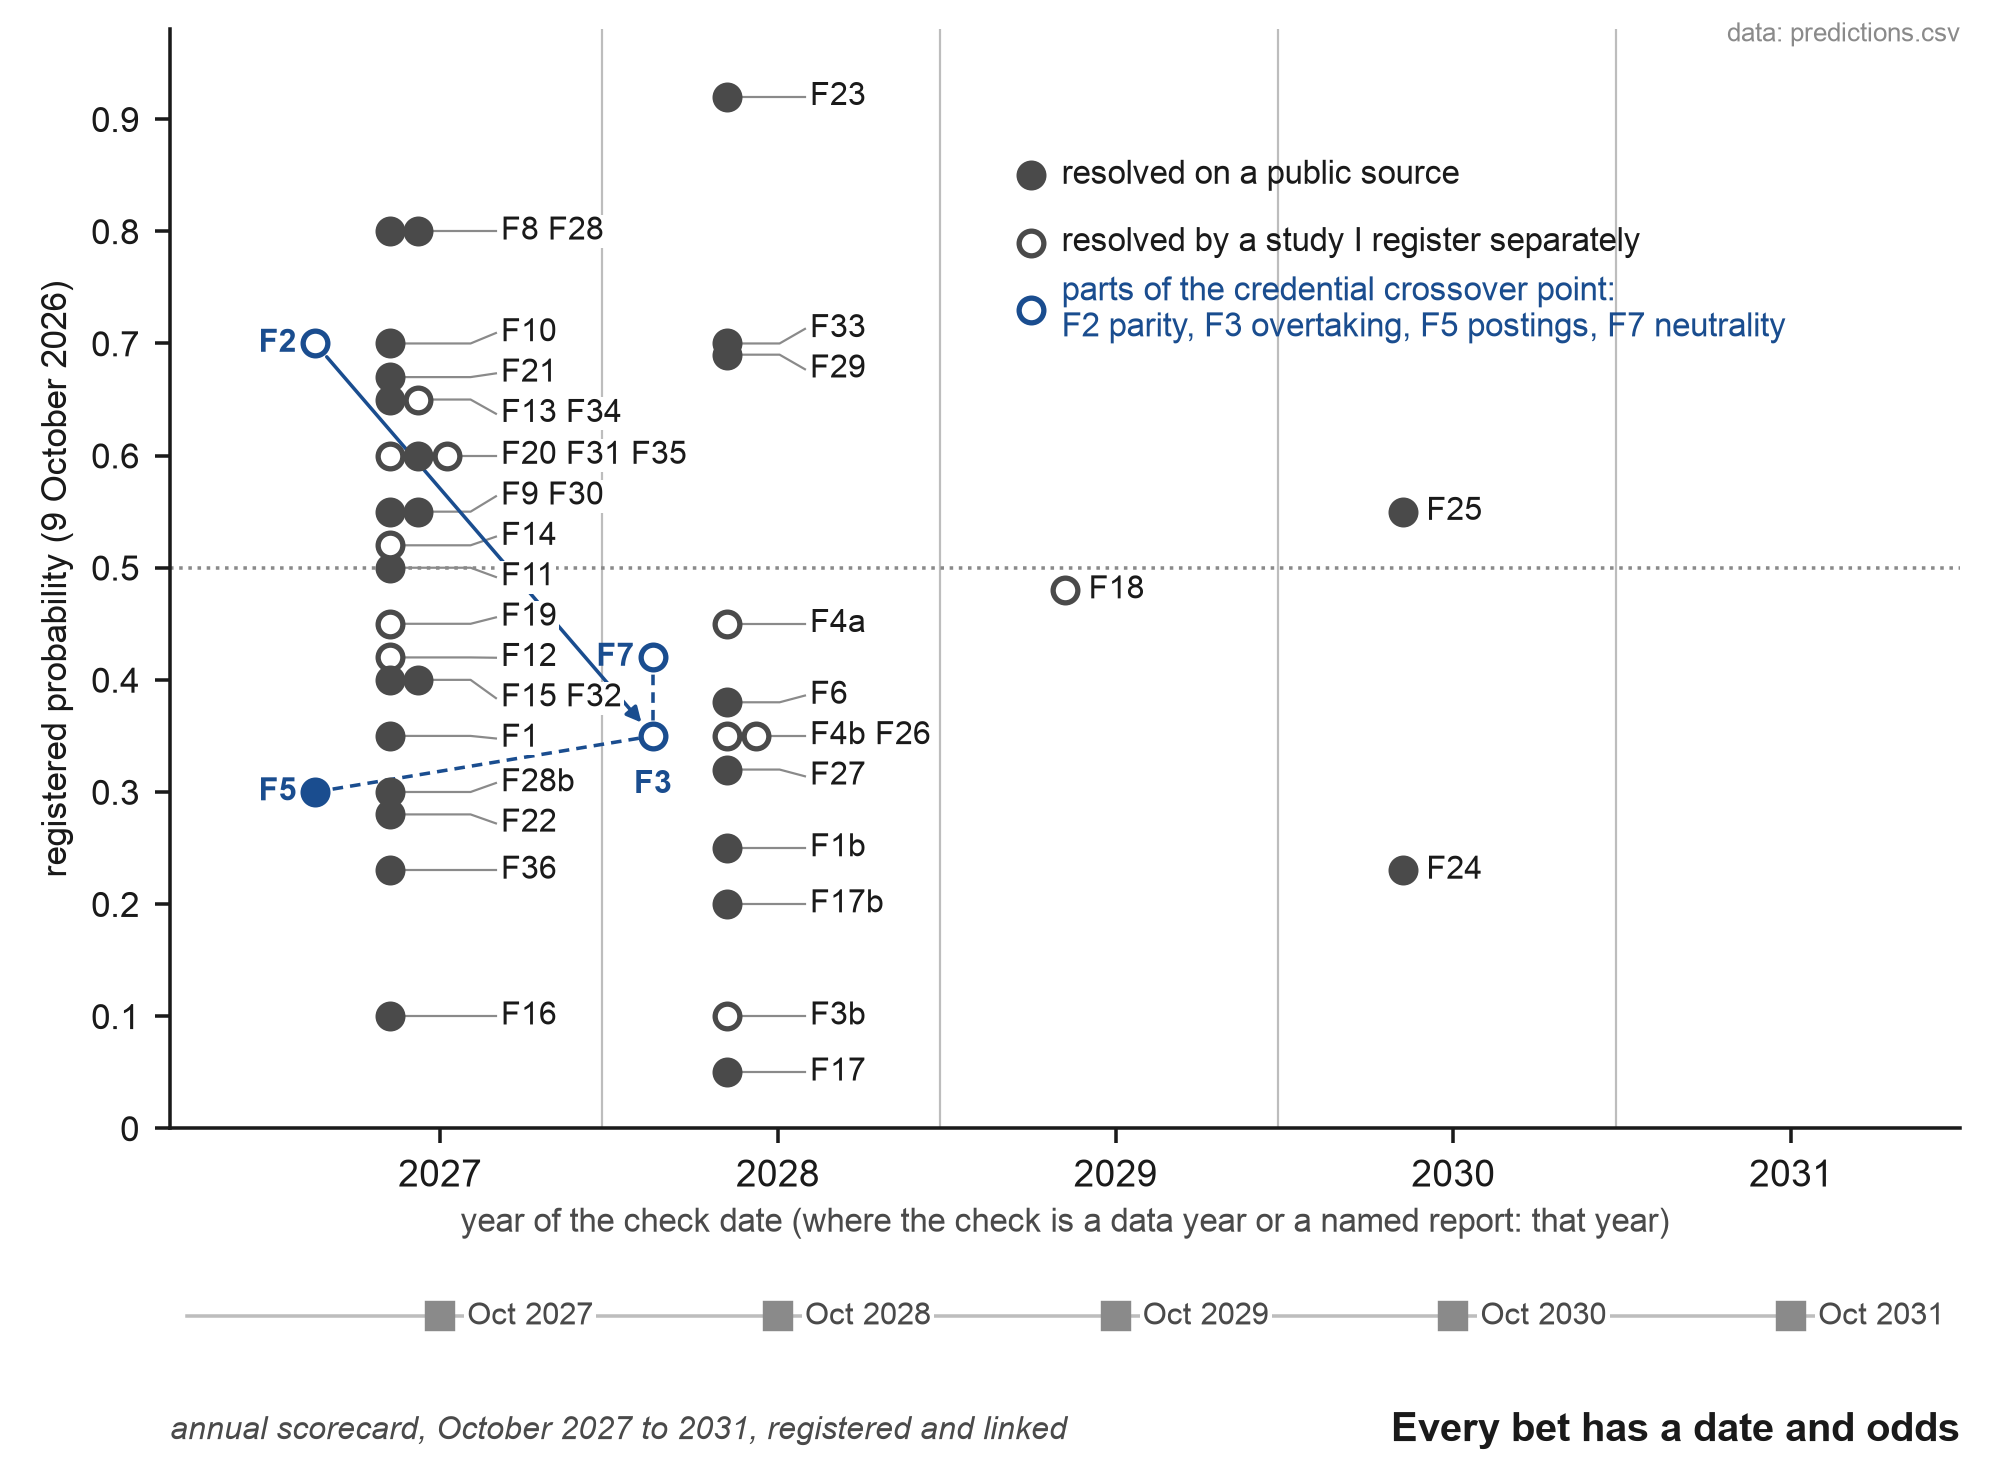
Nota: Cada marcador é uma das 41 previsões da Tabela A6, colocada no ano de sua data de verificação (quando a verificação é um ano de dados ou um relatório nomeado, esse ano) e em sua probabilidade registrada. Marcadores preenchidos são resolvidos em uma fonte pública. Marcadores vazios são resolvidos apenas através de um estudo registrado separadamente antes de dados serem coletados. As quatro partes do ponto de cruzamento de credencial estão na cor de destaque: paridade de qualidade (F2) leva à ultrapassagem (F3). O cruzamento em postagens (F5) é seu sinal visível e a neutralidade de fundo (F7) é seu mecanismo. Apenas paridade é precificada acima de probabilidades iguais (0,70). Ultrapassagem, o próprio momento, fica em 0,35. Quadrados abaixo do eixo marcam os cartões de pontuação anuais, a serem registrados no OSF e vinculados por DOI, outubro de 2027 a 2031. As probabilidades foram fixadas em 9 de outubro de 2026 e estão registradas no OSF.
Uma medição anual acompanha as previsões sem ser uma previsão em si, uma corrida de nomes: cada ano as mesmas consultas contam com que frequência cada candidato da Tabela A2 aparece em postagens dos EUA e em OpenAlex e Crossref. A pergunta que uma vez foi apenas uma verificação de longo prazo, se SOC 2028 nomeará uma ocupação para trabalho direcionado por agente, agora é previsão F23, com uma probabilidade (Bureau of Labor Statistics, 2026b). Em 9 de outubro de 2026, o Bureau of Labor Statistics não havia publicado nem uma estrutura proposta nem final SOC 2028; a estrutura final é esperada em 2027.
11.3 Previsões anteriores
Em 9 de outubro de 2026, pesquisei Metaculus, Manifold, Good Judgment Open, Kalshi, Polymarket e Long Bets, bem como a web aberta (páginas de pesquisa de empresas, comunicados de analistas, arXiv, SSRN e notícias), por previsões datadas de que pessoas sem educação técnica, trabalhando através de agentes de IA, corresponderiam ou superariam programadores que usam os mesmos agentes. Nenhuma encontrada carrega uma data e um resultado de refutação. As mais próximas são estas. Gartner previu em 2021 que até 2024, 80% dos produtos e serviços de tecnologia seriam construídos por pessoas que não são profissionais de tecnologia (Gartner, 2021). Mark Cuban disse em 2017 que preferiria ter se formado em filosofia, esperando que o pensamento crítico superasse a programação (Black Enterprise, 2017). D. H. Hansson respondeu "100%" no Lex Fridman Podcast de 26 de agosto de 2026 quando perguntado se existem problemas para os quais programadores são piores que não-programadores em engenharia agêntica (Lex Fridman Podcast, 2026). Anthropic observou em junho de 2026 que agentes de codificação estão tornando a formação em codificação menos relevante (Anthropic, 2026e). Existem previsões na direção oposta. Gartner espera que 60% dos aplicativos codificados pela vibe sejam descontinuados até 2028 (Gartner, 2026, conforme resumido por Tray.ai, 2026), e esperava em 2024 que até 2026 um quinto das organizações usaria IA para achatar sua estrutura (Gartner, 2024). Srinivasan e Wei (2026) esperam que "agent manager" se torne um título padrão em 12 a 18 meses. Forrester esperava que 60% das empresas da Fortune 100 nomeassem um chefe de governança de IA (Forrester, 2025). Os mercados no Manifold colocaram um terço a menos de papéis de desenvolvedor júnior até 2030 em cerca de 74%, e uma queda de mais de 15% em desenvolvedores dos EUA de 2023 a 2028 em cerca de 42% (Manifold, 2026b; Manifold, 2026c). No Manifold, a probabilidade de ser comum até 2027 que não-programadores escrevam pequenos scripts com IA ficou perto de 27% (Manifold, 2026a), e essa pergunta se refere apenas ao uso, sem medida de qualidade. As previsões aqui diferem de todas essas em comparar pessoas com pessoas que usam o mesmo agente, em fazer da educação a variável, e em carregar uma data, uma medida e um resultado de refutação. O log de busca está no Apêndice B. Adoção em camadas (Rogers, 2003), horizontes de tempo de máquina (Kwa et al., 2025) e a observação de que papéis juniores estão encolhendo são trabalhos anteriores, e nenhuma prioridade é reivindicada para eles.
11.4 Fixação e pontuação
Onde uma previsão deve ficar para que ninguém, nem seu autor, possa alterá-la silenciosamente? Dos locais que esta série utiliza, apenas um congela. Um registro do OSF não pode ser editado ou deletado; pode ser retirado, mas uma página com seu título, datas, DOI e o motivo da retirada permanece (OSF, 2026). Zenodo permite que o depositante altere ou delete arquivos por 30 dias após a publicação, e apenas novas versões após isso (OpenAIRE, 2025). SSRN substitui o PDF na revisão. Portanto, as previsões serão registradas no OSF primeiro, como um registro aberto ao público imediatamente, sem embargo, porque um embargo ocultaria o registro e reteria seu DOI, e uma prioridade que ninguém pode ver vale pouco.
Em 9 de outubro de 2026, a tabela foi registrada no OSF como um conjunto de previsões pré-registradas (DOI 10.17605/OSF.IO/VW6P9), e o artigo foi postado no SSRN e Zenodo; snapshots de cada fonte de referência são arquivados na Wayback Machine. A cada ano de 2027 a 2031, no aniversário do registro, um scorecard é publicado que lista todas as previsões sem exceção, seu status (cumpriu-se, não se cumpriu, ainda não vencido, não resolvido, não conduzido) e a evidência. Relata a pontuação de Brier sobre as previsões resolvidas em geral, por conjunto e por família, onde previsões vinculadas contam uma vez, agrupadas como na coluna de família da tabela registrada (F1 e F1b; F2, F3 e F3b; F4a e F4b; F5, F6 e F33; F9 e F31; F15 e F16; F17 e F17b; F28 e F28b); a fração resolvida; um limite inferior em que todas as previsões após sua data final e ainda não resolvidas, e todas as previsões não conduzidas, são pontuadas como se a previsão tivesse estado errada; a pontuação com e sem as previsões não conduzidas; e a pontuação de habilidade de Brier em relação a três referências: um 0,5 plano, os previsores de modelo agrupados da Tabela 4, e o preço de mercado onde um mercado existia no dia do registro. A não-resolução seletiva, portanto, não pode melhorar a pontuação. O scorecard é registrado no OSF, vinculado ao original por DOI, e depositado no Zenodo. Modelos de pelo menos duas famílias verificam independentemente cada scorecard contra as regras congeladas; onde discordam, a regra decide e o desacordo é reportado. O texto de registro está no Apêndice D, e a Figura A1 (Apêndice D) mostra o calendário completo de datas de verificação e finais. Dois compromissos vencem antes do início da pontuação. A amostra de produtos construídos por agentes para F27 é congelada no Zenodo até 31 de dezembro de 2026, e as linhas de base de F5 e F30 são computadas e arquivadas antes do registro. O protocolo da amostra F27, com um padrão para cada escolha que o registro deixa em aberto, e a ferramenta que a desenha por uma semente fixada antecipadamente e a sela estão no repositório complementar (kits/f27-sample.md, tools/freeze_sample.py).
Quando as previsões são registradas, as públicas também serão postadas onde previsores externos possam precificá-las: cinco mercados no Manifold (F5, F8, F10, F11 e F22, que são livres para postar; esses cinco foram escolhidos porque cada um se resolve em uma fonte pública e uma série externa que qualquer pessoa pode ler, sem nenhum de meus dados), uma pergunta no Metaculus (o cruzamento em postagens, F5), e a Social Science Prediction Platform para os experimentos de F2, F3 e F7, de modo que as previsões de outras pessoas sejam coletadas antes dos dados existirem. Mercados de previsão que negociam dinheiro no resultado não são utilizados.
11.5 O programa de coorte
Conduzo um programa de coorte pré-registrado (OSF, https://osf.io/x4egq, DOI 10.17605/OSF.IO/X4EGQ) que acompanha não-programadores de chat a agentes e orquestração (Chernets, 2026e). Sua primeira coorte é um estudo de viabilidade de um único braço com seus próprios desfechos registrados, que são reportados em seu próprio relatório. Previsões como F7, F14 e F18 a F20, que precisam de dados em nível individual, são testadas em uma coorte posterior registrada para elas antes dos dados serem coletados, com uma pergunta sobre educação em TI entre seus itens congelados. Os registros do Apêndice C, mantidos com consentimento, são os dados naturais para essa coorte.
12. A evidência contra a qual as previsões apostam
As previsões da Seção 11 vão contra vários tipos de evidência de 2026, e cada uma delas moldou uma regra da medida ou uma previsão.
A segurança não acompanhou o ritmo. Em mais de cem modelos, a parcela de código gerado que passou em testes de segurança permaneceu em 56% no relatório de 2026 da Veracode (Veracode, 2026). Esses testes foram executados apenas em modelos, sob prompts padrão sem instruções de segurança e sem sistema agencial, ferramentas ou revisão humana, portanto descrevem o material bruto com o qual uma pessoa começa. Uma varredura passiva de 5.600 aplicações públicas construídas por programação intuitiva encontrou mais de 2.000 vulnerabilidades, mais de 400 segredos expostos e 175 exposições de dados pessoais, e seus autores apresentam estes como um limite inferior (Escape, 2026). É por isso que F2 inclui uma revisão de segurança às cegas, e por que trabalho irreversível precisa que cada peça passe (Seção 5.2).
Passar em testes fica aquém de ser aceito. METR pediu aos mantenedores que revisassem correções escritas por agentes que tinham passado nos testes de um benchmark e descobriu que cerca de metade não teria sido mesclada como estava; os agentes eram de uma geração anterior sem um loop de revisão, portanto a parcela agora pode ser menor (METR, 2026b). A regra de pontuação responde com testes ocultos, revisores qualificados e uso real, e F2 adiciona uma mudança de manutenção um mês depois.
A verificação depende da experiência. Em uma pesquisa com 162 pessoas que constroem por programação intuitiva, cada grupo reconheceu os riscos do código gerado, mas como verificavam variava com a experiência. Os autores chamam isso de lacuna percepção-ação (Fawzy et al., 2026). Usuários de negócios e novatos produzem protótipos funcionais rapidamente, enquanto a qualidade do código é desigual e o retrabalho segue (Gama et al., 2026). Usuários de negócios também perderam erros materiais na análise de um IA mesmo depois de serem advertidos (Virk & Liu, 2025). Um estudo randomizado de 52 engenheiros juniores aprendendo uma nova biblioteca encontrou pontuações de compreensão de 50% com IA contra 67% sem, e nenhum ganho significativo em velocidade. Aqueles que pediram ao modelo por explicações pontuaram 65% ou mais, e aqueles que entregaram todo o código pontuaram menos de 40% (Anthropic, 2026c). Esta é a razão mais forte pela qual a medida repousa no letramento de aceitação e erros plantados: a habilidade que separa as pessoas é a que esses estudos mostram variando.
Nenhuma comparação publicada coloca não-programadores contra programadores que usam os mesmos agentes. Esnaola et al. (2026) descobriram que alguns não-programadores usando GPT-4o através do ChatGPT resolveram pequenos problemas de programação bem especificados a um nível comparável ao de programadores trabalhando sem IA, e mais rapidamente; os autores chamam o estudo de exploratório. Os programadores trabalhavam sem IA, então o design não tinha um braço de programadores-com-IA, e estudava tarefas individuais curtas, não desenvolvimento sustentado; um pacote de replicação é público (Esnaola et al., 2026). Nos dados da Anthropic, pessoas que eram novas em uma tarefa tinham uma taxa de sucesso verificada de 15% contra 28% a 33% para usuários mais experientes (Anthropic, 2026e). Lá, "novato" significa um novato na tarefa, conforme julgado por um modelo, e não diz nada sobre educação em TI. Se essa lacuna reflete educação ou familiaridade com a tarefa é o que F7 foi escrito para separar. Ainda antes disso, IA generativa em uma empresa de suporte ao cliente aumentou a produtividade de agentes novatos e pouco qualificados mais e a dos mais experientes pouco (Brynjolfsson et al., 2025), um estudo anterior aos agentes. Em 2024 um experimento de campo na Procter & Gamble com modelos de chat descobriu que indivíduos com IA igualaram equipes sem ela e produziram trabalho equilibrado independentemente de seu histórico profissional, um trabalho anterior aos agentes (Dell'Acqua et al., 2025). F2, F3 e F7 foram desenvolvidos para fornecer a comparação faltante.
Vozes respeitadas discordam da versão forte. Karpathy mantém um piso e um teto (Seção 2.1). Andrew Ng argumentou em agosto de 2026 que desenvolvedores que entendem profundamente como os programas funcionam superam em muito aqueles que programam intuitivamente sem esse entendimento (Ng, 2026). Dados de contratação apontam da mesma forma por enquanto: postagens que exigem habilidades de IA ainda são mais propensas a exigir um diploma de quatro anos do que postagens comparáveis que não exigem (Lightcast, 2026b), e LinkedIn atribui grande parte da fraqueza na contratação de nível básico à economia (Seção 2.4). As previsões tomam essas visões como sua contraparte, com probabilidades declaradas antecipadamente.
13. Escopo e condições de contorno
Tempo. As evidências cobrem até 9 de outubro de 2026. Os fatos sobre produtos envelhecem rapidamente, portanto a medida é definida em horas e verificações de referência, sem nenhum produto nomeado.
Fontes. Grande parte das evidências mais fortes vem dos fornecedores sobre seus próprios produtos: OpenAI sobre seu agente de codificação, Anthropic sobre suas sessões. Estas são marcadas como dados de fornecedor e usadas para o que os fornecedores podem saber. Vários episódios relatados pela imprensa, como os rankings de tokens, baseiam-se em relatórios de outlets nomeados e são citados como tal. Fontes secundárias (Growthy, Startup Fortune, Shopifreaks) são arquivadas na Wayback Machine antes de publicação, e o relatório primário é citado onde quer que pudesse ser alcançado.
População. O argumento refere-se ao trabalho realizado em um computador, através de agentes, por pessoas que possam verificá-lo. Pessoas sem um computador que controlem e trabalho que não possa ser verificado de forma alguma ficam fora da medida.
O que a medida afirma. Um horizonte verificado descreve o que uma pessoa entregou sob um regime de verificação, em um domínio, em uma data. Não afirma que maior é melhor para cada tarefa. Muito trabalho pertence a Hour, e escolher manter o trabalho manual é uma decisão legítima. Em domínios onde um erro não pode ser desfeito, o limite mais rigoroso da Seção 5.2 se aplica, e algum trabalho não deveria ser confiado a agentes de forma alguma.
Nomes. O mapa da Seção 3 registra o uso encontrado em 8 e 9 de outubro de 2026. Os nomes serão adotados e abandonados depois disso, razão pela qual o mapa é emparelhado com uma corrida anual de nomes e nenhum nome único é escolhido.
A tese forte. Que pessoas sem educação técnica construirão produtos melhores do que programadores é declarado como um conjunto de previsões com datas e limites (F2 a F7). Eu a apresento como uma previsão, para ser pontuada publicamente.
Atos reservados por lei. Onde a lei reserva um ato a uma licença, nem a medida nem a perda de peso pelas comportas de rótulo (Seções 6.2 e 6.5) move esse ato. No Reino Unido, ninguém que não seja elegível para nomeação pode atuar como auditor estatutário, o que requer filiação a um órgão supervisor reconhecido e elegibilidade sob suas regras (Companies Act 2006, ss. 1212 e 1213), e nos Estados Unidos, apenas uma firma registrada no Public Company Accounting Oversight Board pode preparar ou emitir um relatório de auditoria sobre um emissor (Sarbanes-Oxley Act de 2002, s. 102). Em contabilidade, tais reservas são estreitas: um escrevente de contabilidade nos Estados Unidos geralmente não é obrigado a manter nem mesmo uma certificação (Bureau of Labor Statistics, 2026c). Em lei, elas são mais amplas: Inglaterra e País de Gales reservam seis atividades legais, entre elas a conduta de litígio e atividades de sucessão (Legal Services Act 2007, s. 12). O trabalho pode, portanto, se mover enquanto a assinatura permanece, e o signatário licenciado então realiza a função de garantidor da Seção 7.2 em uma forma que a lei já precifica. Até que ponto uma licença em si admite por um rótulo ou por trabalho verificado é discutido na Seção 6.2.
Dados pré-agente. Séries de antes de 2025 entram apenas como predecessoras, porque descrevem trabalho sem agentes. A macroeconomia da contratação é levada pelos dados do LinkedIn de 2026 (Seção 2.4), que apontam mais para a economia do que para IA.
Status de afirmações. A Tabela A7 (Apêndice F) aplica a linguagem de confiança da série a cada elemento.
14. Conclusão
Uma contadora comparando agentes de codificação e uma advogada construindo seu próprio verificador de contratos agora trabalham da forma como uma desenvolvedora trabalha quando passa um módulo a um agente e verifica o resultado. Em 2026, os três compartilham um fluxo de trabalho, e nenhuma das antigas hierarquias pode dizer qual deles está mais avançado. Um título não resolveria, porque todo título proposto em 2026 é ou um slogan ou um anúncio de emprego de alguém, e o mercado não escolheu entre eles. Uma medida pode resolvê-lo, desde que conte a coisa certa.
A medida proposta aqui não espera que a profissão seja nomeada. Ela lê a contadora, a advogada e a desenvolvedora em uma única escala, o tamanho do trabalho que cada uma passou a agentes e teve verificado, em um domínio e em uma data, com um segundo eixo para quanto trabalho verificado uma hora de sua própria atenção comprou. Seus limites são versionados e testados na prática, e o teste na prática já corrigiu um deles; suas regras nomeiam as formas como o registro pode ser manipulado e uma defesa para cada uma, e seu teto explica por que o preço da verificação estabelece o limite independentemente da velocidade do agente. Para um empregador, uma escola ou uma plataforma, a pergunta muda. Em vez de perguntar se uma pessoa é uma programadora ou quanto IA ela usou, eles pedem um dia de trabalho no seu próprio campo que passou em uma verificação que a pessoa não projetou. Qualquer nome que o mercado escolher pode ser lido nessa escala.
Previsões datadas carregam a tese que começou este artigo. Domínio por domínio, produtos feitos por pessoas sem educação em TI começarão a ultrapassar os de programadores que usam os mesmos agentes. Em um horizonte de delegação verificada igual, uma educação em programação deixará de prever a qualidade do trabalho verificado. E em anúncios de emprego, as linhas para requisitos de grau se cruzarão, primeiro em domínios onde especialistas podem aceitar o trabalho eles mesmos e por último em software. Se os scorecards de 2027 e 2028 forem contra essas previsões, eles dirão em público, com um escore de Brier. Se as previsões se mantiverem, as palavras junior e senior podem sobreviver, com seu significado deslocado para o tamanho do trabalho que uma pessoa pode provar; se grandes empregadores substituem suas escadas de classificação por tal medida é em si uma previsão aqui (F17), registrada em p = 0.05.
Uma fronteira permanecerá seja qual for o resultado dessas previsões. Construir está se tornando uma alfabetização, como escrever. Responder pelo que é construído permanece uma profissão, e entre os dois fica a obscuridade, a condição do mercado de 2026, em que o bom trabalho passa despercebido e as plataformas fecham as portas para os desconhecidos. A pessoa que constrói através de agentes precisará de um parceiro que assine pelo trabalho, ou terá que se tornar esse parceiro, e o garante por sua vez pode ser medido pelo que garantiu e quanto disso se manteve.
Um ditado americano afirma que Deus criou homens e o Coronel Colt os tornou iguais. Os agentes fazem algo semelhante para a fabricação: com um, uma pessoa fora de um ofício pode produzir trabalho que parece o do ofício. Verificação é mais difícil de igualar (Seções 5.2 e 12). No estudo de avaliadores do Apêndice G, quase um em cada cinco pessoas admitidas na amostra de contabilidade por sua própria palavra responderam incorretamente a uma pergunta de primeira semana do ofício, e em uma comparação exploratória classificaram as tarefas maiores em menos horas do que o resto fez (Apêndice G2). Se um processo de verificações independentes pode fazer pela verificação o que agentes fizeram pela fabricação é a questão aberta da Seção 6.5. O que ainda separa as pessoas é o que elas podem verificar e aceitar, e é isso que o horizonte de delegação verificada mede.
Declarações
Financiamento. Nenhum financiamento externo apoiou este trabalho.
Conflito de interesses. O autor desenvolve métodos de orquestração de múltiplos modelos e apresentou candidaturas de patentes relacionadas (pendentes; nenhuma patente foi concedida). O autor projetou o programa de coorte pré-registrado descrito na Seção 11.5 e Apêndice G e seus materiais, e desenvolve uma aplicação de ensino que ajuda as pessoas a trabalhar com agentes de IA. Nenhuma descoberta neste artigo depende da implementação do autor; o instrumento no Apêndice C usa apenas a biblioteca padrão do Python.
Ferramentas e verificação. Assistentes de IA foram usados como instrumentos sob a direção do autor; as ideias, pesquisa e conclusões são do autor. Afirmações quantitativas e citações foram verificadas em relação a fontes primárias ou cópias arquivadas até 9 de outubro de 2026, ou até 10 de outubro de 2026 para as fontes adicionadas naquele dia, quando essas puderam ser recuperadas. Quando apenas um relatório de imprensa ou página de fornecedor estava disponível, a afirmação é atribuída a esse relatório ou fornecedor no texto. Os títulos dados entre colchetes nas referências são títulos descritivos para páginas cuja manchete não foi relida literalmente.
Disponibilidade de dados e código. O código e esquema do Apêndice C, o teste de mesa dos limites (Apêndice E) e os arquivos de predição são lançados sob a licença MIT em um repositório complementar (https://github.com/vadimchernets/delegation-horizon), arquivado no Zenodo como versão v1.1.0 (DOI conceitual 10.5281/zenodo.23267444, que resolve para a versão mais recente); o código impresso no Apêndice C é idêntico ao do repositório, byte a byte, e tools/paper_sync.py verifica isso, o exemplo trabalhado e as Tabelas 4 e A6 em relação ao repositório sempre que seus testes são executados junto a este texto. As predições das Tabelas 4 e A6 foram registradas no OSF em 9 de outubro de 2026 (DOI 10.17605/OSF.IO/VW6P9). O estudo de avaliadores Prolific do Apêndice G foi registrado no OSF em 9 de outubro de 2026, antes de quaisquer dados serem coletados (DOI 10.17605/OSF.IO/V92R8); seu script de análise (pilot/human_raters.py) é parte desse registro e está no repositório complementar tal como foi apresentado, com o SHA-256 que o OSF relata para cada arquivo apresentado listado em pilot/registered-SHA256.txt, junto com os scripts que convertem as exportações do Prolific, imprimem a Tabela G2 e executam a comparação de G2 que não foi registrada. Os dados anonimizados, com identificadores do Prolific substituídos por rótulos simples, serão adicionados à mesma pasta. Os arquivos registrados com as predições são listados com seu SHA-256 em predictions/registered-SHA256.txt e no manifesto apresentado no OSF, e um teste do repositório compara cada um deles com ele.
Ética. O Apêndice G relata duas fontes de dados de pessoas. O estudo de avaliadores Prolific é uma tarefa de classificação anônima online: profissionais adultos deram consentimento informado no Prolific antes de participar, foram pagos através da plataforma e não forneceram nomes ou detalhes de contato. O relato de coorte resume, sem nomes, locais ou idiomas, os registros de adultos que consentiram com o programa de coorte pré-registrado (OSF, DOI 10.17605/OSF.IO/X4EGQ) e com a publicação anonimizada; os resultados registrados do programa são relatados separadamente. O trabalho foi realizado por um pesquisador independente sem um comitê de ética institucional. Os tópicos públicos discutidos na Seção 9 são parafraseados, e seus autores não são nomeados.
Contribuições do autor. Único autor.
Correspondência. vadimchernets9@gmail.com · ORCID: 0009-0007-4845-3163
References
9to5Mac. (2026). [App Store new apps doubled in the first half of 2026, Sensor Tower data reported by The New York Times]. https://9to5mac.com/?p=1061510
AI Certification Standards. (2026). AI Competence Framework (version of 23 August 2026). https://www.aicertificationstandards.org/framework
AI Futures Project. (2026, April 2). Q1 2026 timelines update. https://blog.aifutures.org/p/q1-2026-timelines-update
aicodex. (2026). AI agent manager vs agent operator. https://www.aicodex.to/articles/ai-agent-manager-vs-agent-operator
Alenezi, M. (2026). From determinism to delegation: AI-native software engineering and the evolution of the agentic engineer. arXiv:2606.28791. https://arxiv.org/abs/2606.28791
Alonso, M. N. (2026). The artificial intelligence economy [working paper, ResearchGate; contains the proposition "A delegation horizon"].
AlternativeTo. (2026, January). OpenAI rolls out age prediction for ChatGPT accounts. https://alternativeto.net/news/2026/1/openai-rolls-out-age-prediction-for-chatgpt-accounts-to-automatically-estimate-your-age/
Andrist, R. K. (1962). Gold! American Heritage, 14(1). https://www.americanheritage.com/content/gold
Amplifying. (2026). What Claude Code actually chooses. https://amplifying.ai/research/claude-code-picks
Anthropic. (2025a, December 2). How AI is transforming work at Anthropic. https://www.anthropic.com/research/how-ai-is-transforming-work-at-anthropic
Anthropic. (2025b). AI Fluency framework (the four Ds). https://aifluencyframework.org/
Anthropic. (2026a, January 15). Anthropic Economic Index report: Economic primitives. https://www.anthropic.com/research/anthropic-economic-index-january-2026-report
Anthropic. (2026b, January 22). Claude's constitution. https://www.anthropic.com/constitution
Anthropic. (2026c, January 29). [AI assistance and coding skills: a randomised study of junior engineers]. https://www.anthropic.com/research/AI-assistance-coding-skills
Anthropic. (2026d, March 24). Anthropic Economic Index report: Learning curves. https://www.anthropic.com/research/economic-index-march-2026-report
Anthropic. (2026e, June 16). Agentic coding and persistent returns to expertise. https://www.anthropic.com/research/claude-code-expertise
Anthropic. (2026f, June 26). [Anthropic Economic Index report, June 2026]. https://www.anthropic.com/research/economic-index-june-2026-report
Arion Research. (2026, February 7). [The agent manager role]. https://www.arionresearch.com/blog/nfkxv53ktwxqkwtxwm2d03woml1c65
Artificial Lawyer. (2026, January 27). Claude Cowork: the DIY revolution in law. https://www.artificiallawyer.com/2026/01/27/claude-cowork-the-diy-revolution-in-law/
Atkinson, T., & Yamco, S. (2026, January 6). Young workers' employment drops in occupations with high AI exposure. Federal Reserve Bank of Dallas. https://www.dallasfed.org/research/economics/2026/0106
Batko, M. (2026, August 20). [Distribution is the moat]. Startmate. https://startmate.com/writing/distribution-is-the-moat
Benchek, J., et al. (2026). APEX-Accounting. arXiv:2607.27189. https://arxiv.org/abs/2607.27189
Berkeley California Management Review. (2025, July). Rethinking AI agents: A principal-agent perspective. https://cmr.berkeley.edu/2025/07/rethinking-ai-agents-a-principal-agent-perspective/
BetterUp. (2026, May 18). [Workslop research with Stanford]. https://www.betterup.com/blog/workslop-canada
Black Enterprise. (2017). [Mark Cuban on liberal arts and the future of work]. https://www.blackenterprise.com/mark-cuban-right-libreal-arts-key-future/amp/
Bloomberg Law. (2026, April 20). Vibe coding empowers lawyers to influence AI winners, losers. https://news.bloomberglaw.com/legal-exchange-insights-and-commentary/vibe-coding-empowers-lawyers-to-influence-ai-winners-losers
Bone, M., González Ehlinger, E., & Stephany, F. (2025). Skills or degree? The rise of skill-based hiring for AI and green jobs. Technological Forecasting and Social Change. https://doi.org/10.1016/j.techfore.2025.124042
Brier, G. W. (1950). Verification of forecasts expressed in terms of probability. Monthly Weather Review, 78(1), 1-3. https://doi.org/10.1175/1520-0493(1950)078<0001:VOFEIT>2.0.CO;2
Bancroft, H. H. (1888). History of California (Vol. 6, 1848-1859). The History Company. https://archive.org/details/historyofcaliforv6banc
Brynjolfsson, E., Li, D., & Raymond, L. (2025). Generative AI at work. The Quarterly Journal of Economics, 140(2), 889-942. https://doi.org/10.1093/qje/qjae044
Bureau of Labor Statistics. (2025). Photographers. Occupational Outlook Handbook, 2024-34 edition (archived 19 August 2026). https://web.archive.org/web/20260819060531/https://www.bls.gov/ooh/media-and-communication/photographers.htm
Bureau of Labor Statistics. (2026a). Photographers. Occupational Outlook Handbook (updated 27 August 2026). https://www.bls.gov/ooh/media-and-communication/photographers.htm (archived copy: https://web.archive.org/web/20261001165113/https://www.bls.gov/ooh/media-and-communication/photographers.htm)
Bureau of Labor Statistics. (2026b). 2028 SOC revision. https://www.bls.gov/soc/2028/2028_soc_revision.htm
Bureau of Labor Statistics. (2026c). Bookkeeping, accounting, and auditing clerks. Occupational Outlook Handbook (updated 27 August 2026). https://www.bls.gov/ooh/office-and-administrative-support/bookkeeping-accounting-and-auditing-clerks.htm
Burning Glass Institute & Harvard Business School. (2024). Skills-based hiring: The long road from pronouncements to practice. https://www.burningglassinstitute.org/research/skills-based-hiring-2024
Business Insider. (2026, January 22). [Deloitte gives US employees new job titles]. https://www.businessinsider.com/deloitte-gives-us-employees-new-job-titles-leader-role-2026-1
Cagan, M. (2025). The era of the product creator. SVPG. https://www.svpg.com/the-era-of-the-product-creator/
Capps, R. (2025, June 17). [New jobs that AI could create]. The New York Times Magazine. https://www.nytimes.com/2025/06/17/magazine/ai-new-jobs.html
Carta. (2025). Solo founders report 2025. https://carta.com/data/solo-founders-report
Carta. (2026a). 2026 founder ownership report. https://carta.com/data/founder-ownership-2026-full-report/
Carta. (2026b). State of pre-seed: Q2 2026. https://carta.com/data/state-of-pre-seed-q2-2026/
Challenger, Gray & Christmas. (2026). [Job cuts report, June 2026]. https://www.challengergray.com/wp-content/uploads/2026/07/Challenger-Report-June2600986996.pdf
Chen, X., & Meng, S. (2026). When AI levels the playing field: Skill homogenization, asset concentration, and two regimes of inequality. arXiv:2603.05565. https://arxiv.org/abs/2603.05565
Catalini, C., Hui, X., & Wu, J. (2026). Some simple economics of AGI. arXiv:2602.20946. https://arxiv.org/abs/2602.20946
Celenza, B. (2026, October 6). Building Git infrastructure for agent-scale development. GitHub Blog. https://github.blog/engineering/architecture-optimization/building-git-infrastructure-for-agent-scale-development/
Chernets, V. (2026a). After Chat: The three transitions between non-programmers and agentic AI. SSRN. https://doi.org/10.2139/ssrn.7520019 (Zenodo: https://doi.org/10.5281/zenodo.22943313)
Chernets, V. (2026b). Agreement is not independent evidence: Auditable multi-model synthesis without an API. SSRN. https://doi.org/10.2139/ssrn.7390698
Chernets, V. (2026c). AI-Watchbird (Sheckley): When automated oversight widens its own mandate and harms what it guards. SSRN. https://doi.org/10.2139/ssrn.7473658
Chernets, V. (2026d). Architectural trust: Why consumer trust in agentic commerce migrates from AI models to verifiable architecture. SSRN. https://doi.org/10.2139/ssrn.7191261
Chernets, V. (2026e). Three steps into agentic AI: A preregistered feasibility study of how non-programmers cross from chatbot to agent to multi-model orchestration (Cohort 1). OSF. https://doi.org/10.17605/OSF.IO/X4EGQ
CIO. (2026a, May 29). Amazon deletes devs' tokenmaxxing leaderboard to minimize costs. https://www.cio.com/article/4178825/amazon-deletes-devs-tokenmaxxing-leaderboard-to-minimize-costs-2.html
CIO. (2026b, September 4). Meta minimizes role of token-maxing in employee evaluations. https://www.cio.com/article/4218661/meta-minimizes-role-of-token-maxing-in-employee-evaluations-2.html
Clark, M. (2026). [Proposal for a Chartered Financial Intelligence Architect]. SSRN.
Collins Dictionary. (2025). Collins Word of the Year 2025. https://blog.collinsdictionary.com/language-lovers/collins-word-of-the-year-2025-ai-meets-authenticity-as-society-shifts/
Companies Act 2006, c. 46, ss. 1212 and 1213 (United Kingdom). Individuals and firms: eligibility for appointment as a statutory auditor; Effect of ineligibility (accessed 10 October 2026). https://www.legislation.gov.uk/ukpga/2006/46/section/1212 ; https://www.legislation.gov.uk/ukpga/2006/46/section/1213
Computing Research Association. (2026, June). [New CRA Taulbee Survey findings: record degree production alongside a cooling enrollment pipeline]. https://cra.org/crn/2026/06/cra-update-new-cra-taulbee-survey-findings-show-record-degree-production-alongside-a-cooling-enrollment-pipeline/
CSET. (2025). [Translation: China's notice on AI education in primary and secondary schools]. Center for Security and Emerging Technology. https://cset.georgetown.edu/publication/china-primary-secondary-ai-education-notice/
Crunchbase News. (2026, July 2). Crunchbase data: Global startup investment hit record $510B in H1 2026 as AI boom accelerates funding and exits. https://news.crunchbase.com/venture/global-startup-exits-ipo-ma-soar-ai-q2-h1-2026/
Danilova, A., Naiakshina, A., Horstmann, S., & Smith, M. (2021). Do you really code? Designing and evaluating screening questions for online surveys with programmers. 2021 IEEE/ACM 43rd International Conference on Software Engineering (ICSE), 537-548. https://doi.org/10.1109/ICSE43902.2021.00057
Dawson, R. (2026). [Framework: levels of AI delegation in decision making]. https://rossdawson.com/framework-levels-ai-delegation-decision-making
Dealroom. (2026). Mercor doubles to $2B gross revenue run-rate as AI labs buy expert data. https://dealroom.co/news/137121-mercor-doubles-to-2b-gross-revenue-run-rate-as-ai-labs-buy-expert-data/
Dell'Acqua, F., et al. (2025). The cybernetic teammate: A field experiment on generative AI reshaping teamwork and expertise. NBER Working Paper 33641. https://www.nber.org/papers/w33641
Dell'Acqua, F., et al. (2026). Navigating the jagged technological frontier: Field experimental evidence of the effects of artificial intelligence on knowledge worker productivity and quality. Organization Science, 37(2), 403-423. https://doi.org/10.1287/orsc.2025.21838
Digg. (2026). [Your job title is about to change: AI Agent Supervisor]. https://digg.com/aiagentchat/TvbtLF2/your-job-title-is-about-to
Dust. (2026, October 7). [Dust Index: AI strategy beyond models]. https://dust.tt/blog/dust-index-ai-strategy-beyond-models
EdWeek. (2026, June 11). [White House honors AI challenge winners]. https://www.edweek.org/technology/white-house-honors-ai-challenge-winners-as-tech-backlash-grows/2026/06
em360. (2026, September 7). [AI productivity and supervisory capacity]. https://em360tech.com/tech-articles/ai-productivity-supervisory-capacity
Engelbart, D. C. (1962). Augmenting human intellect: A conceptual framework (Summary Report AFOSR-3223). Stanford Research Institute.
Escape. (2026). Methodology: how we discovered vulnerabilities in apps built with vibe coding (accessed 9 October 2026). https://escape.tech/blog/methodology-how-we-discovered-vulnerabilities-apps-built-with-vibe-coding/
Esnaola, L. M., Ramón, H. D., & Lanzarini, L. C. (2026). Can generative AI bridge the gap? A quasi-experimental study of non-programmers with AI vs. programmers without AI. Empirical Software Engineering, 31(3), 75. https://doi.org/10.1007/s10664-026-10813-7 Replication package: https://doi.org/10.5281/zenodo.17803568
Eulerich, M., Sanatizadeh, A., Vakilzadeh, H., & Wood, D. A. (2024). Is it all hype? ChatGPT's performance and disruptive potential in the accounting and auditing industries. Review of Accounting Studies, 29(3), 2318-2349. https://doi.org/10.1007/s11142-024-09833-9
Fawzy, A., Tahir, A., & Blincoe, K. (2026). From prompting to verification: How experience shapes vibe coding practices. arXiv:2605.24521. https://arxiv.org/abs/2605.24521
Feldman, M. Q., & Anderson, C. J. (2024). Non-expert programmers in the generative AI future. CHIWORK 2024 (author version). https://www.feldmanmolly.com/chiwork2024-author-version.pdf
Feng, K. J. K., McDonald, D. W., & Zhang, A. X. (2025). Levels of autonomy for AI agents. arXiv:2506.12469. https://arxiv.org/abs/2506.12469
Flowtivity. (2026, February 24). Your boss will measure you in tokens. https://flowtivity.ai/blog/your-boss-will-measure-you-in-tokens/
Forrester. (2025, October). [Predictions 2026 for AI and technology leadership], as reported by iTWire. https://itwire.com/it-industry-news/strategy/forrester-unveils-2026-predictions-for-ai-and-tech-leadership.html
Fortune. (2025, May 7). [Prompt engineering, a six-figure role, now obsolete]. https://www.fortune.com/2025/05/07/prompt-engineering-200k-six-figure-role-now-obsolete-thanks-to-ai
Fortune. (2026a, January 22). [Deloitte's job title change]. https://www.fortune.com/2026/01/22/deloitte-job-title-change-ai-reshapes-big-4-accounting-consulting-firms
Fortune. (2026b, May 26). [Uber's chief operating officer on AI spending]. https://www.fortune.com/2026/05/26/uber-coo-ai-spending-tokens-claude-code/
Fortune. (2026c, July 7). [Cognition's chief executive on tokenmaxxing]. https://fortune.com/2026/07/07/cognition-ceo-tokenmaxxing-big-tech-carried-away-ai-productivity-gains/
Fox, S., Markham, L., Lail, R., & Karotsieris, M. (2026). LLM judges verify presence, not absence: Omission blindness in AI clinical notes and what recovers it. arXiv:2608.31016. https://arxiv.org/abs/2608.31016
Fu, H. Y., Shrivastava, A., Moore, J., West, P., Tan, C., & Holtzman, A. (2025). AbsenceBench: Language models can't tell what's missing. arXiv:2506.11440. https://arxiv.org/abs/2506.11440
Gama, et al. (2026). [Novice teams building software with AI]. ICSE 2026. arXiv:2512.02750. https://arxiv.org/abs/2512.02750
Gartner. (2009). Gartner Symposium/ITxpo Orlando brochure (use of "citizen developer"). https://www.gartner.com/imagesrv/symposium/pdf/orlando_symposium_conference_brochure.pdf
Gartner. (2021, June 10). Gartner says the majority of technology products and services will be built by professionals outside of IT by 2024. https://www.gartner.com/en/newsroom/press-releases/2021-06-10-gartner-says-the-majority-of-technology-products-and-services-will-be-built-by-professionals-outside-of-it-by-2024
Gartner. (2024, October 22). Gartner unveils top predictions for IT organizations and users in 2025 and beyond. https://www.gartner.com/en/newsroom/press-releases/2024-10-22-gartner-unveils-top-predictions-for-it-organizations-and-users-in-2025-and-beyond
Gartner. (2026). Tyagi, N. Govern vibe coding for citizen developers with self-service platforms (29 June 2026; document 8068765). https://www.gartner.com/en/documents/8068765 (subscriber access; figures cited as summarised by Tray.ai, 2026)
Gigazine. (2025, July 24). What are the results of the 'AccountingBench' benchmark, which tests an AI model for monthly accounting tasks? https://gigazine.net/gsc_news/en/20250724-accountingbench/
Gigazine. (2026, July 21). [Sensor Tower: new App Store apps in the first half of 2026]. https://www.gigazine.net/gsc_news/en/20260721-app-store-new-apps
GitHub. (2025a). Octoverse: A new developer joins GitHub every second as AI leads TypeScript to #1. https://github.blog/news-insights/octoverse/octoverse-a-new-developer-joins-github-every-second-as-ai-leads-typescript-to-1/
GitHub. (2025b, December 8). The new identity of a developer: What changes and what doesn't in the AI era. https://github.blog/news-insights/octoverse/the-new-identity-of-a-developer-what-changes-and-what-doesnt-in-the-ai-era/
Growthy. (2026, September 23). Claude Code vs Codex for bookkeeping. https://growthy.com/blog/claude-code-vs-codex-for-bookkeeping
Haize Labs. (2026). Vertical AI Lead [job posting]. https://job-boards.greenhouse.io/haizelabs/jobs/5173890008
Hashimoto, M. (2026). Vouch [repository]. https://github.com/mitchellh/vouch
HCA Magazine. (2026, July 29). [Atlassian introduces AI wallets for employees]. https://www.hcamag.com/ca/news/general/atlassian-introduces-new-ai-wallets-to-employees/584258
Hosseini, S. M., & Lichtinger, G. (2026, May 6). Generative AI as seniority-biased technological change [Working paper; earlier version SSRN 5425555, 2025]. https://raw.githack.com/s-mahdihosseini/Website/b99fa2962dcc4c165bbc3c41dd283afa99c5ccfb/GenAI_SenBTC_May_2026.pdf
Huang, L., Xiao, W., & Vishnoi, N. K. (2026). Delegation and verification under AI. Accepted at ICML 2026. arXiv:2603.02961. https://arxiv.org/abs/2603.02961
Hwang, J. (2026, February 13). Claude Code is the new Excel. https://nextword.substack.com/p/claude-code-is-the-new-excel
Indeed Hiring Lab. (2026, January 28). Where do college degrees still matter in a "skills-first" job market? https://hiringlab.indeed.com/2026/01/28/where-do-college-degrees-still-matter-in-a-skills-first-job-market/
IT Brew. (2026, June 5). AI orchestrators are the newest in-demand AI role. https://www.itbrew.com/stories/ai-orchestrators-are-the-newest-in-demand-ai-role
Jaques, E. (1956). Measurement of responsibility: A study of work, payment and individual capacity. Tavistock Publications. (Reviewed in Industrial and Labor Relations Review, 10(3), 475. https://doi.org/10.2307/2519792)
Jensen, M. C., & Meckling, W. H. (1976). Theory of the firm: Managerial behavior, agency costs and ownership structure. Journal of Financial Economics, 3(4), 305-360. https://doi.org/10.1016/0304-405X(76)90026-X
Journal of Accountancy. (2025, May 14). AICPA, NASBA approve new CPA licensure path. https://www.journalofaccountancy.com/news/2025/may/aicpa-nasba-approve-new-cpa-licensure-path/
Kamara, S. (2026). Verification friction. SSRN. https://doi.org/10.2139/ssrn.6469865
Karpathy, A. (2025, February 2). [Post introducing "vibe coding"]. X. https://x.com/karpathy/status/1886192184808149383
Karpathy, A. (2026, April 30). Sequoia AI Ascent 2026 [talk notes]. https://karpathy.bearblog.dev/sequoia-ascent-2026/
Khadj, O. J. (2026). The delegation frontier. SSRN. https://doi.org/10.2139/ssrn.7348378
Kim, E., Garg, A., Peng, K., & Garg, N. (2025). Correlated errors in large language models. Accepted at ICML 2025. arXiv:2506.07962. https://arxiv.org/abs/2506.07962
Kingy AI. (2026, May 4). Token spend is coming for your performance review. https://kingy.ai/news/token-spend-is-coming-for-your-performance-review-and-mine/
Ko, A. J., Abraham, R., Beckwith, L., Blackwell, A., Burnett, M., Erwig, M., Scaffidi, C., Lawrance, J., Lieberman, H., Myers, B., Rosson, M. B., Rothermel, G., Shaw, M., & Wiedenbeck, S. (2011). The state of the art in end-user software engineering. ACM Computing Surveys, 43(3), 21. https://doi.org/10.1145/1922649.1922658
Krebs, A. (2026). [Design slop and Show HN]. https://www.adriankrebs.ch/blog/design-slop/
Kwa, T., et al. (2025). Measuring AI ability to complete long tasks. arXiv:2503.14499. https://arxiv.org/abs/2503.14499
Legal Services Act 2007, c. 29, s. 12 (England and Wales). Meaning of "reserved legal activity" and "legal activity" (accessed 10 October 2026). https://www.legislation.gov.uk/ukpga/2007/29/section/12
Lenny's Newsletter. (2025). [Why LinkedIn is replacing PMs]. https://www.lennysnewsletter.com/p/why-linkedin-is-replacing-pms
Lex Fridman Podcast. (2026, August 26). #501, David Heinemeier Hansson [transcript]. https://lexfridman.com/dhh-2-transcript/
Lightcast. (2026a, August 7). Tracking the agentic AI explosion in jobs. https://lightcast.io/resources/blog/tracking-the-agentic-ai-explosion-in-jobs
Lightcast. (2026b, September 9). [Degree requirements still higher for AI jobs]. https://lightcast.io/resources/blog/degree-requirements-ai-jobs
LinkedIn. (2026a, January). LinkedIn gives professionals the edge with verified skills and tools to navigate the job search. https://news.linkedin.com/2026/Professional_Edge_Skills_Verified
LinkedIn. (2026b, April). Q3 earnings and business highlights. https://news.linkedin.com/2026/Q3-Earnings-Highlights
LinkedIn Economic Graph. (2026). AI labor market update, August 2026. https://delivery-p143253-e1476319.adobeaemcloud.com/adobe/assets/urn:aaid:aem:ef153078-1061-4817-82e7-a1c027d7a7d7/original/as/AI-Labor-Market-Update-August-2026-v2.pdf
Manifold. (2026a). [Will it be common for non-programmers to create small scripts using AI by 2027?] (accessed 9 October 2026). https://manifold.markets/jskf/will-it-be-common-for-nonprogrammer-dfc979ea7fec
Manifold. (2026b). [Will the number of junior developer roles fall by a third by 2030?] (accessed 9 October 2026). https://manifold.markets/OliverKuperman/will-the-number-of-junior-developer
Manifold. (2026c). [Will the number of people employed as software developers in the US fall by more than 15% from 2023 to 2028?] (accessed 9 October 2026). https://manifold.markets/MatthewBarnett/will-the-number-of-people-employed
McAleese, N., Pokorny, R. M., Ceron Uribe, J. F., Nitishinskaya, E., Trebacz, M., & Leike, J. (2024). LLM critics help catch LLM bugs. arXiv:2407.00215. https://arxiv.org/abs/2407.00215
McKinsey & Company. (2025, January). Superagency in the workplace: Empowering people to unlock AI's full potential at work. https://www.mckinsey.com/~/media/mckinsey/business%20functions/quantumblack/our%20insights/superagency%20in%20the%20workplace%20empowering%20people%20to%20unlock%20ais%20full%20potential%20at%20work/superagency-in-the-workplace-empowering-people-to-unlock-ais-full-potential-v4.pdf
MediaNama. (2026, April). [Claude users' accounts suspended after being flagged as minors]. https://www.medianama.com/2026/04/223-claude-users-accounts-suspended-flagged-minors/
Memari, M., & Rudolph, G. (2026). The capability ladder. arXiv:2608.07779. https://arxiv.org/abs/2608.07779
Menlo Ventures. (2025). 2025: The state of generative AI in the enterprise. https://menlovc.com/perspective/2025-the-state-of-generative-ai-in-the-enterprise/
Metal Toad. (2026). 6 levels of AI delegation: A framework for AI management. https://www.metaltoad.com/blog/6-levels-of-ai-delegation-a-framework-for-ai-management
Metaview. (2026). [AI use in hiring interviews]. https://www.metaview.ai/resources/blog/ai-baseline-shopify-memo-hiring-process
METR. (2025, July 10). Measuring the impact of early-2025 AI on experienced open-source developer productivity. https://metr.org/blog/2025-07-10-early-2025-ai-experienced-os-dev-study/
METR. (2026a, February 19). [Five lessons from an AI biology randomised trial]. https://metr.org/blog/2026-02-19-five-lessons-from-ai-biology-rct
METR. (2026b, March 10). Many SWE-bench-passing PRs would not be merged into main. https://metr.org/notes/2026-03-10-many-swe-bench-passing-prs-would-not-be-merged-into-main/
METR. (2026c). Time horizons (dashboard, accessed 9 October 2026). https://metr.org/time-horizons/
METR. (2026d). eval-analysis-public, release time-horizon 1.1, runs.jsonl [Data set]. GitHub. https://github.com/METR/eval-analysis-public (accessed 9 October 2026)
Microsoft. (2025, April 23). 2025: The year the Frontier Firm is born. Work Trend Index. https://www.microsoft.com/en-us/worklab/work-trend-index/2025-the-year-the-frontier-firm-is-born
Microsoft. (2026a, May 5). Agents, human agency and the opportunity for every organization. Work Trend Index 2026. https://www.microsoft.com/en-us/worklab/work-trend-index/agents-human-agency-and-the-opportunity-for-every-organization
Microsoft. (2026b, May 5). How Frontier Firms are rebuilding the operating model for the age of AI. https://blogs.microsoft.com/blog/2026/05/05/how-frontier-firms-are-rebuilding-the-operating-model-for-the-age-of-ai/
MindStudio. (2026, June 11). What is agent literacy? https://www.mindstudio.ai/blog/what-is-agent-literacy-core-skill-ai-builders
n8n. (2026). AI Product Builder [job posting]. https://jobs.ashbyhq.com/n8n/42e72645-d99a-4545-97b7-53ba3a699893
Nature Portfolio. (2026, February 9). [Press release: people using language models for medical scenarios, Nature Medicine]. https://www.natureasia.com/en/info/press-releases/detail/9231
Ng, A. (2026, August 28). The AI engineering skills map in detail: Software engineering fundamentals. The Batch. https://www.deeplearning.ai/the-batch/the-ai-engineering-skills-map-in-detail-software-engineering-fundamentals
OECD. (2026, February). Venture capital investments in artificial intelligence through 2025. https://www.oecd.org/en/publications/venture-capital-investments-in-artificial-intelligence-through-2025_a13752f5-en/full-report.html
OECD & European Commission. (2026, June). [AI literacy framework for primary and secondary education]. https://ailiteracyframework.org/blog/empowering-learners-for-the-age-of-ai-literacy-framework/
O'Neill, N. (2026). [The Product Principal, LinkedIn post]. https://www.linkedin.com/posts/nicholasoneill_the-product-principal-activity-7445921322486009856-hAwj
Ono, A. (2026, June 22). [Defining the roles of humans and AI]. World Economic Forum. https://www.weforum.org/stories/artificial-intelligence/future-of-work-define-roles-humans-ai/
Open Source For You. (2026, February). GitHub weighs pull request kill switch as AI slop floods open source. https://www.opensourceforu.com/2026/02/github-weighs-pull-request-kill-switch-as-ai-slop-floods-open-source/
OpenAI. (2026, June). How agents are transforming work. https://openai.com/index/how-agents-are-transforming-work/
OpenAIRE. (2025, December 9). Zenodo introduces a new way to manage and correct published records. https://www.openaire.eu/zenodo-introduces-a-new-way-to-manage-and-correct-published-records
Oregon State Board of Bar Examiners. (2026, January 26). Supervised Practice Portfolio Examination: First annual report to the Oregon Supreme Court. https://www.osbar.org/_docs/sppe/2025SPPEAnnualReport.pdf
OSF. (2026). Updating registrations; Addressing fear of scooping on OSF preregistrations (help pages, accessed 9 October 2026). https://help.osf.io/hc/en-us/sections/4414482864279-Updating-Registrations ; https://help.osf.io/article/634-addressing-fear-of-scooping-on-osf-preregistrations
Page, M. J., McKenzie, J. E., Bossuyt, P. M., et al. (2021). The PRISMA 2020 statement: An updated guideline for reporting systematic reviews. BMJ, 372, n71. https://doi.org/10.1136/bmj.n71
Park, Y. S., et al. (2026). The work behind delegation: A framework for supervising AI coding agents. arXiv:2609.24234. https://arxiv.org/abs/2609.24234
Paul, R. W. (1947). California gold: The beginning of mining in the Far West. Harvard University Press. https://archive.org/details/in.ernet.dli.2015.177982
Patwardhan, T., et al. (2025). GDPval: Evaluating AI model performance on real-world economically valuable tasks. arXiv:2510.04374. https://arxiv.org/abs/2510.04374
Penrose. (2025). Can LLMs do accounting? [AccountingBench]. https://accounting.penrose.com/ (figures cited as reported by Gigazine, 2025)
Phoenix, J. (2026). [Five levels, gated by verification]. https://understandingdata.com/posts/five-levels-gated-by-verification/
PPC Land. (2026, March 6). The app middle class is dying, and RevenueCat's data shows exactly how fast. https://ppc.land/the-app-middle-class-is-dying-and-revenuecats-data-shows-exactly-how-fast/
Prolific. (2026, July 13). How do I use Prolific's filters? Researcher help centre (accessed 10 October 2026). https://researcher-help.prolific.com/en/articles/445159-how-do-i-use-prolific-s-filters
PwC. (2026). AI Jobs Barometer 2026 (press release). https://www.pwc.com/id/en/media-centre/press-release/2026/english/ai-jobs-barometer-en.html
Reid, B., Wagner, M., d'Amorim, M., & Treude, C. (2022). Software engineering user study recruitment on Prolific: An experience report. RoPES 2022. arXiv:2201.05348. https://arxiv.org/abs/2201.05348
Retool. (2026, February 17). Retool's 2026 Build vs. Buy Report (press release). https://www.businesswire.com/news/home/20260217548274/en/Retools-2026-Build-vs.-Buy-Report-Reveals-35-of-Enterprises-Have-Already-Replaced-SaaS-With-Custom-Software
RevenueCat. (2026). State of subscription apps 2026. https://www.revenuecat.com/state-of-subscription-apps ; https://www.revenuecat.com/sosa-26-insights/
Rogers, E. M. (2003). Diffusion of innovations (5th ed.). Free Press. ISBN 978-0743222099.
Sadki, R. (2026, August 14). [Quotes from the agentic AI summit in Berkeley]. https://redasadki.me/2026/08/14/you-cannot-send-an-ai-agent-to-jail-the-scariest-quotes-from-the-agentic-ai-summit-in-berkeley/
Sarbanes-Oxley Act of 2002, Pub. L. No. 107-204, sections 102 and 104 (15 U.S.C. 7212 and 7214) (United States) (accessed 10 October 2026). https://www.law.cornell.edu/uscode/text/15/7212 ; https://www.law.cornell.edu/uscode/text/15/7214
Savva, N. (2026). Context engineering: A principal-agent theory of AI-augmented knowledge work. SSRN. https://doi.org/10.2139/ssrn.6506600
Search Engine Journal. (2026). Marketers report highest rates of AI brain fry. https://www.searchenginejournal.com/marketers-report-highest-rates-of-ai-brain-fry-report-finds/569110/
SemiAnalysis. (2026, February). Claude Code is the inflection point. https://newsletter.semianalysis.com/p/claude-code-is-the-inflection-point
Serafini, R., Otto, C., Horstmann, S. A., & Naiakshina, A. (2024). ChatGPT-resistant screening instrument for identifying non-programmers. Proceedings of the IEEE/ACM 46th International Conference on Software Engineering (ICSE 2024), 1-13. https://doi.org/10.1145/3597503.3639075
Serafini, R., Weber, N., Yardim, A., Horstmann, S. A., & Naiakshina, A. (2026). Robust methods for developer screening in rapidly evolving AI contexts. Proceedings of the 2026 CHI Conference on Human Factors in Computing Systems (CHI '26), 1-18. https://doi.org/10.1145/3772318.3790302
SF Standard. (2026, March 5). [In AI land, everyone's a builder now]. https://sfstandard.com/2026/03/05/engineer-2025-ai-land-everyone-s-builder-now/
Shao, Y., et al. (2025). Future of work with AI agents: Auditing automation and augmentation potential across the U.S. workforce. arXiv:2506.06576. https://arxiv.org/abs/2506.06576
Shapiro, D. (2026, January). The five levels: From spicy autocomplete to the software factory. https://www.danshapiro.com/blog/2026/01/the-five-levels-from-spicy-autocomplete-to-the-software-factory/
Shopifreaks. (2026a). Meta employees compete on an internal AI token leaderboard called Claudeonomics. https://www.shopifreaks.com/meta-employees-compete-on-an-internal-ai-token-leaderboard-called-claudeonomics-that-tracked-60-trillion-tokens-in-30-days/
Shopifreaks. (2026b). Meta stops grading employees on how much AI they use, dropping token counts and AI Native labels from performance reviews (reporting WIRED, 2 September 2026). https://www.shopifreaks.com/meta-stops-grading-employees-on-how-much-ai-they-use-dropping-token-counts-and-ai-native-labels-from-performance-reviews/
Shopify. (2026). AI usage (candidate guide). https://www.shopify.com/careers/candidate-guide/ai-usage
Simon, H. A. (1971). Designing organizations for an information-rich world. In M. Greenberger (Ed.), Computers, communications, and the public interest (pp. 37-72). Johns Hopkins Press.
Srinivasan, S., & Wei, V. (2026, February 12). To thrive in the AI era, companies need agent managers. Harvard Business Review. https://hbr.org/2026/02/to-thrive-in-the-ai-era-companies-need-agent-managers
Stanford Digital Economy Lab. (2026a, August 12). [Canaries in the coal mine: August 2026 update]. https://digitaleconomy.stanford.edu/news/canariesaug26/
Stanford Digital Economy Lab. (2026b, October 7). Task expansion with generative AI: Experimental evidence on middle-skilled early-career workers. https://digitaleconomy.stanford.edu/publication/task-expansion-with-generative-aiexperimental-evidence-on-middle-skilled-early-career-workers/
Stanford HAI. (2026). AI Index Report 2026, chapter 4: Economy. https://hai.stanford.edu/assets/files/ai_index_report_2026_chapter_4_economy.pdf
Startup Fortune. (2026). Guillermo Rauch says AI agents now trigger more than half of all Vercel deployments. https://startupfortune.com/guillermo-rauch-says-ai-agents-now-trigger-more-than-half-of-all-vercel-deployments/
State Street. (2026). Agentic Product Builder, Senior Associate [job posting]. https://statestreet.wd1.myworkdayjobs.com/en-US/Global/job/Agentic-Product-Builder--Sr-Associate---State-Street-Investment-Managment_R-796094
Stenberg, D. (2026, January 26). The end of the curl bug bounty. https://daniel.haxx.se/blog/2026/01/26/the-end-of-the-curl-bug-bounty/
Stripe. (2026, May 28). Solo founding is at an all-time high: Top performers have these traits in common. https://stripe.com/blog/top-solo-founder-traits
TechCrunch. (2026a, September 24). Lovable's annualized revenue crosses $600M as vibe coding takes off. https://techcrunch.com/2026/09/24/lovables-annualized-revenue-crosses-600m-as-vibe-coding-takes-off/
TechCrunch. (2026b, April 18). The App Store is booming again, and AI may be why. https://techcrunch.com/2026/04/18/the-app-store-is-booming-again-and-ai-may-be-why/
TechCrunch. (2026c, July 30). LinkedIn adds a button to report AI-generated "slop". https://techcrunch.com/2026/07/30/linkedin-adds-a-button-to-report-ai-generated-slop/
TechRepublic. (2025). [Prompt engineering jobs called obsolete]. https://www.techrepublic.com/article/news-prompt-engineering-ai-jobs-obsolete/
The Decoder. (2025, September). AI-generated workslop is costing companies millions and hurting team morale, study finds. https://the-decoder.com/ai-generated-workslop-is-costing-companies-millions-and-hurting-team-morale-study-finds/
The Decoder. (2026, July 12). LinkedIn is the undisputed king of long-form AI slop, according to a study spanning five platforms. https://the-decoder.com/linkedin-is-the-undisputed-king-of-long-form-ai-slop-according-to-a-study-spanning-five-platforms/
The geometry of learning under AI delegation. (2026). [Review of the paper]. https://www.themoonlight.io/fr/review/the-geometry-of-learning-under-ai-delegation
Tikhomirov, S. (2026, September). [The AIDEs framework: levels of delegation in software development]. JetBrains Research. https://blog.jetbrains.com/research/2026/09/aides-framework/
Tomašev, N., Franklin, M., & Osindero, S. (2026). Intelligent AI delegation. arXiv:2602.11865. https://arxiv.org/abs/2602.11865
Tray.ai. (2026). Gartner: Govern vibe coding for citizen developers with self-service platforms [Guide summarising Tyagi, 2026]. https://tray.ai/guides/gartner-govern-vibe-coding/
Turkovic, I. (2026, April 24). [AI job titles in 2026: naming chaos]. https://www.ivanturkovic.com/2026/04/24/ai-job-titles-2026-naming-chaos/
Turner, S. (2026). [An AI biosecurity uplift randomised trial by Scale AI and SecureBio]. https://blog.stephenturner.us/p/ai-biosecurity-uplift-rct
University of Lübeck, Institute for Multimedia and Interactive Systems. (2026). [The cost of convenience: decision horizons, CHI 2026]. https://www.imis.uni-luebeck.de/en/node/11007
Veracode. (2026, July 28). LLMs are getting smarter but not safer: Veracode 2026 GenAI code security report. https://www.veracode.com/news/llms-are-getting-smarter-but-not-safer-veracode-2026-genai-code-security-report-finds-ai-generated-code-security-has-stalled-at-56%25-pass-rate/
Verheul, J. (2026). The principal firm: Organisational form when the agency function is performed by machines. SSRN. https://doi.org/10.2139/ssrn.7235518
Veri', D. (2026). Beyond AI literacy: A structured review and exploratory meta-analysis of measures for competent generative-AI use. arXiv:2609.15624. https://arxiv.org/abs/2609.15624
Virk, Y., & Liu, D. (2025). Non-programmers assessing AI-generated code: A case study of business users analyzing data. VL/HCC 2025. arXiv:2508.06484. https://arxiv.org/abs/2508.06484
Wang, S. (2026). The delegation efficient frontier. SSRN. https://doi.org/10.2139/ssrn.7275801
Washington Monthly. (2026, May 29). [AI and entry-level jobs for college graduates]. https://washingtonmonthly.com/2026/05/29/ai-entry-level-jobs-college-graduates/
White House. (2025, April 23). Advancing artificial intelligence education for American youth. https://www.whitehouse.gov/presidential-actions/2025/04/advancing-artificial-intelligence-education-for-american-youth/
Willison, S. (2025a, February 3). A computer can never be held accountable. https://simonwillison.net/2025/Feb/3/a-computer-can-never-be-held-accountable/
Willison, S. (2025b, June 22). [Kent Beck on skills going to zero and up 1000x]. https://simonwillison.net/2025/Jun/22/kent-beck
Willison, S. (2026a). What is agentic engineering? https://simonwillison.net/guides/agentic-engineering-patterns/what-is-agentic-engineering/
Willison, S. (2026b, February 7). [Vouch]. https://simonwillison.net/2026/Feb/7/vouch/
Writer. (2026). [The AI agent owner]. https://writer.com/blog/ai-agent-owner/
Xinhua. (2025, September 19). [Beijing pupils build AI agents in class]. https://english.news.cn/20250919/740f7bd40ec84b69b9d983e1068a94ac/c.html
Yale Budget Lab. (2026, May 7). AI is probably not (yet) the reason for labor market weakening. https://budgetlab.yale.edu/research/ai-probably-not-yet-reason-labor-market-weakening
Yang, et al. (2026). [How people work with an autonomous search agent]. arXiv:2606.07489. https://arxiv.org/abs/2606.07489
Yegge, S. (2026). Welcome to Gas Town. https://steve-yegge.medium.com/welcome-to-gas-town-4f25ee16dd04
Apêndice A. Glossário
Hora de referência. O tempo que um especialista qualificado levaria para realizar um trabalho manualmente, obtido de um banco de tarefas congelado ou de dois avaliadores independentes que não sabem quem fez o trabalho.
Horizonte de delegação verificado. O maior tamanho de trabalho, em horas de referência, no qual uma pessoa regularmente delega trabalho a agentes, o aceita e o faz confirmar por uma verificação independente que os agentes não viram. Avaliado por domínio pela regra da Seção 5.2.
Verificação independente. Testes de aceitação ocultos, um revisor humano qualificado, uso real pelos usuários previstos, ou um modelo de outra família verificando contra fontes, diferindo dos agentes em dados, acesso e incentivos. Autorrevisão e concordância entre modelos de uma mesma família não são verificações independentes.
Erro plantado. Um erro colocado em uma tarefa antes da entrega, que a pessoa deve detectar, seja uma entrada incorreta ou uma omissão de algo que o trabalho deve conter. Uma peça com um erro plantado não detectado não conta como verificada, e qualquer falta na janela de um degrau bloqueia os degraus a partir de Semana para cima.
Ganho de amplificação. Horas de referência de trabalho aceito e verificado divididas pelas horas de atenção da pessoa nos últimos 91 dias no domínio, trabalho falhado incluído no denominador e trabalho feito com ajuda externa excluído do numerador.
Teto de ganho. Em um modelo simplificado, o ganho de amplificação G para uma peça de H horas de referência cuja verificação leva V horas de atenção satisfaz G ≤ H / V, ou seja, um dividido pela fração de tempo manual que a verificação leva.
Degraus. Hora (cerca de 1 hora de referência), Dia (cerca de 8), Semana (cerca de 40), Mês (cerca de 160), Trimestre (cerca de 500). Contagens e janelas das regras v1.1: dez peças em 91 dias para Hora e Dia, seis em 182 dias para Semana, seis em 365 dias para Mês (cinco delas verificadas), três em 365 dias para Trimestre. Para Semana e acima, pelo menos uma peça verificada do tamanho do degrau nos últimos 91 dias.
Registro. Domínio · horizonte · amplificação · data, por exemplo "contabilidade de pequenas empresas · Dia · ×2 · 2026-Q4".
Letramento de aceitação. A competência de afirmar antecipadamente o que contará como concluído e, em seguida, comprová-lo com evidências que um agente não consiga fabricar.
Neutralidade de procedência. A hipótese de que, em um horizonte verificado igual em um domínio, uma educação em programação não prediz a qualidade do trabalho submetido a verificação independente uma vez que a expertise no domínio e o letramento de aceitação sejam considerados.
Ponto de cruzamento de credenciais. O momento, em um domínio, quando produtos de pessoas sem educação em TI, aceitos sob as mesmas verificações, começam a superar aqueles de programadores usando os mesmos agentes, após o qual requisitos de grau e os rótulos júnior e sênior perdem peso preditivo na contratação. Seus componentes são paridade de qualidade (o passo anterior), ultrapassagem (o momento), o cruzamento em postagens (o sinal) e neutralidade de procedência (o mecanismo).
Fiador. Uma pessoa que assina por um produto feito por outros e responde por ele a seu círculo, medida por quantos produtos endossou e quantos se mantiveram.
Finalizador. Uma pessoa que leva um produto a seus usuários.
Dois mercados. Fazer para si mesmo (letramento) e trabalho para outros com consequências (profissão).
Apêndice B. Registro de buscas, 8 e 9 de outubro de 2026
Verificações na web de nomes e termos foram realizadas em 8 de outubro de 2026 com vários assistentes de IA fazendo buscas independentemente e em paralelo, e em 9 de outubro de 2026 por um assistente com busca web estendida. Cada resposta foi mantida na íntegra, com suas fontes. Verificações acadêmicas foram realizadas em 9 de outubro de 2026, conforme apresentado a seguir.
| Base | O que pesquisa | Resultado para os termos deste artigo |
|---|---|---|
| arXiv (API) | Frase exata, todos os campos | "delegation horizon": 0; "delegation ladder" ou "ladder of delegation": 0; "time span of discretion": 0 |
| Semantic Scholar | Título e resumo | Uma busca retornou 0 e outra foi limitada por taxa (HTTP 429); a ser repetida antes da submissão |
| OpenAlex | Título, resumo, alguns textos completos | "credential crossover": 0; "agentwright": apenas correspondências não relacionadas; "background neutrality": não relacionado; "acceptance literacy": trabalhos sobre aceitação de tecnologia apenas |
| Crossref | Metadados incluindo resumos SSRN | "principal" como profissão: teoria de agência apenas |
| Europe PMC | Textos completos abertos | Sem correspondências exatas |
| Zenodo | Registros e descrições | Nenhuma correspondência para nenhum termo |
| DOAJ | Periódicos de acesso aberto | "delegation horizon": quatro correspondências não relacionadas |
| Google Scholar | Textos completos, SSRN | "delegation horizon": 6, usados em artigos de 2026 para máquinas ou empresas (Khadj, 2026; Alonso, 2026); "verified delegation horizon", "credential crossover", "credential crossover point" e "agentwright": 0 (repetido em 9 de outubro de 2026 sem erros); "acceptance literacy", "background neutrality" e "amplification gain": correspondências apenas em outros sentidos |
| DBLP; SSRN pages | Bloqueado por proteção contra bots (DBLP) ou retornou 403 (SSRN); coberto através de Crossref e Scholar |
Previsões anteriores foram pesquisadas em Metaculus, Manifold, Good Judgment Open, Kalshi, Polymarket e Long Bets, e na web aberta; Metaculus e algumas páginas do Gartner retornaram HTTP 403 e foram lidas através de cópias arquivadas ou reimpressas quando disponíveis. Os resultados são resumidos na Seção 11.3. O relato segue o item 6 do PRISMA 2020 (Page et al., 2021): cada base e a data do último acesso estão listadas. Uma correspondência que não é encontrada é relatada como não encontrada naquela data, e nenhuma afirmação é feita sobre bases que não foram pesquisadas.
Apêndice C. O instrumento de medição
Este apêndice fornece um instrumento de pesquisa, um formato de registro e um avaliador, na biblioteca padrão do Python, sob a licença MIT. Ele ensina como as regras da Seção 5.2 se tornam código. Não é um aplicativo e não toma decisão alguma sobre qualquer pessoa além de calcular os dois números de registros que a pessoa ou um pesquisador fornece. Não julga se uma verificação foi bem escolhida; confia nos campos que lhe são fornecidos. Em particular, não testa independência. Das três condições da Seção 5.2 (dados, acesso e incentivos), lê apenas o tipo de verificação e se os agentes a viram, e a independência em si é confirmada pela auditoria aleatória da Tabela 3.
C1. O registro
Uma linha de um arquivo JSON Lines por peça de trabalho entregue aos agentes, escrita quando a peça é aceita, rejeitada ou abandonada. A data em que a entrega começou vai no campo started, esperado das regras v1.1; o avaliador ainda lê linhas sem ela e avisa. As peças que falharam na verificação ou foram abandonadas permanecem no registro.
{"person": "P07", "domain": "small-business bookkeeping", "started": "2026-09-10", "date": "2026-09-14",
 "reference_hours": 8, "reference_basis": "two raters",
 "attention_minutes": 95, "mode": "stages",
 "check": "expert", "agent_saw_check": false, "passed": true,
"irreversible": false, "planted_errors": 0, "planted_missed": 0, "outside_help": false}| Campo | Significado |
|---|---|
| person | Um rótulo pseudônimo, nunca um nome real |
| domain | O domínio em que o trabalho foi aceito |
| date | Data de aceitação, rejeição ou abandono, quando a linha é escrita (formato ISO) |
| started | Data em que a transferência começou (formato ISO); esperado a partir das regras v1.1, não posterior a date |
| reference_hours | Horas de trabalho manual de um especialista qualificado para todo o entregável |
| reference_basis | De onde a referência veio: um banco de tarefas nomeado ou dois avaliadores |
| attention_minutes | Os minutos da pessoa em planejamento, instrução, leitura, verificação e correção |
| mode | one_piece, stages ou together (one_piece conta para a participação diretiva da Seção 5.7) |
| check | hidden_tests, expert, real_use, other_family_with_sources, same_family, self_review ou none |
| agent_saw_check | Se os agentes puderam ver a verificação (deve ser false para contar) |
| passed | Se a verificação passou (false para peças falhadas ou abandonadas) |
| irreversible | Se um erro neste tipo de trabalho não pode ser desfeito (esta peça deve então passar) |
| planted_errors | Quantos erros foram plantados na tarefa antes da transferência |
| planted_missed | Quantos deles a pessoa não conseguiu detectar (qualquer falha torna a peça não verificada e bloqueia Week e acima na janela) |
| outside_help | Se um colega ou contratado ajudou fora do registro (tal peça não adiciona nada ao numerador do ganho) |
| task_id, model, tools | Opcional: identificador do banco de tarefas, os agentes e modelos utilizados e suas ferramentas (Seção 5.4) |
| checker | Opcional: quem ou o que executou a verificação, como um papel, nunca um nome real |
| rater_hours | Opcional: as estimativas dos avaliadores por trás de reference_hours; se houver dois e o maior for mais de 1,5 vezes o menor, o calculador imprime "needs third rater" (Tabela 3); com uma terceira estimativa a mediana decide e a flag não é impressa |
| audit | Opcional: none, passed ou failed, o resultado de uma segunda verificação independente; uma auditoria falhada torna a peça não verificada |
| revoked | Opcional: true se um resultado atrasado revogou a peça (Tabela A4); uma peça revogada é não verificada |
C2. horizon.py
O código abaixo implementa as regras v1.1 e é idêntico, byte por byte, a horizon.py no repositório complementar.
#!/usr/bin/env python3
"""horizon.py: score the verified delegation horizon and the amplification gain.

Teaches: how the rules of Section 5.2 turn a log of work handed to agents into a dated record
"domain . horizon . gain . quarter". Limits: it trusts the fields it is given; it does not
judge whether a check was well chosen or whether the reference hours are fair.
Usage: python3 horizon.py work-log.jsonl --as-of 2026-10-09 [--stable]   Rules v1.1   Licence: MIT
"""
import argparse
import datetime as dt
import json
import math
import sys
import statistics
from collections import Counter, defaultdict

# rung, reference hours, minimum pieces, window in days (provisional; Section 5.8)
RUNGS = [("Quarter", 500.0, 3, 365), ("Month", 160.0, 6, 365), ("Week", 40.0, 6, 182),
         ("Day", 8.0, 10, 91), ("Hour", 1.0, 10, 91)]
PLANTED_FROM = 40.0         # from Week upward a planted error must be in the window
GAIN_STEPS = [60, 20, 5, 2, 1]
GAIN_WINDOW = 91            # gain, directive share and the recent piece of upper rungs (91 days)
PASS_SHARE = 0.8            # 8 of 10; every irreversible piece must pass
INDEPENDENT = {"hidden_tests", "expert", "real_use", "other_family_with_sources"}
RATER_SPREAD = 1.5          # raters further apart than this need a third rater
CHECKS = INDEPENDENT | {"same_family", "self_review", "none"}
MODES = {"one_piece", "stages", "together"}
KEYS = {"person", "domain", "date", "reference_hours", "reference_basis",
        "attention_minutes", "mode", "check", "agent_saw_check", "passed", "irreversible",
        "planted_errors", "planted_missed", "outside_help"}
OPTIONAL = {"started",      # date the hand-over started (expected from v1.1; the line is written at close)
            "task_id", "model", "tools", "checker", "rater_hours", "audit", "revoked"}


def load(path):
    """Every piece handed to agents is a line, including failed and abandoned ones."""
    records, undated = [], 0
    with open(path, encoding="utf-8") as fh:
        for n, line in enumerate(fh, 1):
            if not line.strip():
                continue
            r = json.loads(line)
            if set(r) - OPTIONAL != KEYS:
                sys.exit(f"line {n}: unknown {sorted(set(r) - KEYS - OPTIONAL)}, missing {sorted(KEYS - set(r))}")
            if r["check"] not in CHECKS or r["mode"] not in MODES:
                sys.exit(f"line {n}: check or mode is not one of the allowed values")
            if float(r["reference_hours"]) <= 0 or float(r["attention_minutes"]) < 0:
                sys.exit(f"line {n}: reference hours must be positive, minutes not negative")
            if not 0 <= int(r["planted_missed"]) <= int(r["planted_errors"]):
                sys.exit(f"line {n}: planted_missed must lie between 0 and planted_errors")
            if not isinstance(r["outside_help"], bool) or not isinstance(r.get("revoked", False), bool):
                sys.exit(f"line {n}: outside_help and revoked must be true or false")
            if r.get("audit", "none") not in {"none", "passed", "failed"}:
                sys.exit(f"line {n}: audit must be none, passed or failed")
            if "rater_hours" in r and (len(r["rater_hours"]) < 2 or min(map(float, r["rater_hours"])) <= 0):
                sys.exit(f"line {n}: rater_hours needs two or more positive estimates")
            undated += "started" not in r
            r["date"] = dt.date.fromisoformat(r["date"])
            if "started" in r and dt.date.fromisoformat(r["started"]) > r["date"]:
                sys.exit(f"line {n}: started must not be later than date")
            records.append(r)
    if undated:
        print(f"warning: {undated} lines without started (expected from rules v1.1)", file=sys.stderr)
    return records


def verified(r):
    """A pass counts only if the check was independent, the agents never saw it, no planted error
    was missed, nobody helped off the log, no audit failed and no delayed outcome revoked it.
    Another model family alone never verifies irreversible work."""
    return (r["passed"] is True and r["check"] in INDEPENDENT and r["agent_saw_check"] is False
            and int(r["planted_missed"]) == 0 and not r["outside_help"]
            and not (r["irreversible"] and r["check"] == "other_family_with_sources")
            and r.get("audit") != "failed" and not r.get("revoked", False))


def rung_holds(pieces, hours, minimum, as_of, days):
    start = as_of - dt.timedelta(days=days)
    window = [r for r in pieces if start < r["date"] <= as_of]
    big = [r for r in window if float(r["reference_hours"]) >= hours]
    if len(big) < minimum:
        return False
    if sum(map(verified, big)) / len(big) < PASS_SHARE:
        return False
    if any(r["irreversible"] and not verified(r) for r in big):   # strict rule, these pieces only
        return False
    if hours >= PLANTED_FROM:
        if not any(int(r["planted_errors"]) > 0 for r in big):
            return False
        if any(int(r["planted_missed"]) > 0 for r in window):   # any missed planted error blocks
            return False
    if days > GAIN_WINDOW:                                       # quarterly re-verification
        recent = as_of - dt.timedelta(days=GAIN_WINDOW)
        if not any(verified(r) and r["date"] > recent for r in big):
            return False
    return True


def horizon(pieces, as_of):
    for name, hours, minimum, days in RUNGS:        # from the top rung down
        if rung_holds(pieces, hours, minimum, as_of, days):
            return name
    return "below Hour"


def rung_pieces(pieces, name, as_of):
    """Pieces of the rung's size in its window (Hour's for 'below Hour'): what the count is out of."""
    _, hours, _, days = next(r for r in RUNGS if r[0] == name or (name == "below Hour" and r[0] == "Hour"))
    return [r for r in pieces if as_of - dt.timedelta(days=days) < r["date"] <= as_of
            and float(r["reference_hours"]) >= hours]


def gain(pieces):
    done = math.fsum(float(r["reference_hours"]) for r in pieces
                     if verified(r) and not r["outside_help"])            # outside help excluded
    spent = math.fsum(float(r["attention_minutes"]) for r in pieces) / 60.0   # failures included
    return None if spent == 0 else done / spent


def step(g):
    if g is None:
        return "n/a"
    for s in GAIN_STEPS:
        if g >= s:
            return f"x{s}"
    return "below x1"


def main():
    ap = argparse.ArgumentParser()
    ap.add_argument("log")
    ap.add_argument("--as-of", default=dt.date.today().isoformat())
    ap.add_argument("--stable", action="store_true", help="also score 91 days earlier and label the rung")
    args = ap.parse_args()
    as_of = dt.date.fromisoformat(args.as_of)
    longest = max(days for *_, days in RUNGS) + (GAIN_WINDOW if args.stable else 0)
    groups = defaultdict(list)
    for r in load(args.log):
        if as_of - dt.timedelta(days=longest) < r["date"] <= as_of:
            groups[(r["person"], r["domain"])].append(r)
    quarter = f"{as_of.year}-Q{(as_of.month - 1) // 3 + 1}"
    recent_start = as_of - dt.timedelta(days=GAIN_WINDOW)
    for (person, domain), pieces in sorted(groups.items()):
        recent = [r for r in pieces if r["date"] > recent_start]
        g = gain(recent)
        shown = "n/a" if g is None else f"{g:.2f}"
        failed = sum(1 for r in recent if not verified(r))
        directive = (sum(r["mode"] == "one_piece" for r in recent) / len(recent)) if recent else 0.0
        rung = horizon(pieces, as_of)
        counted = rung_pieces(pieces, rung, as_of)
        label = ""
        if args.stable:
            before = horizon(pieces, as_of - dt.timedelta(days=GAIN_WINDOW))
            label = " stable" if before == rung else f" provisional (was {before})"
        print(f"{person}: {domain} . {rung} ({sum(map(verified, counted))}/{len(counted)}){label}"
              f" . {step(g)} . {quarter}  (pieces in last 91 days: {len(recent)}, not verified: {failed};"
              f" gain {shown}; directive share {directive:.0%})")
        kinds = Counter(r["check"] for r in counted).most_common()
        sizes = [float(r["reference_hours"]) for r in recent if r["passed"]]
        median = f"{statistics.median(sizes):.1f} h" if sizes else "n/a"
        spread = any(max(map(float, r["rater_hours"])) / min(map(float, r["rater_hours"])) > RATER_SPREAD
                     for r in pieces if len(r.get("rater_hours", [])) == 2)   # with three, the median decided
        print(f"  checks: {', '.join(f'{k} {v}' for k, v in kinds) or 'none'};"
              f" median accepted size {median}{'; needs third rater' if spread else ''}")


if __name__ == "__main__":
    main()
C3. brier.py
#!/usr/bin/env python3
"""brier.py: score dated predictions by the Brier rule.

Teaches: why one missed prediction made at 35% says little on its own, and why 'unresolved' is
never a success. Input CSV columns: id,probability,outcome (outcome: 1, 0 or unresolved).
Usage: python3 brier.py predictions.csv                                  Licence: MIT
"""
import csv
import sys


def main(path):
    resolved, pending = [], []
    with open(path, newline="", encoding="utf-8") as fh:
        for row in csv.DictReader(fh):
            p = float(row["probability"])
            if not 0.0 <= p <= 1.0:
                sys.exit(f"{row['id']}: probability must lie between 0 and 1")
            outcome = row["outcome"].strip().lower()
            if outcome in ("0", "1"):
                resolved.append((row["id"], p, int(outcome)))
            else:
                pending.append(row["id"])
    for pid, p, o in resolved:
        print(f"{pid}: p={p:.2f} outcome={o} score={(p - o) ** 2:.3f}")
    if resolved:
        mean = sum((p - o) ** 2 for _, p, o in resolved) / len(resolved)
        print(f"Brier score over {len(resolved)} resolved: {mean:.3f} (always saying 0.5 gives 0.250)")
    print("unresolved or not yet due: " + (", ".join(pending) or "none"))


if __name__ == "__main__":
    main(sys.argv[1])
C4. Um exemplo trabalhado
O registro abaixo contém dez tarefas de escrituração entregues a agentes por uma pessoa entre julho e setembro de 2026.
{"person": "P07", "domain": "small-business bookkeeping", "started": "2026-07-17", "date": "2026-07-20", "reference_hours": 9, "reference_basis": "two raters", "attention_minutes": 95, "mode": "stages", "check": "expert", "agent_saw_check": false, "passed": true, "irreversible": false, "planted_errors": 0, "planted_missed": 0, "outside_help": false}
{"person": "P07", "domain": "small-business bookkeeping", "started": "2026-07-24", "date": "2026-07-28", "reference_hours": 8, "reference_basis": "two raters", "attention_minutes": 80, "mode": "stages", "check": "hidden_tests", "agent_saw_check": false, "passed": true, "irreversible": false, "planted_errors": 0, "planted_missed": 0, "outside_help": false}
{"person": "P07", "domain": "small-business bookkeeping", "started": "2026-07-29", "date": "2026-08-04", "reference_hours": 12, "reference_basis": "two raters", "attention_minutes": 150, "mode": "one_piece", "check": "expert", "agent_saw_check": false, "passed": true, "irreversible": false, "planted_errors": 0, "planted_missed": 0, "outside_help": false}
{"person": "P07", "domain": "small-business bookkeeping", "started": "2026-08-09", "date": "2026-08-11", "reference_hours": 8, "reference_basis": "two raters", "attention_minutes": 70, "mode": "stages", "check": "self_review", "agent_saw_check": false, "passed": true, "irreversible": false, "planted_errors": 0, "planted_missed": 0, "outside_help": false}
{"person": "P07", "domain": "small-business bookkeeping", "started": "2026-08-13", "date": "2026-08-18", "reference_hours": 10, "reference_basis": "two raters", "attention_minutes": 110, "mode": "together", "check": "real_use", "agent_saw_check": false, "passed": true, "irreversible": false, "planted_errors": 0, "planted_missed": 0, "outside_help": false}
{"person": "P07", "domain": "small-business bookkeeping", "started": "2026-08-21", "date": "2026-08-25", "reference_hours": 8, "reference_basis": "two raters", "attention_minutes": 120, "mode": "stages", "check": "expert", "agent_saw_check": false, "passed": false, "irreversible": false, "planted_errors": 0, "planted_missed": 0, "outside_help": false}
{"person": "P07", "domain": "small-business bookkeeping", "started": "2026-08-24", "date": "2026-09-01", "reference_hours": 16, "reference_basis": "two raters", "attention_minutes": 180, "mode": "one_piece", "check": "hidden_tests", "agent_saw_check": false, "passed": true, "irreversible": false, "planted_errors": 0, "planted_missed": 0, "outside_help": false}
{"person": "P07", "domain": "small-business bookkeeping", "started": "2026-09-05", "date": "2026-09-08", "reference_hours": 8, "reference_basis": "two raters", "attention_minutes": 60, "mode": "stages", "check": "expert", "agent_saw_check": false, "passed": true, "irreversible": true, "planted_errors": 0, "planted_missed": 0, "outside_help": false}
{"person": "P07", "domain": "small-business bookkeeping", "started": "2026-09-11", "date": "2026-09-15", "reference_hours": 9, "reference_basis": "two raters", "attention_minutes": 90, "mode": "together", "check": "other_family_with_sources", "agent_saw_check": false, "passed": true, "irreversible": false, "planted_errors": 0, "planted_missed": 0, "outside_help": false}
{"person": "P07", "domain": "small-business bookkeeping", "started": "2026-09-27", "date": "2026-09-29", "reference_hours": 8, "reference_basis": "two raters", "attention_minutes": 75, "mode": "stages", "check": "hidden_tests", "agent_saw_check": false, "passed": true, "irreversible": false, "planted_errors": 0, "planted_missed": 0, "outside_help": false}
Rodando python3 horizon.py work-log.jsonl --as-of 2026-10-09 imprime o registro e uma linha sobre as verificações por trás disso:
P07: small-business bookkeeping . Day (8/10) . x2 . 2026-Q4  (pieces in last 91 days: 10, not verified: 2; gain 4.66; directive share 20%)
  checks: expert 4, hidden_tests 3, self_review 1, real_use 1, other_family_with_sources 1; median accepted size 9.0 h
Todas as dez peças são de pelo menos 8 horas de referência. Duas não contam como verificadas: uma foi verificada apenas por auto-revisão, e uma falhou na verificação de um especialista. Oito de dez é exatamente a proporção que Day requer, e a peça irreversível passou, então o degrau é Day. Week está fora de alcance, pois nenhuma peça atinge 40 horas. As peças verificadas somam 80 horas de referência, contra 1.030 minutos (cerca de 17,2 horas) de atenção gasta em todas as dez, falhas incluídas, o que dá um ganho de 4,66 e o passo ×2. Nenhuma peça tinha erros plantados ou ajuda externa, portanto nenhuma dessas regras altera o resultado. Se a peça que falhou tivesse sido deixada de fora do registro, o degrau teria repousado em nove peças e falhado na contagem de dez, é por isso que as falhas pertencem ao registro. A contagem ao lado do degrau, 8/10, mostra quão próximo o veredicto estava (Apêndice E), e a segunda linha fornece os tipos de verificação por trás das peças contadas e o tamanho mediano aceito, 9,0 horas, para que um leitor possa ver se o horizonte repousa em peças logo acima de um limite (Tabela 3). A atenção da pessoa, 1.030 minutos, é cerca de 18% das 96 horas de referência entregues e cerca de 21% das 80 que foram verificadas. O registro para um currículo lê "contabilidade de pequenas empresas · Day · ×2 · 2026-Q4".
A ferramenta complementar tools/explain.py imprime os motivos por trás do mesmo veredicto, a partir das mesmas regras. Oito de dez peças de tamanho Day são verificadas e oito são necessárias, uma contagem consistente com uma taxa de aprovação verdadeira em qualquer lugar de 44% a 97% (Seção 5.8), portanto nenhuma peça adicional falhada desse tamanho pode ser absorvida. Se nada novo for registrado, Day se mantém até 18 de outubro de 2026; em 19 de outubro a peça fechada em 20 de julho sai da janela de 91 dias, e nove peças de tamanho Day permanecem, uma a menos do que as dez que Day precisa. Para Week ela lista todas as condições ainda faltando: seis peças de pelo menos 40 horas em 182 dias, uma delas com erros plantados e uma verificada nos últimos 91 dias.
O registro construído também carrega um rastreamento que a Tabela 3 nomeia: cinco de suas dez peças foram avaliadas em exatamente 8 horas, o piso de Day, e tools/too_clean.py a marca "auditoria primeiro", com o rastreamento "5 de 10 peças estão logo acima de um limiar de degrau". Um sinalizador envia um registro para auditoria e não decide nada sobre ele; a mediana de 9,0 horas ao lado do degrau mostra o mesmo a um leitor.
C5. O repositório complementar
O repositório complementar (https://github.com/vadimchernets/delegation-horizon) contém o instrumento e os materiais que permitem aos leitores usar cada parte do artigo. Os arquivos principais, por seção:
| Seção | Arquivos | O que fazem |
|---|---|---|
| 5.2, C1 a C4 | horizon.py, log.schema.json, examples/ |
Classificador, esquema de uma linha de registro, o exemplo trabalhado e as linhas que deve imprimir |
| 5.2, 5.3 | tools/log_piece.py, record_card.py, checker.html |
Escrever o registro respondendo perguntas, um cartão de registro com a contagem ao lado do degrau, e a mesma pontuação em uma página do navegador offline; ambos leem uma planilha salva com vírgulas ou com ponto-e-vírgulas |
| 5.2, 5.8, C4 | tools/explain.py |
Por que um registro ganha seu degrau: cada condição que se mantém ou falha, a folga, o dia em que o degrau expira se nada novo for registrado, e o que o próximo degrau precisa |
| 5.1 | tools/reference_hours.py, kits/reference-hours-raters.md |
Horas de referência das estimativas dos avaliadores, e como escolher, admitir e informar os avaliadores |
| 5.8, Tabela 3 | audit_sample.py, tools/too_clean.py, tools/planted.py, kits/ |
Amostra de auditoria reproduzível, sinalizadores para registros que parecem muito limpos, erros plantados selados antes da entrega e classificados por tipo (entrada incorreta ou omissão), guias de auditoria e erro plantado |
| 6.2, 10.3 | tools/verify_record.py |
O lado receptor de um registro portátil: se o registro enviado com ele é o arquivo que foi pontuado, se o pontuador é o mesmo, e se a reclassificação fornece o mesmo registro, campo por campo |
| 6.2 | kits/trade-screen.md, tools/gate_leak.py |
Admitindo pessoas por uma pergunta do ofício em vez de um rótulo, e quanto um rótulo vaza, com um intervalo exato (11 de 60 no Apêndice G2: 9,5% a 30,4%) |
| 6.5, 10.5 | kits/checking-process.md, kits/process-vs-experience-study.md, tools/process_study.py |
Os quatro passos da Seção 6.5 e o que cada um ganha sob a regra (Figura A4), e a comparação da Seção 10.5 como um protocolo para registrar, com sua análise, entradas incorretas e omissões separadas |
| 5.8, Apêndice E | pilot/ |
Teste de mesa dos limites, um banco de 30 tarefas, o protocolo de calibração com seu texto de registro e formulário de consentimento |
| Apêndice G2 | pilot/ |
A análise registrada human_raters.py conforme arquivada no OSF, a conversão das exportações do Prolific, o script que imprime a Tabela G2 com as funções registradas, a comparação da triagem e uma exportação sintética para executá-los |
| 7.2 | templates/, tools/guarantor_record.py |
Cartão de tarefa para um banco de tarefas, um livro de registros de um garantidor, e o registro do garantidor calculado a partir dele: produtos garantidos, quantos duraram 6 e 12 meses, falhas por severidade |
| 11, Tabelas 4 e A6, C3 | predictions/, brier.py, tools/power.py |
As 41 previsões conforme registradas, com o manifesto de seus hashes arquivados no OSF, as regras de resolução e arquivos, as ferramentas de pontuação, que registram uma previsão do Conjunto B não conduzida e relatam a pontuação de Brier tanto sem ela quanto com ela pontuada como errada (Seção 11.2), e os tamanhos de amostra da Seção 11.2 |
| 11, Conjunto B | predictions/set_b.py |
As regras congeladas realizadas e não realizadas das nove previsões do Conjunto B escritas em um intervalo, aplicadas às estimativas de um estudo |
| 11.4, F27 | kits/f27-sample.md, tools/freeze_sample.py, tools/liveness.py |
O protocolo e o sorteio da amostra F27 (o pool fechado registrado primeiro, a chave tomada posteriormente de um beacon de aleatoriedade pública), congelado no Zenodo e seu hash registrado no OSF até 31 de dezembro de 2026, e sua vivacidade em cada data de pontuação pelas palavras de F27 |
| C2 a C4, Tabelas 4 e A6 | tools/paper_sync.py |
Verifica este texto em relação ao repositório: as listagens byte por byte, o exemplo trabalhado e sua saída, as tabelas de previsões, as contagens dos conjuntos, cada arquivo nomeado e cada figura incorporada |
| Apêndice D, Apêndice F | figures/ |
Os scripts que desenham a Figura A1 da tabela de previsão e a Figura A4 das regras do avaliador |
Os mesmos arquivos por leitor:
| Leitor | Comece com | O que fornece |
|---|---|---|
| Uma pessoa que entrega trabalho aos agentes | templates/work-log.csv, record_card.py ou checker.html, tools/explain.py |
Um registro mantido em uma planilha, o registro e seu cartão, e o que o próximo degrau precisa |
| Um empregador ou uma equipe de RH | kits/hiring-test/, kits/trade-screen.md, kits/scope-statement.md, tools/explain.py |
Um teste de trabalho pago de um dia com avaliador cego, uma questão do ofício no lugar de um rótulo, o que um degrau diz e não diz, e quão próximo estava o veredito do candidato |
| Um recém-chegado a um ofício | kits/checking-process.md, kits/acceptance-card.md, kits/planted-errors-guide.md |
As etapas da Seção 6.5 e o que cada uma ganha, "concluído" declarado antes da entrega, e prática em omissões plantadas |
| Um auditor ou um garante | audit_sample.py, tools/too_clean.py, tools/planted.py, kits/audit-checklist.md |
Uma amostra para verificar novamente, os rastros de um registro que parece muito limpo, erros plantados cujo selo mostra se a lista foi alterada |
| Um pesquisador | pilot/, kits/matched-task-study.md, kits/process-vs-experience-study.md, tools/power.py, predictions/ |
O teste de mesa, o estudo do avaliador e seus scripts, protocolos para as comparações, tamanhos de amostra, e as previsões registradas com suas ferramentas de cartão de pontuação |
Apêndice D. Texto de registro para as previsões (OSF)
Título. Previsões datadas sobre trabalho através de agentes de IA, 2026 a 2031: previsões congeladas e pontuação anual.
Tipo. Registro em Aberto, público imediatamente, sem embargo.
Resumo. Este registro congela as previsões datadas declaradas em "After the Programmer Divide: One Measure for People Who Build Through AI Agents" (SSRN 7589918; Zenodo DOI 10.5281/zenodo.23267266). A tabela anexada fornece, para cada previsão: sua redação; sua medida; uma fonte pública e uma fonte de fallback; uma linha de base de 2025 ou 2026 com a data de acesso e um snapshot arquivado; uma data de verificação e uma data final; uma probabilidade fixada na data deste registro; e os limites para três resultados: ocorreu, não ocorreu, não resolvido.
Pontuação. Cada previsão é pontuada na primeira verificação anual em ou após sua data de verificação em que os dados existem, e não depois de sua data final. Previsões resolvidas são pontuadas pela regra de Brier. Uma previsão sem dados comparáveis até sua data final é registrada como não resolvida e não é contada como um sucesso.
Conjuntos e probabilidades. Conjunto A resolve a partir de dados públicos e dos arquivos em predictions/resolve/, cujos hashes SHA-256 são listados neste registro. Conjunto B resolve apenas a partir de estudos registrados separadamente antes da coleta de dados; uma previsão do Conjunto B cujo protocolo não é registrado até 30 de junho de 2027 é registrada como não conduzida, como uma falha do programa de teste; a pontuação de Brier é relatada tanto sobre previsões resolvidas quanto com cada previsão não conduzida pontuada como errada. As probabilidades são condicionadas à resolução. Elas são a mediana de três previsões de modelos cegos coletadas em 9 de outubro de 2026 (Claude Opus, um modelo OpenAI e Gemini) e adotadas pelo autor; as previsões agrupadas anteriores de quatro modelos são anexadas para referência.
Ponto de cruzamento. F2, F3, F5 e F7 são medidos nos mesmos domínios nomeados: escrituração contábil de pequenas empresas, e documentos legais e de marketing, os dois domínios não-software do banco de tarefas (Apêndice E); para o análogo de postagens de F5, eles mapeiam para SOC 43-3031, 23-2011 e 13-1161. O terceiro domínio do banco, pequenas ferramentas web internas, é o domínio inicial dos programadores e não é um domínio de cruzamento. O ponto de cruzamento em um domínio é o primeiro ano em que F3 e o análogo de domínio de F5 são ambos atendidos no mesmo domínio nomeado; nenhum deles sozinho o declara.
Adições de pontuação. Cada cartão de pontuação também relata a parcela resolvida, a pontuação de Brier por conjunto e por família, um limite pior que pontua previsões não resolvidas em atraso como errado, e a pontuação de habilidade de Brier contra 0,5, os previsores de modelos agrupados e os preços de mercado.
Verificações anuais. Cada ano de 2027 a 2031, no aniversário deste registro, o autor publica um cartão de pontuação cobrindo cada previsão registrada aqui. Cada cartão de pontuação é registrado no OSF, vinculado a este registro por DOI, e depositado no Zenodo.
Regras fixas. Nenhuma previsão é removida, reescrita ou recebe uma nova data. Qualquer coisa adicionada posteriormente é registrada separadamente e tem sua própria data. Se uma fonte nomeada parar de publicar ou mudar seu método, a fonte de fallback é usada, desde que meça a mesma quantidade; se nenhuma fonte comparável existir, a previsão é não resolvida.
Verificação independente. Cada cartão de pontuação é verificado contra as regras congeladas aqui por modelos de pelo menos duas famílias diferentes. Quando discordam, a regra decide e a discordância é relatada. Um árbitro humano, nomeado pelo autor antes do primeiro cartão de pontuação, decide disputas entre as duas famílias de modelos.
Dados próprios. Previsões que dependem dos dados de coorte do autor são testadas apenas sob um pré-registro separado arquivado antes desses dados serem coletados, como faz o programa registrado no OSF (DOI 10.17605/OSF.IO/X4EGQ) para cada coorte.
Interesses concorrentes. Conforme declarado no artigo.
Arquivos. Tabela de previsões (CSV, e Tabela A6 do artigo anexado); lista de snapshots arquivados; predictions/resolve/ (consultas congeladas, listas e livro de códigos, com hashes); resolution-rules.md; changelog-v1-v2.md.
A tabela de previsões anexada é a Tabela A6, e a Figura A1 desenha seu calendário.
Figura A1. O calendário de verificações, 2026 a 2031.
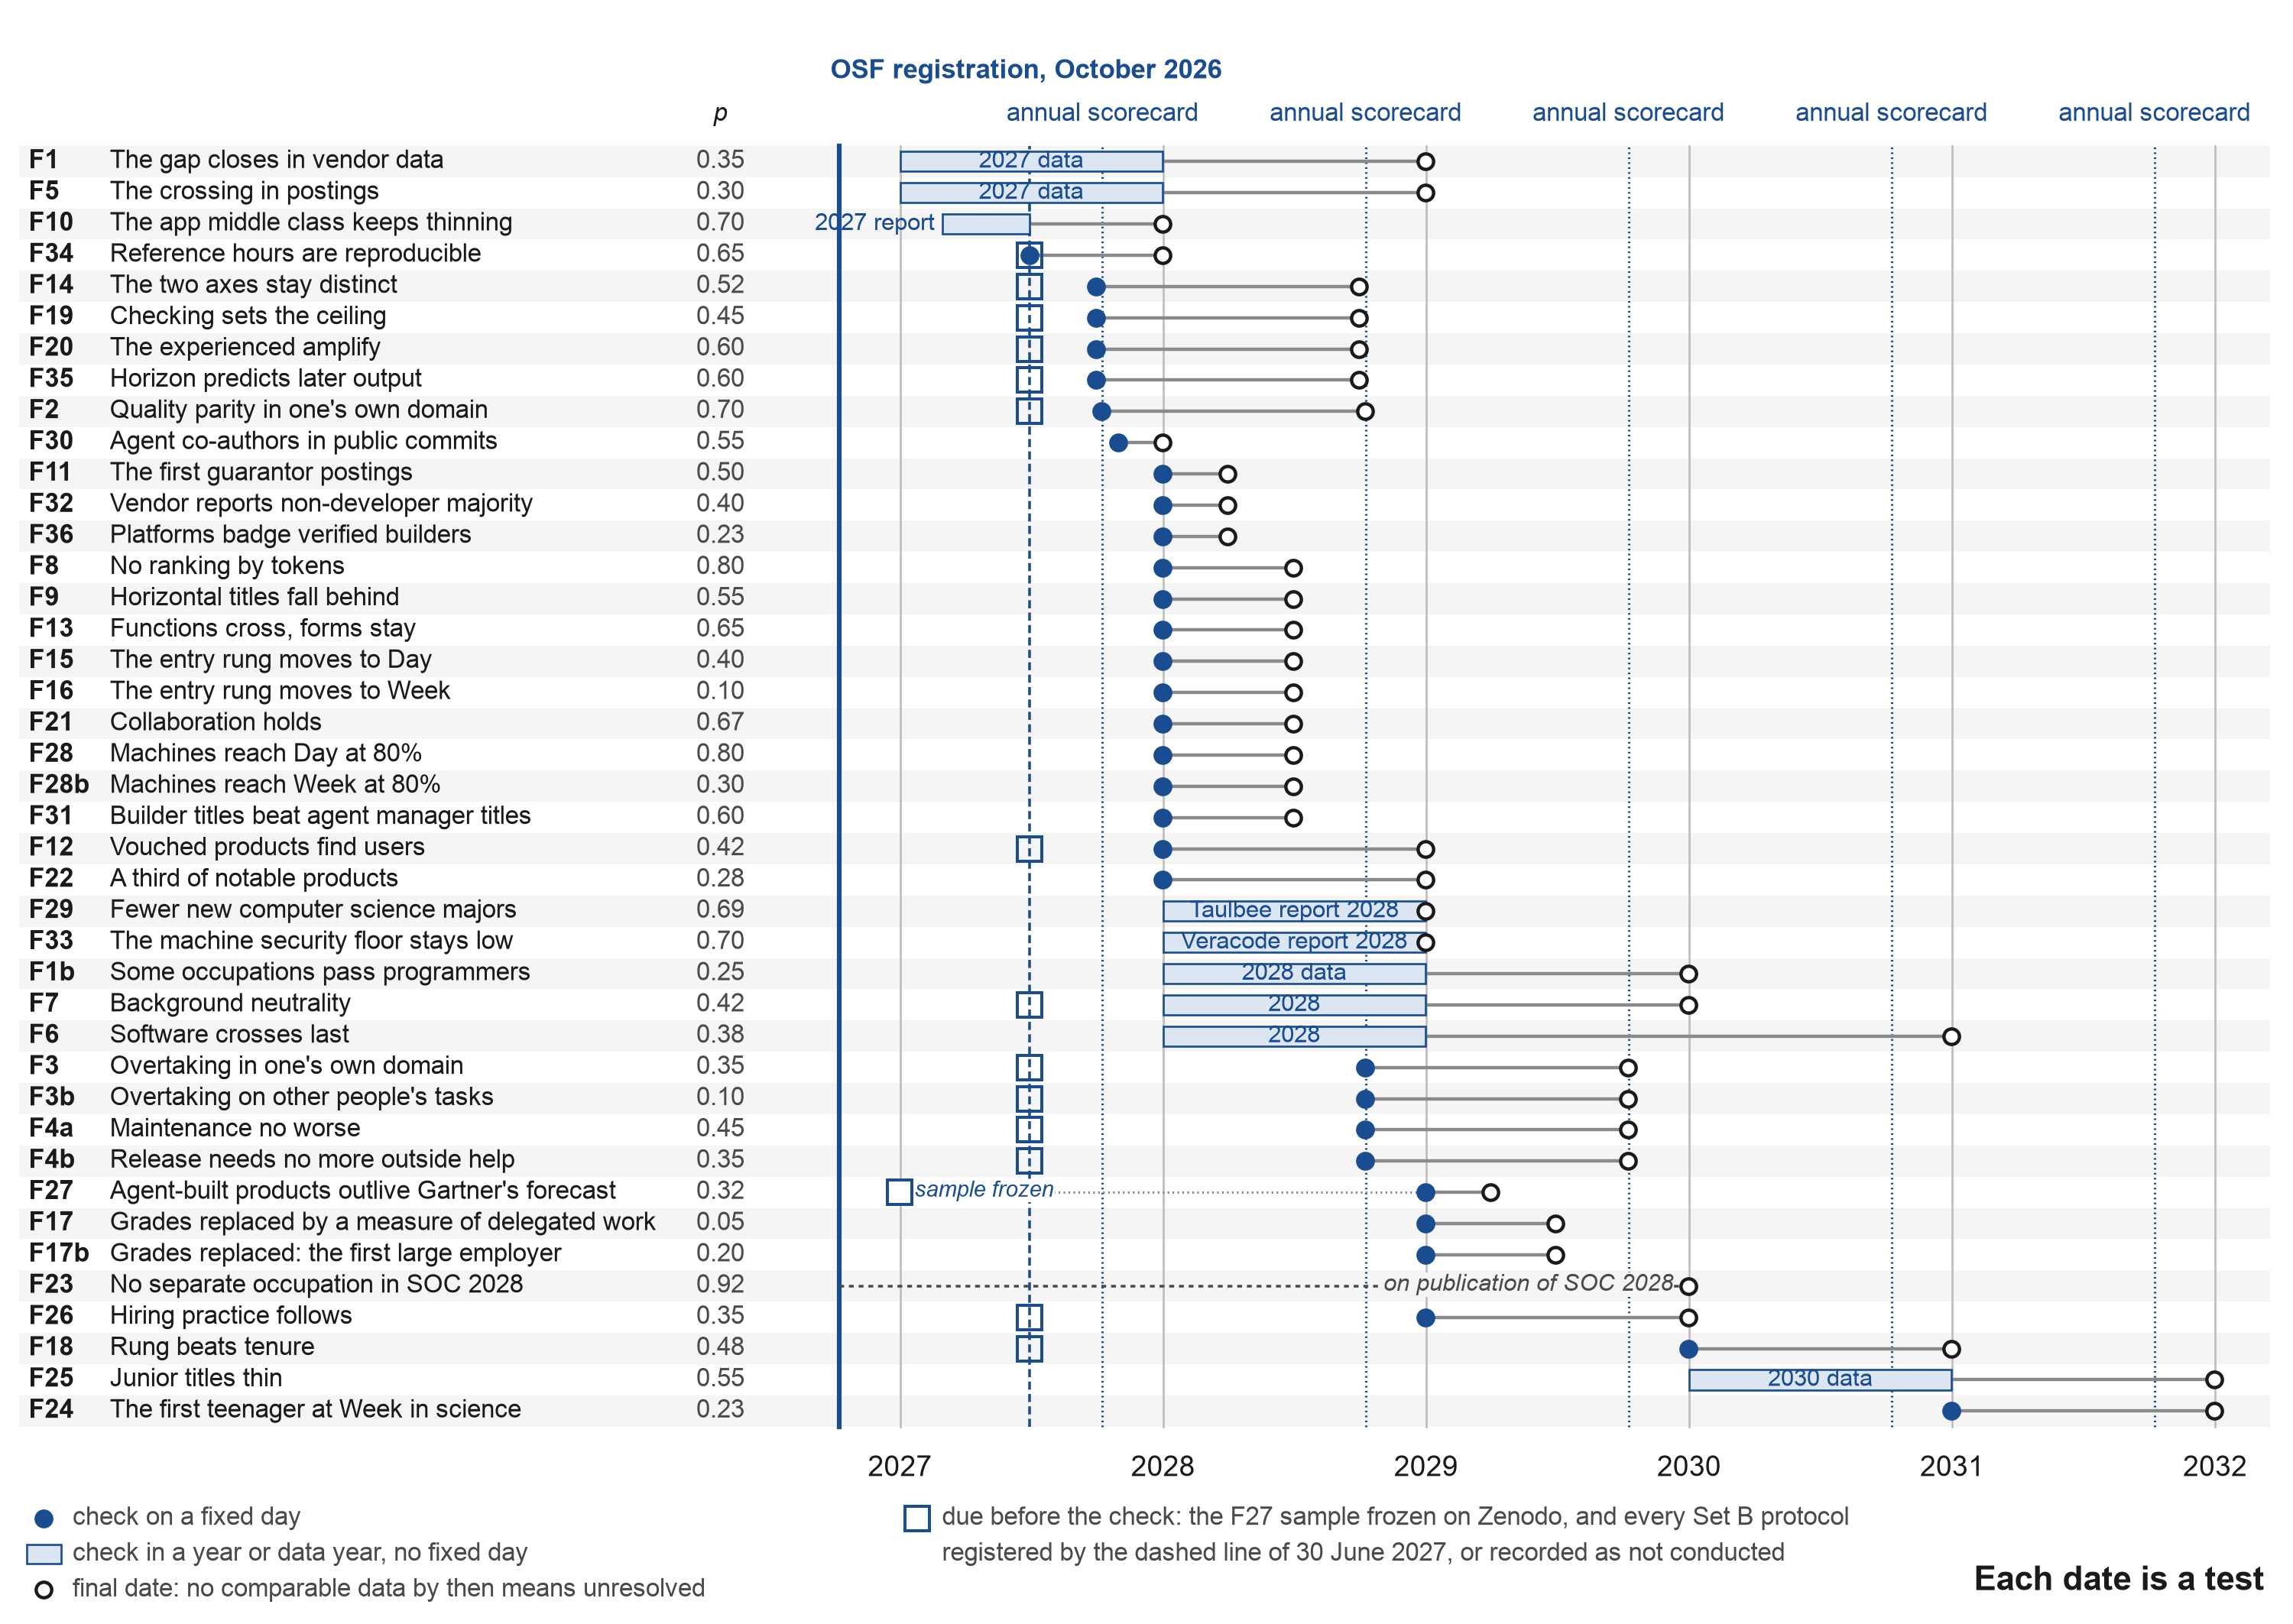
Nota: Uma linha por previsão da Tabela A6, classificada por data de verificação, com sua probabilidade. Um ponto preenchido é uma verificação em um dia fixo. Uma barra leve é uma verificação em um ano ou um ano de dados sem um dia fixo. O anel é a data final, após a qual uma previsão sem dados comparáveis é registrada como não resolvida (Seção 11.4). Linhas pontilhadas marcam os cartões de pontuação anuais, a serem registrados no OSF em outubro de cada ano de 2027 a 2031. Um quadrado vazio marca um compromisso devido antes da verificação: a amostra F27, congelada no Zenodo até 31 de dezembro de 2026, e, na linha tracejada de 30 de junho de 2027, o protocolo de cada um dos 14 estudos do Conjunto B, sem o qual a previsão é registrada como não conduzida (Seção 11.2). A figura é gerada a partir da tabela de previsões em si, por figures/figure_a1_calendar.py no repositório complementar, e muda apenas com ele.
Tabela A6. Todas as 41 previsões datadas: conjuntos, medidas, limites, probabilidades, previsões de modelo, fallbacks e previsões anteriores.
| # (conjunto) | Previsão, medida, linha de base e limite | Datas, probabilidade, previsões de modelo, regra não resolvida, fallback e previsão anterior |
|---|---|---|
| F1 (A) | A lacuna se fecha nos dados do fornecedor. Sucesso verificado em sessões de produção de código, programação contra outras ocupações: 34% contra 29%, inalterado por sete meses (Anthropic, 2026e). A lacuna é a taxa de sucesso das ocupações de programação menos a das outras ocupações, com seu sinal. Ocorreu se a lacuna é de 2 pontos ou menos, valores negativos incluídos, em um relatório comparável sobre dados de 2027; não ocorreu se for mais de 2. Linha de base: Sucesso verificado em sessões de produção de código: programação 34% contra outras ocupações 29%, inalterado por sete meses (Anthropic, 2026e) | Verificação: dados de 2027. Data final: 31 de dezembro de 2028. p = 0,35; modelos 0,39 (0,25 a 0,65). Não resolvido se: Nenhum relatório sobre dados de 2027 até a data final, ou a definição da sessão foi alterada (nunca contabilizado como sucesso). Alternativa: Qualquer relatório de fornecedor comprovando sucesso verificado por ocupação em sessões comparáveis. Previsão anterior ou contrária mais próxima: Anthropic: o intervalo "não se ampliou nem se estreitou" |
| F1b (A) | Algumas ocupações superam programadores. Mesma medida que F1. As 10 maiores ocupações fora da programação são congeladas no registro como as 10 com as maiores participações de sessão em Anthropic (2026e). Uma ocupação supera programação apenas se sua taxa de sucesso é superior em 2 pontos ou mais (uma margem para multiplicidade em 10 comparações). Confirmado se pelo menos 3 dos 10 fazem assim nos dados de 2028. Base de referência: Como F1; gestão já ligeiramente à frente de programação (Anthropic, 2026e) | Verificação: dados de 2028. Data final: 31 de dezembro de 2029. p = 0,25; modelos 0,30 (0,20 a 0,45). Não resolvido se: Nenhum relatório sobre dados de 2028 até a data final, ou a definição da sessão foi alterada (nunca contabilizado como sucesso). Alternativa: Como F1. Previsão anterior ou contrária mais próxima: Gestão já ligeiramente à frente (Anthropic, 2026e) |
| F2 (B) | Paridade de qualidade em seu próprio domínio (o passo antes do ponto de transição). Mesmo agente, mesmo tempo, aceitação cega e verificações de segurança, uma mudança de manutenção por outro agente após um mês; um estudo com 1.500 pessoas por grupo. Confirmado se o limite inferior do intervalo de 95% para (pessoas sem educação em TI menos programadores) está acima de menos 10 pontos; não confirmado se o limite superior está abaixo de menos 10; caso contrário, não resolvido. Base de referência: Sem base de referência pública; estudo pré-registrado separadamente, 1.500 pessoas por grupo | Verificação: 8 de outubro de 2027. Data final: 8 de outubro de 2028. p = 0,70; modelos 0,67 (0,62 a 0,70). Não resolvido se: Nenhum dado comparável até a data final, ou um intervalo que não atende a nenhuma regra (nunca contabilizado como sucesso). Alternativa: Um estudo independente com o mesmo design. Previsão anterior ou contrária mais próxima: D. H. Hansson (2026), "100%" (nenhuma data, nenhuma medida); Esnaola et al. (2026) |
| F3 (B) | Ultrapassagem em seu próprio domínio (o ponto de transição em qualidade). Como F2 (1.500 por grupo oferece cerca de 0,8 de poder para detectar uma verdadeira vantagem de 5 pontos com um alfa de dois lados de 0,05; 400 por grupo ofereceria cerca de 0,3). Confirmado se o limite inferior do intervalo de 95% está acima de zero; não confirmado se o limite superior está abaixo de zero; caso contrário, não resolvido. Base de referência: Como F2 | Verificação: 8 de outubro de 2028. Data final: 8 de outubro de 2029. p = 0,35; modelos 0,33 (0,25 a 0,55). Não resolvido se: Nenhum dado comparável até a data final, ou um intervalo que não atende a nenhuma regra (nunca contabilizado como sucesso). Alternativa: Como F2. Previsão anterior ou contrária mais próxima: Nenhuma encontrada com uma data |
| F3b (B) | Ultrapassagem em tarefas de outras pessoas. Como F3, mas em tarefas fora do domínio próprio dos participantes. Base de referência: Como F2, em tarefas fora do domínio próprio dos participantes | Verificação: 8 de outubro de 2028. Data final: 8 de outubro de 2029. p = 0,10; modelos 0,13 (0,07 a 0,35). Não resolvido se: Nenhum dado comparável até a data final, ou um intervalo que não atende a nenhuma regra (nunca contabilizado como sucesso). Alternativa: Como F2. Previsão anterior ou contrária mais próxima: Argumento de domínio da Seção 6.3 prediz que falha |
| F4a (B) | Manutenção não pior. Participação de produtos aceitos abandonados em 12 meses, pela educação dos autores. Confirmado se o limite superior do intervalo de 95% para a diferença (não-programadores menos programadores) está abaixo de 10 pontos. Base de referência: Sem base de referência pública; Gartner (Tyagi, 2026, conforme resumido por Tray.ai, 2026) espera que 60% das aplicações codificadas por vibes sejam descontinuadas até 2028, contando todas as aplicações | Verificação: 8 de outubro de 2028. Data final: 8 de outubro de 2029. p = 0,45; modelos 0,49 (0,34 a 0,68). Não resolvido se: Nenhum dado comparável até a data final, ou um intervalo que não atende a nenhuma regra (nunca contabilizado como sucesso). Alternativa: Registros de produtos com pesquisas de autores. Previsão anterior ou contrária mais próxima: Gartner (Tyagi, 2026, conforme resumido por Tray.ai, 2026): 60% das aplicações codificadas por vibes descontinuadas até 2028 "pois falham em entregar o valor de negócio previsível"; uma população mais ampla que F4a, que conta apenas produtos aceitos |
| F4b (B) | Lançamento não precisa mais de ajuda externa. Participação de produtos que precisam de ajuda técnica externa no lançamento. Confirmado se não-inferior com uma margem de 10 pontos; espera-se que a lacuna se feche na ordem de protótipo, lançamento, manutenção. Base de referência: Sem base de referência pública | Verificação: 8 de outubro de 2028. Data final: 8 de outubro de 2029. p = 0,35; modelos 0,37 (0,22 a 0,50). Não resolvido se: Nenhum dado comparável até a data final, ou um intervalo que não atende a nenhuma regra (nunca contabilizado como sucesso). Alternativa: Como F4a. Previsão anterior ou contrária mais próxima: Gartner (Tyagi, 2026, conforme resumido por Tray.ai, 2026): 30% das equipes de engenharia de software sob "tensão de capacidade material" ao manter aplicações codificadas por vibes construídas por desenvolvedores cidadãos e usuários empresariais |
| F5 (A) | O cruzamento em postagens (o sinal visível). Postagens dos EUA em um conjunto congelado de ocupações em TI; habilidades agênticas definidas pela versão da taxonomia Lightcast Open Skills atual na data de registro (número da versão registrado em predictions/resolve/F5.md), com a lista congelada de habilidades agênticas; a participação que requer diploma de quatro anos em postagens com essas habilidades comparadas a postagens sem elas correspondidas exatamente em ocupação (SOC 6-digit), senioridade, estado e trimestre. A linha de base agêntica (2026 Q2 e Q3) é coletada e arquivada antes do registro. Confirmado se a diferença é negativa em 2 pontos ou mais, com o intervalo de 95% excluindo zero, em dois trimestres consecutivos de 2027. Base de referência: Postagens de IA ainda mais prováveis de exigir diploma, mas convergindo desde 2024 (Lightcast, 2026b); a linha de base agêntica é coletada antes do registro | Verificação: dados de 2027. Data final: 31 de dezembro de 2028. p = 0,30; modelos 0,34 (0,25 a 0,60). Não resolvido se: Nenhum dado comparável até a data final (nunca contabilizado como sucesso). Alternativa: Barômetro de Empregos em IA da PwC, apenas se relatar requisitos de diploma para postagens com habilidades agênticas comparadas a postagens correspondidas; caso contrário, não resolvido. Previsão anterior ou contrária mais próxima: Gartner (2021): maioria dos produtos de tecnologia construídos fora de TI até 2024; Bone et al. (2025) sobre habilidades de IA em postagens do Reino Unido |
| F6 (A) | Software cruza por último. Lista congelada de domínios: direito, contabilidade e escrituração, educação, administração clínica, marketing, imóveis, seguros, recursos humanos, logística, desenvolvimento de software, infraestrutura de TI, segurança, ferramentas de desenvolvedor. Ordem dos primeiros cruzamentos do tipo F5 por domínio. Realizou-se se desenvolvimento de software, infraestrutura, segurança e ferramentas de desenvolvedor cruzarem após pelo menos metade dos outros domínios. Baseline: Nenhum domínio cruzou ainda (comparação do tipo F5) | Verificar: 2028. Data final: 31 de dezembro de 2030. p = 0,38; modelos 0,37 (0,25 a 0,55). Não resolvido se: Menos da metade dos domínios não-software da lista congelada tiverem cruzado até a data final, ou nenhuma fonte comparável (nunca contado como sucesso). Alternativa: Outra fonte de postagens com a mesma comparação do tipo F5 por domínio; estudos de qualidade (tipo F2) não contam, e sem tal fonte a predição não é resolvida. Previsão anterior mais próxima ou contrária: Hwang (2026): finanças "o canário na mina de carvão" |
| F7 (B) | Neutralidade de fundo. Coorte registrada separadamente com uma questão sobre educação em TI; horizonte pontuado em um conjunto de tarefas, qualidade em tarefas retidas. Razão de chances de passar em verificações independentes associada à educação em TI em degrau igual, controlando para comando de domínio e alfabetização de aceitação. A margem 0,67 a 1,5 é uma razão de chances de 1,5 de qualquer forma, cerca de uma diferença padronizada de 0,22 (conversão de Chinn), convencionalmente um efeito pequeno. Realizou-se se o intervalo de 90% fica dentro de 0,67 a 1,5 (equivalência), separadamente em Day e em Week e acima. Baseline: Sem baseline público; coorte registrada separadamente com uma questão sobre educação em TI | Verificar: 2028. Data final: 31 de dezembro de 2029. p = 0,42; modelos 0,43 (0,40 a 0,48). Não resolvido se: Qualquer outra combinação, incluindo equivalência mostrada apenas em um nível, ou sem dados até a data final (nunca contado como sucesso). Alternativa: Uma coorte independente com os mesmos itens. Previsão anterior mais próxima ou contrária: Observação de Anthropic sobre comando de domínio; Savva (2026), a rival |
| F8 (A) | Sem classificação por tokens. Empregadores da Fortune 500 usando contagens de tokens como critério de avaliação oficial durante 2027, documentado pelo empregador ou por dois meios de comunicação independentes (perguntas sobre uso de IA não contam). Realizou-se se menos de dois empregadores são encontrados. Baseline: Contagens de tokens tentadas como critério de avaliação em 2026 (Seção 4 do artigo) | Verificar: 31 de dezembro de 2027. Data final: 30 de junho de 2028. p = 0,80; modelos 0,79 (0,60 a 0,90). Não resolvido se: Sem dados comparáveis até a data final (nunca contado como sucesso). Alternativa: Pesquisa de arquivos da imprensa comercial com as consultas congeladas em predictions/resolve/F8.md. Previsão anterior mais próxima ou contrária: Kingy AI (2026): "rebaixado, não eliminado"; Flowtivity (2026): "irreversível" |
| F9 (A) | Os títulos horizontais ficam para trás. Postagens dos EUA, mesmas consultas congeladas (predictions/resolve/F9.md), Q4 2026 e Q4 2027, cada contagem dividida por todas as postagens dos EUA no mesmo trimestre: gerente de agente, operador de IA, orquestrador de IA contra títulos que nomeiam um domínio (por exemplo, "líder de IA legal", "líder de IA vertical"). Realizou-se se a participação normalizada de títulos nomeados por domínio cresce por um fator maior do que a dos horizontais. Baseline: Contagens de postagens dos EUA nas consultas congeladas em Q4 2026 | Verificar: 31 de dezembro de 2027. Data final: 30 de junho de 2028. p = 0,55; modelos 0,58 (0,45 a 0,75). Não resolvido se: Ambas as famílias têm menos de 50 postagens em Q4 2026, ou sem dados até a data final (nunca contado como sucesso). Alternativa: Contagens de pesquisa do Indeed ou LinkedIn com as mesmas consultas. Previsão anterior mais próxima ou contrária: Srinivasan e Wei (2026): "gerente de agente" um título padrão em 12 a 18 meses; IT Brew (2026): "os próximos 18 meses" |
| F10 (A) | A classe média de aplicativos continua se afinando. Participação de novos aplicativos de assinatura atingindo US$ 1.000 de receita mensal em dois anos, mesma medida que RevenueCat 2026 (17%). Realizou-se se abaixo de 17%. Baseline: 17% dos novos aplicativos de assinatura atingem US$ 1.000 de receita mensal em dois anos (RevenueCat, 2026) | Verificar: Relatório RevenueCat 2027. Data final: 31 de dezembro de 2027. p = 0,70; modelos 0,68 (0,60 a 0,80). Não resolvido se: Sem dados comparáveis até a data final (nunca contado como sucesso). Alternativa: Limiares de receita da Sensor Tower ou Appfigures. Previsão anterior mais próxima ou contrária: Própria tendência da RevenueCat (nenhuma prioridade reivindicada); muitos aplicativos codificados por vibe ganham com anúncios, que RevenueCat não vê |
| F11 (A) | As primeiras postagens de fiador. Postagens de empregadores com mais de 1.000 funcionários em medicina, direito, finanças ou educação que nomeiam assinatura para trabalho produzido por IA e responsabilidade pessoal por isso. Consultas congeladas em predictions/resolve/F11.md: "sign off" com "IA-gerado", "responsável pela saída de IA", "atestação de IA", "fiador de IA"; postagens onde "fiador" ou "credencial" referem-se a chaves ou acesso são excluídas. Realizou-se se pelo menos 10 postagens de pelo menos 5 empregadores são encontradas e arquivadas. Baseline: Nenhuma postagem encontrada no momento da redação | Verificar: 31 de dezembro de 2027. Data final: 31 de março de 2028. p = 0,50; modelos 0,42 (0,25 a 0,55). Não resolvido se: Sem dados comparáveis até a data final (nunca contado como sucesso). Alternativa: Postagens arquivadas encontradas através do Google Jobs e LinkedIn. Previsão anterior mais próxima ou contrária: Capps (2025), "fiador legal"; Forrester (2025): 60% da Fortune 100 para nomear um chefe de governança de IA |
| F12 (B) | Produtos com apoio encontram usuários. Estudo randomizado próprio: entre produtos elegíveis, um fiador nomeado atribuído aleatoriamente. Participação atingindo dez usuários não relacionados em 90 dias. Realizou-se se a participação apoiada é maior, com o intervalo de 95% excluindo zero. Baseline: Sem baseline público; estudo randomizado próprio | Verificar: 31 de dezembro de 2027. Data final: 31 de dezembro de 2028. p = 0,42; modelos 0,43 (0,30 a 0,60). Não resolvido se: Sem dados comparáveis até a data final (nunca contado como sucesso). Alternativa: Nenhuma. Previsão anterior mais próxima ou contrária: Vouch de Hashimoto (um mecanismo, não uma previsão) |
| F13 (A) | Funções cruzam, formas permanecem. Currículos e postagens em três profissões não-TI, codificados por dois codificadores com um codebook publicado antes da codificação (predictions/resolve/F13-codebook.md): verificação, escolha de modelo por custo e longas execuções ensinadas; gasto pessoal e grupos de modelo encontrados apenas entre usuários de camada superior. Realizou-se se tópicos funcionais superam tópicos de status em pelo menos três para um. Baseline: Sem baseline público; dois codificadores em currículos e postagens em três profissões não-TI | Verificação: 31 de dezembro de 2027. Data final: 30 de junho de 2028. p = 0,65; modelos 0,69 (0,55 a 0,82). Não resolvido se: Sem dados comparáveis até à data final (nunca contado como sucesso). Alternativa: Catálogos de cursos públicos. Previsão anterior ou contrária mais próxima: Rogers (2003), camadas de adoção (nenhuma prioridade reivindicada) |
| F14 (B) | Os dois eixos permanecem distintos. Correlação de Spearman em nível de pessoa entre horizonte de log e ganho de log em pelo menos 200 logs. Realizou-se se a correlação é 0,8 ou inferior e o ganho, adicionado ao horizonte, aumenta o R quadrado fora da amostra para a saída verificada seis meses depois em pelo menos 0,02. Linha de base: Sem linha de base pública; pelo menos 200 logs | Verificação: 30 de setembro de 2027. Data final: 30 de setembro de 2028. p = 0,52; modelos 0,49 (0,45 a 0,50). Não resolvido se: Sem dados comparáveis até à data final (nunca contado como sucesso). Alternativa: Nenhuma. Previsão anterior ou contrária mais próxima: Nenhuma encontrada |
| F15 (A) | O degrau de entrada se move para Dia. Em uma amostra congelada de 200 anúncios de nível de entrada e tarefas para casa em software e três outras profissões, a primeira atribuição mediana, classificada em horas de referência por dois avaliadores, está em Dia ou acima. Linha de base: Amostra congelada de 200 anúncios de nível de entrada e tarefas para casa, classificadas em horas de referência por dois avaliadores | Verificação: 31 de dezembro de 2027. Data final: 30 de junho de 2028. p = 0,40; modelos 0,49 (0,30 a 0,70). Não resolvido se: Sem dados comparáveis até à data final (nunca contado como sucesso). Alternativa: Exemplos de nível de entrada do Indeed Hiring Lab. Previsão anterior ou contrária mais próxima: Washington Monthly (2026): "papéis de nível de entrada estão se tornando mais como papéis de nível médio"; tendência de horizonte ajustada da METR dobrando aproximadamente a cada 4,2 meses |
| F16 (A) | O degrau de entrada se move para Semana. Mesma medida; mediana em Semana ou acima. Linha de base: Como F15 | Verificação: 31 de dezembro de 2027. Data final: 30 de junho de 2028. p = 0,10; modelos 0,14 (0,06 a 0,40). Não resolvido se: Sem dados comparáveis até à data final (nunca contado como sucesso). Alternativa: Como F15. Previsão anterior ou contrária mais próxima: Kwa et al. (2025), horizontes de tempo de máquina (máquinas, não pessoas) |
| F17 (A) | Classificações substituídas por uma medida de trabalho delegado. Dos 50 maiores empregadores dos EUA, aqueles que substituem publicamente escadas de classificação por uma medida de trabalho delegado verificado. Realizou-se se pelo menos 10. Linha de base: Sem linha de base pública | Verificação: 31 de dezembro de 2028. Data final: 30 de junho de 2029. p = 0,05; modelos 0,05 (0,02 a 0,20). Não resolvido se: Sem dados comparáveis até à data final (nunca contado como sucesso). Alternativa: Arquivos e comunicados à imprensa de empregadores. Previsão anterior ou contrária mais próxima: Gartner (2024): até 2026, 20% das organizações usarão IA para achatar estruturas; Microsoft (2025): "chefe agente" |
| F17b (A) | Classificações substituídas: o primeiro grande empregador. Dos 50 maiores empregadores dos EUA, pelo menos um substitui publicamente escadas de classificação por uma medida de trabalho delegado verificado. Linha de base: Sem linha de base pública | Verificação: 31 de dezembro de 2028. Data final: 30 de junho de 2029. p = 0,20; modelos 0,21 (0,05 a 0,50). Não resolvido se: Sem dados comparáveis até à data final (nunca contado como sucesso). Alternativa: Arquivos e comunicados à imprensa de empregadores. Previsão anterior ou contrária mais próxima: Gêmeo mais suave de F17 |
| F18 (B) | Degrau supera tempo de serviço. Em dados de empregador ou coorte, o degrau verificado explica mais variância na remuneração do que anos de experiência (desempenho avaliado é usado apenas quando a remuneração não está disponível, fixado antes da análise). Linha de base: Sem linha de base pública | Verificação: 31 de dezembro de 2029. Data final: 31 de dezembro de 2030. p = 0,48; modelos 0,52 (0,40 a 0,60). Não resolvido se: Sem dados comparáveis até à data final (nunca contado como sucesso). Alternativa: Análises de RH publicadas. Previsão anterior ou contrária mais próxima: Jaques (1956), remuneração por amplitude de responsabilidade |
| F19 (B) | Verificação estabelece o teto (fora da amostra). Pelo menos 200 logs. Parcela de atenção gasta em verificação e horizonte, ambas medidas nos meses 1 a 3; saída verificada (peças aceitas em horas de referência, não a fórmula de ganho) nos meses 4 a 6. Realizou-se se, em pessoas retidas, a parcela de verificação tem uma correlação parcial mais alta com a saída verificada posterior do que horizonte. Linha de base: Sem linha de base pública | Verificação: 30 de setembro de 2027. Data final: 30 de setembro de 2028. p = 0,45; modelos 0,44 (0,30 a 0,65). Não resolvido se: Sem dados comparáveis até à data final (nunca contado como sucesso). Alternativa: Nenhuma. Previsão anterior ou contrária mais próxima: Huang et al. (2026), amplificação de verificação. v1 usava ganho, que contém horizonte por construção; v2 prevê um resultado medido posteriormente e separadamente |
| F20 (B) | Os experientes amplificam. Parcela diretiva: parcela dos turnos de uma pessoa que dão instruções em vez de verificar ou editar, do log. Ganho verificado: horas de referência aceitas por hora de atenção da pessoa. Entre pessoas cuja parcela diretiva caiu ao longo de seis meses, o ganho verificado no mês 6 é pelo menos 95% de seu valor do mês 0 para a maioria. Linha de base: Sem linha de base pública | Verificação: 30 de setembro de 2027. Data final: 30 de setembro de 2028. p = 0,60; modelos 0,62 (0,55 a 0,70). Não resolvido se: Sem dados comparáveis até à data final (nunca contado como sucesso). Alternativa: Nenhuma. Previsão anterior ou contrária mais próxima: Anthropic (2026d), curvas de aprendizado |
| F21 (A) | A colaboração se mantém. Parcela de uso colaborativo (ampliação) na amostra de conversa Claude.ai do Índice Econômico Anthropic, não a amostra de API, permanece acima de 40% em cada relatório publicado em 2027. Linha de base: Uso colaborativo de 52% contra automação de 45% em novembro de 2025 (Anthropic, 2026a) | Verificação: 31 de dezembro de 2027. Data final: 30 de junho de 2028. p = 0,67; modelos 0,68 (0,60 a 0,75). Não resolvido se: Sem dados comparáveis até à data final (nunca contado como sucesso). Alternativa: Parcelas comparáveis em relatórios de outros fornecedores. Previsão anterior ou contrária mais próxima: Anthropic (2026a): 52% contra 45% em novembro de 2025 |
| F22 (A) | Um terço dos produtos notáveis. Os 100 produtos com mais votos nas doze tabelas mensais do Product Hunt de 2027, lista congelada em 1º de janeiro de 2028. Os criadores listados são codificados; um produto conta como feito sem educação em programação se nenhum criador listado declara educação em programação ou trabalho anterior em programação (pessoas autodidatas com empregos em programação contam como programadores). Dois codificadores, cegos um para o outro. Realizou-se se pelo menos 30 dos 100 se qualificarem. Linha de base: Manifold: software codificado por vibe com 100 milhões de usuários mensais até o final de 2026, cerca de 28% | Verificação: 31 de dezembro de 2027. Data final: 31 de dezembro de 2028. p = 0,28; modelos 0,29 (0,14 a 0,50). Não resolvido se: Menos de 50 dos 100 produtos têm uma declaração codificável, ou nenhum dado até a data final (nunca contado como sucesso). Alternativa: Uma segunda classificação congelada (Hacker News Show HN top 100 de 2027). Previsão anterior mais próxima ou contrária: Gartner (2021); Manifold: software codificado por agentes com 100 milhões de usuários mensais até o final de 2026, cerca de 28% |
| F23 (A) | Nenhuma ocupação separada na SOC 2028. A Classificação Ocupacional Padrão dos EUA para 2028 não contém uma ocupação separada para trabalho direcionado por agentes. Linha de base: SOC 2018 não possui tal ocupação | Verificação: Publicação de SOC 2028. Data final: 31 de dezembro de 2029. p = 0,92; modelos 0,93 (0,80 a 0,98). Não resolvido se: Nenhum dado comparável até a data final (nunca contado como sucesso). Alternativa: Aviso de revisão do BLS (verificado em 9 de outubro de 2026: nenhuma estrutura proposta ou final ainda; estrutura final esperada em 2027). Previsão anterior mais próxima ou contrária: Nenhuma encontrada |
| F24 (A) | O primeiro adolescente em Week na ciência. Um produto científico é software, um conjunto de dados ou um artigo usado em pesquisa publicada por pelo menos dez pessoas não relacionadas ou citado em pelo menos um artigo revisado por pares. Um caso documentado publicamente de uma pessoa menor de 18 anos sem treinamento formal cujo produto científico tem tais usuários e ganha Week sob verificação independente. Linha de base: Nenhum caso documentado como esse no momento da redação | Verificação: 31 de dezembro de 2030. Data final: 31 de dezembro de 2031. p = 0,23; modelos 0,21 (0,02 a 0,45). Não resolvido se: Apenas se as fontes de pesquisa não estiverem disponíveis; a ausência de um caso documentado até a data final não é. Alternativa: Nenhuma. Previsão anterior mais próxima ou contrária: Objetivo da China de educação em IA em todas as escolas até 2030 (CSET, 2025) |
| F25 (A) | Títulos de júnior desaparecem. Participação de anúncios de software dos EUA com "júnior" ou "nível de entrada" no título em 2030, em comparação com 2025 nas mesmas consultas. Tornou-se verdadeiro se diminuiu em pelo menos um terço. Linha de base: Participação de anúncios de software dos EUA com "júnior" ou "nível de entrada" no título em 2025, mesmas consultas | Verificação: Dados de 2030. Data final: 31 de dezembro de 2031. p = 0,55; modelos 0,54 (0,45 a 0,60). Não resolvido se: Nenhum dado comparável até a data final (nunca contado como sucesso). Alternativa: Indeed Hiring Lab. Previsão anterior mais próxima ou contrária: Manifold: um terço menos de funções de desenvolvedor júnior até 2030, cerca de 74%; Desenvolvedores dos EUA caíram mais de 15% de 2023 a 2028, cerca de 42%; mercado 0,74 (https://manifold.markets/OliverKuperman/will-the-number-of-junior-developer, 9 de outubro de 2026 (aberturas de SWE júnior diminuíram pelo menos 33% até 1 de janeiro de 2030; uma medida relacionada, não idêntica)) |
| F26 (B) | A prática de contratação segue. Estudo de auditoria próprio: portfólios correspondentes de trabalho verificado diferindo apenas em educação em TI enviados para vagas reais em dois domínios não-TI. Tornou-se verdadeiro se as taxas de retorno de chamada diferem em menos de 3 pontos, com o intervalo de 95% dentro de mais ou menos 5. Linha de base: Sem linha de base pública; estudo de auditoria próprio | Verificação: 31 de dezembro de 2028. Data final: 31 de dezembro de 2029. p = 0,35; modelos 0,32 (0,25 a 0,35). Não resolvido se: Nenhum dado comparável até a data final, ou um intervalo que não atende a nenhuma regra (nunca contado como sucesso). Alternativa: Nenhuma. Previsão anterior mais próxima ou contrária: Burning Glass Institute e Harvard Business School (2024): menos de uma contratação em 700 mudou |
| F27 (A) | Produtos construídos por agentes superam a previsão do Gartner. Uma amostra de pelo menos 300 produtos públicos construídos principalmente com agentes de codificação, lançados de outubro a dezembro de 2026, congelados no Zenodo até 31 de dezembro de 2026; atividade verificada pelo script complementar. Tornou-se verdadeiro se menos de 50% foram aposentados (inacessíveis ou não atualizados por 12 meses) em 31 de dezembro de 2028. Linha de base: Gartner (Tyagi, 2026): 60% de aplicações codificadas por agentes aposentadas até 2028 | Verificação: 31 de dezembro de 2028. Data final: 31 de março de 2029. p = 0,32; modelos 0,35 (0,20 a 0,55). Não resolvido se: A amostra não foi congelada até 31 de dezembro de 2026 (nunca contado como sucesso). Alternativa: Snapshots do Wayback Machine de cada produto. Previsão anterior mais próxima ou contrária: Gartner (Tyagi, 2026): 60% aposentado |
| F28 (A) | Máquinas atingem Day em 80%. O horizonte temporal de 80% do METR para o melhor modelo lançado publicamente atinge 8 horas (Day) até 31 de dezembro de 2027. Linha de base: Cerca de 3,1 horas em 80% em abril de 2026 (METR, 2026c; painel não atualizado após 8 de setembro de 2026) | Verificação: 31 de dezembro de 2027. Data final: 30 de junho de 2028. p = 0,80; modelos 0,66 (0,55 a 0,80). Não resolvido se: Nem METR nem a alternativa relatam um horizonte de 80% até a data final (nunca contado como sucesso). Alternativa: Uma replicação independente do método de METR (por exemplo Epoch AI). Previsão anterior mais próxima ou contrária: A tendência de horizonte ajustado do METR dobrando aproximadamente a cada 4,2 meses |
| F28b (A) | Máquinas atingem Week em 80%. Como F28, limite de 40 horas (Week). Linha de base: Como F28 | Verificação: 31 de dezembro de 2027. Data final: 30 de junho de 2028. p = 0,30; modelos 0,20 (0,10 a 0,55). Não resolvido se: Como F28. Alternativa: Como F28. Previsão anterior mais próxima ou contrária: Como F28 |
| F29 (A) | Menos novos especialistas em ciência da computação. Novos especialistas de graduação em ciência da computação relatados pela Pesquisa Taulbee do CRA publicada em 2028 (ano acadêmico de 2027 a 2028) em relação à pesquisa publicada em 2026. Linha de base: Pesquisa Taulbee do CRA publicada em 2026 | Verificação: Relatório Taulbee 2028. Data final: 31 de dezembro de 2028. p = 0,69; modelos 0,67 (0,50 a 0,75). Não resolvido se: Nenhum dado comparável até a data final (nunca contado como sucesso). Alternativa: Inscrições do Centro de Pesquisa NSC por especialidade. Previsão anterior mais próxima ou contrária: Relatórios do CRA de inscrição em CS decrescente em 2025 e 2026 |
| F30 (A) | Coautores agentes em commits públicos. Participação de eventos de push públicos no Arquivo GH cujas mensagens de commit contêm um trailer de coautor agente (expressões regulares congeladas em predictions/resolve/F30.md), setembro de 2027 em relação a setembro de 2026. Linha de base: Arquivo GH, setembro de 2026, medido e arquivado antes do registro | Verificação: 31 de outubro de 2027. Data final: 31 de dezembro de 2027. p = 0,55; modelos 0,59 (0,40 a 0,75). Não resolvido se: Nenhum dado comparável até a data final (nunca contado como sucesso). Alternativa: GitHub Innovation Graph. Previsão anterior mais próxima ou contrária: Nenhuma encontrada |
| F31 (A) | Títulos de construtor superam títulos de gerenciador de agentes. Anúncios dos EUA, consultas Indeed congeladas (predictions/resolve/F31.md), Q4 2027: títulos da família construtora contra a família gerenciadora de agentes. Linha de base: Contagens no Q4 2026 nas mesmas consultas | Verificação: 31 de dezembro de 2027. Data final: 30 de junho de 2028. p = 0.60; modelos 0.63 (0.50 a 0.74). Não resolvido se: Nenhum dado comparável pela data final (nunca contado como sucesso). Fallback: contagens de busca no LinkedIn com as mesmas consultas. Previsão anterior mais próxima ou contra: Srinivasan e Wei (2026): "agent manager" um título padrão em 12 a 18 meses |
| F32 (A) | Um fornecedor afirma que a maioria dos usuários de seu agente de codificação não são desenvolvedores. Um fornecedor de um agente de codificação criado pela Anthropic, OpenAI, Google ou GitHub relata publicamente que pessoas que não são desenvolvedores de software são a maioria dos usuários semanais desse agente. Linha de base: Nenhum relatório desse tipo no momento da redação | Verificação: 31 de dezembro de 2027. Data final: 31 de março de 2028. p = 0.40; modelos 0.31 (0.13 a 0.70). Não resolvido se: Nenhum dado comparável pela data final (nunca contado como sucesso). Fallback: Relatórios econômicos ou de uso do fornecedor. Previsão anterior mais próxima ou contra: Fornecedores de construtores de aplicativos (Lovable, Replit) já descrevem principalmente usuários não-desenvolvedores; isto o solicita de agentes de codificação gerais |
| F33 (A) | O piso de segurança da máquina permanece baixo. Participação de amostras de código gerado por IA que passam em testes de segurança no relatório de segurança de código GenAI da Veracode. Linha de base: Taxa de aprovação de 56%, estagnada (Veracode, 2026) | Verificação: Relatório Veracode 2028. Data final: 31 de dezembro de 2028. p = 0.70; modelos 0.67 (0.57 a 0.80). Não resolvido se: Nenhum dado comparável pela data final (nunca contado como sucesso). Fallback: Um benchmark independente comparável de segurança no código gerado. Previsão anterior mais próxima ou contra: Veracode: nenhuma melhoria na segurança com modelos mais recentes |
| F34 (B) | As horas de referência são reproduzíveis. Dois painéis independentes de três avaliadores estimam horas de referência para as mesmas 50 tarefas; correlação intraclasse (bidirecional, acordo absoluto) de horas de log. Linha de base: Piloto de mesa dos limites (Apêndice E) | Verificação: 30 de junho de 2027. Data final: 31 de dezembro de 2027. p = 0.65; modelos 0.65 (0.40 a 0.75). Não resolvido se: Nenhum dado comparável pela data final, ou um intervalo que não satisfaz nenhuma regra (nunca contado como sucesso). Fallback: Nenhum. Previsão anterior mais próxima ou contra: Linhas de base humanas do METR (máquinas, não pessoas) |
| F35 (B) | Horizonte prevê saída posterior. Pelo menos 200 logs: horizonte no mês 0 adicionado a permanência e educação em TI aumenta o R² fora da amostra para saída verificada nos meses 4 a 6. Linha de base: Sem linha de base pública | Verificação: 30 de setembro de 2027. Data final: 30 de setembro de 2028. p = 0.60; modelos 0.58 (0.45 a 0.70). Não resolvido se: Nenhum dado comparável pela data final (nunca contado como sucesso). Fallback: Nenhum. Previsão anterior mais próxima ou contra: Instituto Burning Glass e Escola de Negócios de Harvard (2024) |
| F36 (A) | Plataformas certificam construtores verificados. Pelo menos dois de Upwork, Fiverr, GitHub, Product Hunt, Toptal e Contra introduzem um crachá público ou campo de perfil certificando trabalho construído por IA verificado independentemente (não um teste de habilidades). Linha de base: Nenhum crachá desse tipo no momento da redação | Verificação: 31 de dezembro de 2027. Data final: 31 de março de 2028. p = 0.23; modelos 0.24 (0.07 a 0.70). Não resolvido se: Nenhum dado comparável pela data final (nunca contado como sucesso). Fallback: Páginas de ajuda da plataforma e anúncios arquivados. Previsão anterior mais próxima ou contra: Nenhuma encontrada |
Nota: Conjunto A é resolvido a partir de dados públicos; Conjunto B a partir de estudos pré-registrados separadamente (protocolo até 30 de junho de 2027, caso contrário não conduzido, o que o cartão de pontuação conta como uma falha do programa de testes). p é condicional à resolução. Modelos: média geométrica das probabilidades de previsores de modelos independentes que não viram meus números, com seu intervalo; previsões individuais em predictions/m2-probabilities.csv. Regras de realizado e não-realizado para cada linha estão em predictions/predictions.csv. Nas linhas F4a e F4b a previsão do Gartner é citada como a lista de referências a cita, por meio do resumo de Tray.ai (2026), com suas próprias palavras entre aspas; o arquivo registrado fornece a mesma previsão e os mesmos números de forma mais breve e cita Gartner (Tyagi, 2026).
Apêndice E. Teste de mesa dos limiares
Este apêndice relata o teste de mesa das regras da Seção 5.2, executado em 9 de outubro de 2026 por simulação e com avaliadores modelo, e expõe o protocolo de calibração que fixa a próxima versão. Todo número é produzido por dois scripts no repositório de acompanhamento (pilot/), que chamam o avaliador do Apêndice C inalterado e trocam apenas suas constantes.
E1. Com que frequência um degrau é conquistado
Para uma pessoa cujas peças passam independentemente com uma probabilidade verdadeira p, a Tabela E1 fornece a chance de conquistar cada degrau com exatamente a contagem mínima de peças na janela. Os valores são probabilidades binomiais exatas; uma execução de Monte Carlo através de horizon.py, com as peças espalhadas pela janela, o erro plantado e a peça recente em seu lugar, concorda dentro de 0,01.
Tabela E1. Probabilidade de conquistar um degrau, por taxa de aprovação verdadeira.
| Regra | p = 0.95 | p = 0.9 | p = 0.8 | p = 0.7 | p = 0.6 |
|---|---|---|---|---|---|
| Hora e Dia, 8 de 10 em 91 dias | 0.99 | 0.93 | 0.68 | 0.38 | 0.17 |
| Semana, 5 de 6 em 182 dias | 0.97 | 0.89 | 0.66 | 0.42 | 0.23 |
| Mês, primeira versão, 4 de 4 em 365 dias | 0.81 | 0.66 | 0.41 | 0.24 | 0.13 |
| Mês, atual, 5 de 6 em 365 dias | 0.97 | 0.89 | 0.66 | 0.42 | 0.23 |
| Trimestre, 3 de 3 em 365 dias | 0.86 | 0.73 | 0.51 | 0.34 | 0.22 |
Nota: a regra é uma regra de qualificação. Essas probabilidades descrevem a regra, não qualquer pessoa.
Três conclusões a seguir. Primeiro, a primeira versão não foi ordenada: Mês, em quatro de quatro, era mais difícil de conquistar do que Trimestre em cada p. Uma contagem de quatro de cinco teria invertido o erro, tornando Mês mais fácil do que Dia e Semana em p = 0.8 (0,74), portanto Mês agora pede cinco de seis em um ano, cerca de 960 horas de referência em vez de 640. Com isso, Dia, Semana, Mês e Trimestre são ordenados do mais fácil para o mais difícil para cada p de 0,77 e acima, o intervalo onde a qualificação importa. Abaixo de 0,76 Semana é ligeiramente mais fácil do que Dia (0,42 contra 0,38 em p = 0,7). Ambas são então recusadas na maioria das vezes, e isso é relatado e deixado inalterado. Nenhuma contagem de três ou mais peças pode ser ordenada contra três de três em cada p, porque as curvas se cruzam. Segundo, um veredicto é ruidoso: em p = 0,8 o mesmo veredicto se repete na próxima janela para 56% das janelas em Dia, 55% em Semana e Mês e 50% em Trimestre. O registro portanto imprime a contagem ao lado do degrau ("Dia (8/10)"), e um relatório pode marcar um degrau como estável quando também se manteve na janela anterior. Em p = 0,8 um Dia mantido em duas janelas seguidas ocorre em 46% dos casos, portanto estabilidade é um rótulo, não um requisito. Terceiro, uma pessoa confiável ainda pode perder: em p = 0,95 Trimestre é perdido em 14% dos anos, que é o preço de um degrau que repousa em três peças.
A Figura A2, painel A, plota essas probabilidades contra p para as regras v1.1.
E2. Sensibilidade à contagem e à proporção
O artigo prometeu relatar quantas pessoas mudam de degrau quando a contagem se move de dez para oito ou doze e a proporção de 0,8 para 0,7 ou 0,9. A resposta é fornecida para 10.000 registros simulados em Dia, cada um com entre 6 e 16 peças de tamanho Dia na janela e uma taxa de aprovação verdadeira extraída uniformemente entre 0,5 e 1,0. A regra atual (dez, 0,8) fornece Dia para 30% deles, e a Tabela E2 fornece a proporção cujo veredicto muda sob as outras regras.
Tabela E2. Proporção de registros simulados cujo veredicto de Dia muda contra dez peças e uma proporção de 0,8.
| Contagem mínima | Proporção 0.7 | Proporção 0.8 | Proporção 0.9 |
|---|---|---|---|
| 8 | 22% | 8% | 15% |
| 10 | 10% | 0% | 11% |
| 12 | 16% | 9% | 17% |
Nota: a população de registros é uma suposição da simulação. O estudo de campo de E5 repete esta análise em registros reais.
Mover qualquer constante um passo altera cerca de um veredicto em dez. Mover ambas muda até um em cinco. A proporção importa mais do que a contagem.
E3. Ruído do avaliador na borda de um degrau
Se dois avaliadores são imparciais e 80% de seus pares caem dentro de uma razão de 1,5, acima do critério de 70% na Seção 5.8, e a referência é a média geométrica de suas duas estimativas, então uma peça cujo tamanho verdadeiro é 7 horas de referência é pontuada em tamanho de Dia 20% das vezes, e uma peça de 9 horas fica aquém do tamanho de Dia 23% das vezes. É por isso que o registro relata o tamanho mediano aceito ao lado do degrau (Tabela 3): um horizonte construído com peças logo acima de um limite se mostra.
E4. Avaliadores modelo de horas de referência
Quatro modelos de linguagem de quatro famílias (Anthropic, OpenAI, Google e Moonshot), cada um trabalhando sozinho e cego para os outros e para quaisquer tempos publicados, estimaram as horas de referência de 44 tarefas em 9 de outubro de 2026. Trinta eram tarefas de um novo banco em três domínios de baixo risco (contabilidade de pequenas empresas, pequenas ferramentas web internas, documentos legais e de marketing), cada um com uma declaração escrita de feito e uma verificação oculta. Quatorze eram tarefas públicas dos dados de horizonte de tempo da METR (METR, 2026d) com tempos de referência humana medidos de 12 minutos a 14,6 horas, fornecidos aos avaliadores apenas por seu identificador público. A Tabela E3 fornece os resultados.
Tabela E3. Concordância e precisão de quatro avaliadores modelo cegos.
| Medida | Banco de 30 tarefas (declaração de feito) | 14 tarefas com tempos medidos (identificador apenas) |
|---|---|---|
| Pares de estimativas dentro de uma razão de 1,5 (6 pares de avaliadores) | 62% (de 27% a 97% por par) | 35% |
| Correlação intraclasse ICC(2,1), horas de log | 0.89 | 0.60 |
| Todos os quatro avaliadores colocam a tarefa no mesmo tamanho de degrau | 60% | 36% |
| Média dos quatro dentro de 1,5 do tempo medido | não medido | 21% (3 de 14) |
| Média dos quatro dentro de 2 do tempo medido | não medido | 43% (6 de 14) |
Nota: avaliadores de modelo representam os dois avaliadores humanos da Seção 5.1 e não são evidência sobre eles.
Dado um descritivo completo de conclusão, os modelos concordaram em quais tarefas eram maiores, mas não no nível: a média geométrica das estimativas de um avaliador sobre o banco era de 5,1 horas e a de outro, 10,4. Um deslocamento fixo dessa natureza é o erro mais barato de remover, razão pela qual avaliadores no estudo de campo primeiro se calibram em tarefas com tempos medidos. Dado apenas um identificador, as estimativas tinham pouca utilidade, o que corrobora um banco congelado com tempos medidos à mão (Seção 5.1) sobre estimativas feitas a partir de um título. Sob a regra da Tabela 3, onde uma discordância acima de 1,5 envia uma peça para um terceiro avaliador, dois desses avaliadores enviariam cerca de quatro peças em dez para um terceiro.
Figura A2. A regra do degrau na mesa: a chance de ganhar um degrau e o quão bem avaliadores de modelo concordam nas horas.
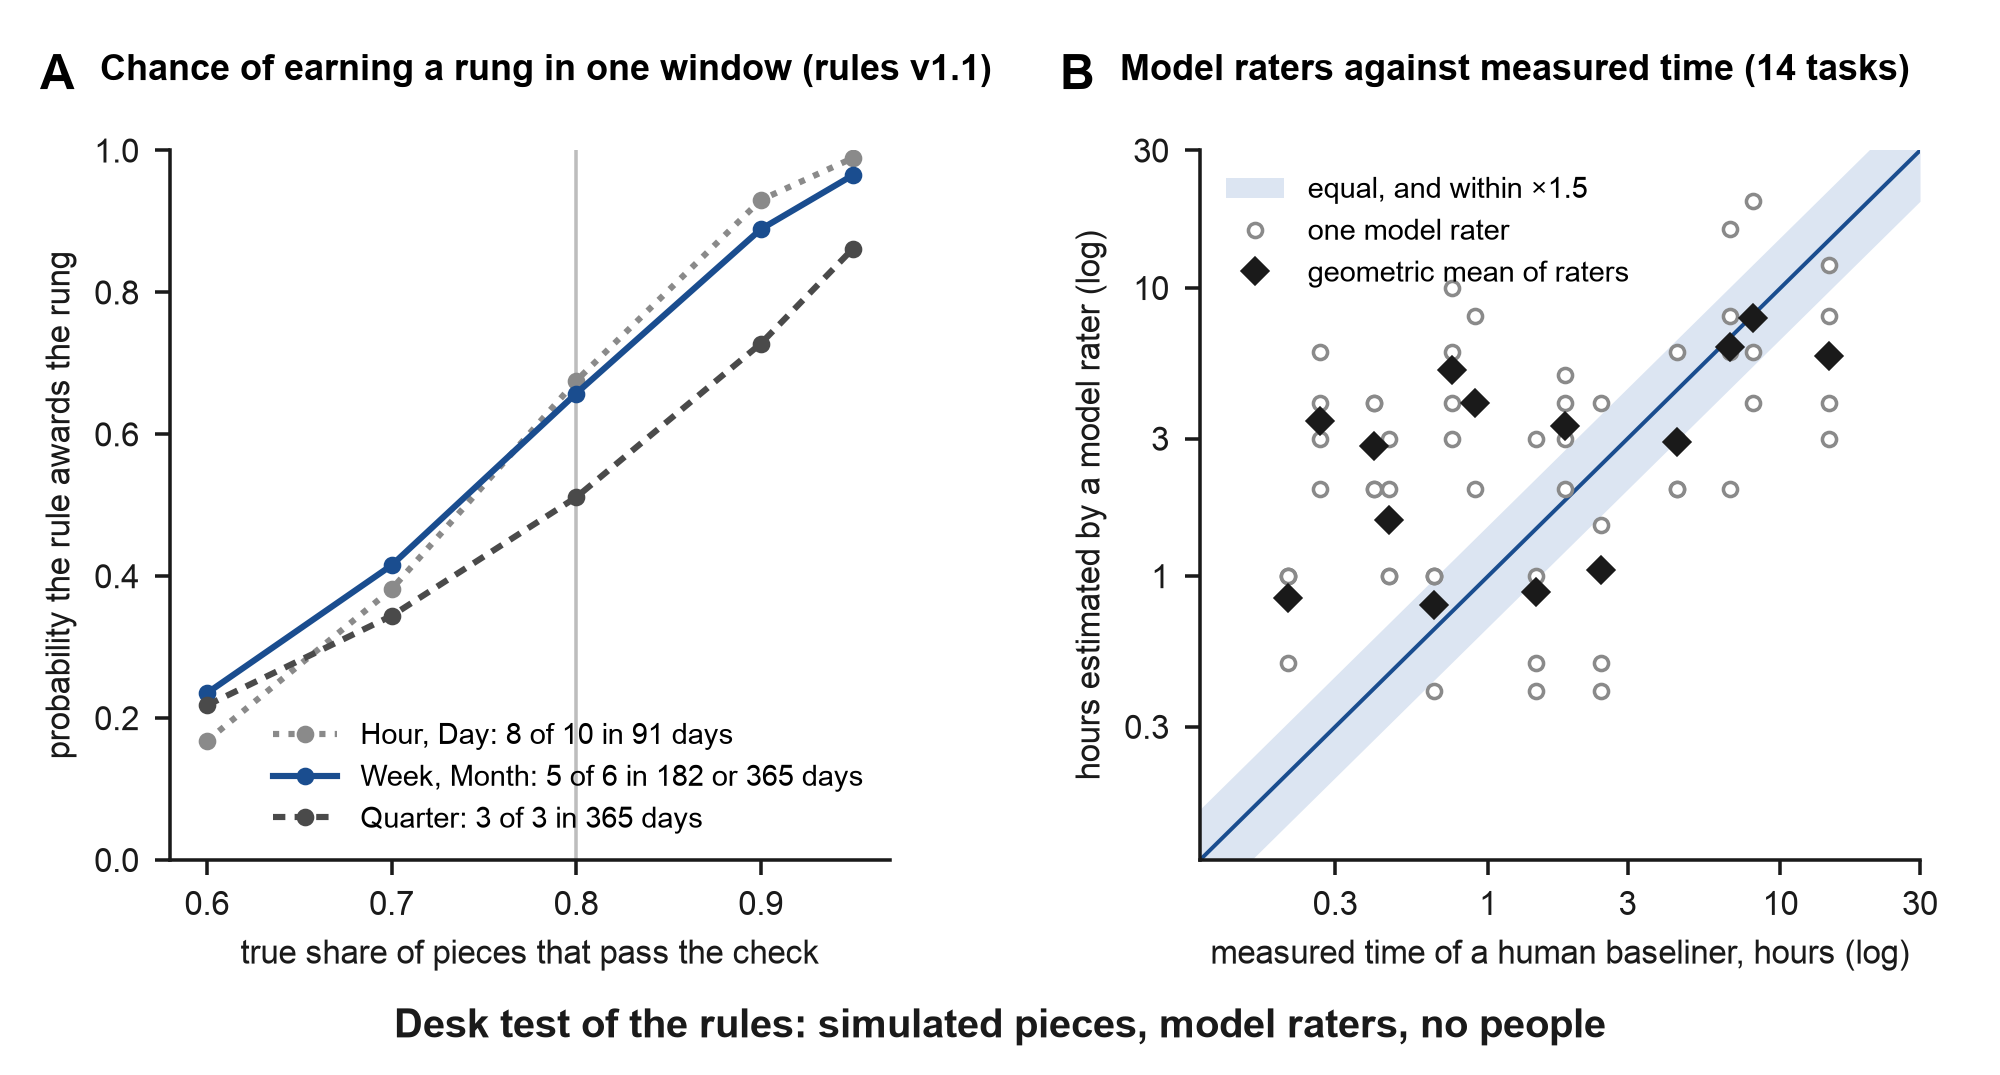
Nota: Um teste de mesa com peças simuladas e avaliadores de modelo. O painel A apresenta, para cada degrau sob as regras v1.1, a probabilidade de que a regra conceda o degrau em uma janela quando cada peça passa sua verificação independentemente com a proporção no eixo horizontal. Degraus com a mesma contagem e o mesmo número de aprovações seguem a mesma curva. O painel B estabelece as horas de referência que quatro avaliadores de modelo, cada um de uma família diferente, estimaram para 14 tarefas em relação ao tempo medido para um avaliador humano de referência (dados de tarefas de METR). A faixa marca concordância dentro de um fator de 1,5. O teste de mesa que produziu ambos os painéis é descrito neste apêndice, e seu código e saídas estão no repositório complementar.
E5. O protocolo de calibração
O protocolo e o texto de registro estão no repositório complementar (pilot/pilot-protocol.md, pilot/preregistration-draft.md). Em resumo, 60 adultos participam, 30 com experiência em software e 30 sem, nos três domínios do banco, durante duas janelas de 91 dias. Todos usam as mesmas ferramentas de agente, com versões registradas, e as verificações são testes ocultos ou dois revisores de domínio às cegas. Os tempos medidos à mão são medidos em um quinto das tarefas do banco, cada entrega é registrada com sua data de início, e um décimo aleatório de peças aceitas é auditado. Os critérios são estabelecidos antes dos dados: pelo menos 70% dos pares de estimativas humanas dentro de 1,5, pelo menos 60% das horas avaliadas dentro de 1,5 das medidas, repetibilidade do degrau em ambas as janelas com um kappa ponderado de pelo menos 0,6, previsão de aprovação de novas tarefas com um AUC de pelo menos 0,7, menos de 5% das linhas de log perdidas e pelo menos 95% das entregas falhadas registradas. O formulário de consentimento é escrito apenas para este estudo e não reutiliza nenhum outro consentimento. Mês e Trimestre, trabalho irreversível e domínios de alto risco estão fora deste estudo de campo de seis meses.
E6. O que o teste de mesa resolve e o que vem a seguir
Mostra como as regras se comportam para uma pessoa de confiabilidade conhecida, onde foram inconsistentes (uma inconsistência agora foi corrigida), o quão sensível um veredicto é às duas constantes, e que avaliadores de modelo ordenam tarefas consistentemente mas discordam no nível. O protocolo de calibração de E5 aborda o que um teste de mesa deixa para as pessoas: como elas se comportam sob as regras, se um degrau se repete para uma pessoa real e se prevê novo trabalho; a concordância entre avaliadores humanos é testada primeiro (Apêndice G). Os limites são, portanto, testados de mesa como regras v1.1, e o estudo de calibração estabelece a próxima versão.
Para reproduzir: python3 pilot/simulate_rules.py e python3 pilot/rater_agreement.py pilot/results/model-ratings.csv pilot/metr-anchor-tasks.csv (Python 3.9 ou posterior, apenas biblioteca padrão; seed 20261009).
Apêndice F. Tabelas e figuras complementares
Objetos numerados A1, A2 e assim por diante são objetos de apêndice. Eles são citados das seções nomeadas em cada nota.
Tabela A1. Sinais de convergência, 2025 a outubro de 2026.
| Sinal | Fonte e data | O que mostra | O que não mostra |
|---|---|---|---|
| Trabalho do desenvolvedor descrito como delegação e verificação | GitHub, 8 de dezembro de 2025 | A descrição do fornecedor sobre o papel mudou | Que o nível dos desenvolvedores é medido dessa forma |
| Não-desenvolvedores dentro de um agente de codificação cresceram 137 vezes (indivíduos) e 189 vezes (organizações) | OpenAI, junho de 2026 | Crescimento rápido a partir de uma base baixa; um quarto dos usuários da amostra fez pelo menos uma solicitação estimada em mais de 8 horas | Qualidade de seus resultados; dados do fornecedor |
| Dez maiores ocupações dentro de 7 pontos das ocupações de programação em sucesso verificado em sessões de produção de código | Anthropic, 16 de junho de 2026 | Pequena lacuna entre ocupações; sucesso apoiado por evidências como testes ou commits; expertise julgada pelo comportamento | Educação (ocupação não é grau); qualidade dos produtos entregues |
| Advogados construindo suas próprias ferramentas; acesso amplo a IA 83% contra 61% | Bloomberg Law, 20 de abril de 2026 | Especialistas em domínio construindo, não comprando | Por quanto tempo essas ferramentas são mantidas |
| Escada renomeada para aproximadamente 181.500 funcionários | Business Insider and Fortune, 22 de janeiro de 2026 | Empregadores mudando títulos | Uma nova medida (níveis internos mantidos) |
| "Frontier Professionals": 3.233 de 20.000 usuários de IA | Microsoft, 5 de maio de 2026 | Um segmento de pesquisa de usuários avançados | Um papel ou uma classificação |
| 16.541 postagens mencionando agentic AI em 2025 (151 em 2024) | Stanford AI Index 2026 | Demanda pela habilidade em postagens | Novas ocupações |
| Contratação de nível inicial caindo mais do que o geral | LinkedIn Economic Graph, agosto de 2026 | Um degrau de entrada mais fraco em meados de 2026 | Que a IA causou (LinkedIn aponta para a economia) |
| Novos graduados em CS caindo 13% em departamentos que concedem doutorado | CRA Taulbee, junho de 2026 | Estudantes reagindo | Uma tendência de longo prazo; todas as instituições |
| Uso de IA discutido em 4,54% das entrevistas no Q2 2026 (0,33% no Q3 2025) | Metaview, 2026 | A pergunta entrou na contratação | Uma escala para a resposta |
Nota: Dados de fornecedor são marcados como tal. Comparações mais antigas (com 2019 ou 2022) são omitidas por regra (Seção 1).
Tabela A2. Nomes em circulação e nomes propostos, por camada, em 9 de outubro de 2026. Parte 1: nomes em uso, com seus proprietários e status. Parte 2: nomes propostos neste estudo, descrições simples e variantes consideradas.
| Camada | Candidato | Introduzido por, e quando (parte 1) | Sentido em que é usado | A favor | Contra |
|---|---|---|---|---|---|
| Parte 1 | |||||
| Habilidade em massa | builder, Full Stack Builder | LinkedIn, dezembro de 2025 (relatado); "agora todos são construtores" (SF Standard, 2026) | Qualquer pessoa que constrói, de qualquer função | Já ganhando em RH | Não diz nada sobre o nível |
| Habilidade em massa | vibe coding, vibe coder | Karpathy, 2 de fevereiro de 2025 | Construir sem ler o código | Amplamente conhecido | Zombaria; nomeia o piso |
| Habilidade em massa | AI fluency (four Ds) | Anthropic, 2025b | Delegação, descrição, discernimento, diligência | Cobre o terreno | Competências sem níveis |
| Habilidade em massa | agent literacy | MindStudio, 11 de junho de 2026 | Delegar, verificar, gerenciar | Próximo em sentido | Tomado; nenhum padrão de prova |
| Profissão | agentic engineer | Karpathy, fevereiro de 2026; Alenezi, junho de 2026 | Um engenheiro que dirige agentes | A palavra dos engenheiros de 2026 | Vinculado à engenharia |
| Profissão | agent boss | Microsoft, 23 de abril de 2025 | Cada funcionário que gerencia agentes | Memorável | Um slogan sem medida |
| Profissão | agent manager | Arion Research, 7 de fevereiro de 2026; Srinivasan e Wei, Harvard Business Review, 12 de fevereiro de 2026 | Um papel que executa agentes em uma equipe | Relatado como o favorito (aicodex, 2026); seus autores esperam que se torne um título padrão dentro de 12 a 18 meses | Um título de gerente horizontal (Seção 6.3) |
| Profissão | AI Agent Owner; AI Agent Supervisor | Writer, 2026; discussão no Digg, 2026 | Uma pessoa responsável por um agente implantado | Nomeia propriedade | Uso de um único fornecedor ou fórum |
| Profissão | AI orchestrator | St. Lawrence, seminário de 2024 e livro de 2025; 739 postagens em fevereiro de 2026 (IT Brew, 2026) | Um profissional de negócios que coordena IA | Em postagens | Tomado muitas vezes; horizontal |
| Profissão | AI Operator | Dust, 7 de outubro de 2026 | Constrói e mantém fluxos de trabalho de agentes compartilhados | Familiar | Soa como um console; em Anthropic um "operator" é uma empresa construindo na API (Anthropic, 2026b) |
| Profissão | AI steward, AI work architect | Ono, World Economic Forum, 22 de junho de 2026 | Uma define os limites do trabalho de IA, a outra verifica as consequências | O antecessor mais próximo em sentido | Dois papéis, sem medida |
| Profissão | product creator | Cagan, SVPG, 2025 | Uma pessoa que leva um produto da ideia ao mercado | Linguagem do produto | Tomado; sem medida |
| Profissão | Product Principal | O'Neill, postagem do LinkedIn, 2026 | Define metas para agentes, aceita e responde pelo resultado | Quase o sentido deste artigo | Tomado nesse sentido; cite como precedente |
| Profissão | Principal Agentic Context Engineer | Título de trabalho coletado por Turkovic, 24 de abril de 2026 | Um grau de antiguidade em trabalho de agente | Mostra "principal" já usado como grau | Grau, não uma profissão |
| Profissão | AI Product Builder; Agentic Product Builder | Publicação n8n, 2026; publicação State Street, 2026 | Produtos construídos e prática de verificação necessários; codificação preferida (n8n) ou necessária (State Street) | Mostra empregadores se movimentando no requisito de codificação em ambas as direções | Títulos de empregadores individuais |
| Profissão | Chartered Financial Intelligence Architect | Clark, SSRN, 2026 | Uma profissão nomeada para uma indústria | Mostra nomes vinculados ao domínio sendo emitidos | Uma proposta, uma indústria |
| Profissão | principal | Agency theory (Jensen & Meckling, 1976); "principals" em Claude's constitution (Anthropic, 2026b); The Principal Firm (Verheul, 2026); principal-agent framing de agentes de IA (Berkeley California Management Review, 2025; Tikhomirov, 2026) | A parte em nome de quem um agente atua e que arca com o custo da verificação | Teoria por trás; corresponde à palavra "agent" | "Agent principal" em gerenciamento de identidade e acesso significa a identidade do próprio agente, o sentido oposto; também o grau Principal Engineer |
| Medida | delegation horizon (sentido de máquina ou empresa) | Khadj, 2026 (uma versão anterior tinha um "Delegation Horizon Index", 0 a 100); Alonso, 2026 ("a delegation horizon" para cadeias de trabalho) | Quão longe uma máquina ou uma empresa pode delegar antes que um humano tenha que intervir | Mostra que a frase é natural | Máquina ou empresa, não uma pessoa |
| Medida | uplift; speedup; autonomy 1 to 5; H1 to H5; supervisory capacity | METR, 2025; Anthropic Economic Index, 2025-2026; Shao et al., 2025; em360, 2026 | Ganhos médios, aceleração em nível de conversa, autonomia de agente, envolvimento humano preferido, saída útil por esforço | Vizinhos estabelecidos do ganho de amplificação | Meça tarefas, conversas ou ferramentas, não a saída verificada de uma pessoa |
| Momento | crossing time | The geometry of learning under AI delegation (2026) | O ponto após o qual delegar para IA custa mais através do decaimento de habilidades do que ganha | Próximo em forma | Sentido oposto: perda de habilidade, não peso de credencial |
| Parceiro | guarantor | "Legal guarantor" em Capps (2025), New York Times Magazine | Fornece a culpabilidade que a IA não pode | Exato | Coloração legal |
| Parceiro | finisher; distribution engineer; GTM engineer | GTM engineer em publicações, 2026 | Leva o produto às pessoas | Pago hoje | Parcialmente automatizável (Seção 7) |
| Sinal falho | tokenmaxxing | Uso na imprensa, 2026 (CIO, 2026a) | Ranking ou competindo por tokens consumidos | Nomeia uma prática real | Não é uma profissão (Seção 4) |
| Nomes mais antigos | desenvolvedor cidadão; engenharia de software do usuário final; Code Runner, Adaptor, Writer, Builder | Gartner, por 2009; Ko et al., 2011; Feldman & Anderson, 2024 | Construindo fora de TI; usuários finais enfrentando problemas de engenharia | Longa linhagem | Vinculado a um lado da divisão antiga |
| Parte 2 | Candidato | Situação | Sentido | Favor | Contra |
| Habilidade em massa | acceptance literacy | Proposto aqui; nenhum uso encontrado nas bases do Apêndice B | Dizendo antecipadamente o que conta como feito, depois mostrando | Nomeia o núcleo | Uma habilidade, não uma pessoa; deve ser distinguida da pesquisa de aceitação de tecnologia |
| Profissão | agentwright | Proposto aqui; nenhum uso encontrado nas bases do Apêndice B | Um que faz trabalho através de agentes, como um dramaturgo faz uma peça | Livre nas bases acadêmicas; carrega autoria | Mecanismos de busca o dividem em "Agent Wright"; soa como uma ferramenta de teste de navegador; parcialmente apropriado por outubro de 2026 (um pacote Python e um catálogo de habilidades de agentes), portanto precisaria de um qualificador |
| Profissão | domain orchestrator (legal orchestrator, fintech orchestrator) | Proposto em um rascunho anterior deste estudo | Uma pessoa com conhecimento profundo de domínio que monta sistemas de agentes para esse domínio | Vincula a função a um vertical (Seção 6.3) | "Multi-domain orchestrator" é um termo estabelecido na gestão de redes 5G e 6G |
| Profissão | setter-acceptor; agent director | Descrições simples | Define a tarefa e aceita o resultado | Exato | Uma descrição, não um nome; "director" é uma classificação de gerente |
| Profissão | Agent-Directed Product Creator; Agentic Work Steward; Agentic Work Producer; Outcome Author; Outcome Architect; agent conductor | Variantes produzidas nas consultas de modelo deste estudo | Variações em autoria e administração de trabalho com agentes | Mostrar o espaço de opções | Longo, ou próximo de nomes apropriados (steward, creator, architect) |
| Escada profissional | Specifier, Verifier, Domain Orchestrator; setter, acceptor, coordinator, loop owner | Escadas iniciais deste estudo | Passos de responsabilidade crescente para trabalho com agentes | Legível | Substituído por degraus em horas, que não precisam tradução entre profissões |
| Medida | verified delegation horizon (também: personal ou human delegation horizon) | Proposto aqui | Maior peça de trabalho verificada que uma pessoa entrega a agentes | Enraizado em Jaques e METR | Deve ser distinguido do sentido de máquina e empresa na parte 1 |
| Medida | amplification gain | Proposto aqui | Trabalho verificado por hora de atenção | Créditos a construtores de loop curto | Precisa de uma referência congelada |
| Momento | credential crossover point | Proposto aqui; nenhum uso encontrado nas bases do Apêndice B | Quando produtos de pessoas sem educação em TI começam a ultrapassar os de programadores sob as mesmas verificações, e as credenciais perdem peso | Observável em partes (Seção 6.2) | "Credential" também significa uma chave secreta em segurança de agente; defina no primeiro uso |
| Momento | Skill Inversion Point; Background Neutrality Point; expertise crossover point; credential decoupling | Variantes consideradas | O mesmo momento visto de habilidades, fundo, expertise ou credenciais | Cada um enfatiza uma parte | Cada um cobre apenas um dos componentes da Seção 6.2 |
| Parceiro | co-signer; trust broker; distribution principal | Variantes consideradas | O parceiro que assina ou carrega o produto | Simples | Mais estreito que garantidor ou finalizador |
| Sinal falhado | senioridade de tokens (tokens como classificação) | Termo usado aqui para o episódio de 2026 | Classificação de pessoas por tokens consumidos | Nomeia um evento real | Não é uma profissão (Seção 4) |
Nota: O status reflete buscas na web e em bancos de dados em 8 e 9 de outubro de 2026 (Apêndice B). "Nenhum uso encontrado" refere-se às bases listadas lá nessas datas e não afirma nada sobre bases que não foram pesquisadas. Variantes na parte 2 vêm de rascunhos próprios do estudo e são listadas para que a família de opções permaneça visível.
Tabela A3. Escalas de 2025 e 2026 e o que cada uma mede (lista completa).
| Escala | Fonte | Unidade medida | Mede uma pessoa por trabalho delegado verificado? |
|---|---|---|---|
| Níveis de autonomia para agentes de IA (operador para observador) | Feng et al., 2025 | O agente | Não |
| Cinco níveis, de autocompletar à fábrica de software | Shapiro, janeiro de 2026 | A máquina ou a configuração da equipe | Não |
| Oito estágios de desenvolvimento auxiliado por IA | Yegge, 2026 | A prática de um programador, pelo número de agentes | Não |
| A Escada de Capacidade (gatilho para equipe de agentes) | Memari & Rudolph, 2026 | A automatização do trabalho | Não |
| Sete estágios de supervisão de agentes de codificação | Park et al., 2026 | Estágios do trabalho de supervisão | Não |
| Cinco níveis de delegação no desenvolvimento (AIDEs) | JetBrains Research (Tikhomirov), setembro de 2026 | A delegação de um desenvolvedor, enquadrada como uma relação principal-agente | Apenas desenvolvedores; nenhuma regra de verificação |
| Níveis de delegação de IA na tomada de decisão | Dawson, 2026; Metal Toad, 2026 | A delegação de uma organização ou gerente | Não |
| Delegação Inteligente de IA | Tomašev et al. (DeepMind), fevereiro de 2026 | Delegação em geral | Nenhuma medida de nível de pessoa |
| A fronteira de delegação (versão inicial: Índice do Horizonte de Delegação, 0 a 100) | Khadj, 2026 | A delegação de uma firma ou agente | Não (máquinas e firmas) |
| Autor, editor, diretor, orquestrador | Microsoft, maio de 2026 | Padrões de trabalho | Não |
| Estrutura de Competência em IA (oito áreas, quatro níveis) | AI Certification Standards, 23 de agosto de 2026 | Competências entre profissões | Nenhum exame ou limiares |
| Fluência em IA (quatro Ds) | Anthropic, 2025b | Alfabetização | Sem níveis |
| Horizonte de tempo da máquina | METR, 2025-2026 | O modelo | Não (apenas máquinas) |
| Horizonte de delegação verificado e ganho de amplificação | Este artigo | Uma pessoa em um domínio | Sim, pela regra da Seção 5.2 |
Nota: "Mede uma pessoa por trabalho delegado verificado" significa que a escala coloca um indivíduo em um nível de acordo com o tamanho do trabalho entregue aos agentes e confirmado por uma verificação que os agentes não viram. Os níveis da JetBrains dizem respeito a quanto os desenvolvedores delegam, e eles já usam a linguagem de principal e agente. Eles são o vizinho mais próximo, e carecem de uma regra de independência para verificações e uma unidade de tamanho.
Tabela A4. Casos difíceis e como as regras os tratam.
| Caso | Tratamento |
|---|---|
| Trabalho que a pessoa nunca poderia ter feito manualmente | Horas de referência ainda vêm de um especialista qualificado; a habilidade própria da pessoa não entra |
| Trabalho cuja qualidade aparece apenas meses depois | Aceito provisoriamente; o resultado atrasado é registrado quando chega e pode revogar a peça |
| Um domínio sem revisor humano qualificado por perto | Testes ocultos ou uso real por usuários pretendidos; um modelo de outra família apenas com fontes que a pessoa abriu |
| Um crítico cego da mesma família de modelos, em um contexto novo | Não é uma verificação independente: registrada como same_family (Apêndice C), não ganha crédito, embora possa melhorar o trabalho antes de uma verificação independente (Seção 6.5) |
| Uma equipe que aceita trabalho juntos | Cada pessoa registra sua própria atenção; a peça conta para a pessoa que assinou a aceitação |
| Uma peça que passa na verificação mas depois é encontrada como errada | Registrada como falhada na próxima re-verificação, e o degrau é rescorificado |
| Trabalho irreversível misturado com trabalho ordinário | A regra mais rigorosa se aplica apenas às peças irreversíveis (Seção 5.2) |
Tabela A5. Tópicos nos fios de discussão dos desenvolvedores e seus contrapartes em outras profissões, 2025-2026 (casos ilustrativos).
| Tópico nos fios | Contraparte fora do software | Fonte | Cruzou? |
|---|---|---|---|
| Quem é culpado pela saída ruim, o modelo ou quem definiu a tarefa | "Workslop": saída de IA que muda o trabalho para seu destinatário, cerca de duas horas por incidente e $186 por funcionário por mês; colegas julgam seus remetentes menos capazes | The Decoder (2025); BetterUp (2026) | Sim, fortemente |
| O preço da verificação ($150 por hora de revisão) | O mesmo custo de workslop | The Decoder (2025) | Sim |
| Um modelo forte planeja e revisa, modelos baratos fazem o trabalho | Orçamentos de IA alocados por função na Atlassian | HCA Magazine (2026) | Em empresas |
| Sobrecarga, mudança constante de ferramentas, medo de perder | "Queimação cerebral de IA" relatada por 25-26% dos profissionais de marketing, 19% em RH, 17% em software | Search Engine Journal (2026) | Sim, mais fortemente fora de TI |
| Ferramentas próprias no lugar de software comprado | Advogados construindo ferramentas com agentes; 35% das empresas pesquisadas substituindo algum software comprado pelos seus (amostra do fornecedor) | Artificial Lawyer (2026); Bloomberg Law (2026); Retool (2026) | Na camada superior |
| Comparando agentes | Guarda-livros comparando dois agentes de codificação | Growthy (2026) | Sim |
| Movendo uma empresa para agentes sem programadores | Advogados e firmas construindo com agentes no lugar de fornecedores | Bloomberg Law (2026); Artificial Lawyer (2026) | Parcialmente; o próprio negócio de consultoria é visto apenas no fio |
| Uma conta pessoal de IA acima de $1.000 por mês como marcador de status | Nenhuma contraparte de status encontrada; as mais próximas são limites de empresa e subsídios (limite de $1.500 por mês da Uber, carteiras de IA da Atlassian) | Fortune (2026b); HCA Magazine (2026); busca de 9 de outubro de 2026 | Não, como status; sim, como linha de orçamento |
| Pertencer ao campo de um agente | Nenhuma contraparte encontrada | Busca de 9 de outubro de 2026 | Não, e não é necessário |
Nota: Os fios são evidência qualitativa escolhida por seus tópicos e não representam uma população. "Cruzamento" registra se uma contraparte foi encontrada nas fontes listadas, em 9 de outubro de 2026.
Figura A3. Horizontes de máquina na escala dos degraus.
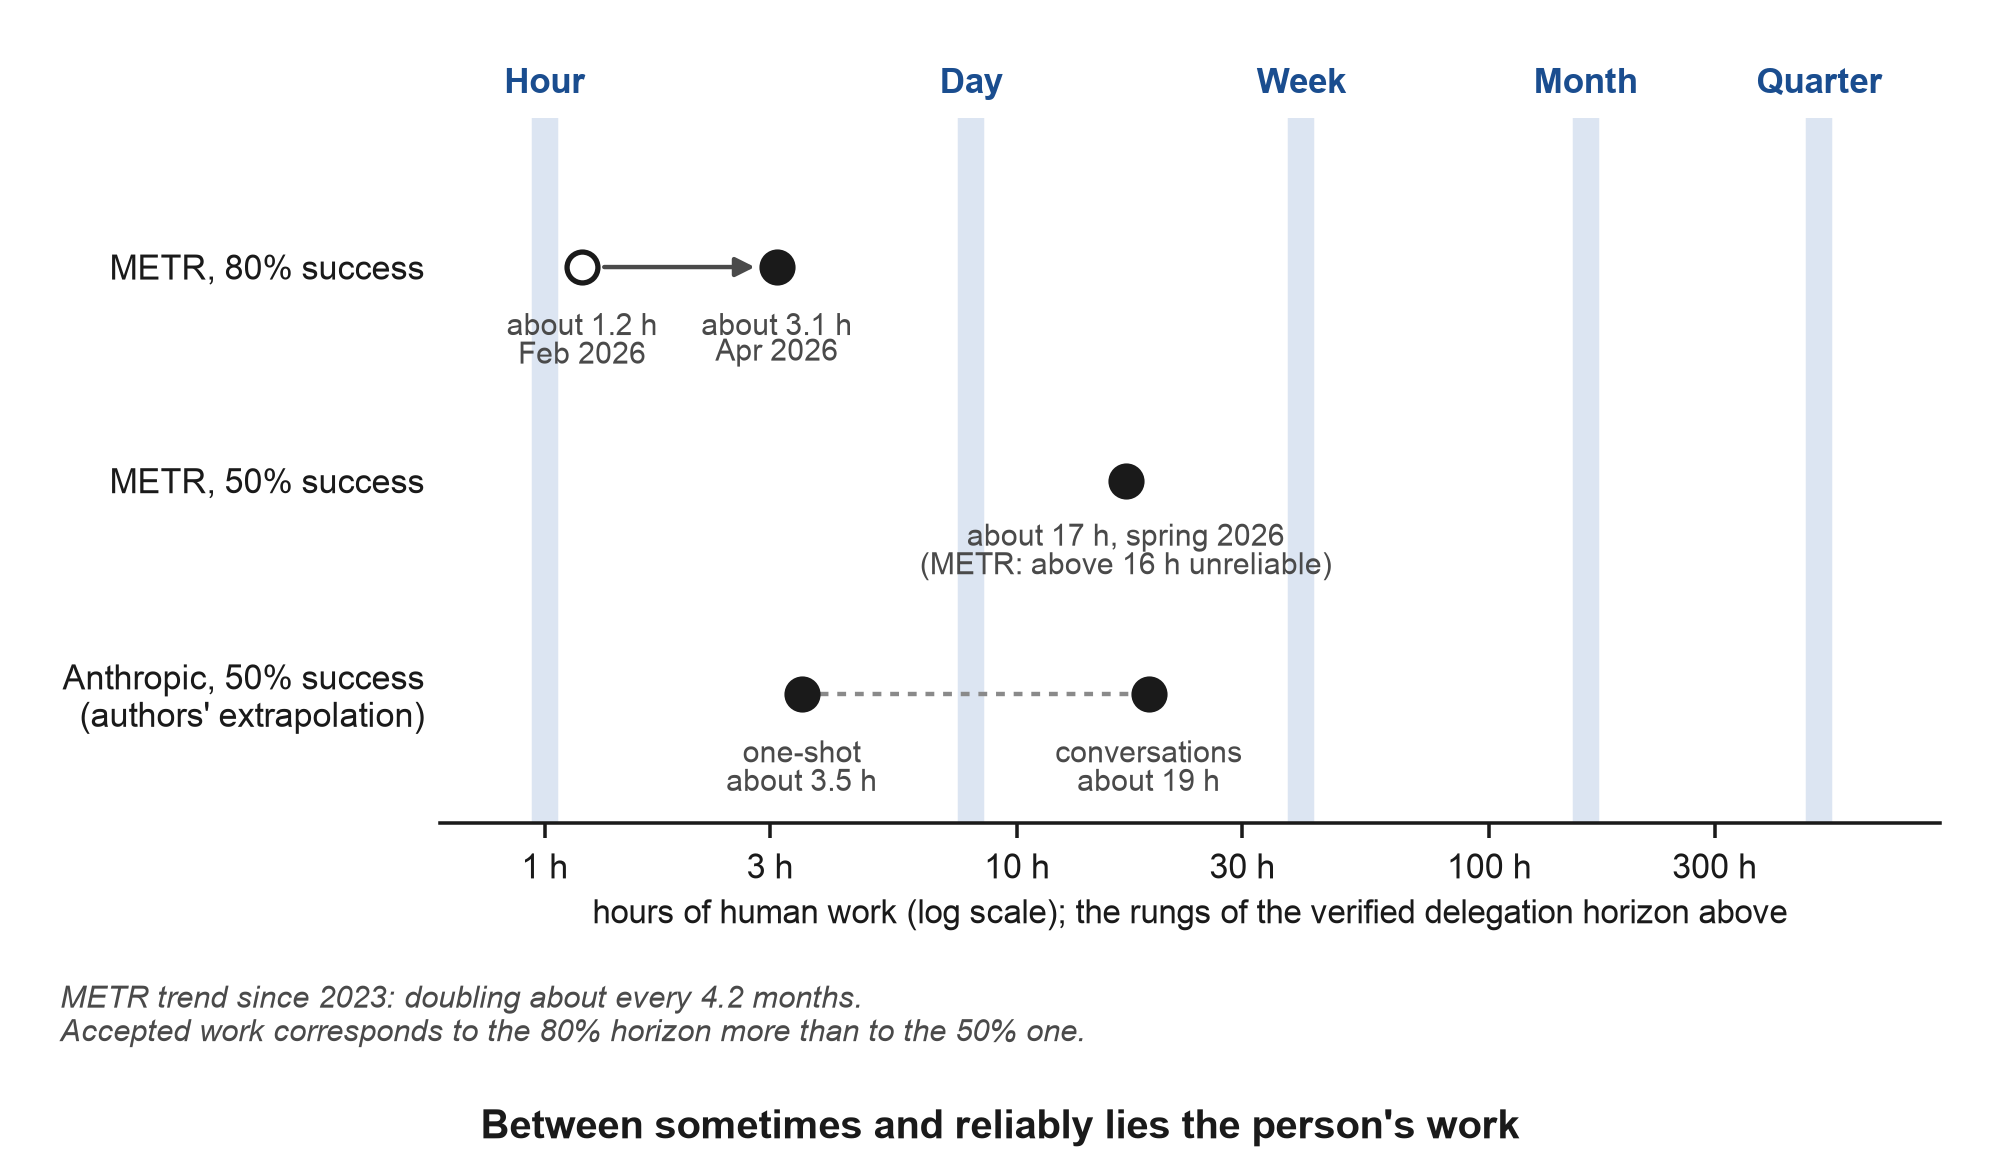
Nota: O horizonte de tempo do METR em 80% de sucesso, cerca de 1.2 horas em fevereiro de 2026 e cerca de 3.1 horas em abril. Em 50% de sucesso, cerca de 17 horas na primavera de 2026, que o próprio METR chama de não confiável acima de 16 horas (METR, 2026c). Os pontos de 50% da Anthropic, cerca de 3.5 horas para solicitações de uma única tentativa e cerca de 19 horas para conversas, são extrapolação dos autores (Anthropic, 2026a). Os horizontes de máquina medem modelos, não pessoas. As colunas sombreadas mostram apenas onde os degraus da Seção 5.3 caem no mesmo eixo de horas (Seção 5.6).
Figura A4. O processo de verificação da Seção 6.5: o que cada passo representa, o que ganha sob a regra, e onde para.
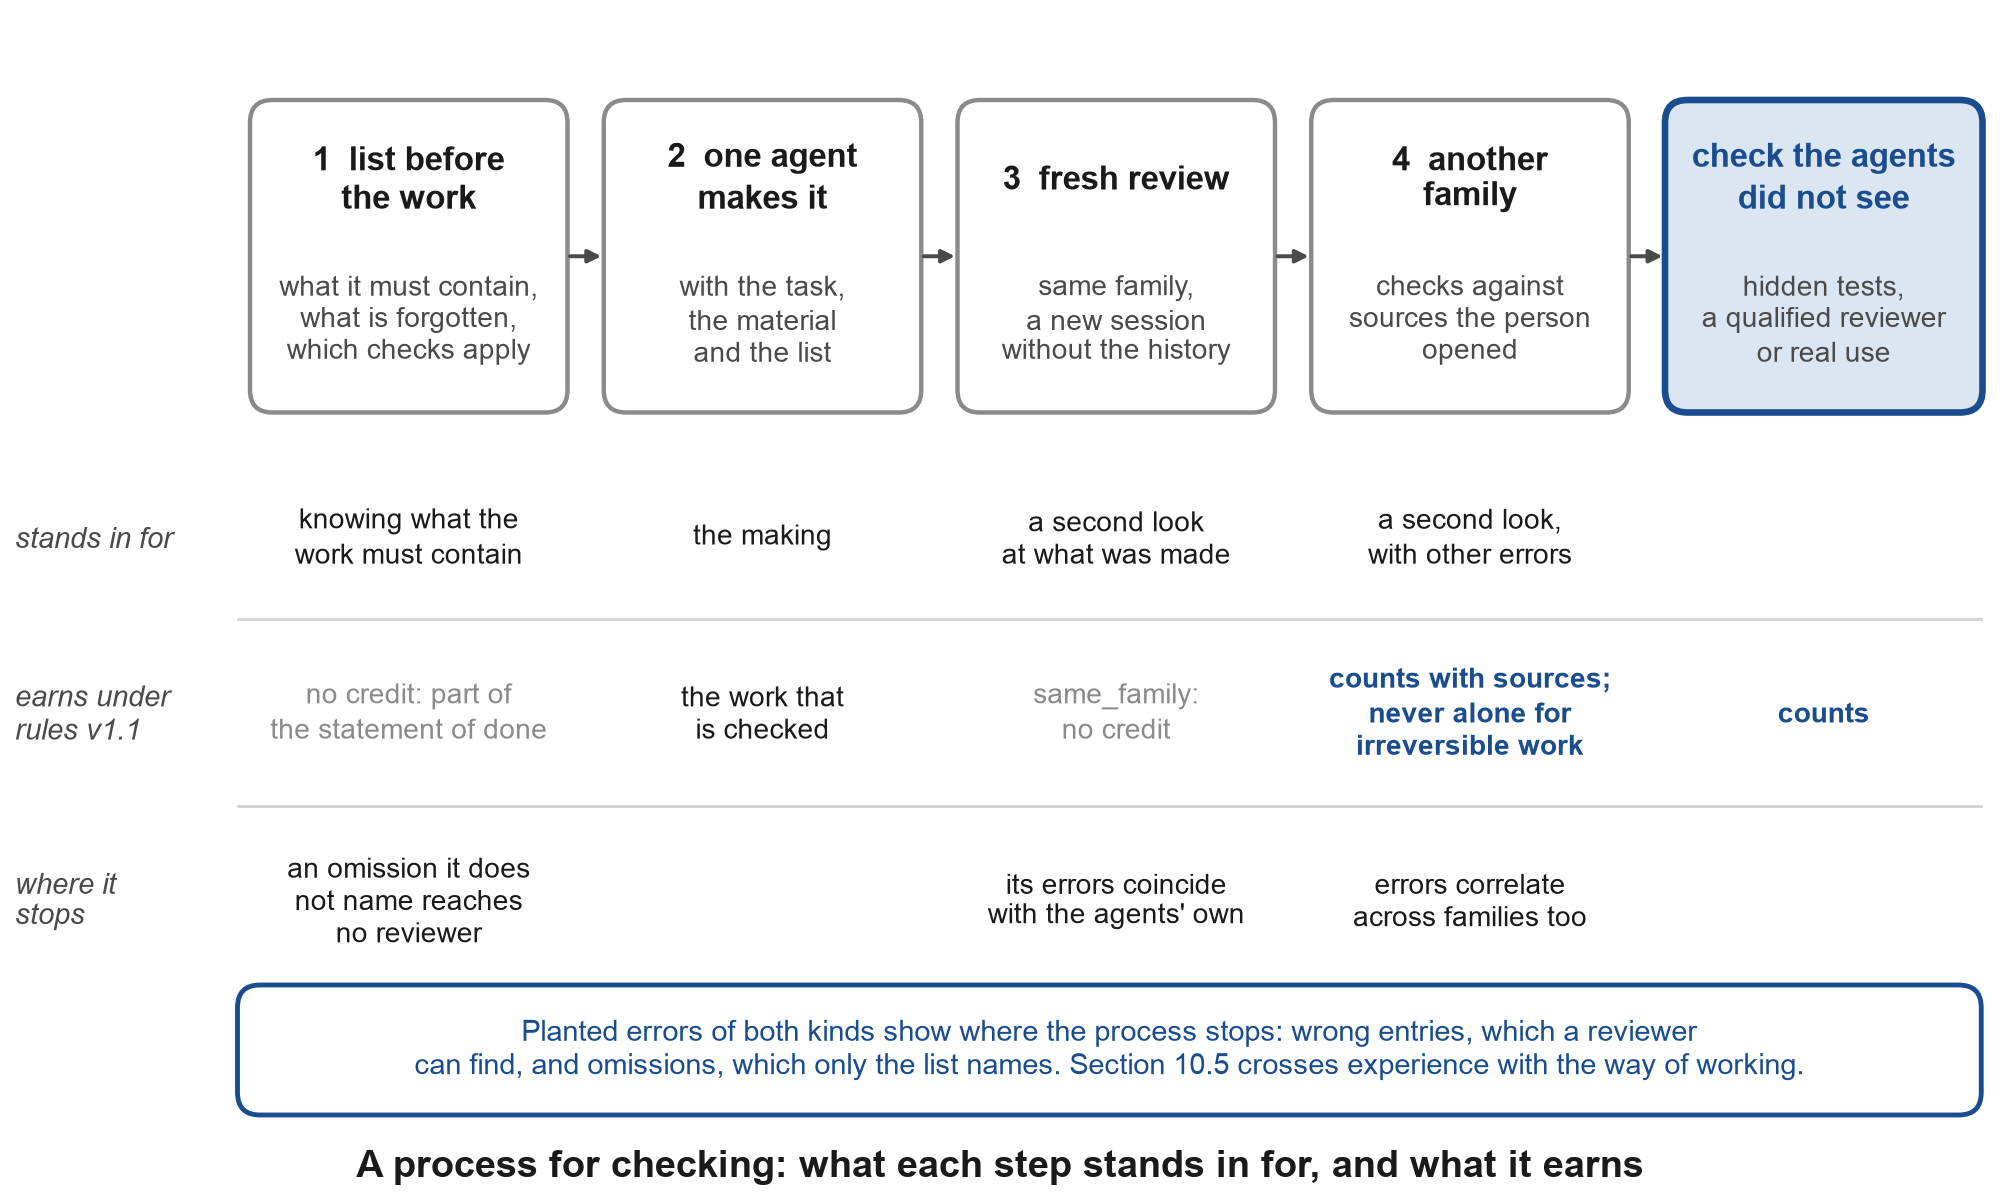
Nota: Os quatro passos e o que cada um representa são os da Seção 6.5. A linha de crédito segue a regra de pontuação da Seção 5.2 e Tabela A4: uma revisão por um modelo da mesma família em um contexto novo é registrada como same_family e não ganha crédito, embora possa melhorar o trabalho; um modelo de outra família conta apenas quando verifica contra fontes que a pessoa abriu, e nunca isoladamente para trabalho irreversível. A última linha resume Fu et al. (2025) sobre omissões e Kim et al. (2025) sobre erros que se correlacionam entre os modelos. Nenhuma previsão registrada testa o processo; a Seção 10.5 apresenta a comparação que o faria. A figura é desenhada por figures/figure_a4_checking_process.py no repositório complementar, que lê o crédito de cada tipo de verificação de horizon.py. Cada passo representa parte da experiência de um ofício; a Seção 14 retorna a isso como uma escada de equalizadores.
Tabela A7. Situação das afirmações neste artigo.
| Elemento | Como é sustentada | Base |
|---|---|---|
| Programadores e outros agora compartilham as tarefas e fluxo de trabalho de delegação e aceitação | Os dados a sustentam no nível de tarefas e fluxos de trabalho; profissões como um todo não se fundiram | Seção 2; logs de fornecedores e pesquisas de 2025-2026 |
| As duas antigas escalas não medem esse trabalho | Observado | Escalas renomeadas sem uma nova medida (Deloitte); questão do uso de IA entrando em entrevistas sem escala |
| Contagens de tokens falham como medida de senioridade | Observado em casos iniciais | Reportagens da imprensa de 2026 (Seção 4): um ranking não oficial de um funcionário na Meta, removido, e a orientação oficial posterior da Meta contra contagens de tokens; um ranking na Amazon, manipulado e removido; o orçamento de IA da Uber gasto em quatro meses, um evento orçamentário |
| Horizonte de delegação verificado e ganho de amplificação | Proposto; regras v1.1 testadas de mesa; protocolo de calibração no repositório complementar; acordo de profissionais sobre horas de referência sob teste registrado | Definições e regras (Seção 5); instrumento (Apêndice C); teste de mesa dos limiares (Apêndice E) |
| Teto do ganho definido pela proporção de verificação | Oferecido como modelo; ilustrado por médias de GDPval | Seção 5.5 |
| Neutralidade de fundo | Hipótese; testes a serem registrados (F7) | Anthropic (2026e) aponta para isso; Savva (2026) é uma abordagem rival |
| Ponto de cruzamento de credenciais | Hipótese; componentes datados separadamente (paridade F2, ultrapassagem F3, postagens F5, neutralidade F7) | Lightcast (2026b) mostra linhas convergentes; Bone et al. (2025) precedem isso para funções de IA |
| Entradas que admitem por vazamento de rótulo auto-informado; entradas que verificam a sustentação do trabalho | Oferecido como modelo; o vazamento é ilustrado uma vez, pela triagem do estudo de classificação | Seções 6.2 e 13; Apêndice G2; Danilova et al. (2021); Reid et al. (2022); Serafini et al. (2024, 2026); Oregon State Board of Bar Examiners (2026) |
| Software cruza por último | Previsão (F6), com 40 outras na Tabela A6, registrada no OSF | Argumento de domínio (Seção 6.3) |
| Um processo de verificação pode representar parte da experiência de um ofício | Hipótese, não registrada; nenhuma previsão registrada a testa, e F3b (p = 0.10) incide sobre ela apenas indiretamente; uma comparação é apresentada na Seção 10.5 | Seção 6.5; Dell'Acqua et al. (2026), McAleese et al. (2024), Eulerich et al. (2024), Fox et al. (2026) e Benchek et al. (2026) de um lado; Kim et al. (2025), Chernets (2026b), Fu et al. (2025) e Virk and Liu (2025) do outro |
| Confiança como segunda fronteira; garantidor como profissão parceira | Oferecido como modelo; previsões F11 e F12 | Seção 7 |
| Não-programadores trabalhando através de agentes | Observado em uma coorte em andamento, descrito sem inferência; resultados registrados informados separadamente | Seção 11.5; Apêndice G |
Tabela A8. Entradas que admitem por rótulo e entradas que verificam o trabalho: o que cada uma verifica, e o que foi observado.
| Entrada | Com base em que admite | O que foi observado | Fonte |
|---|---|---|---|
| Um filtro de participante de uma plataforma de pesquisa | Respostas geralmente dadas com base na palavra da pessoa; idade e país de residência verificados | De 60 pessoas admitidas em uma amostra de contabilidade, 11 responderam incorretamente a uma pergunta da primeira semana do ofício, 8 deles invertendo o débito e o crédito | Prolific (2026); Appendix G2 |
| Habilidade de programação declarada em uma plataforma de crowdwork | A palavra da própria pessoa | 42% não atenderam aos critérios das questões de conhecimento dos pesquisadores | Danilova et al. (2021) |
| Programação em Node.js relatada no Prolific | A palavra da própria pessoa | 55 de 206 passaram em todas as questões de programação | Reid et al. (2022) |
| Uma pergunta de conhecimento estático, em texto ou em imagens | Uma resposta que um modelo de chat pode fornecer | ChatGPT resolveu facilmente as questões de triagem existentes para programadores e, até 2026, superou questões visuais estáticas projetadas para resistir a ele | Serafini et al. (2024, 2026) |
| Uma pergunta de áudio revelada passo a passo sob um limite de tempo rigoroso | Uma resposta dada sob pressão de tempo | Ainda se mantém contra um modelo de chat em 2026 | Serafini et al. (2026) |
| Um requisito de diploma removido de uma política | Um rótulo, removido no papel | Menos de uma contratação em 700 mudou; 19,3% dos anúncios nos EUA no Indeed solicitava um diploma de bacharel ou superior em novembro de 2025, acima de um ano antes | Burning Glass Institute and Harvard Business School (2024); Indeed Hiring Lab (2026) |
| Uma licença por um exame aprovado uma vez | Conhecimento, verificado uma vez | Funciona como um rótulo a partir de então | Section 6.2 |
| Inspeção do trabalho assinado de uma firma de auditoria licenciada | Trabalho assinado, verificado repetidamente | Todo ano para empresas que regularmente auditam mais de 100 emissores, pelo menos uma vez a cada três anos caso contrário | Sarbanes-Oxley Act of 2002, s. 104 |
| Uma licença por um portfólio de trabalho supervisionado | Trabalho verificado, uma vez; o diploma de direito ainda é obrigatório | 205 candidatos haviam se candidatado até 5 de janeiro de 2026 e 49 foram licenciados, o primeiro em dezembro de 2024 | Oregon State Board of Bar Examiners (2026) |
| O horizonte de delegação verificado | Trabalho entregue que passou em uma verificação que os agentes não viram, confirmado a cada trimestre | Um degrau com a contagem por trás dele e os tipos de verificação, falhas mantidas no log | Sections 5.2 and 5.3 |
Nota: As linhas são os casos que a Seção 6.2 cita. Eles provêm de diferentes populações e diferentes questões e são apresentados lado a lado para o que cada portão verifica, não para serem comparados como taxas. Um portão do segundo tipo pode ser adicionado na frente de qualquer portão do primeiro: os avaliadores de horas de referência no repositório complementar são admitidos por uma pergunta do ofício (kits/reference-hours-raters.md), conforme o estudo de avaliadores do Apêndice G2 realizou a triagem de seus avaliadores. kits/trade-screen.md descreve como escrever uma pergunta como essa e relatá-la, e tools/gate_leak.py fornece a proporção que um rótulo deixa passar, com um intervalo exato.
Apêndice G. Pessoas já fazendo: uma coorte de não-programadores e um estudo de avaliadores do Prolific
Este apêndice é um complemento à medida, não parte de seu argumento; as Seções 6.2, 6.5 e 14 citam o resultado da triagem de G2 como uma ilustração. Adiciona dois registros de pessoas: um relato de não-programadores que passaram do chat para o trabalho com agentes em setembro e outubro de 2026 (G1), e um estudo registrado de avaliadores em que profissionais em atividade avaliaram as horas de referência do banco de tarefas (G2).
G1. Não-programadores que passaram do chat para agentes
A partir de 6 de setembro de 2026, orientei adultos sem formação em programação, passo a passo e através de mensagens ordinárias, de um assistente de chat para um agente de codificação instalado em seu próprio computador e pago com sua própria assinatura de consumidor, e depois para trabalhar com vários modelos. Vieram de mais de uma dúzia de ocupações, entre elas contabilidade e trabalho administrativo, direito, marketing e vendas, design, fotografia e retoque, tradução e edição, música, construção, transporte e logística, imóveis, trabalho de cuidado, administração pública e trabalho comunitário sem fins lucrativos; quatro relataram trabalho passado ou presente em software. O relato abaixo é descritivo: relata o que as pessoas fizeram e o que as impediu, conforme registrado em 9 de outubro de 2026, e não calcula nenhuma taxa e não testa nenhuma reivindicação deste artigo.
Tabela G1. Até onde a coorte tinha chegado em 9 de outubro de 2026 (contagens de pessoas).
| Etapa | Pessoas |
|---|---|
| No registro: consentiu e devolveu o questionário de entrada | 119 |
| Instalou um agente em seu próprio computador e assinatura e começou a trabalhar com ele | 35 |
| Produziu um artefato ou completou pelo menos uma etapa em seu próprio trabalho | 24 |
| Parou, com uma razão declarada | 23 |
| dos quais: sem computador próprio (apenas telefone, ou um dispositivo que não consegue executar o agente) | 9 |
| dos quais: o custo de uma assinatura | 5 |
| dos quais: recusaram (o que tinham era suficiente, sem interesse, ou o enquadramento de iniciante não se encaixava) | 6 |
| dos quais: saúde, família ou tempo | 2 |
| dos quais: o serviço não estava disponível onde vivem | 1 |
Nota: Contado manualmente a partir do registro de participantes e do resumo mais recente de medições, usando o evento mais avançado registrado para cada pessoa. As 35 pessoas da segunda linha são as 35 linhas da Tabela G1b, e as 24 da terceira linha são suas primeiras 24 linhas. Um artefato conta quando a pessoa o mostrou ou descreveu o que o agente produziu; uma pessoa que produziu um artefato depois parou (P60) e é contada em ambas as linhas. Os 62 restantes tinham, nessa data, recebido a etapa de instalação sem relatar que estava feita ou ainda não a tinham atingido.
Tabela G1a. A coorte inteira por região e país de residência, e quantos de cada cruzaram para um agente até 9 de outubro de 2026.
| Região e país | Na coorte | Cruzaram para um agente |
|---|---|---|
| América do Norte | 37 | 10 |
| United States | 35 | 10 |
| Canada | 2 | 0 |
| Europa Ocidental | 20 | 7 |
| Germany | 12 | 5 |
| Ireland | 3 | 1 |
| Spain | 2 | 1 |
| United Kingdom | 1 | 0 |
| Austria | 1 | 0 |
| Switzerland | 1 | 0 |
| Europa Central e Oriental, países nomeados | 9 | 1 |
| Poland | 3 | 0 |
| Moldova | 2 | 0 |
| Latvia | 2 | 0 |
| Estonia | 1 | 0 |
| Romania | 1 | 1 |
| País não divulgado | 53 | 17 |
| Total | 119 | 35 |
Nota: A partir da coluna de país do registro de participantes. "País não divulgado" agrupa participantes cujo país é retido sob a regra de privacidade do estudo e aqueles que não forneceram um.
O que as pessoas fizeram com um agente. A Tabela G1b lista todos que cruzaram de um assistente de chat para dirigir um agente até 9 de outubro de 2026, uma linha cada: que tarefa lhe deram e o que ele produziu. Pessoas que produziram um artefato ou terminaram uma etapa em seu próprio trabalho vêm primeiro, ordenadas aproximadamente pelo quão longe tinham chegado; aqueles que instalaram o agente e começaram, sem um resultado relatado ainda, seguem. As profissões são dadas como no registro, em uma redação neutra. As citações curtas são as próprias palavras dos participantes do registro; aquelas marcadas "(traduzido)" foram escritas em outro idioma e são dadas em minha tradução literal.
Tabela G1b. Todos que cruzaram até agora (35 pessoas, em 9 de outubro de 2026).
| # | Participante | Profissão | País ou região | O que fizeram com um agente | Em suas próprias palavras |
|---|---|---|---|---|---|
| 1 | P20 | processamento de imagens, retoque, fotografia | não divulgado | O agente perguntou sobre seus objetivos e construiu um plano de um mês como pastas e arquivos (semanas por tópico, um arquivo de referência, um rastreador); depois o registrou em nove serviços de IA dirigindo o navegador em si e registrou a recusa em seu arquivo de progresso; ele executou uma pergunta através de 11 IAs da web e escreveu resultados e limites em um arquivo; em suas próprias fotografias de arquivo, produziu um CSV de metadados em um comando e o verificou | - |
| 2 | P73 | negócio de vendas de lentes de contato | Ireland | Instalou um segundo agente de outro fornecedor; ambos leram uma cópia de seu próprio plano de mídia social e ela manteve uma página dos pontos em que diferiam; escreveu um arquivo de regras para cada agente e encerrou a noite com um leia-me e um registro de trabalho | "Posso continuar o treinamento." |
| 3 | P48 | trabalho de escritório e vendas on-line | não divulgado | Transformou um documento que escreve toda semana em um modelo com uma checklist e escreveu o próximo a partir dele mais rápido; um segundo funcionário lê seus rascunhos às cegas; fez dois IAs lerem uma pasta de caso inteira e decidiu pessoalmente os três achados mais custosos | "A questão de qual IA é melhor é mal formulada." |
| 4 | P44 | marketing, vendas e consultoria | não divulgado | Criou botões na área de trabalho que executam tarefas do agente ("status do projeto", "inventário de novos itens", "resumo do documento", "nota para o arquivo"); instalou um segundo agente em outra assinatura e fez uma revisão conjunta de uma tarefa: um arquivo de resumo mais duas revisões completas | - |
| 5 | P21 | organização comunitária sem fins lucrativos | Alemanha | Construiu um programa interativo de um mês de habilidades e hábitos com rastreamento de progresso; pediu ao agente para escolher uma direção inicial do catálogo e escrever um plano de quatro semanas; depois executou três sessões do agente em paralelo: uma apresentação em minutos e um bot que monitora anúncios e envia correspondências para seu messenger | "Uma ferramenta adaptada às suas necessidades específicas, em vez de vasculhar a internet por compromissos ou assinaturas pagas." |
| 6 | P05 | assistente de um diretor, ex-programador | Estados Unidos | O agente criou cinco arquivos em sua máquina: uma visão geral e um plano de quatro semanas por tema; posteriormente, enviou convites para uma lista de 76 contatos através de uma página de mensagens web, clicando por si próprio, após uma mensagem de teste para seu próprio número | "A partir de agora, dividirei diferentes tarefas diárias entre eles e realmente compararei os resultados." |
| 7 | P01 | designer de interiores e desenhista, em formação | Espanha | Pediu ao agente para construir um arquivo de vagas de emprego em duas passagens, a segunda mais ampla que a primeira; comparou com dois relatórios de outro chatbot, concordâncias e divergências separadas; reescreveu seu CV e portfólio a partir de uma leitura honesta de seus próprios arquivos e revisou seu perfil profissional | "Quando consegue se aprofundar tanto e criar dados interessantes mas em geral separados para analisá-los." |
| 8 | P18 | marketing na internet | não divulgado | O agente organizou sua área de trabalho: criou documentos, os organizou em pastas, encontrou erros e os corrigiu; posteriormente, configurou alertas de notícias por e-mail sobre seus próprios tópicos | "Eu tinha ouvido falar de coisas assim, mas ver isso em ação realmente me convenceu." |
| 9 | P19 | funcionário de administração pública | não divulgado | Fez a revisão de prova de uma longa edição de texto de múltiplos livros de sua autoria em um único dia; finalizou dois grandes projetos em uma semana; agora está construindo uma coleção de plugins para um fluxo de trabalho de tradução | "Finalizei dois projetos principais em apenas uma semana... uau." |
| 10 | P35 | contratos, faturas e documentos alfandegários | Estados Unidos | Fez a primeira tarefa por voz; o agente limpou o cache do computador, fechou aplicativos e encontrou um horário de consulta em um site de reservas abrindo-o por si próprio; sugeriu uma direção de impressão sob demanda; ajuda com documentação de licitação; agora funciona no terminal | "Sim, funcionou, conseguimos." |
| 11 | P72 | imagens de banco de dados e vídeo feitos com IA | Romênia | Executou uma tarefa através de muitos IAs com a ferramenta de orquestração, configurou entrada de voz e escolheu direções de trabalho freelancer do catálogo | - |
| 12 | P41 | assistente odontológico, em licença parental | Estados Unidos | O agente fez um cronograma, um plano e rascunhos; encontrou seis cópias do próprio instalador e cinco de um pacote de escritório em sua máquina e removeu os extras; ela ditou uma aula para uma turma comunitária e o agente a digitou, adicionou referências e links, traduziu e salvou, depois a reformulou conforme seu desejo | "Estou encantada." |
| 13 | P24 | músico e poeta | Alemanha | Enviou uma tarefa de imagem para onze IAs e salvou os resultados em uma pasta com uma página da galeria; pediu ao agente para construir o esqueleto de um arranjo musical, que o decepcionou | "O aspecto ético da autoria permanece não resolvido para mim." |
| 14 | P102 | gerencia uma empresa de software | não divulgado | Já trabalhava diariamente em um agente na chegada; executou uma pergunta através de 11 IAs (10 responderam) e enviou o arquivo de execução; agora está trabalhando através do catálogo de ganhos | - |
| 15 | P40 | engenheiro de pesquisa e desenvolvedor web | não divulgado | Seguiu o caminho como um iniciante deliberado: cerca de cem arquivos soltos em sua pasta de downloads organizados em pastas, com capturas de tela antes e depois; devolveu duas correções aos materiais do curso | - |
| 16 | P75 | suporte técnico remoto | não divulgado | O agente criou uma pasta em sua área de trabalho com um plano de lançamento para um canal de vídeo de música sazonal (nomes, ideias de faixas, títulos, cronograma de postagem); etapa do terminal concluída | - |
| 17 | P60 | cuidado em casa | Estados Unidos | Depois de algumas perguntas do agente, um plano de um mês dividido em arquivos (doadores, finanças, modelos de carta); posteriormente saiu, achando o enquadramento de iniciante muito básico | - |
| 18 | P64 | serviço público uniformizado, logística e suprimento | não divulgado | Fez um plano mensal com o agente, que criou os arquivos em seu computador; registrou-se em dez serviços de IA | "A IA se adapta à pessoa. Aduleia, em certo sentido." |
| 19 | P28 | serviço público uniformizado | não divulgado | O agente apresentou caminhos de carreira a partir de seu cargo atual e, quando ele rejeitou um, um plano de desenvolvimento para seu ofício anterior, reparo de relógios (habilidades, certificação, oficina própria) | - |
| 20 | P14 | escalador industrial | Estados Unidos | Construiu "Reflex Square", um pequeno treinador de velocidade de reação, com o agente por sua própria sugestão durante a configuração | "Por enquanto, programação em Code não é algo que eu precise em minha vida cotidiana." |
| 21 | P67 | treinador de natação, também vendas diretas | não divulgado | Disse ao agente que havia começado em vendas diretas; ele ofereceu cinco tipos de ajuda e rascunhou um cartão de produto de amostra | - |
| 22 | P12 | estudante | Alemanha | Registrou-se nos serviços de IA gratuitos, executou a pasta de orquestração e com o agente escolheu quatro direções do catálogo (jornalismo, um livro, monetização, aprofundamento em IA); vai lhe fornecer seus próprios ensaios | - |
| 23 | P71 | defesa e saúde pública | Germany | Escreveu seu próprio prompt; o agente o encurtou e teve outros AIs fazendo as imagens; realizou a etapa do terminal e uma tarefa de teste adicional de sua autoria para memorizar os comandos de teclado | "Tarefa concluída, envie a próxima." |
| 24 | P22 | organização comunitária sem fins lucrativos | não divulgado | Realizou a tarefa do catálogo no agente (alguns sites bloquearam seu login); realizou a etapa do terminal e solicitou ao próprio agente para explicar o que foi feito; configurou alertas de notícias por e-mail | "Pronto, o que vem a seguir?" (traduzido) |
| 25 | P59 | videógrafo | United States | Forneceu ao agente um briefing detalhado para encontrar listagens de propriedades lucrativas em seu mercado local (verificações, sem gastos, classificadas por ganho); resultados ainda não apresentados | "Por que preciso de um segundo se o primeiro funciona." |
| 26 | P84 | não informado | não divulgado | Instalou o agente pelo terminal por conta própria; está construindo um site para uma organização comunitária | "Fazendo algo, mas acho que deveríamos conversar." (traduzido) |
| 27 | P66 | administrador de uma instalação de lazer | não divulgado | Comprou um laptop para o curso, instalou o agente e mudou do modo geral para a aba do agente; na etapa de abrir contas em dez AIs | "Tudo está em uma língua estrangeira, e agora?" (traduzido) |
| 28 | P82 | trabalho de segurança; construção de um serviço de despacho para transporte | United States | Instalado; transferiu seus chats e projetos de outro chatbot para comparar os dois | - |
| 29 | P70 | pesquisa e edição de vídeo para redes sociais | United States | Fez o agente funcionar com ajuda de um colega de quarto, após criar primeiro um arquivo de teste manualmente | - |
| 30 | P17 | advogado de direito internacional | não divulgado | Instalação concluída; primeira tarefa enviada | "Fiz tudo." (traduzido) |
| 31 | P93 | profissional de suporte direto em cuidados com idosos | não divulgado | Mudou do chat simples para o agente e pagou; primeira tarefa enviada | - |
| 32 | P54 | faz bolos por encomenda | não divulgado | Instalado e pago em um novo laptop; primeira tarefa enviada | - |
| 33 | P26 | construção de concreto | United States | Instalado em um laptop reparado e enviou uma foto dele; primeira tarefa enviada | "O que vem a seguir" |
| 34 | P03 | diretor de uma empresa de comércio exterior | United States | Instalado junto com P35; primeira tarefa enviada | - |
| 35 | P45 | conteúdo fotográfico e em vídeo, background em programação | Germany | Atingiu a etapa de abrir contas em dez AIs, o que pressupõe um agente funcionando; detalhes não registrados | - |
Nota: Compilado do registro de participantes. As linhas 1 a 24 são a terceira linha da Tabela G1; as linhas 25 a 35 instalaram o agente e começaram sem resultado relatado até 9 de outubro de 2026. "-" significa que o registro não contém palavras utilizáveis do participante para este período.
Como os principiantes falam sobre dirigir agentes. Pessoas que poucas semanas antes tinham apenas usado um assistente de chat descrevem seu novo trabalho com palavras próprias. Coletei todas as passagens que o registro de participantes e as notas de observação diária fornecem na redação própria de um participante para as 35 pessoas que instalaram um agente (161 passagens de 32 pessoas, cerca de 1,070 palavras) e contei, comparando raízes de palavras, as palavras para o sistema que dirigem, o que fazem com ele e consigo mesmos; as contagens são aproximadas, e "it" inclui alguns usos que não se referem à ferramenta.
Tabela G1c. Palavras que os principiantes usam para dirigir agentes (ocorrências em seus próprios relatórios).
| O que a palavra nomeia | Palavras, traduzidas em categorias | Contagem |
|---|---|---|
| O sistema que dirigem | "it" | 35 |
| um nome de modelo ou produto (Claude, GPT, Codex e outros) | 16 | |
| ferramenta, programa, app | 11 | |
| "AI", "the AIs" | 9 | |
| agente | 1 | |
| assistente, auxiliar, trabalhador | 0 | |
| O que fazem com ele | configurar, instalar, executar | 10 |
| perguntar, questionar, solicitar | 9 | |
| tarefa, instrução, prompt | 7 | |
| verificar, comparar | 4 | |
| dividir, transferir | 2 | |
| A si mesmos | desenvolvedor, principiante | 5 |
Algumas de suas próprias palavras (citações em inglês; aquelas marcadas com "(traduzido)" foram escritas em outro idioma e a tradução é minha):
- "Ele não apenas responde perguntas, mas pode realmente trabalhar com arquivos e documentos." (P18, marketing na internet)
- "Um dos maiores erros ao usar AI é assumir que uma resposta confiante é automaticamente correta." (P20, fotógrafo e retocador; traduzido)
- "Eu realmente me sinto como um desenvolvedor agora." (P21, organização comunitária sem fins lucrativos)
- "Para obter o que quero, preciso pensar em como formular o pedido." (P48, trabalho de escritório e vendas online; traduzido)
- "Acho que a resposta é como uma pergunta para duas pessoas." (P59, videógrafo)
- "Uma vez um AI dá o melhor conselho, da próxima vez é o contrário." (P48, trabalho de escritório e vendas online; traduzido)
Três passagens mais longas mostram a mudança na voz dos próprios participantes. Um designer de interiores em treinamento, em sua primeira noite com um agente, antes de alguém lhe mostrar um conselho de modelos: "fez uma pasta também funcionou bem sozinho tipo com documentos abertos [...] e no final consegui dois arquivos chamados vagas deste um vagas daquele e também peguei novamente mandei um para o outro para que avaliassem o trabalho um do outro" (P01, traduzido, de uma transcrição automática de uma mensagem de voz). Um escalador industrial, no dia em que construiu seu primeiro pequeno programa com um agente, já pedindo o próximo desafio: "talvez aprender como construir agentes que pudessem fazer parte do trabalho para mim - postar nas redes sociais, me lembrar de coisas ou dar sugestões." (P14). E um participante em trabalho de comunidade sem fins lucrativos, após suas primeiras semanas: "Sinto um vasto novo potencial se abrindo - como estar à beira de algo novo." (P21).
Eles nomeiam o sistema pelo seu nome de produto ou simplesmente "it", quase nunca "agent", e nenhum dos títulos no mapa da Seção 3 aparece; no entanto, falam de estabelecer tarefas, comparar duas respostas e verificar uma confiável, que é o trabalho que a medida contabiliza. Como no mapa, a função chega antes de um nome para ela, e isto é oferecido como uma descrição, não como um teste de qualquer afirmação.
As mesmas pessoas também participam de um programa separadamente pré-registrado (OSF, DOI 10.17605/OSF.IO/X4EGQ), cujos resultados são reportados lá.
G2. O estudo de avaliadores Prolific: os profissionais concordam sobre horas de referência?
A medida dimensiona cada trabalho em horas de referência, e a regra da Seção 5.2 pede que dois especialistas avaliem um trabalho às cegas e convoca um terceiro quando suas estimativas diferem por mais de um fator de 1.5. O estudo de avaliadores pergunta se profissionais que trabalham concordam tão precisamente. Foi registrado no OSF como um pré-piloto em 9 de outubro de 2026, antes de qualquer dado ser coletado (DOI 10.17605/OSF.IO/V92R8), e lançado no Prolific no mesmo dia.
Desenho. Duas amostras independentes, 119 participantes recrutados e pagos no total: 60 guarda-livros (função atual contador, guarda-livros, contador registrado ou certificado, auditor ou especialista tributário) e 59 desenvolvedores web e de software (função atual engenheiro de software, desenvolvedor de software ou desenvolvedor web). Todos vivem no Reino Unido, nos Estados Unidos, Irlanda, Canadá, Austrália ou Nova Zelândia, têm uma taxa de aprovação Prolific de pelo menos 98% em pelo menos 100 submissões anteriores, e participam de apenas um estudo. Cada participante avalia as dez tarefas do seu próprio domínio do banco de tarefas v0 (BK01 a BK10 ou WT01 a WT10, conforme congelado em pilot/task-bank-v0.csv) em horas de trabalho focado para um profissional qualificado trabalhando sozinho sem ferramentas de IA, avalia uma tarefa novamente (BK03 ou WT03) como um reteste, e responde uma pergunta de competência e uma verificação de atenção. Um participante que falha em qualquer uma delas é excluído e pago; uma estimativa que não é um número positivo ou excede 2000 horas é descartada.
Desfechos. Primário: por domínio, a proporção de pares de avaliadores, em todas as tarefas, cujas duas estimativas situam-se dentro de uma razão de 1.5, em relação ao limiar de 0.70 estabelecido no protocolo de calibração. Secundário: a mesma proporção após remover o nível pessoal de cada avaliador, ICC(2,1) em horas de log, a proporção teste-reteste dentro de 1.5, e a estimativa mediana de cada tarefa em relação ao degrau que o banco pretendia. Para comparação, os quatro avaliadores modelo do Apêndice E colocam 56% de seus pares nessas 20 tarefas dentro de 1.5: 47% nas dez tarefas contábeis e 65% nas dez tarefas web. A análise é o script human_raters.py, arquivado no registro OSF antes dos dados, e o resultado é reportado seja qual for.
Resultados.
Triagem. Os participantes foram admitidos com base na ocupação em seu perfil Prolific, e a maioria das respostas atrás dos filtros Prolific são auto-informadas (Prolific, 2026), então a pergunta de competência era a única verificação do design da profissão. Na amostra contábil era uma pergunta de múltipla escolha sobre partidas dobradas para o pagamento de um cliente recebido no banco. Das 60 pessoas admitidas nessa amostra, 11 (18%) responderam incorretamente, oito delas invertendo o débito e o crédito, e nenhuma falhou na verificação de atenção; conforme registrado, elas são excluídas dos desfechos abaixo e foram pagas. Em uma comparação que não foi registrada, esses 11 avaliaram as tarefas maiores do banco em menos horas do que os outros participantes da amostra fizeram: suas medianas para as três tarefas destinadas ao degrau Week (BK08 a BK10) eram 6, 6 e 8 horas, contra 8, 8 e 12 para os outros 49. Com 11 pessoas isso é uma pista a ser testada, não uma estimativa, e pressa ou uma pergunta mal interpretada deixaria um rastro semelhante; isto se encaixa na leitura de que uma pessoa que não conhece a profissão não vê todos os passos de suas tarefas maiores (Seção 6.5). Na amostra web-tools a mesma comparação não se repetiu: os 8 desenvolvedores que falharam em sua pergunta de competência deram medianas de 24.5, 27.5 e 19 horas para as três tarefas destinadas ao Week, contra 20, 16 e 20 para os outros 50, então a pista repousa apenas na contabilidade (análises exploratórias abaixo).
Os scripts para esta seção estão no repositório complementar (pilot/). prolific_to_long.py escreve o arquivo longo de avaliações das exportações Prolific; ele lê cada estimativa como escrita, mantém uma resposta sem número ou com vários, como um intervalo, como texto para que a regra registrada a descarte, e lista toda resposta que não é um número simples. table_g2.py imprime a Tabela G2 com as funções do script registrado chamadas sem alterações, ao lado dos avaliadores modelo nas mesmas tarefas. screen_compare.py recalcula a comparação da triagem acima, com o intervalo exato e um teste de permutação sobre avaliadores para as tarefas Week.
Concordância. Os lugares foram preenchidos em 9 e 10 de outubro de 2026, e 118 participantes deixaram respostas, 60 contadores e 58 desenvolvedores; as respostas de um desenvolvedor, cuja submissão foi aprovada e paga, não foram salvas pela ferramenta de pesquisa. Após as exclusões registradas (11 contadores e 8 desenvolvedores falharam na pergunta de competência; nenhum falhou na verificação de atenção), 49 contadores e 50 desenvolvedores permanecem. O limiar registrado não foi atendido em nenhum domínio: 28% dos pares de contadores e 25% dos pares de desenvolvedores ficaram dentro de uma razão de 1.5, contra 0.70 (Tabela G3). Os profissionais ordenaram as tarefas consistentemente, com as medianas de cada domínio aumentando das tarefas designadas para Hora para aquelas designadas para Semana, mas discordaram sobre horas mais do que a regra de dois avaliadores permite. Remover o nível pessoal de cada avaliador elevou a proporção apenas para 34% e 35%, portanto, o desacordo diz respeito ao trabalho em si e não a um hábito de arredondar para cima ou para baixo. ICC(2,1) em horas de log foi 0.34 para contabilidade e 0.46 para ferramentas web, e duas estimativas de um avaliador da mesma tarefa concordaram dentro de 1.5 em 53% e 74% dos casos. Os quatro avaliadores de modelo do Apêndice E, com 56% nas mesmas 20 tarefas, concordaram entre si mais estreitamente do que os profissionais, o que diz mais sobre a dispersão dos profissionais do que sobre a precisão dos modelos. Contra praticantes, o banco fica cerca de um degrau acima: cada tarefa designada para Dia tinha uma mediana de 2 a 7 horas, o que é Hora, e cada tarefa designada para Semana uma mediana de 8 a 20 horas, o que é Dia. Na comparação exploratória acima, os 11 contadores excluídos concordaram entre si não melhor do que os outros (28% dos pares dentro de 1.5). Os resultados estabelecem três partes da regra do avaliador. Os avaliadores calibram em tarefas com tempos medidos, o que ancora o nível que as medianas mostram estar incorreto. Um trabalho é dimensionado pela mediana de um painel em vez de por dois avaliadores, pois uma dispersão desta largura enviaria a maioria dos pares para um terceiro avaliador. E o banco de tarefas é re-dividido em faixas a partir das medianas dos praticantes, o que move suas tarefas para baixo um degrau (Tabela G3b).
Tabela G2. Concordância dos profissionais em horas de referência, por domínio.
| Domínio | Mantido | Excluído | Pares dentro de 1.5 | Após remover o nível do avaliador | ICC(2,1), horas de log | Teste-reteste dentro de 1.5 |
|---|---|---|---|---|---|---|
| Contabilidade | 49 | 11 | 0.283 | 0.335 | 0.335 (49 completos) | 0.531 (n = 49) |
| Ferramentas web | 50 | 8 | 0.247 | 0.349 | 0.461 (49 completos) | 0.735 (n = 49) |
Nota: Limiar registrado para pares dentro de 1.5: 0.70, não atendido em nenhum domínio. As exclusões são falhas na pergunta de competência; nenhum participante falhou na verificação de atenção. Os pares são obtidos sobre todas as dez tarefas de um domínio (11,760 para contabilidade, 11,809 para ferramentas web). Teste-reteste compara duas estimativas de um avaliador de BK03 ou WT03. Saída de human_raters.py conforme registrado (DOI 10.17605/OSF.IO/V92R8).
Tabela G3b. Estimativa mediana de cada tarefa contra o degrau que o banco pretendia (horas).
| Degrau pretendido | Tarefa de contabilidade: mediana | Degrau da mediana | Tarefa de ferramentas web: mediana | Degrau da mediana |
|---|---|---|---|---|
| Hora | BK01: 2.0; BK02: 2.0; BK03: 1.5 | Hora | WT01: 1.0; WT02: 1.0; WT03: 2.0 | Hora |
| Dia | BK04: 3.0; BK05: 2.0; BK06: 3.0; BK07: 4.0 | Hora | WT04: 7.0; WT05: 6.0; WT06: 4.0; WT07: 4.0 | Hora |
| Semana | BK08: 8.0; BK09: 8.0; BK10: 12.0 | Dia | WT08: 20.0; WT09: 16.0; WT10: 20.0 | Dia |
Nota: Medianas sobre os avaliadores mantidos. Uma mediana abaixo de 8 horas cai em Hora e uma de 8 até menos de 40 horas em Dia. Cada tarefa designada para Dia ou Semana cai um degrau mais baixo.
Análises exploratórias. As análises neste parágrafo não foram registradas. Elas reutilizam o carregador registrado, exclusões e teste, e seu script e saída são pilot/exploratory_prolific.py e pilot/results/prolific-2026-10/exploratory-output.txt no repositório acompanhante. A reamostragem de avaliadores coloca intervalos de 95% de 0,24 a 0,33 (contabilidade) e 0,21 a 0,29 (ferramentas web) na participação primária. Tamanho do painel (Tabela G4). Para cada tarefa, dois painéis disjuntos de k avaliadores retidos foram sorteados 2.000 vezes e suas medianas comparadas. Nas estimativas brutas, as duas medianas concordaram dentro de 1,5 em pelo menos 70% dos sorteios apenas com 15 contadores ou 21 desenvolvedores por painel. Com o nível pessoal de cada avaliador removido, que é o que a calibração em tarefas com tempos medidos deve fazer, painéis de sete atingiram 0,71 e 0,69, e painéis de nove 0,77 e 0,76. Pousar no mesmo patamar, que é o que a medida registra, precisa de menos: cinco avaliadores calibrados por painel fizeram isso em 0,81 e 0,84 dos sorteios. De acordo com a regra de dois avaliadores da Seção 5.2, um terceiro avaliador seria chamado em 72% e 75% dos itens. Experiência (Tabela G4b). 43 dos 98 avaliadores retidos com respostas completas relataram mais de 10 anos em seu campo. Eles concordaram uns com os outros não mais estreitamente do que o resto, e anos no campo não previram o quão longe um avaliador estava da mediana dos outros (correlação de postos +0,18 e -0,10, permutação p = 0,21 e 0,47). Desenvolvedores sêniors estimaram mais alto do que outros desenvolvedores (1,32 contra 0,76 vezes a mediana dos outros, p = 0,02); contadores sêniors não (1,04 contra 1,07, p = 0,88). Tarefas. O desacordo cresce com o tamanho: cinco dos seis mais disputados dos 20 tarefas eram tarefas destinadas para Week, onde 24% (contabilidade) e 20% (ferramentas web) dos pares ficaram dentro de 1,5, contra 31% e 27% nas tarefas destinadas para Hour; o intervalo interquartil de uma tarefa Week variava de um fator de 4 a 8. Velocidade e unidades. O quarto mais rápido de contadores (3,6 minutos ou menos para a pesquisa inteira) concordou mais estreitamente do que o resto (0,37 contra 0,26), e entre desenvolvedores a velocidade não fez diferença (0,24 contra 0,24). Responder algumas tarefas em minutos em vez de horas não fez diferença em nenhum domínio (0,31 contra 0,31; 0,28 contra 0,31). Dois contadores deram 40 horas ou mais a uma tarefa destinada para Hour, o que parece minutos digitados como horas; sem eles a participação de contabilidade é 0,284. Um desenvolvedor retido digitou texto em vez de números, então apenas uma de suas estimativas entrou na análise. Triagem. Comparando as estimativas de cada avaliador para tarefas Week com suas próprias estimativas para tarefas Hour, de modo que um nível pessoal se cancele, os contadores excluídos avaliaram as tarefas maiores 3,2 vezes as menores contra 6,2 vezes para os retidos (permutação p = 0,10), e os desenvolvedores excluídos 15,8 vezes contra 10,6 (p = 0,37). Reteste. A estimativa repetida foi mais alta do que a primeira para 25 contadores e mais baixa para 4, e mais alta para 17 desenvolvedores e mais baixa para 2 (teste de sinal exato p < 0,001 em ambos), cerca de 30% na média geométrica, o que é consistente com ancoragem nas tarefas maiores avaliadas entre. Juntos, esses resultados colocam a dispersão no trabalho e sua escala em vez de em um subgrupo de avaliadores apressados, juniores ou não qualificados, e eles dimensionam o painel que a regra precisa: avaliadores calibrados, cinco a nove por item, pontuado por patamar (Tabela G4).
Tabela G4. Dois painéis independentes de k avaliadores por tarefa: participação de sorteios cujas medianas concordam dentro de 1,5 / participação no mesmo patamar (exploratório).
| Avaliadores por painel | Contabilidade, bruta | Contabilidade, nível removido | Ferramentas web, bruta | Ferramentas web, nível removido |
|---|---|---|---|---|
| 1 | 0.28 / 0.51 | 0.34 / 0.62 | 0.24 / 0.46 | 0.34 / 0.60 |
| 3 | 0.43 / 0.68 | 0.51 / 0.76 | 0.37 / 0.60 | 0.52 / 0.78 |
| 5 | 0.51 / 0.77 | 0.63 / 0.81 | 0.43 / 0.68 | 0.62 / 0.84 |
| 7 | 0.58 / 0.82 | 0.71 / 0.84 | 0.49 / 0.74 | 0.69 / 0.87 |
| 9 | 0.62 / 0.85 | 0.77 / 0.87 | 0.54 / 0.78 | 0.76 / 0.89 |
| 15 | 0.71 / 0.88 | 0.88 / 0.91 | 0.64 / 0.84 | 0.86 / 0.94 |
| 21 | 0.76 / 0.89 | 0.94 / 0.95 | 0.72 / 0.84 | 0.92 / 0.98 |
Nota: Avaliadores retidos com todas as dez estimativas (49 por domínio); 2.000 sorteios por tarefa, painéis disjuntos dentro de um sorteio; semente 20261011. Nível removido: a razão de log médio de cada avaliador em relação à mediana de todos os avaliadores em cada tarefa é subtraída em amostra, como no resultado secundário registrado, então essas colunas são uma estimativa superior do que a calibração em tarefas de âncora separadas daria. Não registrado; saída de pilot/exploratory_prolific.py.
Tabela G4b. Anos no campo e concordância (avaliadores retidos com respostas completas, exploratório).
| Domínio | Grupo | Avaliadores | Pares dentro de 1,5 dentro do grupo | Nível contra a mediana dos outros |
|---|---|---|---|---|
| Contabilidade | Mais de 10 anos | 23 | 0.268 | 1.04 |
| Contabilidade | 10 anos ou menos | 26 | 0.299 | 1.07 (p = 0.88) |
| Ferramentas web | Mais de 10 anos | 20 | 0.297 | 1.32 |
| Ferramentas web | 10 anos ou menos | 29 | 0.242 | 0.76 (p = 0.02) |
Nota: Nível é a razão da média geométrica das estimativas de um avaliador em relação à mediana dos outros avaliadores nas mesmas tarefas; p é um teste de permutação bilateral (5.000 permutações) da diferença no nível de log médio. Não registrado.
Como citar
Chernets, V. (2026). After the Programmer Divide: One Measure for People Who Build Through AI Agents [Preimpressão]. SSRN. https://doi.org/10.2139/ssrn.7589918
@misc{chernets2026aftertheprogrammerdivide,
  author       = {Chernets, Vadym},
  title        = {{After the Programmer Divide: One Measure for People Who Build Through AI Agents}},
  year         = {2026},
  howpublished = {SSRN},
  doi          = {10.2139/ssrn.7589918},
  url          = {https://doi.org/10.2139/ssrn.7589918}
}