Как сократить затраты на ИИ: платите модели только за решения, которые требуют её
Это перевод. Основная версия — оригинал на английском; ссылайтесь на него.
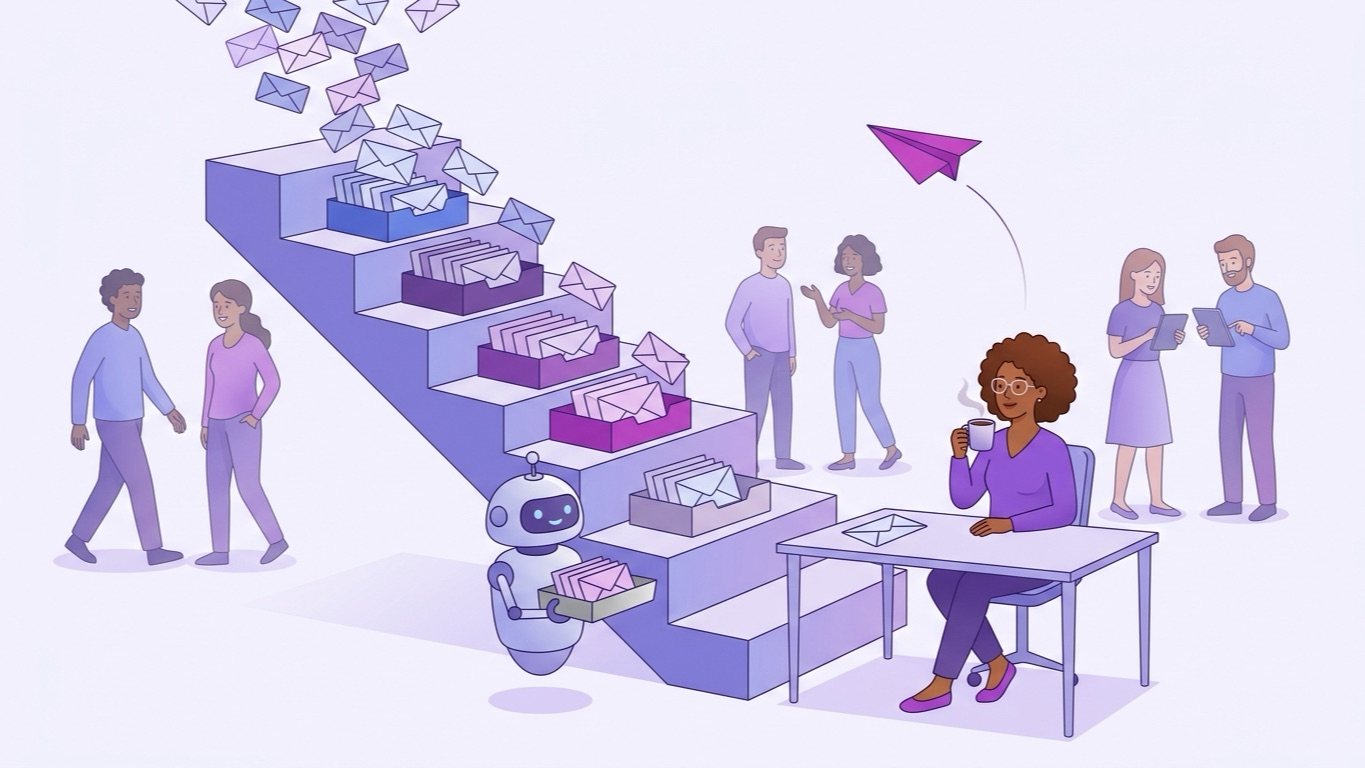
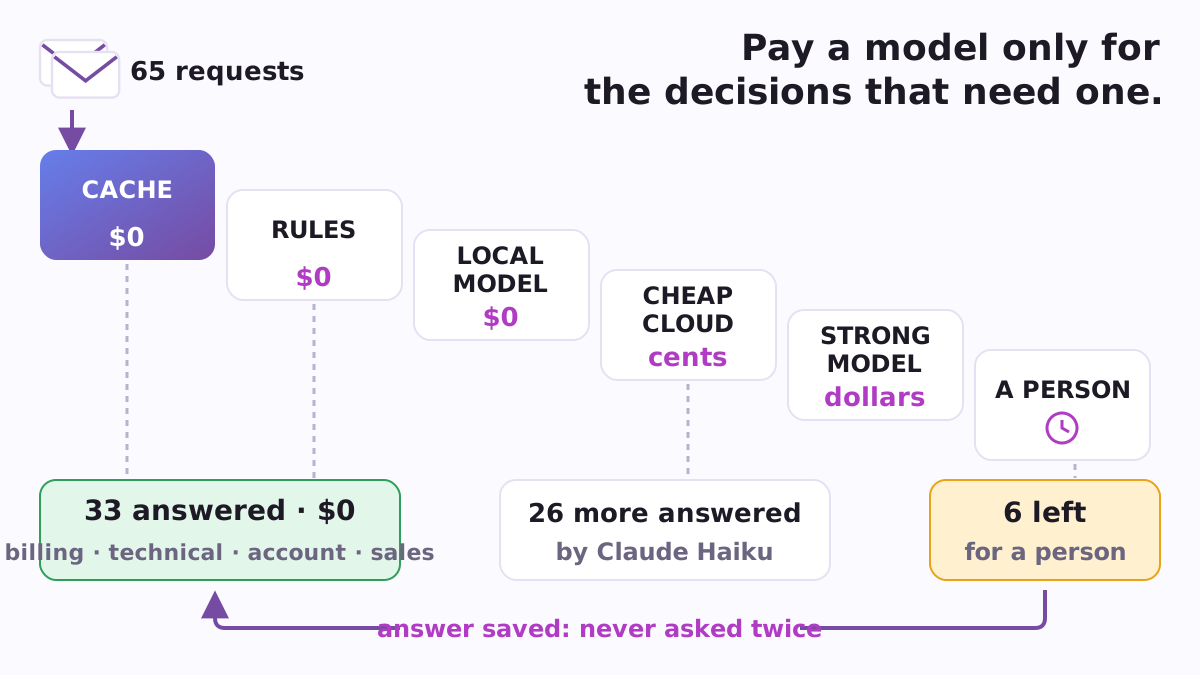
Decidecall автоматизирует повторяющиеся решения, которые принимает компания (кому доставить это сообщение, одобрить или отправить на доработку, срочно это или нет), и отвечает на каждое самым дешёвым надёжным способом. Сначала проверяется сохранённый ответ, затем простые правила, потом модель на вашем компьютере; остальное идёт к платной модели, а что не уверено ни одной моделью — к человеку. Решение человека запоминается, поэтому один и тот же вопрос никогда не обходится дважды.
Decidecall — это бесплатный плагин с открытым исходным кодом для Claude Code, ассистента Anthropic, работающего с файлами на вашем компьютере. Ему не требуется собственная учётная запись, данные платежей и собственный API ключ (код доступа, который программы используют для обращения к ИИ): платная модель вызывается через программу, которую ваша компания уже установила и в которой авторизована.
Почему большинству решений не нужна модель
Многие команды, начинающие работу с ИИ, отправляют в модель каждое сообщение. Это работает, но каждый раз приходится платить за один и тот же ответ: «где мой счёт?» приходит в поддержку каждый день, и слово «счёт» уже говорит, куда это идёт — в биллинг. Тиан Пан описывает команду, которая несколько месяцев использовала модель для маршрутизации обращений в поддержку, прежде чем выяснить, что в 70% обращений в теме указано название продукта, которые простая таблица соответствий маршрутизировала бы с точностью 99%.
Исследователи измерили эту же идею в масштабе. Stanford FrugalGPT сначала спрашивает дешевую модель и переходит к более дорогой только если ответ кажется слабым; она достигла качества лучшей отдельной модели «с сокращением затрат вплоть до 98%». LMSYS RouteLLM, которая выбирает сильную или слабую модель для каждого вопроса, сократила затраты более чем на 85% на одном бенчмарке, сохраняя 95% качества GPT-4.
Как работает цепочка
Каждое решение проходит через одни и те же шесть звеньев и останавливается на первом, который достаточно уверен:
- Кэш: уже полученные ответы. Точный повтор находится даже при разных заглавных буквах, пробелах и пунктуации. С помощью небольшой модели вложений на вашем компьютере (например,
nomic-embed-textв Ollama), вопрос, заданный другими словами, тоже находится: "Почему с моей карты дважды были сняты деньги?" находит ответ на "Со мной дважды произвели списания в этом месяце". - Правила: слова, которые определяют ответ, записанные один раз: "счёт", "возврат" или "начисление" означает выставление счетов. Когда два правила указывают на разные ответы, они молчат, а не предполагают.
- Локальная модель: модель, работающая на вашем собственном компьютере, бесплатная для каждого решения.
- Дешёвые и мощные облачные модели: платные модели, сначала самая дешёвая из разрешённых.
- Человек: тот, кто отвечает за решение, которому показывается лучшее предположение из уже полученных.
Каждое звено дает ответ с решением и уверенностью — числом от 0 до 1. При 0,95 или выше ответ принимается. Ниже того запрашивается следующее звено, и когда два разных источника согласны (и по крайней мере один из них имеет уверенность 0,70 или выше), это решает вопрос. Два звена, работающие на одном семействе моделей, никогда не подтверждают друг друга, и совпадение по смыслу в кэше — это только предложение, которое другое звено должно подтвердить. Когда ничего не уверено, решает человек, и его ответ попадает в кэш. Оба порога вы можете менять.
Вид решения — это один небольшой файл: вопрос, возможные ответы, слова, которые определяют решение, и требуемый уровень уверенности звена. Тот же формат работает для сортировки сообщений поддержки, "утвердить или отправить обратно" на заявки на возмещение расходов или "срочно или нет" на входящую почту.
Практический пример: 65 сообщений поддержки
В репозитории есть входящая почта поддержки для четырёх команд (выставления счётов, техническая поддержка, управление аккаунтами, продажи): 65 сообщений клиентов с повторами, как в реальной поддержке. 2 октября 2026 года цепь была измерена на ней дважды (полные результаты):
| Цепь | Решено без человека | Правильно | Отправлено человеку | Стоимость 65 решений |
|---|---|---|---|---|
| cache + rules | 36 | 36 из 36 | 29 | $0 |
| cache + rules + Claude Haiku 4.5 | 59 | 57 из 59 (96,6%) | 6 | $0,167 по стандартной цене |
Без использования модели более половины входящих сообщений было отсортировано бесплатно и без ошибок (повторный запуск 10 октября 2026 года дал тот же результат). Добавление Claude Haiku 4.5, компактной и быстрой модели Anthropic, оставило шесть сообщений для человека.
Отчёт столь же откровенен о том, что не сработало. Haiku дважды ошибалась при 98% уверенности: сообщение «Я выхожу из системы каждые пять минут» было направлено в техническую поддержку вместо управления аккаунтами, как и его повтор. Именно поэтому цепь запрашивает второй, другой источник перед тем, как доверять повторённому ответу модели. Шестьдесят пять примеров — это первое чтение: инструмент построен так, чтобы вы запускали то же измерение на нескольких сотнях своих прошлых решений.
Что это делает
- Решение одного вопроса: ответ, какая ссылка это выполнила, насколько это было уверено, сколько это стоило.
- Пометка: ответ человека попадает в кэш, поэтому в следующий раз это бесплатно.
- Продвижение: решения, которые модели продолжали принимать одинаково, подтвержденные двумя различными семействами моделей, становятся записями кэша, когда вы говорите да; слова, которые всегда приходили только с одним ответом, предлагаются как новые правила.
- Оценка: ваши собственные помеченные прошлые решения проходят через цепь, показывая, сколько было решено без человека, сколько было правильно, насколько честны были числа доверия, и стоимость одного решения в сравнении с отправкой всего на одну модель.
- Кандидаты: 14 программ и сервисов, которые могут находиться за ссылкой, каждый со своей лицензией и исходной страницей.
Модели решений встраиваются сразу
Новый тип моделей появился ровно для этой задачи. TypeSafe's Jev, объявленная в сентябре 2026, не пишет текст: она принимает ситуацию и вопрос с вариантами ответа и возвращает выбранный вариант с вероятностью, по $0.042 за миллион входных токенов (DataCamp). Открытые модели этого же типа работают на вашем собственном компьютере: Strands Decider, авторы которой сообщают, что её "ответы с уверенностью 0,9 или выше верны примерно в 95% случаев", и, начиная с Ollama 0.35, модели решений, обслуживаемые Ollama, бесплатным инструментом для локального запуска моделей. Decidecall работает с этим интерфейсом напрямую, а также с обычными локальными моделями (Ollama, llama.cpp, vLLM, LM Studio) и Claude через Claude Code, который у вас уже есть; bench показывает на ваших собственных данных, что добавляет каждый из них.
Ваши правила для данных и денег
Decidecall использует тот же файл политики компании, что и другие плагины компании:
- Конфиденциальные данные остаются на компьютере. Отметьте решение красным, и оно обрабатывается только в кэше, правилах и локальных моделях; Decidecall хранит отпечаток текста, но не сам текст.
- Только те поставщики, которых вы разрешаете, или только те, что не сохраняют данные после ответа.
- Ежедневный бюджет: платная ссылка, которая превысила бы его, пропускается, а бесплатные ссылки продолжают работать.
- Ключи остаются в связке ключей, никогда не в файле.
Это один файл Python, который не требует ничего, кроме самого Python, и не инициирует собственное сетевое соединение, поэтому работает даже на компьютере, отключённом от интернета.
Как начать
В Claude Code добавьте каталог Poly A1 и установите Decidecall (git и учетная запись GitHub не требуются):
/plugin marketplace add https://raw.githubusercontent.com/vadimchernets/poly-a1-plugins/main/.claude-plugin/marketplace.json
/plugin install decidecall@poly-a1
Затем скажите, что вы хотите решить, своими словами: «отсортировать наши сообщения поддержки по командам» или «стоит ли Strands Decider для нас». Claude задает свои вопросы один за другим (что решается, возможные ответы, какие слова делают ответ определённым, насколько уверенным он должен быть) и пишет файл задачи с вами. Затем он запускает bench на ваших прошлых решениях перед тем, как что-либо будет оплачено. Decidecall требует Python 3.8 или новее и работает на Mac, Linux и Windows.
Код, пример входящих сообщений и измерения: github.com/vadimchernets/decidecall.
Где это применяется
Decidecall — один из корпоративных плагинов в каталоге плагинов Poly A1. Он работает в паре с Routecall, где мощная модель планирует, а более дешёвые выполняют основной объём, и с Billcall, который подсчитывает затраты на ИИ для компании; Firmcall пишет файл общей политики. Decidecall написана Vadym Chernets, выпущена под лицензией Apache-2.0 и архивирована на Zenodo (DOI 10.5281/zenodo.23116720).
Посмотрите decidecall на GitHub
Vadym Chernets также создаёт Poly A1, приложение, в котором ИИ из разных компаний проверяют работу друг друга.