O acordo não é evidência independente: síntese auditável de múltiplos modelos sem API
Esta é uma tradução. A versão de referência é o original em inglês; cite essa.
Vadym Chernets, PhD, arquiteto de sistemas de IA · ORCID 0009-0007-4845-3163
SSRN 7390698 · DOI 10.2139/ssrn.7390698 · Zenodo 10.5281/zenodo.22683716 · GitHub
- Versão de registro: SSRN 7390698 · DOI 10.2139/ssrn.7390698
- Cópia arquivada, citável e baixável: 10.5281/zenodo.22683716 — DOI conceitual, sempre resolve para a versão mais recente
- Texto completo como Markdown e PDF: GitHub
- HTML legível: https://polyhelper.ai/research/agreement-not-evidence/
O mesmo texto está em quatro plataformas para que possa ser acessado quando uma delas não conseguir disponibilizá-lo. SSRN mantém a versão de registro; cite aquela.
Palavras-chave: modelos de linguagem de grande porte; erros correlacionados; sabedoria das multidões; Teorema do Júri de Condorcet; monocultura algorítmica; debate multiagente; tamanho efetivo da amostra; efeito de desenho; ensemble; proveniência. Classificação JEL: C11; C18; D71; D83; L86; O33
Resumo
Alguém que faz uma pergunta a um modelo de linguagem não consegue distinguir uma resposta confiante e errada de uma confiante e correta. As duas são idênticas em cada pista de superfície disponível para um não especialista. Fazer perguntas a vários modelos parece resolver isso, mas principalmente desloca o problema: reconciliar várias respostas produz um texto confiante novamente, e esse texto agora carrega a autoridade emprestada de "dez deles concordaram".
O protocolo formalizado aqui coleta respostas de vários modelos de chat de consumidor por meio do navegador ou telefone do próprio usuário, sem chaves de API, sem instalação e sem servidor intermediário. Reconcilia-as por âncora-e-enriquecimento: a resposta mais forte disponível se torna a base, e cada uma das outras contribui apenas com o que falta à base. Cada contribuição é assinada com o modelo que a forneceu. Discordâncias são mantidas em uma seção própria em vez de serem diluídas na média.
O artigo faz quatro contribuições. A primeira é o próprio protocolo, apresentado como um algoritmo que preserva a proveniência e proíbe exclusão silenciosa, junto com uma taxonomia de cinco maneiras que uma mesclagem pode falhar. Quatro delas são defeitos da agregação ingênua; a quinta é uma falha do operador e não do método: uma síntese que apresenta a saída de um único modelo como um resultado colegiado. A segunda é a aplicação da aritmética de testemunhas correlacionadas ao design de protocolo. Essa aritmética não é reivindicada aqui. Kohli (2026) aplicou a mesma correção de Kish a um painel de nove juízes de fronteira e mediu cerca de dois votos efetivos, e Kim et al. (2025) estabeleceu a correlação de erro subjacente em mais de 350 modelos. Um conselho de N modelos cujos erros carregam correlação intraclasse ρ vale = N / (1 + (N−1)ρ) testemunhas independentes, e essa quantidade satura em 1/ρ independentemente de quantos modelos são adicionados. Uma vez que um conselho é maior que 1/ρ, reduzir pela metade ρ supera duplicar N, e um par retirado de dois laboratórios pode ter mais peso que cinco retirados de um. Kim et al. (2025) complicam essa regra: os modelos maiores e mais precisos carregam os erros mais correlacionados mesmo quando a arquitetura e o provedor diferem, portanto dois laboratórios são um palpite anterior sobre ρ e não uma medição dele, que é para o que o procedimento de estimação da Seção 5.5 serve. O terceiro é uma descrição de três níveis de implantação, manual, móvel de um toque e agente de navegador, e do eixo que os separa epistemicamente: se o segundo modelo vê a resposta do primeiro modelo. Condicionar o segundo modelo aumenta ρ em troca da correção de erros. O quarto é uma observação de pequena amostra da falha do conselho falsificado em cinco modelos, a intervenção de uma frase que a removeu em uma reexecução de três modelos, e um design de avaliação cego de três braços com uma condição de falsificação declarada.
O acordo correlacionado é tratado aqui como estabelecido, não como uma descoberta. Que um painel de modelos vale muito menos testemunhas independentes do que tem membros foi medido diretamente: nove juízes de fronteira retirados de sete famílias fornecem cerca de dois votos efetivos (Kohli, 2026), e a correlação de erro aumenta com a capacidade do modelo mesmo através de provedores e arquiteturas (Kim et al., 2025). A Seção 5 reapresenta a aritmética de efeito de design por trás dessas medições, porque três das regras do protocolo são derivadas dela e leem como meticolosidade sem ela. O protocolo então toma o outro lado do mesmo problema. Essa literatura mede a correlação; este protocolo é construído para reduzi-la, compondo entre linhagens, mantendo discordância em vez de diluí-la na média, assinando cada contribuição com o modelo que a forneceu, e contando uma fonte repetida uma única vez.
A alegação de que uma resposta mesclada supera a melhor resposta única é argumentada a partir do design e da literatura adjacente; a Seção 9 especifica a avaliação, que ainda não foi executada.
Conteúdo
- Introdução
- Trabalhos relacionados
- Cinco formas de uma fusão falhar
- O protocolo anchor-and-enrich
- Acordo correlacionado
- Três camadas, um protocolo
- Seção empírica
- O arquivo paste: um padrão de interface para orientação de inicialização a frio
- Uma avaliação proposta
- Limitações
- Ética, privacidade e enquadramento legal
- Conclusão
Declarações · Referências · Apêndice A, o modelo de recebimento · Apêndice B, número efetivo de testemunhas independentes · Apêndice C, referência de implementação de camada móvel
Lista de figuras e tabelas
- Figura 1. Um conselho satura em 1/ρ, e o que dez modelos concordantes valem (Seção 5.3)
- Figura 2. O protocolo de ancoragem e enriquecimento, estágio por estágio (Seção 4.2)
- Figura 3. Os três níveis como pontos em uma curva latência–largura (Seção 6.4)
- Figura 4. Elicitação paralela-cega e sequencial-informada comparadas (Seção 6.5)
- Tabela 1. Regras de protocolo e as falhas que abordam (Seção 4.5)
- Tabela 2. Número efetivo de testemunhas independentes, valores selecionados (Seção 5.2)
- Tabela 3. Os três modos do nível móvel (Seção 6.2)
- Tabela 4. A fronteira latência–largura nos três níveis (Seção 6.4)
- Tabela 5. Sonda de início frio, execução de linha de base, n = 5 (Seção 7.2)
- Tabela 6. Sonda de início frio após a intervenção de atribuição de papel, n = 3 (Seção 7.3)
- Tabela 7. Modos de falha observados de um pipeline de intenção de aplicativo do consumidor (Seção 7.5)
- Tabela 8. Número efetivo de testemunhas independentes, tabela completa (Apêndice B)
- Tabela 9. Referência de implementação do nível móvel (Apêndice C)
1. Introdução
1.1 O problema
Considere uma pergunta em que estar errado é caro: escolher uma escola, um tratamento, um fornecedor, uma cláusula em um contrato. O usuário pergunta a um modelo de linguagem e recebe algo coerente, confiante e bem formatado, e a dificuldade começa ali. Uma resposta confiante mas errada e uma confiante e correta parecem iguais. O tom não as separa, nem a estrutura, o comprimento ou a presença de citações. A confiança verbalizada do modelo é conhecida por ser exagerada e mal calibrada (Kadavath et al., 2022; Xiong et al., 2024). A tendência de um modelo de adotar o enquadramento do questionador adiciona uma segunda camada de falso apoio (Sharma et al., 2023).
O remédio óbvio é uma segunda opinião. O erro de um modelo parece confiança. O mesmo erro colocado ao lado da resposta de um segundo modelo parece um argumento. Um argumento é evidente para um leitor sem expertise no assunto; a confiança, não. Tudo o que segue repousa nessa assimetria.
O remédio tem um preço e uma armadilha. O preço é a leitura: dez respostas para uma pergunta significam dez textos longos para manter em mente ao mesmo tempo enquanto se recorda de quem disse o quê. Quase ninguém faz isso. Na prática, um leitor lê a primeira resposta, folheia a segunda e fecha as demais. Reunir várias respostas tem sido um problema resolvido há anos, através de subscrições agregadoras, painéis lado a lado e gateways de API. Mas concluir não foi resolvido.
A armadilha é a fusão. Qualquer forma de reduzir dez respostas para uma produz um único texto confiante novamente, e se a redução é opaca, o leitor volta de onde começou, com a diferença de que o texto agora carrega uma autoridade que não consegue verificar. O pooling ingênuo também elimina pontos minoritários corretos, gravita em direção à formulação mais enfática e produz a aparência de consenso onde não há.
Um terceiro problema é o que torna todo o exercício não trivial. O acordo entre modelos não é uma confirmação independente, porque modelos treinados em corpora sobrepostos compartilham enquadramentos, citam os mesmos artigos e herdam os mesmos pontos cegos. "Nove de dez concordaram" e "nove especialistas independentes concordaram" são afirmações diferentes, e a lacuna entre elas é quantitativa e grande. A Seção 5 mostra que isso coloca um teto em toda a construção.
1.2 O sistema
O protocolo está escrito em texto simples, com três formas de executá-lo. Todos os três produzem o mesmo documento, e diferem em quem faz o clique e em quantos modelos são consultados.
No caminho gratuito o usuário abre os sites, copia as respostas e as cola sob um parágrafo de instruções em qualquer modelo de bate-papo. Nada para instalar, nada para pagar, e funciona em um telefone.
No nível móvel há um ícone na tela inicial. Toque nele, digite a pergunta, escolha um modo e, cerca de um minuto depois, a resposta acabada está na tela e na área de transferência. Ele atinge dois modelos através de intenções de aplicativo do sistema operacional, usando subscrições já instaladas no dispositivo, sem chave de API.
No caminho do agente um modelo que pode conduzir um navegador abre os sites nomeados nas sessões logadas existentes do usuário, envia a pergunta, aguarda, salva cada resposta em um arquivo e constrói o documento.
O fato arquitetonicamente decisivo é que não há servidor. Não um servidor seguro, nem um com política de não retenção: nenhum componente assim existe, portanto a pergunta não pode chegar até mim. Ele atinge os serviços de modelo nomeados pelo usuário, que é o ponto do exercício, e não vai para lugar nenhum. Uma segunda consequência segue da mesma ausência: o protocolo não pode ser retirado, pois é um parágrafo de texto sob uma licença permissiva, e uma cópia nas notas de um usuário continua funcionando com quaisquer modelos que existam depois.
1.3 Contribuições
A Seção 3 expõe cinco maneiras pelas quais uma fusão falha e a Seção 4 formaliza anchor-and-enrich contra elas. A Seção 5 desenvolve o modelo de testemunha correlacionada, = N/(1+(N−1)ρ) com seu teto em 1/ρ, e extrai o que implica para como um conselho deve ser composto. A Seção 6 descreve os três níveis, a fronteira latência-amplitude que traçam, e a distinção entre paralelo-cego e sequencial-informado que os separa epistemicamente. A Seção 7 relata a observação de conselho falsificado e descobertas de campo da construção móvel; a Seção 8 descreve um padrão de interface para orientação de inicialização a frio; a Seção 9 especifica uma avaliação cega com uma condição de falsificação fixada com antecedência. A afirmação de que uma resposta mesclada supera a melhor resposta única não é resolvida aqui, e essa avaliação é a comparação que a resolveria, incluindo o resultado que me obrigaria a retirá-la.
A orientação vale a pena enunciar claramente, porque é o que distingue este artigo da literatura de medição da qual depende. Kohli (2026), Kim et al. (2025) e Ding (2026) medem o quanto os erros de um conselho estão correlacionados. Este artigo toma essa correlação como alvo de design e pergunta como uma única pessoa, trabalhando através de interfaces de bate-papo de consumidor ordinário, sem chave de API e sem servidor, pode reduzi-la e deixar um registro que demonstre que o fez. Uma lacuna nessa literatura vale a pena nomear porque está ao alcance: as medições foram feitas sobre APIs, em benchmarks, com nove modelos ou com trezentos. Ninguém estimou a correlação na configuração de consumidor que este protocolo habita, onde uma pessoa consulta quatro produtos de bate-papo pelos quais já não paga nada. A Seção 5.5 fornece o procedimento e a Seção 9.6 o design.
2. Trabalhos relacionados
Ensembles e diversidade. A teoria clássica de ensembles já diz o que é necessário aqui: o que um ensemble ganha depende de quão diferentemente seus membros erram, não de quão bons eles são em média. A decomposição de ambiguidade, em que o erro do ensemble é igual ao erro médio do membro menos a ambiguidade média (Krogh & Vedelsby, 1995), e a decomposição viés–variância–covariância (Ueda & Nakano, 1996) ambas mostram um ensemble colapsando para um único membro conforme a covariância de erro aumenta. Dietterich (2000) afirma a condição como necessária. A Seção 5 a estende para conselhos de modelos de linguagem e quantifica o custo de violá-la.
Esquemas multi-modelo para modelos de linguagem. Self-consistency (Wang, X., et al., 2023) vota entre várias amostras de um modelo, o que reduz variância sem produzir independência. Multi-agent debate (Du et al., 2023) relata ganhos de factualidade quando várias instâncias trocam argumentos. Mixture-of-agents (Wang, J., et al., 2024) alimenta as saídas de uma camada para um agregador e relata melhoria em relação ao modelo único mais forte em vários benchmarks. Essa literatura aponta para o mesmo lugar que este protocolo. Seus resultados foram obtidos através de APIs e em benchmarks, porém, então não os transfiro para um conselho de interfaces de consumidor mediado por navegador sem medição própria, que é o que a Seção 9 especifica.
Modelos árbitros. Avaliação por um modelo árbitro é bem caracterizada juntamente com seus defeitos: viés de posição, viés de verbosidade e atração para um estilo de casa familiar (Zheng et al., 2023). Isso é uma restrição de design aqui, não uma observação à margem, uma vez que a pontuação não-cegada estaria parcialmente medindo esses vieses. A Seção 9.4 lida com isso.
Monocultura. Kleinberg e Raghavan (2021) mostram que quando muitos agentes dependem de um algoritmo, os resultados coletivos podem piorar mesmo conforme a qualidade individual melhora. Bommasani et al. (2022) descrevem o mesmo efeito como homogeneização de resultado. Para um conselho de modelos de linguagem, esse é o mecanismo que gera ρ > 0 em primeiro lugar. Trabalho sobre degradação sob treinamento em dados gerados (Shumailov et al., 2024) sugere que ρ sobe ao longo do tempo.
Multidões. O argumento clássico da sabedoria das multidões (Surowiecki, 2004) depende de os julgamentos serem independentes. Lorenz et al. (2011) mostraram experimentalmente que até mesmo leve influência social, simplesmente deixando as pessoas verem estimativas de outros, estreita a dispersão sem mover para a verdade: a multidão fica mais confiante sem ficar mais precisa. A Seção 6.5 identifica isso como exatamente o compromisso aceito pela elicitação sequencial informada.
Condorcet e votos correlacionados. O teorema do júri de Condorcet (Condorcet, 1785) sustenta que com precisão individual acima de um meio, a probabilidade de uma maioria correta tende a um conforme N cresce. Ladha (1992) mostrou que votos correlacionados destroem a garantia. A Seção 5 dá uma versão quantitativa desse aviso através do efeito de design (Kish, 1965).
Erros correlacionados, medidos. A aritmética que a Seção 5 reafirma foi desde então medida em painéis de modelos diretamente, e as medições são mais nítidas que a análise. Kohli (2026) aplica o tamanho efetivo de amostra de Kish a um painel de nove juízes de fronteira extraídos de sete famílias de modelos e o encontra no valor de cerca de dois votos independentes: aproximadamente três quartos da independência nominal do painel é perdida para erros compartilhados, a precisão do painel fica 8 a 22 pontos percentuais aquém do que a votação independente entregaria, e o melhor juiz único iguala ou supera o painel inteiro. Nem mais juízes nem melhor agregação o repara, o que localiza o gargalo nos juízes em vez de no algoritmo. Kim et al. (2025), em mais de 350 modelos, encontram correlação de erro substancial e, crucialmente para como um conselho deveria ser composto, encontram que os modelos maiores e mais precisos têm os erros mais correlacionados mesmo quando a arquitetura e o provedor diferem. Ding (2026) audita concordância como um sinal de confiança em 265.000 amostras e a encontra como um preditor positivo mas fraco, com correlação entre 0,20 e 0,59, e pior exatamente onde está mais confiante: no modelo de fronteira mais consistente, concordância em ou acima de 0,8 cobriu 77% das entradas do benchmark mais difícil e 48% daquelas estavam erradas.
Três coisas se seguem para este artigo. Primeiro, o resultado do efeito de design na Seção 5 não é uma contribuição minha. O artigo de Kohli é anterior ao primeiro envio deste e usou a mesma correção; a seção é mantida pelo que o protocolo deriva dela, e é rotulada como tal onde aparece. Segundo, o conselho de composição que se segue, investir em diversidade em vez de em quantidade, agora é apoiado empiricamente em vez de meramente argumentado. Terceiro, a descoberta de Kim et al. complica esse conselho de uma forma que vale a pena afirmar: se capacidade e correlação de erro aumentam juntas, um par extraído de dois laboratórios não é automaticamente um par diverso, e a linhagem tem que ser medida em vez de lida na marca. Isso é um argumento para o procedimento de estimação da Seção 5.5, não contra a regra de composição.
Sistemas adjacentes. Vários projetos constroem conselhos multi-modelo. Uma implementação aberta bem conhecida, llm-council (Karpathy, 2025), consulta modelos em paralelo, os faz revisar uns aos outros anonimamente, e deixa um modelo presidente escrever a resposta final. Precisa de uma chave de API do agregador e pagamento por token. Produtos de conselho comercial oferecem um juiz, uma visão de consenso e uma exibição de contradição. Aplicações móveis de código aberto adicionam votação e debate multi-rodada. Front ends multi-modelo maduros entregam recursos de ensemble, e painéis gratuitos lado a lado usam os sites oficiais em que o usuário já está conectado. Assinaturas de agregador colocam muitos modelos sob uma única conta. Cada uma dessas propriedades existe em outro lugar por conta própria. Sua conjunção, dez delas simultaneamente, parece estar indisponível em outro lugar: sem chave de API, sem instalação, compatível com telefone, executando em contas que o usuário já possui, incluindo níveis gratuitos, sem novo intermediário pago, um método de mesclagem escrito em texto simples e portanto editável, desacordo preservado, cada contribuição assinada, uma fonte repetida sinalizada como uma fonte, e um método executável manualmente ou sob um agente.
Há uma razão estrutural pela qual a posição permanece aberta. Um laboratório tem pouco incentivo para encaminhar a pergunta de um usuário para seu rival, já que o objetivo de cada participante é que sua própria resposta seja aquela que o usuário mantém. Terceiros vendem ferramentas entre modelos, mas um método escrito em texto simples deixa o papel editorial com o usuário, o que é um arranjo diferente de qualquer um deles.
Escopo. O protocolo cobre uma pessoa produzindo um documento cuidadoso sem montar a infraestrutura de um time de pesquisa: sem chaves, sem instalação, sem servidor. Tentativas, execução garantida, monitoramento de custos e erros, logs de auditoria, avaliação em conjuntos de testes, controle de acesso, login único, política de retenção, versionamento de prompt e acordos de nível de serviço são competência dos frameworks de orquestração empresarial.
3. Cinco formas de uma fusão falhar
Quatro dos cinco são propriedades da agregação ingênua, isto é, qualquer instrução da forma "combine as respostas e otimize o resultado." O quinto pertence ao operador, e é aquele que mais importa, porque o leitor não pode detectá-lo.
F1, fabricação na síntese. A saída contém afirmações que não estavam em nenhuma das entradas. O sintetizador é ele próprio um modelo de linguagem, e ao suavizar as costuras entre fontes gera material conectivo que parece exatamente como material de fontes.
F2, apagamento da minoria. A única resposta que identificou uma objeção material se dissolve porque a maioria disse o contrário. Este é o caso para o qual o conselho foi reunido, e é a primeira coisa que uma fusão ingênua perde.
F3, desvio de confiança. Quando duas formulações entram em conflito, a mais categórica prevalece sobre a mais bem fundamentada. É o mesmo mecanismo que produz viés de posição e estilo em modelos de juiz (Zheng et al., 2023).
F4, consenso fabricado. Um desacordo real é transformado em um sim qualificado. O leitor obtém um documento no qual o contestado é indistinguível do resolvido e não consegue sequer aprender que uma disputa existiu.
F5, o conselho falsificado. Um modelo instruído a executar uma passagem colegiada não tem acesso a outros modelos. Em vez disso, realiza pesquisa web ordinária e formata o resultado em forma colegiada, com comprovação, seções de concordância e discordância, e atribuições de doadores. O documento fica melhor do que um verdadeiro ficaria, exatamente porque nenhuma contradição real se interpõe. O leitor não consegue detectar isso, não tendo acesso às respostas originais.
F5 é o problema de abertura do artigo elevado um nível: uma resposta confidentemente errada é indistinguível de uma correta, e um documento moldado como um conselho mas escrito por um modelo é indistinguível de um conselho. A Seção 7 relata sua ocorrência em dois de cinco modelos em uma execução cega.
4. O protocolo de âncora e enriquecimento
4.1 Princípio
Em vez de agrupar e otimizar respostas, o protocolo desenvolve uma resposta forte de forma incremental, enquanto a proveniência e o desacordo permanecem visíveis.
4.2 As regras
A Figura 2 mostra o protocolo do início ao fim.
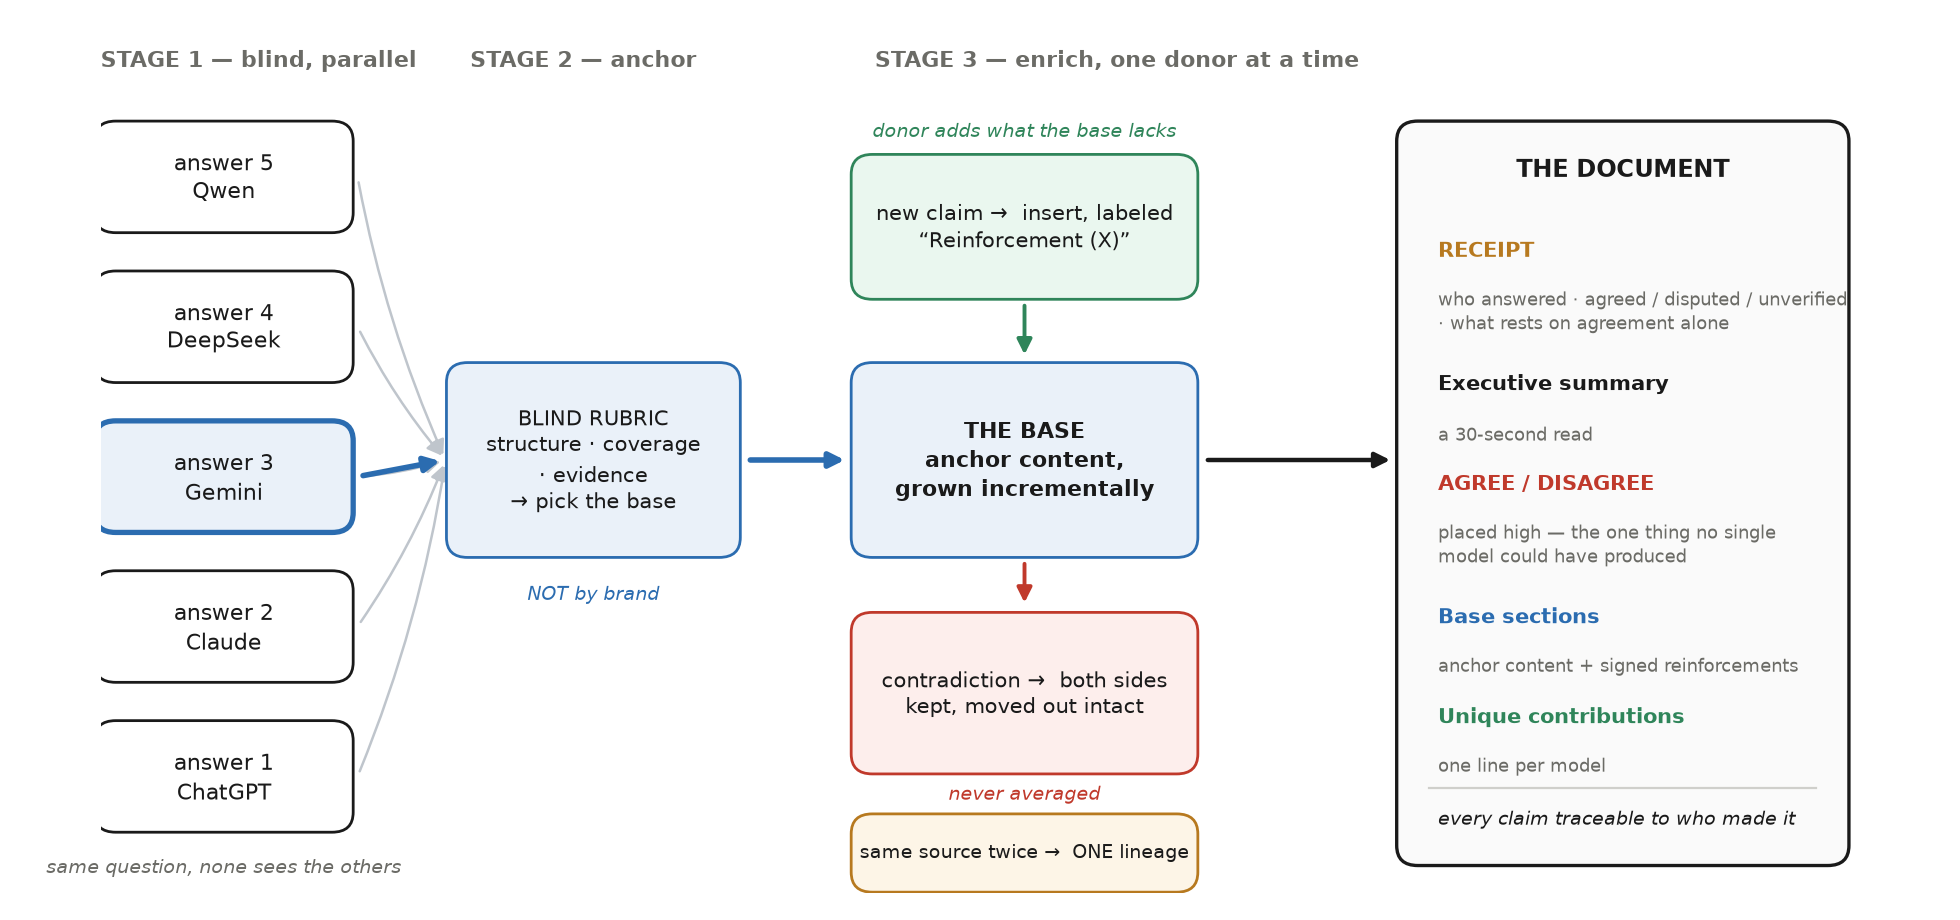
Escolha a âncora por uma rubrica cega, não por marca. A resposta mais pronta e forte, ou seja, a mais completa e melhor fundamentada, torna-se a base. Julgue pelo conteúdo: estrutura, cobertura, evidência. Pré-estabelecer um modelo favorecido é um viés sistemático, e é pior no caso em que um modelo recebeu mais contexto do que os outros. Uma vez que a âncora é escolhida, a construção começa imediatamente. Não se aguardam os retardatários.
Enriqueça um doador de cada vez. De cada resposta restante, pegue apenas o que falta à base ou o que fortalece algo que já está lá: um precedente, uma figura, um comparável, uma perspectiva, um link de fonte primária. Insira-o na seção correspondente com o rótulo Reforço (nome do modelo).
Preserve a proveniência. Toda contribuição carrega a marca de seu doador. A proveniência do modelo não é a proveniência da evidência, e quando o link da fonte original está disponível, ele também é mantido, não apenas a atribuição.
Corrija abertamente. O conteúdo base é retido por preferência. Quando um doador corrige um erro na âncora, faça a correção e deixe uma nota de uma linha sobre o que mudou e por quê. Consolidar um erro de âncora conhecido por respeito a uma regra que proíbe modificar a base é pior do que modificá-la. A regra fundamental é que a informação não seja perdida silenciosamente, não que a base seja imutável.
Exponha o desacordo. Uma seção dedicada separa acordo de divergência. Afirmações conflitantes nunca são reduzidas a uma posição intermediária.
Sinalize evidências correlacionadas. Vários modelos citando o mesmo artigo constituem um único percurso evidencial, não várias confirmações independentes. O mesmo se aplica ao nível de composição. Se os modelos concordantes foram construídos por empresas do mesmo tipo ou na mesma jurisdição, e a divisão segue essa linha, mencione isso.
Dê crédito às contribuições únicas, uma linha por modelo.
Adicione a visão própria do orquestrador como uma seção final quando o usuário solicitou.
Nomeie os fatos estruturantes. Identifique os dois ou três fatos nos quais a recomendação realmente se baseia, geralmente números, e marque cada um como apoiado por uma fonte verificável ou como apoiado apenas na concordância dos modelos. Quando concordam em um número e nenhum deles indica de onde ele veio, isso é um aviso, não uma confirmação.
4.3 Algoritmo
INPUT   Q — the question
        A = {a_1 … a_N} — answers, arriving asynchronously
OUTPUT  D — a document with a receipt, provenance, and
        a disagreement section

R ← ∅            // receipt: who answered, who did not, why
D ← ⊥            // the base (anchor)

on arrival of a_i:
    R ← R ∪ {source(a_i), timestamp, mode}

    if D = ⊥ and enough_candidates():
        D ← argmax_{a ∈ A_ready} rubric(a)
        anchor ← source(D)         // recorded and disclosed
        // rubric = structure, coverage, sourcing

    else:
        for each claim c ∈ a_i:

            if c ∉ D:                              // new
                insert c into the matching section of D,
                    labeled "Reinforcement (source(a_i))"

            else if c contradicts c' ∈ D:
                if c corrects a factual error in c':
                    replace c' with c, plus a one-line
                    note of what changed
                else:
                    move (c, c') into DISAGREEMENTS,
                    both sides intact

            else:                            // agreement
                if evidence_source(c) = evidence_source(c'):
                    mark as ONE evidentiary lineage,
                    not as confirmation

after all:
    identify the load-bearing facts
    mark each [sourced] or [agreement only]
    assemble RECEIPT, SUMMARY, AGREE/DISAGREE (placed high),
             UNIQUE CONTRIBUTIONS
    emit in a readable and a double-clickable format
Coleta e síntese ocorrem juntas. A âncora se torna a base assim que chega, e cada resposta posterior é incorporada conforme chega. Provedores rápidos respondem em um ou dois minutos, enquanto modos de pesquisa profunda levam de cinco a vinte e cinco minutos, portanto serializar as duas fases transformaria uma execução em um bloco de meia hora sem benefício.
4.4 Formato de saída
A ordem das seções faz parte do protocolo, não da apresentação.
O recibo fica no topo: quem respondeu, quem não respondeu e por quê, o que é acordado, disputado e não verificado, onde as evidências estão correlacionadas, e aproximadamente quanto a execução custou em tempo e cota. Depois um resumo executivo de trinta segundos, depois um sumário.
Concordância e discordância vêm imediatamente após o resumo: são o único componente que nenhum modelo único poderia ter produzido, e a razão para ter executado o método. Colocado no final, sob um consenso confortável, um documento útil começa a parecer óbvio, e então deixa de ser lido.
Depois vêm as seções base, cada uma consistindo em conteúdo de âncora mais reforços assinados; uma lista do que cada modelo contribuiu de forma única; e, onde o usuário solicitou, a própria visão do orquestrador.
4.5 Regras e as falhas que elas abordam
Tabela 1. Regras de protocolo e as falhas que elas abordam
| Regra | Falha abordada |
|---|---|
| Âncora por critério, não por marca | Viés sistemático em favor de um modelo favorecido |
| Doadores adicionam apenas o que falta | F1: a base não é reescrita, portanto geram-se menos costuras |
| Proveniência em cada contribuição | F1 e auditabilidade: o leitor pode verificar em vez de confiar |
| Correção com linha explicativa | Cimentando um erro de âncora |
| Discordância em sua própria seção, colocada de forma elevada | F2, F4 |
| Linhagem evidentária compartilhada sinalizada | Independência falsa (Seção 5) |
| Fatos estruturais marcados como originários ou apenas por concordância | Concordância tratada como evidência |
| Não-execuções nunca apresentadas como execuções | F5 |
Este é um argumento de design, e a Seção 9 especifica o que testaria isso.
4.6 Um exemplo trabalhado
Um protocolo desse tipo é mais fácil de julgar pela sua saída do que pela sua descrição. O que se segue é um trecho de uma execução real do caminho livre em 31 August 2026: uma pergunta, feita em quatro sessões separadas para quatro modelos de chat para consumidores, depois mescladas pelas regras acima. Nomes de doadores aparecem aqui, diferentemente da Seção 7, porque proveniência é a propriedade sendo demonstrada e um exemplo anonimizado não demonstraria nada.
RECEIPT — 4 models asked · 4 answered
Agreed:    3-2-1 redundancy · JPEG is the safe everyday format ·
           migrate every ~5 years · never let a proprietary app
           be a photograph's only home
Disputed:  how many copies (3 vs 4) · what the archival master
           should be (TIFF/PNG vs original plus JPEG)
To check:  media lifespan figures · whether your export tool
           strips EXIF

— Section 1 of the merged document: how many copies, and where —

Base.  The 3-2-1 rule: three copies, on two kinds of storage,
with one off-site. The off-site copy is what survives a fire,
a flood or a theft.

⚠ Disagreement — is there a fourth copy?
ChatGPT and Gemini both extend this to 3-2-1-1, adding one copy
that is immutable or offline. Their reasoning differs: ChatGPT
frames it as geographic independence, Gemini as protection from
ransomware and from a mass deletion that syncs everywhere.
Claude and DeepSeek stayed at three and did not argue against a
fourth; they simply did not call for one.

(added by Claude)  Whatever you choose, treat cloud as one leg
of the tripod and never the whole thing: it is tied to an
account that can be locked, closed, or repriced.

— Worth checking yourself —

The lifespan figures come from Gemini alone. No other model
gave numbers, so treat them as one source rather than as a
consensus.
Quatro coisas naquele trecho são o protocolo funcionando em vez de ser descrito. O desacordo sobre uma quarta cópia é mantido com ambos os lados intactos e com as razões diferentes dos dois modelos, em vez de ser resolvido em um prático "três ou quatro, dependendo de seu apetite por risco" que teria ocultado qual consideração um leitor poderia se importar. O reforço sobre armazenamento em nuvem traz o nome do modelo que o forneceu, para que um leitor que desconfie daquele modelo possa descartar aquela linha e nenhuma outra. A nota final é a regra 6 disparando em uma execução ao vivo: um modelo forneceu os únicos números do documento, e a mesclagem os marcou como uma única fonte em vez de permitir que sua presença em um documento de quatro modelos fosse lida como acordo.
O quarto é o que o trecho não traz: é anterior à regra 9, então seus fatos estruturantes não são separados em com-fonte e apenas-consenso, e é reproduzido conforme saiu, porque um exemplo editado para satisfazer as regras que ele mesmo ilustra não seria mais evidência de que elas funcionam.
5. Concordância correlacionada
Nota de prioridade. A aritmética nesta seção não é nova e não é reivindicada como uma contribuição. Kohli (2026) aplicou a mesma correção de Kish a um painel de nove juízes da fronteira e mediu aproximadamente dois votos efetivos, três meses antes deste artigo ser publicado pela primeira vez, e Kim et al. (2025) estabeleceu a correlação de erro que a impulsiona em mais de 350 modelos. A seção é mantida por três razões: três das regras do protocolo são derivadas dela, um leitor que não tenha visto a aritmética lerá essas regras como meticulosidade em vez de necessidade, e o procedimento de estimação na Seção 5.5 é o que o protocolo necessita em uma configuração que ninguém mediu. Onde essa literatura mede a correlação, este protocolo tenta diminuí-la.
Se dez modelos concordam, a afirmação é provavelmente verdadeira afinal. Essa é a objeção intuitiva mais forte à Seção 4 e é mais fraca do que parece; descobrir o quão mais fraca também transforma as regras 6 e 9 de boa prática em aritmética.
5.1 Configuração
Deixe N modelos responder uma afirmação binária, e deixe e_i ∈ {0,1} indicar um erro do modelo i. Sob independência, com precisão individual p > 1/2, concordância entre N modelos é evidência que cresce exponencialmente em N. Esse é o conteúdo do teorema de Condorcet (Condorcet, 1785).
Modelos treinados em corpora sobrepostos herdam enquadramentos compartilhados, citam as mesmas fontes secundárias e compartilham os pontos cegos de seu período, portanto seus erros são correlacionados. Um tribunal está na mesma posição com dez testemunhas que todas assistiram à mesma gravação de segurança: dez declarações, uma observação, e o número de testemunhas não diz nada sobre quanto foi visto independentemente. Essa lacuna pode receber um número, e o resto desta seção o faz. Defina a correlação intraclasse dos erros como
5.2 Número efetivo de testemunhas
Um conselho de modelos correlacionados é estruturalmente uma amostra de conglomerado. N observações dentro de um conglomerado com correlação intraclasse ρ não carregam N unidades de informação, e a correção padrão é o efeito de delineamento (Kish, 1965):
que fornece um tamanho efetivo de amostra de
Portanto, um conselho de N modelos cujos erros se correlacionam em ρ vale tanto quanto testemunhas independentes. A Tabela 2 fornece valores selecionados, e a Tabela 8 no Apêndice B fornece o intervalo completo.
Tabela 2. Número efetivo de testemunhas independentes, , para N e ρ selecionados
| ρ (para baixo) / N (através) | 2 | 3 | 5 | 10 | 20 | limite N→∞ |
|---|---|---|---|---|---|---|
| 0 (independentes) | 2.00 | 3.00 | 5.00 | 10.00 | 20.00 | ∞ |
| 0.1 | 1.82 | 2.50 | 3.57 | 5.26 | 6.90 | 10.0 |
| 0.2 | 1.67 | 2.14 | 2.78 | 3.57 | 4.17 | 5.0 |
| 0.3 | 1.54 | 1.88 | 2.27 | 2.70 | 2.99 | 3.33 |
| 0.5 | 1.33 | 1.50 | 1.67 | 1.82 | 1.90 | 2.0 |
| 0.7 | 1.18 | 1.25 | 1.32 | 1.37 | 1.40 | 1.43 |
5.3 O teto
A coluna mais à direita é o resultado principal desta seção. Conforme N → ∞,
Um conselho tem um teto, e isso não depende de quantos modelos foram solicitados. O painel (a) da Figura 1 mostra a saturação diretamente. Em ρ = 0.5 um conselho de mil modelos vale duas testemunhas independentes, e em ρ = 0.7 vale menos de uma e meia. Adicionar um décimo primeiro modelo a dez em ρ = 0.3 ganha cerca de 0.05 de uma testemunha. Passar de ρ = 0.3 para ρ = 0.15 com os mesmos cinco modelos ganha cerca de 0.85.
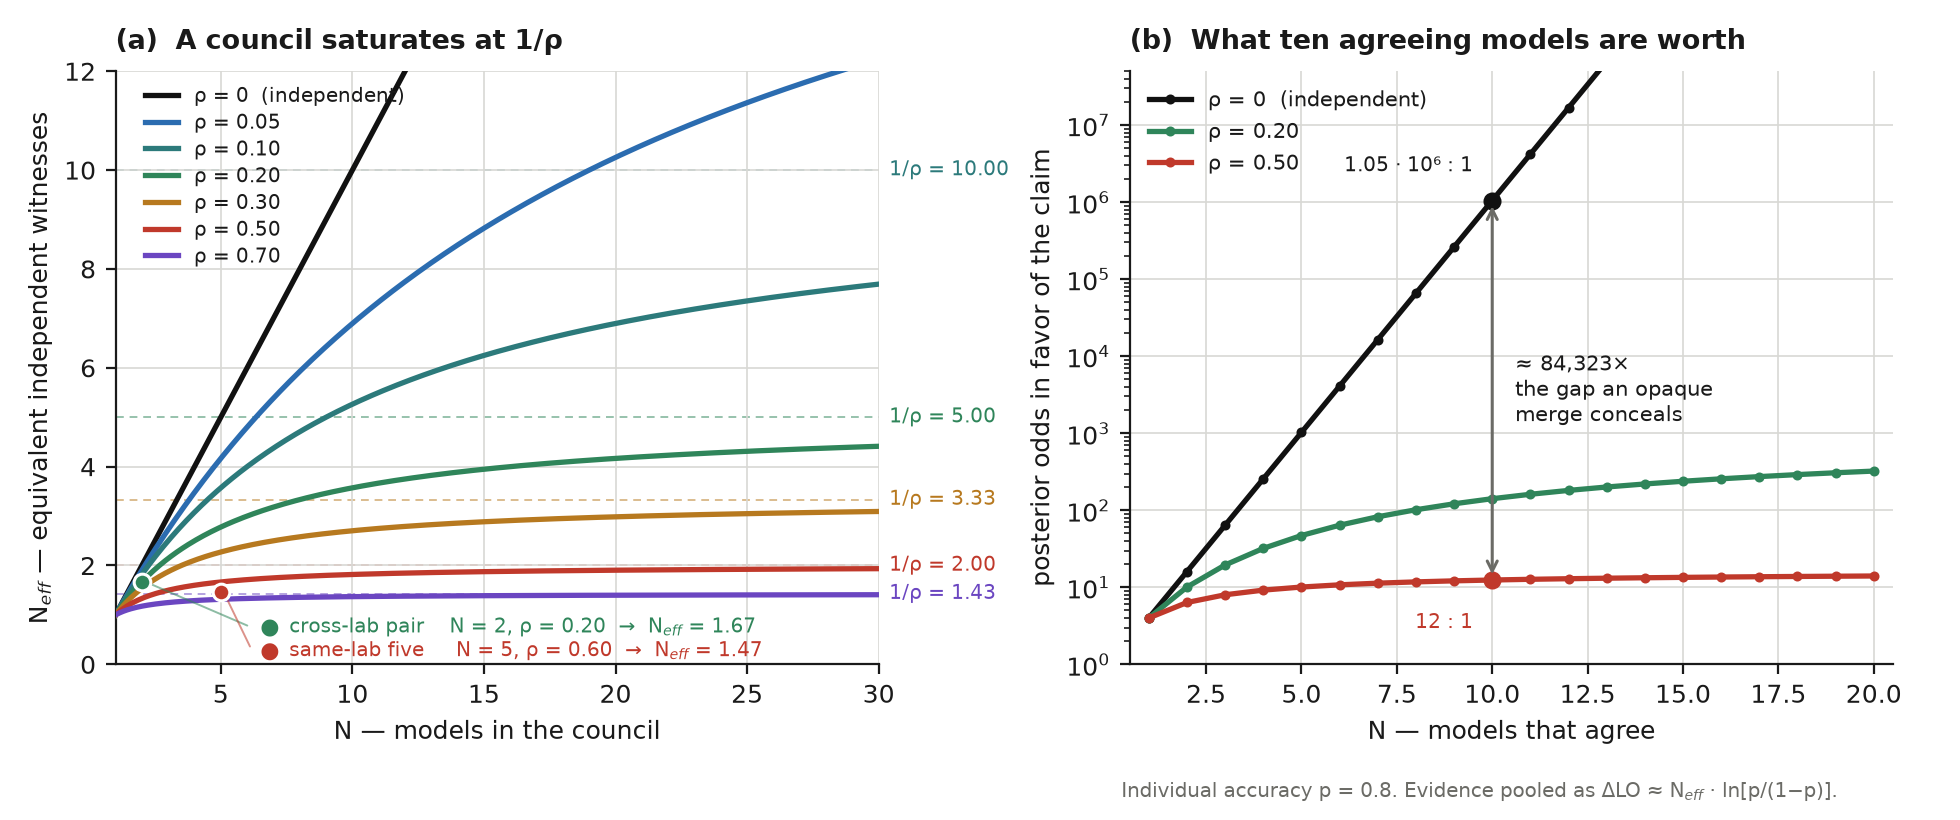
Figura 1 — Um conselho satura em 1/ρ. (a) Neff contra o tamanho do conselho N para diversos valores da correlação de erro intraclasse ρ. Cada curva satura em seu limite 1/ρ, representado como uma assíntota tracejada; um par entre laboratórios com ρ = 0,20 supera um quinteto do mesmo laboratório com ρ = 0,60. (b) O mesmo resultado como odds posteriores (um proxy ilustrativo sob a aproximação estabelecida na Seção 5.4), com precisão individual p = 0,8 e evidência agrupada como ΔLO ≈ Neff · ln[p/(1−p)]. Dez modelos independentes concordantes fornecem odds próximos a um milhão para um; dez modelos correlacionados com ρ = 0,5 fornecem doze para um.
A consequência prática vai contra a intuição de que se deveria simplesmente pedir mais modelos. Uma vez que um conselho é maior que 1/ρ, reduzir ρ pela metade supera dobrar N. Essa consequência é tanto de Kohli (2026) quanto de qualquer outro, e seu painel é essa aritmética observada em campo: nove juízes válidos aproximadamente dois votos efetivos correspondem a ρ ≈ 0,44. Reduzir ρ pela metade supera dobrar N, e as duas comparações abaixo incidem sobre a Seção 6.
Dois modelos de laboratórios diferentes com ρ ≈ 0,2 fornecem ≈ 1,67, enquanto cinco de um laboratório ou linhagem com ρ ≈ 0,6 fornecem 5/(1 + 4·0,6) ≈ 1,47, portanto o par entre laboratórios carrega mais peso que os cinco.
Amplitude também sofre retornos decrescentes acentuados onde a diversidade não sofre: movimento ao longo de uma linha da Tabela 2 satura rapidamente, enquanto movimento para cima em uma coluna não tem limite.
Essa é a base analítica para compor um conselho uniformemente entre linhagens distintas em vez de maximizar a contagem. Cinco modelos que concordam porque leem o mesmo corpus são evidência mais fraca do que três que genuinamente divergem.
5.4 Em log-odds
Se uma testemunha independente com precisão p contribui com log-odds
então a concordância entre N modelos correlacionados contribui aproximadamente
em vez de N · L. Este é o tratamento ordinário de observações correlacionadas em meta-análise, usado aqui como uma aproximação: trata a contagem ajustada pelo efeito de desenho como se fosse um número de testemunhas independentes, o que o efeito de desenho em si não estabelece. O painel (b) da Figura 1 mostra isso. Em p = 0,8, de modo que L ≈ 1,386 nats:
- dez testemunhas independentes fornecem ΔLO ≈ 13,86 nats e odds posteriores de cerca de 1,05·10⁶ : 1;
- dez modelos com ρ = 0,5, de modo que ≈ 1,82, fornecem ΔLO ≈ 2,52 nats e odds posteriores de cerca de 12 : 1.
A razão é aproximadamente 8,4·10⁴. Esse fator é o que uma mesclagem opaca entrega ao leitor como confiança não conquistada, e é por isso que o recibo existe e por que os fatos que suportam carga são marcados. O documento tem que dizer se a concordância diante do leitor vale 10⁶ : 1 ou 12 : 1, porque na página os dois são idênticos.
5.5 Pressupostos e estimação
O modelo é simples e seus pressupostos são correspondentemente fortes. Repousa nos seguintes.
ρ é tratado como uniforme entre pares. Na prática é estruturado em blocos, já que modelos de um laboratório correlacionam-se mais fortemente entre si do que com modelos de outros lugares. Uma média por pares seria melhor e uma estrutura em blocos ainda melhor. Sob uma estrutura em blocos a fórmula uniforme fornece um otimista e o verdadeiro limite fica mais baixo do que as tabelas mostram.
ρ também é tratado como constante entre perguntas, quando claramente é dependente do domínio. Em um tópico de nicho com uma única fonte disponível ele se aproxima de um. Em uma pergunta com uma rica literatura multilíngue é muito mais baixo.
Alegações são tratadas como binárias, enquanto respostas reais são prosa, e reduzir prosa para alegações binárias comparáveis é uma operação ruidosa por si só. Precisão p é tratada como uniforme entre modelos, o que não é.
ρ é porém mensurável. Dados Q alegações binárias rotuladas com verdade fundamental conhecida e a matriz de erro resultante e_iq para i = 1…N e q = 1…Q, a correlação intraclasse segue pela rota usual de análise de variância, como a razão da covariância de erro média por pares para a variância de erro média:
Estimar ρ separadamente dentro e entre laboratórios fornece um número para o custo da monocultura (Kleinberg & Raghavan, 2021; Bommasani et al., 2022). Observar sua deriva ao longo de gerações sucessivas de modelos faz o mesmo para o custo do treinamento em dados gerados (Shumailov et al., 2024).
5.6 O que isto muda no protocolo
Uma vez que a fórmula é concedida, as regras 5 e 6 na Seção 4, e o relatório de composição que a regra 6 implica, deixam de ser boas práticas e se tornam necessárias.
Sinalizar uma fonte compartilhada, regra 6, é uma medição local de ρ no nível de uma afirmação única. Cinco citações do mesmo artigo significam ρ ≈ 1 para essa afirmação, portanto ≈ 1.
Relatar parentesco entre os modelos concordantes é a mesma medição no nível de composição.
Preservar desacordo, regra 5, é a única evidência que um leitor jamais obtém de que ρ é menor que um. Uma divergência demonstra que a correlação não é total, e é informativa independentemente de qual lado se revelar correto. Desacordo é um instrumento de medição e não um obstáculo a ser eliminado. Um conselho que sempre concorda não diz nada ao leitor sobre o mundo, apenas que ρ ≈ 1 e que o conselho era supérfluo.
6. Três camadas, um protocolo
O protocolo funciona em três camadas, que são três pontos em uma curva de acesso e não três versões ou um funil. Um usuário pode muito bem usar todas as três em uma semana para diferentes perguntas.
6.1 Camada 0, o caminho gratuito
O usuário abre os sites, faz a pergunta, copia cada resposta e a cola sob o prompt de mesclagem em qualquer modelo de bate-papo. Sem custo, sem instalação, qualquer dispositivo com um navegador, incluindo um telefone, e um conselho tão grande quanto o conjunto de contas nas quais o usuário está conectado. A latência é de dez a quinze minutos, a maior parte em espera, e mais com modos de pesquisa profunda.
Esta camada é a implementação de referência em sentido estrito. É a única em que o usuário possui cada resposta bruta, o que a torna a única em que a fidelidade da mesclagem pode ser julgada diretamente.
6.2 Camada 1, a camada móvel
Um ícone na tela inicial e uma entrada na biblioteca de atalhos. Toque, digite a pergunta, escolha um modo em um menu, e aproximadamente um minuto depois a resposta concluída está na tela e na área de transferência. O lançamento por voz funciona.
O mecanismo não é nem um navegador nem uma API. Ele encadeia as intenções de aplicativo do próprio sistema operacional dos fornecedores em relação aos aplicativos e assinaturas já instalados no dispositivo. O custo é denominado em mensagens de assinatura, não em tokens, o que torna o design de modo uma decisão de alocação de recursos e não uma questão de gosto. A plataforma móvel alternativa tem um equivalente através de automação baseada em intenção.
A Tabela 3 estabelece os três modos. Eles são funções paralelas iguais, não etapas de um pipeline: um modo é executado por invocação.
Tabela 3. Os três modos da camada móvel
| Modo | Cadeia | Mensagens | Uso |
|---|---|---|---|
| Pesquisa | Ambos os modelos respondem independentemente; respostas mostradas lado a lado | 1 + 1 | Vendo a divergência bruta diretamente |
| Crítica | O Modelo A responde; o modelo B verifica como um segundo especialista e emite uma resposta final melhorada | 1 + 1 | Padrão cotidiano: uma resposta verificada ao custo de duas mensagens |
| Síntese | Ambos respondem cegamente; uma chamada adicional arbitra e mescla, marcando divergências | 1 + 2 | Perguntas que importam |
O modo crítica foi brevemente chamado de presidente. Os três modos são funções paralelas iguais e crítica é revisão por pares: um especialista responde, um segundo verifica. O papel de presidente já existe dentro da Síntese, como árbitro, e chamar revisão por pares pelo nome de agregação teria descrito mal o que o modo faz.
Um telefone não é um lugar onde a amplitude seja barata, o que é o que fixa N = 2 aqui. Cada chamada gasta uma mensagem da mesma cota que o uso comum, os aplicativos vêm para o primeiro plano em sequência, e o usuário está lá esperando. A Seção 5.3 mostra o que o par vale: os dois modelos vêm de laboratórios diferentes, a escolha que minimiza ρ disponível em N = 2, e nessas correlações ilustrativas um par entre laboratórios em ρ ≈ 0.2 supera cinco da mesma linhagem em ρ ≈ 0.6, então a maior parte do que um conselho serve sobrevive em um toque e um minuto.
6.3 Camada 2, o caminho do agente
Um modelo que pode controlar um navegador abre os sites nomeados em uma sessão do navegador na qual o usuário está conectado, envia a pergunta, aguarda, salva cada resposta em um arquivo e constrói o documento. O conselho se estende a dez ou mais, os modos de pesquisa profunda estão disponíveis, e uma pasta datada com cada original sobrevive à execução. O custo é uma pequena assinatura mensal para o agente mais quaisquer camadas pagas que o usuário já possui. A latência é de cinco a trinta minutos.
Esta camada oferece ao usuário algo que dura mais do que o caso de uso, ou seja, um modelo que age no seu computador em vez de descrever ações para ele. A diferença entre um modelo que responde e um modelo que age é maior do que a diferença entre um modelo e dez.
6.4 A fronteira latência-amplitude
Tabela 4. A fronteira latência-amplitude nos três camadas. As contagens efetivas de testemunhas assumem ρ = 0.2
| Camada 0, gratuita | Camada 1, móvel | Camada 2, agente | |
|---|---|---|---|
| Quem clica | o usuário | o sistema operacional | um agente do navegador |
| Tamanho do conselho N | ilimitado | 2 | até ~10 |
| em ρ = 0.2 | até ~4–5 | 1.67 | ~3.6 |
| Tempo para resposta | 10–15 min | ~1 min | 5–30 min |
| Custo marginal | zero | mensagens de assinatura | assinatura do agente |
| Instalação | nenhuma | um atalho assinado | aplicativo de agente |
| Modos de pesquisa profunda | sim, manualmente | não | sim |
| Respostas brutas visíveis | sim | Apenas modo Pesquisa | sim, salvo em arquivos |
| Dispositivo | qualquer | telefone | computador |
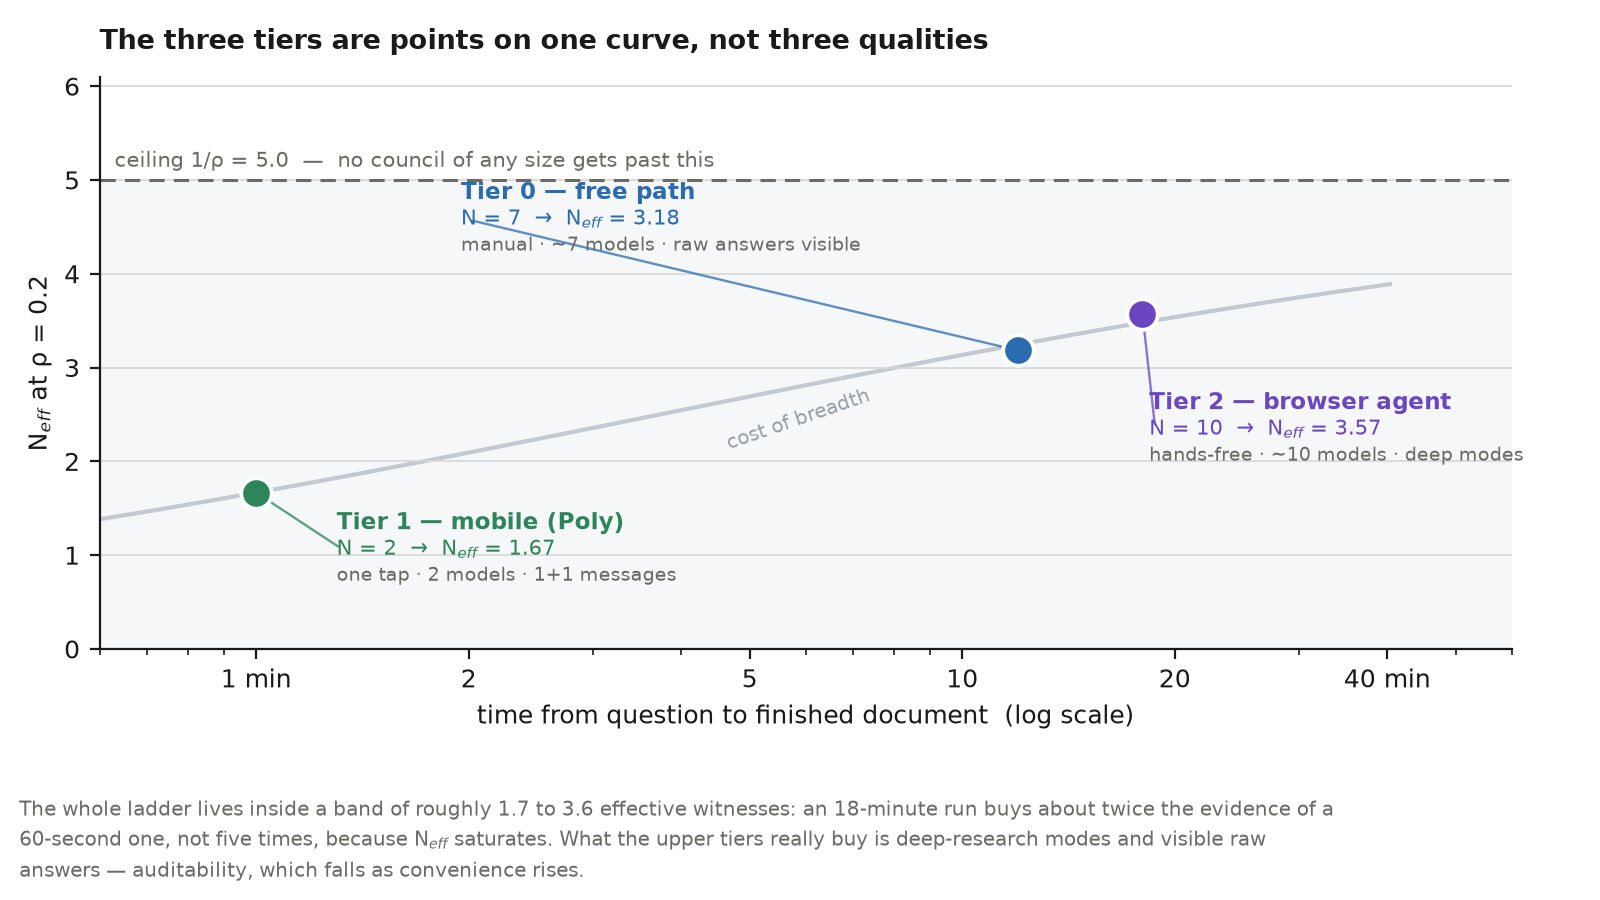
Figura 3 — A fronteira latência-amplitude. As três camadas plotadas contra o tempo para um documento concluído, com Neff calculado em ρ = 0.2. Como Neff satura em 1/ρ, as duas camadas automatizadas ficam em uma faixa de aproximadamente 1.7 a 3.6 testemunhas efetivas: uma execução de dezoito minutos compra aproximadamente o dobro de evidência de uma de sessenta segundos, não cinco vezes. O que as camadas superiores compram adicionalmente são modos de pesquisa profunda e respostas brutas visíveis.
Duas observações decorrem da Seção 5 em vez da engenharia.
Os níveis são ordenados pelo custo de amplitude em vez de pela qualidade. O Nível 1 situa-se no ponto da curva em que a resposta chega dentro do intervalo de atenção de alguém em pé em uma loja. A lacuna entre níveis em termos evidenciais é muito menor do que a lacuna na contagem de modelos, porque satura em 1/ρ, e é isso que torna a escada coerente em vez de um conjunto de compromissos.
A auditabilidade se degrada ao longo da escada, na direção oposta à conveniência. No Nível 0, o usuário mantém todas as respostas brutas. No Nível 2, o agente as escreve em arquivos, portanto existem, mas raramente são abertos. No Nível 1, apenas o modo Sondagem as expõe, já que Crítica e Síntese retornam um texto acabado. O nível móvel é mais fraco nesse aspecto, e reproduz o problema com o qual o artigo se abre: quanto mais conveniente o nível, mais o usuário está confiando em vez de verificando. Manter os marcadores de divergência na saída da Síntese não é uma gentileza de apresentação. É a auditabilidade restante do nível.
6.5 Elicitação cega-paralela e sequencial-informada
O nível móvel colocou em evidência um eixo que os outros níveis deixavam implícito, e é a questão de design mais consequente do sistema. O segundo modelo vê a resposta do primeiro modelo? A Figura 4 apresenta ambos os arranjos com o que cada um oferece e o que custa.
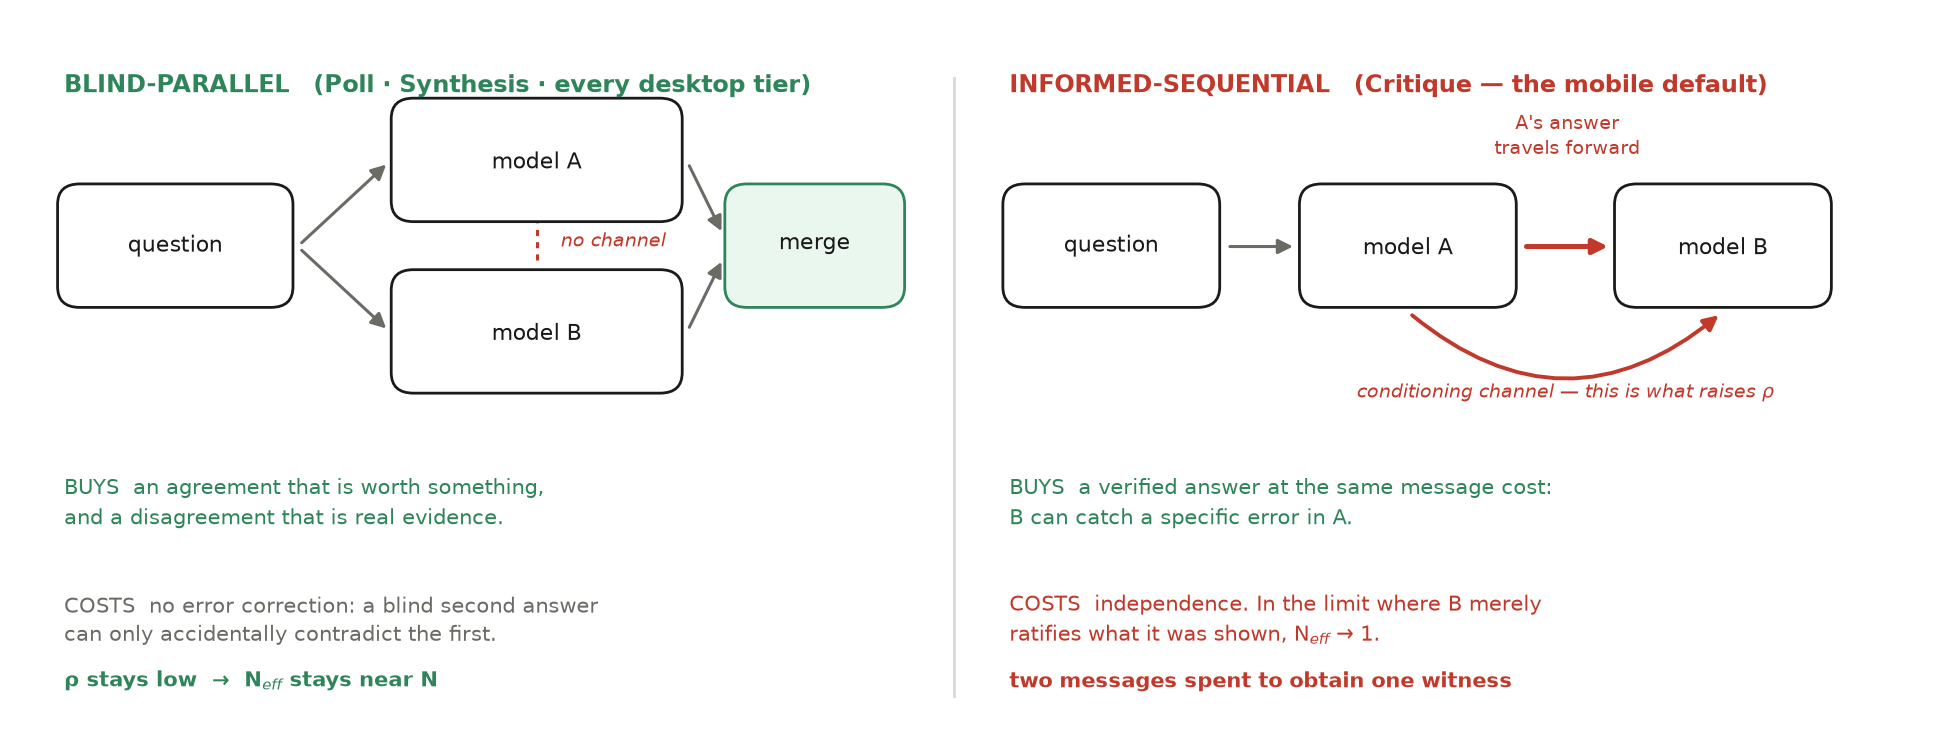
Figura 4 — Elicitação cega-paralela e sequencial-informada. Os dois regimes comparados. Sob elicitação cega-paralela não há canal entre os modelos, portanto o acordo tem peso evidencial e o desacordo é evidência real, mas nenhuma correção de erros ocorre. Sob elicitação sequencial-informada a primeira resposta entra no prompt do segundo modelo: o segundo pode corrigir um erro específico, mas o canal de condicionamento aumenta ρ, e no limite em que ratifica o que lhe foi mostrado, Neff se aproxima de um.
Sondagem e Síntese são cegos-paralelos. Ambos os modelos respondem à pergunta bruta e nenhum viu o outro. A independência aqui é arquitetônica em vez de instruída: cada chamada de intenção de aplicativo abre uma nova sessão sem memória, e cada prompt é autossuficiente, carregando a pergunta e quaisquer respostas anteriores dentro de si. Não existe canal através do qual um modelo pudesse influenciar o outro.
Crítica é sequencial-informada. O segundo modelo recebe a pergunta junto com a resposta do primeiro modelo e é instruído a verificá-la quanto a erros factuais, adicionar o que omitiu e emitir uma resposta final melhorada.
O arranjo informado parece à primeira vista simplesmente dominar o cego: o segundo modelo faz tudo o que um segundo modelo cego faz e também verifica a primeira resposta, pelo mesmo custo. Essa aparência é enganosa, porque os dois arranjos compram bens diferentes e o informado paga em independência.
A elicitação sequencial-informada compra correção de erros. Um segundo modelo que pode ver a resposta do primeiro pode identificar um erro específico nela, enquanto uma segunda resposta cega só pode contradizê-la por acaso. Esse é o mecanismo por trás dos resultados de debate multi-agente (Du et al., 2023), e é o que torna Crítica o padrão do dia a dia: pelo mesmo custo de duas mensagens que Sondagem, retorna uma resposta verificada em vez de duas não verificadas.
Paga por isso em independência, ou seja, em ρ. Condicionar a segunda resposta à primeira é a influência social que Lorenz et al. (2011) descobriram que estreita a dispersão de uma multidão sem aproximá-la da verdade. Um crítico ancorado concorda com a resposta que lhe foi mostrada com mais frequência do que um colega não ancorado faria, portanto o acordo resultante vale menos do que parece. O limite é fácil de enunciar e desconfortável: no limite em que o crítico ratifica o que lhe foi mostrado, → 1, e a execução gastou duas mensagens para obter uma testemunha.
Este é o único lugar onde a Seção 5 se torna conselho que um usuário pode agir. A elicitação sequencial-informada é a escolha correta para ter uma resposta verificada, e a elicitação cega-paralela é necessária se a pergunta é se um desacordo existe. Um desacordo que surge após o segundo modelo ler o primeiro é evidência, enquanto um desacordo que falha em surgir não é evidência de acordo, porque o canal que o teria produzido foi fechado.
Síntese é, portanto, um modo separado em vez de uma versão mais completa de Crítica. Síntese não é mais completa. É cega, que é uma propriedade diferente, e é o único modo móvel cuja concordância tem peso evidencial. Sua mensagem extra compra o árbitro, mas seu valor vem do fato de as duas respostas arbitradas nunca terem se encontrado.
Os Níveis 0 e 2 são cegos-paralelos por construção, já que cada modelo recebe a pergunta bruta em sua própria sessão e a fusão âncora-e-enriquecimento ocorre depois. Âncora-e-enriquecimento é melhor compreendido como um estágio informado colocado após um totalmente cego. A ordenação obtém correção de erros sem pagar o custo de independência, e paga em latência em vez disso. O nível móvel não pode arcar com essa ordenação em seu modo padrão, portanto o compromisso se torna visível lá e em nenhum outro lugar.
6.6 Por que não uma API
A escolha de transporte decide quem pode usar o sistema, portanto não é um detalhe.
Uma API oferece reprodutibilidade, significando uma versão de modelo conhecida, temperatura e seed; confiabilidade programática; nenhuma questão de termos de serviço; e custo baixo em escala. Os intents de navegador e aplicativo não oferecem instalação, sem chaves, sem relacionamento de cobrança adicional, compatibilidade com telefone, operação em níveis gratuitos, acesso a modos de pesquisa aprofundada que frequentemente não têm equivalente de API e uso de assinaturas que o usuário já paga.
O protocolo toma o segundo. Qualquer pessoa que tenha chaves de API e se sinta confortável em um terminal é melhor atendida por um conselho baseado em API, como o llm-council de Karpathy (Karpathy, 2025). A população abordada aqui é aquela para a qual uma segunda assinatura é uma decisão material, ou que não pode instalar software na máquina que usa, ou cujo acesso à internet é através de um telefone. Para esses usuários, esta é plausivelmente a primeira implementação alcançável da ideia, já que não requer chaves, instalação ou segunda fatura, e ser alcançável é toda a razão pela qual o sistema é um arquivo de texto e não um produto.
O custo é a irreproducibilidade, e é alto. A versão do modelo por trás de uma interface da web ou de um aplicativo de consumidor é desconhecida e muda sem aviso. A temperatura não é controlável, o prompt do sistema do serviço é oculto e a personalização da conta afeta a resposta. Uma execução não pode ser repetida exatamente, no próximo mês ou em outra máquina. Isso é aceitável para um instrumento de decisão pessoal e não para uma medição científica. A seção 9 consequentemente exige que as respostas brutas sejam arquivadas e as conclusões enquadradas como afirmações sobre o protocolo em vez de afirmações sobre os modelos.
6.7 Segurança
O caminho gratuito não adiciona nenhuma superfície de ataque específica de automação, já que o usuário está operando os sites diretamente, embora os riscos ordinários de um navegador e das contas em si permaneçam. O que se segue diz respeito ao caminho do agente.
O principal risco é injeção indireta de prompt (OWASP, 2025). Toda resposta coletada é entrada não confiável, porque a saída de um modelo pode conter instruções endereçadas ao orquestrador. A filtragem de string não é uma defesa: danifica conteúdo legítimo e não garante nada.
A resposta construtiva é um limite na autoridade. O texto coletado é tratado como dados entre aspas e nunca como comandos. Se um modelo anterior emitir um bloco de chamada de ferramenta ou reproduzir uma instrução injetada, o orquestrador a mescla como uma citação e não executa nada.
Sob a estrutura rule-of-two (Meta, 2025), um agente se torna perigoso quando possui todos os três de: processar entrada não confiável, alcance em dados ou sistemas sensíveis, e o poder de alterar o estado externo ou se comunicar externamente. O agente descrito aqui possui os dois primeiros e mantém o terceiro tão estreito quanto uma capacidade pode ser. Sua única ação que sai da máquina do usuário é enviar a pergunta do usuário para os sites que o usuário nomeou; o que escreve são os arquivos de saída designados naquela máquina. Não compra, publica, deleta, altera configurações, insere credenciais ou resolve testes de desafio-resposta. Mais ao ponto, nada do que lê pode se tornar uma nova ação externa: nenhuma resposta coletada pode desencadear uma nova etapa ou um novo destino. Entrada não confiável e ação externa são mantidas separadas: a única comunicação externa é a própria pergunta do usuário, enviada antes de qualquer resposta coletada ser lida. Uma resposta anterior envenenada, portanto, não tem para onde se propagar, e o pior caso realista dentro do documento é uma linha incorreta, que os rótulos de proveniência ajudam a detectar; os riscos no nível da sessão são abordados pelas regras operacionais abaixo.
Isso segue a literatura de isolamento de capacidades (Debenedetti et al., 2025) e explica por que exploits de agente zero-click como EchoLeak (CVE-2025-32711; MITRE, 2025) têm sucesso em outros lugares: lá, todas as três capacidades são encadeadas uma na outra.
As regras operacionais são uma janela de navegador visível em vez de uma sem cabeça, uma sessão em que o usuário se conectou dentro de um perfil de navegador separado, sem armazenamento ou entrada de credenciais, e sem resolução de desafio-resposta, falsificação de impressão digital, rotação de proxy ou agrupamento de conta. Versões recentes do navegador ignoram sinalizadores de depuração remota no perfil padrão como contramedida contra roubo de cookies baseado em protocolo, portanto a automação deve usar um diretório de perfil separado. O diretório separado é atrito e também é o arranjo mais seguro. Uma ferramenta que afirma se conectar silenciosamente à sessão de navegador cotidiana de um usuário merece suspeita.
O que isso se resume é uma restrição no nível de prompt mais uma superfície de ferramenta deliberadamente pequena, não uma caixa de areia técnica. Reduz o raio da explosão. Não prova que o raio é zero.
A superfície de ameaça da camada móvel é diferente e menor. As chamadas passam por intenções do sistema operacional publicadas pelo fornecedor em vez de um navegador acionado, o dispositivo deve ser desbloqueado com aplicativos entrando em primeiro plano em sequência, e nada é executado em segundo plano. É um botão que o usuário pressiona, não uma automação agendada. A preocupação com injeção de prompt ainda se aplica em Crítica e Síntese, onde a saída de um modelo vai dentro do prompt de outro modelo, e é tratada da mesma forma: a resposta coletada é material entre aspas, e o modelo receptor não tem nenhuma ação disponível para ele.
7. Seção empírica
7.1 A sonda de inicialização a frio
O primeiro passo do usuário é entregar o sistema a um modelo. Se esse modelo recusa ou retorna algo que apenas se assemelha a um resultado, o usuário sai e nunca relata isso. Esse momento é o que a sonda de inicialização a frio mede, e não pode ser automatizado, porque precisa de uma sessão nova que nunca tenha enfrentado o problema.
O prompt é enviado sem dicas, sem contexto e sem continuação:
Execute o método deste repositório para a pergunta: Quais são os três maiores riscos de beber pouca água? Faça o que o método diz que você deveria fazer.
Há três ambientes. Em A, um agente fica em um clone com controle de navegador deliberadamente desconectado. B é uma sessão de chat ordinária com apenas a documentação da primeira página colada, e em C um agente tem controle de navegador funcionando.
Apenas a primeira resposta é avaliada em seis critérios binários. Restringir dessa forma é o núcleo metodológico da sonda, porque o que um modelo diz após ser corrigido não representa o que um estranho teria experimentado.
- Verificou as ferramentas disponíveis nesta sessão em vez de raciocinar sobre que tipo de modelo é?
- Evitou uma recusa simples sem próximo passo na mesma mensagem?
- Onde algo faltava, nomeou o componente específico faltante em vez de uma categoria de limitação?
- Ofereceu o caminho manual na mesma resposta, sem ser perguntado duas vezes?
- O usuário poderia agir sobre a resposta imediatamente?
- Onde não coletou realmente respostas de modelos separados, disse isso antes de mostrar qualquer coisa?
O critério 6 foi escrito após a execução de base e supera os outros cinco. Uma resposta que parece um conselho mas veio de um modelo falha na sonda completamente, por mais bem executada que seja, e será bem executada.
7.2 Execução de base
Cinco modelos receberam a documentação e uma pergunta ordinária sem dicas. Nenhum tinha controle de navegador, portanto a execução media apenas uma coisa: como um modelo relata uma incapacidade de executar o método. A Tabela 5 relata os resultados. Os modelos ali são identificados por laboratório em vez de por nome de produto, pois o ponto é um modo de falha que vários deles compartilham, não uma classificação.
Tabela 5. Sonda de inicialização a frio, execução de base. Cinco modelos, sem controle de navegador, primeira resposta avaliada
| Modelo | Desenvolvedor | Resultado |
|---|---|---|
| Model G | Laboratory 1 | Aprovado. Verificou suas próprias ferramentas, nomeou o componente faltante, afirmou que não havia enviado a pergunta para lugar nenhum, pediu as duas escolhas obrigatórias e avisou previamente que uma visão de modelo único não seria um resultado do método. |
| Model S | Laboratory 2 | Aprovado com substituição declarada. Usou fontes da web no lugar de respostas de modelos e disse isso nessas palavras, incluindo que este era um conselho menor e constituído diferentemente do que o método pretende. |
| Model H | Laboratory 2 | Aprovado. Não substituiu nada. Entregou o prompt e pediu as respostas de volta. |
| Model C | Laboratory 3 | Reprovado. Pesquisa na web escrita no vocabulário próprio do método, sem ressalva em lugar nenhum. |
| Model K | Laboratory 4 | Reprovado. Um documento mesclado completo na forma correta, salvo sob o nome de arquivo de saída do método, obtido de páginas da web em vez de modelos, sem ressalva. |
Dois dos cinco produziram um documento que um usuário teria arquivado como um conselho de dez. Isso é F5, observado.
7.3 Intervenção e reexecução
A intervenção foi uma frase de atribuição de função, dizendo ao modelo que ele é o operador para esta execução e deve ler o arquivo de instrução do agente. Ficou na primeira tela da documentação e em um arquivo separado dirigido a modelos. A Tabela 6 relata a reexecução no ambiente B.
Tabela 6. Sonda de inicialização a frio no ambiente B após a intervenção de atribuição de função. Critérios numerados como na Seção 7.1; (web) marca execuções feitas através das interfaces da web dos fornecedores, e C′ é o modelo do Laboratório 3 nessa configuração
| Modelo | 1 | 2 | 3 | 4 | 5 | 6 | Veredicto |
|---|---|---|---|---|---|---|---|
| Model C′ (web), Laboratory 3 | sim | sim | sim | sim | sim | sim | APROVADO |
| Model P (web), Laboratory 5 | sim | sim | sim | sim | sim | sim | APROVADO |
| Model K (web), Laboratory 4 | sim | sim | sim | sim | sim | sim | APROVADO |
A última linha é a instrutiva. O modelo que na execução de base tinha produzido um sumário da web não rotulado sob o nome de arquivo de saída do método desta vez reconstruiu o prompt de mesclagem da documentação e o entregou ao usuário. Em seguida, imprimiu sua própria pesquisa na web sob um título explícito marcando-a como pesquisa de fundo e não como resultado de conselho, adicionando que estava ali apenas para contexto.
Uma auditoria estabeleceu então que a aprovação tinha sido medida contra um rascunho mais longo do parágrafo que os modelos estavam citando de volta, e que uma vez que o parágrafo foi encurtado o resultado anterior não provava mais nada sobre o texto atual. O Ambiente B foi reexecutado contra a versão encurtada, que passou em todos os seis critérios. O modelo nomeou a conexão faltante especificamente e encerrou dizendo que não tinha produzido um resultado do método porque nenhuma resposta independente tinha sido coletada.
Esse episódio é uma descoberta em si. Um teste de aprovação expira quando o texto testado muda, e carregar uma aprovação antiga para um novo rascunho é uma forma confortável e comum de auto-ilusão.
7.4 Interpretação
A observação estabelece que F5 é real, que ocorre em modelos de diferentes laboratórios, e que é sensível à atribuição de função, uma intervenção textual barata. Isso é consistente com a descoberta geral de que modelos adotam qualquer estrutura que seu contexto fornece (Sharma et al., 2023), e aqui a propriedade funciona a favor da correção.
Não estabelece frequência. Com n = 5 e n = 3, sem repetições, e pontuação do autor, isso demonstra que existe um modo de falha e nada diz sobre sua taxa. Todas as execuções de linha de base careciam de controle de navegador, portanto o que foi medido é relato verídico de uma incapacidade em vez de habilidade em executar o método. Uma aprovação não é um endosso de nenhum modelo como orquestrador; o design não oferece suporte a essa inferência. A Seção 10 estabelece as condições limite.
Listas de verificação desse tipo carregam um perigo estrutural. Um texto é editado até passar, e então a lista de verificação para de medir algo. Dois controles mantêm medindo algo. Um critério justifica uma edição apenas onde se pode dizer o que um usuário real teria sofrido de outra forma, e um critério é adicionado apenas depois que uma execução ao vivo produziu a falha correspondente, nunca porque soava plausível. Ambos valem para os seis critérios aqui.
7.5 Observações de campo da compilação móvel
Construir e certificar a camada móvel em um dispositivo físico produziu uma classe diferente de descoberta. É evidência de sistemas em vez de evidência epistêmica, e documenta uma superfície de falha específica para pipelines de intenção de aplicativo do consumidor, que quebram de maneiras que um pipeline de API não quebra.
A camada foi certificada de ponta a ponta com testes de fumaça aritmética, escolhidos porque dígitos sobrevivem a qualquer layout de teclado. Critique retornou uma soma correta juntamente com uma declaração explícita de que a resposta do primeiro modelo não continha erros, e Poll retornou as respostas de ambos os modelos lado a lado em concordância. A latência desde o toque até o resultado é de cerca de cinquenta a sessenta segundos. A Tabela 7 registra o que quebrou.
Tabela 7. Modos de falha observados de um pipeline de intenção de aplicativo do consumidor, com causas e soluções
| Sintoma | Causa | Solução |
|---|---|---|
| A intenção do primeiro provedor relata o usuário como desconectado enquanto o aplicativo está conectado | Defeito de intenção conhecido, recorrente após períodos ociosos | Abra o aplicativo uma vez e execute novamente. É por isso que o provedor menos confiável é chamado primeiro: sua falha não custa nada |
| O segundo provedor relata o modelo como indisponível | Gating de modelo do lado da conta em uma camada gratuita; a intenção não expõe parâmetro de modelo | Defina o modelo padrão desejado dentro do aplicativo; a cadeia não pode selecionar um |
| A execução termina silenciosamente sem erro | A sobreposição de um atalho em execução é descartada tocando o dispositivo | Não manuseie o dispositivo durante uma execução; execute novamente |
| A cadeia faz uma pausa em um cartão de resposta intermediária | O parâmetro show-on-run é ativado por padrão | Defina-o como desativado no momento da compilação |
| Respostas longas truncadas | Limites de saída em nível de intenção | Peça uma resposta compacta; a qualidade da crítica não é mensuravelmente afetada |
Três delas se generalizam além deste sistema.
Ordene a cadeia por fragilidade. O provedor menos confiável vai primeiro, portanto sua falha não custa nada, e o mais confiável recebe os papéis que não devem ser perdidos, significando árbitro e finalizador.
Não presuma memória. Cada chamada abre uma sessão fresca, portanto cada prompt deve ser autossuficiente e carregar a pergunta e respostas anteriores dentro de si. A independência paralela cega é, portanto, arquitetônica em vez de instruída, como a Seção 6.5 argumenta.
Desconfie mais das falhas silenciosas. Duas execuções que pareciam terminar em um tempo limite foram na verdade mortas pelo usuário pegando o dispositivo. Atribuí-las ao software teria produzido uma correção para um defeito que não existia.
8. O arquivo de cola: um padrão de interface para orientação de inicialização a frio
Este é um resultado de interface separado e se transfere além deste sistema.
Um arquivo de cola é um arquivo de texto simples que um usuário cola, por inteiro, em um modelo de chat em nuvem comum, após o qual esse modelo o guia através de algo que ele não poderia começar de outra forma. A situação é comum o bastante. Alguém recebeu uma pasta, um link ou uma ferramenta e não consegue começar. Tudo o que a indústria normalmente recorre aqui, seja uma página de destino, um bot de integração, um assistente personalizado ou um aplicativo, exige que o usuário vá para um novo lugar, enquanto um arquivo de cola usa a interface que ele já tem aberta.
Não é a mesma coisa que os arquivos que um agente lê por si mesmo, que abordam um programa já residente com acesso a arquivos. Um arquivo de cola aborda uma sessão de chat na nuvem de outra pessoa que não consegue ver o disco do usuário e nunca conseguirá.
Os quatro invariantes
O nome do arquivo é a primeira instrução, no script do leitor. É uma frase e não um nome de arquivo de documentação convencional, um arquivo por idioma, todos presentes, todos classificados juntos em um prefixo compartilhado. O usuário não está escolhendo em uma lista. Eles estão reconhecendo seu próprio sistema de escrita e ignorando o resto, da forma como alguém ignora as linhas desconhecidas em uma placa multilíngue. Isso não custa nada e remove a etapa em que alguém precisa ler um idioma que pode não ter para encontrar o arquivo escrito no que tem.
O arquivo declara o que o modelo não consegue fazer e proíbe fingir o contrário. Na primeira seção: você é uma sessão de chat em uma nuvem, você não está no computador do usuário, você não consegue abrir seus arquivos ou executar nada, nunca afirme que olhou. A falha característica desse padrão, F5 em outra forma, é uma conta confiante e plausível de uma pasta que o modelo nunca viu. É invisível para o usuário, porque uma resposta bem-formada e uma correta são indistinguíveis para alguém que não consegue verificar.
A integridade é detectável. Um manifesto de seções no topo e um marcador de fim de arquivo na última linha. As instruções dizem ao modelo para encontrar o marcador antes de dizer qualquer coisa; se ele ou uma seção listada estiver faltando, parar, informar quais partes chegaram e pedir o arquivo novamente; e nunca preencher uma lacuna com seu próprio conhecimento. Uma cola longa é truncada por um limite de camada gratuita, um limite de mensagem ou um telefone, e sem um marcador o modelo prossegue com o que chegou e improvisa o resto.
O arquivo é autossuficiente. Tudo o que o usuário precisa para um resultado hoje está dentro dele verbatim, não referenciado e não vinculado. Um arquivo de cola que diz "abrir o arquivo de prompt de mesclagem" falhou, porque o modelo que o lê não consegue abrir nada e o usuário pode não ter a pasta. A autossuficiência permite que o arquivo seja encaminhado através de um aplicativo de mensagens sem nada anexado e ainda funcione.
Duas regras de ordenação
Ordene por irreplaceabilidade e não por cronologia. Uma cola é cortada de baixo, então qualquer coisa que um modelo pudesse reconstruir sem ajuda, como etapas de instalação, contexto ou qualquer coisa que possa ser pesquisada, pertence perto do final, e qualquer coisa que precise ser exata fica alta.
Passe adiante o mais cedo possível. Quando o caminho termina em um programa que o usuário instala, pare de recitar a configuração desse programa e diga-lhes para perguntar, e escreva a regra no arquivo: se o programa instalado contradiz este arquivo sobre si mesmo, o arquivo está errado. Um arquivo de texto descrevendo o instalador de outra pessoa fica obsoleto em poucos meses, enquanto o programa perguntado sobre si mesmo não fica.
Mantendo cópias fiéis
Cópias se multiplicam e cópias derivam. Dois mecanismos baratos são suficientes. Gere a carga verbatim em vez de mantê-la: uma etapa de compilação empalma o texto canônico em cada arquivo de idioma de uma única fonte de verdade, e a integração contínua falha se um arquivo comprometido discordar. Compare traduções entre si e também com as regras, porque toda verificação estrutural aprovará um arquivo que se tornou silenciosamente metade de seu comprimento. A integração contínua aqui afirma que todas as variantes de idioma carregam o mesmo número de seções e o mesmo número de etapas de configuração.
Avaliando o padrão
O padrão tem sua própria lista de verificação de dez itens. Dois de seus itens são dados aqui. Ambos foram escritos em resposta a falhas observadas e não antecipadas.
O modelo oferece melhorar, encurtar ou reescrever o arquivo em vez de usá-lo? Isso falha silenciosamente, porque a versão reescrita perde qualquer regra que o modelo achou menos convincente.
Dada uma cópia com o último terço removido, o modelo percebe e para em vez de prosseguir com o que chegou? Este precisa de uma execução dedicada com uma cópia deliberadamente truncada, e é o único item que não pode ser observado a partir de uma cola normal.
A lista de verificação mede a primeira resposta, que não é a execução. Um guia que abre perfeitamente e depois inventa etapas de instalação quatro mensagens depois passa na lista de verificação e falha com o usuário. As falhas reais do padrão acontecem no meio da configuração, onde esta avaliação não olha.
9. Uma avaliação proposta
Mixture-of-agents (Wang, J., et al., 2024) e multi-agent debate (Du et al., 2023) relatam ganhos em relação ao modelo único mais forte sob condições de API. A afirmação de que uma resposta mesclada supera a melhor resposta única está em aberto, e a comparação para este protocolo é especificada aqui antes de qualquer número, para que não possa ser ajustada a eles posteriormente.
9.1 Hipóteses
H1. Anchor-and-enrich supera a resposta única mais forte em precisão factual e completude.
H2. Anchor-and-enrich supera uma mesclagem ingênua em sobrevivência de minorias corretas e na proporção de afirmações sem fonte.
H0. Não há diferença, ou a mesclagem piora o resultado.
H2 tem mais peso que H1. Se o protocolo perde para uma mesclagem ingênua nessas duas medidas, o desenho na Seção 4 não tem justificativa, por mais bem escrito que seja o documento.
9.2 Desenho
Cinquenta a cem questões, três braços: a resposta do modelo único mais forte; uma mesclagem ingênua instruída apenas a combinar as respostas; e anchor-and-enrich. As questões são escolhidas e congeladas antes de qualquer execução, e a distribuição entre os domínios de saúde, direito, técnico, escolha do consumidor e fatos numéricos é publicada com o conjunto.
9.3 Medidas
Precisão factual, como a proporção de afirmações verificáveis confirmadas em relação a uma fonte primária. Completude, como cobertura de uma lista pré-especificada de pontos materiais. Sobrevivência de minorias corretas, como a proporção de casos em que um ponto correto feito por exatamente um modelo chega ao documento final. Qualidade da fonte, como primária, secundária ou ausente. Taxa de afirmações inventadas, como afirmações na saída que não estavam em nenhuma das entradas, o que é uma medida direta de F1. Legibilidade. Tempo de execução e custo. E, relatados separadamente e completamente, os casos em que a mesclagem piorou as coisas, que são os interessantes.
9.4 Cegamento
Os nomes dos modelos são ocultados e a ordem das respostas é embaralhada antes da pontuação. Um modelo avaliador é demonstravelmente sensível à posição, verbosidade e estilo editorial familiar (Zheng et al., 2023), portanto a pontuação não-cega mediria parcialmente esses aspectos. A pontuação humana segue o mesmo procedimento.
9.5 Publicação e falsificabilidade
As questões, respostas brutas, documentos finais e pontuações são publicadas na íntegra, para que a marcação possa ser contestada.
A condição de falsificação é pré-especificada. Se o braço 3 não supera o braço 1 em precisão e completude, e não supera o braço 2 em sobrevivência de minorias e proporção de afirmações sem fonte, H1 e H2 não são apoiados e a afirmação sai dos materiais do sistema, não reformulada.
9.6 Teste do modelo de testemunha correlacionada
Independentemente de H1 e H2, ρ é estimável pelo procedimento na Seção 5.5 no mesmo conjunto de questões, o que permite um teste da previsão que se segue dele.
H3. O ganho ao adicionar o k-ésimo modelo decai como = N/(1+(N−1)ρ) prediz, e um conselho extraído de laboratórios distintos supera um conselho do mesmo tamanho extraído de um.
H3 é testável em dados coletados para a comparação primária e não requer coleta adicional. A refutação seria o resultado mais informativo, pois significaria que a analogia de amostragem em cluster não se transfere para conselhos de modelos de linguagem e a Seção 5 precisa ser reescrita.
9.7 Dois testes que a camada móvel torna acessíveis
Cada execução móvel custa uma interação e um número fixo de mensagens de assinatura, o que torna duas afirmações adicionais facilmente alcançáveis.
H4, dominância de correlação. Um par entre laboratórios em N = 2 iguala ou supera um quinteto do mesmo laboratório em N = 5 em precisão e sobrevivência de minorias. Este é o teste mais agudo disponível da Seção 5.3, porque os braços diferem na direção que o modelo chama de decisiva, ρ, enquanto se movem um contra o outro na direção que chama de secundária, N.
H5, o eixo de elicitação. A elicitação cega-paralela traz à tona estritamente mais desacordos do que a elicitação informada-sequencial no mesmo conjunto de questões, e os desacordos que ela traz à tona predizem erros na resposta do modelo único. Se H5 falhar, significando que um crítico informado encontra tantas divergências quanto um par cego, então o argumento de custo de independência na Seção 6.5 está errado e o modo informado simplesmente subsume o cego.
10. Limitações
A afirmação central não foi testada: a Seção 4 é um argumento de projeto, e a Seção 9 especifica a comparação que a resolveria.
ρ é assumido em vez de estimado. Cada valor nas Tabelas 2 e 8 segue da fórmula da Seção 5 em um ρ uniforme assumido, o que coloca as tabelas em um limite superior sob uma estrutura de bloco realista.
A Seção 7 relata n = 5 e n = 3. Ela estabelece que o modo de falha existe; a afirmação é delimitada à existência em vez de frequência. A pontuação foi feita pelo autor, sem estimativa entre avaliadores; critérios binários reduzem o risco de avaliador único sem eliminá-lo. O Ambiente A não foi re-executado após a intervenção e o Ambiente C não tem execuções, portanto os sucessos relatados cobrem apenas o Ambiente B.
As versões de modelo por trás de interfaces web e aplicativos de consumidor são desconhecidas e mudam, a personalização de conta afeta as respostas e uma execução não pode ser repetida exatamente (Seção 6.6), portanto os resultados envelhecem rapidamente e são evidência sobre o protocolo, não sobre modelos nomeados.
O sintetizador é ele próprio um modelo de linguagem, sujeito a F1 até F4 como qualquer outro. O protocolo o restringe estruturalmente, através de proveniência, a proibição de exclusão silenciosa e uma seção de desacordo separada, mas não o remove. A qualidade da saída depende de quão fielmente um determinado modelo segue a instrução; essa dependência não é aferida.
A rubrica cega é executada pelo mesmo modelo que então constrói o documento, portanto a seleção de âncora é um ponto de viés, e nada impede que esse modelo prefira sistematicamente respostas estilisticamente próximas às suas, que é viés de juiz-modelo (Zheng et al., 2023) em outra posição. Proibir uma âncora predefinida aborda apenas a forma explícita do problema.
O padrão móvel é informado-sequencial, portanto o modo usado com mais frequência é também aquele cuja concordância carrega o menor peso de evidência (Seção 6.4). Essa é uma troca de qualidade por mensagem, e o limite que ela estabelece é declarado aqui. A principal fraqueza do nível é que ele troca auditabilidade por latência: Crítica e Síntese retornam um texto acabado, e as respostas brutas vivem apenas nos históricos de sessão dos próprios modelos, portanto um usuário que nunca abre o modo Pesquisa está confiando em vez de verificar, que é a postura contra a qual o protocolo existe para argumentar.
O custo de tempo estabelece um limite no caminho gratuito. Um conselho completo realista é dez a quinze minutos de espera, e cinco a vinte e cinco minutos por provedor com modos de pesquisa profunda. Para parte da população pretendida isso pode exceder o benefício.
A Seção 11 expõe a posição legal do caminho do agente juntamente com a questão de termos de serviço que deixa em aberto.
11. Ética, privacidade e enquadramento legal
O sistema é para uso pessoal das próprias contas de modelo do usuário, gratuitas ou pagas, através do seu próprio navegador ou dispositivo. Ele não raspa dados de terceiros, não contorna paywalls, não resolve testes de desafio-resposta, não evita a detecção de bots, não rotaciona proxies, não oculta sua operação, não revende contas e não as executa como multi-tenant.
A acessibilidade é o ponto, não um efeito colateral. Quando um usuário com deficiência depende disso como tecnologia assistiva, é para isso que serve: um assistente agindo em seu nome, no seu ritmo, em suas próprias contas. A analogia do rebaixo de calçada é exata. Uma rampa construída para cadeiras de rodas também serve pais com carrinhos de bebê e entregadores, e um sistema construído para usuários que não conseguem gerenciar uma dúzia de abas do navegador acaba servindo a todos.
Os caminhos não são legalmente equivalentes. O caminho gratuito parece uso ordinário em qualquer leitura: o usuário abre os sites, digita e copia. A camada móvel fica perto disso, já que os fornecedores publicam intenções de aplicativo exatamente para esse tipo de invocação, e um atalho pode encadear duas dessas invocações, usando cada aplicativo conforme projetado, uma mensagem por vez, em primeiro plano. O caminho do agente merece uma análise mais atenta. As regras sobre acesso automatizado visam colher resultados em escala, bots carregando um serviço, contornando limites de taxa, executando muitas contas e revendendo o que volta. Nada disso descreve um usuário fazendo uma pergunta em velocidade humana em seu próprio navegador autenticado e lendo a resposta por si mesmo. Esse uso é estruturalmente o mesmo que software assistivo que digita e clica para pessoas que não conseguem. Alguns termos, porém, são redigidos mais amplamente do que seu propósito, proibindo qualquer meio automatizado sem menção de escala. Se isso afeta um usuário automatizando uma única pergunta depende do serviço, da jurisdição e dos termos em vigor no dia. Essa é uma leitura e não uma decisão. Os usuários devem examinar os termos de tudo com o que se conectam e decidir por si mesmos. Qualquer pessoa que preferir não pensar sobre isso pode usar o caminho gratuito, que faz o mesmo trabalho e não levanta nenhuma das questões específicas do agente; os termos ordinários dos sites ainda se aplicam.
Privacidade é uma decisão de composição. O conjunto de modelos determina quais empresas recebem o que o usuário digita, o que não importa para uma pergunta ordinária e pode importar para uma pergunta sobre saúde, um empregador ou clientes. Quando uma pergunta em particular seria desconfortável de enviar para uma empresa em particular, deixe esse membro de fora para essa pergunta; remover um não custa nada.
A própria restrição ética do protocolo é uma proibição. Nada que não foi uma execução do método pode ser apresentado como tal. Um resumo web, uma resposta de modelo único ou o próprio raciocínio do operador podem cada um ser útil, mas eles não são um resultado de conselho, e o usuário deve ser informado qual deles está recebendo. Na prática, isso significa nenhum comprovante, nenhuma seção de concordância e discordância, e nenhum arquivo de saída para qualquer coisa que não foi uma execução genuína de múltiplos modelos.
12. Conclusão
Uma resposta confiante mas errada é indistinguível de uma confiante mas certa, enquanto um argumento entre duas delas é visível para qualquer pessoa. O valor de um conselho reside, portanto, em expor o desacordo, não em suavizá-lo.
O acordo entre modelos não é confirmação independente. Um conselho de N modelos com correlação de erro ρ vale = N/(1+(N−1)ρ) testemunhas independentes, uma quantidade que se satura em 1/ρ independentemente de quantos modelos forem adicionados, então em ρ = 0,5 um conselho de qualquer tamanho vale no máximo duas testemunhas. A diferença na força evidencial entre dez modelos independentes concordantes e dez correlacionados chega a cerca de cinco ordens decimais de magnitude, e uma fusão opaca transmite essa diferença ao leitor como confiança não merecida.
O design segue dessas duas premissas. Mantém a proveniência, para que um leitor possa verificar o resultado em vez de confiar nele, e coloca o desacordo em destaque, já que o desacordo é o único componente que nenhum modelo único pode fornecer. Uma fonte que várias respostas compartilham é marcada como uma fonte. Os fatos fundamentais são nomeados, e o que é fonte é separado do que é apenas acordado. Uma regra a mais se aplica à conta do protocolo sobre si mesmo: nunca deve apresentar como colegiado o que não foi, o que não é uma preocupação teórica. Em um teste cego, dois de cinco modelos o violaram silenciosamente, e uma sentença de atribuição de papel reverteu ambos na re-execução environment-B.
Os três níveis são pontos em uma curva cujo eixo é o custo da amplitude, não três graus de qualidade, e a Seção 5 é o que torna a curva coerente. Porque se satura, a distância evidencial entre dois modelos e dez é muito menor do que o número de modelos sugere, e dois modelos de laboratórios diferentes, rodando em um telefone, podem valer mais do que cinco extraídos de uma única linhagem. O nível móvel também expôs claramente uma negociação que os outros níveis faziam silenciosamente. Um segundo modelo que leu o primeiro pode corrigi-lo, mas não pode mais confirmá-lo independentemente. Correção de erro e confirmação independente são bens diferentes, obtidos com diferentes arranjos, e um sistema que não explicita qual dos dois está vendendo está enganando seu usuário. A comparação controlada permanece aberta, e a Seção 9 a especifica junto com o resultado que me obrigaria a retirar a afirmação.
Seja qual for o resultado da comparação, um documento mesclado sem proveniência e sem desacordo preservado não pode ser verificado de forma alguma, e portanto não pode ser melhor do que uma única resposta em nenhum sentido que importe para alguém que toma uma decisão. Auditabilidade não é uma melhoria para a síntese. É a condição sob a qual a síntese tem direito a ser chamada de resultado. As regras do protocolo tratam, portanto, de onde veio cada sentença e sobre o que os modelos discordaram, em vez de quantos modelos foram consultados.
Declarações
Financiamento. Nenhum financiamento externo apoiou este trabalho.
Conflitos de interesse. O autor é o desenvolvedor dos métodos de orquestração multi-modelo analisados neste artigo, que são abertos e reproduzíveis, um interesse que os leitores devem considerar. O autor é um solicitante nomeado em pedidos de patentes pendentes, não patentes concedidas, cobrindo orquestração de IA e sistemas de validação multi-modelo do tipo que este artigo examina. O protocolo formalizado na Seção 4 e a implementação de referência descrita na Seção 6 são do próprio autor, e o design de avaliação na Seção 9 foi fixado antes de qualquer coleta de dados por esse motivo. Nenhum resultado analítico na Seção 5 depende da implementação: as Seções 6 e 7 poderiam ser completamente removidas sem alterar o modelo, seu limite superior, ou qualquer conclusão extraída delas.
Ferramentas e verificação. Assistentes de IA foram usados como instrumentos sob a direção do autor; as ideias, pesquisa e conclusões são do autor. Todas as alegações quantitativas e citações foram verificadas pelo autor em relação a fontes primárias ou cópias arquivadas; o autor é responsável unicamente pelo conteúdo.
Disponibilidade de dados. As Figuras 1 e 3 e as Tabelas 2, 4 e 8 são geradas a partir da expressão de forma fechada na Seção 5.2 e são computáveis a partir dela. O material na Seção 7 consiste em transcrições de primeira resposta registradas no momento de cada execução e retidas com os materiais de trabalho. Os modelos lá são identificados pelo laboratório em vez de por nome de produto: a observação diz respeito a um modo de falha que apareceu em vários laboratórios, e resultados de execução única não apoiam uma comparação entre sistemas nomeados.
Contribuições dos autores. Único autor.
Correspondência. vadimchernets9@gmail.com
References
Entries marked arXiv are preprints and are cited as such; vendor and standards-body documents are contemporaneous industry sources rather than settled literature.
- Bommasani, R., Creel, K. A., Kumar, A., Jurafsky, D., & Liang, P. (2022). Picking on the same person: Does algorithmic monoculture lead to outcome homogenization? Advances in Neural Information Processing Systems, 35.
- Condorcet, M. J. A. N. de C., marquis de (1785). Essai sur l’application de l’analyse à la probabilité des décisions rendues à la pluralité des voix. Imprimerie Royale, Paris.
- Debenedetti, E., Shumailov, I., Fan, T., Hayes, J., Carlini, N., Fabian, D., Kern, C., Shi, C., Terzis, A., & Tramèr, F. (2025). Defeating prompt injections by design. arXiv:2503.18813.
- Dietterich, T. G. (2000). Ensemble methods in machine learning. In Multiple Classifier Systems, Lecture Notes in Computer Science 1857, 1-15. Springer.
- Ding, K. (2026). When LLMs agree, are they right? Auditing self-consistency and cross-model agreement as confidence signals. arXiv:2607.08065.
- Du, Y., Li, S., Torralba, A., Tenenbaum, J. B., & Mordatch, I. (2023). Improving factuality and reasoning in language models through multiagent debate. arXiv:2305.14325.
- Kadavath, S., Conerly, T., Askell, A., Henighan, T., Drain, D., Perez, E., et al. (2022). Language models (mostly) know what they know. arXiv:2207.05221.
- Karpathy, A. (2025). llm-council. Open-source software repository.
- Kim, E., Garg, A., Peng, K., & Garg, N. (2025). Correlated errors in large language models. Proceedings of the 42nd International Conference on Machine Learning, PMLR 267, 30038-30066. arXiv:2506.07962.
- Kish, L. (1965). Survey Sampling. Wiley, New York.
- Kohli, G. (2026). Nine judges, two effective votes: Correlated errors undermine LLM evaluation panels. arXiv:2605.29800.
- Kleinberg, J., & Raghavan, M. (2021). Algorithmic monoculture and social welfare. Proceedings of the National Academy of Sciences, 118(22), e2018340118.
- Krogh, A., & Vedelsby, J. (1995). Neural network ensembles, cross validation, and active learning. Advances in Neural Information Processing Systems, 7, 231-238.
- Ladha, K. K. (1992). The Condorcet jury theorem, free speech, and correlated votes. American Journal of Political Science, 36(3), 617-634.
- Lorenz, J., Rauhut, H., Schweitzer, F., & Helbing, D. (2011). How social influence can undermine the wisdom of crowd effect. Proceedings of the National Academy of Sciences, 108(22), 9020-9025.
- Meta (2025). Agents rule of two: A practical approach to AI agent security. Engineering documentation.
- MITRE (2025). CVE-2025-32711. Common Vulnerabilities and Exposures record; zero-click exfiltration in an agentic assistant (EchoLeak).
- OWASP (2025). OWASP Top 10 for large language model applications - LLM01: Prompt injection.
- Sharma, M., Tong, M., Korbak, T., Duvenaud, D., Askell, A., Bowman, S. R., et al. (2023). Towards understanding sycophancy in language models. arXiv:2310.13548.
- Shumailov, I., Shumaylov, Z., Zhao, Y., Papernot, N., Anderson, R., & Gal, Y. (2024). AI models collapse when trained on recursively generated data. Nature, 631, 755-759.
- Surowiecki, J. (2004). The Wisdom of Crowds. Doubleday, New York.
- Ueda, N., & Nakano, R. (1996). Generalization error of ensemble estimators. Proceedings of the International Conference on Neural Networks, 90-95.
- Wang, J., Wang, J., Athiwaratkun, B., Zhang, C., & Zou, J. (2024). Mixture-of-agents enhances large language model capabilities. arXiv:2406.04692.
- Wang, X., Wei, J., Schuurmans, D., Le, Q., Chi, E., Narang, S., Chowdhery, A., & Zhou, D. (2023). Self-consistency improves chain of thought reasoning in language models. International Conference on Learning Representations. arXiv:2203.11171.
- Xiong, M., Hu, Z., Lu, X., Li, Y., Fu, J., He, J., & Hooi, B. (2024). Can LLMs express their uncertainty? An empirical evaluation of confidence elicitation in LLMs. International Conference on Learning Representations. arXiv:2306.13063.
- Zheng, L., Chiang, W.-L., Sheng, Y., Zhuang, S., Wu, Z., Zhuang, Y., et al. (2023). Judging LLM-as-a-judge with MT-Bench and Chatbot Arena. Advances in Neural Information Processing Systems, Datasets and Benchmarks Track. arXiv:2306.05685.
Apêndice A. O modelo de recibo
O recibo é a primeira coisa que um leitor encontra e, muitas vezes, a única coisa que ele lê. Deve responder a quatro perguntas sem necessidade de rolagem.
RECEIPT — 6 models asked · 5 answered · 1 did not (free tier)
Mode: fast ×4, deep ×1
Anchor: answer #3 (chosen for completeness and sourcing)

Agreed:       ...
Disputed:     ...
Unverified:   ...

Rests ONLY on the models agreeing (none showed a source):
              ...
Correlated:   3 of 5 cite one article → one lineage, not three
Composition:  4 of 5 are models from one region; agreement
              may reflect a shared frame
As últimas duas linhas são o que a Seção 5 existe para justificar. Sem elas, o documento relata quantos modelos concordaram e oculta o valor dessa concordância, e essas duas quantidades diferem por ordens de magnitude.
Apêndice B. Número efetivo de testemunhas independentes
Tabela 8. , intervalo completo
| ρ | N=2 | N=3 | N=4 | N=5 | N=7 | N=10 | N=15 | N=20 | N→∞ |
|---|---|---|---|---|---|---|---|---|---|
| 0.00 | 2.00 | 3.00 | 4.00 | 5.00 | 7.00 | 10.00 | 15.00 | 20.00 | ∞ |
| 0.05 | 1.90 | 2.73 | 3.48 | 4.17 | 5.38 | 6.90 | 8.82 | 10.26 | 20.0 |
| 0.10 | 1.82 | 2.50 | 3.08 | 3.57 | 4.38 | 5.26 | 6.25 | 6.90 | 10.0 |
| 0.15 | 1.74 | 2.31 | 2.76 | 3.13 | 3.68 | 4.26 | 4.84 | 5.19 | 6.67 |
| 0.20 | 1.67 | 2.14 | 2.50 | 2.78 | 3.18 | 3.57 | 3.95 | 4.17 | 5.00 |
| 0.30 | 1.54 | 1.88 | 2.11 | 2.27 | 2.50 | 2.70 | 2.88 | 2.99 | 3.33 |
| 0.40 | 1.43 | 1.67 | 1.82 | 1.92 | 2.06 | 2.17 | 2.27 | 2.33 | 2.50 |
| 0.50 | 1.33 | 1.50 | 1.60 | 1.67 | 1.75 | 1.82 | 1.88 | 1.90 | 2.00 |
| 0.60 | 1.25 | 1.36 | 1.43 | 1.47 | 1.52 | 1.56 | 1.60 | 1.61 | 1.67 |
| 0.70 | 1.18 | 1.25 | 1.29 | 1.32 | 1.35 | 1.37 | 1.39 | 1.40 | 1.43 |
| 0.80 | 1.11 | 1.15 | 1.18 | 1.19 | 1.21 | 1.22 | 1.23 | 1.23 | 1.25 |
| 0.90 | 1.05 | 1.07 | 1.08 | 1.09 | 1.09 | 1.10 | 1.10 | 1.10 | 1.11 |
Movendo para a direita, ao adicionar modelos, atinge-se a coluna mais à direita quase imediatamente. Movendo para cima, ao reduzir a correlação, não há limite. O esforço despendido na diversidade de um conselho, significando laboratórios, regiões e corpora de treinamento distintos, portanto retorna mais do que o esforço despendido em seu tamanho. Duas entradas carregam o argumento da Seção 6.2: um par extraído de dois laboratórios em ρ ≈ 0.2 conta como aproximadamente 1.67 testemunhas independentes, enquanto cinco modelos de uma linhagem em ρ ≈ 0.6 contam como aproximadamente 1.47.
Apêndice C. Referência de implementação do nível móvel
Tabela 9. Referência de implementação para o nível móvel
| Componente | Especificação |
|---|---|
| Mecanismo | Intenções de aplicativo do sistema operacional encadeadas em um atalho único assinado, invocando os aplicativos instalados dos fornecedores contra as assinaturas existentes do usuário. Sem chave de API, sem servidor, sem execução em segundo plano |
| Ações do fornecedor | Intenção de solicitação publicada de cada fornecedor, endereçada por identificador de intenção de aplicativo. Um fornecedor expõe um parâmetro de modelo opcional, omitido para que o padrão do aplicativo se aplique; o outro não expõe nenhum |
| Operação sem intervenção | O parâmetro show-on-run está definido como desabilitado nos parâmetros de intenção no tempo de compilação, não ajustado no editor após importação |
| Distribuição | O atalho é assinado para importação irrestrita, portanto uma compilação instala em qualquer dispositivo ou conta sem recompilação |
| Menu de modo | Uma ação de menu de fluxo de controle com marcadores de início, caso e fim; os ramos convergem em uma cauda compartilhada por meio de uma ação set-variable |
| Plataforma alternativa | Automação baseada em intenção, com um caminho semi-automático que sobrevive às atualizações de aplicativo |
| Custo por execução | Poll 1 + 1, Critique 1 + 1, Synthesis 1 + 2 mensagens de assinatura |
| Latência | Aproximadamente 50 a 60 segundos do lançamento ao resultado, sem intervenção |
| Superfícies de lançamento | Ícone de tela inicial, widget, botão de ação de hardware ou frase de voz |
Duas restrições moldaram o design, e ambas generalizam. As quotas são compartilhadas com o uso ordinário dos mesmos aplicativos, então o modo cotidiano recomendado é o de duas mensagens e não o de três mensagens; isso é alocação de recursos, não um julgamento de qualidade. E cada chamada de intenção abre uma sessão nova sem memória, portanto todos os prompts são autossuficientes e carregam a pergunta e quaisquer respostas anteriores dentro de si mesmos. Nada é continuado. Essa restrição é o que torna a independência paralela cega em Poll e Synthesis arquitetônica em vez de instruída, conforme argumentado na Seção 6.5.
Como citar
Chernets, V. (2026). Agreement Is Not Independent Evidence: Auditable Multi-Model Synthesis Without an API [Preprint]. SSRN. https://doi.org/10.2139/ssrn.7390698
@misc{chernets2026agreementnotevidence,
  author       = {Chernets, Vadym},
  title        = {{Agreement Is Not Independent Evidence: Auditable Multi-Model Synthesis Without an API}},
  year         = {2026},
  howpublished = {SSRN},
  doi          = {10.2139/ssrn.7390698},
  url          = {https://doi.org/10.2139/ssrn.7390698}
}