一致性不是独立证据:无API的可审计多模型合成
这是译文。权威版本是英文原文,引用请以原文为准。
Vadym Chernets, 博士, AI系统架构师 · ORCID 0009-0007-4845-3163
SSRN 7390698 · DOI 10.2139/ssrn.7390698 · Zenodo 10.5281/zenodo.22683716 · GitHub
- 记录版本:SSRN 7390698 · DOI 10.2139/ssrn.7390698
- 存档副本,可引用和可下载:10.5281/zenodo.22683716 — 概念DOI,始终解析到最新版本
- Markdown和PDF格式的完整文本:GitHub
- 可读HTML:https://polyhelper.ai/research/agreement-not-evidence/
同一文本在四个平台上,以便在其中一个无法提供时仍可访问。SSRN保存了记录版本;请引用该版本。
关键词:大语言模型;相关错误;群体智慧;Condorcet陪审团定理;算法单一文化;多智能体辩论;有效样本量;设计效应;集成;出处。JEL分类:C11; C18; D71; D83; L86; O33
摘要
向单个语言模型提问的人无法将充满自信的错误答案与充满自信的正确答案区分开来。这两者在对非专家可用的任何表面线索上都是完全相同的。询问多个模型似乎解决了这个问题,但实际上主要是重新定位了这个问题:调和多个答案会再次产生一份充满自信的文本,现在它又获得了"十个都同意"这样借来的权威。
本文正式确立的协议通过用户自己的浏览器或手机从多个消费者聊天模型中收集答案,无需 API 密钥、无需安装和无需中介服务器。它通过"锚-充实"的方式来协调这些答案:最强的可用答案成为基础,其他每个答案仅在基础所缺乏的地方贡献内容。每个贡献都由提供它的模型签名。分歧被单独列出,而不是被平均化处理。
本文做出四项贡献。第一是协议本身,表述为一种保留来源并禁止静默删除的算法,以及五种合并失败方式的分类法。其中四种是朴素合并的缺陷;第五种是操作员的失败而非方法的失败:将单个模型的输出冒充为集体结果的综合。第二是相关证人算术在协议设计中的应用。本文不声称该算术的发现。Kohli (2026) 将相同的Kish修正应用于九位前沿法官组成的小组,测量得约两票有效票,而Kim等人(2025)在350多个模型中确立了潜在的错误相关性。一个包含N个模型的委员会,其错误具有类内相关性ρ,相当于= N / (1 + (N−1)ρ)个独立证人,且该数值在1/ρ处饱和,无论添加多少个模型。一旦委员会规模超过1/ρ,减半ρ的效益超过翻倍N的效益,从两个实验室抽取的一对模型可能会超过从一个实验室抽取的五个。Kim等人(2025)使该规则复杂化:规模更大、准确性更高的模型即使架构和提供者不同,其错误的相关性也最高,因此两个实验室只是对ρ的先验假设而非实际测量,这正是第5.5节估计程序的用途。第三是三个部署层级的描述——手动、一键移动和浏览器代理——以及在认识论层面上区分它们的轴:第二个模型是否看到第一个模型的答案。对第二个模型进行条件处理会提高ρ以换取错误纠正。第四是对五个模型中虚假委员会失败的小样本观察、在三模型重新运行中消除该失败的单句干预,以及具有既定可证伪条件的三盲臂评估设计。
相关协议在本文被视为既定事实,而非新发现。一个模型面板相比其成员数量而言只值得少得多的独立证人,这已被直接测量:来自七个家族的九位前沿法官提供约两票有效票(Kohli, 2026),而且即使跨越提供者和架构,错误相关性也随模型能力增加而上升(Kim等人, 2025)。第5节重述了这些测量背后的设计效应算术,因为协议的三个规则都源自此,缺乏这一背景就显得过于严苛。该协议随后从同一问题的另一角度着手。前人文献测量相关性,而本协议则旨在降低它——通过跨谱系组合、保留分歧而非平均化处理、为每个贡献标注提供者模型,以及将重复来源仅计数一次。
关于合并答案优于最佳单一答案的论点基于设计考虑和相关文献;第9节规定了评估方案,但该评估尚未进行。
目录
- 介绍
- 相关工作
- 合并失败的五种方式
- 锚点和丰富协议
- 相关协议
- 三个层级,一个协议
- 实证部分
- 粘贴文件:冷启动指导的界面模式
- 建议的评估
- 局限性
- 伦理、隐私和法律框架
- 结论
声明 · 参考文献 · 附录 A,收据模板 · 附录 B,独立证人的有效数量 · 附录 C,移动层级实现参考
图表列表
- 图1. 委员会在1/ρ处饱和,十个一致模型的价值(第5.3节)
- 图2. 锚点与富集协议,逐阶段说明(第4.2节)
- 图3. 三个层级作为一条延迟-广度曲线上的点(第6.4节)
- 图4. 盲目并行与知情顺序引出法的比较(第6.5节)
- 表1. 协议规则及其处理的故障(第4.5节)
- 表2. 独立见证人的有效数量,选定值(第5.2节)
- 表3. 移动层的三种模式(第6.2节)
- 表4. 三个层级上的延迟-广度前沿(第6.4节)
- 表5. 冷启动探针、基线运行,n = 5(第7.2节)
- 表6. 角色分配干预后的冷启动探针,n = 3(第7.3节)
- 表7. 消费应用意图流程中观察到的故障模式(第7.5节)
- 表8. 独立见证人的有效数量,完整表格(附录B)
- 表9. 移动层实现参考(附录C)
1. 简介
1.1 问题
考虑一个错误代价高昂的问题:选择学校、治疗方案、供应商或合同条款。用户向语言模型提问,得到的是条理清晰、自信而格式精良的回答,问题就从这里开始。一个自信的错误答案和一个自信的正确答案看起来是一样的。语气无法区分它们,结构、长度或引文的有无也不能。已知模型表述的置信度被高估,且校准效果不佳(Kadavath et al., 2022; Xiong et al., 2024)。模型采纳提问者框架的倾向会增加第二层虚假支持(Sharma et al., 2023)。
显而易见的解决办法是征求第二意见。一个模型的错误看起来像置信。同一个错误与第二个模型的答案并列时,看起来就像一场论证。论证对该领域无专业知识的读者是可见的;而置信不是。下面的一切都基于这种不对称。
这个解决方案有代价,也有陷阱。代价是阅读:一个问题有十个答案意味着要同时在脑海中记住十篇长文本,同时还要记得谁说了什么。几乎没有人这样做。实际上,读者会通读第一个答案,浏览第二个,然后关闭其余的。多年来,通过聚合器订阅、并排显示和API网关,汇集多个答案一直是个已解决的问题。而处理完这些答案还没有被解决。
陷阱是合并。任何将十个答案简化为一个的方法都会再次产生一个自信的文本,如果这种简化过程不透明,读者就会回到原点,除了这次文本承载了他们无法验证的权威。简单的汇集也会抹除正确的少数观点,向最有力的措辞倾斜,并产生不存在的共识假象。
第三个问题是使整个练习变得非平凡的原因。模型之间的一致不是独立的确认,因为在重叠的语料库上训练的模型共享框架、引用相同的文章并继承相同的盲点。「十个中有九个同意」和「九位独立专家同意」是不同的说法,它们之间的差距是量化的且很大。第5节表明这对整个构造设置了上限。
1.2 系统
协议以纯文本形式写出,有三种执行方式。这三种方式都产生相同的文档,它们在谁进行点击以及询问多少个模型方面有所不同。
在免费路径上,用户打开网站,复制答案,并将其粘贴到任何聊天模型中一段说明的下方。无需安装,无需付费,在手机上也能使用。
在移动层,主屏幕上有一个图标。点击它,输入问题,选择一种模式,大约一分钟后,完成的答案就会出现在屏幕上并被复制到剪贴板。它通过操作系统应用意图针对设备上已安装的订阅来访问两个模型,无需API密钥。
在代理路径上,能够驱动浏览器的模型在用户现有的登录会话中打开指定的网站,提交问题,等待,将每个答案保存到文件,并构建文档。
在架构上起决定作用的事实是没有服务器。既不是受保护的服务器,也不是具有无保留政策的服务器:不存在这样的组件,所以问题无法到达我。它确实到达用户指定的模型服务,这正是本练习的要点,但它不会流向其他任何地方。同样的缺失导致了第二个后果:协议无法撤回,因为它是在宽松许可证下的一段文本,用户笔记中的副本会继续与之后存在的任何模型一起工作。
1.3 贡献
第3节列出合并失败的五种方式,第4节针对它们正式确定了anchor-and-enrich。第5节开发了相关证人模型, = N/(1+(N−1)ρ),其上限为1/ρ,并阐明了这对委员会应如何组成的影响。第6节描述了三层、它们所追踪的延迟-广度边界,以及在认识论上将它们区分开的盲目并行与知情顺序的对比。第7节报告了虚假委员会的观察和移动构建的实地发现;第8节描述了冷启动指导的界面模式;第9节规定了具有预先固定的可伪造条件的盲评估。合并答案胜过最佳单个答案的声称在这里未被确定,而那个评估就是能够解决它的比较,包括可能迫使我撤回该声称的结果。
该方向值得明确说明,因为这是将本文与其所依赖的测量文献区别开来的地方。Kohli (2026)、Kim et al. (2025)和Ding (2026)测量委员会错误的相关程度。本文以该相关性为设计目标,并提出一个问题:单个使用者如何通过普通消费者聊天界面(无API密钥和无服务器)来降低它,并留下证明其做法的记录。该文献中的一个差距值得指出,因为它是可以弥补的:这些测量是通过API、在基准上、使用九个或三百个模型进行的。在本协议所处的消费者环境中——一个人查询四个他已经免费使用的聊天产品——没有人估计过相关性。第5.5节给出了程序,第9.6节给出了设计。
2. 相关工作
集成与多样性。古典集成理论已经指出了这里需要什么:集成的收益取决于其成员犯错的方式有多不同,而不是取决于它们平均有多好。模糊分解(其中集成误差等于平均成员误差减去平均模糊性)(Krogh & Vedelsby, 1995)和偏差–方差–协方差分解(Ueda & Nakano, 1996)都表明,当误差协方差增加时,集成会向单个成员坍缩。Dietterich (2000)将该条件陈述为必要条件。第5部分将其应用于语言模型委员会,并量化违反它的代价。
语言模型的多模型方案。自洽性(Wang, X., et al., 2023)在来自一个模型的多个样本上投票,这可以降低方差,但不会产生独立性。多代理辩论(Du et al., 2023)报告了当多个实例交换论据时的事实性收益。混合代理(Wang, J., et al., 2024)将一层的输出提供给聚合器,并报告在多个基准上相对于最强单个模型的改进。该文献指向与本协议相同的方向。然而,其结果是通过API和基准测试获得的,所以我不会将其转移到浏览器调解的消费者界面委员会,除非进行我自己的测试,这正是第9部分所规定的。
评判模型。通过模型评判的评估及其缺陷已得到充分表征:位置偏差、冗余性偏差,以及对熟悉风格的倾向(Zheng et al., 2023)。这是这里的设计约束,而不是附带的,因为未盲化评分会部分地测量这些偏差。第9.4部分处理了这个问题。
单一文化。Kleinberg和Raghavan (2021)表明,当许多代理依赖一个算法时,即使个体质量提高,集体结果也可能恶化。Bommasani等(2022)将同样的效果描述为结果同质化。对于语言模型委员会,这是首先生成ρ > 0的机制。关于在生成数据上训练下的性能降解的研究(Shumailov et al., 2024)表明ρ随时间向上漂移。
群众。古典的群众智慧论证(Surowiecki, 2004)取决于判断的独立性。Lorenz等(2011)通过实验表明,即使是轻微的社会影响,仅仅让人们看到他人的估计,也会缩小范围而不是向真理靠近:人群变得更有信心,但不会变得更准确。第6.5部分将其识别为知情顺序引发所接受的确切权衡。
康多塞与相关投票。康多塞陪审团定理(Condorcet, 1785)认为,当个体准确性超过二分之一时,随着N增长,多数投票正确的概率趋向于1。Ladha (1992)表明相关投票破坏了该保证。第5部分通过设计效应(Kish, 1965)给出了该警告的定量版本。
相关误差,已测量。第5部分重述的算术已直接在模型面板上进行了测量,测量比分析更清晰。Kohli (2026)将Kish有效样本量应用于从七个模型族中抽取的九个前沿评判官的面板,发现其约值两个独立投票:面板名义独立性的大约四分之三被共享的错误所失去,面板的准确性比独立投票会产生的结果低8到22个百分点,最佳单个评判官与整个面板相当或超过。既不是更多的评判官也不是更好的聚合可以修复它,这将瓶颈定位于评判官而不是算法。Kim等(2025)在超过350个模型上发现了实质性的误差相关性,关键是对于如何组成委员会,发现即使架构和提供者不同,更大更准确的模型也有最相关的误差。Ding (2026)在265,000个样本上审计了一致性作为信心信号,发现它是一个正的但弱的预测因子,相关性在0.20和0.59之间,最糟糕的地方恰好是最有信心的地方:在最一致的前沿模型上,0.8或以上的一致性覆盖了更难基准的77%的条目,其中48%是错误的。
由此可得出三点。首先,第5部分的设计效应结果不是我的贡献。Kohli的论文早于本文的首次发表,并使用了相同的更正;该部分被保留是因为协议从中得出的内容,并在出现的地方进行了标记。其次,随后的组成建议,花费在多样性而不是数量上,现在得到了实证支持,而不仅仅是论证。第三,Kim等的发现以值得说明的方式使该建议复杂化:如果能力和误差相关性一起上升,从两个实验室抽取的一对不一定是多样化的对,谱系必须被测量而不是从品牌读出。这是对第5.5部分估计程序的论证,而不是反对组成规则的论证。
相邻系统。多个项目构建了多模型委员会。一个众所周知的开源实现,llm-council (Karpathy, 2025),平行查询模型,让它们匿名审查彼此,并让一个主席模型编写最终答案。它需要一个聚合器API密钥和每个标记的付款。商业委员会产品提供一个评判官、共识视图和矛盾显示。开源移动应用程序添加了投票和多轮辩论。成熟的多模型前端提供了集成功能,免费的并排面板使用用户已经登录的官方网站。聚合器订阅将许多模型放在一个账单下。这些属性中的每一个都在其他地方独立存在。它们的结合,一次十个,似乎在其他地方不可用:没有API密钥、没有安装、手机兼容、在用户已经拥有的账户上运行(包括免费层)、没有新的付费中介、一个用纯文本编写的因此可编辑的合并方法、异议保留、每个贡献都签名、一个重复的来源标记为一个来源、一个方法可以手动或在代理下执行。
该位置保持开放是有结构原因的。实验室几乎没有动力将用户的问题转向其竞争对手,因为每个参与者的目标是其自己的答案是用户保留的那个。第三方确实销售跨模型工具,但用纯文本编写的方法将编辑角色留给用户,这与任何这些方法的安排都不同。
范围。该协议适用于一个人在不组建研究团队基础设施的情况下生成一份精心的文档:无密钥、无安装、无服务器。重试、执行保障、成本和错误监控、审计日志、测试集评估、访问控制、单点登录、保留策略、提示版本控制和服务级别协议属于企业编排框架的范畴。
3. 合并失败的五种方式
五种方式中的四种是朴素池化的属性,我指的是任何形式为"结合这些答案并优化结果"的指令。第五种属于操作员,这是最重要的一种,因为读者无法检测到它。
F1,综合中的虚构。输出包含在任何输入中都没有出现过的声明。综合器本身是一个语言模型,在消除各个源之间的接缝时,它会生成看起来完全像源材料的连接性材料。
F2,少数意见消除。发现实质性异议的那一个答案因为多数意见相反而消失。这正是组建议会的原因,也是朴素合并首先失去的东西。
F3,信心漂移。当两种措辞发生冲突时,更绝对的措辞胜过更有根据的措辞。这与在评判模型中产生位置和风格偏差的机制相同(Zheng et al., 2023)。
F4,制造的共识。真实的分歧被平均成一个有条件的同意。读者得到一份文档,其中争议部分与已定论部分无法区分,甚至无法得知曾存在过争议。
F5,虚假的议会。被要求进行同行评审的模型无法访问其他模型。与其这样说,它执行普通网络搜索,并以同行评审的形式格式化结果,包括来源记录、同意和反对部分以及捐助者属性。该文档看起来比真实的更好,正因为没有真正的矛盾阻挡。读者无法察觉这一点,因为他们无法访问源答案。
F5是论文的开篇问题提升至更高层次:一个自信但错误的答案与正确答案无法区分,一个外形像议会但由单一模型编写的文档与真正的议会无法区分。第7节报告在盲测中五个模型中有两个出现了这个问题。
4. 锚点-充实协议
4.1 原理
该协议不是汇总和优化答案,而是逐步强化一个主要答案,同时保持来源信息和分歧的可见性。
4.2 规则
图2展示了该协议的完整流程。
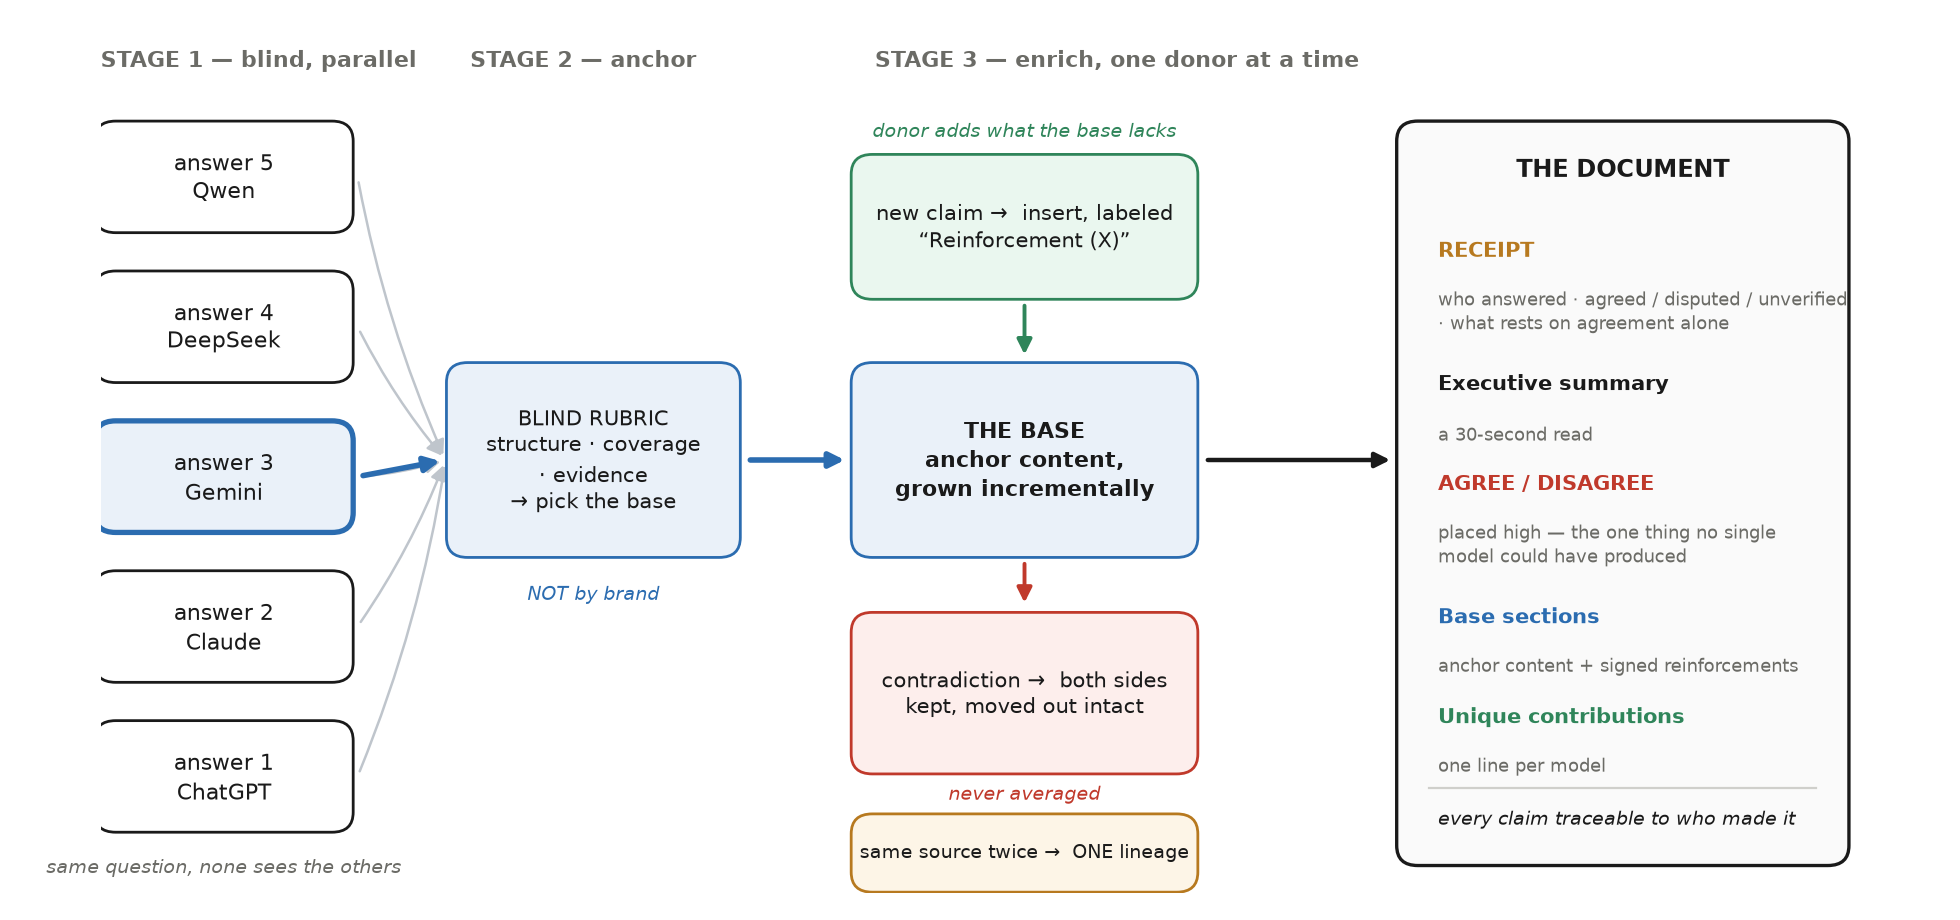
以盲审标准选择锚点,而非品牌。最强的现成答案(即最完整、来源最可靠的答案)成为基础。基于内容评判:结构、覆盖范围、证据。预设偏好的模型是系统性偏差,当某个模型恰好获得比其他模型更多的上下文时最为严重。锚点一旦选定,即刻开始构建。不等待后来者。
一次充实一个捐献者的内容。从每个剩余答案中,仅提取基础答案所缺少的内容或能加强现有内容的内容:先例、数据、类比、视角、原始来源链接。将其插入匹配的部分,标签为强化(模型名称)。
保留来源信息。每项贡献都带有其捐献者的标记。模型来源与证据来源不同,当原始来源链接可用时,应一并携带,而不仅仅是署名。
公开更正。基础内容优先保留。当捐献者更正锚点中的错误时,进行更正并留下一行注释,说明更改内容和原因。为了遵守不接触基础的规则而固守已知的锚点错误,比接触它更糟。管理性规则是信息不能被无声地丢失,而不是基础不可变。
呈现分歧。专门的部分将一致性与差异分开。相互冲突的主张永远不会被平均化为中间立场。
标记关联证据。多个模型引用同一篇文章构成一条证据链,而非多个独立确认。这同样适用于组成层面。如果一致的模型由同类型公司或同一司法管辖区的公司建立,且分歧沿这一线划分,应予以说明。
为独特贡献予以记功,每个模型一行。
在用户提出要求的地方,在最后部分添加协调者自己的观点。
命名承重事实。确定建议实际所依据的两三个事实(通常是数字),并标记每个事实是由可核查的来源支持,还是仅基于模型间的一致性。如果他们在某个数据上达成一致但都没有显示其来源,这是一个警告,而非确认。
4.3 算法
INPUT   Q — the question
        A = {a_1 … a_N} — answers, arriving asynchronously
OUTPUT  D — a document with a receipt, provenance, and
        a disagreement section

R ← ∅            // receipt: who answered, who did not, why
D ← ⊥            // the base (anchor)

on arrival of a_i:
    R ← R ∪ {source(a_i), timestamp, mode}

    if D = ⊥ and enough_candidates():
        D ← argmax_{a ∈ A_ready} rubric(a)
        anchor ← source(D)         // recorded and disclosed
        // rubric = structure, coverage, sourcing

    else:
        for each claim c ∈ a_i:

            if c ∉ D:                              // new
                insert c into the matching section of D,
                    labeled "Reinforcement (source(a_i))"

            else if c contradicts c' ∈ D:
                if c corrects a factual error in c':
                    replace c' with c, plus a one-line
                    note of what changed
                else:
                    move (c, c') into DISAGREEMENTS,
                    both sides intact

            else:                            // agreement
                if evidence_source(c) = evidence_source(c'):
                    mark as ONE evidentiary lineage,
                    not as confirmation

after all:
    identify the load-bearing facts
    mark each [sourced] or [agreement only]
    assemble RECEIPT, SUMMARY, AGREE/DISAGREE (placed high),
             UNIQUE CONTRIBUTIONS
    emit in a readable and a double-clickable format
收集和综合并行进行。锚点一旦到达就成为基础,每个后续答案在到达时被折叠进去。快速的提供者在一到两分钟内响应,而深度研究模式需要五到二十五分钟,因此序列化这两个阶段会将一次运行变成半小时的块,没有任何好处。
4.4 输出结构
部分的顺序是协议的一部分,而不是呈现方式。
记录位于顶部:谁回答了,谁没有回答以及原因,什么是一致的、有争议的和未经验证的,证据关联的位置,以及大致地运行花费了多少时间和配额。然后是三十秒的执行摘要,然后是目录。
一致意见和分歧紧跟在摘要之后:它们是任何单一模型都无法产生的唯一组件,也是运行这种方法的原因。若放在最后、置于舒适的共识之下,有用的文档开始读起来就显得理所当然,然后就不再被阅读。
之后是基础部分,每个部分包含锚点内容加上带署名的强化;一份列表,列出每个模型的独特贡献;以及用户要求的地方,协调者自己的观点。
4.5 规则及其解决的失败
表 1. 协议规则及其解决的失败
| 规则 | 解决的失败 |
|---|---|
| 根据规范锚定,而非品牌 | 系统性偏向于偏好的模型 |
| 捐献者仅添加缺失的内容 | F1:基础未被重写,因此生成的接缝更少 |
| 每项贡献都有溯源信息 | F1 和可审计性:读者可以检查而不是信任 |
| 带解释行的更正 | 固化锚点错误 |
| 分歧单独成节,位置靠前 | F2、F4 |
| 标记共享的证据血统 | 虚假独立性(第 5 部分) |
| 关键事实标记为有来源或仅共识 | 将共识作为证据处理 |
| 非运行从不呈现为运行 | F5 |
这是一个设计论证,第 9 部分规定了什么将对其进行验证。
4.6 一个实际例子
这类协议根据其输出而非描述来判断会更容易。以下是 2026 年 8 月 31 日自由路径实际运行的摘录:一个问题,在四个单独的会话中分别问四个消费者聊天模型,然后按上述规则合并。与第 7 部分不同,捐献者名称在此出现,因为溯源是正在演示的属性,而匿名示例无法演示任何内容。
RECEIPT — 4 models asked · 4 answered
Agreed:    3-2-1 redundancy · JPEG is the safe everyday format ·
           migrate every ~5 years · never let a proprietary app
           be a photograph's only home
Disputed:  how many copies (3 vs 4) · what the archival master
           should be (TIFF/PNG vs original plus JPEG)
To check:  media lifespan figures · whether your export tool
           strips EXIF

— Section 1 of the merged document: how many copies, and where —

Base.  The 3-2-1 rule: three copies, on two kinds of storage,
with one off-site. The off-site copy is what survives a fire,
a flood or a theft.

⚠ Disagreement — is there a fourth copy?
ChatGPT and Gemini both extend this to 3-2-1-1, adding one copy
that is immutable or offline. Their reasoning differs: ChatGPT
frames it as geographic independence, Gemini as protection from
ransomware and from a mass deletion that syncs everywhere.
Claude and DeepSeek stayed at three and did not argue against a
fourth; they simply did not call for one.

(added by Claude)  Whatever you choose, treat cloud as one leg
of the tripod and never the whole thing: it is tied to an
account that can be locked, closed, or repriced.

— Worth checking yourself —

The lifespan figures come from Gemini alone. No other model
gave numbers, so treat them as one source rather than as a
consensus.
摘录中有四个方面体现的是协议的实际运作,而不是对协议的描述。关于第四份副本的分歧被完整地保留下来,并附带两个模型各自的理由,而不是被化解为一个实用性说法"三份或四份,取决于你的风险偏好",后者会隐藏读者可能关心的具体考虑因素。关于云存储的补充说明中标注了提供它的模型名称,因此不信任该模型的读者可以选择忽略该行,而不会影响其他内容。结尾的注记体现了规则6在实际运行中的作用:一个模型提供了文档中仅有的数字,合并过程将其标记为单一来源,而不是让它在四模型文档中的出现被理解为一致意见。
第四个方面是摘录中所缺失的:它早于规则9,因此其承重事实没有分离为有来源的和仅为共识的两类,它被原样重现,因为一个被编辑以满足它所说明的规则的例子将不再能作为这些规则有效的证据。
5. 相关一致性
优先说明。本节的算术并非新颖之处,也不声称这是一项贡献。Kohli (2026)对九名前沿法官的小组适用了同样的Kish修正,并测得约两票有效票数,早于本文初次发布三个月;Kim等人(2025)在超过350个模型中确立了驱动它的误差相关性。保留本节有三个原因:该协议的三条规则源自它,未曾见过该算术的读者会将这些规则理解为过度谨慎而非必要,且第5.5节的估计程序是该协议在无人测量过的背景下所需的。那些文献测量相关性,而本协议试图降低它。
如果十个模型一致,该声明最终可能是真实的。这是对第4节最强有力的直观反对,且其强度弱于表面所感;计算出其弱多少也将第6和第9条规则从良好实践转变为算术。
5.1 设定
令N个模型回答一个二元声明,并令e_i ∈ {0,1}表示模型i的一个误差。在独立性假设下,个体准确度p > 1/2时,N个模型间的一致性是以N呈指数增长的证据。这是孔多塞定理的内容(Condorcet, 1785)。
在重叠语料库上训练的模型继承共享的框架,引用相同的二级资源,并分享其时代的盲点,因此其误差相关。法院与十名都观看了同一安全录像的证人处于相同位置:十份陈述,一次观察,证人数量对独立观看多少没有说明。该差距可以量化,本节其余部分进行此操作。将误差的类内相关定义为
5.2 证人的有效数量
相关模型的委员会在结构上是一个聚类样本。一个聚类内具有类内相关ρ的N个观察不携带N个信息单位,标准修正是设计效应(Kish, 1965):
这给出有效样本大小为
因此,误差以ρ相关的N个模型的委员会相当于个独立证人。表2给出选定的值,附录B中的表8给出完整范围。
表2. 独立证人的有效数量, , 对于选定的N和ρ
| ρ (向下) / N (跨越) | 2 | 3 | 5 | 10 | 20 | 极限 N→∞ |
|---|---|---|---|---|---|---|
| 0 (独立) | 2.00 | 3.00 | 5.00 | 10.00 | 20.00 | ∞ |
| 0.1 | 1.82 | 2.50 | 3.57 | 5.26 | 6.90 | 10.0 |
| 0.2 | 1.67 | 2.14 | 2.78 | 3.57 | 4.17 | 5.0 |
| 0.3 | 1.54 | 1.88 | 2.27 | 2.70 | 2.99 | 3.33 |
| 0.5 | 1.33 | 1.50 | 1.67 | 1.82 | 1.90 | 2.0 |
| 0.7 | 1.18 | 1.25 | 1.32 | 1.37 | 1.40 | 1.43 |
5.3 上界
最右边的列是本节的主要结果。当N → ∞时,
委员会有一个上界,它不依赖于询问的模型数量。图1的(a)面板直接显示了饱和。当ρ = 0.5时,一个包含一千个模型的委员会相当于两个独立证人,而当ρ = 0.7时,它相当于少于一个半的证人。在ρ = 0.3处向十个模型添加第十一个模型大约可以购买0.05个证人。用相同的五个模型从ρ = 0.3移至ρ = 0.15大约可以购买0.85。
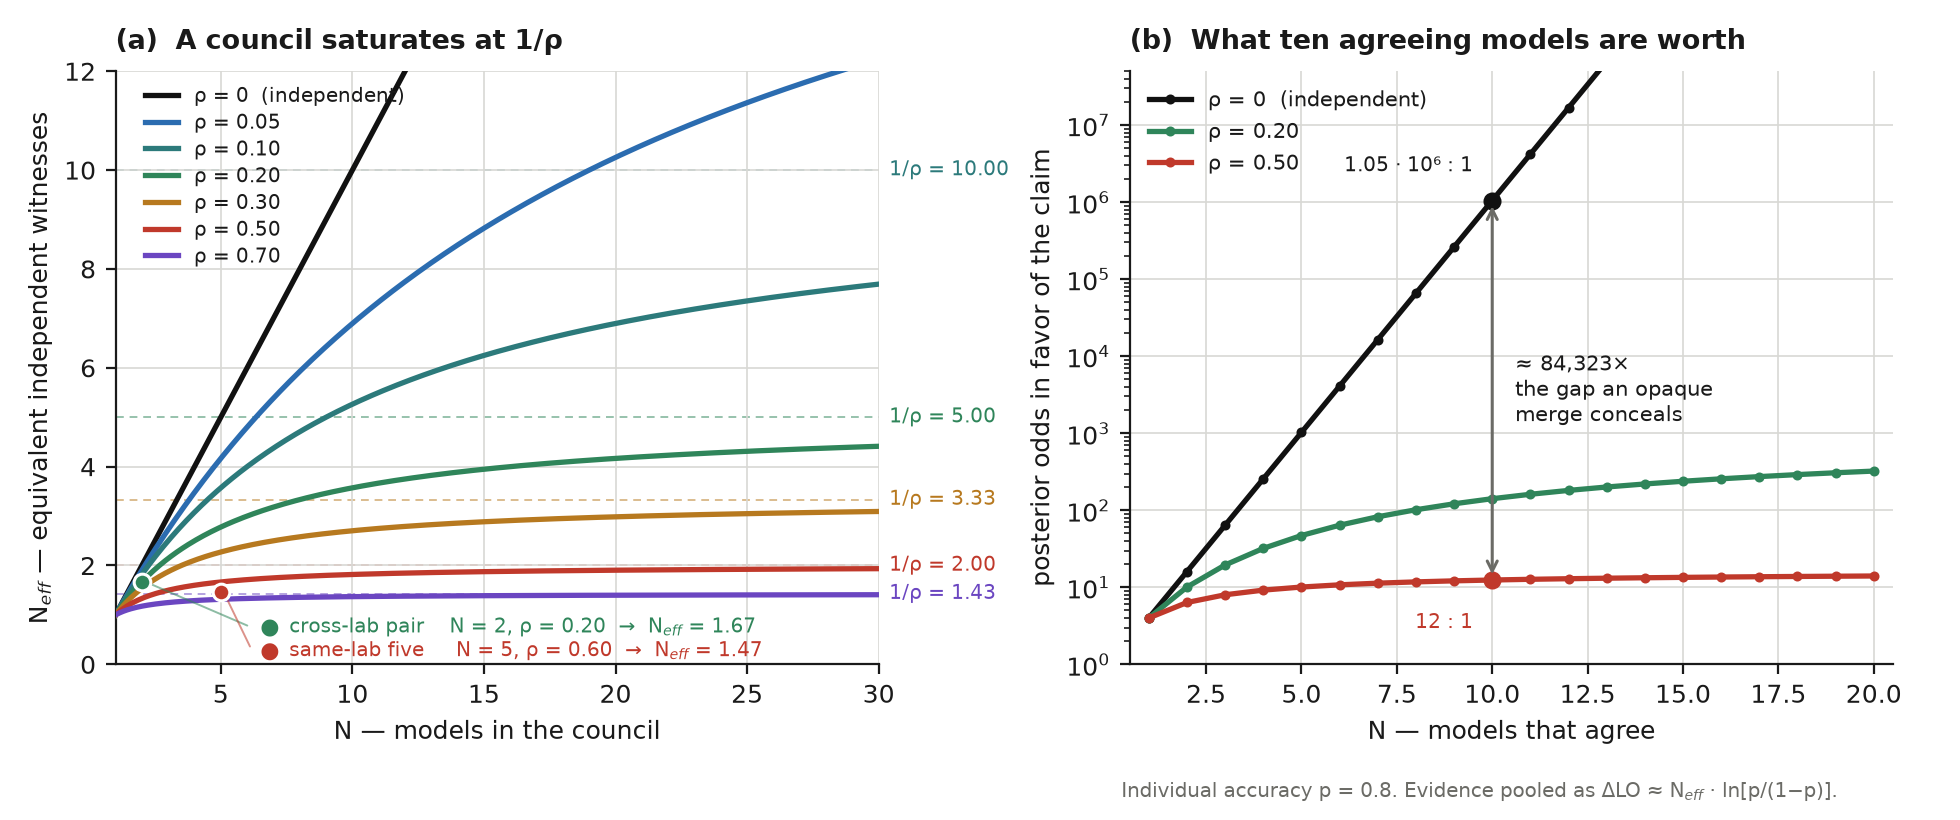
图1 — 委员会在1/ρ处饱和。 (a) Neff与委员会规模N对于多个类内错误相关性ρ值的关系。每条曲线在其上界1/ρ处饱和,绘制为虚线渐近线;ρ = 0.20的跨实验室对胜过ρ = 0.60的同实验室五人组。(b) 作为后验比值的相同结果(第5.4节中所述近似下的说明性代理),个体精度p = 0.8,证据合并为ΔLO ≈ Neff · ln[p/(1−p)]。十个独立一致的模型给出接近一百万比一的比值;ρ = 0.5相关的十个模型给出十二比一。
这个实际后果与直觉相悖,即应该简单地询问更多模型。一旦委员会规模大于1/ρ,将ρ减半胜过将N翻倍。这个后果如Kohli(2026)所述,他的小组面板是在实地观察到的这个算术:九名法官相当于大约两个有效票,对应ρ ≈ 0.44。将ρ减半胜过将N翻倍,下面的两个比较涉及第6节。
来自不同实验室且ρ ≈ 0.2的两个模型给出 ≈ 1.67,而来自同一实验室或谱系且ρ ≈ 0.6的五个模型给出5/(1 + 4·0.6) ≈ 1.47,所以跨实验室对比五个模型承载更多权重。
广度也在多样性不足的地方遭受急剧的边际递减回报:沿表2的一行移动会迅速饱和,而沿列向上移动则没有限制。
这是在不同谱系间均匀组成委员会而不是最大化计数的分析基础。五个因为阅读相同语料库而一致的模型比三个真正不同的模型提供更弱的证据。
5.4 以对数比值表示
如果一个精度为p的独立证人贡献对数比值
那么N个相关模型之间的一致性大约贡献
而不是N · L。这是元分析中对相关观察的常规处理,在这里用作近似:它将设计效应调整后的计数视为独立证人的数量,但设计效应本身并未确立这一点。图1的(b)面板绘制了它。在p = 0.8处,因此L ≈ 1.386纳特:
- 十个独立证人给出ΔLO ≈ 13.86纳特和大约1.05·10⁶ : 1的后验比值;
- ρ = 0.5的十个模型,所以 ≈ 1.82,给出ΔLO ≈ 2.52纳特和大约12 : 1的后验比值。
比率大约为8.4·10⁴。这个因子是不透明合并赋予读者的不劳而获的信心,这就是为什么收据存在以及为什么标记承重事实。文档必须说明读者面前的一致性是否值得10⁶ : 1或12 : 1,因为在页面上两者相同。
5.5 假设和估计
该模型很简单,其假设相应很强。它基于以下条件。
ρ被视为跨对均匀分布。在实践中,它是块结构的,因为来自一个实验室的模型彼此关联更强,而不是与来自其他地方的模型。成对平均会更好,块结构会更好。在块结构下,统一公式给出乐观的,真实的上界低于表格显示的。
ρ也被视为在问题间恒定,而它明显是依赖领域的。在只有一个可用来源的小众话题上,它接近一。在拥有丰富多语言文献的问题上,它要低得多。
声明被视为二进制的,而真实答案是散文,将散文简化为可比较的二进制声明本身就是一个有噪声的操作。精度p被视为在模型间均匀,但事实并非如此。
然而ρ是可测量的。给定Q个标记二进制声明,其已知基真实值和相应的误差矩阵e_iq(其中i = 1…N且q = 1…Q),类内相关性遵循通常的方差分析方法,作为平均成对误差协方差与平均误差方差的比率:
在实验室内部和跨实验室分别估计 ρ 可以给出单一文化成本的一个数值(Kleinberg & Raghavan, 2021; Bommasani et al., 2022)。观察它在连续模型代次中的漂移同样反映了在生成数据上进行训练的成本(Shumailov et al., 2024)。
5.6 这对协议的改变
一旦接受该公式,第 4 节中的规则 5 和 6 以及规则 6 所隐含的组成报告就不再是最佳实践,而是成为必需的。
标记共享源(规则 6)是在单一主张层面上对 ρ 的局部测量。同一文章的五个引用意味着对该主张 ρ ≈ 1,因此 ≈ 1。
报告相互同意的模型之间的亲缘关系是在组成层面上的相同测量。
保留分歧(规则 5)是读者能获得的唯一证据,证明 ρ 小于 1。分歧表明相关性不是完全的,无论哪一方被证明是正确的,都具有信息价值。分歧是一种测量工具,而不是要排除的障碍。总是同意的委员会对读者关于世界的情况一无所知,只表明 ρ ≈ 1 和委员会是多余的。
6. 三层一协议
该协议在三层运行,这三层是访问曲线上的三个点,而非三个版本或一个漏斗。一个用户在一周内很可能会为了不同的问题而使用这三层。
6.1 第0层,免费路径
用户打开网站,提出问题,复制每个答案,并将其粘贴到合并提示下,输入任何聊天模型。无费用,无需安装,任何带浏览器的设备(包括手机),以及用户登录的账户集合那样大的理事会。延迟是十到十五分钟,大部分时间在等待,深度研究模式下时间更长。
这一层从严格意义上讲是参考实现。它是用户持有每个原始答案的唯一层级,也是唯一可以直接判断合并保真度的层级。
6.2 第1层,移动层
主屏幕上有一个图标,快捷库中有一个条目。点击、输入问题、从菜单中选择模式,大约一分钟后,完成的答案就会出现在屏幕上并进入剪贴板。语音启动有效。
该机制既不是浏览器也不是API。它将供应商自己的操作系统应用意图链接到设备上已安装的应用程序和订阅。费用以订阅消息而非代币计算,这使模式设计成为资源分配决策而非品味问题。替代移动平台通过基于意图的自动化提供等效功能。
表3列出了三种模式。它们是相等的并行函数,而非管道的阶段:每次调用运行一种模式。
表3. 移动层的三种模式
| 模式 | 链 | 消息 | 用途 |
|---|---|---|---|
| 轮询 | 两个模型独立回答;答案并排显示 | 1 + 1 | 直接查看原始差异 |
| 评审 | 模型A回答;模型B作为第二位专家进行验证并给出改进的最终答案 | 1 + 1 | 日常默认:成本为两个消息的已验证答案 |
| 合成 | 两者盲目回答;进一步的调用进行仲裁和合并,标记差异 | 1 + 2 | 重要的问题 |
评审模式曾被简短地称为主席。这三种模式是相等的并行函数,评审是同行评审:一个专家回答,第二位验证。主席角色已经在合成内部存在,作为仲裁者,用聚合的名称称呼同行评审会误述此模式的功能。
手机不是广度便宜的地方,这就是这里固定N = 2的原因。每次调用都从与普通使用相同的配额中消费一条消息,应用程序依次进入前景,用户就站在那里等待。第5.3节显示该对的价值:两个模型来自不同的实验室,是N = 2下可获得的ρ最小化选择,在这些说明性相关性下,ρ ≈ 0.2的跨实验室对胜过ρ ≈ 0.6的同血统五个,因此理事会的大部分目的在一次点击和一分钟内得以保留。
6.3 第2层,代理路径
能够驱动浏览器的模型在用户登录的浏览器会话中打开指定的网站,提交问题,等待,将每个答案保存到文件,并生成文档。理事会扩展到十个或更多,深度研究模式可用,包含每个原始内容的带日期文件夹在运行后保存。费用是代理的小月度订阅加上用户已经持有的任何付费层。延迟是五到三十分钟。
这一层为用户提供了超越用例寿命的东西,即一个在其计算机上采取行动的模型,而不是向其描述行动。回答的模型与采取行动的模型之间的差异大于一个模型和十个模型之间的差异。
6.4 延迟-广度前沿
表4. 三层间的延迟-广度前沿。有效证人计数假设ρ = 0.2
| 第0层,免费 | 第1层,移动 | 第2层,代理 | |
|---|---|---|---|
| 点击者 | 用户 | 操作系统 | 浏览器代理 |
| 理事会规模N | 无限制 | 2 | 高达~10 |
| 在ρ = 0.2时 | 高达~4–5 | 1.67 | ~3.6 |
| 回答时间 | 10–15分钟 | ~1分钟 | 5–30分钟 |
| 边际成本 | 零 | 订阅消息 | 代理订阅 |
| 安装 | 无 | 一个已签名的快捷方式 | 代理应用程序 |
| 深度研究模式 | 是,手动 | 否 | 是 |
| 可见原始答案 | 是 | 仅轮询模式 | 是,保存到文件 |
| 设备 | 任何 | 手机 | 计算机 |
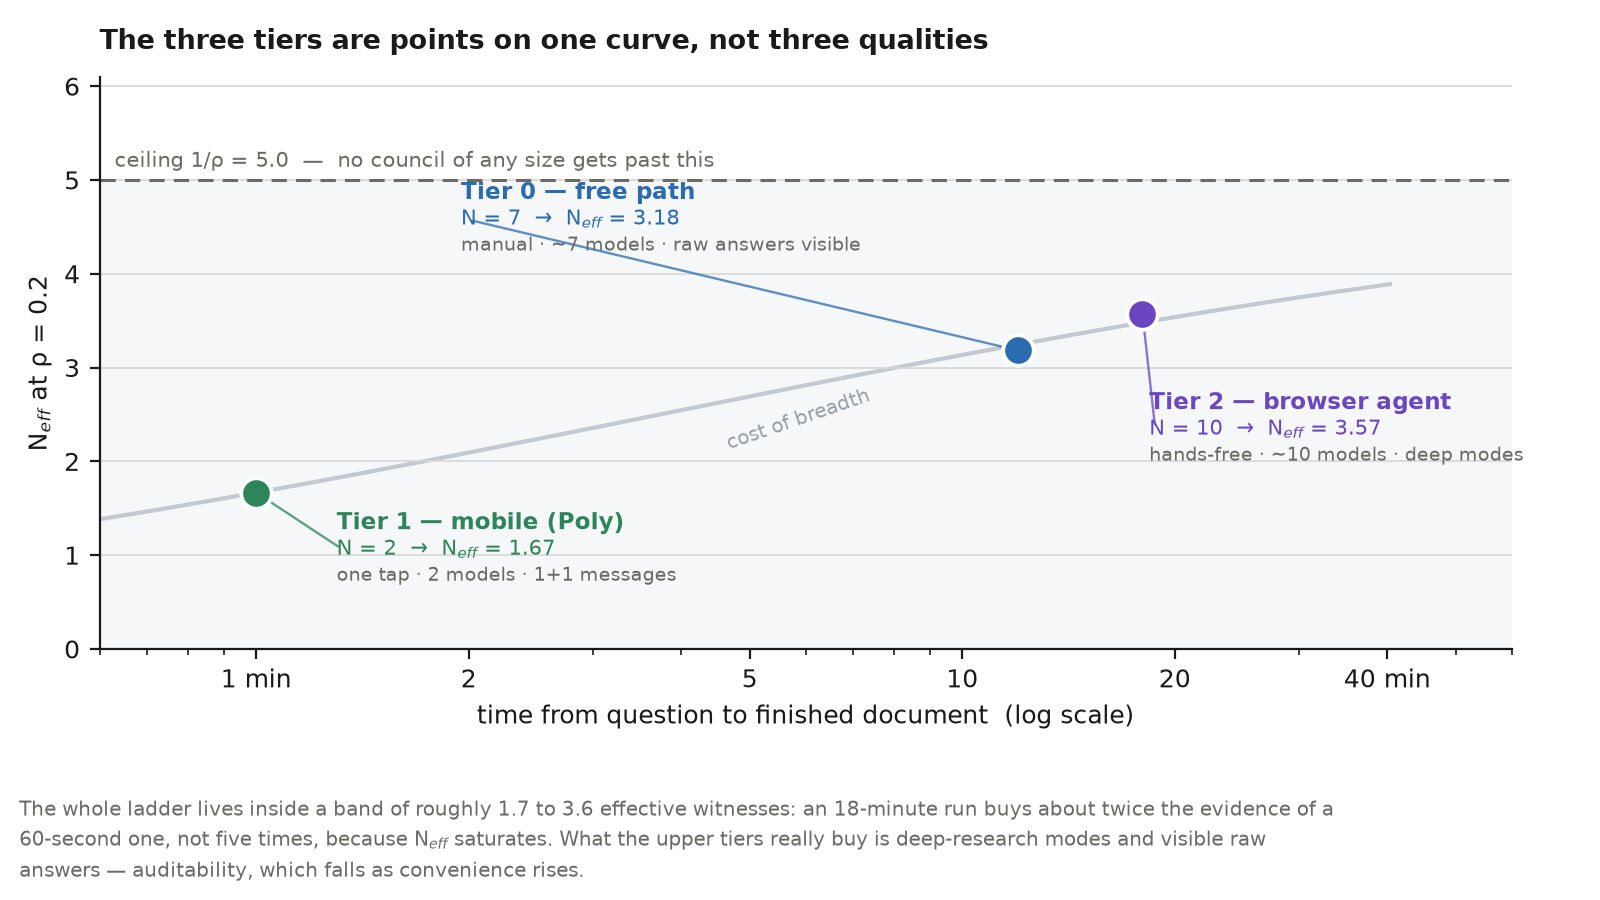
图3 — 延迟-广度前沿。三层相对于完成文档时间的绘图,Neff在ρ = 0.2时计算。由于Neff在1/ρ处饱和,两个自动化层位于大约1.7到3.6个有效证人的范围内:十八分钟的运行获得的证据大约是六十秒的两倍,而不是五倍。上层额外获得的是深度研究模式和可见的原始答案。
两个观察来自第5节而不是来自工程。
各层级按广度成本而非质量排序。第1层位于曲线上答案能在站在商店里的人的注意力持续时间内到达的点。从证据角度来看,各层级之间的差距远小于模型数量的差距,因为在1/ρ处饱和,这正是使阶梯连贯而非折中集合的原因。
沿着阶梯向下,可审计性在与便利相反的方向上下降。在第0层,用户掌握每个原始答案。在第2层,代理将其写入文件,因此它们存在但很少被打开。在第1层,只有Poll模式会公开它们,因为Critique和Synthesis返回成品文本。移动层在这一方面较弱,并重现了论文开篇提出的问题:层级越便利,用户就越相信而非检查。在Synthesis输出中保留分歧标记不仅是表现上的便利,它是该层级剩余的可审计性。
6.5 盲目并行和知情顺序征询
移动层将其他层级一直隐含的一个轴强制公开,这是系统中最重要的设计问题。第二个模型能否看到第一个模型的答案?图4列举了两种安排及其各自的收益和成本。
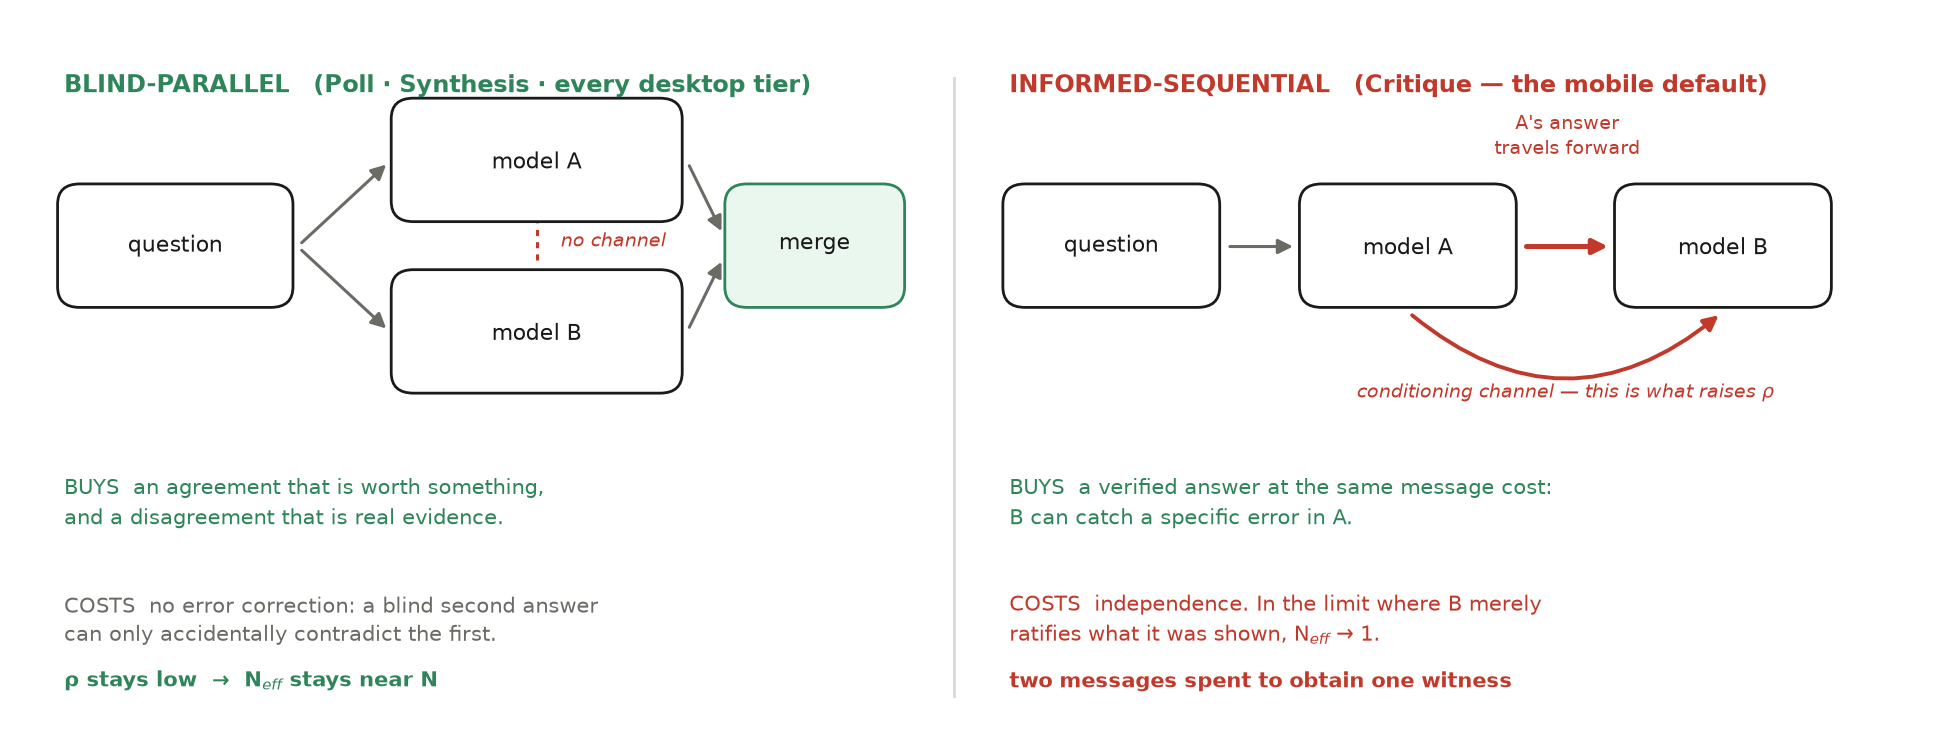
图4——盲目并行和知情顺序征询。两种机制对比。在盲目并行征询下,模型之间没有通道,因此一致性具有证据力,分歧是真实证据,但不会发生错误更正。在知情顺序征询下,第一个答案进入第二个模型的提示词中:第二个模型可以纠正特定错误,但条件通道会提高ρ,在其证实所示内容的极限情况下,Neff接近1。
Poll和Synthesis是盲目并行的。两个模型都回答原始问题,彼此都没有看到对方。这里的独立性是架构性的而非指令性的:每次应用意图调用都会打开一个没有记忆的新会话,每个提示词都是自包含的,在其中包含问题和任何先前的答案。不存在一个模型可以影响另一个模型的通道。
Critique是知情顺序的。第二个模型接收问题和第一个模型的答案,被要求检查其事实错误、添加遗漏的内容并发布一个改进的最终答案。
知情安排初看起来似乎简单地优于盲目安排:第二个模型在相同成本下做了盲目第二模型所做的一切并检查了第一个答案。这种表象具有欺骗性,因为两种安排购买的是不同的商品,知情安排在独立性上付出代价。
知情顺序征询的收益是错误更正。能看到第一个答案的第二个模型可以捕捉其中的特定错误,而盲目的第二个答案只能意外地与其矛盾。这是多代理辩论结果背后的机制(Du et al., 2023),这正是使Critique成为日常默认值的原因:在与Poll相同的两条消息成本下,它返回经验证的答案而非两个未经验证的答案。
它为此付出的代价是独立性,也就是ρ的代价。以第一个答案为条件的第二个答案是Lorenz等人(2011)发现的社会影响,它会缩小人群的分散而不会使其向真理靠近。有锚定的批评者同意所显示答案的频率高于无锚定的同行,因此产生的一致性价值远低于外观。该界限易于表述但令人不适:在批评者证实所示内容的极限情况下, → 1,该运行花费了两条消息才获得一个见证。
这是第5部分变成用户可以采取行动的建议的唯一地方。知情顺序征询是用于验证答案的正确选择,如果问题是是否存在分歧,则需要盲目并行征询。在第二个模型阅读第一个之后浮现的分歧是证据,而未能浮现的分歧不是一致的证据,因为产生它的通道已关闭。
因此Synthesis是一个单独的模式而非Critique的更彻底版本。Synthesis并不更彻底,它是盲目的,这是一个不同的属性,它是唯一一种一致性具有任何证据力的移动模式。其额外消息的成本是仲裁者,但其价值来自两个仲裁答案从未相遇。
第0层和第2层在构造上是盲目并行的,因为每个模型在其自己的会话中获得原始问题,锚定和丰富合并发生在之后。锚定和丰富最好理解为放在完全盲目阶段之后的知情阶段。该顺序获得错误更正而无需支付独立性成本,而是以延迟付费。移动层在其默认模式下无法承受该顺序,因此权衡在那里变得可见,在其他地方都不会。
6.6 为什么不是API
运输方式的选择决定了谁可以使用系统,因此它不是细节问题。
API提供可重现性,即已知的模型版本、温度和种子;编程可靠性;没有服务条款问题;以及大规模的低成本。浏览器和应用意图提供无需安装、无需密钥、无需额外计费关系、电话兼容性、免费层运行、访问通常没有API等效物的深度研究模式,以及使用用户已经支付的订阅。
该协议采用第二种方式。任何持有 API 密钥且能在终端中工作的人都会更好地受益于基于 API 的方案,如 Karpathy 的 llm-council (Karpathy, 2025)。本文针对的人群是那些对于第二份订阅是重大财务或决策负担的人,或无法在其使用的机器上安装软件的人,或其互联网接入仅限于手机的人。对于这些用户,这是该想法的第一个合理可及的实现,因为它不需要密钥、不需要安装也不需要额外费用,而可及性正是该系统作为文本文件而非产品的根本原因。
代价是不可重复性,而这个代价很高。网络界面或消费者应用背后的模型版本是未知的,且会无通知地改变。温度不可控,服务的系统提示是隐藏的,账户个性化会影响答案。运行无法精确重复,无论是下个月还是在另一台机器上。这对于个人决策工具是可以接受的,但对于科学测量则不然。因此,第 9 节要求原始答案被存档,并且结论应框架化为关于协议的声明而不是关于模型的声明。
6.7 安全性
免费路径不添加自动化特定的攻击面,因为用户直接操作网站,尽管浏览器和账户本身的普通风险仍然存在。以下涉及代理路径。
主要风险是间接提示注入 (OWASP, 2025)。每个收集的答案都是不可信的输入,因为模型的输出可以包含针对编排器的指令。字符串过滤不是防御:它会损害合法内容,无法保证任何东西。
建设性的答案是对权限的限制。收集的文本被视为引用数据,而不是命令。如果上游模型发出工具调用块或重现注入的指令,编排器将其作为引文合并,并且不执行任何操作。
在二元规则框架下 (Meta, 2025),当代理同时拥有以下三个条件时变得危险:处理不可信输入、访问敏感数据或系统的能力,以及改变外部状态或外部通信的权力。这里描述的代理拥有前两个,并将第三个限制得尽可能狭窄。它离开用户机器的唯一行动是将用户的问题发送到用户指定的站点;它写入的是该机器上的指定输出文件。它不进行购买、发布、删除、更改设置、输入凭据或解决挑战-响应测试。更重要的是,它读取的任何内容都不能成为新的对外行动:没有收集的答案可以触发新的步骤或新的目的地。不可信的输入和对外行动是分开的:唯一的对外通信是用户自己的问题,在任何收集的答案被读取之前发送。因此,被污染的上游答案无处传播,文档内的现实最坏情况是错误的一行,这通过出处标签帮助捕获;会话级风险由下面的操作规则解决。
这遵循能力隔离文献 (Debenedetti et al., 2025),并解释了为什么零点击代理漏洞(如 EchoLeak (CVE-2025-32711; MITRE, 2025))在其他地方成功:在那里,所有三个能力被链接在一起。
操作规则是使用可见的浏览器窗口而不是无头的,用户在单独的浏览器配置文件中登录的会话,没有凭据的存储或输入,也没有挑战-响应解决、指纹欺骗、代理轮换或账户池。最近的浏览器版本在默认配置文件上忽略远程调试标志,作为防止基于协议的 Cookie 盗窃的对策,所以自动化必须使用单独的配置文件目录。单独的目录造成摩擦,但也是更安全的安排。声称可以无声地附加到用户日常浏览器会话的工具值得怀疑。
这归结为提示级约束加上刻意的小工具界面,而不是技术沙箱。它缩小了影响范围。它不能证明半径为零。
移动层的威胁面是不同的且较小。调用通过供应商发布的操作系统意图而不是驱动的浏览器进行,设备必须通过按顺序进入前景的应用程序解锁,并且没有任何内容在后台运行。它是用户按下的按钮,而不是定时自动化。提示注入的关注仍然适用于批评和综合,其中一个模型的输出进入另一个模型的提示,它以相同的方式处理:收集的答案是引用材料,接收模型没有可用的操作。
7. 实证部分
7.1 冷启动探针
用户的第一步是将系统交给一个模型。如果该模型拒绝,或返回只是类似结果的内容,用户会离开并且永远不会报告它。冷启动探针测量的就是这一刻,而且它无法自动化,因为它需要一个从未遇到过该问题的新鲜会话。
提示词发出时没有提示、没有框架也没有后续:
从这个存储库中运行该方法来回答问题:喝水太少的三个最大风险是什么?按照该方法说你应该做的去做。
有三个环境。在A中,一个代理位于一个克隆中,浏览器控制被刻意断开。B是一个普通的聊天会话,只有前页文档粘贴进去,而在C中一个代理具有工作中的浏览器控制。
仅对第一个答案进行评分,基于六个二元标准。以这种方式限制它是该探针的方法论核心,因为模型在被纠正后所说的内容不代表陌生人会经历的情况。
- 它是否检查了该会话中可用的工具,而不是推理它是什么样的模型?
- 它是否避免了在同一条消息中没有下一步的赤裸裸的拒绝?
- 在缺少某些内容的地方,它是否命名了具体的缺失组件而不是一类限制?
- 它是否在同一答案中提供了手动路径,而无需被询问两次?
- 用户能否立即对答案采取行动?
- 在它实际上没有从单独的模型收集答案的地方,它是否在显示任何内容之前说过这一点?
准则6是在基线运行后编写的,并且比其他五个更重要。一个读起来像委员会但来自一个模型的答案彻底失败了探针,无论执行得多好,而且它会执行得很好。
7.2 基线运行
五个模型都获得了文档和一个没有提示的普通问题。没有一个有浏览器控制,所以该运行只测量了一件事:模型如何报告无法运行该方法的情况。表5报告了结果。那里的模型由实验室而不是产品名称标识,因为关键是它们共享的一种失败模式,而不是排名。
表5. 冷启动探针,基线运行。五个模型,无浏览器控制,第一个答案评分
| 模型 | 开发商 | 结果 |
|---|---|---|
| Model G | 实验室1 | 通过。检查了自己的工具,命名了缺失的组件,声称它没有将问题发送到任何地方,要求了两个必需的答案,并提前警告说单一模型视图不会是该方法的结果。 |
| Model S | 实验室2 | 通过,声明替代。使用网络源代替模型答案并用那些词说了这一点,包括这是一个比该方法打算的更小且结构不同的委员会。 |
| Model H | 实验室2 | 通过。不替代任何东西。移交提示并要求返回答案。 |
| Model C | 实验室3 | 失败。用该方法自己的词汇编写的网络研究,任何地方都没有警告。 |
| Model K | 实验室4 | 失败。一个形状正确的完整合并文档,以该方法的输出文件名保存,来自网页而不是模型,没有警告。 |
五个中的两个生成了用户会归档为十人委员会的文档。这就是F5,观察到的。
7.3 干预和重新运行
干预是一句角色分配语句,告诉模型它是此次运行的操作员,应阅读代理指令文件。它出现在文档的第一个屏幕上,并进入一个单独的文件,用于寻址模型。表6报告了环境B中的重新运行。
表6. 角色分配干预后环境B中的冷启动探针。标准如第7.1节所编号;(web)标记通过供应商网络界面进行的运行,C′是实验室3的模型在该设置中
| 模型 | 1 | 2 | 3 | 4 | 5 | 6 | 裁定 |
|---|---|---|---|---|---|---|---|
| Model C′ (web),实验室3 | 是 | 是 | 是 | 是 | 是 | 是 | 通过 |
| Model P (web),实验室5 | 是 | 是 | 是 | 是 | 是 | 是 | 通过 |
| Model K (web),实验室4 | 是 | 是 | 是 | 是 | 是 | 是 | 通过 |
最后一行是有指导意义的。在基线中在方法输出文件名下生成无标记网络摘要的模型这次从文档中重建了合并提示并将其交给用户。然后它在一个明确的标题下打印了自己的网络研究,标记为背景研究而不是委员会结果,补充说它仅出于背景目的。
随后的审计确定,通过是根据模型正在引用的段落的更长草稿来衡量的,而一旦段落被缩短,较早的结果对当前文本不再证明任何内容。环境B针对缩短版本重新运行,通过了所有六个标准。该模型具体命名了缺失的连接,并通过说它没有生成该方法的结果而关闭,因为没有收集到独立答案。
该事件本身就是一个发现。当被测试的文本改变时,通过的测试就过期了,将旧的通过向前延续到新草稿是一种舒适且常见的自欺形式。
7.4 解释
该观察证实了F5是真实的,它出现在来自不同实验室的模型中,并且对角色分配很敏感,这是一种廉价的文本干预。这与一般发现一致,即模型采用其背景提供的任何框架(Sharma et al., 2023),在这里该属性有利于正确性。
这不能确定频率。以 n = 5 和 n = 3,无重复,由作者评分,这表明存在故障模式,但对其发生率没有说明。所有基准运行都缺乏浏览器控制,因此测量的是对无法执行该方法的真实报告,而不是执行该方法的技能。通过不是对任何模型作为协调者的认可;该设计不支持这一推论。第 10 节列出了边界条件。
这类清单存在结构上的风险。文本经过编辑直至通过,然后清单停止测量任何内容。两个守卫使其继续测量内容。标准只有在能够说明真实用户会因此遭受什么时才能证明编辑的合理性,且标准只有在实际运行产生相应故障后才能添加,绝不是因为听起来似乎合理。这六个标准都符合两者。
7.5 移动构建的现场观察
在物理设备上构建和认证移动层产生了不同类别的发现。这是系统证据而非认识论证据,它记录了消费者应用意图管道特有的故障表面,其故障方式与 API 管道不同。
该层通过算术烟雾测试进行了端到端认证,之所以选择是因为数字可以在任何键盘布局中保留。批评返回了正确的总和,以及明确说明第一个模型的答案不含错误的声明,轮询返回了两个模型并排一致的答案。从点击到结果的免操作延迟约为五十到六十秒。表 7 记录了哪些出现故障。
表 7. 消费者应用意图管道的观察到的故障模式,及其原因和补救措施
| 症状 | 原因 | 补救措施 |
|---|---|---|
| 第一个提供商的意图报告用户已登出,而应用程序已登入 | 已知意图缺陷,在空闲期后反复出现 | 打开应用程序一次并重新运行。这就是为什么首先调用可靠性较低的提供商的原因:其故障不会产生任何成本 |
| 第二个提供商报告模型不可用 | 账户端免费层级的模型门控;意图未公开模型参数 | 在应用程序内设置所需的默认模型;链无法选择一个 |
| 运行无声结束,没有错误 | 正在运行的快捷方式的覆盖层被触摸设备时关闭 | 运行期间不处理设备;重新运行 |
| 链在中间答案卡处暂停 | show-on-run 参数默认启用 | 在构建时将其设置为禁用 |
| 长答案被截断 | 意图级别的输出限制 | 要求紧凑答案;批评质量不受明显影响 |
其中三个具有超越该系统的普遍意义。
按脆弱性排序链。可靠性最低的提供商排在首位,因此其故障不会产生任何成本,而可靠性更高的提供商获得必须不丧失的角色,即仲裁者和终结者。
假设无记忆。每次调用都会打开一个新会话,因此每个提示必须是自包含的,并在其内部包含问题和任何先前的答案。因此,盲并行独立性是架构性的而非指令性的,如第 6.5 节所述。
最不信任无声故障。看似因超时而结束的两次运行实际上是由用户拿起设备而被中止的。将其归因于软件会导致修复一个实际不存在的缺陷。
8. 粘贴文件:冷启动指导的界面模式
这是一个独立的界面结果,它的应用范围超出了这个系统。
粘贴文件是用户完整地粘贴到普通云聊天模型中的纯文本文件,之后该模型可以指导他们完成原本无法开始的事情。这种情况很常见。有人被交了一个文件夹、一个链接或一个工具,却不知道如何开始。业界通常在这种情况下采用的所有方案,无论是着陆页面、入门机器人、定制助手还是应用程序,都需要用户前往新的地方,而粘贴文件则使用他们已经打开的界面。
这与代理自己读取的文件不同,后者涉及已有文件访问权限的驻留程序。粘贴文件涉及的是他人云端上的聊天会话,它看不到用户的磁盘,也永远不会看到。
四个不变量
文件名是第一条指令,用读者自己的书写系统表示。它是一个句子,而不是常规的文档文件名,每种语言一个文件,全部存在,都按照共同前缀排序在一起。用户不是在从列表中选择。他们是在识别自己的书写系统并忽略其余部分,就像在多语言标志上跳过不熟悉的行一样。这没有成本,它消除了有人必须阅读自己可能不懂的语言以找到用自己语言编写的文件的步骤。
文件声明了模型不能做什么,并禁止假装相反。在第一部分中:你是云中的聊天会话,你不在用户的计算机上,你无法打开他们的文件或运行任何东西,永远不要声称你查看过。这种模式的特征性失败,即F5的另一种形式,是模型从未看到的文件夹的有信心且看似合理的描述。这对用户来说是隐形的,因为对于无法检查的人来说,格式良好的答案和正确答案是无法区分的。
完整性是可检测的。顶部有部分清单,最后一行有文件末尾标记。指令告诉模型在说任何话之前找到该标记;如果它或任何列出的部分缺失,则停止、报告哪些部分已到达,并再次请求该文件;永远不要从自己的知识中填补空白。长粘贴可能因免费等级限制、消息限制或手机而被截断,没有标记的情况下,模型会根据已到达的内容进行处理并自行即兴发挥其余部分。
文件是自包含的。用户今天获得结果所需的一切都在其中逐字逐句地写入,而不是被引用或链接。说"打开合并提示文件"的粘贴文件已失败,因为读取它的模型无法打开任何东西,用户可能根本没有该文件夹。自包含性允许该文件通过消息应用程序转发,无需任何附件仍然可以工作。
两条排序规则
按不可替代性而非按时间顺序排序。粘贴从底部被切割,因此任何模型可以无需帮助重建的东西,如安装步骤、背景或任何可查找的东西,应该放在靠近末尾的位置,而任何必须精确的东西应该放在靠前的位置。
尽快移交。当路径以用户安装的程序结束时,停止重述该程序的设置说明,告诉他们向程序本身提问,并将该规则写入文件中:如果已安装的程序与此文件关于其自身的内容相矛盾,则该文件是错的。描述他人安装程序的文本文件在几个月内会过时,而向程序本身提问则不会。
保持副本的忠实
副本倍增,副本会偏离。两个廉价的机制就足够了。生成逐字逐句的有效负载而不是维护它:构建步骤从单一事实来源将规范文本拼接到每个语言文件中,如果提交的文件不一致,连续集成就会失败。将翻译相互比较以及与规则比较,因为每个结构检查都会通过一个已经悄悄变成其长度一半的文件。这里的连续集成声明所有语言变体都应该有相同数量的部分和相同数量的设置步骤。
评估模式
该模式有自己的十项检查清单。其中两项在这里给出。两者都是针对观察到的失败而非预期的失败而编写的。
模型是否提出改进、缩短或重写文件而不是使用它?这会悄悄地失败,因为重写的版本会失去模型认为最不令人信服的任何规则。
给定删除了最后三分之一的副本,模型是否注意到并停止而不是根据已到达的内容进行处理?这需要使用故意截断的副本进行专门运行,这是唯一无法从普通粘贴中观察到的项目。
检查清单衡量的是第一次回复,这不是实际运行。一个开启完美但随后在四条消息后发明安装步骤的指南通过了检查清单但让用户失望了。该模式的真正失败发生在设置的中途,这个评估无法看到。
9. 拟议的评估
Mixture-of-agents(Wang, J., et al., 2024)和 multi-agent debate(Du et al., 2023)在 API 条件下相比最强单一模型报告了性能提升。关于合并答案是否优于最佳单一答案的主张是未定论的,该协议的比较在此预先指定,以免事后拟合。
9.1 假设
H1。Anchor-and-enrich 在事实正确性和完整性上优于最强单一答案。
H2。Anchor-and-enrich 在正确少数意见存活率和无来源声明比例上优于朴素合并。
H0。没有区别,或合并使结果变得更糟。
H2 的权重大于 H1。如果该协议在这两个指标上输给朴素合并,则第 4 节的设计无法正当化,无论文档的可读性多好。
9.2 设计
五十到一百个问题,三个方案:最强单一模型的答案;仅被指示组合答案的朴素合并;以及 anchor-and-enrich。问题在任何运行前被选择并冻结,该问题集在健康、法律、技术、消费者选择和数值事实领域的分布被公布。
9.3 度量
事实正确性,界定为根据主要来源确认的可检验声明的比例。完整性,界定为对预先指定的重要要点列表的覆盖。正确少数意见存活率,界定为恰好由一个模型提出的正确要点进入最终文档的案例比例。来源质量,分为原始的、次要的或缺失的。虚构声明率,定义为输出中但在任何输入中都不存在的声明,这是 F1 的直接度量。可读性。运行时间和成本。以及,单独报告并完整记录使合并恶化的案例,这些是有趣的案例。
9.4 盲评
模型名称被隐藏,答案顺序在评分前被打乱。判断模型明显对位置、冗长度和熟悉的风格敏感(Zheng et al., 2023),所以非盲评会部分地衡量这些。人类评分遵循相同的程序。
9.5 发表和可证伪性
问题、原始答案、最终文档和分数被完整公布,以便评分可以被质疑。
证伪条件是预先指定的。如果方案 3 在正确性和完整性上没有优于方案 1,并且在少数意见存活率和无来源声明比例上没有优于方案 2,则 H1 和 H2 不被支持,该声明来自系统的材料,而非重新表述。
9.6 测试相关证人模型
独立于 H1 和 H2,ρ 可以通过第 5.5 节中的程序在相同问题集上估计,这允许对由此产生的预测进行测试。
H3。从添加第 k 个模型获得的收益按照 = N/(1+(N−1)ρ) 所预测的方式衰减,由不同实验室组成的委员会优于由同一实验室组成的相同规模的委员会。
H3 可以在为主要比较收集的数据上进行测试,不需要额外的数据收集。反驳将是更具信息量的结果,因为它意味着聚类样本类比不适用于语言模型委员会,第 5 节需要重写。
9.7 移动层实现的两项低成本测试
每次移动运行花费一次交互和固定数量的订阅消息,这使得另外两项声明触手可及。
H4,相关性主导。N = 2 的跨实验室对在正确性和少数意见存活率上与 N = 5 的同实验室五人组相当或更好。这是第 5.3 节最尖锐的可用测试,因为这些方案在模型称之为决定性的方向 ρ 上有所不同,同时在它称之为次要的方向 N 上相互对立。
H5,引出轴。盲并行引出在相同问题集上比知情顺序引出揭示更多分歧,并且它揭示的分歧预测单一模型答案中的错误。如果 H5 失败,意味着知情批评者发现与盲目同行一样多的分歧,那么第 6.5 节中的独立性成本论证是错误的,知情模式只是包含了盲目模式。
10. 局限
核心主张未经验证:第 4 章是设计论证,第 9 章规定了可以解决它的比较。
ρ 为假设而非估计。表 2 和表 8 中的每个值都遵循第 5 章公式 在假设的均匀 ρ 下,这将表置于现实的块结构下的上界。
第 7 章报告 n = 5 和 n = 3。它证明了故障模式的存在;主张被限定为存在性而非频率。评分由作者进行,无评分者间估计;二元标准降低了单评分者风险但未消除。环境 A 在干预后未重新运行,环境 C 没有运行,所以报告的通过仅涵盖环境 B。
网络界面和消费者应用程序后面的模型版本未知且不断变化,账户个性化影响答案,运行无法精确重复(第 6.6 节),因此结果会快速过时,是关于协议的证据,而非关于具名模型的证据。
合成器本身是一个语言模型,与其他模型一样受到 F1 到 F4 的约束。该协议通过来源、禁止无声删除和单独的分歧部分对此进行了结构约束,但并未消除这一限制。输出质量取决于给定模型对指令的忠实程度;该依赖性未被测量。
盲评标准由随后构建文档的同一模型执行,因此锚点选择是一个偏差点,没有什么能阻止该模型系统地倾向于风格上接近其自身的答案,这是以另一位置的评判者-模型偏差形式出现的(Zheng et al., 2023)。禁止预设锚点只解决了问题的显式形式。
移动默认为知情顺序模式,因此最常用的模式也是其一致性证据权重最小的模式(第 6.4 节)。这是质量-每条消息的权衡,它设定的边界在此说明。该层级的主要弱点是它用可审计性换取延迟:评论和综合返回完成的文本,原始答案仅存在于模型自己的会话历史中,因此从不打开轮询模式的用户信任而不是检查,这正是该协议旨在反对的立场。
时间成本为免费路径设定了一个边界。一个现实的完整委员会需要十到十五分钟的等待,以及每个提供商五到二十五分钟的深度研究模式。对于部分预期人群来说,这可能会超过其益处。
第 11 章阐述了代理路径的法律地位以及它留下的服务条款问题。
11. 伦理、隐私和法律框架
该系统供用户个人使用自己的模型账户,无论是免费还是付费账户,通过用户自己的浏览器或设备访问。它不从第三方抓取数据、绕过付费墙、解决人机验证测试、规避机器人检测、轮换代理、隐瞒其操作、转售账户或以多租户方式运行它们。
无障碍访问是核心目标而非附带效果。当残障用户依赖此项作为辅助技术时,这正是其用途所在:代表他们行动的助手,按照他们的节奏,在他们自己的账户上操作。路缘切口的类比是准确的。为轮椅使用者建造的坡道也对推着婴儿车的父母和快递员有帮助,而为无法管理十多个浏览器标签页的用户构建的系统最终服务于每个人。
这些路径在法律上并不等同。免费路径在任何解读上看起来都像是普通使用:用户打开网站、输入和复制。移动路径与其接近,因为供应商发布应用意图正是为了这种调用方式,快捷方式可以链接两个这样的调用,按设计使用每个应用程序,一次一条消息,在前台。代理路径需要更仔细的审视。关于自动访问的规则针对的是大规模收获输出、机器人加载服务、绕过速率限制、运行多个账户以及转售返回的内容。这些都不能描述一个用户在自己登录的浏览器中以人类速度提出一个问题并自己阅读答案的情况。这种使用在结构上与为无法进行操作的人输入和点击的辅助软件相同。然而,有些条款被草拟得比其目的更加宽泛,禁止任何自动化手段而未涉及规模。这是否适用于自动化单个问题的用户取决于服务、司法管辖权以及当天生效的条款。这是一种解读而不是裁决。用户应查看所连接内容的条款并自行决定。任何不想思考此问题的人都可以使用免费路径,它可以完成相同的工作,不会引发任何代理特定的问题;网站的常规条款仍然适用。
隐私是一个组合决策。模型集确定哪些公司接收用户输入的内容,这对于普通问题不重要,但对于关于健康、雇主或客户的问题可能重要。如果向特定公司发送特定问题会令人不适,就将该成员排除在该问题之外;舍弃一个不需付出任何代价。
该协议自身的伦理约束是一项禁止。不能将非该方法运行的内容表示为该方法的运行。网络摘要、单一模型答案或操作者自己的推理可能各有用处,但它们不是委员会结果,用户必须被告知他们所持有的是其中哪一个。实际上,这意味着没有收据、没有同意和不同意部分,以及没有不是真正多模型运行的任何内容的输出文件。
12. 结论
一个充满信心但错误的答案与一个充满信心但正确的答案难以区分,而两者之间的争论对任何人都是可见的。因此,委员会的价值在于暴露分歧,而不是将其平均化。
模型之间的一致性不是独立的确认。具有错误相关性 ρ 的 N 个模型的委员会值得 = N/(1+(N−1)ρ) 个独立证人,这个数量在 1/ρ 处饱和,无论添加多少个模型都是如此,因此在 ρ = 0.5 时,任何规模的委员会最多值得两个证人。十个独立一致模型与十个相关模型之间的证据强度差异约为五个数量级,而不透明的合并将这一差异作为不应有的信心交给读者。
该设计源自这两个前提。它保留来源,以便读者可以检查结果而不是信任它,它强调分歧,因为分歧是任何单一模型都无法提供的唯一组成部分。几个答案共享的来源被标记为一个来源。承重的事实被命名,有来源的内容与仅被同意的内容分开。还有一条规则适用于该协议对自身的说明:它绝不能将不是的东西呈现为合议的,这不是一个理论问题。在盲测中,五个模型中的两个默默地违反了它,而在环境 B 重新运行中,一句角色分配句子颠覆了两者。
这三个层级是曲线上的点,其轴是广度的成本,而不是三个质量等级,第 5 部分是使曲线连贯的原因。因为 饱和,两个模型和十个模型之间的证据距离远小于模型数量所暗示的,来自不同实验室、在手机上运行的两个模型可能比从单一血统中提取的五个模型更值得。移动层还强制公开了其他层一直在悄悄进行的交易。一个读过第一个模型的第二个模型可以纠正它,但它不再能独立确认它。错误纠正和独立确认是不同的商品,以不同的顺序购买,而一个没有说明它销售的是两者中哪一个的系统误导了它的用户。受控比较保持开放,第 9 部分将其与会迫使我撤回这一主张的结果一起指定。
无论该比较如何进行,一个没有来源和没有保留分歧的合并文档根本无法检查,因此在对做决定的人重要的任何意义上,它都不能比单一答案更好。可审计性不是对合成的改进。它是合成有任何权利被称为结果的条件。因此,协议的规则涉及每个句子来自哪里以及模型不同意的地方,而不是关于询问了多少个模型。
声明
资金支持。本工作未获得外部资金支持。
利益冲突。作者是本论文所分析的多模型编排方法的开发者,该方法是开放且可复现的,读者应对此利益冲突进行权衡。作者是未授予专利的待决专利申请的命名申请人(非已授予专利的申请人),该申请涉及本论文所考察的AI编排和多模型验证系统。第4节中形式化的协议和第6节中描述的参考实现是作者自己的,第9节的评估设计因此在任何数据收集前即已确定。第5节中没有任何分析结果依赖于该实现:第6和7节可以完全删除而不改变该模型、其上限或由此得出的任何结论。
工具和验证。AI助手在作者指导下被用作工具;思想、研究和结论均为作者的。所有定量声明和引用均由作者根据原始来源或存档副本进行了验证;作者对内容承担全部责任。
数据可用性。图1和3以及表2、4和8由第5.2节中的闭形式表达式生成,可从中重新计算。第7节的材料由在每次运行时记录并与工作材料一起保留的首次回复记录组成。该材料中的模型按实验室而非产品名称标识:该观察涉及出现在各实验室的失效模式,单次运行的结果不足以支持对命名系统之间的比较。
作者贡献。唯一作者。
通讯作者。vadimchernets9@gmail.com
References
Entries marked arXiv are preprints and are cited as such; vendor and standards-body documents are contemporaneous industry sources rather than settled literature.
- Bommasani, R., Creel, K. A., Kumar, A., Jurafsky, D., & Liang, P. (2022). Picking on the same person: Does algorithmic monoculture lead to outcome homogenization? Advances in Neural Information Processing Systems, 35.
- Condorcet, M. J. A. N. de C., marquis de (1785). Essai sur l’application de l’analyse à la probabilité des décisions rendues à la pluralité des voix. Imprimerie Royale, Paris.
- Debenedetti, E., Shumailov, I., Fan, T., Hayes, J., Carlini, N., Fabian, D., Kern, C., Shi, C., Terzis, A., & Tramèr, F. (2025). Defeating prompt injections by design. arXiv:2503.18813.
- Dietterich, T. G. (2000). Ensemble methods in machine learning. In Multiple Classifier Systems, Lecture Notes in Computer Science 1857, 1-15. Springer.
- Ding, K. (2026). When LLMs agree, are they right? Auditing self-consistency and cross-model agreement as confidence signals. arXiv:2607.08065.
- Du, Y., Li, S., Torralba, A., Tenenbaum, J. B., & Mordatch, I. (2023). Improving factuality and reasoning in language models through multiagent debate. arXiv:2305.14325.
- Kadavath, S., Conerly, T., Askell, A., Henighan, T., Drain, D., Perez, E., et al. (2022). Language models (mostly) know what they know. arXiv:2207.05221.
- Karpathy, A. (2025). llm-council. Open-source software repository.
- Kim, E., Garg, A., Peng, K., & Garg, N. (2025). Correlated errors in large language models. Proceedings of the 42nd International Conference on Machine Learning, PMLR 267, 30038-30066. arXiv:2506.07962.
- Kish, L. (1965). Survey Sampling. Wiley, New York.
- Kohli, G. (2026). Nine judges, two effective votes: Correlated errors undermine LLM evaluation panels. arXiv:2605.29800.
- Kleinberg, J., & Raghavan, M. (2021). Algorithmic monoculture and social welfare. Proceedings of the National Academy of Sciences, 118(22), e2018340118.
- Krogh, A., & Vedelsby, J. (1995). Neural network ensembles, cross validation, and active learning. Advances in Neural Information Processing Systems, 7, 231-238.
- Ladha, K. K. (1992). The Condorcet jury theorem, free speech, and correlated votes. American Journal of Political Science, 36(3), 617-634.
- Lorenz, J., Rauhut, H., Schweitzer, F., & Helbing, D. (2011). How social influence can undermine the wisdom of crowd effect. Proceedings of the National Academy of Sciences, 108(22), 9020-9025.
- Meta (2025). Agents rule of two: A practical approach to AI agent security. Engineering documentation.
- MITRE (2025). CVE-2025-32711. Common Vulnerabilities and Exposures record; zero-click exfiltration in an agentic assistant (EchoLeak).
- OWASP (2025). OWASP Top 10 for large language model applications - LLM01: Prompt injection.
- Sharma, M., Tong, M., Korbak, T., Duvenaud, D., Askell, A., Bowman, S. R., et al. (2023). Towards understanding sycophancy in language models. arXiv:2310.13548.
- Shumailov, I., Shumaylov, Z., Zhao, Y., Papernot, N., Anderson, R., & Gal, Y. (2024). AI models collapse when trained on recursively generated data. Nature, 631, 755-759.
- Surowiecki, J. (2004). The Wisdom of Crowds. Doubleday, New York.
- Ueda, N., & Nakano, R. (1996). Generalization error of ensemble estimators. Proceedings of the International Conference on Neural Networks, 90-95.
- Wang, J., Wang, J., Athiwaratkun, B., Zhang, C., & Zou, J. (2024). Mixture-of-agents enhances large language model capabilities. arXiv:2406.04692.
- Wang, X., Wei, J., Schuurmans, D., Le, Q., Chi, E., Narang, S., Chowdhery, A., & Zhou, D. (2023). Self-consistency improves chain of thought reasoning in language models. International Conference on Learning Representations. arXiv:2203.11171.
- Xiong, M., Hu, Z., Lu, X., Li, Y., Fu, J., He, J., & Hooi, B. (2024). Can LLMs express their uncertainty? An empirical evaluation of confidence elicitation in LLMs. International Conference on Learning Representations. arXiv:2306.13063.
- Zheng, L., Chiang, W.-L., Sheng, Y., Zhuang, S., Wu, Z., Zhuang, Y., et al. (2023). Judging LLM-as-a-judge with MT-Bench and Chatbot Arena. Advances in Neural Information Processing Systems, Datasets and Benchmarks Track. arXiv:2306.05685.
附录 A. 回执模板
回执是读者首先遇到的内容,通常也是他们唯一会阅读的内容。它必须在不需要滚动的情况下回答四个问题。
RECEIPT — 6 models asked · 5 answered · 1 did not (free tier)
Mode: fast ×4, deep ×1
Anchor: answer #3 (chosen for completeness and sourcing)

Agreed:       ...
Disputed:     ...
Unverified:   ...

Rests ONLY on the models agreeing (none showed a source):
              ...
Correlated:   3 of 5 cite one article → one lineage, not three
Composition:  4 of 5 are models from one region; agreement
              may reflect a shared frame
最后两行是第5部分存在的理由。没有它们,文件报告了有多少模型同意,但隐瞒了这一同意的价值,而这两个数量相差若干数量级。
附录 B. 独立见证人的有效数量
表 8. ,完整范围
| ρ | N=2 | N=3 | N=4 | N=5 | N=7 | N=10 | N=15 | N=20 | N→∞ |
|---|---|---|---|---|---|---|---|---|---|
| 0.00 | 2.00 | 3.00 | 4.00 | 5.00 | 7.00 | 10.00 | 15.00 | 20.00 | ∞ |
| 0.05 | 1.90 | 2.73 | 3.48 | 4.17 | 5.38 | 6.90 | 8.82 | 10.26 | 20.0 |
| 0.10 | 1.82 | 2.50 | 3.08 | 3.57 | 4.38 | 5.26 | 6.25 | 6.90 | 10.0 |
| 0.15 | 1.74 | 2.31 | 2.76 | 3.13 | 3.68 | 4.26 | 4.84 | 5.19 | 6.67 |
| 0.20 | 1.67 | 2.14 | 2.50 | 2.78 | 3.18 | 3.57 | 3.95 | 4.17 | 5.00 |
| 0.30 | 1.54 | 1.88 | 2.11 | 2.27 | 2.50 | 2.70 | 2.88 | 2.99 | 3.33 |
| 0.40 | 1.43 | 1.67 | 1.82 | 1.92 | 2.06 | 2.17 | 2.27 | 2.33 | 2.50 |
| 0.50 | 1.33 | 1.50 | 1.60 | 1.67 | 1.75 | 1.82 | 1.88 | 1.90 | 2.00 |
| 0.60 | 1.25 | 1.36 | 1.43 | 1.47 | 1.52 | 1.56 | 1.60 | 1.61 | 1.67 |
| 0.70 | 1.18 | 1.25 | 1.29 | 1.32 | 1.35 | 1.37 | 1.39 | 1.40 | 1.43 |
| 0.80 | 1.11 | 1.15 | 1.18 | 1.19 | 1.21 | 1.22 | 1.23 | 1.23 | 1.25 |
| 0.90 | 1.05 | 1.07 | 1.08 | 1.09 | 1.09 | 1.10 | 1.10 | 1.10 | 1.11 |
向右移动,通过添加模型,几乎立即到达最右列。向上移动,通过降低相关性,没有上限。花费在评议委员会多样性上的努力(即来自不同实验室、地区和训练语料库),相比花费在其规模上的努力,获得的回报更多。表中两项数据支持了第 6.2 节的论证:来自两个不同实验室、相关性 ρ ≈ 0.2 的一对模型算作约 1.67 个独立见证人,而来自同一技术路线、相关性 ρ ≈ 0.6 的五个模型算作约 1.47 个。
附录 C. 移动层实现参考
表 9. 移动层实现参考
| 组件 | 规范 |
|---|---|
| 机制 | 在单个已签名的快捷方式中链接的操作系统应用意图,对用户现有订阅调用供应商的已安装应用程序。无 API 密钥,无服务器,无后台执行 |
| 供应商操作 | 每个供应商的已发布询问意图,由应用意图标识符寻址。一个供应商公开了一个可选的模型参数,被省略以便应用程序默认值适用;另一个不公开任何参数 |
| 自动操作 | show-on-run 参数在构建时在意图参数中设置为禁用,而不是在导入后在编辑器中调整 |
| 分发 | 该快捷方式已签名以供无限制导入,因此一个构建可以在任何设备或账户上安装而无需重新构建 |
| 模式菜单 | 具有开始、情况和结束标记的菜单控制流操作;分支通过 set-variable 操作在共享尾部上汇聚 |
| 替代平台 | 基于意图的自动化,具有在应用程序更新后仍能存活的半自动路径 |
| 每次运行的成本 | 轮询 1 + 1、评审 1 + 1、合成 1 + 2 订阅消息 |
| 延迟 | 从启动到结果约 50 到 60 秒,自动操作 |
| 启动方式 | 主屏幕图标、小部件、硬件操作按钮或语音短语 |
两个约束塑造了设计,两者都是通用的。配额与同一应用程序的普通使用共享,因此推荐的日常模式是两消息模式而不是三消息模式;这是资源分配,而非质量判断。每个意图调用都会打开一个没有内存的新会话,因此所有提示都是自包含的,并在自身内部携带问题和任何先前的答案。没有任何内容被保留。正如第 6.5 节所论证的,这个约束使得轮询和合成中的盲目并行独立性成为架构性的而不是指导性的。
如何引用
Chernets, V. (2026). Agreement Is Not Independent Evidence: Auditable Multi-Model Synthesis Without an API [预印本]。SSRN。https://doi.org/10.2139/ssrn.7390698
@misc{chernets2026agreementnotevidence,
  author       = {Chernets, Vadym},
  title        = {{Agreement Is Not Independent Evidence: Auditable Multi-Model Synthesis Without an API}},
  year         = {2026},
  howpublished = {SSRN},
  doi          = {10.2139/ssrn.7390698},
  url          = {https://doi.org/10.2139/ssrn.7390698}
}