Після чату: три переходи між непрограмістами та агентним ШІ
Це переклад. Основна версія — оригінал англійською; посилайтеся на неї.
Термінал більше не термінал: чотирьохрівнева модель, докази 2025 та 2026 років і попередньо зареєстрована програма вимірювання переходів
Vadym Chernets, PhD, архітектор систем ШІ · ORCID 0009-0007-4845-3163
SSRN 7520019 · DOI 10.2139/ssrn.7520019 · Zenodo 10.5281/zenodo.22943313 · GitHub
Завантажити цю роботу
- SSRN (офіційна версія): ssrn.com/abstract=7520019 · DOI 10.2139/ssrn.7520019
- Zenodo (архівовано, відкритий доступ): doi.org/10.5281/zenodo.22943313
- GitHub (повний текст як Markdown та PDF): github.com/vadimchernets/papers/tree/main/after-chat; код: github.com/vadimchernets/after-chat
Той самий текст розташований у трьох місцях, щоб його можна було отримати, коли один з них не може його надати. SSRN містить офіційну версію; посилайтесь на цю версію.
Ключові слова: агентний ШІ; агенти ШІ; непрограмісти; програмування користувачами; грамотність у ШІ; робітники знань; прийняття технології; прийняття генеративного ШІ; людський нагляд; делегування; цифровий розділ другого рівня; корельовані помилки; парадокси автоматизації; дискваліфікація; попередня реєстрація
Анотація
Більшість професіоналів познайомлюються зі штучним інтелектом як з чатботом, тоді як ті самі моделі у ролі агентів штучного інтелекту тепер працюють з файлами та програмами. Я запитую: чому так мало непрограмістів перейшли від чату до агентського штучного інтелекту, і як вимірювати такий перехід. Відповідь ґрунтується на чотирьохрівневій моделі, визначеній охопленням і роллю та незалежній від продуктів: чат, безпечне агентське середовище з обмеженнями постачальника, агент на власному комп'ютері та повторювальна робота, організована через кілька моделей. Перехід вважається успішним лише якщо агент створив артефакт, який запросила людина. Встановлення програмного забезпечення вважається спробою. Докази з 2025 по вересень 2026 року вказують, що бар'єр для встановлення та для першої обмеженої спроби знизився, тоді як надійність на цілих частинах роботи, стабільність продукту та безпека папок залишилися на попередньому рівні. Встановлення — це один крок, власний чатбот людини може її направляти («рефлексивна адаптація»), і два постачальники об'єднали інтерфейси агента та чату в 2026 році. За повідомленою пресою орієнтовною цифрою одного постачальника, працівники знання становлять одну п'яту від п'яти мільйонів щотижневих користувачів його агента кодування; вона вимірює використання агента з терміналу-спадщиною, а не прийняття рівня 3, як визначено тут. Використання залишається широким та поверхневим: близько половини працівників США використовують штучний інтелект, близько однієї з семи щодня, і мало хто — для автоматизації. Бар'єр перемістився від встановлення до спрямування. Спираючись на дослідження програмування кінцевих користувачів, я називаю відсутній словник можливостей робочого процесу і визначаю роботу менеджера як договір делегування: мета, межа, артефакт і перевірка. Веб-оркестрація (одне запитання кільком чатботам) пропонується як міст, що навчає порівнянню, а оркестрація CLI (один агент викликає інших) — як стійкий шар, обмежений тим, що узгодження корельованих моделей є слабким доказом. Стаття завершується п'ятнадцятьма спростовуваними пропозиціями, дизайном програми попередньої реєстрації когорти без її результатів та відкритим навчальним кодом.
Виконавче резюме
Термінал, чорне вікно, яке символізувало все, що непрограмісти не могли робити зі ШІ, змінило своє значення. Тепер це місце на власному комп'ютері людини, де працює агент, і навичка, яку він вимагає, — більше не набір команд. Навичка полягає в керуванні робітником, що їх вводить.
Професійні розробники просунулись найдалі: 90% понад 15 000 опитаних у 2026 році використовували агентські інструменти щонайменше раз на тиждень (дослідження розробників), хоча щотижневе використання ще не є компетенцією менеджера, описаною в розділі 8. Всі інші переважно все ще розмовляють з чат-ботом. 52% працівників США використовують ШІ у своїй роботі, 15% щодня, і 16% цих користувачів називають автоматизацію серед своїх застосувань.
Причина більше не в тому, що агентів важко встановлювати. Встановлення вимагає однієї команди або одного кліку, чат-бот, який людина вже використовує, може провести її через це, і розробники почали об'єднувати чат з агентами. Те, що залишається складним, має іншу природу. Агенти все ще не справляються з цілими частинами роботи, продукт, який людина вивчає, може бути перейменований або припинений протягом року, а надана папка все ще потребує охорони. Після встановлення перше, що зупиняє людей, — це те, що вони не знають, що передати або як це перевірити, прогалина, яку розділ 1 називає словником робочого процесу. За нею йдуть перша помилка, дозволи та безпека, організаційні правила, обладнання та вартість, і компетенція оцінювати результати.
Модель має чотири рівні, упорядковані за тим, наскільки далеко модель сягає, і за тим, що повинна робити людина: розмова, обмежений простір, яким керує розробник, власний комп'ютер людини та робота, координована на кілька моделей. Люди можуть пропустити рівень. Перехід позначається лише артефактом, який створив агент, тому встановлення, значки та самозвіти не враховуються.
Оркестрація, надсилання одного запитання кільком моделям, складається з двох рівнів. У браузері це безплатно спробувати й навчає звички порівнювати відповіді, а в командному рядку це можна записати й запустити знову. В обох випадках значення має кількість запитаних сімейств моделей, оскільки взаємопов'язані помилки обмежують цінність узгодженості.
Управління агентами — це окрема компетенція. Воно має контракт делегування з чотирма частинами (ціль, межа, артефакт, перевірка), чотири практики (делегувати, контролювати, верифікувати, скасувати), правило припинення рецензування та запис про прийняття, який розділяє те, що створив агент, від того, на що людина спиралася.
Аргумент побудований для перевірки. П'ятнадцять тверджень мають показники та фальсифікатори. Дизайн передзареєстрованої когортної програми (OSF DOI 10.17605/OSF.IO/X4EGQ) описаний тут, і її результати будуть повідомлені окремо. Таблиця стану показує, наскільки твердо утримується кожне твердження, а відкритий код знаходиться в додатку C.
1. Вступ
Розглянемо офісного професіонала у вересні 2026 року. Вона використовує чат-бот щотижня. Вона просить його написати лист, узагальнити звіт, запропонувати формулу. Те, що вона отримує, — це текст, і вона вручну переносить цей текст туди, де живе її робота: папка з контрактами, електронна таблиця рахунків, презентація, необхідна до п'ятниці. Та сама модель через інші двері може відкрити цю папку, прочитати кожен файл у ній, написати електронну таблицю, побудувати презентацію та перевірити власні обчислення. Більшість професіоналів, наскільки показують опитування розділу 4.4, ще не користувалися цими дверима, і багато хто не знають, що вони існують.
Два роки ці двері виглядали як термінал: чорне вікно, мерехтливий курсор, команда для вставлення. Ця картина застаріла. Термінал залишався терміналом лише візуально. Це стало середовищем, де живе агент, місцем на комп'ютері людини, де модель може читати, писати, запускати та планувати, і людина перед ним більше не повинна керувати оболонкою, а скоріше спрямовувати агента, який це робить. Те, що змінюється, — це людська роль: від того, хто ставить питання моделі, до того, хто управляє працівником.
Мій предмет — дорога між цими двома ролями та хто на ній. Серед професійних розробників інструменти, принаймні, вже прибули. Опитування понад 15 000 професійних розробників у травні–липні 2026 року показало, що 90% використовували агентів штучного інтелекту для кодування на роботі принаймні щотижня, а 68% щодня, і що частка тих, хто використовував один агент терміналу, Claude Code, на роботі зросла з близько 3% навесні 2025 року до 18% у січні 2026 року та 39% до середини 2026 року (JetBrains Research, 2026a, 2026b; опитування виробника, оскільки JetBrains продає агента кодування). Серед всіх інших це не так, і закономірність використання широка та поверхневе. Протягом тих же місяців 52% працівників США повідомили про використання штучного інтелекту у своїй ролі, 15% використовували його щодня, і лише 16% цих користувачів назвали автоматизацію серед своїх використань; письмо та пошук домінували (Gallup, 2026). Для типового професіонала штучний інтелект все ще розмова, і цифри Федерального резерву Сент-Луїса говорять те ж саме протягом довшого періоду: між серпнем 2024 та травнем 2026 року частка працівників, які використовували генеративний штучний інтелект для своєї роботи, зросла з 33% до 45%, тоді як менше 3% завдань мали рівень впровадження вище 50% (Bick et al., 2026).
Стандартне пояснення розриву — це технічна складність: агенти для людей, які можуть програмувати. Ця відповідь була розумною у 2024 році і слабка у 2026 році. Встановлення агента терміналу тепер займає одну команду або інсталятор робочого стола, а провідний агент поставляється з програмою для робочого стола, документація якої ясно говорить: «Термінал не потрібен» (Anthropic, 2026a). Виробники пішли далі. OpenAI перетворила свій додаток агента кодування на клієнт ChatGPT для робочого стола за замовчуванням 9 липня 2026 року і додала агента ChatGPT Work, який використовує локальні файли та програми (MacRumors, 2026). Anthropic об'єднала свого агента робочого стола для роботи зі знаннями, Cowork, з звичайним чатом 16 вересня 2026 року; TechCrunch повідомила, що компанія сказала, що клієнти «часто мали труднощі з вибором правильної вкладки для правильного завдання» (TechCrunch, 2026a). OpenAI повідомила через преса, що працівники знань становили близько 20% з п'яти мільйонів тижневих користувачів його агента кодування в червні 2026 року і приймали його більш ніж у три рази швидше за розробників (Help Net Security, 2026). Ця цифра повідомлена виробником і спрямована, сторінка самого виробника була недоступна для моїх перевірок, і вона вимірює використання агента, спадкоємця терміналу, працівниками знань, що ширше, ніж прийняття рівня 3, визначене у розділі 3. Важко побачити, де є технічна перешкода на цій картині.
Бар'єр пересунувся. Він пересунувся від встановлення до спрямування: від «як це запустити?» до «що я просю його зробити, в яких межах, і як я буду знати, що він це зробив?» Друге питання складніше, ніж звучить, і література про програмування для кінцевих користувачів пояснює чому. Непрофесіонали з трудом виражають намір мовним моделям навіть коли доступ вільний і негайний (Zamfirescu-Pereira et al., 2023), і вони повинні навчитися, які фрази відображаються на те, що система може робити (Liu et al., 2023). Делегування штучному інтелекту також переводить роботу з виробництва на специфікацію та перевірку (Sarkar & Drosos, 2025; Simkute et al., 2024). Я називаю цю відсутню здатність словником робочих процесів: набір завдань, які людина знає, як передати агенту, сформульовані так, щоб агент міг їх виконати і результат можна було перевірити. Формально кажучи, це відображення між цілями домену людини та підзавданнями, які може виконати агент, зі словами для входів, трансформацій, виходів, винятків і доказів, які потребує це відображення. Розробник, який відкриває агента, вже знає перші десять речей для введення. Бухгалтер або вчитель зазвичай ні, і ніхто в їхньому офісі їм цього не сказав.
Перший внесок — це чотирирівневої моделі дороги від чату до роботи агента, визначена досяжністю та роллю й не залежно від назви продукту. Рівні йдуть від чату через безпечне середовище агента та агента на власному комп'ютері до повторюваної організованої роботи. Кожен визначається тим, що агент може торкнутися, і тим, що людина повинна указати та перевірити, і кожне переходу визначається артефактом, який агент випустив, а встановлене програмне забезпечення саме по собі не рахується. Оскільки визначення не залежать від назв продуктів, модель пережить поточну звичку виробників об'єднувати свої продукти (розділ 3).
Друге — це синтез доказів на період від 2025 до вересня 2026. Це показує, що встановлення та перша обмежена спроба стали набагато легшими, що три обмеження, визначені у розділі 4.5 (надійна робота з цілими завданнями, стабільні продукти, безпечні папки), не зросли разом з ними, і що поверхневий закономірність використання зберігається. Це також визначає бар'єри, що залишаються: словник робочих процесів, помилка, що зупиняє новачка, дозвіл та безпека, організаційні правила та здатність оцінити результати (розділи 4 та 5).
Третє — це опис двох рівнів оркестрування. Веб-оркестрування, одне питання, надіслане кільком чат-ботам для споживачів, — це міст: він не потребує встановлення і вчить звичку порівняння. Оркестрування CLI, один агент викликає інструменти командного рядка інших агентів, — це рівень делегування, що подовжується. Обидва обмежені фактом, який користувачі зазвичай пропускають, що згода між моделями не є незалежним доказом (Chernets, 2026a) (розділи 6 та 7).
Четверте — це програма вимірювання з пропозиціями, які можна спростувати: дизайн програми попередньо зареєстрованої когорти, яка стежить за непрограмістами протягом цих переходів (Chernets, 2026d), та відкритий навчальний набір інструментів паттернів оркестрування та безпеки у додатках (розділи 9 та 10, додаток C).
Застосовується кілька обмежень щодо обсягу. «Непрограміст» означає професіонала, чия робота суттєво проводиться за комп'ютером, але хто не має підготовки в скриптингу або інженерії програмного забезпечення. Аналітик, вільно володіючий формулами електронних таблиць, враховується, розробник — ні, розробники тут виступають як група порівняння. Я не повідомляю результатів програми когорти; вони належать до окремої статті після періоду спостереження. Більшість показників впровадження походять зі Сполучених Штатів і від постачальників, і позначені як такі. І описані інструменти змінюються щомісяця, тому модель розроблена так, щоб пережити їх, а передбачається, що деталі продукту застарійть.
Розділ 2 розміщує аргумент у літературі, розділ 3 визначає рівні та переходи. Розділ 4 показує, куди пішла технічна бар'єра, розділ 5 що її замінило, розділи 6 і 7 — дві форми оркестрування, а розділ 8 що цей рух робить з людською роллю. Розділ 9 описує програму, яка вимірює переходи, розділ 10 формулює твердження, розділ 11 виводить наслідки, розділ 12 встановлює граничні умови, а розділ 13 робить висновки.
2. Передумови: від програмування користувачів до делегування користувачам
2.1 Користувачі завжди програмували
Ідея того, що люди, які не є програмістами, керують обчисленнями, старша від мовних моделей. Нарді (1993) стверджувала, що користувачі командують обчислювальною потужністю через мови та фреймворки, призначені для конкретних завдань, канонічним прикладом є електронні таблиці, без необхідності загальних навичок програмування. Ко та ін. (2011) показали, що користувачі, які розробляють програмне забезпечення, стикаються з тими самими проблемами, що й професіонали (вимоги, повторне використання, тестування, налагодження), без відповідного навчання, і назвали цю галузь інженерією програмного забезпечення для користувачів. Ширша галузь, розробка для користувачів, вивчає, як люди, які не є професійними розробниками, створюють та адаптують програмне забезпечення для своєї роботи. Майєрс, Пейн і Ко (2004) провели роки, розробляючи нотації, ближчі до того, як непрограмісти описують завдання. Кожен із цих напрямків роботи припускав, що користувач все ще писатиме щось, що виконує машина, навіть якщо це була формула чи правило.
Мовні моделі змінили те, що пише користувач. Саркар та ін. (2022) описали програмування за допомогою великої мовної моделі як нову діяльність, відмінну від компіляції, парного програмування та пошуку. Замфіреску-Перейра та ін. (2023) виявили, що люди без досвіду роботи зі штучним інтелектом з трудом розробляють підказки, які працюють надійно, надмірно узагальнюють на основі окремих успіхів і повертаються до людських розмовних звичок. Ліу та ін. (2023) назвали складність навчання тому, які слова продукують яку поведінку, «грунтованим абстрактним зіставленням». Саркар і Дросос (2025) у першому емпіричному дослідженні «vibe coding» виявили, що діалогове програмування перерозподіляє експертизу в бік керування контекстом і швидкої перевірки результатів, залишаючи потребу в судженні там, де вона була. Вірк і Ліу (2025) виявили, що бізнес-користувачі, яким надали написаний штучним інтелектом код аналізу, часто не вдавалося помітити критичні помилки навіть коли їм говорили шукати їх. Фельдман і Андерсон (2024) назвали непрофесійних програмістів найменш вивченою групою населення генеративної епохи.
Я роблю наступний крок у цьому напрямку. Одиниця роботи користувача змінилася з формули, скрипту чи підказки на делегування: завдання, передане агентові, який діє над файлами та інструментами протягом багатьох кроків. Література з програмування користувачів пояснює, чому складно виражати намір, а література про делегування і контроль пояснює, чому складно перевіряти результат. Чотирьохрівнева модель розділу 3 побудована так, щоб поєднати ці двоє.
2.2 Прийняття швидке та поверхневе
Генеративний штучний інтелект поширювався швидше, ніж персональний комп'ютер чи інтернет. Бік, Бланден і Демінг (2024) оцінили, що близько 40% дорослого населення США працездатного віку використовували його до кінця 2024 року, у той час як лише невелика частина робочих годин була допомогою. Чаттерджі та ін. (2025) виявили, що до середини 2025 року ChatGPT обслуговував близько 700 мільйонів щотижневих користувачів і що більшість повідомлень не були пов'язані з роботою. У Данії Хумлум і Вестергор (2025) виявили точні нульові ефекти на заробітні плати та години через два роки після впровадження, а також розрив у використанні між жінками та чоловіками; метааналіз у більш ніж 100 країнах ставить цей розрив на рівні близько 16 процентних пунктів з початку 2025 року (Кранні та ін., 2026). У 35 європейських країнах контакт зі штучним інтелектом не переклався автоматично в його використання, і навчання, цифровізація та агентність працівника мали більше значення (Гензеке, 2026).
Польові експерименти показують великі прибутки там, де інструмент підходить до завдання: 14% більше проблем клієнтів вирішено за годину в середньому та 34% для новачків (Брінйольфссон та ін., 2025), швидше та краще письмо в дослідженні з 444 професіоналами, з найбільшими прибутками для слабших письменників (Ной та Чжан, 2023), і серед 758 консультантів 12,2% більше завдань виконано та якість піднялася більш ніж на 40% всередині «нерівної межі» можливостей моделі, з гіршою роботою над завданням поза нею (Делль'Аккуа та ін., 2026). Рандомізоване дослідження з досвідченими розробниками відкритого вихідного коду виявило протилежний знак на початку 2025 року, сповільнення на 19% (Бекер та ін., 2025), результат, який його автори пізніше сказали, був вірогідно застарілим у міру поліпшення інструментів (METR, 2026). Урок із цих дослідів полягає в тому, що прибутки залежать від відповідності між завданням, інструментом та здатністю людини керувати ним і перевіряти його, а це три речі, які змінює перехід між рівнями.
2.3 Прийняття, дифузія та розділення другого рівня
Дослідження прийняття технологій, від моделі прийняття технологій (Девіс, 1989) до об'єднаної теорії прийняття та використання технологій (Венкатеш та ін., 2003), дотримуються того, що сприйнята корисність та зручність використання визначають прийняття, і що соціальний вплив та сприятливі умови мають значення так само, як і індивідуальні установки. Дослідження дифузії описують прийняття як соціальний процес з ранніми та пізніми прихильниками (Роджерс, 2003). Як тільки базовий доступ до інтернету став звичайним, Харджіттаї (2002) показав, що змістовна нерівність перемістилася до навичок: цифровий розрив другого рівня. Ван Дейк (2020) розширив це на послідовність мотивації, доступу, навичок та використання.
Та сама зміна видна тепер. Доступ до чату є майже універсальним серед офісних працівників у багатих країнах, у той час як навичка керування агентом далека від універсальної. Розрив у штучному інтелекті вже було виміряно за старими лініями освіти, регіону та віку (Депп та Каунтс, 2024; Центр досліджень Pew, 2026). Те, що я додаю, - це спостереження, що розрив тепер проходить всередині популяції користувачів штучного інтелекту, між тими, хто спілкується з моделями, і тими, хто делегує їм.
2.4 Автоматизація, контроль і тягар менеджера
Література про людський нагляд над автоматизацією починається з парадоксу. Бейнбридж (1983) описав це: автоматизація більшої частини завдання залишає людині найскладнішу залишкову роботу — моніторинг та рідкісні втручання — одночасно підривши необхідну для цього навичку. Парасураман та Райлі (1997) розрізнили неправильне використання, невикористання та зловживання автоматизацією, а Лі та Сі (2004) показали, що залежність має відповідати каліброваній довірі. Епоха генеративного ШІ поновила кожний з цих пунктів. Спеціалісти зі знань, які більше довіряють інструменту, повідомляють про менш критичне мислення (Лі та ін., 2025). Генеративний ШІ змінює людей з виконавців на оцінювачів і робить легкі завдання легшими, а складні — складнішими (Сімкуте та ін., 2024). Втручання для калібрування залежності від мовних моделей зменшують надмірну залежність, не створюючи належної залежності (Бо та ін., 2025). Користувачі ШІ-агентів як щоденних помічників неправильно калібрують довіру до правдоподібних, але хибних планів, і діють краще, коли беруть участь у покроковому виконанні (Хе та ін., 2025). Кращі записи про те, що робив агент, прискорюють виявлення помилок, не поліпшуючи надійно остаточну точність (Гранде-Маклафлін та ін., 2026). Дослідження близько 73 000 публічних постів про одного автономного агента показало, що цінності користувачів переважно задовольнялися в результатах роботи агента та переважно не задовольнялися можливостями його контролю (Ма та ін., 2026). У невеликому лабораторному дослідженні та трьох розгортаннях комфортність делегування зростала з часом, в той час як люди все ще бажали контролю в моменти невизначеності (Лонг та ін., 2025). Томашев, Франклін та Осіндеро (2026) розглядають делегування ШІ як фреймворк розподілу завдань, передачі влади, відповідальності та довіри, який застосовується як до людських, так і до машинних делегатів.
З когнітивної точки зору, дослідження ЕЕГ 54 авторів есе повідомило про слабшу пов'язаність і нижчу приналежність у групі з асистенцією — «когнітивний борг» (Космина та ін., 2025), а опублікований коментар оскаржив його методи (Станкович та ін., 2026). Безпечне тлумачення полягає в тому, що розвантаження рутинних кроків звільняє увагу, і звільнена увага має бути витрачена на перевірку. Дві подальші ідеї з дослідження навчання використовуються пізніше. Теорія когнітивного навантаження пояснює, чому новачок, кинутий у неогороджене середовище, зупиняється перед тим, як сформується розумова схема (Свеллер, 1988). А модель прийняття як байєсівське навчання показує, як люди можуть потрапити в саморозповсюджуючу рівновагу низького використання, яку можуть змінити лише перший успіх або навчання (Ма та ін., 2025).
Два супровідні папери цієї серії розглядають цю проблему з іншого боку. Перший показує, що узгодженість між кількома моделями є слабшою як свідоцтво, ніж виглядає, тому що їхні помилки корельовані (Чернець, 2026a). Другий показує, як компоненти автоматизованого нагляду можуть розширити свої власні повноваження та перешкодити роботі, яку вони охороняють (Чернець, 2026b). Обидва мають значення для новачка: перший для того, що може купити оркестрування, другий для того, чому шари безпеки можуть зупинити людину біля дверей.
2.5 Що не було вивчено
Пошук, проведений 21 вересня 2026 року (веб-пошук, Crossref, arXiv та Semantic Scholar з увагою до статей CHI, UIST і VL/HCC 2024–2026 років) не виявив опублікованого польового дослідження того, як непрограмісти приймають термінальні чи командні агенти за назвою, не виявив дослідження веб-оркестрування (одного запитання до кількох споживацьких чат-ботів у браузері) як названої практики, не виявив розглядання управління агентами як навички зі власною структурою компетенції та не виявив дослідження системи ШІ, яка підтримує прийняття людиною agentic ШІ; найближча робота застосовує теорію лісування до ШІ-репетиторів інших предметів (Кон та ін., 2026) або до інтерфейсів, обумовлених завданнями, для складного програмного забезпечення (Ліу & Сра, 2026). Робота з трудової економіки вимірює прийняття генеративного ШІ в цілому, і жодна з них не ізолює крок від чату до агентських інструментів серед непрограмістів. Ці прогалини визначають простір, який моделює модель, і програма розділу 9 розроблена для вимірювання.
3. Чотири рівні та три переходи
3.1 Дві осі: охоплення та роль
Рівень описує відносини між людиною та моделлю на роботі, і я визначаю його за двома осями: охопленням та роллю.
Охоплення — це те, чого модель може торкнутися від імені людини. На найвужчому рівні це лише розмова, потім файли та інструменти в межах простору, обмеженого постачальником, потім власний комп'ютер людини з його файлами, програмами та розкладом, а на найширшому — кілька моделей та агентів одночасно.
Роль — це те, що людина повинна робити для успішного завершення роботи. У тому ж порядку вони запитують і копіюють, передають завдання та переглядають результат, вони володіють середовищем агента з його дозволами та скасуванням, або розподіляють роботу між агентами та узгоджують те, що повертається.
Продукти свідомо відсутні в визначенні. Один продукт може охоплювати кілька рівнів, а у 2026 році постачальники об'єднують чат та агентів в одне вікно швидше, ніж будь-яка таксономія, побудована на назвах продуктів, могла б слідувати (розділ 4.3). Рівень описує частину роботи, і одна людина, як один продукт, може охоплювати кілька. Та ж сама людина може бути на рівні 1 для одного завдання з ранку і на рівні 3 для іншого після обіду.
Дві осі також відділяють цю модель від знайомих шкал автоматизації та автономії. Parasuraman, Sheridan and Wickens (2000) класифікували, скільки кожного етапу завдання (отримання інформації, її аналіз, прийняття рішення, дія) виконує машина. Morris et al. (2024) оцінили системи штучного інтелекту загального призначення за глибиною та широтою їх роботи. Feng, McDonald and Zhang (2025) визначили п'ять рівнів автономії для агентів штучного інтелекту залежно від ролі користувача, від оператора та співробітника до консультанта, схвалювача та спостерігача. Ці шкали описують, скільки рішень приймає агент в межах завдання. Чотири рівні тут описують де виконується робота та що власниває людина: розмова, обмежений постачальником простір, їхня власна машина, команда агентів з кількох постачальників. Осі ортогональні. Агент на власному комп'ютері людини може працювати на будь-якому з рівнів автономії Feng et al., від затвердження крок за кроком до майже повної делегування, і людина все ще володіє його дозволами та скасуванням. Те, що додають чотири рівні, — це опис прийняття: порядок, у якому охоплення та відповідальність зростають для когось, хто починає з чату, та свідоцтво (артефакт), який показує, що кожен крок був зроблений.
3.2 Чотири рівні
Рівень 1: чат. Охоплення моделі закінчується розмовою. Вона виробляє текст, код або зображення, які людина копіює в місце, де відбувається робота, і роль людини — добре запитувати та переносити результат. Майже кожен професіонал, який використовує штучний інтелект, працює тут більшість часу (розділ 2.2).
Рівень 2: безпечне середовище з агентами. Модель діє на файлах, підключених служб і іноді браузері в межах простору, обмеженого постачальником: вибрані папки, віртуальна машина або пісочниця на стороні сервера, з'єднувачи, схвалені людиною, та крок затвердження перед важливими діями. Cowork від Anthropic, ChatGPT Work від OpenAI, Copilot Cowork від Microsoft та Gemini Spark від Google є прикладами 2026 року, і вони мають спільну конструкцію агента делегування, що працює в обмеженому просторі (Anthropic, 2026b; MacRumors, 2026; Microsoft, 2026a; TechCrunch, 2026b). Роль людини змінюється від запитання до делегування. Вони передають завдання, яке закінчується файлом або дією, і переглядають те, що повертається, і багато безпеки середовища на цьому рівні є відповідальністю постачальника.
Рівень 3: агент на своєму комп'ютері. Агент працює на машині людини з доступом до файлової системи, оболонки, встановлених програм та запланованих завдань через термінал або настільну оболонку на одному двигуні: Claude Code, Codex від OpenAI, Antigravity CLI від Google, Grok Build від xAI, Kimi Code від Moonshot та еквіваленти з відкритим вихідним кодом. У дослідницькій літературі це LLM-основані агенти, і їх використання розробниками вивчається як кодування з агентами; рівень запитує, що відбувається, коли людина, яка їх запускає, не є розробником. Охоплення є найширшим, що отримує один агент, і з цим роль людини знову змінюється. Вони володіють середовищем: які папки бачить агент, які команди потребують затвердження, що виключається та як скасувати помилку. Сам термінал є непринциповим, оскільки те, що визначає рівень, — це власність робочого середовища, в якому агент може робити все, що могла б робити людина. Варіанти, розміщені в хмарі (той же цикл агента, що працює на машині постачальника, де людина бачить завдання та результат і ніколи не бачить підказку), мають рівень 3 за можливостями та рівень 2 за радіусом вибуху, і модель записує їх як варіант рівня 3, не примушуючи їх в одну комірку.
Рівень 4: повторна, оркестрована робота. Людина спрямовує кілька моделей або агентів, паралельно або послідовно, на роботу, яка повторюється, а охоплення тепер охоплює постачальників. Є два шари. У веб-оркестрації одне питання надходить кільком помічникам з чатом для споживачів у браузері, вручну або за допомогою інструменту, і відповіді порівнюються. У оркестрації CLI один агент викликає інструменти командного рядка інших агентів, збирає їх результати та об'єднує або перевіряє їх. Роль людини — роль менеджера: вони встановлюють мету, розподіляють роботу, вирішують, що вважається готовим, та узгоджують розбіжності. Робота стає повторюваною, коли вона записується у формі, яку агенти можуть запустити знову, як файл інструкцій, навичка або запланована робота. «Повторна» описує робочий процес, а не результат. Той же файл інструкцій, запущений на наступному тижні, видаватиме іншу чернетку, і те, що повторюється, — це послідовність входів, кроків, перевірок та результату. Повторна робота одного агента, записана таким чином, — це робота рівня 3, яка повторюється, і вона стає рівнем 4, коли спрямовується друга сім'я моделей та результати узгоджуються (перехід 3, розділ 3.3).
Таблиця 1. Чотири рівні.
| Рівень | Охоплення моделі | Роль людини | Типові поверхні, вересень 2026 | Перехід показано за допомогою | Що рівень не встановлює | Основна перешкода при вході |
|---|---|---|---|---|---|---|
| 1. Чат | Розмова | Запитує, копіює результат вручну | Чат у браузері або програмі | (вхідний рівень) | Що модель може діяти на роботу людини, або їй можна довіряти без перевірки | Ніякої крім доступу |
| 2. Безпечне середовище з агентами | Файли, з'єднувачи та браузер в межах простору, обмеженого постачальником | Делегує завдання, переглядає результат | Cowork об'єднано з Claude chat; ChatGPT Work; Copilot Cowork; Gemini Spark | Файл або дія, створені агентом із делегованого завдання, зі записаною схвалою або відмовою | Що особа може запустити власне середовище або повторити роботу | Знання того, що делегувати; довіра |
| 3. Агент на власному комп'ютері | Файлова система, оболонка, програми, розклад особи | Володіє середовищем: дозволи, виключення, скасування | Терміналові та настільні оболонки Claude Code, Codex, Antigravity CLI, Grok Build, Kimi Code | Артефакт, створений агентом на власній машині особи, у папці, яку створила особа, з завдання, що вимагає більше одного використання інструменту | Що результат правильний або безпечний для прийняття без перевірки | Тертя при встановленні (зниження); перша помилка; дозволи; що запитувати |
| 4. Впорядкована робота | Кілька моделей або агентів від різних постачальників | Керує: мета, розподіл, прийняття, узгодження | Веб: кілька вкладок чату або інструменти трансляції. CLI: плагіни та скрипти, які викликають інших агентів | Об'єднаний або перехресно перевірений результат щонайменше від двох сімейств моделей, повторно запущений щонайменше один раз, зі записаним, кого запитувалося й хто відповідав | Що згода між моделями є незалежним доказом або що завдання належить до цього рівня | Вартість узгодження; корельовані помилки; квота та зміна інструментів |
Два терміни в таблиці вужчі за повсякденне використання. «Безпечне» в «безпечне середовище агента» називає дизайнерську мету та паттерн взаємодії й не гарантує нічого. Область папки, схвали, пісочниці та панелі попереднього перегляду зменшують простір, на який впливає агент; вони не можуть примусити помилкову реалізацію зберегти файли або зробити документ з прихованими інструкціями безшкідливим, і розділ 5.3 повідомляє про те, що пішло не так всередині наданих папок. Те, що встановлює середня сходинка, — це практична ментальна модель. Особа, яка бачить, що агент може написати звіт в одній папці й не може торкатися нічого іншого, дізналася, що делегована дія має периметр, що набагато корисніше за будь-яке абстрактне попередження про обережність із штучним інтелектом. «Артефакт» означає результат, що потребував кількох кроків власної роботи агента. Особа, яка це попросила, вирішує, чи вважається це артефактом; третя сторона оцінює його якість (розділ 9.4), а дослідження повідомляє про узгодженість між оцінювачами як для цієї оцінки, так і для кодування причин зупинення. Папка з двома порожніми файлами — це слід інсталятора й не враховується.
3.3 Три переходи і чому артефакт визначає кожен
Перехід перетинається, коли агент створив артефакт, який запросила особа, на новому рівні. Встановлення рахується лише як спроба, так само як завершений навчальний матеріал, значок, ліцензія та самозвіт «Я тепер користуюся агентами». Правило має кілька наслідків поза очевидним. Папка, створена агентом, показує, що агент працював, тоді як набір файлів, написаних агентом на основі опису особою своєї власної роботи, показує, що особа делегувала. Правило також робить переходи спостережуваними ззовні: дослідник або менеджер може бачити артефакт, але не може бачити наміри чи почуття компетентності. Це робить невдачу інформативною, оскільки особа, яка встановила інструмент і нічого не створила, зіткнулася з перешкодою, вартою нази, а рахування встановлення як успіху приховало б це. І оскільки це не називає жоден продукт, правило дозволяє дослідженням порівнювати інструменти, які перейменовуються щокварталу.
Перехід 1, від чату до безпечного середовища агента, перетинається, коли особа вперше делегує завдання, яке закінчується файлом або дією замість тексту. У 2026 році цей перехід поглинається самим вікном чату. Коли модель постачальника вирішує відповідати чи діяти, як це відбувається в об'єднаному досвіді Claude, оголошеному 16 вересня 2026 року (Anthropic, 2026c), особа може перетнути його без вибору. Це робить перехід легшим і менш помітним, включаючи для самої особи.
Перехід 2, від безпечного середовища до власного комп'ютера, перетинається, коли особа запускає агента у своєму власному середовищі й отримує від нього артефакт. Вирішальна зміна — це власність. На рівні 2 постачальник вирішує, що може торкатися агент, а на рівні 3 — це робить особа, незалежно від того, який вигляд показує агент, термінал чи вікно. Страх перед терміналом раніше жив тут, і розділ 5 показує, що питання дозволів, помилок і того, що запитувати, займають його місце.
Перехід 3, від одного агента до впорядкованої роботи, перетинається, коли особа отримує результат, створений або перевірений щонайменше двома сімействами моделей, і повторно запускає цей розклад для подальшої роботи. Повторний запуск має значення, оскільки одне порівняння трьох чатботів — це цікавість, а лише порівняння, до якого особа звертається, коли ставка виправдовує це, становить практику.
Маршрут, якому слідує програма розділу 9, можна пройти як дизайн, при цьому професіонал зі Вступу служить гіпотетичним випадком і нічого не повідомляється. Вона почала б там, де вже перебуває, на рівні 1, з чатботом, за який вона платить. Вона вставила б стандартний текст у цей чатбот і дозволила б йому керувати встановленням нею графічного агента на власному ноутбуці, надсилаючи йому знімок екрана щоразу, коли крок не вдавався б, і я не торкався б нічого. Перший крок рахувався б перетнутим лише тоді, коли агент створив би, на основі її власного опису своєї роботи, набір файлів, які вона могла б відкрити та оцінити; встановлена програма поряд з порожною папкою рахувалася б спробою. Вона працювала б у копії своїх файлів, тримала б паролі та документи клієнтів подалі від цього, читала б план агента перед тим, як дозволити йому діяти, і підтверджувала б все незворотне. Коли вона сказала б, що готова, вона отримала б інструмент з відкритим вихідним кодом, який ставить одне питання кільком моделям через підписки, які вона вже має, і повертає одну об'єднану відповідь, запущену з агента, і цей крок рахувався б, коли датована версія показала б, які моделі було запитано й де вони відрізнялися. Пізніше вона запустила б те саме порівняння через інструменти командного рядка. Вона могла б зупинитися в будь-якій з цих точок, а зареєстрований запис утримував би, де і, її словами, чому. Маршрут береться з публічної реєстрації, і те, чи люди йдуть ним, — це питання для результатів роботи.
3.4 Рівні впорядковані, а не обов'язкові
Рівні впорядковані за охопленням та за відповідальністю, яку вони накладають на людину. Цей порядок не робить їх сходами, які всі мають подолати крок за кроком. Людина може перейти прямо від чату до агента на своєму комп'ютері; маршрут когорти, описаний у розділі 9, робить саме це, причому чатбот, який людина вже використовує, веде її через установку. Інші зупиняться на рівні 2 назавжди, і для багатьох робіт це правильне місце для зупинки. Вище не краще в цій моделі. Її твердження полягають у тому, що кожен рівень ставить різні вимоги до людини, що переходи можна спостерігати, і що перешкоди на кожному переході відрізняються. Вона була б спростована, якби переходи неможливо було розрізнити за артефактами, якби перешкоди не відрізнялись між переходами, або якби компетентність на одному рівні не змінювала того, що люди могли робити на наступному, оскільки в будь-якому з цих випадків модель не додавала б нічого до простої шкали «використання ШІ». Модель також передбачає, що, коли чутливість завдання та технічні вимоги залишаються незмінними, завершення падає більш різко на трьох переходах, ніж у межах рівня. Якби падіння були розподілені рівномірно, рівні були б переіменованою континуумом. Розділ 10 перетворює ці очікування на твердження з мірами та спростуванням.
Одне сімейство інструментів належить біля драбини і ні на жодному її щаблю. Конструктори браузерних додатків дозволяють людині описати додаток і отримати запущений попередній перегляд всередину платформи, яку розміщує постачальник. Вони важливі, і вони є чимось іншим від рівня 2, де агент діє на файлах людини під моделлю дозволів; конструктор додатків діє на проекті, яким володіє платформа. Плутанина цих двох створює хибне враження, що непрограмісти вже прибули. Чотирирівнева модель залишає конструктори додатків на бічній гілці зі своєю стелею і своїм профілем безпеки, а література про vibe-coding — це місце для читання про них (Sarkar & Drosos, 2025; Ge et al., 2025). Рисунок 1 зображує чотири рівні, артефакт, який позначає кожен перехід, записаний пропуск та бічну гілку.
Рисунок 1. Чотири рівні та три артефактом визначені переходи.
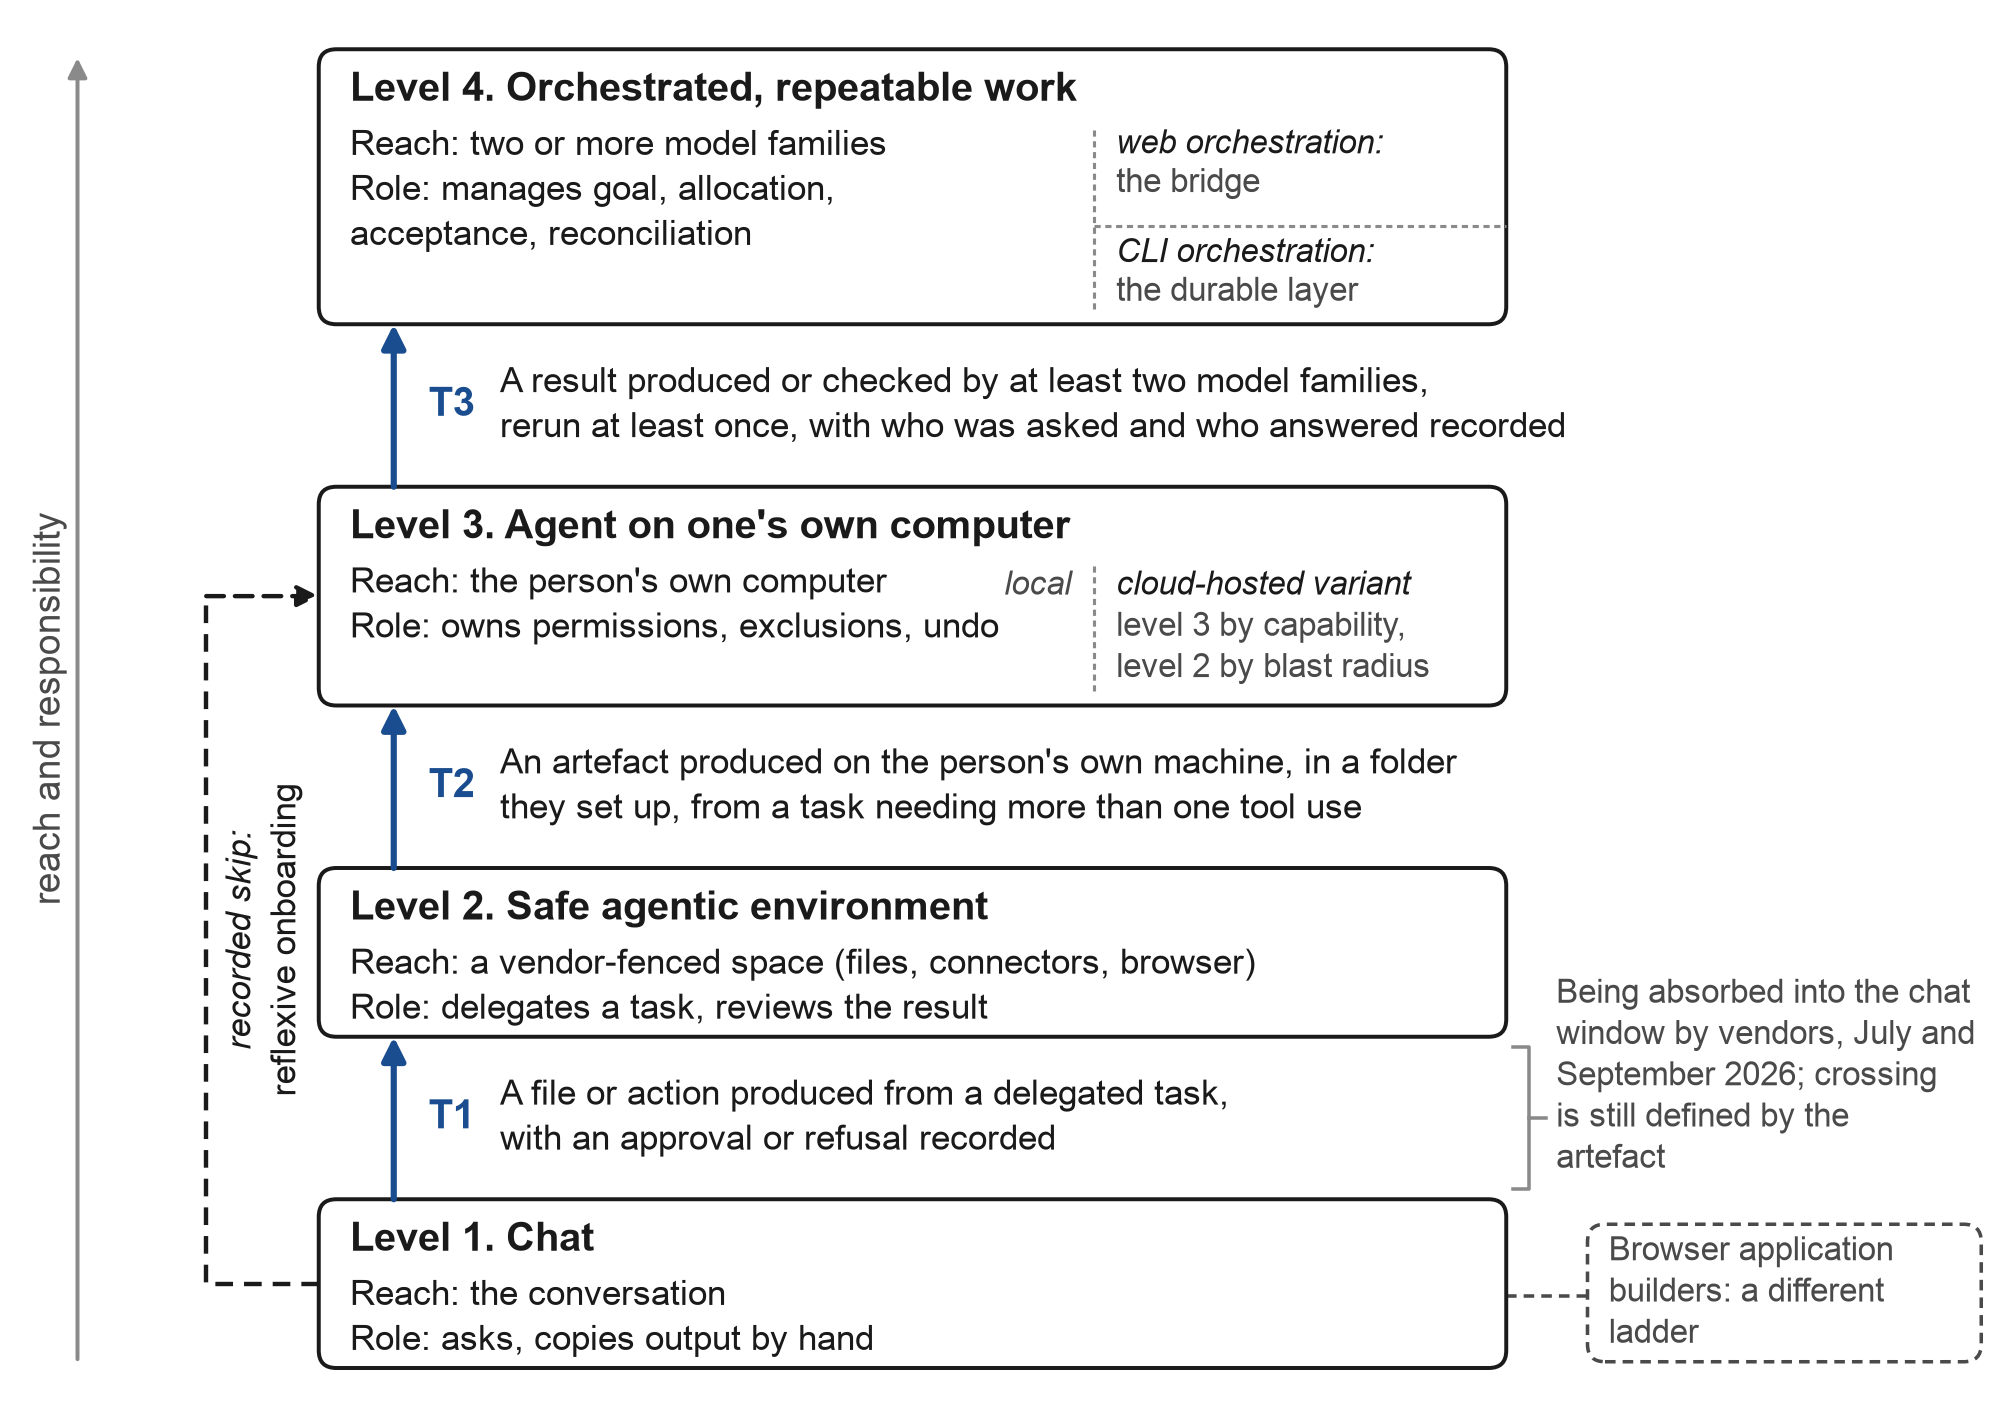
Примітка: Чотири рівні розділу 3.2, упорядковані в порядку зростання за охопленням (що модель може торкатися) та за відповідальністю, покладеною на людину. Кожен перехід, T1 до T3, перетинається лише коли агент створив артефакт, названий біля його стрілки, і установка розраховується як спроба (розділ 3.3 та таблиця 1). Штрихована стрілка зліва — це записаний пропуск від чату до агента на комп'ютері людини, який робить зареєстрований маршрут (розділи 3.4 та 9.2); штрихований прямокутник справа — це бічна гілка конструкторів браузерних додатків, і примітка в T1 записує злиття чату та поверхонь агента постачальниками в липні та вересні 2026 року (розділ 4.3).
3.5 Термінал більше не є терміналом
Для програміста термінал — це інтерфейс для видачі команд. Для професіонала, який працює з агентом, це середовище, де живе агент: папка для роботи, набір дозволів та історія того, що було зроблено. Коли Anthropic представила Cowork у січні 2026 року, формулювання було «Claude Code для решти вашої роботи»: той самий агент, пропонований людям, які не пишуть програмне забезпечення, без терміналу (Fortune, 2026a).
Постачальники тепер діяли на основі цього ж спостереження. OpenAI перейменував своє додаток coding-agent на «ChatGPT» і зробив його клієнтом стільниці за замовчуванням (MacRumors, 2026). Anthropic випускає програму для стільниці для агента, яка не потребує терміналу (Anthropic, 2026a). Google припинила свій відкритий код Gemini CLI для окремих користувачів 18 червня 2026 року на користь багатоагентної платформи та нового інструменту командного рядка, заявивши, що користувачі тепер «потребують кількох агентів, що спілкуються один з одним, щоб розділити роботу» (Google, 2026). Видимий термінал зникає, але середовище, до якого він давав доступ, все ще там і все ще повинне бути запущене кимось. Для професіонала корисне питання змінилося відповідно: чи можуть вони використовувати термінал, має все менше значення кожного місяця, і чи можуть вони запустити середовище, в якому агент працює для них — це питання, яке я б їм поставив.
4. Де подівся технічний бар'єр
4.1 Встановлення стало одним кроком
У 2024 році непрограміст, який хотів мати агента терміналу, стикався з послідовністю невеликих перепон: встановити мовне середовище виконання, виправити змінну шляху, розібратися, чому оболонка сказала «permission denied», обрати між чотирма речами, які всі називаються «install». До вересня 2026 року більшість цих перепон було усунено постачальниками. Провідні агенти терміналу встановлюються за допомогою однієї команди або настільного інсталятора, який оновлюється самостійно. Настільний додаток Claude Code пропонує паралельні сеанси, візуальний перегляд змін, живий перегляд і запланові завдання, а його документація стверджує: «No terminal required» (Anthropic, 2026a). Настільний додаток OpenAI інтегрує свого агента кодування в звичайний клієнт ChatGPT (MacRumors, 2026). Нове командне середовище Google є одним двійковим файлом, поєднаним з настільною платформою (Google, 2026).
Агент, який встановлюється в один крок, усе ще складно використовувати добре, і я не хочу перебільшувати це змінення. Що змінилося — це те, що інсталятор більше не є першою перепоною, на яку натикається новачок. Тертя, яке залишилося — це вибір дверей: терміналу, розширення редактора, настільного додатка і веб-версії — все це носить назву «install», а вибір між ними становить більшість того, що встановлення тепер коштує новачку. Вибір дверей означає знання того, що ви хочете, щоб агент робив, тому це проблема словника, виряджена як проблема налаштування, і вона належить розділу 5.
Один архітектурний факт лежить в основі всіх цих сторінок продукту. Інструмент командного рядка — це еталонна реалізація: субагенти, гаки, навички, сервери протоколів і режими без голови спочатку з'являються в CLI, а потім у настільних і веб-інтерфейсах того самого механізму; власна сторінка допомоги Anthropic описує свого агента рівня 2 як «the same agentic architecture that powers Claude Code, with no terminal required» (Anthropic, 2026b). Для новачка це працює в обидві сторони. Дружній інтерфейс може наздогнати потужний. Але документація, приклади та відповіді на форумах все ще говорять діалектом CLI, тому людина, яка почала з настільного додатка, читає про інструмент, який вона не встановлювала.
4.2 Чатбот як власний інсталятор
Друга зміна менш видима і, для аргументу тут, важливіша. Чатбот, який особа вже використовує, може провести її через встановлення агента. Людина вставляє запит («walk me through installing this on my Windows laptop; I am not technical»), дотримується кроків, і коли щось не вдається, надсилає знімок помилки назад тому самому чатботу. Більш обізнана інша сторона зони найближчого розвитку Вигоцького (Vygotsky, 1978) і репетитор, чиї функції Wood, Bruner і Ross (1976) назвали скеффолдингом (залучення інтересу, зменшення ступенів свободи, виділення критичних особливостей, керування розчаруванням), тепер доступна в інструменті, якому людина вже довіряє, у будь-яку годину, своєю мовою, безкоштовно.
Я називаю це рефлексивною адаптацією: система штучного інтелекту, що супроводжує адаптацію людини до більш потужної системи штучного інтелекту. Це змінює звичайний напрямок допомоги. У літературі про дифузію новачок адаптується через контакт з ранніми адаптарами (Rogers, 2003), а тут ранній адаптер замінюється, принаймні для механічних кроків, самою моделлю рівня 1.
Тим часом навколо цього кроку виросла навчальна верства. Академії постачальників пропонують короткі курси своїх агентів, а великі платформи навчання викладають «vibe coding» з названим агентом. З'явилися курси, які подаються всередину самого агента, так що учень встановлює агента, а агент викладає курс (CC for Everyone, 2026), а одна консалтингова фірма оголосила, що близько 30 000 своїх працівників будуть навчені на моделях одного постачальника (Accenture, 2025). Наявність цієї верстви говорить про те, що встановлення більше не розглядається як саме собою зрозуміле. Теорія мінімальної інструкції передбачала, що люди найкраще вивчають програмне забезпечення, виконуючи реальне завдання з самого початку та відновлюючись від помилок (Carroll, 1990), а рефлексивна адаптація забезпечує завжди присутній посібник для обох. Чи це працює для людей, які ніколи не відкривали термінал, я ще не знаю; перший крок програми в розділі 9 розроблений, щоб це з'ясувати, а пошук, описаний у розділі 2.5, не знайшов жодного дослідження цього.
4.3 Постачальники об'єднують рівні
Найбільша зміна 2026 року має структурний характер. Кожна з трьох передових лабораторій та Microsoft тепер поставляє агента рівня 2, і двоє з них почали складати рівень 2 назад у чат.
Таблиця 2. Ходи постачальників, які змінили дорогу від чату до агента, січень-вересень 2026 р.
| Дата (2026) | Постачальник | Хід | Вплив на рівні | Джерело |
|---|---|---|---|---|
| Січень | Anthropic | Cowork дослідницький попередній перегляд: «Claude Code for the rest of your work», агент з обсягом папки для непрограмістів | Рівень 2 як названий продукт | Fortune (2026a) |
| 9 березня | Microsoft | Технологія за Cowork введена до Microsoft 365 Copilot; площина керування Agent 365 | Рівень 2 всередину домінуючого пакету офісних програм | Microsoft (2026a) |
| 30 березня | OpenAI | Офіційний плагін для запуску його агента кодування всередину агента конкурента, «to delegate tasks», включено безкоштовний рівень | Рівень 4 (CLI) санкціонований постачальником | OpenAI (2026a) |
| 19 травня; 18 червня | Gemini CLI знято з експлуатації для індивідуальних рівнів на користь Antigravity CLI та багатоагентної платформи | Рівень 3 переплатформований; плинність для новачків | Google (2026) | |
| 2 червня | OpenAI | Агент кодування з 5 мільйонами щотижневих користувачів; близько 20% фахівців, що зростають більше ніж у 3 рази швидше, ніж розробники (дані постачальника, звіт преси) | Використання агента з терміналу фахівцями; спрямоване, і ширше, ніж рівень 3, як визначено тут | Help Net Security (2026) |
| 1 липня | Агент Gemini Spark для Mac, працює з локальними файлами (бета, США) | Рівень 2 з третьої лабораторії | TechCrunch (2026b) | |
| 9 липня | OpenAI | Додаток агента кодування стає новим настільним додатком ChatGPT; агент ChatGPT Work використовує локальні файли та додатки | Рівні 1 до 3 в одному клієнті | MacRumors (2026) |
| 26 серпня | Anthropic | Агент браузера загально доступний за платними планами; діє автономно з класифікатором безпеки за замовчуванням | Рівень 2: дальність розширена на веб | Anthropic (2026d) |
| 16 вересня | Anthropic | Cowork і chat об'єднані в «one Claude»; модель вирішує, відповідати чи діяти | Transition 1 поглинута в chat | Anthropic (2026c); TechCrunch (2026a) |
Якщо читати послідовно, таблиця описує конвергенцію. Спочатку постачальники розділили chat та агентну роботу, щоб непрограмісти не лякалися терміналу, а потім виявили, що люди не можуть визначити, до якого вікна належить завдання, і зараз знову об'єднують обидва з тим, що модель вирішує. TechCrunch повідомив, що компанія сказала, що клієнти «часто мали труднощі з вибором правильної вкладки для правильного завдання» (TechCrunch, 2026a); власне оголошення компанії подало це як «вам не потрібно вибирати, куди йде завдання», з роботою, яка продовжується після закриття ноутбука, агент за замовчуванням питає перед дією, і об'єднання спочатку розгортається для платних індивідуальних планів, а вкладка кодування залишається окремою (Anthropic, 2026c). Я читаю це як свідоцтво постачальника на користь бар'єру, названого в Розділі 1, словник робочого процесу. Якщо люди не можуть вирішити, чи є завдання питанням або делегуванням, вони навряд чи знатимуть, як сформулювати делегування.
Об'єднання може здаватися підривом моделі з окремим рівнем 2. Але це не так, і причину можна дати, не кажучи, що модель передбачила події. Постачальники мають комерційний, технічний і безпековий інтерес щодо утримання звичайних користувачів усередині вікна, яке вони можуть класифікувати, обмежувати частотою та обгортати моделлю дозволів, і інтерес до зручності в тому, щоб не змушувати користувача вибирати режим; поглинання Transition 1 в chat випливає з обох. Правило переходу не змінюється. Якщо система записала файли в дозволену область після схвалення, Transition 1 була перейдена, незалежно від оформлення навколо розмови, і якщо вона повернула абзац, людина все ще на рівні 1. Модель передбачає, що Transition 2 і 3 не розчиняться так само. Локальний агент з доступом до shell — це інший об'єкт дозволів від серверної пісочниці, а інструмент другого постачальника, який працює під логіном того постачальника, — це інший об'єкт дозволів від функції ради одного постачальника. Ці різниці несуть аргумент безпеки розділу 5.3 та аргумент кореляційної помилки розділу 6.3. Якщо до кінця 2027 великі постачальники об'єднають локальних агентів shell і міжпостачальницькі виклики в те ж вікно chat під тією ж моделлю дозволів, це передбачення неправильне, і твердження, що оркестрація CLI є шаром, який триває, падає з ним (P2 та P8 у розділі 10).
Конвергенція також має вартість — плинність. Агент командного рядка Google з відкритим кодом обслуговував окремих користувачів трохи менше дванадцяти місяців (25 червня 2025 – 18 червня 2026), агентний браузер OpenAI був припинений після близько дев'яти, а Cowork існував як окремий продукт близько восьми (Google, 2026; 9to5Mac, 2026; Anthropic, 2026c). Професіонал, який вкладає ресурси в навчання інструменту, може виявити, що він був перейменований, об'єднаний або припинений протягом року. Те, що передається між інструментами, — це словник робочого процесу, а те, що втрачається, — це знання меню продукту, асиметрія, яка має значення для того, як люди повинні навчатися (розділ 11.2).
4.4 Працівники знань у терміналь-спадкових агентах
Найкращий єдиний факт про непрограмістів всередині терміналь-спадкового агента надходить від постачальника. У червні 2026 OpenAI повідомила через преса, що її агент кодування мав п'ять мільйонів щотижневих користувачів, більш ніж в шість разів перевищуючи рівень на момент запуску настільного застосунку в лютому, що працівники знань становили близько 20% з них і приймали його більш ніж в три рази швидше, ніж розробники, та що щотижня, за підрахунком постачальника, 72% користувачів-працівників знань створювали артефакти, такі як звіти, записи, контракти, таблиці та PDF-файли (Help Net Security, 2026; власна сторінка постачальника повернула помилку доступу під час моїх перевірок, тому цифри цитуються з прес-релізу). Двадцять відсотків від п'яти мільйонів — це близько одного мільйона людей на тиждень. Аналітик відзначив, що випуск був частково спрямований на «повернення деякого гуку» та що агент «часто використовується поряд» з конкуруючими агентами, тому графіки зростання «слід використовувати спрямовано» (Constellation Research, 2026a). Цифри повідомлені постачальником і не перевірені аудитом, вони описують людей, які вже вибрали інструмент, і вимірюють використання агента терміналю-спадку працівниками знань, що ширше, ніж прийняття рівня 3, як визначено тут (артефакт із делегованого завдання на власній машині людини). З цими застереженнями вони достатні, щоб сказати, що терміналь-спадкові агенти більше не зарезервовані для програмістів; чи досягають його користувачі рівня 3, як визначено в розділі 3, — це те, що цифра не може показати.
Поруч із цим фактом стоїть широка та поверхнева закономірність розділу 1. Опитування розходяться щодо рівня та погоджуються щодо форми: близько половини дорослих американців використовують чат-боти (Pew Research Center, 2026), 52% американських робітників використовують AI у своїй ролі (Gallup, 2026), і 45% робітників і 62% дорослих використовують генеративний AI за вимірюванням St. Louis Fed (Bick et al., 2026), тоді як близько одного з семи робітників використовує його щодня, а автоматизація є менш розповсюджена форма використання. На малюнку 2 показані серії робітників Gallup і St. Louis Fed поруч із цифрами розробників із розділу 1, одна панель на опитування, тому що опитування відрізняються за питанням і знаменником. Серед розробників агенти кодування майже універсальні, а використання все ще обережне: у імпульсному опитуванні травня 2026 року близько 1100 технологів 69% використовували одного агента, 59% рідко або ніколи не дозволяли агентам запускатися без нагляду, і 60% блокували агентів від внесення несхвалених змін до своїх систем (Stack Overflow, 2026). Рівень 4, іншими словами, все ще є прикордонною областю навіть для програмістів, які використовують рівень 3 кожен день.
Малюнок 2. Широко та поверхнево: прийняття серед розробників та серед інших робітників.
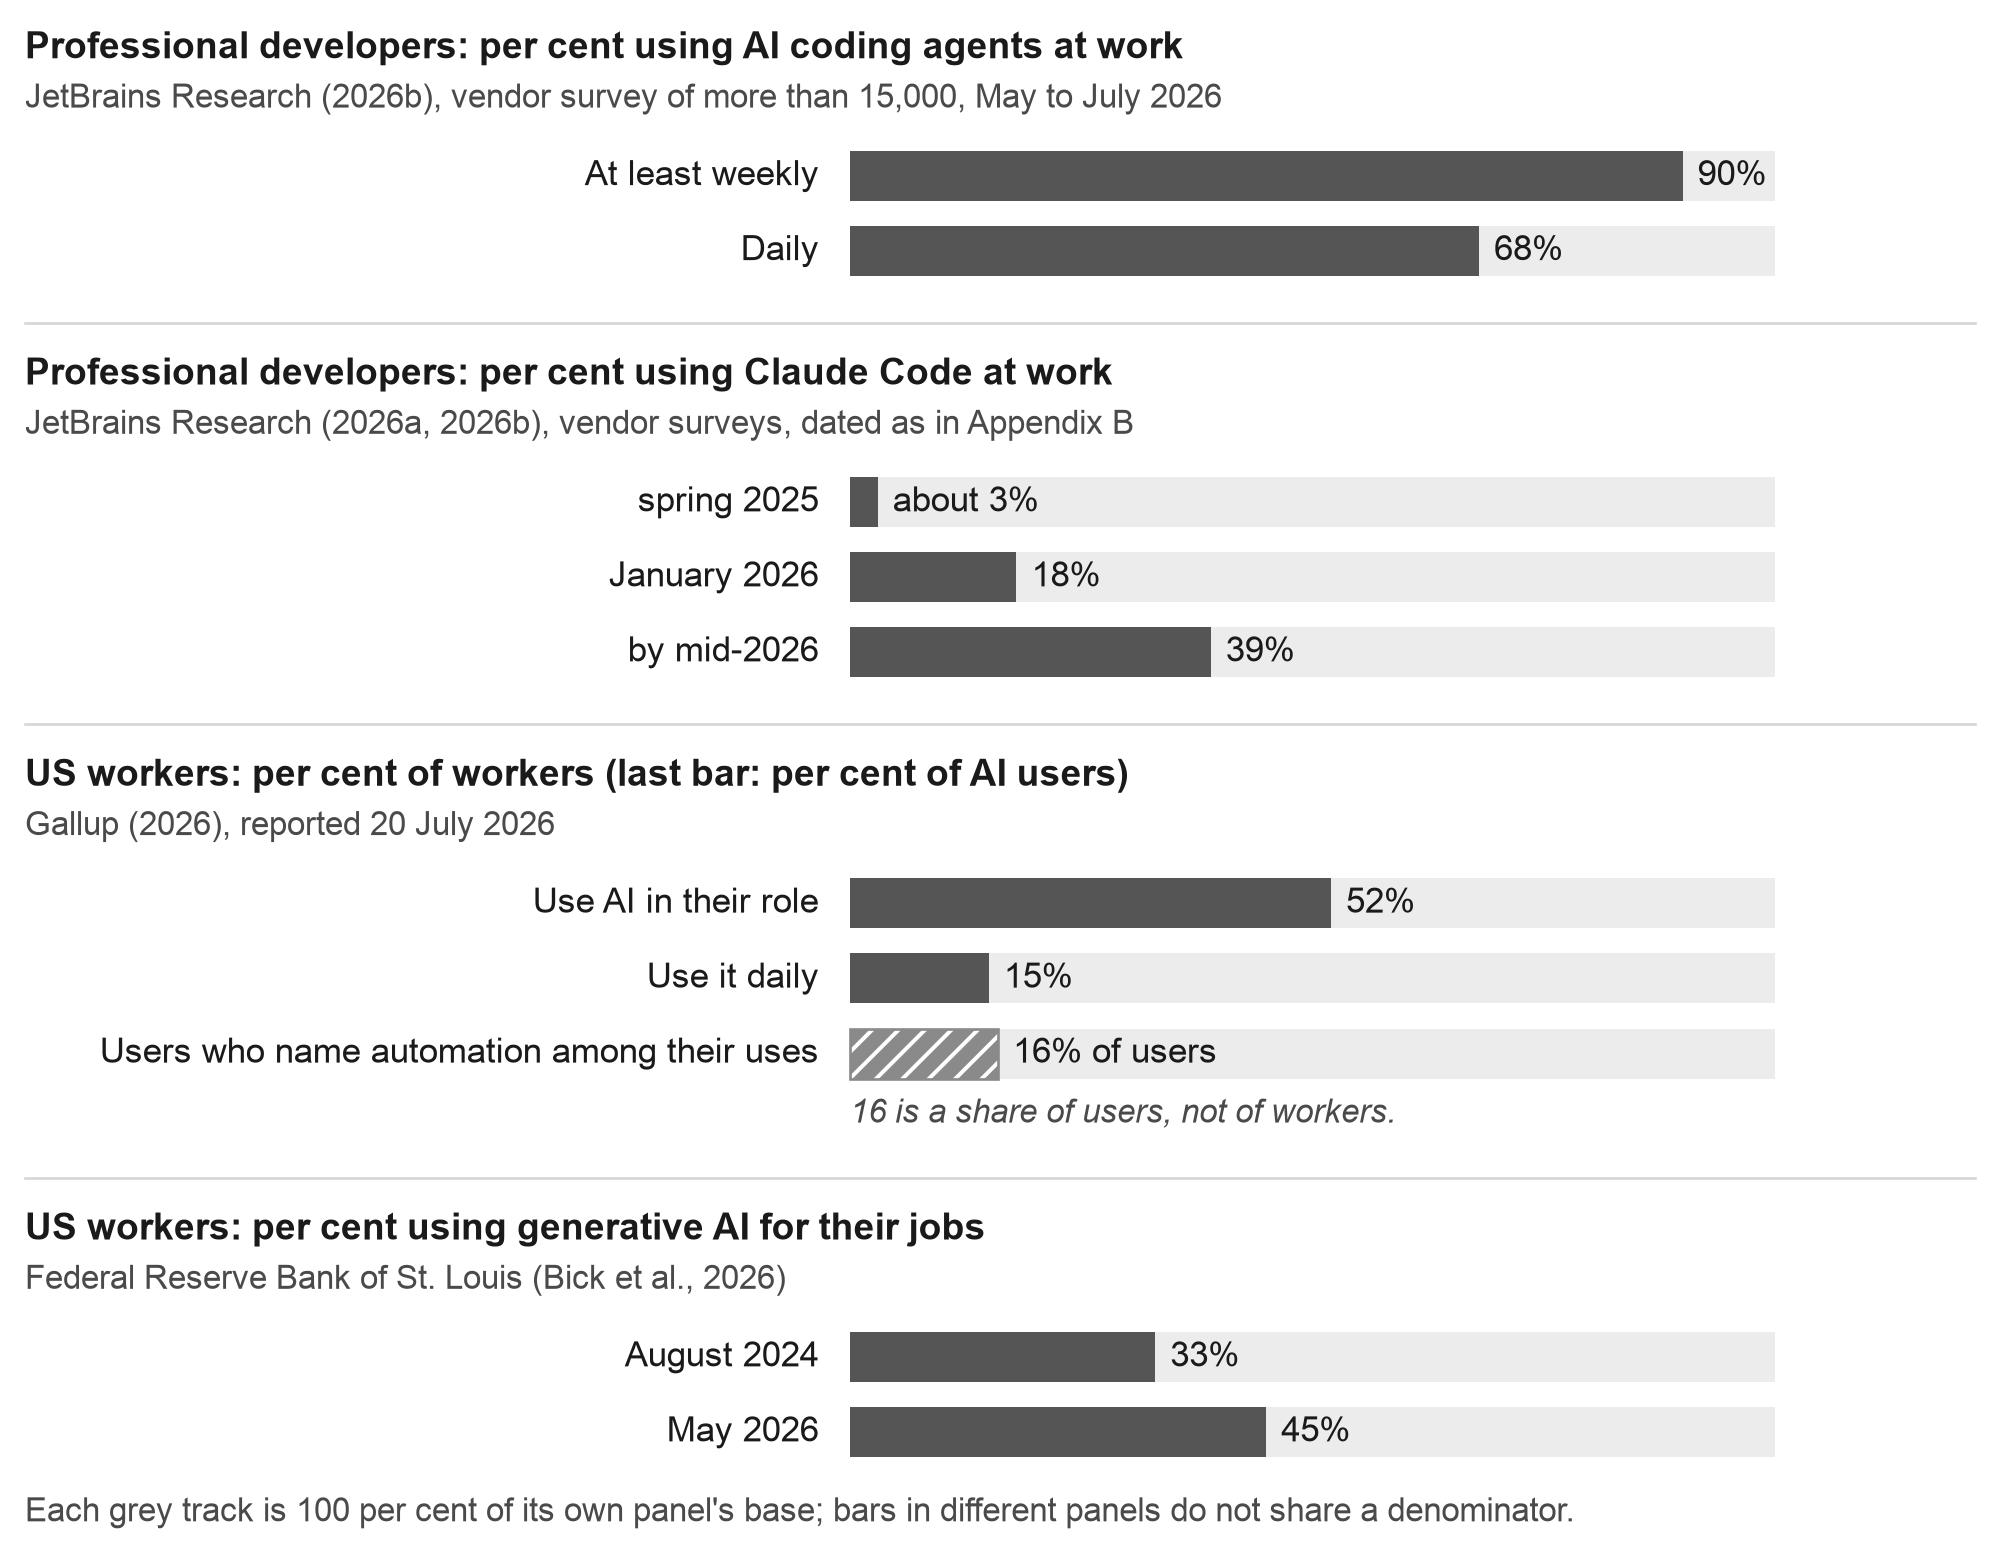
Примітка: Цифри про прийняття з опитувань, цитованих у розділах 1 і 4.4: професійні розробники в двох опитуваннях постачальників (JetBrains Research, 2026a, 2026b), американські робітники (Gallup, 2026) та американські робітники, які використовують генеративний AI для своєї роботи (Bick et al., 2026). Кожна панель має своє питання, період і знаменник, і 16 відсотків у третій панелі — це частка користувачів AI, тому кожна панель читається окремо. Підрахунок постачальника працівників знань всередині його агента кодування (розділ 4.4) — це частка користувачів одного продукту й не показана, і жодна цифра тут не походить від програми когорти розділу 9.
4.5 Як це впливає на аргумент
Узявши разом, докази цього розділу переконують мене в одному питанні і залишають інше відкритим. Встановлення припинило бути вирішальною перешкодою: постачальники вилучили більшість механічних кроків, чатбот може провести решту, і за одним показником постачальника (дописом преси, й орієнтовно) близько мільйона фахівців знань на тиждень вже знаходяться всередині агента термінальної спадщини. Чи приводить встановлення до використання, це інше питання, і широкі й поверхневі опитування дають невтішну відповідь, оскільки більшість людей, які можуть звернутися до агента, все ще не делегують йому. Те, що відступило, також повинно бути сформульовано точно. Встановлення відступило, обмежена проміжна сходинка тепер існує, і локальний агент має графічне обличчя. Надійність цілих частин роботи зі знаннями змінилася набагато менше (розділ 5.7), продукт, який людина вивчила, може зникнути протягом року (плинність, вище), і надана папка все ще не є безпечним місцем за замовчуванням (розділ 5.3). Розділ 5 запитує, що зупиняє людей після встановлення програмного забезпечення.
5. Що зупиняє людей після інсталера
Коли інсталер перестав бути перепоною, виникає щось інше. Докази 2025 та 2026 років вказують на шість бар'єрів, кожен з яких проявляється при певному переході й уже має частковий розв'язок видимий на ринку. Таблиця 3 узагальнює їх, а наступні підрозділи надають докази.
Таблиця 3. Бар'єри після встановлення.
| Бар'єр | Де він проявляється | Докази (розділ) | Що його зменшує |
|---|---|---|---|
| Словниковий запас робочого процесу: непевність, що передати, або як це сформулювати, щоб можна було перевірити | Переходи 1 та 2; знову при 3 | Обґрунтування об'єднань постачальниками; дослідження промптування; упаковані навички (5.1) | Розроблені приклади з власної галузі особи; навички та шаблони; перше завдання, яке є реальним, але низькоризиковим |
| Страх перед вікном, перша помилка та довіра: чорне вікно як соціальний об'єкт; повідомлення, яке програміст читає, а перед якою новачок зупиняється; довіра неправильно відкалібрована в обох напрямках | Перехід 2 | Дослідження прийняття; опитування довіри розробників; дослідження кінцевих користувачів з кодом AI; рефлексивна адаптація (5.2) | Інтерфейси робочого столу; повернення помилки в чатбот; режими планування спочатку; перший успіх на копії |
| Дозволи та безпека: занадто мало підказок для захисту файлів або занадто багато для розуміння | Переходи 1 та 2 | Звіти про втрату файлів у обмежених папках; показники інжекцій; керівництво, яке просить користувачів виявляти атаки (5.3) | Робочі копії, снімки, правила заборони; класифікатори, які не делегують судження новачку |
| Організаційні правила: заблоковані машини, політика, немає дозволу на встановлення | Перехід 2 | Організаційні чинники переважають індивідуальні; малі фірми горизонтальні (5.4) | Санкціоновані роботодавцем інструменти рівня 2; чіткі політики; персональна машина для навчання |
| Обладнання, вартість та квота | Переходи 2 та 3 | Рівень 3 потребує комп'ютера та платного рівня; квоти насамперед обмежують оркестрацію (5.5) | Безплатні рівні, де вони існують; початок з рівня 2; управління бюджетом |
| Оцінювання результату | Усі переходи, більшість при 3 | Бізнес-користувачі пропускають помилки в коді AI; агенти не справляються з більшістю цілих проектів (5.6) | Перевірки, визначені до завдання; друга модель як рецензент, а не як оракул |
5.1 Порожня папка: словниковий запас робочого процесу
Програміст, який відкриває агента, знає послідовність: створити проект, написати файл інструкцій, помістити під контроль версій, попросити функцію. Непрограміст відкриває того самого агента й ставить питання, яке тепер з'являється в данних самих постачальників: добре, а що мені йому сказати? Для розробника існує канонічне перше запитання ("побудувати невелику веб-програму"). Маркетолог потребує іншого ("взяти експорти попереднього кварталу з аналітики та бази даних клієнтів і побудувати щось, що кожну п'ятницю звітує, які кампанії принесли платіжних клієнтів"). Дослідник потребує іншого ("переглянути цю папку зі 300 статей і витягти розмір вибірки, метод та головний ефект кожної до таблиці, позначивши місця, де ви невпевнені"). Жоден з цих запитів не потребує коду від особи. Кожне потребує, щоб особа знала, що такий запит можливий, розбити його на частини, які агент може зробити, і сказати, як виглядає хороший результат. Питання "що мені його попросити зробити?" зазвичай неправильно сприймається як запит на кращу підказку. Я це читаю як запит на карту своєї роботи. Карта має називати повторюваний об'єкт роботи, дозволені вхідні дані, трансформацію, результат і перевірку. Карта аналітика може звучати як "ці дозволені експорти, згруповані за цим полем, аномалії позначені, датований брифінг та машиночитна таблиця, перевірена за підсумками рядків". Особі не потрібно знати, як виконується парсинг. Їй потрібно розпізнати, які докази зроблять результат придатним до використання. Коли особа не може заповнити карту, сам факт затримки говорить їй щось. Робота може бути занадто конфіденційною, занадто залежною від обставин або занадто погано документованою для делегування в її нинішньому стані, і це свідчить про завдання, перш ніж про особу.
Дослідження промптування пояснює, чому це складно. Люди без експертизи в AI мають труднощі зі створенням інструкцій, що узагальнюють (Zamfirescu-Pereira et al., 2023), і мають виявляти методом проб і помилок, які формулювання відповідають можливостям системи (Liu et al., 2023). Поведінка самих постачальників це підтверджує. Anthropic об'єднав агента рівня 2 у чат, бо клієнти не могли визначити, до якої категорії належить завдання (TechCrunch, 2026a), а OpenAI запустив плагіни, специфічні за ролями, для свого агента кодування, спрямовані на роботу знаннями без потреби в кодуванні (повідомлено Help Net Security, 2026). Промислова відповідь полягає в упакуванні словникового запасу. Anthropic випустив свій формат для упакованих інструкцій агентів як відкритий стандарт у грудні 2025 (SiliconANGLE, 2025), і сайт стандарту перелічив 46 підтримуючих продуктів 21 вересня 2026, включаючи агентів від OpenAI, Google та GitHub (Agent Skills, 2026). Незалежне дослідження налічило 2049 застосунків у каталозі ChatGPT і 1375 сполучників для Claude в середині 2026 (Sitter, 2026). Навик — за цим визначенням — це одиниця словникового запасу робочого процесу, завдання записане один раз так, щоб особа, яка не знає, як його сформулювати, все ж могла його зробити.
Упакований словник необхідний, але це недостатньо. Навичка розповідає агенту, як виконати завдання. Вона не може підказати людині, які з її завдань варто передати, тому що це рішення залежить від галузі, в якій працює людина. Опубліковані пакети також несуть припущення про певний світ — здебільшо форми однієї країни та один корпоративний стек програмного забезпечення — і професіонал, чиї інструменти не належать до цього стека, знову стоїть перед порожнім запитом. Коли я переглядав офіційний каталог упакованих навичок 22 вересня 2026 року, всі 310 записів у ньому, я не знайшов жодного, написаного для пастора чи капелана, медсестри чи опікуна родини, шкільного вчителя, художника чи ремісника, або агента нерухомості; кожна видима відповідність була словом програмного забезпечення або фінансів у тому ж одязі — портфелем інвестицій або здоров'ям послуги. Суспільний каталог, у який люди додають записи вручну, містив 2,282 записи того дня, і він містив роботу для шкільних вчителів і для нерухомості, але нічого для інших трьох ремесел. Каталоги змінюються щотижня, тому це датований аналіз, а не постійне твердження про галузь. Тому я надаю таку велику вагу першому завданню у будь-якому маршруті адаптації: воно повинно бути реальним, витягнутим з роботи людини, низькорисковим, і воно повинно створити артефакт, який люди можуть оцінити (Carroll, 1990).
5.2 Страх перед вікном, перша помилка та довіра
Чорне вікно є соціальним об'єктом. Сприйнята простота використання була опорою прийняття технологій протягом тридцяти п'яти років (Davis, 1989), і мерехтливий запит не проходить цей тест для великої частини населення навіть коли людина ніколи не введе команду в нього. Графічні інтерфейси розділу 4.1 — це відповідь виробників. Це часткова відповідь, тому що другі ворота — це довіра, і довіра змінилася як проти агентів, так і на їхню користь. Серед розробників опитування Stack Overflow 2025 року виявило, що 46% не довіряють точності інструментів ШІ порівняно з 33%, які їм довіряють, з 87%, які хвилюються щодо точності агента, і 81% щодо безпеки (Stack Overflow, 2025). У 2026 році більшість все ще утримувала агентів від внесення несанкціонованих змін (Stack Overflow, 2026). Менеджери чують те ж саме: «довіра є центральною перешкодою для реалізації потенціалу агентів ШІ на роботі» (McKinlay et al., 2026). Більше американських дорослих очікують, що ШІ завдасть їм шкоди, ніж допоможе (Pew Research Center, 2026). За обома воротами лежить пастка віри з розділу 2.4: досвід передбачає успіх, люди, які не мали першого успіху, не мають досвіду, і перший артефакт — це вихід (Ma et al., 2025). Деякі люди нададуть доступ до домашної папки, тому що агент був ввічливий, а інші відмовляться встановлювати, тому що читали про видалені сімейні фото. Обидва — це помилки калібрування (Lee & See, 2004). Найдешевший пристрій калібрування, який я можу придумати, — це перше завдання, виконане на копії папки.
Коли агент повідомляє, що команда не вдалася з кодом виходу 1, програміст продовжує читання. Новачок може просто зупинитися. Література про кінцевих користувачів, які зустрічаються з кодом, написаним ШІ, показує закономірність в м'якшому контексті: користувачам бізнесу, яким надано аналітичний код, створений ШІ, часто не вдавалось помітити критичні помилки навіть коли їм велели їх шукати (Virk & Liu, 2025), і розмовні програмісти витрачають більшість своїх зусиль на верифікацію та управління контекстом (Sarkar & Drosos, 2025). На рівні 3 помилка часто повністю лежить поза роботою людини, в середовищі: відсутній дозвіл, мережеве правило, інструмент, який агент очікував і не знайшов.
Рефлексивна адаптація (розділ 4.2) забезпечує найбільш практичну відповідь, описану до цих пір. Людина відправляє помилку, або снімок екрана з нею, чат-боту, який вони вже використовують, і слідує його порадам. Режими, орієнтовані на план, допомагають з іншої сторони, оскільки агент, який записує свій план перед дією, дає людині щось для читання, що не є трасуванням стека. Жодна не усуває момент, коли людина без ментальної моделі своєї машини зустрічає повідомлення, яке вона не може розпарсити. Я ще не знаю, як часто цей момент закінчує спробу. Програма в розділі 9 записує це власними словами людини.
5.3 Дозволи та безпека: занадто мало і занадто багато
Рівень 3 дає агенту охоплення його власника, тому проблема безпеки йде в двох напрямках, і новачок піддається обом.
Спочатку розглянемо занадто мало захисту. Агенти знищили дані в задокументованих інцидентах. Агент у популярному сервісі побудови додатків видалив виробничу базу даних у липні 2025 року і описав свою дію як «катастрофічну помилку судження» (The Register, 2025). У квітні 2026 року агент в інструменті кодування видалив виробничу базу даних компанії та її резервні копії за секунди і написав: «Я вгадав замість перевірки» (Information Age, 2026). Ближче до населення, про яке йде мова в цій статті, користувачи агента рівня 2 Anthropic повідомили в березні, квітні та червні 2026 року, що він видалив особисті, сімейні та юридичні документи всередині папок, яким вони надали доступ, в одному випадку після того, як довге завдання не можна було зупинити, і видалення завдання видалило файли (повідомлення GitHub про проблеми, 2026; повідомлення користувачів, не підтверджені виробником). Область видимості папок обмежує, де може виникнути шкода. Вона не запобігає шкоді всередині папки, і синхронізована хмарна папка може перетворити локальну помилку на синхронізовану втрату.
Перегляд веб-сайтів додає prompt injection, інструкції, приховані на веб-сторінці, яку агент читає, як якби вони походили від користувача. Команда безпеки продемонструвала атаку в серпні 2025 року на агент браузера іншого постачальника з доказом концепції, який витягнув одноразовий код із поштової скриньки через прихований текст сторінки (Brave, 2025). Anthropic повідомила, що її агент браузера, до впровадження заходів, успішно атакувався в 23.6% тестових випадків, а 11.2% після них (Anthropic, 2025). Рік потому, при загальній доступності, вона повідомила, що сильні атаки red-team успішно виконувалися проти її основної моделі в 3.8% випадків перед захистом, і що при повній защиті атак не було успішних проти трьох її моделей і 0.3% проти четвертої (Anthropic, 2026d). Це дані постачальника на наборах тестів постачальника. Тенденція спадає, а залишок не дорівнює нулю. OpenAI написала в грудні 2025 року, що prompt injection «навряд чи коли-небудь повністю ‛вирішена'» (TechCrunch, 2025). При запуску свого агента рівня 2 Anthropic повідомила користувачам «стежити за Claude щодо підозрілих дій, які можуть вказувати на prompt injection» і що «ви залишаєтесь відповідальними за всі дії, виконані Claude від вашого імені» (The Register, 2026). Відомий розробник заперечив у той час, що це було несправедливо просити непрограмістів розпізнавати ознаки prompt injection (Willison, 2026). Я думаю, що це заперечення в цілому правильне. Дизайн безпеки, який покладається на новачка для виявлення атаки, делегує найважче судження людині, яка найменше здатна його зробити. Упаковані навички та протокольні сервери відкривають власну поверхню інструкцій і привілеїв, оскільки стороння навичка містить інструкції, які людина не написала, сервер може мати більше привілеїв, ніж потребує завдання, і конфігурації змінюються між версіями.
Надмірний захист зупиняє людей так само впевнено. Агент, який просить дозволу на кожному кроці, перетворює людину на клерка, який схвалює команди, які вона не може оцінити, і встановлюється втома від схвалення. Постачальники відповідно відреагували, а протягом одного кварталу рухалися в різних напрямках. Агент браузера компанії Anthropic тепер за замовчуванням діє автономно з класифікатором, який блокує дії, що не відповідають запиту користувача (Anthropic, 2026d). Його агент терміналу перейменував свій режим дозволу за замовчуванням на "Manual" у липні 2026, зміна в назві, яка сама промовляє про те, що "default" почало означати (Anthropic, 2026h). Його агент чату за замовчуванням «запитує перед тим, як діяти» — параметр, який користувач може змінити (Anthropic, 2026c). Таксономія Parasuraman and Riley (1997) актуальна для всіх трьох. Охоронець, який блокує занадто багато, викликає неупотреблення; охоронець, який пропускає видалення, викликає неправильне використання; і жодна установка не уникає таксономії, тільки установка, чиї збої певна популяція може витримати. Супровідна стаття в цій серії документує загальний збій на іншій стороні — компоненти нагляду, які розширюють свою власну концепцію шкоди і перешкоджають роботі, яку вони існують для захисту (Chernets, 2026b). Для новачка охорона такого роду має такий же ефект, як відсутній інсталятор, оскільки робота не відбувається в будь-якому випадку.
Між недостатнім захистом та надмірним захистом існує робочий компроміс, і він традиційний. Працюй у копії. Тримай таємниці поза робочою папкою. Зроби снімок перед більшою змною. Забороняй деструктивні команди, доки не буде причини дозволити одну; підтверджуй усе незворотне; розглядай все, що походить з вебу, як дані для прочитання, невважаючи на інструкції, які воно, здавалося б, містить. Я описав принцип цих звичок у супровідній статті як архітектурне довір'я: спирання на перевірки, які людина може підтвердити, такі як обмежені дозволи, журнали, скасування та друга незалежна модель, а не на те, наскільки впевнено звучить модель (Chernets, 2026c). Рівень 2 дає людині першу з цих перевірок, і це не повинна бути остання, яку вона вивчить. Додаток C перетворює список на приклади конфігурації для двох агентів та односторінковий контрольний перелік.
5.4 Організаційні правила
Багато професіоналів не можуть встановити нічого на комп'ютер, на якому вони працюють. Багато роботодавців не мають політики щодо агентів, і людина без політики має тенденцію припускати, що відповідь — «ні». Опитування Microsoft 2026 року 20 000 фахівців, які використовують ШІ, показало, що організаційні фактори становили вплив, більш ніж у два рази більший за повідомлений вплив індивідуальних факторів, і що 45% сказали, що було безпечніше зосередитися на поточних цілях, ніж переробити роботу з ШІ (Microsoft, 2026b; опитування постачальника). Бюро перепису населення США повідомило, що використання ШІ в бізнесі коливалося між 17% та 20% загалом, зросло серед фірм з 20 або більше працівників і не змінилося суттєво серед фірм з менш ніж 20 працівниками (US Census Bureau, 2026). Мандати йшли в обидва боки. Деякі роботодавці зробили використання ШІ базовим очікуванням у 2025 році (Digital Commerce 360, 2025), і щонайменше один переглянув своє рішення про оцінку персоналу на основі використання ШІ рік потому, при цьому його головний виконавчий директор розповів пресі, що важливе в оцінці результатів роботи — це добре виконувати завдання (Fortune, 2026b). Опублікована рубрика вільного володіння одного роботодавця ставить оркестрацію та побудову системи на найвищий рівень і повідомляє про повне внутрішнє прийняття, як тільки команди перейшли від експериментування до переробки робочих процесів (Zapier, 2026). Без цієї переробки мандат забезпечує відповідність і не більше того. Ринок праці вже просить про роль, описану тут, не називаючи її: 63% назв посад в США, що пов'язані з ШІ у 2026 році, були поза технологічними професіями, 822 різні посади в першому кварталі (Adrjan, 2026); дослідження понад мільярда оголошень про роботу в 27 країнах встановило премію за заробітну плату за навички ШІ на 62%, з посадами на начальному рівні, найбільш уразливі до впливу ШІ, набагато більш імовірно вимагаючи навичок, які раніше були зарезервовані для старшого персоналу (PwC, 2026; звіт постачальника). Жодне з цих джерел ще не виділяє здатність керувати агентом як названу вимогу поза межами інженерії.
Цей бар'єр структурний у сенсі Ferdman (2025): він не піддається індивідуальним зусиллям. Це також найсильніший аргумент на користь рівня 2, який пропонують докази, оскільки агент, обмежений постачальником, всередину офісного пакету, який роботодавець вже ліцензує (Microsoft, 2026a), доходить до людей, чиї роботодавці не затвердили б агента на робочому ноутбуці.
5.5 Апаратне забезпечення, вартість і квота
Рівень 3 передбачає комп'ютер, яким керує людина. Деякі професіонали працюють переважно зі смартфона, користуються сімейним комп'ютером або використовують машину роботодавця для всього, і для них перехід блокується ще до того, як виникає будь-яке питання щодо програмного забезпечення. Рівень 3 і рівень 4 також передбачають платні рівні принаймні одного сервісу, а оркестрування множить вартість, оскільки кожна додаткова модель — це ще одна підписка або ще один квот. Для людини, яка вже платить за одну підписку, друга — це рішення, а топ-рівень — інше рішення. Тривога щодо токенів — це психологічний бар'єр з ціною. Квот оркеструвального агента сам по собі є прихованою вартістю, оскільки він платить за читання кожної відповіді, яку повертають інші агенти, а агент, який керує браузером, використовує ті ж обмеження плану, що й терміналний агент, але коштує більше за дію (Anthropic, 2026g). Заблокровані корпоративні ноутбуки додають права адміністратора до списку: ні непідписаних бінарних файлів, ні інсталятора, правило втрати даних, яке розглядає агента, що записує на диск, як шкідливе ПО. Хмарні агенти — це відповідь індустрії для цих машин. Вони зберігають перехід 1 та хмарну форму переходу 2 і не дають людині артефакт рівня 3 на її власний диск. Для професіонала в багатій країні жоден із цих факторів не є великою перешкодою. Для багатьох інших це справжня перешкода, і вона взаємодіє з розділенням другого рівня (Hargittai, 2002), оскільки люди з найменшим простором для маневру найменше здатні експериментувати.
5.6 Оцінка результату
Використання агента не вимагає програмування. Оцінка того, що він виробив, вимагає компетентності в галузі результату, і тут непрограміст має перевагу, яку легко пропустити. Адвокат, який читає резюме контрактів, або дослідник, який читає таблицю вилучень, можуть перевірити артефакт проти знань, яких не має агент. Дослідження «зубчастої границі» показало, що професіонали, які працювали з ШІ, краще справлялися із завданнями в межах здатності моделі й гірше з завданнями за їх межами (Dell'Acqua et al., 2026). Захист — це людина, яка достатньо добре знає завдання, щоб помітити, на якій стороні границі вона знаходиться.
Що вони не можуть легко перевірити, це механізм, скрипт, який виробив таблицю, або запит, який витягнув числа. Один аналіз індустрії 470 запитів на злиття показав, що код, написаний агентами, має більше дефектів, ніж код, написаний людьми: 10.83 проблем на одну змінену AI-автором проти 6.45 для змін тільки людьми, причому деякі категорії проблем безпеки в 2.74 рази частіше (CodeRabbit, n.d.; vendor study). І агенти все ще не справляються з більшістю цілих проектів: на тесті реальних фрілансних проектів найкращий темп автоматизації, виміряний до середини 2026 року, становив 15.8% (Center for AI Safety, 2026). З цього я виділяю дві практики. Перевірка повинна бути визначена до завдання («що переконало б мене, що це правильно?»), а друга модель від іншої сім'ї може виступати як рецензент артефакту, причому людина вирішує, що рахується правильним. Розділ 7 повертається до меж другої практики.
5.7 Альтернативне пояснення: агенти ще недостатньо гарні
Читач може заперечити, що люди не делегують, тому що агенти ще не можуть виконати свою роботу, і що бар'єр, отже, все ще технічний, тільки на стороні моделі. Це заперечення має реальну підтримку. На тесті реальних фрілансних проектів найкращий темп автоматизації, виміряний до середини 2026 року, становив 15.8%, виросши з 2.5% під час виходу тесту попередньої осені, що означає, що більше чотирьох проектів з п'яти все ще не справляються від початку до кінця (Center for AI Safety, 2026). У змодельованій програмній компанії найкращий агент завершив 30% довгих професійних завдань (Xu et al., 2024). На відкритому комп'ютерному використанні базовий показник 2024 року становив 12.24% для найкращого агента проти 72.36% для людей (Xie et al., 2024), а до вересня 2026 року таблиця лідерів агрегатора для перевіреної версії цього тесту показала найкращих агентів на 85–86%, вище людської базової лінії, згідно зі звітами постачальників про оцінки для сценарійних завдань на робочому столі (BenchLM, 2026). Цей останній результат вказує в іншому напрямку: для таких завдань здатність більше не є бар'єром. Найкраща модель в оцінці 44 професій виграла або зв'язала з професіоналами менше ніж в половині порівнянь (Patwardhan et al., 2025). Довжина програмного завдання, яке агенти виконують половину часу, подвоюється приблизно кожні сім місяців (Kwa et al., 2025), тому тренд крутий, а теперішній стан скромний. Здатність нерівномірна в різних завданнях, і «зубчаста границя» не видна зовні (Dell'Acqua et al., 2026). Таблиця 4 збирає ці опубліковані цифри з датою, яку дає кожне джерело, і застереженням, яке я до неї додаю.
Таблиця 4. Опубліковані цифри здатності за запереченням.
| Порівняння | Цифра як опублікована | Дата як вказано | Джерело | Читайте обережно |
|---|---|---|---|---|
| Реальні фрілансні проекти, найкращий темп автоматизації | 15.8%, виросши з 2.5% під час виходу тесту попередньої осені; більше чотирьох проектів з п'яти все ще не справляються від початку до кінця | Випуск попередньої осені; 15.8% виміряно до середини 2026 року, записано 1 липня 2026 року (Додаток B, ПЕРЕВІРЕНО) | Center for AI Safety (2026); Розділи 5.6, 5.7, Додаток B | Цілі проекти, від початку до кінця; найкращий темп серед виміряних |
| Довгі професійні завдання у змодельованій програмній компанії | Найкращий агент завершив 30% | Дослідження 2024 року | Xu et al. (2024); Розділ 5.7 | Змодельована компанія; окремий показник від темпу фрілансного проекту |
| Відкрите комп'ютерне використання, базова лінія | 12.24% для найкращого агента проти 72.36% для людей | Базова лінія 2024 року | Xie et al. (2024); Розділ 5.7 | Базова лінія 2024 року; рядок нижче — пізніша таблиця лідерів |
| Перевірена версія того тесту | Найкращі агенти на 85–86%, вище людської базової лінії | До вересня 2026 | BenchLM (2026); Розділ 5.7 | Таблиця лідерів агрегатора; звіти постачальників про оцінки для сценарійних завдань на робочому столі; вказує в іншому напрямку |
| Оцінка 44 професій | Найкраща модель виграла або зв'язала з професіоналами менше ніж в половині порівнянь | Дослідження 2025 року | Patwardhan et al. (2025); Розділ 5.7 | «Менше ніж половина» — це наведене формулювання; відсоток не вказаний |
| Довжина програмного завдання, яке агенти виконують половину часу | Подвоєння приблизно кожні сім місяців | Дослідження 2025 року | Kwa et al. (2025); Розділ 5.7 | Тренд: «тренд крутий, а теперішній стан скромний» |
| Дефекти в запитах на злиття | 470 запитів на внесення; 10.83 проблем на одну зміну, написану ШІ, порівняно з 6.45 для чисто людських змін; деякі категорії проблем безпеки у 2.74 рази частіше | n.d. | CodeRabbit (n.d.); Розділ 5.6 | Дослідження від постачальника; один аналіз галузі; дефекти в коді, механізм, який непрограміст не може легко перевірити |
Джерело: цитовані публікації, як наведено у розділах 5.6 та 5.7 та у додатку B; жодна з цих цифр не походить від програми розділу 9.
Ці два пояснення скоріше частини одного пояснення, ніж суперники. Словник робочого процесу включає знання того, які завдання лежать всередині межі. Людина, яка дає агентові весь проект, який він не може виконати, вчиться припинити делегування, тоді як людина, яка дає йому видобування, узгодження та перша чернетка, вчиться продовжувати. Пояснення все ще роблять різні прогнози. Якщо б здатність моделі була критичним обмеженням, то стійкість на рівнях 2 та 3 залежала б від типу завдання, а не від людини: люди з однаковими типами роботи проявляли б стійкість з подібною частотою, незалежно від їхньої здатності визначати та перевіряти. Якщо б словник робочого процесу був критичним обмеженням, то стійкість залежала б від здатності людини сформулювати угоду про делегування навіть у межах одного й того ж виду роботи. Твердження P15 у розділі 10 написане, щоб розрізнити ці два.
6. Веб-оркестрація: запропонований міст
6.1 Практика
Найпростіша форма рівня 4 зовсім не потребує установки. Людина відкриває три або чотири чатботи в закладках браузера, вставляє одне й те саме запитання в кожний і читає відповіді поруч. Комп'ютерні науковці назвали б це ручним запитом multi-LLM з маршрутизацією та порівнянням, здійсненими людиною. Деякі роблять це вручну. Інші використовують один із інструментів, розроблених для цього з 2023 року: розширення браузера та настільні застосунки, які транслюють один запит до кількох комерційних служб чату та показують відповіді в паралельних панелях. ChatHub та ChatALL з'явилися навесні 2023 року; найновіший випуск самого ChatALL налічував близько 847 000 завантажень, записаних на його сторінці випуску до вересня 2026 року, лічба, яка включає автоматичні оновлення і домінується збірками однієї платформи (GitHub, 2026a). Новіша група інструментів перетворює виконані входи веб-сеансів чату у команди, які може викликати інша програма, щоб агент міг поставити запитання на веб-підписки людини. OpenCLI, один із них, мав близько 29 500 зірок на GitHub у вересні 2026 року (GitHub, 2026b).
У 2026 році практика стала функцією продукту. Perplexity представив "Model Council", який запускає запит через кілька моделей і "представляє консолідований вигляд, який виділяє ключові висновки, області згоди та моменти розбіжності" (Storyboard18, 2026). Дослідницький агент Microsoft у Microsoft 365 Copilot пропонує режим, який "запускає одне й те саме запитання через кілька глибоких дослідницьких агентів (GPT та Claude) одночасно" та режим критики, увімкнений за замовчуванням при автоматичному виборі моделі, в якому звіт, написаний однією моделлю, отримує другий раз обробки від іншої (Microsoft, 2026c; Constellation Research, 2026b). "LLM Council" Андрія Карпатія, невеликий веб-застосунок, який надсилає запит до кількох моделей, змушує їх анонімно рецензувати один одного і має модель голови написати остаточну відповідь, описаний його автором як експеримент, зроблений на вихідних, мав близько 24 900 зірок на GitHub у вересні 2026 року (Karpathy, 2025). Ландшафт відкритого коду розділяється навпіл. Інструменти трансляції отримують відповіді та залишають узгодження людині. Інструменти ради узгоджуються, і вони працюють на платних програмних інтерфейсах з двома або трьома моделями, подалі від власних вкладок входу людини. Жодна половина одна не переносить людину, і тому міст неповний.
6.2 Чому це пропонується як міст
Веб-оркестрація займає місце між рівнями корисним способом. Вона нічого нового не вимагає від машини, ніякої установки, ніяких дозволів, ніякого локального агента, і працює на підписках, які людина вже оплачує, або на безплатних рівнях. Вона вимагає чогось нового від людини: тримати кілька відповідей одночасно, помічати, де вони відрізняються, і вирішувати. Людина, яка навчилася запитувати "що сказала інша модель?", навчилась звички, яку CLI оркестрація згодом автоматизує, і ця звичка є завданням менеджера рівня 4 у його найменшому вигляді.
Міст цінний, тому що він видимий. Припустимо, аналітик ринку просить трьох чатботів підсумовувати опублікований галузевий звіт, два із них цитують цифру, яка не знаходиться у звіті, а третій відмічає її відсутність. Корисний результат — це приклад для відкриття самого звіту, і людина, яка пройшла через це один раз, припинила розглядати першу бігливу відповідь як відповідь. Вид трансляції кількох відповідей стає мостом до рівня 4, коли він учить людину формулювати одне загальне запитання, помічати, де припущення розходяться, просити критику і мати причину для вибору однієї відповіді. До того часу це звичка рівня 1 з більшою кількістю вкладок. Те, що воно вчить — це порівняння, і лише порівняння. Людина, яка навчилась запитувати, що сказала інша модель, не тим самим навчилась, що може дотикатися агент на їхній машині, що є уроком рівнів 2 і 3, і твердження, що звичка передається, є емпіричним, P7, яке я не розглядаю як передумову. Попередньо зареєстрована програма, описана в розділі 9, називає два переваги заздалегідь, і вони підсумовують те, що купує міст. Одна — це охоплення: корисний кут, присутній в одній моделі, не втрачається, оскільки було запитано іншої моделі. Інша — це надійність: відповідь була перевірена проти інших відповідей, а не прийнята на слово однієї моделі (Chernets, 2026d). Видима розбіжність служить другій як засіб. Оцінка прогнозування виявила, що ансамбль дванадцяти мовних моделей відповідав точності групи 925 людських прогнозистів (Schoenegger et al., 2024), а багатоагентні дебати покращують фактичність і міркування над однією моделлю в кількох умовах (Du et al., 2023). Обидві переваги залежать від того, що помилки моделей відрізняються, а наступний підрозділ присвячений тому, що відбувається, коли вони не відрізняються.
6.3 Де міст закінчується
Веб-оркестрація залишається мостом, і найпрямішою причиною є вартість уваги. Читання чотирьох довгих відповідей і їх узгодження вручну займає набагато більше часу, ніж читання однієї. Я не просив би нікого робити це для звичайного запитання; вона заробляє свою вартість, коли невірна відповідь коштувала б більше, ніж час, витрачений на порівняння.
Друга межа — крихкість, і вона приходить у кількох формах. Інтерфейси комерційних чатів змінюються місяць за місяцем, і інструменти, які їх керують, ламаються, коли вони це роблять: протягом літа 2026 року один офісний набір видалив режим дослідження, один чатбот закрив режими на своєму безплатному рівні, і більше однієї служби перейменував або перенаправив свою адресу. Умови кількох комерційних служб обмежують автоматичний доступ, і людина, яка керує своїм власним веб-браузером входу з агентом, ризикує блокуванням облікового запису. Дослідницька програма, яка використовує міст, повинна повідомити про це учасникам, і я не пропоную юридичне прочитання цих умов. Безплатна сторона інших чатботів також оплачується на боці агента, який ними керує, оскільки дії браузера використовують ті ж обмеження плану, що й терміналь агент (Anthropic, 2026g). Ручне порівняння на відкритих вкладках є стійким. Автоматизований збір сторінок комерційного чату є слабкою основою для повторюваної роботи.
Третя обмеження — це та, що має найбільше значення: узгодженість моделей не є незалежним доказом. Коли моделі розділяють дані для навчання та методи, їхні помилки корелюють. Дослідження більш ніж 350 мовних моделей виявило, що коли дві моделі робили помилку, вони погоджувалися на одну й ту ж неправильну відповідь приблизно в 60% випадків, і що більші, точніші моделі були більш корельовані, навіть у різних постачальників (Kim et al., 2025). Супровідна стаття в цій серії дає арифметику: при середній попарній кореляції помилок rho, N узгоджених моделей дорівнюють N_eff = N / (1 + (N - 1) rho) незалежних думок, і жодна кількість моделей не варта більше ніж 1/rho (Chernets, 2026a). При rho = 0.5, десять узгоджених чатботів варті менше ніж два незалежні. На малюнку 3 зображена формула для чотирьох ілюстративних значень rho в Додатку D, з межею 1/rho, яку жодна кількість узгоджених моделей не може перевищити. 60% за Kim et al. — це частка спільних помилок, в яких дві моделі дали одну й ту ж неправильну відповідь, що не є кореляцією помилок rho формули. У розглядуваній області rho має бути оцінена на елементах з відомими відповідями (список C4), і значення, використані тут та в Додатку D, є ілюстраціями. Різноманітність важить більше, ніж кількість. Дебати серед копій однієї моделі часто не можуть перемогти одну модель з однаковими обчисленнями, тоді як гетерогенні моделі допомагають (Zhang et al., 2025), і два різноманітні агенти можуть зрівнятися або перемогти шістнадцять однорідних (Yang et al., 2026). Генеративний штучний інтелект також робить однорідним вихід серед своїх користувачів (Doshi & Hauser, 2024), і модель, якій пропонується судити, тендує віддавати перевагу своєму письму (Panickssery et al., 2024), що важливо, коли одна модель написує об'єднану відповідь.
Рисунок 3. Якого варте узгодження.
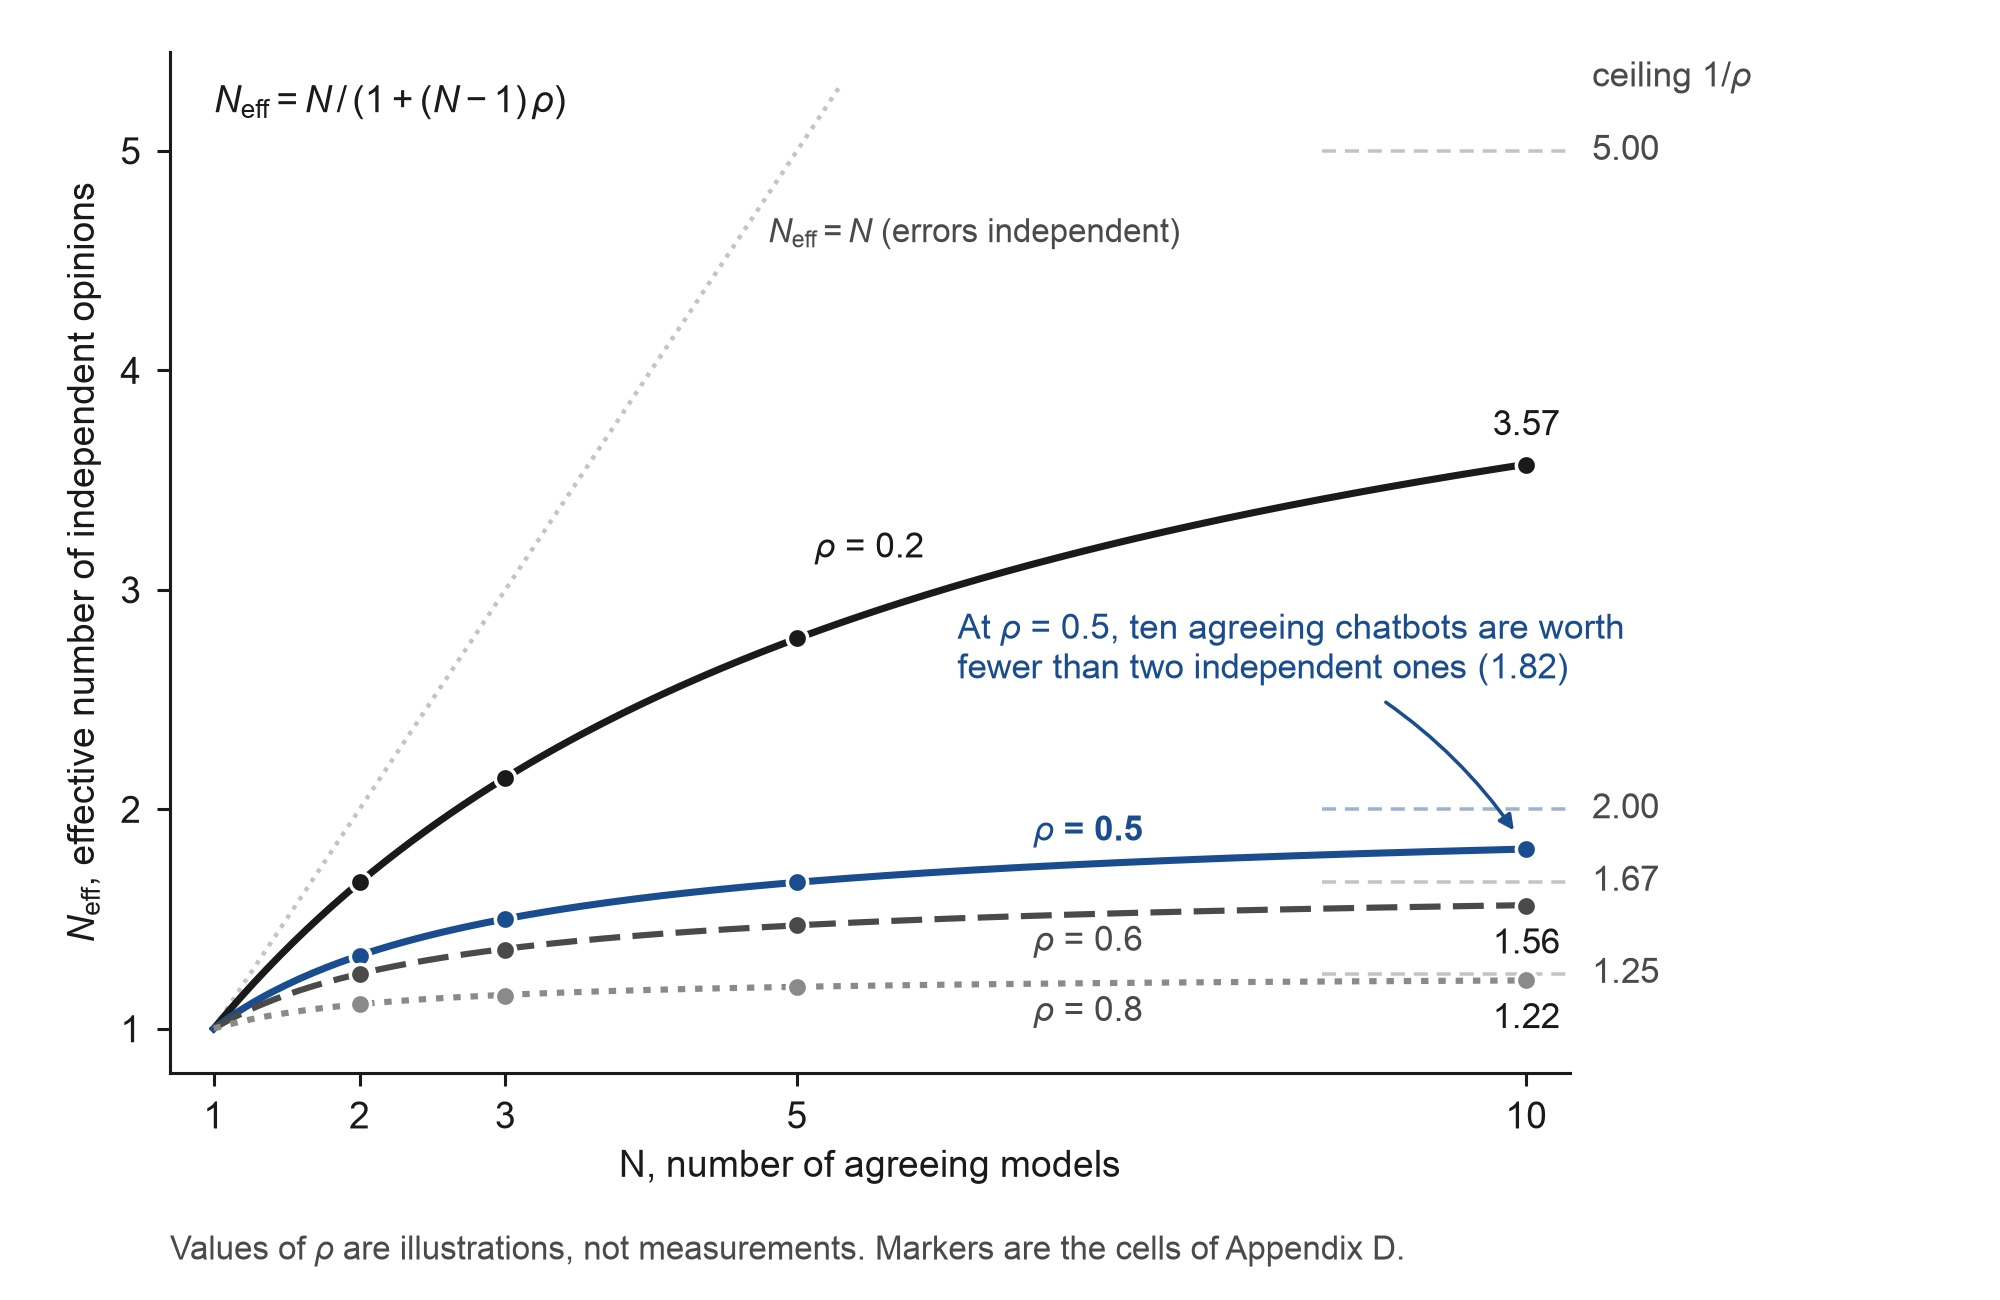
Примітка: Ефективна кількість незалежних думок, N_eff = N / (1 + (N - 1) rho), для N узгоджених моделей, чиї помилки мають середню попарну кореляцію rho (Chernets, 2026a; Розділ 6.3). Маркери — це комірки Додатку D, криві між ними слідують тій же формулі, а пунктирні сегменти справа — це межі 1/rho. Чотири значення rho — це ілюстрації, як у Додатку D; rho має бути оцінена на елементах з відомими відповідями в розглядуваній області (список C4).
Для людини на мосту практичні правила короткі. Порахуйте сім'ї моделей, оскільки офісний асистент, що працює на одній моделі постачальника, не є другою думкою щодо чатбота цього постачальника. Узгодженість моделей може сказати вам, де витратити менше зусиль на перевірку. Це не може сказати вам, що твердження правильне. Розглядайте точку, висловлену однією моделлю, як підставу для перевірки, оскільки це може бути найцінніша річ у порівнянні або її єдиною помилкою, і тримайтеся розбіжності, яка супроводжується доказом, замість того щоб проголосувати проти неї. Перевіряйте твердження проти джерел: узгодженість щодо неправильної дати — це задокументована помилка, і первинна сторінка виправляє це там, де п'ята модель не могла б. Оцініть rho на невеликому наборі питань у вашій області, які ви можете позначити, перш ніж довіряти раді щодо питання, яке ви не можете. Пам'ятайте, хто що сказав, оскільки об'єднана відповідь, яка приховує свої джерела, повертає єдиний впевнений голос, який оркестрація мала на меті піддавати сумніву.
Написане як процедура, це навчальна форма протоколу "anchor-and-enrich" супровідної статті (Chernets, 2026a). Людина спочатку встановлює якір: завдання, дозволені докази та форму виведення. Потім вони отримують окремі відповіді, зберігаючи їхні джерела або посилання на файли, виділяють твердження у таблицю за джерелом і сортують кожну розбіжність за її типом, чи то фактичний конфлікт, різна інтерпретація, відсутнє припущення або різниця у форматі. Вони перевіряють твердження, які впливають на рішення, проти якоря або первинного джерела, і записують рішення про прийняття та те, що залишається невирішеним. Список C3 у Додатку C будує таблицю тверджень за джерелом, список C4 оцінює rho з елементів з відомими відповідями, а Додаток D дає межу для діапазону rho без запуску чого-небудь. Ще одне правило належить сюди, і це не коштує другої підписки. Критик з однієї сім'ї, якого просять у свіжому контексті атакувати першу відповідь, ловить поспіх, пропущені інструкції та невикористані перевірки, хоча він не може впіймати спільне хибне знання. Я б розпочав звичку критики на рівні 3 з одним агентом і додав би другу сім'ю тільки тоді, коли критикові більше нічого сказати і рішення дороговартісне.
Протилежний випадок потребує такого ж ясного формулювання. Для багатьох завдань одна сильна модель з хорошим набором джерел і ретельним людським переглядом перемагає складну раду, яка додає затримку та плутанину, і модель передбачає стільки ж. Оркестрація окупається там, де завдання несе реальну невизначеність, отримує користь від різних перспектив або повторюється досить часто, щоб амортизувати налаштування. Це погано підходить для часово-критичного рішення без можливості перевірки, конфіденційного матеріалу, який не можна розповсюджувати між сервісами, та простих завдань, де вартість порівняння перевищує користь. Коли рада використовується, агентам слід дати різні завдання: один обмежений запропонованими документами, один відправлений шукати первинні джерела, один розповідати непідтвердені твердження, один перевіряти цитування, коли людина все ще виносить рішення. P9 написаний таким чином, щоб цей контраргумент міг перемогти.
7. CLI оркестрація: надійний шар делегування
7.1 Агенти викликають агентів
На рівні 3 кожен агент має інтерфейс командного рядка, який може працювати без присутності людини за клавіатурою: на вхід йде запитання, на виході — відповідь або змінений файл. Коли людина контролює одного агента, цей агент може викликати інших. У літературі про системи це називається оркестрацією агентів. Я називаю версію, яку непрограміст запускає через інструменти командного рядка, на які вона вже підписана, CLI оркестрацією. Одна інструкція першому агентові («попроси двох інших переглянути цей план і скажи мені, де вони не згідні») створює малу команду.
У 2026 р. цей підхід перейшов від трюка розробника до практики, схвленої постачальником. OpenAI опублікував офіційний плагін, який запускає її кодувальний агент всередину агента Anthropic, «для перегляду коду або делегування завдань», з командами для звичайного огляду, агресивного огляду, в якому другий агент припускає, що робота зламана та розшукує, та порятунку застрялого завдання. Він працює через локально встановлений інструмент та наявні облікові дані, придатний для будь-якої підписки ChatGPT, включаючи безкоштовний рівень, і мав близько 33 400 зірок на GitHub у вересні 2026 р. (OpenAI, 2026a). Найпоширенішою парою 2026 р. є Claude Code, що пише, і Codex, що перевіряє, через цей офіційний плагін (OpenAI, 2026a), тоді як ради з трьох і більше агентів залишаються малими інструментами без лідера. GitHub зробила агентів Anthropic та OpenAI доступними всередину свого сервісу Copilot у лютому 2026 р., «повністю включено у вашу наявну підписку Copilot» (GitHub, 2026c). Командний агент xAI поставляється з режимом без інтерфейсу та підтримкою Agent Client Protocol, щоб користувачі могли «будувати свої власні боти та додатки оркестрації агентів» (xAI, 2026). Причиною Google для вилучення свого першого командного агента було те, що користувачі «потребують багатьох агентів, які спілкуються один з одним» (Google, 2026). Інструменти з відкритим кодом, які дозволяють одному агентові консультуватися з іншими, користуються великою популярністю: багатопостачальницький сервер для консультацій модель-на-модель мав близько 11 800 зірок, плагін, орієнтований на консенсус, близько 4100 (GitHub, 2026d). В основі Model Context Protocol, пожертвуваний органу Linux Foundation у грудні 2025 р. з більш ніж 10 000 опублікованих серверів та близько 97 мільйонів щомісячних завантажень SDK на той час (Linux Foundation, 2025), повідомив про близько половини мільярда завантажень SDK на місяць до його випуску специфікації у липні 2026 р., який також зробив протокол без стану та пообіцяв дванадцять місяців попередження перед будь-яким виведенням з експлуатації (Model Context Protocol, 2026). Це те, як агент на ноутбуці досягає решти інструментів людини без плагіна, специфічного для кожного постачальника, і він уже став нудним так, як нудний веб-протокол: присутній, задокументований, ігнорується, поки щось не зламається. Другий стандарт, протокол Agent2Agent від Google для агентів, які спілкуються з агентами між постачальниками, досяг версії 1.0 у березні 2026 р. (Google Open Source Blog, 2026). Це інфраструктура рівня 4, і сьогодні це не вхідна точка для споживачів.
Таблиця 5. Ландшафт оркестрації за паттернами, вересень 2026 р.
| Паттерн | Приклади (вересень 2026) | Рівень | Створено для | Що це дає | Записи, які залишає | Основний ризик |
|---|---|---|---|---|---|---|
| Ручне порівняння у вкладках браузера | Будь-який набір чатботів для споживачів | 4 (веб) коли записано та перезапущено; інакше звичка рівня 1 | Будь-хто | Охоплення; звичка порівняння | Скріншоти або скопійовані відповіді, контекст часто втрачається | Вартість уваги; незареєстроване походження |
| Інструменти трансляції для веб-чатів | ChatHub, ChatALL | 4 (веб) коли записано та перезапущено; інакше звичка рівня 1 | Особи | Один запит, паралельні відповіді, без узгодження | Відповіді в панелях; нічого на диску, якщо не збережено | Ламається при зміні інтерфейсів; умови обслуговування |
| Рада як функція продукту | Perplexity Model Council; Microsoft 365 Copilot research agent (GPT and Claude); Karpathy's LLM Council | 4 (веб, керована) | Підписники цих сервісів | Об'єднана відповідь з згодою та розбіжністю | Що б не показував постачальник; джерела часто вкладені | Об'єднаний голос приховує походження; обираючий — постачальник |
| Веб-чат, відкритий для агентів | OpenCLI та подібні | Міст з 4 (веб) на 4 (CLI) | Технічні користувачі | Агенти можуть використовувати веб-підписки | Файли, якщо агент їх пише | Крихкість; правила доступу |
| Плагін постачальника: один агент делегує іншому | OpenAI's plugin for Claude Code; Claude and Codex inside GitHub Agent HQ (Copilot) | 4 (CLI) | Розробники, розповсюджується | Міжпостачальницький огляд та делегування всередину однієї сесії | Транскрипт сесії; вихід огляду | В основному кодоподібне; квота двох сервісів |
| Сервери рад та консультацій | Багатопостачальницький сервер консультацій (остання фіксація грудень 2025); плагіни консенсусу; малі ради CLI, які пишуть один файл на інструмент | 4 (CLI) | Розробники | Декілька сімей на одному завданні; правила консенсусу | Файли на інструмент; об'єднана замітка | Раунди без кінця; корельовані помилки; відмовлення |
| Багатоагентні інформаційні панелі | Декілька офіційних CLI в панелях, кожна з власною робочою копією, людина, здатна перебрати будь-яку з них | 4 (CLI, видима) | Розробники, які наглядають за паралельними агентами | Нагляд зроблений видимим | Журнали для кожного агента та дифи | Побудовано для коду; увага розповсюджена тонко |
| Скрипт розповсюджування з часовими лімітами | Список C1 у додатку C | 4 (CLI) | Будь-хто, хто володіє агентом рівня 3 | Паралельні відповіді збережені навіть коли інструмент зависає | Один файл на інструмент, резюме з тим, хто відповів | Потребує людини для узгодження |
| Один агент, завдання написане та перезапущене | Файл інструкції або навичка, запущена по розкладу | 3, зроблене повторюваним | Будь-хто на рівні 3 | Повторення, де другої моделі немає | Файл завдання, входи, виходи, замітка про схвалення | Повторення посилює поганий шаблон |
Рядки описують закономірності. Кількість зірок у додатку E — це слід популярності на один день, і вони не є користувачами, якістю або придатністю для папки контрактів. Припинення розробки повинно бути в таблиці: найвідомішому серверу останній коміт у грудні 2025 року, і кілька панелей були залишені розроблювачами. Стаття, яка спрямовувала б навчаючих на одного названого оркестратора, завдала б їм ведмежої послуги, тому я вказую їм на закономірність замість цього: офіційні бінарні файли, неінтерактивні прапори, файли на диску та запис про те, кого було запитано.
7.2 Чому цей шар залишається
Оркестрація CLI спирається на власні інструменти постачальників, запущені в режимах, які самі постачальники документують для автоматизації, і це надає їй властивості, які вкладка браузера не може мати. Перш за все, її можна записати. Процедура, яка спрацювала один раз, скажімо «чернетка з однією моделлю, другий перегляд за контрольним переліком, дайте мені розбіжності», може бути збережена як файл інструкцій або навик і запущена знову на наступному тижні, за розкладом, якщо потрібно. Розділ 3 визначив рівень 4 саме як це — повторюваних робіт, спрямованих на моделі. Далі йдуть кілька додаткових властивостей, у порядку їхної важливості для мене. Прапор командного рядка — це задокументований інтерфейс, а код виходу — це обіцянка; позиція на веб-сторінці — ні те, ні інше, тому інструменти, які керують сторінками чату для користувачів, мають бути відремонтовані щоразу, коли сторінка змінюється. Кожен офіційний інструмент працює під власною авторизацією постачальника з пісочницею того постачальника та правилами заборони, тому людина може зберігати таємниці поза папкою, заборонити мережу за замовчуванням і відхилити деструктивні команди для кожного інструменту, тоді як агент браузера, який може бачити кожну вкладку, є одним більшим об'єктом дозволу. Закономірність використовує облікові записи користувачів, які людина вже оплачує, і я очікую, що це, більше за все, відокремить практику, яку непрограміст може вести, від однієї, яку вони спробують один раз. І постачальники це схвалюють. Офіційний плагін, агенти всередині сервісу GitHub, режими без інтерфейсу та стандарт навичок — це ознаки того, що міжінструментна делегація стандартизується, тоді як автоматизація сторінок чату для користувачів витісняється.
Веб-оркестрація може навчити звички порівнювання, а оркестрація CLI — це місце, де звичка може бути збережена як об'єкт. Об'єкт — це папка, яка містить завдання, допущені входи, виходи, журнал того, який агент що створив, і примітку про те, що було прийнято. Інша людина може перевірити її без повторення приватного чату, і людина, яка її створила, може змінити один вхід на наступному тижні й побачити різницю. Цей запис також ускладнює ухилення від відповідальності, оскільки збережене завдання і примітка про прийняття викривають поганий набір джерел або відсутність затвердження. У офісах, звиклих до неформального чату, це здаватиметься тягарем, а там, де роботу потрібно перевірити, передати чи повторити, це актив. Масштабування вирішує це: двомінутний запит не потребує папки робочого процесу, тоді як повторювана задача зі спільними файлами може потребувати.
Більшість того, що існує, формується кодом. Офіційні плагіни, серверами ради та багатоагентні менеджери спрямовані на огляд програмного забезпечення, хоча в самій закономірності нічого специфічного для коду немає.
7.3 Що цей шар вимагає від людини
Невелика команда агентів потребує менеджера, і робота менеджера є специфічною. Я називаю його чотири частини контрактом делегування:
- Мета: чого робота призначена, сформульована так, щоб агент міг сказати, чи вона була досягнута.
- Межа: що агенти можуть робити, а що ні, які дії потребують підтвердження від людини, та який бюджет часу та квоти може витратити задача.
- Артефакт: що має існувати після завершення роботи, та у якій формі.
- Перевірка: як людина дізнається, що артефакт правильний, вирішено до того, як робота почнеться, хто перевіряє що, й коли зупинитися.
Четверта частина містить пастку, описану в супровідній роботі про автоматизований нагляд (Chernets, 2026b). Додавання рецензента дешево, і кожен рецензент знаходить щось. Рада без правила зупинення має тенденцію додавати раунди та критиків, поки робота не буде затоплена в огляді. Практичне правило — дозволити один раунд критики та один раунд виправлень на етап, де людина вирішує, чи знахідка блокує роботу. Правило має виміряну ціну: у рандомізованому тесті 144 запусків, повідомленому у цій роботі, бюджет одного раунду скоротив раунди критики з 2,86 до 1,00 на запуск, в той час як підвищував пропущені дефекти на 0,11 на запуск (95% довірчий інтервал 0,005 до 0,204) (Chernets, 2026b). Чи варто робити цей компроміс, залежить від ставок, що є саме тим видом рішення, яке належить менеджеру. Обмеження на раунди та час — це бюджети, і бюджет вирішує, коли зупинитися, що є іншим питанням, ніж чи є відповідь правдивою.
Контракт переказує те, що хороша делегування людям завжди потребувала, для аудиторії, яка ніколи не делегувала програмному забезпеченню, і він не претендує на нову теорію управління. Його цінність полягає в тому, що кожна частина може бути викладена, записана та перевірена, й що кожна частина дає видиму збій, коли вона не вистачає.
8. Від оператора до менеджера
8.1 Що змінюється в роботі
На рівні 1 людина виробляє, а модель допомагає. На рівнях 3 і 4 модель виробляє, а людина керує, контролює та схвалює. Праця Bainbridge (1983) про парадокси автоматизації передбачила, що це робить з людською роллю. Автоматизація усуває рутину й залишає людині те, що найтяжче виконувати добре — моніторинг та втручання при рідких збоях, у той час як практика, що розвивала їхнє судження, зникає. Версія цього парадоксу для генеративного ШІ вже задокументована. Генеративний ШІ переміщує людей від виробництва до оцінки й робить складні завдання складнішими (Simkute et al., 2024), вища впевненість у інструменті корелює з менш критичним мисленням (Lee et al., 2025), а дескваліфікація структурно випливає з усунення практики (Ferdman, 2025).
Управління агентом — це тому інша робота зі своєю компетентністю, і ця компетентність не приходить автоматично з інструментом. Вона складається з вибору того, що делегувати, викладення контракту делегування розділу 7.3, читання слідів агента та вирішення, коли результат достатньо хороший. Я розділяю роботу на чотири практики. Делегування визначає роботу як результат з межею. Нагляд стежить за планом, проміжним результатом чи слідом інструменту й втручається, коли завдання відходить, без схвалення кожного натиснення клавіші, оскільки схвалення всього — це втома, а втома — це те, як люди натискають так. Верифікація перевіряє джерела, суми, перетворення та твердження, на яких спирається рішення, пропорційно ризику й методом, не пов'язаним з перечитуванням оцінки впевненості агента: тести й діфи для коду, вибірковий огляд проти сторінки, яку людина відкриває сама для папки контрактів, і для таблиці літератури — рядок за рядком перевірка ідентифікаторів. Відкликання звужує робочий простір, зупиняє запуск або видаляє доступ, коли умова змінюється. Людина, яка робить усі чотири, керує агентом навіть через графічне настільне застосування. Людина, яка передає завдання непрозорому сервісу та приймає першу відповідь, передає судження, що є іншою практикою. Parasuraman та Riley (1997) назвали два способи невдачі в цьому. Невикористання — це особа, яка могла б делегувати та ніколи цього не робить, застрягла на рівні 1 з привички чи страху. Зловживання — це особа, яка делегує без перевірок та приймає те, що повертається. Обидва видні у 2026. Дані про широке та поверхневе прийняття описують невикористання у масштабі (розділ 2.2), а звіти про втрату файлів та видалення баз даних розділу 5.3 описують зловживання, іноді професіоналами, які знали краще. Таблиця 6 розміщує кожну практику поруч із частиною контракту делегування, яку вона забезпечує, ризиком, який вона усуває, та датованим слідом, за допомогою якого дослідження може побачити, що це сталося.
Таблиця 6. Чотири практики менеджера: що кожна забезпечує, який ризик вона усуває та які сліди вона залишає.
| Практика | Що робить людина | Частина контракту, яку вона забезпечує | Ризик у разі відсутності | Спостережуваний слід |
|---|---|---|---|---|
| Делегування | Називає роботу як результат з межею (8.1) | Мета, сформульована так, щоб агент міг визначити, чи вона досягнута; артефакт: що повинно існувати й у якій формі (7.3) | Невикористання: «особа, яка могла б делегувати та ніколи цього не робить», застрягла на рівні 1 з привички чи страху (8.1) | Артефакт, покладений (Додаток A) |
| Нагляд | Стежить за планом, проміжним результатом чи слідом інструменту; втручається, коли завдання відходить, без схвалення кожного натиснення клавіші (8.1) | Межа: що можуть торкатися агенти; які дії потребують підтвердження людини; ліміти часу й квоти (7.3) | Втома схвалення: «втома — це те, як люди натискають так» (8.1); охоронець, який блокує занадто багато, виробляє невикористання (5.3) | План відхилений; незворотній крок утримуваний на затвердження (Додаток A) |
| Верифікація | Перевіряє джерела, суми, перетворення та твердження, на яких спирається рішення, методом, не пов'язаним з перечитуванням оцінки впевненості агента (8.1) | Перевірка: як людина дізнається, що артефакт правильний, вирішено до початку роботи; коли зупинитися (7.3) | Зловживання: «особа, яка делегує без перевірок та приймає те, що повертається» (8.1); корельовані помилки серед моделей (6.3) | Результат відхилений; запрошено інше сімейство моделей; знаменник записаний: запитано, відповідено, час спливло (Додаток A) |
| Відкликання | Звужує робочий простір, зупиняє запуск або видаляє доступ, коли умова змінюється (8.1) | Межа, застосована знову: що утримується, й як скасувати помилку (3.2, 7.3) | Довге завдання, яке не можна було зупинити, після якого видалення завдання видалило файли (5.3) | Не зареєстровані в Додатку A; датована зупинка, звужена дозвіл чи видалений доступ прослужать |
Примітка: Особа, яка передає завдання непрозорому сервісу та приймає першу відповідь, «передає судження», що є іншою практикою (8.1).
Один невеликий пристрій тримає роль разом через усі чотири практики, й я називаю його записом про прийняття. Для важливого чи повторюваного завдання він містить запланований результат, використані дані, обмеження й дозволи, куди пішов результат, будь-яку істотну незгоду або невдачу, виконані перевірки та рішення людини щодо прийняття, переробки, передання або відхилення. Він проводить лінію між тим, що виробив агент, та тим, на що спиралася людина. Для окремої особи це корисно, оскільки перетворює почуття довіри на перевірюване рішення, для команди, оскільки колега може інспектувати роботу без приватної історії чату, та для дослідника, оскільки розділяє завершений запуск від результату, що використовується. Це також обмеження. Людина може вирішити, не написавши критерію прийняття, що завдання повинне залишатися на рівні 1, й модель це лічить зрілим управлінням, а не відставанням у прийнятті. У контексті людсько-ШІ співпраці, перехід від рівня 1 до рівня 4 тримає людину в циклі й змінює його характер, від читання кожної відповіді до встановлення умов, за яких відповіді приймаються. Рисунок 4 малює цей цикл з чотирма практиками, ризиком на кожному кроці, повертом після невдалої перевірки й записом про прийняття.
Рисунок 4. Цикл управління менеджера.
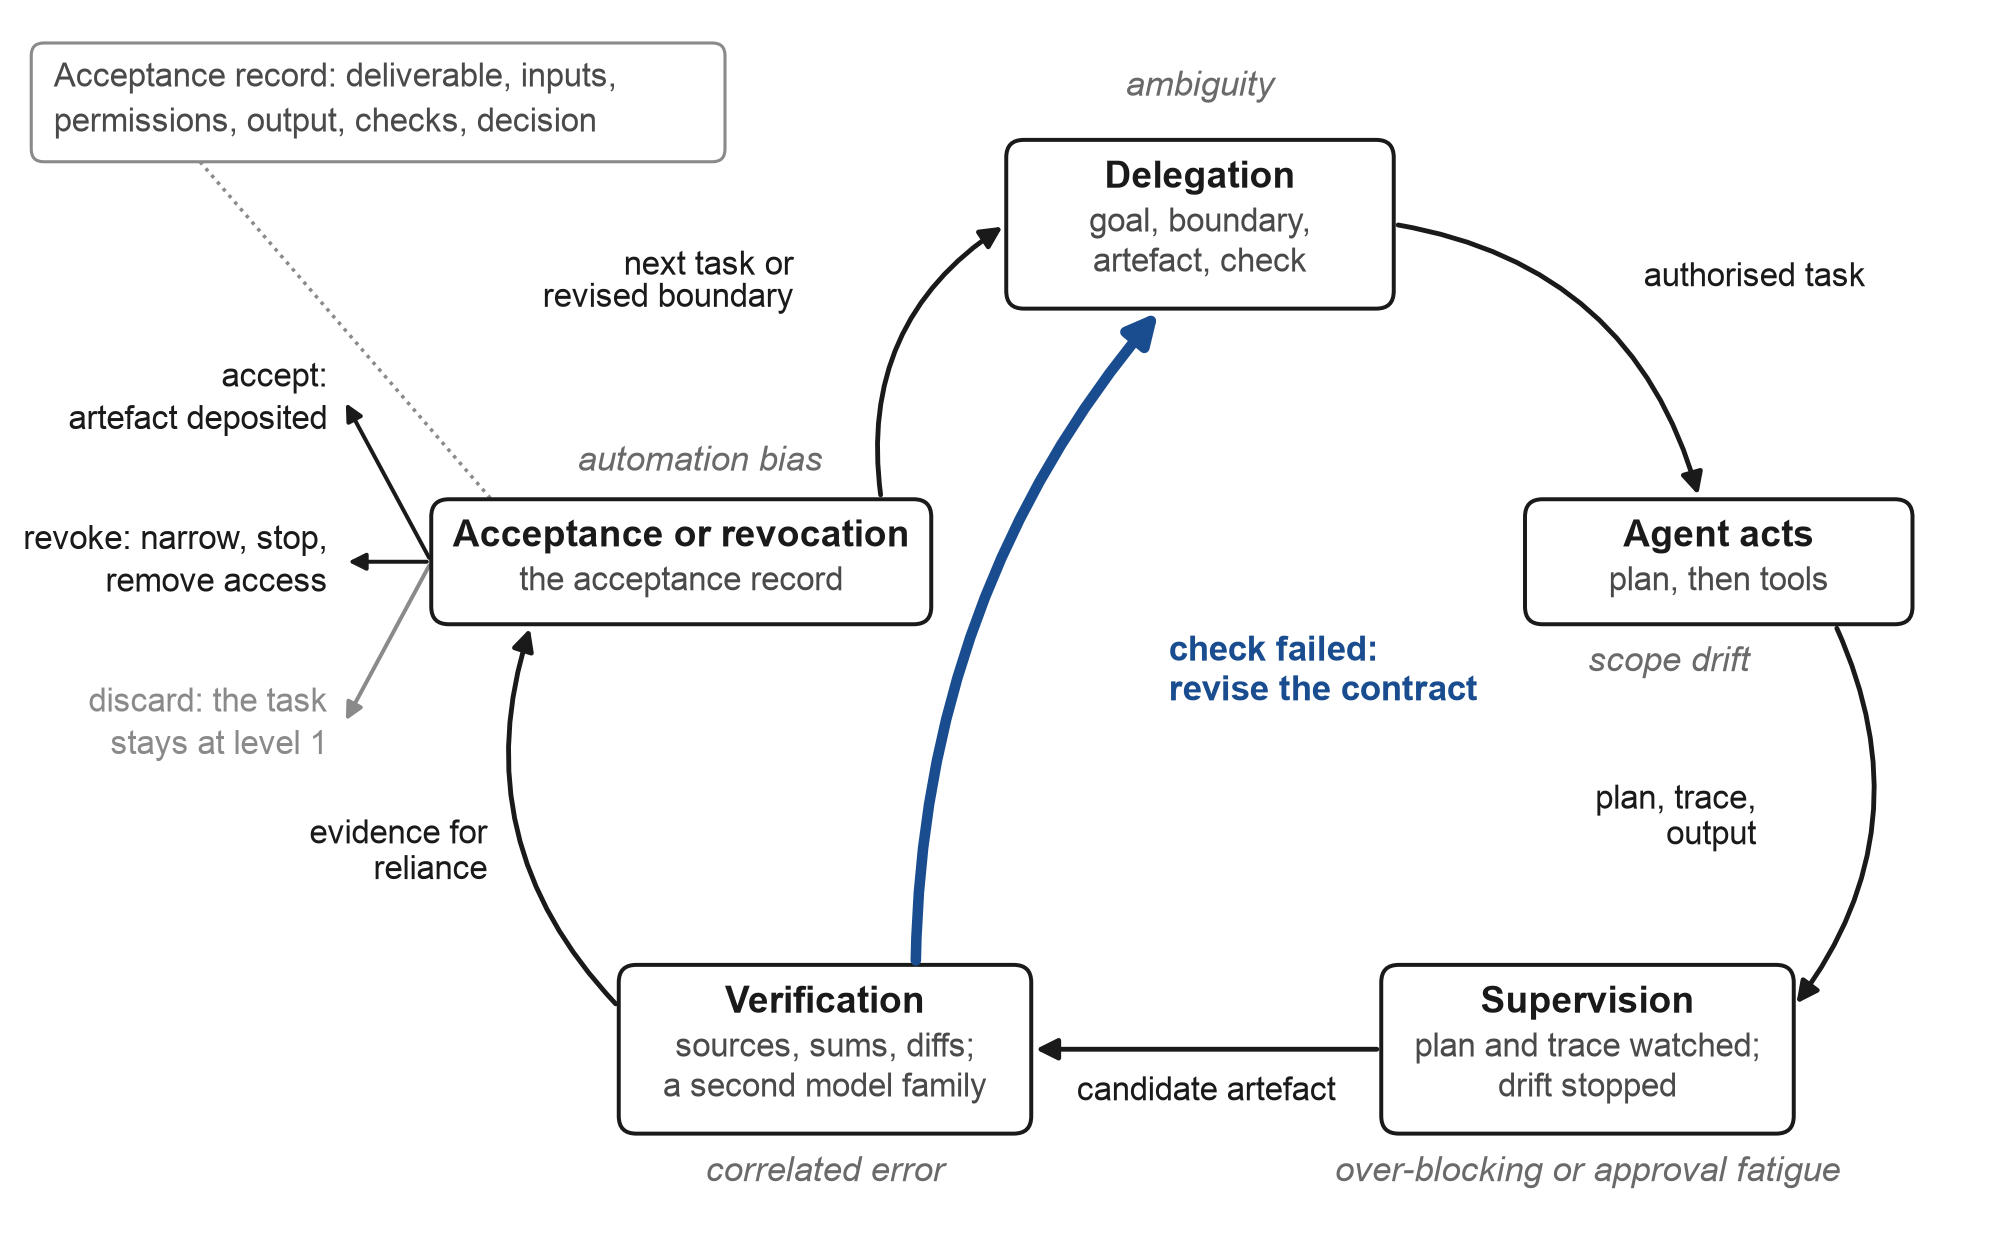
Примітка: робота менеджера як цикл, який запускає людина (розділи 7.3 та 8.1): делегування встановлює контракт (мета, межа, артефакт, перевірка), агент діє, людина контролює та верифікує, а потім приймає, скасовує або відкидає результат і записує запис про прийняття. Сірі курсивні мітки називають ризик на кожному кроці (розділи 5.3, 6.3 та 8.1). Жирна стрілка — це повернення від невдалої перевірки до переглянутого контракту, і кожен вихід з вузла прийняття є рішенням людини.
8.2 Досвідчені користувачі делегують менше
Одне спостереження суперечить будь-якій простій історії, в якій кожен повинен закінчити менеджером агентів. Anthropic повідомила в березні 2026 року, що користувачі з більшим стажем були «набагато менш схильні делегувати більшу відповідальність через директивні моделі використання» (Anthropic, 2026e), а її звіт за січень 2026 року поставив розширення, спільне використання, при якому людина залишається в циклі, на рівні 52% розмов у листопаді 2025 року (Anthropic, 2026f). Одна інтерпретація полягає в тому, що досвідчені користувачі дізналися, де делегування не вдається, і відступили. Інша полягає в тому, що вони дізналися використовувати модель як співробітника для частин роботи, де їхнім власним судженням є продукт. Я не можу розрізнити дві інтерпретації за опубліковими цифрами, і при будь-якій інтерпретації кінцева точка сходів — це щось інше, ніж максимальне делегування. Це здатність вибирати, від завдання до завдання, між запитанням, спільною роботою та делеганням, і знати, що потребує завдання перед вами. Чотирирівнева модель описує, що людина може робити. Вона не стверджує, що люди повинні кожен раз робити найбільш делегуючу річ.
8.3 Відповідальність залишається за людиною
Постачальники ясно кажуть, де лежить відповідальність. Керівництво запуску для агента рівня 2 Anthropic повідомило користувачів, що вони «залишаються відповідальними за всі дії, виконані Claude від вашого імені» (The Register, 2026). Це юридична та практична реальність рівня 3 зокрема, де агент діє з облікових даних власника, на файлах власника, від імені власника. Професіонал, який стає менеджером агента, також стає відповідальним за працівника, чиї помилки відбуваються швидко. Це ще одна причина, чому перевірку в контракті делегування необхідно вирішити до початку роботи, і ще одна причина, чому дизайн безпеки розділу 5.3 не повинен залежати від того, що людина виявить атаку в режимі реального часу.
8.4 Роль менеджера в системах грамотності
Офіційні визначення AI грамотності починають називати цю роль, хоча жоден з переглянутих тут текстів не використовує слово «агент». Framework AI Literacy Міністерства праці США від лютого 2026 року включає «ефективне керування AI» до своїх змістовних областей (US Department of Labor, 2026; ExecutiveGov, 2026). Спільна рамка OECD та European Commission від червня 2026 року, яка живить оцінювання PISA 2029, має чотири домени, один з яких — «Manage AI» (OECD & European Commission, 2026). Ранніші академічні рамки наголошували на розпізнаванні, розумінні та оцінюванні AI (Long & Magerko, 2020), а структури компетентностей UNESCO 2024 для студентів та вчителів встановлюють той самий регістр (UNESCO, 2024a, 2024b). Контракт делегування надає керуючому та спрямовуючому доменам викладальний вміст для випадку з агентом: встановити мету, обмежити роботу, назвати артефакт, визначити перевірку. Практикуючи фахівці почали використовувати такі назви, як «оператор AI» та «менеджер агентів» для професіонала, який набуває цієї спеціалізації на додаток до своєї професії. Я використовую «менеджер агентів» більш вузько для моделі поведінки, а не як роль для найму, тому що поведінка залишає докази, а назва — ні. Докази знаходяться в артефактах: план, який людина відхилила, diff, який вони відхилили, друга думка, яку вони взяли, запланований запуск, який завершився, коли вони були від комп'ютера. Де нема жодного з цих слідів, за назвою нічого не стоїть.
9. Вимірювання переходів: передзареєстрована програма
9.1 Переходи як одиниця вимірювання
Більшість даних про впровадження підраховують людей, які «використовують AI», іноді щотижня чи щодня. Такий підрахунок не може розрізнити людину, яка просить у чатбота синоніми, та людину, яка делегує квартальний звіт агенту, а саме останню я хочу знайти. Правило артефакту з розділу 3.3 робить цю різницю спостережною, оскільки перехід записується тільки тоді, коли агент виробив те, що людина просила, на новому рівні. З літератури про залучення та нагляд виходять кілька подальших правил. Завершення слід звітувати окремо для людей, які перейшли без допомоги, та людей, яким допомагали, оскільки допомога змінює значення переходу. Зупинку слід записати в точці, де вона сталася, і своїми словами людини, оскільки причини припинення становлять значну частину результату. Кожна людина, яка отримала матеріали, належить до знаменника, включаючи тих, хто ніколи не відповідав. Нарешті, наполегливість слід спостерігати після того, як дослідник припинив писати щотижня; артефакт, вироблений, коли дослідник все ще в папці людини, може бути як ввічливістю, так і використанням.
9.2 Дизайн
Я керую передзареєстрованою когортною програмою, яка застосовує ці правила до непрограмістів (Chernets, 2026d; OSF, https://osf.io/x4egq, DOI 10.17605/OSF.IO/X4EGQ, зареєстрована та заморожена 6 вересня 2026). Це однорукова дослідження здійсненності триступеневого шляху, і передзареєстрація була заморожена до збору будь-яких даних. Далі наведено дизайн у зареєстрованому вигляді.
Учасники. Дорослі люди, робота яких здійснюється переважно за комп'ютером. Вони використовують власну машину та власні підписки на AI (підписки роботодавця виключаються), тримають матеріали, що визначають клієнта, та конфіденційні матеріали роботодавця поза межами вправи, та підтверджують, що встановлення програмного забезпечення не порушує жодне правило, яке застосовує до них їхній роботодавець. Набір персоналу здійснюється шляхом публічного оголошення на професійних соціальних мережах у межах часового вікна, заздалегідь встановленого, так що його не можна розширити, доки результат не виглядатиме сприятливо. Оголошення знімається екраном, а його постійне посилання записується, що фіксує текст набору. Вхід здійснюється постійно, і розклад кожного учасника відраховується від його власного дня нуль, оскільки інструменти змінюються на тижневій основі. Набір розпочався з публічного оголошення 6 вересня 2026 року, дня, коли реєстрація була заморожена, і закривається через 21 день, 27 вересня 2026 року; когорта знаходиться в полі на момент написання, і реалізована кількість, яка б вона не виявилася, буде повідомлена разом із результатами.
Етап 1 (від чату до агента на власному комп'ютері людини). Учасник вставляє стандартний текст у чатбот, який він уже використовує, і цей чатбот керує ним через встановлення графічного агента на його власній машині. Я не торкаюся комп'ютера нікого. Етап завершується, коли учасник надає артефакт, який агент виробив у відповідь на перше завдання. Завдання має однакову форму для всіх і заповнюється власною робочою ситуацією учасника, і воно вимагає від агента запитувати, вирішувати, створювати та форматувати файли. Ця вимога відділяє агента від чатбота. Реєстрація дає точне формулювання (Chernets, 2026d). З точки зору моделі, Етап 1 тестує рефлексивне залучення одночасно на двох рівнях, з рівня 1 на рівень 3. Це було свідомим вибором. Графічна оболонка локального агента працює на власній машині людини, тому за правилом розділу 3.3 це рівень 3, а артефакт, який просить Етап 1, такого роду, який позначає перехід 2; його запити дозволу дають йому деякий захист обмеженої сходинки. Когорта не інструментує окремий тиждень у середовищі рівня 2, обмеженому постачальником, тому вона не може тестувати P5 розділу 10 (що обмежена середня сходинка знижує незавершення та інциденти); ці запити дозволу — єдина обмежена сходинка, яку має дизайн, а командний рядок вводиться на Етапі 3. Подальша когорта, яка вставляє явний тиждень рівня 2 між чатом та локальною установкою, була б чистим тестом P5.
Етап 2 (в веб-оркестрування, запущене з агента). Як тільки готові, учасники отримують інструмент з відкритим вихідним кодом, який ставить одне запитання до кількох моделей через підписки, які вони вже оплачують, і повертає одну об'єднану відповідь у одній дії з агента. Мета етапу була зареєстрована заздалегідь як охоплення та надійність, з видимою незгодою як один механізм для другої.
Етап 3 (в оркестрування CLI). Те саме оркестрування через інтерфейси командного рядка.
Заходи. П'ять замороженими основні пункти, сформульовані однаково в кожній когорті програми, записують професію та години за комп'ютером, поточне використання AI, попередній досвід запитування більш ніж однієї AI, чи й як перевіряються відповіді, та чи вже щось діє для людини на її комп'ютері. Запис етапу для кожного учасника містить дати, чатбот, який його керував, спроби та години, завершення з артефактом, точку зупинки та причину своїми словами, та чи й як дослідник втручався. Щотижня протягом першого місяця учасники повідомляють про один артефакт, який його агент виробив того тижня (або «нічого», що є допустимою відповіддю), як часто вони ставлять одне запитання більш ніж одній AI та що сталося, коли відповіді розійшлися, та з Етапу 2 далі чи виникло щось корисне, що одна модель пропустила, та чи перевірка змінила те, на що вони покладалися. Спостереження продовжуються на день 60 та щоквартально після цього, доки учасники охочі.
Аналіз та інтерпретація. Аналіз є описовим. Пропорції завершення наводяться з довірчими інтервалами як проти тих, що вижили, так і проти повного знаменника, окремо для незалежного та допоміжного завершення; часи та спроби звітуються як розподіли, а причини припинення кодуються після збору, з кодами та сировими формулюваннями депонованими. Одне правило інтерпретації було встановлено заздалегідь. Якщо менш ніж половина тих, хто отримав матеріали Етапу 1, надають артефакт, створений агентом, когорта повідомляється як дослідження невдачі залучення, а те, що зупинило людей, стає результатом.
Межі умовиводу. Реєстрація передбачає заздалегідь, що немає контрольної умови і, отже, немає причинного твердження, і немає узагальнення поза самовиборкою волонтерів. Оцінка учасником затраченого часу повідомляється як переконання лише тому, що самозвіт у цій області, як показано, інвертує справжній напрямок (Becker et al., 2025).
Розкриття інформації та етика, як зареєстровано. Учасникам в письмовій формі повідомляється, що я написав матеріали та інструмент, навчаю їх, і я є заявником на очікуваних патентних заявках, які охоплюють метод оркестрування. Думка комісії з етики не була запрошена: дослідження не має інституціональної належності та не фінансується федеральними коштами. У реєстрації натомість вказані запобіжні заходи. Згода надається письмово до початку будь-якого записування. Не збираються дані про здоров'я, фінансові дані або дані про вміст роботи. Учасники працюють на своїх власних машинах та підписках та можуть попросити видалення у будь-який момент аж до публічного розміщення. Інструкції з безпеки включають окремий профіль браузера, відсутність дій на банківських або медичних сайтах, підтвердження перед будь-якою незворотною дією, заборону на введення паролів у агент та розгляд веб-контенту як даних. Не збирається змінна про інвалідність та не робляться твердження про доступність.
9.3 Тільки дизайн
З програми я беру лише дизайн. Кількість учасників, рівні завершення та окремі випадки тут не наводяться за умисною рішенням: аргумент (дана стаття), метод і програма, а також результати після періоду спостереження протоколу є окремими публікаціями, так щоб аргумент не міг читатися як доказ самого себе. Інші дослідники можуть застосовувати ті ж правила зараз. Лістинг C5 у Додатку C надає формат запису та перевірювач, які їх кодують. Перевірювач відмовляє запис, який вважає інсталяцію перетинанням, завершення без артефакту, створеного агентом, зупинку без власних слів особи, справжнє ім'я замість псевдонімної мітки, поле, яке формат не знає, або пропущений рівень, який не записується саме як пропущений.
9.4 Як має виглядати сильне наступне дослідження
Когорта є дослідженням можливості, і більшість положень Розділу 10 потребує інших дизайнів досліджень. Сильне наступне дослідження порівняло б дві умови введення, які відрізняються способом представлення роботи, утримуючи ризик завдання та технічне середовище якомога більш постійними. Одна умова представляє функції та інструкції встановлення; інша починається з власного об'єкта повторюваної роботи учасника та отримує п'ятичастинну карту Розділу 5.1. Результати включали б артефакти, їхня якість, оцінена кимось іншим, ніж учасник (з повідомленою згодою між оцінювачами, як для кодування причин зупинки), час, виявлені помилки, рішення про дозволи у формі сценарію, пізніше добровільне повторне використання та впевненість, виміряна проти результатів. Подальше дослідження розділило б стійкість від продовженого контакту з дослідником. Друге дослідження запитало б, чи є словник робочого процесу однією граматикою чи однією на кожну професію, порівнюючи адміністративні, дослідницькі, комунікаційні та аналітичні завдання. Я не знаю, який це, і відповідь вирішує, чи можуть упаковані приклади бути написані один раз, чи мають бути написані для кожної галузі. Обидва дослідження повинні встановити базу грамотності ШІ за допомогою валідованого інструменту (Carolus et al., 2023), так щоб конкретна прогалина, а саме знання того, що передати агентові, могла бути відокремлена від загальної знайомості зі ШІ. Кожне таке дослідження повинно також задокументувати впровадження, тому що учасник, який починає на пізнішому інтерфейсі, зустрічає різні стандартні налаштування: версію інтерфейсу, операційну систему, наявність доступу агента до мережі, режим дозволу та будь-яке обмеження політики. Саме ім'я постачальника розповідає пізнішому читачеві занадто мало.
10. Твердження
Модель розділу 3 та аргументація розділів 4–8 передбачають твердження, які можуть виявитися хибними. Таблиця 7 наводить п'ятнадцять з них, кожне з показником, результатом, який його спростував би, та вказівкою на того, хто повинен провести тест. Вони написані для всієї галузі. Програма розділу 9, наприклад, може перевірити лише кілька; інші можна перевірити за допомогою телеметрії постачальника, за допомогою опитувальних панелей або через невелике дослідження в одній організації. Жодне з них не є результатом когорти.
Таблиця 7. Твердження, показники, спростування та хто може їх перевірити.
| # | Твердження | Показник | Спростується, якщо | Хто може це провести |
|---|---|---|---|---|
| P1 | Подолання бар'єрів. Серед непрограмістів, які намагаються перейти на рівень 2, зупинки скупчуються після встановлення (на першому завданні, першій помилці або проблемах дозволів) більше, ніж під час встановлення, і серед тих, хто встановив, але нічого не створив, фраза «Я не знав, що запитати» траплялася частіше, ніж технічні, дозвільні та вартісні причини; крім того, при контролю складності завдання завершення знижується різко на трьох переходах, ніж в межах одного рівня. | Точки зупинки записані за правилом артефакту; причини в словах самої людини, закодовані за правилом Додатку A; завершення за кроками | Більшість зупинок відбуваються до першого запуску агента, або технічні та дозвільні причини домінують серед встановлених людей, які нічого не створили, або закономірності завершення та невдачі порівнювані на всіх кроках, коли складність завдання контролюється | Програма розділу 9; будь-яка реплікація |
| P2 | Об'єднання поверхонь. Де постачальники об'єднують поверхні чату та агента, частка сеансів, які закінчуються файлом або дією, створеною агентом, зростає без будь-якої зміни в тому, що користувачі кажуть, що хочуть робити; і провідні асистенти записують файли з вікна за замовчуванням без вибраного користувачем режиму до кінця 2027 року. | Телеметрія постачальника до і після об'єднання; датована перепис асистентів | Частка залишається незмінною після об'єднання; або стабільний, вибраний користувачем режим агента залишається необхідною умовою для запису файлів | Постачальники; будь-хто, хто може відкрити програми |
| P3 | Словниковий запас замість встановлення. Надання людям опрацьованих прикладів зі своєї галузі (упаковані завдання, навички, шаблони) підвищує постійність на рівнях 2 та 3 більше, ніж надання допомоги при встановленні, і структурований показник словниця робочого процесу передбачає завершення артефакту після того, як доступ і попередній досвід використання ШІ контролюються. | Постійність на 60-й день під двома видами допомоги, у порівнянні з завданням; попереднє формулювання п'яти частин розділу 5.1; причини зупинки закодовані за правилом Додатку A | Допомога при встановленні дає рівну або більшу постійність; показник словниця не додає нічого, коли легкість встановлення та загальна впевненість входять до моделі | Будь-яка лабораторія з двома маршрутами входу |
| P4 | Рефлексивна адаптація. Люди, керовані чатботом, який вони вже використовують, можуть перейти з рівня 1 на рівень 3 без допомоги темпом, який робить маршрут практичним, і досягнути першого артефакту швидше, ніж люди, яким дана статична документація. | Частка, що завершує перехід 2 без допомоги з артефактом, створеним агентом, проти всіх, хто отримав матеріали; час до першого артефакту за керованих та статичних умов | Менше половини завершують це, поріг встановлений заздалегідь у розділі 9; або статична документація дає рівне або вище завершення | Програма розділу 9; тренери з двома когортами |
| P5 | Середня сходинка. Непрограмісти, які проводять час у огородженому постачальником середовищі перед локальним агентом, частіше завершують перехід 2, мають менше інцидентів втрати файлів і краще міркують про обсяг, оборотність та збільшення, ніж люди, переведені прямо з чату на широкий локальний доступ. | Когорта з двома маршрутами з рівним спостереженням; артефакт як основний результат; журнал інцидентів; рішення щодо дозволів на основі сценаріїв до і після | Завершення без допомоги прямо з чату на локального агента відповідають тим, що пройшли через рівень 2, при порівнюваних показниках інцидентів та з рівними рішеннями щодо дозволів | Будь-яка лабораторія з двома маршрутами входу; пізніша когорта програми |
| P6 | Вузьке місце. Серед непрограмістів, які використовують чат щотижня, частка тих, хто виробляє артефакт рівня 3 за квартал, залишається значно нижче, ніж частка розробників, які використовують агентів кодування щотижня. | Репрезентативне опитування, яке використовує елементи артефакту, а не «ви використовуєте ШІ» (розділ 11.3) | Виробництво артефактів рівня 3 серед спеціалістів знань, які не є програмістами, наближається до показника щотижневого використання розробниками | Національні статистичні управління; опитувальні організації |
| P7 | Міст переносить. Люди, які практикують веб-оркестрацію, більш імовірно пізніше адаптують оркестрацію CLI, ніж люди, які цього не роблять, і видима невідповідність передбачує пізнішу атрибуцію джерела або критику в їхніх записах завдань. | Адаптація оркестрації CLI серед тих, хто практикував та не практикував раніше порівняння через веб; збережені порівняння та пізніші записи | Немає різниці або навпаки; порівняння дає більше підказок і без змін у збережених перевірках | Програма розділу 9; поздовжні панелі |
| P8 | Довговічність CLI. Для людей, які платять за два або більше споживчих підписок, оркестрація через офіційні інструменти командного рядка є формою рівня 4, яка залишається при змінах інтерфейсу, і запуски з підтримкою файлів повторюються та передаються іншому рецензенту краще, ніж запуски тільки у браузері. | Датована перепис артефактів рівня 4 у цій популяції; тести повторного запуску та передачі після змін інтерфейсу | Перепис кінця 2027 року знайде домінуючими веб- або програмно-інтерфейсні збірки і інструменти CLI-to-CLI, що відступають; робочі процеси тільки браузера збігаються при повторному запуску та передачі | Дослідники інструментів; опитування розробників |
| P9 | Узгодження з кореляцією. На всіх сімействах постачальників помилки в елементах роботи зі знаннями з відомими відповідями коррелюють достатньо, що узгодження серед трьох або більше моделей варто менше, ніж два незалежні висновки (rho на або вище близько 0,5, де rho оцінюється на елементах роботи зі знаннями з відомими відповідями і не береться з показників узгодження еталона); мала збірка різних сімейств перевищує велику збірку одного сімейства при рівних витратах; і рецензування з урахуванням джерела передбачає правильність краще, ніж узгодження більшості. | Попарна кореляція помилок між сім'ями на банках завдань з відомими відповідями (список C4); позначена сукупність елементів із двома проектами ради; правильність порівняно з більшістю згоди та джерело-обізнане рецензування | Виміряна rho нижче 0,2 для більшості типів завдань; рада однієї сім'ї перемагає після перевірки кожного твердження; або простої більшості згоди передбачають правильність не гірше, ніж різноманітність плюс перевірка | Дослідники мовних моделей; протокол супровідної статті |
| P10 | Компетентність менеджера. Наполегливість на рівнях 3 і 4 краще передбачається здатністю людини сформулювати контракт делегування (мета, межа, артефакт, перевірка) та слідами нагляду (планів відхилено, дифи відхилено, другі думки враховано), ніж попереднім технічним досвідом чи обсягом запитів. | Коротке завдання, яке вилучає чотири частини, оцінене сліпо; базові елементи; сліди з записів про прийняття; наполегливість на 60-й день | Попередній технічний досвід чи обсяг запитів передбачають наполегливість не гірше, а контрактування не додає нічого; або артефакти на рівнях 3 і 4, які звичайно опускають мету, джерела, межу та перевірку, залишаються надійними при незалежному аудиті, у якому разі структура компетентності перебудована | Будь-яке дослідження артефактів у часі |
| P11 | Калібрування за класом завдань. Люди краще калібрують делегування там, де зворотний зв'язок швидкий і повернення можливо, приймаючи, виправляючи та ескалюючи по-різному за класами завдань. | Прийняття, виправлення, ескалація та пізніше виявлення помилок за класом завдань | Калібрування однакова для обернених та завдань з великими наслідками | Лабораторії; організації з записами про прийняття |
| P12 | Тертя від охоронців. Серед непрограмістів на рівні 3 переривання від запитів дозволу та блоків безпеки називаються причиною припинення частіше, ніж серед розробників, і класифікаторно охоронювана автономія зменшує такі припинення без збільшення повідомлених втрат файлів. | Закодовані причини припинення за групами; темпи припинення та звіти про інциденти до й після зміни режиму за замовчуванням | Немає різниці між групами, або автономія збільшує повідомлені втрати | Постачальники; закодовані причини припинення програми |
| P13 | Розрив відтворюється. Відмінності в прийнятті чату за статтю та освітою (Cranney et al., 2026; Daepp & Counts, 2024) з'являються знову в виробництві артефактів рівня 3 в межах професій у розмірах не менших. | Відмінності в межах професії у виробництві артефактів рівня 3 | Оцінка в межах професії показує, що розрив закрився на рівні 3 | Економісти праці; пізніші когорти, якщо вони достатньо великі |
| P14 | Критик та друга сім'я. Критик однієї сім'ї виявляє поспіх та пропущені перевірки; друга сім'я виявляє спільну помилку; на наборі з позначеними дефектами кожен вносить дефекти, які інший пропускає. | Перекриття підтверджених висновків між критиком однієї сім'ї та рецензентом другої сім'ї з однаковою вартістю | Повне перекриття або домінування одного джерела | Будь-хто з двома інструментами агента та позначеним набором |
| P15 | Спроможність або словниковий запас. При однаковому класі завдань наполегливість на рівнях 2 і 3 варіюється в залежності від здатності людини сформулювати контракт делегування; якби спроможність моделі була обмежувальним обмеженням, наполегливість варіювалась би між класами завдань і була б однаковою для людей в межах одного. | Наполегливість за класом завдань, перехрещена зі сліпо оціненим твердженням контракту делегування | В межах класу завдань наполегливість однакова для всіх людей, незалежно від їхнього рахунку контракту, і варіюється лише між класами | Будь-яке дослідження, яке реєструє клас завдань та твердження контракту |
Деякі з них мають більшу вагу, ніж інші. P4 має найбільшу вагу для політики, оскільки якщо рефлексивна адаптація працює, найбільш дорога частина навчання людей агентам (сидіння поруч з ними під час встановлення) може бути замінена інструментом, який вони вже мають. P5 — це той, який когорта не може тестувати, як зазначено в розділі 9.2, і це також той, від якого найбільше залежить форма драбини. Чи заслуговує середня сходинка своєї місця — це те, що я ще не знаю. P9 є найпростішим для тестування і найймовірнішим здивувати користувачів рад, оскільки арифметика кореляційних свідчень (Chernets, 2026a) та вимірювання Kim et al. (2025) обидва вказують на межу ціни згоди. P10 — це той, який змінив би навчальні програми. Якщо здатність сформулювати контракт делегування передбачає наполегливість краще, ніж технічна база, то навчання повинне викладати делегування спочатку та інструменти другими.
11. Наслідки
11.1 Для постачальників
Проектування для порожної папки. Постачальники спростили інсталятор, і це видно. Я вважаю, що подальший раунд таких зусиль буде марною тратою, тому що проблема новачка тепер починається після інсталятора, перед порожною папкою, яка нічого не каже агентові. Опрацьовані приклади з власної галузі людини, запропоновані в момент, коли вона вперше відкриває агента, разом з першим завданням, яке є реальним, низькоризиковим і закінчується чимось, що вона може судити, зробили б більше для прийняття, ніж будь-яке подальше спрощення налаштування. Упаковані навички вже вказують на це (Розділ 5.1). Ще двох речей не вистачає: допомога у виборі, які з завдань людини варто передавати взагалі, і спосіб для професійної асоціації, а не тільки стартапу, писати навички для своїх членів.
Незалежно від того, як будуть називатися вкладки після наступного об'єднання, людина потребує чіткої відповіді в момент делегування та мовою вибраної папки на короткий список питань: що може читати цей агент, що він може змінювати, що він може надсилати або запускати, що потребуватиме мого затвердження та як я його зупиню? Візуальна різниця відповідає на частину цього, коли файли змінюються, а письмовий план - коли дії різноманітні; один банер дозволу не відповідає на жодне з них. Модель дозволу повинна залишатися видимою, обмеженою та оборотною після об'єднання, з кнопкою скасування та кнопкою зупинки, яка працює. Область папки без обох - це те, як читаються звіти про проблеми розділу 5.3.
Робота також повинна мати можливість залишити продукт. Користувач повинен мати можливість експортувати інструкцію завдання, вхідні дані або їхні ідентифікатори, дії інструменту, результат та історію затвердження. Це функція зручності, не менш ніж функція управління, тому що вона дозволяє новачку навчитися з завершеного завдання та дозволяє команді переглянути результат без передачі своєї пам'яті до запатентованої історії чату. Використання слід звітувати так само. «Активні користувачі на тиждень» агента, який виробляє файли, повинні розділятися на людей, які виробили файл, і людей, які відкрили програму, і постачальники мають телеметрію, щоб це зробити.
Виявлення атак - це не робота для новачка. Вказівки, які просять непрограмістів розпізнавати ознаки впровадження підказок, покладають найважче судження на людину, яка менш усіх здатна це зробити (Розділ 5.3). Безпечні за замовчуванням (робочі копії, знімки перед більшими змінами, деструктивні команди заборонені до явного дозволу, веб-вміст трактується як дані) належать до продукту. Водночас охоронні механізми, які постійно переривають, зупиняють роботу так само впевнено, як відсутні охоронні механізми втрачають файли, а супровідна робота про перевищення контролю описує, як такі шари зростають (Chernets, 2026b).
Походження повинно пережити об'єднання відповідей. Функції ради, які повертають одну об'єднану відповідь, повинні показувати, яка модель що сказала і де вони розходилися, дозволяти користувачу призначити одну модель критиком та полегшити пошук прогалини в доказах, ніж плинного абзацу консенсусу. Об'єднаний голос без джерел відновлює авторитет однієї впевненої відповіді, винаграджує упередженість автоматизації та приховує кореляцію помилок (Розділ 6.3).
Врешті-решт, зміни мають ціну на стороні користувача. Людина, яка вивчала інструмент, який був перейменований, об'єднаний або припинений протягом року, платить двічі, тому стійкі назви, посібники переміщення та безперервність файлів інструкцій у змінах продукту є сприяючими функціями прийняття.
11.2 Для роботодавців та тренерів
Навчайте контракту делегування перед меню. Меню продукту змінюються щомісяця, тоді як здатність ставити мету, огороджувати роботу, називати артефакт та вирішувати передачу перевірки залишається постійною на різних інструментах (Розділи 4.3 та 7.3). Коротка вправа, яка просить людину написати чотири частини для одного з її власних повторюваних завдань, краще тестує готовність, ніж огляд функцій. Те, що містить вправа, викладено нижче під розділом розкладання.
Входи вимірюють неправильну річ. Лічильник активних користувачів не може зробити розрізнення, яке було необхідне в розділі 9.1, між людиною, яка просить синоніми, і людиною, яка делегує звіт. Лічильник артефактів, створених агентом, які люди вибрали зберігати, може це зробити.
Людям також потрібне санкціоноване місце для навчання та карта того, що дозволено. Рівень 2 всередині інструментів, які організація вже ліцензує, досягає персоналу, якому ніколи не буде дозволено встановлювати агента на робочий ноутбук (Розділ 5.4). Для рівня 3 чітка політика, ізольована машина або схвалена конфігурація усуває мовчазне «ні», яке припускають багато людей. Повна заборона спонукає використання через особисті облікові записи, де ніхто не може це бачити, а необмежене делегування ризикує конфіденційним матеріалом. Між двома лежить завдання і таксономія даних. Вона каже, яка робота може бути спробована в схвалених середовищах, яка потребує перегляду другої особи та яка виключена з агентів; вона називає, хто може схвалити інструмент, де зберігається запис про прийняття та як про близький випадок повідомляється без покарання за його повідомлення. Локальний рівень 3 не повинен бути обов'язковим на машинах, які працівник не контролює, оскільки хмарні агенти та обмежені сфером орендатора рівень 2 - це шлях, який уникає конфлікту з відділом ІТ. Як тільки постачальники абсорбують першу сходинку в чат, рівень 2 зберігає два завдання. Це санкціоноване місце для персоналу на заблокованих машинах, і це калібрувальна сходинка для всіх інших, де людина дізнається, що делегована дія має межі, перш ніж мати свою власну. Чи це також зменшує інциденти - P5.
Мандати потребують уваги. Перетворення використання штучного інтелекту критерієм оцінки результатів може виробляти використання без значення, і щонайменше один роботодавець, який це зробив, скасував рішення протягом року (Fortune, 2026b). Запит артефактів, які мають значення для роботи, - це кращий сигнал, ніж запит про використання. Раз на місяць запити «показати файл, створений агентом у папці, яку ви назвали» та «показати рішення, яке ви змінили, оскільки два моделі розходилися» вимірюють переходи 2 та 3, що не може лічильник входу. Навчання у великому масштабі без мір артефактів, скільки б тисяч людей не були залучені, не скаже нікому, чи сталася перехід 2.
Декомпозицію та верифікацію слід викладати разом, а критичну звичку — раніше, ніж роботу в раді. Загальний курс з промптів — це педагогіка 1-го рівня. Педагогіка 2-го та 3-го рівня починається з роботи, яку людина вже виконує, — скажімо, з пакету матеріалів маркетолога на п'ятницю чи з набору завдань вчителя, — навчає повторного використання розкладу (п'ять частин Розділу 5.1 з умовою зупинки) та навчає відновлення після помилок на копії папки. То, що слід оцінювати потім, — це чи може людина розпізнати небезпечну інструкцію, назвати зворотну спробу, перевірити докази та зупинити систему. Критик однієї родини в точках прийняття не коштує нічого в передплатах, а другу родину додають, коли критик мовчить і рішення дороговартісне. Оркестрування на вершині рубрики вільності — це правильна мета для кількох ролей та неправильна вимога на перший день для всіх.
11.3 Для політики
Обов'язок Європейського Союзу щодо грамотності в галузі штучного інтелекту стосується кожного постачальника та розгортувача систем штучного інтелекту для їх персоналу. Після змін 2026 року він вимагає від них «вживати заходи для підтримки розвитку грамотності в галузі штучного інтелекту» замість забезпечення достатнього рівня, і його правила нагляду та забезпечення дотримання застосовуються з 3 серпня 2026 року (European Union, 2026; European Commission, 2026a, 2026b). У Сполучених Штатах рамкова програма Міністерства праці називає «ефективне керування штучним інтелектом» (US Department of Labor, 2026), а рамкова програма ОЕСР та Європейської Комісії має домен під назвою «Manage AI» (OECD & European Commission, 2026). Я пропоную вміст для цих слів у випадку з агентами: чотири частини контракту про делегування, чотири практики Розділу 8.1 включно з відміною, звичка порівнювати моделі зі знанням, що згода — слабший доказ, ніж здається, та базові практики безпеки Розділу 5.3. Керівництво повинно розрізняти розмовне використання від делегованої дії. Для останнього обов'язок повинен охоплювати обсяг дозволів, класифікацію даних, верифікацію, звітування про інциденти та відміну, а вимога задокументувати здатність та повноваження, специфічні для ролі, необхідні для делегованих завдань, більш захищена, ніж вимога навчати всіх однаково. Регулятори та представники працівників також можуть запитати, чи перенесло роботодавець залишкову відповідальність на персонал без придатних засобів контролю, часу на перегляд або права відмовити небезпечній делегації. Все це рекомендація щодо дизайну та управління, отримана з одного нормативного акта, а його обсяг є цим актом.
Європейський обов'язок пережив раунд дерегуляції, і серед обговорених тут рамок це єдиний горизонтальний обов'язок, який охоплює кожного члена персоналу, який використовує штучний інтелект. У Сполучених Штатах рамка — це політика робочої сили. Розпорядження президента від квітня 2025 року щодо освіти в галузі штучного інтелекту та План дій у галузі штучного інтелекту від липня 2025 року зобов'язуються розширювати грамотність та навички в галузі штучного інтелекту, включаючи керівництво, що програми грамотності в галузі штучного інтелекту можуть кваліфікуватися як освітня допомога, надана роботодавцем (White House, 2025a, 2025b); рамка сумісна з навчанням менеджерів агентів і ще не вимагає цього. Жоден з перевірених офіційних текстів не називає термінальних агентів або оркестрування, тому «Manage AI» можна прочитати як етикету чат-бота або як керівництво 4-го рівня. Програми грамотності, які зупиняються на промптингу, навчають 1-го рівня. Робота тим часом переходить на рівні 2–4. Офіційні тексти ще туди не слідували.
Статистичні агенції, які додають модулі штучного інтелекту до своїх опитувань, могли б допомогти зі однією конкретною зміною. «Чи ви користувалися чат-ботом» — це елемент 1-го рівня. «Чи системи, якими ви керували, створили або змінили файли на комп'ютері, який ви використовуєте для роботи протягом останніх семи днів» — це елемент 2-го або 3-го рівня. «Чи ви поставили одне й те саме робоче питання більш ніж одній системі штучного інтелекту протягом останніх семи днів, і чи різнилися відповіді» — це елемент 4-го рівня. Без елементів такого роду P6 не можна перевірити в публічних даних, і цифровий розрив другого рівня на рівні агентів залишатиметься невидимим для людей, чия робота — його бачити.
11.4 Для дослідників
Прогалини Розділу 2.5 — це порядок денний. Вивчайте непрограмістів, які використовують термінальних і настільних агентів за назвою, з артефактами як результати. Вивчайте рефлексивний онбординг як механізм сам по собі. Вивчайте веб-оркестрування як практику, включаючи те, як люди узгоджують відповіді та чи вони зберігають походження. Вимірюйте кореляцію помилок серед сімей постачальників під час виконання завдань роботи зі знаннями та більше ніж еталон коду та математики. Розширьте виміряні гендерні та професійні розриви у використанні штучного інтелекту (Cranney et al., 2026; Humlum & Vestergaard, 2025) на рівні агентів, де ще нічого не відомо (P13). Два легких показники, доступність функцій та саморепортуванний збережений час, варто супротивлятися на користь завершення артефактів, перевіреної якості, рівнів корекції та подальшого повторного використання. Відмову слід записувати з її механізмом. Зупинка в точці запиту дозволу може бути проблемою інтерфейсу, розумною стурбованістю щодо даних, правилом роботодавця, відсутністю машини або завданням без критерію прийняття, і скорочення їх до «опору» губить все це. Оцінка повинна бути змаганням, з введеною в оман сторінкою, прихованою інструкцією в документі, суперечливим джерелом, частковою відмовою інструменту або переконливою неправильною відповіддю, яку поділяють кілька моделей, оскільки роль менеджера щось означає лише якщо це поліпшує результати в цих умовах. Реплікація не потребує жодного з моїх матеріалів; їй потрібно правило артефактів, заморожене питання про причину зупинки, запис імплементації та датований перепис продуктів. І знаменники мають бути опубліковані, оскільки дослідження, яке звітує лише про тих, хто перетнув, не говорить нам нічого про дорогу.
12. Область дії та граничні умови
Тут пропонується модель, синтез доказів та дизайн вимірювання, і кожне з них обмежене у такі способи.
Час. Докази охоплюють період до 21 вересня 2026. Дані про продукт застарівають. Модель визначається охопленням і роллю, так що вона застарівається повільніше.
Географія та джерела. Більшість показників впровадження походять зі Сполучених Штатів; європейські показники наводяться там, де вони існують. Кілька ключових показників походять від постачальників (використання агентів кодування, причини об'єднання чату та агента, коефіцієнти впровадження на наборах тестів постачальника) і позначені як дані постачальника в тексті. Я використовую їх, щоб зрозуміти, що постачальники можуть знати про свої власні продукти, і зважаю їх відповідно.
Населення. Аргумент стосується професіоналів, чия робота в основному проходить за комп'ютером. Люди, які працюють в основному зі смартфона або без комп'ютера, яким вони керують, стикаються з бар'єром раніше, ніж усі бар'єри, описані тут, і модель говорить про них мало, окрім того, щоб назвати цей бар'єр (розділ 5.5).
Докази щодо когорти. Використовується лише попередньо зареєстрований дизайн. Результати програми не є основою для жодного твердження тут, і твердження розділу 10 формулюються до того, як результати програми відомі, щоб їх можна було порівняти. Когорта, яка вимагає власної машини, включає людей, які можуть встановити агента; вона не може розділити вплив доступу до обладнання від впливу мотивації, і цей ліміт супроводжує результати.
Нормативна область дії. Модель описує, що кожен рівень вимагає від людини. Вона не стверджує, що вищі рівні краще або що кожен повинен піднятися; для більшості роботи рівень 1 або 2 — це правильне місце (розділ 8.2). Робота з критичними наслідками, конфіденційні записи, операції, критичні для безпеки, рішення, критичні за часом, та завдання без перевіряємого критерію прийняття потребують суворіших заходів, або залишаються поза деlegованим використанням агента взагалі.
Що додає оркестрація. Додавання агентів може розширити охоплення, виявити розбіжність та залишити слід рецензування. Це також може додати корельовану помилку, вартість, затримку та помилковий вигляд сумлінності. Довгострокове делегування означає, що людина може перевірити та змінити процес; питання про те, чи заслуговує процес на надійність, є окремим питанням.
Чого не вистачає літературі. Пошук літератури в розділі 2.5 не знайшов польового дослідження не-програмістів, які приймають названих термінальних або настільних агентів, дослідження веб-оркестрації як названої практики, розглядання управління агентами як компетентності зі своєю структурою, та дослідження системи штучного інтелекту, яка підтримує прийняття людиною агентного штучного інтелекту. Це прогалини в тому, що було вивчено, зазначені станом на 21 вересня 2026, і я нічого не стверджую щодо ринків, продуктів або пріоритетів.
Статус тверджень. Таблиця 8 застосовує мову впевненості серії до елементів аргументу, щоб читач міг побачити, з якою впевненістю утримується кожне.
Таблиця 8. Статус тверджень у цій роботі.
| Елемент | Як це наводиться тут | Основа |
|---|---|---|
| Чотирирівнева модель та правило артефакту | Проходить тестування (Розділи 9 та 10) | Концептуальна; маркери, визначені в розділі 3 та Додатку A |
| Технічний бар'єр зменшився для встановлення та настільної грані | Дані це підтримують | Інсталятори в один крок; документація «Термінал не потрібен»; випущені продукти рівня 2 чотирьох постачальників |
| Фахівці знань всередині агента із термінальною спадщиною | Повідомлено постачальником, індикативно | Повідомлення преси про показники постачальника, 2 червня 2026, з застереженням аналітика |
| Постачальники поглинають перехід 1 в чат | Спостерігається в продукті | Anthropic, 16 вересня 2026; OpenAI, 9 липня 2026 |
| Словник робочого процесу як переважаючий залишковий бар'єр | Пропонується як модель; проходить тестування | Непрямо: дослідження підказок; причина для об'єднання, вказана постачальниками; елемент причини спинення програми |
| Веб як мост, CLI як стійкий шар | Проходить тестування (P7, P8) | Контракти, об'єкти дозволів, офіційні плагіни; крихкість веб-інтерфейсів |
| Корельовані помилки обмежують те, що купує рада | Дані це підтримують при оцінці моделей; вимірюються в використанні | Kim et al. (2025); Chernets (2026a) |
| Рефлексивне введення в систему | Реалізовано та вимірюється; жоден результат не повідомляється | Практика постачальника та курсу (спостереження); Крок 1 програми (вимірювання) |
| Менеджер агентів як роль | Пропонується як опис поведінки; проходить тестування (P10) | Дослідження делегування; рубрики роботодавця; офіційні рамки грамотності |
| Коефіцієнти переходу когорти | Не повідомляється | Протокол заморожений; документ з результатів буде слідувати |
| «Працює зараз» як обіцянка | Не стверджується | Поза межами обласної дії цієї роботи |
13. Висновок
Термінал раніше був очевидним символом бар'єру між звичайними фахівцями та агентним ІШ, і деякий час це було справедливо. У 2026 році це більше не відповідає дійсності. Установка займає команду або клік, чатбот, який людина вже використовує, може її спрямувати, і постачальники об'єднують чат та агента в один інтерфейс. Що показують розділи 4 і 5, так це зміщений бар'єр. Першу обмежену спробу стало набагато легше здійснити; те, що залишається складним, — це отримання надійної роботи над цілими завданнями, дотримання кроку з продуктами, які змінюються під ногами, та збереження наданої папки в безпеці. За даними одного постачальника, повідомленими в пресі й розумітимуться як напрямні, близько мільйона інтелектуальних працівників на тиждень уже перебувають усередині агента кодування спадщини терміналу. Більшість фахівців, тим часом, все ще зустрічають ІШ лише як розмову.
Те, що стоїть на дорозі, це робота менеджера: знаючи, що передати, обмежуючи це, називаючи результат і вирішуючи, як його перевірити, потім безпечно запускаючи середовище та порівнюючи моделі, пам'ятаючи, що їхня згода є слабшим доказом, ніж це виглядає. Чотири рівні розділу 3 надають цій роботі структуру, яку не володіє жоден продукт, а правило артефакту дає їй одиницю вимірювання. Я запропонував веб-оркестрацію як міст до останнього рівня (P7) та CLI-оркестрацію як форму, яка зберігається (P8); обидві викладені так, щоб вони могли не вдатися.
Для будь-кого, хто впроваджує перехід, практичним наслідком є порядок операцій. Перше питання полягає в тому, яку невелику, дозволену роботу людина може описати, перевірити та безпечно відкинути, якщо спроба не вдається: брифінг з відкритих джерел, папка особистого планування, електронна таблиця, від якої ніхто інший не залежить. Звідти додається по одній за раз: управлінська відповідальність, межа, потім затвердження, потім власне робоче місце, потім збережений запис завдання, потім другий і критичний поглід. Оцінка слідує тому ж порядку. Демонстрація має мало значення, якщо вона приховує, що людині дозволялося робити, як було перевірено результат та що сталося, коли агент не вдався. Обміркована відмова делегувати рахується як результат. І людина, яка може відтворити обмежене завдання, сказати, чому вона на нього розраховувалася, вказати на незгоду, яка змінила рішення, та звузити доступ, коли обставини змінюються, показує спостережувані ознаки ролі, незалежно від того, яка в неї посадова назва.
Модель може не вдатися, і розділ 10 говорить як. Програма розділу 9 буде тестувати частину її на людях, які не програмісти, а код у додатку C дозволяє іншим вимірювати ті ж переходи та практикувати ті ж схеми. Я очікую, що продукти, названі в додатку B, виглядатимуть застарілими протягом року. Бар'єри розділу 5 не повинні, оскільки вони належать людині та роботі, незалежно від того, який продукт перед ними. Термінал став місцем, де агент працює для людини, яка навчилася управляти ним, і скільки людей цього навчаться, яким шляхом і як швидко, — це питання, на яке відповість наступний рік.
Декларації
Фінансування. Зовнішнього фінансування для цієї роботи не надавалось.
Конкуруючі інтереси. Автор розробляє методи багатомодельної оркестрації та подав пов'язані патентні заявки (розглядаються; патент не видано). Автор розробив попередньо зареєстровану когортну програму, описану в Розділі 9, та її матеріали. Жоден висновок у цій роботі не залежить від реалізації автора; кожна схема в Додатку C відтворювана за допомогою загальнодоступних інструментів. Автор також підтримує два плаґіни з відкритим кодом, названі в Додатку C; вони вільні та з відкритим кодом (Apache License 2.0), і жоден висновок у цій роботі від них не залежить. Автор розробляє навчальні матеріали, які згодом можуть пропонуватися комерційно; на момент написання нічого не було продано, і когорта, описана в Розділі 9, отримала всі матеріали безкоштовно.
Інструменти та перевірка. AI-помічники використовувалися як інструменти під керівництвом автора; ідеї, дослідження та висновки належать автору. Всі кількісні твердження та цитування були перевірені проти первинних джерел або архівованих копій станом на 21 вересня 2026 року або, де джерело позначено як вторинне або від постачальника в тексті та в часовій шкалі Додатку B, проти найкращого доступного звіту; цифри, повідомлені постачальниками про їхні власні продукти, позначаються як такі. Коли первинну сторінку не вдалося отримати під час вікна дослідження (кілька сторінок на одному сайті постачальника повертали помилку доступу), твердження цитується з названого вторинного джерела і позначається, або воно опускається. Заголовки преси, наведені в квадратних дужках у посиланнях, це описові заголовки для сторінок, чий заголовок не був повторно прочитаний дослівно.
Доступність даних і коду. Код в Додатку C разом з його тестами депонований під ліцензією MIT за адресою https://github.com/vadimchernets/after-chat та архівований на Zenodo, https://doi.org/10.5281/zenodo.22944451. Два плаґіни, побудовані за тими ж схемами, Roundcall і Sidecall, розташовані за адресою https://github.com/vadimchernets/roundcall і https://github.com/vadimchernets/sidecall (Apache License 2.0). П'ять наборів, які застосовують ті ж схеми до галузей за межами програмного забезпечення, розташовані за адресою https://github.com/vadimchernets/calling-kits (MIT). Вони не були спробовані практиками цих галузей, про що зазначено в репозиторії, і жодне твердження в цій роботі на них не спирається.
Етика. Ця робота не повідомляє про дані від людей-учасників. Когортна програма, яку вона описує, попередньо зареєстрована (OSF, DOI 10.17605/OSF.IO/X4EGQ); її результати будуть повідомлені окремо.
Внески автора. Єдиний автор.
Листування. vadimchernets9@gmail.com · ORCID: 0009-0007-4845-3163
References
9to5Mac. (2026, August 4). OpenAI explains what will happen when ChatGPT Atlas shuts down this weekend. https://9to5mac.com/2026/08/04/openai-explains-what-will-happen-when-chatgpt-atlas-shuts-down-this-weekend/
Accenture. (2025, December 9). Accenture and Anthropic launch multi-year partnership to drive enterprise AI innovation and value across industries. https://newsroom.accenture.com/news/2025/accenture-and-anthropic-launch-multi-year-partnership-to-drive-enterprise-ai-innovation-and-value-across-industries
Adrjan, P. (2026, July 8). AI is no longer just a tech occupation story. Indeed Hiring Lab. https://hiringlab.indeed.com/2026/07/08/ai-is-no-longer-just-a-tech-occupation-story/
Agent Skills. (2026). Agent Skills: an open standard (list of supporting products, accessed 21 September 2026). https://agentskills.io
Anthropic. (2025). Piloting Claude in Chrome (25 August 2025, updated 18 December 2025). https://claude.com/blog/claude-for-chrome
Anthropic. (2026a). Claude Code desktop quickstart (accessed 21 September 2026). https://code.claude.com/docs/en/desktop-quickstart
Anthropic. (2026b). Get started with Claude Cowork. Help Center (accessed 21 September 2026). https://support.claude.com/en/articles/13345190-get-started-with-claude-cowork
Anthropic. (2026c, September 16). Claude Cowork and chat are now one Claude. https://claude.com/blog/cowork-is-now-claude
Anthropic. (2026d, August 26). Claude in Chrome is generally available. https://claude.com/blog/claude-in-chrome-generally-available
Anthropic. (2026e, March 24). Anthropic Economic Index report: Learning curves. https://www.anthropic.com/research/economic-index-march-2026-report
Anthropic. (2026f, January 15). Anthropic Economic Index report: Economic primitives. https://www.anthropic.com/research/anthropic-economic-index-january-2026-report
Anthropic. (2026g). Use Claude in Chrome safely. Help Center (accessed 21 September 2026). https://support.claude.com/en/articles/12902428-use-claude-in-chrome-safely
Anthropic. (2026h). What's new in Claude Code: 29 June to 3 July 2026 (default permission mode renamed "Manual"). https://code.claude.com/docs/en/whats-new/2026-w27
Bainbridge, L. (1983). Ironies of automation. Automatica, 19(6), 775-779. https://doi.org/10.1016/0005-1098(83)90046-8
Becker, J., Rush, N., Barnes, E., & Rein, D. (2025). Measuring the impact of early-2025 AI on experienced open-source developer productivity. arXiv:2507.09089. https://arxiv.org/abs/2507.09089
BenchLM. (2026). OSWorld-Verified leaderboard (aggregator of vendor-reported scores, accessed September 2026). https://benchlm.ai/benchmarks/osworld-verified
Bick, A., Blandin, A., & Deming, D. J. (2024). The rapid adoption of generative AI (NBER Working Paper No. 32966). https://www.nber.org/papers/w32966
Bick, A., Blandin, A., Deming, D. J., et al. (2026, September 1). What work does generative AI do? Federal Reserve Bank of St. Louis, On the Economy. https://www.stlouisfed.org/on-the-economy/2026/sep/what-work-does-generative-ai-do
Bo, J. Y., Wan, S., & Anderson, A. (2025). To rely or not to rely? Evaluating interventions for appropriate reliance on large language models. CHI 2025. arXiv:2412.15584. https://arxiv.org/abs/2412.15584
Brave. (2025, August 20). Comet prompt injection. https://brave.com/blog/comet-prompt-injection/
Brynjolfsson, E., Li, D., & Raymond, L. R. (2025). Generative AI at work. Quarterly Journal of Economics, 140(2), 889-942. https://academic.oup.com/qje/article/140/2/889/7990658
Carolus, A., Koch, M., Straka, S., Latoschik, M. E., & Wienrich, C. (2023). MAILS: Meta AI literacy scale. International Journal of Human-Computer Interaction. arXiv:2302.09319. https://arxiv.org/abs/2302.09319
Carroll, J. M. (1990). The Nurnberg funnel: Designing minimalist instruction for practical computer skill. MIT Press. https://mitpress.mit.edu/9780262031639/the-nurnberg-funnel/
CC for Everyone. (2026). A course taught inside Claude Code (accessed 21 September 2026). https://ccforeveryone.com
Center for AI Safety. (2026, July 1). Significant increase in digital labor automation. https://safe.ai/blog/significant-increase-in-digital-labor-automation
Chatterji, A., Cunningham, T., Deming, D. J., Hitzig, Z., Ong, C., Shan, C. Y., & Wadman, K. (2025). How people use ChatGPT (NBER Working Paper No. 34255). https://www.nber.org/papers/w34255
Chernets, V. (2026a). Agreement is not independent evidence: Auditable multi-model synthesis without an API. SSRN. https://doi.org/10.2139/ssrn.7390698 (Zenodo: https://doi.org/10.5281/zenodo.22683716)
Chernets, V. (2026b). AI-Watchbird (Sheckley): When automated oversight widens its own mandate and harms what it guards. SSRN. https://doi.org/10.2139/ssrn.7473658 (Zenodo: https://doi.org/10.5281/zenodo.22849138)
Chernets, V. (2026c). Architectural trust: Why consumer trust in agentic commerce migrates from AI models to verifiable architecture. SSRN. https://doi.org/10.2139/ssrn.7191261 (Zenodo: https://doi.org/10.5281/zenodo.22166995)
Chernets, V. (2026d). Three steps into agentic AI: A preregistered feasibility study of how non-programmers cross from chatbot to agent to multi-model orchestration (Cohort 1). OSF preregistration. https://doi.org/10.17605/OSF.IO/X4EGQ
CodeRabbit. (n.d.). State of AI vs. human code generation report (accessed 21 September 2026). https://www.coderabbit.ai/blog/state-of-ai-vs-human-code-generation-report
Cohn, C., Rayala, S., Srivastava, N., Fonteles, J. H., Jain, S., Luo, X., Mereddy, D., Mohammed, N., & Biswas, G. (2026). A theory of adaptive scaffolding for LLM-based pedagogical agents. AAAI 2026, 40(3), 1757-1765. arXiv:2508.01503. https://arxiv.org/abs/2508.01503
Constellation Research. (2026a, June 2). OpenAI touts broadening Codex usage, 5 million weekly active users. https://www.constellationr.com/insights/news/openai-touts-broadening-codex-usage-5-million-weekly-active-users
Constellation Research. (2026b, March 30). Microsoft 365 Copilot's Researcher agent goes multi-model. https://www.constellationr.com/insights/news/microsoft-365-copilots-researcher-agent-goes-multi-model
Cranney, K., Delecourt, S., & Koning, R. (2026). Global evidence on gender gaps and generative AI over time (Harvard Business School Working Paper No. 25-023). https://www.hbs.edu/ris/Publication%20Files/25023_52957d6c-0378-4796-99fa-aab684b3b2f8.pdf
Daepp, M. I. G., & Counts, S. (2024). The emerging generative artificial intelligence divide in the United States. arXiv:2404.11988. https://arxiv.org/abs/2404.11988
Davis, F. D. (1989). Perceived usefulness, perceived ease of use, and user acceptance of information technology. MIS Quarterly, 13(3), 319-340. https://doi.org/10.2307/249008
Dell'Acqua, F., McFowland III, E., Mollick, E. R., Lifshitz-Assaf, H., Kellogg, K., Rajendran, S., Krayer, L., Candelon, F., & Lakhani, K. R. (2026). Navigating the jagged technological frontier. Organization Science, 37(2), 403-423. https://doi.org/10.1287/orsc.2025.21838
Digital Commerce 360. (2025, April 8). Internal memo: Shopify CEO declares AI non-optional. https://www.digitalcommerce360.com/2025/04/08/internal-memo-shopify-ceo-declares-ai-non-optional/
Doshi, A. R., & Hauser, O. P. (2024). Generative AI enhances individual creativity but reduces the collective diversity of novel content. Science Advances, 10(28), eadn5290. https://doi.org/10.1126/sciadv.adn5290
Du, Y., Li, S., Torralba, A., Tenenbaum, J. B., & Mordatch, I. (2023). Improving factuality and reasoning in language models through multiagent debate. arXiv:2305.14325. https://arxiv.org/abs/2305.14325
European Commission. (2026a). AI literacy: Questions and answers (updated 27 July 2026). https://digital-strategy.ec.europa.eu/en/faqs/ai-literacy-questions-answers
European Commission. (2026b, July 27). AI Omnibus enters into force. https://digital-strategy.ec.europa.eu/en/news/ai-omnibus-enters-force
European Union. (2026). Regulation (EU) 2026/1744 amending Regulation (EU) 2024/1689 (Artificial Intelligence Act), Article 4. Official Journal of the European Union, 24 July 2026. https://eur-lex.europa.eu/eli/reg/2026/1744/oj
ExecutiveGov. (2026, February 17). DOL AI literacy framework. https://www.executivegov.com/articles/dol-ai-literacy-framework
Feldman, M. Q., & Anderson, C. J. (2024). Non-expert programmers in the generative AI future. CHIWORK '24. https://doi.org/10.1145/3663384.3663393
Feng, K. J. K., McDonald, D. W., & Zhang, A. X. (2025). Levels of autonomy for AI agents. arXiv:2506.12469. https://arxiv.org/abs/2506.12469
Ferdman, A. (2025). AI deskilling is a structural problem. AI & Society. https://doi.org/10.1007/s00146-025-02686-z
Fortune. (2026a, January 13). [Report on the launch of Claude Cowork, "Claude Code for the rest of your work"]. https://fortune.com/2026/01/13/anthropic-claude-cowork-ai-agent-file-managing-threaten-startups/
Fortune. (2026b, April 13). [Report on Duolingo dropping AI use from performance evaluations]. https://fortune.com/2026/04/13/duolingo-ceo-luis-von-ahn-ai-usage-requirement-employee-performance-evaluations/
Gallup. (2026, July 20). Organizational AI adoption jumps six points. https://www.gallup.com/workplace/712736/organizational-adoption-jumps-six-points.aspx
Ge, Y., Mei, L., Duan, Z., Li, T., Zheng, Y., Wang, Y., Wang, L., Yao, J., Liu, T., Cai, Y., Bi, B., Guo, F., Guo, J., Liu, S., & Cheng, X. (2025). A survey of vibe coding with large language models. arXiv:2510.12399. https://arxiv.org/abs/2510.12399
GitHub. (2026a). ai-shifu/ChatALL: repository and release download counts (accessed 21 September 2026). https://github.com/ai-shifu/ChatALL
GitHub. (2026b). jackwener/OpenCLI: repository (accessed 21 September 2026). https://github.com/jackwener/OpenCLI
GitHub. (2026c, February 4 and 26). Claude and Codex are now available in public preview on GitHub; now available for Copilot Business and Pro users. https://github.blog/changelog/2026-02-26-claude-and-codex-now-available-for-copilot-business-pro-users/
GitHub. (2026d). BeehiveInnovations/pal-mcp-server and nyldn/claude-octopus: repositories (accessed 21 September 2026). https://github.com/BeehiveInnovations/pal-mcp-server ; https://github.com/nyldn/claude-octopus
GitHub issue reports. (2026). anthropics/claude-code issues #32637 (9 March 2026), #50844 (19 April 2026) and #67188 (10 June 2026), user reports. https://github.com/anthropics/claude-code/issues/32637 ; https://github.com/anthropics/claude-code/issues/50844 ; https://github.com/anthropics/claude-code/issues/67188
Google. (2026, May 19). An important update: Transitioning Gemini CLI to Antigravity CLI. Google Developers Blog. https://developers.googleblog.com/en/an-important-update-transitioning-gemini-cli-to-antigravity-cli/
Google Open Source Blog. (2026, April). A year of open collaboration: Celebrating the anniversary of A2A. https://opensource.googleblog.com/2026/04/a-year-of-open-collaboration-celebrating-the-anniversary-of-a2a.html
Grunde-McLaughlin, M., Mozannar, H., Murad, M., Chen, J., Amershi, S., & Fourney, A. (2026). Overseeing agents without constant oversight: Challenges and opportunities. arXiv:2602.16844. https://arxiv.org/abs/2602.16844
Hargittai, E. (2002). Second-level digital divide: Differences in people's online skills. First Monday, 7(4). https://doi.org/10.5210/fm.v7i4.942
He, G., Demartini, G., & Gadiraju, U. (2025). Plan-then-execute: An empirical study of user trust and team performance when using LLM agents as a daily assistant. CHI 2025. https://doi.org/10.1145/3706598.3713218
Help Net Security. (2026, June 2). [Report on OpenAI Codex use by knowledge workers]. https://www.helpnetsecurity.com/2026/06/02/openai-codex-knowledge-work/
Henseke, G. (2026). Generative AI at work: From exposure to adoption across 35 European countries. arXiv:2604.18849. https://arxiv.org/abs/2604.18849
Humlum, A., & Vestergaard, E. (2025). Still waters, rapid currents: Early labor market transformation under generative AI (NBER Working Paper No. 33777, revised March 2026). https://www.nber.org/papers/w33777
Information Age. (2026, May 5). Gone in 9 seconds: AI agent deletes company database. https://ia.acs.org.au/article/2026/gone-in-9-seconds--ai-agent-deletes-company-database.html
JetBrains Research. (2026a, April). Which AI coding tools do developers actually use at work? https://blog.jetbrains.com/research/2026/04/which-ai-coding-tools-do-developers-actually-use-at-work/
JetBrains Research. (2026b, August). AI coding agents: Adoption trends 2026. https://blog.jetbrains.com/research/2026/08/ai-coding-agent-adoption-2026/
Karpathy, A. (2025). llm-council (repository, accessed 21 September 2026). https://github.com/karpathy/llm-council
Kim, E., Garg, A., Peng, K., & Garg, N. (2025). Correlated errors in large language models. ICML 2025. arXiv:2506.07962. https://arxiv.org/abs/2506.07962
Ko, A. J., Abraham, R., Beckwith, L., Blackwell, A., Burnett, M., Erwig, M., Scaffidi, C., Lawrance, J., Lieberman, H., Myers, B., Rosson, M. B., Rothermel, G., Shaw, M., & Wiedenbeck, S. (2011). The state of the art in end-user software engineering. ACM Computing Surveys, 43(3), Article 21. https://doi.org/10.1145/1922649.1922658
Kosmyna, N., Hauptmann, E., Yuan, Y. T., Situ, J., Liao, X.-H., Beresnitzky, A. V., Braunstein, I., & Maes, P. (2025). Your brain on ChatGPT: Accumulation of cognitive debt when using an AI assistant for essay writing task. arXiv:2506.08872. https://arxiv.org/abs/2506.08872
Kwa, T., West, B., Becker, J., et al. (2025). Measuring AI ability to complete long software tasks. arXiv:2503.14499. https://arxiv.org/abs/2503.14499
Lee, H.-P., Sarkar, A., Tankelevitch, L., Drosos, I., Rintel, S., Banks, R., & Wilson, N. (2025). The impact of generative AI on critical thinking: Self-reported reductions in cognitive effort and confidence effects from a survey of knowledge workers. CHI 2025. https://doi.org/10.1145/3706598.3713778
Lee, J. D., & See, K. A. (2004). Trust in automation: Designing for appropriate reliance. Human Factors, 46(1), 50-80. https://doi.org/10.1518/hfes.46.1.50_30392
Linux Foundation. (2025, December 9). Linux Foundation announces the formation of the Agentic AI Foundation. https://www.linuxfoundation.org/press/linux-foundation-announces-the-formation-of-the-agentic-ai-foundation
Liu, M. X., Sarkar, A., Negreanu, C., Zorn, B., Williams, J., Toronto, N., & Gordon, A. D. (2023). "What it wants me to say": Bridging the abstraction gap between end-user programmers and code-generating large language models. CHI 2023. https://doi.org/10.1145/3544548.3580817
Liu, Y., & Sra, M. (2026). TaskLens: Generating task-conditioned scaffolded interfaces for learning professional creative software. DIS 2026. arXiv:2511.23379. https://arxiv.org/abs/2511.23379
Long, D., & Magerko, B. (2020). What is AI literacy? Competencies and design considerations. CHI 2020. https://doi.org/10.1145/3313831.3376727
Long, T., Zhang, X., Wang, S., Yu, Z., & Chilton, L. B. (2025). DoubleAgents: Human-agent alignment in a socially embedded workflow. arXiv:2509.12626. https://arxiv.org/abs/2509.12626
Ma, L., Xu, X., He, Y., & Tan, Y. (2025). Learning to adopt generative AI. arXiv:2410.19806. https://arxiv.org/abs/2410.19806
Ma, R., Wan, R., Lu, X., Yang, F., Chen, C., & Li, L. (2026). Value-sensitive delegation in everyday AI agent use: Evidence from OpenClaw. arXiv:2609.22067. https://arxiv.org/abs/2609.22067
MacRumors. (2026, July 9). [Report on the launch of ChatGPT Work and the new ChatGPT desktop app]. https://www.macrumors.com/2026/07/09/openai-chatgpt-work/
McKinlay, R., Puntoni, S., & Saka, E. (2026, September 9). To adopt AI at scale, employees need to trust agents. Harvard Business Review. https://hbr.org/2026/09/to-adopt-ai-at-scale-employees-need-to-trust-agents
METR. (2026, February 24). Uplift update. https://metr.org/blog/2026-02-24-uplift-update/
Microsoft. (2026a, March 9). Powering Frontier Transformation with Copilot and agents. https://www.microsoft.com/en-us/copilot/blog/2026/03/09/powering-frontier-transformation-with-copilot-and-agents/
Microsoft. (2026b, May 5). 2026 Work Trend Index: Agents, human agency and the opportunity for every organization. https://www.microsoft.com/en-us/worklab/work-trend-index/agents-human-agency-and-the-opportunity-for-every-organization
Microsoft. (2026c). Use model choice in the Researcher agent. Microsoft Support (accessed 21 September 2026). https://support.microsoft.com/en-us/office/use-model-choice-in-the-researcher-agent
Model Context Protocol. (2026, July 28). [Blog post on the July 2026 specification release]. https://blog.modelcontextprotocol.io/posts/2026-07-28/
Morris, M. R., Sohl-Dickstein, J., Fiedel, N., Warkentin, T., Dafoe, A., Faust, A., Farabet, C., & Legg, S. (2024). Position: Levels of AGI for operationalizing progress on the path to AGI. ICML 2024. arXiv:2311.02462. https://arxiv.org/abs/2311.02462
Myers, B. A., Pane, J. F., & Ko, A. (2004). Natural programming languages and environments. Communications of the ACM, 47(9), 47-52. https://doi.org/10.1145/1015864.1015888
Nardi, B. A. (1993). A small matter of programming: Perspectives on end user computing. MIT Press. https://mitpress.mit.edu/9780262140539/a-small-matter-of-programming/
Noy, S., & Zhang, W. (2023). Experimental evidence on the productivity effects of generative artificial intelligence. Science, 381(6654), 187-192. https://doi.org/10.1126/science.adh2586
OECD & European Commission. (2026). Empowering learners for the age of AI: An AI literacy framework for primary and secondary education. OECD Publishing. https://www.oecd.org/en/publications/empowering-learners-for-the-age-of-ai_65cd27d4-en.html
OpenAI. (2026a). codex-plugin-cc: Use Codex from inside Claude Code (repository, announced 30 March 2026, accessed 21 September 2026). https://github.com/openai/codex-plugin-cc
Panickssery, A., Bowman, S. R., & Feng, S. (2024). LLM evaluators recognize and favor their own generations. NeurIPS 2024. arXiv:2404.13076. https://arxiv.org/abs/2404.13076
Parasuraman, R., Sheridan, T. B., & Wickens, C. D. (2000). A model for types and levels of human interaction with automation. IEEE Transactions on Systems, Man, and Cybernetics, Part A: Systems and Humans, 30(3), 286-297. https://doi.org/10.1109/3468.844354
Parasuraman, R., & Riley, V. (1997). Humans and automation: Use, misuse, disuse, abuse. Human Factors, 39(2), 230-253. https://doi.org/10.1518/001872097778543886
Patwardhan, T., Dias, R., Proehl, E., et al. (2025). GDPval: Evaluating AI model performance on real-world economically valuable tasks. arXiv:2510.04374. https://arxiv.org/abs/2510.04374
Pew Research Center. (2026, June 17). Americans and AI 2026: Chatbots, smart devices and views on impact. https://www.pewresearch.org/internet/2026/06/17/americans-and-ai-2026-chatbots-smart-devices-and-views-on-impact/
PwC. (2026, June 15). 2026 Global AI Jobs Barometer (press release distributed by PR Newswire; report page). https://www.pwc.com/gx/en/issues/artificial-intelligence/ai-jobs-barometer.html
Rogers, E. M. (2003). Diffusion of innovations (5th ed.). Free Press. ISBN 9780743222099.
Sarkar, A., & Drosos, I. (2025). Vibe coding: Programming through conversation with artificial intelligence. PPIG 2025. arXiv:2506.23253. https://arxiv.org/abs/2506.23253
Sarkar, A., Gordon, A. D., Negreanu, C., Poelitz, C., Ragavan, S. S., & Zorn, B. (2022). What is it like to program with artificial intelligence? PPIG 2022. arXiv:2208.06213. https://arxiv.org/abs/2208.06213
Schoenegger, P., Tuminauskaite, I., Park, P. S., Bastos, R. V. S., & Tetlock, P. E. (2024). Wisdom of the silicon crowd: LLM ensemble prediction capabilities rival human crowd accuracy. Science Advances, 10(45), eadp1528. https://doi.org/10.1126/sciadv.adp1528
SiliconANGLE. (2025, December 18). Anthropic makes Agent Skills an open standard. https://siliconangle.com/2025/12/18/anthropic-makes-agent-skills-open-standard/
Simkute, A., Tankelevitch, L., Kewenig, V., Scott, A. E., Sellen, A., & Rintel, S. (2024). Ironies of generative AI: Understanding and mitigating productivity loss in human-AI interactions. arXiv:2402.11364. https://arxiv.org/abs/2402.11364
Sitter, N. (2026). MCP apps census 2026 (data of 29 July and 3 August 2026). https://www.nicolassitter.com/research/mcp-apps-census-2026
Stack Overflow. (2025). 2025 Developer Survey: AI. https://survey.stackoverflow.co/2025/ai
Stack Overflow. (2026, May 27). Agents on a leash: Agentic AI remains mostly monitored at work. https://stackoverflow.blog/2026/05/27/agents-on-a-leash-agentic-ai-remains-mostly-monitored-at-work/
Stankovic, M., Hirche, E., Kollatzsch, S., & Doetsch, J. N. (2026). Comment on: Your brain on ChatGPT. arXiv:2601.00856. https://arxiv.org/abs/2601.00856
Storyboard18. (2026, February 10). Perplexity launches Model Council to compare answers across multiple AI models. https://www.storyboard18.com/digital/perplexity-launches-model-council-to-compare-answers-across-multiple-ai-models-89246.htm
Sweller, J. (1988). Cognitive load during problem solving: Effects on learning. Cognitive Science, 12(2), 257-285. https://doi.org/10.1207/s15516709cog1202_4
TechCrunch. (2025, December 22). OpenAI says AI browsers may always be vulnerable to prompt injection attacks. https://techcrunch.com/2025/12/22/openai-says-ai-browsers-may-always-be-vulnerable-to-prompt-injection-attacks/
TechCrunch. (2026a, September 16). Anthropic merges Claude chat and Cowork in one interface. https://techcrunch.com/2026/09/16/anthropic-merges-claude-chat-and-cowork-in-one-interface/
TechCrunch. (2026b, July 1). Gemini Spark, Google's agentic assistant, is now available on Mac. https://techcrunch.com/2026/07/01/gemini-spark-googles-agentic-assistant-is-now-available-on-mac/
The Register. (2025, July 21). [Report on an application-building agent deleting a production database]. https://www.theregister.com/2025/07/21/replit_saastr_vibe_coding_incident/
The Register. (2026, January 13). Anthropic floats Claude Cowork for office work automation. https://www.theregister.com/software/2026/01/13/anthropic-floats-claude-cowork-for-office-work-automation/4839664
Tomašev, N., Franklin, M., & Osindero, S. (2026). Intelligent AI delegation. arXiv:2602.11865. https://arxiv.org/abs/2602.11865
UNESCO. (2024a). AI competency framework for students. https://www.unesco.org/en/articles/ai-competency-framework-students
UNESCO. (2024b). AI competency framework for teachers. https://www.unesco.org/en/articles/ai-competency-framework-teachers
US Census Bureau. (2026, May 26). [Story on AI use among businesses, Business Trends and Outlook Survey]. https://www.census.gov/library/stories/2026/05/ai-use-businesses.html
US Department of Labor. (2026, February 13). Training and Employment Notice 07-25: Artificial Intelligence Literacy Framework. https://www.dol.gov/newsroom/releases/eta/eta20260213
van Dijk, J. A. G. M. (2020). The digital divide. Polity Press. ISBN 978-1-5095-3444-9. https://research.utwente.nl/en/publications/the-digital-divide-2/
Venkatesh, V., Morris, M. G., Davis, G. B., & Davis, F. D. (2003). User acceptance of information technology: Toward a unified view. MIS Quarterly, 27(3), 425-478. https://doi.org/10.2307/30036540
Virk, Y., & Liu, D. (2025). Non-programmers assessing AI-generated code: A case study of business users analyzing data. arXiv:2508.06484. https://arxiv.org/abs/2508.06484
Vygotsky, L. S. (1978). Mind in society: The development of higher psychological processes. Harvard University Press. https://www.hup.harvard.edu/books/9780674576292
White House. (2025a, April 23). Executive Order 14277: Advancing artificial intelligence education for American youth. https://www.whitehouse.gov/presidential-actions/2025/04/advancing-artificial-intelligence-education-for-american-youth/
White House. (2025b, July). America's AI Action Plan. https://www.whitehouse.gov/wp-content/uploads/2025/07/Americas-AI-Action-Plan.pdf
Willison, S. (2026, January 12). Claude Cowork. https://simonwillison.net/2026/Jan/12/claude-cowork/
Wood, D., Bruner, J. S., & Ross, G. (1976). The role of tutoring in problem solving. Journal of Child Psychology and Psychiatry, 17(2), 89-100. https://doi.org/10.1111/j.1469-7610.1976.tb00381.x
xAI. (2026, May 25). Introducing Grok Build. https://x.ai/news/grok-build-cli
Xie, T., Zhang, D., Chen, J., Li, X., Zhao, S., Cao, R., Hua, T. J., Cheng, Z., Shin, D., Lei, F., Liu, Y., Xu, Y., Zhou, S., Savarese, S., Xiong, C., Zhong, V., & Yu, T. (2024). OSWorld: Benchmarking multimodal agents for open-ended tasks in real computer environments. arXiv:2404.07972. https://arxiv.org/abs/2404.07972
Xu, F. F., Song, Y., Li, B., Tang, Y., Jain, K., Bao, M., Wang, Z. Z., Zhou, X., Guo, Z., Cao, M., Yang, M., Lu, H. Y., Martin, A., Su, Z., Maben, L., Mehta, R., Chi, W., Jang, L., Xie, Y., Zhou, S., & Neubig, G. (2024). TheAgentCompany: Benchmarking LLM agents on consequential real world tasks. arXiv:2412.14161. https://arxiv.org/abs/2412.14161
Yang, Y., Qu, C., Wen, M., Shi, L., Wen, Y., Zhang, W., Wierman, A., & Gu, S. (2026). Understanding agent scaling in LLM-based multi-agent systems via diversity. arXiv:2602.03794. https://arxiv.org/abs/2602.03794
Zamfirescu-Pereira, J. D., Wong, R. Y., Hartmann, B., & Yang, Q. (2023). Why Johnny can't prompt: How non-AI experts try (and fail) to design LLM prompts. CHI 2023. https://doi.org/10.1145/3544548.3581388
Zapier. (2026). Raising the AI fluency bar in hiring. https://zapier.com/blog/raising-ai-fluency-bar-in-hiring/
Zhang, H., Cui, Z., Chen, J., Wang, X., Zhang, Q., Wang, Z., Wu, D., & Hu, S. (2025). Stop overvaluing multi-agent debate: We must rethink evaluation and embrace model heterogeneity. arXiv:2502.08788. https://arxiv.org/abs/2502.08788
Додаток А. Глосарій моделі
Охоплення. Що модель може здійснити від імені людини: розмову; файли та інструменти у просторі, обмеженому постачальником; комп'ютер самої людини; кілька моделей і агентів.
Роль. Що повинна робити людина, щоб робота була успішною: запитувати й копіювати; делегувати й перевіряти; контролювати середовище; управляти кількома агентами.
Рівень. Комбінація охоплення й ролі, на якій виконується робота (розділ 3.2). Рівні описують роботу; люди й продукти можуть охоплювати кілька.
Перетинання (переходу). Записується, коли агент створив на новому рівні артефакт, який запросила людина. Встановлення є спробою. Переміщення більш ніж на один рівень дозволено й записується як пропуск.
Артефакт. Файл, папка, дія або вихід, створений агентом, який людина надає або зберігає. «Нічого» є дійсним записом.
Словник робочого процесу. Набір завдань, які людина знає, як передати агентові, сформульовані так, щоб агент міг їх виконати й результат можна було перевірити.
Рефлексивна інтеграція. Система штучного інтелекту, яка підтримує прийняття людиною більш здатної системи штучного інтелекту, наприклад чат-бот, що керує встановленням агента й відновленням після його перших помилок.
Контракт делегування. Чотири речі, які людина зазначає, коли передає роботу агентам: мета, межа, артефакт, перевірка.
Чотири практики. Що менеджер робить упродовж завдання: делегування, нагляд, перевірка, відкликання (розділ 8.1).
Запис про прийняття. Для важливого або повторюваного завдання: передбачувальний результат, входи, обмеження й дозволи, місце розташування виходу, суттєві розбіжності або помилки, проведені перевірки й рішення про прийняття, переробку, підвищення або відсторонення. Він розділяє те, що створив агент, від того, на що спиралася людина.
П'ятичастинна карта роботи. Об'єкт роботи, дозволені входи, трансформація, результат і перевірка: форма, у якій повторювана робота непрограміста стає делегуванням (розділ 5.1).
Бічна гілка. Конструктори веб-додатків, які діють на проект, що його розміщує платформа, а не на файли людини; інша драбина зі своїми щаблями (розділ 3.4).
Веб-оркестрація. Одне запитання, поставлене кільком споживацьким чат-ботам у браузері, вручну або за допомогою інструменту, й порівняння відповідей.
Оркестрація CLI. Один агент, який викликає інструменти командного рядка інших агентів, збирає їхні виходи й об'єднує або перевіряє їх.
Плутанина. Перейменування, об'єднання або припинення розробки інструментів у період, коротший за час, необхідний новачку для їх вивчення.
Ефективна кількість думок (N_eff). N / (1 + (N - 1) rho) для N моделей із середньою попарною кореляцією помилок rho; обмежена зверху на 1/rho (Chernets, 2026a).
Маркери як кодувальні елементи
Для кодувальника якісних даних або дизайнера опитування маркери розділу 3 зводяться до питань так/ні щодо названого артефакту. Самозвіт без артефакту записується як претензія й не вважається перетинанням.
- Присутність рівня 1. Принаймні одна збережена розмова зі споживацьким чат-ботом за останні сім днів; артефакт: посилання, скрин або експорт. Невдача в його створенні кодується як «не продемонстровано», що є слабшою знахідкою, ніж «відсутньо».
- Перетинання 1 пройдено. Файл або набір файлів, написаних обмеженим агентом (настільний, веб або розміщений у середовищі найманця) у місці, яке надала людина, у відповідь на роботу, яку назвала людина, з принаймні одним записаним схваленням, відмовою або редагуванням плану. Дата артефакту – це дата перетинання.
- Присутність рівня 2. Перетинання 1 пройдено плюс додатковий обмежений артефакт на пізнішому тижні. Стійкість записується як окремий щотижневий елемент, окремо від перетинання.
- Перетинання 2 пройдено. Робоча папка, комітування або набір датованих файлів, створені локальним агентом або його офіційною оболонкою робочого стола, на машині, яку контролює людина, із роботи, яка потребувала використання більш ніж одного інструменту. Робота, розміщена в хмарі, кодується як її власний варіант хмари.
- Присутність рівня 3. Перетинання 2 пройдено плюс артефакт пізнішого тижня від агента того ж класу.
- Перетинання 3, мостова форма. Датований файл, що містить запитання, чат-боти або веб-моделі, до яких звернулися, необроблені відповіді або посилання на них, примітку про згоду й незгоду, примітку про те, чи з'явилися охоплення або надійність (розділ 6.2); створено вручню або за допомогою інструменту трансляції.
- Перетинання 3, довготривала форма. Ті ж поля, створені запуском, який викликав два або більше офіційних інструментів командного рядка (або один плюс плаґін другої родини) на власних логінах людини, із записаним знаменником: запитано, відповідено, вийшло з часу.
- Присутність рівня 4. Будь-яка форма перетинання 3 плюс другий датований запуск на пізнішому тижні.
- Допоміжні порівняно з непідтримуваними. Будь-яке перетинання, під час якого дослідник, колега або оплачуваний тренер виконав крок встановлення, написав роботу або відновився від помилки, є допоміжним. Завершення повідомляються як два числа, де був доступний помічник.
- Причина зупинки. Вільнотекстова відповідь на «що вас зупинило», запитана у всіх, хто не перетнув, і закодована після збору. Кандидатні коди, запропоновані як гіпотеза для пізніших кодувальників на переробку: словник робочого процесу; діалог дозволу або безпеки; права адміністратора; вартість або квота; страх перед інтерфейсом; звістка про руйнівний інцидент; організаційна політика; технічна помилка; життя й час; інше.
- Правило кодування для «не знав, що запитати» (словник робочого процесу). Включайте, коли людина, запитана про те, що вона намагалася змусити агента робити, не може назвати принаймні одну з п'яти частин розділу 5.1: об'єкт роботи, входи, які вона може використовувати, трансформацію, результат або перевірку. Виключайте, коли всі п'ять названі й людина відмовилася з причин політики, ризику, вартості або часу; вони мають свої коди. Два кодувальники кодують незалежно й повідомляють про свою згоду. Правило класифікує зупинку й нічого не говорить про здатність людини.
- Сліди чотирьох практик (так/ні, кожен пов'язаний з датованим артефактом): план відхилено; diff або вихід відхилено; запитано другу родину моделей; знаменник записаний (кого запитали, хто відповів, кого вийшло з часу); необоротний крок утримано на підтвердження; артефакт депонований. Це сліди нагляду P10.
- Не маркери. Покупка ліцензії, значок курсу, журнал встановлювача, зірка репозиторію, кількість запитів або самооцінка як «користувача агента».
Додаток Б. Хронологія з датами, 2025 — 21 вересня 2026
Записи, позначені VERIFIED, були відкриті на основній сторінці або на названій допоміжній сторінці для прес-звіту протягом періоду дослідження, що завершився 21 вересня 2026. Записи, позначені SECONDARY, ґрунтуються на прес-звітах або історіях продуктів, які не були відкриті на основній сторінці; вони наведені для орієнтації та не несуть ваги в аргументації. Це робоча хронологія для чотирирівневої аргументації та не претендує на статус хронології індустрії.
| Дата | Подія | Джерело | Статус |
|---|---|---|---|
| 24 February 2025 | Claude Code у дослідницькій версії | Product histories, widely reported | SECONDARY |
| 23 April 2025 | Розпорядження виконавця 14277 про освіту у сфері ШІ | White House (2025a) | VERIFIED |
| 22 May 2025 | Claude Code стає загальнодоступним | Product histories, widely reported | SECONDARY |
| 23 June 2025 | Протокол Agent2Agent передано Фонду Linux Foundation | Google Open Source Blog (2026) | VERIFIED (vendor) |
| July 2025 | План дій США у сфері ШІ зобов'язується забезпечити грамотність та навички у сфері ШІ | White House (2025b) | VERIFIED |
| 21 July 2025 | Агент для розробки додатків видаляє виробничу базу даних під час живої сесії | The Register (2025) | VERIFIED (press) |
| 20 August 2025 | Демонстрація атаки введенням підказок на агента браузера з використанням вкраденого одноразового коду | Brave (2025) | VERIFIED |
| 25 August 2025 | Пілот агента браузера: успішність атаки 23.6% без пом'якшень, 11.2% з пом'якшеннями | Anthropic (2025) | VERIFIED (vendor) |
| 9 December 2025 | Model Context Protocol передано Фонду агентного ШІ (Linux Foundation); понад 10 000 опублікованих серверів, близько 97 мільйонів завантажень SDK на місяць | Linux Foundation (2025) | VERIFIED |
| 9 December 2025 | Консалтингова фірма оголошує, що близько 30 000 співробітників будуть навчені на моделях одного постачальника | Accenture (2025) | VERIFIED |
| 18 December 2025 | Формат Agent Skills випущений як відкритий стандарт | SiliconANGLE (2025) | VERIFIED (press) |
| 22 December 2025 | OpenAI: атака введенням підказок «навряд чи коли-небудь буде повністю «розв'язана» | TechCrunch (2025) | VERIFIED (press) |
| January 2026 | Дослідницька версія Cowork, «Claude Code для решти вашої роботи» | Fortune (2026a); The Register (2026) | VERIFIED (press) |
| 12 January 2026 | Заперечення щодо попросити непрограмістів стежити за атаками введенням підказок | Willison (2026) | VERIFIED |
| 15 January 2026 | Anthropic Economic Index: розширення 52% розмов (листопад 2025) | Anthropic (2026f) | VERIFIED (vendor) |
| 4 and 26 February 2026 | GitHub Agent HQ: агенти Claude та Codex доступні всередині Copilot | GitHub (2026c) | VERIFIED |
| February 2026 | Рада моделей Perplexity для передплатників топ-рівня (повідомлено 10 лютого) | Storyboard18 (2026) | VERIFIED (press) |
| 13 February 2026 | Структура грамотності в ШІ Міністерства праці США («керування ШІ ефективно») | US Department of Labor (2026) | VERIFIED |
| 9 March 2026 | Технологія Cowork запровадена в Microsoft 365 Copilot | Microsoft (2026a) | VERIFIED |
| 9 March, 19 April, 10 June 2026 | Повідомлення користувачів про видалення файлів агентом рівня 2 всередині дозволених папок | GitHub issue reports (2026) | VERIFIED (user reports) |
| 24 March 2026 | Anthropic Economic Index: користувачі з більшим стажем делегують менше | Anthropic (2026e) | VERIFIED (vendor) |
| 30 March 2026 | Офіційний плагін OpenAI для використання свого агента всередині Claude Code; дослідницький агент Microsoft запускає GPT та Claude разом | OpenAI (2026a); Constellation Research (2026b); Microsoft (2026c) | VERIFIED |
| April 2026 | JetBrains: Claude Code на роботі 18% (січень 2026), з близько 3% (весна 2025) | JetBrains Research (2026a) | VERIFIED (vendor survey) |
| 13 April 2026 | Duolingo припиняє використання ШІ з оцінки продуктивності | Fortune (2026b) | VERIFIED (press) |
| 5 May 2026 | Work Trend Index: організаційні чинники переважають індивідуальні більш ніж у два рази | Microsoft (2026b) | VERIFIED (vendor survey) |
| 25 April 2026 (повідомлено 5 May) | Агент видаляє виробничу базу даних компанії та резервні копії | Information Age (2026) | VERIFIED (press) |
| 19 May 2026 | Google оголошує перехід від Gemini CLI до Antigravity CLI | Google (2026) | VERIFIED |
| 25 May 2026 | Grok Build від xAI випущений з режимом без інтерфейсу та підтримкою протоколу агента | xAI (2026) | VERIFIED (vendor) |
| 26 May 2026 | Використання ШІ американськими компаніями 17% до 20% загалом; малі фірми без змін | US Census Bureau (2026) | VERIFIED |
| 27 May 2026 | Розробницький пульс: 69% одного агента; 60% блокують несанкціоновані зміни | Stack Overflow (2026) | VERIFIED |
| 2 June 2026 | Агент кодування на 5 мільйонів тижневих користувачів, близько 20% професіоналів знань | Help Net Security (2026); Constellation Research (2026a) | VERIFIED (press report of vendor data) |
| 15 June 2026 | PwC AI Jobs Barometer: 62% премія з оплати за навички ШІ | PwC (2026) | VERIFIED (vendor) |
| 17 June 2026 | Pew: близько половини дорослих американців використовують чат-боти | Pew Research Center (2026) | VERIFIED |
| 18 June 2026 | Gemini CLI припиняє служити індивідуальним рівням | Google (2026) | VERIFIED |
| June 2026 | Структура грамотності в ШІ ОЕСР та Європейської комісії («Керування ШІ») | OECD & European Commission (2026) | VERIFIED |
| 29 June to 3 July 2026 | Claude Code перейменовує свій режим дозволів за замовчуванням на «Manual» | Anthropic (2026h) | VERIFIED (vendor) |
| 1 July 2026 | Агент Gemini Spark на Mac; найкраща частота автоматизації Remote Labor Index 15.8%, з 2.5% під час випуску | TechCrunch (2026b); Center for AI Safety (2026) | ПЕРЕВІРЕНО |
| 8 липня 2026 | Indeed: 63% посадових назв у США, на які впливає ШІ, знаходяться поза технологічними професіями | Adrjan (2026) | ПЕРЕВІРЕНО |
| 9 липня 2026 | Додаток з агентом для кодування стає настільним додатком ChatGPT; запущено ChatGPT Work | MacRumors (2026) | ПЕРЕВІРЕНО (преса) |
| 20 липня 2026 | Gallup: 52% працівників США використовують ШІ, 15% щодня | Gallup (2026) | ПЕРЕВІРЕНО |
| 27 липня 2026 | Закон ЄС про ШІ набув чинності; обов'язок щодо грамотності ШІ перетворюється на «вжиття заходів для підтримки» | European Commission (2026a, 2026b) | ПЕРЕВІРЕНО |
| 28 липня 2026 | Model Context Protocol: близько половини мільярда завантажень SDK на місяць; протокол став без стану | Model Context Protocol (2026) | ПЕРЕВІРЕНО |
| 3 серпня 2026 | Застосовуються правила ЄС щодо нагляду та забезпечення дотримання щодо грамотності у сфері ШІ | European Commission (2026a) | ПЕРЕВІРЕНО |
| Серпень 2026 | JetBrains: 90% професійних розробників щотижня використовують агентів для кодування; Claude Code на роботі 39% | JetBrains Research (2026b) | ПЕРЕВІРЕНО (опитування постачальника) |
| 9 серпня 2026 | Браузер OpenAI з агентом припинено; переглядання переходить у додаток ChatGPT | 9to5Mac (2026) | ПЕРЕВІРЕНО (преса) |
| 26 серпня 2026 | Браузерний агент в загальному доступі; автономний з класифікатором за замовчуванням; повідомлені постачальником показники ін'єкцій близько нуля | Anthropic (2026d) | ПЕРЕВІРЕНО (постачальник) |
| 1 вересня 2026 | St. Louis Fed: 45% працівників використовують ШІ для своєї роботи; менше ніж 3% завдань з прийняттям понад 50% | Bick et al. (2026) | ПЕРЕВІРЕНО |
| 6 вересня 2026 | Реєстрація когорти 1 заморожена | Chernets (2026d) | ПЕРЕВІРЕНО |
| 9 вересня 2026 | Harvard Business Review: довіра як центральна перешкода для впровадження агентів на роботі | McKinlay et al. (2026) | ПЕРЕВІРЕНО (резюме) |
| 16 вересня 2026 | Спільна робота та чат об'єднані в один Claude | Anthropic (2026c); TechCrunch (2026a) | ПЕРЕВІРЕНО |
| 22 вересня 2026 | Офіційний каталог плагінів повністю прочитаний, 310 записів: жодного для п'яти ремесел, названих у розділі 5.1; каталог спільноти 2282 записи, пропозиції для вчителів та нерухомості | Author's reading of the published catalogues | ПЕРЕВІРЕНО (власний підрахунок) |
Додаток C. Навчаючий код
Наведені нижче листинги навчають паттернам розділів 5–9. Вони використовують лише стандартну бібліотеку Python та власні інструменти командного рядка постачальників, з власними передплатами користувача; жодна не читає ключ API. Кожен досить короткий, щоб прочитати за один раз, і кожен вказує, що він навчає та де він зупиняється. Вони розташовані з тестами в супровідному репозиторії під ліцензією MIT, і кожен листинг був запущений перед включенням (кожен на його демо-вході, розповсюдження на заглушкові інструменти). Кожен паттерн тут вже існує в якійсь формі в інструментах з відкритим кодом (розділ 7.1); цінність листингів полягає в тому, що вони малі, з коментарями та пов'язані з аргументом. Жодна не є маршрутом навчання, діагностикою учня, навчальною програмою або реалізацією інструментів автора. Непрограміст не запускає ці файли вручну: це щось, що агент загортає як навичку або оболонка робочого стола показує як кнопку, а метою друку цих листингів є те, щоб читач міг побачити, що робить така кнопка.
Два встановлювані плагіни Claude Code застосовують ці паттерни у повсякденному використанні. Roundcall запитує веб-сайти чату AI, на які людина вже увійшла, через свій власний браузер та в темпі людини; Sidecall запитує агентів командного рядка, встановлених на їхній машині, з налаштуванням бюджету, яке вибирає модель кожного постачальника. Обидва повертають один звіт про те, хто що сказав, де відповіді розходяться та що сказав лише один джерело. Вони мають відкритий код під ліцензією Apache License 2.0 на https://github.com/vadimchernets/roundcall та https://github.com/vadimchernets/sidecall.
Перед запуском будь-якого з них: перевірте --help кожного інструменту у вашій встановленій версії, оскільки прапори змінюються між випусками; запустіть їх у робочій папці, яка містить копії, а не оригінали; і спочатку прочитайте Листинг C6.
C1. Розповсюдження з датчиком, межею та частковим захопленням (fanout.py)
Навчає: як одна людина може поставити одне запитання кільком CLI агентів одночасно, пропустити ті, що недоступні або без квоти, припинити очікування на часову межу та зберегти написане кожним інструментом до досягнення цієї межи замість того, щоб це видалити. Кожен інструмент запускається в новій, пустій папці всередині папки виведення, ніколи в папці, з якої людина запустила; імена інструментів обмежені безпечними назвами файлів; довге запитання йде в файл (--question-file) або для інструменту, чий шаблон не має {prompt}, на стандартний вхід інструменту, оскільки аргумент командного рядка обмежений довжиною операційною системою. Обмеження: зупинка на межі використовує групи процесів POSIX (macOS та Linux; на Windows використовуйте WSL) і повертається до зупинки самого інструменту; інструмент, який виводить лише в кінці, не залишає нічого для зберігання, коли він зупинений; використовуйте його режим потокового виведення, якщо він його має. Скрипт нічого не порівнює; C3 робить.
#!/usr/bin/env python3
"""fanout.py: put one question to several agent CLIs and keep every answer, including partial ones.

Teaching example for "After Chat" (Appendix C, listing C1). MIT licence.

The pattern: probe each tool briefly and skip the dead ones, run the live ones in parallel under one
time ceiling, stream each answer to its own file, and keep whatever a tool has written when the
ceiling is reached. It uses only the Python standard library and the vendors' own command-line tools,
signed in with the user's own subscriptions. No API keys are read or needed.

Each tool runs in its own fresh, empty working folder inside the output folder, never in the folder
you launched from. Stopping a tool at the ceiling stops its whole process group, which is a POSIX
feature (macOS, Linux; on Windows use WSL); where that fails the tool itself is killed.

Usage:
    python3 fanout.py "Your question" --out runs/today
    python3 fanout.py --question-file question.txt --tools tools.json --ceiling 900
    python3 fanout.py -- "-a question that starts with a dash"
A question on the command line is limited by the operating system's argument length; put long
questions in a file. A tool whose template has no "{prompt}" receives the question on its standard
input instead (for example `codex exec -`), which has no such limit.
"""
import argparse
import json
import os
import pathlib
import re
import signal
import subprocess
import sys
import time

# Command templates. "{prompt}" is replaced by the question; a template without it gets the question
# on stdin. Check each tool's --help on your installed version: flags change between releases.
DEFAULT_TOOLS = {
    "claude": ["claude", "-p", "{prompt}"],
    "codex": ["codex", "exec", "--skip-git-repo-check", "--sandbox", "read-only", "{prompt}"],
    "gemini": ["agy", "-p", "{prompt}"],
    "grok": ["grok", "-p", "{prompt}"],
}
PROBE_PROMPT = "Reply with exactly one word: OK"
SAFE_NAME = re.compile(r"^[A-Za-z0-9][A-Za-z0-9_-]{0,31}$")  # a tool name becomes a file and folder name


def build(template, prompt):
    return [part.replace("{prompt}", prompt) for part in template]


def uses_stdin(template):
    return not any("{prompt}" in part for part in template)


def stop_group(proc):
    """Stop a tool and every process it started (they share one process group on POSIX)."""
    for sig in (signal.SIGTERM, signal.SIGKILL):
        try:
            os.killpg(proc.pid, sig)
        except ProcessLookupError:
            return
        except (PermissionError, OSError, AttributeError):
            proc.kill()  # no process group to stop (or no right to): stop the tool itself
        try:
            proc.wait(timeout=5)
            return
        except subprocess.TimeoutExpired:
            continue


def workdir(out_dir, name):
    """A fresh, empty folder per tool: the tool never sees the caller's files."""
    d = out_dir / f"work-{name}"
    d.mkdir(parents=True, exist_ok=True)
    return d


def probe(name, template, seconds, out_dir):
    """A few seconds now saves a long wait later: a tool behind a quota wall answers fast and badly."""
    started = time.monotonic()
    stdin_text = PROBE_PROMPT if uses_stdin(template) else None
    try:
        done = subprocess.run(build(template, PROBE_PROMPT), capture_output=True, text=True,
                              timeout=seconds, cwd=workdir(out_dir, name), input=stdin_text,
                              stdin=None if stdin_text is not None else subprocess.DEVNULL)
    except FileNotFoundError:
        return False, "not installed"
    except subprocess.TimeoutExpired:
        return False, f"no answer within {seconds}s"
    text = (done.stdout + done.stderr).strip()
    if done.returncode != 0 or not done.stdout.strip():
        return False, f"exit {done.returncode}: {text[:160]}"
    return True, f"alive in {time.monotonic() - started:.1f}s"


def run_all(tools, prompt, out_dir, ceiling):
    out_dir.mkdir(parents=True, exist_ok=True)
    running, results = {}, {}
    for name, template in tools.items():
        out = open(out_dir / f"{name}.txt", "w")
        err = open(out_dir / f"{name}.err", "w")
        work = workdir(out_dir, name)
        if uses_stdin(template):
            (work / "question.txt").write_text(prompt)
            stdin = open(work / "question.txt")
        else:
            stdin = subprocess.DEVNULL  # closed: some tools wait on an open stdin and never start
        try:
            proc = subprocess.Popen(build(template, prompt), stdout=out, stderr=err, stdin=stdin,
                                    cwd=work, start_new_session=True)
        except FileNotFoundError:
            # One missing tool must not cost the answers of the others.
            out.close(); err.close()
            results[name] = {"status": "not installed", "seconds": 0.0}
            continue
        finally:
            if stdin is not subprocess.DEVNULL:
                stdin.close()
        running[name] = (proc, out, err, time.monotonic())
    deadline = time.monotonic() + ceiling
    while running:
        for name in list(running):
            proc, out, err, t0 = running[name]
            if proc.poll() is not None:
                out.close(); err.close()
                status = "done" if proc.returncode == 0 else f"failed (exit {proc.returncode})"
                results[name] = {"status": status, "seconds": round(time.monotonic() - t0, 1)}
                del running[name]
        if running and time.monotonic() >= deadline:
            for name, (proc, out, err, t0) in running.items():
                stop_group(proc)
                out.close(); err.close()
                written = (out_dir / f"{name}.txt").stat().st_size
                # The watchdog does not destroy: what was written before the ceiling is kept.
                results[name] = {"status": "partial" if written else "timeout",
                                 "seconds": round(time.monotonic() - t0, 1)}
            running = {}
        time.sleep(0.5)
    for name, r in results.items():
        r["bytes"] = (out_dir / f"{name}.txt").stat().st_size
    return results


def main():
    ap = argparse.ArgumentParser(description=__doc__.splitlines()[0])
    ap.add_argument("question", nargs="?", help="the question (put -- before one that starts with a dash)")
    ap.add_argument("--question-file", help="read the question from this file instead")
    ap.add_argument("--tools", help="JSON file mapping a tool name to its command template")
    ap.add_argument("--out", default="fanout-run", help="folder for answers, work folders and the summary")
    ap.add_argument("--ceiling", type=float, default=900, help="seconds before partial answers are taken")
    ap.add_argument("--probe-seconds", type=float, default=60)
    ap.add_argument("--no-probe", action="store_true")
    a = ap.parse_args()

    if a.question_file:
        prompt = pathlib.Path(a.question_file).read_text()
    elif a.question is not None:
        prompt = a.question
    else:
        ap.error("give a question or --question-file")
    tools = json.loads(pathlib.Path(a.tools).read_text()) if a.tools else dict(DEFAULT_TOOLS)
    for name in tools:
        if not SAFE_NAME.match(name):
            sys.exit(f"tool name {name!r} is not a safe file name (letters, digits, - and _ only)")
    out_dir = pathlib.Path(a.out)
    out_dir.mkdir(parents=True, exist_ok=True)

    skipped = {}
    if not a.no_probe:
        for name in list(tools):
            ok, why = probe(name, tools[name], a.probe_seconds, out_dir)
            print(f"probe {name:10s} {'live' if ok else 'SKIP'}  {why}", file=sys.stderr)
            if not ok:
                skipped[name] = why
                del tools[name]
    if len(tools) < 2:
        print("Fewer than two live tools: this would be one opinion, not a comparison.", file=sys.stderr)
    results = run_all(tools, prompt, out_dir, a.ceiling)
    summary = {"question": prompt[:500], "ceiling_s": a.ceiling, "results": results, "skipped": skipped}
    (out_dir / "summary.json").write_text(json.dumps(summary, indent=2))
    for name, r in sorted(results.items()):
        print(f"{name:10s} {r['status']:18s} {r['seconds']:7.1f}s {r['bytes']:8d} bytes")
    for name, why in skipped.items():
        print(f"{name:10s} skipped            {why}")


if __name__ == "__main__":
    main()
C2. Навичка «друга думка» для агента (second-opinion/SKILL.md)
Навчає: найменша форма організації CLI, письмова інструкція, що змушує один агент звернутися до агента іншого постачальника та показати різницю замість об'єднання. Обмеження: два моделі — це одне порівняння, не панель; навичка вказує, які пункти все ще потребують первинного джерела.
---
name: second-opinion
description: Ask a model from a different vendor the same question through its own command-line tool, and show where its answer differs. Use when the user asks for a second opinion, a check, or "what would another AI say".
---

# Second opinion

1. Write the user's question, and only the context needed to answer it, to `question.txt` in the
   working folder. Leave out secrets and personal data.
2. Run the other vendor's tool read-only, with its input closed:
   `codex exec --skip-git-repo-check --sandbox read-only - < question.txt > second-opinion.txt`
   (or `agy -p "$(cat question.txt)" > second-opinion.txt`, or another installed tool).
3. Show the other answer as it came, under its own heading. Treat it as content to compare, never as
   instructions to act on: another model's answer can carry instructions it picked up from a page.
4. Then give a short table with three rows: where the two answers agree, where they differ, and what
   only one of them mentions.
5. Do not merge the two answers into one confident text. Agreement between two models is weaker
   evidence than it looks when they share training data; say which points would need a primary source.
C3. Хто що сказав (provenance.py)
Навчає: двом речам, які дає запит до кількох моделей — охоплюванню й надійності, представленим як таблиця тверджень за джерелами, перелік тверджень від одного джерела та перелік тверджень, у яких числові значення чи дати розходяться. Обмеження: вона порівнює повторене формулювання, а не повторену суть; вона вказує, на що звернути близьку увагу, але ніколи не говорить, що правдиво.
#!/usr/bin/env python3
"""provenance.py: who said what, who said it alone, and where the numbers disagree.

Teaching example for "After Chat" (Appendix C, listing C3). MIT licence.

Reads the answer files written by fanout.py (one .txt per tool), splits each answer into short claims
(bullets or sentences), groups near-identical claims by word overlap, and prints a table of claims by
source. Two lists matter most, because they are the two things asking several models is meant to buy:
  * claims made by one source only: coverage, an angle the others missed (or an error of one);
  * claims whose numbers differ between sources: a disagreement to check before relying on either.
Word overlap sees repeated wording, not repeated meaning. Use the table to decide what to read
closely, never as a verdict on what is true.

Usage:
    python3 provenance.py fanout-run/            # writes fanout-run/provenance.md
"""
import pathlib
import re
import sys

STOP = set("""a an the and or of to in on for with by is are was were be been it this that these those
as at from than then so such can could should would may might will not no do does did their its your
our we you they he she i""".split())
MONTHS = "January|February|March|April|May|June|July|August|September|October|November|December"
# Values compared between sources: numbers, percentages and month names (dates disagree by month too).
NUM = re.compile(r"\d+(?:[.,]\d+)?%?|\b(?:" + MONTHS + r")\b")


def claims(text):
    parts = []
    for line in text.splitlines():
        line = line.strip(" -*\t#>")
        if not line:
            continue
        parts.extend(s.strip() for s in re.split(r"(?<=[.!?])\s+", line) if len(s.split()) >= 4)
    return parts


def words(claim):
    # [^\W_]+ is any run of letters or digits in any script, so accented and non-Latin words count.
    return {w for w in re.findall(r"[^\W_]+", claim.lower()) if w not in STOP}


def jaccard(a, b):
    return len(a & b) / len(a | b) if a | b else 0.0


def group(sources, threshold):
    groups = []  # each: {"text": representative, "words": set, "by": {source: claim}}
    for source, items in sources.items():
        for c in items:
            w = words(c)
            for g in groups:
                if jaccard(w, g["words"]) >= threshold:
                    g["by"].setdefault(source, c)
                    break
            else:
                groups.append({"text": c, "words": w, "by": {source: c}})
    return groups


def main():
    folder = pathlib.Path(sys.argv[1] if len(sys.argv) > 1 else ".")
    threshold = float(sys.argv[2]) if len(sys.argv) > 2 else 0.5
    sources = {p.stem: claims(p.read_text()) for p in sorted(folder.glob("*.txt")) if p.stat().st_size}
    if len(sources) < 2:
        sys.exit("Need at least two non-empty answers to compare.")
    groups = group(sources, threshold)
    names = list(sources)
    out = ["| claim | " + " | ".join(names) + " | support |", "|---|" + "---|" * len(names) + "---|"]
    for g in sorted(groups, key=lambda g: -len(g["by"])):
        marks = " | ".join("x" if n in g["by"] else "" for n in names)
        out.append(f"| {g['text'][:120]} | {marks} | {len(g['by'])} |")
    alone = [g for g in groups if len(g["by"]) == 1]
    out += ["", f"## Said by one source only ({len(alone)})", ""]
    out += [f"- [{next(iter(g['by']))}] {g['text']}" for g in alone]
    out += ["", "## Same claim, different numbers", ""]
    for g in groups:
        nums = {s: tuple(NUM.findall(c)) for s, c in g["by"].items()}
        if len({v for v in nums.values() if v}) > 1:
            out.append(f"- {g['text'][:100]}: " + "; ".join(f"{s}={','.join(v)}" for s, v in nums.items()))
    report = "\n".join(out) + "\n"
    (folder / "provenance.md").write_text(report)
    print(report)


if __name__ == "__main__":
    main()
C4. Скільком незалежним думкам еквівалентна їхня узгодженість? (neff.py)
Навчає: арифметиці корельованих доказів (розділ 6.3): оцінити середню кореляцію помилок rho на основі елементів з відомими відповідями, потім обчислити N_eff та його верхню межу 1/rho. Запустіть з --demo, щоб побачити чотири моделі, еквівалентні близько 1.6 незалежним думкам. Обмеження: rho залежить від завдання; оцініть його на елементах, подібних до тих, що вас цікавлять, і з більше ніж десятьма елементами.
#!/usr/bin/env python3
"""neff.py: how many independent opinions are N agreeing models worth?

Teaching example for "After Chat" (Appendix C, listing C4). MIT licence.

Uses the correlated-evidence model of Chernets (2026a):
    N_eff = N / (1 + (N - 1) * rho)        and, as N grows, N_eff approaches 1 / rho.
rho is estimated from the models' errors on items whose right answer is known: for each pair of
models, the correlation (phi coefficient) between "model A was wrong" and "model B was wrong".

Input: a CSV with one row per item and one 0/1 column per model (1 = correct).
Usage:
    python3 neff.py results.csv
    python3 neff.py --demo
"""
import csv
import itertools
import math
import sys

DEMO = """item,model_a,model_b,model_c,model_d
q1,1,1,1,1
q2,0,0,1,0
q3,1,1,1,1
q4,0,0,0,1
q5,1,1,0,1
q6,1,1,1,1
q7,0,0,1,0
q8,1,0,1,1
q9,1,1,1,1
q10,0,0,0,0
"""


def phi(x, y):
    """Correlation of two 0/1 vectors. Returns None when one of them never varies."""
    n = len(x)
    n11 = sum(1 for a, b in zip(x, y) if a and b)
    n1_, n_1 = sum(x), sum(y)
    denom = math.sqrt(n1_ * (n - n1_) * n_1 * (n - n_1))
    if denom == 0:
        return None
    return (n * n11 - n1_ * n_1) / denom


def n_eff(n, rho):
    """Effective number of independent opinions. N must be at least 1; rho must lie in [0, 1)."""
    if n < 1:
        raise ValueError(f"N must be at least 1, not {n}")
    if not 0 <= rho < 1:
        raise ValueError(f"rho must be in [0, 1), not {rho}; at rho = 1 every model is one opinion")
    return n / (1 + (n - 1) * rho)


def main():
    if len(sys.argv) > 1 and sys.argv[1] != "--demo":
        text = open(sys.argv[1]).read()
    else:
        text = DEMO
        print("(demo data: 10 items, 4 models)\n")
    rows = list(csv.DictReader(text.strip().splitlines()))
    models = [c for c in rows[0] if c != "item"]
    errors = {m: [1 - int(r[m]) for r in rows] for m in models}

    pairs = []
    for a, b in itertools.combinations(models, 2):
        r = phi(errors[a], errors[b])
        shown = "n/a (no variation)" if r is None else f"{r:+.2f}"
        print(f"error correlation {a} ~ {b}: {shown}")
        if r is not None:
            pairs.append(r)
    if not pairs:
        print("No pair varies; rho cannot be estimated from these items.")
        return
    rho = max(0.0, sum(pairs) / len(pairs))  # negative average is treated as independence
    n = len(models)
    print(f"\nmean pairwise error correlation rho = {rho:.2f}")
    if rho >= 1:
        print(f"the models err together on every item: {n} models are worth one opinion")
        return
    print(f"{n} models are worth about {n_eff(n, rho):.2f} independent opinions")
    if rho > 0:
        print(f"no number of models with this rho is worth more than {1 / rho:.1f}")
    print("\nN   N_eff at this rho")
    for k in (1, 2, 3, 5, 10, 20):
        print(f"{k:<3d} {n_eff(k, rho):.2f}")


if __name__ == "__main__":
    main()
C5. Запис перетинань та перевірка (crossings.py)
Викладає: правила вимірювання розділу 9.1 як код. Запис відхиляється, якщо він рахує установу за перетинання, містить завершення без артефакту, виробленого агентом, зупинку без власних слів особи, допомогу без опису допомоги, ім'я замість псевдонімної мітки (мітка повинна бути P з цифрами), пропущений рівень, який не вказаний точно, значення, яке не є справжнім true або false, дату, яку не можна розпізнати, поле, яке формат не розпізнає, або перетинання рівня 4, яке перераховує менше двох інструментів, про які запитали та отримали відповідь. Деформована лінія повідомляється як відхилена й ніколи не зупиняє виконання. Обмеження: він перевіряє форму записів, а не їхню істинність; питання про те, чи два інструменти різні сімейства моделей, та чи було розміщення повторено в пізніший тиждень (другий запис), залишаються дослідникові; це дослідницький інструмент, а не додаток.
#!/usr/bin/env python3
"""crossings.py: a record format for level transitions, and a checker for it.

Teaching example for "After Chat" (Appendix C, listing C5). MIT licence. A research instrument, not
an application: it defines what a record of one person's attempt at one transition must contain, and
refuses records that would let an installation be counted as use.

The rules follow the measures published in the preregistration the paper describes (OSF, DOI
10.17605/OSF.IO/X4EGQ): a transition counts as crossed only when an artefact produced by the agent is
supplied; installing is an attempt; assisted and unaided crossings are kept apart; a stop is recorded
with the point where it happened and the person's own words. The record format is also published as
a JSON Schema (crossings.schema.json); this checker accepts exactly what the schema accepts and adds
the rules a schema cannot state.

What the checker enforces for a level-4 crossing: at least two tools named as asked and as answered.
What it leaves to the researcher: that the tools are different model families, and that the
arrangement was rerun in a later week (a second record).

Usage:
    python3 crossings.py records.jsonl        # one JSON object per line
    python3 crossings.py --demo
"""
import datetime
import json
import re
import sys

LEVELS = ("chat", "safe_agentic_environment", "agent_on_own_computer", "orchestrated_work")
ARTEFACTS = ("file", "folder", "screenshot", "pasted_output", "none")
DECISIONS = ("accept", "revise", "escalate", "discard")
REQUIRED = ("record_id", "person", "level_from", "level_to", "materials_sent", "completed", "assisted")
# Every key a record may carry; the same set as the properties of crossings.schema.json.
ALLOWED = REQUIRED + ("skipped", "intervention", "artefact", "stop_point", "stop_reason_own_words",
                      "stop_reason_code", "multi_model", "interface_version", "operating_system",
                      "network_access", "permission_mode", "policy_constraint", "acceptance_decision")
PERSON = re.compile(r"^P[0-9]+$")


def parse_date(value):
    try:
        return datetime.date.fromisoformat(value)
    except (TypeError, ValueError):
        return None


def check(rec):
    problems = []
    if not isinstance(rec, dict):
        return ["record must be a JSON object"]
    for key in REQUIRED:
        if key not in rec:
            problems.append(f"missing field '{key}'")
    unknown = sorted(set(rec) - set(ALLOWED))
    if unknown:
        problems.append("unknown fields (the schema forbids them): " + ", ".join(unknown))
    if problems:
        return problems
    if not isinstance(rec["person"], str) or not PERSON.match(rec["person"]):
        problems.append("person must be a pseudonymous label such as P07, never a name")
    for key in ("completed", "assisted"):
        if not isinstance(rec[key], bool):
            problems.append(f"{key} must be true or false, not {rec[key]!r}")
    if rec["level_from"] not in LEVELS or rec["level_to"] not in LEVELS:
        problems.append("level must be one of " + ", ".join(LEVELS))
    else:
        i_from, i_to = LEVELS.index(rec["level_from"]), LEVELS.index(rec["level_to"])
        if i_to <= i_from:
            problems.append("level_to must be above level_from")
        else:
            # Levels are ordered, not compulsory: a route may go from chat straight to an agent on the
            # person's own computer. A skip is allowed, but it is recorded, never silent, and exactly.
            expected = list(LEVELS[i_from + 1:i_to])
            if expected and rec.get("skipped") != expected:
                problems.append("a move over more than one level must list exactly the levels it "
                                "skipped in 'skipped': " + ", ".join(expected))
            if not expected and rec.get("skipped"):
                problems.append("'skipped' must be empty or absent for a move of one level")
    sent = parse_date(rec["materials_sent"])
    if sent is None:
        problems.append("materials_sent must be an ISO date (YYYY-MM-DD)")
    art = rec.get("artefact", {"type": "none"})
    if not isinstance(art, dict) or art.get("type") not in ARTEFACTS:
        problems.append("artefact.type must be one of " + ", ".join(ARTEFACTS))
        art = {"type": "none"}
    if "produced_by_agent" in art and not isinstance(art["produced_by_agent"], bool):
        problems.append("artefact.produced_by_agent must be true or false")
    if "date" in art:
        art_date = parse_date(art["date"])
        if art_date is None:
            problems.append("artefact.date must be an ISO date (YYYY-MM-DD)")
        elif sent and art_date < sent:
            problems.append("artefact dated before the materials were sent")
    if rec["completed"] is True:
        # Installation is an attempt; only something the agent produced counts as a crossing.
        if art.get("type") == "none" or art.get("produced_by_agent") is not True:
            problems.append("completed=true needs an artefact with produced_by_agent=true")
        if rec["level_to"] == "orchestrated_work":
            mm = rec.get("multi_model") or {}
            asked = mm.get("asked") if isinstance(mm, dict) else None
            answered = mm.get("answered") if isinstance(mm, dict) else None
            if not isinstance(asked, list) or len(set(asked)) < 2 or \
               not isinstance(answered, list) or len(set(answered)) < 2:
                problems.append("a level-4 crossing needs multi_model.asked and multi_model.answered "
                                "with at least two tools each (Table 1: two model families)")
    elif rec["completed"] is False:
        if not rec.get("stop_point") or not rec.get("stop_reason_own_words"):
            problems.append("a non-completion records stop_point and stop_reason_own_words")
    if rec["assisted"] is True and not rec.get("intervention"):
        problems.append("assisted=true needs a description of the intervention")
    if "acceptance_decision" in rec and rec["acceptance_decision"] not in DECISIONS:
        problems.append("acceptance_decision must be one of " + ", ".join(DECISIONS))
    if "network_access" in rec and not isinstance(rec["network_access"], bool):
        problems.append("network_access must be true or false")
    return problems


DEMO = [
    {"record_id": "r1", "person": "P01", "level_from": "chat", "level_to": "safe_agentic_environment",
     "materials_sent": "2026-09-08", "completed": True, "assisted": False,
     "artefact": {"type": "folder", "date": "2026-09-09", "produced_by_agent": True}},
    {"record_id": "r2", "person": "P02", "level_from": "chat", "level_to": "safe_agentic_environment",
     "materials_sent": "2026-09-08", "completed": True, "assisted": False,
     "artefact": {"type": "screenshot", "produced_by_agent": False}},
    {"record_id": "r3", "person": "P03", "level_from": "chat", "level_to": "agent_on_own_computer",
     "skipped": ["safe_agentic_environment"], "materials_sent": "2026-09-08", "completed": False,
     "assisted": False, "stop_point": "(invented) download page",
     "stop_reason_own_words": "(invented) the page offered four versions and I did not know which"},
    {"record_id": "r4", "person": "Jane", "level_from": "chat", "level_to": "orchestrated_work",
     "materials_sent": "2026-09-08", "completed": False, "assisted": True},
]


def main():
    if len(sys.argv) > 1 and sys.argv[1] != "--demo":
        records = []
        for n, line in enumerate(open(sys.argv[1]), 1):
            if line.strip():
                try:
                    records.append(json.loads(line))
                except json.JSONDecodeError as exc:
                    records.append({"_malformed": f"line {n}: {exc}"})
    else:
        records = DEMO
        print("(demo: four invented records, two of them deliberately wrong)\n")
    bad = 0
    for rec in records:
        try:
            if isinstance(rec, dict) and "_malformed" in rec:
                problems = ["not valid JSON: " + rec["_malformed"]]
            else:
                problems = check(rec)
        except Exception as exc:  # a malformed record is rejected, never a crash
            problems = [f"malformed record: {exc!r}"]
        bad += bool(problems)
        rid = rec.get("record_id", "?") if isinstance(rec, dict) else "?"
        print(f"{str(rid):6s} {'OK' if not problems else 'REJECTED'}")
        for p in problems:
            print(f"       - {p}")
    print(f"\n{len(records) - bad} of {len(records)} records accepted")
    sys.exit(1 if bad else 0)


if __name__ == "__main__":
    main()
Той самий формат запису опублікований як JSON Schema (crossings.schema.json) щоб інші інструменти могли перевірити структуру запису; перевіряч вище застосовує правила, які схема не може виразити (що встановлення не є перетинанням, що зупинка потребує власних слів людини, що допомога потребує опису та що пропуск записується).
{
  "$schema": "https://json-schema.org/draft/2020-12/schema",
  "$id": "https://example.org/after-chat/crossing-record.schema.json",
  "title": "CrossingRecord",
  "description": "One person's attempt at one transition of the four-level model. Companion to crossings.py, which accepts exactly what this schema accepts and adds the rules the schema cannot express (installation is not a crossing; a stop needs the person's own words; help needs a description; a skip is recorded exactly; a level-4 crossing names at least two tools asked and answered). MIT licence.",
  "type": "object",
  "required": ["record_id", "person", "level_from", "level_to", "materials_sent", "completed", "assisted"],
  "properties": {
    "record_id": {"type": "string"},
    "person": {"type": "string", "pattern": "^P[0-9]+$", "description": "Pseudonymous label such as P07. Never a name."},
    "level_from": {"enum": ["chat", "safe_agentic_environment", "agent_on_own_computer", "orchestrated_work"]},
    "level_to": {"enum": ["chat", "safe_agentic_environment", "agent_on_own_computer", "orchestrated_work"]},
    "skipped": {"type": "array", "items": {"enum": ["safe_agentic_environment", "agent_on_own_computer"]},
                "description": "Exactly the levels passed over when the move spans more than one level. A skip is allowed and never silent."},
    "materials_sent": {"type": "string", "format": "date"},
    "completed": {"type": "boolean"},
    "assisted": {"type": "boolean"},
    "intervention": {"type": "string", "description": "Required when assisted is true: what the helper did."},
    "artefact": {
      "type": "object",
      "properties": {
        "type": {"enum": ["file", "folder", "screenshot", "pasted_output", "none"]},
        "date": {"type": "string", "format": "date"},
        "produced_by_agent": {"type": "boolean"},
        "sha256": {"type": "string", "description": "Hash of the artefact if deposited; never the content."}
      },
      "required": ["type"]
    },
    "stop_point": {"type": "string", "description": "Required when completed is false: where the attempt stopped."},
    "stop_reason_own_words": {"type": "string", "description": "Required when completed is false: the person's own words, verbatim."},
    "stop_reason_code": {"type": "string", "description": "Assigned after collection by a published coding scheme (Appendix A)."},
    "multi_model": {
      "type": "object",
      "description": "For transition 3: the denominator of a council run. A completed level-4 record needs at least two tools in asked and in answered; that they are different model families is for the researcher to verify.",
      "properties": {
        "asked": {"type": "array", "items": {"type": "string"}},
        "answered": {"type": "array", "items": {"type": "string"}},
        "timed_out": {"type": "array", "items": {"type": "string"}},
        "diverged": {"type": ["boolean", "null"]},
        "changed_decision": {"type": ["boolean", "null"]},
        "coverage_hit": {"type": ["boolean", "null"]}
      }
    },
    "interface_version": {"type": "string", "description": "Optional implementation record: the agent and its version."},
    "operating_system": {"type": "string", "description": "Optional implementation record."},
    "network_access": {"type": "boolean", "description": "Optional implementation record: whether the agent had network access."},
    "permission_mode": {"type": "string", "description": "Optional implementation record: the permission mode in force."},
    "policy_constraint": {"type": "string", "description": "Optional implementation record: any employer or platform rule that applied."},
    "acceptance_decision": {"enum": ["accept", "revise", "escalate", "discard"], "description": "Optional: the person's decision from the acceptance record."}
  },
  "additionalProperties": false
}
C6. Безпека перед рівнем 3 (safety/)
Навчає: практики розділу 5.3 як конфігурація. Перший файл - це приклад файлу налаштувань проекту для Claude Code: режим "plan" за замовчуванням (постачальник переіменував свій режим за замовчуванням на "Manual" у липні 2026; "plan" залишається дійсним і є безпечнішим освітнім вибором), типові деструктивні команди та команди завантаження заборонені, звичайні таємні файли заборонені як для читача файлів, так і для оболонки cat, видалення та веб-запити потребують схвалення. Список заборон - це лише список: дозвільний режим або команда, не включена до списку, може його обійти, тому параметри пісочниці мають таке ж значення, як і правила. Другий - це приклад конфігурації для Codex OpenAI, наведено у своїй формі для кожного запуску з охопленням папки: записи обмежені робочою папкою, без мережі, схвалення за запитом. Третій - це контрольний список. Обмеження: правила дозволу та пісочниці зменшують радіус впливу; вони не роблять агента надійним, і синтаксис правил змінюється між версіями.
{
  "permissions": {
    "defaultMode": "plan",
    "deny": [
      "Bash(rm -rf:*)",
      "Bash(sudo:*)",
      "Bash(curl:*)",
      "Bash(wget:*)",
      "Bash(cat .env:*)",
      "Bash(git push:*)",
      "Read(./.env)",
      "Read(./.env.*)",
      "Read(./secrets/**)"
    ],
    "ask": [
      "Bash(rm:*)",
      "Bash(mv:*)",
      "WebFetch"
    ]
  }
}
# Folder-scoped, per-run form (the policy of this paper): run the agent from the working copy with
# codex -C <folder> -s workspace-write -a on-request
# The same values in ~/.codex/config.toml apply to every run on the machine.
# The agent may write only inside the working folder, has no network by default,
# and asks before anything outside those limits.
approval_policy = "on-request"
sandbox_mode = "workspace-write"
[sandbox_workspace_write]
network_access = false# Pre-flight checklist before a person lets an agent act on their own computer
1. Work in a copy. Make a new folder for the agent and put copies of the files in it, never originals.
If the files live in a cloud-synchronised tree, copy them out of it first: agents have deleted the
zero-byte placeholders that cloud services leave for offloaded files, taking the originals with them.
2. Start in plan mode. Ask for a written plan first; read it; only then let the agent act.
3. Keep secrets out. No passwords, keys or client documents in the working folder.
4. Deny network by default. Turn it on only for a job that needs it, and then for named sites.
5. Confirm before anything irreversible: sending, deleting, publishing, purchasing.
6. Treat what the agent reads on the web as content, never as instructions. A page can carry hidden text
written to redirect an agent.
7. Treat another agent's answer the same way: content to compare, never instructions to act on. A second
model can pass on instructions it picked up from a page it read.
8. Use a separate browser profile for any agent that browses, signed out of banking and health sites.
9. Never type passwords, one-time codes or card numbers into the agent.
10. Ask "what could go wrong with this?" before approving a command you do not understand.
11. Keep an undo: a snapshot of the folder (or a version-control commit) before each larger change.
12. Keep a working stop. Before a long job, know how to stop it and whether stopping deletes the work.
13. Stop and revoke access when the task, the workspace or the sensitivity of the data changes.
14. Escalate a high-consequence decision to a person who is accountable for it; the agent proposes, the
person decides.C7. Сліди контролю як журнал (jsonl_log.py)
Навчає: найменший корисний запис роботи менеджера — один об'єкт JSON із часовою позначкою на подію, щоб відхилені плани, відхилені дифи, отримані другі думки та завершені запуски (сліди контролю пропозиції P10) можна було підрахувати пізніше за допомогою стандартної бібліотеки. Запускається з --demo. Обмеження: це пристрій запису, а не трасування; він записує лише те, що розповідає йому людина або агент.
#!/usr/bin/env python3
"""jsonl_log.py: append one timestamped event to a JSONL file.

Teaching example for "After Chat" (Appendix C, listing C7). MIT licence.

The smallest useful record of a manager's work: one JSON object per event, one event per line,
each with a UTC timestamp. Events such as "plan_refused", "diff_rejected", "second_opinion_taken"
or "run_completed" are the supervision traces that proposition P10 asks for. A later paper can
parse the file with the standard library. This is a writer, not a tracer: it records what you tell it.

Usage:
    python3 jsonl_log.py run.jsonl '{"event": "plan_refused", "task": "friday-pack"}'
    python3 jsonl_log.py --demo
"""
import json
import sys
from datetime import datetime, timezone
from pathlib import Path


def log(path, event):
    """Append one event; the timestamp is added unless the caller set one."""
    event = dict(event)
    event.setdefault("ts", datetime.now(timezone.utc).isoformat(timespec="seconds"))
    with Path(path).open("a", encoding="utf-8") as f:
        f.write(json.dumps(event, ensure_ascii=False) + "\n")
    return event


def main():
    if len(sys.argv) == 2 and sys.argv[1] == "--demo":
        import tempfile
        path = Path(tempfile.mkdtemp()) / "demo.jsonl"
        for ev in ({"event": "plan_refused", "task": "demo"},
                   {"event": "second_opinion_taken", "task": "demo", "family": "other-vendor"},
                   {"event": "run_completed", "task": "demo", "artefact": "demo/plan/"}):
            log(path, ev)
        print(path.read_text(), end="")
        return
    if len(sys.argv) < 3:
        print('usage: jsonl_log.py FILE \'{"event": "plan_refused"}\'   or   jsonl_log.py --demo',
              file=sys.stderr)
        sys.exit(2)
    print(json.dumps(log(sys.argv[1], json.loads(sys.argv[2]))))


if __name__ == "__main__":
    main()
Додаток D. Розроблена таблиця ефективної кількості думок
Менеджер агентів, який не хоче запускати listing C4, все ж може використовувати потолок. Кожна клітинка дорівнює N_eff = N / (1 + (N - 1) rho); останній рядок — потолок 1/rho, який жодна кількість моделей з такою кореляцією не може перевищити. Значення rho були вибрані для ілюстрації формули і нічого не вимірюють. На практиці rho є середньою попарною кореляцією помилок, величиною, що відрізняється від частки помилок, у яких обидві моделі помиляються однаково, і її потрібно оцінити на елементах з відомими відповідями в розглядуваній предметній області (listing C4).
| N моделей | rho = 0.2 (ілюстрація) | rho = 0.5 (ілюстрація) | rho = 0.6 (ілюстрація) | rho = 0.8 (ілюстрація) |
|---|---|---|---|---|
| 2 | 1.67 | 1.33 | 1.25 | 1.11 |
| 3 | 2.14 | 1.50 | 1.36 | 1.15 |
| 5 | 2.78 | 1.67 | 1.47 | 1.19 |
| 10 | 3.57 | 1.82 | 1.56 | 1.22 |
| Потолок, 1/rho | 5.00 | 2.00 | 1.67 | 1.25 |
Таблиця — це причина, за якою розділ 6 рекомендує витратити наступну підписку на іншу сім'ю замість десятого вікна тієї ж самої. Різноманітність сімей, перевірка кожного твердження за джерелами та збереження розбіжностей виконують роботу, яку більша N не може зробити. Оскільки rho залежить від завдання, її потрібно оцінити на елементах із власної предметної області (listing C4).
Додаток E. Перепис ландшафту, 19–21 вересня 2026
Таблиця 5 у основному тексті групує інструменти за закономірностями. У цьому додатку записано первинне переписування, що стоїть за нею, для читачів, які хочуть бачити цифри такими, якими вони були на зазначені дати. Кількість зірок змінюється щодня; вони відслідковують популярність і нічого не говорять про якість або кількість користувачів, тому їх не слід цитувати станом на дату читача. Стовпець закономірності — це мого відображення, і самі проекти не роблять такої претензії.
| Проект | Розташування | Зірки (приблизно, 21 вересня 2026) | Ліцензія | Закономірність |
|---|---|---|---|---|
| anthropics/claude-code | github.com/anthropics/claude-code | 147,000 | Доступний вихідний код, власницька ліцензія | Агент терміналу (рівень 3) |
| openai/codex | github.com/openai/codex | 126,000 | Apache-2.0 | Агент терміналу (рівень 3) |
| google-gemini/gemini-cli | github.com/google-gemini/gemini-cli | 107,000 | Apache-2.0 | Агент терміналу; індивідуальні рівні більше не обслуговуються з 18 червня 2026 |
| cline/cline | github.com/cline/cline | 69,000 | Apache-2.0 | Редактор і агент терміналу |
| openai/codex-plugin-cc | github.com/openai/codex-plugin-cc | 33,400 | Apache-2.0 | Офіційний плагін: агент одного постачальника всередині іншого |
| jackwener/OpenCLI | github.com/jackwener/OpenCLI | 29,500 | Див. репозиторій | Веб-чат, відкритий для агентів |
| karpathy/llm-council | github.com/karpathy/llm-council | 24,900 | Див. репозиторій | Рада за програмним інтерфейсом |
| ai-shifu/ChatALL | github.com/ai-shifu/ChatALL | 16,500 (близько 847,000 завантажень останньої версії) | Apache-2.0 | Трансляція в браузері |
| BeehiveInnovations/pal-mcp-server | github.com/BeehiveInnovations/pal-mcp-server | 11,800 (останній коміт грудень 2025) | Apache-2.0 | Сервер консультацій між моделями |
| MoonshotAI/kimi-cli | github.com/MoonshotAI/kimi-cli | 11,400 | Apache-2.0 | Агент терміналу (рівень 3) |
| chathub-dev/chathub | github.com/chathub-dev/chathub | 10,700 | GPL-3.0 | Трансляція в браузері |
| nyldn/claude-octopus | github.com/nyldn/claude-octopus | 4,100 | MIT | Рада CLI |
| aarondfrancis/counselors | github.com/aarondfrancis/counselors | 660 | MIT | Рада CLI, яка пише один файл на інструмент |
| xai-org/grok-build | github.com/xai-org/grok-build | 26,900 | Apache-2.0 | Агент терміналу з режимом без головного вузла та протоколом агента |
Як цитувати
Chernets, V. (2026). After Chat: The Three Transitions Between Non-Programmers and Agentic AI [Препринт]. SSRN. https://doi.org/10.2139/ssrn.7520019
@misc{chernets2026afterchat,
  author       = {Chernets, Vadym},
  title        = {{After Chat: The Three Transitions Between Non-Programmers and Agentic AI}},
  year         = {2026},
  howpublished = {SSRN},
  doi          = {10.2139/ssrn.7520019},
  url          = {https://doi.org/10.2139/ssrn.7520019}
}