After Chat: Las tres transiciones entre no programadores e IA agencial
Esta es una traducción. La versión de referencia es el original en inglés; cite esa.
La terminal ya no es una terminal: un modelo de cuatro niveles, la evidencia de 2025 y 2026, y un programa preregistrado para medir los cruces
Vadym Chernets, PhD, arquitecto de sistemas de IA · ORCID 0009-0007-4845-3163
SSRN 7520019 · DOI 10.2139/ssrn.7520019 · Zenodo 10.5281/zenodo.22943313 · GitHub
Descargue este artículo
- SSRN (versión de registro): ssrn.com/abstract=7520019 · DOI 10.2139/ssrn.7520019
- Zenodo (archivado, acceso abierto): doi.org/10.5281/zenodo.22943313
- GitHub (texto completo como Markdown y PDF): github.com/vadimchernets/papers/tree/main/after-chat; código: github.com/vadimchernets/after-chat
El mismo texto está en tres lugares para que se pueda acceder cuando uno de ellos no pueda servirlo. SSRN contiene la versión de registro; cite esa.
Palabras clave: IA agencial; agentes de IA; no programadores; programación del usuario final; alfabetización en IA; trabajadores del conocimiento; adopción de tecnología; adopción de IA generativa; supervisión humana; delegación; brecha digital de segundo nivel; errores correlacionados; ironías de la automatización; descualificación; preregistro
Resumen
La mayoría de los profesionales conocen la IA como chatbot, mientras que los mismos modelos, como agentes de IA, ahora actúan sobre archivos y programas. Me pregunto por qué tan pocos no programadores han pasado del chat a la IA agentica, y cómo medir ese paso. La respuesta descansa en un modelo de cuatro niveles definido por alcance y papel, e independiente de productos: chat, un entorno agentico seguro acotado por el proveedor, un agente en la computadora propia, y trabajo repetible orquestado entre varios modelos. Una transición cuenta solo cuando un agente ha producido un artefacto que la persona solicitó. La instalación de software cuenta como un intento. La evidencia de 2025 a septiembre de 2026 indica que la barrera para la instalación y un primer intento acotado ha disminuido, mientras que la confiabilidad en obras completas, la estabilidad del producto y la seguridad de carpetas no lo han hecho. La instalación es un paso; el chatbot propio de la persona puede guiarla ("incorporación reflexiva"), y dos proveedores fusionaron superficies agenticas y de chat en 2026. Una cifra direccional reportada por la prensa de un proveedor sitúa a los trabajadores del conocimiento en una quinta parte de los cinco millones de usuarios semanales de su agente de codificación; mide el uso de un agente de herencia terminal, no la adopción de nivel 3 como se define aquí. El uso sigue siendo amplio y superficial: aproximadamente la mitad de los trabajadores estadounidenses utilizan IA, aproximadamente uno de cada siete diariamente, y pocos para automatización. La barrera se ha desplazado de la instalación a la dirección. Basándome en investigación de programación de usuario final, nombro el vocabulario de flujo de trabajo faltante y presento el trabajo del gestor como un contrato de delegación: objetivo, límite, artefacto y verificación. Se propone la orquestación web (una pregunta a varios chatbots) como el puente que enseña comparación, y la orquestación CLI (un agente llamando a otros) como la capa durable, acotada por el hecho de que el acuerdo entre modelos correlacionados es evidencia débil. El artículo cierra con quince proposiciones falsables, el diseño de un programa de cohorte preregistrado sin resultados, y código de enseñanza abierto.
Resumen ejecutivo
La terminal, la ventana negra que representaba todo lo que los no programadores no podían hacer con IA, ha cambiado su significado. Ahora es el lugar en la máquina propia de una persona donde trabaja un agente, y la habilidad que exige ya no es escribir comandos. La habilidad es gestionar el trabajador que los escribe.
Los desarrolladores profesionales están más avanzados: el 90% de más de 15.000 encuestados en 2026 utilizaron herramientas agentivas al menos semanalmente (una encuesta de proveedores), aunque el uso semanal aún no es la competencia del gestor de la Sección 8. Los demás siguen hablando principalmente con un chatbot. El 52% de los trabajadores estadounidenses utilizan IA en su función, el 15% diariamente, y el 16% de esos usuarios menciona la automatización entre sus usos.
La razón ya no es que los agentes sean difíciles de instalar. Instalar uno requiere un comando o un clic, el chatbot que una persona ya utiliza puede guiarla a través de ello, y los proveedores han comenzado a fusionar chat con agentes. Lo que sigue siendo difícil es de naturaleza diferente. Los agentes aún fallan en tareas completas de trabajo, el producto que aprende una persona puede ser renombrado o retirado dentro de un año, y una carpeta otorgada sigue necesitando protección. Después del instalador, lo primero que detiene a las personas es que no saben qué delegarle o cómo verificarlo, la brecha que la Sección 1 llama vocabulario de flujo de trabajo. Detrás de ello vienen el primer error, los permisos y la seguridad, las reglas organizacionales, el hardware y el costo, y la competencia para juzgar resultados.
El modelo tiene cuatro niveles, ordenados por cuán lejos llega el modelo y por lo que debe hacer la persona: conversación, un espacio aislado que administra el proveedor, la computadora propia de la persona, y trabajo dirigido a través de varios modelos. Las personas pueden saltarse un nivel. Un cruce se muestra solo por un artefacto que produjo el agente, de modo que las instalaciones, insignias y autorreportes no cuentan.
La orquestación, enviar una pregunta a varios modelos, viene en dos capas. En el navegador no cuesta nada intentarlo y enseña el hábito de comparar respuestas, y en la línea de comandos se puede anotar y ejecutar nuevamente. En ambos, lo que cuenta es el número de familias de modelos consultadas, porque los errores correlacionados limitan lo que vale la concordancia.
Gestionar agentes es una competencia por derecho propio. Tiene un contrato de delegación en cuatro partes (objetivo, límite, artefacto, verificación), cuatro prácticas (delegar, supervisar, verificar, revocar), una regla de parada para revisiones, y un registro de aceptación que separa lo que produjo el agente de lo que la persona utilizó.
El argumento está construido para ser probado. Quince proposiciones llevan medidas y falsadores. El diseño de un programa de cohorte preregistrado (OSF DOI 10.17605/OSF.IO/X4EGQ) se describe aquí, y sus resultados se reportarán por separado. Una tabla de estado indica qué tan firmemente se sostiene cada afirmación, y el código abierto está en el Apéndice C.
1. Introducción
Considere una profesional de oficina en septiembre de 2026. Utiliza un chatbot cada semana. Le pide que redacte un correo electrónico, que resuma un informe, que sugiera una fórmula. Lo que recibe es texto, y lo traslada manualmente al lugar donde vive su trabajo: una carpeta de contratos, una hoja de cálculo de cuentas, una presentación vencida el viernes. El mismo modelo, a través de una puerta diferente, puede abrir esa carpeta, leer cada archivo en ella, escribir la hoja de cálculo, construir la presentación y verificar su propia aritmética. La mayoría de los profesionales, según lo que pueden decir las encuestas de la Sección 4.4, aún no han utilizado esa puerta, y muchos no saben que existe.
Durante dos años la puerta parecía una terminal: una ventana negra, un cursor parpadeante, un comando para pegar. Esa imagen está obsoleta. La terminal se mantuvo como terminal solo visualmente. Se convirtió en el entorno en el que vive un agente, el lugar en la propia máquina de una persona donde un modelo puede leer, escribir, ejecutar y programar, y la persona frente a él ya no necesita operar un shell tanto como dirigir al agente que lo hace. Lo que cambia es el rol humano, de alguien que hace preguntas a un modelo a alguien que gestiona a un trabajador.
Mi tema es el camino entre esos dos roles y quién está en él. Entre los desarrolladores profesionales, al menos las herramientas ya han llegado. Una encuesta de más de 15.000 desarrolladores profesionales entre mayo y julio de 2026 encontró que el 90% utilizaba agentes de codificación IA en el trabajo al menos semanalmente y el 68% diariamente, y que la proporción que utilizaba un agente de terminal, Claude Code, en el trabajo había aumentado de aproximadamente el 3% en la primavera de 2025 al 18% en enero de 2026 y al 39% a mediados de 2026 (JetBrains Research, 2026a, 2026b; una encuesta de vendedor, ya que JetBrains vende un agente de codificación). Entre todos los demás no ha ocurrido así, y el patrón de uso es amplio y superficial. En los mismos meses, el 52% de los trabajadores estadounidenses informaron usar IA en su rol, el 15% la utilizaba diariamente, y solo el 16% de esos usuarios nombraron la automatización entre sus usos; la escritura y la búsqueda dominaban (Gallup, 2026). Para el profesional típico, la IA sigue siendo una conversación, y las cifras de la Reserva Federal de St. Louis dicen lo mismo en un período más largo: entre agosto de 2024 y mayo de 2026, la proporción de trabajadores que utilizaban IA generativa para sus trabajos aumentó del 33% al 45%, mientras que menos del 3% de las tareas tenían tasas de adopción superiores al 50% (Bick et al., 2026).
La explicación estándar de la brecha es la dificultad técnica: los agentes son para personas que pueden programar. Esa respuesta fue razonable en 2024 y es débil en 2026. Instalar un agente de terminal ahora toma un comando o un instalador de escritorio, y el agente principal envía una aplicación de escritorio cuya documentación dice claramente, "No se requiere terminal" (Anthropic, 2026a). Los vendedores han ido más lejos. OpenAI convirtió su aplicación de agente de codificación en el cliente de escritorio predeterminado de ChatGPT el 9 de julio de 2026 y agregó un agente, ChatGPT Work, que utiliza archivos y aplicaciones locales (MacRumors, 2026). Anthropic fusionó su agente de escritorio para trabajo de conocimiento, Cowork, en el chat ordinario el 16 de septiembre de 2026; TechCrunch informó que la empresa dijo que los clientes "a menudo tenían dificultades para elegir la pestaña correcta para la tarea correcta" (TechCrunch, 2026a). OpenAI informó, a través de la prensa, que los trabajadores del conocimiento constituían aproximadamente el 20% de los cinco millones de usuarios semanales de su agente de codificación en junio de 2026 y lo adoptaban más de tres veces más rápido que los desarrolladores (Help Net Security, 2026). La cifra es reportada por vendedor y direccional, la propia página del vendedor no fue accesible para mis verificaciones, y mide el uso de un agente heredado del terminal por parte de trabajadores del conocimiento, que es más amplio que la adopción de nivel 3 como se define en la Sección 3. Es difícil ver dónde está la barrera técnica en esa imagen.
La barrera se ha movido. Se ha movido de instalar a dirigir: de "¿cómo hago que esto funcione?" a "¿qué le pido que haga, dentro de qué límites, y cómo sabré que lo hizo?" La segunda pregunta es más difícil de lo que parece, y la literatura sobre programación de usuarios finales explica por qué. Los no expertos luchan por expresar intención a modelos de lenguaje incluso cuando el acceso es gratuito e inmediato (Zamfirescu-Pereira et al., 2023), y deben aprender qué frases se asignan a lo que el sistema puede hacer (Liu et al., 2023). Delegar en una IA también cambia el trabajo de producir a especificar y verificar (Sarkar & Drosos, 2025; Simkute et al., 2024). Llamo a la capacidad faltante vocabulario de flujo de trabajo: un stock de trabajo de tareas que una persona sabe cómo entregar a un agente, fraseado para que el agente pueda ejecutarlas y se pueda verificar el resultado. Declarado formalmente, es la asignación entre los objetivos de dominio de una persona y las subtareas que un agente puede ejecutar, con las palabras para entradas, transformaciones, salidas, excepciones y evidencia que la asignación necesita. Un desarrollador que abre un agente ya sabe las primeras diez cosas que escribir. Un contador o un profesor generalmente no lo sabe, y nadie en su oficina se lo ha dicho.
La primera contribución es un modelo de cuatro niveles del camino desde el chat hasta el trabajo con agentes, definido por alcance y rol y sin ningún nombre de producto. Los niveles van desde chat a través de un entorno agentico seguro y un agente en la propia computadora de alguien hasta trabajo orquestado repetible. Cada uno se define por lo que el agente puede tocar y por lo que la persona debe especificar y verificar, y cada transición se define por un artefacto que el agente produjo, y el software instalado solo no cuenta. Debido a que las definiciones no dependen de nombres de productos, el modelo sobrevive al hábito actual de los vendedores de fusionar sus productos (Sección 3).
La segunda es una síntesis de evidencia para 2025 a septiembre de 2026. Muestra que la instalación y un primer intento limitado se han vuelto mucho más fáciles, que los tres límites establecidos en la Sección 4.5 (trabajo confiable en tareas completas, productos estables, carpetas seguras) no se han movido con ellos, y que el patrón superficial de uso persiste. También localiza las barreras que permanecen: vocabulario de flujo de trabajo, el error que detiene a un novato, permiso y seguridad, normas organizacionales, y la capacidad de juzgar resultados (Secciones 4 y 5).
La tercera es una descripción de las dos capas de orquestación. La orquestación web, una pregunta enviada a varios chatbots de consumo, es el puente: no necesita instalación y enseña el hábito de la comparación. La orquestación CLI, un agente llamando a herramientas de línea de comandos de otros agentes, es la capa de delegación que dura. Ambas están limitadas por un hecho que los usuarios tienden a perder, que el acuerdo entre modelos no es evidencia independiente (Chernets, 2026a) (Secciones 6 y 7).
La cuarta es un programa de medición con proposiciones falsables: el diseño de un programa de cohorte preregistrado que sigue a los no programadores a través de estas transiciones (Chernets, 2026d), y un conjunto de herramientas de enseñanza abierto de patrones de orquestación y seguridad en los apéndices (Secciones 9 y 10, Apéndice C).
Algunos límites de alcance aplican en general. «No programador» significa un profesional cuyo trabajo ocurre sustancialmente en una computadora y que no tiene capacitación en scripting ni ingeniería de software. Un analista versado en fórmulas de hojas de cálculo cuenta como tal, un desarrollador no, y los desarrolladores aparecen aquí como grupo de comparación. No informo resultados del programa de cohorte; esos pertenecen a un artículo separado posterior a su período de observación. La mayoría de las cifras de adopción provienen de los Estados Unidos y de los proveedores, y están marcadas como tales. Y las herramientas descritas cambian cada mes, por lo que el modelo está diseñado para sobrevivirlas y se espera que los detalles del producto queden obsoletos.
La sección 2 sitúa el argumento en la literatura y la sección 3 define los niveles y transiciones. La sección 4 muestra dónde se fue la barrera técnica, la sección 5 qué la reemplazó, las secciones 6 y 7 las dos formas de orquestación, y la sección 8 qué hace el cambio al papel humano. La sección 9 describe el programa que mide los cruces, la sección 10 establece las proposiciones, la sección 11 extrae implicaciones, la sección 12 establece condiciones límite, y la sección 13 concluye.
2. Antecedentes: de la programación por usuarios finales a la delegación por usuarios finales
2.1 Los usuarios finales siempre han programado
La idea de que personas que no son programadores dirijan la computación es anterior a los modelos de lenguaje. Nardi (1993) argumentó que los usuarios finales controlan la potencia computacional a través de lenguajes y marcos específicos para tareas, siendo las hojas de cálculo el caso canónico, sin necesidad de habilidades de programación general. Ko et al. (2011) demostraron que los usuarios finales que construyen software enfrentan los mismos problemas que los profesionales (requisitos, reutilización, pruebas, depuración) sin la formación, y nombraron el campo ingeniería de software para usuarios finales. El campo más amplio, desarrollo por usuarios finales, estudia cómo las personas que no son desarrolladores profesionales crean y adaptan software para su propio trabajo. Myers, Pane y Ko (2004) pasaron años diseñando notaciones más cercanas a la forma en que los no programadores describen tareas. Cada una de estas líneas de trabajo asumía que el usuario final seguiría escribiendo algo que la máquina ejecuta, incluso si eso fuera una fórmula o una regla.
Los modelos de lenguaje cambiaron lo que escribe el usuario final. Sarkar et al. (2022) describieron la programación con un modelo de lenguaje grande como una nueva actividad, distinta de la compilación, la programación en pareja y la búsqueda. Zamfirescu-Pereira et al. (2023) encontraron que las personas sin experiencia en IA luchan por diseñar indicaciones que funcionen de manera confiable, generalizan excesivamente a partir de éxitos únicos y recurren a hábitos conversacionales humanos. Liu et al. (2023) nombraron la dificultad de aprender qué palabras producen qué comportamiento «coincidencia de abstracción fundamentada». Sarkar y Drosos (2025), en el primer estudio empírico de «programación vibe», encontraron que la programación conversacional redistribuye la experiencia hacia la gestión del contexto y la verificación rápida de resultados, y deja la necesidad de juicio donde estaba. Virk y Liu (2025) encontraron que los usuarios empresariales a los que se les proporcionó código de análisis escrito por IA a menudo no lograron detectar errores críticos incluso cuando se les indicó que los buscaran. Feldman y Anderson (2024) llamaron a los programadores no expertos la población menos estudiada de la era generativa.
Doy el siguiente paso en esa línea. La unidad de trabajo del usuario final ha cambiado de una fórmula, un script o una indicación a una delegación: una tarea entregada a un agente que actúa sobre archivos y herramientas en varios pasos. La literatura sobre programación por usuarios finales explica por qué expresar la intención es difícil, y la literatura sobre delegación y supervisión explica por qué verificar el resultado es difícil. El modelo de cuatro niveles de la Sección 3 se construye para unir los dos.
2.2 La adopción es rápida y superficial
La IA generativa se propagó más rápido que la computadora personal o Internet. Bick, Blandin y Deming (2024) estimaron que aproximadamente el 40% de los adultos en edad de trabajar de Estados Unidos la utilizaban a finales de 2024, mientras que solo una pequeña parte de las horas de trabajo fue asistida. Chatterji et al. (2025) encontraron que a mediados de 2025 ChatGPT servía a aproximadamente 700 millones de usuarios semanales y que la mayoría de los mensajes no estaban relacionados con el trabajo. En Dinamarca, Humlum y Vestergaard (2025) encontraron efectos nulos precisos en ganancias y horas dos años después de la adopción, y una brecha en el uso entre mujeres y hombres; un metaanálisis en más de 100 países sitúa esa brecha en aproximadamente 16 puntos porcentuales desde principios de 2025 (Cranney et al., 2026). En 35 países europeos, la exposición a la IA no se tradujo automáticamente en uso, y la formación, la digitalización y la agencia de los trabajadores importaban más (Henseke, 2026).
Los experimentos de campo muestran ganancias sustanciales donde la herramienta se ajusta a la tarea: 14% más problemas de clientes resueltos por hora en promedio y 34% para novatos (Brynjolfsson et al., 2025), escritura más rápida y mejor en un ensayo con 444 profesionales, con las mayores ganancias para los escritores más débiles (Noy & Zhang, 2023), y, entre 758 consultores, 12.2% más tareas completadas y calidad aumentada en más del 40% dentro de la «frontera dentada» de la capacidad del modelo, con trabajo peor en una tarea fuera de ella (Dell'Acqua et al., 2026). Un ensayo aleatorizado con desarrolladores experimentados de código abierto encontró el signo opuesto a principios de 2025, una ralentización del 19% (Becker et al., 2025), un resultado que sus autores dijeron posteriormente que probablemente estaba desactualizado a medida que mejoraban las herramientas (METR, 2026). La lección de estos ensayos es que las ganancias dependen del ajuste entre la tarea, la herramienta y la capacidad de la persona para dirigirla y verificarla, y esas son las tres cosas que cambia una transición entre niveles.
2.3 Aceptación, difusión y la división del segundo nivel
La investigación sobre adopción de tecnología, desde el modelo de aceptación de tecnología (Davis, 1989) hasta la teoría unificada de aceptación y uso de tecnología (Venkatesh et al., 2003), sostiene que la utilidad percibida y la facilidad de uso controlan la adopción, y que la influencia social y las condiciones facilitadoras importan tanto como las actitudes individuales. La investigación sobre difusión describe la adopción como un proceso social con adoptantes tempranos y tardíos (Rogers, 2003). Una vez que el acceso básico a Internet se generalizó, Hargittai (2002) mostró que la desigualdad significativa se desplazó hacia la habilidad: la división digital del segundo nivel. Van Dijk (2020) extendió esto a una secuencia de motivación, acceso, habilidades y uso.
El mismo cambio es visible ahora. El acceso al chat es casi universal entre los trabajadores de oficina en países ricos, mientras que la habilidad de dirigir un agente está lejos de ser universal. Una división de IA ya ha sido medida a lo largo de las antiguas líneas de educación, región y edad (Daepp & Counts, 2024; Pew Research Center, 2026). Lo que añado es la observación de que la división ahora corre dentro de la población de usuarios de IA, entre quienes conversan con modelos y quienes les delegan tareas.
2.4 Automatización, supervisión y la carga del gestor
La literatura sobre la supervisión humana de la automatización comienza con una ironía. Bainbridge (1983) la describió: automatizar la mayor parte de una tarea deja al ser humano el residuo más arduo, la supervisión e intervención rara, mientras erosiona la habilidad necesaria para ello. Parasuraman y Riley (1997) distinguieron el uso incorrecto, el desuso y el abuso de la automatización, y Lee y See (2004) demostraron que la confianza debe corresponder a la confianza calibrada. La era generativa ha renovado cada punto. Los trabajadores del conocimiento que confían más en la herramienta informan de menos pensamiento crítico (Lee et al., 2025). La IA generativa desplaza a las personas de la producción a la evaluación y facilita las tareas fáciles y dificulta las tareas difíciles (Simkute et al., 2024). Las intervenciones para calibrar la confianza en los modelos de lenguaje reducen la confianza excesiva sin producir confianza apropiada (Bo et al., 2025). Los usuarios de agentes de IA como asistentes diarios mal calibran la confianza hacia planes plausibles pero incorrectos, y se desempeñan mejor cuando participan en la ejecución paso a paso (He et al., 2025). Mejores trazas de lo que hizo un agente aceleran la detección de errores sin mejorar necesariamente la precisión final (Grunde-McLaughlin et al., 2026). Un estudio de aproximadamente 73.000 publicaciones públicas en un agente autónomo encontró que los valores de los usuarios se satisficieron en gran medida en lo que el agente proporcionó pero no en cómo podrían supervisarlo (Ma et al., 2026). En un pequeño estudio de laboratorio y tres implementaciones, la comodidad con la delegación creció con el tiempo mientras las personas aún querían control en momentos de incertidumbre (Long et al., 2025). Tomašev, Franklin y Osindero (2026) tratan la delegación a la IA como un marco de asignación de tareas, transferencia de autoridad, responsabilidad y confianza, aplicable tanto a agentes humanos como a máquinas.
En el aspecto cognitivo, un estudio de EEG de 54 escritores de ensayos informó una conectividad más débil y un menor sentido de propiedad en el grupo asistido, una «deuda cognitiva» (Kosmyna et al., 2025), y un comentario publicado cuestionó sus métodos (Stankovic et al., 2026). La lectura segura es que descargar los pasos rutinarios libera la atención y que la atención liberada debe gastarse en la verificación. Dos ideas más de la investigación del aprendizaje se retoman más adelante. La teoría de la carga cognitiva explica por qué un recién llegado arrojado a un entorno sin cercas se detiene antes de que se forme un esquema mental (Sweller, 1988). Y un modelo de adopción basado en el aprendizaje bayesiano muestra cómo las personas pueden caer en un equilibrio de bajo uso autorreforzante que solo un primer éxito o la capacitación pueden modificar (Ma et al., 2025).
Dos artículos complementarios en esta serie abordan el mismo problema desde otra perspectiva. El primero muestra que el acuerdo entre varios modelos es evidencia más débil de lo que parece, porque sus errores están correlacionados (Chernets, 2026a). El segundo muestra cómo los componentes de supervisión automatizada pueden ampliar su propio mandato y obstruir el trabajo que protegen (Chernets, 2026b). Ambos importan para un recién llegado: el primero para lo que la orquestación puede lograr, el segundo para por qué las capas de seguridad pueden detener a una persona en la puerta.
2.5 Lo que no se ha estudiado
Una búsqueda realizada el 21 de septiembre de 2026 (búsqueda web, Crossref, arXiv y Semantic Scholar, con atención a los artículos de CHI, UIST y VL/HCC de 2024 a 2026) no encontró ningún estudio de campo publicado sobre no programadores que adoptaran agentes de terminal o línea de comandos, ningún estudio de orquestación web (una pregunta dirigida a varios chatbots de consumo en el navegador) como una práctica identificada, ningún análisis de la gestión de agentes como una habilidad con su propia estructura de competencias, y ningún estudio de un sistema de IA que proporcione andamiaje para que una persona adopte IA agentica; el trabajo más cercano aplica la teoría del andamiaje a tutores de IA de otros temas (Cohn et al., 2026) o a interfaces condicionadas por tareas para software complejo (Liu & Sra, 2026). El trabajo de economía laboral mide la adopción de IA generativa en general, y ninguno de estos trabajos aísla el paso del chat a las herramientas agenticas entre no programadores. Estas brechas definen el espacio que mapea el modelo y el programa de la Sección 9 está construido para medirlas.
3. Cuatro niveles y tres transiciones
3.1 Dos ejes: alcance y rol
Un nivel describe una relación entre una persona y un modelo en el trabajo, y lo defino en dos ejes: alcance y rol.
El alcance es lo que el modelo puede tocar en nombre de la persona. En su forma más estrecha es solo la conversación; luego, archivos y herramientas dentro de un espacio delimitado por el proveedor; luego, la propia computadora de la persona con sus archivos, programas y calendario; y en su forma más amplia, varios modelos y agentes a la vez.
El rol es lo que la persona debe hacer para que el trabajo tenga éxito. En el mismo orden: preguntan y copian, entregan una tarea y revisan el resultado, poseen el entorno de un agente con sus permisos y su deshacer, o asignan trabajo entre agentes y reconcilian lo que regresa.
Los productos están deliberadamente ausentes de la definición. Un único producto puede abarcar varios niveles, y en 2026 los proveedores están integrando el chat y los agentes en una sola ventana más rápido de lo que cualquier taxonomía construida sobre nombres de productos podría seguir (Sección 4.3). Un nivel describe una pieza de trabajo, y una persona, como un producto, puede abarcar varios. La misma persona puede estar en el nivel 1 para una tarea por la mañana y en el nivel 3 para otra por la tarde.
Los dos ejes también separan este modelo de las escalas familiares de automatización y autonomía. Parasuraman, Sheridan y Wickens (2000) clasificaron cuánto de cada etapa de una tarea (adquirir información, analizarla, decidir, actuar) realiza una máquina. Morris et al. (2024) calificaron los sistemas generales de IA por la profundidad y amplitud de su desempeño. Feng, McDonald y Zhang (2025) definieron cinco niveles de autonomía para agentes de IA según el rol que juega el usuario, desde operador y colaborador hasta consultor, aprobador y observador. Esas escalas describen cuánto decide un agente dentro de una tarea. Los cuatro niveles aquí describen dónde se ejecuta el trabajo y qué posee la persona: una conversación, un espacio delimitado por un proveedor, su propia máquina, un equipo de agentes de varios proveedores. Los ejes son ortogonales. Un agente en la propia computadora de una persona puede ejecutarse en cualquiera de los niveles de autonomía de Feng et al., desde aprobación paso a paso hasta delegación casi total, y la persona aún posee sus permisos y su deshacer. Lo que los cuatro niveles añaden es una descripción de la adopción: el orden en que crecen el alcance y la responsabilidad para alguien que comienza en chat, y la evidencia (un artefacto) que muestra que cada paso fue tomado.
3.2 Los cuatro niveles
Nivel 1: chat. El alcance del modelo termina en la conversación. Produce texto, código o imágenes que la persona copia al lugar donde ocurre el trabajo, y el rol de la persona es preguntar bien y llevar el resultado. Casi todo profesional que usa IA trabaja aquí la mayor parte del tiempo (Sección 2.2).
Nivel 2: un entorno de agentes seguro. El modelo actúa sobre archivos, servicios conectados y a veces un navegador, dentro de un espacio delimitado por el proveedor: carpetas seleccionadas, una máquina virtual o aislador del lado del servidor, conectores que la persona ha aprobado, y un paso de aprobación antes de acciones consecuentes. Anthropic's Cowork, OpenAI's ChatGPT Work, Microsoft's Copilot Cowork y Google's Gemini Spark son ejemplos de 2026, y comparten el diseño de un agente de delegación trabajando en un espacio delimitado (Anthropic, 2026b; MacRumors, 2026; Microsoft, 2026a; TechCrunch, 2026b). El rol de la persona cambia de preguntar a delegar. Entregan una tarea que termina en un archivo o una acción y revisan lo que regresa, y gran parte de la seguridad del entorno, en este nivel, es responsabilidad del proveedor.
Nivel 3: un agente en la propia computadora. El agente se ejecuta en la máquina de la persona con acceso al sistema de archivos, el shell, programas instalados y trabajos programados, a través de una terminal o un shell de escritorio sobre el mismo motor: Claude Code, OpenAI's Codex, Google's Antigravity CLI, xAI's Grok Build, Moonshot's Kimi Code y equivalentes de código abierto. En la literatura de investigación estos son agentes basados en LLM, y su uso por desarrolladores se estudia como codificación agencial; el nivel pregunta qué sucede cuando la persona que los ejecuta no es un desarrollador. El alcance es el más amplio que obtiene un solo agente, y con él el rol de la persona cambia nuevamente. Poseen el entorno: qué carpetas ve el agente, qué comandos necesitan aprobación, qué se mantiene fuera, y cómo deshacer un error. La terminal en sí es incidental, ya que lo que define el nivel es la propiedad de un entorno de trabajo en el que un agente puede hacer cualquier cosa que la persona pudiera hacer. Las variantes alojadas en la nube (el mismo bucle de agente ejecutado en la máquina de un proveedor, con la persona viendo una tarea y un resultado y nunca un indicador) son nivel 3 por capacidad y nivel 2 por radio de explosión, y el modelo las registra como una variante del nivel 3 sin forzarlas en una sola celda.
Nivel 4: trabajo repetible y orquestado. La persona dirige varios modelos o agentes, en paralelo o en secuencia, en trabajo que se repite, y el alcance ahora abarca proveedores. Hay dos capas. En orquestación web una pregunta va a varios chatbots de consumidor en el navegador, manualmente o con una herramienta, y las respuestas se comparan. En orquestación CLI un agente llama a las herramientas de línea de comandos de otros agentes, recopila sus salidas y las fusiona o verifica. El rol de la persona es el de un gerente: establecen el objetivo, asignan el trabajo, deciden qué cuenta como hecho, y reconcilian el desacuerdo. El trabajo se vuelve repetible cuando se escribe en una forma que los agentes pueden ejecutar nuevamente, como un archivo de instrucciones, una habilidad o un trabajo programado. "Repetible" describe el flujo de trabajo, no el resultado. El mismo archivo de instrucciones ejecutado la próxima semana producirá un borrador diferente, y lo que se repite es la secuencia de entradas, pasos, verificaciones y entregables. Un trabajo recurrente de un solo agente escrito de esta manera es trabajo de nivel 3 hecho repetible, y se convierte en nivel 4 cuando se dirige una segunda familia de modelos y se reconcilian los resultados (transición 3, Sección 3.3).
Tabla 1. Los cuatro niveles.
| Nivel | Alcance del modelo | Rol de la persona | Superficies típicas, septiembre de 2026 | El cruce se muestra mediante | Lo que el nivel no establece | Barrera principal al ingreso |
|---|---|---|---|---|---|---|
| 1. Chat | La conversación | Pregunta, copia el resultado manualmente | Chat en navegador o aplicación | (nivel de entrada) | Que el modelo puede actuar sobre el trabajo de la persona, o ser de confianza sin verificar | Ninguno más allá del acceso |
| 2. Entorno de agentes seguro | Archivos, conectores y navegador dentro de un espacio delimitado por el proveedor | Delega una tarea, revisa el resultado | Cowork merged into Claude chat; ChatGPT Work; Copilot Cowork; Gemini Spark | Un archivo o acción producida por el agente a partir de una tarea delegada, con una aprobación o rechazo registrado | Que la persona pueda ejecutar su propio entorno, o repetir el trabajo | Saber qué delegar; confianza |
| 3. Agente en la propia computadora | El sistema de archivos, shell, programas y horario de la persona | Posee el entorno: permisos, exclusiones, deshacer | Shells de terminal y escritorio de Claude Code, Codex, Antigravity CLI, Grok Build, Kimi Code | Un artefacto que el agente produjo en la máquina propia de la persona, en una carpeta que la persona configuró, a partir de una tarea que requería más de un uso de herramienta | Que el resultado es correcto, o seguro de aceptar sin revisión | Fricción de instalación (caída); el primer error; permisos; qué preguntar |
| 4. Trabajo orquestado | Varios modelos o agentes de diferentes proveedores | Gestiona: objetivo, asignación, aceptación, reconciliación | Web: varias pestañas de chat o herramientas de difusión. CLI: complementos y scripts que llaman a otros agentes | Un resultado fusionado o verificado de al menos dos familias de modelos, ejecutado nuevamente al menos una vez, con quién fue consultado y quién respondió registrado | Que el acuerdo entre los modelos es evidencia independiente, o que la tarea pertenece a este nivel | Costo de la reconciliación; errores correlacionados; cambio de cuota y herramientas |
Dos términos en la tabla son más estrechos que el uso cotidiano. "Seguro" en "entorno agentico seguro" designa un objetivo de diseño y un patrón de interacción y no da garantía alguna. El ámbito de carpetas, aprobaciones, sandboxes y paneles de vista previa reducen el área en la que actúa un agente; no pueden hacer que una implementación defectuosa preserve archivos ni que un documento que lleve instrucciones ocultas sea inofensivo, y la Sección 5.3 reporta qué ha salido mal dentro de carpetas concedidas. Lo que el escalafón intermedio sí establece es un modelo mental práctico. Una persona que ve que el agente puede escribir un informe en una carpeta y no puede tocar nada más ha aprendido que la acción delegada tiene un perímetro, lo cual es más útil que cualquier advertencia abstracta de tener cuidado con la IA. "Artefacto" significa un entregable que requirió varios pasos del trabajo propio del agente. La persona que lo pidió decide si cuenta como un artefacto, un tercero califica su calidad (Sección 9.4), y un estudio reporta acuerdo entre evaluadores tanto para esa calificación como para la codificación de razones de parada. Una carpeta con dos archivos vacíos es un rastro de un instalador, y no cuenta.
3.3 Tres transiciones, y por qué un artefacto define cada una
Se cruza una transición cuando el agente ha producido, en el nuevo nivel, un artefacto que la persona pidió. Una instalación cuenta solo como un intento, como también lo hace un tutorial completado, una insignia, una licencia y el autorreporte "ahora uso agentes". La regla tiene varias consecuencias más allá de la obvia. Una carpeta creada por un agente muestra que el agente se ejecutó, mientras que un conjunto de archivos escritos por el agente a partir de la descripción que la persona hace de su propio trabajo muestra que la persona delegó. La regla también hace que las transiciones sean observables desde afuera: un investigador o un gerente puede ver un artefacto y no puede ver una intención o una sensación de competencia. Hace que el fracaso sea informativo, ya que una persona que instaló una herramienta y no produjo nada se ha encontrado con una barrera digna de nombrar, y contar la instalación como un éxito la ocultaría. Y porque no nombra ningún producto, la regla permite que los estudios comparen entre herramientas que se renombran cada trimestre.
La Transición 1, de chat a un entorno agentico seguro, se cruza cuando una persona primero delega una tarea que termina en un archivo o una acción en lugar de en texto. En 2026, esta transición está siendo absorbida en la ventana de chat misma. Cuando el modelo del proveedor decide si responder o actuar, como lo hace en la experiencia Claude fusionada anunciada el 16 de septiembre de 2026 (Anthropic, 2026c), una persona puede cruzarla sin decidir hacerlo. Eso hace que el cruce sea más fácil y también menos visible, incluso para la persona.
La Transición 2, del entorno seguro a la propia computadora, se cruza cuando una persona ejecuta un agente en su propio entorno y recibe un artefacto de él. El cambio decisivo es la propiedad. En el nivel 2, el proveedor decide qué puede tocar el agente, y en el nivel 3, la persona lo decide, cualquiera que sea la cara que muestre el agente, una terminal o una ventana. El miedo a la terminal solía vivir aquí, y la Sección 5 muestra que las preguntas sobre permisos, errores y qué preguntar han tomado su lugar.
La Transición 3, de un agente a trabajo orquestado, se cruza cuando una persona obtiene un resultado que al menos dos familias de modelos produjeron o verificaron, y ejecuta nuevamente ese arreglo en trabajo posterior. La reejecución importa, porque una comparación de tres chatbots es una curiosidad, y solo una comparación a la que la persona recurre cada vez que las apuestas la justifican constituye una práctica.
La ruta que sigue el programa de la Sección 9 puede recorrerse como un diseño, con la profesional de la Introducción como caso hipotético y nada reportado. Comenzaría donde ya está, en el nivel 1, con un chatbot que paga. Pegaría un texto estándar en ese chatbot y dejaría que la guíe a través de instalar un agente gráfico en su propia computadora portátil, enviándole una captura de pantalla cada vez que un paso fallara, y yo no tocaría nada. El primer paso contaría como cruzado solo cuando el agente hubiera producido, a partir de su propia descripción de su trabajo, un conjunto de archivos que pudiera abrir y juzgar; una aplicación instalada junto a una carpeta vacía contaría como un intento. Trabajaría en una copia de sus archivos, mantendría contraseñas y documentos de clientes fuera de ella, leería el plan del agente antes de permitir que actúe, y confirmaría cualquier cosa irreversible. Cuando dijera que estaba lista, recibiría una herramienta de código abierto que plantea una pregunta a varios modelos a través de las suscripciones que ya tiene y devuelve una respuesta fusionada, lanzada desde dentro del agente, y ese paso contaría cuando una ejecución fechada mostrara qué modelos fueron consultados y dónde diferían. Luego ejecutaría la misma comparación a través de herramientas de línea de comandos. Podría detenerse en cualquiera de estos puntos, y el registro registrado mantendría dónde y, en sus palabras, por qué. La ruta se toma del registro público, y si la gente la recorre es una pregunta para el artículo de resultados.
3.4 Los niveles están ordenados, no son obligatorios
Los niveles están ordenados por alcance y por la responsabilidad que imponen en la persona. El orden no los convierte en una escalera que todos deben subir paso a paso. Una persona puede pasar directamente del chat a un agente en su propio ordenador; la ruta de cohorte descrita en la Sección 9 hace exactamente eso, con el chatbot que la persona ya utiliza guiándola a través de la instalación. Otros se detendrán en el nivel 2 definitivamente, y para mucho trabajo ese es el lugar correcto para detenerse. Lo superior no es mejor en este modelo. Sus afirmaciones son que cada nivel pide cosas diferentes a la persona, que los cruces se pueden observar, y que las barreras en cada cruce difieren. Se falsificaría si los cruces no pudieran distinguirse por artefactos, si las barreras no diferían entre cruces, o si la competencia en un nivel no cambiara lo que las personas podrían hacer en el siguiente, ya que en cualquiera de esos casos el modelo no añadiría nada a una simple escala de "uso de IA". El modelo también predice que, una vez que la sensibilidad de una tarea y las demandas técnicas se mantienen constantes, la finalización cae más bruscamente en las tres transiciones que dentro de un nivel. Si las caídas se distribuyeran uniformemente, los niveles serían un continuo simplemente re-etiquetado. La Sección 10 convierte estas expectativas en proposiciones con medidas y falsadores.
Una familia de herramientas pertenece junto a la escalera y no en ningún peldaño de ella. Los constructores de aplicaciones de navegador permiten a una persona describir una aplicación y recibir una vista previa en funcionamiento dentro de una plataforma que aloja el proveedor. Son importantes, y son algo diferente del nivel 2, donde un agente actúa sobre los archivos propios de la persona bajo un modelo de permisos; un constructor de aplicaciones actúa sobre un proyecto que es propiedad de la plataforma. Confundir los dos produce una falsa sensación de que los no programadores ya han llegado. El modelo de cuatro niveles deja los constructores de aplicaciones en una rama lateral con su propio techo y su propio perfil de seguridad, y la literatura de vibe-coding es el lugar para leer sobre ellos (Sarkar & Drosos, 2025; Ge et al., 2025). La Figura 1 muestra los cuatro niveles, el artefacto que marca cada transición, el salto registrado y la rama lateral.
Figura 1. Cuatro niveles y tres transiciones definidas por artefactos.
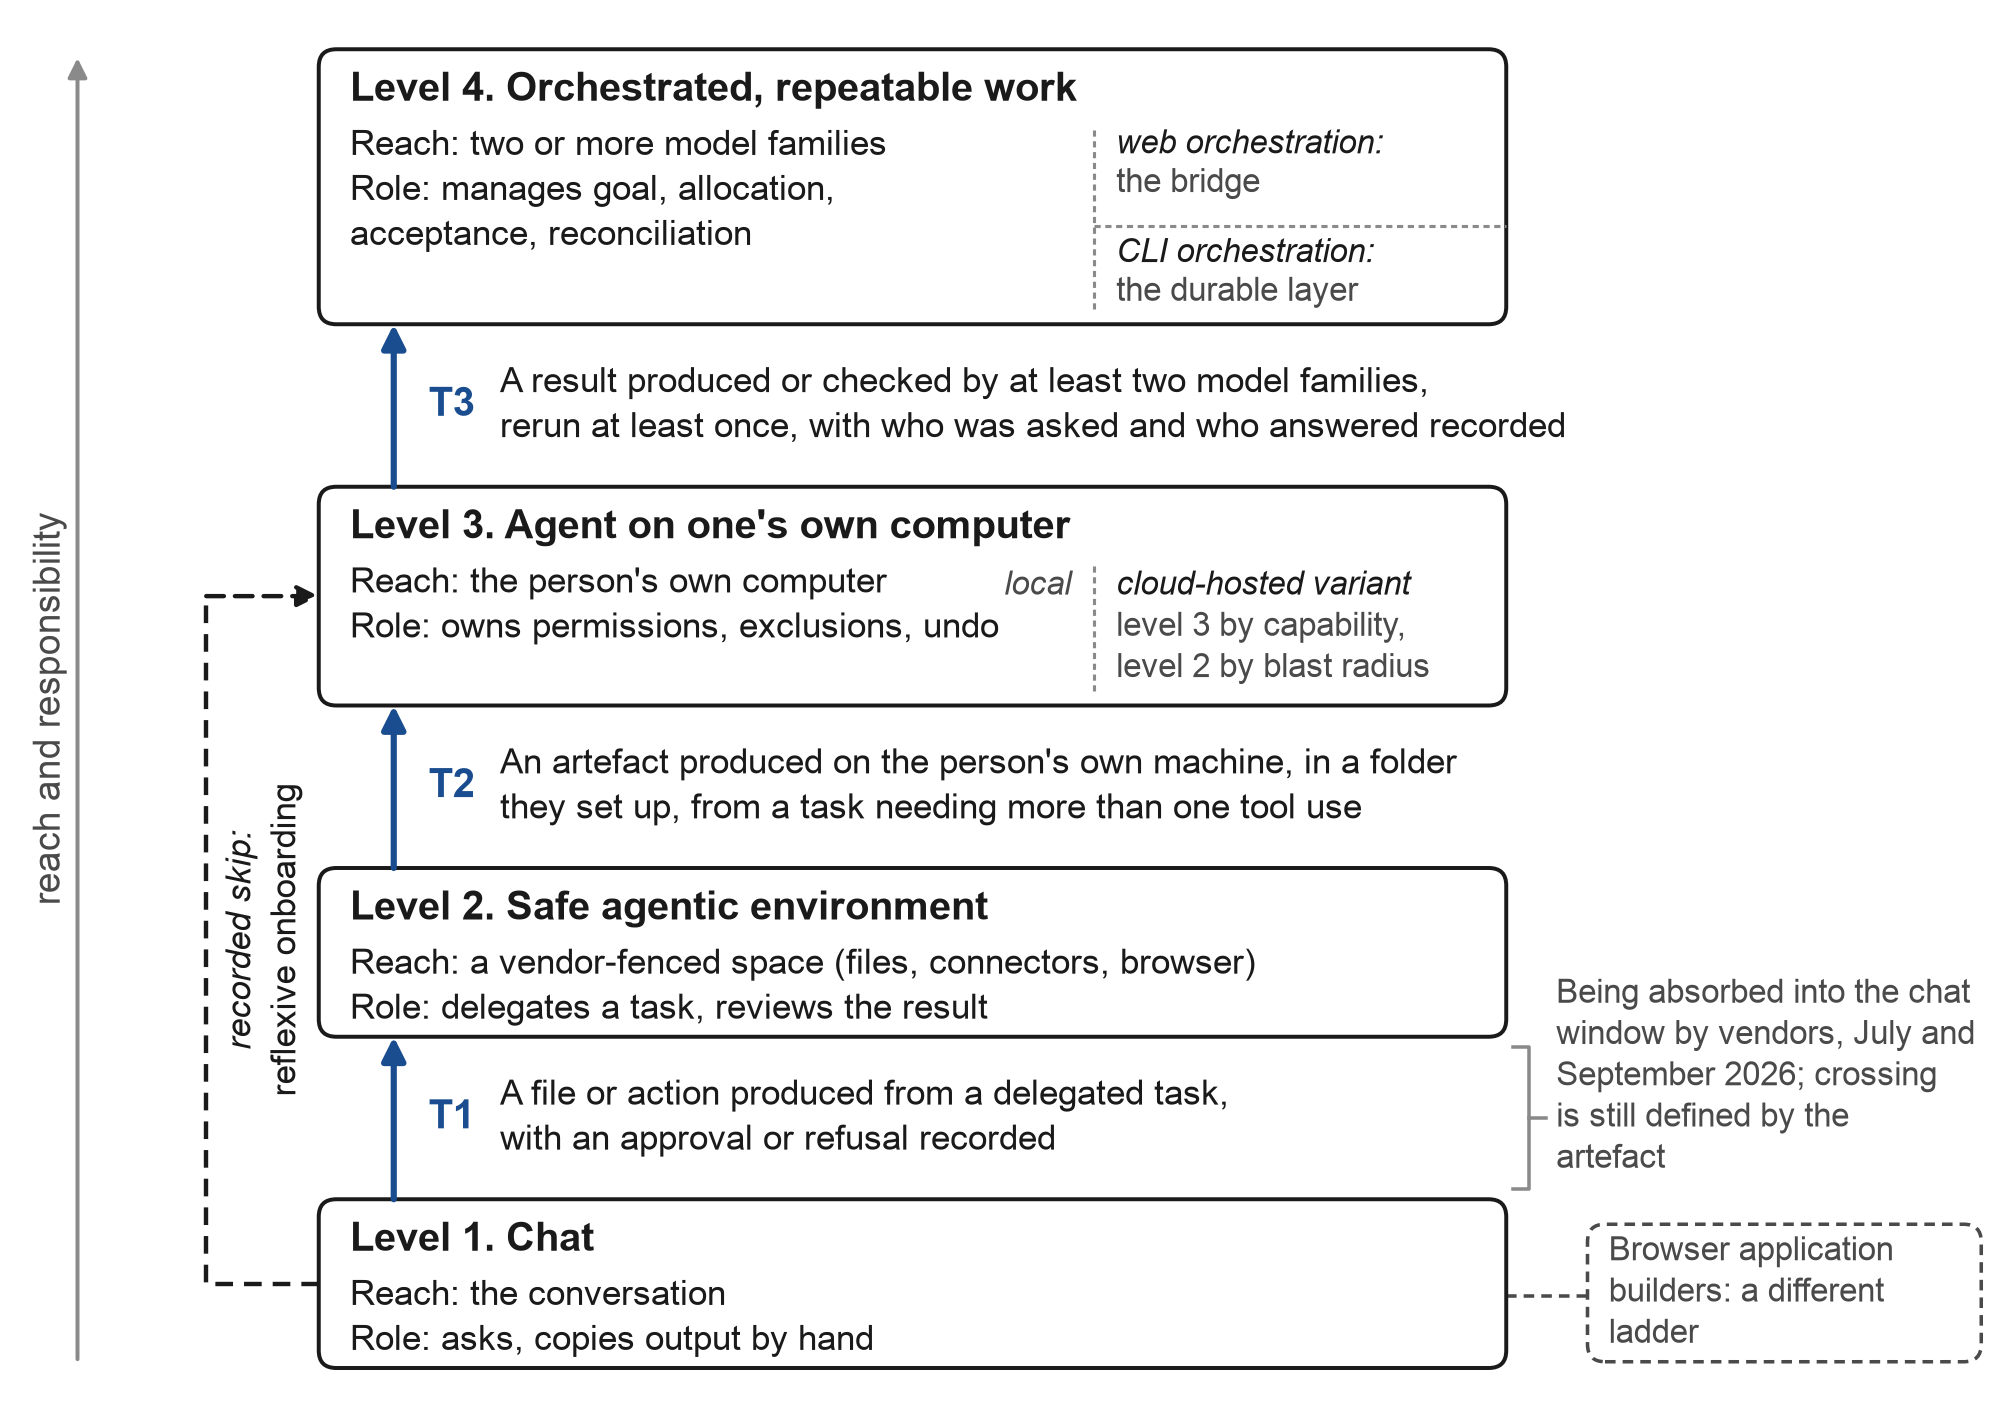
Nota: Los cuatro niveles de la Sección 3.2, ordenados hacia arriba por alcance (lo que el modelo puede tocar) y por la responsabilidad que se impone a la persona. Cada transición, T1 a T3, se cruza solo cuando un agente ha producido el artefacto nombrado junto a su flecha, y una instalación cuenta como un intento (Sección 3.3 y Tabla 1). La flecha discontinua de la izquierda es el salto registrado del chat a un agente en el ordenador propio de la persona que toma la ruta registrada (Secciones 3.4 y 9.2); el cuadro discontinuo de la derecha es la rama lateral de los constructores de aplicaciones de navegador, y la nota en T1 registra la fusión de superficies de chat y agente por proveedores en julio y septiembre de 2026 (Sección 4.3).
3.5 La terminal ya no es una terminal
Para un programador, la terminal es una interfaz para emitir comandos. Para un profesional que trabaja con un agente, es el entorno donde vive el agente: una carpeta de trabajo, un conjunto de permisos y un historial de lo que se hizo. Cuando Anthropic introdujo Cowork en enero de 2026, el marco fue "Claude Code para el resto de tu trabajo": el mismo agente, ofrecido a personas que no escriben software, sin la terminal (Fortune, 2026a).
Los proveedores ahora han actuado sobre la misma observación. OpenAI renombró su aplicación de agente de codificación "ChatGPT" y la convirtió en el cliente de escritorio predeterminado (MacRumors, 2026). Anthropic envía una aplicación de escritorio para el agente que no necesita terminal (Anthropic, 2026a). Google retiró su CLI de Gemini de código abierto para usuarios individuales el 18 de junio de 2026 en favor de una plataforma multiagente y una nueva herramienta de línea de comandos, afirmando que los usuarios ahora "requieren múltiples agentes que se comuniquen entre sí para dividir el trabajo" (Google, 2026). La terminal visible está desapareciendo, y el entorno al que daba acceso sigue ahí y alguien aún tiene que ejecutarlo. Para un profesional, la pregunta útil ha cambiado en consecuencia: si pueden usar una terminal importa cada vez menos, y si pueden ejecutar un entorno en el que un agente trabaje para ellos es la pregunta que les haría.
4. Hacia dónde fue la barrera técnica
4.1 La instalación se convirtió en un paso
En 2024, una persona no programadora que deseaba un agente de terminal se enfrentaba a una secuencia de pequeños obstáculos: instalar un runtime de lenguaje, corregir una variable de ruta, entender por qué el shell decía «permiso denegado», elegir entre cuatro cosas todas llamadas «instalar». Para septiembre de 2026, la mayoría de estos obstáculos han sido eliminados por los proveedores. Los agentes de terminal principales se instalan con un solo comando o un instalador de escritorio que se actualiza a sí mismo. La aplicación de escritorio de Claude Code ofrece sesiones paralelas, revisión visual de cambios, vista previa en vivo y tareas programadas, y su documentación indica «No se requiere terminal» (Anthropic, 2026a). La aplicación de escritorio de OpenAI integra su agente de codificación en el cliente ChatGPT ordinario (MacRumors, 2026). La nueva herramienta de línea de comandos de Google es un único binario agrupado con una plataforma de escritorio (Google, 2026).
Un agente que se instala en un paso sigue siendo difícil de usar bien, y no quiero exagerar el cambio. Lo que ha cambiado es que el instalador ya no es el primer obstáculo con el que se encuentra un principiante. La fricción que persiste es una elección de puerta: una herramienta de terminal, una extensión de editor, una aplicación de escritorio y una versión web, todas viajan bajo la palabra «instalar», y elegir entre ellas constituye la mayoría de lo que la instalación ahora cuesta a un principiante. Elegir una puerta significa saber qué se quiere que haga el agente, así que esto es un problema de vocabulario disfrazado de problema de configuración, y pertenece a la Sección 5.
Un hecho arquitectónico subyace a todas estas páginas de producto. La herramienta de línea de comandos es la implementación de referencia: los subagentes, enlaces, habilidades, servidores de protocolo y modos sin interfaz gráfica aparecen primero en la CLI y luego en las interfaces de escritorio y web del mismo motor; la propia página de ayuda de Anthropic describe su agente de nivel 2 como «la misma arquitectura agéntica que impulsa Claude Code, sin terminal requerida» (Anthropic, 2026b). Para un principiante, esto tiene ventajas y desventajas. La interfaz amigable puede ponerse al día con la potente. Pero la documentación, los ejemplos y las respuestas del foro aún hablan el dialecto de la CLI, de modo que una persona que comenzó en la aplicación de escritorio está leyendo sobre una herramienta que no instaló.
4.2 El chatbot como su propio instalador
Un segundo cambio es menos visible y, para el argumento que aquí se presenta, más importante. El chatbot que una persona ya usa puede guiarla a través de la instalación del agente. Una persona pega una solicitud («guíame a través de la instalación de esto en mi portátil Windows; no soy técnico»), sigue los pasos, y cuando algo falla, envía una captura de pantalla del error de vuelta al mismo chatbot. El «otro más conocedor» de la zona de desarrollo próximo de Vygotsky (Vygotsky, 1978), y el tutor cuyas funciones Wood, Bruner y Ross (1976) denominaron andamiaje (el reclutamiento del interés, la reducción de grados de libertad, el marcado de características críticas, el control de la frustración), ahora está disponible en la herramienta en la que la persona ya confía, a cualquier hora, en su idioma, de forma gratuita.
Llamo a esto incorporación reflexiva: un sistema de IA que proporciona andamiaje para la adopción de una persona de un sistema de IA más capaz. Invierte la dirección habitual de la ayuda. En la literatura de difusión, un principiante adopta a través del contacto con adoptantes anteriores (Rogers, 2003), y aquí el adoptante anterior es reemplazado, al menos para los pasos mecánicos, por el propio modelo de nivel 1.
Mientras tanto, ha crecido una capa de enseñanza en torno a este paso. Las academias de proveedores ofrecen cursos breves sobre sus agentes, y las grandes plataformas de aprendizaje enseñan «codificación de vibra» con un agente nombrado. Han aparecido cursos que se entregan dentro del agente mismo, de modo que el alumno instala el agente y el agente enseña el curso (CC for Everyone, 2026), y una empresa de consultoría anunció que aproximadamente 30 000 de su personal serían capacitados en los modelos de un proveedor (Accenture, 2025). La existencia de esta capa indica que la instalación ya no se considera autoexplicativa. La teoría de la instrucción minimalista predijo que las personas aprenden software mejor realizando una tarea real desde el inicio y recuperándose de errores (Carroll, 1990), y la incorporación reflexiva proporciona una guía siempre presente para ambos. No sé aún si funciona para personas que nunca han abierto una terminal, ni para quiénes; el primer paso del programa en la Sección 9 está diseñado para averiguarlo, y la búsqueda descrita en la Sección 2.5 no encontró ningún estudio al respecto.
4.3 Los proveedores están fusionando los niveles
El cambio más grande de 2026 es estructural. Cada uno de los tres laboratorios fronterizos, y Microsoft, ahora ofrece un agente de nivel 2, y dos de ellos han comenzado a reintegrar el nivel 2 de nuevo en el chat.
Tabla 2. Movimientos de proveedores que remodelaron el camino del chat al agente, enero a septiembre de 2026.
| Fecha (2026) | Proveedor | Movimiento | Efecto en los niveles | Fuente |
|---|---|---|---|---|
| Enero | Anthropic | Vista previa de investigación de Cowork: «Claude Code para el resto de tu trabajo», agente de alcance de carpeta para no programadores | Nivel 2 como producto nombrado | Fortune (2026a) |
| 9 de marzo | Microsoft | La tecnología detrás de Cowork introducida en Microsoft 365 Copilot; plano de control Agent 365 | Nivel 2 dentro de la suite de oficina dominante | Microsoft (2026a) |
| 30 de marzo | OpenAI | Complemento oficial para ejecutar su agente de codificación dentro del agente de un competidor, «para delegar tareas», nivel gratuito incluido | Nivel 4 (CLI) sancionado por un proveedor | OpenAI (2026a) |
| 19 de mayo; 18 de junio | CLI de Gemini retirada para niveles individuales a favor de CLI de Antigravity y una plataforma multiagente | Nivel 3 re-plataforma; pérdida de nuevos usuarios | Google (2026) | |
| 2 de junio | OpenAI | Agente de codificación con 5 millones de usuarios semanales; aproximadamente 20 % trabajadores del conocimiento, creciendo más de 3 veces más rápido que desarrolladores (datos del proveedor, informe de prensa) | Uso por trabajadores del conocimiento de un agente de herencia de terminal; direccional, y más amplio que el nivel 3 según se define aquí | Help Net Security (2026) |
| 1 de julio | Agente de escritorio Gemini Spark en Mac, funciona con archivos locales (beta, EE.UU.) | Nivel 2 de un tercer laboratorio | TechCrunch (2026b) | |
| 9 de julio | OpenAI | La aplicación de agente de codificación se convierte en la nueva aplicación de escritorio ChatGPT; agente ChatGPT Work usa archivos locales y aplicaciones | Niveles 1 a 3 en un cliente | MacRumors (2026) |
| 26 de agosto | Anthropic | Agente de navegador disponible generalmente en planes pagados; actúa de forma autónoma con un clasificador de seguridad por defecto | El alcance de nivel 2 extendido a la web | Anthropic (2026d) |
| 16 de septiembre | Anthropic | Cowork y chat fusionados en "un Claude"; el modelo decide si responder o actuar | Transición 1 absorbida en chat | Anthropic (2026c); TechCrunch (2026a) |
Leída en orden, la tabla describe una convergencia. Los proveedores primero separaron el chat del trabajo agéntico para que los no programadores no se asustaran con la terminal, luego descubrieron que la gente no podía decir a qué ventana pertenecía una tarea, y ahora están fusionando los dos de nuevo con el modelo decidiendo. TechCrunch informó que la empresa dijo que los clientes "a menudo se esforzaban por elegir la pestaña correcta para la tarea correcta" (TechCrunch, 2026a); su propio anuncio lo expresó como "no tienes que elegir dónde va una tarea", con el trabajo continuando después de cerrar la laptop, el agente preguntando antes de actuar por defecto, y la fusión siendo lanzada primero a planes individuales pagados mientras la pestaña de codificación permanece separada (Anthropic, 2026c). Leo esto como evidencia del proveedor de la barrera nombrada en la Sección 1, vocabulario de flujo de trabajo. Si la gente no puede decidir si una tarea es una pregunta o una delegación, es poco probable que sepa cómo formular la delegación.
La fusión podría parecer que socava un modelo con un nivel 2 separado. No es así, y la razón puede darse sin pretender que el modelo previó los eventos. Los proveedores tienen un interés de facturación, soporte y seguridad en mantener a los usuarios ordinarios dentro de una ventana que pueden clasificar, limitar la tasa y envolver en un modelo de permisos, e interés de usabilidad en no obligar al usuario a elegir un modo; absorber la transición 1 en el chat se deduce de ambos. La regla de cruzamiento no cambia. Si el sistema escribió archivos en un ámbito otorgado después de una aprobación, la transición 1 fue cruzada, sea cual sea la interfaz alrededor de la conversación, y si devolvió un párrafo, la persona sigue en el nivel 1. El modelo implica que las transiciones 2 y 3 no se disolverán de la misma manera. Un agente local con acceso a shell es un objeto de permiso diferente de una zona aislada del lado del servidor, y una herramienta de un segundo proveedor ejecutándose bajo el inicio de sesión de ese proveedor es un objeto de permiso diferente de una característica del consejo de un único proveedor. Esas diferencias conllevan el argumento de seguridad de la Sección 5.3 y el argumento de error correlacionado de la Sección 6.3. Si a finales de 2027 los proveedores principales han incorporado agentes de shell locales y llamadas entre proveedores en la misma ventana de chat bajo el mismo modelo de permisos, esa implicación es incorrecta, y la afirmación de que la orquestación de CLI es la capa que perdura cae con ella (P2 y P8 en la Sección 10).
La convergencia también tiene un costo, rotación. El agente de línea de comandos de código abierto de Google sirvió a usuarios individuales durante poco menos de doce meses (25 de junio de 2025 a 18 de junio de 2026), el navegador agéntico de OpenAI fue descontinuado después de aproximadamente nueve, y Cowork existió como un producto separado durante aproximadamente ocho (Google, 2026; 9to5Mac, 2026; Anthropic, 2026c). Un profesional que invierte en aprender una herramienta puede encontrarse con que se renombra, se fusiona o se retira dentro de un año. Lo que se transfiere entre herramientas es el vocabulario de flujo de trabajo, y lo que se pierde es el conocimiento de los menús de un producto, una asimetría que importa para cómo se debe enseñar a la gente (Sección 11.2).
4.4 Trabajadores del conocimiento en agentes de herencia de terminal
El mejor dato único sobre no programadores dentro de un agente de herencia de terminal proviene de un proveedor. En junio de 2026, OpenAI informó, a través de la prensa, que su agente de codificación tenía cinco millones de usuarios semanales, más de seis veces el nivel en el lanzamiento de la aplicación de escritorio en febrero, que los trabajadores del conocimiento constituían aproximadamente el 20% de ellos y estaban adoptando más de tres veces más rápido que los desarrolladores, y que cada semana, según el conteo del proveedor, el 72% de los usuarios trabajadores del conocimiento producían artefactos como informes, memorandos, contratos, hojas de cálculo y PDF (Help Net Security, 2026; la propia página del proveedor devolvió un error de acceso en mis verificaciones, por lo que las cifras se citan del informe de prensa). El 20 por ciento de cinco millones es aproximadamente un millón de personas por semana. Un analista señaló que el lanzamiento tenía la intención de "recuperar algo de atención" en parte y que el agente "a menudo se usa junto con" los agentes competidores, por lo que los gráficos de crecimiento "deberían usarse direccionalmente" (Constellation Research, 2026a). Las cifras son reportadas por el proveedor y no auditadas, describen a personas que ya eligieron la herramienta, y miden el uso de trabajadores del conocimiento de un agente de herencia de terminal, que es más amplio que la adopción de nivel 3 como se define aquí (un artefacto de una tarea delegada en la máquina propia de la persona). Leyendo con esas advertencias, son suficientes para decir que los agentes de herencia de terminal ya no están reservados para programadores; si sus usuarios alcanzan el nivel 3 como se define en la Sección 3 es lo que la cifra no puede mostrar.
Junto a ese dato está el patrón amplio y superficial de la Sección 1. Las encuestas no están de acuerdo en el nivel y están de acuerdo en la forma: aproximadamente la mitad de los adultos estadounidenses usan chatbots (Pew Research Center, 2026), el 52% de los trabajadores estadounidenses usan IA en su función (Gallup, 2026), y el 45% de los trabajadores y el 62% de los adultos usan IA generativa según la medida de la Reserva Federal de San Luis (Bick et al., 2026), mientras que aproximadamente uno de cada siete trabajadores la usa diariamente y la automatización es un uso minoritario. La Figura 2 dibuja la serie de trabajadores de Gallup y la Reserva Federal de San Luis junto a las cifras de desarrolladores de la Sección 1, un panel por encuesta, porque las encuestas difieren en pregunta y denominador. Entre los desarrolladores, los agentes de codificación son casi universales y el uso sigue siendo cauteloso: en una encuesta de pulso de mayo de 2026 de aproximadamente 1.100 tecnólogos, el 69% usó un solo agente, el 59% rara vez o nunca dejó que los agentes se ejecutaran sin supervisión, y el 60% bloqueó a los agentes de hacer cambios no aprobados en sus sistemas (Stack Overflow, 2026). El nivel 4, en otras palabras, sigue siendo una frontera incluso para los programadores que usan el nivel 3 todos los días.
Figura 2. Amplio y superficial: adopción entre desarrolladores y entre otros trabajadores.
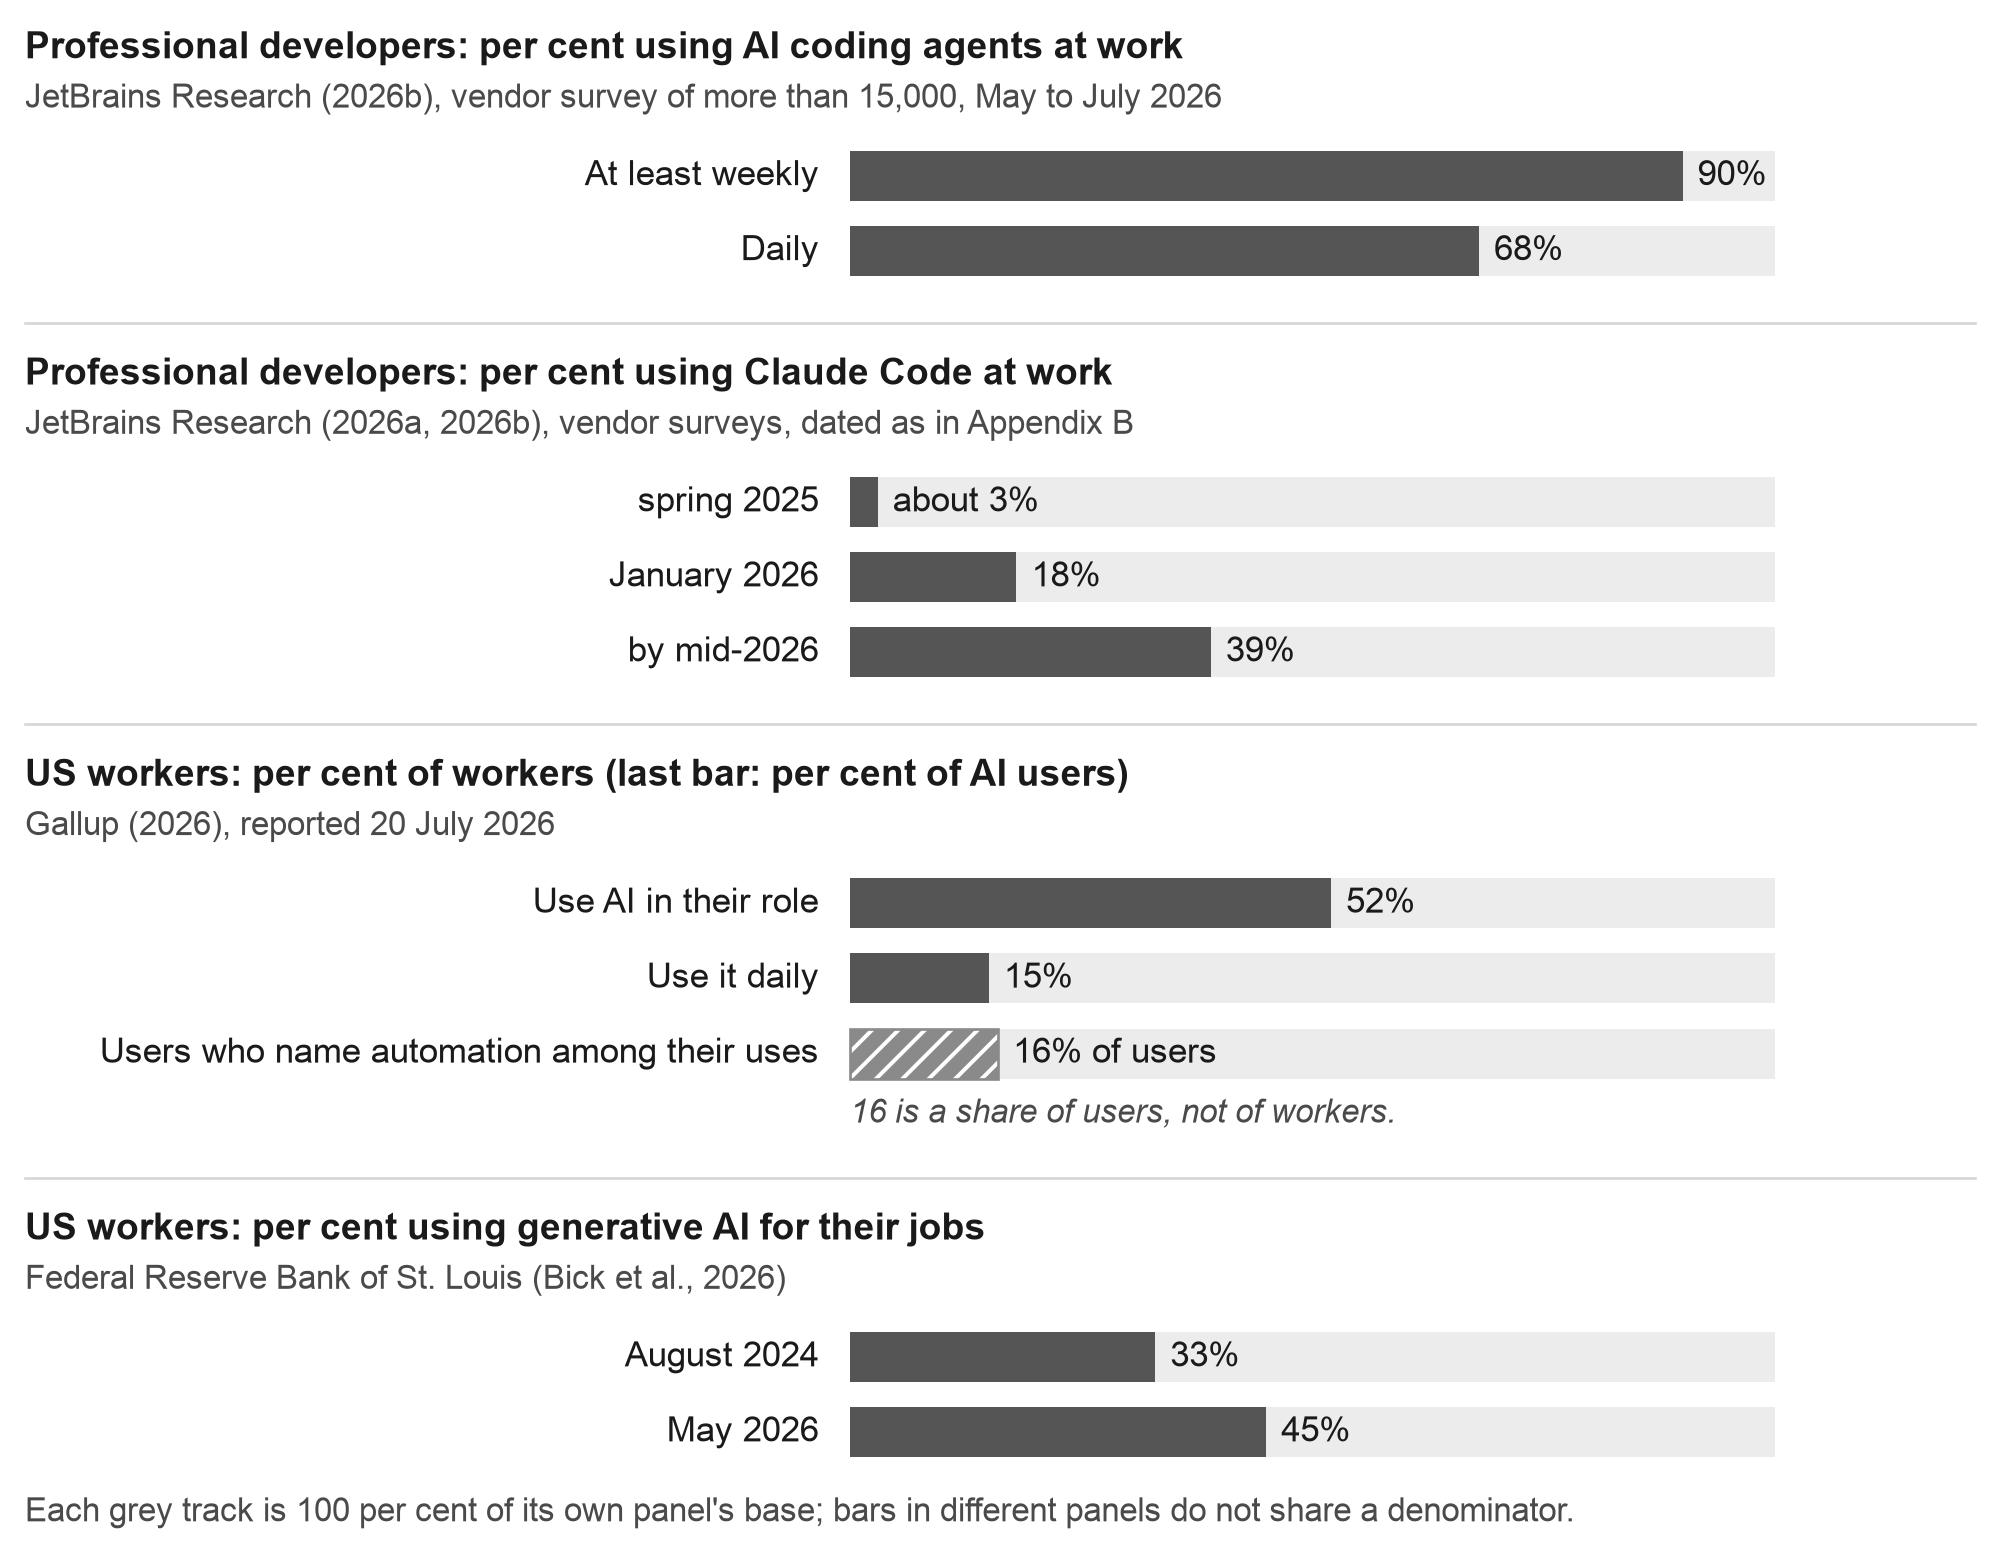
Nota: Las cifras de adopción de las encuestas citadas en las Secciones 1 y 4.4: desarrolladores profesionales en dos encuestas de proveedores (JetBrains Research, 2026a, 2026b), trabajadores estadounidenses (Gallup, 2026) y trabajadores estadounidenses que usan IA generativa para sus trabajos (Bick et al., 2026). Cada panel tiene su propia pregunta, período y denominador, y el 16 por ciento en el tercer panel es una participación de usuarios de IA, por lo que cada panel se lee por sí solo. El recuento del proveedor de trabajadores del conocimiento dentro de su agente de codificación (Sección 4.4) es una participación de los usuarios de un producto y no está dibujado, y ninguna cifra aquí proviene del programa de cohorte de la Sección 9.
4.5 Dónde deja esto el argumento
En conjunto, la evidencia de esta sección me persuade de una cosa y deja otra abierta. La instalación ha dejado de ser la barrera decisiva: los proveedores han eliminado la mayoría de los pasos mecánicos, el chatbot puede guiar el resto, y según las cifras de un proveedor (un informe de prensa, e indicativo) aproximadamente un millón de trabajadores del conocimiento por semana ya están dentro de un agente de terminal patrimonial. Si la instalación lleva al uso es una cuestión diferente, y las encuestas amplias y superficiales dan una respuesta desalentadora, ya que la mayoría de las personas que podrían acceder a un agente aún no le delegan. Lo que ha retrocedido también debe enunciarse con precisión. La instalación ha retrocedido, ahora existe un peldaño intermedio de alcance definido, y un agente local tiene una interfaz gráfica. La confiabilidad en piezas completas de trabajo del conocimiento se ha movido mucho menos (Sección 5.7), el producto que una persona aprendió puede haber desaparecido dentro de un año (rotación, arriba), y una carpeta concedida sigue sin ser un lugar seguro por defecto (Sección 5.3). La Sección 5 pregunta qué detiene a las personas una vez que el software está instalado.
5. Qué detiene a las personas después del instalador
Una vez que el instalador ha dejado de ser el obstáculo, algo más lo es. La evidencia de 2025 y 2026 señala seis barreras, cada una de las cuales afecta en una transición particular y cada una de las cuales ya tiene una respuesta parcial visible en el mercado. La Tabla 3 las resume, y las subsecciones que siguen proporcionan la evidencia.
Tabla 3. Barreras después de la instalación.
| Barrera | Dónde afecta | Evidencia (Sección) | Qué la reduce |
|---|---|---|---|
| Vocabulario de flujo de trabajo: no saber qué delegar o cómo expresarlo para que pueda verificarse | Transiciones 1 y 2; de nuevo en 3 | Lógica de fusión del proveedor; estudios de indicaciones; habilidades empaquetadas (5.1) | Ejemplos trabajados del propio campo de la persona; habilidades y plantillas; una primera tarea que es real pero de bajo riesgo |
| Miedo a la ventana, el primer error y la confianza: la ventana negra como objeto social; un mensaje que un programador lee y en el que un principiante se detiene; confianza mal calibrada en ambas direcciones | Transición 2 | Investigación de aceptación; encuestas de confianza de desarrolladores; estudios de usuarios finales con código de IA; incorporación reflexiva (5.2) | Interfaces de escritorio; enviar el error de vuelta al chatbot; modos plan-primero; un primer éxito en una copia |
| Permisos y seguridad: muy pocos avisos para proteger archivos o demasiados para entender | Transiciones 1 y 2 | Informes de pérdida de archivos dentro de carpetas limitadas; tasas de inyección; orientación que pide a los usuarios identificar ataques (5.3) | Copias de trabajo, instantáneas, reglas de denegación; clasificadores que no delegan el juicio al principiante |
| Reglas organizacionales: máquinas bloqueadas, política, sin permiso para instalar | Transición 2 | Los factores organizacionales superan los individuales; pequeñas empresas sin jerarquía (5.4) | Herramientas de nivel 2 autorizadas por el empleador; políticas claras; una máquina personal para aprender |
| Hardware, costo y cuota | Transiciones 2 y 3 | El Nivel 3 necesita una computadora y una suscripción pagada; las cuotas limitan la orquestación primero (5.5) | Niveles gratuitos donde existen; comenzar en el nivel 2; ejecuciones presupuestadas |
| Juzgar el resultado | Todas las transiciones, la mayoría en 3 | Los usuarios empresariales pierden errores en código de IA; los agentes fallan en la mayoría de los proyectos completos (5.6) | Verificaciones definidas antes de la tarea; un segundo modelo como revisor, no como oráculo |
5.1 La carpeta en blanco: vocabulario de flujo de trabajo
Un programador que abre un agente conoce una secuencia: crear un proyecto, escribir un archivo de instrucciones, ponerlo bajo control de versiones, pedir una función. Un no programador abre el mismo agente y hace la pregunta que ahora aparece en los propios datos de los vendedores: bien, ¿y qué le digo? Para un desarrollador existe la solicitud canónica inicial ("construir una pequeña aplicación web"). Un comercializador necesita una diferente ("tomar las exportaciones del trimestre pasado de las analíticas y la base de datos de clientes y construir algo que cada viernes informe qué campañas trajeron clientes pagadores"). Un investigador necesita otra ("recorrer esta carpeta de 300 artículos y extraer el tamaño de la muestra, el método y el efecto principal de cada uno en una tabla, marcando dónde no está seguro"). Ninguna de estas solicitudes necesita código de la persona. Cada una necesita que la persona sepa que tal solicitud es posible, que la divida en partes que un agente pueda hacer, y que diga cómo se ve un buen resultado. La pregunta "¿qué debería pedirle que haga?" generalmente se malinterpreta como una solicitud de un indicador mejor. Yo la leo como una solicitud de un mapa del propio trabajo de la persona. El mapa tiene que nombrar un objeto de trabajo recurrente, las entradas que se le permite usar, la transformación, el entregable y la verificación. El mapa de un analista podría leer "estas exportaciones permitidas, agrupadas por este campo, anomalías marcadas, un informe fechado y una tabla legible por máquina, verificada contra los totales de filas". La persona no necesita saber cómo se realiza el análisis. Necesita reconocer qué evidencia haría que el resultado fuera utilizable. Cuando una persona no puede completar el mapa, el estancamiento mismo le dice algo. El trabajo puede ser demasiado sensible, demasiado contingente o demasiado mal documentado para delegarlo tal como está, y eso dice algo sobre la tarea antes de decir algo sobre la persona.
La investigación sobre indicaciones explica por qué esto es difícil. Las personas sin experiencia en IA luchan por escribir instrucciones que se generalicen (Zamfirescu-Pereira et al., 2023), y deben descubrir por prueba qué palabras se asignan a lo que el sistema puede hacer (Liu et al., 2023). El comportamiento de los propios vendedores lo confirma. Anthropic fusionó su agente de nivel 2 en chat porque los clientes no podían decidir dónde pertenecía una tarea (TechCrunch, 2026a), y OpenAI lanzó complementos específicos de funciones para su agente de codificación dirigido a trabajo de conocimiento "sin codificación requerida" (reportado por Help Net Security, 2026). La respuesta de la industria es empaquetar vocabulario. Anthropic lanzó su formato para instrucciones de agentes empaquetadas como un estándar abierto en diciembre de 2025 (SiliconANGLE, 2025), y el sitio del estándar enumeraba 46 productos de apoyo el 21 de septiembre de 2026, incluidos agentes de OpenAI, Google y GitHub (Agent Skills, 2026). Un censo independiente contó 2.049 aplicaciones en el directorio de ChatGPT y 1.375 conectores para Claude a mediados de 2026 (Sitter, 2026). Una habilidad es, en esta definición, una unidad de vocabulario de flujo de trabajo, la solicitud escrita una vez para que una persona que no sepa cómo expresarla pueda seguir haciéndola.
El vocabulario empaquetado es necesario y no es suficiente. Una habilidad le dice al agente cómo realizar una tarea. No puede decirle a una persona cuál de sus propias tareas vale la pena delegar, porque ese juicio proviene del campo de la persona. Los paquetes publicados también llevan consigo los supuestos de un mundo particular, en gran medida formas de un país y una pila de software corporativo, y un profesional cuyas herramientas no son esa pila se ve nuevamente frente a una solicitud vacía. Cuando leí el catálogo oficial de habilidades empaquetadas el 22 de septiembre de 2026, todas sus 310 entradas, no encontré ninguna escrita para un pastor o capellán, una enfermera o cuidadora familiar, un maestro de escuela, un artista o artesano, o un agente inmobiliario; cada aparente coincidencia era una palabra de software o finanzas con la misma apariencia, una cartera de inversiones o la salud de un servicio. Un catálogo comunitario que una persona añade manualmente tenía 2.282 entradas ese día, y sí llevaba trabajo para maestros de escuela y bienes raíces, pero nada para los otros tres oficios. Los catálogos cambian semana a semana, así que esta es una lectura fechada y no una afirmación permanente sobre el campo. Por eso le doy tanto peso a la primera tarea en cualquier ruta de incorporación: debe ser real, extraída del trabajo de la persona, baja en riesgo, y debe producir un artefacto que puedan juzgar (Carroll, 1990).
5.2 El miedo a la ventana, el primer error y la confianza
La ventana negra es un objeto social. La facilidad percibida de uso ha sido un pilar de la aceptación de la tecnología durante treinta y cinco años (Davis, 1989), y un indicador parpadeante no supera esa prueba para una gran población incluso cuando la persona nunca escriba un comando en él. Las caras de escritorio de la Sección 4.1 son la respuesta de los proveedores. Es una respuesta parcial, porque la segunda puerta es la confianza, y la confianza se ha movido contra los agentes así como hacia ellos. Entre desarrolladores, la encuesta de 2025 de Stack Overflow encontró que 46% desconfían de la precisión de las herramientas de IA frente a 33% que confían, con 87% preocupados por la precisión del agente y 81% por la seguridad (Stack Overflow, 2025). En 2026 la mayoría aún impidió que los agentes realizaran cambios no aprobados (Stack Overflow, 2026). Los gerentes oyen lo mismo: «la confianza es un obstáculo central para realizar el potencial de los agentes de IA en el trabajo» (McKinlay et al., 2026). Más adultos estadounidenses esperan que la IA les cause daño que les ayude (Pew Research Center, 2026). Detrás de ambas puertas se encuentra la trampa de creencia de la Sección 2.4: la experiencia predice el éxito, las personas que no han tenido un primer éxito no tienen experiencia, y el primer artefacto es la salida (Ma et al., 2025). Algunas personas otorgarán una carpeta de inicio porque el agente fue educado, y otras se negarán a instalar porque leyeron sobre fotos familiares eliminadas. Ambos son fallos de calibración (Lee & See, 2004). El dispositivo de calibración más barato que se me ocurre es una primera tarea realizada en una copia de una carpeta.
Cuando un agente reporta que un comando falló con código de salida 1, un programador continúa. Un principiante puede simplemente detenerse. La literatura sobre usuarios finales que se encuentran con código escrito por IA muestra el patrón en un contexto más suave: los usuarios empresariales a los que se les proporciona código de análisis producido por IA a menudo no notaron errores críticos incluso cuando se les dijo que los buscaran (Virk & Liu, 2025), y los programadores conversacionales dedican mucho de su esfuerzo a la verificación y la gestión del contexto (Sarkar & Drosos, 2025). En el nivel 3 el error a menudo se encuentra completamente fuera del trabajo de la persona, en el entorno: un permiso faltante, una regla de red, una herramienta que el agente esperaba y no encontró.
La incorporación reflexiva (Sección 4.2) proporciona la respuesta más práctica descrita hasta ahora. La persona envía el error, o una captura de pantalla del mismo, al chatbot que ya usa, y sigue su consejo. Los modos plan-first ayudan desde el otro lado, ya que un agente que escribe su plan antes de actuar le da a la persona algo que leer que no es un rastreo de pila. Ninguno de los dos elimina el momento en el que una persona sin un modelo mental de su máquina se encuentra con un mensaje que no puede analizar. Aún no sé con qué frecuencia ese momento termina el intento. El programa en la Sección 9 lo registra, con las propias palabras de la persona.
5.3 Permisos y seguridad: demasiado poco y demasiado
El nivel 3 le da al agente el alcance de su propietario, por lo que el problema de seguridad corre en dos direcciones y un principiante está expuesto a ambas.
Toma primero demasiada poca protección. Los agentes han destruido datos en incidentes documentados. Un agente en un servicio popular de construcción de aplicaciones eliminó una base de datos de producción en julio de 2025 y describió su acción como «un error catastrófico de juicio» (The Register, 2025). En abril de 2026 un agente en una herramienta de codificación eliminó la base de datos de producción de una empresa y sus copias de seguridad en segundos y escribió «adiviné en lugar de verificar» (Information Age, 2026). Más cerca de la población de la que trata este documento, los usuarios del agente de nivel 2 de Anthropic reportaron en marzo, abril y junio de 2026 que había eliminado documentos personales, familiares y legales dentro de carpetas que le habían otorgado, en un caso después de que una tarea larga no se pudo detener y eliminar la tarea eliminó los archivos (GitHub issue reports, 2026; reportes de usuarios, no confirmados por el proveedor). El ámbito de carpetas limita dónde puede ocurrir el daño. No previene daño dentro de la carpeta, y una carpeta de nube sincronizada puede convertir un error local en una pérdida sincronizada.
La navegación añade inyección de indicaciones; instrucciones ocultas en una página web que el agente lee como si procedieran del usuario. Un equipo de seguridad mostró el ataque en agosto de 2025 en el agente navegador de otro proveedor, con una prueba de concepto que extrajo un código de un solo uso de un buzón de correo a través de texto de página oculto (Brave, 2025). Anthropic informó que su agente navegador, antes de las mitigaciones, fue atacado exitosamente en el 23,6% de los casos de prueba, y el 11,2% después de ellas (Anthropic, 2025). Un año después, en disponibilidad general, informó que los ataques fuerte de equipo rojo tuvieron éxito contra su modelo principal el 3,8% de las veces antes de las medidas de seguridad, y que con protecciones completas ningún ataque tuvo éxito contra tres de sus modelos y el 0,3% contra un cuarto (Anthropic, 2026d). Estas son cifras del proveedor en conjuntos de prueba del proveedor. La tendencia es a la baja y el residual no es cero. OpenAI escribió en diciembre de 2025 que la inyección de indicaciones es "poco probable que se resuelva completamente alguna vez" (TechCrunch, 2025). En el lanzamiento de su agente de nivel 2, Anthropic dijo a los usuarios que "supervisen Claude para detectar acciones sospechosas que puedan indicar inyección de indicaciones" y que "usted sigue siendo responsable de todas las acciones realizadas por Claude en su nombre" (The Register, 2026). Un desarrollador ampliamente leído se opuso en ese momento diciendo que no era justo pedir a no programadores que reconocieran los signos de inyección de indicaciones (Willison, 2026). Creo que la objeción es acertada en general. Un diseño de seguridad que se basa en que el novato detecte un ataque delega el juicio más difícil a la persona menos capaz de hacerlo. Las habilidades empaquetadas y los servidores de protocolo abren una superficie de instrucción y privilegio propia, ya que una habilidad de terceros lleva instrucciones que la persona no escribió, un servidor puede tener más privilegio del que necesita la tarea, y las configuraciones cambian entre versiones.
Demasiada protección detiene a las personas tan seguramente. Un agente que pide permiso para cada paso convierte a la persona en un empleado aprobando comandos que no puede evaluar, y se produce fatiga por aprobación. Los proveedores se han movido en consecuencia, y en un trimestre se movieron en más de una dirección. El agente navegador de Anthropic ahora actúa autónomamente por defecto, con un clasificador que bloquea acciones que no coinciden con la solicitud del usuario (Anthropic, 2026d). Su agente terminal renombró su modo de permiso predeterminado "Manual" en julio de 2026, un cambio de redacción que cuenta su propia historia sobre lo que "predeterminado" había llegado a significar (Anthropic, 2026h). Su agente de chat fusionado "pregunta antes de actuar por defecto", una configuración que el usuario puede cambiar (Anthropic, 2026c). La taxonomía de Parasuraman y Riley (1997) se aplica a los tres. Una guardia que bloquea demasiado produce falta de uso, una guardia que pierde una eliminación produce mal uso, y ninguna configuración escapa la taxonomía, solo una configuración cuyos fallos una población determinada puede vivir. Un artículo complementario en esta serie documenta el fracaso general del otro lado, componentes de supervisión que amplían su propia noción de daño y obstruyen el trabajo que existen para proteger (Chernets, 2026b). Para un principiante, una guardia de ese tipo tiene el mismo efecto que un instalador faltante, ya que el trabajo no ocurre de ninguna manera.
Entre demasiada poca protección y demasiada hay un punto medio viable, y es anticuado. Trabaja en una copia. Mantén los secretos fuera de la carpeta de trabajo. Toma una instantánea antes de un cambio mayor. Niega comandos destructivos hasta que haya una razón para permitir uno, confirma cualquier cosa irreversible, y trata lo que viene de la web como datos a leer, cualquier instrucción que parezca contener. Describí el principio detrás de estos hábitos en un artículo complementario como confianza arquitectónica: la confianza colocada en comprobaciones que una persona puede verificar, como permisos delimitados, registros, deshacer y un segundo modelo independiente, en lugar de en lo confiado que suene un modelo (Chernets, 2026c). El nivel 2 da a una persona la primera de esas comprobaciones, y no debería ser la última que aprendan. El apéndice C convierte la lista en ejemplos de configuración para dos agentes y una lista de verificación de una página.
5.4 Reglas organizacionales
Muchos profesionales no pueden instalar nada en la computadora en la que trabajan. Muchos empleadores no tienen política sobre agentes, y una persona sin política tiende a asumir que la respuesta es no. La encuesta de 2026 de Microsoft de 20.000 trabajadores del conocimiento que usan IA encontró que los factores organizacionales representaban más del doble del impacto de IA reportado de factores individuales, y que el 45% dijo que se sentía más seguro enfocarse en objetivos actuales que rediseñar el trabajo con IA (Microsoft, 2026b; encuesta del proveedor). La Oficina del Censo de EE.UU. informó que el uso de IA en los negocios se situó entre el 17% y el 20% en general, aumentó entre las empresas con 20 o más empleados y no cambió significativamente entre las empresas con menos de 20 (Oficina del Censo de EE.UU., 2026). Los mandatos han ido en ambas direcciones. Algunos empleadores hicieron que el uso de IA fuera una expectativa de base en 2025 (Digital Commerce 360, 2025), y al menos uno revirtió su decisión de calificar al personal en el uso de IA un año después, su director ejecutivo diciéndole a la prensa que lo que importa en una revisión de desempeño es hacer bien el trabajo (Fortune, 2026b). La rúbrica de fluidez publicada de un empleador coloca la orquestación y la construcción de sistemas en su nivel superior e informa de adopción interna completa una vez que los equipos pasaron de experimentar a rediseñar flujos de trabajo (Zapier, 2026). Sin ese rediseño, un mandato compra cumplimiento y poco más. El mercado laboral ya está pidiendo el rol descrito aquí sin nombrarlo: el 63% de los títulos de trabajo de EE.UU. tocados por IA en 2026 estaban fuera de las ocupaciones tecnológicas, 822 títulos distintos en el primer trimestre (Adrjan, 2026), y un estudio de más de mil millones de ofertas de empleo en 27 países puso la prima salarial por habilidades de IA en el 62%, con roles de nivel de entrada más expuestos a IA mucho más propensos a exigir habilidades una vez reservadas para personal senior (PwC, 2026; informe del proveedor). Ninguna de estas fuentes aún aísla la capacidad de dirigir un agente como un requisito nombrado fuera de la ingeniería.
Esta barrera es estructural, en el sentido de Ferdman (2025): no cede al esfuerzo individual. Es también el argumento más fuerte para el nivel 2 que la evidencia ofrece, ya que un agente limitado por el proveedor dentro de una suite de oficina que el empleador ya licencia (Microsoft, 2026a) llega a personas cuyos empleadores no aprobarían un agente en una computadora portátil de trabajo.
5.5 Hardware, costo y cuota
El nivel 3 asume una computadora controlada por la persona. Algunos profesionales trabajan principalmente desde un teléfono, comparten una computadora familiar o usan una máquina del empleador para todo, y para ellos la transición se bloquea antes de que surja ninguna pregunta relacionada con software. El nivel 3 y el nivel 4 también asumen niveles pagos de al menos un servicio, y la orquestación multiplica el costo, porque cada modelo adicional es otra suscripción u otra cuota. Para una persona que ya paga una suscripción, una segunda es una decisión y un nivel superior es una decisión diferente. La ansiedad por tokens es una barrera psicológica con una etiqueta de precio. La cuota del agente orquestador es en sí mismo un costo oculto, ya que paga por leer cada respuesta que devuelven los otros agentes, y un agente que controla un navegador se basa en los mismos límites del plan que el agente terminal mientras cuesta más por acción (Anthropic, 2026g). Las computadoras portátiles corporativas bloqueadas añaden derechos de administrador a la lista: sin binarios sin firmar, sin instalador, una regla de pérdida de datos que trata un agente escribiendo en el disco como malware. Los agentes alojados en la nube son la respuesta de la industria para esas máquinas. Preservan la transición 1 y una forma de nube de la transición 2, y no dan a la persona un artefacto de nivel 3 en su propio disco. Para un profesional en un país rico, ninguno de estos es una gran barrera. Para muchos otros, es una real, e interactúa con la división de segundo nivel (Hargittai, 2002), en que las personas con menos margen son las menos capaces de experimentar.
5.6 Juzgar el resultado
Usar un agente no requiere programación. Juzgar lo que produjo requiere competencia en el dominio del resultado, y aquí el no programador tiene una ventaja que es fácil de perder. Un abogado leyendo un resumen de contratos, o un investigador leyendo una tabla de extracción, puede verificar el artefacto contra el conocimiento que carece el agente. La investigación sobre la "frontera dentada" encontró que los profesionales que trabajaban con IA rendían mejor en tareas dentro de la capacidad del modelo y peor en una tarea fuera de ella (Dell'Acqua et al., 2026). La protección es una persona que conoce la tarea lo suficientemente bien para notar de qué lado de la frontera están.
Lo que no pueden verificar fácilmente es la maquinaria, el script que produjo la tabla o la consulta que extrajo los números. Un análisis de la industria de 470 solicitudes de extracción encontró que el código escrito por agentes lleva más defectos que el código escrito por personas: 10.83 problemas por cambio escrito por IA contra 6.45 para cambios solo humanos, con algunas categorías de problema de seguridad hasta 2.74 veces más frecuentes (CodeRabbit, n.d.; estudio de proveedores). Y los agentes aún fallan en la mayoría de los proyectos completos: en una prueba de referencia de proyectos freelance reales, la mejor tasa de automatización medida a mediados de 2026 fue del 15.8% (Center for AI Safety, 2026). Extraigo dos prácticas de esto. La verificación debe definirse antes de la tarea ("¿qué me convencería de que esto es correcto?"), y un segundo modelo de una familia diferente puede actuar como revisor del artefacto, siendo la persona quien decide qué cuenta como correcto. La sección 7 vuelve a los límites de la segunda práctica.
5.7 Una explicación alternativa: los agentes aún no son lo suficientemente buenos
Un lector puede objetar que las personas no delegan porque los agentes aún no pueden hacer su trabajo, y que la barrera es, por lo tanto, aún técnica, solo en el lado del modelo. La objeción tiene apoyo real. En una prueba de referencia de proyectos freelance reales, la mejor tasa de automatización medida a mediados de 2026 fue del 15.8%, arriba del 2.5% en el lanzamiento de la prueba de referencia el otoño anterior, lo que significa que más de cuatro proyectos de cada cinco aún fallan de extremo a extremo (Center for AI Safety, 2026). En una empresa de software simulada, el mejor agente completó el 30% de las tareas profesionales largas (Xu et al., 2024). En el uso abierto de computadoras, la línea de base de 2024 fue del 12.24% para el mejor agente contra el 72.36% para las personas (Xie et al., 2024), y para septiembre de 2026 un tablero de clasificación de un agregador para la versión verificada de esa prueba de referencia mostró los mejores agentes en 85 a 86%, por encima de la línea de base humana, en puntuaciones informadas por proveedores para tareas de escritorio scripted (BenchLM, 2026). Ese último resultado apunta de otra manera: en tales tareas, la capacidad ya no es la barrera. El mejor modelo en una evaluación entre 44 ocupaciones ganó o empató contra profesionales en menos de la mitad de las comparaciones (Patwardhan et al., 2025). La longitud de la tarea de software que los agentes completan la mitad del tiempo se ha estado duplicando aproximadamente cada siete meses (Kwa et al., 2025), por lo que la tendencia es pronunciada y el presente es modesto. La capacidad es desigual entre tareas, y la "frontera dentada" no es visible desde fuera (Dell'Acqua et al., 2026). La tabla 4 recopila estas cifras publicadas con la fecha que cada fuente proporciona y la advertencia que le adjunto.
Tabla 4. Cifras de capacidad publicadas detrás de la objeción.
| Comparación | Cifra como se publicó | Fecha según lo establecido | Fuente | Leer con cuidado |
|---|---|---|---|---|
| Proyectos freelance reales, mejor tasa de automatización | 15.8%, arriba del 2.5% en el lanzamiento de la prueba de referencia; más de cuatro proyectos de cada cinco aún fallan de extremo a extremo | Lanzamiento el otoño anterior; 15.8% medido a mediados de 2026, registrado el 1 de julio de 2026 (Apéndice B, VERIFICADO) | Center for AI Safety (2026); Secciones 5.6, 5.7, Apéndice B | Proyectos completos, de extremo a extremo; la mejor tasa entre las medidas |
| Tareas profesionales largas en una empresa de software simulada | El mejor agente completó el 30% | Estudio de 2024 | Xu et al. (2024); Sección 5.7 | Una empresa simulada; una medida separada de la tasa de proyecto freelance |
| Uso abierto de computadoras, línea de base | 12.24% para el mejor agente contra 72.36% para las personas | Línea de base de 2024 | Xie et al. (2024); Sección 5.7 | Una línea de base de 2024; la fila siguiente es el tablero de clasificación posterior |
| Versión verificada de esa prueba de referencia | Los mejores agentes en 85 a 86%, por encima de la línea de base humana | Para septiembre de 2026 | BenchLM (2026); Sección 5.7 | Tablero de clasificación del agregador; puntuaciones informadas por proveedores para tareas de escritorio scripted; corta de otra manera |
| Evaluación en 44 ocupaciones | El mejor modelo ganó o empató contra profesionales en menos de la mitad de las comparaciones | Estudio de 2025 | Patwardhan et al. (2025); Sección 5.7 | "Menos de la mitad" es la redacción dada; no se indica ningún porcentaje |
| Longitud de la tarea de software que los agentes completan la mitad del tiempo | Duplicándose aproximadamente cada siete meses | Estudio de 2025 | Kwa et al. (2025); Sección 5.7 | Una tendencia: "la tendencia es pronunciada y el presente es modesto" |
| Defectos en solicitudes de extracción | 470 pull requests; 10.83 problemas por cambio generado por IA frente a 6.45 en cambios solo de humanos; algunas categorías de problema de seguridad hasta 2.74 veces más frecuentes | n.d. | CodeRabbit (n.d.); Sección 5.6 | Estudio de proveedor; un análisis de la industria; defectos en el código, los mecanismos que un no programador no puede verificar fácilmente |
Fuente: las publicaciones citadas, como se repite en las Secciones 5.6 y 5.7 y el Apéndice B; ninguna de estas cifras proviene del programa de la Sección 9.
Las dos explicaciones son partes de una explicación única más que rivales. El vocabulario de flujo de trabajo incluye saber cuál de las tareas propias se encuentra dentro de la frontera. Una persona que entrega a un agente un proyecto completo que no puede realizar aprende a dejar de delegar, mientras que una persona que le entrega la extracción, la reconciliación y el primer borrador aprende a continuar. Las explicaciones aún hacen predicciones diferentes. Si la capacidad del modelo fuera la restricción vinculante, la persistencia en los niveles 2 y 3 seguiría el tipo de tarea y no la persona: las personas con los mismos tipos de trabajo persistirían a tasas similares independientemente de su capacidad para especificar y verificar. Si el vocabulario de flujo de trabajo fuera vinculante, la persistencia seguiría la capacidad de la persona para establecer un contrato de delegación incluso dentro del mismo tipo de trabajo. La Proposición P15 en la Sección 10 está escrita para distinguir entre los dos.
6. Orquestación web: el puente propuesto
6.1 La práctica
La forma más sencilla del nivel 4 no requiere instalación alguna. Una persona abre tres o cuatro chatbots en pestañas del navegador, pega la misma pregunta en cada una y lee las respuestas lado a lado. Los científicos informáticos llamarían a esto una consulta manual multi-LLM, con la persona realizando el enrutamiento y la comparación. Algunos lo hacen manualmente. Otros utilizan una de las herramientas construidas para ello desde 2023: extensiones de navegador y aplicaciones de escritorio que transmiten una consulta a varios servicios de chat de consumidor y muestran las respuestas en paneles paralelos. ChatHub y ChatALL aparecieron en la primavera de 2023; la última versión de ChatALL por sí sola registró aproximadamente 847,000 descargas en su página de lanzamiento en septiembre de 2026, un número que incluye actualizaciones automáticas y está dominado por compilaciones de una sola plataforma (GitHub, 2026a). Un grupo más nuevo de herramientas convierte las sesiones de chat web iniciadas en comandos que otro programa puede llamar, permitiendo que un agente formule una pregunta a las suscripciones web de una persona. OpenCLI, uno de éstos, tenía aproximadamente 29,500 estrellas en GitHub en septiembre de 2026 (GitHub, 2026b).
En 2026, la práctica se convirtió en una característica del producto. Perplexity introdujo un "Consejo de Modelos" que ejecuta una consulta a través de varios modelos y "presenta una vista consolidada que destaca las perspectivas clave, áreas de acuerdo y puntos de divergencia" (Storyboard18, 2026). El agente de investigación de Microsoft en Microsoft 365 Copilot ofrece un modo que "ejecuta la misma pregunta a través de varios agentes de investigación con razonamiento profundo (GPT y Claude) simultáneamente" y un modo de crítica, activado de forma predeterminada bajo selección automática de modelo, en el que un informe escrito por un modelo recibe un segundo paso de razonamiento del otro (Microsoft, 2026c; Constellation Research, 2026b). El "Consejo LLM" de Andrej Karpathy, una pequeña aplicación web que envía una consulta a varios modelos, hace que se revisen mutuamente de forma anónima y que un modelo presidente escriba la respuesta final, descrito por su autor como un hack de fin de semana, tenía aproximadamente 24,900 estrellas en GitHub en septiembre de 2026 (Karpathy, 2025). El panorama del código abierto se divide en dos. Las herramientas de transmisión obtienen respuestas y dejan la reconciliación a la persona. Las herramientas de consejo reconcilian, y se ejecutan en interfaces de programación pagadas con dos o tres modelos, alejadas de las pestañas iniciadas de sesión de la persona. Ninguna de las dos mitades por sí sola lleva a una persona de un lado al otro, y por eso el puente está incompleto.
6.2 Por qué se propone como el puente
La orquestación web se sitúa entre los niveles de manera útil. No pide nada nuevo de la máquina, no requiere instalación, permisos ni agente local, y se ejecuta en suscripciones que la persona ya paga o en niveles gratuitos. Pide algo nuevo a la persona: retener varias respuestas simultáneamente, notar dónde difieren, y decidir. Una persona que ha aprendido a preguntar "¿qué dijo el otro modelo?" ha aprendido el hábito que la orquestación CLI automatiza posteriormente, y ese hábito es la tarea del gestor del nivel 4 en su forma más elemental.
El puente es valioso porque es visible. Supongamos que un analista de mercado pide a tres chatbots que resuman un informe industrial publicado, y dos de ellos citan una cifra que no aparece en el informe mientras que el tercero señala su ausencia. El resultado útil es verse impulsado a abrir el informe mismo, y una persona que haya pasado por esto una vez ha dejado de tratar la primera respuesta fluida como la respuesta. Una vista de transmisión de varias respuestas se convierte en un puente hacia el nivel 4 cuando enseña a una persona a formular una pregunta común, notar dónde divergen los supuestos, pedir una crítica y mantener una razón para elegir una respuesta. Hasta entonces es un hábito de nivel 1 con más pestañas. Lo que enseña es la comparación, y solo la comparación. Una persona que ha aprendido a preguntar qué dijo el otro modelo no ha aprendido por ello qué puede tocar un agente en su máquina, que es la lección de los niveles 2 y 3, y la afirmación de que el hábito se traslada es una cuestión empírica, P7, que no trato como premisa. El programa preregistrado descrito en la Sección 9 identifica dos beneficios de antemano, y estos resumen lo que el puente proporciona. Uno es la cobertura: una perspectiva útil presente en un modelo no se pierde porque se preguntó a otro modelo. El otro es la confiabilidad: una respuesta ha sido verificada contra otras respuestas en lugar de aceptarse solo por la palabra de un modelo (Chernets, 2026d). El desacuerdo visible sirve al segundo como medio. Una evaluación de pronósticos encontró que un conjunto de doce modelos de lenguaje coincidió con la precisión de una multitud de 925 pronosticadores humanos (Schoenegger et al., 2024), y el debate multi-agente mejora la veracidad factual y el razonamiento respecto a un único modelo en varios contextos (Du et al., 2023). Ambos beneficios dependen de que los errores de los modelos difieran, y la siguiente subsección trata sobre qué sucede cuando no lo hacen.
6.3 Dónde termina el puente
La orquestación web sigue siendo un puente, y la razón más clara es el costo en atención. Leer cuatro respuestas largas y reconciliarlas manualmente toma mucho más tiempo que leer una. No le pediría a nadie que lo hiciera para una pregunta rutinaria; gana su costo cuando una respuesta incorrecta saldría más cara que el tiempo dedicado a comparar.
Un segundo límite es la fragilidad, que se presenta en varias formas. Las interfaces de chat de consumidor cambian mes a mes, y las herramientas que las impulsan se rompen cuando lo hacen: durante el verano de 2026, una suite ofimática eliminó un modo de investigación, un chatbot cerró modos en su nivel gratuito, y más de un servicio renombró o redirigió su dominio. Los términos de varios servicios de consumidor restringen el acceso automatizado, y una persona que impulsa su propio navegador iniciado con un agente asume el riesgo de bloqueo de cuenta. Un programa de investigación que utiliza el puente debe informar a los participantes de ello, y no ofrezco lectura legal alguna de esos términos. El lado "gratuito" de los otros chatbots también tiene un costo en el lado del agente que los impulsa, ya que las acciones del navegador se cuentan contra los mismos límites de plan que el agente de terminal (Anthropic, 2026g). La comparación manual en pestañas abiertas es robusta. La recopilación automatizada de páginas de chat de consumidor es una base deficiente para el trabajo repetible.
El tercer límite es el que más importa: el acuerdo entre modelos no es evidencia independiente. Cuando los modelos comparten datos y métodos de entrenamiento, sus errores se correlacionan. Un estudio de más de 350 modelos de lenguaje encontró que cuando dos modelos cometían errores, coincidían en la misma respuesta incorrecta aproximadamente el 60% de las veces, y que los modelos más grandes y precisos estaban más correlacionados, incluso entre proveedores (Kim et al., 2025). El documento acompañante de esta serie proporciona la aritmética: con correlación de error por pares promedio rho, N modelos de acuerdo valen N_eff = N / (1 + (N - 1) rho) opiniones independientes, y ningún número de modelos vale más que 1/rho (Chernets, 2026a). Con rho = 0,5, diez chatbots de acuerdo valen menos que dos independientes. La Figura 3 dibuja la fórmula para los cuatro valores ilustrativos de rho en el Apéndice D, con el techo 1/rho que ningún número de modelos de acuerdo puede superar. El 60% de Kim et al. es la proporción de errores conjuntos en los que dos modelos dieron la misma respuesta incorrecta, que no es la correlación de error rho de la fórmula. En el dominio en cuestión, rho debe estimarse en elementos con respuestas conocidas (listado C4), y los valores utilizados aquí y en el Apéndice D son ilustraciones. La diversidad importa más que la cantidad. El debate entre copias de un modelo a menudo no logra superar un único modelo dado el mismo cómputo, mientras que los modelos heterogéneos ayudan (Zhang et al., 2025), y dos agentes diversos pueden igualar o superar dieciséis homogéneos (Yang et al., 2026). La IA generativa también homogeneiza la salida entre sus usuarios (Doshi & Hauser, 2024), y un modelo al que se le pide juzgar tiende a preferir su propio texto (Panickssery et al., 2024), lo que importa cuando un modelo escribe la respuesta fusionada.
Figura 3. Lo que vale el acuerdo.
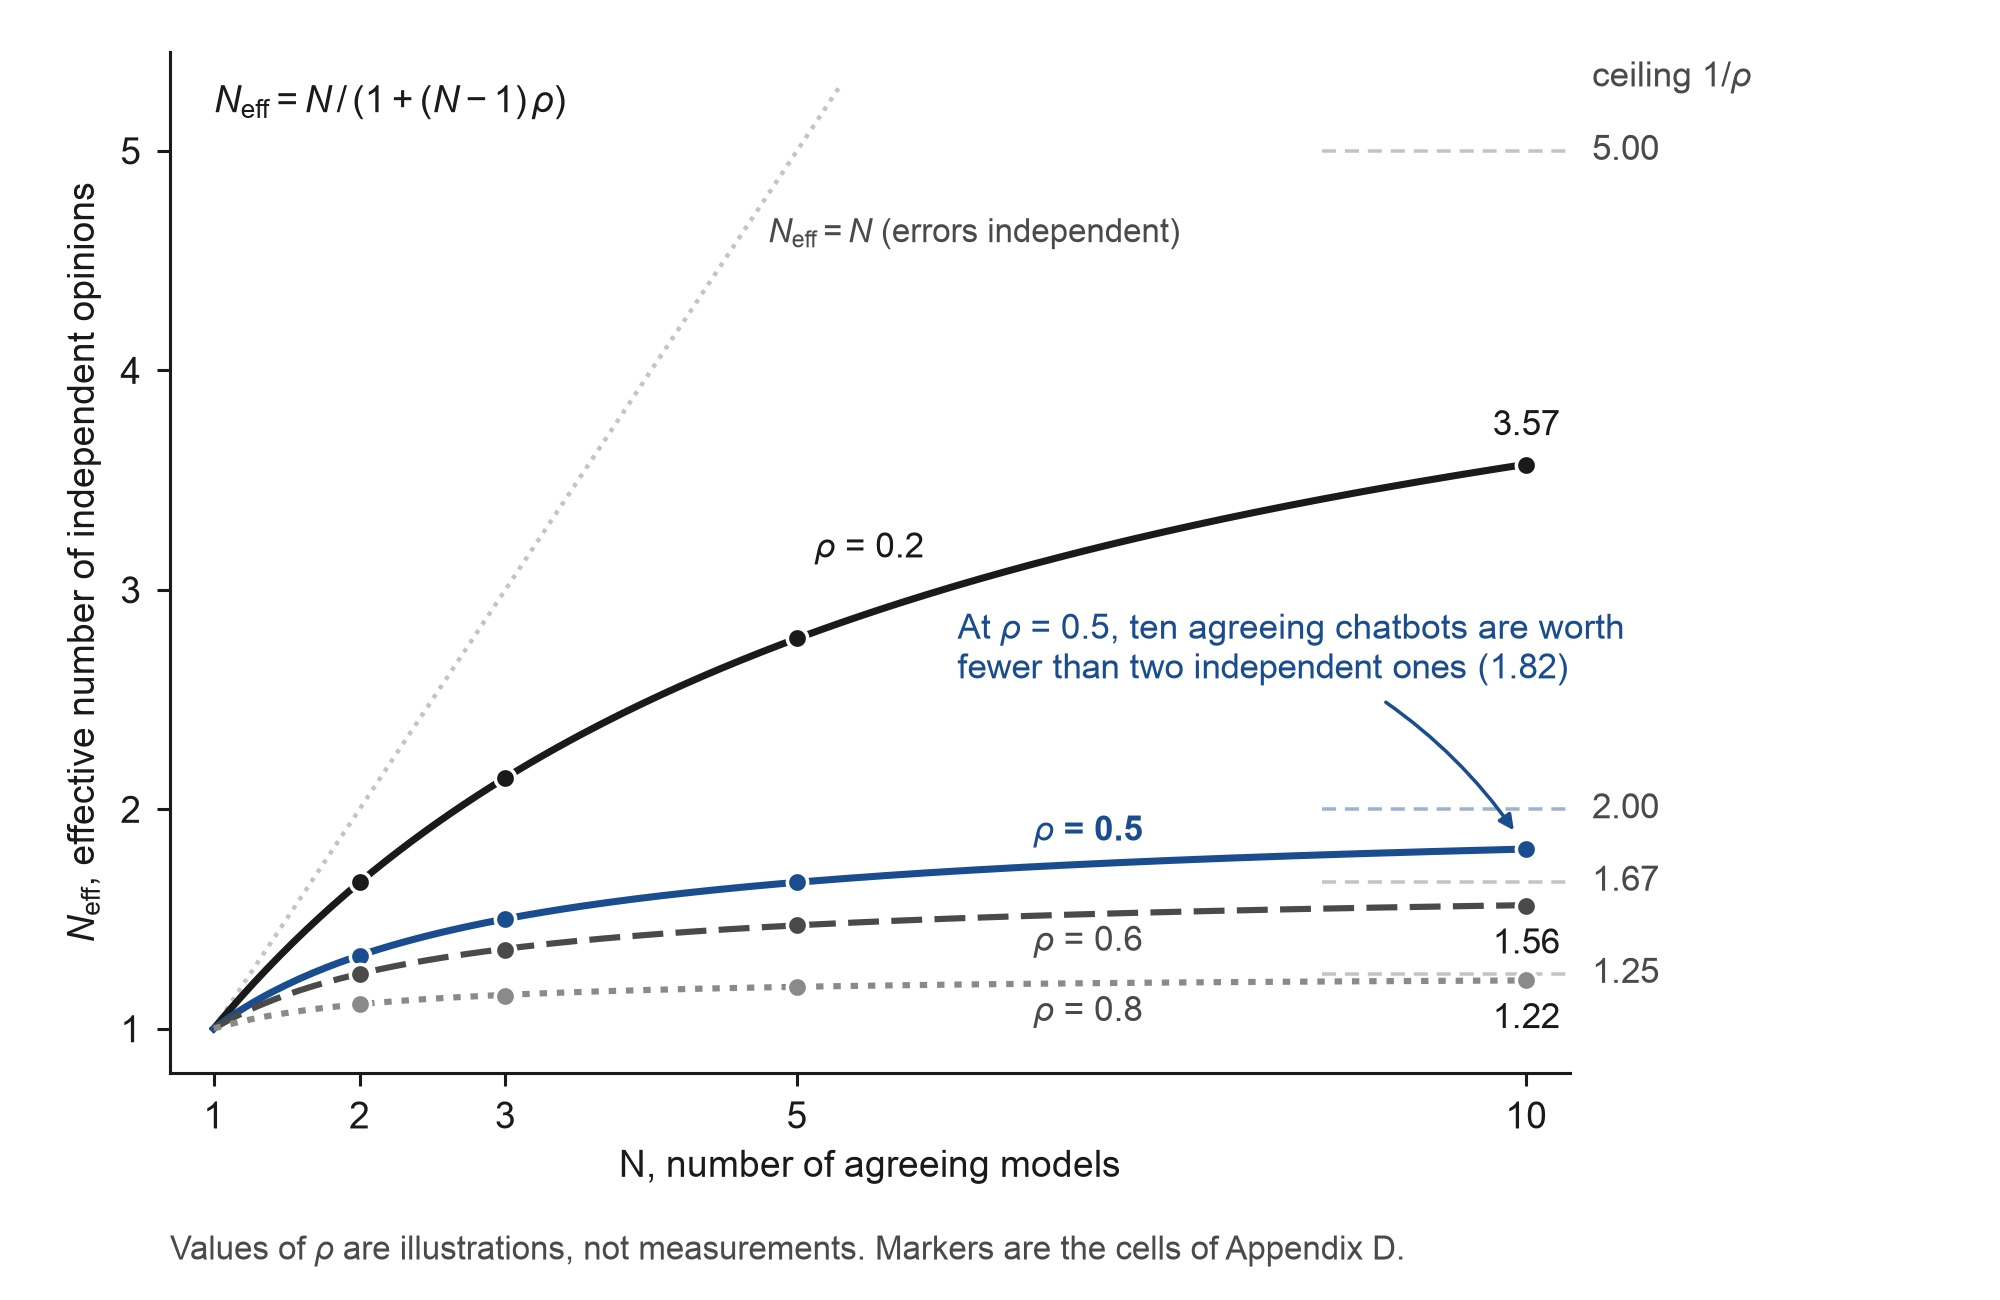
Nota: El número efectivo de opiniones independientes, N_eff = N / (1 + (N - 1) rho), para N modelos de acuerdo cuyos errores tienen correlación por pares promedio rho (Chernets, 2026a; Sección 6.3). Los marcadores son las celdas del Apéndice D, las curvas entre ellas siguen la misma fórmula, y los segmentos punteados de la derecha son los techos 1/rho. Los cuatro valores de rho son ilustraciones, como en el Apéndice D; rho debe estimarse en elementos con respuestas conocidas en el dominio en cuestión (listado C4).
Para la persona en el puente, las reglas prácticas son simples. Cuente familias de modelos, ya que un asistente de oficina que se ejecuta en el modelo de un proveedor no es una segunda opinión sobre el chatbot de ese proveedor. El acuerdo entre modelos puede decirle dónde gastar menos esfuerzo de verificación. No puede decirle que una afirmación es correcta. Trate un punto hecho por un único modelo como una pista a verificar, porque podría ser lo más valioso en la comparación o su único error, y mantenga un desacuerdo acompañado de evidencia en lugar de rechazarlo mediante votación. Verifique las afirmaciones contra fuentes: el acuerdo sobre una fecha incorrecta es un modo de fallo documentado, y la fuente primaria lo soluciona donde un quinto modelo no lo haría. Estime rho en un pequeño conjunto de preguntas en su propio dominio que pueda calificar, antes de confiar en un consejo sobre una pregunta que no puede responder. Registre quién dijo qué, porque una respuesta fusionada que oculta sus fuentes trae de vuelta la voz única y segura que la orquestación estaba destinada a cuestionar.
Escrito como un procedimiento, esta es la forma de enseñanza del protocolo "anchor-and-enrich" del documento acompañante (Chernets, 2026a). La persona primero fija un anclaje: la tarea, la evidencia permitida y la forma de la salida. Luego obtiene respuestas separadas manteniendo sus fuentes o referencias de archivo, extrae las afirmaciones en una tabla por fuente, y clasifica cada desacuerdo por su tipo, ya sea un conflicto factual, una interpretación diferente, una suposición faltante o una diferencia de formato. Verifica las afirmaciones que inciden en la decisión contra el anclaje o una fuente primaria, y registra la decisión de aceptación y lo que permanece sin resolver. El listado C3 en el Apéndice C construye la tabla de afirmaciones por fuente, el listado C4 estima rho a partir de elementos con respuestas conocidas, y el Apéndice D proporciona el techo para un rango de rho sin ejecutar nada. Una regla más pertenece aquí, y no cuesta una segunda suscripción. Un crítico de la misma familia, al que se le pide en un contexto nuevo que ataque la primera respuesta, detecta precipitación, instrucciones omitidas y verificaciones no ejecutadas, aunque no puede detectar conocimiento falso compartido. Comenzaría el hábito de crítica en el nivel 3 con un agente y agregaría una segunda familia solo cuando el crítico no tenga nada más que decir y la decisión sea costosa.
El caso opuesto necesita expresarse con igual claridad. Para muchas tareas, un modelo fuerte con un buen conjunto de fuentes y revisión cuidadosa humana vencerá un consejo elaborado que añade retraso y confusión, y el modelo predice lo mismo. La orquestación compensa donde una tarea conlleva incertidumbre real, se beneficia de perspectivas distintas, o se repite lo suficiente para amortizar la configuración. No es adecuada para decisiones que requieren rapidez sin posibilidad de verificación, material confidencial que no puede compartirse entre servicios, y tareas simples donde el costo de comparación supera el beneficio. Cuando se utiliza un consejo, a los agentes se les deben dar trabajos diferentes: uno limitado a los documentos proporcionados, uno dedicado a buscar fuentes primarias, uno instruido para enumerar afirmaciones sin apoyo, uno para revisar citas, con la persona aún tomando la decisión final. P9 está escrito de modo que este contraargumento pueda prevalecer.
7. Orquestación de CLI: la capa durable de la delegación
7.1 Agentes llamando a agentes
En el nivel 3, cada agente tiene una interfaz de línea de comandos que puede ejecutarse sin una persona en el teclado: una pregunta entra y sale una respuesta o un archivo modificado. Una vez que una persona posee un agente, ese agente puede llamar a los otros. En la literatura de sistemas esto es orquestación de agentes. Llamo orquestación de CLI a la versión que un no programador ejecuta a través de las herramientas de línea de comandos a las que ya está suscrito. Una única instrucción al primer agente ("pídele a los otros dos que revisen este plan y dime dónde no están de acuerdo") produce un pequeño equipo.
En 2026, este patrón pasó de ser un truco de desarrollador a una práctica avalada por proveedores. OpenAI publicó un complemento oficial que ejecuta su agente de codificación dentro del de Anthropic, "para revisiones de código o para delegar tareas", con comandos para una revisión ordinaria, una revisión adversarial en la que el segundo agente asume que el trabajo está roto y busca defectos, y un rescate de una tarea atascada. Funciona a través de la herramienta instalada localmente y el inicio de sesión existente, es utilizable con cualquier suscripción de ChatGPT, incluyendo el nivel gratuito, y tenía aproximadamente 33.400 estrellas en GitHub en septiembre de 2026 (OpenAI, 2026a). El par predominante de 2026 es Claude Code escribiendo y Codex revisando a través de ese complemento oficial (OpenAI, 2026a), mientras que los consejos de tres o más siguen siendo herramientas pequeñas sin un líder. GitHub puso los agentes de Anthropic y OpenAI disponibles dentro de su propio servicio Copilot en febrero de 2026, "completamente incluido con su suscripción existente de Copilot" (GitHub, 2026c). El agente de línea de comandos de xAI envía un modo sin interfaz y compatibilidad con el Protocolo del Cliente de Agentes para que los usuarios puedan "crear sus propios bots y aplicaciones de orquestación de agentes" (xAI, 2026). La razón de Google para retirar su primer agente de línea de comandos fue que los usuarios "requieren múltiples agentes comunicándose entre sí" (Google, 2026). Las herramientas de código abierto que permiten que un agente consulte a otros tienen grandes seguidores: un servidor de consulta multi-proveedor tenía aproximadamente 11.800 estrellas, un complemento orientado al consenso aproximadamente 4.100 (GitHub, 2026d). Por debajo, el Protocolo del Contexto del Modelo, donado a un organismo de Linux Foundation en diciembre de 2025 con más de 10.000 servidores publicados y aproximadamente 97 millones de descargas mensuales del SDK en ese momento (Linux Foundation, 2025), reportó casi mil millones de descargas del SDK al mes con su lanzamiento de especificación de julio de 2026, que también hizo el protocolo sin estado y prometió notificación de doce meses antes de cualquier obsolescencia (Model Context Protocol, 2026). Es cómo un agente en una computadora portátil llega al resto de las herramientas de una persona sin un complemento específico del proveedor para cada una, y ya se ha vuelto aburrido de la manera en que un protocolo web es aburrido: presente, documentado, ignorado hasta que algo se rompe. Un segundo estándar, el protocolo Agent2Agent de Google para agentes hablando entre sí entre proveedores, alcanzó la versión 1.0 en marzo de 2026 (Google Open Source Blog, 2026). Es infraestructura de nivel 4, y hoy no es una rampa de acceso para consumidores.
Tabla 5. El panorama de orquestación por patrón, septiembre de 2026.
| Patrón | Ejemplos (septiembre de 2026) | Nivel | Diseñado para | Lo que obtienes | El registro que deja | Riesgo principal |
|---|---|---|---|---|---|---|
| Comparación manual en pestañas del navegador | Cualquier conjunto de chatbots de consumidor | 4 (web) cuando se registra y se ejecuta de nuevo; de lo contrario, un hábito de nivel 1 | Cualquiera | Cobertura; hábito de comparación | Capturas de pantalla o respuestas copiadas, contexto a menudo perdido | Costo de atención; procedencia no registrada |
| Herramientas de transmisión para chats web | ChatHub, ChatALL | 4 (web) cuando se registra y se ejecuta de nuevo; de lo contrario, un hábito de nivel 1 | Individuos | Una indicación, respuestas paralelas, sin reconciliación | Respuestas en paneles; nada en disco a menos que se guarde | Se rompe cuando cambian las interfaces; términos de servicio |
| Consejo como característica del producto | Consejo de Modelos de Perplexity; agente de investigación Microsoft 365 Copilot (GPT y Claude); Consejo LLM de Karpathy | 4 (web, gestionado) | Suscriptores de esos servicios | Respuesta fusionada con acuerdo y divergencia | Lo que sea que muestre el proveedor; las fuentes a menudo se incluyen | La voz fusionada oculta la procedencia; el selector es el proveedor |
| Chat web expuesto a agentes | OpenCLI y similares | Puente de 4 (web) a 4 (CLI) | Usuarios técnicos | Los agentes pueden usar suscripciones web | Archivos, si el agente los escribe | Fragilidad; reglas de acceso |
| Complemento del proveedor: un agente delega a otro | Complemento de OpenAI para Claude Code; Claude y Codex dentro de GitHub Agent HQ (Copilot) | 4 (CLI) | Desarrolladores, en expansión | Revisión y delegación entre proveedores dentro de una sesión | Transcripción de sesión; salida de revisión | Principalmente en forma de código; cuota de dos servicios |
| Consejos y servidores de consulta | Un servidor de consulta multi-proveedor (último commit diciembre de 2025); complementos de consenso; pequeños consejos de CLI que escriben un archivo por herramienta | 4 (CLI) | Desarrolladores | Varias familias en una tarea; reglas de consenso | Archivos por herramienta; una nota fusionada | Rondas sin fin; errores correlacionados; abandono |
| Paneles de múltiples agentes | Varios CLIs oficiales en paneles, cada uno con su propia copia de trabajo, una persona capaz de hacerse cargo de cualquiera de ellos | 4 (CLI, visible) | Desarrolladores que supervisan agentes paralelos | Supervisión hecha visible | Registros y diffs por agente | Construido para código; atención muy dividida |
| Script de expansión con límites de tiempo | Lista C1 en Apéndice C | 4 (CLI) | Cualquiera que sea propietario de un agente de nivel 3 | Respuestas paralelas mantenidas incluso cuando una herramienta se congela | Un archivo por herramienta, un resumen con quién respondió | Necesita que una persona reconcilie |
| Agente único, tarea escrita y ejecutada de nuevo | Un archivo de instrucciones o habilidad ejecutada según un programa | 3 hecho repetible | Cualquiera en el nivel 3 | Repetición donde un segundo modelo no está disponible | Archivo de tarea, entradas, salidas, nota de aceptación | La repetición amplifica una plantilla deficiente |
Las filas describen patrones. Los conteos de estrellas en el Apéndice E son un rastro de popularidad en un día, y no son usuarios, calidad, ni idoneidad para una carpeta de contratos. El abandono pertenece a la tabla: el servidor de consulta más conocido hizo su último commit en diciembre de 2025, y más de un panel ha tenido sus mantenedores que se desvanecieron. Un artículo que señalara a los aprendices hacia un orquestador nombrado único les haría un flaco servicio, por eso los señalo hacia el patrón en su lugar: binarios oficiales, banderas no interactivas, archivos en disco, y un registro de quién fue consultado.
7.2 Por qué esta capa perdura
La orquestación CLI se basa en las propias herramientas de los proveedores, ejecutadas en los modos que los propios proveedores documentan para la automatización, y eso le da propiedades que una pestaña del navegador no puede tener. Ante todo, puede ser escrita. Un arreglo que funcionó una vez, digamos «elaborar un borrador con un modelo, hacer una segunda revisión contra la lista de verificación, dame los desacuerdos», puede guardarse como archivo de instrucciones o habilidad y ejecutarse nuevamente la próxima semana, según un horario si es necesario. La Sección 3 definió el nivel 4 como exactamente esto, trabajo repetible dirigido entre modelos. Varias propiedades adicionales siguen, en el orden en que las peso. Una bandera de línea de comandos es una interfaz documentada y un código de salida es una promesa; una posición en una página web no es ninguna de las dos, por eso las herramientas que impulsan páginas de chat de consumidor tienen que repararse cada vez que la página cambia. Cada herramienta oficial se ejecuta bajo el inicio de sesión del propio proveedor, con la zona aislada y reglas de denegación de ese proveedor, para que la persona pueda mantener secretos fuera de la carpeta, denegar red por defecto y rechazar comandos destructivos por herramienta, mientras que un agente del navegador que puede ver todas las pestañas es un objeto de permisos más grande. El patrón utiliza inicios de sesión de consumidor que la persona ya paga, y espero que eso, más que nada, separe una práctica que un no programador mantiene de una que prueba una sola vez. Y los proveedores lo bendicen. El complemento oficial, los agentes dentro del servicio de GitHub, los modos sin cabeza y el estándar de habilidades son señales de que la delegación entre herramientas se está estandarizando, mientras que la automatización de páginas de chat de consumidor se está alejando.
La orquestación web puede enseñar el hábito de la comparación, y la orquestación CLI es donde el hábito puede mantenerse, como objeto. El objeto es una carpeta que contiene la asignación, las entradas permitidas, las salidas, un registro de qué agente produjo qué, y una nota de lo que fue aceptado. Otra persona puede inspeccionarlo sin reproducir un chat privado, y la persona que lo hizo puede cambiar una entrada la próxima semana y ver la diferencia. Ese registro también hace que la responsabilidad sea más difícil de evadir, ya que una asignación guardada y una nota de aceptación exponen un conjunto de fuentes deficiente o una aprobación faltante. En oficinas acostumbradas a chat informal, parecerá una carga, y donde quiera que el trabajo tenga que ser verificado, entregado o repetido, es un activo. La proporcionalidad decide cuál: una solicitud de dos minutos no necesita una carpeta de flujo de trabajo, mientras que una tarea recurrente que toca archivos compartidos puede.
La mayoría de lo que existe está moldeado por código. Los complementos oficiales, los servidores del consejo y los gestores multiagente tienen como objetivo la revisión de software, aunque nada en el patrón mismo es específico del código.
7.3 Lo que la capa pide a la persona
Un pequeño equipo de agentes necesita un gestor, y el trabajo del gestor es específico. Llamo a sus cuatro partes el contrato de delegación:
- Objetivo: para qué es el trabajo, establecido de modo que un agente pudiera decir si se ha cumplido.
- Límite: qué pueden tocar los agentes y qué no, qué acciones necesitan confirmación de una persona, y qué presupuesto de tiempo y cuota puede gastar la tarea.
- Artefacto: qué debe existir cuando el trabajo esté hecho, y en qué forma.
- Verificación: cómo sabrá la persona que el artefacto es correcto, decidido antes de que comience el trabajo, quién revisa qué, y cuándo parar.
La cuarta parte contiene una trampa descrita en el artículo complementario sobre supervisión automatizada (Chernets, 2026b). Añadir un revisor es barato, y cada revisor encuentra algo. Un consejo sin una regla de parada tiende a añadir rondas y críticos hasta que el trabajo se entierra en revisión. Una regla práctica es permitir una ronda de crítica y una ronda de correcciones por etapa, con la persona decidiendo si un hallazgo bloquea el trabajo. La regla tiene un precio medido: en una prueba aleatoria de 144 ejecuciones reportada en ese artículo, un presupuesto de una ronda redujo rondas de crítica de 2,86 a 1,00 por ejecución mientras elevaba defectos perdidos por 0,11 por ejecución (intervalo de confianza del 95% 0,005 a 0,204) (Chernets, 2026b). Si vale la pena hacer ese cambio depende de los riesgos, que es exactamente el tipo de decisión que pertenece al gestor. Los límites en rondas y tiempo son presupuestos, y un presupuesto determina cuándo parar, que es una pregunta diferente de si la respuesta es verdadera.
El contrato reafirma lo que la buena delegación a personas siempre ha requerido, para una audiencia que nunca ha delegado a software, y no reclama ninguna teoría nueva de gestión. Su valor es que cada parte puede ser enseñada, escrita y verificada, y que cada parte falla de una manera que puede verse cuando está ausente.
8. De operador a gestor
8.1 Qué cambia en el trabajo
En el nivel 1 la persona produce y el modelo asiste. En los niveles 3 y 4 el modelo produce y la persona dirige, supervisa y acepta. Las ironías de la automatización de Bainbridge (1983) predijeron lo que esto hace con el rol humano. La automatización elimina lo rutinario y deja a la persona el residuo que es más difícil de hacer bien: el monitoreo e intervención en fallos raros, mientras desaparece la práctica que construyó su juicio. La versión de inteligencia artificial generativa de la ironía ya está documentada. La IA generativa desplaza a las personas de producir a evaluar y hace que tareas difíciles sean más difíciles (Simkute et al., 2024), mayor confianza en la herramienta va acompañada de menos pensamiento crítico (Lee et al., 2025), y la descalificación sigue estructuralmente de la eliminación de la práctica (Ferdman, 2025).
Gestionar un agente es, por lo tanto, un trabajo diferente con su propia competencia, y la competencia no viene gratis con la herramienta. Consiste en elegir qué delegar, enunciar el contrato de delegación de la Sección 7.3, leer la traza de un agente, y decidir cuándo el resultado es suficientemente bueno. Divido el trabajo en cuatro prácticas. Delegación define el trabajo como un entregable con un límite. Supervisión vigila el plan, la salida intermedia o la traza de la herramienta e interviene cuando la tarea se desvía, sin aprobar cada paso, porque la aprobación de todo es fatiga y la fatiga es cómo las personas terminan haciendo clic en aceptar. Verificación comprueba fuentes, sumas, transformaciones y las afirmaciones en que descansa una decisión, en proporción al riesgo y por un método que no sea releer la propia confianza del agente: pruebas y diffs para código, una verificación puntual contra una página que la persona abre personalmente para una carpeta de contratos, y para una tabla de literatura una verificación fila por fila de identificadores. Revocación estrecha el espacio de trabajo, detiene una ejecución o elimina acceso cuando cambia una condición. Una persona que realiza las cuatro está gestionando un agente incluso a través de una aplicación de escritorio gráfica. Una persona que entrega una tarea a un servicio opaco y acepta la primera respuesta está externalizando el juicio, que es una práctica diferente. Parasuraman y Riley (1997) nombraron las dos formas de fracasar en ello. Falta de delegación es la persona que podría delegar y nunca lo hace, atrapada en el nivel 1 por hábito o miedo. Mal uso es la persona que delega sin comprobaciones y acepta lo que recibe. Ambos son visibles en 2026. Los datos de adopción amplia y superficial describen la falta de delegación a escala (Sección 2.2), y los informes de pérdida de archivos y eliminaciones de bases de datos de la Sección 5.3 describen el mal uso, a veces por profesionales que sabían mejor. La Tabla 6 establece cada práctica junto a la parte del contrato de delegación que cumple, el riesgo que enfrenta y la traza fechada por la cual un estudio puede ver que sucedió.
Tabla 6. Las cuatro prácticas del gestor: qué cumple cada una, el riesgo que enfrenta y la huella que deja.
| Práctica | Qué hace la persona | Parte del contrato que cumple | Riesgo si falta | Traza observable |
|---|---|---|---|---|
| Delegación | Define el trabajo como un entregable con un límite (8.1) | Objetivo, enunciado de modo que un agente pudiera decir si se ha cumplido; artefacto: qué debe existir y en qué forma (7.3) | Falta de delegación: «la persona que podría delegar y nunca lo hace», atrapada en el nivel 1 por hábito o miedo (8.1) | Un artefacto depositado (Apéndice A) |
| Supervisión | Vigila el plan, la salida intermedia o la traza de la herramienta; interviene cuando la tarea se desvía, sin aprobar cada paso (8.1) | Límite: qué pueden tocar los agentes; qué acciones necesitan confirmación de una persona; qué presupuesto en tiempo y cuota (7.3) | Fatiga por aprobación: «la fatiga es cómo las personas terminan haciendo clic en aceptar» (8.1); un guardián que bloquea demasiado produce falta de delegación (5.3) | Un plan rechazado; un paso irreversible retenido para confirmación (Apéndice A) |
| Verificación | Comprueba fuentes, sumas, transformaciones y las afirmaciones en que descansa una decisión, por un método que no sea releer la propia confianza del agente (8.1) | Comprobación: cómo sabrá la persona que el artefacto es correcto, decidido antes de que comience el trabajo; cuándo parar (7.3) | Mal uso: «la persona que delega sin comprobaciones y acepta lo que recibe» (8.1); errores correlacionados entre modelos (6.3) | Un diff o salida rechazada; se pregunta una segunda familia de modelos; un denominador registrado: preguntado, respondido, tiempo agotado (Apéndice A) |
| Revocación | Estrecha el espacio de trabajo, detiene una ejecución o elimina acceso cuando cambia una condición (8.1) | Límite, aplicado de nuevo: qué se mantiene fuera, y cómo deshacer un error (3.2, 7.3) | Una tarea larga que no se pudo detener, después de la cual eliminar la tarea eliminó los archivos (5.3) | Ninguna entre las trazas fechadas del Apéndice A; un pare fechado, permiso estrechado o acceso eliminado serviría |
Nota: Una persona que entrega una tarea a un servicio opaco y acepta la primera respuesta está «externalizando el juicio», que es una práctica diferente (8.1).
Un pequeño dispositivo mantiene el rol unido en las cuatro prácticas, y lo llamo un registro de aceptación. Para una tarea importante o recurrente contiene el entregable previsto, las entradas utilizadas, las restricciones y permisos, dónde fue la salida, cualquier desacuerdo material o fallo, las comprobaciones realizadas, y la decisión de la persona de aceptar, revisar, escalar o descartar. Traza una línea entre lo que el agente produjo y lo que la persona confió. Para el individuo es útil porque convierte un sentimiento de confianza en una decisión verificable, para un equipo porque un colega puede inspeccionar el trabajo sin un historial de chat privado, y para un investigador porque separa una ejecución completada de un resultado confiable. También es una restricción. Una persona puede decidir, después de no escribir un criterio de aceptación, que la tarea debe permanecer en el nivel 1, y el modelo cuenta eso como gestión madura en lugar de adopción rezagada. En el vocabulario de colaboración humano-IA, el movimiento del nivel 1 al nivel 4 mantiene el humano en el bucle y cambia lo que es el bucle, de leer cada respuesta a establecer los términos en los que se aceptan las respuestas. La Figura 4 dibuja ese bucle con las cuatro prácticas, el riesgo en cada paso, el retorno después de una comprobación fallida y el registro de aceptación.
Figura 4. El bucle de control del gestor.
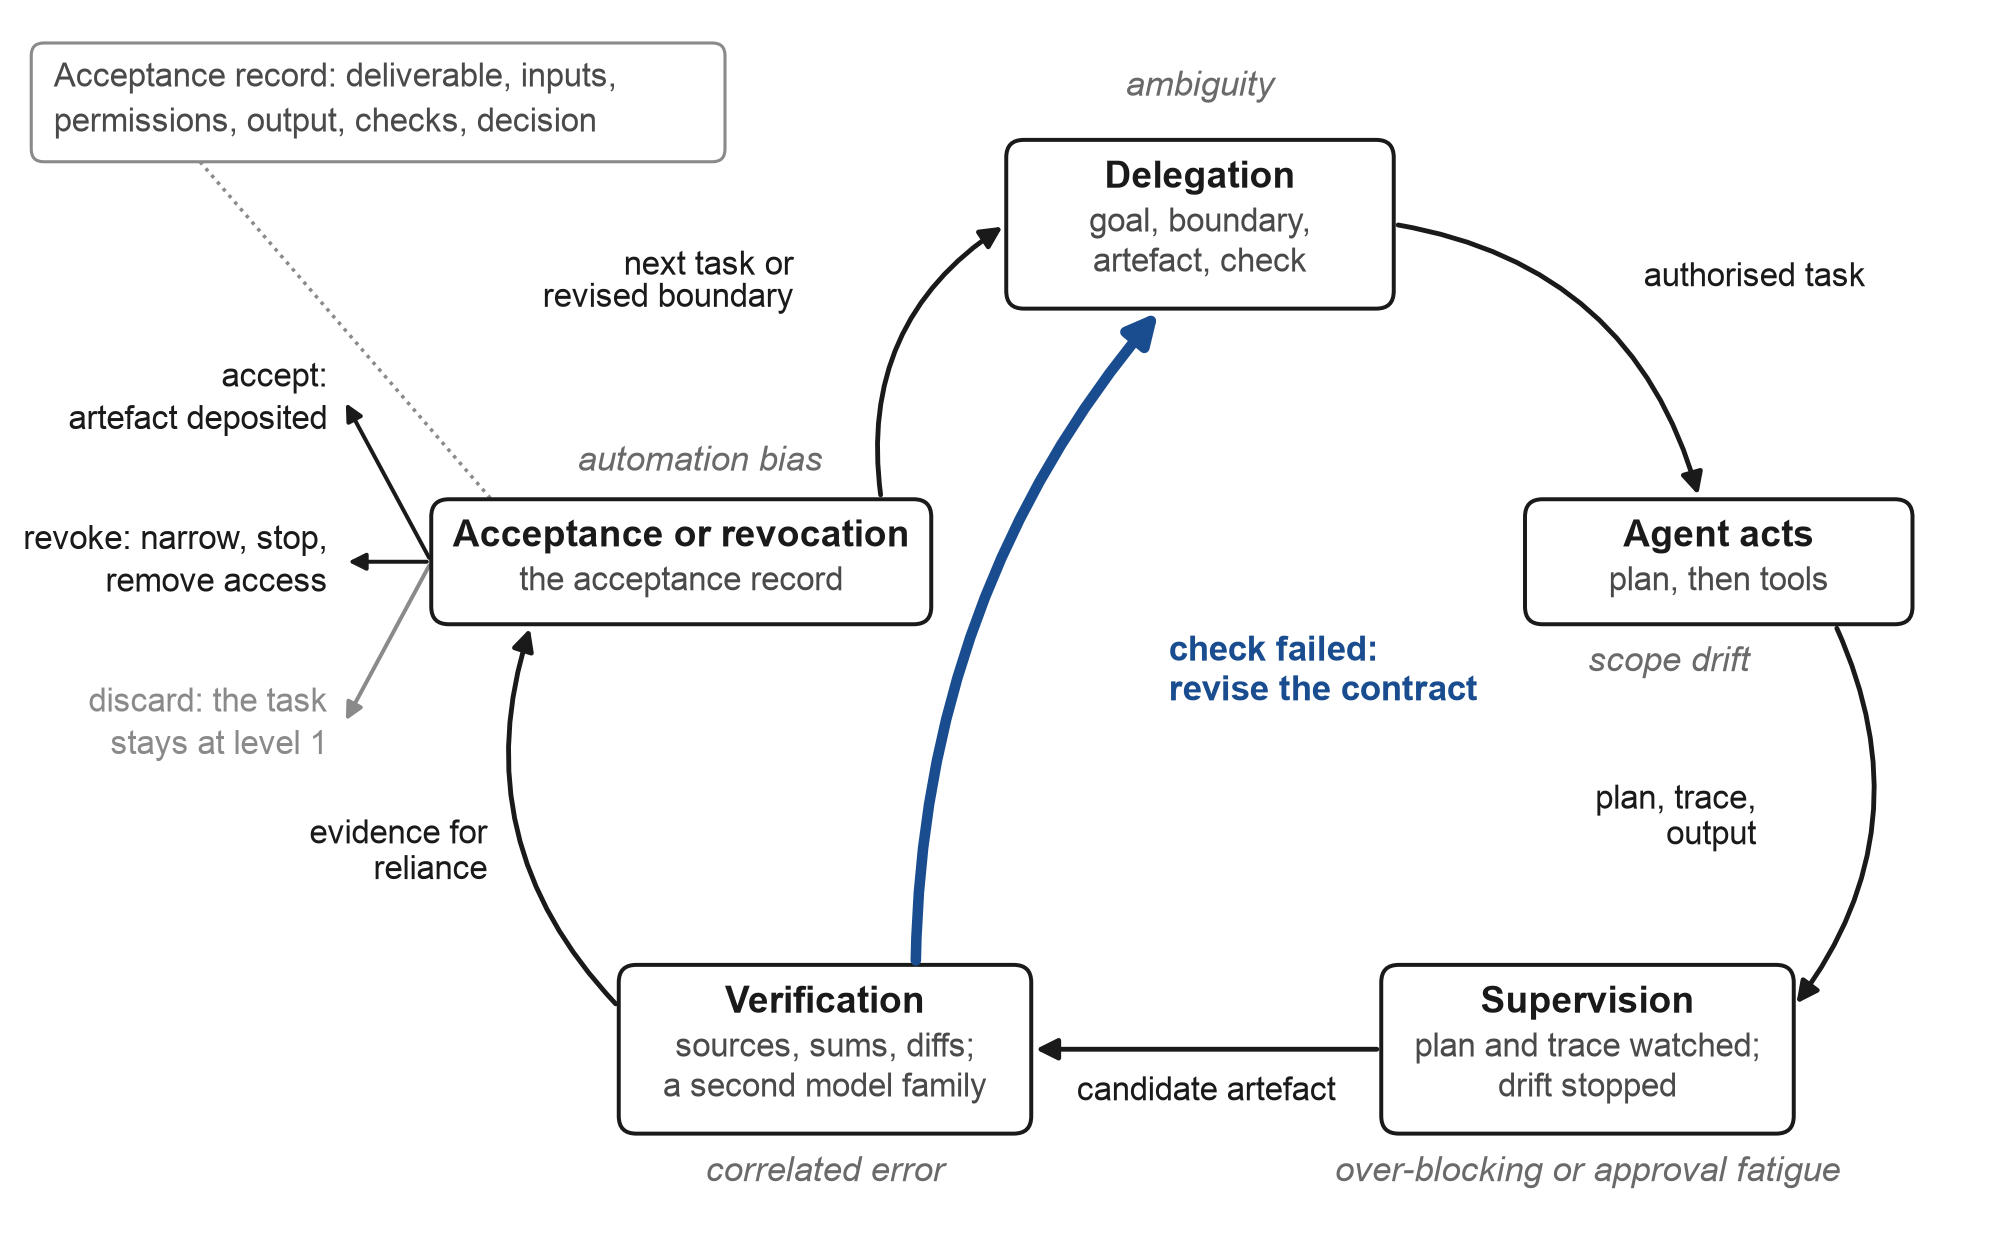
Nota: El trabajo del gerente como un bucle que la persona ejecuta (Secciones 7.3 y 8.1): la delegación establece el contrato (objetivo, límite, artefacto, verificación), el agente actúa, la persona supervisa y verifica, y luego acepta, revoca o descarta el resultado y registra la aceptación. Las etiquetas en cursiva gris nombran el riesgo en cada paso (Secciones 5.3, 6.3 y 8.1). La flecha gruesa es el retorno de una verificación fallida a un contrato revisado, y cada salida del nodo de aceptación es una decisión de la persona.
8.2 Los usuarios experimentados delegan menos
Una observación va en contra de cualquier narración simple en la que todos deberían terminar siendo gerentes de agentes. Anthropic informó en marzo de 2026 que los usuarios con mayor antigüedad tenían "mucha menos probabilidad de delegar mayor responsabilidad a través de patrones de uso directivo" (Anthropic, 2026e), e informó en enero de 2026 que la ampliación, el uso colaborativo en el que la persona permanece en el bucle, representaba el 52% de las conversaciones en noviembre de 2025 (Anthropic, 2026f). Una interpretación es que los usuarios experimentados aprendieron dónde falla la delegación y se echaron atrás. Otra es que aprendieron a usar el modelo como colaborador para las partes del trabajo donde su propio juicio es el producto. No puedo distinguir las dos interpretaciones a partir de los números publicados, y en cualquiera de las interpretaciones el punto final de la escalera es algo distinto a la delegación máxima. Es la capacidad de elegir, tarea por tarea, entre pedir, colaborar y delegar, y saber cuál es la que la tarea delante de ti necesita. El modelo de cuatro niveles describe lo que una persona puede hacer. No sostiene que deban hacer lo más delegado cada vez.
8.3 La responsabilidad permanece con la persona
Los proveedores son claros sobre dónde radica la responsabilidad. La orientación de lanzamiento del agente de nivel 2 de Anthropic dijo a los usuarios que "permanecen responsables de todas las acciones realizadas por Claude en su nombre" (The Register, 2026). Esta es la realidad legal y práctica del nivel 3 en particular, donde el agente actúa con las credenciales del propietario, en los archivos del propietario, bajo el nombre del propietario. Un profesional que se convierte en gerente de un agente también se convierte en responsable de un trabajador que comete errores rápidamente. Es una razón más por la que la verificación en el contrato de delegación tiene que decidirse antes del trabajo, y una razón más por la que el diseño de seguridad de la Sección 5.3 no debe depender de que la persona detecte un ataque en tiempo real.
8.4 El papel del gerente en los marcos de alfabetización
Las definiciones oficiales de alfabetización en IA están comenzando a nombrar este papel, aunque ninguno de los textos revisados aquí utiliza la palabra "agente". El Marco de Alfabetización en IA del Departamento de Trabajo de EE.UU. de febrero de 2026 enumera "dirigir la IA de manera efectiva" entre sus áreas de contenido (US Department of Labor, 2026; ExecutiveGov, 2026). El marco conjunto de la OCDE y la Comisión Europea de junio de 2026, que alimenta la evaluación PISA 2029, tiene cuatro dominios, uno de los cuales es "Gestionar la IA" (OECD & European Commission, 2026). Los marcos académicos anteriores enfatizaban reconocer, entender y evaluar la IA (Long & Magerko, 2020), y los marcos de competencias de la UNESCO de 2024 para estudiantes y maestros establecen el mismo registro (UNESCO, 2024a, 2024b). El contrato de delegación proporciona a los dominios de gestión y dirección un contenido enseñable para el caso de agencia: establecer un objetivo, delimitar el trabajo, nombrar el artefacto, decidir la verificación. Los profesionales han comenzado a usar títulos como "operador de IA" y "gerente de agentes" para un profesional que adquiere esta especialidad además de su profesión. Utilizo "gerente de agentes" de manera más restringida, para un patrón de comportamiento en lugar de un rol para el que alguien deba contratar, porque el comportamiento deja evidencia y un título no. La evidencia está en artefactos: un plan que la persona rechazó, un diff que rechazaron, una segunda opinión que tomaron, una ejecución programada que terminó mientras estaban lejos del teclado. Donde ninguno de esos rastros existe, el título no tiene nada detrás.
9. Midiendo los cruces: un programa preregistrado
9.1 Los cruces como unidad de medida
La mayoría de datos sobre adopción cuentan personas que "utilizan IA", a veces semanalmente o diariamente. Un recuento de ese tipo no puede diferenciar a una persona que le pide sinónimos a un chatbot de una persona que delega un informe trimestral a un agente, y es la segunda persona la que quiero encontrar. La regla del artefacto de la Sección 3.3 hace que la diferencia sea observable, ya que un cruce se registra solo cuando el agente ha producido algo que la persona le pidió, en el nuevo nivel. Varias reglas adicionales se derivan de la literatura sobre incorporación y supervisión. El completamiento debe informarse por separado para las personas que cruzaron sin ayuda y las personas que fueron ayudadas, porque la ayuda cambia lo que significa un cruce. Una parada debe registrarse en el punto donde ocurrió y con las palabras propias de la persona, porque las razones para detenerse son una gran parte del resultado. Toda persona que recibió los materiales pertenece al denominador, incluyendo aquellas que nunca respondieron. La persistencia, finalmente, debe observarse después de que el investigador ha dejado de escribir cada semana; un artefacto producido mientras el investigador aún está en la bandeja de entrada de una persona puede ser cortesía tanto como uso.
9.2 El diseño
Dirijo un programa de cohorte preregistrado que aplica estas reglas a personas sin formación en programación (Chernets, 2026d; OSF, https://osf.io/x4egq, DOI 10.17605/OSF.IO/X4EGQ, registrado y congelado el 6 de septiembre de 2026). Es un estudio de viabilidad de un brazo de una vía de tres pasos, y el preregistro fue congelado antes de que se recopilaran datos. Lo que sigue es el diseño tal como fue registrado.
Participantes. Adultos cuyo trabajo es sustancialmente en una computadora. Utilizan su propia máquina y sus propias suscripciones de IA (las de un empleador están excluidas), mantienen materiales identificables del cliente y confidenciales del empleador fuera del ejercicio, y confirman que la instalación de software no incumple ninguna regla que su empleador les aplique. El reclutamiento se realiza mediante anuncios públicos en redes sociales profesionales dentro de una ventana fijada previamente en el tiempo, de modo que no se puede extender hasta que un resultado se vea favorable. El anuncio se captura en pantalla y se registra su enlace permanente, lo que fija el texto de reclutamiento. La entrada es continua y el cronograma de cada participante cuenta desde su propio día cero, porque las herramientas cambian a escala semanal. El reclutamiento se abrió con el anuncio público el 6 de septiembre de 2026, el día en que se congeló el registro, y cierra 21 días después, el 27 de septiembre de 2026; la cohorte está en el campo en el momento de escribir, y el número realizado, sea cual fuere, se informará con los resultados.
Paso 1 (del chat a un agente en la propia computadora de la persona). El participante pega un texto estándar en el chatbot que ya utiliza, y ese chatbot lo guía a través de la instalación de un agente gráfico en su propia máquina. No toco la computadora de nadie. El paso se completa cuando el participante proporciona un artefacto que el agente produjo en respuesta a una primera tarea. La tarea tiene una forma idéntica para todos y se llena con la propia situación de trabajo del participante, y requiere que el agente pregunte, decida, cree y formate archivos. Ese requisito separa a un agente de un chatbot. El registro proporciona la redacción exacta (Chernets, 2026d). En términos del modelo, el Paso 1 prueba la incorporación reflexiva en dos niveles a la vez, del nivel 1 al nivel 3. Esa fue una opción deliberada. Un shell gráfico de un agente local se ejecuta en la propia máquina de la persona, por lo que según la regla de la Sección 3.3 es nivel 3, y el artefacto que el Paso 1 pide es el tipo que marca la transición 2; sus avisos de permiso le dan algo de la protección de un escalón limitado. La cohorte no instrumenta una semana separada en un entorno de nivel 2 cerrado por el proveedor, por lo que no puede probar P5 de la Sección 10 (que un escalón intermedio limitado reduce el no completamiento e incidentes); esos avisos de permiso son el único escalón limitado que el diseño tiene, y la línea de comando entra en el Paso 3. Una cohorte posterior que inserta una semana de nivel 2 explícita entre el chat y una instalación local sería la prueba clara de P5.
Paso 2 (en orquestación web, lanzado desde el agente). Una vez preparados, los participantes reciben una herramienta de código abierto que hace una pregunta a varios modelos a través de las suscripciones que ya pagan y devuelve una respuesta fusionada, en una sola acción desde dentro del agente. El propósito del paso se registró previamente como cobertura y confiabilidad, con desacuerdo visible como uno de los mecanismos para el segundo.
Paso 3 (en orquestación CLI). La misma orquestación a través de interfaces de línea de comandos.
Medidas. Cinco elementos centrales congelados, redactados idénticamente en cada cohorte del programa, registran profesión y horas en una computadora, uso actual de IA, experiencia previa de hacer preguntas a más de una IA, si las respuestas se verifican y cómo, y si algo ya actúa para la persona en su computadora. Un registro de paso para cada participante contiene las fechas, el chatbot que los guió, intentos y horas, completamiento con el artefacto, el punto exacto de parada y la razón con las palabras propias del participante, y si el investigador intervino y cómo. Semanalmente durante el primer mes, los participantes reportan un artefacto que su agente produjo esa semana (o "nada", que es una respuesta válida), con qué frecuencia hacen una pregunta a más de una IA y qué pasó cuando las respuestas divergieron, y a partir del Paso 2 en adelante si surgió algo útil que un modelo hubiera pasado por alto y si la verificación cambió en qué confiaban. Las observaciones continúan en el día 60 y trimestralmente después de eso, mientras los participantes estén dispuestos.
Análisis e interpretación. El análisis es descriptivo. Las proporciones de completamiento se dan con intervalos de confianza contra el denominador superviviente y el completo, por separado para completamiento sin ayuda y con ayuda; los tiempos e intentos se informan como distribuciones, y las razones para detenerse se codifican después de la recopilación, con códigos y redacción sin procesar depositados. Una regla de interpretación se fijó de antemano. Si menos de la mitad de los que recibieron los materiales del Paso 1 proporcionan un artefacto producido por el agente, la cohorte se informa como un estudio de falla de incorporación, y lo que detuvo a las personas se convierte en el resultado.
Límites de la inferencia. El registro establece de antemano que no hay condición de control y, por lo tanto, sin afirmación causal, y sin generalización más allá de los voluntarios autoseccionados. La estimación de un participante del tiempo ahorrado se informa solo como creencia, porque se ha demostrado que el autorreporte en este dominio invierte la dirección verdadera (Becker et al., 2025).
Divulgación y ética, tal como se registra. Se comunica por escrito a los participantes que escribí los materiales y la herramienta, que los enseño, y que soy solicitante en solicitudes de patentes pendientes que cubren el método de orquestación. No se solicitó opinión de una junta de revisión institucional: no hay afiliación institucional detrás del estudio ni financiamiento federal. El registro establece los salvaguardas en su lugar. El consentimiento es escrito y se otorga antes de que se registre nada. No se recopilan datos de salud, financieros ni de contenido de trabajo. Los participantes trabajan en sus propias máquinas y suscripciones y pueden solicitar la eliminación en cualquier momento hasta el depósito público. Las instrucciones de seguridad incluyen un perfil de navegador separado, sin acciones en sitios bancarios o médicos, confirmación antes de cualquier cosa irreversible, sin contraseñas en el agente, y contenido web tratado como datos. No se recopila ninguna variable de discapacidad y no se hace ninguna afirmación de accesibilidad.
9.3 Solo el diseño
Del programa tomo el diseño y nada más. Aquí no aparecen números de participantes, tasas de finalización o casos individuales, por decisión deliberada: el argumento (este artículo), el método y programa, y los resultados después del período de observación del protocolo son publicaciones separadas, de modo que el argumento no puede leerse como evidencia de sí mismo. Otros investigadores pueden aplicar las mismas reglas ahora. El Listado C5 en el Apéndice C proporciona un formato de registro y un verificador que los codifican. El verificador rechaza un registro que cuente una instalación como un cruce, una finalización sin un artefacto producido por el agente, una detención sin las propias palabras de la persona, un nombre real en lugar de una etiqueta seudónima, un campo que el formato no reconoce, o un nivel omitido que no está registrado exactamente como omitido.
9.4 Cómo se ve un próximo estudio sólido
La cohorte es un estudio de viabilidad, y la mayoría de las proposiciones de la Sección 10 requieren otros diseños. Un próximo estudio sólido compararía dos condiciones de incorporación que difieren en cómo representan el trabajo, manteniendo el riesgo de la tarea y el entorno técnico tan constantes como sea posible. Una condición presenta características e instrucciones de instalación; la otra comienza con el objeto de trabajo recurrente propio del participante y extrae el mapa de cinco partes de la Sección 5.1. Los resultados incluirían artefactos, su calidad calificada por alguien que no sea el participante (con acuerdo entre calificadores informado, como para la codificación de razones de parada), tiempo, errores descubiertos, decisiones de permisos en forma de escenario, reutilización voluntaria posterior, y confianza medida contra resultados. Un seguimiento separaría la persistencia del contacto continuo con el investigador. Un segundo estudio preguntaría si el vocabulario del flujo de trabajo es una gramática o una por profesión, comparando tareas administrativas, de investigación, de comunicaciones y analíticas. No sé cuál es, y la respuesta decide si los ejemplos empaquetados pueden escribirse una vez o deben escribirse para cada campo. Ambos estudios deben establecer línea base en alfabetización en IA con un instrumento validado (Carolus et al., 2023), de modo que la brecha específica, saber qué entregar a un agente, pueda separarse de la familiaridad general con IA. Cada estudio de este tipo también debe documentar la implementación, porque un participante que comienza en una interfaz posterior se encuentra con diferentes valores predeterminados: la versión de la interfaz, el sistema operativo, si el agente tenía acceso a la red, el modo de permiso, y cualquier restricción de política. El nombre del proveedor por sí solo dice muy poco a un lector posterior.
10. Proposiciones
El modelo de la Sección 3 y el argumento de las Secciones 4 a 8 implican afirmaciones que pueden fallar. La Tabla 7 presenta quince de ellas, cada una con una medida, un resultado que la refutaría, y quién está en posición de ejecutar la prueba. Están escritas para el campo en su conjunto. El programa de la Sección 9, por ejemplo, puede probar solo algunas; varias otras se pueden probar con telemetría de proveedores, con paneles de encuestas o con un pequeño estudio en una organización. Ninguna es un hallazgo de la cohorte.
Tabla 7. Proposiciones, medidas, refutadores y quién puede probarlas.
| # | Proposición | Medida | Se refuta si | Quién puede ejecutarla |
|---|---|---|---|---|
| P1 | Migración de barrera. Entre los no programadores que intentan la transición 2, los puntos de detención se agrupan después de la instalación (en la primera tarea, el primer error o permisos) más que durante ella, y entre aquellos que instalaron y no produjeron nada, "No sabía qué preguntar" supera en número a las razones técnicas, de permisos y de costo; y, manteniendo constante la dificultad de la tarea, la finalización cae más bruscamente en las tres transiciones que dentro de un nivel. | Puntos de detención registrados con la regla de artefacto; razones en palabras del individuo, codificadas por la regla del Apéndice A; finalización por paso | La mayoría de los puntos de detención ocurren antes de que el agente se ejecute por primera vez, o las razones técnicas y de permisos dominan entre los no productores instalados, o los patrones de finalización y fracaso son comparables en todos los pasos una vez que se controla la dificultad de la tarea | El programa de la Sección 9; cualquier replicación |
| P2 | Fusión de superficies. Cuando los proveedores fusionan superficies de chat y agente, la proporción de sesiones que terminan en un archivo o acción producida por el agente aumenta sin ningún cambio en lo que los usuarios dicen que quieren hacer; y los asistentes líderes escriben archivos desde la ventana predeterminada sin un modo elegido por el usuario antes del final de 2027. | Telemetría de proveedores antes y después de una fusión; un censo fechado de los asistentes | La proporción se mantiene plana después de una fusión; o un modo de agente estable elegido por el usuario sigue siendo un requisito previo para escribir archivos | Proveedores; cualquiera que pueda abrir las aplicaciones |
| P3 | Vocabulario sobre instalación. Dar a las personas ejemplos resueltos de su propio campo (tareas empaquetadas, habilidades, plantillas) aumenta la persistencia en los niveles 2 y 3 más que proporcionar ayuda de instalación, y una medida estructurada del vocabulario de flujo de trabajo predice la finalización de artefactos después de que se controlan el acceso y el uso previo de IA. | Persistencia en el día 60 bajo los dos tipos de ayuda, en una comparación con la asignación; una declaración previa a la tarea de las cinco partes de la Sección 5.1; razones de detención codificadas por la regla del Apéndice A | La ayuda de instalación produce igual o mayor persistencia; la medida de vocabulario no añade nada una vez que la facilidad de instalación y la confianza genérica están en el modelo | Cualquier laboratorio con dos rutas de incorporación |
| P4 | Incorporación reflexiva. Las personas guiadas por el chatbot que ya utilizan pueden pasar del nivel 1 al nivel 3 sin ayuda a una tasa que hace que la ruta sea práctica, y alcanzar un primer artefacto más rápido que las personas que reciben documentación estática. | Proporción que completa la transición 2 sin ayuda con un artefacto producido por el agente, contra todos los que recibieron los materiales; tiempo hasta el primer artefacto en condiciones guiadas y estáticas | Menos de la mitad lo completan, el umbral fijado de antemano en la Sección 9; o la documentación estática proporciona una finalización igual o superior | El programa de la Sección 9; formadores con dos cohortes |
| P5 | El escalón intermedio. Los no programadores que pasan tiempo en un entorno cerrado por proveedores antes de un agente local completan la transición 2 más frecuentemente, tienen menos incidentes de pérdida de archivos, y razonan mejor sobre alcance, reversibilidad y escalada que las personas que pasan directamente de chat a acceso local amplio. | Cohorte de dos rutas con seguimiento igual; artefacto como resultado primario; un registro de incidentes; decisiones de permiso basadas en escenarios antes y después | Las finalizaciones sin ayuda de chat directamente a un agente local coinciden con las que pasaron por el nivel 2, a tasas de incidentes comparables y con decisiones de permiso iguales | Cualquier laboratorio con dos rutas de incorporación; una cohorte posterior del programa |
| P6 | El cuello de botella. Entre los no programadores que utilizan chat semanalmente, la proporción que produce un artefacto de nivel 3 en un trimestre sigue siendo muy inferior a la proporción de desarrolladores que utilizan agentes de codificación semanalmente. | Una encuesta representativa utilizando elementos de artefacto en lugar de "¿usas IA?" (Sección 11.3) | La producción de artefactos de nivel 3 entre trabajadores del conocimiento no programadores se acerca a la cifra de uso semanal de los desarrolladores | Oficinas estadísticas nacionales; casas de encuestas |
| P7 | El puente lleva. Las personas que practican orquestación web tienen más probabilidades de adoptar orquestación CLI más adelante que las personas que no lo hacen, y el desacuerdo visible predice una atribución de fuente posterior o crítica en sus registros de tareas. | Adopción de orquestación CLI entre aquellos con y sin comparación web anterior; comparaciones guardadas y registros posteriores | Sin diferencia, o lo contrario; la comparación produce más indicaciones y sin cambio en las verificaciones retenidas | El programa de la Sección 9; paneles longitudinales |
| P8 | Durabilidad de CLI. Para las personas que pagan por dos o más suscripciones de consumo, la orquestación a través de herramientas de línea de comandos oficiales es la forma de nivel 4 que sobrevive a los cambios de interfaz, y las ejecuciones respaldadas por archivo se pueden volver a ejecutar y transferir a otro revisor mejor que las ejecuciones solo de navegador. | Un censo fechado de artefactos de nivel 4 en esa población; pruebas de reejecutión y transferencia después de un cambio de interfaz | Un censo de finales de 2027 encuentra consejos de interfaz de web o programación dominantes y herramientas CLI-a-CLI en recesión; los flujos de trabajo solo de navegador coinciden en reejecutión y transferencia | Investigadores de herramientas; encuestas de desarrolladores |
| P9 | Acuerdo correlacionado. Entre familias de proveedores, los errores en elementos de trabajo de conocimiento con respuestas conocidas se correlacionan lo suficiente como para que el acuerdo entre tres o más modelos valga menos que dos opiniones independientes (rho en o por encima de aproximadamente 0.5, donde rho se estima en elementos de trabajo de conocimiento con respuestas conocidas y no se toma de tasas de acuerdo de referencia); un pequeño consejo de diferentes familias vence a un consejo grande de una familia al mismo costo; y la revisión consciente de la fuente predice la corrección mejor que el acuerdo mayoritario. | Correlación de error por pares entre familias en bancos de elementos con respuestas conocidas (listado C4); un conjunto de elementos marcados con dos diseños de consejo; exactitud frente a acuerdo mayoritario y frente a revisión consciente de la fuente | Rho medido por debajo de 0.2 para la mayoría de los tipos de tareas; el consejo de la misma familia gana después de una verificación punto por punto; o el acuerdo de mayoría simple predice la exactitud tan bien o mejor que la diversidad más verificación | Investigadores de modelos de lenguaje; el protocolo del artículo complementario |
| P10 | La competencia del gestor. La persistencia en los niveles 3 y 4 se predice mejor por la capacidad de una persona para enunciar el contrato de delegación (objetivo, límite, artefacto, verificación) y por trazas de supervisión (planes rechazados, diferencias rechazadas, segundas opiniones tomadas) que por experiencia técnica previa o por volumen de indicaciones. | Una tarea breve que elicita las cuatro partes, puntuada a ciegas; elementos de referencia; trazas del registro de aceptación; persistencia en el día 60 | La experiencia técnica previa o el volumen de indicaciones predice la persistencia tan bien o mejor, y enunciar el contrato no añade nada; o los artefactos en los niveles 3 y 4 que rutinariamente omiten objetivo, fuentes, límite y verificación siguen siendo fiables bajo auditoría independiente, en cuyo caso la estructura de competencia está sobrediseñada | Cualquier estudio longitudinal de artefactos |
| P11 | Calibración por clase de tarea. Las personas calibran la delegación mejor cuando la retroalimentación es rápida y la reversión es posible, aceptando, corrigiendo y escalando de manera diferente según la clase de tarea. | Aceptación, corrección, escalada y descubrimiento posterior de errores por clase de tarea | La calibración es uniforme en tareas reversibles y de altas consecuencias | Laboratorios; organizaciones con un registro de aceptación |
| P12 | Fricción de los mecanismos de protección. Entre los no programadores en el nivel 3, las interrupciones por solicitudes de permiso y bloques de seguridad se nombran como razón para detener más a menudo que entre los desarrolladores, y la autonomía protegida por clasificador reduce tales detenciones sin un aumento en la pérdida de archivos informada. | Razones de parada codificadas por grupo; tasas de parada e informes de incidentes antes y después de un cambio en el modo predeterminado | Sin diferencia entre grupos, o la autonomía aumenta las pérdidas informadas | Proveedores; las razones de parada codificadas del programa |
| P13 | La brecha se reproduce. Las diferencias en la adopción del chat por género y educación (Cranney et al., 2026; Daepp & Counts, 2024) reaparecen al menos tan grandes en la producción de artefactos de nivel 3 dentro de las ocupaciones. | Diferencias dentro de la ocupación en la producción de artefactos de nivel 3 | Una estimación dentro de la ocupación muestra la brecha cerrada en el nivel 3 | Economistas laborales; cohortes posteriores si son lo suficientemente grandes |
| P14 | Crítico y segunda familia. Un crítico de la misma familia detecta la prisa y las verificaciones omitidas; una segunda familia detecta errores compartidos; en un conjunto etiquetado por defectos cada uno contribuye defectos que el otro no detecta. | Superposición de hallazgos confirmados entre un crítico de la misma familia y un revisor de segunda familia con igual costo | Superposición completa, o una fuente dominante | Cualquiera con dos herramientas de agente y un conjunto etiquetado |
| P15 | Capacidad o vocabulario. En la misma clase de tarea, la persistencia en los niveles 2 y 3 varía con la capacidad de una persona para enunciar el contrato de delegación; si la capacidad del modelo fuera la restricción vinculante, la persistencia variaría entre clases de tareas y sería uniforme entre personas dentro de una. | Persistencia por clase de tarea, cruzada con una declaración del contrato de delegación puntuada a ciegas | Dentro de una clase de tarea, la persistencia es uniforme entre personas sin importar su puntuación de contrato, y varía solo entre clases | Cualquier estudio que registre la clase de tarea y la declaración del contrato |
Algunos importan más que el resto. P4 lleva el peso más pesado para la política, porque si la incorporación reflexiva funciona, la parte más cara de enseñar a las personas agentes (acompañarlos durante la instalación) puede ser reemplazada por la herramienta que ya tienen. P5 es el que la cohorte no puede probar, como dice la Sección 9.2, y es también el que más determina la forma de la escalera. Si el peldaño intermedio se merece su lugar es algo que aún no sé. P9 es el más fácil de probar y el más probable que sorprenda a los usuarios de consejos, ya que la aritmética de la evidencia correlacionada (Chernets, 2026a) y las mediciones de Kim et al. (2025) ambas apuntan hacia un techo en lo que vale el acuerdo. P10 es el que cambiaría los planes de estudio. Si la capacidad de enunciar un contrato de delegación predice la persistencia mejor que el trasfondo técnico, entonces la capacitación debe enseñar delegación primero y herramientas segundo.
11. Implicaciones
11.1 Para proveedores
Diseño para la carpeta vacía. Los proveedores han simplificado el instalador, y se nota. Creo que una ronda adicional de ese esfuerzo sería desperdiciada, porque el problema del principiante comienza ahora después del instalador, frente a una carpeta vacía sin nada que decir al agente. Ejemplos trabajados del propio campo de la persona, ofrecidos en el momento en que abre por primera vez el agente, junto con una primera tarea que sea real, de bajo riesgo y que termine en algo que puedan juzgar, haría más por la adopción que cualquier simplificación adicional de la configuración. Las habilidades empaquetadas ya señalan esto (Sección 5.1). Faltan dos cosas: ayuda para elegir cuál de las tareas de una persona vale la pena entregar en absoluto, y una forma para que una asociación profesional, y no solo una empresa emergente, escriba habilidades para sus miembros.
Cualquiera que sea el nombre de las pestañas después de la próxima fusión, una persona necesita una respuesta clara, en el momento de la delegación y en el idioma de la carpeta seleccionada, a una breve lista de preguntas: ¿qué puede leer este agente, qué puede cambiar, qué puede enviar o activar, qué necesitará mi aprobación y cómo lo detengo? Un diff visual responde parte de esto cuando los archivos cambian, y un plan escrito lo hace cuando las acciones son diversas; un banner de consentimiento no responde nada de esto. El modelo de permisos debe mantenerse visible, limitado y reversible después de la fusión, con un botón deshacer y un botón detener que funcione. El alcance de carpeta sin uno u otro es cómo se leen los reportes de problemas de la Sección 5.3.
El trabajo también debería poder salir del producto. Un usuario debería poder exportar la instrucción de tarea, las entradas o sus identificadores, las acciones de herramienta, la salida y el historial de aprobación. Esta es una característica de usabilidad tanto como una de gobierno, porque permite que el principiante aprenda de una tarea completada y permite que un equipo revise un resultado sin prestar su memoria al historial de chat propietario. El uso debería reportarse de la misma manera. Los «usuarios activos semanales» de un agente que produce archivos deberían dividirse en personas que produjeron un archivo y personas que abrieron la aplicación, y los proveedores tienen la telemetría para hacerlo.
Detectar ataques no es un trabajo para el novato. La orientación que pide a los no programadores que reconozcan signos de inyección de indicaciones pone el juicio más difícil en la persona menos capaz de hacerlo (Sección 5.3). Los valores predeterminados seguros (copias de trabajo, instantáneas antes de cambios más grandes, comandos destructivos denegados hasta permitirse explícitamente, contenido web tratado como datos) pertenecen al producto. Al mismo tiempo, los guardias que interrumpen constantemente detienen el trabajo tan seguramente como los guardias faltantes pierden archivos, y el documento complementario sobre el exceso de supervisión describe cómo crecen tales capas (Chernets, 2026b).
La procedencia debería sobrevivir a la fusión de respuestas. Las características del consejo que devuelven una respuesta fusionada deberían mostrar qué dijo cada modelo y dónde no estuvieron de acuerdo, permitir que el usuario asigne a un modelo el papel de crítico, y hacer que una brecha de evidencia sea más fácil de encontrar que un párrafo de consenso fluido. Una voz fusionada sin fuentes restaura la autoridad de una respuesta única confiada, recompensa el sesgo de automatización y oculta la correlación de errores (Sección 6.3).
La rotación, finalmente, tiene un costo del lado del usuario. Una persona que aprendió una herramienta que fue renombrada, fusionada o retirada en un año paga dos veces, por lo que los nombres estables, las guías de migración y la continuidad de los archivos de instrucción en los cambios de producto son características de adopción por derecho propio.
11.2 Para empleadores y capacitadores
Enseñe el contrato de delegación antes de los menús. Los menús de producto cambian mensualmente, mientras que la capacidad de enunciar un objetivo, delimitar el trabajo, nombrar el artefacto y decidir la transferencia de verificación entre herramientas (Secciones 4.3 y 7.3) persiste. Un breve ejercicio que pide a una persona que escriba las cuatro partes de una de sus propias tareas recurrentes prueba la preparación mejor que un recorrido de características. Lo que contiene el ejercicio se expone a continuación, bajo descomposición.
Los inicios de sesión miden lo incorrecto. Un recuento de usuarios activos no puede hacer la distinción que la Sección 9.1 necesitaba, entre la persona que pide sinónimos y la persona que delega un informe. Un recuento de artefactos producidos por agentes que las personas eligieron mantener puede hacerlo.
Las personas también necesitan un lugar autorizado para aprender y un mapa de lo que está permitido. El nivel 2 dentro de las herramientas que la organización ya tiene licencia llega al personal que nunca se le permitirá instalar un agente en una computadora portátil de trabajo (Sección 5.4). Para el nivel 3, una política clara, una máquina aislada o una configuración aprobada elimina el «no» silencioso que muchas personas asumen. Una prohibición general impulsa el uso a través de cuentas personales donde nadie puede verlo, y la delegación sin restricciones expone material confidencial. Entre los dos se encuentra una taxonomía de tareas y datos. Dice qué trabajo se puede intentar en entornos aprobados, cuál necesita revisión de una segunda persona y cuál está excluido de los agentes; nombra quién puede aprobar una herramienta, dónde vive el registro de aceptación y cómo se informa de un casi incidente sin castigo por informarlo. El nivel 3 local no debe ser requerido en máquinas que el empleado no controla, ya que los agentes en la nube y el nivel 2 limitado por inquilino son la ruta que evita una confrontación con el departamento de TI. Una vez que los proveedores absorben el primer escalón en el chat, el nivel 2 mantiene dos funciones. Es el lugar autorizado para el personal en máquinas bloqueadas, y es el escalón de calibración para todos los demás, donde una persona aprende que la acción delegada tiene un perímetro antes de poseer uno. Si también reduce incidentes es P5.
Los mandatos necesitan cuidado. Hacer que el uso de IA sea un criterio de desempeño puede producir uso sin valor, y al menos un empleador que lo hizo revirtió la decisión dentro de un año (Fortune, 2026b). Pedir artefactos que importan para el trabajo es una mejor señal que pedir uso. Una vez al mes, «mostrar un archivo que un agente produjo en una carpeta que usted nombró» y «mostrar una decisión que cambió porque dos modelos no estuvieron de acuerdo» mide transiciones 2 y 3, que un recuento de inicio de sesión no puede. La capacitación a escala sin medidas de artefactos, por muchos miles que estén inscritos, no le dirá a nadie si ocurrió la transición 2.
La descomposición y la verificación deben enseñarse juntas, y el hábito crítico antes del consejo. Un curso genérico de indicaciones es pedagogía de nivel 1. La pedagogía de nivel 2 y nivel 3 parte del trabajo que la persona ya tiene, un paquete de viernes de un especialista en marketing, digamos, o un lote de tareas de un docente, enseña una descomposición reutilizable (las cinco partes de la Sección 5.1, con una condición para detenerse) y enseña la recuperación de errores en una copia de la carpeta. Lo que debe evaluarse después es si la persona puede reconocer una instrucción insegura, identificar una prueba reversible, inspeccionar la evidencia y detener el sistema. Un crítico de la misma familia en puntos de aceptación no cuesta nada en suscripciones, y se añade una segunda familia cuando el crítico guarda silencio y la decisión es cara. La orquestación en la parte superior de una rúbrica de fluidez es el destino correcto para algunos roles y el requisito incorrecto del primer día para todos.
11.3 Para la política
El deber de alfabetización en IA de la Unión Europea se aplica a todos los proveedores y desplegadores de sistemas de IA para su personal. Después de las enmiendas de 2026, les requiere "tomar medidas para apoyar el desarrollo de la alfabetización en IA" en lugar de asegurar un nivel suficiente, y sus reglas de supervisión y cumplimiento se aplican a partir del 3 de agosto de 2026 (European Union, 2026; European Commission, 2026a, 2026b). En los Estados Unidos, el marco del Departamento del Trabajo se denomina "dirigir la IA de manera efectiva" (US Department of Labor, 2026), y el marco de la OCDE y la Comisión Europea tiene un dominio llamado "Gestionar la IA" (OECD & European Commission, 2026). Sugiero un contenido para esas palabras en el caso agéntico: las cuatro partes del contrato de delegación, las cuatro prácticas de la Sección 8.1 incluyendo la revocación, el hábito de comparar modelos con el conocimiento de que el acuerdo es evidencia más débil de lo que parece, y las prácticas de seguridad básicas de la Sección 5.3. La orientación debe distinguir el uso conversacional de la acción delegada. Para este último, el deber debe cubrir el alcance de permisos, la clasificación de datos, la verificación, el informe de incidentes y la revocación, y un requisito para documentar la capacidad y autoridad específicas del rol necesarias para las tareas delegadas es más defendible que un requisito de capacitar a todos de manera idéntica. Los reguladores y representantes de los trabajadores también pueden preguntar si un empleador ha trasladado la responsabilidad residual al personal sin controles utilizables, tiempo para revisar, o derecho a rechazar una delegación insegura. Todo esto es una recomendación de diseño y gobernanza extraída de un instrumento regulatorio, y su alcance es ese instrumento.
El deber europeo sobrevivió una ronda desreguladora, y entre los marcos discutidos aquí es la única obligación horizontal que cubre a cada miembro del personal que utiliza IA. En los Estados Unidos, el marco es la política de recursos humanos. Una orden ejecutiva de abril de 2025 sobre educación en IA y el Plan de Acción de IA de julio de 2025 se comprometen a expandir la alfabetización y las habilidades en IA, incluyendo orientación de que los programas de alfabetización en IA pueden calificar como asistencia educativa proporcionada por el empleador (White House, 2025a, 2025b); el marco es compatible con la capacitación de gerentes de agentes y aún no lo requiere. Ninguno de los textos oficiales inspeccionados menciona agentes terminales u orquestación, por lo que "Gestionar la IA" puede leerse como etiqueta de chatbot o como dirección de nivel 4. Los programas de alfabetización que se detienen en indicaciones enseñan nivel 1. Mientras tanto, el trabajo se está moviendo a niveles 2 a 4. Los textos oficiales aún no la han seguido allí.
Las agencias estadísticas que añaden módulos de IA a sus encuestas podrían ayudar con un cambio específico. "¿Ha utilizado un chatbot?" es un elemento de nivel 1. "¿Ha un sistema que dirigió creado o modificado archivos en una computadora que utiliza para trabajar en los últimos siete días?" es un elemento de nivel 2 o nivel 3. "¿Ha puesto la misma pregunta de trabajo en más de un sistema de IA en los últimos siete días, y difirieron las respuestas?" es un elemento de nivel 4. Sin elementos de este tipo, P6 no puede ser probado en datos públicos, y la brecha digital de segundo nivel en el nivel agéntico permanecerá invisible para las personas cuyo trabajo es detectarla.
11.4 Para los investigadores
Los vacíos de la Sección 2.5 son una agenda. Estudiar a personas que no son programadores utilizando agentes de terminal y escritorio, por nombre, con artefactos como resultados. Estudiar la incorporación reflexiva como un mecanismo en sí mismo. Estudiar la orquestación web como una práctica, incluyendo cómo las personas reconcilian respuestas y si conservan la procedencia. Medir la correlación de errores en familias de proveedores en tareas de trabajo de conocimiento, y en más ámbitos que solo los puntos de referencia de código y matemáticas. Extender las brechas de género y ocupación medidas en el uso de IA (Cranney et al., 2026; Humlum & Vestergaard, 2025) a los niveles agénticos, donde aún no se sabe nada (P13). Dos métricas fáciles, disponibilidad de características y tiempo ahorrado autoinformado, vale la pena resistir a favor de la finalización de artefactos, la calidad auditada, las tasas de corrección y la reutilización posterior. El abandono debe registrarse junto con su mecanismo. Una parada en una indicación de permiso puede ser un problema de interfaz, una preocupación sensata sobre datos, una regla del empleador, una máquina faltante o una tarea sin criterio de aceptación, y colapsarlos en "resistencia" pierde todo eso. La evaluación debe ser adversarial, con una página engañosa, una instrucción oculta en un documento, una fuente contradictoria, una falla parcial de herramienta, o una respuesta incorrecta convincente que varios modelos comparten, porque el rol del gerente significa algo solo si mejora los resultados bajo esas condiciones. La replicación no requiere ninguno de mis materiales; requiere la regla de artefacto, una pregunta sobre la razón de parada congelada, un registro de la implementación, y un censo de productos fechado. Y los denominadores deben ser publicados, ya que un estudio que reporta solo a aquellos que cruzaron no nos dice nada sobre el camino.
12. Alcance y condiciones límite
Lo que se ofrece aquí es un modelo, una síntesis de pruebas y un diseño de medición, y cada uno está limitado de las siguientes maneras.
Tiempo. Las pruebas se extienden hasta el 21 de septiembre de 2026. Los hechos del producto tienen fecha y envejecerán. El modelo se define por alcance y función para que envejezca más lentamente.
Geografía y fuentes. La mayoría de las cifras de adopción provienen de los Estados Unidos; se citan cifras europeas donde existen. Varias cifras clave provienen de vendedores (uso de agentes de codificación, las razones para fusionar chat y agente, tasas de inyección en conjuntos de pruebas de vendedores) y se marcan como datos de vendedores en el texto. Las uso para lo que los vendedores pueden saber sobre sus propios productos y las ponderan en consecuencia.
Población. El argumento se refiere a profesionales cuyo trabajo se realiza sustancialmente en una computadora. Las personas que trabajan principalmente desde un teléfono, o sin una computadora que controlen, encuentran una barrera antes de cualquiera descrita aquí, y el modelo dice poco sobre ellas más allá de nombrar esa barrera (Sección 5.5).
Pruebas sobre la cohorte. Solo se utiliza el diseño preregistrado. Ningún resultado del programa informa ninguna afirmación aquí, y las proposiciones de la Sección 10 se enuncian antes de que se conozcan sus resultados, para que puedan ser juzgadas contra ellos. Una cohorte que requiere una máquina propia muestrea a personas capaces de instalar un agente; no puede separar el acceso a equipos de la motivación, y ese límite viaja con los resultados.
Alcance normativo. El modelo describe lo que cada nivel le pide a una persona. No sostiene que los niveles superiores sean mejores o que todos deban ascender; para la mayoría del trabajo, el nivel 1 o 2 es el lugar correcto (Sección 8.2). El trabajo de altas consecuencias, los registros confidenciales, las operaciones críticas de seguridad, las decisiones críticas en el tiempo y las tareas sin criterio de aceptación inspectable necesitan arreglos más estrictos, o permanecen completamente fuera del uso delegado de agentes.
Lo que agrega la orquestación. Agregar agentes puede ampliar la cobertura, exponer desacuerdos y dejar un rastro de revisión. También puede agregar error correlacionado, costo, retraso y una apariencia falsa de diligencia. La delegación que dura significa que una persona puede inspeccionar y alterar el proceso; si el proceso merece confianza es una pregunta separada.
Lo que falta en la literatura. La búsqueda bibliográfica de la Sección 2.5 no encontró ningún estudio de campo de no programadores adoptando agentes de terminal o escritorio por nombre, ningún estudio de orquestación web como práctica nombrada, ningún tratamiento de la gestión de agentes como una competencia con su propia estructura, y ningún estudio de un sistema de IA que proporciona andamios para la adopción de IA agencial de una persona. Estas son brechas en lo que se ha estudiado hasta el 21 de septiembre de 2026, y no reclamo nada sobre mercados, productos o prioridad.
Estado de las afirmaciones. La Tabla 8 aplica el lenguaje de confianza de la serie a los elementos del argumento, para que un lector pueda ver qué tan firmemente se sostiene cada uno.
Tabla 8. Estado de las afirmaciones en este documento.
| Elemento | Cómo se dice aquí | Base |
|---|---|---|
| Modelo de cuatro niveles y la regla del artefacto | En prueba (Secciones 9 y 10) | Conceptual; marcadores especificados en la Sección 3 y Apéndice A |
| La barrera técnica ha retrocedido para la instalación y la cara de escritorio | Los datos lo apoyan | Instaladores de un paso; documentación «No se requiere terminal»; productos de nivel 2 de cuatro vendedores enviados |
| Trabajadores del conocimiento dentro de un agente de herencia terminal | Reportado por vendedor, direccional | Informe de prensa de cifras de vendedores, 2 de junio de 2026, con una advertencia del analista |
| Vendedores absorbiendo la transición 1 en chat | Observado en el producto | Anthropic, 16 de septiembre de 2026; OpenAI, 9 de julio de 2026 |
| Vocabulario de flujo de trabajo como la barrera dominante restante | Ofrecido como modelo; en prueba | Indirecto: estudios de prompting; la razón declarada por los vendedores para fusionar; el elemento de razón de parada del programa |
| Web como puente, CLI como capa durable | En prueba (P7, P8) | Contratos, objetos de permiso, complementos oficiales; fragilidad de interfaces web |
| Los errores correlacionados limitan lo que un consejo compra | Los datos lo apoyan en evaluaciones de modelos; en medición de uso | Kim et al. (2025); Chernets (2026a) |
| Incorporación reflexiva | Implementado y en medición; ningún resultado reportado | Práctica de vendedor y curso (observación); Paso 1 del programa (medición) |
| El gestor de agentes como un rol | Ofrecido como descripción del comportamiento; en prueba (P10) | Estudios de delegación; rúbricas del empleador; marcos de alfabetización oficial |
| Tasas de cruce de cohorte | No reportado | Protocolo congelado; documento de resultados por venir |
| «Funciona ahora» como promesa | No reclamado | Fuera del alcance de este documento |
13. Conclusión
La terminal solía ser la imagen evidente de la barrera entre profesionales ordinarios e IA agentica, y durante un tiempo fue una imagen justa. En 2026 ya no encaja. La instalación requiere un comando o un clic, el chatbot que una persona ya usa puede guiarla a través del proceso, y los proveedores están fusionando el chat y el agente en una única interfaz. Lo que las secciones 4 y 5 muestran es una barrera que se ha desplazado. El primer intento acotado se ha vuelto mucho más fácil de realizar; lo que sigue siendo difícil es obtener trabajo confiable en tareas completas, mantenerse al día con productos que cambian constantemente, y mantener una carpeta otorgada segura. Según cifras de un proveedor, reportadas a través de la prensa y que deben leerse como direccionales, aproximadamente un millón de trabajadores del conocimiento por semana ya están dentro de un agente de codificación con herencia de terminal. Mientras tanto, la mayoría de los profesionales todavía se encuentran con la IA solo como una conversación.
Lo que obstaculiza ahora es el trabajo del gerente: saber qué delegar, delimitarlo, nombrar el resultado y decidir cómo verificarlo, luego ejecutar un entorno de forma segura y comparar modelos recordando que su acuerdo es una evidencia más débil de lo que parece. Los cuatro niveles de la sección 3 le dan a ese trabajo una estructura que ningún producto posee, y la regla de artefacto le da una unidad de medida. He propuesto orquestación web como el puente al último nivel (P7) y orquestación CLI como la forma que perdura (P8); ambas se expresan de modo que puedan fallar.
Para cualquiera que introduzca la transición, la consecuencia práctica es un orden de operaciones. La primera pregunta es qué pequeño trabajo permitido puede describir, inspeccionar y descartar con seguridad una persona si el intento falla: un informe de fuentes públicas, una carpeta de planificación personal, una hoja de cálculo de la que nadie más depende. A partir de ahí, se añade una responsabilidad de gestión a la vez: un límite, luego una aprobación, luego un espacio de trabajo propio, luego un registro de tarea guardado, luego una segunda vista crítica. La evaluación sigue el mismo orden. Una demostración tiene poco valor si oculta lo que la persona podía hacer, cómo se verificó el resultado y qué sucedió cuando el agente falló. Una negativa considerada a delegar cuenta como resultado. Y una persona que puede reproducir una tarea acotada, explicar por qué confió en ella, señalar un desacuerdo que cambió una decisión y limitar el acceso cuando las circunstancias cambian está mostrando los signos observables del rol, independientemente de lo que diga su título de trabajo.
El modelo puede fallar, y la sección 10 explica cómo. El programa de la sección 9 lo probará en parte en personas que no son programadores, y el código en el apéndice C permite a otros medir los mismos puntos de cruce y practicar los mismos patrones. Espero que los productos mencionados en el apéndice B se vean anticuados en un año. Las barreras de la sección 5 no deberían, porque pertenecen a la persona y al trabajo, sin importar qué producto tengan delante. La terminal se ha convertido en un lugar donde un agente trabaja para una persona que ha aprendido a gestionarlo, y cuánta gente aprenderá eso, a través de qué ruta y qué tan rápido, es la pregunta que el próximo año responderá.
Declaraciones
Financiamiento. Ningún financiamiento externo apoyó este trabajo.
Conflictos de intereses. El autor desarrolla métodos de orquestación multimodelo y ha presentado solicitudes de patente relacionadas (pendientes; ninguna patente ha sido concedida). El autor diseñó el programa de cohorte preregistrado descrito en la Sección 9 y sus materiales. Ningún hallazgo en este artículo depende de la implementación del autor; cada patrón en el Apéndice C es reproducible con herramientas disponibles públicamente. El autor también mantiene los dos complementos de código abierto nombrados en el Apéndice C; son gratuitos y de código abierto (Licencia Apache 2.0), y ningún hallazgo en este artículo depende de ellos. El autor está desarrollando materiales didácticos que pueden ofrecerse comercialmente más adelante; nada se ha vendido al momento de la redacción, y la cohorte descrita en la Sección 9 recibió todos los materiales sin costo.
Herramientas y verificación. Se utilizaron asistentes de IA como instrumentos bajo la dirección del autor; las ideas, la investigación y las conclusiones son del autor. Todas las afirmaciones cuantitativas y citas fueron verificadas contra fuentes primarias o copias archivadas a partir del 21 de septiembre de 2026 o, donde una fuente está marcada como secundaria o de vendedor en el texto y en la cronología del Apéndice B, contra el mejor informe disponible; las cifras reportadas por vendedores sobre sus propios productos están marcadas como tales. Cuando una página primaria no pudo recuperarse durante la ventana de investigación (varias páginas en el sitio de un vendedor devolvieron un error de acceso), la afirmación se cita de una fuente secundaria nombrada y etiquetada, u se omite. Los títulos de prensa dados entre corchetes en las referencias son títulos descriptivos de páginas cuyos titulares no fueron releídos textualmente.
Disponibilidad de datos y código. El código en el Apéndice C, con sus pruebas, está depositado bajo la licencia MIT en https://github.com/vadimchernets/after-chat y archivado en Zenodo, https://doi.org/10.5281/zenodo.22944451. Dos complementos construidos con los mismos patrones, Roundcall y Sidecall, están en https://github.com/vadimchernets/roundcall y https://github.com/vadimchernets/sidecall (Licencia Apache 2.0). Cinco kits que aplican los mismos patrones a oficios fuera del software están en https://github.com/vadimchernets/calling-kits (MIT). No han sido probados por profesionales de esos oficios, lo que el repositorio indica, y ninguna afirmación en este artículo se basa en ellos.
Ética. Este artículo no reporta datos de participantes humanos. El programa de cohorte que describe está preregistrado (OSF, DOI 10.17605/OSF.IO/X4EGQ); sus resultados se reportarán por separado.
Contribuciones del autor. Autor único.
Correspondencia. vadimchernets9@gmail.com · ORCID: 0009-0007-4845-3163
References
9to5Mac. (2026, August 4). OpenAI explains what will happen when ChatGPT Atlas shuts down this weekend. https://9to5mac.com/2026/08/04/openai-explains-what-will-happen-when-chatgpt-atlas-shuts-down-this-weekend/
Accenture. (2025, December 9). Accenture and Anthropic launch multi-year partnership to drive enterprise AI innovation and value across industries. https://newsroom.accenture.com/news/2025/accenture-and-anthropic-launch-multi-year-partnership-to-drive-enterprise-ai-innovation-and-value-across-industries
Adrjan, P. (2026, July 8). AI is no longer just a tech occupation story. Indeed Hiring Lab. https://hiringlab.indeed.com/2026/07/08/ai-is-no-longer-just-a-tech-occupation-story/
Agent Skills. (2026). Agent Skills: an open standard (list of supporting products, accessed 21 September 2026). https://agentskills.io
Anthropic. (2025). Piloting Claude in Chrome (25 August 2025, updated 18 December 2025). https://claude.com/blog/claude-for-chrome
Anthropic. (2026a). Claude Code desktop quickstart (accessed 21 September 2026). https://code.claude.com/docs/en/desktop-quickstart
Anthropic. (2026b). Get started with Claude Cowork. Help Center (accessed 21 September 2026). https://support.claude.com/en/articles/13345190-get-started-with-claude-cowork
Anthropic. (2026c, September 16). Claude Cowork and chat are now one Claude. https://claude.com/blog/cowork-is-now-claude
Anthropic. (2026d, August 26). Claude in Chrome is generally available. https://claude.com/blog/claude-in-chrome-generally-available
Anthropic. (2026e, March 24). Anthropic Economic Index report: Learning curves. https://www.anthropic.com/research/economic-index-march-2026-report
Anthropic. (2026f, January 15). Anthropic Economic Index report: Economic primitives. https://www.anthropic.com/research/anthropic-economic-index-january-2026-report
Anthropic. (2026g). Use Claude in Chrome safely. Help Center (accessed 21 September 2026). https://support.claude.com/en/articles/12902428-use-claude-in-chrome-safely
Anthropic. (2026h). What's new in Claude Code: 29 June to 3 July 2026 (default permission mode renamed "Manual"). https://code.claude.com/docs/en/whats-new/2026-w27
Bainbridge, L. (1983). Ironies of automation. Automatica, 19(6), 775-779. https://doi.org/10.1016/0005-1098(83)90046-8
Becker, J., Rush, N., Barnes, E., & Rein, D. (2025). Measuring the impact of early-2025 AI on experienced open-source developer productivity. arXiv:2507.09089. https://arxiv.org/abs/2507.09089
BenchLM. (2026). OSWorld-Verified leaderboard (aggregator of vendor-reported scores, accessed September 2026). https://benchlm.ai/benchmarks/osworld-verified
Bick, A., Blandin, A., & Deming, D. J. (2024). The rapid adoption of generative AI (NBER Working Paper No. 32966). https://www.nber.org/papers/w32966
Bick, A., Blandin, A., Deming, D. J., et al. (2026, September 1). What work does generative AI do? Federal Reserve Bank of St. Louis, On the Economy. https://www.stlouisfed.org/on-the-economy/2026/sep/what-work-does-generative-ai-do
Bo, J. Y., Wan, S., & Anderson, A. (2025). To rely or not to rely? Evaluating interventions for appropriate reliance on large language models. CHI 2025. arXiv:2412.15584. https://arxiv.org/abs/2412.15584
Brave. (2025, August 20). Comet prompt injection. https://brave.com/blog/comet-prompt-injection/
Brynjolfsson, E., Li, D., & Raymond, L. R. (2025). Generative AI at work. Quarterly Journal of Economics, 140(2), 889-942. https://academic.oup.com/qje/article/140/2/889/7990658
Carolus, A., Koch, M., Straka, S., Latoschik, M. E., & Wienrich, C. (2023). MAILS: Meta AI literacy scale. International Journal of Human-Computer Interaction. arXiv:2302.09319. https://arxiv.org/abs/2302.09319
Carroll, J. M. (1990). The Nurnberg funnel: Designing minimalist instruction for practical computer skill. MIT Press. https://mitpress.mit.edu/9780262031639/the-nurnberg-funnel/
CC for Everyone. (2026). A course taught inside Claude Code (accessed 21 September 2026). https://ccforeveryone.com
Center for AI Safety. (2026, July 1). Significant increase in digital labor automation. https://safe.ai/blog/significant-increase-in-digital-labor-automation
Chatterji, A., Cunningham, T., Deming, D. J., Hitzig, Z., Ong, C., Shan, C. Y., & Wadman, K. (2025). How people use ChatGPT (NBER Working Paper No. 34255). https://www.nber.org/papers/w34255
Chernets, V. (2026a). Agreement is not independent evidence: Auditable multi-model synthesis without an API. SSRN. https://doi.org/10.2139/ssrn.7390698 (Zenodo: https://doi.org/10.5281/zenodo.22683716)
Chernets, V. (2026b). AI-Watchbird (Sheckley): When automated oversight widens its own mandate and harms what it guards. SSRN. https://doi.org/10.2139/ssrn.7473658 (Zenodo: https://doi.org/10.5281/zenodo.22849138)
Chernets, V. (2026c). Architectural trust: Why consumer trust in agentic commerce migrates from AI models to verifiable architecture. SSRN. https://doi.org/10.2139/ssrn.7191261 (Zenodo: https://doi.org/10.5281/zenodo.22166995)
Chernets, V. (2026d). Three steps into agentic AI: A preregistered feasibility study of how non-programmers cross from chatbot to agent to multi-model orchestration (Cohort 1). OSF preregistration. https://doi.org/10.17605/OSF.IO/X4EGQ
CodeRabbit. (n.d.). State of AI vs. human code generation report (accessed 21 September 2026). https://www.coderabbit.ai/blog/state-of-ai-vs-human-code-generation-report
Cohn, C., Rayala, S., Srivastava, N., Fonteles, J. H., Jain, S., Luo, X., Mereddy, D., Mohammed, N., & Biswas, G. (2026). A theory of adaptive scaffolding for LLM-based pedagogical agents. AAAI 2026, 40(3), 1757-1765. arXiv:2508.01503. https://arxiv.org/abs/2508.01503
Constellation Research. (2026a, June 2). OpenAI touts broadening Codex usage, 5 million weekly active users. https://www.constellationr.com/insights/news/openai-touts-broadening-codex-usage-5-million-weekly-active-users
Constellation Research. (2026b, March 30). Microsoft 365 Copilot's Researcher agent goes multi-model. https://www.constellationr.com/insights/news/microsoft-365-copilots-researcher-agent-goes-multi-model
Cranney, K., Delecourt, S., & Koning, R. (2026). Global evidence on gender gaps and generative AI over time (Harvard Business School Working Paper No. 25-023). https://www.hbs.edu/ris/Publication%20Files/25023_52957d6c-0378-4796-99fa-aab684b3b2f8.pdf
Daepp, M. I. G., & Counts, S. (2024). The emerging generative artificial intelligence divide in the United States. arXiv:2404.11988. https://arxiv.org/abs/2404.11988
Davis, F. D. (1989). Perceived usefulness, perceived ease of use, and user acceptance of information technology. MIS Quarterly, 13(3), 319-340. https://doi.org/10.2307/249008
Dell'Acqua, F., McFowland III, E., Mollick, E. R., Lifshitz-Assaf, H., Kellogg, K., Rajendran, S., Krayer, L., Candelon, F., & Lakhani, K. R. (2026). Navigating the jagged technological frontier. Organization Science, 37(2), 403-423. https://doi.org/10.1287/orsc.2025.21838
Digital Commerce 360. (2025, April 8). Internal memo: Shopify CEO declares AI non-optional. https://www.digitalcommerce360.com/2025/04/08/internal-memo-shopify-ceo-declares-ai-non-optional/
Doshi, A. R., & Hauser, O. P. (2024). Generative AI enhances individual creativity but reduces the collective diversity of novel content. Science Advances, 10(28), eadn5290. https://doi.org/10.1126/sciadv.adn5290
Du, Y., Li, S., Torralba, A., Tenenbaum, J. B., & Mordatch, I. (2023). Improving factuality and reasoning in language models through multiagent debate. arXiv:2305.14325. https://arxiv.org/abs/2305.14325
European Commission. (2026a). AI literacy: Questions and answers (updated 27 July 2026). https://digital-strategy.ec.europa.eu/en/faqs/ai-literacy-questions-answers
European Commission. (2026b, July 27). AI Omnibus enters into force. https://digital-strategy.ec.europa.eu/en/news/ai-omnibus-enters-force
European Union. (2026). Regulation (EU) 2026/1744 amending Regulation (EU) 2024/1689 (Artificial Intelligence Act), Article 4. Official Journal of the European Union, 24 July 2026. https://eur-lex.europa.eu/eli/reg/2026/1744/oj
ExecutiveGov. (2026, February 17). DOL AI literacy framework. https://www.executivegov.com/articles/dol-ai-literacy-framework
Feldman, M. Q., & Anderson, C. J. (2024). Non-expert programmers in the generative AI future. CHIWORK '24. https://doi.org/10.1145/3663384.3663393
Feng, K. J. K., McDonald, D. W., & Zhang, A. X. (2025). Levels of autonomy for AI agents. arXiv:2506.12469. https://arxiv.org/abs/2506.12469
Ferdman, A. (2025). AI deskilling is a structural problem. AI & Society. https://doi.org/10.1007/s00146-025-02686-z
Fortune. (2026a, January 13). [Report on the launch of Claude Cowork, "Claude Code for the rest of your work"]. https://fortune.com/2026/01/13/anthropic-claude-cowork-ai-agent-file-managing-threaten-startups/
Fortune. (2026b, April 13). [Report on Duolingo dropping AI use from performance evaluations]. https://fortune.com/2026/04/13/duolingo-ceo-luis-von-ahn-ai-usage-requirement-employee-performance-evaluations/
Gallup. (2026, July 20). Organizational AI adoption jumps six points. https://www.gallup.com/workplace/712736/organizational-adoption-jumps-six-points.aspx
Ge, Y., Mei, L., Duan, Z., Li, T., Zheng, Y., Wang, Y., Wang, L., Yao, J., Liu, T., Cai, Y., Bi, B., Guo, F., Guo, J., Liu, S., & Cheng, X. (2025). A survey of vibe coding with large language models. arXiv:2510.12399. https://arxiv.org/abs/2510.12399
GitHub. (2026a). ai-shifu/ChatALL: repository and release download counts (accessed 21 September 2026). https://github.com/ai-shifu/ChatALL
GitHub. (2026b). jackwener/OpenCLI: repository (accessed 21 September 2026). https://github.com/jackwener/OpenCLI
GitHub. (2026c, February 4 and 26). Claude and Codex are now available in public preview on GitHub; now available for Copilot Business and Pro users. https://github.blog/changelog/2026-02-26-claude-and-codex-now-available-for-copilot-business-pro-users/
GitHub. (2026d). BeehiveInnovations/pal-mcp-server and nyldn/claude-octopus: repositories (accessed 21 September 2026). https://github.com/BeehiveInnovations/pal-mcp-server ; https://github.com/nyldn/claude-octopus
GitHub issue reports. (2026). anthropics/claude-code issues #32637 (9 March 2026), #50844 (19 April 2026) and #67188 (10 June 2026), user reports. https://github.com/anthropics/claude-code/issues/32637 ; https://github.com/anthropics/claude-code/issues/50844 ; https://github.com/anthropics/claude-code/issues/67188
Google. (2026, May 19). An important update: Transitioning Gemini CLI to Antigravity CLI. Google Developers Blog. https://developers.googleblog.com/en/an-important-update-transitioning-gemini-cli-to-antigravity-cli/
Google Open Source Blog. (2026, April). A year of open collaboration: Celebrating the anniversary of A2A. https://opensource.googleblog.com/2026/04/a-year-of-open-collaboration-celebrating-the-anniversary-of-a2a.html
Grunde-McLaughlin, M., Mozannar, H., Murad, M., Chen, J., Amershi, S., & Fourney, A. (2026). Overseeing agents without constant oversight: Challenges and opportunities. arXiv:2602.16844. https://arxiv.org/abs/2602.16844
Hargittai, E. (2002). Second-level digital divide: Differences in people's online skills. First Monday, 7(4). https://doi.org/10.5210/fm.v7i4.942
He, G., Demartini, G., & Gadiraju, U. (2025). Plan-then-execute: An empirical study of user trust and team performance when using LLM agents as a daily assistant. CHI 2025. https://doi.org/10.1145/3706598.3713218
Help Net Security. (2026, June 2). [Report on OpenAI Codex use by knowledge workers]. https://www.helpnetsecurity.com/2026/06/02/openai-codex-knowledge-work/
Henseke, G. (2026). Generative AI at work: From exposure to adoption across 35 European countries. arXiv:2604.18849. https://arxiv.org/abs/2604.18849
Humlum, A., & Vestergaard, E. (2025). Still waters, rapid currents: Early labor market transformation under generative AI (NBER Working Paper No. 33777, revised March 2026). https://www.nber.org/papers/w33777
Information Age. (2026, May 5). Gone in 9 seconds: AI agent deletes company database. https://ia.acs.org.au/article/2026/gone-in-9-seconds--ai-agent-deletes-company-database.html
JetBrains Research. (2026a, April). Which AI coding tools do developers actually use at work? https://blog.jetbrains.com/research/2026/04/which-ai-coding-tools-do-developers-actually-use-at-work/
JetBrains Research. (2026b, August). AI coding agents: Adoption trends 2026. https://blog.jetbrains.com/research/2026/08/ai-coding-agent-adoption-2026/
Karpathy, A. (2025). llm-council (repository, accessed 21 September 2026). https://github.com/karpathy/llm-council
Kim, E., Garg, A., Peng, K., & Garg, N. (2025). Correlated errors in large language models. ICML 2025. arXiv:2506.07962. https://arxiv.org/abs/2506.07962
Ko, A. J., Abraham, R., Beckwith, L., Blackwell, A., Burnett, M., Erwig, M., Scaffidi, C., Lawrance, J., Lieberman, H., Myers, B., Rosson, M. B., Rothermel, G., Shaw, M., & Wiedenbeck, S. (2011). The state of the art in end-user software engineering. ACM Computing Surveys, 43(3), Article 21. https://doi.org/10.1145/1922649.1922658
Kosmyna, N., Hauptmann, E., Yuan, Y. T., Situ, J., Liao, X.-H., Beresnitzky, A. V., Braunstein, I., & Maes, P. (2025). Your brain on ChatGPT: Accumulation of cognitive debt when using an AI assistant for essay writing task. arXiv:2506.08872. https://arxiv.org/abs/2506.08872
Kwa, T., West, B., Becker, J., et al. (2025). Measuring AI ability to complete long software tasks. arXiv:2503.14499. https://arxiv.org/abs/2503.14499
Lee, H.-P., Sarkar, A., Tankelevitch, L., Drosos, I., Rintel, S., Banks, R., & Wilson, N. (2025). The impact of generative AI on critical thinking: Self-reported reductions in cognitive effort and confidence effects from a survey of knowledge workers. CHI 2025. https://doi.org/10.1145/3706598.3713778
Lee, J. D., & See, K. A. (2004). Trust in automation: Designing for appropriate reliance. Human Factors, 46(1), 50-80. https://doi.org/10.1518/hfes.46.1.50_30392
Linux Foundation. (2025, December 9). Linux Foundation announces the formation of the Agentic AI Foundation. https://www.linuxfoundation.org/press/linux-foundation-announces-the-formation-of-the-agentic-ai-foundation
Liu, M. X., Sarkar, A., Negreanu, C., Zorn, B., Williams, J., Toronto, N., & Gordon, A. D. (2023). "What it wants me to say": Bridging the abstraction gap between end-user programmers and code-generating large language models. CHI 2023. https://doi.org/10.1145/3544548.3580817
Liu, Y., & Sra, M. (2026). TaskLens: Generating task-conditioned scaffolded interfaces for learning professional creative software. DIS 2026. arXiv:2511.23379. https://arxiv.org/abs/2511.23379
Long, D., & Magerko, B. (2020). What is AI literacy? Competencies and design considerations. CHI 2020. https://doi.org/10.1145/3313831.3376727
Long, T., Zhang, X., Wang, S., Yu, Z., & Chilton, L. B. (2025). DoubleAgents: Human-agent alignment in a socially embedded workflow. arXiv:2509.12626. https://arxiv.org/abs/2509.12626
Ma, L., Xu, X., He, Y., & Tan, Y. (2025). Learning to adopt generative AI. arXiv:2410.19806. https://arxiv.org/abs/2410.19806
Ma, R., Wan, R., Lu, X., Yang, F., Chen, C., & Li, L. (2026). Value-sensitive delegation in everyday AI agent use: Evidence from OpenClaw. arXiv:2609.22067. https://arxiv.org/abs/2609.22067
MacRumors. (2026, July 9). [Report on the launch of ChatGPT Work and the new ChatGPT desktop app]. https://www.macrumors.com/2026/07/09/openai-chatgpt-work/
McKinlay, R., Puntoni, S., & Saka, E. (2026, September 9). To adopt AI at scale, employees need to trust agents. Harvard Business Review. https://hbr.org/2026/09/to-adopt-ai-at-scale-employees-need-to-trust-agents
METR. (2026, February 24). Uplift update. https://metr.org/blog/2026-02-24-uplift-update/
Microsoft. (2026a, March 9). Powering Frontier Transformation with Copilot and agents. https://www.microsoft.com/en-us/copilot/blog/2026/03/09/powering-frontier-transformation-with-copilot-and-agents/
Microsoft. (2026b, May 5). 2026 Work Trend Index: Agents, human agency and the opportunity for every organization. https://www.microsoft.com/en-us/worklab/work-trend-index/agents-human-agency-and-the-opportunity-for-every-organization
Microsoft. (2026c). Use model choice in the Researcher agent. Microsoft Support (accessed 21 September 2026). https://support.microsoft.com/en-us/office/use-model-choice-in-the-researcher-agent
Model Context Protocol. (2026, July 28). [Blog post on the July 2026 specification release]. https://blog.modelcontextprotocol.io/posts/2026-07-28/
Morris, M. R., Sohl-Dickstein, J., Fiedel, N., Warkentin, T., Dafoe, A., Faust, A., Farabet, C., & Legg, S. (2024). Position: Levels of AGI for operationalizing progress on the path to AGI. ICML 2024. arXiv:2311.02462. https://arxiv.org/abs/2311.02462
Myers, B. A., Pane, J. F., & Ko, A. (2004). Natural programming languages and environments. Communications of the ACM, 47(9), 47-52. https://doi.org/10.1145/1015864.1015888
Nardi, B. A. (1993). A small matter of programming: Perspectives on end user computing. MIT Press. https://mitpress.mit.edu/9780262140539/a-small-matter-of-programming/
Noy, S., & Zhang, W. (2023). Experimental evidence on the productivity effects of generative artificial intelligence. Science, 381(6654), 187-192. https://doi.org/10.1126/science.adh2586
OECD & European Commission. (2026). Empowering learners for the age of AI: An AI literacy framework for primary and secondary education. OECD Publishing. https://www.oecd.org/en/publications/empowering-learners-for-the-age-of-ai_65cd27d4-en.html
OpenAI. (2026a). codex-plugin-cc: Use Codex from inside Claude Code (repository, announced 30 March 2026, accessed 21 September 2026). https://github.com/openai/codex-plugin-cc
Panickssery, A., Bowman, S. R., & Feng, S. (2024). LLM evaluators recognize and favor their own generations. NeurIPS 2024. arXiv:2404.13076. https://arxiv.org/abs/2404.13076
Parasuraman, R., Sheridan, T. B., & Wickens, C. D. (2000). A model for types and levels of human interaction with automation. IEEE Transactions on Systems, Man, and Cybernetics, Part A: Systems and Humans, 30(3), 286-297. https://doi.org/10.1109/3468.844354
Parasuraman, R., & Riley, V. (1997). Humans and automation: Use, misuse, disuse, abuse. Human Factors, 39(2), 230-253. https://doi.org/10.1518/001872097778543886
Patwardhan, T., Dias, R., Proehl, E., et al. (2025). GDPval: Evaluating AI model performance on real-world economically valuable tasks. arXiv:2510.04374. https://arxiv.org/abs/2510.04374
Pew Research Center. (2026, June 17). Americans and AI 2026: Chatbots, smart devices and views on impact. https://www.pewresearch.org/internet/2026/06/17/americans-and-ai-2026-chatbots-smart-devices-and-views-on-impact/
PwC. (2026, June 15). 2026 Global AI Jobs Barometer (press release distributed by PR Newswire; report page). https://www.pwc.com/gx/en/issues/artificial-intelligence/ai-jobs-barometer.html
Rogers, E. M. (2003). Diffusion of innovations (5th ed.). Free Press. ISBN 9780743222099.
Sarkar, A., & Drosos, I. (2025). Vibe coding: Programming through conversation with artificial intelligence. PPIG 2025. arXiv:2506.23253. https://arxiv.org/abs/2506.23253
Sarkar, A., Gordon, A. D., Negreanu, C., Poelitz, C., Ragavan, S. S., & Zorn, B. (2022). What is it like to program with artificial intelligence? PPIG 2022. arXiv:2208.06213. https://arxiv.org/abs/2208.06213
Schoenegger, P., Tuminauskaite, I., Park, P. S., Bastos, R. V. S., & Tetlock, P. E. (2024). Wisdom of the silicon crowd: LLM ensemble prediction capabilities rival human crowd accuracy. Science Advances, 10(45), eadp1528. https://doi.org/10.1126/sciadv.adp1528
SiliconANGLE. (2025, December 18). Anthropic makes Agent Skills an open standard. https://siliconangle.com/2025/12/18/anthropic-makes-agent-skills-open-standard/
Simkute, A., Tankelevitch, L., Kewenig, V., Scott, A. E., Sellen, A., & Rintel, S. (2024). Ironies of generative AI: Understanding and mitigating productivity loss in human-AI interactions. arXiv:2402.11364. https://arxiv.org/abs/2402.11364
Sitter, N. (2026). MCP apps census 2026 (data of 29 July and 3 August 2026). https://www.nicolassitter.com/research/mcp-apps-census-2026
Stack Overflow. (2025). 2025 Developer Survey: AI. https://survey.stackoverflow.co/2025/ai
Stack Overflow. (2026, May 27). Agents on a leash: Agentic AI remains mostly monitored at work. https://stackoverflow.blog/2026/05/27/agents-on-a-leash-agentic-ai-remains-mostly-monitored-at-work/
Stankovic, M., Hirche, E., Kollatzsch, S., & Doetsch, J. N. (2026). Comment on: Your brain on ChatGPT. arXiv:2601.00856. https://arxiv.org/abs/2601.00856
Storyboard18. (2026, February 10). Perplexity launches Model Council to compare answers across multiple AI models. https://www.storyboard18.com/digital/perplexity-launches-model-council-to-compare-answers-across-multiple-ai-models-89246.htm
Sweller, J. (1988). Cognitive load during problem solving: Effects on learning. Cognitive Science, 12(2), 257-285. https://doi.org/10.1207/s15516709cog1202_4
TechCrunch. (2025, December 22). OpenAI says AI browsers may always be vulnerable to prompt injection attacks. https://techcrunch.com/2025/12/22/openai-says-ai-browsers-may-always-be-vulnerable-to-prompt-injection-attacks/
TechCrunch. (2026a, September 16). Anthropic merges Claude chat and Cowork in one interface. https://techcrunch.com/2026/09/16/anthropic-merges-claude-chat-and-cowork-in-one-interface/
TechCrunch. (2026b, July 1). Gemini Spark, Google's agentic assistant, is now available on Mac. https://techcrunch.com/2026/07/01/gemini-spark-googles-agentic-assistant-is-now-available-on-mac/
The Register. (2025, July 21). [Report on an application-building agent deleting a production database]. https://www.theregister.com/2025/07/21/replit_saastr_vibe_coding_incident/
The Register. (2026, January 13). Anthropic floats Claude Cowork for office work automation. https://www.theregister.com/software/2026/01/13/anthropic-floats-claude-cowork-for-office-work-automation/4839664
Tomašev, N., Franklin, M., & Osindero, S. (2026). Intelligent AI delegation. arXiv:2602.11865. https://arxiv.org/abs/2602.11865
UNESCO. (2024a). AI competency framework for students. https://www.unesco.org/en/articles/ai-competency-framework-students
UNESCO. (2024b). AI competency framework for teachers. https://www.unesco.org/en/articles/ai-competency-framework-teachers
US Census Bureau. (2026, May 26). [Story on AI use among businesses, Business Trends and Outlook Survey]. https://www.census.gov/library/stories/2026/05/ai-use-businesses.html
US Department of Labor. (2026, February 13). Training and Employment Notice 07-25: Artificial Intelligence Literacy Framework. https://www.dol.gov/newsroom/releases/eta/eta20260213
van Dijk, J. A. G. M. (2020). The digital divide. Polity Press. ISBN 978-1-5095-3444-9. https://research.utwente.nl/en/publications/the-digital-divide-2/
Venkatesh, V., Morris, M. G., Davis, G. B., & Davis, F. D. (2003). User acceptance of information technology: Toward a unified view. MIS Quarterly, 27(3), 425-478. https://doi.org/10.2307/30036540
Virk, Y., & Liu, D. (2025). Non-programmers assessing AI-generated code: A case study of business users analyzing data. arXiv:2508.06484. https://arxiv.org/abs/2508.06484
Vygotsky, L. S. (1978). Mind in society: The development of higher psychological processes. Harvard University Press. https://www.hup.harvard.edu/books/9780674576292
White House. (2025a, April 23). Executive Order 14277: Advancing artificial intelligence education for American youth. https://www.whitehouse.gov/presidential-actions/2025/04/advancing-artificial-intelligence-education-for-american-youth/
White House. (2025b, July). America's AI Action Plan. https://www.whitehouse.gov/wp-content/uploads/2025/07/Americas-AI-Action-Plan.pdf
Willison, S. (2026, January 12). Claude Cowork. https://simonwillison.net/2026/Jan/12/claude-cowork/
Wood, D., Bruner, J. S., & Ross, G. (1976). The role of tutoring in problem solving. Journal of Child Psychology and Psychiatry, 17(2), 89-100. https://doi.org/10.1111/j.1469-7610.1976.tb00381.x
xAI. (2026, May 25). Introducing Grok Build. https://x.ai/news/grok-build-cli
Xie, T., Zhang, D., Chen, J., Li, X., Zhao, S., Cao, R., Hua, T. J., Cheng, Z., Shin, D., Lei, F., Liu, Y., Xu, Y., Zhou, S., Savarese, S., Xiong, C., Zhong, V., & Yu, T. (2024). OSWorld: Benchmarking multimodal agents for open-ended tasks in real computer environments. arXiv:2404.07972. https://arxiv.org/abs/2404.07972
Xu, F. F., Song, Y., Li, B., Tang, Y., Jain, K., Bao, M., Wang, Z. Z., Zhou, X., Guo, Z., Cao, M., Yang, M., Lu, H. Y., Martin, A., Su, Z., Maben, L., Mehta, R., Chi, W., Jang, L., Xie, Y., Zhou, S., & Neubig, G. (2024). TheAgentCompany: Benchmarking LLM agents on consequential real world tasks. arXiv:2412.14161. https://arxiv.org/abs/2412.14161
Yang, Y., Qu, C., Wen, M., Shi, L., Wen, Y., Zhang, W., Wierman, A., & Gu, S. (2026). Understanding agent scaling in LLM-based multi-agent systems via diversity. arXiv:2602.03794. https://arxiv.org/abs/2602.03794
Zamfirescu-Pereira, J. D., Wong, R. Y., Hartmann, B., & Yang, Q. (2023). Why Johnny can't prompt: How non-AI experts try (and fail) to design LLM prompts. CHI 2023. https://doi.org/10.1145/3544548.3581388
Zapier. (2026). Raising the AI fluency bar in hiring. https://zapier.com/blog/raising-ai-fluency-bar-in-hiring/
Zhang, H., Cui, Z., Chen, J., Wang, X., Zhang, Q., Wang, Z., Wu, D., & Hu, S. (2025). Stop overvaluing multi-agent debate: We must rethink evaluation and embrace model heterogeneity. arXiv:2502.08788. https://arxiv.org/abs/2502.08788
Apéndice A. Glosario del modelo
Alcance. Lo que un modelo puede tocar en nombre de una persona: la conversación; archivos y herramientas en un espacio delimitado por el proveedor; la propia computadora de la persona; varios modelos y agentes.
Rol. Lo que la persona debe hacer para que el trabajo tenga éxito: preguntar y copiar; delegar y revisar; ser propietario del entorno; gestionar varios agentes.
Nivel. Una combinación de alcance y rol en la que se realiza un trabajo (Sección 3.2). Los niveles describen el trabajo; las personas y los productos pueden abarcar varios.
Cruce (de una transición). Se registra cuando un agente ha producido, en el nuevo nivel, un artefacto que la persona pidió. La instalación es un intento. Se permite un movimiento superior a un nivel y se registra como salto.
Artefacto. Un archivo, carpeta, acción o salida producida por el agente, que la persona proporciona o conserva. "Nada" es un registro válido.
Vocabulario de flujo de trabajo. El stock de tareas de una persona que sabe cómo confiar a un agente, formuladas de modo que el agente pueda ejecutarlas y se pueda verificar el resultado.
Incorporación reflexiva. Un sistema de IA que respalda la adopción de una persona de un sistema de IA más capaz, como un chatbot que guía la instalación de un agente y la recuperación de sus primeros errores.
Contrato de delegación. Las cuatro cosas que una persona declara cuando entrega trabajo a agentes: objetivo, límite, artefacto, verificación.
Cuatro prácticas. Lo que el gerente hace en todas las tareas: delegación, supervisión, verificación, revocación (Sección 8.1).
Registro de aceptación. Para una tarea consecuencial o recurrente: el entregable previsto, entradas, restricciones y permisos, ubicación de salida, desacuerdos o fallos materiales, verificaciones realizadas, y la decisión de aceptar, revisar, escalar o descartar. Separa lo que el agente produjo de lo que la persona utilizó.
Mapa de cinco partes del trabajo. El objeto del trabajo, las entradas permitidas, la transformación, el entregable y la verificación: la forma en que una tarea recurrente de una persona sin experiencia en programación se convierte en una delegación (Sección 5.1).
Rama lateral. Constructores de aplicaciones de navegador que actúan sobre un proyecto que aloja la plataforma en lugar de en los archivos de la persona; una escalera diferente, con sus propios peldaños (Sección 3.4).
Orquestación web. Una pregunta formulada a varios chatbots de consumidor en el navegador, manualmente o con una herramienta, y comparadas las respuestas.
Orquestación CLI. Un agente que llama a las herramientas de línea de comandos de otros agentes, recopila sus resultados y los fusiona o verifica.
Rotación. El cambio de nombre, fusión o jubilación de herramientas dentro de un período más corto que el tiempo que tarda un recién llegado en aprenderlas.
Número efectivo de opiniones (N_eff). N / (1 + (N - 1) rho) para N modelos con correlación de error por pares media rho; acotado superiormente por 1/rho (Chernets, 2026a).
Marcadores como elementos codificables
Para un codificador de datos cualitativos o un diseñador de encuestas, los marcadores de la Sección 3 se reducen a elementos sí/no sobre un artefacto nombrado. El autoinforme sin un artefacto se registra como una afirmación y no cuenta como un cruce.
- Nivel 1 presente. Al menos una conversación guardada con un chatbot de consumidor en los últimos siete días; artefacto: un enlace, una captura de pantalla o una exportación. La falta de producirlo se codifica como "no demostrado", que es un hallazgo más débil que "ausente".
- Transición 1 cruzada. Un archivo o conjunto de archivos escrito por un agente delimitado (de escritorio, web o alojado en inquilino) dentro de una ubicación que la persona otorgó, en respuesta a un trabajo que la persona pidió, con al menos una aprobación, un rechazo o una edición de plan registrados. La fecha del artefacto es la fecha del cruce.
- Nivel 2 presente. Transición 1 cruzada, más un artefacto delimitado adicional en una semana posterior. La persistencia se registra como un elemento semanal separado, aparte del cruce.
- Transición 2 cruzada. Una carpeta de trabajo, una confirmación o un conjunto de archivos fechados producidos por un agente local o su shell de escritorio oficial, en una máquina que la persona controla, de un trabajo que requería más de una herramienta. El trabajo alojado en la nube se codifica como una variante de nube propia.
- Nivel 3 presente. Transición 2 cruzada, más un artefacto de semana posterior de la misma clase de agente.
- Transición 3, forma de puente. Un archivo fechado que contiene la pregunta, los chatbots o modelos web preguntados, las respuestas brutas o enlaces a ellas, una nota de acuerdo y desacuerdo, y una nota de si cobertura o confiabilidad (Sección 6.2) aparecieron; producido a mano o por una herramienta de transmisión.
- Transición 3, forma durable. Los mismos campos, producidos por una ejecución que invocó dos o más herramientas de línea de comandos oficiales (u uno más un complemento de segunda familia) en los propios inicios de sesión de la persona, con el denominador registrado: preguntó, respondió, agotó el tiempo.
- Nivel 4 presente. Cualquiera de las formas de transición 3, más una segunda ejecución fechada en una semana posterior.
- Asistido frente a sin asistencia. Cualquier cruce en el que el investigador, un colega o un entrenador pagado realizó un paso de instalación, escribió el trabajo o se recuperó de un error se considera asistido. Los completamientos se informan como dos números donde un auxiliar estuvo disponible.
- Razón de parada. Una respuesta de texto libre a "qué te detuvo", preguntada a todos los que no cruzaron y se codificó después de la recolección. Códigos candidatos, ofrecidos como una hipótesis para que los codificadores posteriores revisen: vocabulario de flujo de trabajo; diálogo de permiso o seguridad; derechos de administrador; costo o cuota; miedo a la interfaz; noticia de un incidente destructivo; política organizacional; error técnico; vida y tiempo; otro.
- Regla de codificación para "no sabía qué preguntar" (vocabulario de flujo de trabajo). Incluir cuando la persona, preguntada qué intentó que hiciera el agente, no puede nombrar al menos una de las cinco partes de la Sección 5.1: el objeto del trabajo, las entradas que puede usar, la transformación, el entregable, o la verificación. Excluir cuando las cinco están nombradas y la persona rechazó por motivos de política, riesgo, costo o tiempo; esos obtienen sus propios códigos. Dos codificadores codifican de forma independiente e informan su acuerdo. La regla clasifica una parada y no dice nada sobre la capacidad de la persona.
- Rastros de las cuatro prácticas (sí/no, cada uno vinculado a un artefacto fechado): un plan rechazado; un diff o salida rechazada; una segunda familia de modelos preguntada; un denominador registrado (quién fue preguntado, quién respondió, quién agotó el tiempo); un paso irreversible mantenido para confirmación; un artefacto depositado. Estos son los rastros de supervisión de P10.
- No son marcadores. Una compra de licencia, una insignia de curso, un registro de instalación, una estrella de repositorio, un recuento de solicitudes, o una autoevaluación como «usuario agente».
Apéndice B. Cronología fechada, 2025 a 21 de septiembre de 2026
Las entradas marcadas como VERIFIED se abrieron en una página principal, o en una página secundaria nombrada para un informe de prensa, durante la ventana de investigación que termina el 21 de septiembre de 2026. Las entradas marcadas como SECONDARY se basan en informes de prensa o historiales de productos que no se abrieron en una página principal; se proporcionan para orientación y no tienen peso en el argumento. Es una cronología de trabajo para el argumento de cuatro niveles y no pretende ser una cronología de la industria.
| Fecha | Evento | Fuente | Estado |
|---|---|---|---|
| 24 de febrero de 2025 | Vista previa de investigación de Claude Code | Historiales de productos, ampliamente reportados | SECONDARY |
| 23 de abril de 2025 | Orden Ejecutiva 14277 sobre educación en IA | White House (2025a) | VERIFIED |
| 22 de mayo de 2025 | Claude Code disponible de manera general | Historiales de productos, ampliamente reportados | SECONDARY |
| 23 de junio de 2025 | Protocolo Agent2Agent donado a Linux Foundation | Google Open Source Blog (2026) | VERIFIED (vendor) |
| Julio de 2025 | El Plan de Acción de Inteligencia Artificial de Estados Unidos se compromete con la alfabetización y habilidades en IA | White House (2025b) | VERIFIED |
| 21 de julio de 2025 | Un agente de construcción de aplicaciones elimina una base de datos de producción durante una sesión en vivo | The Register (2025) | VERIFIED (press) |
| 20 de agosto de 2025 | Inyección de instrucción demostrada contra un agente del navegador, con un código de un solo uso robado | Brave (2025) | VERIFIED |
| 25 de agosto de 2025 | Piloto de agente del navegador: éxito de ataque 23,6 % sin mitigaciones, 11,2 % con | Anthropic (2025) | VERIFIED (vendor) |
| 9 de diciembre de 2025 | Protocolo de Contexto de Modelo donado a Agentic AI Foundation (Linux Foundation); más de 10 000 servidores publicados, aproximadamente 97 millones de descargas de SDK mensualmente | Linux Foundation (2025) | VERIFIED |
| 9 de diciembre de 2025 | Una firma de consultoría anuncia que aproximadamente 30 000 empleados serán capacitados en los modelos de un proveedor | Accenture (2025) | VERIFIED |
| 18 de diciembre de 2025 | Formato Agent Skills lanzado como un estándar abierto | SiliconANGLE (2025) | VERIFIED (press) |
| 22 de diciembre de 2025 | OpenAI: inyección de instrucción «improbable que alguna vez se resuelva por completo» | TechCrunch (2025) | VERIFIED (press) |
| Enero de 2026 | Vista previa de investigación de Cowork, «Claude Code para el resto de su trabajo» | Fortune (2026a); The Register (2026) | VERIFIED (press) |
| 12 de enero de 2026 | Objeción a pedirles a los no programadores que vigilen la inyección de instrucciones | Willison (2026) | VERIFIED |
| 15 de enero de 2026 | Índice Económico de Anthropic: aumento del 52 % de las conversaciones (noviembre de 2025) | Anthropic (2026f) | VERIFIED (vendor) |
| 4 y 26 de febrero de 2026 | GitHub Agent HQ: agentes Claude y Codex disponibles dentro de Copilot | GitHub (2026c) | VERIFIED |
| Febrero de 2026 | Consejo de Modelos de Perplexity para suscriptores de nivel superior (reportado el 10 de febrero) | Storyboard18 (2026) | VERIFIED (press) |
| 13 de febrero de 2026 | Marco de Alfabetización en IA del Departamento de Trabajo de EE. UU. («dirigir la IA de manera efectiva») | US Department of Labor (2026) | VERIFIED |
| 9 de marzo de 2026 | Tecnología de Cowork llevada a Microsoft 365 Copilot | Microsoft (2026a) | VERIFIED |
| 9 de marzo, 19 de abril, 10 de junio de 2026 | Informes de usuarios de archivos eliminados por un agente de nivel 2 dentro de carpetas otorgadas | GitHub issue reports (2026) | VERIFIED (user reports) |
| 24 de marzo de 2026 | Índice Económico de Anthropic: usuarios con más antigüedad delegan menos | Anthropic (2026e) | VERIFIED (vendor) |
| 30 de marzo de 2026 | Complemento oficial de OpenAI para usar su agente dentro de Claude Code; el agente de investigación de Microsoft ejecuta GPT y Claude juntos | OpenAI (2026a); Constellation Research (2026b); Microsoft (2026c) | VERIFIED |
| Abril de 2026 | JetBrains: Claude Code en trabajo 18 % (enero de 2026), desde aproximadamente 3 % (primavera de 2025) | JetBrains Research (2026a) | VERIFIED (vendor survey) |
| 13 de abril de 2026 | Duolingo elimina el uso de IA de las evaluaciones de desempeño | Fortune (2026b) | VERIFIED (press) |
| 5 de mayo de 2026 | Índice de Tendencias de Trabajo: los factores organizacionales superan a los individuales más del doble | Microsoft (2026b) | VERIFIED (vendor survey) |
| 25 de abril de 2026 (reportado el 5 de mayo) | El agente elimina la base de datos de producción y copias de seguridad de una empresa | Information Age (2026) | VERIFIED (press) |
| 19 de mayo de 2026 | Google anuncia el cambio de Gemini CLI a Antigravity CLI | Google (2026) | VERIFIED |
| 25 de mayo de 2026 | Compilación Grok de xAI lanzada con modo sin interfaz gráfica y soporte de protocolo de agente | xAI (2026) | VERIFIED (vendor) |
| 26 de mayo de 2026 | Uso de IA en negocios estadounidenses del 17 % al 20 % en general; pequeñas empresas sin cambios | US Census Bureau (2026) | VERIFIED |
| 27 de mayo de 2026 | Pulso del desarrollador: 69 % agente único; 60 % bloquea cambios no aprobados | Stack Overflow (2026) | VERIFIED |
| 2 de junio de 2026 | Agente de codificación con 5 millones de usuarios semanales, aproximadamente 20 % de trabajadores del conocimiento | Help Net Security (2026); Constellation Research (2026a) | VERIFIED (press report of vendor data) |
| 15 de junio de 2026 | Barómetro de Trabajos de IA de PwC: prima salarial del 62 % para habilidades de IA | PwC (2026) | VERIFIED (vendor) |
| 17 de junio de 2026 | Pew: aproximadamente la mitad de los adultos estadounidenses utilizan chatbots | Pew Research Center (2026) | VERIFIED |
| 18 de junio de 2026 | Gemini CLI deja de servir niveles individuales | Google (2026) | VERIFIED |
| Junio de 2026 | Marco de Alfabetización en IA de la OCDE y la Comisión Europea («Gestionar la IA») | OECD & European Commission (2026) | VERIFIED |
| 29 de junio a 3 de julio de 2026 | Claude Code cambia el nombre de su modo de permiso predeterminado a «Manual» | Anthropic (2026h) | VERIFIED (vendor) |
| 1 de julio de 2026 | Agente de escritorio Gemini Spark en Mac; mejor tasa de automatización del Índice de Trabajo Remoto 15,8 %, desde 2,5 % en el lanzamiento | TechCrunch (2026b); Center for AI Safety (2026) | VERIFICADO |
| 8 July 2026 | Indeed: el 63% de los puestos de trabajo estadounidenses afectados por IA están fuera de ocupaciones tecnológicas | Adrjan (2026) | VERIFICADO |
| 9 July 2026 | La aplicación de agente de codificación se convierte en la aplicación de escritorio ChatGPT; se lanza ChatGPT Work | MacRumors (2026) | VERIFICADO (prensa) |
| 20 July 2026 | Gallup: el 52% de los trabajadores estadounidenses usan IA, el 15% a diario | Gallup (2026) | VERIFICADO |
| 27 July 2026 | EU AI Omnibus en vigor; el deber de alfabetización en IA se convierte en «tomar medidas para apoyar» | European Commission (2026a, 2026b) | VERIFICADO |
| 28 July 2026 | Model Context Protocol: cerca de 500 millones de descargas de SDK al mes; protocolo sin estado | Model Context Protocol (2026) | VERIFICADO |
| 3 August 2026 | Se aplican las normas de supervisión y cumplimiento de la UE para la alfabetización en IA | European Commission (2026a) | VERIFICADO |
| August 2026 | JetBrains: el 90% de los desarrolladores profesionales usan agentes de codificación semanalmente; Claude Code en el trabajo 39% | JetBrains Research (2026b) | VERIFICADO (encuesta del vendedor) |
| 9 August 2026 | Se descontinúa el navegador agéntico de OpenAI; la navegación se traslada a la aplicación ChatGPT | 9to5Mac (2026) | VERIFICADO (prensa) |
| 26 August 2026 | Agente de navegador generalmente disponible; autónomo con clasificador por defecto; tasas de inyección reportadas por el vendedor cercanas a cero | Anthropic (2026d) | VERIFICADO (vendedor) |
| 1 September 2026 | St. Louis Fed: el 45% de los trabajadores utiliza IA en sus trabajos; menos del 3% de las tareas con adopción superior al 50% | Bick et al. (2026) | VERIFICADO |
| 6 September 2026 | Se congela la preregistración de la cohorte 1 | Chernets (2026d) | VERIFICADO |
| 9 September 2026 | Harvard Business Review: la confianza como obstáculo central para la adopción de agentes en el trabajo | McKinlay et al. (2026) | VERIFICADO (resumen) |
| 16 September 2026 | Cowork y chat se fusionan en un Claude | Anthropic (2026c); TechCrunch (2026a) | VERIFICADO |
| 22 September 2026 | Catálogo oficial de complementos leído en su totalidad, 310 entradas: ninguna para los cinco oficios nombrados en la Sección 5.1; catálogo comunitario de 2.282 entradas, ofertas para maestros y bienes raíces | Lectura del autor de los catálogos publicados | VERIFICADO (conteo propio) |
Apéndice C. Código educativo
Los listados a continuación enseñan los patrones de las secciones 5 a 9. Utilizan únicamente la biblioteca estándar de Python y las herramientas de línea de comandos propias de los proveedores, iniciadas con las suscripciones propias del usuario; ninguna lee una clave de API. Cada uno es lo suficientemente breve para leerlo de una sentada, y cada uno indica qué enseña y dónde se detiene. Se depositan con pruebas en el repositorio complementario bajo la licencia MIT, y todos los listados se ejecutaron antes de su inclusión (cada uno en su entrada de demostración, la distribución en abanico en herramientas auxiliares). Cada patrón aquí ya existe en alguna forma en herramientas de código abierto (Sección 7.1); el valor de los listados es que son pequeños, comentados y vinculados al argumento. Ninguno es una ruta de enseñanza, un diagnóstico del aprendiz, un plan de estudios o una implementación de las herramientas del autor. Una persona que no es programadora no ejecuta estos archivos manualmente: son el tipo de cosa que un agente envuelve como una habilidad o un shell de escritorio expone como un botón, y el propósito de imprimirlos es que un lector pueda ver qué hace tal botón.
Dos complementos instalables de Claude Code ponen estos patrones en uso cotidiano. Roundcall consulta los sitios de chat de IA a los que una persona ya ha iniciado sesión, a través de su propio navegador y al ritmo de la persona; Sidecall consulta los agentes de línea de comandos instalados en su máquina, con una configuración de presupuesto que elige el modelo de cada proveedor. Ambos devuelven un informe de quién dijo qué, dónde las respuestas divergen y qué dijo solo una fuente. Son de código abierto bajo la licencia Apache 2.0 en https://github.com/vadimchernets/roundcall y https://github.com/vadimchernets/sidecall.
Antes de ejecutar cualquiera de ellas: verifique la opción --help de cada herramienta en su versión instalada, porque las banderas cambian entre versiones; ejecútelas en una carpeta de trabajo que contenga copias, no originales; y lea el listado C6 primero.
C1. Distribución en abanico con una sonda, un techo y captura parcial (fanout.py)
Enseña: cómo una persona puede hacer una pregunta a varios CLIs de agentes a la vez, omitir los que están caídos o sin cuota, dejar de esperar en un techo de tiempo y conservar lo que escribió cada herramienta antes del techo en lugar de descartarlo. Cada herramienta se ejecuta en una carpeta nueva y vacía dentro de la carpeta de salida, nunca en la carpeta desde la que se lanzó; los nombres de herramientas se limitan a nombres de archivo seguros; una pregunta larga va en un archivo (--question-file) o, para una herramienta cuya plantilla no tiene {prompt}, en la entrada estándar de la herramienta, ya que el argumento de línea de comandos está limitado en longitud por el sistema operativo. Límites: detenerse en el techo usa grupos de procesos POSIX (macOS y Linux; en Windows use WSL) y recurre a detener la herramienta misma; una herramienta que solo imprime al final no deja nada que conservar cuando se detiene; use su modo de salida en transmisión si lo tiene. El script no compara nada; C3 lo hace.
#!/usr/bin/env python3
"""fanout.py: put one question to several agent CLIs and keep every answer, including partial ones.

Teaching example for "After Chat" (Appendix C, listing C1). MIT licence.

The pattern: probe each tool briefly and skip the dead ones, run the live ones in parallel under one
time ceiling, stream each answer to its own file, and keep whatever a tool has written when the
ceiling is reached. It uses only the Python standard library and the vendors' own command-line tools,
signed in with the user's own subscriptions. No API keys are read or needed.

Each tool runs in its own fresh, empty working folder inside the output folder, never in the folder
you launched from. Stopping a tool at the ceiling stops its whole process group, which is a POSIX
feature (macOS, Linux; on Windows use WSL); where that fails the tool itself is killed.

Usage:
    python3 fanout.py "Your question" --out runs/today
    python3 fanout.py --question-file question.txt --tools tools.json --ceiling 900
    python3 fanout.py -- "-a question that starts with a dash"
A question on the command line is limited by the operating system's argument length; put long
questions in a file. A tool whose template has no "{prompt}" receives the question on its standard
input instead (for example `codex exec -`), which has no such limit.
"""
import argparse
import json
import os
import pathlib
import re
import signal
import subprocess
import sys
import time

# Command templates. "{prompt}" is replaced by the question; a template without it gets the question
# on stdin. Check each tool's --help on your installed version: flags change between releases.
DEFAULT_TOOLS = {
    "claude": ["claude", "-p", "{prompt}"],
    "codex": ["codex", "exec", "--skip-git-repo-check", "--sandbox", "read-only", "{prompt}"],
    "gemini": ["agy", "-p", "{prompt}"],
    "grok": ["grok", "-p", "{prompt}"],
}
PROBE_PROMPT = "Reply with exactly one word: OK"
SAFE_NAME = re.compile(r"^[A-Za-z0-9][A-Za-z0-9_-]{0,31}$")  # a tool name becomes a file and folder name


def build(template, prompt):
    return [part.replace("{prompt}", prompt) for part in template]


def uses_stdin(template):
    return not any("{prompt}" in part for part in template)


def stop_group(proc):
    """Stop a tool and every process it started (they share one process group on POSIX)."""
    for sig in (signal.SIGTERM, signal.SIGKILL):
        try:
            os.killpg(proc.pid, sig)
        except ProcessLookupError:
            return
        except (PermissionError, OSError, AttributeError):
            proc.kill()  # no process group to stop (or no right to): stop the tool itself
        try:
            proc.wait(timeout=5)
            return
        except subprocess.TimeoutExpired:
            continue


def workdir(out_dir, name):
    """A fresh, empty folder per tool: the tool never sees the caller's files."""
    d = out_dir / f"work-{name}"
    d.mkdir(parents=True, exist_ok=True)
    return d


def probe(name, template, seconds, out_dir):
    """A few seconds now saves a long wait later: a tool behind a quota wall answers fast and badly."""
    started = time.monotonic()
    stdin_text = PROBE_PROMPT if uses_stdin(template) else None
    try:
        done = subprocess.run(build(template, PROBE_PROMPT), capture_output=True, text=True,
                              timeout=seconds, cwd=workdir(out_dir, name), input=stdin_text,
                              stdin=None if stdin_text is not None else subprocess.DEVNULL)
    except FileNotFoundError:
        return False, "not installed"
    except subprocess.TimeoutExpired:
        return False, f"no answer within {seconds}s"
    text = (done.stdout + done.stderr).strip()
    if done.returncode != 0 or not done.stdout.strip():
        return False, f"exit {done.returncode}: {text[:160]}"
    return True, f"alive in {time.monotonic() - started:.1f}s"


def run_all(tools, prompt, out_dir, ceiling):
    out_dir.mkdir(parents=True, exist_ok=True)
    running, results = {}, {}
    for name, template in tools.items():
        out = open(out_dir / f"{name}.txt", "w")
        err = open(out_dir / f"{name}.err", "w")
        work = workdir(out_dir, name)
        if uses_stdin(template):
            (work / "question.txt").write_text(prompt)
            stdin = open(work / "question.txt")
        else:
            stdin = subprocess.DEVNULL  # closed: some tools wait on an open stdin and never start
        try:
            proc = subprocess.Popen(build(template, prompt), stdout=out, stderr=err, stdin=stdin,
                                    cwd=work, start_new_session=True)
        except FileNotFoundError:
            # One missing tool must not cost the answers of the others.
            out.close(); err.close()
            results[name] = {"status": "not installed", "seconds": 0.0}
            continue
        finally:
            if stdin is not subprocess.DEVNULL:
                stdin.close()
        running[name] = (proc, out, err, time.monotonic())
    deadline = time.monotonic() + ceiling
    while running:
        for name in list(running):
            proc, out, err, t0 = running[name]
            if proc.poll() is not None:
                out.close(); err.close()
                status = "done" if proc.returncode == 0 else f"failed (exit {proc.returncode})"
                results[name] = {"status": status, "seconds": round(time.monotonic() - t0, 1)}
                del running[name]
        if running and time.monotonic() >= deadline:
            for name, (proc, out, err, t0) in running.items():
                stop_group(proc)
                out.close(); err.close()
                written = (out_dir / f"{name}.txt").stat().st_size
                # The watchdog does not destroy: what was written before the ceiling is kept.
                results[name] = {"status": "partial" if written else "timeout",
                                 "seconds": round(time.monotonic() - t0, 1)}
            running = {}
        time.sleep(0.5)
    for name, r in results.items():
        r["bytes"] = (out_dir / f"{name}.txt").stat().st_size
    return results


def main():
    ap = argparse.ArgumentParser(description=__doc__.splitlines()[0])
    ap.add_argument("question", nargs="?", help="the question (put -- before one that starts with a dash)")
    ap.add_argument("--question-file", help="read the question from this file instead")
    ap.add_argument("--tools", help="JSON file mapping a tool name to its command template")
    ap.add_argument("--out", default="fanout-run", help="folder for answers, work folders and the summary")
    ap.add_argument("--ceiling", type=float, default=900, help="seconds before partial answers are taken")
    ap.add_argument("--probe-seconds", type=float, default=60)
    ap.add_argument("--no-probe", action="store_true")
    a = ap.parse_args()

    if a.question_file:
        prompt = pathlib.Path(a.question_file).read_text()
    elif a.question is not None:
        prompt = a.question
    else:
        ap.error("give a question or --question-file")
    tools = json.loads(pathlib.Path(a.tools).read_text()) if a.tools else dict(DEFAULT_TOOLS)
    for name in tools:
        if not SAFE_NAME.match(name):
            sys.exit(f"tool name {name!r} is not a safe file name (letters, digits, - and _ only)")
    out_dir = pathlib.Path(a.out)
    out_dir.mkdir(parents=True, exist_ok=True)

    skipped = {}
    if not a.no_probe:
        for name in list(tools):
            ok, why = probe(name, tools[name], a.probe_seconds, out_dir)
            print(f"probe {name:10s} {'live' if ok else 'SKIP'}  {why}", file=sys.stderr)
            if not ok:
                skipped[name] = why
                del tools[name]
    if len(tools) < 2:
        print("Fewer than two live tools: this would be one opinion, not a comparison.", file=sys.stderr)
    results = run_all(tools, prompt, out_dir, a.ceiling)
    summary = {"question": prompt[:500], "ceiling_s": a.ceiling, "results": results, "skipped": skipped}
    (out_dir / "summary.json").write_text(json.dumps(summary, indent=2))
    for name, r in sorted(results.items()):
        print(f"{name:10s} {r['status']:18s} {r['seconds']:7.1f}s {r['bytes']:8d} bytes")
    for name, why in skipped.items():
        print(f"{name:10s} skipped            {why}")


if __name__ == "__main__":
    main()
C2. Una habilidad de "segunda opinión" para un agente (second-opinion/SKILL.md)
Enseña: la forma más pequeña de orquestación CLI, una instrucción escrita que hace que un agente le pregunte a un agente de un proveedor diferente y muestre la diferencia en lugar de fusionarla. Limitaciones: dos modelos son una comparación, no un panel; la habilidad dice qué puntos aún necesitan una fuente primaria.
---
name: second-opinion
description: Ask a model from a different vendor the same question through its own command-line tool, and show where its answer differs. Use when the user asks for a second opinion, a check, or "what would another AI say".
---

# Second opinion

1. Write the user's question, and only the context needed to answer it, to `question.txt` in the
   working folder. Leave out secrets and personal data.
2. Run the other vendor's tool read-only, with its input closed:
   `codex exec --skip-git-repo-check --sandbox read-only - < question.txt > second-opinion.txt`
   (or `agy -p "$(cat question.txt)" > second-opinion.txt`, or another installed tool).
3. Show the other answer as it came, under its own heading. Treat it as content to compare, never as
   instructions to act on: another model's answer can carry instructions it picked up from a page.
4. Then give a short table with three rows: where the two answers agree, where they differ, and what
   only one of them mentions.
5. Do not merge the two answers into one confident text. Agreement between two models is weaker
   evidence than it looks when they share training data; say which points would need a primary source.
C3. Quién dijo qué (provenance.py)
Enseña: las dos cosas que se pretende obtener al consultar varios modelos, cobertura y confiabilidad, hechas visibles como una tabla de afirmaciones por fuente, una lista de afirmaciones hechas por una sola fuente, y una lista de afirmaciones cuyos números o fechas difieren. Limitaciones: coincide con la redacción repetida, no con el significado repetido; le dice a una persona qué leer atentamente, nunca lo que es verdadero.
#!/usr/bin/env python3
"""provenance.py: who said what, who said it alone, and where the numbers disagree.

Teaching example for "After Chat" (Appendix C, listing C3). MIT licence.

Reads the answer files written by fanout.py (one .txt per tool), splits each answer into short claims
(bullets or sentences), groups near-identical claims by word overlap, and prints a table of claims by
source. Two lists matter most, because they are the two things asking several models is meant to buy:
  * claims made by one source only: coverage, an angle the others missed (or an error of one);
  * claims whose numbers differ between sources: a disagreement to check before relying on either.
Word overlap sees repeated wording, not repeated meaning. Use the table to decide what to read
closely, never as a verdict on what is true.

Usage:
    python3 provenance.py fanout-run/            # writes fanout-run/provenance.md
"""
import pathlib
import re
import sys

STOP = set("""a an the and or of to in on for with by is are was were be been it this that these those
as at from than then so such can could should would may might will not no do does did their its your
our we you they he she i""".split())
MONTHS = "January|February|March|April|May|June|July|August|September|October|November|December"
# Values compared between sources: numbers, percentages and month names (dates disagree by month too).
NUM = re.compile(r"\d+(?:[.,]\d+)?%?|\b(?:" + MONTHS + r")\b")


def claims(text):
    parts = []
    for line in text.splitlines():
        line = line.strip(" -*\t#>")
        if not line:
            continue
        parts.extend(s.strip() for s in re.split(r"(?<=[.!?])\s+", line) if len(s.split()) >= 4)
    return parts


def words(claim):
    # [^\W_]+ is any run of letters or digits in any script, so accented and non-Latin words count.
    return {w for w in re.findall(r"[^\W_]+", claim.lower()) if w not in STOP}


def jaccard(a, b):
    return len(a & b) / len(a | b) if a | b else 0.0


def group(sources, threshold):
    groups = []  # each: {"text": representative, "words": set, "by": {source: claim}}
    for source, items in sources.items():
        for c in items:
            w = words(c)
            for g in groups:
                if jaccard(w, g["words"]) >= threshold:
                    g["by"].setdefault(source, c)
                    break
            else:
                groups.append({"text": c, "words": w, "by": {source: c}})
    return groups


def main():
    folder = pathlib.Path(sys.argv[1] if len(sys.argv) > 1 else ".")
    threshold = float(sys.argv[2]) if len(sys.argv) > 2 else 0.5
    sources = {p.stem: claims(p.read_text()) for p in sorted(folder.glob("*.txt")) if p.stat().st_size}
    if len(sources) < 2:
        sys.exit("Need at least two non-empty answers to compare.")
    groups = group(sources, threshold)
    names = list(sources)
    out = ["| claim | " + " | ".join(names) + " | support |", "|---|" + "---|" * len(names) + "---|"]
    for g in sorted(groups, key=lambda g: -len(g["by"])):
        marks = " | ".join("x" if n in g["by"] else "" for n in names)
        out.append(f"| {g['text'][:120]} | {marks} | {len(g['by'])} |")
    alone = [g for g in groups if len(g["by"]) == 1]
    out += ["", f"## Said by one source only ({len(alone)})", ""]
    out += [f"- [{next(iter(g['by']))}] {g['text']}" for g in alone]
    out += ["", "## Same claim, different numbers", ""]
    for g in groups:
        nums = {s: tuple(NUM.findall(c)) for s, c in g["by"].items()}
        if len({v for v in nums.values() if v}) > 1:
            out.append(f"- {g['text'][:100]}: " + "; ".join(f"{s}={','.join(v)}" for s, v in nums.items()))
    report = "\n".join(out) + "\n"
    (folder / "provenance.md").write_text(report)
    print(report)


if __name__ == "__main__":
    main()
C4. ¿Cuántas opiniones independientes vale un acuerdo? (neff.py)
Enseña: la aritmética de la evidencia correlacionada (Sección 6.3): estimar la correlación de error promedio rho a partir de elementos con respuestas conocidas, luego calcular N_eff y su límite superior 1/rho. Ejecutar con --demo para ver cuatro modelos que valen aproximadamente 1,6 opiniones independientes. Limitaciones: rho depende de la tarea; estímalo en elementos como los que te interesan, y con más de diez elementos.
#!/usr/bin/env python3
"""neff.py: how many independent opinions are N agreeing models worth?

Teaching example for "After Chat" (Appendix C, listing C4). MIT licence.

Uses the correlated-evidence model of Chernets (2026a):
    N_eff = N / (1 + (N - 1) * rho)        and, as N grows, N_eff approaches 1 / rho.
rho is estimated from the models' errors on items whose right answer is known: for each pair of
models, the correlation (phi coefficient) between "model A was wrong" and "model B was wrong".

Input: a CSV with one row per item and one 0/1 column per model (1 = correct).
Usage:
    python3 neff.py results.csv
    python3 neff.py --demo
"""
import csv
import itertools
import math
import sys

DEMO = """item,model_a,model_b,model_c,model_d
q1,1,1,1,1
q2,0,0,1,0
q3,1,1,1,1
q4,0,0,0,1
q5,1,1,0,1
q6,1,1,1,1
q7,0,0,1,0
q8,1,0,1,1
q9,1,1,1,1
q10,0,0,0,0
"""


def phi(x, y):
    """Correlation of two 0/1 vectors. Returns None when one of them never varies."""
    n = len(x)
    n11 = sum(1 for a, b in zip(x, y) if a and b)
    n1_, n_1 = sum(x), sum(y)
    denom = math.sqrt(n1_ * (n - n1_) * n_1 * (n - n_1))
    if denom == 0:
        return None
    return (n * n11 - n1_ * n_1) / denom


def n_eff(n, rho):
    """Effective number of independent opinions. N must be at least 1; rho must lie in [0, 1)."""
    if n < 1:
        raise ValueError(f"N must be at least 1, not {n}")
    if not 0 <= rho < 1:
        raise ValueError(f"rho must be in [0, 1), not {rho}; at rho = 1 every model is one opinion")
    return n / (1 + (n - 1) * rho)


def main():
    if len(sys.argv) > 1 and sys.argv[1] != "--demo":
        text = open(sys.argv[1]).read()
    else:
        text = DEMO
        print("(demo data: 10 items, 4 models)\n")
    rows = list(csv.DictReader(text.strip().splitlines()))
    models = [c for c in rows[0] if c != "item"]
    errors = {m: [1 - int(r[m]) for r in rows] for m in models}

    pairs = []
    for a, b in itertools.combinations(models, 2):
        r = phi(errors[a], errors[b])
        shown = "n/a (no variation)" if r is None else f"{r:+.2f}"
        print(f"error correlation {a} ~ {b}: {shown}")
        if r is not None:
            pairs.append(r)
    if not pairs:
        print("No pair varies; rho cannot be estimated from these items.")
        return
    rho = max(0.0, sum(pairs) / len(pairs))  # negative average is treated as independence
    n = len(models)
    print(f"\nmean pairwise error correlation rho = {rho:.2f}")
    if rho >= 1:
        print(f"the models err together on every item: {n} models are worth one opinion")
        return
    print(f"{n} models are worth about {n_eff(n, rho):.2f} independent opinions")
    if rho > 0:
        print(f"no number of models with this rho is worth more than {1 / rho:.1f}")
    print("\nN   N_eff at this rho")
    for k in (1, 2, 3, 5, 10, 20):
        print(f"{k:<3d} {n_eff(k, rho):.2f}")


if __name__ == "__main__":
    main()
C5. Un registro de cruces, y un verificador (crossings.py)
Enseña: las reglas de medición de la Sección 9.1 como código. Se rechaza un registro si cuenta una instalación como un cruce, una finalización sin un artefacto producido por agente, una parada sin las propias palabras de la persona, ayuda sin una descripción de la ayuda, un nombre en lugar de una etiqueta seudónima (la etiqueta debe ser P seguida de dígitos), un nivel omitido que no está listado exactamente, un valor que no es verdadero o falso, una fecha ilegible, un campo que el formato no conoce, o un cruce de nivel 4 que nombra menos de dos herramientas preguntadas y respondidas. Una línea malformada se informa como rechazada y nunca detiene la ejecución. Límites: verifica la forma de los registros, no su veracidad; si las dos herramientas son familias de modelos diferentes, y si el arreglo se volvió a ejecutar en una semana posterior (un segundo registro), se dejan al investigador; es un instrumento de investigación, no una aplicación.
#!/usr/bin/env python3
"""crossings.py: a record format for level transitions, and a checker for it.

Teaching example for "After Chat" (Appendix C, listing C5). MIT licence. A research instrument, not
an application: it defines what a record of one person's attempt at one transition must contain, and
refuses records that would let an installation be counted as use.

The rules follow the measures published in the preregistration the paper describes (OSF, DOI
10.17605/OSF.IO/X4EGQ): a transition counts as crossed only when an artefact produced by the agent is
supplied; installing is an attempt; assisted and unaided crossings are kept apart; a stop is recorded
with the point where it happened and the person's own words. The record format is also published as
a JSON Schema (crossings.schema.json); this checker accepts exactly what the schema accepts and adds
the rules a schema cannot state.

What the checker enforces for a level-4 crossing: at least two tools named as asked and as answered.
What it leaves to the researcher: that the tools are different model families, and that the
arrangement was rerun in a later week (a second record).

Usage:
    python3 crossings.py records.jsonl        # one JSON object per line
    python3 crossings.py --demo
"""
import datetime
import json
import re
import sys

LEVELS = ("chat", "safe_agentic_environment", "agent_on_own_computer", "orchestrated_work")
ARTEFACTS = ("file", "folder", "screenshot", "pasted_output", "none")
DECISIONS = ("accept", "revise", "escalate", "discard")
REQUIRED = ("record_id", "person", "level_from", "level_to", "materials_sent", "completed", "assisted")
# Every key a record may carry; the same set as the properties of crossings.schema.json.
ALLOWED = REQUIRED + ("skipped", "intervention", "artefact", "stop_point", "stop_reason_own_words",
                      "stop_reason_code", "multi_model", "interface_version", "operating_system",
                      "network_access", "permission_mode", "policy_constraint", "acceptance_decision")
PERSON = re.compile(r"^P[0-9]+$")


def parse_date(value):
    try:
        return datetime.date.fromisoformat(value)
    except (TypeError, ValueError):
        return None


def check(rec):
    problems = []
    if not isinstance(rec, dict):
        return ["record must be a JSON object"]
    for key in REQUIRED:
        if key not in rec:
            problems.append(f"missing field '{key}'")
    unknown = sorted(set(rec) - set(ALLOWED))
    if unknown:
        problems.append("unknown fields (the schema forbids them): " + ", ".join(unknown))
    if problems:
        return problems
    if not isinstance(rec["person"], str) or not PERSON.match(rec["person"]):
        problems.append("person must be a pseudonymous label such as P07, never a name")
    for key in ("completed", "assisted"):
        if not isinstance(rec[key], bool):
            problems.append(f"{key} must be true or false, not {rec[key]!r}")
    if rec["level_from"] not in LEVELS or rec["level_to"] not in LEVELS:
        problems.append("level must be one of " + ", ".join(LEVELS))
    else:
        i_from, i_to = LEVELS.index(rec["level_from"]), LEVELS.index(rec["level_to"])
        if i_to <= i_from:
            problems.append("level_to must be above level_from")
        else:
            # Levels are ordered, not compulsory: a route may go from chat straight to an agent on the
            # person's own computer. A skip is allowed, but it is recorded, never silent, and exactly.
            expected = list(LEVELS[i_from + 1:i_to])
            if expected and rec.get("skipped") != expected:
                problems.append("a move over more than one level must list exactly the levels it "
                                "skipped in 'skipped': " + ", ".join(expected))
            if not expected and rec.get("skipped"):
                problems.append("'skipped' must be empty or absent for a move of one level")
    sent = parse_date(rec["materials_sent"])
    if sent is None:
        problems.append("materials_sent must be an ISO date (YYYY-MM-DD)")
    art = rec.get("artefact", {"type": "none"})
    if not isinstance(art, dict) or art.get("type") not in ARTEFACTS:
        problems.append("artefact.type must be one of " + ", ".join(ARTEFACTS))
        art = {"type": "none"}
    if "produced_by_agent" in art and not isinstance(art["produced_by_agent"], bool):
        problems.append("artefact.produced_by_agent must be true or false")
    if "date" in art:
        art_date = parse_date(art["date"])
        if art_date is None:
            problems.append("artefact.date must be an ISO date (YYYY-MM-DD)")
        elif sent and art_date < sent:
            problems.append("artefact dated before the materials were sent")
    if rec["completed"] is True:
        # Installation is an attempt; only something the agent produced counts as a crossing.
        if art.get("type") == "none" or art.get("produced_by_agent") is not True:
            problems.append("completed=true needs an artefact with produced_by_agent=true")
        if rec["level_to"] == "orchestrated_work":
            mm = rec.get("multi_model") or {}
            asked = mm.get("asked") if isinstance(mm, dict) else None
            answered = mm.get("answered") if isinstance(mm, dict) else None
            if not isinstance(asked, list) or len(set(asked)) < 2 or \
               not isinstance(answered, list) or len(set(answered)) < 2:
                problems.append("a level-4 crossing needs multi_model.asked and multi_model.answered "
                                "with at least two tools each (Table 1: two model families)")
    elif rec["completed"] is False:
        if not rec.get("stop_point") or not rec.get("stop_reason_own_words"):
            problems.append("a non-completion records stop_point and stop_reason_own_words")
    if rec["assisted"] is True and not rec.get("intervention"):
        problems.append("assisted=true needs a description of the intervention")
    if "acceptance_decision" in rec and rec["acceptance_decision"] not in DECISIONS:
        problems.append("acceptance_decision must be one of " + ", ".join(DECISIONS))
    if "network_access" in rec and not isinstance(rec["network_access"], bool):
        problems.append("network_access must be true or false")
    return problems


DEMO = [
    {"record_id": "r1", "person": "P01", "level_from": "chat", "level_to": "safe_agentic_environment",
     "materials_sent": "2026-09-08", "completed": True, "assisted": False,
     "artefact": {"type": "folder", "date": "2026-09-09", "produced_by_agent": True}},
    {"record_id": "r2", "person": "P02", "level_from": "chat", "level_to": "safe_agentic_environment",
     "materials_sent": "2026-09-08", "completed": True, "assisted": False,
     "artefact": {"type": "screenshot", "produced_by_agent": False}},
    {"record_id": "r3", "person": "P03", "level_from": "chat", "level_to": "agent_on_own_computer",
     "skipped": ["safe_agentic_environment"], "materials_sent": "2026-09-08", "completed": False,
     "assisted": False, "stop_point": "(invented) download page",
     "stop_reason_own_words": "(invented) the page offered four versions and I did not know which"},
    {"record_id": "r4", "person": "Jane", "level_from": "chat", "level_to": "orchestrated_work",
     "materials_sent": "2026-09-08", "completed": False, "assisted": True},
]


def main():
    if len(sys.argv) > 1 and sys.argv[1] != "--demo":
        records = []
        for n, line in enumerate(open(sys.argv[1]), 1):
            if line.strip():
                try:
                    records.append(json.loads(line))
                except json.JSONDecodeError as exc:
                    records.append({"_malformed": f"line {n}: {exc}"})
    else:
        records = DEMO
        print("(demo: four invented records, two of them deliberately wrong)\n")
    bad = 0
    for rec in records:
        try:
            if isinstance(rec, dict) and "_malformed" in rec:
                problems = ["not valid JSON: " + rec["_malformed"]]
            else:
                problems = check(rec)
        except Exception as exc:  # a malformed record is rejected, never a crash
            problems = [f"malformed record: {exc!r}"]
        bad += bool(problems)
        rid = rec.get("record_id", "?") if isinstance(rec, dict) else "?"
        print(f"{str(rid):6s} {'OK' if not problems else 'REJECTED'}")
        for p in problems:
            print(f"       - {p}")
    print(f"\n{len(records) - bad} of {len(records)} records accepted")
    sys.exit(1 if bad else 0)


if __name__ == "__main__":
    main()
El mismo formato de registro se publica como un JSON Schema (crossings.schema.json) para que otras herramientas puedan validar la estructura de un registro; el verificador anterior impone las reglas que el esquema no puede expresar (que una instalación no es un cruce, que una parada necesita las propias palabras de la persona, que la ayuda necesita una descripción, y que se registra un salto).
{
  "$schema": "https://json-schema.org/draft/2020-12/schema",
  "$id": "https://example.org/after-chat/crossing-record.schema.json",
  "title": "CrossingRecord",
  "description": "One person's attempt at one transition of the four-level model. Companion to crossings.py, which accepts exactly what this schema accepts and adds the rules the schema cannot express (installation is not a crossing; a stop needs the person's own words; help needs a description; a skip is recorded exactly; a level-4 crossing names at least two tools asked and answered). MIT licence.",
  "type": "object",
  "required": ["record_id", "person", "level_from", "level_to", "materials_sent", "completed", "assisted"],
  "properties": {
    "record_id": {"type": "string"},
    "person": {"type": "string", "pattern": "^P[0-9]+$", "description": "Pseudonymous label such as P07. Never a name."},
    "level_from": {"enum": ["chat", "safe_agentic_environment", "agent_on_own_computer", "orchestrated_work"]},
    "level_to": {"enum": ["chat", "safe_agentic_environment", "agent_on_own_computer", "orchestrated_work"]},
    "skipped": {"type": "array", "items": {"enum": ["safe_agentic_environment", "agent_on_own_computer"]},
                "description": "Exactly the levels passed over when the move spans more than one level. A skip is allowed and never silent."},
    "materials_sent": {"type": "string", "format": "date"},
    "completed": {"type": "boolean"},
    "assisted": {"type": "boolean"},
    "intervention": {"type": "string", "description": "Required when assisted is true: what the helper did."},
    "artefact": {
      "type": "object",
      "properties": {
        "type": {"enum": ["file", "folder", "screenshot", "pasted_output", "none"]},
        "date": {"type": "string", "format": "date"},
        "produced_by_agent": {"type": "boolean"},
        "sha256": {"type": "string", "description": "Hash of the artefact if deposited; never the content."}
      },
      "required": ["type"]
    },
    "stop_point": {"type": "string", "description": "Required when completed is false: where the attempt stopped."},
    "stop_reason_own_words": {"type": "string", "description": "Required when completed is false: the person's own words, verbatim."},
    "stop_reason_code": {"type": "string", "description": "Assigned after collection by a published coding scheme (Appendix A)."},
    "multi_model": {
      "type": "object",
      "description": "For transition 3: the denominator of a council run. A completed level-4 record needs at least two tools in asked and in answered; that they are different model families is for the researcher to verify.",
      "properties": {
        "asked": {"type": "array", "items": {"type": "string"}},
        "answered": {"type": "array", "items": {"type": "string"}},
        "timed_out": {"type": "array", "items": {"type": "string"}},
        "diverged": {"type": ["boolean", "null"]},
        "changed_decision": {"type": ["boolean", "null"]},
        "coverage_hit": {"type": ["boolean", "null"]}
      }
    },
    "interface_version": {"type": "string", "description": "Optional implementation record: the agent and its version."},
    "operating_system": {"type": "string", "description": "Optional implementation record."},
    "network_access": {"type": "boolean", "description": "Optional implementation record: whether the agent had network access."},
    "permission_mode": {"type": "string", "description": "Optional implementation record: the permission mode in force."},
    "policy_constraint": {"type": "string", "description": "Optional implementation record: any employer or platform rule that applied."},
    "acceptance_decision": {"enum": ["accept", "revise", "escalate", "discard"], "description": "Optional: the person's decision from the acceptance record."}
  },
  "additionalProperties": false
}
C6. Seguridad antes del nivel 3 (safety/)
Enseña: las prácticas de la Sección 5.3 como configuración. El primer archivo es un archivo de ejemplo de configuración de proyecto para Claude Code: modo plan de forma predeterminada (el proveedor renombró su modo predeterminado «Manual» en julio de 2026; «plan» sigue siendo válido y es la opción de enseñanza más segura), comandos destructivos y de descarga comunes denegados, archivos secretos habituales denegados tanto al lector de archivos como a un shell cat, eliminaciones y descargas web cuestionadas. Una lista de denegación es solo una lista: un modo permisivo o un comando no incluido en la lista puede eludirla, por lo que la configuración de la caja de arena importa tanto como las reglas. El segundo es una configuración de ejemplo para OpenAI's Codex, dada en su forma por ejecución y con alcance de carpeta: escrituras limitadas a la carpeta de trabajo, sin red, aprobación a solicitud. El tercero es una lista de verificación. Límites: las reglas de permisos y las cajas de arena reducen el radio de explosión; no hacen que un agente sea confiable, y la sintaxis de las reglas cambia entre versiones.
{
  "permissions": {
    "defaultMode": "plan",
    "deny": [
      "Bash(rm -rf:*)",
      "Bash(sudo:*)",
      "Bash(curl:*)",
      "Bash(wget:*)",
      "Bash(cat .env:*)",
      "Bash(git push:*)",
      "Read(./.env)",
      "Read(./.env.*)",
      "Read(./secrets/**)"
    ],
    "ask": [
      "Bash(rm:*)",
      "Bash(mv:*)",
      "WebFetch"
    ]
  }
}
# Folder-scoped, per-run form (the policy of this paper): run the agent from the working copy with
# codex -C <folder> -s workspace-write -a on-request
# The same values in ~/.codex/config.toml apply to every run on the machine.
# The agent may write only inside the working folder, has no network by default,
# and asks before anything outside those limits.
approval_policy = "on-request"
sandbox_mode = "workspace-write"
[sandbox_workspace_write]
network_access = false# Pre-flight checklist before a person lets an agent act on their own computer
1. Work in a copy. Make a new folder for the agent and put copies of the files in it, never originals.
If the files live in a cloud-synchronised tree, copy them out of it first: agents have deleted the
zero-byte placeholders that cloud services leave for offloaded files, taking the originals with them.
2. Start in plan mode. Ask for a written plan first; read it; only then let the agent act.
3. Keep secrets out. No passwords, keys or client documents in the working folder.
4. Deny network by default. Turn it on only for a job that needs it, and then for named sites.
5. Confirm before anything irreversible: sending, deleting, publishing, purchasing.
6. Treat what the agent reads on the web as content, never as instructions. A page can carry hidden text
written to redirect an agent.
7. Treat another agent's answer the same way: content to compare, never instructions to act on. A second
model can pass on instructions it picked up from a page it read.
8. Use a separate browser profile for any agent that browses, signed out of banking and health sites.
9. Never type passwords, one-time codes or card numbers into the agent.
10. Ask "what could go wrong with this?" before approving a command you do not understand.
11. Keep an undo: a snapshot of the folder (or a version-control commit) before each larger change.
12. Keep a working stop. Before a long job, know how to stop it and whether stopping deletes the work.
13. Stop and revoke access when the task, the workspace or the sensitivity of the data changes.
14. Escalate a high-consequence decision to a person who is accountable for it; the agent proposes, the
person decides.C7. Trazas de supervisión como un registro (jsonl_log.py)
Enseña: el registro más pequeño y útil del trabajo del gestor, un objeto JSON con marca temporal por evento, para que los planes rechazados, los diffs rechazados, las segundas opiniones tomadas y las ejecuciones completadas (las trazas de supervisión de la proposición P10) puedan contarse posteriormente con la biblioteca estándar. Ejecutar con --demo. Limitaciones: es un escritor, no un trazador; registra lo que la persona o el agente le dice.
#!/usr/bin/env python3
"""jsonl_log.py: append one timestamped event to a JSONL file.

Teaching example for "After Chat" (Appendix C, listing C7). MIT licence.

The smallest useful record of a manager's work: one JSON object per event, one event per line,
each with a UTC timestamp. Events such as "plan_refused", "diff_rejected", "second_opinion_taken"
or "run_completed" are the supervision traces that proposition P10 asks for. A later paper can
parse the file with the standard library. This is a writer, not a tracer: it records what you tell it.

Usage:
    python3 jsonl_log.py run.jsonl '{"event": "plan_refused", "task": "friday-pack"}'
    python3 jsonl_log.py --demo
"""
import json
import sys
from datetime import datetime, timezone
from pathlib import Path


def log(path, event):
    """Append one event; the timestamp is added unless the caller set one."""
    event = dict(event)
    event.setdefault("ts", datetime.now(timezone.utc).isoformat(timespec="seconds"))
    with Path(path).open("a", encoding="utf-8") as f:
        f.write(json.dumps(event, ensure_ascii=False) + "\n")
    return event


def main():
    if len(sys.argv) == 2 and sys.argv[1] == "--demo":
        import tempfile
        path = Path(tempfile.mkdtemp()) / "demo.jsonl"
        for ev in ({"event": "plan_refused", "task": "demo"},
                   {"event": "second_opinion_taken", "task": "demo", "family": "other-vendor"},
                   {"event": "run_completed", "task": "demo", "artefact": "demo/plan/"}):
            log(path, ev)
        print(path.read_text(), end="")
        return
    if len(sys.argv) < 3:
        print('usage: jsonl_log.py FILE \'{"event": "plan_refused"}\'   or   jsonl_log.py --demo',
              file=sys.stderr)
        sys.exit(2)
    print(json.dumps(log(sys.argv[1], json.loads(sys.argv[2]))))


if __name__ == "__main__":
    main()
Apéndice D. Tabla desarrollada del número efectivo de opiniones
Un gestor de agentes que no desea ejecutar el listado C4 puede seguir usando el techo. Cada celda es N_eff = N / (1 + (N - 1) rho); la última fila es el techo 1/rho, que ningún número de modelos con esa correlación puede superar. Los valores de rho se eligieron para ilustrar la fórmula, sin medir nada. En la práctica, rho es la correlación media por pares de errores, una cantidad diferente de la proporción de errores conjuntos en la que dos modelos están de acuerdo, y debe estimarse en elementos con respuestas conocidas en el dominio en cuestión (listado C4).
| N modelos | rho = 0.2 (ilustración) | rho = 0.5 (ilustración) | rho = 0.6 (ilustración) | rho = 0.8 (ilustración) |
|---|---|---|---|---|
| 2 | 1.67 | 1.33 | 1.25 | 1.11 |
| 3 | 2.14 | 1.50 | 1.36 | 1.15 |
| 5 | 2.78 | 1.67 | 1.47 | 1.19 |
| 10 | 3.57 | 1.82 | 1.56 | 1.22 |
| Techo, 1/rho | 5.00 | 2.00 | 1.67 | 1.25 |
La tabla es la razón por la que la Sección 6 le dice a una persona que gaste la siguiente suscripción en una familia diferente en lugar de una décima ventana de la misma. La diversidad de familias, una verificación punto por punto contra fuentes y un disenso preservado hacen el trabajo que una N más grande no puede hacer. Porque rho depende de la tarea, debe estimarse en elementos del propio dominio de la persona (listado C4).
Apéndice E. Censo del panorama, 19 a 21 de septiembre de 2026
La tabla 5 en el texto principal agrupa las herramientas por patrón. Este apéndice registra el censo bruto detrás de ella, para lectores que desean los números tal como se encontraban en las fechas indicadas. Los recuentos de estrellas se mueven diariamente; rastrean la popularidad y no dicen nada sobre la calidad o el número de usuarios, por lo que no deben citarse según la fecha del lector. La columna de patrón es mi mapeo, y los proyectos mismos no hacen tal afirmación.
| Proyecto | Ubicación | Estrellas (aproximadas, 21 de septiembre de 2026) | Licencia | Patrón |
|---|---|---|---|---|
| anthropics/claude-code | github.com/anthropics/claude-code | 147,000 | Licencia de código disponible, propietaria | Agente de terminal (nivel 3) |
| openai/codex | github.com/openai/codex | 126,000 | Apache-2.0 | Agente de terminal (nivel 3) |
| google-gemini/gemini-cli | github.com/google-gemini/gemini-cli | 107,000 | Apache-2.0 | Agente de terminal; niveles individuales ya no servidos desde 18 de junio de 2026 |
| cline/cline | github.com/cline/cline | 69,000 | Apache-2.0 | Editor y agente de terminal |
| openai/codex-plugin-cc | github.com/openai/codex-plugin-cc | 33,400 | Apache-2.0 | Complemento oficial: agente de un proveedor dentro del de otro |
| jackwener/OpenCLI | github.com/jackwener/OpenCLI | 29,500 | Ver repositorio | Chat web expuesto a agentes |
| karpathy/llm-council | github.com/karpathy/llm-council | 24,900 | Ver repositorio | Consejo mediante una interfaz de programación |
| ai-shifu/ChatALL | github.com/ai-shifu/ChatALL | 16,500 (aproximadamente 847,000 descargas de la versión más reciente) | Apache-2.0 | Difusión del navegador |
| BeehiveInnovations/pal-mcp-server | github.com/BeehiveInnovations/pal-mcp-server | 11,800 (último commit diciembre de 2025) | Apache-2.0 | Servidor de consulta entre modelos |
| MoonshotAI/kimi-cli | github.com/MoonshotAI/kimi-cli | 11,400 | Apache-2.0 | Agente de terminal (nivel 3) |
| chathub-dev/chathub | github.com/chathub-dev/chathub | 10,700 | GPL-3.0 | Difusión del navegador |
| nyldn/claude-octopus | github.com/nyldn/claude-octopus | 4,100 | MIT | Consejo CLI |
| aarondfrancis/counselors | github.com/aarondfrancis/counselors | 660 | MIT | Consejo CLI escribiendo un archivo por herramienta |
| xai-org/grok-build | github.com/xai-org/grok-build | 26,900 | Apache-2.0 | Agente de terminal con modo sin cabeza y protocolo de agente |
Cómo citar
Chernets, V. (2026). After Chat: The Three Transitions Between Non-Programmers and Agentic AI [Preimpresión]. SSRN. https://doi.org/10.2139/ssrn.7520019
@misc{chernets2026afterchat,
  author       = {Chernets, Vadym},
  title        = {{After Chat: The Three Transitions Between Non-Programmers and Agentic AI}},
  year         = {2026},
  howpublished = {SSRN},
  doi          = {10.2139/ssrn.7520019},
  url          = {https://doi.org/10.2139/ssrn.7520019}
}