编程人员的分化之后:衡量通过AI代理进行构建的人员的一项度量
这是译文。权威版本是英文原文,引用请以原文为准。
经过验证的委托地平线、放大收益、一份角色名称的定年地图,以及每年评分的41个注册预测,至2031年止
Vadym Chernets,PhD,AI系统架构师 · ORCID 0009-0007-4845-3163
SSRN 7589918 · DOI 10.2139/ssrn.7589918 · Zenodo 10.5281/zenodo.23267267 · GitHub
下载本文
- SSRN(官方版本):ssrn.com/abstract=7589918 · DOI 10.2139/ssrn.7589918
- Zenodo(已归档,开放存取):doi.org/10.5281/zenodo.23267266
- OSF(41项预测,2026年10月9日注册):doi.org/10.17605/OSF.IO/VW6P9
- GitHub(完整文本为Markdown格式):github.com/vadimchernets/papers/tree/main/after-the-programmer-divide;附录 C 的代码:github.com/vadimchernets/delegation-horizon
SSRN 持有官方版本;引用该版本。
关键词:AI代理;代理型AI;非程序员;编码代理;职位名称;基于技能的招聘;委托代理理论;最终用户软件工程;AI素养;经过验证的委托地平线;凭证交叉点;预注册预测
摘要
簿记员向代理请求调账工具;开发者向代理请求修改计费系统。每个人都必须接受一天的工作并证明其有效。到2026年10月,律师也开始为同一批代理设置任务。在约400,000个会话中,对代码生成工作的厂商验证成功率在编程职业中为34%,在其他职业中为29%,尽管职业并不等于教育。没有职业阶梯能说明通过代理构建的人可以被信任交付什么。我提议用一项指标代替职位名称。经验证的委托范围是一个人定期交给代理并在代理没有看到的独立检查后接受的最大连贯工作,以合格专家的参考小时数衡量。放大增益是每小时注意力所获得的经验证参考小时数,是经验证的吞吐量,而非导致加速的因果估计。两者都按领域、小时到季度进行评分;一次测试纠正了一个阈值。三家大型雇主在2026年尝试了令牌计数并放弃了它们:一个排名被移除,一个排行榜被操纵,一个预算被花光。已检查的工作更难通过支出进行操纵,每条剩余的途径都满足既定的防御。一份注日期的地图记录了竞争的名称(构建者、代理经理、主任等),不做选择。背景中立假说是,在相等的水平处,编程教育停止预测已检查的质量。凭证交叉点是按领域划分的时刻,此时没有IT教育背景的人的产品在同样检查下开始超越程序员的产品,在此之后学位和资历标签失去预测力。四十一项注日期的预测,按照2026年10月9日三个盲目模型预测的中位数定价,在OSF上注册并每年评分直到2031年;从未进行过的研究计为失败,在自己的领域中的超越概率为0.35。
执行摘要
到2026年,簿记员以程序员一年前的对比方式来对比编码代理,律师们正用它们构建自己的工具,非软件行业的人已成为某供应商编码代理用户的快速增长部分;在另一供应商的记录中,约400,000次会话里,不编程的职业在编码工作上的验证成功率仅比程序员少几个百分点(34%对29%)。在实际工作中,程序员与其他人之间的界限已变薄。但在职位名称、薪级和简历上,现状如故。
现在,一些程序员和一些领域专业人士共享一个工作流程:他们将工作交给代理并决定是否接受。任务和工作流程已先于整个专业合并,因此关于一个人的有信息意义的问题是他们能交付并证明多大的工作量,无论他们来自旧界限的哪一边。我为此提议的衡量指标是已验证的委托范围,它基于几个设计选择,本摘要阐述了每个选择的理由。单位是合格专家需要的时间(一小时、一天、一周、一个月、一个季度),因为两条旧的职业路径都能理解它,不需要跨专业转换。簿记员的对账工具和开发者的账单变更遵循同一规则。只有通过代理未参与的检查的工作才算数,同系列模型间的一致性不被视为有效检查,因为它们的错误相关联。第二个数字是放大增益,记录该人每小时的注意力产生多少已验证的工作(失败的工作仍消耗注意力,而代理的闲置时间不计),这样与代理在短循环中协作的人获得与一次性交付大量工作的人同等认可。两个数字按领域分别记录,理由是对称的:进入软件的律师和进入法律的程序员都会失去同一样东西,即在陌生领域接受工作的能力。阈值作为规则v1.1版本化并经过桌面测试,桌面测试已改正了其中之一(附录E)。
名称尚未确定。构建者、代理工程师、代理管理员、人工智能操作员、编排员和主管到2026年10月都在使用中,各有所有者和日期。我不加偏见地列举它们,以便无论哪个术语最终采用,都可以用同一尺度来衡量:构建者处于周级别,代理管理员处于日级别。
市场已尝试过捷径。在2026年,令牌计数被尝试作为大型雇主的员工衡量指标,但在数月内失败:Meta的一名员工的非官方排名被撤下,公司后来的官方指导排除了令牌计数,Amazon的排行榜被空任务破坏并删除,Uber在四个月内花光年度人工智能预算。按输入计数会奖励高支出。已接受且经独立检查的工作计数,按设计更难以这种方式被人为膨胀。仍然存在的途径(简单检查、宽松评估、隐形帮助和碎片化工作)在第5.8节各有对应防线:随机审计、独立的工时评估、失败的公开记录、完整的工作单位和设置的陷阱错误。
两个预测支撑我的有时间标记的论题。背景中立性表明,在同一级别上,编程教育不再预测已验证的质量。资格交叉点是一个领域中的时刻,当没有IT教育背景的人制造的产品开始超越使用相同代理的程序员的产品时,之后学位和初级、高级的标签就失去分量。质量均等先于这一时刻到来,职位发布中学位要求的交叉是其可见标志,每个部分都有日期并单独测试。主要预测与当前观点相反,论文在陈述预测处说明了这一点。每个预测也命名会反驳它的结果,这样读者可以提前看到失败的样子。所有41个预测出现在一张表中,包含概率、阈值、备用数据来源和最终日期,在2026年10月9日于OSF注册(DOI 10.17605/OSF.IO/VW6P9),每年按Brier规则评分至2031年。二十七个从公开数据得出。十四个需在收集数据前单独注册研究,缺失或不确定的证据记为未解决,不计为成功;从未进行的研究是测试程序的失败,保留在记分卡上。概率在2026年10月9日被固定为我采用的三个盲预测模型的中位数,已在OSF注册;在自己领域内超越的概率是0.35。
当构建成本很低时,信任成为稀缺的过滤器。应用商店和代码托管平台泛滥,平台关闭了对陌生贡献者的大门,代理越来越多地编写解决方案而非采用他人的。在构建者身旁,两个合作伙伴功能是可见的:完成者将产品交付给用户,保证人为其背书。第二个名称来自该角色的2025年描述,我也为保证人提议一个衡量指标。
1. 介绍
2026年9月23日,一个面向簿记员的博客比较了两个编码代理(Claude Code和Codex)在交易分类和账户对账方面的表现(Growthy,2026)。一年前,这种比较还属于程序员的范畴,在程序员的论坛中仍然如此,伴随着各种立场和忠诚度。改变的是读者。现在在代理之间做选择的人是簿记员、签订合同者和运营活动的人,他们选择的代理是软件开发人员使用的那些。
几十年来,经济中一直存在两条职业阶梯。在软件领域,职级包括初级、中级、高级、员工和总监,其薪酬由经验年数和项目所需工程师数量决定。在其他领域,职级是分析师、顾问、经理、主管和合伙人。这两条阶梯在IT部门的门口相遇,即第二条阶梯上的专业人士是从第一条阶梯上的人那里委托获得软件的。在2025年和2026年,两条职业阶梯开始描述同样的工作。开发人员被告知他们的主要活动已变成委托和验证(GitHub,2025b)。软件领域外的专业人士,通过终端或桌面窗口中的代理,开始构建他们曾经委托开发的工具、网站和小应用程序(Bloomberg Law,2026;OpenAI,2026)。两条阶梯都没有说这样的人可以被信任去交付什么,也没有说如何比较现在做同样工作的前开发人员和前分析师。
接下来的问题是:在那条边界合并一侧的人应该被称为什么,一旦学位和工作年限停止向雇主表明他们能交付什么,应该如何衡量他们的水平,以及边界何时可能消失。其中最后一个问题以带有日期的预测形式得到答案。
那个问题也有一个有日期的起源。2026年10月8日,我提出了一个预测:在一到两年内,代理能力将增长到不再需要技术教育的程度,没有技术教育的人将构建更好的应用程序、网站和产品,代码优于程序员的代码。同一个晚上晚些时候,我补充了一个推论。当没有IT教育背景的人制造的产品开始超过IT专业人士制造的产品时,IT学位以及初级和高级的标签将在简历上迅速失去分量。(两个陈述都翻译自我那天的笔记。)第6部分和第11部分将两者都转化为带有日期、措施、阈值和可能反驳它们的结果的预测。第二个陈述命名了论文其余部分所谓的凭证交叉点的时刻。
本系列的配套论文跟踪了非程序员从聊天到代理的发展过程,并根据代理工作的地点和人员必须拥有的东西定义了四个级别(Chernets,2026a)。它只有在代理生成了制品时才计算一次升级,并且拒绝将代理的管理者变成一个职位名称,而是用该术语来指代一种行为模式,而不是任何人应该聘用的角色,原因是"行为留下证据,而职位名称不会"(Chernets,2026a,第8.4节)。本论文从这个条件开始:一个级别只有在有证据的情况下才被授予,任何职位名称都可能与之相关联,证据指的是交给代理的工作,由一个人接受,并由代理看不到的检查确认。
第3部分给出了2026年10月流通名称的带有日期的地图。第5部分给出了任何这些名称都可以读取的规模、已验证的委托界限及其第二轴(放大增益)。第6部分阐述了两个假设——背景中立性和凭证交叉点——并询问一个检查过程可以代替多少的行业经验。第7部分和第8部分讨论了信任这条不溶解的边界,以及构建者旁边的两个伙伴职能。第11部分列出了带有概率、阈值和备用来源的带有日期的预测,在OSF上注册,并在公开场合每年评分至2031年。
我不在这些名称中进行选择。市场会选择,可能在几个月内,而下注一个词的论文在另一个词胜出的那一天就错了。论文能固定的是规模。第5部分完整地定义了它;简而言之,已验证的委托界限询问一个人定期交给代理并通过独立检查接受的工作量有多大(以合格专家所需的小时数衡量),放大增益询问该人自身注意力的每一小时产生多少小时。两者都按域保存、带有日期注记,并放在从小时到季度的五级阶梯上。图1将两条旧的职业阶梯放在那条旁边。
凭证交叉点的一个定义贯穿整篇论文。在一个域中,它是没有IT教育背景的人制造的产品(在相同的独立检查下接受)开始超过使用相同代理的程序员的产品的时刻,在此之后,学位和初级与高级的标签在招聘中失去分量。质量等价性是该时刻之前的步骤,招聘启事中学位要求的改变是其可见的标志。背景中立性是教育停止在相等级别预测检查质量的假设,这是解释它的机制。这四个部分中的每一个都有自己的带有日期的预测(第6.2部分)。
证据来自2025年和2026年,在这个时期内,一个月的代理开发可以改变衡量标准必须计算的内容。一个广泛引用的数字表明,大型科技公司的新毕业生招聘远低于其2019年水平。它被排除,与2022年招聘高峰的比较也被排除,因为它们测量的是代理出现之前的世界。代理出现之前的数据系列仅作为前驱进入,招聘的宏观经济学由第2.4部分的LinkedIn对比来承载。较早的工作也作为理论、先例或类比进入:Jaques关于责任时间跨度的工作、Jensen和Meckling关于委托成本的工作、淘金热和摄影师的参考。
图1。两条职业阶梯和一个衡量标准。
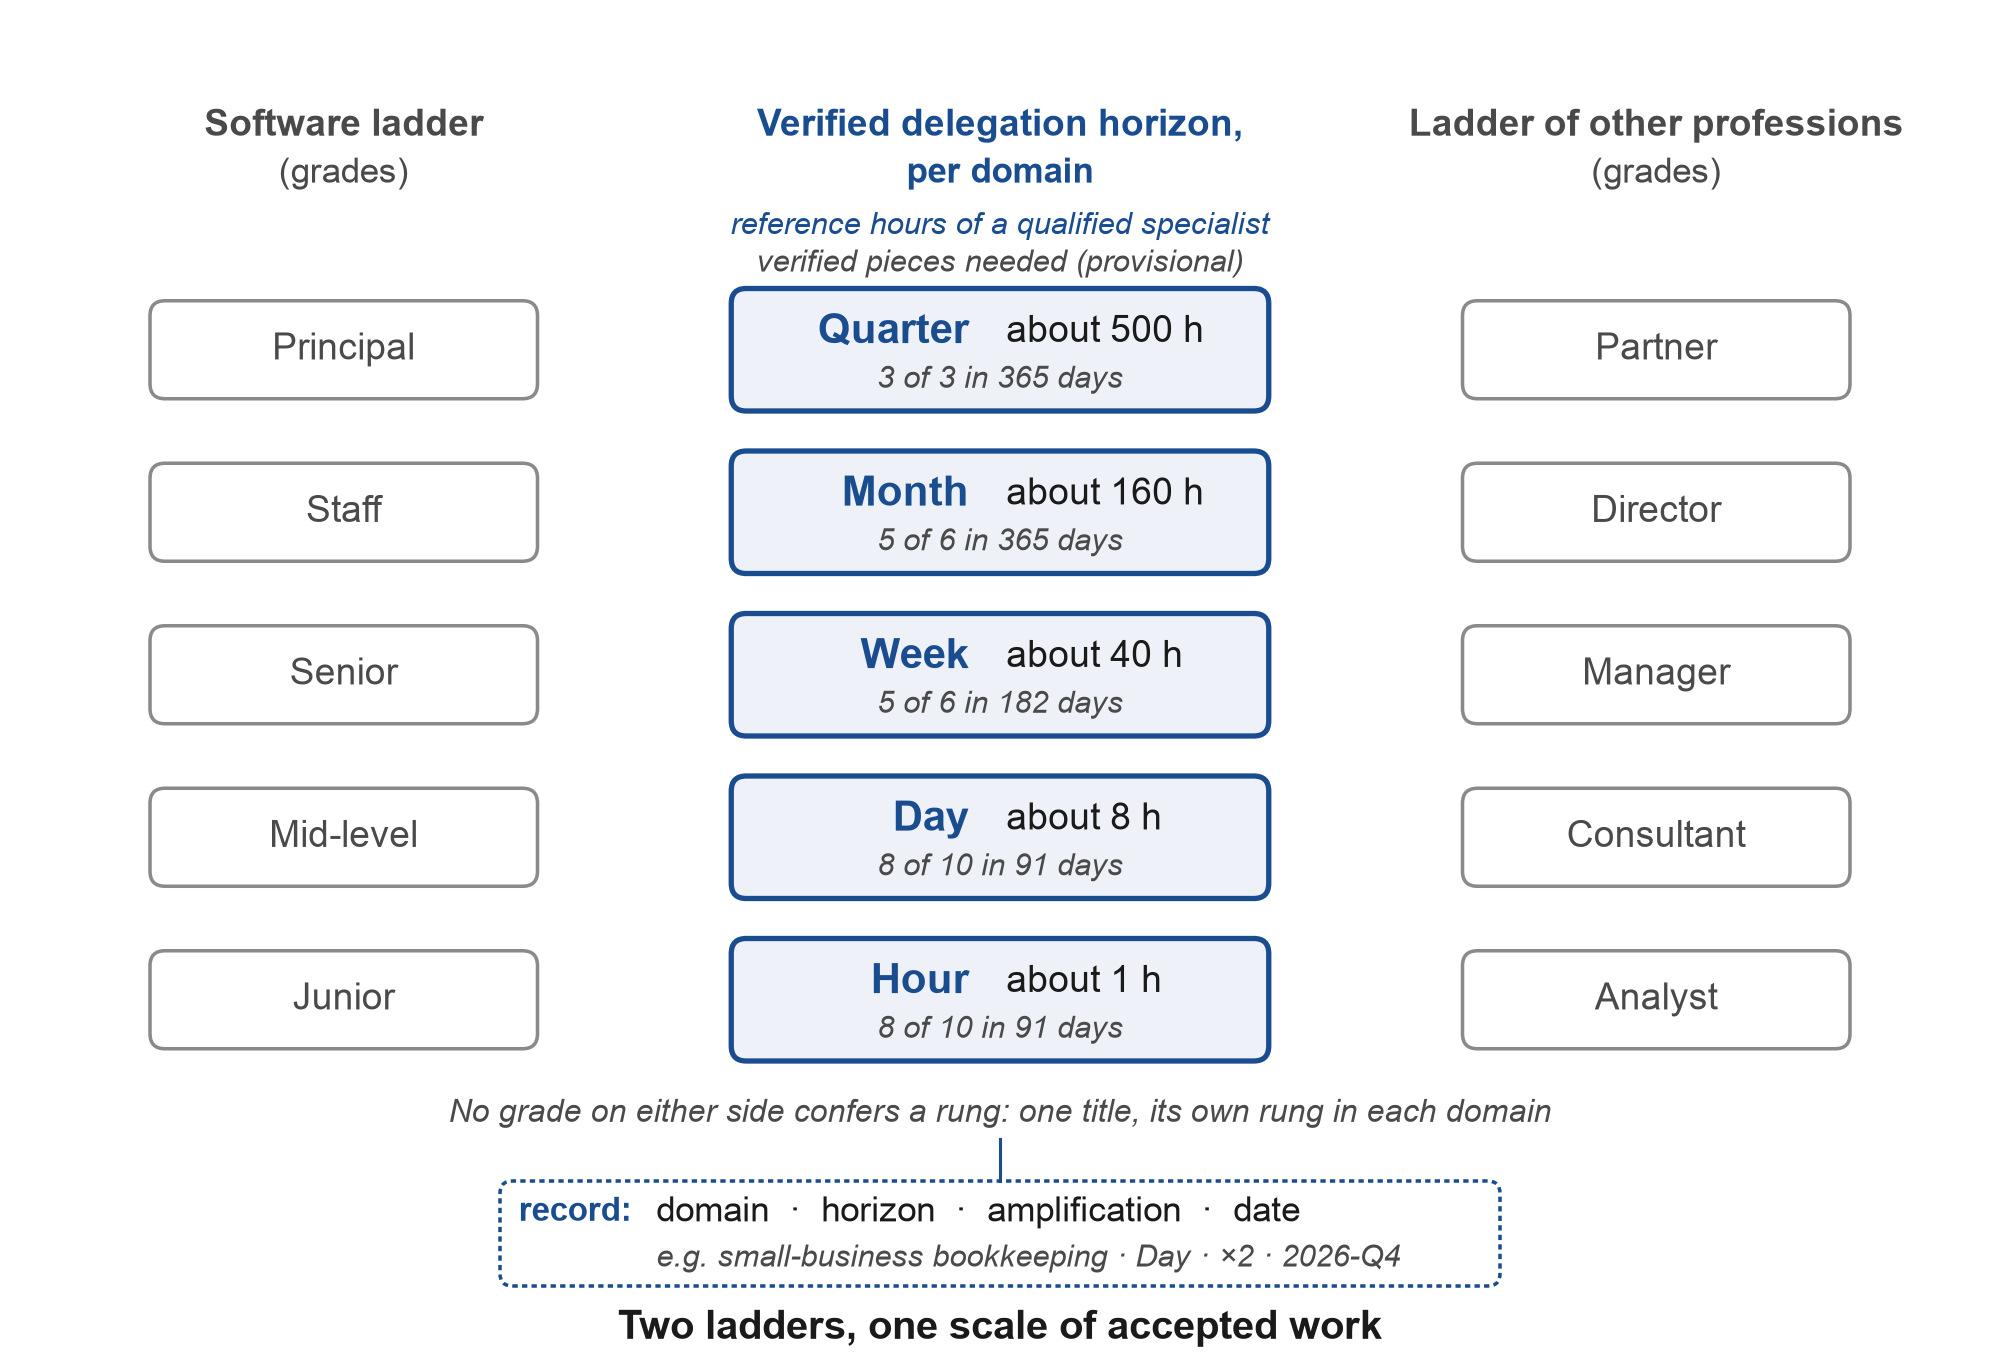
注:旧的职业阶梯与五个新等级并排绘制,并有意不连接:旧阶梯上的任何等级都不自动赋予新阶梯上的等级,同一个人在每个域中持有一个单独的等级(第5.2部分)。这些等级按合格专家的参考小时数计算,具有第5.2部分的计数和窗口(规则v1.1)。显示的记录是附录C4的已解决示例打印的记录。
在这些部分中,第2部分阐述了收敛的证据,第4部分说明了市场首次措施如何失败,这就是这类措施的特点。第9部分检查了程序员对话中哪些主题涉及其他行业,第10部分推导出了其含义。第12部分收集了反对该论点的证据,第13部分阐述了其边界条件,第14部分得出了结论。
2. 两个世界的汇聚:来自2025年和2026年的证据
2.1 程序员的工作,重新描述
向开发者销售产品的供应商现在将开发者的工作描述为指挥代理。GitHub对"开发者的新身份"的阐述将委托和验证置于工作的中心(GitHub, 2025b)。Anthropic在2025年8月调查了其132名工程师和研究人员。他们报告在约60%的工作中使用AI,自我评估的生产力提升约50%,并将自己描述为变得更加"全栈"。大多数人表示他们只能充分委托不超过五分之一的工作,27%的AI辅助工作由完全不使用AI就不会进行的任务组成(Anthropic, 2025a)。因此,仅基于完全委托的衡量标准最多只能看到世界上最先进用户用AI做的工作的五分之一,这就是为什么第5部分增加了第二个轴。同一份报告提到了"监督悖论":监督该模型需要编程技能,而当所有工作都交给它时这些技能会逐渐衰退(Anthropic, 2025a)。
这些词汇追随了实践。Andrej Karpathy在2025年2月2日命名了"vibe coding"(Karpathy, 2025),Collins将其列为年度词汇(Collins Dictionary, 2025),一年后Karpathy转向了"agentic engineering"。在Sequoia的AI Ascent大会上(2026年4月30日),他将差异表述为"vibe coding提升了下限,agentic engineering外推了上限"(Karpathy, 2026; Willison, 2026a)。一篇学术论文将agentic engineer描述为一个新的职业原型,其中责任从代码的创作转向成果的所有权(Alenezi, 2026),Microsoft描述了其客户的工作模式为作者、编辑、导演和编排者(Microsoft, 2026b)。
2.2 其他人,在同一个代理内
两家供应商报告了软件以外的人广泛使用编码代理的情况,采用不同的选择和衡量标准。OpenAI在2026年6月报告称,自2025年8月以来,非开发者编码代理周用户在个人用户中增长了137倍,在组织中增长了189倍(OpenAI, 2026)。基数很低,数据来自供应商。同一份报告提供了对第5部分很重要的分布数据。在2026年5月代理个人用户中约0.1%的样本中,80.6%至少提出过一个请求,其手工完成时间(根据模型估计)超过30分钟,70.2%至少一个超过一小时,25.6%至少一个超过八小时。这些是提出长期请求的用户份额,持续时间由模型估计,这与完成率或经过验证的时间范围不同,第5部分解释了为什么这种差异很重要。代理对业务职能的工作中超过四分之一是工程工作。
Anthropic对Claude Code的研究发表于2026年6月16日,是与该论文最接近的公开数据(Anthropic, 2026e)。它分析了约235,000人在2025年10月至2026年4月期间的约400,000个会话。专业知识通过行为判断,有三个标志:该人陈述任务的精确程度、他们要求验证的内容,以及谁纠正了谁。一个没有Python知识但写出精确对账规则并发现边界情况的簿记员被评为专家。在生成代码的会话中,十大职业中的每一个在经过验证的成功率上落后于编程职业不超过七个百分点,其中成功意味着由通过测试或已提交工作等证据支持的成就。供应商的分类部分基于会话记录中的信号,如用户的明确确认,报告指出经理的略高比率可能部分反映了他们报告成功的方式,因此这里的"经过验证的"是供应商的术语,而不是独立检查。在生成代码的会话中汇总为34%对29%(在所有会话中约为30%对26%),管理人员的表现略好于程序员。这些数据按职业对人进行分类,对教育一无所知:一个会计师可能持有计算机科学学位,程序员可能没有。报告得出结论,"编码代理使编码背景对成功编程的相关性降低"。人做出了约70%的关于做什么的决定,代理做出了约80%的关于如何做的决定。专家的指令集触发了约12个代理行动,新手的约5个。
同样的转变出现在不是来自销售代理的公司的资源中。律师,从初级律师到合伙人,一直在用Claude Code构建自己工具的工作原型,而不是等待供应商,拥有广泛AI访问权的律师比例从2025年的61%上升到2026年的83%(Bloomberg Law, 2026; Artificial Lawyer, 2026)。簿记员比较代理(Growthy, 2026)。Lovable(一个基于浏览器的应用构建器)在2026年9月超过了6亿美元的年化收入(TechCrunch, 2026a)。据估计,Claude Code在2026年2月初约占GitHub上公开提交的4%(SemiAnalysis, 2026)。
2.3 阶梯承压
雇主已开始重新命名他们的阶梯,但尚未说明什么取代他们。从2026年6月1日起,Deloitte为其大约181,500名美国员工提供了按工作系列组织的新头衔,并添加了领导级别(Business Insider, 2026)。其内部级别和薪酬原则保持不变(Fortune, 2026a),所以这是一个重命名,衡量标准保持不变。LinkedIn据报道将其助理产品经理项目替换为"Associate Product Builder"项目,并向来自任何职能的人开放了"Full Stack Builder"角色(Lenny's Newsletter, 2025)。Microsoft将其调查的20,000个AI用户中的3,233个(约16%)计为"Frontier Professionals",他们运行多步骤代理并重新设计其流程(Microsoft, 2026a)。Srinivasan和Wei在2026年2月的《哈佛商业评论》中辩称公司需要代理经理,并预计该职位将在12至18个月内成为标准(Srinivasan & Wei, 2026)。一些雇主走得更远,在招聘启事中写入了新角色:State Street刊登了一个仍需要编程的"Agentic Product Builder"(State Street, 2026)。2026年10月7日,Dust推出了"AI Operator",作为构建和维护共享代理工作流的人(Dust, 2026)。
招聘已注意到。候选人使用AI被讨论的工作面试比例从2025年第三季度的0.33%上升到2026年第二季度的4.54%(Metaview, 2026)。这个问题在任何答案的规模存在之前就进入了招聘。
2.4 招聘启事、入门级招聘和教育
提及"agentic AI"的美国招聘信息从2024年的151条增加到2025年的16,541条(Stanford HAI, 2026)。Lightcast进行的另一项统计发现,2025年有超过86,000条招聘信息提及agentic AI技能,这是这些技能提及量的280%年度增长,中位数广告薪资为$153,000;这些技能主要被添加到现有的职位名称中(Lightcast, 2026a)。AI Index统计的是包含短语"agentic AI"的职位,而Lightcast的博客在其自有分类法中统计带有agentic技能的职位,这解释了16,541和约86,000之间的大部分差异。这些数字衡量的是不同的事物,在此保持分开。
初级招聘已经减弱,原因存在争议。LinkedIn发现2026年4月至6月美国初级招聘环比下降7.6%,而所有级别下降6.9%,在AI增强的职业中,初级招聘下降9.6%,而这些职业中所有级别下降6.5%(LinkedIn Economic Graph, 2026)。LinkedIn本身将下降更多地归咎于经济不确定性而非AI,并指出在初级职位中,不受AI影响的职位在法国、英国和美国下降最为明显。Stanford "canaries"研究的2026年8月更新发现,在AI暴露的职业中,22至25岁人群的就业约低于预期19%,而经验丰富的工作者没有可比的差距,并将结果描述为描述性的(Stanford Digital Economy Lab, 2026a)。另外两个来源发现了相同的机制。达拉斯联邦储备银行的经济学家使用当前人口调查微数据,发现与AI暴露相关的就业下降仅发生在年轻工作者中,主要由进入劳动力的人数减少而非裁员驱动(Atkinson & Yamco, 2026)。在涵盖约6500万工作者的简历数据中,采用生成式AI的公司中初级就业比非采用者低约9%,采用后的六个季度内,同样是通过较慢的招聘而非人员离职实现的(Hosseini & Lichtinger, 2026)。在整个经济中,Yale Budget Lab仍然没有发现AI暴露的职业表现比相当的非暴露职业更差的明确迹象(Yale Budget Lab, 2026),所以压力在初级阶梯,而非整个职业。雇主在2026年上半年宣布的就业裁员中引用AI达101,743个,约占所有宣布裁员的23%(Challenger, Gray & Christmas, 2026)。
教育也在变化。在2026年Taulbee调查涵盖的系中,新的本科计算机科学专业人数下降13%,该调查统计北美授予博士学位的系;其作者将这描述为招生管道收缩的第一个明确迹象,同时伴随创纪录的学位授予(Computing Research Association, 2026)。一项涉及673名德国IT学徒的现场实验发现,当他们能够使用AI时,在正规培训以外的任务上获得26至31个百分点的提升(Stanford Digital Economy Lab, 2026b)。2026年6月由OECD和European Commission联合发布的框架包括一个名为"Manage AI"的领域(OECD & European Commission, 2026)。
表A1(附录F)列出了此次收敛的十个信号及其来源,以及每个信号显示和未显示的内容。综合来看,它们也显示了测量缺失之处:关于编程代理中非开发人员的供应商数据显示增长,而非其结果的质量。在已验证的成功中,职业的接近程度关乎职业而非学位。重新命名的阶梯和调查部分是名称,而非指标。并且较弱的初级阶梯未被证明是由AI引起的。
这些信号以相当高的把握表明,agent工作的设置和接纳现在发生在旧边界的两侧,并且雇主、学校和供应商已开始重新命名事物。软件以外的人是否能和程序员一样好地做这项工作?这些信号对此没有给出明确答案,也没有提供相关测量。第5部分提出了这一测量方法,第11部分为质量问题规定了时间表,第12部分列出了预测必须克服的证据。
2026年的证据区分了能够证明结果正确的人和不能证明的人。编程教育是获得这种能力的一条途径。对领域的掌握、检查的习惯和检查工具是其他获得该能力的方式,第2.2部分的数据表明它们可以比旧阶梯假设的更经常地代替编程教育,尽管还不总能做到。第5部分的测量是为了测试这一主张而建立的。
3. 流通中的名称:一份有时间标记的地图
3.1 我为什么不选择一个名称
2026年每隔几周,一些公司或顾问,有时还有杂志,都会为这里描述的人们提议一个名称,其中一些名称会流行开来。由于用法未定,与其推荐一个名称,我做两件事:绘制已在流通中的名称地图,包括那些已被采纳的名称,记录每个名称的引入者、引入时间和含义,并提供一个衡量标准,可以据此理解其中任何一个。如果"构建者"赢了,记录读为"周级构建者";如果"代理管理者"赢了,就读为"日级代理管理者"。优先权被声称属于衡量标准、阶梯、定义和预测,包括给它们命名的术语(verified delegation horizon、amplification gain、credential crossover point),但不属于任何角色名称;第3.3节中添加的角色名称作为候选提供,无优先权。
3.2 六个层级
候选名称并非都争夺同一个位置。有些名称几乎每个人都会具有,有些则是职业、衡量标准、时刻、伙伴或失败的信号。表A2(附录F)列出了已在使用的名称及其所有者,在第二部分列出了本研究中提议或仅在此处用作纯描述的名称,以及已考虑但搁置的变体,以便读者可以看到整个系列。图2按层级和引入时间对名称进行排列。
图2。流通中的名称,按层级和引入时间排列。
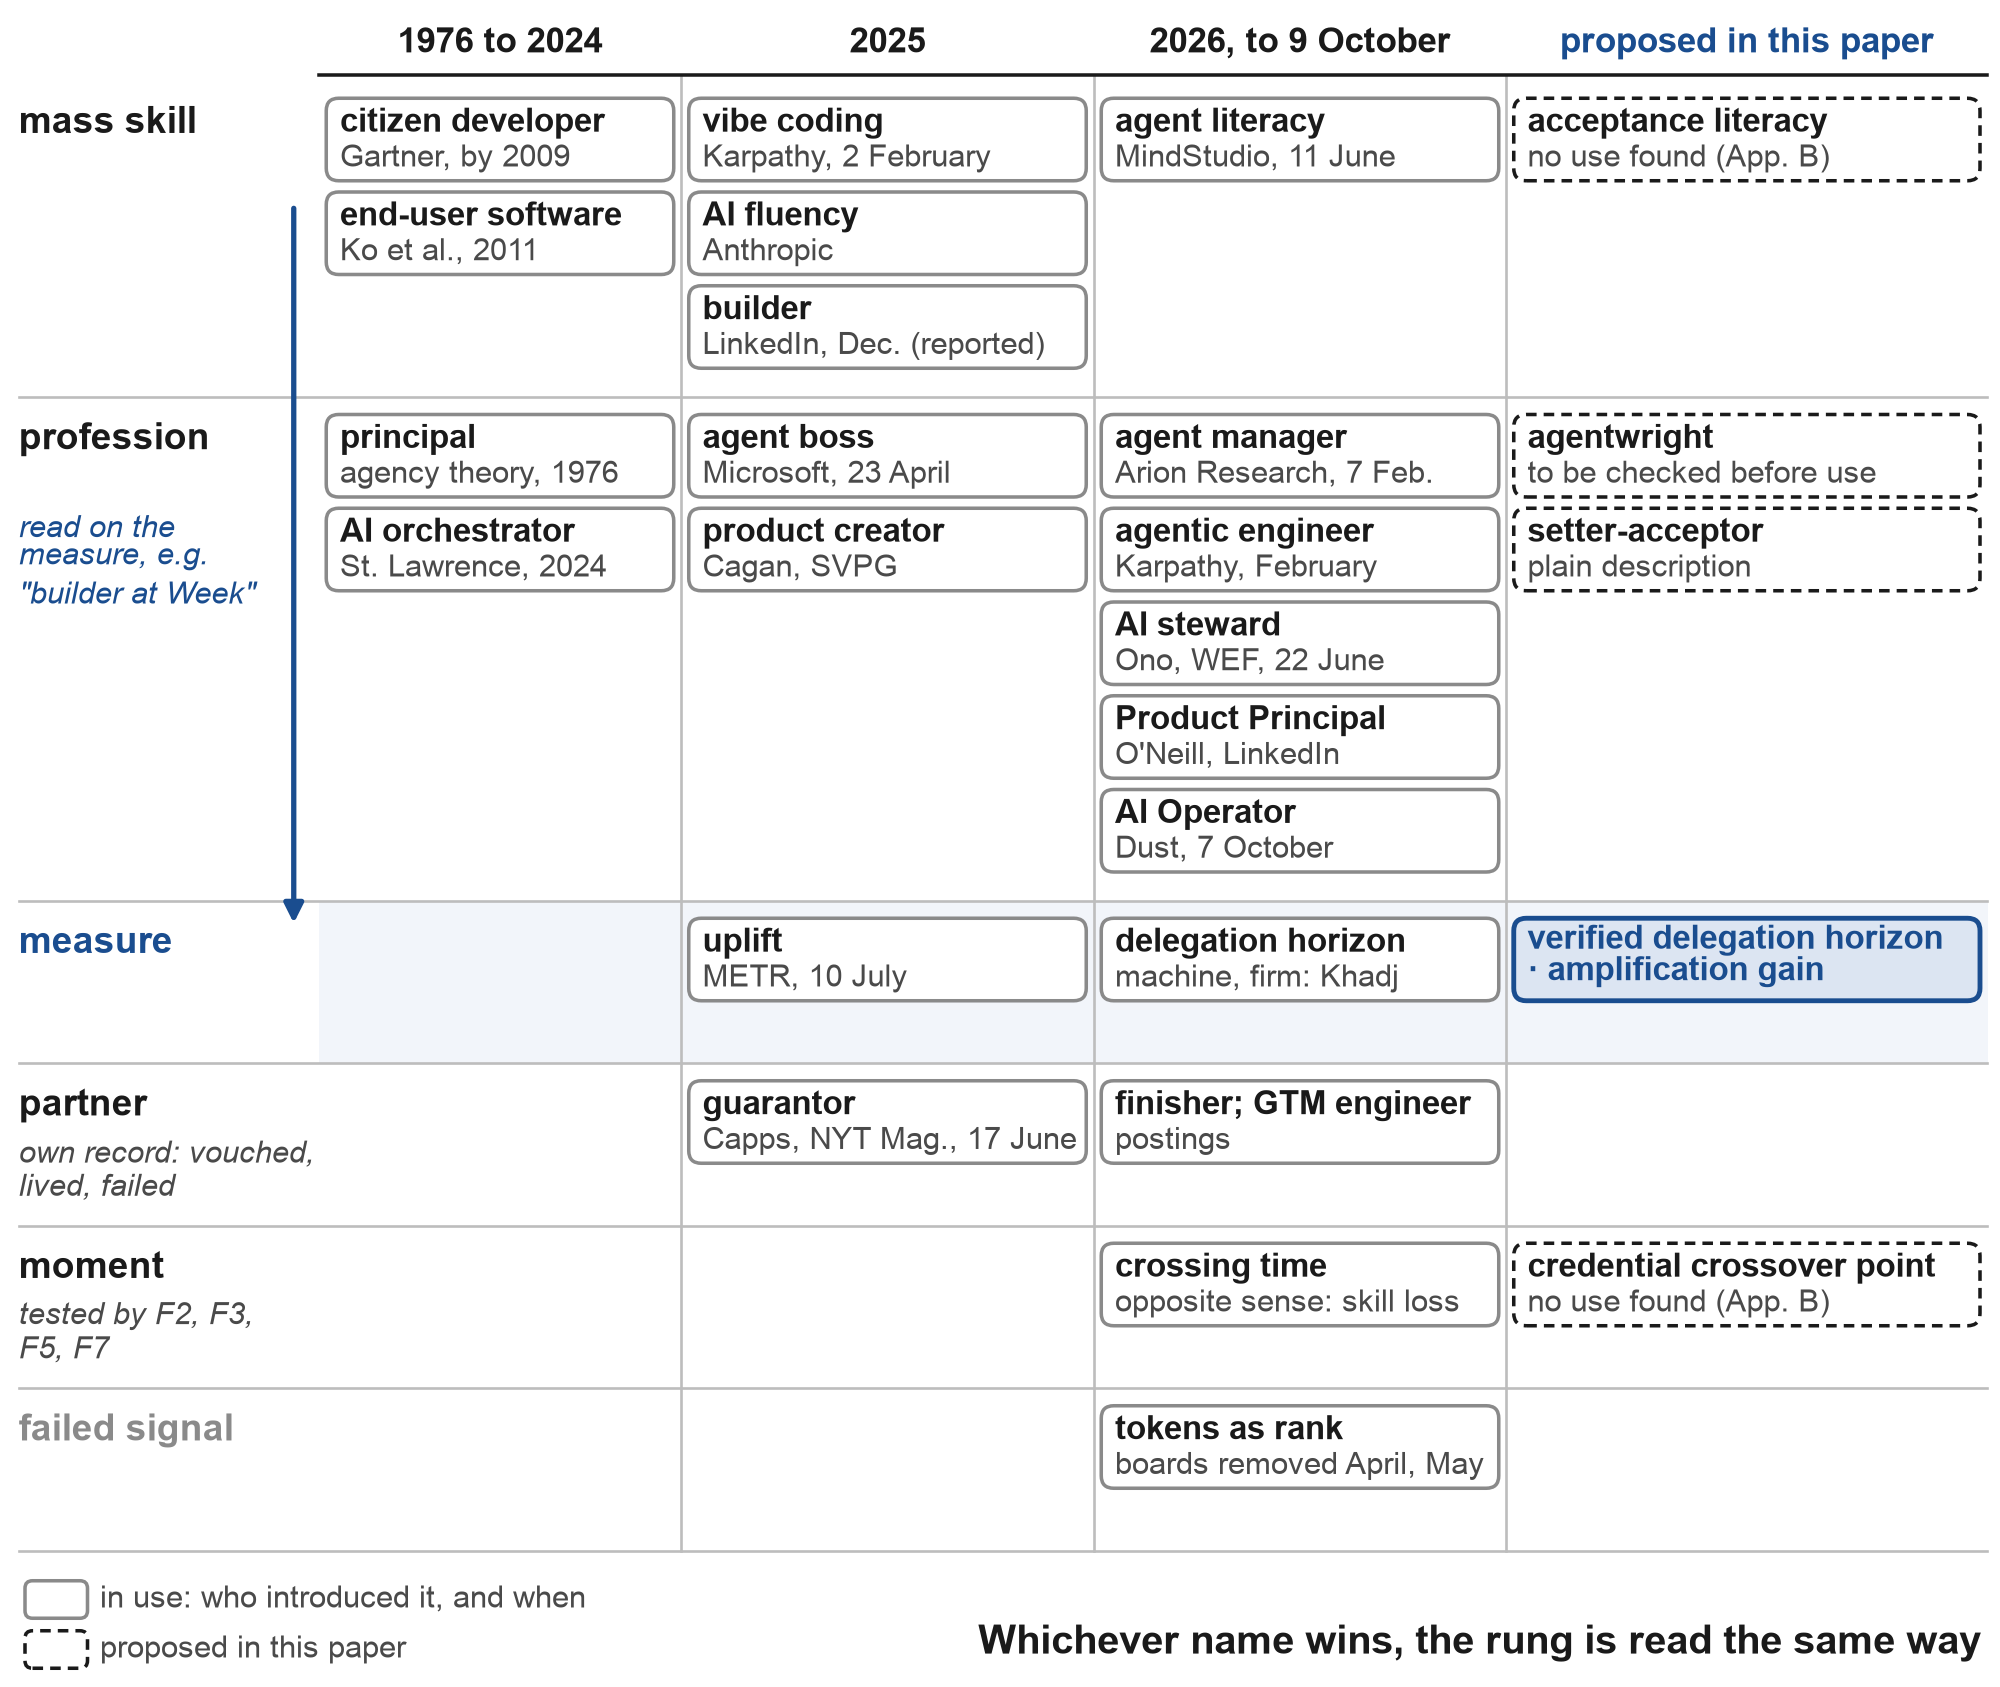
注:所有者和日期遵循表A2。名称来源仅给出年份的不包括月份。该图为选择图;表A2列出了所有候选。衡量标准仅应用于大众技能和职业层级("周级构建者"、"日级代理管理者"、第3.1节)。伙伴有自己的记录,即有多少产品被担保、每个产品存活多久以及有多少失败(第7.2节),而时刻不是一个梯级,而是通过日期预测F2、F3、F5和F7进行检验的(第11.2节)。衡量标准行中的"Delegation horizon"是机器或公司意义(Khadj, 2026;Alonso, 2026),而不是第5节的个人衡量。该图对哪个名称会占上风不做判断。
3.3 地图备注
"构建者"可能正在大众人力资源中获胜:LinkedIn已采纳了它,2026年记者写道,现在湾区的每个人都是构建者(SF Standard, 2026)。没有理由反对这个词,因为它对级别说不出什么,而级别正是衡量标准所提供的。
管理类名称(代理管理者、AI操作员、编排者)是横向的:它们描述的是通常运行代理,而不在任何特定领域。第6.3节给出了预期它们会跟随提示词工程师的理由,这个职位在2023年随处可见,在2025年被称为过时(Fortune, 2025;TechRepublic, 2025)。
"委托人"有最强大的理论支撑但冲突最严重。在代理理论中,委托人是委托方,承担监督成本(Jensen & Meckling, 1976),Anthropic对其模型的宪章将"委托人"定义为代表其行动的那些人(Anthropic, 2026b)。Verheul(2026)辩称,当机器执行代理职能时,公司内的人只持有委托人职位,职业梯级消失。我接受这一诊断并为其提议一个新梯级。不过在身份和访问管理中,"代理委托人"指的是代理本身的身份,这与预期意义相反,所以英文短语"Agent Principal"不应用于人。O'Neill的"产品委托人"是近似这个意义的先例且如此被引用,而JetBrains的AIDEs框架已将开发者级别描述为委托人-代理关系的属性(Tikhomirov, 2026)。
此处提议的名称(agentwright、setter-acceptor、agent director)作为候选加入该系列,其中没有特别偏好。Agentwright在搜索的学术数据库中未被占用,但搜索引擎将其分割为"Agent Wright",它听起来像开发者熟知的浏览器测试工具,到2026年10月,该词已被用于Python包和代理技能目录,所以它仍是需要限定词的变体。
关于含义的一个观察可以被记录下来,而不从市场中夺取选择权。从含义上讲,"委托人"最接近第8节的职业,即为他人做的工作并对结果承担责任的工作,而"构建者"最接近大众技能,即为自己做的工作。
4. 为什么是一项度量:代币被尝试用作资历的那一年
市场没有等待任何度量标准。在2026年,它尝试了几个,由于这些事件在性质上不同,它们在这里按照发生的顺序分开讨论。
在Meta,一名员工构建了一个内部仪表板,昵称为"Claudeonomics",按消耗的代币对约85,000名同事进行了排名,其中三十天内消耗的代币超过60万亿个(Shopifreaks,2026a)。这是一名员工的项目,不具有官方身份,在被报告给公司外部后于4月被撤下。Meta的官方立场则采取了不同的方向。从二月开始,AI使用正式成为了员工评估的一部分,九月初,WIRED和CIO报告了新的指导意见,根据该指导意见,Meta"不会使用AI采用仪表板或代币计数来评估影响",并取消了"AI Native"作为评估标准的资格(CIO,2026b;Shopifreaks,2026b)。在Amazon,代币使用排行榜被空任务操纵并于5月被移除(CIO,2026a),这是Goodhart法则的最纯粹形式:一旦度量变成了目标,它就停止了测量。Uber的情况是一个预算事件。该公司在四个月内花费完了其年度AI预算,并将员工限制在每月$1,500(Fortune,2026b)。七月,Cognition的首席执行官表示,公司应该测量生产力,而不是AI使用(Fortune,2026c)。
反例同样重要。Shopify在其绩效评估和同事评审中增加了关于AI使用的问题(Shopify,2026),一位评论员预计代币指标会被"下调而非取消"(Kingy AI,2026)。关于一个人如何使用AI的问题与按使用量进行排名完全不同,第11节的预测F8对它们进行了区分。
第9节中审视的开发人员线程在单个人身上表现出相同的本能。他们通过投入来介绍自己:每月$1,148的AI账单、订阅的截图、600个拉取请求中约330个已完成(线程中描述为非常近似的单位)、三天内构建的36个阶段。其中一人发布了他的代理为他计算的节省费用,而没有检查计算,这就是代币事件在一个人身上的重复。这些都计算了花费或产出的内容;但是什么被接受了、由谁接受、经过哪种检查,这些都没有记录。
我从度量中得出一个直接的教训:计算工作,并且仅计算通过代理未执行的检查的工作。同一系列模型之间的协议不能是那种检查,因为它们的错误是相关的,而且它们的协议所代表的独立意见数少于看起来的那样(Chernets,2026b)。花费更多代币不能增加这样构建的度量,因为未被接受的工作对其贡献为零。其他的增加方式仍然存在,第5.8节列出了它们及其防御措施。
5. 度量:经认证的委托范围和放大增益
5.1 参考小时
两个轴都使用一个单位,即参考小时:一名合格的专家手工完成同一项工作所需的时间。参考值刻意设置为外部的。个人是否能够自己完成这项工作不在度量范围内,其背景也不在。簿记员的对账工具和开发人员的计费模块都是按照一名有能力的专业人士会花费的时间来衡量的。
参考小时来自两个来源之一。一个是冻结的任务库,其手工完成时间在2025年和2026年进行了测量;GDPval包含来自44个职业的任务及专家的时间数据,展示了可以建立这样的库(Patwardhan等人,2025)。另一个来源是两名独立评分者,他们在不知道工作由谁完成的情况下估计所需小时数;当某个领域的评分者相差太大时,参考值可能改为由五到九名校准评分者组成的小组的中位数,按级别评分(附录G2)。我故意冻结这个库,就像米尺曾经被保存在巴黎附近的金库里一样,因为几年后很少有人还会手工完成这些任务,将没有东西可以用来比较。库应该为每个领域保存各个级别的任务,每个任务都附有书面陈述说明什么算作完成、测量的手工时间、隐藏的检查方法,以及一些人为植入的错误(检测这些错误是验收的一部分)。GDPval的手工时间是专家经过验证的自我报告,其审查时间则是测量得出的,这是库应该达到或改进的标准。为了防止度量方法自我评判,范围是在一组任务上评分的,用来测试关于它的假设的质量(第6部分)则在另一组任务上。
5.2 经认证的委托范围
定义。 某人在某个领域的经认证的委托范围是工作的最大规模(以参考小时衡量),在这个规模下,此人定期将工作交给代理,接受完成的工作,并由代理未看到的独立检查进行确认。
一句话规则。 一项委托工作只有在以下所有条件都满足时,才能被视为经认证的,并进入范围。它必须附带书面陈述说明什么算作完成,其参考小时来自库或两名评分者。此人将其作为一个连贯的交付物接受:一个月分成160个一小时工单的工作总共是160小时,而分阶段完成并最终作为整体接受的工作则按该整体的参考小时计数。独立检查已确认其完成,检查是独立的当且仅当它在数据、访问权限和激励上与代理的工作不同(数据:代理未产生的输入;访问:代理无法查看或编辑;激励:运行检查的人从通过结果中无利可图)。四种检查符合条件:隐藏的验收测试、合格的人工审查者、预期用户的实际使用,或来自不同家族的模型,该模型针对此人开放的来源进行验证,并留下可审计的结论。自我审查和同一家族模型的一致性不计,因为它们的盲点与代理的盲点相同。在级别的时间窗口内(小时和天级别91天,周级别182天,月和季度级别365天),此人接受了至少该规模的所需数量的工作,小时和天级别十个,周和月级别六个,季度级别三个,其中至少十个中有八个通过了检查,即周和月级别六个中有五个通过,季度级别三个全部通过。从周级别开始,至少其中一项包含人为植入的错误。遗漏任何一个人为植入的错误,无论什么类型,都会导致该窗口中周级别及以上的级别被阻止,包含该错误的工作既不计入级别也不计入放大增益。如果错误无法撤销(资金已转账、患者记录、无法撤回的申报),则每项这样的工作都必须通过,默认检查方式是隐藏测试或合格的人工审查,来自不同家族的模型作为第二道防线,更严格的规则仅适用于这些工作。每次交接都被记录,包括失败和放弃的工作,以及它们所需的关注。每个季度再次确认级别:对于周级别及以上,该级别规模的至少一项经认证工作必须在过去91天内完成,因此范围不能基于接近一年前的工作。下面的段落解释了每一部分的原因。
评分规则。 在为每个级别设定的时间窗口内(小时和天级别为91天,周级别为182天,月和季度级别为365天),如果此人在该领域接受了至少该规模所需数量的工作(小时和天级别十个,更高级别为更少,如下所述),且至少十个中有八个通过了以下任一类型的检查:隐藏的验收测试、合格的人工审查者、预期用户的实际使用,或来自不同家族的模型针对来源进行的验证,则该级别计数。自我审查和同一家族模型的一致性不计。如果错误无法撤销(资金已转账、患者记录、无法撤回的申报),则每项这样的工作都必须通过,更严格的阈值仅适用于这些工作。对于这些工作,默认检查是隐藏测试或合格的人工审查,以来自不同家族的模型作为第二道防线。
更高级别。 单一要求十项工作会使更高级别超出任何人的能力范围,因为在三个月内十项40参考小时的工作相当于一名专家的400小时工作,十项500小时的工作则是5,000小时。因此,规则随着级别上升而延长时间窗口并降低数量要求:小时和天级别要求91天内十项,周级别要求182天内六项,月级别要求365天内六项,季度级别要求365天内三项,通过率相同为十个中八个(即周和月级别中六个中有五个通过,季度级别中三个全部通过)。早期版本要求月级别为四个全部通过;附录E的桌面测试表明,这使得月级别对任何可靠性的人来说都比季度级别更难达到,因此该要求被改变了。从周级别开始,窗口内该级别规模的至少一项必须包含人为植入的错误。此人遗漏的任何人为植入的错误,无论什么类型,都会阻止该窗口中周级别及以上的级别,包含遗漏的人为植入错误的工作既不计作经认证的(不计入级别),也不计入放大增益。季度级别旨在保持为稀有级别,上述数字的设置就是为了实现这一点。
每次交接都被记录。日志记录了交给代理的每一项任务,包括未通过检查的和在检查前放弃的,只有被接受为一个完整可交付成果的任务才计入阶梯的一级。分成160个一小时任务的一个月的工作是160小时,而不是一个月:参考小时数是为用户、客户或审核者接受的完整可交付成果估计的,遵循METR的相干任务精神。反之亦然:分阶段进行并被接受为一个完整可交付成果的工作计为完整的,按该可交付成果的参考小时数计,无论花费多少阶段。
独立性。当检查在数据(使用代理未产生的输入)、访问权限(代理无法查看或编辑)和激励(运行检查的人从通过中获得任何收益)上与代理不同时,检查是独立的。另一类模型增加了错误的多样性。只有当它针对该人员打开的源进行验证时才计数,其判决是可以审计的一个输入。
一项工作经历这个路径(图3)。任务通过说明什么将计为完成的书面声明来设置。其参考小时数来自银行或两个评分者。代理进行工作,而该人花费注意力,这被记录下来。该人接受、拒绝或放弃该任务,独立检查确认或反驳,日志行在那一刻被写入,起始日期作为单独的字段保持,在相关时保持。如果存在延迟的结果(被接受的提交、一个月后仍在运行的发布),在它到达时记录。地平线和收益从这些记录计算,带有日期。
图3。一项工作,一条记录。
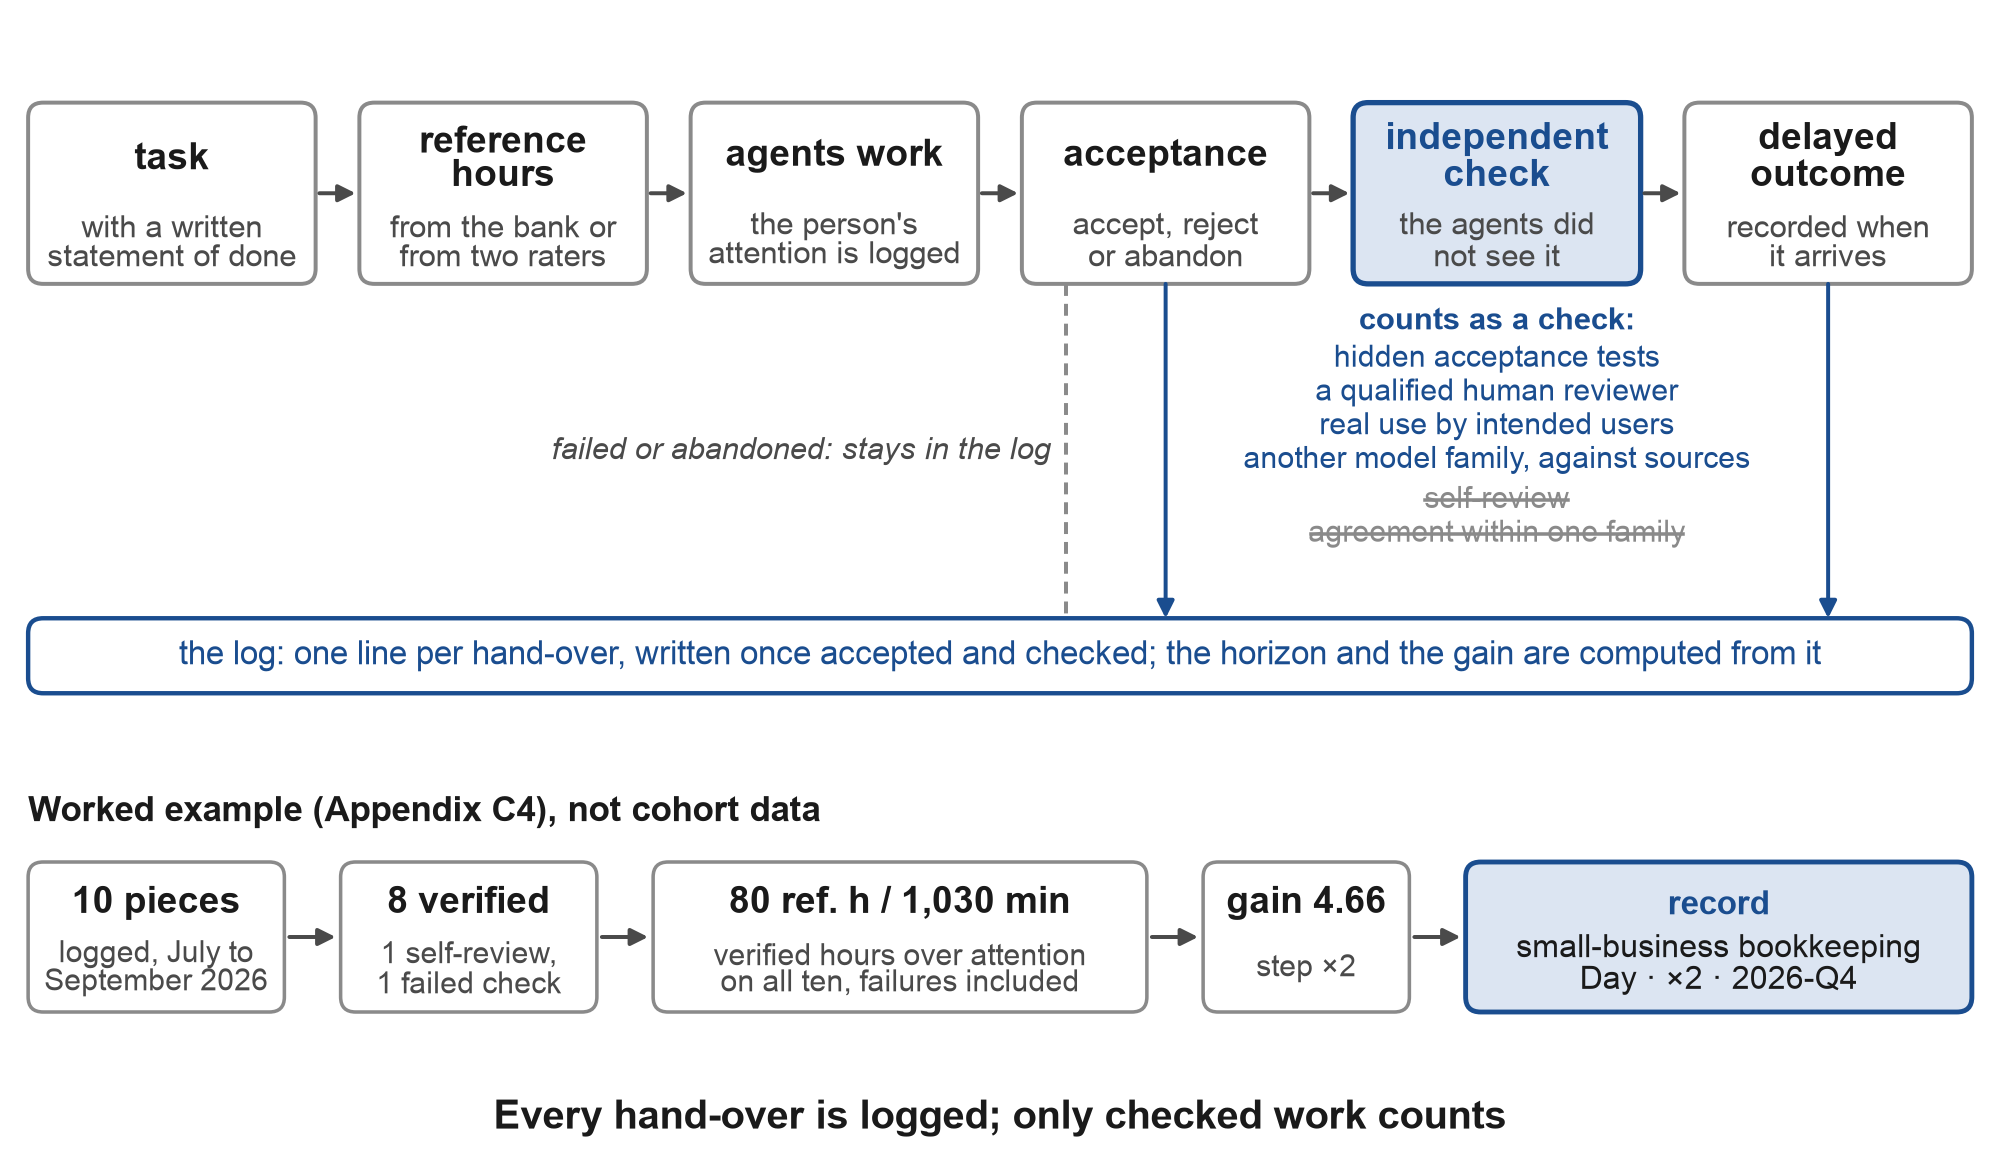
注:上一行是第5.2节的路径。四种独立检查是评分规则的那些。自我审查和同一类模型之间的一致不计数。失败和放弃的任务留在日志中,其分钟数添加到放大增益的分母。下一行是附录C4的有效示例,构建的日志,不是队列数据:十项,八项已验证,80个参考小时相对于1,030分钟的注意力,收益4.66(步骤×2)和记录"小企业簿记·日·×2·2026-Q4"。
重新验证。地平线每季度再次确认。Anthropic的监督悖论(第2.1节)解释了原因:在检查技能衰退期间获得的地平线是借来的,季度检查显示它是否仍然有效。对于窗口运行时间长于一个季度的阶梯(小时、日、周、月和季度),检查有具体形式:至少一个该阶梯大小的已验证任务必须在过去91天内,以便阶梯不能建立在接近一年的旧任务上。
5.3 阶梯
我用时间单位命名五个阶梯,因为时间单位不需要在专业间翻译,可以从日志中阅读,并随着技术增长而无需重新命名。表1给出了它们的例子和每个需要的计数。
表1。已验证委派地平线的阶梯。
| 阶梯 | 移交和验证的工作规模 | 软件中的示例 | 其他地方的示例 | 需要的已验证任务、窗口 |
|---|---|---|---|---|
| 小时 | 大约1个参考小时 | 一个脚本、一个小的修复 | 从一堆文档中提取的答案 | 91天内10个中的8个 |
| 日 | 大约8个 | 一个功能、一个小的内部工具 | 一个月末报告及其检查 | 91天内10个中的8个 |
| 周 | 大约40个 | 一个符合规范的网站或内部工具,具有夜间运行 | 一个完整的尽职调查包、一个活动系统 | 182天内6个中的5个 |
| 月 | 大约160个,通常在几个流中 | 一个产品发布;其他人遵循的接受规则 | 一个实践的工具,具有同事使用的规则 | 365天内6个中的5个 |
| 季度 | 大约500个 | 一个有实时用户的产品线 | 通过代理运行的服务线 | 365天内3个中的3个 |
注:一个阶梯只能通过第5.2节的评分规则获得,在每个领域中分别获得,具有规则v1.1的计数(附录E)。旧阶梯上的没有等级赋予阶梯,一个人可以在金融工具中处于周级别,在网络应用中处于日级别。
简历或人力资源文件的记录包含领域、地平线、放大倍数和日期,例如"小企业簿记·日·×2·2026-Q4"。日期属于记录,因为同一阶梯一年后将意味着不同的东西,随着技术的发展。
5.4 放大增益
并非每个与代理合作良好的人都会交给他们大块任务。第9节中的一个开发人员,用四台机器构建,将其中三台描述为"个人效率提升",没有自主代理在其上。他还运行的自主代理"没有根植"于日常工作,他写道,并且他倾向于"增强,而不是委派"(翻译)。他最长的流程在三天内运行36个阶段,每个阶段移交并提交,然后要求代理确认一切都已部署。根据第5.2节的规则,该确认是自我审查,所以他发布的记录完全没有显示已验证的阶梯,线程没有给出他的增益的数字。他在独立检查中的立场取决于什么被接受。如果36个阶段被接受为一个完整可交付成果,流程计为完整的,按其参考小时数,如附录C第C4节的阶段工作一样。如果每个阶段都被单独接受,每个都是一个小任务,他在第一轴上处于小时级别。该帖子没有说是哪一个。然而,他构建的工具替代了他曾经购买的软件,当他称时间为唯一的瓶颈时,他自己命名了第二轴的分母。
他不是一个例外。Anthropic 报告称,具有六个月或以上经验的用户"通过指令性使用模式委派更大责任的可能性要低得多",与模型互动更具迭代方式,并处理更复杂的任务,在控制变量后成功率提高了三到五个百分点(Anthropic, 2026d)。在 Claude.ai 中,2025 年 11 月协作使用的占比领先自动化 52% 至 45%,对话的成功率高于一次性程序请求,分别为 67% 和 49%(Anthropic, 2026a)。高薪职业中的人员花费的轮次大约多 1.5 倍,同一职业中女性的自动化程度比男性低 7.3 个百分点(Anthropic, 2026f)。在 Stanford 对 1,500 名工作者的调查中,在 104 个职业中的 47 个中,最受欢迎的安排是人与代理之间的平等伙伴关系(Shao et al., 2025)。因此,仅以委派为基础的度量将低估最有经验的用户、收入最高的用户和女性,尽管这些数据中没有任何内容表明他们的工作更差。
定义。放大增益是指在过去 91 天内,在该领域中被接受和验证的工作的参考小时数除以该人投入的注意力小时数,无论该人的工作级别如何。通过外部帮助(同事或承包商在日志外修复)完成的工作被记录为此类,并不向分子添加任何值,而该人在其上花费的分钟数保留在分母中。注意力包括规划、指导、阅读、检查和修复。代理在该人进行其他活动时运行的时间不计入。
放大增益是经过验证的吞吐量:每小时注意力投入的已接受、已检查产出。它不是对同一个人使用代理时比不使用代理时工作速度快多少的因果估计。该比较意义上的增益需要一个基线,即同一个人或配对的人在没有代理的情况下从事相同类型工作,并且只有比较研究才能提供它。
失败的工作向分子添加任何内容,所有分钟都添加到分母中,这使自欺欺人保持可见。在 METR 的 2025 试验中,经验丰富的开发人员相信人工智能加快了他们的速度,而测量结果显示他们的速度反而慢了 19%(METR, 2025)。
第二轴的步骤是 ×1("一天对一天")、×2、×5("一周对一天")、×20("一月对一天")和 ×60("一季度对一天")。两个量表是独立的,因此一个量表上的步骤不等于另一个量表上的级别。当一个人并行运行多个代理时,注意力仍然只计算一次,以该人自己的分钟数计:观看三个流花费的一小时是分母中的一小时,按照记录到每个部分的分钟数在各部分之间共享。分数与产生它的设置一起报告(模型和工具、检查类型和任务的级别),因为同一个人在更严格的检查下会获得不同的分数。
5.5 两轴、四个档案和一个上限
将人员放置在两个轴上会产生四个档案(图 4)。学徒具有短期视野和低增益。放大器具有短期视野和高增益,就像那位 36 个阶段的构建者一样,如果他的各个阶段能够逐个被接受的话。委派者具有长期视野和高增益。第四个档案,我称之为监督者,是长期视野和低增益的组合:代理运行时间长,而检查和返工会抵消收益,因此这更多是一个警告信号而非一个级别。
两个轴受一个上限联系。注意力投入到设置一项工作中,也投入到检查它中。设 H 为一项工作的参考小时数,V 为检查它所需的注意力小时数,S 为设置它所花费的小时数。则增益 G = H / (S + V + 返工),因此 G ≤ H / V。如果仅检查就占手工操作时间的四分之一,则无论代理运行多长时间,增益也不能超过 ×4。同样的界限,步骤 ×2、×5、×20 和 ×60 仅在检查分别不超过手工操作时间的 50%、20%、5% 和约 1.7% 时才开放(图 4)。这是一个简化的模型,具有明确的会计边界:它忽略了该人根本无法完成的工作的价值,它假设检查时间与工作量成正比,并且它按件适用,因此一个便宜地检查小件工作的人可以超越为大件工作计算的上限。在经济学层面,Catalini 等人(2026)提出了相同的观点:约束条件变成"人工验证带宽",一个"可测量性差距"在代理可以执行的操作和人们负担得起的验证之间产生。
GDPval 在实践中展示了这个界限的含义。在其 220 项任务的黄金子集上,其专家报告(作者也验证了)平均每项任务手工操作 404 分钟,而审阅交付成果需要经测量的 109 分钟,约占 27%,这将此类任务的上限设置在约 ×3.7。这些模型生成的草稿速度比专家快 90 到 327 倍。然而,在一个人尝试模型然后修复其工作的场景中,作者的计算(而非测量)给出 GPT-5 的加速倍数为 1.12(模型尝试一次)和 1.39(多次尝试),这是同一表的两个不同列(Patwardhan et al., 2025)。无论代理的速度如何,检查的代价设置了上限,而且这个代价随着工作量增加而上升,因为更大的工作需要花费更多时间来检查。Kamara (2026) 称这种成本为验证摩擦。第 9 节讨论区中的实践者用他们自己的话表达了这一点:过了某个点,检查代理代码"与手工重写的差异越来越小",并且可能比自己编写代码花费的时间更长(翻译)。
同样的增益可以通过两条不同的道路实现。长链条交付大块工作并在末尾检查;短、快速的循环交付小块工作并在每个到达时检查。我的假设是,随着进度逐项检查小块工作通常比在末尾检查大型结果的成本要低,而 Anthropic 的数据也指向这一点。对话的成功率高于一次性请求,根据作者自己的推断,一次性请求在约 3.5 小时的任务上达到 50% 成功率,而对话在约 19 小时的任务上达到 50% 成功率(Anthropic, 2026a)。协作使用的份额在 2025 年 8 月低于自动化,但到 11 月回升至领先,52% 对 45%。短循环道路接近人工智能协作文献研究的内容,放大增益对其的认可程度与长期委派一样充分。第 11 节中的预测 F19 到 F21 测试了短循环道路。
图 4。两轴、四个档案和检查设定的上限。
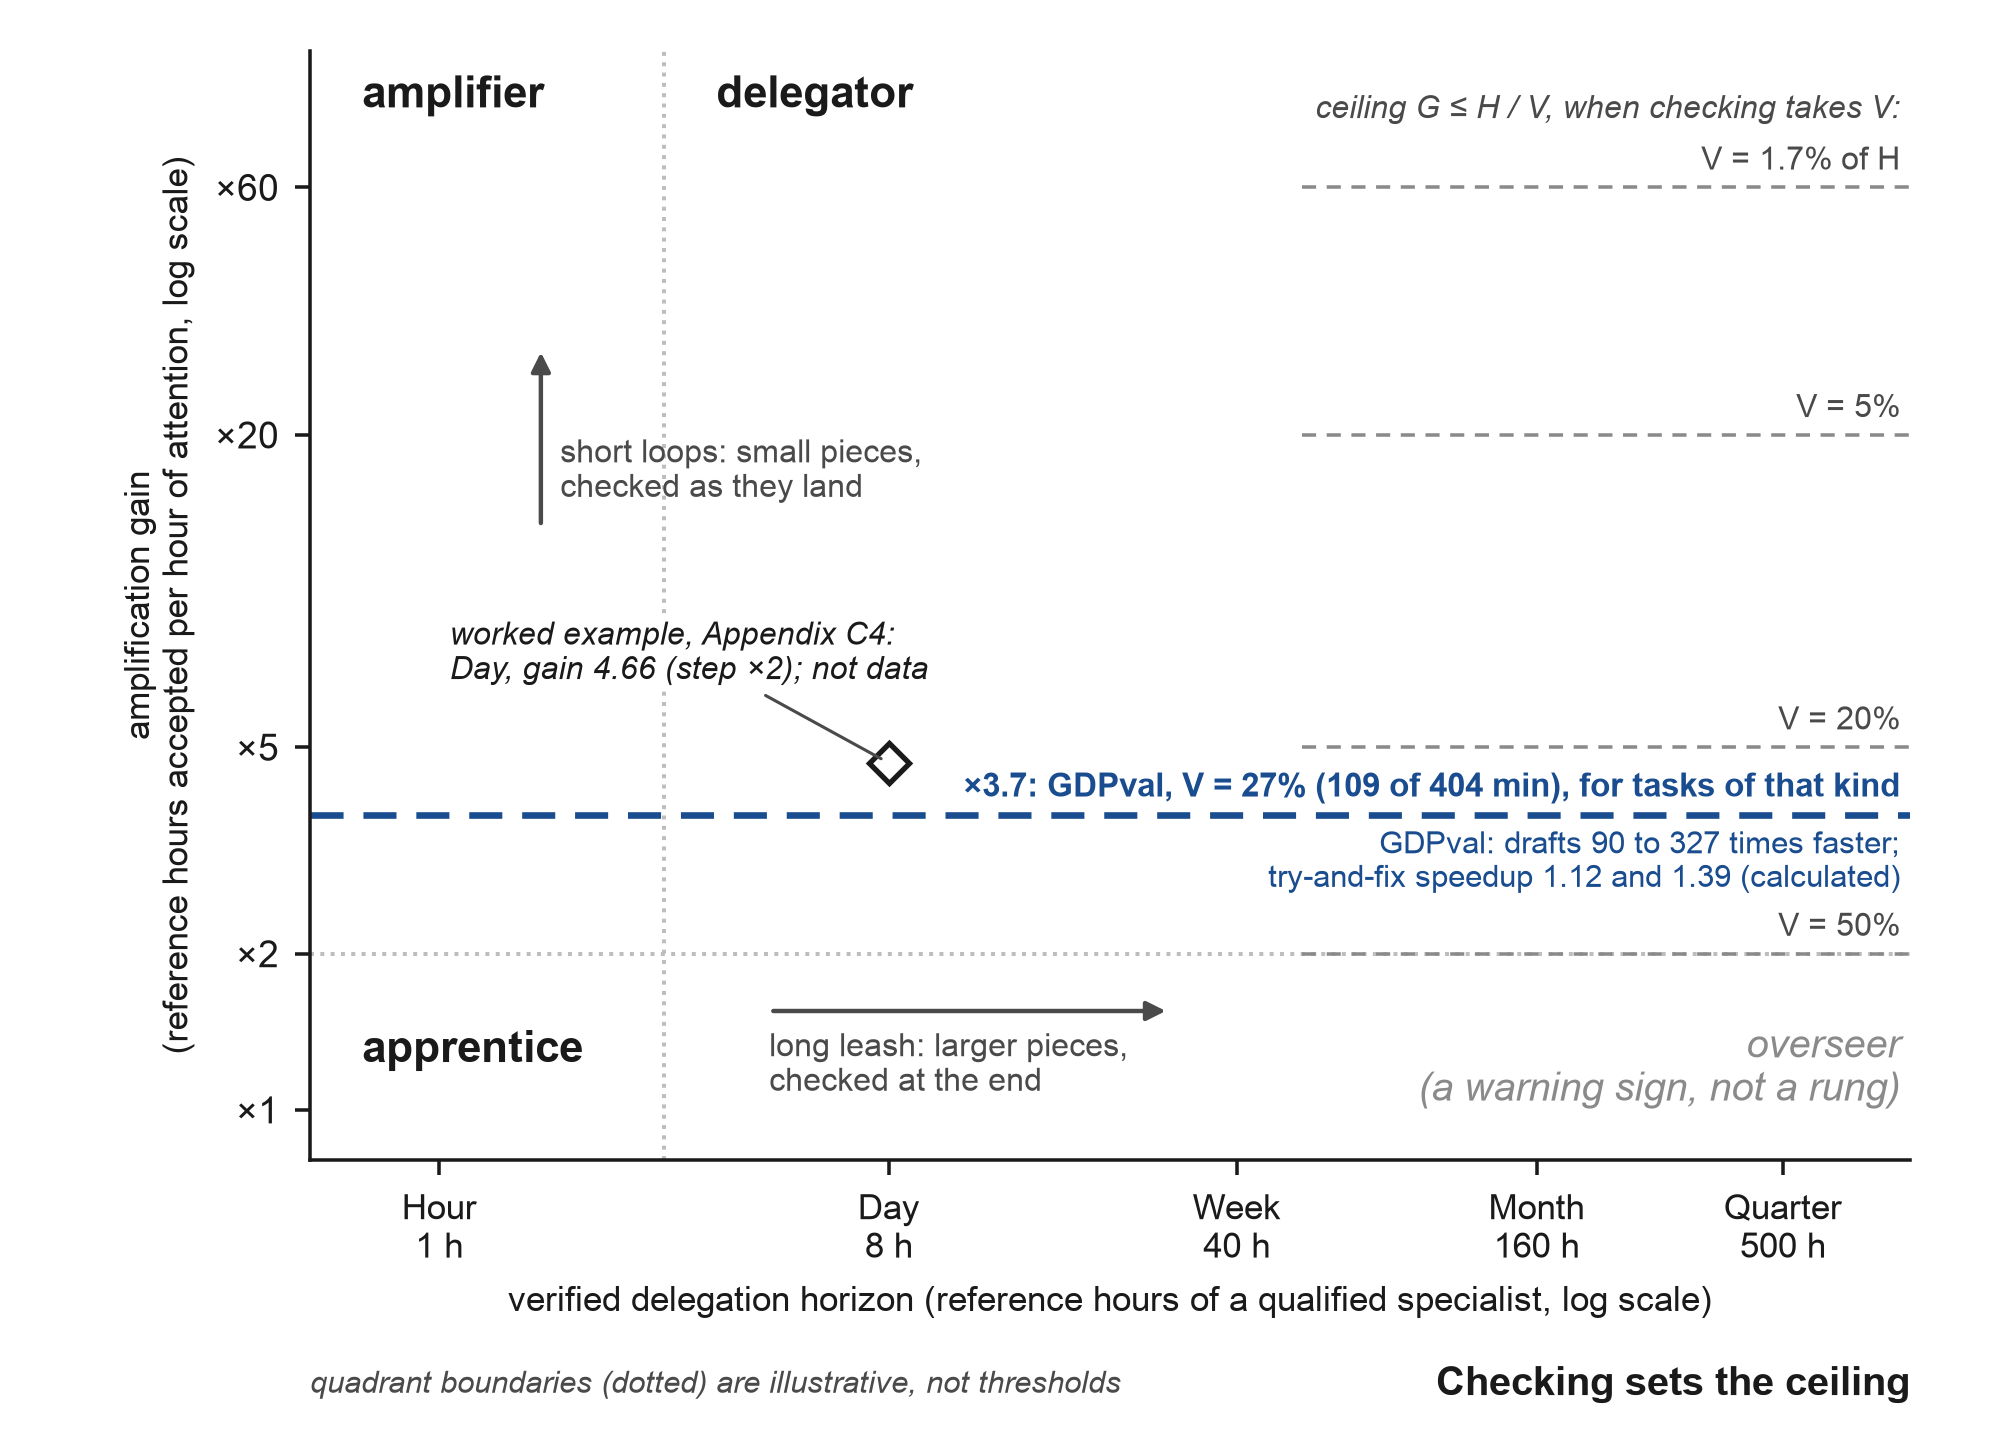
注意:象限是档案类型,不是等级,其边界是示意性的。每条灰线代表第5.5节中的约束G ≤ H / V,其中V是手工时间H中检查时间的比例。重点线使用GDPval在其220个任务的黄金子集上的平均值,404分钟手工时间和109分钟对模型输出的专家审查(Patwardhan et al., 2025),适用于该类任务。加速倍数1.12和1.39是作者计算的结果,不是测量值。菱形是附录C4中的计算示例,不是数据。它位于GDPval线上方,因为天花板是按任务类型计算的,廉价检查的小块可能会超过为大块计算的天花板(第5.5节)。第5.4节中36个阶段的情况未绘制:该部分没有收益,也没有独立检查。
5.6 度量的来源及其新颖之处
该度量有其历史渊源,其中最古老的是Elliott Jaques,他通过裁量权的时间跨度来衡量任何职能中任何工作的级别:即一个人在他人评审结果之前凭自己判断力进行工作的最长时间。他主张公平薪酬随着该跨度而增加(Jaques, 1956)。经过验证的委派范围将这一思想带入智能体时代,但有一个改变。Jaques衡量的是一个人不受检查地工作的时间长度,而该度量计算的是一个人交给智能体的工作量、接受的工作量和经过检查的工作量。两者可能不同,而且他的分层(按月和年计数)不会映射到这些等级上。
委托-代理理论是第二个历史渊源。Jensen和Meckling (1976)将委派定价为监督成本、担保成本和剩余损失。检查是将工作交给智能体的监督成本,范围标记着检查更大块工作不再有回报的点。
METR在同一轴线上测量机器。其时间范围是模型在给定成功率下完成的任务长度(以人类小时计)(Kwa et al., 2025)。在2026年春季,其仪表板上的前沿模型在50%成功率下达到约17小时,尽管METR本身警告说,以其当前任务而言,16小时以上的测量值不可靠。80%成功率的范围从2026年2月的约1.2小时上升到4月的约3.1小时,这两个数据点说明了增长速度,但没有测量其速率。自2023年以来在仪表板上拟合的跨模型趋势约每4.2个月(128.7天)翻倍,仪表板在2026年9月8日上次访问后未更新(METR, 2026c)。AI Futures Project的预测者采用4至4.5个月的翻倍时间(AI Futures Project, 2026)。接受的工作更多对应于80%范围而不是50%范围。模型有时完成的工作和可靠完成的工作之间的差距是个人的工作,即证明结果是正确的并将其贯彻始终。图A3(附录F)将这些机器范围与等级进行了比较。
2026年的理论指向同样的差距。Huang、Xiao和Vishnoi (2026)建立了AI下的委派模型,发现验证能力的微小差异会导致结果的巨大差异:AI帮助那些进行检查的人,伤害那些过度委派的人。他们的论文在ICML 2026上被接受,他们称这种效应为验证放大。对24项研究的系统审查发现,其焦点语料库中没有任何经过验证的工具涵盖监督智能体所需的全部技能组合(范围、权限、恢复、独立审查和证据为基础的结束),尽管某些工具涵盖其中的部分(Veri', 2026)。DeepMind关于智能AI委派的框架一般性地描述了委派,但不包含个人级别的度量(Tomašev et al., 2026),委派经济学现在有了自己的前沿模型(Wang, 2026)。Chen和Meng (2026)表明生成型AI压缩了任务内的技能差异,并将价值转向稀缺的补充资产,他们补充说测试其预测所需的个人-任务面板数据"目前还不存在大规模数据"。我提出的度量产生的正是这种数据,因为每个记录的片段都携带一个人、一个大小和一个日期。
第二个轴线也有其邻近概念,放大收益是它们的个人级别、经过验证的形式。Engelbart (1962)将计算框架化为增强人类智慧,"超级代理"是麦肯锡在2025年对同一希望的措辞(McKinsey, 2025)。Anthropic Economic Index通过加速比(不使用AI的时间除以使用AI的时间)和智能体自主性对话进行评分,两者都在1到5的量表上,都由一个模型判断(Anthropic, 2026a)。Stanford的WORKBank将工作者偏好的人类参与程度评级从H1到H5(Shao et al., 2025)。一篇2026年的论文将监督能力定义为有用的经过验证的输出对人力工作的比率,并明确拒绝给它一个数字(em360, 2026),"放大监督"是AI安全领域的一个术语,用于帮助人们监督比自己更强大的系统。对搜索智能体的观察显示了同样的人类时间向检查转变:智能体在每个会话中独立工作26分钟,而普通搜索用时33秒(Yang et al., 2026)。在委派方面,Khadj (2026)和Alonso (2026)使用"委派范围"来表示机器或公司可以委派多远,CHI 2026关于"决策范围"的工作研究了自主性的丧失(University of Lübeck, 2026),Dawson (2026)和Metal Toad (2026)发布了从业者的AI委派级别。这些都没有将一个人按独立检查确认的工作放在一个级别上。
最接近的最近框架在这里直接进行比较。JetBrains Research的AIDEs框架(Tikhomirov, 2026)与该度量共享两个特征:它将委派视为委托-代理关系,并将委派按五个级别进行排序,由自主性和规划等属性进行描述。它在四个方面有所不同。其主题是软件开发,而范围在任何领域都有评分。其级别描述工作如何被委派,而等级是由工作的大小决定的,以合格专家的参考小时数计。它没有检查必须独立于智能体的规则,而等级只计算由智能体未看到的检查确认的片段。它没有时间窗口的计数,也没有第二个轴线,而等级需要在有日期的窗口上的通过率,放大收益增加了注意力小时数。代理的语言是共享的;该论文提议的是单位、独立规则和超越软件的范围。
2025年和2026年发布了许多量表,表2中的任何量表都没有按经过验证的工作来衡量一个人。表2按它们衡量的内容对主要的分组进行了分组;表A3(附录F)列出了每一个。
表2。 2025年和2026年的量表,按衡量内容分组。
| 类别 | 示例 | 衡量单位 | 通过已验证的委托工作对个人进行分级? |
|---|---|---|---|
| 代理和机器的自主权级别 | Feng et al., 2025; Shapiro, January 2026; Memari & Rudolph, 2026; METR, 2025-2026 | 代理、模型或团队的设置 | 否 |
| 开发者实践的阶段 | Yegge, 2026; Park et al., 2026; Microsoft, May 2026 | 实践、监督工作或工作模式 | 否 |
| 组织和公司的委托 | Dawson, 2026; Metal Toad, 2026; Tomašev et al. (DeepMind), February 2026; Khadj, 2026 | 组织、经理、公司或一般委托 | 否 |
| 开发者委托作为委托人-代理人关系 | JetBrains Research (Tikhomirov), September 2026 | 开发者的委托 | 仅限开发者;检查无独立规则,无大小单位 |
| 能力和素养框架 | AI Certification Standards, 23 August 2026; Anthropic AI Fluency, 2025b | 能力或素养 | 无考试、阈值或级别 |
| 已验证的委托地平线和放大收益 | This paper | 某领域中的个人 | 是的,根据第5.2节的规则 |
注:"通过已验证的委托工作对个人进行分级"是指该量表根据个人交给代理的工作规模,以及通过代理未见到的检查进行的确认,将该个人置于某个级别。最接近的例子是JetBrains的五个级别:它们共享委托人和代理的语言,在验证规则(代理未见到的独立检查)和单位(参考小时)上有所不同。表A3(附录F)单独列出了每个量表。
一位实践者很好地提出了对任何个人量表的异议:"你的自主权级别是存储库的属性,而不是开发者的属性,也不是模型的属性"(Phoenix, 2026)。我部分同意。地平线属于一个人,在一个领域内,在一个检查制度下,一个设计良好的带有隐藏测试的存储库是该制度的一部分,这是为什么地平线按领域和日期记录的原因之一。
5.7 来自伴随论文的两个问题
伴随论文留下了一个未解决的问题:为什么经验丰富的用户委托工作较少,是因为他们有过失败经历还是因为他们的判断是产品(Chernets, 2026a)。第二个轴可以区分这两者。如果指令使用的份额下降而已验证的收益上升,则判断是产品;如果收益也下降,则他们有过失败经历。伴随论文还询问委托的词汇是一种语法还是每个专业一种。我的立场是:语法是一种(设置任务,然后基于证据接受),但什么算作证据因领域而异,这是为什么梯级是共享的,评分按领域进行的原因。
附录C的工具为每个人和领域报告指令份额,按片段计数(一次性交接的片段比例,与分阶段或联合工作相对),因此可以在提供梯级的相同记录上运行第一个粗略测试。预测F20表述该测试及其注册测度的日期,即"日志中给出指令而不是检查或编辑的人的转动份额"(表A6):那里份额是根据会话日志的转动而不是附录C的工作日志的片段进行计数,因此它是两个计数中更精细的一个。
5.8 如何操纵该衡量方法及其防御措施
计数已接受的、经过独立检查的工作阻止了最便宜的作弊方式,但坚定的人或追求目标的雇主仍然有其他选择。表3列出了这些方法和规则提供的防御措施。防御措施需要付出代价,这种代价是设计的一部分:经过审计的梯级比自我报告的梯级更有价值,就像经过审计的账户比声明更有价值一样。
表3. 操纵衡量方法的途径及其防御措施。
| 途径 | 表现形式 | 防御措施 |
|---|---|---|
| 简单检查 | 薄弱解决方案通过的隐藏测试;仓促进行审查的审查员 | 由第二个独立检查员对已接受项目份额的随机审计;从"周"级别及以上的植入错误;检查类型打印在分数旁边 |
| 选择刚好高于阈值的任务 | 许多8.1参考小时的片段以达到"日"级别 | 从大小分布中读取的梯级,已接受的中位数大小报告在梯级旁边 |
| 对小时评分方面慷慨的评分员 | 膨胀参考小时的评分员 | 两个不知道该人身份的评分员;超过固定比率的分歧将项目发送到冻结库或第三个评分员;评分员的记录经过审计 |
| 隐藏帮助 | 同事或承包商在日志外修复工作 | 每个项目记录的注意;随机访谈或重放;外部帮助记录为字段并从该人的收益中排除 |
| 切片 | 一个月的工作切成一小时的票证 | 只有作为一个整体被接受的连贯可交付成果才能计入梯级 |
| 隐藏失败 | 日志中遗漏的被放弃或失败的项目 | 每次交接记录,包括其开始日期,并在接受、拒绝或放弃时关闭;失败的公开记录;看起来过于干净的通过率会触发审计 |
| 相关检查 | 同一类别的第二个模型同意 | 不计数(5.2节) |
| 平行流 | 每个流计数一次的注意 | 每人-分钟计数一次的注意(5.4节) |
这些阈值是设计选择,规则版本为v1.1,仅在获得数据后的新版本中更改。窗口中十个项目是最小计数,其中80%的通过比例才具有意义(十项中八项通过)。下层梯级的91天窗口以及上层梯级所需的最近任务与季度重新验证和工具变化的步伐相匹配。梯级规则是资格规则,不对人员可靠性做出任何估计。十次中八次通过与真实通过率一致,范围从约44%到97%(精确95%置信区间),三次中三次通过与通过率低至约37%一致(单侧95%界限)。已注册的校准研究估计可靠性。80%的比例遵循METR将80%作为可靠工作水平的做法,而1、8、40、160和500小时的梯级分别对应工作小时、日、周、月和季度,因此在不同专业间无需转换。对阈值的桌面测试通过模拟和模型评级人检查了规则(附录E)。它计算了可靠性已知的人获得每个梯级的频率(图A2,附录E)。在真实通过率为0.8时,Day在68%的窗口中获得,同样的判决在下一个窗口中的重复率为56%,这就是为什么记录在梯级旁打印计数,如"Day (8/10)"。它还在规则的第一版本中发现了一个错误:Month的4/4比Quarter的3/3更难获得(在通过率为0.8时,41%对51%),因此Month现在要求一年内六个中五个。将计数从十改为八或十二,或将比例从0.8改为0.7或0.9,改变模拟日志中8%至11%的Day判决,同时改变两者则最多改变22%。来自四个系列的四名模型评级人在盲目估计参考小时数时,对30个任务的排序一致(对数小时的类内相关性0.89),但只有62%的配对在1.5倍范围内,与校准协议的70%标准相比,且在总体水平上相差两倍;仅给定任务的公共标识符时,他们的平均估计对于14个任务中的3个落在测量的人类时间的1.5倍范围内。因此,模型评级人不能替代两名人类评级人,而现场研究的评级人首先使用具有测量时间的任务进行校准。校准协议提前确定下一步测试:人类评级人之间的一致性(标准:至少70%的配对在1.5倍范围内)、人员在两个连续窗口间梯级的重复性(加权Kappa至少0.6),以及梯级预测通过相同规模新任务能力(AUC至少0.7)。其协议和注册文本在伴随存储库中,与从业专业人士进行的第一次测试(关于他们对参考小时的一致性)已注册并在附录G中描述。
表A4(附录F)给出了首先出现的困难情况的规则。
附录C第C4节逐步演示了一个人的十行日志如何生成单条记录。
6. 背景中立性和凭证交叉点
6.1 背景中立性
假设是:在某个领域等同的已验证水平上,一旦考虑到对该领域的掌握和接受素养,编程教育就不再能预测独立检查工作的质量。
Anthropic的发现即"引导Claude取得成功的能力更多地来自对领域的掌握,而不是编程能力"与该假设一致,但并未对其进行检验(Anthropic, 2026e):其数据按职业而非教育背景对人员进行分类,第2.2节的34%对29%差距是职业间的差距。只有F7研究对该假设进行了检验。另一种强有力的替代假设也存在。Savva (2026)将AI增强知识工作建模为委托-代理问题,并预测AI会缩小人们在简单任务上的差距,同时扩大他们在难度较高任务上的差距。如果Savva是正确的,背景中立性将在短期任务上成立,而在更高层级上失效,因此预测F7在Day级别和Week及更高级别上分别评分,在这些层级上该假设面临最严峻的考验。
接受素养是该假设所依靠的技能。它指的是提前说明什么算是完成,然后加以说明:通过隐藏测试、第二类模型对源进行检查、与该人自己打开的源进行比较,或用制品代替保证。代理素养涵盖一般的委托、检查和管理(MindStudio, 2026);接受素养以证明标准为中心。它还不同于TAM传统意义上的技术接受,后者研究人们是否采用一项技术,因为这里的接受是决定接受一项工作的决定。配套论文的接受记录成为每一层级的证据单位。
6.2 凭证交叉点
某个领域的凭证交叉点是指由没有IT教育背景的人在相同独立检查下被接受的产品开始超越使用相同代理的程序员制作的产品的时刻,之后IT学位和初级及高级标签在该领域的招聘中失去了预测权重。
这个定义是对我2026年10月8日预测的精确表述(第1节)。其各组成部分都是可观察的,并各自有日期,以便当它们对齐时可以读取该时刻。质量平价是该时刻前的一步:在某个领域,没有IT教育背景的人的产品不逊于具有相同代理的程序员的产品,在相同任务上,在盲检下(预测F2)。超越是该时刻本身,当这些产品在相同检查上变得更好时(F3,发布和维护阶段在F4a和F4b中)。职位发布中的交叉是可见的标志,当要求代理技能的职位发布对学位的要求频率低于不要求代理技能的可比职位发布时(F5)。背景中立性是该机制,因为在等同层级上教育停止预测检查的质量(F7)。
某个领域的交叉点的日期是该同一命名领域中首次显示超越(F3)且职位发布中交叉的领域类似物满足(在该领域的职位发布上计算F5;附录D)的第一年。没有超越的平价是接近该点的方式,没有超越的职位发布中的交叉会表明雇主走在证据前面。因此F2、F3、F5和F7在相同的命名领域上构成一个方案:这些领域在注册中是固定的,F2、F3和F7的实验在其中进行,F5既在冻结的IT职业集合上计算,也在每个这些领域的职位发布上计算。凭证交叉点仅当质量规则(F3)和招聘规则(F5的领域类似物)都在同一领域满足时才为该领域宣布;单独任何一个都不宣布任何东西。
前两个组成部分由匹配任务上的实验进行检验(第11节)。第三个已经可以在职位发布中观察到。Lightcast在2026年9月报告称,需要AI技能的IT职位仍然比不需要AI技能的IT职位更可能要求四年制学位。然而,在AI职位中,学位要求自2024年以来一直呈"明显下降",而在其他IT职位中有所上升(Lightcast, 2026b)。这两条线正在汇聚,尚未交叉(图5)。Lightcast用300多种AI技能来定义AI职位,因此其线条描述一般的AI工作。由冻结的代理技能列表定义的代理子集(Lightcast, 2026a)是预测使用的,其基线在注册前获取。
这个方向有先例。Bone、González Ehlinger和Stephany (2025)使用截至2024年中期的约1100万个英国职位空缺,发现AI角色中的教育要求下降,并比较了与技能和学位相关的薪资溢价。该工作在代理出现前就记录了基于技能的AI招聘。本文将这条线扩展到代理技能,附带一个带日期的阈值和与匹配职位发布的比较,并提议在待进行预注册的测试中将职位发布要求与独立检查的性能联系起来。PwC的AI工作晴雨表报告了各国相同的方向,并在测量相同数量的地方作为备用来源(PwC, 2026)。
第二个指标是雇主所说的和所做的之间的距离。许多雇主在代理出现前从其政策中删除了学位要求,但Burning Glass Institute和Harvard Business School发现该变化影响了不到700分之1的招聘(Burning Glass Institute & Harvard Business School, 2024)。职位发布的方向相反:2025年11月,Indeed上19.3%的美国职位发布要求学士学位或更高学位,比一年前有相当大的增长(Indeed Hiring Lab, 2026)。纸面上删除的学位要求是一个政策变化,交叉仅在招聘本身发生变化时才显示。一项审计研究,将仅在教育上不同的匹配作品集发送到实际职位发布,会首先观察到这一点,而预测F26为此设置了一个。
学位属于通过标签接纳人员的一类闸门:平台上的档案、职位名称、学位以及在某种程度上的执照。标签能告诉雇主的关于工作的信息,仅限于拥有标签与能够从事该工作的相关程度。代理从一侧削弱了这种联系,因为没有标签的人现在生产出看起来像该行业的工作(第2.2节),而基于个人自述的标签总是容易冒充的。直接检查工作本身的闸门不依赖于任何一方。《附录G》的评级研究偶然遇到了这种差异。Prolific通过过滤器让参与者进入研究,这些过滤器的答案大多是自我报告的,年龄和居住国是它验证的主要例外(Prolific, 2026)。在其过滤器允许进入簿记样本的60人中,11人答错了该行业的基础问题(附录G2):标签让他们进入,而该行业的问题阻止了他们。
在代理出现之前,在此类平台上招募程序员的研究人员报告了相同的模式,并用自己的知识问题进行了筛选:在一项研究中,42%自称具有编程技能的平台工作者未能满足此类问题的标准(Danilova et al., 2021),在另一项研究中,在Prolific上,206位报告在Node.js中编程的受访者中有55位通过了其所有编程问题(Reid et al., 2022)。知识问题本身是一个比审查交付工作更弱的闸门,聊天模型也会削弱它:在模拟攻击中,ChatGPT轻易地解决了现有的程序员筛选问题(Serafini et al., 2024),到2026年,它也绕过了为抵抗它而设计的静态视觉问题,而在严格时间限制下逐步揭示其内容的音频问题仍然有效(Serafini et al., 2026)。就招聘而言,上述定义预测的学位权重下降表现为第一类闸门让位于第二类闸门,已验证的委托范围是第二类闸门:它记录的不是一个人说他们是谁,而是他们交付了什么以及通过了代理看不到的检查。
执照介于两者之间。基于一次通过的考试的执照自此作为标签发挥作用;其持有人工作受到检查的执照更接近于检查。在美国注册于Public Company Accounting Oversight Board的审计公司的审计工作受到检查,如果他们定期审计超过100家发行人则每年一次,否则至少每三年一次,除非董事会以规则设定另一时间表(Sarbanes-Oxley Act of 2002,第104条),这是一个针对公司签署工作的较慢对应物,对应于第5.2节对地平线要求的重新验证。执照本身已开始朝第二类发展。自2024年5月,俄勒冈州向法律毕业生提供了一条无需参加律师考试即可获得执照的途径——Supervised Practice Portfolio Examination:在至少675小时的监督实践中,候选人提交八份书面作品、参加两次客户互动和两次谈判,由应用Board of Bar Examiners标准进行评卷的评卷员判断每一项是否显示最低能力。到2026年1月5日,205位候选人已申请,其中49人成为持证律师,首批于2024年12月获得执照(Oregon State Board of Bar Examiners, 2026)。法律学位仍然是必需的,因此经过检查的工作替代了考试,而非学校。在会计领域,这一变动较小:2025年5月,AICPA和NASBA批准了获得CPA执照途径的示范立法,要求用第二年专业经验代替学士学位以外的30个学分学习,保留考试,每个州必须制定它才能让候选人使用(Journal of Accountancy, 2025)。法律为执照保留的内容仍然是测度的边界(第13节)。表A8(附录F)根据每个闸门检查的内容并排设置了本节的闸门。
"凭证"一词在代理安全中有第二种含义,其中它指秘密密钥或令牌。这里它指学位或证书。在这个意义上,短语"凭证交叉点"在2026年10月9日搜索的学术数据库中没有返回匹配项(附录B)。
图5. 已验证成功之间的差距和职位中的学位要求:所观察的及2027年将测试的。
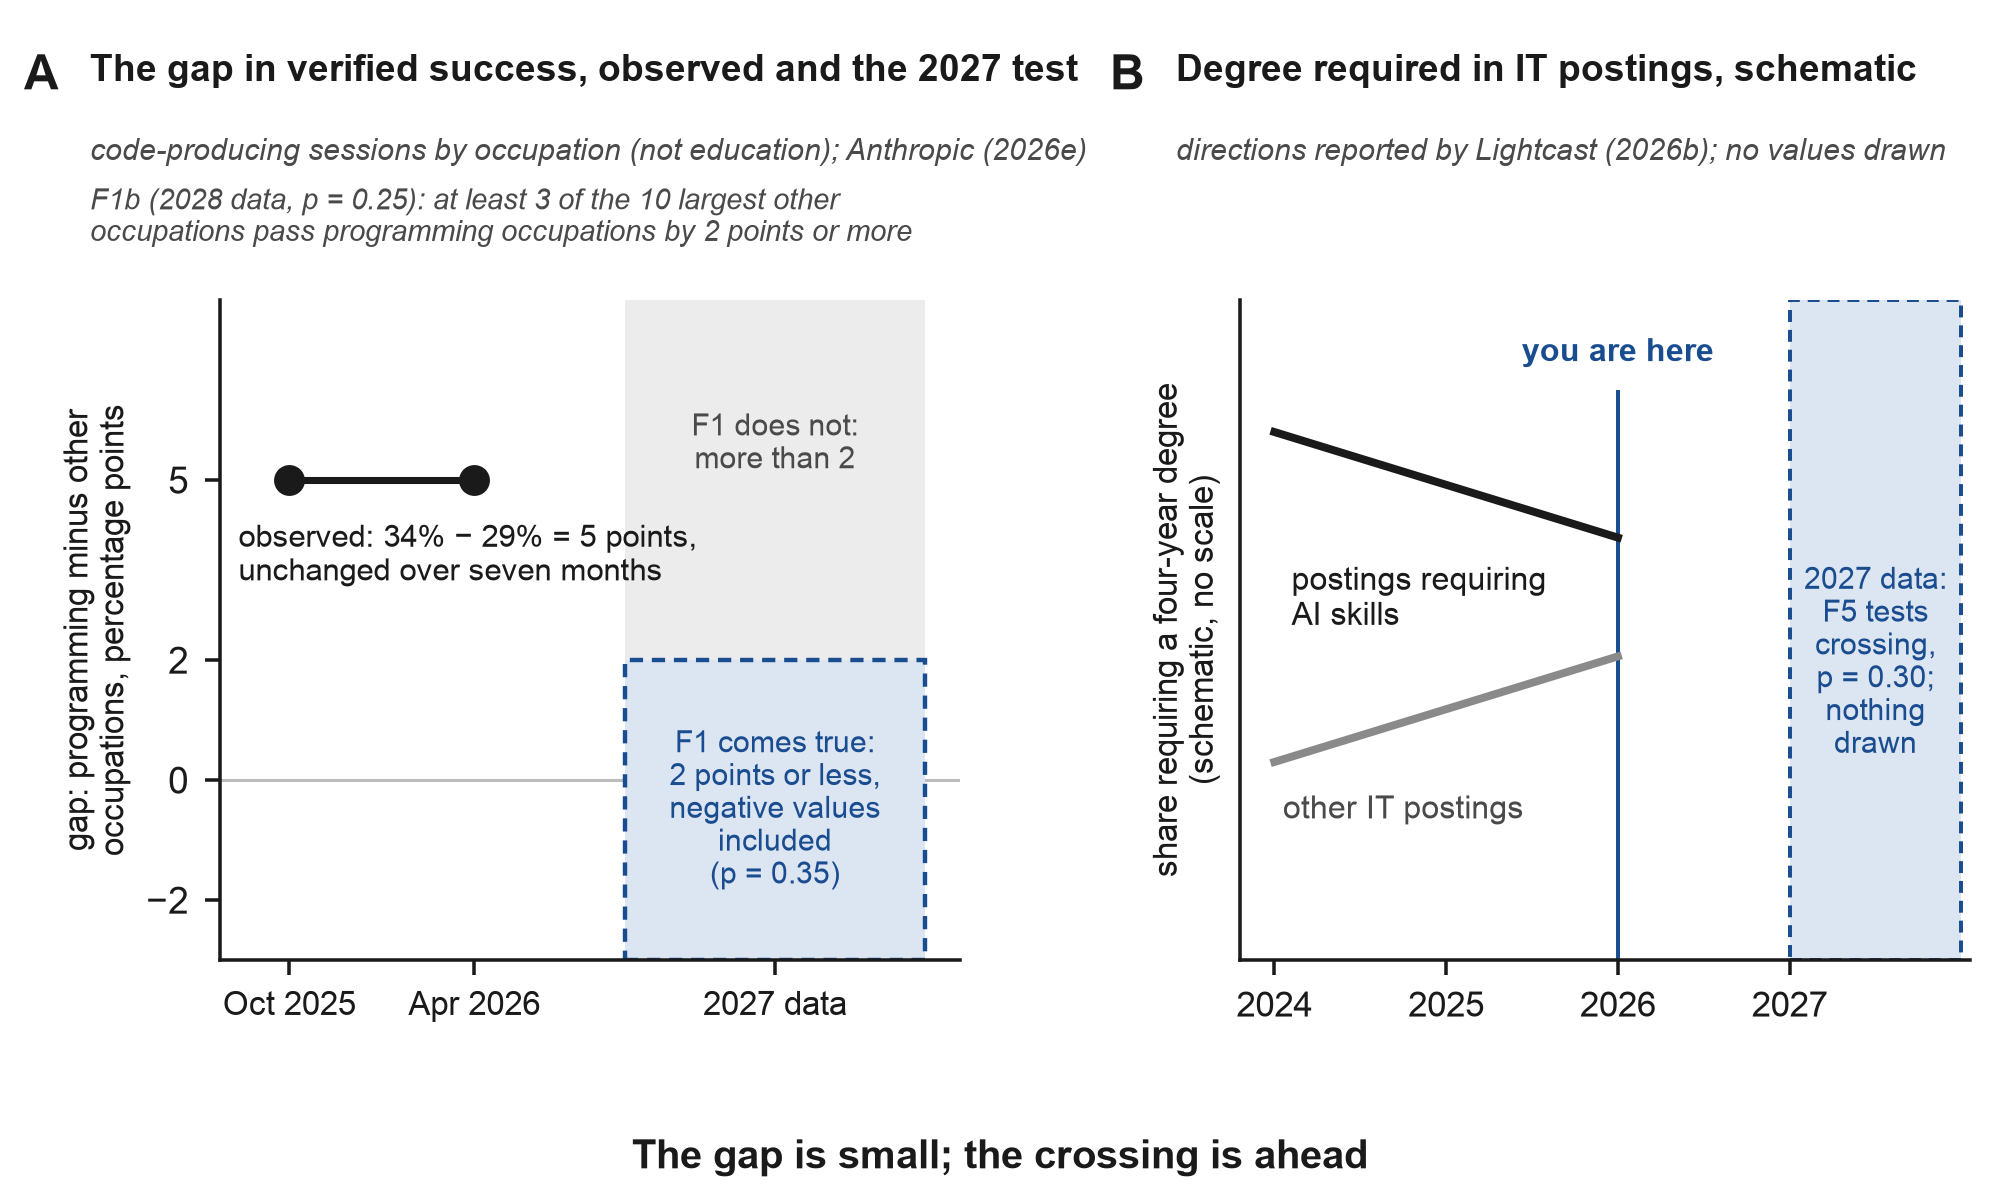
说明:面板A使用Anthropic(2026e)、代码生成会话,编程职业为34%,其他职业为29%,七个月内未改变。职业不同于教育,成功意味着由测试或提交等证据支持的成就。带状区是预测F1的阈值(差距为2个点或更少,包括负值,概率0.35);F1b(概率0.25)在表A6中。面板B仅绘制Lightcast(2026b)报告到2026年的方向,不包含其值。2027年窗口留空:未绘制交叉点,因为预测F5(概率0.30)是将决定它的。
6.3 域:程序员的优势为何是水平的
AI首先降低成本的是任何行业都相同的横向能力,其机制显而易见:跨行业传递的能力是通用模型可以同时为所有行业提供的能力。对模型的薄层包装、通用软件和通用的编码能力都已经这样走了。提示工程师曾是2023年最时髦的职位,到2025年却被称为过时,因为这一技能融入了工具中,成为了所有人都具备的能力(Fortune, 2025)。程序员的传统优势也是横向的。代码在任何行业都能运行,所以程序员可以为律师事务所或医院开发产品,而无需了解其中任何一个,而代理通过降低代码成本,正在夺走这一优势。不需要任何人成为程序员就能发生这种变化。软件成为了众多垂直领域中的一个(基础设施和安全是其紧邻的邻域),在其中程序员仍然最强。同样的逻辑适用于人和公司:没有垂直领域的人就是AI的包装,和薄层包装产品一样容易被替代。当代理使通用软件更容易构建时,传统垂直软件可能会面临来自两个方面的压力,一是来自实验室(它们获取信息层),二是来自构建自有工具的专业人士。假说是领域知识与接受代理工作的能力相结合会获得价值。垂直性本身不保护任何人;深度才能,即在该领域接受工作的能力,这是模型或新来者无法伪造的。
这里的垂直领域是一个人可以接受代理工作的领域,它可能是也可能不是他们拥有学位的领域。要接受法律工作,需要充分理解法律,足以发现一个看似合理的错误。第9部分评论中的一位开发者直白地说:要识别输出中的胡言乱语,你需要至少知道一点该领域的知识(translated)。接受工作的权责仍由该人承担,该人的名字和在结果下的签名也是如此,该人自身的背景(客户、数据、当地规则、语言),以及发布后的维护。
实验室正在购买各垂直领域的信息层。Mercor公司向AI实验室销售专家时间,通过销售放射科医生等专家的时间,在2026年6月达到了20亿美元的年总运行率(Dealroom, 2026)。企业在垂直AI应用上的支出在2025年增长接近三倍,达到35亿美元(Menlo Ventures, 2025)。这种分化为领域专家带来两种命运。捐献者将知识以标签形式出售给实验室,该知识被一次性消费。专业从业者将知识保留在自己的产品内部,并对结果负责,知识则持续发挥作用。
对这一衡量标准的后果是,视野不能在领域之间完全转移。进入软件领域的律师和进入法律领域的程序员失去了同样的东西,即在他们不了解的领域接受工作的能力。这种对称性就是程序员特殊地位终结的样子,它是可以衡量的。转折点也将逐个领域到来。它应该首先出现在以下地方:代码已经变得便宜、验证需要领域知识,以及市场很小或本地化的地方,例如法律、记账、教育、诊所管理、狭窄的企业对企业利基、使用较小语言的市场。软件本身应该最后到来。一位分析师在2026年2月作出了相关预测,将金融称为"煤矿中的金丝雀",并预期每项可验证的任务都将在2027年前遵循金融和会计的轨迹(Hwang, 2026)。Anthropic的发现表明,管理人员在编码会议上已经略微超越程序员,这是一个早期迹象(Anthropic, 2026e)。第5.3部分的记录在其第一个字段中命名了该领域,任何专业名称都可以放在其前面。
同样的推理预测了职位的命运。横向职位如代理经理、AI运营者和编排者描述的是通常对代理进行包装的人。一位从业者预期代理管理这项工作还能持续"接下来的18个月",然后AI也会做(IT Brew, 2026),而Srinivasan和Wei (2026)预期"代理经理"将在12到18个月内成为标准职位;预测F9对此两种观点进行了对比。同一篇文章统计了2026年2月的739个AI编排者职位发布,增长了1,294%,这个数字则指向相反的方向。与领域相关的职位,如负责每个垂直领域代理部署的"垂直AI主管"(Haize Labs, 2026),应该增长得更快,第11部分对这个对比做出了预测。
6.4 拥有前沿模型的儿童
一个反对意见触及了领域论证的根本。一个前沿模型知道的生物学知识比大学部门还多。一个有新想法的孩子可以向代理描述它,并在一周内拥有一个关于生物学或汽车的工作网站或应用程序,根本没有任何专业知识。那么为什么领域还重要呢?
这一前提的一部分已经成立。在北京,六年级学生在2025年9月在课堂上用图形化平台构建了自己的AI代理(Xinhua, 2025)。中国教育部设定了到2030年在基本上所有中小学实现AI教育的目标(CSET, 2025)。在美国,2025年4月的行政命令启动了总统AI挑战,其获胜的学校项目包括家庭作业助手、反欺凌聊天机器人和为视障学生设计的工具(White House, 2025; EdWeek, 2026)。然而,年龄仍然限制了对前沿代理的访问。Claude是为成年人设计的,被标记为属于未成年人的账户被暂停(MediaNama, 2026)。OpenAI引入了年龄预测和面向青少年的受限模式(AlternativeTo, 2026)。儿童更有可能通过学校平台和青少年模式而不是通过终端来接近前沿模型,而"一年内每所学校"看起来更像是2027年到2030年。
深层次的答案来自纸面与现实的差异。在纸面上,孩子赢了:前沿模型在研究生级科学问题上的表现超过了典型专家,在一个随机对照试验中,拥有模型的新手在书面生物学任务上的准确度约为对照组的四倍(Turner, 2026)。在现实中,优势消失了。在一项涉及1,298人、发表在《自然医学》上的研究中,仅有模型的情况下,模型在94.9%的病例中识别出了正确的病症,而使用相同模型的人在少于34.5%的病例中做到了这一点,不比对照组更好(Nature Portfolio, 2026)。在METR进行的为期八周的湿实验室试验中,有153名新手参与,获得模型没有带来显著收益,每组约有5%的人完成了整个协议(METR, 2026a)。
提出这一异议的人是对的,传统的纵向(多年学习)正在失去价值,因为知识在模型中是免费的。知识无法替代的是区分正确结果与合理结果的能力,以及与现实(用户、测试、实验、数据)的联系,这种联系可以判断两者的差别。这个接纳循环就是新的纵向,它解决了"领域很重要"与"儿童不需要专业化"之间表面上的矛盾。从这一意义上讲,纵向是通过实践建立的接纳循环,而多年学习只是建立它的方式之一。一个青少年可能通过自己的产品及其用户在数周内建立它,无需学位;没有它,一周的代理工作仍然只是一幅令人信服的图景。儿童是背景中立性的最纯净测试,因为他们没有学位,没有多年的从业经历,只有循环,而且他们也需要有人为其产品负责,即第7部分所指的伙伴。这个循环能否如此快速建立是个过时的问题。到2026年10月,尚未找到任何经过验证的案例显示没有正式训练的青少年的科学产品拥有用户并通过了独立检查,预测F24标注了第一个这样的案例。
6.5 通过流程核查进入新领域的人
第6.3部分认为,进入陌生领域的人会失去为该领域工作背书的能力,而第6.4部分的异议有其成人版本:流程能在多大程度上恢复这种能力?以一位既无簿记培训也无多年从业经验的新手为例,他分四个步骤进行工作。工作前,向多个模型询问这样的交付物必须包含什么、通常被遗漏什么以及适用哪些核查。一个代理执行工作。另一个在新的背景下审查它,不查看其执行过程。另一个系列的模型根据该人打开的源代码对其进行核查。每一步都代替经验曾经提供的某些东西:代理代表执行工作,新审查者和另一系列代理代表对已完成工作的重新审视,事先列出的清单代表了解工作必须包含什么。这样的新手能否交付的工作比仅凭目视接纳一个代理输出的资深簿记员通过更多独立核查的工作?
部分证据支持新手。经验不能保护停止核查的专业人士。在咨询公司的一次实地实验中,一项代理前期的研究显示,在被选定超出其能力范围的任务上使用模型的顾问不太可能达到正确解决方案,而不使用模型的顾问则更可能达到(Dell'Acqua等,2026),在METR的试验中,经验丰富的开发者认为自己被加快了速度,但实际上被减速了(第5.4部分)。在这个领域仅凭目视接纳一个代理的输出也是一个薄弱的策略:在160项会计任务(对账、计提费用、记账和生成报告)上,这些任务根据会计专家编写的评分标准进行评分,九个前沿模型中最好的平均满足56%的标准,没有一个模型在超过2.6%的任务上在其所有八次尝试中都产生完全正确的结果(Benchek等,2026)。可以嵌入一个评论者:为此目的训练的评论者模型在模型编写的代码中发现的缺陷比被聘进行代码审查的人类承包商更多,尽管它们也报告了不存在的缺陷,与这样的评论者合作的承包商发现的缺陷数量与单独的评论者大致相同,但虚假报告更少(McAleese等,2024),这也是代理前期的研究。事先列出的清单给新手提供了接纳素养的前一半,即对什么将被视为完成的陈述(第6.1部分),而且列出这些清单的模型知道一个行业的考试要求什么:GPT-4在获得已有示例和计算器等工具的情况下,以平均85.1%的分数通过了CPA、CMA、CIA和EA考试的每个部分(Eulerich等,2024),这也是代理前期的研究。首先列出清单也有助于核查:模型评判者能够区分有遗漏的临床笔记和完整临床笔记的能力略好于掷硬币,当他们首先列出源确定的事实然后逐个检查笔记时做得更好,尽管即使这样他们也仅标记了25%至37%存在遗漏的笔记(Fox等,2026)。特定客户的知识来自与该客户的合作,而不是学位。谁为结果负责由谁愿意并被信任来回答决定(第7.2部分),除非法律保留签名权(第13部分)。
其中一部分并非如此。根据第5.2节的规则,同一系列的新审查者属于系列内的一致,虽然这可能改进工作,但作为检查不获得认可,而另一系列的模型仅在针对该人已打开的来源进行检查时才被计算;在错误无法撤销的地方,它只是隐藏测试或合格人类之后的第二防线。跨系列的一致是比看起来更弱的证据:在超过350个模型中,即使架构和提供商不同,较大和更准确的模型也产生了高度相关的错误,虽然共享的架构或提供商是提高相关性的因素之一(Kim et al., 2025)。因此,第二个系列比同一系列的第二个模型更接近于独立检查,但不是独立性的测量(Chernets, 2026b)。提前制定的列表面临更窄的限制。模型在注意文本中缺少的内容方面远差于查找其中的内容,即使原文在其旁边也是如此(Fu et al., 2025);列表仅在完整时才有帮助,缺少的应计是没有审查者看到的遗漏。警告也不会让局外人成为检查者:被要求检查人工智能营销数据分析的营销和销售专业人士,即使被多次告知人工智能会犯错,仍然错过了关键缺陷;将分析作为明确的步骤列出,每个决策都有替代方案,虽然有所帮助,但参与者经常仍然难以通过推理来理解(Virk & Liu, 2025)。账目平衡也不是证明。在一个会计软件制造商的2025年基准测试中,被要求逐月结账的模型要么在第一个月内放弃,要么累积错误,当其数字与银行余额不符时,一些模型会引入无关的交易使其一致(Penrose, 2025,据Gigazine报道,2025)。没有看到某个步骤的新人将不会要求对其进行检查,除非列表中明确说明。附录G2的探索性比较显示没有列表的情况下差距有多大:那些错误回答了该行业第一周问题的人,仅从其描述对其任务进行评级,将其较大任务的时间估计比其他人少四分之一到三分之一。由模型制定的列表是否能缩小差距,由第10.5节的比较来说明。从比喻的角度看,这个过程是一个均衡器的阶梯:代理已经均衡了大部分的制作,工作前的列表和其后的批评者可能会均衡部分检查,虽然模型之间的相关错误(Kim et al., 2025)和对遗漏的盲目性(Fu et al., 2025)设定了限制,剩下的将由该度量来说明。图A4(附录F)将四个步骤与每个步骤的代表内容、根据第5.2节规则各自的得分以及各自的停止位置进行了对比,配套存储库为以这种方式工作的人提供了一个工具包(kits/checking-process.md)。
该度量不会提前解决问题,也不会询问检查的能力是通过哪条路线获得的。如果新人的流程通过了代理没有看到的检查,在种植的错误中既有遗漏也有错误条目,新人的视野就像任何人一样上升;如果没有,记录也会显示这一点。如果第6.1节的对立观点是对的(Savva, 2026),该流程在短期、明确指定的任务上效果最好,在上层阶梯上效果最差,其中了解一件作品必须包含的内容最重要,采用相同流程的经验丰富的专业人士应该比任何一方都做得更好。如果一个流程能代表一个行业经验的一部分,经验的标签,其中包括初级和高级,出于与学位相同的原因失去了权重,这是第6.2节中交叉点所指的损失。没有注册预测测试该流程:F3b在参与者自身领域外的任务上的超越价格在第6.3节的领域论证中为0.10,仅间接涉及该问题。第10.5节列出了一个将对其进行测试的比较。
7. 第二道边界:信任
7.1 模糊性是市场的常态
当每个人都能构建时会发生什么?2026年的答案是,大部分被构建出来的东西永远找不到。根据Sensor Tower的估计,约560,000个新应用在2026年上半年进入App Store,接近2025年全年大约600,000个,下载量增长约2%;这一数据首先由《纽约时报》报道,后由其他媒体总结(9to5Mac, 2026; Gigazine, 2026)。第一季度的发布量同比增长约60%(TechCrunch, 2026b)。在RevenueCat的2026年报告中(该报告涵盖使用其软件的应用),17%的新订阅应用在两年内达到了每月1,000美元的收入,而前一年为19%;自2025年以来推出的应用在2026年1月的订阅收入中约占3%(RevenueCat, 2026; PPC Land, 2026)。GitHub报告了Octoverse年份(截至2025年8月)新建的121,000,000个存储库,平均每分钟超过230个(GitHub, 2025a),2026年9月单月就有7,380,000,000次提交,是一年前的五倍多(Celenza, 2026)。这些数字统计的是生产情况,而不是找到用户的产品。一个大型开发者论坛的"Show HN"版块主持人报告说,由生成式AI产生的项目以噪音形式淹没了该版块,并限制了新账户的增长(Krebs, 2026)。Startmate的一位投资者在2026年8月表示,当构建成本低廉时,分发才是保护产品的关键,并描述了一些强大的产品孤立无援、用户寥寥无几的情况(Batko, 2026)。
创始人中出现了相同的模式。在Carta上2025年成立的初创公司中,独立创始人约占36%,而2024年为31%(Carta, 2026a);在通过Stripe Atlas成立的C类公司中,2026年第二季度迄今为63%,这是该服务的纪录(Stripe, 2026)。独自开始变得普遍;独自盈利却并非如此。在Atlas上的独立创始人中,2025年前六个月的中位数收入同比下降23%,而最高十分位数增长了19%,因此最高十分位数约是中位数的61倍,而四年前约为34倍(Stripe, 2026)。在Carta之前的报告中,独立创始人在2024年成立的初创公司中占30%,但在该年的定价股权融资中仅获得了筹集资金的14.7%(Carta, 2025)。这两个样本都来自这些供应商的自己客户,而非所有新公司,但它们展示了本节所述的现象:更多人能够开始创业,而回报集中在顶部。
平台通过拒绝那些无名者来保护自己免受洪流冲击。curl项目在2026年1月结束了其漏洞赏金计划,原因是AI生成的报告淹没了它,其中"不足五分之一"是真实的(Stenberg, 2026)。GitHub权衡了是否限制拉取请求仅限于受信任的贡献者(Open Source For You, 2026)。Mitchell Hashimoto发布了Vouch,新来者在没有现有参与者担保的情况下无法对项目做出贡献(Hashimoto, 2026; Willison, 2026b)。防洪的屏障也会将新来者挡在门外,这是伴随论文对一般自动化监督所描述的模式(Chernets, 2026c)。因此,担保作为一种机制而存在,而它是否会成为一种职业则是第7.2节要探讨的问题。
新的守门人是代理。在一项涉及2,430次运行的研究中,Claude Code在12个(共20个)类别中编写了自己的解决方案,而不是采用现有产品;当它采用某个产品时,它选择了知名的名字(Amplifying, 2026)。到2026年7月,约一半的Vercel部署由代理触发(Startup Fortune, 2026)。代码托管平台上的免费产品正在与用户的代理能在一小时内编写的任何东西竞争,而代理本身无法写出的是信任、维护、标准或一个会给出答复的人。
长远的视角不能造就市场。视角记录一个人能够交付和证明什么,信任决定了外人是否会使用它,而模糊性则是两者之间的间隙。Herbert Simon在1971年发现了这一现象的经济学本质:信息的丰富创造了注意力的稀缺(Simon, 1971)。代理降低了代码的准入门槛,上述证据表明,面对这波浪潮,平台和用户要求新的信任信号才会让新来者进入。
7.2 两个伙伴职业
一种反对声音认为,通过代理进行构建的人如果缺乏触及用户的技能就是不完整的。我的理解不同:触及用户是第二个轴向,两个相辅相成的功能沿着它发展。
完成者通过渠道、发布以及在AI搜索中的可见性来将产品推送给人群。这个角色的名称早已确定(增长工程师、开发者关系、GTM工程师,是2026年广泛招聘的一个职位),代理将自动化其中的一部分,因为邮件和发布很容易自动化,而筛选器也会相应地变得更加严格。
担保人用自己的名字为一个产品背书,并对自己的社交圈子承担责任。2025年6月,《纽约时报》杂志为这个角色命名为"法律担保人":"为AI无法提供的责任承诺的人"(Capps, 2025)。一份来自1979年的IBM培训幻灯片于2017年首次在线发布,原件已失,用一句话解释了原因:"计算机永远不能被追究责任"(Willison, 2025a)。Neil Lawrence在2026年8月表达了同样的观点:计算机在会计方面表现得很好,"但在问责方面表现得不好"(Sadki, 2026)。这个功能最难实现自动化,因为其价值在于一个人的承诺。用代理理论的术语来说,担保人销售的是一份保证:由担保人自己的声誉支撑的承诺,在成熟形式下由明确分配责任的合同和对其进行定价的保险所支撑(Jensen & Meckling, 1976)。
功能和职业是两个不同的问题。功能存在于任何人为自己未完成的工作签名的地方。职业只有在这种签名被定期地作为独立项目进行买卖时才会出现,预测F11和F12标明了这种情况何时发生。担保人还有一个自然的衡量标准,即他们为多少产品背书、每个产品存活了多长时间以及多少产品失败,按失败的严重程度加权;伴随的代码库从担保人的账本计算这一指标,其中严重程度的权重由阅读记录的任何人说明(tools/guarantor_record.py)。第9节第二个线程中的指南用四个词总结了这一点:口碑就是声誉(已翻译)。信任应该建立在可以验证的事物之上,正如本系列的一篇早期论文对代理商务所论证的那样(Chernets, 2026d),而担保人的记录就是这样一个事物。
第三种类型出现在第9部分的一个线索中:一位指导者,销售一种使整个公司转向代理的方法。这个线索展示了销售。将他理解为组织的保证人——即对公司管理层的结果负责的人——是我对他所建立的角色的解释。
通过代理进行构建的人向内负责,对其从代理接受的内容负责。保证人向外负责,就所发布的内容向人负责。一个人可以同时承担两种角色,就像婚礼摄影师既拍摄又负责一样;当产品过多时,两种功能就会分离,正如作者与出版商或科学家与期刊曾经的分化一样。
8. 两个市场:淘金热和婚礼摄影师
1849年,人们蜂拥而至加州淘金。矿工的平均日收入或雇佣矿工的日工资从1848年的约20美元跌至1849年的16美元、1850年的10美元和1852年的6美元(Paul, 1947, p. 349)。Bancroft将1852年每个矿工开采的黄金价值定为"仅600美元,或勉强每天2美元",当时普通劳动力工资要高两到三倍(Bancroft, 1888, pp. 423-424)。向矿工出售工具的Sam Brannan表明,"最可靠的致富方式是把采矿留给他人"(Andrist, 1962),而工具和布匹的卖家生意很好。这个模式在2026年仍然可见。五分之一或更少的新订阅应用程序每月达到1000美元(第7.1章),而工具的卖家增长迅速:例如Lovable的收入(TechCrunch, 2026a),以及Uber的年度AI预算在四个月内支出(Fortune, 2026b),流向实验室。
风险投资遵循相同的路径,规模更大。2025年,AI公司获得了全球风险投资的61%,即427.1亿美元中的258.7亿美元,大型交易约占AI投资价值的73%(OECD, 2026)。2026年上半年,OpenAI和Anthropic两家实验室共筹集了约217亿美元,占全球初创公司融资的约43%(Crunchbase News, 2026)。在另一方面,Carta上美国平均种子前融资工具在2026年第二季度达到创纪录的276,000美元,而工具数量同比下降约五分之一(Carta, 2026b)。如果构建变得便宜而判断谁会成功还没有,那么大额支票给更少的新手是合乎预期的。仅凭能够构建这一证据,一个人不一定是能够融资的人。
这个类比在某个地方出现了断裂,而这个断裂比契合更重要。黄金的价格由法律规定,所以随着更多的黄金被开采,黄金不会变便宜,矿工亏损是因为砂矿枯竭,人群增加。软件几乎可以免费复制。每个新产品都会为其他产品增加一个接近的替代品,接近替代品的价格下降到接近零的复制成本。黄金不会枯竭;它变成了沙子,除非有不能被复制的东西(信任、签名、维护的服务)与它一起出售。
摄影是更接近的类比。2026年,美国劳动统计局统计2025年约有145,000个摄影师工作岗位,预计2025年至2035年下降1%,其前一版本预计2024年至2034年增长2%(Bureau of Labor Statistics, 2025, 2026a)。与前一版本不同,新版本提到了AI:智能手机照片可能会降低对专业人士的需求,库存照片"预计将部分被人工智能(AI)生成的图像所取代",而肖像和商业工作的需求继续,自雇就业增长(Bureau of Labor Statistics, 2026a)。2026年,新婚夫妇仍然雇用婚礼摄影师,并为他们付费。当事件不能重复、错误不能被撤销、一个有名有姓的人必须为结果负责、客户不能提前判断质量因此购买信任时,一份工作作为有报酬的职业而存在。
这些条件将市场分为两部分(图6)。手机快照是人们为自己和团队制作的东西:一个通知系统、笔记工具的替代品、律师自己的合同检查器。为自己创作是识字能力,就像写作一样,几乎每个人都会有它。婚礼是为他人工作且有后果:向陌生人发布的产品、金钱、健康、法律、基础设施。为他人工作是职业,由经过验证的范围和一个负责的人定义。在两个市场之间矗立着模糊的障碍,担保人在那个障碍上工作。
这个分裂也回答了我开始提出的问题,"这些人应该叫什么?"有两个答案,一个是大众技能的名称,另一个是职业的名称,第3章的地图已经为两者各自提供了候选者。
Kent Beck用一句话描述了对旧资历的影响:"我90%的技能刚刚跌至零美元,10%的技能刚刚上升了1000倍"(Willison, 2025b)。一些资深工程师将成为软件的婚礼摄影师,被雇用来处理失败无法撤销的小部分系统。在2026年的数据中,就业的弱点显示在初级工作者中(Stanford Digital Economy Lab, 2026a),所以我把资深方面作为一个形象保留,而预测F25遵循初级方面。
图6。 两个市场、它们之间的模糊之墙,以及穿越它的两个伙伴。
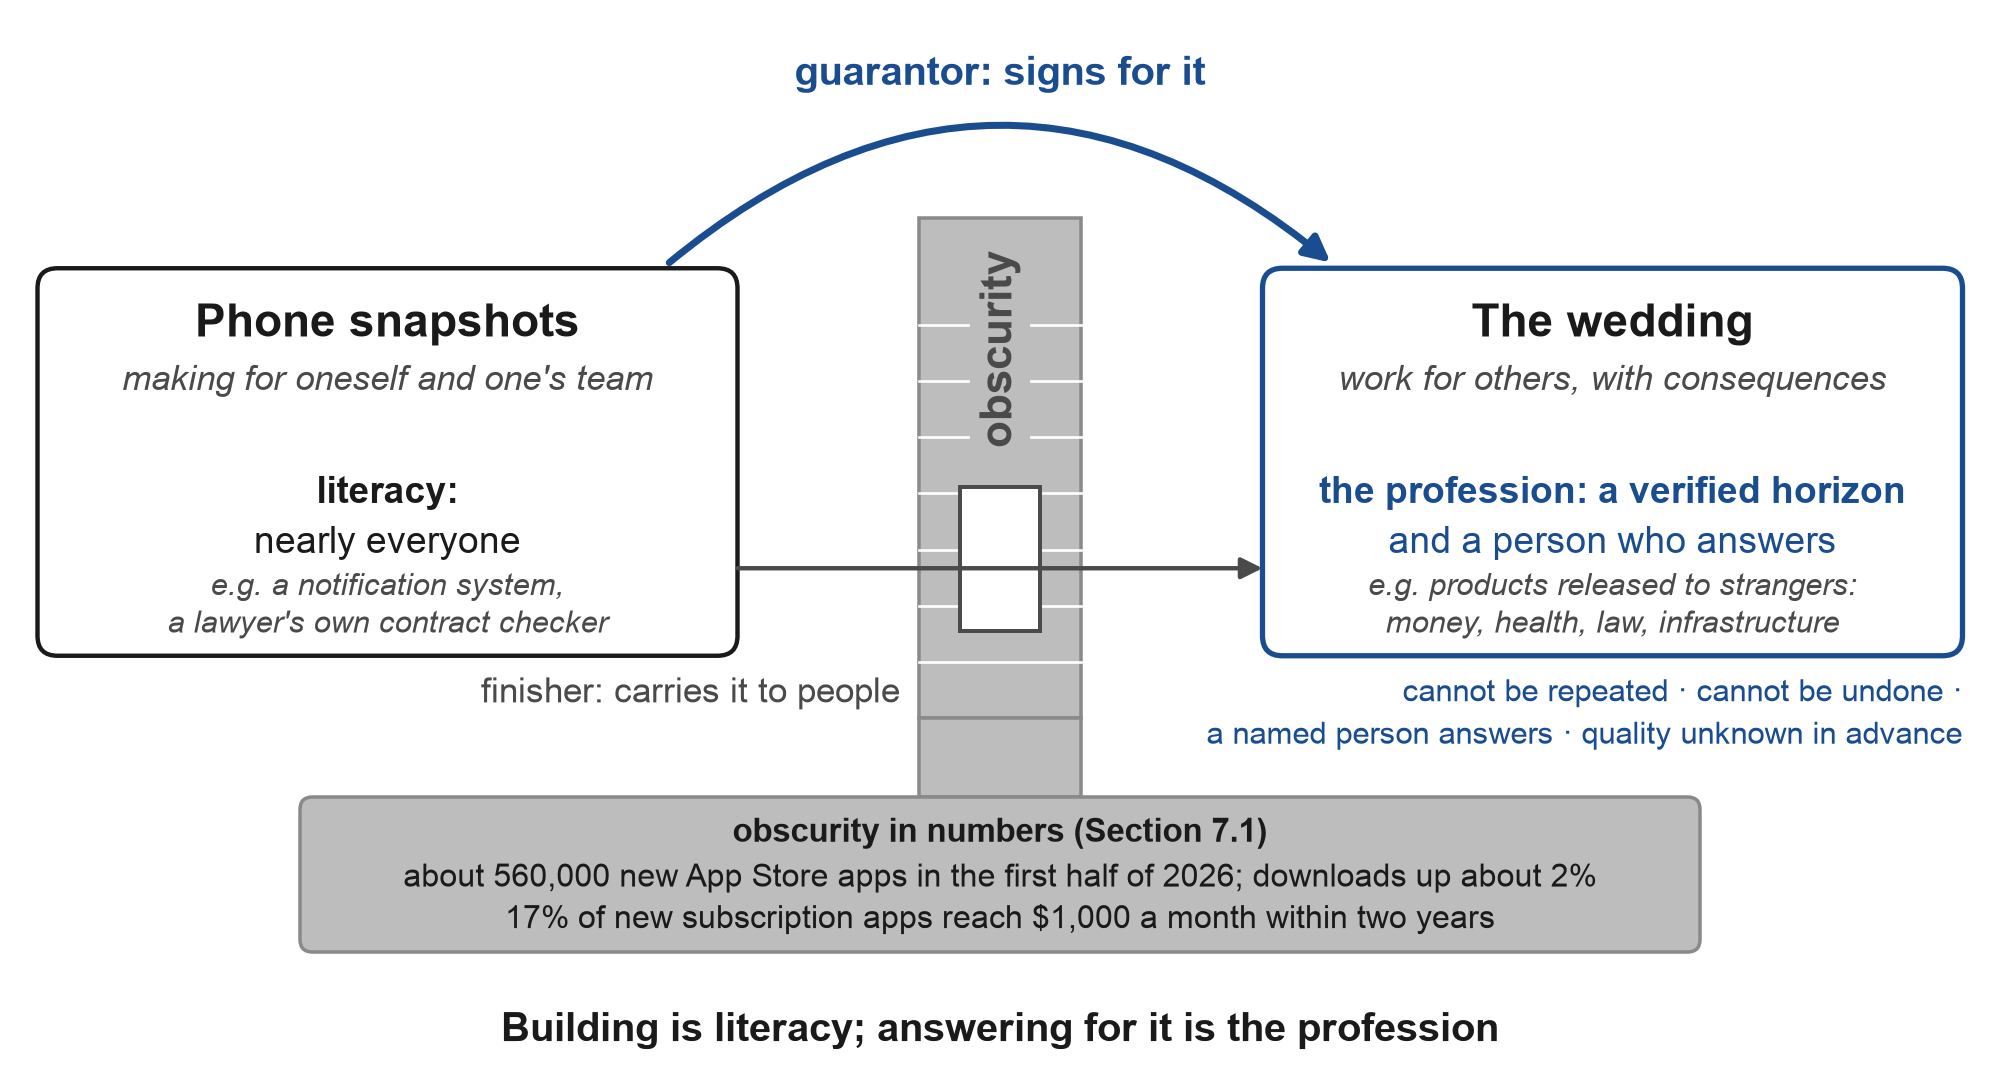
注:这两个数字属于模糊之墙,不属于完成者:2026年上半年约560,000个新App Store应用,下载量增长约2%(Sensor Tower估计,如9to5Mac和Gigazine 2026所报告),以及17%的新订阅应用程序在两年内每月达到1000美元(RevenueCat, 2026)。每个极点的示例都来自第8章。这四个条件是第8章的;拱门和门是第7.2章的两个伙伴函数。
9. 程序员对话中的跨越
2026年程序员的对话可能就是2027年每个职业的对话。为了验证这一点,我阅读了Facebook上的三个公开讨论线程,这些讨论收集于2026年10月8日(包括帖子和评论;评论者在此未被命名)。
在第一个讨论中,一位作者质疑那些说AI编写破损代码的开发者,要求他们展示一个已应用了所有最佳实践但代码仍然失败的案例。他自己确信这样的情况根本不会发生。讨论线程演变成了关于采纳的争论,一位参与者总结了这一点:问题是生产过程是否可以组织得使得AI的结果能被检查、接受和使用(已翻译)。另一位从事安全修复工作的人报告说,即使有测试和说明,强大的模型也经常无法为CVSS评分在9分以上的漏洞生成正确的缓解方案,并且自动审查和修复循环变得昂贵。一位拥有三十年IT经验的经理回复说,人类程序员向来都给出了完全相同的麻烦。另一位评论者将这个新任务定价为每小时150美元,这是检查和修复AI编写的代码的审查员的费率,第三位评论者描述了一位拥有二十年经验的资深工程师,他发现很难接受自己的技能已失去价值的事实。
在第二个讨论中,一个自称两种语言都不懂的人正在将一个包含650,000行代码的平台从一种编程语言迁移到另一种,大约600个拉取请求中有330个已完成,每月在AI上花费1,148美元。他销售一种将公司转移到智能体的方法,并辩称对于那个任务,程序员的危害多于好处。他还通过公开支出、项目清单、促销代码、一门课程和为大型公司提供的免费时间使自己变得引人瞩目。实际上,他正在建立第7.2节中指南的角色,并通过内容与默默无闻作斗争。
第三个讨论显示了一个在四台机器上为自己构建的人,使用第5.4节的36阶段流程。他报告说他六个月到一年前的工作流都没有存活下来,他预计在三个月内再次改变它们,并且他感到不断的害怕错过。评论围绕哪个智能体属于哪个阵营而争论。
表A5(附录F)将讨论的主题与2025年和2026年软件行业外的人们可见的内容进行对比。其行是说明性案例,而非样本。
表A5所显示的是功能跨越而形式落后。一个簿记员学会使用一个模型族检查另一个,仍然会称其为"对账规则"和"谁检查了",不会有对工具的专门说法,也不会将智能体的选择视为身份认同问题。讨论线程的地位象征、巨大的个人账单、阵营和四台机器停留在每个职业的顶层,就像摄影师争论镜头而他们的客户不这样做一样。
跨越也分层出现:首先是每个职业的前十分之一左右,然后是培训项目,然后是隐藏内部设置的产品。这个序列是应用于智能体的扩散理论,这里不声称优先性;Rogers(2003)将创新者和早期采用者放在约六分之一的采用者中。OpenAI自己的报告指出,在公司外部"技术使用仍然是主要模式"(OpenAI, 2026),Anthropic发现技术用户首先出现,然后是从事低薪任务的人(Anthropic, 2026f)。第11节将功能的跨越陈述为一个可通过阅读课程和帖子来检查的预测。
10. 影响
10.1 对雇主和人力资源部门
按照记录评分的雇主从"Domain · horizon · amplification · date"中获得的信息比从"senior"或"manager"中获得的更多,而且该记录在各职能部门间流转。随之而来的是招聘测试:交给候选人一天的工作,在他们自己的领域内完成,通过代理人执行,并由候选人未设计的检查来验证是否正确,其中包含候选人必须找到的一些植入错误。Jaques关于薪酬的逻辑,即公平薪酬随责任范围的增加而提高,为按照经过验证的horizon的薪酬提供了一个初步假设。这是否成立是一个实证问题,第11节中的预测F18说明了这一点:当雇主按照经过验证的工作进行评分时,该级别应该比工作年限更好地预测薪酬和绩效。
按token排名是另一回事,第4节的案例表明它会导向何处。如果讨论使用情况,它应该像任何方法一样出现在绩效评审中,作为众多输入之一。
最后,需要关注的是组织实际招聘的人。从政策页面上移除学位要求本身的改变不大(第6.2节)。在相同经过验证的horizon下,被招聘人员的变化是从公司内部看交叉点的样子。
10.2 对教育和学校
对于学校来说,教训是先教授接受,后教语法。能让一个人在阶梯上上升的技能——陈述什么算作完成、选择代理人看不到的检查、认识自己领域中的合理错误——可以在任何学科中教授。证书的价值取决于其检查的价值,因此证书应该说明它证明的经过验证的horizon,包括领域和日期。
在课程中加入人工智能素养的学校可以为OECD和欧盟委员会框架的"Manage AI"领域赋予具体内容:交付一小件工作,提前固定的检查,以及对任何向陌生人发布的内容负责的成年人。
10.3 对供应商和平台
供应商可以让接受离开产品。一个人应该能够导出任务、输入、检查和接受决定,以便记录可以流转给雇主或学校。使用情况会以相同的方式报告,通过计算接受经过验证工作的人员数量,而不是打开应用程序的人员数量。
一个平台已经从供应商的角度开始走这条路。2026年1月,LinkedIn开始展示由Lovable、Replit、Descript和Relay.app颁发的经过验证的人工智能技能,基于成员实际如何使用每种工具(LinkedIn, 2026a)。这样的徽章证明了对工具的使用,由工具自己的供应商根据供应商设置的层级进行判断;它不证明由该人未选择的人检查的结果。同一平台向招聘人员销售代理人,到2026年4月,代理招聘产品的年收入运行率超过4.5亿美元(LinkedIn, 2026b),2026年7月给成员一个按钮来报告"看起来像AI垃圾"的帖子(TechCrunch, 2026c),在检测器供应商Pangram估计2026年4月至6月该网站上41%的长帖子完全是生成的之后(The Decoder, 2026)。当关于某人工作的文本花费零成本生成时,个人资料说得更少,而不依赖于任何单一供应商的经过验证的工作记录说得更多。
那些关闭了对未知者大门的平台,如2026年许多平台一样,可以通过担保开放第二扇门。一个新来者的工作由一个已知的人签署就通过,而担保者的记录随着接下来发生的事情而增长或缩小。
10.4 对将人们引入代理人的产品
入职产品通常在首屏将"初学者"和"程序员"分开。这个措施建议用一个问题替换两扇门:你已经可以交给代理人并检查什么,还没有、一小时、一天还是一周?直到这两扇门合并,一次征得同意后询问IT教育,可以让背景中立性在产品自己的用户上进行测试。
10.5 对研究人员
研究人员可以构建Chen和Meng(2026)所说的不存在的人-任务面板,在盲目检查下比较使用相同代理人的人,报告分母时包括检查失败的工作,并保持参考库冻结和发布。附录C的仪器已经做到这一点:它不计算检查记录为非独立的作品,并用日期报告两个轴。
一个比较来自第6.5节,还没有运行。在库的相同任务上,在代理人看不到的检查下,以及两种植入错误——错误条目和缺少条目——的情况下,它会将职业中的经验(存在或不存在)与工作方式(一个代理人的输出被接受原样,或第6.5节的检查过程)相交叉。经验将通过知识筛选和工作记录确定,而不是通过个人资料标签(第6.2节),而且无法撤销的错误的作品将由隐藏测试或合格的人检查,如第5.2节所要求的。遗漏和错误条目将分开评分:提前起草的清单针对第一种,审查者针对第二种,附录G2建议的差距是第一种。该比较将显示一个流程可以代替职业经验的多少,以及在哪一级停止。与不使用代理人工作的专业人士的比较在这里不会解决任何问题,原因见第11.1节。第11节的预测是冻结的,不包括这个比较,它将在数据收集之前单独注册。配套存储库将其作为可适应和注册的协议保存(kits/process-vs-experience-study.md),带有一个在交付前封存任务的植入错误并在之后分开评分错误条目和遗漏的工具(tools/planted.py),以及一个分析,打印四个条件,对于每种错误分别分析流程对新来者的影响、单代理人下经验影响及其相互作用,采用人群重新抽样的区间(tools/process_study.py)。
11. 已注册和评分的日期预测
11.1 编写预测的规则
我按照能够验证的规则编写了这些预测。比较对象相同:非程序员与使用相同代理、完成相同任务、花费相同时间的程序员进行比较,因为与不使用人工智能的程序员进行比较在这里无法解决问题。
"更好"分为三个含义,每个都单独测试。对于代码,测试包括隐藏测试、安全审查以及另一个代理在一个月后进行的更改以检查可维护性。对于产品,测试是它是否到达陌生人并在六个月后仍然存在。对于简历,测试是学位在招聘信息中的权重。流行度不被用作"更好"的衡量标准,因为它测试的是分布,这可能是一个独立的专业(第7.2节)。
这些预测也不取决于职业的名称。它们讨论的是"没有IT教育背景但通过代理工作的人",因此无论哪个名称胜出,它们都适用。
11.2 预测
表4以简短形式给出十项核心预测;表A6(附录D)和配套存储库中的文件predictions/predictions.csv给出全部41项,每一项都包含一个衡量标准、2025或2026年的基线、三个结果的规则(成真、未成真、未解决)、检查日期和最终日期、概率、备选来源和最接近的先前或反向预测。概率不能为预测失败的预报者辩解,但它使错误可评分。一个概率为35%的预测失败本身意义不大。35%是否是正确的数字只能通过整个集合来看,其中大约三分之一的此类预测应该成真。Brier规则(Brier, 1950)给出整个集合的一个总体准确度评分,结合了校准和区分发生和不发生情况的能力。主要预测与当前观点相反,因为招聘数据仍然倾向于AI工作的学位,Gartner预期大多数氛围编码应用将被淘汰,Andrew Ng主张对程序的深刻理解会获胜。该表格以既定赔率押注另一种方式:在自己的领域中超越的登记概率(F3)为0.35。它低于1:1赔率,因为供应商数据仍然使编程职业领先约5个百分点(第2.2节),Savva(2026)预测在更困难的任务中会出现更大的差距(第6.1节),高于0.25是因为前一步的奇偶性定价为0.70;独立模型预测者的范围从0.25到0.55。图7将每个预测放在其检查年份和概率处。
这些预测分为两组。集合A(27个预测)从公开数据和predictions/resolve/中的冻结查询、列表和代码簿中解决,因此任何人都可以不需要我就能对其进行评分。集合B(14个预测:F2、F3、F3b、F4a、F4b、F7、F12、F14、F18、F19、F20、F26、F34、F35)是一项研究计划:它需要任何公开来源都没有发布的数据,仅从在收集数据之前单独注册的研究中解决,具有指定的所有者、协议和功率计算。对于规则以区间形式编写的九个集合B预测,配套存储库将冻结的成真和未成真规则应用于研究的估计,并在每个判决旁边打印冻结的词(predictions/set_b.py)。协议未在2027年6月30日之前注册的集合B预测被记录为未进行,并在每个记分卡上列为测试计划的失败。然后Brier评分被报告两次,仅在已解决的预测上,以及每个未进行的预测都被评分为就像预测是错误的一样,因此从未进行的研究无法从计数中删除。F2、F3和F3b的实验是一项研究,每组有1,500人:这提供了约0.8的功率来检测5个百分点的真实优势(双边alpha 0.05,通过率约为50%,最不利的情况),其中每组400人只能在约30%的时间显示它。对于每个基于研究的预测,既不符合成真规则也不符合未成真规则的区间是未解决的,而不是失败。
概率在2026年10月9日固定。每个都是来自三个系列(Claude Opus、OpenAI模型和Gemini)的模型的三个盲预测的中位数,这些模型在看不到我的数字的情况下对相同的表格进行了定价;我采用这些中位数作为我的概率,它们在OSF上注册,我早期草稿中的每个更改都记录在更改日志中。早期一轮来自4个系列的4个独立模型预测者也盲目地对表格进行了定价。每个都提供了一个参考类别、单行论证和概率,其汇总预测(赔率的几何平均数)显示在表4中注册的概率旁边,CSV中有分布情况。如果注册的概率与该轮的中位数相差超过0.15(F28和F32),原因会在更改日志中给出。所有概率都以预测被解决为条件,因为Brier评分是在已解决的预测上计算的。已解决的份额报告在其旁边。
表4。 十项核心预测,包括阈值、最终日期和概率(所有41项在表A6中)。
| # | 预测 | 阈值 | 最终日期 | p | 模型 | 数据 |
|---|---|---|---|---|---|---|
| F1 | 供应商数据中已验证成功的差距缩小 | 编程减去其他职业2个百分点或更少(现在34%对29%) | 2028年12月31日 | 0.35 | 0.39(0.25至0.65) | 公开 |
| F2 | 在自己的领域中的质量奇偶性 | (非IT减去程序员)的下限95%界限在减去10个百分点以上;每组1,500人 | 2028年10月8日 | 0.70 | 0.67(0.62至0.70) | 自有研究 |
| F3 | 在自己的领域中的超越(质量的交叉点) | 下限95%界限在零以上;同一项研究 | 2029年10月8日 | 0.35 | 0.33(0.25至0.55) | 自有研究 |
| F5 | 招聘信息中的交叉 | 代理招聘信息中的学位份额比匹配招聘信息低2个百分点或更多,2027年连续两个季度 | 2028年12月31日 | 0.30 | 0.34(0.25至0.60) | 公开 |
| F7 | 背景中立性 | IT教育赔率比的90%区间在0.67至1.5之间,在日期和周处 | 2029年12月31日 | 0.42 | 0.43(0.40至0.48) | 自有研究 |
| F14 | 两个轴保持不同 | log horizon 与 log gain 的 Spearman 系数为 0.8 或以下;gain 增加样本外 R 平方 0.02 | 30 September 2028 | 0.52 | 0.49 (0.45 to 0.50) | 自有研究 |
| F19 | 检查设置了上限 | 月份 1 至 3 的检查份额在预测月份 4 至 6 的已验证产出方面优于 horizon | 30 September 2028 | 0.45 | 0.44 (0.30 to 0.65) | 自有研究 |
| F26 | 招聘实践随之而来 | 审计研究:回调差距在 3 个点以下,95% 区间在 5 以内 | 31 December 2029 | 0.35 | 0.32 (0.25 to 0.35) | 自有研究 |
| F27 | 代理构建的产品超越预测寿命 | 在 2026 年 12 月 31 日冻结的样本中,不到 50% 的产品在 2028 年底停用(Gartner:60%) | 31 March 2029 | 0.32 | 0.35 (0.20 to 0.55) | 公开 |
| F28 | 机器在 80% 时达到 Day | METR 80% horizon 到 2027 年底达到 8 小时或更长(2026 年 4 月为 3.1 小时) | 30 June 2028 | 0.80 | 0.66 (0.55 to 0.80) | 公开 |
注:p 是已注册的概率,表示在预测得到解决的条件下其成真的可能性:这是我采纳的 2026 年 10 月 9 日三个独立模型预测的中位数。模型:来自独立预测者的汇总预测(这些预测者没有看到我的数字),使用赔率的几何平均值计算(及其范围)。数据:公开表示可以由任何人从公开来源解决(集合 A);自有研究表示单独预注册的研究(集合 B)。所有预测的成真、未成真、未解决时的规则、备用来源和先前预测都在表 A6 和 predictions/predictions.csv 中。在最终日期没有可比数据的预测被视为未解决,不会被计为成功。在 OSF 注册的计划(Chernets, 2026e)没有假设,不涉及 IT 教育,因此无法测试集合 B。
图 7. 预测登记:每项有日期的预测及其检查年份和既定概率。
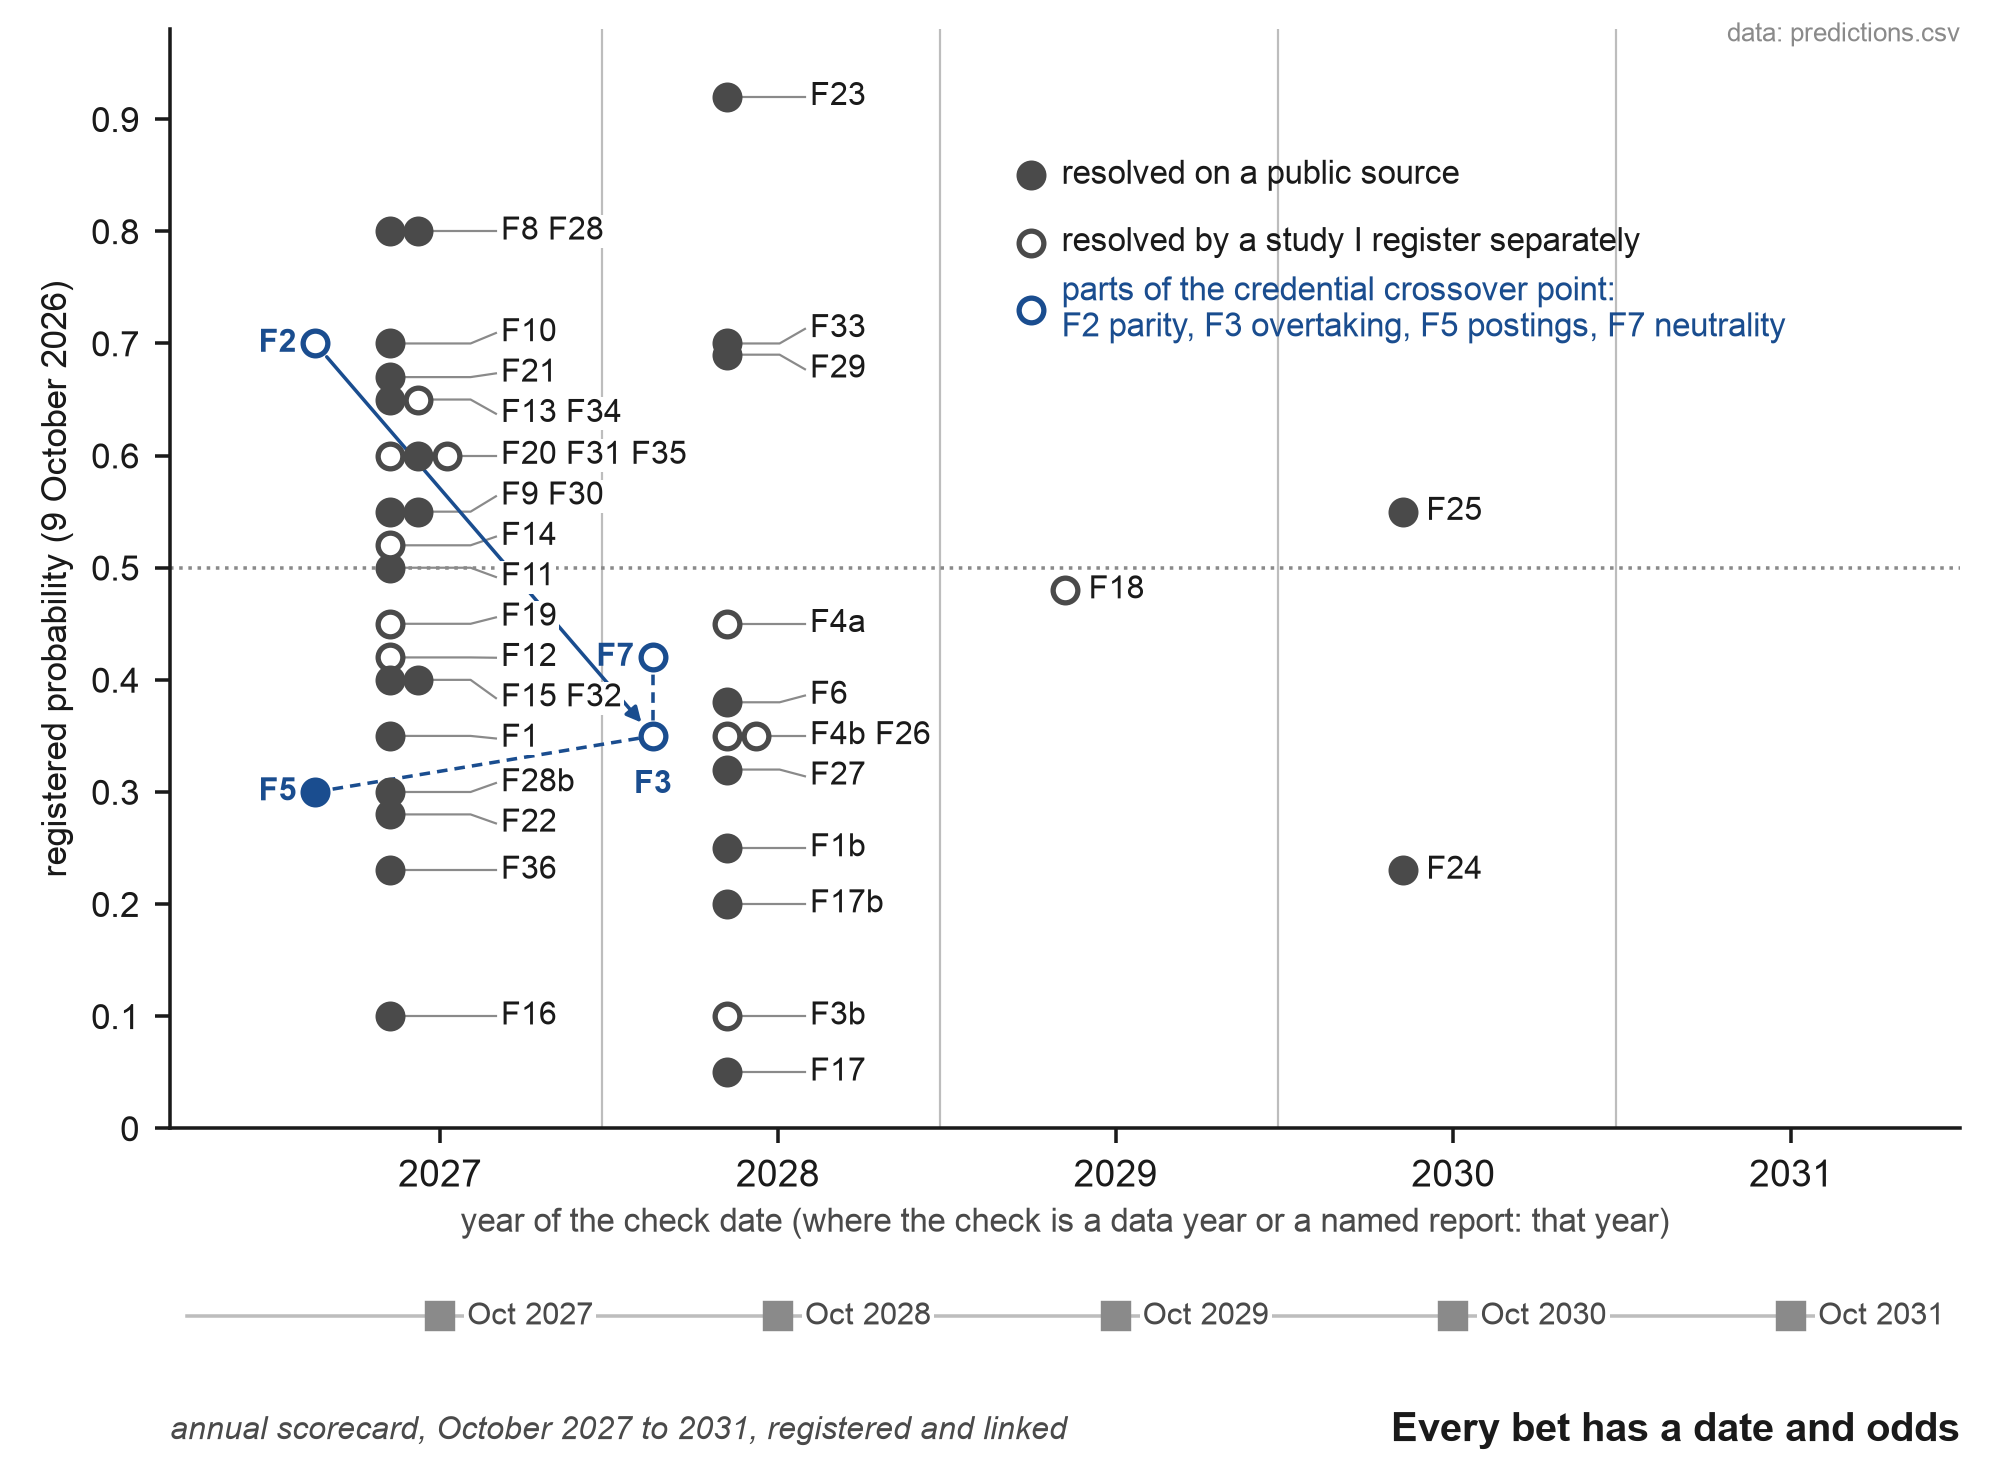
注:每个标记代表表 A6 中 41 项预测之一,位于其检查日期的年份(其中检查是数据年份或指定报告的年份),以及其已注册的概率位置。实心标记通过公开来源解决。空心标记仅通过在收集数据前单独注册的研究解决。凭证交叉点的四个部分用强调色表示:质量平价(F2)导致超越(F3)。发布中的交叉(F5)是其可见迹象,背景中立(F7)是其机制。只有平价的概率高于均等赔率(0.70)。超越这一刻的概率为 0.35。轴下方的正方形标记年度记分卡,将于 2027 年 10 月至 2031 年注册在 OSF 上,并通过 DOI 链接。概率固定于 2026 年 10 月 9 日,并注册在 OSF 上。
一项年度测量伴随这些预测但本身不是预测,这是一场名字竞赛:每年相同的查询计算表 A2 中的每个候选者在美国发布、OpenAlex 和 Crossref 中出现的频率。曾经仅作为长期监测的问题——SOC 2028 是否会为代理指导工作设立职业代码——现在是预测 F23,具有一定的概率(美国劳动统计局,2026b)。在 2026 年 10 月 9 日,美国劳动统计局既未发布 SOC 2028 的提议版本,也未发布最终版本;最终版本预计在 2027 年发布。
11.3 先前的预测
在 2026 年 10 月 9 日,我搜索了 Metaculus、Manifold、Good Judgment Open、Kalshi、Polymarket 和 Long Bets,以及开放网络(公司研究页面、分析师发布、arXiv、SSRN 和新闻),寻找有日期的预测,即没有技术教育背景的人通过 AI 代理工作会与使用相同代理的程序员相匹配或超过其表现。找到的预测都没有既定的日期和反驳性的结果。最接近的有以下几个。Gartner 在 2021 年预测,到 2024 年,80% 的技术产品和服务将由非技术专业人士构建(Gartner, 2021)。Mark Cuban 在 2017 年表示,他宁愿主修哲学,预期批判性思维会超越编程的价值(Black Enterprise, 2017)。D. H. Hansson 在 2026 年 8 月 26 日的 Lex Fridman 播客中回答"100%",当被问到是否存在程序员在代理工程方面表现不如非程序员的问题时(Lex Fridman Podcast, 2026)。Anthropic 在 2026 年 6 月观察到,编码代理正在使编码背景变得不那么相关(Anthropic, 2026e)。存在相反方向的预测。Gartner 预期 60% 的氛围编码应用将在 2028 年前停用(Gartner, 2026,由 Tray.ai, 2026 总结),并在 2024 年预期在 2026 年之前五分之一的组织将使用 AI 来扁平化它们的结构(Gartner, 2024)。Srinivasan 和 Wei (2026) 预期"代理管理员"将在 12 到 18 个月内成为标准职位。Forrester 预期 60% 的财富 100 强公司将任命 AI 治理负责人(Forrester, 2025)。Manifold 上的市场将 2030 年少三分之一的初级开发者职位的概率设定在约 74%,将美国开发者从 2023 年到 2028 年下降超过 15% 的概率设定在约 42%(Manifold, 2026b; Manifold, 2026c)。在 Manifold 上,到 2027 年非程序员用 AI 编写小脚本变得普遍的概率接近 27%(Manifold, 2026a),该问题仅涉及使用情况,不涉及质量衡量。本文预测与以上所有预测的区别在于:它们比较的是使用相同代理的人与人之间的差异,将教育作为变量,并且具有明确的日期、衡量指标和可被反驳的结果。搜索日志在附录 B 中。分层采纳(Rogers, 2003)、机器时间视野(Kwa et al., 2025)和关于初级职位正在缩减的观察是先前的工作,不对这些工作主张优先权。
11.4 冻结和评分
预测应该存放在哪里才能让任何人(包括其作者)都无法悄悄改变它?这个系列使用的地方中,只有一个冻结了。OSF注册不能编辑或删除;它可以撤销,但保留一个包含其标题、日期、DOI和撤销原因的页面(OSF,2026)。Zenodo允许存款人在发布后30天内更改或删除文件,之后只能发布新版本(OpenAIRE,2025)。SSRN在修订时替换PDF。因此,预测将首先在OSF上注册,作为立即公开的开放式注册,不设禁运期,因为禁运期会隐藏记录并隐瞒其DOI,而无人能看到的优先权价值甚微。
2026年10月9日,该表在OSF上注册为一套预注册预测(DOI 10.17605/OSF.IO/VW6P9),论文发布在SSRN和Zenodo上;每个基线源的快照都存档在Wayback Machine中。从2027年到2031年,每年在注册周年纪念日,发布一份记分卡,列出每项预测,无一例外,其状态(已实现、未实现、尚未到期、未解决、未进行)和证据。它报告所有已解决预测的Brier分数,按集合和按家族分类,其中链接的预测计算一次,按注册表的家族列分组(F1和F1b;F2、F3和F3b;F4a和F4b;F5、F6和F33;F9和F31;F15和F16;F17和F17b;F28和F28b);已解决的份额;最坏界限,其中每个超过最终日期且仍未解决的预测,以及每个未进行的预测,都被评分为预测错误;有和没有未进行的预测的分数;以及针对三个参考基准的Brier技能分数:固定的0.5、表4的汇总模型预测者,以及注册当天存在市场的市场价格。因此,选择性不解决不能改进分数。记分卡本身在OSF上注册,通过DOI链接到原始内容,并存放在Zenodo上。来自至少两个家族的模型独立地对照冻结规则检查每份记分卡;当它们不同意时,规则决定并报告分歧。注册文本在附录D中,图A1(附录D)显示检查和最终日期的完整日历。在评分开始前,两项承诺到期。F27的代理构建产品样本在2026年12月31日前在Zenodo上冻结,F5和F30的基线在注册前计算和存档。F27样本的协议,为注册保留开放的每个选择提供默认值,以及通过预先固定的种子绘制并密封它的工具在伴随存储库中(kits/f27-sample.md、tools/freeze_sample.py)。
预测注册后,公开的预测也将发布在外部预测者可以给它们定价的地方:Manifold上的五个市场(F5、F8、F10、F11和F22,可以自由发布;之所以选择这五个是因为每个都在公共来源和任何人都可以读取的外部系列上解决,没有我自己的数据),Metaculus上的一个问题(发布中的交叉,F5),以及社会科学预测平台用于F2、F3和F7的实验,以便在数据存在之前收集其他人的预测。不使用交易金钱结果的预测市场。
11.5 队列计划
我运营一个预注册队列计划(OSF,https://osf.io/x4egq,DOI 10.17605/OSF.IO/X4EGQ),追踪非程序员从聊天到代理到编排的过程(Chernets,2026e)。其首个队列是一项单臂可行性研究,有其自身已注册的结果,在其自身的报告中报告。诸如F7、F14和F18至F20这样需要人员级数据的预测,在数据收集前为其注册的后续队列中进行测试,其冻结项中包括关于IT教育的问题。附录C的记录,经同意保留,是该队列的自然数据。
12. 预测所反对的证据
第11章的预测与2026年的多种证据相悖,其中每一种都影响了测量规则或预测。
安全防护未能跟上步伐。在Veracode的2026年报告中,超过一百个模型中,通过安全测试的生成代码的比例保持在56%(Veracode, 2026)。这些测试仅在模型上进行,使用标准提示且没有安全指令,没有代理框架、工具或人工审查,因此描述的是一个人开始时的原始材料。对5,600个通过实感编码构建的公共应用程序的被动扫描发现了超过2,000个漏洞、400多个暴露的秘密和175个个人数据泄露,其作者将这些呈现为下界(Escape, 2026)。这就是为什么F2包括盲审,以及为什么不可逆转的工作需要每一部分都通过(第5.2节)。
通过测试不足以被接受。METR要求维护者审查通过基准测试的代理编写的修复,发现大约一半的修复按原样不会被合并;这些代理是早期版本,没有审查循环,因此比例现在可能更低(METR, 2026b)。评分规则通过隐藏测试、合格的审阅者和实际应用来应对,F2在一个月后添加维护更改。
验证取决于经验。在对162名通过实感编码构建的人进行的调查中,每个小组都认识到生成代码的风险,但他们的检查方式随经验而异。作者称之为感知-行动差距(Fawzy et al., 2026)。业务用户和新手快速生成工作原型,但代码质量参差不齐,随之进行返工(Gama et al., 2026)。业务用户即使在被警告后也会错过AI分析中的重大错误(Virk & Liu, 2025)。一项涉及52名学习新库的初级工程师的随机研究发现,使用AI的理解力得分为50%,不使用AI为67%,速度上没有显著改进。那些向模型请求解释的人得分65%或更高,而那些将代码完全交由模型处理的人得分低于40%(Anthropic, 2026c)。这是该测量基于使用者素养和植入错误的最强理由:将人们区分开来的技能正是这些研究所表明会变化的技能。
还没有已发表的比较将非程序员与使用相同代理的程序员进行对比。Esnaola et al. (2026)发现,一些非程序员通过ChatGPT使用GPT-4o解决小规模、明确指定的编程问题,其水平与不使用AI的程序员相当,且速度更快;作者将该研究称为探索性研究。程序员在没有AI的情况下工作,因此设计中没有"程序员+AI"的对照组,且研究的是短期个别任务而非持续开发;复制包是公开的(Esnaola et al., 2026)。在Anthropic的数据中,任务新手的验证成功率为15%,而更有经验的用户为28%至33%(Anthropic, 2026e)。其中,"新手"是指在特定任务上的新手,由模型判断,与IT教育水平无关。这一差距是否反映了教育差异还是对任务的熟悉程度,这正是F7旨在区分的。更早期的研究中,一家客户支持公司的生成AI最显著地提高了新手和低技能员工的生产力,而对最有经验员工的影响很小(Brynjolfsson et al., 2025),这是在代理概念出现之前的研究。2024年,宝洁公司使用聊天模型进行的一项实地实验发现,使用AI的个人与不使用AI的团队表现相当,不论其专业背景如何都能产出平衡的工作成果,这是代理概念出现前的研究(Dell'Acqua et al., 2025)。F2、F3和F7旨在提供缺失的比较。
有权威声音对强版本观点表示不同意。Karpathy设定了下限和上限(第2.1节)。Andrew Ng在2026年8月辩称,深刻理解程序如何工作的开发人员的表现远优于那些不具有这种理解的实感编码开发者(Ng, 2026)。招聘数据目前也指向同样的方向:需要AI技能的职位仍然比不需要的类似职位更可能要求四年制学位(Lightcast, 2026b),LinkedIn将入门级招聘的大部分疲软归因于经济状况(第2.4节)。这些预测以这些观点为对标,赔率已提前陈述。
13. 范围和边界条件
时间。 证据截至2026年10月9日。产品事实会迅速过时,因此该指标根据参考小时数和检查来定义,不涉及具体产品名称。
来源。 许多最有力的证据来自供应商对其自身产品的描述:OpenAI关于其编码代理,Anthropic关于其会话。这些被标记为供应商数据,用于供应商已知的内容。几个媒体报道的事件,例如代币排名,基于具名媒体机构的报告,并以此方式引用。二级来源(Growthy、Startup Fortune、Shopifreaks)在发布前已存档在Wayback Machine中,原始报告在可以访问的地方进行引用。
总体。 该论证涉及通过代理在计算机上完成、并能够被检查的工作。没有自己控制的计算机的人,以及根本无法检查的工作,都不在该指标的范围内。
该指标的主张。 一个经验证的地平线描述了一个人在特定日期、特定领域中,在检查制度下所交付的成果。它不声称数值越高对所有任务都越好。许多工作属于小时层级,选择保持手工进行是一个合法的决定。在错误无法撤销的领域,第5.2节中更严格的阈值适用,某些工作根本不应交给代理。
名称。 第3节的地图记录了2026年10月8日和9日发现的使用情况。名称在那之后会被采纳和放弃,因此该地图与名称的年度竞争相配对,并且不选择单一名称。
强论题。 没有技术教育的人将会构建比程序员更好的产品,这一主张表述为一套具有日期和阈值的预测(F2到F7)。我将其作为预测提出,以供公开评分。
法律保留的行为。 当法律将某项行为保留给许可证时,该指标及标签门控导致的权重损失(第6.2和6.5节)都不会改变该行为。在英国,不符合任职资格的人不得担任法定审计师,该资格需要成为公认监管机构的成员并符合其规则(《2006年公司法》第1212和1213条),在美国,仅有向上市公司会计监督委员会注册的公司可以为发行人编制或出具审计报告(《2002年萨班斯-奥克斯利法案》第102条)。在簿记领域,此类保留范围很窄:美国的簿记员通常不需要持有任何证书(美国劳工统计局,2026c)。在法律中,范围更广:英格兰和威尔士保留了六项法律活动,其中包括诉讼事务和遗产事务(《2007年法律服务法案》第12条)。因此工作可以转移,但签名保持不变,持证签署人随后以法律既有规定的形式执行第7.2节的担保人职能。许可证本身在多大程度上可以通过标签或检查工作来满足,第6.2节对此进行讨论。
代理前的数据。 2025年之前的系列仅作为前驱进入,因为它们描述的是没有代理的工作。招聘的宏观经济学由2026年的LinkedIn数据(第2.4节)体现,其更多指向经济而非人工智能。
主张的状态。 表A7(附录F)将该系列的置信度语言应用于各个要素。
14. 结论
比较编码代理的簿记员和构建自己合约检查工具的律师现在的工作方式与开发者相同——开发者将模块交给代理并检查结果。到2026年,这三类人共享一个工作流程,旧的职业阶梯中没有人能说出谁走得更远。一个头衔无法解决这个问题,因为2026年提出的每一个职位头衔要么是标语,要么是某人的职位广告,市场还没有在它们之间做出选择。一个衡量标准可以解决这个问题,前提是它衡量的是正确的东西。
这里提出的衡量标准不会等待职业被命名。它在一个尺度上评估簿记员、律师和开发者——即每个人交给代理并进行了检查的工作规模,涉及某个领域和某个日期;第二个轴显示他们投入一小时自己的时间能购得多少已验证的工作。其阈值是版本化的并经过书桌测试,书桌测试已经修正了其中之一;其规则说明了记录可能被游戏化的方式及针对每种方式的防御,其上限解释了为什么检查的价格设定了限制,无论代理的速度如何。对于雇主、学校或平台,问题会改变。他们不是在问一个人是否是程序员,或他们使用了多少人工智能,而是要求该人所在领域中通过了该人未设计的检查的一天工作。市场选择的任何名称都可以在该尺度上衡量。
带日期的预测承载了本论文开篇的论点。逐个领域,由没有信息技术教育的人创建的产品将开始超越使用相同代理的程序员创建的产品。在相等的已验证地平线处,编程教育将停止预测已检查工作的质量。在职位发布中,学位要求的变化将首先出现在专家可以自行接受工作的领域,最后出现在软件领域。如果2027年和2028年的计分卡与这些预测相悖,它们将使用Brier评分公开这样说。如果预测成立,初级和高级这些词可能会存活,但其含义将转向一个人可以证明的工作规模;大型雇主是否用这样的衡量标准替代其等级阶梯本身就是这里的一个预测(F17),在p = 0.05时注册。
无论这些预测发生什么,一个界限将保持不变。构建正在成为一种基本素养,就像写作一样。对所构建的东西负责仍然是一个职业,在这两者之间是模糊性,这是2026年市场的状况,在这个市场中,优秀的工作看不见,平台对未知的事物关上了大门。通过代理进行构建的人将需要一个为工作签署的合作伙伴,或者必须成为那个合作伙伴,而担保人反过来可以通过他们为之担保的东西及其中有多少保持住而被衡量。
有句美国谚语说,上帝创造了人,科尔特上校使他们平等。代理对创造工作做了类似的事情:有了一个代理,一个行业外的人可以创建看起来像该行业的工作。检查更难平等化(第5.2和12节)。在附录G的评分者研究中,几乎五分之一凭自己的说法被纳入簿记样本的人对该行业的第一周问题回答是错误的,在探索性比较中,他们以比其他人更少的小时数评估了更大的任务(附录G2)。一个独立检查的过程是否能为检查做代理为创造所做的事情是第6.5节的开放问题。仍然分隔人们的是他们可以检查和接受的东西,这正是已验证委托地平线所衡量的。
声明
资金。本工作未获得任何外部资金支持。
利益冲突。作者开发多模型编排方法,并已提交相关专利申请(待审;尚未授予专利)。作者设计了第11.5节和附录G中描述的预注册队列项目及其材料,并开发了一个教学应用程序,帮助人们使用AI代理。本文的任何发现都不依赖于作者的实现;附录C中的工具仅使用Python标准库。
工具和验证。AI助手在作者指导下被用作工具;思想、研究和结论均为作者的。定量声明和引用均根据初级来源或存档副本进行了核实,截至2026年10月9日,或2026年10月10日(针对当天添加的来源),在能够检索的情况下。如果仅有新闻报道或供应商页面可用,该声明在文本中被归属于该报道或供应商。参考文献中方括号内给出的标题是对那些未逐字重新阅读标题的页面的描述性标题。
数据和代码可用性。附录C的代码和模式、阈值的桌面测试(附录E)和预测文件在MIT许可下在配套存储库中发布(https://github.com/vadimchernets/delegation-horizon),在Zenodo上存档为发布版本v1.1.0(概念DOI 10.5281/zenodo.23267444,指向最新版本);附录C中打印的代码与存储库的代码逐字节相同;tools/paper_sync.py在其测试与此文本一同运行时,会根据存储库检查此代码、已计算示例和表4和A6。表4和A6的预测于2026年10月9日在OSF上注册(DOI 10.17605/OSF.IO/VW6P9)。附录G的Prolific评分者研究于2026年10月9日在OSF上注册,在收集任何数据之前(DOI 10.17605/OSF.IO/V92R8);其分析脚本(pilot/human_raters.py)已与该注册一起提交,并在配套存储库中按提交时的状态保存,OSF为每个提交的文件报告的SHA-256在pilot/registered-SHA256.txt中列出,以及转换Prolific导出、打印表G2并运行未注册G2比较的脚本。匿名化数据(Prolific标识符已替换为纯标签)将添加到同一文件夹。预测注册的文件的SHA-256在predictions/registered-SHA256.txt中列出(该清单已在OSF上提交),存储库的测试会将每个文件与其进行比较。
伦理。附录G报告了来自人的两个数据源。Prolific评分者研究是一个匿名在线评分任务:成年专业人士在Prolific上参与前给予了知情同意,通过平台获得报酬,未提供姓名或联系方式。队列账户在不包含姓名、地点或语言的情况下总结了同意预注册队列项目(OSF,DOI 10.17605/OSF.IO/X4EGQ)和匿名发布的成年人的记录;该项目的注册结果单独报告。该工作由一名独立研究人员在没有机构伦理委员会的情况下进行。第9节讨论的公开讨论被改写,其作者未被命名。
作者贡献。唯一作者。
通讯。vadimchernets9@gmail.com · ORCID: 0009-0007-4845-3163
References
9to5Mac. (2026). [App Store new apps doubled in the first half of 2026, Sensor Tower data reported by The New York Times]. https://9to5mac.com/?p=1061510
AI Certification Standards. (2026). AI Competence Framework (version of 23 August 2026). https://www.aicertificationstandards.org/framework
AI Futures Project. (2026, April 2). Q1 2026 timelines update. https://blog.aifutures.org/p/q1-2026-timelines-update
aicodex. (2026). AI agent manager vs agent operator. https://www.aicodex.to/articles/ai-agent-manager-vs-agent-operator
Alenezi, M. (2026). From determinism to delegation: AI-native software engineering and the evolution of the agentic engineer. arXiv:2606.28791. https://arxiv.org/abs/2606.28791
Alonso, M. N. (2026). The artificial intelligence economy [working paper, ResearchGate; contains the proposition "A delegation horizon"].
AlternativeTo. (2026, January). OpenAI rolls out age prediction for ChatGPT accounts. https://alternativeto.net/news/2026/1/openai-rolls-out-age-prediction-for-chatgpt-accounts-to-automatically-estimate-your-age/
Andrist, R. K. (1962). Gold! American Heritage, 14(1). https://www.americanheritage.com/content/gold
Amplifying. (2026). What Claude Code actually chooses. https://amplifying.ai/research/claude-code-picks
Anthropic. (2025a, December 2). How AI is transforming work at Anthropic. https://www.anthropic.com/research/how-ai-is-transforming-work-at-anthropic
Anthropic. (2025b). AI Fluency framework (the four Ds). https://aifluencyframework.org/
Anthropic. (2026a, January 15). Anthropic Economic Index report: Economic primitives. https://www.anthropic.com/research/anthropic-economic-index-january-2026-report
Anthropic. (2026b, January 22). Claude's constitution. https://www.anthropic.com/constitution
Anthropic. (2026c, January 29). [AI assistance and coding skills: a randomised study of junior engineers]. https://www.anthropic.com/research/AI-assistance-coding-skills
Anthropic. (2026d, March 24). Anthropic Economic Index report: Learning curves. https://www.anthropic.com/research/economic-index-march-2026-report
Anthropic. (2026e, June 16). Agentic coding and persistent returns to expertise. https://www.anthropic.com/research/claude-code-expertise
Anthropic. (2026f, June 26). [Anthropic Economic Index report, June 2026]. https://www.anthropic.com/research/economic-index-june-2026-report
Arion Research. (2026, February 7). [The agent manager role]. https://www.arionresearch.com/blog/nfkxv53ktwxqkwtxwm2d03woml1c65
Artificial Lawyer. (2026, January 27). Claude Cowork: the DIY revolution in law. https://www.artificiallawyer.com/2026/01/27/claude-cowork-the-diy-revolution-in-law/
Atkinson, T., & Yamco, S. (2026, January 6). Young workers' employment drops in occupations with high AI exposure. Federal Reserve Bank of Dallas. https://www.dallasfed.org/research/economics/2026/0106
Batko, M. (2026, August 20). [Distribution is the moat]. Startmate. https://startmate.com/writing/distribution-is-the-moat
Benchek, J., et al. (2026). APEX-Accounting. arXiv:2607.27189. https://arxiv.org/abs/2607.27189
Berkeley California Management Review. (2025, July). Rethinking AI agents: A principal-agent perspective. https://cmr.berkeley.edu/2025/07/rethinking-ai-agents-a-principal-agent-perspective/
BetterUp. (2026, May 18). [Workslop research with Stanford]. https://www.betterup.com/blog/workslop-canada
Black Enterprise. (2017). [Mark Cuban on liberal arts and the future of work]. https://www.blackenterprise.com/mark-cuban-right-libreal-arts-key-future/amp/
Bloomberg Law. (2026, April 20). Vibe coding empowers lawyers to influence AI winners, losers. https://news.bloomberglaw.com/legal-exchange-insights-and-commentary/vibe-coding-empowers-lawyers-to-influence-ai-winners-losers
Bone, M., González Ehlinger, E., & Stephany, F. (2025). Skills or degree? The rise of skill-based hiring for AI and green jobs. Technological Forecasting and Social Change. https://doi.org/10.1016/j.techfore.2025.124042
Brier, G. W. (1950). Verification of forecasts expressed in terms of probability. Monthly Weather Review, 78(1), 1-3. https://doi.org/10.1175/1520-0493(1950)078<0001:VOFEIT>2.0.CO;2
Bancroft, H. H. (1888). History of California (Vol. 6, 1848-1859). The History Company. https://archive.org/details/historyofcaliforv6banc
Brynjolfsson, E., Li, D., & Raymond, L. (2025). Generative AI at work. The Quarterly Journal of Economics, 140(2), 889-942. https://doi.org/10.1093/qje/qjae044
Bureau of Labor Statistics. (2025). Photographers. Occupational Outlook Handbook, 2024-34 edition (archived 19 August 2026). https://web.archive.org/web/20260819060531/https://www.bls.gov/ooh/media-and-communication/photographers.htm
Bureau of Labor Statistics. (2026a). Photographers. Occupational Outlook Handbook (updated 27 August 2026). https://www.bls.gov/ooh/media-and-communication/photographers.htm (archived copy: https://web.archive.org/web/20261001165113/https://www.bls.gov/ooh/media-and-communication/photographers.htm)
Bureau of Labor Statistics. (2026b). 2028 SOC revision. https://www.bls.gov/soc/2028/2028_soc_revision.htm
Bureau of Labor Statistics. (2026c). Bookkeeping, accounting, and auditing clerks. Occupational Outlook Handbook (updated 27 August 2026). https://www.bls.gov/ooh/office-and-administrative-support/bookkeeping-accounting-and-auditing-clerks.htm
Burning Glass Institute & Harvard Business School. (2024). Skills-based hiring: The long road from pronouncements to practice. https://www.burningglassinstitute.org/research/skills-based-hiring-2024
Business Insider. (2026, January 22). [Deloitte gives US employees new job titles]. https://www.businessinsider.com/deloitte-gives-us-employees-new-job-titles-leader-role-2026-1
Cagan, M. (2025). The era of the product creator. SVPG. https://www.svpg.com/the-era-of-the-product-creator/
Capps, R. (2025, June 17). [New jobs that AI could create]. The New York Times Magazine. https://www.nytimes.com/2025/06/17/magazine/ai-new-jobs.html
Carta. (2025). Solo founders report 2025. https://carta.com/data/solo-founders-report
Carta. (2026a). 2026 founder ownership report. https://carta.com/data/founder-ownership-2026-full-report/
Carta. (2026b). State of pre-seed: Q2 2026. https://carta.com/data/state-of-pre-seed-q2-2026/
Challenger, Gray & Christmas. (2026). [Job cuts report, June 2026]. https://www.challengergray.com/wp-content/uploads/2026/07/Challenger-Report-June2600986996.pdf
Chen, X., & Meng, S. (2026). When AI levels the playing field: Skill homogenization, asset concentration, and two regimes of inequality. arXiv:2603.05565. https://arxiv.org/abs/2603.05565
Catalini, C., Hui, X., & Wu, J. (2026). Some simple economics of AGI. arXiv:2602.20946. https://arxiv.org/abs/2602.20946
Celenza, B. (2026, October 6). Building Git infrastructure for agent-scale development. GitHub Blog. https://github.blog/engineering/architecture-optimization/building-git-infrastructure-for-agent-scale-development/
Chernets, V. (2026a). After Chat: The three transitions between non-programmers and agentic AI. SSRN. https://doi.org/10.2139/ssrn.7520019 (Zenodo: https://doi.org/10.5281/zenodo.22943313)
Chernets, V. (2026b). Agreement is not independent evidence: Auditable multi-model synthesis without an API. SSRN. https://doi.org/10.2139/ssrn.7390698
Chernets, V. (2026c). AI-Watchbird (Sheckley): When automated oversight widens its own mandate and harms what it guards. SSRN. https://doi.org/10.2139/ssrn.7473658
Chernets, V. (2026d). Architectural trust: Why consumer trust in agentic commerce migrates from AI models to verifiable architecture. SSRN. https://doi.org/10.2139/ssrn.7191261
Chernets, V. (2026e). Three steps into agentic AI: A preregistered feasibility study of how non-programmers cross from chatbot to agent to multi-model orchestration (Cohort 1). OSF. https://doi.org/10.17605/OSF.IO/X4EGQ
CIO. (2026a, May 29). Amazon deletes devs' tokenmaxxing leaderboard to minimize costs. https://www.cio.com/article/4178825/amazon-deletes-devs-tokenmaxxing-leaderboard-to-minimize-costs-2.html
CIO. (2026b, September 4). Meta minimizes role of token-maxing in employee evaluations. https://www.cio.com/article/4218661/meta-minimizes-role-of-token-maxing-in-employee-evaluations-2.html
Clark, M. (2026). [Proposal for a Chartered Financial Intelligence Architect]. SSRN.
Collins Dictionary. (2025). Collins Word of the Year 2025. https://blog.collinsdictionary.com/language-lovers/collins-word-of-the-year-2025-ai-meets-authenticity-as-society-shifts/
Companies Act 2006, c. 46, ss. 1212 and 1213 (United Kingdom). Individuals and firms: eligibility for appointment as a statutory auditor; Effect of ineligibility (accessed 10 October 2026). https://www.legislation.gov.uk/ukpga/2006/46/section/1212 ; https://www.legislation.gov.uk/ukpga/2006/46/section/1213
Computing Research Association. (2026, June). [New CRA Taulbee Survey findings: record degree production alongside a cooling enrollment pipeline]. https://cra.org/crn/2026/06/cra-update-new-cra-taulbee-survey-findings-show-record-degree-production-alongside-a-cooling-enrollment-pipeline/
CSET. (2025). [Translation: China's notice on AI education in primary and secondary schools]. Center for Security and Emerging Technology. https://cset.georgetown.edu/publication/china-primary-secondary-ai-education-notice/
Crunchbase News. (2026, July 2). Crunchbase data: Global startup investment hit record $510B in H1 2026 as AI boom accelerates funding and exits. https://news.crunchbase.com/venture/global-startup-exits-ipo-ma-soar-ai-q2-h1-2026/
Danilova, A., Naiakshina, A., Horstmann, S., & Smith, M. (2021). Do you really code? Designing and evaluating screening questions for online surveys with programmers. 2021 IEEE/ACM 43rd International Conference on Software Engineering (ICSE), 537-548. https://doi.org/10.1109/ICSE43902.2021.00057
Dawson, R. (2026). [Framework: levels of AI delegation in decision making]. https://rossdawson.com/framework-levels-ai-delegation-decision-making
Dealroom. (2026). Mercor doubles to $2B gross revenue run-rate as AI labs buy expert data. https://dealroom.co/news/137121-mercor-doubles-to-2b-gross-revenue-run-rate-as-ai-labs-buy-expert-data/
Dell'Acqua, F., et al. (2025). The cybernetic teammate: A field experiment on generative AI reshaping teamwork and expertise. NBER Working Paper 33641. https://www.nber.org/papers/w33641
Dell'Acqua, F., et al. (2026). Navigating the jagged technological frontier: Field experimental evidence of the effects of artificial intelligence on knowledge worker productivity and quality. Organization Science, 37(2), 403-423. https://doi.org/10.1287/orsc.2025.21838
Digg. (2026). [Your job title is about to change: AI Agent Supervisor]. https://digg.com/aiagentchat/TvbtLF2/your-job-title-is-about-to
Dust. (2026, October 7). [Dust Index: AI strategy beyond models]. https://dust.tt/blog/dust-index-ai-strategy-beyond-models
EdWeek. (2026, June 11). [White House honors AI challenge winners]. https://www.edweek.org/technology/white-house-honors-ai-challenge-winners-as-tech-backlash-grows/2026/06
em360. (2026, September 7). [AI productivity and supervisory capacity]. https://em360tech.com/tech-articles/ai-productivity-supervisory-capacity
Engelbart, D. C. (1962). Augmenting human intellect: A conceptual framework (Summary Report AFOSR-3223). Stanford Research Institute.
Escape. (2026). Methodology: how we discovered vulnerabilities in apps built with vibe coding (accessed 9 October 2026). https://escape.tech/blog/methodology-how-we-discovered-vulnerabilities-apps-built-with-vibe-coding/
Esnaola, L. M., Ramón, H. D., & Lanzarini, L. C. (2026). Can generative AI bridge the gap? A quasi-experimental study of non-programmers with AI vs. programmers without AI. Empirical Software Engineering, 31(3), 75. https://doi.org/10.1007/s10664-026-10813-7 Replication package: https://doi.org/10.5281/zenodo.17803568
Eulerich, M., Sanatizadeh, A., Vakilzadeh, H., & Wood, D. A. (2024). Is it all hype? ChatGPT's performance and disruptive potential in the accounting and auditing industries. Review of Accounting Studies, 29(3), 2318-2349. https://doi.org/10.1007/s11142-024-09833-9
Fawzy, A., Tahir, A., & Blincoe, K. (2026). From prompting to verification: How experience shapes vibe coding practices. arXiv:2605.24521. https://arxiv.org/abs/2605.24521
Feldman, M. Q., & Anderson, C. J. (2024). Non-expert programmers in the generative AI future. CHIWORK 2024 (author version). https://www.feldmanmolly.com/chiwork2024-author-version.pdf
Feng, K. J. K., McDonald, D. W., & Zhang, A. X. (2025). Levels of autonomy for AI agents. arXiv:2506.12469. https://arxiv.org/abs/2506.12469
Flowtivity. (2026, February 24). Your boss will measure you in tokens. https://flowtivity.ai/blog/your-boss-will-measure-you-in-tokens/
Forrester. (2025, October). [Predictions 2026 for AI and technology leadership], as reported by iTWire. https://itwire.com/it-industry-news/strategy/forrester-unveils-2026-predictions-for-ai-and-tech-leadership.html
Fortune. (2025, May 7). [Prompt engineering, a six-figure role, now obsolete]. https://www.fortune.com/2025/05/07/prompt-engineering-200k-six-figure-role-now-obsolete-thanks-to-ai
Fortune. (2026a, January 22). [Deloitte's job title change]. https://www.fortune.com/2026/01/22/deloitte-job-title-change-ai-reshapes-big-4-accounting-consulting-firms
Fortune. (2026b, May 26). [Uber's chief operating officer on AI spending]. https://www.fortune.com/2026/05/26/uber-coo-ai-spending-tokens-claude-code/
Fortune. (2026c, July 7). [Cognition's chief executive on tokenmaxxing]. https://fortune.com/2026/07/07/cognition-ceo-tokenmaxxing-big-tech-carried-away-ai-productivity-gains/
Fox, S., Markham, L., Lail, R., & Karotsieris, M. (2026). LLM judges verify presence, not absence: Omission blindness in AI clinical notes and what recovers it. arXiv:2608.31016. https://arxiv.org/abs/2608.31016
Fu, H. Y., Shrivastava, A., Moore, J., West, P., Tan, C., & Holtzman, A. (2025). AbsenceBench: Language models can't tell what's missing. arXiv:2506.11440. https://arxiv.org/abs/2506.11440
Gama, et al. (2026). [Novice teams building software with AI]. ICSE 2026. arXiv:2512.02750. https://arxiv.org/abs/2512.02750
Gartner. (2009). Gartner Symposium/ITxpo Orlando brochure (use of "citizen developer"). https://www.gartner.com/imagesrv/symposium/pdf/orlando_symposium_conference_brochure.pdf
Gartner. (2021, June 10). Gartner says the majority of technology products and services will be built by professionals outside of IT by 2024. https://www.gartner.com/en/newsroom/press-releases/2021-06-10-gartner-says-the-majority-of-technology-products-and-services-will-be-built-by-professionals-outside-of-it-by-2024
Gartner. (2024, October 22). Gartner unveils top predictions for IT organizations and users in 2025 and beyond. https://www.gartner.com/en/newsroom/press-releases/2024-10-22-gartner-unveils-top-predictions-for-it-organizations-and-users-in-2025-and-beyond
Gartner. (2026). Tyagi, N. Govern vibe coding for citizen developers with self-service platforms (29 June 2026; document 8068765). https://www.gartner.com/en/documents/8068765 (subscriber access; figures cited as summarised by Tray.ai, 2026)
Gigazine. (2025, July 24). What are the results of the 'AccountingBench' benchmark, which tests an AI model for monthly accounting tasks? https://gigazine.net/gsc_news/en/20250724-accountingbench/
Gigazine. (2026, July 21). [Sensor Tower: new App Store apps in the first half of 2026]. https://www.gigazine.net/gsc_news/en/20260721-app-store-new-apps
GitHub. (2025a). Octoverse: A new developer joins GitHub every second as AI leads TypeScript to #1. https://github.blog/news-insights/octoverse/octoverse-a-new-developer-joins-github-every-second-as-ai-leads-typescript-to-1/
GitHub. (2025b, December 8). The new identity of a developer: What changes and what doesn't in the AI era. https://github.blog/news-insights/octoverse/the-new-identity-of-a-developer-what-changes-and-what-doesnt-in-the-ai-era/
Growthy. (2026, September 23). Claude Code vs Codex for bookkeeping. https://growthy.com/blog/claude-code-vs-codex-for-bookkeeping
Haize Labs. (2026). Vertical AI Lead [job posting]. https://job-boards.greenhouse.io/haizelabs/jobs/5173890008
Hashimoto, M. (2026). Vouch [repository]. https://github.com/mitchellh/vouch
HCA Magazine. (2026, July 29). [Atlassian introduces AI wallets for employees]. https://www.hcamag.com/ca/news/general/atlassian-introduces-new-ai-wallets-to-employees/584258
Hosseini, S. M., & Lichtinger, G. (2026, May 6). Generative AI as seniority-biased technological change [Working paper; earlier version SSRN 5425555, 2025]. https://raw.githack.com/s-mahdihosseini/Website/b99fa2962dcc4c165bbc3c41dd283afa99c5ccfb/GenAI_SenBTC_May_2026.pdf
Huang, L., Xiao, W., & Vishnoi, N. K. (2026). Delegation and verification under AI. Accepted at ICML 2026. arXiv:2603.02961. https://arxiv.org/abs/2603.02961
Hwang, J. (2026, February 13). Claude Code is the new Excel. https://nextword.substack.com/p/claude-code-is-the-new-excel
Indeed Hiring Lab. (2026, January 28). Where do college degrees still matter in a "skills-first" job market? https://hiringlab.indeed.com/2026/01/28/where-do-college-degrees-still-matter-in-a-skills-first-job-market/
IT Brew. (2026, June 5). AI orchestrators are the newest in-demand AI role. https://www.itbrew.com/stories/ai-orchestrators-are-the-newest-in-demand-ai-role
Jaques, E. (1956). Measurement of responsibility: A study of work, payment and individual capacity. Tavistock Publications. (Reviewed in Industrial and Labor Relations Review, 10(3), 475. https://doi.org/10.2307/2519792)
Jensen, M. C., & Meckling, W. H. (1976). Theory of the firm: Managerial behavior, agency costs and ownership structure. Journal of Financial Economics, 3(4), 305-360. https://doi.org/10.1016/0304-405X(76)90026-X
Journal of Accountancy. (2025, May 14). AICPA, NASBA approve new CPA licensure path. https://www.journalofaccountancy.com/news/2025/may/aicpa-nasba-approve-new-cpa-licensure-path/
Kamara, S. (2026). Verification friction. SSRN. https://doi.org/10.2139/ssrn.6469865
Karpathy, A. (2025, February 2). [Post introducing "vibe coding"]. X. https://x.com/karpathy/status/1886192184808149383
Karpathy, A. (2026, April 30). Sequoia AI Ascent 2026 [talk notes]. https://karpathy.bearblog.dev/sequoia-ascent-2026/
Khadj, O. J. (2026). The delegation frontier. SSRN. https://doi.org/10.2139/ssrn.7348378
Kim, E., Garg, A., Peng, K., & Garg, N. (2025). Correlated errors in large language models. Accepted at ICML 2025. arXiv:2506.07962. https://arxiv.org/abs/2506.07962
Kingy AI. (2026, May 4). Token spend is coming for your performance review. https://kingy.ai/news/token-spend-is-coming-for-your-performance-review-and-mine/
Ko, A. J., Abraham, R., Beckwith, L., Blackwell, A., Burnett, M., Erwig, M., Scaffidi, C., Lawrance, J., Lieberman, H., Myers, B., Rosson, M. B., Rothermel, G., Shaw, M., & Wiedenbeck, S. (2011). The state of the art in end-user software engineering. ACM Computing Surveys, 43(3), 21. https://doi.org/10.1145/1922649.1922658
Krebs, A. (2026). [Design slop and Show HN]. https://www.adriankrebs.ch/blog/design-slop/
Kwa, T., et al. (2025). Measuring AI ability to complete long tasks. arXiv:2503.14499. https://arxiv.org/abs/2503.14499
Legal Services Act 2007, c. 29, s. 12 (England and Wales). Meaning of "reserved legal activity" and "legal activity" (accessed 10 October 2026). https://www.legislation.gov.uk/ukpga/2007/29/section/12
Lenny's Newsletter. (2025). [Why LinkedIn is replacing PMs]. https://www.lennysnewsletter.com/p/why-linkedin-is-replacing-pms
Lex Fridman Podcast. (2026, August 26). #501, David Heinemeier Hansson [transcript]. https://lexfridman.com/dhh-2-transcript/
Lightcast. (2026a, August 7). Tracking the agentic AI explosion in jobs. https://lightcast.io/resources/blog/tracking-the-agentic-ai-explosion-in-jobs
Lightcast. (2026b, September 9). [Degree requirements still higher for AI jobs]. https://lightcast.io/resources/blog/degree-requirements-ai-jobs
LinkedIn. (2026a, January). LinkedIn gives professionals the edge with verified skills and tools to navigate the job search. https://news.linkedin.com/2026/Professional_Edge_Skills_Verified
LinkedIn. (2026b, April). Q3 earnings and business highlights. https://news.linkedin.com/2026/Q3-Earnings-Highlights
LinkedIn Economic Graph. (2026). AI labor market update, August 2026. https://delivery-p143253-e1476319.adobeaemcloud.com/adobe/assets/urn:aaid:aem:ef153078-1061-4817-82e7-a1c027d7a7d7/original/as/AI-Labor-Market-Update-August-2026-v2.pdf
Manifold. (2026a). [Will it be common for non-programmers to create small scripts using AI by 2027?] (accessed 9 October 2026). https://manifold.markets/jskf/will-it-be-common-for-nonprogrammer-dfc979ea7fec
Manifold. (2026b). [Will the number of junior developer roles fall by a third by 2030?] (accessed 9 October 2026). https://manifold.markets/OliverKuperman/will-the-number-of-junior-developer
Manifold. (2026c). [Will the number of people employed as software developers in the US fall by more than 15% from 2023 to 2028?] (accessed 9 October 2026). https://manifold.markets/MatthewBarnett/will-the-number-of-people-employed
McAleese, N., Pokorny, R. M., Ceron Uribe, J. F., Nitishinskaya, E., Trebacz, M., & Leike, J. (2024). LLM critics help catch LLM bugs. arXiv:2407.00215. https://arxiv.org/abs/2407.00215
McKinsey & Company. (2025, January). Superagency in the workplace: Empowering people to unlock AI's full potential at work. https://www.mckinsey.com/~/media/mckinsey/business%20functions/quantumblack/our%20insights/superagency%20in%20the%20workplace%20empowering%20people%20to%20unlock%20ais%20full%20potential%20at%20work/superagency-in-the-workplace-empowering-people-to-unlock-ais-full-potential-v4.pdf
MediaNama. (2026, April). [Claude users' accounts suspended after being flagged as minors]. https://www.medianama.com/2026/04/223-claude-users-accounts-suspended-flagged-minors/
Memari, M., & Rudolph, G. (2026). The capability ladder. arXiv:2608.07779. https://arxiv.org/abs/2608.07779
Menlo Ventures. (2025). 2025: The state of generative AI in the enterprise. https://menlovc.com/perspective/2025-the-state-of-generative-ai-in-the-enterprise/
Metal Toad. (2026). 6 levels of AI delegation: A framework for AI management. https://www.metaltoad.com/blog/6-levels-of-ai-delegation-a-framework-for-ai-management
Metaview. (2026). [AI use in hiring interviews]. https://www.metaview.ai/resources/blog/ai-baseline-shopify-memo-hiring-process
METR. (2025, July 10). Measuring the impact of early-2025 AI on experienced open-source developer productivity. https://metr.org/blog/2025-07-10-early-2025-ai-experienced-os-dev-study/
METR. (2026a, February 19). [Five lessons from an AI biology randomised trial]. https://metr.org/blog/2026-02-19-five-lessons-from-ai-biology-rct
METR. (2026b, March 10). Many SWE-bench-passing PRs would not be merged into main. https://metr.org/notes/2026-03-10-many-swe-bench-passing-prs-would-not-be-merged-into-main/
METR. (2026c). Time horizons (dashboard, accessed 9 October 2026). https://metr.org/time-horizons/
METR. (2026d). eval-analysis-public, release time-horizon 1.1, runs.jsonl [Data set]. GitHub. https://github.com/METR/eval-analysis-public (accessed 9 October 2026)
Microsoft. (2025, April 23). 2025: The year the Frontier Firm is born. Work Trend Index. https://www.microsoft.com/en-us/worklab/work-trend-index/2025-the-year-the-frontier-firm-is-born
Microsoft. (2026a, May 5). Agents, human agency and the opportunity for every organization. Work Trend Index 2026. https://www.microsoft.com/en-us/worklab/work-trend-index/agents-human-agency-and-the-opportunity-for-every-organization
Microsoft. (2026b, May 5). How Frontier Firms are rebuilding the operating model for the age of AI. https://blogs.microsoft.com/blog/2026/05/05/how-frontier-firms-are-rebuilding-the-operating-model-for-the-age-of-ai/
MindStudio. (2026, June 11). What is agent literacy? https://www.mindstudio.ai/blog/what-is-agent-literacy-core-skill-ai-builders
n8n. (2026). AI Product Builder [job posting]. https://jobs.ashbyhq.com/n8n/42e72645-d99a-4545-97b7-53ba3a699893
Nature Portfolio. (2026, February 9). [Press release: people using language models for medical scenarios, Nature Medicine]. https://www.natureasia.com/en/info/press-releases/detail/9231
Ng, A. (2026, August 28). The AI engineering skills map in detail: Software engineering fundamentals. The Batch. https://www.deeplearning.ai/the-batch/the-ai-engineering-skills-map-in-detail-software-engineering-fundamentals
OECD. (2026, February). Venture capital investments in artificial intelligence through 2025. https://www.oecd.org/en/publications/venture-capital-investments-in-artificial-intelligence-through-2025_a13752f5-en/full-report.html
OECD & European Commission. (2026, June). [AI literacy framework for primary and secondary education]. https://ailiteracyframework.org/blog/empowering-learners-for-the-age-of-ai-literacy-framework/
O'Neill, N. (2026). [The Product Principal, LinkedIn post]. https://www.linkedin.com/posts/nicholasoneill_the-product-principal-activity-7445921322486009856-hAwj
Ono, A. (2026, June 22). [Defining the roles of humans and AI]. World Economic Forum. https://www.weforum.org/stories/artificial-intelligence/future-of-work-define-roles-humans-ai/
Open Source For You. (2026, February). GitHub weighs pull request kill switch as AI slop floods open source. https://www.opensourceforu.com/2026/02/github-weighs-pull-request-kill-switch-as-ai-slop-floods-open-source/
OpenAI. (2026, June). How agents are transforming work. https://openai.com/index/how-agents-are-transforming-work/
OpenAIRE. (2025, December 9). Zenodo introduces a new way to manage and correct published records. https://www.openaire.eu/zenodo-introduces-a-new-way-to-manage-and-correct-published-records
Oregon State Board of Bar Examiners. (2026, January 26). Supervised Practice Portfolio Examination: First annual report to the Oregon Supreme Court. https://www.osbar.org/_docs/sppe/2025SPPEAnnualReport.pdf
OSF. (2026). Updating registrations; Addressing fear of scooping on OSF preregistrations (help pages, accessed 9 October 2026). https://help.osf.io/hc/en-us/sections/4414482864279-Updating-Registrations ; https://help.osf.io/article/634-addressing-fear-of-scooping-on-osf-preregistrations
Page, M. J., McKenzie, J. E., Bossuyt, P. M., et al. (2021). The PRISMA 2020 statement: An updated guideline for reporting systematic reviews. BMJ, 372, n71. https://doi.org/10.1136/bmj.n71
Park, Y. S., et al. (2026). The work behind delegation: A framework for supervising AI coding agents. arXiv:2609.24234. https://arxiv.org/abs/2609.24234
Paul, R. W. (1947). California gold: The beginning of mining in the Far West. Harvard University Press. https://archive.org/details/in.ernet.dli.2015.177982
Patwardhan, T., et al. (2025). GDPval: Evaluating AI model performance on real-world economically valuable tasks. arXiv:2510.04374. https://arxiv.org/abs/2510.04374
Penrose. (2025). Can LLMs do accounting? [AccountingBench]. https://accounting.penrose.com/ (figures cited as reported by Gigazine, 2025)
Phoenix, J. (2026). [Five levels, gated by verification]. https://understandingdata.com/posts/five-levels-gated-by-verification/
PPC Land. (2026, March 6). The app middle class is dying, and RevenueCat's data shows exactly how fast. https://ppc.land/the-app-middle-class-is-dying-and-revenuecats-data-shows-exactly-how-fast/
Prolific. (2026, July 13). How do I use Prolific's filters? Researcher help centre (accessed 10 October 2026). https://researcher-help.prolific.com/en/articles/445159-how-do-i-use-prolific-s-filters
PwC. (2026). AI Jobs Barometer 2026 (press release). https://www.pwc.com/id/en/media-centre/press-release/2026/english/ai-jobs-barometer-en.html
Reid, B., Wagner, M., d'Amorim, M., & Treude, C. (2022). Software engineering user study recruitment on Prolific: An experience report. RoPES 2022. arXiv:2201.05348. https://arxiv.org/abs/2201.05348
Retool. (2026, February 17). Retool's 2026 Build vs. Buy Report (press release). https://www.businesswire.com/news/home/20260217548274/en/Retools-2026-Build-vs.-Buy-Report-Reveals-35-of-Enterprises-Have-Already-Replaced-SaaS-With-Custom-Software
RevenueCat. (2026). State of subscription apps 2026. https://www.revenuecat.com/state-of-subscription-apps ; https://www.revenuecat.com/sosa-26-insights/
Rogers, E. M. (2003). Diffusion of innovations (5th ed.). Free Press. ISBN 978-0743222099.
Sadki, R. (2026, August 14). [Quotes from the agentic AI summit in Berkeley]. https://redasadki.me/2026/08/14/you-cannot-send-an-ai-agent-to-jail-the-scariest-quotes-from-the-agentic-ai-summit-in-berkeley/
Sarbanes-Oxley Act of 2002, Pub. L. No. 107-204, sections 102 and 104 (15 U.S.C. 7212 and 7214) (United States) (accessed 10 October 2026). https://www.law.cornell.edu/uscode/text/15/7212 ; https://www.law.cornell.edu/uscode/text/15/7214
Savva, N. (2026). Context engineering: A principal-agent theory of AI-augmented knowledge work. SSRN. https://doi.org/10.2139/ssrn.6506600
Search Engine Journal. (2026). Marketers report highest rates of AI brain fry. https://www.searchenginejournal.com/marketers-report-highest-rates-of-ai-brain-fry-report-finds/569110/
SemiAnalysis. (2026, February). Claude Code is the inflection point. https://newsletter.semianalysis.com/p/claude-code-is-the-inflection-point
Serafini, R., Otto, C., Horstmann, S. A., & Naiakshina, A. (2024). ChatGPT-resistant screening instrument for identifying non-programmers. Proceedings of the IEEE/ACM 46th International Conference on Software Engineering (ICSE 2024), 1-13. https://doi.org/10.1145/3597503.3639075
Serafini, R., Weber, N., Yardim, A., Horstmann, S. A., & Naiakshina, A. (2026). Robust methods for developer screening in rapidly evolving AI contexts. Proceedings of the 2026 CHI Conference on Human Factors in Computing Systems (CHI '26), 1-18. https://doi.org/10.1145/3772318.3790302
SF Standard. (2026, March 5). [In AI land, everyone's a builder now]. https://sfstandard.com/2026/03/05/engineer-2025-ai-land-everyone-s-builder-now/
Shao, Y., et al. (2025). Future of work with AI agents: Auditing automation and augmentation potential across the U.S. workforce. arXiv:2506.06576. https://arxiv.org/abs/2506.06576
Shapiro, D. (2026, January). The five levels: From spicy autocomplete to the software factory. https://www.danshapiro.com/blog/2026/01/the-five-levels-from-spicy-autocomplete-to-the-software-factory/
Shopifreaks. (2026a). Meta employees compete on an internal AI token leaderboard called Claudeonomics. https://www.shopifreaks.com/meta-employees-compete-on-an-internal-ai-token-leaderboard-called-claudeonomics-that-tracked-60-trillion-tokens-in-30-days/
Shopifreaks. (2026b). Meta stops grading employees on how much AI they use, dropping token counts and AI Native labels from performance reviews (reporting WIRED, 2 September 2026). https://www.shopifreaks.com/meta-stops-grading-employees-on-how-much-ai-they-use-dropping-token-counts-and-ai-native-labels-from-performance-reviews/
Shopify. (2026). AI usage (candidate guide). https://www.shopify.com/careers/candidate-guide/ai-usage
Simon, H. A. (1971). Designing organizations for an information-rich world. In M. Greenberger (Ed.), Computers, communications, and the public interest (pp. 37-72). Johns Hopkins Press.
Srinivasan, S., & Wei, V. (2026, February 12). To thrive in the AI era, companies need agent managers. Harvard Business Review. https://hbr.org/2026/02/to-thrive-in-the-ai-era-companies-need-agent-managers
Stanford Digital Economy Lab. (2026a, August 12). [Canaries in the coal mine: August 2026 update]. https://digitaleconomy.stanford.edu/news/canariesaug26/
Stanford Digital Economy Lab. (2026b, October 7). Task expansion with generative AI: Experimental evidence on middle-skilled early-career workers. https://digitaleconomy.stanford.edu/publication/task-expansion-with-generative-aiexperimental-evidence-on-middle-skilled-early-career-workers/
Stanford HAI. (2026). AI Index Report 2026, chapter 4: Economy. https://hai.stanford.edu/assets/files/ai_index_report_2026_chapter_4_economy.pdf
Startup Fortune. (2026). Guillermo Rauch says AI agents now trigger more than half of all Vercel deployments. https://startupfortune.com/guillermo-rauch-says-ai-agents-now-trigger-more-than-half-of-all-vercel-deployments/
State Street. (2026). Agentic Product Builder, Senior Associate [job posting]. https://statestreet.wd1.myworkdayjobs.com/en-US/Global/job/Agentic-Product-Builder--Sr-Associate---State-Street-Investment-Managment_R-796094
Stenberg, D. (2026, January 26). The end of the curl bug bounty. https://daniel.haxx.se/blog/2026/01/26/the-end-of-the-curl-bug-bounty/
Stripe. (2026, May 28). Solo founding is at an all-time high: Top performers have these traits in common. https://stripe.com/blog/top-solo-founder-traits
TechCrunch. (2026a, September 24). Lovable's annualized revenue crosses $600M as vibe coding takes off. https://techcrunch.com/2026/09/24/lovables-annualized-revenue-crosses-600m-as-vibe-coding-takes-off/
TechCrunch. (2026b, April 18). The App Store is booming again, and AI may be why. https://techcrunch.com/2026/04/18/the-app-store-is-booming-again-and-ai-may-be-why/
TechCrunch. (2026c, July 30). LinkedIn adds a button to report AI-generated "slop". https://techcrunch.com/2026/07/30/linkedin-adds-a-button-to-report-ai-generated-slop/
TechRepublic. (2025). [Prompt engineering jobs called obsolete]. https://www.techrepublic.com/article/news-prompt-engineering-ai-jobs-obsolete/
The Decoder. (2025, September). AI-generated workslop is costing companies millions and hurting team morale, study finds. https://the-decoder.com/ai-generated-workslop-is-costing-companies-millions-and-hurting-team-morale-study-finds/
The Decoder. (2026, July 12). LinkedIn is the undisputed king of long-form AI slop, according to a study spanning five platforms. https://the-decoder.com/linkedin-is-the-undisputed-king-of-long-form-ai-slop-according-to-a-study-spanning-five-platforms/
The geometry of learning under AI delegation. (2026). [Review of the paper]. https://www.themoonlight.io/fr/review/the-geometry-of-learning-under-ai-delegation
Tikhomirov, S. (2026, September). [The AIDEs framework: levels of delegation in software development]. JetBrains Research. https://blog.jetbrains.com/research/2026/09/aides-framework/
Tomašev, N., Franklin, M., & Osindero, S. (2026). Intelligent AI delegation. arXiv:2602.11865. https://arxiv.org/abs/2602.11865
Tray.ai. (2026). Gartner: Govern vibe coding for citizen developers with self-service platforms [Guide summarising Tyagi, 2026]. https://tray.ai/guides/gartner-govern-vibe-coding/
Turkovic, I. (2026, April 24). [AI job titles in 2026: naming chaos]. https://www.ivanturkovic.com/2026/04/24/ai-job-titles-2026-naming-chaos/
Turner, S. (2026). [An AI biosecurity uplift randomised trial by Scale AI and SecureBio]. https://blog.stephenturner.us/p/ai-biosecurity-uplift-rct
University of Lübeck, Institute for Multimedia and Interactive Systems. (2026). [The cost of convenience: decision horizons, CHI 2026]. https://www.imis.uni-luebeck.de/en/node/11007
Veracode. (2026, July 28). LLMs are getting smarter but not safer: Veracode 2026 GenAI code security report. https://www.veracode.com/news/llms-are-getting-smarter-but-not-safer-veracode-2026-genai-code-security-report-finds-ai-generated-code-security-has-stalled-at-56%25-pass-rate/
Verheul, J. (2026). The principal firm: Organisational form when the agency function is performed by machines. SSRN. https://doi.org/10.2139/ssrn.7235518
Veri', D. (2026). Beyond AI literacy: A structured review and exploratory meta-analysis of measures for competent generative-AI use. arXiv:2609.15624. https://arxiv.org/abs/2609.15624
Virk, Y., & Liu, D. (2025). Non-programmers assessing AI-generated code: A case study of business users analyzing data. VL/HCC 2025. arXiv:2508.06484. https://arxiv.org/abs/2508.06484
Wang, S. (2026). The delegation efficient frontier. SSRN. https://doi.org/10.2139/ssrn.7275801
Washington Monthly. (2026, May 29). [AI and entry-level jobs for college graduates]. https://washingtonmonthly.com/2026/05/29/ai-entry-level-jobs-college-graduates/
White House. (2025, April 23). Advancing artificial intelligence education for American youth. https://www.whitehouse.gov/presidential-actions/2025/04/advancing-artificial-intelligence-education-for-american-youth/
Willison, S. (2025a, February 3). A computer can never be held accountable. https://simonwillison.net/2025/Feb/3/a-computer-can-never-be-held-accountable/
Willison, S. (2025b, June 22). [Kent Beck on skills going to zero and up 1000x]. https://simonwillison.net/2025/Jun/22/kent-beck
Willison, S. (2026a). What is agentic engineering? https://simonwillison.net/guides/agentic-engineering-patterns/what-is-agentic-engineering/
Willison, S. (2026b, February 7). [Vouch]. https://simonwillison.net/2026/Feb/7/vouch/
Writer. (2026). [The AI agent owner]. https://writer.com/blog/ai-agent-owner/
Xinhua. (2025, September 19). [Beijing pupils build AI agents in class]. https://english.news.cn/20250919/740f7bd40ec84b69b9d983e1068a94ac/c.html
Yale Budget Lab. (2026, May 7). AI is probably not (yet) the reason for labor market weakening. https://budgetlab.yale.edu/research/ai-probably-not-yet-reason-labor-market-weakening
Yang, et al. (2026). [How people work with an autonomous search agent]. arXiv:2606.07489. https://arxiv.org/abs/2606.07489
Yegge, S. (2026). Welcome to Gas Town. https://steve-yegge.medium.com/welcome-to-gas-town-4f25ee16dd04
附录 A. 词汇表
参考小时。 一名有资质的专家手工完成一项工作所需的时间,取自冻结的任务库或来自两名不知道谁完成了该工作的独立评价者。
已验证的委托规模。 一个人定期向代理交付工作、接受结果并通过代理未见过的独立检查来确认的最大工作规模(以参考小时计)。根据第5.2节的规则按域计分。
独立检查。 隐藏的验收测试、有资质的人工审核者、预期用户的实际使用,或来自另一个系列的模型对比源进行验证,在数据、访问权限和激励方面与代理不同。自我审查和同一系列模型之间的一致性不算独立检查。
植入错误。 在交接前放入任务中的错误,该人员必须捕捉,可能是错误的条目或遗漏工作必须包含的内容。遗漏植入错误的工作不算作已验证,任何在某一阶梯窗口中的遗漏会阻止从周及更高阶梯的晋升。
放大增益。 接受的、经过验证的工作的参考小时数除以该人员在过去91天内在该域中的关注小时数,失败的工作包含在分母中,由外部帮助完成的工作从分子中排除。
增益上限。 在简化模型中,对于H参考小时的工作(其检查需要V小时的关注),放大增益G满足G ≤ H / V,即检查占手工时间份额的倒数。
阶梯。 小时(约1个参考小时)、天(约8个)、周(约40个)、月(约160个)、季度(约500个)。规则v1.1的计数和窗口:小时和天为91天内十件,周为182天内六件,月为365天内六件(其中五件经过验证),季度为365天内三件。对于周及以上,在过去91天内至少有一件该阶梯规模的已验证工作。
记录。 域 · 范围 · 放大 · 日期,例如"小企业记账 · 天 · ×2 · 2026-Q4"。
验收素养。 提前说明什么将被视为完成,然后用代理无法伪造的证据来展示的技能。
背景中立性。 假设在一个域中具有相同经过验证的范围时,一旦考虑了领域知识和验收素养,编程教育就不会预测独立检查工作的质量。
资格交叉点。 在一个域中的某个时刻,没有IT教育背景的人的产品在同样的检查下被接受,并开始超越使用相同代理的程序员的产品,之后学位要求和初级、高级标签在招聘中失去预测权重。其组成部分是质量对等(之前的步骤)、超越(时刻)、职位发布中的交叉(符号)和背景中立性(机制)。
保证人。 一个为他人的产品背书并向其圈子负责的人,以他们背书的产品数量和其中成功的数量来衡量。
完成人。 将产品交付给用户的人。
两个市场。 为自己创建(素养)和为他人工作并承担后果(职业)。
附录B. 搜索日志,2026年10月8日和9日
对名称和术语的网络检查于2026年10月8日由多个AI助手独立并行执行,于2026年10月9日由一个具有扩展网络搜索功能的助手执行。每个答案均保留完整,附带其来源。学术检查于2026年10月9日进行,具体如下。
| 数据库 | 搜索内容 | 本论文术语的结果 |
|---|---|---|
| arXiv (API) | 精确短语,所有字段 | "delegation horizon": 0; "delegation ladder"或"ladder of delegation": 0; "time span of discretion": 0 |
| Semantic Scholar | 标题和摘要 | 一个搜索返回0,另一个受到速率限制(HTTP 429);需在提交前重新执行 |
| OpenAlex | 标题、摘要、部分全文 | "credential crossover": 0; "agentwright": 仅无关匹配; "background neutrality": 无关; "acceptance literacy": 仅涉及技术接纳的工作 |
| Crossref | 元数据,包括SSRN摘要 | "principal"作为专业术语:仅出现在代理理论中 |
| Europe PMC | 开放全文 | 无精确匹配 |
| Zenodo | 记录和描述 | 任何术语均无匹配 |
| DOAJ | 开放获取期刊 | "delegation horizon": 四个无关匹配 |
| Google Scholar | 全文、SSRN | "delegation horizon": 6条,在2026年关于机器或企业的论文中使用(Khadj, 2026; Alonso, 2026); "verified delegation horizon"、"credential crossover"、"credential crossover point"和"agentwright": 0(于2026年10月9日重复搜索无误); "acceptance literacy"、"background neutrality"和"amplification gain": 仅在其他意义上有匹配 |
| DBLP; SSRN页面 | 被机器人保护阻止(DBLP)或返回403(SSRN);已通过Crossref和Scholar涵盖 |
之前的预测在Metaculus、Manifold、Good Judgment Open、Kalshi、Polymarket和Long Bets以及开放网络上进行了搜索;Metaculus和一些Gartner页面返回HTTP 403,在可用时通过存档或重印副本阅读。结果总结在第11.3节。报告遵循PRISMA 2020(Page et al., 2021)的第6项:列出每个数据库和最后访问日期。未找到的匹配项报告为在该日期未找到,对未搜索的数据库不做任何声明。
附录 C. 测量工具
本附录提供了一个研究工具、一个记录格式和一个评分器,这些都在 Python 标准库中,以 MIT 许可证发布。它阐述了第 5.2 节中的规则如何转化为代码。它不是应用程序,对任何人不作出决定,仅计算从该人或研究人员提供的记录中的两个数字。它不判断检查的选择是否恰当;它信任给定的字段。特别是,它不测试独立性。在第 5.2 节的三个条件(数据、访问和激励)中,它仅读取检查的类型以及代理是否看到了它,独立性本身由表 3 中的随机审计确认。
C1. 记录
JSON Lines 文件中的每一行对应一个分配给代理的工作片段,在该片段被接受、拒绝或被放弃时编写。交接开始的日期放在字段 started 中,这是规则 v1.1 所预期的;评分器仍然读取没有该字段的行并发出警告。未通过检查或被放弃的片段保留在日志中。
{"person": "P07", "domain": "small-business bookkeeping", "started": "2026-09-10", "date": "2026-09-14",
 "reference_hours": 8, "reference_basis": "two raters",
 "attention_minutes": 95, "mode": "stages",
 "check": "expert", "agent_saw_check": false, "passed": true,
"irreversible": false, "planted_errors": 0, "planted_missed": 0, "outside_help": false}| 字段 | 含义 |
|---|---|
| person | 一个假名标签,绝不是真实姓名 |
| domain | 接受该工作的领域 |
| date | 接受、拒绝或放弃的日期,当该行被写入时(ISO格式) |
| started | 交接开始的日期(ISO格式);根据规则v1.1的预期,不迟于date |
| reference_hours | 合格专家为整个交付物所花的手工小时数 |
| reference_basis | 参考的来源:指定的任务库或两个评定者 |
| attention_minutes | 该人员花在规划、指导、阅读、检查和修复上的分钟数 |
| mode | one_piece、stages或together(one_piece计入第5.7节的指令份额) |
| check | hidden_tests、expert、real_use、other_family_with_sources、same_family、self_review或none |
| agent_saw_check | 代理是否可以看到检查(必须为false才能计数) |
| passed | 检查是否通过(对于失败或放弃的部分为false) |
| irreversible | 此类工作中的错误是否无法撤销(此部分随后必须通过) |
| planted_errors | 在交接前在任务中植入了多少个错误 |
| planted_missed | 该人员未能捕获其中多少个(任何遗漏都使该部分未经验证,并阻止窗口中Week及以上的内容) |
| outside_help | 是否有同事或承包商在日志之外提供帮助(此类部分对增益的分子没有贡献) |
| task_id, model, tools | 可选:任务库标识符、使用的代理和模型及其工具(第5.4节) |
| checker | 可选:谁或什么运行了检查,作为角色,绝不是真实姓名 |
| rater_hours | 可选:reference_hours背后的评定者估计;如果有两个且较大的超过较小的1.5倍,评分者打印"needs third rater"(表3);如果有第三个估计,中位数决定且该标志不被打印 |
| audit | 可选:none、passed或failed,第二次独立检查的结果;失败的审计使该部分未经验证 |
| revoked | 可选:如果延迟的结果撤销了该部分(表A4),则为true;被撤销的部分未经验证 |
C2. horizon.py
以下代码实现规则v1.1,且与配套存储库中的horizon.py逐字节相同。
#!/usr/bin/env python3
"""horizon.py: score the verified delegation horizon and the amplification gain.

Teaches: how the rules of Section 5.2 turn a log of work handed to agents into a dated record
"domain . horizon . gain . quarter". Limits: it trusts the fields it is given; it does not
judge whether a check was well chosen or whether the reference hours are fair.
Usage: python3 horizon.py work-log.jsonl --as-of 2026-10-09 [--stable]   Rules v1.1   Licence: MIT
"""
import argparse
import datetime as dt
import json
import math
import sys
import statistics
from collections import Counter, defaultdict

# rung, reference hours, minimum pieces, window in days (provisional; Section 5.8)
RUNGS = [("Quarter", 500.0, 3, 365), ("Month", 160.0, 6, 365), ("Week", 40.0, 6, 182),
         ("Day", 8.0, 10, 91), ("Hour", 1.0, 10, 91)]
PLANTED_FROM = 40.0         # from Week upward a planted error must be in the window
GAIN_STEPS = [60, 20, 5, 2, 1]
GAIN_WINDOW = 91            # gain, directive share and the recent piece of upper rungs (91 days)
PASS_SHARE = 0.8            # 8 of 10; every irreversible piece must pass
INDEPENDENT = {"hidden_tests", "expert", "real_use", "other_family_with_sources"}
RATER_SPREAD = 1.5          # raters further apart than this need a third rater
CHECKS = INDEPENDENT | {"same_family", "self_review", "none"}
MODES = {"one_piece", "stages", "together"}
KEYS = {"person", "domain", "date", "reference_hours", "reference_basis",
        "attention_minutes", "mode", "check", "agent_saw_check", "passed", "irreversible",
        "planted_errors", "planted_missed", "outside_help"}
OPTIONAL = {"started",      # date the hand-over started (expected from v1.1; the line is written at close)
            "task_id", "model", "tools", "checker", "rater_hours", "audit", "revoked"}


def load(path):
    """Every piece handed to agents is a line, including failed and abandoned ones."""
    records, undated = [], 0
    with open(path, encoding="utf-8") as fh:
        for n, line in enumerate(fh, 1):
            if not line.strip():
                continue
            r = json.loads(line)
            if set(r) - OPTIONAL != KEYS:
                sys.exit(f"line {n}: unknown {sorted(set(r) - KEYS - OPTIONAL)}, missing {sorted(KEYS - set(r))}")
            if r["check"] not in CHECKS or r["mode"] not in MODES:
                sys.exit(f"line {n}: check or mode is not one of the allowed values")
            if float(r["reference_hours"]) <= 0 or float(r["attention_minutes"]) < 0:
                sys.exit(f"line {n}: reference hours must be positive, minutes not negative")
            if not 0 <= int(r["planted_missed"]) <= int(r["planted_errors"]):
                sys.exit(f"line {n}: planted_missed must lie between 0 and planted_errors")
            if not isinstance(r["outside_help"], bool) or not isinstance(r.get("revoked", False), bool):
                sys.exit(f"line {n}: outside_help and revoked must be true or false")
            if r.get("audit", "none") not in {"none", "passed", "failed"}:
                sys.exit(f"line {n}: audit must be none, passed or failed")
            if "rater_hours" in r and (len(r["rater_hours"]) < 2 or min(map(float, r["rater_hours"])) <= 0):
                sys.exit(f"line {n}: rater_hours needs two or more positive estimates")
            undated += "started" not in r
            r["date"] = dt.date.fromisoformat(r["date"])
            if "started" in r and dt.date.fromisoformat(r["started"]) > r["date"]:
                sys.exit(f"line {n}: started must not be later than date")
            records.append(r)
    if undated:
        print(f"warning: {undated} lines without started (expected from rules v1.1)", file=sys.stderr)
    return records


def verified(r):
    """A pass counts only if the check was independent, the agents never saw it, no planted error
    was missed, nobody helped off the log, no audit failed and no delayed outcome revoked it.
    Another model family alone never verifies irreversible work."""
    return (r["passed"] is True and r["check"] in INDEPENDENT and r["agent_saw_check"] is False
            and int(r["planted_missed"]) == 0 and not r["outside_help"]
            and not (r["irreversible"] and r["check"] == "other_family_with_sources")
            and r.get("audit") != "failed" and not r.get("revoked", False))


def rung_holds(pieces, hours, minimum, as_of, days):
    start = as_of - dt.timedelta(days=days)
    window = [r for r in pieces if start < r["date"] <= as_of]
    big = [r for r in window if float(r["reference_hours"]) >= hours]
    if len(big) < minimum:
        return False
    if sum(map(verified, big)) / len(big) < PASS_SHARE:
        return False
    if any(r["irreversible"] and not verified(r) for r in big):   # strict rule, these pieces only
        return False
    if hours >= PLANTED_FROM:
        if not any(int(r["planted_errors"]) > 0 for r in big):
            return False
        if any(int(r["planted_missed"]) > 0 for r in window):   # any missed planted error blocks
            return False
    if days > GAIN_WINDOW:                                       # quarterly re-verification
        recent = as_of - dt.timedelta(days=GAIN_WINDOW)
        if not any(verified(r) and r["date"] > recent for r in big):
            return False
    return True


def horizon(pieces, as_of):
    for name, hours, minimum, days in RUNGS:        # from the top rung down
        if rung_holds(pieces, hours, minimum, as_of, days):
            return name
    return "below Hour"


def rung_pieces(pieces, name, as_of):
    """Pieces of the rung's size in its window (Hour's for 'below Hour'): what the count is out of."""
    _, hours, _, days = next(r for r in RUNGS if r[0] == name or (name == "below Hour" and r[0] == "Hour"))
    return [r for r in pieces if as_of - dt.timedelta(days=days) < r["date"] <= as_of
            and float(r["reference_hours"]) >= hours]


def gain(pieces):
    done = math.fsum(float(r["reference_hours"]) for r in pieces
                     if verified(r) and not r["outside_help"])            # outside help excluded
    spent = math.fsum(float(r["attention_minutes"]) for r in pieces) / 60.0   # failures included
    return None if spent == 0 else done / spent


def step(g):
    if g is None:
        return "n/a"
    for s in GAIN_STEPS:
        if g >= s:
            return f"x{s}"
    return "below x1"


def main():
    ap = argparse.ArgumentParser()
    ap.add_argument("log")
    ap.add_argument("--as-of", default=dt.date.today().isoformat())
    ap.add_argument("--stable", action="store_true", help="also score 91 days earlier and label the rung")
    args = ap.parse_args()
    as_of = dt.date.fromisoformat(args.as_of)
    longest = max(days for *_, days in RUNGS) + (GAIN_WINDOW if args.stable else 0)
    groups = defaultdict(list)
    for r in load(args.log):
        if as_of - dt.timedelta(days=longest) < r["date"] <= as_of:
            groups[(r["person"], r["domain"])].append(r)
    quarter = f"{as_of.year}-Q{(as_of.month - 1) // 3 + 1}"
    recent_start = as_of - dt.timedelta(days=GAIN_WINDOW)
    for (person, domain), pieces in sorted(groups.items()):
        recent = [r for r in pieces if r["date"] > recent_start]
        g = gain(recent)
        shown = "n/a" if g is None else f"{g:.2f}"
        failed = sum(1 for r in recent if not verified(r))
        directive = (sum(r["mode"] == "one_piece" for r in recent) / len(recent)) if recent else 0.0
        rung = horizon(pieces, as_of)
        counted = rung_pieces(pieces, rung, as_of)
        label = ""
        if args.stable:
            before = horizon(pieces, as_of - dt.timedelta(days=GAIN_WINDOW))
            label = " stable" if before == rung else f" provisional (was {before})"
        print(f"{person}: {domain} . {rung} ({sum(map(verified, counted))}/{len(counted)}){label}"
              f" . {step(g)} . {quarter}  (pieces in last 91 days: {len(recent)}, not verified: {failed};"
              f" gain {shown}; directive share {directive:.0%})")
        kinds = Counter(r["check"] for r in counted).most_common()
        sizes = [float(r["reference_hours"]) for r in recent if r["passed"]]
        median = f"{statistics.median(sizes):.1f} h" if sizes else "n/a"
        spread = any(max(map(float, r["rater_hours"])) / min(map(float, r["rater_hours"])) > RATER_SPREAD
                     for r in pieces if len(r.get("rater_hours", [])) == 2)   # with three, the median decided
        print(f"  checks: {', '.join(f'{k} {v}' for k, v in kinds) or 'none'};"
              f" median accepted size {median}{'; needs third rater' if spread else ''}")


if __name__ == "__main__":
    main()
C3. brier.py
#!/usr/bin/env python3
"""brier.py: score dated predictions by the Brier rule.

Teaches: why one missed prediction made at 35% says little on its own, and why 'unresolved' is
never a success. Input CSV columns: id,probability,outcome (outcome: 1, 0 or unresolved).
Usage: python3 brier.py predictions.csv                                  Licence: MIT
"""
import csv
import sys


def main(path):
    resolved, pending = [], []
    with open(path, newline="", encoding="utf-8") as fh:
        for row in csv.DictReader(fh):
            p = float(row["probability"])
            if not 0.0 <= p <= 1.0:
                sys.exit(f"{row['id']}: probability must lie between 0 and 1")
            outcome = row["outcome"].strip().lower()
            if outcome in ("0", "1"):
                resolved.append((row["id"], p, int(outcome)))
            else:
                pending.append(row["id"])
    for pid, p, o in resolved:
        print(f"{pid}: p={p:.2f} outcome={o} score={(p - o) ** 2:.3f}")
    if resolved:
        mean = sum((p - o) ** 2 for _, p, o in resolved) / len(resolved)
        print(f"Brier score over {len(resolved)} resolved: {mean:.3f} (always saying 0.5 gives 0.250)")
    print("unresolved or not yet due: " + (", ".join(pending) or "none"))


if __name__ == "__main__":
    main(sys.argv[1])
C4. 实例
下列日志包含十项簿记工作,由一人于2026年7月至9月间转交给代理。
{"person": "P07", "domain": "small-business bookkeeping", "started": "2026-07-17", "date": "2026-07-20", "reference_hours": 9, "reference_basis": "two raters", "attention_minutes": 95, "mode": "stages", "check": "expert", "agent_saw_check": false, "passed": true, "irreversible": false, "planted_errors": 0, "planted_missed": 0, "outside_help": false}
{"person": "P07", "domain": "small-business bookkeeping", "started": "2026-07-24", "date": "2026-07-28", "reference_hours": 8, "reference_basis": "two raters", "attention_minutes": 80, "mode": "stages", "check": "hidden_tests", "agent_saw_check": false, "passed": true, "irreversible": false, "planted_errors": 0, "planted_missed": 0, "outside_help": false}
{"person": "P07", "domain": "small-business bookkeeping", "started": "2026-07-29", "date": "2026-08-04", "reference_hours": 12, "reference_basis": "two raters", "attention_minutes": 150, "mode": "one_piece", "check": "expert", "agent_saw_check": false, "passed": true, "irreversible": false, "planted_errors": 0, "planted_missed": 0, "outside_help": false}
{"person": "P07", "domain": "small-business bookkeeping", "started": "2026-08-09", "date": "2026-08-11", "reference_hours": 8, "reference_basis": "two raters", "attention_minutes": 70, "mode": "stages", "check": "self_review", "agent_saw_check": false, "passed": true, "irreversible": false, "planted_errors": 0, "planted_missed": 0, "outside_help": false}
{"person": "P07", "domain": "small-business bookkeeping", "started": "2026-08-13", "date": "2026-08-18", "reference_hours": 10, "reference_basis": "two raters", "attention_minutes": 110, "mode": "together", "check": "real_use", "agent_saw_check": false, "passed": true, "irreversible": false, "planted_errors": 0, "planted_missed": 0, "outside_help": false}
{"person": "P07", "domain": "small-business bookkeeping", "started": "2026-08-21", "date": "2026-08-25", "reference_hours": 8, "reference_basis": "two raters", "attention_minutes": 120, "mode": "stages", "check": "expert", "agent_saw_check": false, "passed": false, "irreversible": false, "planted_errors": 0, "planted_missed": 0, "outside_help": false}
{"person": "P07", "domain": "small-business bookkeeping", "started": "2026-08-24", "date": "2026-09-01", "reference_hours": 16, "reference_basis": "two raters", "attention_minutes": 180, "mode": "one_piece", "check": "hidden_tests", "agent_saw_check": false, "passed": true, "irreversible": false, "planted_errors": 0, "planted_missed": 0, "outside_help": false}
{"person": "P07", "domain": "small-business bookkeeping", "started": "2026-09-05", "date": "2026-09-08", "reference_hours": 8, "reference_basis": "two raters", "attention_minutes": 60, "mode": "stages", "check": "expert", "agent_saw_check": false, "passed": true, "irreversible": true, "planted_errors": 0, "planted_missed": 0, "outside_help": false}
{"person": "P07", "domain": "small-business bookkeeping", "started": "2026-09-11", "date": "2026-09-15", "reference_hours": 9, "reference_basis": "two raters", "attention_minutes": 90, "mode": "together", "check": "other_family_with_sources", "agent_saw_check": false, "passed": true, "irreversible": false, "planted_errors": 0, "planted_missed": 0, "outside_help": false}
{"person": "P07", "domain": "small-business bookkeeping", "started": "2026-09-27", "date": "2026-09-29", "reference_hours": 8, "reference_basis": "two raters", "attention_minutes": 75, "mode": "stages", "check": "hidden_tests", "agent_saw_check": false, "passed": true, "irreversible": false, "planted_errors": 0, "planted_missed": 0, "outside_help": false}
运行 python3 horizon.py work-log.jsonl --as-of 2026-10-09 输出记录和关于其背后检查的一行:
P07: small-business bookkeeping . Day (8/10) . x2 . 2026-Q4  (pieces in last 91 days: 10, not verified: 2; gain 4.66; directive share 20%)
  checks: expert 4, hidden_tests 3, self_review 1, real_use 1, other_family_with_sources 1; median accepted size 9.0 h
所有十件作品都至少有8个参考小时。其中两件不被计为已验证:一件仅通过自评审进行了检查,另一件未能通过专家检查。十件中的八件正好是Day要求的份额,那一件不可逆转的作品通过了,所以等级是Day。Week无法达到,因为没有作品达到40小时。已验证的作品总计80个参考小时,对比在所有十件作品上花费的1,030分钟(约17.2小时)的关注,包括失败的作品,这给出了4.66的收益和×2的步长。没有作品携带植入的错误或外部帮助,所以这两条规则都不改变结果。如果失败的作品被排除在日志之外,等级将依赖于九件作品,并且会不满足十件的计数,这就是为什么失败应该记录在案。等级旁边的计数8/10显示了判决有多接近(附录E),第二行给出了计数作品背后的检查类型和中位数接受的大小(9.0小时),这样读者就可以看到地平线是否依赖于刚好在阈值以上的作品(表3)。该人的关注(1,030分钟)约占移交的96个参考小时的18%,约占已验证的80个的21%。简历上的记录是"small-business bookkeeping · Day · ×2 · 2026-Q4"。
配套工具tools/explain.py从相同的规则中打印出相同判决背后的原因。十件Day大小的作品中有八件被验证,需要八件,这个计数与44%到97%之间任何真实通过率一致(第5.8节),所以不能再吸收该大小的失败作品。如果没有新的日志记录,Day将保持到2026年10月18日;在10月19日,7月20日关闭的作品离开91天窗口,Day大小的作品剩余九件,少于Day所需的十件。对于Week,它列出了仍然缺少的每个条件:182天内至少40小时的六件作品,其中一件有植入的错误,一件在最后91天内被验证。
构造的日志还携带了表3命名的跟踪:其十件作品中的五件被评为恰好8小时(Day的下限),tools/too_clean.py将其标记为"audit first",并附上跟踪信息"5 of 10 pieces sit just above a rung threshold"。一个标记将日志发送到审计,但对其不做任何决定;等级旁边的9.0小时中位数向读者显示同样的内容。
C5. 配套仓库
配套仓库(https://github.com/vadimchernets/delegation-horizon)包含了允许读者使用论文各部分的工具和材料。主要文件,按部分:
| 部分 | 文件 | 功能 |
|---|---|---|
| 5.2, C1 to C4 | horizon.py, log.schema.json, examples/ |
评分器、一条日志行的模式、已解决的示例及其必须打印的行 |
| 5.2, 5.3 | tools/log_piece.py, record_card.py, checker.html |
通过回答问题来写日志、一张记录卡显示等级背后的计数,以及离线浏览器页面中的相同评分;两者都读取以逗号或分号保存的电子表格 |
| 5.2, 5.8, C4 | tools/explain.py |
日志为什么获得其等级:每个条件的成立或失败、松弛度、如果未记录新日志等级失效的日期,以及下一个等级需要什么 |
| 5.1 | tools/reference_hours.py, kits/reference-hours-raters.md |
来自评审者估计的参考小时,以及如何选择、接纳和简短介绍评审者 |
| 5.8, Table 3 | audit_sample.py, tools/too_clean.py, tools/planted.py, kits/ |
可重现的审计样本、标记看起来太干净的日志、在移交前密封并按类型评分的植入错误(错误条目或遗漏)、审计和植入错误指南 |
| 6.2, 10.3 | tools/verify_record.py |
可移植记录的接收端:与其一起发送的日志是否是被评分的文件、评分者是否相同,以及重新评分是否给出相同的记录(逐字段) |
| 6.2 | kits/trade-screen.md, tools/gate_leak.py |
通过行业问题而不是标签来接纳人员,以及标签泄露的程度,具有精确的区间(附录G2中的11/60:9.5%至30.4%) |
| 6.5, 10.5 | kits/checking-process.md, kits/process-vs-experience-study.md, tools/process_study.py |
第6.5节的四个步骤及每个步骤在规则下的收益(图A4),以及第10.5节作为注册协议的比较,及其分析、错误条目和遗漏分开 |
| 5.8, Appendix E | pilot/ |
阈值的桌面测试、30个任务库、包含其注册文本和同意表单的校准协议 |
| Appendix G2 | pilot/ |
在OSF上提交的已注册分析human_raters.py、Prolific导出的转换、使用已注册函数打印表G2的脚本、筛选的比较以及运行它们的合成导出 |
| 7.2 | templates/, tools/guarantor_record.py |
任务库的任务卡、担保人账本,以及从中计算的担保人记录:担保的产品、有多少存活6个月和12个月、按严重性分类的失败 |
| 11, Tables 4 and A6, C3 | predictions/, brier.py, tools/power.py |
已注册的41个预测、其哈希清单在OSF上提交、解决规则和文件、评分工具,这些工具记录未进行的Set B预测,并报告Brier分数(既不包括它,也包括将其评为错误的(第11.2节))以及第11.2节的样本大小 |
| 11, Set B | predictions/set_b.py |
在间隔上书写的九个Set B预测的冻结的真实和不真实规则,应用于研究的估计 |
| 11.4, F27 | kits/f27-sample.md, tools/freeze_sample.py, tools/liveness.py |
F27样本的协议和抽签(关闭的池先注册,密钥之后从公开随机性信标中获取),在Zenodo上冻结并在2026年12月31日前在OSF上注册其哈希,以及其在每个评分日期的生动性(根据F27的措辞) |
| C2 to C4, Tables 4 and A6 | tools/paper_sync.py |
针对存储库检查此文本:列表的逐字节对比、已解决的示例及其输出、预测表、集合的计数、每个命名文件和每个嵌入的图表 |
| 附录D、附录F | figures/ |
根据预测表绘制图A1、根据评分器规则绘制图A4的脚本 |
按读者分类的相同文件:
| 读者 | 初始 | 提供内容 |
|---|---|---|
| 向代理人分配工作的人 | templates/work-log.csv, record_card.py or checker.html, tools/explain.py |
保存在电子表格中的日志、记录及其卡片,以及下一步所需的内容 |
| 雇主或人力资源团队 | kits/hiring-test/, kits/trade-screen.md, kits/scope-statement.md, tools/explain.py |
由盲评员进行的有偿一日工作测试、用行业问题代替标签、某个等级所说和未说的内容,以及候选人的判决有多接近 |
| 行业新手 | kits/checking-process.md, kits/acceptance-card.md, kits/planted-errors-guide.md |
第6.5节的步骤及其收益、交接前声明"已完成",以及对植入遗漏的练习 |
| 审计员或担保人 | audit_sample.py, tools/too_clean.py, tools/planted.py, kits/audit-checklist.md |
要再次检查的样本、看起来过于干净的日志痕迹、其密封显示列表是否已更改的植入错误 |
| 研究人员 | pilot/, kits/matched-task-study.md, kits/process-vs-experience-study.md, tools/power.py, predictions/ |
桌面测试、评分员研究及其脚本、比较协议、样本量,以及带有记分卡工具的注册预测 |
附录D。预测的注册文本(OSF)
标题。 关于通过AI代理进行工作的定期预测,2026至2031年:冻结预测和年度评分。
类型。 开放式注册,立即公开,无禁期。
摘要。 本注册冻结了《After the Programmer Divide: One Measure for People Who Build Through AI Agents》(SSRN 7589918;Zenodo DOI 10.5281/zenodo.23267266)中陈述的定期预测。附表为每项预测提供:其措辞;其度量;一个公共来源和一个备用来源;2025或2026年基线及访问日期和存档快照;检查日期和最终日期;在本注册日期固定的概率;以及三种结果的阈值:成立、不成立、未解决。
评分。 每项预测在其检查日期当日或之后的第一次年度检查时进行评分,前提是数据存在,且不晚于其最终日期。已解决的预测根据Brier规则进行评分。在其最终日期前没有可比数据的预测被记录为未解决,不计为成功。
集合和概率。 集合A从公共数据和predictions/resolve/中的文件解决,其SHA-256哈希值在本注册中列出。集合B仅从在数据收集前单独注册的研究中解决;未在2027年6月30日前注册协议的集合B预测被记录为未实施,作为测试计划的失败;Brier得分既报告已解决的预测,也将每项未实施的预测评分为错误。概率以解决为条件。它们是2026年10月9日收集的三个盲目模型预测的中位数(Claude Opus、OpenAI模型和Gemini),由作者采纳;早期四个模型的汇聚预测附件仅供参考。
交叉点。 F2、F3、F5和F7在相同命名的领域中测量:小企业簿记以及法律和营销文件,任务库的两个非软件领域(附录E);对于F5的职位类比,它们映射到SOC 43-3031、23-2011和13-1161。第三个库领域,小型内部网络工具,是程序员的主要领域,不是交叉领域。领域中的交叉点是F3和F5的领域类似物在同一命名领域中都满足的第一年;单独任何一个都不能宣布它。
评分补充。 每个记分卡还报告已解决的份额、按集合和按家族的Brier得分、对逾期未解决预测评分为错误的最坏界限,以及针对0.5、汇聚的模型预测器和市场价格的Brier技能得分。
年度检查。 从2027年至2031年,每年在本注册周年纪念日,作者发布涵盖此处注册的每项预测的记分卡。每个记分卡本身在OSF上注册,通过DOI链接到本注册,并存放在Zenodo上。
固定规则。 不删除、改述或给予预测新日期。稍后添加的任何内容都单独注册并带有其自己的日期。如果命名来源停止发布或改变其方法,则使用备用来源,前提是它测量相同的数量;如果不存在可比来源,则预测未解决。
独立检查。 每个记分卡都由来自至少两个不同家族的模型根据此处冻结的规则进行检查。如果他们不同意,规则决定并报告分歧。由作者在第一个记分卡之前命名的人类仲裁者决定两个模型家族之间的争议。
自有数据。 依赖于作者队列数据的预测仅在收集这些数据之前提交的单独预注册下进行测试,如在OSF注册的计划(DOI 10.17605/OSF.IO/X4EGQ)为每个队列所做的那样。
竞争利益。 如论文中所声明。
文件。 预测表(CSV和附加论文的表A6);存档快照列表;predictions/resolve/(冻结的查询、列表和代码簿,带有哈希);resolution-rules.md;changelog-v1-v2.md。
附加的预测表是表A6,图A1绘制其日历。
图A1。 2026至2031年的检查日历。
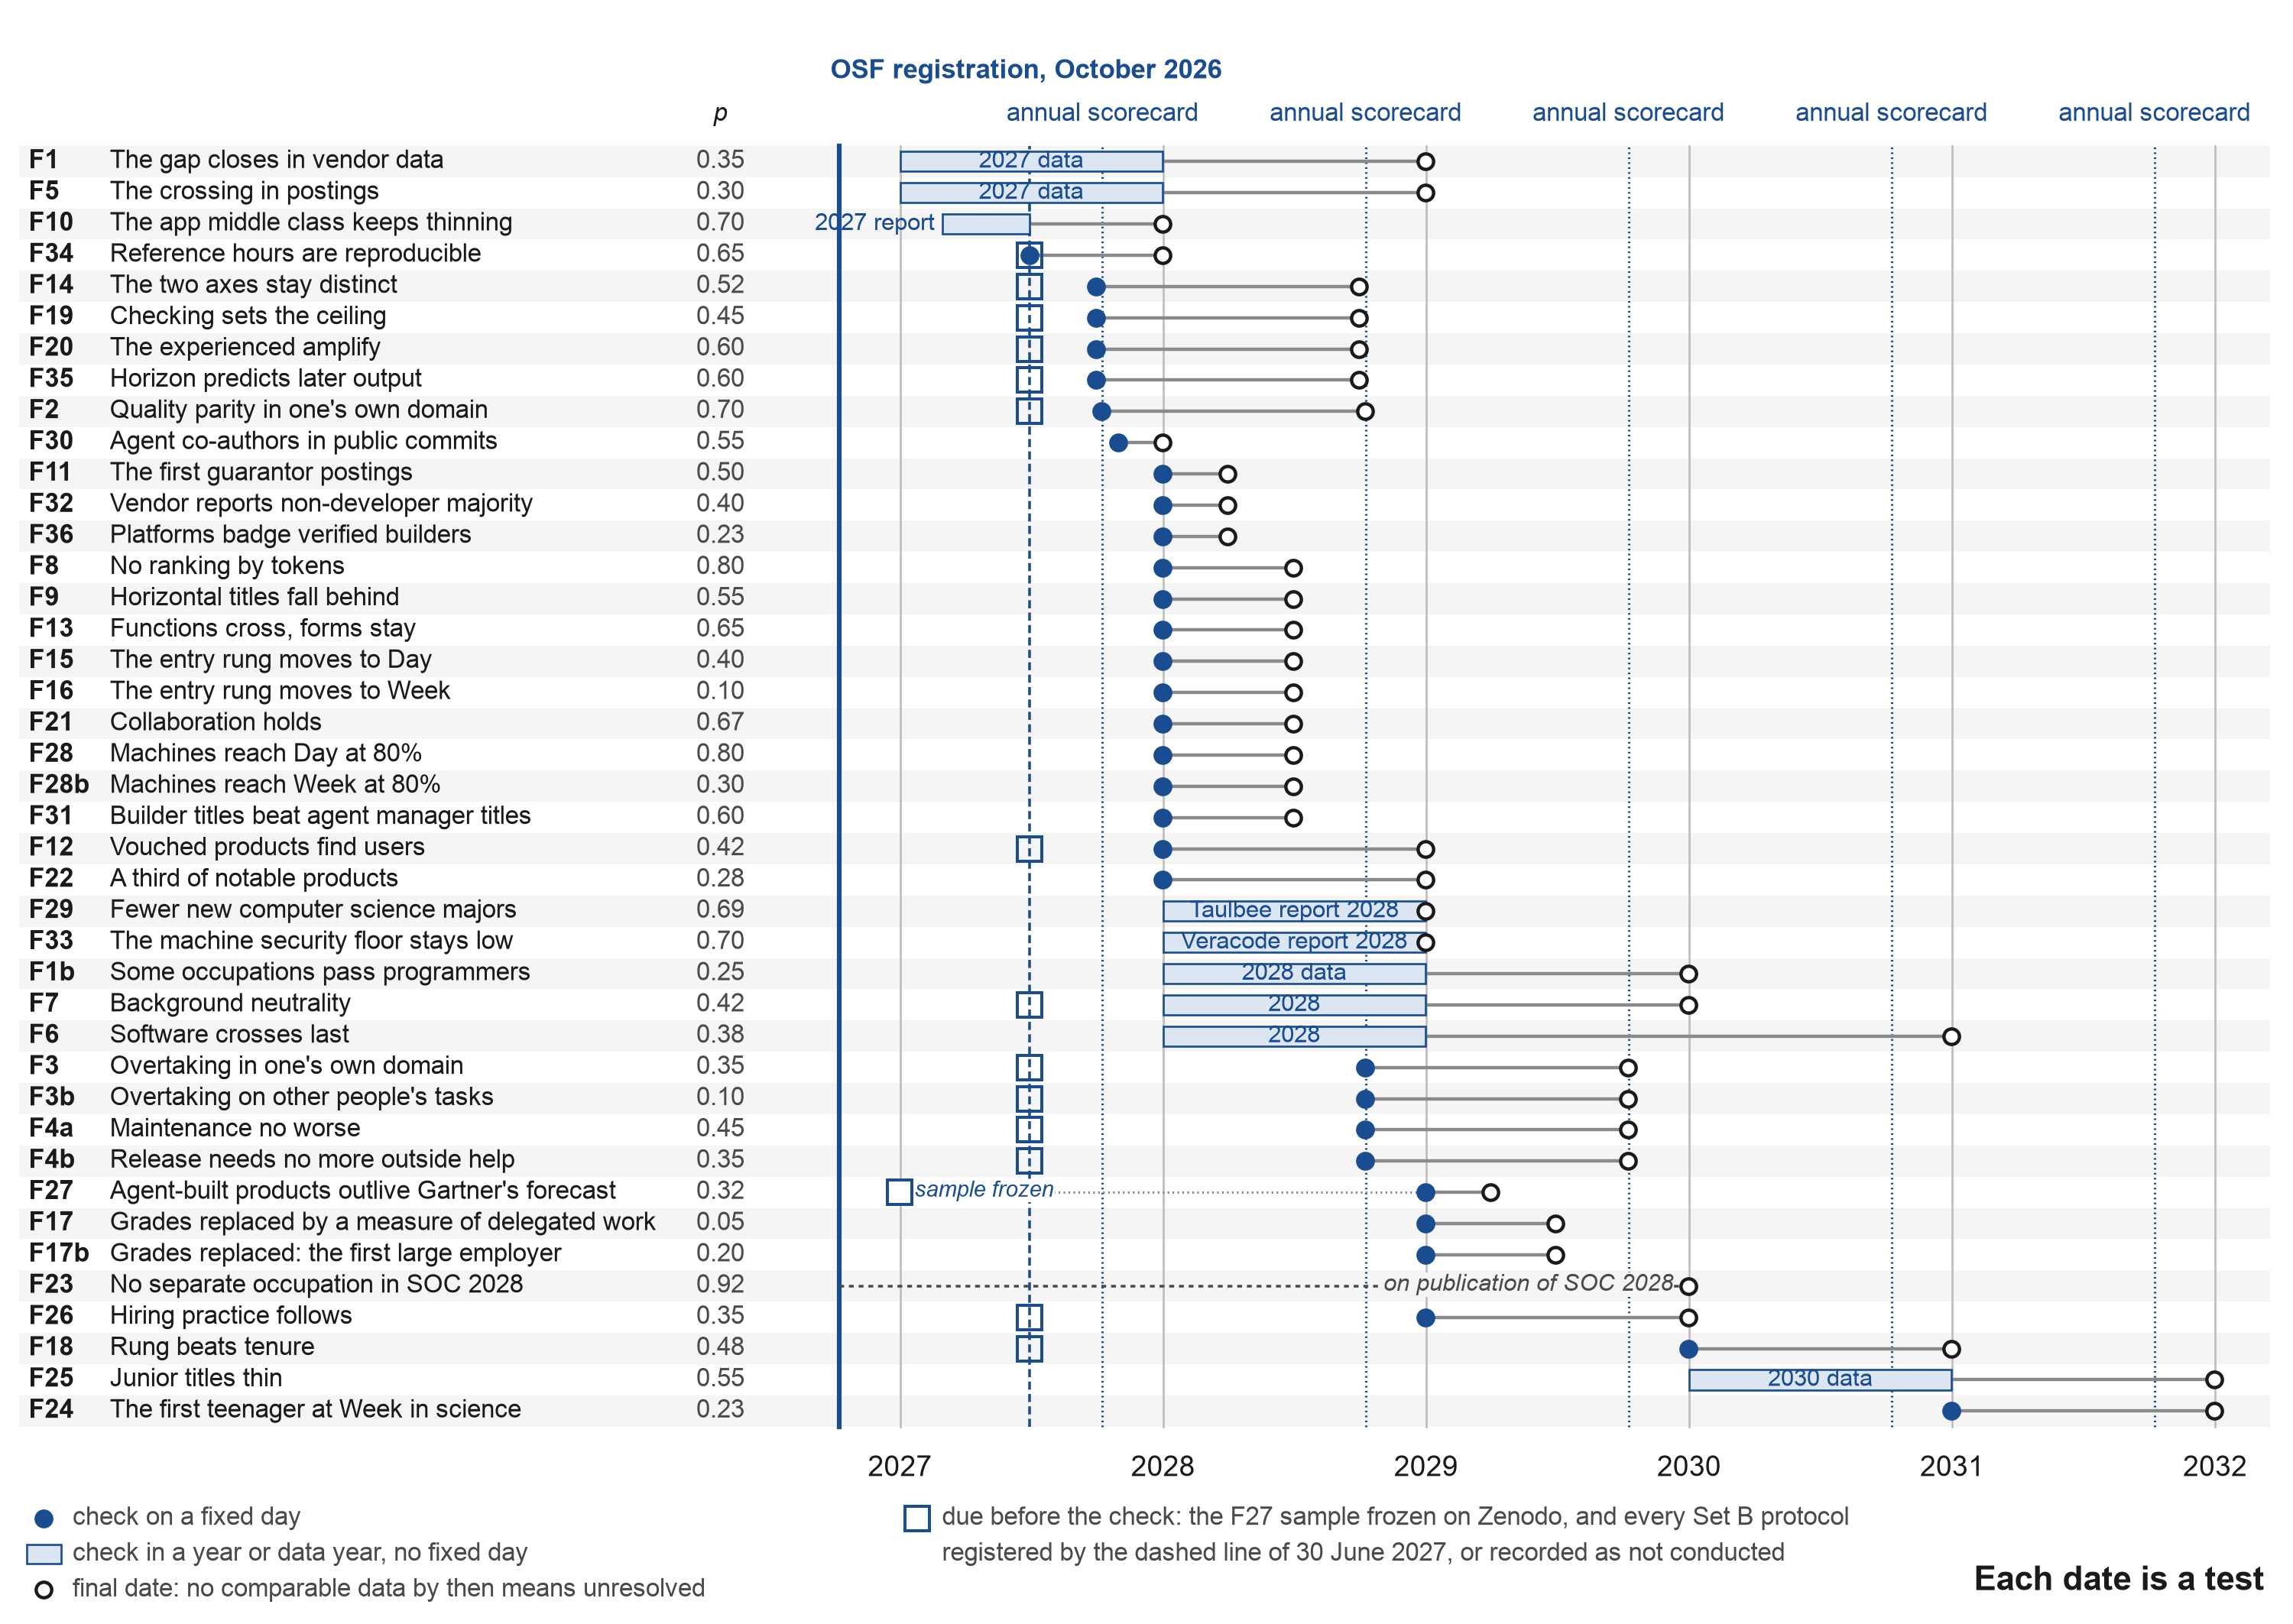
注:表A6的每项预测一行,按检查日期排序,并标注其概率。填充的点是在固定日期的检查。浅色条是在一年内或没有固定日期的数据年的检查。环是最终日期,之后没有可比数据的预测被记录为未解决(第11.4节)。虚线标记年度记分卡,从2027年至2031年每年10月在OSF上注册。空心方块标记在检查前到期的承诺:F27样本,在2026年12月31日前冻结于Zenodo,以及在2027年6月30日的虚线上,14项集合B研究中每项的协议,没有它预测被记录为未实施(第11.2节)。该图是从预测表本身生成的,由伴随存储库中的figures/figure_a1_calendar.py生成,并仅随之改变。
表A6。 全部41项定期预测:集合、度量、阈值、概率、模型预测、备用和先前预测。
| #(集合) | 预测、度量、基线和阈值 | 日期、概率、模型预测、未解决规则、备用和先前预测 |
|---|---|---|
| F1(A) | 供应商数据中的差距缩小。 在代码生成会话中验证的成功,编程与其他职业相比:34%对29%,七个月不变(Anthropic,2026e)。差距是编程职业的成功率减去其他职业的成功率,带有其符号。如果差距在2027年数据的可比报告中为2点或更少(包括负值),则成立;否则不成立。基线:在代码生成会话中验证的成功:编程34%对其他职业29%,七个月不变(Anthropic,2026e) | 检验:2027年数据。最终日期:2028年12月31日。p = 0.35;模型0.39 (0.25 至 0.65)。未解决情况:到最终日期没有2027年数据报告,或会话定义改变(从不计为成功)。备选方案:任何供应商报告显示按职业在可比较会话中有验证过的成功。最接近的先前或相反预测:Anthropic:该差距"既未扩大也未缩小" |
| F1b (A) | 某些职业超越程序员。测量方法与F1相同。10个最大的非编程职业在注册时被冻结为Anthropic中会话份额最大的10个职业(2026e)。只有当某一职业的成功率高于编程职业2个百分点或以上时,该职业才超越编程(对10次比较的多重性进行修正)。如果在2028年数据中至少有3个职业这样做,则预测成真。基线:如F1;管理职位已经略高于编程(Anthropic,2026e) | 检验:2028年数据。最终日期:2029年12月31日。p = 0.25;模型0.30 (0.20 至 0.45)。未解决情况:到最终日期没有2028年数据报告,或会话定义改变(从不计为成功)。备选方案:如F1。最接近的先前或相反预测:管理职位已经略高于编程(Anthropic,2026e) |
| F2 (B) | 自己领域内的质量平价(交叉点前的一步)。相同代理,相同时间,盲评和安全检查,一个月后由另一代理进行维护更改;每组1,500人的一项研究。如果(无IT教育的人减去程序员)的95%置信区间下界高于负10个百分点,则预测成真;如果上界低于负10,则预测不成真;否则未解决。基线:无公开基线;单独预注册研究,每组1,500人 | 检验:2027年10月8日。最终日期:2028年10月8日。p = 0.70;模型0.67 (0.62 至 0.70)。未解决情况:到最终日期无可比较数据,或不符合任何规则的置信区间(从不计为成功)。备选方案:具有相同设计的独立研究。最接近的先前或相反预测:D. H. Hansson (2026),"100%" (无日期,无测量);Esnaola等人(2026) |
| F3 (B) | 在自己的领域中超越(质量的交叉点)。如F2 (每组1,500人可以以双侧alpha = 0.05的显著性水平检测到5个百分点的真实优势的功效约为0.8;每组400人的功效约为0.3)。如果95%置信区间下界高于零,则预测成真;如果上界低于零,则预测不成真;否则未解决。基线:如F2 | 检验:2028年10月8日。最终日期:2029年10月8日。p = 0.35;模型0.33 (0.25 至 0.55)。未解决情况:到最终日期无可比较数据,或不符合任何规则的置信区间(从不计为成功)。备选方案:如F2。最接近的先前或相反预测:未发现带有日期的预测 |
| F3b (B) | 在他人的任务上超越。如F3,但在参与者自己领域之外的任务上。基线:如F2,在参与者自己领域之外的任务上 | 检验:2028年10月8日。最终日期:2029年10月8日。p = 0.10;模型0.13 (0.07 至 0.35)。未解决情况:到最终日期无可比较数据,或不符合任何规则的置信区间(从不计为成功)。备选方案:如F2。最接近的先前或相反预测:第6.3节的领域论证预测其会失败 |
| F4a (B) | 维护不更差。按作者教育背景划分,12个月内被放弃的已接受产品的份额。如果非程序员减去程序员的差异的95%置信区间上界低于10个百分点,则预测成真。基线:无公开基线;Gartner (Tyagi, 2026,由Tray.ai, 2026总结)预期到2028年60%的直观编码应用程序退役,计算所有应用程序 | 检验:2028年10月8日。最终日期:2029年10月8日。p = 0.45;模型0.49 (0.34 至 0.68)。未解决情况:到最终日期无可比较数据,或不符合任何规则的置信区间(从不计为成功)。备选方案:包含作者调查的产品登记。最接近的先前或相反预测:Gartner (Tyagi, 2026,由Tray.ai, 2026总结):到2028年60%的直观编码应用程序退役"因为它们未能提供可预测的商业价值";比F4a涵盖范围更广,后者仅计算已接受的产品 |
| F4b (B) | 发布不再需要外部帮助。在发布时需要外部技术帮助的产品份额。如果在10个百分点的差距内非劣效,则预测成真;该差距预期在原型、发布、维护的顺序中逐步缩小。基线:无公开基线 | 检验:2028年10月8日。最终日期:2029年10月8日。p = 0.35;模型0.37 (0.22 至 0.50)。未解决情况:到最终日期无可比较数据,或不符合任何规则的置信区间(从不计为成功)。备选方案:如F4a。最接近的先前或相反预测:Gartner (Tyagi, 2026,由Tray.ai, 2026总结):30%的软件工程团队面临"重大产能压力",维护由公民开发者和业务用户构建的直观编码应用程序 |
| F5 (A) | 招聘信息中的交叉(显示的迹象)。美国IT职业固定集合中的招聘信息;代理技能由Lightcast Open Skills分类法在注册日期当前的发布版本定义(版本号记录在predictions/resolve/F5.md中),包括代理技能的固定列表;在具有这些技能的招聘信息和不具有这些技能的招聘信息中需要四年制学位的份额,在职业(SOC 6位数字)、资历、州和季度上精确匹配。代理基线(2026年Q2和Q3)在注册前获取并存档。如果在2027年连续两个季度中差异为负2个百分点或更多,且95%置信区间排除零,则预测成真。基线:AI招聘信息仍然更可能需要学位但自2024年以来趋势收敛(Lightcast, 2026b);代理基线在注册前获取 | 检验:2027年数据。最终日期:2028年12月31日。p = 0.30;模型0.34 (0.25 至 0.60)。未解决情况:到最终日期无可比较数据(从不计为成功)。备选方案:PwC AI Jobs Barometer,仅当其报告具有代理技能的招聘信息和匹配招聘信息的学位要求时;否则未解决。最接近的先前或相反预测:Gartner (2021):到2024年大多数技术产品在IT外部构建;Bone等人(2025)关于英国招聘信息中的AI技能 |
| F6 (A) | 软件最后跨越。 冻结的领域列表:法律、会计与簿记、教育、诊所管理、营销、房地产、保险、人力资源、物流、软件开发、IT基础设施、安全、开发者工具。按领域第一个F5类型跨越的顺序。如果软件开发、基础设施、安全和开发者工具都在至少一半的其他领域之后跨越,则成立。基线:尚无任何领域跨越(F5类型比较) | 检查:2028年。最终日期:2030年12月31日。p = 0.38;模型0.37(0.25至0.55)。未解决条件:到最终日期时,冻结列表上不到一半的非软件领域已跨越,或没有可比较的源(从不算作成功)。备用方案:具有相同F5类型按领域比较的另一个发布源;质量研究(F2类型)不计算,没有这样的源则预测未解决。最接近的先前或反向预测:Hwang(2026):金融"煤矿中的金丝雀" |
| F7 (B) | 背景中立性。 单独注册的队列,包含关于IT教育的问题;水平在一个任务集评分,质量在保留的任务上评分。在相同水平处,与IT教育相关的通过独立检查的比值比,控制领域掌握和接受素养。0.67至1.5的范围代表任一方向的1.5倍比值比,约0.22的标准化差异(Chinn转换),按惯例是小效应。如果90%区间在0.67至1.5范围内(等价性),分别在日级和周级及以上成立。基线:无公开基线;单独注册的队列,包含关于IT教育的问题 | 检查:2028年。最终日期:2029年12月31日。p = 0.42;模型0.43(0.40至0.48)。未解决条件:任何其他组合,包括等价性仅在一个水平显示,或到最终日期无数据(从不算作成功)。备用方案:一个具有相同项目的独立队列。最接近的先前或反向预测:Anthropic对领域掌握的观察;Savva(2026),反方 |
| F8 (A) | 不按token排名。 财富500强雇主在2027年间使用token计数作为官方评估标准,由雇主或两个独立媒体渠道记录(关于AI使用的问题不计数)。如果找到少于两个这样的雇主,则成立。基线:Token计数在2026年作为评估标准进行了尝试(论文第4部分) | 检查:2027年12月31日。最终日期:2028年6月30日。p = 0.80;模型0.79(0.60至0.90)。未解决条件:到最终日期无可比数据(从不算作成功)。备用方案:在商业媒体档案中搜索predictions/resolve/F8.md中的冻结查询。最接近的先前或反向预测:Kingy AI(2026):"降级,未被淘汰";Flowtivity(2026):"不可逆的" |
| F9 (A) | 水平头衔落后。 美国招聘发布,相同冻结查询(predictions/resolve/F9.md),2026年Q4和2027年Q4,每个计数除以同季度的所有美国招聘发布:代理经理、AI操作员、AI协调员与命名领域的头衔相对(例如"法律AI负责人"、"垂直AI负责人")。如果领域命名头衔的归一化份额增长因子大于水平头衔的增长因子,则成立。基线:2026年Q4冻结查询上的美国招聘发布计数 | 检查:2027年12月31日。最终日期:2028年6月30日。p = 0.55;模型0.58(0.45至0.75)。未解决条件:任一族群在2026年Q4的招聘发布少于50条,或到最终日期无数据(从不算作成功)。备用方案:使用相同查询的Indeed或LinkedIn搜索计数。最接近的先前或反向预测:Srinivasan和Wei(2026):"代理经理"在12至18个月内成为标准头衔;IT Brew(2026):"接下来的18个月" |
| F10 (A) | 应用中产阶级继续萎缩。 新订阅应用在两年内达到月收入$1,000的份额,与RevenueCat 2026相同的测量方法(17%)。如果低于17%,则成立。基线:17%的新订阅应用在两年内达到月收入$1,000(RevenueCat,2026) | 检查:RevenueCat 2027报告。最终日期:2027年12月31日。p = 0.70;模型0.68(0.60至0.80)。未解决条件:到最终日期无可比数据(从不算作成功)。备用方案:Sensor Tower或Appfigures收入阈值。最接近的先前或反向预测:RevenueCat自身趋势(未声称优先级);许多氛围导向的应用从广告获益,这是RevenueCat看不到的 |
| F11 (A) | 第一批担保人招聘发布。 由超过1,000名员工的雇主在医学、法律、金融或教育领域发布的招聘,明确指出签署AI生成工作和对其个人责任。predictions/resolve/F11.md中的冻结查询为:"签署同意"加"AI生成的"、"对AI输出负责"、"AI证明"、"AI担保人";其中"担保人"或"凭据"指密钥或访问权限的招聘被排除。如果找到并存档了来自至少5个雇主的至少10个这样的招聘,则成立。基线:截至撰写时未找到这样的招聘 | 检查:2027年12月31日。最终日期:2028年3月31日。p = 0.50;模型0.42(0.25至0.55)。未解决条件:到最终日期无可比数据(从不算作成功)。备用方案:通过Google Jobs和LinkedIn找到的存档招聘。最接近的先前或反向预测:Capps(2025),"法律担保人";Forrester(2025):财富100强的60%将任命AI治理负责人 |
| F12 (B) | 经担保的产品找到用户。 自有随机研究:在符合条件的产品中,随机分配一个指定的担保人。在90天内达到十个无关用户的份额。如果经担保的份额更高,且95%区间不包括零,则成立。基线:无公开基线;自有随机研究 | 检查:2027年12月31日。最终日期:2028年12月31日。p = 0.42;模型0.43(0.30至0.60)。未解决条件:到最终日期无可比数据(从不算作成功)。备用方案:无。最接近的先前或反向预测:Hashimoto's Vouch(一个机制,而不是预测) |
| F13 (A) | 功能跨越,形式保留。 三个非IT专业的课程和帖子,由两个编码员编码,使用在编码前发布的编码簿(predictions/resolve/F13-codebook.md):检查、按成本的模型选择和长期运行的教学;个人支出和模型阵营仅在顶层用户中找到。如果功能性话题比状态话题至少多三倍,则成立。基线:无公开基线;两个编码员对三个非IT专业的课程和帖子编码 | 检查:2027年12月31日。最终日期:2028年6月30日。p = 0.65;模型0.69(0.55至0.82)。未解决如果:最终日期前无可比数据(从不计为成功)。备选方案:公共课程目录。最接近的先前或反向预测:Rogers (2003),采纳层(不要求优先级) |
| F14 (B) | 两个轴保持不同。 至少200条日志中人员级别的log horizon与log gain之间的Spearman相关系数。如果相关系数为0.8或以下,且增益加上地平线会在六个月后使验证输出的样本外R平方提高至少0.02,则成立。基准:无公开基准;至少200条日志 | 检查:2027年9月30日。最终日期:2028年9月30日。p = 0.52;模型0.49(0.45至0.50)。未解决如果:最终日期前无可比数据(从不计为成功)。备选方案:无。最接近的先前或反向预测:未发现 |
| F15 (A) | 进入等级转向Day。 在冻结的包含200个美国入门级职位发布和软件及其他三个行业带回家任务的样本中,由两名评分者按参考小时数评级的中位数首次分配处于Day或以上。基准:冻结的200个美国入门级职位发布和带回家任务样本,由两名评分者按参考小时数评级 | 检查:2027年12月31日。最终日期:2028年6月30日。p = 0.40;模型0.49(0.30至0.70)。未解决如果:最终日期前无可比数据(从不计为成功)。备选方案:Indeed Hiring Lab入门级样本。最接近的先前或反向预测:Washington Monthly (2026):"入门级职位正变得更像中级职位";METR的拟合地平线趋势约每4.2个月翻倍 |
| F16 (A) | 进入等级转向Week。 相同指标;中位数为Week或以上。基准:同F15 | 检查:2027年12月31日。最终日期:2028年6月30日。p = 0.10;模型0.14(0.06至0.40)。未解决如果:最终日期前无可比数据(从不计为成功)。备选方案:同F15。最接近的先前或反向预测:Kwa et al. (2025),机器时间地平线(机器,而非人类) |
| F17 (A) | 等级被委派工作衡量所取代。 在50个最大的美国雇主中,那些公开将等级阶梯替换为验证委派工作衡量的雇主。如果至少10个则成立。基准:无公开基准 | 检查:2028年12月31日。最终日期:2029年6月30日。p = 0.05;模型0.05(0.02至0.20)。未解决如果:最终日期前无可比数据(从不计为成功)。备选方案:雇主备案和新闻。最接近的先前或反向预测:Gartner (2024):至2026年,20%的组织将使用人工智能扁平化结构;Microsoft (2025):"agent boss" |
| F17b (A) | 等级被取代:第一个大型雇主。 在50个最大的美国雇主中,至少一个公开将等级阶梯替换为验证委派工作的衡量。基准:无公开基准 | 检查:2028年12月31日。最终日期:2029年6月30日。p = 0.20;模型0.21(0.05至0.50)。未解决如果:最终日期前无可比数据(从不计为成功)。备选方案:雇主备案和新闻。最接近的先前或反向预测:F17的较温和版本 |
| F18 (B) | 等级胜过任期。 在雇主或队列数据中,验证的等级比工作年限解释更多的薪酬差异(评级绩效仅在薪酬不可用的情况下使用,在分析前固定)。基准:无公开基准 | 检查:2029年12月31日。最终日期:2030年12月31日。p = 0.48;模型0.52(0.40至0.60)。未解决如果:最终日期前无可比数据(从不计为成功)。备选方案:已发布的人力资源分析。最接近的先前或反向预测:Jaques (1956),按职责范围支付 |
| F19 (B) | 检查设定上限(样本外)。 至少200条日志。第1至3个月期间花费在检查和地平线上的关注份额;第4至6个月期间的验证输出(参考小时中的接受部分,而非增益公式)。如果在保留的人员中,检查份额与后来验证输出的偏相关系数强于地平线,则成立。基准:无公开基准 | 检查:2027年9月30日。最终日期:2028年9月30日。p = 0.45;模型0.44(0.30至0.65)。未解决如果:最终日期前无可比数据(从不计为成功)。备选方案:无。最接近的先前或反向预测:Huang et al. (2026),验证放大。v1使用增益,其本质上包含地平线;v2预测后来单独测量的结果 |
| F20 (B) | 经验丰富者放大。 指令份额:日志中给出指令而非检查或编辑的人员轮次份额。验证增益:每人小时关注的接受参考小时。在指令份额在六个月内下降的人员中,第6个月的验证增益至少是第0个月值的95%。基准:无公开基准 | 检查:2027年9月30日。最终日期:2028年9月30日。p = 0.60;模型0.62(0.55至0.70)。未解决如果:最终日期前无可比数据(从不计为成功)。备选方案:无。最接近的先前或反向预测:Anthropic (2026d),学习曲线 |
| F21 (A) | 协作保持。 Anthropic经济指数的Claude.ai对话样本(而非API样本)中协作使用(增强)的份额在2027年发布的每份报告中都保持在40%以上。基准:2025年11月协作使用52%对自动化45%(Anthropic, 2026a) | 检查:2027年12月31日。最终日期:2028年6月30日。p = 0.67;模型0.68(0.60至0.75)。未解决如果:最终日期前无可比数据(从不计为成功)。备选方案:其他供应商报告中的可比份额。最接近的先前或反向预测:Anthropic (2026a):2025年11月52%对45% |
| F22 (A) | 三分之一的显著产品。 2027年Product Hunt十二份月度排行榜中获赞最多的100款产品,列表在2028年1月1日冻结。列出的制作者进行了编码;如果没有列出的制作者声称具有编程教育或过去的编程工作,则产品计为不具有编程教育而制作(具有编程工作的自学者计为程序员)。两位编码员,彼此盲目。如果100个中至少30个符合条件则成立。基准:Manifold:到2026年底拥有1亿月度用户的体感编码软件,约28% | 检查:2027年12月31日。最终日期:2028年12月31日。p = 0.28;模型 0.29 (0.14 至 0.50)。未解决如果:100个产品中少于50个具有可编码的陈述,或到最终日期没有数据(从不计为成功)。备用方案:第二个冻结排名(Hacker News Show HN top 100 of 2027)。最接近的先前或反驳预测:Gartner (2021);Manifold:代码-vibe软件,1亿月度用户,2026年底,约28% |
| F23 (A) | SOC 2028中没有单独的职业。美国《标准职业分类》2028版不包含为通过代理人指导的工作单独设立的职业。基准:SOC 2018没有这样的职业 | 检查:SOC 2028的发布。最终日期:2029年12月31日。p = 0.92;模型 0.93 (0.80 至 0.98)。未解决如果:到最终日期没有可比数据(从不计为成功)。备用方案:BLS修订通知(检查于2026年10月9日:暂无提议或最终结构;最终结构预期于2027年)。最接近的先前或反驳预测:未找到 |
| F24 (A) | 第一位青少年在Week。科学产品是指在已发表研究中由至少十个无关人员使用,或在至少一篇同行评审论文中引用的软件、数据集或论文。一个公开记录的案例,涉及一个没有正式培训的18岁以下人士,其科学产品有这样的用户,并在独立检查下获得Week。基准:撰写时没有这样的记录案例 | 检查:2030年12月31日。最终日期:2031年12月31日。p = 0.23;模型 0.21 (0.02 至 0.45)。未解决如果:仅当搜索源不可用时;到最终日期没有记录案例的情况是没有。备用方案:无。最接近的先前或反驳预测:中国到2030年在所有学校实现人工智能教育的目标(CSET, 2025) |
| F25 (A) | 初级标题变薄。美国2030年标题中包含"初级"或"入门级"的软件招聘启事的比例,与2025年相同查询对比。如果下降至少三分之一则成立。基准:2025年美国标题中包含"初级"或"入门级"的软件招聘启事的比例,相同查询 | 检查:2030年数据。最终日期:2031年12月31日。p = 0.55;模型 0.54 (0.45 至 0.60)。未解决如果:到最终日期没有可比数据(从不计为成功)。备用方案:Indeed Hiring Lab。最接近的先前或反驳预测:Manifold:到2030年初级开发者职位减少三分之一,约74%;美国开发者从2023年到2028年下降超过15%,约42%;市场 0.74 (https://manifold.markets/OliverKuperman/will-the-number-of-junior-developer, 2026年10月9日 (初级SWE职位空缺到2030年1月1日下降至少33%;相关但不相同的指标)) |
| F26 (B) | 招聘实践跟进。自有审计研究:经过验证的工作组合(仅在IT教育方面不同)发送到两个非IT领域的真实招聘启事。如果回电率相差少于3个百分点,且95%区间在正负5以内则成立。基准:无公开基准;自有审计研究 | 检查:2028年12月31日。最终日期:2029年12月31日。p = 0.35;模型 0.32 (0.25 至 0.35)。未解决如果:到最终日期没有可比数据,或区间不符合任何规则(从不计为成功)。备用方案:无。最接近的先前或反驳预测:Burning Glass Institute和Harvard Business School (2024):700个招聘中改变少于1个 |
| F27 (A) | 代理构建的产品超越Gartner预测。至少300个公开产品的样本,主要由编码代理构建,于2026年10月至12月推出,于2026年12月31日在Zenodo上冻结;活跃度由伴随脚本检查。如果2028年12月31日时少于50%的产品被淘汰(无法访问或12个月未更新)则成立。基准:Gartner (Tyagi, 2026):到2028年60%的代码-vibe应用被淘汰 | 检查:2028年12月31日。最终日期:2029年3月31日。p = 0.32;模型 0.35 (0.20 至 0.55)。未解决如果:样本在2026年12月31日前未冻结(从不计为成功)。备用方案:每个产品的Wayback Machine快照。最接近的先前或反驳预测:Gartner (Tyagi, 2026):60%被淘汰 |
| F28 (A) | 机器在80%达到Day。METR对最佳公开发布模型的80%时间范围在2027年12月31日前达到8小时(Day)。基准:2026年4月80%约3.1小时(METR, 2026c;仪表板在2026年9月8日后未更新) | 检查:2027年12月31日。最终日期:2028年6月30日。p = 0.80;模型 0.66 (0.55 至 0.80)。未解决如果:METR和备用方案都未在最终日期前报告80%范围(从不计为成功)。备用方案:METR方法的独立复制(例如Epoch AI)。最接近的先前或反驳预测:METR的拟合范围趋势约每4.2个月翻倍 |
| F28b (A) | 机器在80%达到Week。如F28,阈值40小时(Week)。基准:如F28 | 检查:2027年12月31日。最终日期:2028年6月30日。p = 0.30;模型 0.20 (0.10 至 0.55)。未解决如果:如F28。备用方案:如F28。最接近的先前或反驳预测:如F28 |
| F29 (A) | 计算机科学专业新生减少。计算机科学新本科专业,由2028年发布的CRA Taulbee调查报告(学年2027至2028),与2026年发布的调查对比。基准:2026年发布的CRA Taulbee调查 | 检查:Taulbee报告2028。最终日期:2028年12月31日。p = 0.69;模型 0.67 (0.50 至 0.75)。未解决如果:到最终日期没有可比数据(从不计为成功)。备用方案:NSC Research Center按专业的入学人数。最接近的先前或反驳预测:CRA关于2025年和2026年CS入学人数下降的报告 |
| F30 (A) | 代理共同作者在公开提交。GH Archive中公开推送事件的比例,其提交消息中含有代理共同作者预告(冻结的正则表达式在predictions/resolve/F30.md),2027年9月与2026年9月对比。基准:GH Archive,2026年9月,测量和存档于注册前 | 检查:2027年10月31日。最终日期:2027年12月31日。p = 0.55;模型 0.59 (0.40 至 0.75)。未解决如果:到最终日期没有可比数据(从不计为成功)。备用方案:GitHub Innovation Graph。最接近的先前或反驳预测:未找到 |
| F31 (A) | Builder标题胜过Agent Manager标题。美国招聘启事,冻结的Indeed查询(predictions/resolve/F31.md),2027年第4季度:builder家族的标题与agent manager家族对比。基准:2026年第4季度相同查询的计数 | 检查:2027年12月31日。最终日期:2028年6月30日。p = 0.60;模型 0.63 (0.50 至 0.74)。未解决条件:到最终日期前没有可比较的数据(从不计为成功)。备选方案:LinkedIn 搜索结果采用相同查询。最接近的既有预测或相反预测:Srinivasan and Wei (2026):"agent manager"在12至18个月内成为标准职位名称 |
| F32 (A) | 某供应商表示其编码代理的大多数用户不是开发人员。由Anthropic、OpenAI、Google或GitHub开发的编码代理供应商公开报告,非软件开发人员在该代理的周用户中占多数。基线:撰写本文时没有此类报告 | 检查:2027年12月31日。最终日期:2028年3月31日。p = 0.40;模型 0.31 (0.13 至 0.70)。未解决条件:到最终日期前没有可比较的数据(从不计为成功)。备选方案:供应商经济或使用情况报告。最接近的既有预测或相反预测:应用构建工具供应商(Lovable、Replit)已经表示其用户主要是非开发人员;这对通用编码代理提出了同样的问题 |
| F33 (A) | 机器安全水平保持较低。在Veracode的GenAI代码安全报告中通过安全测试的AI生成代码样本的份额。基线:56%通过率,停滞不前(Veracode, 2026) | 检查:Veracode 2028年报告。最终日期:2028年12月31日。p = 0.70;模型 0.67 (0.57 至 0.80)。未解决条件:到最终日期前没有可比较的数据(从不计为成功)。备选方案:生成代码安全性的可比独立基准。最接近的既有预测或相反预测:Veracode:新模型在安全性方面没有改进 |
| F34 (B) | 参考小时数可重现。两个独立的三人评分小组为相同的50个任务估计参考小时数;日志小时的级内相关系数(双向绝对一致性)。基线:阈值的初步试点(附录E) | 检查:2027年6月30日。最终日期:2027年12月31日。p = 0.65;模型 0.65 (0.40 至 0.75)。未解决条件:到最终日期前没有可比较的数据,或不符合任何规则的区间(从不计为成功)。备选方案:无。最接近的既有预测或相反预测:METR的人类基线(机器,而非人员) |
| F35 (B) | Horizon预测后期输出。至少200条日志:Horizon在月0时的值与任期和IT教育相结合,提高了对第4至6个月已验证输出的样本外R平方。基线:无公开基线 | 检查:2027年9月30日。最终日期:2028年9月30日。p = 0.60;模型 0.58 (0.45 至 0.70)。未解决条件:到最终日期前没有可比较的数据(从不计为成功)。备选方案:无。最接近的既有预测或相反预测:Burning Glass Institute和Harvard Business School (2024) |
| F36 (A) | 平台徽章验证构建者。Upwork、Fiverr、GitHub、Product Hunt、Toptal和Contra中至少有两个推出公开徽章或个人资料字段,证明独立验证的AI构建工作(不是技能测试)。基线:撰写本文时没有此类徽章 | 检查:2027年12月31日。最终日期:2028年3月31日。p = 0.23;模型 0.24 (0.07 至 0.70)。未解决条件:到最终日期前没有可比较的数据(从不计为成功)。备选方案:平台帮助页面和存档公告。最接近的既有预测或相反预测:未找到 |
注:集合A从公共数据解析;集合B从单独预注册的研究解析(协议须在2027年6月30日前完成,否则不进行研究,计分卡将其计为测试计划的失败)。p以成功解析为条件。模型:未获知我的预测值的独立模型预测者的赔率的几何平均数及其范围;个别预测在predictions/m2-probabilities.csv中。每一行的成真和未成真规则在predictions/predictions.csv中。在行F4a和F4b中,Gartner预测按照参考文献的引用方式被引用,通过Tray.ai (2026)的摘要并引用其原文;已注册文件更简洁地给出相同的预测和数字,并引用Gartner (Tyagi, 2026)。
附录 E. 阈值的办公桌测试
本附录报告了第 5.2 节规则的办公桌测试,该测试由模拟和模型评分员在 2026 年 10 月 9 日运行,并制定了确定下一版本的校准协议。每个数字都由附随存储库(pilot/)中的两个脚本生成,这些脚本调用附录 C 的评分器保持不变,仅交换其常数。
E1. 获得一个等级的频率
对于其项目独立通过且真实通过概率为 p 的人员,表 E1 给出了在时间窗口内恰好以最少项目数获得每个等级的概率。这些值是精确的二项式概率;通过 horizon.py 运行的蒙特卡洛模拟,项目分散在窗口上,植入错误和最近的项目到位,一致性在 0.01 以内。
表 E1。 按真实通过率获得等级的概率。
| 规则 | p = 0.95 | p = 0.9 | p = 0.8 | p = 0.7 | p = 0.6 |
|---|---|---|---|---|---|
| 小时和日,91 天内 10 个中有 8 个 | 0.99 | 0.93 | 0.68 | 0.38 | 0.17 |
| 周,182 天内 6 个中有 5 个 | 0.97 | 0.89 | 0.66 | 0.42 | 0.23 |
| 月,第一版本,365 天内 4 个中有 4 个 | 0.81 | 0.66 | 0.41 | 0.24 | 0.13 |
| 月,当前版本,365 天内 6 个中有 5 个 | 0.97 | 0.89 | 0.66 | 0.42 | 0.23 |
| 季度,365 天内 3 个中有 3 个 | 0.86 | 0.73 | 0.51 | 0.34 | 0.22 |
注:该规则是资格认证规则。这些概率描述的是规则,而不是任何人。
下面有三个发现。首先,第一版本没有排序:月份(4 个中有 4 个)在每个 p 值处都比季度更难获得。6 个中有 5 个的计数会反转错误,在 p = 0.8 时使月份比日和周更容易(0.74),所以月份现在要求一年内 6 个中有 5 个,约 960 参考小时而不是 640。有了它,对于 0.77 及以上的每个 p,日、周、月和季度都按从最容易到最难的顺序排列,这是资格认证重要的范围。在 0.76 以下,周略比日容易(p = 0.7 时 0.42 对 0.38)。两者随后大多数时候都被拒绝,这被报告并保持不变。任何三个或更多项目的计数都不能在所有 p 值处相对于 3 个中的 3 个进行排序,因为曲线相交。其次,判决具有噪声:在 p = 0.8 时,相同的判决在下一个窗口中对日重复 56% 的窗口,对周和月重复 55%,对季度重复 50%。因此,记录在等级旁边打印计数("日 (8/10)"),当一个等级在前一个窗口中也保持时,报告可能会将其标记为稳定。在 p = 0.8 时,连续两个窗口中保持的日在 46% 的情况下发生,所以稳定性是一个分类标签,而不是一个要求。第三,一个可靠的人仍然可能失手:在 p = 0.95 时,季度在 14% 的年份中被错过,这是基于三个项目的等级的代价。
图 A2 的面板 A 针对规则 v1.1 绘制了这些概率与 p 的关系。
E2. 对计数和比例的敏感性
论文承诺报告当计数从 10 变化到 8 或 12 且比例从 0.8 变化到 0.7 或 0.9 时,有多少人改变等级。答案是根据 10,000 个日级的模拟日志给出的,每个日志在窗口中有 6 到 16 个日级大小的项目,真实通过率在 0.5 到 1.0 之间均匀分布。当前规则(十、0.8)给了其中 30% 的日,表 E2 给出了在其他规则下判决改变的比例。
表 E2。 模拟日志的比例,其日判决相对于 10 个项目和 0.8 的比例改变。
| 最小计数 | 比例 0.7 | 比例 0.8 | 比例 0.9 |
|---|---|---|---|
| 8 | 22% | 8% | 15% |
| 10 | 10% | 0% | 11% |
| 12 | 16% | 9% | 17% |
注:日志的总体是模拟的假设。E5 的实地研究在真实日志上重复此分析。
移动任一常数一步约改变十分之一的判决。移动两个可改变高达五分之一。比例比计数更重要。
E3. 等级边缘处的评分员噪声
如果两个评分员是无偏的,且其 80% 的对数落在 1.5 的比率内,高于第 5.8 节中 70% 的标准,并且参考是其两个估计的几何平均值,那么真实大小为 7 参考小时的项目在 20% 的时间内以日大小评分,9 小时的项目在 23% 的时间内低于日大小。这就是为什么记录在等级旁边报告中位数接受的大小(表 3):基于刚好在阈值以上的项目构建的地平线显示。
E4. 参考小时的模型评分员
来自四个家族(Anthropic、OpenAI、Google 和 Moonshot)的四个语言模型各自独立工作,对彼此和任何已发布的时间都不知情,在 2026 年 10 月 9 日估计了 44 项任务的参考小时数。30 个是新银行在三个低风险领域(小企业簿记、小内部网络工具、法律和营销文档)的任务,每个都有一份书面完成声明和隐藏检查。14 个是来自 METR 时间地平线数据(METR, 2026d)的公开任务,具有从 12 分钟到 14.6 小时的测量人类基线时间,仅通过其公开标识符提供给评分员。表 E3 给出了结果。
表 E3。 四个盲目模型评分员的一致性和准确性。
| 衡量 | 30 项任务的银行(完成声明) | 14 项任务,具有测量的时间(仅标识符) |
|---|---|---|
| 估计对在 1.5 比率内(6 对评分员) | 62%(从 27% 到 97% 按对计) | 35% |
| 类内相关 ICC(2,1),对数小时 | 0.89 | 0.60 |
| 所有四个评分员将任务放在相同的等级大小 | 60% | 36% |
| 四个的平均值在测量时间的 1.5 以内 | 未测量 | 21%(14 个中的 3 个) |
| 四个的平均值在测量时间的 2 以内 | 未测量 | 43%(14 个中的 6 个) |
注意:模型评估员代替第 5.1 节的两位人工评估员,不是关于他们的证据。
给定完整的完成声明,模型对哪些任务更大达成一致,但对程度不同意:一位评估员在整个库上的估计的几何平均值为 5.1 小时,另一位为 10.4。这样的固定偏移是最容易纠正的错误,这就是为什么实地研究中的评估员首先在测量过时间的任务上进行校准。仅给定标识符,估计值用处有限,这支持使用手工测量的冻结库(第 5.1 节)而不是从标题生成的估计。根据表 3 的规则,当不同意见超过 1.5 时一件工作被发送给第三位评估员,两位这样的评估员大约会将十分之四的工作发送给第三位。
图 A2。 办公桌上的梯级规则:获得梯级的可能性以及模型评估员在小时上的一致程度。
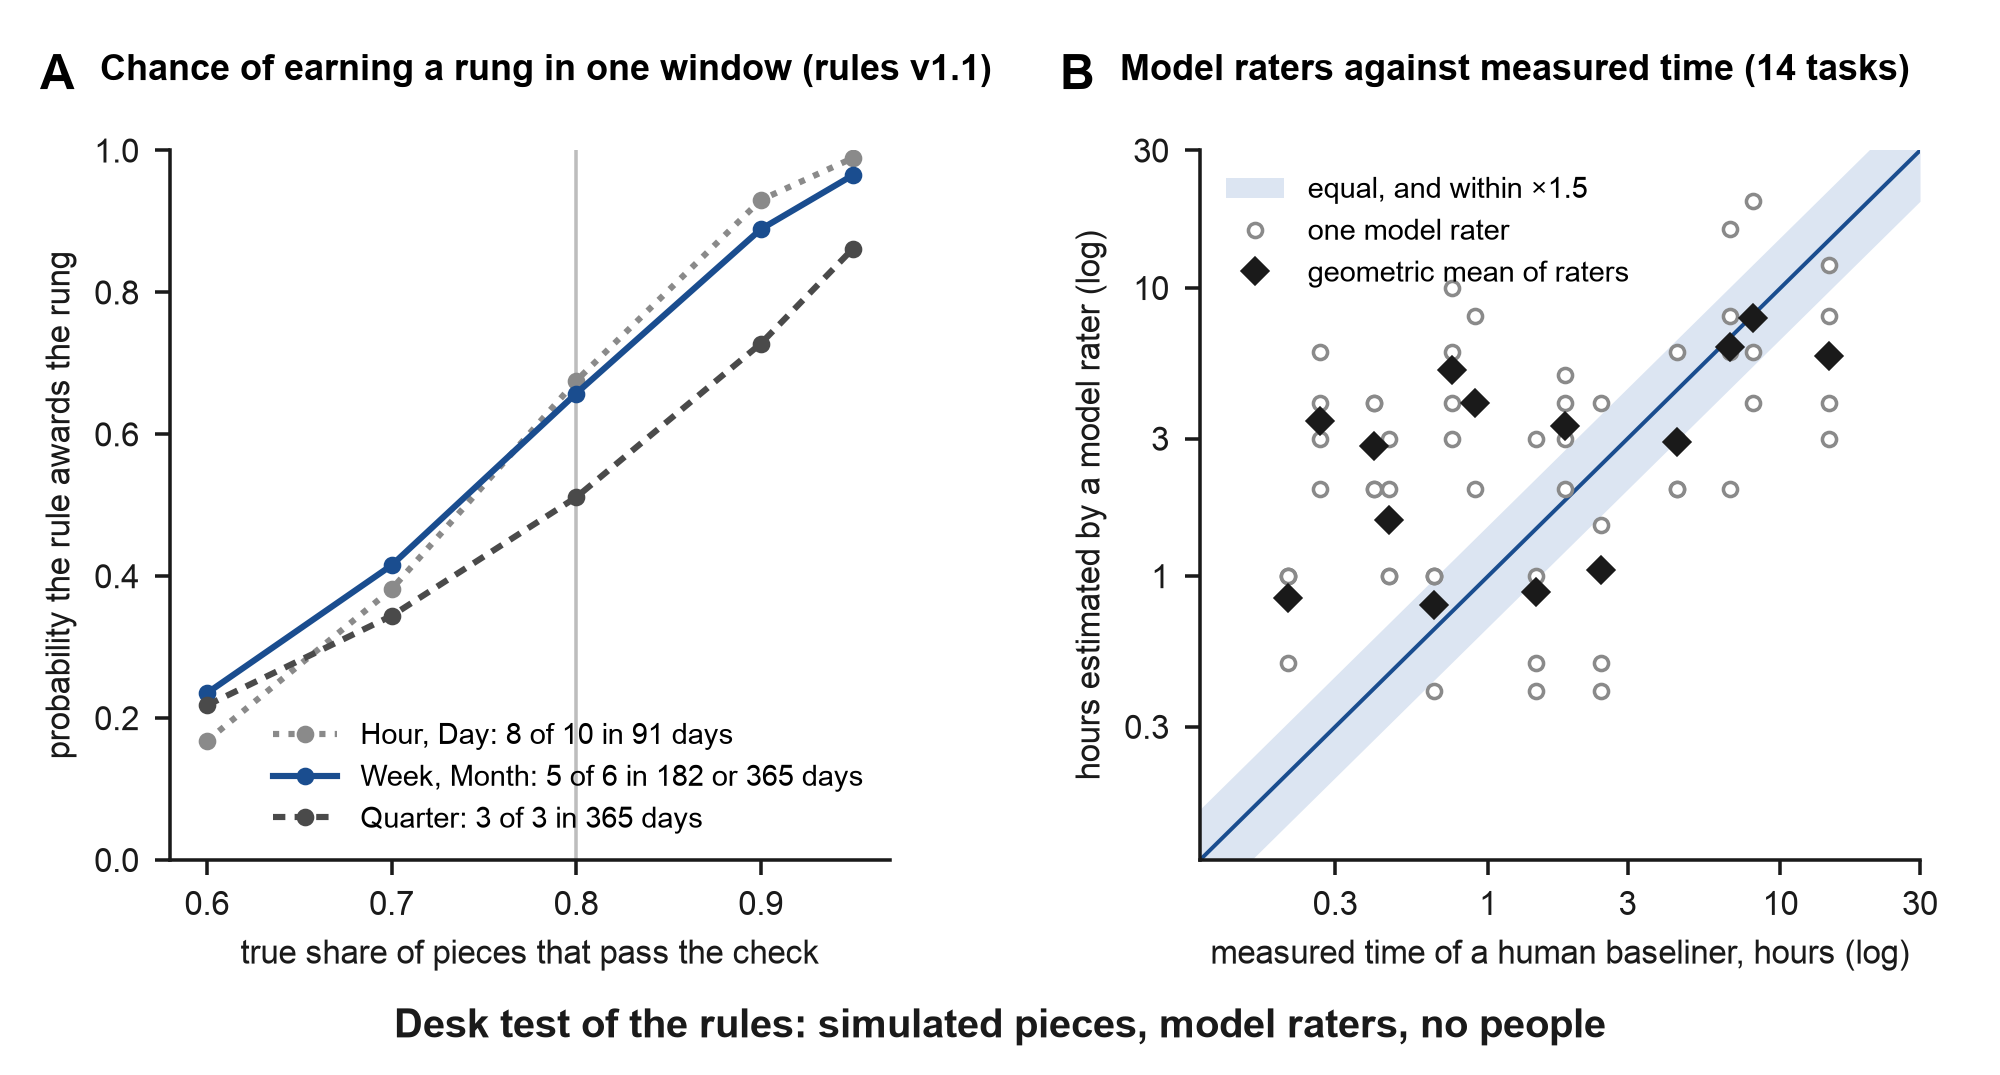
注意:一项使用模拟工作和模型评估员的办公桌测试。面板 A 给出,对于规则 v1.1 下的每个梯级,当每个工作以水平轴上给定的比例独立通过检查时,规则在一个窗口中授予梯级的概率。具有相同计数和相同通过次数的梯级遵循相同的曲线。面板 B 设置了四个模型评估员(各来自不同系列)为 14 项任务估计的参考小时数,与人工基准线测量的时间相对(METR 的任务数据)。波段表示在 1.5 倍以内的一致性。产生两个面板的办公桌测试在本附录中描述,其代码和输出在伴随存储库中。
E5. 校准协议
协议和注册文本在伴随存储库中(pilot/pilot-protocol.md、pilot/preregistration-draft.md)。简而言之,60 名成年人参与,其中 30 人有软件背景,30 人无,涉及库的三个领域,历时两个 91 天的周期。所有人都使用相同的代理工具,版本已记录,检查是隐藏测试或两位盲目的领域审查员。手工时间在库五分之一的任务上测量,每次工作交接都记录其开始日期,接受的工作中随机十分之一被审计。标准在数据之前制定:至少 70% 的人工估计对在 1.5 倍以内,至少 60% 的评级小时数在 1.5 倍测量值以内,梯级在两个窗口间的可重复性加权 kappa 至少为 0.6,预测通过新任务的 AUC 至少为 0.7,丢失的日志行少于 5%,至少 95% 的失败交接被记录。同意书仅为本研究撰写,不沿用其他研究的同意书。月期、季期、不可逆工作和高风险领域不在这个为期六个月的实地研究范围内。
E6. 办公桌测试如何解决以及接下来会发生什么
它展示了规则对已知可靠性人员的表现、规则中存在的不一致(现已纠正一个)、判决对两个常数的敏感性,以及模型评估员在任务排序上的一致性但在程度上的分歧。E5 的校准协议补充了办公桌测试在真实人员方面的不足:他们在规则下如何行为、梯级是否对真实人员可重复、以及是否能预测新工作;人工评估员之间的一致性首先被测试(附录 G)。因此,这些阈值以规则 v1.1 的形式进行办公桌测试,而校准研究确定下一个版本。
要重现:python3 pilot/simulate_rules.py 和 python3 pilot/rater_agreement.py pilot/results/model-ratings.csv pilot/metr-anchor-tasks.csv(Python 3.9 或更高版本,仅标准库;种子 20261009)。
附录 F. 补充表格和图表
编号为 A1、A2 等的对象是附录对象。它们引自各注释中提到的部分。
表 A1. 收敛信号,2025 年至 2026 年 10 月。
| 信号 | 来源和日期 | 显示内容 | 不显示的内容 |
|---|---|---|---|
| 开发人员的工作被描述为委派和验证 | GitHub,2025 年 12 月 8 日 | 供应商对该角色的描述已经改变 | 开发人员的水平按这种方式测量 |
| 编码代理内的非开发人员增长了 137 倍(个人)和 189 倍(组织) | OpenAI,2026 年 6 月 | 从低基数快速增长;四分之一的抽样用户至少提出了一项估计超过 8 小时的请求 | 其结果的质量;供应商数据 |
| 十个最大的职业在代码生成会话中与编程职业的验证成功相差 7 分 | Anthropic,2026 年 6 月 16 日 | 职业间差距小;成功有测试或提交等证据支持;根据行为判断专业知识 | 教育(职业不是学位);发货产品的质量 |
| 律师自建工具;广泛的人工智能访问 83% 对比 61% | Bloomberg Law,2026 年 4 月 20 日 | 领域专家自建,不是购买 | 这些工具维护多长时间 |
| 约 181,500 名员工的职级重新命名 | Business Insider 和 Fortune,2026 年 1 月 22 日 | 雇主更改职位 | 一种新的衡量标准(保留内部级别) |
| "边界专业人士":20,000 名人工智能用户中有 3,233 人 | Microsoft,2026 年 5 月 5 日 | 先进用户的调查段 | 一个角色或等级 |
| 2025 年提及代理型人工智能的 16,541 个职位发布(2024 年为 151 个) | Stanford AI Index 2026 | 职位发布中对该技能的需求 | 新职业 |
| 入职级招聘下降幅度大于整体 | LinkedIn Economic Graph,2026 年 8 月 | 2026 年中期的进入层级较弱 | 人工智能造成的(LinkedIn 指向经济) |
| 博士学位授予部门的新计算机科学专业减少了 13% | CRA Taulbee,2026 年 6 月 | 学生的反应 | 长期趋势;所有机构 |
| 2026 年第二季度 4.54% 的采访中讨论了人工智能的使用(2025 年第三季度为 0.33%) | Metaview,2026 | 这个问题已经进入招聘 | 答案的衡量标准 |
注:供应商数据被标记为此类。按照规则省略了较早的比较(与 2019 年或 2022 年相比)(第 1 节)。
表 A2. 2026 年 10 月 9 日流通中的名称和提议的名称,按层级分类。第 1 部分:使用中的名称、其所有者和状态。第 2 部分:本研究中提议的名称、简单说明和考虑的变体。
| 层级 | 候选名称 | 引入者及时间(第 1 部分) | 使用意义 | 支持 | 反对 |
|---|---|---|---|---|---|
| 第 1 部分 | |||||
| 大众技能 | builder, Full Stack Builder | LinkedIn,2025 年 12 月(报道);"现在每个人都是建设者"(SF Standard,2026) | 任何从任何职能部门进行构建的人 | 已经在人力资源中获胜 | 没有说明级别 |
| 大众技能 | vibe coding, vibe coder | Karpathy,2025 年 2 月 2 日 | 不阅读代码就进行构建 | 广为人知 | 嘲笑;命名底线 |
| 大众技能 | AI fluency (four Ds) | Anthropic,2025b | 委派、描述、辨别、勤勉 | 覆盖全面 | 无级别的能力 |
| 大众技能 | agent literacy | MindStudio,2026 年 6 月 11 日 | 委派、检查、管理 | 意义接近 | 已被采用;没有证明标准 |
| 专业 | agentic engineer | Karpathy,2026 年 2 月;Alenezi,2026 年 6 月 | 指导代理的工程师 | 2026 年工程师的用语 | 与工程相关 |
| 专业 | agent boss | Microsoft,2025 年 4 月 23 日 | 管理代理的每个员工 | 易记 | 没有衡量标准的口号 |
| 专业 | agent manager | Arion Research,2026 年 2 月 7 日;Srinivasan 和 Wei,Harvard Business Review,2026 年 2 月 12 日 | 在团队中运行代理的角色 | 被报告为领跑者(aicodex,2026);其作者预计它将在 12 至 18 个月内成为标准职位 | 一个横向经理的职位(第 6.3 节) |
| 专业 | AI Agent Owner; AI Agent Supervisor | Writer,2026;Digg discussion,2026 | 对已部署代理负责的人 | 命名所有权 | 单一供应商或论坛的用法 |
| 专业 | AI orchestrator | St. Lawrence,2024 年研讨会和 2025 年书籍;2026 年 2 月的 739 个职位发布(IT Brew,2026) | 协调人工智能的业务专业人士 | 在职位发布中 | 被多次采用;横向 |
| 专业 | AI Operator | Dust,2026 年 10 月 7 日 | 构建和维护共享代理工作流 | 熟悉 | 听起来像一个控制台;在 Anthropic,"operator"是建立在 API 上的公司(Anthropic,2026b) |
| 专业 | AI steward, AI work architect | Ono,World Economic Forum,2026 年 6 月 22 日 | 一个设置人工智能工作的界限,另一个检查后果 | 意义上最接近的前身 | 两个角色,没有衡量标准 |
| 专业 | product creator | Cagan,SVPG,2025 | 一个将产品从想法推向市场的人 | 产品语言 | 已被采用;没有衡量标准 |
| 专业 | Product Principal | O'Neill,LinkedIn post,2026 | 为代理设置目标,接受并对结果负责 | 几乎是本文的意思 | 按该意义被采用;引用为先例 |
| 专业 | Principal Agentic Context Engineer | Job title collected by Turkovic,2026 年 4 月 24 日 | 代理工作中的资深等级 | 显示"principal"已被用作等级 | 等级,不是职业 |
| 职业 | AI 产品构建者;智能体产品构建者 | n8n 职位发布,2026;State Street 职位发布,2026 | 需要已构建产品和验证实践;编码优先(n8n)或必需(State Street) | 表明雇主在编码要求上有双向转变 | 单个雇主的职位名称 |
| 职业 | 特许金融智能架构师 | Clark,SSRN,2026 | 以一个行业命名的职业 | 表明特定领域名称被颁发 | 一个提案,一个行业 |
| 职业 | 委托人 | 代理理论(Jensen & Meckling,1976);Claude 宪法中的"委托人"(Anthropic,2026b);The Principal Firm(Verheul,2026);AI 代理的委托人-代理框架(Berkeley California Management Review,2025;Tikhomirov,2026) | 代理人为其行动的委托方,同时承担检查成本 | 其背后的理论;与"agent"一词相对应 | 身份和访问管理中的"Agent principal"表示代理人的自身身份,含义相反;也是 Principal Engineer 等级 |
| 度量 | 委托地平线(机器或企业意义) | Khadj,2026(早期版本包含"Delegation Horizon Index",0 到 100);Alonso,2026(工作链的"委托地平线") | 机器或企业在人类必须介入之前能够委托的距离 | 表明该短语符合自然用法 | 机器或企业,不是个人 |
| 度量 | 提升;加速;自主性 1 到 5;H1 到 H5;监管能力 | METR,2025;Anthropic Economic Index,2025-2026;Shao et al.,2025;em360,2026 | 平均收益、对话级加速、智能体自主性、首选人工参与、每单位努力的有用产出 | 放大收益的既定相邻概念 | 衡量任务、对话或工具,不是个人的经过验证的产出 |
| 时刻 | 交叉时点 | AI 委托下的学习几何学(2026) | 委托给 AI 所产生的技能衰退成本超过其收益的时点 | 形式相近 | 相反的含义:技能丧失而非凭证权重 |
| 合作伙伴 | 担保人 | Capps(2025)《纽约时报杂志》中的"法律担保人" | 提供 AI 无法提供的责任 | 精确 | 法律色彩 |
| 合作伙伴 | 完成者;分发工程师;GTM 工程师 | 2026 年职位发布中的 GTM 工程师 | 向人们推广产品 | 目前有报酬 | 部分可自动化(第 7 节) |
| 失败的信号 | tokenmaxxing | 2026 年新闻用法(CIO,2026a) | 按消耗的 token 数排名或竞争 | 命名了一个真实做法 | 不是职业(第 4 节) |
| 旧名称 | 公民开发者;最终用户软件工程;Code Runner、Adaptor、Writer、Builder | Gartner,2009 年前;Ko et al.,2011;Feldman & Anderson,2024 | IT 之外的构建;最终用户遇到工程问题 | 源远流长 | 局限于旧分界的一侧 |
| 第 2 部分 | 候选项 | 状态 | 含义 | 支持 | 反对 |
| 群体技能 | 验收素养 | 在此提出;附录 B 的数据库中未发现使用 | 提前规定完成标准,然后展示 | 命名了核心 | 一种技能,不是一个人;必须与技术接受研究区分开 |
| 职业 | agentwright | 在此提出;附录 B 的数据库中未发现使用 | 通过智能体创作工作的人,如剧作家创作剧本 | 在学术数据库中未被占用;承载作者身份 | 搜索引擎将其分为"Agent Wright";听起来像浏览器测试工具;到 2026 年 10 月部分被占用(一个 Python 包和智能体技能目录),因此需要限定符 |
| 职业 | 领域编排者(法律编排者、金融科技编排者) | 在本研究的早期草稿中提出 | 具有深厚领域知识并为该领域组装智能体系统的人 | 将角色绑定到垂直领域(第 6.3 节) | "Multi-domain orchestrator"是 5G 和 6G 网络管理中的既定术语 |
| 职业 | 设定者-验收者;智能体主管 | 简单描述 | 设定任务并接受结果 | 精确 | 这是一个描述,而不是名称;"director"是管理层的等级 |
| 职业 | 智能体导向产品创造者;智能体工作管理者;智能体工作生产者;结果创作者;结果架构师;智能体指挥者 | 在本研究的模型咨询中产生的变体 | 关于智能体工作创作和管理的变体 | 展示选项范围 | 过长,或与已有名称相近(管理者、创造者、架构师) |
| 职业阶梯 | 规范者、验证者、领域编排者;设定者、验收者、协调者、循环所有者 | 本研究的早期阶梯 | 智能体工作中责任逐步增加的层级 | 易读 | 被按小时数量化的级别所取代,无需跨职业翻译 |
| 度量 | 经过验证的委托地平线(也:个人或人类委托地平线) | 在此提出 | 一个人交付给智能体的最大已验证工作量 | 根植于 Jaques 和 METR | 必须与第 1 部分的机器和企业含义区别开来 |
| 度量 | 放大收益 | 在此提出 | 每小时投入的经过验证的工作量 | 承认短反馈循环构建者的贡献 | 需要固定的参考点 |
| 时刻 | 凭证交叉点 | 在此提出;附录 B 的数据库中未发现使用 | 没有 IT 教育背景的人的产品开始在相同审查下超过程序员的产品,且凭证权重下降时 | 可在部分观察到(第 6.2 节) | "Credential"在智能体安全中也表示秘密密钥;在首次使用时定义 |
| 时刻 | 技能反转点;背景中立点;专业知识交叉点;凭证解耦 | 考虑的变体 | 从技能、背景、专业知识或凭证的角度看待的相同时刻 | 各自强调一个部分 | 各只涵盖第 6.2 节的一个方面 |
| 合作伙伴 | 共同签署人;信任经纪人;分发委托人 | 考虑的变体 | 签署或负责交付产品的合作伙伴 | 普通 | 比担保人或完成人更窄 |
| 失败信号 | 代币级别(代币作为等级) | 本文中用于2026事件的术语 | 按消耗的代币对人员进行排名 | 命名真实事件 | 不是职业(第4节) |
注:状态反映2026年10月8日和9日的网络和数据库搜索(附录B)。"未发现使用"是指在这些日期列出的数据库,对未搜索的数据库不做任何声称。第2部分的变体来自该研究自己的草稿,列出是为了保持选项族的可见性。
表A3。 2025年和2026年的量表及各自测量的内容(完整清单)。
| 量表 | 来源 | 测量单位 | 通过已验证的委托工作测量人员吗? |
|---|---|---|---|
| 人工智能代理的自主权等级(从操作员到观察者) | Feng et al., 2025 | 代理 | 否 |
| 五个等级,从自动完成到软件工厂 | Shapiro, January 2026 | 机器或团队的设置 | 否 |
| 人工智能辅助开发的八个阶段 | Yegge, 2026 | 程序员的实践,按代理的数量 | 否 |
| 能力阶梯(从触发器到代理团队) | Memari & Rudolph, 2026 | 工作的自动化 | 否 |
| 监督编码代理的七个阶段 | Park et al., 2026 | 监督工作的阶段 | 否 |
| 开发中的五个委托级别(人工智能辅助开发环境) | JetBrains Research (Tikhomirov), September 2026 | 开发者的委托,框架化为委托-代理关系 | 仅限开发者;无验证规则 |
| 决策中的人工智能委托级别 | Dawson, 2026; Metal Toad, 2026 | 组织或经理的委托 | 否 |
| 智能人工智能委托 | Tomašev et al. (DeepMind), February 2026 | 一般的委托 | 无人级别的衡量 |
| 委托边界(早期版本:委托地平线指数,0至100) | Khadj, 2026 | 公司或代理的委托 | 否(机器和公司) |
| 作者、编辑、导演、策划者 | Microsoft, May 2026 | 工作模式 | 否 |
| 人工智能能力框架(八个领域,四个级别) | AI Certification Standards, 23 August 2026 | 跨职业的能力 | 无考试或阈值 |
| 人工智能流畅性(四个D) | Anthropic, 2025b | 素养 | 无级别 |
| 机器时间地平线 | METR, 2025-2026 | 模型 | 否(仅限机器) |
| 已验证的委托地平线和放大收益 | This paper | 某个领域的人员 | 是的,根据第5.2节的规则 |
注:"通过已验证的委托工作测量人员"意味着量表根据交付给代理的工作规模将个人置于一个级别上,并通过代理没有看到的检查进行确认。JetBrains的级别涉及开发者委托多少,他们已经使用委托人和代理的语言。他们是最近的邻居,他们缺乏检查的独立性规则和大小单位。
表A4。 难以处理的案例及规则如何处理这些案例。
| 案例 | 处理方式 |
|---|---|
| 人员无法手工完成的工作 | 参考小时仍然来自合格的专家;人员自身的技能不计入 |
| 质量只在数月后显现的工作 | 暂时接受;延迟的结果在到达时记录,可以撤销该作品 |
| 附近没有合格人类评审者的领域 | 隐藏测试或预期用户的实际使用;另一系列模型仅限于该人打开的来源 |
| 同一模型族的盲目评论家,在新的背景下 | 不是独立检查:记录为同族(附录C),不计入信用,尽管在独立检查之前可能改进工作(第6.5节) |
| 团队共同接受工作 | 每个人记录自己的关注;该作品计入签署接受的人员 |
| 通过检查但后来发现错误的作品 | 在下次重新验证时记录为失败,并对该阶段重新评分 |
| 不可逆工作与普通工作混合 | 更严格的规则仅适用于不可逆作品(第5.2节) |
表A5。 开发者讨论中的主题及其在其他职业中的对应物,2025-2026年(示例案例)。
| 讨论中的主题 | 软件外的对应物 | 来源 | 跨越了吗? |
|---|---|---|---|
| 谁对不良输出负责,模型还是设定任务的人 | "工作垃圾":将工作转向其接收者的人工智能输出,约每次事件两小时,每名员工每月186美元;同事判断其发送者能力较弱 | The Decoder (2025); BetterUp (2026) | 是的,强烈 |
| 检查的价格(审查每小时150美元) | 相同的工作垃圾成本 | The Decoder (2025) | 是的 |
| 强大的模型计划和审查,廉价模型完成工作 | Atlassian按角色分配的人工智能预算 | HCA Magazine (2026) | 在公司中 |
| 过载、工具持续变化、害怕落后 | "人工智能脑炎"由25-26%的营销人员、19%的人力资源和17%的软件人员报告 | Search Engine Journal (2026) | 是的,在IT外更强 |
| 用自己的工具替代购买的软件 | 律师用代理构建工具;35%的受调查企业用自己的软件替代购买的软件(供应商样本) | Artificial Lawyer (2026); Bloomberg Law (2026); Retool (2026) | 在顶层 |
| 比较代理 | 簿记员比较两个编码代理 | Growthy (2026) | 是的 |
| 将公司转移到没有程序员的代理上 | 律师和公司用代理代替供应商进行构建 | Bloomberg Law (2026); Artificial Lawyer (2026) | 部分地;咨询业务本身仅在线程中可见 |
| 个人月度AI费用超过$1,000作为身份标记 | 未找到身份对应项;最接近的是公司上限和津贴(Uber的月度$1,500上限、Atlassian的AI钱包) | Fortune (2026b); HCA Magazine (2026); 2026年10月9日搜索 | 否,作为身份;是,作为预算项 |
| 属于某个代理的阵营 | 未找到对应项 | 2026年10月9日搜索 | 否,也不需要 |
注:这些线程是根据其主题选择的定性证据,并不代表总体。"相应"记录是否在9月9日列出的来源中找到了对应项。
图表A3。 机器地平线与阶梯尺度。
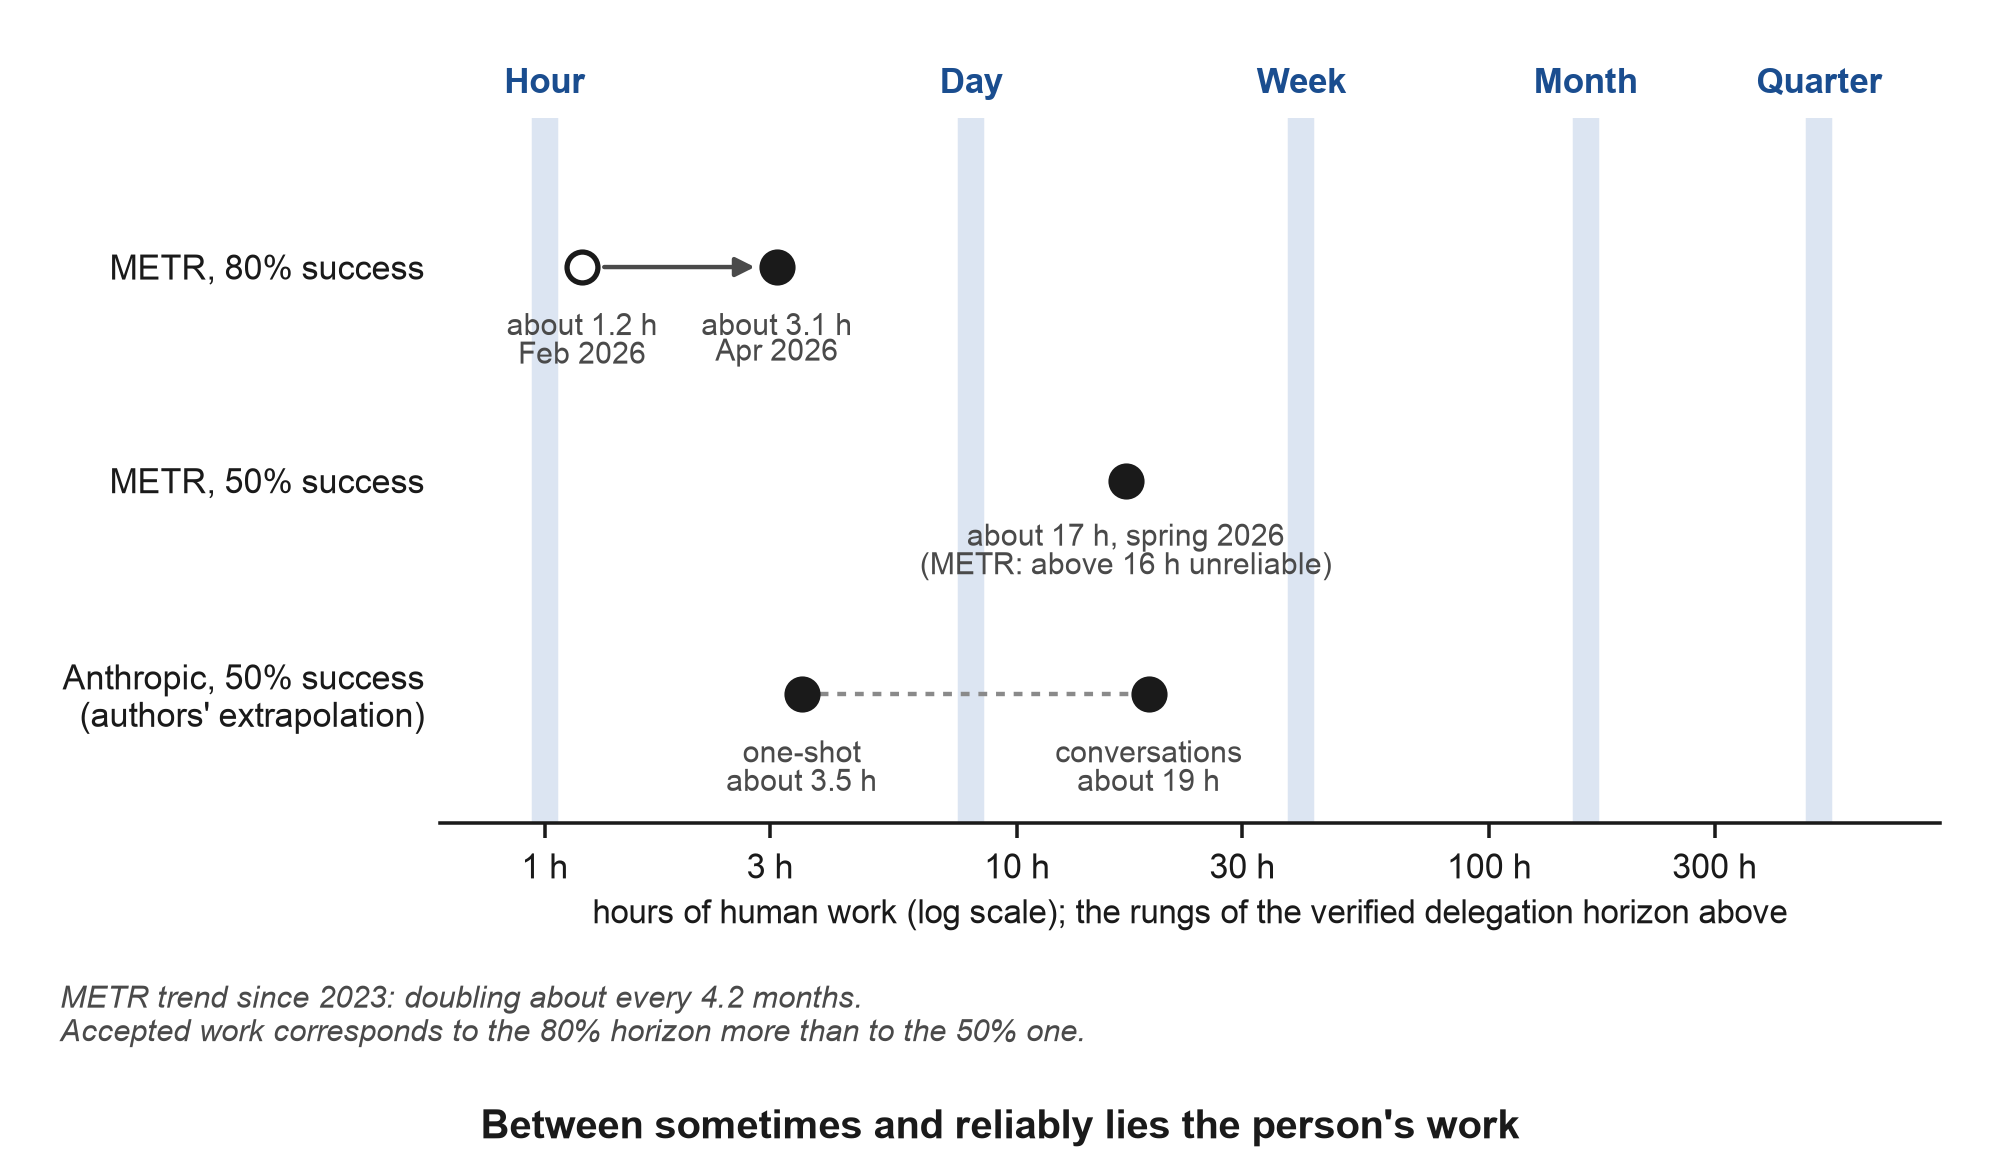
注:METR在80%成功率下的时间地平线约为2026年2月的1.2小时和4月的3.1小时。在50%成功率下,约为2026年春季的17小时,METR本身认为16小时以上不可靠(METR,2026c)。Anthropic的50%阈值约为单次请求的3.5小时和对话的19小时,是作者的外推估计(Anthropic,2026a)。机器地平线测量模型而非人。阴影列仅显示第5.3节的阶梯在相同小时轴上的对应位置(第5.6节)。
图表A4。 第6.5节的检查流程:每个步骤的含义、在规则下获得的内容以及停止的位置。
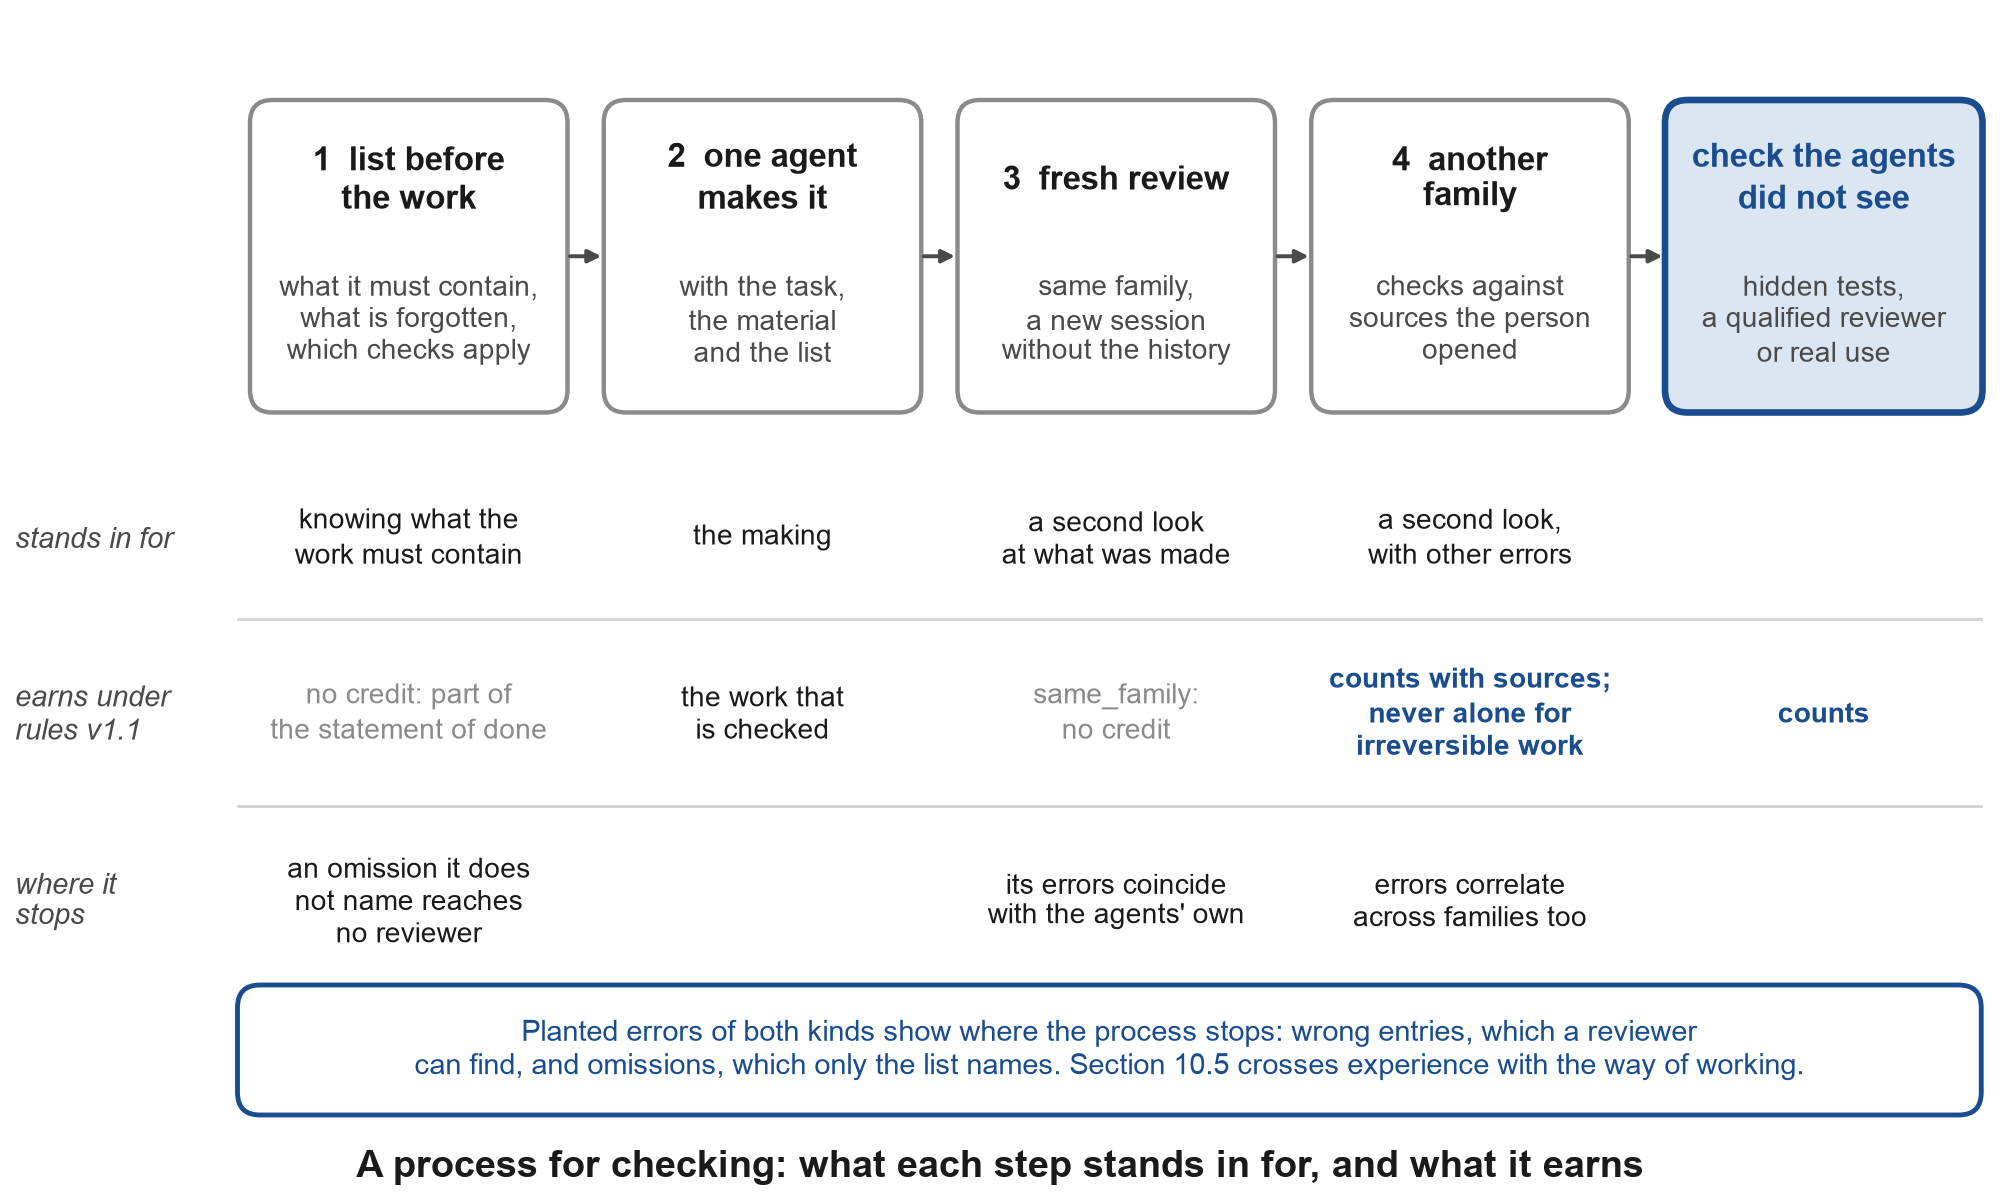
注:四个步骤及各步骤的含义见第6.5节。信用行遵循第5.2节和表A4的评分规则:同一系列模型在新鲜语境中的审查被记录为same_family且不获得信用,尽管可能改进工作;来自另一系列的模型仅在检查该人员打开的来源时计数,绝不单独用于不可逆工作。最后一行总结了Fu等人(2025)关于遗漏和Kim等人(2025)关于模型间相关错误的研究。无注册预测测试该流程;第10.5节说明了应进行的比较。本图由伴随存储库中的figures/figure_a4_checking_process.py绘制,该脚本从horizon.py读取各类检查的信用值。每个步骤代表部分职业经验;第14节将此作为均衡器阶梯重新讨论。
表格A7。 本论文主张的现状。
| 要素 | 其论证方式 | 基础 |
|---|---|---|
| 程序员和他人现在共享委托和接受的任务和工作流 | 数据在任务和工作流层面上予以支持;整个职业并未合并 | 第2节;供应商日志和2025-2026年的调查 |
| 两个旧阶梯不测量该工作 | 已观察 | 重命名的阶梯不伴有新措施(Deloitte);AI使用进入访谈而无量表的问题 |
| 令牌计数作为资历测量的失效 | 在早期案例中观察 | 2026年新闻报道(第4节):员工在Meta的非官方排名被删除,Meta随后的官方指导反对令牌计数;Amazon的排行榜被操纵后移除;Uber的AI预算在四个月内耗尽,一个预算事件 |
| 已验证的委托地平线和放大增益 | 提议;规则v1.1进行了桌面测试;伴随存储库中有校准协议;注册测试下专业人士对参考时数的同意 | 定义和规则(第5节);工具(附录C);阈值的桌面测试(附录E) |
| 由检查份额确定的收益上限 | 作为模型提供;由GDPval平均值说明 | 第5.5节 |
| 背景中立性 | 假设;待注册的测试(F7) | Anthropic(2026e)指出;Savva(2026)是竞争观点 |
| 凭证交叉点 | 假设;组件分别标注(同等性F2、超越F3、岗位F5、中立性F7) | Lightcast(2026b)显示收敛线;Bone等人(2025)在AI岗位中先行 |
| 通过自报标签泄露承认的门;检查工作的门 | 作为模型提供;泄露一次通过评估者研究筛选予以说明 | 第6.2和13节;附录G2;Danilova等人(2021);Reid等人(2022);Serafini等人(2024、2026);Oregon State Board of Bar Examiners(2026) |
| 软件最后交叉 | 预测(F6),与表A6中的其他40个预测一起注册在OSF上 | 领域论证(第6.3节) |
| 检查流程可代表部分职业经验 | 假设,未注册;无注册预测测试;F3b(p = 0.10)仅间接相关;第10.5节设定了应进行的比较 | 第6.5节;Dell'Acqua等人(2026)、McAleese等人(2024)、Eulerich等人(2024)、Fox等人(2026)和Benchek等人(2026)一方;Kim等人(2025)、Chernets(2026b)、Fu等人(2025)和Virk与Liu(2025)另一方 |
| 信任作为第二边界;担保人作为伙伴职业 | 作为模型提供;预测F11和F12 | 第7节 |
| 非程序员通过代理工作 | 在运行队列中观察,不进行推断的描述;注册结果另行报告 | 第11.5节;附录G |
表格A8。 通过标签承认的门和检查工作的门:各检查什么,以及所观察到的内容。
| 门 | 其承认依据 | 所观察到的内容 | 来源 |
|---|---|---|---|
| 研究平台的参与者筛选器 | 答案大多基于该人自述;已验证年龄和居住国 | 在纳入簿记样本的60人中,11人对该行业第一周的问题回答错误,其中8人错误地颠倒了借方和贷方 | Prolific (2026); Appendix G2 |
| 在众包平台上自述的编程技能 | 该人的自述 | 42%未能达到研究人员知识问题的标准 | Danilova et al. (2021) |
| 在Prolific上报告的Node.js编程 | 该人的自述 | 206名中55人通过了所有编程问题 | Reid et al. (2022) |
| 静态知识问题,以文本或图像形式呈现 | 聊天模型可以给出的答案 | ChatGPT轻松解决了现有的程序员筛选问题,到2026年已超越为抵抗它而设计的静态视觉问题 | Serafini et al. (2024, 2026) |
| 在严格时间限制下逐步揭示的音频问题 | 在时间压力下给出的答案 | 在2026年仍对聊天模型有效 | Serafini et al. (2026) |
| 从政策中移除的学位要求 | 标签,在纸上移除 | 700次聘用中改变的不足1次;2025年11月,Indeed上19.3%的美国职位要求学士学位或更高学历,相比一年前有所增加 | Burning Glass Institute and Harvard Business School (2024); Indeed Hiring Lab (2026) |
| 通过一次考试获得的执照 | 知识,检查一次 | 从此作为标签而发挥作用 | Section 6.2 |
| 对持证审计公司签署工作的检查 | 已签署的工作,反复检查 | 对于定期审计100多个发行人的公司,每年一次;否则至少每三年一次 | Sarbanes-Oxley Act of 2002, s. 104 |
| 通过监督工作组合获得的执照 | 已检查的工作,一次检查;仍需法律学位 | 截至2026年1月5日,205名候选人已申请,49人获得执照,首个在2024年12月获得 | Oregon State Board of Bar Examiners (2026) |
| 已验证的委派范围 | 通过代理未看到的检查的已交付工作,每季度确认一次 | 一个等级,附带对应的计数和检查类型,失败记录在日志中 | Sections 5.2 and 5.3 |
注意:这些行是第6.2节引用的案例。它们来自不同的人群和不同的问题,并排列在一起以展示每个门检查的内容,而不是用于比较比率。第二类门可以添加在任何第一类门的前面:配套存储库中参考小时的评估者通过该行业的一个问题(kits/reference-hours-raters.md)获得认可,正如附录G2的评估者研究筛选了其评估者一样。kits/trade-screen.md说明了如何编写这样的问题并报告它,而tools/gate_leak.py给出了标签允许通过的份额,具有精确的间隔。
附录 G. 已在做的人:非程序员队列和 Prolific 评分员研究
本附录是对该测量的补充,而非其论证的一部分;第 6.2、6.5 和 14 节引用 G2 的筛选结果作为说明。它添加了两份来自人员的记录:非程序员从聊天转向通过代理工作的账户说明,时间为 2026 年 9 月和 10 月 (G1),以及一项注册评分员研究,其中在职专业人士对任务库的参考小时数进行了评分 (G2)。
G1. 从聊天转向代理的非程序员
从 2026 年 9 月 6 日起,我逐步地通过普通消息指导没有编程背景的成年人,从聊天助手发展到在自己的计算机上安装并从自己的消费者订阅中支付的编码代理,然后与多个模型一起工作。他们来自十多种职业,包括簿记和办公室工作、法律、营销和销售、设计、摄影和修饰、翻译和编辑、音乐、建筑、运输和物流、房地产、护理工作、公共管理和非营利社区工作;四人报告了过去或现在从事软件工作。以下账户是描述性的:它报告了人们所做的事情和什么阻止了他们,如 2026 年 10 月 9 日所记录的,它不计算任何速率也不测试本文的任何主张。
表 G1。 该队列到 2026 年 10 月 9 日走了多远(人数统计)。
| 步骤 | 人数 |
|---|---|
| 在记录中:同意并返回入场问卷 | 119 |
| 在自己的计算机和订阅上安装代理并开始使用它工作 | 35 |
| 产生了工件,或在自己的工作中完成了至少一个步骤 | 24 |
| 停止,并有说明的理由 | 23 |
| 其中:没有自己的计算机(仅手机,或不能运行代理的设备) | 9 |
| 其中:订阅成本 | 5 |
| 其中:拒绝(他们拥有的足够了,没有兴趣,或初学者框架不适合) | 6 |
| 其中:健康、家庭或时间 | 2 |
| 其中:服务在他们居住的地方不可用 | 1 |
注:从参与者记录和最新测量摘要中手工计数,使用为每个人记录的最先进的事件。第二行的 35 人是表 G1b 的 35 行,第三行的 24 人是其前 24 行。当人们展示工件或描述代理产生的内容时,工件计数;一个产生了工件但后来停止的人 (P60) 在两行中都计数。到那个日期为止,其余 62 人要么已收到安装步骤但未报告完成,要么尚未到达。
表 G1a。 整个队列按居住地区和国家划分,以及到 2026 年 10 月 9 日为止,每个地区有多少人转向代理。
| 地区和国家 | 在队列中 | 转向代理 |
|---|---|---|
| 北美 | 37 | 10 |
| 美国 | 35 | 10 |
| 加拿大 | 2 | 0 |
| 西欧 | 20 | 7 |
| 德国 | 12 | 5 |
| 爱尔兰 | 3 | 1 |
| 西班牙 | 2 | 1 |
| 英国 | 1 | 0 |
| 奥地利 | 1 | 0 |
| 瑞士 | 1 | 0 |
| 中欧和东欧,指定国家 | 9 | 1 |
| 波兰 | 3 | 0 |
| 摩尔多瓦 | 2 | 0 |
| 拉脱维亚 | 2 | 0 |
| 爱沙尼亚 | 1 | 0 |
| 罗马尼亚 | 1 | 1 |
| 国家未披露 | 53 | 17 |
| 总计 | 119 | 35 |
注:来自参与者记录的国家列。"国家未披露"将其国家根据研究隐私规则被保留的参与者和未提供国家的参与者分组。
人们用代理做了什么。表 G1b 列出了到 2026 年 10 月 9 日为止从聊天助手转向指挥代理的每个人,每行一个:他们给了它什么任务,它产生了什么。产生工件或在自己的工作中完成步骤的人首先出现,大致按他们走了多远排列;那些已安装代理并开始但尚未有报告结果的人随后出现。职业如记录中所示,采用中立措辞。简短引号是参与者从记录中自己的话;那些标记为"(已翻译)"的是用另一种语言编写的,以我的逐字翻译给出。
表 G1b。 到目前为止已转向的每个人(35 人,截至 2026 年 10 月 9 日)。
| # | 参与者 | 职业 | 国家或地区 | 他们用代理做了什么 | 用他们自己的话 |
|---|---|---|---|---|---|
| 1 | P20 | 图像处理、修饰、摄影 | 未披露 | 代理询问了他的目标并作为文件夹和文件建立了一个月计划(按主题分周、参考文件、跟踪器);然后它通过自己驱动浏览器在九个 AI 服务中注册了他,并在其进度文件中记录了一个拒绝;他通过 11 个网络 AI 运行了一个问题,并将结果和限制写入文件;在他自己的库存照片上,它在一条命令中生成了元数据 CSV 并进行了检查 | - |
| 2 | P73 | 隐形眼镜销售业务 | 爱尔兰 | 从另一个供应商安装了第二个代理;两者都读了她自己的社交媒体计划的副本,她保留了一页他们不同的要点;为每个代理编写了规则文件,并以 readme 和工作日志结束了晚上 | "我可以继续培训。" |
| 3 | P48 | 办公工作和在线销售 | 未披露 | 她把每周编写的文件转换为带有检查清单的模板,并从中更快地编写了下一份;另一名员工盲审她的草稿;让两个AI阅读了整个案卷,并自己决定了三个成本最高的发现 | "'哪个AI更好'这个问题的提法是错误的。"(翻译后) |
| 4 | P44 | 营销、销售和咨询 | 未披露 | 制作了运行代理任务的桌面按钮("项目状态""新项目清单""文件摘要""文件备注");在另一个订阅上安装了第二个代理,并对一项任务进行了联合审查:一份摘要文件加上两份完整评论 | - |
| 5 | P21 | 非营利社区组织 | Germany | 构建了一个为期一个月的交互式技能和习惯计划,配备进度跟踪;让代理从目录中选择一个起始方向并制定四周计划;然后并行运行三个代理会话:一个几分钟内的演示,以及一个监视列表并将匹配项发送到其信使的机器人 | "一个根据您具体需求定制的工具,而不是在网上搜索折中方案或付费订阅。" |
| 6 | P05 | 某主任的助理,前程序员 | United States | 该代理在她的机器上创建了五个文件:一份概览和按主题分类的四周计划;之后在向她自己的号码发送测试消息后,通过网络消息页面向76个联系人的列表发送邀请,自动点击 | "从现在起,我将在他们之间分配不同的日常任务,并真正比较结果。" |
| 7 | P01 | 室内设计师和制图员,在培训中 | Spain | 让代理分两次扫描构建职位空缺文件,第二次范围比第一次更广;将其与另一个聊天机器人的两份报告进行比较,分别列出一致之处和差异;从对自己文件的真实阅读中改写了简历和作品集,并修改了职业档案 | "当它能够深入挖掘并创建有趣但总体上独立的数据来分析它们时。"(翻译后) |
| 8 | P18 | 互联网营销 | 未披露 | 该代理整理了她的桌面:创建了文件,将它们分类到文件夹中,发现错误并修复了它们;之后为她自己的主题设置了电子邮件新闻提醒 | "我听说过这样的事情,但看到它的实际运作真的让我信服了。" |
| 9 | P19 | 公共行政官员 | 未披露 | 在一天内校对了自己的一份长多册文本版本;在一周内完成了两个大型项目;现在为翻译工作流程构建插件集合 | "我在短短一周内完成了两个重大项目...哇。"(翻译后) |
| 10 | P35 | 合同、发票和海关文件 | United States | 通过语音完成了第一项任务;代理清理了她计算机的缓存,关闭了应用程序,并通过自动打开预订网站来找到预约时段;提议了按需打印方向;帮助处理招标文件;现在在终端中运行 | "是的,它有效,我们做到了。"(翻译后) |
| 11 | P72 | 用AI制作的库存图像和视频 | Romania | 使用编排工具通过多个AI运行一项任务,设置语音输入,并从目录中选择自由职业方向 | - |
| 12 | P41 | 牙科助理,在产假中 | United States | 代理制定了日程表、计划和草稿;在她的机器上找到了六个自己的安装程序副本和五个办公套件副本,并删除了多余的;她口述了一堂社区课程,代理将其记录下来,添加了参考文献和链接,翻译并保存了它,然后按她的要求进行了重新加工 | "我很高兴。" |
| 13 | P24 | 音乐家和诗人 | Germany | 向11个AI发送了一项图像任务,并将结果保存到带有图库页面的文件夹中;让代理构建了音乐编排的框架,这让他失望 | "作者身份的伦理方面对我来说仍未解决。" |
| 14 | P102 | 管理一家软件公司 | 未披露 | 到达时已经每天在代理中工作;通过11个AI运行了一个问题(10个回答)并发送了运行文件;现在正在通过收益目录工作 | - |
| 15 | P40 | 研究工程师和网络开发者 | 未披露 | 作为有意的初学者走了这条路:他下载文件夹中大约100个分散的文件被分类到文件夹中,附有前后的屏幕截图;向课程材料提交了两个修复 | - |
| 16 | P75 | 远程技术支持 | 未披露 | 代理在他的桌面上创建了一个文件夹,其中包含季节性音乐视频频道的启动计划(名称、曲目想法、标题、发布时间表);终端步骤完成 | - |
| 17 | P60 | 居家护理 | United States | 代理提出几个问题后,制定了一个为期一个月的计划,分成多个文件(捐赠者、财务、信件模板);后来离开,认为初学者框架过于基础 | - |
| 18 | P64 | 制服公共服务、物流和供应 | 未披露 | 与代理制定了一个月计划,代理在他的计算机上创建了文件;在十个AI服务中注册 | "AI适应人。从某种意义上说,它是奉承。"(翻译后) |
| 19 | P28 | 制服公共服务 | 未披露 | 代理从他目前的职位规划了职业道路,当他拒绝一条时,提出了他早期行业(手表维修)的发展计划(技能、认证、自己的工作坊) | - |
| 20 | P14 | 工业攀登者 | United States | 在设置过程中按代理的建议与其一起构建了"反射广场",一个小型反应速度训练器 | "目前,用Code编程不是我日常生活中需要的东西。" |
| 21 | P67 | 游泳教练,也从事直销 | 未披露 | 告诉代理她已经开始从事直销;它提供了五种帮助方式并起草了示例产品卡 | - |
| 22 | P12 | 学生 | Germany | 在免费AI服务中注册,运行了编排文件夹,与代理从目录中挑选了四个方向(新闻学、一本书、变现、深入了解AI);将给它他自己的论文 | - |
| 23 | P71 | 倡导和公共卫生 | Germany | 自己编写了提示词;代理程序缩短了它,让其他AI生成图像;进行了终端步骤和额外的自己创建的测试任务来记住键盘操作 | "任务完成,发送下一个。" |
| 24 | P22 | 非营利社区组织 | 未披露 | 在代理程序中完成了目录任务(某些网站阻止了其登录);进行了终端步骤,然后要求代理程序本身解释已完成的工作;设置了电子邮件新闻提醒 | "完成了,接下来呢?"(翻译) |
| 25 | P59 | 摄像师 | United States | 向代理程序提供了在当地市场寻找盈利房产列表的详细简报(检查、无支出、按收益排名);结果尚未显示 | "如果第一个有效,我为什么需要第二个。" |
| 26 | P84 | 未说明 | 未披露 | 通过终端自己安装了代理程序;为社区组织建立网站 | "在做某些事,但我认为我们应该谈谈。"(翻译) |
| 27 | P66 | 休闲设施管理员 | 未披露 | 为课程购买了笔记本电脑,安装了代理程序,从一般模式切换到代理程序选项卡;处于在十个AI中打开账户的步骤 | "所有内容都是外语,接下来呢?"(翻译) |
| 28 | P82 | 安保工作;建立卡车调度服务 | United States | 安装完毕;将他的聊天和项目从另一个聊天机器人移过来进行比较 | - |
| 29 | P70 | 社交媒体的研究和视频编辑 | United States | 在室友的帮助下让代理程序工作,之前先手动创建了测试文件 | - |
| 30 | P17 | 国际律师 | 未披露 | 安装完成;已发送第一个任务 | "我完成了所有事情。"(翻译) |
| 31 | P93 | 老年护理直接支持专业人员 | 未披露 | 从纯聊天切换到代理程序并支付;已发送第一个任务 | - |
| 32 | P54 | 定制蛋糕制作 | 未披露 | 在新笔记本电脑上安装并支付;已发送第一个任务 | - |
| 33 | P26 | 混凝土建筑 | United States | 在修复后的笔记本电脑上安装并发送了照片;已发送第一个任务 | "下一步是什么" |
| 34 | P03 | 外贸公司董事 | United States | 与P35一起安装;已发送第一个任务 | - |
| 35 | P45 | 照片和视频内容,编程背景 | Germany | 到达在十个AI中打开账户的步骤,这需要一个正常工作的代理程序;详情未记录 | - |
注:根据参与者记录编纂。第1至24行是表G1的第三行;第25至35行在2026年10月9日之前已安装代理程序并开始,但未报告结果。"-"表示该时期的记录中没有该参与者的可用语言。
新手如何谈论指导代理程序。几周前只使用过聊天助手的人用自己的话描述他们的新工作。我收集了参与者记录和日常观察笔记中为35位安装了代理程序的人提供的所有自己表述的段落(来自32人的161个段落,约1070个词),并通过匹配词干统计了他们用来指代系统、他们对系统的操作以及他们自己的词汇;计数是粗略的,"it"包括一些不指代该工具的用法。
表G1c。新手用于指导代理程序的词汇(在他们自己的报告中出现)。
| 该词命名的内容 | 词汇,转译为类别 | 计数 |
|---|---|---|
| 他们指导的系统 | "it" | 35 |
| 模型或产品名称(Claude、GPT、Codex等) | 16 | |
| 工具、程序、应用 | 11 | |
| "AI"、"the AIs" | 9 | |
| agent | 1 | |
| 助手、帮助者、工作者 | 0 | |
| 他们对其所做的事 | 设置、安装、运行 | 10 |
| 提问、疑问、请求 | 9 | |
| 任务、指令、提示 | 7 | |
| 检查、比较 | 4 | |
| 分配、移交 | 2 | |
| 他们自己 | 开发者、初学者 | 5 |
他们自己的一些词语(英文引用;标记为"(translated)"的是用另一种语言写的,翻译是我的):
- "它不仅可以回答问题,还可以实际处理文件和文档。"(P18, 互联网营销)
- "使用AI时最大的错误之一是假设自信的答案自动是正确的。"(P20, 摄影师和修饰师;翻译)
- "我现在真的感觉像个开发者了。"(P21, 非营利社区组织)
- "为了得到我想要的,我需要思考如何提出请求。"(P48, 办公工作和在线销售;翻译)
- "我认为答案就像对两个人的提问。"(P59, 摄像师)
- "一次一个AI给出更好的建议,下一次情况相反。"(P48, 办公工作和在线销售;翻译)
三段较长的段落展示了参与者声音中的转变。一位室内设计师在训练中,在他与代理程序相处的第一个晚上,在任何人向他展示模型小组之前:"它创建了一个文件夹,在文档打开的情况下也能很好地自己工作[...]最后,我从这个获得了两个名为vacancy的文件,从那个获得vacancies,我再次拿走它们,相互发送,以便他们评估彼此的工作"(P01, 翻译, 来自语音消息的自动转录)。一位工业登山者,在他用代理程序构建第一个小程序的那天,已经在要求下一个角色:"也许学会如何构建能为我做部分工作的代理程序 - 在社交网络上发布、提醒我的事情或给我建议。"(P14)。以及一位从事非营利社区工作的参与者,在他的前几周后:"我感觉到一个巨大的新潜力正在打开 - 就像站在某个新事物的门槛上。"(P21)。
他们用产品名称或简单地用"it"来命名该系统,几乎从不使用"agent",第3节地图上的任何标题都不会出现;然而他们谈论设置任务、比较两个答案和检查一个有把握的答案,这是该测量方法所计算的工作。如同在地图中一样,该功能出现在其名称之前,这被作为描述而非任何主张的测试提出。
这些人还参加了一个单独预先注册的项目 (OSF, DOI 10.17605/OSF.IO/X4EGQ),其结果在那里报告。
G2. Prolific评分者研究:专业人士是否对参考小时数意见一致?
该测量方法以参考小时数衡量每项工作,第5.2节的规则要求两名专家进行盲评,当其估计相差超过1.5倍时则调用第三位。评分者研究询问工作专业人士是否能达到这样紧密的一致。它在2026年10月9日被注册在OSF上作为前试点,在收集任何数据之前(DOI 10.17605/OSF.IO/V92R8),同一天在Prolific上启动。
设计。两个独立样本,共招募并支付119名参与者:60名簿记员(其当前角色为会计、簿记员、特许或认证会计师、审计师或税务专家之一)和59名网络和软件开发者(其当前角色为软件工程师、软件开发者或网络开发者之一)。所有人都居住在英国、美国、爱尔兰、加拿大、澳大利亚或新西兰,在至少100次先前提交中有至少98%的Prolific认可率,并且仅参与一项研究。每位参与者从任务库v0的其所属领域中评分十项任务(BK01到BK10或WT01到WT10,如pilot/task-bank-v0.csv中冻结),以合格专业人士独自工作且不使用AI工具的专注工作小时数为单位;再次评分一项任务(BK03或WT03)作为重测;回答一个能力问题和一个注意力检查。在能力问题或注意力检查中不及格的参与者被排除并获得报酬;不是正数或超过2000小时的估计被删除。
预期结果。主要:按领域,在所有任务中,两个估计在1.5倍比率内的评分者对的份额,对比校准协议中设定的0.70阈值。次要:移除每个评分者个人水平后的相同份额、对数小时上的ICC(2,1)、重测配对中在1.5内的份额,以及每项任务的中位数估计与银行预期的级别的对比。为了比较,附录E的四个模型评分者在这20项任务中有56%的评分对在1.5内:十项簿记任务中有47%,十项网络任务中有65%。分析使用脚本human_raters.py,在收集数据之前已与OSF注册一起提交,无论结果如何都会被报告。
结果。
筛选。参与者根据其Prolific档案中所列的职业被录取,Prolific过滤器使用的大多数答案是自我报告的(Prolific, 2026),因此能力问题是该设计对职业的唯一核查。在簿记样本中,这是一道关于客户向银行支付收入的复式记账的多项选择题。在该样本的60名参与者中,11人(18%)回答错误,其中8人颠倒了借方和贷方,没有人未通过注意力检查;如已注册,他们被排除在下面的结果之外并获得报酬。在未注册的比较中,这11人对银行的较大任务的评分小时数少于样本中的其他参与者:他们为周级别的三项任务(BK08到BK10)给出的中位数分别为6、6和8小时,而其他49人为8、8和12小时。样本量为11人,这只是一个需要进一步测试的线索,而非确定的结论,匆忙或误读问题会留下类似的痕迹;这符合一个不了解行业的人看不到其复杂任务所有步骤的理解(第6.5节)。在网络工具样本中,这种比较没有出现:8名未通过能力问题的开发者给出的周级别三项任务的中位数分别为24.5、27.5和19小时,对比其他50人的20、16和20小时,因此该差异仅限于簿记样本(下面的探索性分析)。
该部分的脚本位于伴随存储库(pilot/)中。prolific_to_long.py将Prolific导出中的评分写入长格式文件;它按原样读取每个估计,将没有数字或包含多个值(如范围)的答案保留为文本,以便注册规则删除它,并列出所有非数值答案。table_g2.py使用注册脚本中的函数(未修改)来打印表G2,将结果与同一任务上的模型评分者结果并列。screen_compare.py重新计算上面的筛选比较,使用确切的区间和对周任务评分者的排列检验。
一致性。调查于2026年10月9日和10日进行,共118名参与者提交了回复,其中60名簿记员和58名开发者;其中一名开发者的答案(其提交已获批并已支付)未被调查工具保存。按注册的排除后(11名簿记员和8名开发者未通过能力问题;无人未通过注意力检查),保留49名簿记员和50名开发者。两个领域都未达到注册的阈值:簿记员对中的28%和开发者对中的25%的比率在1.5以内,而目标是0.70(表G3)。专业人士对任务的排序保持一致,各领域的中位数从小时级任务上升到周级任务,但他们在小时数上的分歧超过了双评分者规则允许的范围。删除每个评分者的个人水平后,占比仅提高到34%和35%,因此分歧在于工作本身而非舍入习惯。以对数小时计,簿记的ICC(2,1)为0.34,网络工具为0.46,评分者对同一任务的两次估计在53%和74%的情况下在1.5以内一致。附录E中的四个模型评分者在相同的20项任务上达到56%的一致程度,相比之下专业人士的一致程度更低,这更多地说明了专业人士之间的分散而非模型的准确性。与从业者相比,银行的估计大约高一级:所有预期为日级的任务中位数为2至7小时,这对应于小时级,所有预期为周级的任务中位数为8至20小时,这对应于日级。在上面的探索性比较中,11名被排除的簿记员之间的一致程度不亚于其他人(28%的对在1.5以内)。结果规定了评分者规则的三个部分。评分者在具有测量时间的任务上校准,这将中位数显示的水平锚定为偏差。通过面板的中位数而不是两个评分者来确定项目大小,因为这种宽度的分散会将大多数对发送给第三个评分者。任务库根据从业者的中位数重新分级,这将其任务下移一级(表G3b)。
表G2。按领域划分专业人士对参考小时的一致性。
| 领域 | 保留 | 排除 | 1.5以内的对 | 排除评分者水平后 | ICC(2,1), 对数小时 | 重测在1.5以内 |
|---|---|---|---|---|---|---|
| 簿记 | 49 | 11 | 0.283 | 0.335 | 0.335 (49完整) | 0.531 (n = 49) |
| 网络工具 | 50 | 8 | 0.247 | 0.349 | 0.461 (49完整) | 0.735 (n = 49) |
注:1.5以内对的注册阈值:0.70,两个领域均未达到。排除为能力问题的失败;无参与者未通过注意力检查。对数遍历领域的所有十项任务(簿记11,760,网络工具11,809)。重测比较评分者对BK03或WT03的两次估计。输出自human_raters.py如注册(DOI 10.17605/OSF.IO/V92R8)。
表G3b。每项任务的中位数估计与库预期的级别(小时)。
| 预期级别 | 簿记任务:中位数 | 中位数的级别 | 网络工具任务:中位数 | 中位数的级别 |
|---|---|---|---|---|
| 小时 | BK01: 2.0; BK02: 2.0; BK03: 1.5 | 小时 | WT01: 1.0; WT02: 1.0; WT03: 2.0 | 小时 |
| 日 | BK04: 3.0; BK05: 2.0; BK06: 3.0; BK07: 4.0 | 小时 | WT04: 7.0; WT05: 6.0; WT06: 4.0; WT07: 4.0 | 小时 |
| 周 | BK08: 8.0; BK09: 8.0; BK10: 12.0 | 日 | WT08: 20.0; WT09: 16.0; WT10: 20.0 | 日 |
注:保留评分者的中位数。中位数低于8小时时落在小时级,8至40小时以下的中位数落在日级。所有预期为日级或周级的任务下移一级。
探索性分析。 本段的分析未经注册。它们重复使用了注册的加载程序、排除条件和测试,其脚本和输出是伴随存储库中的 pilot/exploratory_prolific.py 和 pilot/results/prolific-2026-10/exploratory-output.txt。重新采样评估者对初级份额得到 95% 区间为 0.24 至 0.33(簿记)和 0.21 至 0.29(网络工具)。面板规模(表 G4)。对于每项任务,k 个保留评估者的两个不相交面板被抽取 2,000 次,其中位数进行比较。在原始估计上,仅当每个面板有至少 15 个簿记员或 21 个开发人员时,两个中位数在至少 70% 的抽取中在 1.5 以内一致。在去除每个评估者的个人水平后(这就是对有测量时间的任务进行校准的目的),由 7 个评估者组成的面板达到 0.71 和 0.69,由 9 个评估者组成的面板达到 0.77 和 0.76。落在同一档位(这是测量记录的内容)需要更少:5 个校准的评估者每个面板在 0.81 和 0.84 的抽取中这样做。在第 5.2 节的两评估者规则下,第三个评估者将在 72% 和 75% 的片段上被调用。经验(表 G4b)。有全部十个估计的保留评估者中,98 个保留评估者中有 43 个报告其领域内拥有超过 10 年的经验。他们彼此之间的一致性不比其他人高,且领域中的年数没有预测评估者偏离他人中位数的程度(秩相关 +0.18 和 -0.10,排列 p = 0.21 和 0.47)。资深开发人员的估计值高于其他开发人员(相对他人中位数分别为 1.32 倍和 0.76 倍,p = 0.02);资深簿记员则没有此差异(1.04 对比 1.07,p = 0.88)。任务。 分歧程度随规模增大:20 个任务中最有争议的 6 个中有 5 个是针对 Week 的任务,其中 24%(簿记)和 20%(网络工具)的对在 1.5 以内,而针对 Hour 的任务上为 31% 和 27%;Week 任务的四分位间距为 4 倍至 8 倍。速度和单位。 速度最快的四分之一的簿记员(整个调查用时 3.6 分钟或更少)与他人的一致性更高(0.37 对比 0.26),而在开发人员中,速度无差异(0.24 对比 0.24)。用分钟而非小时回答某些任务在两个领域均无差异(0.31 对比 0.31;0.28 对比 0.31)。两个簿记员花费 40 小时或以上时间在一个本应为 Hour 的任务上,这看起来像分钟被误输入为小时;排除他们后,簿记份额为 0.284。一个保留的开发人员输入了文本而非数字,因此只有他的一个估计被纳入了分析。筛选。 将每个评估者对 Week 任务的估计与他们自己对 Hour 任务的估计进行比较,以便个人水平相消,被排除的簿记员将较大任务评为较小任务的 3.2 倍,而被保留的评估者为 6.2 倍(排列 p = 0.10),被排除的开发人员为 15.8 倍相比被保留的 10.6 倍(p = 0.37)。重测。 重复估计高于初始估计的簿记员有 25 个,低于初始估计的有 4 个;开发人员中高于初始估计的有 17 个,低于初始估计的有 2 个(在两种情况下精确符号检验 p < 0.001),按几何平均数计约 30%,这与在中间评估的较大任务上的锚定效应一致。这些结果表明差异源于工作及其规模,而非来自匆促、初级或不合格的评估者,他们确定了规则所需的面板规模:校准的评估者,每个片段 5 至 9 个,按档位评分(表 G4)。
表 G4。 每项任务 k 个评估者的两个独立面板:中位数在 1.5 以内一致的抽取份额 / 在同一档位上的份额(探索性)。
| 每个面板的评估者数 | 簿记,原始 | 簿记,水平已移除 | 网络工具,原始 | 网络工具,水平已移除 |
|---|---|---|---|---|
| 1 | 0.28 / 0.51 | 0.34 / 0.62 | 0.24 / 0.46 | 0.34 / 0.60 |
| 3 | 0.43 / 0.68 | 0.51 / 0.76 | 0.37 / 0.60 | 0.52 / 0.78 |
| 5 | 0.51 / 0.77 | 0.63 / 0.81 | 0.43 / 0.68 | 0.62 / 0.84 |
| 7 | 0.58 / 0.82 | 0.71 / 0.84 | 0.49 / 0.74 | 0.69 / 0.87 |
| 9 | 0.62 / 0.85 | 0.77 / 0.87 | 0.54 / 0.78 | 0.76 / 0.89 |
| 15 | 0.71 / 0.88 | 0.88 / 0.91 | 0.64 / 0.84 | 0.86 / 0.94 |
| 21 | 0.76 / 0.89 | 0.94 / 0.95 | 0.72 / 0.84 | 0.92 / 0.98 |
注:有全部十个估计的保留评估者(每个领域 49 名);每项任务 2,000 次抽取,面板在一次抽取内不相交;种子 20261011。水平已移除:在样本中减去了每个评估者相对每项任务所有评估者中位数的平均对数比率,如在注册的次要结果中所述,因此这些列是对在单独锚点任务上进行校准会给出的内容的上限估计。未注册;pilot/exploratory_prolific.py 的输出。
表 G4b。 领域中的年数和一致性(有完整答案的保留评估者,探索性)。
| 领域 | 组别 | 评估者 | 组内 1.5 以内的对 | 相对他人中位数的水平 |
|---|---|---|---|---|
| 簿记 | 超过 10 年 | 23 | 0.268 | 1.04 |
| 簿记 | 10 年或更少 | 26 | 0.299 | 1.07 (p = 0.88) |
| 网络工具 | 超过 10 年 | 20 | 0.297 | 1.32 |
| 网络工具 | 10 年或更少 | 29 | 0.242 | 0.76 (p = 0.02) |
注:水平是评估者估计值与其他评估者在相同任务上的中位数比值的几何平均数;p 是平均对数水平差异的双尾排列测试(5,000 次排列)的结果。未注册。
如何引用
Chernets, V. (2026). After the Programmer Divide: One Measure for People Who Build Through AI Agents [Preprint]. SSRN. https://doi.org/10.2139/ssrn.7589918
@misc{chernets2026aftertheprogrammerdivide,
  author       = {Chernets, Vadym},
  title        = {{After the Programmer Divide: One Measure for People Who Build Through AI Agents}},
  year         = {2026},
  howpublished = {SSRN},
  doi          = {10.2139/ssrn.7589918},
  url          = {https://doi.org/10.2139/ssrn.7589918}
}