人工智能辅助诉讼中的缺失变量:架构与非律师当事人司法救济获取质量
这是译文。权威版本是英文原文,引用请以原文为准。
Vadym Chernets,博士,人工智能系统架构师 · ORCID 0009-0007-4845-3163
SSRN 7120940 · DOI 10.2139/ssrn.7120940 · Zenodo 10.5281/zenodo.22168724 · GitHub
- 记录版本: SSRN 7120940 · DOI 10.2139/ssrn.7120940
- 存档副本,可引用且可下载: 10.5281/zenodo.22168724 — 概念DOI,始终解析到最新版本
- Markdown 和 PDF 完整文本:GitHub
- 可读的 HTML 版本:https://polyhelper.ai/research/missing-variable/
同一文本存在于四个平台,以便在其中一个无法提供时可以访问。SSRN 保存的是权威版本;请引用该版本。
人工智能辅助诉讼中的缺失变量
架构与自代诉讼的司法获取质量
Vadym Chernets, PhD1
首次发布于 2026 年 7 月;本版本发布于 2026 年 9 月
作者声明
作者对本文的利益关系有三个方面,每个方面都实质相关。首先,作者是 Chernets v. Google LLC et al., No. 1:25-cv-05691-RER-RML (E.D.N.Y.) 诉讼的原告,该诉讼是本文的案例研究对象。其次,作者是本文所审视的多模型编排系统的开发者,并是第三部分所述专利族国际申请的指定申请人;因此作者对本文所分析的方法具有利益关系。第三,作者是分析师。第四部分规定的方法论约束条件制约该分析:仅依赖公开诉讼记录、不推断和解动机,以及对系统自我报告的性能指标进行非证据性处理。第七部分阐明了限制。
第二部分和附录中各有一个段落是作者关于他为什么构建该系统以及为什么提起诉讼的自述;这些段落已标注为作者本人的观点,任何发现都不以这些段落为基础。除此之外,本文完全基于联邦公开诉讼记录和公开可获得的来源;不披露涉及对未和解被告待决主张的特权诉讼策略。作者不是律师。AI 助手是在作者指导下作为工具使用的;思想、研究和结论均为作者的。
摘要
关于人工智能在诉讼中的应用的几乎所有论述都建立在一个未言明的假设之上:人工智能辅助是单一的东西。这个假设引发的争论围绕数量和虚构:联邦自代理原告比率从11%上升到近17%、法院描述的"存在性威胁"、因虚假引用而增加的禁止令决定卷宗。现有汇总研究尚不能显示的是,人工智能辅助的任何配置是否改变了自代理诉讼人工作的质量。这里使用的记录是一个联邦案件的公开卷宗,它呈现出音量和幻觉账户无法预测的一种模式。一个完全没有律师代理的自代理诉讼人,根据作者的说法,使用多模型编排系统(独立模型并行查询、分歧被表明而非平均化、引用经外部资源验证),在四天内回复了六封协调的预审动议信函,在截止日期前六周提交了实质性异议,并在一份由来自顶级律师事务所的律师代理的七名被告提交的诉状中发现了一个可验证的法定引用错误,该案件涉及十三个科技被告。这三项中最后一项是与主导文献中的失败模式相反的情况。本文提出了架构依赖假设:人工智能辅助的架构、单模型提示与多模型编排本身就是自代理诉讼质量的一个经验变量,而非实现细节,也不同于人工智能的可用性。这里涉及的教义后果包括作品产权学说(联邦法院在2026年初意见分歧)和非法执业框架。该案件被作为可证伪的存在性证明和研究议程呈现;作者既是诉讼人、系统开发者,也是分析师。
关键词: 自代理诉讼;自代理诉讼人;司法可及性;人工智能辅助诉讼;生成式人工智能;多代理辩论;多模型编排;虚假引用;引用验证;作品产权学说;披露;常设令;第11条规则;非法执业;第III编;架构依赖假设。 JEL分类: K41(诉讼程序);K10(法律基本领域、综合);O33(技术变革:选择与后果)。 # 目录
I. 引言 4
II. 司法可及性差距与自代理人工智能转向 6
III. 从单模型提示到编排:认知外骨骼 11
IV. 方法与证据基础 15
V. 研究发现 18
A. 初次有缺陷提交后法律框架的重建 19
B. 对协调预审动议实践的回应 20
C. 对合并抗辩的及时回应 21
D. 发现防守备忘录中的法定引用错误 22
E. 早期和解 23
VI. 教义含义 25
A. 作品产权与自代理诉讼人 25
B. 非法执业 27
C. 重新表述,而非解决 29
VII. 局限性与未来工作 29
VIII. 结论 32
附录. 一个辅助架构,具体规定以便能够运行 34
选定的参考文献和权威 42
I. 引言
一个诉讼人,十三家人工智能公司:这里审查的案件将本文提出的问题压缩为单一卷宗。美国人民的民事法律需求与满足这些需求的可用资源之间的差距是美国司法制度中最持久的问题之一。美国法律服务公司最近的全国研究发现,低收入美国人对实质性影响其生活的民事法律问题的92%没有或获得不足的帮助,近四分之三的低收入家庭在一年内经历至少一个此类问题。2 对于大多数自代理诉讼人,障碍不是提交费用,而是之后的一切:定位正确的法院、确定适用的诉因、向公司被告送达、在压缩的期限内回应由经验丰富的律师起草的动议。
自生成式人工智能广泛可用以来,这个人口迅速增长。最近的一项大规模实证研究报告称,联邦民事自代理原告率在二十年来稳定在约11%的水平,在2025财政年度上升到16.8%(图1),并且由该研究测量的含有人工智能生成文本标记的抽样联邦民事诉状份额从2019年的几乎为零上升到2026年初的18%以上。该样本来自RECAP档案中提交的既有自代理也有代理律师的诉状,作者提醒该样本代表性不足,低估了没有律师的提交。3
法院和评论人士的反应大多是担忧。当时的一个联邦地区法院首席法官将总体问题描述为"对联邦法院的存在性威胁"。4 律师协会警告称,消费者聊天机器人可能会跨越非法执业的界限,越来越多的禁止令决定涉及有代理和无代理的诉讼人,他们提交的诉状引用不存在的案件。
这种担忧是有根据的,但它描述的是人工智能使用的一种特定方式。通过聚焦这种方式,现有的实证工作隐含地将人工智能辅助视为同质的,本文主张这个假设已经不再站得住脚。已记录的失败(幻觉权威、奉承式同意、无差别的大量生成)是单模型提示的特征:诉讼人向一个通用模型提出问题并提交结果。几乎整个自代理人工智能使用的实证图景都依赖于这种方式。
这里考察的是一个不同的架构,问题在于这种差异是否重要。在多模型编排中,一个查询被同时派遣给多个独立的模型,它们的输出被进行比较。一致和分歧被明确化,分歧——包括标记可能错误的少数信号——被保留而不是被平均化。这里提出的主张很狭隘,但如果正确的话是有深远意义的:驱动当前关切的单模型故障模式可能不是AI辅助诉讼的内在特征,编排架构可能会将AI的使用从增加诉讼体积的来源转变为改善质量的工具。贡献是方法论上的:本文提议将AI协助的架构视为一个独立的实证变量而不是实现细节,随后的案例被提供为一个有文件记录的例子来支持这一提议。四个词的主张:架构,而非可用性。
该主张通过一个单一的案例研究——Chernets v. Google LLC et al.——进行阐述,这是一项联邦诉讼,其中一名自代表诉讼人使用(据其自述)多模型编排系统,对抗一群由众多律师事务所律师代理的技术被告。分析完全建立在公开档案之上:诉讼文件、日期和文件号——任何读者都可以验证。该记录显示的行为既无法被流行的体积和幻觉叙述描述,也无法被汇总式AI协助诉讼研究检测到:对抗协调防守而维持的完整答辩周期,六份协调的诉讼前信件在四天内得到答复,实质性反对意见提前数周提交截止期,以及对被告联盟答辩中可验证的法定引用错误的识别。四名被告提前和解(保密条款;第V.E部分)。该案仍在待决中,对其进行审视的目的是利用可验证的记录来隔离一种现象,根据流行的叙述,这种现象不应该存在,文献迄今尚未密切审视过。
一个由当事人撰写的单一案例可以确立现象发生过,而不是它发生的频率或是否具有普遍性;第VII部分说明了局限性。论证是AI协助的架构是AI协助诉讼研究中的一个独立变量,是目前聚焦于可用性和体积的现有框架未能隔离的变量。这就是架构依赖假说;第IV部分正式表述了它。
本文的组织如下。第II部分将本研究置于获取司法权文献和新兴的自代表AI使用学术研究中。第III部分区分了单模型提示与编排,并说明了机制。第IV部分阐述了案例研究方法及其在公开档案中的证据基础。第V部分呈现了研究发现。第VI部分审视了对工作产品原则和违规法律实践框架的影响。第VII部分阐述了局限性和未来工作。第VIII部分总结。
II. 获取司法权的差距与自代表诉讼人的AI转向
司法差距是美国民事制度的结构性特征,而非边缘现象。大量低收入和中等收入美国人无法获得对其民事问题的有意义的法律帮助,在许多案件类别中自代表诉讼是常态而非例外(Carpenter, Shanahan, Steinberg & Mark 2022)。自20世纪70年代的比较获取司法权运动以来(Cappelletti & Garth 1978),学者们将这个问题框架化为分配问题:法律专业知识是一种稀缺资源,分布不均,而最无力承担律师费的诉讼人往往是利益最大的群体(Sandefur 2019)。该文献询问获取司法权意味着获取什么;这里追求的是那样东西的质量。
在这一背景下,生成型AI作为一种矛盾的发展而出现。一种观点认为,它有望民主化法律能力,为无律师代理的诉讼人提供律师所提供的研究、起草和分析的类似物。这一承诺通过一个前沿模型通过了统一律师考试而具体化了(Katz, Bommarito, Gao & Arredondo 2024),尽管那种性能基准改变了对能力的期待但未能隔离架构差异。Simshaw早期警告说AI反而可能强化一个二元制度,其中资源充足的人获得专家人类判断,而其他人都获得自动化近似。5 自那以后浮现的经验图景更加具体:最近的工作通过分析数百万联邦诉讼文件,记录了自代表诉讼人比率在生成型AI广泛提供后急剧上升,并在诉讼状本身中识别了AI一致性起草的指标。那个汇总记录还不能显示这是否让任何自代表诉讼人的处境有所改善。正如该研究最谨慎的读者所指出的,让新原告进入法庭大门与帮助他们一旦进入后的情况并非同一回事(Engstrom & Caspi 2026)。
图1. 生成型AI广泛提供后联邦民事自代表诉讼人数量的上升。
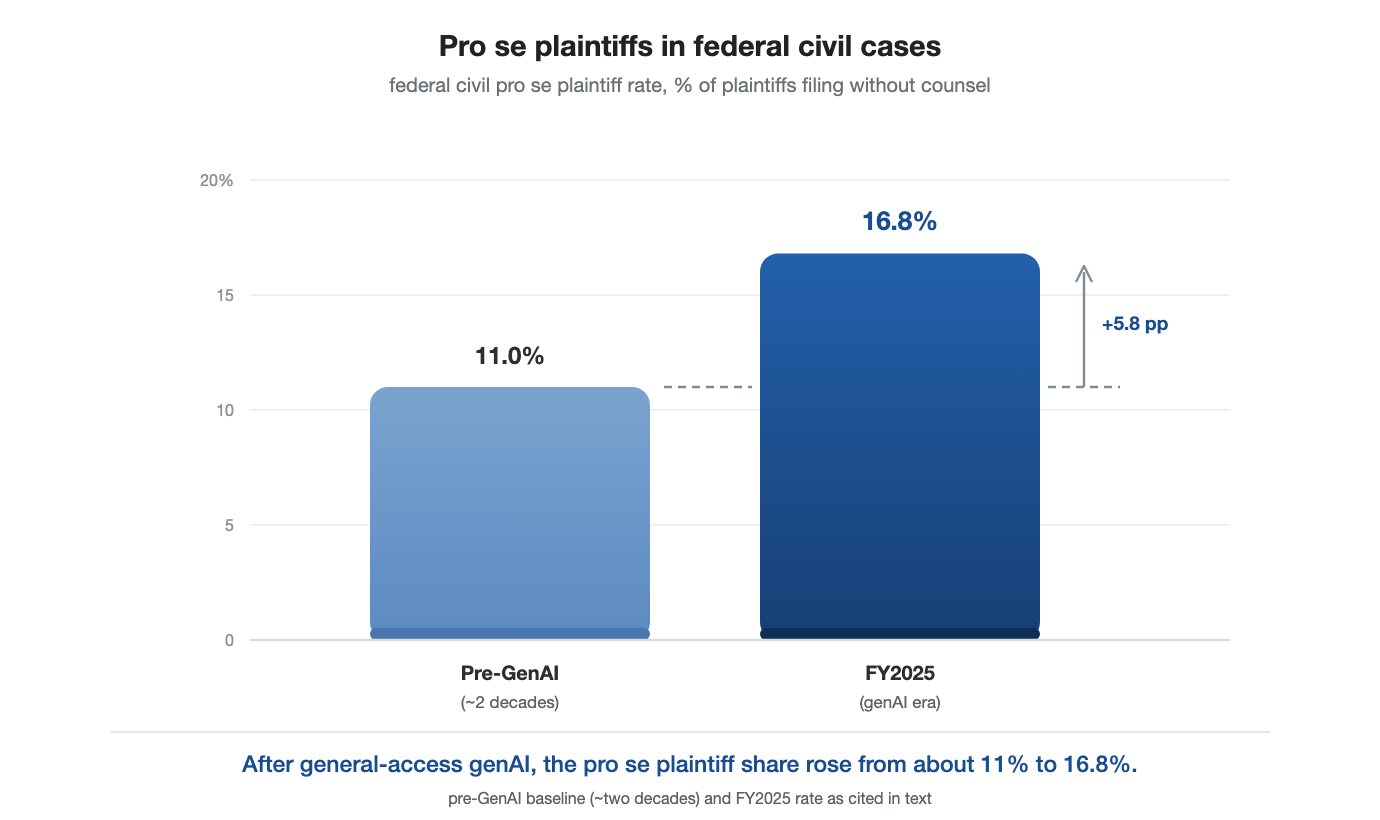
来源:改编自Shah & Levy (2026);数字四舍五入。
法院和执业律师界的反应主要采取谨慎态度,所关切的问题集中在虚构、无权执业和诉讼量上。关于虚构问题,现已形成的重要判例系列对提交引用不存在案例的诉状的诉讼当事人和律师进行了制裁,6这种失败模式直接源于生成式模型产生的看似合理但虚构的权威依据。这种失败模式已导致一系列被追踪记录的判决,其中法院发现或认定某份诉状依赖于人工智能生成的虚构内容:全球范围内到2026年9月已超过两千起(Charlotin 2026),现在还包括一个广泛报道的事件,即华尔街最著名的一家律师事务所之一因向联邦破产法院提交的紧急诉状中存在不准确的引文和其他错误(其中一些是人工智能"幻觉")而向法院道歉。7该卷宗的构成本身就很有启发意义:最初主要表现为自诉现象的事情并未保持这种状态。到2026年中期,持证律师约占已记录事件的五分之二,他们在新近记录的发现中所占的比例正在增长。8律师协会和评论员也担忧无权执业问题,质疑提供法律指导的消费者聊天机器人是否超越了将法律执业保留给持证律师的界限,以及运营这些平台的实体是否可能需要承担责任。9至于诉讼量,法官们将人工智能辅助的自诉诉状的涌入描述为对司法资源的压力,在最尖锐的表述中是对联邦法院的生存威胁。
司法回应采取了进一步的、启人深思的形式。自2023年中期以来,联邦和州的法官已在其法庭中发布涉及生成式人工智能的常设命令(公共追踪系统现列出了数百项,互不相同),要求当事人披露诉状草稿中是否使用了人工智能,对引文是否得到验证进行证明,或两者兼有。10这些命令的设计特征是共同的(表1):它们规范人工智能使用的事实及其输出的验证。架构——协助是单模型还是多模型编排型、是否具有自我验证功能——是这里分离的变量,且在作者查找到的任何命令中都未出现。如果法院对本研究的案件适用此类命令,只会记录使用了人工智能。披露制度和实证文献目前都缺乏关于如何使用的词汇,而这种缺失正是上述齐一性假设以监管形式的体现。
表1. 新兴的人工智能披露制度:常设命令要求什么,不要求什么。
| 该命令要求什么 | 在制度中的存在 |
| 起草时是否使用了生成式AI? | 常规要求 |
| 引用和引文是否已核实? | 常规要求 |
| 使用了哪种工具或模型? | 有时需要 |
| 辅助是单一模型还是协调的(架构)? | 未在任何已定位的命令中找到 |
| 模型之间的分歧是否被提出和解决? | 未在任何已定位的命令中找到 |
来源:司法常设命令的公共追踪器(Law360 Pulse; Legal AI Governance),截至2026年7月;参见注释9。覆盖范围的界定是作者的。
图2。缺失的变量:现有的实证研究改变了人工智能辅助的可用性;其架构未被测量。
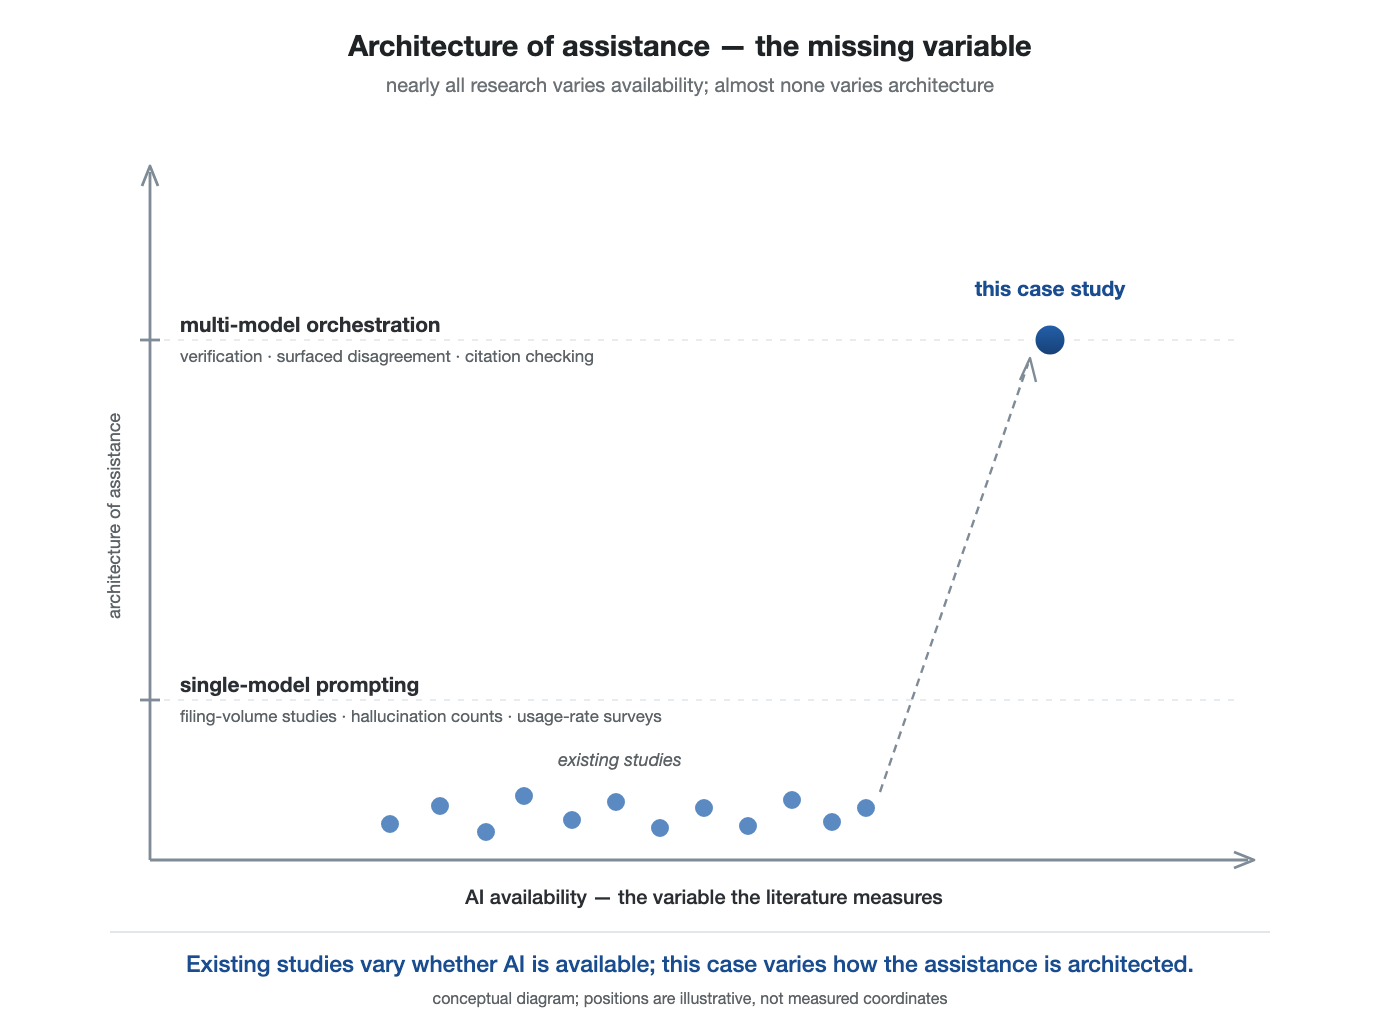
来源:本部分讨论的实证文献的作者示意图。
这两个发展汇聚在本文追求的问题中。司法鸿沟解释了为什么自我代理很重要:对于大多数诉讼人来说,自我代理的替代方案就是根本没有代理。自我代理的最近增加与生成式人工智能的广泛可用性同时出现,这解释了为什么人工智能辅助的架构已成为一个重要的研究问题,而不仅仅是一个附带细节。如果未代理的诉讼人现在大规模地通过人工智能行动,11那么人工智能的配置方式可能会影响呈递到法院的内容的质量,原则上可能会缩小个人与他们面对的机构之间的问题解决能力差距。
进一步的框架改变了对编排目的的理解。对于患有运动、脊柱或视觉障碍且无法同时操作多个浏览器界面的用户,身体健全的用户觉得仅仅繁琐的手动工作流程(打开每个提供商,粘贴查询,阅读,比较)对他们来说不是繁琐的问题,而是根本无法进行的。统一的多模型访问不是生产力偏好,而是合理便利问题(参见Blanck 2014,关于认知障碍人士的网络可访问性;对运动、脊柱和视觉障碍的延伸是作者自己的)。在结构上,阻止对一个人本可以手动执行的工作流程的辅助自动化,对最无法手动执行该工作流程的用户施加了最沉重的负担,并且对于这样的用户,架构将关于非授权实践的争论转变为一个合理便利问题。12
我为我的一个家庭成员构建了它,他无法手工进行 --- 他无法在浏览器标签页之间切换。一根拐杖,一条导盲犬:某样东西做一个人无法做的部分。说一遍,就完成了。这就是这个案例的内容。
这些关切共有的特点,以及本文所寻求揭示的,是关于自诉当事人使用AI的一个隐含模式:一个人、一个通用模型、最少验证、最大输出。然而,这并非唯一可用的架构,而且实证文献(图2)还未检查基于不同架构的案例。该学术研究衡量了AI辅助自诉诉讼的数量和其最常见形式的可靠性;但在很大程度上并未追问不同的援助架构是否会产生不同质量的诉讼行为。本文通过提供一个密切记录的使用方式案例来解决这一空白,而这种使用方式是汇总研究所未分离的。
III. 从单一模型提示到编排:认知外骨骼
"认知外骨骼"这一术语标明了法律-AI辩论往往混淆的一个区分。外骨骼增强其内部的人;它不代替该人行动,没有该人它就处于惰性状态。这种增强和替代之间的区分贯穿第六部分所讨论的两个教义问题。工作成果保护自然附加于增强,因为受保护的战略仍属于当事人本身,而对替代则显得不适当。未授权执业框架针对替代(一个实体代表他人执业法律)而设计,而对一个人用来为自己执业的工具的把握则较差。某一给定系统是前者还是后者,是一个架构和使用的问题,而非标签的问题。第二部分所列举的关切共享一个隐含的架构。在典范性问题案例中,自诉当事人向单一通用模型提出一个问题,然后提交其输出。随之而来的病理在很大程度上是该单一模型配置的特性:捏造的引文、对法律的自信但错误的陈述、对用户前提的谄媚同意(Sharma等人2024)。单独的模型没有内部对手,管道中没有任何东西被定位来反驳它。其错误,无论多么自信,都会通过而不受质疑。在文献中占主导地位的单一模型故障模式,从这个意义上说,不是人工智能的特性;它们是配置的特性。
几十年来,AI与法律研究通过显式知识工程追求可靠性,在规则和基于案例的模型中编码法律推理(Ashley 2017),之后机器学习的转变将问题从编码规则转向学习模式(Surden 2014)。一个独立的计算机科学研究体系表明,这种配置并非唯一可用的,其故障模式部分是架构性的而非本质性的。在通常被称为多智能体辩论的方法中,多个模型实例独立地生成答案,然后在连续的轮次中相互批评彼此的推理,最后收敛于一个回应。基础研究报告称,这一"思想社会"程序提高了事实有效性,并减少了单一模型容易出现的错误答案和幻觉。13 后续工作扩展和限定了这一发现,报告称结构化分歧在数学、逻辑和问答基准上减少了幻觉,同时也指出了限制,如超过少数几个智能体和轮次后收益递减,以及需要评估中间论证的质量而不仅是最终答案。14 基准领域在这里很重要。该文献主要在数学、逻辑和问答基准(具有可验证答案的领域)上验证了结构化分歧。其收益是否转移到法律论证中(许多问题在法律论证中缺乏单一可检查的答案,模型可能会礼貌地收敛于共同的错误),这是未经测试的,这种转移是这里所考查的设计的一个假设,而不是一个演示的结果。
对于当前的分析,该机制中重要的部分是可靠性收益的来源。假设是收益来自模型之间的关系,而非来自任何单一模型的更强能力,来自分歧被表面化和裁决而非被压制。编排的价值不是更多的答案,而是更好支持的答案。一个模型主张而另一个模型质疑的事实是最需要审视的事实,而辩论程序将注意力引导到它,而单一模型提示则无法做到。该机制在其他领域有可认识的亲戚(机器学习中的集成方法、信息论中的纠错码、群体审议科学中的结构化异议),这表明它是冗余的、分歧保留系统的一般特性,而不是任何一个产品的人工因素。
表 2. 单模型提示与多模型编排,按设计属性。
| 属性 | 单模型提示 | 多模型编排 |
| 内部对手 | 无;输出未受质疑 | 模型相互交叉审查 |
| 引用来源 | 从模型权重生成 | 针对外部数据库进行验证 |
| 分歧处理 | 未呈现 | 保留;可触发审查 |
| 特征故障模式 | 虚构、谄媚 | 减少虚构(根据辩论文献) |
来源:根据多智能体辩论文献(例如 Du et al. 2024; Liang et al. 2024; Chan et al. 2023)的设计特性,以及编排列的系统文档。
本案例研究具有自反性结构,据笔者所知,迄今为止没有其他诉讼具有这种特征:争议涉及的技术正是进行争议的技术。几位被告开发的模型是这类系统查询的对象,涉案的编排系统协调那些相同的公开可用模型,而第V部分所审视的诉讼行为发生在该协调系统正在使用期间。基于本文提出的假设,没有单个模型提供了这种能力。每个模型都具有上述描述的单模型故障模式,而且每个开发组成模型的被告,根据构造,最多只能访问其自己的组成模型。重要的配置是关系型的:来自相互对立的提供商的异构模型,并行查询,相互检验。自反性之所以具有分析价值,是因为它保持了组成技术恒定:记录所显示的任何差异都不能仅仅归因于诉讼人获得的组成模型优于被告的,因为几个组成模型是被告自己的;配置、访问权限和操作人员技能仍然是可能的解释。这条研究线索对被告来说也不是外部的。主要的人工智能实验室已经自行发表了关于多代理和集合配置相对于单一模型的优势的文章,在所研究的期间开始转向在其自有产品中商业化跨模型验证。涉案的架构是业界本身越来越支持的一种。15
编排将多代理辩论推广为一个可操作的系统(图3)。其中辩论通常运行一个模型的多个实例,而编排跨不同提供商的异构模型分派查询,规范化其输出,计算共识,最为关键的是,将分歧保留为一等信号,而不是将其平均化为单一答案。案例研究中使用的编排系统是该模式的一个实现:根据其技术文档,它包含了异构模型查询、共识形成、分歧保留和对外部源的引用验证。16
所述的编排架构是一种指定的、工程化的设计。它是一族待审专利申请的主题,包括根据《专利合作条约》在2025年和2026年提交的多项国际申请。17
两种配置在几个设计轴上存在差异,总结如表2所示。其中两项承诺在分析上具有重要意义。一项是针对外部来源的引文验证。诉讼中单一模型的主导性失败——幻觉案例——产生的原因是模型从学习的模式中生成引文而不是检索引文,而一种针对实时数据库验证每个引文、对其无法确认的任何内容进行标记而非包含的架构,则在其根源处针对该失败。另一项是保留分歧。在模型对法律解释存在分歧之处,编排系统可被配置为将分歧作为保守性和人工审查的触发器,而不是作为通过多数票解决的噪音。在高风险领域,独立系统之间的分歧本身可能构成可操作的信息而非统计噪音:表明可能错误的少数信号被保留和提升。它不被丢弃。
图3。 编排原理:并行查询、比较和分歧保留。
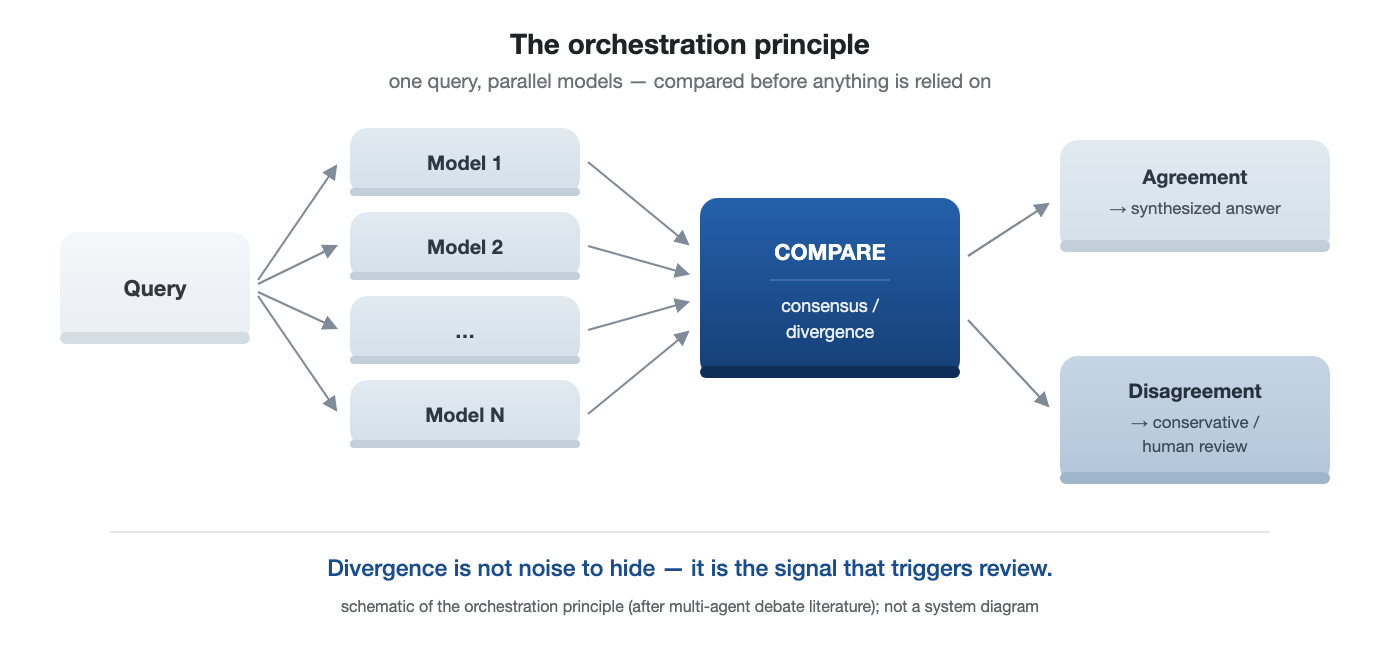
来源:多智能体辩论文献中一般原则的示意图;不是任何特定产品架构的图表。
结构上的要点是,使法院对当事人自代使用人工智能持谨慎态度的具体问题是单模型提示的特点,协调架构正是为解决这些问题而设计的。已记录的失败是配置的属性。它们不是人工智能辅助本身的属性。从这个意义上讲,该架构将可靠性的来源从孤立的模型转变为模型之间的关系:从孤立的智能转变为协调的智能。协调并非什么特殊的东西:商业路由和多模型产品越来越多地展现这些相同的设计属性,这使得实证法律文献中缺乏对架构讨论的情况显得更加令人瞩目。该架构差异是否会在可观察的诉讼行为中产生差异是一个实证问题,本文的其余部分转向可以根据可核实记录进行考查的一个案例。
IV. 方法和证据基础
该设计是一项单案例研究,这一选择反映了所研究现象的性质:多模型协调在真实联邦诉讼中目前很罕见,这里的目标不是估计其频率,而是根据可核实的诉讼记录确立某一特定行为模式确实发生了,并对其特点进行描述。本文所指的质量是从诉讼卷宗中可核实的可观察诉讼行为:期限遵守、引证准确性、程序正确性、对诉讼记录的应答性及提交论证的连贯性。它不涉及任何单一案例都无法保证的结果。这样的案例值得关注:真实世界的对抗性诉讼,具有期限、对手和后果,可能为观察人工智能辅助的人类推理提供比仅进行实验室评估更有意义的背景。第七部分将回到这一局限。在这些维度中,第五部分的发现主要关涉期限遵守、程序正确性和引证准确性;提交论证的连贯性由诉讼记录证明,而不是独立评分,没有任何发现取决于待决动议的结果。
证据基础可以独立检索:本文中引用的每份文件都由其ECF编号标识,任何读者可以直接从下方案号对应的PACER中获取,而无需依赖作者。该基础包括Chernets v. Google LLC et al.案的公开联邦卷宗,案号No. 1:25-cv-05691-RER-RML (E.D.N.Y.),以及早期诉讼的卷宗,案号No. 1:25-cv-07770 (S.D.N.Y.),其被告不同。该案件的结构可用数据表示,均可从卷宗验证:在十三名被告中,十人出庭;七人加入共同驳回诉讼动议;四人和解并被驳回(禁止重新提诉);六人截至2026年6月仍在诉讼中(表3)。十三名被告中有三人从未出庭,记录显示针对这些被告存在送达和实体身份识别困难;但未确定他们未出庭的原因。一名外国被告通过中国中央机构根据《海牙公约》进行送达。没有任何回应:既无确认,也无拒绝。一名国内被告在传票送达其注册代理人之前需要在多个州进行四次尝试,由宣誓程序送达员确认。随后未出庭。第三人援引其公司结构对被命名的实体进行了质证。公司结构和跨境程序在实践中可以作为程序防护,处理这一问题通常是代理方交给专业律师或供应商的任务,而在此案中,自代理原告对所有十三名被告自行处理。第V部分关于诉讼行为的所有事实主张均源自已提交的文件,以卷宗编号和日期标识,任何读者可以独立检索,诉讼人使用AI协助的方式除外,卷宗未记录该方式。本文涉及法庭陈述时,依据官方庭审记录;涉及当事人辩论时,依据提交的文件本身(被告的共同动议和支持备忘录,以及原告的反对意见),而不是任何当事人的表述。18
作者角色产生三项方法论约束,已在开始时披露。首先,分析限于公开记录;不基于作者对诉讼策略的特权知识,也不披露涉及对不和解被告尚未解决的主张的工作产物。其次,本文始终区分卷宗确立的内容(日期、提交的文件、裁决、文件文本)与未确立的内容:当事人的主观动机,特别是任何和解的原因,其条款是机密的。第三,编排系统自身关于其性能的文件中的声明被视为自我报告的,不能作为有效性证据;发现基于记录中可见的诉讼行为,而不是系统对自身的描述。
证据基础中的一个不对称之处对刚才描述的方法进行了限定。本研究的因变量诉讼行为可以完全通过卷宗验证:第V部分分析的每份提交文件、日期和文件都可以被任何读者检索。独立变量不能以这种方式检索。公开记录确立了编排系统的存在并记录了其架构:生效的诉状描述了该系统,专利申请指定了设计,反对方的技术附件描述了其编排特征。卷宗无法显示哪种AI协助模式生成了任何特定的提交文件,或诉讼人的工作方法何时改变。这些事实基于作者对其过程的自我描述,本文在它们出现的地方标记了这一点。因此,该研究将可验证的输出记录与自我报告的输入记录配对,第VII部分提议的受控设计构建为观察架构变量而非报告;附录为此目的规定了运行清单。
卷宗确立了使用编排系统的自代理诉讼人按特定时间表生成特定提交文件。无法确立该系统(而非诉讼人自身能力)产生了其观察到的特征。因此,本文描述了该行为及其架构背景,并将因果关系问题视为开放性的,由第VII部分提议的受控研究来解决。
正式说明,本文提出的假设如下:
架构依赖假设。在生成性AI的可用性保持不变的情况下,AI协助的架构(单模型提示与多模型编排)作为一个独立的经验变量发挥作用(图4):协助模式与可观测到的诉讼行为中的可测量差异相关,包括截止期限遵守、引用准确性、程序正确性和对案卷的回应。该假设是可证伪的:按协助模式编码的自代理提交文件的系统比较,如果未发现此类关联,则会驳斥该假设。
图4:架构依赖假说作为一系列主张的链。每个环节都是待验证的主张,而非发现。
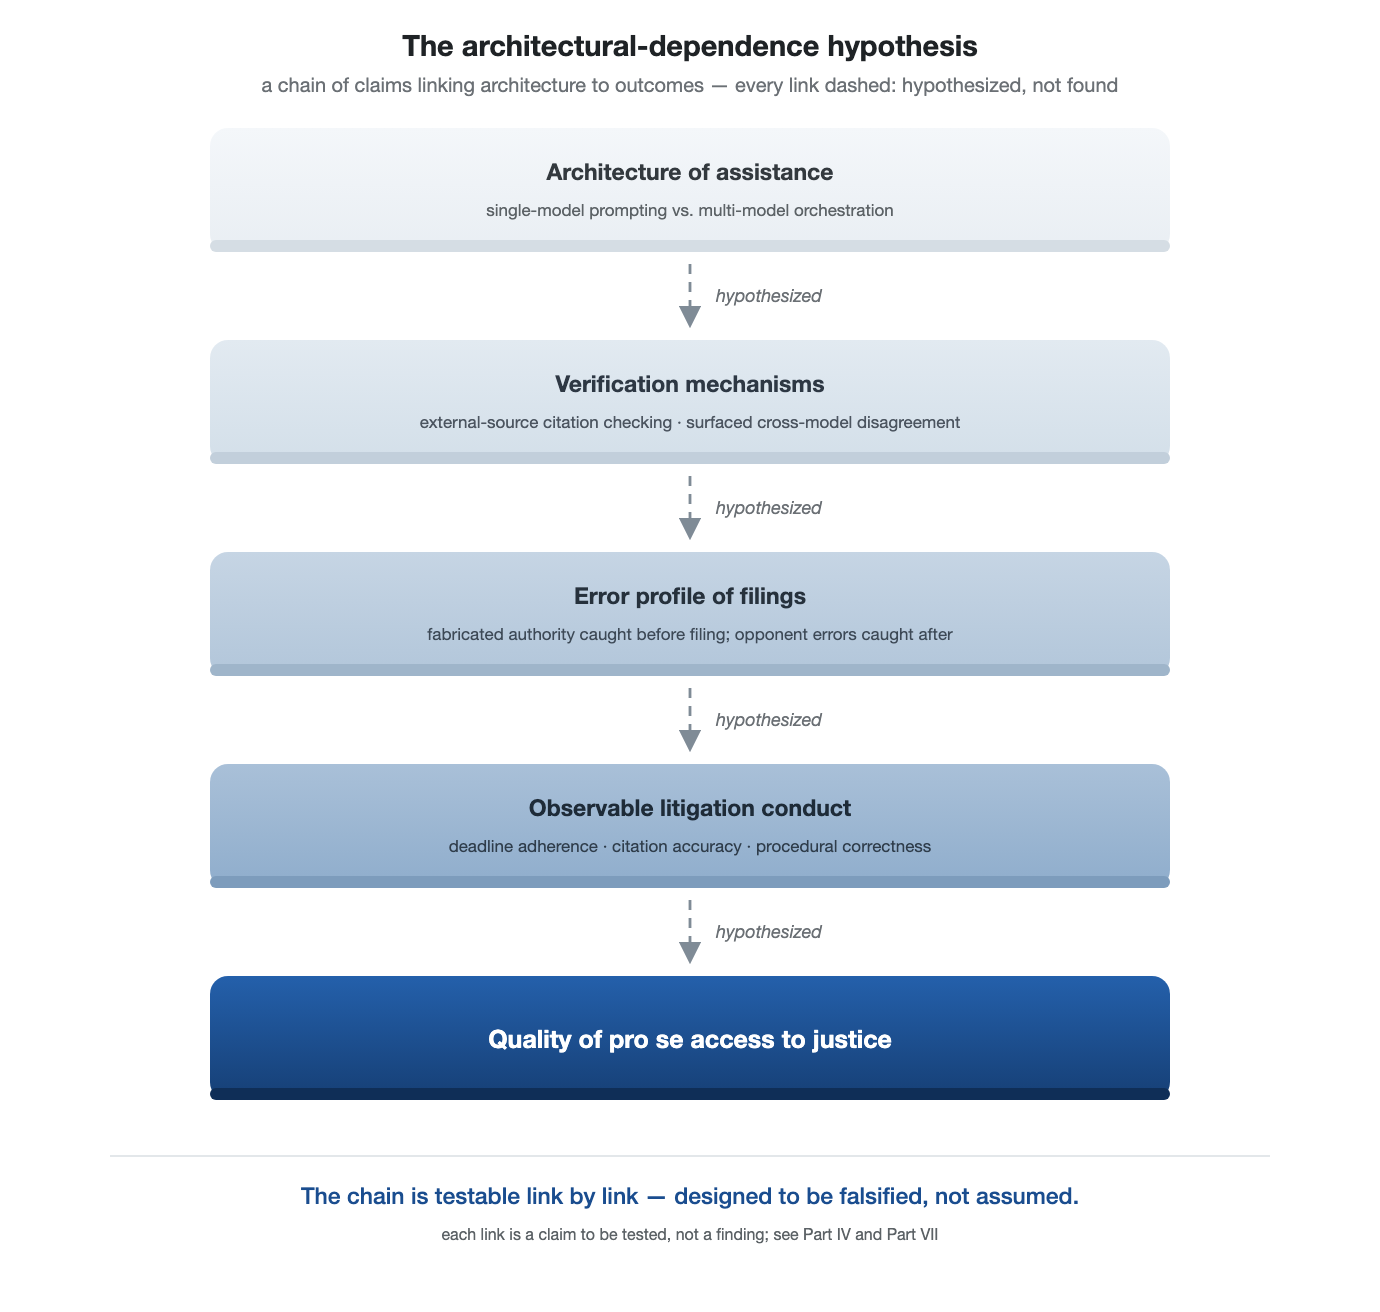
来源:文本中所述假说的作者示意图;虚线箭头标记假设的、未经检验的联系。
V. 发现
诉讼的几个特征与这里提出的问题有关,图5将其依序排列。
本案中法律资源的悬殊不是该研究中的附带特征,而是赋予该研究意义的条件。一方是一名无法律背景、完全没有律师代理(甚至没有有限范围的律师代理)的自代理诉讼人。另一方则是来自众多知名律师事务所的律师组成的共同防线,他们代表七名被告提交了联合驳回动议,并相互协调诉讼文件。一个无代理个人在与该共同防线对抗中完成完整的诉讼程序、按时答复、就案件实质答辩、并发现律师们未发现的错误的情况,接近于司法获取文献所认为不会发生的事。本部分的其余部分在公开法庭记录中对此进行了记录;本文所追求的问题恰在于解释这一现象的原因。
图 5. 案件诉讼程序编年表。
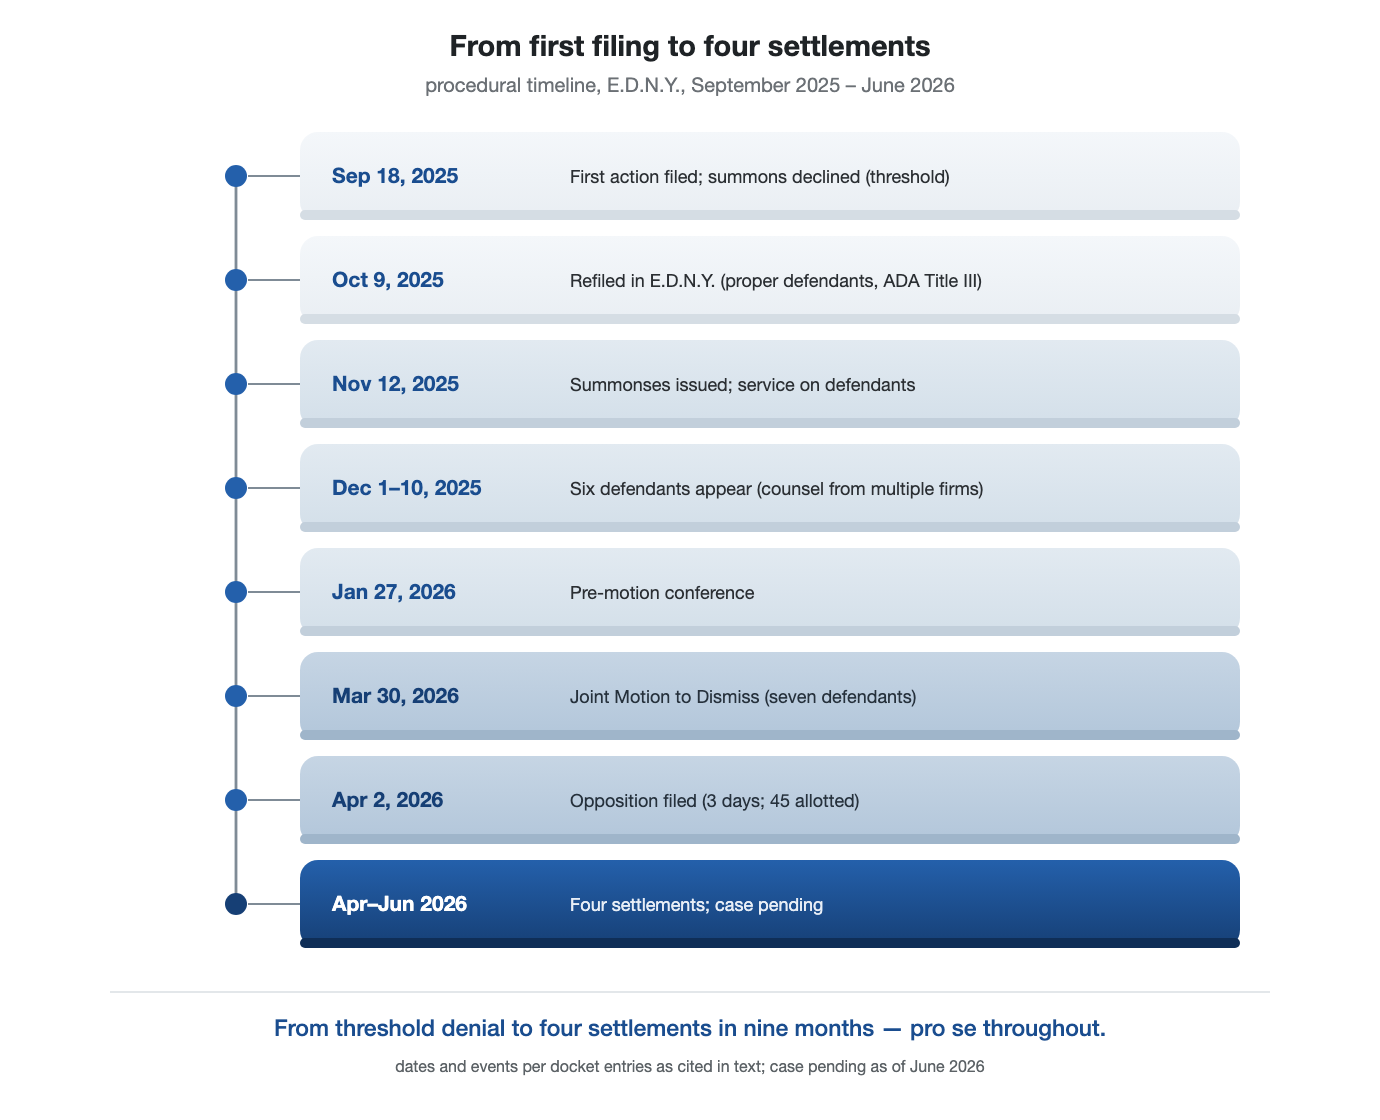
来源:公开卷宗,Chernets v. Google LLC, No. 1:25-cv-05691-RER-RML (E.D.N.Y.),及相关的早期诉讼。
A. 初始缺陷诉讼后的法律框架重建。
诉讼当事人的第一份诉讼于2025年9月提出,属于公开记录,在几个独立方面存在程序缺陷:该诉讼以有限责任公司的名义提起(有限责任公司未经律师代理不能进行诉讼);针对了错误的被告;在错误的管辖区;以及根据《美国残疾人法》(ADA)的错误条款。法院在起诉阶段就驳回了该案,拒绝发出传票。大约三周后,诉讼当事人以个人名义在正确的管辖区提起第二份诉讼,根据法律的适当条款重新表述了诉讼请求,指定了适当的被告,并附上了大幅扩展的证据材料。与该更正相伴随的是方法上的一项变化。根据作者自己的说法,在第一份诉讼中,诉讼当事人在消费者设备上使用了单个模型,而该重新架构与首次使用通过直接模型访问的完整多模型编排相吻合。案卷无法确认该时间顺序,这也不是作为原因提出的。案卷确实显示的是该更正本身,这是本文所研究的第一个事例:记录反映了从在起诉阶段被驳回的诉讼状到进行了送达并促使多个由代理律师代表的被告人出庭应诉的诉讼状的快速转变。这种重新架构是一种广泛的、经过交叉检验的法律框架修订,一个在诉讼程序、诉讼原因和诉讼标准上查询多个模型的编排工作流正是为了支持这类修订而设计的。
B. 对协调的动议前做法的回应
在2026年1月12日的一个晚上,六名被告在大约四个半小时内提交了六份预动议函件,他们已经共同申请了延期,以便能够一起提交。19 根据法院的个别规则,原告必须在五个工作日内对每份函件提交答辩意见书。六份答辩意见书,每份分别针对特定被告的论证,在四天内提交。20 这一事件涉及的问题不仅仅是速度:对协调的、多方面的提交的回应不能提前完成,因为它的针对性是由六份文件所固定的,而这些文件直到提交的那晚才存在。但是,在这类案件中,被告可获得的论证来自可预见的范围:诉讼资格、Title III对数字服务的适用性、诉状不足。一个勤勉的当事人可以事先草拟对预期论证的模块化回应,并在函件到达后进行调整。因此,事先草拟受到这一事件的限制,而不是被完全阻止:四天的时间间隔所确立的是六份分别针对六份不同提交的意见书的汇编、调整和提交。它不能确定的是这些意见书中有多少内容是在这些函件提交之前就已经准备好的。
C. 对整合防御的及时回应
在法院邀请被告减少重复诉讼文件的动议前会议之后,七名被告(包括所有六名提交过动议前信函的被告)提出了一份附带支持性备忘录的联合驳回申请。根据法院的安排,原告的异议文状应在大约四十五天后提交。该异议文状的日期为2026年4月2日(比3月30日提交的申请晚三天),并于翌日输入诉讼卷宗,较5月14日答辩期限约提前六周。这是一份二十八页的备忘录,附带一份声明和大量证物。图6将两个答辩回合中的答辩时间间隔与被告的准备时间间隔进行了对比。观察到的是实质上、及时和相称的答辩这一事实,而非其本身的是非,由自代理诉讼人对多家律师事务所代理的协调防御所提出。相关要点是结构性的而非个人性的:同时就有据可依的基础上针对多份不同的诉讼文件作出回应,正是多模型工作流程被设计来分配的那种并行多线程任务,与文献所假定的单线程提示形成对比。时机对合规以外的事项很重要:在整个答辩期间内,一份在公开诉讼卷宗上长期未答复的申请,对于在此期间阅读诉讼卷宗的任何人来说,只会呈现提议人的说法。在数日内提交的异议会缩短这一间隔。这种不对称通常对自代理诉讼人不利,他们通常无法缩短这个间隔。
图6。 按答辩回合划分的准备和答辩时间间隔。
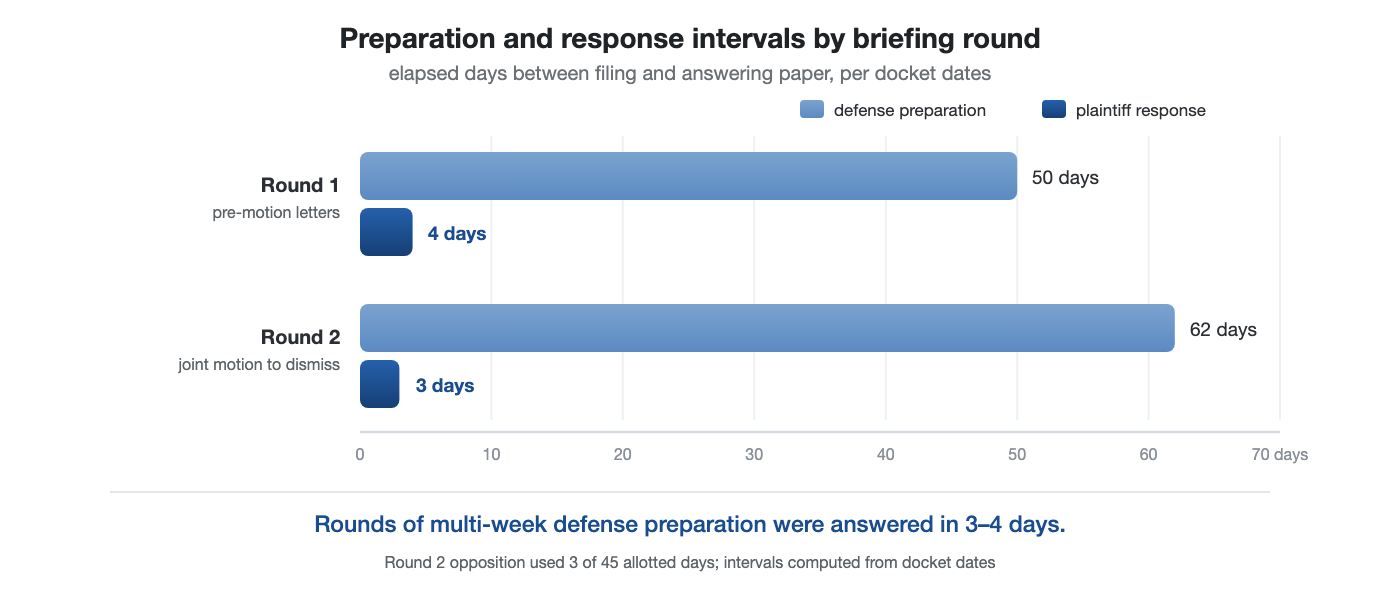
来源:公开诉讼卷宗;各回合中有效提交与答辩提交日期之间的经过天数(文件日期;诉讼卷宗条目可能随后一天输入)。第一回合中被告的间隔是从送达完成(2025年11月)到2026年1月12日的协调一致的动议前信函期间测量的。经过的时间间隔上限界定了准备时间;它们不区分草稿时间和战略时机。
D. 识别防御备忘录中法定引用错误。
原告的异议指出了联合动议所依据的法定权限中的一个错误。在处理"充分和平等享受"要素时,被告简状引用了42 U.S.C. § 12184(ECF No. 69-1,第15页),这是规管私人实体提供的特定公共交通(如公交车、出租车和豪华轿车)的条款,而诉求根据42 U.S.C. § 12182(公共便利设施条款)提起(原告异议,ECF No. 76,第17页)。21关于自代理AI使用的典范关切是虚构引用:不存在的法定权限,由模型生成并由诉讼人提交。这里,可验证的引用错误出现在由律师提交的文件中,它在自代理诉讼人利用编排系统提交的文件中被识别,该系统的设计明确包括对外部来源的引用验证。第三部分中定义的编排包含两个机制,即跨模型分歧和对外部来源的验证,而条款编号的错位正是第二个机制所设计用来捕捉的那种缺陷。此处不需要多模型辩论机制。按作者的说法,该错误是由工作流而非诉讼人发现的:一个模型标记了引用条款与诉求所基于条款之间的不匹配,整合模型进行了检查并确认了它,评论者再次检查了它。该诉讼人不是律师,无法自行发现错误或验证纠正。所涉及的特性是验证组件,而非整体的包。纠正的方向与文献所引导人们预期的模式相反;其在动议处理中的分量由法院裁决。任何读者都可以独立验证该错误:这两个条款在《美国法典》同一章中相隔两个条款,防御备忘录对§ 12184的引用在页面上是可见的。这两个条款具有平行的规定性语言,各自在其适用范围内保证"充分和平等享受",因此该替换是读者在阅读时不会注意到但在逐一检查每个引用与其来源时不会遗漏的那种类型。区别在于覆盖范围:§ 12184规管私人实体提供的特定公共交通,而非公共便利设施场所。原告的异议强调错误引用"不仅仅是笔误",因为它出现在备忘录对具有决定性作用的要素的处理中;条款编号的错位不是虚构的法定权限。在对方简状中检测到错误放置的法定引用是自代理AI使用文献中主导失败模式的反面,即在自己的简状中生成错误放置的引用。
责任归属是与错误本身不同的问题。文献的隐含规则将AI辅助的自代理诉讼人犯下的错误归为技术的表现证据,而将律师犯下的错误归为个人疏忽,视为总体上可靠实践中的过失。这里记录的事件对该规则提供了一个检验,最好表述为一个问题:如果一个使用生成式AI的自代理诉讼人在某个决定性要素上引用了《美国残疾人法》的运输条款而非公共便利设施条款,该错误是否会被理解为一个孤立的疏忽,还是非专业人士与聊天机器人诉讼时所发生事件目录中的又一项?这两种解读不太可能一致,这种责任归属的不对称而非错误本身,是架构依赖假说要求文献审视的部分:即行为是根据谁产生的而非根据如何产生的来编码的。而且,这种不对称性针对不断变化的基准线持续存在:如第二部分所记录的,已记录的幻觉事件不再主要是自代理现象,但系统性威胁的框架仍然依附于诉讼名册的自代理一侧。
E. 早期和解。
Figure 7. 四次和解的顺序。
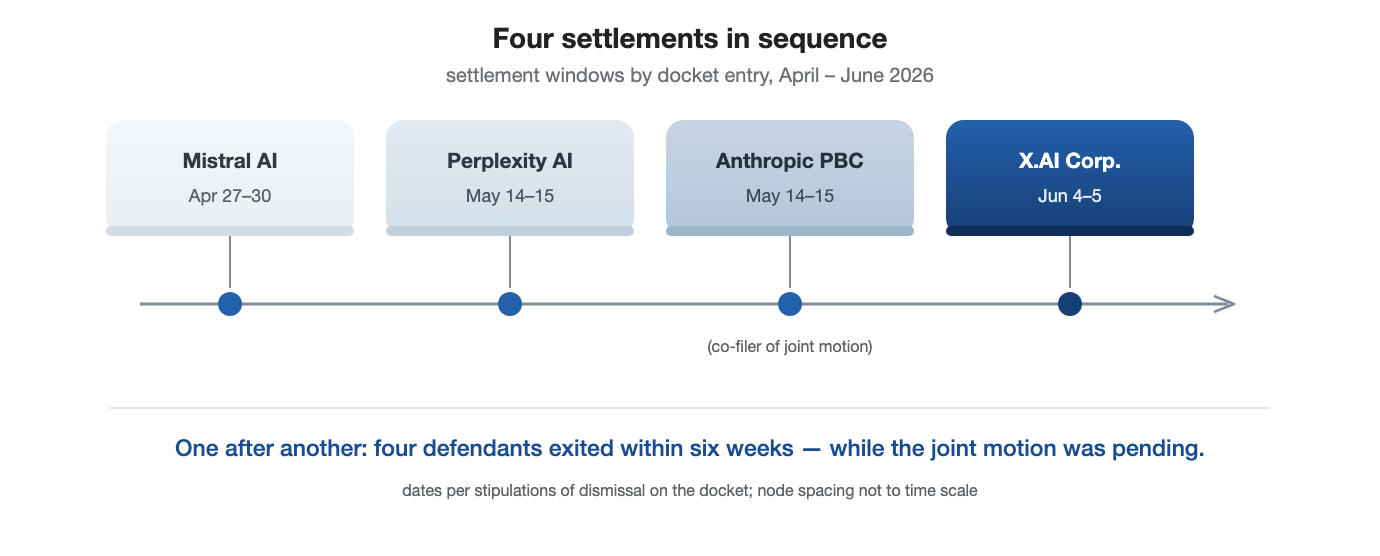
来源:公开诉讼记录,ECF Nos. 83-86和94(附带偏见的驳回协议;ECF Nos. 83和84是Mistral协议的两份同日申请,驳回令引用第84号)。
四名已进入诉讼的被告在一个压缩期间内与原告解决了争议,并被附带偏见地驳回(图7)。按照惯例,公开诉讼记录中仅显示驳回协议;和解条款是保密的,原因不在记录中,没有推断出任何原因。本小节将一个通常不可见的和解序列记入记录,从而使其可验证。
该序列的两个特征值得说明,因为它们在公开诉讼记录中是可见的。至少在两个案例中,与协调防御对齐的被告随后通过驳回协议离开了它,一个在提出反对意见之后、联盟回复之前和解;另一个在首先将联盟的联合备忘录纳入其自己的动议之后。时间顺序的模式是公开申请的问题:已进入共同阵线的被告一次一个地退出了它,而他们加入的动议仍未决。
另一个特征是企业被告与自代理诉讼人之间的和解通常是保密的,在公开记录中几乎不留痕迹。这里驳回协议本身就是诉讼记录条目,这使得该序列异常清晰;该记录的证据价值在于其可验证性。
Table 3. 十三名被告的身份状态(截至2026年6月)。
| 身份状态 | 被告 |
| 未出庭 | Samsung; DeepSeek; OpenAI |
| 已和解并驳回 | Mistral AI; Perplexity AI; Anthropic PBC; X.AI Corp. |
| 继续中 | Microsoft; Apple; Google; Meta; Amazon; Alibaba Cloud |
来源:公开诉讼记录,截至2026年6月。
图8再现了2026年6月4日单天的诉讼记录序列,作为主要记录。包括这个是为了让读者可以直接检查时间安排。人工智能辅助诉讼的哪些配置会产生这种形状的记录,频率有多高?该问题属于第VII部分提出的系统研究。
Figure 8. 2026年6月4日的诉讼记录序列。
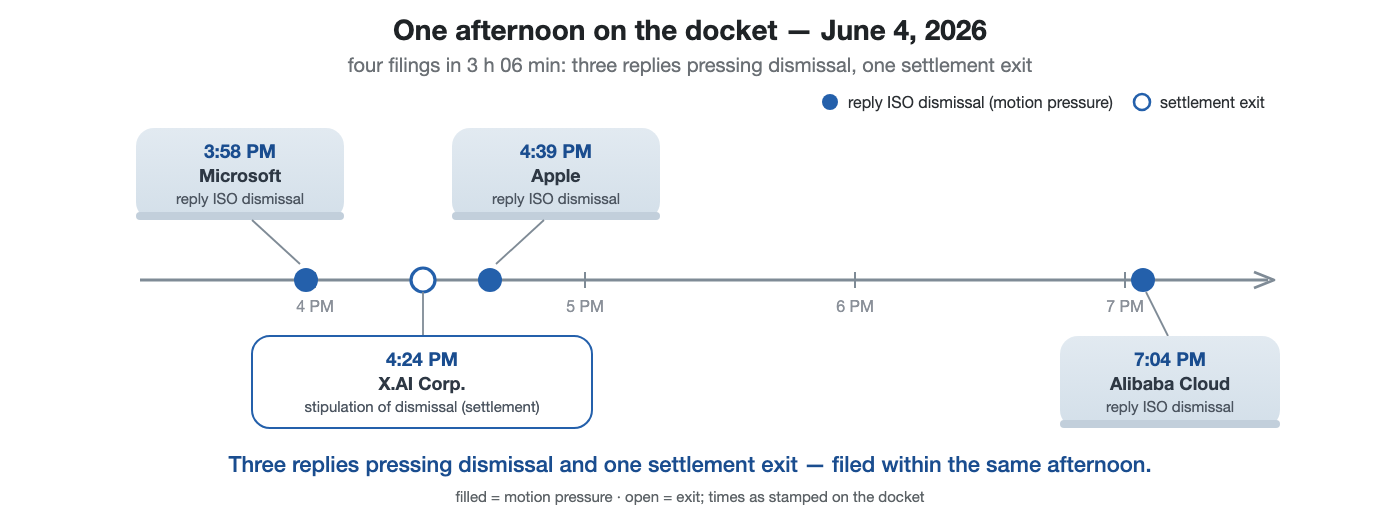
来源:公开诉讼记录;单日申请时间,ECF Nos. 93-96。
这些特征一起描述了一个自代理诉讼人通过完整的简报周期维持多方联邦诉讼,按时提交,按比例应对,并识别对手错误的能力,对抗协调的、由律师代理的防御。这不是现有说法所描述的模式。该说法涉及无差别的数量和不可靠的输出,描述了一个分布,单个案例无法与分布相矛盾;但这里记录的模式超出了汇总研究测量的范围,这就是为什么它对他们来说一直是不可见的。编排架构是否对该模式负责,以及该模式是否在各种案例中重复出现,是下一部分为系统调查而提出的问题。
VI. 学说含义
更难的问题是学说性的,其中两个正在联邦法院推进。目的是展示基于编排、注重质量的自代理人工智能使用说法如何重新框架化每一个问题。法院已经拥有一个发达的框架来评估人工智能输出作为证据(Grimm, Grossman & Cormack 2021)。这里的问题是相邻的:它们不是关于机器输出是否可被采纳;两者都关乎谁拥有产生输出的过程以及该过程是否从事法律活动。
A. 工作成果与自代理诉讼人。
诉讼当事人与人工智能系统的互动是否作为工作成果而免于发现披露,这是一个新兴争议。在2026年初的七周内,三家联邦法院涉及人工智能使用和工作成果保护的交汇点,它们的观点并不一致。22在Warner v. Gilbarco, Inc.案中,一名裁判官驳回了强制自代理就业诉讼原告提交其生成式人工智能查询及其收到的回复的动议,认定这些材料根据《民事诉讼联邦规则》第26(b)(3)条属于工作成果保护:自代理诉讼人充当自己的律师,这些材料反映了她的心理印象和准备工作,向生成式人工智能系统(一种工具而非个人)的披露并非放弃保护所需的对抗性披露。该判决遵循该学说最古老的层级,因为《Hickman v. Taylor》案最强力保护的是律师的心理印象、结论和理论:这是法院视为几乎绝对保护的工作成果层级(《Hickman v. Taylor》案,329 U.S. 495, 510–11 (1947))。诉讼当事人提出的查询、他修订的草稿以及他舍弃的论证属于该层级在自代理情形下的类似物。一周后,在United States v. Heppner案中,法院作出了相反的裁决:一名有律师代理的刑事被告曾凭自己的主动使用公共人工智能助手,未经律师任何参与,法院命令提交由此产生的文件,强调他在律师没有指导的情况下行动,且该平台的消费者条款允许提供商保留和使用其输入。Morgan v. V2X, Inc.案是该系列中第三个也是最详尽的判决,扩展了《Warner》案的核心判决,认定自代理诉讼人在诉讼准备中使用人工智能"密切类似于第26(b)(3)条旨在保护的机密、战略性迭代工作成果"。不过,同一判决书要求诉讼当事人披露他在其他一方指定的机密材料中使用的任何人工智能工具的名称,并修正了保护令以限制使用主流人工智能服务处理此类材料。23法院所作的区分在分析上是重要的,因为它解释了为什么《Warner》案和《Heppner》案不存在冲突:有律师代理的当事人绕过律师会在当事人和代理人之间造成间隙,这一间隙在《Heppner》案中证明是致命的,而自代理诉讼人"同时是当事人和代理人",因此不存在这样的间隙。该保护并非无限制的:法院认定人工智能工具的身份本身不受保护,并将人工智能在机密发现材料上的使用以合同保障为前提,以防止培训、保留和第三方披露。因此,这三项判决在将传统学说应用于人工智能方面趋同,但在谁可能主张保护和什么构成放弃方面出现分歧。它们所划分的界线是架构性的,尽管措辞出自本文:判决书涉及代理权、机密性和放弃。《Heppner》案主张失败的原因不是使用人工智能,而是所采用的配置:一种消费者工具,其条款允许保留和培训。相比之下,《Morgan》案则将保护限制于合同禁止培训、保留和第三方披露的配置。机密性态势与验证一样,是协助架构的特性,而非人工智能本身的特性。本文的变量在此出现在学说本身之中(表4)。
表4. 2026年初工作成果三分法,按配置分类。
| 案件 | 诉讼当事人 | 代理间隙? | 工具配置 | 判决 |
| Warner | 自代理原告 | 无——当事人和代理人是同一人 | 生成式人工智能用作自己的准备工具 | 受工作成果保护 |
| Heppner | 有律师代理的被告,但未经律师指导而行动 | 有——当事人绕过代理人 | 消费者工具;条款允许提供商保留和培训 | 命令提交 |
| Morgan | 自代理原告 | 无——"同时是当事人和代理人" | 在机密材料上的使用以合同保障为条件:禁止培训、保留或第三方披露 | 受保护,但有条件;工具身份不受保护 |
来源:Warner, 2026 WL 373043; Heppner, 2026 WL 436479; Morgan, 2026 WL 864223。这些判决在应用传统学说方面趋同,在配置事实方面出现分歧;最后两列的架构解读出自本文,而非法院——架构改变了学说所权衡的事实,而非法律。
Morgan案于2026年3月30日判决,这是联合驳回动议在本案中提交的同一天:该学说在案件进行答辩期间形成。
综合审视,2026年初的这些决定使该工具的架构越来越具有决定性:谁指挥了它、它做了什么、其记录如何保存。编排说明明确了这一方面的利害所在。如果对自我代理当事人的人工智能协助仅仅是机械性的文本生成,那么将其视为受保护的策略的论据就会很薄弱;一个编排工作流程——当事人在其中提出问题、权衡不同模型的输出、并迭代以形成立场——在功能上难以与工作成果学说一直以来在律师手中保护的充满策略考量的迭代过程区分。一个当事人指挥一批不同的分析引擎,其情形与一位首席律师指挥初级律师团队没有什么两样。该学说的根本目的是防止一方搭另一方诉讼准备的便车,无论该准备是由律师执行还是由通过多模型系统工作的当事人执行,其适用的力度都是相同的。Morgan指向这一方向,编排框架提供了功能上的理由。
工作成果保护取决于保密性,可以通过自愿公开披露而放弃,至少就所披露的内容而言。因此,发布关于自己未决案件的说明有可能放弃Morgan所认可的保护,至少就其所披露的内容而言。
B. 未经授权的法律执业。
在自行代理诉讼的背景下,未经授权的法律执业的顾虑经检视后显得框架奇特。未经授权的法律执业规则将法律执业保留给执业律师,以保护公众免受他人不合格的代理。24这些规则源于州法,其对执业的定义因司法管辖区而异;下文涉及该框架的共同逻辑,而非任何单一州的边界。消费者法律人工智能引发的真正问题是,该工具或运营该工具的公司是否通过向诉讼当事人提供建议而从事未经授权的法律执业。该问题实质上取决于建议的可靠性:一个自信地杜撰法律权威的工具看起来就像未经授权的法律执业规则试图防止的不称职的执业。
然而,自行代理诉讼的当事人仅代表自己。他有法定权利这样做(28 U.S.C. § 1654),对有缺陷的诉状的处罚落在他身上而非客户。当这样的当事人使用人工智能系统时,未经授权的法律执业框架必须将"法律执业"定位在某处:在工具中、在其开发者中,或根本不在,而这些答案都很尴尬。真正激发这种顾虑的不是授权问题,而是可靠性,即害怕一个无执照、无问责的系统会向一个无能力检查的人自信地提供错误的法律。可靠性并非全部,因为法院既通过问责也通过专业能力来监督法律执业:执业律师可能被制裁、暂停执业或除名,而人工智能系统则都不能。问责差距是真实存在的,而协调方案解决的是可靠性问题,而不是问责问题。如果一个协调系统出现系统性错误,责任可能落在三个地方之一:在签署诉状的操作人员身上(目前第11规则所能约束的唯一行为人)、在架构的提供者身上,或根本没有人。法律选择三者中的哪一个将决定问责差距是缩小还是仅仅转移。
这里单一模型与协调的区分起到了真实的作用。激发未经授权的法律执业顾虑的可靠性不足是单一模型配置的特征,而围绕跨模型验证和引文验证构建的架构针对该不足。这并不化解未经授权的法律执业问题,因为即使是高度可靠的工具仍然可能被称为"从事法律执业"。它所做的是分离辩论往往合并的两件事:可靠性和授权是分析上不同的问题,将它们混为一谈会掩盖这样一个事实,即架构修复可以解决第一个问题而不涉及第二个问题。如果可靠性是真正的顾虑,那么架构,而不仅仅是许可证,就成为分析的一部分,而一个设计用来浮现和解决分歧而不是声称单一答案的系统在其自身条件下解决了这种顾虑。如果可靠性是架构的,它也是可设计和可认证的,是重新设计法律服务监管提案所依赖的那种对象(Hadfield 2017)。一个拒绝发出它无法验证的内容,并将不可约化的不确定性交由人类处理的架构,开始作为设计合规而不是作为无执照的顾问发挥作用。
C. 重新框架化,而非解决。
两个学说领域仍未确定。关于自代理AI使用的主流"规模和幻觉"解释塑造了这些学说辩论,而质量导向的、基于编排的解释则重新框架化了它们。当将AI使用理解为迭代策略而非机械输出时,工作产品保护显得更加连贯;当将可靠性视为架构变量而非固有缺陷时,UPL辩论看起来就不同了。
七、局限与未来工作
四个限制界定了设计。首先,也是最根本的,这是一个单一案件(n = 1),由案件的一方撰写。第五部分的发现是存在性主张而非分布性主张。这样的案件所能做的是定性方法长期以来对于极端或揭示性案例所认可的:揭露标准设计尚未触及的现象,并生成系统研究随后必须检验的假设。
其次,作者既是诉讼当事人、开发者,也是分析师;第四部分的约束由此而生。
第三,因果关系无法隔离。该记录无法将架构的贡献与诉讼当事人自身的技能、事先准备、未付费当事人的激励或其他混淆因素区分开来。第三部分的架构讨论提供了一个看似合理的机制,而非已被证明的机制。
仍有多个竞争性解释是可信的。该诉讼当事人可能只是有能力的:受过教育、积极主动且未被计费,自代理当事人可以在一个案件上花费数百小时,而律师只会花费数十小时。三天的反对意见可能衡量的是准备工作而非处理工作(第五部分B)。选择在两个层面上进行。在案件层面,这个案件之所以成为文章的主题是因为其记录是有利的,而编排辅助诉讼当事人失败的案件不会生成文章。在事件层面,选择是作者自己的:卷宗包含的事件多于本文所描述的五个,作者选择了要展示的内容。针对该选择,完整性陈述是卷宗可验证的:截至2026年6月,记录不包含对原告的制裁令、不包含驳回其任何诉状的令状,也不包含他错过的任何截止日期。该记录最接近不利程序说明的地方在于案件的门槛处,法院在该处否决了原告的贫困诉讼申请(诉讼费随后在允许的时间内支付),并指出在提供送达地址之前无法签发传票,该地址随后被提供。该陈述可被任何拥有PACER访问权限的人证伪;事件层面的选择仍然可以隐藏的是强调,而非不利的裁定。下面提出的研究旨在裁决这些竞争性解释。
进一步的限制涉及范围而非有效性。第二部分从Legal Services Corporation研究的低收入美国人的角度框架化司法差距,而这里的诉讼当事人是一位博士级别的AI系统架构师,运营自己设计的系统,是一位从技术能力分布的远端尾部抽取的自代理原告。存在性证明并未因此而削弱,但其范围比第二部分关注的人群更窄:本案中没有任何内容表明编排辅助诉讼实际上可供该人群使用,对于他们而言,成本、数字访问和技术能力本身就是障碍。架构的益处是否能够在从专家操作者转移到典型的自代理诉讼当事人的过程中存续,这是一个经验问题,对于第二部分的辅助框架,可以说是决定性的;下面提出的研究的残障部分旨在涉及它。转移不仅仅是技术设置的问题。编排将操作者的认知负担从起草转移到仲裁:阅读竞争性输出、权衡呈现出的分歧、决定保留哪一项。仲裁本身是一项要求很高的技能。该负担是否可以由界面设计而非操作者专业知识来承担,以及对具有认知、视觉或教育障碍的诉讼当事人的成本如何,这是一个设计问题,也是一个经验问题。
第四,案件待决;这里的任何发现都不取决于它如何结束。
该案例所产生的假设,即编排架构与比单模型提示更高质量的自代理诉讼行为相关联,是可检验的。一项系统性研究可以对各种诉讼行为(期限遵守、引用准确性、动议结果)进行比较,涵盖按人工智能协助模式编码的自代理诉讼文件样本,利用实证文献已开始发展的人工智能一致起草指标和LegalBench(一个协作构建的法律推理基准)(Guha et al. 2023)。一个任务类别——植入错误检测——直接源自第V部分。试用案状书被植入了可验证的缺陷,类型如第V部分所述:错误排列的法定条款、错误引用的权威性来源、虚构的引用。随后在各协助模式中比较检测率,从单模型提示到编排验证,律师和非律师操作者作为单独的分组。架构的组成部分(外部来源验证和跨模型分歧)分别进行消融,以便确定每个机制的贡献,而不是将其归功于整体(表5)。此类设计,由独立研究者在多个案例中进行,可以将此处提出的存在声明转化为分布性声明,或予以驳斥。更强有力的设计是可行的且应该被优先采用:在相同法律任务上进行单模型和编排协助的对照比较,采用预先注册的方案、公开的材料和对系统自身声明的盲集验证,包括其引用验证率;准实验识别,如围绕多模型工具公开可用性的双重差分设计;以及为患有运动、视觉或认知障碍的参与者设立的专门分组,对于他们而言,第II部分的辅助框架并非假设。法律协助的随机评估有先例:获取司法途径文献已进行了关于代理提议和无捆绑协助的随机研究(Greiner, Pattanayak & Hennessy 2013),此处提出的协助模式比较将该设计传统扩展至架构变量。更广泛地说,该假设提出了该领域尚未采纳的标准:人工智能系统不仅应按其输出质量评估,还应按其推理架构的质量评估。其中没有任何内容特定于法律:无论在何处将重要工作委托给生成系统(无论在医学、工程或金融中),同样的问题都会出现,同样的变量也保持未被衡量。它还重新框架了获取司法途径分析长期以来视为既定的变量。申请人的进入成本是$405的申请费,被告律师的正式进入成本是$200的临时出庭许可费(ECF Nos. 19, 52, 60)。两者都是数百美元量级,他们处于长期以来实际上无法逾越的资源差距的两端;比较仅涉及正式进入费用,不涉及代理费用。可能改变的不是进入法庭的价格,而是保持所需诉讼能力的边际成本。该成本实际上是否已下降,下降幅度如何,是提议研究的实证问题;它已成为变量而非常数这一事实本身就是值得检验的假设。
表5. 提议的研究,按分组分类。
| 分组 | 配置 | 它所分离的内容 |
| 1 | 仅人工,无人工智能(对照组) | 无协助的基线检测 |
| 2 | 单模型提示 | 文献所记录的模式 |
| 3 | 编排,完整版本 | 部署的整体方案 |
| 4 | 无外部来源验证的编排 | 引用检查的贡献 |
| 5 | 无跨模型分歧的编排 | 表面分歧的贡献 |
注:每个分组分别与律师和非律师操作者共同运行,并有一个单独的残疾人士分组,在五个编号分组之外进行,针对患有运动、视觉或认知障碍的参与者,结果测量在会议前预先注册;详见正文。
VIII. 结论
关于人工智能在自代理诉讼中的主流叙述是一个关于数量和不可靠性的故事:更多诉讼人,提交速度更快,虚构权威的风险更高。它未言明但默认假设人工智能协助意味着一个诉讼人提示一个通用模型,而这一假设已不再成立。
根据作者的叙述,本案例建立在不同的架构基础上:多个独立的模型被并行查询,它们的分歧被表面化和解决,而不是被压制。对诉讼行为的描述完全基于可验证的公开记录;该记录包含了数量和幻觉叙述既不描述也不预测的行为:对缺陷文件的快速重建、比计划大幅提前提交的实质性反对意见,以及在协调一致的答辩中发现的法定引用错误。该文章随后展示了将人工智能协助理解为编排,以及作为质量问题,如何重新框架了目前在联邦法院面前进行的两场教义辩论。对于无法以诉讼要求的速度进行打字、查看或组织的诉讼人来说,架构差异不是效率问题,而是按照《美国残疾人法案》关于充分和平等享受的无障碍问题:人工智能协助的配置方式是否是使得自代理成为可能的关键因素。
主张是人工智能协助的架构,而不仅仅是其可用性,应当纳入对自代理诉讼人现在能够做什么的分析中。当基础模型的原始能力趋同时,这一主张变得更加紧迫,因为当模型本身差异较小时,它们的组合方式将差异更大。架构依赖假说认为架构并非实现细节,而是决定人们和法院能做什么的质量的因素。人工智能是否参与法律工作已不再是问题;仍然开放的是哪些架构做什么。按照这个说法,法律自助人工智能问题是一个设计问题,而不是智能问题,设计问题有设计答案。前面的工作是指定特定架构并相互测试,而不是等待更好的单个模型。附录精确地陈述了一种这样的架构,足以运行和批评,并随附了一个参考实现。
附录。一种协助架构,精确指定以供运行
本文的论证是"人工智能协助"是指一系列具有不同故障特性的架构。一旦至少有一种架构的规范足够精确以供运行和批评,这个主张就更容易测试。下面的协议就是这样一个陈述。这里将其称为盲合并协议25,以最清楚地将其与多代理辩论区分开的阶段为名,在后者中模型相互阅读。26它仅使用公共模型,任何具有三个供应商的消费者级或API级访问权的人都可以复制它。
下面的协议在架构层面陈述了第三部分所述的族:异构模型以隔离方式查询、在明确规则下形成共识且保留分歧而不是平均化、每条引文都核查其来源。它与第三部分所述系统在最后核查的进行方式上有所不同:在那里是一个组件对实时数据库进行验证,这里是启用搜索的模型后跟一个人;下面的约束三明确指出模型的批准不是核查。它在这里作为规范而不是证据来陈述:本文未在输出中提供案例研究诉讼文件,也不从中得出推论(保留内容见注24)。协议对该论证的贡献是运行清单。本文中的架构变量是自我报告的(第四部分);清单是外部读者在确认其他任何内容之前所需的。第五部分的诉讼文件不包含任何内容。
它解决的问题。
自代理当事人可以通过免费消费者级服务接触多个前沿模型,成本、数字获取和技术熟练程度仍然是障碍(Part VII):下面的高风险类别是付费API访问,而后面规定的保密条件将大多数免费层级排除在外,对于最需要保护的内容更是如此。常见做法是向其中之一提问、阅读答案并提交。记录在案的失败是:一个自信的模型产生了不存在的引用,而整个过程中没有任何机制能够发现这个错误。该协议用一个通用任务陈述和随后的四个阶段取代了单一提问。它保持每个模型的准确性不变;它协调多个系统,使得一个系统的错误必须能够在与其他组织训练的系统接触中幸存,并记录各自的回答。
角色。
该协议由每个角色被允许看到的内容定义。四条规则确定了这一点:
1. 生成器只能看到任务陈述,别无其他。没有人能看到另一个生成器的草稿。
2. 整合器在中性标签R1至Rn下看到每个草稿,顺序随机。它永远不会了解哪个供应商生成了哪个草稿。
3. 第一个审查者在整合器自己的家族内部以新的语境进行阅读。它看到任务陈述和整合后的文档,但看不到产生它的整合过程。
4. 最后的读者是来自不同于整合器的供应商的审查者。它看到任务陈述、整合后的文档和第一个审查者的报告,其判决关闭此次运行。
任何来自不同供应商的满足四条规则的前沿模型组合都可以运行该协议。作为说明,以下是2026年9月可用且可以填补这些角色的公共模型:
表6. 2026年9月可用的可以填补四个角色的公共模型。
| 角色 | 常规文档 | 高风险文档 |
|---|---|---|
| 生成器,隔离 | claude-sonnet-5(带搜索);gpt-5.6-terra(带搜索);gemini-3.1-pro-high(带搜索);一个开放权重模型 | claude-opus-5(带搜索);gpt-6-astra(带搜索);gemini-3.1-pro-high(带搜索);Grok (xAI);一个开放权重模型 |
| 整合器,盲目 | claude-sonnet-5 | claude-fable-5-1 |
| 审查者1,整合器家族,新语境 | claude-sonnet-5 | claude-fable-5-1 |
| 审查者2,不同供应商,最后阅读 | gpt-5.6-terra | gpt-6-astra |
来源:截至2026年9月的供应商文档。模型对角色的分配是作者的;角色而不是标识符定义了该协议。
该表是可用内容的说明,标识符会过时。角色不会。Grok按供应商命名,开放权重模型按类别命名,因为它们的托管标识符因主机而异,gemini-3.1-pro-high是托管接口的别名,而不是供应商API文档中的模型代码。高风险列添加了第五个生成器,其整合器是一个没有编写草稿的模型,因此它永远不会在标签下判断自己的文本。图9按角色描绘了该协议。
家族对角色的分配基于作者的使用,而不是基于测量。在2025年和2026年约2000小时的工作中,当充当盲目审查者的模型来自与整合器相同的家族时,在新的语境中,它返回了最严格和最有用的验证,即使所审查的文本由该家族生成也是如此。来自其他供应商的评论者并不是更弱的读者;他们发现了不同的东西,这就是为什么该协议保留了其中一个并给予它最后的判决。四条规则是关于每个角色可以看到什么,而不是关于哪个供应商填补它,如果读者更喜欢在整合器或第一个审查者处使用不同家族,可以替换一个,仍然在运行该协议。
图9。 盲整合协议,按角色:隔离生成、盲整合和两次验证。
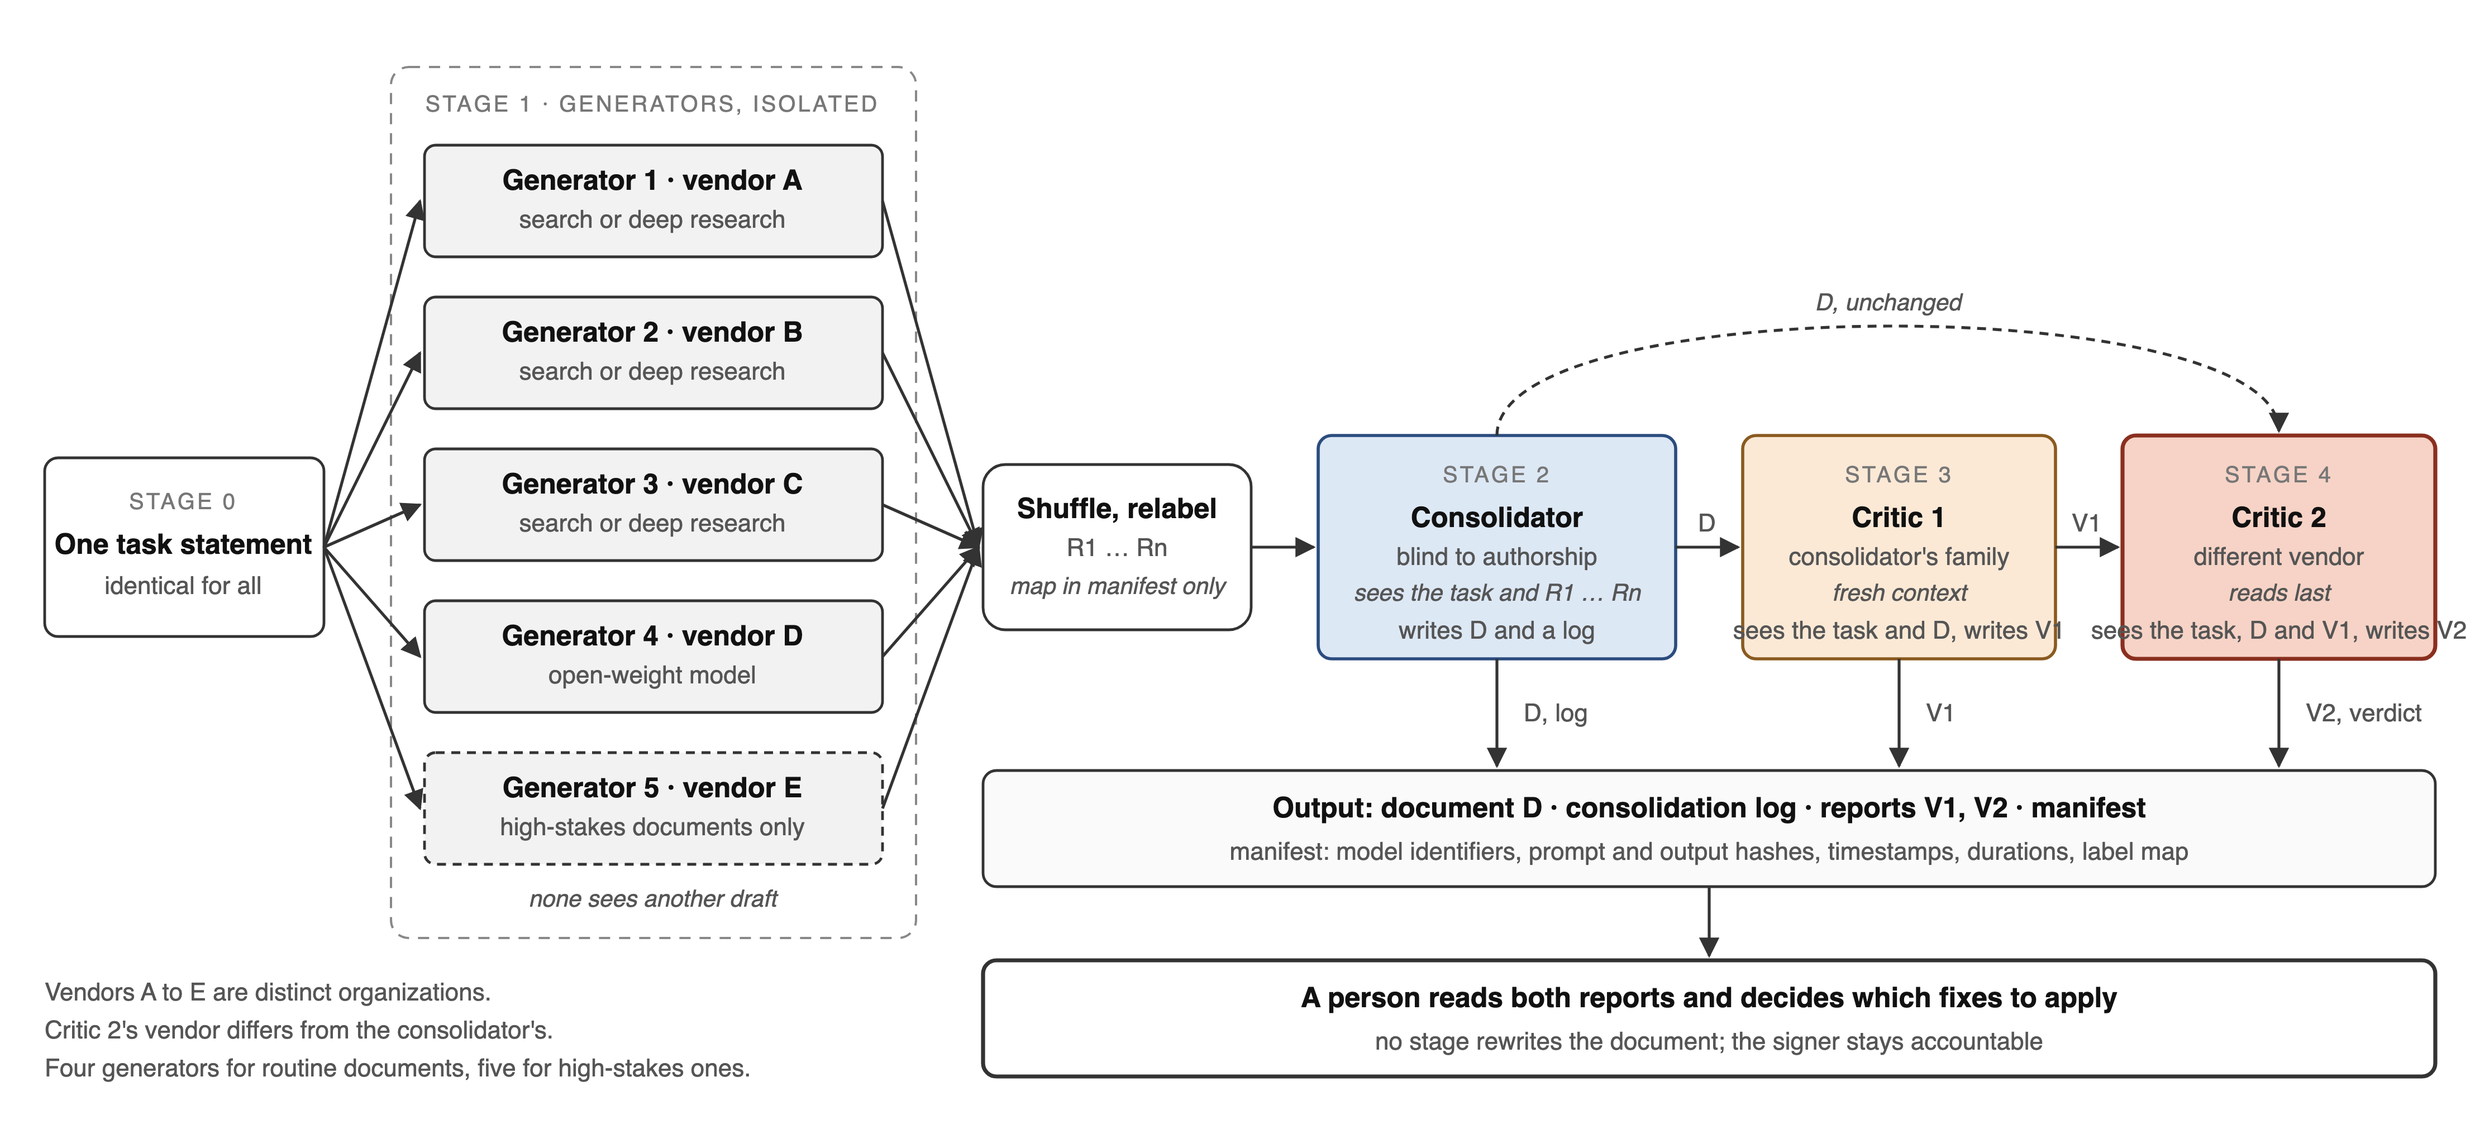
来源:本附录中指定的协议的作者图表。
这是一个坡道。它是为不能走楼梯的人建造的:不能同时打开五个界面,相互对比阅读,并将答案带回。这个坡道被到达门的每个人使用,而不仅仅是为其建造的那个人。上述公式被记录下来,以便任何人都可以采用它。
阶段。
阶段0。单一任务陈述。单一书面陈述规定了目标、司法管辖权、所需格式、什么算作来源,以及如何处理无法验证的声明。每个模型不变地接收它,以便草稿之间的差异来自模型。
阶段1。隔离生成。每个生成器并行生成完整草稿,在接口或API支持的任何地方启用网络搜索,在任务需要深入研究的地方进行深入研究。这些供应商的消费者接口默认进行搜索;一些程序端点不包含搜索工具,在其中一个上运行的生成器从权重中起草,运行记录必须显示这一点。每个都需要为每个事实和法律命题引用可验证的来源,将其无法验证的内容标记为未验证,并以其待解问题结束。隔离是机制。由不同组织在不同语料库上构建的模型发明不同的东西,多个模型独立生成的声明(各有自己的引文)与单个模型生成的声明相比处于不同的证据位置。看到另一份草稿的起草者同意它的原因与声明是否真实无关。
阶段2。盲目合并。一个模型将草稿作为R1到Rn接收,顺序随机选择并仅在运行清单中记录,按明确规则合并它们。由多份草稿或可验证引文支持的声明优先纳入,这是关于什么进入草稿的规则,而不是关于它们是否真实的发现。在单一草稿中发现的材料在带有可验证引文时保留。冲突通过证据解决或在文本中标记。草稿之间的一致被记录为一致,永远不会被提升为证明。新材料仅在合并者自身验证时才进入,并标记为已添加。每个实质性声明都带有一个标签,说明支持它的草稿。合并者还写一份日志:草稿同意的内容、不同意的内容及如何解决每个冲突,以及删除的内容和原因。日志是分歧存活的地方。因为标签映射被保留,后来的读者可以将标签与其对照并测量合并者多经常偏好其自己的供应商的草稿。
阶段3。内部验证。来自合并者家族的批评者在新的背景下阅读合并文档,对合并没有记忆。其任务是验证,它不返回改进的文档。它检查每个引文是否存在和准确,测试推理是否有间隙和夸大,确认任务陈述已满足,并报告分为关键、重大和轻微的发现,判决为:批准、带修复批准或拒绝。
阶段4。跨供应商验证。来自不同供应商的批评者阅读相同的文档和第一份报告。它确认、质疑或扩展每项发现,添加自己的发现,并给出最终判决。这个阶段存在是因为前两个阶段的弱点:由其自己的家族检查的合并者会共享该家族的盲点,而由他处受训的读者是识别这些盲点的最直接途径。
管道的输出内容。
交付物包括合并后的文档、合并日志、两份验证报告和清单。任何阶段都不会用评论者的输出覆盖该文档。由人员阅读报告并决定应用哪些修复。在诉讼中,签署诉讼文件的人对其内容负责,而无声地改写文本的管道会模糊谁决定了什么。
清单为每个阶段记录模型标识符、提示哈希、输出哈希、开始时间和持续时间,以及标签映射。没有它,以这种方式准备的文档与提问单个模型两次产生的文档无法区分。有了它,不在场的读者可以审计操作员关于运行的记录:为哪个角色配置了哪个标识符、草稿按什么顺序标记、每个阶段接收和返回了什么。这是一份结构化的自我报告,而不是证明。标识符来自配置而非经过身份验证的响应,手动运行的阶段依赖于操作员对界面中所发生事件的说法,而提供搜索工具的记录不等同于核实来源的记录。使变量被观察而非报告需要第三方对运行的保管,这是第七部分的设计所提供但文件格式无法提供的。
参考实现。
一个参考实现 docprep 在开放许可证下发布(注 25):一个文件中约五百行 Python 代码,包含表 6 的配置、清单格式和无需账户或密钥即可运行的离线测试。
该实现区分了它强制执行的内容和它仅要求的内容。四个角色规则被强制执行。生成器的提示仅由任务陈述组装;草稿到达合并器时被打乱和重新标记,其中映射仅写入清单;若配置的第一个评论者来自合并器的供应商家族外,或最后一个评论者来自该家族内,则该配置在调用任何模型之前被拒绝(图 10)。第二阶段的合并规则仅被要求:它们是合并器提示中的指令,模型可以违反它们。合并结果事后被检查,因为没有日志的合并会导致运行停止。
图 10。作为运行前提条件的角色规则:对最后评论者的检查及其打印的拒绝。
home = family(cfg, cons) # the consolidator's vendor family
. . .
if critics and family(cfg, critics[-1]) == home:
problems.append(f"{critics[-1]['name']} is from the consolidator's family "
f"({home}); the last reader must come from another vendor")
. . .
if problems and enforce:
sys.exit(f"formula '{formula_name}' breaks the protocol:\n - "
+ "\n - ".join(problems))
$ python3 docprep.py run --formula manual
formula 'manual' breaks the protocol:
- critic_cross is from the consolidator's family (anthropic);
the last reader must come from another vendor
来源:docprep,docprep.py,函数 validate(),版本 v1.0.0(注 25);省略已标记。下面是所示命令在示例配置上的输出,其中最后评论者被重新分配给合并器的供应商。存储库的离线测试也显示相同的拒绝。
执行受清单的限制。角色的供应商家族在配置中声明,但未经验证。手动运行的阶段是盲目的,仅凭操作员的话。重新标记删除名称,而不是样式。拒绝可以关闭,此时清单会记录它已被关闭,并列出被违反的规则。规则针对操作员的错误进行强制执行,而不是针对操作员本身。
法律范畴。
一种通过增加供应商来降低错误相关性的架构,同时提高了材料流出的地点数量。对于在美国法院自行代理的诉讼人来说,这种权衡不是抽象的。
截至2026年9月,美国的现状有三个方面:申请人必须披露的内容、可以发送给供应商的内容,以及该工作是否作为工作成果而存在。第二部分和表1阐述了披露制度;第六部分A阐述了工作成果分析及其权威来源。没有通常适用的联邦诉讼程序规则要求申请人披露AI的使用或命名一个模型:2026年4月,民事规则咨询委员会从议程中撤销了两项旨在处理伪造权威的提案,同意此时进行规则制定将不适当。27地方规则和个别常设命令确实要求这样做,但它们有所不同。德克萨斯州北区要求在简报的首页披露AI使用事实,但不要求说明使用的是哪个模型。国际贸易法院的瓦登法官要求说明所用的程序、它生成的文本的具体部分,以及证明该使用未向未授权方披露任何机密或商业专有信息的认证。28
2026年春季的两项规则制定行动容易混淆,而混淆会改变答案。民事规则咨询委员会审议了两项修改第11条规则的提案,以处理不存在的权威引用,同意此时进行规则制定将不适当,并于2026年4月14日撤销了该项目。三周后,证据规则咨询委员会审议了拟议的《联邦证据规则》第707条,该条管辖机器生成的证据的可采性,而非AI使用的披露;它修订了草案并继续进行研究,而不是推进它。第一项行动涉及申请人的认证内容,第二项涉及法院可能准许的内容,两者都没有创建披露义务。这两项在记录本身中是相关联的,这就是为什么它们被解读为一个整体:民事规则委员会的4月备忘录引用了第707条规则的草案,其记录注明证据规则委员会正在研究该规则。
另一方指定为机密的材料是更困难的情况,它直接涉及这个架构。在Morgan案中,法院允许自行代理的原告将这样的材料输入AI服务,但仅当供应商在合同上受约束,不得存储或使用该输入来训练或改进其模型,不得向第三方披露,除非披露对于提供服务是必需的且接收者受到等价保护的约束,以及应请求移除或删除材料时;它要求原告说明与该材料相关的任何工具的名称,并保留这些保障措施的书面文件。法院指出,该条件排除了大多数主流的低成本或免费AI。这些是一项保护令的条款,而非国家规则,它们是作者所找到的最严格的条款;该协议将其作为自己的设计政策采纳。
随之而来的是三个约束。这些是该协议的设计规则,而不是关于法律对诉讼人要求的声明。
1. 公开提交的文件和操作者可自由传输的材料可以进入模型。密封材料、受保护令约束的材料和另一方的机密发现不能,除非命令允许且供应商的条款符合Morgan施加的条件。该限制涵盖每个阶段和每个接收者,不仅仅是生成者:整合者和两名评论者都会收到合并的草案,保留的工件随之传输。文件的所有权本身并不能免除附加于其的保密义务。清单使暴露可审计;但并不使其合法。
2. 清单支持披露;但它不是披露。它记录哪个模型标识符生成了哪个工件以及何时生成,这是法院询问所用程序时想要的材料,无论主审法官是否要求,都值得保留。它不提交常设命令要求的通知,不识别瓦登法官之类的规则所涉及的最终文件部分,也不提供任何认证。
3. 对每个引用与其来源的验证由一个人完成。第11(b)条规则根据其条款适用于未代理的当事人,其标准是在这些情况下的合理调查,而非任何特定程序;第二部分阐述了伪造引用记录所显示的内容。模型间的一致性和两名评论者的批准不是验证。
要求因地区和法官而异,主审法官的常设命令具有约束力。
局限
消费者界面的深度研究模式在供应商 API 中没有精确的等效物。需要此功能的阶段是手动运行的:提示被写入文件,操作员在界面中运行它并将答案粘贴回来,清单记录该阶段是以这种方式运行的。该备选方案是手动的,第二部分阐述了为什么对于具有运动或视觉障碍的诉讼人来说,跨多个界面的手动工作流远不止是更慢这么简单。依赖它的协议会继承该限制。
模型之间的一致既是相关性的证据,也是真实的证据。在重叠语料库上训练的模型会共享错误,一致的草稿集可能一起出错。该协议降低了其能达到的相关性,并记录其余部分。
该协议尚未与单模型提示进行比较。能够确定其价值的比较是盲评:用两种方式准备相同的任务,由不知道哪个是哪个的读者对生成的文档进行评分,评分依据是引用准确性、与任务陈述的完整性以及法院会注意到的错误。该协议在此阐述,以便能够进行这样的比较。
上文提到的仓库包含管道、配置和离线测试。
精选参考文献和权威资料
ABA Model Rules of Professional Conduct r. 5.5.
Americans with Disabilities Act, 42 U.S.C. §§ 12181--12188.
Ashley, Kevin D., Artificial Intelligence and Legal Analytics: New Tools for Law Practice in the Digital Age (Cambridge Univ. Press 2017).
Avery, Joseph J., Patricia Sánchez Abril & Alissa del Riego, ChatGPT, Esq.: Recasting Unauthorized Practice of Law in the Era of Generative AI, 26 Yale J.L. & Tech. 64 (2024).
Blanck, Peter, eQuality: The Struggle for Web Accessibility by Persons with Cognitive Disabilities (Cambridge Univ. Press 2014).
Cappelletti, Mauro & Bryant Garth, Access to Justice: The Newest Wave in the Worldwide Movement to Make Rights Effective, 27 Buff. L. Rev. 181 (1978).
Carpenter, Anna E., Colleen F. Shanahan, Jessica K. Steinberg & Alyx Mark, Judges in Lawyerless Courts, 110 Geo. L.J. 509 (2022).
Centers for Disease Control and Prevention, Disability Impacts All of Us (2022 BRFSS 数据).
Chan, Chi-Min, Weize Chen, Yusheng Su, Jianxuan Yu, Wei Xue, Shanghang Zhang, Jie Fu & Zhiyuan Liu, ChatEval: Towards Better LLM-Based Evaluators Through Multi-Agent Debate, arXiv:2308.07201 (2023).
Charlotin, Damien, AI Hallucination Cases Database, https://www.damiencharlotin.com/hallucinations/ (最后访问于 2026 年 9 月).
Chernets, Vadym, docprep: A Reference Implementation of the Blind-Consolidation Protocol, release v1.0.0 (2026), https://github.com/vadimchernets/docprep (MIT license; 附录中指定的协议和运行它的代码).
Chernets v. Google LLC et al., No. 1:25-cv-05691-RER-RML (E.D.N.Y.) (公开卷宗); PolyHelper.AI LLC v. United States of America, No. 1:25-cv-07770 (S.D.N.Y. 2025) (早期诉讼,不同被告).
Cohen-Sasson, Or, Stochastic Justice: Legal Inconsistency by Humans and AI, 105 Neb. L. Rev. (待发表 2026).
Du, Yilun, Shuang Li, Antonio Torralba, Joshua B. Tenenbaum & Igor Mordatch, Improving Factuality and Reasoning in Language Models through Multiagent Debate, 第41届国际机器学习会议论文集(ICML 2024),arXiv:2305.14325.
Engstrom, Nora Freeman & Aviv Caspi, Opening the Courthouse Door---or Just Lowering the Threshold?, JOTWELL: Legal Profession (2026 年 7 月 3 日).
Fed. R. Civ. P. 26(b)(3).
Greiner, D. James, Cassandra Wolos Pattanayak & Jonathan Hennessy, The Limits of Unbundled Legal Assistance: A Randomized Study in a Massachusetts District Court and Prospects for the Future, 126 Harv. L. Rev. 901 (2013).
Grimm, Paul W., Maura R. Grossman & Gordon V. Cormack, Artificial Intelligence as Evidence, 19 Nw. J. Tech. & Intell. Prop. 9 (2021).
Guha, Neel, et al., LegalBench: A Collaboratively Built Benchmark for Measuring Legal Reasoning in Large Language Models, Advances in Neural Information Processing Systems 36 (2023).
Hadfield, Gillian K., Rules for a Flat World: Why Humans Invented Law and How to Reinvent It for a Complex Global Economy (Oxford Univ. Press 2017).
Hannaford-Agor, Paula, Scott Graves & Shelley Spacek Miller, The Landscape of Civil Litigation in State Courts (National Center for State Courts 2015).
Hickman v. Taylor, 329 U.S. 495 (1947).
Katz, Daniel Martin, Michael James Bommarito, Shang Gao & Pablo Arredondo, GPT-4 Passes the Bar Exam, 382 Phil. Trans. R. Soc. A 20230254 (2024).
Legal Services Corporation, The Justice Gap: The Unmet Civil Legal Needs of Low-Income Americans (2022).
Liang, Tian, Zhiwei He, Wenxiang Jiao, Xing Wang, Yan Wang, Rui Wang, Yujiu Yang, Shuming Shi & Zhaopeng Tu, Encouraging Divergent Thinking in Large Language Models Through Multi-Agent Debate, 2024 年自然语言处理实证方法会议论文集(2024).
Magesh, Varun, Faiz Surani, Matthew Dahl, Mirac Suzgun, Christopher D. Manning & Daniel E. Ho, Hallucination-Free? Assessing the Reliability of Leading AI Legal Research Tools, Stanford HAI (2024).
Mata v. Avianca, Inc., 678 F. Supp. 3d 443 (S.D.N.Y. 2023).
Morgan v. V2X, Inc., No. 25-cv-01991-SKC-MDB, 2026 WL 864223 (D. Colo. Mar. 30, 2026).
New York State Bar Association, Pro Se Advocacy in the AI Era: Benefits, Challenges, and Ethical Implications (2026).
Park v. Kim, 91 F.4th 610 (2d Cir. 2024).
Sandefur, Rebecca L., Access to What?, 148 Daedalus 49 (2019).
Shah, Anand V. & Joshua Y. Levy, Access to Justice in the Age of AI: Evidence from U.S. Federal Courts (2026 年 3 月 20 日) (未发表的手稿), https://ssrn.com/abstract=6766859.
Sharma, Mrinank, et al., Towards Understanding Sycophancy in Language Models, ICLR (2024).
Simshaw, Drew, Access to A.I. Justice: Avoiding an Inequitable Two-Tiered System of Legal Services, 24 Yale J.L. & Tech. 150 (2022).
Surden, Harry, Machine Learning and Law, 89 Wash. L. Rev. 87 (2014).
System Documentation (由作者保存).
U.S. Bureau of Labor Statistics, People with a Disability: Labor Force Characteristics --- 2025, USDL-26-0364 (Mar. 3, 2026).
United States v. Heppner, No. 25-cr-503, 2026 WL 436479 (S.D.N.Y. Feb. 17, 2026).
Warner v. Gilbarco, Inc., No. 2:24-cv-12333, 2026 WL 373043 (E.D. Mich. Feb. 10, 2026).
* AI系统架构师。作者作为原告、系统开发者和分析师的角色在下面的《作者披露声明》中说明。欢迎评论:vadimchernets9@gmail.com。↩︎
Legal Services Corporation, The Justice Gap: The Unmet Civil Legal Needs of Low-Income Americans (2022), https://justicegap.lsc.gov。就自代理的规模而言,在一项主要的多司法管辖区研究中,至少有四分之三以上的民事案件中有一方是自代理的。参见Paula Hannaford-Agor、Scott Graves和Shelley Spacek Miller,《The Landscape of Civil Litigation in State Courts》第iv卷(National Center for State Courts 2015)。↩︎
Anand V. Shah和Joshua Y. Levy,《Access to Justice in the Age of AI: Evidence from U.S. Federal Courts》(2026年3月20日)(未发表的手稿),https://ssrn.com/abstract=6766859(分析超过450万非死刑犯联邦民事案件,FY2005--FY2026,以及4600万条匹配的PACER卷宗条目);另见Or Cohen-Sasson,《Stochastic Justice: Legal Inconsistency by Humans and AI》,105 Neb. L. Rev.(待刊2026)。↩︎
首席法官Patrick J. Schiltz(D. Minn.),引自Mattathias Schwartz和Zach Montague,《Artificial Intelligence Floods Court Dockets with Home-Brewed Lawsuits》,《N.Y. Times》(2026年5月25日)。↩︎
Drew Simshaw,《Access to A.I. Justice: Avoiding an Inequitable Two-Tiered System of Legal Services》,24 Yale J.L. & Tech. 150 (2022)。↩︎
见,例如,Mata v. Avianca, Inc.,678 F. Supp. 3d 443 (S.D.N.Y. 2023);Park v. Kim,91 F.4th 610 (2d Cir. 2024)。↩︎
Andrew J. Dietderich(Sullivan & Cromwell LLP)于2026年4月18日致首席法官Martin Glenn(U.S. Bankruptcy Court, S.D.N.Y.)的信(为"不准确的引文和其他错误"表示歉意,其中一些是AI"幻觉",出现在Prince Global Holdings Ltd.第15章诉讼中的4月9日紧急动议中);见Sullivan & Cromwell为AI幻觉向法官道歉,Bloomberg Law(2026年4月21日)。↩︎
AI Hallucination Cases Database(Damien Charlotin),https://www.damiencharlotin.com/hallucinations/(2026年7月2日的快照):在全球1,668起已记录的事件中,975起涉及自代理诉讼人,653起涉及代理律师;在2023年,大约十分之七涉及自代理诉讼人,律师新记录发现的比例在2025--2026年间稳步上升。↩︎
New York State Bar Association,《Pro Se Advocacy in the AI Era: Benefits, Challenges, and Ethical Implications》(2026);另见《Georgetown Journal of Legal Ethics》(2026)上关于AI和非法执业的评论。↩︎
见Law360 Pulse,《Tracking Federal Judge Orders on Artificial Intelligence》(最后访问时间2026年7月);Legal AI Governance,《Federal and State Court Orders on AI》,https://legalaigovernance.com/tracker/court-orders/(最后访问时间2026年7月)。↩︎
见《How Courts Are Coping with a Flood of AI-Generated Lawsuits》,MIT Technology Review(2026年6月4日)(报道称,自代理方在佛蒙特州的案件提交数从2022年前的大约每年45份增至2024年的1,100多份)。↩︎
案例研究中的投诉以这些条款描述该系统;该框架被注明为原告的法律理论,而不是案情判定。就受影响人口规模而言,美国超过四分之一的成年人——超过7000万——在2022年报告了残疾,见疾病控制和预防中心《Disability Impacts All of Us》(2022年BRFSS数据),残疾人的就业人口比率为22.8%(2025年),而非残疾人为65.2%,见美国劳动统计局《People with a Disability: Labor Force Characteristics --- 2025》,USDL-26-0364(2026年3月3日)。↩︎
Yilun Du、Shuang Li、Antonio Torralba、Joshua B. Tenenbaum和Igor Mordatch,《Improving Factuality and Reasoning in Language Models through Multiagent Debate》,第41届国际机器学习会议论文集(ICML 2024),arXiv:2305.14325。↩︎
见,例如,Tian Liang、Zhiwei He、Wenxiang Jiao、Xing Wang、Yan Wang、Rui Wang、Yujiu Yang、Shuming Shi和Zhaopeng Tu,《Encouraging Divergent Thinking in Large Language Models through Multi-Agent Debate》,2024年自然语言处理经验方法会议论文集(EMNLP 2024)17889;Chi-Min Chan等,《ChatEval: Towards Better LLM-Based Evaluators through Multi-Agent Debate》,arXiv:2308.07201(2023)。↩︎
原告的反对意见将这样一项进展纳入卷宗,记录了被告对跨提供商、多模型共识功能的公开宣布。见《Plaintiff's Opposition》,ECF No. 76。↩︎
系统技术文档(仅为设计目的引用)。↩︎
该架构是作者为命名申请人的待决国际专利申请族的主题;该申请族在诉讼的公开记录中有文件记载(见《Plaintiff's Opposition》,Ex. 3),其标识符在此省略,因为它对分析而言不重要。↩︎
联合驳回动议及支持备忘录,Chernets v. Google LLC,案号1:25-cv-05691-RER-RML(E.D.N.Y.),ECF Nos. 69, 69-1;原告法律反对意见备忘录,ECF No. 76(2026年4月2日);庭前会议记录,ECF No. 55(2026年1月27日)。↩︎
ECF Nos. 28(同意动议)、30、32-34、36-37(2026年1月12日)。这些信件相互协调;一名被告明确采纳了其共同被告在动议前提交的信件中提出的理由和论点。↩︎
ECF Nos. 39-44(2026年1月15-16日)。↩︎
比较《驳回动议联合支持备忘录》ECF No. 69-1 与《原告反对意见》ECF No. 76(第17页)。↩︎
Warner v. Gilbarco, Inc., No. 2:24-cv-12333, 2026 WL 373043 (E.D. Mich. Feb. 10, 2026) (Patti, M.J.); United States v. Heppner, No. 25-cr-503, 2026 WL 436479 (S.D.N.Y. Feb. 17, 2026) (Rakoff, J.); Morgan v. V2X, Inc., No. 25-cv-01991-SKC-MDB, 2026 WL 864223 (D. Colo. Mar. 30, 2026)。↩︎
Morgan v. V2X, Inc., 2026 WL 864223, at *3 (D. Colo. Mar. 30, 2026)。↩︎
见ABA Model Rules of Prof'l Conduct r. 5.5;Joseph J. Avery、Patricia Sánchez Abril和Alissa del Riego,ChatGPT, Esq.: Recasting Unauthorized Practice of Law in the Era of Generative AI,26 Yale J.L. & Tech. 64(2024)。↩︎
本文仅描述已向被告和公众披露的公开提交文件和系统架构特征。本文不披露所使用的提示词、系统对任何特定问题的决策逻辑以及所有工作草稿。↩︎
docprep是盲合并协议的参考实现,https://github.com/vadimchernets/docprep(MIT许可证);此处描述的版本为release v1.0.0。该库在单个文件中包含可运行的管道、表6的配置、清单格式和无需账户或密钥即可运行的离线测试,以及作为独立规范的本附录(CC BY 4.0许可)。模型标识符和访问权限必须由操作者为自己的账户进行配置。↩︎
民事规则咨询委员会2026年4月14日会议草稿纪要第18页,转载于《诉讼规则委员会议程书》第383页(2026年6月3-4日)(第17项,"人工智能幻觉");另见民事规则咨询委员会《议程书》第438-50页(2026年4月14日)(建议25-CV-S和25-CV-V,均涉及规则11);民事规则咨询委员会报告第60页(2026年5月6日),见上述议程书第364页(议程中删除的事项)。纪要草稿待委员会2026年秋季会议批准。拟议《联邦证据规则707》(管辖机器生成证据的可采性而非披露)是一个单独的事项:证据规则咨询委员会于2026年5月7日修订了它,并将其列为继续研究的事项而非推进。↩︎
N.D. Tex. Civ. R. 7.2(f)(在诉状首页披露生成式人工智能的使用,如果主审法官要求,还需进一步披露所准备的部分);美国国际贸易法院(U.S. Court of International Trade)《人工智能命令》(Vaden, J.)(2023年6月8日)(要求明确所使用的程序、其所生成的文本具体部分,并证明该使用未向任何无权方披露机密或商业专有信息)。↩︎
如何引用
Chernets, V. (2026). The Missing Variable in AI-Assisted Litigation: Architecture and the Quality of Pro Se Access to Justice [Preprint]. SSRN. https://doi.org/10.2139/ssrn.7120940
@misc{chernets2026missingvariable,
  author       = {Chernets, Vadym},
  title        = {{The Missing Variable in AI-Assisted Litigation: Architecture and the Quality of Pro Se Access to Justice}},
  year         = {2026},
  howpublished = {SSRN},
  doi          = {10.2139/ssrn.7120940},
  url          = {https://doi.org/10.2139/ssrn.7120940}
}