聊天之后:非程序员与智能体AI之间的三个转变
这是译文。权威版本是英文原文,引用请以原文为准。
终端不再是终端:一个四级模型、2025年和2026年的证据,以及用来测量这些转变的预注册计划
Vadym Chernets, 博士, AI系统架构师 · ORCID 0009-0007-4845-3163
SSRN 7520019 · DOI 10.2139/ssrn.7520019 · Zenodo 10.5281/zenodo.22943313 · GitHub
下载本文
- SSRN (权威版本): ssrn.com/abstract=7520019 · DOI 10.2139/ssrn.7520019
- Zenodo (存档,开放获取): doi.org/10.5281/zenodo.22943313
- GitHub (完整文本,包括Markdown和PDF格式): github.com/vadimchernets/papers/tree/main/after-chat; 代码: github.com/vadimchernets/after-chat
同一文本在三个地方,以便在其中一个无法提供时仍可访问。SSRN保存权威版本;请引用该版本。
关键词: 智能体AI; AI智能体; 非程序员; 最终用户编程; AI素养; 知识工作者; 技术采用; 生成AI采用; 人类监督; 委托; 第二级数字鸿沟; 相关错误; 自动化的讽刺; 去技能化; 预注册
摘要
大多数专业人士是通过聊天机器人的形式接触AI的,而这些相同的模型作为AI代理,现在可以对文件和程序进行操作。我追问为什么很少有非编程人员已从聊天进入到代理AI,以及如何衡量这种过渡。答案基于一个由覆盖范围和角色定义、独立于产品的四层模型:聊天、供应商有界的安全代理环境、自己计算机上的代理,以及在多个模型间协调的可重复工作。转变仅在代理生成了人员请求的工件时才算数。安装软件算作一次尝试。2025年至2026年9月的证据表明,安装和首次有界尝试的障碍已经降低,而整体工作的可靠性、产品稳定性和文件夹安全性则未能改善。安装是一个步骤,人员自己的聊天机器人可以指导它("反射性入职"),两个供应商在2026年整合了代理和聊天界面。一个供应商新闻报道的方向性数据表明,知识工作者占其编码代理周用户五百万的五分之一;它衡量的是终端遗产代理的使用,而不是这里定义的第3级采用。使用仍然广泛但浅层:大约一半的美国工作者使用AI,约七分之一的人每天使用,很少人用于自动化。障碍已从安装转向指导。基于最终用户编程研究,我将缺失的能力命名为工作流词汇,并将管理者的工作界定为委托合同,包括:目标、边界、工件和检查。提议将网页编排(一个问题发送给多个聊天机器人)作为教授比较的桥梁,将CLI编排(一个代理调用其他代理)作为持久层,受制于相关模型间的一致性只是弱证据这一事实。本文以15个可证伪的命题、一个预注册队列项目的设计(不含其结果)和开放教学代码作为结尾。
执行摘要
终端,即代表非程序员无法用AI做的一切的黑色窗口,其含义已经改变。它现在是个人计算机上代理工作的地方,它所要求的技能不再是输入命令。所需的技能是管理代理。
专业开发者走在最前面:2026年调查的15,000多名专业人士中,90%至少每周使用一次代理工具(厂商调查),尽管每周使用还不是第8节所说的管理者能力。其他人大多仍在与聊天机器人对话。52%的美国工作者在工作中使用AI,其中15%每天使用,16%的这些用户将自动化列为他们的使用方式之一。
原因不再是代理很难安装。安装一个代理只需要一条命令或一次点击,一个人已经使用的聊天机器人可以引导他们完成,厂商已经开始将聊天与代理合并。真正困难的是质的不同。代理仍然会在整个工作块上失败,一个人学到的产品可能在一年内被重新命名或停用,分配的文件夹仍然需要保护。在安装之后,阻止人们的第一件事是他们不知道要移交什么或如何检查,这是第1节称为"工作流词汇"的差距。在它之后是第一个错误、权限和安全、组织规则、硬件和成本,以及判断结果的能力。
该模型有四个级别,按照模型的覆盖范围和人必须做什么来排序:对话、厂商运行的受限空间、个人的计算机以及跨多个模型的工作。人们可以跳过一个级别。一个跨越只由代理产生的工件来表示,这样安装、徽章和自我报告就不算数。
编排(将一个问题发送到多个模型)有两个层次。在浏览器中尝试无需费用,并教会比较答案的习惯,在命令行上可以写下并再次运行。在两种情况下,重要的是所询问的模型族的数量,因为相关错误限制了共识的价值。
管理代理是一项独立的能力。它有一个分为四部分的委派协议(目标、边界、工件、检查),四种实践(委派、监督、验证、撤销),一条审查的停止规则,以及一份验收记录,将代理产生的与人员所依赖的分开。
该论证是为了被测试而构建的。十五个命题包含度量指标和反驳条件。一份预注册队列研究的设计(OSF DOI 10.17605/OSF.IO/X4EGQ)在这里描述,其结果将另行报告。一份状态表显示了每项声明被支持的程度,开放代码在附录C中。
1. 引言
考虑一位在2026年9月的办公专业人士。她每周使用一次聊天机器人。她让它起草电子邮件、总结报告、建议一个公式。她收到的是文本,她必须手工将该文本转移到她的工作场所:一个合同文件夹、一个账户电子表格、一个周五需要提交的幻灯片。同一个模型通过另一个途径可以打开该文件夹、读取其中的每个文件、编写电子表格、制作幻灯片并检查其自己的计算。根据第4.4节的调查,大多数专业人士尚未使用过这种途径,许多人甚至不知道它的存在。
在过去的两年里,这扇门看起来像一个终端:一个黑色窗口、一个闪烁的光标、一条待粘贴的命令。这幅景象已经过时了。终端在视觉上仍然只是一个终端。它成为了一个代理生活的环境,即一个人自己机器上的地方,其中一个模型可以读取、写入、运行和调度,而在它前面的人不再需要操作shell,而是指导执行的代理。改变的是人类的角色,从向模型提问的人变成了管理一个工作者的人。
我的主题是这两个角色之间的道路,以及谁在其上。在专业开发人员中,至少工具已经到来。在2026年5月至7月对超过15,000名专业开发人员的调查发现,90%的人至少每周在工作中使用AI编码代理,68%的人每天使用,而在工作中使用一个终端代理Claude Code的比例从2025年春季的约3%上升到2026年1月的18%,到2026年中期达到39%(JetBrains Research, 2026a, 2026b;一项供应商调查,因为JetBrains销售编码代理)。在其他所有人中情况并非如此,使用模式广泛而浅薄。在同样的几个月里,52%的美国工人报告在其职位中使用AI,15%的人每天使用,而只有16%的这些用户将自动化列为他们的用途;写作和搜索占主导地位(Gallup, 2026)。对于典型的专业人士,AI仍然是一个对话,圣路易斯联储在更长的时间跨度内给出了相同的数据:在2024年8月至2026年5月之间,在工作中使用生成AI的工人比例从33%上升到45%,而少于3%的任务的采用率超过50%(Bick et al., 2026)。
对差距的标准解释是技术难度:代理是为能编程的人设计的。这个答案在2024年是合理的,但在2026年就显得薄弱了。安装一个终端代理现在只需一个命令或一个桌面安装程序,而领先的代理提供一个桌面应用程序,其文档清楚地说"不需要终端"(Anthropic, 2026a)。供应商已经走得更远。OpenAI在2026年7月9日将其编码代理应用程序变成了默认的ChatGPT桌面客户端,并添加了一个代理ChatGPT Work,它使用本地文件和应用程序(MacRumors, 2026)。Anthropic在2026年9月16日将其知识工作桌面代理Cowork合并到普通聊天中;TechCrunch报道该公司表示客户"经常难以为正确的任务选择正确的选项卡"(TechCrunch, 2026a)。OpenAI通过新闻报道称,知识工作者在2026年6月占其编码代理500万周活用户的约20%,并且采用速度是开发人员的三倍多(Help Net Security, 2026)。这个数字是供应商报告的和方向性的,供应商自己的页面在我的检查中无法访问,它衡量知识工作者对源自终端的代理的使用,这比第3节中定义的3级采用更广泛。在这幅图景中,很难看出技术障碍究竟在哪里。
障碍已经转移。它从安装转移到指导:从"我如何让这个运行?"到"我应该要求它做什么,在什么限制范围内,我如何知道它做了?"第二个问题比听起来更难,关于终端用户编程的文献解释了为什么。即使在免费和即时访问的情况下,非专家也很难向语言模型表达意图(Zamfirescu-Pereira et al., 2023),他们必须学习哪些措辞对应于系统可以做的事情(Liu et al., 2023)。委托给AI也会将工作从生产转变为规范和检查(Sarkar & Drosos, 2025; Simkute et al., 2024)。我称缺失的能力为工作流词汇:一个人知道如何交给代理的工作任务库,措辞使得代理能够执行这些任务并可以检查结果。形式上讲,它是一个人的领域目标和代理能够执行的子任务之间的映射,包括映射所需的输入、转换、输出、异常和证据的词汇。打开代理的开发人员已经知道前十件要键入的事情。会计或教师通常不知道,他们的办公室里没有人告诉他们。
第一个贡献是一个四级模型,描述从聊天到代理工作的道路,由覆盖范围和角色定义,不涉及产品名称。这些级别从聊天经过安全的代理环境和一个人自己计算机上的代理,到可重复的编排工作。每一级由代理可以接触的范围和人必须规范和检查的内容定义,每一级的转变由代理生成的工件定义,而仅安装的软件不计算在内。因为定义不依赖于产品名称,该模型可以幸存于供应商目前合并其产品的做法(第3节)。
第二个是2025年至2026年9月的证据综合。它显示安装和第一个有限的尝试变得容易得多,第4.5节中列出的三个限制(整个任务上的可靠工作、稳定的产品、安全的文件夹)没有相应改善,而浅层的使用模式仍然存在。它还定位了仍然存在的障碍:工作流词汇、阻止新手的错误、权限和安全、组织规则,以及判断结果的能力(第4和5节)。
第三个是两个编排层的说明。Web编排,即向多个消费者聊天机器人提出同一个问题,是桥梁:它不需要安装,并培养了比较的习惯。CLI编排,即一个代理调用其他代理的命令行工具,是持久的委托层。两者都因一个常被用户忽视的事实而受到限制,即模型之间的一致性不是独立的证据(Chernets, 2026a)(第6和7节)。
第四个是一个具有可证伪命题的测量计划:一个预注册的队列研究的设计,该研究跟踪非编程人员在这些转变中的情况(Chernets, 2026d),以及附录中关于编排和安全模式的开放教学工具包(第9和10节,附录C)。
贯穿全文有几项范围限制。"非程序员"是指主要在计算机上工作但未受过脚本编程或软件工程培训的专业人士。精通电子表格公式的分析师算作非程序员,开发者则不算,开发者在此作为对比组出现。本文未报告队列项目的结果;这些结果属于其观察期后发表的另一篇论文。大多数采纳数据来自美国和供应商,且已作相应标记。所述工具按月份而变,因此该模型设计用意在于超越其生命周期,产品细节预计会过时。
第2节将论点置于相关文献中,第3节定义各层级与转换。第4节阐述技术障碍所在,第5节阐述什么取代了它,第6和7节论述两种编排形式,第8节论述这一转变对人类角色的影响。第9节描述测量过渡的项目,第10节陈述命题,第11节推导含义,第12节设定边界条件,第13节得出结论。
2. 背景:从终端用户编程到终端用户委托
2.1 终端用户一直在编程
非程序员指挥计算的想法比语言模型的出现要早。Nardi(1993)论证终端用户通过特定任务的语言和框架(以电子表格为典范)控制计算能力,而无需通用编程技能。Ko 等人(2011)表明构建软件的终端用户面临与专业人士相同的问题(需求、复用、测试、调试),但没有受过培训,并将该领域命名为终端用户软件工程。更广泛的领域——终端用户开发——研究非专业开发人员如何为自己的工作创建和适配软件。Myers、Pane 和 Ko(2004)花费多年时间设计更接近非程序员描述任务方式的记号法。这些工作的每一条线都假设终端用户仍然会编写机器执行的某些东西,即使那东西是公式或规则。
语言模型改变了终端用户编写的内容。Sarkar 等人(2022)将大型语言模型编程描述为一种新活动,不同于编译、结对编程和搜索。Zamfirescu-Pereira 等人(2023)发现没有人工智能专业知识的人难以设计可靠的提示词,过度概括单次成功并回归人类对话习惯。Liu 等人(2023)将学习哪些词语产生何种行为的困难称为"有根据的抽象匹配"。Sarkar 和 Drosos(2025)在首次对"氛围编码"的实证研究中发现,对话式编程将专业知识重新分配到上下文管理和快速结果验证方面,而对判断的需求保持不变。Virk 和 Liu(2025)发现被赋予人工智能生成的分析代码的商业用户即使被告知寻找错误,也往往无法发现关键错误。Feldman 和 Anderson(2024)称非专家程序员为生成时代研究最不足的人群。
我在这条线的基础上迈出了下一步。终端用户工作的单位已从公式、脚本或提示词转变为委托:交给代理的任务,该代理在多个步骤中对文件和工具进行操作。终端用户编程的文献解释了为什么表达意图很困难,委托和监督的文献解释了为什么检查结果很困难。第 3 节的四级模型旨在将这两者结合。
2.2 采用速度快且深度浅
生成式人工智能的传播速度比个人计算机或互联网还要快。Bick、Blandin 和 Deming(2024)估计到 2024 年底约 40% 的美国工作年龄成年人使用了它,但仅有少量工作时间得到帮助。Chatterji 等人(2025)发现到 2025 年中期 ChatGPT 服务约 7 亿周活用户,且大多数消息与工作无关。在丹麦,Humlum 和 Vestergaard(2025)在采用两年后发现收入和工作时间没有精确的零影响,且存在男女使用差异;一项跨 100 多个国家的荟萃分析表明自 2025 年初以来这一差异约为 16 个百分点(Cranney 等人,2026)。在 35 个欧洲国家,接触人工智能并未自动转化为使用,培训、数字化和工人代理权的影响更大(Henseke,2026)。
田间实验表明,当工具与任务相匹配时,收益巨大:平均每小时解决 14% 更多的客户问题,初学者则为 34%(Brynjolfsson 等人,2025),在 444 名专业人士的试验中写作更快且质量更好,收益最大的是写作能力较弱的人(Noy & Zhang,2023),在 758 名顾问中,在模型能力的"参差边界"内完成的任务增加 12.2%,质量提高超过 40%,在其外的任务工作较差(Dell'Acqua 等人,2026)。2025 年初与经验丰富的开源开发人员进行的随机试验发现相反的迹象,速度下降 19%(Becker 等人,2025),其作者后来表示随着工具改进,这个结果可能已过时(METR,2026)。这些试验的教训是,收益取决于任务、工具和人指挥和检查它的能力之间的匹配程度,这三个东西正是层级转换会改变的。
2.3 接纳、扩散和第二级别分化
从技术接受模型(Davis,1989)到接受和使用技术的统一理论(Venkatesh 等人,2003),技术采用研究表明感知的有用性和易用性制约采用,社会影响和便利条件的重要性与个人态度相当。扩散研究将采用描述为一个社会过程,涉及早期和晚期采用者(Rogers,2003)。一旦互联网的基本接入变得普遍,Hargittai(2002)表明有意义的不平等转移到了技能上:第二级别数字鸿沟。Van Dijk(2020)将其扩展为动机、接入、技能和使用的序列。
同样的转变现在是可见的。在富裕国家的办公室工作者中,聊天接入几乎普遍,而指挥代理的技能远非普遍。人工智能鸿沟已沿着教育、地区和年龄的传统线被衡量(Daepp & Counts,2024;Pew 研究中心,2026)。我补充的观察是,这一分化现在在人工智能用户人群内部运行,在与模型对话的用户和将任务委托给它们的用户之间。
2.4 自动化、监督和管理者的负担
自动化人类监督的文献以一个讽刺开篇。Bainbridge (1983)对此进行了描述:自动化一项任务的大部分会使人类获得最困难的残留部分,即监控和罕见的干预,同时侵蚀进行这项工作所需的技能。Parasuraman和Riley (1997)区分了自动化的误用、弃用和滥用,Lee和See (2004)表明依赖应该遵循校准的信任。生成式时代更新了这些要点。更信任该工具的知识工作者报告的批判性思维较少(Lee et al., 2025)。生成式AI使人们从生产转向评估,使简单任务变得更简单,困难任务变得更困难(Simkute et al., 2024)。校准对语言模型依赖的干预减少了过度依赖,但不会产生适当的依赖(Bo et al., 2025)。将AI代理用作日常助手的用户对看似合理但错误的计划进行了信任的误校准,当他们参与逐步执行时会做得更好(He et al., 2025)。更好地追踪代理的行为加速了错误检测,但不能可靠地改进最终准确性(Grunde-McLaughlin et al., 2026)。一项关于某个自主代理大约73,000条公开帖子的研究发现,用户的价值观在代理交付的内容中基本上得到满足,但在他们如何监督它的方式上基本上未得到满足(Ma et al., 2026)。在一项小型实验室研究和三个部署中,随着时间的推移,对授权的舒适度增长,而人们仍然希望在不确定时刻拥有控制权(Long et al., 2025)。Tomašev、Franklin和Osindero (2026)将对AI的授权视为任务分配、权力转移、问责和信任的框架,适用于人类和机器代理。
从认知角度来看,一项对54名论文作者的脑电图研究报告了辅助组中的连接较弱和所有权较低,即"认知债务"(Kosmyna et al., 2025),而一条已发表的评论质疑了其方法(Stankovic et al., 2026)。安全的理解是,卸载例行步骤可以释放注意力,而释放的注意力必须用于检查。学习研究中的两个进一步想法稍后会用到。认知负荷理论解释了为什么一个被放入无围栏环境中的新手在形成心理图式之前会停滞(Sweller, 1988)。采用作为贝叶斯学习的模型展示了人们如何陷入自我强化的低使用均衡,只有首次成功或培训才能改变这一点(Ma et al., 2025)。
本系列的两篇配套论文从另一方面关注同一问题。第一篇表明,几个模型之间的一致性是比看起来更弱的证据,因为它们的错误是相关的(Chernets, 2026a)。第二篇展示了自动化监督组件如何可以扩大其自身权限并阻止它们保护的工作(Chernets, 2026b)。两者对新手都很重要:第一篇关于编排可以带来什么,第二篇关于为什么安全层可以在门口阻止一个人。
2.5 尚未研究的内容
在2026年9月21日进行的搜索(网络搜索、Crossref、arXiv和Semantic Scholar,特别关注2024至2026年的CHI、UIST和VL/HCC论文)发现没有已发表的非程序员采用终端或命令行代理的田野研究,没有关于网络编排(在浏览器中向多个消费者聊天机器人提出一个问题)作为命名实践的研究,没有将管理代理视为具有自己能力结构的技能的讨论,以及没有关于AI系统为人采用代理性AI提供支架的研究;最接近的工作将支架理论应用于其他科目的AI导师(Cohn et al., 2026)或复杂软件的任务条件界面(Liu & Sra, 2026)。劳动经济学工作通常衡量生成式AI采用,但没有一项将非程序员从聊天到代理工具的步骤隔离出来。这些差距定义了该模型映射的空间,第9节中的程序是为了测量而构建的。
3. 四个层级和三个转变
3.1 两个轴:覆盖范围和角色
一个层级描述的是一个人与一个模型在工作中的关系,我通过两个轴来定义它:覆盖范围和角色。
覆盖范围是指模型代表人可以接触到的内容。最狭窄的时候只是对话,然后是供应商边界内空间中的文件和工具,再然后是人自己的计算机及其文件、程序和日程,最宽泛的时候可以是多个模型和代理。
角色是指一个人为了使工作成功必须做的事情。按照同样的顺序,他们提问和复制,他们交付任务并审查结果,他们拥有一个代理的环境以及它的权限和撤销功能,或者他们在代理之间分配工作并协调返回的结果。
产品被有意地排除在定义之外。一个单一产品可以跨越多个层级,在2026年,供应商将聊天和代理整合到一个窗口的速度超过了任何基于产品名称构建的分类法所能跟上的速度(第4.3节)。一个层级描述的是一项工作,一个人就像一个产品一样,可以跨越多个层级。同一个人早上可能在某项任务中处于第1个层级,下午在另一项任务中处于第3个层级。
这两个轴也将这个模型与熟悉的自动化和自主性量表区分开来。Parasuraman、Sheridan和Wickens(2000)分类了机器在任务的每个阶段(获取信息、分析信息、决策、行动)中执行的程度。Morris等人(2024)根据性能的深度和广度对通用人工智能系统进行了分级。Feng、McDonald和Zhang(2025)根据用户发挥的角色定义了人工智能代理的五个自主性级别,从操作者和合作者到顾问、批准者和观察者。这些量表描述的是代理在任务内的决策程度。这里的四个层级描述的是工作运行的位置和人拥有的内容:一个对话、一个供应商的受限空间、他们自己的机器、来自多个供应商的代理团队。这些轴是正交的。一个人自己计算机上的代理可以在Feng等人的任何自主性级别上运行,从逐步审批到近乎完全的授权,人仍然拥有它的权限和撤销功能。四个层级添加的是对采用的描述:对于从聊天开始的人来说,覆盖范围和责任增长的顺序,以及显示每个步骤已被采取的证据(一个工件)。
3.2 四个层级
层级1:聊天。模型的覆盖范围止于对话。它生成文本、代码或图像,由人复制到工作发生的地方,人的角色是好好提问并传达输出。几乎每个使用人工智能的专业人士大部分时间都在这里工作(第2.2节)。
层级2:安全的代理环境。模型在供应商划定的空间内对文件、连接的服务以及有时的浏览器进行操作:选定的文件夹、虚拟机或服务器端沙盒、人已批准的连接器,以及在执行重要操作前的审批步骤。Anthropic的Cowork、OpenAI的ChatGPT Work、Microsoft的Copilot Cowork和Google的Gemini Spark是2026年的例子,它们都采用了在受限空间中工作的委托代理设计(Anthropic, 2026b; MacRumors, 2026; Microsoft, 2026a; TechCrunch, 2026b)。人的角色从提问转变为委托。他们交付一项以文件或行动结束的任务并审查返回的内容,在这个层级,环境安全的大部分由供应商负责。
层级3:一台计算机上的代理。代理在人的机器上运行,可以通过终端或桌面shell访问文件系统、shell、已安装程序和定时任务,基于相同引擎:Claude Code、OpenAI的Codex、Google的Antigravity CLI、xAI的Grok Build、Moonshot的Kimi Code以及开源等效产品。在研究文献中,这些是基于大型语言模型的代理,开发者对它们的使用被作为代理编码研究;这个层级提出的问题是当运行它们的人不是开发者时会发生什么。覆盖范围是单个代理能到达的最宽泛的范围,随之而来,人的角色再次改变。他们拥有环境:代理看到哪些文件夹、哪些命令需要审批、什么被排除在外,以及如何撤销错误。终端本身是附带的,因为定义这个层级的是对工作环境的所有权,在这个环境中代理可以做人可以做的任何事。云托管变体(相同的代理循环在供应商的机器上运行,人只看到任务和结果,从不看到提示)在能力上是层级3,在影响半径上是层级2,模型将它们记录为层级3的变体,而不是强行放入一个单元格。
层级4:可重复的、编排的工作。人指导多个模型或代理,以并行或顺序的方式处理重复的工作,覆盖范围现在跨越供应商。有两个层次。在网络编排中,一个问题由手动或使用工具向浏览器中的多个消费者聊天机器人提出,并比较答案。在命令行编排中,一个代理调用其他代理的命令行工具,收集它们的输出并合并或检查它们。人的角色是管理者的角色:他们设定目标、分配工作、决定什么算是完成,并协调分歧。当工作以代理可以再次运行的形式写下来时,它就变成可重复的,比如指令文件、技能或定时任务。"可重复"描述的是工作流程,而不是输出。相同的指令文件在下周运行时会产生不同的草稿,重复的是输入、步骤、检查和交付物的序列。像这样写下来的重复单代理工作是使层级3工作变得可重复,当第二个模型家族被指导并且结果被协调时,它就变成层级4(转变3,第3.3节)。
表1. 四个层级。
| 层级 | 模型的覆盖范围 | 人的角色 | 典型界面,2026年9月 | 跨越由以下显示 | 该层级未建立的内容 | 入场的主要障碍 |
|---|---|---|---|---|---|---|
| 1. 聊天 | 对话 | 提问,手动复制输出 | 浏览器或应用中的聊天 | (入口级别) | 模型可以对人的工作进行操作,或在不检查的情况下被信任 | 除访问外无其他 |
| 2. 安全的代理环境 | 供应商边界内的空间中的文件、连接器和浏览器 | 委托任务,审查结果 | Cowork merged into Claude chat; ChatGPT Work; Copilot Cowork; Gemini Spark | 代理从委派任务中生成的文件或操作,已记录批准或拒绝 | 该人可以运行自己的环境,或重复该工作 | 了解委派什么;信任 |
| 3. 在自己的计算机上的代理 | 该人的文件系统、shell、程序、日程 | 拥有环境:权限、排除项、撤销 | Claude Code、Codex、Antigravity CLI、Grok Build、Kimi Code 的终端和桌面 shell | 代理在该人自己的机器上、该人设置的文件夹中从需要多个工具使用的任务中生成的成果 | 结果是正确的,或可以安全接受而无需审查 | 安装摩擦(下降);第一个错误;权限;要询问什么 |
| 4. 编排的工作 | 来自多个供应商的多个模型或代理 | 管理:目标、分配、接受、调和 | Web:多个聊天标签页或广播工具。CLI:调用其他代理的插件和脚本 | 来自至少两个模型族的合并或交叉检查的结果,至少重新运行一次,记录了提问者和回答者 | 模型之间的一致是独立证据,或该任务属于此级别 | 协调成本;相关错误;配额和工具流失 |
表格中的两个术语的含义比日常用法更窄。"安全智能体环境"中的"安全"命名了一个设计目标和交互模式,不提供任何保证。文件夹范围、批准、沙箱和预览窗格缩小了代理作用的区域;它们不能使有缺陷的实现保留文件或使承载隐藏指令的文档无害,第 5.3 节报告了在授予的文件夹内发生了什么问题。中间层建立的是一个实际的心智模型。看到代理可以在一个文件夹中编写报告而无法触及其他任何内容的人已经了解到委派操作有一个周边,这比任何关于谨慎使用人工智能的抽象警告更有用。"成果"指的是需要代理自己工作的多个步骤的可交付物。要求它的人决定它是否算作成果,第三方评估其质量(第 9.4 节),一项研究报告了该评级和停止原因编码的评估者之间的一致性。包含两个空文件的文件夹是安装程序的痕迹,不算数。
3.3 三个过渡,以及为什么成果定义了各个过渡
过渡是指代理在新级别上生成了该人要求的成果时跨越的界限。安装仅计为一次尝试,完成的教程、徽章、许可证和自我报告"我现在在使用代理"也是如此。该规则有许多超越明显结果的后果。代理创建的文件夹显示代理已运行,而代理根据该人对自己工作的描述编写的一组文件表明该人进行了委派。该规则还使过渡可以从外部观察到:研究人员或经理可以看到成果,无法看到意图或能力感受。它使失败具有信息性,因为安装了工具但未生成任何内容的人遇到了值得命名的障碍,将安装计为成功会隐藏它。由于它没有命名任何产品,该规则使研究能够跨越每个季度都被重新命名的工具进行比较。
过渡 1,从聊天到安全智能体环境,是在人员首次委派以文件或操作而不是文本结束的任务时跨越的。在 2026 年,这个过渡正在被吸收到聊天窗口本身中。当供应商的模型决定是回答还是采取行动时,正如在 2026 年 9 月 16 日宣布的合并 Claude 体验中所做的那样(Anthropic,2026c),人员可以在不决定的情况下跨越它。这使跨越更容易,也更不可见,包括对该人。
过渡 2,从安全环境到自己的计算机,是在人员在自己的环境中运行代理并从中接收成果时跨越的。决定性的变化是所有权。在第 2 级,供应商决定代理可以触及什么,在第 3 级,该人决定,无论代理呈现什么样子,终端或窗口。对终端的恐惧曾经住在这里,第 5 节显示权限、错误和要询问什么的问题已经取代了它。
过渡 3,从一个代理到编排的工作,是在人员获得至少两个模型族生成或检查的结果,并在后续工作中重新运行该安排时跨越的。重新运行很重要,因为三个聊天机器人的一次比较是一个奇闻,只有人员每当赌注合理时所采用的比较才构成一种实践。
第 9 节的计划可以作为一个设计来进行,以引入中的专业人士作为假设案例,没有任何报告。她将从她已经所在的第 1 级开始,使用她为其付费的聊天机器人。她将标准文本粘贴到该聊天机器人中,让它指导她在自己的笔记本电脑上安装图形代理,每当一个步骤失败时发送它一个屏幕截图,我不会触及任何内容。第一步仅在代理从她对自己工作的描述中生成了一组她可以打开和判断的文件时才被计为跨越;安装的应用程序旁边有一个空文件夹会计为一次尝试。她会在文件的副本中工作,将密码和客户文档保留在其外,在让代理行动前读取代理的计划,并确认任何不可逆转的内容。当她说她已准备好时,她会收到一个开源工具,通过她已有的订阅向多个模型提出一个问题并返回一个合并的答案,从代理内部启动,该步骤在日期运行显示询问了哪些模型以及它们在哪里不同时才被计为跨越。稍后,她将通过命令行工具运行相同的比较。她可能会在这些点中的任何一个停止,注册的记录将保存位置,用她的话说,为什么。该路线取自公共注册表,人们是否走这条路是一个关于结果论文的问题。
3.4 级别是有序的,而不是强制的
各级别按覆盖范围和对使用者的责任要求进行排序。这种顺序并不意味着它们是一个每个人都必须逐级攀登的阶梯。一个人可以直接从聊天跳到自己计算机上的代理;第9节中描述的队列路由正是这样做的,通过该人已经使用的聊天机器人指导他们完成安装。其他人会永久停留在第2级,对于许多工作来说,这是正确的停止点。在这个模型中,更高并不一定更好。它声称每个级别对使用者提出不同的要求,这些过渡是可以观察到的,并且每个过渡处的障碍各不相同。如果过渡无法通过工件进行区分,如果过渡处的障碍没有差异,或者如果一个级别的能力没有改变人们在下一个级别能做什么,那么它将被证伪;在任何这些情况下,该模型对简单的"人工智能使用"量表没有任何贡献。该模型还预测,一旦任务的敏感性和技术需求保持恒定,完成率在三个过渡处下降得更急剧,而不是在一个级别内。如果下降分布均匀,那么这些级别就是重新标记的连续体。第10节将这些预期转化为具有措施和证伪者的命题。
一类工具应该放在阶梯旁边,而不是阶梯上的任何一级。浏览器应用构建器让使用者描述一个应用程序,并在供应商托管的平台内接收一个运行中的预览。它们很重要,与第2级不同的是,在第2级,代理在权限模型下对使用者自己的文件进行操作;应用构建器对平台拥有的项目进行操作。混淆这两者会产生一种非程序员已经到达的错误感觉。四级模型将应用构建器放在一个有自己上限和自己安全配置文件的分支上,vibe-coding文献是阅读有关内容的地方(Sarkar & Drosos,2025;Ge等,2025)。图1绘制了四个级别、标记每个过渡的工件、记录的跳跃和分支。
图1。 四个级别和三个由工件定义的过渡。
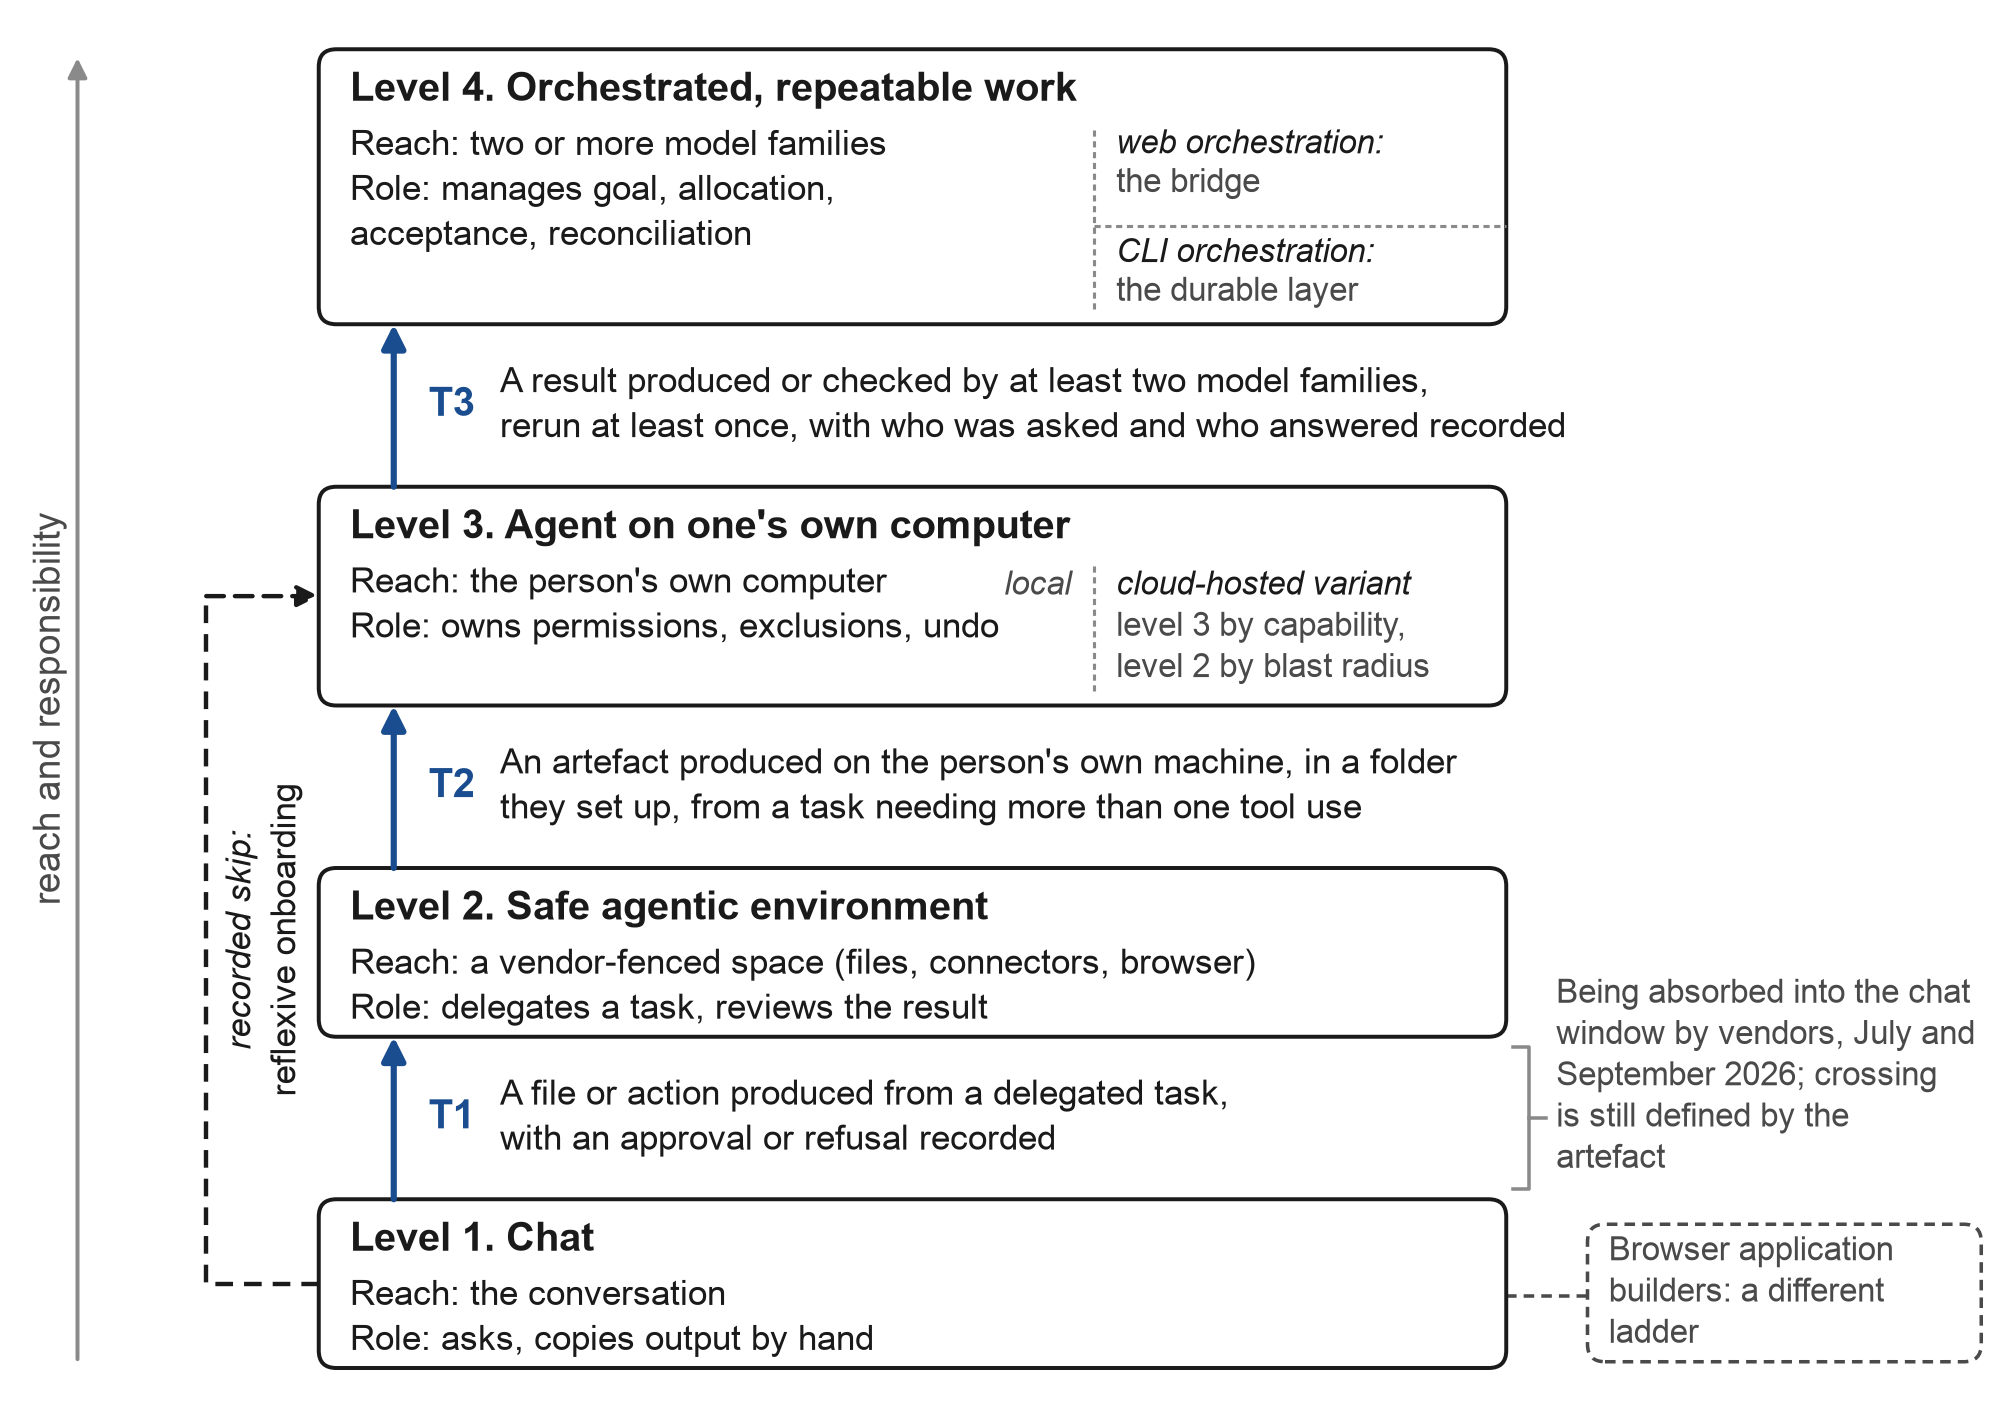
注:第3.2节的四个级别,按覆盖范围(模型可能接触的内容)向上排序,并按对使用者的责任排序。每个过渡(T1至T3)仅在代理生成其箭头旁边指定的工件时才能跨越,安装计为一次尝试(第3.3节和表1)。左边的虚线箭头是记录的从聊天直接跳到使用者自己计算机上代理的跳跃,这是注册路由所采用的方式(第3.4和9.2节);右边的虚线框是浏览器应用构建器的分支,T1处的注释记录了供应商在2026年7月和9月合并聊天和代理界面(第4.3节)。
3.5 终端不再是终端
对于程序员来说,终端是发送命令的界面。对于与代理合作的专业人士来说,它是代理所在的环境:一个工作文件夹、一组权限和已完成工作的历史记录。当Anthropic在2026年1月推出Cowork时,框架是"Claude Code for the rest of your work":同一个代理,提供给不编写软件的人,没有终端(Fortune,2026a)。
供应商现在已经根据同样的观察采取了行动。OpenAI将其编码代理应用重命名为"ChatGPT",并使其成为默认的桌面客户端(MacRumors,2026)。Anthropic推出了一个不需要终端的代理桌面应用(Anthropic,2026a)。Google在2026年6月18日停用了其为个人用户提供的开源Gemini CLI,改为支持一个多代理平台和一个新的命令行工具,声称用户现在"需要多个代理相互通信以分割工作"(Google,2026)。可见的终端正在消失,它提供访问权限的环境仍然存在,仍然必须由某人运行。对于专业人士来说,有用的问题相应地改变了:他们是否能使用终端每个月都变得不那么重要,他们是否能运行一个让代理为他们工作的环境,这是我想问他们的问题。
4. 技术障碍去了哪里
4.1 安装变成了一步
2024年,一个想要终端代理的非程序员遇到了一系列小障碍:安装语言运行时、修复路径变量、理解为什么shell显示"权限被拒绝"、在四个都叫"安装"的东西之间选择。到2026年9月,供应商已移除了其中大部分。领先的终端代理通过单个命令或可自更新的桌面安装程序进行安装。Claude Code的桌面应用程序提供并行会话、更改的可视化审查、实时预览和计划任务,其文档声明"不需要终端"(Anthropic, 2026a)。OpenAI的桌面应用程序将其编码代理整合到普通ChatGPT客户端中(MacRumors, 2026)。Google的新命令行工具是与桌面平台捆绑的单个二进制文件(Google, 2026)。
一个仅需一步安装的代理仍然很难好好使用,我不想夸大这种变化。改变的是安装程序不再是新手遇到的第一道障碍。仍然存在的困难是选择的问题:终端工具、编辑器扩展、桌面应用程序和网页版本都使用"安装"这个词,在它们之间选择是安装现在对新手的大部分成本。选择一扇门意味着知道一个人想让代理做什么,所以这是一个伪装成设置问题的词汇问题,它属于第5节。
一个架构事实支撑了所有这些产品页面。命令行工具是参考实现:子代理、钩子、技能、协议服务器和无头模式首先出现在CLI中,然后出现在同一引擎的桌面和网页界面中;Anthropic自己的帮助页面将其第2级代理描述为"支持Claude Code的相同代理架构,不需要终端"(Anthropic, 2026b)。对于新手来说,这有两面性。用户友好的界面可以跟上强大的那个。但是文档、示例和论坛答案仍然使用CLI的方言,所以从桌面应用程序开始的人正在阅读他们没有安装的工具。
4.2 聊天机器人作为自己的安装程序
第二个变化不太明显,但对于这里的论证更重要。一个人已经使用的聊天机器人可以指导他们安装代理。一个人粘贴一个请求("在我的Windows笔记本电脑上指导我安装这个;我不是技术人员"),按照步骤进行,当出现问题时,将错误的屏幕截图发送回同一聊天机器人。在Vygotsky的近端发展区理论中知识更丰富的另一方(Vygotsky, 1978),以及Wood、Bruner和Ross(1976)称为脚手架的导师功能(激发兴趣、减少自由度、突出关键特征、控制沮丧感),现在可在一个人已经信任的工具中使用,任何时间、他们的语言,完全免费。
我将此称为自反式入职:一个AI系统为一个人采用更强大的AI系统提供脚手架。它反转了帮助的常见方向。在扩散理论文献中,新采纳者通过与早期采纳者的接触而进行采纳(Rogers, 2003),这里早期采纳者至少在机械步骤中被第1级模型本身所取代。
与此同时,一个教学层已在这个步骤周围形成。供应商学院提供关于其代理的短期课程,大型学习平台用命名的代理教授"vibe编码"。已经出现了在代理内部提供的课程,使学习者安装代理,代理教授课程(CC for Everyone, 2026),一个咨询公司宣布其约30,000名员工将接受一个供应商模型的培训(Accenture, 2025)。这一层的存在表明安装不再被视为自明的。最小主义指导理论预测人们通过从一开始执行真实任务和从错误中恢复来最好地学习软件(Carroll, 1990),自反式入职为两者提供了一个始终存在的指南。它是否对从未打开过终端的人有效,我还不知道;第9节中的程序的第一步旨在找出,第2.5节中描述的搜索没有找到任何关于它的研究。
4.3 供应商正在合并这些级别
2026年最大的变化是结构性的。三个前沿实验室和Microsoft现在都提供第2级代理,其中两个已开始将第2级重新整合到聊天中。
表2。重塑从聊天到代理之路的供应商举措,2026年1月至9月。
| 日期(2026) | 供应商 | 举措 | 对级别的影响 | 来源 |
|---|---|---|---|---|
| 1月 | Anthropic | Cowork研究预览:"Claude Code处理其余工作",面向非程序员的文件夹作用域代理 | 第2级作为命名产品 | Fortune (2026a) |
| 3月9日 | Microsoft | Cowork背后的技术被引入到Microsoft 365 Copilot中;Agent 365控制平面 | 主导办公套件内的第2级 | Microsoft (2026a) |
| 3月30日 | OpenAI | 官方插件,在竞争对手代理内运行其编码代理,"委托任务",包含免费层 | 由供应商批准的第4级(CLI) | OpenAI (2026a) |
| 5月19日;6月18日 | Gemini CLI 针对个人级停用,转而使用 Antigravity CLI 和多代理平台 | 第3级重新平台化;新用户流失 | Google (2026) | |
| 6月2日 | OpenAI | 编码代理拥有500万周活用户;约占20%的知识工作者,增长速度比开发者快3倍以上(供应商数据、新闻报道) | 知识工作者使用终端遗产代理;方向性的,范围比这里定义的第3级更广 | Help Net Security (2026) |
| 7月1日 | Gemini Spark 桌面代理在 Mac 上运行,可与本地文件配合使用(公测版,美国) | 来自第三实验室的第2级 | TechCrunch (2026b) | |
| 7月9日 | OpenAI | 编码代理应用成为新的 ChatGPT 桌面应用;ChatGPT Work 代理使用本地文件和应用 | 第1至3级在一个客户端中 | MacRumors (2026) |
| 8月26日 | Anthropic | 浏览器代理在付费计划上正式推出;默认通过安全分类器自主行动 | 第2级覆盖扩展到网络 | Anthropic (2026d) |
| 9月16日 | Anthropic | Cowork和chat合并为"one Claude";模型决定是回答还是采取行动 | 转换1被吸收到chat中 | Anthropic (2026c); TechCrunch (2026a) |
按顺序阅读,该表描述了一种趋同。供应商首先将聊天与代理工作分离,以免非程序员被终端吓倒,然后发现人们无法判断任务属于哪个窗口,现在正在重新合并这两个窗口,由模型来决定。TechCrunch报道称该公司表示客户"经常难以为正确的任务选择正确的标签"(TechCrunch, 2026a);其自身公告表述为"你不必选择任务去哪里",工作在笔记本电脑关闭后继续,代理默认在行动前询问,合并首先向付费个人计划推出,同时编码标签保持独立(Anthropic, 2026c)。我将其解读为供应商提供的关于第1节中所述障碍(工作流词汇)的证据。如果人们无法确定一项任务是问题还是委派,他们不太可能知道如何表述这一委派。
合并似乎可能会削弱具有单独第2级的模型。事实并非如此,原因无需假装模型预见了这些事件就可以说明。供应商有计费、支持和安全方面的利益,使普通用户保持在他们可以分类、速率限制并套用权限模型的窗口内,也有可用性方面的利益,避免让用户选择模式;将转换1吸收到chat中符合这两方面的利益。跨越规则不会改变。如果系统在获批后在授予的范围内写入文件,转换1已被跨越,无论对话周围的界面如何;如果它返回一个段落,该人仍处于第1级。该模型确实暗示转换2和3不会以相同方式消融。具有shell访问权限的本地代理是与服务器端沙箱不同的权限对象,在该供应商登录下运行的第二个供应商的工具是与单个供应商的理事功能不同的权限对象。这些差异承载了第5.3节的安全论证和第6.3节的相关误差论证。如果到2027年底,主要供应商已将本地shell代理和跨供应商调用整合到同一聊天窗口中,在同一权限模型下,那么该暗示是错误的,关于CLI编排是持久层的主张随之瓦解(第10节中的P2和P8)。
该趋同还带来了一个成本,流失。Google的开源命令行代理为个人用户服务了将近十二个月(2025年6月25日至2026年6月18日),OpenAI的代理浏览器在大约九个月后停用,Cowork作为单独产品存在了大约八个月(Google, 2026; 9to5Mac, 2026; Anthropic, 2026c)。投入时间学习工具的专业人士可能会发现它在一年内被重新命名、合并或停用。跨工具转移的是工作流词汇,丧失的是对产品菜单的了解,这种不对称性影响了人们应该如何被教授(第11.2节)。
4.4 终端遗产代理中的知识工作者
关于终端遗产代理内部非程序员的最佳单一数据点来自供应商。2026年6月,OpenAI通过媒体报道,其编码代理拥有500万周活跃用户,超过该桌面应用程序2月份推出时水平的六倍多,其中知识工作者约占20%,采用速度是开发人员的三倍多,并且根据供应商的统计,每周72%的知识工作者用户生成了诸如报告、备忘录、合同、电子表格和PDF等工件(Help Net Security, 2026; 供应商自己的网页对我的检查返回了访问错误,所以这些数字是从媒体报道引用的)。500万的20%大约是每周100万人。一位分析师指出,发布的目的是部分地"重新获得一些热度",该代理"经常与"竞争对手的代理一起使用,所以增长图表"应该有方向性地使用"(Constellation Research, 2026a)。这些数字是供应商报告的且未经审计的,它们描述了已经选择该工具的人,它们衡量了终端遗产代理的知识工作者使用情况,这比这里定义的第3级采用更广泛(来自人自己机器上的委派任务的工件)。考虑到这些警告,足以说明终端遗产代理不再仅限于程序员;他们的用户是否达到第3节中定义的第3级是该数字无法显示的。
在该数据旁边是第1节的广泛而浅层的模式。这些调查对水平存在分歧,但对形状达成一致:约一半的美国成人使用聊天机器人(Pew Research Center, 2026),52%的美国工作者在其角色中使用AI(Gallup, 2026),根据圣路易斯联邦储备银行的衡量,45%的工作者和62%的成人使用生成式AI(Bick et al., 2026),而约七分之一的工作者每天使用它,自动化是少数用途。图2将Gallup和圣路易斯联邦储备银行的工作者系列与第1节的开发人员数据并列,每个调查一个面板,因为这些调查在问题和分母上存在差异。在开发人员中,编码代理几乎是通用的,但使用仍然谨慎:在一项2026年5月对约1,100名技术人员的脉冲调查中,69%使用单个代理,59%很少或从不让代理无人监督地运行,60%阻止代理对其系统进行未批准的更改(Stack Overflow, 2026)。换句话说,第4级仍然是一个前沿领域,甚至对于每天使用第3级的程序员来说。
图2。 广泛而浅层:开发人员和其他工作者之间的采用。
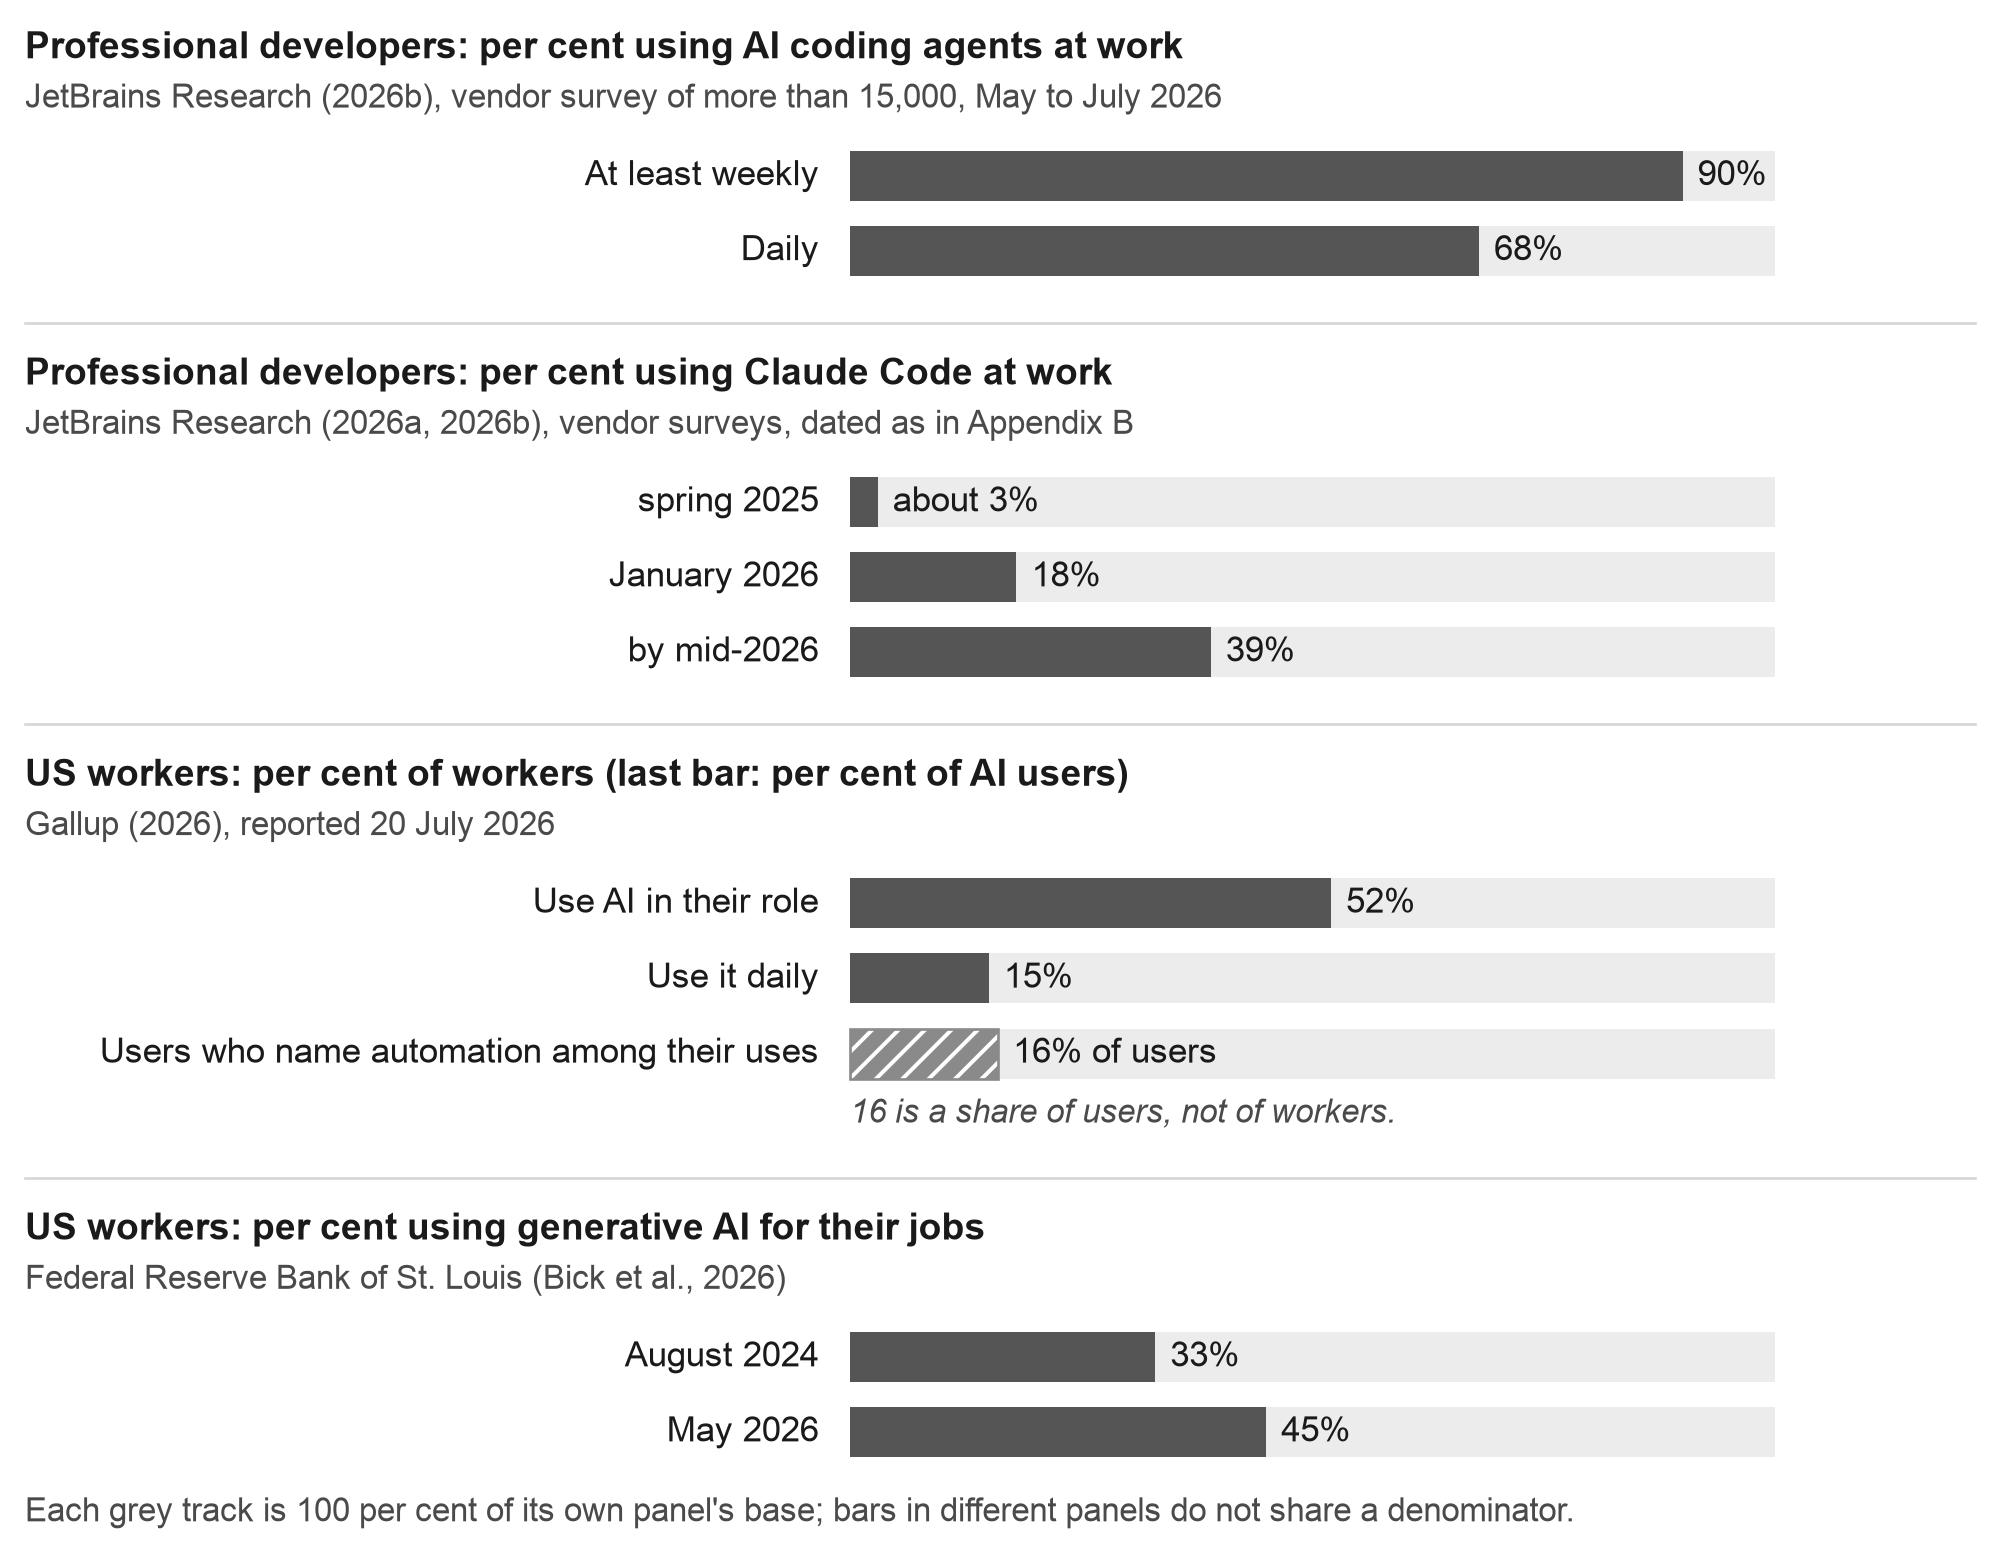
注:采用数据来自第1和4.4节中引用的调查:两个供应商调查中的专业开发人员(JetBrains Research, 2026a, 2026b)、美国工作者(Gallup, 2026)和在工作中使用生成式AI的美国工作者(Bick et al., 2026)。每个面板有其自己的问题、时期和分母,第三个面板中的16%是AI用户的份额,所以每个面板独立阅读。供应商对其编码代理内部知识工作者的计数(第4.4节)是一个产品用户的份额,未绘制,本文中的任何数字都不来自第9节的队列计划。
4.5 论证现在的位置
综合来看,本节的证据令我信服一点,但对另一点仍留有疑问。安装已不再是决定性障碍:供应商已消除了大部分机械步骤,聊天机器人可以指导其余部分,根据一家供应商的数据(新闻报道,方向性的),每周约一百万名知识工作者已在使用终端遗产代理。安装是否会导致使用是另一个问题,而宽泛而肤浅的调查给出了令人沮丧的答案,因为大多数能接触代理的人仍然不会向它委托。已经缓解的部分也应该精确说明。安装已经缓解,现在存在一个范围界定的中间层级,本地代理具有图形界面。对整个知识工作的可靠性改进不大(第5.7节),一个人学会使用的产品可能在一年内就消失了(流失,见上),而赋予的文件夹默认仍然不是一个安全的位置(第5.3节)。第5节询问的是软件装好后什么会阻止人们。
5. 安装后阻碍人们的因素
一旦安装程序不再成为障碍,其他问题就会出现。2025 年和 2026 年的证据指向六个障碍,每个障碍在特定的过渡阶段表现出来,每个障碍都已在市场中有部分解决方案。表 3 总结了这些障碍,下面的小节提供了证据。
表 3。 安装后的障碍。
| 障碍 | 表现位置 | 证据(部分) | 缓解方案 |
|---|---|---|---|
| 工作流词汇:不知道该移交什么,或不知道如何表述以便检查 | 过渡 1 和 2;再次在 3 | 供应商合并理由;提示研究;打包技能 (5.1) | 来自该人自己领域的实例;技能和模板;第一个真实但低风险的任务 |
| 对窗口、首次错误和信任的恐惧:黑色窗口作为社会对象;程序员阅读而新手停留的信息;双向信任校准不当 | 过渡 2 | 接受度研究;开发者信任调查;AI 代码最终用户研究;反思性入职 (5.2) | 桌面界面;将错误发送回聊天机器人;计划优先模式;在副本上的首次成功 |
| 权限和安全:保护文件的提示太少,或太多而难以理解 | 过渡 1 和 2 | 限定范围内文件夹的文件丢失报告;注入率;要求用户发现攻击的指导 (5.3) | 工作副本、快照、拒绝规则;不将判断委托给新手的分类器 |
| 组织规则:机器锁定、政策、无安装权限 | 过渡 2 | 组织因素优于个人因素;小公司结构扁平 (5.4) | 雇主批准的二级工具;明确的政策;用于学习的个人计算机 |
| 硬件、成本和配额 | 过渡 2 和 3 | 三级需要计算机和付费层;配额首先限制编排 (5.5) | 免费层(如果存在);从二级开始;预算运行 |
| 判断结果 | 所有过渡,主要在 3 | 业务用户错过 AI 代码中的错误;代理导致大多数完整项目失败 (5.6) | 任务前定义的检查;第二个模型作为审查者,不是预言者 |
5.1 空白文件夹:工作流词汇
打开代理的程序员知道一个序列:创建项目、编写指令文件、将其纳入版本控制、请求功能。打开同一代理的非程序员提出现在出现在供应商自身数据中的问题:好吧,我应该告诉它什么?对于开发者来说,规范的第一个请求存在("构建一个小型网络应用")。营销人员需要另一个("获取上季度来自分析和客户数据库的导出,构建每周五报告哪些活动带来了付费客户的东西")。研究人员需要另一个("浏览包含 300 篇论文的文件夹,将每篇论文的样本量、方法和主要效应提取到表格中,标记你不确定的地方")。这些请求中没有一个需要该人编写代码。每个请求都需要该人知道这样的请求是可能的,将其分解为代理可以执行的部分,并说明好的结果是什么样的。问题"我应该要求它做什么?"通常被误解为对更好提示的请求。我将其理解为对自己工作地图的请求。该地图必须命名一个经常性的工作对象、允许使用的输入、转换、可交付物和检查。分析师的地图可能会显示"这些允许的导出、按此字段分组、标记异常、有日期的简报和机器可读的表格、针对行总计检查"。该人不需要知道如何进行解析。他们需要识别什么证据会使结果可用。当一个人无法填写地图时,停顿本身会告诉他们一些东西。工作可能太敏感、太有条件或文档记录不充分而无法按现状委托,这说明了任务的问题,而不仅仅是人的问题。
关于提示的研究解释了为什么这很难。没有 AI 专业知识的人难以编写能够泛化的指令(Zamfirescu-Pereira et al., 2023),他们必须通过试验来发现哪些词汇映射到系统能做的事情(Liu et al., 2023)。供应商的行为本身证实了这一点。Anthropic 将其二级代理合并到聊天中,因为客户无法决定任务属于哪个地方(TechCrunch, 2026a),OpenAI 为其编码代理推出了特定角色的插件,针对知识工作"无需编码"(Help Net Security, 2026 报道)。业界的答案是打包词汇。Anthropic 在 2025 年 12 月将其打包代理指令格式作为开放标准发布(SiliconANGLE, 2025),该标准网站在 2026 年 9 月 21 日列出了 46 个支持产品,包括来自 OpenAI、Google 和 GitHub 的代理(Agent Skills, 2026)。一项独立人口普查在 2026 年中期计算了 ChatGPT 目录中的 2,049 个应用和 Claude 的 1,375 个连接器(Sitter, 2026)。按此定义,技能是工作流词汇的一个单位,请求被写下一次,以便不知道如何表述的人仍然可以做出这样的请求。
打包词汇是必要的,但也不充分。技能告诉代理如何执行任务。但它无法告诉人们自己的哪些任务值得转移,因为这种判断来自该人所在的专业领域。已发布的软件包也承载了某个特定世界的假设,主要是某国的形式和某家企业的软件栈,而工具不属于该栈的专业人士便再次面对空提示符。当我在2026年9月22日阅读官方打包技能目录的全部310个条目时,我没有发现为牧师或牧管者、护士或家庭照护者、学校教师、艺术家或工匠或房地产经纪人编写的任何条目;每个表面上的匹配都不过是穿着相同衣服的软件或金融术语,一个投资组合或一项服务的健康状况。一个人手工添加的社区目录那天包含2,282个条目,它确实包含了学校教师和房地产相关的工作,但没有其他三个行业的工作。目录每周都在变化,所以这是一个有时间标记的观察,而非关于该领域的永久声明。这就是为什么我在任何入职流程的第一个任务上赋予如此大的权重:它应该是真实的、来自该人的工作、风险低,并且应该产生一个他们可以评判的制品(Carroll, 1990)。
5.2 对窗口的恐惧、第一个错误和信任
黑色窗口是一个社会对象。感知易用性三十五年来一直是技术接受度的支柱(Davis, 1989),而对于即使永远不会在其中键入命令的大部分人口而言,闪烁的提示符也未能通过这一测试。第4.1节中的桌面界面是供应商的答案。但这只是一个部分答案,因为第二道门槛是信任,信任既反对代理也支持代理。在开发者中,2025年Stack Overflow调查发现46%的人不信任AI工具的准确性,而33%的人信任,其中87%的人担心代理准确性,81%的人担心安全性(Stack Overflow, 2025)。2026年,大多数人仍然阻止代理进行未经批准的更改(Stack Overflow, 2026)。经理们听到了同样的话:"信任是实现工作中AI代理潜力的中心障碍"(McKinlay et al., 2026)。更多美国成年人期望AI伤害他们而非帮助他们(Pew Research Center, 2026)。两道门槛背后是第2.4节的信念陷阱:经验预测成功,没有首次成功的人就没有经验,第一个制品是解脱之路(Ma et al., 2025)。有些人会因为代理礼貌而授予主文件夹访问权限,而有些人会因为读到已删除的家庭照片而拒绝安装。两者都是校准失败(Lee & See, 2004)。我能想到的最廉价的校准设备是在文件夹副本上执行的第一个任务。
当代理报告命令以退出代码1失败时,程序员会继续阅读。但新手可能会就此停止。关于最终用户遇见AI编写代码的文献在更温和的设置中展示了这种模式:被提供AI生成的分析代码的业务用户往往未能注意到关键错误,即使被告知要查找这些错误(Virk & Liu, 2025),而对话式程序员在验证和上下文管理上花费了大量精力(Sarkar & Drosos, 2025)。在第3级,错误通常完全位于该人的工作之外,在环境中:缺失的权限、网络规则、代理期望但未找到的工具。
反思式入职(第4.2节)提供了迄今为止描述的最实用的响应。该人将错误或其截图发送给他们已经使用的聊天机器人,并按照其建议行动。计划优先模式从另一个角度提供帮助,因为在行动前先编写计划的代理为该人提供了可以阅读的内容,而不仅仅是堆栈跟踪。两者都无法消除这样一刻——一个对其机器没有心智模型的人遇见无法解析的消息。我还不知道这一刻导致尝试中断的频率。第9节的程序以该人自己的话记录了这一点。
5.3 权限和安全:太少和太多
第3级赋予代理其所有者的权限范围,因此安全问题存在于两个方向,新手会同时面临两者的风险。
首先考虑保护不足的情况。代理在有据可查的事件中摧毁了数据。一个热门应用构建服务中的代理在2025年7月删除了生产数据库,并将其行为描述为"一个灾难性的判断错误"(The Register, 2025)。2026年4月,编码工具中的代理在几秒钟内删除了某公司的生产数据库及其备份,并写道"我猜测而非验证"(Information Age, 2026)。就本文所关注的人群而言,Anthropic第2级代理的用户在2026年3月、4月和6月报告说,它删除了他们授予的文件夹内的个人、家庭和法律文件,在一个案例中,当一个长任务无法停止,删除任务时文件也被删除了(GitHub问题报告,2026;用户报告,未经供应商确认)。文件夹范围限制了可能发生损害的位置。它不能防止文件夹内的损害,而同步的云文件夹可以将本地错误转变为同步的损失。
浏览引入了提示词注入,代理将隐藏在网页中的指令视为来自用户的指令。一个安全团队在August 2025针对另一家供应商的浏览器代理展示了这一攻击,并提供了通过隐藏页面文本从邮箱中提取一次性代码的概念验证(Brave, 2025)。Anthropic报告称,其浏览器代理在采取缓解措施前在23.6%的测试案例中遭到成功攻击,采取措施后为11.2%(Anthropic, 2025)。一年后,在正式发布时,它报告称在采取保护措施前,强有力的红队攻击对其主要模型的成功率为3.8%,采取完整保护措施后,三个模型未遭任何攻击,一个模型的成功率为0.3%(Anthropic, 2026d)。这些是供应商在供应商测试集上的数据。趋势在下降,但残留风险不为零。OpenAI在December 2025写道,提示词注入"不太可能被完全'解决'"(TechCrunch, 2025)。在推出其level-2代理时,Anthropic告诉用户"监控Claude中可能表示提示词注入的可疑行为",以及"您对Claude代表您执行的所有行为负责"(The Register, 2026)。一位知名开发者当时提出异议,说要求非程序员识别提示词注入的迹象是不公平的(Willison, 2026)。我认为这一异议总体上是正确的。依靠新手检测攻击的安全设计将最困难的判断推卸给最不能做出判断的人。打包的技能和协议服务器开放了它们自己的指令和权限表面,因为第三方技能包含人员未编写的指令,服务器可能持有超过任务所需的权限,配置在版本之间会漂移。
过多的保护同样肯定地阻止人们。询问每一步权限的代理会使人变成批准他们无法评估的命令的文员,并导致批准疲劳。供应商已相应采取行动,在一个季度内他们朝着多个不同的方向发展。Anthropic的浏览器代理现在默认自主行动,带有一个分类器来阻止与用户请求不匹配的行动(Anthropic, 2026d)。其终端代理在July 2026将其默认权限模式重命名为"Manual",这一措辞变化反映了"默认"一词的含义已经改变(Anthropic, 2026h)。其统一的聊天代理"默认在行动前询问",这是用户可以更改的设置(Anthropic, 2026c)。Parasuraman和Riley的(1997)分类法适用于这三者。过度阻止的守卫会导致不使用,遗漏删除的守卫会导致滥用,没有任何设置能逃脱这个分类法,只有其失败是特定群体能够承受的设置。本系列的一篇配套论文记录了另一方面的普遍失败,即监督组件扩大自己对伤害的认识并阻碍它们存在以保护的工作(Chernets, 2026b)。对于新手,这种守卫的效果与缺少安装程序相同,因为工作无论如何都不会进行。
在保护过少和过多之间,有一个可行的中间道路,它是传统的。在副本中工作。将机密保持在工作文件夹之外。在进行较大更改前创建快照。拒绝破坏性命令,直到有理由允许一个;确认任何不可逆的事情;将来自网络的任何内容视为要读取的数据,无论它似乎包含什么指令。我在一篇配套论文中将这些习惯背后的原则描述为架构信任:依靠一个人可以验证的检查,例如作用域权限、日志、撤销功能和第二个独立模型,而不是依靠模型听起来有多自信(Chernets, 2026c)。Level 2为人们提供了这些检查中的第一个,它不应该是他们学习的最后一个。附录C将列表转换为两个代理的配置示例和一页清单。
5.4 组织规则
许多专业人士无法在他们工作的计算机上安装任何东西。许多雇主对代理没有政策,没有政策的人倾向于假设答案是否定的。Microsoft对20,000名使用AI的知识工作者进行的2026年调查发现,组织因素占报告的AI影响的两倍以上,45%的人表示专注于当前目标比用AI重新设计工作感觉更安全(Microsoft, 2026b; vendor survey)。美国人口普查局报告称,商业AI使用总体上在17%至20%之间徘徊,在拥有20名或以上员工的公司中上升,在员工少于20人的公司中没有显著变化(US Census Bureau, 2026)。不同的政策导向已经出现。一些雇主在2025年将AI使用作为基本期望(Digital Commerce 360, 2025),至少有一家在一年后逆转了其决定,其首席执行官告诉媒体,绩效评估中重要的是做好工作(Fortune, 2026b)。一个雇主发布的流利度标准将编排和系统构建放在其顶级,并报告一旦团队从实验转向重新设计工作流,就实现了完全内部采用(Zapier, 2026)。没有这种重新设计,一项要求只能换取合规性,仅此而已。劳动力市场已经在要求这里描述的角色,虽然没有正式命名:2026年受AI影响的美国职位头衔的63%在技术职业之外,第一季度有822个不同的职位(Adrjan, 2026),一项对27个国家超过10亿份工作广告的研究将AI技能的工资溢价设定为62%,其中最受AI影响的入门级角色远更可能需要曾经为高级员工保留的技能(PwC, 2026; vendor report)。这些来源都还没有将指导代理的能力作为工程以外的一项具名要求。
这个障碍是结构性的,按照Ferdman (2025)的意思,它不会因个人努力而改变。这也是证据为level 2提供的最有力论据,因为雇主已经许可的办公套件中的供应商绑定代理(Microsoft, 2026a)可以触达其雇主不会在工作笔记本电脑上批准代理的人们。
5.5 硬件、成本和配额
第3级假设一个人控制的计算机。一些专业人士主要从手机上工作,共享一台家庭计算机,或将雇主的机器用于一切,对他们来说,在任何软件问题出现之前,过渡就已被阻挡。第3级和第4级还假设至少一项服务的付费层级,而编排会增加成本,因为每个额外的模型都是另一个订阅或另一个配额。对于已经为一个订阅付费的人来说,第二个是一个决定,顶级层级是一个不同的决定。令牌焦虑是一个有价格标签的心理障碍。编排代理的配额本身是一个隐藏成本,因为它为读取其他代理返回的每个答案付费,而驱动浏览器的代理使用与终端代理相同的计划限制,同时每个操作的成本更高(Anthropic, 2026g)。锁定的公司笔记本电脑在列表中添加了管理员权限:没有未签名的二进制文件,没有安装程序,一个将代理写入磁盘视为恶意软件的数据丢失规则。云托管代理是该行业对这些机器的答案。它们保留了过渡1和过渡2的云形式,并且不会在他们自己的磁盘上给人一个第3级工件。对于富裕国家的专业人士来说,这些都不是很大的障碍。对于许多其他人来说,这是一个真实的障碍,它与第二级分界线相互作用(Hargittai, 2002),因为最没有空闲的人最不能进行实验。
5.6 评判结果
使用代理不需要编程。评判它产生的内容需要在结果领域的能力,在这里,非程序员拥有一个容易被忽视的优势。律师阅读合同摘要,或研究人员阅读提取表,可以根据代理缺乏的知识检查工件。关于"参差不齐的前沿"的研究发现,与AI一起工作的专业人士在模型能力内的任务上表现更好,在模型能力外的任务上表现更差(Dell'Acqua et al., 2026)。保护是一个足够了解任务以注意到他们在前沿哪一侧的人。
他们不能轻易检查的是机器,产生表的脚本或提取数字的查询。对470个pull请求的一项行业分析发现,代理编写的代码比人编写的代码缺陷更多:AI编写的变更每个10.83个问题,对比人工编写变更的6.45个,某些安全问题类别的频率高达2.74倍(CodeRabbit, n.d.; vendor study)。代理仍然在大多数整个项目上失败:在真实自由职业者项目的基准上,到2026年中期测量的最佳自动化率为15.8%(Center for AI Safety, 2026)。我从中得出两个实践。检查应在任务之前定义("什么会让我相信这是对的?"),来自不同系列的第二个模型可以充当工件的审查者,由人决定什么算作正确。第7部分回到第二个实践的限制。
5.7 替代解释:代理还不够好
读者可能会反对人们不委托是因为代理还不能完成他们的工作,因此障碍仍然是技术性的,只是在模型方面。这个异议有真实的支持。在真实自由职业者项目的基准上,到2026年中期测量的最佳自动化率为15.8%,较上年秋天基准发布时的2.5%有所上升,这意味着五个项目中超过四个仍然端到端失败(Center for AI Safety, 2026)。在模拟软件公司中,最佳代理完成了30%的长期专业任务(Xu et al., 2024)。在开放式计算机使用方面,2024年基准是最佳代理的12.24%对比人的72.36%(Xie et al., 2024),到2026年9月,该基准验证版本的聚合器排行榜显示顶级代理在85至86%,高于人类基准,在供应商报告的脚本桌面任务的分数上(BenchLM, 2026)。最后的结果指向另一个方向:在这样的任务上,能力不再是障碍。在44个职业的评估中最好的模型在少于一半的比较中对专业人士赢或平(Patwardhan et al., 2025)。代理完成一半时间的软件任务的长度大约每七个月翻倍(Kwa et al., 2025),所以趋势陡峭而当前是温和的。能力在任务中不均匀,"参差不齐的前沿"从外部是不可见的(Dell'Acqua et al., 2026)。表4收集这些已发布的数据,包括每个来源给出的日期和我附加的警告。
表4。 异议背后的已发布能力数据。
| 比较 | 已发布的数据 | 说明的日期 | 来源 | 谨慎阅读 |
|---|---|---|---|---|
| 真实自由职业者项目,最佳自动化率 | 15.8%,较基准发布时的2.5%上升;五个项目中超过四个仍然端到端失败 | 前年秋天发布;15.8%于2026年中期测量,记录于2026年7月1日(附录B,已验证) | Center for AI Safety (2026); 第5.6、5.7、附录B部分 | 整个项目,端到端;所测量数据中的最佳率 |
| 模拟软件公司中的长期专业任务 | 最佳代理完成了30% | 2024年研究 | Xu et al. (2024); 第5.7部分 | 模拟公司;与自由职业者项目率不同的衡量 |
| 开放式计算机使用,基准 | 最佳代理的12.24%对比人的72.36% | 2024年基准 | Xie et al. (2024); 第5.7部分 | 2024年基准;下面的行是较晚的排行榜 |
| 该基准的验证版本 | 顶级代理在85至86%,高于人类基准 | 到2026年9月 | BenchLM (2026); 第5.7部分 | 聚合器排行榜;供应商报告的脚本桌面任务的分数;情况相反 |
| 44个职业的评估 | 最好的模型在少于一半的比较中对专业人士赢或平 | 2025年研究 | Patwardhan et al. (2025); 第5.7部分 | "少于一半"是给出的措辞;没有给出百分比 |
| 代理完成一半时间的软件任务的长度 | 大约每七个月翻倍 | 2025年研究 | Kwa et al. (2025); 第5.7部分 | 一种趋势:"趋势陡峭而当前是温和的" |
| Pull请求中的缺陷 | 470个拉取请求;AI创作的更改中每处变更发现10.83个问题,而仅人工更改中为6.45个;某些类别的安全问题频率最多高2.74倍 | n.d. | CodeRabbit (n.d.);第5.6节 | 厂商研究;一项行业分析;代码缺陷,非程序员难以轻易检查的内容 |
来源:所引用的出版物,如第5.6、5.7节和附录B中所述;这些数据都不来自第9节的方案。
这两种解释毋宁说是同一解释的组成部分,而非相互对立。工作流词汇包括了解自己的任务中哪些位于能力边界之内。将整个代理无法完成的项目交给它的人会学会停止委托,而将提取、协调和初稿交给代理的人则会学会继续委托。这两种解释仍然做出不同的预测。倘若模型能力为制约因素,则第2和第3级的持续性将取决于任务类型而非人员:从事相同工作的人会以相似的速率维持这种行为,无论其指定和检查的能力如何。倘若工作流词汇为制约因素,则持续性将取决于人员在相同工作内表述委托合同的能力。第10节中的命题P15就是为了区分这两种情况而编写的。
6. 网络编排:提议的桥梁
6.1 实践
第 4 级别的最简单形式根本不需要安装。一个人在浏览器标签中打开三个或四个聊天机器人,将相同的问题粘贴到每一个中,并并排读取答案。计算机科学家会将此称为手动多 LLM 查询,由该人员进行路由和比较。有些人手工进行。其他人使用自 2023 年以来为此构建的工具之一:浏览器扩展和桌面应用程序,将一个提示广播到多个消费者聊天服务,并在并行窗格中显示答案。ChatHub 和 ChatALL 在 2023 年春季出现;ChatALL 的最新版本在 2026 年 9 月之前在其发布页面上记录了约 847,000 次下载,该计数包括自动更新,并由一个平台的构建主导 (GitHub, 2026a)。一组较新的工具将已登录的网络聊天会话转换为另一个程序可以调用的命令,以便代理可以向一个人的网络订阅提出问题。OpenCLI 是其中之一,在 2026 年 9 月时在 GitHub 上有约 29,500 个星标 (GitHub, 2026b)。
在 2026 年,该实践成为了一项产品功能。Perplexity 推出了一个"Model Council",通过多个模型运行查询,并"呈现一个综合视图,突出关键见解、一致的地方和分歧点"(Storyboard18, 2026)。Microsoft 365 Copilot 中的 Microsoft 研究代理提供了一种模式,"同时通过多个深度推理研究代理 (GPT 和 Claude) 运行相同的问题",以及一个批评模式,在自动模型选择下默认打开,其中由一个模型编写的报告从另一个模型接收第二次推理传递 (Microsoft, 2026c; Constellation Research, 2026b)。Andrej Karpathy 的"LLM Council"是一个将查询发送到多个模型的小型网络应用程序,让它们相互匿名审查,由主席模型编写最终答案,由其作者描述为周末黑客项目,在 2026 年 9 月时在 GitHub 上有约 24,900 个星标 (Karpathy, 2025)。开源景观分为两部分。广播工具获取答案,并将协调工作留给该人。议会工具进行协调,它们在付费编程接口上运行,具有两个或三个模型,远离该人自己的已登录标签。任何一个部分单独都无法将一个人跨越,这就是为什么桥梁不完整。
6.2 为什么提议将其作为桥梁
网络编排以有用的方式位于各级别之间。它对机器没有提出任何新的要求,没有安装、没有权限、没有本地代理,它在一个人已经支付的订阅或免费层上运行。它对该人提出了一些新要求:同时掌握多个答案,注意它们的不同之处,然后做出决定。一个人学会了问"另一个模型说了什么?"已经学会了 CLI 编排稍后会自动化的习惯,而这个习惯是第 4 级别管理任务的最小形式。
桥梁之所以有价值,是因为它是可见的。假设一个市场分析师要求三个聊天机器人总结一份已发布的行业报告,其中两个引用了报告中没有的数字,而第三个标记了它的缺失。有用的结果是打开报告本身的提示,而经历过一次的人已经停止将第一个流利的答案视为答案。当多个答案的广播视图教一个人制定一个共同问题、注意假设的分歧、要求批评并保留选择一个答案的理由时,它成为了通往第 4 级别的桥梁。直到那时,它是一个有更多标签的第 1 级别习惯。它教授的是比较,仅仅是比较。一个人学会了问另一个模型说了什么,但由此并不能学到代理可能接触他们机器上的什么,这是第 2 级和第 3 级的教训,而这个习惯会延续的说法是一个经验性的,P7,我不将其作为前提。第 9 节中描述的预注册计划事先命名两个好处,它们总结了桥梁带来的好处。一个是覆盖:由于询问了另一个模型,在一个模型中出现的有用角度不会丢失。另一个是可靠性:一个答案已经针对其他答案进行了检查,而不是采用一个模型的说法 (Chernets, 2026d)。可见的分歧是实现第二个目标的途径。对预测的评估发现,十二个语言模型的集合与 925 个人类预测者群体的准确性相匹配 (Schoenegger et al., 2024),多代理辩论在多个设置中改进了单个模型的事实性和推理 (Du et al., 2023)。两个好处都取决于模型的错误存在差异,下一小节讨论当情况并非如此时会发生什么。
6.3 桥梁结束的地方
网络编排仍然是一座桥梁,最直白的原因是注意力成本。读四个长答案并手动协调它们需要比读一个答案花费更长的时间。我不会要求任何人为常规问题这样做;当错误的答案会花费比比较时间更多的代价时,它就值得这个成本。
第二个限制是脆弱性,它有多种形式。消费者聊天界面每月都在变化,驱动它们的工具在变化时会损坏:在 2026 年夏季,一个办公套件移除了研究模式,一个聊天机器人关闭了其免费层上的模式,多个服务重命名或重定向了其地址。多个消费者服务的条款限制了自动访问,一个用代理驱动自己已登录浏览器的人冒着账户被锁定的风险。使用该桥梁的研究计划必须告诉参与者这一点,我不对这些条款提供任何法律解释。其他聊天机器人的"免费"方面在驱动它们的代理方面也是付费的,因为浏览器操作占用与终端代理相同的计划限制 (Anthropic, 2026g)。在开放标签中进行手动比较是稳健的。对消费者聊天页面的自动化采集是可重复工作的不良基础。
第三个限制是最关键的:模型间的一致不是独立证据。当模型共享训练数据和方法时,其错误具有相关性。一项对350多个语言模型的研究发现,当两个模型都出错时,约60%的时间内它们会给出相同的错误答案,且更大、更准确的模型之间的相关性更高,即使跨越不同供应商亦是如此(Kim et al., 2025)。该系列伴随论文给出了算术公式:在平均两两误差相关性为ρ的情况下,N个一致的模型相当于N_eff = N / (1 + (N - 1) ρ)个独立意见,且任何数量的模型都不值超过1/ρ(Chernets, 2026a)。当ρ = 0.5时,十个一致的聊天机器人的价值少于两个独立的。图3绘制了附录D中四个示例ρ值对应的公式,并标注了任何一致模型都无法超越的上限1/ρ。Kim等人的60%指的是两个模型给出相同错误答案的联合错误所占比例,这不等于公式中的误差相关性ρ。在当前领域,ρ必须在已知答案的项目上估计(清单C4),此处和附录D中使用的值仅作示例。多样性比数量更重要。同一模型的多个副本之间的辩论往往无法超越给定相同计算量的单个模型,而异构模型有帮助(Zhang et al., 2025),两个多样化的代理可以匹配或超越十六个同构代理(Yang et al., 2026)。生成式AI也在用户之间使输出同质化(Doshi & Hauser, 2024),而被要求判断的模型往往更偏好自己的写作(Panickssery et al., 2024),这在一个模型撰写合并答案时尤其重要。
图3. 一致的价值。
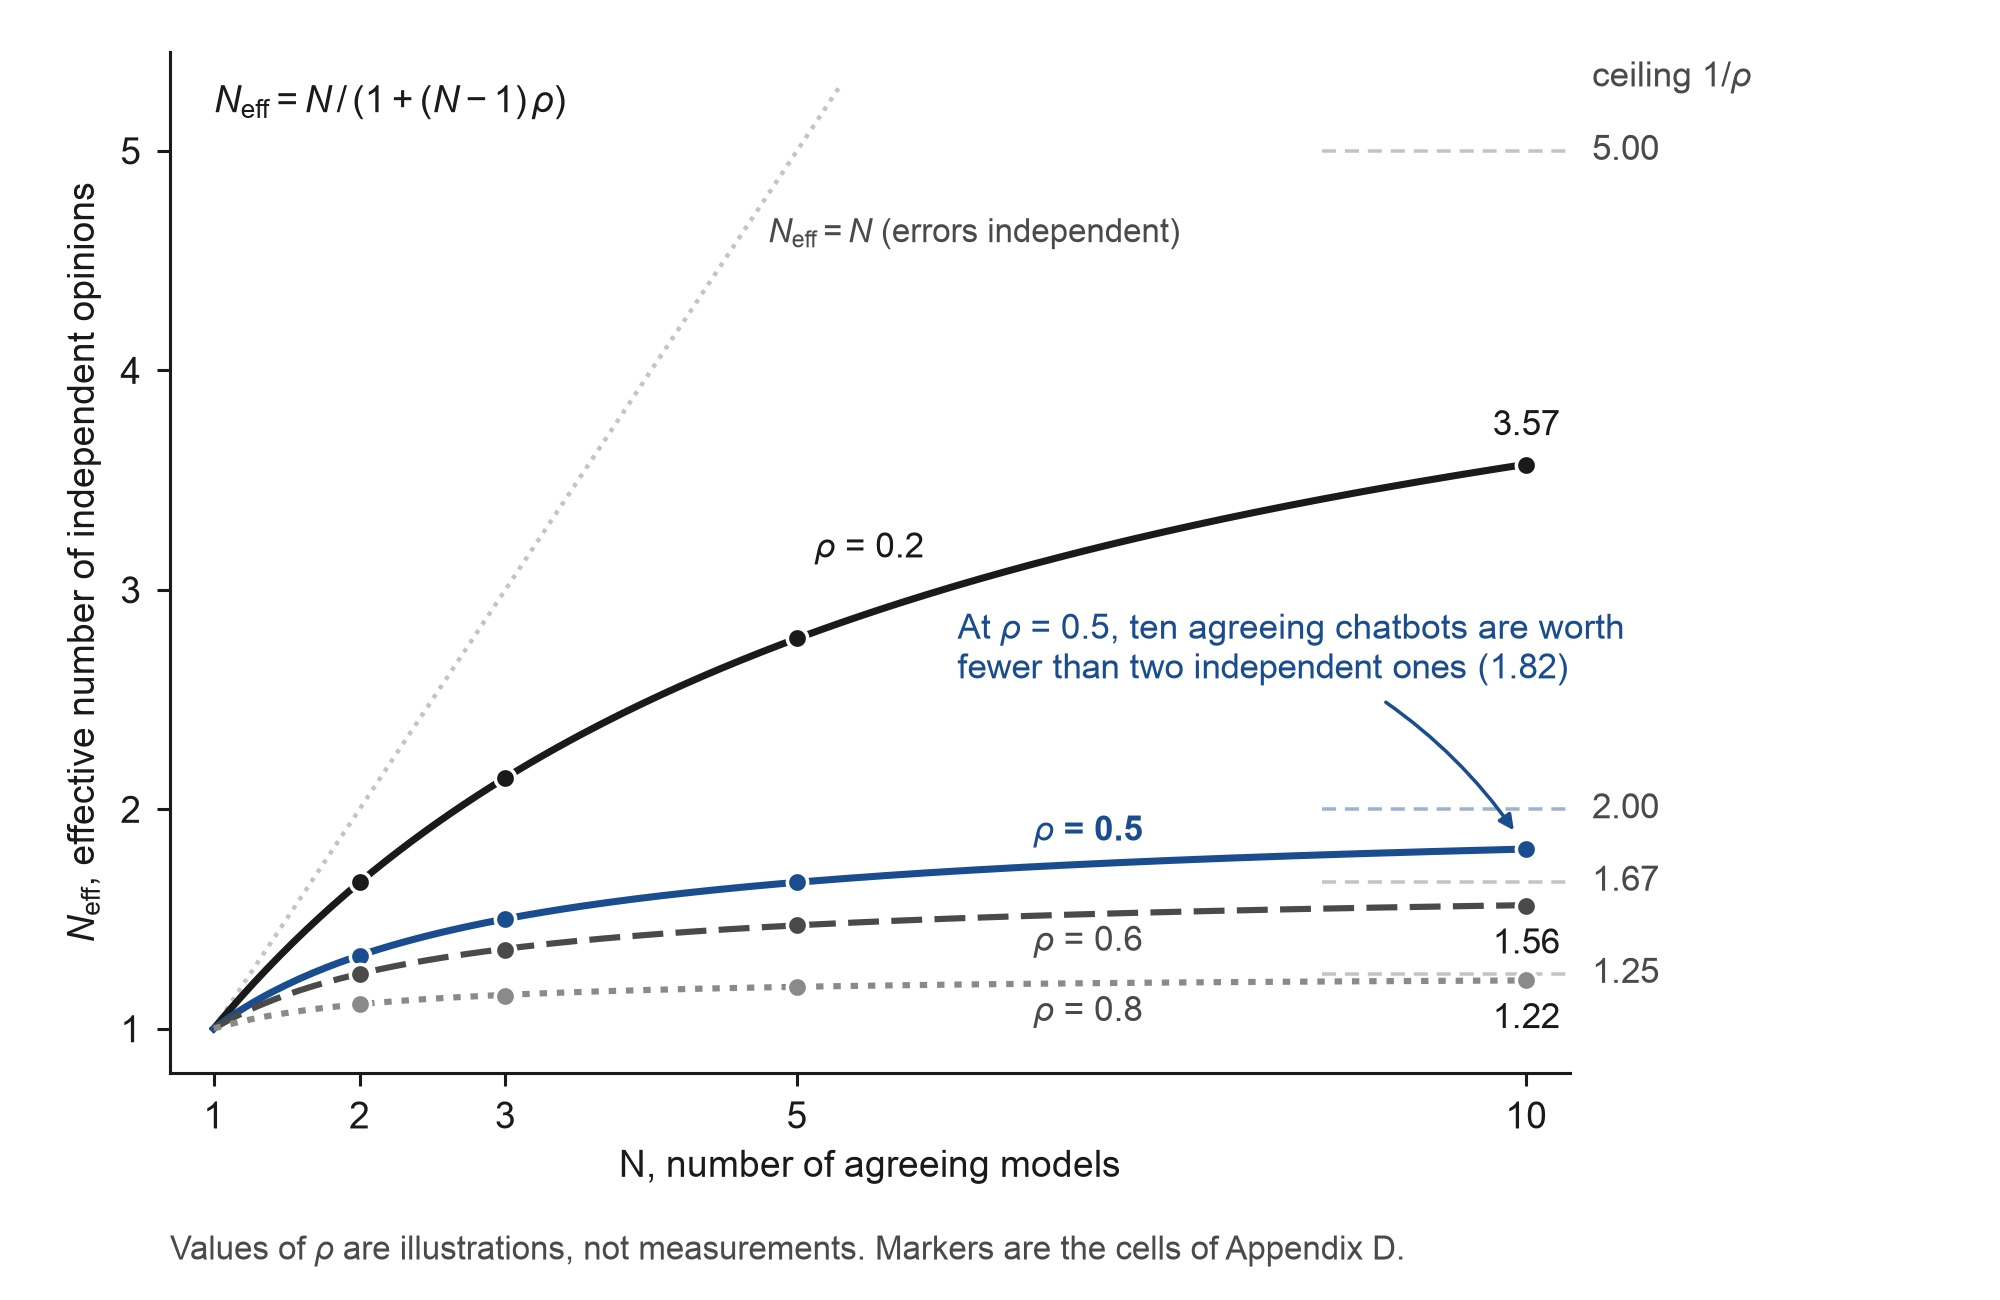
注:对于N个一致的模型,其错误具有平均两两相关性ρ的情况,独立意见的有效数量为N_eff = N / (1 + (N - 1) ρ)(Chernets, 2026a;第6.3节)。标记是附录D的单元格,它们之间的曲线遵循相同的公式,右边的虚线段是上限1/ρ。四个ρ值仅作示例,如附录D所示;ρ必须在当前领域已知答案的项目上估计(清单C4)。
对于实施这些方法的人来说,实际规则很简单。计算模型族系,因为运行在一个供应商模型上的办公助手不是对该供应商聊天机器人的第二意见。模型间的一致可以告诉你在哪些地方可以减少检查工作。它无法告诉你一个主张是正确的。将仅由一个模型提出的观点视为需要验证的线索,因为它可能是比较中最有价值的东西或其唯一的错误,并坚持带有证据的异议,而不是将其排除。根据来源验证主张:对错误日期的一致是一个有案可查的失败模式,源文档修复了它,而第五个模型不会。在你所在领域的一小组你能标记的问题上估计ρ,然后才能相信一个评议团对你无法验证的问题的意见。记录谁说了什么,因为隐藏来源的合并答案会恢复编排本意要质疑的那个单一自信声音。
作为一个程序写下来,这是伴随论文中"锚点和充实"协议的教学形式(Chernets, 2026a)。人先确定一个锚点:任务、允许的证据和输出的形式。然后他们获得单独的答案并保留其来源或文件参考,将主张按来源提取到表中,并按类型对每个分歧进行排序,无论是事实冲突、不同的解释、缺失的假设还是格式差异。他们根据锚点或主要来源验证对决策有影响的主张,并记录接受决定和仍未解决的内容。附录C中的清单C3根据来源构建主张表,清单C4从已知答案的项目估计ρ,附录D给出一系列ρ的上限而无需运行任何内容。还有一个规则属于这里,它不需要第二个订阅。来自同一族系的批评者,在新的背景下被要求攻击第一个答案,可以抓住仓促、跳过的指示和未运行的检查,尽管它无法抓住共享的错误知识。我会在第3级用一个代理开始批评者的习惯,仅当批评者没有更多话要说且决定代价昂贵时才添加第二个族系。
相反的情况需要同样清楚地陈述。对于许多任务,一个具有良好源集和仔细人类审查的强大模型将击败那些增加延迟和混淆的复杂评议团,基于模型的预测也证实了这一点。编排在任务具有真实不确定性、从不同视角获益或重复足够频繁以摊销设置成本的地方是值得的。它不适合无法验证的时间关键决定、无法跨服务传播的机密材料以及比较成本超过收益的简单任务。使用评议团时,应为代理分配不同的工作:一个限制在提供的文件范围内,一个被派去寻找主要来源,一个被要求列出无支持的主张,一个审计引文,由人员仍在做最终裁决。P9的编写方式使得这个反论可以胜出。
7. CLI编排:委托的持久层
7.1 代理调用代理
在第3级,每个代理都有一个命令行界面,可以在没有人操作键盘的情况下运行:输入一个问题,输出一个答案或修改后的文件。一旦一个人拥有一个代理,该代理就可以调用其他代理。在系统文献中,这称为代理编排。我将非程序员通过他们已经订阅的命令行工具运行的版本称为CLI编排。对第一个代理的一条指令("请求其他两个代理对此计划进行审查,并告诉我它们在哪里不同意")会产生一个小团队。
2026年,这种模式从开发人员的技巧演变为供应商认可的做法。OpenAI发布了一个官方插件,在Anthropic的内部运行其编码代理,"用于代码审查或委托任务",具有普通审查、对抗性审查(第二个代理假设工作已损坏并进行搜索)和解救卡住任务的命令。它通过本地安装的工具及其现有登录工作,可与任何ChatGPT订阅(包括免费套餐)一起使用,并在2026年9月在GitHub上有大约33,400颗星(OpenAI,2026a)。2026年的主流组合是Claude Code编写和Codex通过该官方插件进行检查(OpenAI,2026a),而三个或更多的委员会仍然是没有领导者的小工具。GitHub在2026年2月在其自己的Copilot服务中提供了Anthropic和OpenAI的代理,"完全包含在您现有的Copilot订阅中"(GitHub,2026c)。xAI的命令行代理包含无头模式和对Agent Client Protocol的支持,以便用户可以"构建自己的机器人和代理编排应用程序"(xAI,2026)。Google停用其第一个命令行代理的原因是用户"需要多个代理相互通信"(Google,2026)。允许一个代理咨询其他代理的开源工具拥有大量追随者:一个用于模型间咨询的多提供商服务器有大约11,800颗星,一个面向共识的插件有大约4,100颗星(GitHub,2026d)。在底层,Model Context Protocol在2025年12月捐赠给Linux Foundation机构,当时拥有超过10,000个已发布的服务器和约9700万次月度SDK下载(Linux Foundation,2025),到其2026年7月规范版本发布时,报告月度SDK下载次数接近5亿,该版本还使协议无状态,并承诺在任何弃用前提前12个月通知(Model Context Protocol,2026)。这是笔记本电脑上的代理访问一个人的其他工具而不需要每个工具都有特定于供应商的插件的方式,它已经以网络协议无聊的方式变得无聊:存在、有文档、被忽视直到出现问题。第二个标准,Google的Agent2Agent协议用于代理在供应商之间相互通信,在2026年3月达到1.0版本(Google Open Source Blog,2026)。这是第4级管道,今天它没有消费者入口。
表5. 2026年9月的编排格局(按模式划分)。
| 模式 | 示例(2026年9月) | 级别 | 为以下内容而构建 | 它带来什么 | 它留下的记录 | 主要风险 |
|---|---|---|---|---|---|---|
| 浏览器标签页中的手动比较 | 任何一组消费者聊天机器人 | 4(网络)当录制和重新运行时;否则为第1级习惯 | 任何人 | 覆盖范围;比较习惯 | 截图或复制的回复,上下文经常丢失 | 注意力成本;未记录的来源 |
| 用于网络聊天的广播工具 | ChatHub、ChatALL | 4(网络)当录制和重新运行时;否则为第1级习惯 | 个人 | 一个提示,多个答案,无协调 | 窗格中的答案;除非保存,否则磁盘上没有任何内容 | 当界面更改时中断;服务条款 |
| 作为产品功能的委员会 | Perplexity Model Council;Microsoft 365 Copilot研究代理(GPT和Claude);Karpathy的LLM Council | 4(网络,托管) | 这些服务的订户 | 带有同意和分歧的合并答案 | 供应商显示的任何内容;来源通常会折叠 | 合并的声音隐藏了来源;选择器是供应商 |
| 暴露给代理的网络聊天 | OpenCLI及类似工具 | 从4(网络)到4(CLI)的桥梁 | 技术用户 | 代理可以使用网络订阅 | 文件,如果代理写入它们 | 脆弱性;访问规则 |
| 供应商插件:一个代理委托给另一个 | OpenAI用于Claude Code的插件;GitHub Agent HQ(Copilot)内的Claude和Codex | 4(CLI) | 开发人员,正在扩展 | 一个会话内的跨供应商审查和委托 | 会话记录;审查输出 | 主要是代码形状;两个服务的配额 |
| 委员会和咨询服务器 | 多提供商咨询服务器(最后提交2025年12月);共识插件;为每个工具编写一个文件的小型CLI委员会 | 4(CLI) | 开发人员 | 一个任务上的几个家族;共识规则 | 每个工具的文件;合并的笔记 | 无休止的回合;相关错误;放弃 |
| 多代理仪表板 | 窗格中的多个官方CLI,每个都有自己的工作副本,一个人能够接管其中任何一个 | 4(CLI,可见) | 监督并行代理的开发人员 | 监督变得可见 | 每个代理的日志和差异 | 为代码而构建;注意力分散 |
| 具有时间上限的扇出脚本 | 附录C中的列表C1 | 4(CLI) | 任何拥有第3级代理的人 | 即使工具停止,也保持并行答案 | 每个工具一个文件,一份汇总说明谁回答 | 需要一个人来协调 |
| 单个代理,任务写下并重新运行 | 一个指令文件或按计划运行的技能 | 3使其可重复 | 任何第3级的人 | 当第二个模型不可用时的重复 | 任务文件、输入、输出、验收说明 | 重复放大了坏的模板 |
这些行描述了模式。附录E中的星标计数是某一天的流行度跟踪,它们不代表用户数、质量或文件夹契约的适应性。放弃的项目应该在表中记录:最知名的咨询服务器最后一次提交是在2025年12月,多个仪表板的维护者已经停止维护。一篇仅指向学习者一个特定编排工具的论文会对他们造成伤害,这就是为什么我反而指向这个模式:官方二进制文件、非交互式标志、磁盘上的文件,以及被咨询者的名单。
7.2 这一层为什么会持久存在
CLI编排依赖于供应商自己的工具,按照供应商本身为自动化所记录的模式运行,这赋予它浏览器选项卡无法拥有的特性。最重要的是,它可以被记录下来。一个曾经有效的安排,比如"用一个模型起草,对照清单进行第二次审查,告诉我分歧之处",可以保存为指令文件或技能,下周再运行,如果需要的话可以按计划运行。第3部分将第4级定义为完全这样,在多个模型间指导的可重复工作。接下来是几个更多的特性,按照我权衡它们的顺序。命令行标志是一个文档化的接口,退出代码是一个承诺;网页上的位置既不是这两样,这就是为什么驱动消费者聊天页面的工具每当页面改变时都必须修复。每个官方工具都在其自己的供应商登录下运行,具有该供应商的沙盒和拒绝规则,因此这个人可以将秘密保留在文件夹之外,默认拒绝网络,并为每个工具拒绝执行破坏性命令,而一个可以看到每个选项卡的浏览器代理则是一个更大的权限对象。该模式使用这个人已经为其支付费用的消费者登录,我期望这个因素比任何其他因素更能区分一个非程序员持续进行的实践和他们仅尝试一次的实践。而且供应商认可它。官方插件、GitHub服务内的代理、无头模式和技能标准是跨工具委派正在被标准化的迹象,而消费者聊天页面的自动化则正在遭到否定。
网络编排可能会教授比较的习惯,CLI编排是这个习惯可以以对象的形式保持的地方。这个对象是一个文件夹,它保存任务、允许的输入、输出、记录每个代理产出的日志,以及已接受内容的说明。另一个人可以检查它而不需要重新播放私人聊天,制作它的人可以在下周改变一个输入并看到差异。这个记录也使问责更难规避,因为一个保存的任务和一个接受说明暴露了一个问题源集或缺失的批准。在习惯了非正式聊天的办公室中,它会感觉像一个负担,而在任何需要检查、交接或重复工作的地方,它都是一种优势。规模决定了这一点:一个两分钟的请求不需要工作流文件夹,而一个接触共享文件的重复任务可能需要。
大多数现有工具都是围绕代码而形成的。官方插件、理事会服务器和多代理管理器针对软件审查,尽管模式本身没有特定的代码。
7.3 这一层对人的要求
一个小的代理团队需要一个管理者,管理者的工作是具体的。我将其四个部分称为委派合同:
- 目标:工作是为了什么,以一种代理可以判断它是否已经满足的方式来陈述。
- 边界:代理可以接触的和不可以接触的,哪些行动需要人的确认,以及任务可以花费多少时间和配额。
- 制品:工作完成时应该存在什么,以及什么形式。
- 检查:人如何知道制品是正确的,在工作开始前决定,谁审查什么,以及何时停止。
第四部分包含在关于自动化监督的配套论文中描述的陷阱(Chernets, 2026b)。添加审阅者很便宜,每个审阅者都会发现什么。没有停止规则的理事会倾向于添加轮次和批评者,直到工作被评审所埋没。一个实用的规则是为每个阶段允许一轮批评和一轮修复,由人决定一个发现是否阻止工作。这个规则有一个量化的代价:在那篇论文中报告的144次运行的随机化测试中,一轮预算将批评轮次从每次运行的2.86降低到1.00,同时将遗漏缺陷增加了每次运行的0.11(95%置信区间0.005至0.204) (Chernets, 2026b)。这种折衷是否值得取决于利害关系,这恰好是属于管理者的决定的那种。轮次和时间的限制是预算,预算决定何时停止,这是与答案是否正确不同的问题。
合同重述了对人的良好委派一直需要什么,针对从未委派给软件的受众,并且它没有声称管理的新理论。它的价值在于每个部分都可以被教授、写下来和检查,并且当某个部分缺失时,其失败会以明显的方式显现出来。
8. 从操作员到管理者
8.1 工作中的变化
在第1级,人生产,模型辅助。在第3级和第4级,模型生产,人指导、监督和接受。Bainbridge的(1983)自动化讽刺预测了这对人类角色的影响。自动化消除了常规工作,留给人的是最难做好的残留工作——监控和在罕见故障中进行干预,而建立其判断力的实践随之消失。生成式AI版本的讽刺已有文献记载。生成式AI将人从生产转向评估,使困难的任务更加困难(Simkute等,2024),对工具的信心越高,批判性思维就越少(Lee等,2025),去技能化从结构上源于实践的移除(Ferdman,2025)。
因此,管理一个代理是一项具有自身能力要求的不同工作,而这种能力并非工具免费提供。它包括选择什么要委托、陈述第7.3节的委托合同、阅读代理的日志,以及决定结果何时足够好。我将这项工作分为四种实践。委托将工作定义为具有边界的可交付物。监督观察计划、中间输出或工具日志,并在任务偏离时进行干预,而不是批准每一次按键,因为批准一切会导致疲劳,而疲劳正是人们点击"是"的原因。验证检查来源、求和、转换和决策所依赖的声明,方法不同于重新阅读代理自身的置信度:对于代码检查测试和差异,对于合同文件夹检查人员亲自打开的页面,对于文献表逐行检查标识符。撤销在条件改变时缩小工作区、停止运行或移除访问权限。完成这四项的人即使通过图形桌面应用程序也在管理代理。将任务交给不透明服务并接受第一个答案的人是在外包判断,这是一种不同的做法。Parasuraman和Riley(1997)给不做好这一点的两种方式命名。不使用是本可以委托但从不委托的人,因为习惯或恐惧而卡在第1级。误用是委托时不进行检查、接受返回结果的人。两者在2026年都是可见的。广泛浅层的采用数据描述了大规模的不使用(第2.2节),第5.3节的文件丢失报告和数据库删除描述了误用,有时甚至包括本应知道得更好的专业人士。表6将每种实践与其强制执行的委托合同部分、它应对的风险和研究能观察到其发生的有日期的日志放在一起。
表6. 管理者的四种实践:每种实践强制执行的内容、应对的风险和留下的日志。
| 实践 | 人做什么 | 强制执行的合同部分 | 缺失的风险 | 可观察的日志 |
|---|---|---|---|---|
| 委托 | 将工作定义为具有边界的可交付物(8.1) | 目标,阐述使代理能判断是否已达成;工件:应该存在什么,以什么形式存在(7.3) | 不使用:"本可以委托但从不委托的人",因为习惯或恐惧卡在第1级(8.1) | 一个已存放的工件(附录A) |
| 监督 | 观察计划、中间输出或工具日志;在任务偏离时进行干预,而不是批准每一次按键(8.1) | 边界:代理可以触及什么;哪些操作需要人的确认;时间和配额预算是多少(7.3) | 批准疲劳:"疲劳是人们点击'是'的原因"(8.1);过度保护的防守导致不使用(5.3) | 被拒的计划;不可逆步骤的确认暂停(附录A) |
| 验证 | 检查来源、求和、转换和决策所依赖的声明,方法不同于重新阅读代理的置信度(8.1) | 检查:人如何知道工件正确,在工作前决定;何时停止(7.3) | 误用:"委托时不进行检查、接受返回结果的人"(8.1);模型间的相关错误(6.3) | 被拒的差异或输出;询问第二个模型系列;记录的分母:已请求、已答复、超时(附录A) |
| 撤销 | 条件改变时缩小工作区、停止运行或移除访问权限(8.1) | 边界,再次应用:保留什么,如何撤销错误(3.2, 7.3) | 无法停止的长期任务,之后删除任务删除了文件(5.3) | 附录A的有日期日志中无;有日期的停止、受限权限或移除的访问权限可作证明 |
注:一个将任务交给不透明服务并接受第一个答案的人是在"外包判断",这是一种不同的做法(8.1)。
一个小小的机制将这个角色连接在所有四种实践中,我称之为验收记录。对于有后果或重复的任务,它记录了预期的可交付物、使用的输入、限制和权限、输出的去处、任何实质性分歧或失败、所执行的检查,以及人是接受、修改、上报还是舍弃的决定。它在代理生成的内容和人依赖的内容之间划了一条线。对个人而言,它很有用,因为它将信任感变为可检查的决定;对团队而言,同事可以不通过私人聊天记录检查工作;对研究人员而言,它将已完成的运行与依赖的结果分开。它也是一种制约。一个人在无法写出验收标准后,可能决定该任务应停在第1级,模型会将此视为成熟管理而非采用滞后。用人工智能协作的术语来说,从第1级到第4级的转变保留了人在循环中的位置,但改变了循环的内容——从阅读每个答案转变为设定答案被接受的条件。图4用四种实践、每一步的风险、检查失败后的反馈和验收记录来画出这个循环。
图4. 管理者的控制回路。
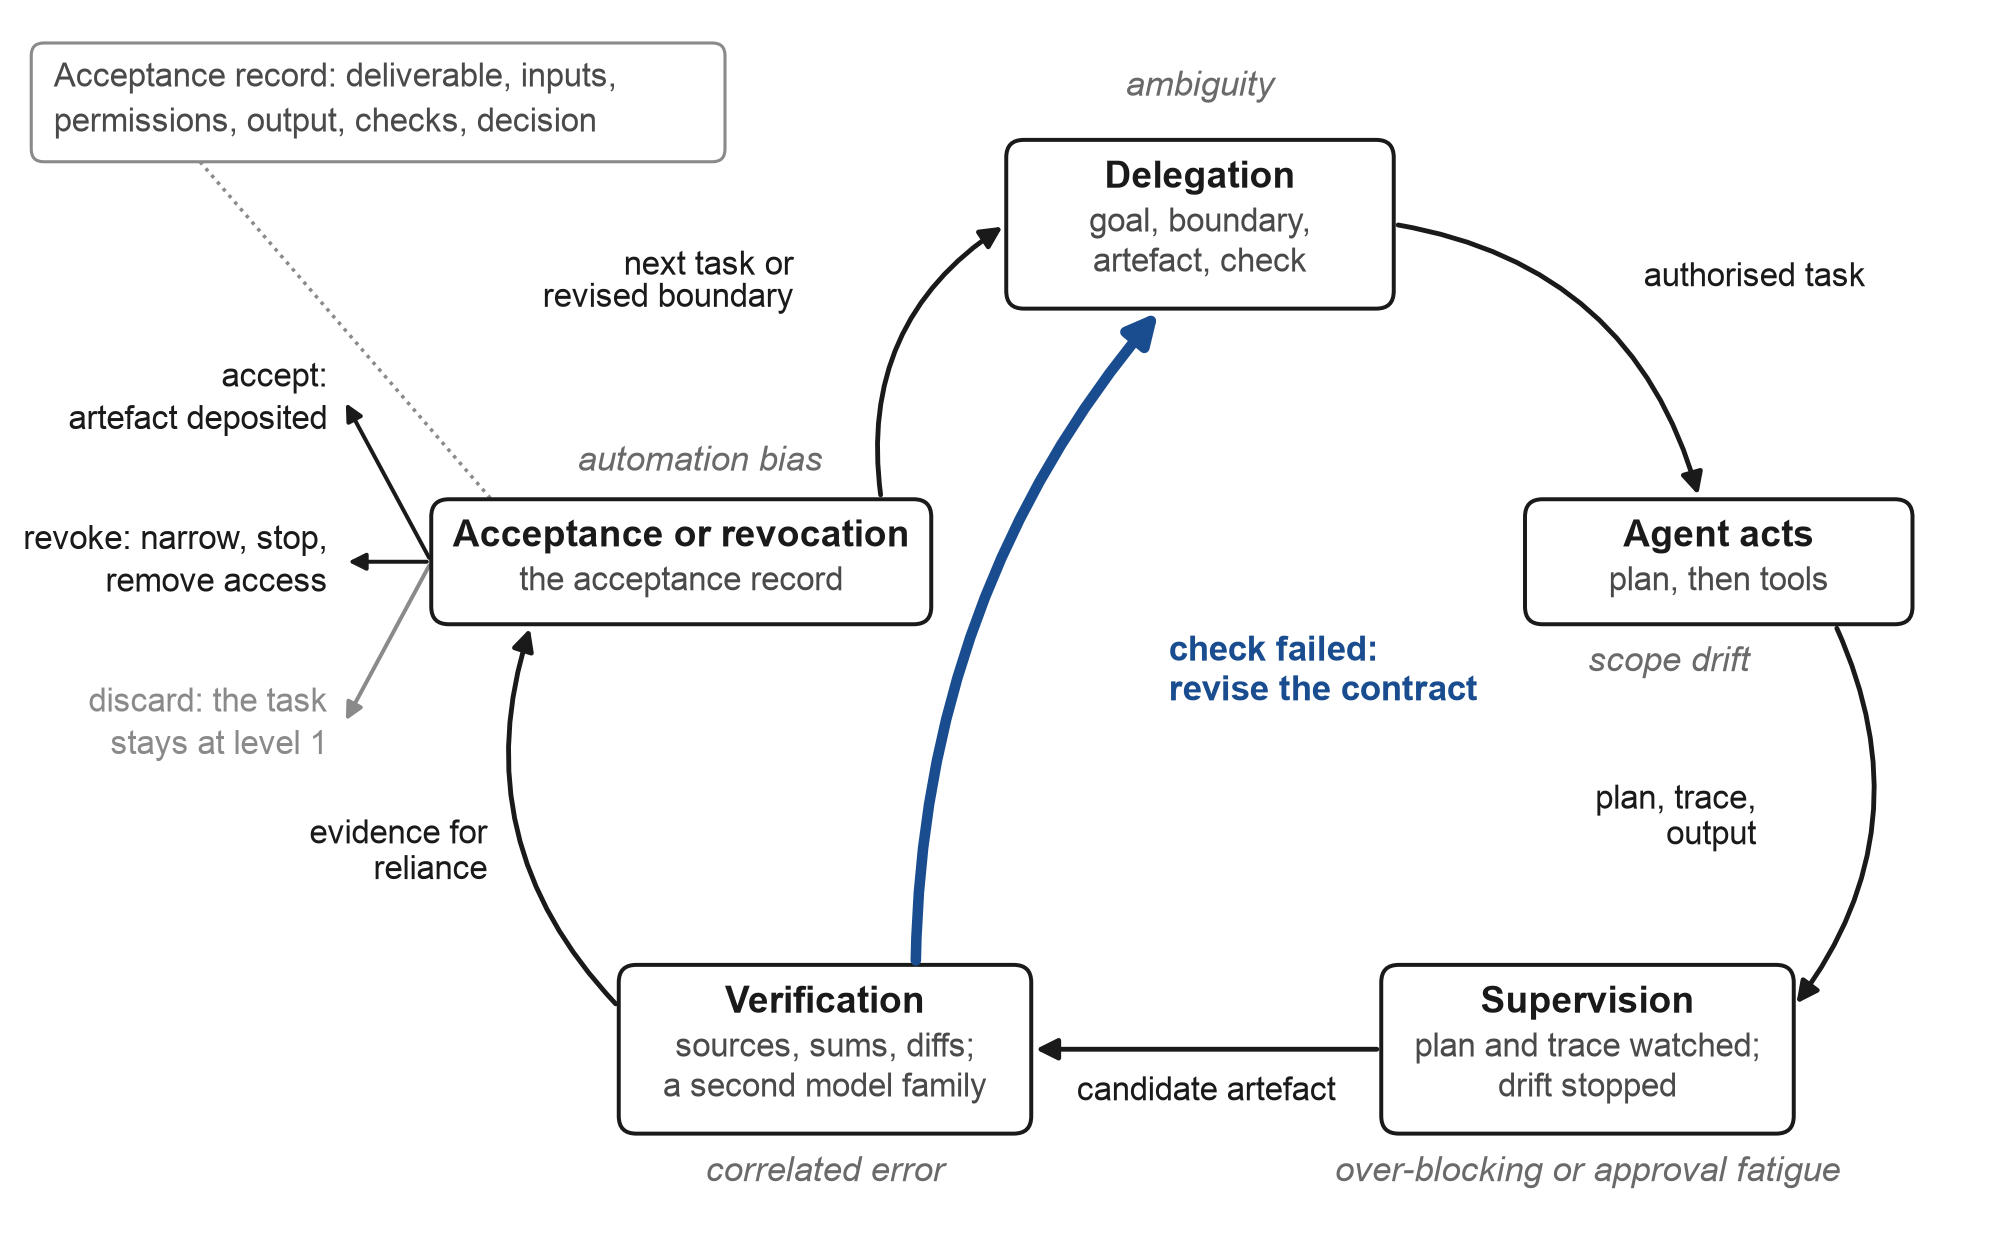
注:管理者的工作是一个人运行的循环(第7.3和8.1节):委托阐述合同(目标、边界、制品、检查),代理采取行动,该人进行监督和验证,然后接受、撤销或丢弃结果并写入接受记录。灰色斜体标签在每个步骤中标明风险(第5.3、6.3和8.1节)。粗箭头表示从失败的检查返回到修订的合同,从接受节点的每个出口都是该人的决定。
8.2 经验丰富的用户委托更少
一个观察反驳了任何认为每个人最终都应该成为代理管理者的简单故事。Anthropic在2026年3月报告称,任期较长的用户"通过指令使用模式委托更大责任的可能性要低得多"(Anthropic, 2026e),其2026年1月的报告将增强功能(协作使用,其中该人保持在循环中)的比例定为2025年11月对话的52%(Anthropic, 2026f)。一种解读是,经验丰富的用户学会了在哪里委托失败,因此有所退缩。另一种解读是,他们学会了在他们的判断构成产品的工作部分中,将模型用作合作者。我无法从发布的数据中区分这两种解读,但在任何一种解读中,阶梯的终点不是最大委托。这是任务接任务地在提问、协作和委托之间进行选择的能力,以及了解你面前的任务需要什么。四级模型描述了一个人能够做什么。它没有声称他们每次都应该做最具委托性的事情。
8.3 责任留给该人
供应商对问责的所在很清楚。Anthropic的第2级代理的启动指南告诉用户,他们"对代表您采取的由Claude执行的所有操作保持责任"(The Register, 2026)。这是第3级特别重要的法律和实际现实,其中代理以所有者的凭证、在所有者的文件上、以所有者的名义行动。成为代理管理者的专业人士也会对一个犯错速度很快的员工承担责任。这是委托合同中的检查必须在工作之前决定的另一个原因,也是第5.3节的安全设计不应该依赖于该人实时发现攻击的另一个原因。
8.4 管理者在素养框架中的角色
AI素养的正式定义开始为这一角色命名,尽管这里审视的所有文本都没有使用"代理"一词。US Department of Labor的2026年2月AI素养框架在其内容领域中列出了"有效指挥AI"(US Department of Labor, 2026;ExecutiveGov, 2026)。OECD和European Commission的2026年6月联合框架(为PISA 2029评估提供信息)有四个域,其中一个是"管理AI"(OECD & European Commission, 2026)。早期的学术框架强调了识别、理解和评估AI(Long & Magerko, 2020),UNESCO的2024年学生和教师能力框架设定了相同的基调(UNESCO, 2024a, 2024b)。委托合同为代理情况下的管理和指挥域提供了可教授的内容:设定目标、界定工作、命名制品、决定检查。从业者开始使用"AI操作员"和"代理管理者"等职称来指代在其专业基础上获得这种专业的专业人士。我对"代理管理者"的使用范围更窄,指的是行为模式而非任何人应该招聘对象的角色,因为行为会留下证据而职称不会。证据在制品中:该人拒绝的计划、他们拒绝的diff、他们采纳的第二意见、在他们离开键盘时完成的预定运行。在不存在这些痕迹的地方,该职称没有任何支持。
9. 测量跨越:一个预先注册的计划
9.1 跨越作为测量单位
大多数采用数据统计"使用AI"的人,有时是每周或每天一次。这样的统计无法区分向聊天机器人询问同义词的人和将季度报告委托给代理的人,而我要找的是第二类人。第3.3节的产物规则使差异可观察,因为只有当代理在新水平上生成了人要求的东西时,才会记录一次跨越。从入职和监督文献中还有几条规则遵循。完成情况应分别报告给未获帮助而跨越的人和获得帮助的人,因为帮助改变了跨越的含义。应在停止发生的位置用该人自己的语言记录停止,因为停止的原因是结果的重要组成部分。每个收到材料的人都属于分母,包括从未回复的人。最后,应在研究人员停止每周写作后观察持久性;在研究人员仍在某人收件箱中时生成的产物可能与礼貌一样是使用。
9.2 设计
我运行一个预先注册的队列计划,将这些规则应用于非程序员(Chernets, 2026d; OSF, https://osf.io/x4egq, DOI 10.17605/OSF.IO/X4EGQ,已于2026年9月6日注册并冻结)。这是一项关于三步骤路径的单臂可行性研究,预先注册在收集任何数据之前就已冻结。以下是注册的设计。
参与者。工作主要在电脑上进行的成年人。他们使用自己的机器和自己的AI订阅(排除雇主的),将客户标识和雇主机密材料排除在外,并确认安装软件不违反雇主对他们适用的规则。招募是通过在专业社交网络上的公开宣布进行的,时间窗口提前固定,这样就不能延长到结果看起来有利为止。该公告被截图,其永久链接被记录,这固定了招聘文本。入场是滚动的,每个参与者的日程从他们自己的第零天开始计算,因为工具每周更换。招募于2026年9月6日随公开宣布开始,即注册冻结的那一天,并于21天后的2026年9月27日关闭;队列在写作时在现场,无论实现的数字是什么,都将与结果一起报告。
第1步(从聊天到该人自己计算机上的代理)。参与者将标准文本粘贴到他们已经使用的聊天机器人中,该聊天机器人指导他们在自己的机器上安装图形代理。我不接触任何人的电脑。该步骤完成时,参与者提供代理为响应第一个任务而生成的产物。该任务对所有人的形状都相同,并填充了参与者自己的工作情况,它要求代理询问、决定、创建和格式化文件。该要求将代理与聊天机器人分开。注册给出了确切的措辞(Chernets, 2026d)。在模型术语中,第1步同时在两个级别上测试反射式入职,从级别1到级别3。这是一个深思熟虑的选择。本地代理的图形壳在该人自己的机器上运行,因此根据第3.3节的规则,它是第3级,而第1步要求的产物是标志转换2的那种;其权限提示给了它范围的梯级的一些保护。该队列不在供应商栅栏的第2级环境中仪表化单独的一周,因此它不能测试第10节的P5(范围的中间梯级降低不完成和事件);那些权限提示是设计中唯一范围的梯级,命令行在第3步进入。在聊天和本地安装之间插入明确的第2级周的后来队列将是P5的清晰测试。
第2步(进入网络编排,从代理启动)。准备好后,参与者会收到一个开源工具,该工具通过他们已经支付的订阅将一个问题提出给多个模型,并在来自代理内部的单一操作中返回一个合并的答案。该步骤的目的在事前登记为覆盖率和可靠性,以明显的分歧作为第二者的一种机制。
第3步(进入CLI编排)。通过命令行界面的相同编排。
测量。五个冻结的核心项目,在计划的每个队列中措辞相同,记录职业和计算机上的小时数、当前AI使用情况、询问多个AI的先前经验、是否以及如何检查答案,以及是否有任何东西已经在计算机上为该人采取行动。每个参与者的步骤记录保存日期、指导他们的聊天机器人、尝试和小时数、与产物的完成、确切的停止点和他们自己语言中的原因,以及调查人员是否以及如何进行干预。第一个月每周,参与者报告他们的代理在该周生成的一个产物(或"无",这是有效答案),他们多久向多个AI提出一个问题以及答案分歧时发生了什么,从第2步开始是否有任何一个模型遗漏的有用内容出现以及检查是否改变了他们所依赖的内容。观察在第60天和之后每季度继续,只要参与者愿意。
分析和解释。分析是描述性的。完成比例与生存和完整分母的置信区间一起给出,分别用于未获帮助和辅助完成;时间和尝试作为分布报告,停止的原因在收集后编码,代码和原始措辞被存放。一个解释规则在事前被固定。如果收到第1步材料的人中少于一半提供代理生成的产物,该队列被报告为入职失败的研究,停止人员的因素变成结果。
推断的限制。注册在事前声明没有对照条件,因此没有因果主张,并且不推广到自选志愿者之外。参与者对节省时间的估计仅作为信念报告,因为已证明该领域的自我报告反转了真实方向(Becker等人,2025)。
披露和伦理,已注册。 参与者被书面告知我编写了这些材料和工具、教授它们,并且是涵盖编排方法的待决专利申请的申请人。未寻求机构审查委员会的意见:该研究背后没有机构隶属关系,也没有联邦资金。注册文件中详述了这些保障措施。同意为书面形式,并在记录任何内容之前获得。不收集任何健康、财务或工作内容数据。参与者在自己的机器和订阅上工作,可在公开存档之前的任何时刻申请删除。安全说明包括单独的浏览器配置文件、不在银行或医疗网站上采取行动、在任何不可逆操作之前确认、不向代理输入密码以及将网络内容视为数据。不收集任何残疾变量,也不做任何无障碍声明。
9.3 仅设计
我仅从程序中提取设计。根据有意的决定,此处未出现任何参与者数量、完成率或个别案例:论证(本文)、方法和程序,以及协议观察期后的结果是独立出版物,以便论证不会被读作为其自身的证据。其他研究人员现在可以应用相同的规则。附录C中的清单C5提供了记录格式和编码它们的检查程序。检查程序拒绝以下记录:将安装计为交叉的记录、没有代理生成工件的完成、没有该人自己的话语的停止、用真名代替假名标签、格式不认识的字段,或未恰当记录为跳过的跳过级别。
9.4 强有力的后续研究应该是什么样的
该队列是一项可行性研究,第10部分的大多数主张需要其他设计。一项强有力的后续研究将比较两种入职条件,这两种条件在如何表示工作上有所不同,同时尽可能保持任务风险和技术环境不变。一种条件展示功能和安装说明;另一种从参与者自己的重复工作对象开始,并引出第5.1部分的五部分框架。结果将包括工件、由除参与者外的其他人评估的工件质量(报告评估者之间的一致性,如同停止原因的编码)、时间、发现的错误、以情景形式的权限决策、后来的自愿重用,以及根据结果衡量的信心。后续研究将持久性与与研究人员的继续接触分开。第二项研究将通过比较行政、研究、通信和分析任务,询问工作流词汇是一种语法还是每个专业一种。我不知道是哪一个,而答案决定了打包的示例是否可以编写一次,还是必须为每个领域分别编写。两项研究都应该用一个经过验证的工具(Carolus等人,2023)为AI素养建立基线,以便具体的差距——知道给代理交付什么——可以与AI的一般熟悉度分开。每项这样的研究也应该记录实现,因为在后来的界面上开始的参与者会遇到不同的默认设置:界面版本、操作系统、代理是否有网络访问、权限模式和任何策略约束。仅凭供应商的名称对后来的读者来说信息太少。
10. 命题
第3节的模型和第4至8节的论证包含可能失败的主张。表7列举了其中15个,每个都包含一个测度、一个能够证伪它的结果,以及能够运行该测试的主体。它们是为整个领域而写的。第9节的程序只能测试其中少数几个;其他几个可以通过供应商遥测、调查面板或单个组织内的小规模研究来测试。没有任何一个是队列的发现。
表7。 命题、测度、证伪条件及其测试者。
| # | 命题 | 测度 | 证伪条件 | 谁可以运行 |
|---|---|---|---|---|
| P1 | 障碍迁移。 在尝试转换2的非程序员中,停止现象在安装后(在第一个任务、第一个错误或权限处)比安装期间更多,并且在那些安装后没有产生任何东西的人中,"我不知道该怎么问"超过了技术、权限和成本原因;并且,在任务难度保持不变的情况下,完成度在三个转换处的下降幅度比在同一级别内更大。 | 用制品规则记录的停止点;用该人自己的话表述的原因,按附录A的规则编码;按步骤的完成度 | 大多数停止发生在代理首次运行之前,或技术和权限原因在已安装的非生产者中占主导,或在控制任务难度后完成和失败模式在所有步骤中相当 | 第9节的程序;任何复制 |
| P2 | 表面合并。 在供应商合并聊天和代理表面的地方,以代理生成的文件或操作结尾的会话份额上升,而用户所说的想要做的事情没有任何改变;并且到2027年底,领先的助手在没有用户选择的模式情况下从默认窗口进行文件写入。 | 合并前后的供应商遥测;一份有日期的助手普查 | 合并后份额保持平稳;或稳定的用户选择的代理模式仍然是写入文件的先决条件 | 供应商;任何能够打开应用程序的人 |
| P3 | 词汇优于安装。 为人们提供来自其自身领域的已完成示例(打包任务、技能、模板)比提供安装帮助更能提高第2级和第3级的坚持度,并且工作流词汇的结构化测度在访问和先前AI使用被控制后预测制品完成。 | 两种帮助下第60天的坚持度对比;第5.1节五个部分的任务前陈述;按附录A的规则编码的停止原因 | 安装帮助产生相等或更大的坚持度;一旦安装容易性和通用信心在模型中,词汇测度不添加任何内容 | 任何具有两条入职路线的实验室 |
| P4 | 反思性入职。 由其已使用的聊天机器人指导的人们可以以使该路线实用的速率从第1级无辅助地跨越到第3级,并比获得静态文档的人更快地到达第一个制品。 | 用代理生成的制品无辅助完成转换2的比例,相对于所有收到材料的人;在引导和静态条件下到达第一个制品的时间 | 少于一半的人完成它,阈值在第9节中提前固定;或静态文档给出相等或更高的完成度 | 第9节的程序;具有两个队列的培训师 |
| P5 | 中间的梯级。 在本地代理之前在供应商围栏环境中花费时间的非程序员更经常完成转换2,具有较少的文件丢失事件,并且在范围、可逆性和升级方面比直接从聊天转移到广泛本地访问的人推理更好。 | 具有相等后续的两路队列;制品作为主要结果;事件日志;基于场景的权限决策前后对比 | 从聊天直接到本地代理的无辅助完成与通过第2级的完成相匹配,具有可比的事件率和相等的权限决策 | 任何具有两条入职路线的实验室;该程序的后续队列 |
| P6 | 瓶颈。 在每周使用聊天的非程序员中,在一个季度内生成第3级制品的份额远低于每周使用编码代理的开发人员的份额。 | 使用制品项目而不是"你使用AI吗"的代表性调查(第11.3节) | 非程序员知识工作者之间的第3级制品生成接近开发人员的每周使用数据 | 国家统计机构;调查机构 |
| P7 | 桥梁携带。 练习Web编排的人比不练习的人更有可能随后采用CLI编排,并且明显的分歧预示着其任务记录中随后的来源属性或批评。 | 具有和不具有较早Web比较的人之间的CLI编排采用;保存的比较和后续记录 | 没有区别,或相反;比较产生更多提示且对保留的检查没有变化 | 第9节的程序;纵向面板 |
| P8 | CLI耐久性。 对于支付两个或更多消费者订阅的人,通过官方命令行工具进行编排是能够在界面更改后存活的第4级形式,并且文件备份的运行比仅浏览器运行更好地重新运行和转移给另一个审核者。 | 该人群中第4级制品的有日期的普查;界面更改后的重新运行和转移测试 | 一份2027年末的普查发现Web或编程界面委员会占主导,CLI到CLI工具衰退;仅浏览器工作流在重新运行和转移上匹配 | 工具研究人员;开发人员调查 |
| P9 | 相关一致性。 跨供应商家族,具有已知答案的知识工作项上的错误关联度足够高,以至于三个或更多模型之间的一致性值少于两个独立意见(rho在约0.5或以上,其中rho在具有已知答案的知识工作项上估计,而不是从基准一致性率获取);不同家族的小委员会在相等成本下击败单个家族的大委员会;并且源感知审查比多数一致性更好地预测正确性。 | 跨家族在已知答案的项目库上的成对错误相关性(列表C4);带有两个委员会设计的标记项集;针对多数同意和源感知审查的正确性 | 对大多数任务类型,测得的rho低于0.2;同族委员会在逐项检查后胜出;或简单多数同意与多样性加验证一样或更好地预测正确性 | 语言模型研究人员;配套论文的协议 |
| P10 | 管理人员的能力。第3和第4级的持久性通过一个人陈述委托契约(目标、边界、工件、检查)的能力和监督痕迹(拒绝的计划、拒绝的差异、采取的第二意见)比通过先前的技术经验或提示量更好地预测。 | 引出四部分的简短任务,进行盲评;基准项;来自接受记录的痕迹;第60天的持久性 | 先前的技术经验或提示量与持久性一样或更好地预测,而契约陈述没有增加任何东西;或第3和第4级的工件,通常省略目标、来源、边界和检查,在独立审计下仍然可靠,在这种情况下,能力结构被过度构建 | 任何纵向工件研究 |
| P11 | 按任务类别校准。在反馈快速和可逆转的地方,人们更好地校准委托,按任务类别以不同方式接受、纠正和升级。 | 按任务类别的接受、纠正、升级和后期错误发现 | 校准在可逆转和高后果任务中是一致的 | 实验室;具有接受记录的组织 |
| P12 | 来自守卫的摩擦。在第3级的非程序员中,权限提示和安全块的中断比开发人员中更频繁地被列为停止的原因,分类器守卫的自主权减少了这样的停止,而不会增加报告的文件丢失。 | 按组编码的停止原因;停止率和事件报告在默认模式更改前后 | 组之间没有差异,或自主权提高报告的损失 | 供应商;该计划的编码停止原因 |
| P13 | 差距重现。按性别和教育划分的聊天采用差异(Cranney等人,2026年;Daepp & Counts,2024年)在职业内的第3级工件生产中至少以同样大小重现。 | 职业内第3级工件生产的差异 | 职业内估计显示第3级的差距已弥合 | 劳动经济学家;如果足够大的话后续队列 |
| P14 | 批评家和第二族。同族批评家抓住仓促和跳过的检查;第二族抓住共享的错误;在缺陷标记的集合上,每个都贡献了另一个遗漏的缺陷。 | 同族批评家和第二族审阅者之间成本相等的经过确认发现的重叠 | 完全重叠,或一个来源占主导地位 | 任何拥有两个代理工具和标记集的人 |
| P15 | 能力或词汇。在相同任务类别中,第2和第3级的持久性随一个人陈述委托契约的能力而变化;如果模型能力是约束因素,持久性会在任务类别之间变化,在一个类别内的人群中保持一致。 | 按任务类别的持久性,与委托契约的盲评陈述交叉 | 在一个任务类别内,无论其契约评分如何,持久性在人群中保持一致,仅在类别之间变化 | 任何记录任务类别和契约陈述的研究 |
其中一些比其他的更重要。P4对政策的权重最大,因为如果反思性入职有效,教导人们代理的最昂贵的部分(在安装期间坐在他们身边)可以被他们已经拥有的工具所取代。P5是队列无法测试的,如第9.2节所述,它也是梯子的形状最取决于的那个。中间踏级是否能获得其位置是我还不知道的事情。P9是最容易测试的,也最可能让委员会的用户感到惊讶,因为相关证据的算术(Chernets,2026a)和Kim等人的测量(2025年)都指向关于协议值有多少的上限。P10是将改变课程的那个。如果陈述委托契约的能力比技术背景更好地预测持久性,那么培训应该首先教导委托,其次是工具。
11. 启示
11.1 对供应商而言
为空白文件夹而设计。供应商已经简化了安装程序,这显而易见。我认为进一步的努力将被浪费,因为新用户的问题现在从安装程序之后才开始,面对一个空文件夹且无法与代理进行沟通。来自用户自身领域的实际案例,在其首次打开代理时呈现,配合一个真实的、低风险且以可评估的成果结束的初始任务,对采用的推动作用将超过任何进一步的安装简化。预打包的技能已经指向这个方向(第5.1节)。仍然缺少两样东西:帮助人们判断哪些任务值得交接,以及让专业协会(而不仅仅是初创公司)为其成员编写技能的方式。
无论下次合并后标签如何命名,一个人在委派的那一刻,用所选文件夹的语言,都需要一个明确的答案来回答一个简短的问题清单:这个代理可以读什么,可以改什么,可以发送或触发什么,什么需要我的批准,我如何停止它?可视化差异在文件变化时回答其中一部分,书面计划在操作多样化时也会回答;但单个同意横幅都无法回答。权限模型在合并后应保持可见、有范围限制且可逆转,并配备有效的撤销和停止按钮。没有撤销和停止按钮的文件夹范围就是第5.3节问题报告所反映的情况。
该工作成果也应能够脱离产品而独立存在。用户应能够导出任务指令、输入或其标识符、工具操作、输出和批准历史记录。这既是一个可用性功能,也是一个治理功能,因为它让新用户能够从已完成的任务中学习,也让团队能够审查结果,而无需将其记忆借给专有聊天历史。使用情况应以相同的方式报告。生成文件的代理的"周活跃用户"应分为生成文件的人和打开应用程序的人,供应商拥有实现此操作的遥测数据。
识别攻击不是新手的任务。要求非程序员识别提示注入迹象的指导将最困难的判断推给最不能做出判断的人(第5.3节)。安全默认值(工作副本、较大更改前的快照、破坏性命令在显式允许前被拒绝、网络内容被视为数据)应属于产品。与此同时,不断中断的防护措施会像缺失防护措施一样肯定地停止工作并丧失文件,关于监督权越界的配套论文描述了这些层级如何增长(Chernets, 2026b)。
出处应在答案合并后得以保留。返回单个合并答案的委员会功能应显示哪个模型说了什么以及他们在哪里不同意,让用户将一个模型分配为批评者的角色,并使证据差距比流畅的共识段落更容易找到。没有来源的合并声音恢复了单一自信答案的权威,奖励了自动化偏差并隐藏了错误的相关性(第6.3节)。
最后,用户流失对用户方面有成本。学习了在一年内被重命名、合并或弃用的工具的人会付出双倍代价,因此稳定的名称、迁移指南和产品变更间的指令文件连续性本身就是采用促进因素。
11.2 对雇主和培训者而言
在菜单之前教授委派合同。产品菜单每月变化,但陈述目标、围栏工作、命名工件和决定检查的能力跨工具转移(第4.3和7.3节)。一个简短的练习,要求人们为其中一个重复性任务编写四个部分,比功能演示更好地测试准备就绪。该练习的内容列举如下,见分解部分。
登录是错误的衡量指标。活跃用户计数无法做出第9.1节所需的区分——即请求同义词的人和委派报告的人之间的区分。人们选择保留的代理生成工件的计数可以做到。
人们还需要一个获得授权的学习场所和一份关于允许内容的指南。第2级在组织已许可的工具内覆盖了永远不被允许在工作笔记本电脑上安装代理的员工(第5.4节)。对于第3级,明确的政策、沙盒环境或批准的配置会消除许多人默认假设的"不行"。全面禁令会导致人们通过个人账户使用,而这是不可见的,不受限制的委派会暴露机密材料。两者之间在于任务和数据分类法。它规定了哪些工作可以在经批准的环境中尝试,哪些需要他人审查,哪些被排除在代理之外;它指定了谁可以批准工具,接受记录存放在哪里,以及如何在无风险的情况下报告近似失误。在员工不能控制的机器上不应该要求本地第3级,因为云代理和租户范围的第2级是避免与IT部门冲突的方式。一旦供应商将第一级别并入聊天,第2级仍保持两项职能。它是被锁定计算机上员工的获授权场所,也是其他所有人的校准级别,是人们学到委派操作具有范围限制的地方。它是否也能降低事件是待定项(P5)。
强制要求需要谨慎处理。将AI使用作为绩效标准可能导致无实质性价值的使用,至少有一个采取该措施的雇主在一年内撤销了该决定(Fortune, 2026b)。要求与岗位相关的工件是比要求使用更好的指标。每月一次,"展示代理在你指定文件夹中生成的文件"和"展示你因两个模型不同意而改变的决定"可以衡量转换2和3,而登录计数无法做到。大规模培训如果没有工件指标,无论有多少千人参加,都无法告知转换2是否确实发生。
分解与验证应当一起教授,议会前应养成批评习惯。通用提示课程属于第1级教学法。第2级和第3级教学法从该人员已有的工作开始,比如营销人员的周五资料包或教师的成批作业,教授可重用的分解方法(第5.1节的五个部分,配有停止条件),并在文件夹副本上教授错误恢复。之后要评估的是该人员是否能够识别不安全指令、命名可逆试验、检查证据并停止系统。在受理点使用同族评论者无需额外订阅成本,当该评论者沉默而决策成本高时则应加入第二族。流利度评分标准顶端的编排是少数角色的正确目标,但对所有人来说都不应该是第一天的要求。
11.3 政策
欧盟的人工智能素养义务适用于每个人工智能系统的提供商和部署商及其员工。在2026年修正案后,该义务要求他们"采取措施支持人工智能素养发展",而不是确保达到充分水平,其监督和执法规则从2026年8月3日起生效(European Union, 2026; European Commission, 2026a, 2026b)。在美国,劳工部框架称之为"有效指导人工智能"(US Department of Labor, 2026),经合组织和欧盟委员会框架有一个名为"管理人工智能"的领域(OECD & European Commission, 2026)。我建议在代理案例中为这些词提供内容:委托合同的四个部分、第8.1节的四项实践(包括撤销)、比较模型的习惯(同时认识到一致是比表面看起来更弱的证据)以及第5.3节的基本安全实践。指导应区分对话使用和委托行动。对于后者,该职责应涵盖权限范围、数据分类、验证、事件报告和撤销,并且要求文档化委托任务所需的角色特定能力和权限比要求对所有人进行相同培训更具可防御性。监管机构和工人代表也可以询问雇主是否在没有可用控制措施、审查时间或拒绝不安全委托权的情况下将剩余责任转移到了员工身上。所有这些都是从一个监管工具中得出的设计和治理建议,其范围仅限于该工具。
欧盟责任在去监管回合中幸存下来,在这里讨论的框架中,它是唯一涵盖每个使用人工智能的员工的横向义务。在美国,框架是劳动力政策。2025年4月关于人工智能教育的行政命令和2025年7月的人工智能行动计划致力于扩展人工智能素养和技能,包括人工智能素养项目可能符合雇主提供的教育援助的指导(White House, 2025a, 2025b);该框架与培训代理管理者兼容,但尚不要求。所检查的官方文本都未提及终端代理或编排,所以"管理人工智能"可理解为聊天机器人礼仪或第4级指导。仅停留在提示的识字项目教授的是第1级。与此同时,实际工作正在向第2到第4级发展。官方文本尚未在那里跟进。
第2.5节的空白构成议程。研究按名称使用终端和桌面代理的非程序员,以成果物为结果。研究反思性入职作为独立的一种机制。研究网络编排作为实践,包括人们如何调和答案以及是否保留来源。测量不同供应商系列在知识工作任务中错误的相关性,而不仅限于代码和数学基准。将测得的人工智能使用中的性别和职业差距(Cranney et al., 2026; Humlum & Vestergaard, 2025)扩展到代理级别,那里目前一无所知(P13)。两个容易的指标、功能可用性和自报时间节省值得用成果物完成、经审计的质量、更正率和后续重用来代替。放弃应与其机制一起记录。在权限提示处的停止可能是界面问题、对数据的合理关切、雇主规则、机器丢失或缺乏受理标准的任务,将这些笼统地归为"抵触"会丧失所有这些信息。评估应该是对抗性的,包含误导性页面、文档中的隐藏指令、矛盾的来源、部分工具故障或几个模型共享的令人信服的错误答案,因为经理角色仅当它在这些条件下改进结果时才有意义。复制不需要我的任何材料;它需要成果物规则、冻结的停止原因问题、实现的记录和有日期的产品普查。分母应当公布,因为仅报告跨越者的研究对道路一无所知。
11.4 研究人员
第2.5节的空白构成议程。研究按名称使用终端和桌面代理的非程序员,以成果物为结果。研究反思性入职作为独立的一种机制。研究网络编排作为实践,包括人们如何调和答案以及是否保留来源。测量不同供应商系列在知识工作任务中错误的相关性,而不仅限于代码和数学基准。将测得的人工智能使用中的性别和职业差距(Cranney et al., 2026; Humlum & Vestergaard, 2025)扩展到代理级别,那里目前一无所知(P13)。两个容易的指标、功能可用性和自报时间节省值得用成果物完成、经审计的质量、更正率和后续重用来代替。放弃应与其机制一起记录。在权限提示处的停止可能是界面问题、对数据的合理关切、雇主规则、机器丢失或缺乏受理标准的任务,将这些笼统地归为"抵触"会丧失所有这些信息。评估应该是对抗性的,包含误导性页面、文档中的隐藏指令、矛盾的来源、部分工具故障或几个模型共享的令人信服的错误答案,因为经理角色仅当它在这些条件下改进结果时才有意义。复制不需要我的任何材料;它需要成果物规则、冻结的停止原因问题、实现的记录和有日期的产品普查。分母应当公布,因为仅报告跨越者的研究对道路一无所知。
12. 范围和边界条件
这里提供的是一个模型、证据综合和测量设计,每一个都以以下方式受到限制。
时间。证据至2026年9月21日。产品事实有日期,会逐渐失效。该模型由覆盖范围和角色定义,因此它的失效速度更慢。
地理位置和来源。大多数采用数据来自美国;欧洲数据在存在时被引用。几个关键数据来自供应商(编码代理的使用、合并聊天和代理的原因、供应商测试集上的注入率),并在文本中标记为供应商数据。我用它们来了解供应商对自己产品的了解,并相应地权衡它们。
人口。论证涉及工作主要在计算机上进行的专业人士。主要从手机工作或没有自己控制的计算机的人在任何这里描述的障碍之前遇到一个障碍,该模型除了指出这个障碍(第5.5节)外对他们说得很少。
关于队列的证据。仅使用预注册设计。本计划的任何结果都未用于此处的任何主张,第10节的命题在其结果已知之前就已陈述,以便可以根据结果来判断它们。一个要求参与者拥有自己计算机的队列样本了能够安装代理的人;它不能将设备访问与动机分开,该限制随结果一起传播。
规范范围。该模型描述了每个级别对一个人的要求。它不认为更高级别更好或每个人都应该上升;对于许多工作,第1级或第2级是正确的位置(第8.2节)。高后果工作、机密记录、安全关键操作、时间关键决策和没有可检查接受标准的任务需要更严格的安排,或完全留在委托代理使用之外。
编排增加什么。添加代理可以扩大覆盖范围、暴露分歧并留下审核线索。它也可以增加相关误差、成本、延迟和虚假的勤勉外观。持久的委托意味着一个人可以检查和改变过程;该过程是否值得依赖是一个单独的问题。
文献缺乏什么。第2.5节的文献搜索没有找到非程序员采用名为终端或桌面代理的任何实地研究,没有关于网络编排作为命名实践的研究,没有将管理代理作为具有自己结构的能力的处理,也没有关于AI系统支持人们采用代理式AI的研究。这些是截至2026年9月21日的研究缺口,我对市场、产品或优先级不做任何主张。
主张的状态。表8将系列的置信语言应用于论证的元素,以便读者可以看到每个元素的牢固程度。
表8。 本文中主张的状态。
| 元素 | 这里如何表述 | 依据 |
|---|---|---|
| 四级模型和工件规则 | 正在测试(第9和10节) | 概念性;在第3节和附录A中指定的标记 |
| 安装和桌面方面的技术障碍已减少 | 数据支持它 | 单步安装程序;"无需终端"文档;四家供应商的2级产品已发货 |
| 终端遗产代理内的知识工作者 | 供应商报告,具有方向性 | 供应商数据的新闻报道,2026年6月2日,带有分析师的警告 |
| 供应商将过渡1融合到聊天中 | 在产品中观察到 | Anthropic,2026年9月16日;OpenAI,2026年7月9日 |
| 工作流词汇成为主要剩余障碍 | 作为模型提供;正在测试中 | 间接的:提示研究;供应商合并的陈述原因;程序的停止原因项 |
| Web作为桥梁,CLI作为持久层 | 正在测试中(P7、P8) | 合同、权限对象、官方插件;网络界面的脆弱性 |
| 相关误差限制了委员会购买的东西 | 数据在模型评估中支持它;在使用中测量 | Kim et al. (2025);Chernets (2026a) |
| 反思性入职 | 已实现并正在测量;未报告结果 | 供应商和课程实践(观察);程序的第1步(测量) |
| 代理管理者作为一个角色 | 作为行为描述提供;正在测试中(P10) | 委托研究;雇主标准;官方能力框架 |
| 队列交叉率 | 未报告 | 协议已冻结;结果论文待发 |
| "现在有效"作为承诺 | 未声称 | 超出本文范围 |
13. 结论
终端曾经是普通专业人士与代理型AI之间障碍的明显象征,一段时间内这种说法是合理的。到2026年,这已不再成立。安装只需一条命令或一次点击,一个人已在使用的聊天机器人可以引导他们完成,而供应商正在将聊天和代理合并到单一界面。第4和第5章所示的是一个已经转移的障碍。首次有限的尝试变得容易得多;仍然困难的是在整个任务上获得可靠的工作、跟上不断变化的产品、保持已授权的文件夹安全。根据一家供应商的数据(通过媒体报道,应作为方向性数据理解),每周约有一百万知识工作者已经在终端遗产编程代理内部。与此同时,大多数专业人士仍然只是通过对话的方式接触AI。
现在的障碍是管理者的工作:知道要交付什么、对其进行限制、命名结果并决定如何检查它,然后安全地运行环境并比较模型,同时要记住它们的一致性作为证据比看起来要弱。第3章的四个级别为这项工作提供了任何产品都不拥有的结构,而制品规则为其提供了一个测量单位。我提议将网络编排作为通向最后一个级别(P7)的桥梁,将CLI编排作为其持久的形式(P8);两者的陈述方式都使它们可能失败。
对于任何推进这一转变的人来说,实际的后果是一个操作顺序。首要问题是,一个人能够描述、检查并在尝试失败时安全地放弃的小的、被许可的工作是什么:来自公开来源的简报、个人规划文件夹、没有其他人依赖的电子表格。从那里开始,每次添加一项管理职责、一个边界、然后是批准、然后是自己的工作空间、然后是已保存的任务记录、然后是第二个和关键的视图。评估遵循相同的顺序。如果一个演示隐藏了该人被允许做什么、输出如何被检查以及代理失败时发生了什么,那么这个演示就几乎没有价值。经过思考的委派拒绝也算作一个结果。一个能够复现一个有界的任务、说明他们为什么依赖它、指出改变了决定的分歧并在情况变化时缩小访问权限的人,正在表现出这个角色的可观察迹象,无论他们的职位名称是什么。
模型可能会失败,第10章说明了如何。第9章的计划将在非程序员身上测试其中的一部分,附录C中的代码让其他人能够测量相同的交叉点并练习相同的模式。我预计附录B中命名的产品在一年内会显得过时。第5章的障碍不应该如此,因为它们属于人和工作,无论哪个产品在他们面前。终端已成为一个代理为已学会管理它的人工作的地方,有多少人会学到这一点、通过什么路线以及速度有多快,是下一年将回答的问题。
声明
资助。本工作未获得任何外部资助。
利益冲突。作者开发了多模型编排方法,并已提交相关专利申请(待批;暂未获得批准)。作者设计了第9节中所述的预注册队列计划及其材料。本文中的任何发现都不依赖于作者的实现;附录C中的每个模式都可以用公开可用的工具进行复制。作者还维护了附录C中提到的两个开源插件;它们是免费且开源的(Apache License 2.0),本文中的任何发现都不依赖于它们。作者正在开发可能稍后商业提供的教学材料;在撰写时尚未销售任何内容,第9节中所述的队列免费获得了所有材料。
工具与验证。人工智能助手在作者的指导下被用作工具;思想、研究和结论均为作者的。所有定量声称和引用都根据截至2026年9月21日的原始资源或存档副本进行了核实,或在文本和附录B的时间线中标记为次要来源或供应商的情况下,根据最佳可用报告进行了核实;供应商关于其自身产品的数据都做了相应标记。在研究期间无法检索到原始页面的情况下(某供应商网站上的多个页面返回了访问错误),该声称从指名的次要来源引用并进行标记,或被省略。参考文献中方括号内给出的新闻标题是对那些标题未逐字重新阅读的页面的描述性标题。
数据和代码可用性。附录C中的代码及其测试以MIT许可证存放在https://github.com/vadimchernets/after-chat并存档在Zenodo,https://doi.org/10.5281/zenodo.22944451。基于相同模式构建的两个插件Roundcall和Sidecall位于https://github.com/vadimchernets/roundcall和https://github.com/vadimchernets/sidecall(Apache License 2.0)。将相同模式应用于软件外行业的五个工具包位于https://github.com/vadimchernets/calling-kits(MIT)。据存储库所述,它们尚未被这些行业的从业者尝试过,本文中的任何声称都不依赖于它们。
伦理。本文未报告来自人类参与者的数据。本文所描述的队列计划已预注册(OSF,DOI 10.17605/OSF.IO/X4EGQ);其结果将单独报告。
作者贡献。唯一作者。
通信。vadimchernets9@gmail.com · ORCID: 0009-0007-4845-3163
References
9to5Mac. (2026, August 4). OpenAI explains what will happen when ChatGPT Atlas shuts down this weekend. https://9to5mac.com/2026/08/04/openai-explains-what-will-happen-when-chatgpt-atlas-shuts-down-this-weekend/
Accenture. (2025, December 9). Accenture and Anthropic launch multi-year partnership to drive enterprise AI innovation and value across industries. https://newsroom.accenture.com/news/2025/accenture-and-anthropic-launch-multi-year-partnership-to-drive-enterprise-ai-innovation-and-value-across-industries
Adrjan, P. (2026, July 8). AI is no longer just a tech occupation story. Indeed Hiring Lab. https://hiringlab.indeed.com/2026/07/08/ai-is-no-longer-just-a-tech-occupation-story/
Agent Skills. (2026). Agent Skills: an open standard (list of supporting products, accessed 21 September 2026). https://agentskills.io
Anthropic. (2025). Piloting Claude in Chrome (25 August 2025, updated 18 December 2025). https://claude.com/blog/claude-for-chrome
Anthropic. (2026a). Claude Code desktop quickstart (accessed 21 September 2026). https://code.claude.com/docs/en/desktop-quickstart
Anthropic. (2026b). Get started with Claude Cowork. Help Center (accessed 21 September 2026). https://support.claude.com/en/articles/13345190-get-started-with-claude-cowork
Anthropic. (2026c, September 16). Claude Cowork and chat are now one Claude. https://claude.com/blog/cowork-is-now-claude
Anthropic. (2026d, August 26). Claude in Chrome is generally available. https://claude.com/blog/claude-in-chrome-generally-available
Anthropic. (2026e, March 24). Anthropic Economic Index report: Learning curves. https://www.anthropic.com/research/economic-index-march-2026-report
Anthropic. (2026f, January 15). Anthropic Economic Index report: Economic primitives. https://www.anthropic.com/research/anthropic-economic-index-january-2026-report
Anthropic. (2026g). Use Claude in Chrome safely. Help Center (accessed 21 September 2026). https://support.claude.com/en/articles/12902428-use-claude-in-chrome-safely
Anthropic. (2026h). What's new in Claude Code: 29 June to 3 July 2026 (default permission mode renamed "Manual"). https://code.claude.com/docs/en/whats-new/2026-w27
Bainbridge, L. (1983). Ironies of automation. Automatica, 19(6), 775-779. https://doi.org/10.1016/0005-1098(83)90046-8
Becker, J., Rush, N., Barnes, E., & Rein, D. (2025). Measuring the impact of early-2025 AI on experienced open-source developer productivity. arXiv:2507.09089. https://arxiv.org/abs/2507.09089
BenchLM. (2026). OSWorld-Verified leaderboard (aggregator of vendor-reported scores, accessed September 2026). https://benchlm.ai/benchmarks/osworld-verified
Bick, A., Blandin, A., & Deming, D. J. (2024). The rapid adoption of generative AI (NBER Working Paper No. 32966). https://www.nber.org/papers/w32966
Bick, A., Blandin, A., Deming, D. J., et al. (2026, September 1). What work does generative AI do? Federal Reserve Bank of St. Louis, On the Economy. https://www.stlouisfed.org/on-the-economy/2026/sep/what-work-does-generative-ai-do
Bo, J. Y., Wan, S., & Anderson, A. (2025). To rely or not to rely? Evaluating interventions for appropriate reliance on large language models. CHI 2025. arXiv:2412.15584. https://arxiv.org/abs/2412.15584
Brave. (2025, August 20). Comet prompt injection. https://brave.com/blog/comet-prompt-injection/
Brynjolfsson, E., Li, D., & Raymond, L. R. (2025). Generative AI at work. Quarterly Journal of Economics, 140(2), 889-942. https://academic.oup.com/qje/article/140/2/889/7990658
Carolus, A., Koch, M., Straka, S., Latoschik, M. E., & Wienrich, C. (2023). MAILS: Meta AI literacy scale. International Journal of Human-Computer Interaction. arXiv:2302.09319. https://arxiv.org/abs/2302.09319
Carroll, J. M. (1990). The Nurnberg funnel: Designing minimalist instruction for practical computer skill. MIT Press. https://mitpress.mit.edu/9780262031639/the-nurnberg-funnel/
CC for Everyone. (2026). A course taught inside Claude Code (accessed 21 September 2026). https://ccforeveryone.com
Center for AI Safety. (2026, July 1). Significant increase in digital labor automation. https://safe.ai/blog/significant-increase-in-digital-labor-automation
Chatterji, A., Cunningham, T., Deming, D. J., Hitzig, Z., Ong, C., Shan, C. Y., & Wadman, K. (2025). How people use ChatGPT (NBER Working Paper No. 34255). https://www.nber.org/papers/w34255
Chernets, V. (2026a). Agreement is not independent evidence: Auditable multi-model synthesis without an API. SSRN. https://doi.org/10.2139/ssrn.7390698 (Zenodo: https://doi.org/10.5281/zenodo.22683716)
Chernets, V. (2026b). AI-Watchbird (Sheckley): When automated oversight widens its own mandate and harms what it guards. SSRN. https://doi.org/10.2139/ssrn.7473658 (Zenodo: https://doi.org/10.5281/zenodo.22849138)
Chernets, V. (2026c). Architectural trust: Why consumer trust in agentic commerce migrates from AI models to verifiable architecture. SSRN. https://doi.org/10.2139/ssrn.7191261 (Zenodo: https://doi.org/10.5281/zenodo.22166995)
Chernets, V. (2026d). Three steps into agentic AI: A preregistered feasibility study of how non-programmers cross from chatbot to agent to multi-model orchestration (Cohort 1). OSF preregistration. https://doi.org/10.17605/OSF.IO/X4EGQ
CodeRabbit. (n.d.). State of AI vs. human code generation report (accessed 21 September 2026). https://www.coderabbit.ai/blog/state-of-ai-vs-human-code-generation-report
Cohn, C., Rayala, S., Srivastava, N., Fonteles, J. H., Jain, S., Luo, X., Mereddy, D., Mohammed, N., & Biswas, G. (2026). A theory of adaptive scaffolding for LLM-based pedagogical agents. AAAI 2026, 40(3), 1757-1765. arXiv:2508.01503. https://arxiv.org/abs/2508.01503
Constellation Research. (2026a, June 2). OpenAI touts broadening Codex usage, 5 million weekly active users. https://www.constellationr.com/insights/news/openai-touts-broadening-codex-usage-5-million-weekly-active-users
Constellation Research. (2026b, March 30). Microsoft 365 Copilot's Researcher agent goes multi-model. https://www.constellationr.com/insights/news/microsoft-365-copilots-researcher-agent-goes-multi-model
Cranney, K., Delecourt, S., & Koning, R. (2026). Global evidence on gender gaps and generative AI over time (Harvard Business School Working Paper No. 25-023). https://www.hbs.edu/ris/Publication%20Files/25023_52957d6c-0378-4796-99fa-aab684b3b2f8.pdf
Daepp, M. I. G., & Counts, S. (2024). The emerging generative artificial intelligence divide in the United States. arXiv:2404.11988. https://arxiv.org/abs/2404.11988
Davis, F. D. (1989). Perceived usefulness, perceived ease of use, and user acceptance of information technology. MIS Quarterly, 13(3), 319-340. https://doi.org/10.2307/249008
Dell'Acqua, F., McFowland III, E., Mollick, E. R., Lifshitz-Assaf, H., Kellogg, K., Rajendran, S., Krayer, L., Candelon, F., & Lakhani, K. R. (2026). Navigating the jagged technological frontier. Organization Science, 37(2), 403-423. https://doi.org/10.1287/orsc.2025.21838
Digital Commerce 360. (2025, April 8). Internal memo: Shopify CEO declares AI non-optional. https://www.digitalcommerce360.com/2025/04/08/internal-memo-shopify-ceo-declares-ai-non-optional/
Doshi, A. R., & Hauser, O. P. (2024). Generative AI enhances individual creativity but reduces the collective diversity of novel content. Science Advances, 10(28), eadn5290. https://doi.org/10.1126/sciadv.adn5290
Du, Y., Li, S., Torralba, A., Tenenbaum, J. B., & Mordatch, I. (2023). Improving factuality and reasoning in language models through multiagent debate. arXiv:2305.14325. https://arxiv.org/abs/2305.14325
European Commission. (2026a). AI literacy: Questions and answers (updated 27 July 2026). https://digital-strategy.ec.europa.eu/en/faqs/ai-literacy-questions-answers
European Commission. (2026b, July 27). AI Omnibus enters into force. https://digital-strategy.ec.europa.eu/en/news/ai-omnibus-enters-force
European Union. (2026). Regulation (EU) 2026/1744 amending Regulation (EU) 2024/1689 (Artificial Intelligence Act), Article 4. Official Journal of the European Union, 24 July 2026. https://eur-lex.europa.eu/eli/reg/2026/1744/oj
ExecutiveGov. (2026, February 17). DOL AI literacy framework. https://www.executivegov.com/articles/dol-ai-literacy-framework
Feldman, M. Q., & Anderson, C. J. (2024). Non-expert programmers in the generative AI future. CHIWORK '24. https://doi.org/10.1145/3663384.3663393
Feng, K. J. K., McDonald, D. W., & Zhang, A. X. (2025). Levels of autonomy for AI agents. arXiv:2506.12469. https://arxiv.org/abs/2506.12469
Ferdman, A. (2025). AI deskilling is a structural problem. AI & Society. https://doi.org/10.1007/s00146-025-02686-z
Fortune. (2026a, January 13). [Report on the launch of Claude Cowork, "Claude Code for the rest of your work"]. https://fortune.com/2026/01/13/anthropic-claude-cowork-ai-agent-file-managing-threaten-startups/
Fortune. (2026b, April 13). [Report on Duolingo dropping AI use from performance evaluations]. https://fortune.com/2026/04/13/duolingo-ceo-luis-von-ahn-ai-usage-requirement-employee-performance-evaluations/
Gallup. (2026, July 20). Organizational AI adoption jumps six points. https://www.gallup.com/workplace/712736/organizational-adoption-jumps-six-points.aspx
Ge, Y., Mei, L., Duan, Z., Li, T., Zheng, Y., Wang, Y., Wang, L., Yao, J., Liu, T., Cai, Y., Bi, B., Guo, F., Guo, J., Liu, S., & Cheng, X. (2025). A survey of vibe coding with large language models. arXiv:2510.12399. https://arxiv.org/abs/2510.12399
GitHub. (2026a). ai-shifu/ChatALL: repository and release download counts (accessed 21 September 2026). https://github.com/ai-shifu/ChatALL
GitHub. (2026b). jackwener/OpenCLI: repository (accessed 21 September 2026). https://github.com/jackwener/OpenCLI
GitHub. (2026c, February 4 and 26). Claude and Codex are now available in public preview on GitHub; now available for Copilot Business and Pro users. https://github.blog/changelog/2026-02-26-claude-and-codex-now-available-for-copilot-business-pro-users/
GitHub. (2026d). BeehiveInnovations/pal-mcp-server and nyldn/claude-octopus: repositories (accessed 21 September 2026). https://github.com/BeehiveInnovations/pal-mcp-server ; https://github.com/nyldn/claude-octopus
GitHub issue reports. (2026). anthropics/claude-code issues #32637 (9 March 2026), #50844 (19 April 2026) and #67188 (10 June 2026), user reports. https://github.com/anthropics/claude-code/issues/32637 ; https://github.com/anthropics/claude-code/issues/50844 ; https://github.com/anthropics/claude-code/issues/67188
Google. (2026, May 19). An important update: Transitioning Gemini CLI to Antigravity CLI. Google Developers Blog. https://developers.googleblog.com/en/an-important-update-transitioning-gemini-cli-to-antigravity-cli/
Google Open Source Blog. (2026, April). A year of open collaboration: Celebrating the anniversary of A2A. https://opensource.googleblog.com/2026/04/a-year-of-open-collaboration-celebrating-the-anniversary-of-a2a.html
Grunde-McLaughlin, M., Mozannar, H., Murad, M., Chen, J., Amershi, S., & Fourney, A. (2026). Overseeing agents without constant oversight: Challenges and opportunities. arXiv:2602.16844. https://arxiv.org/abs/2602.16844
Hargittai, E. (2002). Second-level digital divide: Differences in people's online skills. First Monday, 7(4). https://doi.org/10.5210/fm.v7i4.942
He, G., Demartini, G., & Gadiraju, U. (2025). Plan-then-execute: An empirical study of user trust and team performance when using LLM agents as a daily assistant. CHI 2025. https://doi.org/10.1145/3706598.3713218
Help Net Security. (2026, June 2). [Report on OpenAI Codex use by knowledge workers]. https://www.helpnetsecurity.com/2026/06/02/openai-codex-knowledge-work/
Henseke, G. (2026). Generative AI at work: From exposure to adoption across 35 European countries. arXiv:2604.18849. https://arxiv.org/abs/2604.18849
Humlum, A., & Vestergaard, E. (2025). Still waters, rapid currents: Early labor market transformation under generative AI (NBER Working Paper No. 33777, revised March 2026). https://www.nber.org/papers/w33777
Information Age. (2026, May 5). Gone in 9 seconds: AI agent deletes company database. https://ia.acs.org.au/article/2026/gone-in-9-seconds--ai-agent-deletes-company-database.html
JetBrains Research. (2026a, April). Which AI coding tools do developers actually use at work? https://blog.jetbrains.com/research/2026/04/which-ai-coding-tools-do-developers-actually-use-at-work/
JetBrains Research. (2026b, August). AI coding agents: Adoption trends 2026. https://blog.jetbrains.com/research/2026/08/ai-coding-agent-adoption-2026/
Karpathy, A. (2025). llm-council (repository, accessed 21 September 2026). https://github.com/karpathy/llm-council
Kim, E., Garg, A., Peng, K., & Garg, N. (2025). Correlated errors in large language models. ICML 2025. arXiv:2506.07962. https://arxiv.org/abs/2506.07962
Ko, A. J., Abraham, R., Beckwith, L., Blackwell, A., Burnett, M., Erwig, M., Scaffidi, C., Lawrance, J., Lieberman, H., Myers, B., Rosson, M. B., Rothermel, G., Shaw, M., & Wiedenbeck, S. (2011). The state of the art in end-user software engineering. ACM Computing Surveys, 43(3), Article 21. https://doi.org/10.1145/1922649.1922658
Kosmyna, N., Hauptmann, E., Yuan, Y. T., Situ, J., Liao, X.-H., Beresnitzky, A. V., Braunstein, I., & Maes, P. (2025). Your brain on ChatGPT: Accumulation of cognitive debt when using an AI assistant for essay writing task. arXiv:2506.08872. https://arxiv.org/abs/2506.08872
Kwa, T., West, B., Becker, J., et al. (2025). Measuring AI ability to complete long software tasks. arXiv:2503.14499. https://arxiv.org/abs/2503.14499
Lee, H.-P., Sarkar, A., Tankelevitch, L., Drosos, I., Rintel, S., Banks, R., & Wilson, N. (2025). The impact of generative AI on critical thinking: Self-reported reductions in cognitive effort and confidence effects from a survey of knowledge workers. CHI 2025. https://doi.org/10.1145/3706598.3713778
Lee, J. D., & See, K. A. (2004). Trust in automation: Designing for appropriate reliance. Human Factors, 46(1), 50-80. https://doi.org/10.1518/hfes.46.1.50_30392
Linux Foundation. (2025, December 9). Linux Foundation announces the formation of the Agentic AI Foundation. https://www.linuxfoundation.org/press/linux-foundation-announces-the-formation-of-the-agentic-ai-foundation
Liu, M. X., Sarkar, A., Negreanu, C., Zorn, B., Williams, J., Toronto, N., & Gordon, A. D. (2023). "What it wants me to say": Bridging the abstraction gap between end-user programmers and code-generating large language models. CHI 2023. https://doi.org/10.1145/3544548.3580817
Liu, Y., & Sra, M. (2026). TaskLens: Generating task-conditioned scaffolded interfaces for learning professional creative software. DIS 2026. arXiv:2511.23379. https://arxiv.org/abs/2511.23379
Long, D., & Magerko, B. (2020). What is AI literacy? Competencies and design considerations. CHI 2020. https://doi.org/10.1145/3313831.3376727
Long, T., Zhang, X., Wang, S., Yu, Z., & Chilton, L. B. (2025). DoubleAgents: Human-agent alignment in a socially embedded workflow. arXiv:2509.12626. https://arxiv.org/abs/2509.12626
Ma, L., Xu, X., He, Y., & Tan, Y. (2025). Learning to adopt generative AI. arXiv:2410.19806. https://arxiv.org/abs/2410.19806
Ma, R., Wan, R., Lu, X., Yang, F., Chen, C., & Li, L. (2026). Value-sensitive delegation in everyday AI agent use: Evidence from OpenClaw. arXiv:2609.22067. https://arxiv.org/abs/2609.22067
MacRumors. (2026, July 9). [Report on the launch of ChatGPT Work and the new ChatGPT desktop app]. https://www.macrumors.com/2026/07/09/openai-chatgpt-work/
McKinlay, R., Puntoni, S., & Saka, E. (2026, September 9). To adopt AI at scale, employees need to trust agents. Harvard Business Review. https://hbr.org/2026/09/to-adopt-ai-at-scale-employees-need-to-trust-agents
METR. (2026, February 24). Uplift update. https://metr.org/blog/2026-02-24-uplift-update/
Microsoft. (2026a, March 9). Powering Frontier Transformation with Copilot and agents. https://www.microsoft.com/en-us/copilot/blog/2026/03/09/powering-frontier-transformation-with-copilot-and-agents/
Microsoft. (2026b, May 5). 2026 Work Trend Index: Agents, human agency and the opportunity for every organization. https://www.microsoft.com/en-us/worklab/work-trend-index/agents-human-agency-and-the-opportunity-for-every-organization
Microsoft. (2026c). Use model choice in the Researcher agent. Microsoft Support (accessed 21 September 2026). https://support.microsoft.com/en-us/office/use-model-choice-in-the-researcher-agent
Model Context Protocol. (2026, July 28). [Blog post on the July 2026 specification release]. https://blog.modelcontextprotocol.io/posts/2026-07-28/
Morris, M. R., Sohl-Dickstein, J., Fiedel, N., Warkentin, T., Dafoe, A., Faust, A., Farabet, C., & Legg, S. (2024). Position: Levels of AGI for operationalizing progress on the path to AGI. ICML 2024. arXiv:2311.02462. https://arxiv.org/abs/2311.02462
Myers, B. A., Pane, J. F., & Ko, A. (2004). Natural programming languages and environments. Communications of the ACM, 47(9), 47-52. https://doi.org/10.1145/1015864.1015888
Nardi, B. A. (1993). A small matter of programming: Perspectives on end user computing. MIT Press. https://mitpress.mit.edu/9780262140539/a-small-matter-of-programming/
Noy, S., & Zhang, W. (2023). Experimental evidence on the productivity effects of generative artificial intelligence. Science, 381(6654), 187-192. https://doi.org/10.1126/science.adh2586
OECD & European Commission. (2026). Empowering learners for the age of AI: An AI literacy framework for primary and secondary education. OECD Publishing. https://www.oecd.org/en/publications/empowering-learners-for-the-age-of-ai_65cd27d4-en.html
OpenAI. (2026a). codex-plugin-cc: Use Codex from inside Claude Code (repository, announced 30 March 2026, accessed 21 September 2026). https://github.com/openai/codex-plugin-cc
Panickssery, A., Bowman, S. R., & Feng, S. (2024). LLM evaluators recognize and favor their own generations. NeurIPS 2024. arXiv:2404.13076. https://arxiv.org/abs/2404.13076
Parasuraman, R., Sheridan, T. B., & Wickens, C. D. (2000). A model for types and levels of human interaction with automation. IEEE Transactions on Systems, Man, and Cybernetics, Part A: Systems and Humans, 30(3), 286-297. https://doi.org/10.1109/3468.844354
Parasuraman, R., & Riley, V. (1997). Humans and automation: Use, misuse, disuse, abuse. Human Factors, 39(2), 230-253. https://doi.org/10.1518/001872097778543886
Patwardhan, T., Dias, R., Proehl, E., et al. (2025). GDPval: Evaluating AI model performance on real-world economically valuable tasks. arXiv:2510.04374. https://arxiv.org/abs/2510.04374
Pew Research Center. (2026, June 17). Americans and AI 2026: Chatbots, smart devices and views on impact. https://www.pewresearch.org/internet/2026/06/17/americans-and-ai-2026-chatbots-smart-devices-and-views-on-impact/
PwC. (2026, June 15). 2026 Global AI Jobs Barometer (press release distributed by PR Newswire; report page). https://www.pwc.com/gx/en/issues/artificial-intelligence/ai-jobs-barometer.html
Rogers, E. M. (2003). Diffusion of innovations (5th ed.). Free Press. ISBN 9780743222099.
Sarkar, A., & Drosos, I. (2025). Vibe coding: Programming through conversation with artificial intelligence. PPIG 2025. arXiv:2506.23253. https://arxiv.org/abs/2506.23253
Sarkar, A., Gordon, A. D., Negreanu, C., Poelitz, C., Ragavan, S. S., & Zorn, B. (2022). What is it like to program with artificial intelligence? PPIG 2022. arXiv:2208.06213. https://arxiv.org/abs/2208.06213
Schoenegger, P., Tuminauskaite, I., Park, P. S., Bastos, R. V. S., & Tetlock, P. E. (2024). Wisdom of the silicon crowd: LLM ensemble prediction capabilities rival human crowd accuracy. Science Advances, 10(45), eadp1528. https://doi.org/10.1126/sciadv.adp1528
SiliconANGLE. (2025, December 18). Anthropic makes Agent Skills an open standard. https://siliconangle.com/2025/12/18/anthropic-makes-agent-skills-open-standard/
Simkute, A., Tankelevitch, L., Kewenig, V., Scott, A. E., Sellen, A., & Rintel, S. (2024). Ironies of generative AI: Understanding and mitigating productivity loss in human-AI interactions. arXiv:2402.11364. https://arxiv.org/abs/2402.11364
Sitter, N. (2026). MCP apps census 2026 (data of 29 July and 3 August 2026). https://www.nicolassitter.com/research/mcp-apps-census-2026
Stack Overflow. (2025). 2025 Developer Survey: AI. https://survey.stackoverflow.co/2025/ai
Stack Overflow. (2026, May 27). Agents on a leash: Agentic AI remains mostly monitored at work. https://stackoverflow.blog/2026/05/27/agents-on-a-leash-agentic-ai-remains-mostly-monitored-at-work/
Stankovic, M., Hirche, E., Kollatzsch, S., & Doetsch, J. N. (2026). Comment on: Your brain on ChatGPT. arXiv:2601.00856. https://arxiv.org/abs/2601.00856
Storyboard18. (2026, February 10). Perplexity launches Model Council to compare answers across multiple AI models. https://www.storyboard18.com/digital/perplexity-launches-model-council-to-compare-answers-across-multiple-ai-models-89246.htm
Sweller, J. (1988). Cognitive load during problem solving: Effects on learning. Cognitive Science, 12(2), 257-285. https://doi.org/10.1207/s15516709cog1202_4
TechCrunch. (2025, December 22). OpenAI says AI browsers may always be vulnerable to prompt injection attacks. https://techcrunch.com/2025/12/22/openai-says-ai-browsers-may-always-be-vulnerable-to-prompt-injection-attacks/
TechCrunch. (2026a, September 16). Anthropic merges Claude chat and Cowork in one interface. https://techcrunch.com/2026/09/16/anthropic-merges-claude-chat-and-cowork-in-one-interface/
TechCrunch. (2026b, July 1). Gemini Spark, Google's agentic assistant, is now available on Mac. https://techcrunch.com/2026/07/01/gemini-spark-googles-agentic-assistant-is-now-available-on-mac/
The Register. (2025, July 21). [Report on an application-building agent deleting a production database]. https://www.theregister.com/2025/07/21/replit_saastr_vibe_coding_incident/
The Register. (2026, January 13). Anthropic floats Claude Cowork for office work automation. https://www.theregister.com/software/2026/01/13/anthropic-floats-claude-cowork-for-office-work-automation/4839664
Tomašev, N., Franklin, M., & Osindero, S. (2026). Intelligent AI delegation. arXiv:2602.11865. https://arxiv.org/abs/2602.11865
UNESCO. (2024a). AI competency framework for students. https://www.unesco.org/en/articles/ai-competency-framework-students
UNESCO. (2024b). AI competency framework for teachers. https://www.unesco.org/en/articles/ai-competency-framework-teachers
US Census Bureau. (2026, May 26). [Story on AI use among businesses, Business Trends and Outlook Survey]. https://www.census.gov/library/stories/2026/05/ai-use-businesses.html
US Department of Labor. (2026, February 13). Training and Employment Notice 07-25: Artificial Intelligence Literacy Framework. https://www.dol.gov/newsroom/releases/eta/eta20260213
van Dijk, J. A. G. M. (2020). The digital divide. Polity Press. ISBN 978-1-5095-3444-9. https://research.utwente.nl/en/publications/the-digital-divide-2/
Venkatesh, V., Morris, M. G., Davis, G. B., & Davis, F. D. (2003). User acceptance of information technology: Toward a unified view. MIS Quarterly, 27(3), 425-478. https://doi.org/10.2307/30036540
Virk, Y., & Liu, D. (2025). Non-programmers assessing AI-generated code: A case study of business users analyzing data. arXiv:2508.06484. https://arxiv.org/abs/2508.06484
Vygotsky, L. S. (1978). Mind in society: The development of higher psychological processes. Harvard University Press. https://www.hup.harvard.edu/books/9780674576292
White House. (2025a, April 23). Executive Order 14277: Advancing artificial intelligence education for American youth. https://www.whitehouse.gov/presidential-actions/2025/04/advancing-artificial-intelligence-education-for-american-youth/
White House. (2025b, July). America's AI Action Plan. https://www.whitehouse.gov/wp-content/uploads/2025/07/Americas-AI-Action-Plan.pdf
Willison, S. (2026, January 12). Claude Cowork. https://simonwillison.net/2026/Jan/12/claude-cowork/
Wood, D., Bruner, J. S., & Ross, G. (1976). The role of tutoring in problem solving. Journal of Child Psychology and Psychiatry, 17(2), 89-100. https://doi.org/10.1111/j.1469-7610.1976.tb00381.x
xAI. (2026, May 25). Introducing Grok Build. https://x.ai/news/grok-build-cli
Xie, T., Zhang, D., Chen, J., Li, X., Zhao, S., Cao, R., Hua, T. J., Cheng, Z., Shin, D., Lei, F., Liu, Y., Xu, Y., Zhou, S., Savarese, S., Xiong, C., Zhong, V., & Yu, T. (2024). OSWorld: Benchmarking multimodal agents for open-ended tasks in real computer environments. arXiv:2404.07972. https://arxiv.org/abs/2404.07972
Xu, F. F., Song, Y., Li, B., Tang, Y., Jain, K., Bao, M., Wang, Z. Z., Zhou, X., Guo, Z., Cao, M., Yang, M., Lu, H. Y., Martin, A., Su, Z., Maben, L., Mehta, R., Chi, W., Jang, L., Xie, Y., Zhou, S., & Neubig, G. (2024). TheAgentCompany: Benchmarking LLM agents on consequential real world tasks. arXiv:2412.14161. https://arxiv.org/abs/2412.14161
Yang, Y., Qu, C., Wen, M., Shi, L., Wen, Y., Zhang, W., Wierman, A., & Gu, S. (2026). Understanding agent scaling in LLM-based multi-agent systems via diversity. arXiv:2602.03794. https://arxiv.org/abs/2602.03794
Zamfirescu-Pereira, J. D., Wong, R. Y., Hartmann, B., & Yang, Q. (2023). Why Johnny can't prompt: How non-AI experts try (and fail) to design LLM prompts. CHI 2023. https://doi.org/10.1145/3544548.3581388
Zapier. (2026). Raising the AI fluency bar in hiring. https://zapier.com/blog/raising-ai-fluency-bar-in-hiring/
Zhang, H., Cui, Z., Chen, J., Wang, X., Zhang, Q., Wang, Z., Wu, D., & Hu, S. (2025). Stop overvaluing multi-agent debate: We must rethink evaluation and embrace model heterogeneity. arXiv:2502.08788. https://arxiv.org/abs/2502.08788
附录 A. 模型术语表
覆盖范围。一个模型代表一个人可以接触到的内容:对话;供应商限定空间内的文件和工具;个人的计算机;多个模型和智能体。
角色。为了工作成功,一个人必须做什么:提问和复制;委派和审查;拥有环境;管理多个智能体。
级别。执行一项工作时覆盖范围和角色的组合(第3.2节)。级别描述工作;人员和产品可以跨越多个级别。
跨越(过渡)。当智能体在新级别生成个人要求的工件时记录。安装是一次尝试。允许跨越多个级别的移动,并记录为跳过。
工件。由智能体生成、个人提供或保留的文件、文件夹、操作或输出。"无"是有效的记录。
工作流词汇。一个人知道如何交给智能体的任务库存,措辞方式使得智能体可以执行它们并且结果可以被检查。
反射性入职。一个AI系统为人采用更强大的AI系统提供支架,例如聊天机器人指导智能体的安装和从其首次错误的恢复。
委派合约。一个人向智能体分配工作时陈述的四件事:目标、边界、工件、检查。
四项实践。管理者在任务中执行的操作:委派、监督、验证、撤销(第8.1节)。
接受记录。对于有后果的或重复的任务:预期的交付物、输入、约束和权限、输出位置、重大分歧或失败、执行的检查,以及接受、修订、升级或丢弃的决定。它将智能体生成的内容与个人依赖的内容分开。
工作的五部分映射。工作的对象、允许的输入、转换、交付物和检查:非程序员的重复任务变成委派的形式(第5.1节)。
侧分支。浏览器应用程序构建器,作用于平台托管的项目而非个人的文件;一个不同的阶梯,有其自己的阶级(第3.4节)。
网页编排。一个问题提交给浏览器中的多个消费者聊天机器人,手动或使用工具,然后比较答案。
CLI编排。一个智能体调用其他智能体的命令行工具,收集其输出并合并或检查它们。
工具变动。工具在短于新手学习它们时间的周期内重新命名、合并或退役。
有效意见数 (N_eff)。对于具有平均成对误差相关性 rho 的 N 个模型,N / (1 + (N - 1) rho);上界为 1/rho(Chernets, 2026a)。
标记为可编码项目
对于定性数据编码者或调查设计者,第3节的标记简化为关于命名工件的是/否项目。没有工件的自我报告被记录为主张,不计为跨越。
- 第1级存在。过去七天内与消费者聊天机器人至少一次保存的对话;工件:链接、屏幕截图或导出。未能生成它被编码为"未演示",这比"不存在"是更弱的发现。
- 转变1已跨越。由作用域智能体(桌面、网络或租户托管)在个人授予的位置内编写的文件或文件集,响应个人命名的工作,至少记录了一次批准、拒绝或计划修改。工件的日期是跨越日期。
- 第2级存在。转变1已跨越,加上后续周中的进一步作用域工件。持久性作为单独的每周项目记录,与跨越分开。
- 转变2已跨越。由本地智能体或其官方桌面壳在个人控制的机器上生成的工作文件夹、提交或日期文件集,来自需要多个工具使用的工作。云托管工作被编码为其自己的云变体。
- 第3级存在。转变2已跨越,加上来自同一类智能体的后续周工件。
- 转变3(桥接形式)。一个日期文件,包含问题、被问询的聊天机器人或网络模型、原始答案或其链接、同意和不同意的注释,以及覆盖或可靠性(第6.2节)是否出现的注释;由手工或广播工具生成。
- 转变3(耐用形式)。相同的字段,由在个人自己的登录上调用两个或多个官方命令行工具(或一个加上第二系列插件)的运行生成,分母记录为:提问、回答、超时。
- 第4级存在。转变3的任一形式,加上后续周的第二个日期运行。
- 有协助与无协助。任何跨越,其中调查者、同事或付费教练执行了安装步骤、编写了工作或从错误中恢复的,被视为有协助的。只要有辅助者,完成情况就报告为两个数字。
- 停止原因。对"什么阻止了你"的自由文本回答,问所有未跨越的人,在收集后编码。候选编码,作为后续编码者修订的假设提供:工作流词汇;权限或安全对话;管理员权限;成本或配额;对界面的恐惧;破坏性事件的新闻;组织政策;技术错误;生活和时间;其他。
- "不知道问什么"的编码规则(工作流词汇)。包括当被问及他们尝试让智能体执行的操作时,个人无法命名第5.1节的五个部分中的至少一个:工作的对象、他们可以使用的输入、转换、交付物或检查。排除当所有五个都被命名且个人以政策、风险、成本或时间为由拒绝时;那些获得自己的编码。两个编码者独立编码并报告他们的一致性。该规则分类停止,并不说明个人的能力。
- 四项实践的痕迹(是/否,每个与日期工件相关):拒绝的计划;拒绝的差异或输出;请求的第二个模型系列;记录的分母(谁被问及、谁回答、谁超时);为确认而保留的不可逆步骤;存放的工件。这些是P10的监督痕迹。
- 非标记。 许可证购买、课程徽章、安装程序日志、仓库星标、提示词计数或自我评价为"智能体用户"。
附录B. 年表,2025至2026年9月21日
标记为VERIFIED的条目是在研究窗口期间(截至2026年9月21日)在主要页面或新闻报道指定的次要页面上打开的。标记为SECONDARY的条目基于未在主要页面上打开的新闻报道或产品历史记录;它们用于提供方向,在论证中不具有权重。这是四级论证的工作年表,不试图建立行业年表。
| 日期 | 事件 | 来源 | 状态 |
|---|---|---|---|
| 24 February 2025 | Claude Code研究预览 | 产品历史记录,广泛报道 | SECONDARY |
| 23 April 2025 | 行政令14277关于AI教育 | White House (2025a) | VERIFIED |
| 22 May 2025 | Claude Code正式可用 | 产品历史记录,广泛报道 | SECONDARY |
| 23 June 2025 | Agent2Agent协议捐献给Linux基金会 | Google Open Source Blog (2026) | VERIFIED (供应商) |
| July 2025 | 美国AI行动计划承诺AI素养和技能 | White House (2025b) | VERIFIED |
| 21 July 2025 | 应用构建代理在实时会话期间删除生产数据库 | The Register (2025) | VERIFIED (新闻) |
| 20 August 2025 | 针对浏览器代理的提示注入演示,使用被盗一次性代码 | Brave (2025) | VERIFIED |
| 25 August 2025 | 浏览器代理试点:无缓解措施的攻击成功率23.6%,有缓解措施的11.2% | Anthropic (2025) | VERIFIED (供应商) |
| 9 December 2025 | 模型上下文协议捐献给代理AI基金会(Linux基金会);超过10,000个已发布服务器,约9,700万月度SDK下载 | Linux Foundation (2025) | VERIFIED |
| 9 December 2025 | 一家咨询公司宣布约30,000名员工将接受培训使用一个供应商的模型 | Accenture (2025) | VERIFIED |
| 18 December 2025 | Agent Skills格式作为开放标准发布 | SiliconANGLE (2025) | VERIFIED (新闻) |
| 22 December 2025 | OpenAI: 提示注入"不太可能永远被完全'解决'" | TechCrunch (2025) | VERIFIED (新闻) |
| January 2026 | Cowork研究预览,"Claude Code为您其余的工作" | Fortune (2026a); The Register (2026) | VERIFIED (新闻) |
| 12 January 2026 | 反对要求非程序员防范提示注入的意见 | Willison (2026) | VERIFIED |
| 15 January 2026 | Anthropic经济指数:增强占会话的52%(2025年11月) | Anthropic (2026f) | VERIFIED (供应商) |
| 4 and 26 February 2026 | GitHub Agent HQ: Claude和Codex代理在Copilot内可用 | GitHub (2026c) | VERIFIED |
| February 2026 | Perplexity Model Council为顶级订阅者提供(于2月10日报道) | Storyboard18 (2026) | VERIFIED (新闻) |
| 13 February 2026 | 美国劳工部AI素养框架("有效管理AI") | US Department of Labor (2026) | VERIFIED |
| 9 March 2026 | Cowork技术集成到Microsoft 365 Copilot | Microsoft (2026a) | VERIFIED |
| 9 March, 19 April, 10 June 2026 | 用户关于级别2代理删除授予文件夹内文件的报告 | GitHub issue reports (2026) | VERIFIED (用户报告) |
| 24 March 2026 | Anthropic经济指数:任期较长的用户授权较少 | Anthropic (2026e) | VERIFIED (供应商) |
| 30 March 2026 | OpenAI的官方插件用于在Claude Code内使用其代理;Microsoft的研究代理同时运行GPT和Claude | OpenAI (2026a); Constellation Research (2026b); Microsoft (2026c) | VERIFIED |
| April 2026 | JetBrains: Claude Code在工作中18%(2026年1月),从约3%(2025年春) | JetBrains Research (2026a) | VERIFIED (供应商调查) |
| 13 April 2026 | Duolingo在性能评估中停止使用AI | Fortune (2026b) | VERIFIED (新闻) |
| 5 May 2026 | 工作趋势指数:组织因素比个人因素的权重高超过两倍 | Microsoft (2026b) | VERIFIED (供应商调查) |
| 25 April 2026 (于5月5日报道) | 代理删除了公司的生产数据库和备份 | Information Age (2026) | VERIFIED (新闻) |
| 19 May 2026 | Google宣布从Gemini CLI转向Antigravity CLI | Google (2026) | VERIFIED |
| 25 May 2026 | xAI的Grok Build发布,包含无头模式和代理协议支持 | xAI (2026) | VERIFIED (供应商) |
| 26 May 2026 | 美国商业AI使用整体17%至20%;小型企业保持平稳 | US Census Bureau (2026) | VERIFIED |
| 27 May 2026 | 开发者脉动:69%单代理;60%阻止未批准更改 | Stack Overflow (2026) | VERIFIED |
| 2 June 2026 | 编码代理拥有500万周活用户,约占知识工作者的20% | Help Net Security (2026); Constellation Research (2026a) | VERIFIED (新闻报道的供应商数据) |
| 15 June 2026 | PwC AI工作晴雨表:AI技能薪资溢价62% | PwC (2026) | VERIFIED (供应商) |
| 17 June 2026 | Pew:约一半的美国成年人使用聊天机器人 | Pew Research Center (2026) | VERIFIED |
| 18 June 2026 | Gemini CLI停止为个人层级提供服务 | Google (2026) | VERIFIED |
| June 2026 | OECD和欧洲委员会AI素养框架("管理AI") | OECD & European Commission (2026) | VERIFIED |
| 29 June to 3 July 2026 | Claude Code将其默认权限模式重命名为"Manual" | Anthropic (2026h) | VERIFIED (供应商) |
| 1 July 2026 | Mac上的Gemini Spark桌面代理;最高远程劳动指数自动化率15.8%,从发布时的2.5% | TechCrunch (2026b); Center for AI Safety (2026) | 已验证 |
| 8 July 2026 | Indeed:美国63%受AI影响的工作职位不属于技术职业 | Adrjan (2026) | 已验证 |
| 9 July 2026 | Coding-agent app成为ChatGPT桌面应用;推出ChatGPT Work | MacRumors (2026) | 已验证 (新闻) |
| 20 July 2026 | Gallup:美国52%的员工使用AI,15%每日使用 | Gallup (2026) | 已验证 |
| 27 July 2026 | EU AI Omnibus生效;AI扫盲义务转变为"采取措施支持" | European Commission (2026a, 2026b) | 已验证 |
| 28 July 2026 | Model Context Protocol:每月接近5亿次SDK下载;协议变为无状态 | Model Context Protocol (2026) | 已验证 |
| 3 August 2026 | EU关于AI素养的监督和执行规则开始适用 | European Commission (2026a) | 已验证 |
| August 2026 | JetBrains:90%的专业开发人员每周使用编码代理;Claude Code在工作中占39% | JetBrains Research (2026b) | 已验证 (供应商调查) |
| 9 August 2026 | OpenAI的智能浏览器停用;浏览功能转入ChatGPT应用 | 9to5Mac (2026) | 已验证 (新闻) |
| 26 August 2026 | 浏览器代理普遍可用;默认自主且配备分类器;供应商报告的注入率接近零 | Anthropic (2026d) | 已验证 (供应商) |
| 1 September 2026 | St. Louis Fed:45%的员工在其工作中使用AI;少于3%的任务采用率超过50% | Bick et al. (2026) | 已验证 |
| 6 September 2026 | Cohort 1预注册冻结 | Chernets (2026d) | 已验证 |
| 9 September 2026 | Harvard Business Review:信任是工作场所采用代理的核心障碍 | McKinlay et al. (2026) | 已验证 (摘要) |
| 16 September 2026 | Cowork与chat合并为单一Claude | Anthropic (2026c); TechCrunch (2026a) | 已验证 |
| 22 September 2026 | 官方插件目录已完整阅读,310条条目:第5.1节中的五个行业均无;社区目录2,282条条目,包括教师和房地产的产品 | Author's reading of the published catalogues | 已验证 (自行计数) |
附录 C. 教学代码
下面的代码清单教授第 5 至 9 节的模式。它们仅使用 Python 标准库和供应商自己的命令行工具,使用用户自己的订阅登录;没有任何工具读取 API key。每个都足够短,可以在一次阅读中完成,每个都说明它教什么以及在哪里停止。它们与测试一起存储在 MIT 许可证下的配套存储库中,每个清单都在包含前运行过(每个都在其演示输入上运行,扇出在存根工具上运行)。这里的每个模式都已经以某种形式存在于开源工具中(第 7.1 节);代码清单的价值在于它们很小、有注释且与论证相关联。没有一个是教学路线、学习者诊断、课程或作者工具的实现。非程序员不会手动运行这些文件:它们是那种代理可以作为技能包装、或桌面 shell 作为按钮公开的东西,打印它们的重点是读者可以看到这样的按钮做什么。
两个可安装的 Claude Code 插件将这些模式投入日常使用。Roundcall 通过个人已经登录的浏览器,以个人的速度向 AI 聊天网站提出问题;Sidecall 向安装在其机器上的命令行代理提出问题,使用预算设置来选择每个供应商的模型。两者都返回一份报告,说明谁说了什么、答案在哪里不一致以及只有一个来源说了什么。它们在 Apache License 2.0 下是开源的,网址为 https://github.com/vadimchernets/roundcall 和 https://github.com/vadimchernets/sidecall。
在运行其中任何一个之前:检查每个工具在您安装的版本上的 --help,因为标志在不同版本之间可能会改变;在包含副本而不是原始文件的工作文件夹中运行它们;并首先阅读清单 C6。
C1. 带有探针、天花板和部分捕获的扇出 (fanout.py)
教授:一个人如何可以一次向多个代理 CLI 提出一个问题,跳过那些已关闭或配额已满的,在时间天花板处停止等待,并保留每个工具在天花板之前写的内容而不是丢弃它。每个工具在输出文件夹内的新的空文件夹中运行,从不在该人启动的文件夹中运行;工具名称限制为安全的文件名;长问题放在文件中 (--question-file),或者对于其模板中没有 {prompt} 的工具,则放在工具的标准输入上,因为命令行参数的长度受操作系统限制。限制:在天花板处停止使用 POSIX 进程组(macOS 和 Linux;在 Windows 上使用 WSL)并回退到停止工具本身;仅在最后打印的工具在停止时没有什么可保留的;如果有流式输出模式,请使用它。该脚本不进行比较;C3 进行。
#!/usr/bin/env python3
"""fanout.py: put one question to several agent CLIs and keep every answer, including partial ones.

Teaching example for "After Chat" (Appendix C, listing C1). MIT licence.

The pattern: probe each tool briefly and skip the dead ones, run the live ones in parallel under one
time ceiling, stream each answer to its own file, and keep whatever a tool has written when the
ceiling is reached. It uses only the Python standard library and the vendors' own command-line tools,
signed in with the user's own subscriptions. No API keys are read or needed.

Each tool runs in its own fresh, empty working folder inside the output folder, never in the folder
you launched from. Stopping a tool at the ceiling stops its whole process group, which is a POSIX
feature (macOS, Linux; on Windows use WSL); where that fails the tool itself is killed.

Usage:
    python3 fanout.py "Your question" --out runs/today
    python3 fanout.py --question-file question.txt --tools tools.json --ceiling 900
    python3 fanout.py -- "-a question that starts with a dash"
A question on the command line is limited by the operating system's argument length; put long
questions in a file. A tool whose template has no "{prompt}" receives the question on its standard
input instead (for example `codex exec -`), which has no such limit.
"""
import argparse
import json
import os
import pathlib
import re
import signal
import subprocess
import sys
import time

# Command templates. "{prompt}" is replaced by the question; a template without it gets the question
# on stdin. Check each tool's --help on your installed version: flags change between releases.
DEFAULT_TOOLS = {
    "claude": ["claude", "-p", "{prompt}"],
    "codex": ["codex", "exec", "--skip-git-repo-check", "--sandbox", "read-only", "{prompt}"],
    "gemini": ["agy", "-p", "{prompt}"],
    "grok": ["grok", "-p", "{prompt}"],
}
PROBE_PROMPT = "Reply with exactly one word: OK"
SAFE_NAME = re.compile(r"^[A-Za-z0-9][A-Za-z0-9_-]{0,31}$")  # a tool name becomes a file and folder name


def build(template, prompt):
    return [part.replace("{prompt}", prompt) for part in template]


def uses_stdin(template):
    return not any("{prompt}" in part for part in template)


def stop_group(proc):
    """Stop a tool and every process it started (they share one process group on POSIX)."""
    for sig in (signal.SIGTERM, signal.SIGKILL):
        try:
            os.killpg(proc.pid, sig)
        except ProcessLookupError:
            return
        except (PermissionError, OSError, AttributeError):
            proc.kill()  # no process group to stop (or no right to): stop the tool itself
        try:
            proc.wait(timeout=5)
            return
        except subprocess.TimeoutExpired:
            continue


def workdir(out_dir, name):
    """A fresh, empty folder per tool: the tool never sees the caller's files."""
    d = out_dir / f"work-{name}"
    d.mkdir(parents=True, exist_ok=True)
    return d


def probe(name, template, seconds, out_dir):
    """A few seconds now saves a long wait later: a tool behind a quota wall answers fast and badly."""
    started = time.monotonic()
    stdin_text = PROBE_PROMPT if uses_stdin(template) else None
    try:
        done = subprocess.run(build(template, PROBE_PROMPT), capture_output=True, text=True,
                              timeout=seconds, cwd=workdir(out_dir, name), input=stdin_text,
                              stdin=None if stdin_text is not None else subprocess.DEVNULL)
    except FileNotFoundError:
        return False, "not installed"
    except subprocess.TimeoutExpired:
        return False, f"no answer within {seconds}s"
    text = (done.stdout + done.stderr).strip()
    if done.returncode != 0 or not done.stdout.strip():
        return False, f"exit {done.returncode}: {text[:160]}"
    return True, f"alive in {time.monotonic() - started:.1f}s"


def run_all(tools, prompt, out_dir, ceiling):
    out_dir.mkdir(parents=True, exist_ok=True)
    running, results = {}, {}
    for name, template in tools.items():
        out = open(out_dir / f"{name}.txt", "w")
        err = open(out_dir / f"{name}.err", "w")
        work = workdir(out_dir, name)
        if uses_stdin(template):
            (work / "question.txt").write_text(prompt)
            stdin = open(work / "question.txt")
        else:
            stdin = subprocess.DEVNULL  # closed: some tools wait on an open stdin and never start
        try:
            proc = subprocess.Popen(build(template, prompt), stdout=out, stderr=err, stdin=stdin,
                                    cwd=work, start_new_session=True)
        except FileNotFoundError:
            # One missing tool must not cost the answers of the others.
            out.close(); err.close()
            results[name] = {"status": "not installed", "seconds": 0.0}
            continue
        finally:
            if stdin is not subprocess.DEVNULL:
                stdin.close()
        running[name] = (proc, out, err, time.monotonic())
    deadline = time.monotonic() + ceiling
    while running:
        for name in list(running):
            proc, out, err, t0 = running[name]
            if proc.poll() is not None:
                out.close(); err.close()
                status = "done" if proc.returncode == 0 else f"failed (exit {proc.returncode})"
                results[name] = {"status": status, "seconds": round(time.monotonic() - t0, 1)}
                del running[name]
        if running and time.monotonic() >= deadline:
            for name, (proc, out, err, t0) in running.items():
                stop_group(proc)
                out.close(); err.close()
                written = (out_dir / f"{name}.txt").stat().st_size
                # The watchdog does not destroy: what was written before the ceiling is kept.
                results[name] = {"status": "partial" if written else "timeout",
                                 "seconds": round(time.monotonic() - t0, 1)}
            running = {}
        time.sleep(0.5)
    for name, r in results.items():
        r["bytes"] = (out_dir / f"{name}.txt").stat().st_size
    return results


def main():
    ap = argparse.ArgumentParser(description=__doc__.splitlines()[0])
    ap.add_argument("question", nargs="?", help="the question (put -- before one that starts with a dash)")
    ap.add_argument("--question-file", help="read the question from this file instead")
    ap.add_argument("--tools", help="JSON file mapping a tool name to its command template")
    ap.add_argument("--out", default="fanout-run", help="folder for answers, work folders and the summary")
    ap.add_argument("--ceiling", type=float, default=900, help="seconds before partial answers are taken")
    ap.add_argument("--probe-seconds", type=float, default=60)
    ap.add_argument("--no-probe", action="store_true")
    a = ap.parse_args()

    if a.question_file:
        prompt = pathlib.Path(a.question_file).read_text()
    elif a.question is not None:
        prompt = a.question
    else:
        ap.error("give a question or --question-file")
    tools = json.loads(pathlib.Path(a.tools).read_text()) if a.tools else dict(DEFAULT_TOOLS)
    for name in tools:
        if not SAFE_NAME.match(name):
            sys.exit(f"tool name {name!r} is not a safe file name (letters, digits, - and _ only)")
    out_dir = pathlib.Path(a.out)
    out_dir.mkdir(parents=True, exist_ok=True)

    skipped = {}
    if not a.no_probe:
        for name in list(tools):
            ok, why = probe(name, tools[name], a.probe_seconds, out_dir)
            print(f"probe {name:10s} {'live' if ok else 'SKIP'}  {why}", file=sys.stderr)
            if not ok:
                skipped[name] = why
                del tools[name]
    if len(tools) < 2:
        print("Fewer than two live tools: this would be one opinion, not a comparison.", file=sys.stderr)
    results = run_all(tools, prompt, out_dir, a.ceiling)
    summary = {"question": prompt[:500], "ceiling_s": a.ceiling, "results": results, "skipped": skipped}
    (out_dir / "summary.json").write_text(json.dumps(summary, indent=2))
    for name, r in sorted(results.items()):
        print(f"{name:10s} {r['status']:18s} {r['seconds']:7.1f}s {r['bytes']:8d} bytes")
    for name, why in skipped.items():
        print(f"{name:10s} skipped            {why}")


if __name__ == "__main__":
    main()
C2. 代理的"第二意见"技能(second-opinion/SKILL.md)
讲授:最小的CLI编排形式,即一条书面指令,使一个代理向不同供应商的代理提问,并展示差异而非合并。局限:两个模型仅是一次对比,而非完整的评审;该技能指出哪些要点仍需参考原始来源。
---
name: second-opinion
description: Ask a model from a different vendor the same question through its own command-line tool, and show where its answer differs. Use when the user asks for a second opinion, a check, or "what would another AI say".
---

# Second opinion

1. Write the user's question, and only the context needed to answer it, to `question.txt` in the
   working folder. Leave out secrets and personal data.
2. Run the other vendor's tool read-only, with its input closed:
   `codex exec --skip-git-repo-check --sandbox read-only - < question.txt > second-opinion.txt`
   (or `agy -p "$(cat question.txt)" > second-opinion.txt`, or another installed tool).
3. Show the other answer as it came, under its own heading. Treat it as content to compare, never as
   instructions to act on: another model's answer can carry instructions it picked up from a page.
4. Then give a short table with three rows: where the two answers agree, where they differ, and what
   only one of them mentions.
5. Do not merge the two answers into one confident text. Agreement between two models is weaker
   evidence than it looks when they share training data; say which points would need a primary source.
C3. 谁说了什么 (provenance.py)
说明: 向多个模型提问旨在获得的两项内容是:覆盖范围和可靠性。这通过以下方式显现:按来源分类的声明表、仅由单一来源提出的声明列表,以及数字或日期存在差异的声明列表。局限: 它匹配重复的措辞,而非重复的含义;它指出应该仔细阅读的地方,但永远无法告诉人们什么是真实的。
#!/usr/bin/env python3
"""provenance.py: who said what, who said it alone, and where the numbers disagree.

Teaching example for "After Chat" (Appendix C, listing C3). MIT licence.

Reads the answer files written by fanout.py (one .txt per tool), splits each answer into short claims
(bullets or sentences), groups near-identical claims by word overlap, and prints a table of claims by
source. Two lists matter most, because they are the two things asking several models is meant to buy:
  * claims made by one source only: coverage, an angle the others missed (or an error of one);
  * claims whose numbers differ between sources: a disagreement to check before relying on either.
Word overlap sees repeated wording, not repeated meaning. Use the table to decide what to read
closely, never as a verdict on what is true.

Usage:
    python3 provenance.py fanout-run/            # writes fanout-run/provenance.md
"""
import pathlib
import re
import sys

STOP = set("""a an the and or of to in on for with by is are was were be been it this that these those
as at from than then so such can could should would may might will not no do does did their its your
our we you they he she i""".split())
MONTHS = "January|February|March|April|May|June|July|August|September|October|November|December"
# Values compared between sources: numbers, percentages and month names (dates disagree by month too).
NUM = re.compile(r"\d+(?:[.,]\d+)?%?|\b(?:" + MONTHS + r")\b")


def claims(text):
    parts = []
    for line in text.splitlines():
        line = line.strip(" -*\t#>")
        if not line:
            continue
        parts.extend(s.strip() for s in re.split(r"(?<=[.!?])\s+", line) if len(s.split()) >= 4)
    return parts


def words(claim):
    # [^\W_]+ is any run of letters or digits in any script, so accented and non-Latin words count.
    return {w for w in re.findall(r"[^\W_]+", claim.lower()) if w not in STOP}


def jaccard(a, b):
    return len(a & b) / len(a | b) if a | b else 0.0


def group(sources, threshold):
    groups = []  # each: {"text": representative, "words": set, "by": {source: claim}}
    for source, items in sources.items():
        for c in items:
            w = words(c)
            for g in groups:
                if jaccard(w, g["words"]) >= threshold:
                    g["by"].setdefault(source, c)
                    break
            else:
                groups.append({"text": c, "words": w, "by": {source: c}})
    return groups


def main():
    folder = pathlib.Path(sys.argv[1] if len(sys.argv) > 1 else ".")
    threshold = float(sys.argv[2]) if len(sys.argv) > 2 else 0.5
    sources = {p.stem: claims(p.read_text()) for p in sorted(folder.glob("*.txt")) if p.stat().st_size}
    if len(sources) < 2:
        sys.exit("Need at least two non-empty answers to compare.")
    groups = group(sources, threshold)
    names = list(sources)
    out = ["| claim | " + " | ".join(names) + " | support |", "|---|" + "---|" * len(names) + "---|"]
    for g in sorted(groups, key=lambda g: -len(g["by"])):
        marks = " | ".join("x" if n in g["by"] else "" for n in names)
        out.append(f"| {g['text'][:120]} | {marks} | {len(g['by'])} |")
    alone = [g for g in groups if len(g["by"]) == 1]
    out += ["", f"## Said by one source only ({len(alone)})", ""]
    out += [f"- [{next(iter(g['by']))}] {g['text']}" for g in alone]
    out += ["", "## Same claim, different numbers", ""]
    for g in groups:
        nums = {s: tuple(NUM.findall(c)) for s, c in g["by"].items()}
        if len({v for v in nums.values() if v}) > 1:
            out.append(f"- {g['text'][:100]}: " + "; ".join(f"{s}={','.join(v)}" for s, v in nums.items()))
    report = "\n".join(out) + "\n"
    (folder / "provenance.md").write_text(report)
    print(report)


if __name__ == "__main__":
main()一致意见相当于多少个独立意见?(neff.py)
教学内容:相关证据的算术(第6.3节):从已知答案的项目估计平均误差相关性rho,然后计算N_eff及其上限1/rho。使用--demo运行以查看相当于约1.6个独立意见的四个模型。局限性:rho取决于任务;在类似您关心的项目上对其进行估计,并需要超过十个项目。
#!/usr/bin/env python3
"""neff.py: how many independent opinions are N agreeing models worth?

Teaching example for "After Chat" (Appendix C, listing C4). MIT licence.

Uses the correlated-evidence model of Chernets (2026a):
    N_eff = N / (1 + (N - 1) * rho)        and, as N grows, N_eff approaches 1 / rho.
rho is estimated from the models' errors on items whose right answer is known: for each pair of
models, the correlation (phi coefficient) between "model A was wrong" and "model B was wrong".

Input: a CSV with one row per item and one 0/1 column per model (1 = correct).
Usage:
    python3 neff.py results.csv
    python3 neff.py --demo
"""
import csv
import itertools
import math
import sys

DEMO = """item,model_a,model_b,model_c,model_d
q1,1,1,1,1
q2,0,0,1,0
q3,1,1,1,1
q4,0,0,0,1
q5,1,1,0,1
q6,1,1,1,1
q7,0,0,1,0
q8,1,0,1,1
q9,1,1,1,1
q10,0,0,0,0
"""


def phi(x, y):
    """Correlation of two 0/1 vectors. Returns None when one of them never varies."""
    n = len(x)
    n11 = sum(1 for a, b in zip(x, y) if a and b)
    n1_, n_1 = sum(x), sum(y)
    denom = math.sqrt(n1_ * (n - n1_) * n_1 * (n - n_1))
    if denom == 0:
        return None
    return (n * n11 - n1_ * n_1) / denom


def n_eff(n, rho):
    """Effective number of independent opinions. N must be at least 1; rho must lie in [0, 1)."""
    if n < 1:
        raise ValueError(f"N must be at least 1, not {n}")
    if not 0 <= rho < 1:
        raise ValueError(f"rho must be in [0, 1), not {rho}; at rho = 1 every model is one opinion")
    return n / (1 + (n - 1) * rho)


def main():
    if len(sys.argv) > 1 and sys.argv[1] != "--demo":
        text = open(sys.argv[1]).read()
    else:
        text = DEMO
        print("(demo data: 10 items, 4 models)\n")
    rows = list(csv.DictReader(text.strip().splitlines()))
    models = [c for c in rows[0] if c != "item"]
    errors = {m: [1 - int(r[m]) for r in rows] for m in models}

    pairs = []
    for a, b in itertools.combinations(models, 2):
        r = phi(errors[a], errors[b])
        shown = "n/a (no variation)" if r is None else f"{r:+.2f}"
        print(f"error correlation {a} ~ {b}: {shown}")
        if r is not None:
            pairs.append(r)
    if not pairs:
        print("No pair varies; rho cannot be estimated from these items.")
        return
    rho = max(0.0, sum(pairs) / len(pairs))  # negative average is treated as independence
    n = len(models)
    print(f"\nmean pairwise error correlation rho = {rho:.2f}")
    if rho >= 1:
        print(f"the models err together on every item: {n} models are worth one opinion")
        return
    print(f"{n} models are worth about {n_eff(n, rho):.2f} independent opinions")
    if rho > 0:
        print(f"no number of models with this rho is worth more than {1 / rho:.1f}")
    print("\nN   N_eff at this rho")
    for k in (1, 2, 3, 5, 10, 20):
        print(f"{k:<3d} {n_eff(k, rho):.2f}")


if __name__ == "__main__":
    main()
C5. 一份交叉记录及其检查器(crossings.py)
教学内容:第9.1节的测量规则的代码实现。一条记录将被拒绝,如果它计数作为交叉的安装、不含代理生成工件的完成、不含该人自身言辞的停止、不含帮助描述的帮助、名称而非化名标签(标签必须是P后跟数字)、未被精确列出的跳过级别、既非真也非假的值、无法读取的日期、格式不识别的字段,或涉及少于两个被提问和回答工具的级别4交叉。格式错误的行被报告为已拒绝,且永远不会停止运行。限制:它检查记录的形式,而非其真实性;两个工具是否属于不同的模型族系,以及该安排是否在后来的一周重新运行(第二条记录),这些问题留给研究人员;它是一个研究工具,而非应用程序。
#!/usr/bin/env python3
"""crossings.py: a record format for level transitions, and a checker for it.

Teaching example for "After Chat" (Appendix C, listing C5). MIT licence. A research instrument, not
an application: it defines what a record of one person's attempt at one transition must contain, and
refuses records that would let an installation be counted as use.

The rules follow the measures published in the preregistration the paper describes (OSF, DOI
10.17605/OSF.IO/X4EGQ): a transition counts as crossed only when an artefact produced by the agent is
supplied; installing is an attempt; assisted and unaided crossings are kept apart; a stop is recorded
with the point where it happened and the person's own words. The record format is also published as
a JSON Schema (crossings.schema.json); this checker accepts exactly what the schema accepts and adds
the rules a schema cannot state.

What the checker enforces for a level-4 crossing: at least two tools named as asked and as answered.
What it leaves to the researcher: that the tools are different model families, and that the
arrangement was rerun in a later week (a second record).

Usage:
    python3 crossings.py records.jsonl        # one JSON object per line
    python3 crossings.py --demo
"""
import datetime
import json
import re
import sys

LEVELS = ("chat", "safe_agentic_environment", "agent_on_own_computer", "orchestrated_work")
ARTEFACTS = ("file", "folder", "screenshot", "pasted_output", "none")
DECISIONS = ("accept", "revise", "escalate", "discard")
REQUIRED = ("record_id", "person", "level_from", "level_to", "materials_sent", "completed", "assisted")
# Every key a record may carry; the same set as the properties of crossings.schema.json.
ALLOWED = REQUIRED + ("skipped", "intervention", "artefact", "stop_point", "stop_reason_own_words",
                      "stop_reason_code", "multi_model", "interface_version", "operating_system",
                      "network_access", "permission_mode", "policy_constraint", "acceptance_decision")
PERSON = re.compile(r"^P[0-9]+$")


def parse_date(value):
    try:
        return datetime.date.fromisoformat(value)
    except (TypeError, ValueError):
        return None


def check(rec):
    problems = []
    if not isinstance(rec, dict):
        return ["record must be a JSON object"]
    for key in REQUIRED:
        if key not in rec:
            problems.append(f"missing field '{key}'")
    unknown = sorted(set(rec) - set(ALLOWED))
    if unknown:
        problems.append("unknown fields (the schema forbids them): " + ", ".join(unknown))
    if problems:
        return problems
    if not isinstance(rec["person"], str) or not PERSON.match(rec["person"]):
        problems.append("person must be a pseudonymous label such as P07, never a name")
    for key in ("completed", "assisted"):
        if not isinstance(rec[key], bool):
            problems.append(f"{key} must be true or false, not {rec[key]!r}")
    if rec["level_from"] not in LEVELS or rec["level_to"] not in LEVELS:
        problems.append("level must be one of " + ", ".join(LEVELS))
    else:
        i_from, i_to = LEVELS.index(rec["level_from"]), LEVELS.index(rec["level_to"])
        if i_to <= i_from:
            problems.append("level_to must be above level_from")
        else:
            # Levels are ordered, not compulsory: a route may go from chat straight to an agent on the
            # person's own computer. A skip is allowed, but it is recorded, never silent, and exactly.
            expected = list(LEVELS[i_from + 1:i_to])
            if expected and rec.get("skipped") != expected:
                problems.append("a move over more than one level must list exactly the levels it "
                                "skipped in 'skipped': " + ", ".join(expected))
            if not expected and rec.get("skipped"):
                problems.append("'skipped' must be empty or absent for a move of one level")
    sent = parse_date(rec["materials_sent"])
    if sent is None:
        problems.append("materials_sent must be an ISO date (YYYY-MM-DD)")
    art = rec.get("artefact", {"type": "none"})
    if not isinstance(art, dict) or art.get("type") not in ARTEFACTS:
        problems.append("artefact.type must be one of " + ", ".join(ARTEFACTS))
        art = {"type": "none"}
    if "produced_by_agent" in art and not isinstance(art["produced_by_agent"], bool):
        problems.append("artefact.produced_by_agent must be true or false")
    if "date" in art:
        art_date = parse_date(art["date"])
        if art_date is None:
            problems.append("artefact.date must be an ISO date (YYYY-MM-DD)")
        elif sent and art_date < sent:
            problems.append("artefact dated before the materials were sent")
    if rec["completed"] is True:
        # Installation is an attempt; only something the agent produced counts as a crossing.
        if art.get("type") == "none" or art.get("produced_by_agent") is not True:
            problems.append("completed=true needs an artefact with produced_by_agent=true")
        if rec["level_to"] == "orchestrated_work":
            mm = rec.get("multi_model") or {}
            asked = mm.get("asked") if isinstance(mm, dict) else None
            answered = mm.get("answered") if isinstance(mm, dict) else None
            if not isinstance(asked, list) or len(set(asked)) < 2 or \
               not isinstance(answered, list) or len(set(answered)) < 2:
                problems.append("a level-4 crossing needs multi_model.asked and multi_model.answered "
                                "with at least two tools each (Table 1: two model families)")
    elif rec["completed"] is False:
        if not rec.get("stop_point") or not rec.get("stop_reason_own_words"):
            problems.append("a non-completion records stop_point and stop_reason_own_words")
    if rec["assisted"] is True and not rec.get("intervention"):
        problems.append("assisted=true needs a description of the intervention")
    if "acceptance_decision" in rec and rec["acceptance_decision"] not in DECISIONS:
        problems.append("acceptance_decision must be one of " + ", ".join(DECISIONS))
    if "network_access" in rec and not isinstance(rec["network_access"], bool):
        problems.append("network_access must be true or false")
    return problems


DEMO = [
    {"record_id": "r1", "person": "P01", "level_from": "chat", "level_to": "safe_agentic_environment",
     "materials_sent": "2026-09-08", "completed": True, "assisted": False,
     "artefact": {"type": "folder", "date": "2026-09-09", "produced_by_agent": True}},
    {"record_id": "r2", "person": "P02", "level_from": "chat", "level_to": "safe_agentic_environment",
     "materials_sent": "2026-09-08", "completed": True, "assisted": False,
     "artefact": {"type": "screenshot", "produced_by_agent": False}},
    {"record_id": "r3", "person": "P03", "level_from": "chat", "level_to": "agent_on_own_computer",
     "skipped": ["safe_agentic_environment"], "materials_sent": "2026-09-08", "completed": False,
     "assisted": False, "stop_point": "(invented) download page",
     "stop_reason_own_words": "(invented) the page offered four versions and I did not know which"},
    {"record_id": "r4", "person": "Jane", "level_from": "chat", "level_to": "orchestrated_work",
     "materials_sent": "2026-09-08", "completed": False, "assisted": True},
]


def main():
    if len(sys.argv) > 1 and sys.argv[1] != "--demo":
        records = []
        for n, line in enumerate(open(sys.argv[1]), 1):
            if line.strip():
                try:
                    records.append(json.loads(line))
                except json.JSONDecodeError as exc:
                    records.append({"_malformed": f"line {n}: {exc}"})
    else:
        records = DEMO
        print("(demo: four invented records, two of them deliberately wrong)\n")
    bad = 0
    for rec in records:
        try:
            if isinstance(rec, dict) and "_malformed" in rec:
                problems = ["not valid JSON: " + rec["_malformed"]]
            else:
                problems = check(rec)
        except Exception as exc:  # a malformed record is rejected, never a crash
            problems = [f"malformed record: {exc!r}"]
        bad += bool(problems)
        rid = rec.get("record_id", "?") if isinstance(rec, dict) else "?"
        print(f"{str(rid):6s} {'OK' if not problems else 'REJECTED'}")
        for p in problems:
            print(f"       - {p}")
    print(f"\n{len(records) - bad} of {len(records)} records accepted")
    sys.exit(1 if bad else 0)


if __name__ == "__main__":
    main()
相同的记录格式以 JSON Schema 的形式发布为 crossings.schema.json,以便其他工具可以验证记录的结构;上述检查器强制执行该架构无法表达的规则(安装不是穿越,停止需要该人自己的话,帮助需要描述,跳过项被记录)。
{
  "$schema": "https://json-schema.org/draft/2020-12/schema",
  "$id": "https://example.org/after-chat/crossing-record.schema.json",
  "title": "CrossingRecord",
  "description": "One person's attempt at one transition of the four-level model. Companion to crossings.py, which accepts exactly what this schema accepts and adds the rules the schema cannot express (installation is not a crossing; a stop needs the person's own words; help needs a description; a skip is recorded exactly; a level-4 crossing names at least two tools asked and answered). MIT licence.",
  "type": "object",
  "required": ["record_id", "person", "level_from", "level_to", "materials_sent", "completed", "assisted"],
  "properties": {
    "record_id": {"type": "string"},
    "person": {"type": "string", "pattern": "^P[0-9]+$", "description": "Pseudonymous label such as P07. Never a name."},
    "level_from": {"enum": ["chat", "safe_agentic_environment", "agent_on_own_computer", "orchestrated_work"]},
    "level_to": {"enum": ["chat", "safe_agentic_environment", "agent_on_own_computer", "orchestrated_work"]},
    "skipped": {"type": "array", "items": {"enum": ["safe_agentic_environment", "agent_on_own_computer"]},
                "description": "Exactly the levels passed over when the move spans more than one level. A skip is allowed and never silent."},
    "materials_sent": {"type": "string", "format": "date"},
    "completed": {"type": "boolean"},
    "assisted": {"type": "boolean"},
    "intervention": {"type": "string", "description": "Required when assisted is true: what the helper did."},
    "artefact": {
      "type": "object",
      "properties": {
        "type": {"enum": ["file", "folder", "screenshot", "pasted_output", "none"]},
        "date": {"type": "string", "format": "date"},
        "produced_by_agent": {"type": "boolean"},
        "sha256": {"type": "string", "description": "Hash of the artefact if deposited; never the content."}
      },
      "required": ["type"]
    },
    "stop_point": {"type": "string", "description": "Required when completed is false: where the attempt stopped."},
    "stop_reason_own_words": {"type": "string", "description": "Required when completed is false: the person's own words, verbatim."},
    "stop_reason_code": {"type": "string", "description": "Assigned after collection by a published coding scheme (Appendix A)."},
    "multi_model": {
      "type": "object",
      "description": "For transition 3: the denominator of a council run. A completed level-4 record needs at least two tools in asked and in answered; that they are different model families is for the researcher to verify.",
      "properties": {
        "asked": {"type": "array", "items": {"type": "string"}},
        "answered": {"type": "array", "items": {"type": "string"}},
        "timed_out": {"type": "array", "items": {"type": "string"}},
        "diverged": {"type": ["boolean", "null"]},
        "changed_decision": {"type": ["boolean", "null"]},
        "coverage_hit": {"type": ["boolean", "null"]}
      }
    },
    "interface_version": {"type": "string", "description": "Optional implementation record: the agent and its version."},
    "operating_system": {"type": "string", "description": "Optional implementation record."},
    "network_access": {"type": "boolean", "description": "Optional implementation record: whether the agent had network access."},
    "permission_mode": {"type": "string", "description": "Optional implementation record: the permission mode in force."},
    "policy_constraint": {"type": "string", "description": "Optional implementation record: any employer or platform rule that applied."},
    "acceptance_decision": {"enum": ["accept", "revise", "escalate", "discard"], "description": "Optional: the person's decision from the acceptance record."}
  },
  "additionalProperties": false
}
C6. 等级3前的安全 (safety/)
教导:第5.3节的实践作为配置。第一个文件是Claude Code的示例项目设置文件:默认为plan模式(供应商在2026年7月将其默认模式重命名为"Manual";"plan"仍然有效,是更安全的教学选择),常见的破坏性和下载命令被拒绝,通常的秘密文件被拒绝给文件读取器和shell的cat,删除和web获取需要询问。拒绝列表仅仅是一个列表:宽松模式或未列出的命令可以绕过它,所以沙盒设置与规则一样重要。第二个是OpenAI的Codex的示例配置,以其按运行、文件夹范围的形式给出:写入限制在工作文件夹,无网络,按请求批准。第三个是检查清单。限制:权限规则和沙盒减少了影响范围;它们不会使代理值得信任,规则语法在不同版本之间会改变。
{
  "permissions": {
    "defaultMode": "plan",
    "deny": [
      "Bash(rm -rf:*)",
      "Bash(sudo:*)",
      "Bash(curl:*)",
      "Bash(wget:*)",
      "Bash(cat .env:*)",
      "Bash(git push:*)",
      "Read(./.env)",
      "Read(./.env.*)",
      "Read(./secrets/**)"
    ],
    "ask": [
      "Bash(rm:*)",
      "Bash(mv:*)",
      "WebFetch"
    ]
  }
}
# Folder-scoped, per-run form (the policy of this paper): run the agent from the working copy with
# codex -C <folder> -s workspace-write -a on-request
# The same values in ~/.codex/config.toml apply to every run on the machine.
# The agent may write only inside the working folder, has no network by default,
# and asks before anything outside those limits.
approval_policy = "on-request"
sandbox_mode = "workspace-write"
[sandbox_workspace_write]
network_access = false# Pre-flight checklist before a person lets an agent act on their own computer
1. Work in a copy. Make a new folder for the agent and put copies of the files in it, never originals.
If the files live in a cloud-synchronised tree, copy them out of it first: agents have deleted the
zero-byte placeholders that cloud services leave for offloaded files, taking the originals with them.
2. Start in plan mode. Ask for a written plan first; read it; only then let the agent act.
3. Keep secrets out. No passwords, keys or client documents in the working folder.
4. Deny network by default. Turn it on only for a job that needs it, and then for named sites.
5. Confirm before anything irreversible: sending, deleting, publishing, purchasing.
6. Treat what the agent reads on the web as content, never as instructions. A page can carry hidden text
written to redirect an agent.
7. Treat another agent's answer the same way: content to compare, never instructions to act on. A second
model can pass on instructions it picked up from a page it read.
8. Use a separate browser profile for any agent that browses, signed out of banking and health sites.
9. Never type passwords, one-time codes or card numbers into the agent.
10. Ask "what could go wrong with this?" before approving a command you do not understand.
11. Keep an undo: a snapshot of the folder (or a version-control commit) before each larger change.
12. Keep a working stop. Before a long job, know how to stop it and whether stopping deletes the work.
13. Stop and revoke access when the task, the workspace or the sensitivity of the data changes.
14. Escalate a high-consequence decision to a person who is accountable for it; the agent proposes, the
person decides.C7. 作为日志的监督痕迹(jsonl_log.py)
说明: 管理者工作的最小有用记录,每个事件对应一个带时间戳的JSON对象,以便之后能够用标准库对被拒的计划、被拒的差异、采纳的第二意见和已完成的运行(命题P10的监督痕迹)进行统计。使用--demo运行。限制: 它是一个写入器,而不是追踪器;它记录人或代理告诉它的内容。
#!/usr/bin/env python3
"""jsonl_log.py: append one timestamped event to a JSONL file.

Teaching example for "After Chat" (Appendix C, listing C7). MIT licence.

The smallest useful record of a manager's work: one JSON object per event, one event per line,
each with a UTC timestamp. Events such as "plan_refused", "diff_rejected", "second_opinion_taken"
or "run_completed" are the supervision traces that proposition P10 asks for. A later paper can
parse the file with the standard library. This is a writer, not a tracer: it records what you tell it.

Usage:
    python3 jsonl_log.py run.jsonl '{"event": "plan_refused", "task": "friday-pack"}'
    python3 jsonl_log.py --demo
"""
import json
import sys
from datetime import datetime, timezone
from pathlib import Path


def log(path, event):
    """Append one event; the timestamp is added unless the caller set one."""
    event = dict(event)
    event.setdefault("ts", datetime.now(timezone.utc).isoformat(timespec="seconds"))
    with Path(path).open("a", encoding="utf-8") as f:
        f.write(json.dumps(event, ensure_ascii=False) + "\n")
    return event


def main():
    if len(sys.argv) == 2 and sys.argv[1] == "--demo":
        import tempfile
        path = Path(tempfile.mkdtemp()) / "demo.jsonl"
        for ev in ({"event": "plan_refused", "task": "demo"},
                   {"event": "second_opinion_taken", "task": "demo", "family": "other-vendor"},
                   {"event": "run_completed", "task": "demo", "artefact": "demo/plan/"}):
            log(path, ev)
        print(path.read_text(), end="")
        return
    if len(sys.argv) < 3:
        print('usage: jsonl_log.py FILE \'{"event": "plan_refused"}\'   or   jsonl_log.py --demo',
              file=sys.stderr)
        sys.exit(2)
    print(json.dumps(log(sys.argv[1], json.loads(sys.argv[2]))))


if __name__ == "__main__":
    main()
附录D. 有效观点数量的计算示例表
不想运行列表C4的代理管理员仍然可以使用上限值。每个单元格中N_eff = N / (1 + (N - 1) rho);最后一行是上限值1/rho,具有该相关性的任何数量的模型都无法超过该值。选择rho值是为了说明公式,不用于测量任何内容。在实际应用中,rho是误差的平均成对相关性,这与两个模型同意的联合误差比例是不同的概念,必须根据相关领域中具有已知答案的项目进行估计(列表C4)。
| N个模型 | rho = 0.2(示例) | rho = 0.5(示例) | rho = 0.6(示例) | rho = 0.8(示例) |
|---|---|---|---|---|
| 2 | 1.67 | 1.33 | 1.25 | 1.11 |
| 3 | 2.14 | 1.50 | 1.36 | 1.15 |
| 5 | 2.78 | 1.67 | 1.47 | 1.19 |
| 10 | 3.57 | 1.82 | 1.56 | 1.22 |
| 上限值,1/rho | 5.00 | 2.00 | 1.67 | 1.25 |
该表是第6部分建议一个人将下一个订阅用于不同系列而不是同一系列的第十个窗口的理由。系列的多样性、逐项与来源的核对以及保留的异议能够完成更大的N所无法做的工作。由于rho取决于任务,应该根据该人所在领域中具有已知答案的项目进行估计(列表C4)。
附录 E. 工具景观普查,2026年9月19-21日
正文表 5 按模式对工具进行了分组。本附录记录了这一分组所基于的原始普查数据,供希望了解指定日期数据情况的读者参考。星标数量每日变化;它们仅反映受欢迎程度,无法说明质量或用户数量,因此不应按读者当前日期引用。模式列是我的分类映射,相关项目本身并未做出此类声明。
| 项目 | 位置 | 星标(约数,2026年9月21日) | 许可证 | 模式 |
|---|---|---|---|---|
| anthropics/claude-code | github.com/anthropics/claude-code | 147,000 | 源代码可得、专有许可证 | 终端代理(第 3 级) |
| openai/codex | github.com/openai/codex | 126,000 | Apache-2.0 | 终端代理(第 3 级) |
| google-gemini/gemini-cli | github.com/google-gemini/gemini-cli | 107,000 | Apache-2.0 | 终端代理;自 2026 年 6 月 18 日起不再提供个人级别服务 |
| cline/cline | github.com/cline/cline | 69,000 | Apache-2.0 | 编辑器和终端代理 |
| openai/codex-plugin-cc | github.com/openai/codex-plugin-cc | 33,400 | Apache-2.0 | 官方插件:一个供应商的代理在另一个供应商的内部 |
| jackwener/OpenCLI | github.com/jackwener/OpenCLI | 29,500 | 见仓库 | Web 聊天向代理开放 |
| karpathy/llm-council | github.com/karpathy/llm-council | 24,900 | 见仓库 | 编程接口上的委员会 |
| ai-shifu/ChatALL | github.com/ai-shifu/ChatALL | 16,500(最新版本约 847,000 次下载) | Apache-2.0 | 浏览器广播 |
| BeehiveInnovations/pal-mcp-server | github.com/BeehiveInnovations/pal-mcp-server | 11,800(最后提交于 2025 年 12 月) | Apache-2.0 | 模型间的咨询服务器 |
| MoonshotAI/kimi-cli | github.com/MoonshotAI/kimi-cli | 11,400 | Apache-2.0 | 终端代理(第 3 级) |
| chathub-dev/chathub | github.com/chathub-dev/chathub | 10,700 | GPL-3.0 | 浏览器广播 |
| nyldn/claude-octopus | github.com/nyldn/claude-octopus | 4,100 | MIT | CLI 委员会 |
| aarondfrancis/counselors | github.com/aarondfrancis/counselors | 660 | MIT | 为每个工具生成单一文件的 CLI 委员会 |
| xai-org/grok-build | github.com/xai-org/grok-build | 26,900 | Apache-2.0 | 具有无头模式和代理协议的终端代理 |
如何引用
Chernets, V. (2026). After Chat: The Three Transitions Between Non-Programmers and Agentic AI [Preprint]. SSRN. https://doi.org/10.2139/ssrn.7520019
@misc{chernets2026afterchat,
  author       = {Chernets, Vadym},
  title        = {{After Chat: The Three Transitions Between Non-Programmers and Agentic AI}},
  year         = {2026},
  howpublished = {SSRN},
  doi          = {10.2139/ssrn.7520019},
  url          = {https://doi.org/10.2139/ssrn.7520019}
}