¿Qué significa 7 descargas? Ceguera métrica y el arranque en frío de la atención académica después del cese de los rankings de SSRN
Esta es una traducción. La versión de referencia es el original en inglés; cite esa.
Vadym Chernets, PhD, arquitecto de sistemas de IA · ORCID 0009-0007-4845-3163
SSRN 7296358 · DOI 10.2139/ssrn.7296358 · Zenodo 10.5281/zenodo.22166896 · GitHub
- Versión de registro: SSRN 7296358 · DOI 10.2139/ssrn.7296358
- Copia archivada, citable y descargable: 10.5281/zenodo.22166896 — DOI de concepto, siempre se resuelve a la versión más reciente
- Texto completo como Markdown y PDF: GitHub
- HTML legible: https://polyhelper.ai/research/download-metrics/
El mismo texto se encuentra en cuatro superficies para que se pueda acceder cuando una de ellas no puede servirlo. SSRN tiene la versión de registro; cite esa.
¿Qué significa 7 descargas?
Ceguera métrica y el arranque en frío de la atención académica después del cese de los rankings de SSRN
Tipo de manuscrito: Síntesis crítica, marco metodológico y agenda empírica lista para preregistro
Versión: septiembre de 2026
Autor: Vadym Chernets, PhD1
Afiliación: Arquitecto de sistemas de IA
Resumen
El 15 de julio de 2026, la Red de investigación de ciencias sociales (SSRN) retiró sus rankings públicos, las tablas de clasificación de artículos, autores e instituciones que durante mucho tiempo habían suministrado el único marco comparativo ampliamente accesible de la plataforma, mientras que los conteos de descargas y las estadísticas de citación se mantuvieron en artículos individuales y perfiles de autores (SSRN Blog, 15 de julio de 2026). El resultado fue un evento de medición asimétrico: los autores conservaron los números y perdieron la norma. Los contadores de SSRN no se volvieron sin sentido; se volvieron ilegibles. Cada conteo de descargas se convirtió en un número sin escala.
Este artículo argumenta que la pregunta "¿Qué significa 7 descargas?" está científicamente mal formulada hasta que se especifique la clase de referencia de un artículo. Un conteo de uso acumulativo bruto no puede interpretarse sin la antigüedad del artículo, el campo, la cohorte de publicación, la exposición de distribución y la visibilidad previa del autor. El problema es más agudo para artículos nuevos y autores de baja visibilidad, cuya atención temprana está moldeada menos por el interés académico que por la arquitectura de la plataforma, la distribución de alertas de correo electrónico, la indexación de búsqueda, el prestigio del autor y la dinámica de cola pesada de la atención. Nombramos esta condición como el arranque en frío de la atención académica. El requisito no es nuevo: normalizar conteos por campo, antigüedad y tipo de documento es una práctica establecida desde hace mucho tiempo en bibliometría de citación, y la pregunta paralela para datos de uso ya se estaba planteando hace década y media (Kurtz & Bollen, 2010). Los indicadores bibliométricos de ese tipo asumen una base de datos en la que el campo, la antigüedad y el tipo se conocen y el indicador se calcula en nombre del lector, mientras que una plataforma de preimpresión entrega a sus autores un número entero desnudo sin clase de referencia, sin herramientas y (desde julio de 2026) sin marco comparativo en absoluto. Lo que falta no es el método sino su instanciación: SSRN no proporciona un instrumento que lo aplique para un autor.
La evidencia disponible muestra por qué los promedios simples engañan. En el único estudio reciente publicado externamente de gran muestra de una red SSRN (2.361 documentos de trabajo de marketing), las descargas promedio fueron 221,3 mientras que la mediana fue 87, y el promedio incluso superó el percentil 75 (206) (Jo & Li, 2026). Las distribuciones de descargas son cuasi-logarítmicas con colas superiores extremas, y dentro de una única red disciplinaria las descargas promedio difieren aproximadamente por un factor de ocho entre subcampos (Whalen, 2018), por lo que un promedio de toda la plataforma no describe ningún documento en particular; evaluar un nuevo documento en relación con él es calibrarse contra una ficción de agregación. Según la evidencia de conversión disponible, un recuento como 7 descargas de 40 vistas de resumen no indica fracaso. Es un resultado de cribado con un intervalo amplio a su alrededor, y debe leerse a través del alcance, la conversión, la antigüedad y el campo.
A partir de esa evidencia, el artículo construye un marco de interpretación para métricas SSRN posteriores a los rangos, que separa la exposición, la vista de resumen, la descarga de texto completo y el uso posterior, y añade un diagnóstico de alcance por conversión que distingue la invisibilidad del rechazo. En lugar de un único número de vanidad, propone el Benchmark de Atención Académica de Arranque en Frío (CSAB), una alternativa multidimensional. Un protocolo de expediente lo acompaña, bajo el cual cada métrica reportada lleva su fuente, ventana de tiempo, clase de referencia y limitaciones. El artículo luego establece una agenda lista para el preregistro para reconstruir la escala faltante: un panel prospectivo de nuevos documentos SSRN observados del día 1 al día 180, cuasiexperimentos utilizando distribución de alertas de correo electrónico seleccionada y la jubilación de Rangos en sí, un banco de percentiles construido por la comunidad y una auditoría de la visibilidad de preimpresos en motores de respuesta de IA. La base de evidencia combina los estudios citados con la sección transversal archivística no representativa del Apéndice E; el artículo especifica cómo se puede reconstruir la referencia faltante y por qué ningún recuento de descargas debe circular sin su contexto en una plataforma que no proporciona ninguno.
Palabras clave: recuentos de descargas; métricas de uso; normalización de campo; evaluación de investigación; preimpresos; cienciometría; promoción y cátedra; erudición legal; altmétricas; efecto Mateo; ventaja acumulativa; economía de la atención; vistas de resumen; revistas depredadoras; optimización de motores generativos.
Clasificación JEL: A14; D83; I23; O33; L86
Destacados
Los recuentos de descargas brutos de SSRN no tienen una interpretación estable sin antigüedad de documento, campo, cohorte de publicación, exposición de distribución y visibilidad previa del autor.
El ocaso de los Rangos del 15 de julio de 2026 eliminó el único marco comparativo público de la plataforma mientras que cada contador sobrevivió: los autores mantuvieron los números y perdieron la norma.
En la única distribución de gran muestra publicada recientemente, las descargas están fuertemente sesgadas hacia la derecha, media 221,3 frente a mediana 87: el documento "promedio" es atípico por construcción.
Separar el alcance (vistas de resumen) de la conversión (descargas por vista) distingue la invisibilidad del rechazo: diagnósticos diferentes que justifican acciones diferentes.
Los anclajes de conversión publicados de vistas a descargas se agrupan en una banda de aproximadamente 11–19%, en la que 7 descargas de 40 vistas de resumen es consistente con el rango como resultado de cribado: no, según la evidencia disponible, un signo de fracaso.
El Benchmark de Atención Académica de Arranque en Frío (CSAB) reporta alcance normalizado, desempeño de descarga, conversión, impulso y validación posterior en lugar de un único número de vanidad.
Una agenda prespecificada y lista para el preregistro (un panel prospectivo, dos cuasiexperimentos inusualmente oportunos creados por las propias reformas de la plataforma, un banco de percentiles comunitario y una auditoría de motor de respuestas de IA requerida antes de que la optimización de motores generativos pueda tratarse como basada en evidencia) especifica cómo reconstruir la escala faltante.
Alcance y Disciplina de Evidencia
Este artículo es una síntesis crítica, combinada con un marco metodológico y una agenda empírica lista para el preregistro, y los únicos datos nuevos que reporta son la sección transversal archivística no representativa del Apéndice E. Tres clases de evidencia se mantienen separadas en toda la extensión, y cada número en el artículo viaja con su clase:
1. Estimaciones verificadas: números publicados verificados contra su fuente primaria y citados con su marco de muestreo y antigüedad, o verificados con advertencias declaradas donde la verificación es parcial.
2. Anclajes históricos: muestras anteriores y características de plataforma retiradas, retenidas porque revelan estructura distribucional, no porque sigan siendo normas calibradas para 2026.
3. Resultados conceptuales y propuestos: predicciones prespecificadas, plantillas de referencia y diseños de estudio, explícitamente etiquetados como tales y sin contener hallazgos sintéticos.
El problema de interpretabilidad, el argumento de clase de referencia y la descomposición de alcance-conversión son afirmaciones analíticas defendidas en la evidencia anterior. La infraestructura que propone el artículo se ofrece como un diseño para que la comunidad construya y evalúe, no como una prescripción establecida: un registro de percentiles comunitario (Sección 8.8), una calculadora orientada al autor y la arquitectura de orquestación de la Sección 8.10. Ninguna afirmación de diagnóstico en el artículo depende de que ninguno de estos se adopte.
En un campo que acaba de perder su referencia pública más utilizada, el bien público escaso es un protocolo replicable que cualquier autor, en cualquier lugar, puede ejecutar, junto con una síntesis que establece la procedencia y antigüedad de los números existentes.
El caso de 40 vistas de resumen y 7 descargas recorre esta síntesis metodológica porque ilustra las preguntas catalogadas en la Tabla 1; las conclusiones descansan en la evidencia citada, no en ningún panel único.
Tres reglas gobiernan la síntesis en sí. Las unidades se normalizan a dos denominadores comunes, descargas de toda la vida por documento y descargas de doce meses por documento. El enlace se realiza solo donde una fuente reporta la proporción requerida, y la unidad nativa se retiene siempre que la conversión exigiría suposiciones que las fuentes no apoyan. Cada afirmación fáctica lleva un nivel de verificación (verificado contra la fuente primaria, verificado con advertencias declaradas, o verificación pendiente) registrado en las columnas de confianza de fuente de las tablas. Donde las fuentes entran en conflicto, más prominentemente sobre la fecha de ocaso efectiva, el conflicto se resuelve a favor de la fuente oficial posterior y se señala. Cada estimación mantiene su nivel, antigüedad y advertencia de envejecimiento siempre que se reutiliza.
Una única regla rige la inclusión de fuentes: una referencia se conserva cuando aporta un mecanismo distinto, un resultado, un dato de plataforma, una advertencia de medición, o un precedente de diseño; la cantidad de citas no es un objetivo. Publicar y ser leído son logros distintos; este artículo trata del segundo, y del colapso de los instrumentos para medirlo. Una tabla de aspecto plausible no es evidencia, y en un artículo sobre números descontextualizados esa regla vincula el artículo mismo en primer lugar.
1. Introducción
1.1 Cuarenta visualizaciones, siete descargas
Considere a un investigador (en fase inicial de carrera, quizás sin afiliación institucional, o simplemente nuevo en la plataforma) que sube un documento de trabajo cuidadosamente preparado a SSRN y, unas semanas después, en agosto de 2026, abre el panel de estadísticas del artículo. El panel de control muestra "40 Visualizaciones del resumen" y "7 Descargas". En ese momento, sin un conocimiento práctico de las estadísticas de atención académica, el autor no puede determinar si estas cifras significan un rechazo catastrófico de los colegas, una línea de base estadística estándar para un texto especializado, o el comienzo de una trayectoria inusualmente fuerte. El autor pregunta a sus colegas: "¿Eso es terrible?" Nadie puede decirlo. Ni el panel de control, ni la literatura académica, ni la plataforma en sí proporcionan una respuesta, y no hay escala de referencia para interpretar el recuento. La condición es ceguera métrica, la incapacidad, frente a los propios contadores, de distinguir entre fracaso, desempeño normal y éxito. El término se introduce aquí como constructo teórico, no como cantidad medida. El Estudio 4 (Sección 8.6) proporciona el indicador concreto (la proporción de autores que informan nunca haber comparado su propio recuento con ningún punto de referencia, junto con la distribución de lecturas iniciales que un recuento bajo provoca) de modo que "ceguera métrica" nombre algo que una encuesta preregistrada pueda estimar.
Una escena complementaria, relatada por autores en foros comunitarios y ofrecida aquí como anécdota ilustrativa, es más extrema. Un investigador sube su primer preimpreso y ve que el panel de control permanece en cero visualizaciones y cero descargas, mientras que en cuestión de días, llegan cinco correos de revistas solicitando el manuscrito, todos ellos depredadores. La única respuesta que recibe el novato proviene de revistas depredadoras. La Sección 7 desarrolla esta asimetría como un conjunto de hipótesis explícitas, y el Estudio 3 (Sección 8.6) especifica cómo medirla. La escena es el equivalente vivido del vacío informativo: la economía de atención legítima le da a este autor un recuento sin nada con que compararlo, mientras que la economía parásita suministra halagos pero ningún lector.
Hasta el verano de 2026, existía una respuesta aproximada. Las Clasificaciones públicas de SSRN (Artículos principales, Autores principales y tablas de liga institucionales) permitían a un autor situar un recuento dentro de una distribución visible. El 15 de julio de 2026, esas clasificaciones fueron retiradas [149]. El cese de estas clasificaciones vino después de un anuncio del 12 de junio de 2026 que enmarcó la decisión con la declaración de que "la investigación debe hablar por sí sola" [148] y de un reenfoque estratégico anterior, anunciado el 13 de abril de 2026, de los recursos de la plataforma en su misión central de investigación [146]. La eliminación fue asimétrica: los recuentos de descargas por artículo y las estadísticas de citación "se seguirán registrando y mostrando en sus artículos individuales y perfil de autor" [149], mientras que la distribución que había dado escala a esos recuentos había desaparecido. La situación del investigador frente al panel de control fue así generalizada a toda la base de usuarios de la plataforma: más de 1,9 millones de autores y 1,5 millones de artículos [49].
Este artículo trata sobre esa situación, y su tesis tiene dos partes. El cierre de las Clasificaciones eliminó el contexto, no los datos. Los contadores por artículo sobrevivieron a la puesta de sol y todavía se muestran; la escala comparativa a través de la cual esos contadores podían interpretarse ha desaparecido, que es por qué las métricas son ilegibles aunque no carecen de significado.
La segunda es que la pregunta, "¿qué significa 7 descargas?", está científicamente mal planteada hasta que se especifiquen el denominador correcto y el grupo de comparación. Proporcionar ese denominador y los instrumentos para usarlo es la tarea de este artículo.
1.2 Un número sin escala
El problema interpretativo parece más simple de lo que es. Diez descargas después de siete días y diez descargas después de noventa días son recuentos idénticos cuyos significados casi seguramente difieren, y vuelven a diferir si un trabajo lleva el nombre de un profesor internacionalmente reconocido en una institución altamente visible y el otro es el debut de un autor primerizo. Las métricas de uso académico se presentan no obstante en exactamente esta forma libre de contexto, así que cada número inevitablemente se convierte en una prueba de Rorschach: las mismas "40 vistas" provocan pánico en un autor e indiferencia en otro, porque no hay un punto de referencia compartido.
El valor esperado de un recuento bruto de descargas cambia con todo aquello que el contador no muestra: la antigüedad del trabajo, su campo, su cohorte de publicación y entorno calendario, su exposición de distribución real, y la visibilidad previa de sus autores. Cada una de estas dependencias está documentada empíricamente. Las descargas promedio de por vida difieren aproximadamente por un factor de ocho en las revistas electrónicas de una única red disciplinaria, desde aproximadamente 438 en derecho corporativo y de valores hasta aproximadamente 53 en derecho agrícola [168]. La actividad de acceso varía con el calendario mismo, cayendo aproximadamente un 11% en fines de semana y aproximadamente un 50% en los meses de verano en los datos de acceso a revistas [178]. La posición y la exposición importan independientemente del contenido: los trabajos que aparecen en la posición más visible de las listas de anuncios de arXiv ganaron posteriormente una audiencia y citas sustancialmente superiores, con ganancias de citas medianas de aproximadamente 83% en astrofísica [72]. Las ideas que se originan en instituciones prestigiosas se difunden más rápida y ampliamente que ideas comparables de las menos prestigiosas [111], un patrón consistente con evidencia de larga data sobre estatus y atención [104][105][140][103]. En SSRN específicamente, un coautor adicional en el top 50 se asocia con una prima medible en las tasas de descarga [83]. La maquinaria de distribución propia de la plataforma también moldea el contador: los autores seleccionan hasta siete clasificaciones, la inclusión en alertas de correo electrónico basadas en temas curados no está garantizada, y los temas de alto volumen pueden enfrentar retrasos de hasta 45 días [53][57]. El recuento temprano de un trabajo puede no reflejar nada más que si su distribución relevante ya ha ocurrido.
Las reglas de conteo de la plataforma agregan una segunda capa que los autores rara vez ven. SSRN filtra sus contadores, descartando la actividad aparente de robots y descargas repetidas por la misma persona [144][66][69]; sin tales filtros, los recuentos se inflarían "en un factor de cinco o más" [18]. Las vistas y las descargas están vinculadas por una conversión aproximadamente estable, y Black y Caron reportaron, en 2006, que "en general, tres vistas de resúmenes en el sitio web de SSRN resultan en una descarga real de artículo" [18]. Muestras posteriores sitúan la conversión entre aproximadamente el 11% y el 19% de vistas de resúmenes [139][172], con una muestra de marketing reciente promediando aproximadamente 24 descargas por 100 vistas [83]. Un autor que conozca esta anatomía ya puede verificar las 40 vistas y 7 descargas del artículo (la Sección 5.2 lleva a cabo el cálculo, que se ubica dentro de la banda reportada como un resultado de screening de intervalo amplio), pero nada en la plataforma lo comunica.
Ninguna escala externa llena el vacío, lo que hace que sea un fallo de medición y no un inconveniente. Para el índice h [79], existe un género completo de guías "qué es un buen X" [118][128]. Para descargas de SSRN, la auditoría de la Sección 2.5 no encontró ningún análogo en agosto de 2026 en ninguna fuente pública. La literatura bibliométrica reporta distribuciones [85][139][168][83], pero ninguna de ellas las traduce en normas comprensibles para autores. Académicos individuales han creado puntos de referencia caseros a partir de sus propios portafolios [42], y las guías de bibliotecas explican qué son los contadores sin decir qué significan [161][50]. El número que todo autor googlea no se puede encontrar.
1.3 Lo que está en juego: carreras profesionales, ansiedad e incentivos para inflar
La brecha es importante porque los números tienen consecuencias. La propia documentación de SSRN describe sus métricas como aquellas "que los autores utilizan para fines de promoción y titularización y que las instituciones utilizan en sus actividades de contratación y clasificación" [52]. El uso es concreto y documentado: un destacado jurista informó estar "clasificado 13.º entre 3.000 autores juristas en el número total de descargas de todos los tiempos, lo que la escuela de derecho ha tenido en cuenta en varias decisiones de promoción y relacionadas" [12]; las guías de presentación de revistas de derecho aconsejan mencionar "descargas de SSRN (si hay muchas)" y apariciones en listas de los Diez Mejores en cartas de presentación [95]; e instituciones emitieron comunicados de prensa sobre sus posiciones en SSRN hasta semanas antes del cierre [101]. A nivel agregado, las descargas de SSRN correlacionan con 0,84 con clasificaciones basadas en citas de cien escuelas de derecho [77], una asociación a nivel de institución que no desciende a artículos o autores individuales, la advertencia de inferencia ecológica de la Sección 6.2(iii). Que las instituciones actúen en base a tales medidas es un caso de una dinámica bien documentada: las clasificaciones públicas son reactivas, remodelando el comportamiento de los mismos actores que pretenden describir. El mecanismo se estableció en detalle para las clasificaciones de escuelas de derecho, donde la conmensurabilidad y la profecía autocumplida llevaron a las escuelas a reorganizarse en torno a la medida [58][132]. SSRN reforzó la moneda directamente, enviando correos electrónicos periódicamente a los 30.000 autores principales (aproximadamente el 8 % de unos 360.000 autores listados) para decirles que estaban "en el top 10 %" [161]. El "10 %" es una proporción de autores listados (30.000/360.000 ≈ 8,3 %), y frente a la base completa de autores registrados de más de 1,9 millones [49], los mismos 30.000 están más cerca del top 2 %, por lo que la formulación describe autores clasificados en lugar de todos los inscritos. El consejo sobre carreras profesionales, mientras tanto, advierte que las métricas autopublicadas por sí solas "probablemente no contarán para fines de promoción y titularización en escuelas de derecho" [33], y la literatura de evaluación más amplia documenta tanto cuán profundamente la evaluación basada en indicadores penetra la contratación y la titularización como cuán mal diseñada es a menudo [110][115][153]. Las descargas en sí son medidas de atención, no medidas directas de calidad: el uso temprano predice citas posteriores solo modestamente (correlaciones alrededor de 0,4, explicando aproximadamente el 16 % de la varianza en trabajos tempranos [25], y 0,11–0,35 en estimaciones posteriores [80]), y los conjuntos de artículos altamente descargados y altamente citados difieren sustancialmente [108]. Las instituciones tratan estos números como evidencia de carrera aunque carecen de escala y solo tienen una conexión débil con el impacto académico, lo que es una invitación permanente al malentendimiento en dos direcciones simétricas: sin escala, un autor puede abandonar prematuramente una línea de trabajo por la fuerza de un contador mal interpretado, o gastar tiempo y capital social escasos promoviendo un artículo cuyos números nunca fueron anómalos. Las Clasificaciones, cualesquiera que sean sus defectos, alimentaron exactamente esa decisión recurrente sobre si la promoción adicional de un artículo estaba justificada, y su eliminación dejó la elección para ser tomada sin datos (un punto abordado en la Sección 6.4).
Las apuestas también son emocionales: lo que los autores experimentan en el panel de control es una forma distintiva de ansiedad métrica, y los números de descargas se monitorean compulsivamente. Los observadores cientométricos describieron el género de herramientas de seguimiento de visibilidad personal como "tecnologías del narcisismo" ya en 2012 [177], y la admisión de un prominente académico de derecho de que monitorear sus números era "como la cocaína para mí" (Bainbridge, 2007, citado en la literatura sobre comportamiento de juego en SSRN) se ha vuelto emblemática [44]. El mismo programa de investigación estableció experimentalmente lo que produce la ansiedad: los autores descargan sus propios artículos para inflar números, y lo hacen más intensamente cerca de los umbrales de visibilidad de las listas de los Diez Mejores y bajo comparación social desfavorable con colegas [44]. Los bucles de retroalimentación social de este tipo son una propiedad general de los mercados de atención: las señales sociales tempranas amplifican la desigualdad e imprevisibilidad en los mercados culturales [131], las señales positivas iniciales sesgan las evaluaciones posteriores [112], y el éxito engendra éxito en experimentos de campo [162]. Los hitos autoinformados en las redes sociales, sesgados hacia los de mejor desempeño, agudizan la comparación para todos aquellos cuyo panel muestra 7. Por lo tanto, la ausencia de un punto de referencia público crea ansiedad, alimenta malinterpretaciones e incentiva la inflación artificial que socava la métrica para todos. El problema es uno de medición antes de serlo de desempeño: una métrica que es simultáneamente visible, emocionalmente cargada, relevante para la carrera y no interpretable es un fracaso genuino de la infraestructura de medición, no una deficiencia personal de la persona observando el panel de control.
1.4 A quién afecta más: la dimensión de equidad
Los costos de métricas ilegibles no se distribuyen de manera uniforme. Los autores con redes profesionales densas pueden hacer comparativas de manera informal; los autores establecidos mantienen visibilidad previa de un artículo a otro. La ausencia de normas públicas pesa más sobre investigadores en etapa inicial de carrera, académicos independientes y sin afiliación, autores en campos muy especializados, autores fuera de las disciplinas históricamente dominantes en la plataforma, y autores fuera de instituciones de élite. La desventaja es estructural y no meramente informacional: el mecanismo de descubrimiento de SSRN dirige la atención a través de series de documentos de trabajo institucionales y alertas de revistas electrónicas de suscripción [57]. Un investigador sin afiliación puede publicar, pero no puede insertar un artículo en una serie institucional de alto tráfico, y depende enteramente de la clasificación por tema para tener visibilidad [168][53]. Para tal autor, el canal de exposición institucional está efectivamente cerrado, por lo que el peso del descubrimiento recae desproporcionadamente en las capas de búsqueda e IA. La visibilidad de máquina, examinada en la Sección 8, es por lo tanto una cuestión de equidad y no meramente una cuestión técnica. La pertenencia al campo por sí sola desplaza las descargas esperadas varias veces antes de que intervenga evaluación alguna del mérito [168]. Los efectos de prestigio operan en el momento de la primera exposición, porque una página pública de SSRN muestra nombres de autores y afiliaciones junto al título y resumen. La revisión ciega funciona de otra manera: la eliminación de identidades de autores reduce mediblemente las puntuaciones de revisores para autores prestigiosos (en un estudio de 5,027 envíos de ICLR, con un efecto mucho menos determinado en las decisiones de aceptación) [154], y las evaluaciones responden a señales de identidad experimentalmente [64]. En el fondo de la distribución de atención, el fenómeno es ausencia más que desigualdad: en datos de altmetric, la atención social mediana de investigación sin financiamiento es cero en todos los campos estudiados en una gran muestra enfocada en SDG [41], y la atención en plataformas abiertas adyacentes es más desigual que el ingreso en economías desarrolladas, con coeficientes de Gini por encima de 0.9 [180]. Para el autor mediano, la pregunta "¿son 7 descargas malas?" es un intento de leer la única señal que devuelve el sistema, en un juego cuyas probabilidades son estructuralmente desiguales, en lugar de una demostración de vanidad. Cualquier marco de interpretación que ignore esta asimetría diagnosticará sistemáticamente mal a los desfavorecidos al leer la invisibilidad como rechazo. La asimetría también se proyecta hacia adelante: si la capa de respuesta de IA emergente hereda los sesgos de marca y posición documentados para la optimización de motores generativos comerciales [5][164], reproducirá en lugar de remediar esta desigualdad. Esa perspectiva pesa más sobre investigadores sin afiliación y autores en el Sur Global, y es una razón por la cual la auditoría de visibilidad de máquina de la Sección 8.6 pertenece a la agenda de equidad en lugar de a curiosidades de plataforma.
1.5 La demanda documentada de interpretación
La demanda de una escala no es hipotética. Es uno de los patrones más persistentes en el discurso de la comunidad académica, y antecede al cierre en al menos una década. La tabla 1 resume las agrupaciones recurrentes de preguntas e inquietudes de los autores, con la evidencia documentada más sólida para cada una, el atajo inseguro que cada agrupación invita (la respuesta breve que parece útil pero es incorrecta), y la sección de este artículo que responde a ello.
Tabla 1. La demanda de interpretación: agrupaciones de problemas documentados en la comunidad (2005–2026)
| # | Agrupación | Lo que los autores preguntan o reportan | Evidencia documentada (confianza) | Atajo inseguro | Abordado en |
|---|---|---|---|---|---|
| 1 | "¿Es mi número normal?" — la referencia faltante | Si un número de descargas dado es bueno, malo o típico para un artículo comparable | Pregunta pública "Importance of paper download statistics," Academia StackExchange, 2016 (título y fecha verificados a través de la API oficial) [3]; preguntas de usuarios sobre publicar en SSRN y su valor [126]; hilos de foro recurrentes preguntando cuántas descargas cuentan como "buenas" (existencia del hilo confirmada; respuestas individuales no verificables de manera independiente, y material de foro se trata a lo largo como evidencia débil de demanda, no como datos) [B-3]; solicitud de un autor por primera vez de "consejo honesto" sobre un documento de trabajo recién publicado (Reddit, abril de 2026; existencia verificada a través de archivos de terceros) [B-5] | Un umbral de conteo bruto universal ("N descargas = bueno") | Secciones 3, 5–6 |
| 2 | Confusión mecánica — vistas versus descargas | Por qué las vistas superan las descargas; si una relación baja significa un resumen débil | Regla práctica histórica 3:1 [18]; banda de conversión reportada 11–19% [139][172]; media de muestra reciente ≈24% [83]; guías de bibliotecas documentan la incertidumbre de los autores sobre qué incluyen los contadores [161] | La afirmación automática de que una relación baja significa que el resumen es malo | Secciones 4–5 |
| 3 | Emoción y comparación social | Revisión compulsiva; vergüenza tanto con números bajos como altos | "Como crack para mí" (Bainbridge, 2007, citado en [44]); evidencia experimental de auto-descargas cerca de umbrales de listas superiores bajo comparación social [44] | Compararse contra el promedio de toda la plataforma o contra las estrellas visibles | Secciones 1, 5 |
| 4 | Evidencia de carrera — qué reemplaza la línea de rango en un expediente | Qué citar en materiales de permanencia, promoción y contratación después del cierre | Clasificación de descargas "tomada en cuenta en varias decisiones de promoción y relacionadas" [12]; correos de notificación de los 10% superiores [161]; consejo de carta de presentación [95]; comunicados de prensa institucionales [101]; descripción de plataforma sobre el uso evaluativo [52] | Citar un conteo acumulativo bruto sin fecha, fuente o denominador | Sección 6 (Tabla 13) |
| 5 | Spam de solicitud posterior a la publicación | Invitaciones de revistas no solicitadas que llegan poco después de la publicación | "Todos los días recibo al menos dos de estos correos" (Reddit r/AskAcademia, 2023; verificado a través de archivo; el autor había publicado en una revista MDPI, no en SSRN) [127]; recolección de direcciones de artículos "p. ej. aquellos publicados en SSRN" [107]; auditorías de volumen de solicitud [9][84][63]; una revisión sistemática identificando 29 estudios empíricos de spam académico [61] | Inferir la identidad o la intención de los lectores de un contador agregado | Sección 7 |
| 6 | Confianza en los contadores — bots, manipulación, caídas repentinas | Si los números son reales; por qué los contadores bajan | "SSRN no hace absolutamente nada para validar su exactitud" (Goldman, 2005, anterior a los filtros actuales; una actualización posterior registra que SSRN descuenta descargas repetidas de la misma fuente) [66]; filtrado de integridad de datos publicado por SSRN [144][66][69]; tráfico de bots constituyendo ~74% de vistas de resúmenes pero solo ~7% de descargas en datos tempranos de RePEc [99]; episodios de filtrado de bots a gran escala en RePEc a través de 2025–2026 [129] | Tratar el número mostrado como un conteo exacto de lectores humanos únicos | Secciones 4, 9 |
| 7 | Diagnóstico — "¿por qué cero descargas?" | Qué significan cero o un estancamiento en las primeras semanas | Incertidumbre del autor posterior al cierre documentada en hilos comunitarios (existencia confirmada a través de archivos de terceros) [B-5]; las páginas de soporte de la plataforma describen las métricas pero, a partir de agosto de 2026, no ofrecen orientación interpretativa [52][50] (auditoría de búsqueda, Sección 2.5) | Tratar un cero anterior a la distribución como rechazo | Secciones 4–6 |
Nota. Solo las citas verificadas de forma independiente contra una fuente activa o archivada se reproducen textualmente; todo otro material comunitario se parafrasea y se marca por su estado de confianza. La ética de citar publicaciones de usuarios, incluyendo la anonimización y el manejo del contenido eliminado, se aborda en la Sección 9.
La agrupación más fuerte en la tabla 1 es la pregunta crónica "¿es mi número normal?", que se repite a lo largo de años, plataformas y disciplinas. Incluso los expertos de la plataforma no ofrecen una referencia a cambio, y el sarcasmo que a menudo la responde en foros comunitarios señala que nadie, incluyendo usuarios experimentados, posee la escala faltante [B-3]. Las agrupaciones también están conectadas causalmente: la referencia faltante (agrupación 1) produce la carga emocional (agrupación 3), que produce el incentivo de manipulación documentado en [44], que a su vez erosiona la confianza investigada en la agrupación 6. Restaurar la interpretabilidad aborda la cadena en su raíz. El marco no apunta a aumentar descargas sino a restaurar el significado.
1.6 Lo que este artículo sostiene: ocho posiciones
Estas son las posiciones que el artículo defiende, cada una argumentada en la sección indicada.
1. Los recuentos brutos son ininterpretables sin una clase de referencia. Un recuento acumulado de descargas no tiene un significado estable sin condicionarse a la edad del artículo, campo, cohorte de publicación, canal de distribución, y visibilidad previa del autor [83][168][178][53]. Este es el problema de la clase de referencia de la Sección 5, y hace que "¿son 7 descargas algo bueno?" sea un problema mal planteado tal como se formula.
2. Bajo alcance y baja conversión son diagnósticos diferentes. Un artículo que pocas personas encuentran presenta un problema diferente al de un artículo que muchas personas ven pero pocas descargan, y requiere acciones diferentes. La invisibilidad no es un rechazo del contenido. Las Secciones 4–5 desarrollan esta distinción en un diagnóstico de alcance por conversión (Tabla 9), incluyendo la configuración de "interés oculto" en la que la conversión fuerte coexiste con alcance débil.
3. Los contadores sobrevivieron; la escala comparativa no. La asimetría de la desactivación (números retenidos, normas eliminadas [149]) describe exactamente la condición post-Rankings, y convierte un problema de interpretabilidad latente de largo plazo en uno urgente y universal (Sección 2).
4. Un índice percentil es un bien público. El número que todo autor busca en Google y no puede encontrar es una tabla de percentiles por disciplina y edad del artículo. Las Secciones 5 y 8 especifican cómo la comunidad puede construir y mantener una, ahora que ya no puede leerse de la plataforma.
5. Las normas calibradas requieren un panel observado desde la publicación. La evidencia publicada consiste en secciones transversales envejecidas e instantáneas únicas [139][85][168][83]. El único estudio grande reciente explícitamente identifica datos de panel como el siguiente paso necesario [83]. Sin observación desde el día cero, las normas de "primera semana" y "primer mes" son extrapolaciones y deben etiquetarse como tales (Sección 8).
6. Un índice multidimensional supera a una única puntuación de vanidad. Reportar alcance normalizado, desempeño de descargas, conversión, impulso, y validación posterior por separado (CSAB, Tabla 10) preserva la información diagnóstica que cualquier índice compuesto destruye (Sección 5).
7. La capa de respuesta de IA se está convirtiendo en un nuevo guardián de la atención. El descubrimiento está migrando hacia arriba en la pila, desde la marca de revista a repositorio a motor de búsqueda a motores de respuesta de IA que sintetizan una única respuesta y citan un puñado de fuentes [5][164]. Un cuarto de adultos estadounidenses ya usan chatbots de IA diariamente [121], mientras que la confiabilidad de estos motores como canales de citación sigue siendo cuestionada [82] y aún no existe un estudio controlado de la visibilidad de preprints académicos en ellos [100]. La Sección 8 establece el protocolo de auditoría compacto; la auditoría completa se reserva para el trabajo complementario.
8. Se necesita ahora un protocolo de panel de control y expediente. Los autores y comités no pueden esperar a una nueva infraestructura de datos. La Sección 6 proporciona reglas provisionales para leer un panel de control y un protocolo de evidencia de siete pasos para expedientes (Tabla 13) cuyo requisito rector es que todo número reportado muestre su fuente, su ventana de tiempo, y sus limitaciones.
1.7 Contribuciones
La lista a continuación expone lo que el artículo aporta a la literatura existente, en el orden en que lo desarrollan las secciones.
1. Un diagnóstico. Identifica el problema de la clase de referencia en las métricas de uso de plataformas y nombra el fenómeno subyacente: el cold start de la atención académica. El término se adapta de la literatura de sistemas de recomendación, donde un elemento cold-start carece del historial de interacciones necesario para posicionarlo [133]. En este cold start, nuevos artículos y nuevos autores entran en un sistema de difusión en el que la atención temprana depende sustancialmente de la arquitectura de la plataforma, la distribución y la reputación anterior antes de que la calidad sustancial pueda ejercer su plena influencia [72][111][140][83]. La afirmación central es la tesis del mal-planteamiento de la Sección 1.1: la pregunta principal no tiene respuesta hasta que se suministren su denominador y su grupo de comparación.
2. Un mapa de puntos de referencia consolidados. Reúne, por primera vez desde el cierre (auditoría de la Sección 2.5, agosto de 2026), todos los puntos de referencia empíricos verificados para descargas de SSRN y vistas del resumen en una sola tabla (Tabla 7), con marcos de muestreo explícitos, antigüedades, advertencias de envejecimiento, y una calificación de confianza de fuente para cada fila. Los puntos de referencia son la evidencia distribucional de muestra grande [83], las extracciones de listas superiores cuasi-lognormales [85], muestras de erudición legal [139][168][171][172], y agregados de plataforma [1][49].
3. Un marco de embudo de atención con diagnósticos. Descompone la difusión en exposición, vista del resumen, descarga de texto completo, y uso posterior. Luego deriva la matriz de alcance por conversión (Tabla 9), que separa la invisibilidad del rechazo e incluye la configuración de interés oculto que los conteos brutos ocultan sistemáticamente.
4. Instrumentos de interpretación. Convierte el mapa de puntos de referencia en una escala de interpretación graduada (Incipiente / Modesto / Sólido / Fuerte / Excepcional; Tabla 8), una banda de conversión con ejemplos trabajados, y el Punto de Referencia de Atención Académica de Cold-Start (CSAB; Tabla 10), un formato de reporte multidimensional normalizado por campo, edad, cohorte, y visibilidad previa del autor. Las bandas de la escala son comparativas solo dentro del mismo campo y edad del artículo, ya que la pertenencia al campo por sí sola desplaza las descargas esperadas múltiples veces, y cada límite está fundamentado en fuentes o explícitamente marcado como estimación del autor.
5. Una capa de práctica. Proporciona reglas para leer el propio panel de control, diagnósticos para el caso de descarga cero, una tabla de acciones por situación (Tabla 23), una tipología hipotética de señales de solicitud depredadora con la advertencia de que el spam de solicitud ni mueve los contadores ni evidencia la lectura (Tabla 14), y el protocolo de expediente de siete pasos (Tabla 13).
6. Una agenda de investigación lista para preregistro. Especifica un panel prospectivo con observación a 1, 3, 7, 14, 30, 60, 90, y 180 días desde la publicación, y dos diseños cuasi-experimentales: distribución de alertas de correo electrónico curada como un shock de atención dentro del artículo, y el retiro de Rankings como un experimento natural en interpretabilidad de métricas. Además especifica un conjunto de datos de percentiles construido por la comunidad como la única ruta restante hacia percentiles nuevos, un protocolo compacto de auditoría de visibilidad de máquina para motores de respuesta de IA, y un registro prespecificado, puramente descriptivo de la propia trayectoria de descargas de este artículo. Cada estudio es ejecutable a bajo costo y dentro de los límites de acceso y ética de la Sección 9, con predicciones numéricas expresadas como bandas prespecificadas en lugar de hallazgos.
1.8 Organización del artículo
El resto del artículo consta de nueve secciones adicionales y cinco apéndices. La Sección 2 reconstruye el evento y su contexto: la cronología completa del paquete de reforma de 2026, qué se mantiene y qué se eliminó (Tabla 2, Figura 1), y la justificación declarada de la plataforma sobre reasignación de recursos y reenfoque. La Sección 3 presenta la evidencia distribucional verificada y muestra por qué el promedio es engañoso. Abarca la brecha media-mediana [83], la cola cuasilognormal [85] y la heterogeneidad disciplinaria [168] (Figuras 2–4, Tablas 3–5), contrastada con el trasfondo teórico del efecto Mateo y la ventaja acumulativa [104][105][131][162] (dinámicas que se han cuantificado directamente en carreras longitudinales y trayectorias de citación [120]), y la distinción entre medidas de atención y medidas de calidad [25][80][108][178]. La Sección 4 examina la mecánica de los contadores: filtrado e integridad de datos [144][66], tráfico de robots y fantasmas con los contraargumentos necesarios [99][106][129], arquitecturas de plataforma (Tabla 6) e higiene de metadatos y versionado. La Sección 5 establece el núcleo de interpretación: el argumento de clase de referencia, el mapa de puntos de referencia consolidado (Tabla 7), la escala de interpretación (Tabla 8), la banda de conversión, la matriz de alcance por conversión (Tabla 9) y CSAB (Tabla 10). La Sección 6 traduce el marco a la práctica para autores y comités de evaluación, incluyendo el protocolo de dosier (Tabla 13) y, en Apéndice A, orientación basada en situaciones (Tabla 23). La Sección 7 analiza la capa parasitaria de la economía de la atención, solicitudes depredadoras tratadas como señales de visibilidad hipotéticas, con todas las afirmaciones de tiempo y prevalencia enunciadas como hipótesis [9][61][63][84][107]. La Sección 8 enuncia la agenda empírica lista para preregistro, incluyendo un tratamiento compacto de la migración de atención hacia la capa de respuesta de IA en la pila y sus implicaciones para la discoverabilidad de preprints [5][100][82][121][164]. La Sección 9 detalla limitaciones, incluyendo el carácter de fuente única de la mejor evidencia distribucional disponible [83], el envejecimiento de las muestras de 2012–2015 y la inestabilidad de la documentación de la plataforma. La Sección 10 concluye con recomendaciones de política para SSRN (principalmente, bandas de percentiles anónimos por disciplina y edad del artículo como reemplazo que restaura el contexto sin revivir la competencia de clasificaciones) y para la comunidad científica.
2. El Evento: El Ocaso de los Rankings y Su Contexto
2.1 Qué Fueron las Clasificaciones
Durante la mayor parte de la historia de SSRN, sus contadores de uso se situaban dentro de un aparato comparativo denso. A nivel de artículo, la plataforma mantenía listas de los 10.000 principales por descargas de doce meses y totales, junto con listas de «artículos principales recientes» por eJournal calculadas en ventanas móviles de sesenta días. A nivel de autor, mantenía una lista de los 30.000 principales en todas las disciplinas y ligas disciplinarias tales como los 3.000 principales autores de derecho, ordenables por descargas nuevas, descargas totales, descargas por artículo y citas. A nivel institucional, mantenía tablas de liga mensuales que incluían las 350 principales Facultades de Derecho de EE.UU. y las 500 principales Facultades de Derecho Internacionales [B-9, páginas históricas de clasificación; todas esas URLs han devuelto un error o una página de marcador desde el 15 de julio de 2026 y pueden citarse solo desde copias archivadas]. La plataforma también tradujo la clasificación en retroalimentación percentil directa. Como documentó la guía de métricas de SSRN de la Gallagher Law Library de la Universidad de Washington, «SSRN envía periódicamente mensajes a los 30.000 principales autores, por descargas nuevas y por descargas totales, para hacerles saber que están en el 10% superior». Comparado con la propia cifra de la guía de «más de 360.000 autores», ese umbral correspondía aproximadamente al 8% superior de autores listados (30.000 de aproximadamente 360.000) [161, accedido el 14 de agosto de 2026], un nivel superior amplio en lugar de una élite estrecha; la Sección 1.3 señala que en relación con la base completa registrada, los mismos 30.000 se sitúan más cerca del 2% superior. Estas listas y mensajes fueron, en efecto, la única información percentil proporcionada por la plataforma dirigida a autores sobre descargas de SSRN que jamás se haya hecho pública.
El aparato comparativo no era decorativo. Black y Caron propusieron en 2006 que las descargas de SSRN podrían servir como una medida «beta» del desempeño académico de los profesores de derecho, complementando encuestas de reputación y conteos de citas [18]. El mismo volumen del simposio contiene un examen crítico de la propuesta [45]. Institucionalmente, la propuesta tuvo éxito: los rangos de descargas ingresaron en materiales de contratación, archivos de promoción y publicidad institucional. La propia documentación de apoyo de SSRN describe sus métricas como cifras «que los autores usan para propósitos de promoción y estabilidad laboral y que las instituciones usan en sus actividades de contratación y clasificación» [52, accedido el 14 de agosto de 2026]. La guía de publicación del Legal Writing Institute recomendó a los autores mencionar «descargas de SSRN (si son muchas), inclusión en listas de Descargas de los Diez Principales de SSRN» en cartas de presentación a revistas de derecho [95]. En junio de 2026, Stephen Bainbridge puso la función de carrera en el registro: fue «clasificado en el lugar 13º de 3.000 autores de derecho por el número total de descargas de todos los tiempos, lo que la facultad de derecho ha tenido en cuenta en varias decisiones de promoción y relacionadas» [12]. El propio liderazgo de SSRN documentó la transformación de la plataforma de la comunicación académica legal en un preprint de su entonces director ejecutivo [68]. Las instituciones también comercializaban las ligas: tan recientemente como en enero de 2026, la Universidad de Maynooth anunció que su Facultad de Derecho y Criminología se clasificó en primer lugar entre los departamentos irlandeses en las 500 principales Facultades de Derecho Internacionales de SSRN, citando más de 143.500 descargas [101]. El agarre del aparato sobre el comportamiento está documentado en el análisis de registros del servidor de SSRN de Edelman y Larkin. El estudio encontró que las auto-descargas engañosas se intensificaron en el momento exacto cuando un artículo se acercaba al límite de una lista de los diez principales, e identificó la comparación social, más que solo las consideraciones de carrera, como el impulsor principal de la manipulación [44]. El mismo estudio circuló la observación, atribuida a Bainbridge en 2007, de que monitorizar los conteos de descargas era «como crack para mí» [44].
El aparato tenía una segunda función que atrajo menos atención. Las citas y encuestas de reputación se mueven en ciclos de varios años; las clasificaciones devolvieron retroalimentación en tiempo casi real, y permitieron que académicos al inicio de su carrera y autores fuera de instituciones prestigiosas demostraran impacto visible directamente, sin esperar mecanismos de control de entrada más lentos y conservadores. Cualesquiera que sean sus defectos, las tablas de liga eran el único dispositivo comparativo igualmente visible para cada autor en la plataforma. Esa es parte de la razón por la que su eliminación plausiblemente pesa más pesadamente, como argumenta la Sección 1.4, sobre los autores que tienen los sustitutos informales más escasos. No existe aún evidencia distribucional directa sobre los efectos de la eliminación, así que esta es una expectativa direccional que RQ1 (Sección 8.5) prueba: bidireccional, pregunta si la eliminación concentró o dispersó la atención sin presuponer el signo.
2.2 Cronología de la Retirada de 2026
La eliminación de los Rankings el 15 de julio de 2026 fue la culminación de una secuencia de decisiones de plataforma que comenzó a finales de 2025, resumida en la Figura 1.
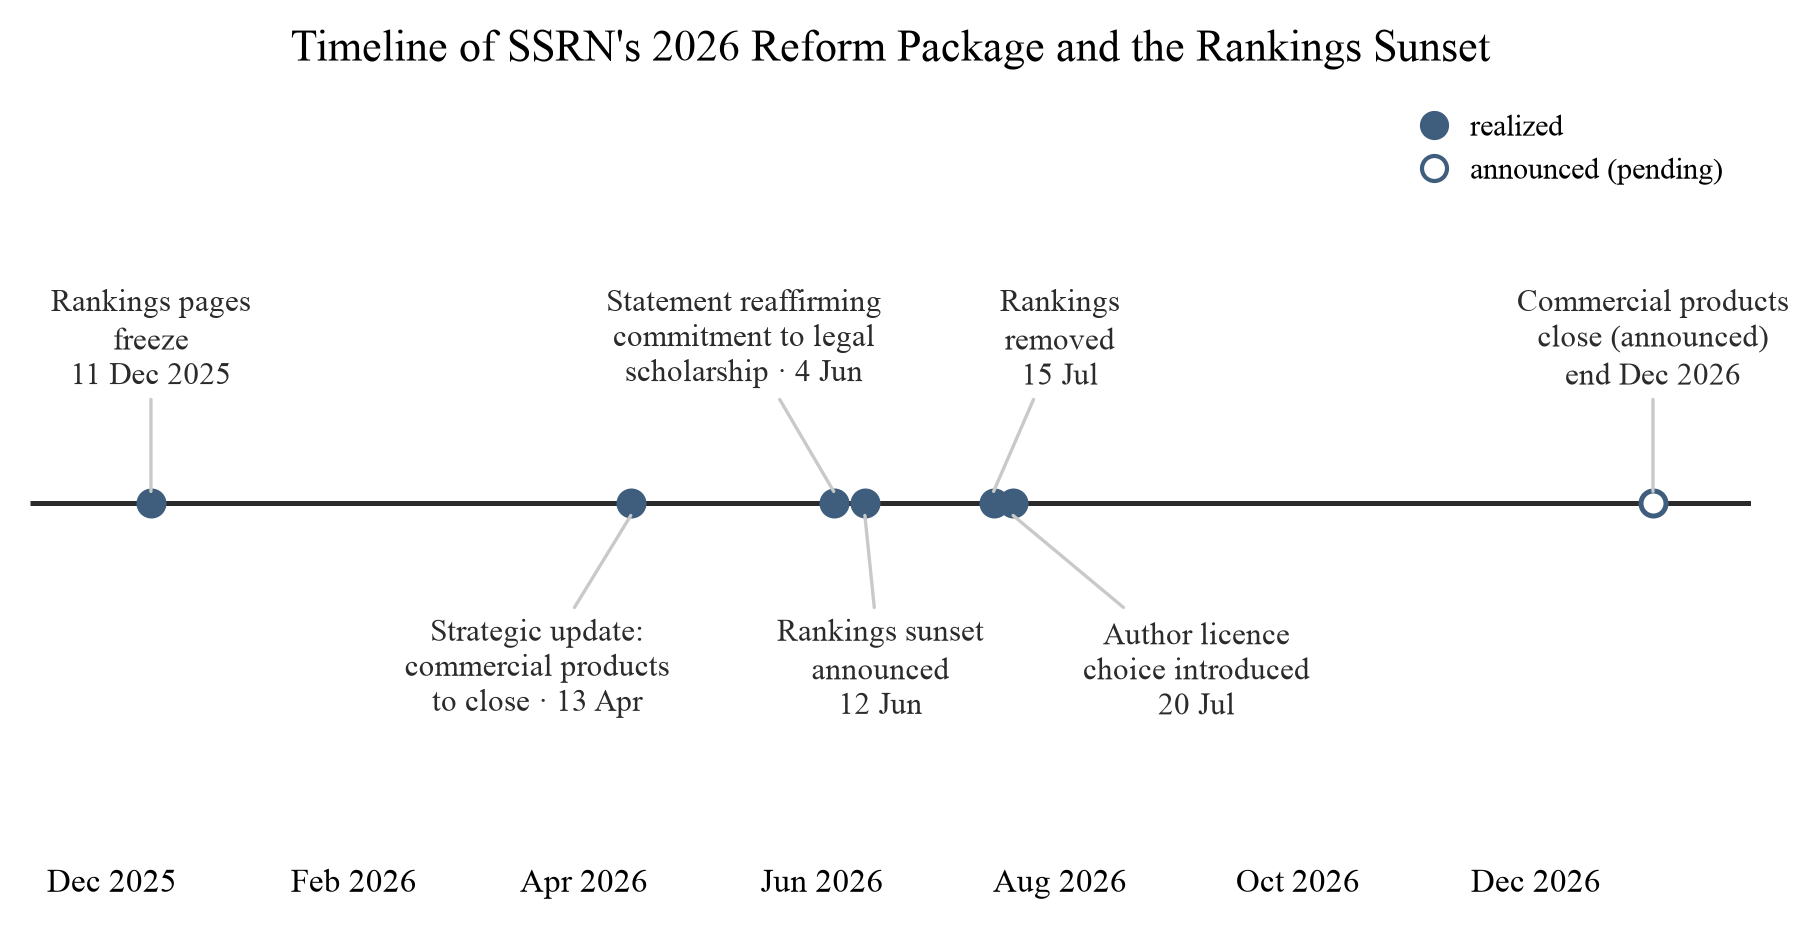
Figura 1. Cronología del paquete de reforma de 2026 de SSRN. Eventos: congelación de las páginas de clasificación de descargas de eJournal (desde el 11 de diciembre de 2025, documentado en una publicación del blog TaxProf del 25 de enero de 2026 [B-2]); actualización estratégica anunciando el cierre de todos los productos comerciales antes del final de 2026 (13 de abril de 2026) [146]; declaración pública reafirmando el compromiso de SSRN con la investigación legal (4 de junio de 2026) [147]; anuncio de que los Rankings serían retirados "a partir del 1 de julio de 2026" (12 de junio de 2026) [148]; eliminación real de los Rankings (15 de julio de 2026) [149]; introducción de la opción de licencia de autor (20 de julio de 2026) [150]; cierre anunciado de los productos comerciales restantes (finales de diciembre de 2026) [146]. Fuentes: [146][147][148][149][150][B-2].
La degradación comenzó antes de cualquier anuncio formal. El 11 de diciembre de 2025, las páginas de clasificación de descargas por eJournal dejaron de actualizarse. Paul Caron había ejecutado una columna semanal "Top Five New Tax Papers" basada en esas clasificaciones durante más de dos décadas. En una publicación del 25 de enero de 2026, documentó que las clasificaciones de impuestos se habían congelado en la ventana "12 Oct 2025 – 11 Dec 2025" y escribió que "esto puede ser el fin de SSRN Top Five New Tax Papers" [B-2, citado como una paráfrasis de la publicación del 25 de enero de 2026, no de ningún anuncio de SSRN].
El 13 de abril de 2026, SSRN publicó una "Actualización Estratégica" anunciando un enfoque renovado en su "misión central de compartir investigaciones" y el cierre de todos los productos comerciales (Research Paper Series, Sponsored Networks, Site Subscriptions, procedimientos de conferencias pagados, paneles de análisis, empleos y anuncios, y fuentes de datos) antes del final de diciembre de 2026 [146]. Los observadores de bibliotecas registraron el cambio en cuestión de días [34], y la unidad Digital Commons de Elsevier publicó una guía de migración para las instituciones cuyas colecciones de Research Paper Series estaban siendo retiradas [47].
El anuncio provocó controversia pública en la academia legal, la comunidad más invertida en la infraestructura de clasificación. El 3–4 de junio de 2026, Bainbridge publicó una crítica ampliamente leída bajo el título "The Social Science Research Network Has Jumped the Shark", seguida de una publicación que registraba que SSRN había respondido a sus quejas con aclaraciones sobre el cronograma del cierre de series de documentos y la preservación de eJournals temáticos [12]. El 4 de junio de 2026, SSRN emitió una declaración sobre su "compromiso continuo con la investigación legal", prometiendo que las distribuciones de eJournal y las alertas de correo electrónico "continuarían sin cambios" [147]. El 7 de junio de 2026, Caron respondió a Bainbridge en TaxProf Blog bajo el título "SSRN Has Not Jumped the Shark" [B-11]. El intercambio es un registro público compacto de lo que la comunidad consideraba que valían las características comparativas de la plataforma en vísperas de su eliminación.
El 12 de junio de 2026, SSRN anunció que "retiraría los Rankings a partir del 1 de julio de 2026", afirmando que "en SSRN, siempre hemos creído que la investigación debe hablar por sí sola" [148]. La retirada entró en vigor dos semanas más tarde de lo anunciado inicialmente: el 15 de julio de 2026, se eliminaron las clasificaciones de documentos, autores e instituciones [149]. Cinco días después, el 20 de julio de 2026, una reforma adicional introdujo la opción de licencia del autor [150]. La brecha de dos semanas entre las fechas anunciadas y reales, y la ventana de un mes entre el anuncio y la ejecución, son en sí mismas analíticamente relevantes: crearon un período de anticipación durante el cual los autores e instituciones pudieron observar el cambio que se avecinaba, un punto que se toma en el diseño cuasiexperimental de la Sección 8.
2.3 La Justificación Oficial y Su Evolución
La justificación establecida para el cierre fue la asignación de recursos y el reenfoque de la plataforma. El anuncio de julio explicó que los rankings "requieren una asignación significativa de recursos de producto y desarrollo" y encuadró la decisión dentro de un reenfoque en publicación más rápida, mejor descubribilidad e integridad de la investigación. También afirmó que "los recuentos de descargas y las estadísticas de citas seguirán siendo registrados y mostrados en sus artículos individuales y perfil de autor" [149]. El anuncio deja abierta la posibilidad del regreso de características comparativas: SSRN escribió que "podría reconsiderar la idea de varios rankings" [149], por lo que la eliminación no debe describirse como permanente. El silencio en el registro también es importante: los anuncios no atribuyen la decisión a manipulación de métricas, manipulación o mal uso competitivo de los rankings, y los argumentos que proporcionan tales motivos van más allá de los textos publicados [148][149].
El tono de la explicación oficial evolucionó entre el anuncio y la página de destino que reemplazó las URL de los rankings. Mientras que la publicación de junio habló de asignación de recursos, la página de reemplazo afirma que la nueva dirección de SSRN "pone a los autores individuales y su trabajo en el centro de todo lo que hacemos," y que "las tablas clasificatorias agregadas de instituciones y departamentos ya no encajan en esa imagen" [B-8; la página se sirve detrás de restricciones de acceso y estas frases se citan de copias del índice de búsqueda, por lo que una instantánea archivada debe acompañar cualquier cita]. La publicación de junio presenta el cierre como una decisión de costo, la página de reemplazo como una reorientación principista alejada de la comparación institucional en general.
SSRN no dejó a los autores enteramente sin un indicador oficial del contexto. Su documentación de soporte sobre la medición del impacto de un artículo dirige a los autores a los contadores a nivel de artículo (vistas de resumen y descargas) complementados por PlumX Metrics, un producto de altmétricas de Elsevier que agrega citas, uso y señales de redes sociales [50, consultado el 14 de agosto de 2026]. PlumX se presenta así como el reemplazo de facto de la plataforma para el contexto interpretativo. Es un reemplazo parcial: agrega señales adicionales para un artículo individual pero no proporciona distribución, percentil o comparación de cohortes. Esos son los elementos que los Rankings, aunque imperfectamente, habían proporcionado. Los retiros no se extienden a la integración de SSRN con los flujos de trabajo de revistas: el programa First Look continúa conectando la plataforma a más de 1.200 revistas de Elsevier [48][145]. El gobierno comercial de la plataforma también sitúa estas decisiones de producto dentro de un mercado de publicación académica altamente concentrado [94].
2.4 Lo Que Permanece y Lo Que Fue Eliminado
La Tabla 2 mapea el estado posterior al ocaso de la plataforma, junto con la implicación de medición de cada elemento: qué significa cada característica superviviente, desaparecida o no reportada para quienquiera que intente leer un conteo. La eliminación fue asimétrica. Cada contador por artículo y por perfil supervive. El aparato comparativo construido sobre esos contadores fue retirado completamente.
Tabla 2. Lo que permanece y lo que fue eliminado después del ocaso de Rankings del 15 de julio de 2026, con implicaciones de medición. Fuentes: [147][149][161][B-8][B-9]; filas de maquinaria de exposición: [53][57][55][144][66][69].
| Característica | Estado después del 15 de julio de 2026 | Bases de fuentes | Implicación de medición |
|---|---|---|---|
| Conteos de descargas por artículo | Permanecen; se muestran en las páginas de artículos | Confirmado textualmente en el anuncio del ocaso [149] | El uso bruto permanece observable pero ahora no tiene su propia clase de referencia |
| Vistas de resumen por artículo | Permanecen (no se mencionan textualmente en el anuncio del ocaso, que enumera "conteos de descargas y estadísticas de citación"; las vistas continúan siendo mostradas) | [149], observación de la plataforma, accedido el 14 de agosto de 2026 | El alcance permanece observable, por lo que los diagnósticos de alcance-conversión por artículo (Tabla 9) permanecen computables |
| Estadísticas de citación (artículo y perfil de autor) | Permanecen | Confirmado textualmente [149] | El uso posterior aún puede complementar las medidas de atención temprana |
| Perfil de autor (artículos, afiliaciones) | Permanece | Observación de la plataforma, accedido el 14 de agosto de 2026 | La agregación a nivel de cartera sigue siendo posible, con el mismo denominador faltante |
| Suscripciones a revistas electrónicas y alertas por correo electrónico | Permanecen | "Continúan sin cambios," declaración del 4 de junio de 2026 [147] | El canal de exposición de inserción persiste, por lo que los contadores tempranos permanecen dependientes de la arquitectura (Sección 4.4) |
| Clasificaciones de temas (1–7, seleccionadas por autor) | Permanecen; conducen el enrutamiento de revistas electrónicas | Documentación de la plataforma [53] | La clasificación es una variable de exposición potencialmente consecuente |
| Distribución de revistas electrónicas curadas | Continúa; la inclusión "curada y dirigida, no garantizada" | [53][57][147] | El estado y la fecha de distribución deben modelarse como un tratamiento, no como fondo |
| Retraso de distribución en temas de alto volumen | Continúa; hasta 45 días | [53] | Los conteos del primer mes pueden mezclar regímenes anteriores y posteriores a la distribución |
| Indexación externa (Google, Google Scholar) | Continúa, en el cronograma controlado por el motor de búsqueda ("6–9 meses o más") | [55] | Un proceso de exposición censurado por intervalos: la fecha de exposición está acotada, no observada |
| Filtrado de actividad sospechosa | Continúa | [144][66][69] | Los conteos son eventos filtrados, no lectura verificada o respaldo |
| Recuperación de respuestas de IA de artículos | No reportado por SSRN | No existe reportaje de plataforma; Sección 8.6 | La visibilidad de máquina requiere una auditoría independiente y repetida (Estudio 2) |
| Métricas de PlumX en páginas de artículos | Permanecen; indicador oficial para evaluación de impacto | Documentación de soporte [50] | Señales adicionales por artículo, pero sin distribución, percentil o comparación de cohorte (Sección 2.3) |
| Listas de Artículos Principales (Top 10,000; por revista electrónica reciente/todo el tiempo) | Removidas; las URL devuelven un error o la página de aterrizaje del ocaso | [149][B-8][B-9] | Un marco comparativo importante — y una posible superficie de descubrimiento — desapareció |
| Listas de Autores Principales (Top 30,000; ligas disciplinarias) | Removidas | [149][B-9] | La posición de percentil a nivel de autor ya no es públicamente observable |
| Ligas a nivel institucional (Top 350 U.S. / Top 500 Escuelas de Derecho Internacionales, etc.) | Removidas | [149][B-8][B-9] | La comparación institucional ya no puede calcularse a partir de datos de la plataforma |
| Marco de percentil público (rango de autor, posicionamiento "top 10%") | Removida con la infraestructura de clasificaciones | [149][161] | La clase de referencia debe reconstruirse ahora externamente (Secciones 5, 8) |
| Correos electrónicos de notificación "Top 10% de autores" | Destino no abordado en las comunicaciones oficiales; los correos electrónicos estaban vinculados a la infraestructura de clasificaciones | [161][149] | Una señal de percentil utilizable en expedientes ya no puede asumirse que llegará |
Las filas supervivientes en Table 2 son exactamente los contadores brutos y la maquinaria de exposición que los alimenta: la plataforma continúa produciendo números al mismo ritmo que antes. Las filas eliminadas son exactamente el conjunto de marcos comparativos: distribuciones, umbrales, rangos y mensajes de percentiles. El evento, por lo tanto, tiene una estructura informacional precisa (datos retenidos, clase de referencia retirada), y esa estructura convierte un problema latente de larga data, cómo leer un número SSRN, en uno agudo y universal. Llamamos opacidad de referencia a la propiedad de la plataforma que cambió: una propiedad graduada de una plataforma que describe si publica las estadísticas distribucionales necesarias para situar un conteo individual (percentiles, medianas, distribuciones de cohortes), o solo contadores brutos, promedios y listas top-N. El 15 de julio de 2026, SSRN pasó en un solo paso de una transparencia parcial a una opacidad de referencia casi completa, y el resto del artículo puede leerse como un estudio de lo que esa propiedad cuesta a sus usuarios. La opacidad, así definida, tiene al menos cuatro dimensiones: cobertura de población (a quién describen las estadísticas publicadas), granularidad de la clase de referencia (si condicionan sobre el campo, la edad y la cohorte), estabilidad temporal (si las definiciones y ventanas se mantienen comparables a lo largo del tiempo), y auditabilidad (si las reglas de conteo son lo suficientemente públicas para verificar). Los cuatro funcionan en parte de forma independiente: las clasificaciones pueden reducir una forma de opacidad mientras empeoran otra si sus denominadores y reglas de selección no están claros. Esa independencia parcial es por lo que las recomendaciones de plataforma de la Sección 10.4 (elementos 4 y 8) abordan la divulgación en sí y no solo el retorno de números comparativos. Para que la propiedad sea medible, cada dimensión se puntúa en una lista de verificación ordinal explícita aplicada a la interfaz pública y la documentación de una plataforma: cobertura de población (0 = solo conteos brutos, 1 = estadísticas de resumen de toda la plataforma publicadas, 2 = estadísticas distribucionales para poblaciones definidas); granularidad de la clase de referencia (0 = ninguna, 1 = un eje como campo, 2 = condicionamiento conjunto campo × edad × cohorte); estabilidad temporal (0 = definiciones de conteo y ventanas sin documentar o revisadas silenciosamente, 1 = documentadas, 2 = documentadas y versionadas); y auditabilidad (0 = reglas de conteo no publicadas, 1 = descritas en prosa, 2 = publicadas en detalle verificable). El perfil de opacidad de una plataforma es entonces la cuádrupla de puntuaciones en lugar de una etiqueta única. El mismo instrumento puntúa SSRN antes y después de la puesta de sol (moviéndolo hacia abajo en cobertura, granularidad y, para las listas retiradas, granularidad de la clase de referencia), y permite que las comparaciones entre plataformas de Table 6 se expresen como puntuaciones en lugar de impresiones. Una plataforma puede mostrar muchos números y permanecer casi completamente opaca. La rúbrica es una primera operacionalización, para ser refinada y probada inter-evaluadores, no un índice terminado.
2.5 La Demanda de Interpretación
La pregunta que el atardecer hizo urgente ya estaba siendo formulada mucho antes. La Tabla 1 (Sección 1.5) reúne los conglomerados documentados de demanda de interpretación de autores, restringida a fuentes verificadas. El material de foro se cita allí como evidencia de demanda, no de distribuciones, y las citas de publicaciones de usuarios se reproducen solo donde la publicación misma fue localizada (la ética de citar publicaciones de foro semi-públicas se aborda en la Sección 9).
Las afirmaciones negativas que siguen se basan en una auditoría de búsqueda estructurada en lugar de búsqueda casual, como lo hacen las afirmaciones paralelas en las Secciones 1.2, 1.5 (Tabla 1) y 8.8. El protocolo se establece aquí una vez. Construimos un inventario de más de 25 formulaciones de consultas en inglés, organizadas en seis grupos de intención: normativas ("cuántas descargas de SSRN son buenas"), definitoria ("qué incluye el recuento de descargas de SSRN"), de navegación post-atardecer ("clasificaciones de SSRN desaparecidas — dónde comparar"), evaluativa ("descargas de SSRN como evidencia de permanencia"), diagnóstica ("por qué el artículo de SSRN tiene cero descargas"), y práctica ("cómo aumentar descargas de SSRN"). Para cada consulta, registramos quién la responde actualmente y qué tan bien, siendo el criterio si alguna fuente devuelta ofrece valores de referencia graduados y condicionados por el campo en lugar de una descripción de la métrica o una anécdota. Como control positivo, ejecutamos consultas análogas para el h-index, la puntuación de ResearchGate y los recuentos de citas, que obtienen de manera confiable el género de guía de umbral documentado en [118][128]. Las mismas formulaciones de intención para descargas de SSRN no obtuvieron equivalente, antes ni después del atardecer. La brecha se extiende a las referencias comunitarias más ampliamente consultadas: las descripciones al estilo de una enciclopedia de la plataforma describen qué son los contadores pero no ofrecen normas interpretativas para ellos [170]. La auditoría se realizó en julio-agosto de 2026 utilizando una canalización personalizada que abarca motores de búsqueda web de propósito general y motores de respuesta de IA para consumidores, automatizando la ejecución de consultas y la puntuación de calidad de respuesta. La lista completa de consultas está disponible del autor. El resultado es un hallazgo negativo y se reclama únicamente como tal: ausencia de evidencia a partir de la ventana de auditoría, en los idiomas y motores cubiertos, no como prueba de que no pueda existir tal recurso.
Para métricas vecinas, la demanda interpretativa documentada en la Tabla 1 (Sección 1.5) ha sido satisfecha durante mucho tiempo por un género de audiencia masiva: "qué es un buen h-index" es atendido por docenas de guías de umbral graduadas y condicionadas por el campo [118], y las normas de citas a nivel disciplinario son objeto de explicadores ampliamente leídos [128]. Para descargas de SSRN no existe tal género. Peor aún, la mejor guía estructurada que existía, la página de la biblioteca de derecho de University of Washington, continuó después del 15 de julio de 2026 describiendo las clasificaciones de Top Authors y Top Papers en tiempo presente, haciéndola parcialmente engañosa justo cuando la demanda alcanzó su máximo [156, accedido el 14 de agosto de 2026]. El atardecer no creó el problema de interpretación; eliminó la única respuesta parcial que tenía el ecosistema, en el momento en que la memoria institucional de las distribuciones comenzaba a deteriorarse.
3. Lo que muestran los datos: Por qué la media miente
3.1 Qué miden los contadores y qué no miden
Cualquier uso de los contadores supervivientes presupone una cuenta de qué miden. La tabla 3 resume el contenido de medición de cada métrica, sus principales confusiones y el papel diagnóstico que puede desempeñar legítimamente.
Tabla 3. Qué miden las métricas de SSRN y qué no miden.
| Métrica | Interpretación sustantiva más cercana | Principales confusiones | Papel diagnóstico apropiado |
|---|---|---|---|
| Vistas de página de resumen | Alcance a la página de destino de un artículo | Exposición en búsqueda, colocación en plataforma, reputación del autor, promoción externa, título, tamaño del campo, tiempo en línea | Exposición / alcance |
| Descargas de texto completo | Intención de inspeccionar o usar el artículo completo | Todo lo que afecta las vistas, además de la calidad y relevancia del resumen y la fricción de descarga | Participación |
| Descargas por vista de resumen | Transición condicional de la exposición de la página de destino a la adquisición de texto completo | Denominadores pequeños, comportamiento repetido, fuentes de tráfico heterogéneas | Conversión |
| Citas | Incorporación observable en documentos académicos posteriores | Normas de citas del campo, retraso de publicación, cobertura de base de datos, autocita, efectos de estado | Uso académico descendente |
| Señales de Altmetric / PlumX | Participación en línea más amplia | Composición de plataforma y comportamiento del usuario | Evidencia de difusión complementaria |
El contenido de la tabla se puede comprimir en un contraste de dos ecuaciones. La lectura que el panel invita silenciosamente es Descargas = Calidad científica. La representación defendible es
Descargas observadas = f(Q, E, R, C, T, P, ε),
donde Q denota características relacionadas con la calidad o relevancia de la investigación, E exposición, R reputación, C características de comunicación, T tiempo y edad, P mecanismos de plataforma y ε influencias no observadas. La expresión clasifica los confusores; no se especifica ninguna forma funcional ni coeficiente. La clasificación establece exactamente la dificultad práctica: el investigador ordinariamente observa solo el lado izquierdo.
Se aplican dos condiciones de frontera a la tabla. Los contadores no son registros de tráfico sin procesar. SSRN ha filtrado sus recuentos desde al menos los años 2000: la plataforma declara que excluye descargas repetidas aparentes por la misma persona y descargas aparentes de robots, utilizando "cues for irregular activity", y que las descargas anónimas bajo sospecha se excluyen del total del autor [144]. Black y Caron estimaron que sin tal filtrado los contadores se inflarían "by a factor of five or more" [18]. Una descarga contada registra un evento de participación y nada sobre respaldo. Los contadores miden etapas de un proceso de atención. Ninguno de ellos mide el mérito científico, y cada uno se confunde por factores de visibilidad que operan antes de que cualquier lector evalúe el contenido [44][72][144]. Esos límites han sido reconocidos desde los primeros análisis bibliométricos de datos de lectura [91]. Las etapas también pueden desacoplarse una de la otra, a través de dos mecanismos hipotetizados: los artículos sobre temas relevantes para las políticas pueden ser descargados fuertemente por profesionales que leen pero no citan, mientras que los artículos especializados pueden obtener pocas descargas pero ser citados constantemente por la pequeña comunidad de expertos que los necesita. Cualquiera de estos patrones separa la visibilidad del uso descendente, que es una razón por la cual los conjuntos de artículos altamente descargados y altamente citados se superponen solo parcialmente [108].
3.2 Agregados de plataforma y la ficción del promedio
Los únicos números relevantes para la distribución que SSRN publica son los totales de plataforma, y lo primero que hay que observar sobre los datos es lo que sucede cuando esos totales se promedian. La Tabla 4 recopila las estadísticas de plataforma verificadas con sus fechas de corte.
Tabla 4. Estadísticas de plataforma SSRN verificadas, con fechas de corte y estado de verificación.
| Cantidad | Valor | Fecha de corte | Fuente | Estado de verificación |
|---|---|---|---|---|
| Artículos de texto completo | 1,157,048 | 18 Dec 2023 | ALL-SIS Citation Methods White Paper [1] | Verificado contra el PDF publicado |
| Resúmenes | 1,309,385 | 18 Dec 2023 | [1] | Verificado |
| Autores | 1,479,875 | 18 Dec 2023 | [1] | Verificado |
| Descargas acumuladas | 256,678,716 | 18 Dec 2023 | [1] | Verificado |
| Descargas de los últimos 12 meses | 40,642,329 | 18 Dec 2023 | [1] | Verificado |
| Artículos de texto completo (punto de referencia anterior) | 571,040 | 6 Jul 2016 | [1] | Verificado |
| Descargas, últimos 12 meses (punto anterior) | 12,897,685 | 6 Jul 2016 | [1] | Verificado |
| Preimpresiones / artículos; autores | "1.5+ million"; "1.9+ million" | página de producto 2026 | Elsevier SSRN documentación del producto [49], consultado el 14 Aug 2026 | Verificado (cifras de marketing redondeadas) |
| Artículos; autores; descargas totales; descargas últimos 12 meses | >1.7M; >2.4M; >344M; >54M | 1 Nov 2025 | Plantilla de anuncio SSRN [B-6] | Orden de magnitud corroborado; los decimales exactos (344.8M / 54.7M) requieren copias archivadas del anuncio antes de citar |
| Derivado: media de descargas durante la vida útil por artículo de texto completo | ≈222 | Base de diciembre de 2023 | Calculado por el autor: 256,678,716 ÷ 1,157,048 [1] | Aritmética basada en cifras verificadas |
| Derivado: descargas medias por artículo por año | ≈35 | Base de diciembre de 2023 | Calculado por el autor: 40,642,329 ÷ 1,157,048 [1] | Aritmética basada en cifras verificadas |
Las dos últimas filas se calculan por autor y están etiquetadas como tales; SSRN no publica promedios por artículo. Los totales de toda la plataforma difieren según la fuente, la fecha y la definición (texto completo versus artículos totales), por lo que las derivaciones por artículo se toman de las cifras de texto completo reconciliadas de diciembre de 2023 [1]; la plantilla sin procesar de noviembre de 2025 [B-6] se conserva arriba como datos solamente, utilizable exclusivamente junto con copias archivadas (por ejemplo, a través de web.archive.org), ya que las páginas de anuncio originales ya no se pueden recuperar directamente.
En las cifras reconciliadas de diciembre de 2023, el artículo «promedio» de SSRN ha acumulado aproximadamente 222 descargas a lo largo de su vida útil y aproximadamente 35 en el año pasado [1]. Este número derivado es lo más parecido a una norma de toda la plataforma que un autor puede calcular, y es sistemáticamente engañoso, porque el promedio es una ficción de la agregación. Todo estudio empírico de la distribución de descargas de SSRN encuentra una fuerte asimetría a la derecha: la media está muy por encima de la mediana por una larga cola superior, por lo que el «artículo promedio» describe casi ningún artículo real. El resto de esta sección establece el tamaño y las consecuencias de esa brecha. Un agregado adicional importa para la calibración. Las descargas anuales de la plataforma crecieron de aproximadamente 0.5 millones en 2000 a aproximadamente 3 millones en 2005 [18], 12.9 millones en 2016 y 40.6 millones para 2023 [1]. El flujo de descargas por artículo ha aumentado: las descargas anuales crecieron aproximadamente 3.15 veces de 2016 a 2023 mientras que el acervo de artículos creció aproximadamente 2.03 veces [1], elevando el flujo por artículo aproximadamente un 55%. Un estudio anterior, por lo tanto, subestima los conteos absolutos que un artículo comparable obtendría hoy. La dirección hacia la que apunta este sesgo depende de la comparación: un umbral antiguo fijo es un límite inferior en los conteos de hoy, lo que lo convierte en un criterio indulgente, no conservador, cuando se lee como una banda de nivel absoluta de 2026. La manipulación inversa es igualmente no autorizada: un umbral antiguo no puede «envejecerse» en una norma de 2026 multiplicándolo por el crecimiento de la plataforma, porque un repositorio más grande cambia simultáneamente el numerador, el denominador, la composición de autores, los canales de distribución, el filtrado de bots y la competencia por la atención. La lectura con sesgo de antigüedad utilizada en todo se basa en la aritmética agregada de flujo y acervo anterior, no en ningún reescalado de umbrales antiguos. La propia revisión anual de la plataforma confirma un crecimiento continuo: más de 250,000 artículos nuevos se publicaron en 2025 (un aumento del 20% respecto a 2024), con más de 53 millones de descargas durante el año [145].
3.3 La Media No Es el Artículo Típico: Evidencia Directa
La evidencia distribucional publicada más reciente para SSRN proviene de Jo y Li, quienes analizan 2.361 artículos de la Marketing Research Network de SSRN en una única instantánea transversal recopilada el 15 de agosto de 2025 [83]. La Tabla 5 siguiente reproduce sus estadísticas descriptivas en su totalidad, y el mapa de referencia consolidado de la Sección 5 las incorpora. Las descargas promedio fueron 221,346 contra una mediana de 87: la media es aproximadamente 2,54 veces la mediana. El percentil 95, 726, es más de ocho veces la mediana. La media supera incluso el percentil 75 (206), lo que sitúa más de tres cuartas partes de los artículos de la muestra por debajo del «artículo promedio». Un investigador al que se le dijera que el artículo promedio en esta red tiene aproximadamente 221 descargas concluiría que un artículo con 100 descargas está sustancialmente por debajo de lo normal, aunque 100 supera la mediana publicada por un amplio margen. La Figura 2 muestra esta estructura directamente.
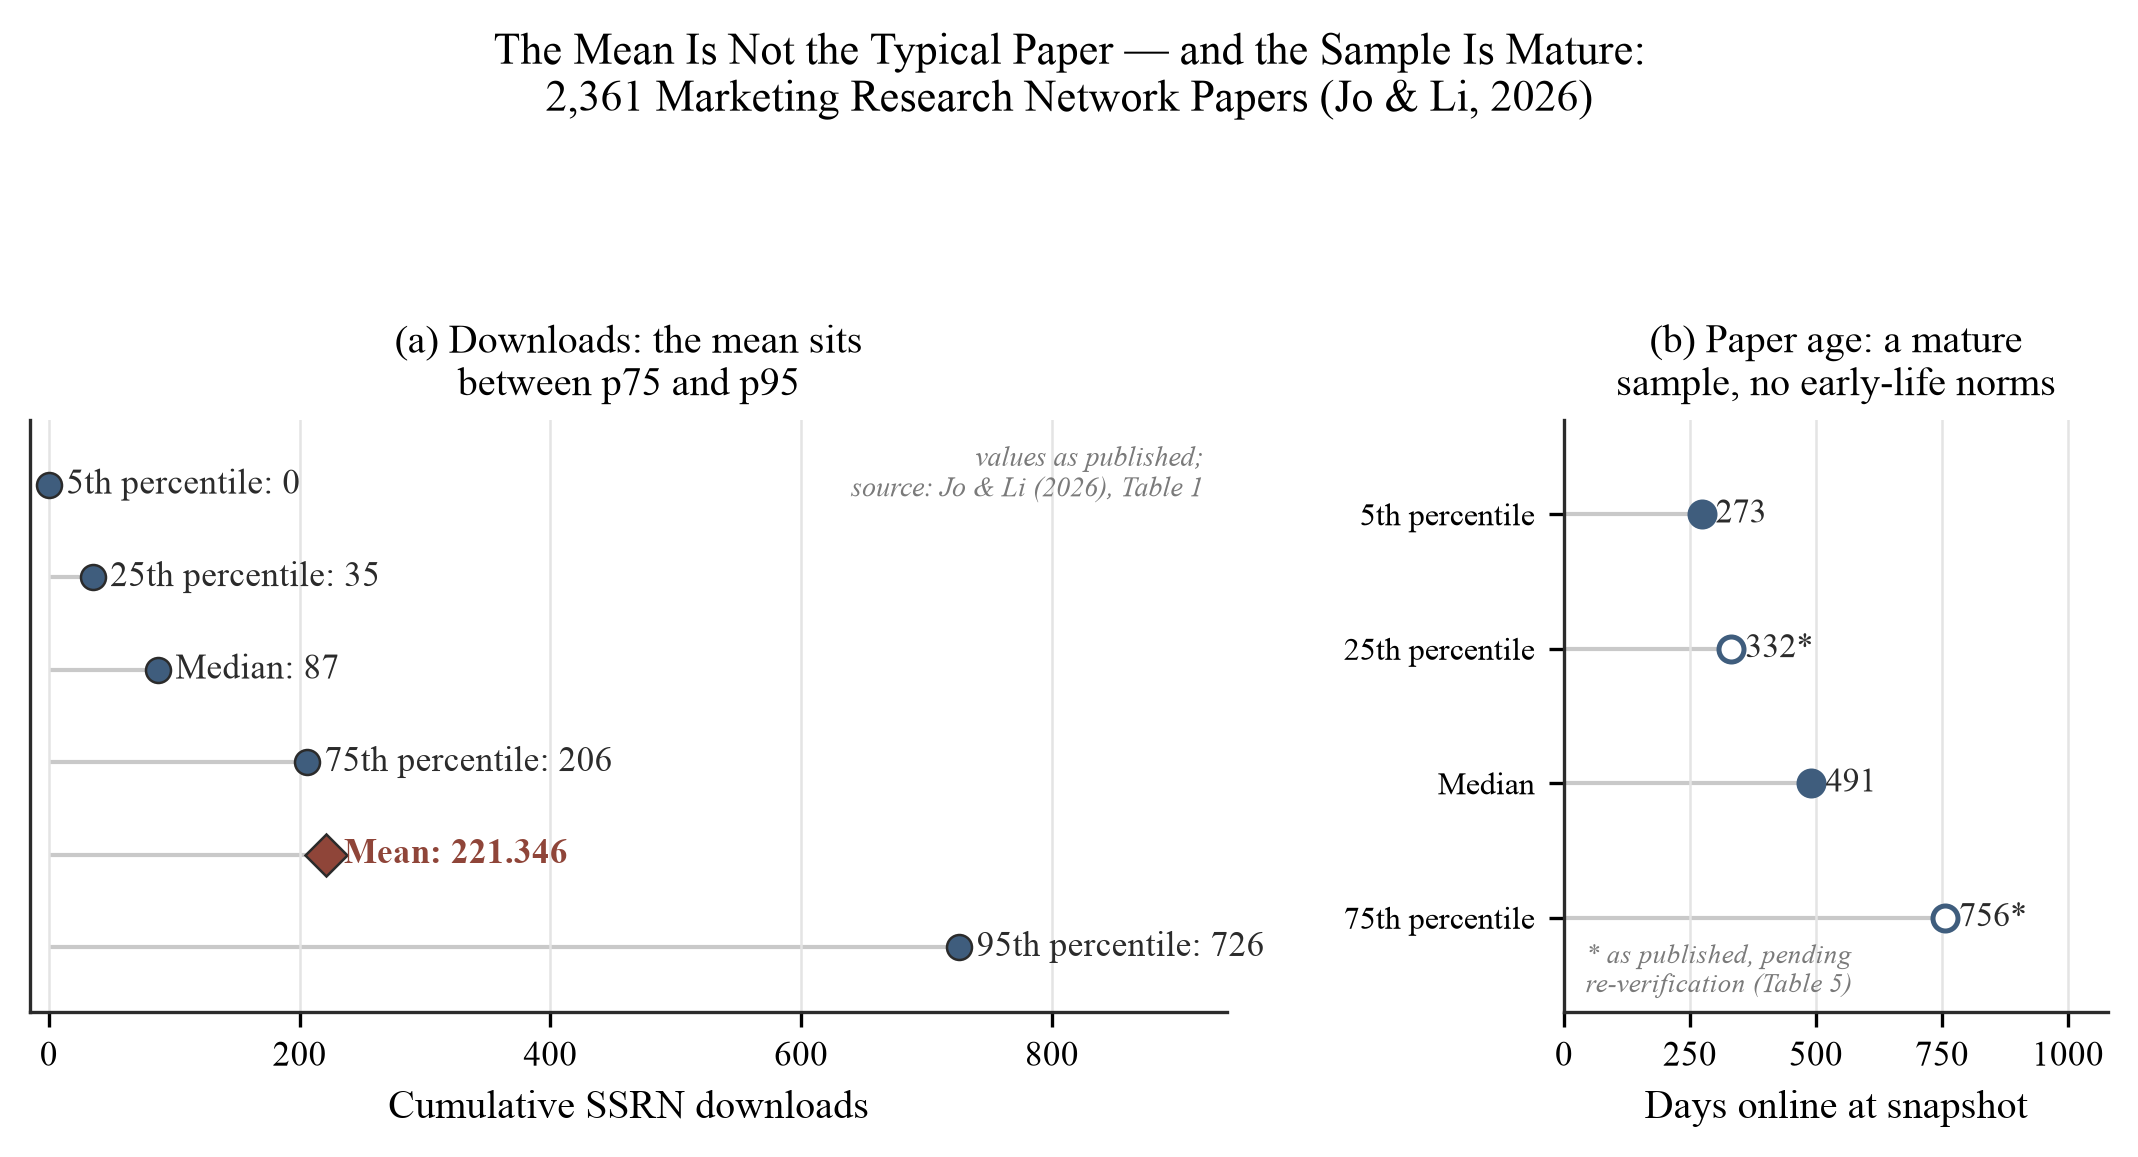
Figura 2. Estadísticas descriptivas publicadas para 2.361 artículos de la Marketing Research Network. Panel (a): descargas — p5 = 0, p25 = 35, mediana = 87, p75 = 206, media = 221,346, p95 = 726, trazados en orden de valor (nótese que la media se encuentra entre p75 y p95). Panel (b): antigüedad del artículo en la misma muestra — percentil 5 de 273 días y mediana de 491 días verificados contra la fuente; los percentiles 25 (332 días) y 75 (756 días) reproducidos «tal como se publicó» (Tabla 5). Dos valores en la Tabla 1 de la fuente están marcados y reproducidos «tal como se publicó», pero son anomalías de diferentes tipos. El percentil 95 de vistas de resumen (966) se sitúa apenas aproximadamente 0,32 DE por encima de la media reportada (611,973; DE 1.100,5) — casi imposible para un recuento tan sesgado cuyo p75 ya es 833 — por lo que es un error de fuente sospechoso, muy probablemente un error tipográfico aunque no se puede descartar un error de transcripción o redondeo, y las otras celdas de la fila de vistas de resumen se tratan como potencialmente afectadas por el mismo error correlacionado (marcado para una consulta de autor a Jo y Li, cuya respuesta aún no está disponible). El percentil 95 de conversión (77,7, contra 27,2 en p75) es un fenómeno diferente: un artefacto de razón de denominador pequeño del tipo exacto que predice la Sección 5.2, no una imposibilidad estadística. El panel de antigüedad hace visible el límite interpretativo: estas son estadísticas de artículos maduros, y la muestra no puede suministrar normas de vida temprana. Fuente: Jo y Li (2026), Tabla 1 [83].
La Tabla 5 reproduce las estadísticas descriptivas completas del estudio, sus variables acompañantes así como la distribución de descargas, porque esta es la única muestra de SSRN publicada con un panel de percentil completo; varias de sus celdas realizan trabajo interpretativo en otras partes de este artículo. Las desviaciones estándar establecen la cola pesada como un número único: una DE de 940,9 contra una media de 221,3 para descargas. El percentil 5 de descargas es exactamente cero, por lo que un contador cero se encuentra dentro del rango normal incluso de una muestra madura. Los percentiles de conversión enmarcan la banda entre estudios de la Sección 5.2 desde ambos lados (p25 = 12,1, mediana = 18,9, p75 = 27,2 por 100 vistas). Los percentiles de antigüedad (rango intercuartílico 332–756 días) fijan la madurez de la muestra, y las filas de autoría y empaque suministran las normas covariables utilizadas en las Secciones 6.4 y 8.3.
Tabla 5. Estadísticas descriptivas publicadas completas de la muestra de Jo y Li (2026), «tal como se publicó» (N = 2.361 artículos de la Marketing Research Network; instantánea del 15 de agosto de 2025). Todos los valores se reproducen de la Tabla 1 [83] de la fuente. El núcleo distribucional — las medias y medianas de descarga y vista, y cuartiles; la media y mediana de conversión; la mediana de antigüedad y percentil 5 — ha sido verificado contra la tabla publicada (véase la Tabla 7). Las celdas restantes (las desviaciones estándar; los percentiles de conversión y antigüedad más allá del núcleo; las filas de autores, páginas y longitud de resumen) se reproducen «tal como se publicó» y no se han rederivado de forma independiente aquí; la existencia, lugar y autoría de la fuente fueron confirmados a través de Crossref el 14 de agosto de 2026. Dos anomalías internas se mantienen «tal como se publicó» y se marcan en lugar de corregirse, y no son del mismo tipo de problema. El percentil 95 de vistas de resumen (966) se encuentra solo aproximadamente 0,32 DE por encima de la media reportada (611,973; DE 1.100,5) — estadísticamente casi imposible para un recuento tan sesgado e inconsistente con el p75 de 833 de la fila — por lo que es un error tipográfico sospechoso en la fuente; las celdas restantes de vistas de resumen se marcan como potencialmente afectadas por un error correlacionado y se rebajan a reverificación pendiente una consulta de autor a Jo y Li. El percentil 95 de conversión (77,704, contra 27,187 en p75) es en cambio un artefacto de razón de denominador pequeño predicho por la Sección 5.2, no una anomalía distribucional del mismo tipo.
| Variable | Media | DE | p5 | p25 | Mediana | p75 | p95 |
|---|---|---|---|---|---|---|---|
| Descargas | 221,346 | 940,855 | 0 | 35 | 87 | 206 | 726 |
| Vistas de resumen | 611,973 | 1.100,536 | 151 | 288 | 504 | 833 | 966 («tal como se publicó») |
| Descargas por 100 vistas de resumen | 23,699 | 20,118 | 0 | 12,105 | 18,944 | 27,187 | 77,704 («tal como se publicó») |
| Disponibilidad en SSRN, días | 550,210 | 230,557 | 273 | 332 | 491 | 756 | 955 |
| Número de autores | 2,578 | 1,705 | 1 | 1 | 2 | 3 | 5 |
| Número de páginas | 32,734 | 29,186 | 1 | 13 | 27 | 46 | 75 |
| Longitud del resumen, palabras | 182,274 | 71,641 | 87 | 137 | 178 | 217 | 295 |
Tres características adicionales del estudio son importantes para la interpretación. Las vistas de resúmenes muestran la misma asimetría a un nivel superior: las vistas medias fueron 611.973 frente a una mediana de 504 (p5 = 151, p25 = 288, p75 = 833; el p95 de 966 se reproduce "tal como se publicó" pero es un presunto error tipográfico de la fuente, solo ≈0.32 SD por encima de la media y por debajo de la cola implicada por un p75 de 833, y no entra en ningún cálculo posterior; ver la nota de la Figura 2), con una tasa de conversión publicada de 23.699 descargas por 100 vistas [83]. El estudio también separa el alcance de la conversión: en el modelo de exposición de Poisson de los autores, el prestigio institucional predijo descargas condicionadas a las vistas de resúmenes (coeficiente 0.192, y para un artículo de tres autores, un autor afiliado a los 50 principales correspondía a una tasa de descarga estimada un 6.6% más alta por vista de resumen), y esta prima de prestigio se debilitó a medida que aumentó la asistencia de IA en los resúmenes (interacción −0.627, p < .01) [83]. SSRN ahora requiere la divulgación del uso material de IA generativa en la presentación [54][56]. Por lo tanto, la atención rastrea señales de estado incluso después de que un lector ha llegado a la página de resumen, lo que es evidencia directa de que los recuentos de descargas incorporan efectos de visibilidad y reputación en lugar de solo evaluación de contenido. La limitación que los autores exponen ellos mismos establece la agenda: una única instantánea de una única red disciplinaria no puede revelar las trayectorias temporales de la atención, e identifican explícitamente los datos de panel como el paso siguiente requerido [83], el paso retomado en la Sección 8.
La muestra es una red en un campo, observada en una fecha: estas cifras no son puntos de referencia SSRN universales, y su valor radica en la estructura. La relación media/mediana de 2.54 y la relación p95/mediana superior a 8 son firmas de sesgo derecho fuerte que recurren en todos los demás cuerpos de evidencia de SSRN, incluida una muestra de una disciplina y década diferentes: en la única muestra de tipo censo de erudición legal, los artículos publicados en la Red de Erudición Legal en 2012 y medidos dos años después (n = 1,107) tenían una mediana de 63 descargas frente a una media de 122.55, una brecha de casi dos veces después de solo dos años de exposición [139].
3.4 La forma de la distribución: cuasi-lognormalidad y la cola larga
La anatomía a gran escala de la distribución fue establecida por Kakushadze, quien analizó las listas públicas de SSRN: 29,985 autores en la lista Top 30,000 y los 367,478 artículos asociados a ellos (una extracción de clasificaciones de 2015) [85]. El hallazgo central es que las descargas son cuasi-lognormales, muy sesgadas con una cola superior larga en niveles y aproximadamente gaussianas en el logaritmo (parámetros ajustados para ln descargas por artículo: media 5.406, desviación estándar 1.016) [85]. Kakushadze extrae explícitamente el corolario práctico de la lognormalidad: la aritmética lineal falla con tales datos. Una aplicación directa del índice h a las descargas no es informativa: los recuentos de descargas son órdenes de magnitud mayores que los recuentos de citas, por lo que el índice se reduce al número de artículos. En su lugar, propone un índice construido sobre la parte entera del logaritmo de las descargas, k = ⌊ln D⌋ [85]. Para la interpretación, esto significa que las diferencias significativas en descargas son multiplicativas, no aditivas. Esta forma no es peculiar de las descargas: la distribución del impacto científico individual es aproximadamente lognormal en sí misma, como el Q-model de Sinatra, Wang, Deville, Song, and Barabási (2016) estableció a lo largo de carreras científicas [181], por lo que la lectura multiplicativa que exigen los contadores es la norma para la atención académica, no un artefacto de SSRN.
El mismo conjunto de datos proporciona los únicos puntos de anclaje de umbral publicados para la distribución superior. La entrada en la lista de los 10,000 artículos principales (aproximadamente el 1,8% superior del stock de artículos de texto completo de la plataforma, 571,040, julio de 2016 [1], consistente con más que por encima de las cifras "top 1–2%" a veces citadas) requería un mínimo de 160 descargas, con una mediana de 805, una media de 1,800, y un máximo de 152,242 [85]. Entre los autores de los 30,000 principales, las descargas totales mínimas fueron 129, el total de autores mediano fue 1,626, las descargas por artículo mediana fueron 210, y el máximo, Michael C. Jensen, fue 824,762 [85]. La escasez persiste a nivel de artículo incluso dentro de esta muestra élite: de los 367,478 artículos analizados, solo 112,793 (aproximadamente 30,7%) tenían suficientes descargas para figurar en el índice logarítmico de sus autores [85]. La mayoría de los artículos individuales de los autores más descargados de la plataforma atraen atención modesta, y fuera de las listas principales la proporción solo puede ser menor. La figura 3 visualiza la distribución ajustada con los umbrales publicados marcados.
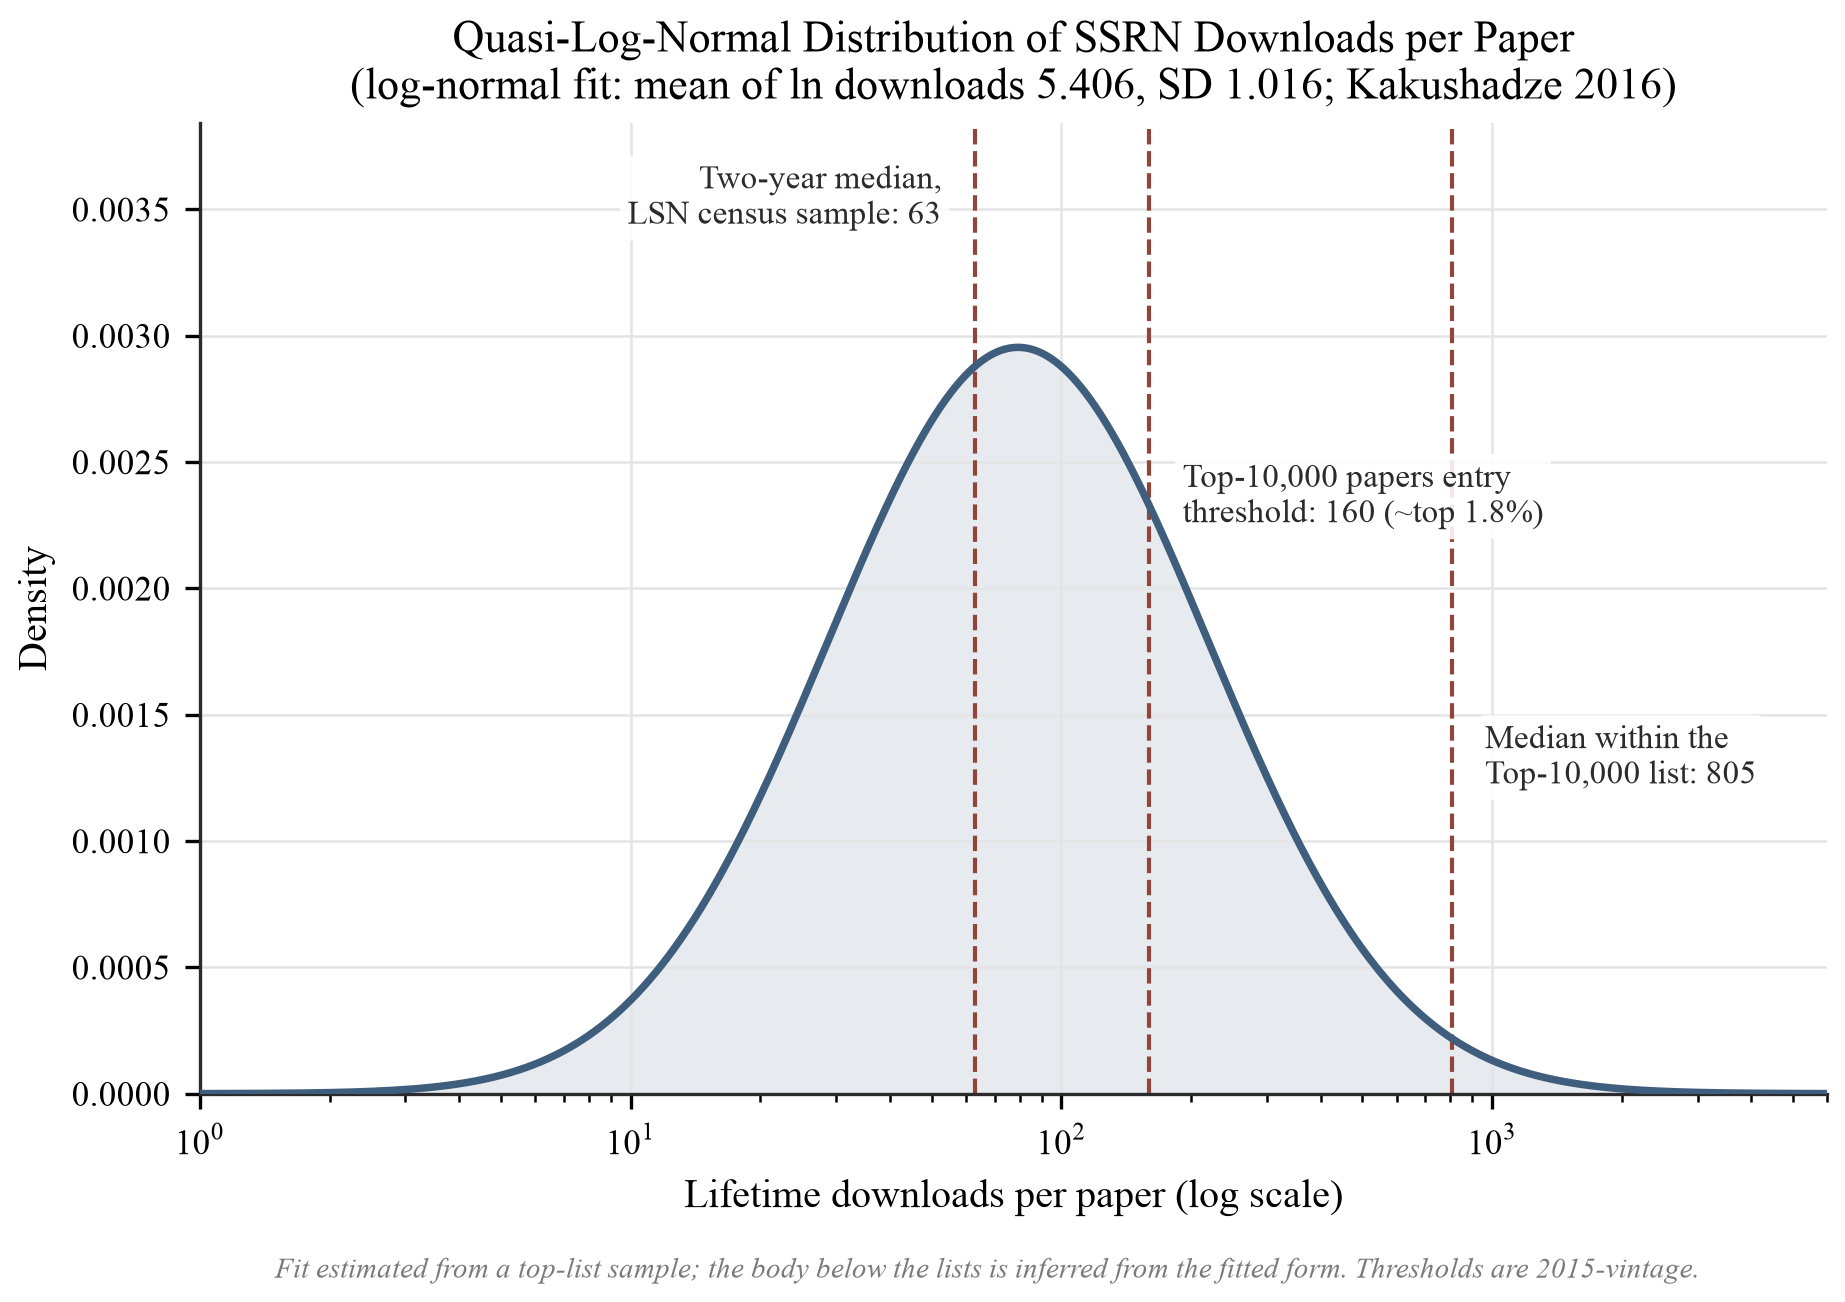
Figura 3. Densidad lognormal ajustada con los parámetros reportados por Kakushadze (media de ln descargas 5.406, DE 1.016) [85]; la mediana ajustada, exp(5.406) ≈ 223, se sitúa aproximadamente 6% por encima de la mediana dentro del grupo por artículo reportada de 210, un ajuste adecuado pero imperfecto a la distribución de la lista principal. Las líneas punteadas marcan la mediana de dos años de 63 descargas de la muestra de investigación jurídica de estilo censitario [139], el umbral de entrada de artículos Top-10,000 de 160 (aproximadamente el 1,8% superior del stock de artículos de texto completo de la plataforma, 571,040 en julio de 2016 [1]), y la mediana dentro de la lista Top 10,000 (805) [85]. El ajuste se estima a partir de una muestra de lista principal — aproximadamente el decil superior de autores de la plataforma — por lo que el cuerpo de la distribución debajo de las listas se infiere de la forma ajustada en lugar de observarse; los umbrales son de 2015 (inflación desde entonces: Sección 5.1). Una precaución cuantitativa es apropiada para la figura porque la curva invita a leer su cola inferior: bajo esta densidad ajustada, las masas implícitas de la cola inferior son P(X ≤ 63) ≈ 10,7% y P(X ≤ 10) ≈ 0,1% — dos a tres órdenes de magnitud por debajo de la proporción de ≤10 descargas de 15–30% que el Estudio 1 (Sección 8.6) predice para una muestra de probabilidad de toda la plataforma. La divergencia no es una contradicción sino una medida directa del dominio del ajuste: una densidad estimada en el decil superior de autores no puede describir la cola inferior que nunca observó, por lo que los marcadores de estilo censitario (mediana de dos años de [139] de 63; la entrada Top-10,000 de 160 y su mediana de 805) se trazan como puntos de referencia externos colocados en la curva ajustada, no como afirmaciones de que el ajuste los reproduce. La distancia entre los marcadores y donde la curva ajustada coloca los mismos valores es en sí misma la evidencia visual de que el cuerpo debajo de las listas no se observa, y ninguna proporción de cola inferior de toda la plataforma debe leerse de esta curva.
Estos puntos de anclaje necesitan dos advertencias. El marco de muestreo es la parte superior de la distribución, por lo que las estadísticas de Kakushadze describen la cola, y la masa de artículos ordinarios debajo de las listas se caracteriza solo a través de la forma lognormal ajustada. La atribución es a un único autor: el estudio es Kakushadze (2016), Journal of Informetrics [85]; una cita errónea recurrente añade un segundo autor y debe evitarse.
Una sección transversal de archivo independiente reportada en el Apéndice E observa el cuerpo de la distribución directamente, en una muestra aleatoria de todos los campos de 1,360 artículos cuyos contadores anteriores a su retirada se recuperan de archivos públicos. Encuentra la distribución observada aproximadamente lognormal (asimetría de ln descargas ≈ 0,18), corroborando en el cuerpo la forma que Kakushadze solo pudo ajustar en la cola, e independientemente reproduce la brecha media-mediana, la banda de conversión, y el multiplicador de campo. Su propio sesgo de selección al alza deja la cola inferior extrema insuficientemente observada. Sin embargo, reproduce el único ancla de distribución completa moderna en la que la síntesis se apoya: la media de la reconstrucción (219) coincide con la media publicada de la red de marketing de 221, por lo que la forma principal es corroborada por una fuente de datos completamente separada también. (Sobre la recuperación de datos web históricos del Internet Archive como método validado de ciencia social, y sobre sus sesgos de cobertura y frecuencia de rastreo, véase Arora, Li, Youtie & Shapira, 2016, Journal of the Association for Information Science and Technology, 67(8), 1904–1915, doi:10.1002/asi.23503.)
3.5 Descalibración por la cola visible
La estructura conjunta de las Secciones 3.2–3.4 explica un error psicológico sistemático. El autor más descargado en el análisis de 2015 alcanzó 824.762 descargas, aproximadamente 500 veces la mediana del propio grupo de autores principales (1.626), y cuatro órdenes de magnitud por encima del artículo típico [85]. Bajo una ley cuasi logarítmica normal, las distancias que importan son multiplicativas: el paso de la mediana de artículos ordinarios (decenas de descargas) al umbral de entrada en la lista superior (160) es menor que el paso de ese umbral a la mediana de la lista superior (805), que a su vez es empequeñecido por la distancia al máximo de la cola [85][139]. Sin embargo, los números que circulan públicamente (anuncios de hitos, perfiles de «autor principal», comunicados de prensa institucionales [101]) se extraen casi exclusivamente de la cola visible. Por lo tanto, los autores calibran «bueno» contra una clase de referencia ubicada cientos de múltiplos por encima de la mediana, mientras que la masa de la distribución se sitúa cerca de la mediana. Una lectura del panel de 7 descargas se experimenta entonces como fracaso incluso donde es ordinaria dada la antigüedad y el campo del artículo. La media participa en el mismo error de forma más leve: como mostró la Sección 3.3, se sitúa por encima del percentil 75, por lo que incluso el «promedio» con apariencia oficial es un punto de referencia contaminado por la cola. Ese es el sentido en el que la media miente: se calcula correctamente y luego se la confunde con un valor típico en una distribución que no tiene valor típico.
Varios cuerpos de evidencia refuerzan la conclusión de que los contadores brutos reflejan la estructura de visibilidad al menos tanto como el contenido. La atención responde a la posición: en las listas de anuncios de arXiv, los artículos que aparecen en posición 1 obtuvieron aproximadamente 83% más citas medianas en astro-ph, un efecto que los autores atribuyen sustancialmente a la visibilidad más que a la auto-selección sola [72]. También responde al retraso en la indexación. SSRN mismo señala que la indexación externa de su contenido por Google Scholar es controlada por los motores de búsqueda y puede tomar «6–9 meses o más» [54, acceso el 14 de agosto de 2026], por lo que los contadores de un artículo joven se generan antes de que un canal importante de descubrimiento haya comenzado a operar. La atención también fluye hacia atrás desde las citas hasta las descargas: ser citado atrae lectores (entre ellos los autores citados y sus propias redes) al artículo que cita, y el análisis de causalidad de Granger encuentra esta ruta de citas a descargas activa para una parte considerable de artículos [80][39], por lo que parte de un contador indexa la posición de un artículo en la red de citación y colaboración en lugar del veredicto de cualquier lector sobre su contenido. Cada uno de estos mecanismos moldea el contador a través de la estructura de visibilidad (posición, retraso de descubrimiento, ubicación de red) en lugar de a través del juicio de un lector sobre la calidad, y ninguno es visible en el número del panel. La economía de atención más amplia muestra la misma concentración de forma extrema: en las redes sociales, los coeficientes de Gini de atención alcanzan 0,90–0,94, con el 1% superior de cuentas recibiendo más atención que el 99% inferior combinado [180], un eco moderno de la máxima de Simon de que una riqueza de información crea una pobreza de atención [141]. La atención académica en SSRN pertenece, de forma más leve, a la misma familia de procesos de difusión sesgada. La audiencia más cómoda en SSRN, economistas y estudiosos del derecho, reconocerán la estructura de las finanzas. El análisis de Bessembinder de datos de CRSP para 1926–2016 encontró que aproximadamente $34,8 billones de creación neta de riqueza del mercado de valores fue atribuible a menos del 4% de las empresas cotizadas, la mayoría de las acciones no lograron superar los bonos del Tesoro durante su vida útil [16]. El paralelo se ofrece como una ilustración, no como una prueba: en la riqueza como en la atención, los totales agregados son generados por una cola extrema delgada, y medirse contra un promedio dominado por gigantes es un error de categoría. Tampoco la escasez se limita a los contadores de uso: en la erudición legal en general, el 43% de los artículos de revistas de derecho en un censo de 2007 nunca fueron citados en absoluto, y solo el 18% de la cohorte de 2015–2019 atrajo una sola cita en cinco años [171].
3.6 El multiplicador de campo: Estructura disciplinaria de la norma
La distribución no es una distribución: difiere de campo a campo. El análisis de Whalen de poco menos de un cuarto de millón de artículos clasificados en los 94 eJournals de la Legal Scholarship Network muestra que la línea base disciplinaria varía aproximadamente por un factor de ocho incluso dentro de una única disciplina paraguas: el promedio de descargas de por vida por artículo osciló entre 438,35 en Derecho Corporativo, de Valores y Finanzas y 53,48 en Derecho y Política Agrícola [168]. La Figura 4 muestra el gradiente.
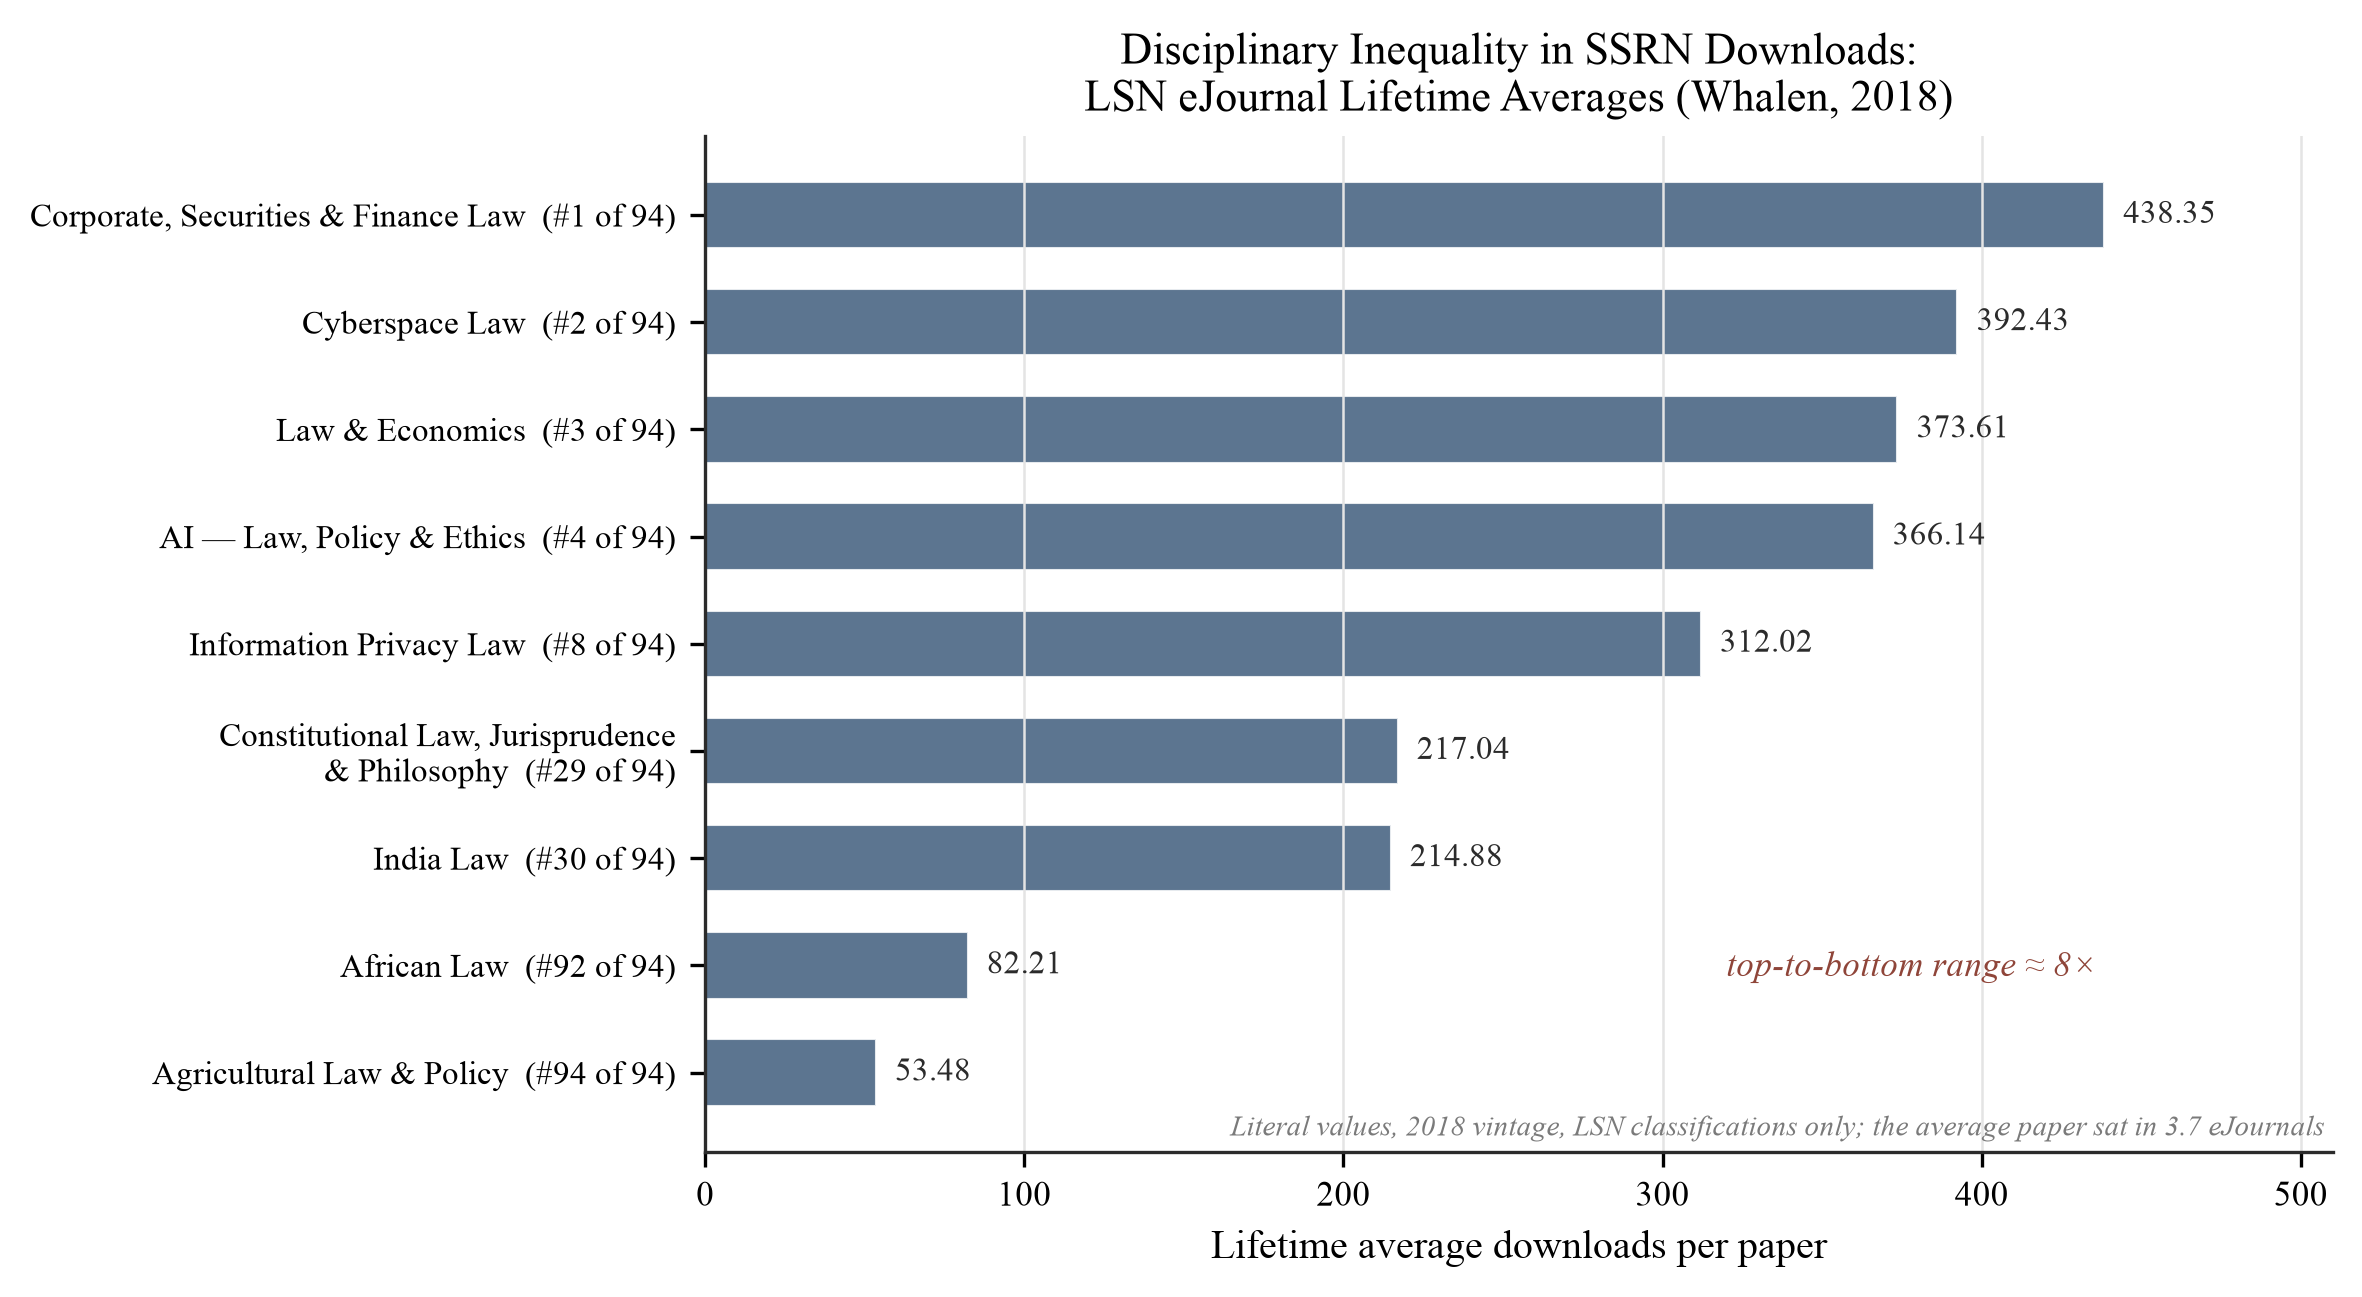
Figura 4. Descargas promedio de por vida por artículo para eJournals LSN seleccionados, valores literales de Whalen (2018) [168]: Derecho Corporativo, de Valores y Finanzas 438,35 (rango 1 de 94); Derecho del Ciberespacio 392,43 (2); Derecho y Economía 373,61 (3); IA – Derecho, Política y Ética 366,14 (4); Derecho de Privacidad de la Información 312,02 (8); Derecho Constitucional, Jurisprudencia y Filosofía 217,04 (29); Derecho Indio 214,88 (30); Derecho Africano 82,21 (92); Derecho y Política Agrícola 53,48 (94). El rango de máximo a mínimo es aproximadamente ocho veces. Los valores son del año 2018 y cubren solo clasificaciones LSN; el artículo promedio fue asignado a 3,7 eJournals.
El mecanismo es estructural más que meritocrático: el descubrimiento de SSRN se basa en la clasificación (los suscriptores a un eJournal reciben alertas para artículos clasificados en él), por lo que la audiencia direccionable de un artículo se fija por la base de suscriptores de su campo antes de que operen señales de calidad. Whalen además descubre que los artículos con más clasificaciones obtienen más descargas y tienen menor probabilidad de registrar cero descargas [168]. La estructura del campo también moldea los contadores a través de la cultura de citas: Black y Caron observaron que las razones de descargas a citas difieren sistemáticamente entre campos porque la erudición legal cita trabajos anteriores más completamente que la economía o las finanzas [18], y dentro del derecho, la atención se concentra en temas y características del autor particulares: en la muestra del censo de 2012, los temas de derecho corporativo e internacional, la autoría estadounidense y la afiliación top-20 predijeron todos recuentos significativamente más altos [139], determinantes que se repiten en comentarios de bibliotecas legales contemporáneos [175]. Por lo tanto, un número que no es notable en derecho corporativo puede ser excepcional en historia legal o derecho agrícola, y cualquier punto de referencia o escala (incluida la construida en la Sección 5) debe leerse como relativa al campo. Hay un precedente bien establecido para esto en el lado de las citas: Radicchi, Fortunato y Castellano (2008) demostraron que las distribuciones de citas se colapsan en una única curva universal solo después de que el recuento de cada artículo se reescala por la media de su campo [182], el análogo de la clase de referencia que este artículo argumenta que los recuentos de uso requieren por igual.
Tres ejemplos, construidos completamente sobre los anclajes verificados anteriores, hacen concretas las apuestas. Un autor en derecho agrícola cuyo artículo tiene 60 descargas de por vida se sitúa por encima de la media de su eJournal de 53,48 [168], sin embargo, calibrando contra los recuentos de derecho corporativo que circulan más visiblemente, puede leer el mismo número como fracaso. Un autor en derecho corporativo y de valores con los mismos 60 se sitúa muy por debajo de la media de ese campo de 438,35 [168]. Y un autor cuyo artículo de marketing alcanza la mediana de la red de 87 [83] puede subestimar un resultado que es, por construcción, típico. El error de la escala faltante va en ambas direcciones: produce desesperación injustificada y deja el éxito sin ser reconocido.
Las Secciones 3.2–3.6 establecen el núcleo empírico de este artículo. La distribución de descargas de SSRN está fuertemente sesgada a la derecha y es aproximadamente lognormal, y la media supera no solo la mediana sino el percentil 75. La cola visible se extiende a 500 veces las medianas de élite y contamina la calibración informal; los contadores incrustan efectos de prestigio, posición, indexación y estructura de campo que operan independientemente del contenido; y la línea base disciplinaria varía ocho veces dentro de un único dominio académico. Un recuento de descargas sin procesar leído contra la media, o contra la cola, es por lo tanto no interpretable por construcción. Una lectura defendible requiere una clase de referencia: una distribución condicionada por campo, edad del artículo y cohorte. Las Clasificaciones, a pesar de todos sus defectos, fueron el único gesto público de la plataforma hacia tal clase de referencia, y su eliminación hace que la construcción de una externa (el mapa de referencia e escala de interpretación de la Sección 5) sea la tarea central del resto de este artículo.
4. La mecánica de los contadores: Un contador bajo una regla
Antes de que cualquier número en un panel de control de SSRN pueda ser interpretado, es necesario establecer qué registra realmente ese número. SSRN muestra dos métricas de uso de nivel de artículo primarias, vistas de resumen y descargas, junto con estadísticas de citas e indicadores PlumX [50]. Después de la retirada de las Clasificaciones el 15 de julio de 2026, estos contadores permanecieron en su lugar: SSRN declaró que "los recuentos de descargas y estadísticas de citas continuarán siendo registrados y mostrados en sus artículos individuales y perfil de autor" [149]. La escala comparativa desapareció, pero los datos permanecieron. Los contadores que permanecen, sin embargo, no son observaciones brutas de la lectura humana: son el producto conjunto de la arquitectura de la plataforma, la maquinaria de distribución, el tráfico no humano y el filtrado de integridad. Cada una de esas capas se descompone a continuación, y la Sección 5 luego construye un marco de interpretación sobre ellas.
4.1 Qué es una vista y un registro de descarga, y qué no son
Una vista de resumen registra una solicitud a la página de destino del artículo. Una descarga registra la recuperación del PDF de texto completo. Ambas son eventos de participación; ninguna es evidencia directa de lectura, comprensión, aval o aprobación científica. Esa distinción delimita todas las afirmaciones presentadas en el resto de este artículo.
Los contadores públicos de SSRN no son simples registros de solicitud HTTP. La plataforma ha aplicado filtrado de integridad de datos desde sus primeros años [69] y ha descrito su enfoque públicamente: las descargas automatizadas, descargas repetidas de sí mismo, e intentos de manipular los conteos se filtran utilizando "señales de actividad irregular," y las descargas sospechosas (incluyendo, en algunas circunstancias, descargas anónimas) se excluyen de los totales presentados al autor [144]. Observadores independientes documentaron el mismo comportamiento anteriormente: las descargas repetidas desde una única dirección IP no se acreditan al contador [66]. El contador de descargas es, por lo tanto, una estadística depurada, materialmente más sólida que un registro de servidor sin procesar. El filtrado elimina la actividad más detectable no humana y manipuladora y nada más. Un contador es siempre un contador bajo una regla y no una unidad natural, y las reglas cambian (Sección 4.3).
4.2 Tráfico no humano y la asimetría entre vistas y descargas
Los agentes automatizados representan más de la mitad del tráfico general de internet en las mediciones recientes de la industria [158]. Esa cifra no puede transferirse a los contadores de SSRN: no se identificó ninguna medición publicada de la proporción de bots en las vistas o descargas de resúmenes de SSRN, y cualquier porcentaje específico afirmado para SSRN carecería de fundamento. Lo que puede establecerse es la estructura del problema, abordado desde dos direcciones: los mecanismos que plausiblemente inflan las vistas, y el registro transparente de filtrado de una plataforma vecina.
Varios mecanismos pueden generar plausiblemente vistas de resúmenes no humanas. Los rastreadores de motores de búsqueda indexan rutinariamente las páginas de resúmenes recién publicadas. Los sistemas institucionales de seguridad del correo electrónico, más prominentemente Safe Links en Microsoft Defender para Office 365, escanean y obtienen previamente las direcciones URL contenidas en los correos entrantes, lo que puede registrar solicitudes del lado del servidor antes de que cualquier destinatario humano abra el mensaje [106]. Debido a que el canal de distribución principal de SSRN es el correo electrónico (Sección 4.4), el escaneo de enlaces en correos de anuncio es una fuente plausiblemente estructural de vistas fantasma. Ningún estudio publicado mide la contribución de la obtención previa de proxy de seguridad a los contadores de vistas de SSRN, y el propio SSRN audita sus métricas y excluye la actividad irregular de los recuentos de descargas [144][66][69], por lo que la plataforma bien podría estar filtrando una parte sustancial de tal tráfico, particularmente en el lado de las descargas. La afirmación de que "la mayoría de las vistas de SSRN no son humanas" aparece en discusiones informales pero nunca ha sido medida.
El caso transparente es RePEc. Su servicio de registro, LogEc, publica tanto su metodología de filtrado como su historial de filtrado, y el registro demuestra cuán severa y cuán asimétrica puede ser la contaminación no humana. Ya en julio de 2007, los robots representaban aproximadamente el 74% de las vistas de resúmenes en los servicios RePEc monitoreados pero solo aproximadamente el 7% de las descargas [99]. El historial de filtrado se lee como una cronología de una carrera armamentista: se añadieron heurísticas contra los escáneres de enlaces antimalware en julio de 2010; se abordó un nuevo tipo de descarga masiva sistemática en enero de 2017; los filtros de mitigación de DDoS introducidos en enero de 2022 eliminaron el 54% de las vistas de resúmenes pero solo el 7% de las descargas [99]. A partir de octubre de 2025, RePEc documentó un aumento del tráfico de bots impulsado por IA haciéndose pasar por usuarios humanos [129]. En septiembre de 2025, más del 99,5% del tráfico sin procesar a IDEAS fue descartado como no humano [129]. Después de la limpieza, el informe de RePEc para junio de 2026 contabilizó aproximadamente 2,36 millones de vistas de resúmenes y 238 mil descargas en todos sus servicios [129].
La evidencia de RePEc respalda dos inferencias para SSRN. La contaminación es asimétrica por construcción: los agentes automatizados rastrean las páginas de resúmenes HTML mucho más agresivamente de lo que ejecutan recuperaciones de PDF de texto completo, por lo que los contadores de vistas se inflan mucho más que los contadores de descargas donde el filtrado es imperfecto. Esa asimetría, robots en ~74% de las vistas pero ~7% de las descargas en la medición de 2007 [99], es una propiedad arquitectónica del tráfico del repositorio y ninguna idiosincrasia de RePEc. Las proporciones específicas no son transferibles: las reglas de filtrado de SSRN, el modelo de distribución y la audiencia difieren, y SSRN no publica un registro de filtrado equivalente. La Sección 5.2 desarrolla la consecuencia práctica, que es que los ratios construidos sobre vistas (como la tasa de conversión) deben leerse como límites inferiores en la calidad de la participación humana, porque el denominador es la cantidad más contaminada. Esta dirección de límite inferior es dependiente de la época en lugar de una ley: se mantiene mientras el filtrado del lado de las vistas se queda atrás del filtrado del lado de las descargas, que es el régimen documentado históricamente [99], pero se debilitaría o invertiría si los filtros de vistas de una plataforma se pusieran al día con sus filtros de descargas, o si la contaminación del lado de las descargas creciera más rápido que la del lado de las vistas (como el episodio de bots de IA 2025–2026 elevó ambos [129]). La dirección debe ser revisada nuevamente cada vez que una plataforma revisa sus reglas de conteo.
Una consideración adicional ha surgido desde que estos regímenes de filtrado fueron diseñados. Los filtros fueron construidos para eliminar solicitudes automatizadas de un recuento destinado a servir como proxy de la atención humana, y esa regla aún elimina ruido. Lo que ya no puede hacer sin examen es tratar el resto como humano, porque tres clases de solicitud automatizada ahora se sientan donde el filtro vio una: rastreos que recopilan texto para entrenamiento de modelos, rastreadores que indexan para un servicio de búsqueda o respuesta, y recuperaciones que un sistema realiza en tiempo real en nombre de una persona que ha pedido algo. Los primeros dos siguen siendo ruido para un recuento de atención. El tercero es un acto delegado con una persona detrás, ya que un sistema que recupera el texto completo de un artículo para responder a la pregunta de un usuario o respaldar una búsqueda bibliográfica ha sido servido el contenido y lo ha utilizado, aunque ninguna persona cargó nunca la página. Una solicitud automatizada no es por sí misma evidencia de que algo haya sido leído. El proxy se ha debilitado, no el filtro: humano contra máquina ya no rastrea de manera confiable la distinción que este artículo necesita, que es si un evento es evidencia de atención académica, humana o delegada.
El Proyecto COUNTER ha comenzado a abordar esto en su vocabulario de informes en lugar de en su filtro. La guía de mejores prácticas sobre el uso de IA, emitida en abril de 2026 y actualizada el 30 de junio de 2026 para Release 5.1.1, pone a disposición un Access_Method opcional de Agent, definido como contenido y metadatos accedidos por un sistema de IA, junto con tipos de métricas específicas de IA, mientras que Release 5.1.1 continúa requiriendo que "la actividad generada por bots y rastreadores tradicionales DEBE ser excluida de todos los informes COUNTER" [125]. El instrumento tiene tres límites que importan aquí. Es una extensión opcional, producida solo en informes que un proveedor elige generar y orientada primero a sistemas de IA integrados en la plataforma propia de un proveedor en lugar de rastreadores entrantes. Sus elementos "NO DEBEN ser incluidos en ninguna Vista Estándar de los Informes COUNTER" [125], por lo que una vista estándar no distinguirá el acceso de agentes incluso cuando un proveedor implemente la guía. Si los eventos de agentes etiquetados se eliminan entonces de los totales predeterminados o se llevan en ellos sin etiquetar es un asunto de implementación sobre el cual la guía no se pronuncia. También clasifica el acceso que fue proporcionado y no el acceso que fue rechazado: la guía establece que "no hay métricas de denegación asociadas específicamente con Access_Method Agent" [125]. Nada de esto llega a un contador público básico en ningún caso, ya que tal contador no es un informe COUNTER y no lleva método de acceso; el estándar es un análogo contra el cual puede ser juzgado, no una descripción del mismo.
El rechazo tampoco es hipotético, y funciona en sentido ascendente respecto a cualquier regla de conteo, pero sus instrumentos difieren en naturaleza y no actúan como uno solo. El archivo robots.txt de una plataforma solicita a agentes nombrados que no rastreen; una reserva de minería de textos y datos afirma una posición legal; los términos de uso vinculan contractualmente; un servicio de desafío retiene la página de los clientes que no pueden completarlo. Solo el último de estos es cumplimiento obligatorio. En la plataforma estudiada aquí, recuperada el 29 de agosto de 2026, robots.txt nombró tres agentes (GPTBot, ChatGPT-User y Google-Extended) y permaneció en silencio respecto a otros, siendo el silencio el comportamiento predeterminado de la Exclusión de Robots que los rastreadores bien comportados leen como permiso; las respuestas llevaban una reserva de minería que apuntaba a la política del editor, que permite la minería para propósitos comprendidos bajo el Artículo 3 de la Directiva de Mercado Único Digital de la UE y requiere una licencia en otros casos; los términos de uso reservan derechos sobre minería de textos y datos y entrenamiento de IA excepto cuando un autor ha elegido una licencia abierta, opción disponible solo desde el 20 de julio de 2026 y con valor predeterminado de todos los derechos reservados; y una única solicitud no autenticada realizada sin un motor JavaScript recibió un desafío gestionado por Cloudflare en lugar de la página. Uno de los agentes nombrados es un recuperador activado por el usuario en lugar de un rastreador de entrenamiento: esa es la clase delegada del párrafo anterior. Estos materiales registran restricciones publicadas y una observación de configuración. No establecen cuántas solicitudes, automatizadas o humanas, fueron rechazadas. Las directivas se honran de manera desigual: en una medición a gran escala del comportamiento del rastreador, algunos agentes respetaban completamente todos los disallows del sitio, pero cumplían con los disallows a nivel de ruta en menos de un tercio de los casos, y otros ignoraban el archivo completamente [87]. Tampoco el efecto colateral es unidireccional, ya que los despliegues de desafío han interrumpido a usuarios humanos legítimos en otros lugares (una biblioteca universitaria registró dos de tales incidentes en los primeros cuatro meses de uso [29]).
Por lo tanto, la asimetría histórica no puede simplemente extrapolarse. La confianza en el hallazgo de 2007, robots en aproximadamente el 74% de vistas de resúmenes pero alrededor del 7% de descargas [99], se basaba en rastreadores que navegaban páginas de inicio y rara vez recuperaban texto completo. Un sistema que recupera documentos para fundamentar una respuesta no tiene razón para detenerse en el resumen, por lo que el lado de descargas ya no puede considerarse inherentemente el recuento más limpio. Donde el tráfico académico bruto se ha medido en 2025–26, la parte automatizada no ha sido marginal, y se ha encontrado dentro de los recuentos de descargas y visitas en lugar de solo en vistas de página: una colección de patrimonio cultural revisó un recuento de visitas de marzo de 2025 de 1,000,000 a 125,000 después de que se eliminó el tráfico de bots sospechosos [167]; una clasificación de proveedores de aproximadamente treinta millones de solicitudes de acceso en un repositorio institucional etiquetó solo alrededor de una cuarta parte de ellas como humanas [98]; y un repositorio que respondía a una encuesta de repositorios abiertos atribuyó al menos una cuarta parte de sus propias descargas de bots, aproximadamente medio millón de solicitudes, a once agentes de IA nombrados [135]. Ninguna de estas cifras es una medición de la plataforma estudiada aquí: se extraen de diferentes plataformas con diferentes, en varios casos ausentes, defensas, y dos de los tres cuentan visitas o solicitudes en lugar de los eventos de descarga que muestra un contador público. Establecen la condición previa en lugar de una magnitud. En el entorno actual, la interpretabilidad de cualquier recuento de uso es una función de la calidad del filtro, y donde una plataforma no publica su filtrado, esa calidad no ha sido auditada.
Dos problemas de identificación se derivan, y se refuerzan mutuamente. Primero la composición: de un contador público de vida útil únicamente, las proporciones de eventos humanos, automatizados convencionales y mediados por agentes no son estimables, y la propia vista de la plataforma puede no ser mejor, ya que se han observado clientes automatizados presentándose como navegadores de escritorio [167]. Respecto a la selección, un contador no puede revelar qué proporción del acceso intentado fue servida, desafiada o excluida antes de que se aplicara cualquier regla de conteo. Las políticas publicadas revelan que existen tales mecanismos. No revelan con qué frecuencia operan, cómo operaron en el pasado, o su efecto en la inclusión. Las solicitudes intentadas, las solicitudes desafiadas, los eventos de acceso a texto completo servido, las descargas mostradas y las respuestas generadas a partir de un artículo recuperado son, por lo tanto, cinco poblaciones diferentes, y no deben tratarse como intercambiables. Lo que permanece indeterminado para esta plataforma es tanto una magnitud como una dirección. El uso académico sin filtrado ahora se sabe que puede ser inflado por tráfico automatizado, incluyendo descargas, pero no se ha medido si los filtros no publicados, las reglas de desafío y las políticas de rastreador de esta plataforma dejan un residuo de mayor peso humano, una brecha en el descubrimiento mediado por agentes, ambos o ninguno. Tampoco la mezcla es estable a lo largo de los años que abarca un recuento de vida útil total, que se extienden desde un período de robots anterior a 2024, pasando por la oleada de raspado de 2025–26, hasta un cambio de licencia predeterminado introducido en julio de 2026. Las consecuencias posteriores de esta cuestión están documentadas: los sitios que bloquean un rastreador importante de IA son recuperados mucho menos frecuentemente por motores de respuestas de IA incluso cuando el contenido sigue siendo accesible [70]. No existe estimación publicada de la proporción de agentes para ningún servidor de preimpresión importante; es una brecha de investigación, no evidencia de un pequeño efecto, y la auditoría especificada en la Sección 8 está diseñada para medirla. Un recuento total de vida útil público es una suma sobre una mezcla desconocida, extraída de una proporción desconocida de acceso intentado, sin estimador externo para ninguno de ellos y sin fundamento para asumir que sean invariables.
4.3 Contadores que caen como eventos de medición
Los contadores también pueden disminuir o ser reformulados cuando cambian las reglas de filtrado, una consecuencia adicional del registro de filtrado que ningún panel explica. La revisión del filtro de RePEc de enero de 2022 eliminó la mitad de las vistas de resúmenes previamente contadas en un solo paso [99]. Su episodio de bot de IA de 2025–2026 obligó a cambios metodológicos adicionales [129]. Las estadísticas de descargas reportadas por proveedores se sabe, en general, que son sensibles a las convenciones de conteo: una auditoría de la biblioteca encontró que los informes de descargas de un editor importante fueron aproximadamente el doble de altos que en plataformas comparables, con conteos "deflacionados" del 43% de la cifra reportada [176]. Una caída repentina en los contadores de SSRN de un autor es por lo tanto tan probable que sea un evento de medición, un cambio de filtrado o reformulación del lado de la plataforma, como un evento de lectura, y nunca debe ser interpretado como pérdida de reputación sin corroboración. El mismo razonamiento rige cualquier uso de métricas en un dossier, donde deben preservarse los registros fechados (un protocolo desarrollado en la Sección 6). Los números de la plataforma pueden ser revisados, y el archivo fechado del autor no puede ser revisado.
4.4 Empuje versus extracción: la arquitectura da forma a la proporción
La arquitectura de distribución es la última capa mecánica. Difiere cualitativamente entre los principales repositorios e influye directamente en la relación entre visualizaciones y descargas. SSRN opera predominantemente en un modelo de empuje. Al presentar, los autores seleccionan entre una y siete clasificaciones temáticas (el artículo LSN promedio llevaba 3,7 asignaciones de eJournal [168]), y estas determinan la colocación en redes de investigación y la elegibilidad para alertas de correo electrónico de eJournal específicas del tema. La inclusión en una alerta es "curada y dirigida, no garantizada", y la distribución en temas de alto volumen puede tomar hasta 45 días [53]. Los suscriptores reciben anuncios a nivel de resumen por correo electrónico [57]. Cada destinatario que hace clic en un anuncio, ya sea por interés enfocado o curiosidad leve, registra una visualización de resumen. arXiv, en contraste, opera predominantemente como una plataforma de extracción: un repositorio sin fines de lucro cuyo tráfico es impulsado por investigadores que visitan activamente listados y fuentes [11][65], donde incluso la posición dentro de una lista de anuncios diaria afecta mediblemente la lectura y las citas [72]. RePEc agrega metadatos de archivos descentralizados y aplica el filtrado pesado documentado descrito anteriormente [99][129].
La Tabla 6 resume la comparación entre plataformas como un esquema cualitativo de gobernanza y mecánica de descubrimiento. Los datos de tráfico comparable entre plataformas no existen en el registro publicado.
Tabla 6. Arquitecturas de plataformas y su efecto mecánico en las métricas de uso (esquema cualitativo).
| Característica | SSRN | arXiv | RePEc / IDEAS |
|---|---|---|---|
| Gobernanza | Comercial (Elsevier, desde mayo de 2016) [46] | Sin fines de lucro (Universidad de Cornell) [11] | Red voluntaria descentralizada [99] |
| Canal principal de descubrimiento | Empuje: alertas de correo electrónico de eJournal curadas impulsadas por clasificaciones seleccionadas por el autor (1–7; distribución hasta 45 días en temas de alto volumen) [53][57] | Extracción: visitas impulsadas por la intención a listados y fuentes; efectos posicionales dentro de anuncios documentados [11][72] | Agregación de archivos distribuidos; descubrimiento a través de IDEAS/EconPapers [99] |
| Transparencia del filtrado | Política descrita cualitativamente; sin registro público de filtrado [144] | No publicado centralmente para métricas de uso | Metodología completamente documentada e historial de revisión (LogEc) [99][129] |
| Efecto mecánico esperado en la proporción visualización : descarga | Visualizaciones elevadas respecto a descargas: los clics en correos electrónicos registran visualizaciones desde exposición de baja intención | Mayor conversión de visitas en descargas: el tráfico es impulsado por la intención | Proporción significativa solo después del recorte pesado de bots; los conteos publicados son posteriores al filtro [129] |
La arquitectura influye en la psicología del autor, ya que una alta proporción de visualización a descarga en SSRN es en gran medida un resultado de diseño: el modelo de empuje genera una exposición amplia de baja intención. El escaneo de resúmenes también es un comportamiento académico legítimo (los investigadores monitorean rutinariamente campos a través de resúmenes sin descargar textos completos), por lo que una visualización que no se convierte puede significar que el resumen ya entregó su carga informativa en lugar de repeler al lector. La propia regla general histórica de SSRN, reportada por Black y Caron, fue que aproximadamente "tres visualizaciones de resumen… resultan en una descarga real de artículo" [18]. Los mismos autores señalaron que sin filtros de integridad, los contadores brutos se inflarían "por un factor de cinco o más" [18]. La Sección 5.2 coloca estos anclajes fechados junto a mediciones modernas.
Dos características mecánicas de cómo se presenta un artículo rigen la conversión junto con el interés del lector, lo que hace que la tasa de conversión medida sea en parte una propiedad de la interfaz en lugar de la investigación. Una es la interfaz de usuario de la plataforma. Si el texto completo se ofrece como una representación HTML en línea en el navegador o solo como un PDF descargable cambia materialmente si un lector interesado activa el contador de descargas, ya que un lector que consume el texto completo en el navegador satisface la misma intención mientras incrementa solo las visualizaciones. La otra es la composición de dispositivos de la audiencia. El acceso móvil reduce la recuperación de PDF de texto completo respecto al escritorio, por lo que un artículo cuyos lectores llegan predominantemente en teléfonos (desde un enlace de redes sociales o un cliente de correo móvil) registrará sistemáticamente descargas más bajas y visualizaciones comparativamente más altas para un interés académico idéntico. Ambos efectos van en la misma dirección que la inflación mecánica del denominador ya establecida anteriormente, y ambos son razones adicionales para leer la banda empírica de la Sección 5.2 como un rango condicional de plataforma en lugar de un umbral fijo: una norma de conversión estimada en la interfaz de una plataforma y la mezcla de dispositivos debe recalibrarse en lugar de trasplantarse cuando algo cambia. La literatura de métricas de uso plantea la misma precaución de confiabilidad sobre la comparabilidad de informes de descarga entre plataformas y convenciones de conteo [176].
4.5 Consecuencias predecibles: autocoincidencias de similitud e higiene de metadatos
Dos consecuencias mecánicas adicionales del depósito de preimpresiones son predecibles, y ambas generan rutinariamente alarma innecesaria, por lo que ambas corresponden al resto de la maquinaria.
La autocoincidencia de similitud. Cuando un documento de trabajo depositado en SSRN se envía posteriormente a una revista, la revisión de similitud de la revista marcará, en el caso esperado, una coincidencia casi total con la preimpresión propia del autor. La documentación de iThenticate establece explícitamente ambas partes de la interpretación: el software "no verifica el plagio; verifica la similitud" y "si ve una coincidencia de preimpresión del mismo autor, esto no es plagio" [81]. El mecanismo también está documentado. Las preimpresiones registradas como Contenido Depositado de Crossref se incluyen en las bases de datos de comparación de verificación de similitud, por lo que una coincidencia con la preimpresión propia depositada es el sistema funcionando como se diseñó [36]. Las coincidencias pueden surgir incluso cuando los editores excluyen fuentes de preimpresión, porque los agregadores secundarios que duplican metadatos del repositorio también se rastrean [81]. La respuesta del autor debe ser administrativa en lugar de defensiva: identificar la fuente marcada ante el editor responsable como la preimpresión propia del autor con marca de tiempo. La orientación de Crossref e iThenticate aconseja una revisión editorial cualitativa en lugar de umbrales de puntuación de similitud mecánicos [36][81]. No se especifica ningún umbral numérico aquí, ya que ninguno es aprobado por los servicios de detección mismos. La compostura que este consejo presupone tiene una base documentada en la política editorial: el depósito de un documento de trabajo en un servidor de preimpresiones está permitido bajo las políticas de publicación previa de la mayoría de las revistas académicas, aunque las políticas varían y debe verificarse la política actual de la revista objetivo; las posturas sobre preimpresiones se indexan públicamente en registros como Sherpa Romeo. Las excepciones destacadas se agrupan en medicina y campos clínicos adyacentes, donde algunas revistas aún restringen o desaconsejan el depósito previo de preimpresiones. Los autores en esos campos deben verificar la política de preimpresión de la revista objetivo antes de depositar en lugar de después de enviar.
Detección de escritura IA: un canal de falsa alarma adyacente. Una capa de detección más nueva conlleva un riesgo estructuralmente similar de falsa alarma. Los detectores de escritura IA producen falsos positivos documentados, y la carga recae de manera desproporcionada en escritores de inglés como segundo idioma: en una evaluación de Stanford de siete detectores GPT disponibles públicamente (el estudio no incluyó Turnitin), un promedio del 61,3% de los ensayos TOEFL escritos por hablantes no nativos fueron clasificados erróneamente como generados por IA [97]. La práctica institucional ha registrado la preocupación. En agosto de 2023, la Universidad de Vanderbilt desactivó públicamente la función de detección de IA de su software de verificación de similitud, citando su falta de confiabilidad: la tasa de falsos positivos reclamada por el proveedor, la ausencia de cualquier metodología de detección publicada y la misma carga desproporcionada en escritores de inglés como segundo idioma documentada anteriormente [163]. La postura defensiva aquí es paralela a la autocoincidencia de similitud y es administrativa en lugar de adversarial: preserve el historial de versiones del manuscrito y los registros de redacción como prueba contemporánea de autoría (un argumento adicional para la higiene de versiones a continuación), y responda cualquier marca con documentación en lugar de alarma.
Versionado e higiene de metadatos. Debido a que los contadores se acumulan por página de documento, la práctica de revisión afecta directamente la integridad de las métricas. SSRN admite publicar versiones revisadas en la misma página de documento, preservando los contadores acumulados y la URL indexada, mientras que eliminar un documento e reenviarlo restablece las métricas e interrumpe los enlaces existentes (Preguntas frecuentes de SSRN; una página de soporte sujeta a revisión, accedida el 14 de agosto de 2026 [B-7]). Las opciones de clasificación también tienen consecuencias métricas, ya que determinan el enrutamiento de revistas electrónicas y, por lo tanto, los eventos principales de exposición del documento [53]. La indexación externa se ejecuta en un reloj más largo del que los autores esperan: SSRN afirma que la indexación de Google Scholar es controlada por el motor de búsqueda y puede tardar "6 a 9 meses o más" [55]. Los contadores iniciales de un documento se generan, por lo tanto, casi en su totalidad por la maquinaria de distribución interna de la plataforma, que ancla la interpretación de ceros iniciales en la Sección 5.6.
5. Un Marco de Interpretación: Reconstruyendo la Escala Faltante
La pregunta "¿es este número bueno?" es científicamente mal planteada hasta que se especifique un grupo de comparación. Esta sección reúne el registro empírico publicado en el aparato comparativo faltante: un mapa de referencia consolidado con confianza de fuente explícita (5.1), una banda de conversión empírica (5.2), una escala de interpretación graduada (5.3), un diagnóstico de alcance-conversión bidimensional (5.4), una especificación de referencia multidimensional (5.5) y un protocolo de lectura temporal (5.6). Los valores se indican en todo momento con sus marcos de muestreo y antigüedad. Ninguno es un percentil calibrado para la plataforma 2026, y todos deben leerse sujetos a la advertencia de inflación de la Sección 5.1.
5.1 Mapa de referencia consolidado
La Tabla 7 consolida todos los puntos de referencia publicados utilizables para métricas de uso de SSRN identificados en la auditoría de la Sección 2.5, cada uno con su marco de muestreo y una declaración explícita de confianza en la fuente. Dado que un punto de referencia se utiliza incorrectamente en el momento en que se extiende más allá de su marco, cada entrada también nombra el rol inferencial que la fuente puede jugar legítimamente y la limitación principal que lo delimita. La evidencia es limitada: el mapa se basa en cinco estudios con marcos distintos: una muestra de estilo censal de una red legal en 2012 [139], una recopilación de las listas principales propias de la plataforma en 2015 [85], una instantánea transversal de una sola red en 2025 [83], agregados a nivel de plataforma [1], y una descomposición de un subcampo [168]. Estos marcos no son intercambiables: los raspados de listas principales describen la cola de élite, los censos de redes describen artículos típicos y los agregados de plataforma no describen ninguno. Cada distribución involucrada también está fuertemente sesgada hacia la derecha, por lo que los promedios sistemáticamente superan las medianas y describen artículos atípicos.
Tabla 7. Mapa de referencia consolidado para métricas de uso de SSRN, con marcos de muestreo, confianza en la fuente, roles inferenciales permitidos y limitaciones principales.
| Punto de referencia | Valor | Fuente (año; marco de muestreo) | Confianza en la fuente | Rol inferencial permitido | Limitación principal |
|---|---|---|---|---|---|
| Descargas de artículos medianos después de ~2 años en la plataforma | 63 (promedio 122.55) | Siems 2016 [139]; n = 1,107 documentos LSN publicados en dos ventanas de 2012, contadores leídos dos años después | Medio-alto: cifras de muestra y descarga verificadas; solo derecho; cohorte de 2012 | Vista histórica de la distribución de artículos ordinarios | Un ancla de red legal de dos años, no una norma actual de toda la plataforma |
| Visualizaciones de resúmenes de artículos medianos después de ~2 años | 369 (promedio 564.62; correlación vistas–descargas 0.852) | Siems 2016 [139] | Medio-alto: cifras verificadas contra la Tabla 1 de la fuente; solo derecho; cohorte de 2012 | Vista histórica del alcance de artículos ordinarios | Marco de edad similar y disciplina única; los contadores de visualizaciones son la cantidad más contaminada (Sección 4.2) |
| Descargas de artículos medianos, instantánea de red única | 87 (promedio 221.3; p25 = 35; p75 = 206; p95 = 726; edad mediana del artículo 491 días) | Jo & Li 2026 [83]; N = 2,361 artículos de Marketing Research Network, instantánea del 15 de agosto de 2025 | Alto: verificado contra la tabla publicada; nota dos anomalías de diferentes tipos reportadas «tal como se publicó» — vistas p95 = 966 es un presunto error tipográfico de la fuente (≈0.32 SD por encima de la media; fila degradada para reverificación), conversión p95 = 77.7 es un artefacto de relación de denominador pequeño (Sección 5.2); panel completo en la Tabla 5 | Distribución transversal reciente y modelo de conversión | Una red, un campo, una fecha; artículos maduros; sin trayectorias |
| Visualizaciones de resúmenes de artículos medianos, instantánea de red única | 504 (promedio 611.973; p5 = 151; p25 = 288; p75 = 833; p95 = 966 «tal como se publicó») | Jo & Li 2026 [83]; misma muestra que arriba | Alto: verificado contra la tabla publicada; el valor p95 (966) es un presunto error tipográfico de la fuente — ≈0.32 SD por encima de la media — reproducido «tal como se publicó» y degradado a reverificación pendiente de consulta del autor | Distribución de alcance transversal reciente | Marco de red única y fecha única igual |
| Conversión vistas→descargas, banda empírica | 11–19% (≈ una descarga cada 5.3–9 visualizaciones de resumen) | Siems 2016 [139]; Willey & Knapp 2022/23 [172]; Jo & Li 2026 [83] | Medio-alto: cifras de Siems, Willey–Knapp y Jo & Li verificadas contra las tablas de fuentes | Norma de compromiso condicional (conversión) | Pocos marcos de muestreo; el denominador es inflable por bots, por lo que la conversión medida es un límite inferior mientras que las vistas siguen siendo el contador más inflado (Sección 4.2) |
| Regla práctica histórica de toda la plataforma | ~3 visualizaciones de resumen : 1 descarga (~33%) | Black & Caron 2006 [18], reportando la estadística propia de SSRN | Medio: verificado textualmente; fechado (2006); de toda la plataforma | Anatomía de métrica e historia de integridad | Era temprana de la plataforma; un ancla superior, no una norma actual |
| Umbral de entrada, artículos Top-10,000 de todos los tiempos | ≥160 descargas de por vida (≈ top 1.8% del acervo de artículos de texto completo de la plataforma, 571,040 en julio de 2016 [1]); mediana dentro del grupo 805; promedio 1,800; máximo 152,242 | Kakushadze 2016 [85]; recopilación de listas principales de SSRN, 2015; 367,478 artículos | Alto: verificado contra las tablas publicadas; marco de lista principal; trabajo de autor único | Forma de distribución y comportamiento de cola | Selección de lista principal; inadecuado para estimar el artículo mediano contemporáneo |
| Umbral de entrada, autores Top-30,000 | 129 descargas totales (mínimo); mediana dentro del grupo 1,626 totales; mediana 210 descargas por artículo; máximo 824,762 | Kakushadze 2016 [85]; el grupo de cartas propias de SSRN descrito como el «top 10%» de autores [161] | Alto: verificado contra las tablas publicadas | Comportamiento de cola a nivel de cartera de autores | Misma selección de lista principal; vintage de 2015 |
| Media de vida sin ajustar de toda la plataforma | ~222 descargas por artículo (~35 en los últimos 12 meses) | Calculado a partir de totales de plataforma a partir de diciembre de 2023: 256,678,716 descargas de por vida en 1,157,048 artículos de texto completo; ALL-SIS 2024 [1] | Medio: agregado derivado; inflado mecánicamente por artículos antiguos; no es una vara de medir personal | Calibración de agregado solo de escala de plataforma | Un promedio de dos décadas de acumulación; describe casi ningún artículo real (Sección 3.3) |
| Dispersión de subcampo dentro de una disciplina única | ~8× en descargas promedio por artículo (438.35 Derecho Corporativo/Valores/Finanzas vs 53.48 Derecho Agrícola) | Whalen 2018 [168]; 94 revistas electrónicas LSN, ~250,000 artículos | Medio-alto: verificado desde la fuente; 2018; promedios, no medianas | Clasificación y heterogeneidad de subcampos | Promedios, no medianas igualadas por edad; solo derecho; 2018 |
| Descargas tempranas → citas posteriores | r ≈ 0.39–0.43 durante los primeros 180 días (≈16% de la varianza explicada) | Brody, Harnad & Carr 2006 [25]; arXiv (HEP), N = 14,442 | Alto: verificado; plataforma diferente, transferabilidad asumida en lugar de mostrada | Validación predictiva descendente | Plataforma y era diferentes; las correlaciones a nivel de artículo son modestas |
| Estructura de calendario de acceso; retraso acceso→citación | Accesos ~11% más bajos en fines de semana y ~50% más bajos en verano; respuesta de citación de elasticidad unitaria aproximada ~9 meses después de un cambio de acceso | Yuret 2026 [178]; >1,500 artículos de siete revistas seguidos ~1 año | Alta: DOI, lugar de publicación y título verificados a través de Crossref (14 de agosto de 2026); las cuatro cifras — más de 1,500 artículos de siete revistas, accesos aproximadamente 11% más bajos en fines de semana y aproximadamente 50% más bajos en verano, y una respuesta de citación de elasticidad unitaria aproximada (un aumento del 10% en los accesos asociado con aproximadamente un 10% de aumento en las citaciones) aproximadamente nueve meses después — verificadas literalmente contra el resumen del artículo publicado (Springer, 15 de agosto de 2026) | Normalización temporal y validación predictiva — el anclaje de normalización de calendario detrás de CSAB | Datos de acceso de revistas, no específicos de SSRN |
| Sensibilidad de los recuentos a convenciones de conteo | Los informes de descarga de proveedores pueden ser ~2× superiores a los de plataformas comparables (recuentos "deflacionados" al 43% de la cifra informada); las métricas a nivel de artículo requieren un filtrado explícito de integridad de datos | Wood-Doughty et al. 2019 [176]; Gordon et al. 2015 [69] | Medio-alta: ambas fuentes verificadas y ya citadas en las Secciones 4.1–4.3 | Advertencia de integridad y comparabilidad — limita la precisión de cualquier comparación entre plataformas o entre proveedores | No es un punto de referencia directo de SSRN; no existe una auditoría específica de SSRN |
A continuación se presentan tres lecturas estructurales del mapa.
La media no es el artículo típico. En la única distribución publicada reciente, la media (221.3) es 2.54 veces la mediana (87) e incluso supera el percentil 75 (Sección 3.3) [83]. En el censo anterior de Siems, la media era aproximadamente el doble de la mediana [139]. La media a nivel de plataforma de ~222 descargas de por vida [1] es la vara de medida personal menos adecuada de todas: agrega dos décadas de acumulación por artículos de todas las edades.
Cada punto de referencia tiene un año de referencia, y la dirección del sesgo de antigüedad depende de la comparación. Las descargas anuales de la plataforma crecieron de aproximadamente 0.5 millones en 2000 y 3 millones en 2005 [18] a 12.9 millones en 2016 y 40.6 millones en 2023 [1], un aumento de 3.15 veces entre 2016 y 2023, mientras que el stock de artículos creció aproximadamente 2.03 veces en el mismo periodo (571,040 a 1,157,048 [1]). La Figura 5 muestra esta trayectoria. Porque las descargas crecieron más rápido que el stock de artículos, el flujo de descargas por artículo aumentó aproximadamente un 55% (de aproximadamente 22.6 a aproximadamente 35.1 por artículo por año [1]), por lo que un umbral fijo de 2015 ahora representa una menor proporción de lo que un artículo típico gana que entonces. Leído como una banda de nivel absoluto para 2026, un umbral antiguo como la entrada de lista superior de ~160 descargas es por lo tanto permisivo en lugar de conservador: superarlo es menos selectivo hoy que en 2015, no más. El sesgo depende de la composición. Para la posición de percentil bajo sesgo continuo hacia la derecha, los antiguos anclajes aún pueden subestimar la cola, pero para recuentos absolutos la inflación de descargas los hace blandos, por lo que ningún umbral antiguo debe citarse como un "piso conservador" sin esta aclaración. Multiplicar un umbral de 2015 por el crecimiento de plataforma posterior es igualmente injustificado: la composición de autores, los canales de distribución, el filtrado y la competencia por la atención todos cambiaron junto con el flujo de descargas.
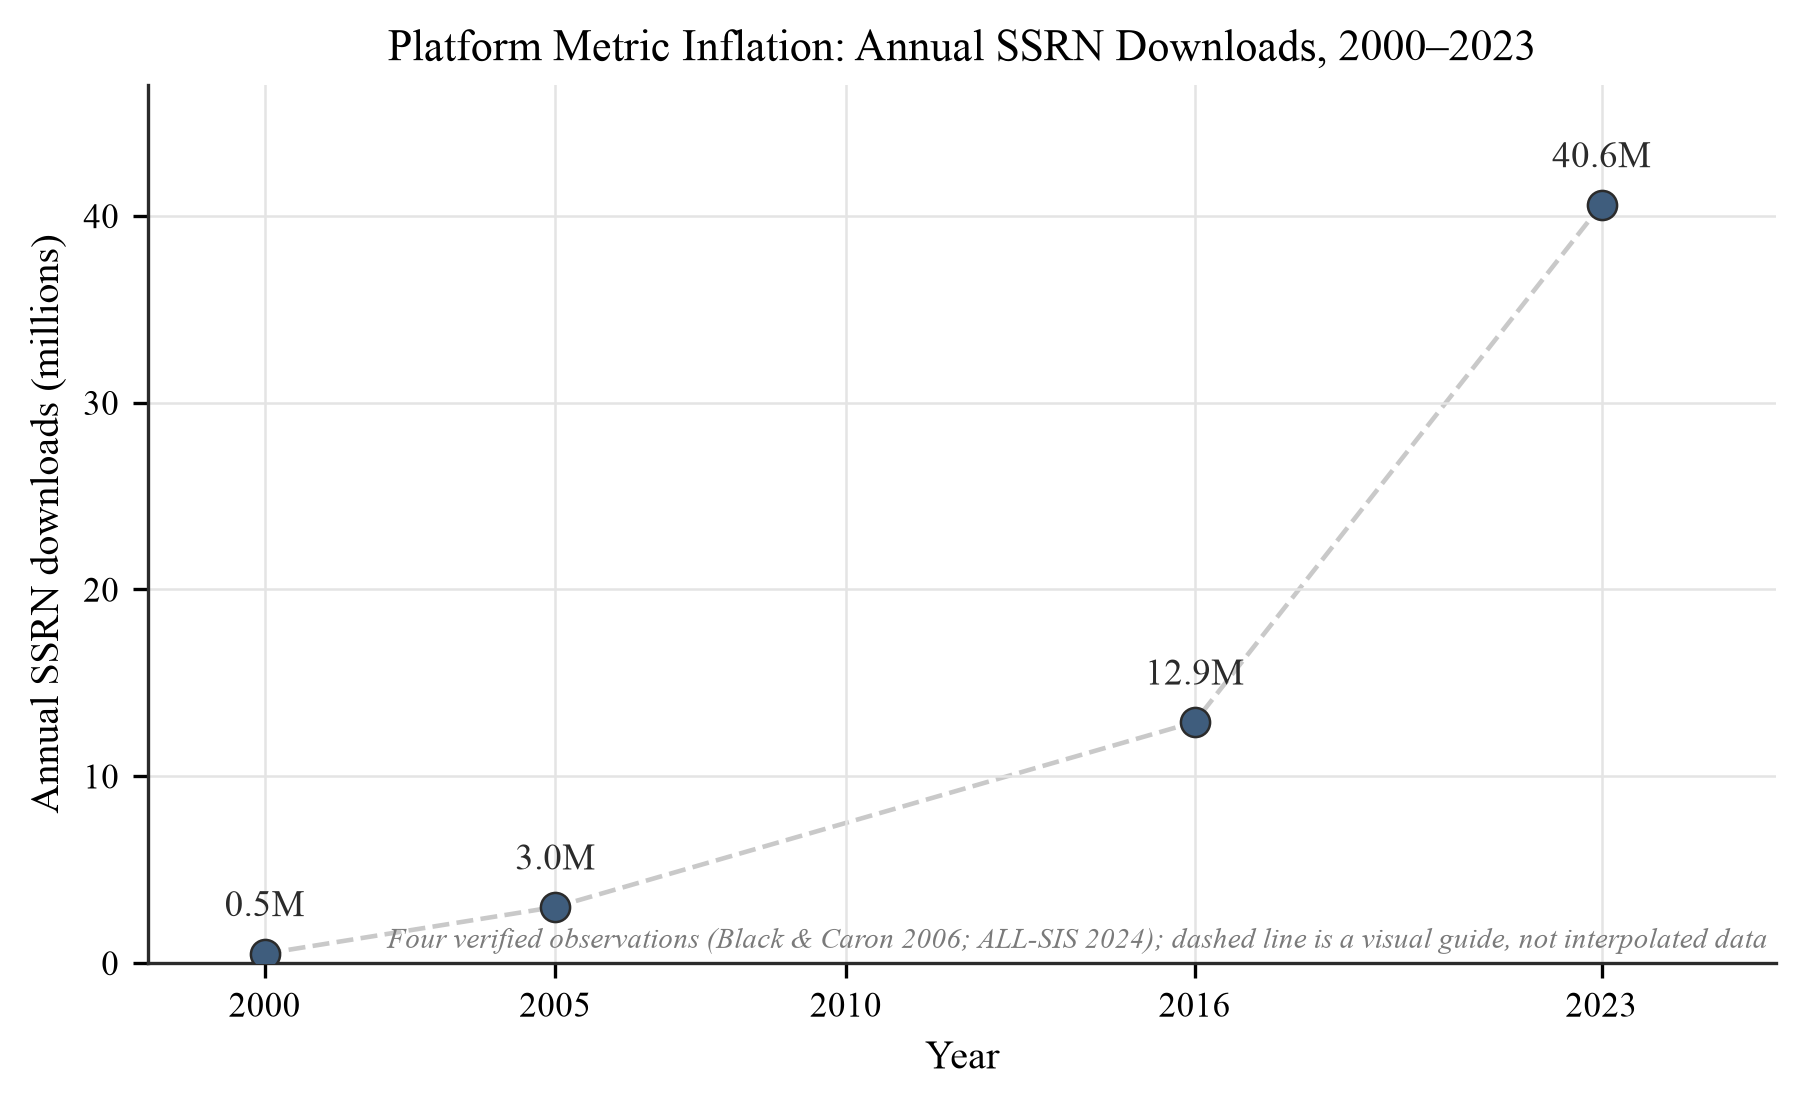
Figura 5. Inflación métrica de la plataforma, 2000–2023. Descargas anuales de SSRN: ~0.5 millones (2000) y ~3 millones (2005) [18]; 12.9 millones (2016) y 40.6 millones (2023) [1]. Porque el flujo de descargas ha crecido más rápido que el stock de artículos (≈3.15× versus ≈2.03× de 2016 a 2023 [1]), aumentando el flujo de descargas por artículo aproximadamente un 55%, los puntos de referencia absolutos estimados en muestras de 2012–2015 se leen como bandas permisivas en lugar de conservadoras para lecturas de 2026. Solo se trazan los cuatro valores de año verificados listados aquí; no se implica interpolación entre ellos.
No existe una fuente de percentiles actual. No se identificó ningún estudio de distribución a nivel de plataforma posterior a 2020 de descargas de SSRN en la auditoría de la Sección 2.5 (la instantánea de red única de 2025 [83], publicada en 2026, es la única muestra externa publicada reciente), y después del 15 de julio de 2026 la plataforma misma no publica datos comparativos a partir de los cuales podrían reconstruirse los percentiles. La brecha es una de actualidad y especificidad de plataforma. La distribución e desigualdad de la atención de preimpresiones es un área de investigación madura en otros repositorios (el perfil de citación y altmétrica de los depósitos de bioRxiv ha sido caracterizado en todo el servidor [62]), y la forma cuasi-lognormal de las descargas de SSRN específicamente ya fue establecida antes de 2020 por Kakushadze [85]. Lo que falta es una distribución de percentiles actual, específica de SSRN, posterior al cierre. El mapa anterior se ensambla a partir de los marcos disponibles, lo que respalda el conjunto de datos de punto de referencia comunitario propuesto en la agenda de investigación (Sección 8).
5.2 La banda de conversión
La relación entre descargas y visualizaciones de resumen es la única cantidad del panel que cuenta con una norma interestudios razonablemente estable, y los autores la interpretan erróneamente de manera más consistente que cualquier otra. Leído ingenuamente, cada visualización que no se convierte cuenta como un rechazo, y un autor con 40 visualizaciones y 7 descargas percibe una «tasa de fracaso del 82,5%». Esa lectura es incorrecta tanto en términos mecánicos como empíricos.
La Sección 4 estableció la mecánica: el denominador (visualizaciones) es la cantidad más contaminada por bots e inflada por la arquitectura, ya que los clics de correo electrónico del modelo de inserción y el tráfico de rastreadores acumulan visualizaciones sin implicar intención del lector, mientras que el contador de descargas se audita activamente [144][99][106]. Mientras el tráfico automatizado infle las visualizaciones más que las descargas, una tasa de conversión medida es un límite inferior en la conversión de visitantes humanos genuinamente interesados; la Sección 4.2 explica por qué esa asimetría ya no puede darse por supuesta donde los sistemas de IA recuperan el texto completo, y el límite se debilita en consecuencia. Empíricamente, las mediciones publicadas convergen en una banda estrecha. Siems midió una relación mediana de descargas por visualización de 0,171 (media 0,187) en el censo LSN [139]; Willey y Knapp reportan conversión del 15% entre su grupo de artículos principales y del 11% entre artículos de cita única [172]. La instantánea de Jo y Li produce una mediana de 18,9 descargas por 100 visualizaciones de resumen [83]. La banda empírica resultante es 11–19%, es decir, aproximadamente una descarga por cada 5,3–9 visualizaciones de resumen. La regla empírica fechada propia de SSRN de ~3 : 1 (~33%) [18] se sitúa por encima de la banda y se lee mejor como un anclaje superior de la era inicial, a nivel de plataforma, más que como una norma actual. Como ilustración entre dominios (las poblaciones e intenciones difieren categóricamente), una tasa de exploración a confirmación en este rango se consideraría alta en software de consumo, donde los puntos de referencia de conversión freemium a pago típicos se agrupan en dígitos bajos [10]. La comparación es solo ilustrativa, y reencuadra la intuición de que «7 de cada 40» señala falta de interés. La Figura 6 representa gráficamente las estimaciones.
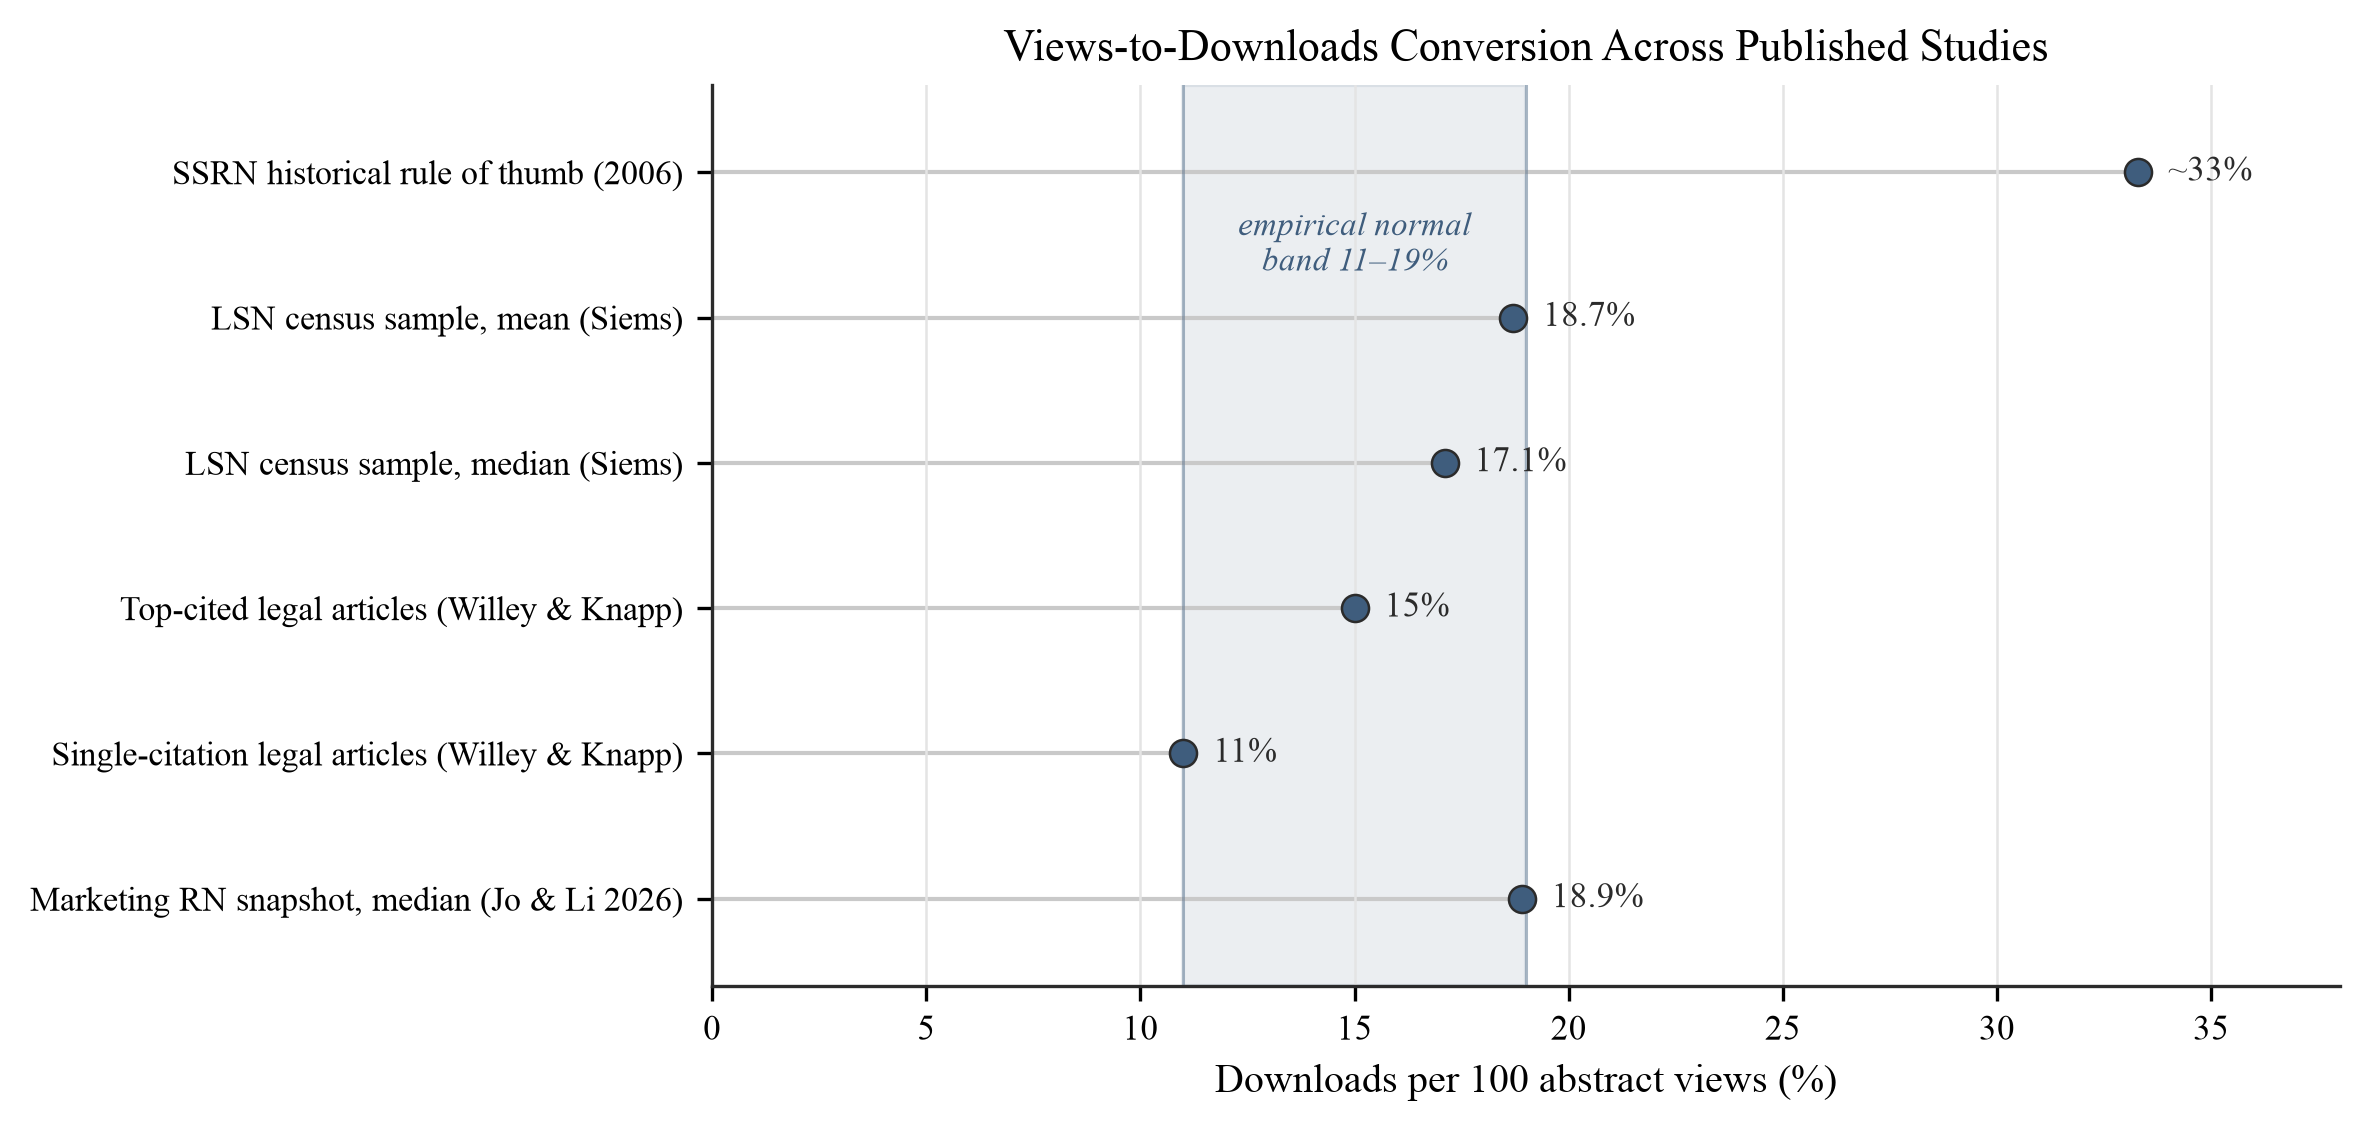
Figura 6. Conversión de visualizaciones a descargas en diferentes estudios. Estimaciones de conversión en el registro publicado: la regla empírica histórica de SSRN de ~33% (según se informó en 2006) [18]; media del censo LSN 18,7% y mediana 17,1% [139]; 15% entre artículos más citados y 11% entre artículos legales de cita única [172]; mediana 18,9 descargas por 100 visualizaciones de resumen en la instantánea de la Red de Investigación de Marketing 2025 [83]. La banda sombreada marca el rango normal empírico del 11–19% — una envoltura de estimaciones heterogéneas (medianas de toda la red junto con cifras de muestras seleccionadas por citas cuyo tipo de estadística la fuente deja sin especificar); la media de la muestra de Jo y Li (23,7 por 100) se sitúa por encima. Todos los valores se publican tal como aparecen en las fuentes citadas; no se introducen nuevas estimaciones.
Los miembros de la banda son estadísticas diferentes de muestras diferentes, por lo que es la envoltura de estimaciones puntuales heterogéneas. Las cifras de Siems (17,1%) y Jo y Li (18,9%) son medianas de muestras de toda la red, mientras que los valores de Willey y Knapp del 15% y 11% se reportan para submuestras seleccionadas por citas (artículos legales más citados frente a artículos de cita única), cuyo tipo de estadística la fuente no especifica y cuya selección es la razón por la que el borde inferior de la banda se sitúa donde lo hace. El borde superior es aún más suave: la conversión media en la muestra de Jo y Li, 23,7 descargas por 100 visualizaciones [83], se sitúa por encima de la banda, y diverge bruscamente de la relación de las medias agregadas de esa muestra (221.346 ÷ 611.973 = 36,2 por 100). Que una relación de medias de 36,2 se sitúe tan por encima de una media de relaciones de 23,7 es en sí mismo diagnóstico. Debido a que la relación de medias es algebraicamente el promedio ponderado por visualizaciones de las tasas de conversión por artículo, su superación de la media de relaciones no ponderada implica una covarianza positiva entre alcance y conversión: los artículos con más visualizaciones se convierten a tasas algo más altas, no más bajas. La lectura es conservadora: la inflación del denominador pequeño empujaría la media de relaciones no ponderada hacia arriba, trabajando contra este ordenamiento, por lo que observar la relación de medias por encima de ella de todas formas hace que la conclusión de dependencia positiva sea más robusta, no menos.
La banda suministra el ejemplo trabajado central de este artículo. En los anclajes publicados, se esperaría que un artículo con 40 visualizaciones de resumen produjera aproximadamente 4–8 descargas. Las «7 descargas» del título, en 40 visualizaciones, es una conversión del 17,5%, una estimación puntual que se sitúa dentro de la banda pero conlleva una amplia incertidumbre en este denominador. El intervalo exacto de Clopper–Pearson del 95% en 7 de 40 va de aproximadamente 7,3% a aproximadamente 32,8%, ocupando la banda en ambos lados: con solo 40 visualizaciones la estimación no puede resolverse al ancho de la banda, por lo que la lectura es un resultado de cribado, no una clasificación. Dos cosas limitan aún más el ejemplo. El denominador es pequeño (la inestabilidad anotada más adelante), y la comparación no está emparejada por edad: 40 visualizaciones en aproximadamente el día 20 es una lectura de vida temprana, mientras que los anclajes medianos provienen de muestras maduras (Siems en dos años [139], Jo y Li en una edad mediana de artículo de 491 días [83]), y las Posiciones 1 y 5 y la Sección 5.6 argumentan que la exposición en la vida temprana es un régimen diferente, por lo que el eje de edad no está alineado. Por lo tanto, la lectura defendible es que el 17,5% es consistente con la banda interestudios como un resultado de cribado, no un percentil de población preciso, y no «cómodamente dentro» de ella. La angustia que causa tal cifra refleja la ausencia de una escala más que la ausencia de lectura. La antigüedad y alcance de los anclajes subyacentes se establecen en la Sección 9.
Los denominadores pequeños hacen que la proporción sea inestable. Un artículo con dos visualizaciones y una descarga tiene una conversión nominal del 50%, pero esa estimación no merece más confianza que una construida sobre 500 visualizaciones; para cualquier evaluación comparativa pública, la contracción empírica de Bayes hacia la tasa de clase de referencia debe evitar que los denominadores pequeños produzcan puntuaciones extremas (Secciones 8.3 y 8.8). La banda también funciona como un diagnóstico en ambas direcciones. La conversión muy por debajo de la banda, en un denominador no trivial, suele indicar una falta de coincidencia entre título, resumen y texto: los lectores llegan, leen el resumen y se van, un problema de comunicación accionable (reescribir el título y el resumen), no un veredicto sobre la investigación. La conversión muy por encima de la banda señala tráfico que la navegación por resúmenes no explica (cobertura mediática, adopción en cursos o circulación viral) y debe impulsar una verificación del origen de las visualizaciones. Ninguna desviación, por sí sola, establece nada sobre la calidad de la investigación. Una calificación adicional es una hipótesis más que un hallazgo. La conversión puede variar sistemáticamente entre campos como una propiedad del estilo de lectura de la audiencia más que de artículos individuales: los campos grandes pueden exhibir comportamiento de "compras por ventana", con muchas visitas de resumen y pocas descargas, mientras que las comunidades pequeñas y muy comprometidas se convierten a tasas más altas. La banda anterior se estima a partir de muy pocos fotogramas para resolverlo, por lo que el Estudio 1 (Sección 8.6) incluye la conversión estratificada por campo entre sus resultados.
Un diagnóstico, nunca un objetivo: la restricción anti-juego. La banda de conversión es poderosa porque puede leerse como una norma, y ese poder conlleva un peligro. La Ley de Goodhart sostiene que una medida adoptada como objetivo deja de ser una buena medida [67], un principio paralelo a la Ley de Campbell sobre la corrupción de indicadores sociales utilizados para la toma de decisiones [27]. Si la banda del 11–19%, o cualquier componente del marco de evaluación comparativa de la Sección 5.5, fuera adoptada como umbral de promoción ("los artículos deben estar dentro de la banda de conversión para contar"), la proporción se convertiría inmediatamente en un objeto de optimización más que de observación. El ataque es concreto y barato: porque el denominador es la cantidad más manipulable (Sección 4.2), una inflación coordinada de vistas de resumen en proporción fija a las descargas mantendría la proporción dentro de la banda y haría que una señal artificial fuera estadísticamente indistinguible de la conversión orgánica. La respuesta del marco es una cuestión de definición. La banda de conversión, el diagnóstico de alcance-conversión (Sección 5.4), y los componentes CSAB (Sección 5.5) son un vector de diagnóstico, nunca un objetivo, y ningún componente puede leerse como criterio de promoción. La maquinaria que resiste el juego está integrada en el diseño: la banda se establece como un límite inferior porque su denominador es inflable por bots, por lo que la lectura es conservadora contra la inflación por construcción; el protocolo de anomalía de la Sección 8.3 es señalar, no eliminar, por lo que un pico artificial se preserva y se hace visible en lugar de ser absorbido silenciosamente; y el filtrado de integridad de la Sección 4.1 ya filtra la actividad coordinada más detectable. Leída como diagnóstico, la banda expone el juego como una firma fuera de banda o internamente inconsistente; leída como un objetivo, invitaría la misma coordinación que se pretende detectar. Esta posición alinea el marco con el consenso establecido de reforma de evaluación de investigación: la Declaración de San Francisco sobre Evaluación de Investigación (DORA), que rechaza sustitutos de número único y marca de revista a favor de la evaluación en el contenido propio de la investigación [8], y el Manifiesto de Leiden, cuyos principios advierten contra exactamente esta sustitución de un indicador fácil por el juicio experto [78].
Las descargas no tienen registro de auditoría pública: otra razón para leer la banda como un piso. Una asimetría estructural entre citas y descargas agudiza la preocupación sobre el juego. Una cita deja un rastro público e inspeccionable: el documento citador existe, es descubrible y puede verificarse, por lo que la manipulación de citas es en principio auditable por cualquier tercero. Un contador de descargas no deja tal rastro público. Es un recuento privado en los servidores de la plataforma, sin registro externo de qué solicitudes fueron contadas, filtradas o reexpresadas, lo que la deja únicamente expuesta al juego encubierto que ningún observador externo puede reconstruir después del hecho. Esa exposición es una razón independiente, más allá de la contaminación de bots del denominador, para tratar la tasa de conversión medida como un límite inferior en lugar de una estimación puntual (sujeto a la advertencia de la Sección 4.2 sobre recuperación de IA), y siempre emparejar el contador con el protocolo de anomalía y el filtrado de integridad documentado en el que se basa el marco (Sección 4.1). La ausencia de un rastro de auditoría no es una razón para desconfiar del contador; es una razón para leerlo conservadoramente e insistir en la disciplina de señalar-no-eliminar que mantiene una lectura manipulada detectable (Sección 8.3).
La banda es un objetivo de calibración, no una constante. Una consecuencia se sigue sobre cómo se debe citar la cifra del 11–19%, y cada umbral CSAB: son cantidades a calibrar por campo y por plataforma (Secciones 4.4, 5.5). El mecanismo para esa calibración ya está especificado: el Estudio 1 estratificado por campo (Sección 8.6) está diseñado para entregar las distribuciones de conversión y descarga por campo que el marco requiere y está construido para consumir. Hasta que el Estudio 1 informe, la sección transversal de archivo del Apéndice E proporciona una estimación resuelta por campo. En los catorce campos que contienen al menos veinte artículos, la conversión mediana varía de 0.134 en Energía a 0.195 en Ciencia de la Computación, una dispersión de aproximadamente 1,5 veces, y manteniendo fija la edad del artículo varía de 0.134 a 0.224, aproximadamente 1,7 veces. Comparado con la dispersión de campo de tres a cinco veces en las propias descargas, la conversión es la más portátil de las dos cantidades, lo que es lo que la hace utilizable como diagnóstico. La edad es la dimensión que no sobrevive: en cada campo lo suficientemente grande para probar, la conversión cae a medida que los artículos envejecen, con coeficientes de Spearman de −0.14 a −0.41 en los ocho campos que contienen al menos cuarenta artículos. Una banda de conversión citada sin edad de artículo está haciendo menos trabajo del que parece.
5.3 La escala de interpretación graduada
Los autores de Post-Rankings carecen notoriamente de una escala graduada, en el formato establecido de guías de interpretación del índice h [118], que convierta contadores crudos en bandas de lenguaje simple. Las secciones 5.1–5.2 proporcionan los ingredientes para ello. La tabla 8 presenta la escala propuesta para cuatro cantidades: descargas de vida útil a nivel de artículo, descargas del primer mes, conversión de vistas a descargas, y descargas totales a nivel de autor.
Tabla 8. Escala de interpretación propuesta para métricas de SSRN. Las bandas sintetizan evidencia de 2012–2015 [139][85][18][172]; puesto que el flujo de descargas por artículo ha aumentado desde entonces (sección 5.1), sus umbrales absolutos se leen mejor como laxas en lugar de bandas conservadoras para 2026, y en cualquier caso como una aproximación. La columna del primer mes no es un escalón calibrado de la escala sino una predicción preregistrada que conlleva amplia incertidumbre, a ser probada por el panel prospectivo del Estudio 1 (sección 8.6); sus celdas no deben leerse como umbrales o escalones de promoción (véase el texto). El límite Fuerte/Excepcional en 10.000 es una estimación provisional del autor: ninguna fuente publicada identificada en la auditoría de la sección 2.5 vincula 10.000 descargas a un percentil. La banda Naciente no introduce números nuevos: su techo es el anclaje mediano de dos años existente de 63 [139]. Los límites de banda se establecen en números redondos y se mantienen aproximadamente un ancho de banda completo: el techo de precisión establecido por la literatura de integridad (secciones 3.1, 4.1–4.3) hace que gradaciones más finas sean espuriamente precisas, por lo que la tosquedad de las bandas es por diseño. La columna de veredicto de lenguaje simple describe la descargas escala solo y no se transfiere a la columna de conversión: una conversión mediana del 18,9% es ordinaria en lugar de «Sólida», y un p75 del 27,2% no es «Fuerte». Los límites de descargas de vida útil no se superponen por construcción (Naciente por debajo de 63, Modesto 63–159, Sólido 160 y superior); donde la tabla imprime un punto de conexión compartido entre las filas superiores — 800 entre Sólido y Fuerte, y los correspondientes cortes de conversión y a nivel de autor — el intervalo es semiabierto, cada valor compartido perteneciente a la banda superior. Los dos valores de límite de vida útil se extraen de clases de referencia inconmensurables: 63 es una mediana de ventana de dos años para un censo de una sola disciplina de investigación jurídica [139], mientras que 160 es un umbral de entrada vitalicia para la lista superior de toda la plataforma [85]. Por lo tanto, se encuentran en relojes diferentes (una edad de artículo fija de dos años versus acumulación vitalicia ilimitada) y describen poblaciones diferentes (un campo versus todos los campos), por lo que agruparlos en una sola escala absoluta es una combinación de clases de referencia con diferentes edades, campos y reglas de selección — una limitación que los percentiles específicos de campo y edad del Estudio 1 están diseñados para eliminar. Un límite estructural de estos anclajes merece énfasis: como los puntos de referencia disponibles se agrupan en la mediana de dos años (63 [139]) y en la cola superior de la plataforma, cuatro de las cinco bandas verbales — Modesto, Sólido, Fuerte y Excepcional — describen artículos en o por encima de la mediana, por lo que la escala es densa por encima de la mediana y discrimina débilmente en el amplio rango de percentil 50-98 en el que la mayoría de los artículos realmente caen. Esta compresión es una consecuencia directa del anclaje en evidencia de cola superior; resolver lo ordinario de lo meramente-por-encima-de-la-mediana espera los percentiles específicos de campo y edad del Estudio 1. La escala es ilustrativa, no normativa: ningún límite de banda debe entrar en una decisión de permanencia, contratación o promoción como umbral de aprobado/suspenso hasta que el panel prospectivo del Estudio 1 (sección 8.6) haya calibrado percentiles específicos de campo y edad para reemplazar estos anclajes absolutos anticuados.
| Banda | Artículo: descargas de vida útil | Artículo: descargas del primer mes (extrapoladas) | Conversión (descargas / vistas) | Autor: descargas totales | Veredicto de lenguaje simple |
|---|---|---|---|---|---|
| Naciente | Por debajo de la mediana de dos años de 63 [139] | — (sin anclaje separado; véase el texto) | — (denominador típicamente demasiado pequeño; sección 5.2) | — | Demasiado pronto, o por debajo de la mediana del campo — la norma estadística para artículos jóvenes y de nicho; diagnosticar exposición primero (secciones 5.4, 5.6), no calidad |
| Modesto | 63–159 | <15 | <11% | <~130 | Típico de la plataforma; la banda mediana |
| Sólido | 160–800 | 15–50 | 11–19% | ~130–1.600 | En o más allá de la entrada de la lista superior histórica |
| Fuerte | 800–10.000 | 50–250 | 19–30% | 1.600–10.000 | Típico de las listas superiores históricas |
| Excepcional | >10.000 (estimación provisional del autor) | >250 | >30% | >10.000 (estimación provisional del autor) | Más allá del rango documentado de circulación erudita ordinaria |
Cada anclaje interior está vinculado a un umbral publicado. La banda Nascent cubre la región por debajo de la mediana de LSN de dos años de 63 [139]. Esa región es poblada, no anómala: las bandas prespecificadas del Estudio 1 (Sección 8.6) anticipan que una parte sustancial de los artículos de la plataforma, del orden del 15–30% bajo la banda de predicción establecida, tienen diez o menos descargas de por vida, por lo que una escala cuya banda más baja comenzara cerca de la mediana dejaría fuera de la escala por completo los artículos más numerosos de la plataforma, siendo este artículo su protagonista entre ellos. El veredicto Nascent es no evaluativo. Por debajo de la mediana del campo, y especialmente a una edad de artículo joven, el contador no otorga ningún juicio de calidad, y el primer paso diagnóstico es la exposición (Secciones 5.4 y 5.6) en lugar del contenido. La banda Modest está anclada en la mediana de LSN de dos años de 63 [139]. «Modest» es la banda mediana: la tipicidad no es fracaso. El límite Modest/Solid (~160 descargas de por vida) es el punto de entrada de Kakushadze a los 10.000 artículos principales de todos los tiempos, aproximadamente el 1,8% superior del stock de artículos en texto completo de la plataforma (571.040, julio de 2016 [1]) [85]. Operacionalmente, un artículo «Solid» es un artículo en lista superior. El límite Solid/Strong (~800) es la mediana dentro de ese grupo de élite (805) [85]: separa los artículos que simplemente ingresan a la élite histórica de los artículos típicos de ella. En la escala de cartera, la columna de nivel de autor refleja esta lógica: el grupo que las propias notificaciones de SSRN describen como el 10% superior de autores [161] tenía un mínimo de entrada de 129 descargas totales y una mediana interna de 1.626 [85]. Debido a que cada anclaje de nivel de autor se extrae de esa lista clasificada, la columna de autor describe la cola superior de la distribución de autores en lugar del autor típico. Un autor por debajo del límite ~130 no es meramente «Modest»: ese autor cae completamente fuera del grupo históricamente clasificado, por lo que las bandas inferiores de la columna se leen como «por debajo de la élite histórica», no como una posición calibrada entre todos los autores. Este es el mismo anclaje de cola superior que comprime la escala de nivel de artículo; los anclajes de la columna de autor esperan los percentiles de nivel de cartera del Estudio 1. La columna de conversión es la banda entre estudios de la Sección 5.2. El límite Strong/Exceptional a 10.000 no tiene un anclaje de percentil publicado y se conserva como un horizonte de orden de magnitud.
La columna del primer mes tiene un estado diferente. Es una predicción preregistrada, un pronóstico falsable con amplia incertidumbre que el Estudio 1 (Sección 8.6) está diseñado para probar, y ninguna celda del primer mes puede usarse como umbral o peldaño interpretativo. No existe un punto de referencia directo del primer mes en la literatura publicada, por lo que la columna es una proyección en lugar de una medición, extrapolada de la concentración temprana documentada de descargas (los picos de atención se agrupan en las primeras semanas, particularmente bajo cobertura externa [18][116][138]) sobre los umbrales de por vida anteriores. Los límites específicos derivan de un anclaje publicado: en la muestra de lista superior de Kakushadze, aproximadamente el 1,8% superior del stock de artículos en texto completo de la plataforma (571.040, julio de 2016 [1]), el recuento medio de descargas de doce meses fue 247 [85]. Un primer mes por encima de ~250 por lo tanto excedería la norma anual de la élite histórica de la plataforma, de ahí el límite Exceptional, mientras que descargas del primer mes de 15–50, si se sostienen, se proyectan sobre el umbral de entrada de por vida ~160, de ahí Solid. Estas celdas son proyecciones de un único anclaje histórico y son las celdas más débiles de la tabla; si se citan, llevan esta derivación.
Dos advertencias rigen el uso de la escala. El calificador disciplinario no es opcional: dentro de una sola disciplina, las descargas promedio por artículo difieren aproximadamente por un factor de ocho entre subcampos (438,35 en Derecho Corporativo/Valores/Financiero versus 53,48 en Derecho Agrícola) [168], por lo que cada declaración de banda debería llevar una etiqueta de campo. Estos son promedios de por vida y no se ajustan según la edad del artículo, y la sección transversal del archivo del Apéndice E muestra por qué eso importa: el nivel aparente de un campo se mueve con el perfil de edad de los artículos muestreados del mismo, y mantener la edad fija reduce la dispersión a aproximadamente tres a cinco veces. El segundo es que las heurísticas alternativas de un solo número propuestas en este espacio (índices de desempeño relativo basados en relación (las descargas de un artículo divididas por la mediana de una cohorte coincidente), heurísticas de nivel logarítmico basadas en ⌊ln D⌋, y veredictos verbales de tarjeta de puntuación («comienzo rápido / interés constante / comienzo lento»)) se subsumen aquí como heurísticas de autor no calibradas, porque ninguna tiene bandas numéricas validadas. La intuición logarítmica en sí es sólida y vale la pena mantenerla en palabras: bajo una distribución cuasilognormal [85], pasar de 7 a 20 descargas es un desplazamiento de una unidad de logaritmo natural en visibilidad, y leerlo como la suma de 13 clics no lo capta.
La escala también explica por qué los autores sistemáticamente juzgan mal sus propios contadores. Los números que circulan en hitos, perfiles y anuncios provienen, como lo documentó la Sección 3.5, de una cola visible cientos de múltiplos por encima de la mediana, mientras que la masa de la distribución se encuentra cerca de la mediana de LSN de 63, y bajo la ley cuasilognormal las distancias entre peldaños son multiplicativas, no aditivas. La Figura 7 organiza estos valores (mediana de artículo ordinario, umbrales de entrada, medianas de élite, cola) como una escalera de referencia en una escala logarítmica.
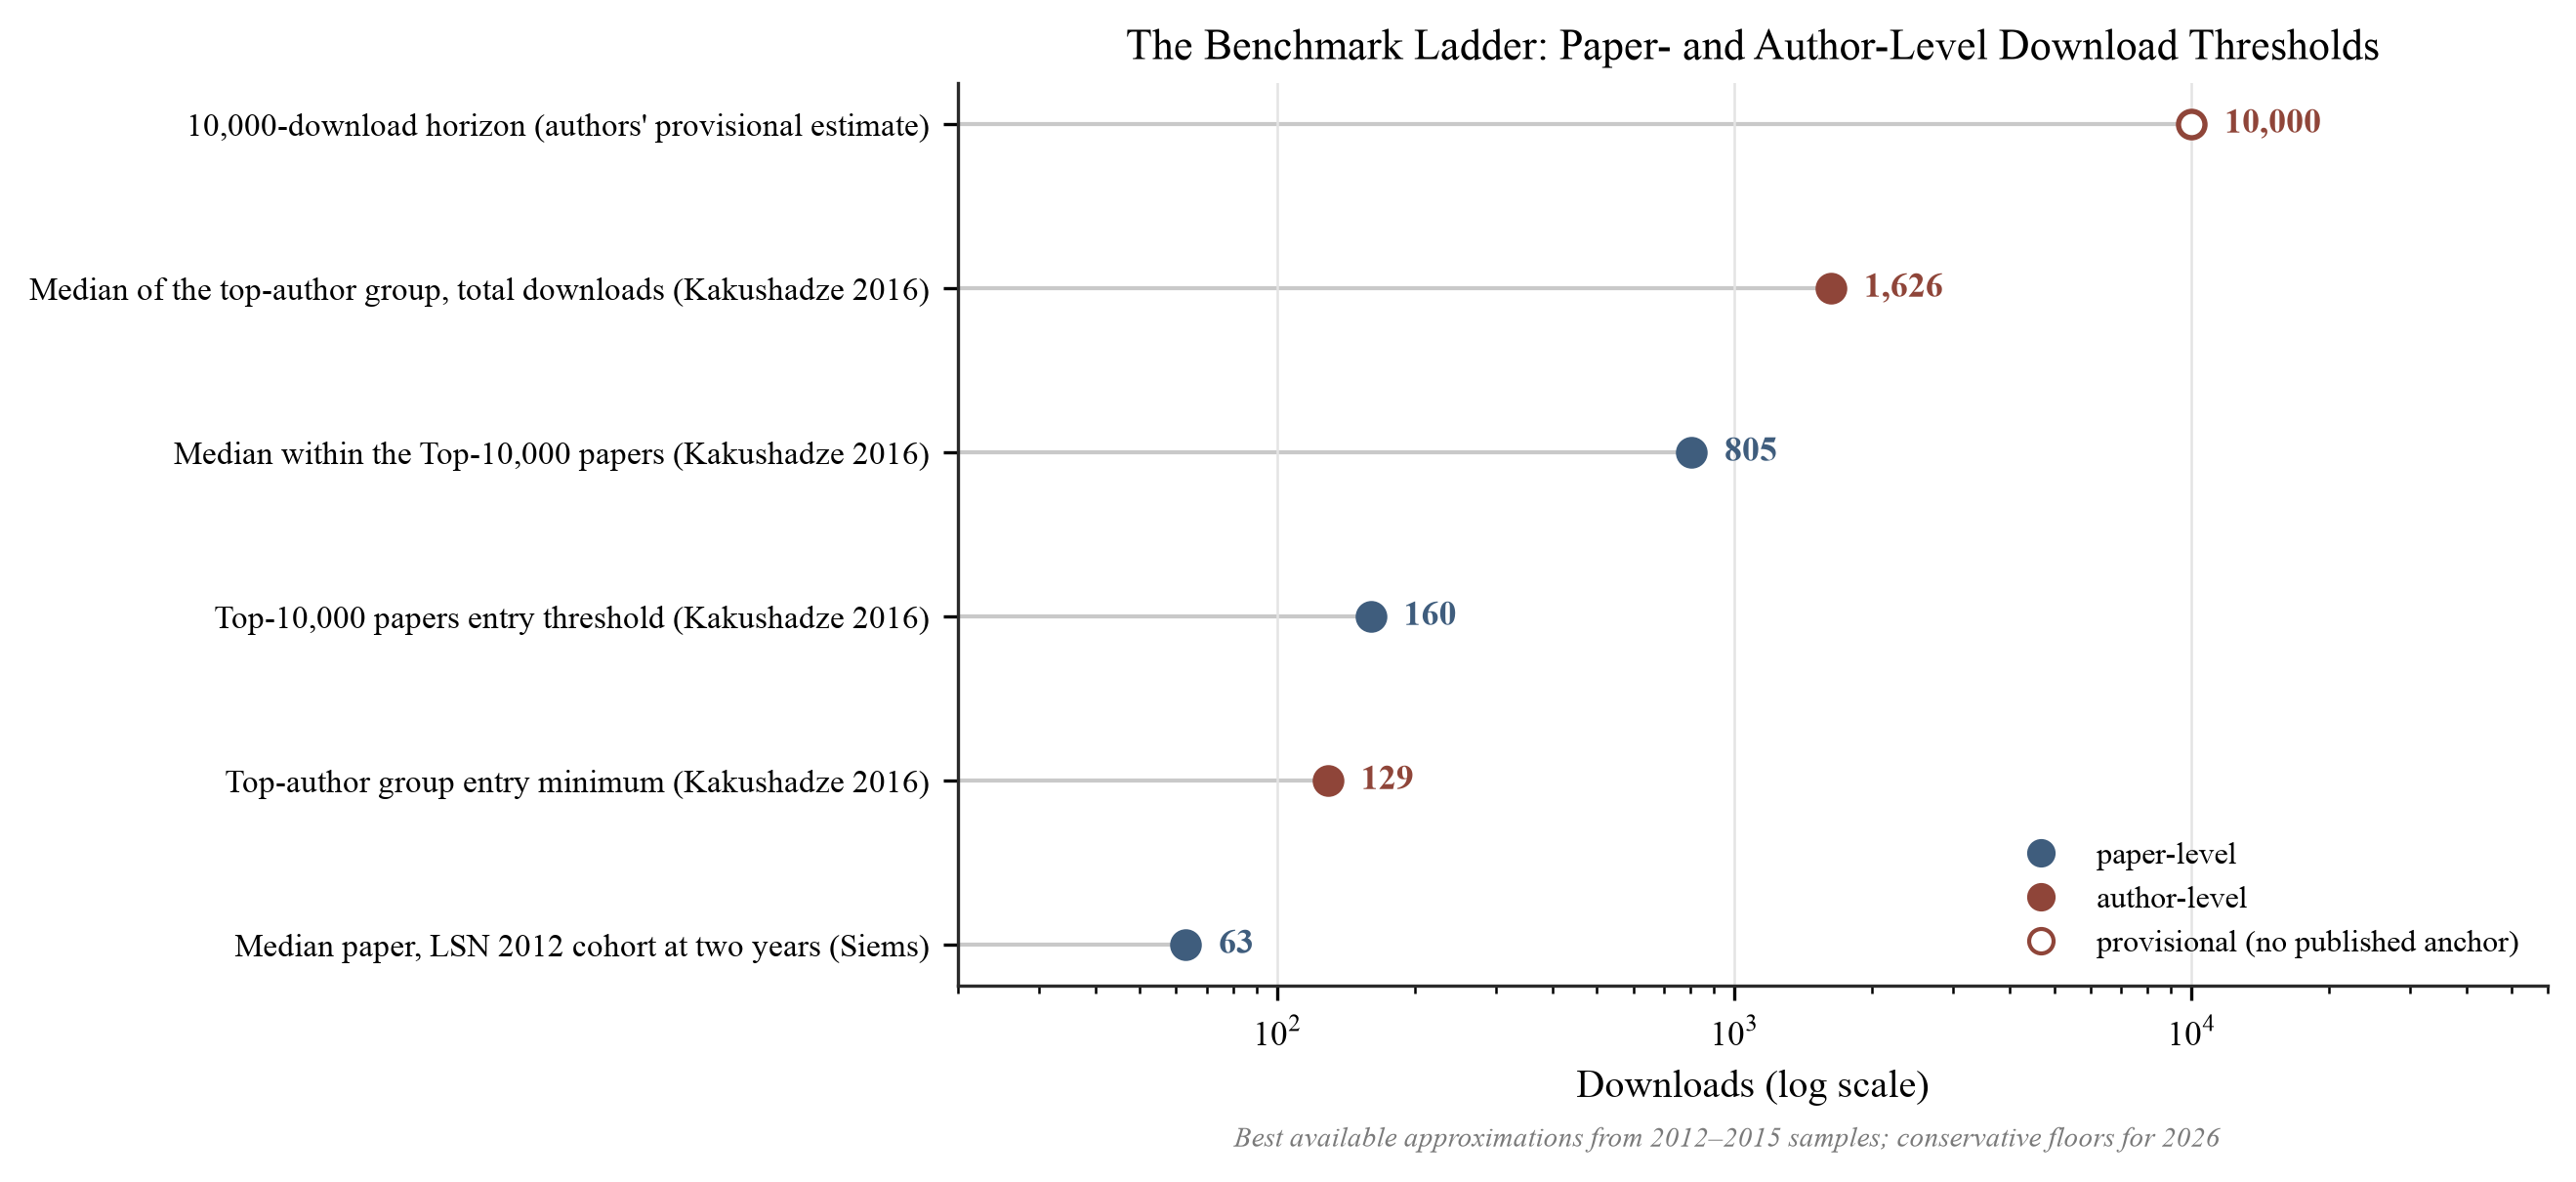
Figura 7. La escalera de referencia. Umbrales de descarga de nivel de papel y autor en una escala logarítmica: mediana de LSN de dos años 63 [139]; mínimo de entrada de autor superior 129 y entrada de papel superior ~160 [85]; mediana dentro de los 10.000 artículos principales 805 [85]; mediana del grupo de autor superior 1.626 [85]; el horizonte de descarga de 10.000 (estimación provisional del autor, sin anclaje de percentil publicado). La región por debajo de la mediana de dos años de 63 corresponde a la banda Nascent de la Tabla 8. Los valores provienen de muestras de 2012–2015 (inflación desde entonces: Sección 5.1).
5.4 Alcance versus conversión: un diagnóstico bidimensional
Un recuento único, incluso si está agrupado, no puede distinguir entre los diferentes mecanismos que lo producen. La mecánica de la Sección 4 tiene una implicación que más importa en la práctica: el fracaso de visibilidad y la falta de respuesta de contenido son diagnósticos diferentes: un artículo puede ser poco descargado porque pocos lectores lo encontraron, o porque quienes lo encontraron rechazaron el texto completo. La Tabla 9 cruza las dos dimensiones normalizadas.
Tabla 9. Matriz de diagnóstico alcance–conversión. El alcance y la conversión se evalúan como percentiles dentro de una clase de referencia de artículos comparables (mismo campo, cohorte de publicación, antigüedad del artículo y visibilidad anterior del autor; Sección 5.5), con la mediana de la clase como límite. No hay puntos de corte numéricos absolutos que sean defendibles según la evidencia actual, y no se proporcionan. La pantalla 2×2 dicotomiza cada eje en la mediana de la clase para legibilidad; los percentiles de alcance y conversión subyacentes son continuos (Sección 5.4), y se disponen particiones más finas como tercilos.
| Conversión baja | Conversión alta | |
|---|---|---|
| Alcance bajo | «Inicio en frío» (alcance bajo, conversión baja). El artículo no es ampliamente encontrado ni frecuentemente descargado después de su exposición. Los datos no establecen si la investigación subyacente es débil; solo establecen que la difusión no ha comenzado. | «Interés oculto» (alcance bajo, conversión alta). Los lectores que encuentran el artículo responden bien, pero demasiados pocos lo encuentran. La detectabilidad es el cuello de botella primario observable: un problema de distribución, no un problema de contenido. |
| Alcance alto | «Atención sin adopción» (alcance alto, conversión baja). El título, tema o ubicación de la plataforma parecen atraer visitas, pero pocos visitantes obtienen el texto completo. Descartar un denominador contaminado antes de diagnosticar un desajuste de comunicación: el alcance alto puede ser vistas fantasma en lugar de atención genuina, porque las vistas son el contador más contaminado de los dos (Sección 4.2) — en el registro transparente de RePEc/LogEc, los robots representaron aproximadamente 74% de las vistas de resumen pero solo alrededor de 7% de las descargas [99], por lo que el tráfico no humano sin filtrar produce exactamente esta firma de alcance alto, conversión baja. Solo una vez que se excluyen las vistas infladas por bots, los datos residuales justifican investigar la adecuación de la audiencia y la comunicación título–resumen. | «Difusión temprana fuerte» (alcance alto, conversión alta). El artículo llega a una audiencia comparativamente grande y convierte la exposición en interés por el texto completo. |
Los cuatro cuadrantes se etiquetan por el patrón de difusión que muestran los dos percentiles (inicio en frío, interés oculto, atención sin adopción, difusión temprana fuerte). Las etiquetas describen un patrón de difusión, no la investigación en sí, y lo que importa operacionalmente es la separación de mecanismos; ninguno de los cuadrantes de alcance bajo autoriza una inferencia sobre la calidad de la investigación, un punto que se relaciona directamente con cualquier uso evaluativo de estas métricas. El cuadrante de baja difusión lleva el nombre del diagnóstico propio de este artículo, el inicio en frío. La matriz es prácticamente valiosa porque la intervención apropiada difiere por cuadrante: un candidato de interés oculto necesita distribución (revisión de clasificación, tiempo de anuncio, visibilidad externa), mientras que la atención sin adopción requiere reparación de comunicación (título y resumen) o una auditoría de tráfico. La Figura 8 presenta el plano como una plantilla.
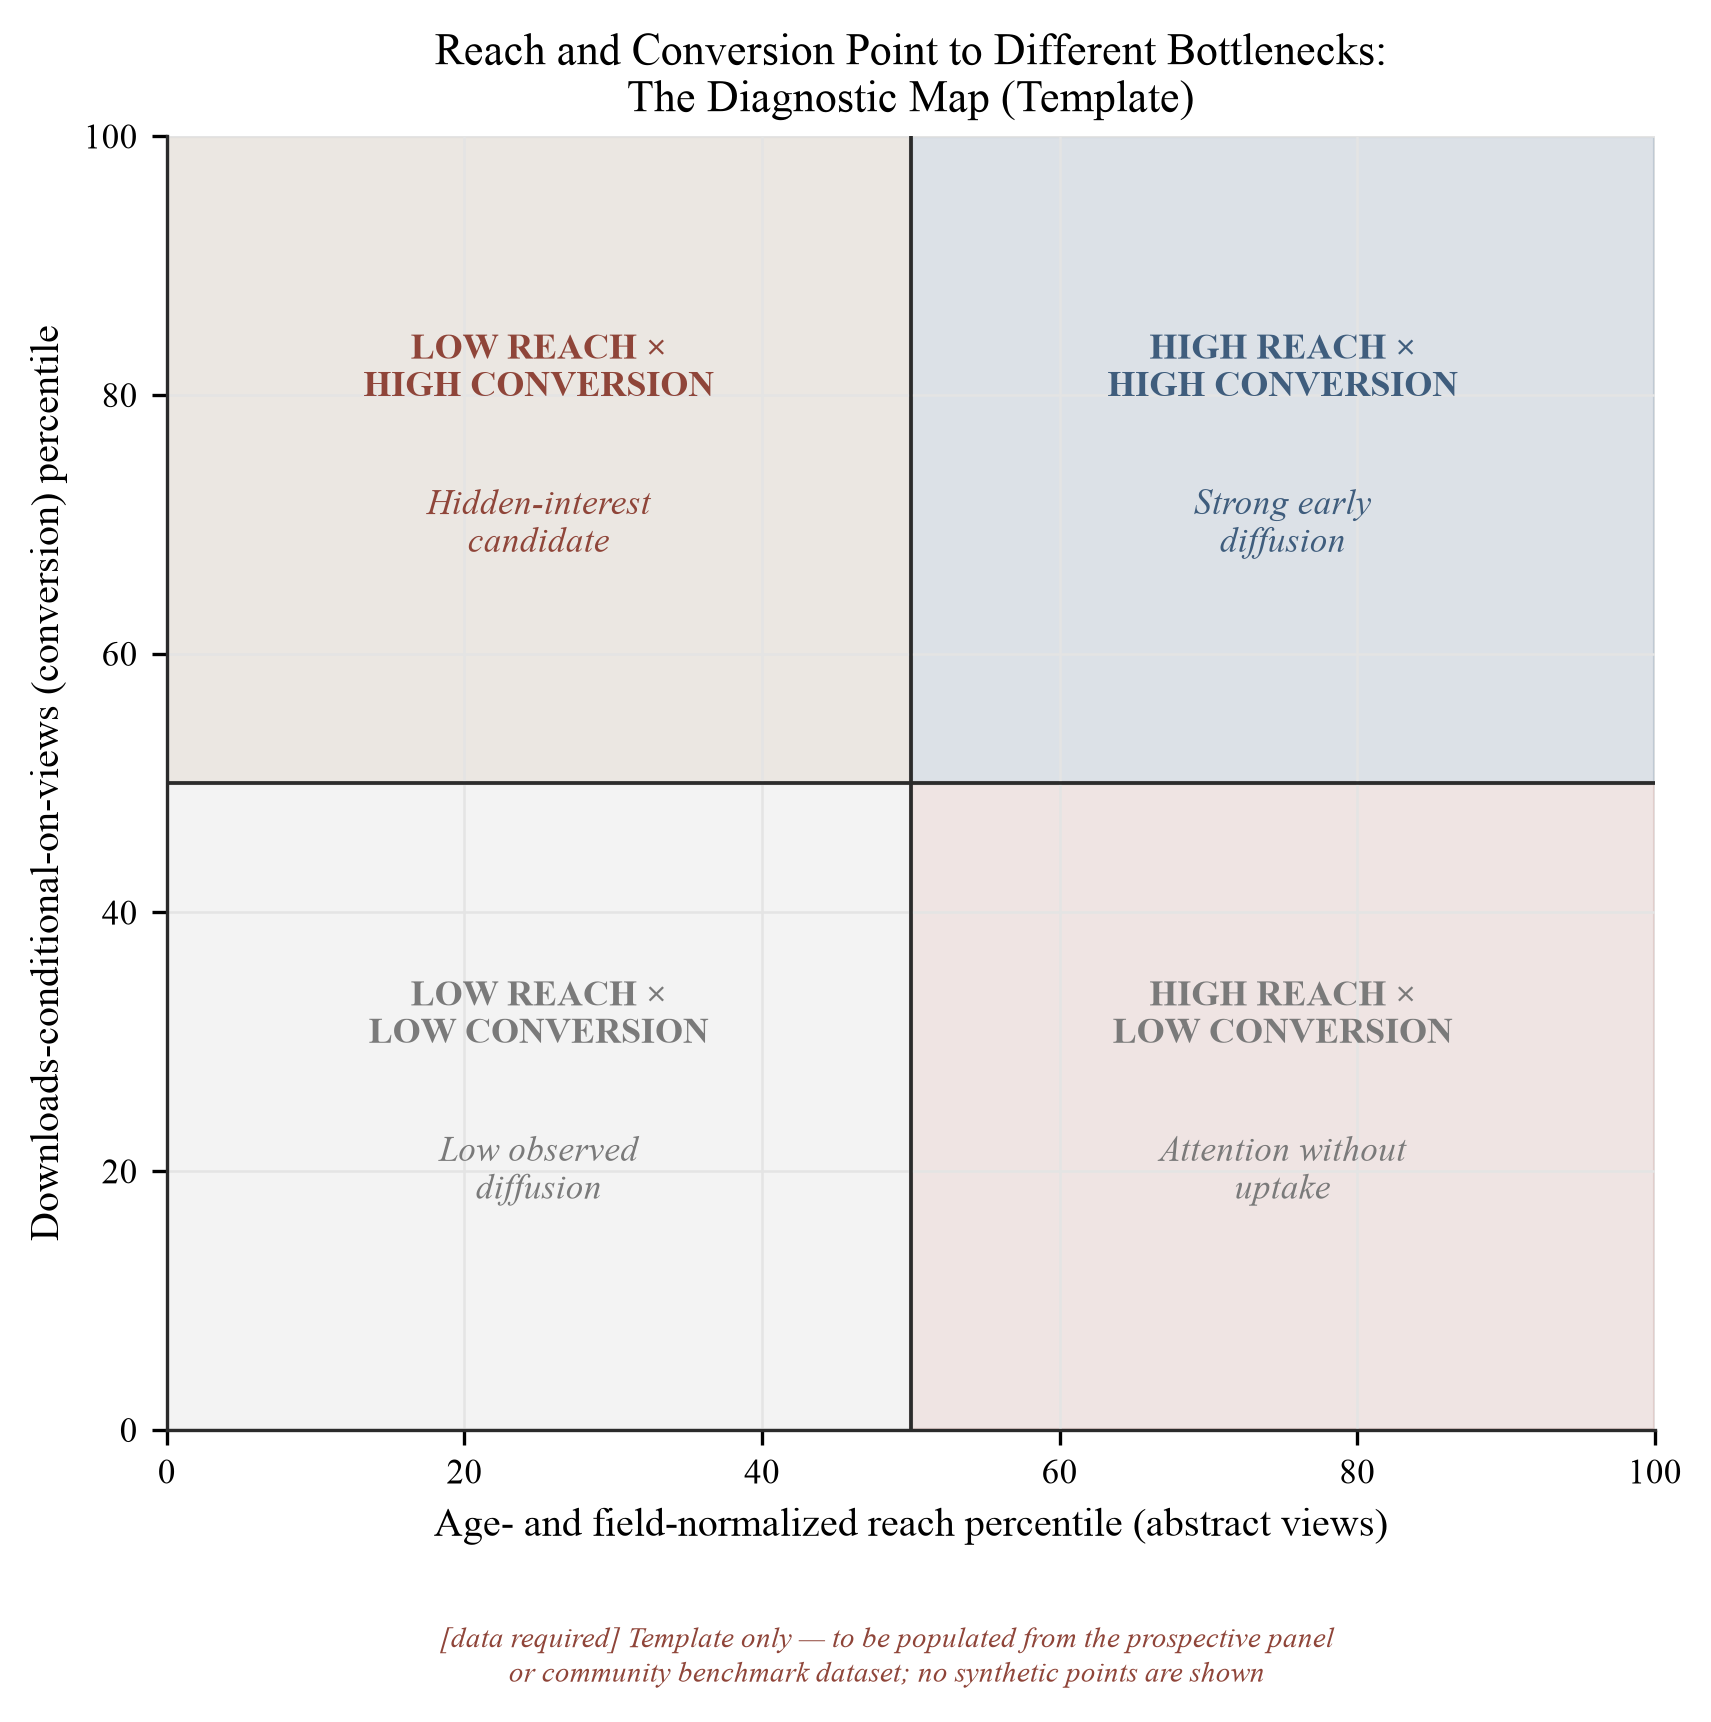
Figura 8. El mapa alcance–conversión. Plantilla para posicionar artículos por percentil de vista normalizado por edad, campo, cohorte y visibilidad (alcance, horizontal) y percentil de descargas condicional a vistas (conversión, vertical), con cuadrantes como en la Tabla 9 (inicio en frío, interés oculto, atención sin adopción, difusión temprana fuerte). El cuadrante superior izquierdo identifica artículos con conversión superior a la mediana a pesar del alcance inferior a la mediana, una clase que los recuentos brutos de descargas subestiman sistemáticamente. No se muestran valores empíricos; el mapa se debe completar a partir del panel prospectivo o del conjunto de datos de referencia de la comunidad de la Sección 8.
5.5 De un número titular a un punto de referencia: las dimensiones de CSAB
Cada una de las subsecciones precedentes repara un modo de fallo del contador bruto, y el Benchmark de Atención Académica de Inicio Frío (CSAB) es esa integración: un marco de presentación de informes que reemplaza el número titular único con cinco componentes normalizados (Tabla 10). Las variables de normalización (antigüedad del artículo, campo, cohorte de publicación y visibilidad previa del autor) están cada una motivadas empíricamente: las métricas acumulativas aumentan mecánicamente con la edad; las normas de campo difieren hasta un orden de magnitud en la media [168]; las condiciones del calendario cambian la atención de manera mensurable (los accesos de artículos caen ~11% los fines de semana y ~50% en los meses de verano [178]); y un nuevo usuario de la plataforma no se enfrenta a la misma audiencia inicial que un autor establecido [83]. Una convención de población debe ser fijada antes de que se compute cualquier percentil. Un contador acumulativo se define sobre un stock de artículos con supervivencia heterogénea (los artículos se retiran ocasionalmente, se fusionan o se superseden por versiones posteriores), por lo que cada percentil de CSAB es una declaración sobre el stock superviviente en la fecha de observación. El Estudio 1 (Sección 8.6) prespecifica la regla de inclusión (manejo de versiones, retiros y resolución de duplicados) en lugar de dejar la población de referencia implícita.
Los dos componentes centrales admiten una definición compacta. Para el artículo i a la edad τ (días desde la publicación), en el campo f, cohorte de publicación c y estrato de visibilidad previa s:
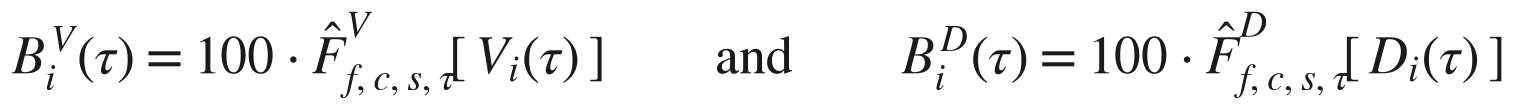
donde V_i(τ) y D_i(τ) son vistas y descargas acumulativas de resúmenes y F̂^V, F̂^D son las funciones de distribución empírica de esos conteos dentro de la clase de referencia definida por f, c, s, y τ. La definición fija el estimando, un percentil dentro de una clase de referencia establecida. Ningún F̂ puede ser escrito hoy, porque las distribuciones de referencia no existen (Sección 5.1). La fórmula es la especificación que el Estudio 1 y el panel de la Sección 8 están diseñados para estimar, y la misma notación se mantiene en el diseño de validación predictiva de la Sección 8.9. La normalización por percentil y clase de referencia es en sí misma un método bibliométrico establecido: los percentiles son una forma estándar de normalizar los conteos de una publicación por campo, tipo de documento y año de publicación [22], con procedimientos dedicados para la normalización de campo y tiempo de indicadores dominados por ceros [23], exactamente el régimen que ocupa un contador de descargas. Normalizar métricas de uso específicamente (descargas y vistas en lugar de citas) contra una clase de referencia es igualmente una línea de trabajo madura: la literatura de bibliometría de uso ha tratado durante mucho tiempo el impacto basado en descargas como una distribución que se debe condicionar a las características de la comunidad de usuarios y el marco de muestreo [92][19], y los programas de factor de uso de diarios construyeron exactamente tales indicadores de uso normalizados a partir de datos compatible con COUNTER [137]. La estandarización del conteo de uso en sí es el sujeto de una infraestructura de practicantes madura, el Código de Práctica COUNTER [125]. Los indicadores de lectura normalizados por campo tienen un precedente establecido comparable en la literatura de altmétricas [179]. El método es por lo tanto establecido. La contribución aquí es su aplicación a descargas de SSRN y la construcción de una clase de referencia estratificada por edad, campo y cohorte para un entorno post-Rankings.
El estimando es limpio, pero tres preguntas de operacionalización deben resolverse antes de que cualquier F̂ se ajuste. La primera es la más consecuente, porque se refiere a qué es el punto de referencia para. Condicionar la clase de referencia a la visibilidad previa del autor (el estrato s) es correcto cuando la pregunta es diagnóstica: "¿cómo le va a este artículo entre artículos comparables de autores comparablemente visibles?" Es exactamente incorrecto cuando la pregunta es la pregunta de equidad de H1–H3, porque normalizar por visibilidad previa resta la brecha principiante-versus-establecido que el marco de equidad existe para medir. Un percentil dentro de s no puede detectar desventaja de inicio en frío, ya que la desventaja ha sido condicionada por construcción. El marco por lo tanto separa dos usos distintos de CSAB que nunca deben colapsar en un número. Como un punto de referencia descriptivo reporta la posición de un autor dentro de una clase de referencia completamente estratificada (incluyendo s), que es lo que un autor individual quiere en el panel. Como un estimando ajustado para H1–H3 elimina la visibilidad previa del conjunto de condicionamiento y la trata en su lugar como el predictor de interés, midiendo el gradiente en lugar de eliminarlo. Las dos respuestas difieren, responden preguntas diferentes, y cualquier informe que presente un percentil normalizado por visibilidad debe declarar cuál de los dos es. Una segunda pregunta es el tamaño de muestra. Estratificar por campo × cohorte × estrato de visibilidad × ocho puntos de edad agota rápidamente una muestra de probabilidad de 3,000–5,000 artículos (Sección 8.6): el conteo de celda completamente cruzado llega a los miles, por lo que la mayoría de las celdas son diminutas o vacías. La contracción empírica-Bayes hacia clases de referencia más amplias se nombra por esta razón (Secciones 8.3, 8.8), pero la contracción requiere su propia especificación: una estructura jerárquica mínima (campo dentro de un área amplia, edad dentro de una banda de edad gruesa) y una regla mínima de celda prespecificada para estimación, por debajo de la cual una celda toma prestado de su celda padre en lugar de reportar un percentil bruto. Esta regla mínima de celda del lado de la estimación es distinta de, y más estricta de razonar que, la regla mínima de celda impulsada por privacidad que rige la liberación pública en el Apéndice D; las dos sirven propósitos diferentes y se especifican por separado. La última pregunta es el momento (Tabla 10), definido como el cambio en una posición normalizada estimada. Una puntuación de cambio en una cantidad estimada invita regresión a la media: un artículo que aterriza alto en el día 7 en parte por ruido de estimación tenderá a caer en el día 30 por razones puramente estadísticas. El momento por lo tanto requiere un modelo explícito de la trayectoria subyacente (por ejemplo, una contracción o estimación empírica-Bayes de la posición latente con su error de medición propagado) en lugar de una diferencia bruta de dos snapshots de percentil, y la diferencia bruta se reporta, si acaso, solo como un acompañante descriptivo a la cantidad modelada.
Tabla 10. El Cold-Start Scholarly Attention Benchmark (CSAB): cinco dimensiones en lugar de un número. Se proporciona una plantilla de informe copiable a nivel de oración para estas dimensiones en el Apéndice B.
| Dimensión | Métrica | Pregunta central | Interpretación |
|---|---|---|---|
| Alcance | Percentil de vista normalizado por edad/campo/cohorte/novato | ¿Las audiencias relevantes encontraron el artículo? | Detectabilidad |
| Rendimiento de descarga | Percentil de descarga acumulativo normalizado | ¿Cuántas adquisiciones de texto completo ocurrieron en relación con artículos comparables? | Difusión temprana general |
| Conversión | Descargas condicionadas a oportunidades de vista (Sección 5.2) | ¿Los lectores expuestos buscaron el texto completo? | Compromiso condicional |
| Impulso | Cambio en la posición normalizada o la atención a nivel de intervalo | ¿Se está acelerando, estabilizando o desvaneciendo la difusión? | Trayectoria temporal |
| Validación posterior | Citación posterior o uso condicionado a métricas tempranas | ¿Predijo la atención temprana la adopción académica posterior? | Validez predictiva |
El marco rechaza cualquier umbral bruto universal de «éxito». El éxito debe definirse en relación con un propósito analítico: para detectabilidad, un percentil de alcance alto entre artículos de la misma edad y campo; para adopción del lector, conversión superior a la clase de referencia condicionada a la exposición; para difusión, la distribución conjunta de ambas; para influencia científica, citas posteriores o uso documentado. El uso temprano por sí solo es insuficiente para ese último propósito, ya que las descargas tempranas explican solo aproximadamente el 16 % de la varianza de citas posteriores [25]. Esto hace exacta la interpretación del ejemplo del título. Siete descargas es «bueno» solo en la medida en que siete descargas colocan el artículo inusualmente alto entre artículos de otra forma comparables en la misma etapa de su ciclo de vida. Un valor de día 7 y un valor de día 180 no pueden evaluarse en el mismo punto de referencia.
Cuatro opciones de diseño siguen el octavo principio del Manifiesto de Leiden: que los indicadores cuantitativos no deben permitirse que superen la solidez de los supuestos detrás de ellos, y que la falsa precisión es en sí misma una falta de medición [78]. El marco informa bandas, no puntuaciones puntuales (Tabla 8); fija CSAB como un vector diagnóstico en lugar de un objetivo (Sección 5.2); dibuja sus figuras de salida, el mapa de alcance-conversión (Figura 8) y el abanico de referencia (Figura 14), sin escala numérica, para que una forma no pueda confundirse con un valor calibrado; y adjunta un nivel de verificación y antigüedad a cada número que utiliza (Tabla 7). Cada una de estas opciones retiene la precisión que la evidencia no puede respaldar, como DORA exige a la evaluación de la investigación cuando rechaza indicadores de número único y marca editorial para la evaluación sustantiva del contenido de un artículo [8]. Reducir CSAB nuevamente a una puntuación reintroduciría exactamente la falsa precisión contra la cual ambos documentos advierten.
Para un autor, el informe CSAB reemplazaría la línea simple «Descargas: 12» con algo como esto: 12 descargas después de 14 días: percentil de descarga general entre artículos comparables: 67º; percentil de alcance: 39º; percentil de conversión: 81º; interpretación: alto interés condicional, exposición por debajo de la mediana. Cada número en este ejemplo ilustrativo es solo indicativo, ya que tales percentiles no existen hasta que se estimen las distribuciones de referencia de la Sección 8, y ninguno de estos valores puede citarse como punto de referencia, pero el formato muestra qué compra la descomposición. El mismo recuento bruto que se lee como decepción indiferenciada se resuelve en un diagnóstico específico: los lectores que encuentran el artículo responden inusualmente bien, pero demasiado pocos lo encuentran, por lo que la intervención indicada es distribución, no revisión. El ejemplo trabajado es el homólogo CSAB del cuadrante de «interés oculto» de la Tabla 9. El Apéndice B fija este formato como una plantilla de informe copiable cuyos campos de percentil permanecen en blanco hasta que existan las distribuciones de la Sección 8.
5.6 Trayectorias de lectura: la exposición es un tratamiento, no ruido de fondo
El componente final del marco es temporal: un artículo recién publicado no entra en un entorno de atención homogéneo. Pasa a través de distintos regímenes de exposición (publicación → descubrimiento interno → distribución por correo electrónico → indexación externa → difusión en red), y un total acumulado colapsa estos regímenes en un número. Los límites del régimen están establecidos por la maquinaria de la Sección 4: la distribución de eJournal es curada y puede tomar hasta 45 días en temas de alto volumen [53], y la indexación de búsqueda externa puede tomar 6–9 meses o más [55].
El estado del panel más generador de ansiedad se sigue directamente de esto: cero descargas en la primera semana es una pre-distribución normal, no un rechazo. Antes de que se complete el ciclo de anuncios, el artículo aún no ha sido expuesto a su audiencia principal. La secuencia de diagnóstico para un cero temprano es administrativa: confirmar que el artículo está publicado públicamente; confirmar la asignación de eJournal; esperar a que se complete el ciclo de anuncios; solo entonces leer los contadores. Por el contrario, los conteos del primer mes, una vez que se ha producido la distribución, son el indicador principal más temprano y ruidoso: las descargas tempranas se correlacionan con citas posteriores aproximadamente en r ≈ 0,4 [25], informativo pero lejos de un veredicto, y los picos tempranos son frecuentemente eventos de exposición (cobertura de blog o medios) en lugar de interés duradero [116][138].
Debido a que el raspado retrospectivo de conteos acumulados no puede reconstruir lo que tenía un artículo en el día 3 o el día 30, la interpretación basada en trayectoria (y la agenda de investigación del panel de la Sección 8) requiere observación desde el nacimiento en una cuadrícula estandarizada. La Tabla 11 especifica el cronograma mínimo. Funciona también como una plantilla de automonitoreo para autores individuales. Una trayectoria se clasifica solo provisionalmente en las lecturas de 60 y 90 días de la cuadrícula de la Tabla 11 y con confianza en la lectura de 180 días, nunca en el día 7.
Tabla 11. Cronograma mínimo de observación longitudinal para artículos de SSRN.
| Edad del artículo | Propósito principal de la observación |
|---|---|
| Día 1 | Exposición inmediata de la plataforma |
| Día 3 | Descubrimiento muy temprano |
| Día 7 | Punto de referencia de la primera semana (valor esperado para la mayoría de artículos: cero o cercano a cero, pre-distribución) |
| Día 14 | Estabilización temprana |
| Día 30 | Punto de referencia del primer mes |
| Día 60 | Maduración de distribución y búsqueda (ciclos de eJournal completados [53]) |
| Día 90 | Difusión temprana de mediano plazo |
| Día 180 | Transición hacia la medición de impacto descendente |
Cuando sea factible, la observación diaria durante los primeros 45 días es preferible, porque la distribución por correo electrónico puede ocurrir en momentos variables dentro de esa ventana [53]. Las lecturas a nivel de intervalo en esta cuadrícula convierten el panel de un veredicto estático en una trayectoria, la única forma en que las métricas tempranas de SSRN tienen información defendible.
Las Secciones 4 y 5 reemplazan la pregunta que un autor no puede responder («¿son 7 descargas buenas?») con cuatro que el registro publicado puede respaldar: ¿dónde se sitúa el conteo frente al mapa de puntos de referencia y sus cohortes (5.1, 5.3); está la conversión dentro de la banda empírica (5.2); ¿en qué cuadrante del plano alcance-conversión se encuentra el artículo (5.4); y qué muestra la trayectoria en la cuadrícula de observación (5.6)? Ninguna de estas preguntas requiere los Rankings retirados, pero todas requieren los datos comparativos cuya recopilación las secciones finales de este artículo proponen.
6. Un Manual Práctico para Autores
El mapa de puntos de referencia de la Sección 5 (Tabla 7) restaura la escala faltante, y esta sección la pone a trabajar para el autor que abre el panel de estadísticas después del 15 de julio de 2026 y ve conteos sin contexto [148][149]. Tiene cuatro tareas a su vez: una rutina para observar los propios contadores (6.1–6.2), sustitutos del marco comparativo que los rankings solían proporcionar (6.3), palancas que pueden mejorar legítimamente la visibilidad (6.4), y un protocolo para convertir contadores en evidencia de carrera defendible (6.5–6.6). Cada anclaje numérico utilizado aquí se remonta a una fuente publicada con un marco de muestreo explícito y ventana temporal; la Tabla 7 los consolida. Las prácticas que circulan en la comunidad de autores que no tienen apoyo probatorio se marcan como no verificadas dondequiera que aparezcan y se recopilan, como hipótesis candidatas para pruebas, al final del Apéndice A.
La Tabla 12 comprime el núcleo del manual en un protocolo de siete preguntas, formuladas en orden, cada una emparejada con la evidencia que vale la pena conservar y la conclusión más fuerte que la respuesta puede legítimamente autorizar. Las Secciones 6.1–6.2 desarrollan este protocolo en rutinas y reglas de lectura, y la Tabla 23 (Apéndice A) sigue siendo su acompañante situacional, indexada por los estados del panel que los autores realmente encuentran.
Tabla 12. Un protocolo de autor para interpretar un contador de SSRN: siete preguntas, la evidencia a preservar y la conclusión permisible. Ningún paso trata un contador como una puntuación de calidad; la columna final indica el límite de lo que cada respuesta puede respaldar.
| Paso | Pregunta | Evidencia a preservar | Conclusión permisible |
|---|---|---|---|
| 1 | ¿Cuál era la edad del artículo cuando se observó el conteo? | Captura de pantalla o exportación con fecha, más la fecha de publicación | Una observación específica de tiempo, no un veredicto de por vida |
| 2 | ¿Había ocurrido la distribución curada e indexación externa? | Aviso de distribución y fecha cuando esté disponible; estado del índice de búsqueda | Identificación del régimen pre- versus post-exposición (Sección 5.6) |
| 3 | ¿Qué son vistas, descargas y conversión juntas? | Ambos contadores y el denominador | Un diagnóstico de alcance versus compromiso condicional (Tabla 9), no un único veredicto |
| 4 | ¿Cuál es la clase de referencia más estrecha y defendible? | Campo, cohorte, edad del artículo, estado de nuevo, historial de clasificación | Posición relativa solo dentro de esa clase (Sección 5.5) |
| 5 | ¿Está cambiando la trayectoria? | Observaciones repetidas en las edades fijas de la Tabla 11 | Impulso o meseta, sujeto a eventos de exposición — no aceleración de «calidad» |
| 6 | ¿Hay corroboración descendente? | Citas, contactos sustanciales, publicación o uso documentado | Evidencia estratificada de adopción, no prueba de calidad |
| 7 | ¿Puede reproducirse la afirmación? | Fuente, fecha, regla de conteo, registro archivado | Un informe auditable, no un hito sin respaldo |
6.1 Una rutina de medición
La interpretación comienza con un registro disciplinado, porque SSRN muestra solo los contadores acumulativos actuales sin historial bajo el control del autor. Seis pasos, aplicados desde el día de la publicación, producen el registro mínimo que toda inferencia posterior requiere.
1. Registra ambos contadores y su razón. Anota las visualizaciones de resúmenes, descargas y la razón de conversión de descargas a visualizaciones en intervalos fijos. La cuadrícula de observación de la Tabla 11 (días 1, 3, 7, 14, 30, 60, 90, 180) especifica el cronograma y el propósito de cada lectura. Una captura de pantalla con fecha en cada intervalo es la única versión del registro que el autor controla, ya que los contadores de la plataforma pueden ser reestablecidos cuando cambian las reglas de filtrado [144][69]. El registro acumulativo es un paquete de pruebas versionado: la versión del manuscrito, sus metadatos y clasificaciones, instantáneas del panel con fecha, avisos de distribución, un registro con fecha de los eventos de promoción del propio autor (un hilo publicado, una charla, un anuncio de lista de correo) y citas posteriores y contactos sustanciales. El registro de promoción es importante porque las promociones son tratamientos de exposición. Sin un registro con fecha de la propia publicidad de uno, un autor no puede distinguir un pico orgánico de uno autogenerado, ni tampoco puede hacerlo nadie que audite la afirmación (Sección 8.3).
2. Normaliza por el tiempo transcurrido desde la publicación. Expresa el desempeño inicial como descargas por mes durante los primeros tres a seis meses en lugar de como un conteo acumulativo sin procesar. Un artículo de tres meses comparado contra los totales históricos de trabajos más antiguos produce conclusiones sistemáticamente engañosas, porque los contadores se acumulan durante la vida útil de un artículo en una plataforma cuyo volumen de descargas anuales ha crecido de aproximadamente 12,9 millones en 2016 a 40,6 millones en 2023 [1].
3. Nunca mezcles ventanas de observación. Un conteo semanal no puede compararse con un promedio de doce meses, y un conteo de 90 días no puede compararse con totales de por vida. Toda comparación en este manual empareja ventanas similares con similares. Las violaciones de esta regla fueron entre los errores interpretativos más comunes en el uso anterior a la desaparición de las estadísticas de clasificación [161].
4. Sitúa el artículo en su vecindario disciplinario, no contra la plataforma. Las descargas promedio por artículo difirieron en aproximadamente un factor de ocho solo en las eJournals de Legal Scholarship Network (438,35 en Corporate/Securities/Finance versus 53,48 en Agricultural Law, datos de 2018) [168]. Un conteo que es poco notable en un subcampo es excepcional en otro. La clase de referencia relevante es el eJournal propio del artículo o la red temática, examinada a la misma edad del artículo.
5. No sobreinterprete los conteos pequeños individuales. La literatura sobre integridad establece un límite superior en la precisión de los contadores de uso: las descargas reportadas por los editores pueden ser el doble de las de plataformas comparables [176], los filtros de la plataforma descartan una gran parte del tráfico sin procesar [99][129][144], y sin tales filtros los contadores propios de SSRN estarían inflados "por un factor de cinco o más" [18]. Las pequeñas diferencias entre números comparables, por lo tanto, no contienen información.
6. Monitorea la acumulación a largo plazo en lugar de reaccionar a las cifras iniciales. La atención en las plataformas de documentos de trabajo se concentra al principio [116][28] (el último hallazgo proviene de datos de NBER en lugar de SSRN), pero los niveles de descubrimiento maduran lentamente: SSRN informa que la indexación en Google Scholar tarda "6–9 meses o más" [55]. Además, la lectura decae en varias escalas de tiempo a la vez, y la lectura y la citación no necesariamente siguen el mismo proceso temporal [91], por lo que ninguna lectura única de "vida media" de la propia curva es segura. Una trayectoria puede clasificarse provisionalmente en las lecturas de 60–90 días de la cuadrícula de la Tabla 11 y con mayor confianza a los 180 días, nunca en la lectura del día 7.
6.2 Cinco reglas para leer el panel de control
Con ese registro en la mano, la evidencia distribucional de la Sección 5 se reduce a cinco reglas prácticas para leer un panel de control día a día.
(i) Comparar contra medianas, no promedios ni estrellas visibles. El único ejemplo de censo de artículos ordinarios sitúa la mediana en 63 descargas y 369 visualizaciones de resumen después de dos años (LSN, artículos publicados en 2012) [139]. En la única muestra publicada reciente, la mediana es de 87 descargas, frente a un promedio de 221.3 que se sitúa por encima incluso del percentil 75 (Sección 3.3) [83]. Los números de hito que circulan provienen de la cola visible, cuyos máximos de 2015 alcanzaron cientos de miles de descargas (Sección 3.5) [85]; un autor que se calibra contra ellos se está calibrando contra la cola de una distribución cuasilognormal, lo que garantiza un error de calibración. El promedio de toda la plataforma de ~222 descargas de por vida por artículo calculado a partir de agregados de diciembre de 2023 [1] es tan inutilizable como una vara de medir personal.
(ii) Verificar la relación de conversión, no solo el número. Las mediciones independientes convergen en una banda normal de aproximadamente 11–19% descargas por visualización de resumen: la media del 18.7% y la mediana del 17.1% de la muestra LSN [139], y las cifras del 15% (artículos más citados) y 11% (artículos con una sola cita) de los estudios de citas legales [172]. La regla práctica histórica de SSRN de tres visualizaciones por descarga [18] se sitúa por encima de esa banda en lugar de dentro de ella. La muestra reciente de Marketing-network se sitúa ligeramente por encima de esa banda, con un promedio de 23.7 descargas por 100 vistas [83]. La Figura 6 representa gráficamente las estimaciones juntas. Ejecutar el ejemplo resuelto central de la Sección 5.2 a través de la regla: las 40 visualizaciones de resumen y 7 descargas del título se convierten al 17.5%, dentro de la banda como una estimación puntual, pero con un intervalo de Clopper–Pearson del 95% amplio (≈7.3–32.8%). Con n = 40, la lectura no es un fracaso ni un percentil preciso: un resultado de cribado consistente con la conversión ordinaria. Una conversión muy por debajo de la banda es consistente con un desajuste entre el resumen y el artículo, donde los lectores llegan, leen el resumen y se van. Eso es accionable, y la acción es revisar el título y el resumen. Una conversión muy por encima de la banda señala tráfico que la navegación de resúmenes no explica, como enlaces directos de medios o cobertura de agregadores, y debe indicar una verificación de dónde provienen las vistas. Ambas lecturas son diagnósticos de cribado: ningún estudio ha validado causalmente la inferencia de la conversión baja a la calidad del resumen, y el diagnóstico debe registrarse como una hipótesis sobre el propio artículo.
(iii) Tratar las descargas del primer mes como la señal de citación más temprana y más ruidosa. Las descargas tempranas se correlacionan con citas posteriores en aproximadamente r ≈ 0.4 en los datos de arXiv, lo que los propios autores originales traducen en solo aproximadamente el 16% de la varianza explicada [25]. La señal más temprana de este tipo registrada es biomédica: los conteos de clics en línea en la primera semana después de la publicación en BMJ se correlacionaron en aproximadamente 0.50 con citas acumuladas durante los años siguientes [119]. En la erudición jurídica, Black y Caron reportaron correlaciones de descargas-citas a nivel de artículo del orden de 0.50, aumentando a aproximadamente 0.55 en una muestra de cien profesores de derecho jóvenes [18]. En todos los campos y horizontes, las correlaciones a nivel de artículo oscilan entre aproximadamente 0.1 y 0.6 [80][25], y los conteos de descargas de arXiv pierden significancia estadística como predictores una vez que se controla la atención contemporánea en Twitter [138]. En el nivel agregado, la asociación se fortalece: 0.84 entre clasificaciones basadas en descargas y basadas en citas de cien facultades de derecho [77], y R = 0.724 entre descargas de PDF de seis meses y citas posteriores en el propio análisis de una revista [114]. Esas cifras agregadas no determinan dónde terminará ningún artículo individual, y un primer mes de descargas es una señal temprana sobre citas posteriores.
(iv) Cero descargas en la primera semana es distribución previa normal, no rechazo. Un artículo recién publicado llama la atención solo después de pasar la moderación, ser clasificado en revistas electrónicas temáticas y entrar en el ciclo de anuncio. La propia documentación de SSRN describe la clasificación como curada en lugar de garantizada, con retrasos de hasta 45 días para temas muy cargados [53], y se confirmó explícitamente que las distribuciones de revistas electrónicas y las alertas de correo electrónico continuasen sin cambios después del fin [147][57]. La secuencia de diagnóstico es: confirmar que el artículo está publicado públicamente, confirmar la clasificación de la revista electrónica, esperar el ciclo de anuncio y leer los contadores solo después de eso. El descubrimiento a través de motores de búsqueda llega aún más tarde [55].
(v) Un contador descendente o plano puede reflejar filtrado, no pérdida de lectoría. SSRN documenta públicamente que descarta descargas repetidas aparentes, descargas de robots y otras actividades irregulares [144][66][69]. La experiencia de RePEc/LogEc muestra cuán grandes pueden ser tales correcciones: en julio de 2007, los robots representaban aproximadamente el 74% de las visualizaciones de resumen pero solo aproximadamente el 7% de las descargas [99], y en septiembre de 2025, más del 99.5% del tráfico sin procesar de IDEAS se descartó en medio de la interferencia de bots de IA [129]. Una caída repentina, o un replanteamiento, es por lo tanto tan probable que sea un evento de medición como un evento de lectoría, y nunca debe interpretarse como una pérdida de reputación sin corroboración.
6.3 Evaluación comparativa sin clasificaciones
Las clasificaciones proporcionaban un marco comparativo. Un autor hoy tiene tres sustitutos para ello, ordenados de menor a mayor trabajo.
Micro-comparativas. El sustituto más directo es un grupo de referencia que uno construye por sí mismo: identificar tres a cinco artículos metodológicamente comparables de colegas en instituciones comparables, publicados en el mismo mes, y hacer seguimiento de sus contadores públicos en la misma cronología de la Tabla 11 que la de uno. El resultado es una línea de base percentil localizada contra exactamente la clase de referencia correcta, emparejada por construcción según campo, antigüedad del artículo y era de la plataforma, donde las clasificaciones retiradas comparaban artículos de todas las edades y campos en una sola liga. Es un procedimiento propuesto que utiliza únicamente conteos públicos por artículo, y debe registrarse como tal en cualquier uso de expediente. También presupone cierta familiaridad con la literatura de pares que los recién llegados más aislados, precisamente los autores a los que más afecta la condición de inicio en frío, pueden no tener. Para ellos, el remedio del lado de la plataforma de la Sección 10.4 (bandas de percentil anónimas) es la corrección estructural, ya que no requiere una red auto-ensamblada para usarse.
Una razón de desempeño relativo. La misma lógica se puede expresar como un número único: la razón entre las descargas de un artículo a una edad determinada y las descargas medianas de una cohorte emparejada, es decir, la misma disciplina, la misma antigüedad del artículo y, si es posible, el mismo tipo de artículo. Una razón de 1,0 significa visibilidad exactamente mediana para la cohorte, y los valores por encima o por debajo de 1,0 se leen en consecuencia. El índice ordena artículos dentro de una cohorte emparejada; las bandas de percentil aguardan la distribución de referencia. Las medianas publicadas a partir de las cuales podría construirse una línea de base de cohorte son antiguas y estrechas (63 descargas en dos años para becas legales publicadas en 2012 [139], 87 para trabajos de marketing observados en 2025 [83]), y mapear valores de razón en percentiles requiere la distribución completa, no solo la mediana. Asignar etiquetas de percentil a bandas de razón sin esa distribución produce una precisión falsa. La agenda pre-registrada de la Sección 8 incluye la calibración de las bandas; hasta entonces, la razón es un dispositivo de ordenamiento, no una escala de calificación. Dos precauciones adicionales limitan el dispositivo. No debe calcularse en absoluto en conteos pequeños, ya que la inestabilidad del pequeño denominador de la Sección 5.2 se aplica tanto al numerador de la razón como a una mediana de cohorte delgada, y el encogimiento empírico-Bayes (Secciones 8.3, 8.8) es la reparación apropiada siempre que tal razón se reporte públicamente. Una razón dada no se traduce en un percentil fijo: "el doble de la mediana de la cohorte" corresponde a diferentes posiciones de percentil en distribuciones de formas diferentes, por lo que la razón ordena artículos dentro de una cohorte pero no puede compararse entre cohortes o épocas cuyas formas de distribución difieren.
Lenguaje de veredictos para trayectorias. Las herramientas orientadas a la comunidad han propuesto clasificar la trayectoria temprana de un artículo en tres veredictos cualitativos (comienzo rápido, interés constante, comienzo lento) como una alternativa humanitaria a los números crudos. Merece la pena retener el vocabulario, ya que convierte un conteo en una declaración sobre una trayectoria, y "comienzo lento" explícitamente no es un sinónimo de fracaso. Los umbrales originalmente propuestos para estos veredictos se basaban en comparaciones de ventanas de tiempo no coincidentes y en una estadística "promedio de red" en toda la plataforma que no existe como métrica pública: SSRN no ofrece API de autoservicio pública ni punto final de estadísticas [51], y la métrica histórica más cercana ("Nuevas Descargas Por Artículo", una estadística de clasificación a nivel de autor) fue retirada con las clasificaciones ([B-9], citada con la advertencia de que las páginas de clasificación históricas ya no son accesibles). Asigne veredictos, entonces, solo a partir de comparaciones coincidentes: el grupo de micro-comparativas o la razón de mediana de cohorte anterior, leída no antes de la marca de 60–90 días.
Sea cual sea el sustituto utilizado, la triangulación externa lo fortalece. Los datos de capa de citas de Crossref y OpenAlex [35][124] y los indicadores de PlumX mostrados en páginas de SSRN [50] responden a una pregunta diferente, sobre uso posterior en lugar de visibilidad. Una herramienta de cita de política como Overton extiende la misma triangulación al alcance de política y práctica mapeando dónde se cita un artículo en documentos gubernamentales e institucionales [187], lo que se adapta a la base de ley, economía y política de SSRN. Estas capas se examinan conjuntamente con los contadores en el marco CSAB de la Tabla 10 y los diagnósticos de alcance–conversión de la Tabla 9. Los indicadores de Altmetric son una capa de triangulación adicional. Concebidos desde el principio como señales de atención temprana [123][122], siguen patrones distintos de las citas [74][20] y admiten normalización de campo [21]. También son vulnerables a la inflación automatizada [75] y requieren interpretación guiada por la teoría en lugar de lectura de valor nominal [76].
6.4 Mejorar la visibilidad legítima
Antes del cambio normativo, los Rankings proporcionaban retroalimentación cruda pero real para una decisión recurrente del autor: si la promoción adicional de un artículo valía la pena (Sección 1.3). Después del cambio normativo, esa decisión debe tomarse a partir de los mecanismos y diagnósticos reunidos aquí. La literatura sobre determinantes identifica un pequeño conjunto de mecanismos bajo el control del autor y coherentes con las reglas de la plataforma. Cada uno actúa sobre la visibilidad, no sobre la calidad, y ninguno cambia el contenido del artículo. La difusión rápida y la retroalimentación temprana se encuentran entre los propósitos reconocidos de la publicación de preprints en la literatura metodológica sobre preprints [24], y un manual para la visibilidad legítima utiliza esa función declarada.
Presentación. En la muestra LSN, las características del título, la longitud del resumen y la relevancia del tema se asociaron significativamente con la atención, con la advertencia del propio autor de que tales variables pueden servir como proxy para la calidad no observable [139]. En los estudios de citas legales, los artículos del decil superior llevaban más palabras clave y resúmenes más largos que los artículos del decil inferior [172] (los números específicos aguardan verificación contra el original). La página del resumen es la superficie de conversión en la que opera la regla (ii), por lo que cuando la conversión se mantiene persistentemente por debajo de la banda, el título y el resumen son lo primero que hay que revisar. Cualquier revisión de este tipo tiene como objetivo la alineación entre la promesa y el contenido, no tráfico indiscriminado: reescribir un resumen ya claro para maximizar clics puede dañar su precisión, y al atraer visitantes desajustados puede empujar la conversión más lejos de la banda en lugar de hacia ella.
Clasificación. Los artículos clasificados en más eJournals tuvieron en promedio más descargas y menos resultados de cero descargas en el análisis LSN de 2018 [168]. SSRN permite una a siete clasificaciones por artículo y cura la inclusión [53]. Un refinamiento comunitario popular, no verificado porque ningún estudio compara estrategias de clasificación, limita las clasificaciones a tres, elegidas como una principal, una amplia y una eJournal interdisciplinaria; ese consejo pertenece entre las hipótesis verificables del Apéndice A.
Distribución y atención externa. La alerta de correo electrónico de la eJournal sigue siendo el canal de inserción principal de la plataforma y continúa después del cambio normativo [147][57][152]. Fuera de la plataforma, la cobertura de blogs produjo picos de descarga tempranos marcados en la única prueba empírica de la pregunta [116], la posición visible en la lista aumentó la lectura y las citas en los estudios posicionales de arXiv [72], y la participación en conferencias se asoció con 17–26 descargas adicionales por artículo en un estudio cuasiexperimental construido alrededor de una reunión de ciencias políticas cancelada ([B-4], citado con la salvedad de que el contexto es APSA 2012, no una muestra de SSRN-economía). Las guías prácticas recopilan herramientas de distribución adicionales para la beca legal [169]. El caso de la difusión abierta temprana se establece de forma independiente: un ensayo aleatorizado de acceso abierto encontró más descargas aunque sin ganancia de cita a corto plazo [37], mientras que los estudios de cohortes y de campo reportan ventajas de cita de aproximadamente 10% a dos veces [59][86][17][93], incluyendo +53% para revisiones de derecho americano [40], y una auditoría de citas legales encontró que el 87% de los artículos más citados estaban disponibles en SSRN versus 44–46% de artículos poco citados, con el 95% del grupo más citado publicado en SSRN en o antes de su año de publicación [172]. El depósito de preprints se asocia con citas más altas y descargas de sitios de editores más bajas en arXiv [38], y las descargas de bioRxiv se correlacionan con los resultados de la revista [62]. En el censo de todos los preprints de bioRxiv, los recuentos de descargas se correlacionan con el factor de impacto de la revista en la que se publica posteriormente un preprint (Kendall τb = 0,59), una asociación cuya dirección de causalidad se desconoce [2]. Las capas de descubrimiento automático (motores de búsqueda y motores de respuesta generativa) se tratan por separado en el marco de auditoría de la Sección 8 y la agenda de auditoría de características de la Tabla 20 [5][164].
Gestión de versiones. Las revisiones cargadas en la misma página de SSRN preservan los contadores acumulados y la URL estable, mientras que eliminar y volver a publicar reinicia las métricas a cero ([B-7], citado con la salvedad de que la redacción de la página de soporte cambia con el tiempo y debe volver a verificarse en el envío). La afirmación de la comunidad de que una revisión menor el día 3 desencadena un nuevo anuncio y una "segunda ola" de atención no está documentada, y se encuentra entre las prácticas no verificadas en el Apéndice A. La identidad necesita el mismo cuidado. Vincular un ORCID iD verificado al perfil de autor de SSRN mantiene los artículos y sus contadores asociados a la persona correcta en lugar de a un homónimo, y es una protección de bajo costo contra el problema de desambiguación de autores que el diseño del panel de la Sección 8.3 debe resolver de otro modo estadísticamente ([B-7], misma salvedad de verificación).
Qué no hacer. Las autodescarga y la manipulación relacionada están documentadas en los registros del servidor propio de SSRN, intensificadas cerca de los umbrales de lista superior, e impulsadas por la comparación social [44]. Los filtros de fraude de la plataforma son públicos [144][69], y los comités de evaluación conscientes de este historial descartan afirmaciones no respaldadas. Entonces, la literatura sobre juegos lleva una advertencia práctica junto con la de integridad: los recuentos manipulados son detectables y costosos reputacionalmente. La Figura 9 ilustra la firma temporal en cuestión en datos simulados. La atención orgánica se acumula como un pico temprano con una cola larga, mientras que la manipulación produce picos concentrados exactamente del tipo que los filtros de integridad están diseñados para marcar [144][69].
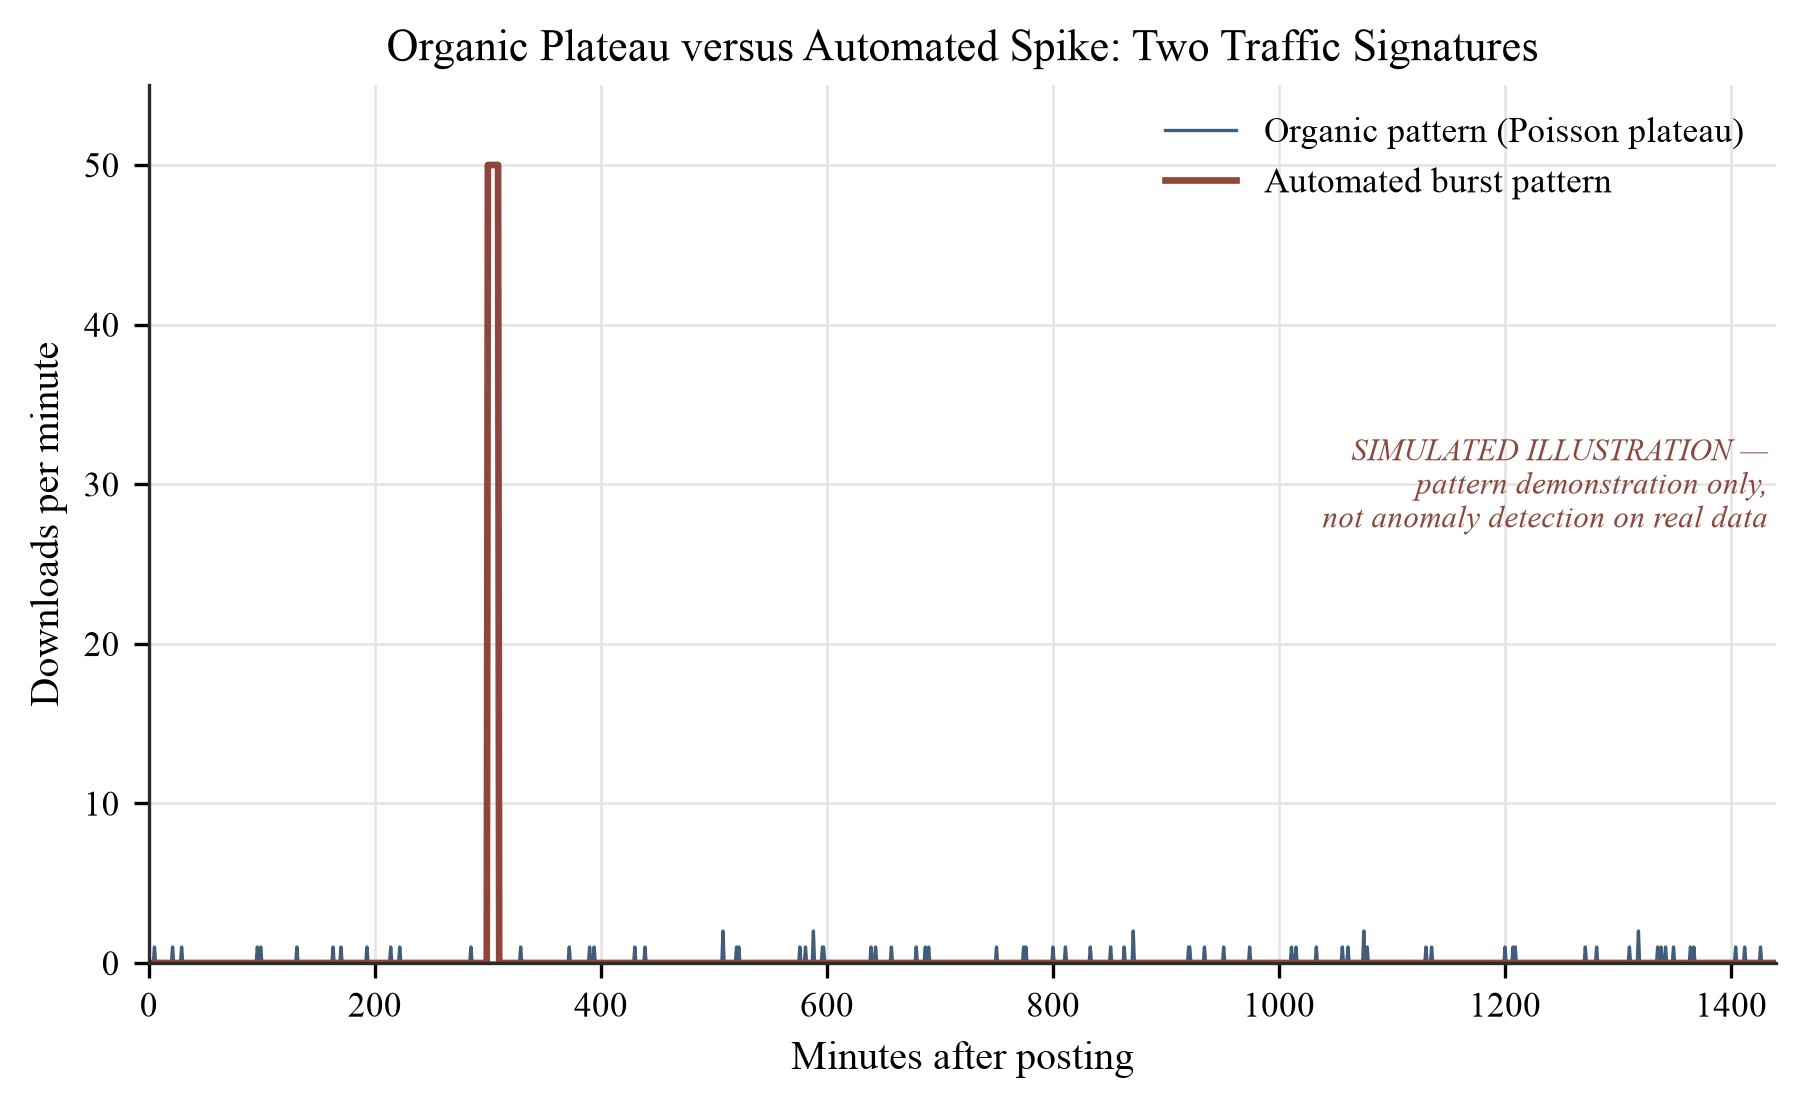
Figura 9. Acumulación orgánica versus un pico de manipulación. Una trayectoria de descarga orgánica suave contrastada con un pico de un día abrupto característico de autodescarga, motivando la advertencia de manipulación de la Sección 6.4 y la discusión de integridad de la Sección 4 [44][69][144]. Todos los datos mostrados son simulados; no existe un conjunto de datos de detección de anomalías empírico para SSRN.
6.5 Convirtiendo contadores en evidencia de carrera: el protocolo de dosier
Antes de la suspensión, la evidencia basada en clasificaciones de SSRN era un componente estándar del dosier. La clasificación pública de un autor se incorporaba directamente en los archivos de promoción: "clasificado en el lugar 13 entre 3.000 autores de derecho en el número total de descargas de todos los tiempos, que la facultad de derecho ha considerado en varias decisiones de promoción y relacionadas" [12]. Las guías de cartas de presentación aconsejaban citar conteos de descargas y apariciones en listas de los Diez Mejores [95], la orientación para profesionales simultáneamente advertía que el trabajo publicado por el autor "probablemente no contará para propósitos de promoción y tenencia en la facultad de derecho" [33], y la propia documentación de la plataforma describía sus métricas como datos "que los autores utilizan para propósitos de promoción y tenencia y que las instituciones utilizan en sus actividades de contratación y clasificación" [52]. Cada uno de estos artefactos presupone un marco comparativo público que ya no existe [149]. El uso evaluativo de los contadores fue cuestionado desde su primera propuesta, además: el argumento de Black y Caron en 2006 sobre las descargas como una medida "beta" del desempeño académico [18] fue respondido en el mismo volumen del simposio por la crítica de Eisenberg sobre qué pueden medir válidamente las clasificaciones basadas en SSRN [45]. Un dosier que cita descargas hereda ese debate sin resolver. La Tabla 13 establece un protocolo de siete pasos para reconstruir evidencia defendible a partir de lo que permanece, y su requisito rector, aplicado en la tercera y cuarta columnas, es que cada número citado en un dosier debe acompañarse de su fuente, su ventana de tiempo y sus limitaciones. Una afirmación traducida que se endurece en una precisión sin fuentes es peor que ninguna afirmación.
Tabla 13. Protocolo de evidencia posterior a la suspensión para métricas de SSRN en dosiers de tenencia, promoción y contratación. Cada paso nombra la acción, la base de pruebas con su ventana de tiempo, la limitación que debe divulgarse junto con cualquier número, el antipatrón a evitar y la conclusión más sólida que el paso puede autorizar.
| Paso | Acción | Base de pruebas (fuente; ventana de tiempo) | Limitaciones a divulgar | Evitar | Conclusión permisible |
|---|---|---|---|---|---|
| 1. Preservar | Archivar capturas de pantalla fechadas del panel de estadísticas de cada artículo y del perfil del autor en los intervalos de la Tabla 11 y antes de cualquier presentación; ensamblarlas, con avisos de distribución y un registro fechado de los eventos de promoción propios del autor, en el paquete de evidencia versionado de la Sección 6.1. | Los contadores por artículo sobreviven a la suspensión ([148][149]; 2026). Los contadores pueden reexpresarse cuando cambian las reglas de filtrado ([144][69]; documentado desde 2018). | Un archivo personal fechado es la única versión de registro bajo el control del autor; los números de la plataforma son revisables y no existe historial público. | "El artículo tiene X descargas" — citado sin fecha o denominador. | Un registro fechado y auditable de lo que mostró la plataforma — una observación específica del tiempo, no un veredicto de por vida. |
| 2. Traducir | Convertir conteos en lenguaje de banda usando la Tabla 8 (por ejemplo, "descargas de por vida por encima del umbral de entrada ~160 de la lista de 2015 de los 10.000 mejores artículos, es decir, aproximadamente el 1,8% superior del stock de artículos de texto completo de la plataforma, 571.040 en julio de 2016 [1], en ese momento"), siempre nombrando fuente, muestra y año; la plantilla CSAB del Apéndice B proporciona el formato a nivel de oración, con sus campos de percentil dejados en blanco hasta que exista un panel de referencia. | Umbrales a nivel de artículo: entrada ≥160, mediana dentro del grupo 805 (extracción de lista superior; 2015) [85]. A nivel de autor: entrada mínima de 129 descargas totales, mediana dentro del grupo 1.626 (misma extracción) [85]. Anclajes de artículos típicos: mediana 63 a dos años (LSN; 2012→2014) [139]; mediana 87 (red de Marketing; instantánea 2025) [83]. | Todos los umbrales derivan de muestras de 2012–2015 (inflación desde entonces [1]: Sección 5.1); el marco de 2015 cubre solo listas superiores; los dos anclajes de mediana son de una sola disciplina. El lenguaje de banda no debe reexpresarse como un percentil calibrado. | Etiquetas universales como "excelente" colgadas de un umbral bruto antiguo. | Posición relativa dentro de la muestra nombrada, campo y año — nada más amplio. |
| 3. Triangular | Emparejar contadores de SSRN con evidencia de citación independiente: Google Scholar, HeinOnline para derecho, RePEc para economía, Crossref/OpenAlex como capas de citación abiertas, PlumX como se muestra en SSRN. | Las clasificaciones de descarga de SSRN a nivel de escuela y las clasificaciones de citación de HeinOnline se correlacionan en 0,84 (100 facultades de derecho estadounidenses; 2019) [77]; las correlaciones de descarga–citación a nivel de artículo van ~0,1–0,6 dependiendo del campo y horizonte [80][25]; infraestructura de citación abierta [35][124]; PlumX [50]. | La cifra de 0,84 es una correlación a nivel de escuela y no desciende a ningún artículo o autor individual (precaución de inferencia ecológica, Sección 6.2(iii)); las descargas miden la demanda, no la lectura o respaldo; las correlaciones a nivel de artículo son modestas, y los conjuntos altamente descargados y altamente citados se superponen solo parcialmente [108]. La evidencia de citación convergente, no solo el contador, lleva la afirmación de impacto. | Equiparar una descarga con respaldo o corrección. | Evidencia estratificada de adopción, no prueba de calidad. |
| 4. Normalizar-por-campo | Establecer explícitamente el marco disciplinario (por ejemplo, "dentro de la beca de derecho corporativo, donde las medias de revistas electrónicas difieren aproximadamente por un factor de ocho entre subdisciplinas legales"). | Medias de subdisciplina de 438,35 frente a 53,48 descargas/artículo (revistas electrónicas LSN; 2018) [168]; las proporciones de descargas a citaciones están ellas mismas estructuradas por campo [18]. | La estimación de dispersión es solo de derecho y de 2018; la transferencia interdisciplinaria de cualquier umbral requiere precaución, y el lenguaje de percentil sin un calificador de campo es ininterpretable. | Comparar un artículo nuevo con un total acumulativo de varios años, o trasplantar un umbral entre campos. | Una comparación calificada por campo y edad — nunca una calificación universal. |
| 5. Complementar | Citar repositorios institucionales y otros canales de distribución junto con SSRN. | Los contadores de SSRN no dicen nada sobre descargas del mismo artículo de otros servicios [161]; las reformas de 2026 convirtieron las series basadas en repositorio en la ruta de migración para la distribución institucional [47][146]. | El contador de ninguna plataforma única mide la circulación total de un artículo; la afirmación del dosier es sobre el artículo, no sobre un contador. | Presentar el contador de una plataforma como la circulación total del artículo. | Una afirmación sobre la circulación del artículo, con el contador de cada canal nombrado por separado. |
| 6. Integridad | Indicar la regla de conteo de la plataforma junto con cualquier cifra citada y conservar el archivo fechado que documenta el número tal como se muestra. | El filtrado y la reafirmación son comportamientos documentados de la plataforma ([144][69][66]; en curso); las estadísticas de descargas informadas por el proveedor dependen de convenciones de conteo ([69][176]; 2015–2019). | Los contadores son estimaciones filtradas y revisables; no existe historial público de reafirmación, por lo que el archivo fechado del autor es el único registro estable. | Tratar los contadores como números exactos de lectores humanos únicos. | Una estimación filtrada bajo una regla especificada en una fecha especificada — no un censo de lectores. |
| 7. Evaluación de expertos | Presentar cada línea de métrica como contexto para la evaluación cualitativa de la contribución y el rigor del trabajo, nunca como su reemplazo. | Las métricas miden etapas de difusión, no validez (Secciones 3.1, 5.5); los conjuntos altamente descargados y altamente citados se solapan solo parcialmente [108]. | Ninguna métrica de uso, normalizada o cruda, evalúa si la investigación es correcta o importante. | Sustitución de métricas por el juicio de pares. | Evidencia contextual que acompaña la revisión de expertos — la afirmación de calidad descansa en la revisión, no en el número. |
La columna Evitar recopila los anti-patrones del protocolo. Dos advertencias delimitan el protocolo en su conjunto. Una descarga registra demanda pasiva más que lectura, aprobación o calidad, y los conteos responden a dinámicas de publicidad (cobertura de blog, títulos destacados, olas temáticas) tanto como a la erudición [116][139][138]. Los comités que conocen el registro de manipulación [44] descuentan números sin apoyo, y los ingredientes que sobreviven a tal descuento son exactamente aquellos que el protocolo requiere: capturas de pantalla fechadas, lenguaje de banda con fuentes adjuntas, calificadores de campo y triangulación.
6.6 El corolario de la solicitación
Publicar tiene un efecto secundario documentado que ningún panel de control reporta: invitaciones no solicitadas de revistas y conferencias depredadoras, producidas por la recopilación de nombres, afiliaciones y títulos de artículos de plataformas de preprints [107][159]. El volumen es sustancial en auditorías adyacentes, donde estudios especializados documentan flujos de invitaciones que van desde docenas por académico por quincena hasta miles por grupo de especialidad por mes (Sección 7.2) [9][84][63]. El primer contacto con una revista depredadora es un correo electrónico no solicitado en aproximadamente el 41% de los casos encuestados [32]. La Sección 7 y la Tabla 14 analizan el fenómeno. Para el manual, las consecuencias se reducen a cuatro instrucciones. Espera solicitudes como una consecuencia predeterminada de la visibilidad, y nunca interpretes su volumen como reconocimiento académico: los remitentes apuntan a la visibilidad mecánicamente, no al mérito selectivamente [159][63]. Canaliza la correspondencia a través de una dirección dedicada para que la recopilación no contamine la bandeja de entrada principal; un perfeccionamiento ampliamente repetido, que consiste en ocultar la dirección de correo electrónico del perfil durante las primeras dos semanas después de la publicación, es una práctica no verificada (Apéndice A). Nunca pagues, porque el modelo de negocio es la tarifa, con cargos de procesamiento de artículos en medios depredadores auditados que van de $25 a $1,800 [136]. El dinero es la apuesta menor: los mismos comités de evaluación que examinan dossieres (Sección 6.5) también leen bibliografías, y un medio depredador conocido en una lista de publicaciones impone un costo de reputación que perdura más que cualquier tarifa. Verifica cualquier medio que invita contra un servicio de detección mantenido como Cabells Predatory Reports ([B-1]; la lista de Beall no ha sido actualizada desde enero de 2017 y no debe utilizarse como fuente activa), y contra las listas de verificación de Think. Check. Submit. [159]. El mecanismo de recopilación también proporciona un filtro cualitativo: una revista que envía una invitación por correo electrónico dentro de días de la publicación de un preprint, antes de que plausiblemente pudiera haberse formado alguna lectura humana, es abrumadoramente improbable que sea legítima. Eso es una heurística; ningún estudio ha medido su incidencia [63].
6.7 Alcance del manual
Los pilares del manual datan de 2012 a 2015 y son de índole jurídica y comercial [139][85][83][1]. El flujo de descargas por artículo ha aumentado desde entonces (Sección 5.1). Los datos percentiles frescos estratificados por disciplina aún no existen; su recopilación, por la plataforma o por la comunidad, es el tema de las Secciones 8 y 10. El manual reduce las malinterpretaciones y no mide la calidad. Cuatro reglas hacen que su uso sea mecánico: comparar casos coincidentes, mantener constante la ventana de observación, asignar una fuente a cada número y etiquetar una hipótesis como tal.
7. La capa de atención parasitaria: visibilidad y solicitud depredadora
El marco interpretativo desarrollado hasta ahora trata la atención como un único embudo que va desde la exposición a la vista del resumen hasta la descarga y el uso posterior. La experiencia vivida de publicar un preimpreso, sin embargo, frecuentemente incluye un segundo flujo de "atención" que llega a través de un canal completamente diferente: invitaciones por correo electrónico no solicitadas de revistas, conferencias y servicios editoriales de legitimidad cuestionable [14][61][117][142]. A continuación se presenta un análisis conceptual de ese segundo flujo, junto con la evidencia de auditoría de su escala documentada.
7.1 Un modelo de atención de dos capas
El entorno posterior a la publicación se trata aquí como una economía de atención de dos capas (Figure 10). La Capa 1 es el embudo legítimo descrito en las Secciones 4 y 6: distribución de eJournal, vistas de resúmenes, descargas y uso académico eventual. La Capa 2 es una capa parasitaria, un ecosistema de editores depredadores y proveedores de servicios que se alimentan de la misma infraestructura pública (títulos, resúmenes, nombres de autores y afiliaciones) y tienen como objetivo convertir a los autores en clientes que paguen, no leer su trabajo. La literatura de solicitud-auditoría documenta el ciclo de vida. Los metadatos públicos de preprints (títulos SSRN, resúmenes, nombres de autores y afiliaciones) se recopilan [107][159], se envían invitaciones miméticas que reflejan llamadas legítimas para artículos [61][63], y los autores que participan se convierten en clientes que paguen. El motor económico también está documentado: los cargos de procesamiento de artículos en presuntas revistas depredadoras promedian aproximadamente $178, con un rango reportado de $25–$1,800 [136].
La asimetría entre las dos capas es importante para la interpretación. La Capa 1 requiere que un lector humano note, abra y valore el artículo, mientras que la Capa 2 solo requiere que los metadatos del artículo sean legibles por máquina. Por lo tanto, un preprint puede ser procesado completamente por la capa parasitaria mientras permanece efectivamente no leído en la legítima. Esa es la situación de los artículos de descarga casi nula de la plataforma, los "artículos fantasma", que las máquinas procesan y los humanos efectivamente no leen.
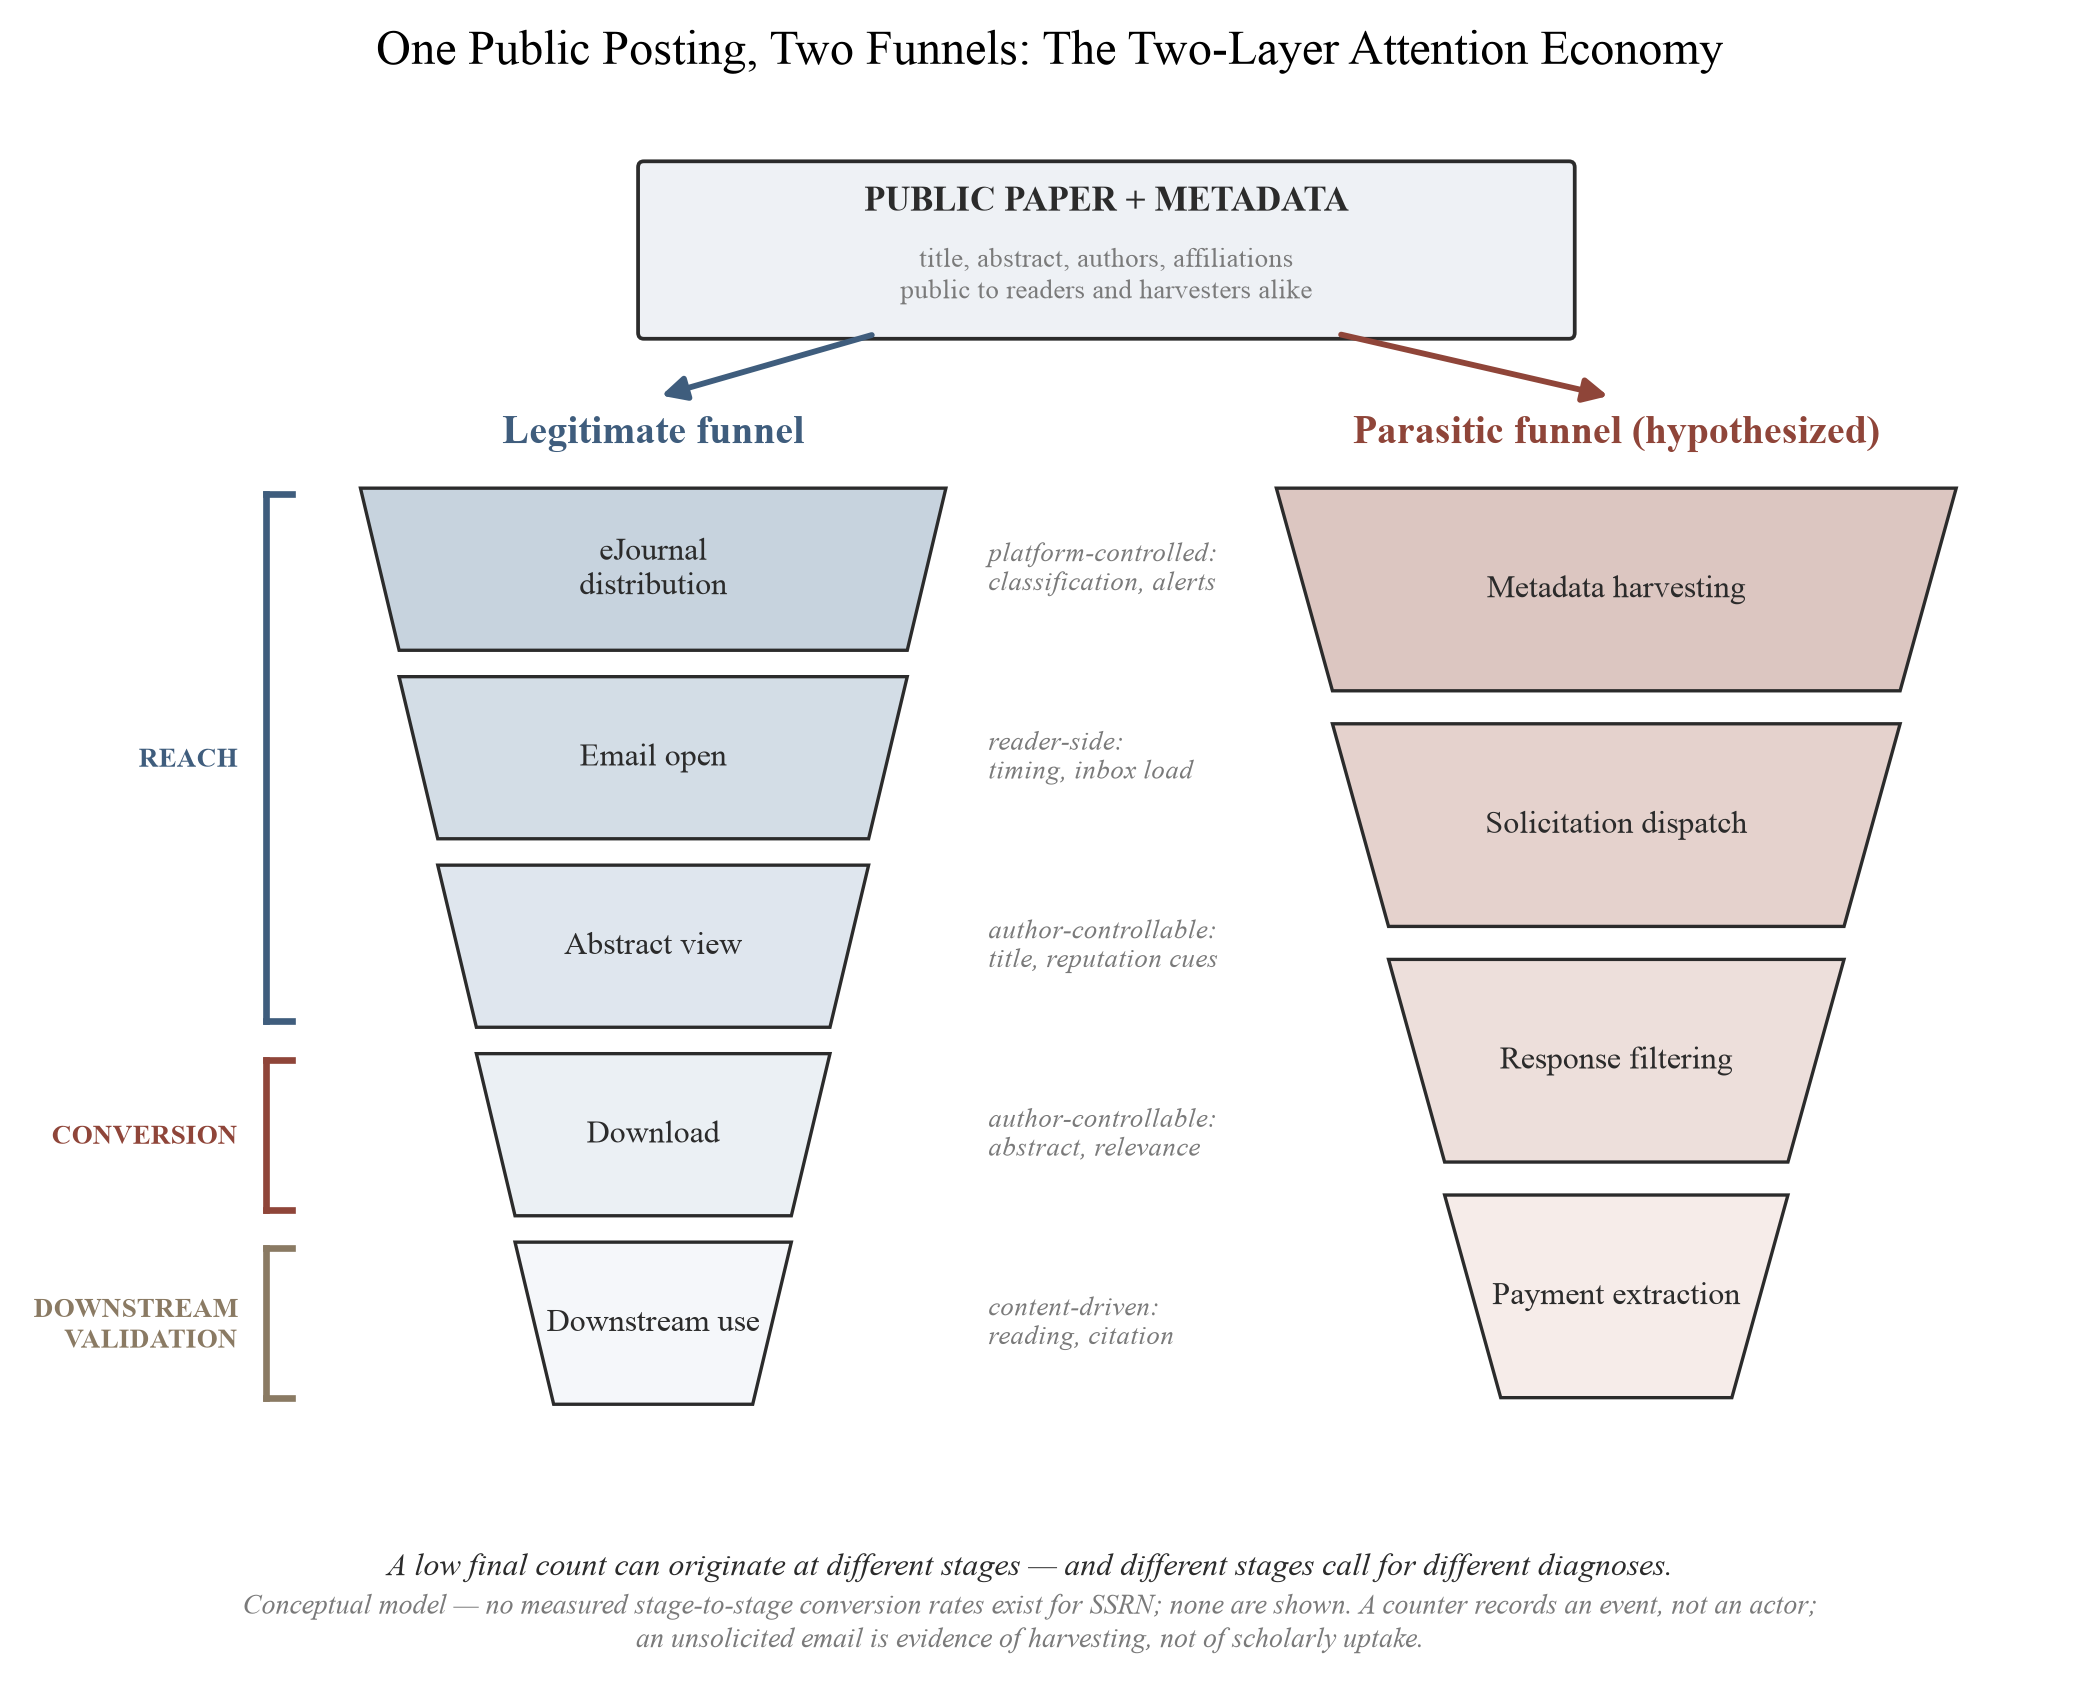
Figura 10. Modelo conceptual de la economía de atención de dos capas. Ambos embudos se muestran como secuencias de etapas cualitativas; no se muestran tasas de conversión de etapa a etapa porque no se han medido tales tasas para SSRN. El embudo parasitario es una reconstrucción hipotética basada en la literatura de solicitud-auditoría [61][63][107][159] (Sección 7.3).
7.2 La Escala Documentada de Solicitación Depredadora
No hay duda de que la solicitación depredadora es un fenómeno a gran escala. Una revisión de 2026 identificó veintinueve estudios empíricos de correo no deseado académico, convergiendo en un repertorio de tácticas: solicitación aduladora, falsas declaraciones editoriales y aserciones dudosas sobre métricas e indexación [61]. Los volúmenes medidos son sustanciales. Catorce oftalmólogos académicos recibieron 1,813 correos de solicitación de 383 editores únicos, abarcando 696 revistas únicas, dentro de una ventana de 30 días [84]. Los radiólogos académicos promediaron 20.7 invitaciones de manuscritos y 4.1 invitaciones de presentación durante un período de dos semanas [9]. Una auditoría exploratoria catalogó 422 correos de solicitación recibidos por un único urólogo durante 2023–24 [63], y un estudio de caso en publicación académica registró 1,024 correos no deseados de revistas durante 391 días [89]. Una observación de un solo investigador durante un año siguiendo publicaciones de preimpresiones registró 875 invitaciones de 256 revistas, el 76% de las cuales aparecieron en listas de bloqueo curadas, una fuente condicional, citada aquí con la advertencia de que no se midieron los retrasos en la llegada después de la publicación [B-10]. La solicitación también demuestra ser efectiva. Entre los autores que habían publicado en revistas presumiblemente depredadoras, el 41% informó que su primer contacto con la revista fue una invitación por correo electrónico no solicitada [32], y los análisis de contenido de corpora de solicitación documentan lenguaje adulador, plazos fabricados y alcance temático vago como dispositivos de persuasión recurrentes [96].
Ni la evidencia se limita a la medicina. En las ciencias sociales, disciplinariamente mucho más cercanas a la propia base de SSRN, tres investigadores en ciencias de la educación recibieron 210 invitaciones de revistas no solicitadas en tres meses, trazadas a 139 revistas y 37 editores, la mayoría de ellos clasificables como depredadores; aproximadamente la mitad de las invitaciones estaban fuera de los campos de especialización de los destinatarios, la firma de una segmentación impulsada por metadatos en lugar de basada en la audiencia lectora [155]. La carga recae más temprano en el protagonista de este artículo, el autor en fase inicial de carrera. Una autoauditoría longitudinal de un académico en fase inicial de carrera registró 1,280 solicitudes depredadoras (990 de revistas, 220 de conferencias, y 70 de otros tipos) a lo largo de aproximadamente ocho años, junto con intentos documentados y en gran medida infructuosos de darse de baja [160].
Dos características de esta base de evidencia deben tenerse presentes. Las auditorías más grandes provienen de la medicina, y las auditorías de ciencias sociales anteriores, aunque disciplinariamente más cercanas a SSRN, son más pequeñas; ninguno de estos volúmenes de investigación puede trasplantarse a los autores de SSRN. Decisivo para este artículo, ninguno de estos estudios midió el tiempo de las solicitudes relativo a un evento de publicación de preimpresión. La auditoría en [63], por ejemplo, catalogó contenido y procedencia pero no vinculó los tiempos de llegada a la actividad de SSRN. Por lo tanto, cada afirmación que conecta la capa parasitaria al acto de publicar es una hipótesis de mecanismo, no un hallazgo.
7.3 Mecanismos de focalización hipotéticos
Para llegar a un preprint recién publicado, la capa parasitaria debe localizarlo primero. Los mecanismos a continuación son hipótesis respaldadas parcialmente en la literatura; ningún corpus vincula solicitudes a publicaciones en SSRN.
H-S1 (recopilación de metadatos). Las operaciones depredadoras raspan páginas de resúmenes públicos y listados de nuevos artículos para obtener títulos, nombres de autores y afiliaciones. Fuentes de profesionales y asesores describen este comportamiento: se reporta que revistas depredadoras escanean servidores de preprints y envían invitaciones no solicitadas que hacen referencia al título del artículo [159]. Un comentario de jurisprudencia sostiene que los solicitantes "recopilan correos electrónicos, nombres, afiliaciones, etc., rastreando artículos académicos existentes, p. ej., los publicados en SSRN" [107], y una guía de biblioteca jurídica vincula la publicación de preprints con "un aumento del spam de editores depredadores que solicitan a los investigadores que republiquen sus artículos por una tarifa" [117]. Una regularidad medida se ajusta a este mecanismo. En la auditoría de radiología, las auditorías de especialidad reportan altos volúmenes de solicitudes entre autores que publican activamente [9], consistente con la recopilación de la superficie bibliográfica acumulativa de un autor en lugar de cualquier evento de publicación individual. El Estudio 3 (Sección 8.6) registra en consecuencia controles de exposición a nivel de autor junto con la publicación focal.
H-S2 (adquisición de contacto). La solicitud requiere una dirección de correo electrónico. Las páginas de resumen de SSRN históricamente incluían información de contacto del autor [151], y las direcciones también circulan a través de los propios artículos, páginas institucionales y publicaciones anteriores. Aún no se ha probado si SSRN actualmente expone los correos de autores en forma recopilable; el estudio de registro de solicitudes instrumentado se especifica para medirlo. El canal de adquisición para cualquier solicitud dada no se observa.
H-S3 (aprovechamiento de distribución). Los resúmenes de eJournal y las fuentes de tipo RSS redistribuyen metadatos de nuevos artículos a los suscriptores [57][51]. Un actor parasitario suscrito a estos canales recibiría información estructurada sin raspar. Ninguna auditoría ha verificado esta ruta.
La cadena causal desde la publicación hasta ser objetivo no se ha establecido empíricamente; la Sección 8 especifica una prueba preregistrada de estos mecanismos: registro de llegadas de solicitudes con respecto a marcas de tiempo de publicación conocidas para artículos recién publicados.
7.4 Una tipología hipotética de señales de solicitud
Si los mecanismos de orientación de la Sección 7.3 funcionan, diferentes clases de solicitud deberían portar información diferente sobre la visibilidad de máquina de un artículo. La Tabla 14 lo presenta como una tipología hipotética, cuyas categorías de estrategia se basan en tácticas de persuasión documentadas: desajuste de credenciales y personalización fuera de objetivo [9][63], plazos fabricados y halagos [96], afirmaciones falsas de métricas e indexación [61], y tasas ocultas contra un mercado APC documentado [136]. La columna final es inferencial y no probada. La tabla no proporciona porcentajes de prevalencia ni estimaciones de tiempo de llegada.
Tabla 14. Una tipología hipotética de señales de solicitud depredadora posteriores al envío de preimpresión. Los ejemplos de fraseología son ilustrativos, paráfrasis inventadas de patrones documentados en auditorías de solicitud [9][61][96], no citas textuales de ningún mensaje específico.
| Patrón de solicitud | Descripción | Fraseología ilustrativa | Información hipotética sobre visibilidad |
|---|---|---|---|
| Dirección genérica, sin referencia a documento | Invitación automatizada sin mención del documento o campo específico | "Dear Esteemed Researcher, submit your valuable work…" | Bajo: la dirección puede derivarse de cualquier fuente; sin evidencia de que el documento en sí fue visto |
| Desajuste de credenciales | Invitación que cita experiencia en un campo no relacionado con el documento [9] | "Given your expertise in quantum physics…" (to a law paper) | Bajo o nulo: indica cosecha masiva sin análisis de metadatos |
| Orientado, con referencia de título | Invitación que nombra la preimpresión específica y una sede temáticamente adyacente [159] | "Your recent paper '[exact title]' would suit our journal…" | Más alto (hipotético): los metadatos del documento llegaron al remitente, lo que implica indexación exitosa y acceso a raspador |
| Personalización mediante halagos | Elogio del trabajo específico como "innovador" o "estimado" [96] | "Your groundbreaking contribution…" | Ninguno más allá del acceso al título: el elogio es de plantilla, no leído |
| Urgencia e métricas fabricadas | Plazos inventados, "factores de impacto" con asterisco, afirmaciones de indexación [61][96] | "Impact Factor 4.2*; submit within 7 days" | Ninguno: dispositivo de persuasión independiente del documento objetivo |
| Tasas ocultas | APC divulgado tarde o solo en adjuntos; rango de mercado $25–$1,800 [136] | Fee absent from invitation body | Ninguno: estrategia de fijación de precios, no señal de visibilidad |
| Invitación a conferencia, con referencia a documento | Invitación para presentarse o presentar una solicitud a una conferencia cuestionable, a menudo nombrando el documento específico; las invitaciones de oradores son un componente medido del spam académico [61][9] | "We invite you to present your paper '[exact title]' as a keynote at…" | Como para la solicitud orientada (hipotética): los metadatos del documento llegaron al remitente; sin evidencia de lectura sustancial |
| Servicios de autor pagados | Ofertas de revisión rápida de pares, traducción o servicios de edición dirigidos a una preimpresión recién publicada [61][84] | "Fast-track review and professional language polishing for your new preprint…" | Ninguno establecido: el spam de servicios rastrea metadatos de nuevas publicaciones, no contenido del documento |
Las filas de halagos llevan una dimensión psicológica que la lectura mecánica oscurece. El elogio de plantilla cae sobre un autor que puede estar mirando un contador estancado, para quien la solicitud es la única "validación" que la publicación ha producido hasta ahora. El modelo de dos capas predice así una inversión cruel en la que los primeros en responder a una preimpresión nueva frecuentemente son depredadores en lugar de lectores (Sección 7.5), y un recién llegado puede malinterpretar el spam como interés porque aún no ha llegado ninguna señal legítima. Un autor que espera el gancho puede descartarlo.
La Tabla 14 examina los mensajes entrantes para determinar lo que podrían revelar sobre la visibilidad de un documento. Cómo codificar esos mensajes en absoluto es la pregunta complementaria, y se basa en una distinción dejada implícita hasta ahora, entre contacto académico legítimo y solicitud de mayor riesgo. La Tabla 15 presenta esa distinción como una tipología de seis señales cuya columna final presenta las advertencias de codificación: cada señal es probabilística y ninguna constituye prueba por sí sola. La tipología también es el esqueleto del libro de códigos del Estudio 3 (Sección 8.6), ya que un estudio de solicitud sin una clase positiva de contacto legítimo no puede medir la asimetría que la Sección 7.5 plantea como hipótesis.
Tabla 15. Separar el contacto académico legítimo de la solicitud de mayor riesgo: seis señales con advertencias de codificación. Un esquema de codificación hipotético, no un clasificador validado. La columna de visibilidad de la Tabla 14 plantea una pregunta diferente y no se ve afectada: el mismo mensaje se puede codificar en ambas cuadrículas.
| Señal | Contacto académico legítimo | Solicitud de mayor riesgo | Advertencia de codificación |
|---|---|---|---|
| Especificidad | Se ocupa de un argumento, método o resultado concreto | Elogio genérico con el título o palabras clave insertadas | La especificidad puede ser imitada |
| Identidad de la sede | Historial verificable de revista, editor, institución o conferencia | Propiedad poco clara, marca copiada, junta no verificable | Las nuevas sedes no son automáticamente depredadoras |
| Solicitud | Pregunta sustancial, colaboración o invitación transparente | Solicitud urgente de presentación o pago no relacionada con el trabajo | Las tasas por sí solas no son decisivas; la transparencia importa |
| Tiempo | Cualquier tiempo; a menudo sigue a la lectura real | Contacto rápido de plantilla poco después de la publicación pública | La proximidad temporal no prueba la fuente de cosecha |
| Idioma | Específico del tema y profesionalmente responsable | Halagos, familiaridad falsa, urgencia artificial, alcance vago | Las características del idioma son probabilísticas, no prueba |
| Verificación | Detalles de contacto y políticas independientemente verificables | Identificadores rotos, métricas falsas, afirmaciones de indexación engañosas | Se requiere revisión humana bajo criterios documentados |
En la práctica, la tipología produce una heurística de cribado más que un diagnóstico: una solicitud de revista que llega en los primeros días después de publicar, antes de que hayan operado plausiblemente los canales de distribución legítimos, es muy probable que sea depredadora. No se informa que revistas de alto impacto legítimas realicen llamadas en frío a autores de manuscritos recién publicados [174], mientras que la invitación temprana no solicitada es el modo de primer contacto documentado de las revistas depredadoras [32][174]. Proponemos el umbral específico a veces propuesto en discusiones entre profesionales (tratando cualquier correo de revista en aproximadamente las primeras 96 horas como presuntamente depredador) como una heurística para autores pendiente de validación. Ningún estudio ha medido la distribución del retraso que calibraría tal umbral. La precaución temporal de la Tabla 15 se aplica a la heurística misma: la proximidad temporal genera sospecha pero no prueba que el remitente haya cosechado esta publicación particular, puesto que la dirección puede ser anterior al preprint en su totalidad, por lo que el cribado de 96 horas ordena buzones sin proporcionar evidencia.
7.5 La Paradoja del Spam y la Asimetría de Velocidad
Dos proposiciones más sobre la capa parasitaria se derivan del modelo de dos capas.
La Paradoja del Spam. Si la solicitud dirigida requiere una cosecha exitosa de metadatos, entonces en el entorno posterior a Rankings, la ausencia de spam depredador puede ser un indicador más fuerte de invisibilidad de plataforma que su presencia lo es de cualquier otra cosa. Un artículo que nunca activa ni siquiera la capa parasitaria puede haber fallado en superar la barra mínima de distribución legible por máquina. El atractivo analítico de esta inversión, con el spam como proxy involuntario y tóxico para la indexación, es que convierte una molestia inevitable en un instrumento de observación gratuito. Su poder diagnóstico es por ahora solo una hipótesis: la correlación entre la recepción de solicitudes y cualquier métrica de visibilidad nunca se ha medido, y las filas de solicitud genérica de la Tabla 14 muestran por qué el volumen bruto de spam sería una señal ruidosa incluso en principio.
Los depredadores llegan antes que los lectores. El embudo legítimo funciona con retrasos institucionales: la inclusión en eJournal es seleccionada en lugar de garantizada, con retrasos de hasta 45 días reportados para clasificaciones de alto volumen [53], e indexación de Google Scholar toma seis a nueve meses o más [55]. Las descargas cercanas a cero en la primera semana son consistentes con una pre-distribución normal en lugar de un rechazo (Sección 6). La capa parasitaria, si cosecha metadatos programáticamente, no enfrenta ninguno de estos retrasos. Por lo tanto, hipotizamos que para un autor cuya información de contacto es adquirible, el tiempo esperado hasta la primera solicitud depredadora atribuible a una publicación es más corto que el tiempo esperado hasta el primer contacto académico genuino, de modo que el autor desconocido se encontraría con la capa parasitaria antes que la legítima. La falsación es directa: el contacto genuino precede de manera confiable a la solicitud.
Los volúmenes de solicitud documentados medidos en días y semanas [9][84], contrastados con la mecánica de distribución medida en semanas y meses [55][53], hacen que la hipótesis sea plausible. Solo el estudio de registro especificado en la Sección 8 puede probarlo, porque los corpus existentes no fueron vinculados temporalmente a los eventos de publicación [63].
7.6 Lo que la capa parasitaria no dice a un autor
Tres afirmaciones de frontera delimitan las conclusiones de esta sección.
Primero, el correo de solicitud no mueve los contadores de la plataforma. Una invitación enviada al autor no genera ninguna vista de resumen ni ninguna descarga del artículo. En la medida en que los raspadores visitan páginas de resumen, SSRN afirma que filtra actividades irregulares y automatizadas de sus recuentos de descargas [66][69][144]. El volumen de correo no deseado nunca es evidencia de lectura, y una bandeja de entrada llena de solicitudes que coexiste con descargas de un solo dígito no implica contradicción: las dos capas cuentan cosas diferentes.
Segundo, la capa parasitaria también afecta más duramente a los autores menos equipados para absorber sus costos: los investigadores en etapas tempranas de carrera y no hablantes nativos de inglés se han identificado como particularmente vulnerables a la solicitud [142]. El protocolo práctico de la Sección 6 por lo tanto trata la higiene de la bandeja de entrada (filtrado mediante listas de bloqueo de cualquier sitio de solicitud, no respuesta a invitaciones no solicitadas, verificación a través de servicios seleccionados en lugar de listas inactivas) como parte de la interpretación de métricas en lugar de una preocupación separada. El filtrado automatizado de sitios depredadores es en sí mismo una dirección de investigación activa [157].
Tercero, la visibilidad temprana tiene un efecto secundario adicional que los autores encuentran como una acusación aparente: en un envío posterior a la revista, el software de verificación de similitud marcará una coincidencia casi completa entre el manuscrito y su versión anterior en SSRN, ya que los artículos de preimpresión se indexan en el corpus Crossref Posted Content utilizado por iThenticate [36]. La documentación del proveedor es explícita en que una coincidencia de preimpresión del mismo autor es un resultado esperado y no plagio [81]. La respuesta apropiada es comunicar la preimpresión al editor, no retirarla.
La capa parasitaria es donde la afirmación central de este artículo es más fácil de ver: después de la puesta de sol de las Clasificaciones, las señales crudas (descargas, vistas y ahora incluso correo no deseado) tienen significado interpretable solo cuando se especifica el mecanismo que las generó. Esa especificación está parcialmente disponible para la capa legítima, y para la capa parasitaria todavía es un programa de investigación.
8. Una agenda de investigación lista para preregistro: Reconstrucción de la clase de referencia faltante
Las secciones anteriores sintetizaron la evidencia verificable sobre las métricas de atención de SSRN y propusieron un marco de interpretación para el ambiente post-Clasificaciones. Esta sección es una agenda lista para preregistro para responder empíricamente las preguntas abiertas del marco. No reporta resultados, por diseño: bandas prespecificadas y falsables en lugar de hallazgos. Cada diseño, hipótesis y banda de predicción a continuación está listo para ser registrado en el Open Science Framework antes de cualquier recopilación de datos, con código de análisis liberado simultáneamente. El retiro de las Clasificaciones de SSRN el 15 de julio de 2026 [149], anunciado el 12 de junio de 2026 con una fecha objetivo inicialmente anterior [148] e integrado en un enfoque de plataforma más amplio [146], hace que esta agenda sea inusualmente sensible al tiempo: algunos de los diseños a continuación explotan una discontinuidad cuyo período anterior se aleja con cada mes, y uno de ellos, el registro de percentiles de la Sección 8.8, aborda una brecha de medición que la puesta de sol misma hizo permanente para observadores externos.
8.1 Principios de diseño
Cuatro principios rigen la agenda.
Observación desde el nacimiento. El raspado retrospectivo de contadores acumulativos no puede reconstruir lo que un artículo tenía el día 3, día 7 o día 30. Por lo tanto, cualquier panel de referencia creíble debe inscribir artículos en su publicación y registrar sus contadores en edades estandarizadas: días 1, 3, 7, 14, 30, 60, 90 y 180 (Tabla 11), siendo preferible la observación diaria durante los primeros 45 días, porque SSRN indica que la distribución de alertas en temas muy suscritos puede tomar hasta 45 días [53]. Este principio también protege contra fugas: las medidas de reputación previa del autor deben estar congeladas en la fecha de publicación focal para que el éxito futuro no pueda contaminar las covariables de referencia. Su disciplina complementaria, trasladada de la Sección 5.6, es que los eventos de distribución, indexación y promoción entran en los diseños a continuación como tratamientos con fechas especificadas y nunca como contexto no modelado.
Separación del alcance y la conversión. Siguiendo la lógica diagnóstica de la Sección 5 (Tabla 9), cada diseño a continuación registra las vistas de resúmenes y descargas como resultados distintos y modela las descargas condicionadas a las vistas. El bajo alcance y la baja conversión son diagnósticos diferentes: la falta de entrada en el conjunto de consideración del lector frente a la falta de adquisición tras la exposición. Agruparlos en un único conteo descarta la información que un autor necesita.
Resultados distribucionales, no solo medias. Dado que la atención de la plataforma tiene cola pesada [83][85][180], las intervenciones y cambios de plataforma pueden alterar la forma de la distribución dejando su media prácticamente invariada. Los resultados incluyen el coeficiente de Gini de atención, las participaciones de descargas del top-1% y top-10%, la participación de artículos en cero o próximos a cero, y las proporciones de atención entre recién llegados y establecidos, en la tradición de la medición de desigualdad de atención en otros medios [180].
Falsabilidad. Cada hipótesis va acompañada de una estrategia de identificación y una condición establecida bajo la cual falla. El marco en sí está expuesto al rechazo: si las métricas tempranas normalizadas por edad y campo no superan los recuentos crudos fuera de muestra (RQ3 a continuación), la supuesta ventaja de medición de la normalización debe ser rechazada o limitada. La falsabilidad también es cuantitativa: los tamaños de muestra en toda la agenda deben ser finalizados por simulación de potencia contra los tamaños de efecto más pequeños de interés. La estrategia de multiplicidad para un programa de cinco hipótesis, tres preguntas de investigación y cinco proposiciones se establece en el prerregistro, y los análisis confirmatorios y exploratorios se etiquetan como tales por adelantado. La atrición (artículos retirados, fusionados o materialmente revisados) se registra e informa en lugar de descartarse silenciosamente, con un diagrama de flujo de cohortes en cada informe empírico del programa (Sección 8.8).
8.2 Hipótesis y proposiciones
El marco genera cinco hipótesis y tres preguntas de investigación relacionadas con la asignación de la atención temprana, y cinco proposiciones relacionadas con su estructura. La Tabla 16 vincula las hipótesis, las preguntas de investigación y las proposiciones con diseños dedicados (P2, P3b, P4) a un resultado, un contraste y un diseño preferido; P1 y P3 son respaldados por los Estudios 1 y 2 en la Tabla 17.
H1 (Desventaja de inicio en frío). Condicionado al campo, cohorte de publicación, tema observable, características del documento y condiciones de calendario, los artículos redactados enteramente por nuevos usuarios de la plataforma reciben menos visualizaciones iniciales de la página de resumen que los artículos con al menos un autor previamente visible de SSRN. El resultado central son las visualizaciones en lugar de descargas por visualización, porque H1 concierne la formación de la audiencia y no la conversión.
H2 (Prestigio y exposición). El prestigio institucional y del autor predice positivamente el alcance temprano de la página de resumen después de controlar la actividad previa en la plataforma y características observables del artículo, extendiendo la literatura sobre atención y estatus [104][105][111][140][60] a la primera etapa de la difusión de preprints.
H3 (Prestigio y conversión condicional). El prestigio institucional predice positivamente la descarga de texto completo condicionada a la exposición a la página de resumen. Jo y Li proporcionan evidencia reciente específica del campo consistente con este patrón en Marketing, una prima de prestigio de aproximadamente +6.6% en la tasa de descarga para un artículo de tres autores con un autor del top-50 [83], pero una prueba longitudinal más amplia sigue siendo necesaria. Conjuntamente, H2 y H3 definen el estimando principal del panel: una descomposición de alcance versus conversión del gradiente de prestigio, es decir, la fracción de la desigualdad observada relacionada con el prestigio en las descargas que surge antes de la visita a la página de resumen (exposición) versus después de la misma (conversión condicional). Un hallazgo de que la mayor parte del gradiente se forma antes de que algún lector haya visto el resumen ubicaría la desigualdad en los mecanismos de descubrimiento en lugar de en la evaluación del contenido, de forma directamente medible.
H4 (La comunicación como ecualizador). La mayor claridad del resumen y la eficiencia informativa se asocian con mejoras más grandes en la conversión condicional entre autores con baja visibilidad previa que entre autores ya visibles. H4 es la única hipótesis cuyo tratamiento se encuentra completamente bajo el control del autor. Debe ser probada con medidas textuales prespecificadas y, por separado, un experimento de resumen aleatorizado diseñado según estándares de experimento de campo en línea [30]. No debe confiar únicamente en clasificadores automatizados "escritos por IA", que introducen su propia incertidumbre de medición.
H5 (Persistencia de choques de exposición). Los choques de exposición temprana exógenos o cuasi-exógenos predicen una atención posterior elevada más allá de la ventana de exposición inmediata: el análogo de plataforma académica de la dinámica donde el éxito genera más éxito documentada experimentalmente en otros lugares [112][131][162] y de efectos de exposición posicional en arXiv [72][73].
RQ1. ¿El retiro del 15 de julio de 2026 de Rankings cambió la concentración, distribución o gradiente de prestigio de la atención? Dos predicciones opuestas son ambas plausibles, y la pregunta se deja bidireccional: eliminar clasificaciones puede debilitar bucles de retroalimentación de popularidad [112][131], o puede aumentar la dependencia de redes de autores preexistentes al eliminar una superficie de descubrimiento a través de la cual los artículos desconocidos podrían hacerse visibles una vez que comenzaran a atraer atención.
RQ2. ¿La distribución de alertas de correo electrónico curadas produce ganancias de atención proporcionales más grandes para los recién llegados o para los autores establecidos?
RQ3. ¿Las métricas tempranas normalizadas observadas en los días 7 y 30 predicen mejor los resultados posteriores de citación académica o publicación que las descargas acumulativas brutas?
Las proposiciones reiteran las afirmaciones estructurales del marco en forma falsable:
P1 (Sesgo y la mayoría invisible). En una muestra estratificada aleatoria de artículos de SSRN, la distribución de descargas de por vida tiene cola pesada y sesgo hacia la derecha tal que la mediana es menor que la mitad de la media, y una parte sustancial de artículos tienen diez o menos descargas de por vida. Falsador: mediana ≥ 0.5 × media, o una participación negligible ≤10-descargas. La razón publicada de media a mediana de la red de Marketing (aproximadamente 2.54) [83] y el ajuste cuasi-lognormal de los datos de lista superior de 2015 [85] motivan pero no establecen P1 para la plataforma en general.
P2 (La clasificación rige la visibilidad). Dentro de la capa de repositorio, el número de clasificaciones de eJournal se asocia positivamente con descargas y se asocia negativamente con la probabilidad de descargas cercanas a cero, controlando la edad y la red, una replicación y actualización del patrón transversal de 2018 de Whalen [168] bajo la mecánica de distribución curada de la plataforma [53][57]. Falsador: sin asociación significativa después de controles. El recuento de clasificación es en sí mismo potencialmente endógeno: los artículos de relevancia más amplia pueden tanto recibir más clasificaciones como atraer más lectores, por lo que la asociación transversal sobrestima cualquier efecto de visibilidad. La identificación preferida es, por lo tanto, cambios de clasificación dentro del artículo donde esté disponible, con la estimación transversal reportada explícitamente como un límite superior.
P3 (La visibilidad de máquina es baja y depende de características). Para consultas construidas de modo que un preprint de SSRN específico sea la mejor fuente disponible, los motores de respuesta de IA de consumo citan el preprint mismo en una minoría de casos, y la visibilidad de máquina aumenta con características análogas a factores de optimización de motor generativo documentados [5][164]. Falsador: los preprints se citan la mayoría de las veces independientemente de las características, o ninguna característica predice la visibilidad.
P3b (Un efecto Mateo en la capa de máquina). Condicionado a la relevancia de consulta validada por expertos, los artículos con mayor visibilidad previa en la web y académica son citados por sistemas de respuesta de IA más frecuentemente que artículos de inicio en frío por lo demás comparables. Bajo la alternativa de equidad, los motores generativos recuperan basándose en relevancia sin una prima sobre la visibilidad previa y P3b es rechazado, un resultado bajo el cual la capa de máquina sería más igualitaria que las capas de descubrimiento humano de H1–H3, no menos. Falsador: ningún gradiente de visibilidad en consultas de relevancia coincidente. P3b extiende la línea de ventaja acumulativa de H1–H3 a la parte superior de la pila de descubrimiento. Probarla requiere la covariable de visibilidad previa y estratificación de consulta especificada en el Estudio 2 (Sección 8.6).
P4 (Los depredadores llegan antes que los lectores). Para un preimpreso recién publicado cuya información bibliográfica y vía de contacto pueden extraerse del documento publicado o de páginas públicas asociadas, el tiempo esperado hasta la primera solicitud depredadora atribuible a la publicación es más corto que el tiempo esperado hasta el primer contacto académico genuino. Falsador: el contacto genuino precede de manera confiable a la solicitud depredadora. P4 se plantea condicionalmente sobre la recolectabilidad porque la visibilidad pública de los detalles de contacto del autor en la interfaz de la plataforma actual no está establecida. El mecanismo de recolección en sí está documentado para repositorios de preimpresos en general [107][159][151], y el correo electrónico no solicitado es el primer contacto con una revista depredadora para una proporción sustancial de autores solicitados [32]. La atribución, por lo tanto, requiere el diseño instrumentado del Estudio 3 en lugar de la inferencia solo del tiempo de la bandeja de entrada.
Tabla 16. Hipótesis, preguntas de investigación y estrategias de identificación.
| Pregunta | Resultado principal | Contraste principal | Diseño preferido |
|---|---|---|---|
| H1: desventaja del principiante | Vistas incrementales | Principiante vs. establecido | Modelo de conteo longitudinal jerárquico |
| H2: prestigio y alcance | Vistas incrementales | Mayor vs. menor prestigio previo | Panel ajustado por covariables + análisis de sensibilidad pareado |
| H3: prestigio y conversión | Descargas condicionadas a vistas | Mayor vs. menor prestigio | Modelo de exposición binomial negativo/Poisson |
| H4: ecualizador de comunicación | Probabilidad de descarga condicional/tasa | Claridad × visibilidad previa | Modelo de texto observacional + replicación aleatorizada |
| H5: atención acumulativa | Vistas/descargas posteriores al shock | Shock de exposición vs. trayectoria previa al shock | Estudio de eventos dentro del documento |
| RQ1: jubilación de clasificaciones | Atención diaria; Gini; cuotas principales; volumen de nuevas publicaciones por campo | Campos anteriormente expuestos a clasificación vs. campos de comparación | Diseño de estudio de eventos/interrumpido |
| RQ2: distribución de correo electrónico | Vistas/descargas diarias | Antes vs. después de la distribución | Estudio de eventos dentro del documento (Distribución × Principiante) |
| RQ3: validez predictiva | Citas de 6/12/18 meses | Métricas tempranas normalizadas vs. crudas | Comparación predictiva fuera de muestra |
| P2: la clasificación gobierna la presentación | Descargas; probabilidad de descargas cercanas a cero | Conteo de clasificación; cambios de clasificación dentro del documento donde estén disponibles | Regresión de panel + diseño de cambio dentro del documento |
| P3b: efecto Matthew de capa de máquina | Cita directa por sistema de respuesta | Alta vs. baja visibilidad previa en relevancia de consulta pareada | Auditoría de recuperación multinivel repetida (Estudio 2) |
| P4: depredadores antes que lectores | Tiempo hasta el primero y tasa de mensajes entrantes codificados | Ventanas previas vs. posteriores a la publicación; contacto depredador vs. genuino | Cohorte prospectivo instrumentado + modelo de historial de eventos (Estudio 3) |
Nota. Todas las filas son diseños prospectivos. Ninguno ha sido ejecutado. Los resultados, contrastes, reglas de exclusión y clases de referencia deben preregistrarse antes de la recopilación de datos.
8.3 El panel principal
El diseño de referencia es una cohorte multidisciplinaria de artículos recién publicados en SSRN seguida durante al menos doce meses desde su publicación, observada según el calendario de la Tabla 11. A nivel de artículo, el conjunto de datos preserva la versión más antigua disponible del título, resumen, nombres y orden de autores, afiliaciones, fecha de publicación, clasificaciones, palabras clave, número de páginas, DOI cuando está disponible, historial de revisiones, vistas públicas del resumen, descargas públicas e indicadores de citas posteriores, con coincidencia de identidad de autor contra infraestructura bibliográfica abierta [35][124] validada manualmente en una submuestra aleatoria antes de que la reputación inferida se use a escala. El estado de novato se define como que ningún autor del artículo focal tiene un artículo en SSRN con fecha anterior a la publicación focal, con definiciones de sensibilidad basadas en recuentos de artículos previos y stock de citas previas a la publicación. El prestigio institucional no forma parte de esta definición: porque el prestigio es en sí mismo una variable explicativa en H2 y H3, incorporarlo al estado de novato confundiría mecánicamente la novedad de la plataforma con la visibilidad previa del autor y colapsaría las hipótesis que el diseño pretende separar. Por lo tanto, el prestigio entra en los modelos solo como una covariable distinta. La normalización por visibilidad previa debe manejarse con cuidado correspondiente por razones de equidad: restar una línea de base de visibilidad previa demasiado agresivamente penalizaría el éxito temprano genuino de un autor junior y borraría estadísticamente, en lugar de exponer, cualquier falta de exposición sistémica de autores marginalizados y del Sur Global. La respuesta del marco es medir dónde se forma la desigualdad en lugar de descontarla: la descomposición de alcance versus conversión localiza si una brecha de visibilidad surge en la exposición o en la conversión, y el prestigio entra como una covariable a ser entendida, no como ruido a ser silenciosamente diferenciado. El efecto distributivo del prestigio en la atención es un resultado primario de los cuasiexperimentos (Secciones 8.4–8.5). Los controles de calendario incluyen día de la semana, semana del año, temporada académica y efectos fijos de fecha. La variación documentada de fin de semana y estacional en el acceso a artículos (actividad aproximadamente 11% menor los fines de semana y 50% menor en verano en un panel reciente de siete revistas [178]) hace difícil justificar su omisión en cualquier estudio de uso de alta frecuencia. El diccionario completo de variables del panel (del orden de dos docenas de campos, incluidos incrementos de intervalo en lugar de solo recuentos acumulativos, la fecha de distribución donde se consintió, stocks de citas a los 6, 12 y 18 meses, y número de revisión) se especifica en el Apéndice C (Tabla C1), y el mismo archivo de esquema se deposita con los materiales de preregistro (Sección 8.8; Declaraciones).
El alcance se modela como un proceso binomial negativo jerárquico para vistas incrementales, con efectos de campo por edad, efectos de calendario y heterogeneidad a nivel de artículo. La conversión condicional se modela como descargas incrementales con vistas incrementales de registro como exposición, de modo que ganar una visita de página de destino y convertir esa visita están estadísticamente separadas. En forma compacta, para artículo i en intervalo t:
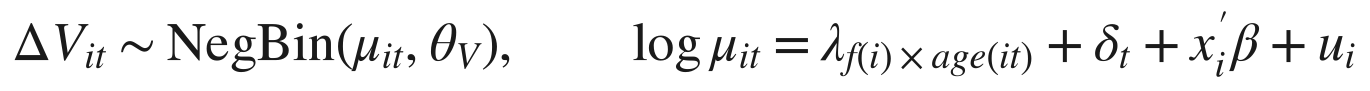

donde λ_{f×age} son efectos de campo por edad, δ_t efectos de fecha de calendario, u_i y w_i heterogeneidad a nivel de artículo, y el desplazamiento de vistas de registro en la segunda ecuación hace que las descargas sean condicionales a la exposición de la página de destino. La interacción Novato × Claridad γ_3 es la prueba H4. Estas ecuaciones fijan los estimandos prespecificados y la separación de alcance y conversión, y la estructura jerárquica realiza exactamente el agrupamiento parcial empírico-Bayes que las Secciones 5.2 y 8.8 requieren antes de que se publique el percentil de cualquier celda escasa. Los controles temáticos en x_i se construyen a partir de incrustaciones título-resumen congeladas y agrupadas en el preregistro, antes de que se observe ningún resultado, para que la composición temática no pueda ajustarse a los resultados. Como los artículos ocupan hasta siete clasificaciones simultáneamente, los efectos de clasificación se estiman con estructuras jerárquicas de membresía múltiple en lugar de forzar cada artículo en un único campo. Como los efectos fijos de artículo absorben medidas de estado invariantes en el tiempo, los efectos de novato y prestigio de línea de base se estiman entre artículos, mientras que los efectos fijos de artículo se reservan para tratamientos intra-artículo tales como eventos de distribución. La sobredispersión y los ceros excesivos se prueban formalmente, se reportan alternativas de obstáculo e infladas en ceros donde está justificado, y la cola pesada se maneja mediante estimación cuantil y robusta en lugar de eliminar artículos exitosos. Las reglas de limpieza de datos se prespecifican en lugar de ser discrecionales, y el protocolo de anomalía es marcar, no eliminar. La lista de señales prespecificada cubre: un intervalo extremo contra el historial del propio artículo, un pico de visualización sin movimiento en descargas, una discontinuidad en la conversión, marcas de tiempo idénticas repetidas y una reafirmación de la plataforma. Un intervalo marcado nunca se elimina del archivo: se retiene con un código de razón, y cada resultado principal se reporta en una escalera de sensibilidad de cuatro capas: (i) contadores no modificados; (ii) excluyendo solo actividad inválida confirmada por la plataforma; (iii) estimación robusta o winsorizada; (iv) excluyendo todos los intervalos marcados, de modo que cualquier conclusión que sobreviva en solo una capa sea visible como frágil. Los umbrales se calibran contra la distribución observada en lugar de establecerse a priori. Donde los registros de asociados están disponibles, los campos de referencia, agente de usuario y geografía distinguen tráfico de boletín, blog, recuperación previa y rastreador. Los picos de descarga impulsados por blog documentados en SSRN [116] ilustran por qué un valor extremo suele ser un éxito orgánico en lugar de contaminación. La detección de anomalías es una herramienta de medición. No autoriza descartar el éxito inconveniente.
La misma disciplina se aplica a la estructura temporal. El panel distingue entre atención marginal y acumulada: curvas de cohortes de descargas por intervalo ΔD, y la proporción de descargas de 180 días de un artículo acumuladas por cada edad, en lugar de solo considerar los totales de toda la vida. No impone una única vida media exponencial en el decaimiento, ya que la lectura decae en varios plazos de tiempo simultáneamente [91]. Las curvas de edad se ajustan por lo tanto con splines o estimadores no paramétricos por defecto, con transformaciones logarítmicas utilizadas para estudiar la estructura y recuentos brutos mantenidos para informes de comparación. La robustez se maneja de la misma manera: el prestigio se operacionaliza a través de varias medidas alternativas en lugar de un único umbral de clasificación, el estado de principiante se vuelve a probar bajo definiciones progresivamente más estrictas, y los resultados se informan con comprobaciones de sensibilidad winsorizada y gráficos de distribución completa junto con las estimaciones de cuantiles.
Debido a que no hay una API pública de SSRN [134][51], la recopilación de datos procede por tres rutas, en orden de preferencia: una solicitud formal de datos a o asociación con SSRN/Elsevier; exportaciones de panel de control con consentimiento de los autores, en las que los autores participantes contribuyen sus propios datos del panel de estadísticas bajo consentimiento informado, el nivel intermedio en el que ya se basa el registro de la Sección 8.8; y muestreo limitado de velocidad y que respeta robots.txt por artículo de páginas públicas, cuya viabilidad técnica se establece por herramientas de recopilación de código abierto existentes [134]. El diseño excluye el raspado en masa que violaría los términos de servicio, y no representa ningún punto final no documentado como una API estable. Las restricciones de acceso se discuten como una limitación en la Sección 9.
8.4 Cuasi-experimento I: distribución de alertas por correo electrónico como un choque atencional
Las secciones 8.4 y 8.5 forman un módulo analítico, estudiando dos intervenciones a nivel de plataforma como tratamientos complementarios en la misma cohorte de panel. La distribución de alertas añade una superficie de exposición, la retirada de Rankings eliminó una, y ambas se interpretan contra un conjunto común de resultados distributivos (cuota de principiantes, gradiente de prestigio, Gini de atención, cuotas superiores). El mecanismo de alerta de SSRN es analíticamente valioso porque la publicación y la distribución no necesariamente coinciden. Los artículos se ponen públicamente disponibles primero, y el trabajo elegible se distribuye posteriormente a través de alertas de revistas electrónicas curadas cuyo cronograma varía y no está garantizado [53][57]. Para autores que aceptan proporcionar sus fechas de estado de distribución, un estudio de eventos intra-artículo puede estimar la trayectoria atencional alrededor de la fecha de distribución, sirviendo cada artículo como su propio control de modo que las diferencias estables en atractivo temático, identidad del autor e institución se absorban. La especificación es la forma estándar de estudio de eventos: para el resultado Y_it (vistas de intervalo o descargas),
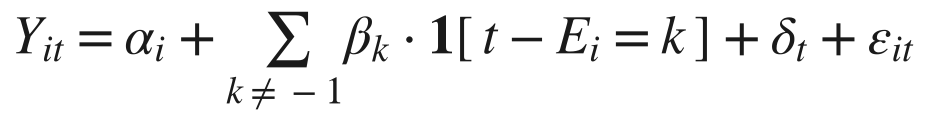
donde E_i es la fecha de distribución del artículo i, α_i son los efectos fijos del artículo, δ_t efectos de fecha de calendario, y los β_k, normalizados al período de referencia anterior a la distribución k = −1, trazan la trayectoria atencional alrededor del evento. La ecuación especifica el estimando para el preregistro. El efecto heterogéneo clave es la interacción Distribución × Principiante, estimado al interactuar los β_k con el estado de principiante. Si las alertas mejoran desproporcionadamente el alcance de los principiantes, la distribución curada funciona como igualador a nivel de plataforma; si los beneficios se acumulan desproporcionadamente en autores prestigiosos, la distribución amplifica las ventajas de reputación existentes (RQ2). La evidencia previa de que eventos de exposición discretos (listados en primera posición en arXiv [72][73], cobertura de blog de artículos SSRN [116]) producen picos de atención tempranos marcados indica que el diseño tiene una primera etapa detectable. La especificación prespecificada también incluye ventanas de eventos alternativas alrededor de la fecha de distribución e informes separados para artículos distribuidos rápidamente versus después de una larga cola de clasificación, dado que el retraso de hasta 45 días [53] de otro modo mezclaría historiales de exposición heterogéneos en un único momento de evento. Los efectos fijos del artículo absorben solo el atractivo invariante en el tiempo, por lo que tres condiciones de diseño son críticas. La sincronización de distribución es curada, no aleatoria: la plataforma selecciona qué artículos elegibles distribuye y cuándo [53][57]. La fecha del evento, por lo tanto, conlleva una selección que varía en el tiempo basada en la topicalidad (un artículo distribuido la semana en que un tema se vuelve destacado difiere del mismo artículo distribuido en una semana tranquila), y esta selección persiste incluso con efectos fijos del artículo, que es la razón por la cual la especificación se condiciona en la latencia de distribución e informa los estratos de sincronización de distribución por separado. Las fechas de estado de distribución también se observan solo para autores que aceptan, por lo que la muestra de estimación es un subconjunto autoselectivo del panel. El estado del consentimiento se registra, por lo tanto, y la muestra del estudio de eventos se compara con la cohorte completa en covariables observables; la selección limita la validez externa. Y los autores pueden cronometrar su propia promoción con la alerta: un pico de autopromoción coordinado se disfrazaría de efecto de distribución. Un registro de autopromoción del autor con fecha (el paquete de pruebas versionado de la Sección 6.1) es, por lo tanto, un requisito de este diseño: sin él, un pico de distribución orgánico no se puede separar de uno autogenerado, y la escalera de anomalías de la Sección 8.3 marca en lugar de eliminar cualquier pico que coincida con la autopromoción registrada.
8.5 Cuasiexperimento II: el retiro de Rankings como un experimento natural
El ocaso del 15 de julio de 2026 [149] permite un segundo análisis si la exposición histórica al ranking puede reconstruirse a partir de páginas de ranking archivadas. Dos características del diseño debilitan un estudio de evento de una sola fecha limpia. El tratamiento no llegó en una fecha: las páginas de ranking por eJournal dejaron de actualizarse a partir del 11 de diciembre de 2025 (Sección 2.2 [B-2]), aproximadamente siete meses antes de la eliminación del 15 de julio de 2026, por lo que el retiro de la superficie de descubrimiento de ranking se modela mejor como un proceso escalonado, un primer congelamiento de las páginas activas seguido de su eliminación final, que como una única fecha de evento común. Por lo tanto, la especificación lleva al menos dos tiempos de evento (el congelamiento de diciembre y la eliminación de julio), con la forma escalonada como modelo principal y el ajuste de una sola fecha probado en su contra. Tampoco se puede asumir que las disciplinas "anteriormente expuestas al ranking" procedan de la estructura de la plataforma: los rankings eran en toda la plataforma, por lo que la exposición diferencial es endógena y no se operacionaliza nombrando campos que "se sentían" clasificados. La exposición debe ser medida, no asignada: por ejemplo, a partir de páginas de ranking archivadas recuperadas a través de Internet Archive, como la proporción de documentos de un campo que alguna vez entraron en las listas públicas principales o la densidad de la presencia de un campo en las páginas por eJournal. Si el archivo cubre las páginas de ranking de cada campo con suficiente densidad para producir una medida de exposición utilizable aún no se ha establecido; el diseño informa esa densidad junto con la medida de exposición. Con la exposición así medida, una especificación de estudio de evento a nivel de documento compara trayectorias de atención en campos de alta y baja exposición alrededor de las fechas de congelamiento y eliminación: la ecuación de la Sección 8.4 con los coeficientes de interés en interacciones Exposure_f × EventTime_k en lugar de solo en los términos de tiempo de evento. Los resultados más informativos son distribucionales (Sección 8.1). El mecanismo de ranking podría cambiar la concentración de atención mientras deja las medias prácticamente intactas, y como se espera que cualquier efecto se concentre en los documentos de la cola ya visible que poblaban las listas, los resultados de media de campo carecen de poder por construcción. Por lo tanto, los coeficientes de Gini, las medidas de participación superior, las relaciones novato/establecido y los gradientes de prestigio son los resultados principales, con la predicción bidireccional de RQ1, y la simulación de poder de la Sección 8.1 debe dirigirse a estas estadísticas distribucionales, no a la atención media, o el estudio corre el riesgo de ser declarado nulo por falta de poder sobre el estimador incorrecto.
Dos predicciones nombradas y direccionales refinan la RQ1 bidireccional sin reemplazarla, ambas pruebas de heterogeneidad prespecificadas. La hipótesis de acantilado de visibilidad sostiene que las cohortes posteriores al ocaso que publican en campos anteriormente expuestos al ranking experimentan una caída discreta en el alcance temprano en relación con cohortes anteriores al ocaso coincidentes, porque una superficie de descubrimiento fue eliminada en una fecha conocida. Bajo una hipótesis compensatoria, si Rankings funcionaba como un mecanismo de visibilidad compensatorio para campos con ecosistemas de descubrimiento débiles, el efecto de su retiro debería ser mayor en campos con pequeñas bases de suscripción de eJournal, el extremo inferior del gradiente de Whalen [168].
Un resultado secundario económico extiende el diseño de la asignación de atención a la salud de la plataforma en sí: el volumen de nuevos envíos por campo, en ventanas antes y después del 15 de julio de 2026. Si Rankings suministraba parte del incentivo para publicar, su retiro podría enfriar nuevos envíos. Ese es un resultado conductual distinto de los resultados de atención anteriores, observable a partir de listados de documentos nuevos públicos contra la línea de base propia de la plataforma de más de 250.000 documentos nuevos en 2025 [145], y una respuesta empírica directa a la polémica contemporánea 'jumped the shark' registrada en la Sección 2.2 [12][B-11]. La predicción se deja bidireccional, como RQ1, y el resultado de volumen de envío se conecta al elemento (3) de la encuesta del Estudio 4 ("evitar nuevas cargas").
El análisis es cuasiexperimental. Cinco amenazas son materiales. Una es el anuncio y los efectos de anticipación: el retiro fue anunciado el 12 de junio de 2026 con un objetivo inicial del 1 de julio y ejecutado el 15 de julio, por lo que existía una ventana de anticipación genuina y cambió [148][149]. Un grupo de cambios de plataforma concurrentes en 2026 comparte el calendario del ocaso y no puede ser separado por ninguna fecha de evento única: el reenfoque estratégico anunciado el 13 de abril de 2026, el retiro de la Research Paper Series comercial ejecutándose hasta finales de diciembre de 2026, y el cambio de licencia de autor del 20 de julio de 2026, cinco días después de la eliminación [146][150]. Dado que estas intervenciones se superponen a la ventana de julio, una única fecha de evento común atribuiría su efecto combinado al ocaso únicamente. La identificación por lo tanto se basa en el cronograma escalonado anterior (el congelamiento de diciembre precede a todos ellos), en fechas de placebo y en la firma distribucional específica para un retiro de ranking, y el diseño reporta qué cambios simultáneos permanecen sin separar. Luego está la depresión de atención de verano: mediados de julio coinciden con la caída estacional documentada en el acceso académico, con accesos que caen alrededor del 50% en los meses de verano [178], por lo que un contraste entre campos ejecutado a través de la fecha de eliminación confunde el ocaso con la estacionalidad de verano propia de un campo, que difiere por disciplina. Los efectos fijos de fecha de calendario absorben solo el componente estacional común. Por lo tanto, el diseño requiere líneas base estacionales específicas del campo (una comparación de la misma ventana del año anterior por campo). Las diferencias no aleatorias entre campos de alta y baja exposición son una amenaza adicional, abordada por la operacionalización de exposición medida anterior y por grupos de comparación coincidentes. La amenaza restante es prospectiva: SSRN ha declarado que puede reconsiderar los rankings, por lo que un restablecimiento parcial durante la ventana de observación introduciría un segundo evento. El diseño preregistra el tratamiento de cualquier restablecimiento como un punto de censura para el período posterior y lo modela como un tratamiento distinto en lugar de incluirlo en el contraste de ocaso. En todos los reportes, el tiempo de evento se divide en tres períodos nombrados, anuncio (del 12 de junio de 2026), transición, y retiro (del 15 de julio de 2026), de modo que se estimen los efectos de anticipación. Por lo tanto, el diseño prespecificado incluye pruebas de pre-tendencia de tiempo de evento, anchos alternativos, fechas de placebo, tendencias de tiempo específicas del campo y líneas base estacionales específicas del campo, y análisis de sensibilidad excluyendo el período de transición del anuncio al retiro. La Figura 11 presenta los resultados previstos de ambos estudios de evento como plantillas de diseño.
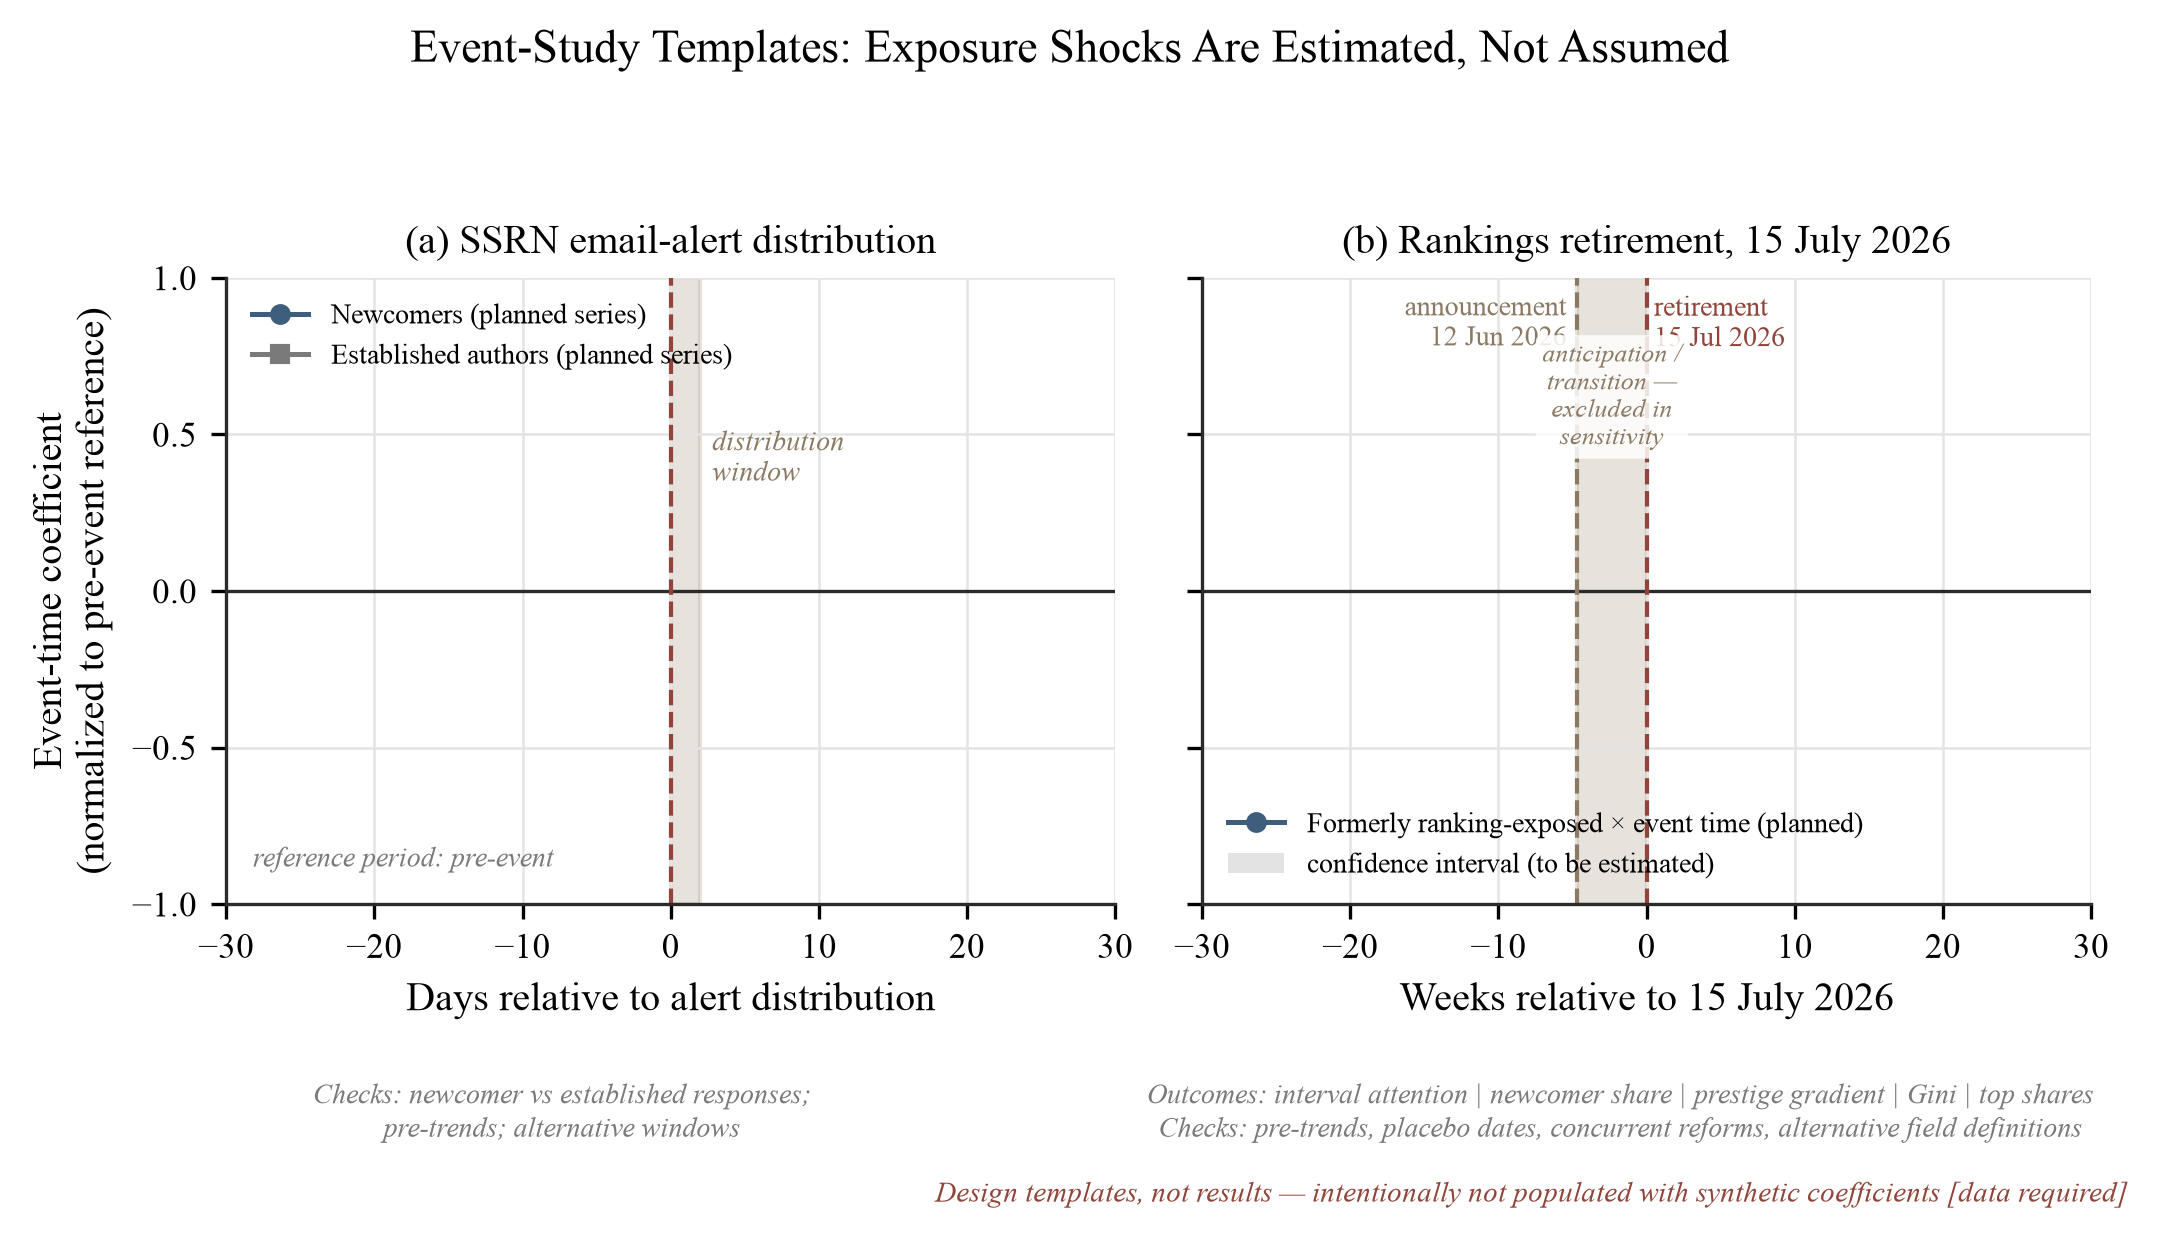
Figura 11. Plantillas de diseño de estudio de eventos para los dos cuasiexperimentos de plataforma. Resultados de estudio de eventos prespecificados para los diseños de las Secciones 8.4–8.5: (a) atención alrededor de la distribución de alertas por correo electrónico, usuarios nuevos frente a autores establecidos, con la ventana de distribución sombreada porque las alertas llegan como una ventana, no de manera instantánea; (b) resultados de atención y de desigualdad alrededor de la retirada de Rankings, con tanto el anuncio (12 de junio de 2026) como la fecha de retirada (15 de julio de 2026) marcados y el período de anticipación/transición sombreado — la ventana excluida en los análisis de sensibilidad prespecificados. Los resultados distribucionales (atención de intervalo, participación de usuarios nuevos, gradiente de prestigio, Gini, participaciones principales) y las verificaciones requeridas se indican en la figura misma. Los coeficientes se normalizan al período de referencia previo al evento; las regiones sombreadas en gris denotan intervalos de confianza. Estos paneles son plantillas de diseño; no se muestran valores empíricos, y el código de generación se publicará con los materiales de preregistro.
8.6 Cuatro estudios preestablecidos
Junto al panel central, se especifican cuatro estudios y se resumen en la Tabla 17. Los dos estudios de datos públicos (1 y 2) pueden ser realizados por cualquier investigador sin permisos de acceso restringido, dentro de los límites de acceso señalados en la Sección 9 (recopilación limitada por velocidad conforme a los términos de servicio de la plataforma). Los dos estudios con sujetos humanos (3 y 4) requieren participantes y se realizan bajo las aprobaciones éticas indicadas en las Declaraciones. Los cuatro existen para comenzar a llenar el vacío de referencia inmediatamente, en lugar de esperar a que un panel de varios años madure.
Tabla 17. Los cuatro estudios preestablecidos.
| Estudio 1 | Estudio 2 | Estudio 3 | Estudio 4 | |
|---|---|---|---|---|
| Pregunta de investigación | ¿Cuál es la distribución de descargas mediana/percentil? | ¿Los motores de respuesta de IA citan el preimpreso en sí? | ¿Lector o depredador primero? | ¿Cómo leen los autores sus propios contadores? |
| Datos | 3000–5000 ID de artículos SSRN estratificados | 100–200 preguntas especializadas × ~5 motores | 2 publicaciones instrumentadas, registro de entrada de 90 días | Encuesta de autor preregistrada, cuatro elementos de redacción fija |
| Método | Mediana, Gini, curvas de decaimiento, regresión de conteo de clasificación | Codificación de recuperación + regresión logística | Seguimiento de alias por canal + codificación de mensajes | Cuestionario de forma cerrada + proporciones descriptivas |
| Resultado primario | Mediana; proporción de descargas ≤10; Gini de atención | Visibilidad de máquina V | t_reader vs. t_predator | Proporción que nunca compara contadores con ninguna referencia; distribución de primera lectura para «7 descargas» |
| Predicción falsable | mediana < 0,5 × media; Gini 0,75–0,90 | Preimpreso citado en 10–35% de los ensayos | t_predator < t_reader | La mayoría reporta nunca comparar con ninguna referencia |
| Entregable principal | Tablas de referencia de percentiles públicas, legibles por máquina, estratificadas por edad, campo y cohorte | Protocolo de auditoría de recuperación y atribución reproducible con instantánea con marca de tiempo | Protocolo de publicación instrumentada abierto con línea de base previa a la publicación y manual de codificación | Distribución documentada de interpretaciones de autor y cambio de comportamiento reportado |
| El diseño fracasa si | La normalización no mejora la estabilidad o la predicción fuera de muestra sobre conteos brutos | Las características no predicen nada más allá de la relevancia de consulta, motor y fecha | Sin discontinuidad posterior a la publicación después de los controles de línea de base y exposición, o codificación poco confiable | El reclutamiento o la auto-selección dejan incluso las proporciones descriptivas imposibles de interpretar |
| Perfil de recursos | Datos públicos; raspado estándar y estadística | Consultas de motores de IA públicos; codificación manual | Dos publicaciones instrumentadas; registro de bandeja de entrada (IRB) | Encuesta de autor anónima (IRB) |
Nota. Cada estudio debe registrarse en OSF antes de la recopilación de datos, con código liberado.
Estudio 1: «Anatomía de la mediana». El estudio extrae una muestra aleatoria estratificada de 3000–5000 ID de resúmenes de SSRN, un rango de planificación, con la N final establecida por simulación de potencia contra las bandas de predicción preestablecidas y los efectos más pequeños de interés (Sección 8.1). La estratificación es por año de publicación y red, y se recopilan descargas de por vida por artículo, vistas de resumen, fecha de publicación y conteo de clasificación a través de las rutas de acceso de la Sección 8.3. Estimandos: descargas de por vida mediana; las proporciones de artículos con cero y con diez o menos descargas; el Gini de atención con intervalos de confianza de bootstrap; la tasa de conversión de vistas a descargas, estimada en general y estratificada por red (una prueba de la hipótesis del estilo de lectura de audiencia de la Sección 5.2); curvas de decaimiento de descargas; y una regresión de descargas de registro en conteo de clasificación con efectos fijos de año y red (una prueba directa de P2 [168]). Las bandas de predicción preestablecidas (descargas de por vida medianas aproximadamente 30–80, una proporción de descargas ≤10 de 15–30%, Gini 0,75–0,90) son extrapolaciones de los anclajes con fecha de la Sección 5 [83][85][139] y de magnitudes de Gini de atención en medios adyacentes [180], establecidas por adelantado para que el estudio pueda falsarlas. El Estudio 1 es la semilla empírica de la referencia de percentil analizada en la Sección 8.8.
Estudio 2: «¿Las máquinas te leen?» Una proporción cada vez mayor de búsqueda de información ahora comienza en interfaces generativas: aproximadamente la mitad de los adultos estadounidenses reportan usar chatbots de IA, y aproximadamente una cuarta parte los usan diariamente [121], con una minoría sustancial ya tratando un chatbot como su primer motor de búsqueda en muestras de conveniencia [4]. La introducción (Sección 1.6) conceptualizó esto como una migración ascendente del guardián del descubrimiento (marca de revista → repositorio → motor de búsqueda → capa de respuesta de IA) con cada paso reubicando el control más lejos del autor y más lejos de cualquier referencia pública (Figura 12). Si la capa superior recupera preimpresos en absoluto es desconocido: la literatura de optimización de motores generativos se ha concentrado hasta ahora en marcas y comercio [5][100][164], y las auditorías de búsqueda de IA se han enfocado en atribución de noticias en lugar de fuentes académicas [82]. Esas auditorías aconsejan escepticismo sobre la confiabilidad del nuevo guardián: en la auditoría del Tow Center (1600 consultas en ocho motores), los motores colectivamente no recuperaron información correcta en más del 60% de los ensayos, con el mejor desempeño (Perplexity) respondiendo incorrectamente el 37% de las veces y el peor (Grok-3) el 94%, y típicamente cometían errores con confianza injustificada en lugar de negarse a responder [82], cifras de una prueba de atribución de noticias, no de búsqueda académica. No existía ningún estudio controlado de visibilidad de preimpresos académicos en motores de respuesta de IA a agosto de 2026 [100]. La contribución se sitúa contra dos líneas de trabajo adyacentes. Los estudios de optimización de motores generativos en los que se basa este artículo miden y manipulan la visibilidad de marcas y páginas comerciales [5][164], no la recuperación de artefactos académicos. Una línea separada muestra que cuando los modelos de lenguaje generan referencias en absoluto, reproducen y amplifican la tendencia humana a citar trabajo ya muy citado, extendiendo un efecto Mateo a la capa de máquina [7], que es el mecanismo que P3b (Sección 8.2) prueba. Ninguna línea ha examinado la capacidad de descubrimiento de preimpresos científicos bajo relevancia de consulta controlada, y específicamente su capacidad de recuperación después de que se elimina una superficie de clasificación de plataforma, que es el objeto que el Estudio 2 aísla.
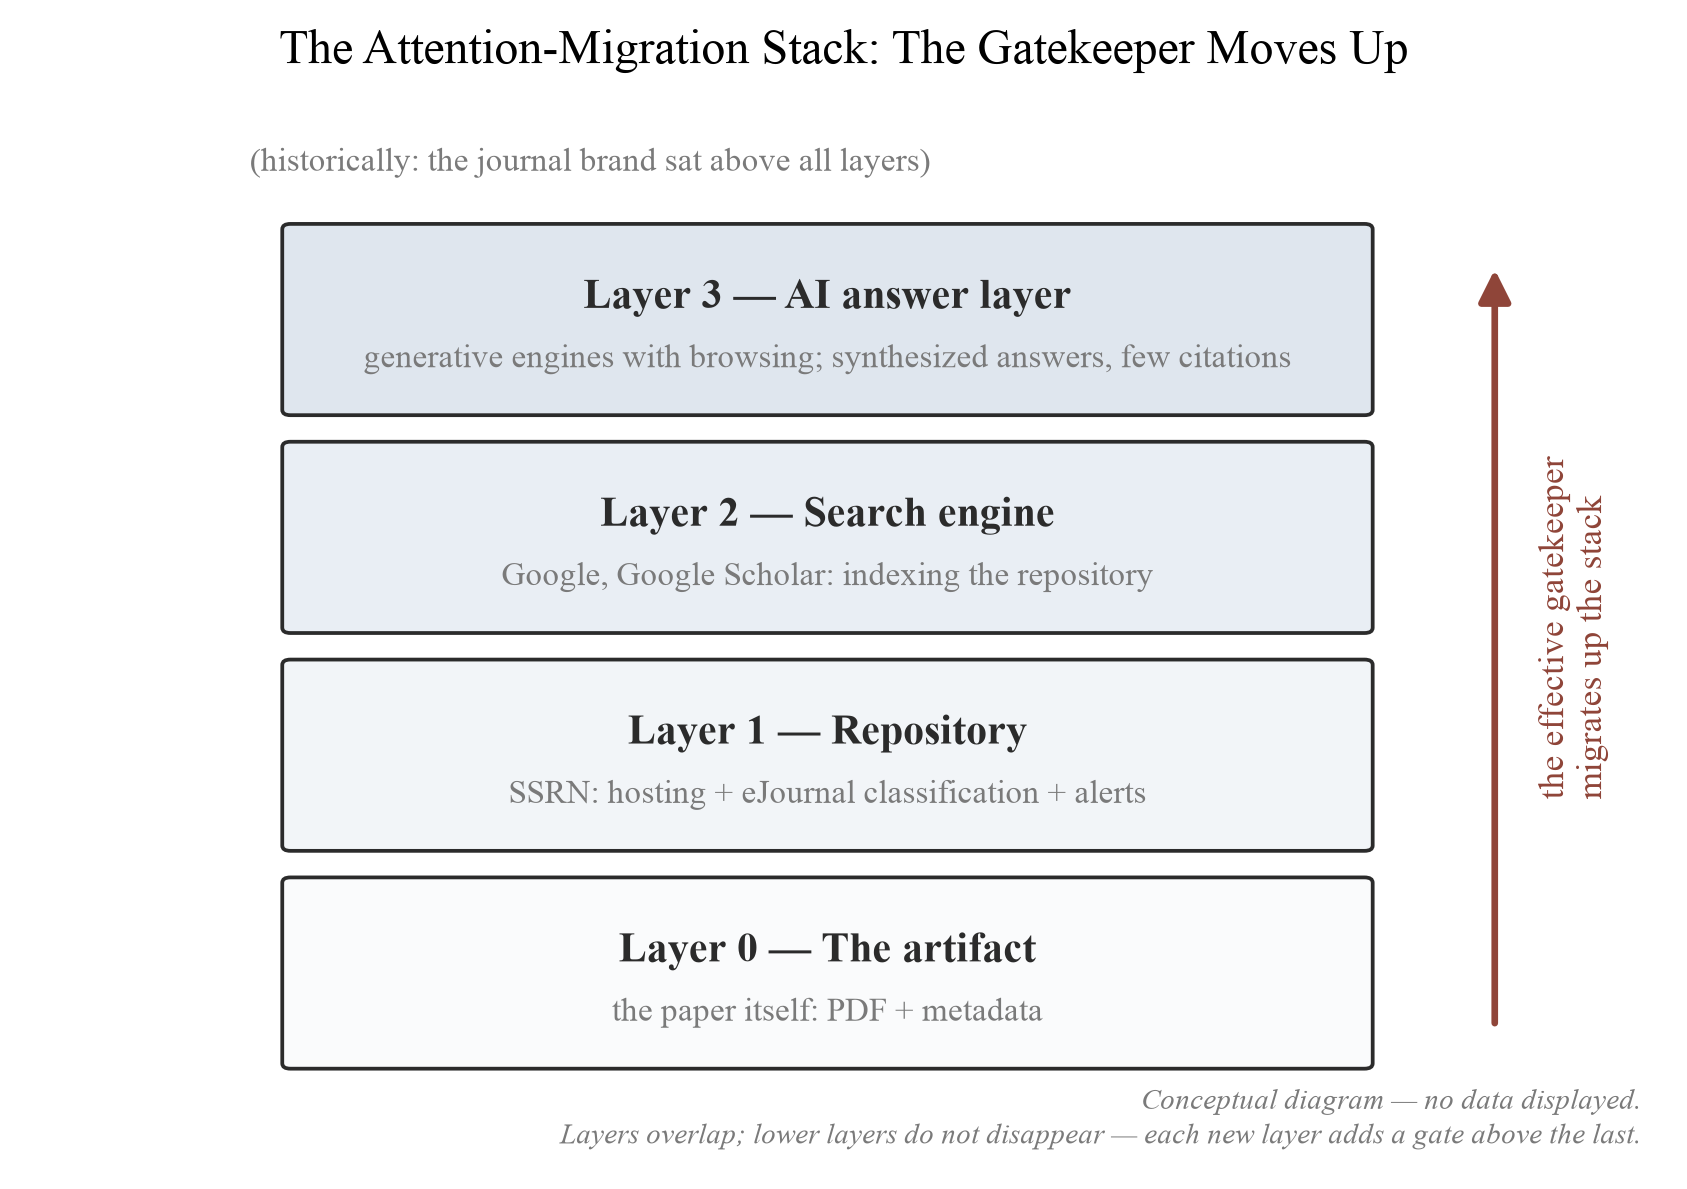
Figura 12. La pila de migración de atención. La ruta estratificada desde un manuscrito terminado hasta la atención de un lector. La tesis de migración sostiene que el guardaespaldas efectivo —la capa que decide qué artefactos reciben atención— se ha desplazado hacia arriba con el tiempo, desde la marca de la revista a través del repositorio y el motor de búsqueda hasta la capa de respuesta de IA; cada movimiento hacia arriba traslada el control más lejos del autor y más lejos de cualquier referencia pública. La pila es un modelo conceptual.
El estudio 2 construye 100–200 preguntas de nicho, cada una diseñada para que un preimpreso específico de SSRN sea la mejor fuente disponible, una afirmación de relevancia validada por evaluadores expertos ciegos en lugar de autocertificada por los autores de la consulta. Consulta los principales sistemas de IA de consumo con navegación habilitada y codifica el resultado en seis categorías mutuamente excluyentes: (1) el preimpreso focal en sí citado; (2) la versión publicada o un espejo del mismo artículo citado, un caso que un esquema más grueso clasificaría erróneamente como ausencia; (3) cobertura secundaria citada sin el artículo; (4) una fuente diferente pero defendible citada; (5) ninguna fuente rastreable; y (6) rechazo del motor (Figura 13). Para cada respuesta que cita el artículo focal o una versión del mismo, una bandera binaria de fidelidad de atribución registra adicionalmente si la afirmación en la respuesta es realmente respaldada por la fuente citada. La visibilidad y la fidelidad se reportan por separado y nunca se fusionan en una puntuación única, porque un motor puede citar un artículo de manera destacada mientras lo tergiversa (lavado de citas) o reproducir su contenido sin ninguna cita (influencia sin atribución). La regresión confirmatoria sigue siendo logística, en el contraste "artículo focal o su versión citada" versus todos los demás resultados, con errores estándar agrupados, o preferiblemente una estructura de efectos aleatorios cruzados ajustada, para respetar la no independencia de observaciones que comparten un motor, una consulta o un artículo focal, ya que el mismo artículo consultado en múltiples motores y el mismo motor consultado en múltiples artículos inducen resultados correlacionados que los errores de ensayos independientes ingenuos subestimarían. Formalmente, el estimando de la auditoría es M_pqe: la probabilidad de que el artículo p sea citado por el motor e en respuesta a la consulta q. M_pqe no es una propiedad del artículo únicamente, ya que varía según consultas, motores, fechas y versiones de modelo, por lo que la notación define el estimando y cada ejecución con fecha se lee como una estimación de M_pqe en su fecha. La muestra del motor debe extenderse más allá de los chatbots de consumo hasta la capa de recuperación académica emergente (herramientas como Consensus, Elicit, Scite y Semantic Scholar, que se basan en corpus académicos y citan artículos reales), ya que un preimpreso invisible para los motores de consumo aún puede ser expuesto por los específicos de la disciplina, y la divergencia entre las dos capas es en sí una resultado de interés. La visibilidad de máquina se regresa entonces en características de artículos operacionalizadas en la Tabla 18, incluida la covariable de visibilidad previa que P3b requiere: la huella web y académica anterior a la auditoría de cada artículo, congelada en la construcción de consulta. La muestra de consulta se estratifica por visibilidad previa para que los artículos de arranque en frío estén representados por diseño. Dado que los motores generativos no son estacionarios, el diseño empareja una instantánea principal con fecha con un protocolo de reejecutación escrito que otros pueden repetir. Se especifican previamente tres requisitos adicionales de higiene de auditoría: controles negativos (artículos prestigiosos pero irrelevantes, variantes de título e indicaciones que no deben recuperar la obra focal) hacen detectable la citación indiscriminada; cada consulta se ejecuta en variantes de indicación equivalentes bajo estado de sesión registrado (sesiones limpias versus sesiones iniciadas; motor, versión de modelo, fecha y geografía), de modo que los artefactos específicos de indicación y sesión sean separables del comportamiento de recuperación estable; y una submuestra aleatoria de resultados se codifica doblemente, con acuerdo entre evaluadores reportado. La lista de verificación completa paso a paso de auditoría se deposita con los materiales de prerregistro. La entrada principal del estudio es el tiempo del investigador (la validación de relevancia ciega de 100–200 preguntas y la codificación doble) en lugar de datos de acceso restringido o infraestructura especializada. Un estudio que debe pagar el tiempo del evaluador experto a precios de mercado debe presupuestar explícitamente esa mano de obra. La predicción preespecificada es que el preimpreso en sí es citado en una minoría de ensayos (banda 10–35%), con características de resumen estructurado y versión publicada elevando la visibilidad (P3). El estudio 2 es un protocolo entre cinco elementos de la agenda. Una auditoría completa de visibilidad de máquina académica, incluidas comparaciones entre motores y repositorios, es el tema de un artículo complementario planeado.
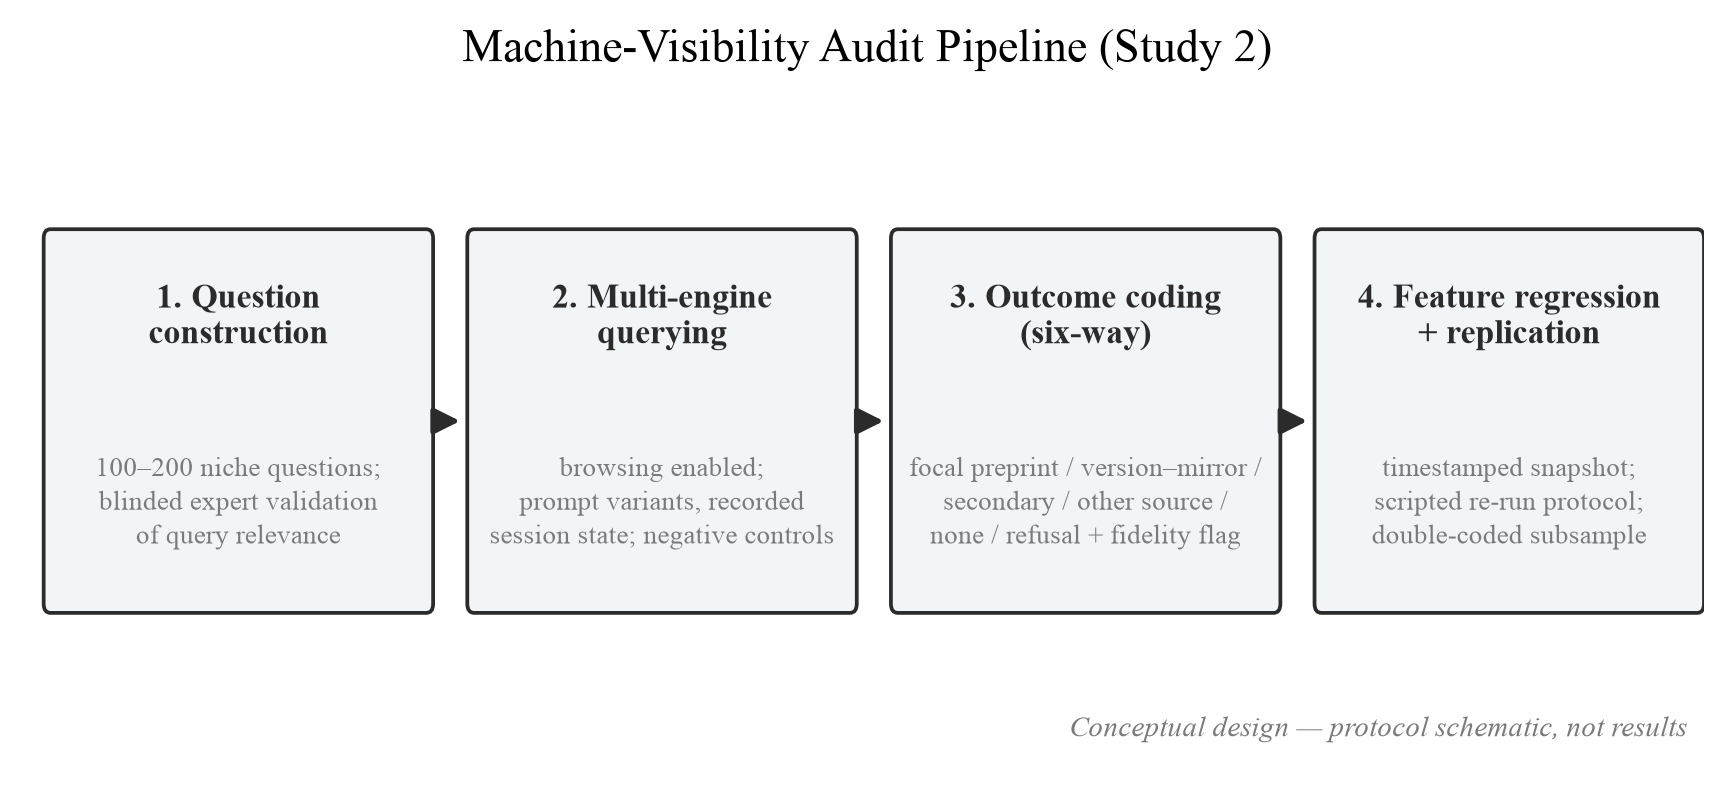
Figura 13. El canal de auditoría de visibilidad de máquina (Estudio 2). El canal de estudio 2 de cuatro pasos. La codificación de seis vías separa la cita del preimpreso focal de la cita de su versión publicada o espejo —previniendo la clasificación falsa de ausencia— y la bandera de fidelidad de atribución mantiene "¿fue citado?" distinto de "¿fue citado truthfully?" La estructura de instantánea más replicación aborda la no estacionariedad del modelo: la instantánea principal tiene fecha y el protocolo de reejecutación permite a cualquier investigador reproducir la auditoría en una fecha posterior.
Tabla 18. Operacionalización de características de visibilidad de máquina (Estudio 2).
| Variable | Definición | Codificación |
|---|---|---|
| DOI presente | Página de artículo expone un DOI registrado | 1/0 |
| Tipo de título | Título descriptivo versus alusivo | descriptivo = 1 |
| Estructura del resumen | Estructurado/rico en estadísticas versus narrativo | estructurado = 1 |
| Edad | Meses desde la primera publicación | entero |
| Cantidad de clasificación | Número de ejournals asignados | entero |
| Cobertura secundaria | ≥1 mención indexada de blog/noticia existe | 1/0 |
| Versión publicada | Existe una versión de registro en revista | 1/0 |
| Visibilidad previa | Huella previa en la web y ámbito académico del artículo y sus autores, congelada en la construcción de la consulta (P3b) | ordinal estratificado |
| Resultado V | Resultado de recuperación para el artículo focal | seis categorías: preimpresión focal / versión publicada o espejo / solo secundaria / otra fuente defendible / ninguna rastreable / rechazo; más bandera binaria de fidelidad de atribución para casos citados |
Nota. Las elecciones de características adaptan factores documentados de optimización de motores generativos [5][164] a artefactos académicos. La auditoría más grande de este tipo, del orden de 252 000 ensayos en seis motores basados en LLM, identificó la relevancia temática y la posición en la lista dentro del contexto recuperado como los principales impulsores de ser citado primero [164]. La posición en la lista es por lo tanto una hipótesis separada y transferible para el Estudio 2, y la posición en la lista de resultados debe registrarse dondequiera que sea observable.
La tabla 19 complementa la tabla 18 en un nivel diferente de descripción. La tabla 18 operacionaliza las características a nivel de artículo cuyos efectos el Estudio 2 estima, mientras que la tabla 19 especifica los constructos de medición de la auditoría: qué se mide, bajo qué controles y contra qué amenaza principal a la validez. Cada constructo es una afirmación distinta sobre la capa de máquina, y cada amenaza nombra la forma específica en que una auditoría ingenua fracasaría.
Tabla 19. Constructos de medición de la auditoría de visibilidad de máquina (Estudio 2).
| Constructo | Medida operativa | Controles requeridos | Amenaza principal |
|---|---|---|---|
| Visibilidad directa de máquina | Preimpresión focal citada o vinculada en la respuesta | Relevancia de consulta, motor, fecha, estado de sesión | Derivación de modelo e índice |
| Sustitución de fuente | Versión publicada, espejo o cobertura secundaria citada en lugar de la preimpresión | Coincidencia de versión, DOI, variantes de título | Clasificación falsa como ausencia |
| Posición de citación | Rango y prominencia de la cita focal dentro de la respuesta | Longitud de respuesta y recuento de citas | Presentación específica de interfaz |
| Fidelidad de atribución | Afirmación en la respuesta respaldada con precisión por el artículo citado | Verificación de afirmación y fuente sin sesgos | Lavado de citas o alucinación |
| Sensibilidad de consulta | Variación de resultados en formulaciones de consulta equivalentes | Variantes de indicación aleatorizadas | Artefactos específicos de indicación |
| Replicabilidad | Mismo resultado en una fecha posterior o en una nueva ejecución limpia | Protocolo archivado y metadatos del sistema | No estacionariedad del motor |
La transferencia más defendible de la literatura comercial de GEO es una agenda de auditoría de características, no una receta promocional: la tabla 20 enumera características candidatas cuya asociación con la visibilidad de máquina el Estudio 2 está diseñado para confirmar o refutar. Cada fila es una hipótesis en lugar de una táctica establecida, y una característica asociada con la recuperación aún puede ser un proxy para la madurez del artículo, la popularidad del tema o la visibilidad previa en lugar de una palanca.
Tabla 20. Agenda de auditoría de características para visibilidad de máquina (hipótesis para el Estudio 2, no recomendaciones).
| Característica candidata | Mecanismo hipotetizado | Evidencia de apoyo |
|---|---|---|
| Registrar un DOI | El identificador estable ayuda en la recuperación y coincidencia de citas | [164] |
| Resumen estructurado, rico en estadísticas | La adición de estadísticas elevó la visibilidad generativa hasta ~40% en puntos de referencia comerciales | [5] |
| Título descriptivo, denso en relevancia | La relevancia temática es un impulsor principal de citación en respuestas de IA | [164] |
| Maximizar clasificaciones precisas de revistas electrónicas | Más clasificaciones asociadas con más descargas, menos ceros | [168] |
| Asegurar ≥1 elemento de cobertura secundaria | Los motores a menudo citan cobertura secundaria sobre fuentes primarias | [82] |
Estudio 3: "¿Quién Llega Primero?" Un protocolo de publicación instrumentado prueba P4 directamente. Se publican dos artículos de trabajo reales utilizando alias de correo electrónico únicos con dirección plus por canal de exposición, con un registro de entrada de 90 días precedido por una ventana de línea de base previa a la publicación de dos a cuatro semanas en los mismos alias. Sin una línea de base, un aumento en el volumen de solicitudes no puede atribuirse en absoluto a la publicación, ya que el spam académico llega continuamente contra una tasa de fondo alta. Cada mensaje se codifica como contacto académico genuino o solicitud depredadora utilizando firmas de solicitud publicadas [96] y criterios tipo lista de bloqueo seleccionados, contra las tasas de fondo altas documentadas en las auditorías especializadas revisadas en la Sección 7.2 [9][84][63][61]. El resultado es la comparación del tiempo hasta el primer contacto genuino y el tiempo hasta la primera solicitud depredadora atribuible a la publicación. La predicción preespecificada, según P4, es que la solicitud precede al contacto genuino. Dos reglas de medición se fijan antes del lanzamiento. Las ventanas de línea de base y posterior a la publicación tienen longitudes desiguales (aproximadamente dos a cuatro semanas frente a noventa días), por lo que la comparación es de tasas de llegada (eventos por alias-día) y de funciones de supervivencia, nunca de conteos de eventos sin procesar, que la asimetría de la ventana distorsionaría de otro modo. Y el tiempo hasta el primer contacto está censurado por la derecha por construcción: con dos artículos, un alias que no recibe contacto genuino dentro de la ventana de 90 días produce una observación censurada, no cero, por lo que la regla de censura está preespecificada. Las observaciones se censuran por la derecha a los 90 días, los alias sin evento contribuyen tiempo censurado a la estimación de supervivencia en lugar de ser descartados o codificados como inmediatos, y con N = 2 las curvas resultantes se informan con su incertidumbre exacta de muestra pequeña en lugar de como estimaciones puntuales. El estimando causal del diseño de replicación distribuida es el cambio en la tasa de riesgo de solicitud después de la publicación (no la identidad de ningún descargador), estimado con métodos de supervivencia/historia de eventos en ventanas coincidentes previas y posteriores a la publicación. Debido a que la productividad visible de un autor probablemente predice el volumen de solicitudes independientemente de cualquier publicación única (la solicitud se cosecha de la salida pública acumulada de un autor, por lo que las tasas de fondo altas documentadas en las auditorías especializadas de la Sección 7.2 se escalan con esa salida), las replicaciones distribuidas deben registrar controles de exposición a nivel de autor (publicaciones previas, volumen de publicación y superficie de contacto pública) junto con el evento focal. Este es un estudio de caso instrumentado N = 2, una prueba de mecanismo y un protocolo abierto que invita a replicación distribuida, que colectivamente produciría una estimación con potencia. N = 2 demuestra la viabilidad de la instrumentación, no la prevalencia ni la magnitud causal. A diferencia de los Estudios 1, 2 y 4, que están potenciados para tamaños de efecto preespecificados, el Estudio 3 es un piloto de viabilidad y un protocolo de replicación abierta.
El marco de codificación se fija antes del lanzamiento. Los mensajes entrantes se codifican en siete tipos: solicitud de revista, invitación a conferencia, solicitud de revisión por pares, invitación a junta editorial, invitación a capítulo de libro, oferta de servicio comercial y correspondencia académica genuina, un marco más amplio que una división predatoria/genuina binaria. Cada registro lleva un conjunto mínimo de campos: marca de tiempo, alias receptor (canal), nombre del lugar, divulgación de tarifa, especificidad para el artículo focal, lenguaje de urgencia, resultado de verificación contra servicios de selección mantenidos y confianza del codificador. Los casos limítrofes y los lugares legítimos de bajo prestigio se rigen por reglas preespecificadas en lugar de juicio ad hoc. Un lugar nuevo u oscuro no es automáticamente depredador. Una submuestra aleatoria está codificada doblemente con concordancia entre evaluadores reportada. Solo se publican conteos agregados (Sección 9; Declaraciones), y el libro de códigos completo se deposita con el preregistro. El volumen de solicitudes no es evidencia de lectura, y la solicitud no mueve los contadores públicos: el sistema de integridad de SSRN excluye la actividad automatizada anómala de los conteos oficiales [144], y no se autoriza ninguna inferencia de la bandeja de entrada al panel de control en ninguna dirección.
Estudio 4: «Cómo leen los autores sus contadores». Una encuesta de autores preespecificada convierte la evidencia de demanda del foro registrada en la Tabla 1 en una medición directa. El instrumento comprende cuatro elementos con enunciados fijos: (1) «¿Ha comparado alguna vez sus descargas de SSRN con algún punto de referencia o norma?», con opciones de respuesta que distinguen un número específico publicado, una tabla específica de la disciplina, comparación informal entre pares y nunca; (2) «Cuando ve '7 descargas' en su panel de control, ¿cuál es su primer pensamiento?», con opciones que abarcan fracaso inferido, demasiado pronto para decirlo, sin idea de cuál es la norma, y esperado o satisfactorio; (3) «¿El cierre de las Clasificaciones de julio de 2026 cambió su comportamiento de preimpresión?», con opciones para dejar de revisar estadísticas, evitar nuevas cargas, cargar pero revisar con menos frecuencia y ningún efecto; y (4) «¿Cree que los comités de contratación y promoción académica entienden las métricas de SSRN?». Las predicciones preespecificadas son que la mayoría de los encuestados informan nunca haber comparado sus contadores con ningún punto de referencia, y que las primeras lecturas de un recuento bajo se sesgan más hacia el fracaso inferido que hacia la lectura prematura que la Sección 5.6 muestra que suele ser la predeterminada correcta. El objetivo de tamaño de muestra, los canales de reclutamiento y el código de análisis se fijan en el registro. La autoselección hacia autores comprometidos, y plausiblemente más ansiosos, limita la muestra, como lo hace el registro de la Sección 8.8. El formato de opción fija también admite un componente cualitativo complementario: codificación temática preespecificada de preguntas públicas de autores (con criterios de inclusión explícitos y confiabilidad entre codificadores, bajo la ética de citación establecida en la Sección 9) e entrevistas semiestructuradas sobre cómo leen los autores sus contadores y cómo se sienten al respecto, alcanzando las consecuencias humanas de la presentación de métricas que los elementos de forma cerrada no pueden. Una limitación del diseño afecta al constructo central. Cuatro elementos fijos administrados solo a autores de SSRN miden un nivel de lectura libre de puntos de referencia, no un contraste, y un nivel no puede por sí solo identificar la ruta afirmada del artículo desde la opacidad de puntos de referencia a la ceguera métrica. Una alta proporción de nunca comparado en SSRN es igualmente consistente con una indiferencia general hacia los contadores que no tiene nada que ver con la opacidad de la plataforma. La capacidad discriminante y causal por lo tanto requiere una condición de comparación: el mismo instrumento administrado a autores que publican en plataformas con diferente exposición a puntos de referencia, arXiv (basado en respaldo y listado, con sus propias superficies de visibilidad) y OSF Preprints, convierte "cómo leen los autores de SSRN sus contadores" en "si los autores en plataformas más y menos opacas leen sus contadores de manera diferente", que es el contraste que la afirmación de opacidad a ceguera métrica en realidad predice. El componente multiplataforma se preespecifica como parte del Estudio 4; sin él, un resultado de una sola plataforma seguiría siendo descriptivo de SSRN en lugar de una prueba del mecanismo. El Estudio 4 entonces prueba las afirmaciones interpretativas de las Secciones 1 y 5 directamente, midiendo lo que los autores creen que sus contadores significan en lugar de lo que los contadores son.
8.7 El artículo como su propio experimento
La propia trayectoria de descargas de este artículo también está preespecificada. Sus contadores se registrarán a los 30, 90 y 180 días después de la publicación y se reportarán contra la mediana del Estudio 1 una vez que esa mediana sea conocida. El registro es descriptivo y no conlleva reglas de interpretación, porque ambas lecturas direccionales favorecerían la tesis, y un dispositivo en el que cada resultado confirma el argumento no prueba nada; los números se publicarán conforme lleguen. Una lectura iría en contra del encuadre del artículo: una trayectoria que se sitúa en la mediana del campo y edad, ni elevada ni suprimida, indicaría que el diseño autorreferencial no confiere una ventaja de descubribilidad medible en este único caso. La reflexividad no puede evitarse, puesto que este artículo estudia una métrica que el mismo acumulará; los mecanismos catalogados se evalúan mediante las pruebas directas de la Sección 8, no por este registro.
8.8 El índice de percentiles como bien público
El artefacto único más útil que esta agenda puede producir es una tabla de percentiles para descargas de preimpresos, el número que todo autor busca y no puede encontrar. La plataforma ha publicado históricamente medias y listas de N principales pero no medianas o percentiles, y desde el 15 de julio de 2026 solo muestra conteos por artículo y por autor sin contexto comparativo alguno [149]. Para el índice h e indicadores similares existe un género de masa de guías graduadas "¿es X bueno?" [118][128]; la auditoría de la Sección 2.5 no encontró equivalente para descargas de SSRN. Los materiales en bruto para tal tabla han existido en impresión durante años [18][83][85][139][168], y lo que falta es la traducción de esas distribuciones a una escala orientada al autor.
Después del ocaso, la recopilación externa de percentiles de toda la plataforma ya no es posible: las listas principales que filtraron umbrales de distribución fueron la única ventana pública hacia la cola, y se han ido [149]. Dos rutas complementarias permanecen. Una es la muestra estratificada del Estudio 1, que produce percentiles de plataforma a nivel de artículo. La otra ruta es un registro participativo de contadores autoinformados: un conjunto de datos comunitario voluntario en el que los autores contribuyen instantáneas del panel con fecha (edad del artículo, campo, visualizaciones de resumen, descargas), ensambladas antes de que la memoria institucional de las distribuciones pre-ocaso decaiga aún más. El paso de preservación del protocolo de expediente (Tabla 13), si se adopta a escala, es la semilla de exactamente tal registro. También hay un precedente de funcionamiento para extender en lugar de inventar. IRUS (Jisc) ya agrega estadísticas de uso de nivel de elemento estandarizadas, conforme a COUNTER, Total_Item_Requests entre ellas, en repositorios institucionales participantes [185], lo que muestra que la agregación de uso entre instituciones es operativamente viable. Un registro de preimpresos es ese modelo establecido ampliado para incluir las variables de clase de referencia que importan aquí (campo, cohorte de publicación, y etapa de carrera). Una contraparte norteamericana, CC-PLUS, proporciona la misma capacidad como infraestructura de código abierto, con cosecha automatizada de SUSHI de uso de COUNTER 5 en consorcios [188], por lo que un registro puede extender una plataforma en funcionamiento en lugar de ser encargado desde cero. Un registro de esta clase constituiría la primera distribución de descarga fresca, multidisciplinaria desde las muestras de mediados de 2010 [85][139]. Las debilidades conocidas son la auto-selección hacia autores comprometidos y probablemente por encima de la mediana, reportes auto-informados no verificables a menos que se requieran capturas de pantalla con fecha, y brechas de cobertura en campos pequeños. Los percentiles derivados de ello deben por lo tanto publicarse con advertencias de selección explícitas y, donde sea posible, calibrados contra la muestra de probabilidad del Estudio 1, y las celdas escasas de campo por edad deben reportarse bajo encogimiento empírico-Bayes hacia clases de referencia más amplias en lugar de como percentiles crudos inestables (Secciones 5.2, 8.3). El protocolo de registro y las reglas de verificación se publicarán con los materiales de pre-registro, y el formato de contribución se fija aquí: un registro es un subconjunto definido del esquema de panel del Apéndice C (los dominios de identidad, tiempo, uso, exposición, y auditoría), de modo que los registros auto-informados sigan siendo fusionables con el panel del Estudio 1 en lugar de acumularse como segundo conjunto de datos incompatible.
Los formatos de salida del registro se preestablecen junto con su protocolo, y dos artefactos están comprometidos. Uno es una tabla de traducción que toma un solo número (digamos 10, 40, o 100 descargas) y devuelve, para cada campo cubierto, su posición percentil y la banda de lenguaje simple de la Tabla 8; con ella, la respuesta a "¿7 descargas es bueno?" finalmente puede buscarse en lugar de adivinarse. El otro es una figura de 'abanico' de percentiles que traza las curvas de descarga percentil 25, 50, 75 y 95 como funciones de la edad del artículo, por campo y estrato de principiante: el formato en el cual un índice de referencia responde a «¿cuánto es normal en el día X?» (Figura 14; [datos requeridos]: ninguno de los artefactos puede rellenarse con valores sintéticos). Cada lanzamiento de percentil de cualquiera de las rutas (la muestra de probabilidad o el registro) se publica bajo la especificación de transparencia del Apéndice D, incluidas sus reglas de privacidad de celda mínima, de modo que el índice de referencia que esta agenda propone no reproduzca la opacidad que fue diseñado para curar. Sobre los datos hay una capa delgada de auto-servicio, una calculadora en línea pública en la que un autor introduce campo, edad del artículo, y contadores y recibe una banda percentil y un veredicto verbal. Convertiría las heurísticas no calibradas de estilo tarjeta de puntuación de la Sección 6.3 en un instrumento calibrado una sola vez que las distribuciones de referencia existan. La Sección 8.10 propone una arquitectura multi-modelo a través de la cual tal servicio podría ser operado y mantenido actual. Esa misma capa de auto-servicio evita que el protocolo de reporte imponga una nueva carga de trabajo en comités de contratación y tenencia, ya que la normalización por número que pide el formato de expediente (Tabla 13) es realizada por la calculadora (esta sección) y, a escala, por la capa de orquestación (Sección 8.10). Su ruta de despliegue realista corre a través de la tubería de información de investigación existente, es decir, sistemas actuales de información de investigación (CRIS) y perfiles vinculados a ORCID, de modo que una lectura con índice de referencia pueda producirse a partir de los identificadores de un artículo en lugar de ensamblarse a mano. Una extensión natural entre plataformas es un protocolo de depósito paralelo que compara la trayectoria del mismo artículo en SSRN, arXiv (donde sea apropiado para el campo), y OSF Preprints, una prueba directa de si las bandas de la Tabla 8 se transfieren entre arquitecturas de empuje y tracción (Tabla 6).
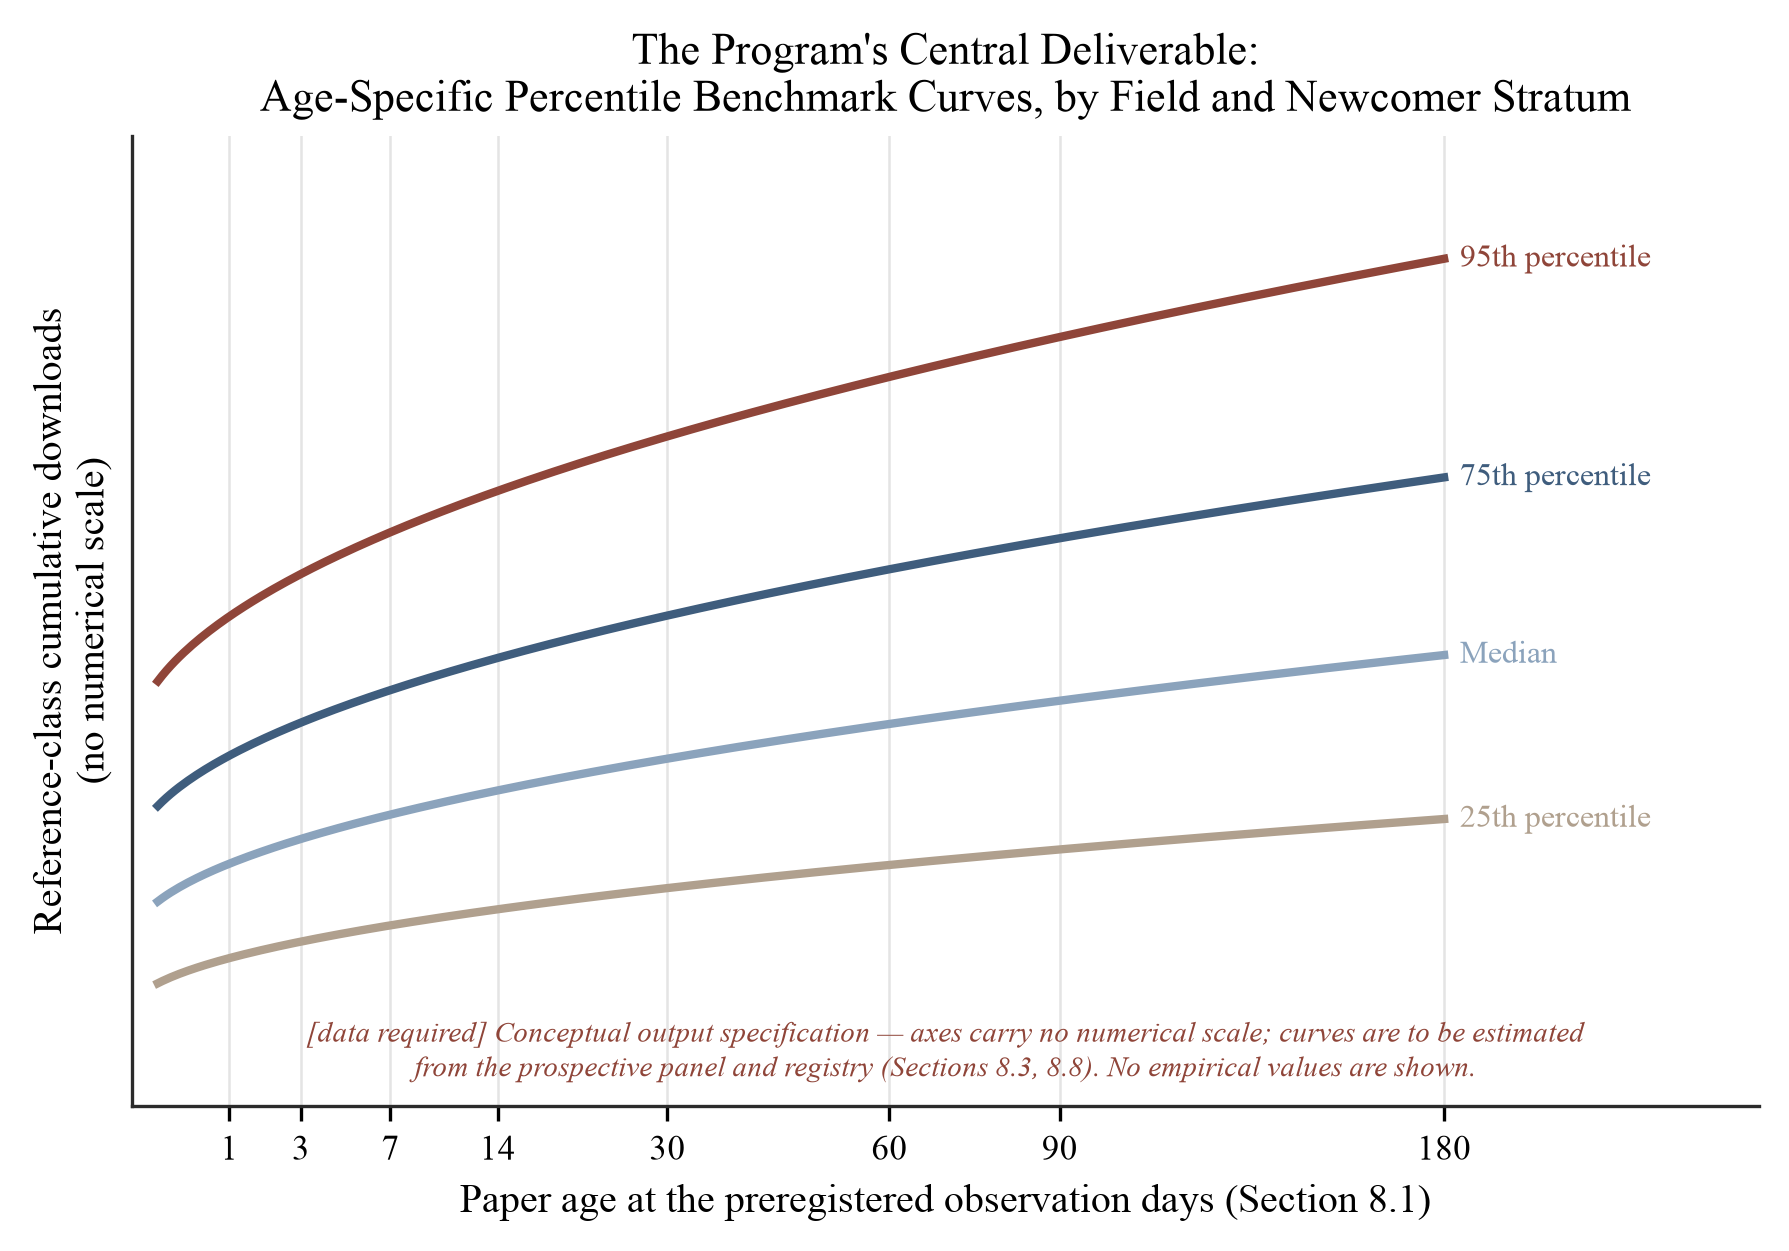
Figura 14. El abanico de índice de referencia específico de edad: el producto central del programa. Curvas de descarga percentil (25, 50, 75 y 95) como funciones de la edad del artículo, evaluadas en los días de observación preestablecidos de la Sección 8.1 y a ser estimadas por campo y estrato de principiante de la muestra del Estudio 1 y del registro comunitario. Los ejes no tienen escala numérica; la figura es una especificación de salida conceptual, y es el formato de presentación detrás de tanto la recomendación de plataforma de la Sección 10.4 como la calculadora pública descrita arriba.
Todo artículo empírico del programa se compromete con un paquete mínimo de informes: un diagrama de flujo de cohortes; distribuciones brutas y normalizadas lado a lado; alcance y conversión informados por separado; historiales de exposición; resultados de sensibilidad a anomalías en la escalera de cuatro capas de la Sección 8.3; resultados nulos y contrarios informados con la misma prominencia que las confirmaciones; y una tabla de referencia legible por máquina, la condición bajo la cual la salida del Estudio 1 puede realmente alimentar la calculadora pública descrita anteriormente. Los resúmenes de artículos del programa distinguen estimaciones verificadas de expectativas preespecificadas.
8.9 Validación predictiva
La prueba sumativa de la agenda (RQ3) pregunta si la normalización justifica su complejidad. El uso temprano y las citas posteriores están asociados positiva pero imperfectamente en diferentes contextos: correlaciones del orden de 0,11–0,35 en análisis de Granger a nivel de revista [80], aproximadamente 0,4 en cohortes tempranas de arXiv, donde r ≈ 0,4 explica solo aproximadamente el 16% de la varianza [25], con asociaciones comparables reportadas para preprints de química hace dos décadas [26], para descargas a nivel de revista y artículo en general [71], en datos de uso de RePEc [31], y en cohortes de bioRxiv [62], y correlaciones de rango moderadas en el uso de megarevistas [102]. Los conjuntos altamente descargados y altamente citados se superponen solo parcialmente [108][39]. Evidencia de panel reciente vincula el acceso a las citas con un desfase: en un panel de siete revistas, la asociación fue aproximadamente de elasticidad unitaria, con un aumento del 10% en accesos asociado con aproximadamente un aumento del 10% en citas alrededor de nueve meses después [178]. En la notación de la Sección 5.5, las comparaciones sumativas estiman
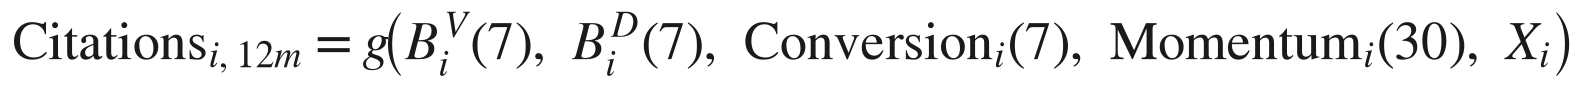
con g ajustada flexiblemente y evaluada solo fuera de la muestra. La ecuación fija qué entradas normalizadas compiten contra recuentos sin procesar. Los modelos que predicen citas de 6, 12 y 18 meses a partir de métricas de día 7 y día 30 normalizadas por edad, campo y cohorte deben compararse fuera de la muestra (por verosimilitud validada cruzadamente, calibración, correlación de rango y error predictivo) con modelos que utilizan solo descargas acumuladas sin procesar, un problema de política de predicción en el sentido de Kleinberg et al. [88]. Un resultado particularmente informativo sería que los recuentos sin procesar favorezcan a autores establecidos mientras que las medidas de inicio en frío normalizadas predigan mejor la adopción de citas posteriores. Ese patrón implicaría que parte de lo que miden los contadores tempranos sin procesar es una oportunidad inicial en lugar de una demanda intelectual posterior. Si la normalización no agrega información predictiva, la afirmación de medición del marco se rechaza o se reduce en consecuencia.
La Figura 15 reúne la agenda. Una cohorte prospectiva alimenta los cuatro estudios y los dos cuasi-experimentos de plataforma en paralelo, y cada módulo se deposita en el mismo conjunto de salidas públicas versionadas. Esa estructura compartida convierte la agenda en un programa de investigación.
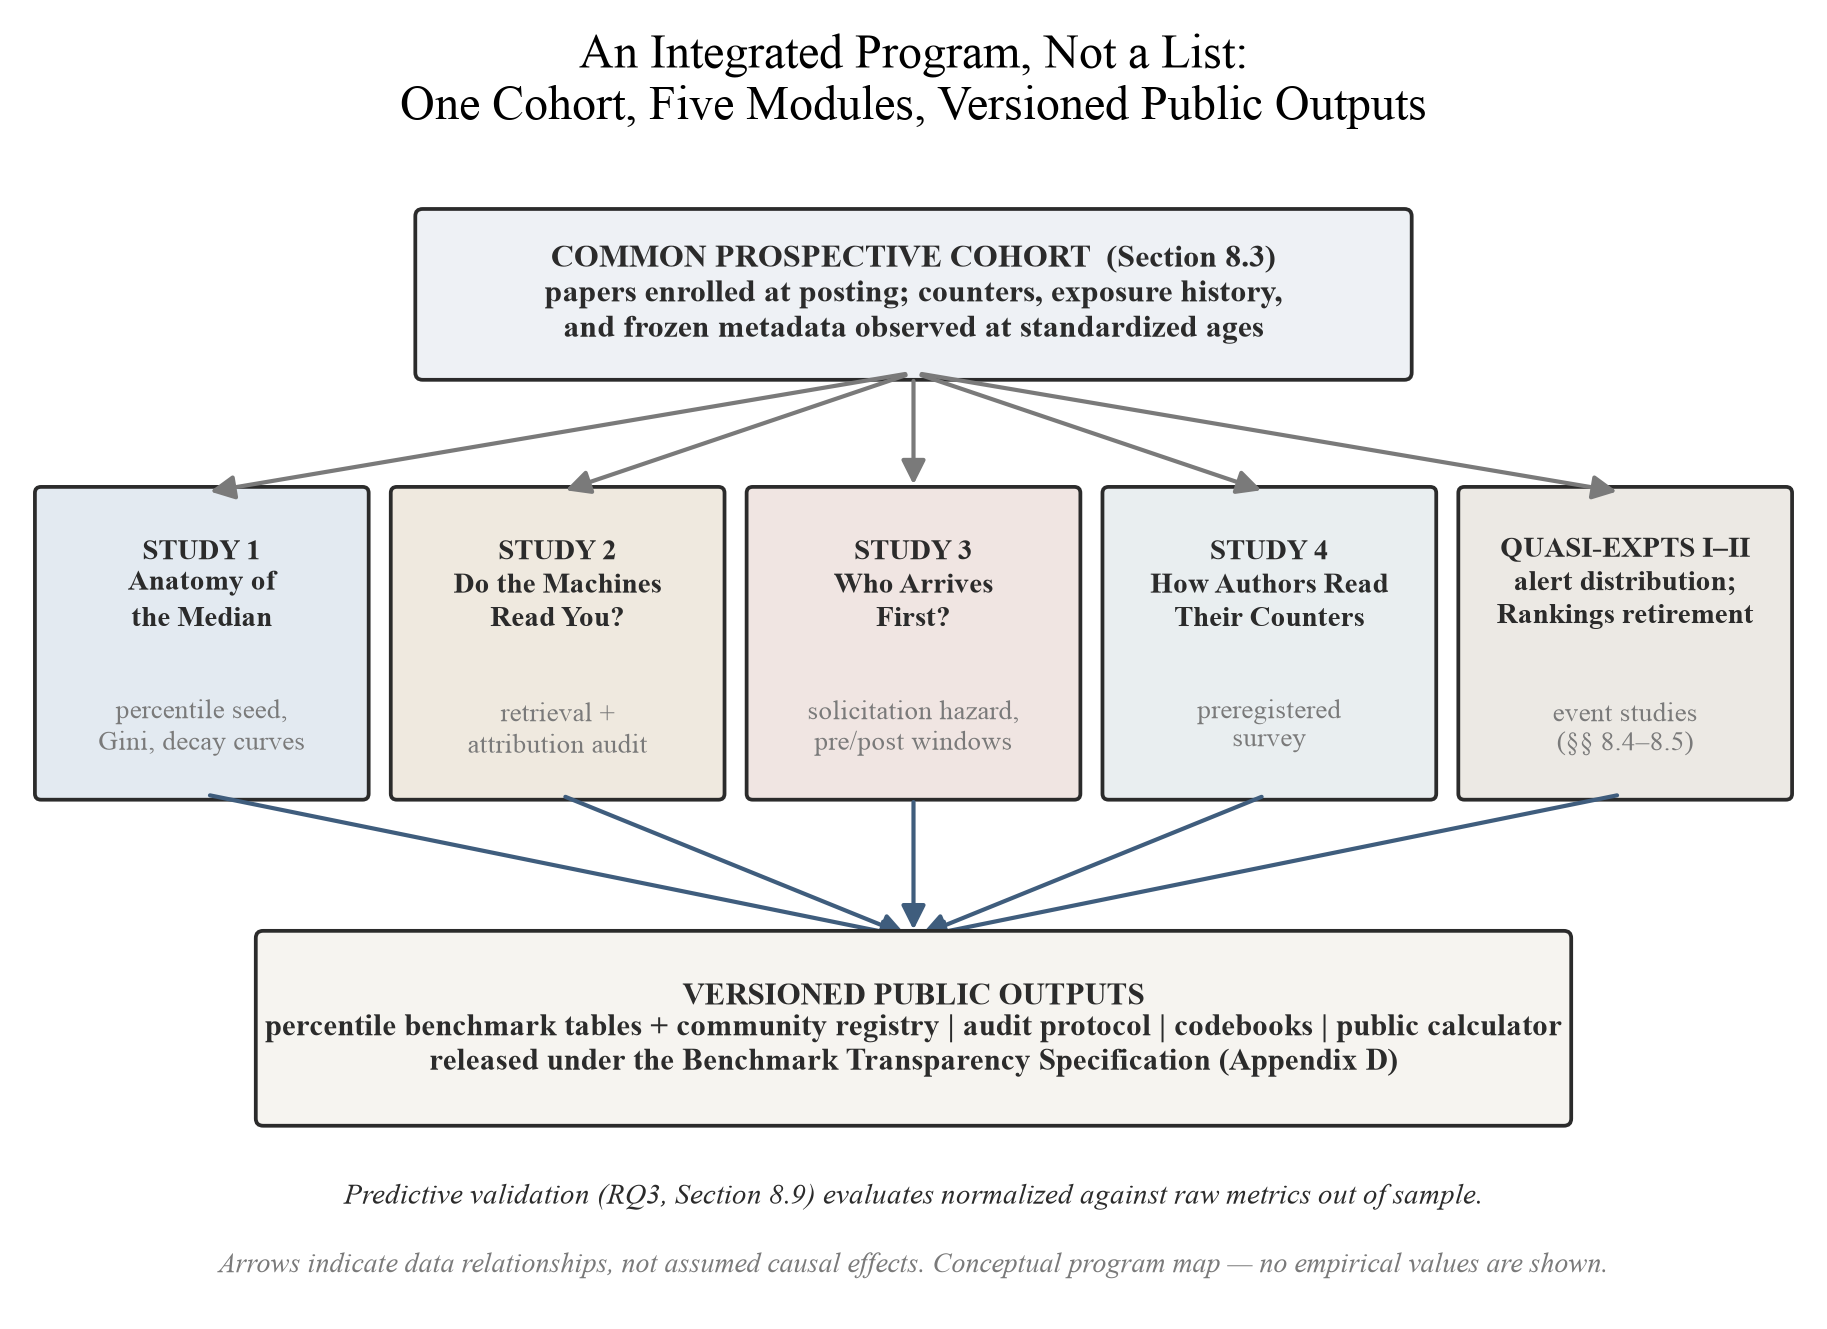
Figura 15. El programa de investigación integrado. Una cohorte prospectiva (Sección 8.3) alimenta los cuatro estudios (Sección 8.6) y los dos cuasi-experimentos de plataforma (Secciones 8.4–8.5); todos los módulos se depositan en salidas públicas versionadas — las tablas de referencia de percentiles y el registro comunitario (Sección 8.8), el protocolo de auditoría, los libros de códigos y la calculadora pública — publicados bajo la Especificación de Transparencia de Referencia del Apéndice D, mientras que la validación predictiva (Sección 8.9) evalúa el punto de referencia resultante fuera de la muestra. Las flechas indican relaciones de datos, no efectos causales asumidos.
8.10 Una propuesta de diseño: modelos de frontera orquestados como capa de entrega de la evaluación comparativa
Una publicación aislada no puede entregar lo que requieren los productos de la agenda. Las tablas de percentiles, el registro comunitario, el formato de informes CSAB (Sección 5.5; Apéndice B), y la calculadora pública (Sección 8.8) deben ser ensamblados desde fuentes dispersas y deterioradas, verificados afirmación por afirmación, mantenidos actuales conforme las reglas de conteo y características de plataforma cambian, y entregados a autores individuales en lenguaje calibrado. Una arquitectura candidata para esa capa de entrega y mantenimiento es una tubería orquestada de modelos de frontera de IA especializados (una clase de sistema que el autor desarrolla; véase Conflictos de interés). Todo en esta subsección es una propuesta de diseño. No existe implementación, no se reclama rendimiento empírico, y ninguna cifra de precisión, costo, o tiempo ahorrado se aserta en lugar alguno más abajo.
Una alternativa a un sistema orquestado es un modelo generalista único. Un autor que pregunta a un chatbot de consumidor «¿son 7 descargas buenas?» recibe una aseveración fluida e inverificable, el modo de fallo que documentan las auditorías del motor de respuestas, en el cual los sistemas yerran con confianza injustificada en lugar de rechazar responder [82]. Debajo de eso yace un problema estructural. La interpretación de métricas se descompone en subtareas con objetivos diferentes, parcialmente adversariales. Adquirir y datar la evidencia, examinar un contador para tráfico no humano o anómalo, normalizar el conteo examinado contra una clase de referencia de edad, campo, cohorte, y visibilidad previa, traducir la posición normalizada a lenguaje de bandas, y cuestionar esa traducción antes de su lanzamiento no son la misma tarea, y un componente optimizado para uno es un pobre juez del otro. El modelo que redacta una lectura reconfortante no debe ser la única autoridad sobre si el número subyacente está contaminado, y el modelo que redacta lenguaje de expediente no debe certificar que el lenguaje evita la sobreafirmación. El principio organizador es por lo tanto una división de trabajo epistémico: la generación y verificación se asignan a componentes separados con objetivos independientes, y el desacuerdo se preserva y reporta en lugar de promediar. La convergencia de evaluadores independientemente solicitados o arquitectónicamente distintos no es verdad, aunque es un terreno más fuerte para una lectura que la fluidez de un modelo único, una intuición de diseño consistente con evidencia experimental que el debate multiagente entre instancias de modelos de lenguaje mejora mediblemente la validez factual y reduce la alucinación relativa a un modelo único respondiendo solo [43]. Donde los evaluadores divergen, la divergencia es en sí misma información de diagnóstico, tal como las fuentes en conflicto fueron tratadas como señal en lugar de ruido en las propias reglas de síntesis del artículo (Alcance y Disciplina de Evidencia). Dos precauciones de diseño temperan esa intuición. El acuerdo entre componentes no es en sí mismo evidencia: puede surgir de datos de entrenamiento compartidos, resultados de recuperación compartidos, suposiciones de solicitud comunes, o contaminación a través del orquestador mismo. Las familias de modelos de diferentes proveedores no son independientes científicamente, e independencia debe ser diseñada, a través de instrucciones separadas, flujo de información restringido entre componentes, salidas intermedias preservadas, y evaluación contra evidencia que ningún componente generador está permitido editar. Verificación tampoco se vuelve confiable meramente porque un segundo modelo la realice: las afirmaciones que son disputadas o consecuentes requieren inspección de la fuente subyacente por el usuario humano.
La Figura 16 muestra la tubería propuesta, y la Tabla 21 la descompone por función. El procesamiento comienza desde un archivo de caso congelado, no desde una solicitud de forma libre: los contadores con sus fechas de observación, edad del artículo, campo declarado y cohortes de referencia candidatas, historial de exposición, y la pregunta real del autor. Las entradas faltantes permanecen faltantes, y el sistema no puede fabricar una distribución de percentiles ausente, imputar un denominador, o aceptar un número generado por modelo en lugar de uno observado. El flujo de información entonces reproduce la secuencia interpretativa que el artículo defiende a lo largo: contadores brutos → examen de integridad → normalización de clase de referencia → interpretación bajo restricción. Un componente de monitoreo recupera contadores, documentos de plataforma, y registros de registro con procedencia datada, de modo que cada valor posterior sea trazable a una fuente archivada. Cada salida factual viaja entre componentes como una entrada en un libro mayor de afirmaciones. Cada entrada registra la afirmación, su fuente de apoyo o campo de datos, un localizador estable, tiempo de recuperación, cualquier transformación aplicada, su clase de referencia, y su estado de verificación, de modo que ninguna salida no apoyada pueda silenciosamente convertirse en una premisa de una etapa posterior. El examen de integridad aplica detección de anomalías de serie temporal convencional (una tarea para métodos estadísticos, no generación de texto libre) contra el trasfondo documentado del filtrado de bots y contaminación de rastreador de IA [129][144]. Atribuye rupturas de trayectoria a eventos de exposición datados donde el registro de exposición lo permite (Sección 5.6). Normalización se realiza mediante código estadístico determinista invocado como una herramienta: las posiciones de percentiles se calculan contra las tablas versionadas de Estudio 1 y de registro bajo las reglas de contracción de la Sección 8.3. La aritmética de percentiles nunca se delega a generación de texto libre. Solo entonces un modelo intérprete redacta la lectura orientada al autor, confinada al lenguaje de bandas de la Tabla 8, el diagnóstico de alcance versus conversión de la Tabla 9, y la plantilla CSAB del Apéndice B, con fuente, antigüedad, y nivel de confianza adjuntos a cada número. Un verificador y crítico separados verifican cada afirmación contra su evidencia registrada antes del lanzamiento, reportando cada una como verificada, disputada, no apoyada, o no evaluable, cuatro estados distintos que nunca se comprimen en una única puntuación de confianza sintética. Dos restricciones se transfieren del marco sin cambios. Cualquier recomendación es condicional al cuello de botella diagnosticado, dado que los artículos limitados por alcance y limitados por conversión justifican diferentes acciones (Tabla 9), y un sistema que no puede distinguirlos debe no decir nada en lugar de emitir consejo genérico. La otra restricción es que una recomendación lanzada es una hipótesis: predice qué mecanismo debe moverse si el diagnóstico es correcto, y observaciones posteriores prueban esa predicción. La función objetivo del sistema es correspondientemente estrecha: eliminar fricción interpretativa identificable entre un artículo y su clase de referencia apropiada, y nunca la maximización de ningún contador, un límite fijado por las políticas de integridad de plataforma e IA generativa [54][144] y por el historial de juego de la Sección 3 [44].
Tabla 21. Descomposición funcional de la capa de orquestación propuesta: función, tipo de componente, modo de fallo principal y mecanismo que la verifica de manera independiente. Cada fila es una hipótesis sobre una división del trabajo viable.
| Función | Modelo o tipo de componente | Modo de fallo principal | Mecanismo de verificación independiente |
|---|---|---|---|
| Orquestación y procedencia | Enrutador de tareas que mantiene el archivo de caso congelado y el libro mayor de reclamaciones | Una suposición no respaldada temprana se propaga como premisa de cada etapa posterior | Ninguna salida no verificada puede convertirse en una premisa confiable; fuente, transformación, tiempo de recuperación e incertidumbre preservados en cada transferencia |
| Adquisición y supervisión de evidencia | Modelo de recuperación que utiliza herramientas en un cronograma de re-ejecución; coincidencia bibliográfica contra infraestructura de citación abierta [35][124] | Fuentes fabricadas, desajustadas o recuperadas selectivamente | Registro de procedencia fechado; cada valor rastreable hasta una instantánea archivada; submuestra aleatoria recuperada independientemente por un segundo componente; búsquedas fallidas y resultados contrarios registrados, no descartados |
| Cribado de integridad | Detección de anomalías de series temporales no generativa [129][144] | Un pico etiquetado como «bot» —o «lector»— sin evidencia de ninguna de las dos identidades | Banderas de anomalía publicadas junto con agregados (Sección 8.8); sensibilidad informada en la escalera de robustez de cuatro capas de la Sección 8.3; anomalía tratada como bandera, nunca como reclamo de identidad |
| Normalización de clase de referencia | Código estadístico determinista invocado como herramienta | Pares convenientes confundidos con una población de comparación válida | Recálculo contra tablas de referencia públicas versionadas (Apéndice D); campo, edad, cohorte, visibilidad previa y antigüedad de la fuente indicados o el módulo se abstiene; ninguna aritmética de texto libre aceptada en el registro |
| Redacción de interpretación | Modelo de lenguaje generalista restringido al lenguaje de banda de la Tabla 8 y la plantilla CSAB (Apéndice B) | Exageración fluida —certeza, alcance o estado causal más allá de lo que permite la evidencia | Verificación a nivel de afirmación por un verificador separado contra la evidencia registrada; cada afirmación reportada como verificada, controvertida, no respaldada o no evaluable; oraciones no respaldadas rechazadas, no suavizadas |
| Revisión adversarial | Modelo crítico con objetivos adversariales al redactor | Crítica ritual, o un consenso sintético que oculta el desacuerdo material | Informe de desacuerdo estructurado —estado de evidencia, patrón de evaluador, sensibilidad de decisión (¿el desacuerdo cambia el diagnóstico o solo su redacción?), incertidumbre residual— entregado sin fusionar, nunca colapsado en un número de confianza |
| Clasificación de solicitudes | Clasificador especializado sobre el marco de codificación de las Tablas 14–15 | Un veredicto categórico de «depredador» que supera la evidencia y arriesga daño reputacional | Solo marca y revisa, nunca auto-elimina y nunca una acusación publicada; tasas de error reportadas en conjuntos etiquetados; límites documentados y sesgos de clasificación de texto de IA reconocidos [157][97] |
| Mantenimiento de referencia | Orquestación programada de todos los componentes | Desvío silencioso: fuentes obsoletas o versiones sobrescritas sin dejar rastro | Versiones fechadas bajo el Apéndice D; revisiones registradas, nunca sobrescritas silenciosamente —un mapa de referencia vivo en lugar de una instantánea estática |
| Interpretación final y cualquier uso de carrera | Autor humano | Sesgo de automatización y difusión de responsabilidad | Aprobación humana obligatoria antes de cualquier uso externo; lenguaje del expediente sigue el protocolo de la Tabla 13, con fuente, ventana de tiempo y limitaciones adjuntas |
Dos límites completan la especificación. Uno es un límite de permisos: el acceso de solo lectura es el predeterminado, y la capa redacta pero nunca ejecuta. No puede editar autónomamente un manuscrito, alterar metadatos de plataforma, contactar académicos o lugares de publicación, publicar públicamente ni eliminar un mensaje de solicitud, y cualquier flujo de trabajo implementado debe preservar la responsabilidad humana y las obligaciones de divulgación de las políticas de plataforma y envío aplicables [54][56][144]. El otro es un límite de abstención: la salida nula es un resultado legítimo (a menudo el correcto), y cada etapa puede detenerse en lugar de pasar una entrada defectuosa adelante. Los desencadenantes de abstención obligatoria incluyen una clase de referencia faltante o indefendible; una fuente inverificable central para la lectura; desacuerdo no resuelto sobre si una formulación propuesta preserva los reclamos del artículo; cualquier solicitud de conclusión causal de un patrón puramente descriptivo o para una predicción de citaciones o resultados de carrera sin un conjunto de datos de predicción validado (Sección 8.9); y cualquier solicitud de manipular, comprar, simular u otro inflar atención. Ese último desencadenante impide que la capa se convierta en el instrumento de juego de métricas cuyo historial documenta la Sección 3 [44][69][144]. Una última separación rige los dos flujos de evidencia de la agenda. Las tablas de percentiles versionadas de las Secciones 8.6 y 8.8 son la única fuente de normalización admisible de la capa, mientras que la auditoría de visibilidad de máquina del Estudio 2 alimenta una verificación distinta de recuperación y atribución. La recuperación de máquina no es un percentil de la atención humana, y la capa no puede mezclar los dos.
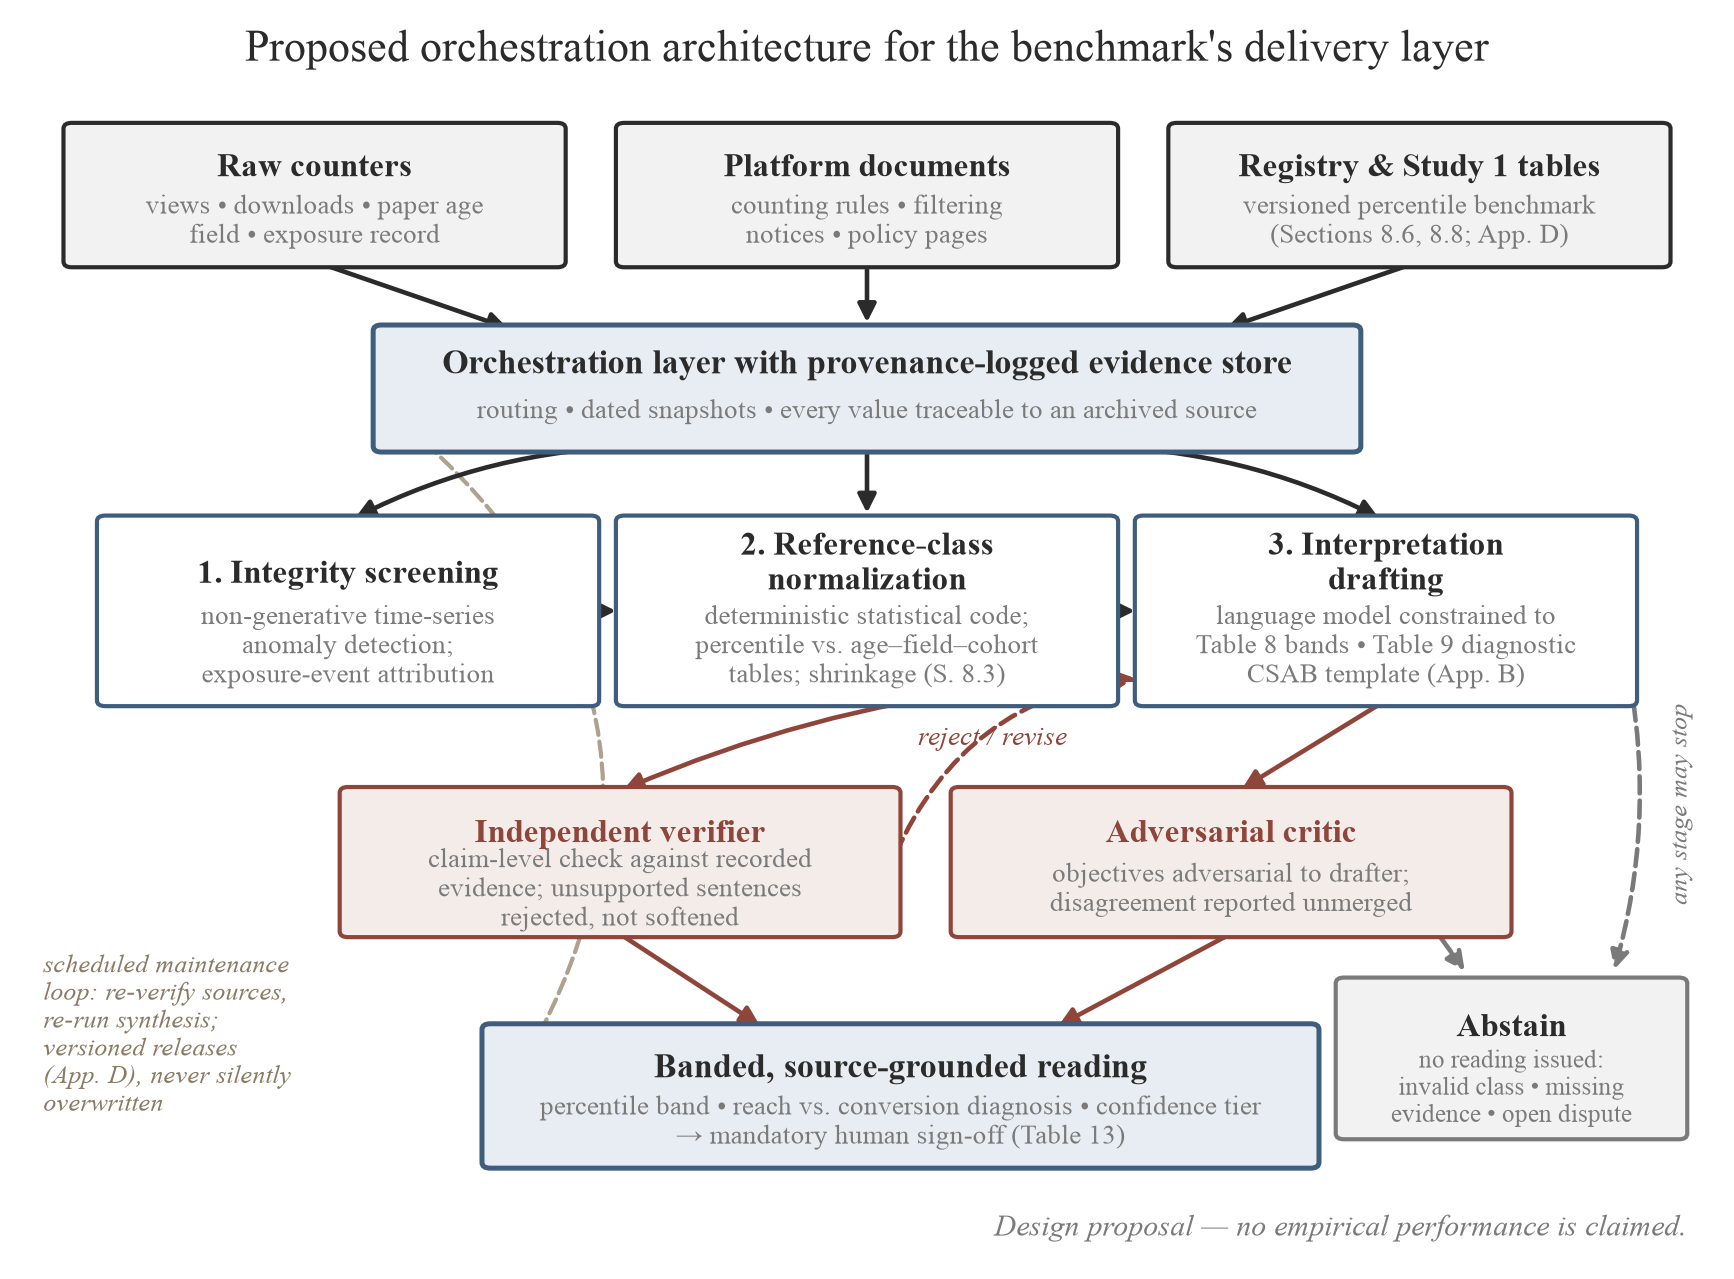
Figura 16. Arquitectura de orquestación propuesta para la capa de entrega de la referencia (Sección 8.10; Tabla 21). Los componentes especializados separan la adquisición de evidencia, el cribado de integridad, la normalización e interpretación, con verificación independiente interpuesta entre generación y lanzamiento, una ruta de abstención disponible en cada etapa y un bucle programado que mantiene la referencia versionada de la Sección 8.8.
La misma disciplina limita lo que la capa puede hacer una vez que tiene un diagnóstico. La tabla 22 establece la política de acción: cada patrón observado (alcance y conversión leídos conjuntamente con impulso, en el vocabulario de las tablas 9–10) se asigna a un diagnóstico provisional, una forma acotada de asistencia permisible, la prueba de mecanismo que podría corroborar o debilitar el diagnóstico, y la inferencia o acción que permanece prohibida. La columna de prueba de mecanismo operacionaliza la regla indicada anteriormente de que una recomendación publicada es una hipótesis. Si una corrección de clasificación se supone que debe eliminar un cuello de botella de alcance, el resultado que cuenta es el alcance ajustado por edad, y una narrativa retrospectiva sobre descargas totales no puede sustituirlo. Una predicción fallida se registra como una intervención fallida y se devuelve al diagnóstico, nunca se vuelve a calificar contra una medida de éxito más lisonjera. La secuencia completa así forma un ciclo: medir → validar → normalizar → diagnosticar → proponer → criticar y verificar → decidir → observar → actualizar o detener (Figura 17). Dentro de ese ciclo, la decisión humana se sitúa entre la verificación y cualquier acción, las observaciones posteriores a la decisión vuelven al archivo del caso, y la ruta de abstención termina el ciclo cada vez que la evidencia es insuficiente. El ciclo también controla la complejidad: cuando la evidencia respalda solo la preservación y el monitoreo, o cuando una regla determinista del manual de autor (Sección 6) ya responde la pregunta, la orquestación no añade nada y no debe ejecutarse.
Tabla 22. Política de diagnóstico a acción para la capa de orquestación propuesta. Los patrones se leen dentro de una clase de referencia defendible bajo las convenciones percentiles de la Tabla 9; cada fila es una hipótesis de política, y ninguna celda afirma una frecuencia empírica.
| Patrón observado (alcance, conversión, impulso) | Diagnóstico provisional | Asistencia permisible | Prueba de mecanismo | Inferencia o acción prohibida |
|---|---|---|---|---|
| Alcance bajo, conversión alta, estable o en aumento | Un cuello de botella de descubrimiento es más consistente con el patrón que un cuello de botella de adopción de manuscritos ("interés oculto," Tabla 9) | Auditar identificadores, clasificaciones, metadatos, indexación y capacidad de descubrimiento de títulos; distribución acotada y genuinamente relevante | Después de un cambio de metadatos o clasificación, ¿el alcance aumenta mientras la conversión se mantiene? | Reescribir un resumen que convierte bien solo para hacerlo más promocional |
| Alcance alto, conversión baja, estable o en declive | La falta de coincidencia en la comunicación, la falta de coincidencia de audiencia y la exposición de baja intención son explicaciones competidoras ("atención sin adopción") | Probar la alineación título-resumen, la claridad del alcance y la adecuación de la audiencia; solo alternativas que preserven las afirmaciones | ¿Cambia la conversión bajo exposición comparable, con una verificación de fidelidad en cada revisión? | Aumentar la promoción indiscriminada; concluir que los lectores rechazaron la ciencia |
| Alcance bajo, conversión baja | Subidentificado: exposición débil, clase de referencia incorrecta, falla de metadatos, fricción de comunicación o demanda de nicho encajan todos ("inicio en frío") | Validar primero la clase de referencia y el registro de exposición; luego auditar metadatos y comunicación por separado | Cambiar un mecanismo medible a la vez; preservar el resultado nulo | Inferir baja calidad de bajo uso; devolver un veredicto de causa única |
| Alcance alto, conversión alta, en aumento | Difusión temprana fuerte relativa a la clase declarada | Preservar la procedencia; monitorear en edades fijas; no cambiar nada sin causa | ¿Persiste el patrón después del evento de exposición y bajo sensibilidad de anomalía? | Fabricar amplificación adicional; tratar la atención como prueba de calidad |
| Alcance alto, conversión alta, incrementos en caída pronunciada | Atención impulsada por eventos, decaimiento ordinario, o saturación (Sección 5.6) | Identificar el evento de exposición; comparar incrementos de intervalo, no totales acumulados | ¿Difiere el decaimiento de las trayectorias emparejadas por edad condicionales al evento? | Llamar a los incrementos decrecientes fracaso científico — los totales acumulados casi siempre se aplanan en términos de tasa |
| Alcance bajo, conversión alta, incrementos en declive | El interés condicional puede ser real mientras la exposición continua es débil | Auditar si la distribución o indexación terminó; identificar canales acotados y relevantes | ¿La exposición restaurada aumenta el alcance sin degradar la conversión? | Ampliar las afirmaciones o eliminar la especificidad técnica para perseguir una audiencia más amplia |
| Alcance alto, conversión baja, exposición en aumento | Las llegadas están creciendo sin adopción proporcional de texto completo | Probar tráfico de baja intención (Sección 4.2), falta de coincidencia de audiencia y claridad de presentación | ¿Responde la conversión a un cambio de presentación fiel a las afirmaciones bajo exposición comparable? | Optimizar solo la parte superior del embudo; contar cada vista como un lector humano |
| Cualquier patrón con un contador reafirmado, pico inexplicable, cohorte inválida o denominador faltante | La métrica actualmente no es interpretable en el nivel deseado | Preservar instantáneas; ejecutar análisis de sensibilidad; limitar la afirmación; abstenerse | ¿La lectura sobrevive a la exclusión del intervalo disputado, o una clase de referencia mejor? | Etiquetar el tráfico como humano o automatizado sin evidencia; emitir un percentil de un denominador fabricado |
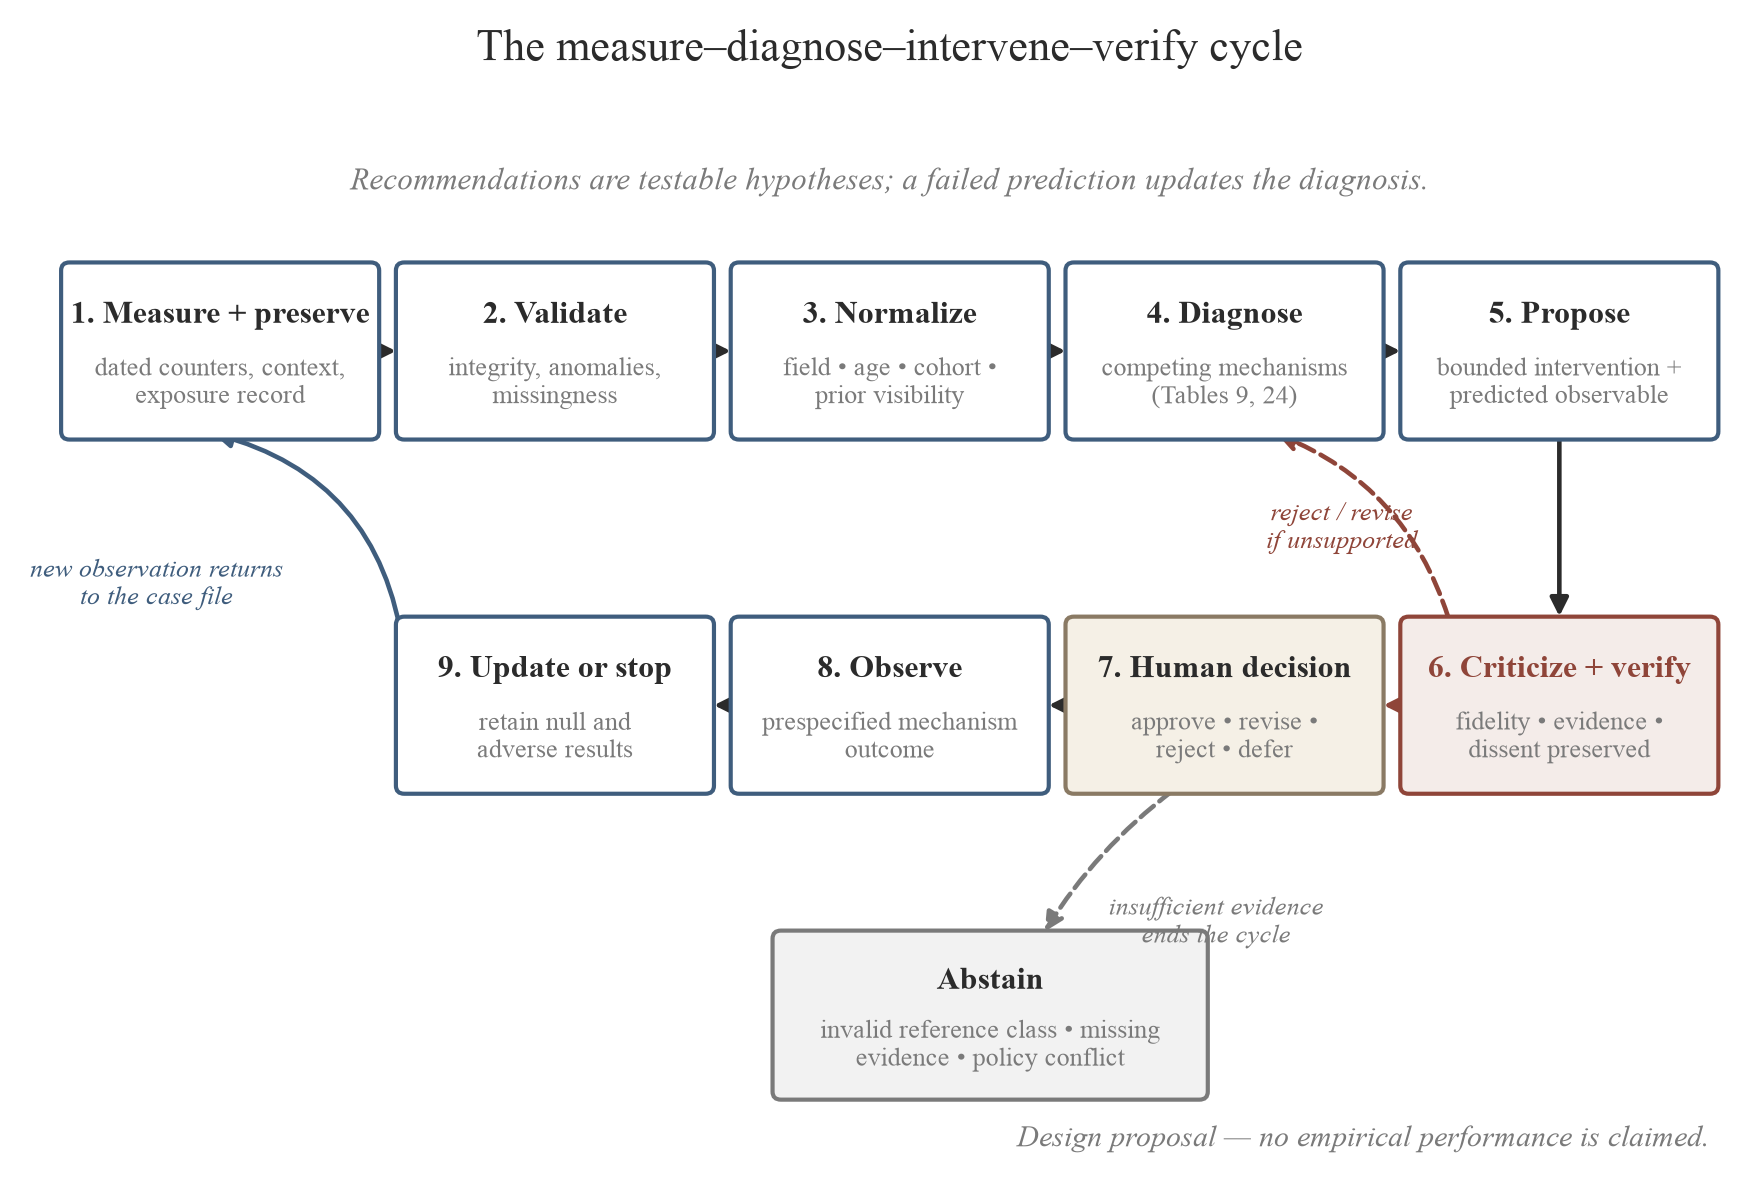
Figura 17. El ciclo medir-diagnosticar-intervenir-verificar (Sección 8.10; Tabla 22). Las recomendaciones dejan el ciclo solo como hipótesis contrastables: cada una nombra el mecanismo que se pretende mover y la observación posterior que podría corroborar o debilitar el diagnóstico. Las predicciones fallidas vuelven al diagnóstico y permanecen en el registro de auditoría; la decisión humana se sitúa entre la verificación y cualquier acción; y la ruta de abstención termina el ciclo cada vez que no existe una clase de referencia defendible o evidencia suficiente. El ciclo optimiza la interpretación que preserva la evidencia, no la atención bruta.
Cuatro limitaciones limitan la propuesta. La generación no es recuperación. Ningún modelo, por mucho que esté orquestado, puede regenerar las distribuciones percentiles que dejaron de ser observables cuando se eliminaron las listas de los mejores [149], y la capa solo puede mantener una aproximación, con las advertencias de piso conservador de la Sección 5 intactas. Tampoco la orquestación puede identificar un descargador, distinguir el tráfico humano del automatizado solo con contadores (Sección 4.2), convertir el volumen de solicitudes en evidencia de lectura (Sección 7.6), hacer que las salidas correlacionadas del modelo sean independientes renombrándolas como «agentes», reemplazar el juicio entre pares o transferir la responsabilidad del investigador a un flujo de trabajo. El orquestador en sí necesita un auditor. Una capa de interpretación desplegada se convierte en un nuevo guardián en la pila que este artículo mapea (Figura 12), y no debe heredar la opacidad que fue construida para reparar: los rastros de razonamiento y los registros de procedencia deben estar abiertos a inspección, y el comportamiento propio de recuperación e interpretación de la capa debe ser auditado con la disciplina del Estudio 2 (instantáneas con marca de tiempo más un protocolo de replicación con guion), porque la no estacionariedad del modelo hace que cada salida sea una estimación fechada, nunca un valor duradero. Costo y equidad. Operar tal canal no es gratuito, y una capa interpretativa pagada excluiría a los autores de bajos recursos y no afiliados en los que se centra este marco. Los sesgos conocidos de los clasificadores de texto de IA contra autores cuya lengua materna no es el inglés [97] harían lo mismo sin mitigación. La falsa precisión es el riesgo residual. Una capa que emite veredictos en bandas sin niveles de confianza automatizaría la miscalibración diagnosticada en la Sección 3: un recuento sin escala comparativa reemplazado por un veredicto sin incertidumbre adjunta. La arquitectura es en sí misma un objeto falsable y pertenece a la agenda en esos términos, evaluada contra la asistencia más simple y no inferida de la sofisticación de su diagrama. El diseño apropiado es gradual. Los paquetes de casos realistas con ambigüedades plantadas (citas inválidas, contraafirmaciones, cohortes indefendibles, solicitudes genuinamente fronterizas) se aleatorizan entre condiciones que añaden un ingrediente a la vez: el protocolo manual de las tablas de este artículo (la línea de base correcta, ya que un método sin IA ya existe), un único modelo generalista, el mismo modelo con recuperación y cálculo determinista, generación más crítica independiente, y el flujo de trabajo gobernado completo. Las ablaciones que eliminan el verificador, la calculadora determinista, la visibilidad del desacuerdo o la compuerta humana aíslan entonces qué ingrediente de gobernanza justifica su costo. Los resultados se califican por separado, nunca como un compuesto: fidelidad de afirmación y cita; validez de clase de referencia; calibración de creencias del autor (instrumento del Estudio 4) y abstención apropiada en casos ambiguos; tiempo del investigador y carga de supervisión; fallos de gobernanza (acciones externas autónomas, asesoramiento de juego métrico, acusaciones categóricas de lugar); y, central al argumento de arranque en frío del artículo, heterogeneidad de beneficio según la visibilidad previa del autor y estado de recién llegada, ya que una capa que ayuda principalmente a autores ya visibles reproduciría la desigualdad que fue diseñada para reducir. Los resultados de equidad nulos y adversos son hallazgos reportables. Las versiones del modelo, indicaciones, permisos de herramientas e instantáneas de origen se archivan, porque en un sistema no estacionario cada resultado es una estimación fechada. Dos estimandos se mantienen separados en todo: el efecto en la calidad de la interpretación y el efecto en la difusión posterior. Una capa que mejora el diagnóstico sin afectar las descargas es un éxito, mientras que una que aumenta las descargas distorsionando afirmaciones es un fallo de gobernanza. El diseño falla si el flujo de trabajo gobernado no supera un modelo único fuerte en precisión de la evidencia y calibración: «varios modelos» no es la contribución, y la hipótesis bajo prueba es la división del trabajo epistémico. La propuesta especifica un papel comprobable para la interpretación asistida por IA. La IA puede ayudar a un autor a hacer una pregunta mejor sobre un número; solo la evidencia verificada puede responderla.
9. Limitaciones
Las afirmaciones de este artículo están limitadas por las limitaciones a continuación, cada una adjunta al artefacto que limita.
Envejecimiento y composición de la base de evidencia. Los anclajes distribucionales más antiguos en el mapa de referencia (Tabla 7) se basan en muestras recolectadas entre 2012 y 2015 y dominadas por beca legal [85][139]; la entrada reciente es la instantánea de red única discutida a continuación [83]. Las bandas de la escala de interpretación (Tabla 8) se leen mejor como bandas permisivas en lugar de bandas absolutas conservadoras para 2026 (Sección 5.1). El volumen anual de descargas en toda la plataforma creció varias veces entre mediados de 2010 y 2020 [1][143], elevando el flujo de descarga por artículo y haciendo que un umbral antiguo fijo sea una barrera más blanda hoy que cuando fue estimado. Ninguna corrección multiplicativa puede reparar esto, ya que el crecimiento cambia el numerador, denominador y composición simultáneamente (Sección 3.2). Las bandas de la Tabla 8 son aproximaciones derivadas de la aritmética agregada en lugar de normas reescaladas. No se identificó ningún estudio distribucional de toda la plataforma posterior a 2020 de descargas de SSRN.
Evidencia contemporánea de una sola fuente. La única evidencia distribucional reciente utilizada aquí es una única instantánea publicada de una red disciplinaria: 2,361 artículos de Marketing observados el 15 de agosto de 2025 [83]. Demuestra sesgo y una prima de prestigio condicional, pero no establece referencias de toda la plataforma, y dos valores internos de su tabla publicada se reproducen «tal como se publicaron» con una nota cautelosa. Las generalizaciones de esta fuente a otras redes de SSRN son extrapolaciones. El Apéndice E reduce esta dependencia al agregar una sección transversal de archivo independiente de todos los campos (n = 1,360) que reproduce el sesgo, la brecha de la media a la mediana, la banda de conversión, el multiplicador de campo y la lognormalidad en el cuerpo observado. Lleva su propio sesgo de selección ascendente y corrobora la forma de la distribución entre disciplinas. La agenda de la Sección 8 aún apunta a la referencia representativa de la plataforma.
Sesgo de la lista superior. El ajuste de muestra grande de 2015 cubre solo las listas superiores (aproximadamente el decil superior de autores y sus artículos [85]), por lo que el cuerpo de la distribución por debajo de las listas de la élite se infiere de una lognormal ajustada en lugar de observarse. Las afirmaciones de percentiles derivadas de ese ajuste se basan en modelos.
La semántica de los contadores es inestable. Lo que registran las vistas y descargas ha cambiado con el tiempo y continuará cambiando con rediseños de interfaz y filtrado de bots en evolución. El sistema de integridad de la plataforma excluye algunas actividades sospechosas de los conteos oficiales [144][66][69], e la infraestructura adyacente RePEc/LogEc documenta tanto la escala histórica del tráfico de robots como las olas recientes de rastreadores de IA que requirieron descartar la abrumadora mayoría del tráfico sin procesar [99][129]. Las normas de conversión citadas en la Sección 5 son por lo tanto cantidades específicas de época, y las comparaciones de contadores entre años confunden cambios de comportamiento y filtrado. Las estadísticas generales de bots web [158] no se pueden extrapolar a los contadores filtrados de SSRN en ninguna dirección.
Volatilidad de plataforma y desviación de origen. El retiro de Rankings está integrado en una reestructuración de producto más amplia de 2026 [146][149][150], por lo que ningún análisis debe tratar el 15 de julio de 2026 como una intervención aislada. Esta amenaza está integrada en el diseño de la Sección 8.5 pero no puede ser completamente eliminada. Las páginas de soporte de la plataforma se revisan sin previo aviso; todas estas páginas se citan aquí con fechas de acceso, y el lenguaje de plataforma citado debe re-verificarse contra copias archivadas antes de la presentación formal.
Sin datos de percentiles. Nunca han existido datos públicos de percentiles de plataforma completa, y después del 15 de julio de 2026 ningún marco de percentiles representativo de la plataforma puede ser recopilado externamente, porque los rankings que previamente filtraban umbrales de lista superior han sido removidos [149]. Una distribución de referencia basada en muestras aún puede ser ensamblada a partir de capturas archivadas, y el Apéndice E reporta una; fija la forma de la distribución y no entrega percentiles de plataforma. Algunas cantidades de interés (por ejemplo, el destino de los correos de notificación de autores del "top 10%" [161]) están oficialmente sin documentar, y notamos su desaparición del marco público sin afirmar su terminación.
El uso no es lectura, y tampoco es calidad. Una descarga puede preceder a lectura cuidadosa, inspección superficial, almacenamiento de archivo, o ningún uso en absoluto. Las descargas no son un indicador directo de la calidad de la investigación y no son una fuente causal garantizada de citas: la asociación descargas-citas es positiva pero heterogénea (aproximadamente 0.1 a 0.6 dependiendo del campo, nivel de agregación, y horizonte [18][25][39][80][102][108]) y las poblaciones altamente descargadas y altamente citadas se superponen solo parcialmente [108]. Las citas en sí pueden ser positivas, negativas, superficiales o estratégicas, y el proceso de citación está sistemáticamente sesgado contra el trabajo novedoso [166]. Nada en este artículo autoriza la sustitución de métricas por juicio experto; el uso defendible del marco es diagnóstico y descriptivo.
Exposición inobservable y prestigio no aleatorio. No toda exposición es observable: los lectores encuentran títulos en correo electrónico, redes sociales, resultados de búsqueda y correspondencia antes de que cualquier vista de página de resumen sea registrada, y los autores bien conectados generan exposición fuera de plataforma correlacionada con prestigio y calidad. Los coeficientes de prestigio observacional por lo tanto mezclan atención basada en estado con diferencias genuinas en recursos, temas y redes [111][140]. La manipulación experimental de señales de identidad de autor [154][64] complementa pero no reemplaza la observación de plataforma. La clasificación de campo es parcialmente seleccionada por el autor, y los artículos ocupan varias categorías, complicando asignaciones de campo único.
Limitaciones de la agenda en sí. Los diseños cuasi-experimentales de las Secciones 8.4–8.5 enfrentan efectos de anuncio, cambios de plataforma concurrentes y diferencias de campo no aleatorias. Se etiquetan como cuasi-experimentales porque un evento de plataforma general no ofrece ningún grupo de control sin tratar. La instantánea del Estudio 2 envejecerá con los motores que audita, y su protocolo de replicación mitiga pero no elimina la no estacionariedad. El Estudio 3 es un estudio de caso N = 2 cuyo valor es mecanismo y protocolo, no una estimación de población, y su lógica de atribución depende de alias por canal en lugar de cualquier afirmación sobre visibilidad de correo electrónico público. El registro de colaboración colectiva hereda problemas de auto-selección y verificación indicados en la Sección 8.8. El acceso a datos para todos los diseños depende de cooperación de la plataforma o recopilación de tasa limitada dentro de los términos de servicio [134][51]; ninguno está garantizado.
Amplitud de la bibliografía. La bibliografía es amplia porque el artículo es una síntesis; muchos de los estudios citados comparten marcos, campos y límites de diseño, y las publicaciones de la comunidad documentan la experiencia sin establecer parámetros de población. La evidencia de una afirmación es su nivel de verificación y marco de muestreo, no el número de referencias detrás de ella.
Las bandas son objetivos de calibración, no constantes. La banda de conversión del 11–19% y los umbrales CSAB son cantidades para ser calibradas por campo y por plataforma, no constantes universales del comportamiento académico (Secciones 4.4, 5.2). Su forma actual es una banda de campo cruzado único, para ser reemplazada por las distribuciones por campo que el marco requiere cuando el Estudio 1 estratificado por campo (Sección 8.6) reporta.
La generalización más allá de SSRN requiere recalibración, no trasplante. El problema de interpretabilidad diagnosticado aquí (contadores de uso mostrados sin una escala comparativa pública) y la lógica de alcance versus conversión que lo repara no son específicos de SSRN; se aplican a cualquier servidor de preimpresión que muestre conteos de uso, incluyendo bioRxiv, medRxiv, arXiv, y OSF Preprints [11][62][2][24]. Lo que no se transfiere es la banda específica del 11–19% o los umbrales CSAB. La curación, arquitectura de distribución e interfaz difieren entre servidores: el tráfico de extracción impulsado por intención de arXiv y sus listas de anuncios por correo electrónico contra las alertas de inserción curadas de SSRN (Tabla 6). Los anclajes numéricos deben por lo tanto ser re-estimados en cada plataforma antes de ser citados allí. El marco es portátil; su calibración es local. El protocolo de depósito paralelo de la Sección 8.8 es la prueba empírica directa de qué tan lejos viajan las bandas de SSRN. La escala de esa recalibración es fácil de subestimar: la descarga mediana de corpus completo de bioRxiv (aproximadamente 279, y aproximadamente 496 en genómica [2]) es varias veces la mediana de 60 en la sección transversal de archivo del Apéndice E: aproximadamente cinco veces en general y aproximadamente ocho veces en genómica. La comparación es solo indicativa. La cifra de bioRxiv proviene de un censo de corpus completo, mientras que el 60 proviene de una muestra de archivo que sobre-representa páginas capturadas, mezcla edades y campos cuya composición cambia con la edad, y resuelve la edad a años completos. La dirección de la brecha es segura de leer; su tamaño no lo es.
Ética. La rama de discurso comunitario de este artículo consiste en publicaciones públicas auto-seleccionadas utilizadas únicamente como evidencia de demanda, nunca como sentimiento representativo, y citadas solo donde existe una fuente viva y verificable. Las publicaciones de usuarios se citan prestando atención a la ética de citar contenido de foros semi-públicos, incluyendo paráfrasis en lugar de cita textual donde los autores podrían ser identificados en contra de sus expectativas, consistente con las normas de transparencia para evidencia cualitativa [6]. El Estudio 3 registra solo mensajes enviados sin solicitud al autor instrumentado y no recopila datos personales de terceros más allá de lo que los remitentes ofrecen voluntariamente. El Estudio 4 recopila solo respuestas voluntarias y anónimas de cuestionarios bajo consentimiento informado. El diseño del panel utiliza contadores mostrados públicamente y metadatos bibliográficos, y cualquier recopilación de información del tablero no pública (como fechas de estado de distribución) requiere consentimiento informado del autor y, cuando sea aplicable, revisión institucional. Los dos estudios que involucran participantes humanos y datos generados por participantes son el Estudio 4 (la encuesta de autores) y el Estudio 3 (publicación instrumentada con registro de bandeja de entrada). Debido a que ambos son investigaciones con sujetos humanos, ambos se enviarán para aprobación por la junta de revisión institucional relevante o comité de ética de investigación y se llevarán a cabo bajo el consentimiento informado de los participantes antes de que comience cualquier recopilación de datos, y los datos personales contenidos en los registros de la bandeja de entrada se agregan y se desidentifican antes de cualquier análisis o informe. Este protocolo es una precondición de ejecución y se reproduce en las Declaraciones.
10. Conclusión y Recomendaciones de Política
10.1 Lo que el análisis estableció
La retirada de SSRN Rankings el 15 de julio de 2026 eliminó la única escala comparativa pública [149]. Los contadores permanecieron en cada artículo y perfil, lo que dejó métricas ilegibles en lugar de sin sentido. Frente a esa pérdida, este artículo reúne cada anclaje empírico verificable en un mapa de referencia con salvedades explícitas de antigüedad y confianza (Tabla 7), construye un marco de interpretación, la escala de cinco bandas, la descomposición alcance-conversión y el protocolo de dossier (Tablas 8, 9, 13), que traduce contadores en diagnósticos, y presenta la agenda lista para preregistro de la Sección 8, que especifica cómo pueden reconstruirse las distribuciones faltantes.
El mecanismo en el núcleo del argumento se reduce a esto:
Nadie sabe qué significan siete descargas sin saber siete descargas comparadas con qué, y después del 15 de julio de 2026 la plataforma ya no responde «con qué».
Las contribuciones difieren en naturaleza. Nombrar el problema de la clase de referencia es el diagnóstico: un conteo en bruto no responde pregunta alguna hasta que la edad, el campo, la cohorte y la exposición definen su grupo de comparación. La contribución instrumental es el mapa de referencia y CSAB, que normalizan un número emocionalmente destacado pero científicamente ambiguo en un diagnóstico interpretable. El manual de procedimientos y el protocolo de dossier son la contribución práctica, permitiendo que autores y comités actúen sobre contadores hoy sin malinterpretarlos. En términos de política, la contribución es la banda de percentil anonimizado: contexto comparativo restaurado en una forma que no identifica a nadie y no revive ninguna tabla de clasificación.
Basándose en la evidencia reunida, la pregunta en el título de este artículo está mal planteada hasta que se especifique una clase de referencia. Frente a cada anclaje disponible, los conteos pequeños son la norma estadística de la plataforma más que un veredicto sobre el trabajo. Un artículo con 40 vistas de resumen y 7 descargas es consistente, como resultado de cribado, con la banda de conversión empírica de la Sección 5 [139][172][83], mientras que la regla práctica más antigua de tres vistas por descarga [18] se sitúa encima de esa banda en lugar de dentro de ella. El artículo mediano en la única muestra estilo censo acumuló 63 descargas en dos años [139], y la entrada en la lista de los 10.000 mejores de 2015, aproximadamente el 1,8% superior del stock de artículos de texto completo de la plataforma (571.040, julio de 2016 [1]), requería 160 descargas de por vida [85]. Bajo un régimen de atención cuasilognormal, la mayoría de los autores se encuentran en los peldaños inferiores de la escalera por construcción. La preimpresión mediana vive en la cola larga de una distribución lognormal que su autor no puede ver, y aparece a través de mecánicas de clasificación que favorecen a los afiliados. Es solicitada por depredadores antes de ser leída por pares, y ha perdido la clasificación que una vez la ubicaba. La escala coloca un artículo en algún lugar de esa escalera, y la angustia que lleva la pregunta es producida por la escala faltante más que por el número.
Nada de esto es peculiar a una plataforma, y el evento no es sin precedentes. ResearchGate retiró su propia puntuación compuesta RG ampliamente criticada en agosto de 2022 [130], después de crítica metodológica sostenida [90], y en 2022-2023 docenas de escuelas de derecho estadounidenses, lideradas por Yale y Harvard, se retiraron de los rankings de escuelas de derecho de U.S. News [13]. Retirar una medida controvertida no es un acto cosmético, porque la medida nunca fue una descripción pasiva: la literatura de reactividad que surgió de los rankings de escuelas de derecho muestra que una clasificación pública remodela el comportamiento de aquellos a los que clasifica [58][132], por lo que tanto su imposición como su eliminación cambian la conducta en lugar de meramente cambiar lo que se informa. Un contador y su marco comparativo son conjuntamente una métrica, y retirar el marco mientras se mantiene el contador deja a cada usuario con un conteo sin nada con lo que compararlo. La interpretabilidad, la disponibilidad de una distribución pública para un contador público, debe tratarse como una dimensión de calidad de primera clase de cualquier indicador, junto con la validez y la confiabilidad. Las métricas superan su infraestructura interpretativa, y una métrica sin contexto es ruido, una instancia de la disciplina general de lectura escéptica de números descontextualizados [15]. La misma métrica con contexto es una calibración que empodera a los autores, mejora la comunicación académica y sustenta la confianza en los repositorios que la muestran.
El marco requiere algunos hábitos ordinarios de su usuario. Compara lo similar con lo similar, y mantén el alcance separado de la conversión. Lee trayectorias en lugar de totales, trata cada número como fechado, y no dejes que ningún conteo viaje sin su fuente, ventana y limitaciones.
10.2 Recomendaciones para autores
Los autores pueden actuar ahora, sin esperar nuevos datos. Tomen capturas de pantalla fechadas de contadores a nivel de artículo, que preservan el contexto: después de su cese, son el único registro de posición que permanece bajo el control del autor, y alimentan el registro comunitario de la Sección 8.8. Informen los recuentos solo con su marco (antigüedad, campo, cohorte y fuente), siguiendo el protocolo de expediente de la Tabla 13, en el que cada número lleva su fuente, ventana temporal y limitaciones. Lean el panel de control diagnósticamente en lugar de emocionalmente: separen el alcance de la conversión (Tabla 9), traten una primera semana sin descargas como un comportamiento normal previo a la distribución [53], y comparen con tres a cinco artículos de colegas publicados en el mismo mes en lugar de hacerlo contra la cola visible, cuyos números de hito en circulación garantizan una mala calibración bajo un régimen de cola pesada [85][180]. Traten el correo de solicitud como un fenómeno de extracción de datos, no como reconocimiento, y no como evidencia sobre los contadores [61][107][144].
10.3 Recomendaciones para evaluadores
Las instituciones que importaron descargas de SSRN como moneda de evaluación [12][18][161][52] enfrentan una cuestión de gobernanza ahora que la escala pública de la moneda ha desaparecido. Los recuentos brutos de descargas no deben entrar en archivos de contratación, promoción o titularización: son manipulados exactamente en los umbrales que importan [44], varían hasta ocho veces en todos los subcampos dentro de una sola red [168], y ahora son opacos en términos de puntos de referencia. La unidad mínimamente defendible es un percentil dentro de un cohorte definido (mismo campo, mismo grupo etario, mismo período de publicación) acompañado de su fuente y antigüedad, y la evidencia de uso debe complementar, no sustituir, las citas, la evaluación de pares y el juicio sustantivo [108][109][110]. El consenso establecido sobre la reforma de la evaluación de investigación funciona sobre ese principio. La injunción central de DORA es no usar un número único o un proxy de medio como sustituto para evaluar la investigación en sí [8], y el Leiden Manifesto insiste en que la evaluación cuantitativa apoye, no suplane, el juicio experto cualitativo [78]. La revisión de Metric Tide refuerza esa insistencia, pidiendo indicadores que sean robustos, modestos, transparentes, diversos y reflexivos y utilizados en apoyo de la evaluación de expertos en lugar de como sustituto de ella [173], como lo hace también el más reciente CoARA Agreement on Reforming Research Assessment, cuyas varias centenas de organizaciones signatarias se comprometen con una evaluación cualitativa apoyada por, no suplantada por, el uso cuantitativo responsable [183]. El consenso completo se aplica con toda su fuerza a un contador de descargas cuya escala pública ha sido eliminada. Dos de las cinco dimensiones de Metric Tide se refieren directamente al método propuesto aquí: la diversidad es la normalización de campo en la que este artículo insiste, y la reflexividad es la postura de la Sección 8.7, en la que el artículo mide su propia atención. El sucesor de la revisión orientado hacia el REF lleva los mismos cinco principios a la práctica actual del Reino Unido [184]. Este consenso es en sí mismo una expresión de la crítica más amplia del exceso métrico en la vida institucional [113]. Los comités de evaluación deben esperar y aceptar el formato de protocolo de la Tabla 13 (la forma contextualizada y narrativa de evidencia que los formatos de evaluación emergentes como el Résumé for Research and Innovation (R4RI) del Reino Unido están construidos para llevar [186]) en lugar del lenguaje de clasificación "top 10%" retirado. En los Estados Unidos el mismo mecanismo de lenguaje de expediente es el foco de la Higher Education Leadership Initiative for Open Scholarship (HELIOS Open), que trabaja con universidades para reescribir criterios de promoción y titularización [189]; la línea de uso contextualizado especificada aquí es exactamente la rúbrica concreta que tales reformas a menudo carecen de.
10.4 Recomendaciones para la plataforma
Retirar los rankings sin un contexto de reemplazo cambia una señal defectuosa por ninguna señal. Las consecuencias van más allá de la comodidad de los autores. Si la desaparición enfría los nuevos envíos, el resultado del volumen de envíos especificado en la Sección 8.5, es una cuestión empírica abierta sobre la propia salud de la plataforma. El marco implica una dirección de producto concreta que no recrea el aparato de tabla de clasificaciones que SSRN eligió retirar [149]:
1. Bandas de percentil anonimizadas por disciplina y antigüedad del artículo. Mostrar la posición de descargas y visualizaciones de cada artículo como una banda de percentil aproximada dentro de su cohorte disciplina-por-antigüedad: información que todo autor necesita, publicada de una forma que no identifica a nadie, no crea clasificaciones, y reduce la dinámica donde el ganador se lleva todo de las listas top-N. El contexto de percentil preserva la privacidad mientras restaura la legibilidad. El formato de visualización objetivo es exactamente el abanico de referencia específico de la antigüedad de la Figura 14.
2. Visualización normalizada por tiempo. Mostrar comparaciones ajustadas por antigüedad en lugar de solo conteos de por vida, de modo que un artículo de 14 días de antigüedad nunca se compare implícitamente con trabajo que ha acumulado atención durante años.
3. Separar alcance de conversión. Reportar visualizaciones de resúmenes y descargas como señales distintas con su proporción, en lugar de invitar a una lectura de un solo número que confunda invisibilidad con rechazo.
4. Clases de referencia transparentes. Cualquier indicador comparativo debe indicar la población, el campo, el período y la banda de edad con la que se compara; un «top X%» sin etiquetar es científicamente no informativo. El Apéndice D especifica los diez campos de divulgación que una publicación de percentil versionada debe llevar, desde definiciones de población y cohorte hasta reglas de privacidad de celda mínima e historial de versiones citables.
5. Auditar el diseño para la ventaja acumulativa. La clasificación, distribución de alertas, clasificación de búsqueda y señales de popularidad visible asignan atención escasa y deben ser evaluadas por sus efectos distributivos. Los diseños empíricos de las Secciones 8.4–8.5 son directamente utilizables para tal auditoría.
6. Planificar el residuo interpretativo al retirar características. Cuando se retiran características comparativas, la pérdida interpretativa debe ser evaluada y mitigada con el mismo cuidado que la migración de datos, a través de distribuciones archivadas, percentiles de resumen publicados, o una transferencia explícita a la comunidad, ya que una métrica que no puede ser leída no puede informar.
7. Mecánica de contacto resistente a la cosecha, reduciendo la externalidad de solicitud de visibilidad documentada en la Sección 7 [107][159]. Un candidato concreto: retrasar u ofuscar la exposición pública de las rutas de contacto del autor durante aproximadamente las primeras 48–72 horas después de la publicación, la ventana en la que la distribución legítima típicamente aún no ha comenzado pero la cosecha programática es más probable. El efecto de cualquier medida de este tipo debe ser evaluado empíricamente, no asumido. El intercambio es real, ya que ocultar la información de contacto también podría desventajar exactamente a los principiantes que dependen de la retroalimentación directa.
8. Un registro de filtrado público y mecánicas de distribución documentadas. Publicar un registro de estilo LogEc de lo que los filtros de integridad descartan, y documentar cómo operan la distribución de eJournal y la selección de resumen. La infraestructura adyacente RePEc/LogEc demuestra que tal transparencia es factible a escala [99][129], mientras que SSRN actualmente describe sus filtros sin publicar su historial [144] (Tabla 6). Cuando el filtrado está documentado, las reafirmaciones de un contador pueden ser leídas como eventos de medición en lugar de eventos reputacionales.
9. Hacer el historial de exposición legible. Una página de artículo o panel de autor debe distinguir entre publicación pública, asignación de clasificación, distribución curada, confirmación de indexación y reafirmaciones principales de contadores, de modo que un autor pueda separar «aún no expuesto» de «expuesto pero no convertido». Este es el equivalente del lado de la plataforma de la lectura del régimen de exposición de la Sección 5.6, y el tratamiento más económico para el estado del panel más ansioso, el cero inicial.
10.5 Recomendaciones para la comunidad de investigación
La comunidad no necesita esperar a la plataforma. El registro de la Sección 8.8 (instantáneas de panel autodeclaradas y fechadas contribuidas bajo un protocolo abierto) puede producir la primera distribución de descargas nuevas en una década. Los dos estudios de datos públicos de la Tabla 17 (1 y 2) son ejecutables por cualquier investigador dentro de los límites de acceso señalados en la Sección 9, mientras que los dos estudios de participantes (3 y 4) requieren voluntarios y las aprobaciones éticas indicadas en las Declaraciones. La Cienciometría debe tratar la interpretabilidad métrica como parte de su materia de estudio: el caso presente, en el que los contadores de una década sobrevivieron a su única escala pública, es improbable que sea el último. La replicación distribuida del protocolo de publicación instrumentado, el mantenimiento comunitario de tablas de percentiles (y de la calculadora pública orientada al autor construida sobre ellas, Secciones 8.8 y 8.10), y la evaluación del impacto interpretativo de los cambios de plataforma son todas contribuciones de investigación por derecho propio, y cada una de ellas convierte el trabajo de reparación de este artículo en prevención.
10.6 Cierre
La pregunta «¿qué significan mis siete descargas?» ha recorrido este artículo porque es la pregunta que los casi dos millones de autores de la plataforma se quedaron sosteniendo el 15 de julio de 2026 [49][149]. La respuesta reunida aquí no es ni tranquilidad ni alarma, sino calibración. El número es consistente con la evidencia de conversión disponible pero sigue siendo un resultado de detección; la ansiedad es fabricada por la escala faltante, que puede reconstruirse, en parte de la literatura, como lo hicieron las secciones 3–6, y en parte de datos nuevos, como especifica la sección 8.
El artículo se abrió con la pregunta que todo autor se queda sosteniendo:
«¿Qué significan mis 7 descargas?»
El marco lo reemplaza con esto:
«¿Dónde se sitúa este trabajo entre trabajos comparables de la misma edad, campo, cohorte e historial de distribución? ¿Su restricción es alcance o conversión? ¿Y está siendo recuperado y acreditado por los sistemas a través de los cuales los lectores ahora descubren investigación?»
Esa es una pregunta que la cienciometría puede responder, y este artículo ha especificado cómo.
Lo que registran los contadores son eventos, y solo eventos. Las vistas no son descargas; las descargas no son lectura; una media no es una norma; un contador no es un veredicto; la solicitud no es reconocimiento; la recuperación por IA no es atribución fiel; y un número sin escala no es información.
Mientras las plataformas muestren un contador separado de su contexto, los autores, evaluadores y plataformas seguirán leyendo hechos distributivos como veredictos personales. El acceso abierto ganó la batalla que libró (el derecho a publicar y descargar sin barreras de precio) y, al ganarla, expuso una batalla que nunca libró: la asignación de atención. Los autores pueden leer contadores con campo, edad y conversión. Las métricas de SSRN siguen teniendo valor, pero solo para un autor que entienda qué significan.
Apéndice A. Situación → Guía de acción
La tabla 23 condensa las secciones 4–6 en las situaciones que los autores más frecuentemente reportan [161][127][139]. Su columna central establece solo lo que la evidencia reunida autoriza, con fuentes y ventanas. La columna de advertencias lleva la limitación que debe acompañar cada lectura. Los números que aparecen aquí son los de las tablas 6–7 y la figura 6 del texto principal.
Tabla 23. Situación → qué dice la evidencia → qué hacer.
| # | Tu situación | Qué dice la evidencia | Qué hacer | Fuentes y advertencias |
|---|---|---|---|---|
| 1 | «7 descargas y 40 visualizaciones de resumen en el primer mes.» | La conversión es 17,5 %, dentro de la banda entre estudios de 11–19 % como estimación puntual, aunque el intervalo de Clopper–Pearson del 95 % en 7/40 (≈7,3–32,8 %) es amplio y se ubica en la banda; el trabajo mediano de LSN alcanzó 63 descargas solo después de dos años, y el trabajo mediano de marketing se situó en 87 a una edad mediana de 16 meses — anclajes de muestra madura, no ajustados por edad para una lectura del día 20. Un resultado de detección con un intervalo amplio, no evidencia de fracaso. | Continúa el calendario de observación de la tabla 11; clasifica la trayectoria no antes del día 60–90. | Banda: [18][139][172]; medianas: [139] (LSN 2012), [83] (Marketing 2025). Todos los anclajes son de una sola disciplina y envejecidos; la conversión de 7/40 es una estimación de detección de intervalo amplio, no ajustada por edad a los anclajes maduros. |
| 2 | «Cero descargas en la primera semana.» | Pre-distribución normal: la clasificación está curada y puede tomar hasta 45 días para temas cargados; las alertas de eJournal impulsan vistas tempranas y continúan después de la puesta; la indexación de Google Scholar toma 6–9 meses o más. | Confirma la publicación pública; confirma la clasificación de eJournal; verifica si el trabajo está indexado bajo su título exacto — la prueba de indexación más barata disponible; espera que pase el ciclo de anuncio; solo entonces lee los contadores. | [53][147][57][55]. Cambios en la redacción de la página de soporte; re-verificar con fechas de acceso. |
| 3 | «Muchas visualizaciones, pocas descargas — conversión muy por debajo del 11 %.» | Consistente con un desajuste resumen–texto: los lectores llegan y se van en el resumen. Las variables de empaque (título, resumen, palabras clave) son los mecanismos de atención más robustamente asociados con contadores. | Revisa el título y el resumen; re-observa la conversión en la siguiente ventana antes de más cambios. | [139][168][172]. La lectura causal «conversión baja = resumen débil» es una hipótesis de detección, no un diagnóstico validado. |
| 4 | «Conversión muy por encima de la banda, o un pico de vistas repentino.» | Tráfico que la navegación de resúmenes no explica — vínculos de medios o agregadores, o tráfico no humano que los filtros aún no han eliminado. | Identifica la fuente externa (cobertura, listas de correo); no cites el pico como lectura sin corroboración. | [116][138][144][102 — Mecanismo de pre-obtención de enlaces seguros, con la advertencia de que el propio filtrado de SSRN ya puede excluir ese tráfico]. |
| 5 | «Mi contador bajó, o los números fueron replanteados.» | Las plataformas revisan los contadores cuando cambian las reglas de filtrado; RePEc descartó la gran mayoría del tráfico bruto en episodios documentados (robots ≈74% de vistas en 2007; >99,5% del tráfico de IDEAS en septiembre de 2025). | Trátalo como un evento de medición; verifica tus capturas de pantalla fechadas; nunca lo reportes como lectura perdida sin corroboración. | [144][69][99][129][66]. |
| 6 | «Las clasificaciones se han ido y no sé dónde me sitúo.» | No queda marco de percentil público, y ninguno representativo de la plataforma puede recopilarse externamente. La sección transversal de archivo del apéndice E proporciona una distribución de referencia basada en muestras, y la comparación emparejada sigue siendo el sustituto de los percentiles de la plataforma. | Construye un micro-benchmark de 3–5 trabajos de pares publicados el mismo mes y monitoréalos según tu propio calendario; opcionalmente calcula la relación de tus descargas a una mediana de cohorte emparejada. | [149][51]; anclajes [139][83][85]. La relación no tiene bandas de interpretación calibradas (sección 6.3). |
| 7 | «Un comité verá mis conteos.» | Las líneas de clasificación en expedientes son práctica documentada, y su marco comparativo se ha ido; el lenguaje de banda con fuentes, calificadores de campo y triangulación de citas sobrevive al escrutinio donde los conteos brutos no. | Aplica el protocolo de siete pasos de la tabla 13: preservar, traducir, triangular, normalizar por campo, complementar, integridad, evaluación de expertos. | [12][95][33][52][77][108]. Las descargas miden la demanda, no la calidad; el historial de manipulación [44] es conocido por los evaluadores. |
| 8 | "Las invitaciones depredadoras comenzaron a llegar días después de que publiqué." | Un subproducto documentado de la extracción de plataformas de preprints; auditorías adyacentes reportan decenas de invitaciones por quincena por académico. El volumen señala visibilidad para raspadores, no reconocimiento de lectores. | Nunca pague; verifique los lugares a través de Cabells y Think. Check. Submit.; enrute la correspondencia a través de una dirección dedicada; vea la Tabla 14 para la tipología. | [107][159][9][84][63][32][136]; [B-1] (la lista de Beall no funciona desde 2017). Las regularidades de tiempo no se miden; la pantalla "días-después-de-la-publicación" es cualitativa. |
| 9 | "La verificación de similitud de una revista marcó mi envío como coincidente con mi propio preprint de SSRN." | El sistema de cribado está funcionando según lo diseñado: los preprints registrados como Crossref Posted Content forman parte del corpus de comparación, y la orientación de iThenticate establece que una coincidencia de preprint del mismo autor no es plagio. La publicación de un documento de trabajo está permitida por las políticas de previa publicación de la mayoría de revistas, pero las políticas varían y se debe verificar la revista de destino; las principales excepciones están en medicina y campos clínicos. | Identifique la fuente marcada ante el editor gestor como su propio preprint con marca de tiempo; no retire el preprint; para venues médicas y clínicas, verifique la política de preprint de la revista de destino (p. ej., a través del registro Sherpa Romeo) antes del envío. | [81][36]; Sección 4.5. Las políticas de las revistas varían y cambian; verifique la política actual de la revista de destino en lugar de confiar en la regla general. |
| 10 | "Las Clasificaciones desaparecieron — ¿debo trasladar mis artículos a ResearchGate o Academia.edu?" | No se documenta migración de autores post-cierre; los contadores de descargas no son transferibles entre plataformas; y las plataformas comparables tienen el mismo problema de interpretabilidad — ResearchGate retiró su propio RG Score compuesto en agosto de 2022 después de la crítica metodológica. | Mantenga el registro de SSRN y complemente en lugar de reubicar: deposite el mismo artículo en un repositorio institucional o temático (Tabla 13, paso 5), preserve instantáneas de contadores con fecha, y no elimine y reenvíe en otro lugar, lo que pierde contadores acumulados. | [130][90][149]; [47][146] (complemento de repositorio); [161] (el contador de una plataforma no dice nada sobre otros canales); [B-7] (eliminar y reenviarse reinicia las métricas). La ausencia de migración documentada es ausencia de evidencia, no prueba de estabilidad. |
Prácticas comunitarias no verificadas (hipótesis candidatas para la agenda de la Sección 8). Las siguientes recomendaciones circulan en comunidades de autores y aparecen en borradores anteriores de guías prácticas; ningún estudio las respalda, y se registran aquí como hipótesis comprobables y no deben citarse como hallazgos: (a) limitación de clasificaciones eJournal a tres (uno núcleo, uno amplio, uno interdisciplinario) en lugar de usar más de los siete permitidos [53][168]; (b) citar documentos de trabajo de SSRN para que sus autores sean notificados a través de alertas de Google Scholar y correspondan con atención; (c) ocultación de la dirección de correo electrónico del perfil durante los primeros catorce días después de la publicación para reducir la extracción; (d) carga de una revisión menor el día 3 para activar el re-anuncio (SSRN solo documenta que las revisiones in situ conservan contadores y URL [B-7]); (e) cualquier incidencia numérica adjunta a la pantalla "la invitación dentro de 96 horas es depredadora"; (f) divulgación directa a tres a cinco autores citados en el artículo (un mensaje breve que señale la cita de su trabajo de SSRN) como canal a una primera audiencia legítima, enmarcado como comunicación académica ordinaria en lugar de promoción. Cada uno es falsable con los diseños observacionales de la Sección 8; hasta que se pruebe, su forma de citación adecuada es "práctica comunitaria, no verificada".
La Tabla 24 reordena el manual cronológicamente. Cada celda apunta a una sección y sus fuentes. La vista de línea de tiempo responde la pregunta que los autores realmente hacen ("¿qué hago ahora?") en el orden en que surgen las situaciones, y complementa la Tabla 23 indexada por situación.
Tabla 24. El manual como línea de tiempo: tres fases × tres ejes. Todas las celdas resumen evidencia e instrucciones ya indicadas en las Secciones 4–7; las prácticas comunitarias no verificadas se excluyen (ver la lista anterior).
| Fase | Mecánica de plataforma y medición | Audiencia y distribución | Defensa contra solicitudes |
|---|---|---|---|
| Antes de publicar | Trate el título y el resumen como la superficie de conversión y redáctelos en consecuencia (§6.4; [139][172]); planifique clasificaciones eJournal — se permiten hasta siete, y más clasificaciones se asocian con más descargas y menos ceros [53][168] | Identifique la cohorte de micro-referencia de 3–5 artículos para rastrear junto con su propio artículo (§6.3) | Enrute la correspondencia a través de una dirección dedicada antes de que los metadatos se hagan públicos (§6.6) |
| Al publicar | Confirme la publicación pública y la clasificación eJournal; registre la línea de base del día 1 de la cuadrícula de la Tabla 11 (§6.1) | Las alertas de correo electrónico de eJournal son el canal push principal de la plataforma y continúan post-cierre [147][57] | Espere solicitudes como una consecuencia predeterminada de la visibilidad, no como una señal de mérito (§6.6; [159][63]) |
| Primeras semanas (días 1–45) | Lea un cero temprano como pre-distribución, no rechazo (§6.2 regla iv; [53]); registre contadores en el cronograma de la Tabla 11; clasifique la trayectoria no antes del día 60–90 (§6.3) | Aplique palancas externas legítimas cuando sea apropiado — la cobertura de blog y lista produjo picos tempranos medibles (§6.4; [116][72]) | Nunca pague; examine cualquier lugar invitante ([B-1]; Think. Check. Submit. [159]); verifique las invitaciones contra la tipología de la Tabla 14; nunca lea el volumen de spam como lectura (§7.6) |
Apéndice B. Plantilla de Informe de CSAB
Una declaración CSAB mínima dirigida al autor o evaluador (Sección 5.5; Tabla 10) reporta:
A la antigüedad del artículo [X días], el artículo tenía [V] visualizaciones de resumen y [D] descargas validadas. En relación con [campo definido / cohorte / clase de referencia de usuario nuevo], su percentil de alcance fue [RV], su percentil de descarga [RD] y su percentil de conversión ajustado por contracción [RC]. El artículo [había recibido / no había recibido] distribución curada documentada en esa observación. Entre [edad 1] y [edad 2], su posición normalizada [aumentó / se mantuvo estable / disminuyó]. Estos indicadores describen la difusión y no establecen la calidad o corrección de la investigación.
Hasta que se haya estimado un panel de referencia contemporáneo (Secciones 5.5, 8.3), los campos de percentil deben permanecer en blanco: ningún valor puede ser ingresado desde la intuición, desde promedios de toda la plataforma, o desde muestras antiguas. Se pueden reportar anclajes históricos junto a la plantilla: la mediana LSN de 2012 de 63 descargas a los dos años [139] y la mediana de red de marketing de 2025 de 87 [83], cada una con su muestra, campo y edad establecidos, pero nunca sustituidos por la clase de referencia faltante. La plantilla es el equivalente a nivel de oración de la etapa de Traducción del protocolo del expediente (Tabla 13, paso 2).
Apéndice C. Diccionario de Variables del Panel
La Tabla C1 establece el registro de intervalo de artículo mínimo para el panel central de la Sección 8.3: el esquema más pequeño suficiente para reproducir las estimaciones de CSAB de la Sección 5.5 y los análisis de eventos de plataforma de las Secciones 8.4–8.5. Los lanzamientos públicos reemplazan identificadores directos con claves de estudio estables dondequiera que la vinculación no sea analíticamente necesaria, y las contribuciones del registro (Sección 8.8) utilizan el subconjunto de este esquema indicado allí.
Tabla C1. Esquema de datos de intervalo de artículo mínimo para el panel central.
| Dominio | Variable | Definición o formato |
|---|---|---|
| Identidad | paper_id | Identificador de estudio estable |
| Identidad | ssrn_abstract_id | Identificador de plataforma; con hash o restringido en lanzamientos públicos |
| Temporización | posted_at | Fecha de primer anuncio público |
| Temporización | observed_at | Marca de tiempo de observación de métrica (cuadrícula de la Tabla 11) |
| Temporización | paper_age_days | Días desde el primer anuncio |
| Uso | abstract_views_cum | Vistas acumulativas públicas de página de resumen |
| Uso | downloads_cum | Descargas acumulativas validadas públicas |
| Uso | views_interval, downloads_interval | Incrementos de la observación válida anterior |
| Exposición | classification_ids | Todas las clasificaciones de eJournal activas en la observación |
| Exposición | distributed_status, distributed_at | Indicador y fecha de distribución curada, donde se consintió |
| Exposición | search_indexed | Estado de índice externo definido por protocolo (prueba de título exacto) |
| Documento | title_frozen, abstract_frozen, keywords, page_count, doi | Metadatos de manuscrito observados más tempranamente, congelados en la primera observación |
| Documento | authors_frozen, affiliations_frozen | Nombres de autores, orden y afiliaciones en la primera observación |
| Control de versiones | revision_id, revision_at, material_change_flag | Historial de versiones con un indicador de cambio material |
| Autores | author_count, platform_newcomer, prior_ssrn_papers | Estructura del equipo e historial de plataforma anterior al anuncio (definiciones de la Sección 8.3) |
| Reputación | prior_citations, prior_works, institution_measure | Congelado antes del anuncio focal y normalizado por campo |
| Calendario | day_of_week, week, season, holiday_flag | Controles temporales predefinidos [178] |
| Posteriores | citations_6m, citations_12m, citations_18m, publication_status | Resultados de validación posteriores con fuente y fecha (horizontes de la Sección 8.9) |
| Auditoría | collection_method, source_url, quality_flag | Procedencia, ruta de acceso y documentación de anomalías (bandera, no eliminar; Sección 8.3) |
Apéndice D. Especificación de Transparencia de Punto de Referencia
Para evitar que el punto de referencia de percentil de la Sección 8.8 y cualquier sucesor mantenido por la plataforma o por la comunidad (Sección 10.4, recomendaciones 1 y 4) reproduzcan la opacidad de punto de referencia que este artículo critica, cada lanzamiento de percentil se publica con una especificación acompañante versionada que especifica:
1. la población de artículos elegibles, redes, tipos de documento y exclusiones;
2. fechas de cohorte de anuncio y edades de observación;
3. la regla de asignación de campo, incluyendo el tratamiento de clasificaciones múltiples;
4. las definiciones de vistas, descargas, actores únicos, repeticiones y tráfico validado en vigor en el lanzamiento;
5. la mediana, rango intercuartil, P10/P25/P75/P90/P95, participación cero, coeficiente de Gini y participaciones principales;
6. tamaños de muestra e intervalos de incertidumbre para cada clase de referencia reportada;
7. el manejo de valores faltantes, retiros, revisiones, fusiones y reafirmaciones de contraparte;
8. las variables de distribución y promoción externa incluidas en cualquier ajuste;
9. reglas de privacidad y celda mínima: para el registro colaborativo de la Sección 8.8, donde celdas pequeñas campo-por-edad podrían de otro modo identificar a contribuyentes individuales, este elemento es una restricción vinculante regida por la ley de protección de datos (en el Reino Unido, GDPR del Reino Unido y la Ley de Protección de Datos 2018), no una formalidad. El control de divulgación debe extenderse más allá de la anonimización simple a k-anonimidad o agregados con ruido añadido (diferencialmente privados) para celdas sparsas, y una regla de uso permitido debe vincular el registro a la interpretación en lugar de evaluación, prohibiendo su uso para contratación, promoción, asignación de recursos o reensamblaje en cualquier tabla de líderes pública;
10. un historial de versiones y una referencia permanente y citable para el lanzamiento.
Ninguna puntuación compuesta puede reemplazar estos componentes. Razones simples respecto a una mediana de cohorte (la alternativa sin calibración de la Sección 6.3) pueden ser inestables cuando la celda del denominador es pequeña y pueden sugerir falsamente que «el doble de la mediana» corresponde a un percentil fijo en campos de formas diferentes. Los informes orientados a autores utilizan por lo tanto estimaciones de percentil bajo la contracción empírica de Bayes ya especificada para celdas sparsas en la Sección 8.3, mientras que las distribuciones brutas permanecen disponibles para auditoría.
Apéndice E. Una sección transversal de archivo independiente de la distribución de descargas
Para obtener evidencia reciente de distribución completa, la síntesis de las Secciones 3 y 5 se basa en una única instantánea publicada [83]. Este apéndice informa sobre una sección transversal independiente y reproducible compilada para este artículo que corrobora la estructura distribucional en todos los campos, utilizando únicamente datos públicos y sin acceso privilegiado a la plataforma. Es una reconstrucción de archivo única con un sesgo ascendente conocido, ofrecida como corroboración de forma, distinta del panel preregistrado de la Sección 8.6, que observa artículos prospectivamente desde su publicación.
Método. Se extrajo una muestra aleatoria de artículos de SSRN de OpenAlex (fuente S4210172589, "SSRN Electronic Journal") en veintitrés semillas aleatorias independientes. Para cada artículo muestreado se leyeron los contadores de descargas y visualizaciones de resumen anteriores al retiro de la captura más reciente del artículo en Internet Archive, localizada a través del punto final de disponibilidad pública de Wayback Machine, en lugar de desde el sitio activo, que está protegido por acceso (Sección 4) y ya no publica marcos comparativos. Leer los contadores de copias archivadas en lugar de consultar la plataforma mantiene el procedimiento limitado por velocidad, respetuoso con la plataforma y reproducible a partir de los identificadores publicados. Debido a que los contadores por artículo sobrevivieron al cierre de Rankings sin cambios, y solo se retiraron los Rankings comparativos, una captura fechada después del 15 de julio de 2026 sigue siendo una lectura válida de los recuentos acumulativos de un artículo. Por lo tanto, las instantáneas no se restringieron a la ventana anterior al cierre, y la fecha de captura se retiene solo para calcular la antigüedad del artículo. Se descartaron las capturas que devolvieron un desafío de bot intersticial en lugar del contenido de la página. De 2,600 artículos muestreados, el 64% tenía una captura archivada utilizable y el 52% produjo un recuento de descarga legible por máquina, dando n = 1,360 artículos que abarcan veinticinco campos, catorce de ellos con al menos veinte artículos, y antigüedades de artículos desde el año de publicación hasta más de dos décadas. El conjunto de datos se publica como appendixE-wayback-downloads.csv y se deposita en https://doi.org/10.5281/zenodo.22285871, donde el mismo archivo lleva el nombre study1-wayback-downloads.csv. Dos propiedades de la muestra limitan lo que se puede leer de ella. Las fechas de publicación incluyen solo el año, no el mes: 1,358 de los 1,360 registros tienen la marca del 1 de enero, porque OpenAlex informa sobre publicaciones de SSRN con resolución de año. La antigüedad se calcula por lo tanto como año de captura menos año de publicación, informada en años completos, y no se puede defender ningún intervalo más corto. Las capturas también se concentran en el tiempo: 688 de ellas, la mitad de la muestra, caen en un único rastreo entre el 25 de abril y el 7 de mayo de 2025, y el 81,5 por ciento caen en 2025, por lo que la antigüedad de un artículo aquí corre cerca de ser una reformulación de su año de publicación y los dos no pueden separarse. La primera de estas es eliminable. La línea de publicación "Posted: DD Mon YYYY" aparece en las mismas capturas archivadas, por lo que las fechas completas pueden recuperarse mediante re-análisis, lo que la puerta de acceso del sitio activo no impide. La Tabla E1 hace explícita esta atrición.
Tabla E1. Construcción de la sección transversal de archivo y atrición en cada etapa.
| Etapa | Artículos | % del inicial | % del anterior |
|---|---|---|---|
| Registros de OpenAlex muestreados aleatoriamente (SSRN Electronic Journal) | 2,600 | 100.0 | — |
| Captura utilizable de Internet Archive localizada | ≈1,660 | 63.8 | 63.8 |
| La captura contenía un recuento de descarga legible por máquina | 1,360 | 52.3 | 81.9 |
| Muestra analítica final | 1,360 | 52.3 | 100.0 |
Resultados. La sección transversal reproduce cada característica cualitativa que sostienen los trabajos publicados (Tabla E4). Las descargas tienen un sesgo fuertemente hacia la derecha: media 219, mediana 60 (IC bootstrap 95% 55–69), razón media-a-mediana 3,65, con la media superando el percentil 75 (158). También exhiben una cola superior pesada (percentil 95 816, más de trece veces la mediana; Gini 0,75, IC 95% 0,71–0,78). En el logaritmo, la distribución es cercana a simétrica (asimetría de ln descargas ≈ 0,18), coherente con log-normalidad aproximada en el cuerpo observado de la distribución, propiedad que Kakushadze solo pudo ajustar en las listas superiores (Sección 3.4). La conversión descargas-a-visualizaciones tiene una mediana del 16,2% y una media del 17,3%, dentro de la banda de estudios cruzados 11–19% (Sección 5.2). Las descargas medianas difieren entre campos a la misma antigüedad del artículo. Manteniendo la banda de edad fija, la dispersión entre la mediana de campo más alta y la más baja varía de aproximadamente tres a aproximadamente cinco veces, la cifra exacta depende de la banda y del tratamiento de campos escasamente muestreados. Agrupada en todas las edades, la dispersión alcanza aproximadamente doce veces, y esa cifra mayor refleja la composición cambiante de la muestra: Engineering aporta entre el 21 y el 27 por ciento de los artículos con antigüedad de tres años o menos y como máximo el 5 por ciento de los de nueve años o más, mientras que Economics aporta entre el 9 y el 12 por ciento y entre el 37 y el 54 por ciento de los mismos grupos, y la edad mediana de un artículo de Economics aquí es de nueve años frente a un año para Engineering. La dirección concuerda con el multiplicador de campo de la Sección 3.6. Las magnitudes no son comparables, porque ese multiplicador se basa en medias de vida útil en 94 subdisciplinas de una sola disciplina y esta dispersión en medianas en 25 disciplinas, y ninguna se ajusta por edad. Las descargas medianas son mayores en las bandas de edad más antiguas, con intervalos de confianza bootstrap 95% que no se superponen entre la mayoría de bandas adyacentes (mediana 12 en el año de publicación, 172 más allá de diez años), que es la dependencia de la edad que motiva el argumento de clase de referencia. Dentro de un solo campo, la diferencia se concentra en los primeros tres o cuatro años: entre la banda de cinco a diez y la banda más allá de diez no alcanza significancia (Mann-Whitney p = 0,57 para Economics, 0,82 para Social Sciences, 0,23 para Business). Aproximadamente una cuarta parte del gradiente agrupado es composición de campo en lugar de edad. La edad en esta muestra también se ajusta aproximadamente a una reformulación del año de publicación, ya que la mitad de las capturas se realizaron en un rastreo entre el 25 de abril y el 7 de mayo de 2025 y el 81,5 por ciento cae en 2025, por lo que la edad y la cohorte no se pueden separar aquí y las bandas informan niveles en lugar de la trayectoria de ningún artículo individual. La media de la muestra (219) coincide con la media publicada de la red de marketing (221) [83], mientras que la mediana de la muestra (60) se sitúa al nivel de la mediana legal de estilo de censo (63) [139]. La Tabla E2 proporciona la distribución de descargas por antigüedad del artículo y la Tabla E3 por campo, ambas con intervalos de confianza bootstrap 95% y tamaños de muestra. Los intervalos de confianza son más amplios para los campos más pequeños, por lo que la dispersión de campos se describe como aproximadamente un orden de magnitud en lugar de un múltiplo único y preciso. El caso de apertura del artículo se puede leer directamente contra la muestra. Entre artículos menores de dos años con 30 a 50 visualizaciones de resumen, la banda en la que cae ese caso, el recuento mediano de descargas es 7, con un rango intercuartílico de 4 a 11 (n = 42). El caso en el título es el caso típico para su banda de visualización y edad. En el año de publicación, el 35 por ciento de la muestra registra 7 descargas o menos, el recuento mediano de visualización de resumen es 66, y la propia conversión del caso del 17,5 por ciento se sitúa en el percentil 57 de la muestra. La banda de conversión 11–19% de la Sección 5.2 es una banda de medianas en lugar de artículos: el 41 por ciento de la muestra cae dentro de ella, el 23 por ciento por debajo y el 36 por ciento por encima. La mitad de la muestra, el 51 por ciento, se sitúa por debajo de la mediana legal de estilo de censo de 63 [139], lo que coloca el rango incipiente en la parte poblada de la distribución.
Tabla E2. Distribución de descargas por antigüedad del artículo en la sección transversal del archivo.
| Antigüedad del artículo | n | Mediana [IC 95%] | Media | RIC (P25–P75) |
|---|---|---|---|---|
| año de publicación | 203 | 12 [11–14] | 33 | 5–21 |
| 1 año | 253 | 25 [23–29] | 94 | 15–44 |
| 2–4 años | 375 | 52 [47–57] | 110 | 28–100 |
| 5–9 años | 188 | 130 [110–151] | 384 | 72–374 |
| 10 años o más | 341 | 172 [157–189] | 453 | 96–336 |
| Todos los artículos | 1,360 | 60 [55–69] | 219 | 23–158 |
Tabla E3. Distribución de descargas por campo (campos con n ≥ 20) en la sección transversal del archivo.
| Campo (n ≥ 20) | n | Mediana [IC 95%] | Media | RIC |
|---|---|---|---|---|
| Economics | 285 | 150 [134–169] | 443 | 76–302 |
| Business | 161 | 150 [126–188] | 335 | 72–330 |
| Psychology | 24 | 107 [35–192] | 179 | 32–229 |
| Social Sciences | 241 | 85 [78–117] | 219 | 45–189 |
| Decision Sciences | 32 | 74 [56–158] | 615 | 49–260 |
| Computer Science | 63 | 42 [36–73] | 167 | 26–104 |
| Medicine | 40 | 42 [24–59] | 81 | 22–66 |
| Agric. & Biological Sci. | 36 | 31 [24–57] | 65 | 23–67 |
| Biochemistry | 21 | 30 [23–37] | 38 | 20–38 |
| Environmental Science | 72 | 26 [18–32] | 44 | 14–50 |
| Engineering | 196 | 24 [20–26] | 46 | 13–46 |
| Physics & Astronomy | 21 | 23 [15–38] | 112 | 13–45 |
| Materials Science | 55 | 18 [15–25] | 26 | 11–36 |
| Energy | 21 | 12 [11–22] | 25 | 11–22 |
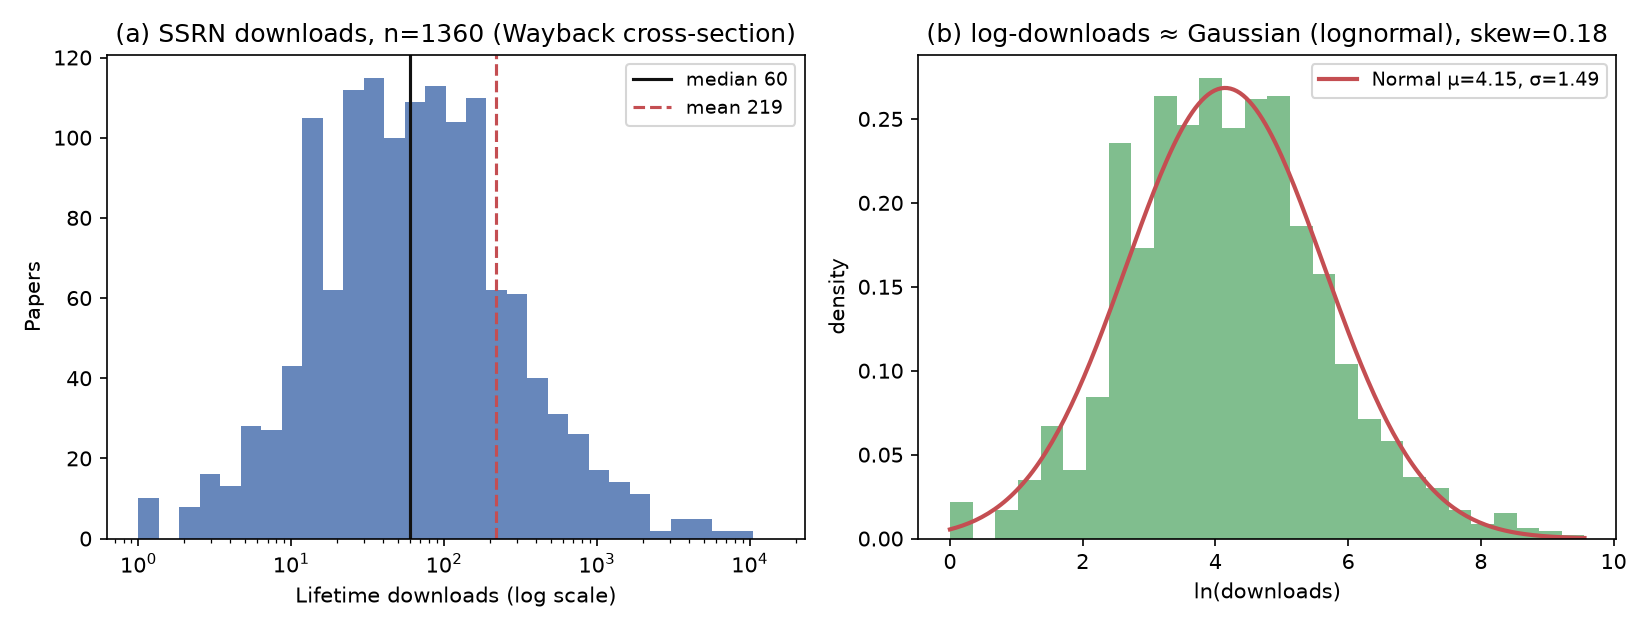
Figura E1. (a) La distribución de descargas en escala logarítmica con la media y mediana marcadas; (b) un histograma de ln(descargas) con una densidad normal ajustada. Sesgo de log-descargas ≈ 0,18. n = 1.360.
Tabla E4. Anclajes publicados versus la sección transversal archivada independiente (n = 1.360).
| Característica | Ancla publicada | Sección transversal archivada |
|---|---|---|
| Descargas promedio | 221 (comercialización) [83] | 219 |
| Descargas medianas | 87 (comercialización) [83]; 63 (derecho) [139] | 60 |
| Media / mediana | 2,54 [83] | 3,65 |
| Percentil 95 / mediana | > 8 [83] | 13,6 |
| Conversión descarga-a-vista | banda 11–19% (§5.2) | mediana 16,2% |
| Dispersión de campos (medianas) | ≈ 8× medias de campo, sin ajuste de edad [168] | ≈ 3–5× a edad igual; 12,5× agrupado |
| Forma de distribución | log-normal, solo cola [85] | sesgo log 0,18 (cuerpo observado) |
Lo que establece la sección transversal. La sección transversal corrobora la forma de la distribución y su estructura central y superior en disciplinas, en una muestra independiente de todos los campos mucho más amplia en cobertura de campos que cualquier única captura SSRN publicada. No estima percentiles representativos de la plataforma, y dos características de su construcción la sesgan hacia arriba. Los archivos capturados sobrerrepresentan páginas visibles, por lo que los trabajos con muchas descargas tienen más probabilidad de ser capturados. Un trabajo también entra en la muestra solo si tenía una página archivada con un contador legible, lo que censura la cola baja extrema: la proporción de la muestra de trabajos con diez o menos descargas (aproximadamente 10%) es en consecuencia muy inferior al 15–30% que las secciones 3.4 y 8.6 anticipan para una muestra completa de plataforma insesgada, y no debe leerse como una estimación de esa proporción. Que la mediana de la muestra (60) no obstante caiga en o por debajo de las medianas legales (63) y de comercialización (87) publicadas indica que el sesgo hacia arriba es modesto para la masa central y que las conclusiones de sesgo y cola pesada son, si acaso, conservadoras. Para puntos de referencia calibrados, los instrumentos apropiados siguen siendo las bandas de percentiles representativos de la plataforma recomendadas en la sección 10 y el panel preregistrado de la sección 8.6; esta sección transversal corrobora que la estructura que medirían es la que describe este artículo. Tres de las bandas de predicción que el Estudio 1 fija con anticipación (sección 8.6) pueden leerse contra esta muestra, teniendo en cuenta su sesgo hacia arriba. La mediana de la muestra de 60 descargas cae dentro de la predicción de 30 a 80. El Gini de atención de 0,75 cae en el borde inferior de los 0,75 a 0,90 predichos, que es la dirección que predice el sesgo de muestreo, ya que la cola baja censurada comprime la desigualdad medida. La razón mediana-media de 0,27 está por debajo del techo predicho de 0,5. Nada de esto valida el diseño prospectivo, cuyo valor es que observa trabajos desde la publicación en una muestra de probabilidad; sí registra que las bandas no se establecieron de manera implausible.
Declaraciones
Disponibilidad de datos. Cada ancla sintetizado reproducido aquí se remonta a las fuentes publicadas citadas en el texto y tablas, con marcos de muestreo y estado de verificación indicados en el punto de uso, y ningún nuevo conjunto de datos representativo de la población subyace a las afirmaciones de punto de referencia del artículo. El único conjunto de datos original generado para este artículo es la sección transversal archivada independiente del Apéndice E, una muestra aleatoria de todos los campos de 1.360 trabajos cuyos contadores previos al cierre se recuperaron de archivos públicos, publicado como appendixE-wayback-downloads.csv (un conjunto de datos del Apéndice E, no el Estudio 1 prospectivo) con el código de análisis, para que el procedimiento pueda ser re-ejecutado y extendido; corrobora la forma de la distribución y no es un punto de referencia representativo de la plataforma. El conjunto de datos se deposita en https://doi.org/10.5281/zenodo.22285871 bajo CC BY 4.0, donde el mismo archivo lleva el nombre study1-wayback-downloads.csv, y se envía con una herramienta abierta que interpreta un recuento de descargas comparándolo con ella, estratificado por edad del trabajo y campo, en https://github.com/vadimchernets/ssrn-benchmark (licencia MIT, solo biblioteca estándar de Python). Los lectores que deseen colocar su propio contador en esta clase de referencia pueden ejecutar esa herramienta en lugar de reconstruir el análisis. Los materiales para la agenda lista para preregistro de la sección 8, incluido el diccionario de variables del panel (Apéndice C, Tabla C1) e inventario de consultas de auditoría de búsqueda, se preparan para depositar en preregistro (sección 8.8); las contribuciones del registro siguen el subconjunto de esquema definido en la sección 8.8, y cualquier lanzamiento de percentil del programa de punto de referencia se publica bajo la especificación de transparencia del Apéndice D. La plantilla de informe CSAB del Apéndice B puede ser reutilizada libremente, sujeto a su regla de percentil en blanco. El 24 de agosto de 2026, una solicitud formal fue presentada a SSRN Support (ticket 260824-003051) para la clase de referencia agregada que los Rangos retirados implicaban — mediana, rango intercuartílico, y bandas de deciles de descargas estratificadas por campo y edad de trabajo, sin identificadores por trabajo; su resultado (otorgamiento, rechazo, o no respuesta) será reportado en una revisión posterior.
Acceso abierto a este artículo. Una copia con licencia abierta de este manuscrito está depositada en https://doi.org/10.5281/zenodo.22166896 (CC BY 4.0), donde el texto completo es recuperable directamente sin restricciones de acceso. El depósito se proporciona porque el registro canónico en SSRN se sirve detrás de mitigación de bots que rechaza clientes sin un motor JavaScript, una condición documentada en la sección 4.2; los lectores, gestores de referencias y clientes automatizados que no pueden alcanzar la copia canónica pueden obtener el mismo texto del depósito. Los documentos complementarios se depositan en los mismos términos en https://doi.org/10.5281/zenodo.22166995 y https://doi.org/10.5281/zenodo.22168724.
Disponibilidad del código. El código de recopilación y análisis para la sección archival independiente del Apéndice E se publica junto con su conjunto de datos en https://github.com/vadimchernets/ssrn-benchmark, de modo que el procedimiento pueda reproducirse y la clase de referencia pueda derivarse nuevamente de los contadores sin procesar. Por lo demás, el artículo no reporta resultados que requieran código de análisis; las plantillas de generación de figuras para los diseños empíricos de la Sección 8 serán publicadas como un apéndice en línea que acompañe los materiales de preregistro.
Ética. Los diseños empíricos de la Sección 8 se basan en contadores a nivel de documento mostrados públicamente y metadatos bibliográficos; cualquier recopilación de información de panel no pública, fechas de estado de distribución, o mensajes de correo electrónico requiere consentimiento informado y, donde sea aplicable, revisión institucional (véase la Sección 9). Los dos diseños que constituyen investigación con sujetos humanos, Estudio 4 (la encuesta de autores) y Estudio 3 (publicación instrumentada con registro de bandeja de entrada), serán sometidos para aprobación de junta de revisión institucional o comité de ética en investigación y conducidos bajo consentimiento informado de los participantes antes de que comience cualquier recopilación de datos. Los conjuntos de datos de mensajes se agregan y se desidentifican antes de cualquier informe, y las publicaciones de la comunidad se citan solo donde existe una fuente verificable vigente, con paráfrasis donde los autores podrían ser identificados en contra de sus expectativas. La recopilación de datos se limita a los medios permitidos por los términos de servicio de las plataformas: los diseños utilizan contadores mostrados públicamente y metadatos bibliográficos y no emplean ningún raspado que violaría los términos de uso de una plataforma, y cualquier diseño que requiera datos masivos o no públicos procede a través de una solicitud de datos formal y revisión legal en lugar de extracción automatizada. La citación de contenido de foro semipúblico atiende al consentimiento del colaborador y al riesgo de reidentificación, que es la razón por la que tal material es parafraseado en lugar de reproducirse textualmente dondequiera que un autor pudiera ser identificado en contra de sus expectativas. El artículo no etiqueta ninguna revista o editorial específica como «depredadora»; la selección de plataformas aplica criterios validados y transparentes, lo que mantiene toda clasificación defendible y evita la difamación.
Agradecimientos. El autor agradece a Stefanie Haustein por sus comentarios críticos, enviados por correo electrónico en agosto de 2026, que condujeron a revisiones de la Sección 4.2, y a Vincent Larivière, cuya pregunta en correspondencia —sobre qué normalización única un autor debería insistir en primer lugar— e su insistencia en ver datos en lugar de argumentos, motivó la sección archival cruzada reportada en el Apéndice E.
Conflictos de interés. El autor es el desarrollador de los métodos de orquestación de múltiples modelos discutidos en la Sección 8.10, que son abiertos y reproducibles, un interés que los lectores deben sopesar. El autor es un solicitante nombrado en solicitudes de patentes pendientes, no patentes concedidas, que cubren sistemas de orquestación de IA y validación de múltiples modelos del tipo discutido en esa sección. El diseño de entrega de capa de orquestación propuesto en la Sección 8.10 es una especificación conceptual en la que ninguno de los hallazgos del artículo descansa. La Sección 8.10 podría ser eliminada completamente sin alterar ningún diagnóstico, resultado, o recomendación en otra parte del artículo.
Herramientas y verificación. Se utilizaron asistentes de IA como instrumentos bajo la dirección del autor; las ideas, investigación y conclusiones son del autor. Todos los reclamos cuantitativos y citas fueron verificados por el autor contra sus fuentes primarias o copias archivadas; el autor asume la responsabilidad única del contenido.
Referencias
Las fuentes citadas en el texto como [B-n] (páginas de plataforma, hilos de foro, publicaciones de blog, y otros materiales de apoyo) se enumeran por separado a continuación bajo «Fuentes adicionales». Las páginas de plataforma con fecha de acceso son inestables y deben ser verificadas nuevamente contra copias archivadas.
[1] AALL / ALL-SIS (2024, 14 de junio). Documento sobre métodos de citación. https://www.aallnet.org/allsis/wp-content/uploads/sites/4/2024/07/ALL-SIS_CitationMethodsWhitePaper_6_14_24_final.pdf
[2] Abdill, R. J., & Blekhman, R. (2019). Seguimiento de la popularidad y los resultados de todos los preprints de bioRxiv. eLife, 8, e45133. DOI 10.7554/eLife.45133
[3] Academia StackExchange (2016, 28 de mayo). "Importance of paper download statistics". https://academia.stackexchange.com/questions/69421/
[4] Adobe / Adobe Express Blog (2025; encuesta realizada en mayo de 2025). "Using ChatGPT as a search engine". https://www.adobe.com/express/learn/blog/chatgpt-as-a-search-engine
[5] Aggarwal, P., Murahari, V., Rajpurohit, T., Kalyan, A., Narasimhan, K., & Deshpande, A. (2024). GEO: Optimización de motor generativo. KDD '24. DOI 10.1145/3637528.3671900; arXiv:2311.09735
[6] Aguinis, H., & Solarino, A. M. (2019). Transparencia y replicabilidad en la investigación cualitativa. Strategic Management Journal, 40(8), 1291–1315. DOI 10.1002/smj.3015
[7] Algaba, A., Mazijn, C., Holst, V., Tori, F., Wenmackers, S., & Ginis, V. (2025). Los grandes modelos de lenguaje reflejan patrones de citación humana con un sesgo de citación elevado. Findings of the Association for Computational Linguistics: NAACL 2025, 6844–6879. DOI 10.18653/v1/2025.findings-naacl.381; arXiv:2405.15739
[8] American Society for Cell Biology and co-signing organizations and individuals (2012/2013). San Francisco Declaration on Research Assessment (DORA). Redactada el 16 de diciembre de 2012 en la Reunión Anual de ASCB, San Francisco; publicada en 2013. https://sfdora.org/read/
[9] Ansari, S., Khan, M., Weinstein, D., Conant, E. F., Mirza-Aghazadeh-Attari, M., & Yousem, D. M. (2023). Ubicuidad de invitaciones de revistas abiertas en especialidades radiológicas. Current Problems in Diagnostic Radiology, 52(6), 534–539. DOI 10.1067/j.cpradiol.2023.04.002; PubMed 37150715
[10] Artisan Growth Strategies; Lenny's Newsletter; First Page Sage — benchmarks de conversión freemium. https://www.artisangrowthstrategies.com/blog/freemium-conversion-rate-benchmarks ; https://www.lennysnewsletter.com/p/what-is-a-good-free-to-paid-conversion
[11] arXiv (Cornell University). Páginas de ayuda sobre formatos de envío. https://info.arxiv.org/help/submit_pdf.html ; https://info.arxiv.org/help/policies/format_requirements.html
[12] Bainbridge, S. (2026). "The Social Science Research Network Has Jumped the Shark" (03.06.2026), https://www.stephenbainbridge.com/p/the-social-science-research-network ; "SSRN Responds to My Complaints With Changes and/or Clarifications" (04.06.2026), https://www.stephenbainbridge.com/p/ssrn-responds-to-my-complaints-with
[13] Bauer-Wolf, J. (2022, 16 de noviembre). Las escuelas de derecho de Yale y Harvard se retiran de los rankings de U.S. News, diciendo que socavan los principios de la profesión legal. Higher Ed Dive. https://www.highereddive.com/news/yale-harvard-law-schools-drop-out-of-us-news-rankings-saying-they-under/636742/
[14] Beall, J. (2012). Predatory publishers are corrupting open access. Nature, 489, 179. DOI 10.1038/489179a
[15] Bergstrom, C. T., & West, J. D. (2020). Calling Bullshit: The Art of Skepticism in a Data-Driven World. Random House.
[16] Bessembinder, H. (2018). Do stocks outperform Treasury bills? Journal of Financial Economics, 129(3), 440–457. DOI 10.1016/j.jfineco.2018.06.004; SSRN 2900447
[17] Björk, B.-C., & Solomon, D. (2012). Open access versus subscription journals: a comparison of scientific impact. BMC Medicine, 10:73. DOI 10.1186/1741-7015-10-73
[18] Black, B. S., & Caron, P. L. (2006). Ranking Law Schools: Using SSRN to Measure Scholarly Performance. Indiana Law Journal, 81(1), 83 ss. SSRN abstract_id=784764; https://www.repository.law.indiana.edu/ilj/vol81/iss1/7/ ; PDF: https://ilj.law.indiana.edu/articles/81/81_1_Black.pdf
[19] Bollen, J., & Van de Sompel, H. (2008). Usage impact factor: The effects of sample characteristics on usage-based impact metrics. Journal of the American Society for Information Science and Technology, 59(1), 136–149. DOI 10.1002/asi.20746
[20] Bornmann, L. (2014). Do altmetrics point to the broader impact of research? Journal of Informetrics, 8(4), 895–903. DOI 10.1016/j.joi.2014.09.005; arXiv:1406.7091
[21] Bornmann, L., & Haunschild, R. (2016). How to normalize Twitter counts? A first attempt based on journals in the Twitter Index. Scientometrics, 107(3), 1405–1422. DOI 10.1007/s11192-016-1893-6
[22] Bornmann, L., Leydesdorff, L., & Mutz, R. (2013). The use of percentiles and percentile rank classes in the analysis of bibliometric data: Opportunities and limits. Journal of Informetrics, 7(1), 158–165. DOI 10.1016/j.joi.2012.10.001; arXiv:1211.0381
[23] Bornmann, L., & Haunschild, R. (2018). Normalization of zero-inflated data: An empirical analysis of a new indicator family and its use with altmetrics data. Journal of Informetrics, 12(3), 998–1011. DOI 10.1016/j.joi.2018.01.010
[24] Bourne, P. E., Polka, J. K., Vale, R. D., & Kiley, R. (2017). Ten simple rules to consider regarding preprint submission. PLOS Computational Biology, 13(5), e1005473. DOI 10.1371/journal.pcbi.1005473
[25] Brody, T., Harnad, S., & Carr, L. (2006). Earlier Web usage statistics as predictors of later citation impact. JASIST, 57(8), 1060–1072. DOI 10.1002/asi.20373; arXiv cs/0503020
[26] Brown, C. (2003). The role of electronic preprints in chemical communication: Analysis of citation, usage, and acceptance in the journal literature. JASIST, 54(5), 362–371. DOI 10.1002/asi.10223
[27] Campbell, D. T. (1979). Assessing the impact of planned social change. Evaluation and Program Planning, 2(1), 67–90. DOI 10.1016/0149-7189(79)90048-X
[28] Carrell, S., Figlio, D., & Lusher, L. (2023). Congestion on the information superhighway: Inefficiencies in economics working papers. Journal of Public Economics, 225, 104978 (también NBER WP 29153)
[29] Casden, J., Romani, D., Shearer, T., & Campbell, J. (2025). Mitigating Aggressive Crawler Traffic in the Age of Generative AI: A Collaborative Approach from the University of North Carolina at Chapel Hill Libraries. The Code4Lib Journal, 61. https://journal.code4lib.org/articles/18489
[30] Chen, Y., & Konstan, J. A. (2015). Online field experiments. Journal of the Economic Science Association, 1(1), 29–42. DOI 10.1007/s40881-015-0005-3
[31] Chu, H., & Krichel, T. (2007). Downloads vs. citations in economics: relationships, contributing factors and beyond. En Actas de ISSI 2007 (11th International Conference of the International Society for Scientometrics and Informatics), Madrid.
[32] Cobey, K. D., et al. (2019). Knowledge and motivations of researchers publishing in presumed predatory journals. BMJ Open, 9(3), e026516. DOI 10.1136/bmjopen-2018-026516
[33] Cooley Law School Blog (2021, December 7). "Showcase Your Scholarship, Part Three: Self-Publishing". https://cooley.edu/blog/showcase-your-scholarship-part-three-self-publishing
[34] CRIV Connection / CRIV Blog (2026, April 20). "Social Science Research Network (SSRN) Ending Commercial Products". https://crivblog.com/2026/04/20/social-science-research-network-ssrn-ending-commercial-products/
[35] Crossref. Documentación de API REST. https://www.crossref.org/documentation/retrieve-metadata/rest-api/
[36] Crossref. Documentación de Similarity Check. https://www.crossref.org/documentation/similarity-check/similarity-report-understand/
[37] Davis, P. M., et al. (2008). Open access publishing, article downloads, and citations: randomised controlled trial. BMJ, 337, a568. DOI 10.1136/bmj.a568
[38] Davis, P. M., & Fromerth, M. J. (2007). Does the arXiv lead to higher citations and reduced publisher downloads for mathematics articles? Scientometrics, 71(2), 203–215. DOI 10.1007/s11192-007-1661-8
[39] Ding, Y., Dong, X., Bu, Y., Zhang, B., Lin, K., & Hu, B. (2021). Revisiting the relationship between downloads and citations: a perspective from papers with different citation patterns in the case of the Lancet. Scientometrics, 126(9), 7609–7621. DOI 10.1007/s11192-021-04099-3
[40] Donovan, J. M., Watson, C. A., & Osborne, C. (2014). The Open Access Advantage for American Law Reviews. SSRN abstract_id=2506913. https://papers.ssrn.com/sol3/papers.cfm?abstract_id=2506913
[41] Dorta-González, P., & Dorta-González, M. I. (2023). The funding effect on citation and social attention: the UN Sustainable Development Goals (SDGs) as a case study. Online Information Review, 47(7), 1358–1376. DOI 10.1108/OIR-05-2022-0300; arXiv:2304.00862
[42] Douma, M. J. (2021, January 12). "How many reads does a typical academic article get?" https://michaeljdouma.com/2021/01/12/how-many-reads-does-a-typical-academic-article-get/
[43] Du, Y., Li, S., Torralba, A., Tenenbaum, J. B., & Mordatch, I. (2023). Improving Factuality and Reasoning in Language Models through Multiagent Debate. arXiv:2305.14325. https://arxiv.org/abs/2305.14325
[44] Edelman, B., & Larkin, I. (2015). Social Comparisons and Deception Across Workplace Hierarchies: Field and Experimental Evidence. Organization Science, 26(1), 78–98. DOI 10.1287/orsc.2014.0938; SSRN abstract_id=1346397; HBS WP 09-096 (circulado desde 2009)
[45] Eisenberg, T. (2006). Assessing the SSRN-Based Law School Rankings. Indiana Law Journal, 81(1), 285–291. https://www.repository.law.indiana.edu/ilj/vol81/iss1/13/
[46] Elsevier (2016, May). "Elsevier Acquires the Social Science Research Network (SSRN)…". PR Newswire. https://www.prnewswire.com/news-releases/elsevier-acquires-the-social-science-research-network-ssrn-the-leading-social-science-and-humanities-repository-and-online-community-579752311.html (también LSE Impact Blog, 18 May 2016)
[47] Elsevier Digital Commons. "SSRN Research Paper Series Sunset — DC Options". https://digitalcommons.elsevier.com/en_US/integration-preservation/ssrn-research-paper-series-sunset-dc-options
[48] Elsevier. "SSRN First Look" (página de producto). https://www.elsevier.com/products/ssrn-preprint-services/first-look
[49] Elsevier. "SSRN for Authors and Researchers" (página de producto). https://www.elsevier.com/products/ssrn-preprint-services/author-researchers
[50] Elsevier/SSRN Support. "How can researchers gauge a paper's impact?" https://www.elsevier.support/ssrn/answer/gauge-impact (consultado 14.08.2026)
[51] Elsevier/SSRN Support. "What are RSS and Data Feeds on SSRN". https://www.elsevier.support/ssrn/answer/what-are-rss-and-data-feeds-on-ssrn
[52] Elsevier/SSRN Support. "What is SSRN?" https://www.elsevier.support/ssrn/answer/what-is-ssrn (consultado 14.08.2026)
[53] Elsevier/SSRN Support. Classification and distribution. https://www.elsevier.support/ssrn/answer/classification-distribution (consultado 14.08.2026)
[54] Elsevier/SSRN Support. Generative AI policy. https://www.elsevier.support/ssrn/answer/AI (consultado 14.08.2026)
[55] Elsevier/SSRN Support. Google / Google Scholar indexing. https://www.elsevier.support/ssrn/answer/google-scholar (consultado 14.08.2026)
[56] Elsevier/SSRN Support. Submission guidelines / Get started. https://www.elsevier.support/ssrn/answer/get-started (consultado 14.08.2026)
[57] Elsevier/SSRN Support. Subscriptions (eJournal mailings). https://www.elsevier.support/ssrn/answer/subscriptions ; también https://www.ssrn.com/index.cfm/en/subscribe/
[58] Espeland, W. N., & Sauder, M. (2007). Rankings and reactivity: How public measures recreate social worlds. American Journal of Sociology, 113(1), 1–40. DOI 10.1086/517897
[59] Eysenbach, G. (2006). Citation Advantage of Open Access Articles. PLoS Biology, 4(5), e157. DOI 10.1371/journal.pbio.0040157
[60] Farys, R., & Wolbring, T. (2021). Matthew effects in science and the serial diffusion of ideas. Quantitative Science Studies, 2(2), 505–526. DOI 10.1162/qss_a_00129
[61] Fernández-Ramos, A., Comas-Forgas, R., & Rodríguez-Bravo, B. (2026). Identifying academic spam and recommendations for dealing with it: a literature review. European Science Editing, 52, e174423. DOI 10.3897/ese.2026.e174423 (publicado 8 de mayo de 2026)
[62] Fraser, N., et al. (2020). The relationship between bioRxiv preprints, citations and altmetrics. Quantitative Science Studies, 1(2), 618–638. DOI 10.1162/qss_a_00043
[63] Fung, A., Razi, B., Basto, C., Bariol, S., Hossack, T., Baskaranathan, S., Ende, D., & Woo, H. (2026). Trust, but Verify: An Exploratory Audit of Predatory Journal and Publisher Solicitations. ANZ Journal of Surgery. DOI 10.1111/ans.70568
[64] Giannakakos, V., et al. (2025). Impact of author characteristics on outcomes of single- versus double-blind peer review: a systematic review of comparative studies in scientific abstracts and publications. Scientometrics, 130, 399–421. DOI 10.1007/s11192-024-05213-x
[65] Ginsparg, P. (2011). ArXiv at 20. Nature, 476(7359), 145–147. https://www.nature.com/articles/476145a
[66] Goldman, E. "SSRN and Download Statistics" (2005), https://personal.ericgoldman.org/ssrn_and_downlo/ ; "Update on SSRN", https://personal.ericgoldman.org/update_on_ssrn/
[67] Goodhart, C. A. E. (1975). Problems of monetary management: The U.K. experience. In Papers in Monetary Economics, Vol. I. Sydney: Reserve Bank of Australia. Reprinted in C. A. E. Goodhart (1984), Monetary Theory and Practice: The U.K. Experience (ch. 4). London: Macmillan. DOI 10.1007/978-1-349-17295-5_4
[68] Gordon, G. J. (2016). The Digital Lawyer's Evolving Education in Scholarly Research. SSRN abstract_id=2754647
[69] Gordon, G., Lin, J., Cave, R., & Dandrea, R. (2015). The Question of Data Integrity in Article-Level Metrics. PLOS Biology. https://pmc.ncbi.nlm.nih.gov/articles/PMC4546647/
[70] Grossman, R., Liu, S., Chen, M. K., Smith, M., Borcea, C., & Chen, Y. (2026). How Generative AI Disrupts Search: An Empirical Study of Google Search, Gemini, and AI Overviews. arXiv:2604.27790. https://arxiv.org/abs/2604.27790
[71] Guerrero-Bote, V. P., & Moya-Anegón, F. (2014). Relationship between downloads and citations at journal and paper levels, and the influence of language. Scientometrics. DOI 10.1007/s11192-014-1243-5
[72] Haque, A., & Ginsparg, P. (2009). Positional effects on citation and readership in arXiv. JASIST, 60(11), 2203–2218. DOI 10.1002/asi.21166
[73] Haque, A., & Ginsparg, P. (2010). Last but not least: Additional positional effects on citation and readership in arXiv. JASIST, 61(12), 2381–2388. DOI 10.1002/asi.21428; arXiv:1010.2757
[74] Haustein, S., Costas, R., & Larivière, V. (2015). Characterizing social media metrics of scholarly papers. PLOS ONE, 10(3), e0120495. DOI 10.1371/journal.pone.0120495
[75] Haustein, S., Bowman, T. D., Holmberg, K., Tsou, A., Sugimoto, C. R., & Larivière, V. (2016). Tweets as impact indicators: Examining the implications of automated "bot" accounts on Twitter. JASIST, 67(1), 232–238. DOI 10.1002/asi.23456
[76] Haustein, S., Bowman, T. D., & Costas, R. (2016). Interpreting "altmetrics": viewing acts on social media through the lens of citation and social theories. In: Theories of Informetrics and Scholarly Communication (De Gruyter Mouton), 372–405; arXiv:1502.05701
[77] Heald, P. J., & Sichelman, T. (2019). Ranking the Academic Impact of 100 American Law Schools. Jurimetrics, 60(1), 1–39 (Otoño 2019). SSRN abstract_id=3483325
[78] Hicks, D., Wouters, P., Waltman, L., de Rijcke, S., & Rafols, I. (2015). Bibliometrics: The Leiden Manifesto for research metrics. Nature, 520(7548), 429–431. DOI 10.1038/520429a. https://www.nature.com/articles/520429a
[79] Hirsch, J. E. (2005). An index to quantify an individual's scientific research output. PNAS, 102(46), 16569–16572.
[80] Hu, B., et al. (2021). On the relationship between download and citation counts: An introduction of Granger-causality inference. Journal of Informetrics, 15(2), 101125. DOI 10.1016/j.joi.2020.101125
[81] iThenticate/Turnitin. Guías: "Understanding the Similarity Report"; "Preprints". https://guides.ithenticate.com/hc/en-us/articles/27842305774605 ; https://guides.ithenticate.com/hc/en-us/articles/27848481223693-Preprints
[82] Jaźwińska, K., & Chandrasekar, A. (2025, 6 de marzo). AI search has a citation problem. Columbia Journalism Review / Tow Center. https://www.cjr.org/tow_center/we-compared-eight-ai-search-engines-theyre-all-bad-at-citing-news.php
[83] Jo, W., & Li, J. (2026). Can AI reduce the reputation premium in knowledge diffusion? Evidence from SSRN marketing working papers. Marketing Letters, 37, Article 32. DOI 10.1007/s11002-026-09827-4
[84] Justin, G. A., et al. (2024). An Analysis of Solicitations From Predatory Journals in Ophthalmology. American Journal of Ophthalmology. PMC11257792; https://www.ajo.com/article/S0002-9394(24)00087-4/abstract — fuente de la cifra de "1813 correos electrónicos"
[85] Kakushadze, Z. (2016). An index for SSRN downloads. Journal of Informetrics, 10(1), 9–28. DOI 10.1016/j.joi.2015.11.005; arXiv:1511.04275; SSRN 2656600
[86] Kim, Heekyung Hellen (2014). The Effect of Open Access (AEA Conference 2014). https://www.aeaweb.org/conference/2014/retrieve.php?pdfid=58
[87] Kim, T., Bock, K., Luo, C., Liswood, A., Poroslay, C., & Wenger, E. (2025). Scrapers selectively respect robots.txt directives: evidence from a large-scale empirical study. Proceedings of the ACM Internet Measurement Conference (IMC '25). DOI 10.1145/3730567.3764471
[88] Kleinberg, J., Ludwig, J., Mullainathan, S., & Obermeyer, Z. (2015). Prediction policy problems. American Economic Review, 105(5), 491–495. DOI 10.1257/aer.p20151023
[89] Kozak, M., Iefremova, O., & Hartley, J. (2016). Spamming in Scholarly Publishing: A Case Study. JASIST, 67(8), 2009–2015. DOI 10.1002/asi.23521
[90] Kraker, P., & Lex, E. (2015). A critical look at the ResearchGate Score as a measure of scientific reputation. Presentado en ASCW'15 (Quantifying and Analysing Scholarly Communication on the Web), Web Science Conference 2015, Oxford. http://ascw.know-center.tugraz.at/2015/05/26/kraker-lex-a-critical-look-at-the-researchgate-score/ (versión popular: "The ResearchGate Score: a good example of a bad metric," LSE Impact Blog, 9 Dec 2015)
[91] Kurtz, M. J., et al. (2005). The bibliometric properties of article readership information. JASIST, 56(2), 111–128. DOI 10.1002/asi.20096
[92] Kurtz, M. J., & Bollen, J. (2010). Usage bibliometrics. Annual Review of Information Science and Technology, 44(1), 3–64. DOI 10.1002/aris.2010.1440440108
[93] Langham-Putrow, A., et al. (2021). Is the open access citation advantage real? A systematic review of the citation of open access and subscription-based articles. PLOS ONE, 16(6), e0253129. DOI 10.1371/journal.pone.0253129
[94] Larivière, V., Haustein, S., & Mongeon, P. (2015). The oligopoly of academic publishers in the digital era. PLOS ONE, 10(6), e0127502. DOI 10.1371/journal.pone.0127502
[95] Legal Writing Institute. "Publishing Tips" (PDF). https://www.lwionline.org/sites/default/files/Publishing-Tips.pdf
[96] Lewinski, A. A., & Oermann, M. H. (2018). Characteristics of e-mail solicitations from predatory nursing journals and publishers. The Journal of Continuing Education in Nursing, 49(4), 171–177. DOI 10.3928/00220124-20180320-07
[97] Liang, W., Yuksekgonul, M., Mao, Y., Wu, E., & Zou, J. (2023). GPT detectors are biased against non-native English writers. Patterns, 4(7), 100779. DOI 10.1016/j.patter.2023.100779
[98] Lloyd, T. (2026, May 7). Guest Post — Love, Death & Robots: Scholarly Edition. The Scholarly Kitchen. https://scholarlykitchen.sspnet.org/2026/05/07/guest-post-love-death-robots-scholarly-edition/
[99] LogEc / RePEc. About LogEc (metodología de filtración de tráfico). https://logec.repec.org/about.htm ; https://logec.repec.org/
[100] Martinez, O. (2026). Optimizing Visibility in Generative Engines: A Critical Survey of Generative Engine Optimization (2023–2026). arXiv:2607.14035 (enviado 15 de julio de 2026). https://arxiv.org/abs/2607.14035
[101] Maynooth University News (2026, January). "Maynooth University's School of Law and Criminology ranks first…". https://www.maynoothuniversity.ie/news-events/maynooth-university-s-school-law-and-criminology-ranks-first-social-science-research-networks-2
[102] McGillivray, B., & Astell, M. (2019). The relationship between usage and citations in an open access mega-journal. Scientometrics, 121, 817–838. DOI 10.1007/s11192-019-03228-3
[103] Medoff, M. H. (2006). Evidence of a Harvard and Chicago Matthew Effect. Journal of Economic Methodology, 13(4), 485–506. DOI 10.1080/13501780601049079
[104] Merton, R. K. (1968). The Matthew effect in science. Science, 159(3810), 56–63. DOI 10.1126/science.159.3810.56
[105] Merton, R. K. (1988). The Matthew effect in science, II: Cumulative advantage and the symbolism of intellectual property. Isis, 79(4), 606–623. DOI 10.1086/354848
[106] Microsoft Learn. "Safe Links in Microsoft Defender for Office 365". https://learn.microsoft.com/en-us/defender-office-365/safe-links-about (+ Microsoft Q&A sobre clics en UrlClickEvents; + Suped sobre aperturas falsas)
[107] Milanovic, M. EJIL:Talk! "Academic Spam [UPDATED]". https://www.ejiltalk.org/academic-spam/
[108] Moed, H. F., & Halevi, G. (2016). On full text download and citation distributions in scientific-scholarly journals. JASIST, 67(2), 412–431. DOI 10.1002/asi.23405
[109] Moed, H. F. (2017). Applied Evaluative Informetrics. Springer. DOI 10.1007/978-3-319-60522-7
[110] Moher, D., et al. (2018). Assessing scientists for hiring, promotion, and tenure. PLoS Biology, 16(3), e2004089. DOI 10.1371/journal.pbio.2004089
[111] Morgan, A. C., et al. (2018). Prestige drives epistemic inequality in the diffusion of scientific ideas. EPJ Data Science, 7:40. DOI 10.1140/epjds/s13688-018-0166-4
[112] Muchnik, L., Aral, S., & Taylor, S. J. (2013). Social influence bias: A randomized experiment. Science, 341(6146), 647–651. DOI 10.1126/science.1240466
[113] Muller, J. Z. (2018). The Tyranny of Metrics. Princeton, NJ: Princeton University Press. ISBN 978-0-691-17495-2.
[114] Nature Neuroscience, Editorial (2008). https://www.nature.com/articles/nn0608-619
[115] Northwestern University LibGuides (research assessment/metrics). https://libguides.northwestern.edu/c.php?g=1372178&p=10205721
[116] Ohm, P. (2007). Do Blogs Influence SSRN Downloads? Empirically Testing the Volokh and Slashdot Effects. U. Colorado Law Legal Studies Research Paper No. 07-15. https://ssrn.com/abstract=980484
[117] Pace Law Library. "Get Published — Guide for Law Review Members". https://libraryguides.law.pace.edu/lawreviews/publishing
[118] Paperpile. "What is a good h-index?" https://paperpile.com/g/what-is-a-good-h-index/ (similar guides: Elsevier, Researcher.Life, Academia Insider)
[119] Perneger, T. V. (2004). Relation between online "hit counts" and subsequent citations: prospective study of research papers in the BMJ. BMJ, 329(7465), 546–547. DOI 10.1136/bmj.329.7465.546
[120] Petersen, A. M., et al. (2014). Reputation and impact in academic careers. PNAS, 111(43), 15316–15321. DOI 10.1073/pnas.1323111111
[121] Pew Research Center (2026, 17 de junio). Estadounidenses e IA 2026: Chatbots, dispositivos inteligentes e impacto de la IA. https://www.pewresearch.org/internet/2026/06/17/americans-and-ai-2026-chatbots-smart-devices-and-views-on-impact/
[122] Piwowar, H. (2013). Altmetrics: Valorar todos los productos de investigación. Nature, 493(7431), 159. https://www.nature.com/articles/493159a
[123] Priem, J., Taraborelli, D., Groth, P., & Neylon, C. (2010). Altmetrics: Un manifiesto. http://altmetrics.org/manifesto/ (copia archivada en web.archive.org)
[124] Priem, J., Piwowar, H., & Orr, R. (2022). OpenAlex: Un índice completamente abierto de trabajos académicos, autores, sedes, instituciones y conceptos. arXiv:2205.01833. DOI 10.48550/arXiv.2205.01833
[125] Project COUNTER (2026). COUNTER Code of Practice, Release 5.1.1. Publicado 30 de junio de 2026 (Release 5.1 publicado 5 de mayo de 2023). https://www.countermetrics.org/ ; "Mejores prácticas en uso de IA" (orientación para R5.1.1, actualizado 30 de junio de 2026), https://www.countermetrics.org/code-of-practice/best-practice/bp-ai/
[126] Quora. "¿Hasta qué punto recomendaría o desaconsejaría publicar un artículo de trabajo académico en SSRN...?". https://www.quora.com/To-what-extent-would-you-recommend-or-discourage-publishing-an-academic-working-paper-on-SSRN-to-claim-and-put-a-stake-in-the-ground-e-g-before-any-journal-submission
[127] Reddit r/AskAcademia (2023, 10 de agosto). Hilo 15newc2 "Spam sin fin desde que publiqué un artículo hace unos meses". https://www.reddit.com/r/AskAcademia/comments/15newc2/ (confirmado mediante el archivo pullpush.io)
[128] Remler, D. (2014, 23 de abril). ¿Realmente el 90% de los artículos académicos nunca son citados? Revisión de la literatura sobre citaciones académicas. LSE Impact Blog. https://blogs.lse.ac.uk/impactofsocialsciences/2014/04/23/academic-papers-citation-rates-remler/
[129] RePEc Blog: "Cómo RePEc cuenta las vistas y descargas" (06.11.2021), https://blog.repec.org/2021/11/06/how-repec-counts-views-and-downloads/ ; "Cuestiones de IA en RePEc" (10.11.2025), https://blog.repec.org/2025/11/10/ai-issues-in-repec/ ; "RePEc en junio de 2026" (13.07.2026), https://blog.repec.org/2026/07/13/repec-in-june-2026/
[130] ResearchGate (2022, agosto). "Eliminación de la puntuación RG". https://www.researchgate.net/researchgate-updates/removing-the-rg-score
[131] Salganik, M. J., Dodds, P. S., & Watts, D. J. (2006). Estudio experimental de la desigualdad e impredecibilidad en un mercado cultural artificial. Science, 311, 854–856. DOI 10.1126/science.1121066
[132] Sauder, M., & Espeland, W. N. (2009). La disciplina de los rankings: Acoplamiento estrecho y cambio organizacional. American Sociological Review, 74(1), 63–82. DOI 10.1177/000312240907400104
[133] Schein, A. I., Popescul, A., Ungar, L. H., & Pennock, D. M. (2002). Métodos y métricas para recomendaciones de inicio en frío. En Proceedings of the 25th Annual International ACM SIGIR Conference on Research and Development in Information Retrieval (SIGIR '02), 253–260. DOI 10.1145/564376.564421
[134] Schumann, E. Paquete R de SSRN. https://github.com/enricoschumann/SSRN (también rastreadores github.com/talsan/ssrn, github.com/karthiktadepalli1/ssrn-scraper)
[135] Shearer, K., & Walk, P. (2025, 3 de junio). El impacto de los bots y rastreadores de IA en repositorios abiertos: Resultados de una encuesta de COAR, abril de 2025. Confederation of Open Access Repositories. https://coar-repositories.org/wp-content/uploads/2025/06/Report-of-the-COAR-Survey-on-AI-Bots-June-2025-1.pdf
[136] Shen, C., & Björk, B.-C. (2015). Acceso abierto «depredador»: un estudio longitudinal de volúmenes de artículos y características del mercado. BMC Medicine, 13, 230. DOI 10.1186/s12916-015-0469-2
[137] Shepherd, P. T. (2007). La viabilidad de desarrollar e implementar factores de uso de revistas: un proyecto de investigación patrocinado por UKSG. Serials: The Journal for the Serials Community, 20(2), 117–123. DOI 10.1629/20117
[138] Shuai, X., Pepe, A., & Bollen, J. (2012). Cómo reacciona la comunidad científica ante preprints recientemente presentados. PLOS ONE, 7(11), e47523. DOI 10.1371/journal.pone.0047523
[139] Siems, M. M. (2016). Investigación jurídica en busca de atención: Una evaluación cuantitativa. King's Law Journal, 27(2), 170–187. DOI 10.1080/09615768.2015.1105560. Versión de trabajo: "Qué determina las descargas en SSRN", SSRN abstract_id=2836950; Durham: https://durham-repository.worktribe.com/OutputFile/1387250
[140] Simcoe, T. S., & Waguespack, D. M. (2011). Estado, calidad y atención: ¿Qué hay en un nombre (faltante)? Management Science, 57(2), 274–290. DOI 10.1287/mnsc.1100.1270
[141] Simon, H. A. (1971). Diseño de organizaciones para un mundo rico en información. En M. Greenberger (Ed.), Computers, Communications, and the Public Interest (pp. 37–72). Johns Hopkins Press.
[142] Soler, J., & Cooper, A. (2019). Correos electrónicos inesperados para enviar su trabajo: ¿Spam u ofertas legítimas? Publications, 7(1), 7. DOI 10.3390/publications7010007
[143] SSRN (2018, 13 de abril). Anuncio de eLibrary Stats. https://www.ssrn.com/index.cfm/en/fen/ads/04132018ann014/
[144] SSRN Blog (2018, 5 de junio). Lo que SSRN significa cuando hablamos de integridad de datos. https://blog.ssrn.com/2018/06/05/what-ssrn-means-when-we-talk-about-data-integrity/
[145] SSRN Blog (2025, 16 de diciembre). Revisión del año 2025: Cómo SSRN mejoró el acceso a preprints e investigación en fase temprana. https://blog.ssrn.com/2025/12/16/2025-year-in-review-how-ssrn-enhanced-access-to-preprints-and-early-stage-research/
[146] SSRN Blog (2026, 13 de abril). Actualización estratégica de SSRN: Enfoque renovado en la misión central de intercambio de investigación (autor del post: S. Decker-Lucke). https://blog.ssrn.com/2026/04/13/ssrn-strategic-update-renewed-focus-on-core-research-sharing-mission/
[147] SSRN Blog (2026, 4 de junio). Compromiso continuo de SSRN con la beca legal. https://blog.ssrn.com/2026/06/04/ssrns-ongoing-commitment-to-legal-scholarship/
[148] SSRN Blog (2026, 12 de junio). SSRN descontinuará las clasificaciones a partir del 1 de julio de 2026. https://blog.ssrn.com/2026/06/12/ssrn-to-sunset-rankings-from-july-1st-2026/
[149] SSRN Blog (2026, 15 de julio). La clasificación de SSRN ha sido descontinuada a partir del 15 de julio de 2026. https://blog.ssrn.com/2026/07/15/ssrn-to-sunset-rankings-from-15th-july-2026/
[150] SSRN Blog (2026, 20 de julio). SSRN ahora te permitirá elegir la licencia que sea adecuada para tu trabajo. https://blog.ssrn.com/2026/07/20/ssrn-will-now-allow-you-to-choose-the-licence-thats-right-for-your-work/
[151] SSRN. Preguntas frecuentes históricas (copia en PDF, Scuola Superiore Sant'Anna). https://www.sssup.it/UploadDocs/4461_SSRN_FAQ.pdf
[152] SSRN. Página de suscripción. https://www.ssrn.com/index.cfm/en/subscribe/
[153] Sugimoto, C. R., & Larivière, V. (2018). Medición de investigación: Lo que todos necesitan saber. Oxford University Press. ISBN 9780190640118
[154] Sun, M., Barry Danfa, J., & Teplitskiy, M. (2022). ¿Reduce la revisión por pares a doble ciego el sesgo? Evidencia de una conferencia informática destacada. JASIST, 73(6), 811–819. DOI 10.1002/asi.24582 (apellido del segundo autor según Crossref: "Barry Danfa")
[155] Sureda-Negre, J., Calvo-Sastre, A., & Comas-Forgas, R. (2022). Revistas y editoriales depredadoras: Características e impacto del spam académico en investigadores de ciencias de la educación. Learned Publishing, 35(4), 441–447. DOI 10.1002/leap.1450
[156] TaxProf Blog (Caron, P.): "SSRN e-Journal Rankings By Average Downloads Per Paper" (2018, May), https://taxprof.typepad.com/taxprof_blog/2018/05/ssrn-e-journal-rankings-by-average-downloads-per-paper.html ; "SSRN Has Not Jumped the Shark" (07.06.2026), https://taxprofblog.aals.org/2026/06/07/
[157] Teixeira da Silva, J. A., Tsigaris, P., & Moussa, S. (2023). ¿Pueden los sistemas de IA detectar revistas depredadoras? El caso de las revistas FT50. SSRN abstract_id=4391108. DOI 10.2139/ssrn.4391108
[158] Thales / Imperva (2025). Informe de Bots Maliciosos de Imperva 2025. https://cpl.thalesgroup.com/about-us/newsroom/2025-imperva-bad-bot-report-ai-internet-traffic
[159] Think. Check. Submit. (2022, February 4). "Is a journal interested in your preprint? Separating the wheat from the chaff in journal solicitations to submit". https://thinkchecksubmit.org/2022/02/04/is-a-journal-interested-in-your-preprint-separating-the-wheat-from-the-chaff-in-journal-solicitations-to-submit/
[160] Tomlinson, O. W. (2023). Análisis de correos electrónicos depredadores en académicos en fase temprana y esfuerzos de prevención. Learned Publishing, 36(2), 156–163. DOI 10.1002/leap.1500
[161] University of Washington Gallagher Law Library. LibGuide "SSRN Metrics" (updated 29 Sep 2025). https://lib.law.uw.edu/c.php?g=1238218&p=9061272 (+ página p=9061269 sobre revistas electrónicas)
[162] van de Rijt, A., et al. (2014). Experimentos de campo en dinámicas de éxito-genera-éxito. PNAS, 111(19), 6934–6939. DOI 10.1073/pnas.1316836111
[163] Vanderbilt University, Brightspace (Center for Teaching / Office of Innovative Technologies) (2023). Orientación sobre Detección de IA y Por Qué Deshabilitamos el Detector de IA de Turnitin. Publicado 16 de agosto de 2023. https://www.vanderbilt.edu/brightspace/2023/08/16/guidance-on-ai-detection-and-why-were-disabling-turnitins-ai-detector/ (accedido 15 de agosto de 2026).
[164] Vishwakarma, R., Kumar, A., & Jamidar, S. (2026). Qué se cita: GEO competitivo en motores de respuesta de IA. SIGIR '26, 4950–4954. DOI 10.1145/3805712.3808445; arXiv:2605.25517
[165] Wallace, K. L., Hartley, M., & Lepird, C. (2023). Expansión de la Drake Journal of Agricultural Law: La Edición Verde. Drake Journal of Agricultural Law, 28, 114–127. https://aglawjournal.wp.drake.edu/wp-content/uploads/sites/66/2023/07/Wallace-Ready-for-PRODUCTION.pdf
[166] Wang, J., Veugelers, R., & Stephan, P. (2017). Sesgo contra la novedad en la ciencia. Research Policy, 46(8), 1416–1436. DOI 10.1016/j.respol.2017.06.006
[167] Weinberg, M. (2025, June). ¿Están los bots de IA dejando fuera de línea el patrimonio cultural? GLAM-E Lab (NYU Engelberg Center / University of Exeter). https://www.glamelab.org/files/Are_AI_Bots_Knocking_Cultural_Heritage_Offline.pdf
[168] Whalen, R. (2018, May 3). Revistas electrónicas de SSRN y descargas. https://ryanwhalen.com/2018/05/03/ssrn-e-journals-and-downloads/
[169] Wherry, J. L. (2022). "Tools for Improving Distribution, Discussion, and Downloads…" SSRN abstract_id=4191909. DOI 10.2139/ssrn.4191909 (publicado en U. Detroit Mercy Law Review)
[170] Wikipedia: "Social Science Research Network"; "List of academic journals by preprint policy"; "Preprint". https://en.wikipedia.org/wiki/Social_Science_Research_Network y páginas relacionadas.
[171] Willey, R., & Knapp, M. (2021). "How to Increase Citations to Legal Scholarship." Ohio State Technology Law Journal, 18. SSRN 3801190; PDF: https://moritzlaw.osu.edu/sites/default/files/2022-01/HOW%20TO%20INCREASE%20CITATIONS%20TO%20LEGAL.pdf
[172] Willey, R., & Knapp, M. (2022/2023). "SSRN's Impact on Citations to Legal Scholarship and How to Maximize It." University of Arkansas at Little Rock Law Review, 45(3), 475–507. SSRN abstract_id=4037744; https://research.ualr.edu/bowen_lawreview/vol45/iss3/2/
[173] Wilsdon, J., et al. (2015). "The Metric Tide: Report of the Independent Review of the Role of Metrics in Research Assessment and Management." HEFCE. DOI 10.13140/RG.2.1.4929.1363. https://doi.org/10.13140/RG.2.1.4929.1363
[174] Wilson, P. (2022). "Unsolicited solicitations: identifying characteristics of unsolicited emails from potentially predatory journals and the role of librarians." Journal of the Medical Library Association, 110(4), 520–524. DOI 10.5195/jmla.2022.1554; PMC10124592. https://pmc.ncbi.nlm.nih.gov/articles/PMC10124592/
[175] WisBlawg, UW–Madison Law Library (2016, September 21). "Which Legal Articles Generate the Most Attention on SSRN". https://wisblawg.law.wisc.edu/2016/09/21/which-legal-articles-generate-the-most-attention-on-ssrn
[176] Wood-Doughty, A., Bergstrom, T., & Steigerwald, D. G. (2019). ¿Miden fiablemente los informes de descargas el uso de revistas? College & Research Libraries, 80(5). https://crl.acrl.org/index.php/crl/article/view/17824/19653
[177] Wouters, P., & Costas, R. (2012). Usuarios, narcisismo y control — seguimiento del impacto de las publicaciones académicas en el siglo XXI. SURF Foundation, Utrecht. https://www.cni.org/news/surf-report-users-narcissism-and-control
[178] Yuret, T. (2026). Accesos a artículos: vínculos a citas, efectos de fin de semana y estacionalidad. Scientometrics (publicado 23.07.2026). DOI 10.1007/s11192-026-05710-1
[179] Zahedi, Z., Costas, R., & Wouters, P. (2017). El número de lectores en Mendeley como herramienta de filtrado para identificar publicaciones altamente citadas. Journal of the Association for Information Science and Technology, 68(10), 2511–2521. DOI 10.1002/asi.23883
[180] Zhu, L., & Lerman, K. (2016). Desigualdad de atención en las redes sociales. arXiv:1601.07200
[181] Sinatra, R., Wang, D., Deville, P., Song, C., & Barabási, A.-L. (2016). Cuantificación de la evolución del impacto científico individual. Science, 354(6312), aaf5239. DOI 10.1126/science.aaf5239
[182] Radicchi, F., Fortunato, S., & Castellano, C. (2008). Universalidad de las distribuciones de citas: Hacia una medida objetiva del impacto científico. PNAS, 105(45), 17268–17272. DOI 10.1073/pnas.0806977105
[183] CoARA (2022). "The Agreement on Reforming Research Assessment." Coalition for Advancing Research Assessment. https://coara.eu/agreement/the-agreement-full-text/
[184] Curry, S., Gadd, E., & Wilsdon, J. (2022). "Harnessing the Metric Tide: Indicators, infrastructures & priorities for UK responsible research assessment." Research on Research Institute. https://doi.org/10.6084/m9.figshare.21701624
[185] IRUS (Jisc). Estadísticas de uso estandarizadas y conformes a COUNTER para repositorios. https://irus.jisc.ac.uk
[186] UK Research and Innovation (2024). Résumé for Research and Innovation (R4RI): orientación. https://www.ukri.org/apply-for-funding/develop-your-application/resume-for-research-and-innovation-r4ri-guidance/
[187] Overton. La herramienta de inteligencia política. https://www.overton.io
[188] CC-PLUS. Consorcios que colaboran en una plataforma para estadísticas de uso de bibliotecas (recopilación SUSHI/COUNTER-5 de código abierto; financiada por IMLS, PALCI et al.). https://www.cc-plus.org/
[189] HELIOS Open. Iniciativa de Liderazgo en Educación Superior para la Investigación Abierta. https://www.heliosopen.org/
Fuentes adicionales
Fuentes adicionales citadas en el texto como [B-n]: páginas de plataforma, hilos de foros, publicaciones de blogs y otros materiales que apoyan puntos específicos en el texto. Las páginas de plataforma son inestables y deben re-verificarse contra copias archivadas.
[B-1] Cabells Predatory Reports (servicio activo de detección de revistas depredadoras); Beall's List (solo archivada; no actualizada desde enero de 2017).
[B-2] Caron, P. TaxProf Blog (2026, 25 de enero). "The SSRN Top Five New Tax Papers Ranking Is Broken". https://taxprofblog.aals.org/2026/01/25/the-ssrn-top-five-new-tax-papers-ranking-is-broken/
[B-3] EconJobRumors (EJMR), hilos de discusión sobre descargas de SSRN y clasificaciones de autores (p. ej., /topic/ssrn-downloads-and-views; /topic/top-10-of-authors-on-ssrn-by-downloads). Foro anónimo; citado solo como evidencia de que tales discusiones existen.
[B-4] de Leon, F. L. L., & McQuillin, B. (2020). The Role of Conferences on the Pathway to Academic Impact. Journal of Human Resources, 55(1), 164. https://jhr.uwpress.org/content/55/1/164
[B-5] Reddit r/AskAcademia, hilo 1seeyq3 (6 de abril de 2026, "I've uploaded a working paper to SSRN… honest advice"); Reddit r/academia, hilo 13w6zjw (31 de mayo de 2023, "SSRN Approval Time is Absurd"). Existencia confirmada a través de archivos de Reddit de terceros.
[B-6] SSRN — texto estándar de anuncios (p. ej., https://www.ssrn.com/index.cfm/en/ern/ads/06042025ann001/) y el anuncio de abril de 2018 (04132018ann002). Páginas de plataforma; verificar contra copias archivadas. Copia archivada: https://web.archive.org/web/20251229194317/https://www.ssrn.com/index.cfm/en/ern/ads/06042025ann001/ (captura del 29 de diciembre de 2025; accedido el 15 de agosto de 2026).
[B-7] SSRN FAQ — versionado y ORCID. https://www.ssrn.com/index.cfm/en/faq/ (accedido en 2026; verificar contra una copia archivada).
[B-8] SSRN — página de inicio "SSRN has Sunset Rankings". https://www.ssrn.com/ssrn/rankings-sunset. Copia archivada: https://web.archive.org/web/20260719233259/https://www.ssrn.com/ssrn/rankings-sunset (captura del 19 de julio de 2026; accedido el 15 de agosto de 2026).
[B-9] SSRN — páginas de clasificaciones históricas en hq.ssrn.com / papers.ssrn.com/topten: Top 10,000 Papers (TRN_gID=10), Top 30,000 Authors (TRN_gID=7), Top 3,000 Law Authors, Top 350 U.S. Law Schools, Top 500 International Law Schools, Eigenfactor, Recent Top Papers (60 days), "Ranking Data Explained" (ranking_data_explain.cfm?id=6 / id=10). Páginas históricas; desde el 15 de julio de 2026 estas URLs devuelven respuestas 403/marcador de posición — citar a través de copias archivadas. Copia archivada de la página Top 10,000 Papers: https://web.archive.org/web/20260714112806/https://hq.ssrn.com/rankings/Ranking_display.cfm?TRN_gID=10 (captura del 14 de julio de 2026, el día anterior al cierre; accedido el 15 de agosto de 2026).
[B-10] Teixeira da Silva, J. A. (2024/2025). Spam, unwanted or unsolicited emails following the publication of preprints (year-long observation: 875 invitations from 256 journals, 76% from blocklists). DOI 10.1080/10875301.2025.2550600; publicación de ResearchGate 384286174.
[B-11] Caron, P. TaxProf Blog (2026, 7 de junio). "SSRN Has Not Jumped the Shark". https://taxprofblog.aals.org/2026/06/07/ssrn-has-not-jumped-the-shark/ (respuesta a Bainbridge [12]; accedido en septiembre de 2026).
Correspondencia: vadimchernets9@gmail.com.↩︎
Cómo citar
Chernets, V. (2026). What Does 7 Downloads Mean? Metric Blindness and the Cold Start of Scholarly Attention After the SSRN Rankings Sunset [Preprint]. SSRN. https://doi.org/10.2139/ssrn.7296358
@misc{chernets2026downloadmetrics,
  author       = {Chernets, Vadym},
  title        = {{What Does 7 Downloads Mean? Metric Blindness and the Cold Start of Scholarly Attention After the SSRN Rankings Sunset}},
  year         = {2026},
  howpublished = {SSRN},
  doi          = {10.2139/ssrn.7296358},
  url          = {https://doi.org/10.2139/ssrn.7296358}
}