7 次下载意味着什么?指标盲点与 SSRN 排名关闭后学术关注的冷启动
这是译文。权威版本是英文原文,引用请以原文为准。
Vadym Chernets,博士,人工智能系统架构师 · ORCID 0009-0007-4845-3163
SSRN 7296358 · DOI 10.2139/ssrn.7296358 · Zenodo 10.5281/zenodo.22166896 · GitHub
- 版本记录:SSRN 7296358 · DOI 10.2139/ssrn.7296358
- 存档副本,可引用且可下载:10.5281/zenodo.22166896 — 概念 DOI,始终指向最新版本
- 完整文本(Markdown 和 PDF):GitHub
- 可读 HTML:https://polyhelper.ai/research/download-metrics/
同一文本位于四个平台上,以便在其中一个无法提供服务时可以访问。SSRN 保存记录版本;请引用该版本。
7 次下载意味着什么?
指标盲点与 SSRN 排名关闭后学术关注的冷启动
手稿类型:批判性综合、方法论框架和预注册就绪的实证议程
版本:2026 年 9 月
作者:Vadym Chernets,博士1
机构:人工智能系统架构师
摘要
2026 年 7 月 15 日,社会科学研究网络(SSRN)停用了其公开排名——论文、作者和机构排行榜,这些排行榜长期以来一直是该平台唯一广泛可用的比较框架,而下载计数和引用统计数据仍保留在各个论文和作者资料中(SSRN 博客,2026 年 7 月 15 日)。结果是一个不对称的测量事件:作者保留了数字,但失去了规范。SSRN 的计数器并未变得毫无意义;它们变得不可读。每个下载计数都成为一个没有标度的数字。
本文论证,问题"7 次下载意味着什么?"在指定了论文的参考类之前在科学上是表述不当的。原始累积使用计数若不考虑论文年龄、领域、发表队列、分布曝露和既有作者知名度,就无法解释。该问题对新论文和低可见性作者最为严重,他们的早期关注受平台架构、电子邮件警报分发、搜索索引、作者声望和注意力的重尾动态的影响,而不是学术兴趣。我们将这种现象称为学术关注的冷启动。这项要求并非新要求:按领域、年龄和文档类型对计数进行规范化是引文计量学中长期既定的实践,对使用数据的类似问题早在十年半前就已提出(Kurtz & Bollen,2010)。这类文献计量指标假设一个字段、年龄和类型已知的数据库,指标为读者计算,而预印本平台向其作者提供的是一个没有参考类、没有工具且(自 2026 年 7 月以来)完全没有比较框架的单纯整数。缺失的不是方法,而是其具体实现:SSRN 没有为作者提供应用该方法的工具。
现有证据表明简单平均值为何具有误导性。在唯一一项最近发表的关于SSRN网络的外部大样本研究中(2,361篇营销工作论文),平均下载次数为221.3,而中位数为87,平均值甚至超过第75百分位数(206)(Jo & Li, 2026)。下载分布呈准对数正态分布,具有极端上尾,在单个学科网络内,平均下载次数在不同子领域之间大约相差8倍(Whalen, 2018),因此平台范围内的平均值并不能描述任何特定论文;将新论文与之进行基准比较就是对聚合虚构进行校准。根据现有的转化证据,7次下载(来自40个摘要浏览)的计数不表示失败。这是一个具有广泛间隔的筛选结果,必须通过覆盖范围、转化、年龄和领域来解读。
基于该证据,本文为排名后SSRN指标建立了一个解释框架,将曝光、摘要浏览、全文下载和下游使用分离开,并添加了一个覆盖范围转化比诊断方法,用以区分不可见性和拒绝。该文提出了冷启动学术关注基准(CSAB),作为单个虚荣数字的多维度替代方案。随附的是一份档案协议,根据该协议,每个报告的指标都应携带其来源、时间窗口、参考类别和限制。本文随后提出了一个预注册就绪的议程,用于重建缺失的规模:从第1天到第180天观察新SSRN论文的前瞻性小组、使用精心策划的电子邮件警报分发和排名退休本身进行的准实验、社区构建的百分位基准以及AI答案引擎中预印本可见性的审计。证据基础结合了引用的研究与附录E的非代表性档案横截面;本文指定了如何重建缺失的基准,以及为什么在提供零上下文的平台上任何下载计数都不应该流通。
关键词:下载计数;使用指标;领域标准化;研究评估;预印本;科学计量学;晋升和终身职位;法学研究;altmetrics;Matthew效应;累积优势;注意力经济;摘要浏览;掠夺性期刊;生成引擎优化。
JEL分类:A14; D83; I23; O33; L86
要点
原始SSRN下载计数如果没有论文年龄、领域、发布队列、分布曝光和先前作者可见性,就没有稳定的解释。
2026年7月15日的排名日落移除了该平台唯一的公共比较框架,而每个计数器都存活了下来:作者保留了数字,但失去了规范。
在唯一最近发表的大样本分布中,下载呈强烈右偏,平均值221.3对比中位数87:"平均"论文在构造上是非典型的。
将覆盖范围(摘要浏览)与转化(每次浏览的下载次数)分开,可以区分不可见性和拒绝:不同的诊断需要采取不同的行动。
已发表的浏览-下载转化锚点聚集在大约11–19%的频带中,其中来自40个摘要浏览的7次下载作为筛选结果与该范围一致:根据现有证据,这不是失败的迹象。
冷启动学术关注基准(CSAB)报告了归一化的覆盖范围、下载性能、转化、动力和下游验证,而不是单个虚荣数字。
一个预先指定的预注册就绪议程(一个前瞻性小组、由平台自身改革创建的两个异常及时的准实验、社区百分位基准,以及在生成引擎优化被视为以证据为基础之前需要进行的AI答案引擎审计)指定了如何重建缺失的规模。
范围和证据纪律
本文是批判性综合,结合了方法论框架和预注册就绪的实证议程,其报告的唯一新数据是附录E的非代表性档案横截面。三类证据在整个过程中保持分离,文章中的每个数字都附带其分类:
1. 经验证的估计:已根据其主要来源进行检查并按其采样框架和年份引用的已发表数字,或在验证不完整的情况下按说明的注意事项进行验证。
2. 历史锚点:较早的样本和已停用的平台功能,之所以保留是因为它们揭示了分布结构,而不是因为它们仍然是2026年的校准规范。
3. 概念和提议的输出:预先指定的预测、基准模板和研究设计,明确标记为这样,不包含合成的发现。
可解释性问题、参考类别论证和覆盖范围转化分解是基于上述证据进行辩护的分析性主张。本文提出的基础设施作为社区构建和评估的设计而提供,而不是作为确定的规定:社区百分位登记处(第8.8节)、作者面向计算器和第8.10节的编排架构。文章中的任何诊断声明都不取决于其中任何一个被采纳。
在刚刚失去最常用公共基准的领域中,稀有的公共商品是任何作者在任何地方都可以运行的可复制协议,以及陈述现有数字来源和年份的综合。
40个摘要浏览和7次下载的案例在本方法论综合中重复出现,因为它阐明了表1中列出的问题;结论基于引用的证据,而不是任何单个仪表板。
三条规则管理综合本身。单位标准化为两个公分母:每篇论文的终身下载次数和每篇论文的十二个月下载次数。桥接仅在源本身报告所需比率的情况下进行,并在转换需要源不支持的假设的任何地方保留本机单位。每个事实陈述都附带一个验证层(根据主要来源进行验证、按说明的注意事项进行验证或等待验证),记录在表的源信心列中。当来源冲突时,最突出的是关于有效日落日期,冲突将有利于较晚的官方来源进行解决并标记。每个估计在任何地方重复使用时都保留其层级、年份和时间相关说明。
一条基本规则管理来源的纳入:当引用贡献了不同的机制、结果、平台事实、测量警告或设计先例时,该引用被保留;引用数量不是目标。发布和被阅读是不同的成就;本文讨论的是第二种,也讨论了测量它的工具的衰落。看起来合理的表格不是证据,在讨论无上下文数字的文章中,那条规则首先约束了文章本身。
1. 引言
1.1 四十次浏览,七次下载
考虑一位研究者(也许是早期职业研究者,可能无任何机构从属关系,或只是该平台的新用户),他将精心准备的工作论文上传到SSRN,几周后在2026年8月打开论文的统计面板。仪表板报告"40个摘要浏览"和"7次下载"。此时,如果缺乏对学术注意力统计的实际工作知识,作者无法判断这些数字是否表示同行的灾难性拒绝、专业文本的标准统计基线,还是不同寻常的强势轨迹的开始。作者问同事:"这很糟糕吗?"没有人能回答。仪表板、学术文献和平台本身都没有提供答案,而且这个计数没有可对照的尺度。这种情况被称为指标盲目性,即面对自己的计数器时无法区分失败、正常表现和成功。这一术语在此作为理论构建而不是测量量来引入。研究4(第8.6节)提供了具体指标(报告从未将自己计数与任何基准进行比较的作者比例,以及低计数所引发的首次阅读分布),使得"指标盲目性"成为预注册调查可以估计的事物。
一个配套场景由作者在社区论坛中讲述,在此作为说明性轶事呈现,更加鲜明。一位研究者上传了第一份预印本,看着仪表板停留在零浏览和零下载,而就在几天内,收件箱收到了五封来自期刊的电子邮件,请求该手稿,所有这些都来自掠夺性期刊。新来者收到的唯一回复来自掠夺性期刊。第7节将这种不对称性开发为一组明确的假设,研究3(第8.6节)指定了如何对其计时。这一场景是信息真空的生活对应物:合法的注意力经济给予这位作者一个无任何可对照的计数,而寄生性经济提供奉承和没有读者。
直到2026年夏季,还存在着一个大致的答案。SSRN的公开排名(顶级论文、顶级作者和机构排行榜)允许作者在可见分布中定位一个计数。2026年7月15日,这些排名被停用[149]。这一停用之前是2026年6月12日的公告,该公告以"研究应该自己说话"[148]来框架化这一决定,以及之前在2026年4月13日宣布的对平台资源在其核心研究共享使命上的战略重新聚焦[146]。这一删除是不对称的:每篇论文的下载计数和引用统计"将继续在您的个别论文和作者资料中记录和显示"[149],而曾给予这些计数尺度的分布已消失。研究者在仪表板前的状况因此被推广到该平台的整个用户基础:超过190万作者和150万论文[49]。
本文关于该情况,其论点分为两部分。排名的关闭删除了上下文,而不是数据。每篇论文的计数器在日落中幸存并仍在显示;可以读取这些计数器的比较尺度已消失,这就是为什么指标是不可读的而不是无意义的。
第二个是问题"7次下载意味着什么?"在指定正确的分母和比较组之前,在科学上是不当的。提供该分母和使用它的工具是本文的任务。
1.2 无标度的数字
解释问题看起来比实际情况简单。七天后的十次下载和九十天后的十次下载是相同的计数,其含义几乎肯定不同,如果一篇论文署名来自国际公认的教授,该教授就职于知名度很高的机构,而另一篇是首次发表者的处女作,差异就更加明显。然而,学术使用指标恰恰以这种完全脱离上下文的形式呈现,因此每个数字都不可避免地成为了罗夏墨迹测试:同样的"40次浏览"会在一个作者心中引发恐慌,在另一个作者心中引起冷漠,因为缺乏共同的参考点。
原始下载计数的期望值随着计数器未显示的所有因素而改变:论文的年龄、其所属领域、其发布时间和日历环境、其实际分发接触,以及其作者的先前知名度。这些因素中的每一个都有实证记录。在单个学科网络的电子期刊中,平均生命周期下载数大致相差八倍,从公司和证券法的约438次到农业法的约53次[168]。访问活动随日历本身而变化,在周末下降约11%,在期刊访问数据中的夏季下降约50%[178]。位置和接触与内容无关而起作用:出现在arXiv公告列表最显眼位置的论文随后获得了显著更高的阅读量和被引用次数,在天体物理学中中位被引用增加约83%[72]。源自著名机构的想法比来自较不著名机构的可比想法传播速度更快、范围更广[111],这种模式与关于地位和关注的长期证据一致[104][105][140][103]。在SSRN上,额外的前50位合著者与可测量的下载率溢价相关[83]。该平台自身的分发机制也影响计数器:作者可选择最多七种分类,纳入策划的基于主题的电子邮件提醒不保证,高容量主题可能面临长达45天的延迟[53][57]。论文的早期计数可能仅反映其相关分发是否已发生。
该平台的计数规则增加了作者很少看到的第二层。SSRN过滤其计数器,丢弃明显的机器人活动和同一人员的重复下载[144][66][69];没有这样的过滤,计数会被夸大"五倍或更多"[18]。浏览和下载通过大致稳定的转换相关联,Black和Caron在2006年报告说,"一般来说,SSRN网站上的三次摘要浏览会导致一次实际的论文下载"[18]。较晚的样本将转换率放在摘要浏览的大约11%至19%之间[139][172],近期营销样本平均每100次浏览约有24次下载[83]。了解这种结构的作者已经可以检查该标题的40次浏览和7次下载(第5.2节进行了计算,该计算落在报告范围内,作为宽间隔筛选结果),但该平台上没有任何信息传达这一点。
没有外部标度来填补这一空白,这使其成为一个测量失败,而不是一个不便。对于h指数[79],存在整个"什么是好的X"指南的类型[118][128]。对于SSRN下载,第2.5节审计截至2026年8月在任何公共来源中都没有找到类似的内容。文献计量学文献报告分布[85][139][168][83],但都没有将它们转化为作者面向的规范。个别学者已经从自己的投资组合中临时制定了厨房基准[42],图书馆指南解释了计数器是什么,但没有说明它们的含义[161][50]。每个作者谷歌搜索的数字找不到。
1.3 风险:职业、焦虑与虚夸的激励
这个差距很重要,因为这些数字后果重大。SSRN自身的文档将其指标描述为"作者用于晋升和终身教职目的,以及机构用于招聘和排名活动"的指标[52]。其使用是具体的且有据可查的:一位著名的法律学者报告说他被"在法律作者所有下载总数中排名第13位,法学院已在各种晋升和相关决定中考虑了这一排名"[12];法律评论投稿指南建议在求职信中提及"SSRN下载量(如果很多)"和"十强榜"名列[95];机构在服务关闭前数周内发布了关于其SSRN排名的新闻稿[101]。在总体层面上,SSRN下载量与百所法学院的引用基排名的相关系数为0.84 [77],这是学校层面的关联,不适用于个别论文或作者,需注意第6.2(iii)节中的生态推断警告。机构对这些措施的任何行动都是一个有良好文献记录的现象的例证:公共排名是反应性的,重塑了它们声称描述的行为体的行为。这一机制在法学院排名中得到了详细阐述,其中可比性和自我实现预言驱动学校围绕该措施重新组织[58][132]。SSRN直接强化了这种用途,定期向前30,000名作者(约360,000名列出的作者中的前8%)发送电子邮件,告诉他们他们在"前10%"[161]。"10%"是列出的作者的比例(30,000/360,000 ≈ 8.3%),而针对超过190万的完整注册作者库[49],同样的30,000接近前2%,因此该措辞描述的是排名作者而非所有注册用户。与此同时,职业建议警告说,单独的自发布指标"可能不会被计入法学院晋升和终身教职目的"[33],更广泛的评估文献记录了基于指标的评估如何深入渗透招聘和终身教职,以及它的设计往往有多糟糕[110][115][153]。下载本身是注意力指标,而不是质量的直接指标:早期使用仅适度预测后来的引用(相关系数约为0.4,解释早期工作中约16%的方差[25],以及后来估计中的0.11–0.35 [80]),高下载量和高引用量的论文集合差异很大[108]。机构将这些数字视为职业证据,尽管它们没有量度并且与学术影响的联系很松散,这对两个对称方向的误读造成了长期的邀请:没有量度,作者可能会因为误读计数器而过早放弃一条研究线,或者花费宝贵的时间和社会资本推广一篇其数字从未异常的论文。排名,无论其有何缺陷,确实为这个关于是否进一步推广论文是否正当的反复出现的决定提供了支持,而其移除使这个选择在没有数据的情况下进行(第6.4节涉及的一个点)。
利害关系也是情感上的:作者在仪表板上体验到的是一种独特形式的指标焦虑,下载计数受到强迫性监视。科学计量学观察者早在2012年就将自我追踪可见性工具的类型描述为"自恋技术"[177],而一位著名的法律学者的承认即监控他的计数"对我来说就像毒品一样"(Bainbridge, 2007,在SSRN游戏行为文献中引用)已经成为具有象征意义的[44]。同一研究计划在实验上确立了焦虑产生的结果:作者自我下载自己的论文以夸大计数,并在顶十榜单的可见性阈值附近以及与同行的不利社会比较下最为激烈地这样做[44]。这种社交反馈循环是注意力市场的一般属性:早期社交信号放大文化市场中的不平等和不可预测性[131],初始正信号偏向后续评估[112],成功在田间试验中产生成功[162]。社交媒体上自我报告的里程碑偏向于高绩效者,加强了仪表板显示7的每个人的比较。因此,公共基准的缺失造成焦虑,激发误解,并激励人为通胀,这破坏了每个人的指标。问题首先是测量问题而不是性能问题:一个同时具有可见性、情感上的指控、职业相关性和不可解释性的指标是测量基础设施的真正失败,而不是盯着仪表板的人的个人缺陷。
1.4 谁受害最深:公平性维度
难以解读的指标的成本分布并不均匀。拥有密集专业网络的作者可以非正式地进行对标;已建立声誉的作者将先前的可见度从一篇论文延续到另一篇论文。公共规范的缺失对早期职业研究人员、独立与无所属机构的学者、狭窄子领域的作者、在平台上历史上占主导地位的学科之外的作者以及精英机构之外的作者造成最沉重的负担。这种劣势是结构性的,而不仅仅是信息性的:SSRN的发现机制通过机构工作论文系列和订阅eJournal提醒来引导注意力[57]。无所属机构的研究人员可以发布论文,但无法将其纳入高流量的机构系列,而是完全依赖主题分类来获得可见性[168][53]。对于这样的作者,机构曝光渠道实际上已经关闭,因此发现的重任不成比例地落在搜索和AI层上。第8节中审视的机器可见性因此是一个公平问题,而不仅仅是技术问题。仅凭领域成员身份就能在任何价值判断之前使预期下载量增加数倍[168]。声望效应在首次曝光的瞬间起作用,因为公共SSRN页面在标题和摘要旁边显示作者名称和所属机构。双盲评审则不同:删除作者身份可以显著降低有声望的作者的评审分数(在一项涉及5,027份ICLR提交的研究中,对录取决定的影响不太明确)[154],评估在实验中对身份信号有反应[64]。在关注分布的最底部,现象是缺失而非不平等:在替代计量数据中,在一个大型以SDG为重点的样本中研究的所有领域中,无资助研究的中位社会关注都为零[41],而相关开放平台上的关注比发达经济体中的收入分配更加不平等,基尼系数超过0.9[180]。对于中位作者来说,"7次下载是否很差?"这个问题是尝试解读系统返回的唯一信号,在一个几率在结构上不对等的游戏中,而不是虚荣心的表现。任何忽视这种不对称性的解释框架都会通过将不可见性误读为拒绝而对处于劣势的群体进行系统性错误诊断。这种不对称性也向前延伸:如果新兴的AI答案层继承了商业生成式引擎优化中所记录的品牌和位置偏差[5][164],它将再现而非弥补这种不平等。这一前景对无所属机构的研究人员和全球南方的作者影响最重,这是第8.6节的机器可见性审计属于公平议程而非平台琐事的原因之一。
1.5 对解释的文献记录的需求
对量表的需求不是假设性的。这是学术界讨论中最持久的模式之一,并且其早于日落至少十年。表1总结了作者问题和关切的反复出现的群集,以及每个群集最强的文献记录证据、每个群集引发的不安全的捷径(看起来有帮助但实际上是错误的简短答案),以及本文中回应它的部分。
表1. 对解释的需求:文献记录的社区痛点群集(2005–2026)
| # | 群集 | 作者提出或报告的内容 | 文献记录的证据(置信度) | 不安全的捷径 | 在以下部分解决 |
|---|---|---|---|---|---|
| 1 | "我的数字正常吗?" — 缺失的基准 | 给定的下载计数对于可比论文是否为好、坏或典型 | 公开问题"Importance of paper download statistics",Academia StackExchange,2016年(标题和日期已通过官方API验证)[3];关于在SSRN上发布及其价值的用户问题[126];反复出现的论坛帖子询问多少下载算作"好"(线程存在已确认;个别回复不可独立验证,且论坛材料始终被视为需求的弱证据,而非数据)[B-3];首次作者对新发布的工作论文的"诚实意见"的请求(Reddit,2026年4月;存在已通过第三方存档验证)[B-5] | 一个通用的原始计数阈值("N个下载=好") | 第3、5–6节 |
| 2 | 机制混淆 — 浏览与下载 | 为什么浏览超过下载;低比例是否意味着摘要较弱 | 历史上的3:1经验法则[18];报告的转换范围11–19%[139][172];最近样本均值≈24%[83];图书馆指南记录了作者对计数器包含内容的不确定性[161] | 自动声称低比例意味着摘要较差 | 第4–5节 |
| 3 | 情感和社会比较 | 强迫性检查;对低和高计数都感到尴尬 | "对我来说像毒品一样"(Bainbridge,2007年,引自[44]);社会比较下靠近顶级列表阈值自下载的实验证据[44] | 将自己与平台范围的平均值或排名靠前的论文进行比较 | 第1、5节 |
| 4 | 职业证据 — 在档案中替代排名行的内容 | 在日落之后在终身职位、晋升和招聘材料中引用的内容 | 下载排名"在各种晋升和相关决定中被考虑"[12];前10%通知邮件[161];求职信建议[95];机构新闻稿[101];平台对评估用途的描述[52] | 引用没有日期、来源或分母的原始累计下载数 | 第6节(表13) |
| 5 | 发布后招揽垃圾邮件 | 发布后不久收到的未邀请的期刊邀请 | "我每天至少收到两封这样的电子邮件"(Reddit r/AskAcademia,2023年;已通过存档验证;作者曾在MDPI期刊上发表,而非在SSRN上)[127];从论文中进行地址收集"例如在SSRN上发布的那些"[107];招揽量审计[9][84][63];确认29项学术垃圾邮件实证研究的系统评价[61] | 从聚合计数器推断读者的身份或意图 | 第7节 |
| 6 | 对计数器的信任 — 机器人、作弊、突然下降 | 数字是否真实;计数器下降的原因 | "SSRN完全没有做任何事情来验证其准确性"(Goldman,2005年,早于当前过滤器;之后的更新记录SSRN对重复的同一来源下载进行折扣)[66];SSRN发布的数据完整性过滤[144][66][69];机器人流量在早期RePEc数据中占摘要浏览的~74%,但仅占下载的~7%[99];2025–2026年间RePEc上的大规模机器人过滤事件[129] | 将显示的数字视为独特人类读者的精确计数 | 第4、9节 |
| 7 | 诊断 — "为什么零下载?" | 零或停滞在前几周意味着什么 | 社区线程中记录的日落后作者不确定性(存在已通过第三方存档确认)[B-5];平台支持页面描述了指标,但截至2026年8月,没有提供解释指导[52][50](搜索审计,第2.5节) | 将分发前的零视为拒绝 | 第4–6节 |
注。只有对现场或存档源独立验证的引用才会逐字再现;所有其他社区材料都被改写并用其置信度状态标记。第9节讨论了引用用户帖子的伦理,包括匿名化和已删除内容的处理。
表1中最强的群集是长期问题"我的数字正常吗?",这在多年、平台和学科中反复出现。即使平台内部人士也无法提供基准,而社区论坛中经常出现的讽刺回应表明,包括资深用户在内,没有人掌握这份缺失的量表[B-3]。这些群集也是因果相连的:缺失的基准(群集1)产生了情感负荷(群集3),这产生了[44]中记录的游戏激励,这反过来又削弱了群集6中探测的信任。恢复可解释性在其根源处解决了这个链。该框架的目标不是增加下载,而是恢复意义。
1.6 本文论证的观点:八个立场
以下是本文辩护的观点,每个观点都在相应的章节中进行了论证。
1. 原始计数若无参考类别则无法解释。 累积下载数若不根据论文年龄、研究领域、发布批次、分发渠道和作者先前知名度进行调整,就没有稳定的含义[83][168][178][53]。这是第5节的参考类别问题,它使得"7次下载算不错吗?"这个问题本身就是不适定的。
2. 低覆盖率和低转化率是不同的诊断。 接触人数少的论文所带来的问题不同于被许多人查看但很少下载的论文,需要采取不同的对策。不可见性并不等同于内容被拒。第4-5节将这一区分发展为覆盖-转化率诊断框架(表9),包括强转化率与弱覆盖共存的"隐性兴趣"配置。
3. 计数器保留了下来,但比较尺度没有。 落幕的不对称性(数字保留、规范被移除[149])恰当地描述了后排名时代的条件,并将一个长期潜在的可解释性问题转化为一个紧迫而普遍的问题(第2节)。
4. 百分位基准是一种公共品。 每位作者都会搜索但找不到的数据就是按学科和论文年龄分类的百分位表。第5和8节阐明了社区如何在无法再从平台上直接获取这些数据的情况下,建立和维护这样的表格。
5. 校准的规范需要从发布时起就观察的面板数据。 已发表的证据包括老化的横截面数据和单一快照[139][85][168][83]。最近的一项大型研究明确指出面板数据是必要的下一步[83]。如果没有从第零天开始的观察,第一周和第一个月的"规范"就是推算值,必须如此标注(第8节)。
6. 多维基准优于单一虚荣指标。 分别报告规范化覆盖、下载表现、转化率、势头和下游验证(CSAB,表10)保留了任何复合指数都会丧失的诊断信息(第5节)。
7. 人工智能答案引擎正在成为注意力分配的新守门人。 发现渠道正在向上移移,从期刊品牌、存储库、搜索引擎到人工智能答案引擎(后者综合给出单一回答并引用少数来源)[5][164]。四分之一的美国成年人已经每天使用AI聊天机器人[121],但这些引擎作为引用渠道的可靠性仍存争议[82],目前还没有关于学术预印本在其中可见性的对照研究[100]。第8节阐述了简化版审计协议;完整审计留待后续工作中进行。
8. 现在需要建立仪表板和档案协议。 作者和委员会不能等待新的数据基础设施。第6节为阅读仪表板提供了临时规则,为档案提供了七步证据协议(表13),其管制要求是每个报告的数字都要显示其来源、时间范围和限制。
1.7 贡献
下面的列表说明本文对现有文献的补充,按各部分展开的顺序排列。
1. 诊断。它指出了平台使用指标中的参考类问题,并命名了底层现象:学术关注的冷启动。该术语改编自推荐系统文献,其中冷启动项目缺乏将其放置所需的交互历史[133]。在这种冷启动中,新论文和新作者进入扩散系统,其中早期关注主要取决于平台架构、分发和先前的声誉,然后才能充分发挥实质性质量的影响[72][111][140][83]。核心主张是第1.1节的不适定性论题:标题问题直到其分母和比较组被提供后才有答案。
2. 整合的基准地图。自日落以来(第2.5节审计,2026年8月),它首次将SSRN下载和摘要浏览的每个已验证经验基准汇总到一个表中(表7),具有明确的抽样框架、年份、老化警告和每行的来源置信度评级。基准是大样本分布证据[83]、准对数正态的前列表抓取[85]、法律学术样本[139][168][171][172]和平台聚合[1][49]。
3. 具有诊断功能的关注漏斗框架。它将扩散分解为曝光、摘要浏览、全文下载和下游使用。然后它推导出到达转换矩阵(表9),该矩阵将不可见性与拒绝分开,并包括原始计数系统地掩盖的隐藏兴趣配置。
4. 解释工具。它将基准地图转换为分级解释规模(初期/适度/扎实/强大/卓越;表8)、带有实际例子的转换带和冷启动学术关注基准(CSAB;表10),一种按领域、年龄、队列和先前作者可见性归一化的多维报告格式。规模的带仅在同一领域和论文年龄内具有比较性,因为字段成员资格本身会将预期下载量移动多倍,每个边界要么来自来源,要么显式标记为作者估计。
5. 实践层。它提供阅读自己仪表板的规则、零下载情况诊断、基于情况的操作表(表23)、掠夺性征求信号的假设分类法(但需注意的是诈骗垃圾邮件既不移动计数器也不证明阅读)(表14)、以及七步档案协议(表13)。
6. 预注册就绪的研究议程。它指定了一个前瞻性队列,观察自发布后的第1、3、7、14、30、60、90和180天,以及两个准实验设计:策划的电子邮件警报分发作为论文内关注冲击,排名退休作为度量可解释性的自然实验。它进一步指定了社区构建的百分位数据集作为获取新鲜百分位的唯一剩余途径、针对AI答案引擎的紧凑机器可见性审计协议,以及本文自身下载轨迹的预先指定的纯描述性记录。每项研究都可在低成本和第9节的访问和伦理限制范围内执行,数值预测陈述为预先指定的区间而非发现。
1.8 文章的组织
本文的余下内容包括九个进一步的部分和五个附录。第2部分重构了该事件及其背景:2026年改革方案的完整时间表、保留的内容和移除的内容(表2、图1),以及该平台声称的资源重新配置和重新聚焦的理由。第3部分呈现经验证的分布证据,并说明为什么平均值会误导。它涵盖了均值-中位数差距[83]、准对数正态尾部[85]和学科异质性[168](图2-4、表3-5),衬托于马太效应和累积优势的理论背景[104][105][131][162](这些动态已在纵向职业生涯和引文轨迹中被直接量化[120]),以及注意力措施和质量措施之间的区别[25][80][108][178]。第4部分考察计数器的机制:筛选和数据完整性[144][66]、机器人和幽灵流量以及必要的反驳论证[99][106][129]、平台架构(表6),以及元数据和版本控制卫生。第5部分阐述了解释的核心:参考类论证、综合基准图(表7)、解释尺度(表8)、转换带、覆盖-转换矩阵(表9),以及CSAB(表10)。第6部分将该框架转化为对作者和评估委员会的实践指导,包括档案规程(表13)以及在附录A中的基于情况的指导(表23)。第7部分分析了注意力经济的寄生层,将掠夺性招揽视为假设的可见性信号,所有时间和流行率声明都作为假设表述[9][61][63][84][107]。第8部分阐述了预注册就绪的实证议程,包括注意力向堆栈上层的AI答案层迁移的简明处理及其对预印本可发现性的影响[5][100][82][121][164]。第9部分详细说明了局限性,包括最佳可用分布证据的单一来源特征[83]、2012-2015样本的老化,以及平台文档的不稳定性。第10部分以对SSRN的政策建议作为结论(首先是按学科和论文年份的匿名百分位数范围作为替代方案,在恢复背景信息的同时不重新激发排名竞争),以及对研究社区的建议。
2. 事件:排名日落及其背景
2.1 排名的构成
在SSRN历史的大部分时期,其使用计数器位于一个密集的比较体系内。在论文层面,该平台维护了按十二个月和历史总下载量排名的前10,000名论文列表,以及各电子期刊的"最近顶级论文"列表,这些列表按滚动六十天时间窗口计算。在作者层面,它维护了跨所有学科的前30,000名作者列表和学科排行榜,如前3,000名法律作者,可按新增下载、总下载、每篇论文的下载数和引用次数排序。在机构层面,它维护了包括美国前350所法学院和国际前500所法学院的月度排行榜[B-9, 历史排名页面;自2026年7月15日以来,所有此类URL都返回错误或占位符页面,只能从存档副本中引用]。该平台还将排名转化为直接的百分位数反馈。正如University of Washington Gallagher Law Library的SSRN度量指南所记录的,"SSRN定期向按新增下载和历史总下载量排名的前30,000位作者发送消息,告诉他们他们在前10%"。根据该指南自身的"超过360,000名作者"数据,该阈值大致对应于已列出作者的前8%(约360,000人中的30,000人)[161, 2026年8月14日访问],是一个宽泛的上层而非狭隘的精英;第1.3节指出,与全部注册基础相比,同样的30,000人更接近前2%。实际上,这些列表和消息是唯一由平台提供的、面向作者的关于SSRN下载的百分位数信息,曾被公开。
这个比较体系并非装饰性的。Black和Caron在2006年提议SSRN下载可以作为法律院系学术表现的"测试"衡量标准,补充声誉调查和引用计数[18]。同一研讨会卷包含了对该提议的批判性审查[45]。从制度上讲,该提议取得了成功:下载排名进入了招聘材料、晋升文件和机构宣传。SSRN自己的支持文档将其指标描述为"作者用于晋升和终身职位目的的数据,以及机构在其招聘和排名活动中使用的数据"[52, 2026年8月14日访问]。The Legal Writing Institute的出版指南建议作者在投稿至法律评论期刊的信函中提及"SSRN下载(如果很多)、列入SSRN前十下载列表"[95]。2026年6月,Stephen Bainbridge将职业功能列入记录:他"在3,000名法律作者中按历史总下载数排名第13位,法学院在各种晋升和相关决定中已考虑过这一点"[12]。SSRN自己的领导层在其当时首席执行官的预印本中记录了该平台对法律学术交流的变革[68]。机构也推销这些排行榜:直到2026年1月,Maynooth University宣布其School of Law and Criminology在SSRN国际前500所法学院排行榜中在爱尔兰部门中排名第一,引用了超过143,500次下载[101]。Edelman和Larkin对SSRN服务器日志的分析记录了该体系对行为的控制。该研究发现,当一篇论文接近前十名列表的边界时,欺骗性自下载强度增加,并确定社会比较而非职业利益本身是操纵的主要驱动力[44]。同一项研究流传了一则言论,据称是2007年Bainbridge说的,监控自己的下载数"对我来说就像毒品一样"[44]。
该体系有第二个不太引人注意的功能。引用和声誉调查按多年周期运作;排名以近乎实时的方式返回反馈,让早期职业学者和来自非名校的作者能够直接展示可见的影响,而无需等待更慢和更保守的把关工具。无论其缺陷如何,排行榜是平台上每位作者都能平等看到的唯一比较工具。这部分解释了为什么它们的移除可能最严重地影响那些非正式替代品最少的作者,如第1.4节所论证的。关于排名移除的影响的直接分布证据还不存在,所以这是RQ1(第8.5节)测试的方向性期望:双向的,它询问移除是否集中或分散了关注,而不预设符号。
2.2 2026年撤回的时间顺序
2026年7月15日对排名的删除是自2025年末开始的一系列平台决策的顶点,如图1所示。
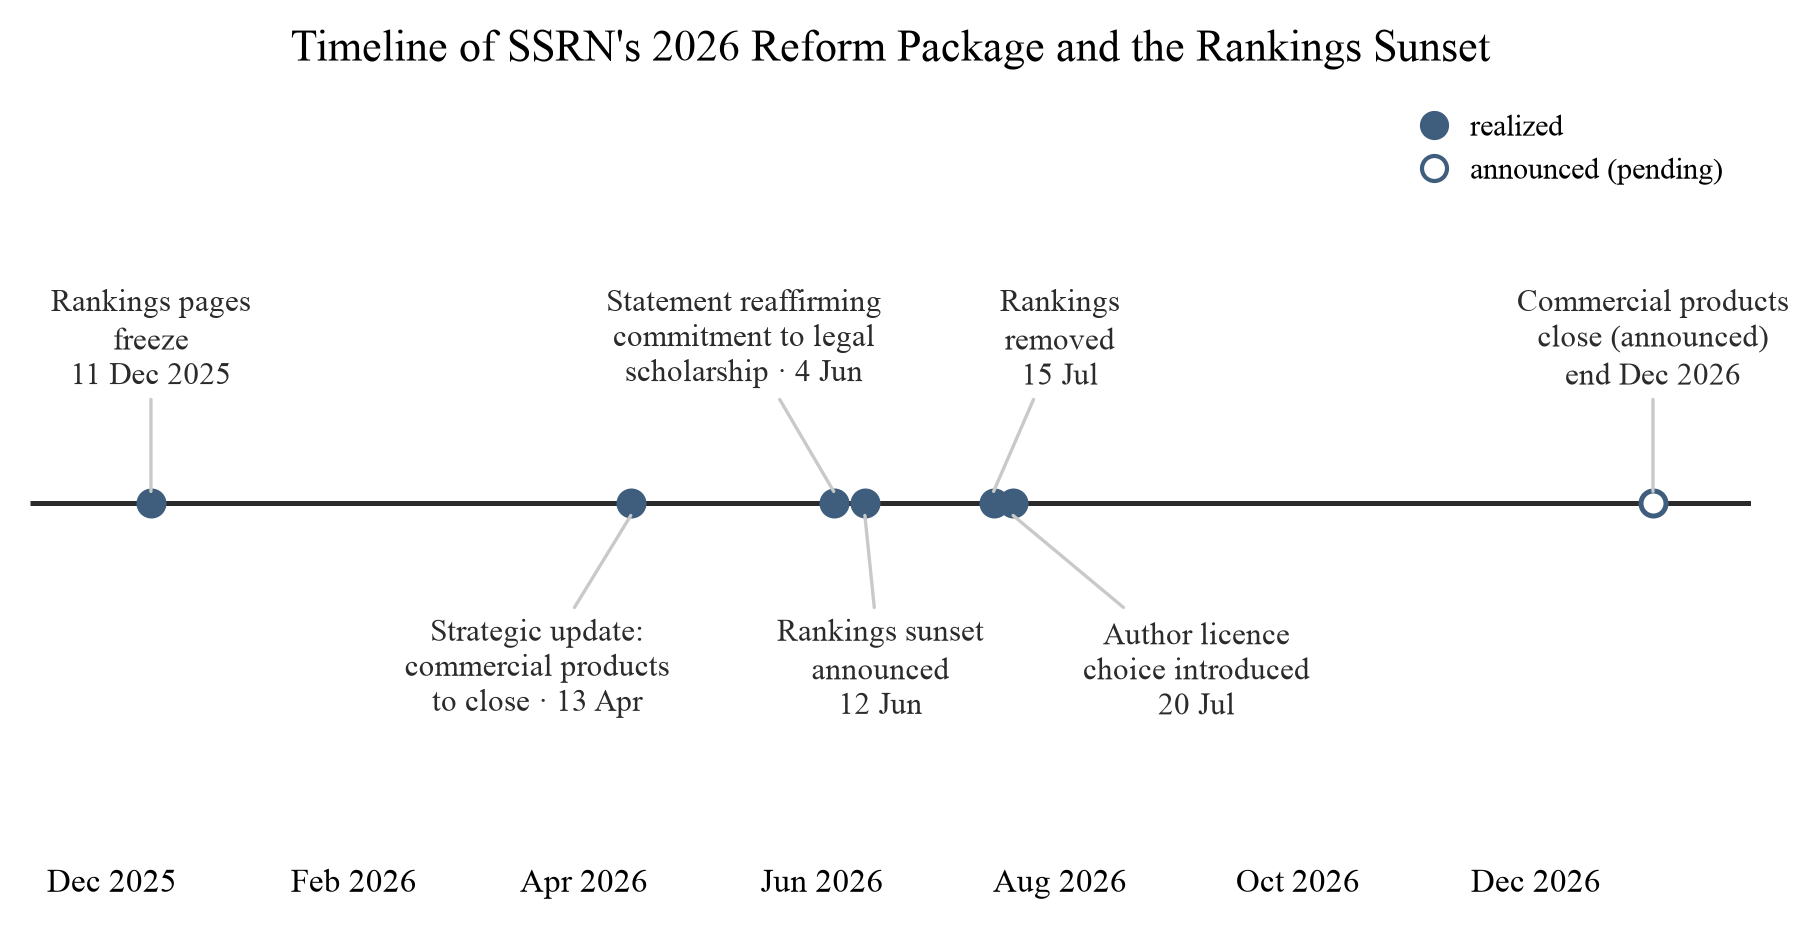
图1. SSRN 2026年改革方案时间表。事件:按电子期刊划分的下载排名页面的冻结(从2025年12月11日开始,如2026年1月25日TaxProf博客文章所记录[B-2]);宣布到2026年底关闭所有商业产品的战略更新(2026年4月13日)[146];重申SSRN对法律学术承诺的公开声明(2026年6月4日)[147];宣布排名将从"2026年7月1日"起停用(2026年6月12日)[148];排名的实际移除(2026年7月15日)[149];引入作者许可证选择(2026年7月20日)[150];宣布剩余商业产品的关闭(2026年12月底)[146]。资料来源:[146][147][148][149][150][B-2]。
恶化开始于任何正式公告之前。2025年12月11日,按电子期刊划分的下载排名页面停止更新。Paul Caron已运营基于这些排名的每周"新税收论文前五名"栏目二十多年。在2026年1月25日的一篇文章中,他记录了税收排名已冻结在"2025年10月12日至2025年12月11日"的时间窗口,并写道"这可能是SSRN新税收论文前五名的终结"[B-2,摘自2026年1月25日文章的转述,而非任何SSRN公告]。
2026年4月13日,SSRN发布了"战略更新",宣布将重新关注其"核心研究分享使命",并宣布到2026年底关闭所有商业产品(研究论文系列、赞助网络、网站订阅、付费会议论文集、分析仪表板、招聘和公告以及数据源)[146]。图书馆工作人员在数日内注意到了这一变化[34],Elsevier的Digital Commons部门为其研究论文系列收藏被停用的机构发布了迁移指南[47]。
这一宣布在法学学术界引发了公众争议,这个社区最依赖排名系统。2026年6月3-4日,Bainbridge发表了一篇广泛阅读的批评文章,题为"社会科学研究网络跳过了鲨鱼",之后又发表了一篇记录SSRN对其投诉的回应(包含关于论文系列关闭时间表和学科电子期刊保留情况的澄清)的文章[12]。2026年6月4日,SSRN发表了关于其"对法律学术的持续承诺"的声明,承诺电子期刊发行和邮件提醒"将保持不变"[147]。2026年6月7日,Caron在TaxProf博客上回应了Bainbridge,文章题为"SSRN没有跳过鲨鱼"[B-11]。这场交流是一份简明的公开记录,反映了社区在这些特征移除前对该平台比较优势的估价。
2026年6月12日,SSRN宣布将"从2026年7月1日起停用排名",并称"在SSRN,我们一直相信研究应该为自己说话"[148]。关闭比最初宣布的晚两周生效:2026年7月15日,论文、作者和机构的排名被移除[149]。五天后的2026年7月20日,进一步的改革引入了作者许可证选择[150]。宣布日期和实际日期之间的两周差异,以及公告和执行之间的一个月窗口,本身在分析上是相关的:它们创造了一个预期期间,作者和机构可以在此期间观察即将到来的变化,第8节的准实验设计对此进行了分析。
2.3 官方理由及其演变
该措施停用的官方理由是资源配置和平台重新聚焦。七月的公告解释说排名"需要大量的产品和开发资源",并将该决定与更快发布、更好的可发现性和研究诚信等重新聚焦的目标相关联。公告还指出"下载次数和引用统计将继续被记录并显示在您的个人论文和作者资料中" [149]。该公告为比较功能的可能回归留下了空间:SSRN表示它"可能会重新考虑各种排名的理念" [149],因此不应将删除描述为永久性的。记录中的沉默同样重要:这些公告没有将该决定归因于指标博弈、操纵或对排名的竞争性滥用,而声称这些动机的说法超出了已发表文本的范围 [148][149]。
官方解释的语调在公告和替代排名URL的着陆页之间发生了演变。六月的帖子讨论的是资源配置问题,而替代页面指出SSRN"新方向将个人作者及其工作置于我们所做一切的中心",并且"高校和院系的汇总排行榜不再符合这一愿景" [B-8;该页面受访问限制,这些短语引自搜索索引副本,因此任何引用都应附带存档版本]。六月的帖子将停用措施呈现为成本决定,而替代页面呈现为有原则地完全放弃机构比较的重新定位。
SSRN为作者保留了官方参考指导。其评估论文影响的支持文档引导作者查看论文级别的计数器(摘要浏览和下载),辅以PlumX Metrics,一个Elsevier替代计量产品,聚合引用、使用和社交媒体信号 [50, accessed 14 August 2026]。因此,PlumX事实上成为了该平台对解释性背景的替代品。这是一个部分替代品:它为单篇论文聚合额外的信号,但不提供分布、百分位数或同类比较。这些正是排名曾经提供的元素,尽管不完美。停用不包括SSRN与期刊工作流程的整合:First Look计划继续将该平台与1,200多个Elsevier期刊连接 [48][145]。该平台的商业治理也将这些产品决定置于高度集中的学术出版市场的背景下 [94]。
2.4 保留的内容和被移除的内容
表2绘制了该平台日落后的状态,以及每个元素的测量含义:对于任何试图读取计数的人来说,每个存活、消失或未报告的功能意味着什么。此次移除是不对称的。每个论文和每个档案的计数器都被保留。建立在这些计数器基础上的比较机制被完全撤销。
表2. Rankings于2026年7月15日日落后保留的内容和被移除的内容,及其测量含义。 来源:[147][149][161][B-8][B-9];曝光机制行:[53][57][55][144][66][69]。
| 功能 | 2026年7月15日后的状态 | 来源依据 | 测量含义 |
|---|---|---|---|
| 按论文下载计数 | 保留;在论文页面上显示 | 在日落声明中逐字确认[149] | 原始使用情况仍然可以观察到,但现在没有自己的参考类别 |
| 按论文摘要浏览量 | 保留(在日落声明中未逐字命名,该声明列出了"下载计数和引用统计";浏览量继续显示) | [149],平台观察,访问于2026年8月14日 | 覆盖范围仍然可以观察到,所以按论文覆盖-转化诊断(表9)保持可计算 |
| 引用统计(论文和作者档案) | 保留 | 逐字确认[149] | 下游使用仍然可以补充早期关注指标 |
| 作者档案(论文、隶属关系) | 保留 | 平台观察,访问于2026年8月14日 | 作品集级别的聚合仍然可能,但存在相同的缺失分母 |
| eJournal订阅和电子邮件警报 | 保留 | "保持不变",2026年6月4日声明[147] | 推送曝光渠道持续存在,所以早期计数器仍然依赖于架构(第4.4节) |
| 主题分类(1–7,作者选择) | 保留;控制eJournal路由 | 平台文档[53] | 分类是一个潜在有后果的曝光变量 |
| 精心策划的eJournal分发 | 继续;包含"精心策划和有针对性的,不保证" | [53][57][147] | 分发状态和日期应该被建模为一种处理,而不是背景 |
| 高流量主题中的分发延迟 | 继续;最多45天 | [53] | 第一个月的计数可以混合分发前后的阶段 |
| 外部索引(Google、Google Scholar) | 继续,按搜索引擎控制的时间进行("6–9个月或更长时间") | [55] | 一个区间审查曝光过程:曝光日期是有界的,而不是观察到的 |
| 可疑活动过滤 | 继续 | [144][66][69] | 计数是过滤事件,而不是经过验证的阅读或认可 |
| AI答案对论文的检索 | SSRN未报告 | 不存在平台报告;第8.6节 | 机器可见性需要独立、重复的审计(研究2) |
| 论文页面上的PlumX指标 | 保留;影响评估的官方指标 | 支持文档[50] | 额外的按论文信号,但没有分布、百分位数或队列比较(第2.3节) |
| 热门论文列表(前10,000;按eJournal最近/全时) | 移除;URL返回错误或日落登陆页面 | [149][B-8][B-9] | 一个主要的比较框架——以及一个可能的发现途径——消失了 |
| 热门作者列表(前30,000;学科排名) | 移除 | [149][B-9] | 作者级别的百分位数排名不再公开可观察 |
| 机构级别排名(美国前350名/国际法学院前500名等) | 移除 | [149][B-8][B-9] | 机构比较不再能从平台数据计算得出 |
| 公开百分位数框架(作者排名,"前10%"定位) | 与排名基础设施一起移除 | [149][161] | 参考类现在必须在外部重建(第5、8节) |
| "前10%作者"通知电子邮件 | 命运未在官方通信中解决;电子邮件与排名基础设施相关联 | [161][149] | 档案可用的百分位数信号不再能被假定会到达 |
表 2 中存活的行完全是原始计数器和为其提供数据的曝光机制:该平台继续以与之前相同的速率生成数字。被移除的行完全是比较框架的集合:分布、阈值、排名和百分位数信息。因此,该事件具有精确的信息结构(数据保留,参考类别撤回),这种结构将一个长期存在的潜在问题——如何读取 SSRN 号——转化为一个急迫且普遍的问题。我们将发生变化的平台属性称为 基准不透明性:一个平台的分级属性,描述它是否发布了定位单个计数(百分位数、中位数、队列分布)所需的分布统计数据,或者仅发布原始计数、平均值和 top-N 列表。2026 年 7 月 15 日,SSRN 一步到位地从部分透明度转变为接近完全的基准不透明性,本文的其余部分可以被理解为对该属性给用户带来什么代价的研究。所以定义的不透明性至少有四个维度:人口覆盖范围(已发布的统计数据描述的人群)、参考类别粒度(它们是否根据领域、年龄和队列进行条件设定)、时间稳定性(定义和窗口是否在一段时间内保持可比),以及可审计性(计数规则是否足够公开以供检查)。这四个维度在一定程度上独立运行:排名可以减少一种形式的不透明性,同时如果其分母和选择规则不明确,会加剧另一种形式的不透明性。这种部分独立性就是为什么第 10.4 节(第 4 项和第 8 项)的平台建议涉及披露本身,而不仅仅是比较数字的返回。为了使该属性可衡量,每个维度都在应用于平台的公开界面和文档的显式序数检查表上进行评分:人口覆盖范围(0 = 仅原始计数,1 = 发布平台范围的汇总统计数据,2 = 已定义人群的分布统计数据);参考类别粒度(0 = 无,1 = 一个轴,如领域,2 = 联合领域 × 年龄 × 队列条件设定);时间稳定性(0 = 计数定义和窗口未记录或默默修订,1 = 已记录,2 = 已记录并进行版本控制);以及可审计性(0 = 计数规则未发布,1 = 用散文描述,2 = 以可检查的细节发布)。平台的不透明性配置文件则是四元组分数而非单个标签。同一工具对日落前后的 SSRN 进行评分(在覆盖范围、粒度以及对于已停用的列表、参考类别粒度方面向下移动),它还允许将表 6 的跨平台比较表述为分数而不是印象。一个平台可以显示许多数字,同时仍然保持几乎完全的不透明性。该量表是第一个操作化,待完善和评分者间测试,而非最终指标。
2.5 对解释的需求
这个被日落事件赋予紧迫性的问题,其实早就有人在提问。表1(第1.5节)汇编了有文献记载的作者对解释的需求集群,仅限于经验证的来源。论坛材料在那里被引用作为需求的证据,而非分布情况的证据,用户帖子的引文仅在帖子本身所在的位置再现(引用半公开论坛帖子的伦理问题在第9节讨论)。
下面的阴性发现基于系统化搜索审计而非随意搜索,第1.2节、1.5节(表1)和8.8节中的相应陈述也遵循同样的方法。步骤说明如下。我们用英文编制了超过25个查询表述的清单,分为六个意图集群:规范性("有多少SSRN下载量是好的")、定义性("SSRN下载计数包括什么")、日落后导航类("SSRN排名消失——在哪里对比")、评价性("SSRN下载量能作为职位晋升证据")、诊断性("SSRN论文为什么零下载")和实践性("如何增加SSRN下载量")。对于每个查询,我们记录了谁目前在回答它以及回答得如何,标准是返回的任何来源是否提供了分级的、针对具体领域的基准值,而不是对度量的描述或个案举例。作为正对照,我们对h指数、ResearchGate评分和引用计数进行了类似的查询,这些查询清晰地呈现了文献[118][128]中记录的阈值指南类型。对SSRN下载量的相同意图表述在日落前后都没有呈现任何等价物。这一缺口延伸到最广泛查阅的社区参考资料:平台的百科全书式概览描述了计数器是什么,但没有为其提供解释规范[170]。该审查在2026年7月至8月进行,使用跨越通用网络搜索引擎和消费级AI回答引擎的定制管道,自动执行查询和回答质量评分。完整的查询列表可从作者处获得。结果是一个阴性发现,仅作为这样声称:在审查窗口所涵盖的语言和搜索引擎范围内没有发现证据,而非证明此类资源不能存在。
对于相邻的度量,表1(第1.5节)中记录的解释需求长期以来已由大众文体满足:"什么是好的h指数"由数十个分级的、针对具体领域的阈值指南服务[118],学科级引用规范是广泛阅读的解释文章的主题[128]。对于SSRN下载量,没有这样的文体。更糟的是,现存最完善的结构化指南——华盛顿大学法律图书馆页面——在2026年7月15日之后继续用现在时描述顶级作者和顶级论文排名,这使得该指南恰好在需求最迫切时却部分地变得误导人[156,访问于2026年8月14日]。日落事件没有造成解释问题;它移除了生态系统拥有的仅有的部分答案,正是在制度记忆关于分布情况开始衰退的时刻。
3. 数据显示什么:为什么平均值会说谎
3.1 计数器测量的内容及其局限
任何对保留计数器的使用都以理解这些计数器测量内容为前提。表3总结了每个指标的测量内容、主要混淆因素及其可合法发挥的诊断作用。
表3. SSRN指标测量的内容及其不测量的内容
| 指标 | 最接近的实质性解释 | 主要混淆因素 | 适当的诊断作用 |
|---|---|---|---|
| 摘要页面浏览量 | 论文登陆页面的触及范围 | 搜索曝光、平台位置、作者声誉、外部推广、标题、领域规模、在线时间 | 曝光/触及范围 |
| 全文下载 | 检查或使用完整论文的意向 | 影响浏览的所有因素,加上摘要质量、相关性和下载阻力 | 参与度 |
| 每摘要浏览的下载量 | 从登陆页面曝光到全文获取的条件性转变 | 分母过小、重复行为、异质流量来源 | 转化 |
| 引用 | 对后续学术文献的可观察纳入 | 领域引用规范、发表滞后、数据库覆盖、自引用、地位效应 | 下游学术应用 |
| 替代计量指标/PlumX信号 | 更广泛的在线参与 | 平台构成和用户行为 | 补充性扩散证据 |
表格内容可压缩为两个方程的对比。仪表板无言邀请的解读是下载量=科学质量。可防守的表述是
观察下载量 = f(Q, E, R, C, T, P, ε),
其中Q表示与研究质量或相关性相关的特征,E表示曝光,R表示声誉,C表示交流特征,T表示时间和年龄,P表示平台机制,ε表示未观察到的影响。这个表达式对混淆因素进行分类;未指定函数形式或系数。这个分类准确地陈述了实际难点:研究人员通常只能观察到左侧。
该表适用两个边界条件。计数器不是原始流量日志。SSRN自至少2000年代以来就已过滤其计数:该平台声称排除同一人的明显重复下载和明显机器人下载(使用"异常活动的线索"),以及排除作者总数中受疑的匿名下载[144]。Black和Caron估计,没有这种过滤,计数器会被夸大"五倍或更多"[18]。计数的下载记录一个参与事件,与认可无关。计数器测量注意力过程的阶段。其中没有任何一个测量科学价值,且每一个都受到在任何读者评估内容之前起作用的可见性因素的混淆[44][72][144]。这些局限自最早的阅读数据书目计量分析以来就得到认可[91]。这些阶段也可通过两个假设的机制相互分离:政策相关主题的论文可能被从业者大量下载而他们阅读但不引用,而专业论文可能下载量少但被需要它们的小型专家社群稳定引用。任何一种模式都将可见性与下游应用分离,这是高度下载和高度引用的论文集合只部分重叠的原因之一[108]。
3.2 平台聚合及平均数的虚构
SSRN本身发布的唯一与分布相关的数字是平台总数,关于这些数据首先要注意的是这些总数被平均后会发生什么。表4收集了经过验证的平台统计数据及其截至日期。
表4. 经过验证的SSRN平台统计数据,包含截至日期和验证状态。
| 数量 | 数值 | 截至 | 来源 | 验证状态 |
|---|---|---|---|---|
| 全文论文 | 1,157,048 | 2023年12月18日 | ALL-SIS Citation Methods White Paper [1] | 与已发布的PDF核实 |
| 摘要 | 1,309,385 | 2023年12月18日 | [1] | 已验证 |
| 作者 | 1,479,875 | 2023年12月18日 | [1] | 已验证 |
| 累积下载数 | 256,678,716 | 2023年12月18日 | [1] | 已验证 |
| 末12个月下载数 | 40,642,329 | 2023年12月18日 | [1] | 已验证 |
| 全文论文(早期参考点) | 571,040 | 2016年7月6日 | [1] | 已验证 |
| 末12个月下载数(早期点) | 12,897,685 | 2016年7月6日 | [1] | 已验证 |
| 预印本/论文;作者 | "150万+"; "190万+" | 2026年产品页面 | Elsevier SSRN产品文档 [49],访问于2026年8月14日 | 已验证(舍入营销数据) |
| 论文;作者;下载总数;12个月下载数 | >170万; >240万; >3.44亿; >5400万 | 2025年11月1日 | SSRN公告样板文本 [B-6] | 量级已证实;引用精确小数位(3.448亿/5470万)需要公告的存档副本 |
| 推导:每篇全文论文的平均生命周期下载数 | ≈222 | 2023年12月基准 | 作者计算:256,678,716 ÷ 1,157,048 [1] | 经过验证数据的算术运算 |
| 推导:每篇论文每年的平均下载数 | ≈35 | 2023年12月基准 | 作者计算:40,642,329 ÷ 1,157,048 [1] | 经过验证数据的算术运算 |
最后两行由作者计算并标记为此;SSRN不发布每篇论文的平均值。平台范围的总数因来源、日期和定义(全文与全部论文)而异,因此每篇论文的推导数据取自2023年12月的调和全文数据 [1];上面保留的原始2025年11月样板文本 [B-6] 仅作为数据,只能与存档副本一起使用(例如通过web.archive.org),因为原始公告页面不再直接可检索。
根据2023年12月的调和数据,"平均"SSRN论文在其生命周期内获得了大约222次下载,在过去一年内大约35次 [1]。这个推导数字是作者能够计算的最接近平台范围规范的数字,但它具有系统性的误导性,因为平均数是聚合的虚构。对SSRN下载分布的每项实证研究都发现了强右偏:均值被长尾部分拉远高于中位数,因此"平均论文"几乎不描述任何真实论文。本节的其余部分阐述了该差距的规模和后果。还有一个聚合数据对校准很重要。年度平台下载数从2000年的约50万增长到2005年的约300万 [18]、2016年的1290万和2023年的4060万 [1]。每篇论文的下载流本身也在上升:年度下载数从2016年到2023年增长了约3.15倍,而论文库存增长了约2.03倍 [1],使每篇论文的流量提高了约55%。因此,一项较早的研究会低估可比论文今天会获得的绝对计数。这种偏差指向的方向取决于比较:固定的旧阈值是今天计数的下界,当它被读作绝对2026水平范围时,这使其成为一个宽松而非保守的标准。反向操作同样是未经授权的:旧阈值不能通过将其乘以平台增长来"老化"成2026规范,因为更大的存储库同时改变了分子、分母、作者组成、分销渠道、机器人过滤和关注竞争。整个过程中使用的年份偏差解读基于上面的聚合流量和库存算术,而不是任何旧阈值的重新缩放。平台自己的年度总结确认了持续增长:2025年发布了超过25万篇新论文(较2024年增长20%),该年下载数超过5300万次 [145]。
3.3 平均值不是典型论文:直接证据
关于SSRN最近发表的分布证据来自Jo and Li,他们在2025年8月15日收集的一个横截面快照中分析了来自SSRN Marketing Research Network的2,361篇论文[83]。下表5完整再现了他们的描述性统计,第5部分的综合基准图表融合了这些统计数据。平均下载数为221.346,中位数为87:平均值大约是中位数的2.54倍。第95百分位数726是中位数的八倍多。平均值甚至超过了第75百分位数(206),这使得样本中超过四分之三的论文低于"平均论文"。被告知该网络中平均论文有约221次下载的研究人员会得出结论,一篇拥有100次下载的论文实质上低于正常水平,尽管100远远超过已发布的中位数。图2直接显示了这种结构。
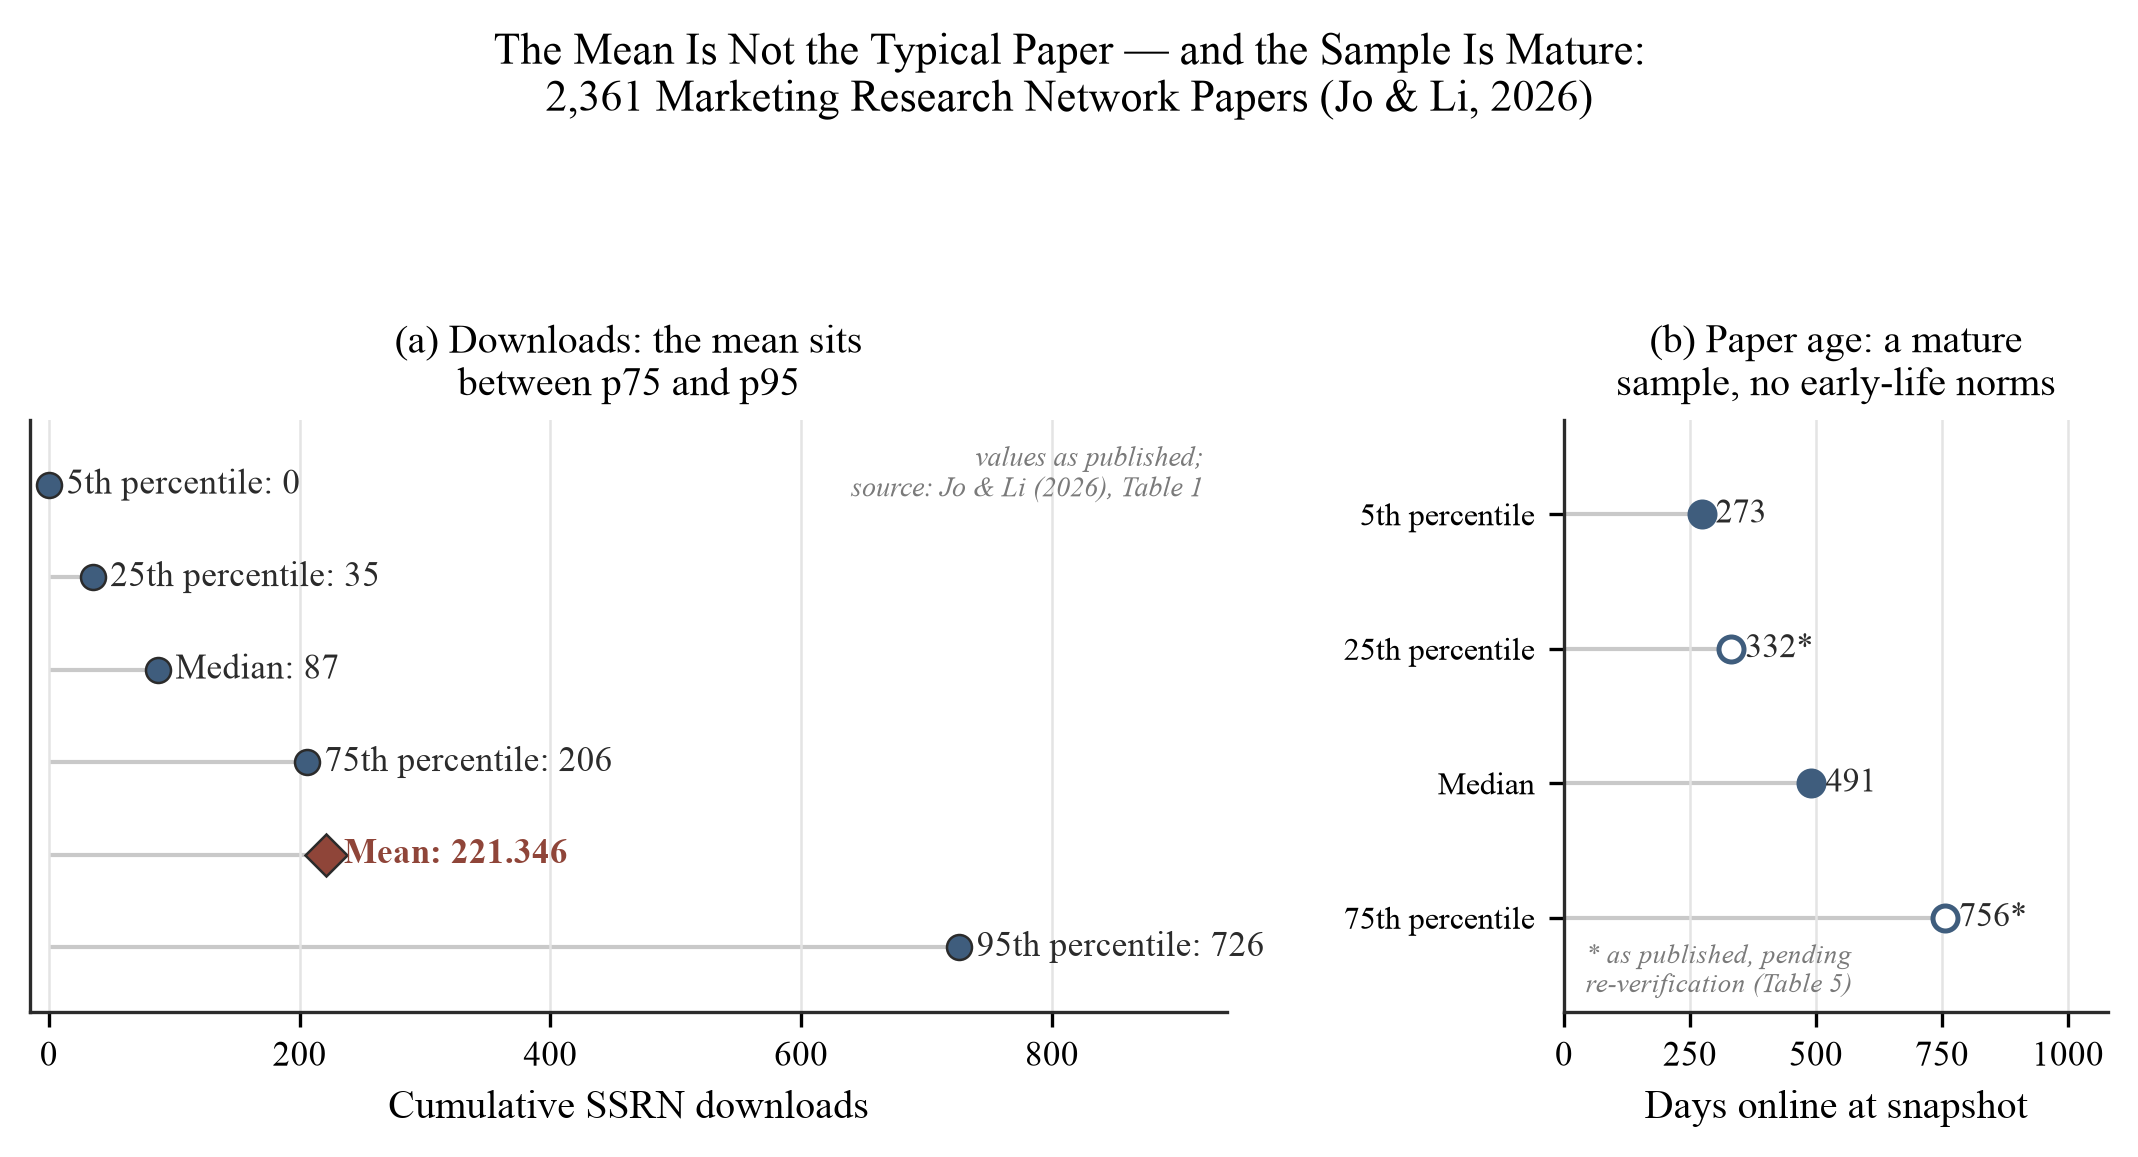
图2。2,361篇Marketing Research Network论文已发布的描述性统计。面板(a):下载 — p5 = 0, p25 = 35, 中位数 = 87, p75 = 206, 平均值 = 221.346, p95 = 726, 按数值顺序绘制(注意平均值介于p75和p95之间)。面板(b):同一样本中论文的年龄 — 第5百分位数273天和中位数491天已针对来源验证;第25百分位数(332天)和第75百分位数(756天)按"已发布"方式再现(表5)。源文件表1中的两个值被标记并按"已发布"方式再现,但它们是不同类型的异常值。摘要浏览量第95百分位数(966)仅比平均值(611.973;SD 1,100.5)高约0.32个标准差——对于p75已经是833的右偏计数来说几乎是不可能的——因此这是一个 可疑的数据来源错误,最可能是打字错误,尽管转录或四舍五入错误也不能排除,并且摘要浏览量行的其他单元格被视为可能受相同相关错误影响(标记为向Jo and Li的作者查询,其回复尚未提供)。转换率第95百分位数(77.7,而p75为27.2)是一个不同的现象:正是第5.2部分预测的小分母比率伪影,不是统计上的不可能。年龄面板使解释限制变得可见:这些是成熟论文的统计数据,样本无法提供早期的规范。来源:Jo and Li (2026),表1 [83]。
表5再现了该研究的完整描述性统计、其伴随变量以及下载分布,因为这是唯一有完整百分位数面板的已发布SSRN样本;其中几个单元格在本文的其他地方进行了解释性工作。标准差用单一数字表示重尾:下载量的SD为940.9,平均值为221.3。下载量的第5百分位数正好是零,所以即使在成熟样本中,零计数也在正常范围内。转换率百分位数从两侧括住第5.2部分的跨研究波段(p25 = 12.1, 中位数 = 18.9, p75 = 27.2每100次浏览)。年龄百分位数(四分位数间距332–756天)确定了样本的成熟度,作者身份和打包行提供了第6.4和8.3部分中使用的协变量规范。
表5。Jo and Li (2026)样本的完整已发布描述性统计,"已发布"(N = 2,361 Marketing Research Network论文;2025年8月15日的快照)。 所有值都从源文件表1 [83]再现。分布核心 — 下载和浏览的平均值、中位数和四分位数;转换率的平均值和中位数;年龄的中位数和第5百分位数 — 已根据已发布的表进行验证(见表7)。其余单元格(标准差;超出核心的转换率和年龄百分位数;作者、页数和摘要长度行)按"已发布"方式再现,在此处未独立重新推导;源文件的存在、来源和作者身份已通过Crossref在2026年8月14日得到确认。两个内部异常按"已发布"方式处理并标记而非纠正,它们不是同一类问题。摘要浏览量第95百分位数(966)仅比报告的平均值(611.973;SD 1,100.5)高约0.32个标准差——对于如此偏斜的计数在统计上几乎是不可能的,且与该行本身的p75 833不一致——因此这是源文件中的 可疑打字错误;其余摘要浏览量单元格被标记为可能受相关错误影响,并降级为待Jo and Li的作者查询后重新验证。转换率第95百分位数(77.704,而p75为27.187)则是第5.2部分预测的小分母比率伪影,不是同类的分布异常。
| 变量 | 平均值 | 标准差 | p5 | p25 | 中位数 | p75 | p95 |
|---|---|---|---|---|---|---|---|
| 下载 | 221.346 | 940.855 | 0 | 35 | 87 | 206 | 726 |
| 摘要浏览量 | 611.973 | 1,100.536 | 151 | 288 | 504 | 833 | 966 ("as published") |
| 每100次摘要浏览的下载量 | 23.699 | 20.118 | 0 | 12.105 | 18.944 | 27.187 | 77.704 ("as published") |
| SSRN上的可用性,天数 | 550.210 | 230.557 | 273 | 332 | 491 | 756 | 955 |
| 作者数 | 2.578 | 1.705 | 1 | 1 | 2 | 3 | 5 |
| 页数 | 32.734 | 29.186 | 1 | 13 | 27 | 46 | 75 |
| 摘要长度,字数 | 182.274 | 71.641 | 87 | 137 | 178 | 217 | 295 |
该研究的另外三个特征对解释很关键。摘要浏览量在更高程度上显示出相同的非对称性:平均浏览量为611.973,中位数为504(p5 = 151,p25 = 288,p75 = 833;p95为966按发表情况复现,但这是可疑的来源打字错误,仅≈0.32 SD高于平均值,低于p75为833所暗示的尾部,不进入任何下游计算;参见图2的注释),已发表的转换为每100次浏览23.699次下载[83]。该研究还将影响范围与转换分开:在作者们的泊松暴露模型中,机构声誉预测了以摘要浏览量为条件的下载量(系数0.192,对于三作者论文,一名来自排名前50机构的作者对应于每次摘要浏览估计下载率高6.6%),这种声誉溢价随着摘要中AI协助的增加而减弱(交互项−0.627,p < .01)[83]。SSRN本身现在要求在提交时披露重大生成式AI使用[54][56]。因此,即使在读者到达摘要页面之后,注意力仍然追踪状态信号,这直接证明下载计数嵌入了可见性和声誉效应,而非仅仅内容评估。作者们自己陈述的限制确定了研究议程:单个学科网络的单个快照无法揭示注意力的时间路径,他们明确指出面板数据是所需的下一步[83],该步骤在第8节中展开。
该样本是在一个领域中的一个网络,在一个时间点观察:这些数字不是普遍的SSRN基准,它们的价值在于结构。2.54的平均值/中位数比率和8以上的p95/中位数比率是重尾右偏的特征,在SSRN证据的每一个其他主体中反复出现,包括来自不同学科和不同十年的样本:在唯一的法律奖学金普查式样本中,在2012年发布到法律奖学金网络并在两年后测量的论文(n = 1,107)的中位数为63次下载,相对于平均值122.55,仅在两年的接触后便存在近乎两倍的差距[139]。
3.4 分布的形状:准对数正态性和长尾
分布的大规模构成由Kakushadze建立,他分析了SSRN的公开排名:排名前30,000的名单中有29,985名作者和与之相关的367,478篇论文(2015年版本排名的抓取数据)[85]。核心发现是下载量呈准对数正态分布,在级别上严重偏斜,上尾较长,在对数中近似高斯分布(每篇论文的ln下载量的拟合参数:均值5.406,标准差1.016)[85]。Kakushadze明确指出对数正态性的实际推论:线性运算对这类数据不适用。h指数直接应用于下载量是没有信息量的:下载计数比引文计数大许多个数量级,因此该指数退化为论文数量。他提议改用基于下载量对数整数部分的指数,k = ⌊ln D⌋ [85]。从解释的角度来说,这意味着下载量中有意义的差异是乘法性的,而不是加法性的。这种形状不是下载量特有的:个体科学影响的分布本身也大约是对数正态的,正如Sinatra、Wang、Deville、Song和Barabási的Q模型(2016)在科学职业中所确立的[181],因此计数器要求的乘法解读是学术关注的常态,而不是SSRN的人为产物。
同一数据集提供了上分布唯一已公布的阈值锚点。进入排名前10,000的论文名单(大约占该平台全文论文库的前1.8%,571,040篇,2016年7月[1],与有时引用的"前1–2%"数字一致,而不是高于它)需要最少160次下载,中位数为805,平均值为1,800,最大值为152,242 [85]。在排名前30,000的作者中,最小总下载量为129,作者总数中位数为1,626,每篇论文的中位数下载量为210,最大值是Michael C. Jensen的824,762 [85]。稀缺性在论文层面上即使在这个精英样本内也依然存在:在分析的367,478篇论文中,只有112,793篇(大约30.7%)有足够的下载量对其作者的对数指数有所贡献[85]。该平台最常下载的作者的大多数个别论文吸引的关注度有限,在排名之外的论文中,比例只会更低。图3可视化了拟合分布,并标记了已公布的阈值。
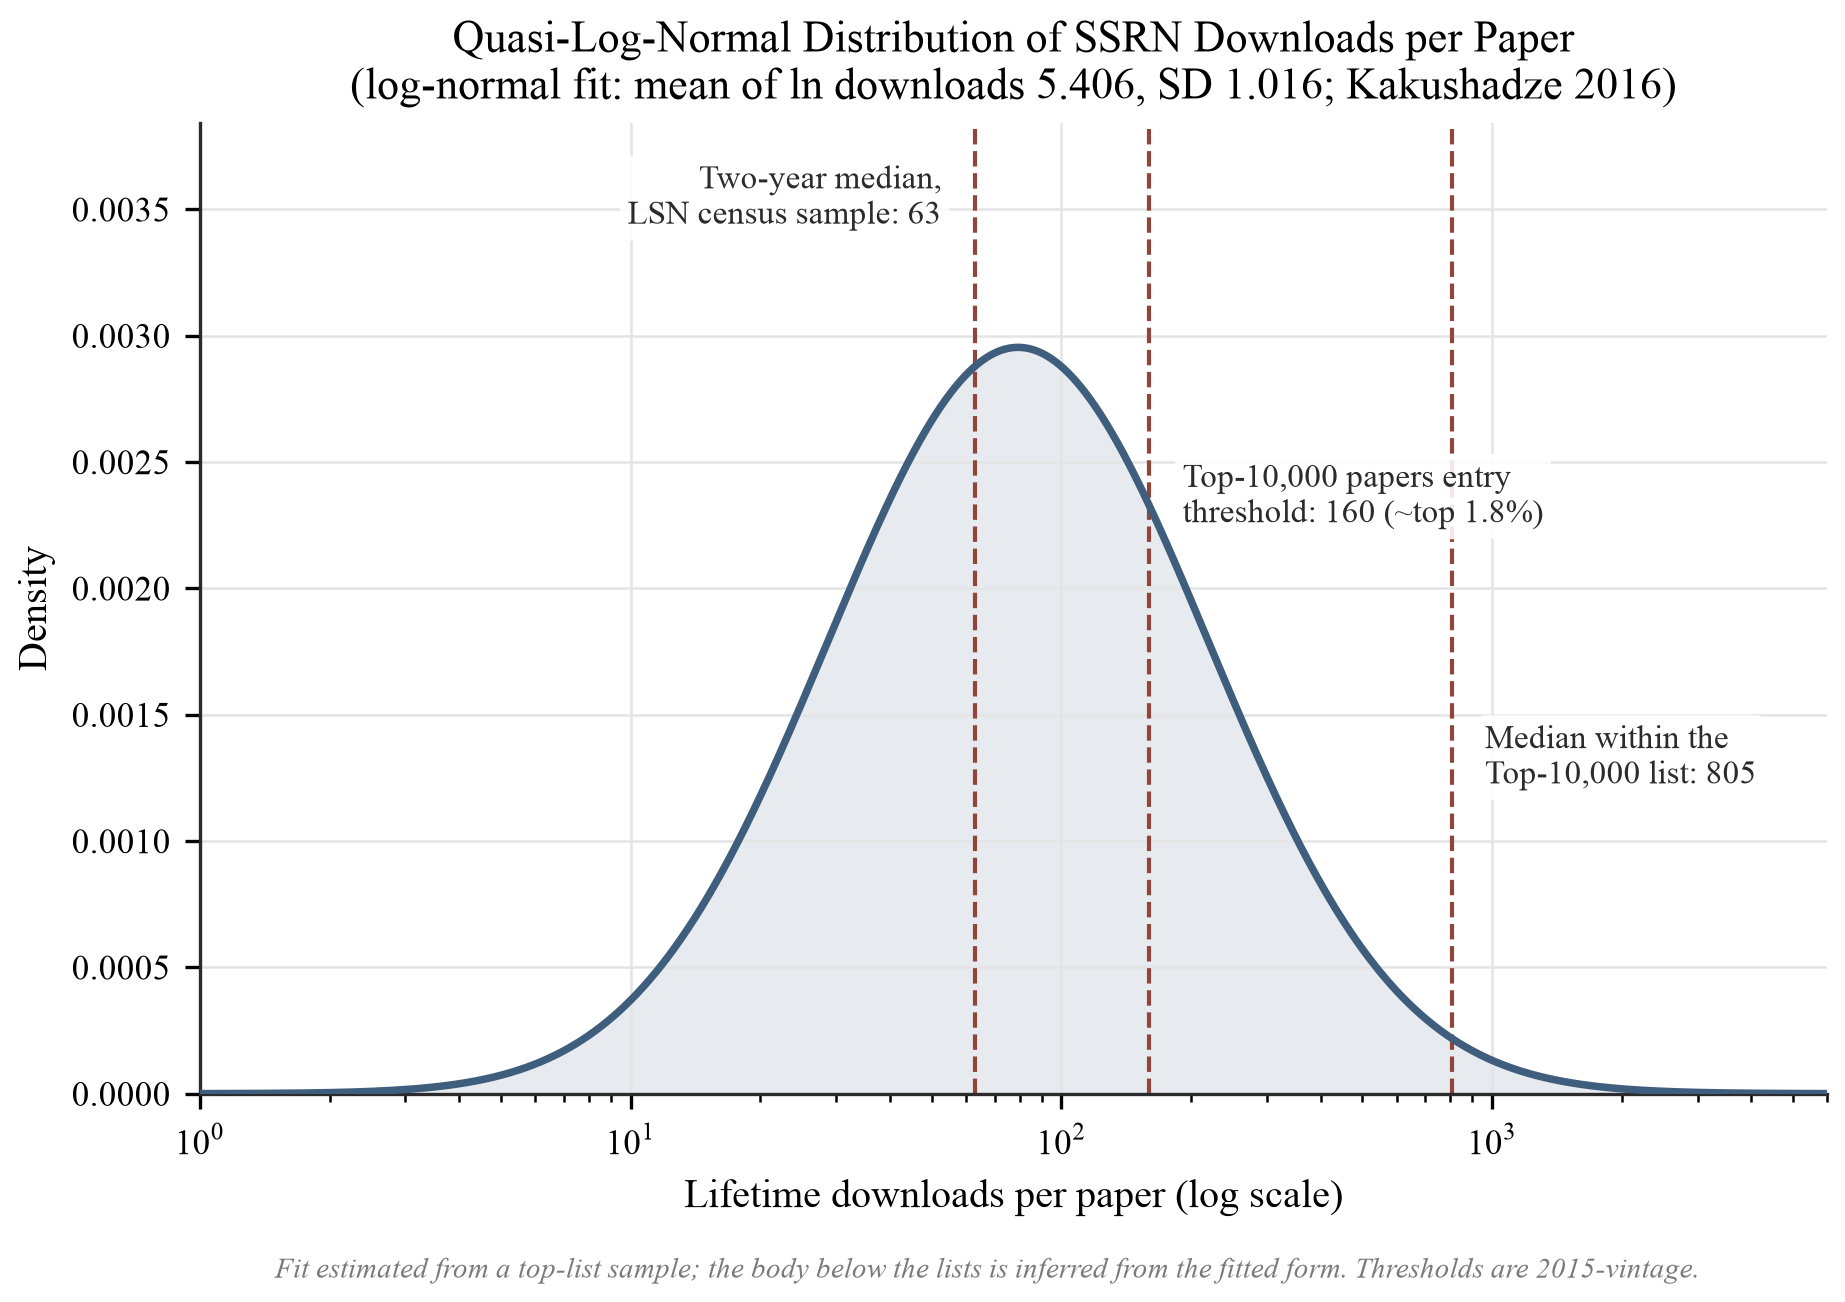
图3. 用Kakushadze报告的参数拟合的对数正态密度(ln下载量的均值5.406,标准差1.016)[85];拟合中位数exp(5.406) ≈ 223,比报告的组内每篇论文中位数210高约6%,对排名顶部分布的拟合充分但不完美。虚线标记了来自普查式法律学术样本的两年中位数63次下载[139],排名前10,000论文的进入阈值160(大约占该平台全文论文库的前1.8%,2016年7月571,040篇[1]),以及排名前10,000名单内的中位数(805)[85]。拟合是从排名顶部样本估计的——大约是该平台的上作者十分位数——因此排名以下分布的主体是从拟合形式推断而来,而不是观察到的;阈值是2015年版本的(此后的通胀:第5.1节)。定量谨慎应该伴随这个图表,因为曲线容易诱导对下尾的解读:在这个拟合密度下,隐含的低尾质量为P(X ≤ 63) ≈ 10.7%和P(X ≤ 10) ≈ 0.1%——比Study 1(第8.6节)为全平台概率样本预测的15–30% ≤10下载份额低两到三个数量级。这种偏差不是矛盾,而是拟合适用域的直接衡量:在上作者十分位数上估计的密度无法描述它从未观察到的下尾,因此普查式标记([139]的两年中位数63;排名前10,000的进入值160及其中位数805)被绘制为外部参考点,放在拟合曲线上,而不是声称拟合再现了它们。标记与拟合曲线对应值之间的距离本身就是排名以下主体未被观察的视觉证据,不应从该曲线推断平台范围的低尾比例。
这些锚点需要两个注意事项。采样框架是分布的顶部,因此Kakushadze的统计数据描述了尾部,排名以下普通论文的集合仅通过拟合的对数正态形式来表征。归属于单个作者:该研究是Kakushadze(2016),《Informetrics杂志》[85];一个常见的错误引用添加了第二个作者,应该避免。
附录E中报告的一个独立档案截面直接观察分布的主体,基于一个随机的全领域样本,包括1,360篇论文,其停用前计数器从公共档案中恢复。它发现观察到的分布近似对数正态(log下载的偏度≈ 0.18),在主体上印证了Kakushadze只能在尾部拟合的形状,并独立地再现了均值到中位数的差距、转换带和学科乘数。它自身的向上选择偏差导致极端低尾未被充分观察。它尽管如此再现了综合分析以其他方式所依赖的唯一现代整体分布锚点:重构的均值(219)与已发布的营销网络均值221一致,因此整体形状也由完全独立的数据源证实。(关于从互联网档案馆恢复历史网络数据作为经过验证的社会科学方法,以及其覆盖范围和爬虫频率偏差,见Arora、Li、Youtie和Shapira,2016,《信息科学与技术协会杂志》,67(8),1904–1915,doi:10.1002/asi.23503。)
3.5 可见尾部的误校准
第3.2–3.4节的联合结构解释了一种系统的心理错误。在2015年的数据中,下载量最多的作者达到824,762次下载,大约是顶级作者群体自身中位数(1,626)的500倍,比典型论文高出四个数量级[85]。在准对数正态分布下,重要的距离是乘法关系:从普通论文中位数(数十次下载)到排行榜入选阈值(160)的跨度小于从该阈值到排行榜中位数(805)的跨度,而这又被到尾部最大值的距离相形见绌[85][139]。然而,公开流传的数字(里程碑式的公告、"顶级作者"档案、机构新闻稿[101])几乎完全来自可见尾部。因此,作者针对位于中位数以上数百倍的参考类来校准"好",而分布的主体位于中位数附近。仪表板上显示7次下载可能被体验为失败,即使这对论文的年龄和领域来说并不显著。平均值以较温和的形式参与同样的错误:如第3.3节所示,它位于第75百分位以上,所以即使听起来很正式的"平均值"也是被尾部污染的基准。这就是平均值谎言的意义所在:它计算正确,但随后被误认为是没有典型值的分布中的典型值。
几个进一步的证据体强化了原始计数器至少反映可见性结构与反映内容相同程度的结论。注意力对位置有反应:在arXiv公告列表中,出现在位置1的论文在astro-ph中获得的引用中位数高约83%,作者将这种效应主要归因于可见性而不仅仅是自选择[72]。它也对索引延迟有反应。SSRN本身注意到,其内容被Google Scholar外部索引受搜索引擎控制,可能需要"6–9个月或更长时间"[54, accessed 14 August 2026],所以年轻论文的计数器是在主要发现渠道开始运作之前生成的。注意力也从引用向下流向下载:被引用吸引读者(包括被引用的作者及其自己的网络)访问引用论文,Granger因果分析发现,对大量文章而言,这条从引文到下载的因果路径是活跃的[80][39],所以计数器的一部分反映的是论文在引用和协作网络中的位置,而不是任何读者对其内容的判断。这些机制中的每一个都通过可见性结构(位置、发现延迟、网络位置)而不是通过读者对质量的判断来塑造计数器,但这些机制在仪表板数字中都不可见。更广泛的注意力经济以极端形式显示相同的集中度:在社交媒体中,注意力基尼系数达到0.90–0.94,前1%的账户获得的注意力超过底部99%的账户总和[180],这是对Simon的格言——信息财富造成注意力贫困——的现代呼应[141]。SSRN上的学术注意力,以较温和的形式,属于相同的倾斜分散过程族。最熟悉SSRN的受众、经济学家和法律学者将从金融中认识这种结构。Bessembinder对1926–2016年CRSP数据的分析发现,大约34.8万亿美元的股市净财富创造可归因于少于4%的上市公司,大多数股票在其整个生命周期中未能超越国库券[16]。这个平行是作为说明而不是证明:在财富和注意力中,总体总额由细长的极端尾部生成,用由巨人主导的平均值来衡量自己是一个范畴错误。稀缺性并非仅限于使用计数器:在整个法律学术中,一项2007年的普查显示,43%的法律评论文章从未被引用过,而2015–2019年的队列中只有18%在五年内被引用过[171]。
3.6 场域乘数:规范的学科结构
分布不是单一的分布:它因领域而异。Whalen对分类到Legal Scholarship Network的94个eJournals中的近25万篇论文的分析表明,即使在单一的综合学科内,学科基线也相差约八倍:论文的终身平均下载次数从企业、证券与金融法的438.35到农业法与政策的53.48[168]。图4展示了这一梯度。
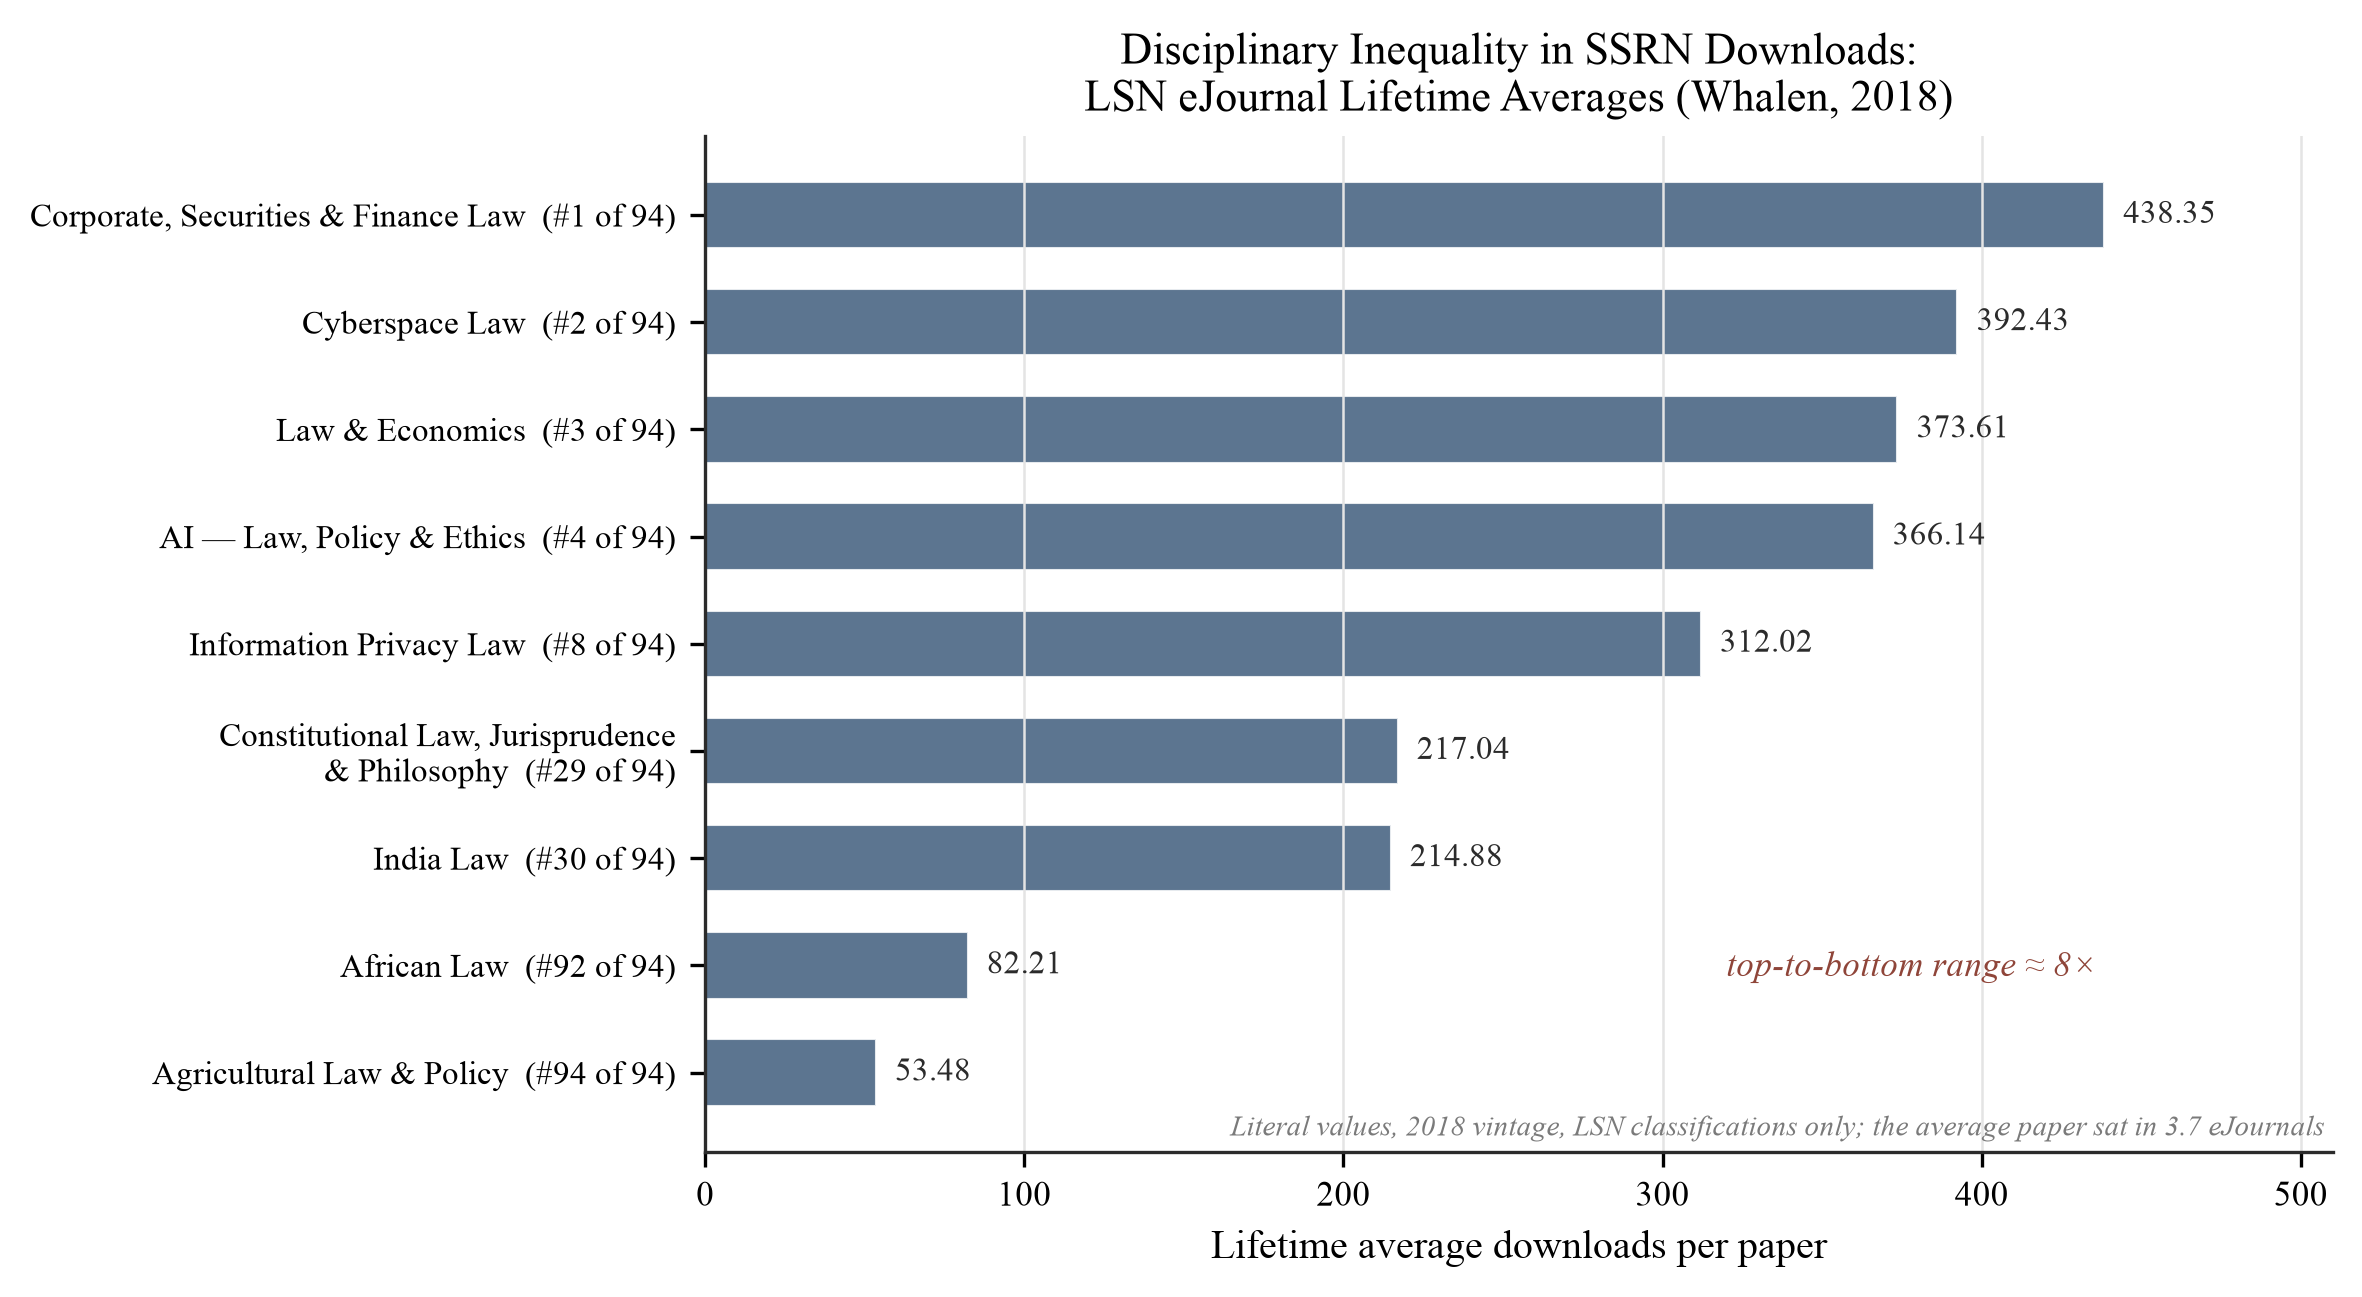
图4. 选定LSN eJournals论文的终身平均下载次数,取自Whalen (2018) [168]的字面值:企业、证券与金融法438.35(排名第1/94);网络空间法392.43(2);法律与经济学373.61(3);人工智能—法律、政策与伦理366.14(4);信息隐私法312.02(8);宪法法、法律哲学与司法理论217.04(29);印度法214.88(30);非洲法82.21(92);农业法与政策53.48(94)。从上到下的范围约为八倍。数据为2018年版本,仅涵盖LSN分类;平均每篇论文被分配到3.7个eJournals。
这种机制是结构性的,而非功绩制的:SSRN的发现是基于分类的(电子期刊的订阅者会收到分类到其中的论文的提醒),因此论文的可寻址受众在任何质量信号发挥作用之前就由其领域的订阅者基数确定。Whalen另外发现,具有更多分类的论文获得更多下载,且更不可能记录零下载[168]。字段结构还通过引文文化塑造计数器:Black和Caron观察到下载-引用比在不同领域之间有系统的差异,因为法律学术引用先前工作比经济学或金融学更完整[18],在法律内,注意力集中在特定的主题和作者特征上:在2012年人口普查样本中,企业和国际法主题、美国作者身份和前20位隶属关系都预示了显著更高的计数[139],这些决定因素在同期法律图书馆评论[175]中有所回应。因此在企业法中不起眼的数字可能在法律史或农业法中是例外的,任何基准或规模(包括第5节中构建的那个)必须被理解为相对于领域的。这方面有一个公认的先例:Radicchi、Fortunato和Castellano (2008)表明,引用分布只有在每篇论文的计数按其领域的平均值重新缩放后才会坍缩到单一通用曲线上[182],这是参考类的类似物,本文主张使用计数也同样需要。
三个例子完全基于上面已验证的锚点,使赌注更加具体。一位农业法领域的作者,其论文获得60次终身下载,高于其eJournal平均值53.48[168],但在与流通最广泛的企业法计数进行校准时,可能会将同样的数字理解为失败。一位企业和证券法领域的作者拥有相同的60次,远低于该领域的平均值438.35[168]。一位营销论文达到网络中位数87[83]的作者可能低估了一个按构造而言是典型的结果。缺失尺度的错误以两个方向运行:它产生无根据的失望,也使成功无法被识别。
第3.2–3.6节确立了本文的经验核心。SSRN下载分布严重向右倾斜且近似对数正态,平均值不仅超过中位数,还超过了第75百分位数。可见的尾部延伸到精英中位数的500倍,并污染了非正式的校准;计数器嵌入了声望、位置、索引和字段结构效应,这些效应独立于内容而运行;学科基线在单一学术领域内相差八倍。原始下载计数相对于平均值或尾部解读因此按构造而言是无法解释的。可防守的解读需要参考类:以字段、论文年龄和同期群为条件的分布。排名(Rankings)虽然有其缺陷,但曾是该平台唯一朝向这样的参考类的公开举措,其停用使构建外部参考类(第5节的基准图和解释规模)成为本文其余部分的中心任务。
4. 计数器的机制:规则下的计数器
在SSRN仪表板上的任何数字都可以被解释之前,有必要确立该数字实际记录了什么。SSRN显示两个主要的论文级使用指标——摘要浏览次数和下载次数,以及引用统计和PlumX指标[50]。在2026年7月15日排名(Rankings)停用后,这些计数器仍然保持不变:SSRN声称"下载计数和引用统计将继续被记录并显示在您的个人论文和作者资料中"[149]。比较尺度消失了,但数据保留了。然而,保留的计数器并非对人类阅读的原始观察:它们是平台架构、分发机制、非人类流量和完整性过滤的联合产品。下面将对这些层进行拆解,第5节随后在其之上构建解释框架。
4.1 视图和下载记录是什么,以及它们所不能表明的
视图记录对论文登陆页的访问请求。下载记录全文PDF的检索。两者都是互动事件;两者都不是阅读、理解、赞同或科学认可的直接证据。这一区分界定了本文其余部分所做的每一个主张。
SSRN的公开计数器不是简单的HTTP请求日志。该平台自早期就采用了数据完整性过滤[69],并已公开说明了其方法:自动下载、重复自下载和试图操纵计数的行为通过"不规则活动线索"进行筛选,可疑的下载(包括在某些情况下的匿名下载)被从面向作者的总数中排除[144]。独立观察者早前记录了同样的行为:来自单个IP地址的重复下载不会被计入计数器[66]。因此,下载计数器是一项精选的统计数据,实质上比原始服务器日志更加可靠。过滤消除最易被发现的非人类和操纵活动,仅此而已。计数器总是在某个规则下的计数器,而不是自然单位,而且规则会变化(第4.3节)。
4.2 非人类流量与浏览量和下载量之间的不对称性
根据最近的行业测量,自动化代理占总互联网流量的一半以上[158]。该数据不能转移到SSRN的计数器:未发现有关SSRN摘要浏览量或下载量中机器人份额的已发表测量,针对SSRN声称的任何具体百分比都将无根据。可以确立的是问题的结构,从两个方向进行处理:看似会增加浏览量的机制,以及邻近平台的透明过滤记录。
多种机制看似能生成非人类摘要浏览量。搜索引擎爬虫定期索引新发布的摘要页面。机构电子邮件安全系统,最突出的是Microsoft Defender for Office 365中的Safe Links,扫描并预获取传入邮件中包含的URL,这可以在任何人类收件人打开邮件之前记录服务器端请求[106]。由于SSRN的主要分发渠道是电子邮件(第4.4节),公告电子邮件的链接扫描在结构上是虚假浏览的一个合理来源。没有已发表的研究测量安全代理预获取对SSRN浏览计数器的贡献,而SSRN本身审计其指标并从下载计数中排除异常活动[144][66][69],因此该平台很可能在过滤大量此类流量,特别是在下载方面。"大多数SSRN浏览量不是人类的"这一说法出现在非正式讨论中,但从未被测量过。
一个透明的案例是RePEc。其日志服务LogEc发布了其过滤方法论和过滤历史,记录证明了非人类污染的严重程度和不对称性。早在2007年7月,在受监测的RePEc服务中,机器人约占摘要浏览量的74%,但仅占下载量的约7%[99]。过滤历史读起来像一段军备竞赛的编年史:2010年7月添加了针对反恶意软件链接扫描程序的启发式方法;2017年1月处理了一种新的系统性大规模下载;2022年1月引入的DDoS缓解过滤器删除了54%的摘要浏览量,但仅删除了7%的下载量[99]。从2025年10月起,RePEc记录了AI驱动的机器人流量伪装成人类用户的激增[129]。2025年9月,IDEAS的原始流量中超过99.5%被判定为非人类流量并被丢弃[129]。清理后,2026年6月的RePEc报告统计其服务中约236万次摘要浏览量和约238千次下载[129]。
RePEc的证据支持对SSRN的两个推论。污染在结构上是不对称的:自动化代理对HTML摘要页面的爬取远比执行全文PDF检索更积极,因此当过滤不完善时,浏览计数器的膨胀远大于下载计数器。这种不对称性——在2007年的测量中机器人占浏览量的约74%而仅占下载量的约7%[99]——是储存库流量的一个架构特性,而非RePEc特有的现象。具体的比例不可转移:SSRN的过滤规则、分发模式和受众不同,且SSRN不发布等价的过滤日志。第5.2节阐述了实际后果:基于浏览量构建的比率(如转化率)必须被理解为人类参与质量的下界,因为分母是受污染程度更高的数量。这个下界方向取决于年份而非绝对规律:当浏览端过滤落后于下载端过滤时它成立,这是历史记录的状态[99],但如果平台的浏览端过滤赶上下载端过滤,或下载端污染上升速度快于浏览端(如2025-2026年AI机器人事件对两者的影响[129]),则会削弱或反转。每当平台修改计数规则时,该方向应重新检验。
自这些过滤制度设计以来,进一步的考虑已经浮现。过滤器被构建为从旨在代理人类注意力的计数中去除自动化请求,该规则仍然有效地去除噪声。但它不再能未经审视地将其余部分视为人类行为,因为现在有三类自动化请求占据了过滤器曾看到的地方:用于模型训练的文本抓取爬虫、为搜索或应答服务编制索引的爬虫,以及系统代表提出请求的人实时执行的获取。前两者仍然是注意力计数中的噪声。第三者是一种背后有人的委托行为,因为检索论文全文以回答用户问题或支持文献搜索的系统已被提供内容并使用它,尽管没有人实际打开该页面。自动化请求本身不是任何东西被阅读的证据。代理已削弱,而非过滤器:人类与机器的对比不再可靠地追踪本文所需的区分,即一个事件是否证明学术注意(人类或委托)。
Project COUNTER已开始在其报告术语中而非过滤器中解决此问题。2026年4月发布的关于AI使用的最佳实践指南,于2026年6月30日针对发行版5.1.1进行了更新,提供了可选的Access_Method属性Agent,定义为AI系统访问的内容和元数据,以及AI特定的指标类型,而发行版5.1.1仍要求"传统机器人和爬虫产生的活动必须从所有COUNTER报告中排除"[125]。该工具有三个相关的限制。它是一个可选扩展,仅在提供商选择生成的报告中产生,首先面向嵌入在提供商自身平台上的AI系统而非入站爬虫。其元素"不得包含在COUNTER报告的任何标准视图中"[125],因此即使提供商实施了指南,标准视图也不会区分代理访问。标记的代理事件是从默认总数中移除还是在其中保留但无标签,取决于实现方式,而指南对此保持沉默。它也分类了被服务的访问而非被拒绝的访问:指南指出"不存在与Access_Method Agent特别相关的拒绝指标"[125]。无论如何,这些都不会到达裸露的公共计数器,因为这样的计数器不是COUNTER报告,不包含访问方法;该标准是用于判断的类比,而非对其的描述。
拒绝也不是假设性的,它在任何计数规则之上运行,但其工具在类型上存在差异且不能统一作用。平台的 robots.txt 请求指定的代理不进行爬取;文本和数据挖掘保留条款声称一个法律立场;使用条款在合同上具有约束力;挑战服务向无法完成挑战的客户端隐藏页面。只有最后一种是强制执行。在本研究的平台上,如 2026 年 8 月 29 日检索所示,robots.txt 命名了三个代理(GPTBot、ChatGPT-User 和 Google-Extended),对其他代理保持沉默,沉默是机器人排除协议的默认设置,行为规范的爬虫将其理解为许可;响应包含指向发布商政策的挖掘保留条款,该政策允许为欧盟数字单一市场指令第 3 条所涵盖的目的进行挖掘,否则需要许可证;使用条款保留对文本、数据挖掘和人工智能训练的权利,除非作者选择了开放许可证(该选项仅从 2026 年 7 月 20 日起可用,默认情况下保留所有权利),单个未认证的请求在没有 JavaScript 引擎的情况下收到 Cloudflare 托管的挑战,而不是页面。其中一个指定的代理是用户触发的提取器,而不是训练爬虫:这是前一段落中的代理类。这些材料记录了已发布的限制和一个配置观察。它们没有确定有多少个自动或人工请求被拒绝。指令的遵守不均匀:在爬虫行为的大规模测量中,某些代理完全尊重整个网站的禁止,但只在少于三分之一的时间内遵守路径级禁止,其他代理则完全忽略该文件 [87]。附带损害也不是单向的,因为挑战部署在其他地方破坏了合法的人类用户(一所大学图书馆在使用的前四个月记录了两起这样的事件 [29])。
因此,历史不对称性不能简单地继续下去。2007 年发现的安慰在于机器人约占摘要浏览的 74%,但仅约占下载的 7% [99],这基于浏览着陆页并很少获取全文的爬虫。为了确定答案而检索文档的系统没有理由停留在摘要阶段,因此下载端不再因结构而被已知为更清晰的统计。在 2025–26 年测量原始学术流量的地方,自动化份额并不边际,它出现在下载和访问计数中,而不仅仅是页面浏览中:一个文化遗产集合在移除可疑机器人流量后将 2025 年 3 月的访问计数从 1,000,000 修改为 125,000 [167];一个供应商对一个机构存储库中大约三千万个访问请求的分类仅将其中约四分之一标记为人工 [98];一个存储库在回应开放存储库调查时,将其自己的至少四分之一的机器人下载(某些五百万个请求)归属于十一个指定的人工智能代理 [135]。这些数据都不是对本研究平台的测量:它们来自不同的平台,这些平台有不同的防御,在某些情况下没有防御,其中两个计数的是访问或请求,而不是公共计数器显示的下载事件。它们确定了先前的条件而不是大小。在当前环境中,任何使用计数的可解释性是过滤质量的函数,当平台不发布其过滤时,该质量是未经审计的。
接下来是两个识别问题,它们会加剧。首先是构成:仅从公共终身计数器来看,人类、常规自动化和代理介导事件的份额是不可估计的,平台自身的观点可能也不会更好,因为自动化客户端已被观察到将自己呈现为桌面浏览器 [167]。在选择方面,计数器无法显示在应用任何计数规则之前,尝试访问的哪个份额被提供、挑战或排除。已发布的政策披露了此类机制的存在。它们没有披露它们多久操作一次、它们在过去如何操作或它们对包含的影响。因此,尝试的请求、受到挑战的请求、提供的全文事件、显示的下载和从检索的论文生成的答案是五个不同的群体,它们不能被视为可互换的。未获许可的是该平台的大小或净符号。现在已知未过滤的学术使用可以通过自动化流量膨胀(包括下载),但该平台未发布的过滤器、挑战规则和爬虫政策是否留下更多人工加权的剩余、代理介导发现中的空白、两者还是都不是,是无法测量的。这种混合在终身总计跨越的多年间也不稳定,从 2024 年前的机器人制度运行,通过 2025–26 年的抓取浪潮,到 2026 年 7 月引入的许可证默认值。问题的下游后果本身已被记录:阻止主要人工智能爬虫的网站由人工智能应答引擎检索的频率明显较低,即使内容仍然可访问 [70]。对于任何主要的预印本服务器,不存在已发布的代理份额估计,这是一个研究空白,而不是小效应的证据,第 8 节中指定的审计旨在测量它。公共终身总计是未知混合的总和,来自未知份额的尝试访问,没有任何一个的外部估计器,也没有基础将任何一个视为固定的。
4.3 下降的计数器作为测量事件
当过滤规则改变时,计数器也可能下降或重新陈述,这是过滤记录的进一步后果,但没有任何仪表板对此做过解释。RePEc在2022年1月的过滤修订一次性地移除了先前计数的摘要浏览量的一半[99]。其2025–2026年AI-bot事件导致进一步的方法论更改[129]。更普遍地说,供应商报告的下载统计数据已知对计数规范很敏感:一项图书馆端审计发现,来自一家主要出版商的下载报告约为可比平台的两倍,其"缩减"后的计数为报告数字的43%[176]。因此,作者SSRN计数器的突然下降同样可能是一个测量事件(即平台端的过滤或重新陈述更改)或阅读事件,不应在没有证实的情况下被解读为声誉损失。相同的推理适用于任何档案对指标的使用,其中应保存有日期的记录(第6节中开发的协议)。平台的数字可以修改,而作者的有日期档案不能修改。
4.4 推送与拉取:架构塑造比率
分发架构是最后一个机械层。它在各大存储库中的差异显著,并直接塑造浏览量和下载量之间的关系。SSRN主要采用推送模式。在提交时,作者在一到七个学科分类之间进行选择(平均LSN论文有3.7个eJournal分配[168]),这些分类决定了其在研究网络中的位置和特定主题eJournal电子邮件警报的资格。包含在警报中是"精心策划且有针对性的,但不保证",在高容量主题中的分发可能需长达45天[53]。订阅者通过电子邮件接收摘要级别的公告[57]。每个从公告中点击的收件人,无论是出于专注兴趣还是轻微好奇,都会登记一次摘要视图。相比之下,arXiv主要作为拉取平台运作:一个非营利存储库,其流量由积极访问列表和源的研究人员驱动[11][65],甚至每日公告列表中的位置都能明显影响可读性和引用[72]。RePEc汇总来自分散存档的元数据,并应用上述详细记录的过滤[99][129]。
表6总结了各平台间作为治理和发现机制的定性模式的比较。已发布记录中不存在可比较的跨平台流量数据。
表6. 平台架构及其对使用指标的机械影响(定性模式)
| 特征 | SSRN | arXiv | RePEc / IDEAS |
|---|---|---|---|
| 治理 | 商业(Elsevier,自2016年5月)[46] | 非营利(Cornell University) [11] | 分散的志愿者网络[99] |
| 主要发现渠道 | 推送:由作者选择的分类驱动的策划eJournal电子邮件警报(1–7;高容量主题中的分发最长45天)[53][57] | 拉取:意图驱动的列表和源访问;公告中的位置效应有文档记录[11][72] | 分散存档的汇总;通过IDEAS/EconPapers的发现[99] |
| 过滤透明度 | 定性描述的政策;无公共过滤日志[144] | 未为使用指标集中发布 | 完整记录的方法和修订历史(LogEc) [99][129] |
| 浏览:下载比率的预期机械影响 | 相对于下载的升高视图:电子邮件点击通过来自低意图暴露,被计为视图 | 访问到下载的更高转换:流量是意图驱动的 | 比率仅在大量机器人修剪后才有意义;发布的计数是后过滤[129] |
该架构影响作者心理,因为SSRN上的高浏览下载比在很大程度上是设计结果:推送模式产生广泛但低意图的暴露。摘要浏览也是合法的学术行为(研究人员经常通过摘要监控领域而不下载全文),因此不转化的视图可能意味着摘要已经传递了其信息内容,而不是它令读者感到厌烦。Black和Caron报告的SSRN自身的历史经验法则是,大约"三个摘要视图...导致一个实际论文下载"[18]。同一作者指出,没有完整性过滤器,原始计数器会被夸大"五倍或更多"[18]。第5.2节将这些过时的锚点与现代测量并列。
论文呈现方式的两个机械特征与读者兴趣一起决定转换,这使所测转换率在很大程度上是界面的属性而非研究的属性。一是平台的用户界面。无论完整文本是作为内联、浏览器内HTML渲染还是仅作为可下载PDF提供,都会大大改变感兴趣的读者是否触发下载计数器,因为在浏览器中阅读完整文本的读者实现了相同的目的,但仅增加了视图。另一是受众的设备组成。相比桌面,移动访问会降低全文PDF检索,因此其读者主要通过手机到达的论文(来自社交媒体链接或移动邮件客户端)将为相同的学术兴趣记录系统性较低的下载和相对较高的视图。两种效应都朝着与上述已建立的分母机械膨胀相同的方向作用,两者都进一步说明应将第5.2节的经验范围理解为平台相关范围而非固定阈值:在一个平台的界面和设备组合上估计的转换规范应在其中任一改变时重新校准而非直接套用。使用指标文献对下载报告在平台和计数约定中的可比性提出了同样的可靠性警告[176]。
4.5 可预测的附带效应:相似性自匹配和元数据卫生
预印本发布的另外两个机械后果是可预测的,两者都经常产生不必要的警报,因此都属于其余机制的范畴。
相似性自匹配。当发布在SSRN上的工作论文后来提交给期刊时,期刊的相似性筛选在预期情况下,会标记与作者自己的预印本的近乎完全的匹配。iThenticate的文档明确说明了解释的两个方面:该软件"不检查抄袭;它检查相似性",以及"如果你看到同一作者的预印本匹配,这不是抄袭"[81]。该机制也有文档记录。注册为Crossref Posted Content的预印本包含在相似性检查比较数据库中,因此与自己存放的预印本的匹配是系统按设计运行[36]。即使编辑排除预印本来源,匹配也可能出现,因为复制存储库元数据的二级聚合器也会被抓取[81]。作者的回应应该是行政性的而非防御性的:向处理编辑确认被标记的来源是作者自己的带时间戳的预印本。Crossref和iThenticate的指导建议采用定性编辑审查而非机械的相似性得分阈值[36][81]。这里没有指定数值阈值,因为筛选服务本身没有认可任何阈值。这一建议所假设的沉着有一个有文件记录的出版商政策基础:在大多数学术期刊的先前发表政策下,将工作论文发布到预印本服务器是被允许的,尽管政策有所不同,应该查看目标期刊的当前政策;预印本立场在Sherpa Romeo等注册表中公开索引。显著的例外集中在医学和相邻的临床领域,其中一些期刊仍然限制或不鼓励先前的预印本发布。这些领域的作者应该在发布之前而不是提交后验证目标期刊的预印本政策。
人工智能写作检测:一个相邻的误报渠道。一个更新的筛选层带来了结构上相似的误报风险。人工智能写作检测器产生有文档记录的误正(假阳性),负担不成比例地落在非英语使用者身上:在斯坦福大学对七个公开可用的GPT检测器的评估中(该研究不包括Turnitin),非英语使用者写的TOEFL论文中平均61.3%被误分类为人工智能生成的[97]。机构实践已经记录了这一关切。2023年8月,范德比尔特大学公开禁用了其相似性检查软件的人工智能检测功能,理由是其不可靠性:供应商声称的假阳性率、缺乏任何发布的检测方法,以及上文记录的对非英语使用者的相同不成比例的负担[163]。这里的防御姿态与相似性自匹配平行,是行政性的而非对抗性的:保存手稿的版本历史和起草记录作为作者身份的同期证据(下面版本卫生的进一步论据),并用文档而非警报回应任何标记。
版本控制和元数据卫生。因为计数器按论文页面累积,修订实践直接影响指标的完整性。SSRN支持将修订版本发布到同一论文页面,保留累积的计数器和索引URL,而删除论文并重新上传会重置指标并破坏现有链接(SSRN常见问题解答;一个可能会修订的支持页面,访问时间为2026年8月14日[B-7])。分类选择同样有指标后果,因为它们决定了eJournal路由,从而决定了论文的主要曝光事件[53]。外部索引的时钟比作者预期的要长:SSRN表示Google Scholar索引由搜索引擎控制,可能需要"6–9个月或更长时间"[55]。论文的早期计数器因此几乎完全由平台的内部分发机制生成,这固定了第5.6节中对早期零值的解释。
5. 一个解释框架:重建缺失的规模
问题"这个数字好吗?"在指定比较组之前在科学上是不适当的。本节将已发表的经验记录组织成缺失的比较装置:一个具有明确来源置信度的综合基准图(5.1)、一个经验转换带(5.2)、一个分级解释规模(5.3)、一个二维reach-转换诊断(5.4)、一个多维基准规范(5.5)和一个时间读取协议(5.6)。值始终与其抽样框架和年龄一起陈述。没有一个是2026年平台的校准百分位数,所有都应该按照第5.1节的通胀警告进行阅读。
5.1 整合基准图
表7整合了第2.5节审计中确定的所有可用已发布SSRN使用指标基准,每个基准都有其抽样框架和明确的来源置信度声明。因为基准一旦超出其框架就会被滥用,每个条目也列出了来源可以合法发挥的推断作用和限制它的主要局限性。证据较少:该图基于五项具有不同框架的研究:2012年一个法律网络的普查式样本[139]、2015年平台自身顶级列表的抓取[85]、2025年单一网络的横截面快照[83]、平台级聚合[1]以及一项子领域分解[168]。这些框架不可互换:顶级列表抓取描述了精英尾部,网络普查描述了典型论文,平台聚合两者都不描述。涉及的每个分布都强烈右偏,因此均值系统地超过中位数并描述了非典型论文。
表7. SSRN使用指标的整合基准图,包括抽样框架、来源置信度、允许的推断作用和主要局限性。
| 基准 | 数值 | 来源(年份;抽样框架) | 来源置信度 | 允许的推断作用 | 主要局限性 |
|---|---|---|---|---|---|
| 平台上约2年后论文下载的中位数 | 63(均值122.55) | Siems 2016 [139];n = 1,107个LSN论文在两个2012窗口中发布,计数器两年后读取 | 中高:样本和下载数据已核实;仅法律;2012队列 | 普通论文分布的历史观点 | 两年的法律网络锚点,而不是当前平台范围的规范 |
| 约2年后论文摘要浏览的中位数 | 369(均值564.62;浏览–下载相关系数0.852) | Siems 2016 [139] | 中高:数据与来源的表1核实;仅法律;2012队列 | 普通论文影响范围的历史观点 | 同一时期、单一学科框架;浏览计数器是更受污染的数量(第4.2节) |
| 论文下载中位数,单一网络快照 | 87(均值221.3;p25 = 35;p75 = 206;p95 = 726;论文年龄中位数491天) | Jo & Li 2026 [83];N = 2,361个Marketing Research Network论文,2025年8月15日快照 | 高:与已发布的表格核实;注意两种不同类型的异常报告为"按发布"——浏览p95 = 966是疑似来源打字错误(≈0.32 SD高于均值;行已降级待重新核实),转换p95 = 77.7是小分母比率伪影(第5.2节);完整面板见表5 | 最近的横截面分布和转换模型 | 一个网络、一个领域、一个日期;成熟论文;无轨迹 |
| 论文摘要浏览中位数,单一网络快照 | 504(均值611.973;p5 = 151;p25 = 288;p75 = 833;p95 = 966"按发布") | Jo & Li 2026 [83];与上文相同样本 | 高:与已发布的表格核实;p95值(966)是疑似来源打字错误——≈0.32 SD高于均值——按发布重现并已降级待作者查询重新核实 | 最近的横截面影响范围分布 | 相同的单一网络、单一日期框架 |
| 浏览→下载转换,经验波段 | 11–19%(≈每5.3–9次摘要浏览下载一次) | Siems 2016 [139];Willey & Knapp 2022/23 [172];Jo & Li 2026 [83] | 中高:Siems、Willey–Knapp和Jo & Li数据已与来源表格核实 | 条件参与规范(转换) | 抽样框架较少;分母可被机器人充气,因此测量的转换是下界,而浏览仍然是更多充气的计数器(第4.2节) |
| 历史平台范围的经验法则 | ~3次摘要浏览:1次下载(~33%) | Black & Caron 2006 [18],报告SSRN自己的统计 | 中等:逐字核实;年代久远(2006);平台范围 | 指标解剖学和完整性历史 | 早期平台时代;上层锚点,而不是当前规范 |
| 进入阈值,历史最高前10,000篇论文 | ≥160次生命周期下载(≈平台全文论文库的前1.8%,2016年7月为571,040篇[1]);组内中位数805;均值1,800;最大值152,242 | Kakushadze 2016 [85];SSRN顶级列表抓取,2015年;367,478篇论文 | 高:与已发布的表格核实;顶级列表框架;单作者工作 | 分布形状和尾部行为 | 顶级列表选择;不适合估计当代中位数论文 |
| 进入阈值,前30,000名作者 | 129次总下载(最少);组内总中位数1,626;每篇论文下载中位数210;最大值824,762 | Kakushadze 2016 [85];该组SSRN自己的信件描述为作者的"前10%"[161] | 高:与已发布的表格核实 | 作者组合级别的尾部行为 | 相同的顶级列表选择;2015年版本 |
| 未调整的平台范围生命周期均值 | ~每篇论文222次下载(~最近12个月中35次) | 根据2023年12月的平台总数计算:1,157,048篇全文论文的256,678,716次生命周期下载;ALL-SIS 2024 [1] | 中等:衍生聚合;因旧论文机械充气;不是个人衡量标准 | 仅平台规模的聚合校准 | 二十年累积的平均值;几乎不描述任何实际论文(第3.3节) |
| 单一学科内的子领域扩展 | 每篇论文平均下载中约8倍的差异(公司/证券/金融法438.35 vs 农业法53.48) | Whalen 2018 [168];94个LSN电子期刊,~250,000篇论文 | 中高:从来源核实;2018年;均值,而非中位数 | 分类和子领域异质性 | 均值,而非年龄匹配的中位数;仅法律;2018年 |
| 早期下载→后期引用 | r ≈ 前180天内0.39–0.43(≈解释16%的方差) | Brody, Harnad & Carr 2006 [25];arXiv (HEP), N = 14,442 | 高:已核实;不同平台,可转移性为假设而非显示 | 下游预测验证 | 不同平台和时代;论文级相关性温和 |
| 访问日历结构;访问→引用滞后 | 周末访问量约低11%,夏季约低50%;访问变化约9个月后出现≈单位弹性引用反应 | Yuret 2026 [178]; >1,500篇来自七种期刊的文章,跟踪约1年 | 高:DOI、场地和标题通过Crossref验证(2026年8月14日);所有四个数字 — 来自七种期刊的1,500多篇文章、周末访问约低11%、夏季约低50%,以及约单位弹性引用反应(访问增加10%与引用增加约10%相关)约九个月后 — 根据已发布的文章摘要逐字验证(Springer,2026年8月15日) | 时间标准化和预测验证 — CSAB背后的日历标准化锚点 | 期刊访问数据,非SSRN特有 |
| 计数对计数惯例的敏感性 | 供应商下载报告可能是可比平台的约2倍("放气"计数为报告数字的43%);文章级指标需要明确的数据完整性筛查 | Wood-Doughty et al. 2019 [176]; Gordon et al. 2015 [69] | 中等偏高:两个来源已验证且已在第4.1–4.3节中引用 | 完整性和可比性警告 — 限制了任何跨平台或跨供应商比较的精度边界 | 不是直接的SSRN基准;不存在SSRN特定的审计 |
地图的三种结构性解读如下。
平均值不是典型论文。在唯一最近发表的分布中,平均值(221.3)是中位数(87)的2.54倍,甚至超过了第75个百分位数(第3.3节)[83]。在Siems的早期统计中,平均值大约是中位数的两倍[139]。平台级别的~222次生命周期下载[1]的平均值是所有最不合适的个人衡量标准:它汇总了各个年龄段论文二十年的累积。
每个基准都带有一个年代特征,年代偏差的方向取决于比较方式。平台年度下载量从2000年的约0.5百万和2005年的3百万[18]增长到2016年的12.9百万和2023年的40.6百万[1],2016至2023年间增长了3.15倍,而同期论文库存增长约2.03倍(571,040至1,157,048[1])。图5绘制了这一轨迹。由于下载增长快于论文库存增长,单篇论文的下载流量增长了约55%(从约22.6增至约35.1次/篇/年[1]),因此固定的2015年阈值现在代表的是典型论文收入的较小份额,比当时更小。作为2026年的绝对水平区间阅读,旧阈值(如~160次下载的热门名单条目)因此是宽松的而非保守的:满足它的选择性今天比2015年更低,而非更高。偏差取决于成分。对于在持续右偏下的百分位数位置,旧锚点可能仍会低估尾部,但对于绝对计数,下载膨胀使其变软,因此不应在没有这一条件的情况下将任何旧阈值引用为"保守底线"。同样,将2015年阈值乘以后续平台增长也是无根据的:作者构成、分发渠道、筛查和注意力竞争都随着下载流量的变化而变化。
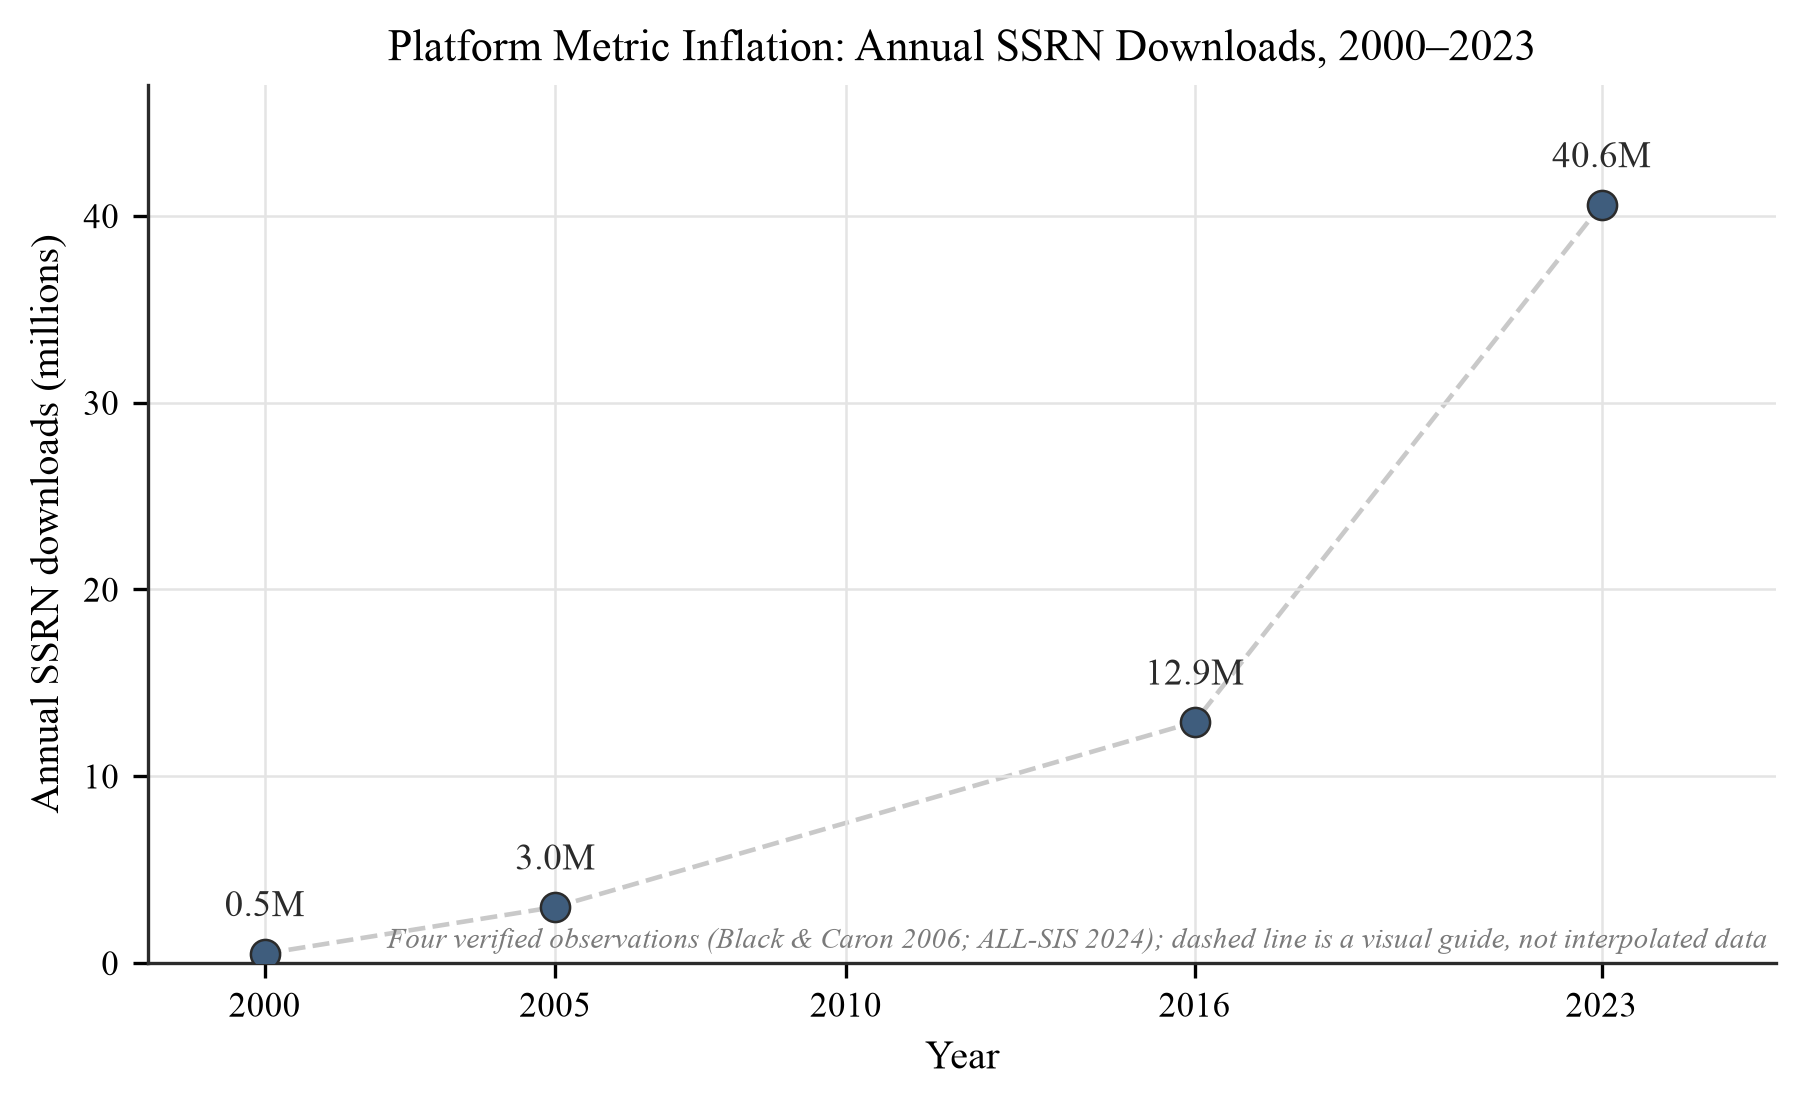
图5. 平台指标膨胀,2000–2023。年度SSRN下载量:~0.5百万(2000)和~3百万(2005)[18];12.9百万(2016)和40.6百万(2023)[1]。由于下载流量增长快于论文库存(2016至2023年间≈3.15×对比≈2.03×[1]),单篇论文下载流量增长约55%,基于2012–2015样本估计的绝对基准对于2026读数而言显示为宽松而非保守的区间。仅此处列出的四个验证年度值被绘制;不暗示在它们之间进行任何插值。
不存在当前的百分位数来源。第2.5节审计中未发现2020年后SSRN下载的平台范围内分布研究(2025年单网络快照[83],2026年发表,是唯一最近发表的外部样本),2026年7月15日之后,平台本身不发布可从中重建百分位数的比较数据。缺口是当前性和平台特异性的问题。预印本关注的分布和不平等在其他存储库中是一个成熟的研究领域(bioRxiv存款的引用和替代指标概况已在整个服务器上表征[62]),SSRN下载的准对数正态形状已于2020年前由Kakushadze建立[85]。缺少的是一个当前的、SSRN特有的、日落后的百分位数分布。上面的地图是由可用框架组装而成的,这是研究议程(第8节)中提出的社区基准数据集的论证。
5.2 转换带
下载数与摘要浏览数的比率是仪表板上具有相当稳定的跨研究规范的唯一指标,作者对其的误读比其他任何指标都更一致。简单地理解,每个未转换的浏览都被计为一次拒绝,一个拥有40次浏览和7次下载的作者会感知到一个"82.5%的失败率"。这种理解在机制上和经验上都是错误的。
第4节阐述了机制:分母(浏览次数)是受机器人污染更多且因架构设计而夸大更多的数量,因为推送型电子邮件点击和爬虫流量会累积浏览次数而不暗示读者意图,而下载计数器受到主动审计[144][99][106]。只要自动化流量对浏览次数的夸大程度超过下载次数,测得的转换率就是真正感兴趣的人类访问者的转换率下界;第4.2节解释了当AI系统检索全文时为什么不能再假设这种不对称性,且界限相应减弱。从经验上讲,已发表的测量值收敛到一个狭窄的区间。Siems在LSN普查中测得的下载与浏览比的中位数为0.171(平均值0.187)[139];Willey和Knapp报告其顶级文章组中的转换率为15%,单引用文章中的转换率为11%[172]。Jo和Li的快照显示每100次摘要浏览有18.9次下载的中位数[83]。由此得出的经验带为11–19%,即大约每5.3–9次摘要浏览有一次下载。SSRN自己的陈旧经验法则为~3:1 (~33%) [18],位于该带之上,最好理解为早期平台范围内的上限锚点,而非当前规范。作为跨领域的说明(群体和意图有根本差异),此范围内的浏览到提交率在消费者软件中会被视为较高,其中典型的免费增值免费到付费转换基准聚集在低个位数[10]。该比较仅供说明之用,它改变了'40中有7'表示缺乏兴趣的直觉。图6绘制了这些估计。
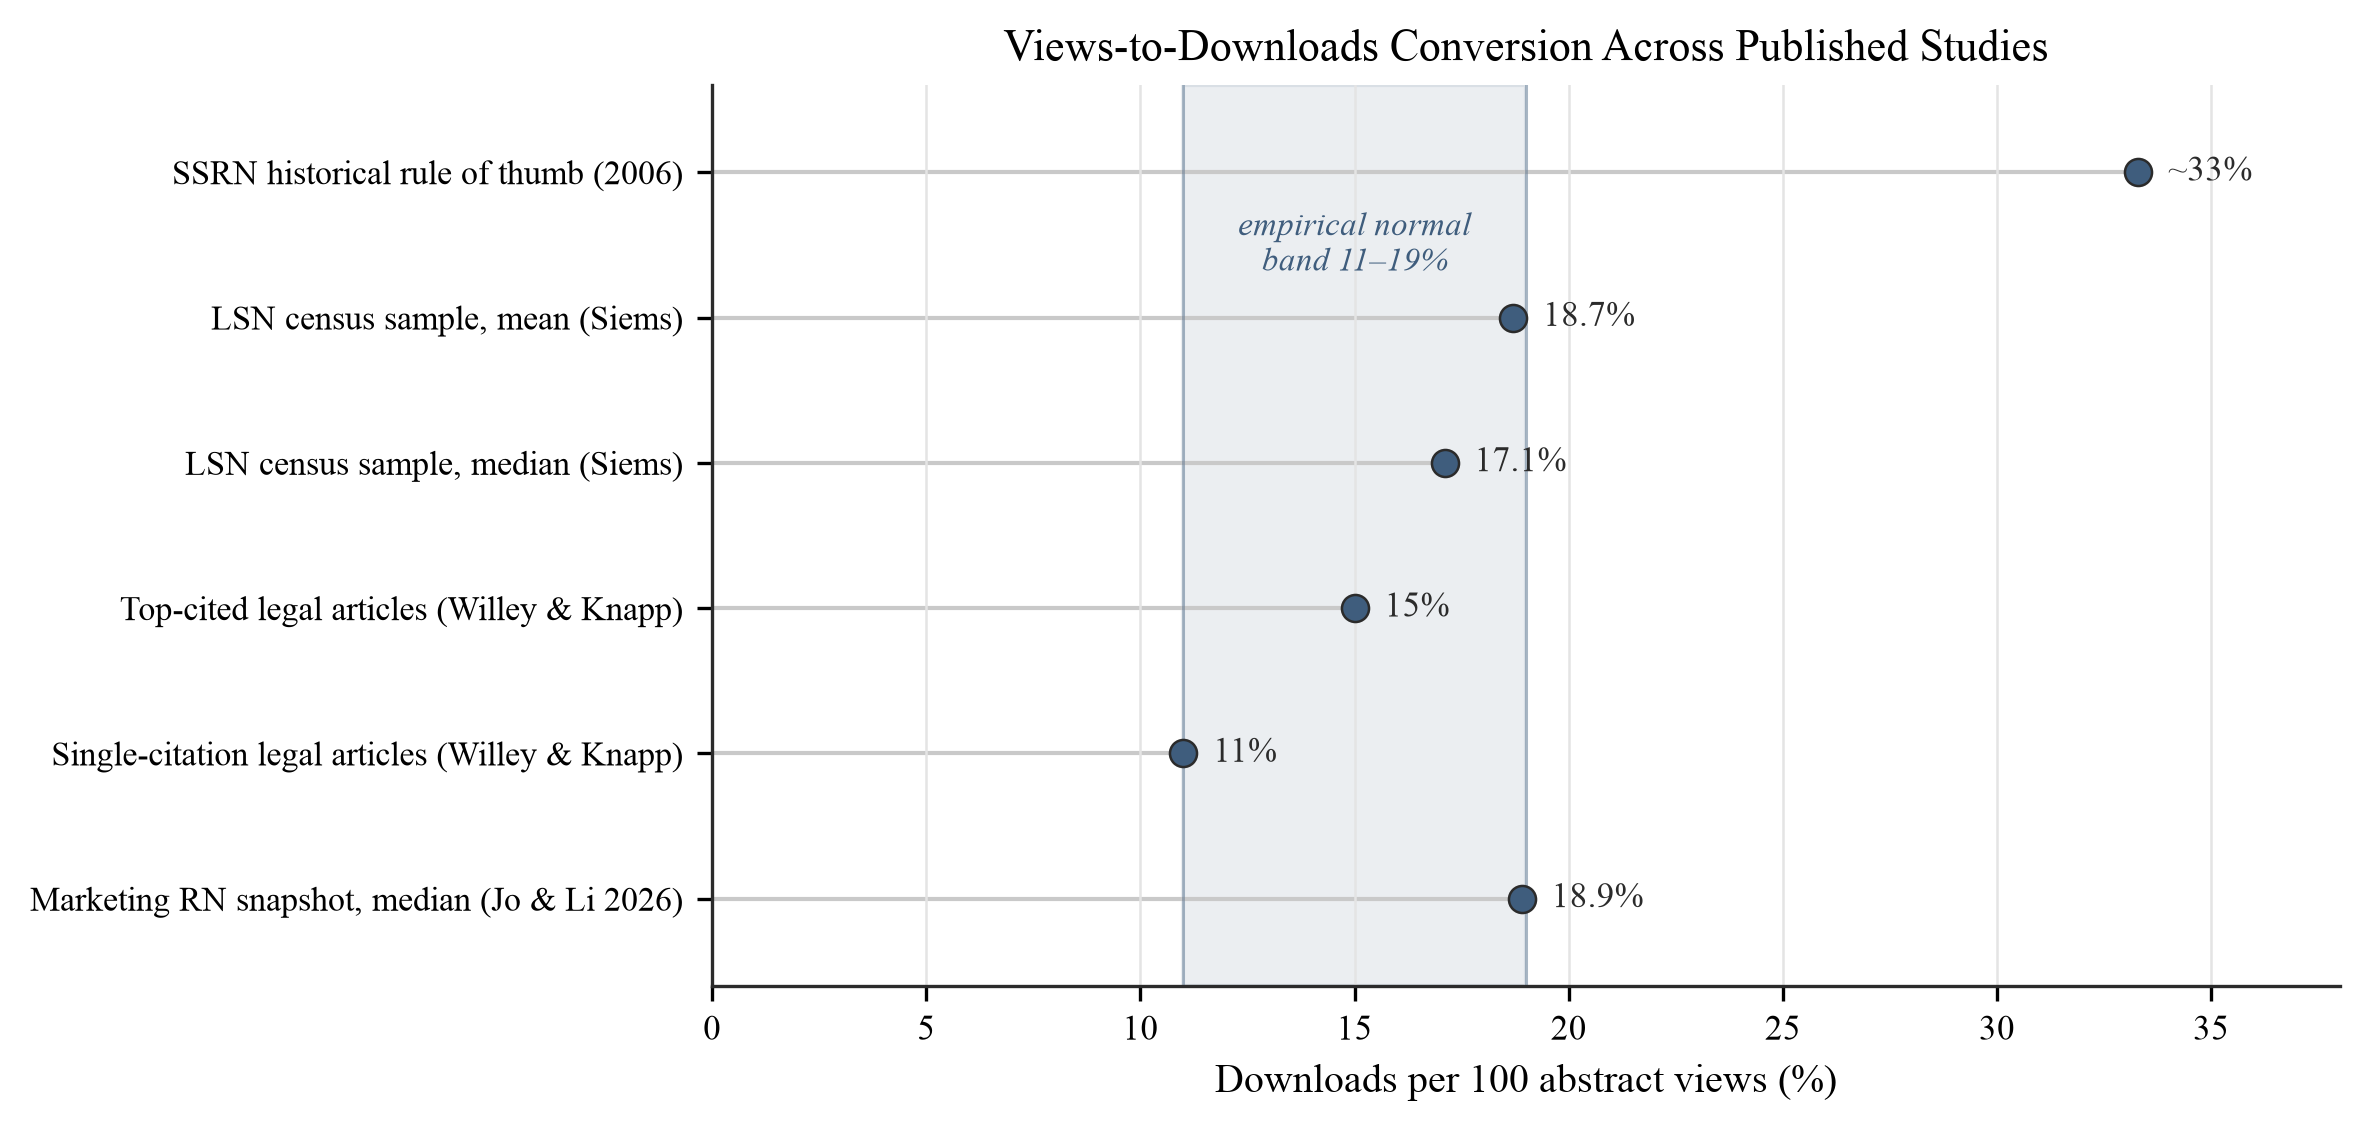
图6. 跨研究的浏览至下载转换。已发表记录中的转换率估计:SSRN的历史经验法则约33% (如2006年所报告) [18]; LSN普查平均值18.7%和中位数17.1% [139]; 顶引用和单次引用法律文章中分别为15%和11% [172]; 2025年营销研究网络快照中每100次摘要浏览有18.9次下载的中位数[83]。阴影带标记了11–19%的经验常规范围 — 异质估计的包络(完整网络中位数与引用选择的子样本数据并列,其统计类型源未指定);Jo和Li样本平均值(每100个中的23.7)位于其上方。所有值都如引用源中所发表的那样;未引入新的估计。
该带的成员是不同样本的不同统计量,因此它是异质点估计的包络。Siems (17.1%) 和Jo和Li (18.9%) 的数据是完整网络样本的中位数,而Willey和Knapp的15%和11%是针对引用选择的子样本报告的(被引最多的与单次引用的法律文章),其统计类型源未指定,其选择是该带下边缘所在位置的原因。上边缘更加模糊:Jo和Li样本中的平均转换率(每100次浏览有23.7次下载)[83]位于该带之上,它与该样本聚合平均值的比率(221.346 ÷ 611.973 = 每100个36.2)相差很大。平均值比36.2远高于比率平均值23.7这一事实本身具有诊断意义。因为平均值比在代数上是单篇论文转换率的浏览加权平均,它超过非加权比率平均值暗示了覆盖范围和转换之间的正相关:浏览次数多的论文以略高的速率转换,而不是更低。这个解读是保守的:小分母膨胀会将非加权比率平均值向上推,与这种顺序相悖,因此尽管如此观察到平均值比仍然在其上方使正相关结论更加稳健,而不是更弱。
该带为本文的核心工作示例提供了基础。根据已发表的基准,具有40次摘要浏览的论文预期会产生大约4–8次下载。标题中的'7次下载'在40次浏览中是17.5%的转换率,一个落在该带内部但在此分母处具有广泛不确定性的点估计。40个中7个的精确95% Clopper–Pearson区间从约7.3%到约32.8%,从两边跨越该带:只有40次浏览,估计的不确定性太大,无法精确到该带的宽度,因此这个读数是筛选结果,而不是分类。两个因素进一步限制了这个例子。分母很小(下面提到的不稳定性),且比较未进行年龄匹配:大约第20天的40次浏览是一个早期阶段的读数,而锚点中位数来自成熟样本(Siems为期两年[139],Jo和Li的中位论文年龄为491天[83]),且第1和5位置以及第5.6节论证早期暴露是一个不同的制度,所以年龄轴未对齐。因此可辩护的读法是17.5%与跨研究带作为筛选结果一致,而不是精确的群体百分位数,也不是"舒适地在其内部"。这样一个数字引起的困扰反映的是缺乏参考标度,而不是缺乏阅读。基础锚点的来源和范围在第9节中阐述。
小分母使比率不稳定。一篇有两次浏览和一次下载的论文名义上的转化率为50%,但这个估计的可信度不应高于基于500次浏览建立的估计;对于任何面向公众的基准测试,经验贝叶斯收缩趋向参考类费率应防止小分母产生极端分数(第8.3和8.8节)。该带状区间在两个方向都可用作诊断工具。转化率远低于该带状区间,在非平凡分母的情况下,通常表示题目–摘要–正文不匹配:读者到达、阅读摘要后离开,这是可采取行动的沟通问题(重写题目和摘要),而非对研究的判决。转化率远高于该带状区间表示摘要浏览无法解释的流量(媒体报道、课程采用或病毒式传播),应提示检查浏览量的来源。两种偏差本身都不能确立关于研究质量的任何内容。进一步的限定是假设而非发现。转化率在各领域间可能系统性地变化,作为受众阅读风格的特性而非个别论文的特性:大型领域可能表现出"橱窗购物"行为,摘要访问量多但下载量少,而小型、高度参与的社区转化率更高。该带状区间估计所基于的框架太少,无法解决这一问题,因此研究1(第8.6节)在其输出中包括分领域分层转化。
诊断工具,绝非目标:反博弈约束。转化带状区间之所以强大,是因为它可以被解读为规范,而这种力量伴随着危险。古德哈特定律认为,作为目标采纳的衡量指标就不再是好指标[67],这一原则与坎贝尔定律相平行,后者讲述社会指标在用于决策时的腐败[27]。如果11–19%的带状区间或第5.5节基准框架的任何组成部分被当作晋升阈值来采纳("论文应位于转化带状区间内才算数"),该比率会立即成为优化的对象而非观察的对象。这种攻击既具体又廉价:由于分母是更易被操纵的量(第4.2节),以固定比例协调膨胀摘要浏览次数与下载次数会使比率保持在带状区间内,使工程化信号在统计上与有机转化无法区分。框架的答案是定义的问题。转化带状区间、覆盖–转化诊断(第5.4节)和CSAB组件(第5.5节)是诊断向量,绝非目标,任何组成部分都不得被解读为晋升标准。抗博弈的机制内置于设计中:该带状区间被陈述为下界,因为其分母易于被机器人膨胀,所以读数在构造上保守地抵抗膨胀;第8.3节的异常协议是标记而非删除,所以工程化峰值被保留并变得可见,而非被无声地吸收;且第4.1节的完整性过滤已经筛选出最易检测的协调活动。作为诊断来读,该带状区间将博弈暴露为带外或内部不一致的特征;作为目标来读,它会邀请正是它意图检测的协调。这一立场使框架与既定的研究评估改革共识相一致:San Francisco Declaration on Research Assessment(DORA),其反对单一数字和期刊品牌代理,赞成根据研究本身的内容进行评估[8],以及Leiden Manifesto,其原则警告不要做出正是这样的将简单指标替代专家判断的替代[78]。
下载没有公开的审计线索:将带状区间理解为下界的进一步原因。引用和下载之间的结构性不对称加剧了博弈的担忧。引用留下公开的、可检查的痕迹:引用文献存在、可被发现且可被检查,因此引用操纵原则上可被任何第三方审计。下载计数器留下没有这样的公开记录。它是平台服务器上的私人统计,没有外部记录说明哪些请求被计数、过滤或重新陈述,这使其独特地暴露于隐蔽的博弈,而任何局外观察者都无法在事后重建。这种暴露是一个独立的原因,超越分母的机器人污染,将测量的转化率视为下界而非点估计(受第4.2节关于AI检索的注意事项约束),并始终将计数器与异常协议和框架依赖的文档化完整性过滤结合使用(第4.1节)。审计线索的缺失不是不信任计数器的原因;它是保守地解读它的原因,也是坚持标记而非删除原则的原因,该原则保持操纵的读数保持可检测(第8.3节)。
该带状区间是校准目标,不是常数。一个后果在于11–19%的数据和每个CSAB阈值应该如何被引用:它们是待由领域和平台校准的量(第4.4和5.5节)。该校准的机制已经指定:分领域分层的研究1(第8.6节)旨在提供框架所需的每个领域转化和下载分布,并内置为消费该数据。在研究1报告之前,附录E的档案截面提供了按领域分解的估计。在拥有至少二十篇论文的十四个领域中,中位转化率从能源领域的0.134到计算机科学领域的0.195,差异约1.5倍;保持论文年龄不变时,从0.134到0.224,差异约1.7倍。与下载本身的三至五倍领域差异相比,转化率是两个量中更具可移植性的,这正是使其可用作诊断工具的原因。年龄是转化率无法克服的维度:在每个足够大以进行测试的领域内,随着论文年龄增长转化率下降,在包含至少四十篇论文的八个领域中,斯皮尔曼系数从−0.14到−0.41。不考虑论文年龄引用的转化带状区间所做的工作少于其表面所示。
5.3 分级解释量表
Post-Rankings的作者最明显地缺乏一个分级量表,该量表采用h-index解释指南[118]既定的格式,将原始计数器转换为通俗易懂的分段。第5.1–5.2节为其提供了组成要素。表8提出了针对四个量的建议量表:论文级终身下载数、首月下载数、浏览转下载比,以及作者级总下载数。
表8. SSRN指标的建议解释量表。 这些分级综合了2012–2015年的证据[139][85][18][172];由于自那时以来单篇论文下载流量有所上升(第5.1节),这些绝对阈值最好被理解为 宽松 而非2026年的保守分级,无论如何都作为近似值。首月列不是该量表的已校准等级,而是一个进行了预注册的预测,具有广泛的不确定性,将由研究1的预期小组(第8.6节)进行测试;其单元格不应被理解为阈值或晋升等级(见正文)。在10,000处的Strong/Exceptional边界是作者的初步估计:第2.5节审计中确认的已发表来源均未将10,000次下载与百分位数相联系。Nascent分级引入无新数字:其上限是既有的两年中位数锚点63[139]。分级边界设置为整数,并大致保持一个完整分级的宽度:完整性文献确立的精度上限(第3.1、4.1–4.3节)使得更精细的分级显得虚假精确,因此分级的粗糙程度是有意设计的。通俗易懂的判断列描述 下载数 量表而不转移到转换列:18.9%的中位数转换是普通而非"Solid",27.2%的p75不是"Strong"。终身下载边界通过构造是互不重叠的(Nascent低于63,Modest 63–159,Solid 160及以上);在表中打印了较高行之间的共享端点处——Solid和Strong之间的800,以及相应的转换和作者级截点——区间是半开的,每个共享值属于较高的分级。这两个终身边界值本身来自互不可通约的参考类:63是单一学科法律学术人口普查的两年窗口中位数[139],而160是整个平台顶级列表的历史终身录入阈值[85]。因此,它们采用不同的时钟尺度(固定的两年论文年龄与无界的终身累积),并描述不同的人口(单一领域与所有领域),因此将它们汇集到单个绝对梯度中是对具有不同年龄、领域和选择规则的参考类的组合——这是研究1的领域和年龄特定百分位数设计要移除的限制。这些锚点的结构限制值得强调:因为可用的参考点聚集在两年中位数(63[139])和平台的上尾,五个口语分级中的四个——Modest、Solid、Strong和Exceptional——描述处于或高于中位数的论文,所以量表在中位数上方是密集的,并且在大多数论文实际落在的广泛第50–98百分位范围内仅弱地区分。这种压缩是锚定顶部尾部证据的直接后果;区分普通论文和仅略高于中位数的论文需要研究1的领域和年龄特定百分位数。该量表是说明性的,而不是规范性的:在研究1的预期小组(第8.6节)使用领域和年龄特定百分位数校准以替换这些过时的绝对锚点之前,任何分级边界都不应作为通过/失败阈值用于终身聘用、聘用或晋升决定。
| 分级 | 论文:终身下载数 | 论文:首月下载数(外推) | 转换率(下载数/浏览数) | 作者:总下载数 | 通俗易懂的判断 |
|---|---|---|---|---|---|
| Nascent | 低于63[139]的两年中位数 | —(无单独的锚点;见正文) | —(分母通常太小;第5.2节) | — | 太早,或低于该领域中位数——年轻论文和利基论文的统计常态;首先诊断其曝光情况(第5.4、5.6节),而不是质量 |
| Modest | 63–159 | <15 | <11% | <~130 | 该平台的典型特征;中位数分级 |
| Solid | 160–800 | 15–50 | 11–19% | ~130–1,600 | 处于或超越历史顶级列表录入水平 |
| Strong | 800–10,000 | 50–250 | 19–30% | 1,600–10,000 | 历史顶级列表的典型特征 |
| Exceptional | >10,000(作者的初步估计) | >250 | >30% | >10,000(作者的初步估计) | 超出已记录的普通学术流通范围 |
每个内部锚点都与已发布的阈值相关联。新生期波段覆盖低于两年LSN中位数63的区域[139]。该区域人口众多,并非异常:预先指定的研究1波段(第8.6节)预期该平台论文的相当一部分(在所述预测波段下约15–30%)的终身下载量为十次或更少,因此,如果一个量表的最低波段从中位数附近开始,将使平台数量最多的论文(包括本文在内)完全排除在量表之外。新生期评判是非评估性的。在领域中位数以下,特别是对于年轻论文,计数器不许任何质量判断,第一诊断步骤是曝光(第5.4和5.6节)而非内容。适度波段锚定在两年LSN中位数63处[139]。"适度"是中位数波段:典型性不等于失败。适度/稳健边界(~160次终身下载)是Kakushadze进入历史最佳1万篇论文的入口点,约占该平台全文论文库的前1.8%(571,040,2016年7月[1])[85]。操作上,"稳健"论文是顶级列表论文。稳健/强劲边界(~800)是该精英组内的中位数(805)[85]:它将仅进入历史精英的论文与典型的精英论文区分开来。在组合量表上,作者级别列镜像了这一逻辑:SSRN自身通知描述为前10%作者的组[161]的入场最低值为129次总下载量,内部中位数为1,626次[85]。因为每个作者级别锚点都来自该排名列表,作者列描述的是作者分布的上尾部而非典型作者。低于~130边界的作者不仅仅是"适度":该作者完全落在历史排名组之外,因此该列的较低波段读作"低于历史精英",而非在所有作者中的校准位置。这与压缩论文级别量表的相同上尾锚定一致;作者列的锚点等待研究1的组合级百分位数。转换列是第5.2节的跨研究波段。10,000处的强劲/例外边界没有已发布的百分位锚点,保留为数量级视野。
首月列有不同的地位。这是一个预注册预测,是一个可证伪的预测,具有广泛的不确定性,研究1(第8.6节)旨在对其进行测试,任何首月单元不得用作阈值或解释基准。已发表的文献中不存在直接的首月基准,因此该列是预测而非测量,从文献记载的下载早期集中(注意力尖峰在最初几周内集中,特别是在外部覆盖下[18][116][138])外推至上述终身阈值。具体的边界来自一个已发布的锚点:在Kakushadze的顶级列表样本中(约占该平台全文论文库的前1.8%(571,040,2016年7月[1])),中位数十二个月下载计数为247次[85]。因此,首月超过~250次将超过该平台历史精英的年度规范,因此是例外边界,而15–50次首月下载,如果持续,投影到~160次终身入门阈值,因此是稳健。这些单元是来自单个历史锚点的投影,是表格中最弱的单元;如果引用,它们应携带此推导。
两个警告控制该量表的使用。学科限定符不是可选的:在同一学科内,各子领域的平均每篇论文下载量相差约8倍(企业/证券/金融法中为438.35,而农业法中为53.48)[168],因此每个波段陈述都应包含一个字段标签。这些是终身平均值,未按论文年龄调整,附录E的档案横截面说明了为什么这很重要:一个字段的表观水平随从该字段采样的论文的年龄概况而变化,保持年龄固定会将分布范围缩小到大约三到五倍。第二个是在这个空间中提出的替代单数字启发式(基于比率的相对性能指数(论文的下载数除以匹配队列的中位数)、基于⌊ln D⌋的对数层级启发式和口头计分卡评判("快速开始/稳定兴趣/缓慢开始"))作为未校准的作者启发式被包含在这里,因为没有一个具有验证的数字波段。对数直觉本身是合理的,值得用文字保留:在准对数正态分布下[85],从7次下载移到20次是可见性中一个自然对数单位的移动,将其读作13次点击的增加是错误的。
该量表还解释了为什么作者系统地误判自己的计数。如第3.5节所记载,在里程碑、资料和公告中流通的数字来自比中位数高几百倍的可见尾部,而分布的质量位于LSN中位数63附近,在准对数正态法则下,梯级之间的距离是乘法的,而非加法的。图7将这些值(普通论文中位数、入门阈值、精英中位数、尾部)排列为对数量表上的基准阶梯。
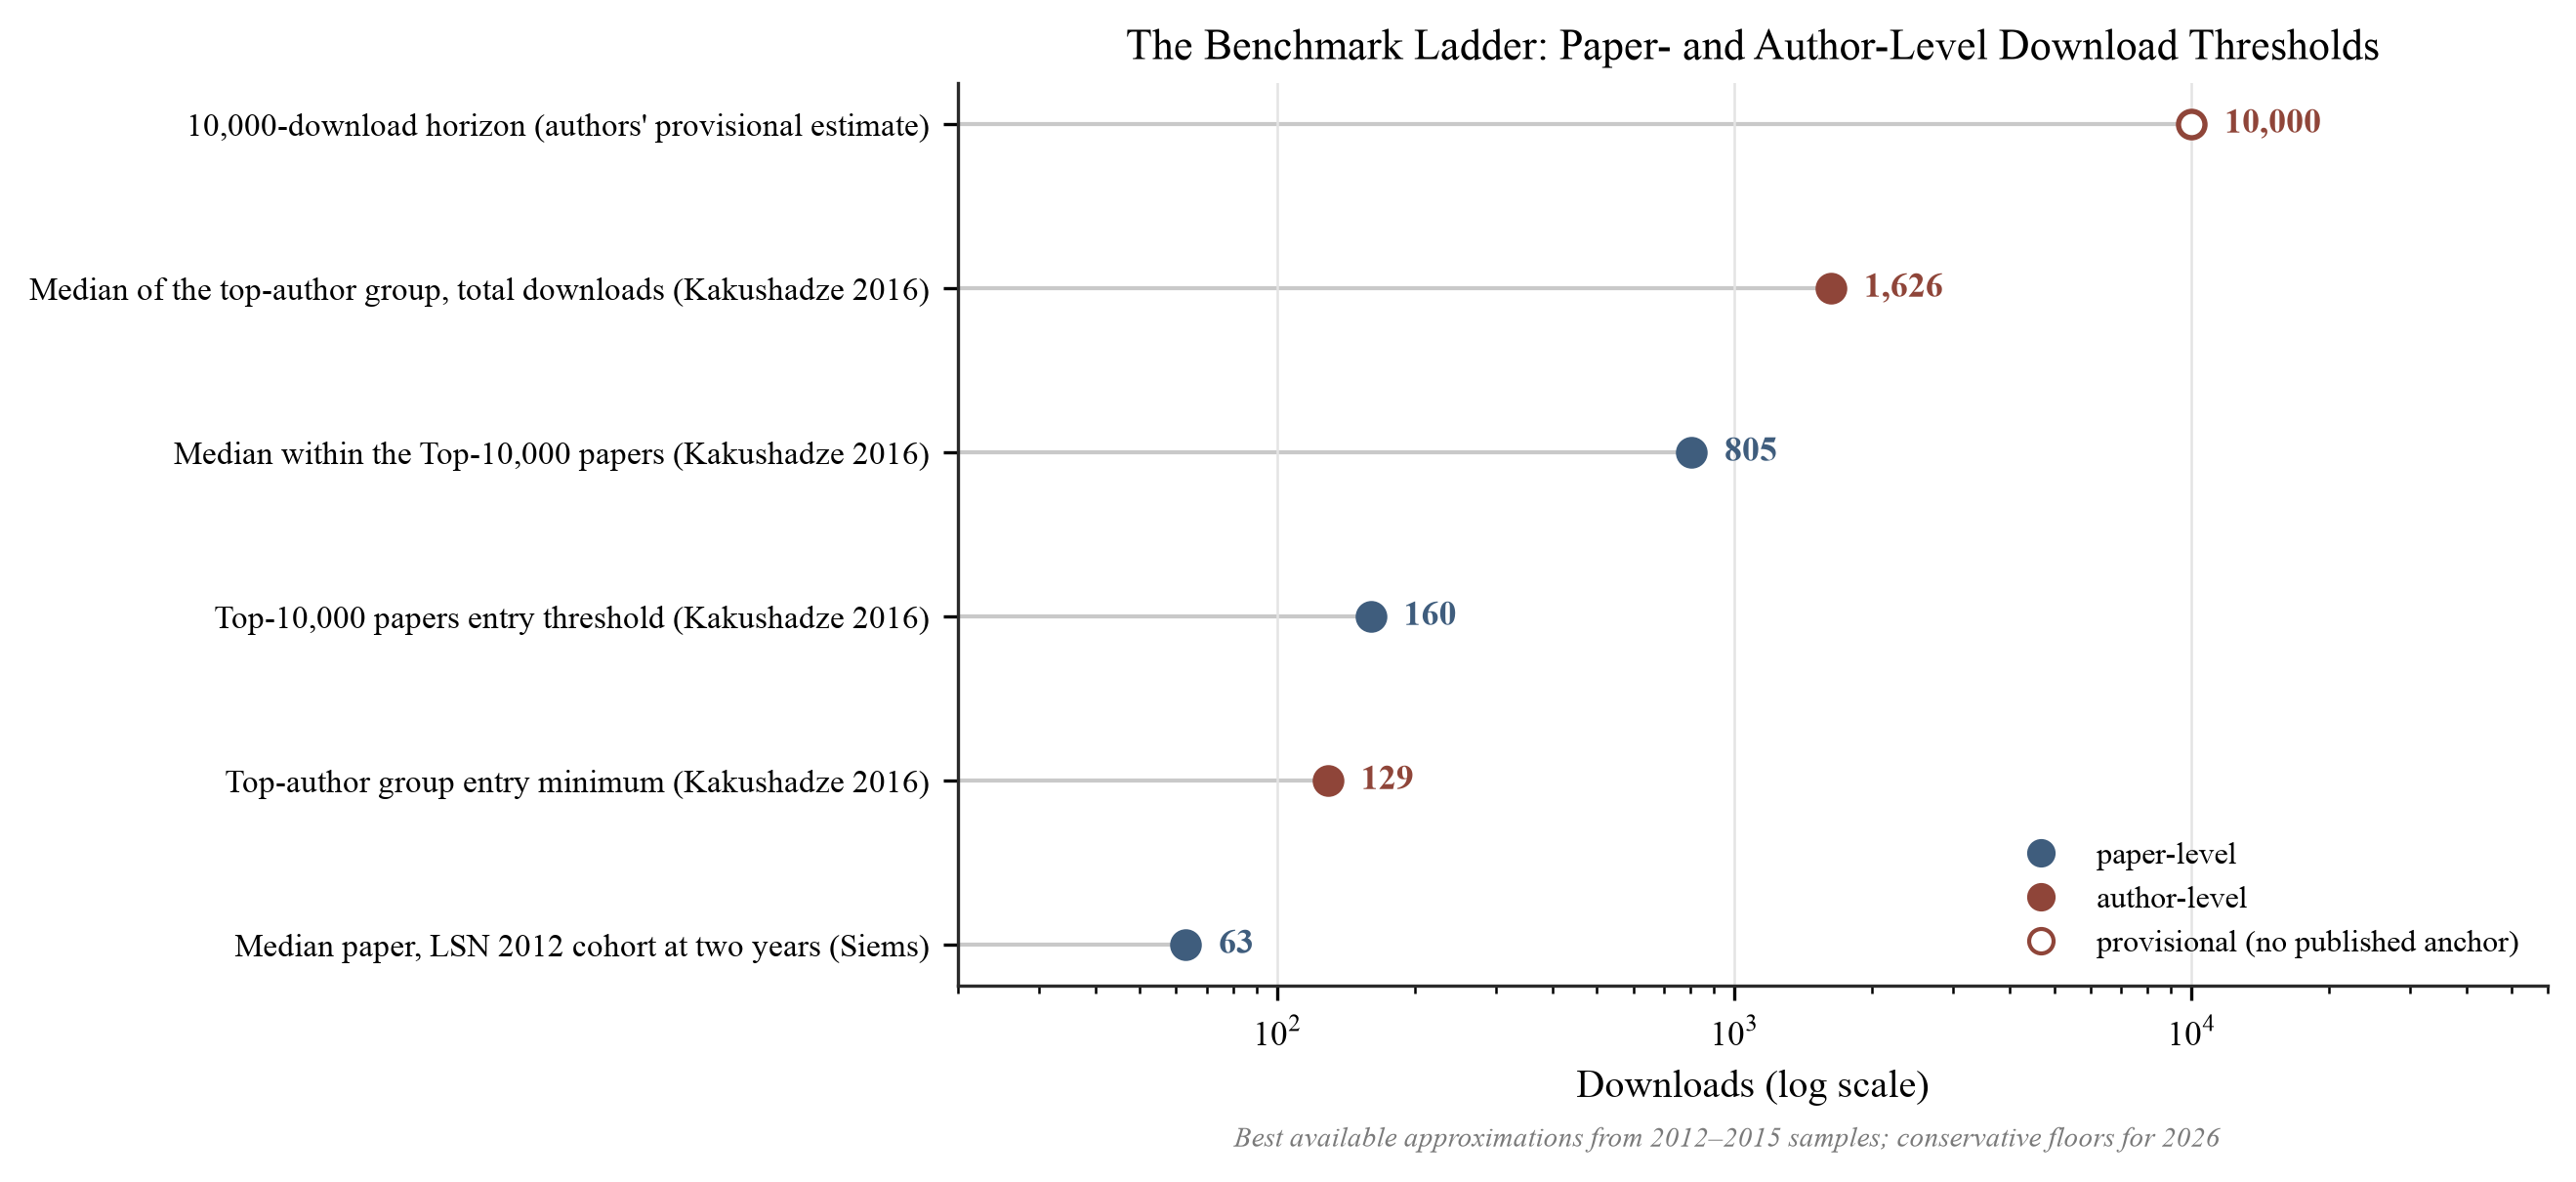
图7。基准阶梯。对数量表上的论文和作者级别下载阈值:LSN两年中位数63[139];顶级作者入门最低129和顶级论文入门~160[85];前10,000篇论文内的中位数805[85];顶级作者组的中位数1,626[85];10,000次下载视野(作者的初步估计,无已发布的百分位锚点)。低于两年中位数63的区域对应于表8的新生期波段。数值来自2012–2015年样本(此后的通货膨胀:第5.1节)。
5.4 覆盖范围与转化:二维诊断
单个计数,即使是分组计数,也无法区分产生该结果的不同机制。第4节的机制有一个在实践中最重要的含义:可见性失败和内容无反应是不同的诊断:一篇论文下载量少可能是因为很少有读者遇到它,或者是因为那些遇到它的人拒绝了全文。表9交叉这两个标准化维度。
表9. 覆盖范围–转化诊断矩阵。覆盖范围和转化在可比论文的参考类别内评估为百分位数(相同领域、发表队列、论文年限和先前作者可见性;第5.5节),以类别中位数作为边界。根据当前证据,没有任何绝对数值截断点是可以辩护的,也没有给出。2×2显示在类别中位数处对每个轴进行二分,以便于阅读;基础的覆盖范围和转化百分位数是连续的(第5.4节),可以使用更细的分割,如三分位数。
| 低转化 | 高转化 | |
|---|---|---|
| 低覆盖范围 | "冷启动"(低覆盖范围、低转化)。该论文既没有被广泛接触,也没有在暴露后被频繁下载。这些数据没有确定基础研究是否薄弱;它们仅确立扩散尚未开始。 | "隐藏的兴趣"(低覆盖范围、高转化)。遇到该论文的读者反应良好,但遇到它的人太少。可发现性是主要的可观察瓶颈——这是一个分发问题,而不是内容问题。 |
| 高覆盖范围 | "没有取得成效的关注"(高覆盖范围、低转化)。标题、主题或平台位置似乎能吸引访问,但很少有访客获得全文。在诊断通信不匹配之前排除受污染的分母:高覆盖范围可能是虚假视图而不是真正的关注,因为视图是两个计数器中污染程度更高的(第4.2节)——在透明的RePEc/LogEc记录中,机器人占抽象视图的大约74%,但只占下载的大约7% [99],因此未过滤的非人类流量产生了正是这种高覆盖范围、低转化的特征。只有当排除了机器人膨胀的视图后,剩余数据才值得调查受众适配度和标题–摘要沟通。 | "强大的早期扩散"(高覆盖范围、高转化)。该论文达到了相当大的受众,并将暴露转化为全文兴趣。 |
四个象限由两个百分位数显示的扩散模式标记(冷启动、隐藏的兴趣、没有取得成效的关注、强大的早期扩散)。这些标签描述的是扩散的模式,而不是研究本身,从操作角度来说重要的是机制的分离;低覆盖范围象限都不允许对研究质量进行推断,这一点与这些指标的任何评估使用直接相关。低扩散象限采用本文自身诊断的名称——冷启动。该矩阵在实践中有价值,因为合适的干预因象限而异:隐藏兴趣候选需要分发(分类审查、公告时间、外部可见性),而没有取得成效的关注需要通信修复(标题和摘要)或流量审计。图8将该平面呈现为模板。
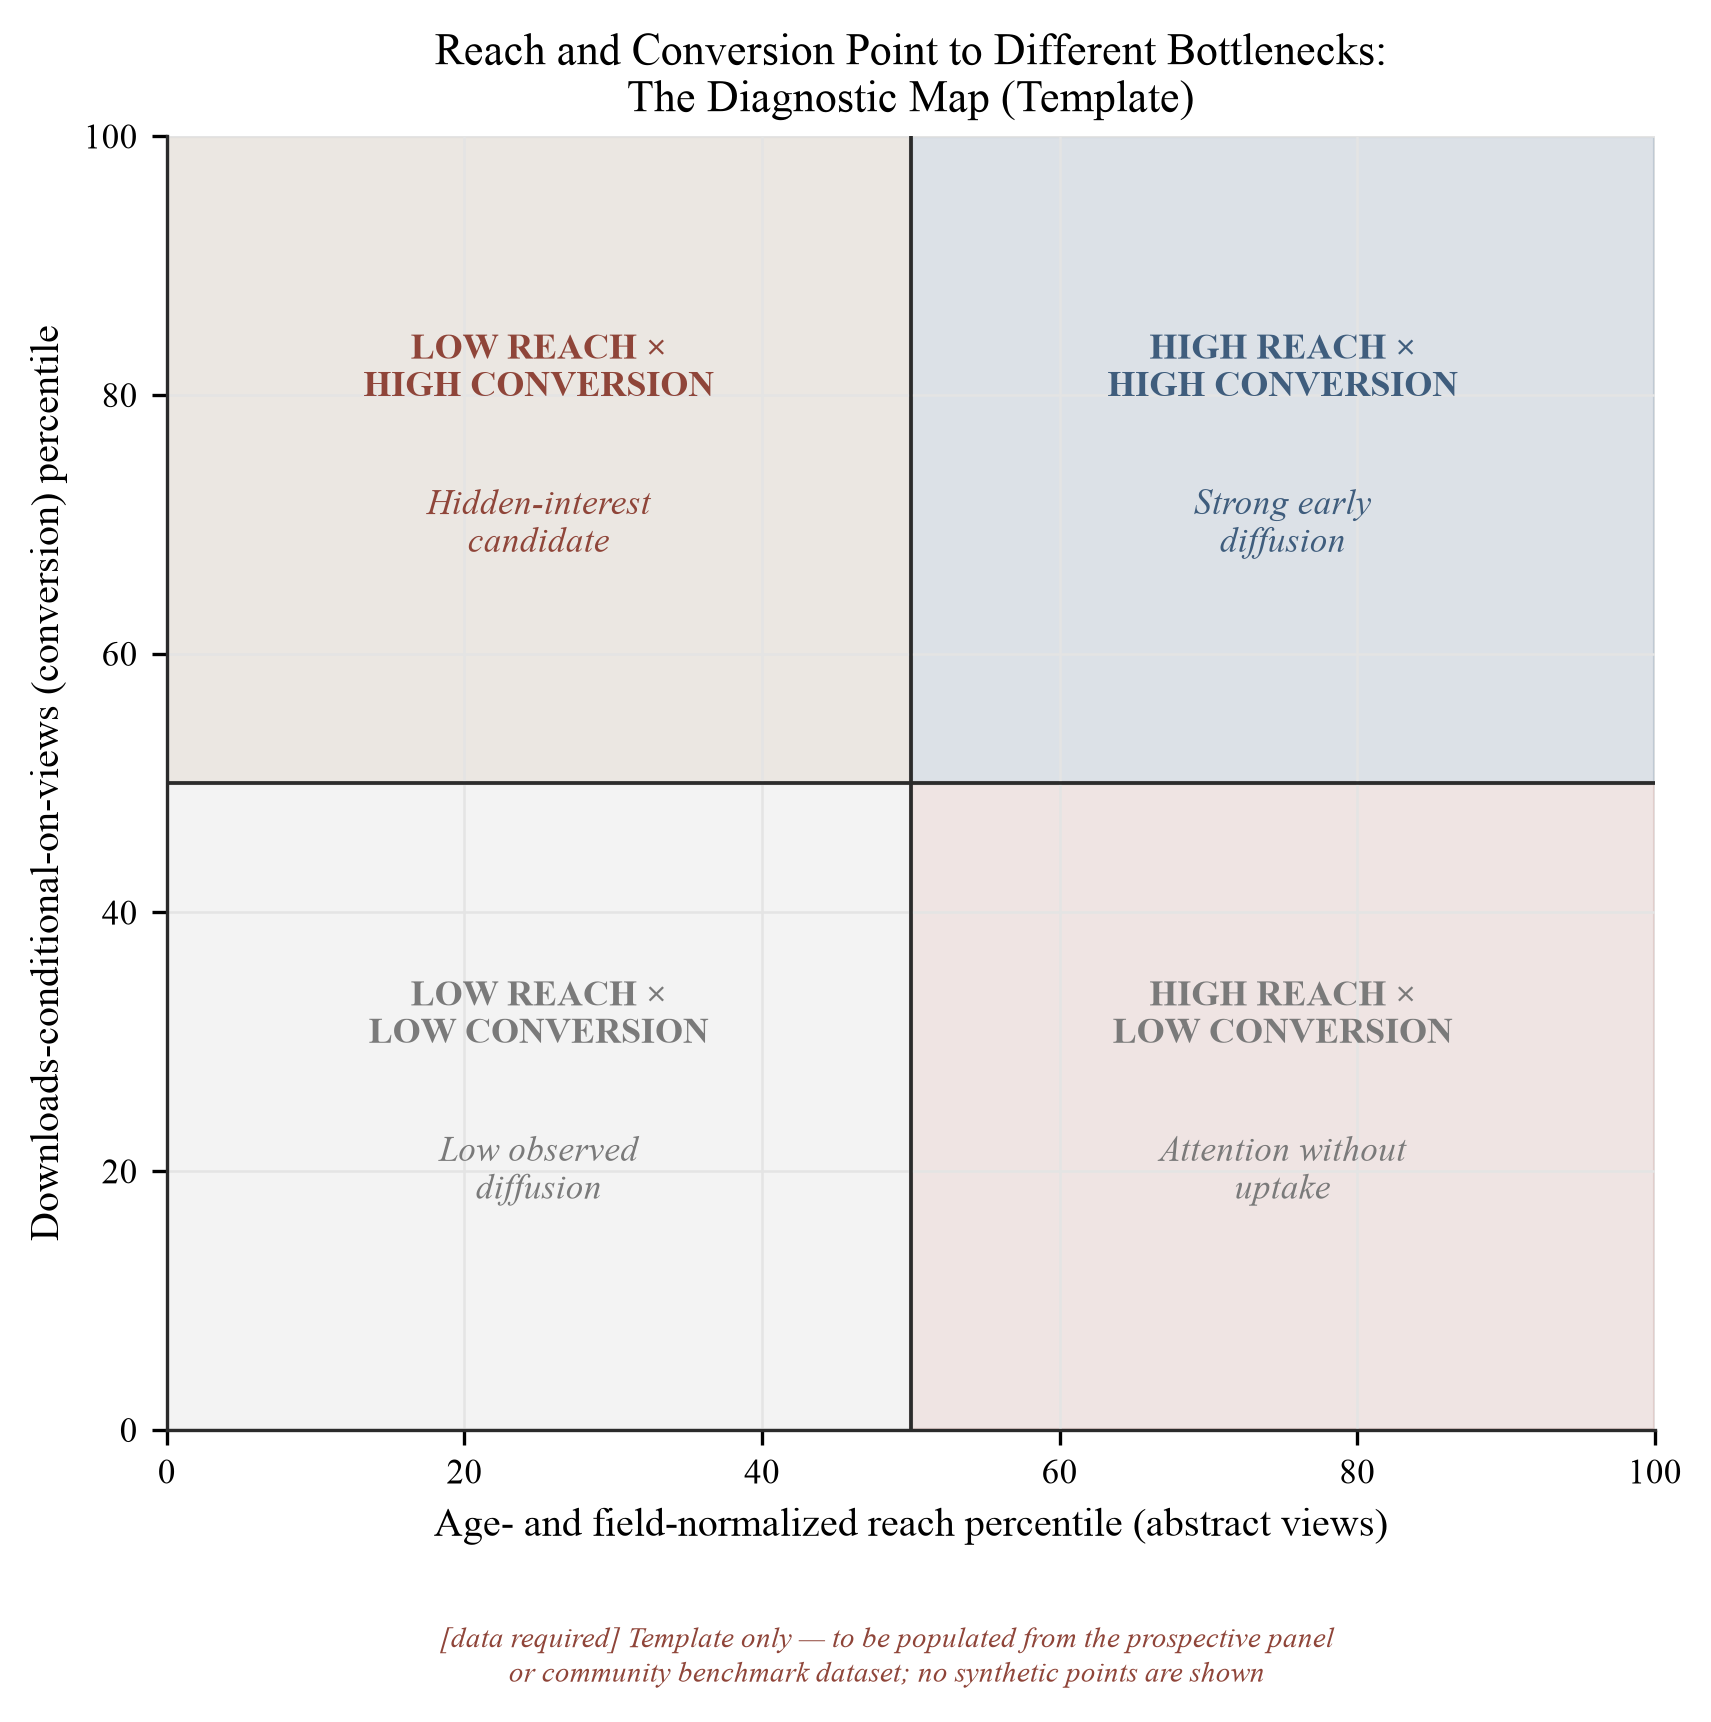
图8. 覆盖范围–转化图。用于按年龄、领域、队列和可见性标准化的视图百分位数(覆盖范围、水平)和以视图为条件的下载百分位数(转化、垂直)定位论文的模板,象限如表9所示(冷启动、隐藏的兴趣、没有取得成效的关注、强大的早期扩散)。左上象限识别了尽管覆盖范围低于中位数但转化率高于中位数的论文,这类论文原始下载计数系统性地低估了其价值。没有显示经验值;该图将从第8节的前瞻性小组或社区基准数据集填充。
5.5 从头条数字到基准:CSAB维度
前面的每个小节都修正了原始计数器的一种故障模式,而冷启动学术关注基准(CSAB)就是这种集成:一个报告框架,用五个归一化组件(表10)取代单个头条数字。归一化变量(论文年龄、领域、发布群组和先前作者知名度)都有实证支持:累积指标随着时间的推移机械性地增长;领域规范的平均值相差最多达到一个数量级[168];日历条件可以明显改变关注度(文章访问量在周末下降约11%,在夏季月份下降约50%[178]);平台新手面临的初始受众与已建立的作者不同[83]。在计算任何百分位数之前,必须固定一个总体约定。累积计数器定义在具有异质生存的论文库上(论文偶尔被撤回、合并或被更新的版本取代),因此每个CSAB百分位数都是关于观察日期时现存论文库的陈述。研究1(第8.6节)预先规定了纳入规则(版本处理、撤回和重复解决),而不是让参考总体保持隐含状态。
两个中心组成部分有一个紧凑的定义。对于发布后τ天(年龄)的论文i,在领域f、发布群组c和先前知名度分层s中:
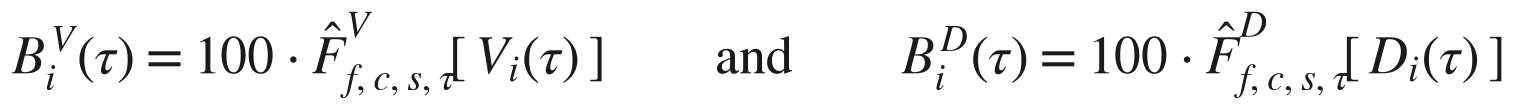
其中V_i(τ)和D_i(τ)是累积的摘要浏览量和下载量,F̂^V、F̂^D是在由f、c、s和τ定义的参考类中这些计数的经验分布函数。该定义固定了估计量,即在规定的参考类中的百分位数。今天无法写出F̂,因为参考分布不存在(第5.1节)。该公式是研究1和第8章的小组设计要估计的规范,同样的符号延续到第8.9节的预测验证设计。百分位数和参考类归一化本身就是一种既定的文献计量方法:百分位数是按领域、文献类型和出版年份对出版物计数进行归一化的标准方法[22],对于由零值主导的指标有专门的领域和时间归一化程序[23],正好是下载计数器所处的情况。特别是针对参考类对使用指标(下载量和浏览量而非引用)进行归一化同样是成熟的研究领域:使用文献计量学文献长期以来一直将基于下载的影响视为需要基于用户群体特征和抽样框架的分布[92][19],期刊使用因子程序正是从符合COUNTER标准的数据中构建这样的归一化使用指标[137]。使用计数的标准化本身是成熟的从业者基础设施的主题,COUNTER实践代码[125]。领域归一化的阅读指标在altmetrics文献中有类似的既定先例[179]。因此该方法是既定的。这里的贡献在于将其应用于SSRN下载量,以及为后排名环境构建年龄、领域和群组分层的参考类。
估计量是清晰的,但在拟合任何F̂之前必须解决三个操作化问题。第一个是最重要的,因为它涉及基准的用途。当问题是诊断性的时,将参考类条件限制在先前作者知名度(分层s)上是正确的:"这篇论文与具有可比知名度的可比作者撰写的论文相比表现如何?"当问题是H1-H3的公平性问题时,这恰恰是错误的,因为按先前知名度进行归一化会减去新手与既有作者之间的差距,而公平框架存在正是为了测量这一差距。一个s内的百分位数无法检测冷启动劣势,因为该劣势已通过构造被条件化掉了。因此,该框架将CSAB的两种不同用途分开,这两种用途绝不能折叠为一个数字。作为描述性基准,它在完全分层的参考类(包括s)中报告作者的位置,这是单个作者在仪表板中想要的。作为H1-H3的调整后的估计量,它从条件集中删除先前知名度,而是将其视为关键预测因素,测量梯度而不是消除它。这两个答案不同,它们回答不同的问题,任何展示知名度归一化百分位数的报告必须说明这是两者中的哪一个。第二个问题是样本大小。按领域×群组×知名度分层×八个年龄点进行分层会快速耗尽3,000-5,000篇论文的概率样本(第8.6节):完全交叉的单元数数以千计,因此大多数单元很小或为空。因此采用向更广泛参考类的经验贝叶斯收缩(第8.3、8.8节),但收缩需要自己的规范:最小分层结构(广泛区域内的领域、粗年龄段内的年龄)和预先指定的用于估计的最小单元规则,该规则以下的单元从其父类借用而不是报告原始百分位数。这个估计方面的最小单元规则不同于隐私驱动的最小单元规则,并且比隐私驱动的最小单元规则更难推理,后者在附录D中管理公共发布;这两者服务不同的目的,并分别指定。最后一个问题是动量(表10),定义为估计的归一化位置的变化。估计量的变化分数容易引发向均值回归:一篇在第7天部分因估计噪声而排名靠前的论文往往会在第30天因纯粹的统计原因而下降。因此,动量需要一个明确的基础轨迹模型(例如,潜在位置的收缩或经验贝叶斯估计,其中测量误差被传播),而不是两个百分位数快照的原始差异,原始差异(如果有的话)仅作为建模量的描述性配套报告。
表10. 冷启动学术关注度基准(CSAB):五个维度而非单一数字。 这些维度的可复制的句子级报告模板在附录B中提供。
| 维度 | 指标 | 核心问题 | 解释 |
|---|---|---|---|
| 覆盖范围 | 年龄/领域/队列/新来者标准化的视图百分位 | 相关受众是否遇到了该论文? | 可发现性 |
| 下载表现 | 标准化累积下载百分位 | 相对于可比论文,发生了多少全文获取? | 总体早期传播 |
| 转化 | 在查看机会条件下的下载(第5.2节) | 接触到的读者是否寻求全文? | 条件性参与 |
| 势头 | 标准化位置中的变化或区间级关注 | 传播是在加速、稳定还是衰落? | 时间轨迹 |
| 下游验证 | 以早期指标为条件的后期引用或使用 | 早期关注是否预测了后续学术采用? | 预测有效性 |
该框架拒绝任何普遍的原始"成功"阈值。成功必须相对于分析目的来定义:对于可发现性,是同龄同领域论文中的高覆盖范围百分位;对于读者采用,是暴露条件下高于参考类的转化;对于传播,是两者的联合分布;对于科学影响力,是下游引用或有记录的使用。仅靠早期使用不足以达到最后一个目的,因为早期下载仅解释了后期引用方差的大约16% [25]。这使得对标题示例的解释变得准确。七次下载是"好的",只有当七次下载在论文生命周期相同阶段的其他可比论文中将其置于异常高位时。第7天的值和第180天的值不能在同一基准上评估。
四个设计选择遵循莱顿宣言的第八原则:定量指标不得被允许超越其背后假设的力度,虚假精度本身就是一种测量失败 [78]。该框架报告区间,而非点分数(表8);它将CSAB确定为诊断向量而非目标(第5.2节);它绘制其输出图形,覆盖范围-转化图(图8)和基准扇形图(图14),没有数值标度,以防止形状被误认为校准值;并且它为其使用的每个数字附加验证等级和数据年份(表7)。这些中的每一个都限制了证据无法支持的精度,正如DORA在拒绝使用单一数字和期刊品牌代理进行论文内容实质性评估时对研究评估所要求的那样 [8]。将CSAB折叠为单一分数将重新引入两份文件所警告的虚假精度。
对于作者来说,CSAB报告将用下面这样的内容取代"下载:12,"这一行:14天后12次下载:可比论文中的总体下载百分位:第67百分位;覆盖范围百分位:第39百分位;转化百分位:第81百分位;解释:条件兴趣高,暴露低于中位数。 这个模拟中的每个数字都是示意性的,因为这样的百分位在第8节的参考分布被估计之前不存在,并且这些值都不能被作为基准引用,但格式显示了分解带来的好处。这个原始计数看起来是无区分的失望,但却解析为一个具体的诊断:遇到论文的读者反应异常良好,但遇到它的人太少,所以指示的干预是分布,而非修订。这个操作示例是表9中"隐藏兴趣"象限的CSAB对应项。附录B将这种格式确定为可复制的报告模板,其百分位字段保持空白,直到第8节的分布存在。
5.6 阅读轨迹:暴露是一种处理,而非背景噪音
框架的最后一个组成部分是时间性的:一篇新发布的论文不会进入一个同质的关注环境。它会经过不同的暴露制度(发布 → 内部发现 → 电子邮件分发 → 外部索引 → 网络扩散),而累积总数将这些制度压缩为一个数字。制度边界由第4部分的机制确定:电子期刊分发是精心策划的,在高流量主题中可能需要长达45天 [53],外部搜索索引可能需要6–9个月或更长时间 [55]。
最令人焦虑的仪表板状态直接来自于此:第一周零下载是正常的分发前状态,而非拒绝。在公告周期开始之前,该论文尚未被暴露给其主要受众。对早期零的诊断序列是行政性的:确认论文已公开发布;确认电子期刊分配;等待公告周期结束;只有这样才能读取计数器。相反,一旦分发发生,第一个月的计数是最早和最嘈杂的领先指标:早期下载与后来的引文的相关系数约为 r ≈ 0.4 [25],有信息价值但远非最终判断,早期峰值通常是暴露事件(博客或媒体报道)而非持久的兴趣 [116][138]。
由于对累积计数的事后抓取无法重建论文在第3天或第30天的数据,基于轨迹的解释(以及第8部分的小组研究议程)需要从出生开始在标准化网格上进行观察。表11指定了最少观察计划。它同时用作个人作者的自我追踪模板。轨迹仅在表11网格的60天和90天读数处进行初步分类,在180天读数处确信地分类,绝不在第7天。
表11. SSRN论文的最小纵向观察计划。
| 论文年龄 | 观察的核心目的 |
|---|---|
| 第1天 | 立即平台暴露 |
| 第3天 | 极早发现 |
| 第7天 | 第一周基准(大多数论文的预期值:处于或接近零,分发前) |
| 第14天 | 早期稳定 |
| 第30天 | 第一个月的基准 |
| 第60天 | 分发和搜索成熟(电子期刊周期完成 [53]) |
| 第90天 | 中期早期扩散 |
| 第180天 | 向下游影响测量的过渡 |
如果可行,在前45天内每日观察是更好的选择,因为电子邮件分发可能在该窗口内的不同时间发生 [53]。该网格上的间隔级读数将仪表板从静态判断转换为轨迹,这是早期SSRN指标携带可防守信息的唯一形式。
第4和第5部分用已发布记录能够支持的四个问题取代了作者无法回答的问题("7次下载好吗?"):计数相对于基准地图及其版本的位置在哪里(5.1、5.3);转换在经验带内吗(5.2);论文在到达–转换平面的哪个象限(5.4);观察网格上的轨迹显示什么(5.6)?这些问题都不需要已退休的排名,但它们都需要本文最后部分提议的比较数据的收集。
6. 作者实用指南
第5部分的基准地图(表7)恢复了缺失的尺度,本部分将其用于在2026年7月15日之后打开统计面板并看到没有背景的计数的作者 [148][149]。它依次有四个任务:观察自己计数器的例程(6.1–6.2),替代排名曾经提供的比较框架(6.3),可以合法地改进可见性的杠杆(6.4),以及将计数器转换为可防守职业证据的协议(6.5–6.6)。这里使用的每个数值锚点都可追溯到具有明确抽样框架和时间窗口的已发布源;表7将其整合。在作者社区中流传的没有证据支持的做法在其出现的任何地方都被标记为未验证,并在附录A的末尾作为候选假设被收集以供测试。
表12将指南的核心压缩为七个问题的协议,按顺序提出,每个问题都与值得保留的证据和答案可以合法地得出的最有力结论相配对。第6.1–6.2部分将此协议展开为例程和阅读规则,表23(附录A)仍然是其情景伴侣,由作者实际遇到的仪表板状态进行索引。
表12. 解释SSRN计数器的作者协议:七个问题、要保留的证据和允许的结论。 没有步骤将计数器视为质量分数;最后一列说明了每个答案能够支持的上限。
| 步骤 | 问题 | 要保留的证据 | 允许的结论 |
|---|---|---|---|
| 1 | 观察计数时论文的年龄是多少? | 带日期的屏幕截图或导出,加上发布日期 | 一个特定时间的观察,而非终身判决 |
| 2 | 策划的分发和外部索引是否已发生? | 分发通知和日期(如果有);搜索索引状态 | 预暴露与暴露后制度的识别(第5.6部分) |
| 3 | 浏览、下载和转换一起是什么? | 计数器和分母 | 到达与条件参与诊断(表9),而非单一判决 |
| 4 | 最狭隘的可防守参考类是什么? | 领域、队列、论文年龄、新手身份、分类历史 | 仅在该类内的相对地位(第5.5部分) |
| 5 | 轨迹是否在变化? | 在表11固定年龄处的重复观察 | 动量或平台,受暴露事件影响—而非"质量"的加速 |
| 6 | 是否有下游证实? | 引用、实质性接触、出版或已记录的使用 | 采纳的多层次证据,而非质量证明 |
| 7 | 该主张是否可复现? | 来源、日期、计数规则、存档记录 | 可审计的报告,而非无根据的里程碑 |
6.1 测量程序
解释始于规范的记录,因为SSRN仅显示当前的累计计数,而不提供作者可以掌握的历史数据。从发布当日开始应用的六个步骤,能够生成任何后续推断所需的最少化记录。
1. 记录两个计数器及其比率。在固定间隔记录摘要浏览量、下载次数以及下载量与浏览量的转换比率。Table 11的观察网格(第1、3、7、14、30、60、90、180天)规定了时间表和每次读数的目的。每个间隔处的带日期的截图是作者唯一可控的记录版本,因为当过滤规则改变时,平台计数器可能会重新计算[144][69]。累积记录是一个版本化证据包:手稿版本、其元数据和分类、带日期的仪表板快照、分发通知、作者自身宣传活动的带日期日志(发布的帖子、演讲、邮件列表公告),以及随后的引用和实质性接触。宣传日志之所以重要,是因为宣传是曝光干预。没有自己宣传的带日期记录,作者无法区分有机增长与自我生成的增长,任何审计该声明的人也无法区分(Section 8.3)。
2. 按发布以来的时间进行标准化。将早期性能表示为前3~6个月内的每月下载次数,而不是原始累计计数。将三个月大的论文与较旧工作的全部累计总数进行比较会产生系统性误导性结论,因为计数器在论文在平台上的整个生命周期内积累,该平台的年度下载量已从2016年的大约12.9 million增长到2023年的40.6 million[1]。
3. 不要混合观察窗口。周计数不能与12个月平均值进行比较,90天计数不能与终身总计进行比较。本手册中的每个比较都将相似的窗口与相似的进行配对。违反此规则是日落前排名统计使用中最常见的解释错误之一[161]。
4. 将论文置于其学科邻域中,而不是与平台相对。仅在Legal Scholarship Network电子期刊中,每篇论文的平均下载次数就相差大约8倍(Corporate/Securities/Finance为438.35,Agricultural Law为53.48,2018年数据)[168]。在一个子领域中不起眼的计数在另一个子领域中可能是异常的。相关的参考类是论文自身的电子期刊或主题网络,在相同的论文年龄时检查。
5. 不要过度解释单个小计数。完整性文献对使用计数器的精度设置了上限:出版商报告的下载次数可能是可比平台的2倍[176],平台过滤器会丢弃大量原始流量[99][129][144],如果没有这些过滤器,SSRN自己的计数器会被夸大"5倍或更多"[18]。因此,可比数字之间的小差异不提供任何信息。
6. 监控长期累积而不是对早期数据做出反应。在工作论文平台上的关注早期集中[116][28](后一项发现来自NBER而非SSRN数据),但发现层成熟缓慢:SSRN报告Google Scholar索引需要"6–9个月或更长时间"[55]。此外,阅读在多个时间尺度上同时衰减,阅读和引用不需要遵循相同的时间过程[91],因此对自己曲线的单一"半衰期"阅读是不安全的。轨迹可以首先在Table 11网格的60–90天读数处进行临时分类,在180天处可以更有信心地分类,但绝不能在第7天读数处进行分类。
6.2 阅读仪表板的五条规则
掌握了这份记录,第5部分的分布证据归结为五条日常阅读仪表板的经验法则。
(i) 与中位数比较,而不是平均数或明显的极值。 唯一的普通论文人口普查式样本将中位数定为两年后63次下载和369次摘要浏览量(LSN,2012年发布的论文)[139]。在最近发布的样本中,中位数为87次下载,而平均数为221.3次,甚至高于第75百分位数(第3.3部分)[83]。流传的里程碑数字来自可见的尾部,其2015年最大值达到数十万次下载(第3.5部分)[85];根据这些数字进行校准的作者实际上是根据准对数正态分布的尾部进行校准,这必然导致误校准。根据2023年12月聚合数据计算出的平台范围内约222次论文终身下载平均数同样不可用作个人参考标准[1]。
(ii) 检查转化率,而不仅仅是计数。 独立测量收敛于大约11–19%下载/摘要浏览的正常范围:LSN样本的平均数为18.7%,中位数为17.1%[139],以及法律引文研究中的15%(高被引论文)和11%(单引论文)的数据[172]。SSRN长期以来的三次浏览一次下载的经验法则[18]位于该范围之上而不是范围内。最近的Marketing-network样本位于该范围略高处,平均每100次浏览有23.7次下载[83]。图6将这些估计值绘制在一起。通过该规则运行第5.2部分的中心示例:标题的40次摘要浏览和7次下载转换为17.5%,作为点估计值位于范围内,但95% Clopper–Pearson区间很宽(≈7.3–32.8%)。在n = 40时,读数既不是失败也不是精确的百分位数:一个与普通转化率一致的筛选结果。远低于范围的转化率与摘要和论文之间的不匹配一致,读者到达、阅读摘要然后离开。这是可行的,行动是修改标题和摘要。远高于范围的转化率表示摘要浏览无法解释的流量,例如来自媒体或聚合器覆盖的直接链接,应该促使检查浏览的来源。两种解读都是筛选诊断:没有研究因果验证从低转化率到摘要质量的推断,诊断应记录为关于自己论文的假说。
(iii) 将首月下载视为最早且最嘈杂的引用信号。 在arXiv数据中,早期下载与后期引用的相关性大约为r ≈ 0.4,原始作者本身将其转化为仅约16%的解释方差[25]。记录中最早的此类信号来自生物医学:BMJ发表后第一周的在线点击数与随后几年内积累的引用数的相关性大约为0.50[119]。在法律学术中,Black和Caron报告了论文级别的下载–引用相关性约为0.50,在一百名初级法律教授的样本中上升到约0.55[18]。在不同领域和时间跨度上,论文级别的相关性范围从大约0.1到0.6[80][25],一旦控制了同时期的Twitter关注,arXiv下载数作为预测因子失去统计显著性[138]。在聚合级别,相关性更紧密:一百所法学院的下载基础排名和引用基础排名之间为0.84[77],在一份期刊自身分析中,六个月PDF下载与后期引用之间的R = 0.724[114]。这些聚合数据并不能决定任何单篇论文最终的结果,首月下载是关于后期引用的早期信号。
(iv) 第一周零下载是正常的发行前状态,而不是拒绝。 新发布的论文只有在通过审核、被分类到主题电子期刊并进入公告周期后才能获得关注。SSRN自己的文档将分类描述为策划性的而非保证性的,对于负荷较重的主题可能延迟长达45天[53],电子期刊分布和电子邮件警报在关闭后明确确认继续不变[147][57]。诊断序列如下:确认论文已公开发布,确认电子期刊分类,等待公告周期过去,然后才能读取计数器。通过搜索引擎的发现会更晚[55]。
(v) 下降或平坦的计数器可能反映过滤,而不是读者流失。 SSRN公开记录表明它丢弃明显的重复下载、机器人下载和其他异常活动[144][66][69]。RePEc/LogEc的经验表明这些更正可能有多大:2007年7月机器人占摘要浏览量的约74%但仅约7%的下载[99],2025年9月超过99.5%的原始IDEAS流量因AI机器人干扰而被丢弃[129]。因此,突然下降或重申与其说是读者事件,不如说是测量事件,它不应该在没有证实的情况下被解读为声誉损失。
6.3 不含排名的基准测试
排名提供了一个比较框架。当今的作者有三个替代方案,按工作量从少到多排列。
微基准。最直接的替代是一个人自己建立的参考组:选择三到五篇方法论可比的论文,作者来自可比机构,发表在同一个月,并按照与自己论文相同的表11时间表跟踪其公开计数。其结果是针对完全正确的参考类别的本地化百分位数基线,通过设计在领域、论文年龄和平台时代方面匹配,而已停用的排名则在单一排行榜中比较了各个年龄和领域的论文。这是一个建议的程序,仅使用公开的每篇论文计数,应在档案中记录为此类程序。它还预设了对同行文献的某种熟悉程度,最孤立的新来者(即冷启动条件影响最大的作者)可能不具备这种熟悉程度。对于他们来说,第10.4节(匿名百分位带)的平台层面补救措施是结构性解决方案,因为使用它不需要自组装网络。
相对绩效比率。相同的逻辑可以用一个数字表达:论文在给定年龄时的下载量与匹配参照集的中位数下载量的比率,即相同学科、相同论文年龄,且尽可能相同的论文类型。比率为1.0表示在该参照集中完全等于中位数的可见性,高于或低于1.0的值相应地解读。该指数在匹配的参照集中排序论文;百分位带则需要参考分布。用于建立参照集基线的已发布中位数已过时且范围狭窄(2012年发表的法律学术文献两年时的中位数为63次下载[139],2025年观察的营销论文为87次[83]),而将比率值映射到百分位数需要完整的分布,而非仅中位数。在没有该分布的情况下为比率带分配百分位标签会产生虚假精度。第8节的预注册议程包括这些带的校准;在此之前,比率是排序工具,而不是分级量表。进一步需要注意以下两点。它根本不应该对小计数进行计算,因为第5.2节的小分母不稳定性既适用于比率的分子,也适用于小样本参照集的中位数,而经验贝叶斯收缩(第8.3、8.8节)是在任何地方公开报告此类比率时的适当修复。一个比率不能转换为固定的百分位数:在不同形状的分布中,"两倍参照集中位数"对应于不同的百分位数位置,因此该比率只能在一个参照集内排序论文,不能在分布形状不同的参照集或时代间进行比较。
轨迹定性判决的措辞。面向社区的工具建议将论文的早期轨迹分类为三个定性判决(快速启动、持续兴趣、缓慢启动)作为原始数字的更人道的替代方案。该措辞值得保留,因为它将计数转换为关于轨迹的陈述,而"缓慢启动"明确不是失败的同义词。这些判决最初提议的阈值依赖于不匹配的时间窗口比较,以及平台范围的"网络平均"统计(该统计并不作为公开指标存在):SSRN不提供公开的自助API或统计端点[51],最近的历史指标("每篇论文新下载",作者级排名统计)与排名一起已停用([B-9],附带说明该历史排名页面不再可访问)。因此,仅从匹配的比较中分配判决:微基准组或上述参照集中位比率,自60–90日开始读取。
无论使用哪个替代方案,外部三角测量都能加强它。来自Crossref和OpenAlex [35][124]的引文层数据与SSRN页面上显示的PlumX指标[50]回答了一个不同的问题:关于下游使用而非可见性。政策引文工具(如Overton)通过映射论文在政府和机构文件中的引用位置[187],将相同的三角测量扩展到政策和实践覆盖,这适合SSRN的法律、经济学和政策学术领域。这些层与表10中CSAB框架内的计数器以及表9中的覆盖–转换诊断一起进行联合检查。Altmetric指标是另一个三角测量层。从一开始就被设计为早期关注信号[123][122],它们遵循不同于引文[74][20]的模式,并支持领域归一化[21]。它们也容易受到自动膨胀[75]的影响,需要理论指导下的解释,而不是按表面值[76]进行解读。
6.4 改进合法可见性
在排名停用之前,排名为一个反复出现的作者决定提供了粗糙但真实的反馈:是否值得进一步推广论文(第1.3节)。排名停用后,必须根据这里汇总的杠杆和诊断工具来做出该决定。决定因素文献确定了一小组在作者控制下且符合平台规则的杠杆。每个杠杆都作用于可见性而非质量,都不改变论文的内容。根据预印本方法论文献,快速传播和早期反馈是预印本发布的公认目的之一[24],而合法可见性的策略手册利用了这一明确的功能。
打包。在LSN样本中,标题特征、摘要长度和话题突出性与关注度显著相关,但作者本人谨慎指出,这些变量可能代理了不可观察的质量[139]。在法律引文研究中,十分位数最高的论文比十分位数最低的论文包含更多关键词和更长的摘要[172](具体数字有待与原文核对)。摘要页面是规则(ii)作用的转化表面,因此当转化率持续低于区间时,标题和摘要是首先要修改的内容。任何这样的修改都旨在实现承诺与内容的一致性,而非盲目引流:改写一份已经清晰的摘要以最大化点击次数可能会损害其精确性,通过吸引不匹配的访问者,它可能会推动转化率进一步远离区间而非向其靠近。
分类。在2018年LSN分析中,分类到更多电子期刊的论文平均下载次数更多,零下载结果更少[168]。SSRN允许每篇论文有一至七个分类,并进行收录策略[53]。一种流行的社区优化方案(因为没有研究比较分类策略而未被验证)将分类限制在三个,分别选为一个核心期刊、一个宽泛期刊和一个跨学科电子期刊;这一建议属于附录A的可测试假设之列。
分发和外部关注。电子期刊电子邮件提醒仍然是该平台的主要推送渠道,并在排名停用后继续使用[147][57][152]。在平台外,博客报道在该问题的一项实证测试中产生了尖锐的早期下载峰值[116],在arXiv位置研究中,可见列表位置提高了可读性和引用次数[72],在围绕一场被取消的政治科学会议进行的准实验研究中,会议参与与每篇论文额外17–26次下载相关联([B-4],但需注意该设置是2012年APSA而非SSRN经济学样本)。从业指南收集了法律学术的进一步分发工具[169]。早期开放传播的案例已独立确立:一项开放获取的随机试验发现下载次数增加,但没有短期引用增益[37],而队列和领域研究报告了大约10%至两倍的引用优势[59][86][17][93],包括美国法律评论的+53%[40],法律引文审计发现87%的被引用最多的文章在SSRN上可获得,而44–46%的被引用较少的文章可获得,95%的被引用最多的文章在其发表年份之前或之年发布在SSRN上[172]。预印本存储与arXiv上的更高引用相关,与较低的出版商网站下载相关[38],bioRxiv下载与期刊结果相关[62]。在所有bioRxiv预印本的普查中,下载次数与预印本后来发表的期刊影响因子相关(Kendall τb = 0.59),这一关联的因果方向不明[2]。机器发现层(搜索引擎和生成式回答引擎)在第8节的审计框架和表20的特征审计议程中单独处理[5][164]。
版本管理卫生。上传到同一SSRN页面的修订版本保留累积的计数器和稳定的URL,而删除和重新发布会将指标重置为零([B-7],但需注意支持页面措辞随时间变化,应在提交时重新验证)。社区进一步声称,第3天的轻微修订会触发重新公告和"第二波"关注,但这是未记录的,属于附录A中未经验证的做法。身份需要同样的关注。将经过验证的ORCID iD链接到SSRN作者档案,可以将论文及其计数器保持与正确的人相关联,而非与同名人相关联,这是抵御作者消歧问题的低成本保护措施,否则需要第8.3节的小组设计在统计上解决([B-7],同样的重新验证说明)。
不该做什么。自我下载和相关操纵在SSRN自身的服务器日志中有记录,在接近顶部列表阈值时增强,并由社会比较驱动[44]。该平台的欺诈过滤器是公开的[144][69],了解这段历史的评估委员会会对未得支持的声明打折扣。因此,游戏化文献在完整性警告的同时也附带了实际警告:操纵的计数是可检测的,且在声誉上代价高昂。图9在模拟数据上说明了相关的时间特征。有机关注累积为早期峰值和长尾分布,而操纵产生完全是完整性过滤器设计目标的集中峰值[144][69]。
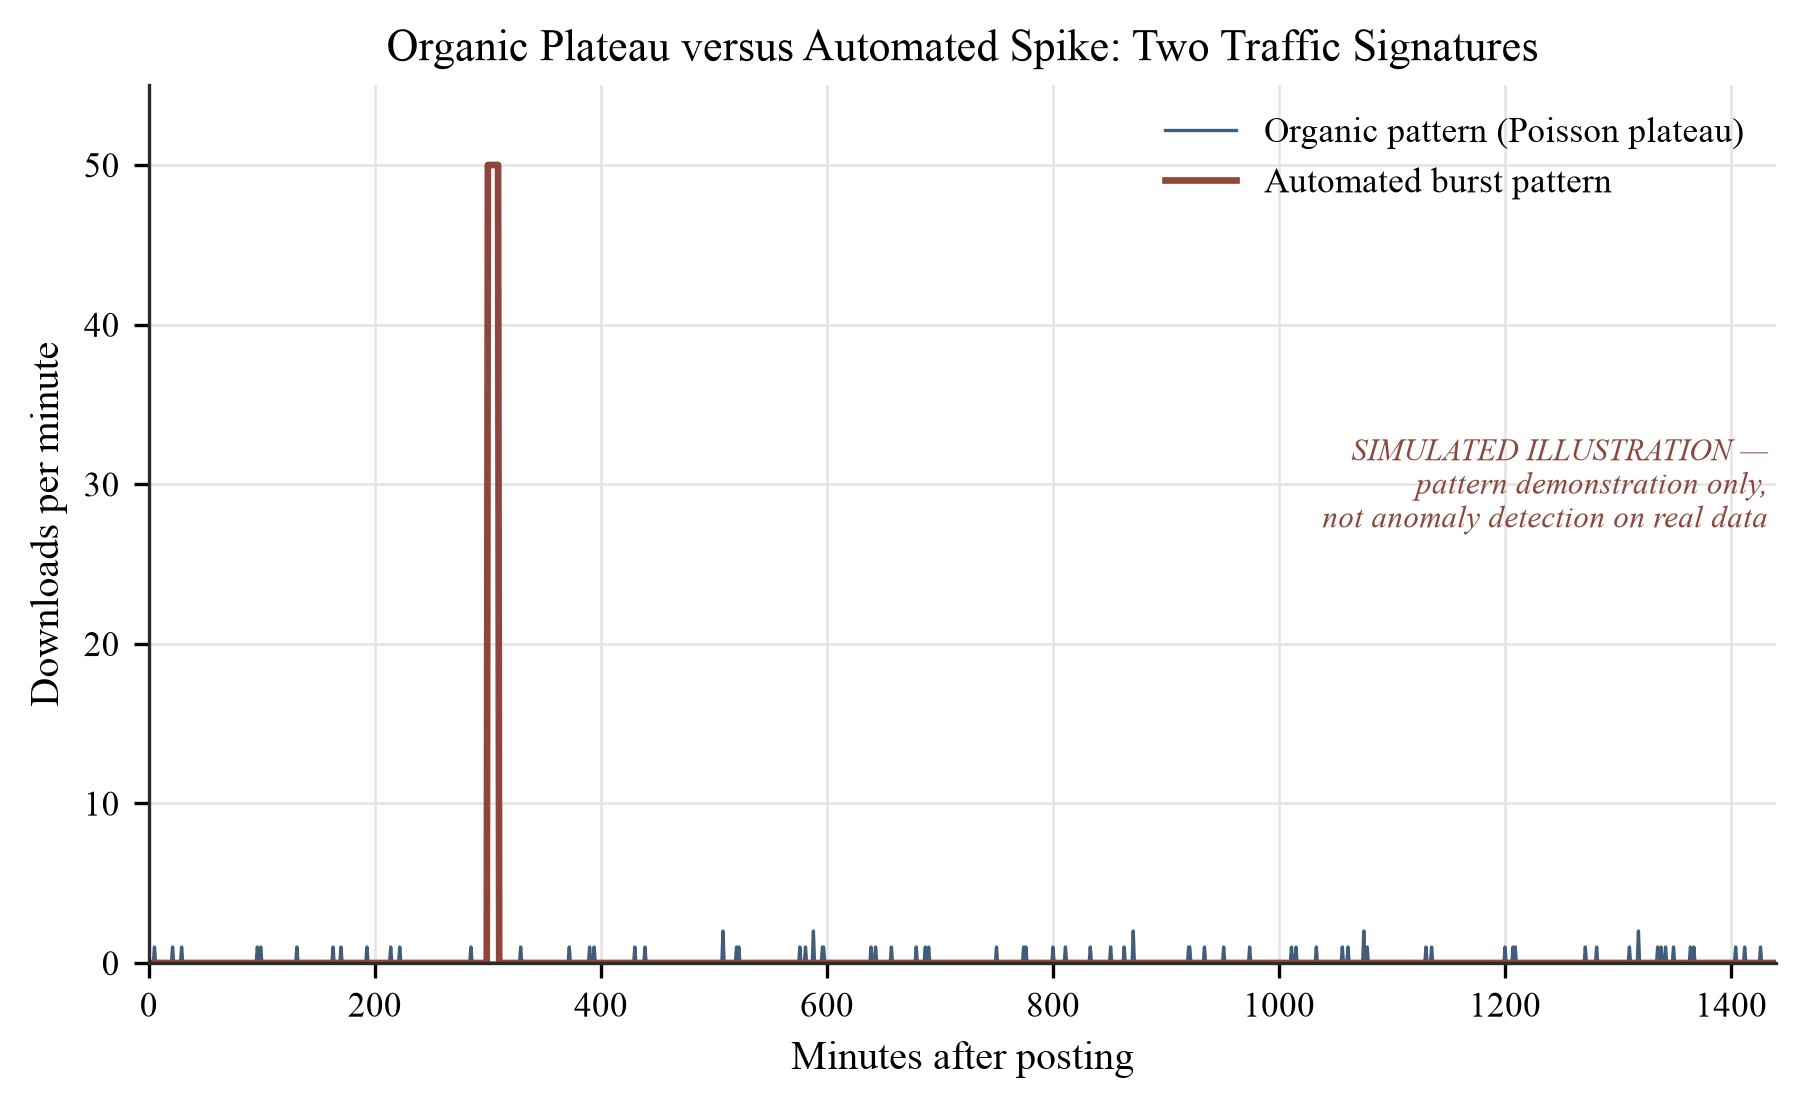
图9. 有机累积与操纵峰值。光滑的有机下载轨迹与自我下载特有的突然单日峰值形成对比,推动了第6.4节的操纵警告和第4节的完整性讨论[44][69][144]。所示的所有数据都是模拟的;SSRN不存在经验异常检测数据集。
6.5 将计数指标转化为职业证据:档案协议
在日落之前,基于排名的SSRN证据是标准化档案成分。作者的公开排名直接进入晋升档案:"在全时间下载总数中排名第13位(共3000名法律作者),这被法学院在各种晋升和相关决定中考虑在内"[12]。求职信指南建议引用下载次数和十佳榜单中的出现[95],从业人士指导同时警告说自行发布的作品"可能不会计入法学院晋升和终身教职目的"[33],平台自身文档将其指标描述为作者用于晋升和终身教职目的以及机构用于招聘和排名活动的数据[52]。这些构件中的每一个都预设了一个不再存在的公开比较框架[149]。此外,计数指标的评估使用从其首次提议就受到了质疑:Black和Caron在2006年提出的将下载次数作为学术表现"beta"衡量标准的论证[18]在同一研讨会论文集中由Eisenberg对SSRN基排名能够有效衡量的内容的批评所回应[45]。引用下载次数的档案继承了这场未解决的辩论。表13列出了从现存内容中重建可防御证据的七步协议,其在第三列和第四列中应用的管理要求是,档案中引用的每个数字必须附带其来源、其时间窗口和其限制。一个被转化为无来源精确陈述的主张,比完全不提出主张更糟。
表13. 终身教职、晋升和招聘档案中SSRN指标的日落后证据协议。 每一步命名操作、具有时间窗口的证据基础、必须与任何数字一起披露的限制、要避免的反模式,以及该步骤可以支持的最强结论。
| 步骤 | 操作 | 证据基础(来源;时间窗口) | 需要披露的限制 | 避免 | 许可的结论 |
|---|---|---|---|---|---|
| 1. 保留 | 在表11的间隔处和任何提交前对每篇论文的统计面板和作者档案进行日期截屏存档;将其与分发通知和作者自身晋升事件的日期日志组成第6.1部分的版本化证据包。 | 单篇论文的计数器在日落中幸存([148][149]; 2026)。当过滤规则改变时,计数器可以重新陈述([144][69]; 自2018年起有文档记录)。 | 日期化的个人存档是作者控制下唯一的官方记录版本;平台数字可被修改,且不存在公开的历史记录。 | "该论文有X次下载"——引用时没有日期或分母。 | 平台显示内容的日期化、可审计的记录——一个特定时间的观察,而不是终身判决。 |
| 2. 翻译 | 使用表8将计数转换为分级语言(例如,"终身下载次数超过2015年排名前10,000论文列表的~160条目阈值,即大约占该平台全文论文库的前1.8%,2016年7月571,040篇[1],当时"),始终命名来源、样本和年份;附录B的CSAB模板提供句级格式,其百分位数字段保持空白,直到存在参考小组。 | 论文级阈值:条目≥160,组内中位数805(顶级列表爬取;2015)[85]。作者级:条目最小值129总下载次数,组内中位数1,626(同一爬取)[85]。典型论文锚点:两年中位数63(LSN;2012→2014)[139];中位数87(营销网络;快照2025)[83]。 | 所有阈值源自2012–2015样本(之后通货膨胀[1]:第5.1节);2015框架仅涵盖排名列表;两个中位数锚点属于单一学科。分级语言不得重新表述为校准的百分位数。 | 挂在旧原始阈值上的通用标签,如"优秀"。 | 在指定样本、字段和年份内的相对地位——不超出此范围。 |
| 3. 三角验证 | 将SSRN计数与独立引用证据配对:Google Scholar、法律HeinOnline、经济学RePEc、Crossref/OpenAlex作为开放引用层、PlumX如SSRN上所示。 | 学校级SSRN下载和HeinOnline引用排名关联度为0.84(100所美国法律学校;2019)[77];论文级下载–引用关联度约为0.1–0.6,取决于字段和时间范围[80][25];开放引用基础设施[35][124];PlumX[50]。 | 0.84这个数字是一个学校级关联度,不会下降到任何单个论文或作者(生态推断警告,第6.2(iii)节);下载衡量需求而非阅读或认可;论文级关联度是适度的,高下载和高引用的集合仅部分重叠[108]。汇聚的引用证据而非单独的计数支撑影响力声称。 | 将下载与认可或正确性等同。 | 分层采纳证据,而非质量证明。 |
| 4. 字段规范化 | 明确陈述学科框架(例如,"在公司法学术中,电子期刊均值在法律子领域间相差大约八倍")。 | 子领域均值438.35对比53.48 downloads/paper(LSN电子期刊;2018)[168];下载与引用比率本身具有字段结构[18]。 | 该分布估计仅限于法律领域,时间为2018年;任何阈值的跨学科转移需要谨慎,没有字段限定符的百分位语言是无法解释的。 | 将新论文与多年累积总数进行比较,或在字段间移植阈值。 | 字段和年龄限定的比较——绝不是通用等级。 |
| 5. 补充 | 在SSRN基础上引用机构存储库和其他分发渠道。 | SSRN计数器对相同论文在其他服务中的下载情况没有任何说明[161];2026年改革使基于存储库的系列成为机构分发的迁移路径[47][146]。 | 没有单一平台的计数器衡量论文的总流通量;卷宗声称是关于论文的,而非关于一个计数器。 | 将一个平台的计数器呈现为论文的总流通量。 | 关于论文传播的声明,每个渠道的计数器分别命名。 |
| 6. 完整性 | 与任何引用的计数一并陈述平台的计数规则,并保留显示该数字的带日期存档。 | 过滤和重述是平台的既有行为([144][69][66];进行中);供应商报告的下载统计取决于计数约定([69][176];2015–2019)。 | 计数器是经过过滤的、可修订的估计值;不存在重述的公开历史,因此作者的带日期存档是唯一的稳定记录。 | 将计数器视为独特人类读者数的精确数字。 | 在既定规则和既定日期下的经过过滤的估计值——而非读者普查。 |
| 7. 专家评估 | 将每个指标行作为工作贡献和严谨性定性评估的背景,而非其替代品。 | 指标衡量传播阶段,而非有效性(第3.1、5.5节);高下载和高被引集合仅部分重叠[108]。 | 无论是标准化还是原始的使用指标都无法评估研究是否正确或重要。 | 用指标替代同行评议。 | 伴随专家评审的背景证据——质量声明取决于评审,而非数字。 |
避免列收集了协议的反模式。两个警告界定了整个协议。下载代表被动需求,而非阅读、认可或质量,计数对宣传动态(博客报道、醒目标题、热点话题)的响应程度与对学术的响应程度相当[116][139][138]。了解操纵记录的委员会[44]会对无来源支持的数字不予采信,而能够经得起这种评估的正是协议所要求的要素:带日期的截图、附带来源的范围表述、领域限定条件和三角验证。
6.6 邀请推论
发布有一个有文献记载但仪表板不报告的副作用:来自掠夺性期刊和会议的未经请求的邀请,由从预印本平台收集的名字、隶属关系和论文标题产生[107][159]。在相邻审计中邀请量很大,其中专业研究记录邀请流量范围从每位学者每两周数十条到每个专业组每月数千条(第7.2节)[9][84][63]。在约41%的受调查案例中,与掠夺性期刊的首次联系是未经请求的电子邮件[32]。第7节和表14分析了这一现象。对于操作手册,后果可归纳为四条指示。期望邀请是可见性的默认后果,永远不要将其数量视为学术认可:发件人机械地针对可见性,而不是选择性地针对优点[159][63]。通过专用地址传送通信,防止收集污染主收件箱;一项广泛重复的改进,即在发布后的前两周隐藏个人资料电子邮件地址,是一个未经验证的做法(附录A)。永远不要付款,因为商业模式是收费,经过鉴定的掠夺性期刊的文章处理费用范围从$25到$1,800[136]。金钱是较小的代价:审查档案的相同评估委员会(第6.5节)也读参考文献,已知掠夺性出版场所在出版列表上造成的声誉代价比任何费用代价都更严重。根据维护的筛选服务(如Cabells掠夺性报告([B-1];Beall列表自2017年1月以来未更新,不能用作实时来源))以及Think. Check. Submit.的核对清单[159]验证任何邀请您的出版场所。收集机制还提供了定性筛选:一份在预印本发布后的几天内发送邀请电子邮件的期刊,在任何人可能读过之前,几乎肯定不是合法的。这是一条经验法则;还没有研究衡量过其发生率[63]。
6.7 指南的范围
该指南的基础来自2012至2015年,侧重于法律和营销方面[139][85][83][1]。自那时以来,论文下载流量有所增加(第5.1节)。新的、按领域分层的百分位数据尚不存在;其收集(由平台或社区进行)是第8和10节的主题。该指南减少误读,但不测量质量。四项规则使其使用机械化:比较匹配的案例、保持观察窗口恒定、为每个数字附加来源、并将假设标记为假设。
7. 寄生性注意力层:可见性与掠夺性邀请
迄今为止开发的解释框架将注意力视为从曝光、摘要查看、下载再到下游使用的单一漏斗。然而,发布预印本的实际体验经常包括通过完全不同渠道到达的第二股'注意力'流:来自学术期刊、会议以及合法性存疑的编辑服务的未请求电子邮件邀请[14][61][117][142]。以下为对该第二股流的概念说明,以及证明其有据可查规模的审查证据。
7.1 注意力的二层模型
发布后的环境在这里被视为一个二层注意力经济(图10)。第1层是第4和6节中描述的合法漏斗:电子期刊发行、摘要浏览、下载和最终学术使用。第2层是一个寄生层,是掠夺性出版商和服务提供商的生态系统,利用相同的公共基础设施(标题、摘要、作者名称和从属关系),旨在将作者转变为付费客户,而不是阅读他们的工作。征求-审计文献记录了生命周期。公共预印本元数据(SSRN标题、摘要、作者名称和从属关系)被收集[107][159],模仿合法论文征集的邀请被发出[61][63],参与的作者被转变为付费客户。经济引擎也有记录:假定掠夺性期刊的文章处理费平均约为$178,报告的范围为$25–$1,800[136]。
两层之间的不对称性对解释很重要。第1层需要一个人类读者注意、打开和重视论文,而第2层只需要论文的元数据变成机器可读的。因此,预印本原则上可以被寄生层完全处理,同时在合法层中保持有效的未读状态。这是该平台几乎零下载论文("幽灵论文")的情况,机器处理但人类实际上没有阅读。
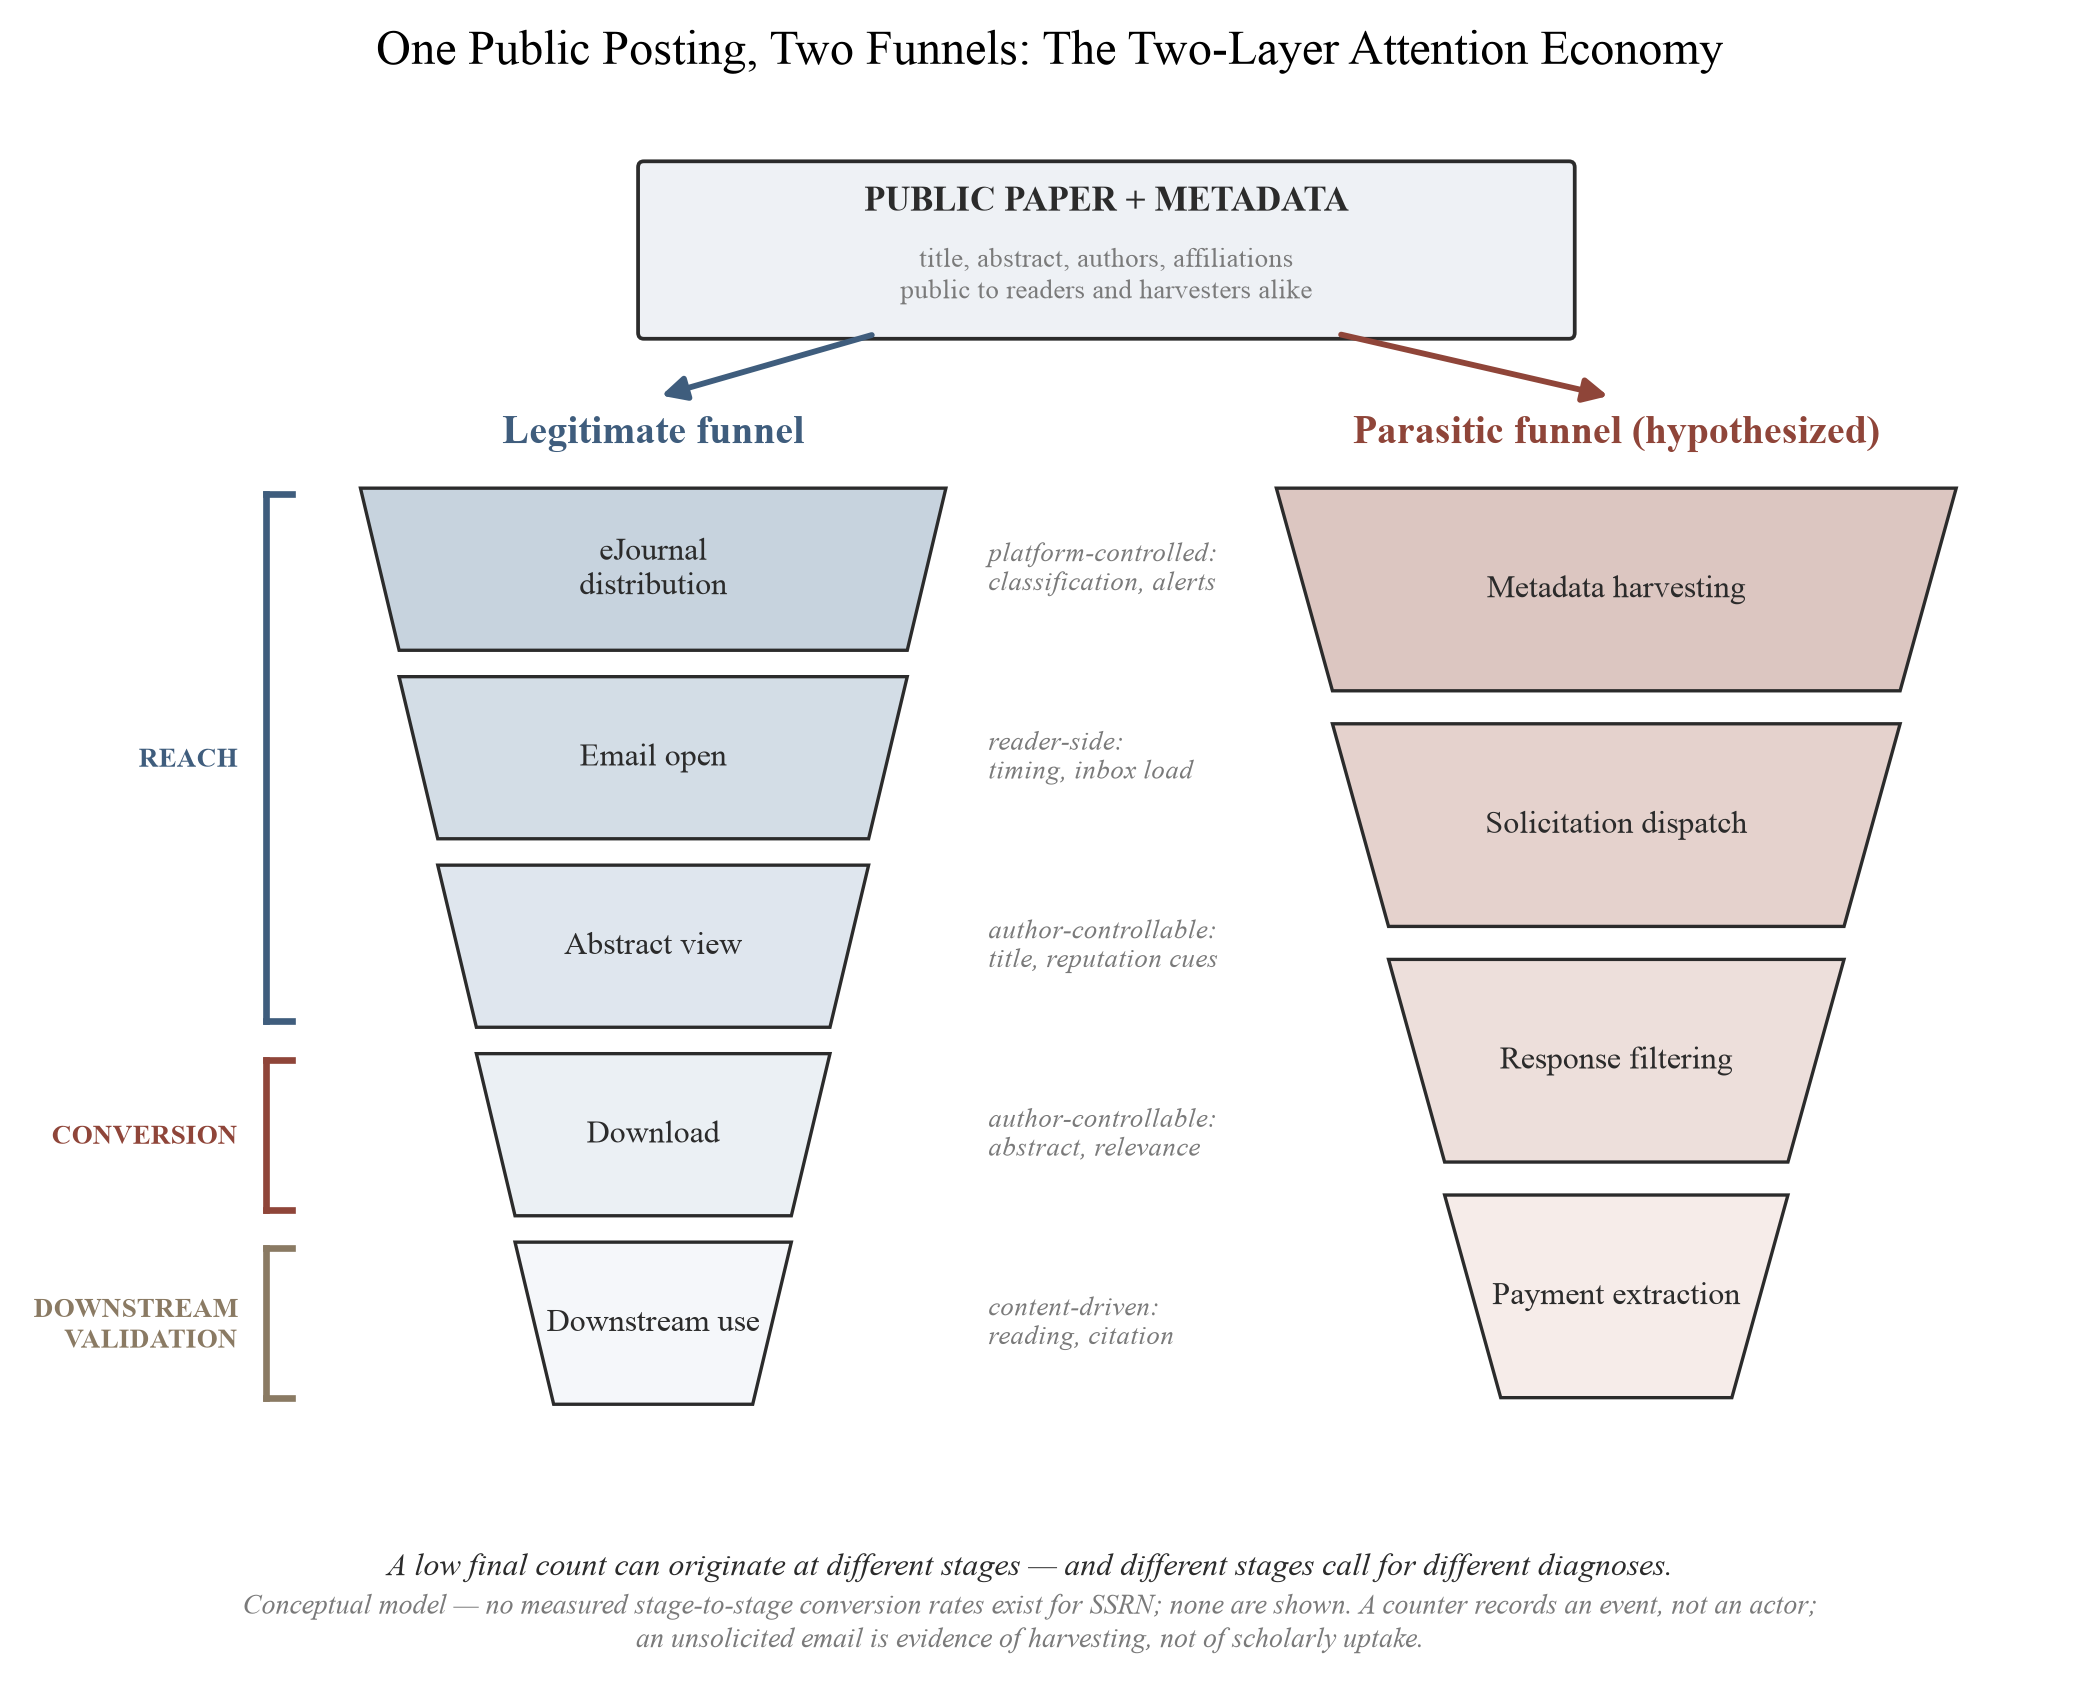
图10. 二层注意力经济的概念模型。两个漏斗都显示为定性阶段序列;没有显示阶段间转换率,因为SSRN尚未测量这样的转换率。寄生漏斗是基于征求-审计文献的假设重建[61][63][107][159](第7.3节)。
7.2 掠夺性征稿的有据规模
掠夺性征稿是大规模现象这一点毫无疑问。2026年的一项综述确认了29项关于学术垃圾邮件的实证研究,汇聚了一套策略:恭维性征稿、虚假编辑声明和可疑的指标与索引主张[61]。测量的数量相当可观。14名眼科医生在单个30天时间内共收到来自383家不同出版社的1,813封征稿邮件,涉及696本不同的期刊[84]。学术放射科医生在两周内平均收到20.7份论文邀请和4.1份发言邀请[9]。一项探索性审计记录了一名泌尿科医生在2023–24年间收到的422封征稿邮件[63],一项学术出版案例研究在391天内记录了来自期刊的1,024封垃圾邮件[89]。一项为期一年的单一研究者观察记录了在预印本发布后来自256本期刊的875份邀请,其中76%出现在精心策划的黑名单中,一个有条件的来源,这里引用时需注意发布后的到达延迟未经测量[B-10]。征稿确实产生了效果。在曾在疑似掠夺性期刊上发表论文的作者中,41%报告他们与期刊的首次接触是一封未请求的电子邮件邀请[32],征稿语料库的内容分析记录了恭维语言、编造截止日期和模糊的主题范围作为反复出现的劝说手段[96]。
这些证据也不仅限于医学。在社会科学中,学科上更接近SSRN的基础,三名教育科学研究者在三个月内收到210份未请求的期刊邀请,来自139本期刊和37家出版社,其中大多数可分类为掠夺性;大约一半的邀请超出了接收者的专业领域,这是元数据驱动而非基于读者群的目标定位的特征[155]。最先面临这一负担的是这篇文章的主角——早期职业生涯的作者。一名早期职业生涯学术工作者的纵向自我审计在大约八年内记录了1,280份掠夺性征稿(期刊990份、会议220份和其他类型70份),以及有据可查且在很大程度上不成功的退订尝试[160]。
这个证据库的两个特征必须铭记在心。最大的审计来自医学,上述社会科学审计虽然在学科上更接近SSRN,但规模较小;这两类文献中的任何数据都不能直接适用于SSRN作者。至关重要的是,这些研究中没有一项测量了相对于预印本发布事件的征稿时间。例如,[63]中的审计记录了内容和出处,但没有将到达时间与SSRN活动联系起来。因此,任何将寄生层与发布行为联系起来的声明都是一个机制假设,而非一个发现。
7.3 假设的针对机制
要找到新发布的预印本,寄生层必须首先定位它。下面的机制是有部分文献支持的假设;没有语料库将征求与SSRN发布相关联。
H-S1(元数据采集)。掠夺性运营从公开的摘要页面和新论文列表中抓取论文标题、作者名称和隶属关系。从业者和咨询来源描述了这种行为:据报道,掠夺性期刊扫描预印本服务器并发送引用论文标题的未经请求的邀请[159]。一篇法律奖学金评论指出,征求者"通过梳理现有学术论文(例如SSRN上发布的论文)来收集电子邮件、名称、隶属关系等"[107],法律图书馆指南将预印本发布与"来自掠夺性出版商的垃圾邮件激增,这些出版商征求研究人员以收费方式重新发布其文章"[117]相关联。一个可测量的规律性符合这一机制。在放射学审计中,各专业审计报告在活跃发表论文的作者中征求数量较高[9],这与从作者累积的文献表面进行采集一致,而非从单一发布事件采集。研究3(第8.6节)相应地记录了作者级别的暴露对照及焦点发布。
H-S2(联系信息获取)。征求需要电子邮件地址。SSRN摘要页面历史上包含作者联系信息[151],地址也通过论文本身、机构页面和先前的出版物流传。SSRN目前是否以可采集的形式公开作者电子邮件仍未测试;已指定配备仪器的征求日志研究来测量这一点。任何特定征求的获取渠道无法观察。
H-S3(分发搭便车)。电子期刊摘要和RSS类型的源向订户重新分发新论文的元数据[57][51]。订阅这些频道的寄生方会接收结构化的线索而无需爬取。没有审计验证过这条途径。
从发布到被针对的因果链尚未被经验证实;第8节指定了这些机制的预注册测试:根据新发布论文的已知发布时间戳记录征求到达。
7.4 一种假设的请求信号类型学
如果第7.3节的定向机制有效,不同类别的请求应该携带不同的论文机器可见性信息。表14将其作为一种假设的类型学呈现,其策略类别基于已记录的说服战术:凭证不匹配和非目标个性化[9][63]、虚构的截止日期和奉承[96]、虚假指标和索引声明[61],以及针对已记录的APC市场[136]的隐藏费用。最后一列是推断性的且未经测试。表中未给出流行度百分比和到达时间估计。
表14。预印本发布后捕食性请求信号的假设类型学。示例措辞是说明性的,是在请求审计中记录的模式的虚拟释义[9][61][96],不是任何特定消息的逐字引用。
| 请求模式 | 描述 | 说明性措辞 | 关于可见性的假设信息 |
|---|---|---|---|
| 通用地址,无论文参考 | 自动邀请,未提及特定论文或领域 | "尊敬的研究员,请提交您宝贵的作品…" | 低:地址可能来自任何来源;没有证据表明论文本身被看到 |
| 凭证不匹配 | 邀请援引与论文无关的领域的专业知识[9] | "鉴于您在量子物理学方面的专业知识…"(针对法律论文) | 低到无:表示不经过元数据解析的大规模收集 |
| 目标化,标题引用 | 命名特定预印本和主题相邻场所的邀请[159] | "您最近的论文'[确切标题]'将适合我们的期刊…" | 更高(假设):论文的元数据到达发送者,暗示成功的索引和抓取器访问 |
| 奉承个性化 | 将特定作品赞誉为"突破性"或"受尊敬"[96] | "您的突破性贡献…" | 除了标题访问外没有:赞美是模板化的,未被阅读 |
| 虚构的紧迫性和指标 | 虚构的截止日期、带星号的"影响因子"、索引声明[61][96] | "影响因子4.2*;请在7天内提交" | 无:与目标论文无关的说服装置 |
| 隐藏费用 | APC在后期披露或仅在附件中;市场范围$25–$1,800[136] | 邀请正文中未提费用 | 无:定价策略,而非可见性信号 |
| 会议邀请,论文引用 | 邀请在可疑会议上呈现或提交,通常命名特定论文;演讲者邀请是学术垃圾邮件的一个衡量组成部分[61][9] | "我们邀请您在…上作为主旨演讲呈现您的论文'[确切标题]'…" | 就目标化请求而言(假设):论文的元数据到达发送者;没有实质性阅读的证据 |
| 付费作者服务 | 对新发布的预印本进行快速同行评审、翻译或编辑服务的推销 [61][84] | "为您的新预印本提供快速审查和专业语言修改…" | 未建立:服务垃圾邮件追踪新发布的元数据,而不是论文内容 |
这些拍马屁的行具有机械阅读所掩盖的心理维度。模板化的赞美落在一位作者身上,他可能在盯着停滞的计数器,对于他来说,这个招揽是该发布迄今为止收到的唯一"验证"。因此,两层模型预测了一个残酷的反演,其中新预印本的首批回应者往往是掠食者而不是读者(第7.5节),新人可能会将垃圾邮件误读为兴趣,因为还没有合法信号到达。预期到这个钓饵的作者可以对其有所怀疑。
表14通过阅读传入的邮件来了解其对论文可见性的揭示。如何对这些邮件进行编码本身是一个互补问题,它依赖于迄今为止隐含的一个区分,即合法的学术联系与高风险招揽之间的区别。表15将这一区分阐述为六信号类型学,其最后一列包含编码注意事项:每个信号都是概率性的,单独任何一个都不能证明。这个类型学也是研究3编码手册的骨架(第8.6节),因为不包含合法联系正类的招揽研究无法衡量第7.5节所假设的不对称性。
表15. 将合法的学术联系与高风险招揽分离:六个信号及编码注意事项。 假设的编码方案,不是经过验证的分类器。表14的可见性列提出的是不同的问题且不受影响:同一条信息可以在两个网格上编码。
| 信号 | 合法的学术联系 | 高风险招揽 | 编码注意事项 |
|---|---|---|---|
| 具体性 | 涉及具体的论证、方法或结果 | 插入标题或关键词的通用赞美 | 具体性可以被模仿 |
| 出版场所身份 | 可验证的期刊、编辑、机构或会议历史 | 所有权不明、品牌复制、编辑委员会无法验证 | 新的出版场所不一定是掠夺性的 |
| 请求 | 实质性问题、合作或透明邀请 | 与工作无关的紧急投稿或付款请求 | 仅收费不是决定性因素;透明度很重要 |
| 时间 | 任何时间;通常在实际阅读之后 | 公开发布后不久的快速模板化联系 | 时间接近不能证明信息来源 |
| 语言 | 特定主题且具有专业责任 | 奉承、虚假熟悉感、人为紧迫感、模糊范围 | 语言特征是概率性的,不是证据 |
| 验证 | 可独立验证的联系方式和政策 | 标识符无效、虚假指标、误导性索引声明 | 需要根据记录的标准进行人工审查 |
实际上,该分类学产生了一种筛选启发法而非诊断方法:期刊约稿在发布后最初几天内送达,此时合法分发渠道未能充分运作,这样的约稿很可能是掠夺性的。据报告,合法的高影响力期刊不会冷联系刚发布手稿的作者[174],而早期的非请求邀请是掠夺性场所已证实的首次接触方式[32][174]。我们提出在从业者讨论中有时被提议的具体截断点(将大约前96小时内的任何期刊电子邮件视为推定掠夺性)作为待验证的作者启发法。没有研究测量过会校准这样一个阈值的滞后分布。表15的时间警告适用于启发法本身:时间接近会引起怀疑,但不能证明发件人采集了这篇特定帖子,因为该地址可能完全早于预印本,所以96小时筛选用于分类收件箱,而非证据。
7.5 垃圾邮件悖论与速度不对称
关于寄生层的两个进一步命题源自两层模型。
垃圾邮件悖论。如果有针对性的征询需要成功的元数据收集,那么在后 Rankings 时代,掠夺性垃圾邮件的缺失可能比其存在对任何事物的指示更能强烈地表明平台的不可见性。一篇从未触发寄生层的论文可能未能达到机器可读分发的最低标准。这种反转的分析价值在于:以垃圾邮件(一个被动的、有毒的索引代理)为工具,将不可避免的麻烦转化为免费的观察工具。其诊断能力目前只是一个假设:收到征询的事实与任何可见性指标之间的关联从未被测量,Table 14 中的通用征询行表明了原始垃圾邮件量为什么即使在原则上也会是一个噪声信号。
掠夺者先于读者到达。合法渠道的运作受机构滞后的制约:eJournal 收录是经过策展选择的,而非自动保证的,据报告高体量分类延迟长达 45 天 [53],而 Google Scholar 索引需要六至九个月或更长时间 [55]。第一周接近零的下载量与正常的分发前状态一致,而非拒绝 (第 6 节)。寄生层如果以编程方式采集元数据,则不会面临这些滞后。因此,我们假设对于联系信息可获得的作者来说,由其发布引发的首次掠夺性征询的预期时间短于首次真正学术接触的预期时间,使得未知的作者会先遇到寄生层而非合法层。可证伪性很直接:真正的学术接触可靠地先于掠夺性征询。
所记录的征询量以天和周为单位测量 [9][84],相对于以周和月为单位的分发机制数据 [55][53],使该假设具有可信性。只有第 8 节指定的日志研究才能对其进行测试,因为现有语料库未按发布事件的时间进行锁定 [63]。
7.6 寄生层未能向作者说明的事项
三项边界陈述限定了本部分的结论。
首先,邀请邮件不会增加平台的计数值。发给作者的邀请不会产生摘要浏览和论文下载。在爬虫访问摘要页面的范围内,SSRN声称它从下载计数中过滤了不规则和自动化活动[66][69][144]。因此,垃圾邮件量永远不是阅读活动的证据,充满邀请的收件箱与个位数下载并存不涉及矛盾:这两层统计的是不同的东西。
其次,寄生层对最无力承担其成本的作者打击最大:早期职业研究人员和非英语母语研究人员被认为特别容易受邀请困扰[142]。因此,第6部分的实际协议将收件箱卫生(对任何邀请场所的黑名单筛选、不回应未经请求的邀请、通过精选服务而非已过时清单的验证)视为度量解释的一部分,而不是单独的关注。对掠食性场所的自动筛选本身是一个活跃的研究方向[157]。
第三,早期可见性还有另一个副作用,作者将其视为明显的指控:在随后向期刊投稿时,相似性检查软件会在手稿与其SSRN前身之间标记近乎完全的匹配,因为预印本已在Crossref Posted Content语料库中被索引,该语料库由iThenticate使用[36]。供应商的文档明确说明,同一作者的预印本匹配是预期结果,而非剽窃[81]。恰当的回应是向编辑披露预印本,而不是撤回它。
寄生层是本文核心主张最容易看到的地方:在排名停用后,原始信号(下载、浏览,现在甚至垃圾邮件)只有在指定了生成它们的机制时才具有可解释的含义。对于合法层,该规范部分可用,对于寄生层,它仍然是一个研究课题。
8. 预注册就绪的研究议程:重建缺失的参考类
前几部分综合了关于SSRN关注度量的可验证证据,并为排名停用后的环境提出了解释框架。本部分是预注册就绪的议程,用于凭经验回答框架的开放问题。按设计,它不报告结果:而是提供预先指定的、可证伪的预测带而非研究发现。下面的每个设计、假设和预测带都可以在任何数据收集之前在开放科学框架上注册,并同步发布分析代码。SSRN排名于2026年7月15日[149]停用,在2026年6月12日宣布(最初目标日期更早[148]),并嵌入更广泛的平台战略调整[146],使这一议程异常时间敏感:下面的一些设计利用了一个不连续性,其前期随着时间推移而缩短,其中之一是第8.8部分的百分位数登记簿,它解决了该停用本身为外部观察者永久造成的测量差距。
8.1 设计原则
四项原则指导议程。
从一开始的观察。对累积计数器的回顾性数据抓取无法重建论文在第3天、第7天或第30天拥有的指标。因此,任何可信的基准面板都必须在发布时纳入论文,并在标准化时间点记录其计数器:第1、3、7、14、30、60、90和180天(表11),在前45天内最好进行每日观察,因为SSRN声称高度订阅主题中的警报分发可能需要长达45天[53]。该原则还可以防止信息泄露:先前作者的声誉度量必须在焦点发布日期冻结,以便未来的成功不会污染基线协变量。其相关原则(从第5.6节延续)是分发、索引和推广事件作为有日期的处理进入下面的设计,而不是作为未建模的背景。
覆盖面和转化的分离。按照第5节的诊断逻辑(表9),下面的每个设计都将摘要浏览和下载记录为不同的结果,并将下载建模为给定浏览次数的条件。低覆盖面和低转化率是不同的诊断:未能进入读者的考虑集合,与接触后的非获取。将它们合并为单一计数会丢弃作者需要的信息。
分布结果,而不仅是平均值。因为平台关注是重尾分布的[83][85][180],干预和平台变化可以改变分布的形状,同时使其平均值几乎保持不变。因此,结果包括关注的基尼系数、前1%和前10%下载份额、零或接近零的论文份额,以及新手到已建立关注的比率,遵循其他媒体中关注不平等测量的传统[180]。
可证伪性。每个假设都配有一个识别策略和一个明确说明其失败条件的说法。该框架本身容易受到拒绝:如果年龄和领域归一化的早期度量在样本外未能优于原始计数(下面的RQ3),应该拒绝或缩小有关归一化的测量优势的声称。可证伪性也是量化的:整个议程中的样本量应通过针对最小感兴趣效果大小的功效模拟来确定。对于包含五个假设、三个研究问题和五个命题的程序,多重性策略在预先注册时确定,确认性和探索性分析事先标记为此类。损耗(撤回、合并或实质修改的论文)被追踪和报告,而不是默认删除,在程序的每份实证报告中都有队列流程图(第8.8节)。
8.2 假设与命题
该框架提出五项关于早期关注分配的假设、三个研究问题,以及五项关于其结构的命题。表16将这些假设、研究问题和命题与专有设计(P2、P3b、P4)联系起来,对应具体结果、对比和优先设计;P1和P3分别由表17中的研究1和研究2所涵盖。
H1(冷启动劣势)。在控制学科领域、发布队列、可观察主题、文献特征和日历条件的前提下,完全由平台新手撰写的论文获得的初始摘要页浏览数少于至少包含一位此前在SSRN平台上可见的作者的论文。核心成果指标是浏览数而非下载与浏览比,因为H1关注的是受众形成机制而非转化。
H2(声望与曝光)。在控制先前平台活动和可观察论文特征的条件下,机构和作者声望对早期摘要页面到达率具有正向预测力,将地位关注文献[104][105][111][140][60]扩展到预印本传播的第一阶段。
H3(声望与条件转化)。在控制摘要页面曝光的条件下,机构声望对全文下载具有正向预测力。Jo和Li在营销中提供了与该模式一致的最新领域特定实证证据,对于包含一位前50名作者的三作者论文,声望溢价约为下载率的+6.6% [83],但仍需更广泛的纵向检验。H2和H3共同定义了该研究的核心估计量:声望梯度的到达-转化分解,即观察到的声望相关下载不平等中,在摘要页面访问前(曝光)相对在访问后(条件转化)所占的比例。若大部分梯度在任何读者看到摘要前就已形成,这将把不平等的根源定位于发现机制而非内容评估,并以可直接测量的形式呈现。
H4(沟通的均等化作用)。摘要的清晰度和信息效率越高,与低先验可见性作者的条件转化改进幅度越大相关联,相比之下已有可见性的作者改进较小。H4是唯一干预措施完全在作者控制范围内的假设。应采用预先规定的文本测度进行检验,另外还应进行按在线现场实验标准[30]设计的随机摘要实验。不应仅依赖自动化的"AI生成"分类器,因为这会引入自身的测量不确定性。
H5(曝光冲击的持续性)。外生或准外生的早期曝光冲击能预测超越即时曝光窗口的后续关注度提升:这是学术平台上成功孕育成功动态的对标,与其他地方实验记录的情况[112][131][162]以及arXiv上的位置曝光效应[72][73]相符。
RQ1。2026年7月15日排行榜退役是否改变了关注度的集中度、分布或声望梯度?两种相反的预测都有合理性,因此这个问题保持为双侧:移除排行榜可能抑制人气反馈循环[112][131],或者反而通过移除一个发现表面来增加对既有作者网络的依赖,而这个表面原本使不知名论文一旦开始吸引关注就能获得可见性。
RQ2。精选电子邮件提醒分发是否为新手或已建立作者产生了更大的相对关注度收益?
RQ3。在第7天和第30天观察到的标准化早期指标是否比原始累积下载更好地预测后续学术引用或出版结果?
这些命题以可证伪的形式重述了框架的结构性主张:
P1(偏度与不可见的大多数)。在SSRN论文的随机分层样本上,终身下载的分布具有重尾和右偏特性,使得中位数少于平均数的一半,且大量论文的终身下载数在十个或更少。证伪条件:中位数≥0.5×平均数,或≤10下载份额可忽略不计。已发表的营销-网络平均数与中位数的比值(约2.54)[83]和2015年排行榜数据的拟对数正态拟合[85]为P1提供了动机但未能为整体平台确立此命题。
P2(分类决定曝光)。在数据库层内,eJournal分类数量与下载量呈正相关,与近零下载概率呈负相关,控制年龄和网络因素,这是Whalen 2018年跨截面模式[168]在平台策展分发机制[53][57]下的复制与更新。证伪条件:控制后无显著关联。分类计数本身可能存在内生性:更广泛相关性的论文可能既获得更多分类也吸引更多读者,因此跨截面关联高估了任何曝光效应。因此优先的识别策略是利用有效的论文内分类变化,并明确将跨截面估计报告为上界。
P3(机器可见性较低且特征依赖)。对于构造使得特定SSRN预印本为最优可用源的查询,消费者AI答案引擎在少数情况下引用该预印本,机器可见性随与已记录的生成引擎优化因素[5][164]相似的特征而上升。证伪条件:预印本无论特征如何都以多数情况被引用,或无特征预测可见性。
P3b(机器层的马太效应)。在专家验证的查询相关性条件下,具有更高先验网络和学术可见性的论文被AI答案系统引用的频率高于其他条件相当的冷启动论文。在平等替代假说下,生成引擎基于相关性检索而不对先验可见性给予溢价,P3b遭拒,在此结果下机器层将比H1–H3的人类发现层更具平等性而非更少。证伪条件:在匹配查询相关性时无可见性梯度。P3b将H1–H3的累积优势线扩展到发现堆栈的顶端。检验它需要研究2(第8.6节)中规定的先验可见性协变量和查询分层。
P4(掠夺者先于读者到来)。 对于新发布的预印本,其书目元数据和联系方式可从所发布文件或相关公开页面中提取,归因于该发布的首次掠夺性邀请的预期时间短于首次真正学术联系的预期时间。 证伪者: 真正的学术联系可靠地先于掠夺性邀请。 P4 以可收获性为条件进行阐述,因为当前平台界面上作者联系详情的公开可见性尚未确立。 收获机制本身已在总体上为预印本存储库所记录[107][159][151],对于被邀请作者的相当大比例而言,未经请求的电子邮件是与掠夺性期刊的首次联系[32]。 因此,归因需要第3项研究的精密设计,而不是仅从收件箱时间推断。
表16. 假说、研究问题和识别策略。
| 问题 | 主要结果 | 主要对比 | 偏好设计 |
|---|---|---|---|
| H1: 新来者劣势 | 增量浏览量 | 新来者与已成立者 | 分层纵向计数模型 |
| H2: 声望与传播范围 | 增量浏览量 | 较高与较低的先前声望 | 协变量调整面板+配对敏感性分析 |
| H3: 声望与转化 | 以浏览为条件的下载 | 较高与较低的声望 | 负二项式/泊松暴露模型 |
| H4: 沟通均衡器 | 条件下载概率/速率 | 清晰度×先前可见性 | 观察文本模型+随机复制 |
| H5: 累积关注 | 冲击后浏览/下载 | 暴露冲击与冲击前轨迹 | 论文内事件研究 |
| RQ1: 排名停用 | 日常关注;基尼系数;顶部份额;按领域新发布量 | 曾排名外露与对照领域 | 中断/事件研究设计 |
| RQ2: 电子邮件分发 | 日常浏览/下载 | 分发前后 | 论文内事件研究(分发×新来者) |
| RQ3: 预测效度 | 6/12/18个月引用 | 标准化与原始早期指标 | 样本外预测比较 |
| P2: 分类支配呈现 | 下载;接近零下载的概率 | 分类计数;论文内分类变化(如有) | 面板回归+论文内变化设计 |
| P3b: 机器层马太效应 | 答案系统的直接引用 | 匹配查询相关性下的高与低先前可见性 | 重复多级检索审计(研究2) |
| P4: 掠夺者先于读者 | 首次时间与编码入站消息速率 | 发布前与发布后窗口;掠夺性与真正联系 | 精密设计的前瞻性队列+事件历史模型(研究3) |
注。 所有行均为前瞻性设计。 未曾执行。 结果、对比、排除规则和参考类别应在数据收集前预注册。
8.3 核心面板
参考设计是一个多学科队列,包含新近发布的SSRN论文,自发布之日起至少跟踪十二个月,按照表11的时间表进行观察。在论文层面,数据集保留了标题、摘要、作者名称和顺序、隶属关系、发布日期、分类、关键词、页数、可用的DOI、修订历史、公开摘要浏览量、公开下载量和后续引用指标的最早可用版本,其中作者身份与开放书目基础设施[35][124]的匹配在推断声望大规模使用之前在随机子样本上进行了手动验证。新人状态被定义为焦点论文上的任何作者都没有在焦点发布之前的SSRN论文,灵敏度定义基于先前论文计数和发布前引用库存。机构声望不是该定义的一部分:因为声望本身是H2和H3中的解释变量,将其纳入新人状态会在机械上将平台新颖性与先前的作者可见性混淆,并折叠该设计旨在分离的假设。因此,声望仅作为独特的协变量进入模型。基于公平考虑,必须谨慎处理先前可见性的规范化:过度激进地减去先前可见性基线会惩罚初级作者的真正早期成功,并会在统计上抹除而不是暴露任何系统性的边缘化和全球南方作者的欠曝光。该框架的答案是测量不平等形成的地方,而不是将其抵消:接触度与转化率分解定位可见性差距是在曝光还是转化时出现的,声望作为要理解的协变量进入,而不是要被静默消差的噪声。声望对关注的分布效应是准实验的主要结果(第8.4–8.5节)。日历控制包括周日期、年周数、学术季节和日期固定效应。已文献记录的文章访问中的周末和季节变化(最近一个七种期刊面板中周末活动约低11%,夏季约低50% [178])使得在任何高频使用研究中难以为其遗漏辩护。完整的面板变量字典(约二十个字段,包括区间增量而不仅是累积计数、征得同意的分布日期、6、12和18个月的引用库存和修订编号)在附录C(表C1)中规定,相同的模式文件与预注册材料一起存放(第8.8节;声明)。
接触度被建模为增量视图的分层负二项过程,具有按字段×年龄效应、日历效应和论文层面异质性。条件转化被建模为增量下载,以对数增量视图作为曝光,使得获得登陆页访问和转化该访问在统计上是分离的。在紧凑形式中,对于间隔t中的论文i:

其中λ_{f×age}是按字段×年龄效应,δ_t是日期效应,u_i和w_i是论文层面的异质性,第二个方程中的对数视图偏移使下载以登陆页曝光为条件。新人×清晰度相互作用γ_3是H4测试。这些方程固定了预指定的估计量和接触度与转化率的分离,分层结构执行了第5.2和8.8节在任何稀疏单元的百分位数发布之前所要求的经验贝叶斯偏池。x_i中的主题控制是从在预注册时冻结和聚类的标题–摘要嵌入构造的,在观察任何结果之前,以便主题组成不能被调整到结果。因为论文同时占据多达七个分类,分类效应是用多成员身份分层结构估计的,而不是通过强制每篇论文进入单个字段。因为论文固定效应吸收了时间不变的地位衡量,基线新人和声望效应在论文之间估计,而论文固定效应保留用于论文内处理,如分布事件。过度分散和过量零进行了正式测试,障碍和零膨胀替代方案在有正当理由的地方报告,重尾通过分位数和稳健估计而不是删除成功的论文来处理。数据清理规则本身是预指定的而不是自由裁量的,异常协议是标记,不删除。预指定的信号列表涵盖:针对论文自身历史的区间极端、视图激增而下载无变化、转化不连续性、重复的相同时间戳和平台端重述。被标记的区间永不从档案中移除:它以原因代码保留,每个标题结果在四层灵敏度梯度上报告:(i)未修改的计数器;(ii)仅排除平台确认的无效活动;(iii)稳健或缩尾估计;(iv)排除所有标记的区间,以便仅在一层上生存的任何结论都显示为脆弱的。阈值根据观察到的分布校准,而不是先验设置。在可获得合作伙伴日志的地方,转介来源、用户代理和地理字段区分新闻通讯、博客、预取和爬虫流量。SSRN上文献记录的博客驱动下载激增[116]说明了为什么极值通常是有机成功而不是污染。异常检测是一个测量工具。它不许可丢弃不方便的成功。
相同的规范也适用于时间结构。该面板区分边际关注与累积关注:间隔下载ΔD的队列曲线,以及论文180天下载中由各年龄段累积的份额,而非仅读取终身总量。由于阅读在多个时间尺度上同时衰减[91],它不强加单一的指数半衰期。因此年龄曲线默认使用样条或非参数估计器拟合,采用对数变换研究结构,保留原始计数用于基准报告。稳健性以相同方式处理:声誉通过多个替代措施进行操作化,而非单一排名阈值,新人身份在逐步更严格的定义下重新测试,结果通过winsorized敏感性检查和完整分布图报告,与分位数估计并列显示。
由于没有公开的SSRN API [134][51],数据收集按优先顺序通过三条途径进行:向SSRN/Elsevier正式提出数据请求或建立合作伙伴关系;作者同意的仪表板导出,参与的作者在知情同意下贡献其统计面板数据,是第8.8节注册表已依赖的中间层;以及受速率限制、尊重robots.txt的每篇论文的公开页面采样,其技术可行性由现有开源收集工具[134]确立。该设计排除了将违反服务条款的批量抓取,并且不将任何无文档端点表示为稳定API。访问约束在第9节中作为限制进行讨论。
8.4 准实验 I:电子邮件提醒分发作为注意力冲击
第8.4和8.5节构成一个分析模块,研究两个平台端的干预措施作为同一面板队列的互补性处理。提醒分发增加了一个接触机会,排名停用移除了一个,两者都针对一组共同的分布结果进行评估(新进入者份额、声望梯度、注意力基尼系数、最高份额)。SSRN的提醒机制在分析上很有价值,因为发布和分发不必一致。论文首先变得公开可用,然后符合条件的工作通过精选的电子期刊提醒进行分发,其时间变化且不保证[53][57]。对于同意提供其分发状态日期的作者,可以进行论文内事件研究以估计围绕分发日期的注意力路径,每篇论文作为其自身对照,使得主题吸引力、作者身份和机构的稳定差异被控制。规范为标准事件研究形式:对于结果Y_it(间隔视图或下载),
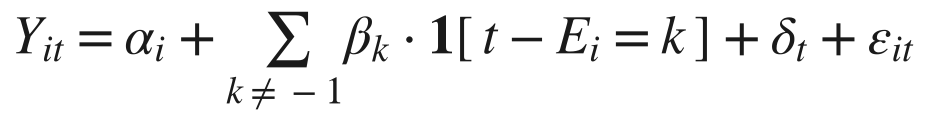
其中E_i是论文i的分发日期,α_i是论文固定效应,δ_t是日历日期效应,β_k归一化到k = −1预分发参考期,描述事件周围的注意力路径。方程指定了预注册的估计量。关键的异质效应是相互作用分发×新进入者,通过将β_k与新进入者状态相互作用来估计。如果提醒不成比例地改善了新进入者的影响力,精选分发则发挥平台级均衡器的作用;如果收益不成比例地落在声誉卓著的作者身上,分发则放大了现有的声望优势(RQ2)。先前的证据表明离散接触事件(arXiv上的前置列表[72][73]、SSRN论文的博客报道[116])产生明显的早期注意力峰值,这表明该设计具有可检测的第一阶段。预先指定的规范还包括围绕分发日期的替代事件窗口,以及对快速分发的论文与经过长期分类队列后分发的论文的单独报告,因为长达45天的延迟[53]否则会将异质曝光历史混入单个事件时间。论文固定效应仅控制时间不变的吸引力,因此三个设计条件至关重要。分发时间是精选的,而非随机的:平台选择分发哪些符合条件的论文及其时间[53][57]。因此,事件日期承载着关于主题性的时间变化的选择(主题变得突出的那周分发的论文不同于在平静周分发的同一论文),这种选择在论文固定效应下仍然存在,这正是规范对分发延迟进行条件化并分别报告分发时间层级的原因。分发状态日期也仅针对同意的作者进行观察,因此估计样本是面板的自选子集。同意状态因此被记录,事件研究样本在可观测协变量上与完整队列进行比较;选择限制了外部有效性。而且作者可以根据提醒时机来调整自己的宣传:协调一致的自我推广峰值可能冒充为分发效应。因此,带日期的作者推广日志(第6.1节的版本化证据包)是该设计的必需条件:没有它,有机分发峰值无法与自生成峰值区分开来,第8.3节的异常梯度是标记而非删除任何与记录的自我推广相巧合的峰值。
8.5 准自然实验 II:排名制度的退役——一个自然实验
2026 年 7 月 15 日的日落期限 [149] 若能从存档的排名页面重建历史排名接触记录,则允许进行第二次分析。设计的两个特征削弱了单一日期事件研究的清晰性。干预并未在一个日期到达:各电子期刊的排名页面自 2025 年 12 月 11 日起停止更新(第 2.2 [B-2] 部分),约在 2026 年 7 月 15 日撤除之前七个月,因此排名发现表面的撤回更好地建模为错开过程——即先冻结实时页面,再最终撤除,而非单一共同的事件日期。规范因此至少包含两个事件时间点(12 月冻结和 7 月撤除),以错开形式为主要模型,并针对其测试单一日期的拟合。也不能从平台结构假设"曾被排名接触"的学科:排名是平台范围的,因此差异化接触是内生的,不通过命名"感觉上"被排名的领域来操作化。接触必须被测量,而非被指定:例如,从通过互联网档案馆恢复的存档排名页面,按某领域论文进入公开顶级列表的比例,或该领域在各电子期刊页面上的密度来计。档案是否足够密集地覆盖每个领域的排名页面以产生可用的接触度量尚未确定;该设计将密度与接触度量一同报告。通过这样测量接触,论文级别的事件研究规范在冻结和撤除日期前后比较高接触和低接触领域的关注轨迹:采用第 8.4 节的方程,其感兴趣的系数置于 Exposure_f × EventTime_k 相互作用而非仅在事件时间项上。最具信息量的结果是分布式的(第 8.1 节)。排名机制可能改变注意力的集中度,同时保持均值基本不变;由于任何效应都预期集中于填充列表的已可见尾部论文,领域均值结果在构造上缺乏功效。因此,基尼系数、顶级份额指标、新旧学者比率和声誉梯度为主要结果,具有 RQ1 的双侧预测;第 8.1 节的功效模拟必须针对这些分布统计而非平均关注,否则该研究有被宣布无效的风险——在错误的估计量上缺乏功效。
两个命名的、有方向性的预测在不替代双向RQ1的情况下细化了它,均为预先指定的异质性检验。能见度悬崖假说认为,在曾经暴露于排名的领域中,日落后发布的队列相对于匹配的日落前队列在早期触及中经历了离散下降,因为发现表面在已知日期被移除。在补偿假说下,如果排名充当了对发现生态系统薄弱领域的补偿性可见性机制,那么其移除的效应应该在电子期刊订阅基数较小的领域、Whalen梯度的低端最为明显[168]。
一个简便的次级结果将设计从注意力分配扩展到平台本身的健康:2026年7月15日前后时间窗口中按领域的新发布数量。如果排名提供了部分发布激励,其退役可能会抑制新提交。这是一个不同于上述注意力效应的行为结果,可从公共新论文列表观察到,与平台自身2025年超过250,000篇新论文的基线相对比[145],是对第2.2节[12][B-11]中记录的同时代"jumped the shark"论战的直接经验答案。预测保持双向的,与RQ1一样,发布量结果与研究4调查的第(3)项("避免新上传")相关联。
该分析是准实验的。有五个主要威胁。其一是公告和预期效应:退役于2026年6月12日公布,初始目标为7月1日,实际于7月15日执行,因此存在真正的预期窗口并发生了改变[148][149]。一组并发的2026年平台变更与日落的日期重合,无法通过任何单一事件日期将其分离开来:2026年4月13日宣布的战略重点调整、运行至2026年12月底的商业研究论文系列的退役,以及2026年7月20日的作者许可证变更,即移除后五天[146][150]。因为这些干预措施与7月窗口重叠,单一共同事件日期会将其综合效果仅归因于日落。因此,识别依赖于上述交错的时间安排(12月冻结先于所有这些)、安慰剂日期、排名撤销特有的分布特征,以及设计报告了哪些共时变化保持未分离。其次是夏季注意力低谷:7月中旬与学术访问的记录季节性下降相吻合,夏季月份的访问下降约50% [178],因此跨越移除日期的跨领域对比会将日落与该领域自身的夏季季节性相混淆,这在各学科中有所不同。日历日期固定效应仅吸收共同季节性成分。因此设计需要特定领域的季节性基线(每个领域的前一年同窗口比较)。高暴露和低暴露领域之间的非随机差异是另一个威胁,由上述的测量暴露操作化和匹配对照组来处理。剩余的威胁是潜在的:SSRN已声明它可能会重新审视排名,因此在观察窗口期间的部分恢复将引入第二个事件。设计预注册将任何此类恢复视为后续期间的截断点,并将其建模为不同的处理,而非折叠到日落对比中。在所有报告中,事件时间被划分为三个命名周期,公告(从2026年6月12日起)、过渡和退役(从2026年7月15日起),以便估计预期效应。因此,预先指定的设计包括事件时间前趋势检验、替代带宽、安慰剂日期、特定领域时间趋势和特定领域季节性基线,以及排除公告-到-退役过渡期的敏感性分析。图11呈现了两个事件研究的预期输出作为设计模板。
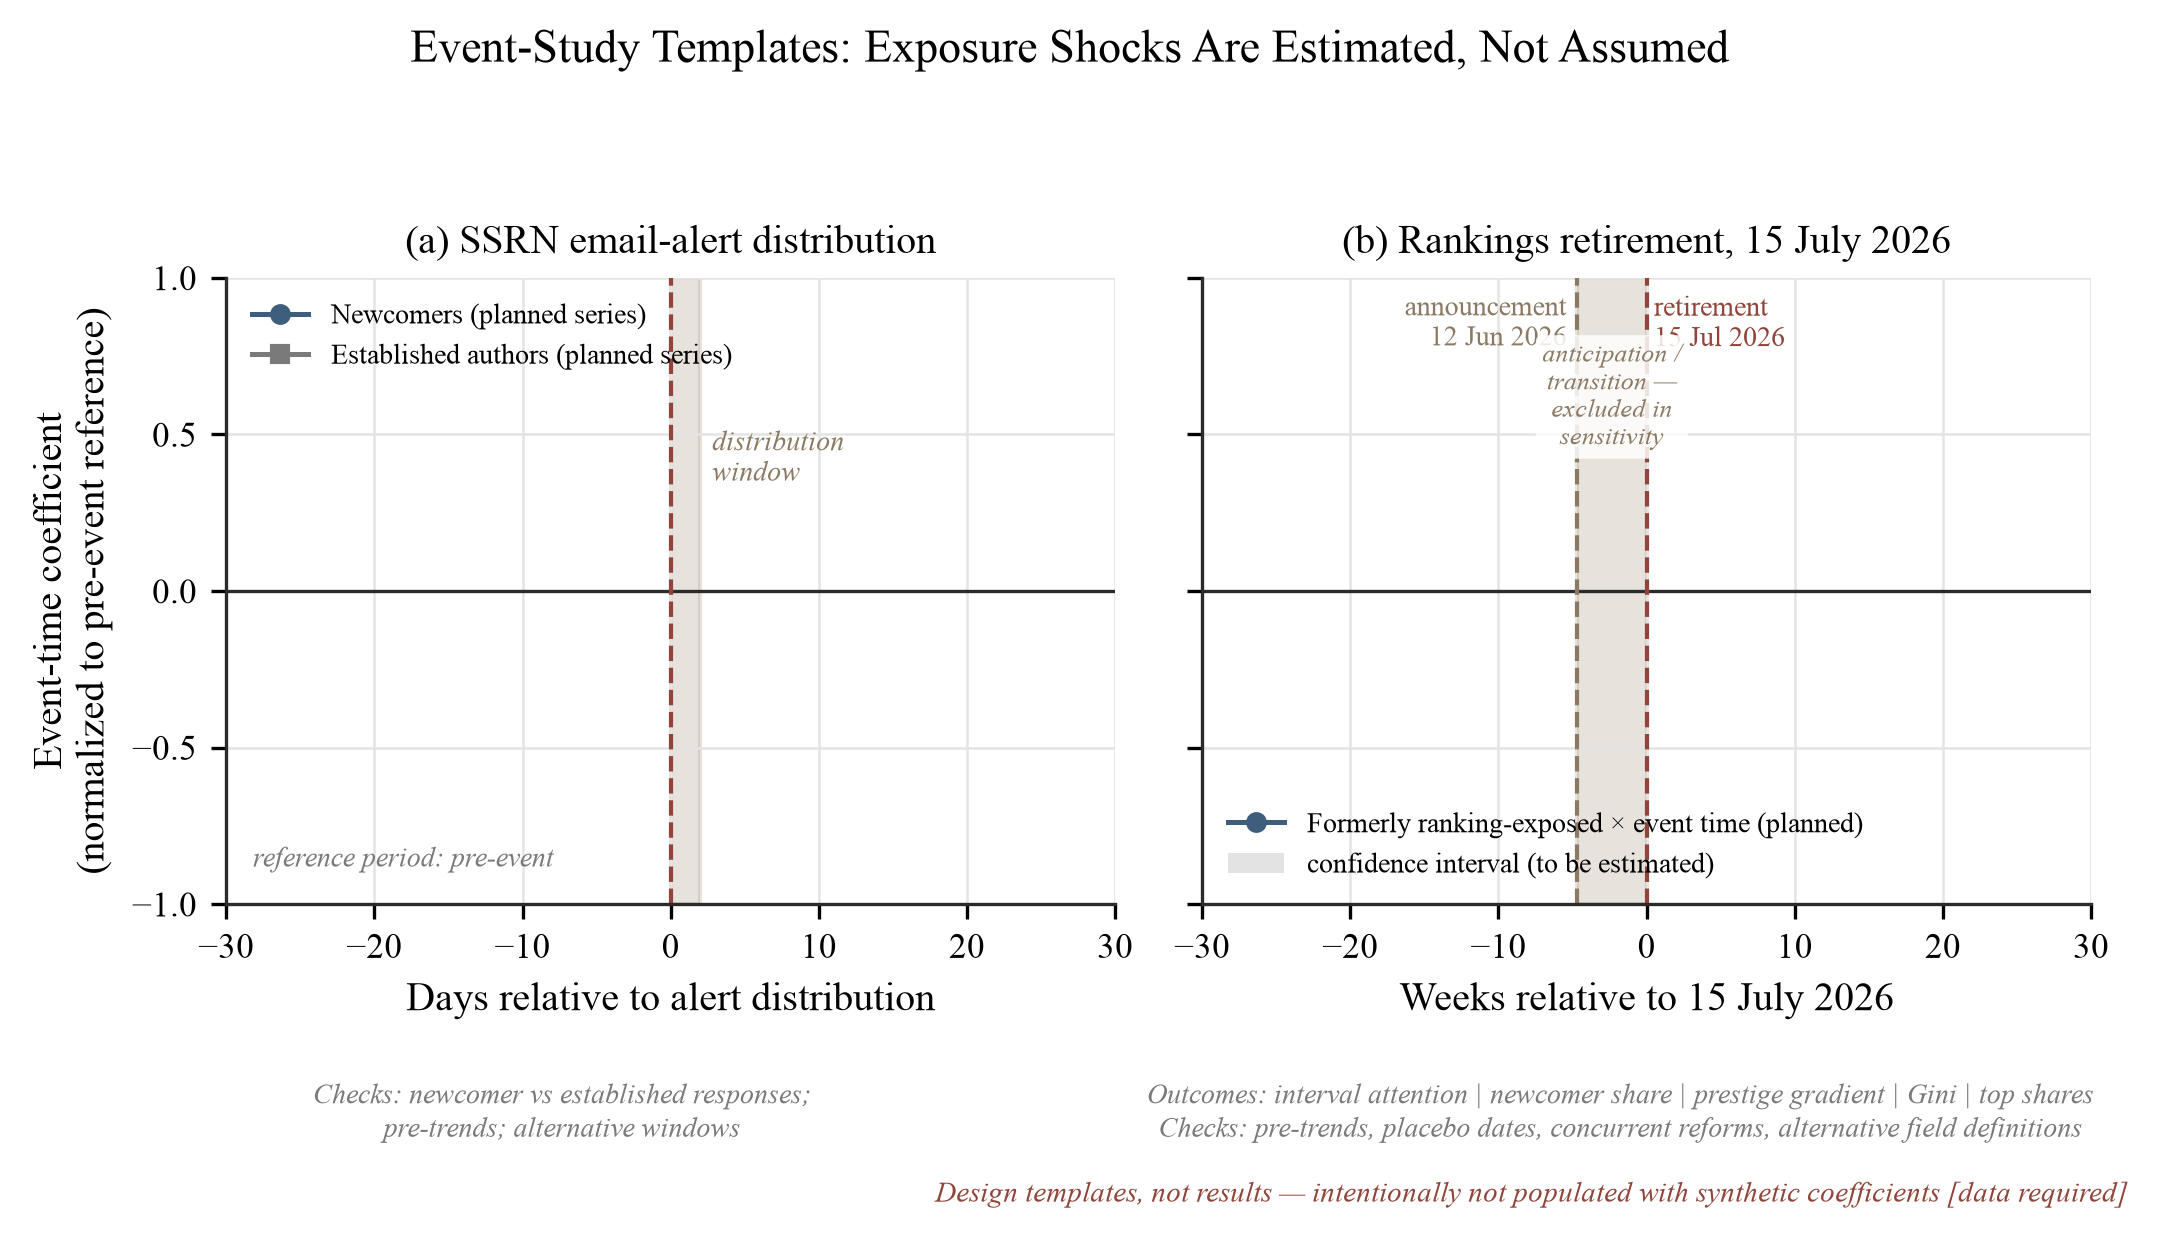
图11. 两个平台准实验的事件研究设计模板。第8.4-8.5节设计的预指定事件研究输出:(a) 围绕电子邮件提醒分发的注意力,新作者与资深作者的对比,分发窗口着色,因为提醒以窗口而非瞬间的形式到达;(b) Rankings退休周围的注意力和不平等结果,标记了公告(2026年6月12日)和退休(2026年7月15日)两个日期,并对预期/过渡期着色——该窗口在预指定的敏感性分析中被排除。分布结果(区间注意力、新作者份额、声誉梯度、基尼系数、最高份额)和所需检查在图上说明。系数已归一化到事件前参考期;着色灰色区域表示置信区间。这些面板是设计模板;未显示实证值,生成代码将随预注册材料发布。
8.6 四项预先指定的研究
除了核心小组外,四项研究在表17中进行了说明和总结。两项公共数据研究(1和2)可由任何研究人员尝试,无需受限访问权限,但受第9节中指出的访问限制(平台服务条款下的速率限制收集)范围内。两项人类受试者研究(3和4)需要参与者参与,并根据《声明》中阐述的伦理批准进行。这四项研究都旨在立即开始填补基准空缺,而不是等待多年小组成熟后再进行。
表17. 四项预先指定的研究。
| 研究1 | 研究2 | 研究3 | 研究4 | |
|---|---|---|---|---|
| 研究问题 | 中位数/百分位数下载分布是什么? | AI回答引擎是否引用预印本本身? | 读者还是恶意行为者优先? | 作者如何解读自己的计数器? |
| 数据 | 3,000–5,000个分层的SSRN论文ID | 100–200个专业问题 × ~5个引擎 | 2项配置监测的发布,90天入站日志 | 预注册作者调查,四个固定措辞项目 |
| 方法 | 中位数、基尼系数、衰减曲线、分类计数回归 | 检索编码 + 逻辑回归 | 按频道别名追踪 + 消息编码 | 结构化问卷 + 描述性比例 |
| 主要结果 | 中位数;≤10下载份额;注意力基尼系数 | 机器可见性V | t_reader vs. t_predator | 从不与任何基准比较计数器的份额;"7次下载"的首次阅读分布 |
| 可证伪预测 | 中位数 < 0.5 × 平均值;基尼系数 0.75–0.90 | 在10–35%的试验中引用预印本 | t_predator < t_reader | 多数报告从不与任何基准进行比较 |
| 主要产出 | 公开的、机器可读的按年龄、领域和队列分层的百分位基准表 | 具有时间戳快照的可重现检索和属性审计协议 | 具有发布前基线和编码代码簿的开放式配置监测发布协议 | 已记录的作者解释分布和报告的行为变化 |
| 设计失效条件 | 归一化相比原始计数不改善稳定性或样本外预测 | 特征除查询相关性、引擎和日期外无预测能力 | 基线和暴露控制后无发布后不连续性,或编码不可靠 | 招聘或自选偏差使得描述性比例也无法解释 |
| 资源配置 | 公共数据;标准爬取和统计 | 公共AI引擎查询;手动编码 | 两项配置监测的发布;收件箱日志(IRB) | 匿名作者调查(IRB) |
注。每项研究应在数据收集前在OSF上进行注册,并公开代码。
研究1:"中位数的剖析。"该研究从3,000–5,000个SSRN摘要ID(一个规划范围)中抽取随机分层样本,最终样本量N通过针对预先指定的预测带和最小感兴趣效应(第8.1节)的功效模拟确定。分层按发布年份和网络进行,每篇论文的终生下载次数、摘要浏览次数、发布日期和分类计数通过第8.3节的访问路由收集。估计量包括:终生下载次数的中位数;零次下载和十次或更少下载的论文份额;带有自助法置信区间的注意力基尼系数;浏览到下载的转换率,整体估计和按网络分层估计(对第5.2节受众阅读风格假设的测试);下载衰减曲线;以及对数下载次数对分类计数的回归,具有年份和网络固定效应(对P2 [168]的直接测试)。预先指定的预测带(终生下载次数中位数大约30–80,≤10下载份额15–30%,基尼系数0.75–0.90)是从第5节的既定锚点[83][85][139]和相邻媒体中的注意力基尼系数规模[180]外推得出的,提前说明以便研究可以证伪它们。研究1是第8.8节讨论的百分位基准的实证基础。
研究2:"机器是否阅读你?"越来越多的信息寻求现在开始于生成式界面:大约一半的美国成年人报告使用AI聊天机器人,约四分之一每天使用它们[121],在便利样本中相当一部分已经将聊天机器人视为他们的首选搜索引擎[4]。引言(第1.6节)将其概念化为发现网关的向上迁移(期刊品牌→资源库→搜索引擎→AI回答层),每一步都将控制权进一步从作者转移,远离任何公开基准(图12)。最上层是否检索预印本完全不清楚:生成式引擎优化文献到目前为止集中在品牌和商业上[5][100][164],而AI搜索审计涉及新闻属性而非学术来源[82]。这些审计对新网关的可靠性提出怀疑:在Tow中心审计(跨八个引擎的1,600个查询)中,引擎集体在超过60%的试验中未能检索正确信息,最佳表现者(Perplexity)在37%的时间内回答错误,最差表现者(Grok-3)在94%,它们通常以毫无根据的信心犯错而不是拒绝回答[82],这些数字来自新闻归因测试,而非学术搜索。截至2026年8月,尚未存在关于AI回答引擎中学术预印本可见性的对照研究[100]。该成果相对于两条相邻的工作方向而言。本文基于的生成式引擎优化研究测量和操纵品牌和商业页面的可见性[5][164],而非学术工件的检索。另一条工作线表明,当语言模型生成参考文献时,它们重现并放大人类倾向于引用已高度被引用的工作,将Matthew效应扩展到机器层[7],这是第8.2节测试的机制P3b。这两条工作线都没有在受控查询相关性下检查科学预印本的可发现性,特别是在移除平台排名表面后它们的可检索性,这正是研究2所隔离的内容。
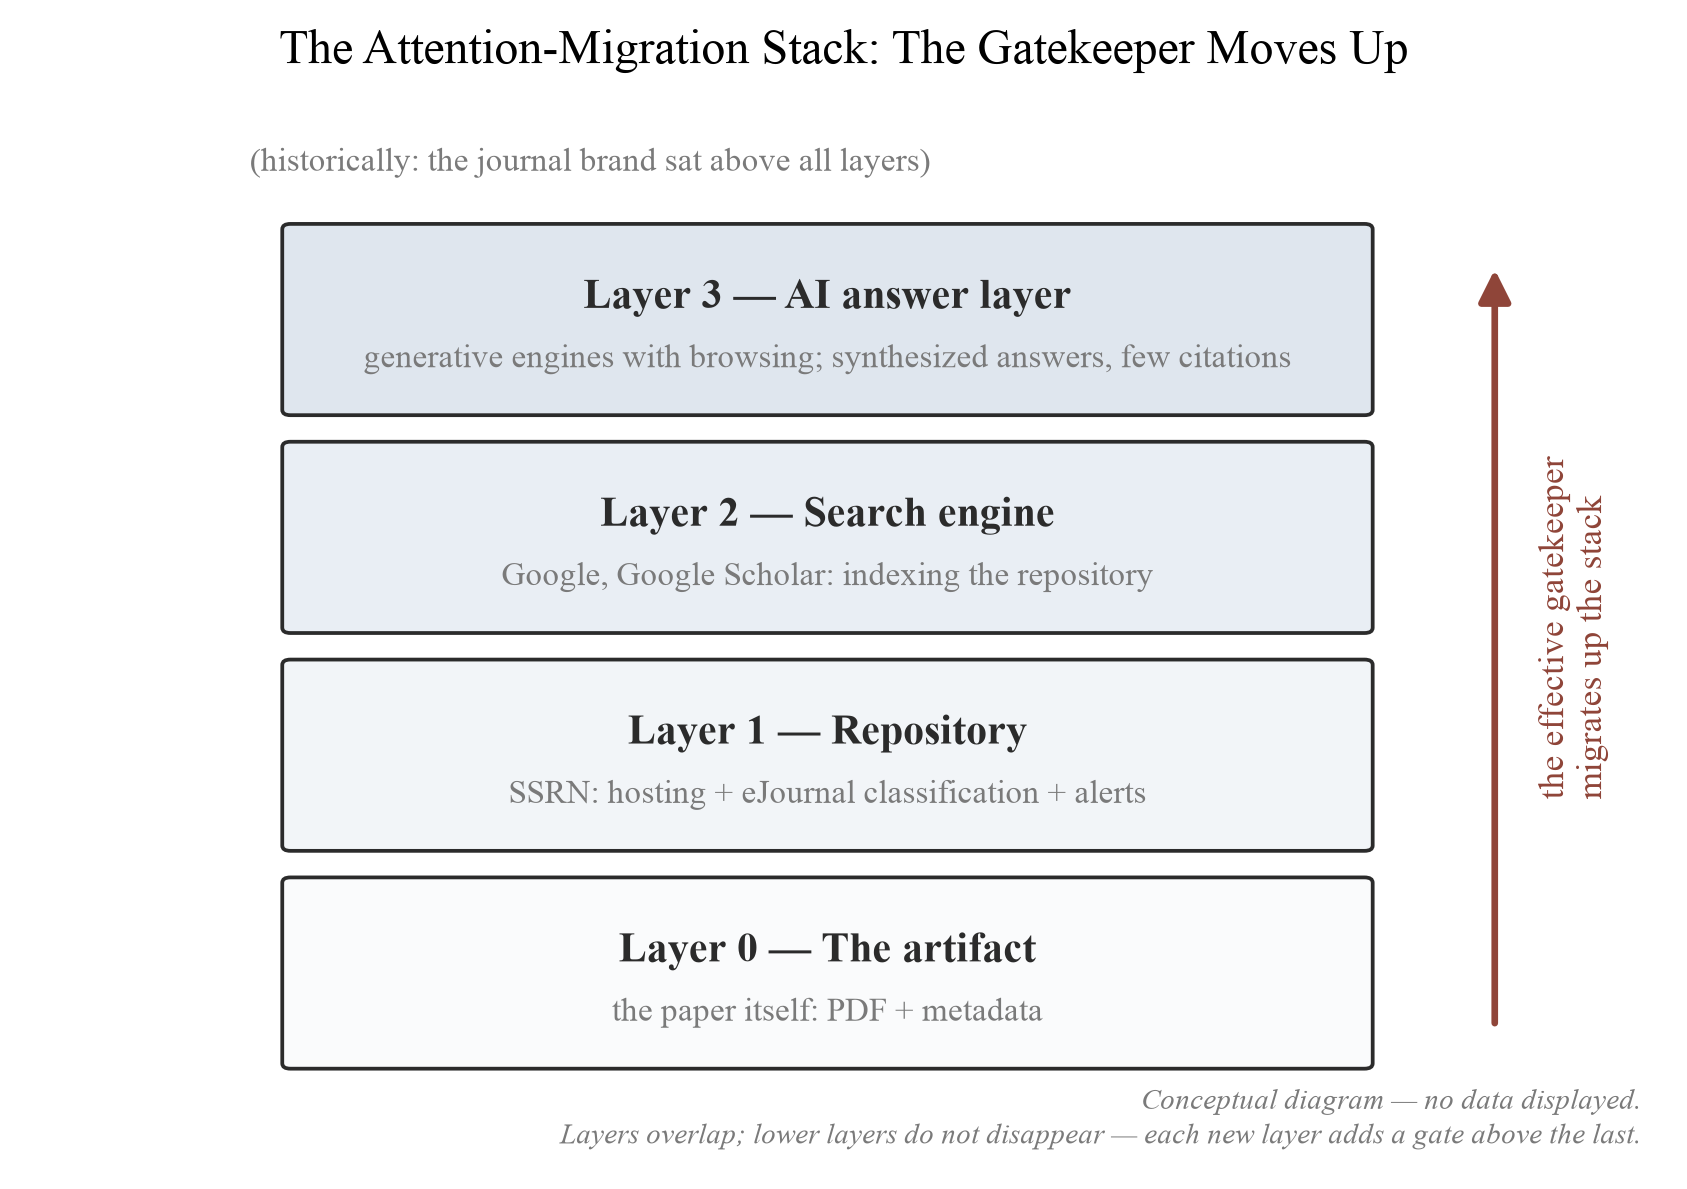
图12. 注意力迁移堆栈。从完成的手稿到读者注意力的分层路径。迁移论文认为,有效的门卫——决定哪些制品获得注意力的层——随时间向上移动,从期刊品牌通过存储库和搜索引擎到AI答案层;每次向上移动都将控制权进一步从作者转移开,并远离任何公共基准。堆栈是一个概念模型。
研究2构建了100–200个细分问题,每个问题都经过精心设计,使得一个特定的SSRN预印本是最佳可用来源,其相关性声明由盲目专家评审员验证,而不是由查询作者自我认证。它使用启用浏览功能的主要消费者AI系统进行查询,并将结果编码为六个相互排斥的类别:(1)引用了焦点预印本本身;(2)引用了已发表版本或同一论文的镜像,在更粗糙的编码方案中会被误分类为缺失;(3)引用了二级报道但没有论文;(4)引用了不同但可辩护的来源;(5)没有可追踪的来源;和(6)引擎拒绝(图13)。对于每个引用焦点论文或其版本的答案,二进制归属保真度标志额外记录答案中的声明是否实际由引用的来源支持。可见性和保真度分别报告,从不合并为单一分数,因为引擎可以突出引用论文同时误述它(引文洗钱)或完全没有引文地复制其内容(无归属的影响)。确认性回归保持逻辑性,对比"焦点论文或其版本被引用"与所有其他结果,使用聚集标准误差,或最好拟合交叉随机效应结构,以尊重共享引擎、查询或焦点论文的观测的非独立性,因为同一论文在引擎间查询和同一引擎在论文间查询各自导致相关结果,朴素的独立试验误差会低估。正式地,审计的估计量是M_pqe:论文p被引擎e引用以响应查询q的概率。M_pqe不是论文单独的属性,因为它在查询、引擎、日期和模型版本间变化,所以符号定义了估计量,每个带时间戳的运行都被读作其日期时M_pqe的估计。引擎样本应该扩展到消费者聊天机器人之外,包括新兴的学术检索层(工具如Consensus、Elicit、Scite和Semantic Scholar,它们以学术语料库为基础并引用真实论文),因为对消费者引擎不可见的预印本可能仍由学科特定的引擎表现,两层之间的分歧本身是一个感兴趣的结果。机器可见性随后对表18中操作化的论文特征进行回归,包括P3b要求的先前可见性协变量:每篇论文的审计前网络和学术足迹,在查询构建时冻结。查询样本按先前可见性分层,以便冷启动论文按设计得到代表。因为生成引擎是非平稳的,设计将带时间戳的主要快照与脚本化的重新运行协议配对,其他人可以重复。三项进一步的审计卫生要求是预先规定的:负面控制(有声望但不相关的论文、标题变体和提示应该不检索焦点工作)使无差别引用可检测;每个查询在记录的会话状态下以等价的提示变体运行(清除与登录会话;引擎、模型版本、日期和地理),以便提示和会话特定的伪影可与稳定检索行为分离;并且结果的随机子样本是双编码的,报告评审者间一致性。完整的逐步审计清单随预注册材料存放。该研究的主要输入是研究者时间(100–200个问题的盲相关性验证和双编码),而不是受限访问数据或专门基础设施。必须按市场费率为专家评审员时间付费的研究应明确预算该劳动。预先指定的预测是预印本本身在少数试验中被引用(范围10–35%),结构化摘要和已发表版本特征提高可见性(P3)。研究2是五个议程项目之一的协议。学术机器可见性的完整审计,包括跨引擎和跨存储库的比较,是计划中的伴随论文的主题。
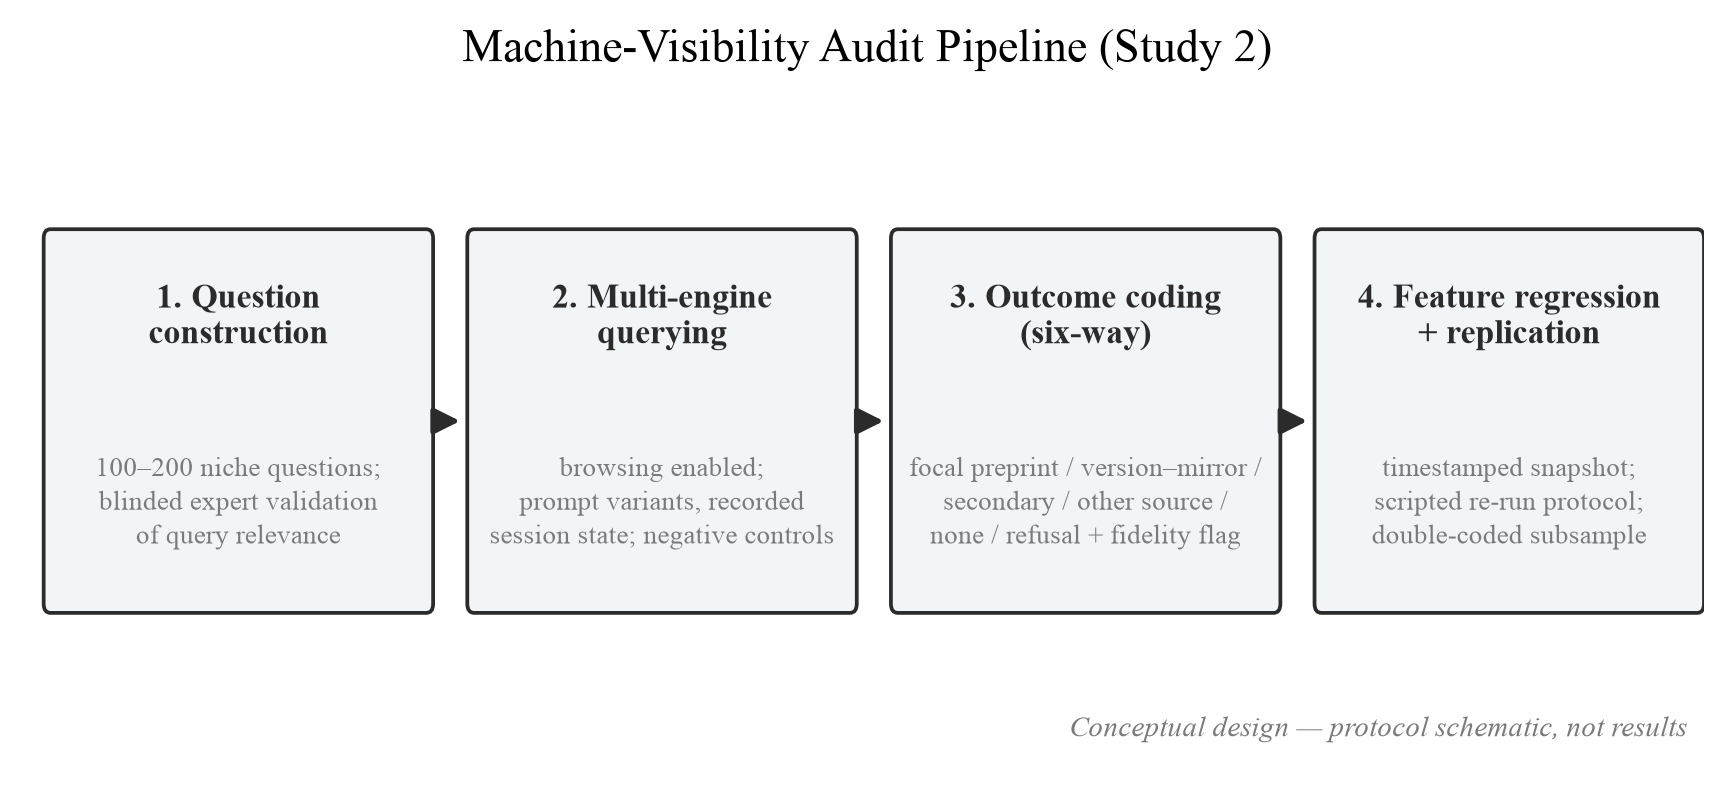
图13. 机器可见性审计流程(研究2)。四步骤研究2流程。六分类编码将目标预印本的引用与其已发表版本或镜像的引用分开——防止对缺失的错误分类——而归因保真标记将"是否被引用"与"是否被忠实引用"区分开来。快照加复制结构解决了模型非平稳性:初始快照带有日期,复现协议允许任何研究人员在后来的日期重现审计。
表18. 机器可见性特征的操作化(研究2)。
| 变量 | 定义 | 编码 |
|---|---|---|
| DOI存在 | 论文页面公开了注册的DOI | 1/0 |
| 标题类型 | 描述性与隐喻性标题 | descriptive = 1 |
| 摘要结构 | 结构化/统计丰富型与叙述型 | structured = 1 |
| 年限 | 首次发布以来的月数 | integer |
| 分类数量 | 分配的eJournals数量 | integer |
| 次级报道 | 存在≥1条被索引的博客/新闻提及 | 1/0 |
| 出版版本 | 存在期刊版本的记录 | 1/0 |
| 先前可见性 | 审计前论文及其作者的网络和学术足迹,在查询构建时冻结 (P3b) | 分层序数 |
| 结果 V | 焦点论文的检索结果 | 六个类别:焦点预印本/已发表版本或镜像/仅次级/其他可防御来源/无可追踪/拒绝;加上被引用案例的二进制归属保真度标志 |
注。特征选择将记录在案的生成式引擎优化因素[5][164]应用于学术制品。规模最大的此类审计(约252,000次试验,跨越六个基于LLM的引擎)确定了主题相关性和检索上下文中的列表位置作为被首次引用的主要驱动因素[164]。因此,列表位置是Study 2的一个独立的、可转移的假设,结果列表位置应在任何可观察的地方被记录。
表19在描述的不同层次上补充了表18。表18将Study 2所估计其效应的论文级特征操作化,而表19则指定了审计的测量构念:测量什么、在哪些控制条件下以及针对哪些主要效度威胁。每个构念都是关于机器层的不同主张,每个威胁都指出了不充分的审计会出错的具体方式。
表19。机器可见性审计的测量构念(Study 2)
| 构念 | 操作测量 | 所需控制 | 主要威胁 |
|---|---|---|---|
| 直接机器可见性 | 焦点预印本在答案中被引用或链接 | 查询相关性、引擎、日期、会话状态 | 模型和索引漂移 |
| 来源替换 | 引用已发表版本、镜像或二级覆盖而不是预印本 | 版本匹配、DOI、标题变体 | 错误分类为缺失 |
| 引用位置 | 答案内焦点引用的排名和突出度 | 答案长度和引用计数 | 特定界面的呈现 |
| 归属保真度 | 答案中的主张由被引用的论文准确支持 | 盲化主张-来源验证 | 引用洗钱或幻觉 |
| 查询敏感性 | 等效查询措辞之间的结果变化 | 随机化提示变体 | 特定提示的人工伪影 |
| 可复制性 | 在后来的日期或干净的重新运行时获得相同的结果 | 存档的协议和系统元数据 | 引擎非平稳性 |
从商业GEO文献中最可防御的转移是特征审计议程,而不是宣传方案:表20列出了候选特征,其与机器可见性的关联是Study 2旨在确认或驳斥的。每一行都是假设而不是既定策略,与检索相关的特征可能仍然是论文成熟度、主题流行度或先前可见性的代理,而不是杠杆。
表20. 机器可见性的特征审计议程(Study 2的假设,非建议)
| 候选特征 | 假设机制 | 支持证据 |
|---|---|---|
| 注册DOI | 稳定标识符有助于检索和引用匹配 | [164] |
| 结构化、统计丰富的摘要 | 在商业基准中,统计添加将生成式可见性提高了约40% | [5] |
| 描述性、相关性密集的标题 | 主题相关性是AI答案引用的顶级驱动因素 | [164] |
| 最大化准确的电子期刊分类 | 更多分类与更多下载和更少的零值相关联 | [168] |
| 获得≥1项二级覆盖 | 引擎通常引用二级覆盖而不是初级来源 | [82] |
研究3:"谁先到达?" 一个精心设计的发布协议直接测试P4。两篇真实的工作论文通过每个暴露渠道的独特加号地址别名进行发布,同时在相同别名上进行监测:先有为期两到四周的发布前基线窗口,然后是为期90天的入站日志。没有基线,邀约量的增加完全无法归因于发布,因为学术垃圾邮件本身就在高本底率下持续不断地到达。每条消息都被编码为真正的学术联系或掠夺性邀约,使用已发布的邀约特征[96]和精心设计的黑名单类型标准,与第7.2节审查的专业审计中记录的高本底率相对照[9][84][63][61]。结果是对可归因于发布的首次真正联系时间和首次掠夺性邀约时间的比较。根据P4的预先指定预测,邀约先于真正联系。两个测量规则在启动前确定。基线和发布后窗口的长度不相等(大约两到四周对比九十天),因此比较基于到达率(每个别名天的事件数)和生存函数,而不是原始事件计数,后者会因为时间窗口的不对称而被扭曲。首次联系的时间在构造上是右删失的:对于两篇论文,在90天窗口内没有收到真正联系的别名会产生删失的(而非零的)观察,因此删失规则是预先指定的。观察在90天处右删失,没有事件的别名对生存估计提供删失时间而不是被删除或标记为立即,对于N = 2,所得曲线连同其精确的小样本不确定性一起报告,而不是作为点估计。分布式复制设计的因果估计量是发布后邀约风险的变化(而不是任何下载者的身份),使用生存/事件历史方法在匹配的发布前和发布后窗口上估计。因为作者的可见学术生产力独立于任何单一发布而合理地预测邀约量(邀约来源于作者的累积公开输出,因此第7.2节专业审计中记录的高本底率随该输出规模增长),分布式复制必须在焦点事件旁记录作者层面的暴露控制(先前的发布、出版数量和公开接触方式)。这是一个N = 2的仪器化案例研究、机制证明,以及邀请分布式复制的开放协议,后者将共同产生一个有统计检验力的估计。N = 2演示了仪器化的可行性,而不是普遍性和因果大小。与针对预先指定效应大小的研究1、2和4不同,研究3是一个可行性试点和开放复制协议。
编码框架在启动前确定。入站消息被编码为七种类型:期刊征稿、会议邀请、同行评审请求、编委会邀请、书籍章节邀请、商业服务提议和真正的学术通信——相比于二元掠夺性/真正分类,这是一个更宽泛的框架。每条记录都携带最少的字段集:时间戳、接收别名(频道)、场地名称、费用披露、与焦点论文的针对性、紧迫语言、对照维护的筛选服务的验证结果和编码员信心。边界情况和合法的低声誉场地由预先规定的规则而非临时判断进行管理。新的或不知名的场地并不自动被视为掠夺性的。随机子样本被双重编码,并报告编码者间的一致性。仅发布汇总计数(第9部分;声明),完整的编码簿与预注册一起存放。征稿量不是阅读量的证据,征稿不会影响公众计数器:SSRN的完整性系统将异常自动化活动排除在官方计数之外[144],且不允许在任何方向上从收件箱推断仪表板。
研究4:"作者如何阅读其计数器"一项预先指定的作者调查将表1中记录的论坛需求证据转化为直接测量。该工具包括四个措辞固定的项目:(1)"你是否曾将你的SSRN下载量与任何基准或规范进行比较?",回答选项区分了特定的已发表数字、学科特定表格、非正式同行比较和从未进行过;(2)"当你在仪表板上看到"7次下载"时,你的第一反应是什么?",选项包括推断为失败、过早判断、不知道什么是正常的、以及预期的或良好的;(3)"2026年7月排名日落是否改变了你的预印本行为?",选项包括停止检查统计数据、避免新上传、上传但检查频率降低和无影响;以及(4)"你认为聘用和终身教职委员会理解SSRN指标吗?"预先指定的预测是,大多数受访者报告从未将其计数器与任何基准进行比较,并且对低计数的首次阅读倾向于推断为失败,而不是第5.6节显示通常是正确默认的过早阅读。样本量目标、招聘渠道和分析代码在注册时是固定的。对参与度高、可能更加焦虑的作者的自我选择限制了样本,第8.8节注册表也是如此。固定选择格式还允许定性配套分支:公开作者问题的预先指定的主题编码(具有明确的纳入标准和编码者间信度,根据第9节所述的引用伦理)以及关于作者如何阅读及其对计数器感受的半结构化访谈,触及闭合形式项目无法捕捉的指标呈现的人类后果。一个设计限制涉及中心构念。仅向SSRN作者施行的四个固定项目测量基准自由阅读的水平,而非对比,单独的水平无法确定本文声称的从基准不透明到指标失明的路径。SSRN上高比例的从未比较份额同样与与平台不透明无关的对计数器的一般冷漠相一致。因此,区别性和因果牵引力需要比较条件:在具有不同基准暴露的平台上发布的作者身上施行相同的工具,arXiv(基于认可和列表,具有其自身可见性表面)和OSF Preprints,将"SSRN作者如何阅读其计数器"转变为"更不透明和较透明的平台上的作者是否以不同方式阅读其计数器",这正是不透明到失明主张实际预测的对比。跨平台分支被预先指定为研究4的一部分;没有它,单平台结果将保持对SSRN的描述性,而不是对机制的检验。研究4随后直接检验第1和5节的解释性声明,测量作者认为其计数器意味着什么,而不是计数器是什么。
8.7 本文作为其自身的实验
本文自身的下载轨迹也是预先规定的。其计数器将在发布后的30、90和180天进行记录,并在确定Study 1中位数后与该中位数进行比较。该记录具有描述性,不包含解释规则,因为两个方向的解读都会支持该论文,而一个其每个结果都能证实论证的机制实际上什么都测试不了;这些数字将按到达时发布。一种解读会与本文的论述相悖:一条位于该领域和年龄中位数、既未提升也未被压制的轨迹,会表明自指设计在这一单个案例中没有提供可测量的可发现性优势。自反性无法避免,因为本文研究的是它本身将积累的指标;列出的杠杆通过第8部分中的直接测试进行评估,而非通过这个记录。
8.8 百分位数基准作为公共产品
该议程能产生的最有用的产品是预印本下载的百分位数表,这是每位作者都在寻找但无法找到的指标。该平台历来发布平均值和前N列表,但未发布中位数或百分位数,自2026年7月15日起,它仅显示按论文和按作者计数,完全没有对比背景[149]。对于h指数和类似指标,存在面向大众的分级"X好吗?"指南[118][128];第2.5节的审计未发现SSRN下载的相应指南。此类表格的原始资料多年来已以印刷形式存在[18][83][85][139][168],缺少的是将这些分布转化为面向作者的量表。
关闭后,平台范围内的百分位数外部收集不再可能:泄露分布阈值的前列表是唯一对尾部的公共窗口,而它们已消失[149]。仍有两条互补的途径。其一是Study 1的分层样本,它在论文级别产生平台百分位数。另一条途径是众包的自报计数器登记:一个自愿社区数据集,作者在其中提供标记日期的仪表板快照(论文年龄、领域、摘要浏览量、下载量),在机构对关闭前分布的记忆进一步衰退之前进行汇总。档案协议(表13)的保存步骤若大规模采用,就是此类登记的种子。还有一个可扩展而非重新发明的工作先例。IRUS(Jisc)已经聚合了标准化的、符合COUNTER的项目级使用统计(包括Total_Item_Requests),跨参与的机构存储库[185],这表明多机构使用统计聚合在操作上是可行的。预印本登记是该既定模型的扩展,用以包含此处相关的参照类变量(领域、发布时期和职业生涯阶段)。北美的对标产品CC-PLUS以开源基础设施的形式提供相同功能,跨财团自动进行COUNTER 5使用的SUSHI采集[188],因此登记可以扩展现有平台而不是从零开始委托开发。这样的登记将构成自2010年代中期样本[85][139]以来首个全新的、多学科的下载分布。已知的弱点是对积极且可能高于中位数的作者的自选择偏差、自报数据的不可验证性(除非要求带日期的截图),以及小领域的覆盖缺口。因此必须发布从其中得出的百分位数,并说明明确的选择注意事项,并在可能的情况下与Study 1概率样本进行校准,稀疏的领域-年龄单元应在经验贝叶斯收缩框架下向更广泛的参照类报告,而非作为不稳定的原始百分位数(第5.2、8.3节)。登记协议和验证规则将与预注册材料一起发布,贡献格式在此规定:登记记录是附录C面板架构的定义子集(身份、时间、使用、暴露和审计字段),以便自报记录与Study 1面板保持可合并,而不是作为不兼容的第二数据集累积。
登记的输出格式与其协议一起预先指定,并承诺产生两个产品。其一是一个查询表,输入单个数字(如10、40或100次下载),对于每个所覆盖的领域返回其百分位位置和表8的通俗分级;有了它,"7次下载好吗?"的答案最终可以查询而不是猜测。另一个是百分位"扇形"图,绘制第25、50、75和95百分位下载曲线作为论文年龄的函数,按领域和新学者阶层分类:基准以"第X天正常多少"来回答的格式(图14;[需要数据]:两个产品都不能用合成值填充)。来自任一途径(概率样本或登记)的每个百分位发布都根据附录D的透明度规范发布,包括最小单元隐私规则,以便本议程提议的基准不会再现其意在解决的不透明现象。在数据基础上应配置一个轻量级自助服务层,一个公开的在线计算器,作者输入领域、论文年龄和计数,获得百分位分级和文字判决。它将第6.3节的未校准的记分卡式启发法转变为校准工具,当且仅当参考分布存在时。第8.10节提出了多模型架构,可以通过该架构运营这样的服务并使其保持最新。该自助服务层防止报告协议对招聘和晋升委员会施加新的工作量,因为档案格式(表13)所要求的逐项规范化由计算器(本节)处理,大规模应用时由编排层(第8.10节)处理。其现实的部署路径通过现有的研究信息基础设施,即当前研究信息系统(CRIS)和ORCID关联的档案,以便可以从论文标识符生成基准评估,而不是手工组装。一个自然的跨平台扩展是平行提交协议,比较同一论文在SSRN、arXiv(如适用领域)和OSF Preprints上的轨迹,直接测试表8的分级是否在推送-拉取架构间推广(表6)。
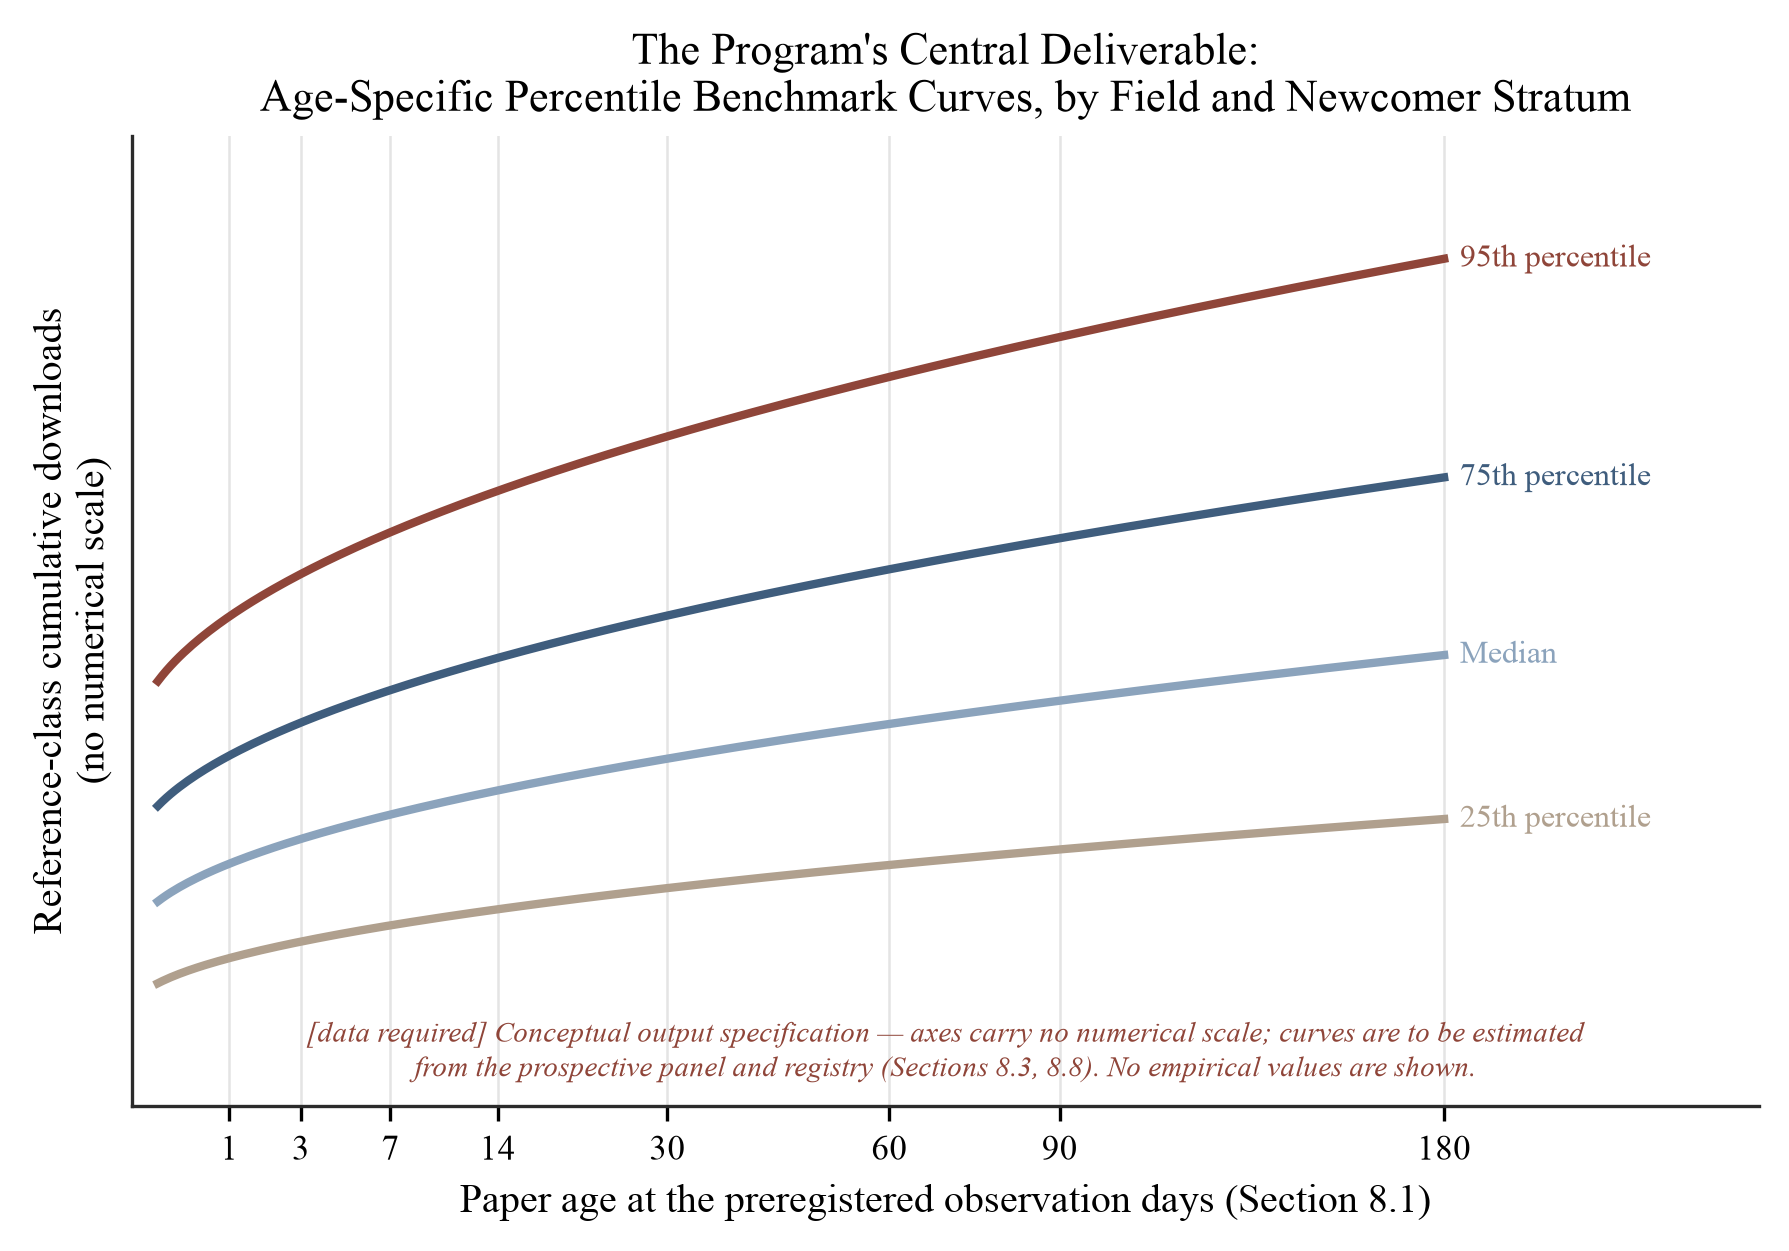
图14.按年龄划分的基准扇:该计划的核心可交付物。百分位下载曲线(第25、50、75和95百分位)作为论文年龄的函数,在第8.1节规定的观察日进行评估,并按领域和新学者阶层从Study 1样本和社区登记进行估计。坐标轴上不标注数值;该图是概念性输出规范,也是第10.4节平台建议和上述公共计算器所采用的显示格式。
该计划的每篇实证文章都致力于最小报告包:队列流程图;原始分布和标准化分布并排显示;分别报告覆盖和转化;暴露历史;第8.3节四层阶梯上的异常敏感性结果;零结果和相反结果与确认结果同样突出地报告;以及机器可读的基准表,即Study 1的输出能够实际馈入上述公共计算器的条件。计划文章的摘要将经过验证的估计值与预先指定的预期区分开来。
8.9 预测验证
议程的总结性测试(RQ3)询问归一化是否值得其复杂性。早期使用和后期引用在各种设置中呈正相关但不完全相关:期刊级Granger分析中相关系数约为0.11–0.35 [80],在早期arXiv队列中约为0.4,其中r ≈ 0.4仅解释约16%的方差[25],化学预印本二十年前报告了可比的关联[26],对于期刊和论文级别的下载一般报告[71],在RePEc使用数据中[31],在bioRxiv队列中[62],以及在mega-journal使用中有中等的秩相关[102]。高下载和高被引用的集合只有部分重叠[108][39]。最近的面板证据表明访问与引用之间存在滞后关系:在一个七期刊面板中,关联大约是单位弹性的,访问量增加10%与大约九个月后引用量增加约10%相关[178]。在第5.5节的符号中,总结比较估计
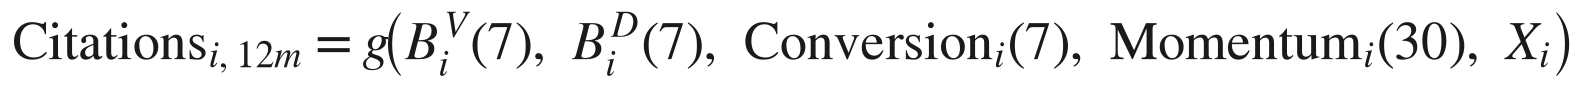
其中g灵活拟合并仅在样本外评估。该方程固定了哪些归一化输入与原始计数竞争。从年龄、领域和队列归一化的第7天和第30天指标预测6个月、12个月和18个月引用的模型应该在样本外进行比较(通过交叉验证似然、标定、秩相关和预测误差)与仅使用原始累积下载的模型,在Kleinberg等人[88]的意义上的预测政策问题。一个特别有信息的结果是原始计数有利于已建立的作者,而归一化的冷启动措施更好地预测后来的引用采用。该模式意味着原始早期计数器测量的一部分是初始机会而不是随后的智力需求。如果归一化未能添加预测信息,框架的测量声称被拒绝或相应地缩小。
图15汇总了议程。一个前瞻性队列并行地为四项研究和两个平台准实验提供数据,每个模块都存储到相同的版本化公共输出集中。共享的结构使议程成为一个研究程序。
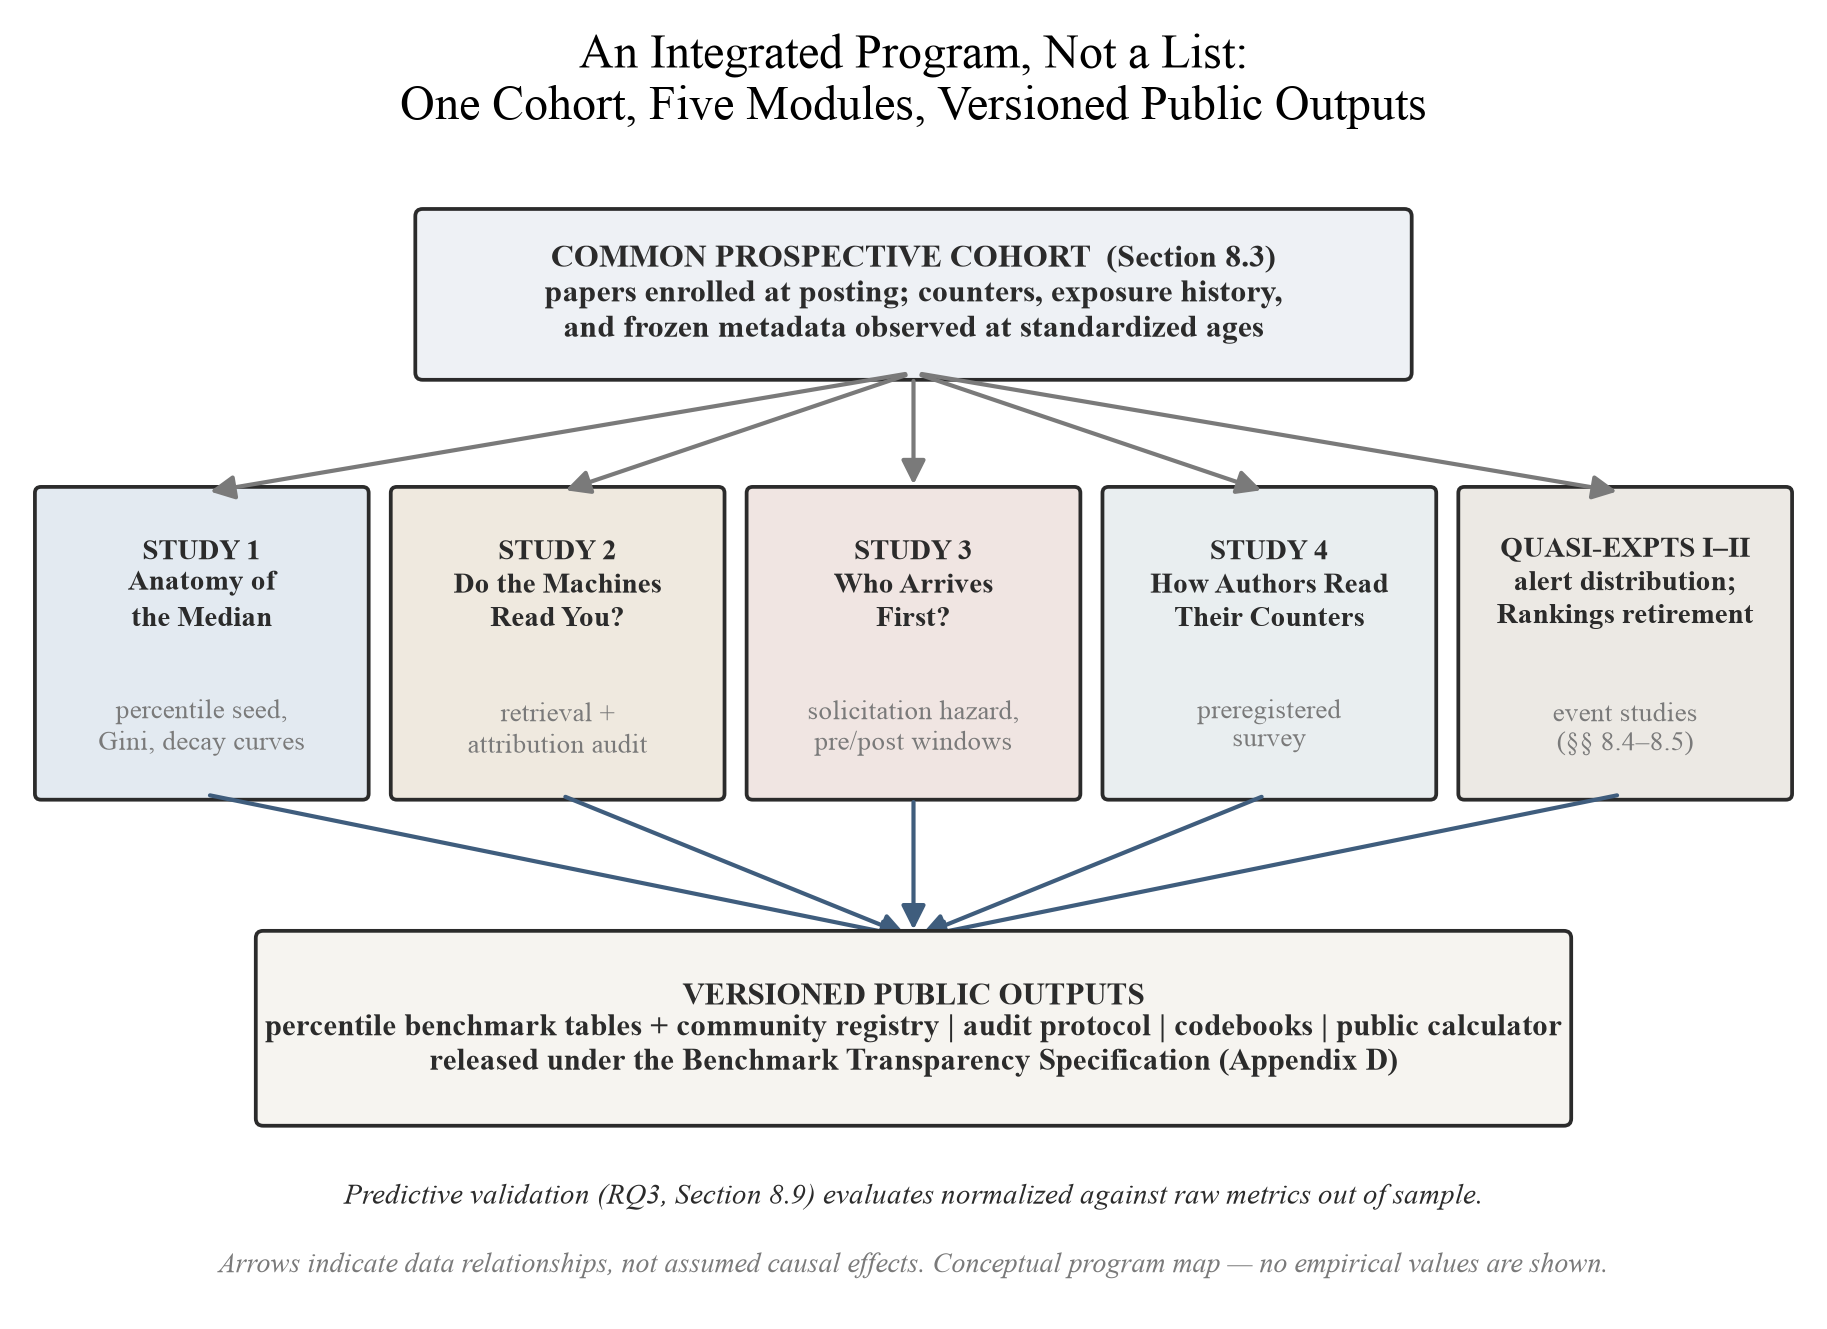
图15。综合研究程序。一个前瞻性队列(第8.3节)为四项研究(第8.6节)和两个平台准实验(第8.4–8.5节)提供数据;所有模块都存储到版本化公共输出中——百分位基准表和社区注册表(第8.8节)、审计协议、编码代码簿和公共计算器——根据附录D的基准透明度规范发布,而预测验证(第8.9节)在样本外评估所得的基准。箭头表示数据关系,而非假定的因果关系。
8.10 设计提案:将编排的前沿模型作为基准的交付层
一次性出版无法交付议程所要求的输出。百分位表、社区注册表、CSAB报告格式(第5.5节;附录B)和公共计算器(第8.8节)都必须从分散且衰落的来源中汇编,逐项验证声明,随着计数规则和平台功能的变化保持最新状态,并以精心校准的语言交付给各个作者。该交付和维护层的候选架构是一个经过协调的专业前沿人工智能模型管道(作者开发的一类系统;见Competing interests)。本小节中的所有内容都是设计提案。不存在实现,不声称任何实证性能,下文任何地方都没有声称关于准确性、成本或节省时间的数字。
编排系统的一个替代方案是单个通用模型。向消费者聊天机器人提问"7次下载好吗?"的作者会收到一个流畅但无法验证的声明,这正是答案引擎审计文档所记录的失败模式,即系统以不合理的信心出错,而不是拒绝回答[82]。这背后存在一个结构性问题。度量解释分解为具有不同的、部分对抗目标的子任务。获取和标注证据的日期、筛选计数器是否存在非人类或异常流量、根据年龄、领域、队列和先前可见性的参考类标准化筛选的计数、将标准化位置转换为分段语言,以及在发布前对该翻译提出质疑——这些不是同一个任务,为其中一个优化的组件不能很好地评判另一个。起草令人安心阅读内容的模型不应该是唯一的权威来判断底层数字是否被污染,起草档案语言的模型也不应该证明该语言避免了过度陈述。因此组织原则是知识劳动的分工:生成和验证被分配给具有独立目标的不同组件,分歧被保留和报告,而不是被平均化。独立提示或架构上不同的评估者的收敛不是真理,尽管它比单个模型的流畅性提供了更坚实的基础,这种设计直觉与实验证据一致,即语言模型实例之间的多代理辩论可以显著改进事实有效性,并减少相对于单个模型单独回答的幻觉[43]。当评估者产生分歧时,分歧本身就是诊断信息,正如在本文自身的合成规则(Scope and Evidence Discipline)中,相互矛盾的来源被视为信号而不是噪声一样。两个设计警告缓和了这种直觉。组件之间的一致本身不是证据:它可能源于共享的训练数据、共享的检索结果、共同的提示假设,或通过编排器本身的污染。来自不同供应商的模型族在科学上不是独立的,独立性必须通过单独的指令、限制组件之间的信息流、保留的中间输出以及评估(确保没有生成组件被允许编辑的证据)来工程化。验证也不会仅仅因为第二个模型执行它而变得可靠:有争议的或重要的声明需要由人类用户检查底层来源。
图16显示了提议的管道,表21按功能对其进行分解。处理从冻结的案例文件开始,而不是自由格式的提示:计数器及其观察日期、论文年龄、声明的领域和候选参考队列、暴露历史,以及作者的实际问题。缺失的输入保持缺失,系统不得制造不存在的百分位分布、推算分母,或接受模型生成的数字代替观察到的数字。信息流然后重现本文始终倡导的解释序列:原始计数→完整性筛选→参考类标准化→受约束的解释。监控组件检索计数器、平台文档和具有标注出处的注册表记录,以便每个下游值都可以追溯到存档源。每个事实输出都作为声明账本中的条目在组件之间传输。每个条目记录声明、其支持来源或数据字段、稳定定位器、检索时间、应用的任何转换、其参考类和其验证状态,以便没有不支持的输出可以默默地成为后期阶段的前提。完整性筛选针对有记录的机器人过滤和AI爬虫污染背景[129][144]应用传统时间序列异常检测(一个统计方法的任务,而不是自由文本生成)。它将轨迹断裂归因于标注的暴露事件,其中暴露记录允许(第5.6节)。标准化由作为工具调用的确定性统计代码执行:百分位位置针对版本化的研究1和注册表表按照第8.3节的收缩规则计算。百分位算术永远不会委派给自由文本生成。只有这样,解释器模型才会起草面向作者的阅读,限制在表8的分段语言、表9的触及对比转换诊断和附录B的CSAB模板内,每个数字都附带了来源、时期和置信度层级。一个单独的验证者和批评者在发布前针对其记录的证据检查每项声明,将每项报告为已验证、有争议、不支持或无法评估,四种不同的状态从不被压缩为单一的综合置信度分数。两个约束从框架中保持不变。任何建议都以诊断的瓶颈为条件,因为触及受限和转换受限的论文需要不同的行动(表9),无法区分它们的系统应该什么都不说,而不是发出通用建议。另一个约束是发布的建议是一个假设:它预测如果诊断正确,应该移动哪种机制,随后的观察测试该预测。系统的目标函数相应地狭隘:消除论文与其适当参考类之间可识别的解释摩擦,永远不是任何计数器的最大化,一个由平台的完整性和生成式AI政策[54][144]以及第3节的博弈历史[44]固定的边界。
表21. 拟议编排层的功能分解:功能、组件类型、主要失效模式和独立验证机制。 每一行都是一个假设 关于可行的劳动分工。
| 功能 | 模型或组件类型 | 主要失效模式 | 独立验证机制 |
|---|---|---|---|
| 编排与溯源 | 维护冻结案例文件和声明账本的任务路由器 | 早期未经支持的假设作为后续每个阶段的前提传播 | 未验证的输出不得成为可信前提;在每次交接时保留源、转换、检索时间和不确定性 |
| 证据获取与监测 | 按重新运行计划的工具使用检索模型;与开放引用基础设施的书目匹配 [35][124] | 伪造、不匹配或选择性检索的源 | 带日期的溯源日志;每个值可追溯到存档快照;随机子样本由第二个组件独立重新获取;失败的搜索和相反结果被记录而不是丢弃 |
| 完整性筛查 | 非生成性时间序列异常检测 [129][144] | 标记为"机器人"或"读者"但缺乏任一身份证据的峰值 | 异常标志与汇总数据一起发布(第8.8节);灵敏度在第8.3节的四层稳健性阶梯上报告;异常被视为标志,而不是身份声明 |
| 参考类正规化 | 作为工具调用的确定性统计代码 | 方便的同行被误认为是有效的比较人群 | 针对版本化的公开基准表重新计算(附录D);陈述字段、年龄、群组、先前可见性和源年份,或模块弃权;不接受自由文本算术进入记录 |
| 解释草拟 | 受限于表8带语言和CSAB模板的通用语言模型(附录B) | 流利的过度陈述——超越证据许可的确定性、范围或因果地位 | 由单独的验证者对照记录的证据进行声明级检查;每项声明报告为已验证、有争议、不支持或无法评估;拒绝不支持的句子,不是软化 |
| 对抗性审查 | 具有与草拟人对抗目标的批评者模型 | 仪式性批评或隐藏实质异议的合成共识 | 结构化分歧报告——证据状态、评估者模式、决策敏感性(纠纷是改变诊断还是仅改变其措辞)、残留不确定性——以未合并的方式交付,从不折叠成一个置信度数字 |
| 征集分类 | 基于表14–15编码框架的专门分类器 | 超越证据的绝对"掠夺性"判决,并冒声誉伤害之风险 | 仅标志和审查,从不自动删除,从不是已发布的指控;在标记集上报告错误率;承认AI文本分类的记录限制和偏见 [157][97] |
| 基准维护 | 所有组件的计划编排 | 无声漂移:陈旧源或被覆盖而无痕迹的版本 | 附录D下的版本化、带日期的版本;记录的修订,从不无声覆盖——一个活动的基准地图而不是静态快照 |
| 最终解释和任何职业使用 | 人类作者 | 自动化偏见和责任扩散 | 在任何外部使用前强制人类签署;档案语言遵循表13协议,并附加源、时间窗口和限制 |
两个边界完成了规范。一个是权限边界:只读访问是默认值,该层起草但从不执行。它不得自主编辑手稿、改变平台元数据、联系学者或场所、公开发布或删除征集消息,任何实现的工作流程必须保留适用平台和提交政策的人类责任和披露义务 [54][56][144]。另一个是弃权边界:空输出是合法的(通常是正确的)结果,每个阶段可能停止而不是将有缺陷的输入传递给下一阶段。强制弃权触发器包括缺失或不可防御的参考类;对阅读至关重要的无法验证的源;关于拟议措辞是否保留论文声明的未解决分歧;任何从纯粹描述性模式得出因果结论或在没有验证预测数据集的情况下预测引用或职业成果的请求(第8.9节);以及任何操纵、购买、模拟或其他方式膨胀注意力的请求。最后一个触发器防止该层成为第3节记录其历史的指标游戏工具 [44][69][144]。最后一个分离规定了议程的两个证据流。第8.6和8.8节的版本化百分位表是该层唯一可接受的规范化源,而研究2的机器可见性审计提供了不同的检索和属性检查。机器检索不是人类注意力的百分位数,该层不得混合两者。
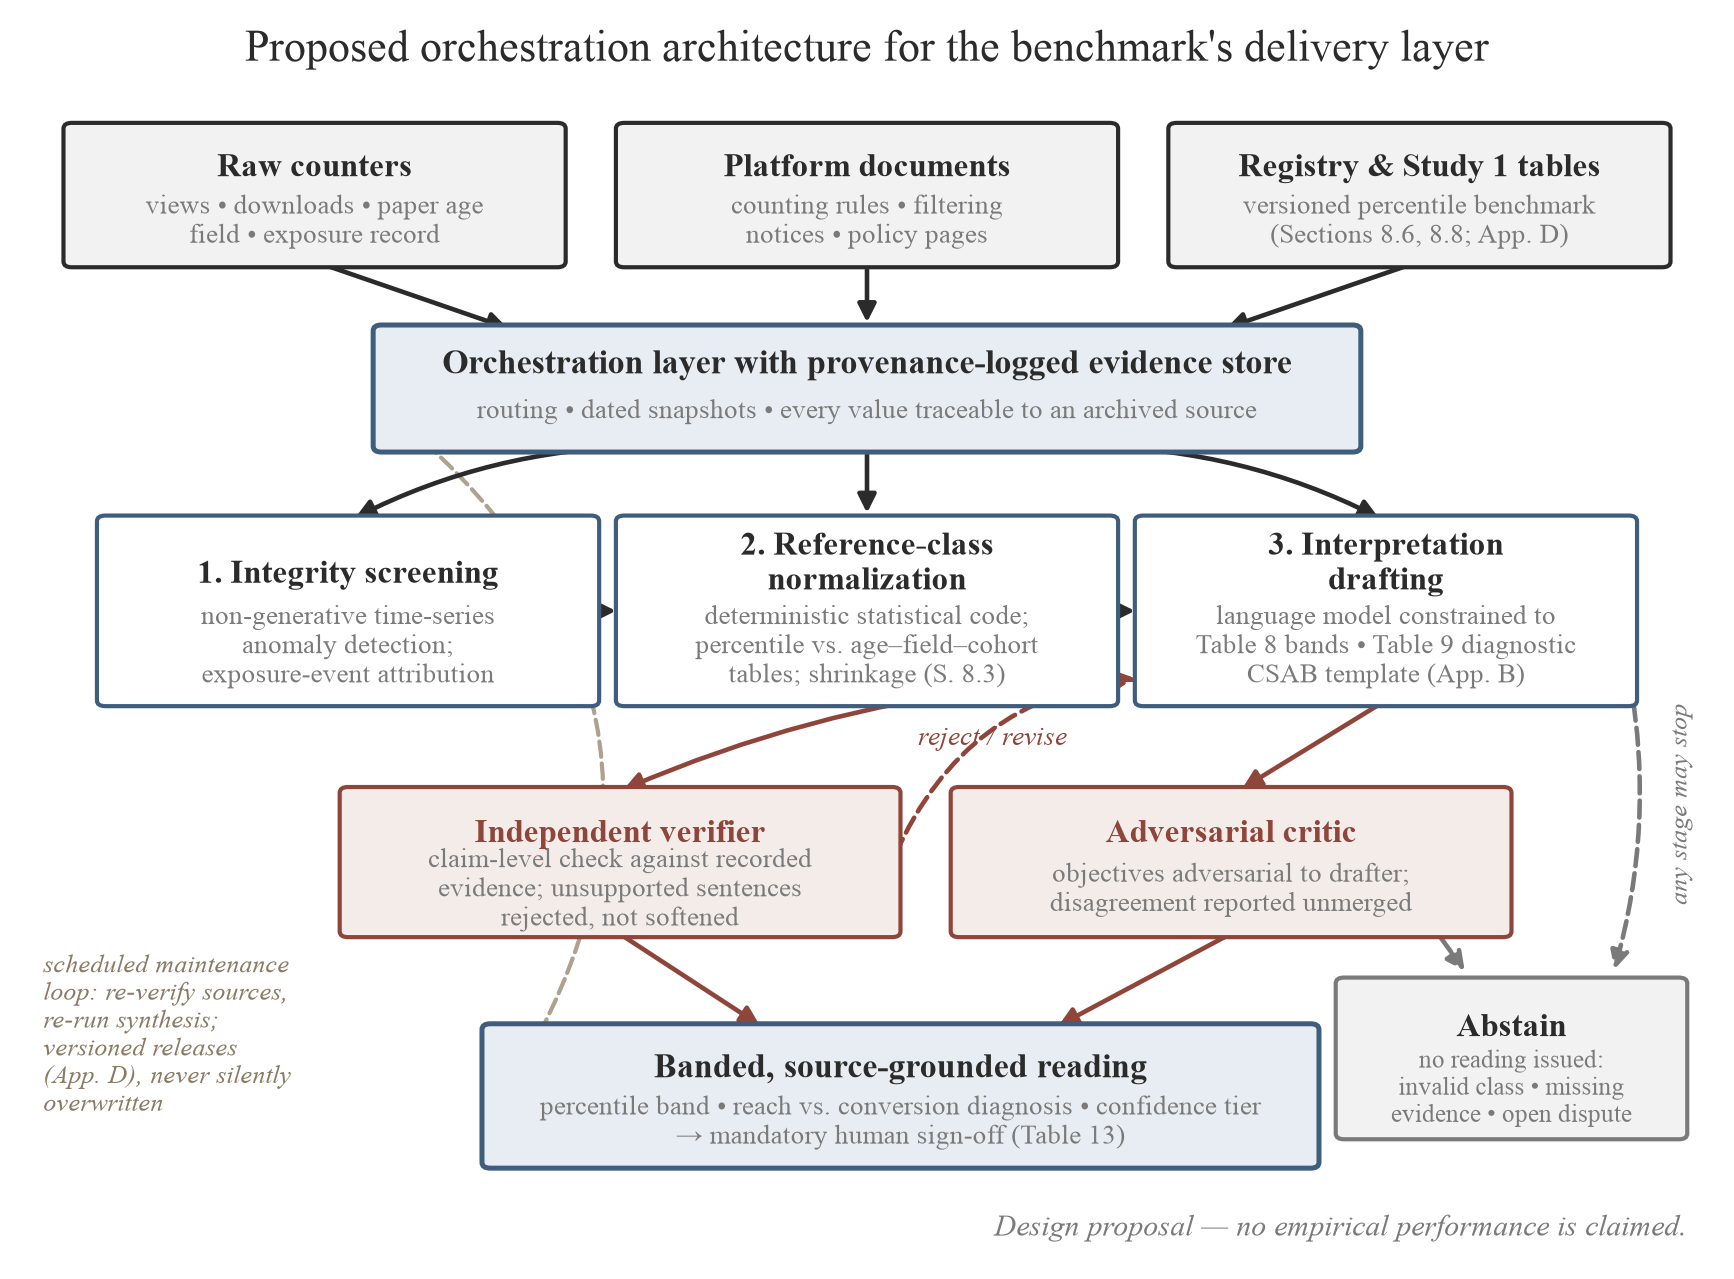
Figure 16. 拟议的基准交付层编排架构(第8.10节;表21)。专门的组件分离证据获取、完整性筛查、规范化和解释,在生成和发布之间进行独立验证,在每个阶段都可使用弃权路径,以及维护第8.8节版本化基准的计划循环。
同样的学科规范在该层获得诊断后可以进行的操作。表22确定了行动政策:每个观察到的模式(在表9–10的词汇中联合阅读的传播、转化和动量)映射到临时诊断、一种有限的允许协助形式、可能支持或削弱诊断的机制测试,以及保持禁止的推论或行动。机制测试列使上述规则具体化:释放的建议是一个假设。如果分类更正旨在消除传播瓶颈,计数的结果是年龄调整的传播,关于总下载量的回顾性叙述不能代替它。失败的预测被记录为失败的干预并返回诊断,从不根据更令人满意的成功指标重新评分。完整的序列因此关闭成一个循环:测量 → 验证 → 规范化 → 诊断 → 提议 → 批评和验证 → 决定 → 观察 → 更新或停止(图17)。在该循环内,人类决定介于验证和任何行动之间,决定后的观察返回到案例文件,当证据不足时,弃权路径终止循环。循环也控制复杂性:当证据仅支持保护和监测时,或当作者剧本的确定性规则(第6节)已经回答了该问题时,编排不添加任何内容,不应该运行。
表22。所提议的编排层的诊断到行动政策。模式在表9的百分位数约定下的可防御参考类中阅读;每行是一个政策假设,没有单元格断言经验频率。
| 观察到的模式(传播、转化、动量) | 临时诊断 | 允许的协助 | 机制测试 | 禁止的推论或行动 |
|---|---|---|---|---|
| 低传播、高转化、稳定或上升 | 可发现性瓶颈比手稿吸收瓶颈与该模式更一致("隐藏兴趣",表9) | 审计标识符、分类、元数据、索引和标题可发现性;有限的、真正相关的分布 | 在元数据或分类更改后,传播是否上升而转化保持不变? | 仅仅为了使其更具促销性而重写一个转化良好的摘要 |
| 高传播、低转化、稳定或下降 | 沟通不匹配、受众不匹配和低意图暴露是相互竞争的解释("注意力而无吸收") | 测试标题–摘要对齐、范围清晰度和受众适配;仅索赔保护备选方案 | 转化是否在可比的暴露下改变,对每次修订进行保真度检查? | 增加不加区分的促销;得出读者拒绝了科学的结论 |
| 低传播、低转化 | 未充分识别:弱暴露、错误的参考类、元数据故障、沟通摩擦或小众需求都适用("冷启动") | 首先验证参考类和暴露记录;然后分别审计元数据和沟通 | 一次改变一个可测量的机制;保留零结果 | 从低使用情况推断低质量;返回单一原因的判决 |
| 高传播、高转化、上升 | 相对于所述类的强劲早期扩散 | 保护出处;按固定年龄监测;无缘由不改变任何内容 | 暴露事件后和异常敏感性下该模式是否持续? | 制造进一步的放大;将注意力视为质量的证明 |
| 高传播、高转化、急剧下降的增量 | 事件驱动的注意力、普通衰减或饱和(第5.6节) | 确定暴露事件;比较区间增量,而不是累积总计 | 衰减是否与以事件为条件的年龄匹配轨迹不同? | 称下降的增量为科学失败——累积计数在速率术语中几乎总是变平 |
| 低传播、高转化、下降的增量 | 条件兴趣可能是真实的,而持续暴露是弱的 | 审计分布或索引是否已结束;确定有限的、相关的频道 | 恢复的暴露是否在不降低转化的情况下提高传播? | 扩大声明或删除技术特殊性以追求更广泛的受众 |
| 高传播、低转化、上升的暴露 | 到达人数在增长,但全文吸收没有相应增加 | 测试低意图流量(第4.2节)、受众不匹配和演示文稿清晰度 | 转化是否对可比暴露下的索赔忠实演示文稿更改做出响应? | 仅优化漏斗的顶部;将每个视图计为人类读者 |
| 任何具有重新陈述的计数器、无法解释的峰值、无效群组或缺少分母的模式 | 该指标目前在所需级别上不可解释 | 保存快照;运行敏感性分析;缩小声明;弃权 | 阅读是否在排除争议区间或更好的参考类后存活? | 在没有证据的情况下标记流量为人类或自动化;从虚假分母发出百分位数 |
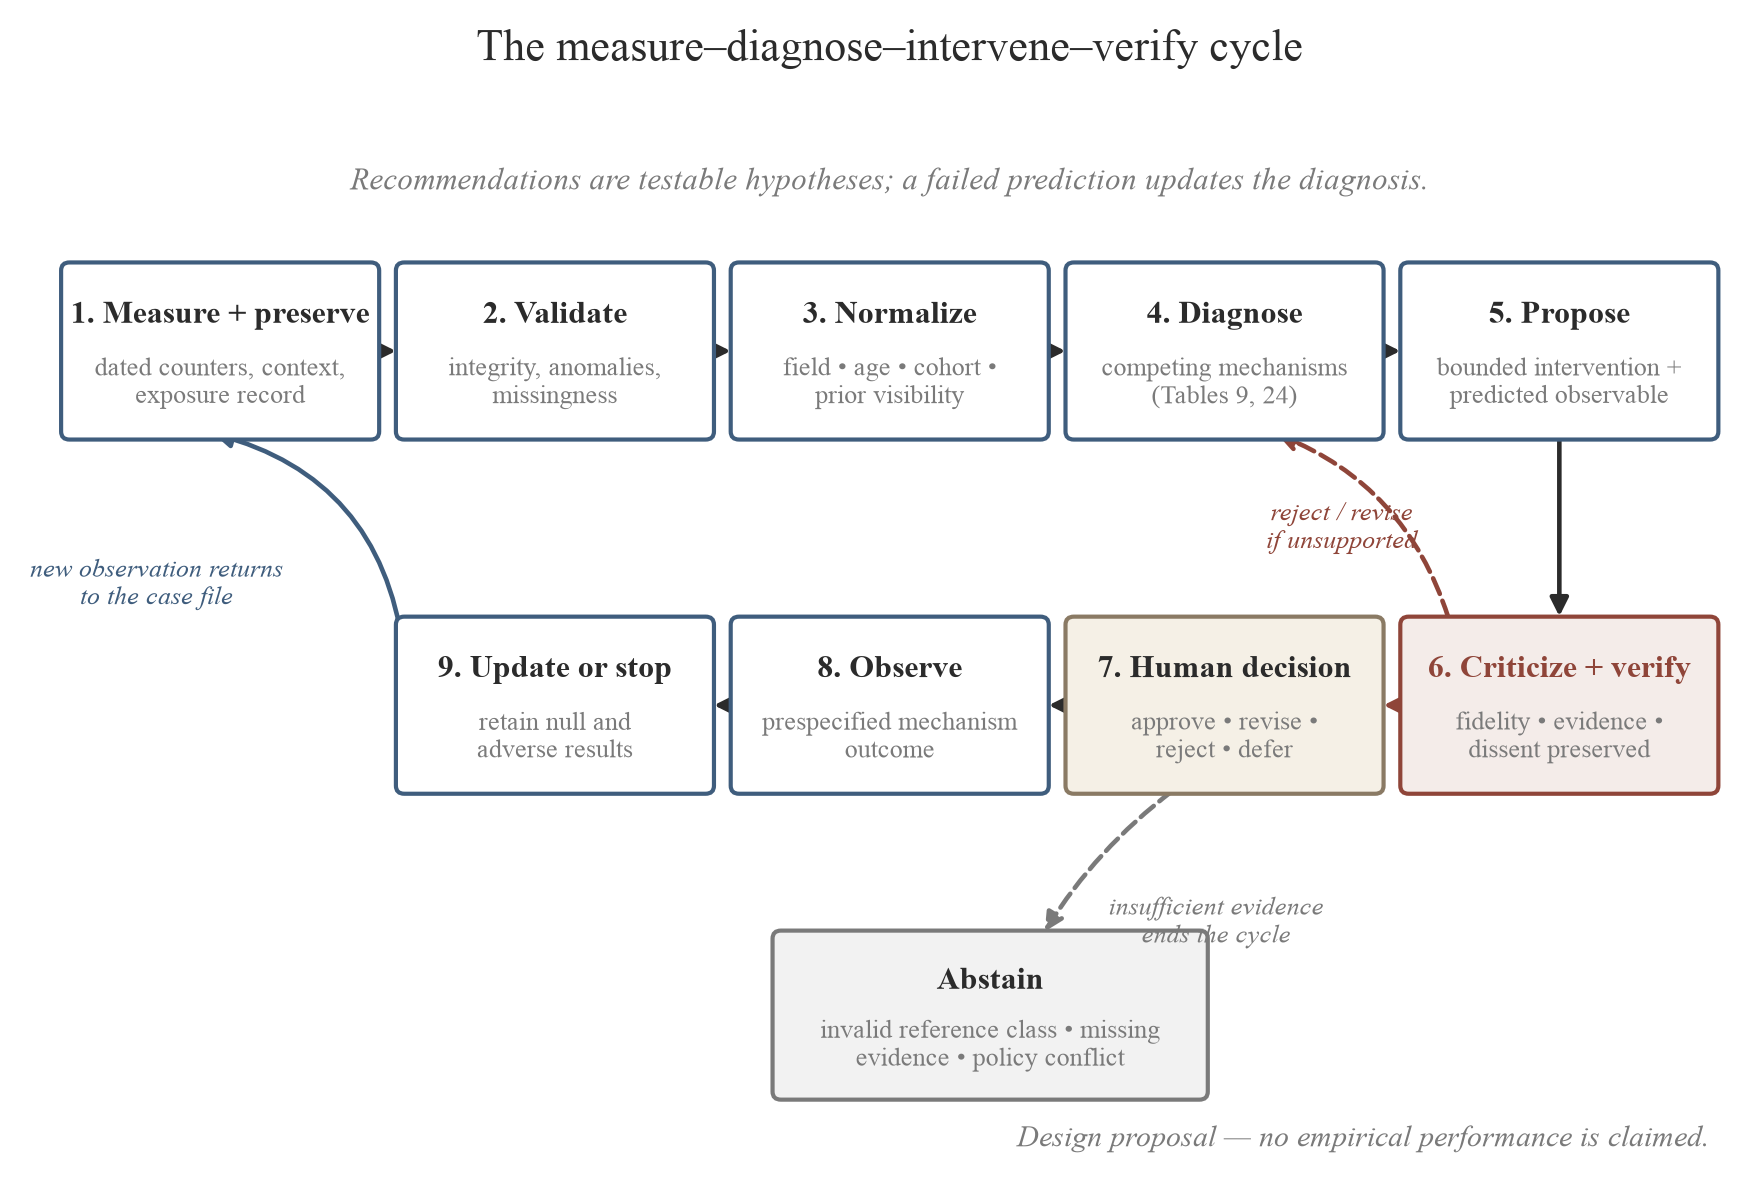
图17。测量–诊断–干预–验证循环(第8.10节;表22)。建议仅作为可测试的假设离开循环:每个都命名了它打算移动的机制和可能支持或削弱诊断的后续观察。失败的预测返回诊断并保留在审计记录中;人类决定介于验证和任何行动之间;当不存在可防御的参考类或充分证据时,弃权路径结束循环。循环优化证据保护解释,而不是原始注意力。
四项限制约束该提议。生成不是恢复。任何模型,无论如何编排,都无法重新生成当移除顶部列表时不再可观察的百分位数分布[149],且该层只能保持近似,第5节的保守下限注意事项完整无损。编排也无法识别下载者、仅从计数器区分人工和自动化流量(第4.2节)、将招募量转换为阅读证据(第7.6节)、通过将相关模型输出重新标记为"代理"来使其独立、替代同行评审,或将责任从研究者转移到工作流程。编排者本身需要审计员。已部署的解释层成为本文映射的堆栈中的新守门人(图12),且它不必继承为其修复而内置的不透明性:推理痕迹和来源日志必须对检查开放,该层自身的检索和解释行为应根据研究2的规范进行审计(带时间戳的快照加上脚本化复制协议),因为模型非平稳性使每个输出都是有日期的估计,永远不是持久的价值。成本和公平性。操作这样的管道不是免费的,付费的解释层会排除该框架所关注的低资源和无关联的作者。AI文本分类器对非英语母语使用者的已知偏见[97]在未减轻的情况下也会产生同样的结果。虚假精确性是残余风险。一个发出无置信度等级的分组裁决的层会自动化第3节诊断出的错误校准:没有比较尺度的计数被替换为没有附加不确定性的裁决。该架构本身是一个可证伪的对象,并根据这些条件属于议程,应根据更简单的辅助进行评估,而不是从其图的复杂性推断。适当的设计是分级的。带有植入歧义的真实案例数据包(无效引文、反论述、无法辩护的队列、真正边界的招募)在条件中随机化,每次添加一种成分:本文表格的手工协议(正确的基线,因为非AI方法已存在)、单一泛化模型、具有检索和确定性计算的相同模型、生成加独立批评,以及完整的受管理管道。移除验证者、确定性计算器、分歧的可见性或人工门的消融然后隔离哪个治理成分值得其成本。结果单独评分,从不作为一个复合体:声明和引文保真度;参考类有效性;作者信念的校准(研究4的工具)和对模糊案件的适当弃权;研究者时间和监督负担;治理失败(自主外部行动、指标游戏建议、分类场所指控);以及,中心是本文的冷启动论证,根据先前作者可见性和新人状态的利益异质性,因为主要帮助已可见作者的层会再现它旨在减少的不平等。零和负面公平性结果是可报告的发现。模型版本、提示、工具权限和源快照被存档,因为在非平稳系统中每个结果都是有日期的估计。两个估计量始终保持分离:对解释质量的影响和对后续扩散的影响。改进诊断而不移动下载的层是成功的,而在扭曲声明的同时提高下载的层是治理失败。如果受管理的管道在证据准确性和校准方面不胜过强单一模型,则设计失败:"几个模型"不是贡献,测试下的假设是认识论劳动的分工。该提议为AI辅助解释指定了可测试的角色。AI可以帮助作者对数字提出更好的问题;只有经过验证的证据才能回答它。
9. 限制
本文的声明受以下限制约束,每个限制都附加到其约束的工件。
证据库的老化和组成。基准图中较旧的分布锚点(表7)基于2012至2015年期间收集的样本,主要为法律学术[85][139];唯一最近的条目是下面讨论的单一网络快照[83]。解释量表的频段(表8)最好被理解为2026年的宽松而非保守的绝对频段(第5.1节)。在2010年代中期至2020年代期间,平台范围内的年度下载量增长了数倍[1][143],提高了每篇论文的下载流,使固定的旧阈值今天成为比估计时更软的标准。没有乘法校正可以修复这个问题,因为增长同时改变分子、分母和组成(第3.2节)。表8的频段是从聚合算术派生的近似值,而不是重新缩放的规范。未确定2020年后SSRN下载的平台范围分布研究。
单源当代证据。这里使用的唯一最近的分布证据是一个学科网络的单一已发布快照:2025年8月15日观察到的2,361篇营销论文[83]。它展示了偏斜和条件性声誉溢价,但不确立平台范围的基准,其已发布表格的两个内部值以警告性注释"按发布"重现。从这个来源对其他SSRN网络的推广是外推。附录E通过添加独立的全领域档案横截面(n = 1,360)来减少这种依赖,该横截面再现了观察体上的偏斜、均值中位数差距、转换频段、领域乘数和对数正态性。它具有自己的向上选择偏差,并验证了跨学科分布的形状。第8节的议程仍然针对平台代表性基准。
顶部列表偏差。2015年的大样本拟合仅涵盖顶部列表(大约是作者及其论文的上十分位数[85]),因此精英列表下方分布的主体是从拟合的对数正态推断的,而不是观察到的。从该拟合派生的百分位数语句是基于模型的。
计数语义不稳定。 浏览量和下载量的记录方式随着时间推移而改变,并将继续随着界面重新设计和不断演进的机器人过滤而改变。该平台的完整性系统从官方计数中排除了一些可疑活动 [144][66][69],相邻的 RePEc/LogEc 基础设施记录了机器人流量的历史规模和最近需要丢弃绝大多数原始流量的 AI 爬虫浪潮 [99][129]。因此,第 5 节中引用的转换规范是特定版本的数量,跨年份的计数器比较将行为变化和过滤变化混为一谈。一般网络机器人统计数据 [158] 不能向任何方向推断到 SSRN 的过滤计数器。
平台波动性和来源漂移。 排名停用嵌入在更广泛的 2026 年产品重组中 [146][149][150],因此没有分析应该将 2026 年 7 月 15 日视为孤立干预。这一威胁内置在第 8.5 节的设计中,但无法完全消除。平台支持页面在没有通知的情况下进行修订;此处引用的所有此类页面都附有访问日期,引用的平台语言应在正式提交前对照存档副本重新验证。
没有百分位数据。 公开的完整平台百分位数据从未存在过,在 2026 年 7 月 15 日之后,无法从外部收集平台代表性的百分位数框架,因为之前泄露了前列表阈值的排名已被删除 [149]。仍然可以从存档捕获中组建样本基础的参考分布,附录 E 报告了一个;它固定了分布的形状,但不提供平台百分位数。某些感兴趣的数量(例如,前 10% 作者通知电子邮件的命运 [161])在官方上没有记录,我们注意到它们从公开框架中消失,但没有声称它们被终止。
使用不等于阅读,都不等于质量。 下载可能会导致仔细阅读、粗略检查、存档存储或根本没有使用。下载不是研究质量的直接指标,也不是引文的保证因果来源:下载-引文关联是正相关的但异质的(大致从 0.1 到 0.6,取决于领域、聚合级别和时间范围 [18][25][39][80][102][108]),高下载和高被引用的人群只有部分重叠 [108]。引用本身可以是正面的、负面的、敷衍的或战略性的,引用过程系统性偏向于反对新颖工作 [166]。本文中没有任何内容支持用指标替代专家判断;该框架的合理用途是诊断和描述性的。
不可观察的曝光和非随机的声誉。 并非所有曝光都是可观察的:读者在任何摘要页面浏览被记录之前,通过电子邮件、社交媒体、搜索结果和通信中遇到标题,而联系良好的作者会产生与声誉和质量都相关的平台外曝光。因此,观察性声誉系数将基于地位的关注与资源、主题和网络中的真实差异混合 [111][140]。作者身份信号的实验操纵 [154][64] 补充但不替代平台观察。字段分类部分由作者选择,论文占据多个类别,使单字段分配复杂化。
议程本身的局限性。 第 8.4–8.5 节的准实验设计面临公告效应、并发的平台变化和非随机的字段差异。它们被标记为准实验的,因为平台范围的事件没有提供未干预的对照组。研究 2 的快照将随着所审计的引擎而过时,其复制协议可以缓解但不能消除非平稳性。研究 3 是一项 N = 2 个案研究,其价值在于机制和协议而非人口估计,其归因逻辑依赖于按渠道别名而非任何关于公共电子邮件可见性的声明。众包注册表继承了第 8.8 节中所述的自选和验证问题。所有设计的数据访问取决于平台合作或在服务条款范围内的速率限制数据收集 [134][51];都不保证。
参考文献的广度。 参考文献很广泛,因为本文是一篇综述;许多被引用的研究共享框架、字段和设计限制,社区帖子记录了经验而没有建立人口参数。主张的证据是其验证等级和抽样框架,而不是背后的参考文献数量。
带是校准目标,不是常数。 11–19% 转换带和 CSAB 阈值是要按字段和平台校准的数量,而不是学术行为的通用常数(第 4.4、5.2 节)。它们的现在形式是单个跨字段带,将被框架要求的按字段分布所取代,当按字段分层的研究 1(第 8.6 节)报告时。
SSRN 之外的应用需要重新校准,而非直接移植。 这里诊断的可解释性问题(在缺乏公共比较尺度的情况下显示的使用计数)和修复它的覆盖范围与转换逻辑并非 SSRN 特有;它们适用于任何显示使用计数的预印本服务器,包括 bioRxiv、medRxiv、arXiv 和 OSF Preprints [11][62][2][24]。不能转移的是特定的 11–19% 带或 CSAB 阈值。策展、分发架构和界面在各服务器间有所不同:arXiv 的基于意图的拉取流量及其电子邮件公告列表与 SSRN 的精选推送提醒形成对比(表 6)。因此,数值参考点必须在每个平台上重新估计后才能被引用。该框架是可移植的;其校准是本地的。第 8.8 节的平行存款协议是对 SSRN 带的传播范围的直接经验检验。该重新校准的规模容易被低估:bioRxiv 的全语料库中位下载量(约 279,基因组学中约 496 [2])是附录 E 中档案截面的中位数 60 的数倍:总体约五倍,基因组学约八倍。该比较仅供参考。bioRxiv 的数据来自全语料库普查,而 60 来自一个档案样本,该样本被捕获页面的比例过高、混合了不同年龄和字段(其组成随年龄变化),年龄分辨率为整年。差距的方向可以安全解读;其幅度则否。
伦理。本文的社区话语部分由自选公开帖子组成,仅用作需求证据,不代表整体舆论意见,且仅在存在实时可验证来源的情况下才被引用。用户帖子的引用考虑了引用半公开论坛内容的伦理问题,包括在作者可能被识别出来违背其预期的情况下使用意译而非逐字引用,符合定性证据的透明度规范[6]。研究3仅记录发送给被测作者的未经请求的消息,不收集发件人主动提供以外的第三方个人数据。研究4仅在知情同意下收集自愿、匿名的问卷回复。面板设计使用公开显示的计数器和书目元数据,任何非公开仪表板信息的收集(如发布状态日期)需要获得知情的作者同意,并酌情进行机构审查。涉及人类参与者和参与者生成数据的两项研究是研究4(作者调查)和研究3(带有仪表的发帖和收件箱日志记录)。由于两者都属于人类主体研究,两者都将在任何数据收集开始之前提交至相关机构审查委员会或研究伦理委员会进行审批,并在参与者知情同意下进行,收件箱日志中包含的个人数据在任何分析或报告之前都会被汇总和去识别化处理。此协议是执行的先决条件,已在《声明》中复述。
10. 结论与政策建议
10.1 分析确立的内容
SSRN排名在2026年7月15日的退役消除了唯一的公开比较尺度[149]。计数器仍保留在每篇论文和个人资料上,这导致指标无法解读而非无意义。为弥补这一缺陷,本文将每个可验证的经验锚点汇总成一份基准图表,附带明确的年份和置信度说明(表7),建立了一个解释框架、五级尺度、覆盖-转换分解法和档案协议(表8、9、13),将计数器转化为诊断,并提出了第8节的预注册就绪议程,其中规定了如何重建缺失的分布。
论证核心的机制归结为:
没有人知道七次下载意味着什么,除非知道七次下载与什么相比,而在2026年7月15日之后,该平台不再回答"与什么相比"。
这些贡献的性质各不相同。命名参考类问题是诊断性的:原始计数在年龄、领域、队列和曝光度界定其比较组之前无法回答任何问题。工具性贡献是基准图表和CSAB,它将一个情感上显著但科学上模糊的数字规范化为可解释的诊断。剧本和档案协议是实践性贡献,使作者和委员会能够在今天对计数器进行操作而不误读它们。从政策角度讲,贡献是匿名化的百分位数带:以不识别任何人且不复兴任何排名表的形式恢复的比较背景。
根据汇编的证据,本文标题中的问题在指定参考类之前形式不当。根据每个可用的锚点,小计数是该平台的统计常态,而非对工作的判断。一篇论文有40次摘要浏览和7次下载,作为筛选结果,与第5节的经验转换带相一致[139][172][83],而较早的每次下载三次浏览的经验法则[18]位于该带之上而非其内。唯一人口普查式样本中的中位数论文在两年内积累了63次下载[139],而进入2015年前10,000列表(大约占该平台全文论文库的前1.8%,571,040篇,2016年7月[1])需要160次终身下载[85]。在准对数正态注意制度下,大多数作者按构造原理站在梯子的较低档次。中位数预印本生活在其作者看不到的对数正态分布的长尾中,并通过有利于附属机构的分类机制被显示出来。它在被同行阅读之前就被掠食者招募,现已失去了曾经定位它的排名。该尺度将论文放在梯子的某处,而该问题所承载的困扰来自缺失的尺度而非数字本身。
这在任何平台上都不是独特现象,这一事件也非前所未有。ResearchGate在2022年8月停用了其备受批评的复合RG Score[130],在经历了持续的方法学批评[90]之后,在2022-2023年间,由耶鲁和哈佛领导的数十所美国法学院退出了美国新闻法学院排名[13]。撤销有争议的指标不是表面上的行为,因为该指标从不是被动的描述:源于法学院排名的反应性文献表明,公开排名改变了被排名者的行为[58][132],因此其实施和撤销都改变了行为而非仅改变所报告的内容。计数器及其比较框架共同构成指标,退役框架而保留计数器使每个用户手握计数而无法与之比较。可解释性,即为公开计数器提供公开分布的可用性,应被视为任何指标的一流质量维度,与有效性和可靠性并列。指标的寿命超过其解释基础设施,无背景的指标是噪音,是怀疑性阅读去语境化数字这一普遍学科的一个实例[15]。相同的指标若有背景,就成为赋予作者权力、改进学术交流并维持对展示它的存储库信任的校准。
该框架要求使用者养成几个普通习惯。比较相似事物,将覆盖与转换分开。阅读轨迹而非总计,将每个数字视为有日期标记的,让每个计数都附带其来源、时间窗口和局限性。
10.2 对作者的建议
作者现在就可以采取行动,无需等待新数据。为论文级别的计数器拍摄带时间戳的截图,以保留背景信息:在其停用之后,它们是作者控制下仅存的记录,并为第8.8节的社区注册表提供初始数据。仅按其框架(年龄、领域、队列和来源)报告计数,遵循表13的档案协议,其中每个数字都附带其来源、时间窗口和局限性。以诊断方式而非情感方式阅读仪表板:区分到达与转化(表9),将首周零下载视为正常的预发布行为[53],并与同月发布的同事论文中的三到五篇进行基准测试,而不是与可见尾部进行对比,后者的流通里程碑数字在重尾分布下保证了误校准[85][180]。将招揽邮件视为网页抓取现象,而非认可,也非关于计数器的证据[61][107][144]。
10.3 对评估者的建议
将SSRN下载量作为评估指标的机构[12][18][161][52]现在面临一个治理问题,因为该指标的公开衡量标准已经消失。原始下载数不应纳入招聘、晋升或终身教职档案:它们在关键阈值处被人为操纵[44],在单个网络内的子领域间变化高达八倍[168],现在其基准缺乏透明度。最低可防守的单位是在定义的同龄组内的百分位数(相同领域、相同年龄范围、相同发布期间),附带其来源和采集日期,使用证据应补充而非替代引文、同行评估和实质性判断[108][109][110]。既定的研究评估改革共识基于这一原则。DORA的核心指令是不使用单一数字或场地代理来替代对研究本身的评估[8],《莱顿宣言》坚持定量评估应支持而非取代定性专家判断[78]。Metric Tide的评论强化了这一立场,呼吁采用健壮、谦虚、透明、多样和反思性的指标,以支持专家评估而非替代[173],最近的改革研究评估的CoARA协议也是如此,其数百个签署组织承诺进行由负责任的定量应用支持而非被其取代的定性评估[183]。整个共识完全适用于其公开衡量标准已被移除的下载计数器。Metric Tide的五个维度中两个直接关系到这里提出的方法:多样性是本文坚持的领域规范化,反思性是第8.7节的立场,本文在其中衡量自身的关注度。该评论的REF导向后续版本将相同的五项原则应用于当前英国实践[184]。这一共识本身是对制度生活中指标过度使用的更广泛批评的一种表达[113]。评估委员会应期望并接受表13的协议格式(情境化的、叙述性形式的证据,新兴评估格式如英国的Résumé for Research and Innovation(R4RI)就是为承载这种形式而构建的[186]),以代替已停用的"前10%"排名语言。在美国,同样的档案语言杠杆是高等教育开放奖学金领导力倡议(HELIOS Open)的焦点,它与大学合作重写晋升和终身教职标准[189];这里指定的情境化使用说明正是此类改革经常缺乏的具体评分标准。
10.4 对平台的建议
在没有替代背景的情况下停用排名,是用一个有缺陷的信号换取无信号。其后果超出了作者的舒适范围。停用是否会冷却新提交——即第8.5节中指定的发布量结果——是关于平台自身健康的一个开放实证问题。该框架指出了一个具体的产品方向,不会重新创建SSRN选择停用的排名表机制[149]:
1. 按学科和论文年龄的匿名百分位带。将每篇论文的下载和浏览排名显示为其学科年龄群体内的粗百分位带:这是每位作者都需要的信息,以不识别任何人、不创建排行榜、并减少前N名列表中赢者通吃动态的形式发布。百分位背景在保护隐私的同时恢复了可读性。目标显示格式正是图14所示的年龄特定基准扇。
2. 时间归一化显示。显示年龄匹配的比较,而不仅仅是生命周期计数,这样发表仅14天的论文不会被隐含地与多年来积累关注的工作进行比较。
3. 将到达与转换分开。将摘要浏览和下载报告为不同的信号及其比率,而不是邀请单一数字的读取,该读取会将不可见与拒绝混为一谈。
4. 透明的参考类。任何比较指标都应说明其比较的人群、领域、时期和年龄段;未标记的"前X%"在科学上是无信息的。附录D指定了版本化百分位发布应包含的十个披露字段,从人群和队列定义到最小单元隐私规则和可引用的版本历史。
5. 累积优势的审计设计。分类、警报分发、搜索排名和可见热度信号分配稀缺注意力,应评估其分布效应。第8.4–8.5节的实证设计可直接用于此类审计。
6. 计划停用功能时处理解释性残留。删除比较功能时,应以与数据迁移相同的谨慎程度评估和缓解解释损失,通过存档分布、发布的汇总百分位或向社区的明确交接,因为无法读取的指标无法提供信息。
7. 防范编程采集的联系机制,降低第7节[107][159]中文档化的可见性征求外部性。一个具体方案:在发布后约48–72小时内延迟或模糊作者联系路线的公开曝光,这是正常分发通常尚未开始但编程采集最有可能发生的窗口。任何此类措施的效果应通过实证评估,而非假设。权衡是真实的,因为隐藏联系信息也可能直接不利于依靠直接反馈的新人。
8. 公共过滤日志和文档化的分发机制。发布LogEc风格的记录,说明完整性过滤器舍弃的内容,并记录eJournal分发和摘要选择的运作方式。相邻的RePEc/LogEc基础设施表明此类透明度在大规模上可行[99][129],而SSRN目前描述其过滤器但未发布其历史[144](表6)。记录过滤后,计数器的重新陈述可读作测量事件而非声誉事件。
9. 使暴露历史易读。论文页面或作者仪表板应区分公开发布、分类分配、策划分发、索引确认和主要计数器重述,使作者可区分"尚未暴露"和"已暴露但未转化"。这是第5.6节暴露机制读数的平台端对应,也是对最令人焦虑的仪表板状态(早期零值)的最廉价处理。
10.5 对研究社区的建议
该研究社区无需等待该平台。第8.8节的注册表(包含日期的自我报告仪表板快照,根据开放协议提供)可以产生十年来首个全新的下载分布。表17的两项公开数据研究(1和2)任何研究人员都可以在第9节所述的访问限制范围内执行,而两项参与者研究(3和4)需要志愿者和声明中所述的伦理批准。科学计量学应将度量的可解释性作为其研究对象的一部分:在本案例中,十年来计数器的寿命比其唯一的公开量表更长,这种情况不太可能是最后一次。仪表化发布协议的分布式复制、百分位表的社区维护(以及基于此构建的面向作者的公开计算器,第8.8和8.10节),以及平台变化的解释性影响评估,这些都是独立的研究贡献,其中每一项都将本文的修复工作转化为预防工作。
10.6 结语
问题"我的七次下载意味着什么?"贯穿了本文,因为这也正是该平台近两百万作者在2026年7月15日所面对的问题[49][149]。这里汇编的答案既不是安心也不是警报,而是校准。该数字与现有转换证据一致,但仍为初步结果;焦虑源于缺失的尺度,该尺度可以部分从文献(如第3-6节所示)和部分从新数据(如第8节所指定)来重建。
文章以每位作者都会面对的问题开始:
"我的7次下载意味着什么?"
该框架将其替换为:
"这篇论文在同龄、同领域、同队列和同分布历史的可比论文中处于什么位置?其约束是达成还是转换?它是否通过读者现在发现研究的系统被检索和引用?"
这是科学计量学可以回答的问题,本文已经指明了如何回答。
计数器记录的是事件,仅仅是事件。浏览不是下载;下载不是阅读;平均值不是规范;计数器不是判决;招募不是认可;AI检索不是忠实的归属;没有尺度的数字不是信息。
只要平台显示脱离背景的计数器,作者、评估者和平台就会继续将分布事实误读为个人判决。开放获取赢得了它所争取的战役(无价格障碍的发布和下载权),在赢得它的同时,暴露了它从未争取过的战役:对注意力的分配。作者可以通过领域、年龄和转换来阅读计数器。SSRN的指标仍然有价值,但仅对理解其含义的作者有价值。
附录A. 情况→行动指南
表23将第4-6节浓缩为作者最常报告的情况[161][127][139]。其中间列仅陈述证据所支持的内容,附带来源和时间窗口。注意事项列包含必须伴随每次阅读的限制。此处出现的数字来自正文表6-7和图6。
表23. 情况→证据所说的是→应该做什么。
| # | 您的情况 | 证据所说的是 | 应该做什么 | 来源和注意事项 |
|---|---|---|---|---|
| 1 | "第一个月有7次下载和40次摘要浏览。" | 转换率为17.5%,作为点估计值在跨研究范围11-19%内,尽管7/40的95% Clopper–Pearson区间(≈7.3–32.8%)很宽且跨越该范围;中位LSN论文在两年后才达到63次下载,而中位营销论文在中位年龄16个月时为87次——成熟样本锚点,与第20天读数年龄不相匹配。这是一个宽区间的初步结果,而非失败的证据。 | 继续表11的观察计划;在第60-90天时进行分类。 | 范围:[18][139][172];中位数:[139](2012 LSN),[83](2025营销)。所有锚点都是单一学科的且已过时;7/40转换率是宽区间的初步估计,与成熟锚点年龄不相匹配。 |
| 2 | "第一周零下载。" | 正常的发布前阶段:分类由策展人审查,对于已加载的话题可能需要长达45天;eJournal警报推动早期浏览并在停用后继续;Google Scholar索引需要6-9个月或更长时间。 | 确认公开发布;确认eJournal分类;检查论文是否按其确切标题被索引——最便宜的可用索引测试;等待公告周期;只有这样才能读取计数器。 | [53][147][57][55]。支持页面措辞有所更改;使用访问日期重新验证。 |
| 3 | "多次浏览,少次下载——转换率远低于11%。" | 与摘要-全文不匹配一致:读者到达摘要后离开。包装变量(标题、摘要、关键词)是与计数器最强关联的注意力杠杆。 | 修改标题和摘要;在进一步改变之前重新观察下一个时间窗口内的转换率。 | [139][168][172]。因果解读"低转换率=弱摘要"是初步假设,而非经过验证的诊断。 |
| 4 | "转换率远高于范围,或浏览量突然激增。" | 摘要浏览无法解释的流量——媒体或聚合器链接,或过滤器尚未删除的非人类流量。 | 识别外部来源(报道、邮件列表);未经证实不要将激增引用为阅读。 | [116][138][144][102——Safe Links预取机制,但SSRN自身的过滤可能已排除此类流量]。 |
| 5 | "我的计数器下降,或数字被重述。" | 当过滤规则改变时平台会修改计数器;RePEc在有据可查的事件中丢弃了大部分原始流量(2007年机器人≈74%的浏览;2025年9月IDEAS流量>99.5%)。 | 将其视为测量事件;检查您的带日期的截图;未经证实不要将其报告为阅读丧失。 | [144][69][99][129][66]。 |
| 6 | "排名消失了,我不知道自己处于什么位置。" | 不再有公开的百分位框架,也无法从外部收集平台代表性的框架。附录E的档案截面提供了样本参考分布,匹配比较是平台百分位的替代品。 | 建立3-5篇同月发布的同行论文的微基准,按自己的计划跟踪;可选择计算您的下载次数与匹配队列中位数的比率。 | [149][51];锚点[139][83][85]。该比率没有经过校准的解释范围(第6.3节)。 |
| 7 | "一个委员会将查看我的计数。" | 档案中的排名行是记录的实践,其比较框架已消失;带有来源、领域限定符和引用三角测量的范围语言在原始计数无法经受的地方存活下来。 | 应用表13的七步协议:保留、转换、三角测量、领域归一化、补充、完整性、专家评估。 | [12][95][33][52][77][108]。下载量衡量的是需求而非质量;操纵历史[44]为评估者所知。 |
| 8 | "掠夺性邀请在我发布后数日开始陆续到来。" | 这是从预印本平台抓取内容的一个有文献记载的副产物;相关审计报告显示每位学术工作者每两周收到数十份邀请。邀请的大量涌入表明能见度对爬虫的吸引力,而非读者的认可。 | 绝不支付;通过Cabells和Think. Check. Submit.验证期刊;通过专用地址进行通信;查看表14了解类型学。 | [107][159][9][84][63][32][136];[B-1](Beall清单自2017年起已失效)。时间规律尚未被测量;"发布后数日"的筛选是定性的。 |
| 9 | "期刊的相似性检查将我的投稿标记为与我自己的SSRN预印本匹配。" | 筛选系统按设计运行:注册为Crossref Posted Content的预印本是比对语料库的一部分,iThenticate的指导声明同一作者的预印本匹配不构成剽窃。大多数期刊的优先发表政策允许发布工作论文,但政策各异,应检查目标期刊;主要例外是医学和临床领域。 | 向处理编辑说明标记的来源是你自己带时间戳的预印本;不要撤回预印本;对于医学和临床期刊,在投稿前检查目标期刊的预印本政策(例如,通过Sherpa Romeo注册表)。 | [81][36];第4.5节。期刊政策各异且不断变化;验证目标期刊的当前政策,而不是依赖一般规则。 |
| 10 | "排名系统已关闭——我应该把论文迁移到ResearchGate或Academia.edu吗?" | 没有记录显示关闭后的作者迁移;下载计数器在平台间不可转移;比较平台也存在相同的可解释性问题——ResearchGate在经历方法论批评后,于2022年8月停用了其综合RG Score。 | 保留SSRN记录并进行补充而非搬迁:将同一论文存放在机构或学科仓库中(表13,第5步),保存日期标记的计数器快照,不要在其他地方删除并重新发布,这样会失去积累的计数器。 | [130][90][149];[47][146](仓库补充);[161](一个平台的计数器对其他渠道没有说明);[B-7](删除和重新发布重置指标)。缺乏文献记载的迁移案例表明证据不足,但不能证明稳定性。 |
未验证的社群实践(第8节议程的候选假设)。以下建议在作者社群中流传,出现在实践指南的早期草稿中;没有研究支持它们,这里将其记录为可检验的假设,不得作为研究发现引用:(a)将电子期刊分类限制在三个(一个核心、一个广泛、一个跨学科),而不是使用允许的七个[53][168];(b)引用SSRN工作论文,以便其作者通过Google Scholar警报收到通知并互惠关注;(c)在发布后的前十四天隐藏个人资料电子邮件地址以减少抓取;(d)在第3天上传小修订以触发重新宣布(SSRN仅记录原地修订保留计数器和URL [B-7]);(e)任何附加到"96小时内邀请为掠夺性"筛选的数值发生率;(f)直接联系论文中引用的三至五位作者(注明引用其SSRN工作的简短信息),作为进入首个合法受众的渠道,框架为普通学术交流而非推广。每一个都可通过第8节的观察设计进行检验;在测试前,其恰当的引用形式是"未验证的社群实践"。
表24按时间顺序重新整理了实用指南。每个单元格都指向相关章节及其来源。时间线视图按照情况出现的顺序回答作者实际提出的问题("我现在该做什么?"),并补充了情况索引表23。
表24. 作为时间线的实用指南:三个阶段×三个维度。所有单元格都总结了第4-7节已阐述的证据和指导;未验证的社群实践被排除在外(见上面的列表)。
| 阶段 | 平台机制和测量 | 受众和分发 | 招聘防护 |
|---|---|---|---|
| 发布前 | 将题目和摘要视为转化表面并相应地起草(§6.4;[139][172]);规划电子期刊分类——最多允许七个,更多分类与更多下载次数和更少零下载次数相关[53][168] | 识别3-5篇论文的微基准队列,与你自己的论文一起跟踪(§6.3) | 在元数据变为公开前通过专用地址路由通信(§6.6) |
| 发布时 | 确认公开发布和电子期刊分类;记录表11网格的第1天基线(§6.1) | 电子期刊电子邮件警报是平台的主要推送渠道,并在关闭后继续[147][57] | 将招聘视为可见性的默认后果,而非优劣的信号(§6.6;[159][63]) |
| 最初几周(第1-45天) | 将早期的零下载读作预分发而非拒绝(§6.2规则iv;[53]);按表11时间表记录计数器;不早于第60-90天对轨迹进行分类(§6.3) | 在适当的地方应用合法的外部杠杆——博客和列表覆盖产生了可测量的早期峰值(§6.4;[116][72]) | 绝不支付;筛选任何邀请期刊([B-1];Think. Check. Submit. [159]);对照表14类型学检查邀请;绝不将垃圾邮件量视为读者数(§7.6) |
附录B. CSAB报告模板
最小作者或评估者面向的CSAB声明(第5.5节;表10)报告:
在论文发表后[X]天,该论文有[V]次摘要浏览和[D]次经过验证的下载。相对于[定义的领域/队列/新手参考类],其覆盖百分位数为[RV],下载百分位数为[RD],收缩调整的转换百分位数为[RC]。该论文[已/未]在该观察时间点前获得已记录的策划分发。在[年龄1]和[年龄2]之间,其归一化位置[上升/保持稳定/下降]。这些指标描述了扩散情况,不能确立研究质量或正确性。
在估计当代参考面板之前(第5.5、8.3节),百分位数字段必须保持为空:不可从直觉、平台范围的平均值或过时样本中输入任何值。历史基准可与模板一起报告:2012年LSN两年期间63次下载的中位数[139]和2025年Marketing-network的87次中位数[83],每个都标明其样本、领域和年龄,但决不可替代缺失的参考类。该模板是档案协议转换步骤(表13,步骤2)的句子级对应物。
附录C. 面板变量词典
表C1陈述了第8.3节核心面板的最小论文间隔记录:足以重现第5.5节CSAB估计和第8.4–8.5节平台事件分析的最小模式。在不需要分析连接的地方,公开发布版本用稳定研究键替换直接标识符,注册表贡献(第8.8节)使用此处指示的该模式子集。
表C1. 核心面板的最小论文间隔数据模式。
| 域 | 变量 | 定义或格式 |
|---|---|---|
| 身份 | paper_id | 稳定研究标识符 |
| 身份 | ssrn_abstract_id | 平台标识符;在公开发布中进行哈希或限制 |
| 时间 | posted_at | 首次公开发布日期 |
| 时间 | observed_at | 指标观察时间戳(表11网格) |
| 时间 | paper_age_days | 自首次发布以来的天数 |
| 使用 | abstract_views_cum | 公开累计摘要页面浏览 |
| 使用 | downloads_cum | 公开累计经过验证的下载 |
| 使用 | views_interval, downloads_interval | 来自前一个有效观察的增量 |
| 曝光 | classification_ids | 观察时活跃的所有eJournal分类 |
| 曝光 | distributed_status, distributed_at | 策划分发指标和日期(如有同意) |
| 曝光 | search_indexed | 协议定义的外部索引状态(精确标题测试) |
| 论文 | title_frozen, abstract_frozen, keywords, page_count, doi | 最早观察到的稿件元数据,在首次观察时冻结 |
| 论文 | authors_frozen, affiliations_frozen | 首次观察时的作者名称、顺序和所属机构 |
| 版本控制 | revision_id, revision_at, material_change_flag | 版本历史及实质性更改指示器 |
| 作者 | author_count, platform_newcomer, prior_ssrn_papers | 团队结构和发布前平台历史(第8.3节定义) |
| 声誉 | prior_citations, prior_works, institution_measure | 在关键发布前冻结并进行领域标准化 |
| 日历 | day_of_week, week, season, holiday_flag | 预定义的时间控制[178] |
| 下游 | citations_6m, citations_12m, citations_18m, publication_status | 后续验证结果及来源和日期(第8.9节范围) |
| 审计 | collection_method, source_url, quality_flag | 来源、访问路由和异常文档(标记,不删除;第8.3节) |
附录D. 基准透明度规范
为防止第8.8节的百分位基准及平台或社区维护的任何后继版本(第10.4节,建议1和4)重现本文批评的基准不透明性,每个百分位发布都应随附一份注明以下内容的版本化说明文档发布:
1. 合格的论文总体、网络、文档类型和排除项;
2. 发布队列日期和观察年龄;
3. 领域分配规则,包括多个分类的处理;
4. 发布时有效的浏览、下载、唯一参与者、重复和经过验证流量的定义;
5. 中位数、四分位距、P10/P25/P75/P90/P95、零占比、基尼系数及最高占比;
6. 每个报告参考类的样本量和不确定区间;
7. 缺失数据、撤回、修订、合并和反向重述的处理;
8. 任何调整中包含的分布和外部推广变量;
9. 隐私和最小单元规则:对于第8.8节的众包注册表,小的领域-年龄单元可能会识别个人贡献者,此项为由数据保护法(在英国,为UK GDPR和2018年《数据保护法》)管辖的具有约束力的限制,而非形式问题。披露控制应超越简单匿名化,对薄单元采用k-匿名性或添加噪声(差分隐私)的聚合,且允许使用规则应将注册表约束于解释而非评估,禁止用于招聘、晋升、资源分配或重新组合为任何公开排行榜;
10. 版本历史及发布的永久可引用参考。
任何综合评分都不可替代这些组成部分。与队列中位数的简单比率(第6.3节的未校准备选方案)在分母单元较小时可能不稳定,可能错误地暗示"中位数的两倍"映射到不同形状领域中的固定百分位数。因此,面向作者的报告使用第8.3节中已为稀疏单元指定的经验贝叶斯收缩下的百分位数估计,而原始分布保持可用于审计。
附录E. 下载分布的独立档案横截面
针对最近的全分布证据,第3和第5节的综合依靠了单个已发表的快照[83]。本附录报告了为本文组装的一个独立、可重复的横截面,其验证了跨领域的分布结构,仅使用公共数据,无特权平台访问权。这是一次性的档案重建,具有已知向上偏差,作为分布形态的验证,与第8.6节的预登记面板有所不同,后者从发布开始前瞻性地观察论文。
方法。从OpenAlex中抽取了SSRN论文的随机样本(来源S4210172589,"SSRN Electronic Journal"),跨越二十三个独立随机种子。对于每篇抽样论文,从该论文在互联网档案馆的最新捕获中读取退役前的下载和摘要查看计数器,该捕获通过Wayback Machine的公共可用端点定位,而不是从实时站点,该站点是访问受限的(第4节),且不再发布比较框架。从存档副本中读取计数器而不是直接查询平台,使该过程受速率限制,尊重平台,并可从已发布的标识符重现。因为每篇论文的计数器在Rankings降级时保持不变,且只有比较性的Rankings被撤回,所以日期在2026年7月15日之后的捕获仍然是论文累积计数的有效读数。因此,快照不限于降级前窗口,且保留捕获日期仅用于计算论文年龄。返回机器人验证而非页面内容的捕获被舍弃。在2,600篇抽样论文中,64%有可用的存档捕获,52%产生了机器可读的下载计数,得到n = 1,360篇论文,跨越二十五个领域,其中十四个至少有二十篇论文,论文年龄从发布年到二十多年。数据集以appendixE-wayback-downloads.csv的名称发布,并存放在https://doi.org/10.5281/zenodo.22285871,其中同一文件的名称为study1-wayback-downloads.csv。样本的两个特性限制了可以从中读出的内容。发布日期包含年份而无月份:1,360条记录中的1,358条标记为1月1日,因为OpenAlex以年分辨率报告SSRN发布。因此,年龄计算为捕获年减去发布年,以整年报告,不能使用更短的时间段。捕获也集中在时间上:其中688条(占样本的一半)落在单个爬取中,时间在2025年4月25日至5月7日之间,81.5%落在2025年,因此此处论文年龄基本等同于其发布年,两者无法区分。这两个问题中的第一个是可以解决的。发布行"Posted: DD Mon YYYY"出现在相同的存档捕获中,因此可以通过重新解析恢复完整日期,实时站点上的访问门无法阻止这一操作。表E1明确展示了这种消耗。
表E1. 档案横截面的构建和各阶段的消耗。
| 阶段 | 论文 | 占初始的% | 占前一阶段的% |
|---|---|---|---|
| 从OpenAlex随机抽样的记录(SSRN Electronic Journal) | 2,600 | 100.0 | — |
| 找到可用的互联网档案馆捕获 | ≈1,660 | 63.8 | 63.8 |
| 捕获携带机器可读的下载计数 | 1,360 | 52.3 | 81.9 |
| 最终分析样本 | 1,360 | 52.3 | 100.0 |
结果。该截面重现了已发表参考研究所声明的每一个定性特征(表 E4)。下载量严重右偏:平均值 219,中位数 60(95% 自助法置信区间 55–69),均值中位数比 3.65,均值超过第 75 百分位数(158)。它们还具有沉重的右尾(第 95 百分位数 816,是中位数的十三倍以上;基尼系数 0.75,95% CI 0.71–0.78)。在对数上,分布接近对称(ln 下载量的偏度 ≈ 0.18),与观察到的分布主体上的近似对数正态性一致,Kakushadze 的特性只能拟合顶部列表(第 3.4 节)。下载浏览转化率的中位数为 16.2%,平均值为 17.3%,在 11–19% 的跨研究范围内(第 5.2 节)。在相同论文年龄的情况下,中位数下载量在各领域之间存在差异。固定年龄区间,最高和最低领域中位数之间的跨度约为三倍到五倍,具体数字取决于该区间和样本稀少领域的处理方式。汇总所有年龄段,跨度达到约十二倍,而这个更大的数字反映了样本组成的变化:工程学占三岁及以下论文的 21 到 27%,占九岁及以上论文的至多 5%,而经济学占相同群组的 9 到 12% 和 37 到 54%,此处经济学论文的中位年龄是九岁,而工程学是一岁。方向与第 3.6 节的领域乘数一致。数值无法比较,因为那个乘数基于单一学科 94 个子领域的终身平均值,而这个跨度基于 25 个学科的中位数,且两者都未按年龄调整。在较老的年龄段中位数下载量更高,大多数相邻区间之间的 95% 自助法置信区间不重叠(发布年的中位数 12,十年以上的中位数 172),这是推动参考类别论证的年龄依赖性。在单一领域内,差异集中在前三或四年:五到十年区间和十年以上区间之间不具有显著性(经济学的 Mann-Whitney p = 0.57,社会科学为 0.82,商业为 0.23)。汇总梯度的约四分之一是领域组成而非年龄。此样本中的年龄也接近于发布年的重述,因为一半的采集是在 2025 年 4 月 25 日至 5 月 7 日之间的一次爬取中进行的,81.5% 落在 2025 年,因此年龄和队列在此处无法分离,区间报告的是水平而非任何单个论文的路径。样本平均值(219)与已发布的营销网络平均值(221)[83] 一致,而样本中位数(60)处于人口普查式法律中位数(63)[139] 的水平。表 E2 给出了按论文年龄的下载分布,表 E3 按领域给出,两者都包含 95% 自助法置信区间和样本量。最小领域的置信区间最宽,这就是为什么领域跨度被描述为大约一个数量级而非单一精确倍数。该文章的开篇案例可以直接与样本进行比对。在两岁以下、摘要浏览数为 30 到 50 的论文中,该案例所在的区间,中位数下载数为 7,四分位间距为 4 到 11(n = 42)。标题中的案例是其浏览范围和年龄的典型案例。在发布年,35% 的样本记录 7 次或更少的下载,中位数摘要浏览数为 66,该案例自身的 17.5% 转化率位于样本的第 57 百分位数。第 5.2 节的 11–19% 转化率区间是中位数的区间而非论文的区间:41% 的样本落在其内,23% 低于此,36% 高于此。样本的一半(51%)位于人口普查式法律中位数 63 [139] 以下,这将初期范围置于分布中有充分数据的部分。
表 E2. 档案截面中按论文年龄的下载分布。
| 论文年龄 | n | 中位数 [95% CI] | 均值 | 四分位间距(P25–P75) |
|---|---|---|---|---|
| 发布年 | 203 | 12 [11–14] | 33 | 5–21 |
| 1 年 | 253 | 25 [23–29] | 94 | 15–44 |
| 2–4 年 | 375 | 52 [47–57] | 110 | 28–100 |
| 5–9 年 | 188 | 130 [110–151] | 384 | 72–374 |
| 10 年及以上 | 341 | 172 [157–189] | 453 | 96–336 |
| 所有论文 | 1,360 | 60 [55–69] | 219 | 23–158 |
表 E3. 档案截面中按领域的下载分布(n ≥ 20 的领域)。
| 领域(n ≥ 20) | n | 中位数 [95% CI] | 均值 | 四分位间距 |
|---|---|---|---|---|
| 经济学 | 285 | 150 [134–169] | 443 | 76–302 |
| 商业 | 161 | 150 [126–188] | 335 | 72–330 |
| 心理学 | 24 | 107 [35–192] | 179 | 32–229 |
| 社会科学 | 241 | 85 [78–117] | 219 | 45–189 |
| 决策科学 | 32 | 74 [56–158] | 615 | 49–260 |
| 计算机科学 | 63 | 42 [36–73] | 167 | 26–104 |
| 医学 | 40 | 42 [24–59] | 81 | 22–66 |
| 农业与生物科学 | 36 | 31 [24–57] | 65 | 23–67 |
| 生物化学 | 21 | 30 [23–37] | 38 | 20–38 |
| 环境科学 | 72 | 26 [18–32] | 44 | 14–50 |
| 工程学 | 196 | 24 [20–26] | 46 | 13–46 |
| 物理与天文学 | 21 | 23 [15–38] | 112 | 13–45 |
| 材料科学 | 55 | 18 [15–25] | 26 | 11–36 |
| 能源 | 21 | 12 [11–22] | 25 | 11–22 |
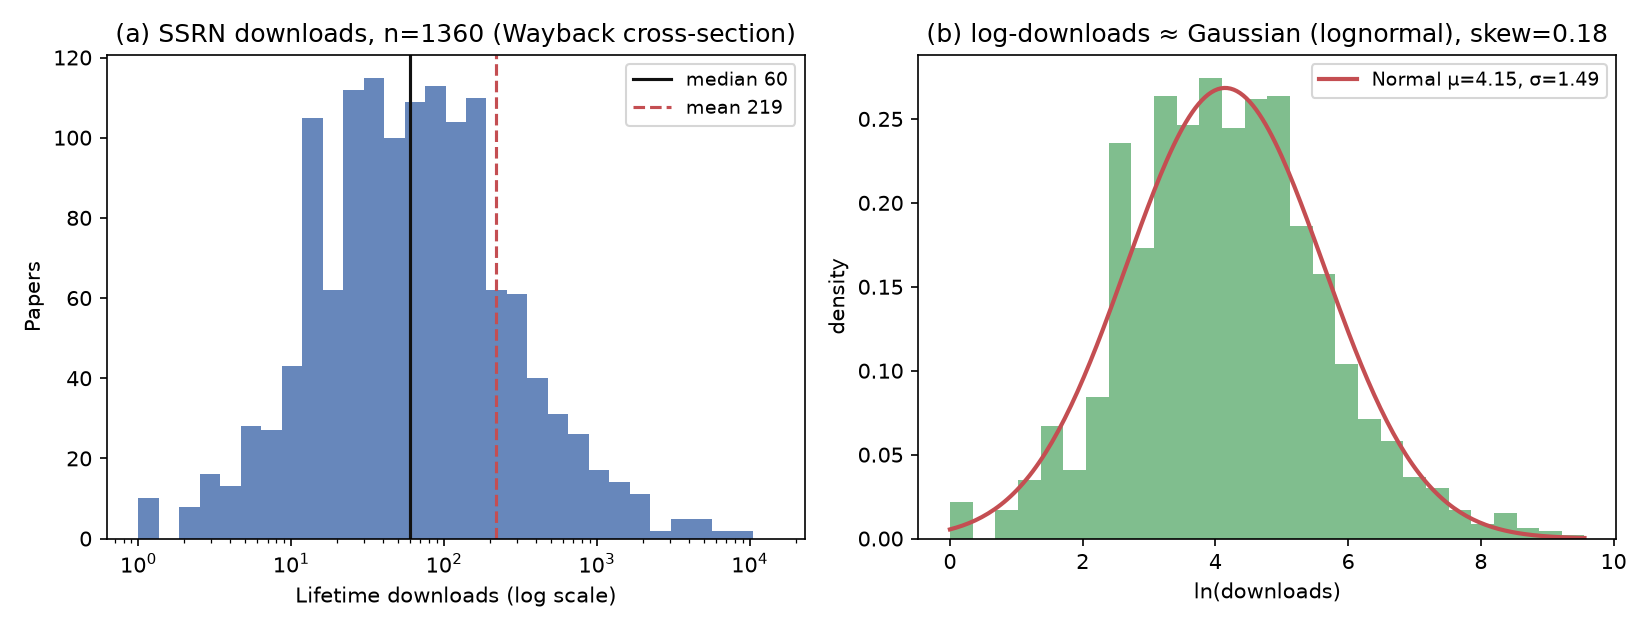
图 E1。(a) 对数刻度上的下载分布,标记了平均值和中位数;(b) ln(downloads) 的直方图,配有拟合的正态密度。对数下载的偏度 ≈ 0.18。n = 1,360。
表 E4。已发布的锚点与独立档案交叉样本的对比(n = 1,360)。
| 特征 | 已发布的锚点 | 档案交叉样本 |
|---|---|---|
| 平均下载数 | 221 (marketing) [83] | 219 |
| 中位数下载数 | 87 (marketing) [83]; 63 (law) [139] | 60 |
| 平均数/中位数 | 2.54 [83] | 3.65 |
| 第 95 百分位数/中位数 | > 8 [83] | 13.6 |
| 下载到浏览的转换率 | 11–19% 带(§5.2) | 16.2% 中位数 |
| 领域分布(中位数) | ≈ 8× 领域平均值,未调整年龄 [168] | ≈ 3–5× 相同年龄;12.5× 汇总 |
| 分布形状 | 对数正态,仅尾部 [85] | 对数偏度 0.18(观察体) |
该交叉样本确立的内容。该交叉样本证实了分布的形状及其在各学科中的中心和上层结构,基于一个独立的全领域样本,其领域覆盖范围远比任何单一已发布的 SSRN 快照更广泛。它不估计平台代表性百分位数,其构造的两个特征使其向上偏移。存档捕获过度代表可见页面,因此下载量大的论文更有可能被捕获。一篇论文也只有在具有带有可读计数器的存档页面时才进入样本,这审查了极低尾部:样本中十次或更少下载的论文所占比例(约 10%)相应远低于第 3.4 和 8.6 节为无偏整个平台样本预期的 15–30%,不应将其理解为对该比例的估计。样本中位数(60)仍然处于已发布的法律(63)和营销(87)中位数的水平或以下,这表明向上偏差对于中心质量来说是适度的,并且偏度和重尾结论如果有的话是保守的。对于校准的基准,合适的工具仍然是第 10 节中推荐的平台代表性百分位数带和第 8.6 节的预注册小组;该交叉样本证实了它们将测量的结构是本文描述的结构。研究 1 提前固定的三个预测带(第 8.6 节)可以根据该样本读取,考虑其向上偏差。60 次下载的样本中位数位于预测的 30 到 80 范围内。注意力基尼系数 0.75 位于预测的 0.75 到 0.90 的下边缘,这是采样偏差预测的方向,因为审查的低尾部压缩了测量的不平等。中位数与平均数的比率 0.27 低于预测的上限 0.5。这些都不验证前瞻性设计,其价值在于它观察从概率样本中发布的论文;它确实记录了这些带没有被设置得不合理。
声明
数据可用性。此处复现的每个合成锚点都可追溯至正文和表格中引用的已发布来源,采样框架和验证状态在使用时说明,没有新的总体代表性数据集支撑本文的基准声明。为本文生成的唯一原始数据集是附录 E 的独立档案交叉样本,一个 1,360 篇论文的随机全领域样本,其停用前计数器从公共档案中恢复,作为 appendixE-wayback-downloads.csv(一个附录 E 数据集,而非前瞻性研究 1)与分析代码一起发布,因此该程序可以重新运行和扩展;它证实了分布的形状,但不是平台代表性基准。该数据集存放在 https://doi.org/10.5281/zenodo.22285871,许可证为 CC BY 4.0,其中同一文件的名称为 study1-wayback-downloads.csv,它附带一个开放工具,可根据论文年龄和领域读取下载计数,位于 https://github.com/vadimchernets/ssrn-benchmark(MIT 许可证,仅使用 Python 标准库)。想在该参考类别中放置自己计数器的读者可以运行该工具,而不是重建分析。第 8 节预注册就绪议程的资料,包括面板变量字典(附录 C,表 C1)和搜索审计查询清单,已准备好在预注册时存放(第 8.8 节);注册表贡献遵循第 8.8 节中定义的架构子集,基准程序的任何百分位数版本在附录 D 的透明度规范下发布。附录 B 的 CSAB 报告模板可自由重复使用,但需遵守其空白百分位数规则。2026 年 8 月 24 日,向 SSRN 支持部门(工单 260824-003051)提交了一份正式请求,要求获取已停用的排名所隐含的聚合参考类别——按领域和论文年龄分层的下载中位数、四分位距和十分位数带,不含单篇论文标识符;其结果(批准、拒绝或无响应)将在后续修订中报告。
本文的开放获取。本手稿的开放许可副本存放在 https://doi.org/10.5281/zenodo.22166896(CC BY 4.0),其中全文可直接检索,无需访问权限。提供存放是因为 SSRN 上的规范记录位于机器人缓解措施之后,该措施拒绝没有 JavaScript 引擎的客户端,这是第 4.2 节中记录的条件;无法访问规范副本的读者、参考文献管理器和自动化客户端可以从存放处获得相同的文本。配套论文存放在相同条款下,网址为 https://doi.org/10.5281/zenodo.22166995 和 https://doi.org/10.5281/zenodo.22168724。
代码可用性。用于附录E独立档案横截面的收集和分析代码随其数据集一起发布于https://github.com/vadimchernets/ssrn-benchmark,因此可以复现该过程并从原始计数重新推导参考类别。本文其他报告结果不需要分析代码;第8节实证设计的图表生成模板将作为在线附录随预注册材料一起发布。
伦理。第8节的实证设计依赖于公开显示的论文级计数器和书目元数据;任何收集非公开仪表板信息、分发状态日期或电子邮件消息的行为都需要知情同意,在适用的地方还需要机构审查(见第9节)。构成人体研究的两项设计,即研究4(作者调查)和研究3(带收件箱日志的工具化发帖),将在任何数据收集开始之前提交机构审查委员会或研究伦理委员会批准,并在参与者知情同意下进行。消息数据集在任何报告之前都经过汇总和去标识化处理,社区帖子仅在存在实时可验证来源的情况下被引用,在可能违背其期望被识别的地方进行改述。数据收集仅限于平台服务条款允许的方式:这些设计使用公开显示的计数器和书目元数据,不采用任何违反平台使用条款的抓取,任何需要大量或非公开数据的设计都通过正式数据请求和法律审查而非自动提取进行。对半公开论坛内容的引用考虑贡献者同意和重新识别风险,这就是在可能违背其期望被识别的地方将此类材料改述而非逐字复制的原因。本文未将任何特定期刊或出版商标记为"掠夺性";场所筛选应用经过验证、透明的标准,这使任何分类都是可辩护的并避免诽谤。
致谢。作者感谢Stefanie Haustein提供的批评意见,该意见于2026年8月通过电子邮件发送,导致了第4.2节的修订,以及Vincent Larivière,他在信函中提出的问题——作者应该首先坚持哪一种单一归一化,以及他坚持查看数据而非论证——促使了附录E中报告的档案横截面。
竞争利益。作者是第8.10节讨论的多模型编排方法的开发者,这些方法是开放且可重现的,是读者应该考虑的利益。作者是待定专利申请的命名申请人,而非已授予的专利,涵盖该节讨论的那种AI编排和多模型验证系统。第8.10节提出的编排层交付设计是一个概念规范,本文的任何发现都不依赖于它。第8.10节可以完全删除,而不会改变本文其他地方的任何诊断、结果或建议。
工具和验证。AI助手在作者指导下被用作工具;思想、研究和结论都是作者的。所有定量声明和引文都由作者对照其原始来源或存档副本进行了验证;作者对内容承担唯一责任。
参考文献
文本中以[B-n]引用的来源(平台页面、论坛帖子、博客文章和其他支持材料)分别列在下面的"其他来源"下。有访问日期的平台页面是不稳定的,应针对存档副本重新验证。
[1] AALL / ALL-SIS (2024, June 14). Citation Methods White Paper. https://www.aallnet.org/allsis/wp-content/uploads/sites/4/2024/07/ALL-SIS_CitationMethodsWhitePaper_6_14_24_final.pdf
[2] Abdill, R. J., & Blekhman, R. (2019). Tracking the popularity and outcomes of all bioRxiv preprints. eLife, 8, e45133. DOI 10.7554/eLife.45133
[3] Academia StackExchange (2016, May 28). "Importance of paper download statistics". https://academia.stackexchange.com/questions/69421/
[4] Adobe / Adobe Express Blog (2025; survey fielded May 2025). "Using ChatGPT as a search engine". https://www.adobe.com/express/learn/blog/chatgpt-as-a-search-engine
[5] Aggarwal, P., Murahari, V., Rajpurohit, T., Kalyan, A., Narasimhan, K., & Deshpande, A. (2024). GEO: Generative Engine Optimization. KDD '24. DOI 10.1145/3637528.3671900; arXiv:2311.09735
[6] Aguinis, H., & Solarino, A. M. (2019). Transparency and replicability in qualitative research. Strategic Management Journal, 40(8), 1291–1315. DOI 10.1002/smj.3015
[7] Algaba, A., Mazijn, C., Holst, V., Tori, F., Wenmackers, S., & Ginis, V. (2025). Large Language Models Reflect Human Citation Patterns with a Heightened Citation Bias. Findings of the Association for Computational Linguistics: NAACL 2025, 6844–6879. DOI 10.18653/v1/2025.findings-naacl.381; arXiv:2405.15739
[8] American Society for Cell Biology and co-signing organizations and individuals (2012/2013). San Francisco Declaration on Research Assessment (DORA). Drafted 16 December 2012 at the ASCB Annual Meeting, San Francisco; released 2013. https://sfdora.org/read/
[9] Ansari, S., Khan, M., Weinstein, D., Conant, E. F., Mirza-Aghazadeh-Attari, M., & Yousem, D. M. (2023). Pervasiveness of open journal invitations across radiology specialties. Current Problems in Diagnostic Radiology, 52(6), 534–539. DOI 10.1067/j.cpradiol.2023.04.002; PubMed 37150715
[10] Artisan Growth Strategies; Lenny's Newsletter; First Page Sage — freemium-conversion benchmarks. https://www.artisangrowthstrategies.com/blog/freemium-conversion-rate-benchmarks ; https://www.lennysnewsletter.com/p/what-is-a-good-free-to-paid-conversion
[11] arXiv (Cornell University). Help pages on submission formats. https://info.arxiv.org/help/submit_pdf.html ; https://info.arxiv.org/help/policies/format_requirements.html
[12] Bainbridge, S. (2026). "The Social Science Research Network Has Jumped the Shark" (03.06.2026), https://www.stephenbainbridge.com/p/the-social-science-research-network ; "SSRN Responds to My Complaints With Changes and/or Clarifications" (04.06.2026), https://www.stephenbainbridge.com/p/ssrn-responds-to-my-complaints-with
[13] Bauer-Wolf, J. (2022, November 16). Yale, Harvard law schools drop out of U.S. News rankings, saying they undermine legal profession's tenets. Higher Ed Dive. https://www.highereddive.com/news/yale-harvard-law-schools-drop-out-of-us-news-rankings-saying-they-under/636742/
[14] Beall, J. (2012). 掠夺性出版商正在破坏开放获取. Nature, 489, 179. DOI 10.1038/489179a
[15] Bergstrom, C. T., & West, J. D. (2020). 胡说八道:数据驱动世界中的怀疑主义艺术. Random House.
[16] Bessembinder, H. (2018). 股票是否表现优于国债? Journal of Financial Economics, 129(3), 440–457. DOI 10.1016/j.jfineco.2018.06.004; SSRN 2900447
[17] Björk, B.-C., & Solomon, D. (2012). 开放获取与订阅期刊:科学影响力的比较. BMC Medicine, 10:73. DOI 10.1186/1741-7015-10-73
[18] Black, B. S., & Caron, P. L. (2006). 法律学校排名:使用SSRN衡量学术业绩. Indiana Law Journal, 81(1), 83 ff. SSRN abstract_id=784764; https://www.repository.law.indiana.edu/ilj/vol81/iss1/7/ ; PDF: https://ilj.law.indiana.edu/articles/81/81_1_Black.pdf
[19] Bollen, J., & Van de Sompel, H. (2008). 使用影响因子:样本特征对基于使用的影响度量的影响. Journal of the American Society for Information Science and Technology, 59(1), 136–149. DOI 10.1002/asi.20746
[20] Bornmann, L. (2014). 替代计量学能否指向研究的更广泛影响? Journal of Informetrics, 8(4), 895–903. DOI 10.1016/j.joi.2014.09.005; arXiv:1406.7091
[21] Bornmann, L., & Haunschild, R. (2016). 如何规范化Twitter计数?基于Twitter指数中期刊的首次尝试。 Scientometrics, 107(3), 1405–1422. DOI 10.1007/s11192-016-1893-6
[22] Bornmann, L., Leydesdorff, L., & Mutz, R. (2013). 百分位数和百分位秩等级在文献计量数据分析中的使用:机遇与局限. Journal of Informetrics, 7(1), 158–165. DOI 10.1016/j.joi.2012.10.001; arXiv:1211.0381
[23] Bornmann, L., & Haunschild, R. (2018). 零膨胀数据的规范化:新指标族的实证分析及其在替代计量学数据中的应用. Journal of Informetrics, 12(3), 998–1011. DOI 10.1016/j.joi.2018.01.010
[24] Bourne, P. E., Polka, J. K., Vale, R. D., & Kiley, R. (2017). 关于预印本提交要考虑的十条简单规则. PLOS Computational Biology, 13(5), e1005473. DOI 10.1371/journal.pcbi.1005473
[25] Brody, T., Harnad, S., & Carr, L. (2006). 早期网络使用统计作为后续引用影响的预测器. JASIST, 57(8), 1060–1072. DOI 10.1002/asi.20373; arXiv cs/0503020
[26] Brown, C. (2003). 电子预印本在化学传播中的作用:期刊文献中引用、使用和接受度的分析. JASIST, 54(5), 362–371. DOI 10.1002/asi.10223
[27] Campbell, D. T. (1979). 评估计划社会变革的影响. Evaluation and Program Planning, 2(1), 67–90. DOI 10.1016/0149-7189(79)90048-X
[28] Carrell, S., Figlio, D., & Lusher, L. (2023). 信息高速公路上的拥堵:经济工作论文中的低效率. Journal of Public Economics, 225, 104978 (also NBER WP 29153)
[29] Casden, J., Romani, D., Shearer, T., & Campbell, J. (2025). 缓解生成式AI时代的激进爬虫流量:来自北卡罗来纳大学教堂山分校图书馆的协作方法. The Code4Lib Journal, 61. https://journal.code4lib.org/articles/18489
[30] Chen, Y., & Konstan, J. A. (2015). 在线田间实验. Journal of the Economic Science Association, 1(1), 29–42. DOI 10.1007/s40881-015-0005-3
[31] Chu, H., & Krichel, T. (2007). 经济学中的下载与引用:关系、促成因素及其他. In Proceedings of ISSI 2007 (11th International Conference of the International Society for Scientometrics and Informetrics), Madrid.
[32] Cobey, K. D., et al. (2019). 在被认为是掠夺性期刊上发表文献的研究人员的知识与动机. BMJ Open, 9(3), e026516. DOI 10.1136/bmjopen-2018-026516
[33] Cooley Law School Blog (2021, December 7). "Showcase Your Scholarship, Part Three: Self-Publishing". https://cooley.edu/blog/showcase-your-scholarship-part-three-self-publishing
[34] CRIV Connection / CRIV Blog (2026, April 20). "Social Science Research Network (SSRN) Ending Commercial Products". https://crivblog.com/2026/04/20/social-science-research-network-ssrn-ending-commercial-products/
[35] Crossref. REST API文档. https://www.crossref.org/documentation/retrieve-metadata/rest-api/
[36] Crossref. Similarity Check文档. https://www.crossref.org/documentation/similarity-check/similarity-report-understand/
[37] Davis, P. M., et al. (2008). 开放获取出版、文章下载和引用:随机对照试验. BMJ, 337, a568. DOI 10.1136/bmj.a568
[38] Davis, P. M., & Fromerth, M. J. (2007). arXiv是否导致数学文章的更高引用和较少的出版商下载? Scientometrics, 71(2), 203–215. DOI 10.1007/s11192-007-1661-8
[39] Ding, Y., Dong, X., Bu, Y., Zhang, B., Lin, K., & Hu, B. (2021). 重新审视下载与引用之间的关系:基于The Lancet中不同引用模式文献的视角. Scientometrics, 126(9), 7609–7621. DOI 10.1007/s11192-021-04099-3
[40] Donovan, J. M., Watson, C. A., & Osborne, C. (2014). 美国法律评论的开放获取优势. SSRN abstract_id=2506913. https://papers.ssrn.com/sol3/papers.cfm?abstract_id=2506913
[41] Dorta-González, P., & Dorta-González, M. I. (2023). 资金对引用和社会关注的影响:以联合国可持续发展目标(SDGs)为案例. Online Information Review, 47(7), 1358–1376. DOI 10.1108/OIR-05-2022-0300; arXiv:2304.00862
[42] Douma, M. J. (2021, January 12). "How many reads does a typical academic article get?" https://michaeljdouma.com/2021/01/12/how-many-reads-does-a-typical-academic-article-get/
[43] Du, Y., Li, S., Torralba, A., Tenenbaum, J. B., & Mordatch, I. (2023). 通过多智能体辩论提高语言模型的事实性和推理能力. arXiv:2305.14325. https://arxiv.org/abs/2305.14325
[44] Edelman, B., & Larkin, I. (2015). 工作场所等级制度中的社会比较与欺骗:田间与实验证据. Organization Science, 26(1), 78–98. DOI 10.1287/orsc.2014.0938; SSRN abstract_id=1346397; HBS WP 09-096 (circulated since 2009)
[45] Eisenberg, T. (2006). 评估基于SSRN的法律学校排名. Indiana Law Journal, 81(1), 285–291. https://www.repository.law.indiana.edu/ilj/vol81/iss1/13/
[46] Elsevier (2016, May). "Elsevier Acquires the Social Science Research Network (SSRN)…". PR Newswire. https://www.prnewswire.com/news-releases/elsevier-acquires-the-social-science-research-network-ssrn-the-leading-social-science-and-humanities-repository-and-online-community-579752311.html (also LSE Impact Blog, 18 May 2016)
[47] Elsevier Digital Commons. "SSRN Research Paper Series Sunset — DC Options". https://digitalcommons.elsevier.com/en_US/integration-preservation/ssrn-research-paper-series-sunset-dc-options
[48] Elsevier. "SSRN First Look" (产品页面). https://www.elsevier.com/products/ssrn-preprint-services/first-look
[49] Elsevier. "SSRN for Authors and Researchers" (产品页面). https://www.elsevier.com/products/ssrn-preprint-services/author-researchers
[50] Elsevier/SSRN Support. "How can researchers gauge a paper's impact?" https://www.elsevier.support/ssrn/answer/gauge-impact (于 14.08.2026 访问)
[51] Elsevier/SSRN Support. "What are RSS and Data Feeds on SSRN". https://www.elsevier.support/ssrn/answer/what-are-rss-and-data-feeds-on-ssrn
[52] Elsevier/SSRN Support. "What is SSRN?" https://www.elsevier.support/ssrn/answer/what-is-ssrn (于 14.08.2026 访问)
[53] Elsevier/SSRN Support. 分类与分布. https://www.elsevier.support/ssrn/answer/classification-distribution (于 14.08.2026 访问)
[54] Elsevier/SSRN Support. 生成式 AI 政策. https://www.elsevier.support/ssrn/answer/AI (于 14.08.2026 访问)
[55] Elsevier/SSRN Support. Google / Google Scholar 索引. https://www.elsevier.support/ssrn/answer/google-scholar (于 14.08.2026 访问)
[56] Elsevier/SSRN Support. 投稿指南 / 快速开始. https://www.elsevier.support/ssrn/answer/get-started (于 14.08.2026 访问)
[57] Elsevier/SSRN Support. 订阅 (电子期刊邮件). https://www.elsevier.support/ssrn/answer/subscriptions ; 另请参阅 https://www.ssrn.com/index.cfm/en/subscribe/
[58] Espeland, W. N., & Sauder, M. (2007). Rankings and reactivity: How public measures recreate social worlds. American Journal of Sociology, 113(1), 1–40. DOI 10.1086/517897
[59] Eysenbach, G. (2006). Citation Advantage of Open Access Articles. PLoS Biology, 4(5), e157. DOI 10.1371/journal.pbio.0040157
[60] Farys, R., & Wolbring, T. (2021). Matthew effects in science and the serial diffusion of ideas. Quantitative Science Studies, 2(2), 505–526. DOI 10.1162/qss_a_00129
[61] Fernández-Ramos, A., Comas-Forgas, R., & Rodríguez-Bravo, B. (2026). Identifying academic spam and recommendations for dealing with it: a literature review. European Science Editing, 52, e174423. DOI 10.3897/ese.2026.e174423 (于 8 May 2026 发表)
[62] Fraser, N., et al. (2020). The relationship between bioRxiv preprints, citations and altmetrics. Quantitative Science Studies, 1(2), 618–638. DOI 10.1162/qss_a_00043
[63] Fung, A., Razi, B., Basto, C., Bariol, S., Hossack, T., Baskaranathan, S., Ende, D., & Woo, H. (2026). Trust, but Verify: An Exploratory Audit of Predatory Journal and Publisher Solicitations. ANZ Journal of Surgery. DOI 10.1111/ans.70568
[64] Giannakakos, V., et al. (2025). Impact of author characteristics on outcomes of single- versus double-blind peer review: a systematic review of comparative studies in scientific abstracts and publications. Scientometrics, 130, 399–421. DOI 10.1007/s11192-024-05213-x
[65] Ginsparg, P. (2011). ArXiv at 20. Nature, 476(7359), 145–147. https://www.nature.com/articles/476145a
[66] Goldman, E. "SSRN and Download Statistics" (2005), https://personal.ericgoldman.org/ssrn_and_downlo/ ; "Update on SSRN", https://personal.ericgoldman.org/update_on_ssrn/
[67] Goodhart, C. A. E. (1975). Problems of monetary management: The U.K. experience. In Papers in Monetary Economics, Vol. I. Sydney: Reserve Bank of Australia. Reprinted in C. A. E. Goodhart (1984), Monetary Theory and Practice: The U.K. Experience (ch. 4). London: Macmillan. DOI 10.1007/978-1-349-17295-5_4
[68] Gordon, G. J. (2016). The Digital Lawyer's Evolving Education in Scholarly Research. SSRN abstract_id=2754647
[69] Gordon, G., Lin, J., Cave, R., & Dandrea, R. (2015). The Question of Data Integrity in Article-Level Metrics. PLOS Biology. https://pmc.ncbi.nlm.nih.gov/articles/PMC4546647/
[70] Grossman, R., Liu, S., Chen, M. K., Smith, M., Borcea, C., & Chen, Y. (2026). How Generative AI Disrupts Search: An Empirical Study of Google Search, Gemini, and AI Overviews. arXiv:2604.27790. https://arxiv.org/abs/2604.27790
[71] Guerrero-Bote, V. P., & Moya-Anegón, F. (2014). Relationship between downloads and citations at journal and paper levels, and the influence of language. Scientometrics. DOI 10.1007/s11192-014-1243-5
[72] Haque, A., & Ginsparg, P. (2009). Positional effects on citation and readership in arXiv. JASIST, 60(11), 2203–2218. DOI 10.1002/asi.21166
[73] Haque, A., & Ginsparg, P. (2010). Last but not least: Additional positional effects on citation and readership in arXiv. JASIST, 61(12), 2381–2388. DOI 10.1002/asi.21428; arXiv:1010.2757
[74] Haustein, S., Costas, R., & Larivière, V. (2015). Characterizing social media metrics of scholarly papers. PLOS ONE, 10(3), e0120495. DOI 10.1371/journal.pone.0120495
[75] Haustein, S., Bowman, T. D., Holmberg, K., Tsou, A., Sugimoto, C. R., & Larivière, V. (2016). Tweets as impact indicators: Examining the implications of automated "bot" accounts on Twitter. JASIST, 67(1), 232–238. DOI 10.1002/asi.23456
[76] Haustein, S., Bowman, T. D., & Costas, R. (2016). Interpreting "altmetrics": viewing acts on social media through the lens of citation and social theories. In: Theories of Informetrics and Scholarly Communication (De Gruyter Mouton), 372–405; arXiv:1502.05701
[77] Heald, P. J., & Sichelman, T. (2019). Ranking the Academic Impact of 100 American Law Schools. Jurimetrics, 60(1), 1–39 (Fall 2019). SSRN abstract_id=3483325
[78] Hicks, D., Wouters, P., Waltman, L., de Rijcke, S., & Rafols, I. (2015). Bibliometrics: The Leiden Manifesto for research metrics. Nature, 520(7548), 429–431. DOI 10.1038/520429a. https://www.nature.com/articles/520429a
[79] Hirsch, J. E. (2005). An index to quantify an individual's scientific research output. PNAS, 102(46), 16569–16572.
[80] Hu, B., et al. (2021). On the relationship between download and citation counts: An introduction of Granger-causality inference. Journal of Informetrics, 15(2), 101125. DOI 10.1016/j.joi.2020.101125
[81] iThenticate/Turnitin. Guides: "Understanding the Similarity Report"; "Preprints". https://guides.ithenticate.com/hc/en-us/articles/27842305774605 ; https://guides.ithenticate.com/hc/en-us/articles/27848481223693-Preprints
[82] Jaźwińska, K., & Chandrasekar, A. (2025, March 6). AI search has a citation problem. Columbia Journalism Review / Tow Center. https://www.cjr.org/tow_center/we-compared-eight-ai-search-engines-theyre-all-bad-at-citing-news.php
[83] Jo, W., & Li, J. (2026). AI能否降低知识扩散中的声誉溢价?来自SSRN营销工作论文的证据。《营销快报》,37,第32条。DOI 10.1007/s11002-026-09827-4
[84] Justin, G. A., et al. (2024). 眼科掠夺性期刊的征稿分析。《美国眼科杂志》。PMC11257792;https://www.ajo.com/article/S0002-9394(24)00087-4/abstract — "1813封电子邮件"数据的来源
[85] Kakushadze, Z. (2016). SSRN下载的指数。《信息计量学杂志》,10(1),9–28。DOI 10.1016/j.joi.2015.11.005;arXiv:1511.04275;SSRN 2656600
[86] Kim, Heekyung Hellen (2014). 开放获取的影响(AEA 2014年会议)。https://www.aeaweb.org/conference/2014/retrieve.php?pdfid=58
[87] Kim, T., Bock, K., Luo, C., Liswood, A., Poroslay, C., & Wenger, E. (2025). 爬虫有选择地遵守robots.txt指令:来自大规模实证研究的证据。《ACM互联网测量会议会议录》(IMC '25)。DOI 10.1145/3730567.3764471
[88] Kleinberg, J., Ludwig, J., Mullainathan, S., & Obermeyer, Z. (2015). 预测政策问题。《美国经济评论》,105(5),491–495。DOI 10.1257/aer.p20151023
[89] Kozak, M., Iefremova, O., & Hartley, J. (2016). 学术出版中的垃圾邮件:案例研究。《美国信息科学与技术学会期刊》,67(8),2009–2015。DOI 10.1002/asi.23521
[90] Kraker, P., & Lex, E. (2015). 对ResearchGate评分作为科学声誉衡量标准的批判性审视。在ASCW'15(网络学术交流的定量化与分析)、2015年牛津网络科学会议上提交。http://ascw.know-center.tugraz.at/2015/05/26/kraker-lex-a-critical-look-at-the-researchgate-score/(通俗版本:"ResearchGate评分:一个不良指标的良好示例",LSE影响博客,2015年12月9日)
[91] Kurtz, M. J., et al. (2005). 文章阅读信息的文献计量学特性。《美国信息科学与技术学会期刊》,56(2),111–128。DOI 10.1002/asi.20096
[92] Kurtz, M. J., & Bollen, J. (2010). 使用文献计量学。《信息科学与技术年度评论》,44(1),3–64。DOI 10.1002/aris.2010.1440440108
[93] Langham-Putrow, A., et al. (2021). 开放获取引用优势真实存在吗?对开放获取和基于订阅的文章引用的系统综述。《公共科学图书馆·综合》,16(6),e0253129。DOI 10.1371/journal.pone.0253129
[94] Larivière, V., Haustein, S., & Mongeon, P. (2015). 数字时代学术出版商的寡头垄断。《公共科学图书馆·综合》,10(6),e0127502。DOI 10.1371/journal.pone.0127502
[95] Legal Writing Institute. "出版技巧"(PDF)。https://www.lwionline.org/sites/default/files/Publishing-Tips.pdf
[96] Lewinski, A. A., & Oermann, M. H. (2018). 掠夺性护理期刊和出版社的电子邮件征稿特征。《护理继续教育杂志》,49(4),171–177。DOI 10.3928/00220124-20180320-07
[97] Liang, W., Yuksekgonul, M., Mao, Y., Wu, E., & Zou, J. (2023). GPT检测器对非母语英文写手存在偏见。《模式》,4(7),100779。DOI 10.1016/j.patter.2023.100779
[98] Lloyd, T. (2026, May 7). 客座评论——爱、死亡与机器人:学术版。《学术厨房》。https://scholarlykitchen.sspnet.org/2026/05/07/guest-post-love-death-robots-scholarly-edition/
[99] LogEc / RePEc. 关于LogEc(流量过滤方法)。https://logec.repec.org/about.htm ;https://logec.repec.org/
[100] Martinez, O. (2026). 优化生成引擎中的可见性:生成引擎优化的批判性综述(2023–2026)。arXiv:2607.14035(提交于2026年7月15日)。https://arxiv.org/abs/2607.14035
[101] Maynooth University News (2026, January). "梅努斯大学法律与犯罪学院在…排名第一"。https://www.maynoothuniversity.ie/news-events/maynooth-university-s-school-law-and-criminology-ranks-first-social-science-research-networks-2
[102] McGillivray, B., & Astell, M. (2019). 开放获取超大期刊中使用与引用之间的关系。《科学计量学》,121,817–838。DOI 10.1007/s11192-019-03228-3
[103] Medoff, M. H. (2006). 哈佛-芝加哥马太效应的证据。《经济学方法论杂志》,13(4),485–506。DOI 10.1080/13501780601049079
[104] Merton, R. K. (1968). 科学中的马太效应。《科学》,159(3810),56–63。DOI 10.1126/science.159.3810.56
[105] Merton, R. K. (1988). 科学中的马太效应,II:累积优势与知识产权的象征性。《伊西斯》,79(4),606–623。DOI 10.1086/354848
[106] Microsoft Learn. "Microsoft Defender for Office 365中的安全链接"。https://learn.microsoft.com/en-us/defender-office-365/safe-links-about(+ 关于UrlClickEvents中点击的Microsoft问答;+ 关于虚假打开的Suped)
[107] Milanovic, M. EJIL:Talk! "学术垃圾邮件[已更新]"。https://www.ejiltalk.org/academic-spam/
[108] Moed, H. F., & Halevi, G. (2016). 科学学术期刊的全文下载和引用分布。《美国信息科学与技术学会期刊》,67(2),412–431。DOI 10.1002/asi.23405
[109] Moed, H. F. (2017). 应用评估信息计量学。Springer。DOI 10.1007/978-3-319-60522-7
[110] Moher, D., et al. (2018). 评估科学家的雇佣、晋升和终身职位。《公共科学图书馆·生物学》,16(3),e2004089。DOI 10.1371/journal.pbio.2004089
[111] Morgan, A. C., et al. (2018). 声誉驱动科学思想扩散中的认识论不平等。《EPJ数据科学》,7:40。DOI 10.1140/epjds/s13688-018-0166-4
[112] Muchnik, L., Aral, S., & Taylor, S. J. (2013). 社会影响偏见:随机实验。《科学》,341(6146),647–651。DOI 10.1126/science.1240466
[113] Muller, J. Z. (2018). 度量的暴政。新泽西州普林斯顿:普林斯顿大学出版社。ISBN 978-0-691-17495-2。
[114] Nature Neuroscience,编辑部(2008)。https://www.nature.com/articles/nn0608-619
[115] 西北大学图书馆指南(研究评估/指标)。https://libguides.northwestern.edu/c.php?g=1372178&p=10205721
[116] Ohm, P. (2007). 博客是否影响SSRN下载?Volokh和Slashdot效应的实证测试。科罗拉多大学法学法律研究论文第07-15号。https://ssrn.com/abstract=980484
[117] Pace法律图书馆。"发表文章——法律评论成员指南"。https://libraryguides.law.pace.edu/lawreviews/publishing
[118] Paperpile. "什么是好的h指数?" https://paperpile.com/g/what-is-a-good-h-index/(类似指南:Elsevier、Researcher.Life、Academia Insider)
[119] Perneger, T. V. (2004). 在线"点击数"与随后引用之间的关系:《英国医学杂志》研究论文的前瞻性研究。《英国医学杂志》,329(7465),546–547。DOI 10.1136/bmj.329.7465.546
[120] Petersen, A. M., et al. (2014). 学术生涯中的声誉与影响。《美国国家科学院院刊》,111(43),15316–15321。DOI 10.1073/pnas.1323111111
[121] Pew Research Center (2026, June 17). Americans and AI 2026: Chatbots, Smart Devices and AI's Impact. https://www.pewresearch.org/internet/2026/06/17/americans-and-ai-2026-chatbots-smart-devices-and-views-on-impact/
[122] Piwowar, H. (2013). Altmetrics: Value all research products. Nature, 493(7431), 159. https://www.nature.com/articles/493159a
[123] Priem, J., Taraborelli, D., Groth, P., & Neylon, C. (2010). Altmetrics: A manifesto. http://altmetrics.org/manifesto/ (archived copy at web.archive.org)
[124] Priem, J., Piwowar, H., & Orr, R. (2022). OpenAlex: A fully-open index of scholarly works, authors, venues, institutions, and concepts. arXiv:2205.01833. DOI 10.48550/arXiv.2205.01833
[125] Project COUNTER (2026). COUNTER Code of Practice, Release 5.1.1. Published 30 June 2026 (Release 5.1 published 5 May 2023). https://www.countermetrics.org/ ; "Best Practice on AI Usage" (guidance for R5.1.1, updated 30 June 2026), https://www.countermetrics.org/code-of-practice/best-practice/bp-ai/
[126] Quora. "To what extent would you recommend or discourage publishing an academic working paper on SSRN…". https://www.quora.com/To-what-extent-would-you-recommend-or-discourage-publishing-an-academic-working-paper-on-SSRN-to-claim-and-put-a-stake-in-the-ground-e-g-before-any-journal-submission
[127] Reddit r/AskAcademia (2023, August 10). Thread 15newc2 "Endless spam since I published a paper a few months ago". https://www.reddit.com/r/AskAcademia/comments/15newc2/ (confirmed via the pullpush.io archive)
[128] Remler, D. (2014, April 23). Are 90% of academic papers really never cited? Reviewing the literature on academic citations. LSE Impact Blog. https://blogs.lse.ac.uk/impactofsocialsciences/2014/04/23/academic-papers-citation-rates-remler/
[129] RePEc Blog: "How RePEc counts views and downloads" (06.11.2021), https://blog.repec.org/2021/11/06/how-repec-counts-views-and-downloads/ ; "AI issues in RePEc" (10.11.2025), https://blog.repec.org/2025/11/10/ai-issues-in-repec/ ; "RePEc in June 2026" (13.07.2026), https://blog.repec.org/2026/07/13/repec-in-june-2026/
[130] ResearchGate (2022, August). "Removing the RG Score". https://www.researchgate.net/researchgate-updates/removing-the-rg-score
[131] Salganik, M. J., Dodds, P. S., & Watts, D. J. (2006). Experimental study of inequality and unpredictability in an artificial cultural market. Science, 311, 854–856. DOI 10.1126/science.1121066
[132] Sauder, M., & Espeland, W. N. (2009). The discipline of rankings: Tight coupling and organizational change. American Sociological Review, 74(1), 63–82. DOI 10.1177/000312240907400104
[133] Schein, A. I., Popescul, A., Ungar, L. H., & Pennock, D. M. (2002). Methods and metrics for cold-start recommendations. In Proceedings of the 25th Annual International ACM SIGIR Conference on Research and Development in Information Retrieval (SIGIR '02), 253–260. DOI 10.1145/564376.564421
[134] Schumann, E. SSRN R package. https://github.com/enricoschumann/SSRN (also scrapers github.com/talsan/ssrn, github.com/karthiktadepalli1/ssrn-scraper)
[135] Shearer, K., & Walk, P. (2025, June 3). The impact of AI bots and crawlers on open repositories: Results of a COAR survey, April 2025. Confederation of Open Access Repositories. https://coar-repositories.org/wp-content/uploads/2025/06/Report-of-the-COAR-Survey-on-AI-Bots-June-2025-1.pdf
[136] Shen, C., & Björk, B.-C. (2015). 'Predatory' open access: a longitudinal study of article volumes and market characteristics. BMC Medicine, 13, 230. DOI 10.1186/s12916-015-0469-2
[137] Shepherd, P. T. (2007). The feasibility of developing and implementing journal usage factors: a research project sponsored by UKSG. Serials: The Journal for the Serials Community, 20(2), 117–123. DOI 10.1629/20117
[138] Shuai, X., Pepe, A., & Bollen, J. (2012). How the scientific community reacts to newly submitted preprints. PLOS ONE, 7(11), e47523. DOI 10.1371/journal.pone.0047523
[139] Siems, M. M. (2016). Legal Research in Search of Attention: A Quantitative Assessment. King's Law Journal, 27(2), 170–187. DOI 10.1080/09615768.2015.1105560. Working-paper version: "What Determines SSRN Downloads", SSRN abstract_id=2836950; Durham: https://durham-repository.worktribe.com/OutputFile/1387250
[140] Simcoe, T. S., & Waguespack, D. M. (2011). Status, Quality, and Attention: What's in a (Missing) Name? Management Science, 57(2), 274–290. DOI 10.1287/mnsc.1100.1270
[141] Simon, H. A. (1971). Designing organizations for an information-rich world. In M. Greenberger (Ed.), Computers, Communications, and the Public Interest (pp. 37–72). Johns Hopkins Press.
[142] Soler, J., & Cooper, A. (2019). Unexpected Emails to Submit Your Work: Spam or Legitimate Offers? Publications, 7(1), 7. DOI 10.3390/publications7010007
[143] SSRN (2018, April 13). eLibrary Stats announcement. https://www.ssrn.com/index.cfm/en/fen/ads/04132018ann014/
[144] SSRN Blog (2018, June 5). What SSRN Means When We Talk About Data Integrity. https://blog.ssrn.com/2018/06/05/what-ssrn-means-when-we-talk-about-data-integrity/
[145] SSRN Blog (2025, December 16). 2025 Year in Review: How SSRN Enhanced Access to Preprints and Early-Stage Research. https://blog.ssrn.com/2025/12/16/2025-year-in-review-how-ssrn-enhanced-access-to-preprints-and-early-stage-research/
[146] SSRN Blog (2026, April 13). SSRN Strategic Update: Renewed Focus on Core Research Sharing Mission (post author: S. Decker-Lucke). https://blog.ssrn.com/2026/04/13/ssrn-strategic-update-renewed-focus-on-core-research-sharing-mission/
[147] SSRN Blog (2026, June 4). SSRN's Ongoing Commitment to Legal Scholarship. https://blog.ssrn.com/2026/06/04/ssrns-ongoing-commitment-to-legal-scholarship/
[148] SSRN Blog (2026, June 12). SSRN to Sunset Rankings from July 1st 2026. https://blog.ssrn.com/2026/06/12/ssrn-to-sunset-rankings-from-july-1st-2026/
[149] SSRN Blog (2026, July 15). SSRN Ranking has sunsetted as of 15 July 2026. https://blog.ssrn.com/2026/07/15/ssrn-to-sunset-rankings-from-15th-july-2026/
[150] SSRN Blog (2026, July 20). SSRN will now allow you to choose the licence that's right for your work. https://blog.ssrn.com/2026/07/20/ssrn-will-now-allow-you-to-choose-the-licence-thats-right-for-your-work/
[151] SSRN. Historical FAQ (PDF copy, Scuola Superiore Sant'Anna). https://www.sssup.it/UploadDocs/4461_SSRN_FAQ.pdf
[152] SSRN. Subscription page. https://www.ssrn.com/index.cfm/en/subscribe/
[153] Sugimoto, C. R., & Larivière, V. (2018). Measuring Research: What Everyone Needs to Know. Oxford University Press. ISBN 9780190640118
[154] Sun, M., Barry Danfa, J., & Teplitskiy, M. (2022). 双盲同行评审是否能减少偏见?来自顶级计算机科学会议的证据。JASIST, 73(6), 811–819. DOI 10.1002/asi.24582 (根据Crossref的第二作者姓氏:"Barry Danfa")
[155] Sureda-Negre, J., Calvo-Sastre, A., & Comas-Forgas, R. (2022). 掠夺性期刊和出版商:学术垃圾邮件对教育科学研究人员的特征和影响。Learned Publishing, 35(4), 441–447. DOI 10.1002/leap.1450
[156] TaxProf Blog (Caron, P.): "SSRN e-Journal Rankings By Average Downloads Per Paper" (2018, May), https://taxprof.typepad.com/taxprof_blog/2018/05/ssrn-e-journal-rankings-by-average-downloads-per-paper.html;"SSRN Has Not Jumped the Shark" (07.06.2026), https://taxprofblog.aals.org/2026/06/07/
[157] Teixeira da Silva, J. A., Tsigaris, P., & Moussa, S. (2023). 人工智能能否检测掠夺性期刊?FT50期刊的案例。SSRN abstract_id=4391108. DOI 10.2139/ssrn.4391108
[158] Thales / Imperva (2025). 2025 Imperva恶意机器人报告。https://cpl.thalesgroup.com/about-us/newsroom/2025-imperva-bad-bot-report-ai-internet-traffic
[159] Think. Check. Submit. (2022, February 4). "Is a journal interested in your preprint? Separating the wheat from the chaff in journal solicitations to submit". https://thinkchecksubmit.org/2022/02/04/is-a-journal-interested-in-your-preprint-separating-the-wheat-from-the-chaff-in-journal-solicitations-to-submit/
[160] Tomlinson, O. W. (2023). 对早期职业学术界掠夺性电子邮件的分析和防范尝试。Learned Publishing, 36(2), 156–163. DOI 10.1002/leap.1500
[161] University of Washington Gallagher Law Library. LibGuide "SSRN Metrics" (updated 29 Sep 2025). https://lib.law.uw.edu/c.php?g=1238218&p=9061272 (+ page p=9061269 on eJournals)
[162] van de Rijt, A., et al. (2014). 成功繁殖成功动态的现场实验。PNAS, 111(19), 6934–6939. DOI 10.1073/pnas.1316836111
[163] Vanderbilt University, Brightspace (Center for Teaching / Office of Innovative Technologies) (2023). 关于人工智能检测的指导以及我们为什么禁用Turnitin的人工智能检测器。Published 16 August 2023. https://www.vanderbilt.edu/brightspace/2023/08/16/guidance-on-ai-detection-and-why-were-disabling-turnitins-ai-detector/ (accessed 15 August 2026).
[164] Vishwakarma, R., Kumar, A., & Jamidar, S. (2026). 什么会被引用:人工智能答案引擎中的竞争性地理位置优化。SIGIR '26, 4950–4954. DOI 10.1145/3805712.3808445; arXiv:2605.25517
[165] Wallace, K. L., Hartley, M., & Lepird, C. (2023). 拓展Drake农业法律期刊:绿色议题。Drake Journal of Agricultural Law, 28, 114–127. https://aglawjournal.wp.drake.edu/wp-content/uploads/sites/66/2023/07/Wallace-Ready-for-PRODUCTION.pdf
[166] Wang, J., Veugelers, R., & Stephan, P. (2017). 科学中对新颖性的偏见。Research Policy, 46(8), 1416–1436. DOI 10.1016/j.respol.2017.06.006
[167] Weinberg, M. (2025, June). 人工智能机器人是否在将文化遗产赶离网络?GLAM-E Lab (NYU Engelberg Center / University of Exeter). https://www.glamelab.org/files/Are_AI_Bots_Knocking_Cultural_Heritage_Offline.pdf
[168] Whalen, R. (2018, May 3). SSRN电子期刊和下载。https://ryanwhalen.com/2018/05/03/ssrn-e-journals-and-downloads/
[169] Wherry, J. L. (2022). 改善分发、讨论和下载的工具…SSRN abstract_id=4191909. DOI 10.2139/ssrn.4191909 (published in U. Detroit Mercy Law Review)
[170] Wikipedia: "Social Science Research Network"; "List of academic journals by preprint policy"; "Preprint". https://en.wikipedia.org/wiki/Social_Science_Research_Network and related pages.
[171] Willey, R., & Knapp, M. (2021). 如何增加对法律学术的引用。Ohio State Technology Law Journal, 18. SSRN 3801190; PDF: https://moritzlaw.osu.edu/sites/default/files/2022-01/HOW%20TO%20INCREASE%20CITATIONS%20TO%20LEGAL.pdf
[172] Willey, R., & Knapp, M. (2022/2023). SSRN对法律学术引用的影响及其最大化方法。University of Arkansas at Little Rock Law Review, 45(3), 475–507. SSRN abstract_id=4037744; https://research.ualr.edu/bowen_lawreview/vol45/iss3/2/
[173] Wilsdon, J., et al. (2015). 度量浪潮:研究评估和管理中度量角色独立审查报告。HEFCE. DOI 10.13140/RG.2.1.4929.1363. https://doi.org/10.13140/RG.2.1.4929.1363
[174] Wilson, P. (2022). 主动征求:潜在掠夺性期刊的未请求电子邮件的识别特征以及图书馆员的角色。Journal of the Medical Library Association, 110(4), 520–524. DOI 10.5195/jmla.2022.1554; PMC10124592. https://pmc.ncbi.nlm.nih.gov/articles/PMC10124592/
[175] WisBlawg, UW–Madison Law Library (2016, September 21). "Which Legal Articles Generate the Most Attention on SSRN". https://wisblawg.law.wisc.edu/2016/09/21/which-legal-articles-generate-the-most-attention-on-ssrn
[176] Wood-Doughty, A., Bergstrom, T., & Steigerwald, D. G. (2019). 下载报告能否可靠地衡量期刊使用情况?College & Research Libraries, 80(5). https://crl.acrl.org/index.php/crl/article/view/17824/19653
[177] Wouters, P., & Costas, R. (2012). 用户、自恋和控制——追踪21世纪学术出版物影响。SURF Foundation, Utrecht. https://www.cni.org/news/surf-report-users-narcissism-and-control
[178] Yuret, T. (2026). 文章访问量:与引用的联系、周末效应和季节性。Scientometrics (published 23.07.2026). DOI 10.1007/s11192-026-05710-1
[179] Zahedi, Z., Costas, R., & Wouters, P. (2017). Mendeley阅读作为识别高被引出版物的过滤工具。Journal of the Association for Information Science and Technology, 68(10), 2511–2521. DOI 10.1002/asi.23883
[180] Zhu, L., & Lerman, K. (2016). 社交媒体中的注意力不平等。arXiv:1601.07200
[181] Sinatra, R., Wang, D., Deville, P., Song, C., & Barabási, A.-L. (2016). 量化个人科学影响的演变。Science, 354(6312), aaf5239. DOI 10.1126/science.aaf5239
[182] Radicchi, F., Fortunato, S., & Castellano, C. (2008). 引用分布的普遍性:科学影响的客观衡量。PNAS, 105(45), 17268–17272. DOI 10.1073/pnas.0806977105
[183] CoARA (2022). 改革研究评估协议。Coalition for Advancing Research Assessment. https://coara.eu/agreement/the-agreement-full-text/
[184] Curry, S., Gadd, E., & Wilsdon, J. (2022). 驾驭度量浪潮:英国负责任研究评估的指标、基础设施和优先事项。Research on Research Institute. https://doi.org/10.6084/m9.figshare.21701624
[185] IRUS (Jisc)。标准化、符合 COUNTER 标准的存储库使用统计。https://irus.jisc.ac.uk
[186] UK Research and Innovation (2024)。Résumé for Research and Innovation (R4RI):指南。https://www.ukri.org/apply-for-funding/develop-your-application/resume-for-research-and-innovation-r4ri-guidance/
[187] Overton。政策智能工具。https://www.overton.io
[188] CC-PLUS。Consortia Collaborating on a Platform for Library Usage Statistics (开源 SUSHI/COUNTER-5 收集;IMLS 资助,PALCI 等)。https://www.cc-plus.org/
[189] HELIOS Open。Higher Education Leadership Initiative for Open Scholarship。https://www.heliosopen.org/
补充资源
文中引用的补充资源标记为 [B-n]:平台页面、论坛帖子、博客文章及其他支持文中特定观点的资料。平台页面不稳定,应对照存档副本重新验证。
[B-1] Cabells Predatory Reports(活跃的掠夺性期刊筛选服务);Beall's List(仅存档;自 2017 年 1 月起未更新)。
[B-2] Caron, P. TaxProf Blog(2026 年 1 月 25 日)。"The SSRN Top Five New Tax Papers Ranking Is Broken"。https://taxprofblog.aals.org/2026/01/25/the-ssrn-top-five-new-tax-papers-ranking-is-broken/
[B-3] EconJobRumors(EJMR),关于 SSRN 下载和作者排名的讨论贴(例如 /topic/ssrn-downloads-and-views;/topic/top-10-of-authors-on-ssrn-by-downloads)。匿名论坛;仅作为此类讨论存在的证据被引用。
[B-4] de Leon, F. L. L., & McQuillin, B. (2020). The Role of Conferences on the Pathway to Academic Impact. Journal of Human Resources, 55(1), 164. https://jhr.uwpress.org/content/55/1/164
[B-5] Reddit r/AskAcademia,帖子 1seeyq3(2026 年 4 月 6 日,"I've uploaded a working paper to SSRN… honest advice");Reddit r/academia,帖子 13w6zjw(2023 年 5 月 31 日,"SSRN Approval Time is Absurd")。存在确认通过第三方 Reddit 档案。
[B-6] SSRN — 公告标准化模板(例如 https://www.ssrn.com/index.cfm/en/ern/ads/06042025ann001/)和 2018 年 4 月公告 (04132018ann002)。平台页面;应对照存档副本进行验证。存档副本:https://web.archive.org/web/20251229194317/https://www.ssrn.com/index.cfm/en/ern/ads/06042025ann001/(快照日期 2025 年 12 月 29 日;访问日期 2026 年 8 月 15 日)。
[B-7] SSRN FAQ — 版本控制和 ORCID。https://www.ssrn.com/index.cfm/en/faq/(访问于 2026 年;应对照存档副本进行验证)。
[B-8] SSRN — "SSRN has Sunset Rankings" 登陆页面。https://www.ssrn.com/ssrn/rankings-sunset。存档副本:https://web.archive.org/web/20260719233259/https://www.ssrn.com/ssrn/rankings-sunset(快照日期 2026 年 7 月 19 日;访问日期 2026 年 8 月 15 日)。
[B-9] SSRN — hq.ssrn.com / papers.ssrn.com/topten 的历史排名页面:Top 10,000 Papers(TRN_gID=10)、Top 30,000 Authors(TRN_gID=7)、Top 3,000 Law Authors、Top 350 U.S. Law Schools、Top 500 International Law Schools、Eigenfactor、Recent Top Papers(60 天)、"Ranking Data Explained"(ranking_data_explain.cfm?id=6 / id=10)。历史页面;自 2026 年 7 月 15 日起,这些 URL 返回 403/占位符响应 — 应通过存档副本引用。Top 10,000 Papers 页面存档副本:https://web.archive.org/web/20260714112806/https://hq.ssrn.com/rankings/Ranking_display.cfm?TRN_gID=10(快照日期 2026 年 7 月 14 日,停用前一天;访问日期 2026 年 8 月 15 日)。
[B-10] Teixeira da Silva, J. A. (2024/2025). Spam, unwanted or unsolicited emails following the publication of preprints(长期观察:875 份邀请来自 256 个期刊,76% 来自黑名单)。DOI 10.1080/10875301.2025.2550600;ResearchGate 出版物 384286174。
[B-11] Caron, P. TaxProf Blog(2026 年 6 月 7 日)。"SSRN Has Not Jumped the Shark"。https://taxprofblog.aals.org/2026/06/07/ssrn-has-not-jumped-the-shark/(回复 Bainbridge [12];访问于 2026 年 9 月)。
通讯:vadimchernets9@gmail.com。↩︎
引用方式
Chernets, V. (2026). What Does 7 Downloads Mean? Metric Blindness and the Cold Start of Scholarly Attention After the SSRN Rankings Sunset [Preprint]. SSRN. https://doi.org/10.2139/ssrn.7296358
@misc{chernets2026downloadmetrics,
  author       = {Chernets, Vadym},
  title        = {{What Does 7 Downloads Mean? Metric Blindness and the Cold Start of Scholarly Attention After the SSRN Rankings Sunset}},
  year         = {2026},
  howpublished = {SSRN},
  doi          = {10.2139/ssrn.7296358},
  url          = {https://doi.org/10.2139/ssrn.7296358}
}