Что означают 7 загрузок? Метрическая слепота и холодный старт научного внимания после закрытия рейтингов SSRN
Это перевод. Основная версия — оригинал на английском; ссылайтесь на него.
Вадым Чернец, PhD, архитектор систем ИИ · ORCID 0009-0007-4845-3163
SSRN 7296358 · DOI 10.2139/ssrn.7296358 · Zenodo 10.5281/zenodo.22166896 · GitHub
- Версия отчета: SSRN 7296358 · DOI 10.2139/ssrn.7296358
- Архивная копия, цитируемая и загружаемая: 10.5281/zenodo.22166896 — концептуальный DOI, всегда разрешается на последнюю версию
- Полный текст в формате Markdown и PDF: GitHub
- Читаемый HTML: https://polyhelper.ai/research/download-metrics/
Один и тот же текст находится на четырех ресурсах, чтобы его можно было получить, когда один из них недоступен. SSRN содержит версию отчета; ссылайтесь на нее.
Что означают 7 загрузок?
Метрическая слепота и холодный старт научного внимания после закрытия рейтингов SSRN
Тип рукописи: Критический синтез, методологическая структура и готовая к предварительной регистрации эмпирическая повестка
Версия: сентябрь 2026
Автор: Вадым Чернец, PhD1
Аффилиация: архитектор систем ИИ
Аннотация
15 июля 2026 г. Social Science Research Network (SSRN) закрыла свои публичные рейтинги — таблицы рейтингов статей, авторов и учреждений, которые долгое время обеспечивали единственную широко доступную сравнительную базу платформы, в то время как счетчики загрузок и статистика цитирования остались на отдельных статьях и профилях авторов (SSRN Blog, 15 июля 2026). Результатом было асимметричное событие измерения: авторы сохранили числа и потеряли норму. Счетчики SSRN не стали бессмысленными; они стали нечитаемыми. Каждый счетчик загрузок стал числом без шкалы.
Статья утверждает, что вопрос «Что означают 7 загрузок?» научно некорректно поставлен до тех пор, пока не указан референтный класс статьи. Совокупный счетчик использования не может быть интерпретирован без учета возраста статьи, области, когорты размещения, охвата распределением и прежней видимости автора. Проблема наиболее острая для новых статей и авторов с низкой видимостью, чье раннее внимание формируется не столько научным интересом, сколько архитектурой платформы, распределением уведомлений по электронной почте, поисковым индексированием, престижем автора и тяжелохвостой динамикой внимания. Мы называем это условие холодным стартом научного внимания. Это требование не ново: нормализация счетов по области, возрасту и типу документа — давно установившаяся практика в библиометрии цитирования, и аналогичный вопрос для данных об использовании уже ставился полтора десятилетия назад (Kurtz & Bollen, 2010). Библиометрические показатели такого рода предполагают базу данных, в которой известны область, возраст и тип и показатель вычисляется от имени читателя, тогда как платформа препринтов передает своим авторам голое целое число без референтного класса, без инструментов и (с июля 2026 г.) без сравнительной базы вообще. Недостающее — это не метод, а его реализация: SSRN не предоставляет инструмента, который применил бы его для автора.
Имеющиеся доказательства показывают, почему простые средние значения вводят в заблуждение. В единственном недавно опубликованном внешнем исследовании на большой выборке сети SSRN (2361 научная работа по маркетингу) среднее число загрузок составило 221,3 при медиане 87, и среднее значение превысило даже 75-й процентиль (206) (Jo & Li, 2026). Распределения загрузок квазилогнормальны с экстремальными верхними хвостами, и в рамках одной дисциплинарной сети средние загрузки различаются примерно в восемь раз в разных подобластях (Whalen, 2018), поэтому среднее значение по всей платформе не описывает ни одну конкретную работу; сравнивание новой работы с ним — это калибровка по фикции агрегации. На основе имеющихся данных о конверсии показатель, такой как 7 загрузок из 40 просмотров аннотации, не указывает на неудачу. Это результат скрининга с широким доверительным интервалом, и его необходимо интерпретировать через охват, конверсию, возраст и область.
На основе этих доказательств статья строит интерпретационную базу для метрик SSRN после отката рейтингов, которая разделяет воздействие, просмотр аннотации, загрузку полного текста и последующее использование, и добавляет диагностику охват-конверсия, которая различает невидимость и отклонение. Вместо единого показателя для демонстрации статуса она предлагает Cold-Start Scholarly Attention Benchmark (CSAB), многомерную альтернативу. Сопроводительный протокол досье его дополняет, согласно которому каждый указанный метрик содержит его источник, временное окно, референтный класс и ограничения. Затем статья излагает готовую к предрегистрации программу восстановления отсутствующей шкалы: проспективную панель новых работ SSRN, наблюдаемых со дня 1 по день 180, два квазиэксперимента с использованием куратированного распределения email-оповещений и самого отката рейтингов, построенный сообществом перцентильный эталон и аудит видимости препринтов в AI answer engines. База доказательств объединяет цитируемые исследования с нерепрезентативным архивным срезом Приложения E; статья указывает, как отсутствующий эталон может быть восстановлен, и почему ни один показатель загрузок не должен циркулировать без его контекста на платформе, которая его не предоставляет.
Ключевые слова: количество загрузок; метрики использования; нормализация по областям; оценка исследований; препринты; наукометрия; продвижение и получение должности; правовые исследования; альтметрики; эффект Матфея; кумулятивное преимущество; экономика внимания; просмотры аннотаций; хищнические журналы; оптимизация для генеративных движков.
Классификация JEL: A14; D83; I23; O33; L86
Основные положения
Необработанные показатели загрузок SSRN не имеют стабильной интерпретации без возраста работы, области, когорты размещения, охвата распределения и предыдущей видимости автора.
Закат рейтингов 15 July 2026 удалил единственную общественную сравнительную базу платформы, в то время как все счетчики сохранились: авторы сохранили цифры и потеряли норму.
В единственном недавно опубликованном распределении на большой выборке загрузки сильно смещены вправо, среднее значение 221,3 против медианы 87: работа со «средним» показателем нетипична по конструкции.
Разделение охвата (просмотры аннотаций) от конверсии (загрузки на просмотр) различает невидимость от отклонения: разные диагнозы, требующие разных действий.
Опубликованные якоря конверсии просмотров в загрузки группируются в диапазон примерно 11–19%, в пределах которого 7 загрузок из 40 просмотров аннотаций соответствует диапазону как результат скрининга: не является, по имеющимся доказательствам, признаком неудачи.
Cold-Start Scholarly Attention Benchmark (CSAB) отчитывает нормализованный охват, производительность загрузок, конверсию, темп роста и последующую валидацию вместо единого показателя для демонстрации статуса.
Предварительно определенная, готовая к предрегистрации программа (проспективная панель, два необычайно актуальных квазиэксперимента, созданные собственными реформами платформы, построенный сообществом перцентильный эталон и аудит AI answer engines, необходимый перед тем, как оптимизация для генеративных движков может рассматриваться как основанная на доказательствах) определяет, как восстановить отсутствующую шкалу.
Сфера действия и дисциплина доказательств
Эта статья является критическим синтезом, объединенным с методологической базой и готовой к предрегистрации эмпирической программой, и единственные новые данные, которые она представляет, — это нерепрезентативный архивный срез Приложения E. Три класса доказательств разделяются на протяжении всей статьи, и каждое число в статье сопровождается его классом:
1. Проверенные оценки: опубликованные числа, проверенные по отношению к их первоисточнику и процитированные с указанием их выборки и возраста, или проверенные с указанными оговорками, где проверка является частичной.
2. Исторические якоря: более ранние выборки и выведенные из эксплуатации функции платформы, сохраненные потому, что они раскрывают структуру распределения, а не потому, что они остаются калибровочными нормами для 2026 года.
3. Концептуальные и предлагаемые выходные данные: предварительно определенные прогнозы, шаблоны эталонов и проекты исследований, явно обозначенные как таковые и не содержащие синтетических выводов.
Проблема интерпретируемости, аргумент референтного класса и разложение охват-конверсия являются аналитическими утверждениями, защищаемыми доказательствами выше. Предлагаемая статьей инфраструктура предлагается как проект для построения и оценки сообществом, а не как устоявшееся предписание: реестр перцентилей сообщества (Section 8.8), калькулятор для авторов и архитектура оркестрации Section 8.10. Ни одно диагностическое утверждение в статье не зависит от его принятия.
В области, которая только что потеряла свой наиболее используемый общественный эталон, редким общественным благом является воспроизводимый протокол, который любой автор в любом месте может запустить, вместе с синтезом, который указывает происхождение и возраст существующих чисел.
Случай с 40 просмотрами аннотаций и 7 загрузками повторяется в этом методологическом синтезе, потому что он иллюстрирует вопросы, каталогизированные в Table 1; выводы основаны на цитируемых доказательствах, а не на какой-либо единственной панели.
Три правила управляют самим синтезом. Единицы нормализуются к двум общим знаменателям: загрузкам за все время на работу и загрузкам за двенадцать месяцев на работу. Связывание выполняется только там, где сам источник сообщает о требуемом соотношении, и исходная единица сохраняется везде, где конверсия потребовала бы предположений, которые источники не поддерживают. Каждое фактическое утверждение содержит уровень проверки (проверено по отношению к первоисточнику, проверено с указанными оговорками или ожидающее проверки), записанный в столбцах уверенности источника таблиц. Когда источники конфликтуют, наиболее заметно по поводу эффективной даты захода, конфликт разрешается в пользу более позднего официального источника и отмечается. Каждая оценка сохраняет свой уровень, возраст и оговорку об устаревании везде, где она используется повторно.
Единственное правило управляет включением источников: ссылка сохраняется, когда она вносит отчётливый механизм, результат, платформенный факт, предупреждение об измерении или проектный прецедент; количество цитирований не является целью. Публикация и её чтение — разные достижения; эта статья о втором, о коллапсе инструментов для его измерения. Правдоподобная таблица не является свидетельством, и в статье о контекстно-свободных числах это правило прежде всего обязывает саму статью.
1. Введение
1.1 Сорок просмотров, семь загрузок
Представьте исследователя (молодого, возможно, без аффилиации или просто новичка на платформе), который загружает тщательно подготовленный рабочий документ на SSRN и, несколько недель спустя, в августе 2026 года, открывает панель статистики статьи. Панель мониторинга показывает "40 просмотров аннотации" и "7 загрузок". В этот момент, без практического понимания статистики научного внимания, автор не может определить, означают ли эти цифры катастрофическое отклонение рецензентами, базовый статистический показатель для специализированного текста или начало необычно сильной траектории. Автор спрашивает коллег: "Это ужасно?" Никто не может ответить. Ни панель мониторинга, ни научная литература, ни сама платформа не дают ответа, и счётчик не имеет масштаба для сравнения. Это состояние называется метрической слепотой — неспособностью отличить при виде собственных счётчиков неудачу от нормальной работы и успеха. Термин вводится здесь как теоретическая конструкция, а не измеренная величина. Исследование 4 (раздел 8.6) предоставляет конкретный показатель (доля авторов, которые сообщают, что никогда не сопоставляли свой счётчик с каким-либо эталоном, вместе с распределением первых чтений, которые вызывает низкий счётчик), так что "метрическая слепота" обозначает то, что может оценить предварительно зарегистрированный опрос.
Сопутствующая сцена, рассказанная авторами на форумах сообщества и приведённая здесь как иллюстративный анекдот, более суровая. Исследователь загружает первый препринт и наблюдает, как панель мониторинга остаётся на нулевых просмотрах и нулевых загрузках, в то время как в течение нескольких дней в входящие приходят пять писем от журналов, запрашивающих рукопись, все они хищнические. Единственный ответ, который получает новичок, приходит от хищнических журналов. Раздел 7 развивает эту асимметрию как набор явных гипотез, а исследование 3 (раздел 8.6) указывает, как это обнаружить. Сцена является пережитым примером информационного вакуума: законная экономика внимания даёт этому автору счётчик, не имеющий масштаба сравнения, в то время как паразитическая экономика предоставляет лесть, но не читателей.
До лета 2026 года существовал приблизительный ответ. Публичные рейтинги SSRN (лучшие статьи, лучшие авторы и таблицы лидеров учреждений) позволили авторам найти свой счётчик в видимом распределении. 15 июля 2026 года эти рейтинги были закрыты [149]. Закрытие последовало за объявлением от 12 июня 2026 года, которое сформулировало решение утверждением, что "исследование должно говорить само за себя" [148], и более ранней стратегической переориентацией, объявленной 13 апреля 2026 года, ресурсов платформы на её основную миссию обмена исследованиями [146]. Удаление было асимметричным: загрузки каждой статьи и статистика цитирования "будут по-прежнему записываться и отображаться на ваших отдельных статьях и профиле автора" [149], в то время как распределение, которое служило масштабом для этих счётчиков, исчезло. Таким образом, ситуация исследователя у панели мониторинга распространилась на всю пользовательскую базу платформы: более 1,9 миллиона авторов и 1,5 миллиона статей [49].
Эта статья посвящена этой ситуации, и её тезис состоит из двух частей. Закрытие рейтингов удалило контекст, а не данные. Счётчики каждой статьи пережили закрытие и остаются отображаемыми; сравнительный масштаб, через который можно было интерпретировать эти счётчики, исчез, поэтому метрики невозможно интерпретировать, но они не лишены смысла.
Второе состоит в том, что вопрос "что означают 7 загрузок?", является некорректно поставленным до тех пор, пока не определены правильный знаменатель и группа сравнения. Предоставление этого знаменателя и инструментов для его использования — задача этой статьи.
1.2 Число без масштаба
Проблема интерпретации выглядит проще, чем это в действительности. Десять загрузок спустя семь дней и десять загрузок спустя девяносто дней — это одинаковые счета, значения которых почти наверняка различаются, и они различаются ещё больше, если одна статья содержит имя признанного на международном уровне профессора из престижного учреждения, а другая является дебютом автора, публикующегося впервые. Метрики научного использования, тем не менее, представляются именно в такой бесконтекстной форме, поэтому каждое число неизбежно становится тестом Роршаха: одни и те же «40 просмотров» вызывают панику у одного автора и безразличие у другого, потому что нет общей точки отсчёта.
Ожидаемое значение необработанного количества загрузок меняется со всем, что счётчик не показывает: возраст статьи, её область, когорта её размещения и календарная среда, фактический охват её распределения и предшествующая видимость её авторов. Каждая из этих зависимостей эмпирически задокументирована. Средние пожизненные загрузки различаются примерно в восемь раз в электронных журналах одной дисциплинарной сети, от примерно 438 в корпоративном и ценнобумажном праве до примерно 53 в сельскохозяйственном праве [168]. Активность доступа варьируется в зависимости от самого календаря, падая примерно на 11% в выходные дни и примерно на 50% в летние месяцы в данных доступа к журналам [178]. Позиция и охват имеют значение независимо от содержания: статьи, появляющиеся на самом видном месте в списках объявлений arXiv, впоследствии получили значительно более высокую читаемость и цитирование, с медианными выигрышами в цитировании около 83% в астрофизике [72]. Идеи, возникающие в престижных учреждениях, распространяются быстрее и шире, чем сравнимые идеи из менее престижных учреждений [111], картина, согласующаяся с давно известными доказательствами влияния статуса и внимания [104][105][140][103]. На SSRN в частности, наличие соавтора в топ-50 связано с измеримым увеличением темпов загрузок [83]. Собственный аппарат распределения платформы также влияет на счётчик: авторы выбирают до семи классификаций, включение в курируемые тематические оповещения по электронной почте не гарантировано, и темы с высоким объёмом могут столкнуться с задержками вплоть до 45 дней [53][57]. Ранний счётчик статьи может отражать лишь то, произошло ли её соответствующее распределение.
Правила подсчёта платформы добавляют второй слой, который авторы редко видят. SSRN фильтрует свои счётчики, отбрасывая очевидную активность роботов и повторные загрузки одного и того же человека [144][66][69]; без таких фильтров счета были бы завышены на коэффициент пять или более [18]. Просмотры и загрузки связаны примерно постоянным соотношением, и Black и Caron сообщили в 2006 году, что «в целом три просмотра аннотации на веб-сайте SSRN приводят к одной фактической загрузке статьи» [18]. Более поздние выборки показывают конвертацию между примерно 11% и 19% просмотров аннотаций [139][172], с последней маркетинговой выборкой, показывающей в среднем примерно 24 загрузки на 100 просмотров [83]. Автор, знающий эту анатомию, может уже проверить это на примере названия (40 просмотров и 7 загрузок) (Раздел 5.2 выполняет расчёт, который попадает в указанный диапазон как результат скрининга в широком диапазоне), но на платформе это не сообщается.
Никакая внешняя шкала не заполняет этот пробел, что делает это ошибкой измерения, а не просто неудобством. Для h-индекса [79] существует целый жанр руководств «что считается хорошим X» [118][128]. Для загрузок SSRN аудит раздела 2.5 не обнаружил никакого аналога в открытых источниках по состоянию на август 2026 года. Библиометрическая литература сообщает о распределениях [85][139][168][83], но ни одна из них не преобразует их в нормы, обращённые к авторам. Отдельные учёные придумали кустарные эталоны из своих портфелей [42], и библиотечные руководства объясняют, как работают счётчики, но не говорят о том, что они означают [161][50]. Число, которое ищет каждый автор, невозможно найти.
1.3 На кон поставлено: карьера, тревожность и стимул к завышению показателей
Разница имеет значение, потому что цифры имеют последствия. Собственная документация SSRN описывает свои метрики как те, "которые авторы используют в целях повышения и получения постоянной должности, а учреждения используют в своей деятельности по найму и рейтингованию" [52]. Использование конкретно и задокументировано: известный правовед сообщил о том, что он "занимает 13-е место среди 3000 юристов по общему количеству загрузок за всё время, что юридическая школа учитывала в различных решениях о повышении и связанных с ними решениях" [12]; руководства по подаче статей в юридические журналы рекомендуют упоминать "загрузки SSRN (если много)" и появления в списке Top Ten в сопроводительных письмах [95]; а учреждения выпускали пресс-релизы о своём положении на SSRN вплоть до недель перед закрытием [101]. На агрегированном уровне загрузки SSRN коррелируют с коэффициентом 0,84 с основанными на цитировании рейтингами сотни юридических школ [77], ассоциация на уровне школы, которая не распространяется на отдельные статьи или авторов, предостережение экологического вывода из раздела 6.2(iii). То, что учреждения вообще действуют на основе таких показателей, является примером хорошо задокументированной динамики: общественные рейтинги являются реактивными, переформатируя поведение самых субъектов, которые они предположительно описывают. Механизм был детально описан для рейтингов юридических школ, где соизмеримость и самореализующееся пророчество заставляли школы перестраиваться вокруг этого показателя [58][132]. SSRN непосредственно подкреплял валюту, периодически отправляя электронные письма 30 000 лучшим авторам (примерно 8% из примерно 360 000 зарегистрированных авторов), чтобы сказать им, что они "входят в топ 10%" [161]. "10%" представляет собой долю зарегистрированных авторов (30 000/360 000 ≈ 8,3%), а по сравнению с полной базой зарегистрированных авторов, превышающей 1,9 миллиона [49], те же 30 000 находятся ближе к топ 2%, поэтому эта формулировка описывает ранжированных авторов, а не всех зарегистрированных лиц. Между тем советы по карьере предостерегают, что самостоятельно опубликованные метрики одни "вероятно не будут учитываться для целей повышения по должности и получения постоянной должности в юридических школах" [33], а более широкая литература по оценке документирует как глубоко индикаторное оценивание проникает в найм и постоянную должность, так и то, насколько плохо оно часто спроектировано [110][115][153]. Загрузки сами по себе являются мерами внимания, а не прямыми мерами качества: раннее использование предсказывает более поздние цитирования только скромно (корреляции около 0,4, объясняющие порядка 16% дисперсии в ранних работах [25], и 0,11–0,35 в более поздних оценках [80]), а совокупности высоко загруженных и высоко цитируемых статей существенно различаются [108]. Учреждения рассматривают эти цифры как свидетельство карьеры, даже хотя они не имеют шкалы и только слабую связь с научным влиянием, что представляет собой постоянное приглашение к неправильному прочтению в двух симметричных направлениях: без шкалы автор может преждевременно отказаться от направления работы на основании неправильного прочтения счётчика, или потратить дефицитное время и социальный капитал на продвижение статьи, чьи цифры никогда не были аномальными. Рейтинги, несмотря на все их недостатки, питали именно это повторяющееся решение о том, было ли оправдано дальнейшее продвижение статьи, а их удаление оставило этот выбор для принятия без данных (пункт, рассмотренный в разделе 6.4).
На кон поставлено и в эмоциональном плане: то, что авторы испытывают на панели управления, является отличительной формой метрической тревожности, и подсчёты загрузок отслеживаются компульсивно. Наблюдатели в области наукометрии описали жанр инструментов самоотслеживания видимости как "технологии нарциссизма" уже в 2012 году [177], а признание одного известного юриста о том, что мониторинг его подсчётов был "как наркотик для меня" (Bainbridge, 2007, как цитируется в литературе о манипулировании SSRN) стало символичным [44]. Та же исследовательская программа экспериментально установила, что производит тревожность: авторы сами загружают свои статьи, чтобы завысить подсчёты, и делают это наиболее интенсивно вблизи порогов видимости списков Top Ten и при неблагоприятном социальном сравнении с коллегами [44]. Социальные циклы обратной связи такого рода являются общим свойством рынков внимания: ранние социальные сигналы усиливают неравенство и непредсказуемость на культурных рынках [131], начальные положительные сигналы смещают последующие оценки [112], и успех порождает успех в полевых экспериментах [162]. Самостоятельно сообщаемые вехи в социальных сетях, смещённые в сторону высокопроизводительных лиц, обостряют сравнение для всех, чьей панели управления показывает 7. Таким образом, отсутствие общественного эталона создаёт тревожность, питает неправильное толкование и стимулирует искусственное завышение, которое подрывает метрику для всех. Проблема состоит в измерении, прежде чем в производительности: метрика, которая одновременно видна, эмоционально заряжена, имеет отношение к карьере и неинтерпретируема, является истинным отказом инфраструктуры измерения, а не личным недостатком человека, смотрящего на панель управления.
1.4 Кто больше всего пострадал: аспект справедливости
Стоимость нечитаемых метрик распределяется неравномерно. Авторы с обширными профессиональными сетями могут проводить неформальное сравнение; признанные авторы переносят предыдущую видимость из одной статьи в другую. Отсутствие публичных норм наиболее тяжело давит на молодых исследователей на начальном этапе карьеры, независимых и неаффилированных ученых, авторов в узких подобластях, авторов вне дисциплин, исторически доминирующих на платформе, и авторов вне элитных учреждений. Недостаток является структурным, а не просто информационным: механизм обнаружения SSRN направляет внимание через серии рабочих документов учреждений и оповещения о подписке eJournal [57]. Неаффилированный исследователь может опубликовать статью, но не может поместить ее в высокопроходимую серию учреждения и полностью зависит от классификации по предметам для видимости [168][53]. Для такого автора канал институционального раскрытия эффективно закрыт, поэтому вес открытия непропорционально падает на слои поиска и ИИ. Машинная видимость, рассматриваемая в разделе 8, является поэтому вопросом справедливости, а не просто техническим вопросом. Только принадлежность к области сдвигает ожидаемые загрузки в несколько раз до того, как появляется какое-либо суждение о достоинстве [168]. Эффекты престижа срабатывают в момент первого раскрытия, потому что публичная страница SSRN отображает имена авторов и аффилиации рядом с названием и аннотацией. Двойное слепое рецензирование работает иначе: скрытие личности авторов существенно снижает оценки рецензентов для престижных авторов (в одном исследовании 5027 отправок ICLR, с намного менее определяющим влиянием на решения о принятии) [154], и оценки реагируют на сигналы идентификации в экспериментах [64]. В нижней части распределения внимания явление представляет собой скорее отсутствие, чем неравенство: в данных альтметрики медианное социальное внимание исследований без финансирования равно нулю во всех изученных областях в большой выборке, сосредоточенной на ЦУР [41], и внимание на смежных открытых платформах распределяется более неравномерно, чем доходы в развитых экономиках, с коэффициентами Джини выше 0,9 [180]. Для среднего автора вопрос "плохо ли 7 загрузок?" — это попытка прочитать единственный сигнал, который возвращает система, в игре с структурно неравными шансами, а не проявление тщеславия. Любая рамка интерпретации, которая игнорирует эту асимметрию, будет систематически неправильно диагностировать находящихся в невыгодном положении, интерпретируя невидимость как отклонение. Асимметрия также проецируется в будущее: если появляющийся слой ответов ИИ унаследует предубеждения бренда и позиции, задокументированные для оптимизации под коммерческие генеративные системы [5][164], он будет воспроизводить, а не исправлять это неравенство. Эта перспектива наиболее остро влияет на неаффилированных исследователей и авторов из глобального юга, и это одна из причин, по которой аудит машинной видимости раздела 8.6 относится к программе справедливости, а не к техническим любопытствам платформы.
1.5 Документированный спрос на интерпретацию
Спрос на шкалу не гипотетичен. Это один из наиболее стойких паттернов в дискурсе научного сообщества, и он предшествует закрытию по крайней мере на десятилетие. В таблице 1 суммированы повторяющиеся кластеры вопросов и проблем авторов, наиболее убедительные документированные доказательства для каждого из них, ненадежный ярлык, который предлагает каждый кластер (краткий ответ, выглядящий полезным, но ошибочный), и раздел этой статьи, рассматривающий это.
Таблица 1. Спрос на интерпретацию: документированные кластеры проблем сообщества (2005–2026)
| # | Кластер | Что авторы спрашивают или сообщают | Документированные доказательства (уверенность) | Ненадежный ярлык | Рассмотрено в |
|---|---|---|---|---|---|
| 1 | «Мое число нормально?» — отсутствующий эталон | Является ли данное количество загрузок хорошим, плохим или типичным для сравнимой статьи | Открытый вопрос «Importance of paper download statistics», Academia StackExchange, 2016 (название и дата проверены через официальный API) [3]; вопросы пользователей о размещении на SSRN и его ценности [126]; повторяющиеся ветки форума, спрашивающие, сколько загрузок считается «хорошим» (существование ветки подтверждено; отдельные ответы не независимо проверяемы, и материал форума рассматривается на протяжении как слабое свидетельство спроса, а не как данные) [B-3]; запрос первого автора на «честный совет» по только что размещенной рабочей статье (Reddit, апрель 2026; существование проверено через архивы третьих сторон) [B-5] | Универсальный порог сырого количества («N загрузок = хорошо») | Разделы 3, 5–6 |
| 2 | Путаница в механике — просмотры или загрузки | Почему просмотры превышают загрузки; означает ли низкий коэффициент слабый реферат | Историческое практическое правило 3:1 [18]; сообщенный диапазон преобразования 11–19% [139][172]; недавнее среднее значение выборки ≈24% [83]; библиотечные руководства документируют неуверенность авторов относительно того, что включают счетчики [161] | Автоматическое утверждение, что низкое соотношение означает плохой реферат | Разделы 4–5 |
| 3 | Эмоции и социальное сравнение | Навязчивая проверка; смущение как при низких, так и при высоких показателях | «Like crack to me» (Bainbridge, 2007, как цитируется в [44]); экспериментальные доказательства самозагрузки вблизи порогов верхних списков при социальном сравнении [44] | Сравнение себя со средним показателем платформы или видимыми звездами | Разделы 1, 5 |
| 4 | Свидетельство карьеры — что заменяет строку рейтинга в досье | На что ссылаться в материалах по присвоению должности, продвижению и найму после закрытия | Рейтинг загрузок «учитывается в различных решениях о продвижении и связанных решениях» [12]; письма с уведомлением о попадании в топ-10% [161]; рекомендации для сопроводительного письма [95]; пресс-релизы учреждений [101]; описание платформой оценочного использования [52] | Цитирование необработанного совокупного числа без даты, источника или знаменателя | Раздел 6 (Таблица 13) |
| 5 | Спам с предложениями после размещения | Незапрошенные приглашения журналов, поступающие вскоре после размещения | «Everyday, I get at least two of these emails» (Reddit r/AskAcademia, 2023; проверено через архив; автор публиковался в журнале MDPI, а не на SSRN) [127]; сбор адресов из статей «например, размещенных на SSRN» [107]; проверки объема предложений [9][84][63]; систематический обзор, выявивший 29 эмпирических исследований академического спама [61] | Вывод идентичности или намерения читателей из совокупного счетчика | Раздел 7 |
| 6 | Доверие к счетчикам — боты, манипуляции, внезапные падения | Реальны ли цифры; почему падают счетчики | «SSRN does absolutely zero to validate their accuracy» (Goldman, 2005, предшествуя текущим фильтрам; позже обновление отмечает, что SSRN не учитывает повторные загрузки из одного источника) [66]; опубликованная SSRN фильтрация целостности данных [144][66][69]; трафик ботов составляющий ~74% просмотров аннотаций, но только ~7% загрузок в ранних данных RePEc [99]; крупномасштабные эпизоды фильтрации ботов на RePEc в течение 2025–2026 [129] | Отношение к отображаемому числу как к точному количеству уникальных читателей-людей | Разделы 4, 9 |
| 7 | Диагностика — «почему нулевые загрузки?» | Что означает нулевое значение или застой в первые недели | Неуверенность авторов после закрытия, документированная в ветках сообщества (существование подтверждено через архивы третьих сторон) [B-5]; страницы поддержки платформы описывают метрики, но по состоянию на август 2026 не предлагают интерпретационного руководства [52][50] (аудит поиска, раздел 2.5) | Отношение к нулевому значению перед распределением как к отказу | Разделы 4–6 |
Примечание. Только цитаты, независимо проверенные против живого или архивированного источника, воспроизводятся дословно; весь остальной материал сообщества перефразируется и обозначается его статусом уверенности. Этика цитирования постов пользователей, включая анонимизацию и обработку удаленного контента, рассматривается в разделе 9.
Самый сильный кластер в таблице 1 — постоянный вопрос «is my number normal?», который повторяется в течение лет, платформ и дисциплин. Даже инсайдеры платформы не предлагают эталона в ответ, и сарказм, который часто отвечает на это в форумах сообщества, сигнализирует, что никто, включая опытных пользователей, не обладает отсутствующей шкалой [B-3]. Кластеры также причинно связаны: отсутствующий эталон (кластер 1) создает эмоциональную нагрузку (кластер 3), которая создает стимул к манипуляциям, документированный в [44], который, в свою очередь, подрывает доверие, исследуемое в кластере 6. Восстановление интерпретируемости решает цепь в ее корне. Рамки рассчитаны не на увеличение загрузок, а на восстановление смысла.
1.6 Позиции, которые отстаивает статья: восемь положений
Это позиции, которые отстаивает статья; каждая аргументируется в отмеченном разделе.
1. Сырые подсчёты неинтерпретируемы без референтного класса. Совокупное число загрузок не имеет устойчивого значения без учёта возраста работы, области, когорты размещения, канала распределения и предшествующей видимости автора [83][168][178][53]. Это проблема референтного класса из раздела 5, и она делает вопрос «7 загрузок — это хорошо?» некорректно поставленным в том виде, в котором задан.
2. Низкий охват и низкая конверсия — разные диагнозы. Работа, с которой сталкиваются немногие, представляет иную проблему, чем работа, которую просматривают многие, но загружают немногие, и требует иного действия. Невидимость — это не отклонение содержания. Разделы 4–5 развивают это различие в диагностику охвата и конверсии (таблица 9), включая конфигурацию «скрытого интереса», в которой сильная конверсия сосуществует со слабым охватом.
3. Счётчики выжили; сравнительная шкала — нет. Асимметрия закрытия (числа сохранены, нормы удалены [149]) описывает состояние после Rankings точно, и это преобразует давно скрытую проблему интерпретируемости в неотложную и универсальную (раздел 2).
4. Процентильный ориентир — общественное благо. Число, которое каждый автор гуглит и не может найти, — это таблица процентилей по дисциплине и возрасту работы. Разделы 5 и 8 определяют, как сообщество может создать и поддерживать такую таблицу, теперь, когда её больше нельзя получить с платформы.
5. Откалиброванные нормы требуют панели, наблюдаемой с момента размещения. Опубликованные доказательства состоят из устаревающих поперечных сечений и отдельных снимков [139][85][168][83]. Одно недавнее крупное исследование явно выявляет данные панели как необходимый следующий шаг [83]. Без наблюдения с нулевого дня нормы за первую неделю и первый месяц являются экстраполяциями и должны быть помечены как таковые (раздел 8).
6. Многомерный ориентир превосходит одиночный показатель тщеславия. Раздельное сообщение нормализованного охвата, производительности загрузок, конверсии, импульса и последующей валидации (CSAB, таблица 10) сохраняет диагностическую информацию, которую любой составной индекс уничтожает (раздел 5).
7. Уровень ответов ИИ становится новым привратником внимания. Обнаружение мигрирует вверх по стеку, от бренда журнала к репозиторию, к поисковой системе, к системам ответов ИИ, которые синтезируют единый ответ и ссылаются на небольшое количество источников [5][164]. Четверть взрослого населения США уже ежедневно использует чат-ботов ИИ [121], тогда как надёжность этих систем как каналов цитирования остаётся спорной [82] и не существует контролируемого исследования видимости научных препринтов в них [100]. Раздел 8 излагает компактный протокол аудита; полный аудит зарезервирован для сопутствующей работы.
8. Протокол панели и досье необходим сейчас. Авторы и комитеты не могут ждать новой инфраструктуры данных. Раздел 6 содержит временные правила для чтения панели и семиэтапный протокол доказательств для досье (таблица 13), главное требование которого заключается в том, чтобы каждое указанное число отображало свой источник, временное окно и ограничения.
1.7 Вклады
Приведённый ниже список описывает, что статья добавляет к существующей литературе, в том порядке, в котором это развивается в разделах.
1. Диагноз. Она выявляет проблему класса сравнения в метриках использования платформы и называет лежащее в её основе явление: холодный старт научного внимания. Термин заимствован из литературы по системам рекомендаций, где элемент холодного старта не имеет истории взаимодействий, необходимой для её ранжирования [133]. При таком холодном старте новые работы и новые авторы входят в систему распространения, в которой раннее внимание существенно зависит от архитектуры платформы, механизмов распределения и предшествующей репутации, прежде чем качество содержания сможет оказать своё полное влияние [72][111][140][83]. Центральное утверждение — тезис о некорректной постановке из раздела 1.1: вопрос из заголовка не имеет ответа до тех пор, пока не будут указаны его знаменатель и группа сравнения.
2. Консолидированная карта ориентиров. Она собирает, впервые после закрытия сервиса (аудит раздела 2.5, август 2026 года), каждый проверенный эмпирический ориентир для загрузок и просмотров аннотаций SSRN в одну таблицу (таблица 7) с явными рамками выборки, временными характеристиками, оговорками об устаревании и оценкой надёжности источника для каждой строки. Эти ориентиры включают доказательства распределения на большой выборке [83], квазилогнормальные выборки из списков лучших [85], выборки юридических работ [139][168][171][172] и платформенные агрегаты [1][49].
3. Модель воронки внимания с диагностикой. Она разбивает распространение на видимость, просмотр аннотации, загрузку полного текста и последующее использование. Затем она выводит матрицу охвата по конверсии (таблица 9), которая отделяет невидимость от отказа и включает конфигурацию скрытого интереса, которую необработанные счётчики систематически скрывают.
4. Инструменты интерпретации. Она преобразует консолидированную карту ориентиров в градуированную шкалу интерпретации (Nascent / Modest / Solid / Strong / Exceptional; таблица 8), диапазон конверсии с разработанными примерами и Эталон холодного старта научного внимания (CSAB; таблица 10) — многомерный формат отчётности, нормализованный по области, возрасту, когорте и предшествующей видимости автора. Диапазоны шкалы являются сравнительными только в пределах одной области и возраста публикации, так как само членство в области смещает ожидаемые загрузки в несколько раз, и каждая граница либо имеет источник, либо явно отмечена как авторская оценка.
5. Практический слой. Она предоставляет правила чтения собственной панели управления, диагностику случая нулевых загрузок, таблицу ситуационных действий (таблица 23), предполагаемую типологию сигналов хищнического спама-привлечения со следующей оговоркой: такой спам не влияет на счётчики и не служит доказательством прочтения (таблица 14), и семиступенчатый протокол досье (таблица 13).
6. Исследовательская программа, готовая к предварительной регистрации. Она определяет перспективную панель с наблюдениями в 1, 3, 7, 14, 30, 60, 90 и 180 дней с момента размещения, и два квазиэкспериментальных дизайна: курируемое распределение оповещений по электронной почте как шок внимания на уровне одной статьи, и отказ от рейтингов как естественный эксперимент в интерпретируемости метрик. Она также определяет набор данных процентилей, созданный сообществом, как единственный оставшийся путь к свежим процентилям, компактный протокол аудита машинной видимости для систем поиска на основе ИИ, и предварительно определённый, чисто описательный отчёт о собственной траектории загрузок данной статьи. Каждое исследование выполнимо при низких затратах и в пределах ограничений доступа и этики раздела 9, с числовыми предсказаниями, изложенными в виде предварительно определённых диапазонов, а не выводов.
1.8 Организация статьи
Остальная часть статьи состоит из девяти дополнительных разделов и пяти приложений. Раздел 2 реконструирует событие и его контекст: полную хронологию пакета реформ 2026 года, что осталось и что было удалено (Таблица 2, Рисунок 1), и заявленную платформой рациональность перераспределения ресурсов и переориентации. Раздел 3 представляет проверенные данные о распределении и показывает, почему среднее значение вводит в заблуждение. Он охватывает разрыв между средним и медианой [83], квазилогнормальный хвост [85] и дисциплинарную неоднородность [168] (Рисунки 2–4, Таблицы 3–5), рассматриваемые на фоне эффекта Матфея и кумулятивного преимущества [104][105][131][162] (динамика, которая была непосредственно количественно определена в продольных карьерах и траекториях цитирования [120]), и различие между показателями внимания и показателями качества [25][80][108][178]. Раздел 4 исследует механику счётчиков: фильтрацию и целостность данных [144][66], трафик роботов и фантомный трафик с необходимыми контраргументами [99][106][129], архитектуры платформ (Таблица 6) и гигиену метаданных и версионирования. Раздел 5 излагает ядро интерпретации: аргумент класса ссылок, консолидированную карту ориентиров (Таблица 7), шкалу интерпретации (Таблица 8), полосу преобразования, матрицу охвата по преобразованиям (Таблица 9) и CSAB (Таблица 10). Раздел 6 переводит фреймворк в практику для авторов и комитетов оценки, включая протокол досье (Таблица 13) и, в Приложении A, руководство на основе конкретных ситуаций (Таблица 23). Раздел 7 анализирует паразитический слой экономики внимания, хищные приглашения, рассматриваемые как гипотетические сигналы видимости, при этом все утверждения о сроках и распространённости сформулированы как гипотезы [9][61][63][84][107]. Раздел 8 излагает готовую к предварительной регистрации эмпирическую повестку дня, включая краткое рассмотрение миграции внимания вверх по стеку на уровень ответов ИИ и его последствия для обнаруживаемости препринтов [5][100][82][121][164]. Раздел 9 детализирует ограничения, включая однобивающий источник лучшей доступной доказательной базы распределения [83], устаревание выборок 2012–2015 и нестабильность документации платформы. Раздел 10 завершает работу политическими рекомендациями для SSRN (главным образом, анонимные процентильные полосы по дисциплине и возрасту статьи в качестве замены, которая восстанавливает контекст без возобновления рейтинговой конкуренции) и для научного сообщества.
2. Событие: закат рейтингов и его контекст
2.1 Какими были рейтинги
На протяжении большей части истории SSRN его счётчики использования были встроены в плотный аппарат сравнительного анализа. На уровне статей платформа поддерживала списки Top 10,000 по загрузкам за двенадцать месяцев и за все время, наряду со списками «последних лучших статей» (per-eJournal), рассчитываемыми по скользящим окнам в шестьдесят дней. На уровне авторов она поддерживала список Top 30,000 во всех дисциплинах и дисциплинарные лиги, такие как Top 3,000 авторов права, сортируемые по новым загрузкам, общим загрузкам, загрузкам на статью и цитированиям. На уровне учреждений она поддерживала ежемесячные таблицы лиг, включая Top 350 U.S. Law Schools и Top 500 International Law Schools [B-9, страницы исторических рейтингов; все такие URL-адреса возвращают ошибку или страницу-заполнитель с 15 июля 2026 года и могут быть процитированы только из архивных копий]. Платформа также переводила рейтинг в прямую обратную связь по процентилям. Как задокументировано в руководстве Библиотеки права имени Галлахера Университета Вашингтона по метрикам SSRN, «SSRN периодически отправляет сообщения авторам из топ 30,000 по новым загрузкам и по общему количеству загрузок, чтобы сообщить им, что они находятся в топ 10%». Согласно собственной цифре руководства «более 360,000 авторов», этот порог соответствовал примерно топ 8% перечисленных авторов (30,000 из примерно 360,000) [161, accessed 14 August 2026], широкий верхний слой, а не узкая элита; Раздел 1.3 отмечает, что в сравнении с полной зарегистрированной базой те же 30,000 находятся ближе к топ 2%. Эти списки и сообщения были, по сути, единственной предоставленной платформой информацией о процентилях загрузок SSRN, ориентированной на авторов, когда-либо ставшей общедоступной.
Аппарат сравнительного анализа был не просто украшением. Black и Caron предложили в 2006 году, что загрузки SSRN могли бы служить «бета»-показателем научной результативности юридических факультетов, дополняя опросы репутации и подсчёты цитирований [18]. Тот же сборник конференции содержит критический анализ предложения [45]. На уровне учреждений предложение удалось: рейтинги загрузок вошли в материалы по найму, файлы повышения и публичные материалы учреждений. Собственная документация поддержки SSRN описывает его метрики как показатели, «которые авторы используют в целях продвижения и получения постоянной должности и которые учреждения используют в своей деятельности по найму и составлению рейтингов» [52, accessed 14 August 2026]. Руководство по публикации Legal Writing Institute советовало авторам упоминать «загрузки SSRN (если их много), включение в списки Top Ten Downloads SSRN» в сопроводительных письмах юридическим журналам [95]. В июне 2026 Stephen Bainbridge открыто задокументировал роль рейтингов в карьере, заявив: «я занимал 13-е место среди 3,000 авторов права по общему количеству загрузок за все время, что факультет принимал во внимание при различных решениях о продвижении и смежных решениях» [12]. Собственное руководство SSRN задокументировало трансформацию платформой юридического научного общения в препринте своего тогдашнего генерального директора [68]. Учреждения также продвигали лиги: еще в январе 2026 года Maynooth University объявила, что её School of Law and Criminology заняла первое место среди факультетов Ирландии в SSRN Top 500 International Law Schools, ссылаясь на более 143,500 загрузок [101]. Влияние аппарата на поведение задокументировано в анализе Edelman и Larkin логов серверов SSRN. Исследование выявило, что обманчивые собственные загрузки интенсифицировались в тот самый момент, когда статья приближалась к границе списка top-ten, и определило социальное сравнение, а не только карьерные интересы, как основной фактор манипулирования [44]. То же исследование привело замечание, приписываемое Bainbridge в 2007 году, что мониторинг своих загрузок был «как crack для меня» [44].
Аппарат имел вторую функцию, которая привлекла меньше внимания. Цитирования и опросы репутации развиваются на протяжении многих лет; рейтинги же обеспечивали обратную связь почти в реальном времени, и они позволяли молодым ученым и авторам вне престижных учреждений демонстрировать видимое воздействие напрямую, без ожидания более медленных и консервативных инструментов контроля доступа. Несмотря на их недостатки, таблицы лиг были единственным сравнительным инструментом, в равной степени видимым для каждого автора на платформе. Это отчасти объясняет, почему их удаление, как утверждается в Разделе 1.4, в большей степени влияет на авторов, у которых наименьше неофициальных альтернатив. Прямых статистических доказательств влияния удаления пока не существует, поэтому это ориентировочное предположение, которое RQ1 (Раздел 8.5) тестирует: двусторонний тест спрашивает, сконцентрировало или рассеяло ли удаление внимание, не предполагая результат.
2.2 Хронология реформирования в 2026 году
Отмена Рейтингов 15 июля 2026 года стала кульминацией последовательности решений платформы, начавшихся в конце 2025 года и резюмированных на рисунке 1.
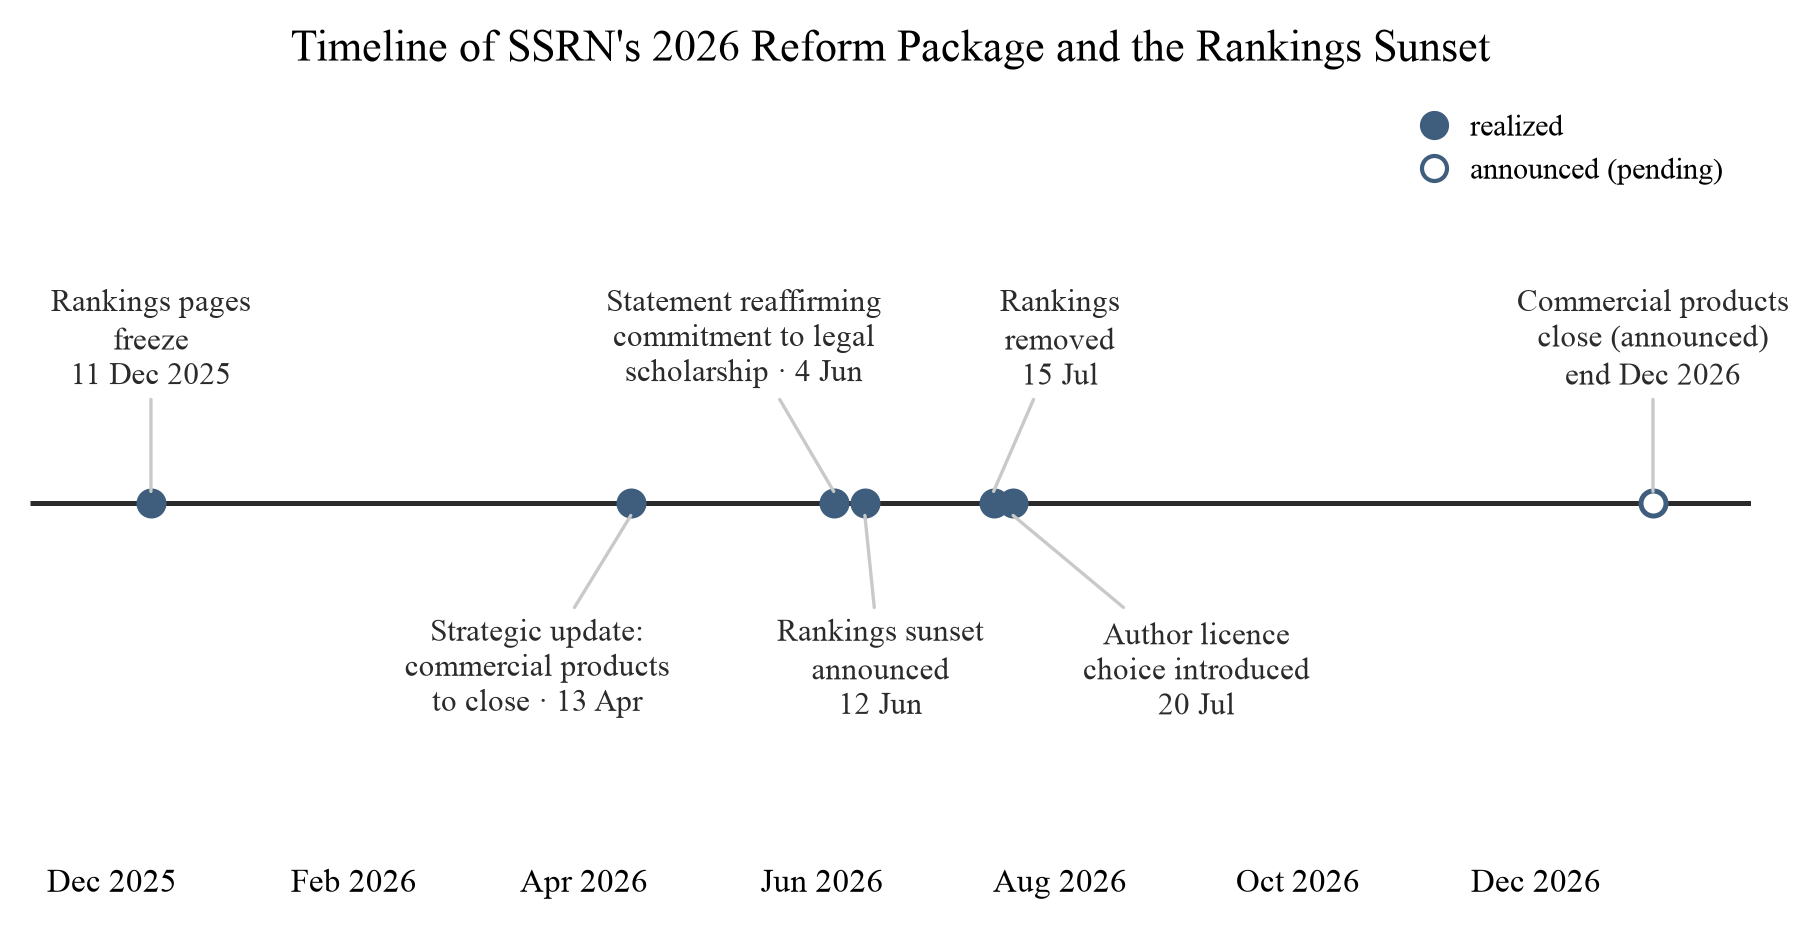
Рисунок 1. Временная шкала пакета реформ SSRN 2026 года. События: замораживание страниц рейтинга загрузок электронных журналов (с 11 декабря 2025 года, как задокументировано в сообщении блога TaxProf от 25 января 2026 года [B-2]); стратегическое обновление, объявляющее о закрытии всех коммерческих продуктов к концу 2026 года (13 апреля 2026 г.) [146]; официальное заявление, подтверждающее приверженность SSRN юридической науке (4 июня 2026 г.) [147]; объявление о том, что Рейтинги будут закрыты «с 1 июля 2026 года» (12 июня 2026 г.) [148]; фактическое удаление Рейтингов (15 июля 2026 г.) [149]; введение выбора лицензии авторами (20 июля 2026 г.) [150]; объявленное закрытие оставшихся коммерческих продуктов (конец декабря 2026 г.) [146]. Источники: [146][147][148][149][150][B-2].
Сворачивание началось еще до какого-либо официального объявления. 11 декабря 2025 года страницы рейтинга загрузок электронных журналов перестали обновляться. Пол Карон в течение более двух десятилетий вел еженедельную колонку «Top Five New Tax Papers», построенную на основе этих рейтингов. В посте от 25 января 2026 года он задокументировал, что налоговые рейтинги были заморозены на периоде «12 октября 2025 г. – 11 декабря 2025 г.» и написал, что «это может быть конец колонки SSRN Top Five New Tax Papers» [B-2, цитируется как парафраза из поста от 25 января 2026 года, а не из какого-либо объявления SSRN].
13 апреля 2026 года SSRN опубликовала «Стратегическое обновление», объявляя о возобновленной приверженности основной миссии обмена исследованиями и о закрытии всех коммерческих продуктов (Research Paper Series, Sponsored Networks, Site Subscriptions, платные материалы конференций, панели аналитики, вакансии и объявления, потоки данных) к концу декабря 2026 года [146]. Специалисты библиотечного сообщества отреагировали на эти изменения в течение дней [34], и подразделение Digital Commons компании Elsevier опубликовало руководство по миграции для учреждений, чьи коллекции Research Paper Series выводились из обращения [47].
Объявление вызвало публичные разногласия в юридическом сообществе, которое было наиболее заинтересовано в инфраструктуре рейтингов. 3–4 июня 2026 года Бейнбридж опубликовал широко читаемую критику под названием «The Social Science Research Network Has Jumped the Shark», за которой последовал пост, в котором отмечалось, что SSRN ответила на его критику уточнениями о сроках закрытия Research Paper Series и сохранении предметных электронных журналов [12]. 4 июня 2026 года SSRN опубликовала заявление о своей постоянной приверженности юридической науке, обещая, что распределение электронных журналов и оповещения по электронной почте будут продолжаться без изменений [147]. 7 июня 2026 года Карон ответил Бейнбриджу на блоге TaxProf под названием «SSRN Has Not Jumped the Shark» [B-11]. Этот обмен высказываниями представляет собой краткий публичный документ о том, какую ценность сообщество придавало сравнительным возможностям платформы накануне их удаления.
12 июня 2026 года SSRN объявила, что будет прекращать работу Рейтингов, начиная с 1 июля 2026 года, заявляя, что «в SSRN мы всегда верили, что исследование должно говорить само за себя» [148]. Отключение вступило в силу на две недели позже, чем первоначально объявлялось: 15 июля 2026 года были удалены рейтинги статей, авторов и учреждений [149]. Пять дней спустя, 20 июля 2026 года, дальнейшая реформа ввела выбор лицензии авторами [150]. Двухнедельный промежуток между объявленными и фактическими датами и месячный интервал между объявлением и выполнением имеют сами по себе аналитическое значение: они создали период ожидания, в течение которого авторы и учреждения могли наблюдать предстоящие изменения, момент, рассмотренный в квазиэкспериментальном дизайне раздела 8.
2.3 Официальное обоснование и его эволюция
Заявленным обоснованием закрытия рейтингов было перераспределение ресурсов и переориентация платформы. Объявление от июля объяснило, что рейтинги «требуют значительных ресурсов на разработку и поддержку продукта» и рассматривало решение в контексте переориентации на более быструю публикацию, лучшую обнаруживаемость и целостность исследований. В нём также говорилось, что «количество загрузок и статистика цитирования будут продолжать регистрироваться и отображаться на ваших отдельных статьях и в профиле автора» [149]. Объявление оставляет открытой возможность восстановления сравнительных функций: SSRN объявила, что может пересмотреть идею различных рейтингов [149], поэтому удаление не следует называть постоянным. Молчание в официальных материалах также имеет значение: объявления не приписывают решение манипуляции метриками, их искажению или конкурентному неправомерному использованию рейтингов, и объяснения, предоставляющие такие мотивы, выходят за рамки опубликованных текстов [148][149].
Тон официального объяснения эволюционировал между объявлением и целевой страницей, заменившей URL-адреса рейтингов. В то время как пост июня говорил о ресурсах, страница замены указывает, что новое направление SSRN ставит отдельных авторов и их работу в центр всего, что мы делаем, и что объединённые таблицы лидеров учреждений и подразделений больше не вписываются в эту картину [B-8; страница находится за ограничениями доступа, и эти фразы цитируются из копий поискового индекса, поэтому архивный снимок должен сопровождать любую цитату]. Пост июня представляет закрытие как решение по затратам, страница замены — как принципиальную переориентацию от межинституционального сравнения.
SSRN не оставил авторов полностью без официального указателя на контекст. Справочная документация по оценке влияния статьи направляет авторов на счётчики на уровне статьи (просмотры аннотаций и загрузки), дополненные PlumX Metrics, продуктом альтметрики Elsevier, агрегирующим цитирование, использование и сигналы из социальных сетей [50, доступно 14 августа 2026]. PlumX таким образом является де-факто заменой интерпретативного контекста платформы. Это частичная замена: она агрегирует дополнительные сигналы для отдельной статьи, но не предоставляет информацию о распределении, процентилях или сравнении когорт. Это те элементы, которые рейтинги, какими бы несовершенными они ни были, предоставляли. Это закрытие не распространяется на интеграцию SSRN с рабочими процессами журналов: программа First Look продолжает подключать платформу к более чем 1200 журналам Elsevier [48][145]. Коммерческое управление платформой также помещает эти решения о продукте в контекст высококонцентрированного рынка научного издательства [94].
2.4 Что осталось и что было удалено
Таблица 2 отображает состояние платформы после завершения рейтингов вместе со значением для измерения каждого элемента: что означает каждая сохранённая, исчезнувшая или неотчётная функция для любого, кто пытается интерпретировать показатель. Удаление было асимметричным. Каждый счётчик на уровне статей и профилей сохранился. Сравнительный аппарат, построенный на основе этих счётчиков, был полностью удалён.
Таблица 2. Что осталось и что было удалено после завершения рейтингов 15 июля 2026 г., со значением для измерения. Источники: [147][149][161][B-8][B-9]; строки механизма экспозиции: [53][57][55][144][66][69].
| Функция | Статус после 15 июля 2026 г. | Основание источника | Значение для измерения |
|---|---|---|---|
| Счётчики загрузок по статьям | Остаются; отображаются на страницах статей | Подтверждено дословно в объявлении о завершении [149] | Сырые данные об использовании остаются видимыми, но теперь не имеют своего референтного класса |
| Просмотры аннотаций по статьям | Остаются (не названы дословно в объявлении о завершении, в котором указаны «счётчики загрузок и статистика цитирования»; просмотры продолжают отображаться) | [149], наблюдение платформы, проверено 14 августа 2026 г. | Охват остаётся видимым, поэтому диагностика охвата-конверсии на уровне статей (Таблица 9) остаётся вычислимой |
| Статистика цитирования (статья и профиль автора) | Остаются | Подтверждено дословно [149] | Последующее использование может по-прежнему дополнять ранние меры внимания |
| Профиль автора (статьи, аффилиация) | Остаётся | Наблюдение платформы, проверено 14 августа 2026 г. | Агрегирование на уровне портфолио остаётся возможным с одним и тем же отсутствующим знаменателем |
| Подписки eJournal и оповещения по электронной почте | Остаются | «Продолжаются без изменений», заявление от 4 июня 2026 г. [147] | Канал распределения push-уведомлений сохраняется, поэтому ранние счётчики остаются зависимыми от архитектуры (раздел 4.4) |
| Классификация по темам (1–7, выбранная автором) | Остаются; определяют маршрутизацию eJournal | Документация платформы [53] | Классификация является потенциально значимой переменной экспозиции |
| Кураторское распределение eJournal | Продолжается; включение «отобрано и нацелено, не гарантировано» | [53][57][147] | Статус распределения и дата должны моделироваться как воздействие, а не как фон |
| Задержка распределения в разделах с большим объёмом | Продолжается; до 45 дней | [53] | Счётчики за первый месяц могут смешивать режимы до и после распределения |
| Внешнее индексирование (Google, Google Scholar) | Продолжается на основе управляемого поисковой системой времени («6–9 месяцев или более») | [55] | Процесс экспозиции с интервальной цензурой: дата экспозиции ограничена, но не наблюдается |
| Фильтрация подозрительной активности | Продолжается | [144][66][69] | Счётчики представляют отфильтрованные события, а не проверенное чтение или одобрение |
| Использование статей в ответах AI | Не сообщается SSRN | Отчётность платформы отсутствует; раздел 8.6 | Видимость для машин требует независимого повторного аудита (Исследование 2) |
| Метрики PlumX на страницах статей | Остаются; официальный указатель для оценки влияния | Документация поддержки [50] | Дополнительные сигналы на уровне статей, но без распределения, процентиля или сравнения когорт (раздел 2.3) |
| Списки лучших статей (Топ 10 000; на каждый eJournal последние/все время) | Удалены; URL-адреса возвращают ошибку или страницу завершения | [149][B-8][B-9] | Основная сравнительная рамка — и возможный механизм обнаружения — исчезла |
| Списки лучших авторов (Топ 30 000; дисциплинарные рейтинги) | Удалены | [149][B-9] | Процентильная позиция на уровне автора больше не видна публично |
| Лиги на уровне учреждений (Топ 350 США / Топ 500 международных школ права и т. д.) | Удалены | [149][B-8][B-9] | Сравнение учреждений больше не может быть вычислено из данных платформы |
| Представление процентилей на публику (рейтинг автора, позиционирование «топ 10%») | Удалено вместе с инфраструктурой рейтингов | [149][161] | Референтный класс теперь должен быть восстановлен внешним образом (разделы 5, 8) |
| Уведомления по электронной почте «Топ 10% авторов» | Судьба не рассмотрена в официальных сообщениях; письма были связаны с инфраструктурой рейтингов | [161][149] | На сигнал процентиля, пригодный для использования в досье, больше нельзя рассчитывать |
Выжившие строки в Таблице 2 — это в точности сырые счета и механизм экспозиции, который их питает: платформа продолжает производить числа с той же скоростью, что и раньше. Удаленные строки — это в точности набор сравнительных фреймов: распределения, пороги, ранги и сообщения по процентилям. Событие таким образом имеет точную информационную структуру (данные сохранены, класс сравнения исключен), и эта структура превращает давнишнюю скрытую проблему, как интерпретировать номер SSRN, в острую и универсальную. Мы называем измененное свойство платформы непрозрачностью эталонов: градуированное свойство платформы, описывающее, публикует ли она распределительную статистику, необходимую для контекстуализации отдельного значения (процентили, медианы, распределения когорт), или только сырые счета, средние значения и списки top-N. 15 июля 2026 года SSRN перешла в один шаг от частичной прозрачности к почти полной непрозрачности эталонов, и остальную часть статьи можно читать как исследование того, во что это свойство обходится её пользователям. Непрозрачность, так определённая, имеет по крайней мере четыре измерения: охват совокупности (кого описывает опубликованная статистика), гранулярность класса сравнения (кондиционируют ли они по полю, возрасту и когорте), временная устойчивость (остаются ли определения и окна сопоставимыми с течением времени) и проверяемость (достаточно ли публичны правила подсчета, чтобы их проверить). Эти четыре измерения работают отчасти независимо: ранжирования могут уменьшить одну форму непрозрачности, одновременно усугубляя другую, если их знаменатели и правила отбора неясны. Эта частичная независимость — причина того, что рекомендации платформы в Разделе 10.4 (пункты 4 и 8) касаются самого раскрытия информации, а не только возврата сравнительных чисел. Чтобы сделать свойство измеримым, каждое измерение оценивается по явному порядковому чеклисту, применяемому к общедоступному интерфейсу и документации платформы: охват совокупности (0 = только сырые счета, 1 = опубликована сводная статистика на уровне платформы, 2 = распределительная статистика для определенных совокупностей); гранулярность класса сравнения (0 = нет, 1 = одна ось, такая как поле, 2 = совместное кондиционирование поле × возраст × когорта); временная устойчивость (0 = определения подсчета и окна не документированы или молча пересмотрены, 1 = документированы, 2 = документированы и версионированы); и проверяемость (0 = правила подсчета не опубликованы, 1 = описаны в прозе, 2 = опубликованы в проверяемых подробностях). Профиль непрозрачности платформы — это четверка баллов, а не одна метка. Один и тот же инструмент оценивает SSRN до и после отключения (снижая её показатели по охвату, гранулярности и, для выведенных списков, гранулярности класса сравнения), и это позволяет кросс-платформенным сравнениям в Таблице 6 быть представленными как баллы, а не впечатления. Платформа может отображать много чисел и остаться почти полностью непрозрачной. Рубрика — это первая операционализация, подлежащая уточнению и проверке между оценивающими, а не готовый индекс.
2.5 Спрос на интерпретацию
Вопрос, который закат сделал срочным, задавался задолго до этого. Таблица 1 (раздел 1.5) собирает задокументированные кластеры спроса авторов на интерпретацию, ограниченные проверенными источниками. Материалы форума цитируются там как свидетельство спроса, а не распределений, и цитаты из постов пользователей воспроизводятся только там, где сам пост был расположен (этика цитирования полуобщественных постов форума рассмотрена в разделе 9).
Нижеследующие отрицательные утверждения основаны на структурированном аудите поиска, а не на случайном поиске, как и параллельные утверждения в разделах 1.2, 1.5 (таблица 1) и 8.8. Протокол излагается здесь один раз. Мы составили перечень более 25 формулировок запросов на английском языке, организованных в шесть кластеров намерения: нормативные ("how many SSRN downloads is good"), дефиниционные ("what does an SSRN download count include"), навигационные после закрытия ("SSRN rankings gone — where to compare"), оценочные ("SSRN downloads as tenure evidence"), диагностические ("SSRN paper zero downloads why") и практические ("how to increase SSRN downloads"). Для каждого запроса мы записали, кто на него в настоящее время отвечает и насколько хорошо, критерием служила способность найденного источника предложить многоуровневые, зависящие от области пороговые значения, а не просто описание метрики или анекдот. В качестве положительного контроля мы выполнили аналогичные запросы для h-индекса, показателя ResearchGate и количества цитирований, которые надежно выявили жанр пороговых руководств, задокументированный в [118][128]. Те же формулировки намерений для загрузок SSRN не выявили эквивалента ни до, ни после закрытия. Пробел распространяется на наиболее часто консультируемые общественные справочники: энциклопедические обзоры платформы описывают, что такое счетчики, но не предлагают интерпретативных норм для них [170]. Аудит был проведен в июле–августе 2026 г. с использованием собственного конвейера, охватывающего поисковые машины общего назначения и потребительские системы ответов на основе искусственного интеллекта, автоматизирующие выполнение запросов и оценку качества ответов. Полный список запросов доступен у автора. Результат представляет собой отрицательный результат и утверждается как именно таковой: отсутствие свидетельств по состоянию на момент проведения аудита, в охватываемых языках и механизмах поиска, а не доказательство того, что такой ресурс не может существовать.
Для смежных метрик интерпретативный спрос, задокументированный в таблице 1 (раздел 1.5), уже давно удовлетворяется массовым жанром: «что считается хорошим h-индексом» обслуживается десятками многоуровневых, зависящих от области пороговых руководств [118], а цитационные нормы на уровне дисциплины являются предметом широко читаемых объяснений [128]. Для загрузок SSRN такого жанра не существует. Более того, лучшее из существовавших структурированных руководств, страница библиотеки Школы права Вашингтонского университета, продолжала после 15 июля 2026 г. описывать рейтинги Top Authors и Top Papers в настоящем времени, что делало это частично вводящим в заблуждение именно в момент, когда спрос достиг пика [156, доступно 14 августа 2026 г.]. Закрытие не создало проблему интерпретации; оно удалило единственный частичный ответ, который был у экосистемы, в момент, когда коллективная память о распределениях начала стираться.
3. Что показывают данные: почему среднее ошибочно
3.1 Что измеряют счетчики и что они не измеряют
Любое использование сохранившихся счетчиков предполагает объяснение того, что они измеряют. Таблица 3 резюмирует содержание измерения для каждой метрики, ее основные смешивающие факторы и диагностическую роль, которую она может надлежащим образом играть.
Таблица 3. Что измеряют метрики SSRN — и что они не измеряют.
| Метрика | Наиболее точное содержательное толкование | Основные смешивающие факторы | Надлежащая диагностическая роль |
|---|---|---|---|
| Просмотры страницы абстракта | Охват целевой страницы статьи | Поисковая индексация, размещение на платформе, репутация автора, внешнее продвижение, название, размер области, время в сети | Видимость / охват |
| Загрузки полного текста | Намерение изучить или использовать полный текст статьи | Все факторы, влияющие на просмотры, плюс качество абстракта и релевантность, а также препятствия при загрузке | Вовлеченность |
| Загрузки на просмотр абстракта | Условный переход от видимости целевой страницы к получению полного текста | Малые знаменатели, повторяющееся поведение, гетерогенные источники трафика | Конверсия |
| Цитирования | Наблюдаемое использование в более поздних научных документах | Нормы цитирования в области, задержка публикации, охват базы данных, самоцитирование, эффекты статуса | Использование в последующих научных работах |
| Сигналы Altmetric / PlumX | Более широкое онлайн-взаимодействие | Состав платформы и поведение пользователей | Дополнительные доказательства распространения |
Содержание таблицы можно сжать в сравнение двух уравнений. Толкование, которое панель приборов молчаливо предлагает, — это Загрузки = Научные достоинства. Защищаемое представление таково:
Наблюдаемые загрузки = f(Q, E, R, C, T, P, ε),
где Q обозначает признаки, связанные с качеством или релевантностью исследования, E — видимость, R — репутация, C — коммуникационные характеристики, T — время и возраст, P — механизмы платформы, ε — ненаблюдаемые факторы. Выражение классифицирует смешивающие факторы; функциональная форма или коэффициент не указаны. Классификация точно формулирует практическую трудность: исследователь обычно наблюдает только левую часть.
К таблице применяются два граничных условия. Счетчики не являются необработанными логами трафика. SSRN применяет фильтрацию своих счетчиков по крайней мере с 2000-х годов: платформа заявляет, что исключает явные повторные загрузки одного и того же лица и явные загрузки роботами, используя «признаки нерегулярной активности», и что подозрительные анонимные загрузки исключаются из итогового показателя автора [144]. Black и Caron подсчитали, что без такой фильтрации счетчики были бы завышены «в пять раз или более» [18]. Зафиксированная загрузка регистрирует событие вовлечения и не содержит информации об одобрении. Счетчики измеряют этапы процесса внимания. Ни один из них не измеряет научные достоинства, и каждый искажается факторами видимости, которые действуют до того, как какой-либо читатель оценит содержание [44][72][144]. Эти ограничения признаны с самых ранних библиометрических анализов данных о читаемости [91]. Этапы также могут становиться независимыми друг от друга через два гипотетических механизма: статьи на политически актуальные темы могут интенсивно загружаться практиками, которые читают, но не цитируют, в то время как специализированные статьи могут получить мало загрузок, но неуклонно цитируются небольшим экспертным сообществом, которому они нужны. Любой из этих паттернов отделяет видимость от последующего использования, что является одной из причин того, что множества высокозагруженных и высокоцитируемых статей пересекаются только частично [108].
3.2 Платформенные агрегаты и иллюзия среднего
Единственные цифры о распределении, которые сама SSRN публикует, — это общие итоги платформы. Первое, что бросается в глаза при анализе этих данных, — это то, что происходит, когда эти итоги усредняются. Таблица 4 содержит проверенную статистику платформы с указанием дат.
Таблица 4. Проверенная статистика платформы SSRN с датами и статусом проверки.
| Показатель | Значение | На дату | Источник | Статус проверки |
|---|---|---|---|---|
| Полные тексты статей | 1,157,048 | 18 Dec 2023 | ALL-SIS Citation Methods White Paper [1] | Проверено по опубликованному PDF |
| Рефераты | 1,309,385 | 18 Dec 2023 | [1] | Проверено |
| Авторы | 1,479,875 | 18 Dec 2023 | [1] | Проверено |
| Кумулятивные загрузки | 256,678,716 | 18 Dec 2023 | [1] | Проверено |
| Загрузки за последние 12 месяцев | 40,642,329 | 18 Dec 2023 | [1] | Подтверждено |
| Полнотекстовые статьи (более ранняя контрольная точка) | 571,040 | 6 Jul 2016 | [1] | Подтверждено |
| Загрузки, последние 12 месяцев (более ранняя контрольная точка) | 12,897,685 | 6 Jul 2016 | [1] | Подтверждено |
| Препринты / статьи; авторы | "1,5+ миллиона"; "1,9+ миллиона" | Страница продукта 2026 | Документация продукта Elsevier SSRN [49], доступ 14 Aug 2026 | Подтверждено (округленные маркетинговые показатели) |
| Статьи; авторы; всего загрузок; загрузок за 12 мес | >1,7M; >2,4M; >344M; >54M | 1 Nov 2025 | Объявление SSRN [B-6] | Порядок величины подтвержден; точные значения (344.8M / 54.7M) требуют архивных копий объявления перед цитированием |
| Рассчитано: средние загрузки за весь период на одну полнотекстовую статью | ≈222 | На основании Dec 2023 | Рассчитано автором: 256,678,716 ÷ 1,157,048 [1] | Арифметика на основе подтвержденных значений |
| Рассчитано: средние загрузки на одну статью в год | ≈35 | На основании Dec 2023 | Рассчитано автором: 40,642,329 ÷ 1,157,048 [1] | Арифметика на основе подтвержденных значений |
Последние два ряда рассчитаны автором и обозначены как таковые; SSRN не публикует средние показатели на одну статью. Общие платформенные показатели различаются по источникам, датам и определениям (полнотекстовые против всех статей), поэтому расчеты на одну статью основаны на согласованных показателях December 2023 за полнотекстовые статьи [1]; необработанное объявление November 2025 [B-6] приведено выше исключительно как данные, которые можно использовать только в сочетании с архивными копиями (например, через web.archive.org), поскольку исходные страницы объявлений больше не доступны напрямую.
На основании согласованных показателей December 2023 среднестатистическая статья SSRN получила примерно 222 загрузки за весь период и примерно 35 в прошлом году [1]. Это рассчитанное число — наиболее близко к платформенной норме, которую может вычислить автор, но оно систематически вводит в заблуждение, потому что среднее значение — это фикция совокупного представления. Каждое эмпирическое исследование распределения загрузок SSRN обнаруживает положительную асимметрию: среднее значение значительно выше медианы из-за длинного верхнего хвоста, поэтому «среднестатистическая статья» описывает почти ни одну реальную статью. Остальная часть этого раздела устанавливает масштаб и последствия этого разрыва. Еще один совокупный показатель имеет значение для калибровки. Годовые загрузки платформы выросли примерно с 0,5 миллиона в 2000 году до примерно 3 миллионов в 2005 году [18], 12,9 миллионов в 2016 году и 40,6 миллионов к 2023 году [1]. Поток загрузок на одну статью также вырос: годовые загрузки выросли примерно в 3,15 раза с 2016 по 2023 год, в то время как запас статей вырос примерно в 2,03 раза [1], подняв поток на одну статью примерно на 55%. Таким образом, более старое исследование занижает абсолютные значения, которые сравнимая статья получит сегодня. Направление смещения зависит от того, как мы проводим сравнение: фиксированный старый порог — это нижняя граница сегодняшних значений, что делает его мягким, а не консервативным стандартом, когда его читают как абсолютный диапазон уровня 2026 года. Обратное манипулирование столь же недопустимо: старый порог не может быть просто перепроектирован в норму 2026 путем умножения его на рост платформы, потому что более крупный репозиторий одновременно изменяет числитель, знаменатель, состав авторов, каналы распределения, фильтрацию ботов и конкуренцию за внимание. Интерпретация с учетом винтажного смещения, используемая везде, основана на приведенной выше совокупной арифметике потока и запаса, а не на перемасштабировании старых порогов. Ежегодный обзор платформы подтверждает продолжающийся рост: более 250 000 новых статей было размещено в 2025 году (рост на 20% по сравнению с 2024), с более чем 53 миллионами загрузок в течение года [145].
3.3 Среднее значение не является типичной статьёй: прямое доказательство
Самые свежие опубликованные данные о распределении для SSRN предоставлены Jo и Li, которые анализируют 2,361 статью из SSRN's Marketing Research Network в одном снимке поперечного сечения, собранном 15 августа 2025 г. [83]. Таблица 5 ниже воспроизводит их описательную статистику полностью, и консолидированная эталонная карта раздела 5 их включает. Среднее число загрузок составило 221.346 при медиане 87: среднее значение примерно в 2.54 раза превышает медиану. 95-й процентиль, 726, более чем в восемь раз превышает медиану. Среднее значение превышает даже 75-й процентиль (206), что ставит более трёх четвертей статей в выборке ниже «средней статьи». Исследователю, которому сказано, что средняя статья в этой сети имеет около 221 загрузки, можно заключить, что статья со 100 загрузками значительно ниже нормы, хотя 100 значительно превышает опубликованную медиану. На рисунке 2 эта структура отображается непосредственно.
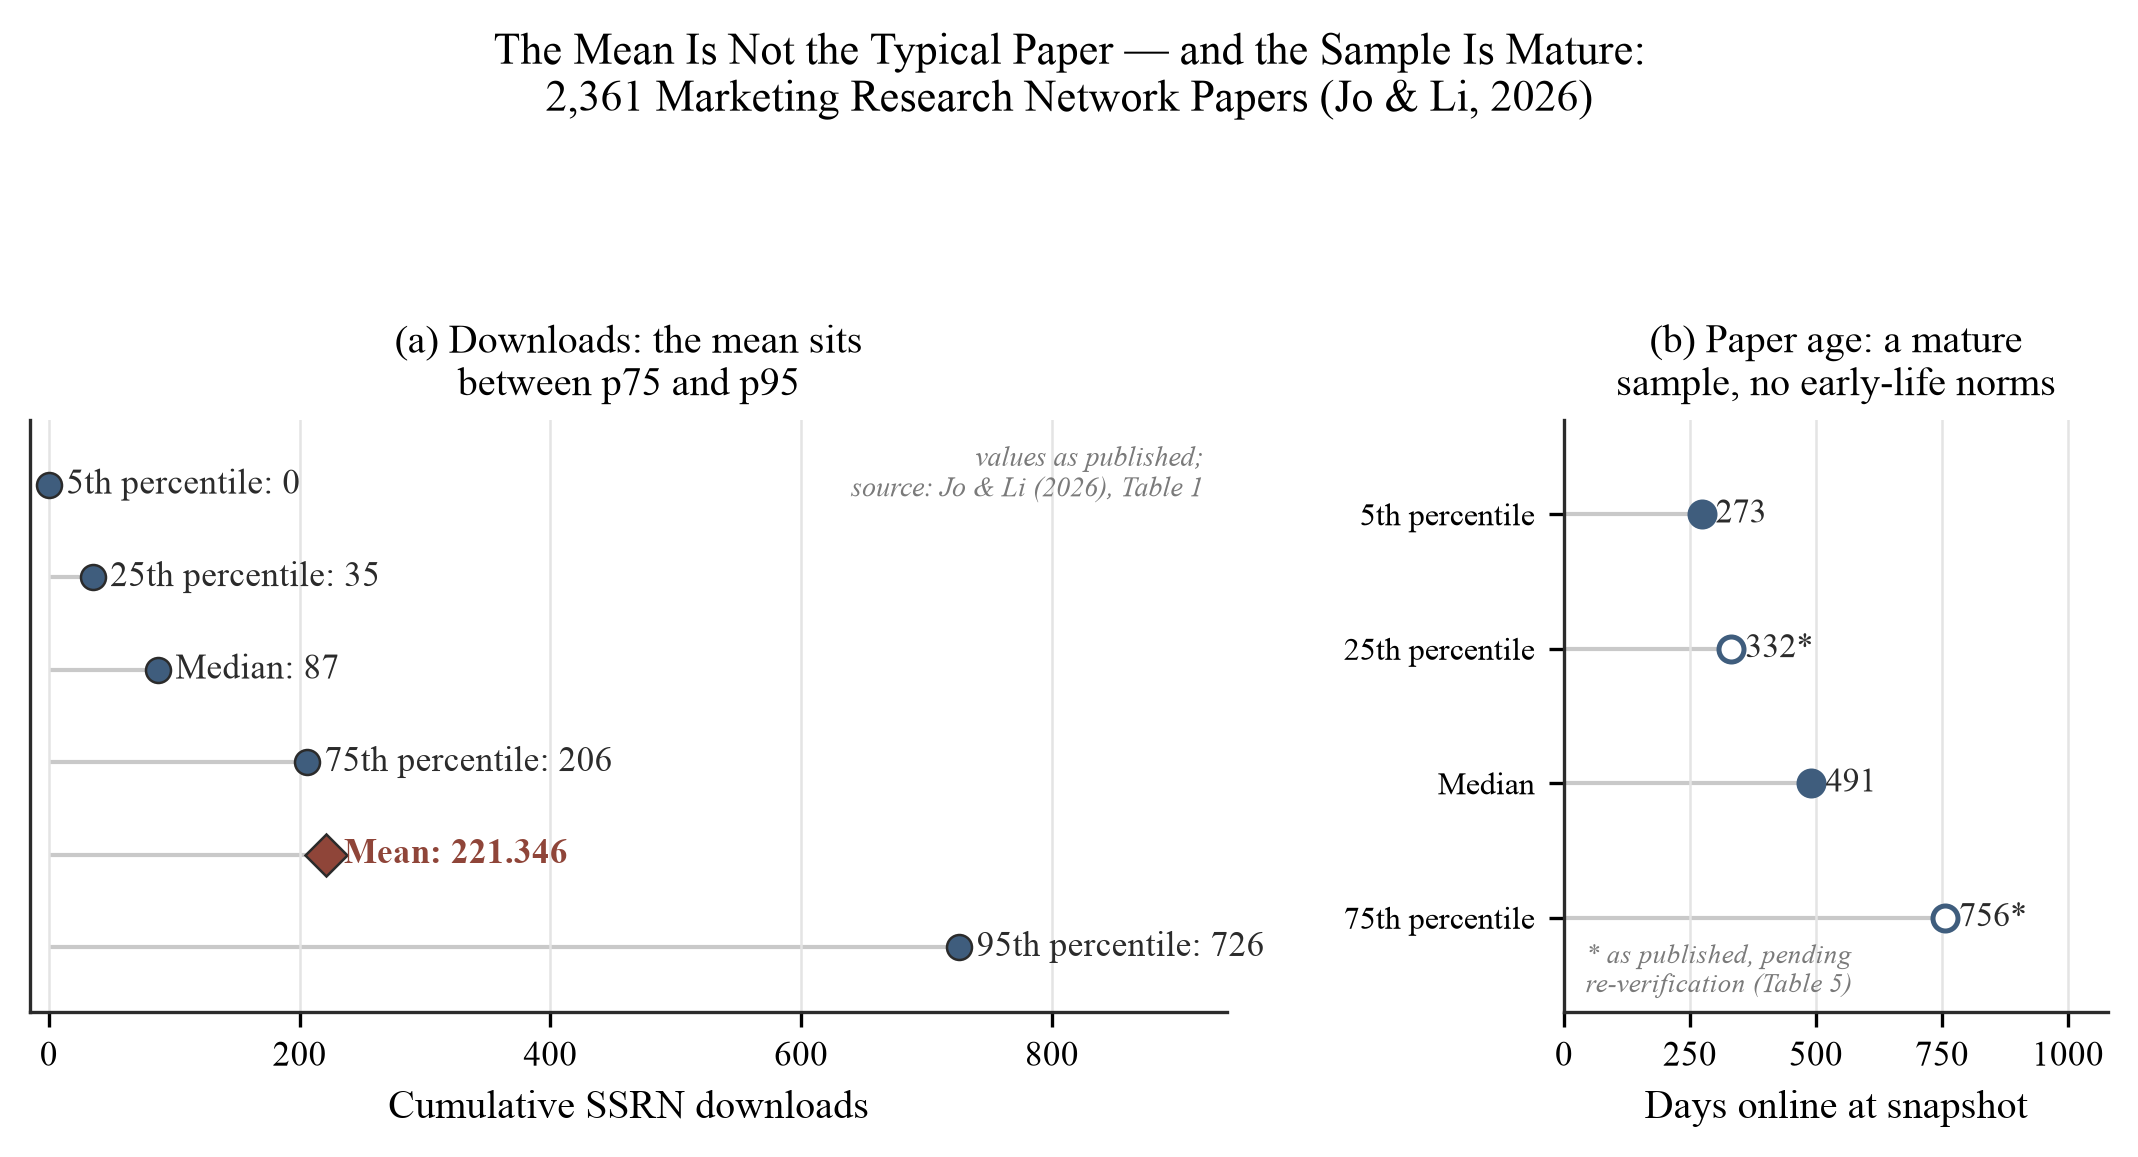
Рисунок 2. Опубликованная описательная статистика для 2,361 статьи Marketing Research Network. Панель (a): загрузки — p5 = 0, p25 = 35, медиана = 87, p75 = 206, среднее = 221.346, p95 = 726, нанесены в порядке значения (примечание: среднее значение находится между p75 и p95). Панель (b): возраст статьи в той же выборке — 5-й процентиль 273 дня и медиана 491 день, проверенные по источнику; 25-й (332 дня) и 75-й (756 дней) процентили воспроизведены «как опубликовано» (Таблица 5). Два значения в исходной таблице 1 отмечены и воспроизведены «как опубликовано», но это аномалии разного рода. 95-й процентиль abstract-views (966) находится всего примерно на 0,32 SD выше указанного среднего значения (611.973; SD 1,100.5) — почти невозможно для правоскошенного счёта, у которого p75 уже равен 833 — так что это предполагаемая ошибка источника, скорее всего опечатка, хотя ошибка переписывания или округления не может быть исключена, и остальные ячейки строки abstract-views рассматриваются как потенциально затронутые той же коррелированной ошибкой (отмечены для запроса автора Jo и Li, ответ которых пока недоступен). 95-й процентиль conversion (77.7, в сравнении с 27.2 при p75) является другим явлением: артефактом отношения с малым знаменателем ровно того вида, который предсказывает раздел 5.2, а не статистической невозможностью. Панель возраста делает интерпретационное ограничение наглядным: это статистика уже опубликованных статей, и выборка не может предоставить нормы для ранней жизни статей. Источник: Jo и Li (2026), таблица 1 [83].
Таблица 5 воспроизводит полную описательную статистику исследования, его сопутствующие переменные, а также распределение загрузок, потому что это единственный опубликованный образец SSRN с полной панелью процентилей; несколько его ячеек выполняют интерпретационную работу в других местах этой работы. Стандартные отклонения выражают тяжелый хвост одним числом: SD 940.9 в сравнении со средним значением 221.3 для загрузок. 5-й процентиль загрузок в точности равен нулю, так что нулевой счётчик находится в нормальном диапазоне даже зрелой выборки. Процентили conversion охватывают межисследовательскую полосу раздела 5.2 с обеих сторон (p25 = 12.1, медиана = 18.9, p75 = 27.2 на 100 просмотров). Процентили возраста (межквартильный размах 332–756 дней) определяют зрелость выборки, а строки авторства и оформления предоставляют нормы ковариат, используемые в разделах 6.4 и 8.3.
Таблица 5. Полная опубликованная описательная статистика образца Jo и Li (2026), «как опубликовано» (N = 2,361 статьи Marketing Research Network; снимок от 15 августа 2025 г.). Все значения воспроизведены из исходной таблицы 1 [83]. Ядро распределения — средние значения загрузок и просмотров, медианы и квартили; среднее значение и медиана conversion; медиана возраста и 5-й процентиль — было проверено по сравнению с опубликованной таблицей (см. Таблицу 7). Остальные ячейки (стандартные отклонения; процентили conversion и возраста за пределами ядра; строки авторов, страниц и длины аннотации) воспроизведены «как опубликовано» и не были независимо переполучены здесь; существование источника, место публикации и авторство были подтверждены через Crossref 14 августа 2026 г. Две внутренние аномалии отнесены «как опубликовано» и отмечены, а не исправлены, и они не одного и того же вида. 95-й процентиль abstract-views (966) находится только примерно на 0,32 SD выше указанного среднего значения (611.973; SD 1,100.5) — статистически почти невозможно для столь асимметричного счёта и несовместимо с собственным p75 этой строки в 833 — так что это предполагаемая опечатка в источнике; остальные ячейки abstract-views отмечены как потенциально затронутые коррелированной ошибкой и понижены до повторной проверки, ожидающей запроса автора Jo и Li. 95-й процентиль conversion (77.704, в сравнении с 27.187 при p75) вместо этого является артефактом отношения с малым знаменателем, предсказанным разделом 5.2, а не аномалией распределения того же вида.
| Переменная | Среднее | SD | p5 | p25 | Медиана | p75 | p95 |
|---|---|---|---|---|---|---|---|
| Загрузки | 221.346 | 940.855 | 0 | 35 | 87 | 206 | 726 |
| Просмотры аннотаций | 611.973 | 1,100.536 | 151 | 288 | 504 | 833 | 966 («как опубликовано») |
| Загрузки на 100 просмотров аннотаций | 23.699 | 20.118 | 0 | 12.105 | 18.944 | 27.187 | 77.704 («как опубликовано») |
| Доступность на SSRN, дни | 550.210 | 230.557 | 273 | 332 | 491 | 756 | 955 |
| Количество авторов | 2.578 | 1.705 | 1 | 1 | 2 | 3 | 5 |
| Количество страниц | 32.734 | 29.186 | 1 | 13 | 27 | 46 | 75 |
| Длина аннотации, слова | 182.274 | 71.641 | 87 | 137 | 178 | 217 | 295 |
Три дополнительные черты исследования важны для интерпретации. Просмотры аннотаций показывают ту же асимметрию на более высоком уровне: средние просмотры составили 611.973 в сравнении с медианой 504 (p5 = 151, p25 = 288, p75 = 833; p95 of 966 воспроизводится «как опубликовано», но это подозреваемая опечатка источника, всего ≈0.32 SD выше среднего значения и ниже хвоста, подразумеваемого p75 of 833, и не входит в дальнейшие расчеты; см. примечание к Рисунку 2), с опубликованным коэффициентом конверсии 23.699 загрузок на 100 просмотров [83]. Исследование также различает охват и конверсию: в авторской модели Пуассоновского воздействия институциональный престиж предсказывал загрузки в зависимости от просмотров аннотаций (коэффициент 0.192, и для статьи с тремя авторами один автор из топ-50 соответствовал приблизительно 6.6% более высокому уровню загрузок на просмотр аннотации), и этот премиум за престиж ослабевал по мере увеличения помощи ИИ в аннотациях (взаимодействие −0.627, p < .01) [83]. SSRN теперь требует раскрытия сведений о существенном использовании генеративного ИИ при подаче [54][56]. Таким образом, внимание отслеживает сигналы статуса даже после того, как читатель попадает на страницу аннотации, что является прямым доказательством того, что количество загрузок отражает эффекты видимости и репутации, а не только оценку содержания. Ограничение, указанное самими авторами, определяет повестку дня: один снимок одной дисциплинарной сети не может выявить временные пути внимания, и они явно определяют панельные данные как необходимый следующий шаг [83], шаг, изложенный в Разделе 8.
Выборка — это одна сеть в одной области, наблюдаемая в одну дату: эти цифры не являются универсальными эталонными показателями SSRN, и их ценность заключается в структуре. Соотношение среднего/медиана 2.54 и соотношение p95/медиана выше 8 являются сигнатурами сильной правой асимметрии, которые повторяются во всех других совокупностях доказательств SSRN, включая выборку из другой дисциплины и десятилетия: в единственной переписной выборке правовой науки статьи, размещенные в Legal Scholarship Network в 2012 году и измеренные два года спустя (n = 1,107), имели медиану 63 загрузки при среднем значении 122.55, почти двукратный разрыв после всего двух лет доступа [139].
3.4 Форма распределения: квазилогнормальность и длинный хвост
Макроскопическую анатомию распределения установил Какушадзе, проанализировав публичные топ-листы SSRN: 29 985 авторов в списке Top 30 000 и 367 478 прикрепленных к ним статей (снимок рейтингов 2015 года) [85]. Основной вывод заключается в том, что загрузки имеют квазилогнормальное распределение, сильно асимметричное с длинным верхним хвостом на уровнях и приблизительно гауссово в логарифмической шкале (подогнанные параметры для ln загрузок на статью: среднее значение 5,406, стандартное отклонение 1,016) [85]. Какушадзе явно указывает на практический следствие логнормальности: линейная арифметика неприменима к таким данным. Прямое применение h-индекса к загрузкам неинформативно: количество загрузок на порядки превосходит количество цитирований, поэтому индекс сводится к числу статей. Вместо этого он предлагает индекс, построенный на целой части логарифма загрузок, k = ⌊ln D⌋ [85]. С точки зрения интерпретации это означает, что значимые различия в загрузках мультипликативны, а не аддитивны. Эта форма распределения не уникальна для загрузок: распределение индивидуального научного влияния само по себе приблизительно логнормально, как установила Q-модель Синатры, Ванга, Девиля, Сонга и Барабаси (2016) для научных карьер [181], поэтому мультипликативное прочтение, требуемое счетчиками, является нормой для научного внимания, а не артефактом SSRN.
Тот же набор данных содержит единственные опубликованные пороговые значения для верхнего распределения. Попадание в список Top 10 000 статей (приблизительно верхние 1,8% полного хранилища статей платформы, 571 040, июль 2016 г. [1], что соответствует, а не превышает иногда упоминаемые цифры «верхние 1–2%») требовало минимум 160 загрузок, с медианой 805, средним значением 1800 и максимумом 152 242 [85]. Среди авторов Top 30 000 минимальные общие загрузки составляли 129, медиана для автора была 1626, медиана загрузок на статью была 210, а максимум, Майкл С. Йенсен, составлял 824 762 [85]. Дефицит сохраняется на уровне статей даже внутри этой избранной выборки: из 367 478 проанализированных статей только 112 793 (приблизительно 30,7%) имели достаточно загрузок, чтобы вообще вносить вклад в логарифмический индекс их авторов [85]. Большинство отдельных статей авторов с наиболее высокими загрузками на платформе привлекают скромное внимание, а вне топ-листов доля может быть только ниже. На рис. 3 показано подогнанное распределение с отмеченными опубликованными пороговыми значениями.
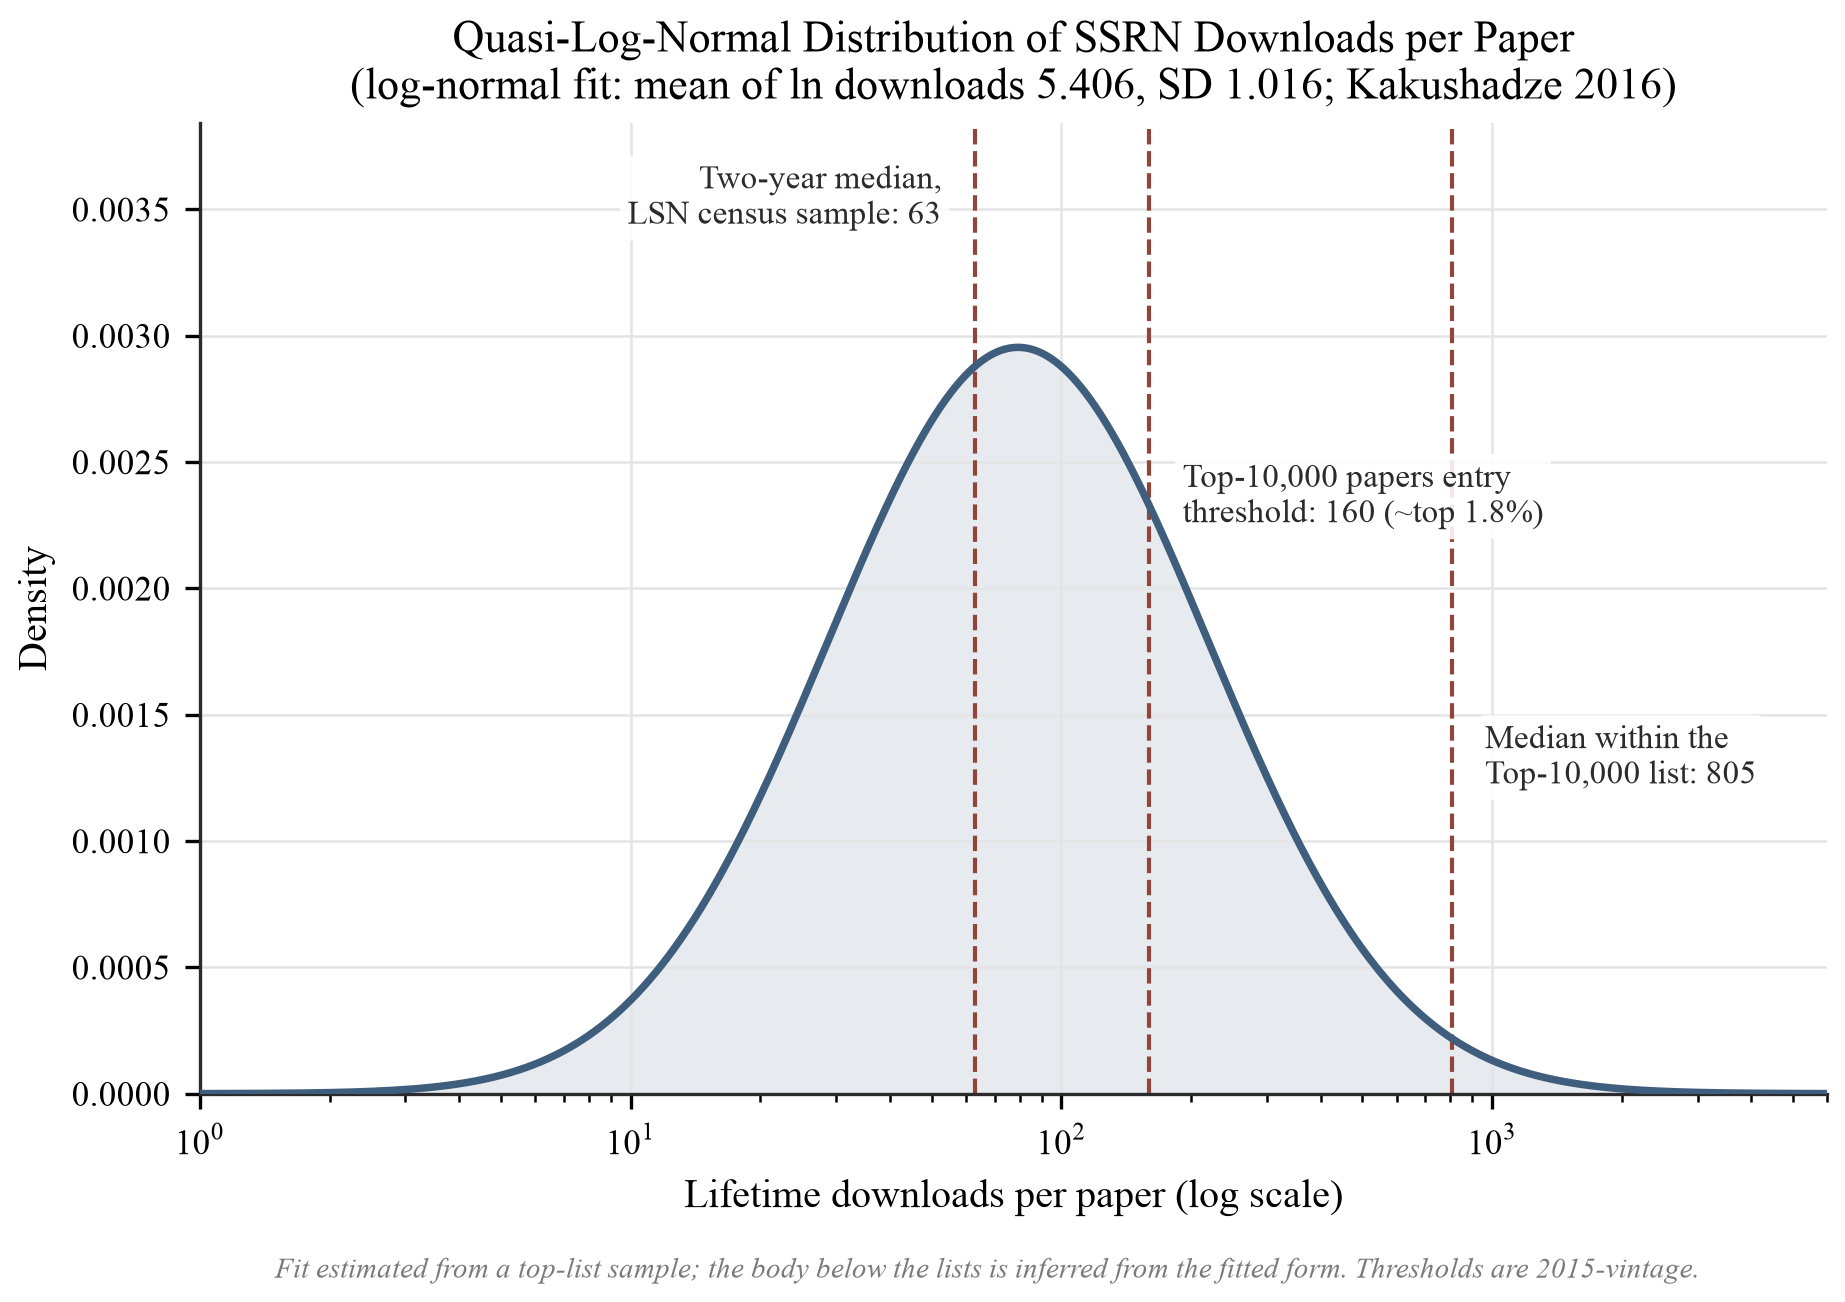
Рис. 3. Логнормальная плотность, подогнанная с параметрами, указанными Какушадзе (среднее ln загрузок 5,406, SD 1,016) [85]; подогнанная медиана, exp(5.406) ≈ 223, находится примерно на 6% выше сообщенной внутригруппой медианы на статью 210, адекватное, но несовершенное соответствие распределению топ-листа. Пунктирные линии обозначают двухлетнюю медиану из 63 загрузок из выборки в стиле переписи в области юридической стипендии [139], пороговое значение входа Top-10 000 статей из 160 (приблизительно верхние 1,8% полного хранилища статей платформы, 571 040 в июле 2016 г. [1]), и медиану в списке Top 10 000 (805) [85]. Подгонка оценивается на выборке топ-листа — примерно верхнем дециле авторов платформы — поэтому тело распределения ниже списков выводится из подогнанной формы, а не наблюдается; пороговые значения имеют возраст 2015 года (инфляция с тех пор: раздел 5.1). С подогнанной кривой связано количественное предостережение, поскольку кривая приглашает прочтение ее нижнего хвоста: под этой подогнанной плотностью подразумеваемые массы нижнего хвоста равны P(X ≤ 63) ≈ 10,7% и P(X ≤ 10) ≈ 0,1% — на два-три порядка ниже доли ≤10-загрузок 15–30%, которую Исследование 1 (раздел 8.6) предсказывает для выборки полной вероятности на платформе. Расхождение не является противоречием, а прямой мерой области действия подгонки: плотность, оцененная на верхнем дециле авторов, не может описать нижний хвост, который она никогда не наблюдала, поэтому маркеры в стиле переписи ([139] двухлетняя медиана из 63; вход Top-10 000 из 160 и его медиана из 805) нанесены как внешние опорные точки, наложенные на подогнанную кривую, а не как утверждения о том, что подгонка их воспроизводит. Расстояние между маркерами и местом, где подогнанная кривая размещает те же значения, само по себе является наглядным доказательством того, что тело ниже списков ненаблюдаемо, и с этой кривой не следует читать никакую долю нижнего хвоста на уровне всей платформы.
Эти пороговые значения требуют двух оговорок. Рамка выборки находится в верхней части распределения, поэтому статистика Какушадзе описывает хвост, а масса обычных статей ниже списков характеризуется только через подогнанную логнормальную форму. Авторство принадлежит одному автору: исследование — это Какушадзе (2016), Journal of Informetrics [85]; повторяющееся неправильное цитирование добавляет второго автора и его следует избегать.
Независимое архивное поперечное сечение, описанное в Приложении E, непосредственно наблюдает тело распределения на случайной выборке всех направлений из 1360 статей, чьи счетчики до прекращения восстановлены из открытых архивов. Оно обнаруживает наблюдаемое распределение приблизительно логнормальным (асимметрия log-загрузок ≈ 0,18), подтверждая в теле форму, которую Какушадзе мог подогнать только на хвосте, и независимо воспроизводит разрыв между средним и медианой, полосу преобразования и полевой множитель. Ее собственное смещение выбора в сторону увеличения оставляет экстремальный нижний хвост неполностью наблюдаемым. Тем не менее она воспроизводит единственный современный якорь полного распределения, на который опирается синтез: среднее значение реконструкции (219) совпадает с опубликованным средним значением маркетинговой сети 221, поэтому основная форма также подтверждена совершенно отдельным источником данных. (О восстановлении исторических веб-данных из Internet Archive как валидированного социально-научного метода и об его охвате и смещениях частоты сканирования см. Arora, Li, Youtie & Shapira, 2016, Journal of the Association for Information Science and Technology, 67(8), 1904–1915, doi:10.1002/asi.23503.)
3.5 Неправильная калибровка по видимому хвосту
Совместная структура разделов 3.2–3.4 объясняет систематическую психологическую ошибку. Наиболее загруженный автор в выборке 2015 года получил 824,762 загрузки, примерно в 500 раз больше медианы самой группы топ-авторов (1626) и на четыре порядка выше типичной работы [85]. В условиях квазилогнормального закона важные расстояния являются мультипликативными: шаг от медианы обычной работы (десятки загрузок) к порогу входа в топ-список (160) меньше, чем шаг от этого порога к медиане топ-списка (805), что в свою очередь кажется ничтожным по сравнению с расстоянием до максимума хвоста [85][139]. Однако числа, которые циркулируют в открытом доступе (объявления о вехах, профили «топ-авторов», институциональные пресс-релизы [101]), почти исключительно черпаются из видимого хвоста. Авторы поэтому калибруют «хорошее» по отношению к группе сравнения, расположенной в сотни раз выше медианы, в то время как основная масса распределения находится вблизи медианы. Показание приборной панели в 7 загрузок затем воспринимается как неудача даже в тех случаях, когда оно типично для возраста и области работы. Среднее значение участвует в той же ошибке в более мягкой форме: как показал раздел 3.3, оно находится выше 75-го процентиля, поэтому даже звучащее официально «среднее» является ориентиром, загрязненным хвостом. В этом смысле среднее лжет: оно вычисляется правильно, а затем ошибочно принимается за типичное значение в распределении, которое не имеет типичного значения.
Несколько дополнительных групп свидетельств подтверждают вывод о том, что необработанные счетчики отражают структуру видимости по крайней мере столько же, сколько содержание. Внимание реагирует на позицию: в списках объявлений arXiv статьи, появляющиеся в позиции 1, получали примерно на 83% более высокие медианные цитирования в astro-ph, эффект, который авторы в значительной степени приписывают видимости, а не только самовыбору [72]. Оно также реагирует на задержку индексирования. SSRN отмечает, что внешнее индексирование его содержания компанией Google Scholar контролируется поисковыми системами и может занять «6–9 месяцев или более» [54, доступно 14 августа 2026], поэтому счетчики молодой статьи генерируются до того, как начнет работать основной канал обнаружения. Внимание также течет в обратном направлении от цитирований к загрузкам: цитирование привлекает читателей (среди них авторы цитируемых работ и их собственные сети) к цитирующей статье, и анализ причинности Грейнджера обнаруживает этот путь от цитирований к загрузкам активным для существенной доли статей [80][39], поэтому часть счетчика индексирует позицию статьи в сети цитирования и сотрудничества, а не какой-либо вердикт читателя о ее содержании. Каждый из этих механизмов формирует счетчик через структуру видимости (позиция, задержка обнаружения, положение в сети), а не через суждение читателя о качестве, и ни один из них не виден в числе на приборной панели. Более широкая экономика внимания показывает ту же концентрацию в экстремальной форме: в социальных сетях коэффициенты Джини для внимания достигают 0,90–0,94, при этом верхние 1% аккаунтов получают больше внимания, чем нижние 99% вместе взятые [180], современное отражение афоризма Саймона о том, что обилие информации создает недостаток внимания [141]. Научное внимание на SSRN принадлежит, в более мягкой форме, к той же семье процессов асимметричной диффузии. Аудитория, которая чувствует себя наиболее комфортно на SSRN, экономисты и правоведы, узнают эту структуру из финансов. Анализ Бессембиндера данных CRSP за 1926–2016 показал, что примерно $34,8 триллиона чистого богатства, созданного на фондовом рынке, были созданы менее чем 4% компаний из списка, в то время как большинство акций на протяжении всего своего существования не превзошли казначейские векселя [16]. Параллель приводится как иллюстрация, а не как доказательство: в богатстве, как и во внимании, совокупные итоги создаются тонким экстремальным хвостом, и измерение себя по среднему показателю, доминируемому гигантами, является категориальной ошибкой. Недостаток не ограничивается счетчиками использования: в правовой науке в целом, согласно переписи 2007 года, 43% статей из правовых обзоров вообще никогда не цитировались, и только 18% когорты 2015–2019 получили одно цитирование в течение пяти лет [171].
3.6 Множитель поля: дисциплинарная структура нормы
Распределение — это не одно распределение: оно различается от поля к полю. Анализ Уилена примерно четверти миллиона статей, классифицированных в 94 электронных журналах Legal Scholarship Network, показывает, что дисциплинарная основа варьируется примерно в восьмикратном диапазоне даже в пределах одной общей дисциплины: среднее количество загрузок за весь период жизни статьи варьировалось от 438,35 в Corporate, Securities & Finance Law до 53,48 в Agricultural Law & Policy [168]. На рисунке 4 показан градиент.
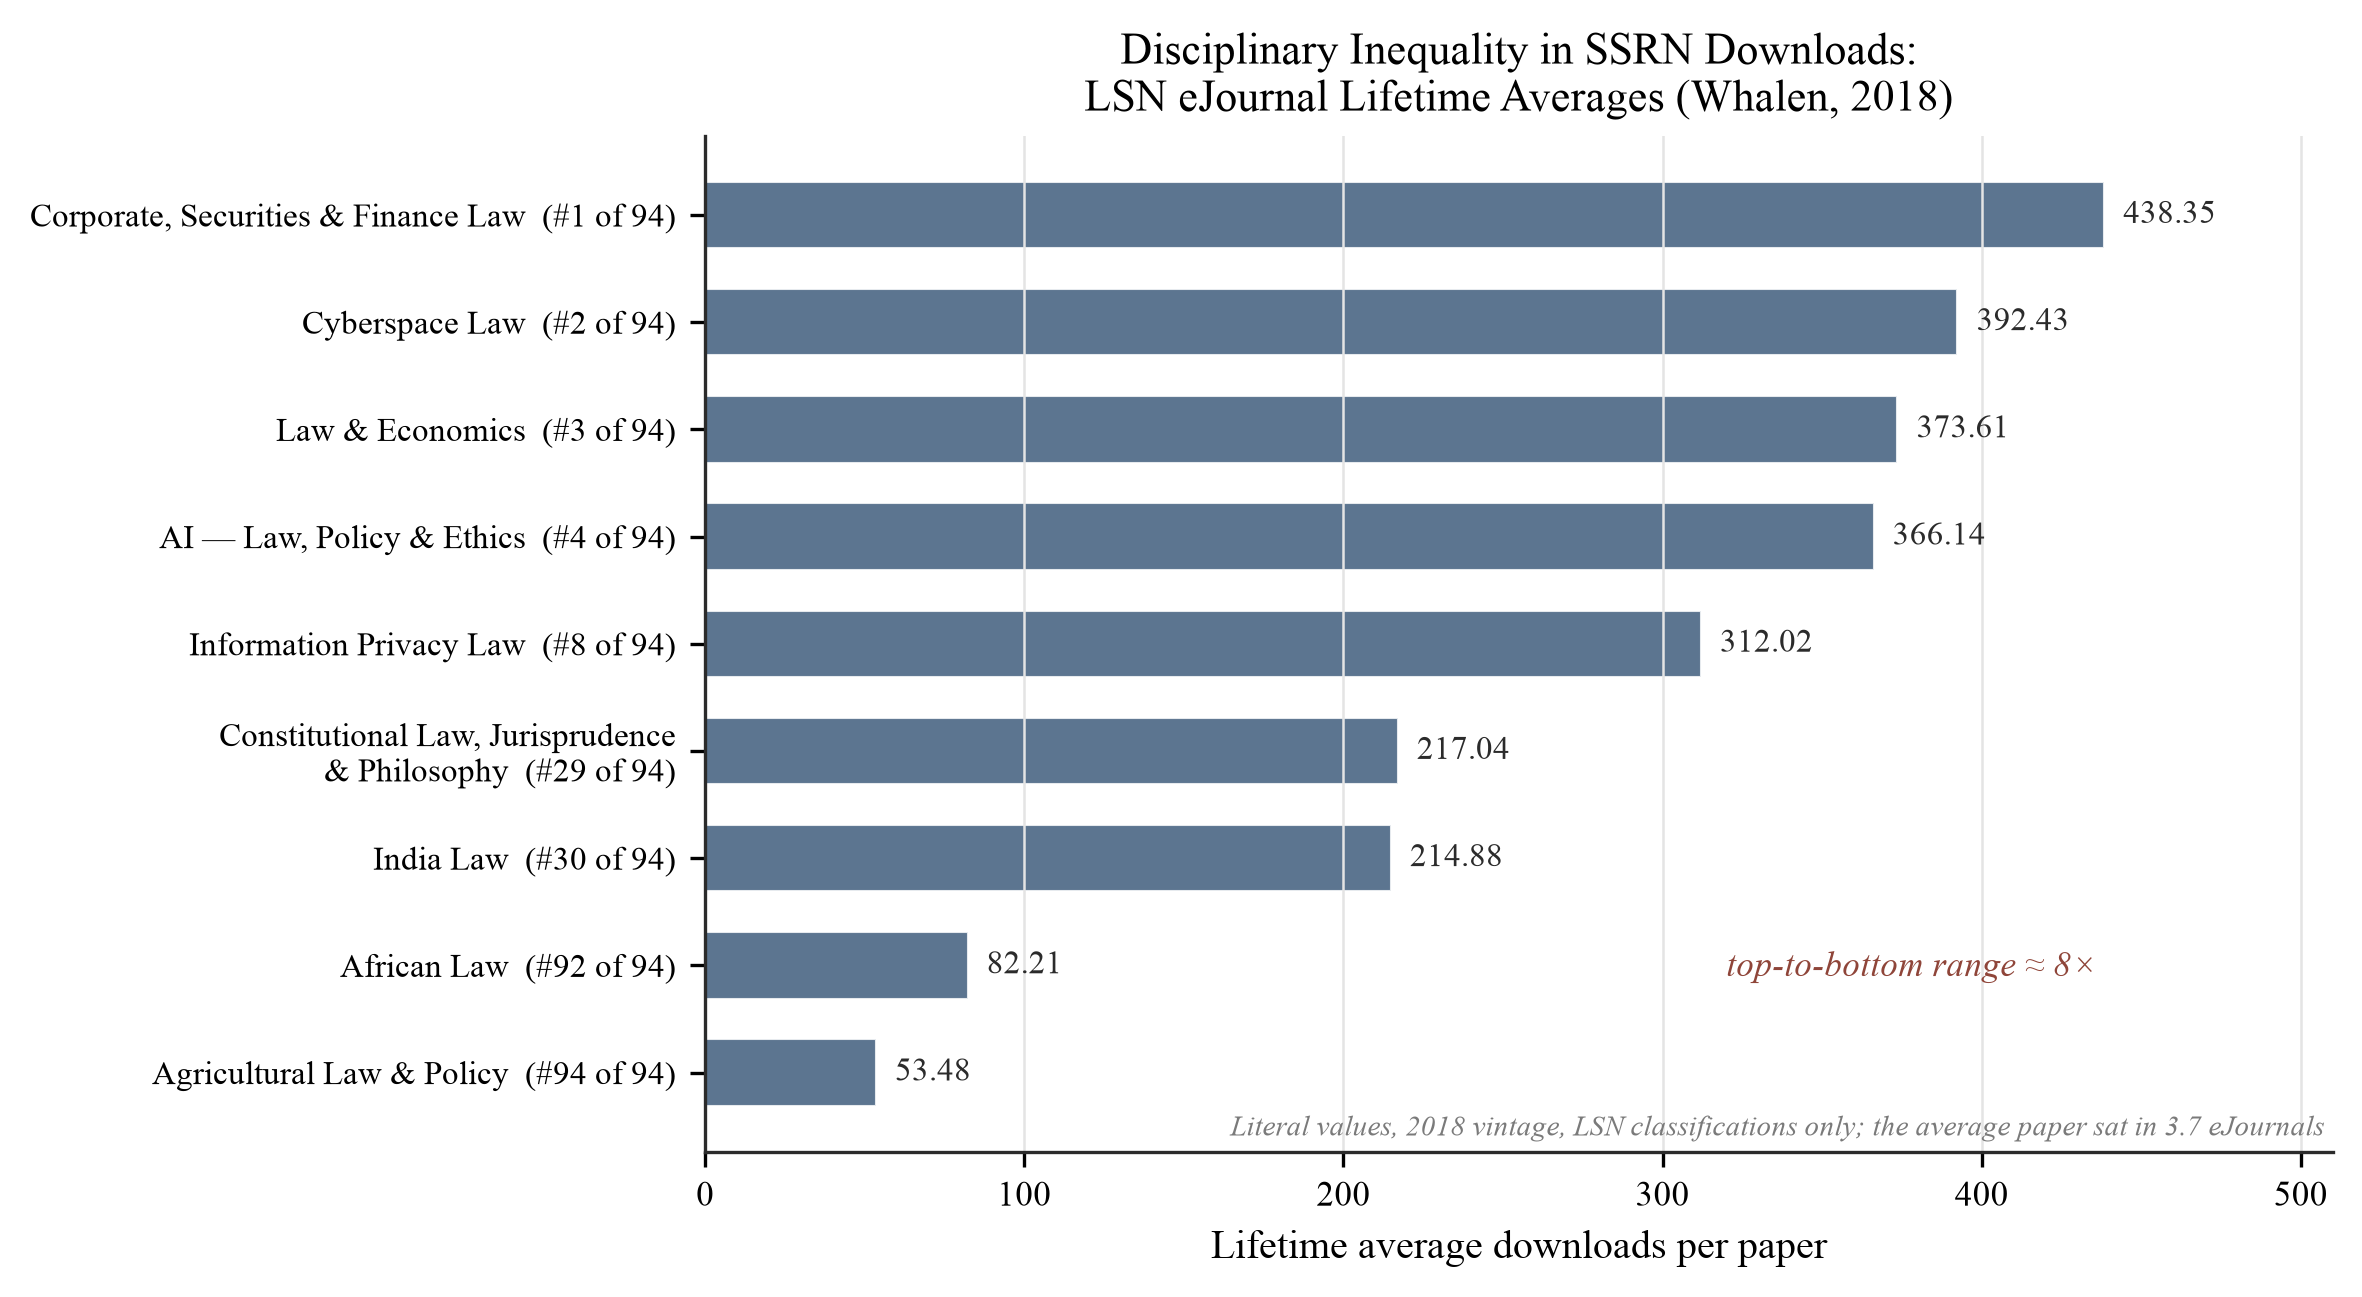
Рисунок 4. Среднее количество загрузок за весь период жизни на одну статью для избранных электронных журналов LSN, точные значения из Whalen (2018) [168]: Corporate, Securities & Finance Law 438,35 (ранг 1 из 94); Cyberspace Law 392,43 (2); Law & Economics 373,61 (3); AI – Law, Policy & Ethics 366,14 (4); Information Privacy Law 312,02 (8); Constitutional Law, Jurisprudence & Philosophy 217,04 (29); India Law 214,88 (30); African Law 82,21 (92); Agricultural Law & Policy 53,48 (94). Диапазон от максимума к минимуму составляет приблизительно восьмикратный. Значения датируются 2018 годом и охватывают только классификации LSN; средняя статья была назначена 3,7 электронных журналам.
Механизм носит структурный характер, а не меритократический: механизм обнаружения SSRN основан на классификации (подписчики на электронный журнал получают оповещения о статьях, классифицированных в нём), поэтому адресная аудитория статьи определяется базой подписчиков её поля до того, как начнёт действовать какой-либо сигнал качества. Уилен дополнительно обнаруживает, что статьи с большим количеством классификаций получают больше загрузок и менее вероятны записать нулевые загрузки [168]. Структура поля также формирует счётчики посредством культуры цитирования: Black и Caron наблюдали, что соотношения загрузок к цитированиям различаются систематически в зависимости от поля, потому что правовая наука цитирует предыдущую работу более полно, чем экономика или финансы [18], и в пределах права внимание сосредотачивается на конкретных темах и характеристиках авторов: в выборке переписи 2012 года темы корпоративного и международного права, авторство США и аффилиация с топ-20 учреждениями — всё это предсказывало значительно более высокие значения [139], факторы, отражённые в современных комментариях из правовых библиотек [175]. Таким образом, число, которое в корпоративном праве кажется обычным, может быть исключительным в истории права или сельскохозяйственном праве, и любой ориентир или шкала (включая построенную в разделе 5) должны быть прочитаны как относительные к полю. Существует хорошо устоявшийся прецедент для этого на стороне цитирования: Radicchi, Fortunato и Castellano (2008) показали, что распределения цитирований сворачиваются на одну единственную универсальную кривую только после того, как количество каждой статьи переформулировано по среднему её поля [182], аналог контрольного класса, который эта статья утверждает, одинаково требует для использования подсчётов.
Три примера, построенные исключительно на проверенных якорях выше, делают ставки конкретными. Автор в сельскохозяйственном праве, чья статья имеет 60 загрузок за весь период, находится выше среднего значения его электронного журнала 53,48 [168], однако, откалибровав против видимо циркулирующих числовых значений корпоративного права, может прочитать то же число как неудачу. Автор в области корпоративного и ценных бумаг право с тем же числом 60 находится далеко ниже среднего показателя этого поля 438,35 [168]. И автор, чья статья по маркетингу достигает сетевой медианы 87 [83], может недооценить результат, который, по конструкции, типичен. Ошибка отсутствующей шкалы действует в обе стороны: она производит неоправданное отчаяние и оставляет успех непризнанным.
Разделы 3.2–3.6 устанавливают эмпирическое ядро этой статьи. Распределение загрузок SSRN сильно смещено вправо и приблизительно логнормально, и среднее значение превышает не только медиану, но и 75-й процентиль. Видимый хвост простирается до значений, в 500 раз превышающих элитные медианы и искажает неформальную калибровку; счётчики встраивают в себя эффекты престижа, позиции, индексирования и структуры поля, которые работают независимо от содержания; и дисциплинарная основа варьируется в восьмикратном диапазоне в пределах одного научного домена. Необработанное количество загрузок, прочитанное относительно среднего значения или хвоста, следовательно, по конструкции неинтерпретируемо. Обоснованное чтение требует референтный класс: распределение, зависящее от поля, возраста статьи и когорты. Рейтинги, несмотря на все их недостатки, были единственным публичным жестом платформы в направлении такого референтного класса, и их удаление делает разработку внешнего (эталонная карта и шкала интерпретации раздела 5) центральной задачей оставшейся части этой статьи.
4. Механика счётчиков: счётчик под правилом
Перед тем как любое число на панели управления SSRN может быть интерпретировано, необходимо установить, что это число действительно записывает. SSRN отображает два основных показателя использования на уровне статьи, просмотры аннотаций и загрузки, наряду со статистикой цитирования и индикаторами PlumX [50]. После отмены Rankings 15 июля 2026 года эти счётчики остались на месте: SSRN заявила, что "количество загрузок и статистика цитирования будут продолжать записываться и отображаться на ваших отдельных статьях и профиле автора" [149]. Сравнительная шкала исчезла, но данные остались. Однако оставшиеся счётчики — это не необработанные наблюдения человеческого чтения: это совместный продукт архитектуры платформы, механизма распределения, нечеловеческого трафика и фильтрации целостности. Каждый из этих слоёв разбирается ниже, и раздел 5 затем строит структуру интерпретации на их основе.
4.1 Что такое просмотр и запись загрузки, и чем они не являются
Просмотр аннотации регистрирует запрос к странице статьи. Загрузка записывает получение полного текста PDF. Оба являются событиями взаимодействия; ни одно из них не является прямым доказательством чтения, понимания, одобрения или научного признания. Это различие определяет границы всех утверждений, сделанных в остальной части данной статьи.
Открытые счетчики SSRN — это не простые логи HTTP-запросов. Платформа применяет фильтрацию целостности данных с самых ранних лет [69] и публично описала свой подход: автоматическое скачивание, повторное самоскачивание и попытки манипулирования счетчиками проверяются с использованием «признаков нерегулярной активности», а подозрительные загрузки (включая, в некоторых случаях, анонимные загрузки) исключаются из доступных авторам итогов [144]. Независимые наблюдатели зафиксировали аналогичное поведение ранее: повторные загрузки с одного IP-адреса не засчитываются в счетчик [66]. Поэтому счетчик загрузок — это отобранная статистика, значительно более надежная, чем необработанный серверный журнал. Фильтрация удаляет наиболее обнаруживаемую нечеловеческую и манипулятивную активность и не более того. Счетчик всегда представляет собой счетчик под правилом, а не естественную единицу, и правила меняются (раздел 4.3).
4.2 Не-человеческий трафик и асимметрия между просмотрами и загрузками
Автоматические агенты составляют более половины всего интернет-трафика согласно недавним измерениям индустрии [158]. Эта цифра не может быть перенесена на счётчики SSRN: не было обнаружено ни одного опубликованного измерения доли ботов в просмотрах или загрузках абстрактов SSRN, и любой конкретный процент, утверждаемый для SSRN, был бы неподтверждён. То, что может быть установлено, — это структура проблемы, рассмотренная с двух направлений: механизмы, которые правдоподобно завышают просмотры, и прозрачная запись фильтрации соседней платформы.
Несколько механизмов правдоподобно генерируют не-человеческие просмотры абстрактов. Краулеры поисковых систем регулярно индексируют вновь размещённые страницы абстрактов. Корпоративные системы безопасности электронной почты, в частности Safe Links в Microsoft Defender for Office 365, сканируют и предварительно загружают URL-адреса, содержащиеся во входящей почте, что может регистрировать запросы на стороне сервера до того, как какой-либо получатель откроет сообщение [106]. Поскольку основной канал распределения SSRN — электронная почта (раздел 4.4), сканирование ссылок в объявительных письмах — это структурно правдоподобный источник фантомных просмотров. Ни одно опубликованное исследование не измеряет вклад предварительной загрузки через прокси безопасности в счётчики просмотров SSRN, и сама платформа SSRN проводит аудит своих метрик и исключает нерегулярную деятельность из подсчёта загрузок [144][66][69], поэтому платформа вполне может отфильтровывать значительную долю такого трафика, особенно на стороне загрузок. Утверждение, что «большинство просмотров SSRN не являются человеческими», появляется в неформальных обсуждениях, но никогда не было измерено.
Прозрачный случай — RePEc. Его служба логирования LogEc публикует как свою методологию фильтрации, так и историю своей фильтрации, и записи демонстрируют, насколько серьёзным и как асимметричным может быть загрязнение не-человеческим трафиком. Уже в июле 2007 года роботы составляли приблизительно 74% просмотров абстрактов на мониторируемых сервисах RePEc, но только около 7% загрузок [99]. История фильтров читается как хронология гонки вооружений: эвристики против сканеров антивредоноса были добавлены в июле 2010 года; новый тип систематического массового скачивания был рассмотрен в январе 2017 года; фильтры защиты от DDoS, введённые в январе 2022 года, удалили 54% просмотров абстрактов, но только 7% загрузок [99]. С октября 2025 года RePEc документировал всплеск трафика ботов, управляемых ИИ и выдающих себя за человеческих пользователей [129]. В сентябре 2025 года более 99,5% необработанного трафика на IDEAS была отброшена как не-человеческий [129]. После очистки отчёт RePEc за июнь 2026 года насчитал порядка 2,36 миллиона просмотров абстрактов и 238 тысяч загрузок на своих сервисах [129].
Доказательства из RePEc поддерживают два вывода для SSRN. Загрязнение асимметрично по построению: автоматические агенты краулят HTML-страницы абстрактов намного более агрессивно, чем выполняют извлечение полнотекстовых PDF-файлов, поэтому счётчики просмотров завышаются намного больше, чем счётчики загрузок везде, где фильтрация несовершенна. Эта асимметрия, роботы на ~74% просмотров, но ~7% загрузок в измерении 2007 года [99], является архитектурным свойством трафика репозитория, а не идиосинкразией RePEc. Конкретные пропорции не переносимы: правила фильтрации SSRN, модель распределения и аудитория различаются, и SSRN не публикует эквивалентный журнал фильтрации. В разделе 5.2 развивается практическое следствие, заключающееся в том, что коэффициенты, построенные на просмотрах (такие как коэффициент конверсии), должны интерпретироваться как нижние границы качества человеческого взаимодействия, потому что знаменатель — более загрязнённое количество. Это направление нижней границы зависит от версии, а не является законом: оно выполняется, пока фильтрация на стороне просмотров отстаёт от фильтрации на стороне загрузок, что является исторически документированным режимом [99], но оно ослабевало бы или реверсировалось, если бы фильтры просмотров платформы догнали бы фильтры загрузок, или если бы загрязнение на стороне загрузок росло быстрее, чем на стороне просмотров (как эпизод с ИИ-ботами 2025–2026 поднял оба [129]). Направление должно перепроверяться всякий раз, когда платформа пересматривает свои правила подсчёта.
Дополнительное соображение возникло с тех пор, как эти режимы фильтрации были разработаны. Фильтры были созданы для удаления автоматических запросов из подсчёта, предназначенного для проксирования человеческого внимания, и это правило по-прежнему удаляет шум. Чего оно уже не может делать без проверки, так это относиться к остальному как к человеческому, потому что три класса автоматических запросов сейчас находятся там, где фильтр видел один: краулы, которые собирают текст для обучения моделей, краулеры, которые индексируют для сервиса поиска или ответов, и выборки, которые система выполняет в реальном времени от имени человека, который что-то попросил. Первые два по-прежнему являются шумом для подсчёта внимания. Третий — это делегированное действие с человеком за ним, так как система, которая извлекает полный текст статьи для ответа на вопрос пользователя или поддержки поиска литературы, была снабжена контентом и использовала его, хотя ни один человек никогда не загружал страницу. Автоматический запрос сам по себе не является доказательством того, что что-либо было прочитано. Ослабела не фильтрация, а прокси: противопоставление человека и машины больше не надёжно отслеживает различие, которое нужно этой статье, а именно является ли событие доказательством учёного внимания, человеческого или делегированного.
Проект COUNTER начал заниматься этим в своей терминологии отчётности, а не в своём фильтре. Руководство по лучшим практикам использования ИИ, выпущенное в апреле 2026 года и обновлённое 30 июня 2026 года для версии 5.1.1, предоставляет опциональный параметр Access_Method Agent, определяемый как контент и метаданные, доступные системе ИИ, вместе со специфичными для ИИ типами метрик, в то время как версия 5.1.1 продолжает требовать, что «деятельность, генерируемая традиционными ботами и краулерами, ДОЛЖНА быть исключена из всех отчётов COUNTER» [125]. Инструмент имеет три ограничения, значимые здесь. Это опциональное расширение, производимое только в отчётах, которые провайдер выбирает создавать, и направленное в первую очередь на системы ИИ, встроенные на собственную платформу провайдера, а не на входящих краулеров. Его элементы «НЕ ДОЛЖНЫ быть включены ни в какие Standard Views отчётов COUNTER» [125], поэтому стандартное представление не будет различать доступ агента даже там, где провайдер реализует руководство. Удаляются ли затем помеченные события агента из суммарных итогов по умолчанию или переносятся в них без меток — это вопрос реализации, о котором руководство молчит. Оно также классифицирует доступ, который был предоставлен, а не доступ, который был отказан: руководство указывает, что «не существует метрик отказа, связанных конкретно с Access_Method Agent» [125]. Ничего из этого не достигает простого публичного счётчика в любом случае, так как такой счётчик не является отчётом COUNTER и не содержит параметра доступа; стандарт является аналогом, по которому его можно оценить, а не его описанием.
Отказ также не гипотетичен и действует выше по потоку любого правила подсчёта, однако его инструменты различаются по характеру и не действуют как единое целое. Файл robots.txt платформы просит названные агенты не сканировать; оговорка о добыче текста и данных занимает правовую позицию; условия использования связывают договорно; служба вызова задерживает страницу от клиентов, которые не могут её пройти. Только последнее из них является принудительным. На исследуемой платформе, как получено 29 августа 2026 г., robots.txt назвал трёх агентов (GPTBot, ChatGPT-User и Google-Extended) и молчал об остальных, молчание являясь стандартом исключения роботов, который хорошо ведущие краулеры читают как разрешение; ответы содержали оговорку о добыче, указывающую на политику издателя, которая разрешает добычу для целей, подпадающих под статью 3 Директивы ЕС об едином цифровом рынке, и требует лицензию иначе; условия использования оставляют за собой права на добычу текста и данных и обучение ИИ, за исключением случаев, когда автор выбрал открытую лицензию, вариант доступный только с 20 июля 2026 г. и по умолчанию сохраняющий все права; и один не аутентифицированный запрос, сделанный без движка JavaScript, получил управляемый Cloudflare вызов вместо страницы. Один из названных агентов — это инициируемый пользователем загружатель, а не краулер обучения: это делегированный класс предыдущего абзаца. Эти материалы записывают опубликованные ограничения и одно наблюдение конфигурации. Они не устанавливают, сколько запросов, автоматизированных или человеческих, было отклонено. Директивы соблюдаются неравномерно: при крупномасштабном измерении поведения краулеров некоторые агенты полностью соблюдали запреты на уровне сайта, но соблюдали запреты на уровне пути менее трети времени, а другие полностью игнорировали файл [87]. Кроме того, побочный эффект не односторонен, поскольку развёртывание вызовов нарушило работу законных пользователей-людей в других местах (одна университетская библиотека записала два таких инцидента в первые четыре месяца использования [29]).
Таким образом, историческую асимметрию нельзя просто перенести дальше. Уверенность в выводе 2007 г., роботы примерно на 74% просмотров аннотаций, но около 7% загрузок [99], основывалась на краулерах, которые просматривали целевые страницы и редко загружали полный текст. Система, которая извлекает документы для обоснования ответа, не имеет причин останавливаться на аннотации, поэтому сторона загрузок больше не известна как более чистый подсчёт по построению. Там, где необработанный научный трафик измерялся в 2025–26, автоматизированная доля оказалась не маргинальной, и она была обнаружена в подсчёте загрузок и посещений, а не только в просмотрах страниц: одна коллекция культурного наследия пересмотрела подсчёт посещений в марте 2025 г. с 1 000 000 на 125 000 после удаления предполагаемого трафика ботов [167]; классификация поставщика примерно тридцати миллионов запросов доступа в одном репозитории учреждения обозначила только примерно четверть из них как человеческие [98]; и репозиторий, ответивший на опрос открытых репозиториев, приписал по крайней мере четверть своих собственных загрузок ботов, примерно полумиллиона запросов, одиннадцати названным агентам ИИ [135]. Ни одна из этих цифр не является измерением изучаемой здесь платформы: они взяты из разных платформ с разной, в некоторых случаях отсутствующей защитой, и два из трёх подсчитывают посещения или запросы, а не события загрузки, отображаемые счётчиком общего доступа. Они устанавливают предыдущее условие, а не величину. В текущей среде интерпретируемость любого подсчёта использования зависит от качества фильтра, и там, где платформа не публикует своё фильтрование, это качество не проверено.
Следуют две проблемы идентификации, и они усугубляют друг друга. Сначала композиция: только по счётчику пожизненного времени общего доступа доли человеческих, обычных автоматизированных и опосредованных агентом событий не поддаются оценке, и собственное мнение платформы может быть не лучше, поскольку автоматизированные клиенты наблюдались, представляя себя в качестве браузеров для рабочего стола [167]. При отборе счётчик не может раскрыть, какую долю попыток доступа было обслужено, оспорено или исключено до применения какого-либо правила подсчёта. Опубликованные политики раскрывают, что такие механизмы существуют. Они не раскрывают, как часто они действуют, как они действовали в прошлом, или их влияние на включение. Попытанные запросы, оспоренные запросы, обслуженные события полного текста, отображаемые загрузки и ответы, созданные из полученной статьи, таким образом, являются пятью разными совокупностями, и они не должны рассматриваться как взаимозаменяемые. То, что остаётся без лицензии, — это величина или чистый знак для этой платформы. Неотфильтрованное научное использование теперь известно как подверженное надуванию автоматизированным трафиком, загрузки включены, но остаются ли неопубликованные фильтры этой платформы, правила вызовов и политики краулеров более взвешенный в сторону человека остаток, промежуток в опосредованном агентом обнаружении, оба или ни один из них, является неизмеренным. Кроме того, смесь не стабильна в течение лет, охватываемых пожизненным итогом, которые проходят от режима робота до 2024 г. через всплеск скрейпинга 2025–26 к лицензии по умолчанию, введённой в июле 2026 г. Нисходящие последствия вопроса сами документированы: сайты, блокирующие крупный краулер ИИ, извлекаются значительно реже двигателями ответов ИИ даже там, где содержание остаётся доступным [70]. Нет опубликованной оценки доли агента ни для одного крупного сервера препринтов, это пробел в исследованиях, а не свидетельство небольшого эффекта, и аудит, указанный в разделе 8, предназначен для его измерения. Пожизненный итог общего доступа — это сумма неизвестной смеси, полученная из неизвестной доли попыток доступа, без внешнего оценивателя того или другого и без основания рассматривать какой-либо из них как стационарный.
4.3 Падающие счётчики как события измерения
Счётчики также могут упасть или быть пересчитаны, когда меняются правила фильтрации — дальнейшее следствие записей о фильтрации, которое ни один дашборд не объясняет. Ревизия фильтра RePEc в январе 2022 года удалила половину ранее учтённых просмотров аннотаций за один раз [99]. Его эпизод AI-bot в 2025–2026 годах вынудил дальнейшие методологические изменения [129]. Статистика скачиваний, сообщаемая поставщиками, в более общем смысле известна своей чувствительностью к соглашениям подсчёта: аудит со стороны библиотеки выявил, что отчёты об скачиваниях от одного крупного издателя были примерно в два раза выше, чем на сопоставимых платформах, с «заниженными» счётчиками на уровне 43% от сообщённой цифры [176]. Резкое падение счётчиков SSRN автора, следовательно, является событием измерения (изменением фильтрации или пересчёта на стороне платформы) с такой же вероятностью, как и событием читаемости, и его никогда не следует расценивать как потерю репутации без подтверждения. Одна и та же логика применяется к любому использованию метрик в досье, где следует сохранять датированные записи (протокол, разработанный в разделе 6). Цифры платформы могут быть пересмотрены, а датированный архив автора не может быть пересмотрен.
4.4 Push и pull: архитектура определяет соотношение
Архитектура распределения является последним механическим уровнем. Она качественно отличается между основными репозиториями и напрямую определяет соотношение между просмотрами и загрузками. SSRN работает преимущественно по модели push. При подаче авторы выбирают от одной до семи классификаций предметных областей (в среднем статья LSN получала 3,7 назначений eJournal [168]), и эти классификации определяют размещение в исследовательских сетях и соответствие критериям включения в тематические рассылки eJournal по электронной почте. Включение в рассылку осуществляется с курированием и целевым направлением и не гарантировано, а распределение в высокообъемных темах может занять вплоть до 45 дней [53]. Подписчики получают уведомления об аннотациях по электронной почте [57]. Каждый получатель, переходящий по ссылке из уведомления, независимо от того, сделал ли он это из серьезного интереса или простого любопытства, регистрирует просмотр аннотации. arXiv же, напротив, работает преимущественно как платформа pull: некоммерческий репозиторий, трафик которого зависит от того, что исследователи активно посещают списки и ленты [11][65], где даже позиция в ежедневном списке объявлений измеримо влияет на читаемость и цитирование [72]. RePEc объединяет метаданные из децентрализованных архивов и применяет подробно документированную фильтрацию, описанную выше [99][129].
Таблица 6 обобщает сравнение платформ в виде качественной схемы управления и механизмов обнаружения. Сопоставимые данные о трафике между платформами не существуют в опубликованной литературе.
Таблица 6. Архитектуры платформ и их механический эффект на метрики использования (качественная схема).
| Характеристика | SSRN | arXiv | RePEc / IDEAS |
|---|---|---|---|
| Управление | Коммерческая (Elsevier, с мая 2016) [46] | Некоммерческая (Корнеллский университет) [11] | Децентрализованная волонтерская сеть [99] |
| Основной канал обнаружения | Push: курируемые рассылки eJournal по электронной почте, управляемые классификациями, выбранными авторами (1–7; распределение до 45 дней в высокообъемных темах) [53][57] | Pull: посещение, управляемое намерением пользователя, списков и лент; документированные позиционные эффекты в объявлениях [11][72] | Агрегация распределенных архивов; обнаружение через IDEAS/EconPapers [99] |
| Прозрачность фильтрации | Политика описана качественно; нет открытого журнала фильтрации [144] | Не опубликовано централизованно для метрик использования | Полностью задокументированная методология и история пересмотров (LogEc) [99][129] |
| Ожидаемый механический эффект на соотношение просмотров : загрузок | Повышенное количество просмотров относительно загрузок: клики из уведомлений по электронной почте регистрируют просмотры от пассивного воздействия, а не сознательного поиска | Более высокая конверсия посещений в загрузки: трафик с сознательным намерением пользователя | Соотношение имеет смысл только после удаления большого количества ботов; опубликованные данные отфильтрованы [129] |
Архитектура влияет на психологию автора, поскольку высокое соотношение просмотров к загрузкам на SSRN в значительной степени является результатом архитектурного решения: модель push генерирует широкое, низкоцелевое воздействие. Просмотр аннотаций также является легитимным научным поведением (исследователи обычно отслеживают развитие поля через аннотации, не загружая полные тексты), поэтому просмотр без последующей загрузки может означать, что аннотация уже выполнила свою информационную функцию, а не то, что она оттолкнула читателя. По сообщению Black и Caron, собственное историческое практическое правило SSRN состояло в том, что примерно «три просмотра аннотации приводят к одной загрузке документа» [18]. Те же авторы отметили, что без фильтров целостности необработанные счетчики могли бы быть завышены «в пять раз или более» [18]. Раздел 5.2 сопоставляет эти исторические ориентиры с современными измерениями.
Две механические характеристики того, как представляется статья, определяют конверсию наряду с интересом читателя, что делает измеренный коэффициент конверсии частично свойством интерфейса, а не самого исследования. Одна из них — пользовательский интерфейс платформы. Предоставляется ли полный текст как встроенный рендеринг HTML в браузере или только как загружаемый PDF существенно изменяет, когда заинтересованный читатель вообще инициирует счетчик загрузок, поскольку читатель, просматривающий полный текст в браузере, удовлетворяет тому же намерению, при этом увеличивая только просмотры. Другая — типы устройств, используемые аудиторией. Мобильный доступ снижает извлечение полного текста PDF по сравнению с настольными компьютерами, поэтому статья, основная аудитория которой обращается с телефонов (по ссылкам из социальных сетей или мобильного почтового клиента), будет показывать систематически более низкие загрузки и сравнительно более высокие просмотры при одинаковом научном интересе читателей. Оба эффекта действуют в одном направлении с механическим завышением знаменателя, уже установленным выше, и оба являются дополнительными причинами воспринимать эмпирический диапазон раздела 5.2 как платформозависимый диапазон, а не фиксированный порог: норму конверсии, оцененную на основе интерфейса одной платформы и состава устройств, следует пересчитать, а не просто перенести при изменении любого из этих факторов. Литература по метрикам использования высказывает аналогичные предостережения о надежности в отношении сравнимости отчетов о загрузках между платформами и различиях в соглашениях подсчета [176].
4.5 Предсказуемые побочные эффекты: совпадения с собственным текстом и гигиена метаданных
Два дополнительных механических следствия публикации препринта являются предсказуемыми, и оба регулярно вызывают ненужное беспокойство, поэтому оба относятся к остальной механике.
Совпадение с собственным текстом. Когда рабочий документ, размещённый на SSRN, позднее отправляется в журнал, проверка на схожесть журнала в ожидаемом случае выявляет почти полное совпадение с собственным препринтом автора. Документация iThenticate явно излагает обе стороны интерпретации: программное обеспечение «не проверяет на плагиат; она проверяет на схожесть» и «если вы видите совпадение с препринтом для того же автора, это не плагиат» [81]. Механизм также задокументирован. Препринты, зарегистрированные как Crossref Posted Content, включены в базы данных сравнения при проверке на схожесть, поэтому совпадение со своим размещённым препринтом — это система, работающая по замыслу [36]. Совпадения могут всплывать даже когда редакторы исключают источники препринтов, потому что вторичные агрегаторы, дублирующие метаданные репозитория, также индексируются [81]. Ответ автора должен быть административным, а не оборонительным: идентифицируйте отмеченный источник ответственному редактору как собственный датированный препринт автора. Рекомендации Crossref и iThenticate советуют качественное редакционное рецензирование, а не механические пороги оценок схожести [36][81]. Здесь не указан числовой порог, так как ни один из них не одобрен самими скрининговыми сервисами. Спокойствие, которое предполагает этот совет, имеет задокументированную основу в политике издателей: публикация рабочего документа на сервере препринтов разрешена политиками предварительной публикации большинства академических журналов, хотя политики варьируются и текущую политику целевого журнала следует проверить; позиции в отношении препринтов публично индексируются в реестрах, таких как Sherpa Romeo. Значимые исключения сосредоточены в медицине и смежных клинических областях, где некоторые журналы по-прежнему ограничивают или обескураживают предварительную публикацию препринтов. Авторам в этих областях следует проверить политику целевого журнала в отношении препринтов перед публикацией, а не после отправки.
Обнаружение письма, написанного ИИ: соседний канал ложной тревоги. Более новый уровень скрининга несёт структурно похожий риск ложной тревоги. Детекторы текстов, написанных ИИ, производят задокументированные ложные срабатывания, и бремя ложных срабатываний падает неравномерно на авторов, говорящих на английском как иностранном: в оценке Stanford семи общедоступных детекторов GPT (исследование не включало Turnitin) в среднем 61,3 % эссе TOEFL, написанных неносителями английского языка, были неправильно классифицированы как написанные ИИ [97]. Институциональная практика зафиксировала озабоченность. В августе 2023 года Vanderbilt University публично отключила функцию обнаружения ИИ в своём программном обеспечении для проверки на схожесть, ссылаясь на его ненадёжность: заявленная поставщиком собственная частота ложных срабатываний, отсутствие какой-либо опубликованной методологии обнаружения и то же неравномерное бремя на авторов, говорящих на английском как иностранном, задокументированное выше [163]. Оборонительная позиция здесь параллельна совпадению с собственным текстом и является административной, а не противостоящей: сохраняйте историю версий рукописи и черновики в качестве современного свидетельства авторства (дополнительный аргумент в пользу гигиены управления версиями ниже), и ответьте на любой флаг документацией, а не тревогой.
Управление версиями и гигиена метаданных. Поскольку счётчики накапливаются на одной странице статьи, практика пересмотра напрямую влияет на целостность метрик. SSRN поддерживает размещение исправленных версий на одной и той же странице статьи, сохраняя накопленные счётчики и индексированный URL, тогда как удаление статьи и её повторная загрузка сбрасывают метрики и нарушают существующие ссылки (SSRN FAQ; страница поддержки, подлежащая пересмотру, доступна 14 августа 2026 г. [B-7]). Выбор классификации также имеет последствия для метрик, так как они определяют маршрутизацию eJournal и, следовательно, основные события воздействия статьи [53]. Внешнее индексирование требует больше времени, чем ожидают авторы: SSRN указывает, что индексирование Google Scholar контролируется поисковой системой и может занять «6–9 месяцев или дольше» [55]. Ранние счётчики статьи поэтому генерируются почти полностью внутренней машиной распределения платформы, которая обосновывает интерпретацию ранних нулей в разделе 5.6.
5. Рамка интерпретации: восстановление недостающей шкалы
Вопрос «это хорошее число?» научно некорректно поставлен, пока не указана группа сравнения. В этом разделе опубликованный эмпирический материал собирается в отсутствующий сравнительный аппарат: консолидированная карта ориентиров с явной уверенностью в источнике (5.1), эмпирическая полоса преобразования (5.2), градуированная шкала интерпретации (5.3), двумерная диагностика охвата–преобразования (5.4), многомерная спецификация ориентира (5.5) и протокол временного чтения (5.6). Значения указаны на протяжении всего текста с их рамками выборки и возрастом. Ни один из них не является откалиброванным процентилем для платформы 2026 года, и все должны быть прочитаны с учётом оговорки об инфляции раздела 5.1.
5.1 Консолидированная карта бенчмарков
Таблица 7 консолидирует все пригодные опубликованные бенчмарки для метрик использования SSRN, выявленные при аудите в разделе 2.5, каждый с его рамкой выборки и явным указанием надёжности источника. Поскольку бенчмарк используется неправильно, когда выходит за пределы своей рамки, каждая запись также указывает допустимую роль при выводах, которую источник может законно играть, и основное ограничение его применимости. Доказательная база скудна: карта основана на пяти исследованиях с различными рамками: переписи одной юридической сети в 2012 году [139], извлечении собственных топ-списков платформы в 2015 году [85], снимке одной сети в поперечном сечении в 2025 году [83], агрегатах на уровне платформы [1] и одной субполевой декомпозиции [168]. Эти рамки не взаимозаменяемы: извлечения из топ-списков описывают элитный хвост, переписи сетей описывают типичные статьи, а платформенные агрегаты описывают ни то ни другое. Каждое задействованное распределение также сильно асимметрично вправо, поэтому средние значения систематически превышают медианы и описывают нетипичные статьи.
Таблица 7. Консолидированная карта бенчмарков для метрик использования SSRN с рамками выборки, надёжностью источника, допустимыми ролями при выводах и основными ограничениями.
| Бенчмарк | Значение | Источник (год; рамка выборки) | Надёжность источника | Допустимая роль при выводах | Основное ограничение |
|---|---|---|---|---|---|
| Медианное число загрузок статей спустя ~2 года на платформе | 63 (среднее 122.55) | Siems 2016 [139]; n = 1,107 статей LSN, размещённых в двух окнах 2012 года, счётчики прочитаны два года спустя | Средне-высокая: выборка и цифры загрузок проверены; только право; когорта 2012 года | Исторический взгляд на распределение типичных статей | Якорь юридической сети на два года, а не текущая норма всей платформы |
| Медианное число просмотров аннотаций статей спустя ~2 года | 369 (среднее 564.62; корреляция просмотров–загрузок 0.852) | Siems 2016 [139] | Средне-высокая: цифры проверены по таблице 1 источника; только право; когорта 2012 года | Исторический взгляд на охват типичных статей | Той же возрастной, однодисциплинарной рамки; счётчики просмотров — более загрязнённая величина (раздел 4.2) |
| Медианное число загрузок статей, снимок одной сети | 87 (среднее 221.3; p25 = 35; p75 = 206; p95 = 726; медианный возраст статьи 491 день) | Jo & Li 2026 [83]; N = 2,361 статья Marketing Research Network, снимок от 15 августа 2025 года | Высокая: проверено по опубликованной таблице; примечание о двух аномалиях разного рода, заявленных «как опубликовано» — просмотры p95 = 966 — предполагаемая ошибка в источнике (≈0.32 SD выше среднего; строка понижена для повторной проверки), конверсия p95 = 77.7 — артефакт отношения с малым знаменателем (раздел 5.2); полная панель в таблице 5 | Недавнее распределение в поперечном сечении и модель конверсии | Одна сеть, одна область, одна дата; зрелые статьи; нет траекторий |
| Медианное число просмотров аннотаций статей, снимок одной сети | 504 (среднее 611.973; p5 = 151; p25 = 288; p75 = 833; p95 = 966 «как опубликовано») | Jo & Li 2026 [83]; та же выборка, что и выше | Высокая: проверено по опубликованной таблице; значение p95 (966) — предполагаемая ошибка в источнике — ≈0.32 SD выше среднего — воспроизведено «как опубликовано» и понижено для повторной проверки в ожидании запроса к авторам | Недавнее распределение охвата в поперечном сечении | Той же односетевой, однодатной рамки |
| Конверсия просмотров→загрузок, эмпирический диапазон | 11–19% (≈ одна загрузка на 5.3–9 просмотров аннотаций) | Siems 2016 [139]; Willey & Knapp 2022/23 [172]; Jo & Li 2026 [83] | Средне-высокая: цифры Siems, Willey–Knapp и Jo & Li проверены по исходным таблицам | Норма условного взаимодействия (конверсия) | Несколько рамок выборки; знаменатель поддаётся искажению ботами, поэтому измеренная конверсия является нижней границей, в то время как просмотры остаются более инфлированным счётчиком (раздел 4.2) |
| Историческое практическое правило платформы | ~3 просмотра аннотаций : 1 загрузка (~33%) | Black & Caron 2006 [18], сообщающие о собственной статистике SSRN | Средняя: дословно проверено; датировано (2006); охватывает всю платформу | Анатомия метрики и история целостности | Ранний период платформы; верхний якорь, а не текущая норма |
| Пороговое значение входа, топ-10 000 статей всех времён | ≥160 загрузок за всю жизнь (≈ топ 1.8% запаса полнотекстовых статей платформы, 571,040 в июле 2016 [1]); медиана в группе 805; среднее 1,800; максимум 152,242 | Kakushadze 2016 [85]; извлечение из топ-списков SSRN, 2015 год; 367,478 статей | Высокая: проверено по опубликованным таблицам; рамка топ-списка; работа одного автора | Форма распределения и поведение хвоста | Отбор из топ-списков; неподходящий для оценки современной медианы статей |
| Пороговое значение входа, топ-30 000 авторов | 129 загрузок всего (минимум); медиана в группе 1,626 загрузок всего; медиана 210 загрузок на статью; максимум 824,762 | Kakushadze 2016 [85]; группа, описанная в собственных письмах SSRN как «топ 10%» авторов [161] | Высокая: проверено по опубликованным таблицам | Поведение хвоста на уровне портфеля автора | Тот же отбор из топ-списков; винтаж 2015 года |
| Неправленное среднее значение платформы за весь период жизни | ~222 загрузки на статью (~35 за последние 12 месяцев) | Рассчитано из итогов платформы по состоянию на декабрь 2023 года: 256,678,716 загрузок за весь период жизни по 1,157,048 полнотекстовым статьям; ALL-SIS 2024 [1] | Средняя: производный агрегат; механически завышен за счёт старых статей; не личная мерка | Калибровка совокупного масштаба платформы только | Среднее значение за два десятилетия накопления; описывает почти ни одну реальную статью (раздел 3.3) |
| Разброс подполя внутри одной дисциплины | ~8× в среднем числе загрузок на статью (438.35 Corporate/Securities/Finance Law против 53.48 Agricultural Law) | Whalen 2018 [168]; 94 электронных журнала LSN, ~250,000 статей | Средне-высокая: проверено из источника; 2018 год; средние значения, не медианы | Классификация и гетерогенность подполей | Средние значения, не согласованные по возрасту медианы; только право; 2018 год |
| Ранние загрузки → более поздние цитирования | r ≈ 0.39–0.43 за первые 180 дней (≈16% объяснённой дисперсии) | Brody, Harnad & Carr 2006 [25]; arXiv (HEP), N = 14,442 | Высокая: проверено; другая платформа, передаваемость предполагается, а не показана | Нисходящая прогностическая валидация | Другие платформа и эра; корреляции на уровне статей скромны |
| Календарная структура доступа; запаздывание доступа→цитирования | Доступы примерно на 11% ниже в выходные и примерно на 50% ниже летом; примерно единичная эластичность ответа цитирования примерно через 9 месяцев после изменения доступа | Yuret 2026 [178]; >1500 статей из семи журналов отслеживались ~ 1 год | Высокая: DOI, место публикации и название проверены через Crossref (14 августа 2026); все четыре значения — более 1500 статей из семи журналов, доступы примерно на 11% ниже в выходные и примерно на 50% ниже летом, и примерно единичная эластичность ответа цитирования (рост доступов на 10% связан примерно с ростом цитирований на 10%) примерно через девять месяцев — проверены дословно по отношению к опубликованной аннотации статьи (Springer, 15 августа 2026) | Временная нормализация и предсказательная валидация — якорь календарной нормализации в основе CSAB | Данные доступа журнала, не специфичные для SSRN |
| Чувствительность подсчётов к соглашениям о подсчёте | Отчёты о загрузках поставщиков могут быть примерно в 2 раза выше, чем на сравнимых платформах («дефлятированные» подсчёты составляют 43% от указанной цифры); метрики на уровне статей требуют явной проверки целостности данных | Wood-Doughty et al. 2019 [176]; Gordon et al. 2015 [69] | Средне-высокая: оба источника проверены и уже цитированы в разделах 4.1–4.3 | Предупреждение об целостности и сравнимости — ограничивает точность любого межплатформенного или межпоставщичьего сравнения | Не прямой тест SSRN; не существует специфичного для SSRN аудита |
Далее следуют три структурных прочтения карты.
Среднее значение не является типичной статьёй. В единственном недавно опубликованном распределении среднее значение (221,3) в 2,54 раза превышает медиану (87) и даже превышает 75-й процентиль (раздел 3.3) [83]. В более ранней переписи Siems среднее значение было примерно в два раза больше медианы [139]. Среднее значение на уровне платформы примерно 222 пожизненных загрузок [1] является наименее подходящим личным мерилом из всех: оно объединяет две декады накопления статьями всех возрастов.
Каждый тест несёт в себе винтаж, и направление смещения винтажа зависит от сравнения. Годовые загрузки платформы выросли примерно с 0,5 миллиона в 2000 году и 3 миллионов в 2005 году [18] до 12,9 миллиона в 2016 году и 40,6 миллиона в 2023 году [1], рост в 3,15 раза между 2016 и 2023 годами, тогда как совокупность статей выросла примерно в 2,03 раза за тот же период (571 040–1 157 048 [1]). На рисунке 5 показана эта траектория. Поскольку загрузки росли быстрее, чем совокупность статей, поток загрузок на статью вырос примерно на 55% (примерно с 22,6 до примерно 35,1 на статью в год [1]), поэтому фиксированный порог 2015 года теперь представляет меньшую долю того, что зарабатывает типичная статья, чем тогда. Рассматриваемая как абсолютная полоса уровня на 2026 год, старый порог, такой как запись в верхнем списке примерно 160 загрузок, является поэтому мягким скорее, чем консервативным: преодолеть его сегодня менее избирательно, чем в 2015 году, а не более. Смещение зависит от композиции. Для позиции процентиля при продолжающемся правом асимметрии старые якоря могут всё ещё недооценивать хвост, но для абсолютных подсчётов инфляция загрузок делает их мягкими, поэтому ни один старый порог не должен цитироваться как «консервативный нижний предел» без этого уточнения. Умножение порога 2015 года на последующий рост платформы также не является обоснованным: композиция авторов, каналы распределения, фильтрация и конкуренция за внимание — всё это изменилось вместе с потоком загрузок.
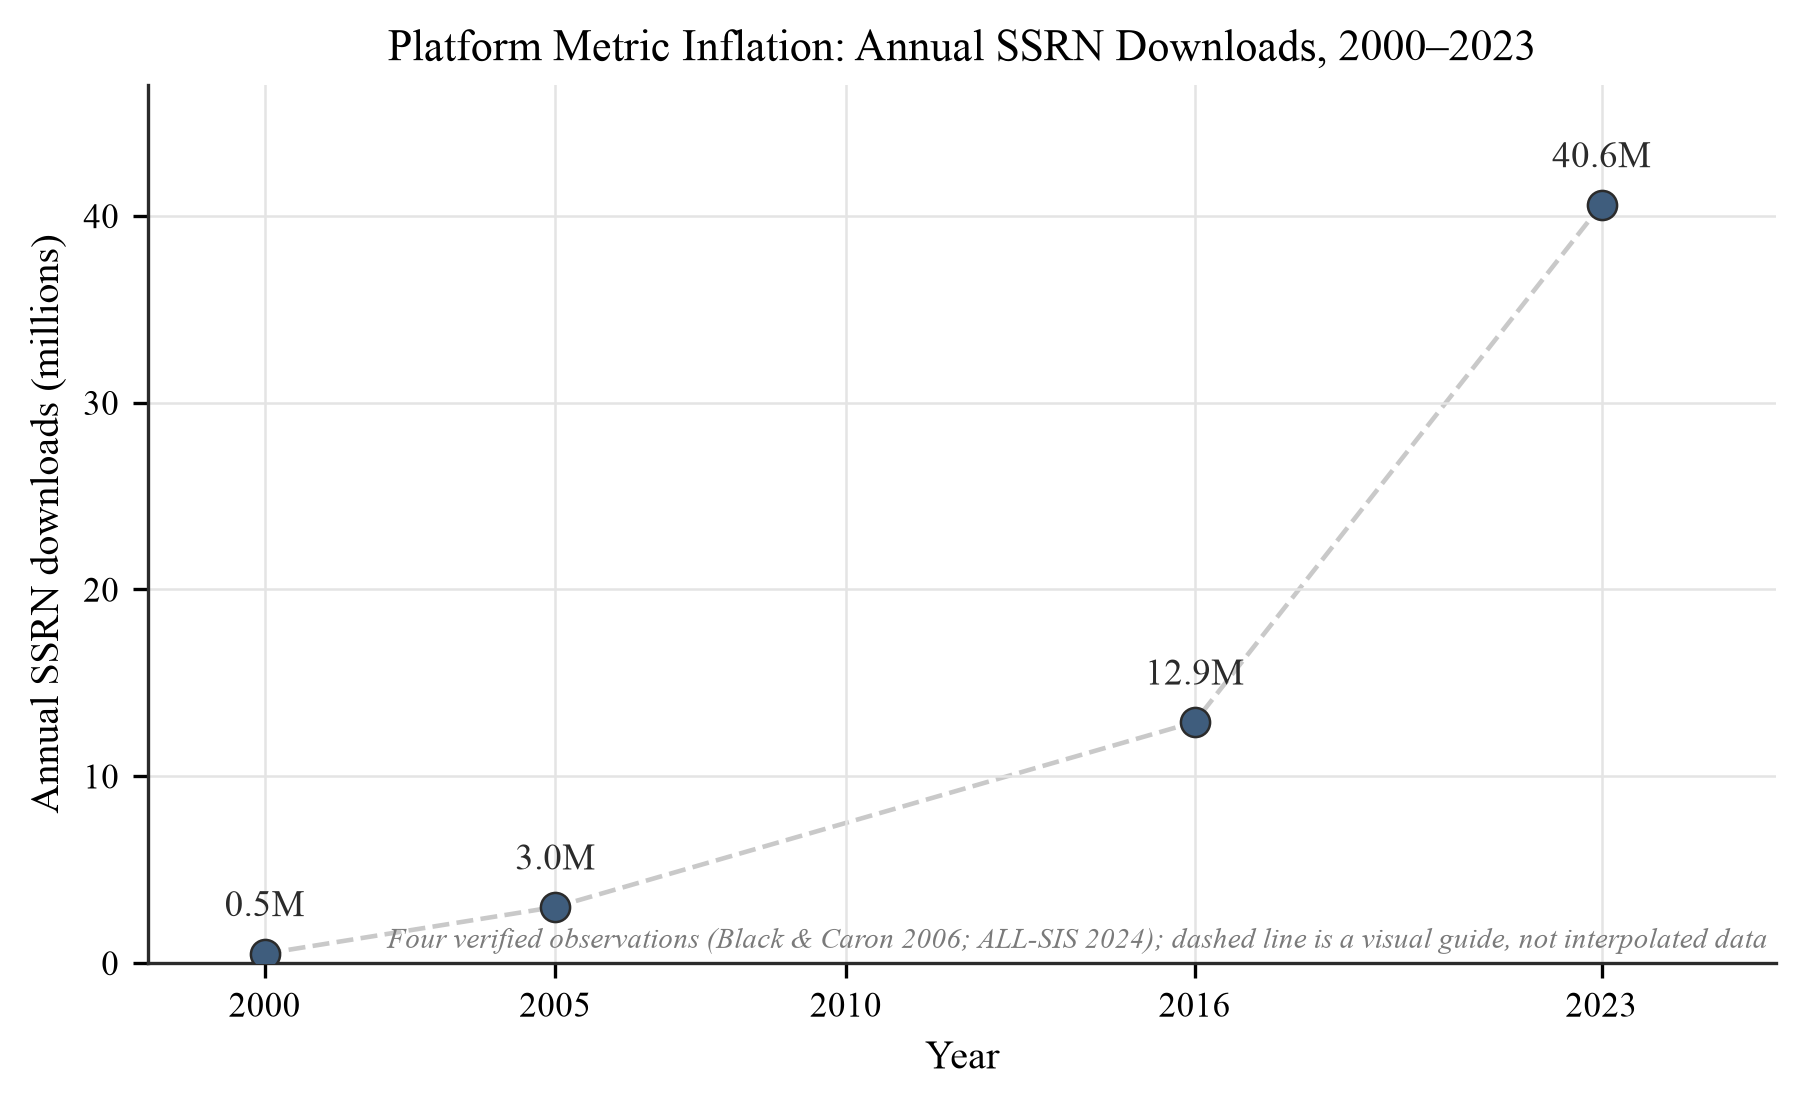
Рисунок 5. Инфляция метрик платформы, 2000–2023. Годовые загрузки SSRN: примерно 0,5 миллиона (2000) и примерно 3 миллиона (2005) [18]; 12,9 миллиона (2016) и 40,6 миллиона (2023) [1]. Потому что поток загрузок растёт быстрее, чем совокупность статей (≈3,15× против ≈2,03× с 2016 по 2023 [1]), поднимая поток загрузок на статью примерно на 55%, абсолютные тесты, оценённые на образцах 2012–2015 годов, читаются как мягкие скорее, чем консервативные полосы для чтений 2026 года. Только четыре проверенные годовые значения, указанные здесь, нанесены на график; никакая интерполяция между ними не подразумевается.
Не существует текущего источника процентиля. Никакое исследование распределения загрузок SSRN на уровне платформы после 2020 года не было выявлено при аудите раздела 2.5 (снимок однократной сети 2025 года [83], опубликованный в 2026 году, является единственным недавно опубликованным внешним образцом), и после 15 июля 2026 года сама платформа не публикует сравнительных данных, из которых можно было бы реконструировать процентили. Пропуск связан с актуальностью и специфичностью платформы. Распределение и неравенство внимания препринтов — это развитая область исследований на других хранилищах (профиль цитирования и альтметрии депозитов bioRxiv был охарактеризован на всём сервере [62]), и квази-логнормальная форма загрузок SSRN в частности была уже установлена до 2020 года Kakushadze [85]. Чего не хватает, так это текущего, специфичного для SSRN, процентильного распределения после заката. Карта выше собрана из доступных кадров, что является аргументом в пользу набора данных сообщественного теста, предложенного в программе исследований (раздел 8).
5.2 Полоса конверсии
Соотношение загрузок к просмотрам аннотаций — это один из показателей на панели мониторинга с достаточно стабильной нормой в кросс-исследовательском смысле, и авторы неправильно его интерпретируют более последовательно, чем любой другой. При наивном прочтении каждый просмотр, который не приводит к загрузке, считается отказом, и автор с 40 просмотрами и 7 загрузками воспринимает это как «отказ в 82,5%». Такое прочтение неверно ни механически, ни эмпирически.
Раздел 4 изложил механику: знаменатель (просмотры) является более загрязненным ботами и более раздутым архитектурой показателем, так как переходы из push-писем и трафик краулеров накапливают просмотры без подразумевания намерения читателя, тогда как счетчик загрузок активно проверяется [144][99][106]. Пока автоматизированный трафик раздувает просмотры более чем загрузки, измеренный коэффициент конверсии является нижней границей конверсии действительно заинтересованных посетителей-людей; раздел 4.2 объясняет, почему эту асимметрию больше нельзя предполагать там, где системы ИИ извлекают полный текст, и граница ослабевает соответственно. Эмпирически опубликованные измерения сходятся на узкой полосе. Siems измерил медиану соотношения загрузок к просмотрам 0,171 (среднее 0,187) в переписи LSN [139]; Willey и Knapp сообщают о конверсии 15% среди своей группы топ-статей и 11% среди однократно цитируемых статей [172]. Снимок Jo и Li дает медиану 18,9 загрузок на 100 просмотров аннотаций [83]. Полученная эмпирическая полоса — это 11–19%, то есть примерно одна загрузка на 5,3–9 просмотров аннотаций. Собственное архаичное эмпирическое правило SSRN примерно 3 : 1 (~33%) [18] находится выше полосы и лучше всего читается как ранний якорь платформы в масштабе всей платформы, а не текущая норма. В качестве кросс-доменной иллюстрации (совокупности и намерения категорически отличаются), коэффициент просмотров к совершению в этом диапазоне считался бы высоким в потребительском ПО, где типичные эталоны конверсии freemium с бесплатного на платное кластеризуются в низкие однозначные цифры [10]. Это сравнение только иллюстративно и переосмысляет интуицию, что «7 из 40» сигнализирует об отсутствии интереса. На рисунке 6 показаны оценки.
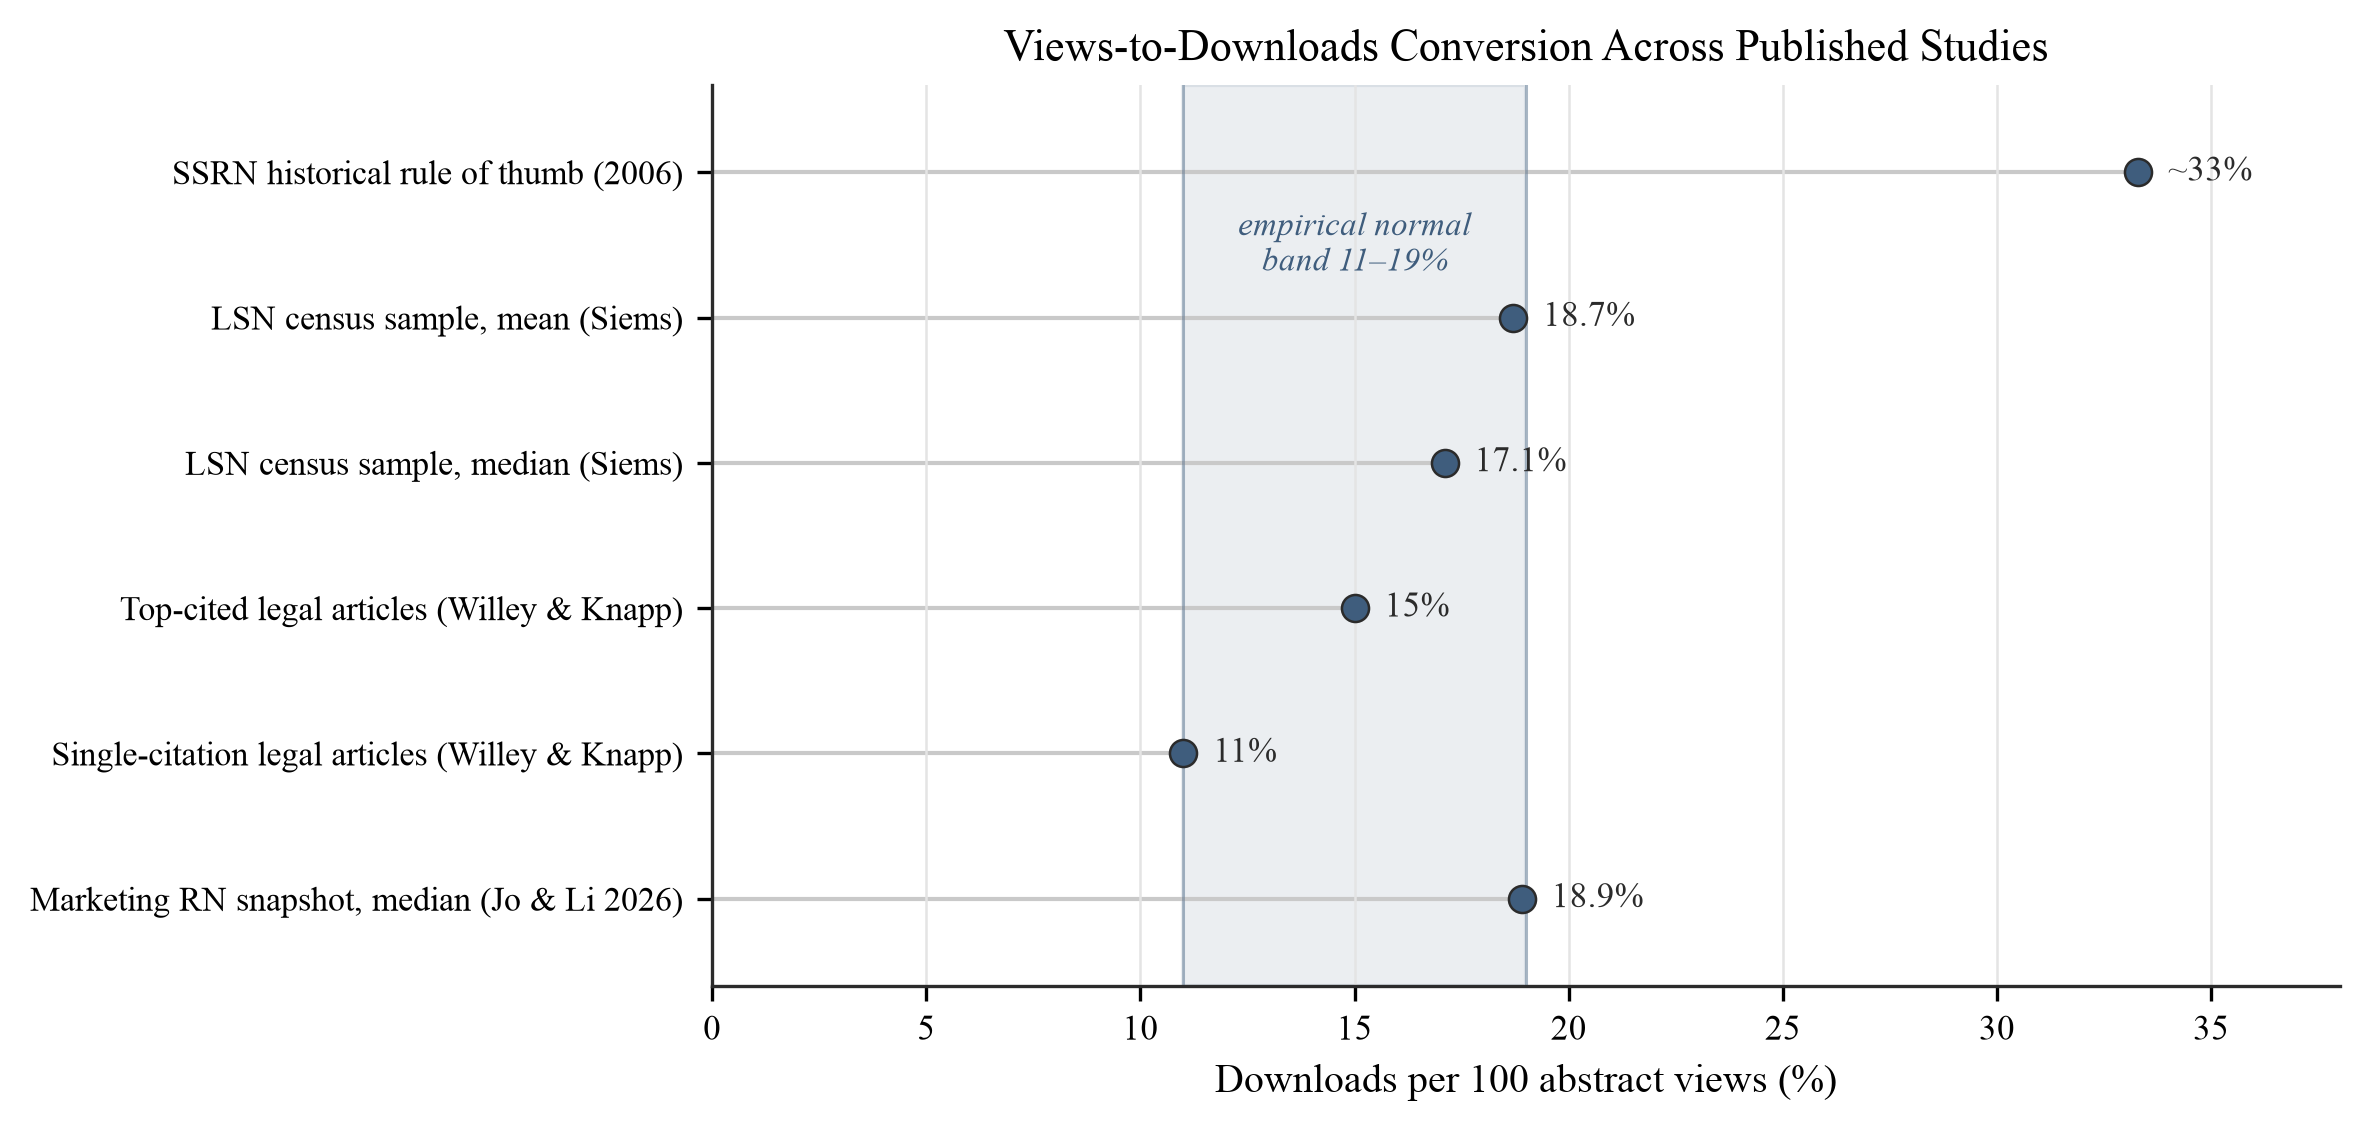
Рисунок 6. Конверсия просмотров в загрузки по исследованиям. Оценки конверсии по всей опубликованной литературе: историческое эмпирическое правило SSRN примерно ~33% (как сообщалось в 2006 году) [18]; среднее значение переписи LSN 18,7% и медиана 17,1% [139]; 15% среди самых цитируемых и 11% среди однократно цитируемых правовых статей [172]; медиана 18,9 загрузок на 100 просмотров аннотаций в снимке Marketing Research Network 2025 года [83]. Заштрихованная полоса отмечает эмпирический нормальный диапазон 11–19% — оболочку неоднородных оценок (медианы по всей сети наряду с цифрами подвыборок, выбранных по критерию цитирования, тип статистики которых источник не указывает); среднее значение выборки Jo и Li (23,7 на 100) лежит выше неё. Все значения приведены в цитируемых источниках; новых оценок не вводится.
Члены полосы представляют собой различные статистики различных выборок, поэтому это оболочка неоднородных точечных оценок. Цифры Siems (17,1%) и Jo и Li (18,9%) являются медианами выборок по всей сети, тогда как цифры Willey и Knapp 15% и 11% сообщаются для выбранных по цитированию подвыборок (самые цитируемые и однократно цитируемые правовые статьи), тип статистики которых источник не указывает, и выбор которых объясняет положение нижнего края полосы. Верхний край еще менее определен: среднее значение конверсии в выборке Jo и Li, 23,7 загрузок на 100 просмотров [83], находится выше полосы и резко отличается от соотношения совокупных средних этой выборки (221.346 ÷ 611.973 = 36,2 на 100). То, что соотношение средних 36,2 лежит так далеко выше среднего соотношений 23,7, само по себе диагностично. Поскольку соотношение средних алгебраически представляет взвешенное по просмотрам среднее коэффициентов конверсии для отдельных статей, его превышение невзвешенного среднего соотношений подразумевает положительную ковариацию между охватом и конверсией: статьи с большим числом просмотров конвертируются с несколько более высокими показателями, а не более низкими. Это прочтение консервативно: инфляция малого знаменателя толкала бы невзвешенное среднее соотношений вверх, противодействуя этому упорядочению, поэтому наблюдение того, что соотношение средних находится выше, делает вывод о положительной зависимости более надежным, а не менее.
Полоса дает центральный рабочий пример в этой статье. По опубликованным якорям документ с 40 просмотрами аннотаций ожидается даст примерно 4–8 загрузок. Точное «7 загрузок» в заголовке при 40 просмотрах — это конверсия 17,5%, точечная оценка, которая падает внутри полосы, но несет значительную неопределенность при таком размере знаменателя. Точный 95%-ный доверительный интервал Clopper–Pearson для 7 из 40 составляет примерно от 7,3% до 32,8%, охватывая полосу с обеих сторон: при только 40 просмотрах оценка не может быть разрешена с точностью до ширины полосы, поэтому интерпретация — это результат скрининга, а не классификация. Два фактора дополнительно ограничивают пример. Знаменатель мал (отмеченная ниже нестабильность), и сравнение не выравнено по возрасту: 40 просмотров примерно в день 20 — это ранний показатель в жизненном цикле, тогда как якорные медианы поступают из зрелых выборок (Siems через два года [139], Jo и Li при медианном возрасте статьи 491 день [83]), и позиции 1 и 5, а также раздел 5.6 утверждают, что раннее воздействие — это отличающийся режим, поэтому временная ось не совпадает. Обоснованное прочтение, таким образом, состоит в том, что 17,5% согласуется с кросс-исследовательской полосой как результат скрининга, а не как точный процентиль совокупности и не как «уютно расположено» внутри неё. Озабоченность, вызываемая такой цифрой, отражает отсутствие масштаба, а не отсутствие читателей. Эпоха и область применения основных якорей описаны в разделе 9.
Малые знаменатели делают отношение нестабильным. Статья с двумя просмотрами и одной загрузкой имеет номинальную конверсию 50%, но эта оценка не заслуживает большего доверия, чем оценка, построенная на 500 просмотрах; для любого публичного тестирования сжатие эмпирического Байеса в направлении эталонного показателя класса должно предотвращать образование экстремальных оценок при малых знаменателях (разделы 8.3 и 8.8). Полоса также работает как диагностический инструмент в обе стороны. Конверсия намного ниже полосы при нетривиальном знаменателе обычно указывает на несоответствие названия–аннотации–текста: читатели приходят, читают аннотацию и уходят, это практическая проблема коммуникации (переписать название и аннотацию), а не заключение о качестве исследования. Конверсия намного выше полосы сигнализирует о трафике, который просмотр аннотаций не объясняет (внимание средств массовой информации, внедрение в учебные программы или вирусное распространение), и должна побудить проверить происхождение просмотров. Ни одно отклонение само по себе ничего не устанавливает о качестве исследования. Дальнейшее уточнение — это скорее гипотеза, чем находка. Конверсия может систематически варьироваться между полями как свойство стиля чтения аудитории, а не отдельных статей: большие поля могут демонстрировать поведение «витринного просмотра», со многими посещениями аннотаций и немногочисленными загрузками, в то время как небольшие, сильно вовлечённые сообщества конвертируют с более высокими коэффициентами. Полоса выше оценена по слишком малому количеству фреймов, чтобы это разрешить, поэтому исследование 1 (раздел 8.6) включает стратифицированную по полям конверсию в свои результаты.
Диагностика, а не цель: ограничение против манипуляций. Полоса конверсии мощна, потому что её можно читать как норму, и эта мощь несёт опасность. Закон Гудхарта гласит, что показатель, принятый в качестве цели, перестаёт быть хорошим показателем [67], принцип, параллельный закону Кэмпбелла о развращении социальных индикаторов, используемых для принятия решений [27]. Если бы полоса 11–19%, или любой компонент эталонной рамки раздела 5.5, была принята в качестве порога продвижения («статьи должны находиться внутри полосы конверсии, чтобы иметь значение»), отношение немедленно стало бы объектом оптимизации, а не наблюдения. Такая атака конкретна и дешёва: потому что знаменатель — более управляемая величина (раздел 4.2), скоординированное увеличение просмотров аннотаций в фиксированной пропорции к загрузкам будет удерживать отношение внутри полосы и делать сконструированный сигнал статистически неотличимым от органической конверсии. Ответ рамки — это вопрос определения. Полоса конверсии, диагностика охвата–конверсии (раздел 5.4) и компоненты CSAB (раздел 5.5) — это диагностический вектор, никогда не цель, и ни один компонент не может быть прочитан как критерий продвижения. Механизм, который противостоит манипуляциям, встроен в конструкцию: полоса указана как нижняя граница, потому что её знаменатель раздуваем ботами, поэтому интерпретация консервативна по отношению к раздуванию по конструкции; протокол аномалий раздела 8.3 — это отметить, не удалять, поэтому сконструированный всплеск сохраняется и становится видимым, а не молча поглощается; и проверка целостности раздела 4.1 уже проверяет наиболее обнаруживаемую скоординированную деятельность. Прочитанная как диагностика, полоса выявляет манипуляцию как внеполосную или внутренне непоследовательную сигнатуру; прочитанная как цель, она бы стимулировала именно ту координацию, которую она предназначена обнаруживать. Эта позиция приводит рамку в соответствие с устоявшимся консенсусом реформы оценки исследований: с Декларацией Сан-Франциско об оценке исследований (DORA), которая отвергает однозначные числовые показатели и показатели на основе журналов в пользу оценки на основе собственного содержания исследования [8], и Лейденским манифестом, чьи принципы предостерегают именно от такой замены простого показателя на экспертное суждение [78].
Загрузки не имеют публичного аудит-следа: дополнительное основание читать полосу как нижний предел. Структурная асимметрия между цитатами и загрузками обостряет озабоченность по поводу манипуляций. Цитата оставляет публичный, поддающийся проверке след: цитирующий документ существует, обнаруживается и может быть проверен, поэтому манипуляция цитатами в принципе поддаётся аудиту третьей стороной. Счётчик загрузок не оставляет такого публичного следа. Это частный подсчёт на серверах платформы, без внешней записи о том, какие запросы были подсчитаны, отфильтрованы или пересчитаны, что делает его особо уязвимым для скрытых манипуляций, которые ни один внешний наблюдатель не может восстановить впоследствии. Эта уязвимость — независимое основание, помимо загрязнения знаменателя ботами, рассматривать измеренный коэффициент конверсии как нижнюю границу, а не точечную оценку (с учётом оговорки раздела 4.2 об извлечении ИИ), и всегда совмещать счётчик с протоколом аномалий и документированной фильтрацией целостности, на которую опирается рамка (раздел 4.1). Отсутствие аудит-следа — не основание для недоверия к счётчику; это основание для консервативного чтения и требования соблюдения дисциплины отметить-не-удалять, которая обеспечивает обнаружимость манипулируемого чтения (раздел 8.3).
Полоса — это цель калибровки, не константа. Из этого вытекает одно следствие для того, как следует приводить цифру 11–19% и каждый порог CSAB: это величины, которые должны быть откалиброваны по каждому полю и по каждой платформе (разделы 4.4, 5.5). Механизм для этой калибровки уже определён: стратифицированное по полям исследование 1 (раздел 8.6) разработано для доставки распределений конверсии и загрузок для каждого поля, которые требует рамка, и предназначено для использования. Пока исследование 1 не опубликовано, архивный срез приложения E предоставляет оценку, разрешённую по полям. Во всех четырнадцати полях, имеющих по крайней мере двадцать статей, медианная конверсия варьируется от 0.134 в Energy до 0.195 в Computer Science, разброс примерно в 1.5 раза, и при фиксированном возрасте статьи она варьируется от 0.134 до 0.224, примерно в 1.7 раза. В сравнении с трёх- до пятикратным полевым разбросом загрузок, конверсия — более универсальная из двух величин, что делает её пригодной для использования в качестве диагностики. Возраст — это измерение, по которому она не сохраняется: в каждом поле, достаточно большом для тестирования, конверсия падает, когда статьи становятся старше, с коэффициентами Спирмена от −0.14 до −0.41 во всех восьми полях, имеющих по крайней мере сорок статей. Полоса конверсии, указанная без учёта возраста статьи, имеет меньше значения, чем кажется.
5.3 Градуированная шкала интерпретации
Авторы Post-Rankings наиболее заметно не имеют градуированной шкалы в установленном формате руководств по интерпретации h-индекса [118], которая преобразует исходные счётчики в описательные диапазоны. Разделы 5.1–5.2 предоставляют необходимые компоненты для этого. Таблица 8 представляет предложенную шкалу для четырёх величин: загрузок на протяжении всей жизни статьи, загрузок за первый месяц, коэффициент конверсии просмотры–загрузки и общие загрузки на уровне автора.
Таблица 8. Предложенная шкала интерпретации метрик SSRN. Диапазоны синтезируют свидетельства 2012–2015 гг. [139][85][18][172]; поскольку поток загрузок на статью вырос с тех пор (раздел 5.1), их абсолютные пороги лучше всего интерпретировать как мягкие скорее чем консервативные диапазоны на 2026 год, и в любом случае как приближение. Столбец первого месяца — не откалиброванный уровень шкалы, а предварительно зарегистрированное прогнозирование с широкой неопределённостью, которое должно быть протестировано потенциальной комиссией исследования 1 (раздел 8.6); его ячейки не должны интерпретироваться как пороги или уровни продвижения (см. текст). Граница между «Сильный» и «Исключительный» на 10 000 — это предварительная оценка автора: ни один опубликованный источник, выявленный в ревизии раздела 2.5, не связывает 10 000 загрузок с процентилью. Диапазон «Зарождающийся» не вводит новые цифры: его потолок — существующий двухлетний медианный якорь 63 [139]. Границы диапазонов установлены круглыми числами и примерно одинаковой ширины: потолок точности, установленный литературой по честности (разделы 3.1, 4.1–4.3), делает более тонкие градации ложно точными, поэтому грубость диапазонов намеренна. Столбец вердикта простым языком описывает загрузки только шкалу и не переносится на столбец конверсии: медианная конверсия 18,9% обычна, а не «Прочный», и p75 27,2% не является «Сильным». Границы загрузок за всю жизнь являются неперекрывающимися по конструкции (Зарождающийся ниже 63, Скромный 63–159, Прочный 160 и выше); где таблица выводит общую точку между верхними строками — 800 между Прочным и Сильным, и соответствующие пороги конверсии и на уровне автора — интервал полуоткрыт, каждое общее значение принадлежит верхнему диапазону. Два граничных значения загрузок за всю жизнь извлечены из несопоставимых справочных классов: 63 представляет двухлетнюю медиану для переписи работ одной дисциплины в области правоведения [139], тогда как 160 — это пожизненный порог входа в список лучших всей платформы [85]. Таким образом, они работают по разным временным шкалам (фиксированный двухлетний возраст статьи в сравнении с неограниченным пожизненным накоплением) и описывают разные совокупности (одна область в сравнении со всеми областями), поэтому объединение их в единую абсолютную лестницу представляет собой комбинацию справочных классов с разными возрастами, областями и правилами отбора — ограничение, которое процентили, специфичные для области и возраста, исследования 1 предназначены устранить. Структурное ограничение этих якорей заслуживает внимания: потому что доступные контрольные точки кластеризируются на двухлетней медиане (63 [139]) и в верхнем хвосте платформы, четыре из пяти словесных диапазонов — Скромный, Прочный, Сильный и Исключительный — описывают статьи на уровне или выше медианы, поэтому шкала плотна выше медианы и слабо различает в широком диапазоне 50-й–98-й процентиля, в котором большинство статей фактически попадают. Эта компрессия является прямым следствием привязки к доказательствам верхнего хвоста; разделение обычного от просто выше медианы ожидает процентилей, специфичных для области и возраста, исследования 1. Шкала является иллюстративной, а не нормативной: ни одна граница диапазона не должна входить в решения о постоянной должности, найме или продвижении как пороговое значение проверки до тех пор, пока потенциальная комиссия исследования 1 (раздел 8.6) не откалибрует процентили, специфичные для области и возраста, чтобы заменить эти устаревшие абсолютные якоря.
| Диапазон | Статья: загрузки за всю жизнь | Статья: загрузки за первый месяц (экстраполированные) | Конверсия (загрузки / просмотры) | Автор: общие загрузки | Вердикт простым языком |
|---|---|---|---|---|---|
| Зарождающийся | Ниже двухлетней медианы 63 [139] | — (нет отдельного якоря; см. текст) | — (знаменатель обычно слишком мал; раздел 5.2) | — | Слишком рано или ниже медианы области — статистическая норма для молодых и нишевых статей; в первую очередь диагностируйте охват (разделы 5.4, 5.6), а не качество |
| Скромный | 63–159 | <15 | <11% | <~130 | Типично для платформы; медианный диапазон |
| Прочный | 160–800 | 15–50 | 11–19% | ~130–1,600 | На уровне или сверх исторического входа в список лучших |
| Сильный | 800–10,000 | 50–250 | 19–30% | 1,600–10,000 | Типично для исторических списков лучших |
| Исключительный | >10,000 (предварительная оценка автора) | >250 | >30% | >10,000 (предварительная оценка автора) | Сверх документированного диапазона обычной научной циркуляции |
Каждый внутренний якорь привязан к опубликованному пороговому значению. Зарождающаяся полоса охватывает область ниже двухлетней медианы LSN 63 [139]. Этот регион многолюден, а не аномален: предварительно определенные полосы Исследования 1 (раздел 8.6) предполагают, что значительная доля статей платформы, порядка 15–30% в соответствии с указанной полосой прогноза, имеют десять или меньше загрузок за всю жизнь, поэтому шкала, у которой самая низкая полоса начиналась бы у медианы, оставила бы наиболее многочисленные статьи платформы, включая эту статью, совершенно вне шкалы. Вердикт зарождающейся полосы не подлежит оценке. Ниже медианы поля, особенно при молодом возрасте статьи, счетчик не выносит суждения о качестве, и первый диагностический шаг — это известность (разделы 5.4 и 5.6), а не содержание. Скромная полоса привязана к двухлетней медиане LSN 63 [139]. «Скромная» — это медианная полоса: типичность — это не неудача. Граница между скромной и надежной полосами (~160 загрузок за всю жизнь) — это точка входа Какушадзе в вечные лучшие 10 000 статей, примерно 1,8% от полного текстового фонда статей платформы (571 040, июль 2016 г. [1]) [85]. На практике статья «надежная» — это статья из лучшего списка. Граница между надежной и мощной полосами (~800) — это медиана в этой элитной группе (805) [85]: она отделяет статьи, которые просто входят в историческую элиту, от статей, типичных для нее. В масштабе портфолио столбец на уровне автора отражает эту логику: группа авторов, которую собственные уведомления SSRN описали как лучшие 10% авторов [161], имела минимальный вход 129 общих загрузок и внутреннюю медиану 1626 [85]. Поскольку каждый якорь на уровне автора извлекается из этого ранжированного списка, столбец автора описывает верхний хвост распределения авторов, а не типичного автора. Автор ниже границы ~130 — это не просто «скромная»: этот автор вообще выходит за пределы исторически ранжированной группы, поэтому нижние полосы столбца читаются как «ниже исторической элиты», а не как калиброванная позиция среди всех авторов. Это то же самое закрепление верхнего хвоста, которое сжимает шкалу на уровне статей; якоря столбца автора ожидают портфельных процентилей Исследования 1. Столбец преобразования — это кросс-исследовательская полоса раздела 5.2. Граница между мощной и исключительной полосами на уровне 10 000 не имеет опубликованного якоря процентиля и сохраняется как горизонт порядка величины.
Столбец первого месяца имеет другой статус. Это предварительно зарегистрированный прогноз, фальсифицируемый прогноз с большой неопределенностью, который Исследование 1 (раздел 8.6) предназначено для проверки, и ни одна ячейка за первый месяц не может использоваться в качестве порога или интерпретативной ступени. В опубликованной литературе не существует прямого эталона за первый месяц, поэтому столбец является проекцией, а не измерением, экстраполированной из документированной ранней концентрации загрузок (всплески внимания сосредоточены в первые недели, особенно при внешнем охвате [18][116][138]) на пороги за всю жизнь выше. Конкретные границы основаны на одном опубликованном якоре: в выборке лучшего списка Какушадзе, примерно 1,8% от полного текстового фонда статей платформы (571 040, июль 2016 г. [1]), медиана количества загрузок за двенадцать месяцев составляла 247 [85]. Первый месяц выше ~250 превысил бы годовую норму исторической элиты платформы, следовательно, граница исключительной полосы, в то время как 15–50 загрузок за первый месяц, если они сохранятся, проецировались бы на порог входа за всю жизнь ~160, следовательно, надежная полоса. Эти ячейки — проекции с одного исторического якоря и являются самыми слабыми ячейками таблицы; при ссылке на них следует указывать их происхождение.
Два предостережения управляют использованием шкалы. Уточнение по дисциплине не является необязательным: в рамках одной дисциплины средние загрузки на статью различаются примерно в восемь раз по подполям (438,35 в корпоративном/ценных бумагах/финансовом праве в сравнении с 53,48 в сельскохозяйственном праве) [168], поэтому каждое утверждение о полосе должно иметь метку области. Это средние значения за всю жизнь и они не корректируются по возрасту статьи, и архивное сечение приложения E показывает, почему это важно: кажущийся уровень области движется в соответствии с возрастным профилем статей, извлеченных из нее, и при фиксировании возраста разброс сужается примерно в три-пять раз. Во-вторых, альтернативные однозначные эвристики, предложенные в этом пространстве (индексы относительной производительности на основе коэффициентов (загрузки статьи, разделенные на медиану согласованной когорты), логарифмические эвристики уровня, основанные на ⌊ln D⌋, и вербальные вердикты карточки оценок («быстрый старт / устойчивый интерес / медленный старт»)) подразумеваются здесь как некалиброванные авторские эвристики, потому что ни одна не имеет валидированных числовых полос. Сама логарифмическая интуиция верна и стоит того, чтобы ее сохранить словами: при квазилогнормальном распределении [85] переход от 7 к 20 загрузкам — это сдвиг на одну единицу естественного логарифма в видимости, и чтение его как добавления 13 щелчков упускает эту суть.
Шкала также объясняет, почему авторы систематически неправильно оценивают свои собственные счетчики. Числа, которые циркулируют в вехах, профилях и объявлениях, происходят, как задокументировано в разделе 3.5, из видимого хвоста в сотни раз выше медианы, в то время как основная часть распределения находится вблизи медианы LSN 63, и в соответствии с квазилогнормальным законом расстояния между ступенями являются мультипликативными, а не аддитивными. На рисунке 7 эти значения (медиана обычной статьи, пороги входа, элитные медианы, хвост) расположены в виде контрольной лестницы в логарифмической шкале.
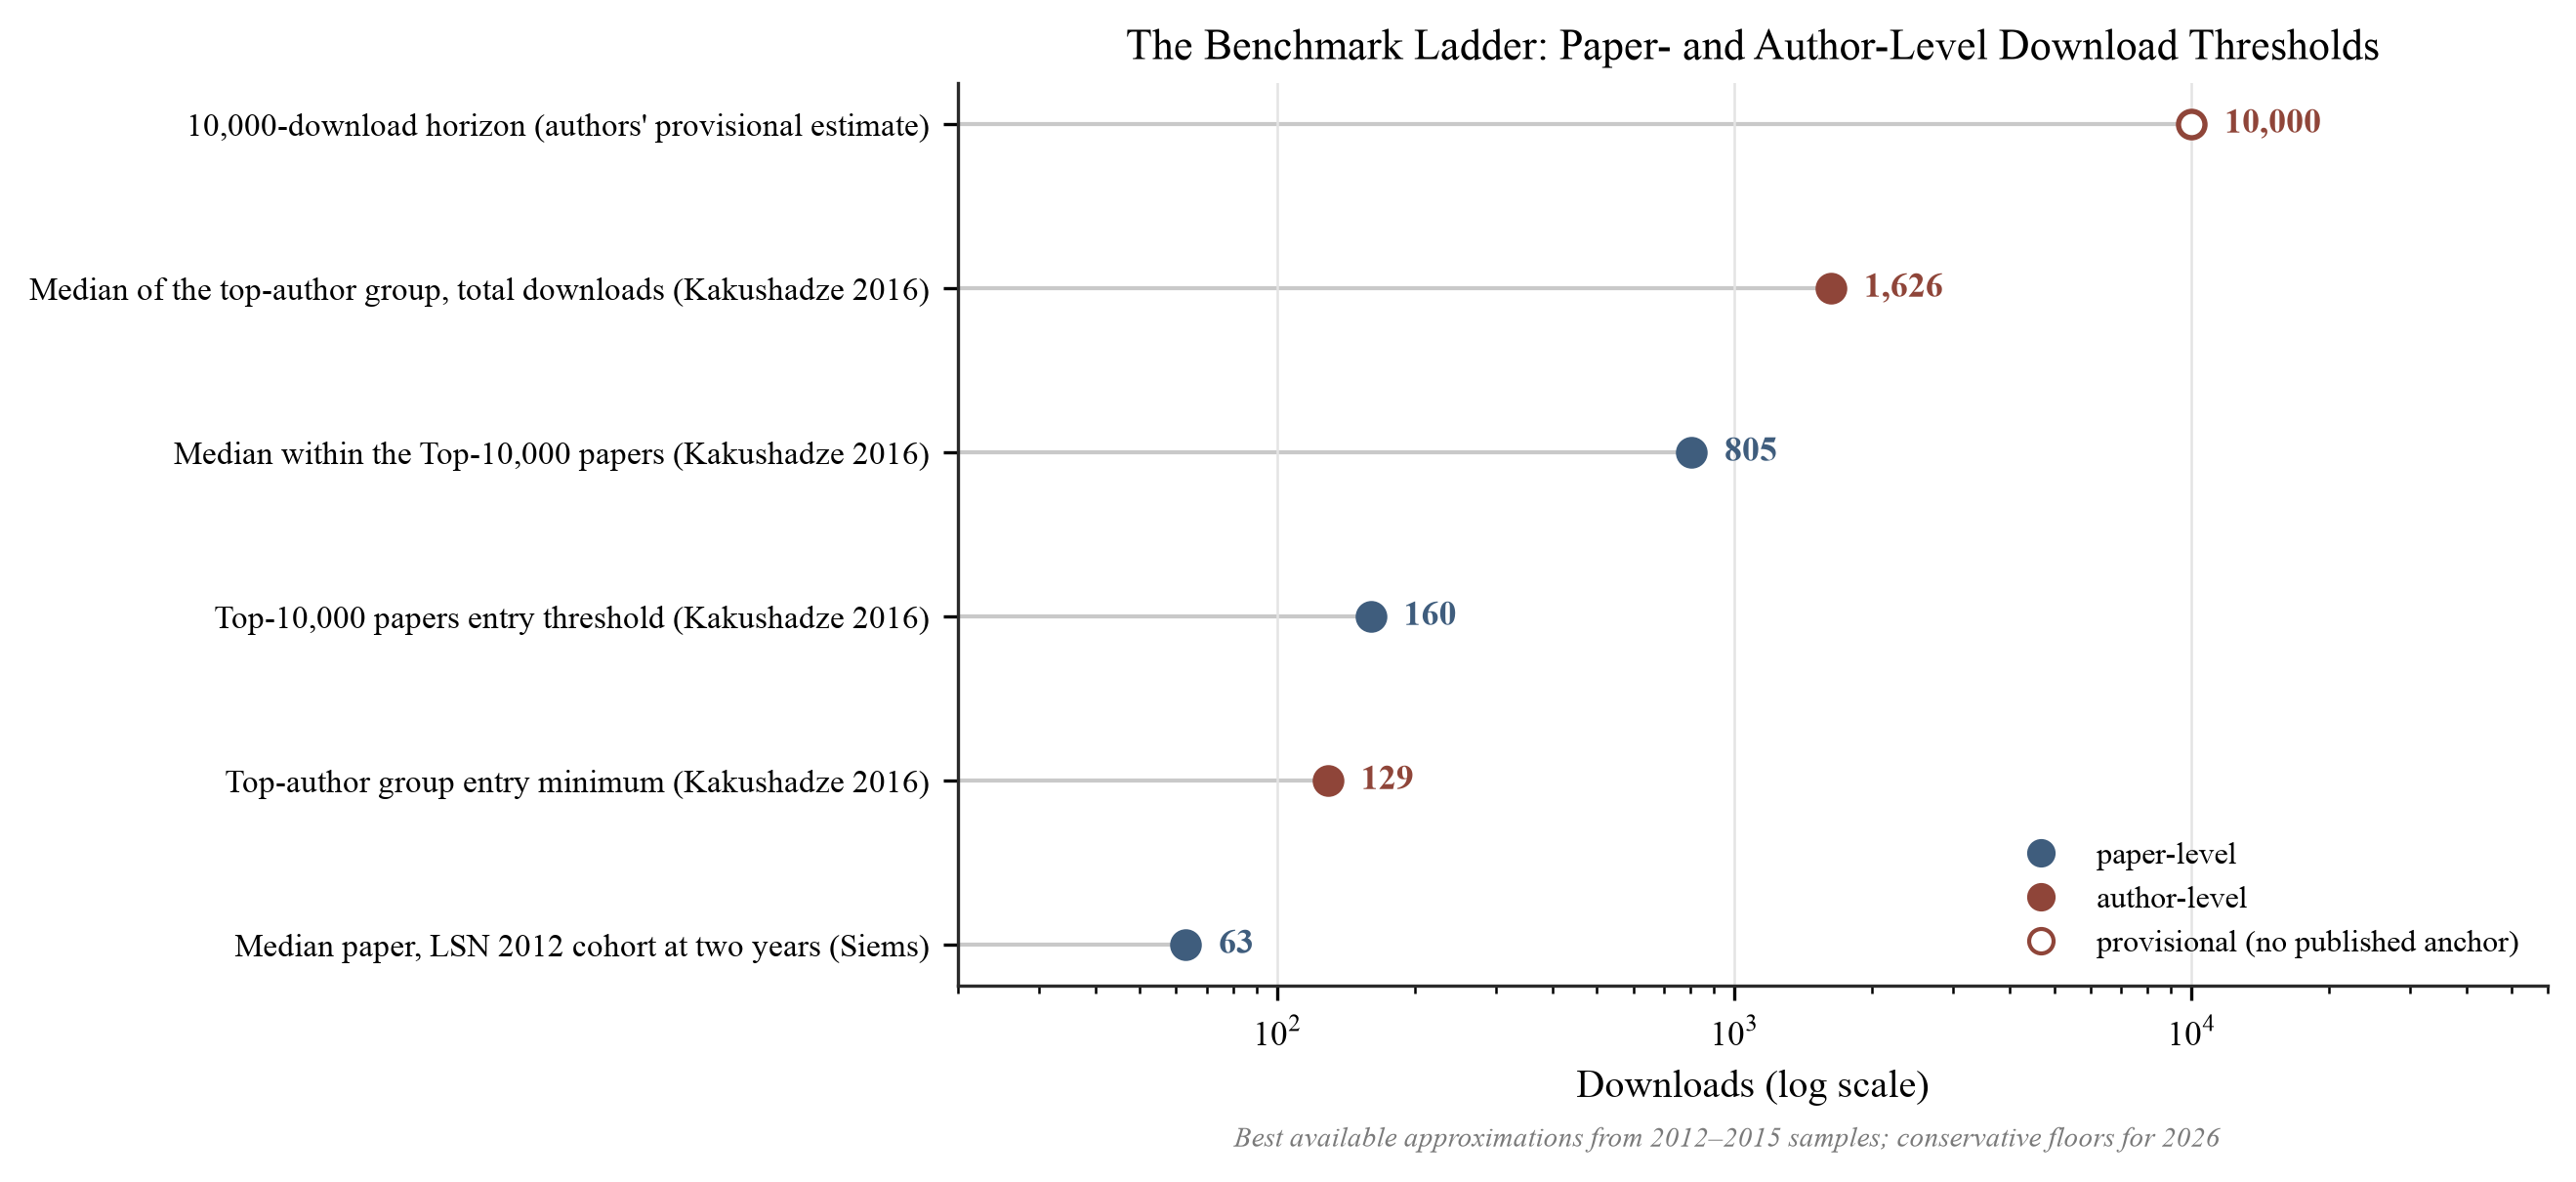
Рисунок 7. Контрольная лестница. Пороги загрузки на уровне статей и авторов в логарифмической шкале: двухлетняя медиана LSN 63 [139]; минимум входа лучших авторов 129 и запись лучших статей ~160 [85]; медиана в лучших 10 000 статей 805 [85]; медиана группы лучших авторов 1626 [85]; горизонт 10 000 загрузок (предварительная оценка автора, опубликованный якорь процентиля отсутствует). Область ниже двухлетней медианы 63 соответствует зарождающейся полосе таблицы 8. Значения получены из выборок 2012–2015 годов (инфляция с тех пор: раздел 5.1).
5.4 Охват и конверсия: двумерная диагностика
Одного показателя, даже разбитого по категориям, недостаточно, чтобы различить разные механизмы, его создающие. Механизмы раздела 4 имеют одно следствие, наиболее важное на практике: отказ видимости и отсутствие ответа на контент — это разные диагнозы: статья может загружаться редко, потому что её встретило мало читателей, или потому что встретившие её отказались от полного текста. В таблице 9 представлены два нормализованных измерения.
Таблица 9. Матрица диагностики охвата и конверсии. Охват и конверсия оцениваются как процентили внутри группы сравнения сопоставимых статей (одна область, когорта размещения, возраст статьи и предыдущая видимость автора; раздел 5.5), где граница — медиана группы. На основе имеющихся данных невозможно защитить никакие абсолютные числовые отсечки, и они не приводятся. Матрица 2×2 дихотомирует каждую ось по медиане группы для удобства чтения; базовые процентили охвата и конверсии являются непрерывными (раздел 5.4), и доступны более тонкие разбиения, такие как терцили.
| Низкая конверсия | Высокая конверсия | |
|---|---|---|
| Низкий охват | «Холодный старт» (низкий охват, низкая конверсия). Статья мало распространяется и редко загружается после попадания в поле зрения. Данные не подтверждают, слабо ли качество исследования; они только показывают, что диффузия не началась. | «Скрытый интерес» (низкий охват, высокая конверсия). Читатели, встретившие статью, реагируют хорошо, но встречают её слишком мало. Обнаруживаемость — основное наблюдаемое узкое место — это проблема распределения, а не проблема контента. |
| Высокий охват | «Внимание без принятия» (высокий охват, низкая конверсия). Название, тема или размещение на платформе привлекают посещения, но мало посетителей получают полный текст. Исключите искажённый знаменатель, прежде чем диагностировать коммуникационное несоответствие: высокий охват может быть фантомными просмотрами, а не подлинным вниманием, потому что просмотры — более загрязнённый из двух счётчиков (раздел 4.2) — в прозрачной записи RePEc/LogEc роботы составляли примерно 74% просмотров аннотаций, но только около 7% загрузок [99], поэтому нефильтрованный нечеловеческий трафик даёт именно эту подпись высокого охвата и низкой конверсии. Только после исключения завышенных роботами просмотров остаточные данные оправдывают исследование соответствия аудитории и коммуникации в названии и аннотации. | «Сильная ранняя диффузия» (высокий охват, высокая конверсия). Статья достигает сравнительно большой аудитории и преобразует попадание в поле зрения в интерес к полному тексту. |
Четыре квадранта обозначены по характеру диффузии, который показывают два процентиля (холодный старт, скрытый интерес, внимание без принятия, сильная ранняя диффузия). Метки описывают характер диффузии, а не само исследование, и операционально важно разделение механизмов; ни один из квадрантов низкого охвата не позволяет делать выводы о качестве исследования — пункт, непосредственно относящийся к любому оценочному использованию этих метрик. Квадрант низкой диффузии назван по диагнозу, представленному в этой статье, — холодный старт. Матрица практически ценна, потому что надлежащее вмешательство различается по квадрантам: кандидат со скрытым интересом нуждается в распределении (пересмотр классификации, сроки объявления, внешняя видимость), тогда как внимание без принятия требует исправления коммуникации (название и аннотация) или аудита трафика. На рис. 8 плоскость представлена как шаблон.
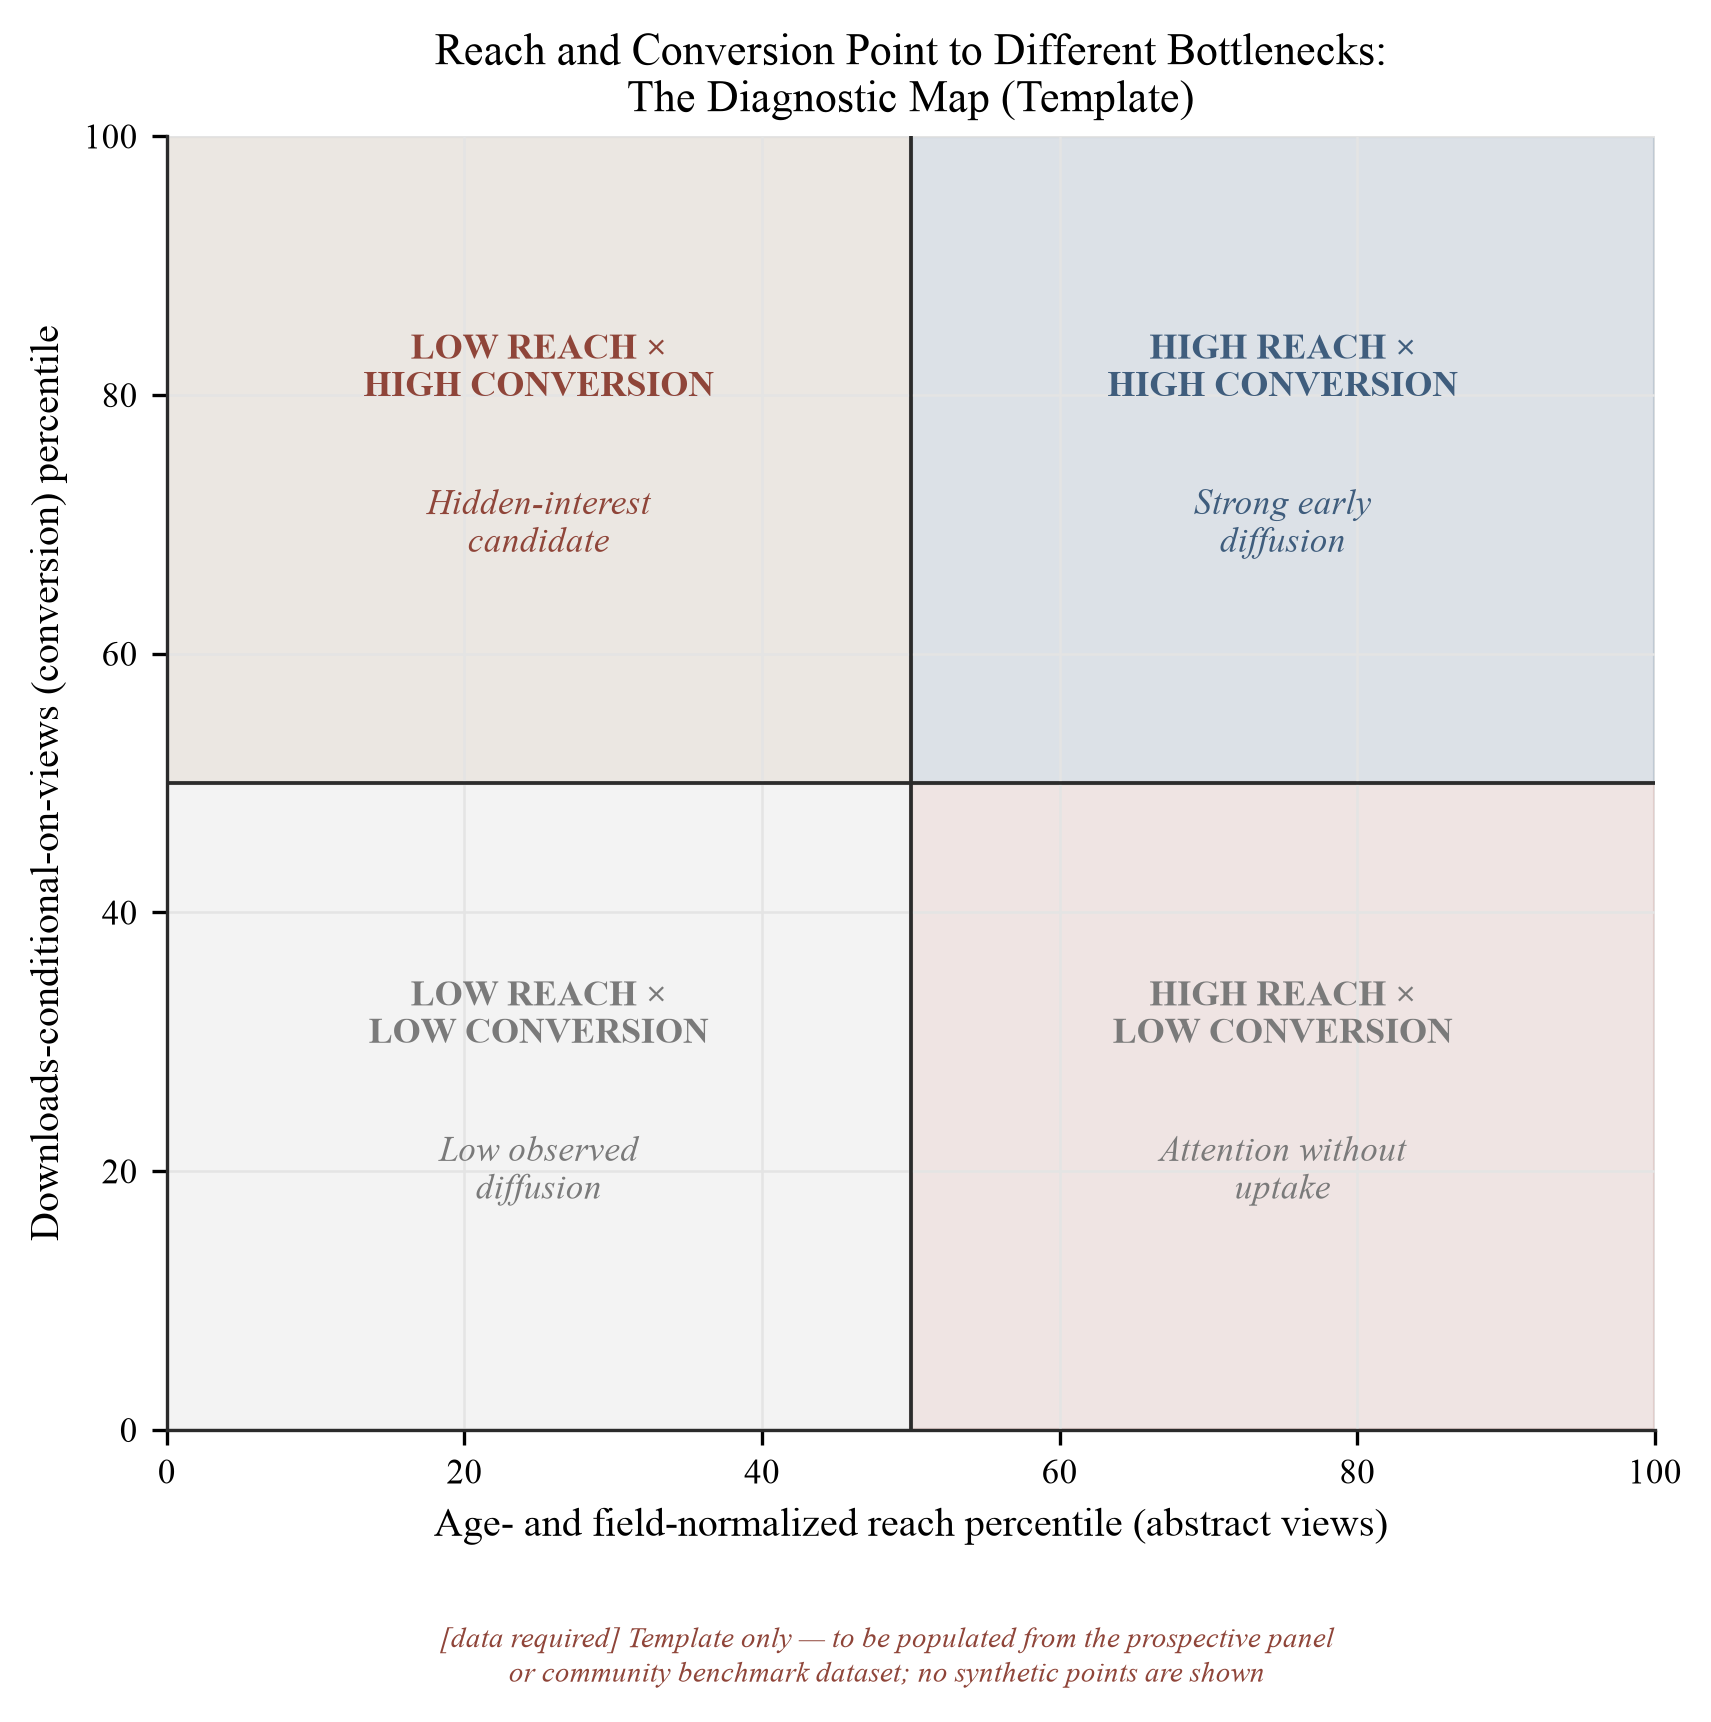
Рис. 8. Карта охвата и конверсии. Шаблон для позиционирования статей по нормализованному по возрасту, области, когорте и видимости процентилю просмотров (охват, горизонтальная ось) и процентилю загрузок при условии просмотров (конверсия, вертикальная ось) с квадрантами, как в таблице 9 (холодный старт, скрытый интерес, внимание без принятия, сильная ранняя диффузия). Верхний левый квадрант выявляет статьи с надмедианной конверсией несмотря на подмедианный охват — класс, который сырые счёты загрузок систематически недооценивают. Эмпирических значений не показано; карта должна быть заполнена из перспективной панели или набора данных сравнительного анализа сообщества раздела 8.
5.5 От основного показателя к эталону: размеры CSAB
Каждый из предыдущих подразделов исправляет один вид отказа необработанного счётчика, и Бенчмарк внимания к научным работам при холодном старте (CSAB) является этой интеграцией: рамка отчётности, которая заменяет единственный основной показатель пятью нормализованными компонентами (Таблица 10). Переменные нормализации (возраст работы, область, когорта публикации и предыдущая видимость автора) каждая эмпирически обоснована: кумулятивные показатели механически возрастают с возрастом; нормы в области отличаются более чем на порядок в среднем [168]; календарные условия заметно смещают внимание (доступы к статьям падают ~11% по выходным и ~50% летом [178]); и новичок на платформе не сталкивается с той же начальной аудиторией, что и утвердившийся автор [83]. Одно предположение о совокупности должно быть зафиксировано, прежде чем будет вычислен какой-либо процентиль. Кумулятивный счётчик определён над совокупностью работ с гетерогенным сроком действия (работы иногда изымаются, объединяются или заменяются более поздними версиями), поэтому каждый процентиль CSAB является утверждением о сохранившейся совокупности на дату наблюдения. Исследование 1 (раздел 8.6) предварительно задаёт правило включения (обработка версий, изъятия и разрешение дубликатов) вместо того, чтобы оставлять эталонную совокупность неявной.
Два основных компонента допускают компактное определение. Для работы i возраста τ (дней с момента публикации), в области f, когорте публикации c и слое предыдущей видимости s:
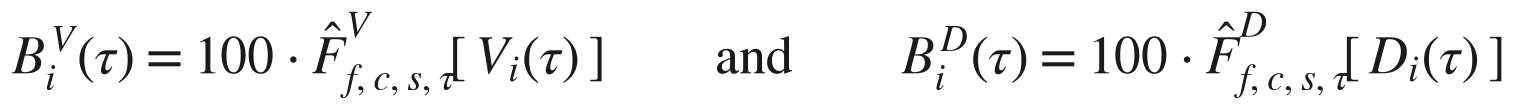
где V_i(τ) и D_i(τ) – это совокупные просмотры аннотаций и загрузки, а F̂^V, F̂^D – эмпирические функции распределения этих подсчётов в пределах эталонного класса, определённого параметрами f, c, s и τ. Определение фиксирует оценку – процентиль в указанном эталонном классе. Ни одна F̂ не может быть записана сегодня, потому что эталонные распределения не существуют (раздел 5.1). Формула – это спецификация, которую предназначены оценить Исследование 1 и панель раздела 8, и та же нотация переносится в конструкцию предсказательной валидации раздела 8.9. Нормализация процентиля и эталонного класса сама по себе является установленным библиометрическим методом: процентили – стандартный способ нормализовать подсчёты публикации по области, типу документа и году публикации [22] с выделенными процедурами для нормализации показателей по области и времени, доминируемых нулями [23], именно режим, в котором работает счётчик загрузок. Нормализация показателей использования конкретно (загрузок и просмотров, а не цитирований) против эталонного класса также является зрелой областью исследований: литература по библиометрике использования давно рассматривает воздействие на основе загрузок как распределение, которое следует обусловливать характеристиками сообщества пользователей и рамкой выборки [92][19], а программы факторов использования журналов построены именно такие нормализованные показатели использования из совместимых с COUNTER данных [137]. Стандартизация самого подсчёта использования является предметом зрелой практической инфраструктуры – Кодекса практики COUNTER [125]. Нормализованные по областям показатели читаемости имеют сопоставимый установленный прецедент в литературе по альтметрике [179]. Метод, таким образом, установлен. Вклад здесь заключается в его применении к загрузкам SSRN и построении эталонного класса, стратифицированного по возрасту, области и когорте, для среды после Рейтингов.
Оценка чистая, но перед тем, как подбирать какую-либо F̂, необходимо разрешить три вопроса операционализации. Первый наиболее важен, потому что касается того, для чего предназначен эталон. Обусловливание эталонного класса предыдущей видимостью автора (слоя s) является правильным, когда вопрос диагностический: «как эта работа развивается среди сравнимых работ авторов сравнимой видимости?» Это именно неправильно, когда вопрос – вопрос справедливости H1–H3, потому что нормализация по предыдущей видимости вычитает разрыв между новичком и авторитетным автором, который существует, чтобы его измерять. Процентиль внутри s не может обнаружить недостаток холодного старта, так как недостаток был исключён из условия по конструкции. Рамка, таким образом, разделяет два отчётливо различных использования CSAB, которые никогда не должны быть объединены в одно число. Как описательный эталон он сообщает позицию автора в полностью стратифицированном эталонном классе (включая s), что нужно автору на приборной панели. Как скорректированная оценка для H1–H3 он исключает предыдущую видимость из набора условий и рассматривает её вместо этого как интересующий предиктор, измеряя градиент, а не удаляя его. Два ответа различаются, они отвечают на разные вопросы, и любой отчёт, который представляет процентиль, нормализованный по видимости, должен указывать, какой из двух это есть. Второй вопрос – размер выборки. Стратификация по области × когорта × слой видимости × восемь возрастных точек быстро исчерпывает вероятностную выборку из 3000–5000 работ (раздел 8.6): полностью пересекающееся количество в ячейке измеряется в тысячах, поэтому большинство ячеек крошечные или пустые. Сокращение эмпирического Байеса в сторону более широких эталонных классов названо по этой причине (разделы 8.3, 8.8), но сокращение требует собственной спецификации: минимальную иерархическую структуру (область в рамках широкой категории, возраст в рамках грубого диапазона возраста) и предварительно заданное минимальное правило ячейки для оценки, ниже которого ячейка заимствует у своего родителя, а не сообщает необработанный процентиль. Это минимальное правило ячейки на стороне оценки отличается от более строгого, чем управляемое конфиденциальностью минимальное правило ячейки, которое управляет общественным выпуском в приложении D; два служат разным целям и задаются отдельно. Последний вопрос – импульс (Таблица 10), определённый как изменение в оценённой нормализованной позиции. Показатель изменения в оценённой величине приглашает регрессию к среднему: работа, которая приземляется высоко на день 7 отчасти из-за шума оценки, будет иметь тенденцию падать к дню 30 по чисто статистическим причинам. Импульс, таким образом, требует явной модели базовой траектории (например, оценки сокращения или эмпирического Байеса скрытой позиции с распространённой ошибкой измерения), а не необработанной разницы двух снимков процентиля, и необработанная разница сообщается, если вообще, только как описательный спутник моделируемой величины.
Таблица 10. Эталон холодного старта научного внимания (CSAB): пять измерений вместо одного числа. Копируемый шаблон для отчетности на уровне предложений по этим измерениям приводится в Приложении B.
| Измерение | Метрика | Основной вопрос | Интерпретация |
|---|---|---|---|
| Охват | Перцентиль просмотров с нормализацией по возрасту/области/когорте/новичкам | Столкнулась ли релевантная аудитория со статьей? | Обнаруживаемость |
| Производительность загрузок | Нормализованный кумулятивный перцентиль загрузок | Сколько получений полного текста произошло по сравнению со сравнимыми статьями? | Общая ранняя диффузия |
| Конверсия | Загрузки при условии наличия возможностей просмотра (раздел 5.2) | Искали ли подвергнутые воздействию читатели полный текст? | Условное взаимодействие |
| Импульс | Изменение нормализованной позиции или внимания на уровне интервала | Ускоряется ли диффузия, остается стабильной или затухает? | Временная траектория |
| Последующая валидация | Последующее цитирование или использование при условии ранних метрик | Предсказала ли раннее внимание последующее научное восприятие? | Предсказательная валидность |
Эта схема отвергает любой универсальный необработанный порог «успеха». Успех должен определяться относительно аналитической цели: для обнаруживаемости — высокий перцентиль охвата среди статей того же возраста и области; для восприятия читателями — превышающая эталонный класс конверсия при условии воздействия; для диффузии — совместное распределение этих двух; для научного влияния — последующие цитирования или задокументированное использование. Раннее использование само по себе недостаточно для этой последней цели, так как ранние загрузки объясняют только около 16% дисперсии последующего цитирования [25]. Это делает интерпретацию примера в названии точной. Семь загрузок являются «хорошими» только в той мере, в какой семь загрузок размещают статью необычно высоко среди иначе сравнимых статей на том же этапе их жизненного цикла. Значение на день 7 и значение на день 180 не могут быть оценены по одному и тому же эталону.
Четыре выбора в дизайне следуют восьмому принципу Лейденского манифеста: что количественные показатели не должны выходить за пределы силы стоящих за ними предположений, и что ложная точность сама по себе является отказом в измерении [78]. Эта схема выводит диапазоны, а не точные оценки (таблица 8); она закрепляет CSAB как диагностический вектор, а не как цель (раздел 5.2); она изображает свои выходные фигуры, карту охват–конверсия (рисунок 8) и вентилятор эталона (рисунок 14), без числовой шкалы, чтобы форма не могла быть ошибочно принята за откалиброванное значение; и она прикрепляет уровень верификации и возраст к каждому числу, которое она использует (таблица 7). Каждый из них ограничивает точность, которую свидетельства не могут обосновать, как того требует DORA при оценке исследований, когда она отвергает одночисловые прокси и журнальные прокси для содержательной оценки содержания статьи [8]. Сведение CSAB обратно в одну оценку повторно внесло бы ровно ту ложную точность, против которой предупреждают оба документа.
Для автора отчетность CSAB заменила бы простую строку «Загрузки: 12» на что-то вроде этого: 12 загрузок через 14 дней: общий перцентиль загрузок среди сравнимых статей: 67-й; перцентиль охвата: 39-й; перцентиль конверсии: 81-й; интерпретация: высокий условный интерес, воздействие ниже медианы. Каждое число в этом макете является иллюстративным, так как такие перцентили не существуют до тех пор, пока не будут оценены эталонные распределения раздела 8, и ни одно из этих значений не может быть цитировано как эталон, но формат показывает, что дает разложение. Один и тот же необработанный подсчет, который выглядит как неразличимое разочарование, превращается в конкретный диагноз: читатели, которые встречают статью, реагируют необычайно хорошо, но слишком мало ее встречают, поэтому указанное вмешательство — это распределение, а не пересмотр. Проработанный пример — это аналог CSAB квадранта «скрытого интереса» таблицы 9. Приложение B фиксирует этот формат как копируемый шаблон отчетности, поля перцентилей которого остаются пустыми до тех пор, пока не существуют распределения раздела 8.
5.6 Траектории чтения: воздействие как лечение, а не фоновый шум
Заключительный компонент рамки является временным: недавно размещённая статья не входит в однородную среду внимания. Она проходит через различные режимы воздействия (размещение → внутреннее обнаружение → рассылка по электронной почте → внешнее индексирование → сетевая диффузия), и совокупный итог схлопывает эти режимы в одно число. Границы режима устанавливаются механизмом раздела 4: распределение eJournal курируется и может занять до 45 дней по темам с большим объёмом [53], а внешнее индексирование поисковыми системами может занять 6–9 месяцев или больше [55].
Состояние панели управления, вызывающее наибольшее беспокойство, вытекает непосредственно из этого: нулевые загрузки на первой неделе — это нормальная донораспределительная стадия, а не отторжение. До завершения цикла объявлений статья ещё не была подвергнута воздействию на своей основной аудитории. Диагностическая последовательность для раннего нуля является административной: подтвердите, что статья размещена публично; подтвердите назначение eJournal; дождитесь завершения цикла объявлений; только затем прочитайте счётчики. Наоборот, первомесячные подсчёты, после того как распределение произошло, являются самым ранним и самым шумным опережающим индикатором: ранние загрузки коррелируют с последующими цитированиями примерно r ≈ 0,4 [25], информативно, но далеко не окончательно, и ранние всплески часто представляют собой события воздействия (блог или медиа-освещение), а не устойчивый интерес [116][138].
Поскольку ретроспективный скрейпинг совокупных подсчётов не может восстановить, что было у статьи на 3-й или 30-й день, интерпретация на основе траектории (и программа исследований панели из раздела 8) требует наблюдения с момента рождения на стандартной сетке. Таблица 11 указывает минимальное расписание. Она также служит шаблоном самоконтроля для отдельных авторов. Траектория классифицируется только предварительно при чтении на 60- и 90-й дни сетки таблицы 11 и с уверенностью при чтении на 180-й день, никогда не на 7-й день.
Таблица 11. Минимальное расписание продольного наблюдения для статей SSRN.
| Возраст статьи | Основная цель наблюдения |
|---|---|
| День 1 | Немедленное воздействие платформы |
| День 3 | Очень раннее обнаружение |
| День 7 | Эталон первой недели (ожидаемое значение для большинства статей: на нуле или близко к нему, до распределения) |
| День 14 | Ранняя стабилизация |
| День 30 | Первомесячный эталон |
| День 60 | Распределение и зрелость поиска (циклы eJournal завершены [53]) |
| День 90 | Среднесрочная ранняя диффузия |
| День 180 | Переход к измерению последующего воздействия |
По возможности, ежедневное наблюдение в течение первых 45 дней предпочтительнее, так как рассылка по электронной почте может происходить в различные моменты времени в этом окне [53]. Чтения на уровне интервалов на этой сетке преобразуют панель управления из статического вердикта в траекторию, единственную форму, в которой ранние показатели SSRN несут защищаемую информацию.
Разделы 4 и 5 заменяют вопрос, на который автор не может ответить («7 загрузок — это хорошо?»), на четыре вопроса, которые может поддержать опубликованная запись: где подсчёт находится в сравнении с картой эталонов и её винтажами (5.1, 5.3); находится ли преобразование внутри эмпирической полосы (5.2); какой квадрант плоскости охвата–преобразования занимает статья (5.4); и что показывает траектория на сетке наблюдения (5.6)? Ни один из этих вопросов не требует снятого рейтинга, но все они требуют сравнительных данных, сбор которых предлагают заключительные разделы этой статьи.
6. Практическое руководство для авторов
Карта эталонов из раздела 5 (таблица 7) восстанавливает отсутствующий масштаб, и этот раздел использует её для автора, который открывает панель статистики после 15 июля 2026 года и видит подсчёты без контекста [148][149]. У неё есть четыре задачи по очереди: процедура наблюдения за собственными счётчиками (6.1–6.2), заменители сравнительного плана, который обеспечивали рейтинги (6.3), рычаги, которые могут законно улучшить видимость (6.4), и протокол преобразования счётчиков в защищаемые доказательства карьеры (6.5–6.6). Каждый числовой якорь, используемый здесь, восходит к опубликованному источнику с явной рамкой выборки и временным окном; таблица 7 их консолидирует. Практики, циркулирующие в сообществе авторов и не имеющие доказательственной поддержки, отмечаются как непроверенные везде, где они появляются, и собираются как гипотезы-кандидаты для тестирования в конце приложения A.
Таблица 12 сжимает суть руководства в протокол из семи вопросов, задаваемых по порядку, каждый спарен с доказательствами, стоящими сохранения, и самым сильным выводом, который ответ может законно обосновать. Разделы 6.1–6.2 развёртывают этот протокол в процедуры и правила чтения, а таблица 23 (приложение A) остаётся его ситуационным спутником, индексируемым по состояниям панели управления, которые фактически встречают авторы.
Таблица 12. Протокол автора для интерпретации счётчика SSRN: семь вопросов, доказательства, которые необходимо сохранить, и допустимый вывод. Ни один шаг не рассматривает счётчик как оценку качества; в последнем столбце указан верхний предел того, что может поддержать каждый ответ.
| Этап | Вопрос | Доказательства, которые необходимо сохранить | Допустимый вывод |
|---|---|---|---|
| 1 | Сколько лет было статье, когда был наблюдаем подсчёт? | Снимок экрана или экспорт с датой, плюс дата размещения | Наблюдение, зависящее от времени, а не пожизненный вердикт |
| 2 | Произошло ли кураторское распределение и внешнее индексирование? | Уведомление о распределении и дата, где доступны; статус индекса поиска | Идентификация режима до- и после воздействия (раздел 5.6) |
| 3 | Что такое просмотры, загрузки и преобразование вместе? | Оба счётчика и знаменатель | Диагностика охвата в сравнении с условным взаимодействием (таблица 9), а не одиночный вердикт |
| 4 | Какой самый узкий защищаемый справочный класс? | Область, когорта, возраст статьи, статус новичка, история классификации | Относительное положение только в пределах этого класса (раздел 5.5) |
| 5 | Меняется ли траектория? | Повторные наблюдения в фиксированные возрастные периоды таблицы 11 | Импульс или плато, подверженные событиям воздействия — не ускорение «качества» |
| 6 | Есть ли последующая поддержка? | Цитирования, содержательные контакты, публикация или документированное использование | Многоуровневые свидетельства распространения, а не доказательство качества |
| 7 | Можно ли воспроизвести утверждение? | Источник, дата, правило подсчёта, архивная запись | Поддающийся проверке отчёт, а не необоснованный рубеж |
6.1 Процедура измерения
Интерпретация начинается с дисциплинированного ведения записей, потому что SSRN отображает только текущие кумулятивные счётчики и не хранит историю, которой управляет автор. Шесть шагов, применяемых со дня опубликования, дают минимальную запись, которая необходима для любых последующих выводов.
1. Ведите запись обоих счётчиков и их соотношения. Отмечайте просмотры аннотаций, загрузки и отношение загрузок к просмотрам через фиксированные интервалы. Сетка наблюдений в таблице 11 (дни 1, 3, 7, 14, 30, 60, 90, 180) определяет расписание и цель каждого считывания. Датированный снимок экрана при каждом интервале — единственная версия записи, которой управляет автор, поскольку счётчики платформы могут пересчитываться при изменении правил фильтрации [144][69]. Накопляемая запись — это пакет версионированных свидетельств: версия рукописи, её метаданные и классификации, датированные снимки панели инструментов, уведомления о распространении, датированный журнал собственных событий продвижения автора (опубликованная нить, доклад, объявление в рассылке) и последующие цитирования и существенные контакты. Журнал продвижения важен, потому что продвижение — это воздействия. Без датированной записи собственной публичности автор не может отличить органический всплеск от вызванного собственным продвижением, и ни один проверяющий утверждение не может (раздел 8.3).
2. Нормализуйте по времени с момента опубликования. Выражайте раннюю производительность как загрузки в месяц за первые три-шесть месяцев, а не как сырое кумулятивное число. Сравнение трёхмесячной статьи с итоговыми показателями более старых работ даёт систематически вводящие в заблуждение выводы, потому что счётчики накапливаются за время существования статьи на платформе, годовой объём загрузок которой вырос примерно с 12,9 млн в 2016 году до 40,6 млн в 2023 году [1].
3. Никогда не смешивайте окна наблюдений. Еженедельный счёт нельзя сравнивать с двенадцатимесячным средним, и девяностодневный счёт нельзя сравнивать с пожизненными итогами. Все сравнения в этом руководстве проводятся между однотипными окнами. Нарушения этого правила были среди наиболее распространённых ошибок интерпретации при использовании статистики рейтингов до её упразднения [161].
4. Поместите статью в её дисциплинарное окружение, а не сравнивайте с платформой. Средние загрузки на статью различались примерно в восемь раз только в электронных журналах сети Legal Scholarship Network (438,35 в разделе «Корпоративное право/Ценные бумаги/Финансы» против 53,48 в разделе «Сельскохозяйственное право», данные 2018 года) [168]. Счёт, который заурядный в одной подотрасли, может быть исключительным в другой. Релевантный класс сравнения — собственный электронный журнал статьи или предметная сеть, рассмотренные при одинаковом возрасте статьи.
5. Не переинтерпретируйте отдельные малые счёты. Литература по целостности данных устанавливает потолок точности счётчиков использования: сообщаемые издателем загрузки могут быть в два раза больше, чем на сравнимых платформах [176], фильтры платформы отбрасывают большую часть сырого трафика [99][129][144], и без таких фильтров собственные счётчики SSRN были бы завышены «в пять или более раз» [18]. Малые различия между сравнимыми числами поэтому не несут никакой информации.
6. Отслеживайте долгосрочное накопление, а не реагируйте на ранние показатели. Внимание на платформах рабочих бумаг концентрируется рано [116][28] (последний результат получен из данных NBER, а не SSRN), но слои обнаружения развиваются медленно: SSRN сообщает, что индексация Google Scholar занимает «6–9 месяцев или дольше» [55]. Число читателей, кроме того, затухает на нескольких временных масштабах одновременно, и чтение и цитирование не обязательно следуют одному и тому же временному процессу [91], поэтому ни одно единичное измерение «полураспада» собственной кривой не является безопасным. Траекторию можно сначала условно классифицировать при показаниях в 60–90 дней сетки таблицы 11 и с большей уверенностью при 180 днях, но никогда при 7-дневном показании.
6.2 Пять правил чтения панели управления
Имея эти данные, доказательства распределения из раздела 5 сводятся к пяти эмпирическим правилам для ежедневного чтения панели управления.
(i) Сравнивайте с медианами, а не со средними значениями или видимыми максимумами. Единственная выборка переписного типа обычных статей показывает медиану в 63 загрузки и 369 просмотров аннотации через два года (LSN, статьи, выложенные в 2012 году) [139]. В одной недавней опубликованной выборке медиана составляет 87 загрузок, в то время как среднее значение равно 221,3 и превышает даже 75-й процентиль (раздел 3.3) [83]. Знаковые цифры, которые циркулируют, происходят из видимого хвоста, максимумы которого в 2015 году доходили до сотен тысяч загрузок (раздел 3.5) [85]; автор, ориентирующийся на них, ориентируется на хвост квазилогнормального распределения, что гарантирует неправильную калибровку. Среднее по всей платформе значение ~222 загрузок за всё время на одну статью, вычисленное из совокупных данных декабря 2023 года [1], столь же непригодно в качестве личной мерки.
(ii) Проверяйте коэффициент конверсии, а не только количество. Независимые измерения сходятся в нормальной полосе примерно 11–19% загрузок на просмотр аннотации: среднее значение выборки LSN 18,7% и медиана 17,1% [139], и значения 15% (наиболее цитируемые статьи) и 11% (статьи с единичным цитированием) из исследований правовых ссылок [172]. Давний эмпирический закон SSRN о трёх просмотрах на загрузку [18] находится выше этой полосы, а не внутри неё. Недавняя выборка Marketing-network находится немного выше этой полосы со средним значением 23,7 загрузок на 100 просмотров [83]. На рисунке 6 все оценки нанесены вместе. Применим центральный решённый пример из раздела 5.2 к этому правилу: 40 просмотров аннотации и 7 загрузок заголовка дают коэффициент 17,5%, находящийся внутри полосы как точечная оценка, но с широким 95% доверительным интервалом Clopper–Pearson (≈7,3–32,8%). При n = 40 этот результат не является ни неудачей, ни точным процентилем: это результат скрининга, соответствующий обычной конверсии. Конверсия значительно ниже полосы согласуется с несоответствием между аннотацией и статьей, когда читатели приходят, читают аннотацию и уходят. Это требует действия, и это действие — пересмотреть заголовок и аннотацию. Конверсия значительно выше полосы указывает на трафик, который просмотр аннотаций не объясняет, такой как прямые ссылки из средств массовой информации или охват агрегаторов, и это должно побудить проверку происхождения просмотров. Оба этих прочтения являются диагностическим скринингом: ни одно исследование не подтвердило причинно-следственное заключение от низкой конверсии к качеству аннотации, и диагноз следует записать как гипотезу о собственной статье.
(iii) Рассматривайте загрузки первого месяца как самый ранний и наиболее зашумленный сигнал цитирования. Ранние загрузки коррелируют с последующим цитированием при примерно r ≈ 0,4 в данных arXiv, что сами исходные авторы переводят только в примерно 16% объяснённой дисперсии [25]. Самый ранний такой сигнал на записи является биомедицинским: счётчики онлайн-просмотров в первую неделю после публикации в BMJ коррелировали при примерно 0,50 с цитированиями, накопленными в последующие годы [119]. В правовой науке Black и Caron сообщили о корреляции загрузок и цитирований на уровне статей порядка 0,50, возрастающей примерно до 0,55 в выборке ста младших профессоров права [18]. Во всех областях и горизонтах корреляции на уровне статей варьируются примерно от 0,1 до 0,6 [80][25], и счётчики загрузок arXiv теряют статистическую значимость как предикторы, когда контролируется одновременное внимание Twitter [138]. На совокупном уровне связь усиливается: 0,84 между основанными на загрузках и основанными на цитированиях рейтингами ста школ права [77], и R = 0,724 между загрузками PDF за шесть месяцев и последующим цитированием в собственном анализе одного журнала [114]. Эти совокупные цифры не определяют, где окончится та или иная статья, и первый месяц загрузок является ранним сигналом о последующем цитировании.
(iv) Ноль загрузок в первую неделю — это нормальное распределение перед публикацией, а не отказ. Недавно выложенная статья получает внимание только после того, как пройдёт модерацию, будет классифицирована в тематические eJournals и войдёт в цикл объявлений. Собственная документация SSRN описывает классификацию как кураторскую, а не автоматическую, с задержками до 45 дней для перегруженных тем [53], и рассылки eJournal и оповещения по электронной почте были явно подтверждены как продолжающиеся без изменений после закрытия сервиса [147][57]. Диагностическая последовательность следующая: подтвердить, что статья общедоступна, подтвердить классификацию eJournal, дождаться завершения цикла объявлений, и читать счётчики только после этого. Обнаружение через поисковые системы происходит ещё позже [55].
(v) Падающий или плоский счётчик может отражать фильтрацию, а не потерю читательства. SSRN публично документирует, что отбрасывает видимые повторные загрузки, загрузки ботов и другую аномальную активность [144][66][69]. Опыт RePEc/LogEc показывает, как велики могут быть такие коррекции: в июле 2007 года боты составляли примерно 74% просмотров аннотаций, но только около 7% загрузок [99], и в сентябре 2025 года более чем 99,5% сырого трафика IDEAS было отброшено из-за помех AI-ботов [129]. Внезапное падение или переформулировка с одинаковой вероятностью могут быть событием измерения или событием читательства, и их никогда не следует интерпретировать как потерю репутации без подтверждения.
6.3 Бенчмаркинг без рейтингов
Рейтинги обеспечивали сравнительную базу. Автор сегодня имеет три замены для неё, упорядоченные от наименьшего количества работы к наибольшему.
Микро-бенчмарки. Наиболее прямая замена — это справочная группа, которую человек создаёт сам: определить три–пять методологически сопоставимых работ коллег из сравнимых учреждений, опубликованных в один месяц, и отслеживать их публичные счётчики по графику Таблицы 11, как и собственные. Результат — локализованная процентильная база на основе именно правильного справочного класса, сопоставленного по построению по области, возрасту работы и эпохе платформы, тогда как снятые с производства рейтинги сравнивали работы всех возрастов и областей в одной лиге. Это предложенная процедура, которая использует только общедоступные счётчики по работе, и она должна быть зафиксирована как таковая при любом использовании досье. Она также предполагает некоторое знакомство с коллегиальной литературой, которого может не быть у наиболее изолированных новичков, именно у авторов, на которых холодный старт больше всего влияет. Для них средство платформы раздела 10.4 (анонимные процентильные полосы) является структурным исправлением, поскольку для его использования не требуется самостоятельно собранная сеть.
Относительный коэффициент производительности. Ту же логику можно выразить одним числом: соотношение количества скачиваний работы в определённом возрасте к медианному количеству скачиваний сопоставленной когорты, то есть той же дисциплины, того же возраста работы и по возможности того же типа работы. Коэффициент 1,0 означает ровно медианную видимость для когорты, а значения выше или ниже 1,0 интерпретируются соответственно. Индекс упорядочивает работы в сопоставленной когорте; процентильные полосы ждут справочного распределения. Опубликованные медианы, на основе которых можно было бы построить базовый уровень когорты, устарели и узки (63 скачивания в течение двух лет для юридических работ, опубликованных в 2012 году [139], 87 для маркетинговых работ, наблюдаемых в 2025 году [83]), а отображение значений коэффициентов на процентили требует полного распределения, а не только медианы. Присвоение процентильных меток полосам коэффициентов без этого распределения создаёт ложную точность. Предварительно зарегистрированная повестка раздела 8 включает калибровку полос; до тех пор коэффициент является устройством упорядочивания, а не шкалой оценивания. Два дополнительных предостережения ограничивают это устройство. Его вообще не следует вычислять на малых значениях, поскольку неустойчивость малого знаменателя из раздела 5.2 применяется как к числителю коэффициента, так и к тонкой медиане когорты, и сжатие эмпирической Байеса (разделы 8.3, 8.8) является надлежащим исправлением везде, где такой коэффициент сообщается публично. Данный коэффициент не переводится в фиксированный процентиль: «дважды медиана когорты» соответствует разным процентильным позициям в распределениях разных форм, поэтому коэффициент упорядочивает работы в одной когорте, но не может быть сравнен между когортами или эпохами, чьи формы распределения различаются.
Вердикт-язык для траекторий. Инструменты, ориентированные на сообщество, предложили классифицировать раннюю траекторию работы на три качественных вердикта (быстрый старт, устойчивый интерес, медленный старт) как гуманную альтернативу сырым цифрам. Словарь стоит сохранить, так как он преобразует счёт в утверждение о траектории, и «медленный старт» явно не является синонимом неудачи. Пороги, первоначально предложенные для этих вердиктов, опирались на сравнения несовпадающих временных окон и на статистику «сетевого среднего» по всей платформе, которая не существует как общедоступная метрика: SSRN не предоставляет общедоступный API самообслуживания или конечную точку статистики [51], а ближайшая историческая метрика («Новые скачивания на работу», статистика рейтинга уровня автора) была снята с производства вместе с рейтингами ([B-9], цитируется с оговоркой, что исторические страницы рейтинга больше не доступны). Присваивайте вердикты, таким образом, только на основе сопоставимых сравнений: группа микро-бенчмарков или соотношение медианы когорты выше, читайте не ранее чем на отметке 60–90 дней.
Какой бы заменитель ни использовался, внешняя триангуляция его усиливает. Данные уровня цитирования из Crossref и OpenAlex [35][124] и показатели PlumX, отображаемые на страницах SSRN [50], отвечают на другой вопрос — о использовании ниже по течению, а не о видимости. Инструмент цитирования политики, такой как Overton, расширяет ту же триангуляцию на охват политики и практики, отображая, где работа цитируется в государственных и институциональных документах [187], что соответствует базе права, экономики и политики SSRN. Эти слои изучаются совместно со счётчиками в структуре CSAB таблицы 10 и диагностикой охвата–преобразования таблицы 9. Показатели Altmetric являются дополнительным слоем триангуляции. Задуманные изначально как сигналы раннего внимания [123][122], они следуют моделям, отличным от цитирований [74][20], и допускают нормализацию по области [21]. Они также уязвимы для автоматической инфляции [75] и требуют интерпретации, основанной на теории, а не простого чтения по номиналу [76].
6.4 Улучшение легальной видимости
До закрытия рейтинги предоставляли грубую, но реальную обратную связь для одного повторяющегося решения автора: стоило ли затрачивать дополнительные усилия на продвижение статьи (Раздел 1.3). После закрытия это решение приходится принимать, исходя из инструментов и диагностики, собранной здесь. Литература по определяющим факторам выявляет небольшой набор инструментов, находящихся под контролем автора и согласованных с правилами платформы. Каждый воздействует на видимость, а не на качество, и ни один не изменяет содержание статьи. Быстрое распространение и ранняя обратная связь входят в признанные цели размещения препринтов в методологической литературе о препринтах [24], и пособие по легальной видимости использует эту задекларированную функцию.
Оформление. В выборке LSN характеристики заголовка, длина аннотации и релевантность темы были значительно связаны с вниманием, с предостережением самого автора о том, что такие переменные могут служить показателями ненаблюдаемого качества [139]. В исследованиях правовых цитирований работы из верхнего дециля содержали больше ключевых слов и более длинные аннотации, чем работы из нижнего дециля [172] (конкретные цифры ожидают проверки по исходным источникам). Страница с аннотацией является поверхностью конверсии, где действует правило (ii), поэтому, когда коэффициент конверсии постоянно находится ниже полосы, заголовок и аннотация — первое, что следует пересмотреть. Любая такая переработка направлена на согласованность между обещанием и содержанием, а не на привлечение случайного трафика: переписывание уже ясной аннотации с целью максимизации кликов может повредить её точность, и привлечение несоответствующих посетителей может отодвинуть коэффициент конверсии дальше от полосы, а не приблизить к ней.
Классификация. Работы, классифицированные в большее количество электронных журналов, в среднем имели больше загрузок и меньше исходов без загрузок в анализе LSN 2018 года [168]. SSRN допускает от одной до семи классификаций на статью и курирует их включение [53]. Популярное уточнение со стороны сообщества, непроверенное, поскольку ни одно исследование не сравнивает стратегии классификации, ограничивает классификации тремя — одной из основных, одной из широких и одной из междисциплинарных категорий электронного журнала; этот совет входит в проверяемые гипотезы Приложения А.
Распределение и внешнее внимание. Оповещение по электронной почте электронного журнала остаётся основным каналом продвижения платформы и продолжает использоваться после закрытия [147][57][152]. Вне платформы освещение в блогах привело к резким ранним всплескам загрузок в одном эмпирическом тесте этого вопроса [116], видимое положение в списке увеличило количество читателей и цитирований в исследованиях позиций на arXiv [72], и участие в конференциях было связано с дополнительными 17–26 загрузками на статью в квази-экспериментальном исследовании, построенном вокруг отменённой встречи по политической науке ([B-4], цитируется с оговоркой, что параметры исследования — APSA 2012, а не выборка из SSRN по экономике). Руководства для практиков собирают дополнительные инструменты распределения для юридических исследований [169]. Обоснование раннего открытого распространения было независимо установлено: рандомизированное испытание открытого доступа выявило больше загрузок, хотя не было краткосрочного прироста цитирований [37], в то время как когортные исследования и исследования в полевых условиях сообщают о преимуществах в цитировании примерно от 10% до двукратного увеличения [59][86][17][93], включая +53% для американских правовых журналов [40], и аудит правовых цитирований выявил, что 87% наиболее цитируемых статей были доступны на SSRN в сравнении с 44–46% малоцитируемых статей, с 95% наиболее цитируемой группы, размещённой на SSRN в год их публикации или раньше [172]. Депозит препринта связан с более высокими цитированиями и более низкими загрузками с сайтов издателей на arXiv [38], и загрузки на bioRxiv коррелируют с результатами журналов [62]. В переписи всех препринтов на bioRxiv количество загрузок коррелирует с импакт-фактором журнала, в котором препринт позднее публикуется (Kendall τb = 0.59), ассоциация, для которой направление причинности неизвестно [2]. Слои машинного обнаружения (поисковые системы и системы выдачи генеративных ответов) рассматриваются отдельно в рамках аудита Раздела 8 и повестке проверки функций Таблицы 20 [5][164].
Гигиена версионирования. Пересмотры, загруженные на ту же страницу SSRN, сохраняют накопленные счётчики и стабильный URL, в то время как удаление и повторная публикация сбрасывают метрики на нуль ([B-7], цитируется с оговоркой, что формулировки на странице поддержки меняются со временем и должны быть переверены при отправке). Дальнейшее утверждение сообщества о том, что незначительное изменение на 3-й день вызывает переанонс и «вторую волну» внимания, не задокументировано и входит в непроверенные практики Приложения А. Идентификация требует такой же осторожности. Привязка проверенного ORCID ID к профилю автора SSRN поддерживает статьи и их счётчики, привязанные к правильному человеку, а не к однофамильцу, и это низкозатратная защита от проблемы уточнения авторства, которую конструкция панели Раздела 8.3 иначе должна решать статистически ([B-7], та же оговорка переверки).
Чего делать не следует. Самостоятельная загрузка и связанные с ней манипуляции задокументированы в собственных логах сервера SSRN, усилены вблизи пороговых значений верхних списков и были обусловлены социальным сравнением [44]. Фильтры борьбы с мошенничеством платформы являются открытыми [144][69], и комитеты по оценке, осведомленные об этой истории, дисконтируют необоснованные претензии. Таким образом, литература об играх несёт практическое предупреждение наряду с предупреждением о целостности: манипулируемые счётчики обнаруживаемы и репутационно дороги. На Рисунке 9 показана временная подпись рассматриваемого явления на смоделированных данных. Органическое внимание накапливается как ранний пик с длинным хвостом, в то время как манипуляция производит сосредоточенные всплески ровно того вида, который фильтры целостности предназначены для обнаружения [144][69].
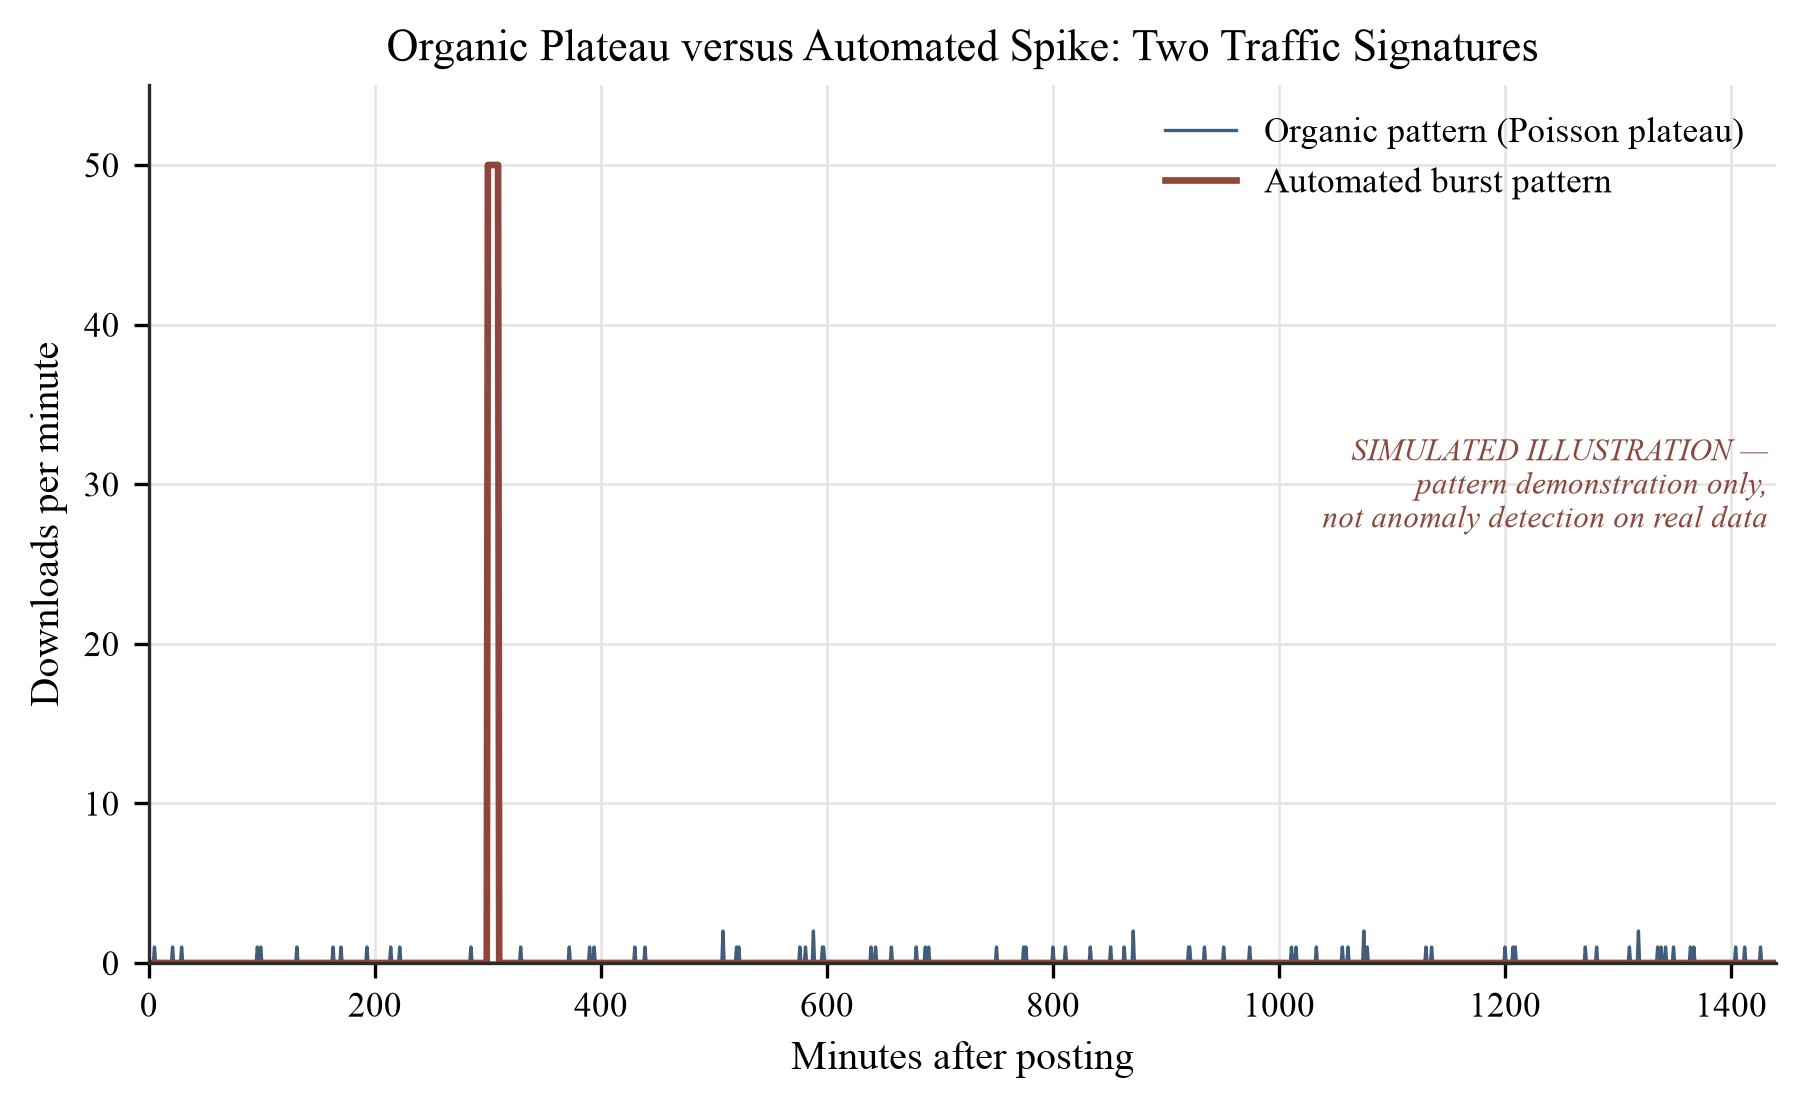
Рисунок 9. Органическое накопление в сравнении с всплеском манипуляции. Плавная траектория органической загрузки в контрасте с резким односторонним всплеском, характерным для самостоятельной загрузки, мотивирующим предупреждение о манипуляции в Разделе 6.4 и обсуждение целостности в Разделе 4 [44][69][144]. Все показанные данные смоделированы; для SSRN не существует эмпирического набора данных для обнаружения аномалий.
6.5 Преобразование счётчиков в доказательства карьеры: протокол досье
До закрытия сервиса ранжированные доказательства SSRN были стандартным компонентом досье. Публичный рейтинг автора напрямую входил в материалы продвижения: «занял 13-е место среди 3 000 юристов по общему количеству загрузок за всё время, что юридическая школа учла при принятии различных решений о продвижении и смежных вопросах» [12]. Руководства по написанию сопроводительных писем рекомендовали ссылаться на количество загрузок и появления в списках Top Ten [95], практические руководства одновременно предостерегали, что самостоятельно размещённые работы «вероятно не будут учитываться для целей продвижения и получения постоянной должности в юридической школе» [33], а собственная документация платформы описывала её метрики как данные, «которые авторы используют для целей продвижения и получения постоянной должности, а учреждения используют при найме и ранжировании» [52]. Каждый из этих артефактов предполагал наличие открытой сравнительной системы отсчёта, которая больше не существует [149]. Более того, оценочное использование счётчиков было оспорено с самого момента его первого предложения: обоснование Black и Caron 2006 года в пользу загрузок как «бета»-меры научной производительности [18] было опровергнуто в том же томе симпозиума критикой Eisenberg относительно того, что могут корректно измерять рейтинги на основе SSRN [45]. Досье, ссылающееся на загрузки, наследует этот неразрешённый спор. Таблица 13 излагает семиэтапный протокол восстановления обоснованных доказательств из того, что осталось, и его управляющее требование, применяемое в третьем и четвёртом столбцах, состоит в том, что каждое число, упомянутое в досье, должно сопровождаться его источником, его временным окном и его ограничениями. Преобразованное утверждение, которое превращается в непроверенную точность, хуже, чем полное отсутствие утверждения.
Таблица 13. Протокол доказательств после закрытия сервиса для метрик SSRN в материалах о постоянной должности, продвижении и найме. На каждом этапе указаны действие, основание доказательств с его временным окном, ограничение, которое должно быть раскрыто рядом с любым числом, антипаттерн, которого следует избегать, и самое сильное заключение, которое может дать этап.
| Этап | Действие | Основание доказательств (источник; временное окно) | Ограничения для раскрытия | Избежать | Допустимое заключение |
|---|---|---|---|---|---|
| 1. Сохранить | Архивировать датированные снимки экрана панели статистики каждой статьи и профиля автора на интервалах Таблицы 11 и перед любым предоставлением; собрать их вместе с уведомлениями о распределении и датированным журналом собственных событий продвижения автора в пакет доказательств версии из раздела 6.1. | Счётчики по статьям сохраняются после закрытия сервиса ([148][149]; 2026). Счётчики можно пересчитать, когда меняются правила фильтрации ([144][69]; задокументировано с 2018 года). | Датированный личный архив — это единственная версия записи под контролем автора; числа платформы пересматриваются, и открытой истории не существует. | «Статья имеет X загрузок» — цитируется без даты или знаменателя. | Датированная, проверяемая запись того, что отобразила платформа — наблюдение, специфичное для времени, а не пожизненный вердикт. |
| 2. Преобразовать | Преобразовать счётчики в диапазонный язык, используя Таблицу 8 (например, «загрузки в течение всей жизни выше порога входа ~160 из списка Top-10,000 статей 2015 года, то есть примерно верхние 1,8% полнотекстового хранилища статей платформы, 571 040 в июле 2016 года [1], в то время»), всегда указывая источник, выборку и год; шаблон CSAB из Приложения B предоставляет формат на уровне предложения с полями процентиля, оставленными пустыми до появления справочной панели. | Пороги на уровне статьи: входной порог ≥160, медиана внутри группы 805 (выборка верхних списков; 2015) [85]. На уровне автора: минимум входного порога 129 загрузок, медиана внутри группы 1 626 (та же выборка) [85]. Якоря типичной статьи: медиана 63 за два года (LSN; 2012→2014) [139]; медиана 87 (сеть Marketing; снимок 2025) [83]. | Все пороги получены из выборок 2012–2015 (инфляция с тех пор [1]: раздел 5.1); рамка 2015 года охватывает только верхние списки; два якоря медианы относятся к одной дисциплине. Диапазонный язык не должен переформулироваться как калиброванный процентиль. | Универсальные метки, такие как «превосходная», применённые к старому необработанному порогу. | Относительное положение в пределах названной выборки, области и года — ничего более широкого. |
| 3. Триангулировать | Сопоставить счётчики SSRN с независимыми доказательствами цитирования: Google Scholar, HeinOnline для правовых наук, RePEc для экономики, Crossref/OpenAlex как открытые слои цитирования, PlumX в том виде, в котором они отображаются на SSRN. | Рейтинги загрузок SSRN и цитирования HeinOnline на уровне школы коррелируют на 0,84 (100 американских юридических школ; 2019) [77]; корреляции загрузок и цитирования на уровне статьи варьируются ~0,1–0,6 в зависимости от области и горизонта [80][25]; открытая инфраструктура цитирования [35][124]; PlumX [50]. | Показатель 0,84 является корреляцией на уровне школы и не применяется к какой-либо отдельной статье или автору (осторожность экологического вывода, раздел 6.2(iii)); загрузки измеряют спрос, а не прочтение или одобрение; корреляции на уровне статьи скромны, и часто загружаемые и часто цитируемые наборы перекрываются только частично [108]. Сходящиеся доказательства цитирования, а не сам счётчик, подтверждают претензию на влияние. | Приравнивание загрузки к одобрению или правильности. | Многоуровневые доказательства распространения, а не доказательство качества. |
| 4. Нормировать по дисциплине | Явно указать дисциплинарную рамку (например, «в рамках исследований корпоративного права, где средние значения журналов eJournal отличаются примерно в восемь раз в зависимости от подполей правовых наук»). | Средние значения подполя 438,35 против 53,48 загрузок на статью (LSN eJournals; 2018) [168]; соотношения загрузок к цитированиям сами по себе структурированы по дисциплинам [18]. | Оценка разброса относится только к правовым наукам и датирована 2018 годом; кросс-дисциплинарное перенесение любого порога требует осторожности, и язык процентилей без дисциплинарного уточнения неинтерпретируем. | Сравнение новой статьи с многолетним совокупным итогом или перенесение порога в другие области. | Сравнение с дисциплинарной и возрастной квалификацией — никогда не универсальная оценка. |
| 5. Дополнить | Ссылаться на репозитории учреждения и другие каналы распределения наряду с SSRN. | Счётчики SSRN не говорят ничего о загрузках той же статьи из других сервисов [161]; реформы 2026 года установили серии, основанные на репозитории, как путь миграции для распределения учреждением [47][146]. | Никакой одиночный счётчик платформы не отражает общее распространение статьи; претензия досье касается статьи, а не одного счётчика. | Представление счётчика одной платформы как общего распространения статьи. | Утверждение о тираже статьи, где счетчик каждого канала назван отдельно. |
| 6. Целостность | Указывайте правило подсчета платформы рядом с любым приводимым счетом и сохраняйте датированный архив, документирующий число в отображаемом виде. | Фильтрация и пересчет — это документированное поведение платформы ([144][69][66]; продолжающееся); сообщаемая поставщиком статистика загрузок зависит от соглашений о подсчете ([69][176]; 2015–2019). | Счетчики — это отфильтрованные, пересматриваемые оценки; не существует публичной истории пересчетов, поэтому датированный архив автора — единственная надежная запись. | Рассмотрение счетчиков как точных чисел уникальных читателей. | Отфильтрованная оценка по установленному правилу на установленную дату — не перепись читателей. |
| 7. Экспертная оценка | Представляйте каждый показатель как контекст для качественной оценки вклада и строгости работы, но никогда как ее замену. | Показатели измеряют этапы распространения, а не валидность (Разделы 3.1, 5.5); наборы с высокими загрузками и высокими цитированиями перекрываются лишь частично [108]. | Никакой показатель использования, нормализованный или сырой, не оценивает, является ли исследование правильным или важным. | Замена экспертного суждения метриками. | Контекстуальные доказательства, сопровождающие экспертный обзор — утверждение о качестве основано на обзоре, а не на числе. |
Столбец «Избегать» собирает антипаттерны протокола. Два предупреждения охватывают весь протокол. Загрузка записывает пассивный спрос, а не чтение, одобрение или качество, и счета реагируют на динамику публичности (освещение в блогах, заметные названия, тематические волны) в такой же мере, как и на научные исследования [116][139][138]. Комитеты, знакомые с историей манипуляций [44], отклонят неподтвержденные числа, и компоненты, которые выдерживают такое отклонение, — это в точности те, которые требует протокол: датированные снимки экрана, язык диапазонов с указанными источниками, квалификаторы полей и триангуляция.
6.6 Следствие непрошеных приглашений
Размещение имеет один документированный побочный эффект, который не фиксируется ни в одном отчете инструментов мониторинга: непрошеные приглашения от хищнических журналов и конференций, создаваемые путем сбора имен, информации об аффилиации и названий статей с платформ препринтов [107][159]. Объем существенен в смежных аудитах, где специализированные исследования документируют потоки приглашений в диапазоне от десятков на одного исследователя в две недели до тысяч на одну специальность в месяц (Раздел 7.2) [9][84][63]. Первый контакт с хищническим журналом — это непрошеное письмо примерно в 41% обследованных случаев [32]. Раздел 7 и Таблица 14 анализируют это явление. Для руководства последствия сводятся к четырем инструкциям. Ожидайте непрошеные приглашения как закономерное следствие видимости и никогда не воспринимайте их объем как научное признание: отправители механически нацеливаются на видимость, а не избирательно на качество работы [159][63]. Направляйте корреспонденцию через выделенный адрес, чтобы сбор не загрязнял основной почтовый ящик; широко распространённый приём скрытия адреса электронной почты профиля в течение первых двух недель после размещения является непроверённой практикой (Приложение A). Никогда не платите, потому что бизнес-модель основана на платежах, при этом платежи за обработку статей в выявленных хищнических изданиях варьируются от $25 до $1,800 [136]. Финансовая потеря — это не главное: те же комиссии по оценке, которые тщательно изучают досье (Раздел 6.5), также читают библиографии, и известное хищническое издание в списке публикаций наносит репутационный ущерб, превосходящий по значимости любой платеж. Проверяйте любое издание, отправляющее приглашения, используя поддерживаемый сервис скрининга, такой как Cabells Predatory Reports ([B-1]; список Beall не обновлялся с января 2017 года и не должен использоваться как актуальный источник), и контрольные списки Think. Check. Submit. [159]. Механизм сбора также предоставляет качественный критерий для отсева: журнал, отправляющий приглашение в течение нескольких дней после размещения препринта, раньше, чем могла бы сформироваться какая-либо аудитория читателей, крайне маловероятно, что является подлинным. Это эвристика; ни одно исследование не измерило её частоту [63].
6.7 Область применения справочника
Основы справочника датируются 2012–2015 годами и сосредоточены в основном на праве и маркетинге [139][85][83][1]. С тех пор объем загрузок на статью увеличился (раздел 5.1). Свежих, стратифицированных по областям процентильных данных еще не существует; их сбор платформой или сообществом является предметом разделов 8 и 10. Справочник снижает неправильное толкование и не оценивает качество. Четыре правила делают его использование механическим: сравнивать сопоставимые случаи, сохранять окно наблюдения постоянным, указывать источник для каждого числа и обозначить гипотезу как гипотезу.
7. Паразитический слой внимания: видимость и хищнические приглашения
Разработанная к настоящему времени интерпретационная схема рассматривает внимание как единую воронку, идущую от воздействия к просмотру аннотации, загрузке и последующему использованию. Однако практический опыт размещения препринта часто включает второй поток «внимания», приходящий через совершенно иной канал: нежелательные приглашения по электронной почте от журналов, конференций и редакционных услуг сомнительной репутации [14][61][117][142]. Ниже следует концептуальное описание этого второго потока вместе с аудиторскими доказательствами его задокументированного масштаба.
7.1 Двухуровневая модель внимания
Среда после размещения рассматривается здесь как двухуровневая экономика внимания (рисунок 10). Уровень 1 — это легитимная воронка, описанная в разделах 4 и 6: распределение электронных журналов, просмотры аннотаций, загрузки и последующее научное использование. Уровень 2 — это паразитический слой, экосистема хищнических издателей и поставщиков услуг, которые питаются той же открытой инфраструктурой (названия, аннотации, имена авторов и аффилиации) и стремятся превратить авторов в платящих клиентов, а не читать их работы. Литература по аудиту приглашений документирует жизненный цикл. Метаданные открытых препринтов (названия SSRN, аннотации, имена авторов и аффилиации) собираются [107][159], отправляются имитирующие приглашения, отражающие легитимные призывы к публикациям [61][63], и авторы, которые участвуют, становятся платящими клиентами. Экономический механизм также задокументирован: комиссии за обработку статей в предполагаемых хищнических журналах в среднем составляют примерно $178, с указанным диапазоном $25–$1800 [136].
Асимметрия между двумя уровнями имеет значение для интерпретации. Уровень 1 требует, чтобы читатель-человек заметил, открыл и оценил статью, в то время как Уровень 2 требует только того, чтобы метаданные статьи стали машиночитаемыми. Препринт, следовательно, в принципе может быть полностью обработан паразитическим уровнем, оставаясь фактически непрочитанным на легитимном уровне. Это ситуация статей платформы с почти нулевой загрузкой, так называемых «фантомных статей», которые обрабатывают машины, а люди фактически не читают.
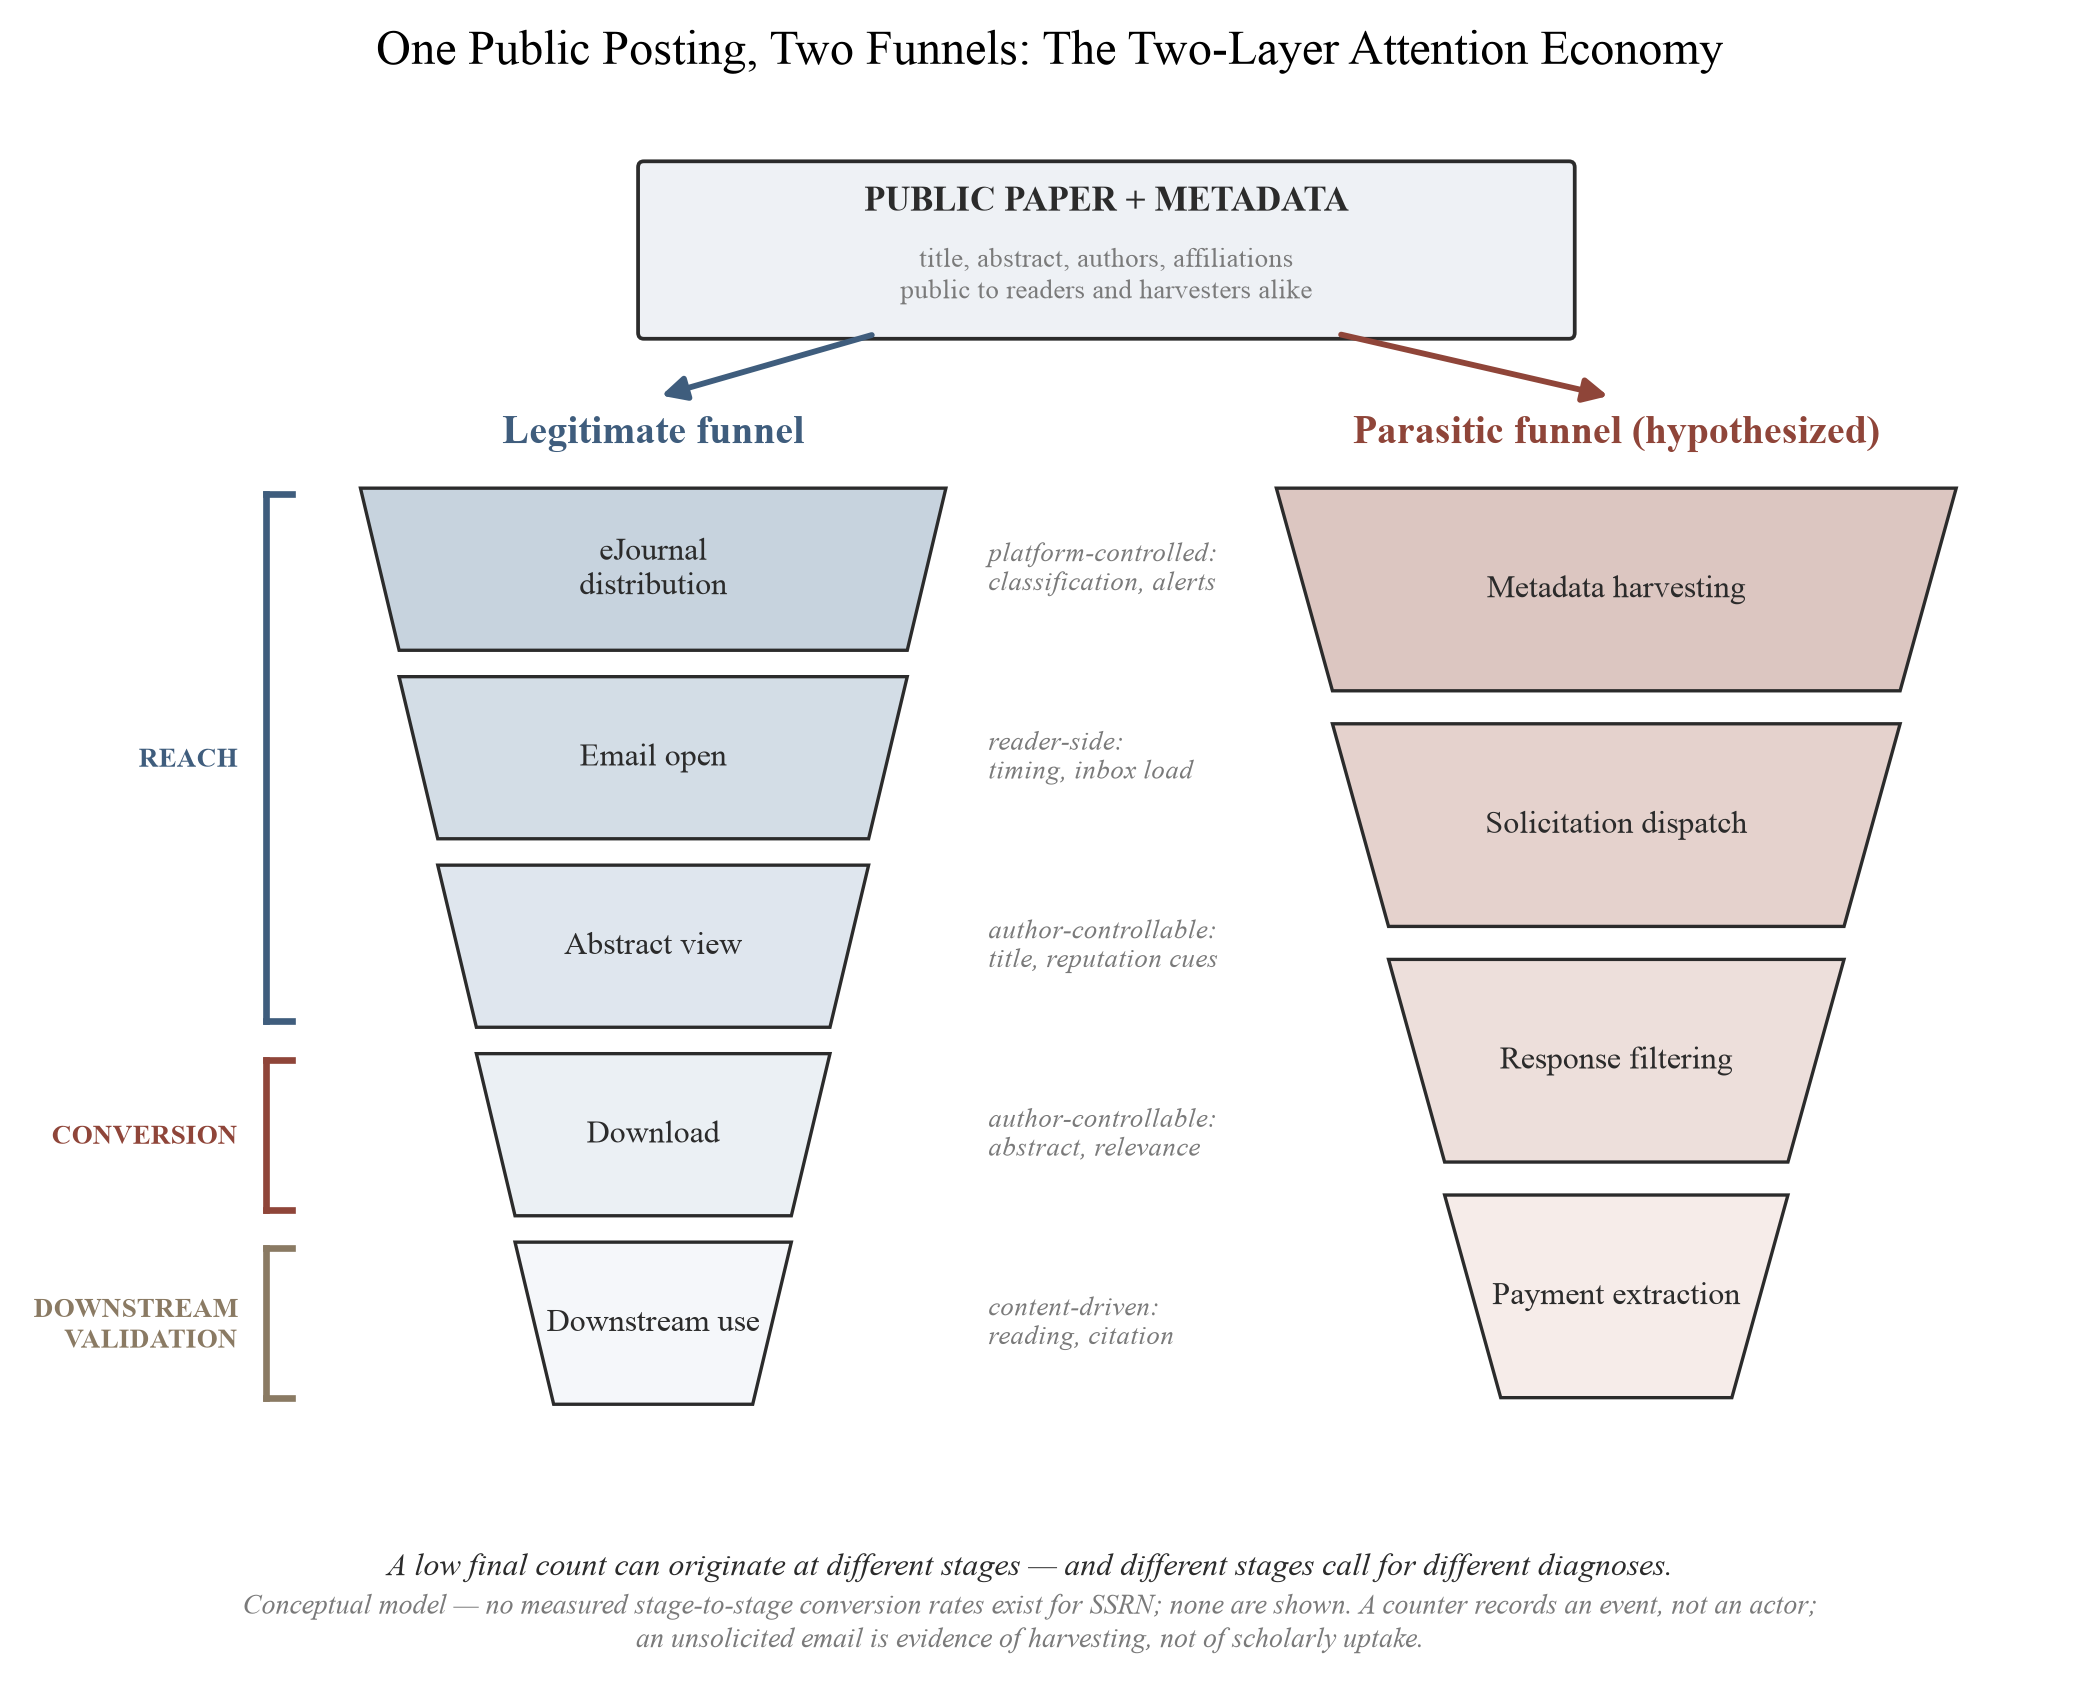
Рисунок 10. Концептуальная модель двухуровневой экономики внимания. Обе воронки показаны как качественные последовательности этапов; коэффициенты преобразования между этапами не отображаются, поскольку такие коэффициенты не были измерены для SSRN. Паразитическая воронка является гипотетической реконструкцией на основе литературы по аудиту приглашений [61][63][107][159] (раздел 7.3).
7.2 Документированные масштабы хищнической рассылки
Что хищническая рассылка приглашений является крупномасштабным явлением, не вызывает сомнений. В обзоре 2026 года выявлены двадцать девять эмпирических исследований академического спама, сходящихся на репертуаре тактик: лестные приглашения, ложные редакционные заявления и сомнительные утверждения о метриках и индексировании [61]. Измеренные объемы значительны. Четырнадцать академических офтальмологов получили 1813 писем с приглашениями от 383 различных издателей, охватывающих 696 различных журналов, в течение одного 30-дневного периода [84]. Академические радиологи в среднем получали по 20,7 приглашения на публикацию статей и 4,1 приглашения на выступление в течение двухнедельного периода [9]. Исследовательский аудит зафиксировал 422 письма с приглашениями, полученные одним урологом в 2023–24 [63], и тематическое исследование в научном издательстве задокументировало 1024 спама из журналов в течение 391 дня [89]. Годовое наблюдение одного исследователя, проведенное после размещения препринтов, зафиксировало 875 приглашений от 256 журналов, 76% из которых появились в курируемых черных списках, условный источник, цитируемый здесь с оговоркой, что интервалы между размещением и прибытием приглашений не были измерены [B-10]. Рассылка приглашений также доказуемо приносит результаты. Среди авторов, опубликовавших статьи в предполагаемых хищнических журналах, 41% сообщили, что их первый контакт с журналом был незапрошенным приглашением по электронной почте [32], а анализ содержания корпусов рассылок документирует лестный язык, сфабрикованные сроки и неясную тематическую область как повторяющиеся приемы убеждения [96].
Однако доказательства не ограничиваются медициной. В общественных науках, дисциплинарно намного более близких к собственной базе SSRN, три исследователя в области педагогических наук получили 210 незапрошенных приглашений от журналов в течение трех месяцев, отнесенных к 139 журналам и 37 издателям, большинство из которых можно классифицировать как хищнические; примерно половина приглашений вышла за пределы областей экспертизы получателей, признак таргетирования на основе метаданных, а не на основе читательской базы [155]. Бремя падает в первую очередь на главного героя этой статьи — молодого ученого, начинающего карьеру. Один продольный самоаудит молодого ученого задокументировал 1280 хищнических приглашений (990 от журналов, 220 от конференций и 70 других видов) в течение примерно восьми лет, вместе с документированными и в основном неудачными попытками отписаться [160].
Два аспекта этой доказательственной базы необходимо иметь в виду. Крупнейшие аудиты проводились в области медицины, и аудиты общественных наук выше, хотя дисциплинарно более близкие к SSRN, меньше; ни один результат из этих двух направлений литературы не может быть напрямую перенесен на авторов SSRN. Критически важно для этой статьи то, что ни одно из этих исследований не измеряло время поступления приглашений по отношению к событию размещения препринта. Аудит в [63], например, каталогизировал содержание и происхождение, но не соотнес время прибытия с активностью SSRN. Таким образом, каждое утверждение, связывающее паразитический слой с актом размещения, является гипотезой о механизме, а не эмпирической находкой.
7.3 Предполагаемые механизмы выявления целей
Чтобы достичь недавно размещённого препринта, паразитический слой должен сначала его найти. Приведённые ниже механизмы являются гипотезами с частичной поддержкой в литературе; нет корпуса, связывающего запросы на публикацию с размещениями на SSRN.
H-S1 (сбор метаданных). Хищные операции извлекают названия статей, имена авторов и их принадлежность с публичных страниц аннотаций и новых списков статей. Практические и консультативные источники описывают подобное поведение: хищные журналы сканируют серверы препринтов и рассылают нежелательные приглашения, которые ссылаются на название статьи [159]. В юридическом научном источнике говорится, что отправители запросов «собирают электронные адреса, имена, принадлежность и т.д., просматривая существующие научные работы, в том числе размещённые на SSRN» [107], а справочник юридической библиотеки связывает размещение препринтов с «ростом спама от хищных издателей, которые предлагают исследователям переопубликовать свои статьи за плату» [117]. Одна измеренная закономерность согласуется с этим механизмом. В радиологическом аудите аудиты по специальностям сообщают о высоких объёмах запросов среди активно публикующихся авторов [9], что согласуется со сбором данных с совокупной библиографической поверхности автора, а не из одного события размещения. Исследование 3 (Раздел 8.6) соответственно включает контроли на уровне автора наряду с целевым размещением.
H-S2 (получение контактных данных). Запрос требует адреса электронной почты. Страницы аннотаций SSRN исторически содержали контактную информацию авторов [151], и адреса также распространяются через сами статьи, институциональные веб-сайты и предыдущие публикации. Открывает ли SSRN в настоящее время электронные адреса авторов в форме, пригодной для извлечения, остаётся неясным; инструментированное исследование с логированием запросов предназначено для его проверки. Источник получения контактов для любого конкретного запроса остаётся неизвестным.
H-S3 (использование каналов распределения). Дайджесты электронных журналов и потоки типа RSS перераспределяют метаданные новых статей подписчикам [57][51]. Паразитический субъект, подписанный на эти каналы, получал бы структурированную информацию без необходимости извлечения данных. Ни один аудит не проверил этот механизм.
Причинно-следственная цепь от размещения к целевому воздействию эмпирически не установлена; Раздел 8 предусматривает предварительно зарегистрированный тест этих механизмов: логирование поступлений запросов в соответствии с известными временными метками размещения для недавно размещённых статей.
7.4 Предполагаемая типология сигналов привлечения
Если механизмы таргетирования из раздела 7.3 работают, различные классы сообщений о привлечении должны содержать разную информацию о видимости статьи для автоматических систем. Таблица 14 представляет это как предполагаемую типологию, её категории стратегий основаны на документированных тактиках убеждения: несоответствие квалификации и неточная персонализация [9][63], сфабрикованные сроки и лесть [96], ложные заявления о метриках и индексировании [61], и скрытые платежи относительно документированного рынка АРС [136]. Последний столбец основан на выводах и не проверен. Таблица не содержит процентных показателей распространения и оценок сроков поступления.
Таблица 14. Предполагаемая типология сигналов хищнического привлечения после размещения препринта. Примеры формулировок являются иллюстративными, выдуманными парафразами паттернов, документированных в аудитах сообщений о привлечении [9][61][96], а не дословными цитатами из какого-либо конкретного сообщения.
| Паттерн привлечения | Описание | Примеры формулировок | Предполагаемая информация о видимости |
|---|---|---|---|
| Неперсонализованное обращение без ссылки на статью | Автоматическое приглашение без упоминания конкретной статьи или области | "Уважаемый исследователь, отправьте вашу ценную работу…" | Низкая: адрес может быть получен из любого источника; нет свидетельства того, что сама статья была просмотрена |
| Несоответствие квалификации | Приглашение со ссылкой на опыт в области, не связанной со статьей [9] | "Учитывая ваш опыт в области квантовой физики…" (для статьи по праву) | Низкая или отсутствует: указывает на массовый сбор данных без анализа метаданных |
| Целевое сообщение со ссылкой на название | Приглашение с указанием конкретного препринта и тематически близкого издания [159] | "Ваша недавняя статья «[точное название]» подходит для нашего журнала…" | Более высокая (предполагается): метаданные статьи достигли отправителя, что подразумевает успешное индексирование и доступ скрейпера |
| Персонализированная похвала | Похвала конкретной работы как «революционной» или «уважаемой» [96] | "Ваш революционный вклад…" | Отсутствует, кроме доступа к названию: похвала является шаблонной, не основана на прочтении |
| Сфабрикованная срочность и метрики | Выдуманные сроки, отмеченные звёздочкой «факторы влияния», заявления об индексировании [61][96] | "Фактор влияния 4.2*; отправьте в течение 7 дней" | Отсутствует: средство убеждения независимо от целевой статьи |
| Скрытые платежи | Плата за обработку статьи раскрывается поздно или только в приложениях; диапазон рынка $25–$1800 [136] | Сбор отсутствует в основном тексте приглашения | Отсутствует: стратегия ценообразования, не сигнал видимости |
| Приглашение на конференцию с упоминанием статьи | Приглашение выступить на сомнительной конференции или подать статью, часто с указанием конкретной статьи; приглашения докладчиков являются измеренным компонентом академического спама [61][9] | "Мы приглашаем вас представить вашу статью «[точное название]» в качестве основного доклада на…" | Как и для целевого привлечения (предполагается): метаданные статьи достигли отправителя; нет свидетельства содержательного прочтения |
| Платные услуги для авторов | Предложения услуг быстрого рецензирования, перевода или редактирования, направленные на недавно опубликованный препринт [61][84] | «Ускоренное рецензирование и профессиональная языковая обработка для вашего нового препринта…» | Не установлены: спам отслеживает метаданные новых публикаций, а не содержание статей |
Строки с лестью несут психологический аспект, который механическое прочтение затемняет. Шаблонная похвала попадает на автора, который может смотреть на застойный счётчик, для которого ходатайство является единственной «валидацией», которую получила публикация. Двухслойная модель таким образом предсказывает жестокую инверсию, при которой те, кто первыми откликнулся на новый препринт, часто являются хищниками, а не читателями (Section 7.5), и новичок может неправильно понять спам как интерес, потому что никакой легитимный сигнал ещё не поступил. Автор, который ожидает крючка, может его отбросить.
Таблица 14 анализирует входящие сообщения на предмет того, что они могут выявить о видимости статьи. Как вообще кодировать эти сообщения — это дополнительный вопрос, и он зависит от различия, остававшегося неявным до сих пор, между легитимным научным контактом и ходатайством с более высоким риском. Таблица 15 излагает это различие как шеститиповую типологию, последний столбец которой содержит предостережения при кодировании: каждый сигнал вероятностен и ни один не является доказательством сам по себе. Типология также является основой кодовой книги исследования 3 (Section 8.6), поскольку исследование ходатайств без положительного класса легитимного контакта не может измерить асимметрию, которую предполагает Section 7.5.
Таблица 15. Отделение легитимного научного контакта от ходатайства с более высоким риском: шесть сигналов с предостережениями при кодировании. Гипотетическая схема кодирования, а не проверенный классификатор. Столбец видимости таблицы 14 ставит другой вопрос и не затронут: одно и то же сообщение может быть закодировано в обеих сетках.
| Сигнал | Легитимный научный контакт | Ходатайство с более высоким риском | Предостережение при кодировании |
|---|---|---|---|
| Специфичность | Задействует конкретный аргумент, метод или результат | Общая похвала с вставленным названием или ключевыми словами | Специфичность может быть имитирована |
| Идентичность площадки | Проверяемый журнал, редактор, учреждение или история конференции | Неясная принадлежность, скопированный бренд, непроверяемое редакционное совет | Новые площадки не являются автоматически хищническими |
| Запрос | Содержательный вопрос, сотрудничество или прозрачное приглашение | Срочный запрос на подачу или оплату, не связанный с работой | Одни только сборы не являются решающими; прозрачность имеет значение |
| Сроки | Любые сроки; часто следует после фактического прочтения | Быстрый шаблонный контакт вскоре после публичной публикации | Временная близость не доказывает источник сбора данных |
| Язык | Специфичный для темы и профессионально ответственный | Лесть, ложная знакомость, искусственная срочность, неопределённая область | Особенности языка вероятностны, а не доказательство |
| Проверка | Независимо проверяемые контактные данные и политики | Нарушенные идентификаторы, ложные метрики, вводящие в заблуждение претензии на индексирование | Требуется проверка человеком согласно документированным критериям |
На практике данная типология дает эвристику скрининга, а не диагностику: письмо от журнала, поступившее в первые дни после размещения, до того как вероятно могли сработать легитимные каналы распространения, весьма вероятно хищническое. Высокорейтинговые легитимные журналы не практикуют необоснованные обращения к авторам только что размещенных рукописей [174], тогда как раннее незапрошенное приглашение является задокументированным способом первого контакта хищнических издательств [32][174]. Мы предлагаем конкретное пороговое значение, иногда выдвигаемое в дискуссиях практиков (рассматривая любое письмо журнала примерно в первые 96 часов как предположительно хищническое) в качестве авторской эвристики, ожидающей проверки. Никакое исследование не измеряло распределение задержек, которое позволило бы откалибровать такой порог. Предостережение по времени из таблицы 15 применимо к самой эвристике: временная близость вызывает подозрение, но не доказывает, что отправитель получил информацию об этом конкретном размещении, так как адрес мог существовать раньше препринта, поэтому проверка на 96 часов помогает организовать входящую корреспонденцию, а не служит доказательством.
7.5 Парадокс спама и асимметрия скорости
Из двухслойной модели следуют ещё два положения о паразитическом слое.
Парадокс спама. Если целевая рассылка требует успешного сбора метаданных, то в пострейтинговой среде отсутствие хищнического спама может быть более сильным индикатором невидимости платформы, чем его наличие является индикатором чего-либо ещё. Статья, которая никогда не вызывает даже паразитический слой, может не пройти минимальный порог машиночитаемого распространения. Аналитическая привлекательность этой инверсии, где спам служит нежелательным и токсичным прокси для индексирования, состоит в том, что она превращает неизбежное неудобство в бесплатный инструмент наблюдения. Его диагностическая мощь в настоящее время только гипотеза: корреляция между получением рассылки и любым метриком видимости никогда не измерялась, и строки общей рассылки Таблицы 14 показывают, почему сырой объем спама был бы шумным сигналом даже в принципе.
Хищники приходят раньше читателей. Легитимная воронка работает с институциональными задержками: включение в eJournal курируется, а не гарантируется, с задержками до 45 дней для классификаций большого объема [53], а индексирование Google Scholar занимает от шести до девяти месяцев или дольше [55]. Почти нулевые загрузки в первую неделю соответствуют нормальному предраспространению, а не отклонению (Раздел 6). Паразитический слой, если он извлекает метаданные программно, не сталкивается с этими задержками. Мы поэтому выдвигаем гипотезу, что для автора, чья контактная информация доступна, ожидаемое время первой хищнической рассылки, связанной с публикацией, короче, чем ожидаемое время первого подлинного научного контакта, так что неизвестный автор встретил бы паразитический слой раньше, чем легитимный. Опровержение прямое: подлинный контакт надежно предшествует рассылке.
Документированные объемы рассылки, измеренные в днях и неделях [9][84], в сравнении с механикой распространения, измеренной в неделях и месяцах [55][53], делают гипотезу правдоподобной. Только исследование логирования, указанное в Разделе 8, может это проверить, потому что существующие корпусы не были привязаны по времени к событиям публикации [63].
7.6 Что паразитарный слой не говорит автору
Три граничных утверждения ограничивают выводы этого раздела.
Во-первых, электронное письмо с предложением не влияет на счётчики платформы. Приглашение, отправленное автору, не генерирует просмотры аннотации и загрузки статьи. В той мере, в какой скрейперы посещают страницы аннотаций, SSRN заявляет, что фильтрует нерегулярную и автоматизированную активность из подсчётов загрузок [66][69][144]. Объём спама, следовательно, никогда не является доказательством прочитанности, и наполненный предложениями почтовый ящик, сосуществующий с однозначным числом загрузок, не содержит противоречия: оба слоя считают разные вещи.
Во-вторых, паразитарный слой также наиболее сильно влияет на авторов, наименее подготовленных к поглощению его затрат: исследователи на ранних этапах карьеры и исследователи, не являющиеся носителями английского языка, отмечены как особенно уязвимые для предложений [142]. Практический протокол раздела 6, следовательно, рассматривает гигиену входящей корреспонденции (фильтрация по чёрному списку любого издательства с предложениями, неответ на нежелательные приглашения, проверку через специально отобранные сервисы, а не устаревшие списки) как часть интерпретации метрик, а не как отдельную проблему. Автоматическая фильтрация хищнических изданий сама по себе является активным направлением исследований [157].
В-третьих, ранняя видимость имеет один дополнительный побочный эффект, с которым авторы сталкиваются как с очевидным обвинением: при отправке в журнал на более позднем этапе программное обеспечение для проверки сходства будет отмечать почти полное совпадение между рукописью и её собственным предшественником на SSRN, поскольку препринты индексируются в корпусе Crossref Posted Content, используемом iThenticate [36]. Документация поставщика явно указывает, что совпадение препринта того же автора является ожидаемым результатом, а не плагиатом [81]. Надлежащий ответ — раскрыть препринт редактору, а не отозвать его.
Паразитарный слой — это место, где центральное утверждение этой статьи видно яснее всего: после закрытия рейтингов сырые сигналы (загрузки, просмотры и теперь даже спам) несут интерпретируемый смысл только тогда, когда указан механизм, который их создал. Эта спецификация частично доступна для легитимного слоя, а для паразитарного слоя она по-прежнему является исследовательской программой.
8. Готовый к предварительной регистрации исследовательский план: восстановление отсутствующего эталонного класса
Предыдущие разделы обобщили проверяемые доказательства по метрикам внимания SSRN и предложили рамки интерпретации для пост-рейтинговой среды. Этот раздел представляет собой готовый к предварительной регистрации план ответа на открытые вопросы рамок эмпирическим путём. Он, по замыслу, не содержит результатов: предварительно заданные, опровергаемые диапазоны вместо выводов. Каждый дизайн, гипотеза и диапазон предсказания ниже готовы быть зарегистрированы на платформе Open Science Framework перед любым сбором данных с одновременным выпуском кода анализа. Закрытие рейтингов SSRN 15 июля 2026 года [149], объявленное 12 июня 2026 года с первоначально более ранней целевой датой [148] и встроенное в более широкое переориентирование платформы [146], делает этот план необычайно чувствительным ко времени: некоторые из приведённых ниже дизайнов используют разрыв, период до которого сокращается с каждым месяцем, и один из них — реестр процентилей раздела 8.8 — решает проблему измерения, которую само закрытие сделало постоянной для внешних наблюдателей.
8.1 Принципы проектирования
Четыре принципа определяют повестку.
Наблюдение с рождения. Ретроспективный сбор кумулятивных счетчиков не может восстановить показатели работы на день 3, день 7 или день 30. Поэтому любая авторитетная эталонная панель должна регистрировать работы при публикации и записывать их счетчики в стандартизированные возрасты: дни 1, 3, 7, 14, 30, 60, 90 и 180 (таблица 11), при этом ежедневное наблюдение предпочтительно в течение первых 45 дней, потому что SSRN указывает на то, что распределение уведомлений в высокоподписанных темах может занять до 45 дней [53]. Этот принцип также защищает от утечек информации: показатели репутации предыдущих авторов должны быть зафиксированы на дату публикации, чтобы будущий успех не мог загрязнить базовые ковариаты. Его сопутствующая дисциплина, перенесенная из раздела 5.6, заключается в том, что события распределения, индексирования и продвижения входят в приведенные ниже конструкции как датированные вмешательства и никогда как неконтролируемый контекст.
Разделение охвата и конверсии. Следуя диагностической логике раздела 5 (таблица 9), каждая конструкция ниже отдельно учитывает просмотры аннотаций и загрузки как различные результаты и моделирует загрузки в зависимости от просмотров. Низкий охват и низкая конверсия — это разные диагнозы: неспособность попасть в набор вариантов, рассматриваемый читателем, в сравнении с отсутствием загрузок после ознакомления. Объединение их в единый счет отбрасывает информацию, необходимую автору.
Распределительные результаты, не только средние значения. Поскольку внимание платформы имеет тяжелый хвост [83][85][180], вмешательства и изменения платформы могут изменить форму распределения, оставляя его среднее значение почти неизменным. Результаты, следовательно, включают коэффициент Джини внимания, доли загрузок в top-1% и top-10%, долю работ с нулевым или близким к нулю числом загрузок и соотношения внимания новых авторов к авторам с устоявшейся репутацией, в соответствии с традицией измерения неравенства внимания в других средствах массовой информации [180].
Фальсифицируемость. Каждая гипотеза сопровождается стратегией идентификации и явно определенным условием, при котором она может быть отвергнута. Сама рамка подвергается риску быть отвергнутой: если ранние метрики, нормализованные по возрасту и области, не превосходят исходные значения вне выборки (RQ3 ниже), то предполагаемое преимущество нормализации как метода измерения должно быть отвергнуто или ограничено. Фальсифицируемость также количественна: размеры выборки для всех анализов должны быть определены на основе анализа статистической мощности относительно наименьших интересующих величин эффекта. Стратегия множественности для программы из пяти гипотез, трех исследовательских вопросов и пяти положений зафиксирована при предварительной регистрации, и подтверждающие и исследовательские анализы обозначены как таковые заранее. Отсев (отозванные, объединенные или существенно переработанные работы) отслеживается и сообщается, а не молчаливо отбрасывается, с диаграммой потока когорты в каждом эмпирическом отчете программы (раздел 8.8).
8.2 Гипотезы и положения
Фреймворк генерирует пять гипотез и три исследовательских вопроса, касающихся распределения раннего внимания, и пять положений, касающихся его структуры. Таблица 16 связывает гипотезы, исследовательские вопросы и положения со специальными проектами (P2, P3b, P4) с результатом, контрастом и предпочтительным проектом; P1 и P3 рассматриваются в Исследованиях 1 и 2 в Таблице 17.
H1 (Дисадвантаж холодного запуска). При условии области, когорты постинга, наблюдаемой темы, характеристик документа и календарных условий, статьи, написанные исключительно новичками платформы, получают меньше начальных просмотров страницы аннотации, чем статьи с по крайней мере одним ранее видимым автором SSRN. Центральный результат — это просмотры, а не загрузки на просмотр, потому что H1 касается формирования аудитории, а не конверсии.
H2 (Престиж и видимость). Престиж учреждения и автора позитивно предсказывает раннее охват страницы аннотации после контроля за предыдущей активностью платформы и наблюдаемыми характеристиками статьи, расширяя литературу о статусе и внимании [104][105][111][140][60] на первый этап распространения препринта.
H3 (Престиж и условная конверсия). Престиж учреждения позитивно предсказывает загрузку полного текста при условии просмотра страницы аннотации. Джо и Ли предоставляют недавние доказательства, специфичные для области и соответствующие этому паттерну в маркетинге: премиум престижа примерно +6,6% в скорости загрузки для статей с тремя авторами, один из которых входит в топ-50 [83], но более широкий продольный тест остается необходимым. Совместно H2 и H3 определяют основной оценитель панели: разложение градиента престижа по охвату и конверсии, то есть долю наблюдаемого неравенства в загрузках, связанного с престижем, которая возникает до просмотра страницы аннотации (охват) и после него (условная конверсия). Вывод о том, что большинство градиента формируется до того, как какой-либо читатель видел аннотацию, локализовал бы неравенство в механике обнаружения, а не в оценке содержания, в непосредственно измеримой форме.
H4 (Коммуникация как уравнитель). Большая ясность аннотации и информационная эффективность связаны с большими улучшениями условной конверсии среди авторов с низкой предыдущей видимостью, чем среди уже видимых авторов. H4 — единственная гипотеза, чье воздействие полностью находится под контролем автора. Она должна быть проверена с предопределенными текстовыми мерами и отдельно — рандомизированным экспериментом с аннотацией, разработанным по стандартам онлайн-полевого эксперимента [30]. Она не должна полагаться исключительно на автоматизированные классификаторы, написанные ИИ, которые вводят свою собственную неопределенность измерения.
H5 (Сохранение ударов воздействия). Экзогенные или квази-экзогенные шоки раннего воздействия предсказывают повышенное последующее внимание за пределами окна немедленного воздействия: аналог платформы ученых динамики успех-порождает-успех, задокументированной экспериментально в других местах [112][131][162] и эффекты позиционного воздействия на arXiv [72][73].
RQ1. Изменила ли отставка Rankings 15 июля 2026 года концентрацию, распределение или градиент престижа внимания? Два противоположных предсказания оба правдоподобны, и вопрос остается двусторонним: удаление рейтингов может ослабить петли обратной связи популярности [112][131], или оно может вместо этого увеличить зависимость от уже существующих сетей авторов, удалив поверхность обнаружения, через которую неизвестные статьи могли бы стать видимыми, когда они начнут привлекать внимание.
RQ2. Производит ли курируемое распределение оповещений по электронной почте больший пропорциональный прирост внимания для новичков или для уже устоявшихся авторов?
RQ3. Предсказывают ли нормализованные ранние метрики, наблюдаемые в дни 7 и 30, более поздние результаты научного цитирования или публикации лучше, чем сырые кумулятивные загрузки?
Положения переформулируют структурные утверждения фреймворка в фальсифицируемой форме:
P1 (Асимметрия и невидимое большинство). На случайной стратифицированной выборке статей SSRN распределение пожизненных загрузок имеет тяжелый хвост и смещено вправо таким образом, что медиана меньше половины среднего значения, и существенная доля статей имеет десять или менее пожизненных загрузок. Опровергатель: медиана ≥ 0,5 × среднее, или незначительная доля ≤10 загрузок. Опубликованное соотношение среднего к медиане сети маркетинга (примерно 2,54) [83] и квази-логнормальное приближение данных из топ-листа 2015 года [85] мотивируют, но не устанавливают P1 для платформы в целом.
P2 (Классификация управляет всплытием). В слое репозитория количество классификаций eJournal позитивно связано с загрузками и негативно связано с вероятностью загрузок, близких к нулю, при контроле возраста и сети — повторение и обновление кросс-секционного паттерна Уэйлена 2018 года [168] в соответствии с механикой курируемого распределения платформы [53][57]. Опровергатель: нет значимой связи после контроля. Количество классификаций само по себе потенциально эндогенно: статьи более широкой релевантности могут и получить больше классификаций, и привлечь больше читателей, поэтому кросс-секционная связь переоценивает любой эффект всплытия. Предпочтительная идентификация — это внутри-статейные изменения классификации, когда доступно, с кросс-секционной оценкой явно представленной как верхняя граница.
P3 (Видимость машины низка и зависит от характеристик). Для запросов, построенных так, чтобы конкретный препринт SSRN был лучшим доступным источником, потребительские механизмы ответов ИИ цитируют препринт сам по себе в меньшинстве случаев, и видимость машины растет с характеристиками, аналогичными задокументированным факторам оптимизации генеративного движка [5][164]. Опровергатель: препринты цитируются большинством времени независимо от характеристик, или никакая характеристика не предсказывает видимость.
P3b (Эффект Матфея на машинном уровне). При условии подтвержденной экспертом релевантности запроса статьи с большей предыдущей веб- и научной видимостью цитируются системами ответов ИИ чаще, чем иначе сравнимые статьи холодного запуска. При альтернативе справедливости генеративные механизмы извлекают информацию на основе релевантности без премии за предыдущую видимость, и P3b отклоняется — результат, при котором машинный слой был бы более эгалитарным, чем человеческие слои обнаружения H1–H3, а не менее. Опровергатель: нет градиента видимости при согласованной релевантности запроса. P3b расширяет линию кумулятивного преимущества H1–H3 на вершину стека обнаружения. Тестирование требует ковариаты предыдущей видимости и стратификации запроса, указанные в Исследовании 2 (Раздел 8.6).
P4 (Хищники прибывают раньше читателей). Для только что размещённого препринта, чьи библиографические метаданные и маршрут контактов могут быть извлечены из размещённого документа или связанных общедоступных страниц, ожидаемое время до первого хищнического обращения, связанного с размещением, короче, чем ожидаемое время до первого подлинного учёного контакта. Опровержение: подлинный контакт надёжно предшествует хищническому обращению. P4 формулируется условно в зависимости от извлекаемости, потому что общедоступность контактных реквизитов автора на текущем интерфейсе платформы не установлена. Механизм извлечения сам по себе задокументирован для репозиториев препринтов в целом [107][159][151], и нежелательная электронная почта является первым контактом с хищническим журналом для значительной доли запрашиваемых авторов [32]. Поэтому атрибуция требует инструментированного дизайна Исследования 3, а не вывода только из времени поступления входящих писем.
Таблица 16. Гипотезы, исследовательские вопросы и стратегии идентификации.
| Вопрос | Основной результат | Основной контраст | Предпочтительный дизайн |
|---|---|---|---|
| H1: невыгодное положение новичка | Дополнительные просмотры | Новичок vs. опытный | Иерархическая продольная модель подсчёта |
| H2: престиж и охват | Дополнительные просмотры | Высший vs. низший предварительный престиж | Скорректированная по ковариатам панель + анализ согласованной чувствительности |
| H3: престиж и конверсия | Загрузки при условии просмотров | Высший vs. низший престиж | Модель экспозиции с отрицательно-биномиальным/пуассоновским распределением |
| H4: коммуникационный уравнитель | Условная вероятность загрузки/скорость загрузки | Ясность × предварительная видимость | Наблюдательная текстовая модель + рандомизированная репликация |
| H5: кумулятивное внимание | Просмотры/загрузки после шока | Шок экспозиции vs. доударная траектория | Событийное исследование внутри статьи |
| RQ1: выход рейтингов из обслуживания | Ежедневное внимание; Джини; лучшие доли; объём новых размещений по областям | Ранее подвергнутые рейтингам vs. поля сравнения | Прерванный/событийный дизайн |
| RQ2: распределение электронной почты | Ежедневные просмотры/загрузки | До vs. после распределения | Событийное исследование внутри статьи (Распределение × Новичок) |
| RQ3: прогностическая валидность | 6/12/18-месячные цитирования | Нормализованные vs. сырые ранние метрики | Вневыборочное прогностическое сравнение |
| P2: классификация управляет всплытием | Загрузки; вероятность близких к нулю загрузок | Количество классификаций; изменения классификации внутри статьи, где доступны | Панельная регрессия + дизайн изменения внутри статьи |
| P3b: машинный эффект Матфея | Прямое цитирование системой ответов | Высокая vs. низкая предварительная видимость при согласованной релевантности запроса | Повторный многоуровневый аудит поиска (Исследование 2) |
| P4: хищники раньше читателей | Время до первого и частота кодированных входящих сообщений | Допостинговые vs. постпостинговые окна; хищнические vs. подлинные контакты | Инструментированная проспективная когорта + модель истории событий (Исследование 3) |
Примечание. Все строки — это проспективные дизайны. Ни один не был выполнен. Результаты, контрасты, правила исключения и контрольные классы должны быть предварительно зарегистрированы перед сбором данных.
8.3 Основная панель
Базовый дизайн представляет собой мультидисциплинарную когорту недавно опубликованных статей SSRN, отслеживаемую в течение как минимум двенадцати месяцев с момента публикации, наблюдаемую по графику Таблицы 11. На уровне статьи набор данных сохраняет самую раннюю доступную версию названия, аннотации, имён и порядка авторов, принадлежности, даты публикации, классификации, ключевые слова, количество страниц, DOI где доступен, историю редакций, количество просмотров аннотаций, количество загрузок и последующие индикаторы цитирования, с сопоставлением идентичности авторов в отношении открытой библиографической инфраструктуры [35][124], вручную проверенным на случайной подвыборке перед использованием выведенной репутации в масштабе. Статус новичка определяется как отсутствие у какого-либо автора целевой статьи статьи SSRN с датой до целевой публикации, с определениями чувствительности, основанными на количестве предыдущих статей и запасе цитирования до публикации. Престиж учреждения не входит в это определение: поскольку престиж сам по себе является объясняющей переменной в H2 и H3, включение его в статус новичка механически смешало бы новизну платформы с предыдущей видимостью авторов и разрушило бы гипотезы, которые дизайн призван разделить. Престиж поэтому входит в модели только как отдельная ковариата. Нормализация по предыдущей видимости должна обрабатываться с соответствующей осторожностью по соображениям справедливости: слишком агрессивное вычитание базовой линии предыдущей видимости наказало бы подлинный ранний успех молодого автора и статистически стёрло бы, а не раскрыло бы систематическую недостаточную демонстрацию маргинализированных авторов и авторов из Глобального Юга. Ответ методологии - измерить, где формируется неравенство, а не его сглаживать: разложение охват-против-конверсия определяет место, возникает ли разрыв видимости при воздействии или при конверсии, и престиж входит как ковариата, которую необходимо понять, а не как шум, который следует молча различить. Распределительный эффект престижа на внимание - это первичный результат квази-экспериментов (Разделы 8.4–8.5). Календарные контролы включают день недели, неделю года, академический сезон и фиксированные эффекты даты. Документированные выходные и сезонные колебания доступа к статьям (активность примерно на 11% ниже в выходные дни и на 50% ниже летом в недавней панели из семи журналов [178]) делают их пропуск трудным для обоснования в любом исследовании с высокой частотой использования. Полный словарь переменных панели (порядка двух дюжин полей, включая приращения интервалов, а не только кумулятивные подсчёты, дату распределения где согласовано, запасы цитирования в 6, 12 и 18 месяцев и номер редакции) указан в Приложении C (Таблица C1), и тот же файл схемы депонирован вместе с материалами предварительной регистрации (Раздел 8.8; Объявления).
Охват моделируется как иерархический отрицательно-биномиальный процесс для дополнительных просмотров, с эффектами поля-по-возрасту, календарными эффектами и разнородностью на уровне статьи. Условная конверсия моделируется как дополнительные загрузки с логарифмическими дополнительными просмотрами как воздействие, так что получение посещения целевой страницы и преобразование этого посещения статистически разделены. В компактной форме для статьи i в интервале t:
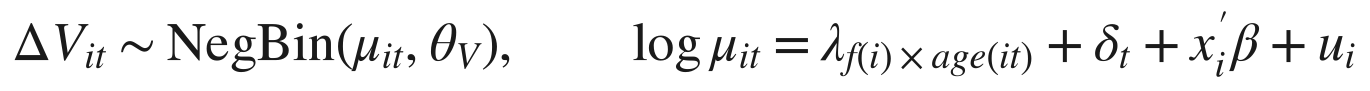

где λ_{f×age} - это эффекты поля-по-возрасту, δ_t - эффекты даты календаря, u_i и w_i - разнородность на уровне статьи, и смещение логарифмических просмотров во втором уравнении делает загрузки условными при воздействии целевой страницы. Взаимодействие Newcomer × Clarity γ_3 - это тест H4. Эти уравнения фиксируют предварительно определённые оценивающие величины и разделение охвата от конверсии, и иерархическая структура выполняет именно частичное объединение эмпирического Байеса, которое требуют разделы 5.2 и 8.8, прежде чем опубликуется процентиль любой разреженной ячейки. Тематические контролы в x_i построены из встраиваний названия–аннотации, замороженных и кластеризованных при предварительной регистрации, до наблюдения какого-либо результата, так что тематический состав не может быть настроен на результаты. Поскольку статьи одновременно занимают до семи классификаций, эффекты классификации оцениваются с иерархическими структурами множественного членства, а не путём принуждения каждой статьи в одном поле. Поскольку фиксированные эффекты статьи поглощают инвариантные во времени меры статуса, базовые эффекты новичка и престижа оцениваются между статьями, в то время как фиксированные эффекты статьи зарезервированы для внутристатейных обработок, таких как события распределения. Избыточная дисперсия и избыточные нули формально проверяются, барьерные и нулевоинфлированные альтернативы сообщаются где обоснованно, и тяжёлый хвост обрабатывается квантильной и надёжной оценкой, а не удалением успешных статей. Правила очистки данных сами предварительно определены, а не дискреционны, и протокол обнаружения аномалий - флаг, не удаление. Список предварительно определённых сигналов охватывает: экстремум интервала по отношению к собственной истории статьи, скачок просмотров без движения в загрузках, разрыв в конверсии, повторяющиеся идентичные временные метки и переформулирование на стороне платформы. Отмеченный интервал никогда не удаляется из архива: он сохраняется с кодом причины, и каждый основной результат сообщается по четырёхслойной лестнице чувствительности: (i) неизменённые счётчики; (ii) исключая только подтверждённую платформой недействительную активность; (iii) надёжная или винсоризованная оценка; (iv) исключая все отмеченные интервалы, так что любое заключение, выживающее только на одном слое, видно как хрупкое. Пороги откалиброваны в сравнении с наблюдаемым распределением, а не установлены априори. Если доступны журналы партнёра, поля реферер, пользовательский агент и география различают трафик рассылки, блога, предварительной загрузки и краулера. Документированные всплески загрузок, вызванные блогом на SSRN [116], иллюстрируют, почему экстремальное значение часто является органическим успехом, а не загрязнением. Обнаружение аномалий - это инструмент измерения. Это не лицензирует отбрасывание неудобного успеха.
Та же строгость применяется к временной структуре. Панель различает маргинальное и кумулятивное внимание: кривые когорты интервальных загрузок ΔD и долю загрузок статьи за 180 дней, накопленную в каждом возрасте, в противоположность рассмотрению только пожизненных итогов. Она не налагает единого экспоненциального периода полураспада на затухание, так как читаемость затухает по нескольким временным шкалам одновременно [91]. Кривые возраста поэтому по умолчанию подгоняются сплайнами или непараметрическими оценивателями, при этом логарифмические преобразования используются для изучения структуры, а исходные значения сохраняются для отчётности по бенчмаркам. Устойчивость обрабатывается тем же способом: престиж операционализируется через несколько альтернативных мер, а не через единый порог ранжирования, статус новичка повторно тестируется под всё более строгими определениями, и результаты представляются с проверками winsorized-чувствительности и графиками полного распределения наряду с оценками квантилей.
Поскольку отсутствует публичный API SSRN [134][51], сбор данных осуществляется тремя путями в порядке предпочтения: формальный запрос данных в SSRN/Elsevier или партнёрство с ними; экспорты информационной панели с согласия авторов, в которых участвующие авторы предоставляют собственные данные статистической панели при информированном согласии, промежуточный уровень, на который уже опирается реестр раздела 8.8; и выборка общедоступных страниц по каждой статье, соблюдающая robots.txt и ограниченная по частоте, чья техническая осуществимость установлена существующими инструментами сбора с открытым исходным кодом [134]. Конструкция исключает массовый скрейпинг, который нарушил бы условия обслуживания, и не представляет никакую недокументированную конечную точку в качестве стабильного API. Ограничения доступа рассматриваются как ограничивающий фактор в разделе 9.
8.4 Квази-эксперимент I: распределение оповещений по электронной почте как шок внимания
Разделы 8.4 и 8.5 образуют один аналитический модуль, исследующий два платформенных вмешательства в качестве дополняющих обработок на одну панельную когорту. Распределение оповещений добавляет поверхность воздействия, выход из рейтингов удалил одну, и оба рассматриваются против общего набора результатов распределения (доля новичков, градиент престижа, коэффициент Джини внимания, топовые доли). Механизм оповещений SSRN аналитически ценен, потому что публикация и распределение не обязательно совпадают. Статьи становятся общедоступными в первую очередь, а соответствующие работы позже распределяются через кураторские оповещения электронного журнала, время которых варьируется и не гарантируется [53][57]. Для авторов, согласившихся предоставить даты статуса распределения, исследование события внутри статьи может оценить путь внимания вокруг даты распределения, причем каждая статья служит своим собственным контролем, так что устойчивые различия в привлекательности темы, идентичности автора и учреждения поглощаются. Спецификация имеет стандартную форму исследования события: для результата Y_it (просмотры или загрузки интервала),
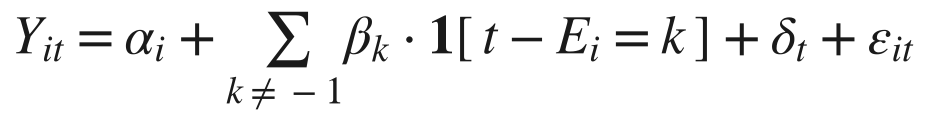
где E_i — дата распределения статьи i, α_i — фиксированные эффекты статьи, δ_t — эффекты календарной даты, и β_k, нормализованные к k = −1 предраспределительному опорному периоду, отслеживают путь внимания вокруг события. Уравнение определяет оценку для предрегистрации. Ключевым гетерогенным эффектом является взаимодействие Distribution × Newcomer, оцениваемое путем взаимодействия β_k со статусом новичка. Если оповещения непропорционально улучшают охват новичков, кураторское распределение функционирует как выравниватель на уровне платформы; если выигрыши непропорционально накапливаются у авторов с высоким престижем, распределение усиливает существующие преимущества репутации (RQ2). Предшествующие доказательства того, что дискретные события воздействия (листинги в верхних позициях на arXiv [72][73], освещение в блогах статей SSRN [116]) создают резкие ранние всплески внимания, указывают на то, что конструкция имеет выявляемый первый этап. Предварительно заданная спецификация также включает альтернативные временные окна вокруг даты распределения и раздельное представление для статей, распределенных быстро, в сравнении со статьями после длительной очереди классификации, поскольку задержка до 45 дней [53] в противном случае объединяет разнородные истории воздействия в единый момент времени события. Фиксированные эффекты статьи поглощают только инвариантную по времени привлекательность, поэтому три условия конструкции являются критически важными. Время распределения определяется кураторски, а не случайно: платформа выбирает, какие соответствующие статьи она распределяет и когда [53][57]. Дата события, следовательно, несет в себе временно-варьирующийся отбор по тематике (статья, распределенная на неделе, когда тема становится актуальной, отличается от той же статьи, распределенной в спокойную неделю), и этот отбор сохраняется при контроле фиксированных эффектов статьи, что является причиной того, что спецификация ставит условия на задержку распределения и отдельно представляет слои времени распределения. Даты статуса распределения также наблюдаются только для согласившихся авторов, поэтому выборка для оценки является самоотобранным подмножеством панели. Статус согласия поэтому фиксируется, и выборка исследования события сравнивается с полной когортой по наблюдаемым ковариатам; отбор ограничивает внешнюю валидность. И авторы могут приурочить свое самопродвижение к оповещению: координированный всплеск самопродвижения выдаст себя за эффект распределения. Датированный журнал самопродвижения автора (комплект версионированных доказательств раздела 6.1) поэтому является требованием этой конструкции: без него органический всплеск распределения не может быть отделен от самогенерируемого, и лестница аномалий раздела 8.3 помечает, а не удаляет, любой всплеск, совпадающий с зафиксированным самопродвижением.
8.5 Квази-эксперимент II: закрытие Rankings как естественный эксперимент
Отключение 15 июля 2026 г. [149] позволяет провести вторичный анализ, если историческая экспозиция рейтинга может быть восстановлена из архивированных рейтинговых страниц. Две особенности дизайна ослабляют чистое исследование события в один день. Воздействие не произошло в один день: страницы рейтинга по журналам прекратили обновляться с 11 декабря 2025 г. (раздел 2.2 [B-2]), примерно за семь месяцев до удаления 15 июля 2026 г., поэтому отзыв поверхности обнаружения рейтинга лучше моделируется как поступенчатый процесс, при котором сначала замораживаются активные страницы, а затем они окончательно удаляются, чем как единая дата события. Спецификация, следовательно, включает по крайней мере две временные точки события (декабрьская заморозка и июльское удаление), при этом поступенчатая форма является основной моделью, а однодневное соответствие проверяется в сравнении с ней. Также нельзя предполагать дисциплины "ранее подвергавшиеся рейтингам" исходя из структуры платформы: рейтинги охватывали всю платформу, поэтому дифференциальная экспозиция эндогенна и не операционализируется путём называния областей, которые "казались" рейтингуемыми. Экспозиция должна быть измерена, а не назначена: например, из архивированных рейтинговых страниц, восстановленных через Интернет-архив, как доля статей области, которые когда-либо попали в публичные топ-списки, или как плотность присутствия области на страницах по журналам. Ещё не установлено, охватывает ли архив рейтинговые страницы каждой области достаточно плотно, чтобы дать применимую меру экспозиции; дизайн сообщает о той плотности вместе с мерой экспозиции. При такой измеренной экспозиции спецификация исследования события на уровне статей сравнивает траектории внимания в областях с высокой и низкой экспозицией вокруг дат заморозки и удаления: уравнение раздела 8.4 с коэффициентами интереса при взаимодействиях Exposure_f × EventTime_k, а не только при временных членах события. Наиболее информативные результаты носят распределительный характер (раздел 8.1). Механизм рейтинга может изменить концентрацию внимания, оставляя средние значения практически неизменными, и поскольку любой эффект ожидается сосредоточиться в уже видимых хвостовых статьях, которые заполняли списки, результаты по средним в полях недостаточно мощны по конструкции. Коэффициенты Джини, меры верхней доли, соотношения новичков/установившихся и градиенты престижа, следовательно, являются основными результатами с двусторонним прогнозом RQ1, и моделирование мощности раздела 8.1 должно быть ориентировано на эти распределительные статистики, а не на среднее внимание, иначе исследование рискует быть признанным пустым из-за отсутствия мощности на неправильном оценивателе.
Два названных направленных предсказания уточняют двусторонний RQ1 без его замены; оба из них — предварительно определённые тесты гетерогенности. Гипотеза об обрыве видимости предполагает, что когорты статей, опубликованные после закрытия рейтингов, в полях, ранее включённых в рейтинги, испытывают дискретное снижение раннего охвата в сравнении со сбалансированными когортами, опубликованными до закрытия, потому что поверхность открытия была удалена в известную дату. Согласно компенсаторной гипотезе, если рейтинги функционировали как компенсирующий механизм видимости для полей со слабой экосистемой открытия, то эффект их удаления должен быть наибольшим в полях с малой базой подписок eJournal, в нижней части градиента Уэлена [168].
Дополнительный исход расширяет дизайн с распределения внимания на здоровье самой платформы: объём новых статей по полям в окнах до и после 15 июля 2026 г. Если рейтинги обеспечивали часть стимула к публикации, то их закрытие могло охладить новые подачи. Это поведенческий исход, отличный от результатов внимания, описанных выше, наблюдаемый на основе публичных списков новых статей в сравнении с собственным базовым уровнем платформы, превышающим 250 000 новых статей в 2025 г. [145], и прямой эмпирический ответ на одновременную полемику "jumped the shark", описанную в разделе 2.2 [12][B-11]. Предсказание остаётся двусторонним, как RQ1, и исход объёма публикаций связан с пунктом (3) опроса Study 4 ("avoiding new uploads").
Анализ является квазиэкспериментальным. Пять угроз являются существенными. Одна из них — это эффекты объявления и предвосхищения: закрытие было объявлено 12 июня 2026 г. с первоначальной целевой датой 1 июля и выполнено 15 июля, таким образом, существовало окно подлинного предвосхищения и оно сместилось [148][149]. Совокупность параллельных изменений платформы в 2026 году совпадает по времени с закрытием и не может быть отделена от него какой-либо одной датой события: стратегическая переориентация, объявленная 13 апреля 2026 г., закрытие коммерческой Research Paper Series, действующей до конца декабря 2026 г., и изменение лицензии автора от 20 июля 2026 г., через пять дней после удаления [146][150]. Поскольку эти вмешательства пересекаются в июльском окне, единая общая дата события приписывала бы их совокупный эффект только закрытию. Идентификация, таким образом, опирается на указанный выше разнесённый график (декабрьское замораживание предшествует всем из них), на даты плацебо и на характерную для удаления рейтинга сигнатуру распределения, и дизайн указывает, какие произошедшие одновременно изменения остаются неотделёнными. Затем идёт летний спад внимания: середина июля совпадает с зарегистрированным сезонным спадом в научном доступе, при этом доступ падает примерно на 50% в летние месяцы [178], поэтому сравнение между полями, проводимое через дату удаления, смешивает закрытие с собственной летней сезонностью каждого поля, которая различается по дисциплинам. Фиксированные эффекты по датам календаря поглощают только общую сезонную компоненту. Дизайн, таким образом, требует сезонные базовые уровни, специфичные для полей (сравнение в аналогичном окне предыдущего года для каждого поля). Неслучайные различия между полями с высокой и низкой экспозицией являются дальнейшей угрозой, устранённой путём операционализации измеренной экспозиции, приведённой выше, и путём использования сбалансированных групп сравнения. Оставшаяся угроза является перспективной: SSRN заявила, что может пересмотреть рейтинги, таким образом, частичное восстановление во время окна наблюдения введёт второе событие. Дизайн предварительно зарегистрирован для рассмотрения любого такого восстановления в качестве точки цензурирования для периода после, и его моделирования как отдельного воздействия, а не его включения в контраст закрытия. Во всех отчётах время события разделено на три названные периода: объявление (с 12 июня 2026 г.), переход и закрытие (с 15 июля 2026 г.), так чтобы эффекты предвосхищения оценивались. Предварительно определённый дизайн, таким образом, включает тесты предварительного тренда по времени события, альтернативные полосы пропускания, даты плацебо, временные тренды, специфичные для полей, сезонные базовые уровни, специфичные для полей, и анализы чувствительности, исключающие переходный период от объявления к закрытию. Рисунок 11 представляет предполагаемые результаты обоих исследований событий в качестве шаблонов дизайна.
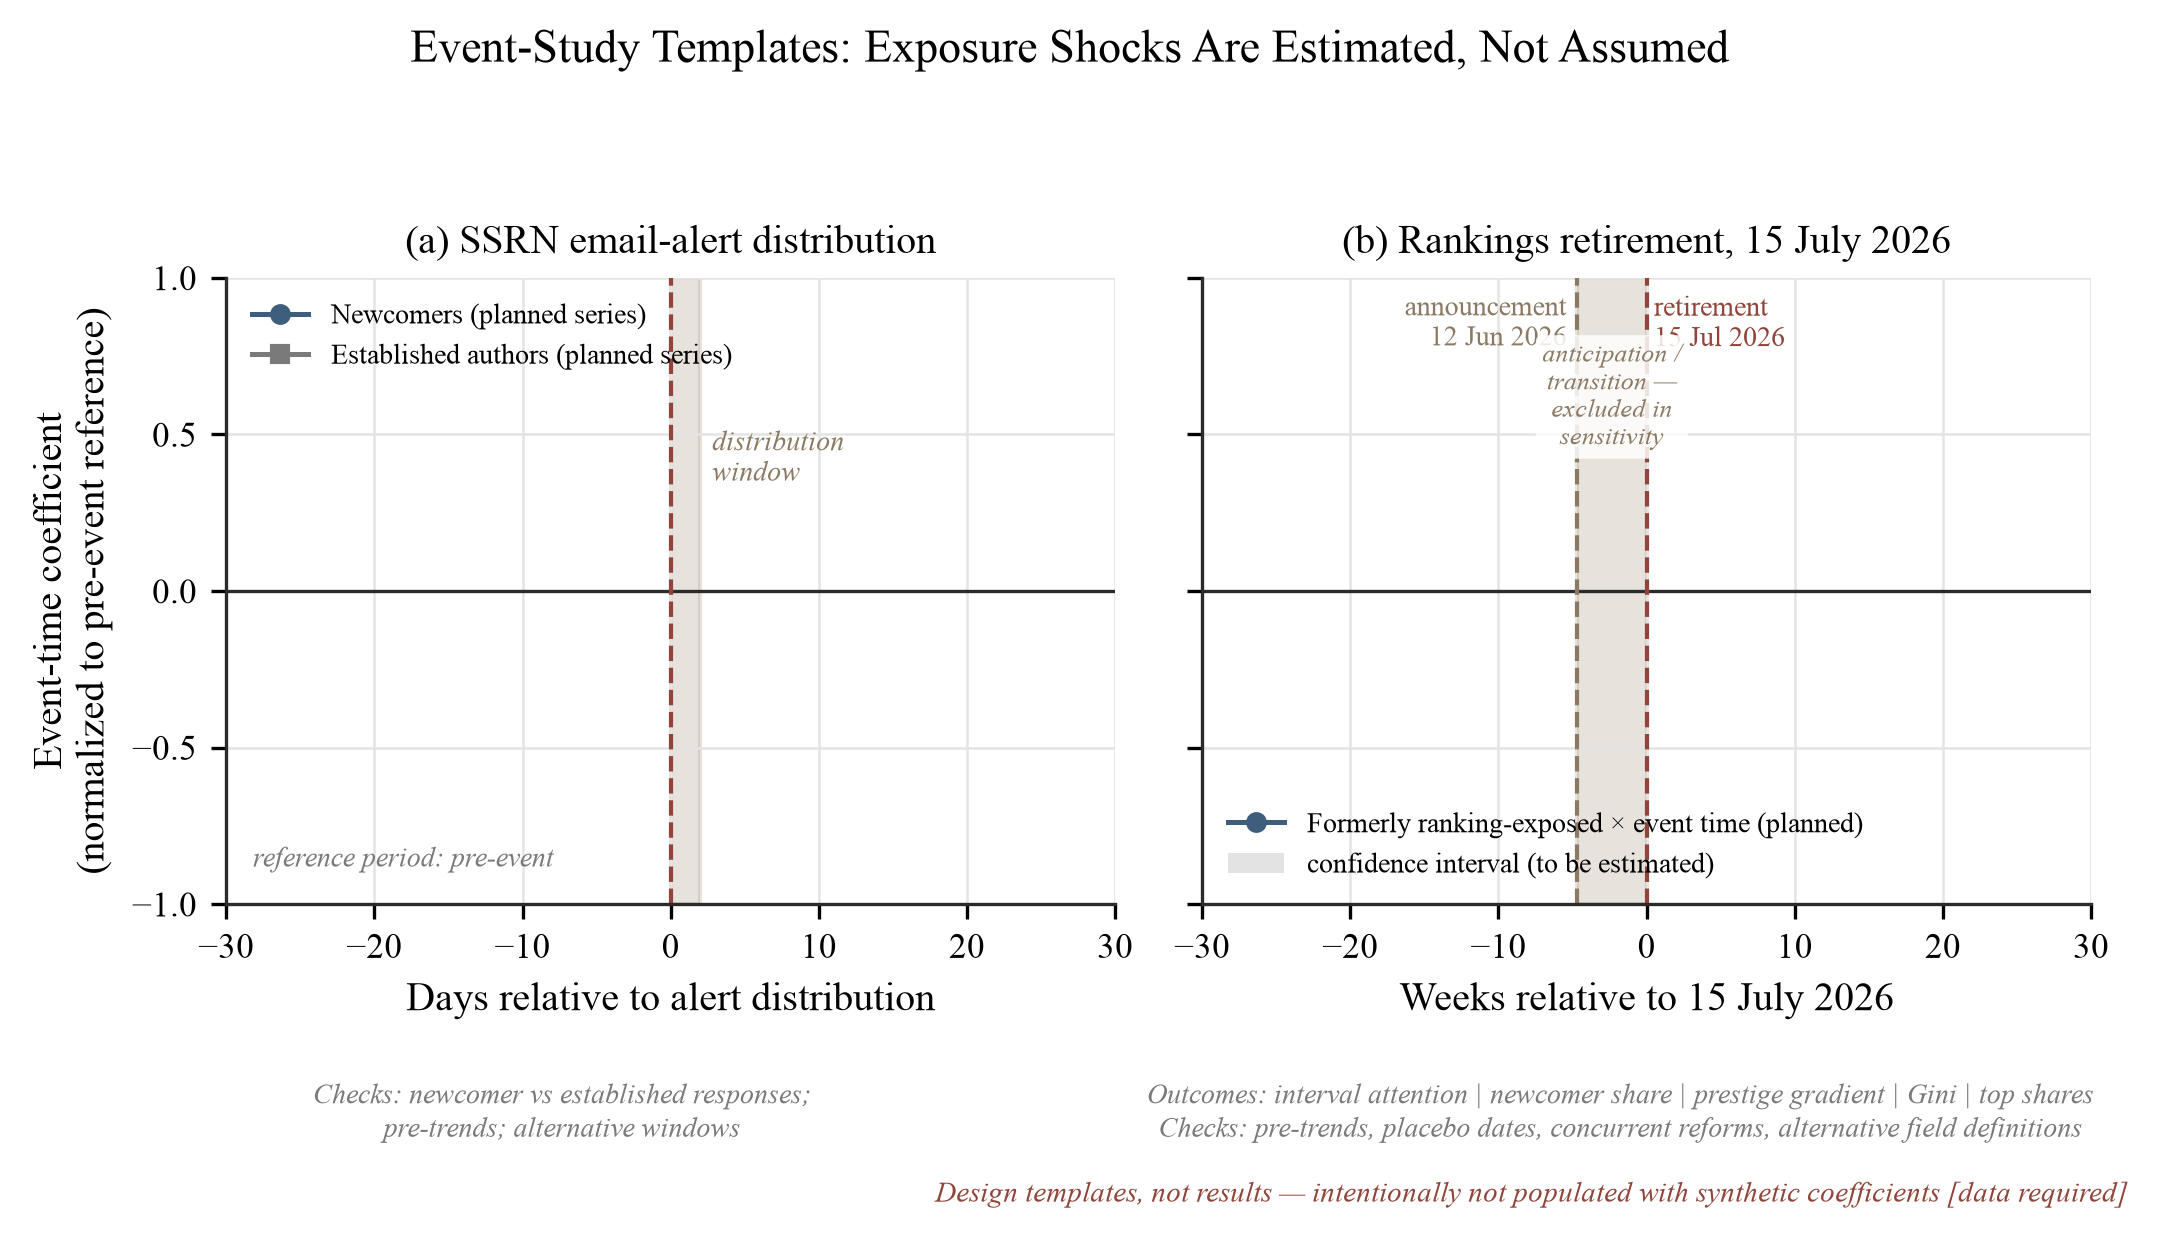
Рисунок 11. Шаблоны дизайна исследования события для двух платформенных квазиэкспериментов. Предварительно установленные результаты исследования события для дизайнов разделов 8.4–8.5: (a) внимание вокруг распределения уведомлений по электронной почте, новых авторов в сравнении с опытными авторами, с окном распределения затемнено, так как уведомления приходят как интервал, а не мгновение; (b) внимание и результаты неравенства вокруг прекращения использования Rankings, с отмеченными датами объявления (12 июня 2026) и прекращения (15 июля 2026) и затемненным периодом ожидания/переходным периодом — окно исключено из предварительно установленных анализов чувствительности. Результаты распределения (интервальное внимание, доля новичков, градиент престижа, Gini, верхние доли) и требуемые проверки указаны на самой фигуре. Коэффициенты нормализованы по отношению к предсобытийному опорному периоду; затемненные серые области обозначают доверительные интервалы. Эти панели — шаблоны дизайна; эмпирические значения не показаны, и код будет выпущен с материалами предварительной регистрации.
8.6 Четыре предопределённые исследования
Наряду с основной панелью четыре исследования указаны и суммированы в Таблице 17. Два исследования с общедоступными данными (1 и 2) могут быть проведены любым исследователем без разрешения на ограниченный доступ, в пределах лимитов доступа, указанных в Разделе 9 (сбор данных с ограничением скорости согласно условиям обслуживания платформы). Два исследования с участием людей (3 и 4) требуют участников и проводятся в соответствии с одобрениями этики, указанными в Декларациях. Все четыре существуют для немедленного начала заполнения пробела в эталонах, а не после созревания многолетней панели.
Таблица 17. Четыре предопределённые исследования.
| Исследование 1 | Исследование 2 | Исследование 3 | Исследование 4 | |
|---|---|---|---|---|
| Исследовательский вопрос | Какое медиальное/процентильное распределение загрузок? | Цитируют ли механизмы ответов AI сам препринт? | Читатель или хищник первым? | Как авторы читают свои собственные счётчики? |
| Данные | 3000–5000 стратифицированных идентификаторов статей SSRN | 100–200 нишевых вопросов × ~5 механизмов | 2 инструментированные публикации, 90-дневный входящий журнал | Предварительно зарегистрированный опрос авторов, четыре позиции с фиксированной формулировкой |
| Метод | Медиана, Джини, кривые спада, регрессия количества классификаций | Кодирование извлечения + логистическая регрессия | Отслеживание псевдонимов по каналам + кодирование сообщений | Закрытая анкета + описательные доли |
| Основной исход | Медиана; доля загрузок ≤10; коэффициент Джини внимания | Видимость машины V | t_reader vs. t_predator | Доля никогда не сравнивающих счётчики с какой-либо эталонной; распределение при первом чтении для «7 загрузок» |
| Фальсифицируемое предсказание | медиана < 0,5 × среднее; Джини 0,75–0,90 | Препринт цитируется в 10–35% испытаний | t_predator < t_reader | Большинство сообщают о том, что никогда не сравнивают ни с каким эталоном |
| Основной результат | Публичные, машиночитаемые таблицы эталонных процентилей, стратифицированные по возрасту, области и когорте | Воспроизводимый протокол аудита извлечения и атрибуции с отметкой времени снимка | Открытый протокол инструментированной публикации с предварительной базовой линией и кодовой книгой | Документированное распределение интерпретаций авторов и сообщённых изменений поведения |
| Дизайн работает неправильно, если | Нормализация не улучшает стабильность или внешнюю прогностическую способность по сравнению с необработанными подсчётами | Признаки не предсказывают ничего, выходящего за рамки релевантности запроса, механизма и даты | Нет разрыва после публикации после базовой линии и контроля воздействия, или ненадёжное кодирование | Набор или самоотбор оставляют даже описательные доли неинтерпретируемыми |
| Профиль ресурсов | Общедоступные данные; стандартный веб-скрейпинг и статистика | Общедоступные запросы к механизмам AI; ручное кодирование | Две инструментированные публикации; логирование входящей почты (IRB) | Анонимный опрос авторов (IRB) |
Примечание. Каждое исследование должно быть зарегистрировано на OSF перед сбором данных с выпущенным кодом.
Исследование 1: «Анатомия медианы». Исследование отбирает случайную стратифицированную выборку из 3000–5000 идентификаторов аннотаций SSRN, диапазон планирования, при этом окончательное N задаётся моделированием мощности в соответствии с предопределёнными полосами прогнозирования и наименьшими интересующими эффектами (Раздел 8.1). Стратификация проводится по году публикации и сети, а загрузки за всю жизнь по документам, просмотры аннотаций, дата публикации и количество классификаций собираются через каналы доступа Раздела 8.3. Оценки: медиана загрузок за всю жизнь; доли документов с нулевой и с десятью или менее загрузками; коэффициент Джини внимания с интервалами доверия бутстрэпа; коэффициент конверсии просмотров в загрузки, оценённый в целом и стратифицированный по сетям (тест гипотезы стиля чтения аудитории Раздела 5.2); кривые спада загрузок; и регрессия логарифма загрузок по количеству классификаций с фиксированными эффектами года и сети (прямой тест P2 [168]). Предопределённые полосы прогнозирования (медиана загрузок за всю жизнь примерно 30–80, доля загрузок ≤10 15–30%, Джини 0,75–0,90) являются экстраполяциями из датированных опор Раздела 5 [83][85][139] и из величин коэффициента Джини внимания в смежных средствах [180], указанные заранее, чтобы исследование могло их фальсифицировать. Исследование 1 является эмпирическим семенем процентильного эталона, обсуждаемого в Разделе 8.8.
Исследование 2: «Читают ли машины вас?» Растущая доля поиска информации теперь начинается с генеративных интерфейсов: примерно половина взрослых в США сообщают об использовании чатботов AI, а около четверти используют их ежедневно [121], при этом существенное меньшинство уже рассматривает чатбот как свой первый поисковой механизм в удобных выборках [4]. Введение (Раздел 1.6) концептуализировало это как восходящую миграцию привратника обнаружения (журнальный бренд → хранилище → поисковой механизм → уровень ответов AI) на каждом шаге смещая контроль дальше от автора и дальше от какого-либо общедоступного эталона (Рисунок 12). Неизвестно, извлекает ли верхний уровень препринты вообще: литература по оптимизации генеративных механизмов на данный момент сосредоточена на брендах и коммерции [5][100][164], а аудиты поиска AI касались атрибуции новостей, а не учёных источников [82]. Эти аудиты рекомендуют скептицизм в отношении надёжности новых привратников: в аудите Tow Center (1600 запросов на восемь механизмов) механизмы в совокупности не смогли получить правильную информацию более чем в 60% испытаний, при этом лучший исполнитель (Perplexity) ответил неправильно в 37% случаев, а худший (Grok-3) в 94%, и они обычно ошибались с необоснованной уверенностью, а не отказывались отвечать [82], цифры из теста атрибуции новостей, а не из учёного поиска. На август 2026 года не существовало контролируемого исследования видимости учёных препринтов в механизмах ответов AI [100]. Вклад располагается рядом с двумя смежными направлениями работы. Исследования оптимизации генеративных механизмов, на которых строится эта статья, измеряют и манипулируют видимостью брендов и коммерческих страниц [5][164], а не извлечением учёных артефактов. Отдельная ветвь показывает, что когда языковые модели генерируют ссылки вообще, они воспроизводят и усиливают человеческую тенденцию цитировать уже высоко цитируемые работы, расширяя эффект Матфея на уровень машины [7], что является механизмом, который P3b (Раздел 8.2) тестирует. Ни одна ветвь не изучала обнаруживаемость научных препринтов при контролируемой релевантности запроса, и специфически их извлекаемость после удаления поверхности ранжирования платформы, что является объектом, который изолирует Исследование 2.
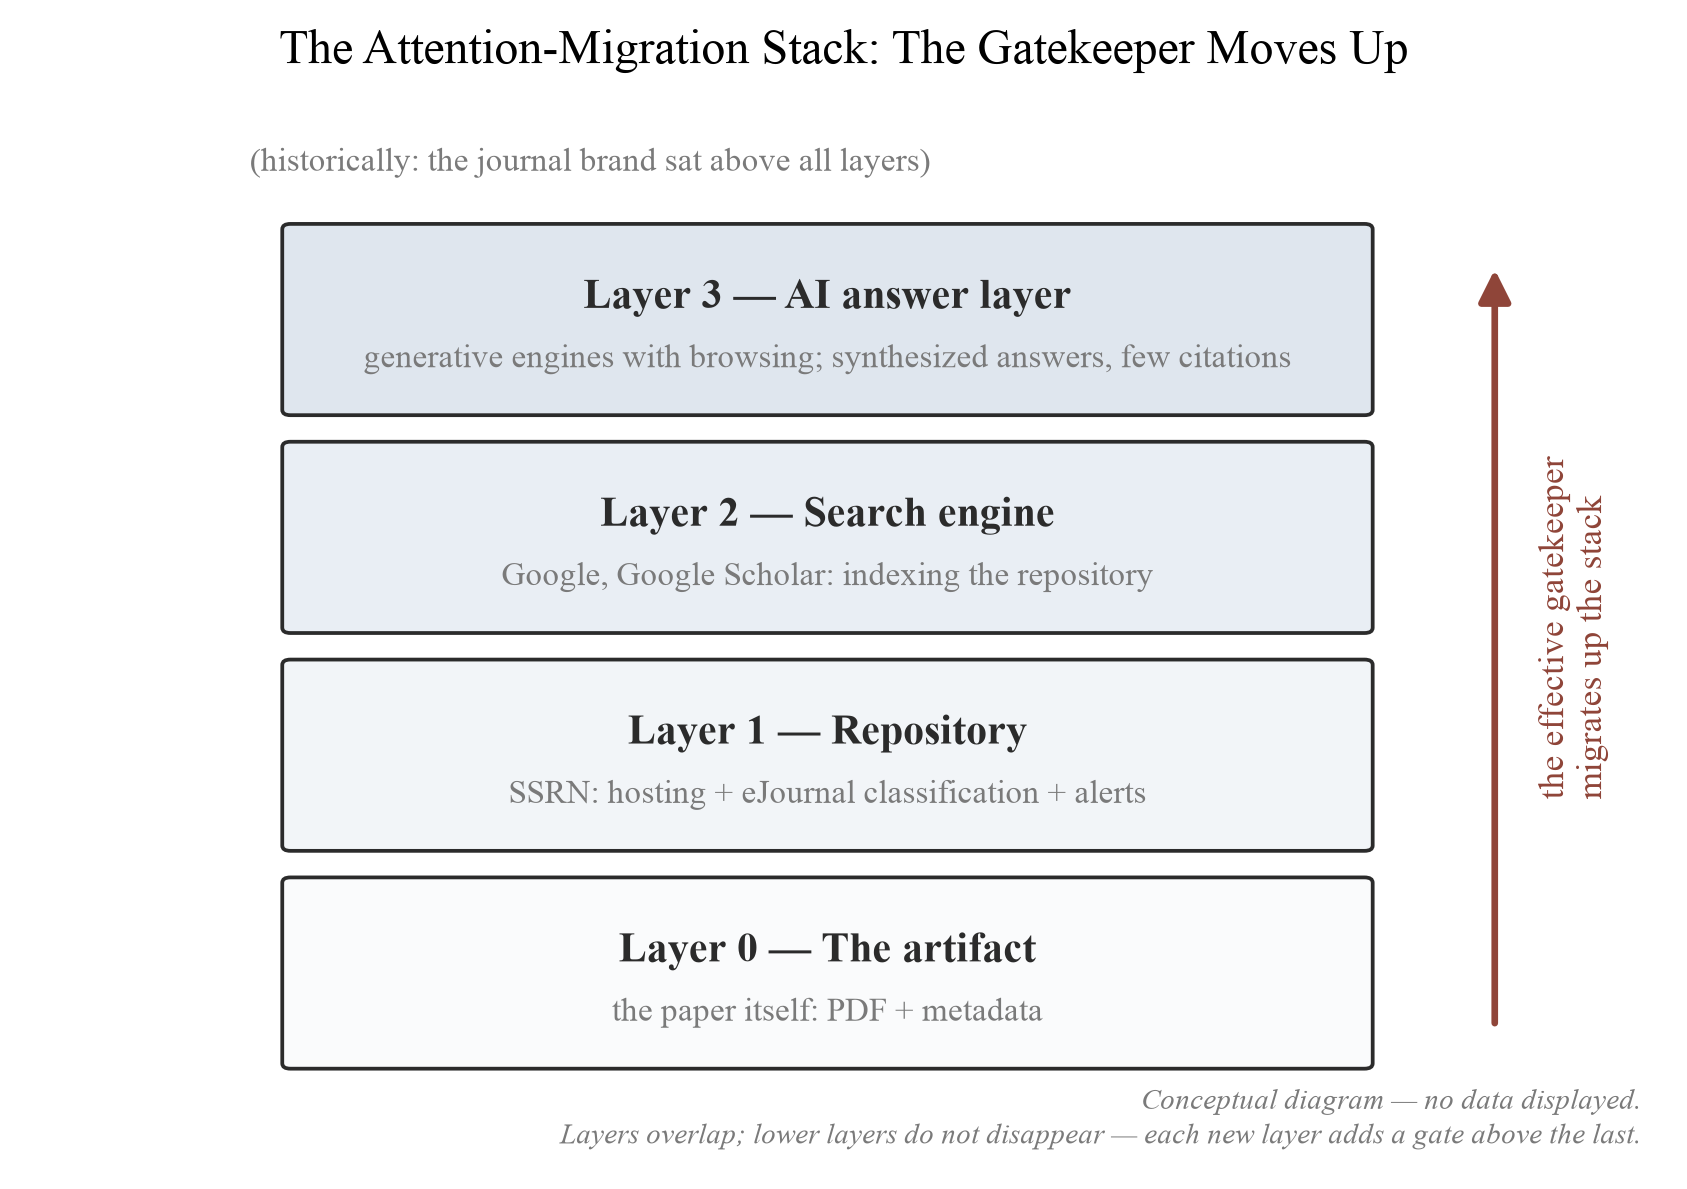
Рисунок 12. Стек миграции внимания. Многоуровневый путь от завершённой рукописи к вниманию читателя. Тезис о миграции утверждает, что эффективный привратник — уровень, определяющий, какие артефакты получают внимание — с течением времени смещался вверх, от журнального бренда через репозиторий и поисковую систему к уровню ответов ИИ; каждый шаг вверх смещает контроль дальше от автора и дальше от любого общественного критерия. Стек — это концептуальная модель.
Исследование 2 создаёт 100–200 узкоспециальных вопросов, каждый разработан так, чтобы один конкретный препринт SSRN являлся лучшим доступным источником, при этом требование релевантности проверяется независимыми экспертами-оценивающими, а не самостоятельно подтверждается авторами запроса. Система запрашивает крупные потребительские системы ИИ с включённым браузингом и кодирует результаты в шесть взаимоисключающих категорий: (1) сам исходный препринт процитирован; (2) опубликованная версия или зеркало той же статьи процитирована — случай, который более грубая схема классифицировала бы как отсутствие; (3) вторичное освещение, процитированное без самой работы; (4) иной, но обоснованный источник процитирован; (5) нет прослеживаемого источника; (6) отказ системы (Рисунок 13). Для каждого ответа, цитирующего исходную работу или её версию, бинарный флаг верности атрибуции дополнительно фиксирует, действительно ли утверждение в ответе подтверждается процитированным источником. Видимость и верность сообщаются раздельно и никогда не объединяются в единую оценку, потому что система может видно процитировать работу, неверно её излагая (присвоение цитирования), или воспроизводить её содержание без какого-либо цитирования (влияние без атрибуции). Подтверждающая регрессия остаётся логистической, для контраста «исходная работа или её версия процитирована» в сравнении со всеми остальными исходами, со стандартными ошибками, сгруппированными или, предпочтительнее, с подогнанной пересекающейся структурой случайных эффектов, чтобы учесть зависимость наблюдений, разделяющих систему, запрос или исходную работу, так как одна и та же работа, запрошенная по разным системам, и одна и та же система, запрошенная по разным работам, порождают коррелированные исходы, которые наивные ошибки независимых испытаний недооценили бы. Формально оцениваемым параметром аудита является M_pqe: вероятность того, что работа p цитируется системой e в ответ на запрос q. M_pqe — это не свойство только самой работы, так как варьируется по запросам, системам, датам и версиям моделей, поэтому обозначение определяет оцениваемый параметр, и каждый отмеченный временной меткой запуск читается как оценка M_pqe на момент его проведения. Выборка систем должна выходить за пределы потребительских чатботов на появляющийся слой научного поиска (инструменты, такие как Consensus, Elicit, Scite и Semantic Scholar, которые основаны на академических корпусах и цитируют реальные статьи), так как препринт, невидимый потребительским системам, может всё ещё быть обнаружен дисциплинарно-специализированными, и расхождение между двумя слоями само по себе является результатом, представляющим интерес. Машинная видимость затем регрессируется по признакам работы, операционализированным в Таблице 18, включая ковариату предыдущей видимости, требуемую P3b: предыдущие веб- и научные следы каждой работы, зафиксированные на момент конструирования запроса. Выборка запросов стратифицирована по предыдущей видимости, чтобы работы с холодным стартом были представлены по замыслу. Так как генеративные системы нестационарны, дизайн сочетает отмеченный временной меткой первичный снимок состояния с протоколом повторного запуска по скрипту, который могут повторить другие. Три дополнительных требования к санитарности аудита предусматриваются заранее: отрицательные контроли (престижные, но нерелевантные работы, варианты названий и подсказки, которые не должны извлекать исходную работу) делают неразборчивое цитирование обнаруживаемым; каждый запрос выполняется в эквивалентных вариантах подсказок при зафиксированном состоянии сеанса (чистые в сравнении с вошедшими в систему сеансами; система, версия модели, дата и география), так чтобы артефакты, специфичные для подсказки и сеанса, были отделимы от стабильного поведения поиска; и случайная подвыборка исходов кодируется дважды, с сообщённым согласием рейтеров. Полный пошаговый контрольный список аудита помещён вместе с материалами предварительной регистрации. Основным вкладом исследования является время исследователя (слепая проверка релевантности 100–200 вопросов и двойное кодирование), а не данные с ограниченным доступом или специализированная инфраструктура. Исследование, которое должно платить за время экспертной оценки по рыночным ставкам, должно явно выделить бюджет на эту работу. Предусмотренное предсказание состоит в том, что препринт сам по себе цитируется в меньшинстве испытаний (полоса 10–35%), при этом признаки структурированной аннотации и опубликованной версии повышают видимость (P3). Исследование 2 — один из пяти пунктов повестки дня. Полный аудит видимости научных машин, включая сравнения между системами и между репозиториями, является предметом планируемой дополнительной работы.
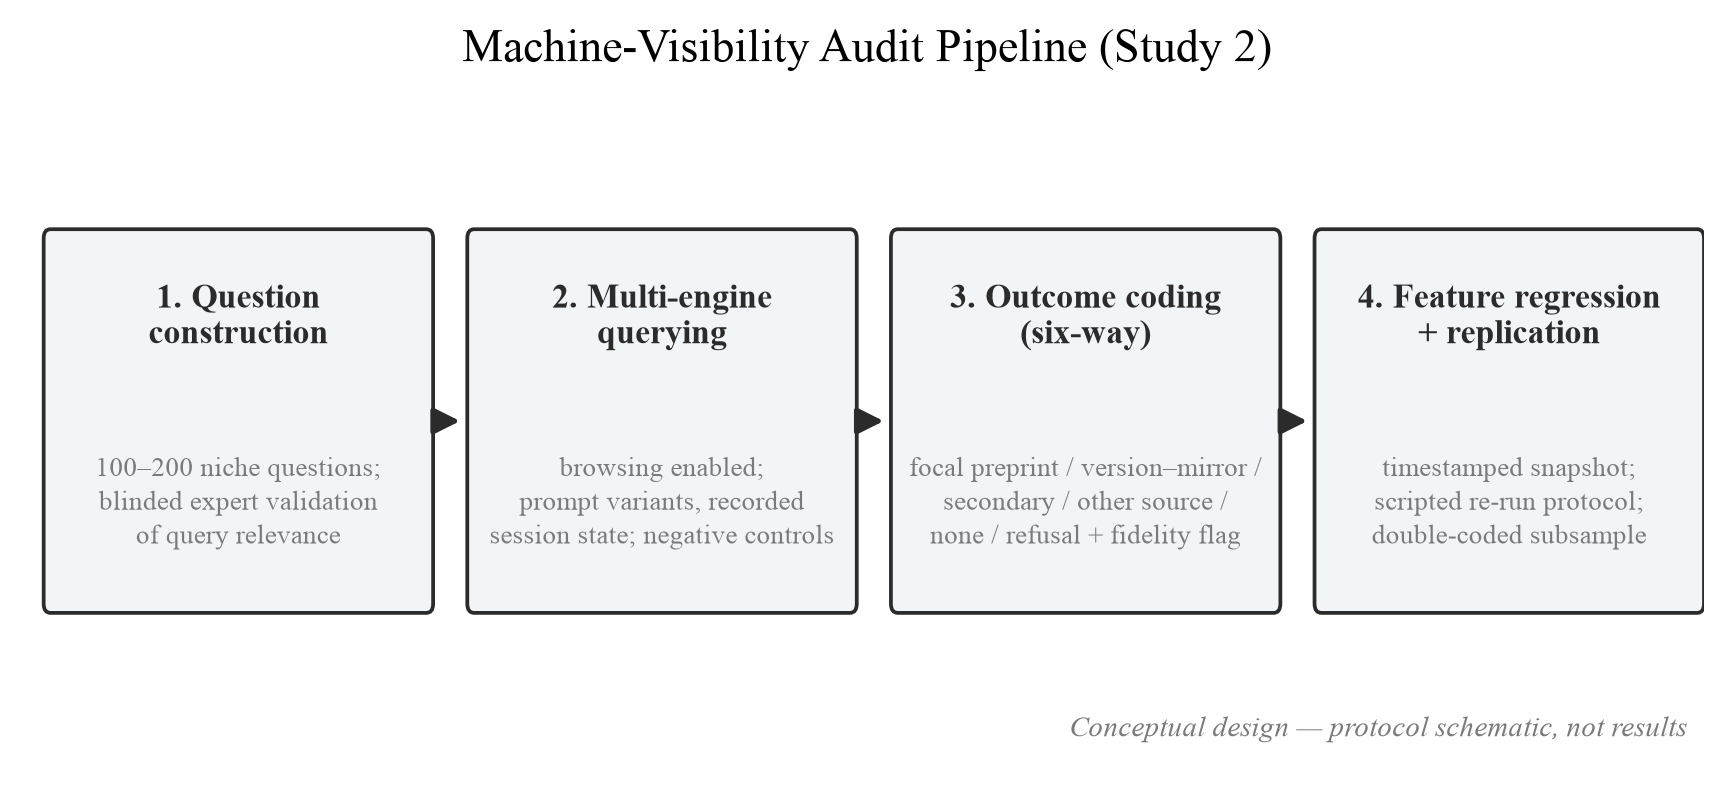
Рисунок 13. Конвейер аудита машинной видимости (Исследование 2). Четырёхэтапный конвейер Исследования 2. Шестиуровневое кодирование отделяет цитирование исходного препринта от цитирования его опубликованной версии или зеркала — предотвращая ошибочную классификацию отсутствия — и флаг верности атрибуции сохраняет "было ли цитировано" отличным от "было ли цитировано правдиво." Структура снимка и репликации решает проблему нестационарности модели: первичный снимок датирован, и протокол переповтора позволяет любому исследователю воспроизвести аудит позже.
Таблица 18. Операционализация признаков машинной видимости (Исследование 2).
| Переменная | Определение | Кодирование |
|---|---|---|
| DOI присутствует | Страница статьи содержит зарегистрированный DOI | 1/0 |
| Тип заголовка | Описательный vs. аллюзивный заголовок | descriptive = 1 |
| Структура аннотации | Структурированная/богатая статистикой vs. повествовательная | structured = 1 |
| Возраст | Месяцы с момента первоначального размещения | integer |
| Количество классификаций | Количество назначенных eJournals | integer |
| Вторичное упоминание | ≥1 упоминание в индексированном блоге/новостях существует | 1/0 |
| Опубликованная версия | Существует опубликованная версия журнала | 1/0 |
| Предыдущая видимость | Веб-след и научный отпечаток статьи и её авторов до аудита, зафиксированные при построении запроса (P3b) | стратифицированный порядковый |
| Исход V | Результат поиска для целевой статьи | шесть категорий: целевой препринт / опубликованная версия или зеркало / только вторичное / другой обоснованный источник / не отслеживается / отказ; плюс двоичный флаг достоверности атрибуции для цитируемых случаев |
Примечание. Выбор особенностей адаптирует документированные факторы оптимизации генеративных движков [5][164] для научных артефактов. Самый крупный такой аудит, на уровне 252 000 испытаний в шести движках на основе LLM, выявил тематическую релевантность и позицию в списке в извлеченном контексте в качестве основных факторов, способствующих первому цитированию [164]. Позиция в списке, следовательно, является отдельной, переносимой гипотезой для Исследования 2, и позиция в списке результатов должна быть зафиксирована везде, где она наблюдается.
Таблица 19 дополняет таблицу 18 на другом уровне описания. Таблица 18 операционализирует особенности уровня статьи, чьи эффекты оценивает Исследование 2, в то время как таблица 19 уточняет конструкты измерения аудита: что измеряется, при каких контрольных условиях и против какой первичной угрозы валидности. Каждый конструкт является отдельным утверждением о машинном уровне, и каждая угроза называет конкретный способ, которым наивный аудит пошёл бы неправильно.
Таблица 19. Конструкты измерения аудита машинной видимости (Исследование 2).
| Конструкт | Операциональная мера | Необходимые контроли | Первичная угроза |
|---|---|---|---|
| Прямая машинная видимость | Целевой препринт цитируется или ссылается в ответе | Релевантность запроса, движок, дата, состояние сеанса | Дрейф модели и индекса |
| Подмена источника | Опубликованная версия, зеркало или вторичное покрытие цитируются вместо препринта | Совпадение версий, DOI, варианты заголовка | Неправильная классификация как отсутствия |
| Позиция цитирования | Ранг и видимость целевого цитирования в ответе | Длина ответа и количество цитирований | Представление, специфичное для интерфейса |
| Достоверность атрибуции | Утверждение в ответе, точно поддерживаемое цитируемой статьёй | Слепая проверка утверждения–источника | Отмывание цитирований или галлюцинация |
| Чувствительность запроса | Вариация результатов в различных эквивалентных формулировках запроса | Рандомизированные варианты подсказок | Артефакты, специфичные для подсказки |
| Воспроизводимость | Тот же результат в более поздний момент или при чистом повторном запуске | Архивированный протокол и метаданные системы | Нестационарность движка |
Наиболее обоснованный перенос из коммерческой литературы по GEO — это программа аудита особенностей, а не рецепт промоции: таблица 20 перечисляет кандидатные особенности, чья связь с машинной видимостью Исследование 2 предназначено подтвердить или опровергнуть. Каждая строка — это гипотеза, а не установленная тактика, и особенность, связанная с поиском, может быть прокси для зрелости статьи, популярности темы или предыдущей видимости вместо рычага.
Таблица 20. Программа аудита особенностей для машинной видимости (гипотезы для Исследования 2, не рекомендации).
| Кандидатная особенность | Предполагаемый механизм | Подтверждающее доказательство |
|---|---|---|
| Зарегистрировать DOI | Стабильный идентификатор помогает поиску и сопоставлению цитирований | [164] |
| Структурированная, насыщенная статистикой аннотация | Добавление статистики повысило генеративную видимость примерно на ~40% в коммерческих бенчмарках | [5] |
| Описательный, богатый релевантностью заголовок | Тематическая релевантность — главный фактор цитирования в ответах ИИ | [164] |
| Максимизировать точные классификации eJournal | Больше классификаций связано с большим количеством загрузок, меньше нулей | [168] |
| Получить ≥1 единицу вторичного покрытия | Движки часто цитируют вторичное покрытие вместо первичных источников | [82] |
Исследование 3: «Кто прибывает первым?» Протокол инструментальной публикации непосредственно проверяет P4. Два реальных рабочих документа публикуются с использованием уникальных адресов электронной почты с плюс-адресацией для каждого канала воздействия, с журналом входящих сообщений за 90 дней, которому предшествует базовое окно перед публикацией от двух до четырех недель на одних и тех же адресах. Без базовой линии увеличение объема ходатайств не может быть приписано публикации вообще, так как академический спам поступает непрерывно на фоне высокой фоновой частоты. Каждое сообщение кодируется как подлинный научный контакт или хищническое ходатайство с использованием опубликованных сигнатур ходатайств [96] и кураторских критериев типа списка блокировки против высоких фоновых частот, задокументированных в специальных аудитах, рассмотренных в разделе 7.2 [9][84][63][61]. Результатом является сравнение времени до первого подлинного контакта и времени до первого хищнического ходатайства, приписываемого публикации. Предварительно определенное предсказание, согласно P4, состоит в том, что ходатайства предшествуют подлинному контакту. Два правила измерения фиксируются перед запуском. Базовое и послепубликационные окна имеют неравномерную длину (примерно от двух до четырех недель против девяноста дней), поэтому сравнение проводится по коэффициентам прибытия (события на адрес-день) и функциям выживания, никогда не по сырым числам событий, что иначе исказила бы асимметрия окна. И время до первого контакта цензурируется справа по конструкции: с двумя документами адрес, который не получает подлинный контакт в течение 90-дневного окна, дает цензурированное, а не нулевое наблюдение, поэтому правило цензурирования предварительно определено. Наблюдения цензурируются справа в 90 дней, адреса без события вносят цензурированное время в оценку выживания, а не удаляются или кодируются как немедленные, и с N = 2 полученные кривые представляются с их точной неопределенностью малой выборки, а не как точечные оценки. Причинный оцениваемый параметр дизайна распределенной репликации — это изменение функции риска ходатайства после публикации (не личность какого-либо загружающего), оцениваемое методами анализа выживания/истории событий на сопоставленных окнах до и после публикации. Поскольку видимая производительность автора правдоподобно предсказывает объем ходатайств независимо от любой отдельной публикации (ходатайства извлекаются из накопленного открытого результата автора, поэтому высокие фоновые частоты, задокументированные в специальных аудитах раздела 7.2, масштабируются с этим результатом), распределенные репликации должны записывать элементы управления воздействием на уровне автора (предыдущие публикации, объем публикаций и открытую контактную поверхность) наряду с фокальным событием. Это инструментальный пример случая N = 2, доказательство механизма и открытый протокол, приглашающий распределенную репликацию, которые в совокупности дали бы надежную оценку. N = 2 демонстрирует осуществимость инструментария, а не распространенность и не причинную величину. В отличие от исследований 1, 2 и 4, которые имеют адекватную статистическую мощь для предварительно определенных размеров эффекта, исследование 3 является пилотным исследованием осуществимости и открытым протоколом репликации.
Рамка кодирования фиксируется перед запуском. Входящие сообщения кодируются в семь типов: ходатайство от журнала, приглашение на конференцию, запрос на рецензирование, приглашение в редакционный совет, приглашение написать главу в книге, предложение коммерческого сервиса и подлинная научная переписка, более широкая рамка, чем бинарное разделение на хищническое/подлинное. Каждая запись содержит минимальный набор полей: временная метка, адрес получения (канал), название площадки, раскрытие сборов, специфичность для фокального документа, язык срочности, результат проверки на основе поддерживаемых служб скрининга и уверенность кодировщика. Пограничные случаи и легитимные низкопрестижные площадки регулируются предварительно определенными правилами, а не ad hoc суждениями. Новая или неясная площадка не является автоматически хищнической. Случайная подвыборка закодирована двумя кодировщиками, с сообщаемым согласием между ними. Выпускаются только совокупные подсчеты (раздел 9; Заявления), а полный кодовник депонируется при предварительной регистрации. Объем ходатайств не свидетельствует о читаемости, и ходатайства не влияют на открытые счетчики: система целостности SSRN исключает аномальную автоматизированную активность из официальных подсчетов [144], и не допускаются выводы от входящей почты к приборной панели в любом направлении.
Исследование 4: "Как авторы читают свои счётчики." Предварительно определённое авторское обследование преобразует зафиксированное в таблице 1 доказательство спроса из форума в прямое измерение. Инструмент состоит из четырех вопросов с фиксированной формулировкой: (1) "Когда-либо ли вы сравнивали ваши загрузки на SSRN с какой-либо контрольной точкой или нормой?", с вариантами ответов, различающими конкретное опубликованное число, таблицу, специфичную для дисциплины, неформальное сравнение с коллегами и никогда; (2) "Когда вы видите '7 загрузок' на своей панели управления, какова ваша первая мысль?", с вариантами, охватывающими предполагаемый отказ, слишком рано говорить, нет понимания того, что является нормальным, и ожидаемое или нормальное; (3) "Изменило ли закрытие рейтингов в июле 2026 г. ваше поведение в отношении препринтов?", с вариантами прекращения проверки статистики, избегания новых загрузок, загрузки при менее частой проверке и отсутствия эффекта; и (4) "Считаете ли вы, что комитеты по найму и служебному продвижению понимают метрики SSRN?". Предварительно определённые прогнозы состоят в том, что большинство респондентов сообщают о том, что никогда не сравнивали свои счётчики ни с какой контрольной точкой, и что первоначальные показания низкого количества смещены в сторону предполагаемого отказа, а не в сторону слишком раннего прочтения, которое раздел 5.6 показывает обычно правильным значением по умолчанию. Целевой размер выборки, каналы рекрутирования и код анализа фиксируются при регистрации. Самоотбор в сторону заинтересованных и, вероятно, более тревожных авторов ограничивает выборку, как и реестр раздела 8.8. Формат с фиксированным выбором также допускает качественный сопутствующий компонент: предварительно определённое тематическое кодирование открытых вопросов авторов (с явными критериями включения и надёжностью между кодировщиками в соответствии с этикой цитирования, изложенной в разделе 9) и полуструктурированные интервью о том, как авторы читают свои счётчики и что они о них чувствуют, охватывая человеческие последствия представления метрик, которые закрытые элементы не могут выявить. Одно ограничение дизайна касается центральной конструкции. Четыре фиксированных вопроса, администрируемых только авторам SSRN, измеряют уровень чтения без контрольной точки, а не контраст, и уровень сам по себе не может идентифицировать заявленный в статье путь от непрозрачности контрольной точки к слепоте метрик. Высокая доля авторов SSRN, никогда не производивших сравнения, одинаково согласуется с общим безразличием к счётчикам, не имеющим никакого отношения к непрозрачности платформы. Дискриминантное и причинное воздействие, следовательно, требуют условия сравнения: тот же инструмент, администрируемый авторам, публикующим на платформах с различной доступностью информации о контрольных точках, arXiv (основанная на одобрении и каталогизации, со своими собственными поверхностями видимости) и OSF Preprints, преобразует "как авторы на SSRN читают свои счётчики" в "читают ли авторы на более и менее непрозрачных платформах свои счётчики по-разному", что является тем контрастом, который утверждение о переходе от непрозрачности к слепоте фактически предсказывает. Кросс-платформенная ветвь предварительно определена как часть исследования 4; без неё результат одной платформы остался бы описательным для SSRN, а не проверкой механизма. Исследование 4 затем прямо проверяет интерпретативные утверждения разделов 1 и 5, измеряя то, во что авторы верят, что означают их счётчики, а не то, что счётчики представляют собой на самом деле.
8.7 Статья как собственный эксперимент
Траектория загрузок этой статьи также предварительно определена. Её показатели будут зафиксированы через 30, 90 и 180 дней после публикации и сравнены с медианой Исследования 1 после того, как эта медиана будет известна. Запись носит описательный характер и не содержит правил интерпретации, поскольку обе возможные интерпретации льстили бы тезису, и аппарат, при котором любой результат подтверждает аргумент, ничего не проверяет; числа будут опубликованы по мере их поступления. Одна интерпретация противоречила бы логике статьи: траектория, находящаяся на медиане области и возраста, ни повышенная, ни подавленная, указывала бы на то, что саморефлексивный дизайн не обеспечивает измеримого преимущества в обнаруживаемости в этом единственном случае. Рефлексивность неизбежна, поскольку эта работа изучает метрику, которую она сама накопит; каталогизированные рычаги оцениваются прямыми тестами в разделе 8, а не этой записью.
8.8 Процентильный бенчмарк как общественное благо
Наиболее полезный артефакт, который может произвести эта повестка, — таблица процентилей для загрузок препринтов, число, которое ищет каждый автор и не может найти. Платформа исторически публиковала средние значения и списки top-N, но не медианы или процентили, а с 15 июля 2026 г. она отображает только подсчеты на статью и на автора без какого-либо сравнительного контекста [149]. Для h-индекса и подобных показателей существует жанр гайдов «хорош ли X?» для массовой аудитории [118][128]; аудит раздела 2.5 не обнаружил эквивалента для загрузок SSRN. Сырые материалы для такой таблицы существуют в печатном виде на протяжении многих лет [18][83][85][139][168], и то, что отсутствует, — это перевод этих распределений в масштаб, ориентированный на автора.
После закрытия внешний сбор полнополномочных процентилей платформы больше невозможен: топ-листы, которые раскрывали пороги распределения, были единственным открытым окном в хвост, и они исчезли [149]. Остаются два дополнительных пути. Один — стратифицированная выборка из Исследования 1, которая дает процентили платформы на уровне статьи. Другой путь — краудсорсированный реестр самоотчетных счетчиков: добровольный набор данных сообщества, в который авторы вносят датированные снимки панели мониторинга (возраст статьи, область, просмотры аннотаций, загрузки), собранные до дальнейшего размытия институциональной памяти о распределениях до закрытия. Этап сохранения протокола досье (таблица 13), если его принять в масштабе, является основой для именно такого реестра. Существует также действующий прецедент расширения, а не изобретения. IRUS (Jisc) уже агрегирует стандартизованную, соответствующую COUNTER статистику использования на уровне элементов, в том числе Total_Item_Requests, по всем участвующим институциональным репозиториям [185], что показывает, что агрегирование использования нескольких учреждений операционно осуществимо. Реестр препринтов — это установленная модель, расширенная для включения переменных справочного класса, которые здесь имеют значение (область, когорта публикации и стадия карьеры). Североамериканский аналог, CC-PLUS, предоставляет такую же функциональность в виде инфраструктуры с открытым исходным кодом, с автоматизированным сбором SUSHI использования COUNTER 5 по консорциумам [188], поэтому реестр может расширить действующую платформу вместо того чтобы быть заказанным с нуля. Реестр такого рода представит собой первое свежее, мультидисциплинарное распределение загрузок со времени выборок середины 2010-х годов [85][139]. Известные недостатки — это самоотбор в сторону вовлеченных и вероятно выше-медианных авторов, непроверяемые самоотчеты, если не требуются датированные снимки экрана, и пробелы в охвате в малых областях. Процентили, полученные из него, должны поэтому публиковаться с явными оговорками по отбору и, где возможно, откалиброваны против вероятностной выборки Исследования 1, а редкие ячейки поле-возраст должны быть представлены под эмпирическим-байесовским сжатием в направлении более широких справочных классов, а не как нестабильные сырые процентили (разделы 5.2, 8.3). Протокол реестра и правила проверки будут опубликованы вместе с материалами предварительной регистрации, и формат вклада определен здесь: запись реестра — это определенное подмножество схемы панели приложения C (домены идентичности, времени, использования, воздействия и аудита), так что самоотчетные записи остаются объединяемыми с панелью Исследования 1, а не накапливаются как несовместимый второй набор данных.
Выходные форматы реестра предварительно определены вместе с его протоколом, и два артефакта обязательны. Один — справочная таблица, которая принимает одно число (скажем, 10, 40 или 100 загрузок) и возвращает для каждой охватываемой области его положение процентиля и простую категорию из таблицы 8; с ней ответ на вопрос «хороши ли 7 загрузок?» можно наконец найти, а не угадать. Другой — график в виде веера процентилей, отображающий кривые загрузок 25-го, 50-го, 75-го и 95-го процентилей как функции возраста статьи, по областям и слоям новичков: формат, в котором бенчмарк отвечает на вопрос «сколько нормально на день X» (рисунок 14; [требуется данные]: ни один артефакт не может быть заполнен синтетическими значениями). Каждый выпуск процентилей из любого маршрута (вероятностная выборка или реестр) публикуется в соответствии со спецификацией прозрачности приложения D, включая его правила конфиденциальности минимальной ячейки, так что бенчмарк, предложенный этой повесткой, не воспроизводит непрозрачность, которую он был предназначен устранять. На данными располагается тонкий слой самообслуживания — общедоступный онлайн-калькулятор, в который автор вводит область, возраст статьи и счетчики и получает полосу процентилей и устный вердикт. Это превратит некалиброванные эвристики в стиле табеля из раздела 6.3 в откалиброванный инструмент один раз и только один раз, когда справочные распределения существуют. Раздел 8.10 предлагает многомодельную архитектуру, через которую такой сервис может работать и оставаться актуальным. Этот же слой самообслуживания предотвращает возложение протоколом отчетности новой нагрузки на комитеты по найму и присуждению тенуре, поскольку нормализация по числам, которую просит формат досье (таблица 13), выполняется калькулятором (в данном разделе) и, в масштабе, слоем оркестровки (раздел 8.10). Его реалистичный путь развертывания проходит через существующую исследовательскую информационную инфраструктуру, а именно текущие системы исследовательской информации (CRIS) и профили, связанные с ORCID, так что откалиброванное прочтение может быть получено из идентификаторов статьи, а не собрано вручную. Одним естественным кроссплатформенным расширением является протокол параллельного депозита, сравнивающий траекторию одной и той же статьи на SSRN, arXiv (где это уместно по области) и OSF Preprints — прямой тест того, передаются ли полосы таблицы 8 между архитектурами push и pull (таблица 6).
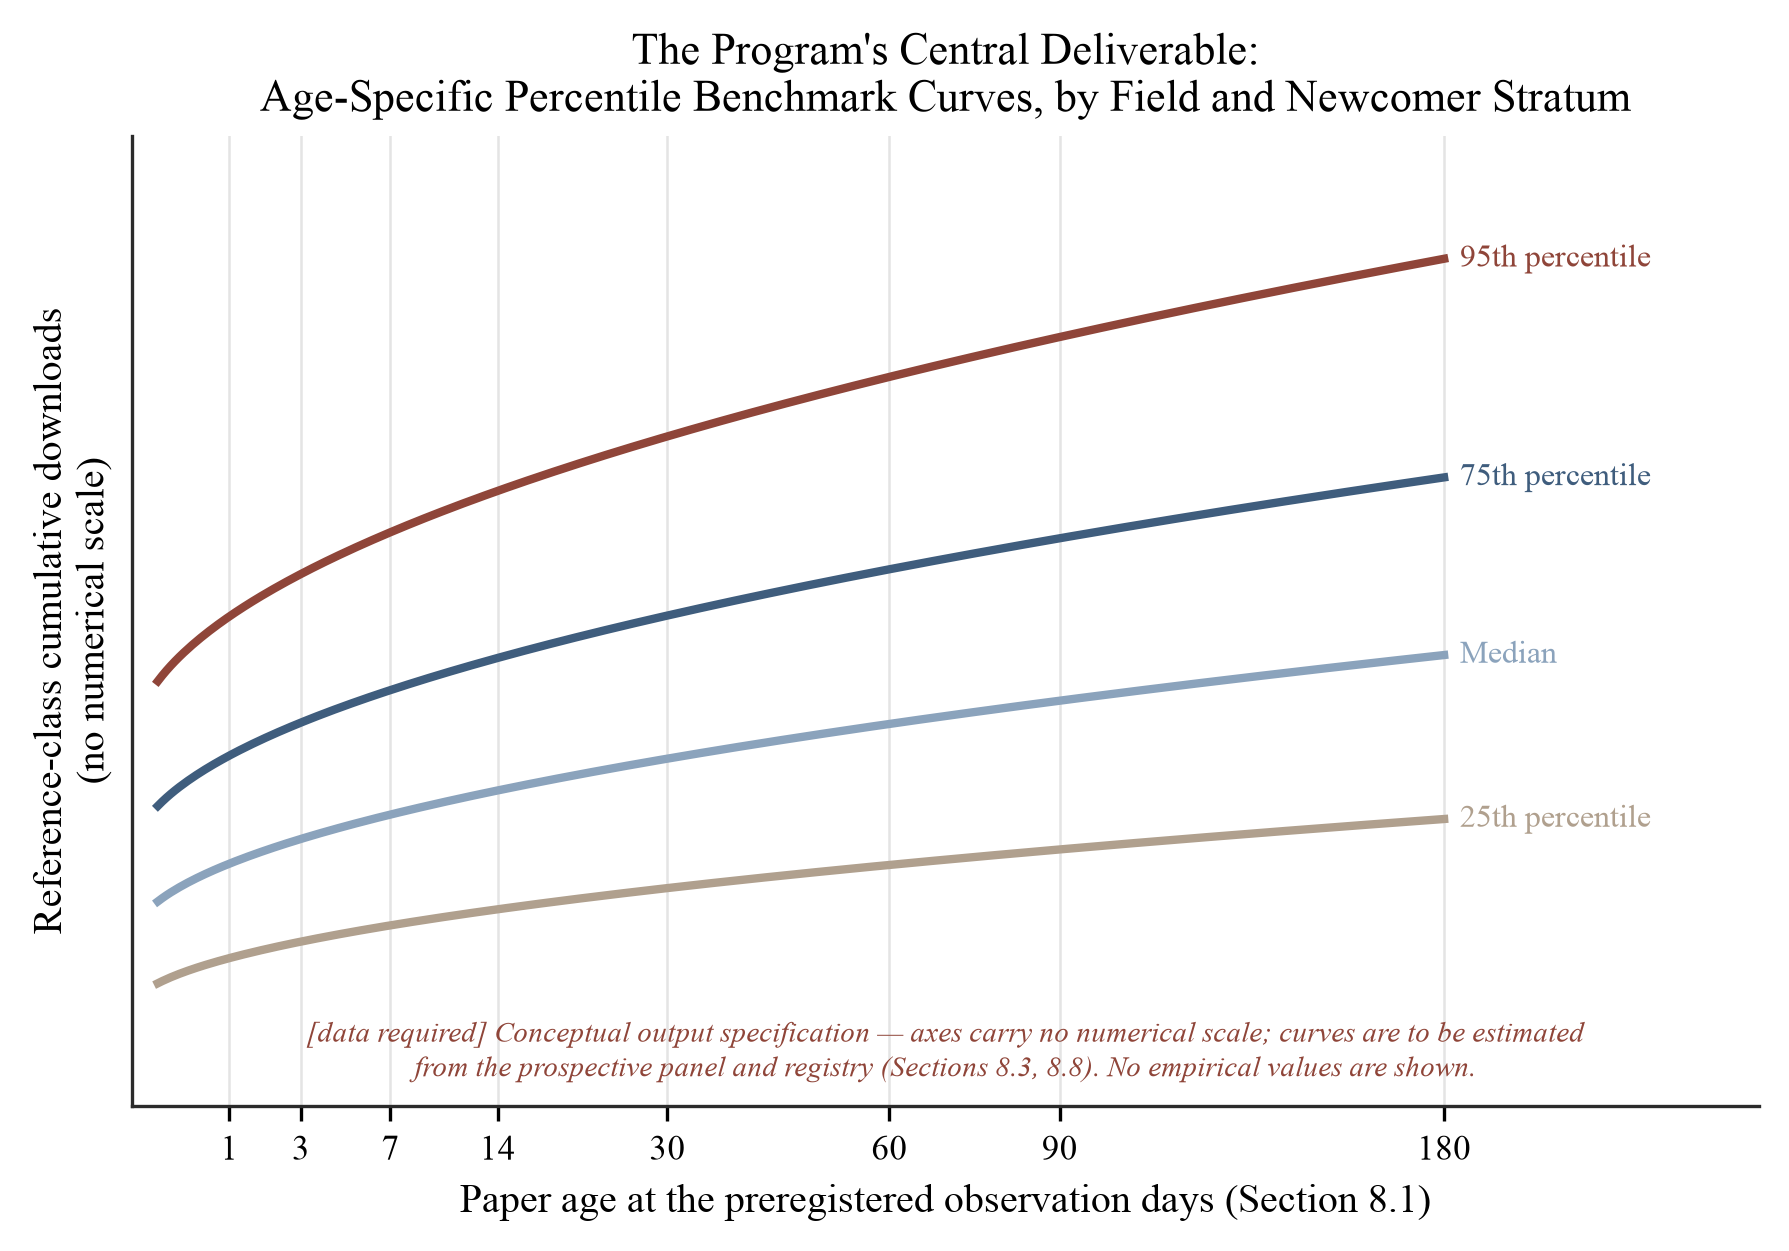
Рисунок 14. Веер бенчмарков по возрасту: центральный результат программы. Кривые загрузок процентилей (25-й, 50-й, 75-й и 95-й) как функции возраста статьи, оцениваемые в предварительно указанные дни наблюдения из раздела 8.1 и подлежащие оценке по областям и слоям новичков из выборки Исследования 1 и реестра сообщества. Оси не содержат численной шкалы; рисунок является спецификацией концептуального выхода, и это формат отображения, лежащий в основе как рекомендации платформы из раздела 10.4, так и общедоступного калькулятора, описанного выше.
Каждая эмпирическая статья программы обязывается придерживаться минимального набора отчётности: диаграмма потока когорты; сырые и нормализованные распределения рядом; охват и конверсия указаны отдельно; истории воздействия; результаты анализа чувствительности к аномалиям на четырёхслойной лестнице раздела 8.3; нулевые и противоположные результаты представлены с той же значимостью, что и подтверждения; и машиночитаемую таблицу эталона, условие, при котором выход Study 1 может фактически питать общедоступный калькулятор, описанный выше. Аннотации статей программы отличают верифицированные оценки от предварительно установленных ожиданий.
8.9 Предиктивная валидация
Суммативный тест повестки дня (RQ3) ставит вопрос, оправданна ли сложность нормализации. Раннее использование и последующие цитирования позитивно, но несовершенно связаны в разных условиях: корреляции порядка 0,11–0,35 в анализах Грэнджера на уровне журнала [80], примерно 0,4 в ранних когортах arXiv, где r ≈ 0,4 объясняет только около 16% дисперсии [25], с сравнимыми ассоциациями, о которых сообщается для препринтов по химии два десятилетия назад [26], для загрузок на уровне журналов и статей в целом [71], в данных об использовании RePEc [31], и в когортах bioRxiv [62], и умеренные ранговые корреляции в использовании мега-журналов [102]. Наиболее скачиваемые и наиболее цитируемые наборы перекрываются только частично [108][39]. Недавние панельные данные связывают доступ с последующими цитированиями с задержкой: в одной семи-журнальной панели ассоциация была приблизительно единично-эластичной, с увеличением доступа на 10%, связанным примерно с увеличением цитирований на 10% примерно через девять месяцев [178]. В обозначениях раздела 5.5 суммативное сравнение оценивает
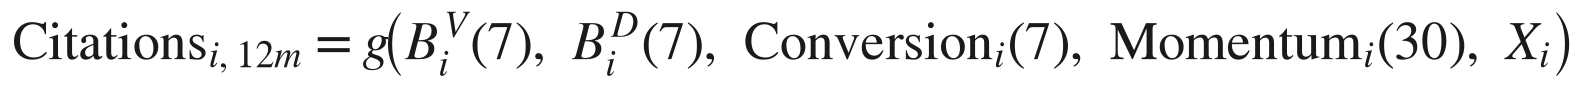
где g подбирается гибко и оценивается только вне выборки. Уравнение определяет, какие нормализованные входные данные конкурируют с сырыми подсчётами. Модели, предсказывающие 6-, 12- и 18-месячные цитирования из нормализованных по возрасту, области и когорте метрик дня 7 и дня 30, должны сравниваться вне выборки (по кросс-валидированной вероятности, калибровке, ранговой корреляции и ошибке предсказания) с моделями, использующими только сырые кумулятивные загрузки, проблема политики предсказания в смысле Kleinberg et al. [88]. Особенно информативным результатом было бы, если бы сырые подсчёты благоприятствовали известным авторам, в то время как нормализованные меры холодного старта лучше предсказывали последующий рост цитирований. Такой паттерн означал бы, что часть того, что измеряют сырые ранние счётчики, это начальная возможность, а не последующий интеллектуальный спрос. Если нормализация не добавляет предиктивную информацию, утверждение о измерении в этой системе отклоняется или сужается соответственно.
Рисунок 15 объединяет повестку дня. Одна проспективная когорта питает четыре исследования и два квази-эксперимента платформы параллельно, и каждый модуль поступает в один и тот же набор версионированных открытых выходов. Эта общая структура делает повестку дня исследовательской программой.
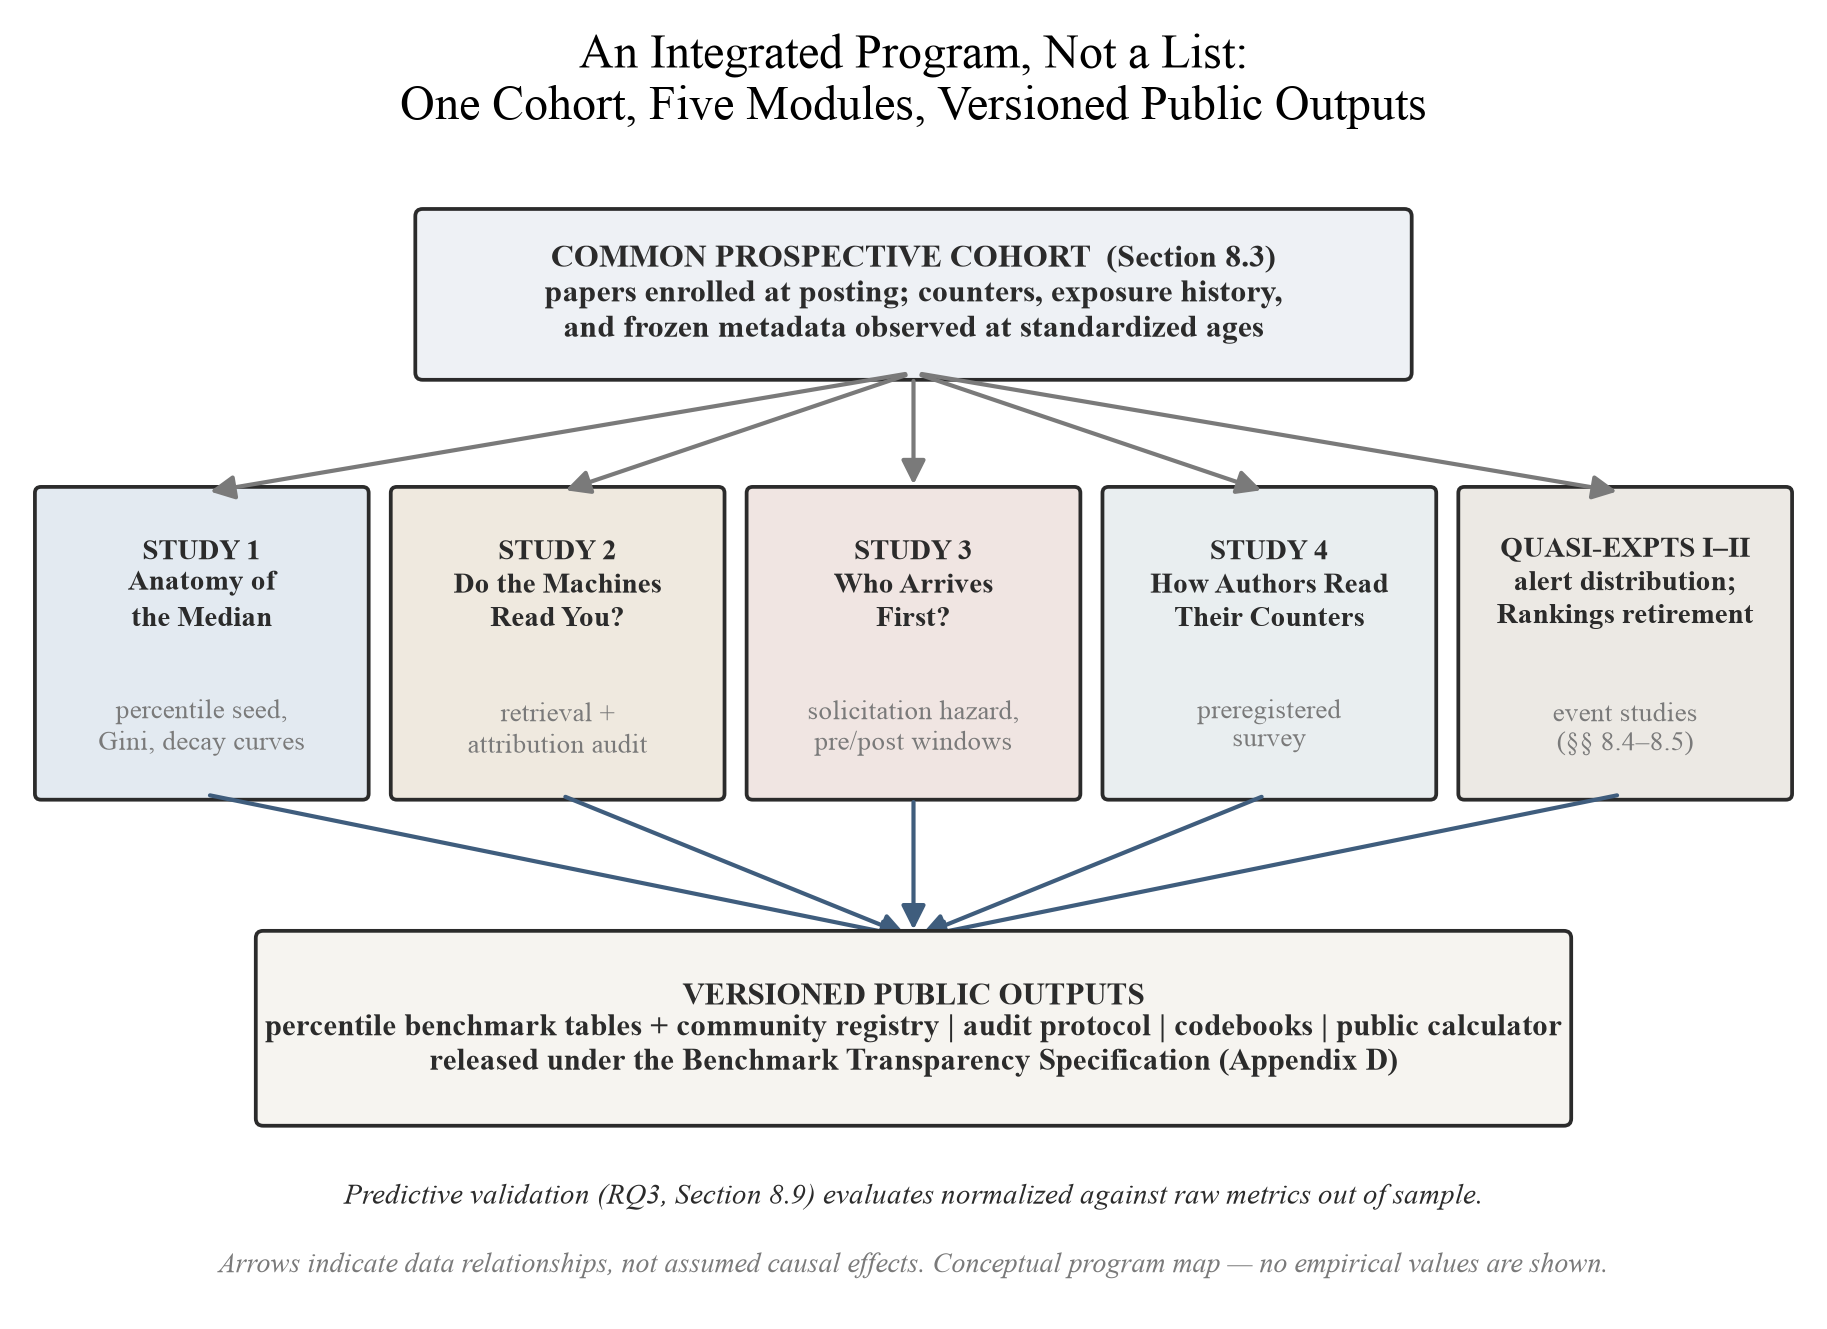
Рисунок 15. Интегрированная исследовательская программа. Одна проспективная когорта (раздел 8.3) питает четыре исследования (раздел 8.6) и два квази-эксперимента платформы (разделы 8.4–8.5); все модули поступают в версионированные открытые выходы — таблицы процентильных эталонов и реестр сообщества (раздел 8.8), протокол аудита, справочники кодирования и открытый калькулятор — выпущены под Спецификацией прозрачности эталонов приложения D, в то время как предиктивная валидация (раздел 8.9) оценивает полученный эталон вне выборки. Стрелки указывают на отношения данных, а не на предполагаемые причинно-следственные связи.
8.10 Проектное предложение: оркестрированные граничные модели как слой доставки эталона
Разовая публикация не может обеспечить то, что требуют результаты повестки дня. Таблицы процентилей, реестр сообщества, формат отчётности CSAB (раздел 5.5; приложение B) и общедоступный калькулятор (раздел 8.8) должны быть собраны из разрозненных и устаревающих источников, проверены заявка за заявкой, поддерживаться в актуальном состоянии по мере изменения правил подсчёта и функций платформы и доставлены отдельным авторам на откалиброванном языке. Кандидатная архитектура для этого слоя доставки и обслуживания — это оркестрированный конвейер специализированных граничных моделей AI (класс системы, разрабатываемой автором; см. Конфликт интересов). Всё в этом подразделе является проектным предложением. Никакая реализация не существует, никакие эмпирические характеристики не заявляются, и никакие цифры точности, стоимости или сэкономленного времени не приводятся ниже.
Одна альтернатива оркестрированной системе — это единая универсальная модель. Автор, который спрашивает потребительский чатбот «7 загрузок — это хорошо?», получает беглое неверифицируемое утверждение — режим отказа, который документируют аудиты механизма ответов, в котором системы допускают ошибки с неоправданной уверенностью вместо того, чтобы отказаться ответить [82]. Под этим кроется структурная проблема. Интерпретация метрики разбивается на подзадачи с разными, отчасти конфликтующими целями. Получение и датирование доказательств, проверка счётчика на нечеловеческий или аномальный трафик, нормализация проверенного счёта по отношению к эталонному классу возраста, области, когорты и предыдущей видимости, перевод нормализованной позиции в полосчатый язык и оспаривание этого перевода перед выпуском — это не одна и та же задача, и компонент, оптимизированный для одного, является плохим судьёй для другого. Модель, которая составляет успокаивающее чтение, не должна быть единственным авторитетом для определения того, загрязнено ли базовое число, и модель, которая составляет язык досье, не должна удостоверять, что язык избегает преувеличений. Организующий принцип, таким образом, — разделение эпистемического труда: генерация и верификация назначаются отдельным компонентам с независимыми целями, и несогласие сохраняется и сообщается, а не усредняется. Сходимость независимо инициируемых или архитектурно различных оценивателей не является истиной, однако это более прочная основа для чтения, чем просто беглость одной модели, интуиция дизайна, соответствующая экспериментальным доказательствам того, что многоагентные дебаты между экземплярами языковых моделей измеримо улучшают фактическую точность и снижают галлюцинации по сравнению с одной моделью, отвечающей самостоятельно [43]. Там, где оцениватели расходятся, расхождение само по себе является диагностической информацией, так же как противоречивые источники рассматривались как сигнал, а не шум в собственных правилах синтеза этой статьи (Область и дисциплина доказательств). Два предостережения в дизайне умеряют эту интуицию. Согласие между компонентами само по себе не является доказательством: оно может возникнуть из общих данных обучения, общих результатов поиска, общих допущений о подсказке или загрязнения через сам оркестратор. Семейства моделей, полученные от разных поставщиков, не являются научно независимыми, и независимость должна быть спроектирована через отдельные инструкции, ограниченный информационный поток между компонентами, сохранённые промежуточные результаты и оценку по сравнению с доказательствами, которые генерирующий компонент не имеет права редактировать. Верификация также не становится надёжной только потому, что её выполняет вторая модель: заявления, которые оспариваются или являются важными, требуют проверки базового источника человеком-пользователем.
На рисунке 16 показан предложенный конвейер, а таблица 21 разбивает его по функциям. Обработка начинается с замороженного файла дела, а не свободной подсказки: счётчики с датами наблюдения, возраст статьи, заявленной области и кандидатных когорт для сравнения, историей воздействия и фактическим вопросом автора. Отсутствующие входные данные остаются отсутствующими, и система не может создавать отсутствующее распределение процентилей, восстанавливать знаменатель или принимать сгенерированное моделью число вместо наблюдаемого. Информационный поток затем воспроизводит интерпретационную последовательность, которую статья защищает на протяжении всего времени: сырые счётчики → проверка целостности → нормализация по эталонному классу → интерпретация при ограничениях. Компонент мониторинга извлекает счётчики, документы платформы и записи реестра с датированным происхождением, так чтобы каждое значение в нижнем потоке можно было отследить до архивированного источника. Каждый фактический выход передаётся между компонентами как запись в реестре заявок. Каждая запись регистрирует заявку, её подтверждающий источник или поле данных, стабильный локатор, время извлечения, любое применённое преобразование, её эталонный класс и состояние верификации, чтобы неподдерживаемый выход не мог бесшумно стать предпосылкой более позднего этапа. Проверка целостности применяет обычное обнаружение аномалий временных рядов (задача для статистических методов, а не для генерации свободного текста) с учётом задокументированной фильтрации ботов и загрязнения от AI-краулеров [129][144]. Она приписывает разрывы траектории датированным событиям воздействия, когда это позволяет запись о воздействии (раздел 5.6). Нормализация выполняется детерминированным статистическим кодом, вызываемым как инструмент: позиции процентилей вычисляются относительно версионированных таблиц исследования 1 и реестра в соответствии с правилами сжатия раздела 8.3. Арифметика процентилей никогда не делегируется генерации свободного текста. Только тогда интерпретирующая модель составляет ориентированное на автора чтение, ограниченное полосчатым языком таблицы 8, диагностикой охвата-против-конверсии таблицы 9 и шаблоном CSAB приложения B, с источником, годом выпуска и уровнем уверенности, прикреплённым к каждому числу. Отдельный верификатор и критик проверяют каждую заявку по отношению к её зафиксированному доказательству перед выпуском, сообщая каждую как проверённую, оспариваемую, неподдерживаемую или неоценяемую — четыре отдельных состояния, которые никогда не сжимаются в единую синтетическую оценку уверенности. Два ограничения переносятся из фреймворка без изменений. Любая рекомендация обусловлена диагностированным узким местом, поскольку статьи с ограничением охвата и статьи с ограничением конверсии требуют различных действий (таблица 9), и система, которая не может их различить, должна молчать вместо того, чтобы издавать универсальные советы. Другое ограничение состоит в том, что выпущенная рекомендация является гипотезой: она предсказывает, какой механизм должен измениться, если диагноз верен, и последующие наблюдения проверяют это предсказание. Целевая функция системы соответственно узка: устранить идентифицируемое интерпретационное трение между статьёй и её надлежащим эталонным классом и никогда не максимизировать никакие счётчики — граница, установленная политикой целостности платформы и политикой генеративного AI [54][144] и историей манипуляций раздела 3 [44].
Таблица 21. Функциональная декомпозиция предложенного слоя оркестрации: функция, тип компонента, основной режим отказа и механизм независимой верификации. Каждая строка — гипотеза о жизнеспособном разделении труда.
| Функция | Модель или тип компонента | Основной режим отказа | Механизм независимой верификации |
|---|---|---|---|
| Оркестрация и происхождение | Маршрутизатор задач, ведущий замороженный файл дела и реестр претензий | Раннее неподтвержденное предположение распространяется как посылка каждого последующего этапа | Ни один непроверенный результат не может стать доверенной посылкой; источник, трансформация, время получения и неопределённость сохраняются при каждой передаче |
| Сбор доказательств и мониторинг | Модель получения данных с использованием инструментов на расписании повторных прогонов; библиографическое сопоставление с инфраструктурой открытых цитирований [35][124] | Сфабрикованные, неправильно подобранные или выборочно полученные источники | Датированный журнал происхождения; каждое значение восстанавливаемо по архивному снимку; случайная подвыборка независимо повторно загружена вторым компонентом; неудачные поиски и противоречащие результаты записаны, не отброшены |
| Проверка целостности | Обнаружение аномалий во временных рядах без генерации [129][144] | Скачок, помеченный как «бот» — или «читатель» — без доказательств ни для одной из этих идентификаций | Флаги аномалий опубликованы вместе с агрегатами (раздел 8.8); чувствительность сообщена на четырехуровневой лестнице надёжности раздела 8.3; аномалия рассматривается как флаг, никогда как утверждение идентичности |
| Нормализация по классу ссылок | Детерминированный статистический код, используемый как инструмент | Удобные однопорядковые объекты, ошибочно принятые за действительную совокупность для сравнения | Пересчет по сверсионированным открытым таблицам эталонных показателей (приложение D); область, возраст, когорта, прежняя видимость и дата источника указаны, или модуль воздерживается; свободный арифметический расчет не принимается в запись |
| Разработка интерпретации | Языковая модель общего назначения, ограниченная языком полосы таблицы 8 и шаблоном CSAB (приложение B) | Убедительное преувеличение — уверенность, масштаб или причинный статус сверх того, что позволяют доказательства | Проверка на уровне утверждения отдельным верификатором по сравнению с записанными доказательствами; каждое утверждение сообщается как проверенное, оспариваемое, неподтвержденное или не подлежащее оценке; неподтвержденные предложения отклонены, не смягчены |
| Состязательная критика | Модель критика с целями, противоречащими целям составителя | Ритуальная критика или синтетический консенсус, скрывающий существенное несогласие | Структурированный отчет о разногласии — статус доказательств, закономерность оценок, чувствительность решения (изменяет ли спор диагноз или только его формулировку), остаточная неопределённость — представлено раздельно, никогда не сведено в один показатель уверенности |
| Сортировка запросов | Специализированный классификатор по кодовой схеме таблиц 14–15 | Категорический вердикт «хищнический», превышающий доказательства и грозящий репутационным ущербом | Только флаг и пересмотр, никогда не автоматическое удаление и никогда не опубликованное обвинение; показатели ошибок, сообщенные на помеченных наборах; документированные ограничения и предубеждения классификации текста ИИ признаны [157][97] |
| Поддержание эталонных показателей | Запланированная оркестрация всех компонентов | Тихий дрейф: устаревшие источники или выпуски перезаписанные без следа | Сверсионированные, датированные выпуски в соответствии с приложением D; пересмотры записаны, никогда не перезаписываются молча — живая карта эталонных показателей, а не статичный снимок |
| Окончательная интерпретация и использование в целях карьеры | Автор-человек | Смещение в сторону автоматизации и рассредоточение ответственности | Обязательное человеческое утверждение перед любым внешним использованием; язык досье следует протоколу таблицы 13 с указанными источником, временным окном и ограничениями |
Две границы завершают спецификацию. Одна из них — граница разрешений: доступ только для чтения является вариантом по умолчанию, и слой готовит проекты, но никогда их не выполняет. Он не может самостоятельно редактировать рукопись, изменять метаданные платформы, связываться с учёными или площадками, публиковать открыто или удалять сообщения с просьбами, и любой реализованный рабочий процесс должен сохранять ответственность человека и обязательства по раскрытию информации применимой платформы и политики подачи [54][56][144]. Другая — граница воздержания: нулевой результат является законным (часто правильным) результатом, и каждый этап может остановиться, а не передать дефектный ввод дальше. Обязательные триггеры воздержания включают отсутствующий или неоправданный класс ссылок; непроверяемый источник, центральный для интерпретации; неразрешённое разногласие о том, сохраняет ли предложенная формулировка утверждения статьи; любой запрос на причинный вывод из чисто описательного паттерна или на прогноз цитирований или результатов карьеры без проверенного набора данных прогноза (раздел 8.9); и любой запрос на манипуляцию, покупку, имитацию или иное завышение внимания. Этот последний триггер предотвращает превращение слоя в инструмент манипулирования метриками, чья история документирована в разделе 3 [44][69][144]. Последнее разделение управляет двумя потоками доказательств в этой повестке дня. Сверсионированные таблицы процентилей разделов 8.6 и 8.8 являются единственным допустимым источником нормализации слоя, в то время как аудит видимости машины исследования 2 питает отдельную проверку получения и атрибуции. Получение машиной не является процентилем внимания человека, и слой не может смешивать эти два.
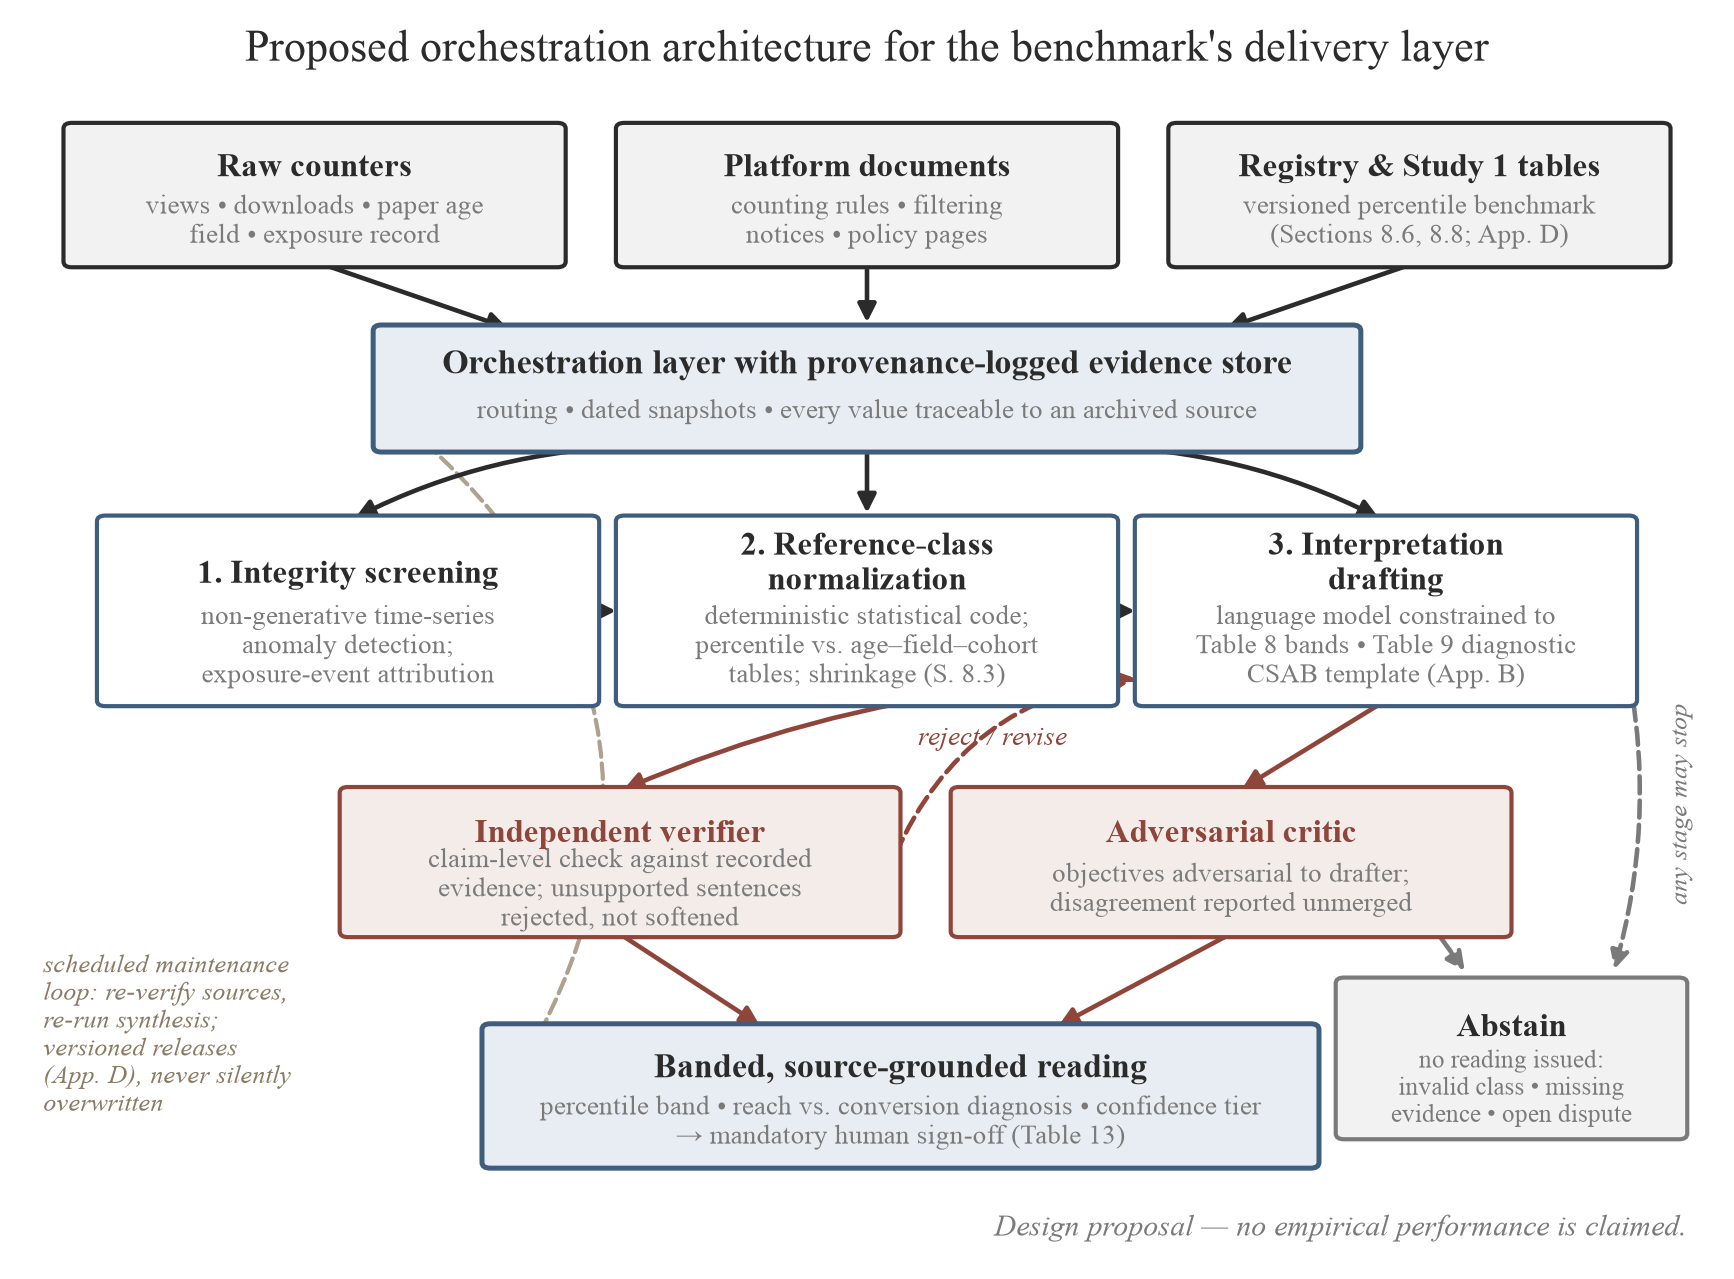
Рисунок 16. Предложенная архитектура оркестрации для слоя доставки эталонных показателей (раздел 8.10; таблица 21). Специализированные компоненты отделяют сбор доказательств, проверку целостности, нормализацию и интерпретацию, с независимой верификацией, встроенной между генерацией и выпуском, путём воздержания, доступным на каждом этапе, и запланированным циклом, поддерживающим сверсионированные эталонные показатели раздела 8.8.
Одна и та же дисциплина ограничивает, что может делать слой после постановки диагноза. Таблица 22 устанавливает политику действий: каждый наблюдаемый паттерн (охват и конверсия, читаемые совместно с импульсом, в словаре таблиц 9–10) соответствует предварительному диагнозу, ограниченной форме допустимой помощи, механистическому тесту, который может подтвердить или ослабить диагноз, и выводу или действию, которое остается запрещено. Столбец механистического теста операционализирует указанное выше правило, согласно которому выпущенная рекомендация является гипотезой. Если исправление классификации должно устранить узкое место охвата, то результатом, который имеет значение, является скорректированный по возрасту охват, и ретроспективный рассказ об общем количестве загрузок не может его заменить. Неудачное предсказание записывается как неудачное вмешательство и возвращается в диагноз, никогда не переоценивается в сравнении с более льстивой мерой успеха. Полная последовательность таким образом замыкается в цикл: измерение → валидация → нормализация → диагноз → предложение → критика и проверка → решение → наблюдение → обновление или остановка (Figure 17). В этом цикле человеческое решение находится между проверкой и любым действием, наблюдения после принятия решения возвращаются в файл дела, и путь воздержания прерывает цикл всякий раз, когда доказательства недостаточны. Цикл также контролирует сложность: когда доказательства поддерживают только сохранение и мониторинг, или когда детерминированное правило из авторского справочника (Section 6) уже отвечает на вопрос, оркестровка не добавляет ничего и не должна запускаться.
Таблица 22. Политика диагноз-действие для предложенного слоя оркестровки. Паттерны читаются в рамках защищаемого опорного класса в соответствии с соглашениями о процентилях в таблице 9; каждая строка — это гипотеза политики, и ни одна ячейка не утверждает эмпирическую частоту.
| Наблюдаемый паттерн (охват, конверсия, импульс) | Предварительный диагноз | Допустимая помощь | Механистический тест | Запрещённый вывод или действие |
|---|---|---|---|---|
| Низкий охват, высокая конверсия, стабильная или растущая | Узкое место обнаруживаемости более согласуется с паттерном, чем узкое место восприятия рукописи («скрытый интерес», таблица 9) | Проверить идентификаторы, классификации, метаданные, индексирование и обнаруживаемость названия; ограниченное, действительно релевантное распределение | После изменения метаданных или классификации растёт ли охват, пока конверсия остаётся прежней? | Переписание хорошо работающей аннотации только для того, чтобы сделать её более рекламной |
| Высокий охват, низкая конверсия, стабильная или падающая | Несоответствие коммуникации, несоответствие аудитории и воздействие с низким намерением — конкурирующие объяснения («внимание без восприятия») | Проверить согласованность названия и аннотации, ясность области и соответствие аудитории; только альтернативы, сохраняющие утверждение | Изменяется ли конверсия при сравнимом воздействии с проверкой верности при каждом пересмотре? | Увеличение бездумной промоции; вывод о том, что читатели отвергли науку |
| Низкий охват, низкая конверсия | Недостаточно идентифицировано: слабое воздействие, неправильный опорный класс, отказ метаданных, коммуникационное трение или спрос в нишевом сегменте подходят («холодный запуск») | Сначала проверьте опорный класс и запись об воздействии; затем отдельно проверьте метаданные и коммуникацию | Изменяйте один измеримый механизм за раз; сохраняйте нулевой результат | Вывод о низком качестве из низкого использования; возврат однопричинного вердикта |
| Высокий охват, высокая конверсия, растущая | Сильная ранняя диффузия относительно указанного класса | Сохранить происхождение; мониторить на фиксированных возрастах; ничего не менять без причины | Сохраняется ли паттерн после события воздействия и при чувствительности к аномалиям? | Создание дальнейшего усиления; отношение к вниманию как к доказательству качества |
| Высокий охват, высокая конверсия, резко снижающиеся приросты | Событийное внимание, обычный спад или насыщение (Section 5.6) | Определить событие воздействия; сравнить приросты интервалов, а не кумулятивные суммы | Отличается ли спад от возрастно-сопоставленных траекторий, обусловленных событием? | Признание снижающихся приростов научным провалом — кумулятивные подсчёты почти всегда выравниваются по темпам |
| Низкий охват, высокая конверсия, падающие приросты | Интерес может быть реальным, хотя постоянное распространение остаётся слабым | Проверить, закончилось ли распределение или индексирование; определить ограниченные, релевантные каналы | Повысит ли восстановленное воздействие охват без ухудшения конверсии? | Расширение утверждений или удаление технической специфичности в погоне за более широкой аудиторией |
| Высокий охват, низкая конверсия, растущее воздействие | Прибытие растёт без пропорционального увеличения полнотекстового восприятия | Проверить трафик с низким намерением (Section 4.2), несоответствие аудитории и ясность представления | Реагирует ли конверсия на изменение представления, сохраняющее исходное утверждение, при сравнимом воздействии? | Оптимизация только верхушки воронки; подсчёт каждого просмотра как человеческого читателя |
| Любой паттерн с переформулированным счётчиком, необъяснённым скачком, недействительной когортой или отсутствующим знаменателем | Метрика в настоящее время не интерпретируется на желаемом уровне | Сохранить снимки; запустить анализы чувствительности; сузить утверждение; воздержаться | Выживает ли чтение исключением оспариваемого интервала или лучшего опорного класса? | Обозначение трафика как человеческого или автоматизированного без доказательств; вывод процентиля из сфабрикованного знаменателя |
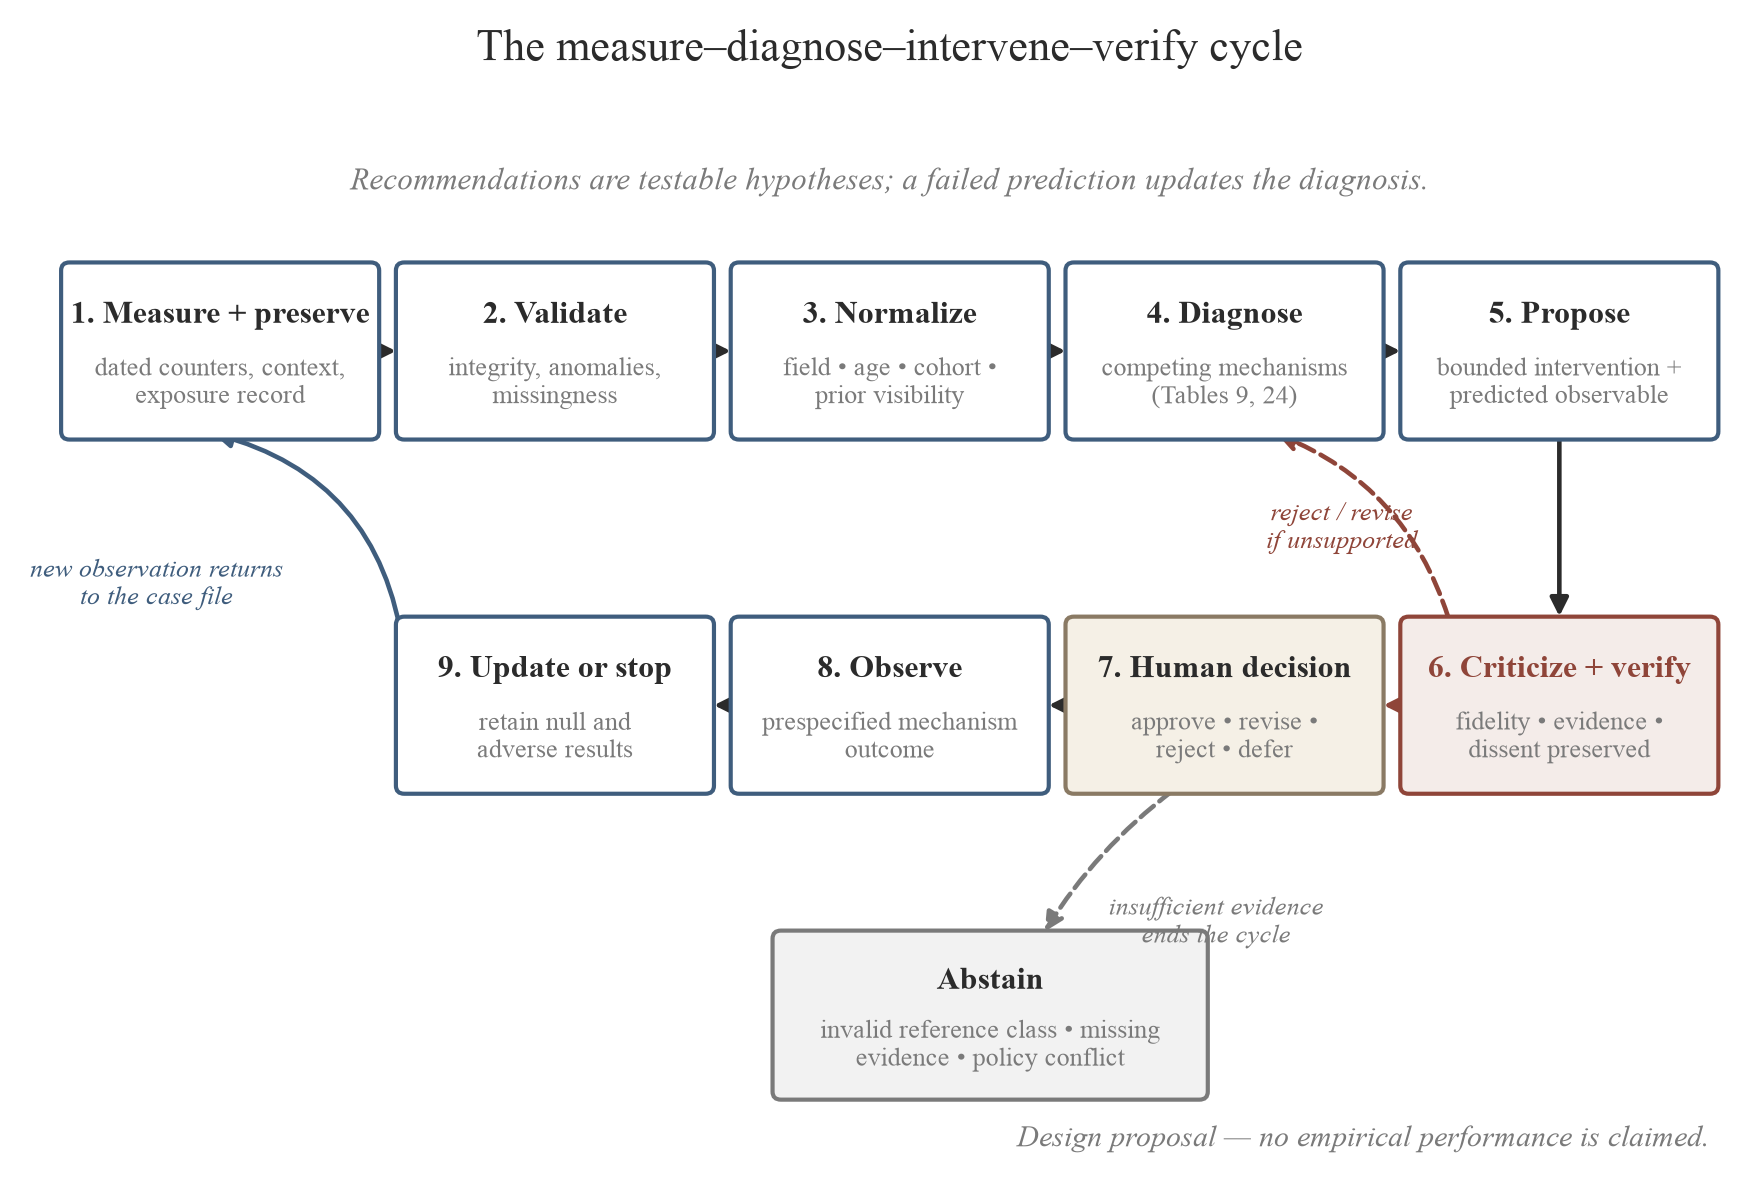
Рисунок 17. Цикл измерение–диагноз–вмешательство–проверка (Section 8.10; таблица 22). Рекомендации покидают цикл только как проверяемые гипотезы: каждая называет механизм, который она предназначена перемещать, и последующее наблюдение, которое может подтвердить или ослабить диагноз. Неудачные предсказания возвращаются в диагноз и остаются в записи аудита; человеческое решение находится между проверкой и любым действием; и путь воздержания заканчивает цикл всякий раз, когда не существует защищаемого опорного класса или достаточных доказательств. Цикл оптимизирует интерпретацию, сохраняющую доказательства, а не сырое внимание.
Четыре ограничения определяют границы предложения. Генерация — это не восстановление. Ни одна модель, как бы она ни была организована, не может восстановить процентильные распределения, которые перестали быть наблюдаемы, когда были удалены топ-листы [149], и слой может сохранять только приближение с сохраненными оговорками о консервативном минимуме из раздела 5. Также оркестровка не может идентифицировать загрузчика, отличить человеческий трафик от автоматизированного только по счетчикам (раздел 4.2), преобразовать объем запросов в свидетельство о прочитанности (раздел 7.6), сделать коррелированные выходы модели независимыми путем переименования их в "агенты", заменить суждение коллег или передать ответственность от исследователя к рабочему процессу. Сам оркестратор нуждается в аудиторе. Развернутый слой интерпретации становится новым привратником в стеке, который отображает эта статья (рисунок 12), и он не должен унаследовать непрозрачность, которую был призван исправлять: следы рассуждений и логи происхождения должны быть открыты для проверки, и собственное поведение слоя при извлечении и интерпретации должно проверяться с дисциплиной Исследования 2 (снимки с временными метками плюс протокол автоматизированной репликации), поскольку нестационарность модели делает каждый выход датированной оценкой, но не долговечным значением. Стоимость и справедливость. Эксплуатация такого конвейера не бесплатна, и платный слой интерпретации исключал бы авторов с ограниченными ресурсами и без аффилиации, на которых сосредоточена эта система. Известные предубеждения классификаторов текстов на основе ИИ против авторов, для которых английский не является родным языком [97], без смягчения делали бы то же самое. Ложная точность — это остаточный риск. Слой, который выдает вердикты с полосами без уровней доверия, автоматизировал бы именно неправильную калибровку, диагностированную в разделе 3: подсчет без сравнительной шкалы заменен вердиктом без связанной с ним неопределенности. Архитектура сама по себе является фальсифицируемым объектом и принадлежит повестке дня на этих условиях, оцениваемая в сравнении с более простой помощью, а не выведена из сложности ее диаграммы. Надлежащий дизайн должен быть ступенчатым. Пакеты реалистичных случаев с внедренными неоднозначностями (неверные ссылки, противоположные переформулировки, неоправданные когорты, подлинно пограничные запросы) рандомизируются по условиям, которые добавляют один ингредиент за раз: ручной протокол таблиц этой статьи (корректная базовая линия, поскольку метод без ИИ уже существует), одна универсальная модель, та же модель с извлечением и детерминированным расчетом, генерация плюс независимая критика и полный управляемый конвейер. Абляции, которые удаляют верификатор, детерминированный калькулятор, видимость разногласия или человеческий вход, затем определяют, какой ингредиент управления оправдывает свои затраты. Результаты оцениваются отдельно, никогда не как один составной показатель: верность утверждений и цитирований; достоверность референтного класса; калибровка авторских убеждений (инструмент Исследования 4) и надлежащее воздержание в неоднозначных случаях; время исследователя и бремя надзора; сбои управления (автономные внешние действия, совет по манипуляции метриками, категоричные обвинения конкретных площадок); и, центральный для аргумента холодного старта этой статьи, неоднородность выгоды по предшествующей видимости автора и статусу новичка, поскольку слой, который в основном помогает уже видимым авторам, воспроизвел бы неравенство, которое был предназначен для сокращения. Нулевые и неблагоприятные результаты справедливости — это сообщаемые результаты. Версии модели, подсказки, разрешения инструмента и снимки источника архивируются, потому что в нестационарной системе каждый результат является датированной оценкой. Две оцениваемые величины остаются отдельными на протяжении всего: влияние на качество интерпретации и влияние на последующее распространение. Слой, который улучшает диагностику без изменения загрузок, является успехом, в то время как один, который повышает загрузки при искажении утверждений, является сбоем управления. Дизайн не работает, если управляемый конвейер не превосходит сильную единую модель по точности свидетельств и калибровке: "несколько моделей" не является вкладом, и гипотеза, проверяемая здесь, заключается в разделении эпистемического труда. Предложение определяет проверяемую роль для интерпретации с помощью ИИ. ИИ может помочь автору задать лучший вопрос к числу; только проверенные свидетельства могут ответить на него.
9. Ограничения
Утверждения этой статьи ограничены приведенными ниже ограничениями, каждое из которых прикреплено к артефакту, который оно ограничивает.
Старение и состав доказательственной базы. Старые якоря распределения в карте контрольных точек (таблица 7) основаны на образцах, собранных между 2012 и 2015 годами и в которых доминирует правовая наука [85][139]; единственная недавняя запись — это снимок одной сети, рассмотренный ниже [83]. Полосы шкалы интерпретации (таблица 8) лучше всего читаются как мягкие, а не консервативные абсолютные полосы для 2026 года (раздел 5.1). Ежегодный объем загрузок по всей платформе вырос в разы между серединой 2010-х и 2020-х годами [1][143], повышая темп потока загрузок на статью и делая фиксированный старый порог более мягкой планкой сегодня, чем когда это было оценено. Никакая мультипликативная коррекция не может исправить это, поскольку рост одновременно изменяет числитель, знаменатель и состав (раздел 3.2). Полосы таблицы 8 — это приблизительные значения, полученные из совокупной арифметики, а не перешкалированные нормы. Ни одного исследования распределения по всей платформе после 2020 года загрузок SSRN не было выявлено.
Современные доказательства из одного источника. Единственное недавнее распределительное свидетельство, использованное здесь, — это один опубликованный снимок одной дисциплинарной сети: 2 361 статья по маркетингу, наблюдаемая 15 августа 2025 года [83]. Это демонстрирует перекос и условную премию престижа, но это не устанавливает контрольные точки по всей платформе, и два внутренних значения его опубликованной таблицы воспроизводятся "как опубликовано" с предостерегающей примечанием. Обобщения из этого источника к другим сетям SSRN являются экстраполяциями. Приложение E уменьшает эту зависимость путем добавления независимого архивного поперечного сечения по всем областям (n = 1 360), которое воспроизводит перекос, разрыв между средним и медианой, полосу преобразования, множитель поля и логнормальность на наблюдаемом теле. Оно имеет собственное смещение отбора в сторону увеличения и подтверждает форму распределения во всех дисциплинах. Программа раздела 8 по-прежнему нацелена на репрезентативную для платформы контрольную точку.
Предвзятость топ-листа. Подгонка большой выборки 2015 года охватывает только топ-листы (примерно верхний дециль авторов и их статей [85]), поэтому тело распределения ниже элитных списков выводится из подогнанного логнормального распределения, а не наблюдается. Процентильные утверждения, полученные из этой подгонки, основаны на модели.
Семантика счётчиков нестабильна. То, что регистрируют просмотры и загрузки, менялось со временем и будет продолжать меняться с переделками интерфейса и развитием фильтрации ботов. Система целостности платформы исключает некоторую подозрительную активность из официальных счётов [144][66][69], а соседняя инфраструктура RePEc/LogEc документирует как исторический масштаб трафика роботов, так и недавние волны AI-краулеров, которые потребовали отбросить подавляющее большинство исходного трафика [99][129]. Нормы конверсии, цитируемые в разделе 5, поэтому являются величинами, специфичными для поколения, и сравнения счётчиков на протяжении лет смешивают поведенческие и фильтровальные изменения. Общая статистика веб-ботов [158] не может быть экстраполирована на отфильтрованные счётчики SSRN ни в какую сторону.
Волатильность платформы и дрейф источников. Снятие рейтингов встроено в более широкую реструктуризацию продукта в 2026 году [146][149][150], поэтому ни один анализ не должен рассматривать 15 июля 2026 года как изолированное вмешательство. Эта угроза встроена в конструкцию раздела 8.5, но не может быть полностью устранена. Страницы поддержки платформы пересматриваются без уведомления; все такие страницы здесь цитируются с датами доступа, и цитируемый язык платформы должен быть переверифицирован по архивным копиям перед официальным представлением.
Отсутствие данных по процентилям. Публичные полные данные по процентилям для всей платформы никогда не существовали, и после 15 июля 2026 года никакие репрезентативные для платформы процентильные данные не могут быть собраны внешним образом, потому что рейтинги, которые ранее раскрывали пороги топ-листов, были удалены [149]. Выборочное эталонное распределение всё ещё можно собрать из архивных снимков, и приложение E приводит одно; оно фиксирует форму распределения и не предоставляет процентили платформы. Некоторые представляющие интерес величины (например, судьба электронных писем уведомления авторам об отметке «топ 10%» [161]) официально не задокументированы, и мы отмечаем их исчезновение из публичного поля без утверждения об их прекращении.
Использование — это не прочтение, и ни одно из них не является показателем качества. Загрузка может предшествовать внимательному прочтению, поверхностному осмотру, архивному хранению или полному отсутствию использования. Загрузки не являются прямым показателем качества исследования и не гарантированным причинно-следственным источником цитирований: связь между загрузками и цитированиями положительна, но неоднородна (примерно от 0,1 до 0,6 в зависимости от области, уровня агрегирования и горизонта [18][25][39][80][102][108]) и совокупности документов с высокими загрузками и высокими цитированиями перекрываются только частично [108]. Сами цитирования могут быть положительными, отрицательными, формальными или стратегическими, и процесс цитирования систематически смещён в сторону против новаторских работ [166]. Ничто в этой статье не позволяет заменять экспертное суждение метриками; обоснованное использование этой структуры ограничивается диагностическими и описательными целями.
Ненаблюдаемая доступность и неслучайный престиж. Не всякая доступность наблюдается: читатели встречают названия в электронной почте, социальных сетях, результатах поиска и корреспонденции до того, как логируется какой-либо просмотр страницы с аннотацией, и авторы из плотных сетей генерируют внеплатформенную доступность, коррелирующую с престижем и качеством. Коэффициенты престижа, основанные на наблюдении, поэтому смешивают внимание, основанное на статусе, с реальными различиями в ресурсах, тематике и сетях [111][140]. Экспериментальное манипулирование сигналами идентичности автора дополняет, но не заменяет платформенное наблюдение. Классификация по областям частично выбирается авторами, и работы занимают несколько категорий, что усложняет отнесение к одной области.
Ограничения самого замысла. Квазиэкспериментальные конструкции разделов 8.4–8.5 сталкиваются с эффектами объявления, одновременными изменениями платформы и неслучайными различиями по областям. Они именуются квазиэкспериментальными, потому что событие на уровне всей платформы не предоставляет необработанную контрольную группу. Снимок исследования 2 будет стареть вместе с движками, которые он проверяет, и его протокол репликации смягчает, но не устраняет нестационарность. Исследование 3 — это анализ конкретных случаев с N = 2, ценность которого заключается в механизме и протоколе, а не в оценке совокупности, и его логика атрибуции зависит от псевдонимов для каждого канала, а не от каких-либо утверждений о видимости публичной электронной почты. Краудсорсированный реестр наследует проблемы самоотбора и проверки, указанные в разделе 8.8. Доступ к данным для всех конструкций зависит либо от сотрудничества платформы, либо от ограниченного по скорости сбора в соответствии с условиями обслуживания [134][51]; ни одно не гарантировано.
Широта библиографии. Библиография широка, потому что статья является синтезом; многие из цитируемых исследований имеют общие схемы, области и конструкционные ограничения, а посты сообщества документируют опыт без установления параметров совокупности. Доказательство утверждения — это его уровень проверки и рамка выборки, а не количество ссылок, которые его поддерживают.
Полосы — это цели калибровки, а не константы. Полоса конверсии 11–19% и пороги CSAB — это величины, которые должны быть откалиброваны по областям и по платформам, а не универсальные константы учёного поведения (разделы 4.4, 5.2). Их нынешняя форма — это единая межобластная полоса, которая будет заменена распределениями по областям, требуемыми этой структурой, когда выходит стратифицированное по областям исследование 1 (раздел 8.6).
Обобщение за пределами SSRN требует переклибировки, а не трансплантации. Выявленная здесь проблема интерпретируемости (счётчики использования, отображаемые без публичной сравнительной шкалы) и логика охват-конверсия, которая её исправляет, не специфичны для SSRN; они применимы к любому серверу препринтов, который показывает счётчики использования, включая bioRxiv, medRxiv, arXiv и OSF Preprints [11][62][2][24]. То, что не переносится, — это конкретная полоса 11–19% и пороги CSAB. Кураторство, архитектура распределения и интерфейс различаются на разных серверах: входящий трафик arXiv, управляемый намерением, и его списки рассылки по электронной почте, в отличие от курируемых push-уведомлений SSRN (таблица 6). Числовые якоря должны быть переоценены на каждой платформе перед тем, как они цитируются там. Эта структура переносима; её калибровка локальна. Протокол параллельного депозита раздела 8.8 — это прямой эмпирический тест того, как далеко распространяются полосы SSRN. Масштаб этой переклибровки легко недооценить: медианная загрузка bioRxiv по всему корпусу (примерно 279, и примерно 496 в геномике [2]) в несколько раз больше медианы 60 в архивной выборке приложения E: примерно в пять раз в целом и примерно в восемь раз в геномике. Это сравнение носит ориентировочный характер. Цифра bioRxiv взята из полной переписи корпуса, а 60 — из архивной выборки, которая избыточно представляет захватанные страницы, смешивает возрасты и области, чей состав меняется с возрастом, и приводит возраст к целым годам. Направление разрыва можно с уверенностью интерпретировать; его величину — нет.
Этика. Раздел данной статьи, посвященный общественному дискурсу, состоит из самостоятельно отобранных публичных постов, используемых только как свидетельство спроса, но не как репрезентативное мнение, и цитируемых только при наличии живого, проверяемого источника. Пользовательские посты цитируются с учетом этики цитирования полупубличного содержимого форумов, включая парафраз вместо дословного цитирования в тех случаях, когда авторы могли бы быть идентифицированы вопреки их ожиданиям, в соответствии с нормами прозрачности для качественных данных [6]. Исследование 3 фиксирует только сообщения, отправленные без запроса инструментированному автору, и не собирает никаких личных данных третьих лиц сверх того, что добровольно предоставляют отправители. Исследование 4 собирает только добровольные, анонимизированные ответы на анкету на основе информированного согласия. Дизайн панели использует открыто отображаемые счетчики и библиографические метаданные, а сбор любой непубличной информации панели управления (такой как даты статуса распределения) требует информированного согласия автора и, где применимо, рассмотрения учреждением. Два исследования, в которых участвуют люди и которые используют данные, генерируемые участниками, это Исследование 4 (опрос авторов) и Исследование 3 (инструментированный пост с логированием входящей почты). Поскольку оба являются исследованиями с участием людей, оба будут представлены на утверждение соответствующей комиссии по этической экспертизе или комитету по этике исследований и проводиться при информированном согласии участников до начала сбора каких-либо данных, а личные данные, содержащиеся в журналах входящей почты, агрегируются и обезличиваются перед любым анализом или отчетностью. Этот протокол является предусловием выполнения и воспроизводится в Заявлениях.
10. Заключение и политические рекомендации
10.1 Что установил анализ
Прекращение работы SSRN Rankings 15 июля 2026 года устранило единственную публичную сравнительную шкалу [149]. Счётчики остались на каждой статье и профиле, что оставило метрики нечитаемыми, а не бессмысленными. Как компенсация этой потери в данной статье собраны все проверяемые эмпирические опорные точки в карту эталонов с явными указаниями на происхождение и предупреждениями о надёжности (Таблица 7), построена интерпретационная структура, пятиполосная шкала, разложение охват–конверсия и протокол досье (Таблицы 8, 9, 13), которые преобразуют счётчики в диагнозы, и излагается готовый к предварительной регистрации план раздела 8, в котором определяется, как восстановить отсутствующие распределения.
Механизм, лежащий в основе аргумента, сводится к следующему:
Никто не знает, что означает семь загрузок, не зная, семь загрузок по сравнению с чем, а после 15 июля 2026 года платформа больше не отвечает на вопрос «с чем».
Вклады различаются по характеру. Определение проблемы эталонного класса — это диагностический вклад: необработанный подсчёт не отвечает на какой-либо вопрос, пока возраст, область, когорта и воздействие не определят его группу сравнения. Инструментальный вклад — это карта эталонов и CSAB, которые нормализуют эмоционально значимое, но научно неоднозначное число в интерпретируемый диагноз. Сборник рекомендаций и протокол досье — это практический вклад, позволяющий авторам и комитетам действовать на основе счётчиков сегодня, не ошибаясь в их интерпретации. В терминах политики вклад — это анонимизированная процентильная полоса: сравнительный контекст восстановлен в форме, которая никого не идентифицирует и не возрождает никакую таблицу лидеров.
На основе собранных доказательств вопрос в заголовке этой статьи некорректно поставлен до тех пор, пока не будет задан эталонный класс. Учитывая все доступные опорные точки, небольшие счёты — это скорее статистическая норма платформы, чем вердикт о работе. Статья с 40 просмотрами аннотации и 7 загрузками согласуется, как результат скрининга, с эмпирической полосой конверсии раздела 5 [139][172][83], в то время как старое практическое правило трёх просмотров на одну загрузку [18] находится выше этой полосы, а не внутри неё. Медианная статья в единственной выборке переписного типа накопила 63 загрузки за два года [139], а попадание в список top-10,000 2015 года, примерно верхние 1,8% полнотекстового хранилища статей платформы (571 040, июль 2016 [1]), требовало 160 загрузок за всё время [85]. В условиях квазилогнормального режима внимания большинство авторов по построению находятся на нижних ступенях лестницы. Медианный препринт живёт в длинном хвосте логнормального распределения, которое его автор не видит, и он выявляется механикой классификации, которая благоприятствует аффилированным. Он запрашивается хищниками прежде, чем его читают коллеги, и теперь потерял рейтинг, который когда-то его определял. Шкала помещает статью куда-то на эту лестницу, а беспокойство, которое несёт с собой вопрос, создаётся отсутствующей шкалой, а не самим числом.
Ничего в этом не является особенным для одной платформы, и это событие не беспрецедентно. ResearchGate прекратил работу своего собственного сильно критикуемого составного показателя RG Score в августе 2022 года [130], после долговременной методологической критики [90], а в 2022–2023 годах десятки американских юридических факультетов во главе с Йельским и Гарвардским университетами вышли из рейтингов U.S. News law-school rankings [13]. Отказ от оспариваемого показателя — это не поверхностный акт, потому что показатель никогда не был пассивным описанием: литература о реактивности, возникшая из рейтингов юридических факультетов, показывает, что публичный рейтинг трансформирует поведение тех, кого он ранжирует [58][132], поэтому его введение и его исключение изменяют поведение, а не просто меняют то, о чём сообщается. Счётчик и его сравнительный фрейм совместно образуют метрику, и исключение фрейма при сохранении счётчика оставляет каждого пользователя с числом, которое не с чем сравнивать. Интерпретируемость, доступность публичного распределения для публичного счётчика, должна рассматриваться как ключевое измерение качества любого индикатора, наряду с корректностью и надёжностью. Метрики переживают свою интерпретационную инфраструктуру, и метрика без контекста — это шум, пример общей дисциплины критического чтения деконтекстуализированных чисел [15]. Та же метрика с контекстом — это калибровка, которая наделяет авторов возможностями, улучшает научную коммуникацию и поддерживает доверие в репозиториях, которые её отображают.
Данная структура требует от пользователя нескольких обычных привычек. Сравнивайте подобное с подобным и держите охват отдельно от конверсии. Читайте траектории, а не итоги, относитесь к каждому числу как к датированному, и не позволяйте ни одному счёту циркулировать без его источника, периода и ограничений.
10.2 Рекомендации авторам
Авторы могут действовать уже сейчас, не дожидаясь новых данных. Делайте снимки экрана с датой показателей на уровне статей, которые сохраняют контекст: после закрытия они остаются единственной записью о статусе, которая остаётся под контролем автора, и служат источником для реестра сообщества раздела 8.8. Сообщайте показатели только с указанием их рамок (возраст, область, когорта и источник), следуя протоколу досье таблицы 13, в котором каждое число указывает свой источник, временное окно и ограничения. Читайте панель управления диагностически, а не эмоционально: отделяйте охват от конверсии (таблица 9), рассматривайте нулевые загрузки в первую неделю как нормальное поведение до распределения [53], и ориентируйтесь на три-пять статей коллег, опубликованных в том же месяце, а не на видимый хвост, чьи циркулирующие числа вех гарантируют ошибку калибровки в условиях режима с тяжёлым хвостом [85][180]. Рассматривайте письма с просьбой как явление скрейпинга, а не как признание, и не как свидетельство о показателях [61][107][144].
10.3 Рекомендации для оценивающих
Учреждения, которые импортировали загрузки SSRN в качестве валюты оценки [12][18][161][52], сталкиваются с вопросом управления теперь, когда публичная шкала валюты исчезла. Необработанные показатели загрузок не должны учитываться при найме, продвижении по карьере или присвоении постоянного статуса: они манипулируются именно на тех критических уровнях, которые имеют значение [44], они варьируются в восьмикратном диапазоне в различных подполях в пределах одной сети [168], и теперь они непрозрачны для бенчмаркинга. Минимально обоснованная единица — это процентиль в пределах определённой совокупности (то же поле, то же возрастной диапазон, тот же период размещения), сопровождаемый его источником и датой происхождения, и доказательство использования должно дополнять, а не заменять цитирование, экспертную оценку и содержательное суждение [108][109][110]. Сложившийся консенсус реформы оценки исследований работает на основе этого принципа. Основное предписание DORA — не использовать одно число или показатель площадки публикации вместо оценки самого исследования [8], а Лейденский манифест настаивает на том, что количественная оценка должна поддерживать, а не подменять качественное экспертное суждение [78]. Обзор Metric Tide усиливает это требование, призывая к показателям, которые являются надёжными, скромными, прозрачными, разнообразными и рефлексивными, и используемые в поддержку экспертной оценки, а не в качестве её замены [173], как и более свежее Соглашение CoARA о реформе оценки исследований, к которому присоединились несколько сотен организаций-подписантов, обязующихся проводить качественную оценку, поддерживаемую, но не подменяемую ответственным количественным использованием [183]. Весь этот консенсус применяется в полной мере к счётчику загрузок, у которого удалена публичная шкала. Два из пяти измерений Metric Tide непосредственно применяются к предложенному здесь методу: разнообразие — это нормализация по полям, на которой настаивает эта статья, и рефлексивность — это позиция Раздела 8.7, в котором статья измеряет собственное внимание. Преемник этого обзора, ориентированный на REF, переносит те же пять принципов в текущую практику Великобритании [184]. Этот консенсус сам по себе является выражением более широкой критики чрезмерного использования метрик в институциональной жизни [113]. Комитеты по оценке должны ожидать и принимать формат протокола из Таблицы 13 (контекстуализированную, повествовательную форму доказательства, которую используют появляющиеся форматы оценки, такие как британский Résumé for Research and Innovation (R4RI) [186]) вместо устаревшего языка рейтинга «топ 10%». В Соединённых Штатах тот же самый рычаг, касающийся языка в документах, является центром внимания Инициативы руководства высшего образования за открытую стипендию (HELIOS Open), которая работает с университетами по переписанию критериев продвижения по карьере и присвоения постоянного статуса [189]; контекстуализированная строка использования, указанная здесь, является именно конкретным инструментом, которого часто не хватает подобным реформам.
10.4 Рекомендации для платформы
Снятие рейтингов без замещающего контекста приводит к замене одного ошибочного сигнала на его полное отсутствие. Последствия выходят за пределы удобства авторов. Остаётся открытым эмпирическим вопрос, будет ли закат рейтингов сдерживать новые представления — то есть исход объёма постинга, указанный в разделе 8.5. Структура подразумевает конкретное направление развития продукта, которое не воссоздаёт систему рейтинговых таблиц, которую SSRN решила снять [149]:
1. Анонимизированные процентильные полосы по дисциплине и возрасту статьи. Отображайте рейтинг загрузок и просмотров каждой статьи как грубую процентильную полосу в рамках её когорты по дисциплине и возрасту: информация, необходимая каждому автору, опубликованная в форме, которая никого не идентифицирует, не создаёт рейтинг и снижает динамику «победитель получает всё» в списках топ-N. Процентильный контекст сохраняет конфиденциальность, восстанавливая читаемость. Целевой формат отображения точно соответствует диаграмме нормативных значений, зависящей от возраста статьи, на рисунке 14.
2. Нормализованное по времени отображение. Показывайте сравнения с учётом возраста, а не только пожизненные показатели, так чтобы статья возрастом 14 дней никогда не сравнивалась неявно с работой, накопившей внимание на протяжении лет.
3. Отделите охват от конверсии. Сообщайте просмотры аннотаций и загрузки как отдельные сигналы с их соотношением, а не приглашайте однозначное прочтение, которое отождествляет невидимость с отказом.
4. Прозрачные референтные классы. Любой сравнительный показатель должен указывать совокупность, область, период и возрастную группу, с которыми он сравнивает; неозначенный «топ X%» научно неинформативен. Приложение D определяет десять полей раскрытия, которые должен содержать версионированный выпуск процентилей: от определений совокупности и когорт до правил приватности минимальной ячейки и цитируемой истории версий.
5. Аудит дизайна на предмет накопительного преимущества. Классификация, распределение оповещений, ранжирование поиска и видимые сигналы популярности распределяют дефицитное внимание и должны быть оценены на предмет их распределительных эффектов. Эмпирические проекты разделов 8.4–8.5 непосредственно пригодны для такого аудита.
6. Планируйте обработку интерпретационного остатка при снятии функций. Когда сравнительные функции удаляются, интерпретационная потеря должна быть оценена и смягчена с той же осторожностью, что и миграция данных, через архивные распределения, опубликованные сводные процентили или явную передачу сообществу, поскольку показатель, который невозможно прочитать, не может информировать.
7. Механика контактов, защищённая от сбора, снижающая вызванную видимостью экстерналию запросов, задокументированную в разделе 7 [107][159]. Один конкретный кандидат: задержать или скрыть публичное раскрытие маршрутов контактов авторов примерно на первые 48–72 часа после размещения, окно, в котором легитимное распределение обычно ещё не началось, но вероятность автоматизированного сбора максимальна. Эффект любой такой меры должен быть оценен эмпирически, а не предположен. Компромисс реален, поскольку скрытие контактной информации может также поставить в невыгодное положение именно новичков, которые зависят от прямой обратной связи.
8. Публичный журнал фильтрации и задокументированная механика распределения. Опубликуйте запись в стиле LogEc того, что отбрасывают фильтры целостности, и задокументируйте, как работают распределение eJournal и выбор дайджеста. Соседняя инфраструктура RePEc/LogEc демонстрирует, что такая прозрачность осуществима в масштабе [99][129], тогда как SSRN в настоящее время описывает свои фильтры без публикации их истории [144] (таблица 6). Когда фильтрация задокументирована, корректировки показателя можно читать как события измерения, а не репутационные события.
9. Сделайте историю видимости разборчивой. Страница статьи или панель управления автора должны различать публичное размещение, назначение классификации, кураторское распределение, подтверждение индексирования и значительные переформулировки показателя, так чтобы автор мог отделить «ещё не видимо» от «видимо, но не преобразовано». Это аналог со стороны платформы понимания режима видимости раздела 5.6 и наиболее дешёвое решение для наиболее вызывающего тревогу состояния панели управления — раннего нуля.
10.5 Рекомендации научному сообществу
Сообщество не должно ждать платформы. Реестр раздела 8.8 (датированные, самоотчётные снимки экрана панели управления, предоставленные в соответствии с открытым протоколом) может произвести первое свежее распределение загрузок за десятилетие. Два исследования открытых данных таблицы 17 (1 и 2) могут быть выполнены любым исследователем в пределах ограничений доступа, указанных в разделе 9, в то время как два исследования участников (3 и 4) требуют добровольцев и одобрения по вопросам этики, указанные в Декларациях. Наукометрия должна рассматривать интерпретируемость метрик как часть своего предмета исследования: данный случай, когда счётчики пережили их единственную публичную шкалу, едва ли будет последним. Распределённая репликация протокола инструментированного постинга, поддержание сообществом таблиц процентилей (и открытого калькулятора, предназначенного для авторов и разработанного на их основе, разделы 8.8 и 8.10), и оценка воздействия изменений платформы на интерпретацию представляют собой исследовательские вклады сами по себе, и каждый из них преобразует исправительную работу данной статьи в профилактику.
10.6 Заключение
Вопрос «что означают мои семь скачиваний?» проходит сквозь всю статью, потому что это вопрос, который остался у почти двух миллионов авторов платформы 15 июля 2026 года [49][149]. Ответ, собранный здесь, - это ни утешение, ни предостережение, а калибровка. Число согласуется с имеющимися данными о конверсии, но остается результатом скрининга; тревога создана отсутствующей шкалой, которую можно восстановить, частично из литературы, как это сделали разделы 3–6, и частично из новых данных, как указано в разделе 8.
Статья открылась с вопроса, который остается у каждого автора:
«Что означают мои 7 скачиваний?»
Методология заменяет его на этот:
«Где стоит эта статья среди сопоставимых статей того же возраста, дисциплины, когорты и истории распределения? Является ли ограничивающим фактором охват или конверсия? И извлекается ли она и цитируется ли системами, через которые читатели теперь открывают исследования?»
Это вопрос, на который может ответить наукометрия, и эта статья объяснила, как.
Что записывают счетчики - это события, и только события. Просмотры - это не скачивания; скачивания - это не чтение; среднее значение - это не норма; счетчик - это не вердикт; привлечение - это не признание; извлечение ИИ - это не верная атрибуция; и число без шкалы - это не информация.
Пока платформы показывают счетчик отдельно от его контекста, авторы, эксперты и платформы будут продолжать читать факты распределения как личные вердикты. Открытый доступ выиграл битву, которую он вел (право публиковать и скачивать без ценовых барьеров), и, выиграв ее, обнаружил битву, которую он никогда не вел: распределение внимания. Авторы могут осмысленно читать счетчики с учетом дисциплины, возраста и конверсии. Метрики SSRN по-прежнему имеют ценность, но только для автора, который понимает, что они означают.
Приложение A. Ситуация → Руководство действий
Таблица 23 сводит разделы 4–6 к ситуациям, которые авторы чаще всего описывают [161][127][139]. Её средний столбец указывает только то, что подтверждают собранные свидетельства, с источниками и периодами. Столбец оговорок содержит оговорки, которые должны сопровождать каждое утверждение. Приведенные здесь числа взяты из таблиц 6–7 и рисунка 6 основного текста.
Таблица 23. Ситуация → что говорят свидетельства → что делать.
| # | Ваша ситуация | Что говорят свидетельства | Что делать | Источники и оговорки |
|---|---|---|---|---|
| 1 | «7 скачиваний и 40 просмотров реферата в первый месяц.» | Конверсия составляет 17,5%, находясь в пределах кросс-исследовательского диапазона 11–19% как точечная оценка, хотя 95% интервал Клоппера–Пирсона для 7/40 (≈7,3–32,8%) широк и перекрывает диапазон; медианная статья LSN достигла 63 скачиваний только через два года, и медианная статья о маркетинге составила 87 при медианном возрасте 16 месяцев — якоря для зрелых выборок, не соответствующие по возрасту чтению в день 20. Результат скрининга с широким интервалом, а не свидетельство неудачи. | Продолжайте график наблюдений из таблицы 11; классифицируйте траекторию не ранее чем на день 60–90. | Диапазон: [18][139][172]; медианы: [139] (2012 LSN), [83] (2025 Marketing). Все якоря относятся к одной дисциплине и давние; конверсия 7/40 является широкоинтервальной оценкой скрининга, не соответствующей по возрасту зрелым якорям. |
| 2 | «Нулевые скачивания в первую неделю.» | Нормальное допредставление: классификация проводится вручную и может занять до 45 дней для загруженных тем; оповещения eJournal генерируют ранние просмотры и продолжаются позже; индексирование Google Scholar занимает 6–9 месяцев или дольше. | Подтвердите открытое размещение; подтвердите классификацию eJournal; проверьте, индексирована ли статья под точным названием — это самый простой тест индексирования; ждите завершения цикла объявлений; только потом смотрите счетчики. | [53][147][57][55]. Изменения в формулировках страницы поддержки; переподтвердите с датами доступа. |
| 3 | «Много просмотров, мало скачиваний — конверсия намного ниже 11%.» | Согласуется с несовпадением реферата и полного текста: читатели приходят и уходят, прочитав реферат. Элементы представления (название, реферат, ключевые слова) — это рычаги, наиболее надежно влияющие на счетчики. | Измените название и реферат; переследите конверсию в следующем периоде перед дальнейшими изменениями. | [139][168][172]. Причинное прочтение «низкая конверсия = слабый реферат» является скрининговой гипотезой, а не проверенным диагнозом. |
| 4 | «Конверсия намного выше диапазона или внезапный скачок просмотров.» | Трафик, который просмотр реферата не объясняет — ссылки из СМИ или агрегаторов, или нечеловеческий трафик, который фильтры еще не удалили. | Определите внешний источник (публикации в СМИ, рассылки); не приписывайте скачок читаемости без проверки. | [116][138][144][102 — механизм предварительной загрузки Safe Links, с оговоркой, что собственная фильтрация SSRN может уже исключать такой трафик]. |
| 5 | «Мой счетчик упал, или числа были пересчитаны.» | Платформы пересчитывают счетчики, когда меняются правила фильтрации; RePEc отбросил большинство необработанного трафика в документированных эпизодах (роботы ≈74% просмотров в 2007 году; >99,5% трафика IDEAS в сентябре 2025 года). | Рассматривайте это как событие переизмерения; проверьте свои датированные скриншоты; никогда не докладывайте об этом как о потере читаемости без проверки. | [144][69][99][129][66]. |
| 6 | «Рейтинги исчезли, и я не знаю, каково мое положение.» | Не осталось открытой системы процентилей, и никакую репрезентативную для платформы нельзя собрать извне. Архивный срез приложения E предоставляет эталонное распределение на основе выборки, и парное сравнение остается заменой платформенных процентилей. | Создайте микро-бенчмарк из 3–5 коллегиальных работ, размещенных в том же месяце, и отслеживайте их; по желанию вычислите отношение ваших скачиваний к медиане соответствующей когорты. | [149][51]; якоря [139][83][85]. Отношение не имеет калиброванных интерпретационных полос (раздел 6.3). |
| 7 | «Комитет увидит мои показатели.» | Ранговые строки в досье — это задокументированная практика, и их сравнительный контекст исчез; язык диапазонов с источниками, полевыми уточнениями и цитационной триангуляцией выдерживает критику там, где необработанные счетчики — нет. | Применяйте семиэтапный протокол из таблицы 13: сохранение, преобразование, триангуляция, нормализация по дисциплине, дополнение, целостность, экспертная оценка. | [12][95][33][52][77][108]. Загрузки отражают спрос, а не качество; история манипуляций [44] известна экспертам. |
| 8 | «Хищнические приглашения начали приходить через несколько дней после публикации». | Документированный побочный эффект сбора данных с платформ препринтов; смежные аудиты сообщают о десятках приглашений в две недели на одного исследователя. Большой объем сигнализирует о видимости для скреперов, а не о признании со стороны читателей. | Никогда не платите; проверяйте издания через Cabells и Think. Check. Submit.; организуйте переписку через отдельный адрес; см. таблицу 14 для типологии. | [107][159][9][84][63][32][136]; [B-1] (Beall's list закончился в 2017 году). Временные закономерности не измерены; экран «дней после публикации» носит качественный характер. |
| 9 | «Проверка сходства в журнале пометила мою подачу как совпадающую с моим препринтом на SSRN». | Система проверки работает как задумано: препринты, зарегистрированные как Crossref Posted Content, являются частью корпуса сравнения, и указания iThenticate указывают, что совпадение препринта того же автора не является плагиатом. Публикация рабочего документа разрешена политиками предварительной публикации большинства журналов, но политики варьируются и целевой журнал должен быть проверен; основные исключения — в области медицины и клинических исследований. | Определите источник с отметкой редактору как ваш собственный препринт с меткой времени; не отзывайте препринт; для медицинских и клинических изданий проверьте политику препринтов целевого журнала (например, через реестр Sherpa Romeo) перед подачей. | [81][36]; Раздел 4.5. Политики журналов варьируются и изменяются; проверьте текущую политику целевого журнала, а не полагайтесь на общее правило. |
| 10 | «The Rankings ушли — должен ли я перемещать свои статьи на ResearchGate или Academia.edu?» | Миграция авторов после закрытия не документирована; счетчики загрузок не переносятся между платформами; и платформы-компараторы имеют ту же проблему интерпретируемости — ResearchGate прекратила использование своей собственной составной оценки RG Score в августе 2022 года после методологической критики. | Сохраняйте запись SSRN и дополняйте, а не переносите: разместите одну и ту же статью в институциональном или предметном репозитории (таблица 13, шаг 5), сохраняйте снимки счетчика с датой и не удаляйте и не переповторно публикуйте в других местах, что приводит к потере накопленных счетчиков. | [130][90][149]; [47][146] (дополнение репозитория); [161] (счетчик одной платформы ничего не говорит о других каналах); [B-7] (удалить и переповторно опубликовать сбрасывает метрики). Отсутствие документированной миграции — это отсутствие доказательств, а не доказательство стабильности. |
Непроверенные практики сообщества (гипотезы-кандидаты для повестки Раздела 8). Следующие рекомендации циркулируют в сообществах авторов и появляются в ранних черновиках практических руководств; ни одно исследование их не поддерживает, и они записаны здесь как проверяемые гипотезы и не должны цитироваться как выводы: (a) ограничение классификаций eJournal тремя (одна основная, одна широкая, одна междисциплинарная) вместо использования большего количества из разрешенных семи [53][168]; (b) цитирование рабочих документов SSRN таким образом, чтобы их авторы получали уведомления через оповещения Google Scholar и отвечали вниманием; (c) сокрытие адреса электронной почты профиля в течение первых четырнадцати дней после публикации для снижения сбора данных; (d) загрузка небольшого исправления на день 3 для повторного объявления (SSRN документирует только то, что исправления на месте сохраняют счетчики и URL [B-7]); (e) любые численные частоты, связанные с экраном «приглашение в течение 96 часов — хищническое»; (f) прямое обращение к трем-пяти авторам, цитируемым в статье (краткое сообщение с указанием на цитирование их работы на SSRN) как канал к первой законной аудитории, представленный как обычная научная коммуникация, а не продвижение. Каждая подлежит фальсификации с помощью наблюдательных проектов Раздела 8; до проверки надлежащая форма их цитирования — «практика сообщества, не проверенная».
Таблица 24 переупорядочивает руководство в хронологическом порядке. Каждая ячейка указывает обратно на раздел и его источники. Представление в виде временной шкалы отвечает на вопрос, который авторы действительно задают («что мне делать сейчас?») в порядке возникновения ситуаций и дополняет таблицу 23 с индексацией по ситуациям.
Таблица 24. Руководство как временная шкала: три этапа × три оси. Все ячейки суммируют доказательства и инструкции, уже изложенные в разделах 4–7; непроверенные практики сообщества исключены (см. список выше).
| Этап | Механика платформы и измерение | Аудитория и распределение | Защита от ходатайств |
|---|---|---|---|
| Перед публикацией | Рассматривайте название и аннотацию как поверхность конверсии и составляйте их соответственно (§6.4; [139][172]); спланируйте классификации eJournal — разрешено до семи, и больше классификаций связано с большим количеством загрузок и меньшим количеством нулевых значений [53][168] | Определите когорту микроэталонов из 3–5 статей для отслеживания вместе с вашей статьей (§6.3) | Организуйте переписку через отдельный адрес до того, как метаданные станут общедоступными (§6.6) |
| При публикации | Подтвердите публичную публикацию и классификацию eJournal; запишите базовое значение дня 1 сетки таблицы 11 (§6.1) | Оповещения по электронной почте eJournal — это основной канал push платформы и продолжаются после закрытия [147][57] | Ожидайте ходатайств как естественное следствие видимости, а не сигнал качества (§6.6; [159][63]) |
| Первые недели (дни 1–45) | Читайте раннее нулевое значение как пред-распределение, а не отказ (§6.2 правило iv; [53]); логируйте счетчики по расписанию таблицы 11; классифицируйте траекторию не ранее дня 60–90 (§6.3) | Применяйте законные внешние рычаги, где целесообразно — блог и охват списков производили измеримые ранние всплески (§6.4; [116][72]) | Никогда не платите; проверьте любое приглашающее издание ([B-1]; Think. Check. Submit. [159]); проверьте приглашения против типологии таблицы 14; никогда не читайте объем спама как читательство (§7.6) |
Приложение B. Шаблон отчета CSAB
Минимальное заявление CSAB, обращенное к автору или оценивающему (раздел 5.5; таблица 10), содержит:
На возраст статьи [X дней] статья получила [V] просмотров аннотации и [D] подтвержденных загрузок. Относительно [определённого поля / когорты / справочного класса новичков], его процентиль охвата составил [RV], процентиль загрузок [RD] и скорректированный на сжатие процентиль конверсии [RC]. Статья [получила / не получила] документированное курируемое распространение к моменту наблюдения. Между [возраст 1] и [возраст 2] его нормализованная позиция [выросла / осталась стабильной / упала]. Эти показатели описывают распространение и не устанавливают качество или корректность исследования.
Пока не будет оценена современная справочная панель (разделы 5.5, 8.3), поля процентилей должны оставаться пустыми: никакое значение не может быть введено из интуиции, из средних значений по платформе или из устаревших образцов. Исторические якоря могут быть приведены наряду с шаблоном: медиана LSN за 2012 г. из 63 загрузок в течение двух лет [139] и медиана Marketing-network за 2025 г. из 87 [83], каждая с указанием образца, поля и возраста, но никогда не подставляемые вместо отсутствующего справочного класса. Шаблон является эквивалентом на уровне предложения этапа Translate протокола досье (таблица 13, шаг 2).
Приложение C. Словарь переменных панели
Таблица C1 представляет минимальную запись интервала статьи для основной панели раздела 8.3: наименьшую схему, достаточную для воспроизведения оценок CSAB раздела 5.5 и анализов событий платформы разделов 8.4–8.5. Публичные выпуски заменяют прямые идентификаторы стабильными ключами исследования везде, где связь не требуется аналитически, и вклады реестра (раздел 8.8) используют подмножество этой схемы, указанное там.
Таблица C1. Минимальная схема данных интервала статьи для основной панели.
| Область | Переменная | Определение или формат |
|---|---|---|
| Идентификация | paper_id | Стабильный идентификатор исследования |
| Идентификация | ssrn_abstract_id | Идентификатор платформы; хеширован или ограничен в публичных выпусках |
| Время | posted_at | Дата первого публичного размещения |
| Время | observed_at | Временная метка наблюдения метрики (сетка таблицы 11) |
| Время | paper_age_days | Дни с момента первого размещения |
| Использование | abstract_views_cum | Публичные совокупные просмотры страниц аннотаций |
| Использование | downloads_cum | Публичные совокупные подтвержденные загрузки |
| Использование | views_interval, downloads_interval | Приращения от предыдущего корректного наблюдения |
| Воздействие | classification_ids | Все классификации eJournal, активные на момент наблюдения |
| Воздействие | distributed_status, distributed_at | Показатель и дата курируемого распространения, где дано согласие |
| Воздействие | search_indexed | Статус внешнего индекса, определённый протоколом (тест точного названия) |
| Статья | title_frozen, abstract_frozen, keywords, page_count, doi | Метаданные рукописи, наблюдавшиеся в первый раз, замороженные при первом наблюдении |
| Статья | authors_frozen, affiliations_frozen | Имена авторов, их порядок и аффилиации при первом наблюдении |
| Контроль версий | revision_id, revision_at, material_change_flag | История версий с показателем существенного изменения |
| Авторы | author_count, platform_newcomer, prior_ssrn_papers | Структура команды и история платформы до размещения (определения раздела 8.3) |
| Репутация | prior_citations, prior_works, institution_measure | Замороженные перед основным размещением и нормализованные по полю |
| Календарь | day_of_week, week, season, holiday_flag | Предопределённые временные управления [178] |
| Нисходящие | citations_6m, citations_12m, citations_18m, publication_status | Последующие результаты валидации с источником и датой (горизонты раздела 8.9) |
| Аудит | collection_method, source_url, quality_flag | Происхождение, маршрут доступа и документирование аномалий (флаг, а не удаление; раздел 8.3) |
Приложение D. Спецификация прозрачности эталона
Чтобы процентильный эталон раздела 8.8 и любой его преемник, поддерживаемый платформой или сообществом (раздел 10.4, рекомендации 1 и 4), не воспроизвёл непрозрачность эталона, которую критикует эта статья, каждый выпуск процентилей публикуется с версионированным сопутствующим документом, в котором указывается:
1. имеющая право популяция статей, сети, типы документов и исключения;
2. даты когорт размещений и возраста наблюдений;
3. правило назначения поля, включая обработку множественных классификаций;
4. определения просмотров, загрузок, уникальных действующих лиц, повторений и подтвержденного трафика, действующие при выпуске;
5. медиана, межквартильный размах, P10/P25/P75/P90/P95, доля нулей, коэффициент Джини и верхние доли;
6. размеры выборок и интервалы неопределённости для каждого указанного справочного класса;
7. обработка пропусков, отзывов, пересмотров, слияний и встречных переформулировок;
8. переменные распределения и внешнего продвижения, включённые в любую корректировку;
9. правила конфиденциальности и минимальной ячейки: для краудсорсированного реестра раздела 8.8, где маленькие ячейки «поле-возраст» иначе могли бы идентифицировать отдельных участников, этот пункт является обязывающим ограничением, регулируемым законом о защите данных (в Великобритании — UK GDPR и Законом о защите данных 2018 года), а не просто формальностью. Контроль раскрытия информации должен выходить за пределы простой анонимизации к k-анонимности или добавляющим шум (дифференциально приватным) агрегатам для тонких ячеек, и правило разрешённого использования должно привязывать реестр к интерпретации, а не к оценке, запрещая его использование для найма, продвижения, распределения ресурсов или переборки в любой публичный рейтинг;
10. история версий и постоянная, цитируемая ссылка на выпуск.
Никакой составной показатель не может заменить эти компоненты. Простые отношения к медиане когорты (некалиброванный резервный метод раздела 6.3) могут быть нестабильны, когда ячейка знаменателя мала, и могут ошибочно предположить, что «дважды медиана» соответствует фиксированному процентилю в различных по форме полях. Таким образом, отчёты для авторов используют оценки процентилей в соответствии с эмпирическим байесовским сжатием, уже указанным для разреженных ячеек в разделе 8.3, в то время как сырые распределения остаются доступными для аудита.
Приложение E. Независимое архивное поперечное сечение распределения загрузок
Для свидетельств по полному распределению в последнее время синтез разделов 3 и 5 опирается на один опубликованный снимок [83]. Это приложение содержит независимое, воспроизводимое поперечное сечение, собранное для данной статьи, которое подтверждает структуру распределения в различных областях, используя только общедоступные данные и без привилегированного доступа к платформе. Это одноразовая архивная реконструкция с известным смещением в сторону увеличения, представленная как подтверждение формы распределения, отличная от предварительно зарегистрированной панели раздела 8.6, которая отслеживает статьи перспективно начиная с момента их публикации.
Методология. Случайная выборка статей SSRN была произведена из OpenAlex (источник S4210172589, "SSRN Electronic Journal") с использованием двадцати трех независимых случайных семян. Для каждой выбранной статьи счетчики загрузок и просмотров аннотаций до отключения были считаны из последнего доступного захвата статьи в Internet Archive, найденного через общедоступную конечную точку доступности Wayback Machine, а не с живого сайта, который требует авторизации доступа (раздел 4) и больше не публикует сравнительные таблицы рейтингов. Считывание счетчиков из архивных копий вместо прямого запроса к платформе ограничивает частоту обращений, соблюдает интересы платформы и обеспечивает воспроизводимость на основе выпущенных идентификаторов. Поскольку счетчики для отдельных статей пережили отключение рейтингов без изменений, и были отозваны только сравнительные рейтинги, захват с датой после 15 июля 2026 г. остается действительным показателем кумулятивных загрузок статьи. Снимки поэтому не были ограничены периодом до отключения, а дата захвата сохраняется только для расчета возраста статьи. Захваты, которые вернули интерстициальную проверку бота вместо содержания страницы, были исключены. Из 2600 выбранных статей 64% имели пригодный архивный захват, а 52% дали машиночитаемый счетчик загрузок, в результате чего получилось n = 1360 статей, охватывающих двадцать пять областей, из них четырнадцать по крайней мере с двадцатью статьями, и возрастом статей от года публикации до более двух десятилетий. Набор данных выпущен как appendixE-wayback-downloads.csv и размещен в https://doi.org/10.5281/zenodo.22285871, где тот же файл имеет имя study1-wayback-downloads.csv. Два свойства выборки накладывают ограничения на то, что можно из нее извлечь. Даты публикации содержат только год, без месяца: 1358 из 1360 записей имеют дату 1 января, потому что OpenAlex сообщает размещения SSRN с годовым разрешением. Возраст поэтому рассчитывается как год захвата минус год публикации, представляется в целых годах, и использование более короткого интервала невозможно оправдать. Захваты также сконцентрированы во времени: 688 из них, половина выборки, приходятся на один краулинг между 25 апреля и 7 мая 2025 года, и 81,5 процента приходятся на 2025 год, поэтому возраст статьи здесь близко соответствует году публикации, и эти два не могут быть разделены. Первое из этих ограничений можно устранить. Строка публикации "Posted: DD Mon YYYY" появляется в тех же архивных захватах, поэтому полные даты можно восстановить путем их повторного анализа, чему не препятствует барьер доступа на живом сайте. Таблица E1 делает эту убыль явной.
Таблица E1. Построение архивного поперечного сечения и убыль на каждом этапе.
| Этап | Статьи | % от начального | % от предыдущего |
|---|---|---|---|
| Случайно выбранные записи OpenAlex (SSRN Electronic Journal) | 2,600 | 100,0 | — |
| Найдены пригодные захваты Internet Archive | ≈1,660 | 63,8 | 63,8 |
| Захват содержал машиночитаемый счетчик загрузок | 1,360 | 52,3 | 81,9 |
| Финальная аналитическая выборка | 1,360 | 52,3 | 100,0 |
Результаты. Выборка воспроизводит все качественные особенности, которые демонстрируют опубликованные эталонные значения (Table E4). Распределение загрузок сильно смещено вправо: среднее значение 219, медиана 60 (95% bootstrap CI 55–69), отношение среднего к медиане 3,65, среднее превышает 75-й процентиль (158). Распределение также имеет тяжелый верхний хвост (95-й процентиль 816, более чем в тринадцать раз превышает медиану; коэффициент Джини 0,75, 95% CI 0,71–0,78). В логарифмической шкале распределение близко к симметричному (асимметрия ln загрузок ≈ 0,18), что согласуется с приблизительной логнормальностью наблюдаемого тела распределения — свойство, которое Какушадзе мог подогнать только к топ-спискам (Section 3.4). Медиана конверсии загрузок в просмотры составляет 16,2%, среднее значение 17,3%, что находится в диапазоне 11–19% кросс-исследовательской полосы (Section 5.2). Медианные загрузки различаются по дисциплинам при одном возрасте статьи. При фиксированном диапазоне возраста разброс между наибольшей и наименьшей медианой по дисциплинам составляет примерно три-пять раз, точная цифра зависит от диапазона и способа обработки дисциплин с малыми выборками. При объединении всех возрастных групп разброс достигает примерно двенадцатикратного, и эта большая цифра отражает меняющийся состав выборки: инженерные науки представляют 21–27% статей возрастом три года и менее и максимум 5% статей возрастом девять лет и старше, в то время как экономика представляет 9–12% и 37–54% в этих же группах, при этом медианный возраст статьи в экономике составляет девять лет против одного года в инженерных науках. Направление согласуется с мультипликатором дисциплины в Section 3.6. Величины не сравнимы, потому что этот мультипликатор основан на средних значениях за весь период на 94 подобластях одной дисциплины, а этот разброс — на медианах по 25 дисциплинам, и оба не скорректированы с учетом возраста. Медианные загрузки выше в старших возрастных группах, с неперекрывающимися 95% bootstrap доверительными интервалами между большинством соседних групп (медиана 12 в год публикации, 172 в период более десяти лет), что является возрастной зависимостью, мотивирующей аргумент класса сравнения. В пределах одной дисциплины различие сосредоточено в первые три-четыре года: между группой пять-десять и группой свыше десяти лет оно не достигает значимости (Mann-Whitney p = 0,57 для экономики, 0,82 для социальных наук, 0,23 для бизнеса). Примерно четверть совокупного градиента объясняется составом дисциплин, а не возрастом. Возраст в этой выборке также близко соответствует году публикации, поскольку половина снимков была сделана в одном сборе между 25 апреля и 7 мая 2025 г. и 81,5% попадают в 2025 г., поэтому возраст и когорта здесь не могут быть разделены, и группы отражают уровни, а не траекторию какой-либо отдельной статьи. Среднее значение выборки (219) совпадает с опубликованным средним значением маркетинговой сети (221) [83], в то время как медиана выборки (60) находится на уровне медианы по типу переписи (63) [139]. Table E2 дает распределение загрузок по возрасту статьи, а Table E3 — по дисциплине, обе с 95% bootstrap доверительными интервалами и размерами выборки. Доверительные интервалы наиболее широкие для наименьших дисциплин, что является причиной описания разброса по дисциплинам как примерно порядка величины, а не одного точного множителя. Начальный пример статьи можно непосредственно прочитать в сравнении с выборкой. Среди статей возрастом менее двух лет с 30–50 просмотрами аннотации, в группе, в которую попадает этот пример, медианное количество загрузок составляет 7, с интерквартильным размахом 4–11 (n = 42). Пример в названии является типичным примером для своей группы просмотров и возраста. В год публикации 35% выборки фиксируют 7 загрузок или меньше, медианное количество просмотров аннотации составляет 66, и собственная конверсия примера 17,5% находится на 57-м процентиле выборки. Полоса конверсии 11–19% в Section 5.2 — это полоса медиан, а не статей: 41% выборки попадает внутрь, 23% ниже и 36% выше. Половина выборки, 51%, находится ниже медианы по типу переписи 63 [139], что размещает зарождающийся диапазон в населенной части распределения.
Table E2. Распределение загрузок по возрасту статьи в архивной выборке.
| Возраст статьи | n | Медиана [95% CI] | Среднее | МВР (P25–P75) |
|---|---|---|---|---|
| год публикации | 203 | 12 [11–14] | 33 | 5–21 |
| 1 год | 253 | 25 [23–29] | 94 | 15–44 |
| 2–4 года | 375 | 52 [47–57] | 110 | 28–100 |
| 5–9 лет | 188 | 130 [110–151] | 384 | 72–374 |
| 10 лет и более | 341 | 172 [157–189] | 453 | 96–336 |
| Все статьи | 1,360 | 60 [55–69] | 219 | 23–158 |
Table E3. Распределение загрузок по дисциплине (дисциплины с n ≥ 20) в архивной выборке.
| Дисциплина (n ≥ 20) | n | Медиана [95% CI] | Среднее | МВР |
|---|---|---|---|---|
| Экономика | 285 | 150 [134–169] | 443 | 76–302 |
| Бизнес | 161 | 150 [126–188] | 335 | 72–330 |
| Психология | 24 | 107 [35–192] | 179 | 32–229 |
| Социальные науки | 241 | 85 [78–117] | 219 | 45–189 |
| Науки о принятии решений | 32 | 74 [56–158] | 615 | 49–260 |
| Информатика | 63 | 42 [36–73] | 167 | 26–104 |
| Медицина | 40 | 42 [24–59] | 81 | 22–66 |
| Сельск. хоз-во и биол. науки | 36 | 31 [24–57] | 65 | 23–67 |
| Биохимия | 21 | 30 [23–37] | 38 | 20–38 |
| Науки об окружающей среде | 72 | 26 [18–32] | 44 | 14–50 |
| Инженерные науки | 196 | 24 [20–26] | 46 | 13–46 |
| Физика и астрономия | 21 | 23 [15–38] | 112 | 13–45 |
| Наука о материалах | 55 | 18 [15–25] | 26 | 11–36 |
| Энергетика | 21 | 12 [11–22] | 25 | 11–22 |
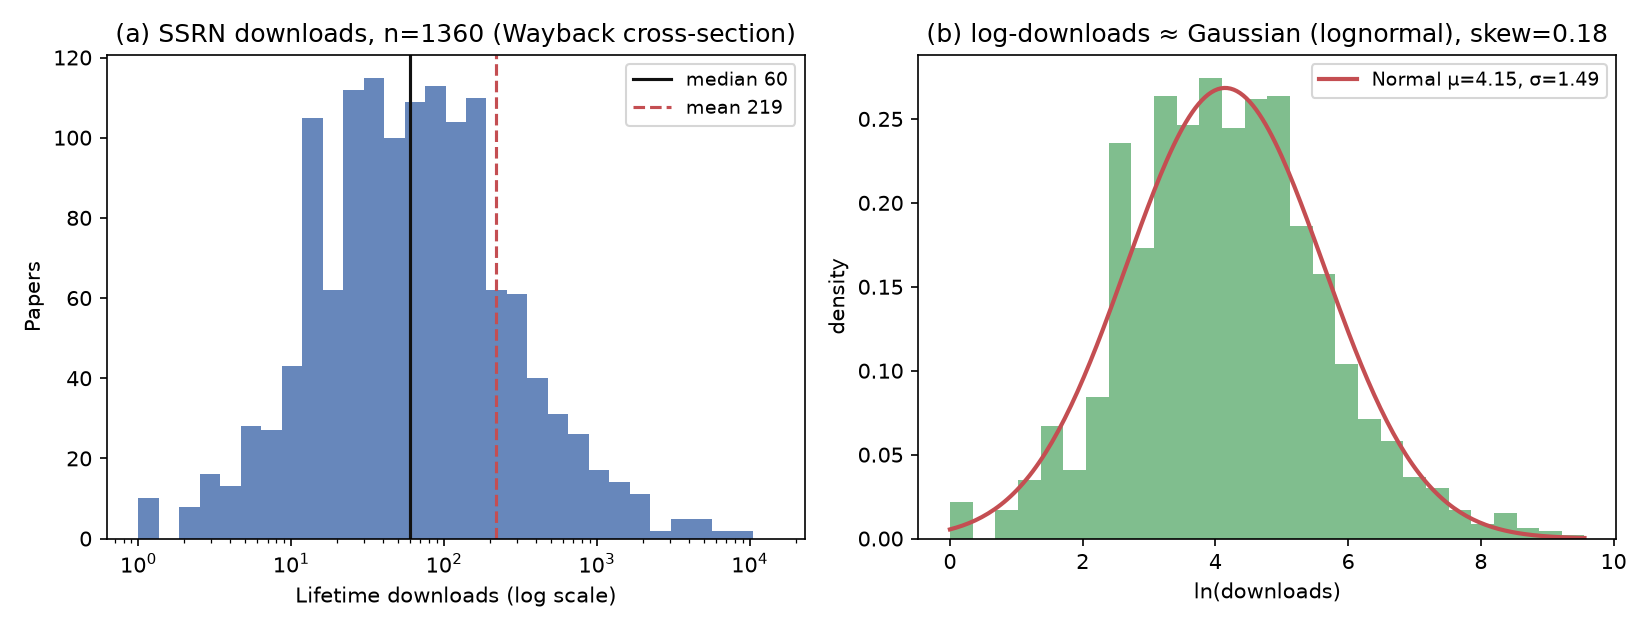
Рисунок E1. (a) Распределение загрузок в логарифмической шкале со отмеченными средним и медианой; (b) гистограмма ln(downloads) с подобранной нормальной плотностью. Асимметрия log-downloads ≈ 0.18. n = 1,360.
Таблица E4. Опубликованные якоря в сравнении с независимым архивным поперечным сечением (n = 1,360).
| Параметр | Опубликованный якорь | Архивное поперечное сечение |
|---|---|---|
| Средние загрузки | 221 (marketing) [83] | 219 |
| Медианные загрузки | 87 (marketing) [83]; 63 (law) [139] | 60 |
| Среднее / медиана | 2.54 [83] | 3.65 |
| 95-й перцентиль / медиана | > 8 [83] | 13.6 |
| Коэффициент конверсии загрузок в просмотры | диапазон 11–19% (§5.2) | медиана 16.2% |
| Разброс по полям (медианы) | ≈ 8× средних по полям, без корректировки по возрасту [168] | ≈ 3–5× при одинаковом возрасте; 12.5× объединённо |
| Форма распределения | логнормальное, только хвост [85] | логарифмическая асимметрия 0.18 (наблюдаемое основание) |
Что демонстрирует поперечное сечение. Поперечное сечение подтверждает форму распределения и его центральную и верхнюю структуру по дисциплинам на независимой выборке по всем полям, намного более широкой по охвату полей, чем любой отдельный опубликованный снимок SSRN. Оно не оценивает репрезентативные для платформы перцентили, и две особенности его конструкции смещают его вверх. Архивированные снимки переоценивают видимые страницы, поэтому статьи с высоким количеством загрузок имеют большую вероятность попадания в выборку. Статья также попадает в выборку только если имела архивированную страницу с читаемым счётчиком, что исключает экстремально низкий хвост: доля выборки статей с десятью или менее загрузками (около 10%) соответственно намного ниже 15–30%, предполагаемых Разделами 3.4 и 8.6 для непредвзятой полнопллатформенной выборки, и не должна интерпретироваться как оценка такой доли. То, что медиана выборки (60) тем не менее находится на уровне или ниже опубликованных юридических (63) и маркетинговых (87) медиан, указывает, что смещение вверх скромно для центральной массы и что выводы об асимметрии и тяжелом хвосте, если что, консервативны. Для откалиброванных бенчмарков надлежащими инструментами остаются рекомендованные в Разделе 10 полосы перцентилей, репрезентативные для платформы, и предварительно зарегистрированная панель Раздела 8.6; это поперечное сечение подтверждает, что структура, которую они будут измерять, совпадает с той, что описывает эта статья. Три полосы предсказания, которые фиксирует Study 1 заранее (Раздел 8.6), можно сопоставить с этой выборкой, учитывая её смещение вверх. Медиана выборки 60 загрузок находится внутри предсказанного диапазона 30–80. Коэффициент Джини внимания 0.75 находится на нижнем краю предсказанного диапазона 0.75–0.90, что соответствует направлению, предсказываемому смещением выборки, поскольку исключённый низкий хвост сжимает измеренное неравенство. Соотношение медиана-к-среднему 0.27 ниже предсказанного потолка 0.5. Ничто из этого не подтверждает проспективный дизайн, который ценен тем, что наблюдает документы с момента их размещения на основе вероятностной выборки; однако это подтверждает, что диапазоны были установлены правдоподобно.
Заявления
Доступность данных. Каждый синтезированный якорь, приведённый здесь, восходит к опубликованным источникам, цитируемым в тексте и таблицах, с указанием рамок выборки и статуса верификации в точке использования, и никакой новый набор данных, репрезентативный для генеральной совокупности, не лежит в основе заявлений статьи о бенчмарках. Единственный оригинальный набор данных, созданный для этой статьи, — это независимое архивное поперечное сечение Приложения E, случайная выборка по всем полям из 1,360 документов, чьи счётчики до снятия с учёта были восстановлены из общедоступных архивов, выпущенная как appendixE-wayback-downloads.csv (набор данных Приложения E, а не проспективное Study 1) вместе с кодом анализа, так что процедуру можно повторить и расширить; она подтверждает форму распределения и не является репрезентативным для платформы бенчмарком. Набор данных депонирован на https://doi.org/10.5281/zenodo.22285871 под лицензией CC BY 4.0, где тот же файл называется study1-wayback-downloads.csv, и он поставляется с открытым инструментом, который считывает количество загрузок в сопоставлении с ним, обусловливая как возраст документа, так и направление, находящимся на https://github.com/vadimchernets/ssrn-benchmark (лицензия MIT, только стандартная библиотека Python). Читатели, которые хотят поместить свой счётчик в этот референтный класс, могут запустить этот инструмент вместо того, чтобы воссоздавать анализ. Материалы для готового к предварительной регистрации плана Раздела 8, включая словарь переменных панели (Приложение C, Таблица C1) и инвентарь запросов аудита поиска, подготовлены для депозирования при предварительной регистрации (Раздел 8.8); вклады в реестр следуют подмножеству схемы, определённому в Разделе 8.8, и любой выпуск перцентилей из программы бенчмарков публикуется в соответствии со спецификацией прозрачности Приложения D. Шаблон отчётности CSAB Приложения B может быть свободно переиспользован при условии его правила пустых перцентилей. 24 августа 2026 года официальный запрос был подан в SSRN Support (билет 260824-003051) для совокупного класса ссылок, который подразумевали снятые с учёта Rankings — медиана, интерквартильный размах и полосы децилей загрузок, стратифицированные по направлению и возрасту документа, без идентификаторов документов; его результат (одобрение, отказ или отсутствие ответа) будет описан в последующей редакции.
Открытый доступ к этой статье. Открыто лицензированная копия этой рукописи депонирована на https://doi.org/10.5281/zenodo.22166896 (CC BY 4.0), где полный текст может быть получен прямо и без проблем с доступом. Депозит предоставляется потому, что каноническая запись на SSRN размещается за защитой от ботов, которая отклоняет клиентов без механизма JavaScript, условие, описанное в Разделе 4.2; читатели, менеджеры ссылок и автоматизированные клиенты, которые не могут получить доступ к канонической копии, могут получить тот же текст из депозита. Сопутствующие статьи депонированы на тех же условиях на https://doi.org/10.5281/zenodo.22166995 и https://doi.org/10.5281/zenodo.22168724.
Доступность кода. Код для сбора и анализа независимой архивной выборки приложения E выпущен вместе с его набором данных по адресу https://github.com/vadimchernets/ssrn-benchmark, так что процедура может быть воспроизведена и класс ссылок может быть переполучен из исходных счётчиков. Статья иным образом не сообщает о результатах, требующих кода анализа; шаблоны для создания рисунков для эмпирических планов раздела 8 будут выпущены как онлайн-приложение, сопровождающее материалы предварительной регистрации.
Этика. Эмпирические планы раздела 8 основаны на открыто отображаемых счётчиках на уровне работ и библиографических метаданных; любой сбор непубличной информации панели управления, дат статуса распределения или электронных писем требует информированного согласия и, где применимо, рассмотрения учреждением (см. раздел 9). Два плана, которые представляют исследование с участием людей, исследование 4 (опрос авторов) и исследование 3 (управляемая публикация с логированием входящей корреспонденции), будут поданы на рассмотрение в совет по рассмотрению в учреждении или в комитет по этике исследований и проведены с информированным согласием участников до начала сбора данных. Наборы данных сообщений агрегируются и обезличиваются перед любым отчётом, и сообщения сообщества цитируются только при наличии живого, проверяемого источника, с перефразированием в местах, где авторов можно было бы идентифицировать вопреки их ожиданиям. Сбор данных ограничивается средствами, разрешёнными условиями обслуживания платформ: планы используют открыто отображаемые счётчики и библиографические метаданные и не применяют скрейпинг, нарушающий условия использования платформы, и любой план, требующий массовых или непубличных данных, реализуется посредством формального запроса данных и юридического рассмотрения, а не автоматизированного извлечения. Цитирование содержимого полуоткрытого форума соблюдает согласие участников и риск переидентификации, поэтому такой материал перефразируется, а не воспроизводится дословно в местах, где автора можно было бы идентифицировать вопреки его ожиданиям. Статья не объявляет ни один конкретный журнал или издателя «хищным»; проверка издания применяет валидированные, прозрачные критерии, которые делают любую классификацию защищаемой и избегают клеветы.
Благодарности. Автор благодарит Stefanie Haustein за критические замечания, отправленные по электронной почте в августе 2026 года, которые привели к пересмотру раздела 4.2, и Vincent Larivière, чей вопрос в переписке — на какой единственной нормализации автор должен настаивать в первую очередь, и его настояние видеть данные, а не аргументы — побудили к архивной выборке, сообщённой в приложении E.
Конфликт интересов. Автор является разработчиком методов оркестрации многомодельных систем, обсуждаемых в разделе 8.10, которые открыты и воспроизводимы, интерес, который читатели должны взвесить. Автор является названным заявителем в ожидающих рассмотрения патентных заявках, а не в полученных патентах, касающихся оркестрации ИИ и систем многомодельной валидации, обсуждаемых в этом разделе. Предложенный в разделе 8.10 проект доставки слоя оркестрации является концептуальной спецификацией, на которой не зиждутся никакие выводы статьи. Раздел 8.10 может быть полностью исключен без изменения какого-либо диагноза, результата или рекомендации в остальной части статьи.
Инструменты и проверка. Помощники ИИ использовались в качестве инструментов под руководством автора; идеи, исследование и выводы принадлежат автору. Все количественные утверждения и ссылки были проверены автором на соответствие основным источникам или архивным копиям; автор несёт единоличную ответственность за содержание.
Литература
Источники, приведённые в тексте как [B-n] (страницы платформ, ветки форумов, записи блогов и прочие вспомогательные материалы), перечислены отдельно ниже в разделе «Дополнительные источники». Страницы платформ с датой доступа нестабильны и должны быть переповторно проверены по архивным копиям.
[1] AALL / ALL-SIS (2024, June 14). Citation Methods White Paper. https://www.aallnet.org/allsis/wp-content/uploads/sites/4/2024/07/ALL-SIS_CitationMethodsWhitePaper_6_14_24_final.pdf
[2] Abdill, R. J., & Blekhman, R. (2019). Tracking the popularity and outcomes of all bioRxiv preprints. eLife, 8, e45133. DOI 10.7554/eLife.45133
[3] Academia StackExchange (2016, May 28). "Importance of paper download statistics". https://academia.stackexchange.com/questions/69421/
[4] Adobe / Adobe Express Blog (2025; survey fielded May 2025). "Using ChatGPT as a search engine". https://www.adobe.com/express/learn/blog/chatgpt-as-a-search-engine
[5] Aggarwal, P., Murahari, V., Rajpurohit, T., Kalyan, A., Narasimhan, K., & Deshpande, A. (2024). GEO: Generative Engine Optimization. KDD '24. DOI 10.1145/3637528.3671900; arXiv:2311.09735
[6] Aguinis, H., & Solarino, A. M. (2019). Transparency and replicability in qualitative research. Strategic Management Journal, 40(8), 1291–1315. DOI 10.1002/smj.3015
[7] Algaba, A., Mazijn, C., Holst, V., Tori, F., Wenmackers, S., & Ginis, V. (2025). Large Language Models Reflect Human Citation Patterns with a Heightened Citation Bias. Findings of the Association for Computational Linguistics: NAACL 2025, 6844–6879. DOI 10.18653/v1/2025.findings-naacl.381; arXiv:2405.15739
[8] American Society for Cell Biology and co-signing organizations and individuals (2012/2013). San Francisco Declaration on Research Assessment (DORA). Drafted 16 December 2012 at the ASCB Annual Meeting, San Francisco; released 2013. https://sfdora.org/read/
[9] Ansari, S., Khan, M., Weinstein, D., Conant, E. F., Mirza-Aghazadeh-Attari, M., & Yousem, D. M. (2023). Pervasiveness of open journal invitations across radiology specialties. Current Problems in Diagnostic Radiology, 52(6), 534–539. DOI 10.1067/j.cpradiol.2023.04.002; PubMed 37150715
[10] Artisan Growth Strategies; Lenny's Newsletter; First Page Sage — freemium-conversion benchmarks. https://www.artisangrowthstrategies.com/blog/freemium-conversion-rate-benchmarks ; https://www.lennysnewsletter.com/p/what-is-a-good-free-to-paid-conversion
[11] arXiv (Cornell University). Help pages on submission formats. https://info.arxiv.org/help/submit_pdf.html ; https://info.arxiv.org/help/policies/format_requirements.html
[12] Bainbridge, S. (2026). "The Social Science Research Network Has Jumped the Shark" (03.06.2026), https://www.stephenbainbridge.com/p/the-social-science-research-network ; "SSRN Responds to My Complaints With Changes and/or Clarifications" (04.06.2026), https://www.stephenbainbridge.com/p/ssrn-responds-to-my-complaints-with
[13] Bauer-Wolf, J. (2022, November 16). Yale, Harvard law schools drop out of U.S. News rankings, saying they undermine legal profession's tenets. Higher Ed Dive. https://www.highereddive.com/news/yale-harvard-law-schools-drop-out-of-us-news-rankings-saying-they-under/636742/
[14] Beall, J. (2012). Хищные издатели портят открытый доступ. Nature, 489, 179. DOI 10.1038/489179a
[15] Bergstrom, C. T., & West, J. D. (2020). Calling Bullshit: The Art of Skepticism in a Data-Driven World. Random House.
[16] Bessembinder, H. (2018). Дают ли акции лучший результат, чем государственные облигации? Journal of Financial Economics, 129(3), 440–457. DOI 10.1016/j.jfineco.2018.06.004; SSRN 2900447
[17] Björk, B.-C., & Solomon, D. (2012). Открытый доступ в сравнении с журналами по подписке: сравнение научного влияния. BMC Medicine, 10:73. DOI 10.1186/1741-7015-10-73
[18] Black, B. S., & Caron, P. L. (2006). Ранжирование юридических школ: использование SSRN для измерения научной производительности. Indiana Law Journal, 81(1), 83 ff. SSRN abstract_id=784764; https://www.repository.law.indiana.edu/ilj/vol81/iss1/7/ ; PDF: https://ilj.law.indiana.edu/articles/81/81_1_Black.pdf
[19] Bollen, J., & Van de Sompel, H. (2008). Фактор влияния использования: влияние характеристик выборки на метрики влияния, основанные на использовании. Journal of the American Society for Information Science and Technology, 59(1), 136–149. DOI 10.1002/asi.20746
[20] Bornmann, L. (2014). Указывают ли альтметрики на более широкое влияние исследований? Journal of Informetrics, 8(4), 895–903. DOI 10.1016/j.joi.2014.09.005; arXiv:1406.7091
[21] Bornmann, L., & Haunschild, R. (2016). Как нормализовать количество твитов? Первая попытка, основанная на журналах в индексе Twitter. Scientometrics, 107(3), 1405–1422. DOI 10.1007/s11192-016-1893-6
[22] Bornmann, L., Leydesdorff, L., & Mutz, R. (2013). Использование процентилей и классов процентильного ранга в анализе библиометрических данных: возможности и ограничения. Journal of Informetrics, 7(1), 158–165. DOI 10.1016/j.joi.2012.10.001; arXiv:1211.0381
[23] Bornmann, L., & Haunschild, R. (2018). Нормализация данных с нулевым раздутием: эмпирический анализ нового семейства индикаторов и его использование с данными альтметрики. Journal of Informetrics, 12(3), 998–1011. DOI 10.1016/j.joi.2018.01.010
[24] Bourne, P. E., Polka, J. K., Vale, R. D., & Kiley, R. (2017). Десять простых правил, которые следует учитывать при отправке препринта. PLOS Computational Biology, 13(5), e1005473. DOI 10.1371/journal.pcbi.1005473
[25] Brody, T., Harnad, S., & Carr, L. (2006). Статистика использования веб-сайта как предикторы более позднего влияния на цитирование. JASIST, 57(8), 1060–1072. DOI 10.1002/asi.20373; arXiv cs/0503020
[26] Brown, C. (2003). Роль электронных препринтов в химической коммуникации: анализ цитирования, использования и принятия в литературе журналов. JASIST, 54(5), 362–371. DOI 10.1002/asi.10223
[27] Campbell, D. T. (1979). Оценка влияния планового социального изменения. Evaluation and Program Planning, 2(1), 67–90. DOI 10.1016/0149-7189(79)90048-X
[28] Carrell, S., Figlio, D., & Lusher, L. (2023). Перегруженность информационной супермагистрали: неэффективность в экономических рабочих документах. Journal of Public Economics, 225, 104978 (also NBER WP 29153)
[29] Casden, J., Romani, D., Shearer, T., & Campbell, J. (2025). Смягчение агрессивного трафика краулеров в эпоху генеративного ИИ: совместный подход библиотек Университета Северной Каролины в Чапел-Хилл. The Code4Lib Journal, 61. https://journal.code4lib.org/articles/18489
[30] Chen, Y., & Konstan, J. A. (2015). Онлайн-полевые эксперименты. Journal of the Economic Science Association, 1(1), 29–42. DOI 10.1007/s40881-015-0005-3
[31] Chu, H., & Krichel, T. (2007). Загрузки в сравнении с цитированиями в экономике: отношения, способствующие факторы и не только. In Proceedings of ISSI 2007 (11th International Conference of the International Society for Scientometrics and Informetrics), Madrid.
[32] Cobey, K. D., et al. (2019). Знания и мотивации исследователей, публикующих в предположительно хищных журналах. BMJ Open, 9(3), e026516. DOI 10.1136/bmjopen-2018-026516
[33] Cooley Law School Blog (2021, December 7). "Витрина вашей стипендии, часть третья: самостоятельное издание". https://cooley.edu/blog/showcase-your-scholarship-part-three-self-publishing
[34] CRIV Connection / CRIV Blog (2026, April 20). "Сеть социальных научных исследований (SSRN) прекращает коммерческие продукты". https://crivblog.com/2026/04/20/social-science-research-network-ssrn-ending-commercial-products/
[35] Crossref. документация REST API. https://www.crossref.org/documentation/retrieve-metadata/rest-api/
[36] Crossref. документация Similarity Check. https://www.crossref.org/documentation/similarity-check/similarity-report-understand/
[37] Davis, P. M., et al. (2008). Публикация открытого доступа, загрузки статей и цитирование: рандомизированное контролируемое исследование. BMJ, 337, a568. DOI 10.1136/bmj.a568
[38] Davis, P. M., & Fromerth, M. J. (2007). Приводит ли arXiv к более высокому цитированию и сокращенным загрузкам издателя для математических статей? Scientometrics, 71(2), 203–215. DOI 10.1007/s11192-007-1661-8
[39] Ding, Y., Dong, X., Bu, Y., Zhang, B., Lin, K., & Hu, B. (2021). Переосмысление связи между загрузками и цитированиями: перспектива от документов с различными моделями цитирования в случае The Lancet. Scientometrics, 126(9), 7609–7621. DOI 10.1007/s11192-021-04099-3
[40] Donovan, J. M., Watson, C. A., & Osborne, C. (2014). Преимущество открытого доступа для американских юридических обзоров. SSRN abstract_id=2506913. https://papers.ssrn.com/sol3/papers.cfm?abstract_id=2506913
[41] Dorta-González, P., & Dorta-González, M. I. (2023). Влияние финансирования на цитирование и социальное внимание: Цели устойчивого развития ООН (ЦУР) как тематическое исследование. Online Information Review, 47(7), 1358–1376. DOI 10.1108/OIR-05-2022-0300; arXiv:2304.00862
[42] Douma, M. J. (2021, January 12). "Сколько прочтений получает типичная академическая статья?" https://michaeljdouma.com/2021/01/12/how-many-reads-does-a-typical-academic-article-get/
[43] Du, Y., Li, S., Torralba, A., Tenenbaum, J. B., & Mordatch, I. (2023). Улучшение фактичности и рассуждений в языковых моделях посредством многоагентных дебатов. arXiv:2305.14325. https://arxiv.org/abs/2305.14325
[44] Edelman, B., & Larkin, I. (2015). Социальные сравнения и обман в иерархиях рабочего места: полевые и экспериментальные данные. Organization Science, 26(1), 78–98. DOI 10.1287/orsc.2014.0938; SSRN abstract_id=1346397; HBS WP 09-096 (circulated since 2009)
[45] Eisenberg, T. (2006). Оценка рейтингов юридических школ на основе SSRN. Indiana Law Journal, 81(1), 285–291. https://www.repository.law.indiana.edu/ilj/vol81/iss1/13/
[46] Elsevier (2016, May). "Elsevier приобретает Social Science Research Network (SSRN)…". PR Newswire. https://www.prnewswire.com/news-releases/elsevier-acquires-the-social-science-research-network-ssrn-the-leading-social-science-and-humanities-repository-and-online-community-579752311.html (also LSE Impact Blog, 18 May 2016)
[47] Elsevier Digital Commons. "SSRN Research Paper Series Sunset — DC Options". https://digitalcommons.elsevier.com/en_US/integration-preservation/ssrn-research-paper-series-sunset-dc-options
[48] Elsevier. "SSRN First Look" (страница продукта). https://www.elsevier.com/products/ssrn-preprint-services/first-look
[49] Elsevier. "SSRN for Authors and Researchers" (страница продукта). https://www.elsevier.com/products/ssrn-preprint-services/author-researchers
[50] Elsevier/SSRN Support. "How can researchers gauge a paper's impact?" https://www.elsevier.support/ssrn/answer/gauge-impact (дата обращения: 14.08.2026)
[51] Elsevier/SSRN Support. "What are RSS and Data Feeds on SSRN". https://www.elsevier.support/ssrn/answer/what-are-rss-and-data-feeds-on-ssrn
[52] Elsevier/SSRN Support. "What is SSRN?" https://www.elsevier.support/ssrn/answer/what-is-ssrn (дата обращения: 14.08.2026)
[53] Elsevier/SSRN Support. Classification and distribution. https://www.elsevier.support/ssrn/answer/classification-distribution (дата обращения: 14.08.2026)
[54] Elsevier/SSRN Support. Generative AI policy. https://www.elsevier.support/ssrn/answer/AI (дата обращения: 14.08.2026)
[55] Elsevier/SSRN Support. Google / Google Scholar indexing. https://www.elsevier.support/ssrn/answer/google-scholar (дата обращения: 14.08.2026)
[56] Elsevier/SSRN Support. Submission guidelines / Get started. https://www.elsevier.support/ssrn/answer/get-started (дата обращения: 14.08.2026)
[57] Elsevier/SSRN Support. Subscriptions (eJournal mailings). https://www.elsevier.support/ssrn/answer/subscriptions ; также https://www.ssrn.com/index.cfm/en/subscribe/
[58] Espeland, W. N., & Sauder, M. (2007). Rankings and reactivity: How public measures recreate social worlds. American Journal of Sociology, 113(1), 1–40. DOI 10.1086/517897
[59] Eysenbach, G. (2006). Citation Advantage of Open Access Articles. PLoS Biology, 4(5), e157. DOI 10.1371/journal.pbio.0040157
[60] Farys, R., & Wolbring, T. (2021). Matthew effects in science and the serial diffusion of ideas. Quantitative Science Studies, 2(2), 505–526. DOI 10.1162/qss_a_00129
[61] Fernández-Ramos, A., Comas-Forgas, R., & Rodríguez-Bravo, B. (2026). Identifying academic spam and recommendations for dealing with it: a literature review. European Science Editing, 52, e174423. DOI 10.3897/ese.2026.e174423 (опубликовано 8 мая 2026)
[62] Fraser, N., et al. (2020). The relationship between bioRxiv preprints, citations and altmetrics. Quantitative Science Studies, 1(2), 618–638. DOI 10.1162/qss_a_00043
[63] Fung, A., Razi, B., Basto, C., Bariol, S., Hossack, T., Baskaranathan, S., Ende, D., & Woo, H. (2026). Trust, but Verify: An Exploratory Audit of Predatory Journal and Publisher Solicitations. ANZ Journal of Surgery. DOI 10.1111/ans.70568
[64] Giannakakos, V., et al. (2025). Impact of author characteristics on outcomes of single- versus double-blind peer review: a systematic review of comparative studies in scientific abstracts and publications. Scientometrics, 130, 399–421. DOI 10.1007/s11192-024-05213-x
[65] Ginsparg, P. (2011). ArXiv at 20. Nature, 476(7359), 145–147. https://www.nature.com/articles/476145a
[66] Goldman, E. "SSRN and Download Statistics" (2005), https://personal.ericgoldman.org/ssrn_and_downlo/ ; "Update on SSRN", https://personal.ericgoldman.org/update_on_ssrn/
[67] Goodhart, C. A. E. (1975). Problems of monetary management: The U.K. experience. В Papers in Monetary Economics, Vol. I. Sydney: Reserve Bank of Australia. Переиздано в C. A. E. Goodhart (1984), Monetary Theory and Practice: The U.K. Experience (ch. 4). London: Macmillan. DOI 10.1007/978-1-349-17295-5_4
[68] Gordon, G. J. (2016). The Digital Lawyer's Evolving Education in Scholarly Research. SSRN abstract_id=2754647
[69] Gordon, G., Lin, J., Cave, R., & Dandrea, R. (2015). The Question of Data Integrity in Article-Level Metrics. PLOS Biology. https://pmc.ncbi.nlm.nih.gov/articles/PMC4546647/
[70] Grossman, R., Liu, S., Chen, M. K., Smith, M., Borcea, C., & Chen, Y. (2026). How Generative AI Disrupts Search: An Empirical Study of Google Search, Gemini, and AI Overviews. arXiv:2604.27790. https://arxiv.org/abs/2604.27790
[71] Guerrero-Bote, V. P., & Moya-Anegón, F. (2014). Relationship between downloads and citations at journal and paper levels, and the influence of language. Scientometrics. DOI 10.1007/s11192-014-1243-5
[72] Haque, A., & Ginsparg, P. (2009). Positional effects on citation and readership in arXiv. JASIST, 60(11), 2203–2218. DOI 10.1002/asi.21166
[73] Haque, A., & Ginsparg, P. (2010). Last but not least: Additional positional effects on citation and readership in arXiv. JASIST, 61(12), 2381–2388. DOI 10.1002/asi.21428; arXiv:1010.2757
[74] Haustein, S., Costas, R., & Larivière, V. (2015). Characterizing social media metrics of scholarly papers. PLOS ONE, 10(3), e0120495. DOI 10.1371/journal.pone.0120495
[75] Haustein, S., Bowman, T. D., Holmberg, K., Tsou, A., Sugimoto, C. R., & Larivière, V. (2016). Tweets as impact indicators: Examining the implications of automated "bot" accounts on Twitter. JASIST, 67(1), 232–238. DOI 10.1002/asi.23456
[76] Haustein, S., Bowman, T. D., & Costas, R. (2016). Interpreting "altmetrics": viewing acts on social media through the lens of citation and social theories. В: Theories of Informetrics and Scholarly Communication (De Gruyter Mouton), 372–405; arXiv:1502.05701
[77] Heald, P. J., & Sichelman, T. (2019). Ranking the Academic Impact of 100 American Law Schools. Jurimetrics, 60(1), 1–39 (осень 2019). SSRN abstract_id=3483325
[78] Hicks, D., Wouters, P., Waltman, L., de Rijcke, S., & Rafols, I. (2015). Bibliometrics: The Leiden Manifesto for research metrics. Nature, 520(7548), 429–431. DOI 10.1038/520429a. https://www.nature.com/articles/520429a
[79] Hirsch, J. E. (2005). An index to quantify an individual's scientific research output. PNAS, 102(46), 16569–16572.
[80] Hu, B., et al. (2021). On the relationship between download and citation counts: An introduction of Granger-causality inference. Journal of Informetrics, 15(2), 101125. DOI 10.1016/j.joi.2020.101125
[81] iThenticate/Turnitin. Руководства: "Understanding the Similarity Report"; "Preprints". https://guides.ithenticate.com/hc/en-us/articles/27842305774605 ; https://guides.ithenticate.com/hc/en-us/articles/27848481223693-Preprints
[82] Jaźwińska, K., & Chandrasekar, A. (2025, 6 марта). AI search has a citation problem. Columbia Journalism Review / Tow Center. https://www.cjr.org/tow_center/we-compared-eight-ai-search-engines-theyre-all-bad-at-citing-news.php
[83] Jo, W., & Li, J. (2026). Может ли ИИ снизить премию репутации при диффузии знаний? Свидетельства из маркетинговых рабочих документов SSRN. Marketing Letters, 37, Article 32. DOI 10.1007/s11002-026-09827-4
[84] Justin, G. A., et al. (2024). Анализ приглашений от хищнических журналов в офтальмологии. American Journal of Ophthalmology. PMC11257792; https://www.ajo.com/article/S0002-9394(24)00087-4/abstract — источник цифры «1813 писем»
[85] Kakushadze, Z. (2016). Индекс для загрузок SSRN. Journal of Informetrics, 10(1), 9–28. DOI 10.1016/j.joi.2015.11.005; arXiv:1511.04275; SSRN 2656600
[86] Kim, Heekyung Hellen (2014). Влияние открытого доступа (AEA Conference 2014). https://www.aeaweb.org/conference/2014/retrieve.php?pdfid=58
[87] Kim, T., Bock, K., Luo, C., Liswood, A., Poroslay, C., & Wenger, E. (2025). Скреперы выборочно соблюдают директивы robots.txt: свидетельства из крупномасштабного эмпирического исследования. Proceedings of the ACM Internet Measurement Conference (IMC '25). DOI 10.1145/3730567.3764471
[88] Kleinberg, J., Ludwig, J., Mullainathan, S., & Obermeyer, Z. (2015). Проблемы политики предсказания. American Economic Review, 105(5), 491–495. DOI 10.1257/aer.p20151023
[89] Kozak, M., Iefremova, O., & Hartley, J. (2016). Спамирование в научных изданиях: тематическое исследование. JASIST, 67(8), 2009–2015. DOI 10.1002/asi.23521
[90] Kraker, P., & Lex, E. (2015). Критический взгляд на ResearchGate Score как показатель научной репутации. Presented at ASCW'15 (Quantifying and Analysing Scholarly Communication on the Web), Web Science Conference 2015, Oxford. http://ascw.know-center.tugraz.at/2015/05/26/kraker-lex-a-critical-look-at-the-researchgate-score/ (популярная версия: «ResearchGate Score: хороший пример плохого показателя», LSE Impact Blog, 9 Dec 2015)
[91] Kurtz, M. J., et al. (2005). Библиометрические свойства информации о прочтении статей. JASIST, 56(2), 111–128. DOI 10.1002/asi.20096
[92] Kurtz, M. J., & Bollen, J. (2010). Библиометрия использования. Annual Review of Information Science and Technology, 44(1), 3–64. DOI 10.1002/aris.2010.1440440108
[93] Langham-Putrow, A., et al. (2021). Является ли преимущество цитирования открытого доступа реальным? Систематический обзор цитирования статей открытого доступа и платных статей. PLOS ONE, 16(6), e0253129. DOI 10.1371/journal.pone.0253129
[94] Larivière, V., Haustein, S., & Mongeon, P. (2015). Олигополия академических издателей в цифровую эпоху. PLOS ONE, 10(6), e0127502. DOI 10.1371/journal.pone.0127502
[95] Legal Writing Institute. «Советы по публикации» (PDF). https://www.lwionline.org/sites/default/files/Publishing-Tips.pdf
[96] Lewinski, A. A., & Oermann, M. H. (2018). Характеристики электронных приглашений от хищнических журналов по сестринскому делу и издателей. The Journal of Continuing Education in Nursing, 49(4), 171–177. DOI 10.3928/00220124-20180320-07
[97] Liang, W., Yuksekgonul, M., Mao, Y., Wu, E., & Zou, J. (2023). Детекторы GPT предвзяты по отношению к авторам, не являющимся носителями английского языка. Patterns, 4(7), 100779. DOI 10.1016/j.patter.2023.100779
[98] Lloyd, T. (2026, May 7). Гостевой пост — Любовь, Смерть и Роботы: Научное издание. The Scholarly Kitchen. https://scholarlykitchen.sspnet.org/2026/05/07/guest-post-love-death-robots-scholarly-edition/
[99] LogEc / RePEc. О LogEc (методология фильтрации трафика). https://logec.repec.org/about.htm ; https://logec.repec.org/
[100] Martinez, O. (2026). Оптимизация видимости в генеративных системах: критический обзор оптимизации генеративных систем (2023–2026). arXiv:2607.14035 (submitted 15 July 2026). https://arxiv.org/abs/2607.14035
[101] Maynooth University News (2026, January). «Школа права и криминологии Университета Мейнута занимает первое место…». https://www.maynoothuniversity.ie/news-events/maynooth-university-s-school-law-and-criminology-ranks-first-social-science-research-networks-2
[102] McGillivray, B., & Astell, M. (2019). Отношение между использованием и цитированием в мегажурнале открытого доступа. Scientometrics, 121, 817–838. DOI 10.1007/s11192-019-03228-3
[103] Medoff, M. H. (2006). Свидетельства эффекта Матфея Гарварда и Чикаго. Journal of Economic Methodology, 13(4), 485–506. DOI 10.1080/13501780601049079
[104] Merton, R. K. (1968). Эффект Матфея в науке. Science, 159(3810), 56–63. DOI 10.1126/science.159.3810.56
[105] Merton, R. K. (1988). Эффект Матфея в науке, II: кумулятивное преимущество и символизм интеллектуальной собственности. Isis, 79(4), 606–623. DOI 10.1086/354848
[106] Microsoft Learn. «Безопасные ссылки в Microsoft Defender для Office 365». https://learn.microsoft.com/en-us/defender-office-365/safe-links-about (+ Microsoft Q&A по кликам в UrlClickEvents; + информация о ложных открытиях)
[107] Milanovic, M. EJIL:Talk! «Академический спам [ОБНОВЛЕНО]». https://www.ejiltalk.org/academic-spam/
[108] Moed, H. F., & Halevi, G. (2016). О загрузке полного текста и распределении цитирования в научных журналах. JASIST, 67(2), 412–431. DOI 10.1002/asi.23405
[109] Moed, H. F. (2017). Applied Evaluative Informetrics. Springer. DOI 10.1007/978-3-319-60522-7
[110] Moher, D., et al. (2018). Оценка учёных при найме, повышении по должности и получении должности. PLoS Biology, 16(3), e2004089. DOI 10.1371/journal.pbio.2004089
[111] Morgan, A. C., et al. (2018). Престиж способствует эпистемическому неравенству при распространении научных идей. EPJ Data Science, 7:40. DOI 10.1140/epjds/s13688-018-0166-4
[112] Muchnik, L., Aral, S., & Taylor, S. J. (2013). Смещение социального влияния: рандомизированный эксперимент. Science, 341(6146), 647–651. DOI 10.1126/science.1240466
[113] Muller, J. Z. (2018). The Tyranny of Metrics. Princeton, NJ: Princeton University Press. ISBN 978-0-691-17495-2.
[114] Nature Neuroscience, Editorial (2008). https://www.nature.com/articles/nn0608-619
[115] Northwestern University LibGuides (оценка исследований/показатели). https://libguides.northwestern.edu/c.php?g=1372178&p=10205721
[116] Ohm, P. (2007). Влияют ли блоги на загрузки SSRN? Эмпирическая проверка эффектов Волоха и Slashdot. U. Colorado Law Legal Studies Research Paper No. 07-15. https://ssrn.com/abstract=980484
[117] Pace Law Library. «Опубликуйте — руководство для членов юридического обзора». https://libraryguides.law.pace.edu/lawreviews/publishing
[118] Paperpile. «Что такое хороший индекс Хирша?» https://paperpile.com/g/what-is-a-good-h-index/ (похожие руководства: Elsevier, Researcher.Life, Academia Insider)
[119] Perneger, T. V. (2004). Связь между количеством онлайн-просмотров и последующим цитированием: перспективное исследование исследовательских работ в BMJ. BMJ, 329(7465), 546–547. DOI 10.1136/bmj.329.7465.546
[120] Petersen, A. M., et al. (2014). Репутация и влияние в научных карьерах. PNAS, 111(43), 15316–15321. DOI 10.1073/pnas.1323111111
[121] Pew Research Center (2026, June 17). Americans and AI 2026: Chatbots, Smart Devices and AI's Impact. https://www.pewresearch.org/internet/2026/06/17/americans-and-ai-2026-chatbots-smart-devices-and-views-on-impact/
[122] Piwowar, H. (2013). Altmetrics: Value all research products. Nature, 493(7431), 159. https://www.nature.com/articles/493159a
[123] Priem, J., Taraborelli, D., Groth, P., & Neylon, C. (2010). Altmetrics: A manifesto. http://altmetrics.org/manifesto/ (архивная копия на web.archive.org)
[124] Priem, J., Piwowar, H., & Orr, R. (2022). OpenAlex: A fully-open index of scholarly works, authors, venues, institutions, and concepts. arXiv:2205.01833. DOI 10.48550/arXiv.2205.01833
[125] Project COUNTER (2026). COUNTER Code of Practice, Release 5.1.1. Published 30 June 2026 (Release 5.1 published 5 May 2023). https://www.countermetrics.org/ ; "Best Practice on AI Usage" (guidance for R5.1.1, updated 30 June 2026), https://www.countermetrics.org/code-of-practice/best-practice/bp-ai/
[126] Quora. "To what extent would you recommend or discourage publishing an academic working paper on SSRN…". https://www.quora.com/To-what-extent-would-you-recommend-or-discourage-publishing-an-academic-working-paper-on-SSRN-to-claim-and-put-a-stake-in-the-ground-e-g-before-any-journal-submission
[127] Reddit r/AskAcademia (2023, August 10). Thread 15newc2 "Endless spam since I published a paper a few months ago". https://www.reddit.com/r/AskAcademia/comments/15newc2/ (подтверждено через архив pullpush.io)
[128] Remler, D. (2014, April 23). Are 90% of academic papers really never cited? Reviewing the literature on academic citations. LSE Impact Blog. https://blogs.lse.ac.uk/impactofsocialsciences/2014/04/23/academic-papers-citation-rates-remler/
[129] RePEc Blog: "How RePEc counts views and downloads" (06.11.2021), https://blog.repec.org/2021/11/06/how-repec-counts-views-and-downloads/ ; "AI issues in RePEc" (10.11.2025), https://blog.repec.org/2025/11/10/ai-issues-in-repec/ ; "RePEc in June 2026" (13.07.2026), https://blog.repec.org/2026/07/13/repec-in-june-2026/
[130] ResearchGate (2022, August). "Removing the RG Score". https://www.researchgate.net/researchgate-updates/removing-the-rg-score
[131] Salganik, M. J., Dodds, P. S., & Watts, D. J. (2006). Experimental study of inequality and unpredictability in an artificial cultural market. Science, 311, 854–856. DOI 10.1126/science.1121066
[132] Sauder, M., & Espeland, W. N. (2009). The discipline of rankings: Tight coupling and organizational change. American Sociological Review, 74(1), 63–82. DOI 10.1177/000312240907400104
[133] Schein, A. I., Popescul, A., Ungar, L. H., & Pennock, D. M. (2002). Methods and metrics for cold-start recommendations. In Proceedings of the 25th Annual International ACM SIGIR Conference on Research and Development in Information Retrieval (SIGIR '02), 253–260. DOI 10.1145/564376.564421
[134] Schumann, E. SSRN R package. https://github.com/enricoschumann/SSRN (также скрейперы github.com/talsan/ssrn, github.com/karthiktadepalli1/ssrn-scraper)
[135] Shearer, K., & Walk, P. (2025, June 3). The impact of AI bots and crawlers on open repositories: Results of a COAR survey, April 2025. Confederation of Open Access Repositories. https://coar-repositories.org/wp-content/uploads/2025/06/Report-of-the-COAR-Survey-on-AI-Bots-June-2025-1.pdf
[136] Shen, C., & Björk, B.-C. (2015). 'Predatory' open access: a longitudinal study of article volumes and market characteristics. BMC Medicine, 13, 230. DOI 10.1186/s12916-015-0469-2
[137] Shepherd, P. T. (2007). The feasibility of developing and implementing journal usage factors: a research project sponsored by UKSG. Serials: The Journal for the Serials Community, 20(2), 117–123. DOI 10.1629/20117
[138] Shuai, X., Pepe, A., & Bollen, J. (2012). How the scientific community reacts to newly submitted preprints. PLOS ONE, 7(11), e47523. DOI 10.1371/journal.pone.0047523
[139] Siems, M. M. (2016). Legal Research in Search of Attention: A Quantitative Assessment. King's Law Journal, 27(2), 170–187. DOI 10.1080/09615768.2015.1105560. Working-paper version: "What Determines SSRN Downloads", SSRN abstract_id=2836950; Durham: https://durham-repository.worktribe.com/OutputFile/1387250
[140] Simcoe, T. S., & Waguespack, D. M. (2011). Status, Quality, and Attention: What's in a (Missing) Name? Management Science, 57(2), 274–290. DOI 10.1287/mnsc.1100.1270
[141] Simon, H. A. (1971). Designing organizations for an information-rich world. In M. Greenberger (Ed.), Computers, Communications, and the Public Interest (pp. 37–72). Johns Hopkins Press.
[142] Soler, J., & Cooper, A. (2019). Unexpected Emails to Submit Your Work: Spam or Legitimate Offers? Publications, 7(1), 7. DOI 10.3390/publications7010007
[143] SSRN (2018, April 13). eLibrary Stats announcement. https://www.ssrn.com/index.cfm/en/fen/ads/04132018ann014/
[144] SSRN Blog (2018, June 5). What SSRN Means When We Talk About Data Integrity. https://blog.ssrn.com/2018/06/05/what-ssrn-means-when-we-talk-about-data-integrity/
[145] SSRN Blog (2025, December 16). 2025 Year in Review: How SSRN Enhanced Access to Preprints and Early-Stage Research. https://blog.ssrn.com/2025/12/16/2025-year-in-review-how-ssrn-enhanced-access-to-preprints-and-early-stage-research/
[146] SSRN Blog (2026, April 13). SSRN Strategic Update: Renewed Focus on Core Research Sharing Mission (post author: S. Decker-Lucke). https://blog.ssrn.com/2026/04/13/ssrn-strategic-update-renewed-focus-on-core-research-sharing-mission/
[147] SSRN Blog (2026, June 4). SSRN's Ongoing Commitment to Legal Scholarship. https://blog.ssrn.com/2026/06/04/ssrns-ongoing-commitment-to-legal-scholarship/
[148] SSRN Blog (2026, June 12). SSRN to Sunset Rankings from July 1st 2026. https://blog.ssrn.com/2026/06/12/ssrn-to-sunset-rankings-from-july-1st-2026/
[149] SSRN Blog (2026, July 15). SSRN Ranking has sunsetted as of 15 July 2026. https://blog.ssrn.com/2026/07/15/ssrn-to-sunset-rankings-from-15th-july-2026/
[150] SSRN Blog (2026, July 20). SSRN will now allow you to choose the licence that's right for your work. https://blog.ssrn.com/2026/07/20/ssrn-will-now-allow-you-to-choose-the-licence-thats-right-for-your-work/
[151] SSRN. Historical FAQ (PDF copy, Scuola Superiore Sant'Anna). https://www.sssup.it/UploadDocs/4461_SSRN_FAQ.pdf
[152] SSRN. Страница подписки. https://www.ssrn.com/index.cfm/en/subscribe/
[153] Sugimoto, C. R., & Larivière, V. (2018). Measuring Research: What Everyone Needs to Know. Oxford University Press. ISBN 9780190640118
[154] Sun, M., Barry Danfa, J., & Teplitskiy, M. (2022). Снижает ли двойное слепое рецензирование предвзятость? Доказательства с ведущей конференции по компьютерным наукам. JASIST, 73(6), 811–819. DOI 10.1002/asi.24582 (фамилия второго автора согласно Crossref: "Barry Danfa")
[155] Sureda-Negre, J., Calvo-Sastre, A., & Comas-Forgas, R. (2022). Хищнические журналы и издатели: характеристики и влияние академического спама на исследователей в области педагогических наук. Learned Publishing, 35(4), 441–447. DOI 10.1002/leap.1450
[156] Блог TaxProf (Caron, P.): "SSRN e-Journal Rankings By Average Downloads Per Paper" (2018, май), https://taxprof.typepad.com/taxprof_blog/2018/05/ssrn-e-journal-rankings-by-average-downloads-per-paper.html ; "SSRN Has Not Jumped the Shark" (07.06.2026), https://taxprofblog.aals.org/2026/06/07/
[157] Teixeira da Silva, J. A., Tsigaris, P., & Moussa, S. (2023). Может ли ИИ обнаружить хищнические журналы? Случай журналов FT50. SSRN abstract_id=4391108. DOI 10.2139/ssrn.4391108
[158] Thales / Imperva (2025). Отчет Imperva о вредоносных ботах 2025. https://cpl.thalesgroup.com/about-us/newsroom/2025-imperva-bad-bot-report-ai-internet-traffic
[159] Think. Check. Submit. (2022, 4 февраля). "Is a journal interested in your preprint? Separating the wheat from the chaff in journal solicitations to submit". https://thinkchecksubmit.org/2022/02/04/is-a-journal-interested-in-your-preprint-separating-the-wheat-from-the-chaff-in-journal-solicitations-to-submit/
[160] Tomlinson, O. W. (2023). Анализ хищнических писем в ранней карьере ученого и попытки их предотвращения. Learned Publishing, 36(2), 156–163. DOI 10.1002/leap.1500
[161] University of Washington Gallagher Law Library. LibGuide "SSRN Metrics" (обновлено 29 сентября 2025). https://lib.law.uw.edu/c.php?g=1238218&p=9061272 (+ страница p=9061269 об электронных журналах)
[162] van de Rijt, A., et al. (2014). Полевые эксперименты динамики самоусиливающегося успеха. PNAS, 111(19), 6934–6939. DOI 10.1073/pnas.1316836111
[163] Vanderbilt University, Brightspace (Center for Teaching / Office of Innovative Technologies) (2023). Руководство по обнаружению ИИ и причины отключения детектора ИИ Turnitin. Опубликовано 16 августа 2023 г. https://www.vanderbilt.edu/brightspace/2023/08/16/guidance-on-ai-detection-and-why-were-disabling-turnitins-ai-detector/ (доступ получен 15 августа 2026 г.).
[164] Vishwakarma, R., Kumar, A., & Jamidar, S. (2026). Что цитируется: конкурентная оптимизация в системах ответов на основе ИИ. SIGIR '26, 4950–4954. DOI 10.1145/3805712.3808445; arXiv:2605.25517
[165] Wallace, K. L., Hartley, M., & Lepird, C. (2023). Расширение Drake Journal of Agricultural Law: выпуск зеленого направления. Drake Journal of Agricultural Law, 28, 114–127. https://aglawjournal.wp.drake.edu/wp-content/uploads/sites/66/2023/07/Wallace-Ready-for-PRODUCTION.pdf
[166] Wang, J., Veugelers, R., & Stephan, P. (2017). Предвзятость против новизны в науке. Research Policy, 46(8), 1416–1436. DOI 10.1016/j.respol.2017.06.006
[167] Weinberg, M. (2025, июнь). Вытесняют ли боты ИИ культурное наследие в оффлайн? GLAM-E Lab (NYU Engelberg Center / University of Exeter). https://www.glamelab.org/files/Are_AI_Bots_Knocking_Cultural_Heritage_Offline.pdf
[168] Whalen, R. (2018, 3 мая). Электронные журналы SSRN и загрузки. https://ryanwhalen.com/2018/05/03/ssrn-e-journals-and-downloads/
[169] Wherry, J. L. (2022). Инструменты для улучшения распределения, обсуждения и загрузок… SSRN abstract_id=4191909. DOI 10.2139/ssrn.4191909 (опубликовано в U. Detroit Mercy Law Review)
[170] Wikipedia: "Social Science Research Network"; "List of academic journals by preprint policy"; "Preprint". https://en.wikipedia.org/wiki/Social_Science_Research_Network и связанные страницы.
[171] Willey, R., & Knapp, M. (2021). Как увеличить цитирование юридических работ. Ohio State Technology Law Journal, 18. SSRN 3801190; PDF: https://moritzlaw.osu.edu/sites/default/files/2022-01/HOW%20TO%20INCREASE%20CITATIONS%20TO%20LEGAL.pdf
[172] Willey, R., & Knapp, M. (2022/2023). Влияние SSRN на цитирование юридических работ и способы его максимизации. University of Arkansas at Little Rock Law Review, 45(3), 475–507. SSRN abstract_id=4037744; https://research.ualr.edu/bowen_lawreview/vol45/iss3/2/
[173] Wilsdon, J., et al. (2015). Волна метрик: доклад независимого обзора роли метрик в оценке научных исследований и управлении ими. HEFCE. DOI 10.13140/RG.2.1.4929.1363. https://doi.org/10.13140/RG.2.1.4929.1363
[174] Wilson, P. (2022). Незапрашиваемые предложения: выявление характеристик незапрашиваемых писем от потенциально хищнических журналов и роль библиотекарей. Journal of the Medical Library Association, 110(4), 520–524. DOI 10.5195/jmla.2022.1554; PMC10124592. https://pmc.ncbi.nlm.nih.gov/articles/PMC10124592/
[175] WisBlawg, UW–Madison Law Library (2016, 21 сентября). "Which Legal Articles Generate the Most Attention on SSRN". https://wisblawg.law.wisc.edu/2016/09/21/which-legal-articles-generate-the-most-attention-on-ssrn
[176] Wood-Doughty, A., Bergstrom, T., & Steigerwald, D. G. (2019). Надежно ли отчеты о загрузках измеряют использование журнала? College & Research Libraries, 80(5). https://crl.acrl.org/index.php/crl/article/view/17824/19653
[177] Wouters, P., & Costas, R. (2012). Пользователи, нарциссизм и контроль — отслеживание воздействия научных публикаций в XXI веке. SURF Foundation, Utrecht. https://www.cni.org/news/surf-report-users-narcissism-and-control
[178] Yuret, T. (2026). Доступы к статьям: связи с цитированиями, эффекты выходных и сезонность. Scientometrics (опубликовано 23.07.2026). DOI 10.1007/s11192-026-05710-1
[179] Zahedi, Z., Costas, R., & Wouters, P. (2017). Читатели Mendeley как инструмент фильтрации для выявления высокоцитируемых публикаций. Journal of the Association for Information Science and Technology, 68(10), 2511–2521. DOI 10.1002/asi.23883
[180] Zhu, L., & Lerman, K. (2016). Неравенство внимания в социальных сетях. arXiv:1601.07200
[181] Sinatra, R., Wang, D., Deville, P., Song, C., & Barabási, A.-L. (2016). Количественная оценка эволюции индивидуального научного воздействия. Science, 354(6312), aaf5239. DOI 10.1126/science.aaf5239
[182] Radicchi, F., Fortunato, S., & Castellano, C. (2008). Универсальность распределений цитирования: к объективной мере научного воздействия. PNAS, 105(45), 17268–17272. DOI 10.1073/pnas.0806977105
[183] CoARA (2022). Соглашение о реформировании оценки научных исследований. Coalition for Advancing Research Assessment. https://coara.eu/agreement/the-agreement-full-text/
[184] Curry, S., Gadd, E., & Wilsdon, J. (2022). Использование волны метрик: показатели, инфраструктура и приоритеты ответственной оценки научных исследований в Великобритании. Research on Research Institute. https://doi.org/10.6084/m9.figshare.21701624
[185] IRUS (Jisc). Стандартизированная статистика использования репозиториев в соответствии с COUNTER. https://irus.jisc.ac.uk
[186] UK Research and Innovation (2024). Résumé for Research and Innovation (R4RI): руководство. https://www.ukri.org/apply-for-funding/develop-your-application/resume-for-research-and-innovation-r4ri-guidance/
[187] Overton. Инструмент политической аналитики. https://www.overton.io
[188] CC-PLUS. Consortia Collaborating on a Platform for Library Usage Statistics (открытый сбор SUSHI/COUNTER-5; финансируется IMLS, PALCI и др.). https://www.cc-plus.org/
[189] HELIOS Open. Higher Education Leadership Initiative for Open Scholarship. https://www.heliosopen.org/
Дополнительные источники
Дополнительные источники, цитируемые в тексте как [B-n]: страницы платформ, ветки форумов, записи блогов и другие материалы, поддерживающие конкретные моменты в тексте. Страницы платформ нестабильны и должны быть перепроверены по архивным копиям.
[B-1] Cabells Predatory Reports (активный сервис скрининга хищнических журналов); Beall's List (только архивная версия; не обновляется с января 2017 г.).
[B-2] Caron, P. TaxProf Blog (2026, January 25). "The SSRN Top Five New Tax Papers Ranking Is Broken". https://taxprofblog.aals.org/2026/01/25/the-ssrn-top-five-new-tax-papers-ranking-is-broken/
[B-3] EconJobRumors (EJMR), ветки обсуждений о загрузках SSRN и рейтингах авторов (например, /topic/ssrn-downloads-and-views; /topic/top-10-of-authors-on-ssrn-by-downloads). Анонимный форум; цитируется только как свидетельство существования таких обсуждений.
[B-4] de Leon, F. L. L., & McQuillin, B. (2020). The Role of Conferences on the Pathway to Academic Impact. Journal of Human Resources, 55(1), 164. https://jhr.uwpress.org/content/55/1/164
[B-5] Reddit r/AskAcademia, thread 1seeyq3 (6 Apr 2026, "I've uploaded a working paper to SSRN… honest advice"); Reddit r/academia, thread 13w6zjw (31 May 2023, "SSRN Approval Time is Absurd"). Существование подтверждено архивами Reddit третьей стороны.
[B-6] SSRN — статистический шаблон объявлений (например, https://www.ssrn.com/index.cfm/en/ern/ads/06042025ann001/) и объявление от апреля 2018 г. (04132018ann002). Страницы платформы; проверьте по архивным копиям. Архивная копия: https://web.archive.org/web/20251229194317/https://www.ssrn.com/index.cfm/en/ern/ads/06042025ann001/ (снимок от 29 декабря 2025 г.; дата обращения 15 августа 2026 г.).
[B-7] SSRN FAQ — версионирование и ORCID. https://www.ssrn.com/index.cfm/en/faq/ (дата обращения 2026; проверьте по архивной копии).
[B-8] SSRN — целевая страница "SSRN has Sunset Rankings". https://www.ssrn.com/ssrn/rankings-sunset. Архивная копия: https://web.archive.org/web/20260719233259/https://www.ssrn.com/ssrn/rankings-sunset (снимок 19 июля 2026 г.; дата обращения 15 августа 2026 г.).
[B-9] SSRN — страницы исторических рейтингов на hq.ssrn.com / papers.ssrn.com/topten: Top 10,000 Papers (TRN_gID=10), Top 30,000 Authors (TRN_gID=7), Top 3,000 Law Authors, Top 350 U.S. Law Schools, Top 500 International Law Schools, Eigenfactor, Recent Top Papers (60 days), "Ranking Data Explained" (ranking_data_explain.cfm?id=6 / id=10). Исторические страницы; с 15 июля 2026 г. эти URL возвращают ответы 403/заполнитель — цитируйте по архивным копиям. Архивная копия страницы Top 10,000 Papers: https://web.archive.org/web/20260714112806/https://hq.ssrn.com/rankings/Ranking_display.cfm?TRN_gID=10 (снимок 14 июля 2026 г., день перед закатом; дата обращения 15 августа 2026 г.).
[B-10] Teixeira da Silva, J. A. (2024/2025). Spam, unwanted or unsolicited emails following the publication of preprints (year-long observation: 875 invitations from 256 journals, 76% from blocklists). DOI 10.1080/10875301.2025.2550600; ResearchGate publication 384286174.
[B-11] Caron, P. TaxProf Blog (2026, June 7). "SSRN Has Not Jumped the Shark". https://taxprofblog.aals.org/2026/06/07/ssrn-has-not-jumped-the-shark/ (ответ на Bainbridge [12]; дата обращения сентябрь 2026).
Корреспонденция: vadimchernets9@gmail.com.↩︎
Как цитировать
Chernets, V. (2026). What Does 7 Downloads Mean? Metric Blindness and the Cold Start of Scholarly Attention After the SSRN Rankings Sunset [Preprint]. SSRN. https://doi.org/10.2139/ssrn.7296358
@misc{chernets2026downloadmetrics,
  author       = {Chernets, Vadym},
  title        = {{What Does 7 Downloads Mean? Metric Blindness and the Cold Start of Scholarly Attention After the SSRN Rankings Sunset}},
  year         = {2026},
  howpublished = {SSRN},
  doi          = {10.2139/ssrn.7296358},
  url          = {https://doi.org/10.2139/ssrn.7296358}
}