ИИ для судебных документов: обнаружьте ложные цитаты перед подачей
Это перевод. Основная версия — оригинал на английском; ссылайтесь на него.
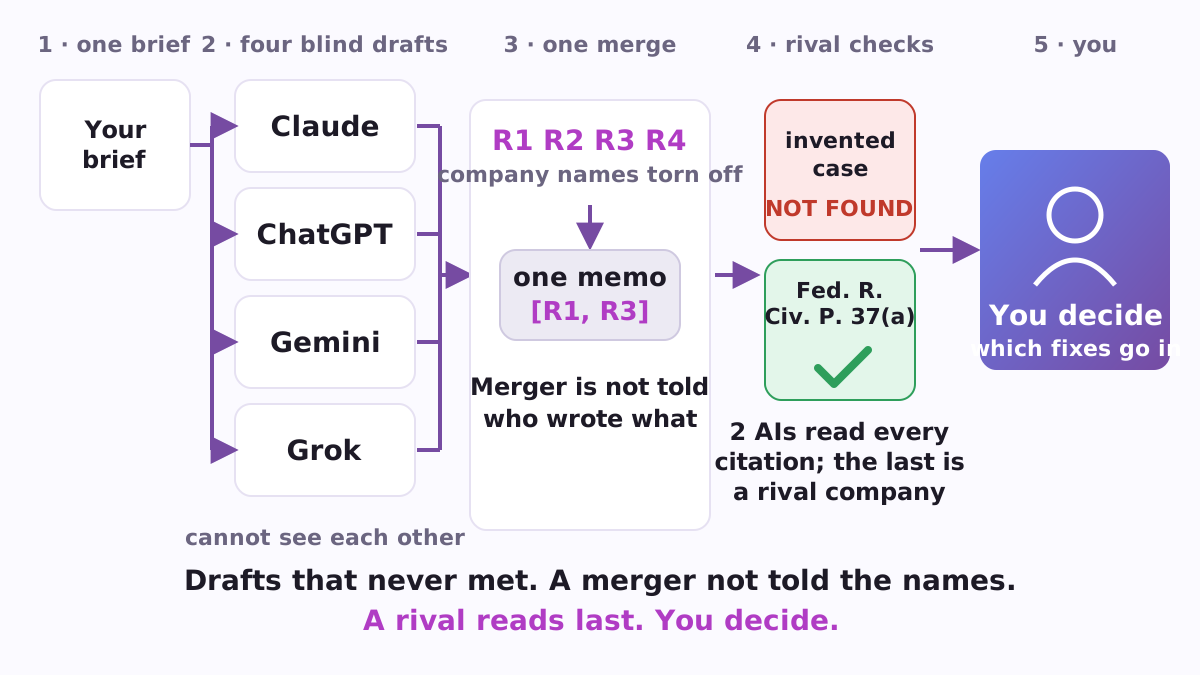
Если вы собираетесь в суд без адвоката и используете ChatGPT, Claude или Gemini для помощи с документами, самая дорогостоящая ошибка – это не неловкое письмо. Это уверенное предложение, которое цитирует дело, которое не существует. Docprep – это бесплатная программа с открытым исходным кодом, которая изменяет расположение ИИ, а не то, какой ИИ вы используете. Несколько ИИ от разных компаний каждый пишут полный черновик одного и того же документа, не видя друг друга. Один ИИ объединяет черновики, не зная, какая компания что написала. Два ИИ затем проверяют объединённый текст, сначала цитаты, и последний из них приходит от другой компании, чем та, что объединила их. Вы получаете документ, оба отчета о проверке и запись о запуске, и вы решаете, какие исправления включить.
Он работает на вашем собственном компьютере. С ключами API (пароли, которые позволяют программе напрямую общаться с моделями компании ИИ) он работает сам по себе. Без них он передаёт вам каждый шаг как файл для вставки в чаты ИИ, которые вы уже используете, и продолжает с того места, где вы остановились. Он работает для любого документа, чьи утверждения нуждаются в источниках, таких как отчет, апелляция страховки или жалоба регулятору, и его примерная задача – это ходатайство, которое может потребоваться самопредставляющемуся истцу.
Почему одного ИИ недостаточно для судебного документа
Придуманные цитаты — это не редкость. 10 октября 2026 г. база данных AI Hallucination Cases, ведомая исследователем Дэмьеном Шарлотеном, содержала 2184 судебных решения, касающихся содержимого, созданного ИИ, такого как поддельные цитаты; в 1259 из них стороной было лицо, представляющее себя в суде. В августе 2026 г. апелляционный суд Калифорнии обязал мужа и жену, которые подали апелляцию без адвоката, оплатить судебные издержки противной стороны по апелляции, потому что они полагались на несуществующие источники и сфабрикованные цитаты (California Courts Newsroom). Федеральный суд Среднего округа Джорджии прямо сообщает сторонам, представляющим себя в суде, что «ИИ не освобождает сторону от ответственности за обеспечение точности всех фактов и правовых источников, на которые ссылаются в судебных документах» (M.D. Ga.).
Это касается все большего числа людей: доля гражданских дел в федеральных судах США, поданных без адвоката, возросла с долгосрочного среднего значения 11% до 16,8% в финансовом году 2025 (Shah and Levy, via beSpacific). Новые модели не решают эту проблему в одиночку. Исследователи Принстона проверили более 8000 цитат из восьми поколений бесплатных моделей ChatGPT и обнаружили, что GPT-5.1 галлюцинирует на уровне 6,57%, что является «статистически значимой регрессией». То же исследование указывает на решение, на основе которого построен Docprep: инструмент проверки ИИ, имеющий доступ к поиску в правовых базах данных и открытой сети, обнаружил все несуществующие цитаты в тесте (Princeton CITP).
Как это работает
Docprep проходит одно письменное задание через пять этапов, и каждый этап определяется тем, что AI в нём может видеть.
- Один бриф. Вы пишете задание один раз: что вам нужно, юрисдикция, формат, что считается источником. В примере запрашивается служебная записка о том, может ли самопредставляющийся истец в федеральном суде подать ходатайство о принудительном раскрытии ответов на открытие, отвеченных только стандартными возражениями.
- Отдельные проекты. По крайней мере три AI из по крайней мере трёх компаний каждый пишут полный проект с веб-поиском, где это доступно. Ни один не видит проект другого. Каждый должен ссылаться на источник для каждого утверждения, отмечать то, что он не смог проверить, как «не проверено», и не занимать компромиссную позицию, чтобы разногласия были видны.
- Слепое объединение. Один AI получает проекты как R1, R2, R3 в случайном порядке; проект, в котором указан его автор, имеет эту фразу заменённой на «[vendor name removed]». Объединяющий AI отмечает каждое утверждение с поддерживающими его проектами, как [R1, R3], и пишет журнал о том, в чём согласились проекты, где они разошлись во мнениях и как каждый конфликт был разрешён. Объединение без этого журнала останавливает процесс.
- Проверка изнутри. AI из собственной компании объединяющего AI читает результат в новой сессии, проверяет, что каждый источник существует и говорит то, что утверждается, классифицирует результаты как Critical, Major и Minor, и выдаёт вердикт.
- Проверка снаружи. AI из другой компании читает документ и первый отчёт, подтверждает или оспаривает каждый результат, добавляет свои и выдаёт итоговый вердикт.
Всё попадает в одну папку: бриф, все инструкции и проекты, объединённый документ, журнал объединения, оба отчёта и запись manifest.json. Исправления критика не применяются к вашему тексту автоматически; вы выбираете. Точные номера страниц заслуживают вашего пристального внимания, так как именно здесь даже проверяющие AI в поиске наиболее слабы (агент Princeton выявил только 18,2% ошибочных пинцитов), а открытие дела на цитируемой странице разрешает вопрос.
Почему эти правила
- Черновики никогда не встречаются. В дебатах с участием ИИ модели часто переходят от правильного ответа к неправильному, когда оппонент убедительно возражает (Wynn, Satija and Hadfield, 2025).
- Объединение не информируется о том, кто что написал. ИИ-судьи склонны оценивать свой собственный вывод выше и могут его распознать (Panickssery, Bowman and Feng, 2024). Ключ к меткам записывается только в архив, поэтому впоследствии вы можете подсчитать, как часто объединение отдавало предпочтение своей компании.
- Завершающий критик представляет другую компанию. В исследовании более 350 моделей, когда обе оказывались неправильными, они давали один и тот же неправильный ответ примерно в 60% случаев на одном рейтинге (Kim et al., ICML 2025). Критик, обученный в другом месте, является наиболее прямым путем выявления общих слепых пятен.
- Каждый критик должен иметь возможность выполнять поиск. Docprep отказывается запускаться, если у критика нет инструмента поиска.
- Правила — это код.
python3 docprep.py checkотклоняет конфигурацию, которая их нарушает, например такую, где завершающий критик представляет компанию объединения или авторы черновиков представляют менее трех компаний.
Что дает запись
Манифест регистрирует на каждом шаге модель, была ли она запущена через API или вручную, отпечатки подсказки и ответа, время, ключ к меткам и обоим вердиктам. Она даже регистрирует, был ли поисковый инструмент действительно прикреплен к каждому запросу. Некоторые суды спрашивают об использовании ИИ: Северный округ Техаса требует, чтобы документ, подготовленный с помощью генеративного ИИ, "раскрывал этот факт на первой странице" (LR 7.2(f)). Папка прогона Docprep содержит ровно необходимый материал для такого уведомления. Это также экономит деньги: resume выполняет только шаги, для которых еще нет файла, поэтому неудачный вызов не повторяет уже оплаченный.
Два способа запустить
Вручную, на сайтах чатов, без ключа API. Ручная формула записывает файл MANUAL-<role>.md для каждого шага с приглашением и используемой моделью. Вы вставляете его в новый чат, вставляете ответ обратно под линию маркера и запускаете resume. Полный запуск включает семь вставок: четыре черновика (Claude, ChatGPT, Gemini и Grok), объединение и две проверки. Правила учитывают, от какой компании модель, а не какой план вы оплачиваете, и этот путь также позволяет использовать режимы глубокого исследования на сайтах чатов.
С ключами API, автоматически. Установите ключи для Anthropic, OpenAI и Google, и Docprep вызывает модели самостоятельно, каждая с собственным инструментом поиска компании; Grok и модель Llama могут присоединиться в качестве дополнительных источников черновиков. Пример конфигурации содержит базовую формулу для обычных документов и расширенную для всего, что будет читать суд, созданную из моделей, доступных в сентябре 2026 года; подойдёт любой набор от разных компаний, который соответствует правилам.
Протокол называет себя пандусом: "Он был создан для человека, который не может подняться: который не может одновременно держать открытыми пять интерфейсов, сравнивать их между собой и передавать ответ обратно." Docprep выполняет этот перенос.
Чем это отличается от совета LLM
Docprep принадлежит к семейству советов LLM, многоагентных дебатов и LLM-as-a-judge. Популярный llm-council от Andrej Karpathy имеет модели, которые ранжируют друг друга с скрытыми именами, затем модель «Председатель» пишет один итоговый ответ. Docprep отличается четырьмя способами, все реализованные в коде: авторы никогда не читают друг друга, объединитель не узнает, кто что писал, заключительный вердикт исходит от другой компании, чем объединитель, и каждый этап оставляет запись. Кроме того, это останавливается перед финальным редактированием: вы получаете документ и отчёты, а не незаметно отредактированный для вас текст.
Как начать
Вам нужны Python 3 и код из страницы GitHub.
git clone https://github.com/vadimchernets/docprep
cd docprep
python3 -m venv .venv && source .venv/bin/activate
pip install -r requirements.txt
cp config.example.yaml config.yaml
python3 docprep.py run --brief briefs/example_brief.md --formula manual
python3 docprep.py resume --run runs/<id>
С помощью ключей API поместите названия моделей, которые предлагают ваши аккаунты, в config.yaml, затем запустите python3 docprep.py check и python3 docprep.py run --brief briefs/my-brief.md --formula enhanced. Автономные тесты (python3 -m pytest tests/test_offline.py, пять тестов) запускают весь конвейер без ключей и сети.
Откуда это берётся
Docprep — эталонная реализация протокола, описанного в работе The Missing Variable in AI-Assisted Litigation: Architecture and the Quality of Pro Se Access to Justice Vadym Chernets (SSRN 7120940, DOI 10.2139/ssrn.7120940). В работе утверждается, что способ организации помощи ИИ (одна модель, запрошенная один раз, или несколько моделей от разных компаний, проверяющих друг друга) является переменной, влияющей на качество документов, подаваемых самопредставляющимися сторонами, и она опирается на реальное федеральное дело, в котором автор был истцом без адвоката. Код — это один файл Python с лицензией MIT, текст протокола PROTOCOL.md находится под лицензией CC BY 4.0, и всё находится на github.com/vadimchernets/docprep. Чтобы задать один вопрос инструментам ИИ на вашем компьютере, см. After Chat и Sidecall; чтобы задавать вопросы сайтам чатов ИИ через ваш браузер, см. Roundcall.
Vadym Chernets также создаёт Poly A1, приложение, в котором ИИ от разных компаний проверяют работу друг друга.