如何通过已验证的工作而非令牌来衡量 AI 生产力
这是译文。权威版本是英文原文,引用请以原文为准。
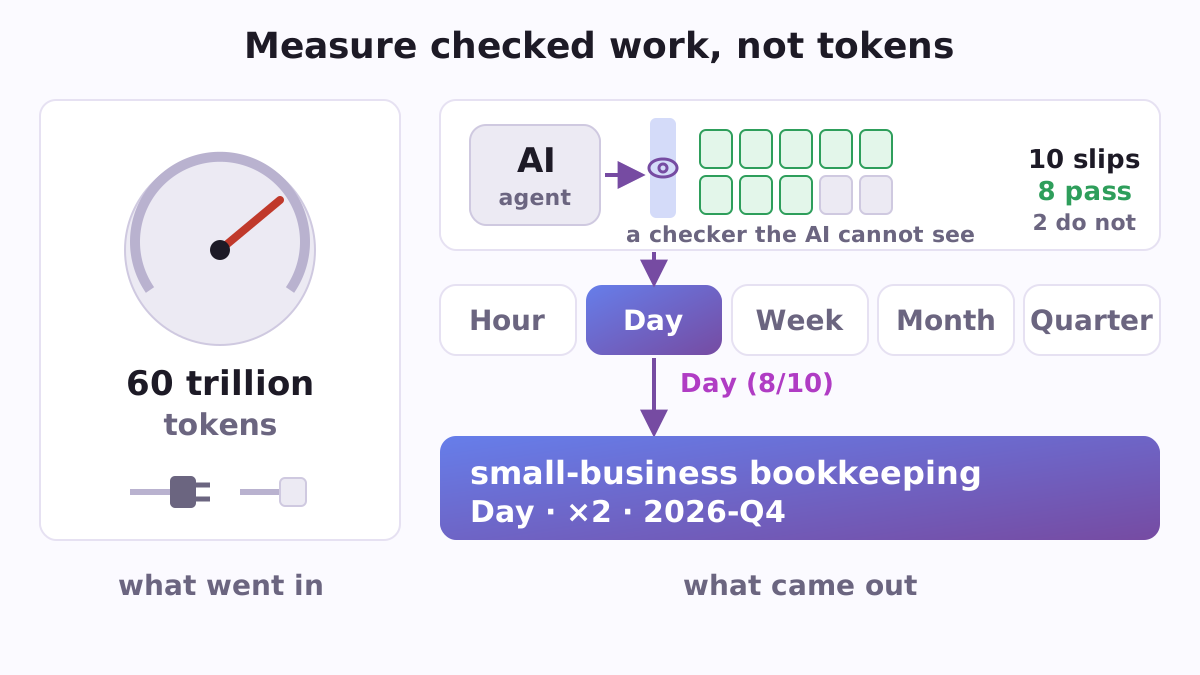
如果您通过将工作交给 AI 代理(Claude Code、Codex、Cursor 等)来完成实际工作,没有职位、学位或简历行能展示您可以信任交付的内容。许多雇主在 2026 年采用的指标——一个人消耗了多少令牌——展示得更少。Delegation Horizon 是一个免费的开源工具,它将您交给 AI 代理的工作的简单日志转化为一条带日期的行:
small-business bookkeeping · Day · ×2 · 2026-Q4其内容如下:在小企业簿记工作中,这个人定期向AI代理分配工作,这些工作专家手工完成需约一天,而一项代理从未见过的审查证实了这些工作;他们每投入一小时的关注就能产生至少两小时的已审查工作;评分统计于2026年第四季度。你可以在任何电子表格中保存日志,评分在你自己的计算机上通过小型Python脚本或离线运行的网页进行计算。无需账户、无需密钥、无需付费,日志永远不会离开你的计算机。
令牌计数为何失败
2026年,几家大型公司试图通过员工使用多少AI来衡量他们对AI的使用效果,这一做法被新闻界称为tokenmaxxing。在Meta,一个由员工构建的排行榜(昵称为Claudeonomics)在30天内记录了来自85,000多名员工的60万亿个令牌(Shopifreaks)。在Amazon,"员工们在创建AI代理来执行不必要的任务,试图提高他们的分数",该跟踪工具被下线(CIO)。9月,Meta表示它"将不使用AI采用仪表板或令牌计数来评估影响"(CIO)。
令牌计数衡量的是输入的内容,而不是输出的内容;DORA(Google Cloud的研究计划)将其称为"纯粹的输入度量"(DORA)。然而,在LeadDev的2026年调查中,58%的受访者表示他们的组织仍然通过令牌使用来衡量AI影响,而只有19%的人认为这是有效的(LeadDev)。Delegation Horizon则在任何专业中计算输出。
两个数字与一条线
你分配给代理人的每一项工作都会成为日志中的一行:它的领域、一位合格的专家手工完成它需要多长时间(其"参考小时")、它花费了你多少分钟的注意力、它经历了哪一项检查,以及它是否通过了。
- 已验证的委派范围是你定期分配给代理人并由他们未看过的检查确认的最大工作规模。它有五个等级:Hour、Day、Week、Month 和 Quarter(1、8、40、160 和 500 参考小时)。Hour 和 Day 需要在最近91天内有十项这样规模的工作;Week 需要在182天内有六项;Month 在一年内需要六项;Quarter 在一年内需要三项。记账员和开发人员面临相同的规则。
- 放大增益是指在过去91天内每小时注意力的经核实参考小时数(包括失败),以×1、×2、×5、×20 和 ×60 的步长显示。
两者都按字段保存,所以同一个人在财务工具中可以处于周级别,在网络应用中处于日级别。两者都带有日期:每个季度需要重新获得一个等级,从周级别及以上,其中一项必须来自最近91天。
什么算作已检查
每个等级的至少十分之八的作品必须通过以下四种检查之一:隐藏测试、合格的专家、该工作所针对人群的真实使用,或来自另一个AI系列的模型对您自己打开的源进行的检查。您自己的审查和同一系列模型之间的一致被记录但从不计入。失败和被放弃的作品保留在日志中并对您不利,被某人在日志外帮助的作品、后来审计失败的作品和后来被撤回的结果也是如此。错误无法挽回的作品(例如已发送的资金)必须通过,而另一个AI系列本身永远不足以对其进行检查。从Week级及以上,在交接前在至少一个任务中种植故意错误;发现它们表明您真正进行了检查,而错过一个会阻止Week级及以上。
这种严格性有一个原因:人们对自己使用AI的速度判断不佳。在2025年METR进行的一项研究中,16位经验丰富的开发者使用AI工具花费了19%更长的时间,然而随后"他们仍然相信AI让他们快了20%"(METR)。
一个具体示例
该存储库包含虚构簿记员P07的日志:十项工作,每项需要专家花费一天或以上时间,在2026年7月至9月期间分配给代理。于2026年10月9日评分:
P07: small-business bookkeeping . Day (8/10) . x2 . 2026-Q4  (pieces in last 91 days: 10, not verified: 2; gain 4.66; directive share 20%)
  checks: expert 4, hidden_tests 3, self_review 1, real_use 1, other_family_with_sources 1; median accepted size 9.0 h
十个中有八个通过,正是 Day 所需;一件仅由簿记员自行审查,一件未通过专家检查。经检查的八件总计 80 参考小时,而所有十件约 17.2 小时的关注,增益为 4.66,属于 ×2 步长。若簿记员删除了失败的件,日志看起来会更好,但得分会更差:该级别将基于九件,错过十件的计数并低于 Hour,而增益将跳到 ×5。任何收到该记录的人都能立即看出这一点,因为卡片日期上的重新计分不再匹配。这就是为什么失败应该被记录在案。
为通过代理构建的人
record_card.py读取您的电子表格并打印该行和短卡:等级、其对应的计数("在其91天窗口内验证的日期规模的10个部分中的8个")、增益和检查类型。--format md为个人资料或发给雇主的电子邮件生成卡;--format record仅为简历打印该行。tools/explain.py(version 1.1.0中的新功能)告诉您您的日志为何达到该等级:哪个条件成立或失败,哪个部分决定了它,该等级还能承受多少次失败,如果您不记录任何新内容,它会在哪一天失效,以及下一个等级仍然需要什么。它还说明了仅凭自身10个部分能证明多少:十个中的八个符合约44%至97%的任何真实通过率。checker.html在浏览器中离线进行相同的评分;一项测试将其与Python评分器在工作示例和40个随机日志上进行比较。两者都读取用分号、十进制逗号和day.month.year日期保存的电子表格,如欧洲电子表格的保存方式。tools/log_piece.py通过提问来构建日志行。如果您在Claude Code中工作,一个现成的钩子(Claude Code在事件上运行的小脚本)会在每次代理会话结束时打开一个待处理条目,这样失败的片段就不会被遗忘。它不读取任何记录,也不向任何地方发送任何内容;任何能够在会话结束时运行命令的代理工具都可以使用它。tools/planted.py在交付前用指纹密封您的植入错误列表,然后对其进行评分,错误条目和遗漏项目分别计算,并拒绝接受在密封后更改的列表。
对于第四种检查,另一个AI工具系列读取您的来源,Sidecall将一项工作提交给您计算机上的其他AI工具。
为经理和人力资源部门
kits/ai-usage-in-reviews.md 是一个现成的人工智能绩效评估政策。它不按令牌或支出计量,而是要求每个已接受的工作成果都通过检查;不是"每天使用人工智能",而是关注上一季度交给代理处理并验证的最大工作成果。其评审对话有三个问题,开始是:你这个季度交给代理的最大工作成果是什么,你是如何展示它是正确的?
团队保持一个日志,为每个人使用虚构标签(评分者拒绝未知列,所以真实姓名无法混入);examples/team-log.csv 展示了分布在五个字段中的四个人。每个季度,record_card.py 为每个人和字段打印一张卡。要检查一个,tools/verify_record.py 获取记录和日志,逐字段说明日志是否为被评分的文件、评分者是否相同,以及重新评分时记录是否相同。audit_sample.py 根据第二个检查者收到日志后选择的一个词来抽取随机样本进行重新检查,这样没人能猜到会抽取哪些部分,并且 tools/too_clean.py 标记看起来太完美的日志:没有失败、大小几乎不变、每个部分都用同一种方式检查。
参考小时在团队外部设定:来自任务库,或由两个不知道是谁的工作的评分者。tools/reference_hours.py 获取他们的估计,当比值不超过1.5倍时给出几何平均数,否则请第三个评分者;kits/reference-hours-raters.md 说明如何选择和向他们做简报。
为了根据已验证的工作而不是学位进行招聘,kits/hiring-test/ 在候选人自己的领域进行有偿的一天工作测试,包括隐藏检查、植入的错误和未见过简历的评分者。kits/trade-screen.md 在任何人被录取前添加第一周的行业问题,因为档案或工作职位的说明力不如表面看起来那么强:在调查平台的过滤器认定的60个簿记员中,11人在这样的问题上答错了,其中8人因颠倒借贷而答错。
首次人工测试发现了什么
任何"专家小时"度量中最薄弱的环节是估计本身,因此首先对其进行了测试。2026年10月,在Prolific上进行的一项预试点(已在OSF上注册,在任何数据到来之前)付费给119名在职簿记员和网络开发人员,要求他们估计十项任务中每一项手工完成需要多长时间。随机选择的两名评分者在簿记工作中相差不超过1.5倍的任务比例仅为28%,在网络工作中为25%,而该计划的目标是70%。设定为一周工作量的任务获得了8到20小时的中位数估计,同一任务在最后再次询问时,得到更高估计的频率远高于更低估计的频率。
对于任何使用该工具的人,以下是这样的:两个陌生人的猜测波动太大,无法可靠地估计工作规模。更大规模小组的中位数快速趋于稳定;由15名簿记员或21名网络开发人员分别组成的两个独立小组在至少70%的情况下相差不超过1.5倍。因此,参考小时数来自具有测量时间的任务库或来自小组,所有匿名化数据、已注册的分析和探索性分析都保存在pilot/中,供任何人重新运行。
面向研究人员
METR通过时间地平线来衡量AI模型:模型可靠完成的任务长度(以专家小时为单位)。委托地平线对人类提出同样的问题,其80%的比例与METR的80%地平线相对应。基于模拟日志的初步预试验调整了规则(版本1.1),上述Prolific初步预试验测试了参考小时数,与人员进行的完整试点的协议、预注册草案和知情同意书在pilot/中。kits/process-vs-experience-study.md和kits/matched-task-study.md是用于在相同任务上比较组别的现成协议,tools/power.py说明这样的研究需要多少人。
该工具背后的论文也给出了带有日期的、可验证的预测。在Anthropic对约400,000个Claude Code会话的研究中,产生代码的会话在软件工作者中的验证成功率为34%,在其他所有人中为29%(Anthropic)。四十一项预测于2026年10月9日在OSF上注册,每项都附带相应概率,其中包括最佳公开模型的METR 80%地平线在2027年底达到一个工作日的预测(0.80),以及在2027年期间少于两家Fortune 500企业使用令牌计数作为官方评估标准的预测(0.80)。一项测试表明每个已注册的文件与存档的文件仍然完全相同,并且brier.py、predictions/score.py和predictions/skill.py每年对其进行评分;从未运行的研究被计为失败,而不是被悄悄放弃。
如何开始
您需要 Python 3.9 或更新的版本,仅此而已。
- 从 GitHub 页面下载仓库(Code,然后 Download ZIP)或克隆它。
- 在任何电子表格(Excel、Numbers、LibreOffice、Google Sheets)中打开
templates/work-log.csv,并为交给代理的每一项工作添加一行:已接受、已拒绝或已放弃。templates/README.md以简明的语言解释每一列,examples/c4-log.csv是一个可供复制的已填充日志。 - 将其保存为 CSV 并运行卡片,或双击
checker.html(如果您更喜欢使用浏览器)。
git clone https://github.com/vadimchernets/delegation-horizon
cd delegation-horizon
python3 record_card.py examples/c4-log.csv --as-of 2026-10-09
python3 record_card.py my-log.csv --format md --out card.md
python3 tools/explain.py my-log.csv
出处
Delegation Horizon是论文After the Programmer Divide: One Measure for People Who Build Through AI Agents(Vadym Chernets著,2026年10月,SSRN 7589918,DOI 10.2139/ssrn.7589918)的配套代码。当前版本1.1.0(2026年10月11日)在Python 3.9至3.13上的每次推送都经过测试。该代码遵循MIT许可证,并存档于Zenodo(DOI 10.5281/zenodo.23267444,它始终指向最新版本);所有内容位于github.com/vadimchernets/delegation-horizon。同一作者的早期论文After Chat探讨了为什么这么少有人从与AI聊天转向让代理为他们工作;其代码After Chat向多个AI提出一个问题,并显示他们不同意的地方。
Vadym Chernets还开发了Poly A1,一款应用,其中来自不同公司的AI相互检查彼此的工作。